挑战与开放问题
收官讲:三种看待强化学习的视角——工程工具、真实世界的适应者、通用学习范式;以及 Levine 对「信号从哪来」和「该做什么研究」的判断。
0. 本讲导读
前面二十四讲,我们一路从「模仿学习为什么会漂移」推到策略梯度、Actor-Critic、Q-learning、 信赖域方法、变分推断、控制即推断、基于模型的 RL、离线 RL、探索、理论边界、无监督技能发现、 多任务与分层。每一讲的形式都一样:提出一个具体问题 → 给出一个具体算法 → 分析它什么时候失效。 这一讲彻底换一种模式。这里没有新算法,只有 Levine 本人对「深度强化学习这个领域现在在哪里、 接下来该往哪走」的判断。
他把整讲组织成三种看待 RL 的视角(perspectives),这三种视角对应三种完全不同的 研究者身份、三套完全不同的评价标准,也对应今天领域内三条不太交流的技术路线:
- RL 作为工程工具(RL as an Engineering Tool):口号是「凡是你能仿真的,你就能控制」。 这是今天工业界几乎所有 RL 落地的实际形态——包括 AlphaGo、包括 sim-to-real 机器人、 也包括今天的大语言模型 RL。它的角色是一台强大的「求逆引擎」, 它的死穴是你必须先有仿真器。
- RL 与真实世界(RL and the Real World):Levine 借 Moravec 悖论论证, 真实世界之所以难,不是因为 AI 笨,而是因为物理宇宙本身的规则是未知且开放的。 在这种「难宇宙」里,成功的定义不是「最优控制」而是「活下来」,主要问题不是「能不能优化到极致」 而是「能不能泛化和适应」。而 RL 研究几乎从不在这种设定下做实验。
- RL 作为「通用」学习范式(RL as "Universal" Learning): 深度学习之所以成功是「大模型 + 大数据」。要让 RL 也吃到这个红利,就必须让 RL 能消化 廉价的、大规模的、别人早就收集好的数据——也就是离线 RL + 预训练 + 下游微调这条路线。 Levine 给出一个更激进的论断:机器学习之所以存在,唯一的理由就是产生「可适应的、复杂的决策」, 所以决策问题不是机器学习的一个分支,而是它的目的本身。
最后他会回到大图景:信号(supervision signal)到底从哪里来——LeCun 的蛋糕、 模仿与社会性学习、以及「巨大的值回传(the giant value backup)」; 以及给研究者的四条方法论建议。本讲最后我们再加一节全课回顾, 把 25 讲串成一条主线,并给出继续深入的路径。
- 今天绝大多数「成功的 RL」其实是仿真里的 RL。AlphaGo 在自博弈里学, 机器人在 Isaac Gym 里学,LLM 在「可验证奖励」的自动评测器里学——它们都是 「characterize → simulate → run RL」这条老工程路线的现代版,RL 只是把最后一步的 「手工设计控制器」换成了「自动求逆」。
- RL 真正独一无二的能力,是在没有仿真器、规则未知、必须靠自身经验适应的开放世界里学习。 「原则上只有 RL 能做这件事,但我们几乎从不研究这种设定」——这是 Levine 认为最大的错配。
- Moravec 悖论是关于物理宇宙的陈述,不是关于 AI 的陈述:象棋、围棋、火箭发射 属于「易宇宙」(规则封闭、可仿真);小孩在草地上跑、在野外拍照属于「难宇宙」(开放、规则未知)。
- 让 RL 变「通用」的配方:大规模、多样、质量可能很差的历史交互数据 $\to$ 离线 RL / 目标条件 RL / 自监督技能发现 $\to$ 得到尽可能好的初始模型 $\to$ 少量在线交互学下游任务。 数据告诉你世界怎么运转,少量监督告诉你任务是什么。
- RL + LLM 的甜点:那些「LLM 容易仿真、但难以最优执行」的任务。 用 LLM 生成大量不需要好、只需要合理的合成交互,再用值函数类 RL 从中提炼出最优策略。
- 做研究的建议:选对问题(问「它有没有机会解决一个重要问题」); 不要害怕改问题设定(很多挑战靠刷现有 benchmark 是刷不出来的); 重视真实应用;想得大,做得小。
1. 一张图看完 25 讲:为什么 RL 有这么多算法
Levine 开场先放了一张「算法家谱」,把整门课的内容压缩到一页。这张图值得逐个节点读一遍, 因为它同时也是本课的知识地图。
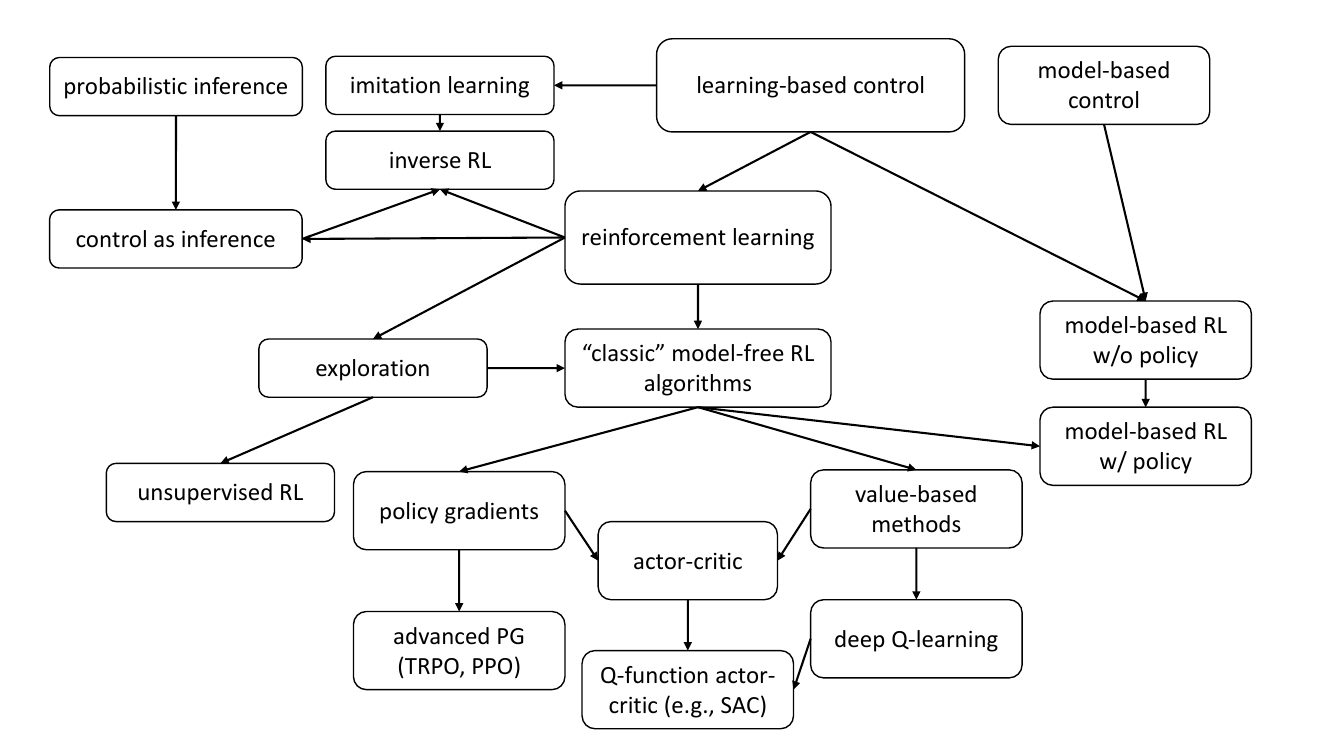
这张图里每一条边都对应本课的一段推导:策略梯度与值函数方法为什么能在 actor-critic 处汇合, 是因为策略梯度里的 $\hat{A}$ 可以用学出来的 $Q^\pi - V^\pi$ 替代; 模仿学习与逆 RL 之间的边,是因为「专家行为最优」这个假设可以反过来当作对 $r$ 的约束; 控制即推断与概率推断之间的边,是因为最优控制可以写成一个图模型上的后验推断。
为什么会有这么多算法?
Levine 在这里抛出一个提问式的过渡页:Why do we have so many RL algorithms? 答案在前面第 4 讲就给过,这里再总结一次。RL 算法的设计空间由几组彼此冲突的取舍撑开:
| 取舍维度 | 一端 | 另一端 | 本质冲突 |
|---|---|---|---|
| 数据用法 | on-policy(PG、TRPO) | off-policy(Q-learning、SAC) | 样本效率 vs 稳定性 |
| 是否学模型 | model-free | model-based(Dyna、MPC) | 渐近性能 vs 样本效率 |
| 优化对象 | 直接优化 $J(\theta)$ | 拟合 $Q$ 再贪心 | 无偏但高方差 vs 有偏但低方差 |
| 更新的信任范围 | 朴素梯度步 | KL 信赖域 / 裁剪 | 步长大小 vs 分布漂移 |
| 数据来源 | 在线交互 | 固定离线数据集 | 可探索 vs 只能保守 |
| 假设强度 | 只要能采样 | 要求可微/可重置/可仿真 | 通用性 vs 效率 |
没有哪一列是绝对更好的。「这么多算法」恰恰说明这些取舍还没有被一个统一的方法吃掉—— 这是本讲后面所有讨论的起点。
RL 到底是什么:两个定义
Levine 强调 RL 这个词有两个含义,而且这两个含义经常被混着用:
- 一套关于「基于学习的决策」的数学形式(mathematical formalism): MDP $(\mathcal{S},\mathcal{A},p,r,\gamma)$、策略 $\pi_\theta(a|s)$、目标 $\max_\theta \E_{\tau\sim p_\theta(\tau)}[\sum_t \gamma^t r(s_t,a_t)]$。 这一层是「语言」,它不告诉你怎么学,只告诉你在优化什么。
- 一套「从经验中学决策与控制」的方法(approach): 强调数据是智能体自己生成的,不是别人标好的。这一层才是 RL 与监督学习真正的分界。
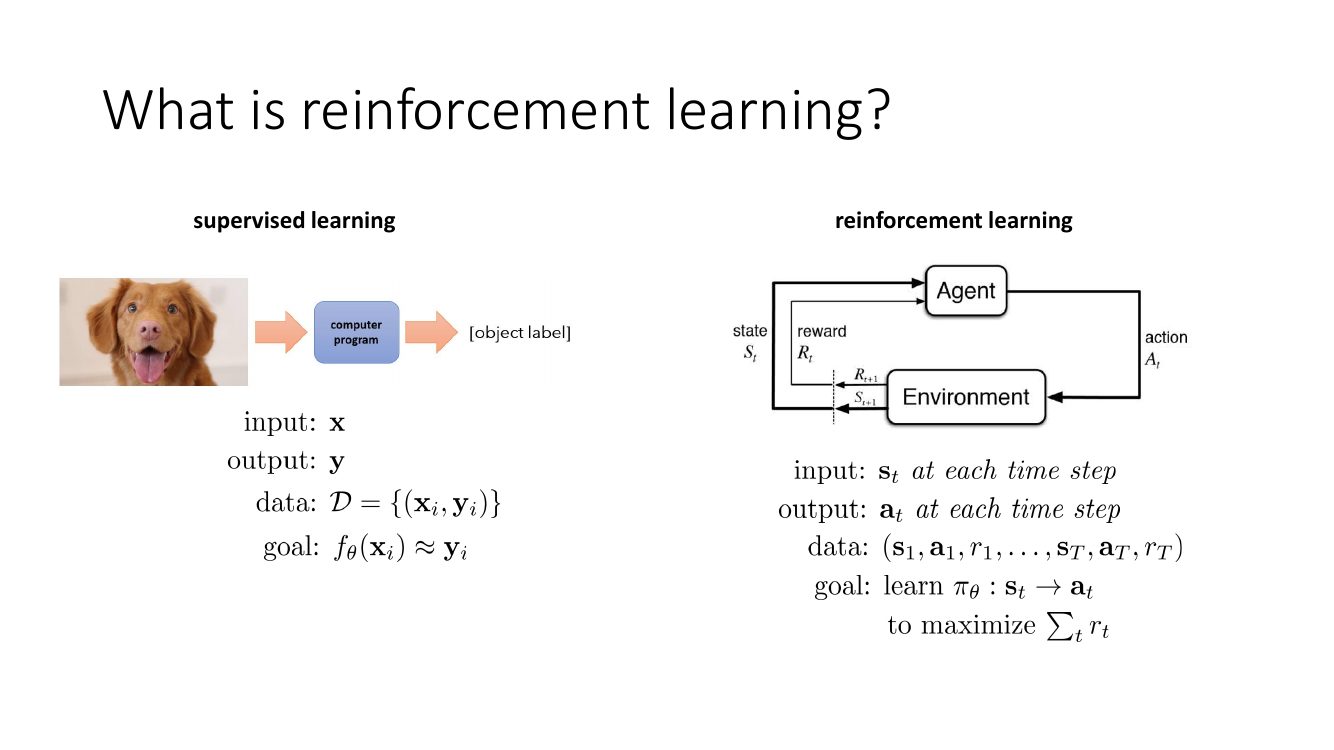
监督学习的损失是 $\E_{(\mathbf{x},\mathbf{y})\sim \mathcal{D}}[\ell(f_\theta(\mathbf{x}),\mathbf{y})]$, 期望里的分布 $\mathcal{D}$ 与 $\theta$ 无关,所以求导只碰 $\ell$。 RL 的目标是 $\E_{\tau\sim p_\theta(\tau)}[r(\tau)]$,期望的分布带 $\theta$, 求导必须动用 log-derivative trick: $\nabla_\theta \E_{p_\theta}[r] = \E_{p_\theta}[r\,\nabla_\theta \log p_\theta(\tau)]$。 本课后面所有的方差爆炸、分布漂移、外推误差、探索难题,根子都在这一个「分布带 $\theta$」上。
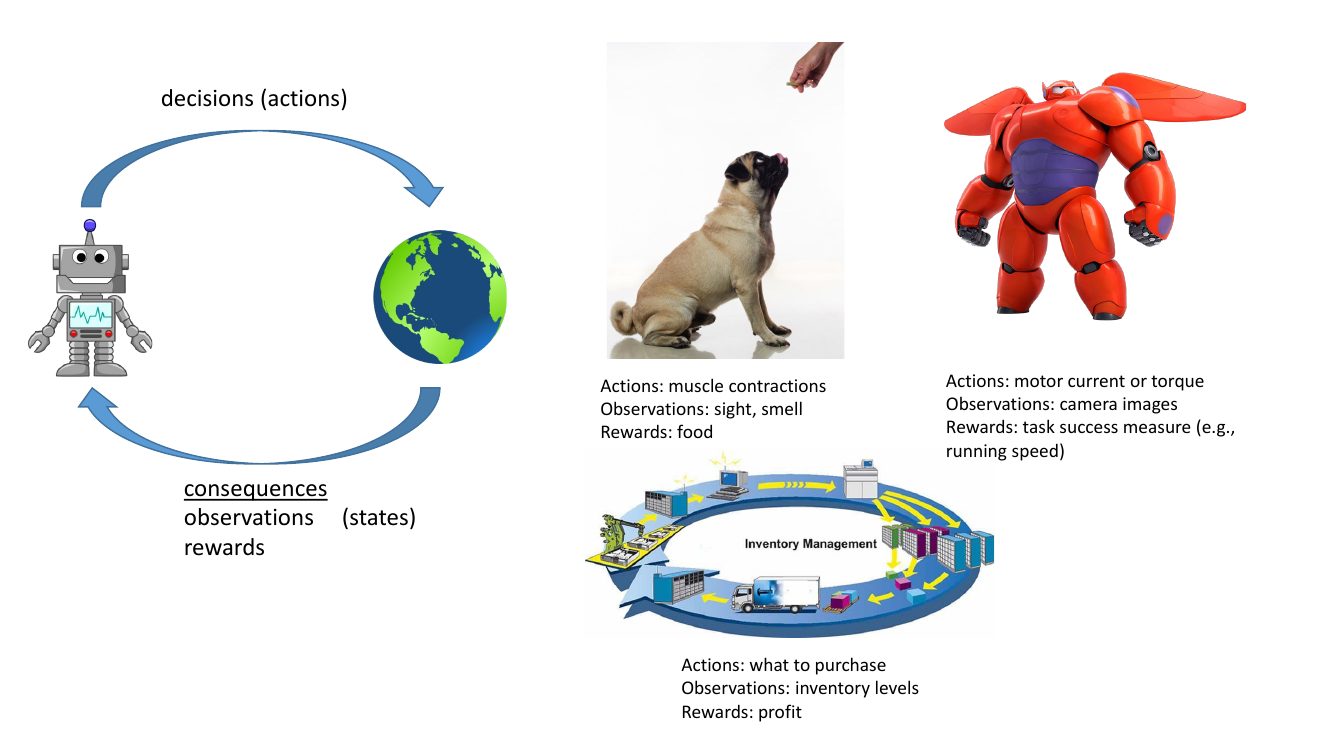
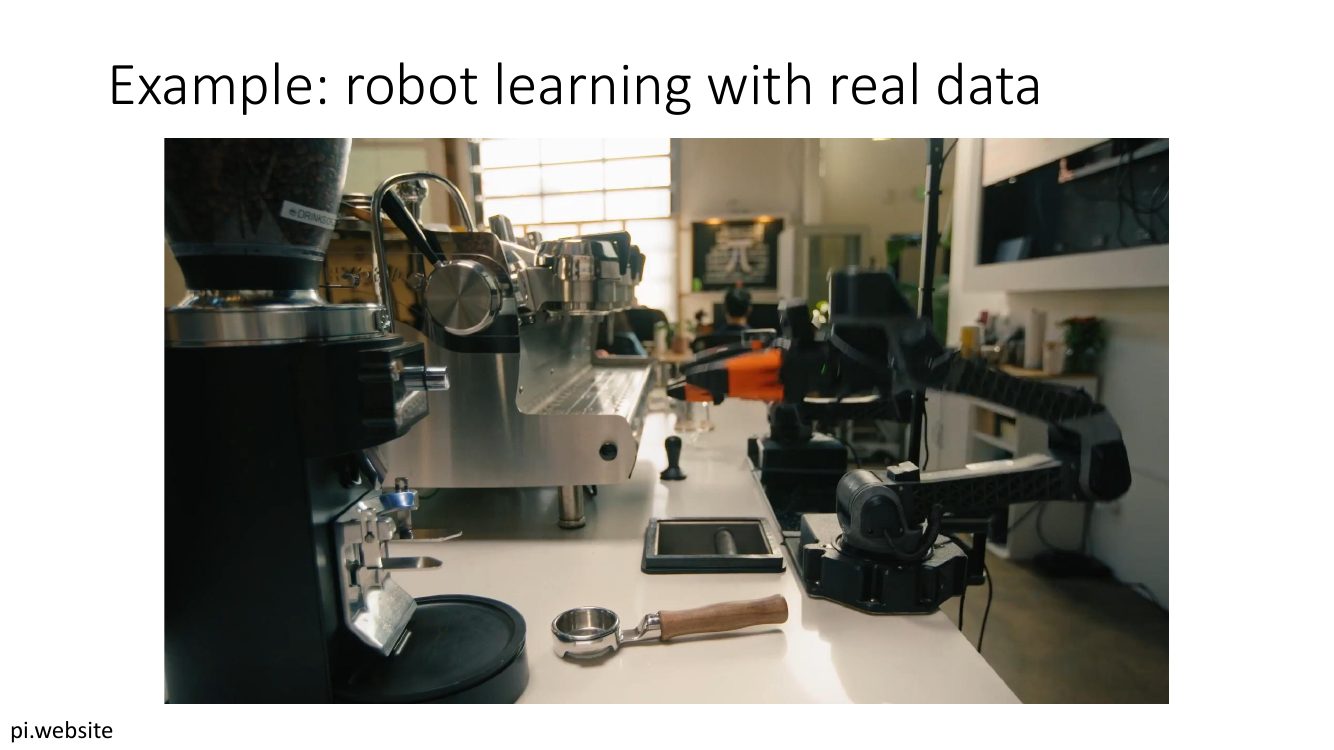
课上给的现实例子横跨三个领域:足式机器人的端到端运动与局部导航(Rudin 等,2022, 在 GPU 大规模并行仿真中训练四足机器人同时学会走路和避障)、 真实机器人操作(如 π 系列在真实咖啡吧台上做手冲/意式咖啡的整套流程)、 以及 RLHF 训练语言模型(从提示集采样、人类对多个输出排序、拟合奖励模型 $r_\theta$、 再用 RL 优化语言模型)。这三个例子在本讲后面会被 Levine 拿来做完全不同的归类—— 其中两个属于「仿真里的 RL」,只有一个真正属于「真实世界的 RL」。
2. 视角一:RL 作为工程工具——「凡是能仿真的,你就能控制」
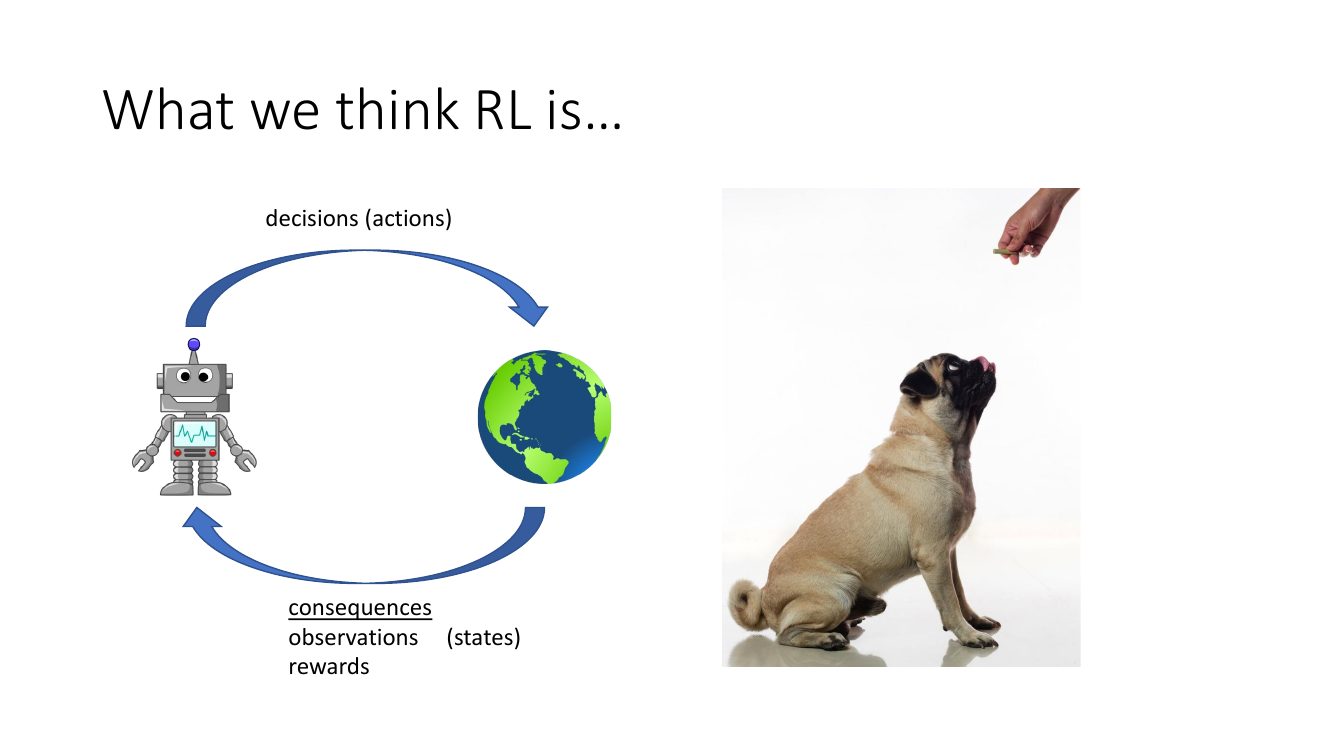
先说我们以为 RL 是什么。教科书第一页那张图:一个智能体扔出动作, 世界返回观测与奖励,就像训狗——你给它一块零食,它学会坐下。 这幅图暗示的是「一个在真实世界里靠试错慢慢学会做事的实体」。
传统工程是怎么造控制系统的
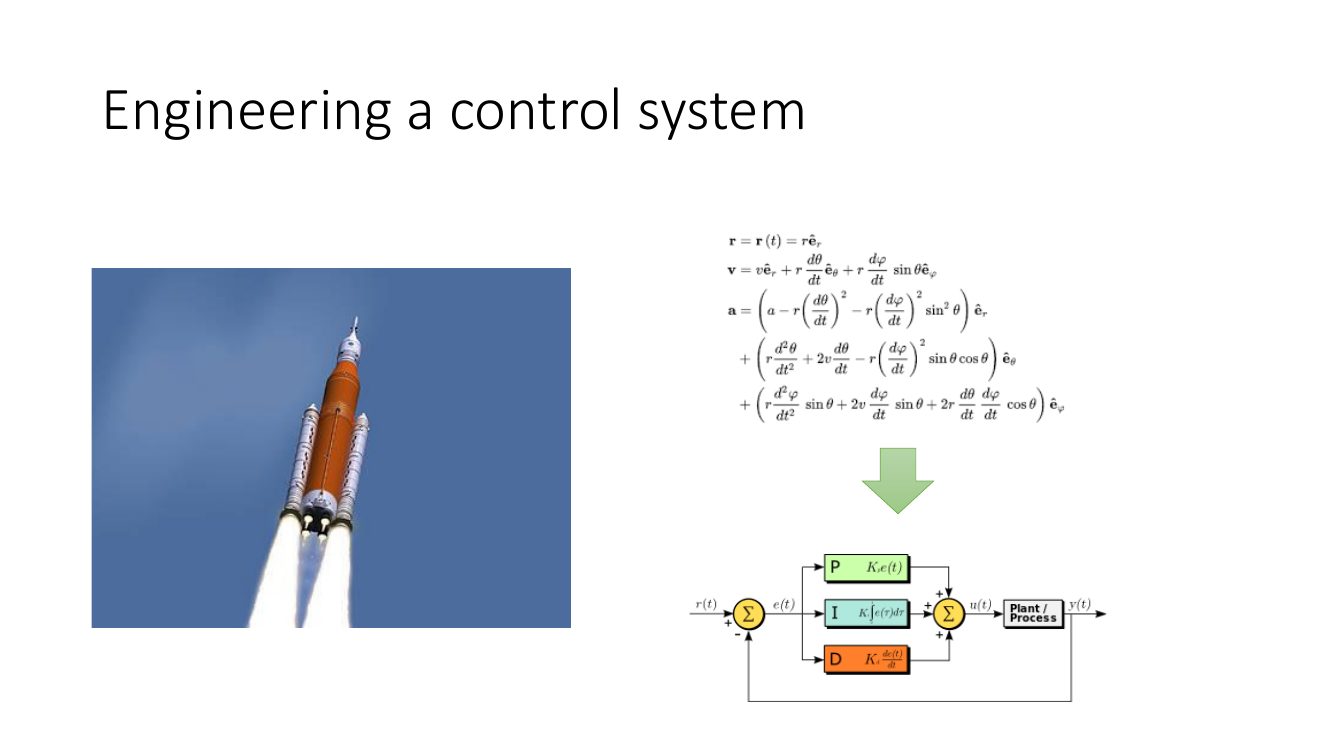
在 RL 出现之前,工程师造一个控制系统的流程是固定的三步:
- 刻画(characterize):用物理学写出被控对象的动力学方程。 比如火箭在球坐标下的加速度分解 $\mathbf{a} = \big(a - r\dot\theta^2 - r\dot\varphi^2\sin^2\theta\big)\hat{\mathbf{e}}_r + \dots$, 一堆看起来很吓人但完全确定的表达式。
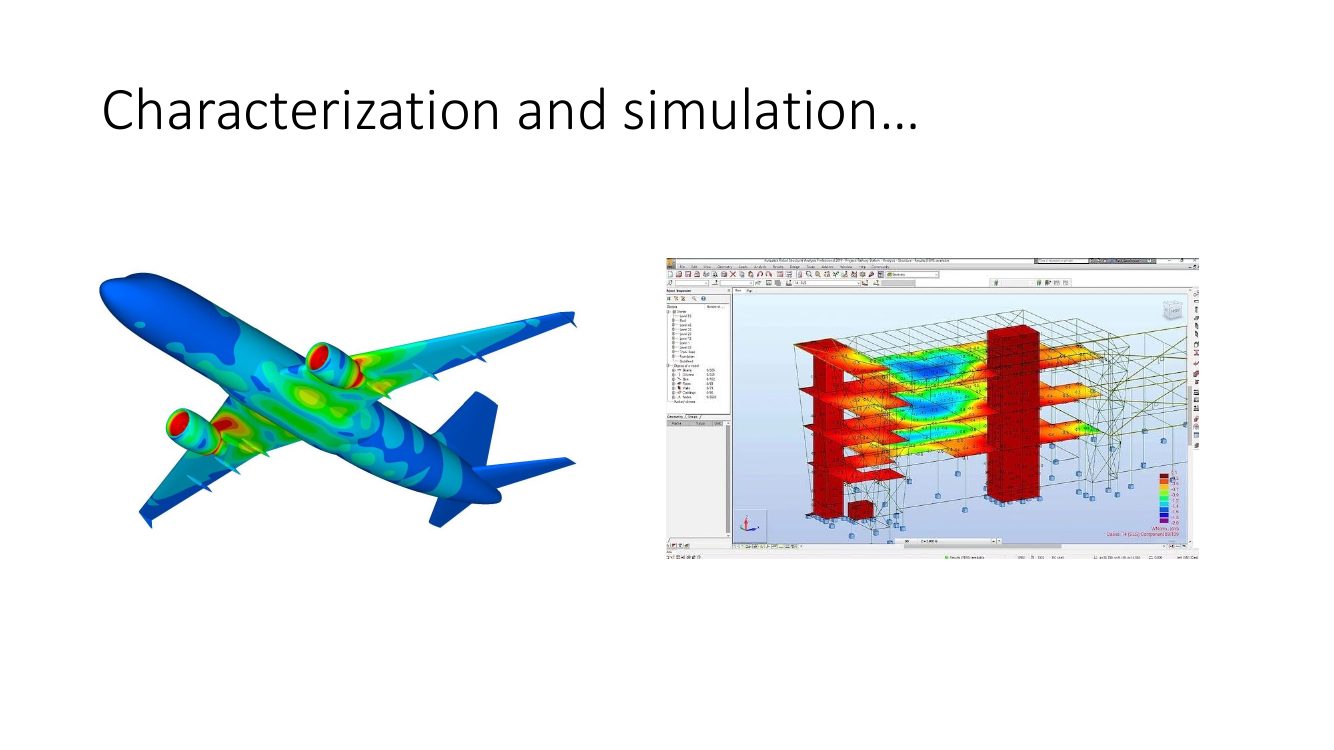
- 仿真(simulate):把方程扔进数值求解器,做有限元、做流体、做结构分析, 在计算机里把这个系统跑起来。
- 控制(control):在仿真上设计并整定一个控制器——最经典的就是 PID, 误差 $e(t)=r(t)-y(t)$,控制量 $u(t)=K_p e(t) + K_i\int e(\tau)d\tau + K_d \frac{de(t)}{dt}$, 调三个增益直到闭环稳定且响应满意。
RL 改了哪一步
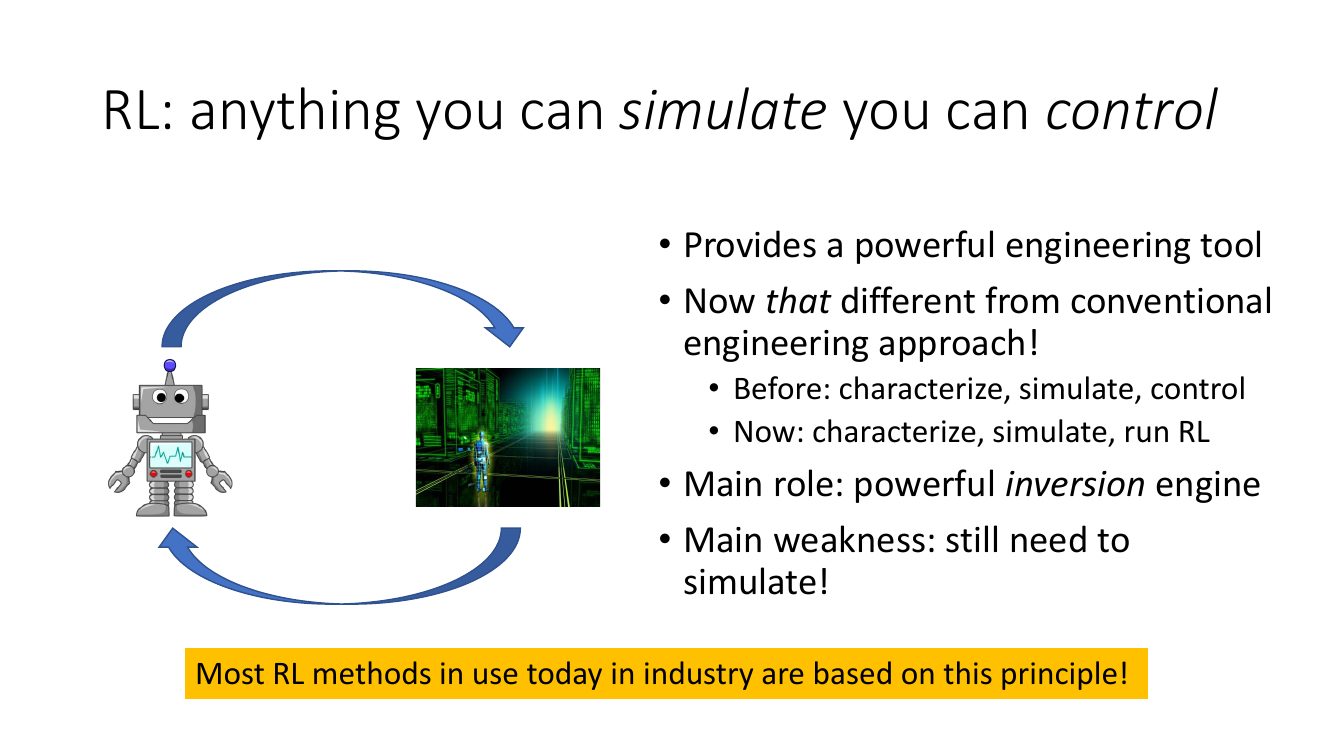
Levine 的观察非常锋利:RL 并没有推翻这套流程,它只替换了第三步。
- 过去:characterize → simulate → control(人手工设计控制器)
- 现在:characterize → simulate → run RL(让优化器自动找出控制器)
所以 RL 在工业界的主要角色是一台强大的「求逆引擎」(inversion engine): 你有一个前向模型「给定动作序列 → 会发生什么」,RL 帮你求它的逆 「想要发生什么 → 该给什么动作」。 主要弱点也一句话:你仍然必须有仿真器。
为什么说这是「求逆」?把仿真器看成一个函数 $F:\ (a_1,\dots,a_T)\mapsto \tau$, 再把任务写成 $\tau$ 上的一个标量偏好 $R(\tau)$。传统控制是人去猜一个能让 $R$ 大的策略结构; RL 则直接在参数空间里做 $\theta^\star = \argmax_\theta \E_{\tau\sim p_\theta}[R(\tau)]$。 只要 $F$ 能便宜地采样,样本效率再差也无所谓——你可以在 GPU 上并行开 4096 个环境, 一天跑出几十亿步。「样本效率低」这个 RL 最大的缺点,在仿真里根本不是缺点。
三个例子:它们都是「仿真里的 RL」
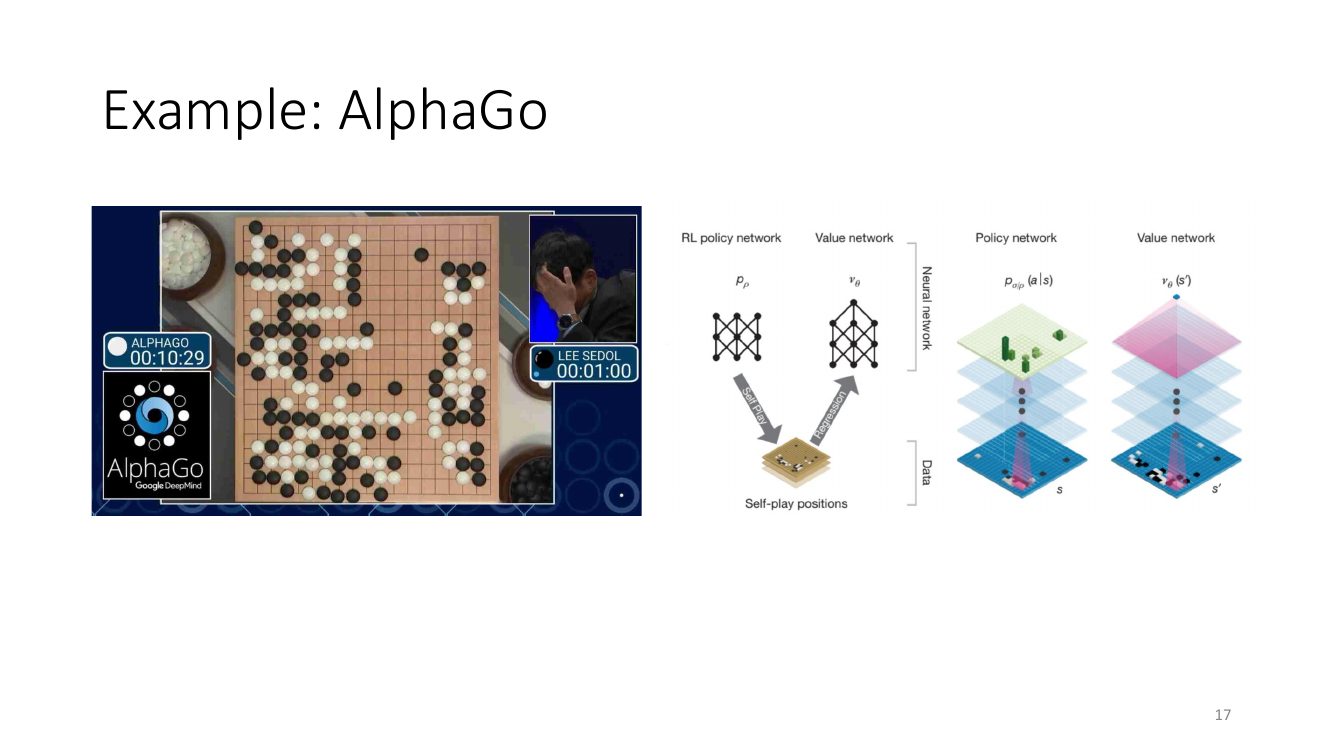
AlphaGo 是最纯粹的例子:围棋的转移函数 $p(s'|s,a)$ 是确定性的、可精确写出的, 奖励只在终局给 $\pm 1$。这意味着智能体可以在「仿真」里无限地采样,而且这个仿真没有 sim-to-real gap—— 因为围棋本身就活在计算机里。
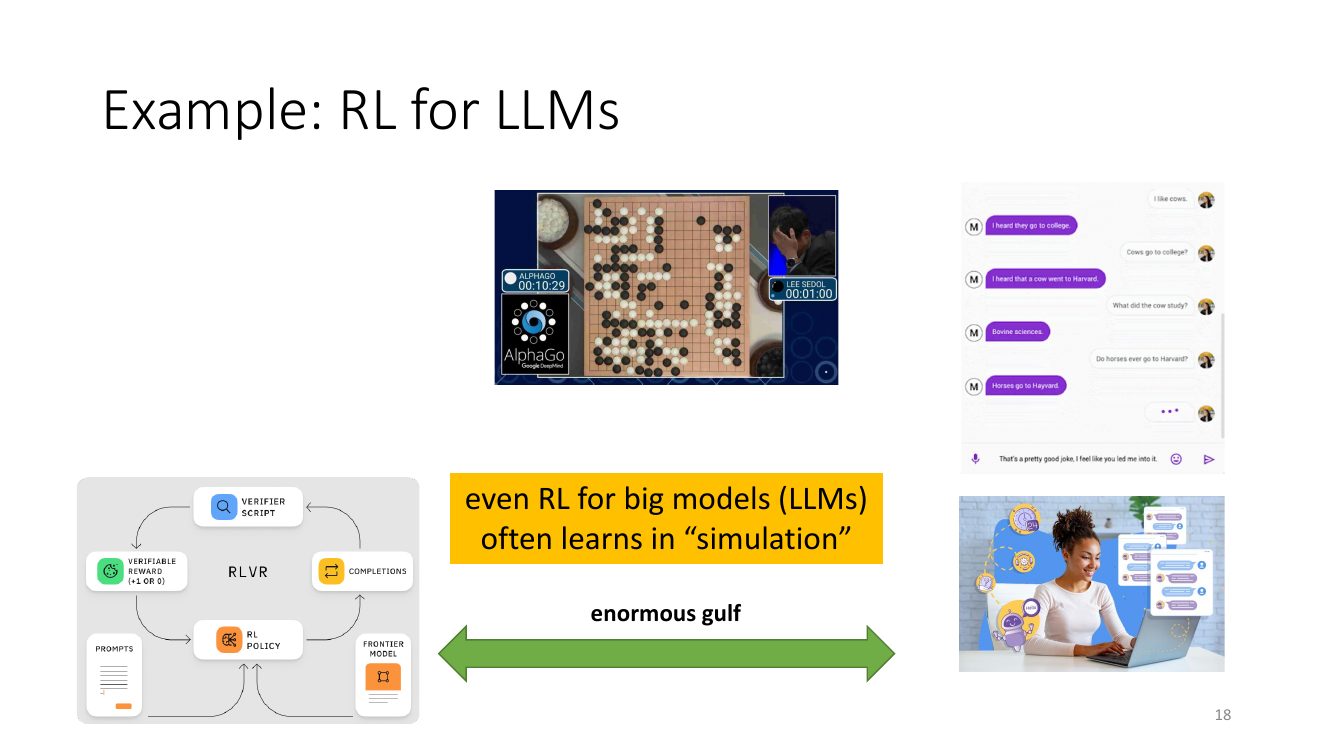
这页值得反复读。今天 LLM 的 RL(RLHF 也好、RLVR 也好)之所以能规模化, 恰恰是因为我们找到了可自动评估的代理任务:数学答案对不对、代码测试过不过、 奖励模型打几分。这些都是「仿真」——它们是对「用户是否真的被帮到」这件事的近似。 一旦优化压力足够大,策略就会去攻击这个近似本身(奖励黑客 / reward hacking)。 所以「RL for LLM 已经解决了真实世界的 RL」这个说法,Levine 明确不同意: 它只是把「仿真」的定义从物理引擎换成了评测脚本。
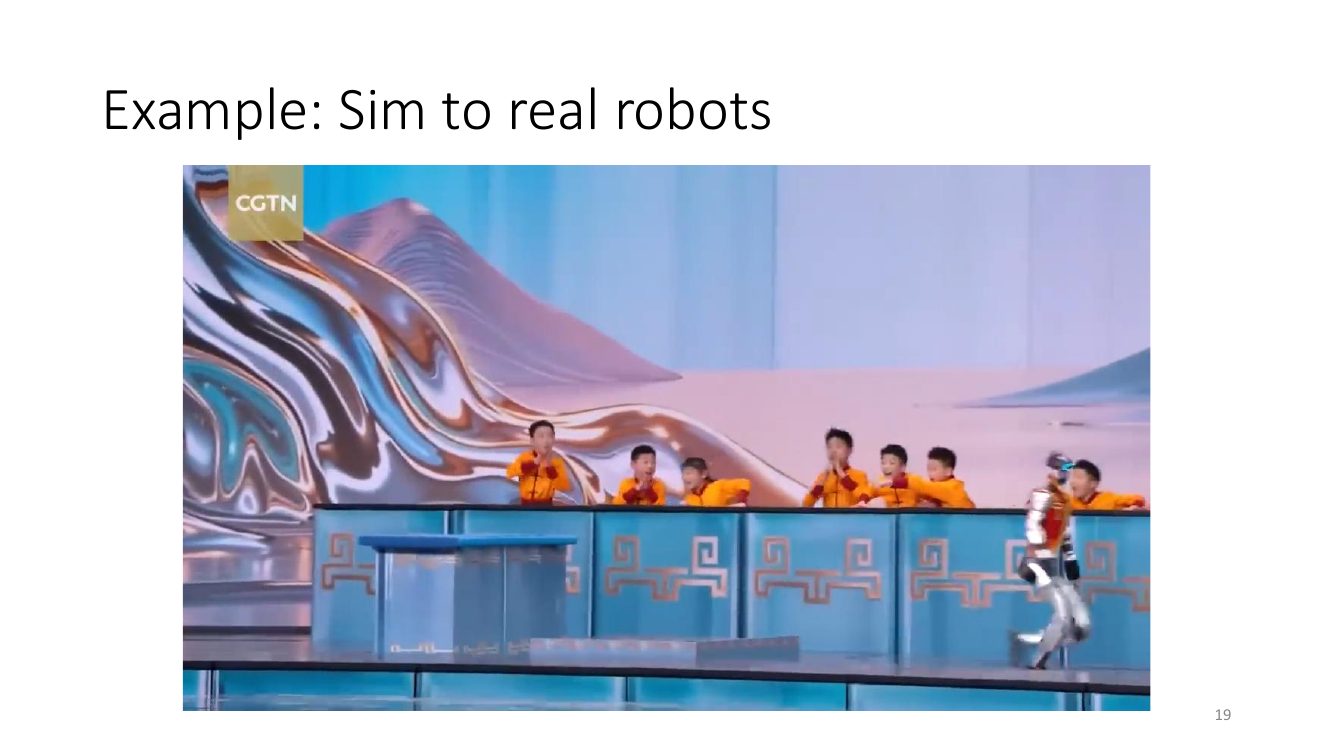
| 案例 | 「仿真器」是什么 | sim-to-real gap | RL 在其中的角色 |
|---|---|---|---|
| AlphaGo | 围棋规则(精确) | 为零 | 在巨大搜索空间中求逆 |
| 足式运动 | 刚体物理引擎 | 中等,靠域随机化压 | 自动设计步态控制器 |
| LLM 的 RLVR | 验证脚本 / 奖励模型 | 巨大("enormous gulf") | 把预训练能力对齐到可测目标 |
| 真实机器人操作 | 没有 | 不适用 | 直接从真实数据学(本讲第 3 节) |
把这一节总结成一句话:RL 作为工程工具是真实的、已经兑现的价值, 但它的成功半径完全等于「我们能仿真什么」的半径。 凡是能被写进仿真器的问题,RL 迟早能解;凡是写不进去的,RL 目前一筹莫展。 这就自然引出第二个视角。
3. 视角二:RL 与真实世界——Moravec 悖论其实是关于宇宙的
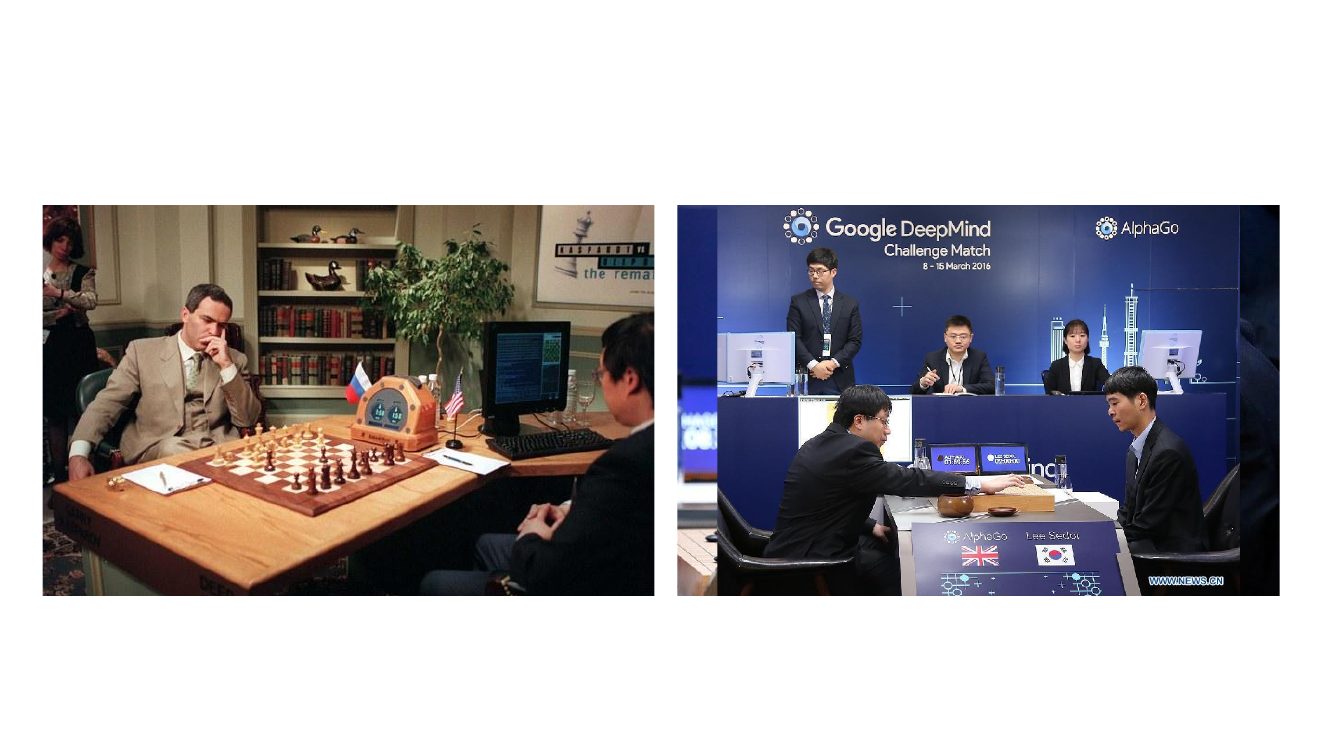
Levine 先放了一张对照图:1997 年 Kasparov 输给 Deep Blue,2016 年李世石输给 AlphaGo。 两次都是「人类智力巅峰被机器攻破」的标志性时刻。然后他问: 既然象棋和围棋这种「最难的」东西早就被解决了, 为什么没有任何机器人能像一个四岁小孩那样在陌生房间里捡起铅笔、走过去、回答一个问题?
Moravec 悖论的常见读法与 Levine 的读法
Moravec 悖论(Moravec's paradox)说:对 AI 来说,高级推理只需要很少的算力, 而低级的感知与运动技能需要极其巨大的算力。Hans Moravec 本人的表述是: 「我们在感知与运动领域都是了不起的奥林匹克选手,好到把困难的事做得看起来很容易。 而抽象思维是一个新技巧,也许只有不到十万年历史,我们还没掌握它。 它其实并没有那么难,只是我们做它的时候感觉很难。」 Steven Pinker 的版本更直接:「三十五年 AI 研究的主要教训是,难的问题是容易的,容易的问题是难的。 一个四岁小孩理所当然具备的心智能力——认出一张脸、拿起一支铅笔、走过一个房间、回答一个问题—— 实际上解决的是有史以来最难的工程问题。」
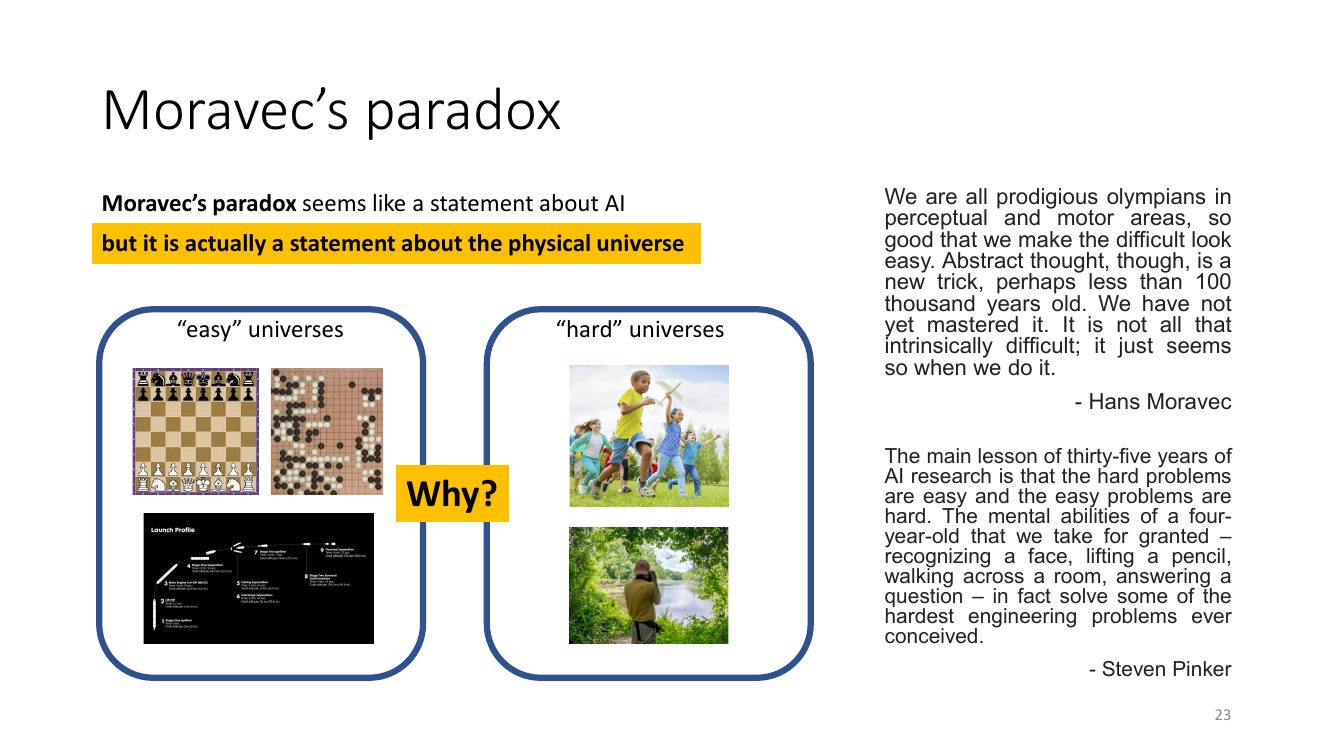
为什么这是关于宇宙而不是关于算法的陈述? 因为「难」与「易」的差别不在于任务需要多少推理深度,而在于 你能不能在动手之前把这个环境完整地写下来。 围棋的状态空间大到 $10^{170}$,但它的转移函数只要几十行代码。 「在陌生厨房里倒一杯水」的状态空间也许没那么大,但它的转移函数—— 水的流体行为、杯子的摩擦系数、桌面是不是湿的、旁边有没有一只猫—— 你永远写不完。难的不是搜索,是建模。
这和 RL 有什么关系
Levine 把「难宇宙」的要求拆成四条。这四条合在一起,几乎就是 RL 这套形式的定义:
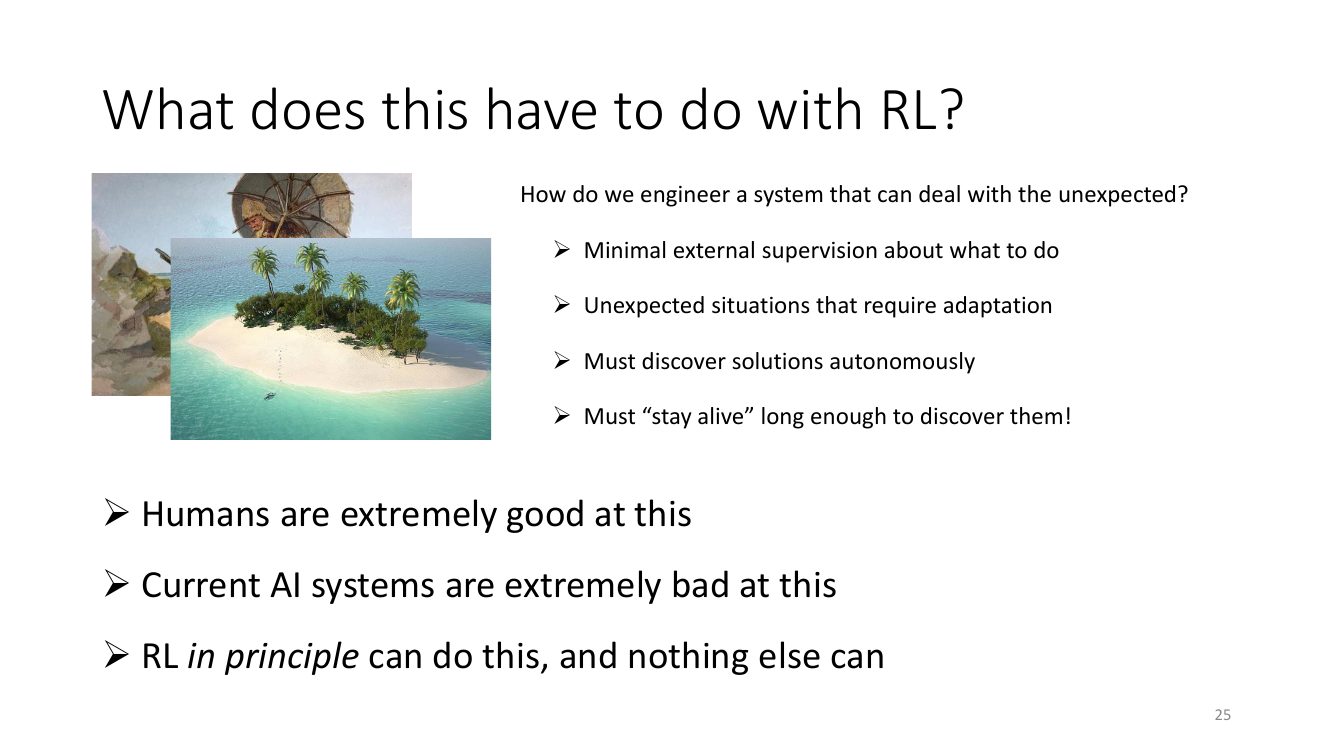
为什么说「只有 RL 能做」?逐条对照即可:
- 「极少外部监督」排除了监督学习——你没有标签。
- 「需要适应」排除了纯离线的策略——你必须用新产生的经验更新自己。
- 「必须自主发现解法」正是探索的定义(第 19、23 讲)。
- 「必须活下来才能学」是 RL 独有的约束:训练过程本身发生在真实系统上, 一次灾难性动作就没有第二次采样机会。这在监督学习里根本不存在对应概念。
那问题出在哪
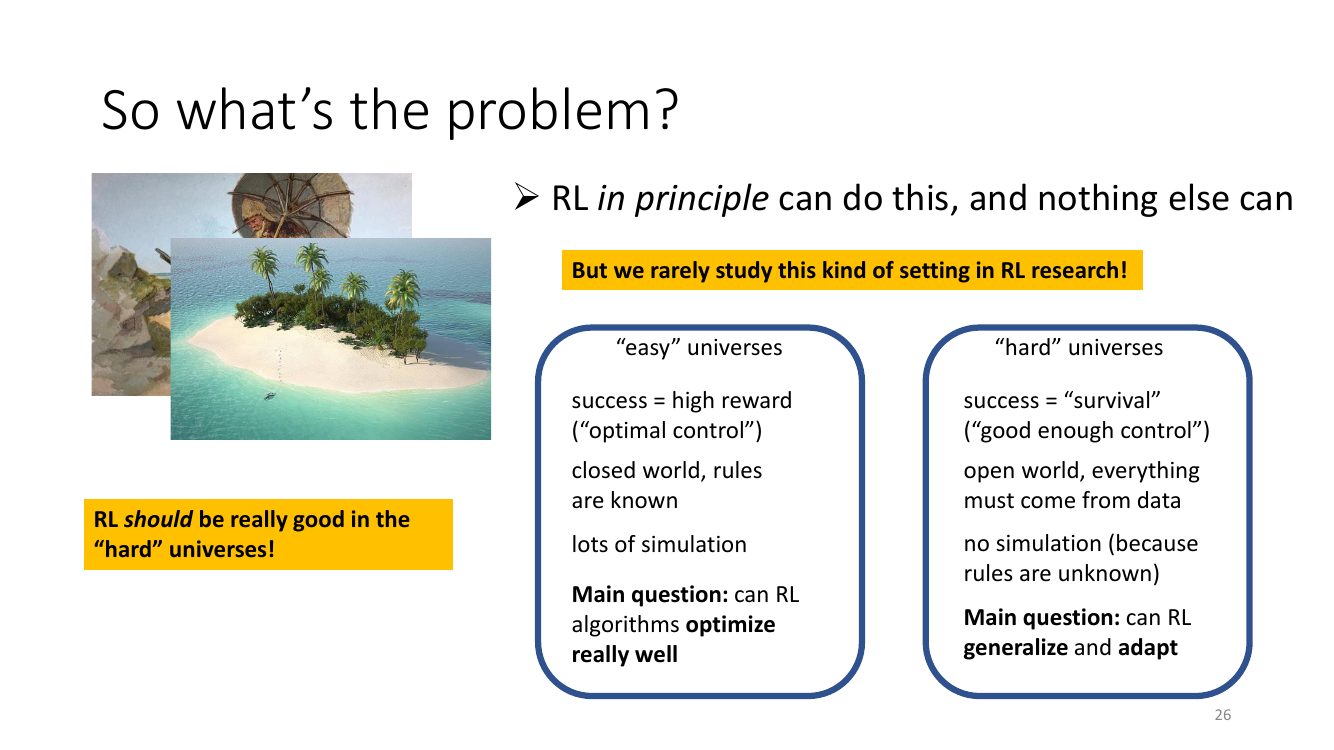
这张表解释了领域内一个长期的错配。绝大多数 RL 论文报告的是 「在 MuJoCo/Atari/某个 benchmark 上我的回报比 baseline 高 15%」—— 这是在回答左框的问题:优化得够不够好。 但如果我们真正在乎的是右框,那么正确的度量应该是: 换一个没见过的环境,它掉多少?给它一个新任务,它需要多少样本? 它会不会在探索时把自己弄坏?
「先在仿真里把优化做到极致,再考虑迁移」——这个思路的问题在于, 两个框里的目标函数根本不同。易宇宙追求 $\max J$,难宇宙追求 「以高概率不掉到某个阈值以下」,即更接近 $\max_\theta \E[\,J\,]\ \text{s.t.}\ \Pr[\text{catastrophe}] \le \delta$, 甚至干脆是最坏情况下的 $\max_\theta \min_{e\in\mathcal{E}} J_e(\theta)$。 把前者优化到极致,通常反而让策略更脆——它会精确地贴着仿真器的边界走, 一点点分布偏移就崩。这正是 sim-to-real 里「越优越脆」现象的来源。
4. 真实世界抛出的五个问题
如果我们真的把 RL 部署到「难宇宙」,会立刻撞上五个在 benchmark 上从来不会出现的问题。 Levine 把它们并列在一页上,并特别强调:这不是关于机器人的—— 机器人只是最容易想象的载体,因为它像我们一样有身体; 但同样的五个问题在推荐系统、库存管理、医疗决策、对话智能体上一字不差地成立。
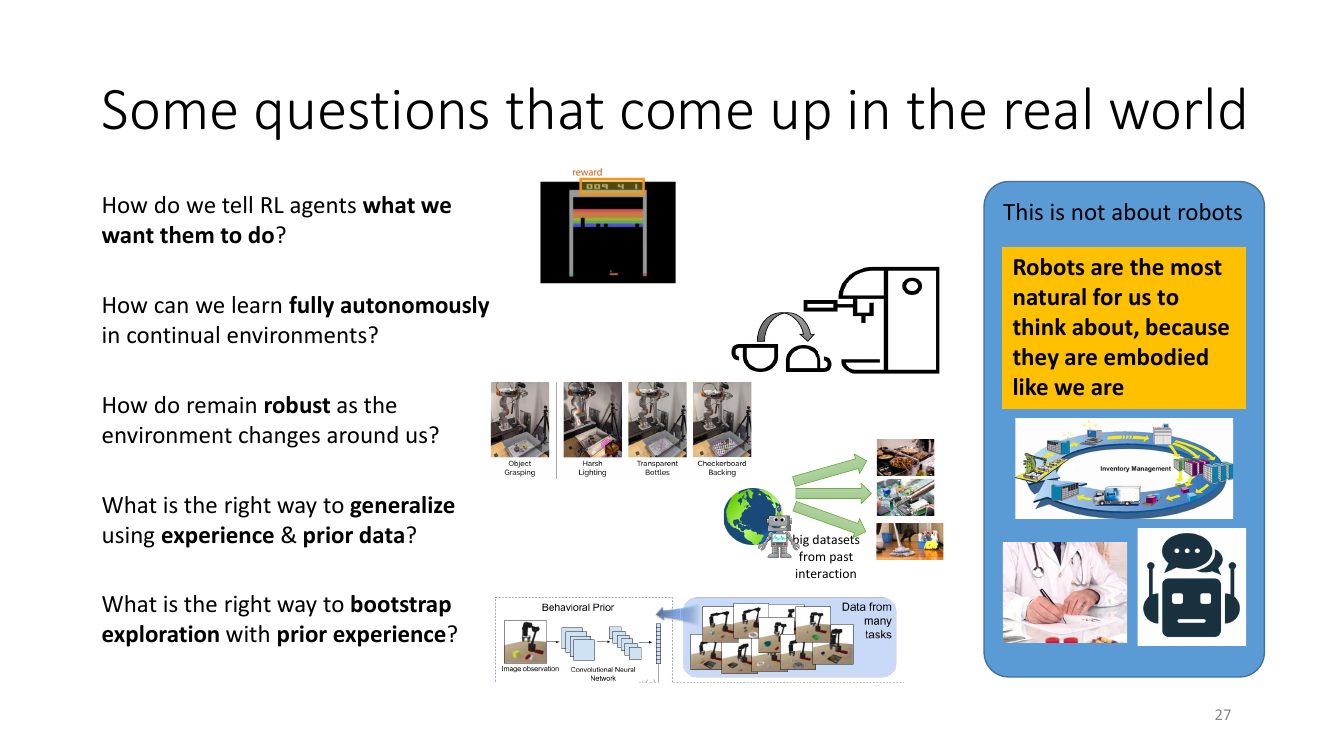
问题一:怎么告诉智能体我们想要什么
在 Atari 里,奖励是屏幕左上角的数字;在 MuJoCo 里,奖励是一行 Python。 在真实世界里,没有人给你 $r(s,a)$。可选的路子本课都讲过,但每条都有代价:
| 指定任务的方式 | 所在讲次 | 代价 / 失效模式 |
|---|---|---|
| 手写奖励函数 | 第 4 讲 | 奖励黑客:策略去优化你写的式子而不是你想要的事 |
| 人类偏好 + 奖励模型(RLHF) | 第 14 讲 | 奖励模型本身会被过优化;标注昂贵 |
| 示范 + 逆 RL | 第 13 讲相关 | 需要专家示范;奖励不可辨识 |
| 目标条件(goal-conditioned) | 第 3、24 讲 | 只能表达「到达某状态」,表达不了过程性偏好 |
| 成功分类器 / 自动检测 | — | 分类器会被对抗;边界样本上不可靠 |
奖励黑客(reward hacking)不是工程 bug,而是优化的必然结果。 设真实目标是 $r^\star$,你写下的代理是 $\hat r = r^\star + \epsilon$,其中 $\epsilon$ 是误差项。 RL 求 $\argmax_\pi \E_\pi[\hat r]$。当策略空间足够大时,最优解会主动去找 $\epsilon$ 取值最大的那片状态区域——也就是你的代理奖励错得最离谱的地方。 优化能力越强,找得越准,这就是所谓 Goodhart 定律的 RL 版本。 缓解手段(KL 正则回参考策略、早停、集成奖励模型取悲观下界)本质上都是在限制 策略离「$\epsilon$ 还算小」的区域有多远——和离线 RL 里的保守性约束是同一个思想。
问题二:完全自主的持续学习
标准 RL 的采样循环里藏着一个几乎从不被讨论的假设:env.reset()。
每个 episode 结束,环境免费回到初始状态分布 $p(s_1)$。
在仿真里这是一行代码;在真实世界里这是一个人走过去把积木摆回原位。
如果一次训练要 $10^5$ 个 episode,就需要 $10^5$ 次人工重置——这直接杀死了真机 RL 的可扩展性。
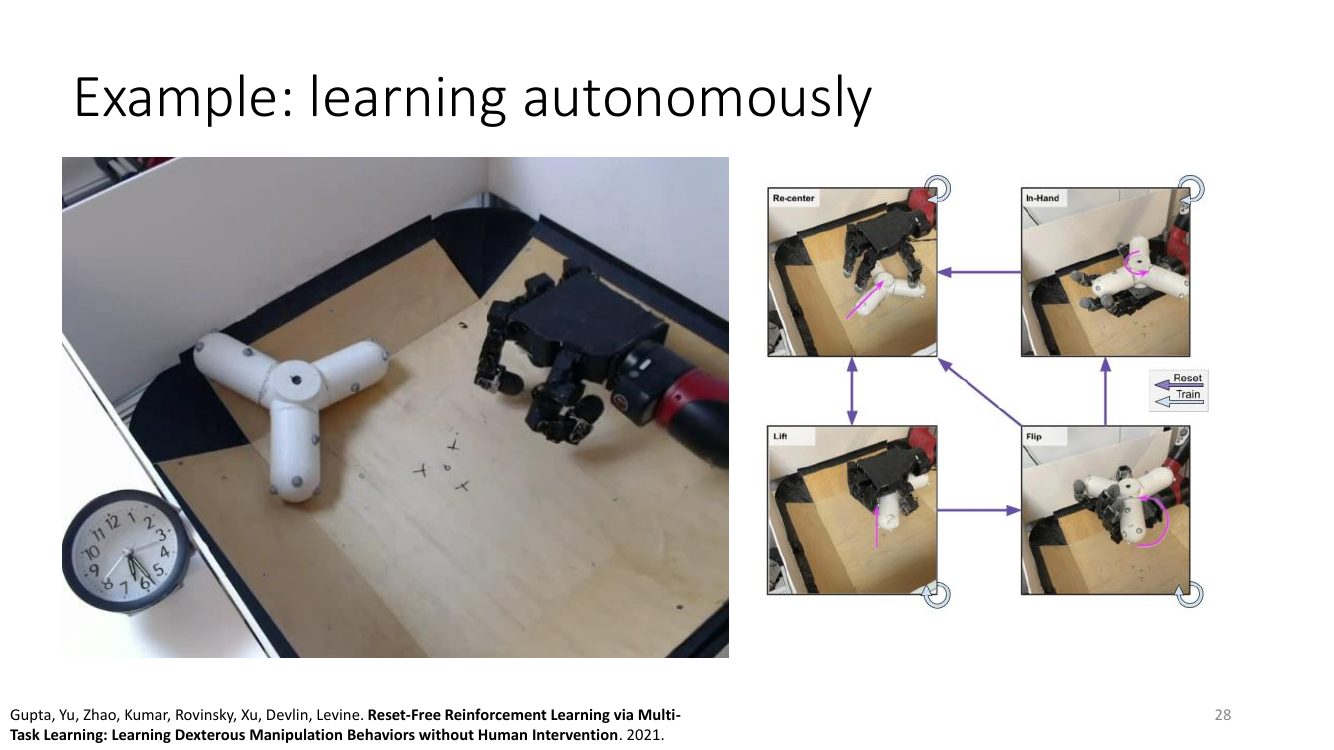
这个思路值得写成代码。核心不是某个新算法,而是把「重置」本身当成一个被学习的策略:
# 无重置的多任务 RL:任务图上的自主循环
# 每个任务 i 有自己的策略 pi_i、成功判据 done_i,
# 以及一张 reset_graph:完成/失败后该切到哪个任务把系统带回可训练状态。

reset_graph = {          # 当前任务 -> 用来"重置"它的任务
    'lift':      'recenter',
    'flip':      'recenter',
    'in_hand':   'flip',
    'recenter':  'lift',      # 图是循环的,没有终点
}

s = env.observe()                     # 真机只有一次初始化,之后永不 reset
cur = 'recenter'
for step in range(TOTAL_STEPS):       # 连续跑几十小时
    a = policies[cur].act(s)
    s2, r = env.step(a), rewards[cur](s)
    buffers[cur].add(s, a, r, s2)     # 每个任务各自的 replay buffer
    s = s2

    if done[cur](s) or timeout(cur):
        cur = reset_graph[cur]        # 切到"重置任务",它本身也在被训练
    if step % TRAIN_EVERY == 0:
        for k in policies:            # 所有任务共享同一批真实经验
            policies[k].update(buffers[k].sample(BATCH))
注意两个细节:第一,没有 env.reset(),
真机从头到尾只被初始化一次;第二,每一步产生的数据对所有任务都可能有用
(用各自的奖励函数重标注即可),这正是第 24 讲多任务 RL 的价值——
多任务不只是为了泛化,它首先是为了让自主学习在物理上成为可能。
问题三到五:鲁棒、泛化、探索的引导
后三个问题是同一件事的三个切面。环境会变(光照、背景、物体换了一批), 策略必须不崩;要不崩就必须见过足够多样的东西; 而在一个新场景里要快速上手,就必须用先验数据把探索约束到合理的行为流形上—— 否则一个随机初始化的策略在真实机械臂上只会疯狂抖动,几百小时都采不到一次成功。
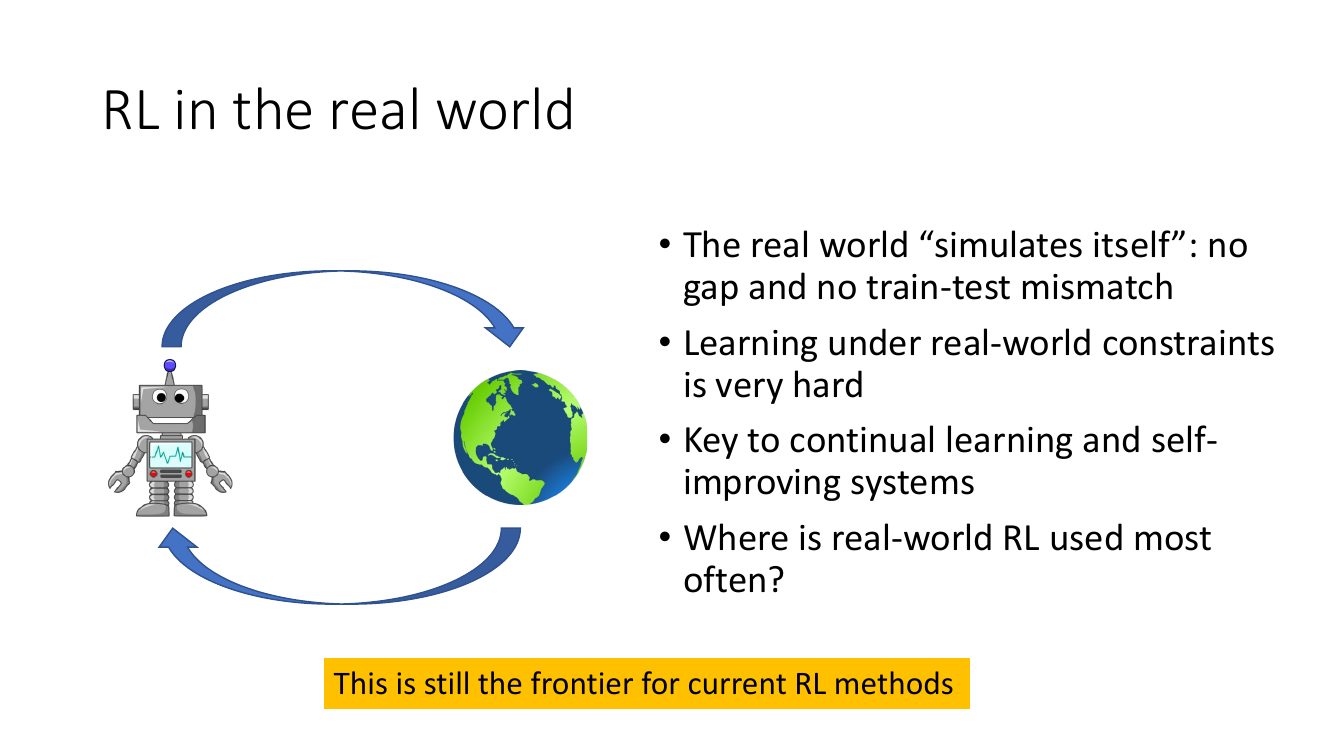
第 (4) 问的答案有点反直觉:不是机器人,而是推荐系统、广告投放、 以及从真实用户反馈里在线改进的产品系统。原因恰恰符合上面的分析—— 在这些系统里,「环境」就是真实用户群体,它天然自己运行、自己产生反馈、 数据量以亿计、单次失败的代价极小(推错一条内容而已)。 换句话说,真实世界 RL 目前的落地,集中在那些「探索代价接近零」的领域。 机器人之所以难,不是因为它是物理的,而是因为它的探索代价高、数据吞吐低、失败不可逆。
5. 视角三:RL 作为「通用」学习范式
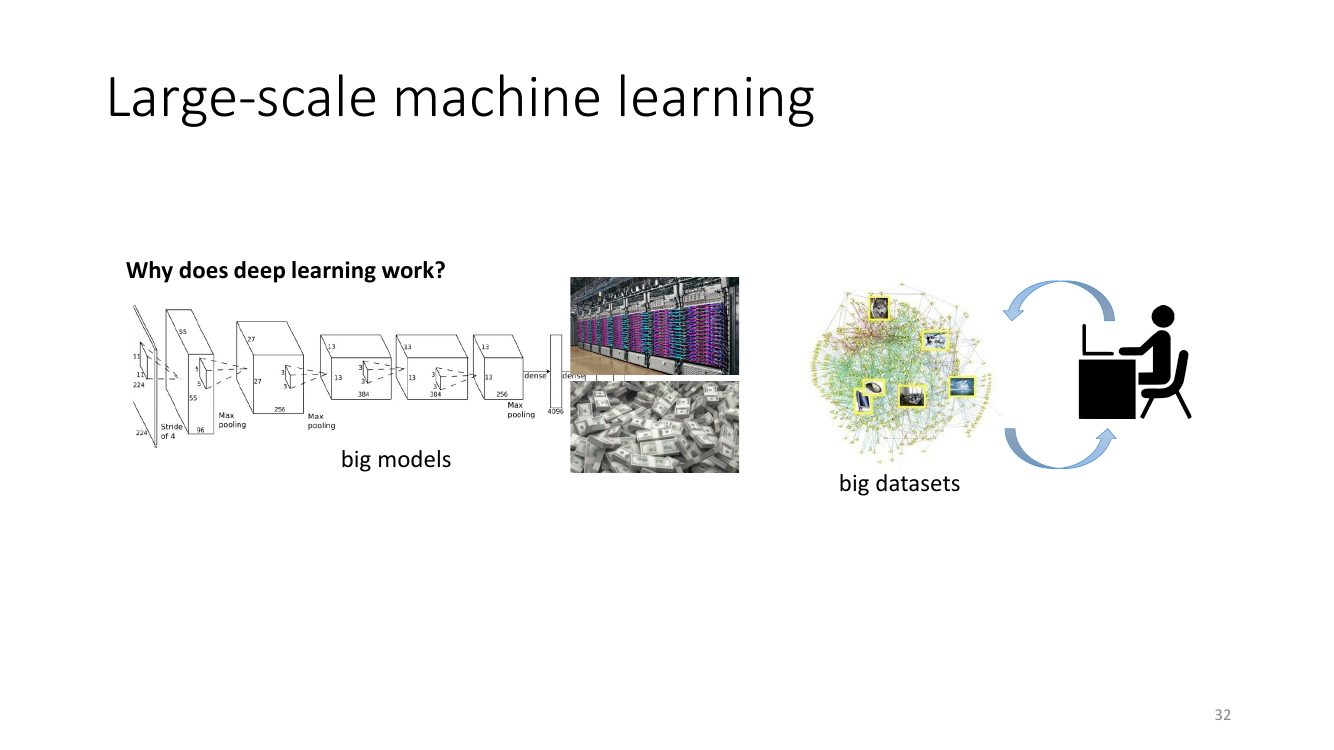
第三个视角从一个更基础的问题问起:深度学习为什么会成功?
能不能靠无监督学习省掉监督?
标准答案是:用一小份有标注的数据 + 一大堆免费的无标注数据(也就是互联网)。 这正是无监督/自监督学习应该做的事——从「巨量的垃圾数据集」中学到表示, 再用少量标签把它对齐到任务上。
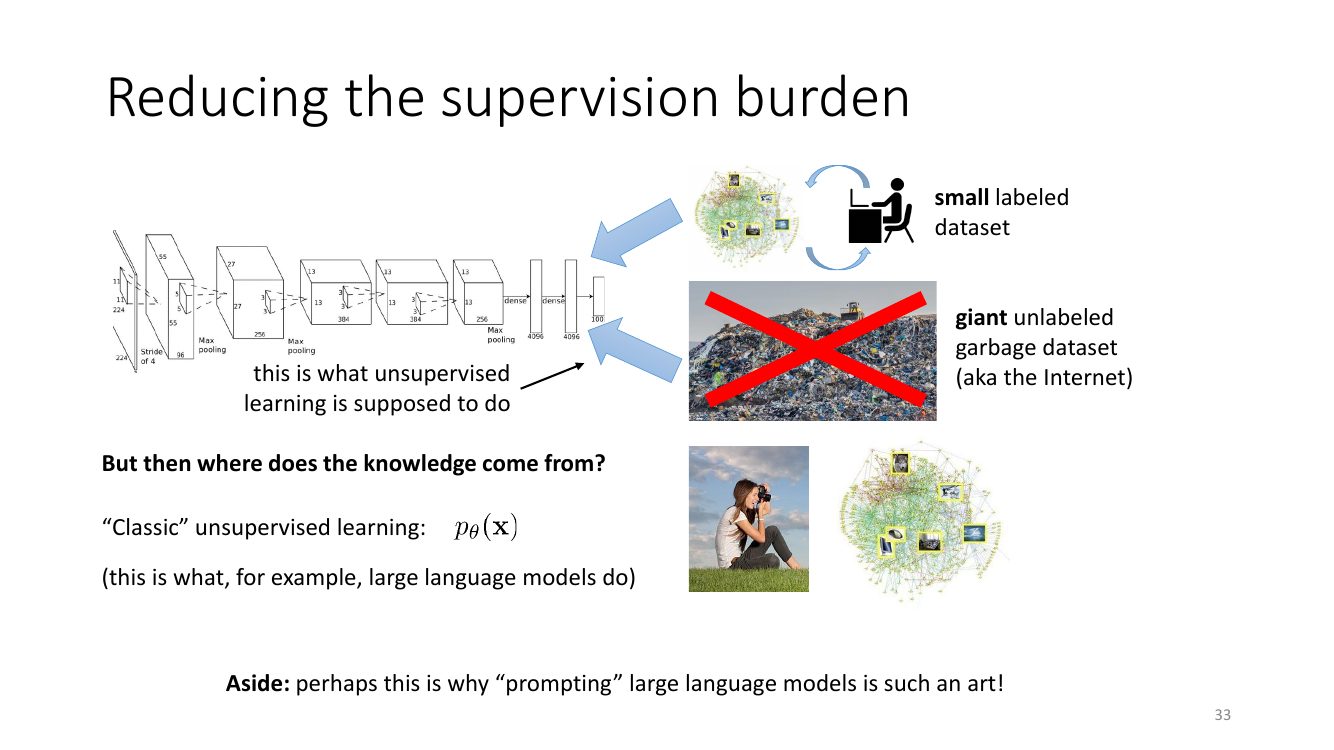
为什么「学 $p_\theta(\mathbf{x})$ 导致 prompting 成为艺术」? 因为一个纯生成模型只知道「什么样的数据是可能出现的」,它并不知道「什么是好的」。 你给它一个前缀,它就补一个在训练分布下最合理的续写。 如果前缀暗示写作者是个新手,它就会真的补出新手水平的答案——这不是模型能力不足, 而是它忠实地在做条件生成。所以人类要靠精心构造前缀,去「捞出」分布中好的那一支。 而 RL 提供的是另一条路:直接告诉模型什么是「好」,让它去优化,而不是去模仿。 这条对比会在下一节的对话智能体例子里被完整地演一遍。
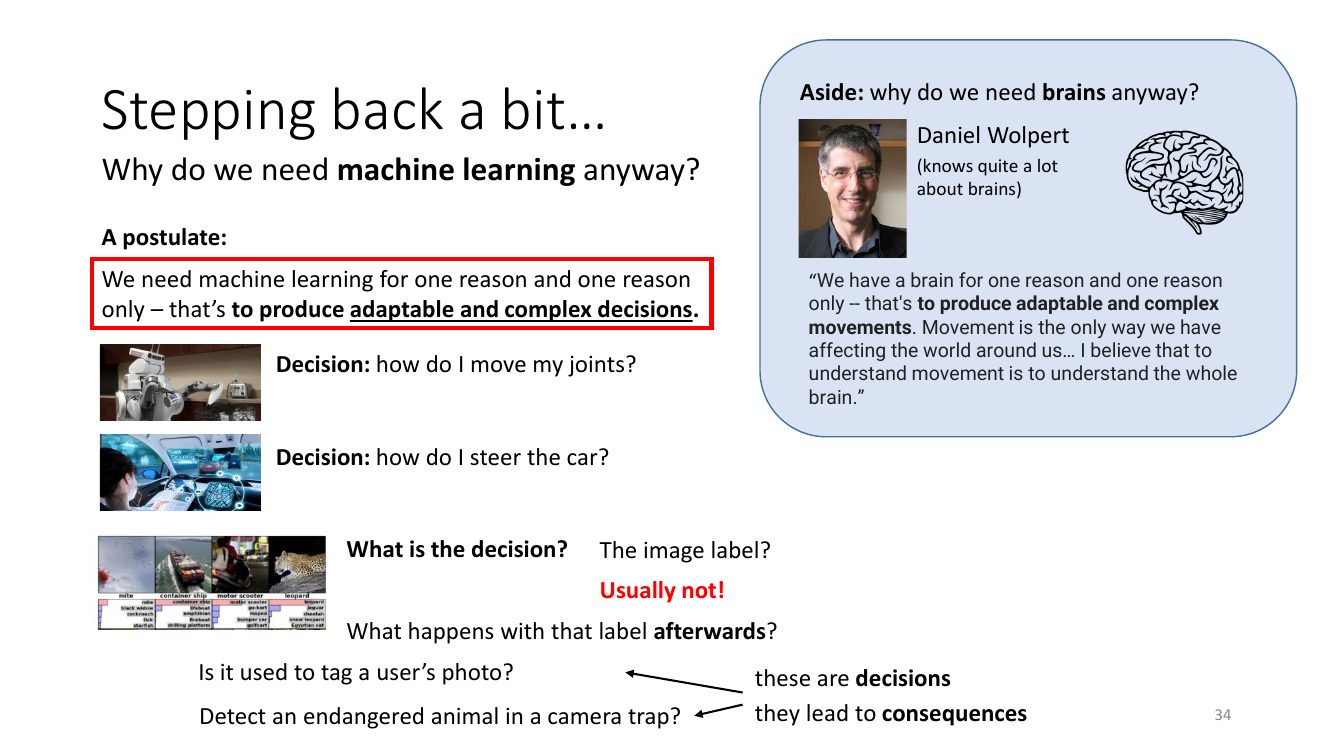
退一步:我们究竟为什么需要机器学习?
Levine 在这里放了整讲最哲学、也是他本人最常引用的一页。 先引神经科学家 Daniel Wolpert 的话:「我们有大脑只有一个理由, 就是产生可适应的、复杂的运动。运动是我们影响周围世界的唯一方式…… 我相信理解运动就是理解整个大脑。」
然后 Levine 给出对应的机器学习版本假设:
我们需要机器学习只有一个理由,就是产生「可适应的、复杂的决策」。
推论:图像分类里那个「标签」通常不是真正的决策。真正的决策是标签之后发生的事—— 这张照片要不要打上某个用户的标签?相机陷阱里检测到的是不是濒危动物、要不要出动护林员? 这些才是决策,而决策会产生后果。既然一切下游都是决策, 那么「决策问题」就不是机器学习的一个子领域,而是它存在的目的。
把 RL 变成「用廉价数据」的方法
如果决策是目的,那么 RL 就必须能像监督学习那样吃下大规模廉价数据。 Levine 给出的划分非常清楚——数据和监督各自负责一件不同的事:
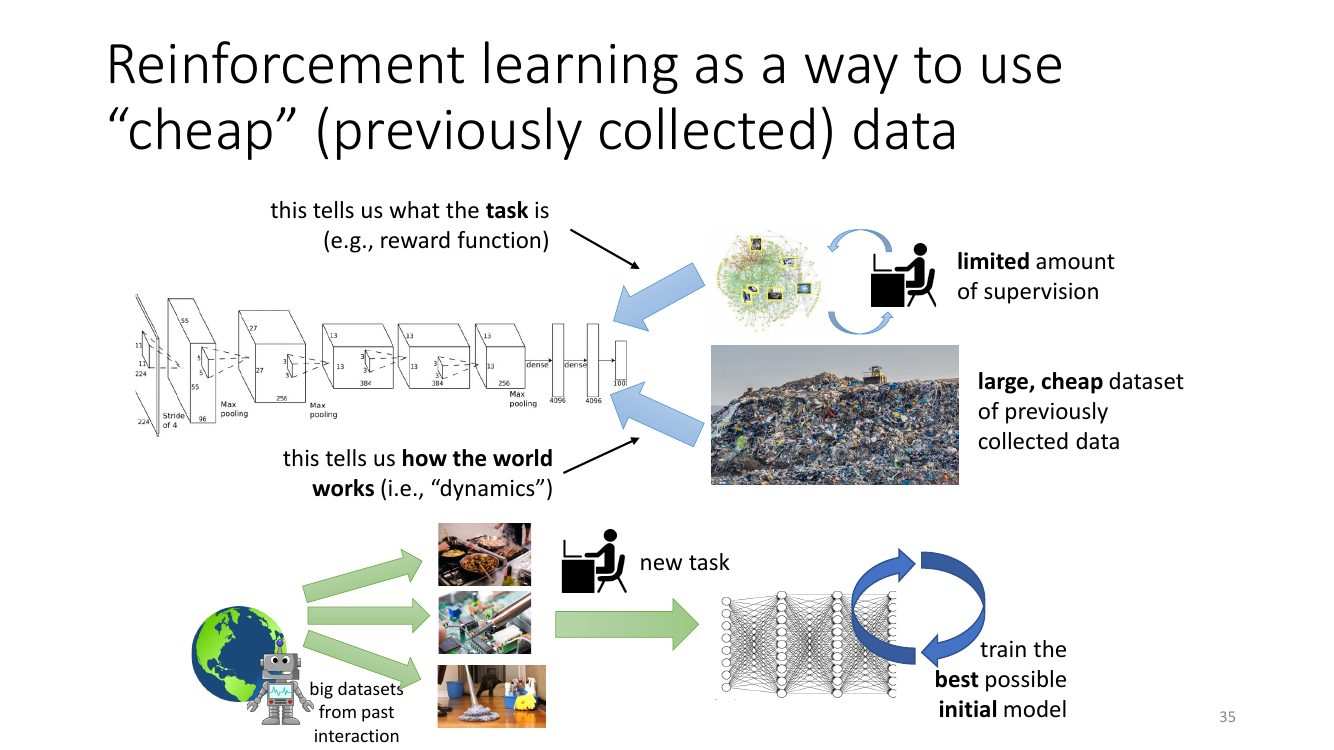
这个分工在数学上是有依据的。回忆轨迹分布的分解:
$$ p_\theta(\tau) = p(s_1)\prod_{t=1}^{T} \pi_\theta(a_t|s_t)\, p(s_{t+1}|s_t,a_t) $$其中 $p(s_{t+1}|s_t,a_t)$ 与任务、与奖励完全无关——它是世界的属性。 任何人、为了任何目的收集的交互数据,都在为估计这个 $p$ 提供信息。 而 $r(s,a)$ 才是任务专属的。所以:「世界怎么运转」可以从别人的数据里免费学, 「我想要什么」才需要昂贵的监督。这就是为什么离线 RL(第 17、18 讲) 在这条路线里是不可替代的枢纽——只有它能把「别人收集的、质量参差的、 在别的策略下产生的」数据转化成决策能力。
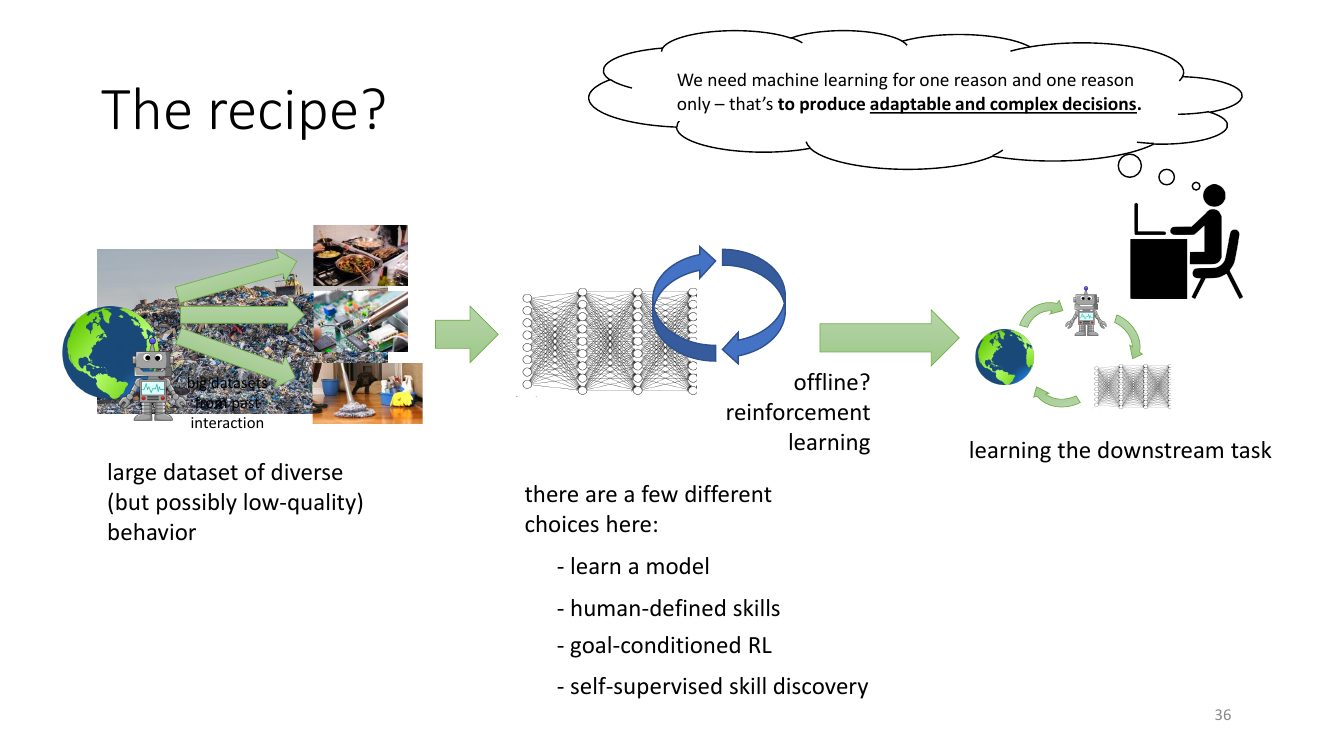
# "配方"的骨架:离线预训练 + 少量在线微调
# 阶段一:从大规模、混杂、非最优的历史数据里做离线 RL 预训练。
#         关键是保守性——不能对数据没覆盖到的动作盲目乐观(第 17/18 讲)。
for it in range(OFFLINE_STEPS):
    s, a, r, s2 = big_mixed_dataset.sample(BATCH)     # 别人收集的数据,质量参差
    with torch.no_grad():
        a2 = pi(s2).sample()
        y = r + GAMMA * (Q_targ(s2, a2) - ALPHA * pi.log_prob(a2, s2))
    td = ((Q(s, a) - y) ** 2).mean()

    # CQL 式保守项:压低"数据里没出现过"的动作的 Q 值
    a_rand = pi(s).sample()
    conservative = (Q(s, a_rand).mean() - Q(s, a).mean())
    (td + BETA * conservative).backward(); opt_q.step()

    pi_loss = -(Q(s, pi(s).rsample())).mean()          # actor 照常最大化 Q
    pi_loss.backward(); opt_pi.step()

# 阶段二:换上下游任务的奖励,用少量真实在线交互微调。
#         此时 BETA 逐步退火 —— 有了新数据就不必再那么保守。
for ep in range(ONLINE_EPISODES):
    traj = rollout(env_downstream, pi)                 # 昂贵:真实交互
    online_buffer.add(traj)
    for _ in range(UPDATES_PER_EP):
        batch = mix(big_mixed_dataset, online_buffer, ratio=0.5)
        sac_update(pi, Q, batch, beta=anneal(ep))
这段代码里没有任何新东西——它就是第 18 讲的 CQL 加第 6 讲的 actor-critic。 新的是它被摆在什么位置:不是「在某个 benchmark 上跑一个离线算法」, 而是「把离线 RL 当成 RL 版的预训练」。这正是 Levine 认为 RL 要走向通用必须补上的那一环。
6. 案例:把 LLM 当仿真器,用 RL 训练对话智能体
这一节是全讲唯一一个完整的技术案例,它同时串起了前面三个视角: 用 LLM 做「仿真器」(视角一)、目标是真实的人类交互(视角二)、 数据是廉价合成的大规模数据(视角三)。
问题:我们想要的和我们得到的不一样
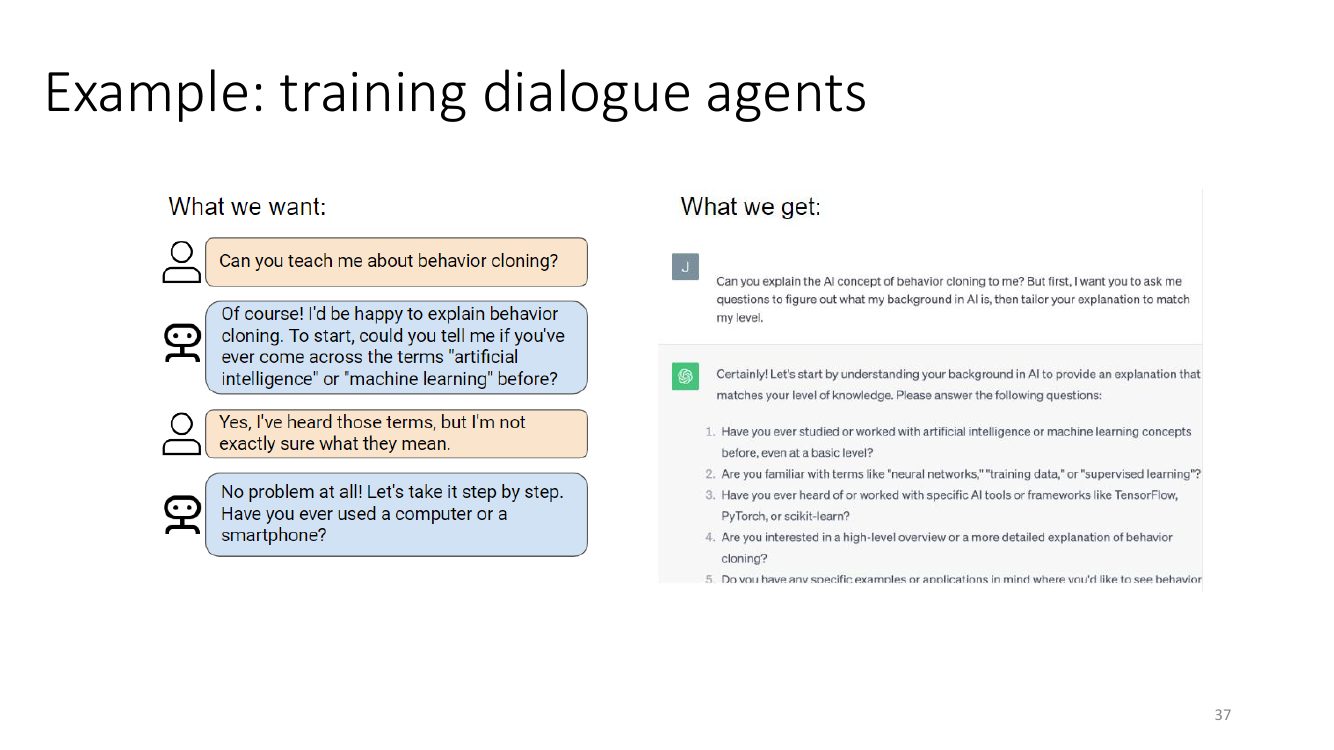
为什么会这样?因为标准的 LLM 训练目标是 $\max_\theta \sum_t \log p_\theta(x_t | x_{\lt t})$, 即模仿人类文本。而人类在写下这段对话时,各种风格都有;模型学到的是这些行为的 平均或典型模式,而不是最优模式。用本课的语言说: 预训练做的是行为克隆(第 2 讲),而行为克隆只能复现数据里的行为分布, 不能超越它。要超越,就必须有一个「什么是好结果」的信号,并对它做优化——那就是 RL。
解法:让 LLM 扮演「人类模拟器」,再对模拟数据做值函数 RL
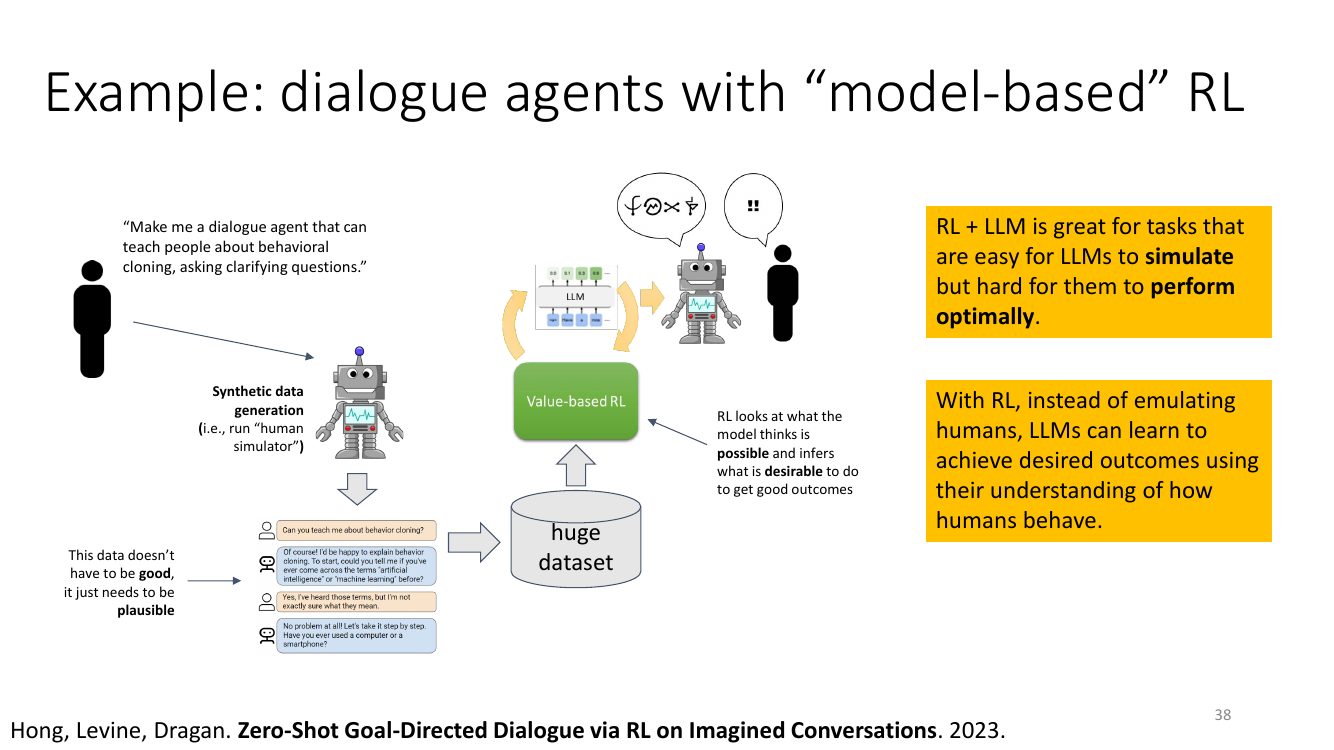
用本课的框架翻译一遍,这就是一个标准的 model-based RL:
| model-based RL 的组件 | 在这个系统里是什么 |
|---|---|
| 状态 $s_t$ | 到目前为止的对话历史 |
| 动作 $a_t$ | 智能体这一轮说的话 |
| 动力学 $p(s_{t+1}|s_t,a_t)$ | LLM 扮演的「人类模拟器」:给定历史与智能体发言,人会怎么回 |
| 奖励 $r(s,a)$ | 任务描述蕴含的成功判据(例如用户最终真的学会了) |
| 规划 / 优化 | 在合成的巨量轨迹上做离线的值函数 RL(如隐式 Q 学习类方法) |
为什么「数据不需要好,只需要合理」就够?因为值函数 RL 的本质是 在数据里做「拼接」(stitching)。第 17 讲讲过: 即使数据集里没有任何一条完整的最优轨迹,只要各段最优行为分别出现在不同轨迹里, Bellman 备份 $Q(s,a)\leftarrow r + \gamma \max_{a'} Q(s',a')$ 就能把它们缝成一条比 任何一条数据都好的策略。所以「人类模拟器」只需要保证转移是合理的 (人不会说出完全不可能的话),至于智能体那一侧的发言好不好,交给 $\max$ 去挑。 这也解释了为什么行为克隆这些合成数据是没用的——BC 会把平庸也一起学进去。
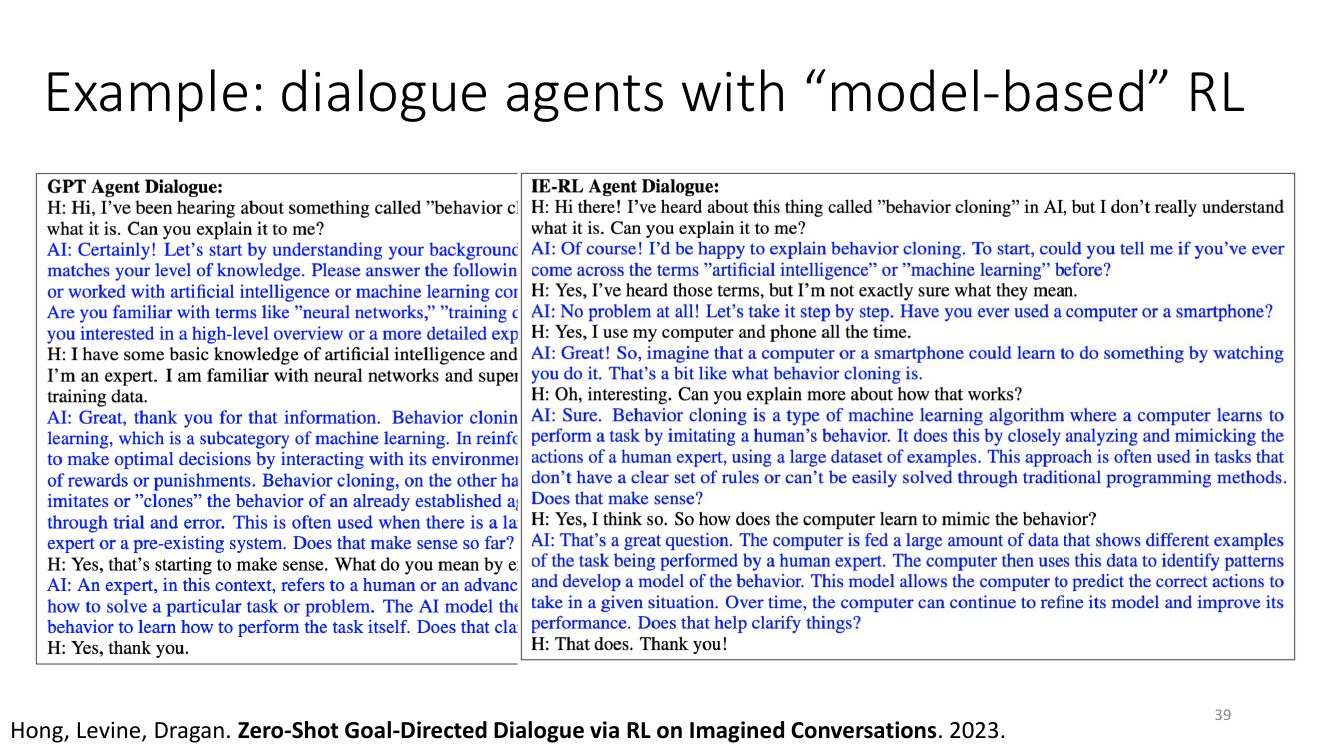
这个例子之所以重要,是因为它给出了「RL 与基础模型结合」的一种非平凡形态: 不是用 RL 去微调模型的语气(RLHF 那种单轮偏好对齐), 而是用模型自己的世界知识充当环境模型,用 RL 在这个模型里做长程规划。 它的适用条件也很清楚——任务必须满足「LLM 容易仿真,但难以最优执行」。 教学对话、谈判、问诊、客服都符合;而需要真实物理后果或真实外部信息的任务不符合, 因为 LLM 模拟不出来。
7. 回到大图景:信号从哪来,以及该做什么研究
为什么是「深度」强化学习
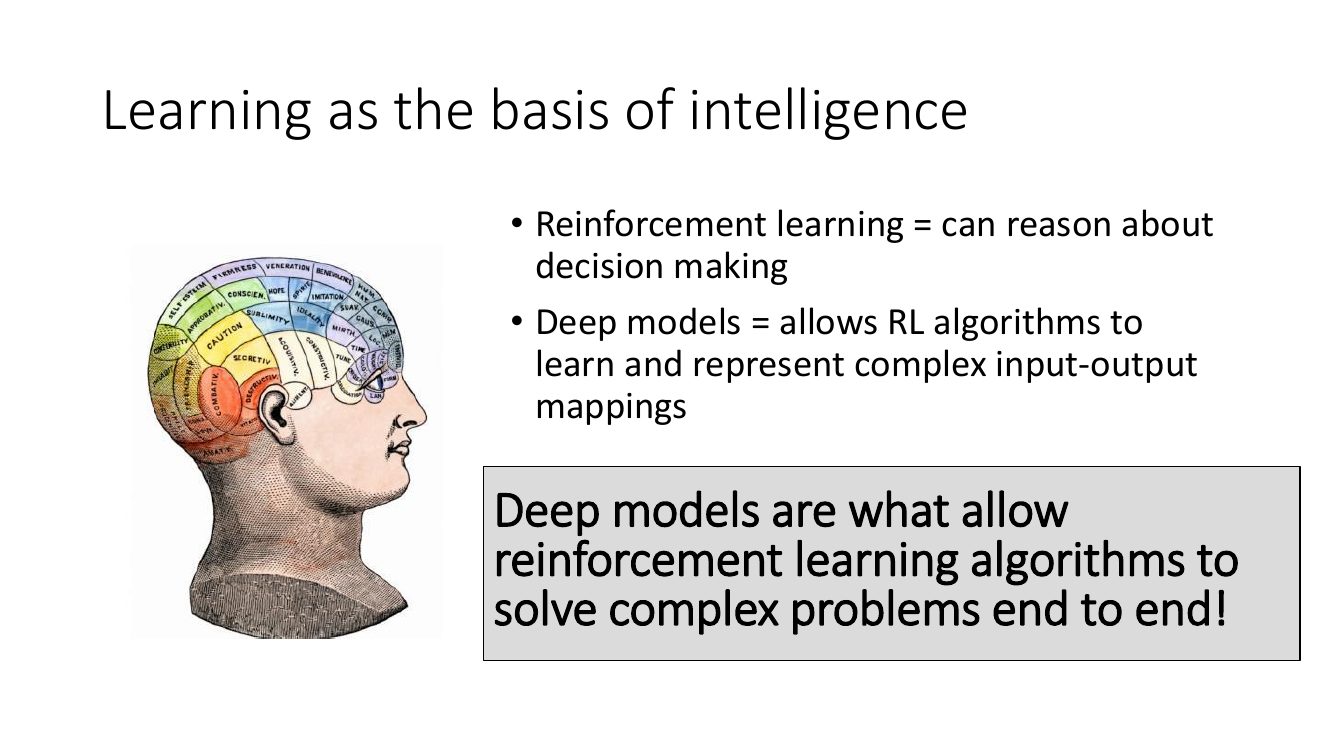
这句话值得对照第 1 讲重新理解。经典 RL(值迭代、TD、策略迭代)在理论上很完备, 但它假设状态可枚举、特征由人设计。深度学习把「表示」这一环自动化了, 于是 RL 的输入端第一次可以直接接上原始感知。反过来,深度学习本身只能做 $\mathbf{x}\mapsto\mathbf{y}$ 的映射拟合,它没有任何机制去表达 「这个动作现在看起来差,但它带来的状态在三十步后会很值钱」—— 这恰恰是 $Q^\pi$、$V^\pi$、Bellman 备份提供的东西。
还缺什么:信号从哪里来
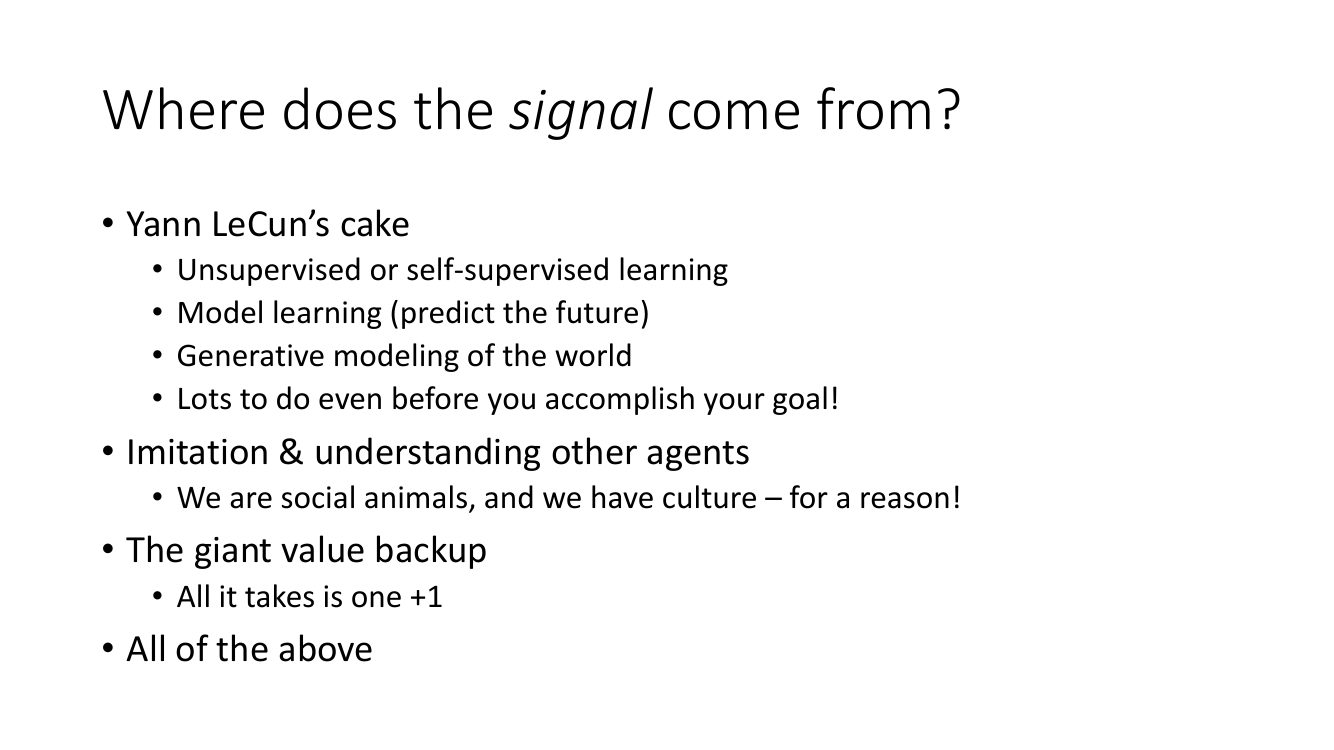
Levine 认为整个领域最核心的缺口不是算法,而是学习信号(signal)的来源。 如果只有稀疏的任务奖励,一个智能体在真实世界里几乎学不动任何东西。 他列出四类可能的信号源:
逐条展开:
(1)LeCun 的蛋糕。这个比喻是说:如果智能是一块蛋糕, 那么无监督/自监督学习是蛋糕胚(每个样本提供百万比特的信息), 监督学习是外面那层糖霜(每个样本几十到几千比特), 而强化学习只是顶上那颗樱桃(每个 episode 可能只有几比特)。 Levine 引用它的用意不是贬低 RL,而是指出:在你的任务奖励到来之前, 预测下一帧、建模动力学、生成式地理解世界,已经能提供海量的监督信号。 这就是第 15、16 讲 model-based RL 的价值主张——学模型的信号密度比学策略高好几个数量级。
(2)模仿与理解其他智能体。人类的绝大多数技能不是自己试错试出来的, 而是看别人做学来的。文化是一台把「别人的经验」压缩并跨代传递的机器。 对 RL 来说,这对应模仿学习(第 2、3 讲)、逆 RL、以及从人类视频里学习—— 不是把别人的动作照抄,而是推断别人为什么这么做。
(3)巨大的值回传。这是最 RL 本位、也最容易被低估的一条。 「你只需要一个 +1」的意思是:只要动态规划机制足够强, 一次成功就能通过 Bellman 备份把信息扩散到整个状态空间。
考虑一条长度 $H$ 的链,只有终点给 $r=+1$,其余处处为 $0$,$\gamma=0.99$,$H=200$。 最优值函数是
$$ V^\star(s_k)=\gamma^{\,H-k},\qquad V^\star(s_1)=0.99^{199}\approx 0.135,\qquad V^\star(s_{100})=0.99^{100}\approx 0.366 $$注意这个值函数在每一个状态上都非零、且严格单调—— 也就是说,那唯一的一个 $+1$ 给出了整整 200 个状态上的排序信息。
关键在于「怎么把它传过去」。用蒙特卡洛回报,你必须再次走到终点才能给早期状态更新, 所需的成功次数随 $H$ 线性增长。而用 Bellman 备份 $V(s_k)\leftarrow \max_a \E[r + \gamma V(s_{k+1})]$, 每扫一遍 buffer 信息就往回传一步;扫 $H$ 遍就传满全程, 而这 $H$ 遍全部在已有数据上离线完成,不需要任何新的环境交互。 这就是「一个 +1 就够」的技术含义:值回传把一次稀疏奖励放大成 整个数据集规模的监督信号。它也正是离线 RL 相对行为克隆的根本优势。
「稀疏奖励下 RL 学不动,所以要做奖励塑形(reward shaping)」——这是把 探索问题和信用分配问题混为一谈了。 稀疏奖励真正难的是第一次怎么撞到那个 $+1$(探索,第 19 讲); 一旦撞到了,值回传的效率其实很高。奖励塑形是在解第一个问题, 代价是可能改变最优策略(除非用势函数塑形 $r'=r+\gamma\Phi(s')-\Phi(s)$,它可证明不改变最优策略)。 用先验数据/技能先验去引导探索(第 23、24 讲)通常是更干净的解法。
该怎么做研究
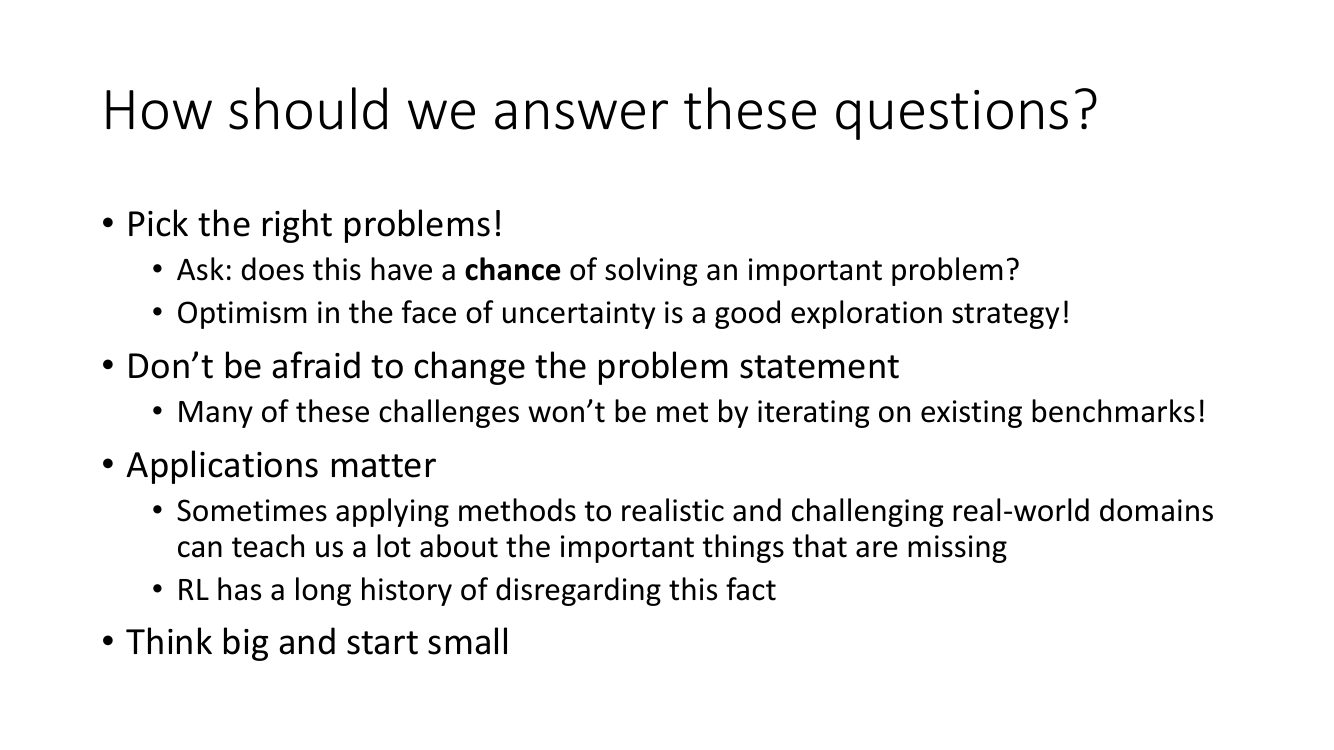
第 (1) 条里那个玩笑值得展开:「面对不确定性时保持乐观」正是第 19 讲 UCB 类探索算法的原理——给不确定的选项加一个 $\sqrt{2\ln T / N(a)}$ 的奖励加成, 从而优先尝试没试过的方向。Levine 把它反用在科研选题上: 一个方向越少人做、你越不确定它行不行,它的「信息价值」就越高。 但注意 UCB 的完整形式还有 $\hat\mu(a)$ 那一项——光有不确定性不够, 期望收益也要够大,这就是第 (1) 条前半句「它有没有机会解决一个重要问题」。
第 (2) 条是对整个 benchmark 文化的批评。如果你的评价指标是 MuJoCo 上的回报曲线, 那么「泛化」「适应」「自主」「安全」这些性质在指标上根本不可见, 于是也就永远不会被优化。改问题设定的成本是短期内没有 baseline 可比, 收益是你在测量真正重要的东西。
8. 全课回顾:把 25 讲串成一条线
这门课不是「算法目录」,它有一条非常清晰的叙事线: 每一块都是因为上一块在某个地方失效,才不得不被发明出来。 下面按六大块回顾,并标出每一块解决的问题与它留下的新问题。
第一块:从模仿开始(L1–L3)
L1 导论先立起问题:为什么决策问题不能当成监督学习做。 L2 行为克隆给出最朴素的答案——把 $(o_t,a_t)$ 当数据做监督学习, 然后立刻暴露它的致命伤:分布漂移。误差在时间上累积, $T$ 步之后期望错误数是 $O(\epsilon T^2)$ 而不是 $O(\epsilon T)$,因为一旦偏离专家分布, 策略进入的是训练时没见过的状态。L3给出两条补丁: DAgger(改数据分布,让专家来标注策略自己访问到的状态)与更强的策略类 (处理非马尔可夫性与多模态,如自回归离散化、扩散策略),并引出目标条件 BC。
留下的问题:BC 永远无法超越示范者;而且它需要示范。 如果我们只有一个「什么算好」的标量呢?
第二块:RL 的形式与两条主干(L4–L10)
L4建立全部记号:MDP、$\pi_\theta(a|s)$、 $J(\theta)=\E_{\tau\sim p_\theta}[\sum_t \gamma^t r]$,并给出算法全景图与四个评价维度 (样本效率、稳定性、假设、收敛性)。之后分成两条主干:
- 策略梯度线:L5 用 log-derivative trick 推出 REINFORCE, 再用因果性(causality)与基线(baseline)压方差; L6 Actor-Critic 把蒙特卡洛回报换成学出来的 $V^\pi$, 以偏差换方差,引入 $A^\pi = r + \gamma V^\pi(s') - V^\pi(s)$ 与 $n$-step / GAE 的偏差-方差旋钮; L9 用重要性采样把策略梯度改造成 off-policy, 并直面 IS 权重连乘导致的方差爆炸,得到裁剪目标与 PPO; L10 从「参数空间的步长不等于策略空间的步长」出发, 推出自然梯度、Fisher 信息矩阵与 KL 信赖域,给出 TRPO 的单调改进保证。
- 值函数线:L7 从策略迭代推到 Q-learning, 证明 Bellman 算子在 $\infty$-范数下是 $\gamma$-收缩,因此表格情形收敛; 但一旦换成函数逼近,投影步不是同一范数下的非扩张映射,收缩性失效——「致命三要素」。 L8 讲工程实践:replay buffer、target network、 Double Q-learning 对最大化偏差的修正、以及连续动作的处理。
留下的问题:这些方法都要求大量在线交互,且对超参数极其敏感。
第三块:概率视角与序列模型(L11–L14)
L11 变分推断与L12补足工具: ELBO、摊销推断、重参数化、VAE 与状态空间模型。 L13 控制即推断把最优控制整个改写成图模型上的后验推断, 推出 soft 值迭代、玻尔兹曼策略 $\pi \propto \exp(A)$, 并说明最大熵 RL(SAC)为什么天然更鲁棒、更适合多模态。 L14 把 RL 接到序列模型与 LLM 上: token 级 MDP、RLHF、以及把「一整段生成」当作一个动作的 bandit 视角。
第四块:学模型(L15–L16)
L15从「已知动力学时怎么规划」讲起(打靶法、CEM、MPPI、LQR/iLQR、MCTS), L16再把模型换成学来的:v1.0 的分布漂移问题、 用 MPC 重规划来缓解、模型集成表达不确定性、以及在潜空间里学动力学。 这一块的信号密度论点在本讲第 7 节又出现了一次。
第五块:数据、探索与理论(L17–L20)
L17 离线 RL指出核心困难不是「分布外泛化」而是 分布外动作上的价值高估被 $\max$ 系统性放大; L18给出解法家族:策略约束、保守值函数(CQL)、 隐式最大化(IQL)、以及模型基的悲观(MOPO)。 L19 探索系统讲乐观(UCB/计数与伪计数)、后验采样(Thompson)、 信息增益三条原理。L20 理论给出样本复杂度与何时可证明高效的边界。 L21与L22是两次系统复习。
第六块:无监督、多任务与收官(L23–L25)
L23讲没有奖励时怎么学:状态熵最大化的无监督探索、 互信息目标的技能发现(DIAYN 类)。L24讲多任务与分层: 目标条件 RL、HER 式重标注、options 框架与半 MDP。本讲 L25 收尾。
把整条线压成一句话:模仿 → 用奖励替代示范 → 用值函数替代蒙特卡洛 → 用信赖域替代盲目步长 → 用模型替代真实交互 → 用历史数据替代在线交互 → 用内在动机替代奖励 → 用多任务替代单任务。 每一步都是在「减少一种昂贵资源的消耗」, 而本讲说的是:下一步要减少的,是对仿真器的依赖。
继续深入的路径
- 先把作业做完。HW1 模仿学习 → HW2 策略梯度 → HW3 Q-learning 与 actor-critic → HW4 LLM 的 RL → HW5 离线 RL。这五个作业覆盖了主干的全部实现细节, 读一百篇论文不如把 PPO 和 CQL 各自跑通一次。
- 选一个方向深挖。建议按本讲的三个视角自问: 你想做「仿真里的优化」(那就往大规模并行 RL、sim-to-real、LLM 后训练走), 还是「真实世界的适应」(那就往离线 RL、机器人学习、持续学习走)。 两者的评价标准与论文品味完全不同。
- 建立自己的复现基线。先复现一个 SAC 或 PPO, 把它当作以后所有实验的对照组;RL 的实验方差极大,没有可信基线就没有可信结论。
- 读论文时优先看「失效分析」那一节。本课的精华就是 「为什么这样不行 → 所以改成这样」,好论文都有这一段。
本讲小结
| 视角 | RL 是什么 | 成功案例 | 瓶颈 | 关键问题 |
|---|---|---|---|---|
| 工程工具 | 仿真器的求逆引擎 | AlphaGo、足式运动、RLVR | 必须先有仿真器 | 能不能优化得足够好 |
| 真实世界 | 开放世界里的自主适应者 | reset-free 机器人、推荐系统 | 不能重置、失败不可逆、数据慢 | 能不能泛化与适应 |
| 通用学习 | 把廉价历史数据变成决策能力 | 离线预训练 + 微调、想象对话 RL | 离线 RL 的分布外高估 | 能不能像监督学习一样吃数据 |
- 「凡是能仿真的就能控制」:RL 只替换了传统工程三部曲的最后一步, 把「手工设计控制器」换成「自动求逆」。这条路线已经兑现了巨大价值, 但它的半径等于我们的仿真能力半径。
- Moravec 悖论是关于宇宙的:难与易的分界不在推理深度,而在「能不能事先写下环境」。 易宇宙里成功=最优控制,难宇宙里成功=活下来。
- 真实世界的五问:怎么说清楚我们要什么(奖励设计与 reward hacking)、 怎么完全自主地持续学习(reset-free)、怎么在环境变化时保持鲁棒、 怎么用先验数据泛化、怎么用先验经验引导探索。
- 数据与监督的分工:大规模廉价数据告诉你世界怎么运转($p(s'|s,a)$), 少量监督告诉你任务是什么($r$)。这是离线 RL 作为「RL 版预训练」的理论依据。
- RL + LLM 的甜点:LLM 易仿真、难最优执行的任务。合成数据不必好,只需合理, 剩下的交给值函数的拼接能力。
- 信号的四个来源:自监督/模型学习(LeCun 的蛋糕)、模仿与理解他人、 巨大的值回传(一个 $+1$ 经 Bellman 备份可以照亮整个状态空间)、以及以上全部。
- 方法论:选对问题、敢改问题设定、重视真实应用、想得大做得小。
延伸阅读
本讲直接提到的工作
- Advanced Skills by Learning Locomotion and Local Navigation End-to-End (Rudin et al., 2022) — 大规模并行仿真里端到端训练足式机器人,视角一的典型代表。
- Reset-Free Reinforcement Learning via Multi-Task Learning (Gupta et al., 2021) — 用「任务互为重置器」的任务图,让灵巧手在真机上无人干预地连续学习几十小时。
- Zero-Shot Goal-Directed Dialogue via RL on Imagined Conversations (Hong, Levine, Dragan, 2023) — 本讲第 6 节的完整案例:LLM 当人类模拟器,值函数 RL 从合成对话里学最优多轮策略。
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives (Levine et al., 2020) — 「让 RL 吃数据」这条路线的纲领性综述,本讲第 5 节的完整版。
真实世界 RL 与自主学习
- Challenges of Real-World Reinforcement Learning (Dulac-Arnold et al., 2019) — 把「部署 RL 会撞到什么」列成九条可测量的挑战,是本讲第 4 节的工程版清单。
- Concrete Problems in AI Safety (Amodei et al., 2016) — 奖励黑客、安全探索、分布偏移下的鲁棒性,写得极其具体。
- A Workflow for Offline Model-Free Robotic RL (Kumar et al., 2021) — 在没有在线评估的前提下,怎么调离线 RL 的超参数。
可复现性与评估
- Deep Reinforcement Learning that Matters (Henderson et al., 2017) — 随机种子、实现细节、超参数对结果的影响可以大过算法本身。做实验前必读。
- Deep RL at the Edge of the Statistical Precipice (Agarwal et al., 2021) — 少量种子下如何做统计上站得住的比较(IQM、分层自助法)。
规模化与基础模型方向
- RT-1: Robotics Transformer for Real-World Control at Scale (2022) — 「大数据 + 大模型」进入机器人的代表作。
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models (2023) — 跨机构汇聚真实机器人数据,本讲「大规模廉价历史数据」的现实版本。
- π0: A Vision-Language-Action Flow Model for General Robot Control (2024) — 视觉-语言-动作基础模型,对应课上那个真实咖啡吧台的例子。
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via RL (2025) — 可验证奖励 RL(RLVR)的代表性公开工作,正是本讲第 2 节讨论的那类「仿真里的 RL」。
经典教材
- Sutton & Barto, Reinforcement Learning: An Introduction(第二版,2018) — 表格式 RL 与值函数理论的标准参考,本课 L7、L20 的背景读物。
- Bertsekas, Dynamic Programming and Optimal Control — 收缩映射、值迭代收敛性等结论的严格出处。