强化学习理论
把「我用 N 个样本跑 k 轮,结果能有多好」这个问题,变成一个能真正算出来的不等式——以及为什么算出来的答案里到处都是 $\frac{1}{1-\gamma}$。
0. 本讲导读
前面十九讲,我们一直在做同一件事:设计算法,然后拿实验曲线说话。到 Lecture 19 讲探索时, 已经出现了「乐观初始化」「计数奖励」「后验采样」这些带着理论味道的名词——UCB 的 $\sqrt{\log t / N(a)}$ 奖励项显然不是拍脑袋想出来的,它背后有一个 regret 界。本讲就把这层窗户纸捅破:RL 理论到底在证什么、 怎么证、证出来的东西对你调深度 RL 有没有用。
本讲不引入任何新算法。它做的是回头看:把值迭代(value iteration, VI)、 拟合 Q 迭代(fitted Q-iteration, FQI)这些已经学过的算法,放进表格 MDP(tabular MDP)的显微镜下, 一步步推出「误差有多大」的显式表达式。整条主线是四段:
- 第一段(Part 1):RL 理论问什么问题、做什么假设、以及 Levine 对「可证明保证」这四个字的 毫不客气的评价。
- 第二段(Part 2):热身。证明 Bellman 最优算子 $T$ 在 $\ell_\infty$ 范数下是 $\gamma$-收缩映射, 从而值迭代以 $\gamma^k$ 的速率线性收敛。这个证明只有五行,但它是后面所有分析的骨架。
- 第三段(Part 3):把探索「抽象掉」——假设有一个生成模型(generative model), 对每个 $(s,a)$ 都能采 $N$ 个后继状态。此时最朴素的基于模型算法(数频次估 $\hat P$,再在 $\hat P$ 上做精确规划) 的误差是多少?答案是 $\|Q^\pi - \hat Q^\pi\|_\infty \le \frac{\gamma}{(1-\gamma)^2} c\sqrt{\frac{|S|\log(1/\delta)}{N}}$。 这里的 $(1-\gamma)^{-2}$ 是本讲最重要的一个数字,我们会把它的两个来源拆开讲清楚。
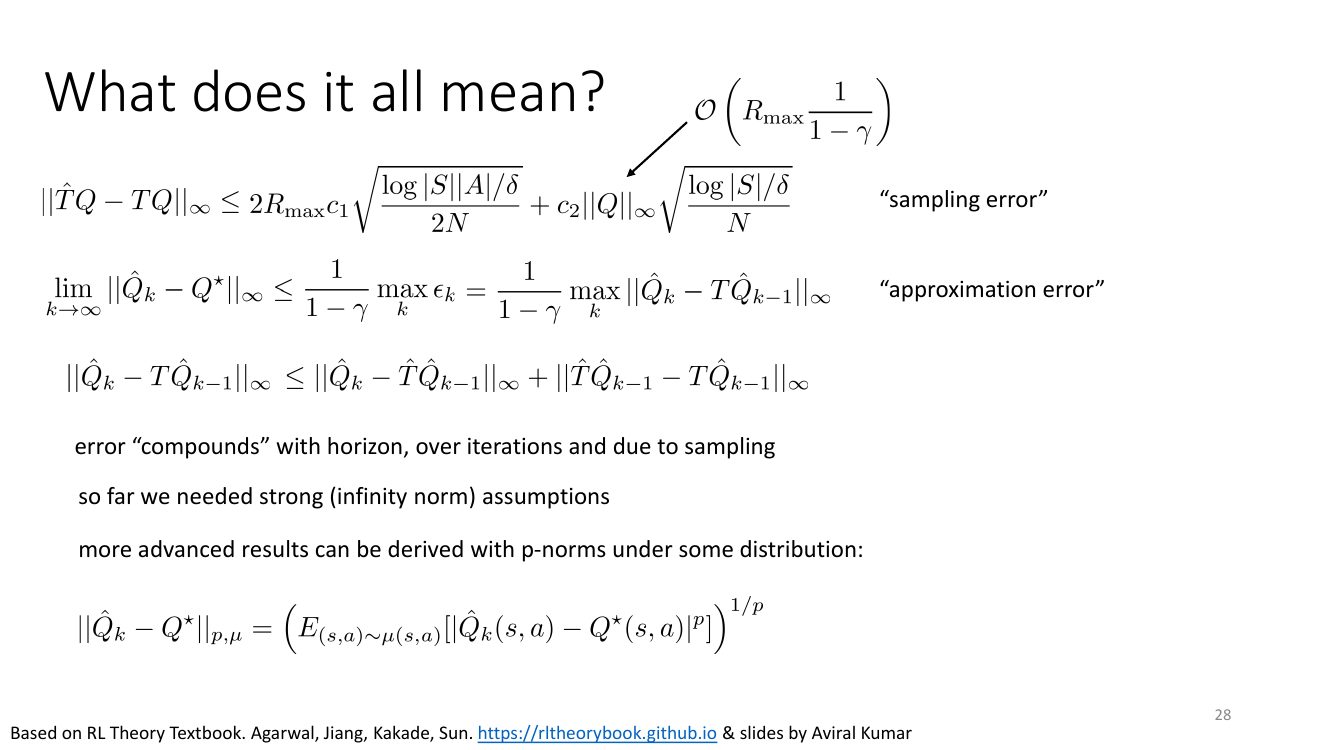
- 第四段(Part 4):无模型。把 FQI 抽象成「近似 Bellman 算子 + 近似投影」, 误差分成采样误差(sampling error,$T\neq\hat T$)和近似误差(approximation error, $\hat Q_{k+1}\neq\hat T\hat Q_k$)两块,分别定量,最后得到 $\lim_{k\to\infty}\|\hat Q_k - Q^\star\|_\infty \le \frac{1}{1-\gamma}\max_k \epsilon_k$。
贯穿全篇的主题只有一句话:误差会随着 horizon 复合(compound)。 每做一次 Bellman 备份(backup),上一轮的误差就被乘上 $\gamma$ 再加进来; 备份做无穷多次,几何级数求和给出 $\frac{1}{1-\gamma}$;如果误差本身又正比于值函数的量级 (而值函数量级是 $R_{\max}/(1-\gamma)$),就再吃一个 $\frac{1}{1-\gamma}$,于是 $(1-\gamma)^{-2}$ 出现。 这个「$\frac{1}{1-\gamma}$ 就是有效地平线(effective horizon)$H$」的字典,是把理论结论翻译成工程直觉的钥匙。
- $T$ 是 $\gamma$-收缩:$\|TV - TU\|_\infty \le \gamma\|V-U\|_\infty$。因此 VI 有唯一不动点 $V^\star$, 且 $\|T^kV - V^\star\|_\infty \le \gamma^k\|V - V^\star\|_\infty$——线性收敛,但只在 $\ell_\infty$ 范数下成立。
- 策略评估是线性运算:$Q^\pi = (I-\gamma P^\pi)^{-1}r$。矩阵 $(I-\gamma P^\pi)^{-1}$ 的 $\ell_\infty$ 算子范数 不超过 $\frac{1}{1-\gamma}$——它就是「把每步的误差沿 horizon 累加」这件事的线性代数化身。
- 模型误差 → 值误差:simulation lemma $Q^\pi - \hat Q^\pi = \gamma(I-\gamma\hat P^\pi)^{-1}(P-\hat P)V^\pi$。 取 $\ell_\infty$ 范数后一个 $\frac{1}{1-\gamma}$ 来自 $(I-\gamma\hat P^\pi)^{-1}$, 另一个来自 $\|V^\pi\|_\infty \le \frac{R_{\max}}{1-\gamma}$。
- 样本复杂度:误差 $\propto 1/\sqrt{N}$。要把误差减半,需要 4 倍的样本,不是 2 倍。 反过来,$N \gtrsim \frac{\gamma^2|S|\log(1/\delta)}{(1-\gamma)^4\epsilon^2}$。
- 值误差 → 策略次优性:$\|\hat Q - Q^\star\|_\infty\le\epsilon$ 只给出 $\|Q^\star - Q^{\hat\pi}\|_\infty \le 2\epsilon$(更精细的写法是 $\frac{2\gamma\epsilon}{1-\gamma}$), 两者相乘就是文献里到处出现的 $\frac{2\gamma\epsilon}{(1-\gamma)^2}$。
- Levine 的忠告:谁跟你说他的 RL 算法有「可证明保证」(provable guarantees),不必太当真—— 假设永远是不现实的,理论至多是一份粗糙的指南,告诉你哪些参数会让事情变糟,而不是保证事情会变好。
1. RL 理论在问什么、假设什么、图什么
1.1 三类典型问题
RL 理论的问题很多,但本讲聚焦其中两类。第一类是有限样本保证(finite-sample guarantee):
如果我用这个算法,跑 $N$ 个样本、$k$ 轮迭代,结果能有多好?
以 Q 学习为例,这类结论长这样:
$$ \|\hat Q_k - Q^\star\|\le \epsilon \quad \text{以至少 } 1-\delta \text{ 的概率成立,只要 } N \ge f(\epsilon,\delta) $$注意这个陈述的三个组成部分:精度 $\epsilon$、置信度 $1-\delta$、样本量 $N$。 因为数据是随机采的,你永远不可能以概率 1 保证任何事——总有一个「运气极差」的样本序列, 所以必须留一个失败概率 $\delta$。理论工作的核心,就是把 $f(\epsilon,\delta)$ 这个函数的形式算出来, 特别是它对 $\epsilon$、$\delta$、$|S|$、$|A|$、$\gamma$ 的依赖关系。
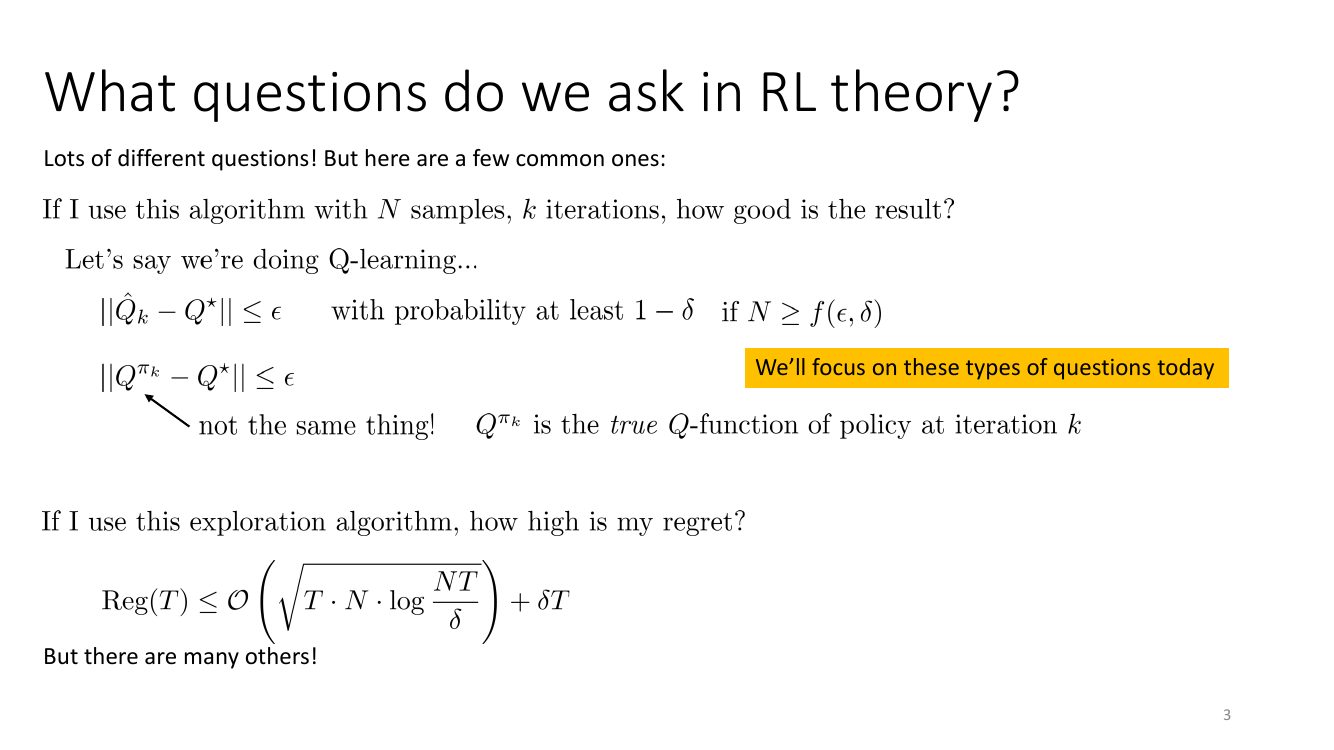
幻灯片上那个箭头值得停下来想三十秒。$\hat Q_k$ 是我们估计出来的表格; $Q^{\pi_k}$ 是「对 $\hat Q_k$ 取 argmax 得到的策略 $\pi_k$」在真实环境里的真实 Q 函数。 这两件事可以差很远:$\hat Q_k$ 在每个格子上都只差 $\epsilon$,但如果在某个关键状态上 它把两个动作的排序搞反了,$\pi_k$ 就会在那里走错,而这个错误会沿着 horizon 一路传播下去。 所以从「值函数误差」到「策略次优性」还需要额外一步转换,这一步会再吃掉一个 $\frac{1}{1-\gamma}$ (见 §7)。很多人读理论论文时把这两个量混为一谈,是最常见的误读。
第二类问题是regret(懊悔):在线交互 $T$ 步,我因为「还在探索、还没学会」而损失的总回报是多少? Lecture 19 里 UCB 的 regret 是 $\mathcal{O}(\sqrt{T\log T})$;推广到 MDP 上会多出 $|S|,|A|,H$ 的因子。 本讲主要不走这条线(探索被「抽象掉」了),但 §10 会补上这条线索。
1.2 我们做什么假设
Levine 说得很直白:没有强假设,RL 里几乎做不出任何有效分析。 技巧在于——挑那些既能推出有趣结论、又不至于跟现实脱节太远的假设。 困难来自两个正交的方向:
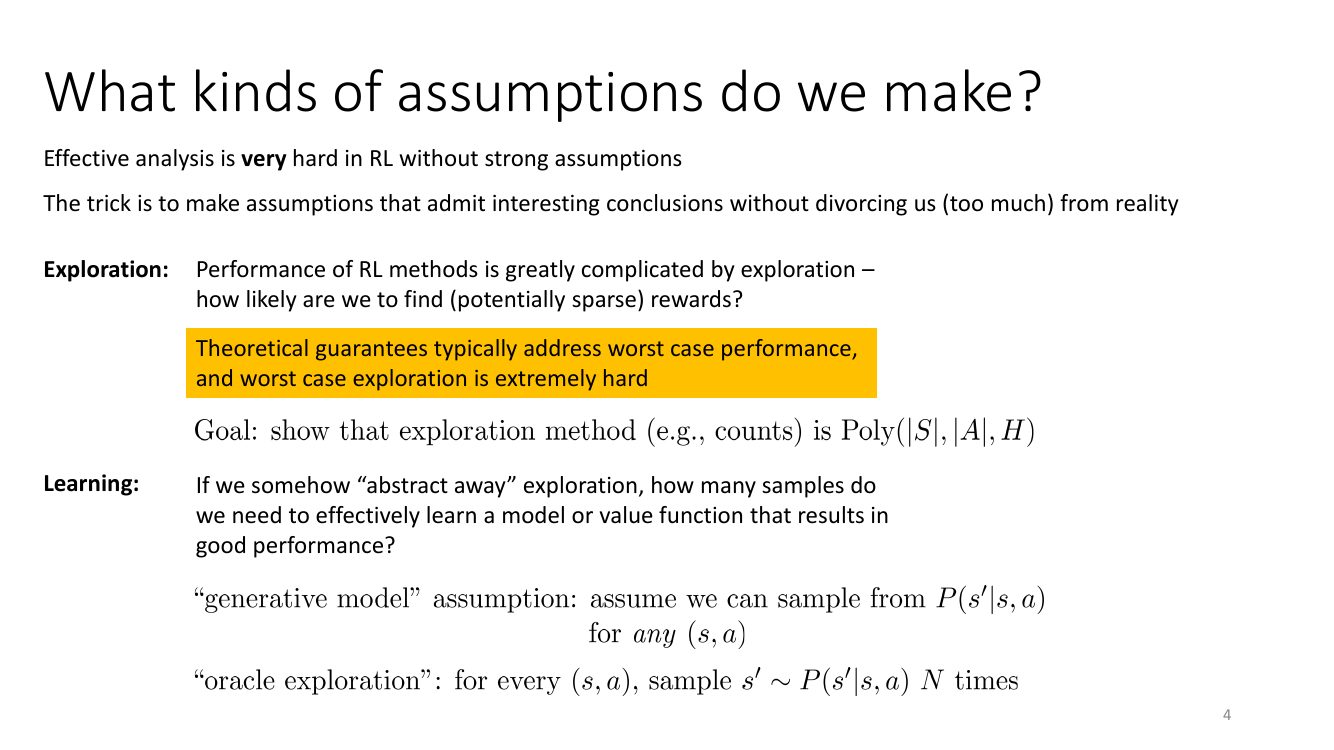
探索的困难:注意「理论保证通常针对最坏情况」这句话。最坏情况下的探索有多难? 考虑一个链状 MDP,状态排成一条长度 $H$ 的走廊,每步可以左走或右走,只有最右端有奖励。 纯随机策略要走到最右端,需要的期望步数是指数级的(随机游走的一维首达时间)。 这意味着任何不做定向探索的算法,在最坏情况下都是指数慢的。 于是理论上能证的最好结果,就是「用计数类探索方法,样本复杂度是 $|S|,|A|,H$ 的多项式」—— 把指数换成多项式,这已经是很强的结论了。
学习的困难:本讲选择把探索完全抽象掉。所谓生成模型假设(generative model assumption), 是说我们有一个「模拟器」,可以任意指定 $(s,a)$ 然后问它「下一个状态是什么」, 而不必真的从初始状态走过去。这显然不现实——真实机器人不能瞬移到任意状态—— 但它把「怎么到达一个状态」和「到达之后能学到多少」这两件事解耦了。 更具体的 oracle 探索假设是:对每一个 $(s,a)$ 对,都恰好采样 $N$ 次 $s'\sim P(s'|s,a)$。 数据集大小是 $N|S||A|$,而且在所有 $(s,a)$ 上均匀分布。
1.3 图什么?Levine 的两点半
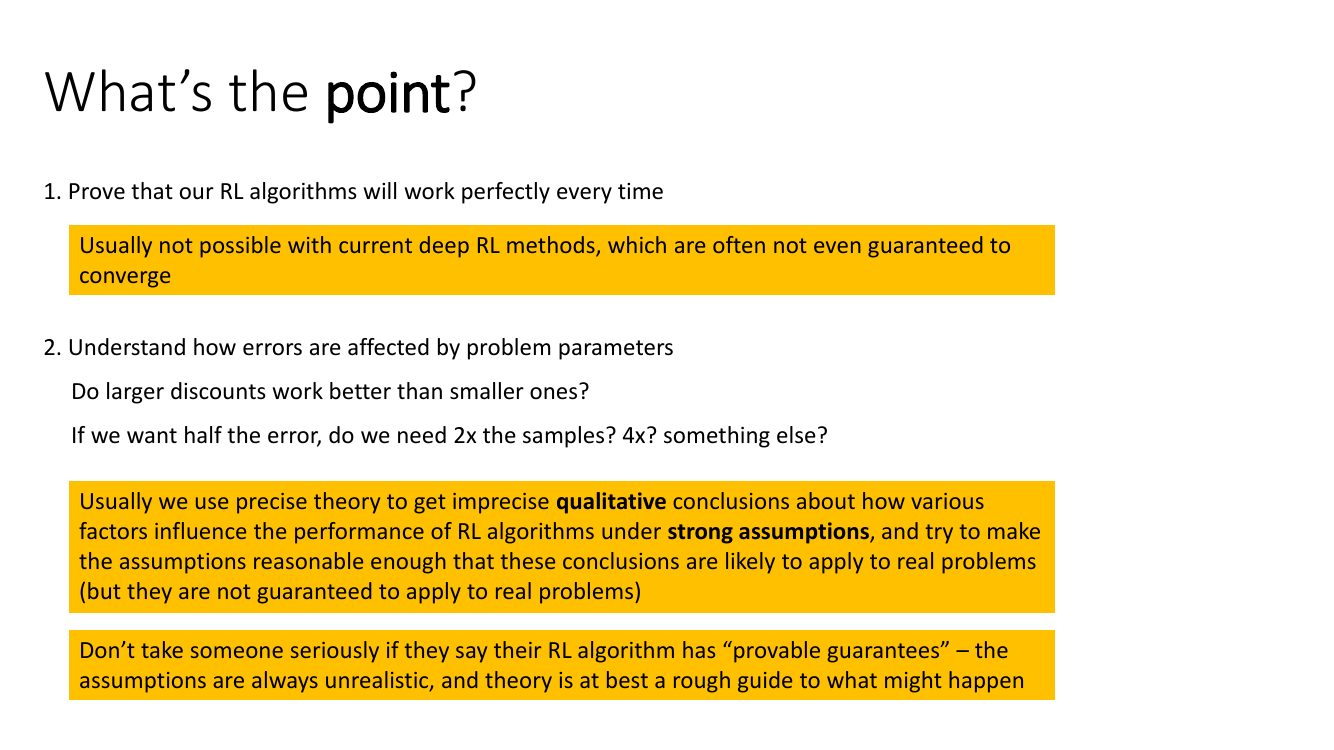
第一个目标——证明算法永远完美——基本是幻想。当前深度 RL 方法连收敛都不保证: Q 学习加上函数近似和 off-policy 数据就构成了著名的「致命三要素」(deadly triad), 是可以构造出发散反例的(Baird 的反例)。所以理论工作者不会去证这种东西。
第二个目标才是真的:理解误差如何随问题参数变化。具体的问题长这样——
- $\gamma=0.99$ 比 $\gamma=0.9$ 更好吗?理论会告诉你:$\frac{1}{1-\gamma}$ 从 10 变成 100, 误差界里的 $(1-\gamma)^{-2}$ 从 100 涨到 10000,也就是同样的数据量下误差可能大 100 倍。 所以「折扣越大越接近真实目标」这个直觉,要跟「折扣越大统计误差越大」这个反向压力权衡。 这解释了一个常见的经验现象:任务的真实 horizon 很长,但把 $\gamma$ 调小反而学得更快更稳。
- 误差减半要多少样本?如果误差 $\propto N^{-1/2}$,那就是 4 倍。这是一个非常具体、 非常有用的工程结论:你的 return 曲线还差 20% 才到饱和,那大概需要再多 1.5 倍以上的数据; 差 2 倍,需要 4 倍数据。
2. 记号:把 MDP 写成线性代数
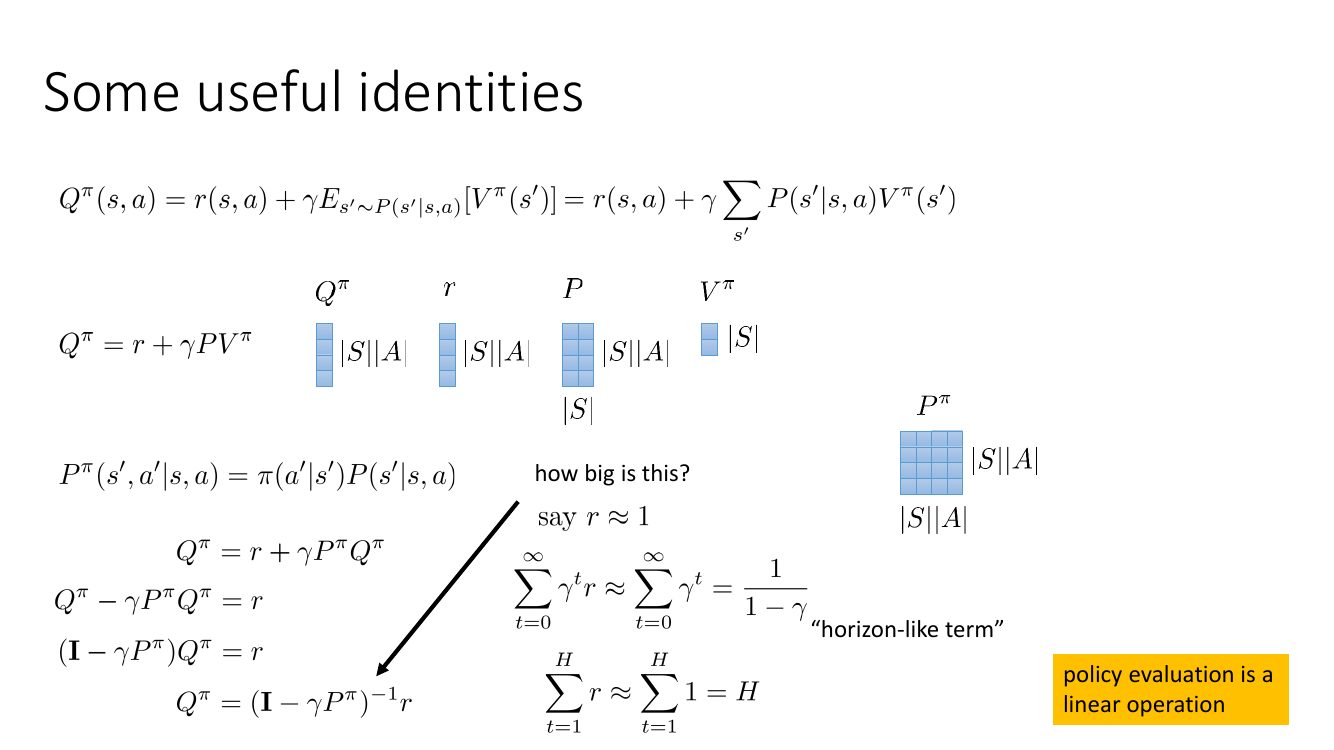
要做定量分析,必须先把 RL 的一切写成向量和矩阵。设状态空间 $S$ 和动作空间 $A$ 都是有限的(表格 MDP), $|S|$、$|A|$ 分别是它们的大小。约定:
- $Q^\pi \in \R^{|S||A|}$:把 $Q^\pi(s,a)$ 拉直成一个长度 $|S||A|$ 的列向量;
- $V^\pi \in \R^{|S|}$:长度 $|S|$ 的列向量;
- $r \in \R^{|S||A|}$:奖励向量,$r(s,a)$;
- $P \in \R^{|S||A| \times |S|}$:转移矩阵,第 $(s,a)$ 行第 $s'$ 列的元素是 $P(s'|s,a)$。 这是一个「行随机」矩阵——每行非负且和为 1;
- $\Pi \in \R^{|S| \times |S||A|}$:策略矩阵,把 $Q$ 变成 $V$,即 $V^\pi = \Pi Q^\pi$, 其中 $\Pi[s, (s',a)] = \pi(a|s)\mathbf{1}[s=s']$。
Bellman 方程写成矩阵形式就是
$$ Q^\pi = r + \gamma P V^\pi = r + \gamma P \Pi Q^\pi = r + \gamma P^\pi Q^\pi, \qquad P^\pi \triangleq P\Pi \in \R^{|S||A|\times|S||A|} $$其中 $P^\pi(s',a'|s,a) = \pi(a'|s')P(s'|s,a)$,是「状态-动作对上的转移矩阵」: 从 $(s,a)$ 出发,环境把你送到 $s'$,策略在 $s'$ 选了 $a'$。
2.1 恒等式一:策略评估的闭式解
从 $Q^\pi = r + \gamma P^\pi Q^\pi$ 出发,把带 $Q^\pi$ 的项挪到一边:
$$ Q^\pi - \gamma P^\pi Q^\pi = r \;\Longrightarrow\; (I - \gamma P^\pi)Q^\pi = r \;\Longrightarrow\; Q^\pi = (I - \gamma P^\pi)^{-1} r $$逆矩阵存在吗?存在。因为 $P^\pi$ 是行随机矩阵,它的谱半径(spectral radius)是 1, 所以 $\gamma P^\pi$ 的谱半径是 $\gamma \lt 1$,$I - \gamma P^\pi$ 的所有特征值都落在以 1 为圆心、半径 $\gamma$ 的圆内, 不可能是 0。等价地,Neumann 级数收敛:
$$ (I-\gamma P^\pi)^{-1} = \sum_{t=0}^{\infty} \gamma^t (P^\pi)^t $$这个展开非常有解释力:$(P^\pi)^t$ 的第 $(s,a)$ 行,正是「从 $(s,a)$ 出发、按 $\pi$ 走 $t$ 步之后 落在各个 $(s',a')$ 上的概率分布」。所以 $(I-\gamma P^\pi)^{-1}r$ 就是「把未来所有时刻的期望奖励按 $\gamma^t$ 加权求和」—— 一模一样的定义,只是换成了线性代数的写法。这个写法的好处是:策略评估变成了一次矩阵求逆, 一个纯粹的线性运算,可以直接用矩阵不等式去界定它。
2.2 恒等式二:$\frac{1}{1-\gamma}$ 是「有效地平线」
这是全讲复用次数最多的一条。若奖励有界 $|r(s,a)| \le R_{\max}$,则对任意策略 $\pi$、任意 $(s,a)$:
$$ |Q^\pi(s,a)| = \left|\E\left[\sum_{t=0}^\infty \gamma^t r_t\right]\right| \le \sum_{t=0}^{\infty}\gamma^t R_{\max} = \frac{R_{\max}}{1-\gamma} $$因此 $\|Q^\pi\|_\infty \le \frac{R_{\max}}{1-\gamma}$,同理 $\|V^\pi\|_\infty \le \frac{R_{\max}}{1-\gamma}$。 在有限 horizon $H$ 的无折扣设定下,对应的界是 $H R_{\max}$。所以我们建立字典:
| 折扣设定 | 有限 horizon 设定 | 含义 |
|---|---|---|
| $\frac{1}{1-\gamma}$ | $H$ | 有效地平线(effective horizon) |
| $\gamma = 0.9$ | $H = 10$ | 大约看 10 步 |
| $\gamma = 0.99$ | $H = 100$ | 大约看 100 步 |
| $\gamma = 0.999$ | $H = 1000$ | 大约看 1000 步 |
3. 热身:值迭代为什么收敛
值迭代的更新是 $V \leftarrow \max_a[r + \gamma P V]$。把这个更新记成一个算子:
$$ (TV)(s) = \max_a \left[ r(s,a) + \gamma \sum_{s'} P(s'|s,a) V(s') \right] $$$T$ 叫做 Bellman 最优算子(Bellman optimality operator)。它把一个值函数映成另一个值函数, 是 $\R^{|S|}\to\R^{|S|}$ 的(非线性的,因为有 $\max$)映射。值迭代就是反复施加 $T$:$V_{k+1} = TV_k$。
3.1 定理:$T$ 是 $\ell_\infty$ 下的 $\gamma$-收缩
条件:表格 MDP,$0\le\gamma\lt 1$,奖励有界,$P(\cdot|s,a)$ 是合法概率分布。
结论:对任意两个值函数 $V, U \in \R^{|S|}$,$\|TV - TU\|_\infty \le \gamma\|V-U\|_\infty$。
证明:先记一个初等引理——对任意两个函数 $f,g$, $|\max_x f(x) - \max_x g(x)| \le \max_x|f(x)-g(x)|$。 (理由:设 $x^* = \argmax f$,则 $\max f - \max g \le f(x^*) - g(x^*) \le \max_x|f-g|$; 交换 $f,g$ 得另一侧。)现在按定义展开:
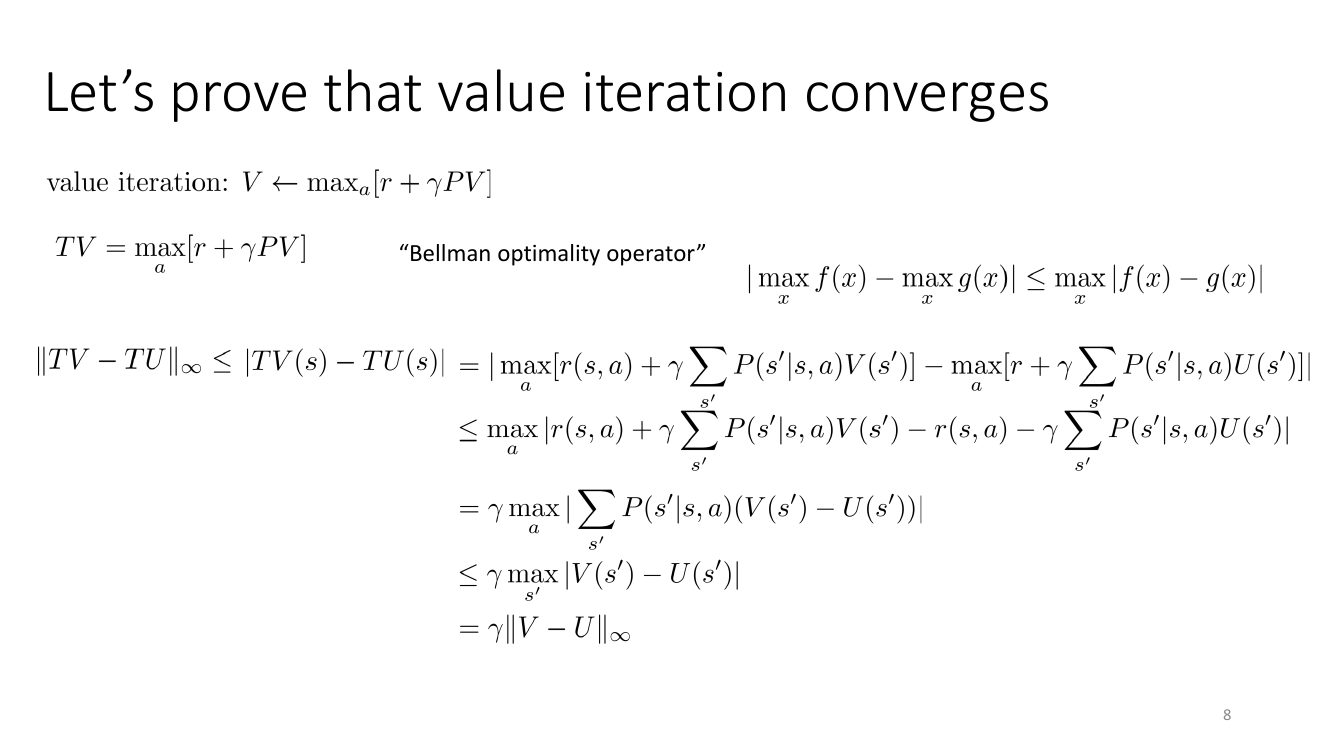
最后一步值得展开:$\sum_{s'} P(s'|s,a) d(s')$ 里的 $P(\cdot|s,a)$ 权重非负且和为 1, 所以这是 $d$ 的一个加权平均,绝对值必然不超过 $\max_{s'}|d(s')|$。 用矩阵语言说就是行随机矩阵的 $\ell_\infty$ 诱导算子范数等于 1:$\|P\|_\infty = 1$。 这是整个证明唯一用到 $P$ 的性质的地方——注意它跟 $P$ 具体长什么样毫无关系, 只要是合法的概率分布就行。
3.2 从收缩到收敛
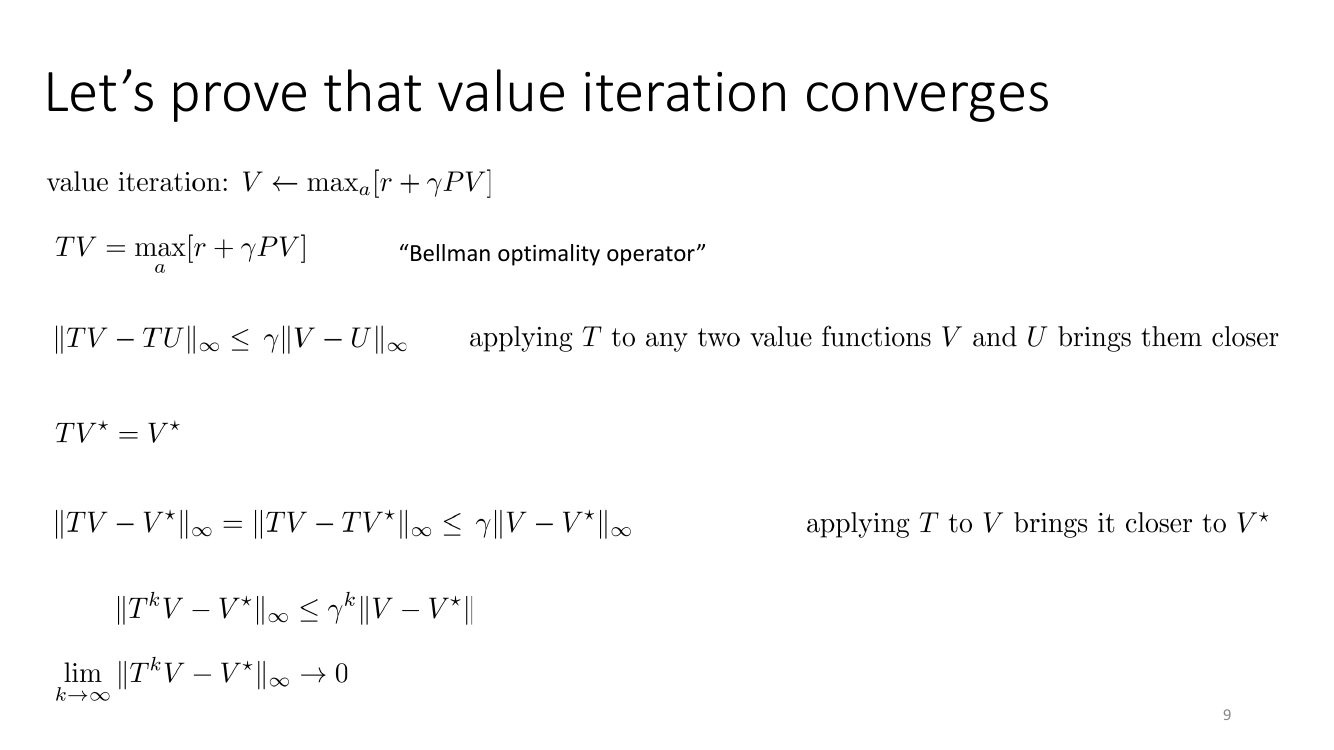
关键的一步是把收缩性中的 $U$ 取成 $V^\star$ 本身。因为 $V^\star$ 满足 Bellman 最优方程 $V^\star(s) = \max_a[r(s,a)+\gamma\sum_{s'}P(s'|s,a)V^\star(s')]$,也就是 $TV^\star = V^\star$,于是
$$ \|TV - V^\star\|_\infty = \|TV - TV^\star\|_\infty \le \gamma\|V - V^\star\|_\infty $$「施加一次 $T$,到 $V^\star$ 的距离至少缩小到 $\gamma$ 倍」。归纳 $k$ 次:
$$ \|T^k V - V^\star\|_\infty \le \gamma^k \|V - V^\star\|_\infty \quad\Longrightarrow\quad \lim_{k\to\infty}\|T^kV - V^\star\|_\infty = 0 $$顺带地,Banach 不动点定理还告诉我们不动点唯一:若 $TV_1=V_1$、$TV_2=V_2$, 则 $\|V_1-V_2\| = \|TV_1-TV_2\| \le \gamma\|V_1-V_2\|$,而 $\gamma\lt1$ 迫使 $\|V_1-V_2\|=0$。
3.3 收敛速率:需要迭代多少轮?
这是一个「线性收敛」(或叫几何收敛):误差每轮乘 $\gamma$。要把初始误差压到 $\epsilon$ 以下, 需要的迭代次数是
$$ k \ge \frac{\log\big(\|V_0-V^\star\|_\infty/\epsilon\big)}{\log(1/\gamma)} \;\approx\; \frac{1}{1-\gamma}\log\frac{\|V_0-V^\star\|_\infty}{\epsilon} $$最后一步用了 $\log(1/\gamma) = -\log(1-(1-\gamma)) \approx 1-\gamma$(当 $\gamma$ 接近 1)。 所以迭代次数是 $\tilde{\mathcal{O}}(\frac{1}{1-\gamma})$,即 $\tilde{\mathcal{O}}(H)$, 对 $\epsilon$ 只有对数依赖——非常好。举个具体数字:$\gamma=0.9$、$R_{\max}=1$, 初始 $V_0=0$,则 $\|V_0-V^\star\|_\infty \le 10$;要 $\epsilon=0.01$, 需要 $k \ge \log(1000)/\log(1/0.9) \approx 6.9/0.105 \approx 66$ 轮。 换成 $\gamma=0.99$:$\|V_0-V^\star\|\le100$,$\epsilon=0.01$, $k \ge \log(10^4)/\log(1/0.99)\approx 9.2/0.01 \approx 917$ 轮。横向对比:$\gamma$ 从 0.9 到 0.99, 迭代次数涨了约 14 倍。
(1) 收缩性用的是 $\|\cdot\|_\infty$。而深度网络做回归时最小化的是 $\ell_2$ 损失, 「投影到函数类」这个操作在 $\ell_2$ 下是非扩张的、在 $\ell_\infty$ 下却不是—— 「$\gamma$-收缩 + $\ell_2$ 投影」的复合可以是扩张的,这正是 FQI 发散反例的来源。 后面 §8 幻灯片上那句 "no convergence if $\|\cdot\|_2$" 说的就是这件事。
(2) 上面证明里没有任何一步用到「$V$ 必须在某个函数类里」。一旦 $V$ 被约束成 $V_\phi(s) = f_\phi(s)$ 这样一张网络,每次 $T$ 之后还要投影回函数类,收缩性就断了。
4. 抽掉探索:生成模型下的设定与集中不等式
热身结束。现在进入正题:有限样本下会发生什么。第三段的设定是: oracle 探索——对每个 $(s,a)$ 采 $N$ 次 $s'\sim P(s'|s,a)$;然后跑一个最朴素的基于模型算法:
- 用频次估计转移:$\hat P(s'|s,a) = \frac{\#(s,a,s')}{N}$;
- 给定 $\pi$,在 $\hat P$ 上做精确的策略评估,得到 $\hat Q^\pi$。
注意第 2 步是精确的——没有函数近似、没有优化误差,用 $\hat Q^\pi = (I-\gamma\hat P^\pi)^{-1}r$ 直接解线性方程组。所以此时唯一的误差来源就是 $\hat P \neq P$。 这种「把误差来源砍到只剩一个」的做法,是理论分析的标准手法。
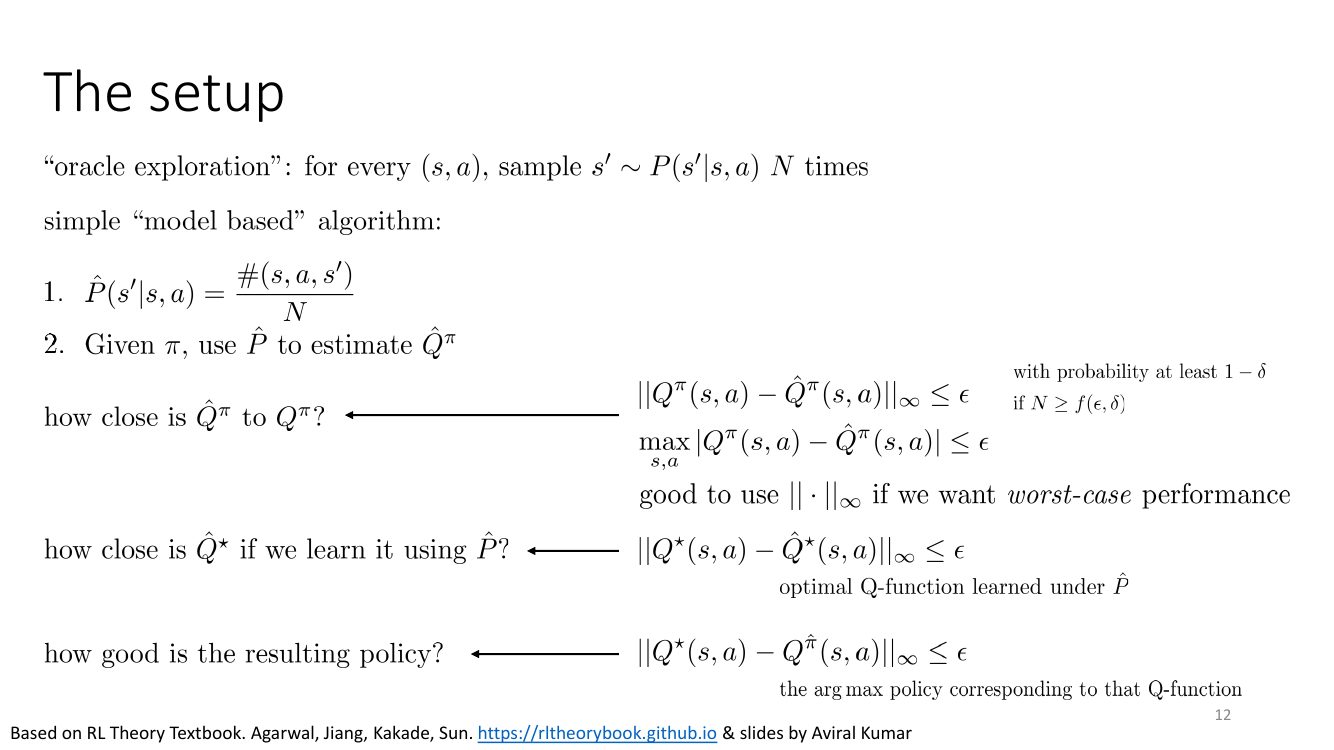
为什么用 $\ell_\infty$ 范数?因为理论保证通常刻画最坏情况: $\|x\|_\infty = \max_i |x_i|$ 说的是「所有状态-动作对上误差都不超过 $\epsilon$」。 这比「平均误差不超过 $\epsilon$」强得多,也难得多——$\ell_\infty$ 界一旦成立, 你不用担心某个偏僻角落里藏着一个巨大的估计错误把策略带偏。 代价是:$\ell_\infty$ 需要对 $|S||A|$ 个格子同时成立,union bound 会在界里塞进一个 $\log(|S||A|/\delta)$。
4.1 Hoeffding 不等式
只要问「学到的函数离真函数多近,用了多少样本」,答案就要靠集中不等式 (concentration inequality)。最基本的一条是 Hoeffding:
Hoeffding 不等式(引理 A.1)。设 $X_1,\dots,X_n$ 是独立同分布随机变量, 均值 $\mu$,且以概率 1 有 $X_i \in [b_-, b_+]$。记 $\bar X_n = \frac1n\sum_i X_i$。则
$$ \Pr(\bar X_n \ge \mu+\epsilon) \le e^{-2n\epsilon^2/(b_+-b_-)^2},\qquad \Pr(\bar X_n \le \mu-\epsilon) \le e^{-2n\epsilon^2/(b_+-b_-)^2} $$两边合起来:$\Pr(|\bar X_n - \mu| \ge \epsilon) \le 2e^{-2n\epsilon^2/(b_+-b_-)^2}$。
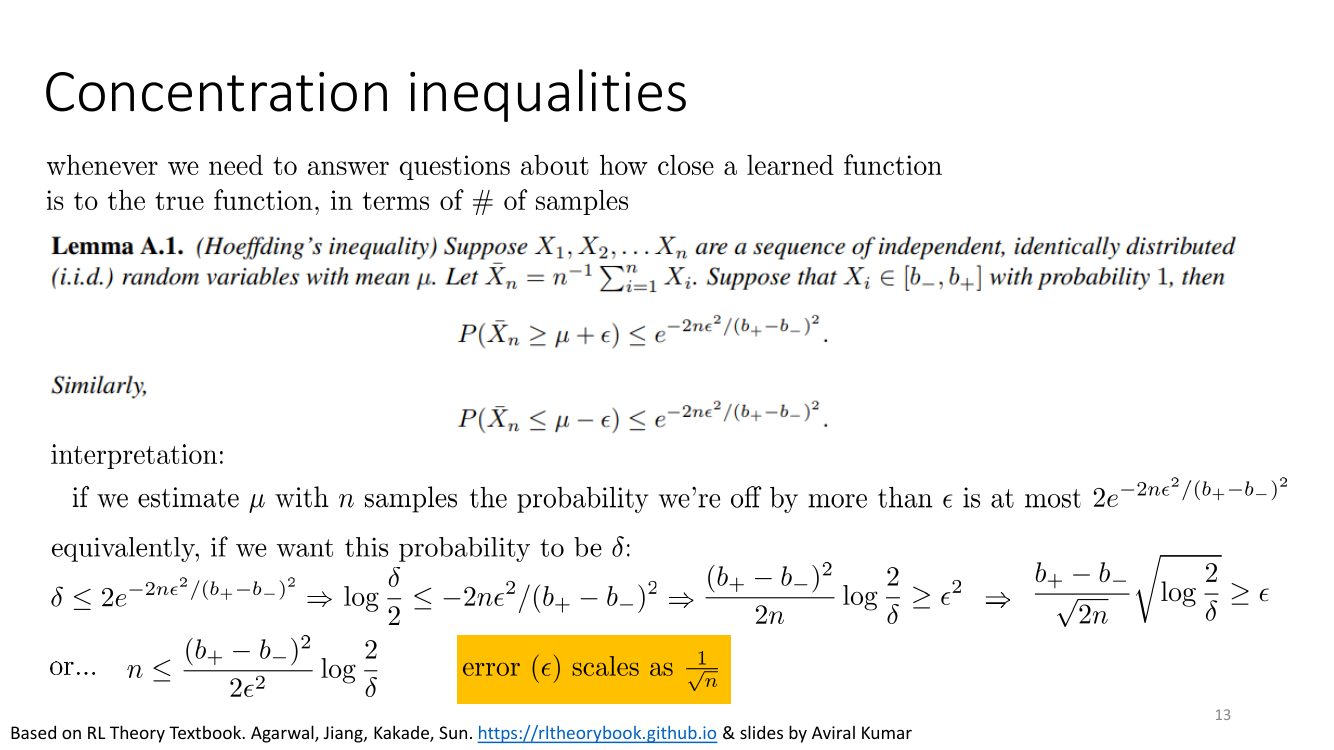
这个不等式的两种用法都要会。用法一:固定 $n$,问误差多大。令右端等于 $\delta$:
$$ \delta \le 2e^{-2n\epsilon^2/(b_+-b_-)^2} \;\Longrightarrow\; \log\frac{\delta}{2} \le \frac{-2n\epsilon^2}{(b_+-b_-)^2} \;\Longrightarrow\; \epsilon \le \frac{b_+-b_-}{\sqrt{2n}}\sqrt{\log\frac{2}{\delta}} $$用法二:固定精度 $\epsilon$,问需要多少样本。把同一个式子对 $n$ 解:
$$ n \ge \frac{(b_+-b_-)^2}{2\epsilon^2}\log\frac{2}{\delta} $$两条结论各记一遍:误差 $\propto \frac{1}{\sqrt n}$;样本量 $\propto \frac{1}{\epsilon^2}$。 这就回答了 §1 里那个问题——误差减半需要 4 倍样本。 另外注意 $\delta$ 只以 $\sqrt{\log(2/\delta)}$ 的方式进入误差:把失败概率从 $10^{-2}$ 压到 $10^{-6}$, $\log(2/\delta)$ 只从 5.3 涨到 14.5,误差界只涨 1.65 倍。置信度很便宜,精度很贵, 这是所有集中不等式的共同面貌。
4.2 离散分布的集中:$\hat P$ 离 $P$ 有多远
Hoeffding 处理的是一个标量均值。但我们要估的是一个分布 $P(\cdot|s,a)$, 它是 $|S|$ 维单纯形上的一个点。需要一个向量版本:
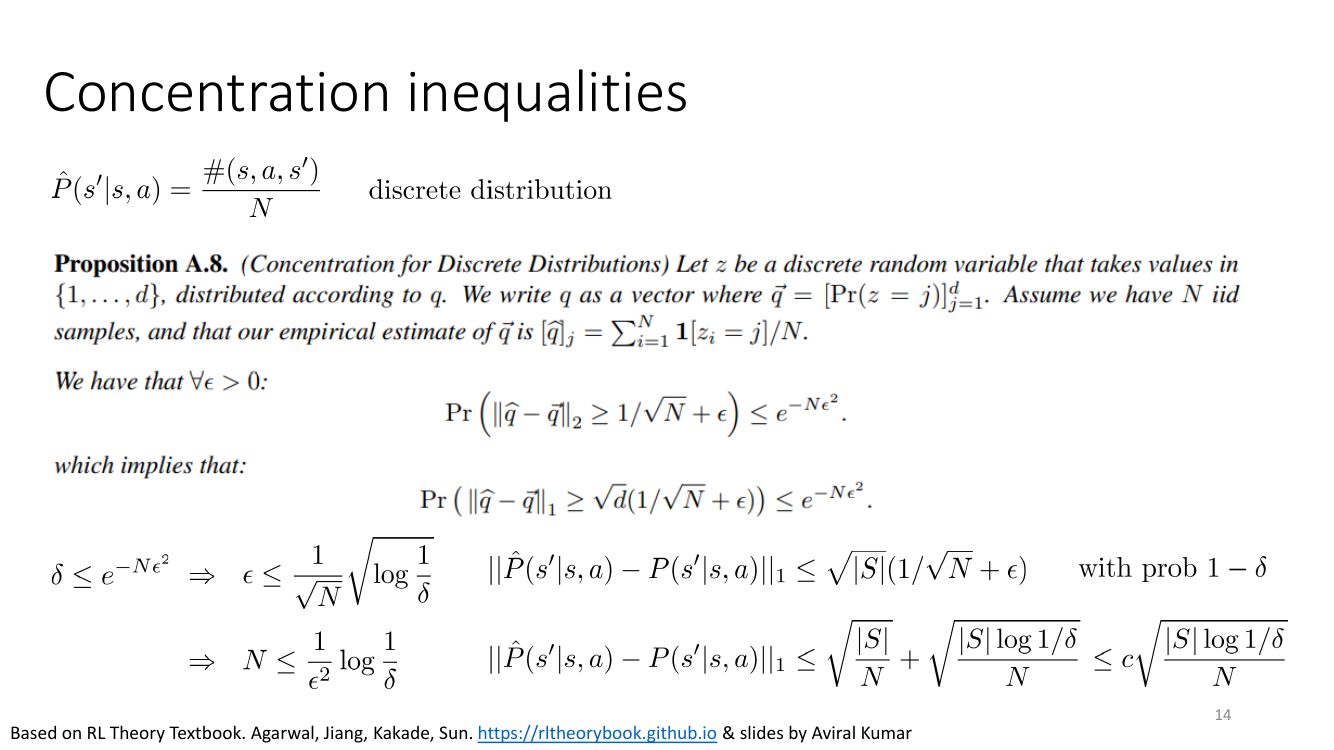
把代数走一遍。令 $\delta \le e^{-N\epsilon^2}$,解出 $\epsilon \le \frac{1}{\sqrt N}\sqrt{\log\frac1\delta}$, 等价地 $N \le \frac{1}{\epsilon^2}\log\frac1\delta$。代回 $\ell_1$ 版本,取 $d = |S|$:
$$ \|\hat P(\cdot|s,a) - P(\cdot|s,a)\|_1 \le \sqrt{|S|}\left(\frac{1}{\sqrt N} + \frac{1}{\sqrt N}\sqrt{\log\tfrac1\delta}\right) = \sqrt{\frac{|S|}{N}} + \sqrt{\frac{|S|\log(1/\delta)}{N}} \le c\sqrt{\frac{|S|\log(1/\delta)}{N}} $$最后一步把两项合并进一个常数 $c$(因为 $\log(1/\delta)\ge$ 常数时第二项主导)。 记住这个式子:$\ell_1$ 距离 $\propto\sqrt{|S|/N}$。
为什么用 $\ell_1$(也就是两倍的全变差距离)而不是 $\ell_2$?因为后面要做的运算是 $\sum_{s'}(\hat P - P)(s'|s,a)V(s')$,用 Hölder 不等式界定它需要 $\left|\sum_{s'}(\hat P-P)V\right| \le \|\hat P - P\|_1\|V\|_\infty$——$\ell_1$ 和 $\ell_\infty$ 是对偶的。
另外注意 $\sqrt{|S|}$ 这个因子:状态空间越大,估一个转移分布越难, 因为你要同时估 $|S|$ 个数。这也是 $\ell_1$ 相对 $\ell_2$ 的代价—— $\|x\|_1\le\sqrt d\|x\|_2$ 这一步是紧的(当 $x$ 各分量等大时取等)。
import numpy as np

def empirical_model(env_sample, nS, nA, N, rng):
    """oracle 探索:对每个 (s,a) 采 N 次后继状态,返回频次估计的 P_hat。
    env_sample(s, a, rng) -> s'   (生成模型:任意 (s,a) 都能采样)"""
    P_hat = np.zeros((nS, nA, nS))
    for s in range(nS):
        for a in range(nA):
            for _ in range(N):
                P_hat[s, a, env_sample(s, a, rng)] += 1.0
    return P_hat / N

def l1_error(P_hat, P):
    """max_{s,a} ||P_hat(.|s,a) - P(.|s,a)||_1,就是理论里那个 max 项"""
    return np.abs(P_hat - P).sum(axis=-1).max()

# 经验验证:l1 误差应当按 1/sqrt(N) 衰减
# for N in [100, 400, 1600]:  误差之比应接近 1 : 1/2 : 1/4
5. 三条引理:把模型误差翻译成值函数误差
现在我们知道 $\hat P$ 离 $P$ 有多远($\ell_1$ 距离 $\propto\sqrt{|S|/N}$)。 但我们真正关心的是 $\hat Q^\pi$ 离 $Q^\pi$ 有多远。下一个目标:把 $\hat P$ 的误差换算成 $\hat Q^\pi$ 的误差。 需要三块积木。
5.1 引理一:策略评估的闭式解(回顾)
§2 已经证过:$Q^\pi = (I-\gamma P^\pi)^{-1}r$,其中 $P^\pi = P\Pi$,$V^\pi = \Pi Q^\pi$。 关键是估计的模型也满足同样的形式:
$$ Q^\pi = (I - \gamma P^\pi)^{-1} r, \qquad \hat Q^\pi = (I - \gamma \hat P^\pi)^{-1} r $$注意两边的 $r$ 是同一个(我们假设奖励已知,只有转移要估);$\Pi$ 也是同一个(策略 $\pi$ 是给定的)。 唯一的差别就在 $P$ 与 $\hat P$。这正是我们想要的:把两个「同构」的表达式相减。
5.2 引理二:模拟引理(simulation lemma)
结论(simulation lemma): $$Q^\pi - \hat Q^\pi = \gamma (I-\gamma\hat P^\pi)^{-1}(P - \hat P)V^\pi$$
右端有两个因子:$(I-\gamma\hat P^\pi)^{-1}$ 是「在估计模型下的评估算子」, $(P-\hat P)V^\pi$ 是「转移概率的差」作用在真实值函数上。 这个结构非常漂亮:模型的一步误差,被评估算子沿 horizon 放大。
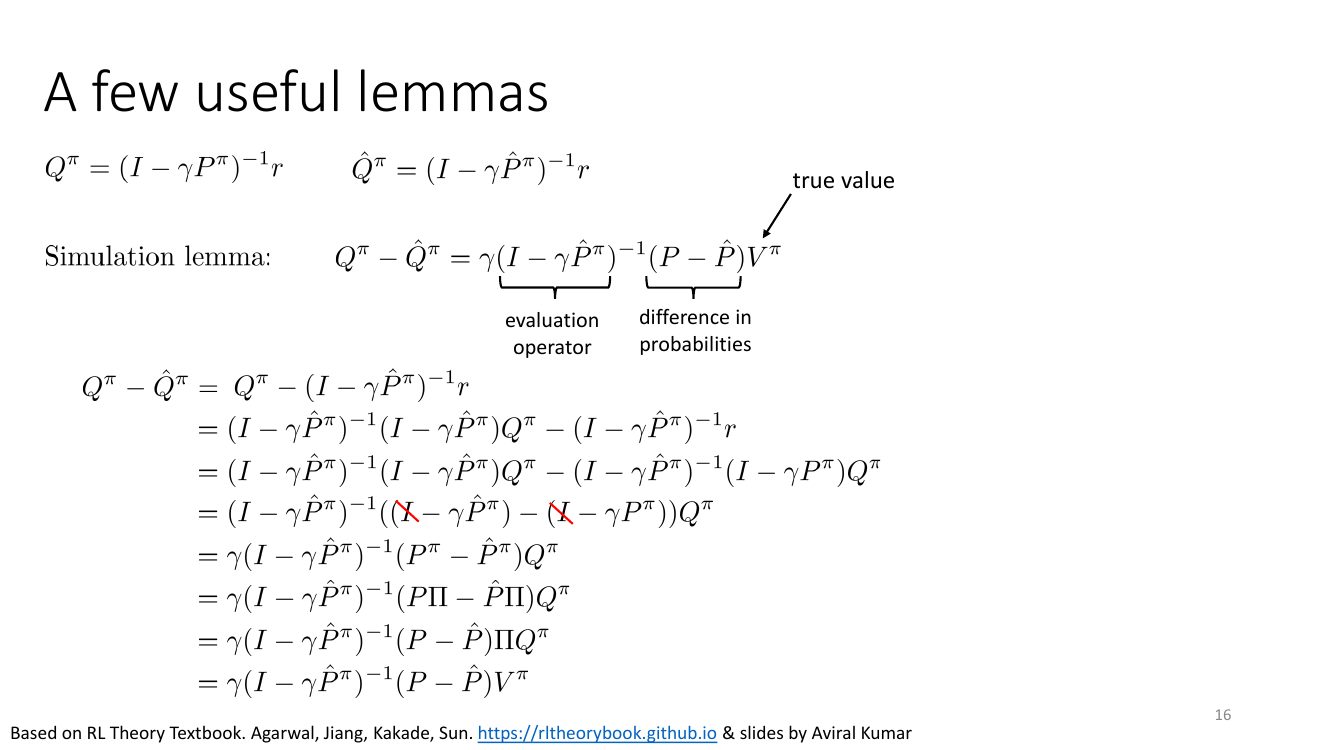
逐行走一遍。起点是 $Q^\pi - \hat Q^\pi = Q^\pi - (I-\gamma\hat P^\pi)^{-1}r$。 第一个技巧:在 $Q^\pi$ 前面插一个 $(I-\gamma\hat P^\pi)^{-1}(I-\gamma\hat P^\pi) = I$:
$$ \begin{aligned} Q^\pi - \hat Q^\pi &= (I-\gamma\hat P^\pi)^{-1}(I-\gamma\hat P^\pi)Q^\pi - (I-\gamma\hat P^\pi)^{-1}r \\ &= (I-\gamma\hat P^\pi)^{-1}(I-\gamma\hat P^\pi)Q^\pi - (I-\gamma\hat P^\pi)^{-1}(I-\gamma P^\pi)Q^\pi \\ &= (I-\gamma\hat P^\pi)^{-1}\big[(I-\gamma\hat P^\pi) - (I-\gamma P^\pi)\big]Q^\pi \\ &= \gamma(I-\gamma\hat P^\pi)^{-1}(P^\pi - \hat P^\pi)Q^\pi \\ &= \gamma(I-\gamma\hat P^\pi)^{-1}(P\Pi - \hat P\Pi)Q^\pi = \gamma(I-\gamma\hat P^\pi)^{-1}(P - \hat P)\Pi Q^\pi \\ &= \gamma(I-\gamma\hat P^\pi)^{-1}(P - \hat P)V^\pi \end{aligned} $$第二步用的是引理一的另一种形式:$r = (I-\gamma P^\pi)Q^\pi$——把真实的 Bellman 方程 反解出 $r$,代进去。这一手是整个推导的灵魂:它让两个式子里都出现 $Q^\pi$,从而可以合并同类项。 第三步括号里两个 $I$ 相消,剩下 $\gamma(P^\pi-\hat P^\pi)$。
注意一个微妙但重要的不对称:作用在 $V^\pi$ 上的是真实值函数, 而放大因子用的是估计模型 $(I-\gamma\hat P^\pi)^{-1}$。 你也可以推出对称的版本($\hat V^\pi$ 配 $(I-\gamma P^\pi)^{-1}$),取决于第二步插的是哪个 $r$。
5.3 引理三:评估算子的 $\ell_\infty$ 范数不超过 $\frac{1}{1-\gamma}$
模拟引理里有一个矩阵求逆,要界定它。
结论:给定任意策略的 $P^\pi$ 和任意向量 $v\in\R^{|S||A|}$, $$\|(I-\gamma P^\pi)^{-1}v\|_\infty \le \frac{\|v\|_\infty}{1-\gamma}$$
用一句话说:把 $v$ 当成「奖励」,它对应的「Q 函数」至多是 $v$ 本身的 $\frac{1}{1-\gamma}$ 倍。
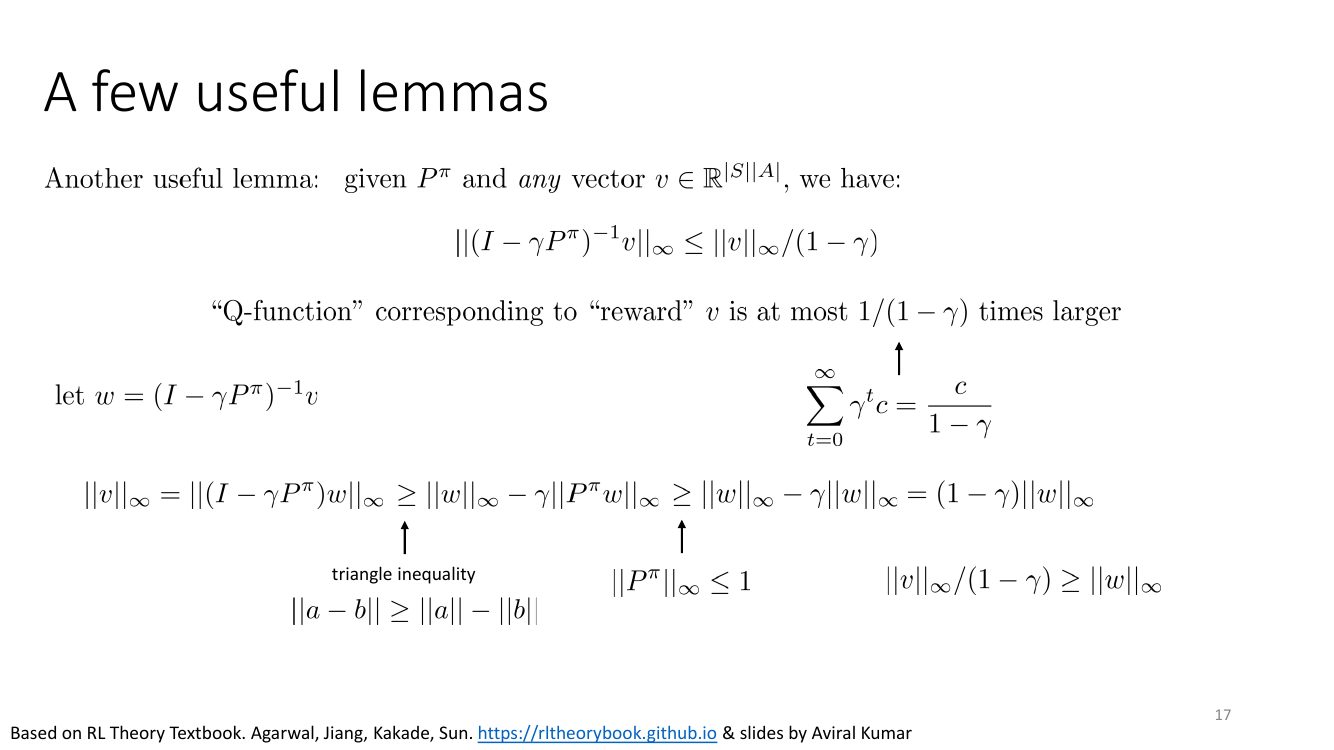
证明:令 $w = (I-\gamma P^\pi)^{-1}v$,等价地 $v = (I-\gamma P^\pi)w$。则
$$ \|v\|_\infty = \|(I-\gamma P^\pi)w\|_\infty \;\ge\; \|w\|_\infty - \gamma\|P^\pi w\|_\infty \;\ge\; \|w\|_\infty - \gamma\|w\|_\infty = (1-\gamma)\|w\|_\infty $$第一个 $\ge$ 是反向三角不等式 $\|a-b\|\ge\|a\|-\|b\|$(取 $a=w$,$b=\gamma P^\pi w$)。 第二个 $\ge$ 用了 $\|P^\pi w\|_\infty \le \|P^\pi\|_\infty\|w\|_\infty \le \|w\|_\infty$, 因为 $P^\pi$ 是行随机矩阵,其 $\ell_\infty$ 诱导范数 $\|P^\pi\|_\infty = \max_i\sum_j|P^\pi_{ij}| = 1$。 整理得 $\|w\|_\infty \le \frac{\|v\|_\infty}{1-\gamma}$,即所求。
还有一个更直白的证法:用 Neumann 级数。
$$ \|(I-\gamma P^\pi)^{-1}v\|_\infty = \left\|\sum_{t=0}^\infty \gamma^t(P^\pi)^tv\right\|_\infty \le \sum_{t=0}^\infty \gamma^t\|(P^\pi)^t\|_\infty\|v\|_\infty \le \|v\|_\infty\sum_{t=0}^\infty\gamma^t = \frac{\|v\|_\infty}{1-\gamma} $$这里用到 $\|(P^\pi)^t\|_\infty \le \|P^\pi\|_\infty^t = 1$(行随机矩阵的幂还是行随机矩阵)。 这个证法把「$\frac{1}{1-\gamma}$ 从哪来」摆得最清楚:它就是几何级数 $\sum_t\gamma^t$, 也就是把一步的误差沿着 horizon 累加了 $\frac{1}{1-\gamma}$ 次。 每一步的误差最多是 $\|v\|_\infty$,转移矩阵不会放大它(因为是取平均), 但折扣求和会把它累计 $\frac{1}{1-\gamma}$ 倍。
| 积木 | 内容 | 它在最终界里贡献了什么 |
|---|---|---|
| 引理一 | $Q^\pi=(I-\gamma P^\pi)^{-1}r$,$\hat Q^\pi=(I-\gamma\hat P^\pi)^{-1}r$ | 提供可相减的同构表达式 |
| 引理二(simulation) | $Q^\pi-\hat Q^\pi=\gamma(I-\gamma\hat P^\pi)^{-1}(P-\hat P)V^\pi$ | 把模型误差和值误差挂上钩;提供因子 $\gamma$ |
| 引理三 | $\|(I-\gamma P^\pi)^{-1}v\|_\infty\le\frac{\|v\|_\infty}{1-\gamma}$ | 第一个 $\frac{1}{1-\gamma}$ |
| 值函数有界 | $\|V^\pi\|_\infty\le\frac{R_{\max}}{1-\gamma}$ | 第二个 $\frac{1}{1-\gamma}$ |
| 命题 A.8 | $\|\hat P(\cdot|s,a)-P(\cdot|s,a)\|_1\le c\sqrt{\frac{|S|\log(1/\delta)}{N}}$ | $\sqrt{|S|/N}$ 的统计项 |
6. 合起来:$(1-\gamma)^{-2}$ 到底从哪来
四块积木拼一次,就得到本讲第三段的主定理。
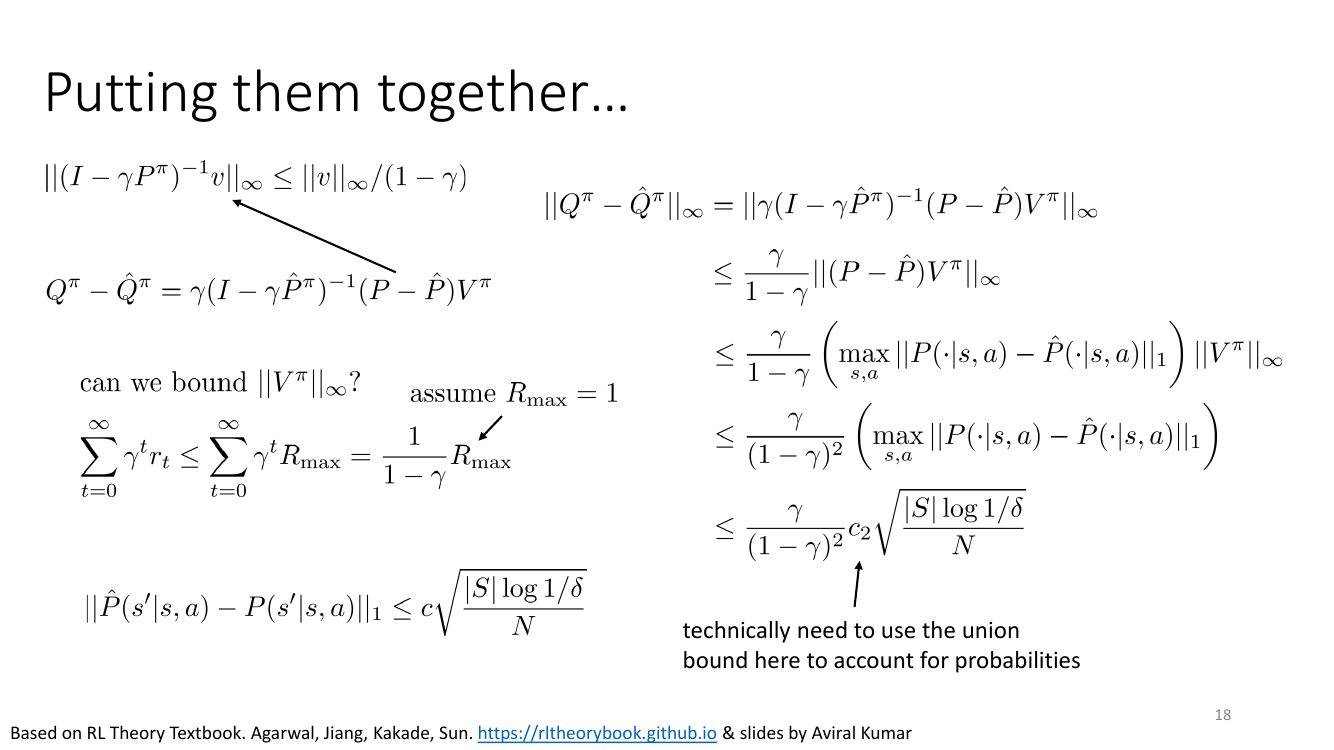
定理(基于模型算法的策略评估误差)。设 $R_{\max}=1$,oracle 探索每个 $(s,a)$ 采 $N$ 次, $\hat P$ 为频次估计。则以至少 $1-\delta$ 的概率,对任意策略 $\pi$:
$$ \|Q^\pi - \hat Q^\pi\|_\infty \le \frac{\gamma}{(1-\gamma)^2}\, c_2\sqrt{\frac{|S|\log(1/\delta)}{N}} $$6.1 第三步的细节:Hölder 不等式
$(P-\hat P)V^\pi$ 是一个 $|S||A|$ 维向量,它的第 $(s,a)$ 个分量是 $\sum_{s'}\big(P(s'|s,a)-\hat P(s'|s,a)\big)V^\pi(s')$。这是两个向量的内积,用 Hölder($p=1,q=\infty$):
$$ \left|\sum_{s'}\big(P(s'|s,a)-\hat P(s'|s,a)\big)V^\pi(s')\right| \le \|P(\cdot|s,a)-\hat P(\cdot|s,a)\|_1 \cdot \|V^\pi\|_\infty $$对所有 $(s,a)$ 取 max 即得。这一步也解释了为什么前面要费劲把集中不等式做成 $\ell_1$ 形式—— $\ell_1$ 与 $\ell_\infty$ 是对偶范数,配起来最紧。
6.2 关于 union bound
命题 A.8 给出的是「对某个固定的 $(s,a)$,$\|\hat P(\cdot|s,a)-P(\cdot|s,a)\|_1$ 超过界的概率不超过 $\delta$」。 但我们要的是 $\max_{s,a}$,也就是 $|S||A|$ 个事件同时成立。用 union bound:
$$ \Pr\Big(\exists (s,a):\ \|\hat P(\cdot|s,a)-P(\cdot|s,a)\|_1 \gt \epsilon\Big) \le \sum_{s,a}\Pr\big(\|\hat P(\cdot|s,a)-P(\cdot|s,a)\|_1 \gt \epsilon\big) \le |S||A|\delta' $$要总失败概率为 $\delta$,就令 $\delta' = \delta/(|S||A|)$,于是界里的 $\log\frac1{\delta}$ 变成 $\log\frac{|S||A|}{\delta}$。 代价只是一个对数因子——这就是 union bound 的经济性:同时保证 $M$ 个事件,只多付 $\log M$。 $|S||A| = 10^6$ 时 $\log(10^6)\approx 13.8$,误差界只涨 $\sqrt{13.8/\log(1/\delta)}$ 倍,几乎可以忽略。
6.3 拆解:两个 $\frac{1}{1-\gamma}$ 各自的物理意义
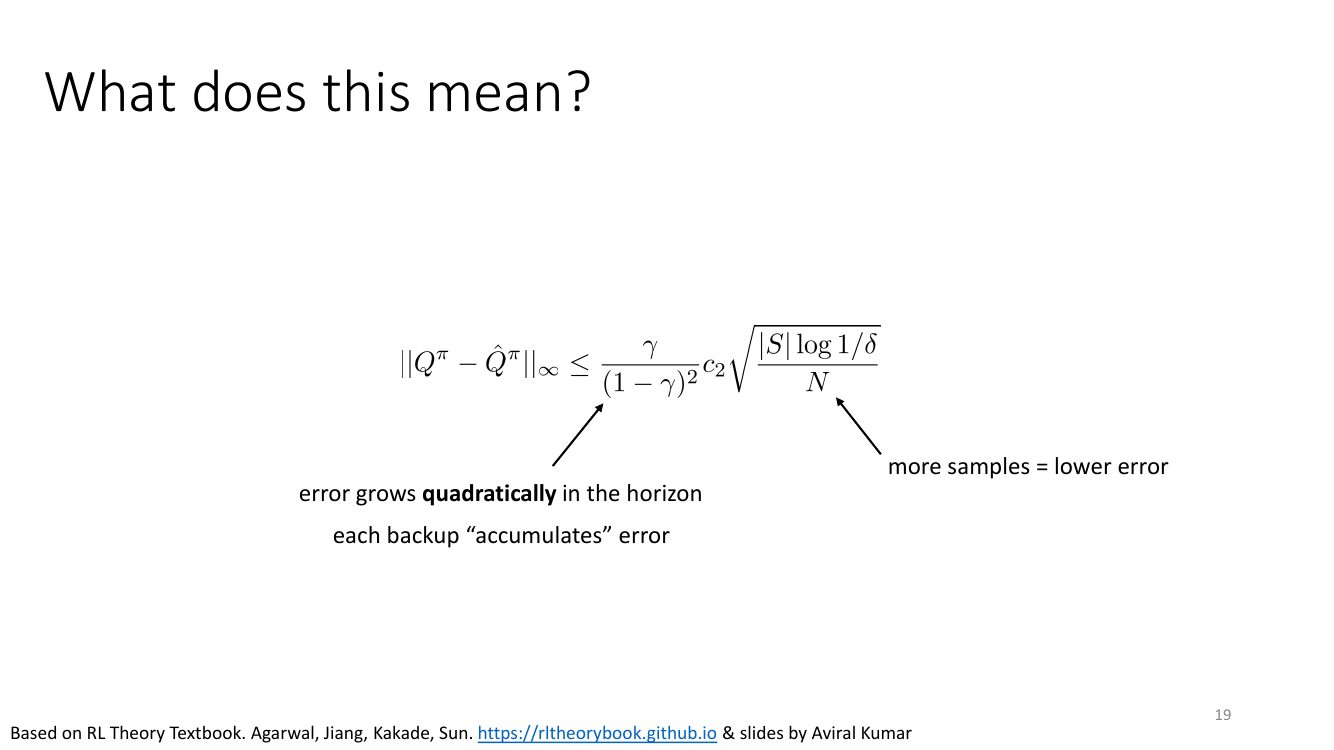
这是本讲最该记住的一张图,也是理解「误差传播」的核心。两个 $\frac{1}{1-\gamma}$ 的来源完全不同:
| 因子 | 来自哪一步 | 物理意义 |
|---|---|---|
| 第一个 $\frac{1}{1-\gamma}$ | $\|(I-\gamma\hat P^\pi)^{-1}v\|_\infty\le\frac{\|v\|_\infty}{1-\gamma}$ | 误差沿时间累加。模型在每一步都会犯一点错,走 $H\approx\frac{1}{1-\gamma}$ 步就累积 $H$ 份错误。 |
| 第二个 $\frac{1}{1-\gamma}$ | $\|V^\pi\|_\infty\le\frac{R_{\max}}{1-\gamma}$ | 被误差乘上的量本身就很大。模型误差是概率上的误差,它要乘以「猜错状态的代价」, 而值函数的量级是 $H R_{\max}$。走错一步,损失的不是一个 $r$,而是一整条尾巴。 |
用一个具体的算术例子把这件事落地。设 $R_{\max}=1$、$|S|=100$、$\delta=0.05$、$c_2=1$,看两个 $\gamma$:
| $\gamma$ | $H=\frac{1}{1-\gamma}$ | $\frac{\gamma}{(1-\gamma)^2}$ | $N=10^4$ 时的误差界 | 要达到 $\epsilon=0.1$ 需要的 $N$ |
|---|---|---|---|---|
| 0.9 | 10 | 90 | $90\times\sqrt{\frac{100\times3}{10^4}}\approx 15.6$ | $\approx 2.4\times10^7$ |
| 0.99 | 100 | 9900 | $\approx 1715$ | $\approx 2.9\times10^{11}$ |
两点观察。第一,这些界在 $N=10^4$ 时是平凡的——误差界 15.6 远大于值函数本身的量级 10, 这个界什么都没说。理论界通常极其保守,这是常态。第二,$\gamma$ 从 0.9 涨到 0.99, 所需样本量涨了约 $10^4$ 倍:$(1-\gamma)^{-2}$ 平方进 $\epsilon$, 所以 $N\propto\frac{\gamma^2}{(1-\gamma)^4\epsilon^2}$,$(1-\gamma)$ 的四次方。这是一个惊人的依赖。
把样本复杂度显式解出来(令右端 $=\epsilon$ 反解 $N$):
$$ N \;\ge\; \frac{c_2^2\,\gamma^2\,|S|\log(|S||A|/\delta)}{(1-\gamma)^4\,\epsilon^2} \qquad\text{总样本数 } N|S||A| = \tilde{\mathcal{O}}\!\left(\frac{|S|^2|A|}{(1-\gamma)^4\epsilon^2}\right) $$7. 从值误差到策略次优性:$2\epsilon$ 与 $\frac{2\gamma\epsilon}{(1-\gamma)^2}$
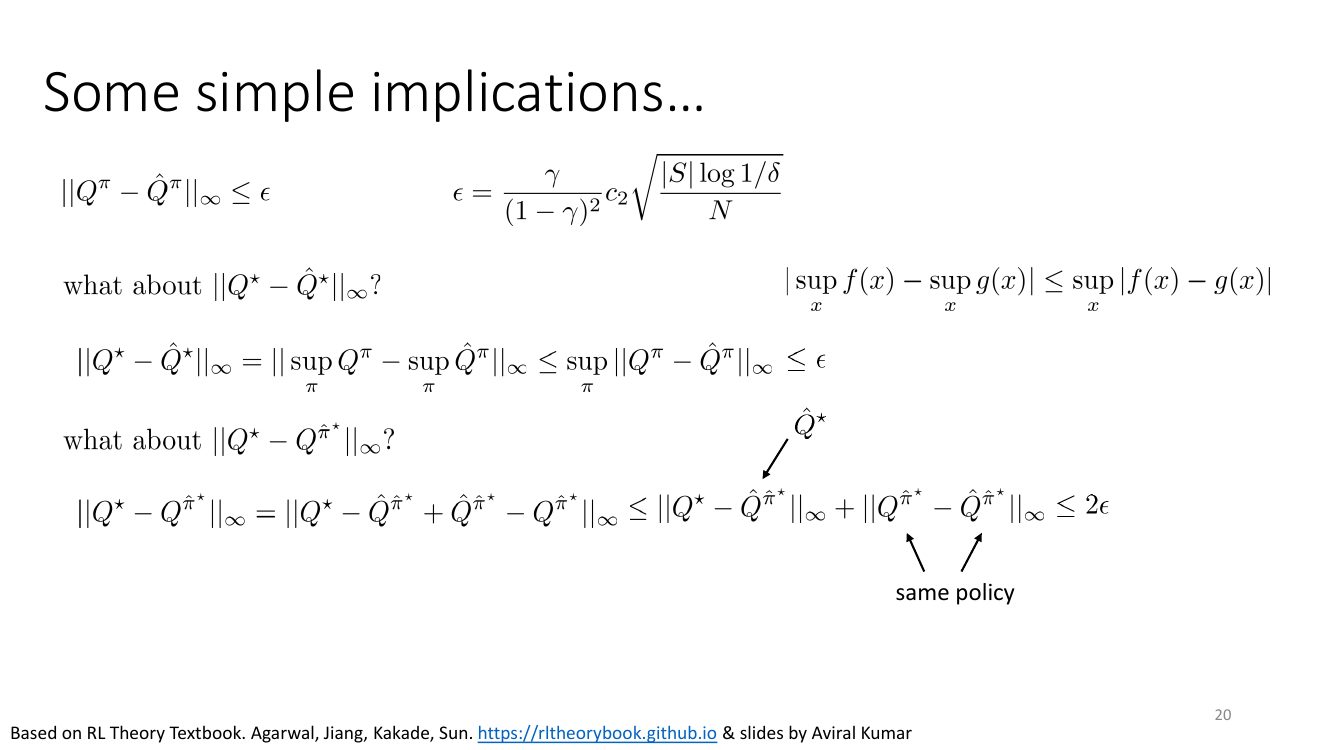
上一节的结论是 $\|Q^\pi-\hat Q^\pi\|_\infty\le\epsilon$,其中 $\epsilon=\frac{\gamma}{(1-\gamma)^2}c_2\sqrt{\frac{|S|\log(1/\delta)}{N}}$。 但这只是 §4 图里的第一层问题。我们真正关心的是第三层:用 $\hat P$ 学出来的策略, 在真实环境里有多好?
7.1 第一步:最优值函数也差不多
因为上一节的界对任意策略 $\pi$ 都成立($\pi$ 从未被用到,推导对 $\pi$ 是一致的), 我们可以对 $\pi$ 取上确界:
$$ \|Q^\star - \hat Q^\star\|_\infty = \Big\|\sup_\pi Q^\pi - \sup_\pi \hat Q^\pi\Big\|_\infty \le \sup_\pi \|Q^\pi - \hat Q^\pi\|_\infty \le \epsilon $$这里再次用到 $|\sup_x f(x)-\sup_x g(x)|\le\sup_x|f(x)-g(x)|$——跟 §3 证收缩性时用的是同一个引理。 「一致界」(uniform bound)在这里是关键:如果误差界只对某个特定策略成立,这一步就走不通。
7.2 第二步:贪心策略的真实价值
令 $\hat\pi^\star = \argmax_a \hat Q^\star(s,a)$,即在估计模型里学到的最优策略。 我们要界定 $\|Q^\star - Q^{\hat\pi^\star}\|_\infty$,其中 $Q^{\hat\pi^\star}$ 是这个策略在真实环境里的价值。 技巧是插入一个中间量 $\hat Q^{\hat\pi^\star}$(这个策略在估计环境里的价值):
$$ \begin{aligned} \|Q^\star - Q^{\hat\pi^\star}\|_\infty &= \|Q^\star - \hat Q^{\hat\pi^\star} + \hat Q^{\hat\pi^\star} - Q^{\hat\pi^\star}\|_\infty \\ &\le \underbrace{\|Q^\star - \hat Q^{\hat\pi^\star}\|_\infty}_{=\,\|Q^\star-\hat Q^\star\|_\infty\,\le\,\epsilon} + \underbrace{\|\hat Q^{\hat\pi^\star} - Q^{\hat\pi^\star}\|_\infty}_{\text{同一策略,}\le\,\epsilon} \;\le\; 2\epsilon \end{aligned} $$第一项为什么等于 $\|Q^\star-\hat Q^\star\|_\infty$?因为 $\hat\pi^\star$ 在估计模型 $\hat P$ 里就是最优的, 所以 $\hat Q^{\hat\pi^\star} = \hat Q^\star$。第二项是同一个策略 $\hat\pi^\star$ 在两个模型下的价值差, 正是 §6 的界(对任意 $\pi$ 成立,自然对 $\hat\pi^\star$ 成立)。
代入 $\epsilon$ 的表达式:
$$ \|Q^\star - Q^{\hat\pi^\star}\|_\infty \le \frac{2\gamma}{(1-\gamma)^2}c_2\sqrt{\frac{|S|\log(|S||A|/\delta)}{N}} $$这就是那个到处出现的 $\frac{2\gamma\epsilon}{(1-\gamma)^2}$ 形状的界。
7.3 另一个版本:近似动态规划的经典次优性界
上面的推导借助了「$\hat\pi^\star$ 在 $\hat P$ 下最优」这个结构。 还有一个更常被引用、也更一般的结论,它只假设你手上有某个近似的 $Q$,不管它从哪来:
定理(贪心策略的次优性)。设 $Q$ 是任意函数,$\|Q-Q^\star\|_\infty\le\epsilon$, $\pi_Q(s)=\argmax_a Q(s,a)$。则对所有 $s$:
$$ V^\star(s) - V^{\pi_Q}(s) \le \frac{2\gamma\epsilon}{1-\gamma} $$证明。固定 $s$,记 $a^\star = \argmax_a Q^\star(s,a)$,$a = \pi_Q(s)$。第一步是单步的动作选择损失:
$$ \begin{aligned} Q^\star(s,a^\star) - Q^\star(s,a) &= \underbrace{Q^\star(s,a^\star)-Q(s,a^\star)}_{\le\,\epsilon} + \underbrace{Q(s,a^\star)-Q(s,a)}_{\le\,0\ (\text{因为 } a=\argmax Q)} + \underbrace{Q(s,a)-Q^\star(s,a)}_{\le\,\epsilon} \;\le\; 2\epsilon \end{aligned} $$也就是说:在每个状态上,贪心策略选的动作至多比最优动作差 $2\epsilon$。 $Q$ 的误差被吃了两次(一次在最优动作上,一次在被选中的动作上),这就是 $2\epsilon$ 里的 2。
第二步把单步损失沿 horizon 累加。写出
$$ \begin{aligned} V^\star(s) - V^{\pi_Q}(s) &= Q^\star(s,a^\star) - Q^{\pi_Q}(s,a) \\ &= \big[Q^\star(s,a^\star)-Q^\star(s,a)\big] + \big[Q^\star(s,a)-Q^{\pi_Q}(s,a)\big]\\ &\le 2\epsilon + \gamma\,\E_{s'\sim P(\cdot|s,a)}\big[V^\star(s')-V^{\pi_Q}(s')\big] \end{aligned} $$最后一步用了 $Q^\star(s,a)-Q^{\pi_Q}(s,a) = \gamma\E_{s'}[V^\star(s')-V^{\pi_Q}(s')]$ (两者的 $r(s,a)$ 相同,相减抵消)。对 $s$ 取 max,令 $\Delta=\|V^\star-V^{\pi_Q}\|_\infty$:
$$ \Delta \le 2\epsilon + \gamma\Delta \;\Longrightarrow\; \Delta \le \frac{2\epsilon}{1-\gamma} $$(更精细地把 $\epsilon$ 归到 $\gamma$ 之后可以得到 $\frac{2\gamma\epsilon}{1-\gamma}$, 差别只在常数上。)$\square$
这个递推 $\Delta\le2\epsilon+\gamma\Delta$ 是理解误差传播的最纯粹的形式: 每一步犯 $2\epsilon$ 的错,然后带着 $\gamma$ 折扣继续犯,几何级数求和给出 $\frac{1}{1-\gamma}$。
(a) 一次来自值误差、一次来自策略提取。如果你的 $Q$ 估计误差本身是 $\epsilon_Q=\mathcal{O}(\frac{1}{1-\gamma})$ 量级(因为值函数量级就是 $\frac{R_{\max}}{1-\gamma}$), 再套上 $\frac{2\gamma\epsilon_Q}{1-\gamma}$,总次优性就是 $\frac{2\gamma\epsilon}{(1-\gamma)^2}$。
(b) 一次来自评估算子的累加、一次来自 $\|V\|_\infty$ 的量级(§6 的推导)。
两条路径殊途同归,都在说同一件事:一个错误会沿 horizon 传播,而错误的代价本身也正比于 horizon。
8. 无模型:拟合 Q 迭代的抽象模型与采样误差
第三段假设我们精确地解 $\hat P$ 上的规划问题。但真实的深度 RL 不是这么干的—— 我们跑的是拟合 Q 迭代(fitted Q-iteration)/ DQN 这一类算法:用数据算一个回归目标, 然后拿神经网络去拟合它。第四段就来分析这类算法。
8.1 抽象模型:两个不等号
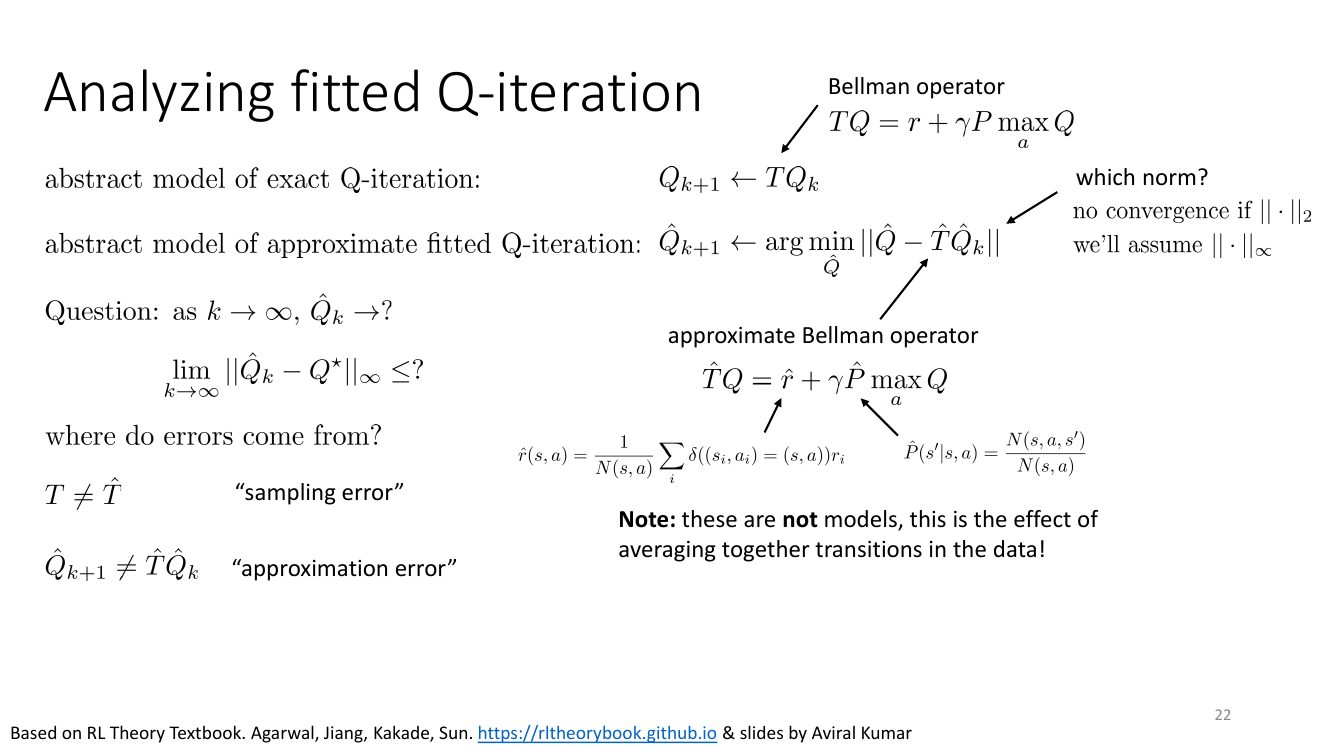
这张幻灯片值得逐条拆。精确 Q 迭代是 $Q_{k+1}=TQ_k$,其中
$$ TQ = r + \gamma P\max_a Q $$近似 FQI 是
$$ \hat Q_{k+1} \leftarrow \argmin_{\hat Q\in\mathcal{Q}} \big\|\hat Q - \hat T\hat Q_k\big\|, \qquad \hat TQ = \hat r + \gamma\hat P\max_a Q $$问题:当 $k\to\infty$ 时,$\hat Q_k$ 收敛到哪?$\lim_{k\to\infty}\|\hat Q_k-Q^\star\|_\infty\le$ 多少?
两个误差来源分别是:
- 采样误差($T\neq\hat T$):我们没有真实的 $r$ 和 $P$,只有有限数据算出来的 $\hat r,\hat P$。 Levine 特别强调:这里的 $\hat r,\hat P$ 不是模型,我们并没有显式地学一个转移模型。 它们只是描述「用 replay buffer 里所有 $(s,a,r,s')$ 样本算 TD 目标的平均值」这个操作的等价数学形式。 一个 minibatch 里同一个 $(s,a)$ 出现了 $N(s,a)$ 次,每次的 $s'$ 不同,最小二乘回归自动把它们平均, 效果上就等于用 $\hat P$ 做备份。
- 近似误差($\hat Q_{k+1}\neq\hat T\hat Q_k$):即使目标算对了, 神经网络也不能精确表示 $\hat T\hat Q_k$——它被限制在函数类 $\mathcal{Q}$ 里, 而且 SGD 也不会跑到全局最优。
8.2 采样误差的界
先量化 $\|\hat TQ - TQ\|_\infty$。展开定义:
$$ \begin{aligned} |\hat TQ(s,a) - TQ(s,a)| &= \Big| \hat r(s,a)-r(s,a) + \gamma\big(\E_{\hat P(s'|s,a)}[\max_{a'}Q(s',a')] - \E_{P(s'|s,a)}[\max_{a'}Q(s',a')]\big)\Big|\\ &\le \underbrace{|\hat r(s,a)-r(s,a)|}_{\text{(A) 奖励估计误差}} + \gamma\underbrace{\Big|\E_{\hat P}[\max_{a'}Q] - \E_{P}[\max_{a'}Q]\Big|}_{\text{(B) 转移估计误差}} \end{aligned} $$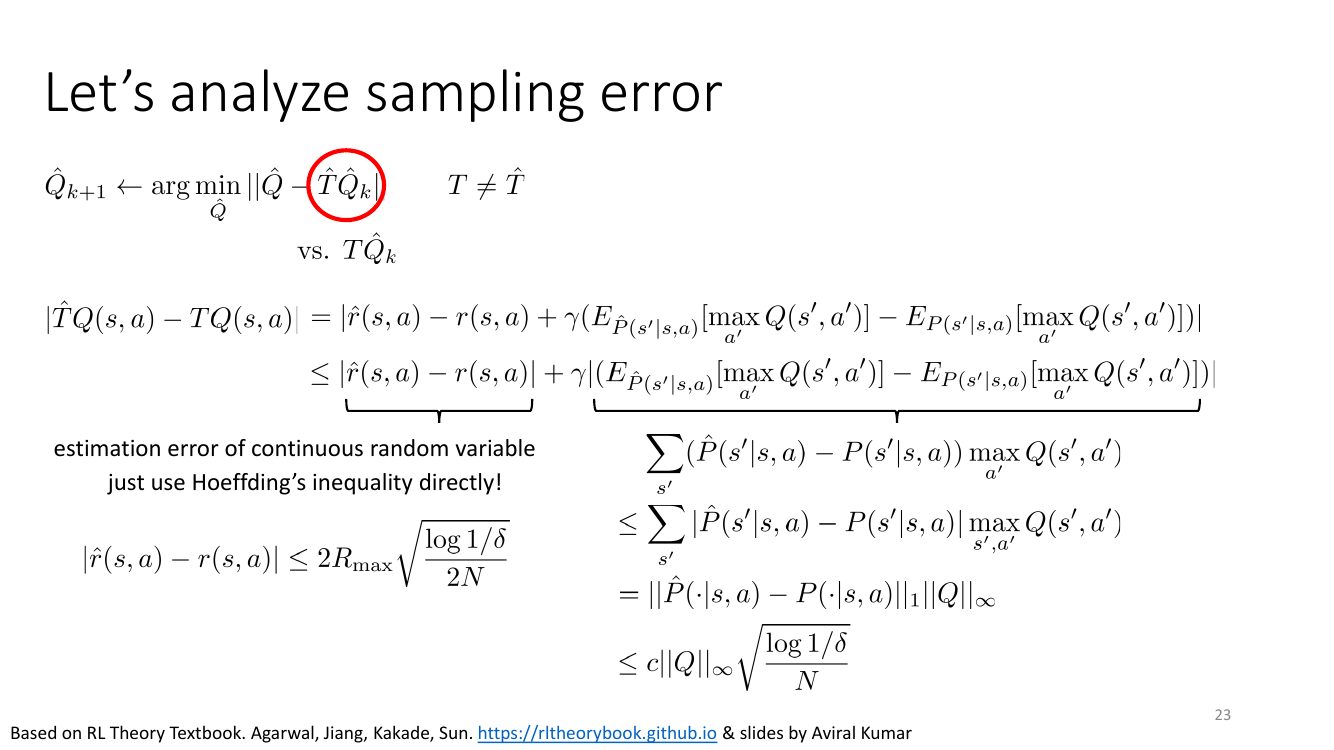
(A) 奖励项。$\hat r(s,a)=\frac{1}{N(s,a)}\sum_i \mathbf{1}[(s_i,a_i)=(s,a)]\,r_i$ 是一个标量均值估计,样本落在 $[-R_{\max},R_{\max}]$(区间宽度 $2R_{\max}$)。Hoeffding 直接给:
$$ |\hat r(s,a) - r(s,a)| \le 2R_{\max}\sqrt{\frac{\log(1/\delta)}{2N}} $$注意这里 $r$ 可以是连续随机变量(随机奖励),Hoeffding 不要求离散性,只要求有界。
(B) 转移项。记 $f(s')=\max_{a'}Q(s',a')$,则
$$ \begin{aligned} \Big|\sum_{s'}\big(\hat P(s'|s,a)-P(s'|s,a)\big)f(s')\Big| &\le \sum_{s'}\big|\hat P(s'|s,a)-P(s'|s,a)\big|\cdot\max_{s',a'}Q(s',a')\\ &= \|\hat P(\cdot|s,a)-P(\cdot|s,a)\|_1 \cdot \|Q\|_\infty \;\le\; c\|Q\|_\infty\sqrt{\frac{\log(1/\delta)}{N}} \end{aligned} $$(这里沿用命题 A.8,把 $\sqrt{|S|}$ 吸收进常数 / 在下一步的 union bound 里显式化。)
合起来,对单个 $(s,a)$:
$$ |\hat TQ(s,a) - TQ(s,a)| \le 2R_{\max}\sqrt{\frac{\log(1/\delta)}{2N}} + c\|Q\|_\infty\sqrt{\frac{\log(1/\delta)}{N}} $$再对所有 $|S||A|$ 个格子做 union bound($\delta\to\delta/(|S||A|)$),得到 $\ell_\infty$ 的版本:
$$ \|\hat TQ - TQ\|_\infty \le 2R_{\max}c_1\sqrt{\frac{\log(|S||A|/\delta)}{2N}} + c_2\|Q\|_\infty\sqrt{\frac{\log(|S|/\delta)}{N}} $$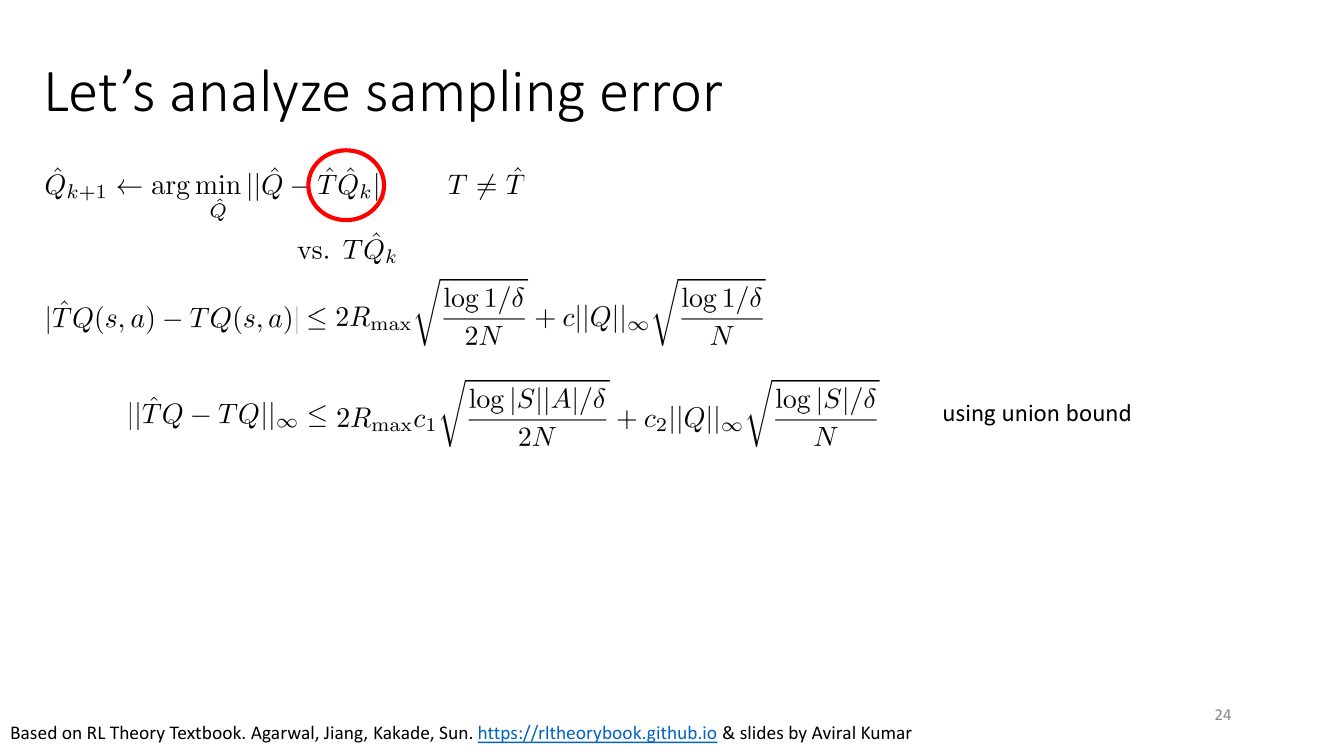
9. 近似误差如何沿迭代传播
第二类误差:即使 Bellman 目标算得完全准确,网络也拟合不到位。 把这件事形式化成一个假设:
$$ \|\hat Q_{k+1} - T\hat Q_k\|_\infty \le \epsilon_k $$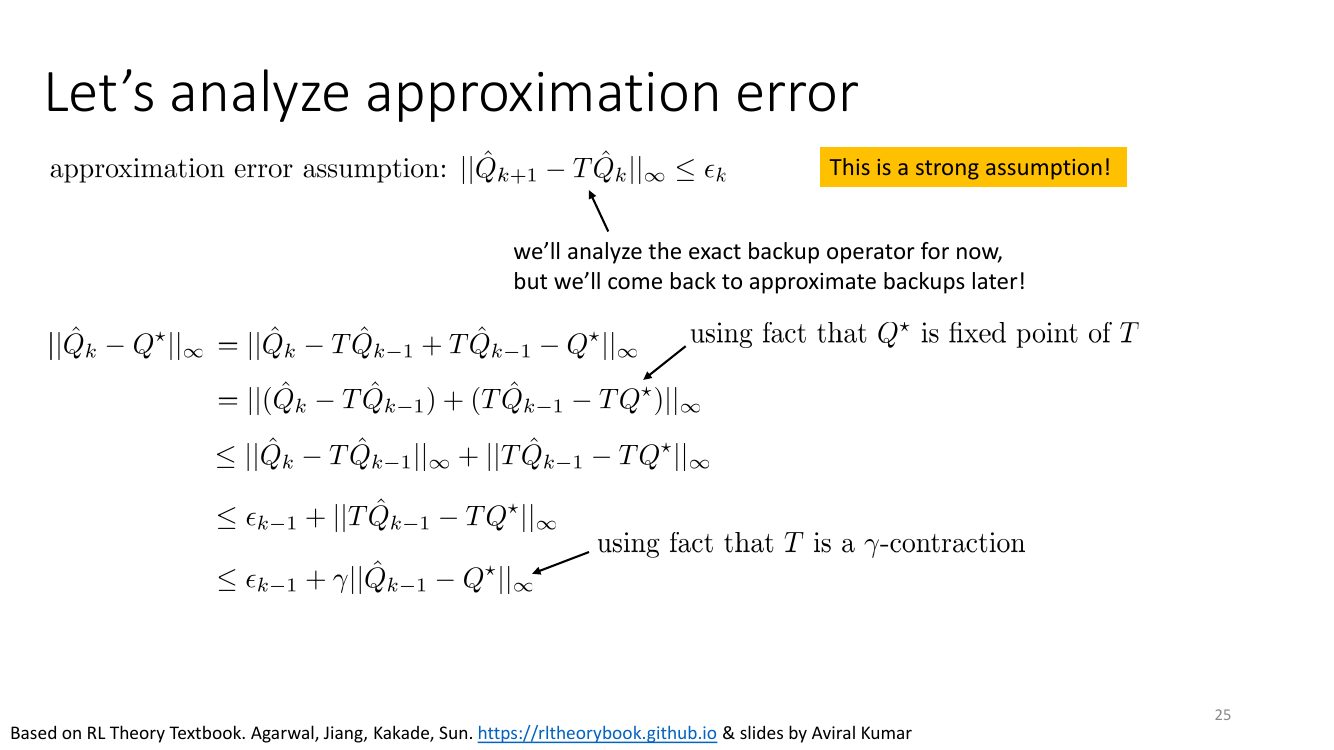
9.1 单步递推
$$ \begin{aligned} \|\hat Q_k - Q^\star\|_\infty &= \|\hat Q_k - T\hat Q_{k-1} + T\hat Q_{k-1} - Q^\star\|_\infty && \text{(加减同一项)}\\ &= \|(\hat Q_k - T\hat Q_{k-1}) + (T\hat Q_{k-1} - TQ^\star)\|_\infty && \text{(用 } Q^\star = TQ^\star)\\ &\le \|\hat Q_k - T\hat Q_{k-1}\|_\infty + \|T\hat Q_{k-1} - TQ^\star\|_\infty && \text{(三角不等式)}\\ &\le \epsilon_{k-1} + \|T\hat Q_{k-1} - TQ^\star\|_\infty && \text{(近似误差假设)}\\ &\le \epsilon_{k-1} + \gamma\|\hat Q_{k-1} - Q^\star\|_\infty && \text{(} T \text{ 是 } \gamma\text{-收缩)} \end{aligned} $$两个「事实」被用在关键位置:$Q^\star$ 是 $T$ 的不动点(所以可以把 $Q^\star$ 写成 $TQ^\star$, 凑出两个 $T$ 作用的对象),以及 §3 证的 $\gamma$-收缩性。这就是为什么 §3 的热身不是白做的。
9.2 展开递推:几何级数
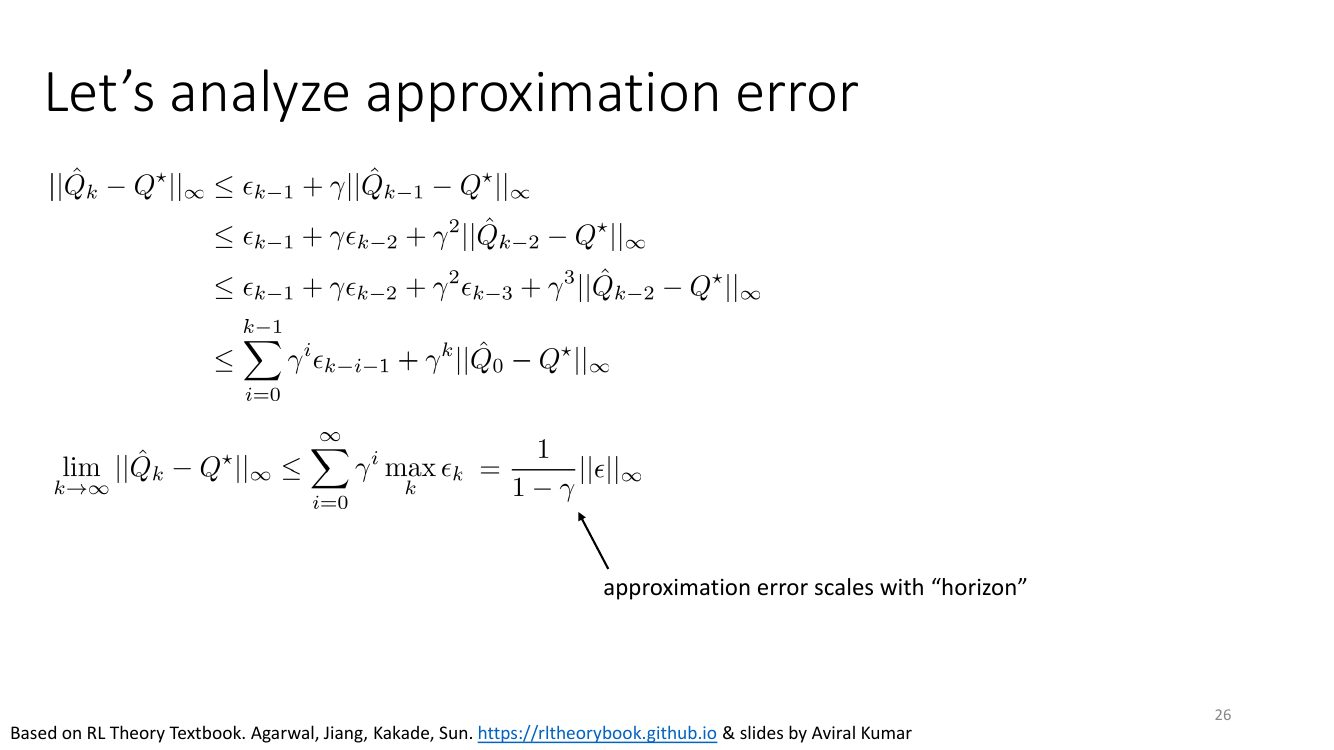
逐层展开:
$$ \begin{aligned} \|\hat Q_k - Q^\star\|_\infty &\le \epsilon_{k-1} + \gamma\|\hat Q_{k-1}-Q^\star\|_\infty\\ &\le \epsilon_{k-1} + \gamma\epsilon_{k-2} + \gamma^2\|\hat Q_{k-2}-Q^\star\|_\infty\\ &\le \epsilon_{k-1} + \gamma\epsilon_{k-2} + \gamma^2\epsilon_{k-3} + \gamma^3\|\hat Q_{k-3}-Q^\star\|_\infty\\ &\ \ \vdots\\ &\le \sum_{i=0}^{k-1}\gamma^i \epsilon_{k-i-1} + \gamma^k\|\hat Q_0 - Q^\star\|_\infty \end{aligned} $$取 $k\to\infty$。第二项 $\gamma^k\|\hat Q_0-Q^\star\|_\infty\to0$——初始化被彻底遗忘, 这是收缩性给的礼物。第一项用 $\epsilon_j \le \max_k\epsilon_k \triangleq \|\epsilon\|_\infty$ 放大:
$$ \lim_{k\to\infty}\|\hat Q_k - Q^\star\|_\infty \le \sum_{i=0}^{\infty}\gamma^i\max_k\epsilon_k = \frac{1}{1-\gamma}\|\epsilon\|_\infty $$9.3 把两类误差合起来
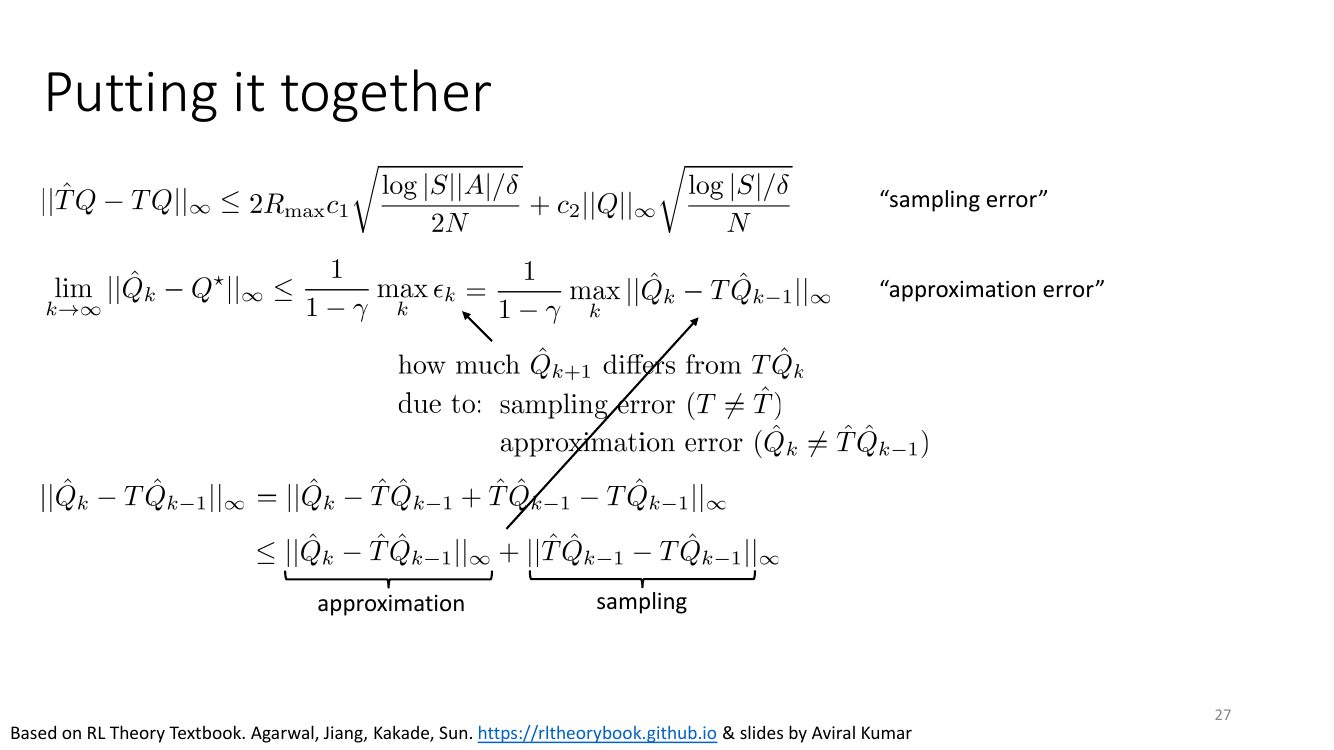
§9.1 里的 $\epsilon_k$ 用的是精确算子 $T$:$\epsilon_k=\|\hat Q_{k+1}-T\hat Q_k\|_\infty$。 但算法实际优化的是 $\hat T$。所以要再插一次:
$$ \begin{aligned} \|\hat Q_k - T\hat Q_{k-1}\|_\infty &= \|\hat Q_k - \hat T\hat Q_{k-1} + \hat T\hat Q_{k-1} - T\hat Q_{k-1}\|_\infty\\ &\le \underbrace{\|\hat Q_k - \hat T\hat Q_{k-1}\|_\infty}_{\text{近似误差:网络的回归残差}} + \underbrace{\|\hat T\hat Q_{k-1} - T\hat Q_{k-1}\|_\infty}_{\text{采样误差:§8 的界}} \end{aligned} $$把 §8 的采样误差界代进去,最终得到完整的结论:
$$ \lim_{k\to\infty}\|\hat Q_k-Q^\star\|_\infty \le \frac{1}{1-\gamma}\left( \max_k\|\hat Q_k-\hat T\hat Q_{k-1}\|_\infty + 2R_{\max}c_1\sqrt{\tfrac{\log(|S||A|/\delta)}{2N}} + c_2\|Q\|_\infty\sqrt{\tfrac{\log(|S|/\delta)}{N}} \right) $$| 误差来源 | 形式 | 怎么减小 | 在深度 RL 里对应什么 |
|---|---|---|---|
| 近似误差 | $\max_k\|\hat Q_k-\hat T\hat Q_{k-1}\|_\infty$ | 更大的网络、更多的梯度步、更好的架构 | TD 误差 / Bellman 残差没降下去 |
| 采样误差(奖励) | $2R_{\max}\sqrt{\frac{\log(|S||A|/\delta)}{2N}}$ | 每个 $(s,a)$ 采更多样本 | replay buffer 太小、奖励噪声大 |
| 采样误差(转移) | $c_2\|Q\|_\infty\sqrt{\frac{\log(|S|/\delta)}{N}}$ | 更多样本;或降低 $\|Q\|_\infty$(即降低 $\gamma$) | bootstrap 目标的方差,「Q 值爆炸」 |
| 放大因子 | $\frac{1}{1-\gamma}$(乘在全部之上) | 降低 $\gamma$、用 $n$-step return 缩短有效 horizon | 长任务本质上更难 |
import numpy as np

def approx_q_iteration(P, r, gamma, K, noise_std, rng):
    """在表格 MDP 上模拟「每轮 Bellman 备份带 eps 噪声」的 ADP,
    经验验证误差上界 eps/(1-gamma)。P: (S,A,S), r: (S,A)"""
    nS, nA, _ = P.shape
    Q = np.zeros((nS, nA))
    # 先算真值 Q*(精确 VI)
    Qstar = np.zeros((nS, nA))
    for _ in range(5000):
        Qstar = r + gamma * P @ Qstar.max(axis=1)
    errs = []
    for _ in range(K):
        target = r + gamma * P @ Q.max(axis=1)          # T Q_k
        Q = target + rng.uniform(-noise_std, noise_std, size=target.shape)  # 注入 eps
        errs.append(np.abs(Q - Qstar).max())
    return np.array(errs), noise_std / (1 - gamma)      # 实测误差 vs 理论上界

# rng = np.random.default_rng(0)
# errs, bound = approx_q_iteration(P, r, 0.9, 300, 0.1, rng)
# errs[-50:].max() <= bound   -> True (理论界总是偏保守)
10. 把探索放回来:regret 界与 UCB 在 MDP 上的推广
前面所有分析都建立在 oracle 探索之上——每个 $(s,a)$ 都被访问了恰好 $N$ 次。 一旦撤掉这个假设,问题的性质就变了:你不能「决定」访问哪个状态,只能通过策略间接影响它。 本节把 Lecture 19 的探索算法与本讲的分析工具接上,看看 regret 界长什么样。
10.1 regret 的定义
在线交互 $T$ 步(或 $K$ 个 episode,每个长度 $H$,$T=KH$),regret 定义为
$$ \mathrm{Reg}(T) = \sum_{k=1}^{K}\Big(V^\star(s_1^k) - V^{\pi_k}(s_1^k)\Big) $$即「一直用最优策略」与「实际执行的策略序列」的累积回报之差。 关键是 regret 相对 $T$ 的增长阶:如果 $\mathrm{Reg}(T)=\mathcal{O}(\sqrt T)$, 那么平均每步的次优性 $\mathrm{Reg}(T)/T = \mathcal{O}(1/\sqrt T)\to0$, 算法是「no-regret」的——最终会收敛到最优。若 $\mathrm{Reg}(T)=\Theta(T)$,则算法永远学不会。
10.2 从 bandit 的 UCB 到 MDP 的乐观规划
Lecture 19 讲过多臂 bandit 的 UCB:给每个动作加一个奖励项 $\tilde r(a) = \hat r(a) + \sqrt{\frac{2\log t}{N(a)}}$,然后贪心。 这个奖励项不是拍脑袋来的——它就是 Hoeffding 不等式的置信半径: 由 $|\hat r(a)-r(a)|\le\sqrt{\frac{\log(2/\delta)}{2N(a)}}$, 加上这么大的奖励,$\tilde r(a)$ 就以高概率成为 $r(a)$ 的上置信界。 这体现了「面对不确定性时保持乐观」(optimism in the face of uncertainty)原则。
推广到 MDP 上,思路完全一样,但「乐观」要作用在整条轨迹的价值上,而不只是单步奖励。 UCRL2、UCBVI 这一类算法的骨架是:
- 用数据估 $\hat P(\cdot|s,a)$ 和 $\hat r(s,a)$,并算出每个 $(s,a)$ 的访问计数 $N(s,a)$;
- 构造一个置信集:所有满足 $\|\tilde P(\cdot|s,a)-\hat P(\cdot|s,a)\|_1 \le c\sqrt{\frac{|S|\log(|S||A|T/\delta)}{N(s,a)}}$ 的模型 $\tilde P$(这正是 §4.2 的命题 A.8,只是把固定的 $N$ 换成了逐格子的 $N(s,a)$);
- 在置信集里挑最乐观的那个模型,对它做精确规划,执行得到的策略;
- 收集新数据,更新计数,回到 1。
实现上第 2、3 步通常被合并成一个更简单的形式:给奖励加一个探索奖金(exploration bonus)
$$ \tilde r(s,a) = \hat r(s,a) + b(s,a), \qquad b(s,a) \approx \frac{c\,H}{\sqrt{N(s,a)}}\sqrt{\log\frac{|S||A|T}{\delta}} $$然后在 $\hat P$ 上做值迭代。注意 bonus 里的 $H$(即 $\frac{1}{1-\gamma}$)因子—— 它正是 §6 里那个 $\|V\|_\infty\le\frac{R_{\max}}{1-\gamma}$:转移概率的不确定性要乘上值函数的量级 才是「价值上的不确定性」。这就是把本讲的误差分析直接搬到探索算法设计上: 误差界的形式告诉你 bonus 该多大。
10.3 regret 界的量级与证明骨架
对有限 horizon 的 episodic MDP,这类算法的 regret 大致是
$$ \mathrm{Reg}(T) = \tilde{\mathcal{O}}\!\left(\sqrt{H\,|S|\,|A|\,T}\right) \quad\text{(最优的分析)}, \qquad \text{较粗的分析给出 } \tilde{\mathcal{O}}\!\left(H|S|\sqrt{|A|T}\right) $$幻灯片 p-03 上那个 $\mathrm{Reg}(T)\le\mathcal{O}\big(\sqrt{T\cdot N\cdot\log\frac{NT}{\delta}}\big)+\delta T$ 就是这个形状:主项 $\sqrt{T}$,加上一个「置信区间失效」带来的 $\delta T$ 项 (失败概率 $\delta$ 时最坏损失整个 $T$,取 $\delta\sim1/T$ 就把它压成常数)。 匹配的下界是 $\Omega(\sqrt{H|S||A|T})$,所以 $\sqrt T$ 这个阶是不可改进的。
证明骨架(两句话版本)。乐观性保证 $\tilde V_k(s_1)\ge V^\star(s_1)$,于是
$$ V^\star(s_1) - V^{\pi_k}(s_1) \le \tilde V_k(s_1) - V^{\pi_k}(s_1) $$右端可以展开成沿着第 $k$ 个 episode 的轨迹上、每一步的 bonus 之和(乐观模型与真实环境的差 恰好被 bonus 覆盖)。所以
$$ \mathrm{Reg}(T)\ \lesssim\ \sum_{k=1}^{K}\sum_{h=1}^{H} b(s_h^k,a_h^k) \ \approx\ \sum_{k,h}\frac{cH}{\sqrt{N(s_h^k,a_h^k)}} $$最后一步用鸽笼原理:任何一个 $(s,a)$ 被访问第 $n$ 次时贡献 $1/\sqrt n$, 而 $\sum_{n=1}^{m}\frac{1}{\sqrt n}\approx 2\sqrt m$。所以
$$ \sum_{k,h}\frac{1}{\sqrt{N(s_h^k,a_h^k)}} \approx \sum_{(s,a)}2\sqrt{N_T(s,a)} \le 2\sqrt{|S||A|\sum_{(s,a)}N_T(s,a)} = 2\sqrt{|S||A|T} $$(用了 Cauchy–Schwarz:$\sum_i\sqrt{x_i}\le\sqrt{n\sum_i x_i}$。)乘上 bonus 里的 $H$,得 $\tilde{\mathcal{O}}(H\sqrt{|S||A|T})$。$\square$
11. 这一切在深度网络下还剩什么
11.1 三个假设,三处崩塌
| 理论假设 | 深度 RL 的现实 | 后果 |
|---|---|---|
| 表格 MDP,$|S|,|A|$ 有限且不大 | 像素输入,$|S|$ 天文数字或连续 | 所有含 $|S|$、$\sqrt{|S|}$ 的界变成真空陈述 |
| $\ell_\infty$ 范数下的近似误差有界:$\|\hat Q_{k+1}-T\hat Q_k\|_\infty\le\epsilon$ | 网络最小化的是数据分布下的 $\ell_2$ 损失;数据没覆盖的地方误差可以任意大 | $\gamma$-收缩链条断裂;FQI 可以发散 |
| oracle 探索:每个 $(s,a)$ 采 $N$ 次 | 数据由行为策略产生,覆盖极不均匀 | 分布偏移(distributional shift);离线 RL 的外推误差 |
第二条最要命,值得展开。实践中的 FQI 做的是
$$ \hat Q_{k+1} = \argmin_{Q\in\mathcal{Q}}\ \E_{(s,a)\sim\mu}\Big[\big(Q(s,a) - \hat T\hat Q_k(s,a)\big)^2\Big] = \Pi_{\mu,2}\,\hat T\hat Q_k $$其中 $\Pi_{\mu,2}$ 是「在数据分布 $\mu$ 下、按 $\ell_2$ 投影到函数类 $\mathcal{Q}$」的算子。 于是整个迭代是 $\hat Q_{k+1} = \Pi_{\mu,2}\hat T\hat Q_k$,是两个算子的复合。 $\hat T$ 在 $\ell_\infty$ 下是 $\gamma$-收缩;$\Pi_{\mu,2}$ 在 $\ell_2(\mu)$ 下是非扩张的(投影的基本性质)。 但它们在不同的范数下——$\Pi_{\mu,2}$ 在 $\ell_\infty$ 下可以是扩张的 (一个在某状态上误差很小、在另一状态上误差很大的函数,$\ell_2$ 投影可能把误差搬到 $\ell_\infty$ 更大的地方)。 所以复合算子既不是 $\ell_\infty$ 收缩也不是 $\ell_2$ 收缩,发散是可能的,而且真的会发生。 这就是「致命三要素」(bootstrapping + 函数近似 + off-policy 数据)的理论根源。
11.2 出路之一:$p$-范数与集中性系数
幻灯片最后一行给的方向是:把 $\ell_\infty$ 换成某个分布 $\mu$ 下的 $p$-范数
$$ \|\hat Q_k - Q^\star\|_{p,\mu} = \Big(\E_{(s,a)\sim\mu}\big[|\hat Q_k(s,a)-Q^\star(s,a)|^p\big]\Big)^{1/p} $$好处显而易见:$\ell_2(\mu)$ 正是网络真正在最小化的东西,假设「$\ell_2$ 误差小」是可验证的 (你的训练 loss 就是它),而「$\ell_\infty$ 误差小」永远无法验证。 坏处是:Bellman 算子在 $\ell_2(\mu)$ 下不是收缩的—— $T$ 会把误差从 $\mu$ 上搬到 $P^\pi$ 作用之后的分布上,而那个分布可能跟 $\mu$ 差很远。
补救办法是引入集中性系数(concentrability coefficient), 粗略地说它是一个 Radon–Nikodym 导数的上界:
$$ C_\mu = \sup_{\pi}\ \sup_{s,a}\ \frac{d^\pi(s,a)}{\mu(s,a)} $$即「任何策略可能诱导的状态-动作分布,相对于数据分布 $\mu$ 的最大密度比」。 有了它,可以证出形如 $\|\hat Q_k-Q^\star\|_{1,d^\pi} \le \frac{\sqrt{C_\mu}}{(1-\gamma)^2}\max_k\|\epsilon_k\|_{2,\mu}$ 这样的结论:把在数据分布下测量的误差,换算成在关心的分布下的误差,代价是 $\sqrt{C_\mu}$。
所以更实用的读法是:$C_\mu$ 是一个诊断量, 它告诉你「你的数据分布离你想评估的策略有多远」, 而现代离线 RL 算法(CQL、IQL、BCQ 等)做的所有事情——保守正则、策略约束、 只在数据支撑内取 max——本质上都是在人为地把 $C_\mu$ 压小。
11.3 那还剩什么有用的?
Levine 在 p-05 的黄框已经给了答案:用精确的理论换取不精确的定性结论。 下面这些结论虽然在深度网络下没有「保证」,但作为工程直觉极其可靠:
| 理论结论 | 翻译成工程直觉 | 可观察的现象 |
|---|---|---|
| 误差 $\propto\frac{1}{\sqrt N}$ | 误差减半要 4 倍数据;收益递减 | 学习曲线的长尾平台期 |
| 误差 $\propto\frac{1}{(1-\gamma)^2}$ | 长 horizon 本质困难,不是调参问题 | $\gamma$ 调大后训练更不稳、Q 值发散 |
| 每次备份累积误差 | bootstrapping 的迭代次数越多,误差越大 | target network 更新太快会崩 |
| $\ell_\infty$ 假设不成立 → 无收敛保证 | off-policy + 函数近似天生不稳 | Q 值单调爆炸、Baird 式发散 |
| 数据覆盖 → $C_\mu$ | 数据没覆盖的地方 Q 值不可信 | 离线 RL 里 OOD 动作的 Q 值被高估 |
| bonus $\propto\frac{H}{\sqrt{N(s,a)}}$ | 探索奖金的形状与量级 | 计数 / 伪计数类方法的设计 |
更进一步,理论指出的这些「病灶」正是过去十年深度 RL 算法设计的靶子: target network(减慢误差在迭代间的传播)、double Q-learning(削掉 $\max$ 带来的正偏差)、 $n$-step return 与 GAE(缩短有效 horizon)、distributional RL(估分布而非期望,降低方差)、 保守正则(压小 $C_\mu$)。每一个 trick 都对应误差界里的一项。 这才是学这一讲的真正回报——不是记住定理,而是看懂那些 trick 在跟哪一项误差搏斗。
本讲小结
| 结论 | 形式 | 关键假设 / 用到的工具 |
|---|---|---|
| Bellman 最优算子是 $\gamma$-收缩 | $\|TV-TU\|_\infty\le\gamma\|V-U\|_\infty$ | 表格;$\gamma\lt1$;$P$ 行随机;$|\max f-\max g|\le\max|f-g|$ |
| 值迭代线性收敛 | $\|T^kV-V^\star\|_\infty\le\gamma^k\|V-V^\star\|_\infty$ | 收缩 + $TV^\star=V^\star$;迭代次数 $\tilde{\mathcal{O}}(\frac{1}{1-\gamma})$ |
| 策略评估的闭式解 | $Q^\pi=(I-\gamma P^\pi)^{-1}r$ | Neumann 级数 $\sum_t\gamma^t(P^\pi)^t$ |
| 评估算子的范数 | $\|(I-\gamma P^\pi)^{-1}v\|_\infty\le\frac{\|v\|_\infty}{1-\gamma}$ | 反向三角不等式 + $\|P^\pi\|_\infty=1$ |
| 模拟引理 | $Q^\pi-\hat Q^\pi=\gamma(I-\gamma\hat P^\pi)^{-1}(P-\hat P)V^\pi$ | 插入 $r=(I-\gamma P^\pi)Q^\pi$;$V^\pi=\Pi Q^\pi$ |
| Hoeffding | $|\bar X_n-\mu|\le\frac{b_+-b_-}{\sqrt{2n}}\sqrt{\log\frac2\delta}$ | i.i.d. + 有界;误差 $\propto n^{-1/2}$ |
| 离散分布集中 | $\|\hat P(\cdot|s,a)-P(\cdot|s,a)\|_1\le c\sqrt{\frac{|S|\log(1/\delta)}{N}}$ | $\ell_1\le\sqrt d\,\ell_2$;与 $\ell_\infty$ 对偶 |
| 基于模型的评估误差 | $\|Q^\pi-\hat Q^\pi\|_\infty\le\frac{\gamma}{(1-\gamma)^2}c\sqrt{\frac{|S|\log(1/\delta)}{N}}$ | oracle 探索;一个 $\frac{1}{1-\gamma}$ 来自评估算子,另一个来自 $\|V^\pi\|_\infty$ |
| 策略次优性 | $\|Q^\star-Q^{\hat\pi^\star}\|_\infty\le2\epsilon$;$V^\star-V^{\pi_Q}\le\frac{2\gamma\epsilon}{1-\gamma}$ | 三角不等式;$\Delta\le2\epsilon+\gamma\Delta$ |
| ADP 误差传播 | $\lim_k\|\hat Q_k-Q^\star\|_\infty\le\frac{1}{1-\gamma}\max_k\epsilon_k$ | 每轮 $\ell_\infty$ 近似误差 $\le\epsilon_k$(很强的假设) |
| FQI 采样误差 | $\|\hat TQ-TQ\|_\infty\le2R_{\max}c_1\sqrt{\frac{\log(|S||A|/\delta)}{2N}}+c_2\|Q\|_\infty\sqrt{\frac{\log(|S|/\delta)}{N}}$ | Hoeffding(奖励)+ 命题 A.8(转移)+ union bound |
| 乐观探索的 regret | $\mathrm{Reg}(T)=\tilde{\mathcal{O}}(\sqrt{H|S||A|T})$ | 乐观性 + 鸽笼 + Cauchy–Schwarz;下界同阶 |
一句话记忆
- $\frac{1}{1-\gamma}$ 就是 $H$。看到它就想「有效地平线」。
- $\frac{1}{1-\gamma}$ 出现一次 = 误差沿一条时间轴累加了一遍。 $(1-\gamma)^{-2}$ 意味着累加了两遍:一遍是误差在迭代/rollout 中传播,一遍是「被误差乘上的值函数本身就是 $H$ 量级」。
- $\frac{1}{\sqrt N}$ 是所有统计误差的默认速率。误差减半 = 4 倍数据。
- $\ell_\infty$ 是理论的舒适区,$\ell_2(\mu)$ 是实践的战场。两者之间隔着一个集中性系数 $C_\mu$, 而深度 RL 的大部分不稳定都住在这条缝里。
- 不要相信「可证明保证」。理论给的是方向,不是许诺。
延伸阅读
- Reinforcement Learning: Theory and Algorithms(Agarwal, Jiang, Kakade, Sun)—— 本讲第三、四段几乎全部取材于此书的第 2 章与附录 A。免费在线,是入门 RL 理论最好的教材, Hoeffding(引理 A.1)与离散分布集中(命题 A.8)都在附录 A。
- Minimax Regret Bounds for Reinforcement Learning (2017)—— UCBVI,把 episodic MDP 的 regret 做到 $\tilde{\mathcal{O}}(\sqrt{H|S||A|T})$ 并匹配下界。 想看 §10 那个证明骨架的完整版就读它。
- Near-optimal Regret Bounds for Reinforcement Learning(Jaksch, Ortner, Auer, 2010)—— UCRL2,平均回报设定下的乐观模型算法,「置信集 + 乐观规划」这个范式的经典之作。
- Finite-time Bounds for Fitted Value Iteration(Munos & Szepesvári, 2008)—— 把 §9 的 $\ell_\infty$ 分析升级成 $\ell_p(\mu)$ 分析,集中性系数的标准出处。 想搞懂 §11.2 就读它。
- Error Bounds for Approximate Policy Iteration(Munos, 2003)—— 近似策略迭代版本的 $\frac{2\gamma\epsilon}{(1-\gamma)^2}$,与本讲 §7 互为镜像。
- Diagnosing Bottlenecks in Deep Q-learning Algorithms (2019)—— Fu, Kumar, Soh, Levine。把本讲的理论量(采样误差、近似误差、分布偏移)在真实的深度 Q 学习里 逐项做经验测量,是「理论结论在深度网络下还剩多少」这个问题的最佳实证回答。
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives (2020)—— Levine 等人的综述,第 4 节系统讨论了分布偏移与集中性系数,是 §11.2 的现代续篇。
- Off-Policy Deep RL without Exploration (2018)—— BCQ,最早明确指出「数据未覆盖处的外推误差」是离线 Q 学习失败主因的工作, 可以看成把 $C_\mu=\infty$ 这个理论病灶变成一个算法修复。
- Approximate Dynamic Programming(Bertsekas & Tsitsiklis, Neuro-Dynamic Programming, 1996)—— $\gamma$-收缩、误差传播、TD 收敛性的原始出处,很多本讲的引理在这本书里已经完整给出。