基于值函数的强化学习:从策略迭代到 Q-Learning
如果值函数已经告诉了我们每个动作有多好,还需要单独维护一个策略网络吗?本讲把 actor 彻底删掉,只留下 critic——代价是失去了几乎所有收敛保证。
0. 本讲导读
上一讲的 actor-critic 算法有两个网络:一个策略网络 $\pi_\theta(a|s)$(actor),一个值函数网络 $\hat Q^\pi_\phi(s,a)$ 或 $\hat V^\pi_\phi(s)$(critic)。critic 的作用是给 actor 提供一个低方差的优势估计 $A^\pi(s,a)$,actor 再沿着策略梯度爬坡。整个流程仍然逃不开策略梯度那一套:高方差、需要小心调学习率、对分布偏移敏感。
本讲提出一个近乎挑衅的问题:既然 critic 已经知道每个动作的好坏,我们为什么还要花力气用梯度去「慢慢推」策略?直接取 $\argmax_a Q(s,a)$ 不就完了吗?这个想法一旦成立,actor 就被彻底删除,我们只需要训练一个网络,也不再需要高方差的策略梯度估计量。这就是本讲的主题:基于值函数的强化学习(value-based RL),它的代表算法叫 Q-learning。
Levine 在本讲的推进方式仍然是一条严密的动机链条,一环扣一环:
- 删掉 actor 合法吗?——要证明「对 $A^\pi$ 取贪心(greedy)」得到的新策略 $\pi'$ 至少不比 $\pi$ 差。这就是策略改进定理(policy improvement theorem),本讲会把证明一步步写全。
- 怎么算 $Q^\pi$?——在状态、动作都离散且不多的表格(tabular)情形下,可以用动态规划(dynamic programming, DP)直接迭代 Bellman 方程。由此得到策略迭代(policy iteration)和更简洁的值迭代(value iteration)。
- 为什么 DP 一定收敛?——因为 Bellman 最优算子 $\mathcal{B}$ 是 $\infty$-范数下模为 $\gamma$ 的压缩映射(contraction mapping)。本讲给出完整证明,并推出误差衰减率 $\|V_k-V^\star\|_\infty\le\gamma^k\|V_0-V^\star\|_\infty$。
- 状态空间太大怎么办?——用神经网络代替表格,得到拟合值迭代(fitted value iteration)。但它需要对每个动作「试一遍」才能算 $\max_a$,这要求我们能任意重置环境、或者知道转移模型 $p(s'|s,a)$。
- 不知道模型怎么办?——把学习对象从 $V$ 换成 $Q$。因为 $Q(s,a)$ 的 $\max_{a'}$ 是在已经算好的函数上取最大,不需要真的去执行动作。这就是 fitted Q-iteration,进而是 Q-learning。
- 为什么它是 off-policy 的?——因为整个更新只依赖四元组 $(s,a,r,s')$,而给定 $s$ 和 $a$ 之后转移与策略无关。于是一个装满历史数据的 replay buffer 可以被反复利用。
- 代价是什么?——一旦离开表格情形,收敛性证明全部失效。Bellman 算子在 $\infty$-范数下压缩,而监督学习的回归投影在 $\ell_2$-范数下压缩,两个不同范数下的压缩复合起来不是压缩。本讲最后给出这个关键负面结果和一个经典发散例子。
与前后讲的关系:上一讲(actor-critic)给出了 critic 的训练方法(bootstrapped policy evaluation),本讲把它推到极致;下一讲(Q-Learning 的工程实践)会告诉你,本讲末尾那个「看起来很干净」的算法如果照着直接写代码,几乎必然不 work——需要 replay buffer、target network、double Q-learning 等一整套工程手段才能救活。用 Levine 自己的话说:「If you try to code this up, it almost certainly won't work.」
- 策略改进定理:令 $\pi'(a|s)=\mathbb{1}[a=\argmax_{a}A^\pi(s,a)]$,则对一切 $s$ 有 $V^{\pi'}(s)\ge V^\pi(s)$。所以「取贪心」永远安全,无需策略梯度。
- 值迭代把策略迭代里的「策略评估 + 策略改进」压缩成一步:$V(s)\leftarrow\max_a\big(r(s,a)+\gamma\E_{s'}[V(s')]\big)$。$\max$ 本身就隐含了贪心改进,策略不必显式存在。
- Bellman 最优算子是 $\gamma$-压缩($\infty$-范数),故有唯一不动点 $V^\star$,且 $\|V_k-V^\star\|_\infty\le\gamma^k\|V_0-V^\star\|_\infty$,线性收敛。
- 为什么必须学 $Q$ 而不是 $V$:$\max_a\big(r(s,a)+\gamma\E[V(s')]\big)$ 需要模型或可重置的模拟器;$\max_{a'}Q(s',a')$ 只是查表/前向传播,不需要真的执行动作。
- Q-learning 是 off-policy 的:更新只用 $(s,a,r,s')$,给定 $(s,a)$ 后 $s'$ 的分布与行为策略无关,且目标里的 $\max_{a'}$ 已经代表了新策略 $\pi'$。数据可以来自任何策略、任何时候。
- 探索必须显式加入:贪心策略是确定性的,在线采集时会卡死在局部。实践中用 $\epsilon$-greedy 或 Boltzmann 探索。
- 负面结果:拟合值迭代 = Bellman 备份($\infty$-范数压缩) + 回归投影($\ell_2$-范数压缩),复合算子在任何范数下都不是压缩,可以构造出发散的例子。actor-critic 的 bootstrapped policy evaluation 有同样的问题。
1. 先看结论:把 actor-critic 里的 actor 删掉
本讲的第一部分标题就叫 "Actor-critic without the actor"。Levine 的教学策略是先把答案摆出来,再回头解释为什么它是对的。我们也照做。
1.1 复习:带 replay buffer 的 off-policy actor-critic
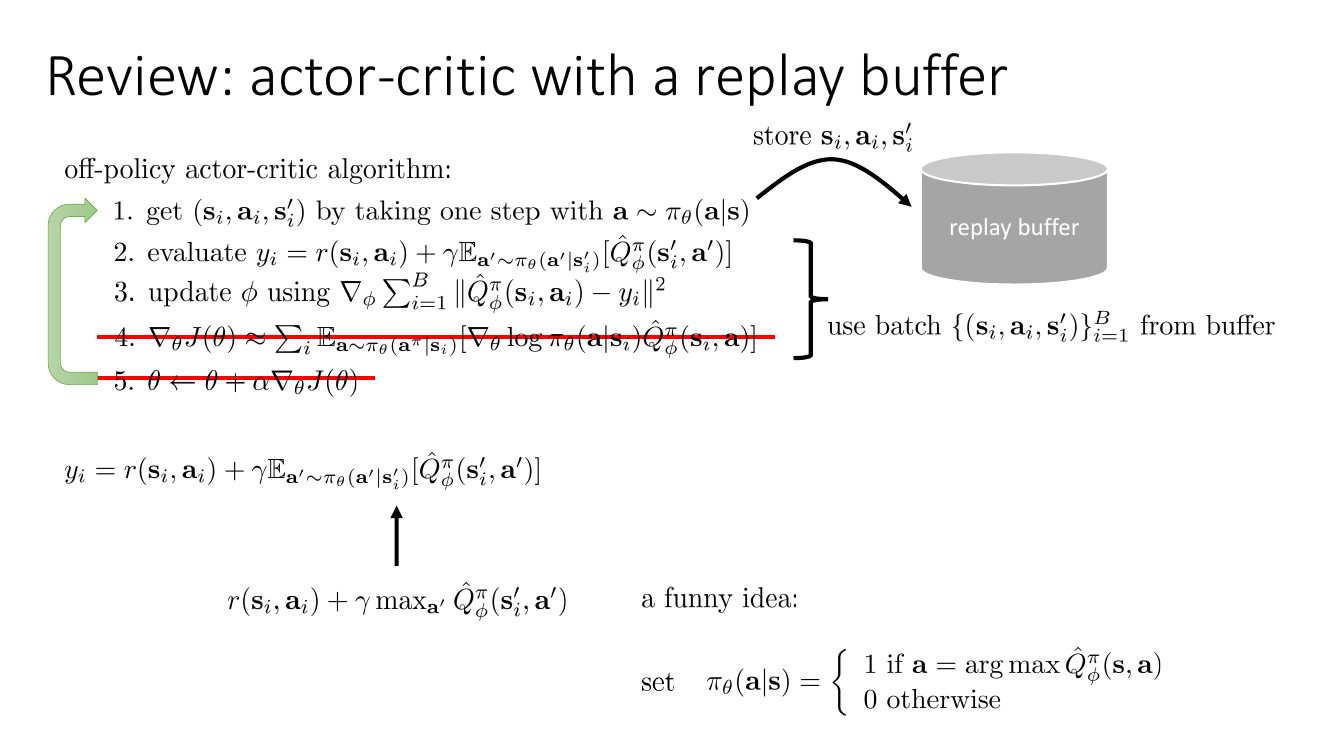
上一讲末尾给出的 off-policy actor-critic 长这样($\theta$ 是策略参数,$\phi$ 是 critic 参数):
- 用当前策略 $a\sim\pi_\theta(a|s)$ 与环境交互一步,得到 $(s_i,a_i,r_i,s_i')$,存入 replay buffer;
- 从 buffer 里取一个 batch $\{(s_i,a_i,s_i')\}_{i=1}^B$,计算回归目标 $$ y_i=r(s_i,a_i)+\gamma\,\E_{a'\sim\pi_\theta(a'|s_i')}\big[\hat Q^\pi_\phi(s_i',a')\big]; $$
- 用 $\nabla_\phi\sum_{i=1}^B\|\hat Q^\pi_\phi(s_i,a_i)-y_i\|^2$ 更新 critic 参数 $\phi$;
- 用策略梯度 $\nabla_\theta J(\theta)\approx\sum_i\E_{a\sim\pi_\theta(a|s_i)}\big[\nabla_\theta\log\pi_\theta(a|s_i)\hat Q^\pi_\phi(s_i,a)\big]$ 更新 actor;
- $\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$,回到第 1 步。
注意第 2 步里的期望 $\E_{a'\sim\pi_\theta}$:因为 buffer 里的 $s_i'$ 的后续动作是旧策略选的,不能直接用 buffer 里记录的下一动作,必须重新从当前 $\pi_\theta$ 采样 $a'$ 再查 critic。这一步是 off-policy 修正的关键。
1.2 那个「有趣的想法」
假设我们不再让策略是一个独立的神经网络,而是由 critic 直接定义:
$$ \pi_\theta(a|s)=\begin{cases}1 & \text{if } a=\argmax_{a}\hat Q^\pi_\phi(s,a)\\ 0 & \text{otherwise}\end{cases} $$这是一个确定性(deterministic)策略。把它代入第 2 步的期望里:
$$ \E_{a'\sim\pi_\theta(a'|s_i')}\big[\hat Q^\pi_\phi(s_i',a')\big]=\hat Q^\pi_\phi\big(s_i',\argmax_{a'}\hat Q^\pi_\phi(s_i',a')\big)=\max_{a'}\hat Q^\pi_\phi(s_i',a') $$期望塌缩成了一个 $\max$。于是第 2 步变成
$$ y_i=r(s_i,a_i)+\gamma\max_{a'}Q_\theta(s_i',a') $$(这里起把 critic 的参数重新记作 $\theta$,因为它现在是唯一的网络了。)第 4、5 步——策略梯度和 actor 更新——整个消失,因为策略不再有自己的参数。
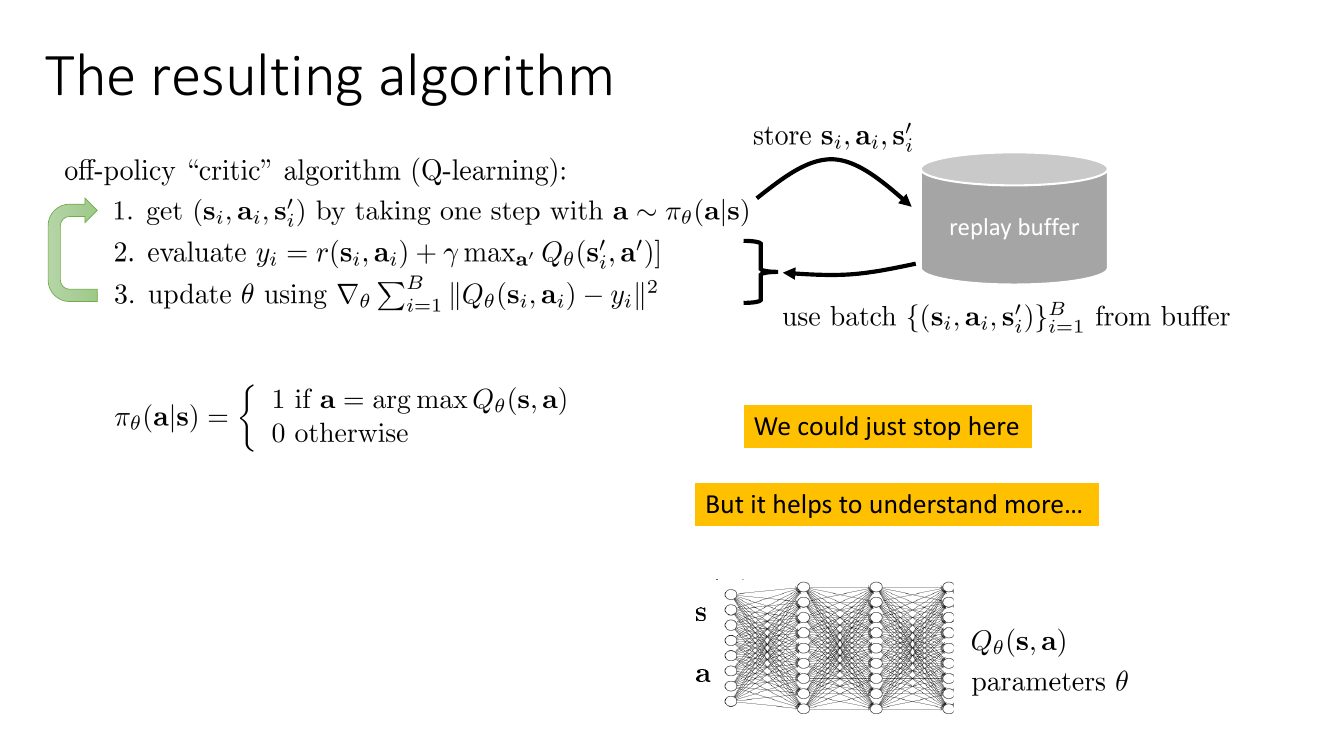
整个 Q-learning 就是上面三行。剩下的四节要回答的是三个「凭什么」:凭什么可以直接取 $\argmax$ 而不用梯度上升(第 2 节,策略改进定理);凭什么这个迭代会收敛(第 3–4 节,压缩映射);凭什么可以用任意来源的数据(第 6 节,off-policy 性质)。以及一个「凭什么不」:凭什么这一切在神经网络下全部失效(第 8 节)。
2. 策略迭代与贪心策略改进定理
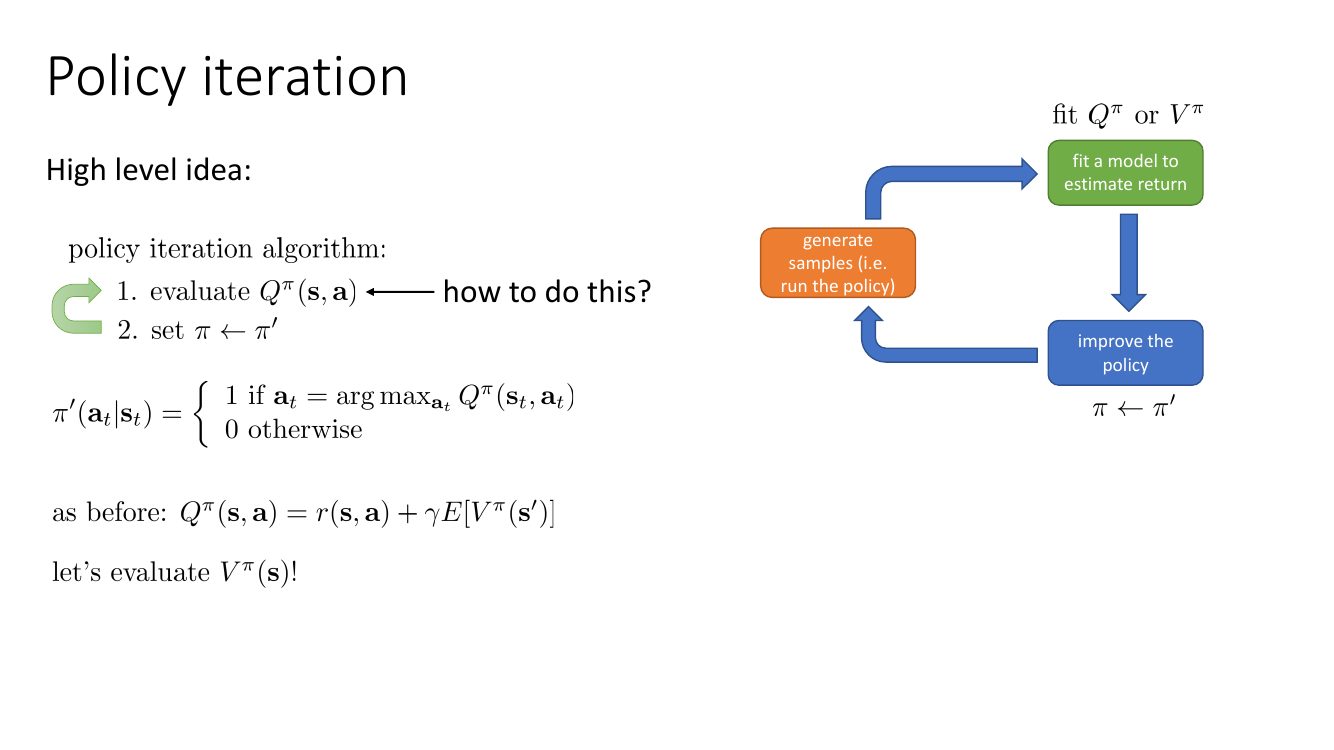
要证明「删掉 actor 是合法的」,先要把这个想法放回一个更古老、更干净的框架里:策略迭代(policy iteration)。它是动态规划时代(Bellman、Howard,1950–60 年代)就有的算法,只有两步:
- 策略评估(policy evaluation):算出当前策略的 $Q^\pi(s,a)$;
- 策略改进(policy improvement):令 $\pi\leftarrow\pi'$,其中 $$ \pi'(a_t|s_t)=\begin{cases}1 & \text{if } a_t=\argmax_{a_t}Q^\pi(s_t,a_t)\\ 0 & \text{otherwise}\end{cases} $$
重复直到策略不再变化。
2.1 为什么第 2 步是安全的:策略改进定理
第 2 步看起来很暴力:直接跳到贪心策略,步子迈这么大不会翻车吗?策略梯度之所以要用小学习率,正是怕迈太大步。但对贪心改进,我们有一个无条件的保证。
先定义优势函数(advantage function):
$$ A^\pi(s,a)=Q^\pi(s,a)-V^\pi(s)=r(s,a)+\gamma\E_{s'\sim p(s'|s,a)}[V^\pi(s')]-V^\pi(s) $$它衡量「在状态 $s$ 先强制执行动作 $a$、之后一直按 $\pi$ 走」相比「一开始就按 $\pi$ 走」多赚了多少。注意 $\argmax_a A^\pi(s,a)=\argmax_a Q^\pi(s,a)$,因为 $V^\pi(s)$ 与 $a$ 无关,减掉一个常数不改变 $\argmax$。所以「对 $A^\pi$ 贪心」和「对 $Q^\pi$ 贪心」是同一件事。
命题. 设 $\pi'$ 是对 $A^\pi$(等价地对 $Q^\pi$)取贪心得到的确定性策略,即 $\pi'(s)=\argmax_a A^\pi(s,a)$。则对一切状态 $s$ 有 $$ V^{\pi'}(s)\ \ge\ V^\pi(s). $$
第一步:贪心保证单步不变差。由 $\pi'$ 的定义,对任意 $s$: $$ A^\pi(s,\pi'(s))=\max_a A^\pi(s,a)\ \ge\ \E_{a\sim\pi(a|s)}[A^\pi(s,a)]=0 $$ 最后一个等号是因为 $\E_{a\sim\pi}[A^\pi(s,a)]=\E_{a\sim\pi}[Q^\pi(s,a)]-V^\pi(s)=V^\pi(s)-V^\pi(s)=0$:优势函数在自己的策略下期望为零。所以贪心动作的优势必然 $\ge 0$。写开就是 $$ Q^\pi(s,\pi'(s))\ \ge\ V^\pi(s).\qquad(\ast) $$
第二步:把 $(\ast)$ 沿时间反复展开。从任意 $s_0=s$ 出发: $$ V^\pi(s_0)\ \le\ Q^\pi(s_0,\pi'(s_0))=r(s_0,\pi'(s_0))+\gamma\,\E_{s_1\sim p(\cdot|s_0,\pi'(s_0))}\big[V^\pi(s_1)\big] $$ 再对括号里的 $V^\pi(s_1)$ 用一次 $(\ast)$:$V^\pi(s_1)\le Q^\pi(s_1,\pi'(s_1))=r(s_1,\pi'(s_1))+\gamma\E[V^\pi(s_2)]$。代回去: $$ V^\pi(s_0)\ \le\ \E_{\pi'}\Big[r(s_0,a_0)+\gamma r(s_1,a_1)+\gamma^2 V^\pi(s_2)\Big] $$ 其中 $\E_{\pi'}$ 表示动作由 $\pi'$ 产生、状态由环境转移产生。归纳地重复 $T$ 次: $$ V^\pi(s_0)\ \le\ \E_{\pi'}\Big[\sum_{t=0}^{T-1}\gamma^t r(s_t,a_t)\Big]+\gamma^{T}\E_{\pi'}\big[V^\pi(s_T)\big] $$
第三步:取极限。若奖励有界 $|r|\le R_{\max}$,则 $|V^\pi|\le R_{\max}/(1-\gamma)$,于是当 $\gamma\lt 1$ 时 $\gamma^{T}\E[V^\pi(s_T)]\to 0$。而前一项收敛到 $V^{\pi'}(s_0)$。因此 $$ V^\pi(s_0)\ \le\ V^{\pi'}(s_0)\quad\text{对一切 } s_0. \qquad\blacksquare $$
2.2 这个证明说明了什么
这个定理的力量在于它的无条件性:只要 $Q^\pi$ 算得准,贪心一步永远不会变差,不管步子有多「大」。对比策略梯度——那里我们必须小心翼翼地选步长,因为大步长会让新策略跑到旧数据覆盖不到的地方、让线性近似失效。这里没有这个问题,因为我们不是在做局部线性近似,而是用整个 $Q^\pi$ 函数(它已经包含了未来所有影响)来决策。
为什么「$\E_{a\sim\pi}[A^\pi(s,a)]=0$」这么关键?它说明:在旧策略自己看来,它的所有动作平均是「不好不坏」的。所以只要挑出其中优势最大的那个(一定 $\ge$ 平均值 $=0$),第一步就至少不亏。而第二步的展开告诉我们,「每一步都不亏」通过折扣求和累积起来,最终整条轨迹的期望回报也不亏。
换句话说:局部贪心 + 值函数正确 = 全局不变差。值函数把「未来」打包进了一个标量,所以短视的选择反而是全局最优的——这正是动态规划的核心思想。
「贪心一定不变差」的前提是 $Q^\pi$ 是精确的。如果 $Q^\pi$ 有估计误差 $\varepsilon=\max_{s,a}|\hat Q^\pi(s,a)-Q^\pi(s,a)|$,那么贪心策略的性能损失可以被界为 $$ V^{\pi'}(s)\ \ge\ V^{\pi}(s)-\frac{2\gamma\varepsilon}{1-\gamma} $$ 分母上的 $1-\gamma$ 意味着误差会被 $1/(1-\gamma)$ 放大:$\gamma=0.99$ 时放大约 100 倍。这就是为什么后面用神经网络近似 $Q$ 时,一点点系统性的高估就足以让策略彻底跑偏——第 8 节和下一讲的 double Q-learning 都在处理这件事。
3. 动态规划:如何精确地评估 $V^\pi$
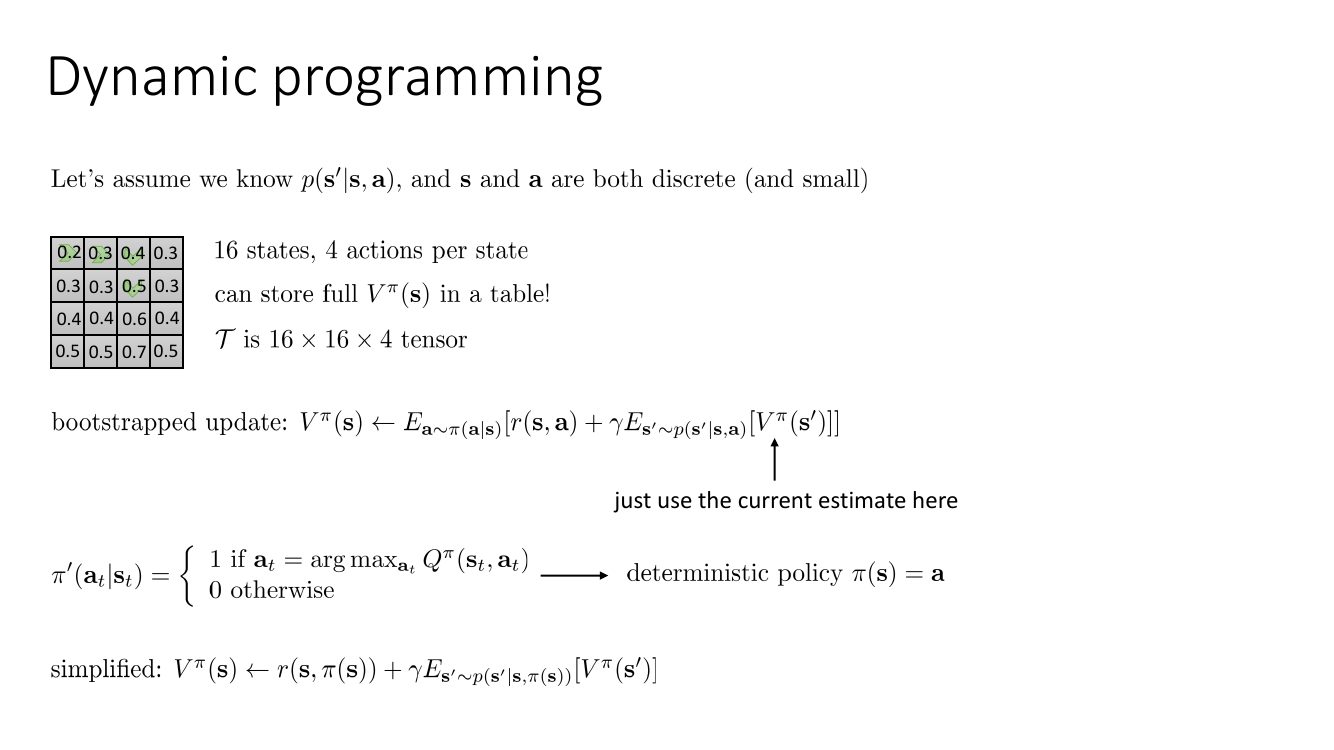
策略迭代的第 1 步「evaluate $Q^\pi$」还欠着。本节在最理想的假设下把它做掉:我们知道转移概率 $p(s'|s,a)$,且状态 $s$ 与动作 $a$ 都是离散且数量很少的。这个设定叫 tabular(表格)情形。
3.1 表格值函数与 bootstrapped 更新
在表格情形下,$V^\pi$ 就是一个长度为 $|\mathcal{S}|$ 的数组。策略评估的更新规则直接来自 Bellman 期望方程:
$$ V^\pi(s)\ \leftarrow\ \E_{a\sim\pi(a|s)}\Big[r(s,a)+\gamma\,\E_{s'\sim p(s'|s,a)}\big[V^\pi(s')\big]\Big] $$右边用的是当前这张表的值,算完之后写回左边。反复扫描所有状态,这张表就会收敛到真正的 $V^\pi$(第 4 节证明)。
如果策略是确定性的——策略迭代产生的贪心策略正是如此,记 $\pi(s)=a$——外层期望消失:
$$ V^\pi(s)\ \leftarrow\ r(s,\pi(s))+\gamma\,\E_{s'\sim p(s'|s,\pi(s))}\big[V^\pi(s')\big] $$这就是策略评估的最终形式:一次全表扫描的代价是 $O(|\mathcal{S}|^2)$(每个状态要对所有可能的 $s'$ 求和)。
设两个状态 $s_A,s_B$,策略确定。$r(s_A)=0$,从 $s_A$ 必然转移到 $s_B$;$r(s_B)=1$,从 $s_B$ 必然自环。初始化 $V_0(s_A)=V_0(s_B)=0$。
第 1 轮:$V_1(s_B)=1+0.9\cdot 0=1$,$V_1(s_A)=0+0.9\cdot 0=0$。
第 2 轮:$V_2(s_B)=1+0.9\cdot 1=1.9$,$V_2(s_A)=0+0.9\cdot 1=0.9$。
第 3 轮:$V_3(s_B)=1+0.9\cdot1.9=2.71$,$V_3(s_A)=0.9\cdot1.9=1.71$。
真值是 $V^\pi(s_B)=1/(1-0.9)=10$,$V^\pi(s_A)=0.9\times10=9$。可以看到误差每轮乘以 $0.9$:第 1 轮误差 9,第 2 轮 8.1,第 3 轮 7.29……这就是下一节要证的 $\gamma^k$ 衰减。$\gamma$ 越接近 1,收敛越慢——这是折扣因子的根本代价。
3.2 拼装成策略迭代
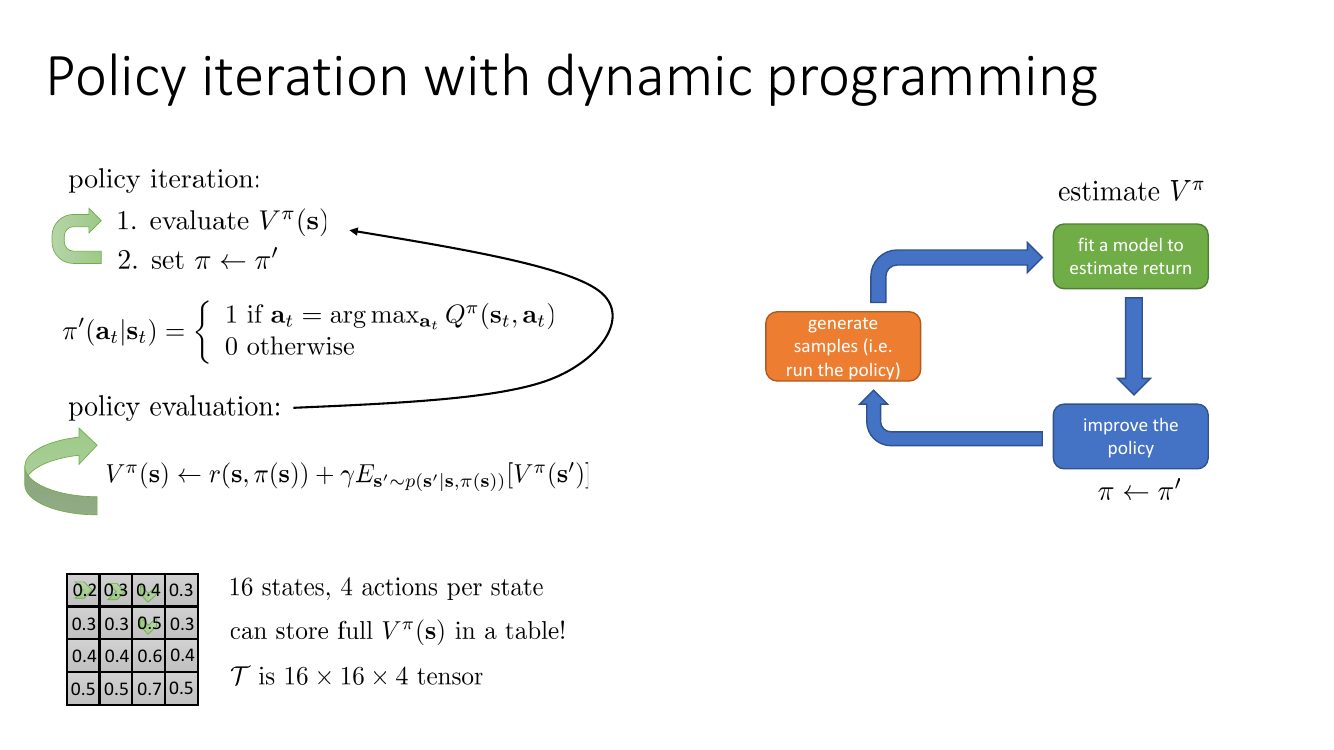
注意这里的双层循环结构:外层每改进一次策略,内层就要把值函数评估到收敛。这很浪费——策略只要变一点,值函数就得重算。有没有办法把两层合成一层?有,而且合并之后算法反而更简单。
3.3 值迭代:把 argmax 吸收进 max
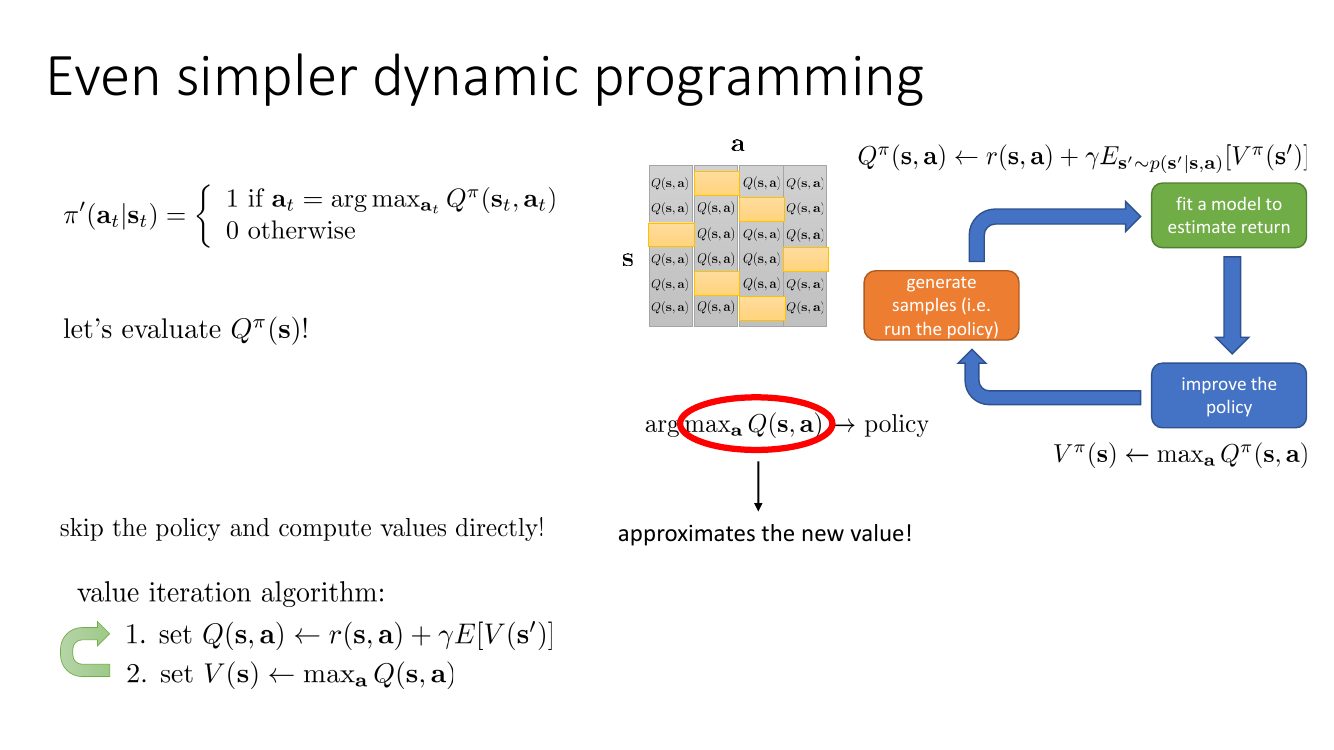
推理是这样的:策略改进后的新策略 $\pi'$ 在状态 $s$ 处的值是多少?如果我们只往前看一步、后面仍用旧的 $V^\pi$ 近似,那就是
$$ V^{\pi'}(s)\ \approx\ Q^\pi(s,\pi'(s))=\max_a Q^\pi(s,a) $$也就是说,$\max_a Q^\pi(s,a)$ 已经是「改进后策略的值」的一个估计。既然如此,我们根本不需要显式地把 $\pi'$ 写出来再拿去评估——直接把 $\max$ 写进值函数的更新里就行了。于是得到
- $Q(s,a)\ \leftarrow\ r(s,a)+\gamma\,\E_{s'\sim p(s'|s,a)}[V(s')]$
- $V(s)\ \leftarrow\ \max_a Q(s,a)$
把两步合并写成一步,就是 Bellman 最优方程的迭代形式: $$ V_{k+1}(s)\ \leftarrow\ \max_a\Big(r(s,a)+\gamma\,\E_{s'\sim p(s'|s,a)}\big[V_k(s')\big]\Big) $$
整个算法里没有出现过策略。策略只在最后需要行动时才被导出:$\pi(s)=\argmax_a Q(s,a)$。这正是本讲标题「value-based RL」的含义——策略是值函数的副产品,而不是一个需要单独训练的对象。
| 策略迭代 | 值迭代 | |
|---|---|---|
| 循环结构 | 双层:外层改进,内层评估到收敛 | 单层:评估与改进合并成一次 $\max$ 备份 |
| 每轮代价 | 内层多次全表扫描 + 一次 $\argmax$ | 一次全表扫描(含 $\max$) |
| 显式策略 | 有,每轮维护一个 $\pi$ | 没有,最后才导出 |
| 收敛所需轮数 | 通常很少(策略空间有限,最多 $|\mathcal{A}|^{|\mathcal{S}|}$ 轮,实际远小于此) | 较多,但每轮更便宜;误差按 $\gamma^k$ 衰减 |
| 是否严格单调 | 是(策略改进定理保证) | 值单调收敛到 $V^\star$(若从 $V_0\le V^\star$ 出发则单调上升) |
4. 为什么值迭代一定收敛:Bellman 算子是 $\gamma$-压缩映射
上一节给出了值迭代的更新式,但没说它为什么会收敛、收敛到哪里、收敛多快。这一节把这三个问题一次性解决。这是全课少数几个「有干净理论保证」的地方,也正因为如此,第 8 节的负面结果才显得刺眼。
4.1 把更新写成算子
把值函数 $V$ 看成 $\R^{|\mathcal{S}|}$ 里的一个向量(表格情形下它确实就是一个向量)。定义 Bellman 最优算子(Bellman optimality operator) $\mathcal{B}:\R^{|\mathcal{S}|}\to\R^{|\mathcal{S}|}$:
$$ (\mathcal{B}V)(s)\ =\ \max_a\Big(r(s,a)+\gamma\sum_{s'}p(s'|s,a)V(s')\Big) $$用矩阵记号写更紧凑:设 $\mathcal{T}_a$ 是动作 $a$ 对应的转移矩阵(第 $(s,s')$ 元为 $p(s'|s,a)$),$r_a$ 是奖励向量,则
$$ \mathcal{B}V=\max_a\big(r_a+\gamma\,\mathcal{T}_a V\big) $$这里的 $\max$ 是逐状态(elementwise)取的:每个状态可以选不同的 $a$。值迭代就是简单地反复施加这个算子:$V_{k+1}=\mathcal{B}V_k$。
关键事实一:最优值函数 $V^\star$ 是 $\mathcal{B}$ 的不动点,即 $\mathcal{B}V^\star=V^\star$。这直接来自 Bellman 最优方程 $V^\star(s)=\max_a\big(r(s,a)+\gamma\E_{s'}[V^\star(s')]\big)$,而后者是「最优策略必然在每一步选最优动作」的直接表述。
4.2 压缩映射的定义
回忆度量空间上的压缩映射:若存在 $\gamma\in[0,1)$ 使得对任意 $V,\bar V$ 都有 $\|\mathcal{B}V-\mathcal{B}\bar V\|\le\gamma\|V-\bar V\|$,则 $\mathcal{B}$ 称为模为 $\gamma$ 的压缩映射。Banach 不动点定理告诉我们:完备度量空间上的压缩映射有唯一不动点,且从任意起点反复迭代都收敛到它,收敛速率是几何级数。
这里用的范数是 $\infty$-范数(无穷范数 / 最大范数):
$$ \|V-\bar V\|_\infty=\max_{s}\big|V(s)-\bar V(s)\big| $$也就是「所有状态上误差的最大值」。范数的选择在这里至关重要,第 8 节的负面结果就出在这一点上。
命题. 对任意两个值函数 $V,\bar V$, $$ \|\mathcal{B}V-\mathcal{B}\bar V\|_\infty\ \le\ \gamma\,\|V-\bar V\|_\infty . $$
引理(max 的差不超过差的 max). 对任意两个实值函数 $f,g$ 定义在同一有限集上, $$ \Big|\max_a f(a)-\max_a g(a)\Big|\ \le\ \max_a\big|f(a)-g(a)\big| $$ 证明:设 $a_f=\argmax_a f(a)$。则 $$ \max_a f(a)-\max_a g(a)=f(a_f)-\max_a g(a)\le f(a_f)-g(a_f)\le\max_a|f(a)-g(a)| $$ (第一个不等号用了 $\max_a g(a)\ge g(a_f)$。)交换 $f,g$ 的角色得到另一方向的不等式,合起来即得引理。$\square$
主证明. 固定任意状态 $s$。令 $f(a)=r(s,a)+\gamma\sum_{s'}p(s'|s,a)V(s')$,$g(a)=r(s,a)+\gamma\sum_{s'}p(s'|s,a)\bar V(s')$。由引理,
$$
\big|(\mathcal{B}V)(s)-(\mathcal{B}\bar V)(s)\big|=\Big|\max_a f(a)-\max_a g(a)\Big|\le\max_a\big|f(a)-g(a)\big|
$$
而奖励项相消:
$$
|f(a)-g(a)|=\gamma\Big|\sum_{s'}p(s'|s,a)\big(V(s')-\bar V(s')\big)\Big|\le\gamma\sum_{s'}p(s'|s,a)\big|V(s')-\bar V(s')\big|
$$
这里用了三角不等式和 $p\ge 0$。再把每一项的绝对值放大到最大值:
$$
\le\gamma\sum_{s'}p(s'|s,a)\cdot\|V-\bar V\|_\infty=\gamma\,\|V-\bar V\|_\infty
$$
最后一个等号用了 $\sum_{s'}p(s'|s,a)=1$——概率归一化是整个证明的技术核心:转移矩阵是随机矩阵,它在 $\infty$-范数下的诱导范数恰好等于 $1$,所以只把误差「搬运」而不放大,剩下的 $\gamma$ 就是纯粹的收缩因子。
由于上式对每个 $a$ 一致成立,也对每个 $s$ 一致成立,取 $s$ 上的最大值即得
$$
\|\mathcal{B}V-\mathcal{B}\bar V\|_\infty\le\gamma\|V-\bar V\|_\infty.\qquad\blacksquare
$$
4.3 直接推论:收敛速率
把 $\bar V$ 取成 $V^\star$,利用 $\mathcal{B}V^\star=V^\star$:
$$ \|V_{k+1}-V^\star\|_\infty=\|\mathcal{B}V_k-\mathcal{B}V^\star\|_\infty\le\gamma\|V_k-V^\star\|_\infty $$归纳下去:
$$ \boxed{\ \|V_k-V^\star\|_\infty\ \le\ \gamma^k\,\|V_0-V^\star\|_\infty\ } $$这就是值迭代的线性(几何)收敛。同时,压缩性保证不动点唯一,所以 $V^\star$ 是值迭代唯一可能的极限——不存在「收敛到别的东西」的风险。
把 $\gamma^k\le\epsilon$ 解出来:$k\ge\dfrac{\log(1/\epsilon)}{\log(1/\gamma)}\approx\dfrac{\log(1/\epsilon)}{1-\gamma}$。所以达到给定精度所需的迭代次数正比于 有效视界(effective horizon)$1/(1-\gamma)$。
具体数字:$\gamma=0.9$ 时有效视界 10,把误差压到 $1\%$ 需要约 44 轮;$\gamma=0.99$ 时有效视界 100,需要约 458 轮;$\gamma=0.999$ 时需要约 4600 轮。折扣因子越接近 1,问题越「长视」,DP 越慢。这也解释了为什么实践中很少用 $\gamma\gt 0.999$:不仅慢,误差放大因子 $1/(1-\gamma)$ 也会让任何近似误差被放大上千倍。
同样的证明几乎一字不改地适用于策略评估算子 $\mathcal{B}^\pi V=r_\pi+\gamma\mathcal{T}_\pi V$(把 $\max_a$ 换成对 $\pi$ 求期望,引理换成「期望的差不超过差的最大值」即可)。所以策略评估内层循环也是 $\gamma$-压缩,收敛到 $V^\pi$。$\mathcal{B}$ 和 $\mathcal{B}^\pi$ 的唯一区别是前者带 $\max$(非线性)、后者是仿射(线性)——这个差别在下面会变得重要:$\mathcal{B}^\pi$ 的不动点可以直接解线性方程组 $V^\pi=(I-\gamma\mathcal{T}_\pi)^{-1}r_\pi$,而 $\mathcal{B}$ 因为有 $\max$ 只能迭代。
下面这段代码把表格值迭代完整跑一遍,并打印出误差的 $\gamma^k$ 衰减:
import numpy as np

def value_iteration(P, R, gamma=0.9, tol=1e-10, max_iter=10000):
    """P: [S, A, S] 转移概率; R: [S, A] 即时奖励。返回 V*, Q*, 贪心策略。"""
    S, A, _ = P.shape
    V = np.zeros(S)
    for k in range(max_iter):
        # Bellman 备份: Q[s,a] = R[s,a] + gamma * sum_s' P[s,a,s'] V[s']
        Q = R + gamma * P.dot(V)          # [S, A]
        V_new = Q.max(axis=1)             # 逐状态取 max ——这一步同时完成了策略改进
        delta = np.abs(V_new - V).max()   # 无穷范数下的变化量
        V = V_new
        if delta < tol:
            break
    Q = R + gamma * P.dot(V)
    return V, Q, Q.argmax(axis=1)

# 一个 3 状态、2 动作的小例子:动作 0 原地不动,动作 1 向右走
S, A = 3, 2
P = np.zeros((S, A, S))
for s in range(S):
    P[s, 0, s] = 1.0                      # 动作 0:停留
    P[s, 1, min(s + 1, S - 1)] = 1.0      # 动作 1:右移,末状态吸收
R = np.zeros((S, A))
R[S - 1, :] = 1.0                         # 只有到达最后一个状态才有奖励

V, Q, pi = value_iteration(P, R, gamma=0.9)
print(V)    # [8.1  9.   10. ]  —— 末状态 1/(1-0.9)=10,每退一格乘 0.9
print(pi)   # [1 1 0 或 1]      —— 前两个状态都应该向右走
输出验证了理论:末状态自环拿常奖励 1,值为 $1/(1-0.9)=10$;往前每退一步乘 $\gamma=0.9$,得到 $9$ 和 $8.1$。贪心策略在前两个状态都选「向右」。
5. 拟合值迭代:把表格换成神经网络
前面所有结论都建立在「表格」这个假设上。现实中这个假设几乎总是不成立。
5.1 维度灾难
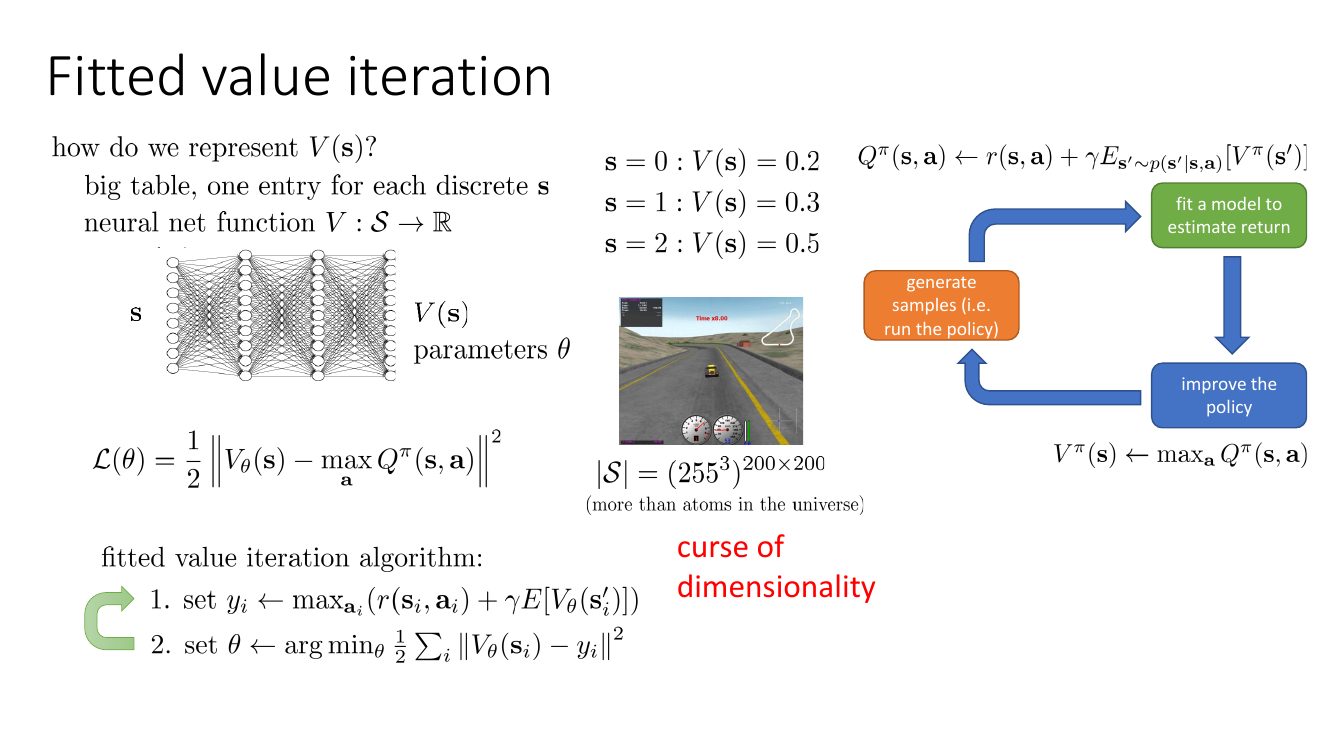
值函数用表格存储,需要为每个离散状态开一个格子。状态数随维度指数增长:如果状态是 $n$ 维、每维离散成 $K$ 档,表格大小是 $K^n$。Levine 举的例子是从像素学开车:一张 $200\times200$ 的 RGB 图像,每个像素每通道 256 个取值,状态空间大小是
$$ |\mathcal{S}|=(255^3)^{200\times200} $$这个数字远远超过可观测宇宙中的原子总数(约 $10^{80}$)。别说存表,连枚举一遍都不可能。
5.2 用回归代替赋值
解决办法很自然:用一个参数化函数 $V_\theta:\mathcal{S}\to\R$(比如神经网络)代替表格。但表格更新是「把新值写进格子」,神经网络没有格子可写——只能用梯度下降去逼近。于是「赋值」变成「回归」:
$$ \mathcal{L}(\theta)=\frac12\Big\|V_\theta(s)-\max_a Q^\pi(s,a)\Big\|^2 $$- 对采样到的每个状态 $s_i$,计算回归目标 $$ y_i\ \leftarrow\ \max_{a_i}\Big(r(s_i,a_i)+\gamma\,\E\big[V_\theta(s_i')\big]\Big) $$
- 做一次(或若干次)监督回归 $$ \theta\ \leftarrow\ \argmin_\theta\ \frac12\sum_i\big\|V_\theta(s_i)-y_i\big\|^2 $$
重复。注意第 1 步里的 $V_\theta$ 用的是更新前的参数——又一次自举。
这个算法的形式很讨喜:第 1 步是纯粹的数值计算,第 2 步是一个标准的监督学习问题,可以直接扔给 PyTorch。函数逼近还带来了泛化:网络在见过的 $s_i$ 上学到的值会推广到没见过的相似状态,这是表格永远做不到的。
表格值迭代每一轮做的是「精确的 Bellman 备份」;拟合值迭代做的是「Bellman 备份 再加一次回归投影」。回归不可能完美——网络容量有限、样本有限、优化不到全局最优。多出来的这一步投影,正是第 8 节所有麻烦的根源。另外,第 2 步只在采样到的状态 $\{s_i\}$ 上做拟合,所以值函数的准确性受限于数据分布:没被访问过的状态区域,$V_\theta$ 的取值完全由网络的外推行为决定,可能是任意的。
5.3 一个致命的实现障碍
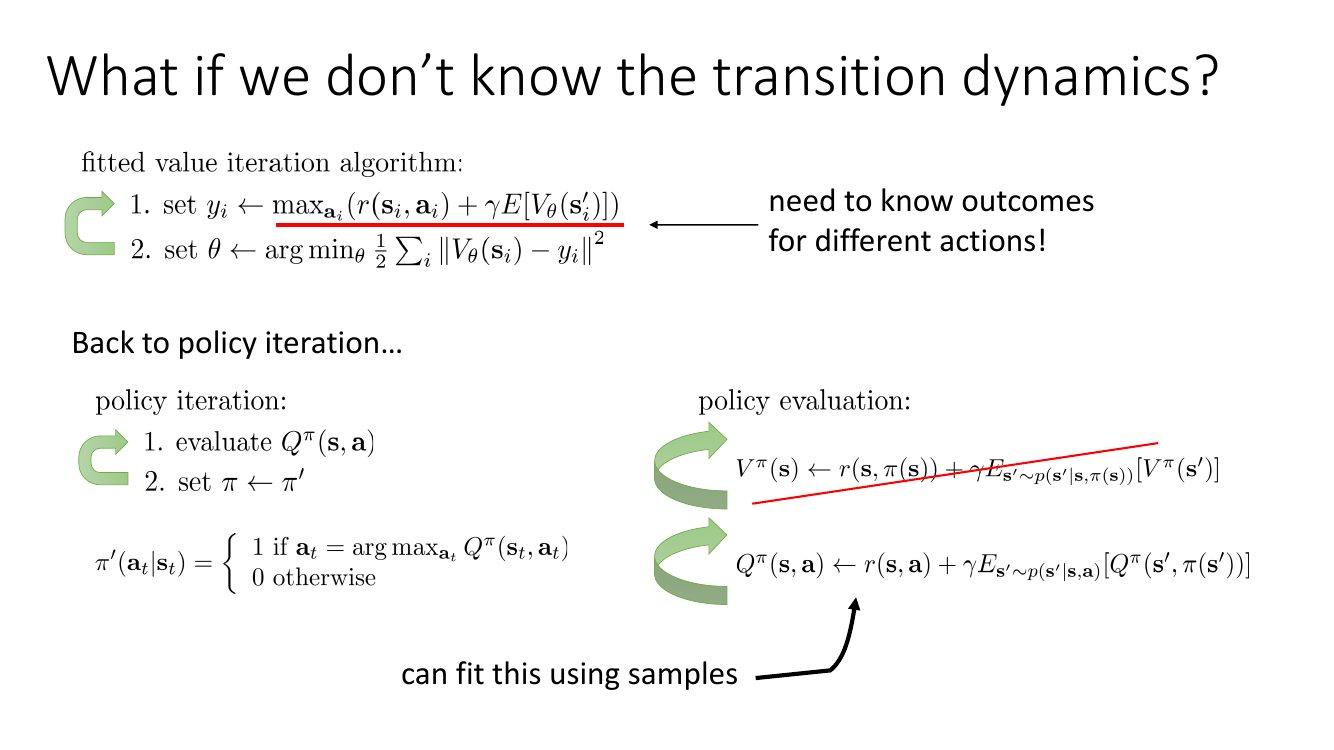
问题出在 $\max_{a_i}$ 上。要算 $\max_a\big(r(s_i,a)+\gamma\E[V_\theta(s')]\big)$,我必须知道:在状态 $s_i$ 执行动作 $a=1$ 会到哪、执行 $a=2$ 会到哪、$a=3$ 会到哪……对每一个动作都要知道它的后果。这有两条路:
- 知道转移模型 $p(s'|s,a)$——但 model-free RL 的前提就是不知道;
- 能把模拟器重置到 $s_i$,然后逐个动作试一遍——在 MuJoCo 这类可存档的模拟器里勉强可行,在真实机器人或真实用户交互中完全不可能,因为「时间不能倒流」。
而我们从环境里能拿到的,只有一条一条的转移 $(s,a,r,s')$:在 $s$ 采了某一个 $a$,看到了那一个后果。用这样的数据没法算 $V$ 的 Bellman 最优备份。
6. 学 $Q$ 而不是 $V$:拟合 Q 迭代
上一节的死结是:$\max_a$ 需要「对每个动作试一遍」。解开这个结的办法出奇地简单——把 $\max$ 挪到一个我们已经算好的函数上去取。
6.1 把策略评估改写成 $Q$ 的形式
先看策略迭代这一支。原本的策略评估是对 $V$ 的备份:
$$ V^\pi(s)\ \leftarrow\ r(s,\pi(s))+\gamma\,\E_{s'\sim p(s'|s,\pi(s))}\big[V^\pi(s')\big] $$这个式子的问题是:它规定了在 $s$ 处必须执行 $\pi(s)$,所以只能用「恰好由 $\pi$ 产生的转移」来估计。改写成 $Q$ 的形式:
$$ Q^\pi(s,a)\ \leftarrow\ r(s,a)+\gamma\,\E_{s'\sim p(s'|s,a)}\big[Q^\pi(s',\pi(s'))\big] $$差别看似微小,意义却完全不同:左边的 $(s,a)$ 现在是自由变量。给定任意一条转移 $(s,a,r,s')$,我都可以拿它做一次更新——不管 $a$ 是不是 $\pi$ 选的。而右边需要的 $Q^\pi(s',\pi(s'))$ 只是在已有的 $Q$ 函数上查一个值,不需要真的在 $s'$ 执行 $\pi(s')$。这就是「不需要模拟动作」的含义。
6.2 再用一次 max 技巧
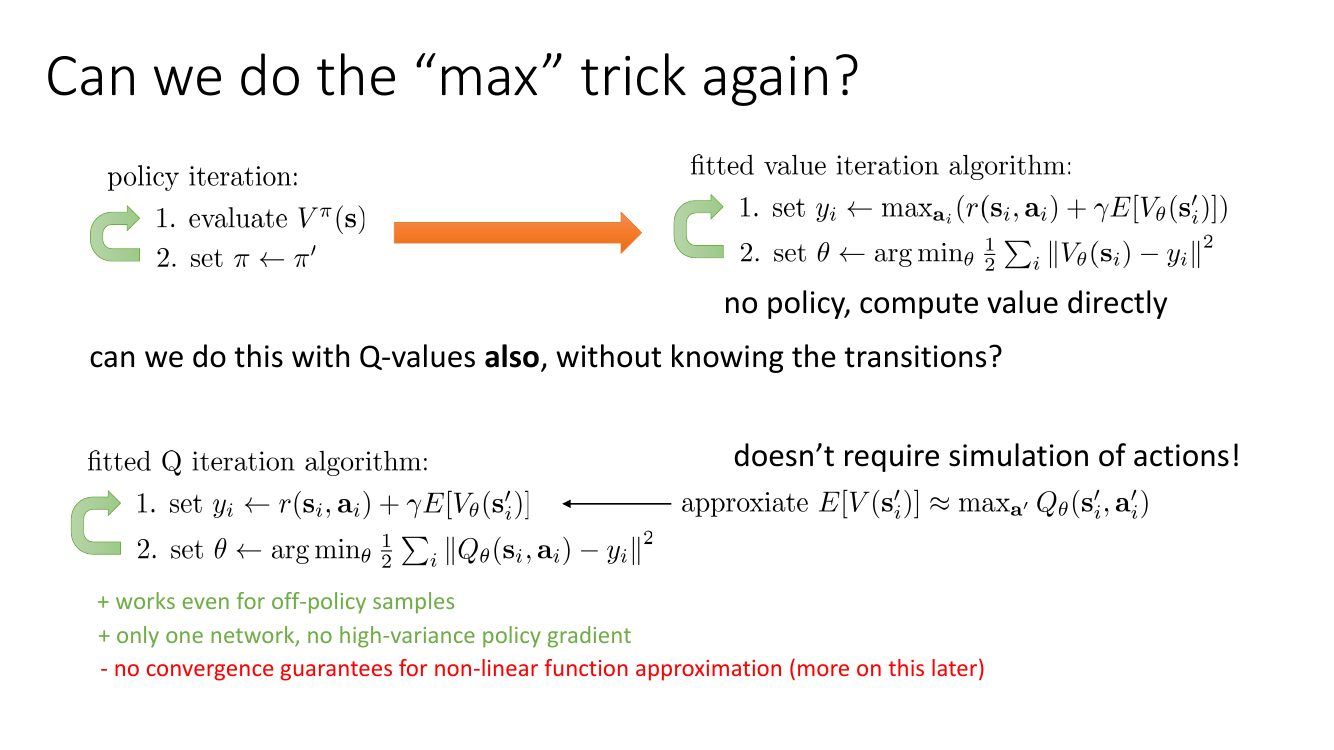
现在把 $\pi$ 也去掉。既然 $\pi$ 就是对 $Q$ 的贪心策略,那么
$$ Q^\pi\big(s',\pi(s')\big)=\max_{a'}Q^\pi(s',a') $$等价地说,我们用 $\max_{a'}Q_\theta(s',a')$ 来近似 $\E[V(s')]$。这个 $\max$ 是在网络的输出上取的——对离散动作空间,把 $s'$ 前向传播一次得到 $|\mathcal{A}|$ 个 Q 值,取最大即可,完全不需要与环境交互。至此死结解开。
$V$ 的 Bellman 最优备份是 $\max_a\big(r(s,a)+\gamma\E_{s'}[V(s')]\big)$:$\max$ 在期望外面,每个 $a$ 都对应一个不同的 $s'$ 分布,所以必须知道模型。
$Q$ 的 Bellman 最优备份是 $r(s,a)+\gamma\E_{s'}\big[\max_{a'}Q(s',a')\big]$:$\max$ 在期望里面,且只作用在 $Q$ 这个已知函数上;期望 $\E_{s'}$ 可以用单个采样 $s'$ 无偏地替代。把 $\max$ 从「需要环境」的位置搬到了「只需要网络」的位置——这就是 Q 函数存在的全部理由。
6.3 完整算法
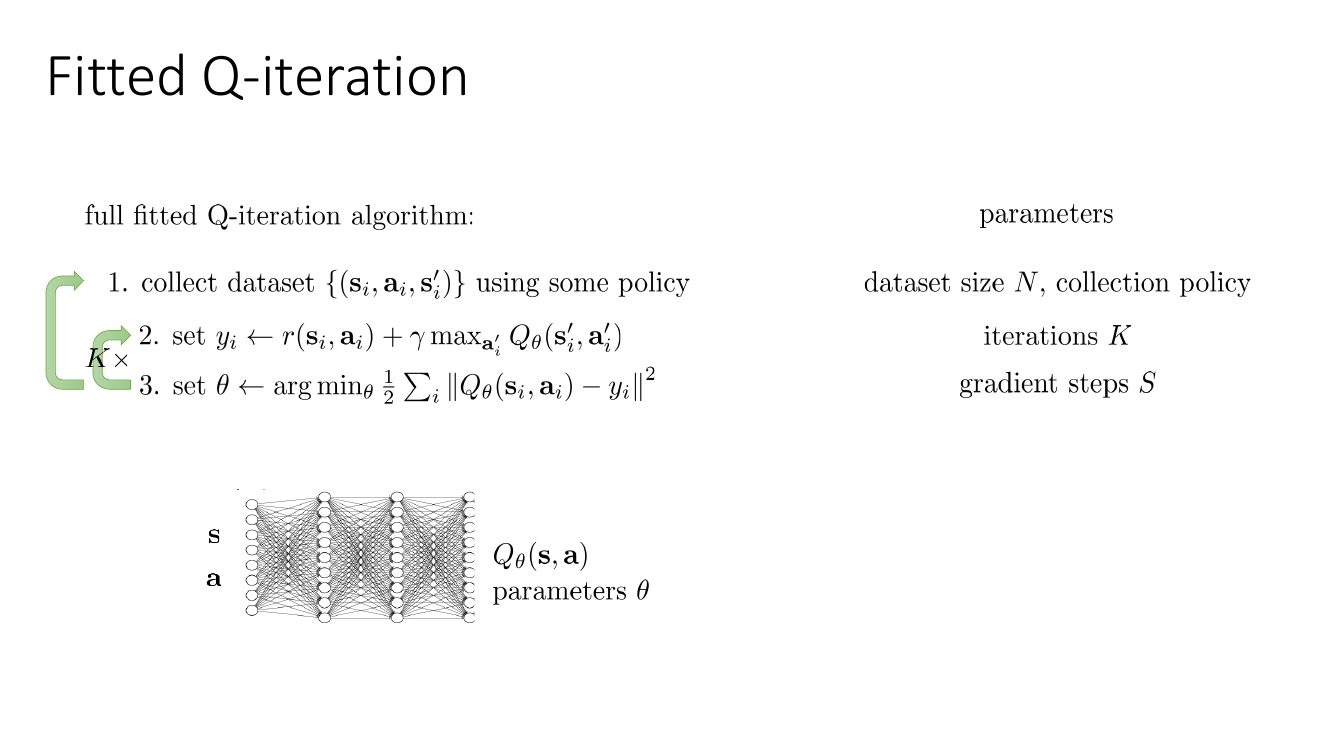
- 用某个策略收集数据集 $\mathcal{D}=\{(s_i,a_i,r_i,s_i')\}_{i=1}^N$;
- 重复 $K$ 次:
- $y_i\ \leftarrow\ r(s_i,a_i)+\gamma\max_{a'}Q_\theta(s_i',a')$,对所有 $i$;
- $\theta\ \leftarrow\ \argmin_\theta\frac12\sum_i\|Q_\theta(s_i,a_i)-y_i\|^2$(实际做 $S$ 步梯度下降);
- 回到第 1 步继续收集数据。
| 超参数 | 含义 | 取大 / 取小的影响 |
|---|---|---|
| $N$(数据集大小) | 每轮收集多少条转移 | 大:分布覆盖好、目标稳定;小:更接近在线、样本效率更高但更不稳 |
| $K$(迭代次数) | 在同一批数据上做多少次 Bellman 备份 | 大:把这批数据的信息榨干,但会过拟合到数据分布、放大外推误差;小:浪费数据 |
| $S$(梯度步数) | 每次回归做多少步 SGD | 大:更接近真正的 $\argmin$,但目标 $y_i$ 是旧的、容易过度拟合旧目标;$S=1$ 就退化成在线 Q-learning |
import torch, torch.nn as nn

class QNet(nn.Module):                      # 输入 s,输出所有动作的 Q 值
    def __init__(self, obs_dim, n_act):
        super().__init__()
        self.f = nn.Sequential(nn.Linear(obs_dim, 128), nn.ReLU(),
                               nn.Linear(128, 128), nn.ReLU(),
                               nn.Linear(128, n_act))
    def forward(self, s):
        return self.f(s)                    # [B, n_act]

def fitted_q_iteration(qnet, data, gamma=0.99, K=10, S=100, lr=1e-3):
    """data: (s, a, r, s_next, done),均为张量;s:[N,obs] a:[N] r:[N] done:[N]"""
    s, a, r, s_next, done = data
    opt = torch.optim.Adam(qnet.parameters(), lr=lr)
    for k in range(K):
        with torch.no_grad():               # 目标不回传梯度:这是「回归」而非「联合优化」
            q_next = qnet(s_next).max(dim=1).values          # max_a' Q(s', a')
            y = r + gamma * (1.0 - done) * q_next            # 终止状态不 bootstrap
        for _ in range(S):
            q_sa = qnet(s).gather(1, a.unsqueeze(1)).squeeze(1)   # Q(s_i, a_i)
            loss = 0.5 * ((q_sa - y) ** 2).mean()
            opt.zero_grad(); loss.backward(); opt.step()
    return qnet
代码里的 torch.no_grad() 不是性能优化,而是算法正确性的一部分。目标 $y_i$ 里含有 $Q_\theta(s_i',a')$,如果让梯度穿过它,你优化的就不再是「拟合值迭代」,而是所谓的残差梯度(residual gradient)——那是一个不同的算法,收敛到不同的解,实践中通常更慢更差。拟合 Q 迭代的正确解读是:$y_i$ 是一个被冻结的常数标签,第 2 步是一个纯粹的监督回归问题。下一讲的 target network 正是把这个「冻结」做得更彻底。
7. 为什么 Q-learning 是 off-policy 的,它在优化什么
7.1 off-policy 性质的来源
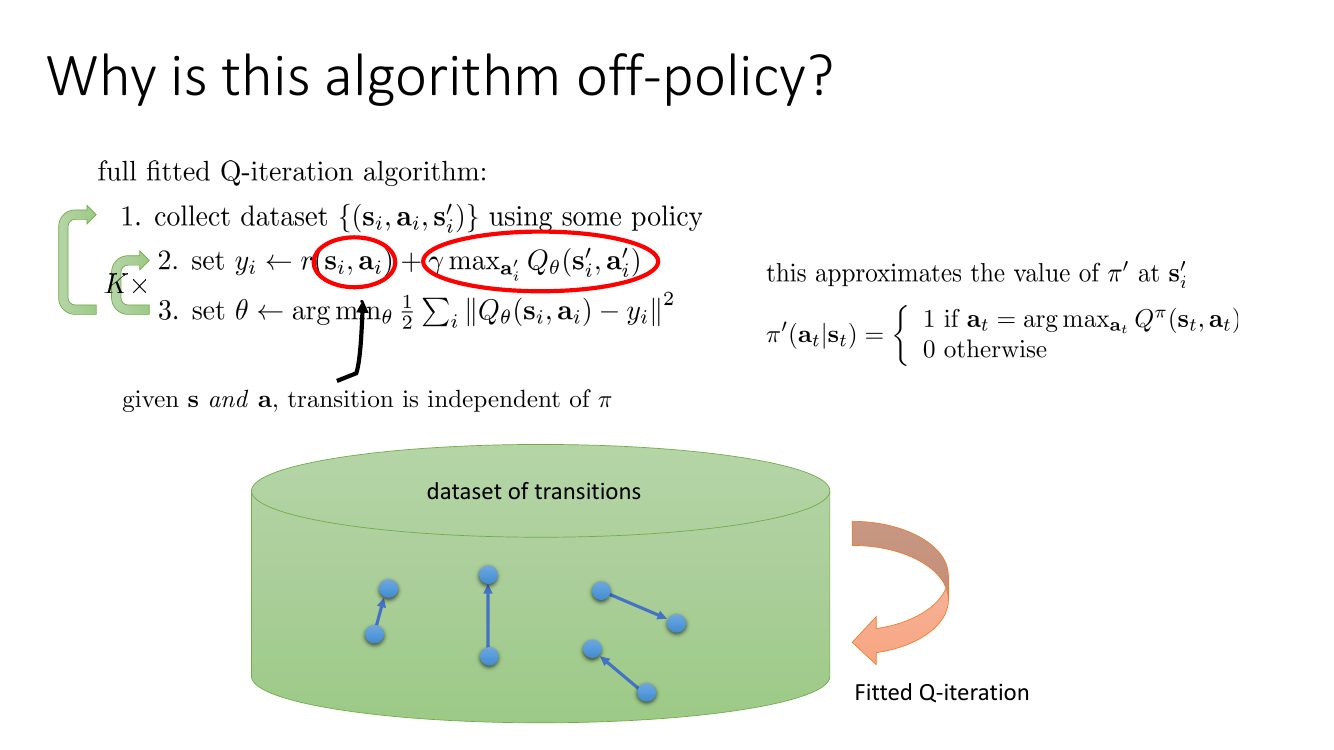
回顾 fitted Q-iteration 的第 2、3 步,问一句:数据必须来自哪个策略?逐项检查:
- $r(s_i,a_i)$:奖励函数是环境给的,与策略无关;
- $s_i'$:由 $p(s'|s_i,a_i)$ 采样得到。给定 $s_i$ 和 $a_i$ 之后,$s_i'$ 的分布与策略无关——策略只影响「你会选哪个 $a_i$」,不影响「选了 $a_i$ 之后会发生什么」;
- $\max_{a'}Q_\theta(s_i',a')$:这是对当前 $Q_\theta$ 的运算,与数据来源无关。而且它恰好等于「新的贪心策略 $\pi'$ 在 $s_i'$ 处的值」;
- $Q_\theta(s_i,a_i)$:网络对给定输入的输出。
结论:整个更新只依赖四元组 $(s,a,r,s')$ 本身,不依赖它是被哪个策略、在什么时候采集的。所以数据可以来自:几百万步之前的旧策略、一个随机策略、人类演示、别人训练好的另一个 agent、甚至一个纯粹的离线数据集。这就是 off-policy 的含义,也是 Q-learning 相对策略梯度最大的实用优势。
策略梯度需要完整轨迹,而且必须是当前策略的轨迹,因为 $\nabla_\theta J=\E_{\tau\sim p_\theta}[\cdots]$ 里的期望下标就是当前的 $\theta$,更新一次参数所有数据全部作废。
Q-learning 需要的只是一堆互不相连的转移片段。你可以把一条 1000 步的轨迹拆成 1000 个独立样本,随机打乱、反复使用。这不仅让 replay buffer 成为可能(提高样本效率),还顺带打破了轨迹内相邻样本的强相关性——这对 SGD 的稳定性很重要,下一讲会详细讨论。
理论上更新式对任何数据都成立,但目标里的 $\max_{a'}Q_\theta(s',a')$ 会去查询数据里可能根本没出现过的动作 $a'$。如果 $Q_\theta$ 在这些没见过的 $(s',a')$ 上高估(神经网络的外推常常如此),这个高估就会通过 Bellman 备份传播到所有前驱状态,而且没有任何数据能纠正它——因为你从没试过那个动作。这就是离线强化学习(offline RL)里的分布偏移(distributional shift)问题,也是本讲末尾负面结果的一个具体表现。数据分布 $\beta$ 覆盖得越差,问题越严重。
7.2 fitted Q-iteration 在优化什么
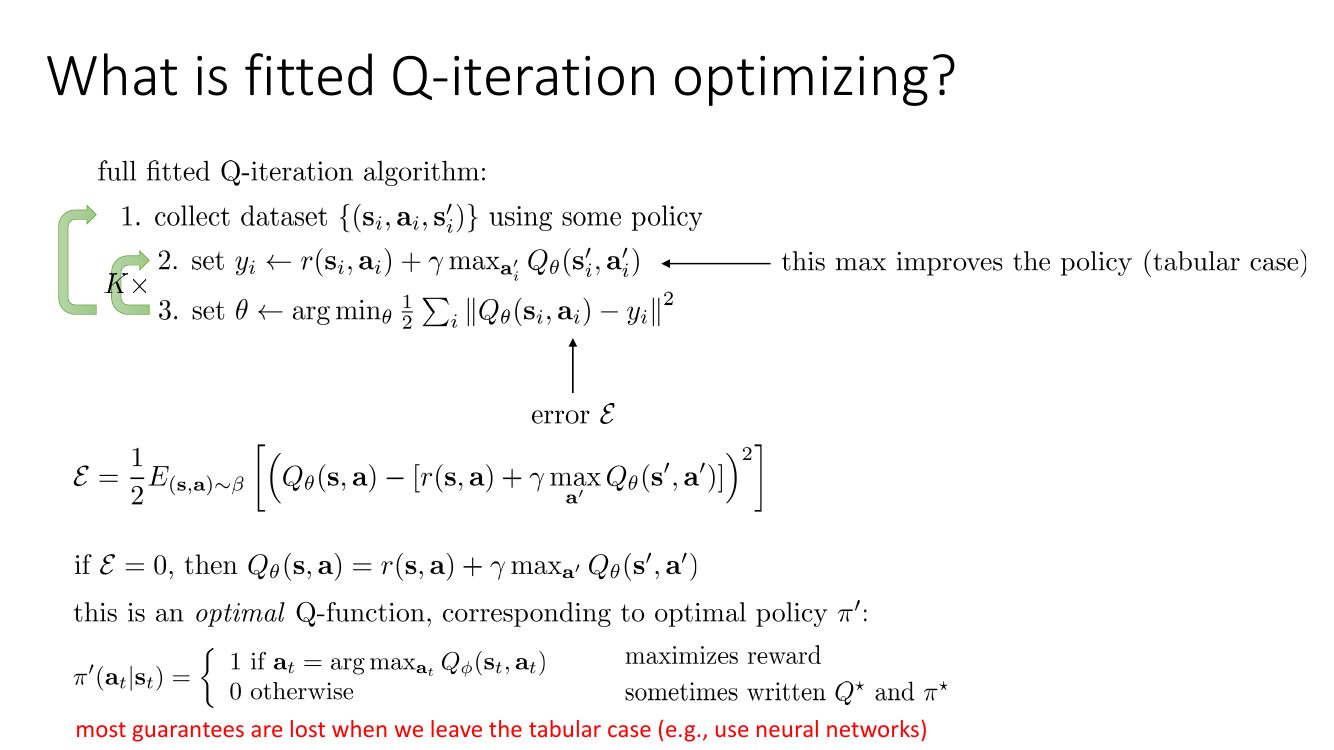
fitted Q-iteration 表面上是在最小化一个回归损失,但那个损失的目标 $y_i$ 每轮都在变,所以它不是在最小化任何固定的函数。真正有意义的「进度指标」是 Bellman 误差:
$$ \mathcal{E}=\frac12\,\E_{(s,a)\sim\beta}\left[\Big(Q_\theta(s,a)-\big[r(s,a)+\gamma\max_{a'}Q_\theta(s',a')\big]\Big)^2\right] $$其中 $\beta$ 是数据的分布。这个量的意义非常清晰:
- 若 $\mathcal{E}=0$(且 $\beta$ 覆盖所有 $(s,a)$),则 $Q_\theta$ 精确满足 Bellman 最优方程 $Q=\mathcal{B}Q$,于是 $Q_\theta=Q^\star$,导出的贪心策略就是最优策略 $\pi^\star$;
- 若 $\mathcal{E}$ 很小但不为零,我们希望策略接近最优。表格情形下确实有界;但用神经网络时,小的 Bellman 误差并不能保证策略好——因为 $\beta$ 覆盖不到的区域可以任意糟,而 $\mathcal{E}$ 对它们视而不见。
很多人训练 DQN 时盯着回归 loss 看,发现 loss 下降就以为在学好,loss 上升就以为出问题了。这是错的。回归 loss 衡量的是「网络拟合当前这批目标拟合得多好」,而目标本身在变。loss 很小可能只是因为 $Q$ 已经塌缩成了一个常数(比如全部高估到同一个大数),这种情况下 Bellman 误差小、策略却毫无意义。判断 Q-learning 是否在进步,唯一靠谱的指标是周期性地跑贪心策略、测真实回报;辅助指标是看 $Q$ 值的量级是否与实际回报的量级相符(严重高估是发散的前兆)。
8. 在线 Q-learning 与探索
8.1 把批量算法推到极限
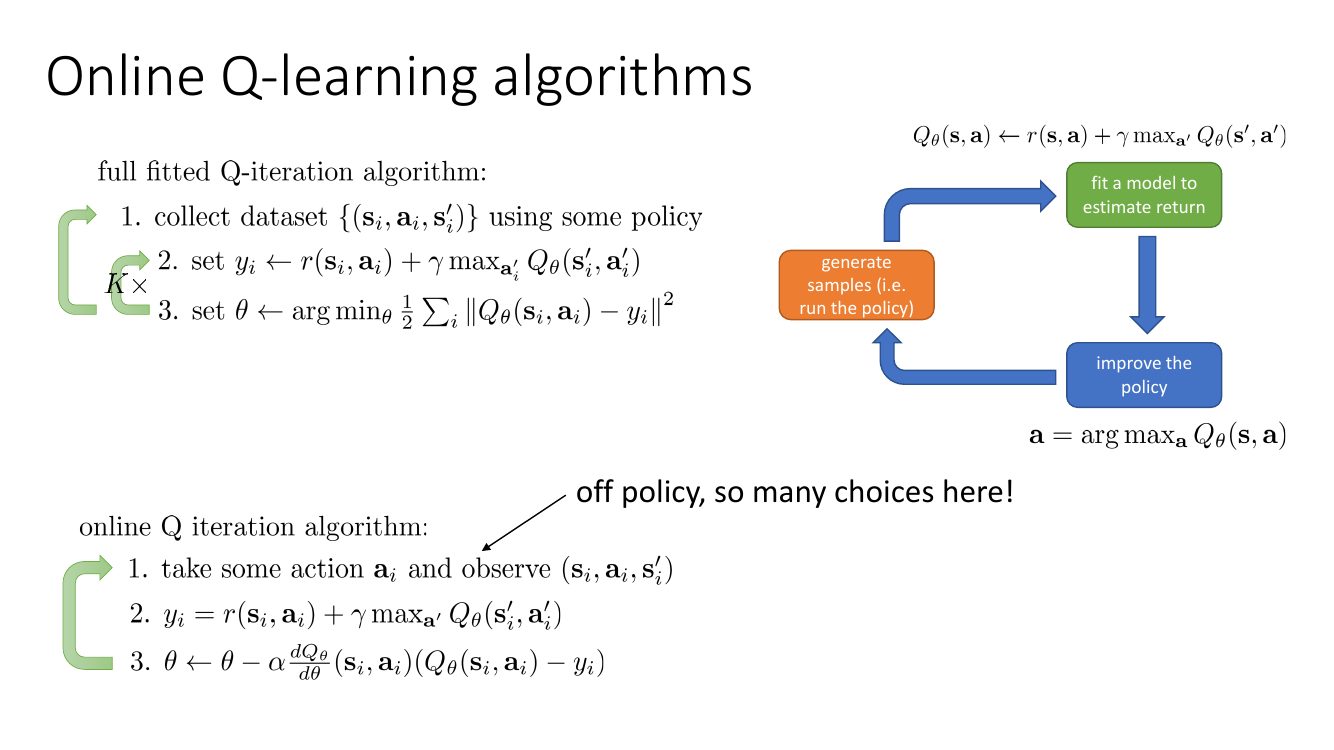
把 fitted Q-iteration 的 $N=1$、$K=1$、$S=1$,就得到最经典的 online Q-learning(Watkins, 1989):
- 执行某个动作 $a_i$,观察到 $(s_i,a_i,r_i,s_i')$;
- $y_i=r(s_i,a_i)+\gamma\max_{a'}Q_\theta(s_i',a')$;
- $\displaystyle\theta\leftarrow\theta-\alpha\,\frac{dQ_\theta}{d\theta}(s_i,a_i)\big(Q_\theta(s_i,a_i)-y_i\big)$
第 3 步就是对损失 $\frac12\big(Q_\theta(s_i,a_i)-y_i\big)^2$ 求梯度:$\nabla_\theta\mathcal{L}=\big(Q_\theta(s_i,a_i)-y_i\big)\nabla_\theta Q_\theta(s_i,a_i)$。在表格情形下 $\nabla_\theta Q_\theta(s_i,a_i)$ 是一个 one-hot 向量,更新退化成大家熟悉的
$$ Q(s,a)\ \leftarrow\ Q(s,a)+\alpha\Big(r+\gamma\max_{a'}Q(s',a')-Q(s,a)\Big) $$括号里的量叫 TD 误差(temporal difference error)。
8.2 探索:为什么不能用贪心策略采数据
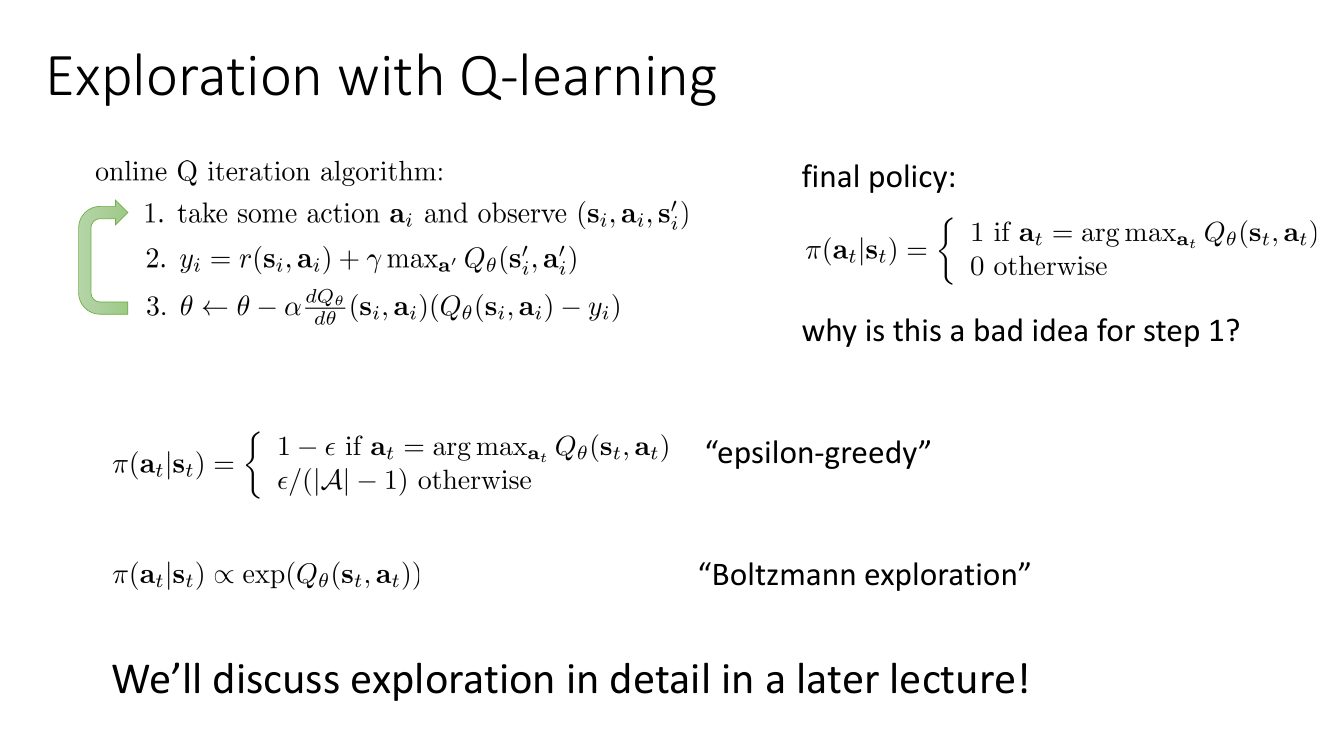
训练结束后我们要部署的确实是贪心策略。但用它来采集训练数据是灾难性的,原因有两个:
- 确定性 = 零覆盖。贪心策略在每个状态只会选一个动作,那么其他动作的 $(s,a)$ 就永远没有数据,$Q_\theta(s,a)$ 永远只是网络的外推猜测,永远得不到修正。
- 初期的 $Q$ 是随机的。训练刚开始时 $Q_\theta$ 基本是噪声,此时的 $\argmax$ 是任意的。如果就此锁死,agent 会永远重复一个由随机初始化决定的动作序列,自我实现地把这个坏策略学成「唯一见过的策略」。举个具体例子:某个动作的真实回报是 10,但初始化时 $Q$ 恰好给它 $-1$,而另一个真实回报 1 的动作被初始化成 $+0.5$;贪心策略永远选后者,前者的 $-1$ 永远不会被修正。
因此第 1 步必须用一个有随机性的行为策略(behavior policy)。因为 Q-learning 是 off-policy 的,这么做不引入任何偏差——这是它相对 on-policy 方法的又一个便利。两个最常用的选择:
| 策略 | 公式 | 特点 |
|---|---|---|
| $\epsilon$-greedy | $\pi(a|s)=\begin{cases}1-\epsilon & a=\argmax_{a}Q_\theta(s,a)\\ \epsilon/(|\mathcal{A}|-1) & \text{otherwise}\end{cases}$ | 实现最简单;但把所有非贪心动作一视同仁,哪怕某个动作明显很糟(比如让机器人摔倒)也会以同样概率被选中。实践中让 $\epsilon$ 随训练衰减(如从 1.0 线性降到 0.05) |
| Boltzmann(softmax)探索 | $\pi(a|s)\propto\exp\big(Q_\theta(s,a)/\tau\big)$ | 按 Q 值大小分配概率:明显糟糕的动作概率指数级地小,而两个 Q 值相近的动作被近乎等概率地尝试——这正是我们想要的「在不确定的地方多试」。温度 $\tau$ 控制随机程度,$\tau\to 0$ 退化为贪心 |
$\epsilon$-greedy 的问题是它不利用 Q 值携带的信息。设三个动作的 Q 值分别是 $10.0,\ 9.9,\ -1000$。$\epsilon$-greedy 会用同样的概率去试第二个和第三个动作——但第二个动作几乎和最优一样好(值得多试,因为估计误差可能让排序反了),第三个动作则明确是灾难(不该浪费样本)。Boltzmann 探索天然做出了这个区分:前两个概率几乎相等,第三个的概率是 $e^{-1010}$ 量级,实际上是零。
反过来说,$\epsilon$-greedy 的均匀性在「Q 值完全不可靠的训练早期」反而是优点,所以实践中常见的做法是早期大 $\epsilon$、后期小 $\epsilon$ 或切换到 Boltzmann。
8.3 合起来:带 replay buffer 的 Q-learning
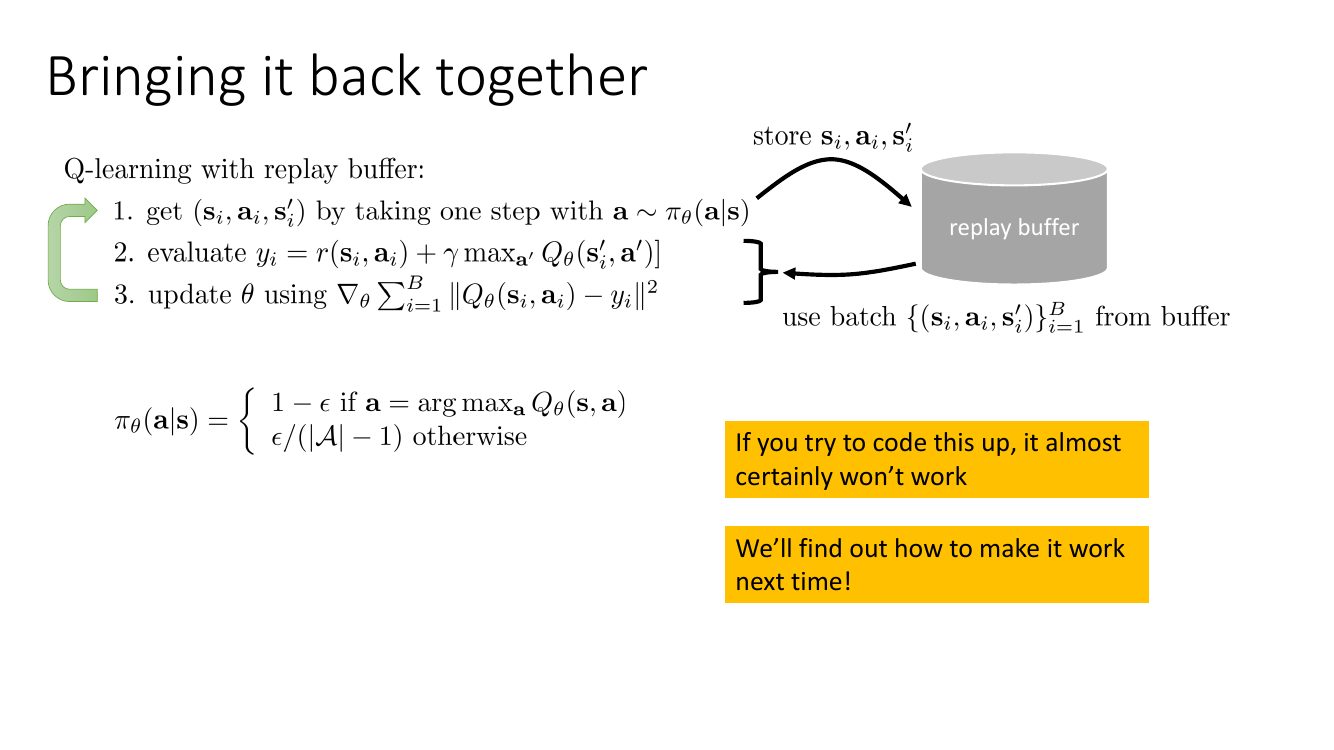
注意这个最终算法相对 online Q-learning 多了 replay buffer:每步交互写入 buffer,训练时从 buffer 随机取 batch。它在 $(N,K,S)$ 的谱系上处于中间位置——既有在线交互的及时性,又有批量数据的稳定性。这正是 DQN 的骨架。
import random, torch
from collections import deque

buffer = deque(maxlen=1_000_000)
eps, gamma, B = 1.0, 0.99, 32

for step in range(total_steps):
    # --- 1. 交互一步(epsilon-greedy 探索)---
    if random.random() < eps:
        a = random.randrange(n_act)
    else:
        with torch.no_grad():
            a = int(qnet(torch.as_tensor(s).float()).argmax())
    s_next, r, done, _ = env.step(a)
    buffer.append((s, a, r, s_next, float(done)))
    s = env.reset() if done else s_next
    eps = max(0.05, 1.0 - step / 100_000)        # 线性衰减探索率

    # --- 2&3. 从 buffer 采样 batch,做一步回归 ---
    if len(buffer) >= B:
        batch = random.sample(buffer, B)
        bs, ba, br, bs2, bd = map(lambda x: torch.as_tensor(x).float(), zip(*batch))
        with torch.no_grad():
            y = br + gamma * (1 - bd) * qnet(bs2).max(dim=1).values
        q = qnet(bs).gather(1, ba.long().unsqueeze(1)).squeeze(1)
        loss = ((q - y) ** 2).mean()
        opt.zero_grad(); loss.backward(); opt.step()
这段代码逻辑上完全正确,但正如 Levine 警告的:它大概率不会 work。缺的是 target network、梯度裁剪、合适的学习率、以及对 $\max$ 造成的系统性高估的处理。下一讲会逐个补上。而它为什么不 work,理论上的根源就是下一节。
9. 关键负面结果:带函数逼近的值迭代不保证收敛
第 4 节我们证明了表格值迭代必然收敛,速率 $\gamma^k$。第 5 节我们把表格换成神经网络,形式上只多了一步「回归」。但这一步毁掉了全部保证。本节解释为什么,这是 Levine 反复强调的一个点,也是理解下一讲所有工程技巧的理论前提。
9.1 把拟合值迭代拆成两个算子
拟合值迭代的一轮可以精确地写成两个算子的复合:
- Bellman 备份 $\mathcal{B}$:$\bar V=\mathcal{B}V$,即 $\bar V(s)=\max_a\big(r(s,a)+\gamma\E_{s'}[V(s')]\big)$。这一步的输出 $\bar V$ 是一个任意的函数,一般不在神经网络能表示的函数集合 $\Omega=\{V_\theta:\theta\in\Theta\}$ 里。
- 投影 $\Pi$:$V'=\Pi\bar V=\argmin_{V'\in\Omega}\frac12\sum_i\|V'(s_i)-\bar V(s_i)\|^2$。这一步把 $\bar V$ 拉回到 $\Omega$ 里离它最近的点——在$\ell_2$ 范数(欧氏距离)意义下最近。
于是拟合值迭代就是 $V_{k+1}=\Pi\mathcal{B}V_k$。表格情形下 $\Omega$ 是全空间,$\Pi=I$(恒等算子),所以退化成纯 $\mathcal{B}$,一切正常。
9.2 两个算子各自都很乖,合起来却不乖
事实一:$\mathcal{B}$ 是 $\infty$-范数下的 $\gamma$-压缩。(第 4 节已证) $$ \|\mathcal{B}V-\mathcal{B}\bar V\|_\infty\le\gamma\|V-\bar V\|_\infty $$
事实二:$\Pi$ 是 $\ell_2$-范数下的非扩张映射(non-expansion)。因为 $\Pi$ 是到集合 $\Omega$ 上的正交投影($\Omega$ 为线性子空间时严格成立),而正交投影总满足 $$ \|\Pi V-\Pi\bar V\|_2\le\|V-\bar V\|_2 $$ 直观上:投影是「把点垂直压到一个平面上」,两点之间的欧氏距离只会缩短,不会拉长。
但是:$\Pi\mathcal{B}$ 在任何范数下都不保证是压缩。这不是证明技巧不够,而是事实如此——下面会给出发散的具体例子。
问题的根源在于两个压缩用的是不同的范数。若两者都在 $\infty$-范数下压缩,复合的模就是乘积 $\le\gamma\cdot 1=\gamma$,仍是压缩。但 $\Pi$ 在 $\infty$-范数下可以是扩张的:最小二乘拟合为了让平均平方误差最小,完全可能在某个单独的状态上把误差放大(牺牲一个点,换其他点的整体更准)。而 $\mathcal{B}$ 在 $\ell_2$ 范数下同样不保证压缩。于是复合算子 $\Pi\mathcal{B}$ 的「模」可以大于 1,迭代就可能发散。
想象一条直线 $\Omega$(可表示函数的集合),真值 $V^\star$ 是平面上的一个点,一般不在这条直线上。当前估计 $V_k$ 在直线上。
$\mathcal{B}$ 这一步把 $V_k$ 拉向 $V^\star$,距离缩短到原来的 $\gamma$——这一步永远是好的,它把 $\mathcal{B}V_k$ 移到了离 $V^\star$ 更近的位置。
$\Pi$ 这一步把 $\mathcal{B}V_k$ 垂直压回直线。它保证「离 $\mathcal{B}V_k$ 最近」,但完全不保证「离 $V^\star$ 更近」——因为 $V^\star$ 根本不在直线上。如果直线的方向和 $V^\star$ 的方向配合得不好,这一压完全可能把点推得比 $V_k$ 离 $V^\star$ 更远。$\gamma$ 越接近 1,$\mathcal{B}$ 拉回的力度越小,越容易被投影的这一推盖过去。
9.3 一个具体的发散例子
最经典的构造(Tsitsiklis & Van Roy, 1997)只需要两个状态、零奖励、一个参数:
- 状态 $s_1,s_2$;转移是确定性的:$s_1\to s_2$,$s_2\to s_2$(自环);
- 奖励恒为 $0$。因此真值函数是 $V^\star(s_1)=V^\star(s_2)=0$;
- 函数类是线性的、只有一个参数:$V_\theta(s)=\theta\,\phi(s)$,特征 $\phi(s_1)=1$,$\phi(s_2)=2$。注意 $\theta=0$ 时可以精确表示真值,所以这不是表达能力不足的问题。
第一步,Bellman 备份。由于奖励为 0、转移确定:
$$ (\mathcal{B}V_\theta)(s_1)=\gamma V_\theta(s_2)=2\gamma\theta,\qquad(\mathcal{B}V_\theta)(s_2)=\gamma V_\theta(s_2)=2\gamma\theta $$第二步,最小二乘投影。在两个状态上等权重拟合,求 $\theta'$ 使
$$ \mathcal{L}(\theta')=\tfrac12\big(1\cdot\theta'-2\gamma\theta\big)^2+\tfrac12\big(2\cdot\theta'-2\gamma\theta\big)^2 $$最小。令导数为零:$(\theta'-2\gamma\theta)+2(2\theta'-2\gamma\theta)=0$,即 $5\theta'=6\gamma\theta$,故
$$ \theta'=\frac{6\gamma}{5}\,\theta $$结论:每一轮参数被乘以 $\tfrac{6\gamma}{5}$。当 $\gamma\gt\tfrac56\approx0.833$ 时这个系数大于 1,$|\theta|$ 指数发散。取常用的 $\gamma=0.9$:系数是 $1.08$,从 $\theta_0=1$ 出发,100 轮后 $\theta\approx 2200$,1000 轮后约 $10^{32}$。而真值就是 $0$,且这个函数类完全能表示 $0$。
它没有神经网络的非凸优化,没有探索不足,没有采样噪声,没有奖励的尺度问题,甚至没有 $\max$ 算子(只有两个状态、一个动作,$\mathcal{B}$ 是线性的)。回归也是精确解到全局最优的。发散纯粹来自「Bellman 备份 + 投影」这个复合本身。把 $\gamma$ 调到 $0.8$(小于 $5/6$)它就收敛了——收敛与否取决于 $\gamma$ 与特征几何的相互关系,而不是任何可以靠调网络解决的东西。
9.4 online Q-learning 也不是梯度下降
还有一个独立的问题。看在线更新:
$$ \theta\leftarrow\theta-\alpha\big(Q_\theta(s,a)-\underbrace{[r+\gamma\max_{a'}Q_\theta(s',a')]}_{y,\ \text{也依赖 }\theta}\big)\nabla_\theta Q_\theta(s,a) $$这不是任何函数的梯度。真正的 $\nabla_\theta\frac12(Q_\theta(s,a)-y(\theta))^2$ 还应包含 $-\nabla_\theta y$ 这一项,但我们故意把它丢掉了(代码里的 no_grad())。这种更新叫 semi-gradient(半梯度)。因此,SGD 的所有收敛理论(哪怕是「收敛到局部极小」这种弱结论)在这里一条都不适用。加上 $-\nabla_\theta y$ 得到的「残差梯度法」确实是真正的梯度下降,但它优化的目标是均方 Bellman 残差,在随机环境下有双采样偏差、且实践中收敛极慢,所以几乎没人用。
9.5 同样的病也在 actor-critic 里
上一讲的 critic 训练是自举式策略评估(bootstrapped policy evaluation):
$$ y_i=r(s_i,a_i)+\gamma\hat V^\pi_\phi(s_i'),\qquad \phi\leftarrow\argmin_\phi\sum_i\|\hat V^\pi_\phi(s_i)-y_i\|^2 $$把它写成算子形式就是 $V_{k+1}=\Pi\mathcal{B}^\pi V_k$,其中 $\mathcal{B}^\pi$ 是策略评估算子。结构与拟合值迭代完全相同:$\mathcal{B}^\pi$ 是 $\infty$-范数压缩,$\Pi$ 是 $\ell_2$ 投影,复合不是压缩。上面那个两状态例子里根本没有用到 $\max$,所以它同时也是 policy evaluation 发散的例子。也就是说:actor-critic 的 critic 同样没有收敛保证,只是实践中 actor-critic 通常更温和一些(因为策略变化慢、且常配合 on-policy 数据)。
Sutton & Barto 把导致发散的三个因素总结为「deadly triad」,三者同时出现才危险:
- 函数逼近(function approximation)——引入投影 $\Pi$;
- 自举(bootstrapping)——用自己的估计做目标,误差会被反复放大而不是被真实回报锚定;
- 离策略(off-policy)——训练分布与被评估策略的访问分布不一致,投影用错了权重。
去掉任何一个就安全:纯蒙特卡洛(去掉自举)总是收敛;表格(去掉逼近)总是收敛;on-policy 的线性 TD(去掉 off-policy)也被证明收敛(Tsitsiklis & Van Roy, 1997)。而 Q-learning + 神经网络 = 三者齐备,所以它是最危险的组合。这就是「照着写几乎肯定跑不通」的理论解释。
「没有收敛保证」不等于「没用」。DQN 在 Atari 上、以及后续的 SAC、TD3 等在连续控制上都工作得很好。理论保证的缺失意味着:你不能指望它自动稳定,必须靠工程手段把它按住——target network(把 $\Pi$ 和 $\mathcal{B}$ 的耦合减弱)、replay buffer(改善数据分布、去相关)、小学习率与梯度裁剪(限制单步移动幅度)、double Q-learning(抑制 $\max$ 带来的系统性高估)。这些正是下一讲的全部内容。反过来,如果你调 Q-learning 时遇到 Q 值爆炸到 $10^6$,请记住这不是 bug,是算法本身的性质。
本讲小结
一条主线
「值函数已经知道哪个动作好 → 那就直接取 $\argmax$,不要 actor」→ 这一步合法(策略改进定理)→ 表格下用 DP 精确实现(策略迭代 / 值迭代),且必然收敛($\gamma$-压缩)→ 状态太多,换神经网络(拟合值迭代)→ 但 $\max_a$ 需要模型,换成学 $Q$(拟合 Q 迭代 / Q-learning)→ 天然 off-policy,可用 replay buffer → 需要显式探索 → 但函数逼近毁掉了收敛保证。
速查表
| 算法 | 核心更新 | 需要模型? | on/off-policy | 收敛保证 |
|---|---|---|---|---|
| 策略迭代(表格) | $V^\pi\leftarrow r_\pi+\gamma\mathcal{T}_\pi V^\pi$,再 $\pi\leftarrow\text{greedy}(Q^\pi)$ | 是 | — | 有限步收敛到 $\pi^\star$ |
| 值迭代(表格) | $V\leftarrow\max_a\big(r(s,a)+\gamma\E[V(s')]\big)$ | 是 | — | $\|V_k-V^\star\|_\infty\le\gamma^k\|V_0-V^\star\|_\infty$ |
| 拟合值迭代 | $y_i=\max_{a}\big(r(s_i,a)+\gamma\E[V_\theta(s_i')]\big)$,回归 | 是(或可重置模拟器) | off | 无($\Pi\mathcal{B}$ 非压缩) |
| 拟合 Q 迭代 | $y_i=r_i+\gamma\max_{a'}Q_\theta(s_i',a')$,回归 $K$ 轮 | 否 | off | 无(表格情形下有) |
| 在线 Q-learning | 同上,$N=K=S=1$,semi-gradient 一步 | 否 | off | 无(表格 + 适当步长下有) |
| Actor-critic(上一讲) | $y_i=r_i+\gamma \hat V^\pi_\phi(s_i')$,回归 + 策略梯度 | 否 | on(或需修正) | critic 同样无保证 |
必须记住的要点
- $\E_{a\sim\pi}[A^\pi(s,a)]=0$:优势函数在自己策略下期望为零,所以贪心动作的优势必然 $\ge 0$,这是策略改进定理的一行核心。
- 贪心改进不需要学习率:只要 $Q^\pi$ 准确,跳多远都不会变差。但 $Q$ 有误差 $\varepsilon$ 时性能损失被 $\tfrac{2\gamma\varepsilon}{1-\gamma}$ 界住,$\gamma\to1$ 时放大剧烈。
- 压缩性证明的技术核心是 $\sum_{s'}p(s'|s,a)=1$:随机矩阵在 $\infty$-范数下诱导范数为 1,所以只搬运误差不放大,剩下的 $\gamma$ 就是收缩因子。
- $Q$ 存在的唯一理由:把 $\max$ 从期望外面(需要模型)搬到期望里面(只需要网络)。
- off-policy 的一行论证:给定 $(s,a)$ 后 $s'$ 的分布与策略无关,且目标中的 $\max$ 已代表新策略。
- 为什么必须探索:贪心策略确定性 → 零覆盖 → 初始化的随机偏好被自我实现地固化。用 $\epsilon$-greedy 或 Boltzmann,off-policy 保证这不引入偏差。
- 发散的根源:$\mathcal{B}$ 在 $\infty$-范数压缩、$\Pi$ 在 $\ell_2$ 范数非扩张,不同范数下的压缩复合起来不是压缩。两状态例子里 $\theta'=\tfrac{6\gamma}{5}\theta$,$\gamma\gt5/6$ 即发散。
- semi-gradient:在线 Q-learning 的更新不是任何函数的梯度,SGD 的理论一条也用不上。
与前后讲的接口
- ← 上一讲(Actor-Critic):本讲的 $\mathcal{B}^\pi$ 分析直接解释了 critic 为什么也可能发散;本讲的 $\max$ 技巧是把 actor 删掉的关键。
- → 下一讲(Q-Learning 的工程实践):replay buffer 的正确用法、target network、DQN、double DQN、multi-step return、以及连续动作空间下怎么算 $\max_a$(DDPG / SAC 的思路)。本讲写下的那段「逻辑正确但跑不通」的代码,会在下一讲被逐行修好。
延伸阅读
经典理论
- R. Bellman, Dynamic Programming (1957) — 值迭代与 Bellman 方程的源头,「维度灾难」一词也出自这里。
- R. Howard, Dynamic Programming and Markov Processes (1960) — 策略迭代的原始提出,含策略改进定理。
- C. Watkins, Learning from Delayed Rewards (PhD thesis, 1989) 与 Watkins & Dayan, Q-learning (1992) — Q-learning 的提出与表格情形下的收敛性证明,是理解「为什么表格能收敛」的必读。
- J. Tsitsiklis & B. Van Roy, An Analysis of Temporal-Difference Learning with Function Approximation (IEEE TAC, 1997) — 本讲第 9 节那个两状态发散例子的出处,同时证明了 on-policy 线性 TD 的收敛性。要真正理解「什么条件下安全」,读这一篇。
- L. Baird, Residual Algorithms: Reinforcement Learning with Function Approximation (ICML, 1995) — 著名的 Baird counterexample(星形 MDP),另一个更极端的发散构造,并提出残差梯度法作为补救。
- D. Bertsekas & J. Tsitsiklis, Neuro-Dynamic Programming (1996) — 把 DP、压缩映射、函数逼近误差界系统串起来的教科书,本讲第 2.2 节那个 $\tfrac{2\gamma\varepsilon}{1-\gamma}$ 界的严格来源。
- R. Sutton & A. Barto, Reinforcement Learning: An Introduction (2nd ed., 2018), 第 4、6、11 章 — 第 4 章讲 DP,第 6 章讲 TD 与 Q-learning,第 11 章专讲 deadly triad 与 off-policy 发散。
拟合 Q 迭代与批量 RL
- D. Ernst, P. Geurts, L. Wehenkel, Tree-Based Batch Mode Reinforcement Learning (JMLR, 2005) — fitted Q-iteration 的正式提出(用随机森林做回归器),本讲第 6 节算法的直接来源。
- M. Riedmiller, Neural Fitted Q Iteration (ECML, 2005) — 用神经网络做 fitted Q-iteration 的早期工作,DQN 的前身。
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives on Open Problems (2020) — Levine 等人写的离线 RL 综述,第 7.1 节提到的「$\max_{a'}$ 查询到数据外动作」问题在这里被完整展开。
深度 Q-learning(下一讲的预习)
- Playing Atari with Deep Reinforcement Learning (2013) — DQN 的第一篇,replay buffer + 卷积网络。
- Deep Reinforcement Learning with Double Q-learning (2015) — 分析 $\max$ 算子造成的系统性高估,并给出两行代码的修正。
- Rainbow: Combining Improvements in Deep Reinforcement Learning (2017) — 把六种 DQN 改进合起来做消融,是判断「哪个技巧真正有用」的最佳参考。
- Continuous Control with Deep Reinforcement Learning (DDPG, 2015) — 连续动作空间下没法枚举 $\max_a$,改用一个「actor 网络」专门去逼近 $\argmax$,是本讲思路在连续控制上的延伸。