控制即变分推断
把「决策」写成一个概率图模型上的推断问题:为什么朴素推断会得到一个赌徒式的乐观规划者,怎样用变分推断把它修好,以及由此长出来的最大熵 RL —— soft Q-learning、SAC 与逆强化学习。
0. 本讲导读
到目前为止,这门课里所有算法都建立在同一个假设上:智能体在最大化期望回报。策略梯度在爬 $J(\theta)$ 的坡,Q-learning 在解 $\max_a Q(s,a)$ 的不动点方程,模型预测控制在 $\argmax$ 一串动作序列。可是如果你要用 RL 去解释真实数据 —— 一个人开车、一只手抓杯子、一段专家演示 —— 「最优」这个假设立刻就崩了。人不是最优的。人是大致最优的:他们朝着目标走,但会绕路、会犹豫、会在几条差不多好的路线之间随机挑一条。
本讲的出发点就是这句话:与其假设行为最优,不如把「最优」当成一个可以被观测到的随机变量。我们在标准的图模型(状态 $s_t$、动作 $a_t$、转移 $p(s_{t+1}|s_t,a_t)$)上再挂一排二值变量 $\mathcal{O}_t$,让 $p(\mathcal{O}_t=1|s_t,a_t)=\exp(r(s_t,a_t))$,然后问一个纯粹的推断问题:已知这一整条轨迹都是「最优的」,动作的后验分布长什么样? 答案惊人地漂亮 —— 它几乎就是动态规划,只是把 $\max$ 换成了 $\log\int\exp$,即所谓的 soft maximum。
但漂亮里藏着一个致命 bug。朴素的推断不但会把动作调整得更「最优」,还会偷偷把动力学也调整得更「最优」:条件在「我拿到了高回报」上,模型会认为「那我大概率中了彩票」。这就是乐观偏差(optimism bias)。本讲的核心技术贡献就是用变分推断(variational inference)修掉它:把变分分布 $q$ 的动力学项钉死成真实动力学,只让动作分布自由,最大化 ELBO —— 于是我们得到了最大熵强化学习(maximum entropy RL)目标
$$ J(\pi)=\sum_t \E_{(s_t,a_t)\sim \pi}\big[\,r(s_t,a_t)+\mathcal{H}(\pi(\cdot|s_t))\,\big]. $$这个目标不是拍脑袋加的「熵正则项」,它是一个严格的变分下界。从它可以一路推导出 soft value iteration、soft Q-learning、带熵的策略梯度,以及当今最常用的 off-policy actor-critic —— SAC(soft actor-critic)。最后我们把整个模型倒过来跑:如果假设人类演示者服从这个模型,就能从演示反推奖励函数,这就是最大熵逆强化学习(MaxEnt IRL),而它在数学上恰好等价于一个 GAN。
与前后讲的关系:上一讲把变分推断的机器(ELBO、amortized inference、reparameterization trick)搭好了,本讲是它在控制问题上最重要的一次应用;下一讲会把 IRL 这条线继续推到序列模型和 LLM 上 —— 你会发现 RLHF 里的 KL 正则目标 $\pi^\star\propto\pi_{\text{ref}}\exp(r/\beta)$ 正是本讲第 6 节那个公式的原样复制。
- 令 $p(\mathcal{O}_t=1|s_t,a_t)=\exp(r(s_t,a_t))$,则 $p(\tau|\mathcal{O}_{1:T})\propto p(\tau)\exp\big(\sum_t r(s_t,a_t)\big)$:高回报轨迹指数级地更可能,但低回报轨迹概率不为零 —— 这正好是「近似最优行为」的模型。
- 反向消息 $\beta_t(s_t,a_t)=p(\mathcal{O}_{t:T}|s_t,a_t)$ 的递推,取对数后就是值迭代;只是 $V=\log\int\exp(Q)\,da$ 是 soft max,$\pi=\exp(Q-V)=\exp(A)$ 是 Boltzmann 策略。
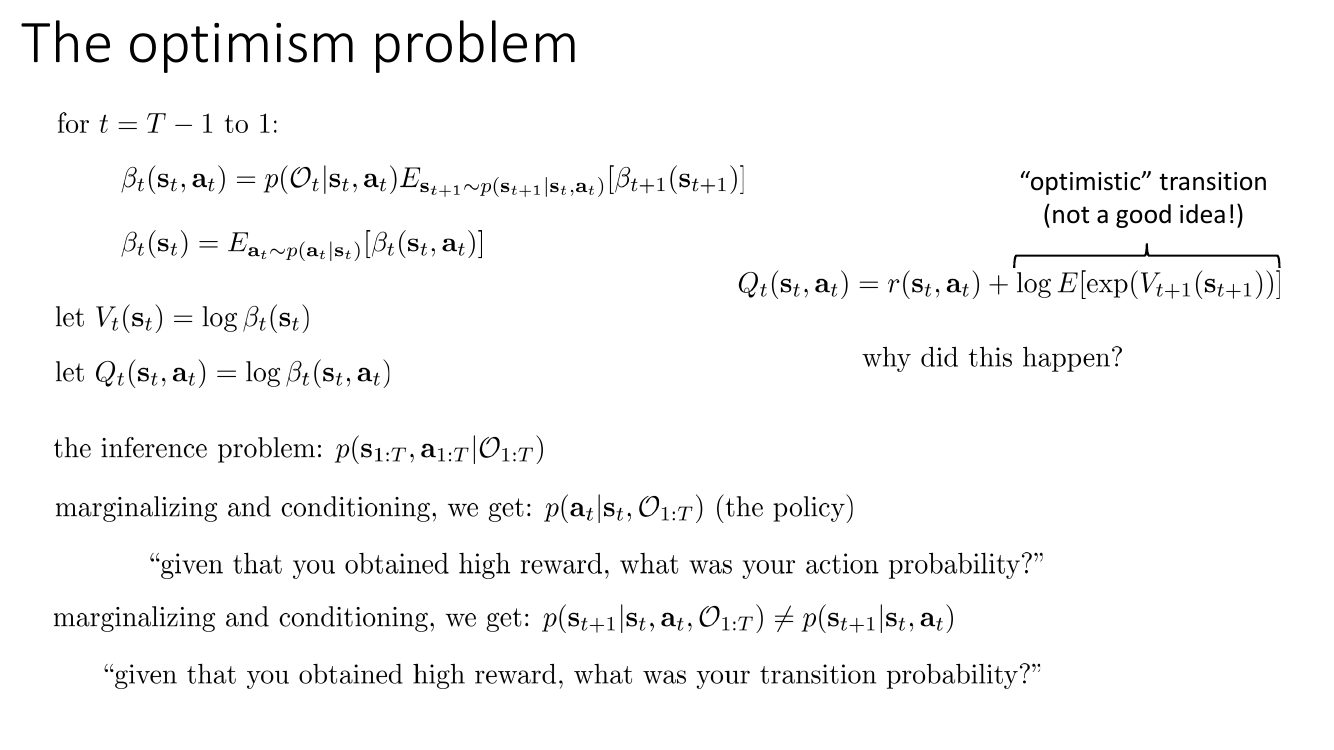
- 朴素推断是错的:$Q=r+\log\E_{s'}[\exp V(s')]$ 中的 $\log\E\exp$ 对下一状态也取了 soft max,等于允许运气配合你 —— 一个 2% 概率的头奖会被当成几乎必得。
- 修法:限制变分族 $q(\tau)=p(s_1)\prod_t p(s_{t+1}|s_t,a_t)\,q(a_t|s_t)$,动力学与 $p$ 完全相同,只优化 $q(a_t|s_t)$。ELBO 里所有动力学项精确抵消,剩下 $\sum_t\E[r+\mathcal{H}]$。
- 变分版的 backup 是 $Q=r+\gamma\E_{s'}[V(s')]$(普通期望)与 $V=\alpha\log\int\exp(Q/\alpha)\,da$(只有动作是 soft 的)。乐观偏差消失。
- 恒等式 $\max_q\{\E_q[Q]+\alpha\mathcal{H}(q)\}=\alpha\log\int e^{Q/\alpha}$,最优解 $q\propto\exp(Q/\alpha)$ —— 这既是 soft value iteration 的 $V$ 更新,也是 SAC 策略改进步的 KL 投影解。
- SAC = off-policy actor-critic + 随机策略 + 熵项进 target + 双 Q + 自动调温;熵的温度 $\alpha$ 本质上等价于奖励尺度,所以必须自动调。
- 把这个模型倒过来学 $r_\psi$,梯度 = 专家样本的特征期望 − 当前 soft 最优策略样本的特征期望;用判别器实现它就是 GAN/GAIL。
1. 人不是最优的:给次优行为建一个概率图模型
先把记号定死。$s_t$ 是状态(满足马尔可夫性),$a_t$ 是动作,$o_t$ 是观测(可能只反映状态的一部分,本讲一律假设全观测,即 $o_t=s_t$)。转移是 $p(s_{t+1}|s_t,a_t)$,奖励是 $r(s_t,a_t)$,轨迹 $\tau=(s_1,a_1,\dots,s_T,a_T)$,策略 $\pi_\theta(a|s)$,折扣 $\gamma$。轨迹的先验概率
$$ p(\tau)=p(s_1)\prod_{t=1}^{T} p(s_{t+1}|s_t,a_t), $$注意这里没有策略项 —— 或者说,我们暂时假设动作的先验 $p(a_t|s_t)$ 是均匀分布,把它当常数吸收进归一化常数里(第 6 节会看到非均匀先验会带来什么,而且那正是 RLHF 的形式)。
最优控制的写法为什么不能解释人
经典最优控制写成
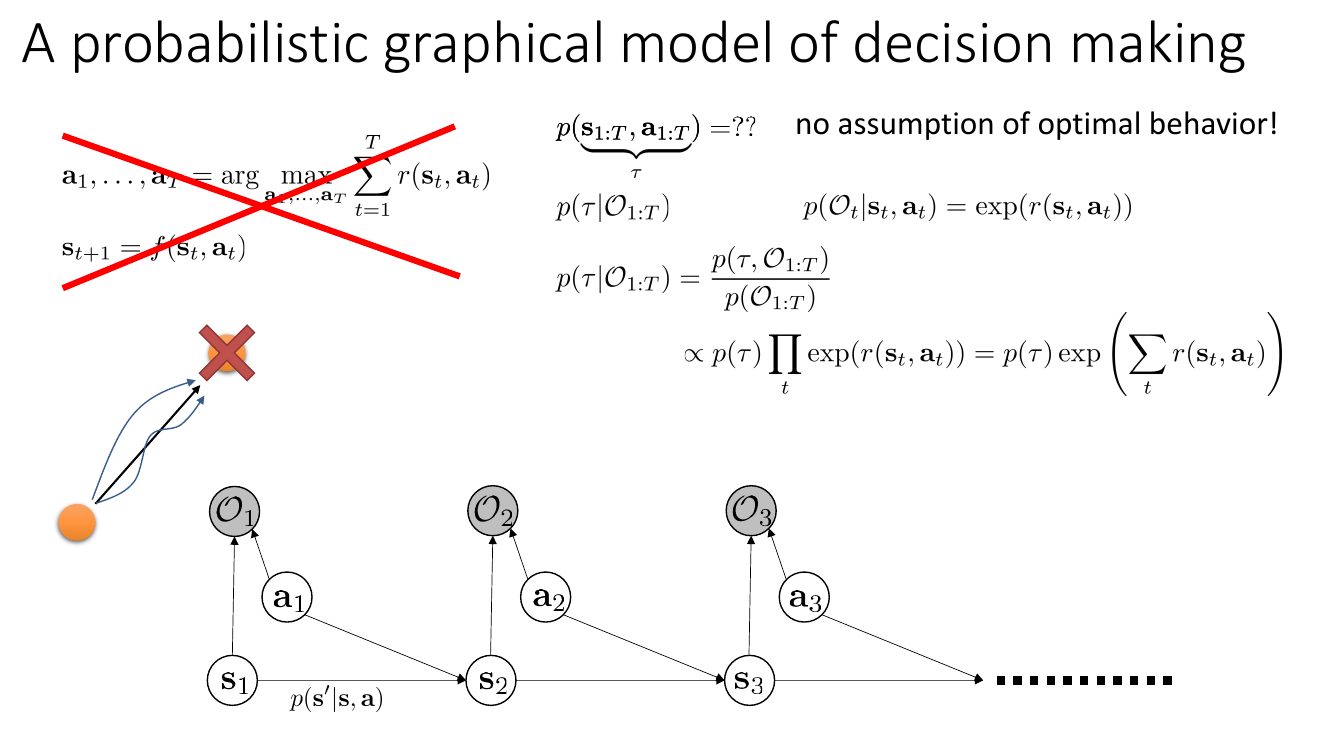
$$ a_1,\dots,a_T=\argmax_{a_1,\dots,a_T}\sum_{t=1}^{T} r(s_t,a_t),\qquad s_{t+1}=f(s_t,a_t). $$Levine 在这一页上直接画了个大红叉。原因很实际:这个式子给出的是一条轨迹。如果你观察一个人从 A 走到 B 走了二十次,走出二十条略有差别的路线,这个模型的似然是零 —— 它没有能力给「差一点点的行为」分配概率。要做逆问题(从行为反推目标)、要拟合真实数据、要在多个几乎一样好的方案之间保留不确定性,我们需要一个随机的、承认次优的模型。
最优性变量
引入二值随机变量 $\mathcal{O}_t\in\{0,1\}$,读作「第 $t$ 步的行为是最优的」。它的条件分布定义为
$$ p(\mathcal{O}_t=1\,|\,s_t,a_t)=\exp\big(r(s_t,a_t)\big). $$以后一律把 $\mathcal{O}_t=1$ 简写成 $\mathcal{O}_t$。注意这个定义要求 $r\le 0$ 才能让右边落在 $[0,1]$ 里。这不是限制:奖励整体加一个常数不改变最优策略,也不改变下面所有后验分布(常数会被归一化吃掉),所以总可以平移到非正。更实用的看法是:把 $\exp(r)$ 当作一个未归一化的势函数(potential),图模型的一切推断公式照样成立。
现在把整条轨迹条件在「每一步都最优」上:
$$ p(\tau|\mathcal{O}_{1:T})=\frac{p(\tau,\mathcal{O}_{1:T})}{p(\mathcal{O}_{1:T})} \propto p(\tau)\prod_{t=1}^{T}p(\mathcal{O}_t|s_t,a_t) = p(\tau)\exp\left(\sum_{t=1}^{T} r(s_t,a_t)\right). $$这一行是本讲所有内容的种子,值得盯着看一会儿。它说:在物理上可行的轨迹里($p(\tau)$ 那一项负责剔除违反动力学的轨迹),回报每高 1 个单位,概率就大 $e$ 倍。
把 $\exp(\sum_t r)$ 想成玻尔兹曼分布里的 $e^{-E/kT}$:回报 $=$ 负能量。回报最高的轨迹是「基态」,概率最大;差 1 分的轨迹概率是它的 $1/e\approx 37\%$;差 5 分的是 $0.7\%$;差 20 分的基本可以忽略。所以这个分布集中在最优解附近但不塌缩到最优解。这正是我们要的「近似最优」。而且注意它是尺度敏感的:如果把奖励整体乘 10,分布会急剧变尖,趋向确定性最优;乘 0.1 则趋向随机。这个尺度后面会变成「温度」$\alpha$,是 SAC 里最重要的超参数。
这个模型可以问三种问题
建好模型之后,剩下的全部是标准的图模型推断,跟 HMM 的 forward-backward、卡尔曼滤波/平滑是同一套东西。具体有三个量要算:
| 要算的量 | 符号 | 含义 | 对应经典 RL 的什么 |
|---|---|---|---|
| 反向消息 | $\beta_t(s_t,a_t)=p(\mathcal{O}_{t:T}|s_t,a_t)$ | 从 $(s_t,a_t)$ 出发,「今后一路最优」的概率 | $Q$ 函数(取对数后) |
| 策略 | $p(a_t|s_t,\mathcal{O}_{1:T})$ | 已知全程最优,在 $s_t$ 会选什么动作 | 最优策略 |
| 前向消息 | $\alpha_t(s_t)=p(s_t|\mathcal{O}_{1:t-1})$ | 「此前一路最优」的条件下,$t$ 时刻在哪 | 状态访问分布 $d^\pi(s)$ |
三者的关系跟 HMM 完全一样:反向消息从未来往回传「还有多大希望」,前向消息从过去往前传「你可能在哪」,两者相乘给出状态的边缘后验。下面三节分别推导。
2. 反向消息:递推推导,以及 soft maximum 是怎么冒出来的
定义反向消息
$$ \beta_t(s_t,a_t)=p(\mathcal{O}_{t:T}\,|\,s_t,a_t),\qquad \beta_t(s_t)=p(\mathcal{O}_{t:T}\,|\,s_t). $$逐步推导递推式
把 $s_{t+1}$ 边缘化进来(这一步只是插入一个积分),然后用图模型的条件独立性拆开:
$$ \beta_t(s_t,a_t)=\int p(\mathcal{O}_{t:T},s_{t+1}\,|\,s_t,a_t)\,ds_{t+1} =\int p(\mathcal{O}_{t+1:T}|s_{t+1})\,p(s_{t+1}|s_t,a_t)\,p(\mathcal{O}_t|s_t,a_t)\,ds_{t+1}. $$为什么可以这样拆?看图:给定 $s_{t+1}$,未来的 $\mathcal{O}_{t+1:T}$ 与 $(s_t,a_t)$ d-分离(所有路径都必须经过 $s_{t+1}$),所以 $p(\mathcal{O}_{t+1:T}|s_{t+1},s_t,a_t)=p(\mathcal{O}_{t+1:T}|s_{t+1})=\beta_{t+1}(s_{t+1})$;而 $\mathcal{O}_t$ 只依赖 $(s_t,a_t)$。$p(\mathcal{O}_t|s_t,a_t)$ 与积分变量无关,提到外面:
$$ \boxed{\;\beta_t(s_t,a_t)=p(\mathcal{O}_t|s_t,a_t)\;\E_{s_{t+1}\sim p(s_{t+1}|s_t,a_t)}\big[\beta_{t+1}(s_{t+1})\big].\;} $$再把动作边缘化掉,用的是动作的先验 $p(a_t|s_t)$(注意:不是策略,图模型里根本没有策略这条边):
$$ \boxed{\;\beta_t(s_t)=\E_{a_t\sim p(a_t|s_t)}\big[\beta_t(s_t,a_t)\big].\;} $$边界条件是 $\beta_{T+1}\equiv 1$(未来没有任何 $\mathcal{O}$ 要满足)。这就是一个从 $t=T$ 倒推到 $t=1$ 的动态规划,与 HMM 的 backward pass 一模一样。
取对数:值函数出现了
$\beta$ 是概率的乘积,会指数级衰减,数值上无法直接算;而且我们想看到它和 RL 的联系。所以定义
$$ V_t(s_t)\;\triangleq\;\log\beta_t(s_t),\qquad Q_t(s_t,a_t)\;\triangleq\;\log\beta_t(s_t,a_t). $$对第一条递推式取对数,代入 $\log p(\mathcal{O}_t|s_t,a_t)=r(s_t,a_t)$ 和 $\beta_{t+1}=\exp(V_{t+1})$:
$$ Q_t(s_t,a_t)=r(s_t,a_t)+\log \E_{s_{t+1}}\big[\exp\big(V_{t+1}(s_{t+1})\big)\big]. $$对第二条递推式取对数,先设动作先验是均匀分布 $p(a_t|s_t)=1/|\mathcal{A}|$(常数被吸收):
$$ V_t(s_t)=\log\int \exp\big(Q_t(s_t,a_t)\big)\,da_t. $$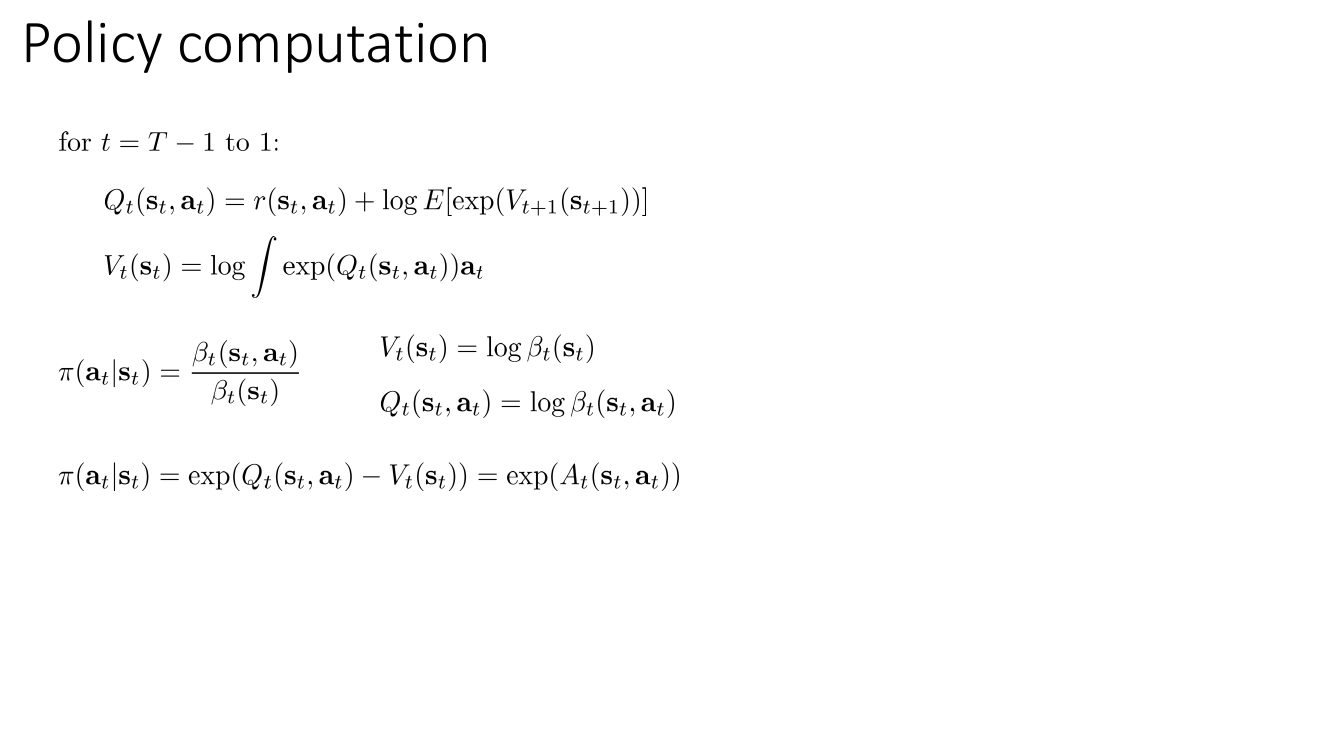
为什么 $\log\int\exp$ 叫 soft maximum
离散动作时它就是 $\log\sum_a e^{Q(s,a)}$,也就是 logsumexp。两条不等式夹住它:
$$ \max_a Q(s,a)\;\le\;\log\sum_a \exp Q(s,a)\;\le\;\max_a Q(s,a)+\log|\mathcal{A}|. $$左边显然(求和至少包含最大那一项);右边把所有项都放大到最大项即可。所以 soft max 与 hard max 的差最多是 $\log|\mathcal{A}|$,且当最大值远远领先时几乎相等。具体数字(两个动作,$Q=(0,g)$):
| $Q$ 的差距 $g$ | $\log(1+e^{g})$ | $\max=g$ | 差值 |
|---|---|---|---|
| 1 | 1.3133 | 1 | 0.313 |
| 2 | 2.1269 | 2 | 0.127 |
| 5 | 5.0067 | 5 | 0.007 |
| 10 | 10.0000 | 10 | $4.5\times10^{-5}$ |
所以 soft max 只在「几个动作打平」的时候才和 hard max 不同 —— 它做的事情是在打平的动作之间保留不确定性。这跟我们建模的初衷(人在几条差不多好的路线之间随机选)完全对上了。
「soft max」在这里不是 $\softmax$ 函数(那个把向量变成概率分布的),而是 $\log\sum\exp$ 这个把向量变成标量的算子。两者的关系是:$\softmax$ 是 $\log\sum\exp$ 的梯度。看到 $V=\log\int\exp Q$ 就想「这是 $\max$ 的光滑版本」,看到 $\pi=\exp(Q-V)$ 才想 $\softmax$。
非均匀动作先验去哪了
如果动作先验 $p(a_t|s_t)$ 不是均匀的,$V_t(s_t)=\log\int p(a_t|s_t)\exp(Q_t)\,da_t$。但注意可以定义 $\tilde r(s,a)=r(s,a)+\log p(a|s)$,就把先验完全吸收进奖励,形式回到均匀先验的情形。所以「均匀先验」不失一般性 —— 这也解释了为什么 Levine 从头到尾不写动作先验。但请记住这个变换:第 6 节我们会把它反过来用,得到 KL 正则化的 RL。
3. 策略与前向消息:另外两个推断问题
策略 $p(a_t|s_t,\mathcal{O}_{1:T})$
先做一个化简:给定 $s_t$,过去的最优性变量 $\mathcal{O}_{1:t-1}$ 与 $a_t$ 条件独立(图上从 $\mathcal{O}_{1:t-1}$ 到 $a_t$ 的所有路径都被 $s_t$ 挡住),所以
$$ p(a_t|s_t,\mathcal{O}_{1:T})=p(a_t|s_t,\mathcal{O}_{t:T}). $$然后套贝叶斯:
$$ p(a_t|s_t,\mathcal{O}_{t:T}) =\frac{p(\mathcal{O}_{t:T}|s_t,a_t)\,p(a_t|s_t)\,p(s_t)/p(\mathcal{O}_{t:T})}{p(\mathcal{O}_{t:T}|s_t)\,p(s_t)/p(\mathcal{O}_{t:T})} =\frac{\beta_t(s_t,a_t)}{\beta_t(s_t)}\,p(a_t|s_t). $$均匀先验下把 $p(a_t|s_t)$ 吸收掉,取对数:
$$ \pi(a_t|s_t)=\frac{\beta_t(s_t,a_t)}{\beta_t(s_t)}=\exp\big(Q_t(s_t,a_t)-V_t(s_t)\big)=\exp\big(A_t(s_t,a_t)\big). $$这是玻尔兹曼策略(Boltzmann policy),指数里是优势函数 $A=Q-V$。它有几个立刻可读的性质:
- $V=\log\int\exp Q$ 恰好是使 $\exp(Q-V)$ 归一化的那个常数 —— 所以 $V$ 天然扮演「配分函数的对数」的角色,soft max 的定义不是凑的,是被归一化条件逼出来的。
- 最优动作($A=0$)概率最高;比最优差 1 的动作概率是它的 $1/e$。
- 加上温度以后 $\pi=\exp\big((Q-V)/\alpha\big)$:$\alpha\to 0$ 退化成贪心策略 $\argmax_a Q$,$\alpha\to\infty$ 退化成均匀随机。
前向消息 $\alpha_t(s_t)$
反向消息回答「从这里出发还有多大希望」,前向消息回答「假设一路走来都表现最优,我现在可能在哪」。定义 $\alpha_t(s_t)=p(s_t|\mathcal{O}_{1:t-1})$,递推为
$$ \alpha_t(s_t)=\int\!\!\int p(s_t|s_{t-1},a_{t-1})\;p(a_{t-1}|s_{t-1},\mathcal{O}_{t-1})\;p(s_{t-1}|\mathcal{O}_{1:t-1})\,ds_{t-1}\,da_{t-1}, $$其中中间那项由贝叶斯给出 $p(a_{t-1}|s_{t-1},\mathcal{O}_{t-1})\propto p(\mathcal{O}_{t-1}|s_{t-1},a_{t-1})p(a_{t-1}|s_{t-1})=\exp(r)\cdot p(a|s)$,最后一项则可以再拆一次:
$$ p(s_{t-1}|\mathcal{O}_{1:t-1})=\frac{p(\mathcal{O}_{t-1}|s_{t-1})\,p(s_{t-1}|\mathcal{O}_{1:t-2})}{p(\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2})}\;\propto\;\beta_{t-1}(s_{t-1})\,\alpha_{t-1}(s_{t-1}). $$所以前向递推需要用到反向消息 —— 和 HMM 的 forward-backward 一样。初值 $\alpha_1(s_1)=p(s_1)$。
两个消息相乘 = 状态边缘后验
$$ p(s_t|\mathcal{O}_{1:T})=\frac{p(\mathcal{O}_{1:T}|s_t)p(s_t)}{p(\mathcal{O}_{1:T})} \propto \underbrace{p(\mathcal{O}_{t:T}|s_t)}_{\beta_t(s_t)}\;\underbrace{p(\mathcal{O}_{1:t-1}|s_t)p(s_t)}_{\propto\;\alpha_t(s_t)} \;\;\propto\;\;\alpha_t(s_t)\,\beta_t(s_t). $$画个二维平面上的导航问题:起点在左,目标在右。$\alpha_t$ 是从起点向右张开的一个「圆锥」(时间越久能到的地方越多);$\beta_t$ 是从目标向左张开的另一个圆锥(离目标越远越不可能按时到达)。两个圆锥相乘,得到一个连接起点与终点的雪茄形区域 —— 这就是「所有近似最优轨迹」聚集的地方,中间粗、两头细。这个乘积正是最优轨迹分布的边缘。它也解释了为什么这套框架天然适合做轨迹分布建模而不只是求一条最优轨迹。
前向消息在纯 RL 算法里几乎用不上(我们只需要策略),但在逆强化学习里它是关键:第 11 节会看到,MaxEnt IRL 的梯度需要 $p(s_t,a_t|\mathcal{O}_{1:T})\propto \alpha_t(s_t)\beta_t(s_t,a_t)$,也就是必须跑一次完整的 forward-backward。
到这里,Part 1 的结论可以总结成三句话:(1) 我们有了一个能表达「近似最优」的最优控制概率图模型;(2) 控制 $=$ 推断,用的工具跟 HMM、扩展卡尔曼滤波是同一套;(3) 得到的算法跟动态规划、值迭代极其相似,只是所有的 $\max$ 都变「软」了。
4. 乐观偏差:朴素推断解出来的是一个赌徒
上一节的推导干净利落,但结果是错的。错在哪一行?就在这一行:
$$ Q_t(s_t,a_t)=r(s_t,a_t)+\underbrace{\log \E_{s_{t+1}}\big[\exp\big(V_{t+1}(s_{t+1})\big)\big]}_{\text{对下一状态取 soft max!}}. $$把它和标准的 Bellman backup $Q=r+\gamma\E_{s'}[V(s')]$ 对比:标准版对下一状态取普通期望,这里取的却是 $\log\E\exp$,也就是又一个 soft max。由 Jensen 不等式($\exp$ 是凸函数):
$$ \log\E\big[\exp V\big]\;\ge\;\E\big[V\big], $$而且当 $V$ 在不同下一状态之间差异很大时,这个不等式可以差出天壤之别。
被污染的转移长什么样
把后验转移显式算出来会更清楚。用和第 2 节同样的 d-分离:
$$ p(s_{t+1}|s_t,a_t,\mathcal{O}_{t:T})\;\propto\;p(\mathcal{O}_{t+1:T}|s_{t+1})\,p(s_{t+1}|s_t,a_t) =p(s_{t+1}|s_t,a_t)\,\exp\big(V_{t+1}(s_{t+1})\big). $$也就是说,后验把真实转移按 $e^{V}$ 做了指数倾斜(exponential tilting):高价值的下一状态概率被放大,低价值的被压低。归一化常数正是 $\exp(\log\E[\exp V])$ —— 这就是 $\log\E\exp$ 的来源。
为什么这件事在策略上是对的、在转移上是错的?因为条件概率是「已知结果好,推断原因」。动作是智能体能选的,所以「已知结果好 ⇒ 你当时多半选了好动作」是一个有用的推断。但转移是环境决定的,智能体无法选择运气;「已知结果好 ⇒ 你当时多半走运了」在推断上没错,但如果把它当成规划的依据,就等于假设「我以后也会一直走运」。这就是 optimism bias。
一个能算出数的例子
三状态 MDP:$s_0$ 起点,$s_1$「头奖」(吸收态,每步 $r=1$),$s_2$「破产」(吸收态,$r=0$)。两个动作:
- 稳妥:留在 $s_0$,每步 $r=0.05$;
- 赌一把:$2\%$ 概率进 $s_1$,$98\%$ 概率进 $s_2$,即时奖励 $0$。
取 $\gamma=0.95$,温度 $\alpha=0.05$。先看标准(hard)值迭代:$V(s_1)=1/(1-0.95)=20$,$V(s_2)=0$,于是
$$ Q(s_0,\text{赌})=0+0.95\times(0.02\times 20+0.98\times 0)=0.38,\qquad Q(s_0,\text{稳妥})=0.05+0.95\,V(s_0)\;\Rightarrow\;V(s_0)=1.0 . $$稳妥 $1.0$ 完胜赌一把 $0.38$,这显然是对的:$2\%$ 的中奖率不值得。现在把这三种 backup 都跑一遍(数值由下面的代码实测得到):
| backup 方式 | 动作最大值 | 下一状态期望 | $Q(s_0,\text{稳妥})$ | $Q(s_0,\text{赌})$ | $\pi(\text{赌})$ |
|---|---|---|---|---|---|
| 标准值迭代 | $\max_a$ | $\E_{s'}$ | 1.000 | 0.380 | 0.00 |
| 变分(最大熵,$\alpha=0.05$) | $\alpha\log\sum e^{Q/\alpha}$ | $\E_{s'}$ | 1.133 | 1.038 | 0.13 |
| 朴素推断(乐观) | $\alpha\log\sum e^{Q/\alpha}$ | $\alpha\log\E e^{V/\alpha}$ | 18.549 | 19.473 | 1.00 |
看第三行:朴素推断认为「赌一把」的价值是 $19.47$,几乎等于直接坐在头奖里的价值($V(s_1)=20.69$)。为什么?把那一步算给你看:
$$ \alpha\log\Big(0.02\,e^{20.693/0.05}+0.98\,e^{0.693/0.05}\Big) \approx 20.693+0.05\log 0.02=20.693-0.196=20.497 . $$$2\%$ 的概率只让结果打了 $0.196$ 的折扣 —— 因为 $\log$ 里的指数项完全压倒了概率权重。模型把「有 2% 可能中头奖」读成了「基本上会中头奖」。相反,第二行的变分 backup 老老实实算 $0.02\times 20.693+0.98\times 0.693=1.093$,结论跟标准值迭代一致(稳妥略优),只是因为熵项而没有把「赌一把」的概率压到零。
不要以为「乐观偏差 $=$ 探索里的乐观初始化,是好事」。探索里的乐观是对认知不确定性(epistemic uncertainty)乐观 —— 没试过的地方假设它好,试过就修正。这里的乐观是对随机性(aleatoric uncertainty)乐观 —— 明知道只有 2% 概率还是按 100% 规划,而且试再多次也不会修正,因为它就写在目标函数里。前者能加速学习,后者会让智能体系统性地做出灾难性决策(走悬崖边、赌博、闯红灯)。
什么时候朴素推断没问题
如果动力学是确定性的,$p(s_{t+1}|s_t,a_t)=\delta(s_{t+1}-f(s_t,a_t))$,那么 $\log\E[\exp V]=V(f(s_t,a_t))=\E[V]$ 精确成立,乐观项彻底消失。所以在确定性系统里,朴素的 control-as-inference 和下面要讲的变分版本完全等价。这解释了为什么这套理论最早的成功案例(linearly-solvable MDP、path integral control、iLQR 的概率版本)大多是确定性或近似确定性的连续控制问题。
5. 变分修正:把动力学钉死,最大化 ELBO
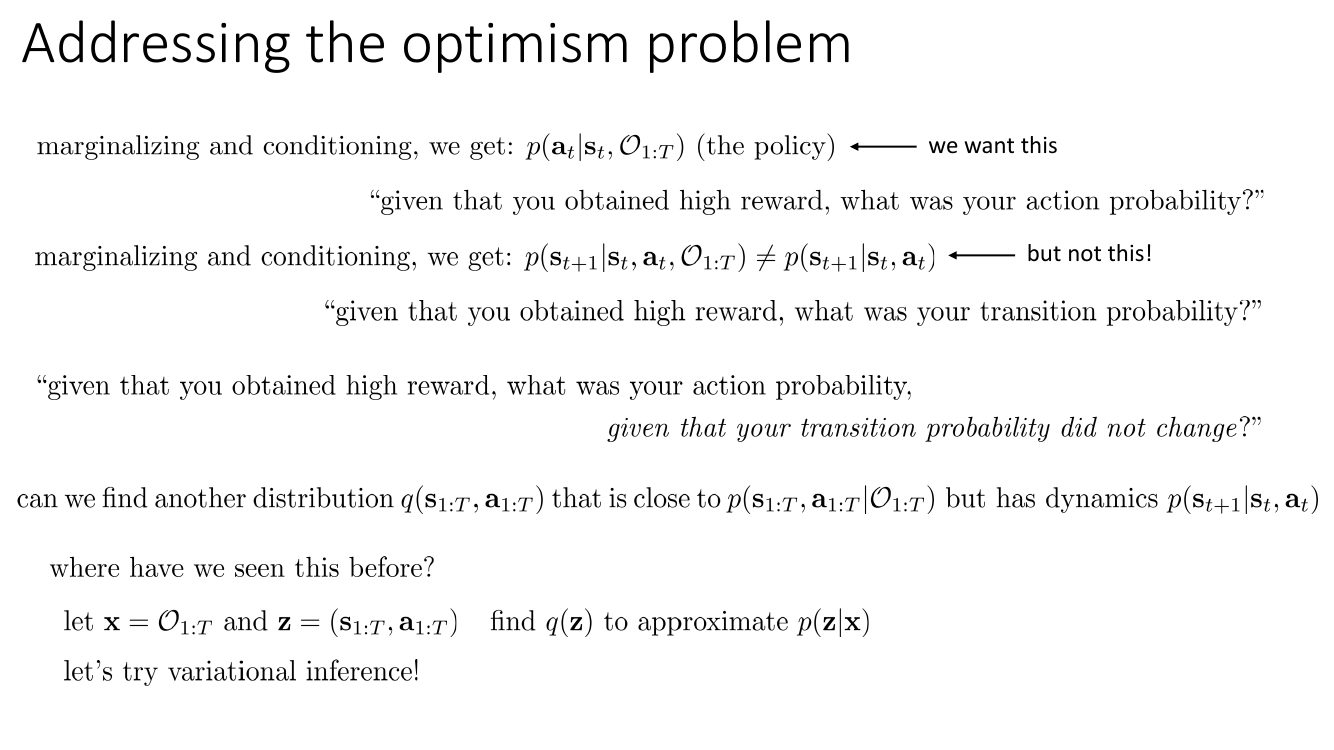
问题定位清楚了:我们想要 $p(a_t|s_t,\mathcal{O}_{1:T})$,但不想要 $p(s_{t+1}|s_t,a_t,\mathcal{O}_{1:T})$。Levine 把它重新表述成一句英文,非常准确:
「已知你拿到了高回报,你的动作分布是什么 —— 在你的转移概率没有改变的前提下?」
变分族的选择
这是整段推导里唯一需要「设计」的地方,也是全部聪明才智所在:
$$ q(s_{1:T},a_{1:T})=p(s_1)\prod_{t=1}^{T}p(s_{t+1}|s_t,a_t)\,q(a_t|s_t). $$逐项看:初始状态分布 $p(s_1)$ 和转移 $p(s_{t+1}|s_t,a_t)$ 与真实模型一模一样,不带任何可学参数;唯一新的东西是 $q(a_t|s_t)$。换句话说,$q$ 就是「在真实环境里跑策略 $q(a|s)$ 所诱导的轨迹分布」。这个变分族在结构上不可能产生乐观动力学 —— 它连表达乐观动力学的能力都没有。
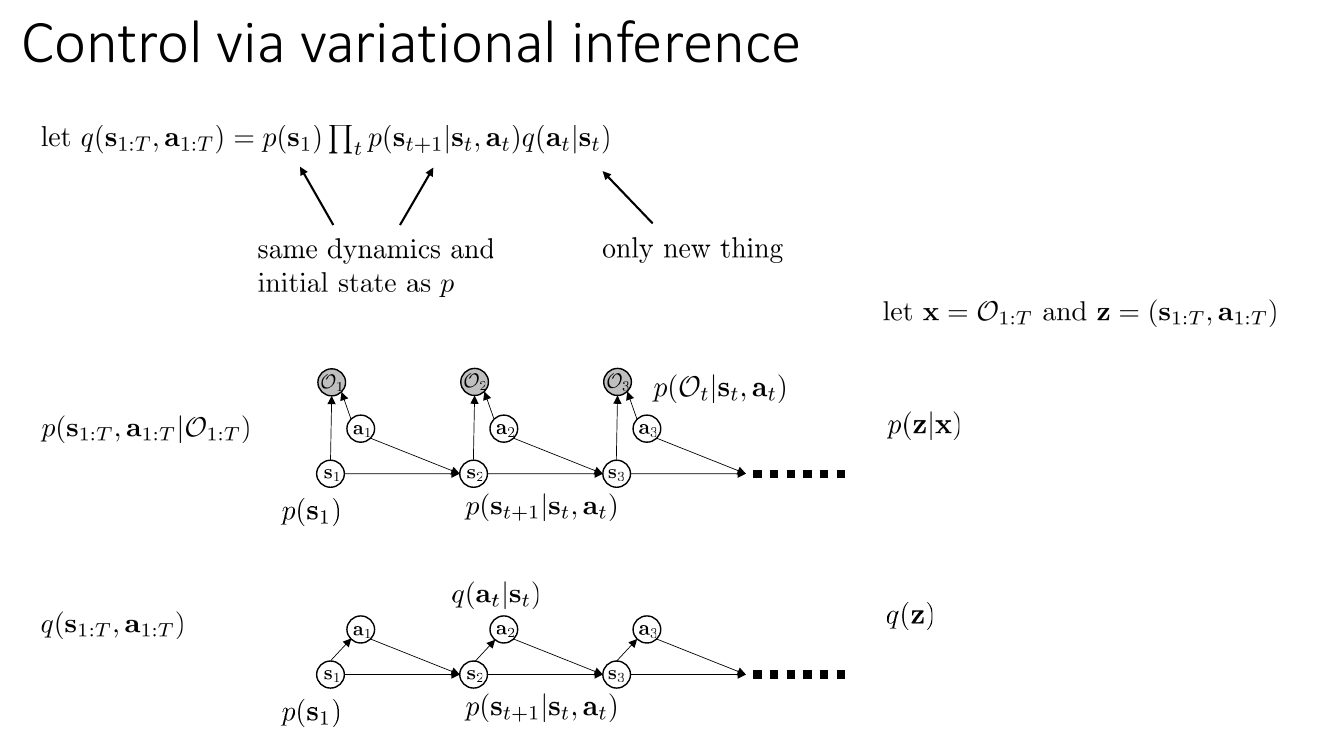
ELBO 的完整推导
第一步:写出通用 ELBO。对任意 $q(\mathbf{z})$,
$$ \log p(\mathbf{x})=\log\int p(\mathbf{x},\mathbf{z})\,d\mathbf{z} =\log\int q(\mathbf{z})\frac{p(\mathbf{x},\mathbf{z})}{q(\mathbf{z})}\,d\mathbf{z} \;\ge\;\E_{\mathbf{z}\sim q}\big[\log p(\mathbf{x},\mathbf{z})-\log q(\mathbf{z})\big], $$不等号来自 Jensen($\log$ 是凹的)。右边第二项 $-\E_q[\log q]$ 就是熵 $\mathcal{H}(q)$,这一点非常关键:熵不是我们加进去的,它是 ELBO 自带的。而且不等式的间隙恰好是 $\KL\big(q(\mathbf{z})\,\|\,p(\mathbf{z}|\mathbf{x})\big)$,所以「最大化 ELBO」$=$「让 $q$ 逼近后验」。
第二步:代入 $\mathbf{x}=\mathcal{O}_{1:T}$、$\mathbf{z}=(s_{1:T},a_{1:T})$。联合分布 $\log p(\mathbf{x},\mathbf{z})=\log p(s_1)+\sum_t\log p(s_{t+1}|s_t,a_t)+\sum_t\log p(\mathcal{O}_t|s_t,a_t)$,变分分布 $\log q(\mathbf{z})=\log p(s_1)+\sum_t\log p(s_{t+1}|s_t,a_t)+\sum_t\log q(a_t|s_t)$。相减:
$$ \log p(\mathcal{O}_{1:T})\;\ge\;\E_{q}\Big[ \cancel{\log p(s_1)}+\cancel{\textstyle\sum_t\log p(s_{t+1}|s_t,a_t)}+\sum_t\log p(\mathcal{O}_t|s_t,a_t) -\cancel{\log p(s_1)}-\cancel{\textstyle\sum_t\log p(s_{t+1}|s_t,a_t)}-\sum_t\log q(a_t|s_t)\Big]. $$第三步:约掉。初始状态项和全部动力学项精确抵消 —— 这正是我们把 $q$ 的动力学钉死成 $p$ 的回报。剩下
$$ \log p(\mathcal{O}_{1:T})\;\ge\;\E_{(s_{1:T},a_{1:T})\sim q}\Big[\sum_t r(s_t,a_t)-\log q(a_t|s_t)\Big]. $$第四步:把 $-\log q$ 写成熵。对每个 $t$ 先对 $a_t$ 求期望再对 $s_t$ 求期望:$\E_{(s_t,a_t)\sim q}[-\log q(a_t|s_t)]=\E_{s_t\sim q}\big[\mathcal{H}(q(\cdot|s_t))\big]$。于是
$$ \boxed{\;\log p(\mathcal{O}_{1:T})\;\ge\;\sum_{t=1}^{T}\E_{(s_t,a_t)\sim q}\big[\,r(s_t,a_t)+\mathcal{H}\big(q(\cdot|s_t)\big)\,\big]\;\triangleq\;\mathcal{L}(q).\;} $$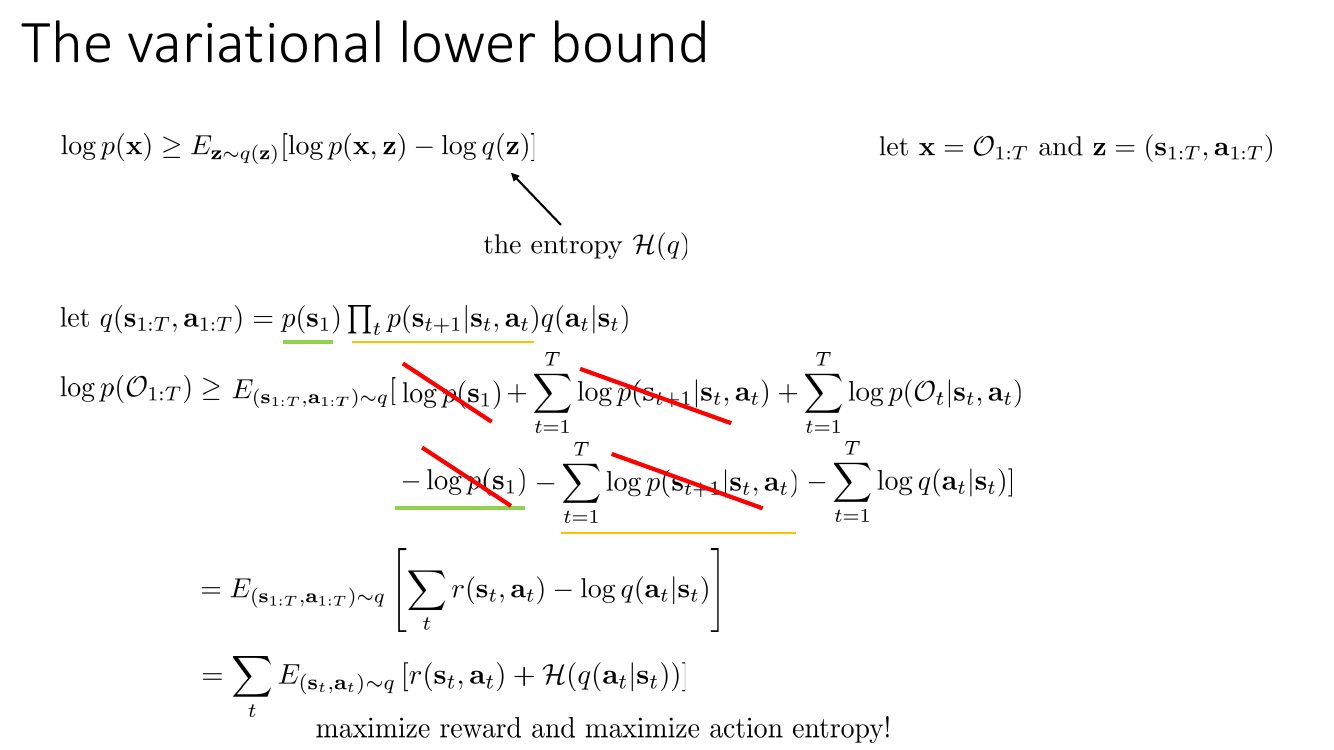
换个角度:这是一次 KL 最小化
记目标轨迹分布 $\tilde p(\tau)=\frac{1}{Z}p(\tau)\exp\big(\sum_t r(s_t,a_t)\big)$。由于 $\log q(\tau)-\log p(\tau)=\sum_t\log q(a_t|s_t)$(动力学再次抵消),
$$ \KL\big(q(\tau)\,\|\,\tilde p(\tau)\big) =\E_q\Big[\sum_t\log q(a_t|s_t)-\sum_t r(s_t,a_t)\Big]+\log Z =-\mathcal{L}(q)+\log Z . $$所以最大化最大熵目标 $\equiv$ 最小化 $\KL(q\|\tilde p)$,即让「策略诱导的轨迹分布」去逼近「按回报指数加权的轨迹分布」。注意这是反向 KL(mode-seeking):$q$ 会去覆盖 $\tilde p$ 的若干个高概率模式,而不是摊平去平均所有模式 —— 这在多模态任务里是好事(不会输出两个正确方案的平均值,那往往是最差的方案)。
最大熵 RL 目标 $\sum_t\E[r+\mathcal{H}]$ 不是一个启发式的正则项,它是「控制即推断」这个概率模型在正确的变分族下的严格证据下界。熵项的系数为 1 也不是随便定的 —— 它由 $\log q$ 在 ELBO 中的系数决定。后面出现的温度 $\alpha$ 实际上是奖励的尺度:用 $r/\alpha$ 代替 $r$ 建模,就等价于把熵的权重设成 $\alpha$。
6. Soft value iteration:变分版的反向传递
ELBO 有了,怎么最优化它?用动态规划,从 $t=T$ 往回做。
关键恒等式:自由能 / KL 投影
对任意函数 $f(a)$ 和任意温度 $\alpha>0$,考虑
$$ \max_{q}\;\Big\{\E_{a\sim q}[f(a)]+\alpha\,\mathcal{H}(q)\Big\}\quad\text{s.t.}\quad\int q(a)\,da=1 . $$令 $Z=\int\exp(f(a)/\alpha)\,da$。把目标除以 $\alpha$ 再配项:
$$ \frac{1}{\alpha}\Big(\E_q[f]+\alpha\mathcal{H}(q)\Big) =\int q(a)\log\frac{\exp(f(a)/\alpha)}{q(a)}\,da =\log Z-\KL\!\left(q\;\Big\|\;\frac{\exp(f/\alpha)}{Z}\right). $$因为 $\KL\ge 0$ 且仅在两分布相等时取零,立刻得到
$$ \boxed{\;q^\star(a)=\frac{\exp\big(f(a)/\alpha\big)}{Z},\qquad \max_q\Big\{\E_q[f]+\alpha\mathcal{H}(q)\Big\}=\alpha\log\int\exp\big(f(a)/\alpha\big)\,da.\;} $$(也可以用变分法直接验证:对拉格朗日量 $\int q(f-\alpha\log q)+\lambda(\int q-1)$ 求泛函导数得 $f-\alpha\log q-\alpha+\lambda=0$,即 $q\propto e^{f/\alpha}$。)
这一个恒等式同时给了我们三样东西:soft max 是最优值,玻尔兹曼分布是最优解,而「最优解」这件事的证明方式是一次 KL 投影。请记住它,第 9 节 SAC 的策略改进步会原样再用一次。
反向递推
末端 $t=T$。ELBO 中只含 $a_T$ 的项是 $\E_{q(a_T|s_T)}[r(s_T,a_T)]+\mathcal{H}(q(\cdot|s_T))$。取 $f=r(s_T,\cdot)$、$\alpha=1$,由恒等式得
$$ q(a_T|s_T)=\frac{\exp(r(s_T,a_T))}{\int \exp(r(s_T,a))\,da},\qquad V_T(s_T)=\log\int \exp\big(r(s_T,a_T)\big)\,da_T . $$归纳步。假设从 $t+1$ 起的最优 ELBO 之和等于 $\E_{s_{t+1}}[V_{t+1}(s_{t+1})]$。含 $a_t$ 的项是
$$ \E_{q(a_t|s_t)}\Big[r(s_t,a_t)+\E_{s_{t+1}\sim p(\cdot|s_t,a_t)}\big[V_{t+1}(s_{t+1})\big]\Big]+\mathcal{H}\big(q(\cdot|s_t)\big). $$注意中间那个期望是对真实转移取的普通期望 —— 因为 $q$ 的转移就是 $p$,我们没有别的选择。定义
$$ Q_t(s_t,a_t)\;=\;r(s_t,a_t)+\E_{s_{t+1}\sim p(s_{t+1}|s_t,a_t)}\big[V_{t+1}(s_{t+1})\big], $$再用一次恒等式($f=Q_t(s_t,\cdot)$):
$$ q(a_t|s_t)=\exp\big(Q_t(s_t,a_t)-V_t(s_t)\big),\qquad V_t(s_t)=\log\int\exp\big(Q_t(s_t,a_t)\big)\,da_t . $$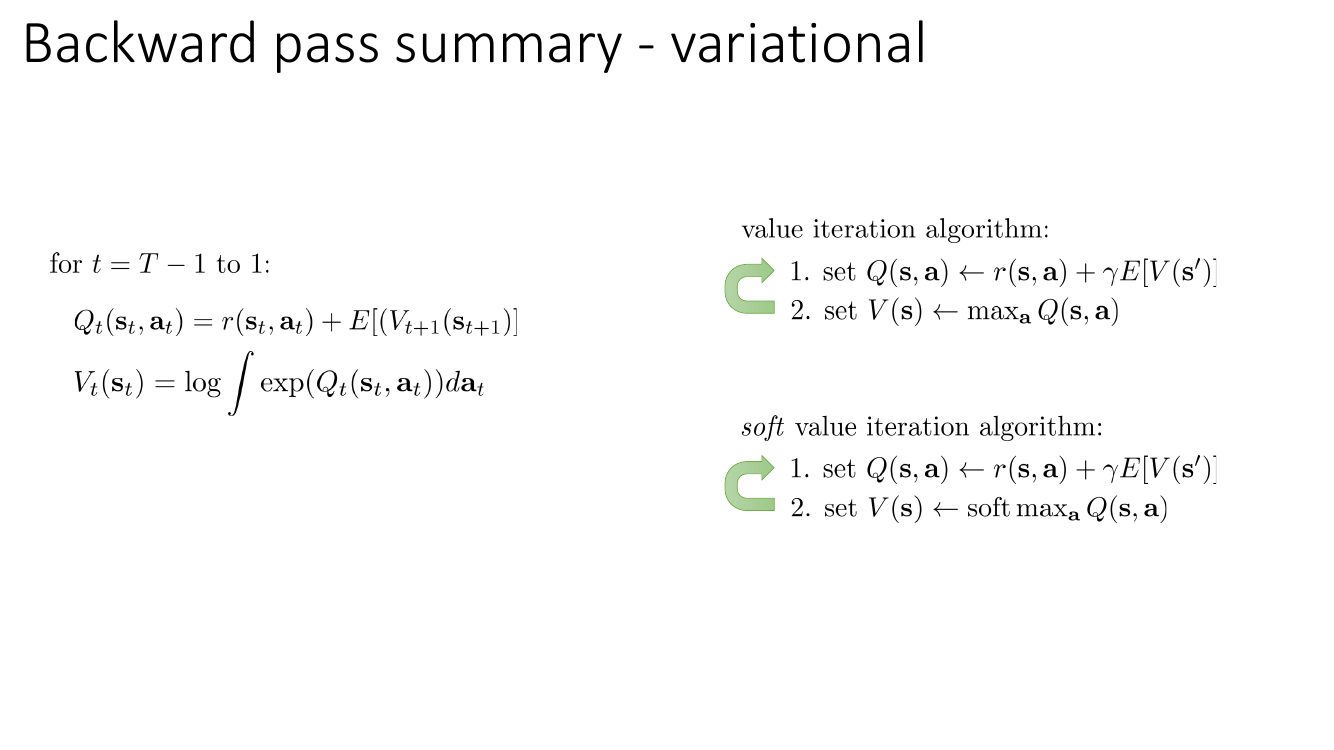
和第 2 节的朴素版本比一比
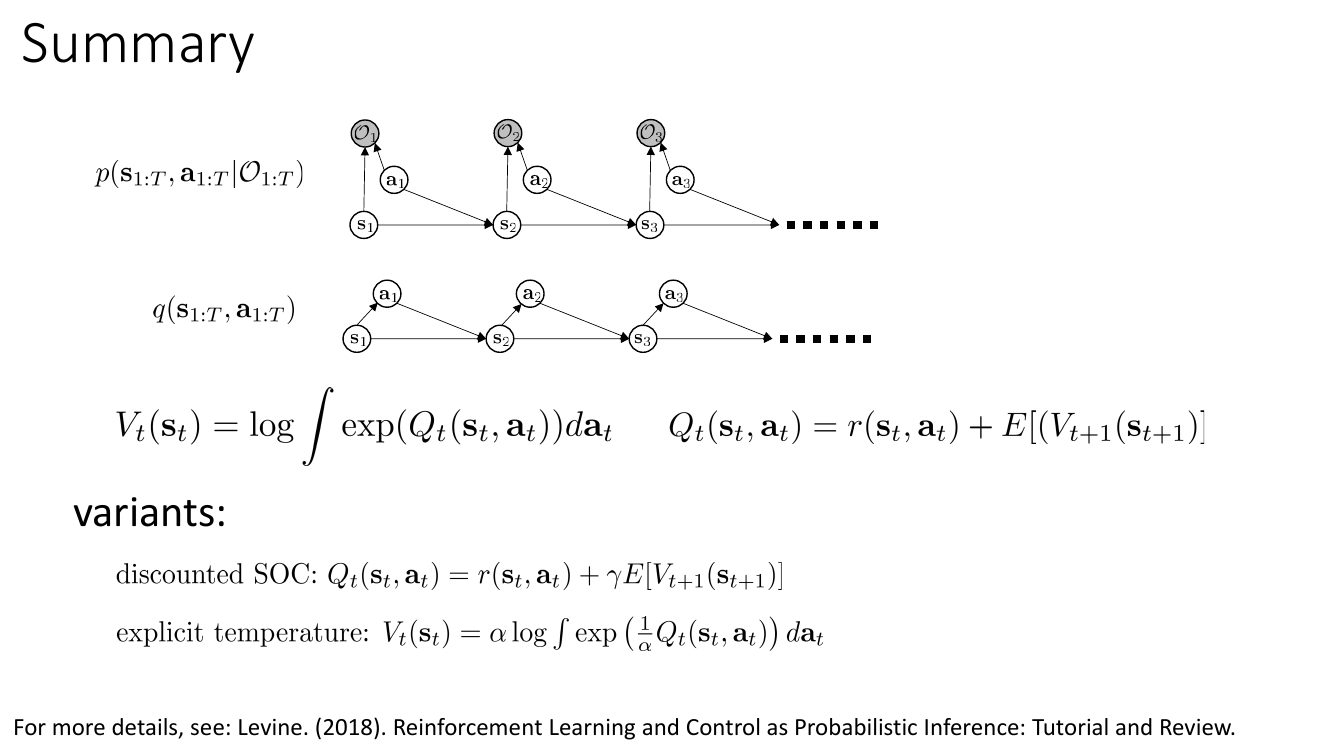
| 标准值迭代 | 朴素推断(乐观) | 变分 / 最大熵 | |
|---|---|---|---|
| $Q$ 更新(对 $s'$) | $r+\gamma\E_{s'}[V]$ | $r+\gamma\,\alpha\log\E_{s'}[e^{V/\alpha}]$ | $r+\gamma\E_{s'}[V]$ |
| $V$ 更新(对 $a$) | $\max_a Q$ | $\alpha\log\int e^{Q/\alpha}da$ | $\alpha\log\int e^{Q/\alpha}da$ |
| 策略 | $\argmax_a Q$(确定性) | $\exp((Q-V)/\alpha)$ | $\exp((Q-V)/\alpha)$ |
| 随机动力学下是否合理 | 是 | 否(乐观偏差) | 是 |
| 确定性动力学下 | — | 两者等价 | |
一句话:变分修正只做了一件事 —— 把「对下一状态的 soft max」换回「对下一状态的普通期望」,同时保留「对动作的 soft max」。
收缩性、偏差与温度
soft Bellman 算子仍是 $\gamma$-压缩。因为 logsumexp 是非扩张映射:对任意 $Q_1,Q_2$,
$$ \alpha\log\sum_a e^{Q_1(a)/\alpha}\le\alpha\log\sum_a e^{(Q_2(a)+\|Q_1-Q_2\|_\infty)/\alpha}=\alpha\log\sum_a e^{Q_2(a)/\alpha}+\|Q_1-Q_2\|_\infty, $$反过来同理,故 $|\operatorname{soft\,max}Q_1-\operatorname{soft\,max}Q_2|\le\|Q_1-Q_2\|_\infty$。再乘上 $\gamma$,得到 $\|\mathcal{T}Q_1-\mathcal{T}Q_2\|_\infty\le\gamma\|Q_1-Q_2\|_\infty$。所以 soft value iteration 和标准值迭代一样有唯一不动点、几何收敛。
不动点相对硬版本的偏差有界。由 $\max_a Q\le\alpha\log\sum_a e^{Q/\alpha}\le\max_a Q+\alpha\log|\mathcal{A}|$,逐步累积得
$$ 0\;\le\;V_{\text{soft}}(s)-V_{\text{hard}}(s)\;\le\;\frac{\alpha\log|\mathcal{A}|}{1-\gamma}. $$在第 4 节的例子里,$\alpha=0.05$、$|\mathcal{A}|=2$、$\gamma=0.95$,上界是 $0.05\times0.693/0.05=0.693$ —— 和实测的 $V(s_1)=20.693$ 对 $20$ 的差恰好吻合。这也告诉你:$\alpha$ 越小越接近标准 RL,代价是策略越确定、探索越差。
动作先验回来了:KL 正则化的 RL
如果动作先验不是均匀的,而是某个参考策略 $\rho(a|s)$,第 2 节末尾的变换告诉我们把 $r$ 换成 $r+\alpha\log\rho$。代入恒等式($f=Q+\alpha\log\rho$):
$$ \max_q\Big\{\E_q[Q]-\alpha\KL\big(q\,\|\,\rho\big)\Big\}=\alpha\log\int\rho(a)\,e^{Q(a)/\alpha}\,da, \qquad q^\star(a)\propto\rho(a)\exp\big(Q(a)/\alpha\big). $$这就是 KL 控制 / KL 正则化 RL。如果你见过 RLHF 的最优解 $\pi^\star(y|x)\propto\pi_{\text{ref}}(y|x)\exp\big(r(x,y)/\beta\big)$,它就是这条公式在「单步 bandit、动作 $=$ 整段回复」情形下的特例 —— 下一讲会正面处理它。所以「最大熵 RL」和「带 KL 惩罚的 RL」不是两件事,是同一件事的两种参数化:熵 $=$ 相对于均匀先验的负 KL。
可运行的小实验
下面这段纯 Python 代码把三种 backup 写在同一个函数里,只用两个 if 区分。第 4 节表格里的数字就是它的输出。
import math

# 3 状态 MDP:s0=起点, s1=头奖(吸收), s2=破产(吸收)
# 动作 0 = "稳妥"(原地不动,每步 +0.05);动作 1 = "赌一把"(2% 进头奖,98% 破产)
P = [ [[1.0, 0.00, 0.00], [0.0, 0.02, 0.98]],     # s0
      [[0.0, 1.00, 0.00], [0.0, 1.00, 0.00]],     # s1 吸收
      [[0.0, 0.00, 1.00], [0.0, 0.00, 1.00]] ]    # s2 吸收
R = [ [0.05, 0.00],
      [1.00, 1.00],
      [0.00, 0.00] ]
S, A, gamma = 3, 2, 0.95

def lse(xs, ws=None, alpha=1.0):
    """alpha * log sum_i w_i exp(x_i / alpha),数值稳定版"""
    ws = ws or [1.0] * len(xs)
    m = max(xs)
    tot = sum(w * math.exp((x - m) / alpha) for x, w in zip(xs, ws) if w > 0)
    return m + alpha * math.log(tot)

def value_iteration(mode, alpha=0.05, iters=5000):
    Q = [[0.0] * A for _ in range(S)]
    for _ in range(iters):
        # --- 对动作取最大值:hard max 还是 soft max? ---
        if mode == 'hard':
            V = [max(Q[s]) for s in range(S)]
        else:
            V = [lse(Q[s], alpha=alpha) for s in range(S)]
        # --- 对下一状态取期望:普通期望 还是 log-E-exp? ---
        Qn = [[0.0] * A for _ in range(S)]
        for s in range(S):
            for a in range(A):
                if mode == 'optimistic':                    # 朴素推断:乐观动力学
                    ev = lse(V, [P[s][a][j] for j in range(S)], alpha)
                else:                                       # 真实动力学
                    ev = sum(P[s][a][j] * V[j] for j in range(S))
                Qn[s][a] = R[s][a] + gamma * ev
        Q = Qn
    V = [max(Q[s]) for s in range(S)] if mode == 'hard' \
        else [lse(Q[s], alpha=alpha) for s in range(S)]
    return Q, V

for mode in ['hard', 'variational', 'optimistic']:
    Q, V = value_iteration(mode)
    pi_gamble = math.exp((Q[0][1] - V[0]) / 0.05) if mode != 'hard' \
                else float(Q[0][1] > Q[0][0])
    print(f'{mode:12s} Q(s0,稳妥)={Q[0][0]:7.3f}  Q(s0,赌)={Q[0][1]:7.3f}  '
          f'V(s0)={V[0]:7.3f}  pi(赌)={pi_gamble:.4f}')

# hard         Q(s0,稳妥)=  1.000  Q(s0,赌)=  0.380  V(s0)=  1.000  pi(赌)=0.0000
# variational  Q(s0,稳妥)=  1.133  Q(s0,赌)=  1.038  V(s0)=  1.140  pi(赌)=0.1308
# optimistic   Q(s0,稳妥)= 18.549  Q(s0,赌)= 19.473  V(s0)= 19.473  pi(赌)=1.0000
7. Soft Q-learning
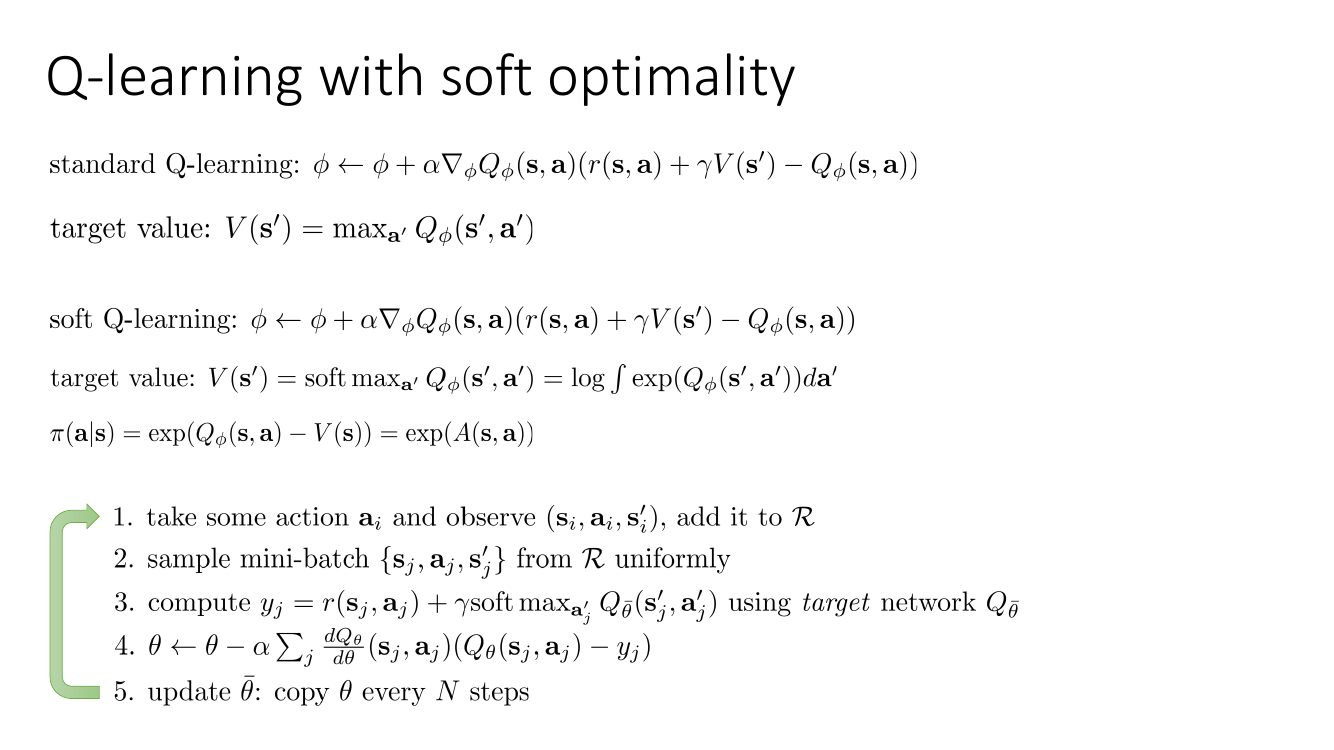
把第 6 节的 soft value iteration 换成基于样本的、带函数逼近的版本,就得到 soft Q-learning。改动只有一处。
离散动作:三行代码的事
import torch

def soft_q_target(r, s2, done, q_target, gamma, alpha):
    """soft Q-learning 的回归目标;与 DQN 的唯一差别是 logsumexp 代替 max"""
    with torch.no_grad():
        q2 = q_target(s2)                                  # (B, |A|)
        # V(s') = alpha * log sum_a exp(Q(s',a)/alpha)      <-- soft max
        v2 = alpha * torch.logsumexp(q2 / alpha, dim=-1)   # (B,)
        # DQN 版本会写成: v2 = q2.max(dim=-1).values
    return r + gamma * (1.0 - done) * v2

def soft_policy(q, alpha):
    """pi(a|s) = exp((Q(s,a) - V(s)) / alpha) = softmax(Q/alpha)"""
    return torch.softmax(q / alpha, dim=-1)
注意 logsumexp 和 softmax 的这层对偶关系:$V$ 是 logsumexp,$\pi$ 是它的梯度即 softmax。所以「soft Q-learning $=$ 用 Boltzmann 策略的 DQN」这个说法只对了一半 —— Boltzmann 探索只改行为策略,soft Q-learning 还改了 target,两者学到的 $Q$ 是不同的不动点。
$\alpha$ 与奖励尺度绑死。如果你的奖励量级是 $O(100)$(比如 Atari 未裁剪的分数),用 $\alpha=1$ 相当于几乎没有熵;如果奖励量级是 $O(0.01)$,$\alpha=1$ 会让策略变成纯随机。实践中要么把奖励归一化,要么按第 9 节的办法自动调 $\alpha$。
连续动作:难点在配分函数
连续动作空间里 $V(s)=\alpha\log\int\exp(Q(s,a)/\alpha)\,da$ 是一个高维积分,没有闭式解。Haarnoja 等人(Reinforcement Learning with Deep Energy-Based Policies, 2017)给出的方案是:
- 用重要性采样估计 soft max:$\log\int e^{Q/\alpha}da\approx\log\frac{1}{K}\sum_{k}\frac{e^{Q(s,a_k)/\alpha}}{\rho(a_k)}$,其中 $\rho$ 取均匀分布或当前策略;
- 用一个「摊销采样器」逼近 $\exp(Q/\alpha)$:训练一个网络 $a=f_\theta(\xi;s)$($\xi$ 是噪声)把噪声映射成能量模型的样本,训练准则用 Stein 变分梯度下降(SVGD)。这就是所谓 amortized SVGD。
这套东西能跑,也确实展示了漂亮的多模态行为(一个走廊问题里,策略同时保留了向左和向右两条路),但工程上很重。SAC 之所以取代 soft Q-learning,就是因为它用一个显式的高斯策略 $+$ 重参数化,绕开了这个配分函数。
8. 带熵的策略梯度:最常见、也最容易做错的那一版
ELBO 的形式 $\mathcal{L}(q)=\sum_t\E_{(s_t,a_t)\sim q}[r+\mathcal{H}(q(\cdot|s_t))]$ 和策略梯度的目标 $J(\theta)=\sum_t\E_{(s_t,a_t)\sim\pi_\theta}[r]$ 只差一个熵项。把 $q$ 换成 $\pi_\theta$,直接得到
$$ J(\theta)=\sum_t\E_{(s_t,a_t)\sim\pi_\theta}\big[r(s_t,a_t)+\mathcal{H}\big(\pi_\theta(\cdot|s_t)\big)\big]. $$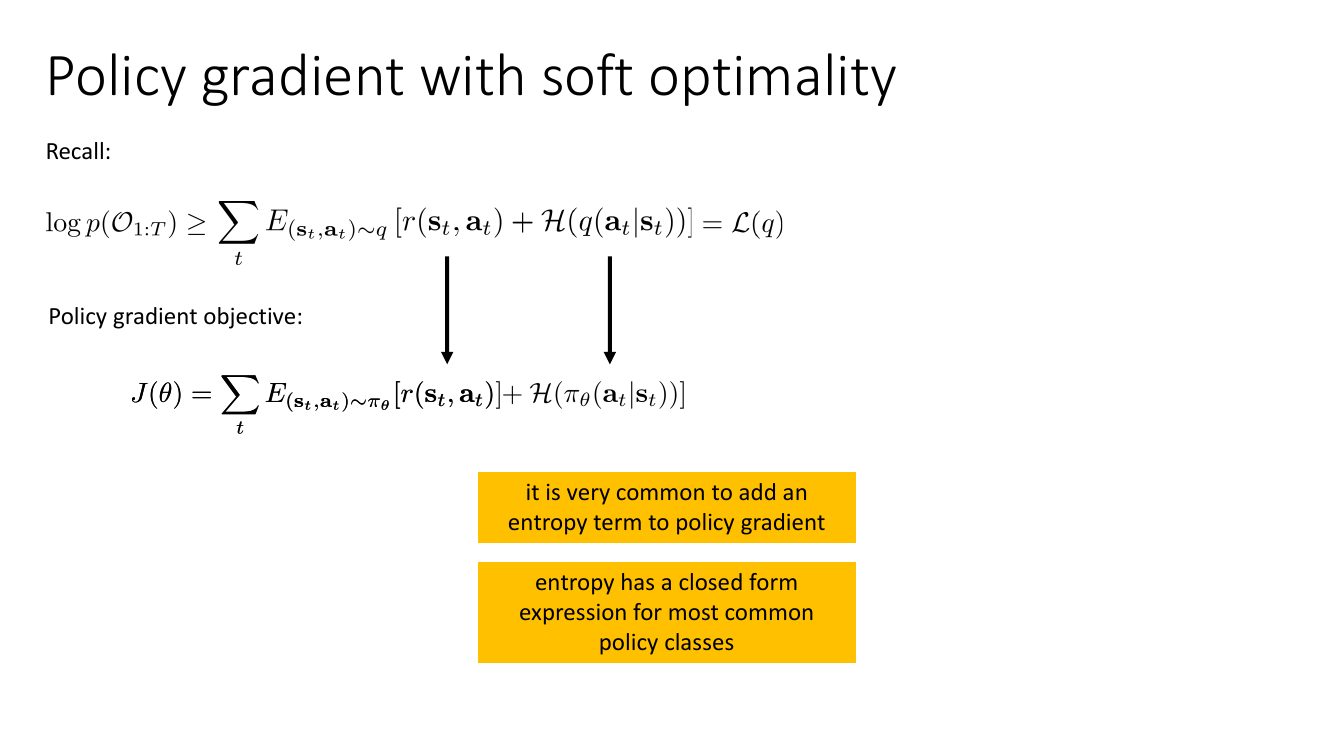
常用策略类的熵($d$ 是动作维度):
| 策略类 | 熵 $\mathcal{H}(\pi(\cdot|s))$ | 说明 |
|---|---|---|
| 离散($K$ 类 softmax) | $-\sum_{k}\pi_k\log\pi_k$ | 上界 $\log K$,可解析求导 |
| 对角高斯 $\mathcal{N}(\mu,\diag(\sigma^2))$ | $\frac{d}{2}\log(2\pi e)+\sum_{i=1}^{d}\log\sigma_i$ | 只依赖 $\sigma$,与 $\mu$ 无关 |
| 一般高斯 $\mathcal{N}(\mu,\Sigma)$ | $\frac{1}{2}\log\big((2\pi e)^d\det\Sigma\big)$ | 同上 |
| tanh-高斯(SAC 用) | 无闭式 | 用 $-\log\pi(a|s)$ 的单样本估计代替 |
A3C/PPO 里那个「熵奖励」(entropy bonus)和这里的最大熵目标不是一回事。前者是在损失里加一项 $-\lambda\mathcal{H}(\pi_\theta(\cdot|s_t))$,只影响当前这一步的策略,是个短视的正则;后者要求熵进入值函数,即 $Q(s,a)=r+\gamma\E_{s'}\big[V(s')\big]$ 而 $V(s')=\E_{a'}[Q(s',a')-\alpha\log\pi(a'|s')]$,未来所有步的熵都会被 bootstrapping 传回来。差别在实践中很明显:短视版本在「现在低熵、以后能到达高熵区域」的状态上不会给任何激励,最大熵版本会。SAC 用的是后者 —— 你会在第 9 节的 target 里看到 $-\log\pi$ 出现在 $\gamma$ 的里面。
另一个实用提示:因为熵有闭式,$\nabla_\theta\mathcal{H}$ 可以直接自动微分,不需要再套一层 $\nabla\log\pi\cdot(\cdot)$ 的 REINFORCE 估计。这能显著降低方差 —— 这正是上一讲 reparameterization trick 对比 policy gradient 的那个结论在这里的应用。
9. Soft Actor-Critic(SAC)
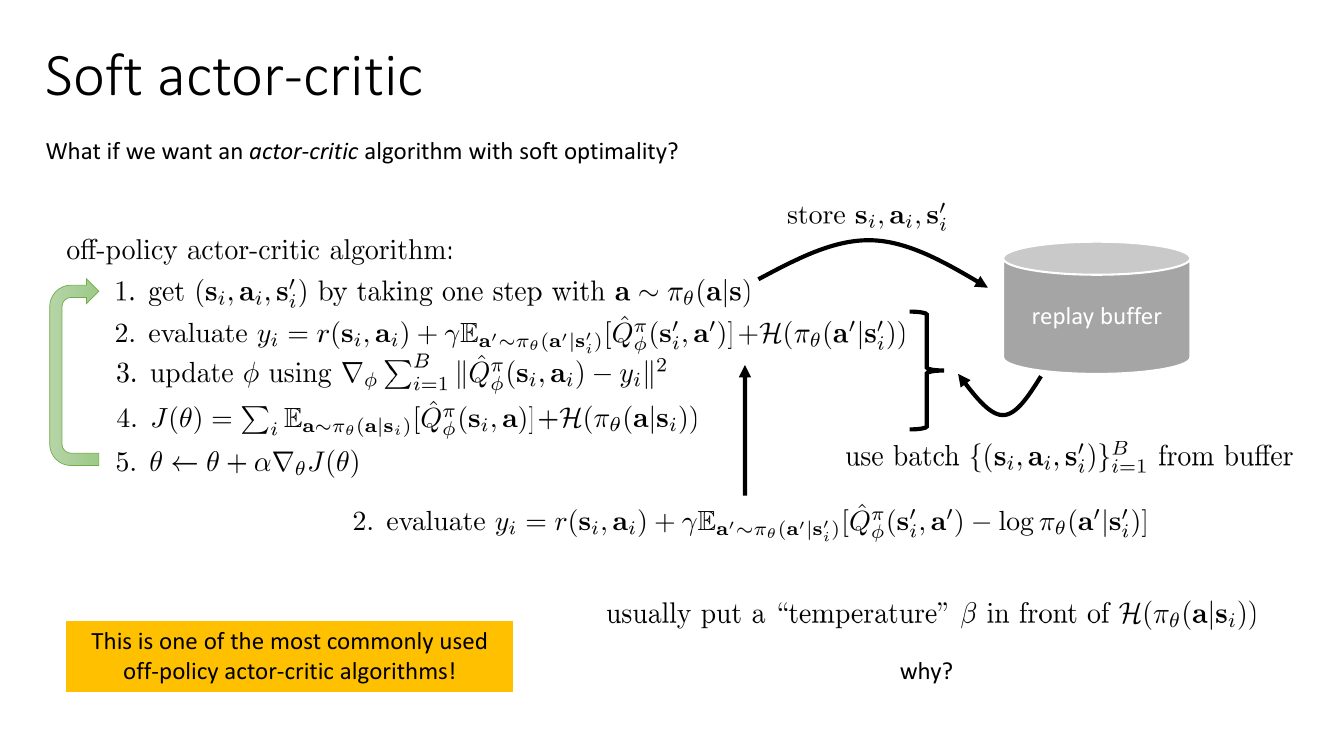
soft Q-learning 处理连续动作很别扭,带熵的策略梯度又是 on-policy 的(样本效率低)。想两头都要:off-policy + 连续动作 + soft 最优性,答案就是 SAC。
三个更新式,逐个拆
(1) Critic:soft Bellman backup。把第 6 节的 $V(s')=\E_{a'\sim\pi}[Q(s',a')-\alpha\log\pi(a'|s')]$ 代进 $Q=r+\gamma\E_{s'}[V(s')]$:
$$ y=r(s,a)+\gamma\,(1-d)\,\E_{a'\sim\pi_\theta(\cdot|s')}\Big[Q_{\bar\phi}(s',a')-\alpha\log\pi_\theta(a'|s')\Big], \qquad \mathcal{L}(\phi)=\E_{(s,a,r,s')\sim\mathcal{D}}\big[(Q_\phi(s,a)-y)^2\big]. $$期望用单个采样 $a'\sim\pi_\theta(\cdot|s')$ 估计即可(无偏)。注意 $-\alpha\log\pi_\theta$ 在 $\gamma$ 的括号里面,这就是第 8 节强调的「熵进值函数」。
(2) Actor:一次 KL 投影。由第 6 节恒等式,在 $s$ 处的理想策略是 $\pi^\star(\cdot|s)\propto\exp\big(Q_\phi(s,\cdot)/\alpha\big)$。但我们的策略被限制在参数族 $\Pi$(比如 tanh-高斯)里,一般达不到这个分布,于是做一次投影:
$$ \pi_{\text{new}}=\argmin_{\pi\in\Pi}\;\KL\!\left(\pi(\cdot|s)\;\Big\|\;\frac{\exp\big(Q_\phi(s,\cdot)/\alpha\big)}{Z_\phi(s)}\right). $$展开这个 KL:$\E_{a\sim\pi}\big[\log\pi(a|s)-Q_\phi(s,a)/\alpha\big]+\log Z_\phi(s)$。$\log Z_\phi(s)$ 与 $\theta$ 无关,可以扔掉(这就是 SAC 绕开配分函数的方式)。乘以 $\alpha$ 后得到 actor 的损失:
$$ \mathcal{L}(\theta)=\E_{s\sim\mathcal{D}}\,\E_{a\sim\pi_\theta(\cdot|s)}\big[\alpha\log\pi_\theta(a|s)-Q_\phi(s,a)\big]. $$这就是「soft policy improvement 为什么是 $\pi\propto\exp(Q/\alpha)$」的完整答案:它是自由能恒等式的最优解,而参数化策略的更新是它在 $\Pi$ 上的反向 KL 投影。原论文还证明了 soft policy iteration(交替做 soft policy evaluation 与这个投影)在表格情形下单调改进并收敛到最优。
梯度怎么算?$a$ 依赖 $\theta$,用重参数化:$a=\tanh\big(\mu_\theta(s)+\sigma_\theta(s)\odot\epsilon\big)$,$\epsilon\sim\mathcal{N}(0,I)$,梯度直接穿过采样穿到 $Q_\phi$ 里 —— 这是上一讲 reparameterization trick 的直接应用,比 REINFORCE 估计方差小一个量级。
(3) 温度 $\alpha$:为什么必须自动调。回到第 1 节的观察:模型是 $p(\mathcal{O}|s,a)=\exp(r/\alpha)$,所以$\alpha$ 和奖励尺度是同一个自由度。把奖励乘 10 等价于把 $\alpha$ 除以 10。更麻烦的是,同一个任务在训练的不同阶段需要的熵也不同:早期需要大熵探索,后期需要小熵收敛。固定 $\alpha$ 几乎必然在某一段是错的。
解法(SAC v2):把它写成约束优化 —— 最大化回报,同时要求平均熵不低于某个目标 $\bar{\mathcal{H}}$:
$$ \max_{\pi}\;\E\Big[\sum_t r(s_t,a_t)\Big]\quad\text{s.t.}\quad \E_{(s,a)\sim\pi}\big[-\log\pi(a|s)\big]\ge\bar{\mathcal{H}} . $$拉格朗日量把 $\alpha\ge 0$ 变成对偶变量,对偶目标为
$$ J(\alpha)=\E_{a\sim\pi_\theta}\big[-\alpha\log\pi_\theta(a|s)-\alpha\bar{\mathcal{H}}\big] \;\Longrightarrow\; \mathcal{L}(\alpha)=-\E\big[\alpha\,\big(\log\pi_\theta(a|s)+\bar{\mathcal{H}}\big)\big]. $$梯度方向一眼可读:若当前熵低于目标(即 $\log\pi+\bar{\mathcal{H}}>0$),损失随 $\alpha$ 增大而下降 $\Rightarrow$ 提高温度、鼓励探索;反之降低温度。经验取值 $\bar{\mathcal{H}}=-\dim(\mathcal{A})$。实现时对 $\log\alpha$ 而非 $\alpha$ 做梯度下降,保证 $\alpha>0$ 且尺度稳定。
为什么 SAC 能 off-policy —— 也就是幻灯片上那个 “why?”
- critic 不需要重要性权重:target 里的 $a'$ 是从当前策略 $\pi_\theta(\cdot|s')$ 现采的,不是回放池里存的动作。回放池只提供 $(s,a,r,s')$ 这个转移元组,而转移的分布与策略无关。
- actor 也不需要:$\E_{a\sim\pi_\theta}[\cdot]$ 同样是现采的,回放池只提供状态 $s$。
- 唯一的近似是状态分布:我们在回放池的状态分布 $\mathcal{D}$ 上做更新,而不是当前策略的 $d^{\pi_\theta}$。这是所有 off-policy actor-critic 共有的偏差,实践中可接受。
那为什么它比 DDPG 稳定得多?DDPG 是确定性策略 $+$ 回放池,一旦 critic 在某个动作区域出现过估计,actor 会立刻塌到那个点,且没有任何机制把它推开。SAC 的熵项强制策略保持分散,等于给 critic 持续提供动作维度上的覆盖,同时熵也让优化景观更平滑。再加上双 Q 网络取 min 抑制过估计(clipped double-Q),就是 SAC 稳定性的三大来源。它对超参数(学习率、网络宽度、奖励尺度)的鲁棒性远高于 DDPG/TD3,这才是「最常用的 off-policy actor-critic」这句话的实际含义。
PyTorch 实现
import copy, math
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.distributions import Normal

LOG_STD_MIN, LOG_STD_MAX = -20.0, 2.0

def mlp(sizes, act=nn.ReLU):
    layers = []
    for i in range(len(sizes) - 1):
        layers.append(nn.Linear(sizes[i], sizes[i + 1]))
        if i < len(sizes) - 2:
            layers.append(act())
    return nn.Sequential(*layers)


class TanhGaussianActor(nn.Module):
    """a = tanh(u), u ~ N(mu(s), sigma(s));返回动作与其 log-density"""
    def __init__(self, obs_dim, act_dim, hid=256, act_limit=1.0):
        super().__init__()
        self.net = mlp([obs_dim, hid, hid, 2 * act_dim])
        self.act_limit = act_limit

    def forward(self, s, deterministic=False):
        mu, log_std = self.net(s).chunk(2, dim=-1)
        log_std = log_std.clamp(LOG_STD_MIN, LOG_STD_MAX)
        dist = Normal(mu, log_std.exp())
        u = mu if deterministic else dist.rsample()      # rsample: 重参数化,梯度可穿过
        logp = dist.log_prob(u).sum(-1)
        # tanh 换元的雅可比修正: -sum_i log(1 - tanh(u_i)^2)
        # log(1 - tanh(u)^2) = 2 * (log 2 - u - softplus(-2u)),数值稳定写法
        logp = logp - (2.0 * (math.log(2.0) - u - F.softplus(-2.0 * u))).sum(-1)
        return torch.tanh(u) * self.act_limit, logp


class DoubleCritic(nn.Module):
    def __init__(self, obs_dim, act_dim, hid=256):
        super().__init__()
        self.q1 = mlp([obs_dim + act_dim, hid, hid, 1])
        self.q2 = mlp([obs_dim + act_dim, hid, hid, 1])

    def forward(self, s, a):
        sa = torch.cat([s, a], dim=-1)
        return self.q1(sa).squeeze(-1), self.q2(sa).squeeze(-1)


class SAC:
    def __init__(self, obs_dim, act_dim, gamma=0.99, tau=0.005, lr=3e-4):
        self.actor = TanhGaussianActor(obs_dim, act_dim)
        self.critic = DoubleCritic(obs_dim, act_dim)
        self.critic_targ = copy.deepcopy(self.critic)
        for p in self.critic_targ.parameters():
            p.requires_grad_(False)
        self.log_alpha = torch.zeros(1, requires_grad=True)
        self.target_entropy = -float(act_dim)          # 经验取值 -dim(A)
        self.opt_pi = torch.optim.Adam(self.actor.parameters(), lr=lr)
        self.opt_q  = torch.optim.Adam(self.critic.parameters(), lr=lr)
        self.opt_al = torch.optim.Adam([self.log_alpha], lr=lr)
        self.gamma, self.tau = gamma, tau

    def update(self, s, a, r, s2, d):
        alpha = self.log_alpha.exp().detach()

        # ---------- 1) critic: soft Bellman backup ----------
        with torch.no_grad():
            a2, logp2 = self.actor(s2)                       # a' ~ pi_theta(.|s'),现采
            q1_t, q2_t = self.critic_targ(s2, a2)
            v2 = torch.min(q1_t, q2_t) - alpha * logp2       # 熵项在 gamma 里面
            y = r + self.gamma * (1.0 - d) * v2
        q1, q2 = self.critic(s, a)
        loss_q = F.mse_loss(q1, y) + F.mse_loss(q2, y)
        self.opt_q.zero_grad(); loss_q.backward(); self.opt_q.step()

        # ---------- 2) actor: 反向 KL 投影到 exp(Q/alpha) ----------
        for p in self.critic.parameters():
            p.requires_grad_(False)                          # 冻结 critic,省一次反传
        a_new, logp = self.actor(s)
        q1_pi, q2_pi = self.critic(s, a_new)
        loss_pi = (alpha * logp - torch.min(q1_pi, q2_pi)).mean()
        self.opt_pi.zero_grad(); loss_pi.backward(); self.opt_pi.step()
        for p in self.critic.parameters():
            p.requires_grad_(True)

        # ---------- 3) 温度 alpha: 对偶变量下降 ----------
        loss_al = -(self.log_alpha * (logp.detach() + self.target_entropy)).mean()
        self.opt_al.zero_grad(); loss_al.backward(); self.opt_al.step()

        # ---------- 4) target 网络 Polyak 平滑 ----------
        with torch.no_grad():
            for p, pt in zip(self.critic.parameters(), self.critic_targ.parameters()):
                pt.mul_(1.0 - self.tau).add_(self.tau * p)

        return dict(loss_q=loss_q.item(), loss_pi=loss_pi.item(),
                    alpha=alpha.item(), entropy=-logp.mean().item())
对照着看:v2 = min(q1_t, q2_t) - alpha * logp2 就是 $V(s')=\E_{a'}[Q-\alpha\log\pi]$;loss_pi = (alpha * logp - min(q1_pi, q2_pi)).mean() 就是那次 KL 投影;loss_al 里的 logp + target_entropy 就是约束的违反量。整个算法真正「新」的东西,只有那两个 $-\log\pi$。
SAC 的每一行都能追溯到本讲前面的推导:target 里的 $-\alpha\log\pi$ 来自 ELBO 的熵项;actor 损失来自自由能恒等式的 KL 投影;温度 $\alpha$ 来自 $p(\mathcal{O}|s,a)=\exp(r/\alpha)$ 中的奖励尺度。剩下的(双 Q、target 网络、Polyak、tanh 挤压)都是深度 RL 的通用工程手段,与 soft 最优性无关。
10. 最大熵 RL 到底好在哪
推导讲完了,值得停下来问:除了「理论上更自洽」,最大熵目标带来什么实际好处?
探索
$\varepsilon$-贪心是「以 $\varepsilon$ 的概率完全随机」,它对所有次优动作一视同仁 —— 哪怕某个动作会直接摔倒。最大熵策略 $\pi\propto\exp(Q/\alpha)$ 是按价值加权的随机:几乎一样好的动作有几乎一样的概率,明显糟糕的动作概率指数级压低。这是一种「有品位的随机」。而且温度会自动衰减(自动调 $\alpha$ 时熵目标固定,但随着 $Q$ 的尺度增长,等效温度相对变小),无须手工设计探索退火表。
多模态解与「不要平均两个正确答案」
标准 RL 求的是单点 $\argmax$,任何 tie 都会被任意打破。最大熵 RL 求的是分布,两条同样好的路径都会被保留。这件事在两个场景下特别重要:(a) 分层与预训练:一个保留了多种解法的策略更容易被下游任务复用;(b) 模仿 / 逆 RL:数据本身就是多模态的(不同的人有不同做法),单模态模型会去拟合「平均行为」,而两个正确方案的平均往往是最差的方案(比如绕过障碍物,一半人往左一半人往右,平均是直着撞上去)。
鲁棒性
最大熵策略对奖励扰动和模型误差更稳。直觉是:既然策略在一片动作区域上都有不可忽略的概率,那么它的回报必须在整片区域上都好,而不能依赖某一个尖峰。等价的形式化说法是,最大熵 RL 的最优策略同时是某个「对手可以在一定范围内扰动奖励/动力学」的鲁棒控制问题的最优解(Eysenbach & Levine, 2021 给了精确的对应关系)。实践上的表现是:在仿真里训出来的 SAC 策略换到略有差异的真机上,性能下降往往小于确定性策略。
迁移与微调
先用一个宽泛的奖励做最大熵预训练,得到一个「什么都会一点、且保留多样性」的策略,再在具体任务上微调,通常比从零开始快得多。反过来,一个熵已经塌缩到零的确定性策略几乎无法微调 —— 它连采样多样性都没有,梯度信号极其贫乏。
数值与优化上的好处
$\max$ 不可微、$\log\sum\exp$ 光滑。把不可微的算子换成光滑的算子,优化景观变好、梯度不再在决策边界处跳变。这也是为什么在很多 benchmark 上 soft 版本的收敛曲线更平滑、方差更小。
与其他框架的连线
| 名字 | 形式 | 与本讲的关系 |
|---|---|---|
| 最大熵 RL | $\sum_t\E[r+\alpha\mathcal{H}(\pi)]$ | 动作先验取均匀分布 |
| KL 控制 / KL 正则 RL | $\sum_t\E[r-\alpha\KL(\pi\|\rho)]$ | 动作先验取参考策略 $\rho$ |
| RLHF / DPO 的最优解 | $\pi^\star\propto\pi_{\text{ref}}\exp(r/\beta)$ | 上一行的单步(bandit)特例 |
| 线性可解 MDP / 路径积分控制 | $V$ 满足线性方程 | 确定性或线性高斯动力学下的闭式特例 |
| MaxEnt IRL | $p(\tau)\propto\exp(\sum_t r_\psi)$ | 同一个模型,但把 $r$ 当未知参数学 |
最大熵 RL 不是免费的。它优化的不是原始回报,而是回报加熵。在需要极致精度的任务上(比如精密装配、比赛级控制),残余的策略随机性会实实在在地扣分。工程上的常规做法是:训练时用随机策略(探索、稳定),部署时用确定性动作 $a=\tanh(\mu_\theta(s))$。代码里 deterministic=True 那个开关就是干这个的。
11. 把模型倒过来:最大熵逆强化学习
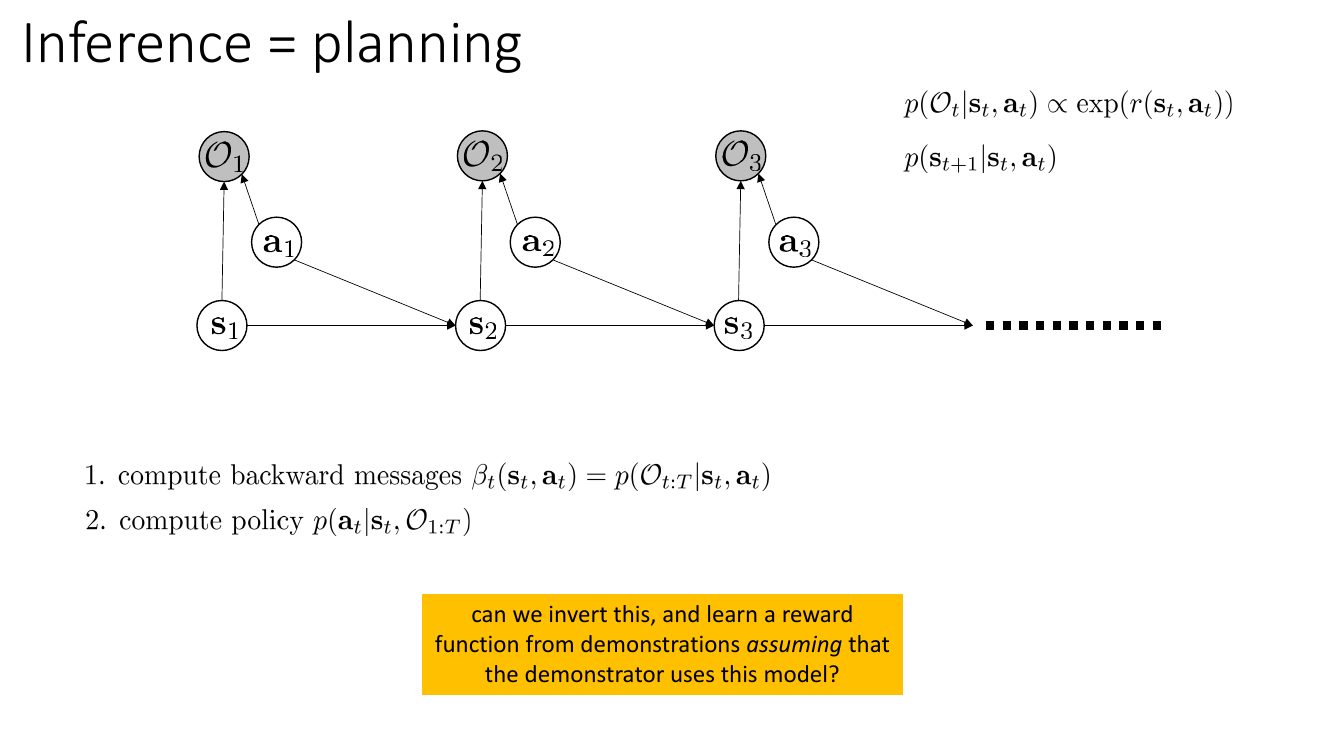
到目前为止,$r$ 是已知的,我们做推断求策略。本讲最后一块内容把箭头反过来:$r$ 未知,行为已知,从演示反推奖励。
为什么要学奖励
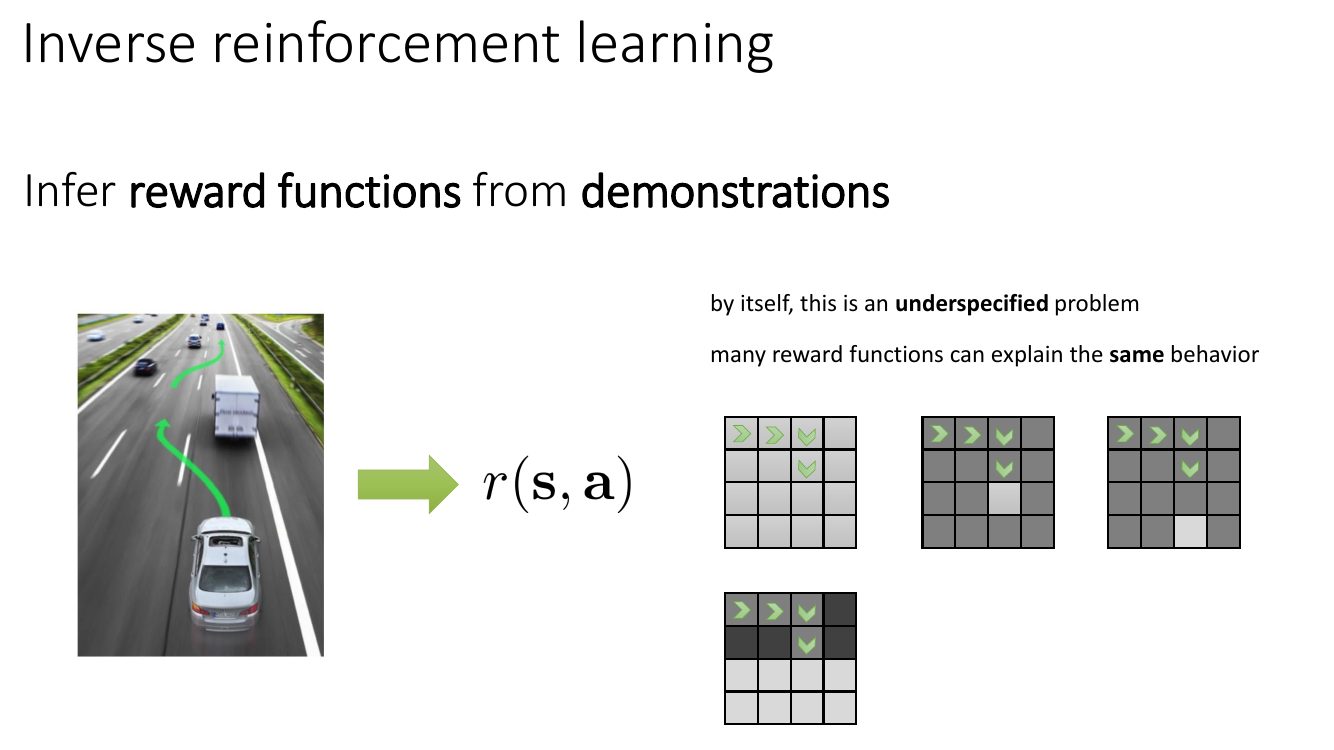
Levine 给了两个角度。模仿学习的角度:标准模仿(行为克隆)是「复制专家的动作」,完全不推理动作的后果;而人类的模仿是「复制专家的意图」,为此可以采取完全不同的动作 —— 小孩看大人用手够不着柜子上的书,会去搬椅子,而不是重复大人徒劳的伸手动作。要复制意图,就得先把意图(奖励)显式地推断出来。强化学习的角度:Atari 有屏幕上的分数可以直接当奖励,但真实世界没有。「安全平稳地在高速上并线」的奖励函数是什么?没人写得出来,但每个司机都会做。
把奖励参数化,做最大似然
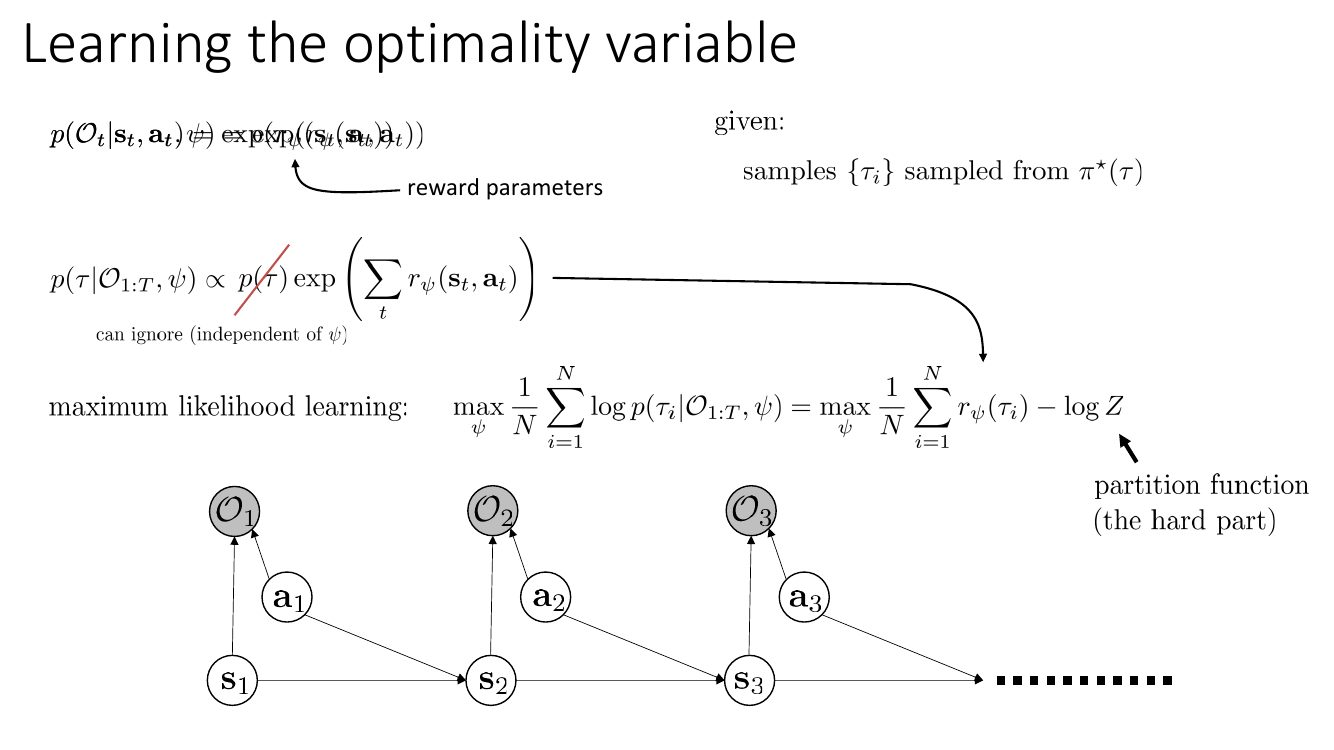
令 $r_\psi$ 是带参数的奖励(线性特征组合,或一个神经网络)。模型不变:
$$ p(\mathcal{O}_t|s_t,a_t,\psi)=\exp\big(r_\psi(s_t,a_t)\big),\qquad p(\tau|\mathcal{O}_{1:T},\psi)\propto p(\tau)\exp\Big(\sum_t r_\psi(s_t,a_t)\Big). $$给定专家样本 $\{\tau_i\}_{i=1}^{N}\sim\pi^\star(\tau)$,做最大似然:
$$ \max_\psi\;\frac{1}{N}\sum_{i=1}^{N}\log p(\tau_i|\mathcal{O}_{1:T},\psi) =\max_\psi\;\frac{1}{N}\sum_{i=1}^{N} r_\psi(\tau_i)-\log Z, \qquad Z=\int p(\tau)\exp\big(r_\psi(\tau)\big)\,d\tau . $$其中 $r_\psi(\tau)\triangleq\sum_t r_\psi(s_t,a_t)$。$p(\tau)$ 与 $\psi$ 无关,在第一项里被丢掉。注意最大熵这个建模选择正好解决了欠定性:在所有能解释演示的奖励里,它偏好那个让轨迹分布尽可能「摊平」的,也就是不做多余假设的那个 —— 这是 Jaynes 最大熵原理在 IRL 上的应用(Ziebart 等人 2008 年的经典工作)。
配分函数的梯度
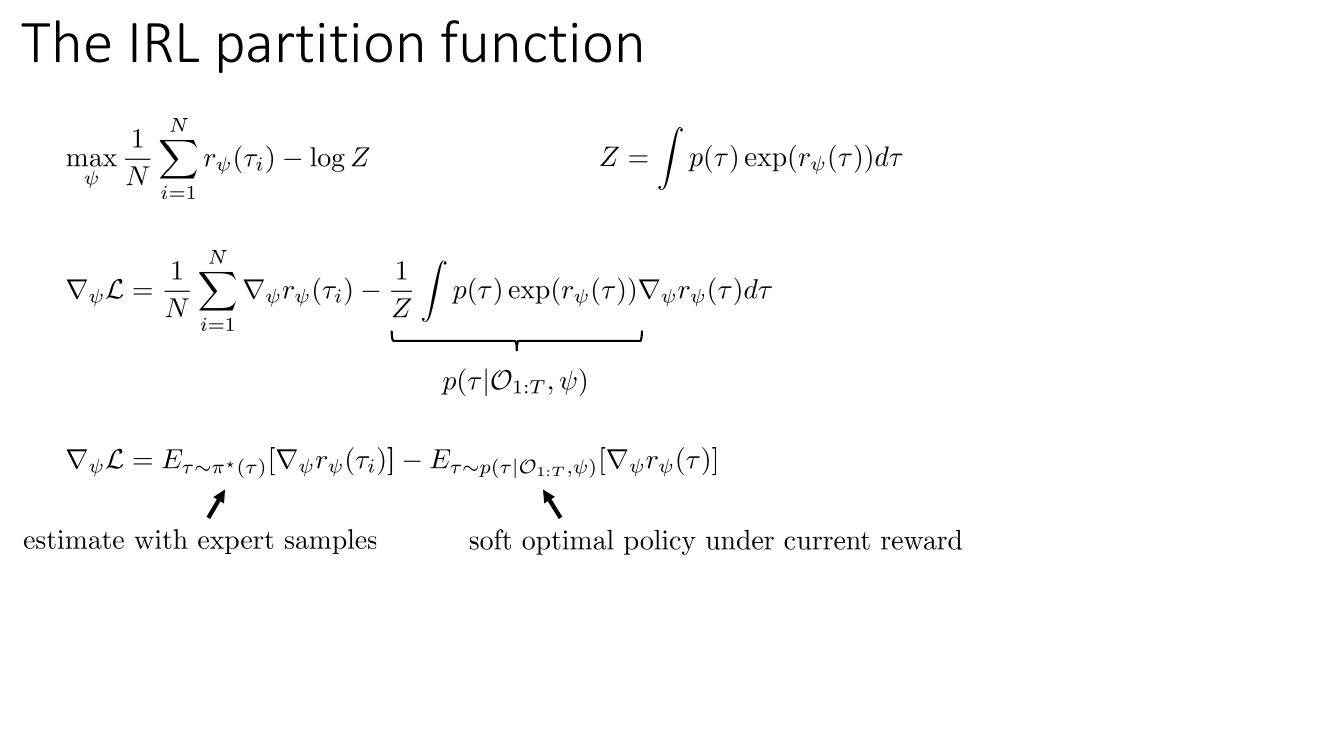
目标 $\mathcal{L}(\psi)=\frac1N\sum_i r_\psi(\tau_i)-\log Z$。第一项求导平凡。第二项:
$$ \nabla_\psi\log Z=\frac{1}{Z}\nabla_\psi\!\int p(\tau)e^{r_\psi(\tau)}d\tau =\frac{1}{Z}\int p(\tau)e^{r_\psi(\tau)}\nabla_\psi r_\psi(\tau)\,d\tau =\E_{\tau\sim p(\tau|\mathcal{O}_{1:T},\psi)}\big[\nabla_\psi r_\psi(\tau)\big], $$因为 $\frac{1}{Z}p(\tau)e^{r_\psi(\tau)}$ 恰好就是后验 $p(\tau|\mathcal{O}_{1:T},\psi)$。于是
$$ \boxed{\;\nabla_\psi\mathcal{L}=\underbrace{\E_{\tau\sim\pi^\star(\tau)}\big[\nabla_\psi r_\psi(\tau)\big]}_{\text{用专家样本估计}}-\underbrace{\E_{\tau\sim p(\tau|\mathcal{O}_{1:T},\psi)}\big[\nabla_\psi r_\psi(\tau)\big]}_{\text{当前奖励下的 soft 最优策略}}.\;} $$这是能量模型(EBM)里最经典的「正相位减负相位」形式:把专家做过的事的奖励往上推,把当前模型自己想做的事的奖励往下压。当两者的期望特征相同时梯度为零 —— 这正好对应经典 IRL 的「特征期望匹配(feature matching)」条件。
怎么估计第二项
小规模、表格化的情形。把轨迹期望拆成逐时刻的状态-动作边缘:
$$ \E_{\tau\sim p(\tau|\mathcal{O},\psi)}\big[\nabla_\psi r_\psi(\tau)\big] =\sum_t \E_{(s_t,a_t)\sim p(s_t,a_t|\mathcal{O}_{1:T},\psi)}\big[\nabla_\psi r_\psi(s_t,a_t)\big], \qquad p(s_t,a_t|\mathcal{O}_{1:T})\propto \alpha_t(s_t)\,\beta_t(s_t,a_t). $$第 3 节推的前向消息在这里终于派上用场了:每次更新 $\psi$,跑一遍完整的 forward-backward 就能精确算出这个边缘。这就是 Ziebart 的 MaxEnt IRL,在离散状态、线性奖励的设定下非常好用。
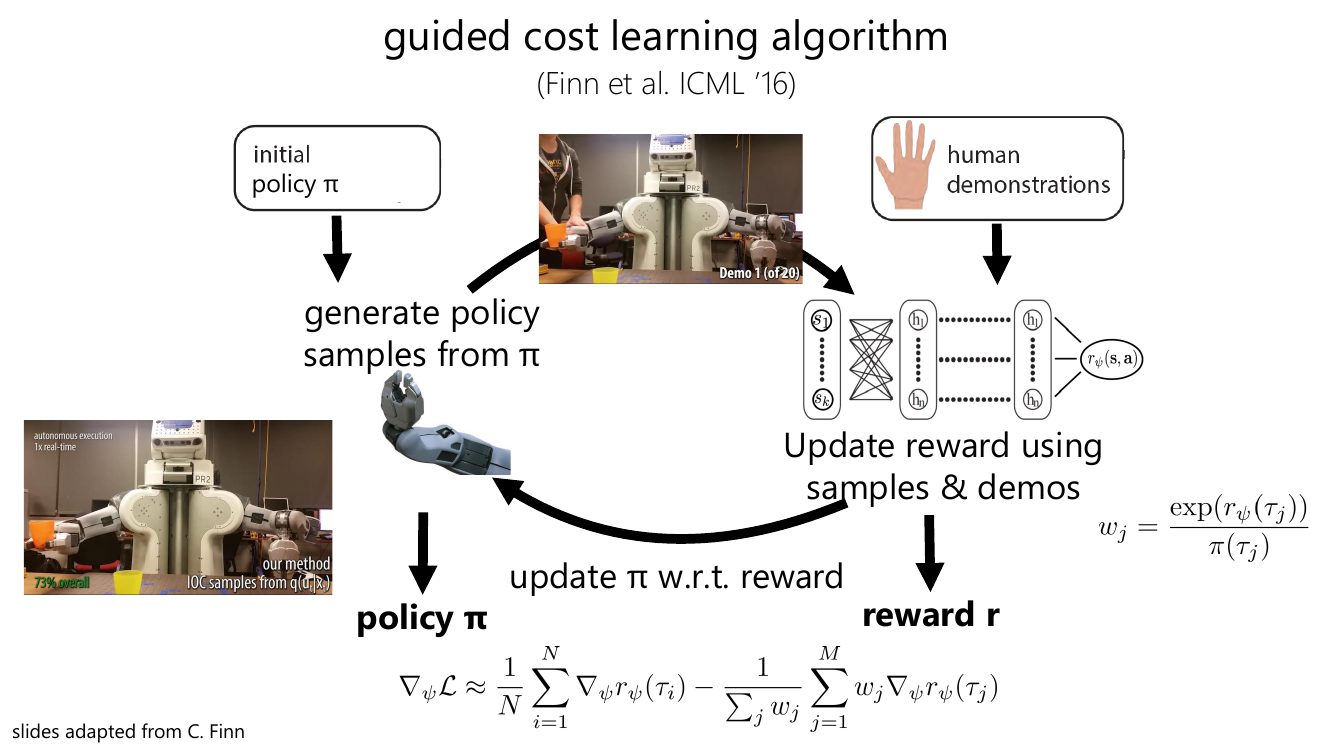
大规模、连续、神经网络奖励的情形。没法做精确推断,改用采样:用任意一个最大熵 RL 算法(第 7–9 节那些)在当前奖励 $r_\psi$ 下学一个策略 $\pi$,其目标正是
$$ J(\theta)=\sum_t\E_{\pi(s_t,a_t)}\big[r_\psi(s_t,a_t)\big]+\E_{\pi(s_t)}\big[\mathcal{H}(\pi(\cdot|s_t))\big], $$然后从 $\pi$ 采 $\{\tau_j\}_{j=1}^{M}$:
$$ \nabla_\psi\mathcal{L}\approx\frac{1}{N}\sum_{i=1}^{N}\nabla_\psi r_\psi(\tau_i)-\frac{1}{M}\sum_{j=1}^{M}\nabla_\psi r_\psi(\tau_j). $$「懒惰」的策略优化 + 重要性采样
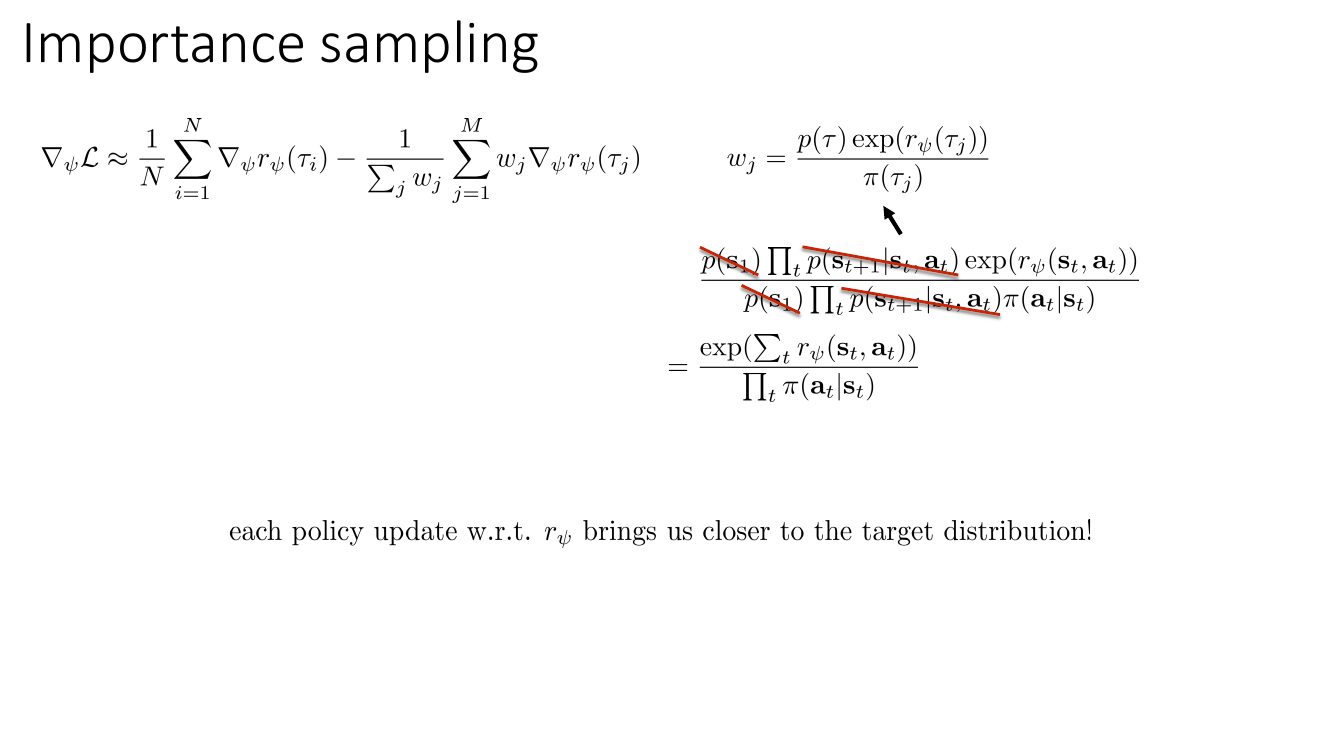
问题来了:每更新一次奖励就要把 RL 完整跑到收敛,代价高得离谱。自然的想法是只把策略改进一点点就去更新奖励。但这样一来 $\{\tau_j\}$ 就不是从 $p(\tau|\mathcal{O},\psi)$ 采的,估计有偏。修正办法是重要性采样:
$$ \nabla_\psi\mathcal{L}\approx\frac{1}{N}\sum_{i=1}^{N}\nabla_\psi r_\psi(\tau_i)-\frac{1}{\sum_j w_j}\sum_{j=1}^{M}w_j\,\nabla_\psi r_\psi(\tau_j), \qquad w_j=\frac{p(\tau_j)\exp\big(r_\psi(\tau_j)\big)}{\pi(\tau_j)} . $$权重可以大幅化简。把 $p(\tau)=p(s_1)\prod_t p(s_{t+1}|s_t,a_t)$ 和 $\pi(\tau)=p(s_1)\prod_t p(s_{t+1}|s_t,a_t)\pi(a_t|s_t)$ 代进去,初始状态分布和全部动力学项上下抵消:
$$ w_j=\frac{\exp\Big(\sum_t r_\psi(s_t,a_t)\Big)}{\prod_t \pi(a_t|s_t)} . $$这个式子只需要奖励和策略的对数概率,完全不需要知道动力学 —— 这正是它能用在真实机器人上的原因。
12. IRL 就是 GAN:对抗式模仿学习
先看结构
把上一节的两个更新放在一起看:
- 奖励更新 $\nabla_\psi\mathcal{L}$:抬高演示的概率,压低策略样本的概率;
- 策略更新 $\nabla_\theta\mathcal{L}\approx\frac{1}{M}\sum_j\nabla_\theta\log\pi_\theta(\tau_j)\,r_\psi(\tau_j)$:改变策略,使它更难与演示区分。
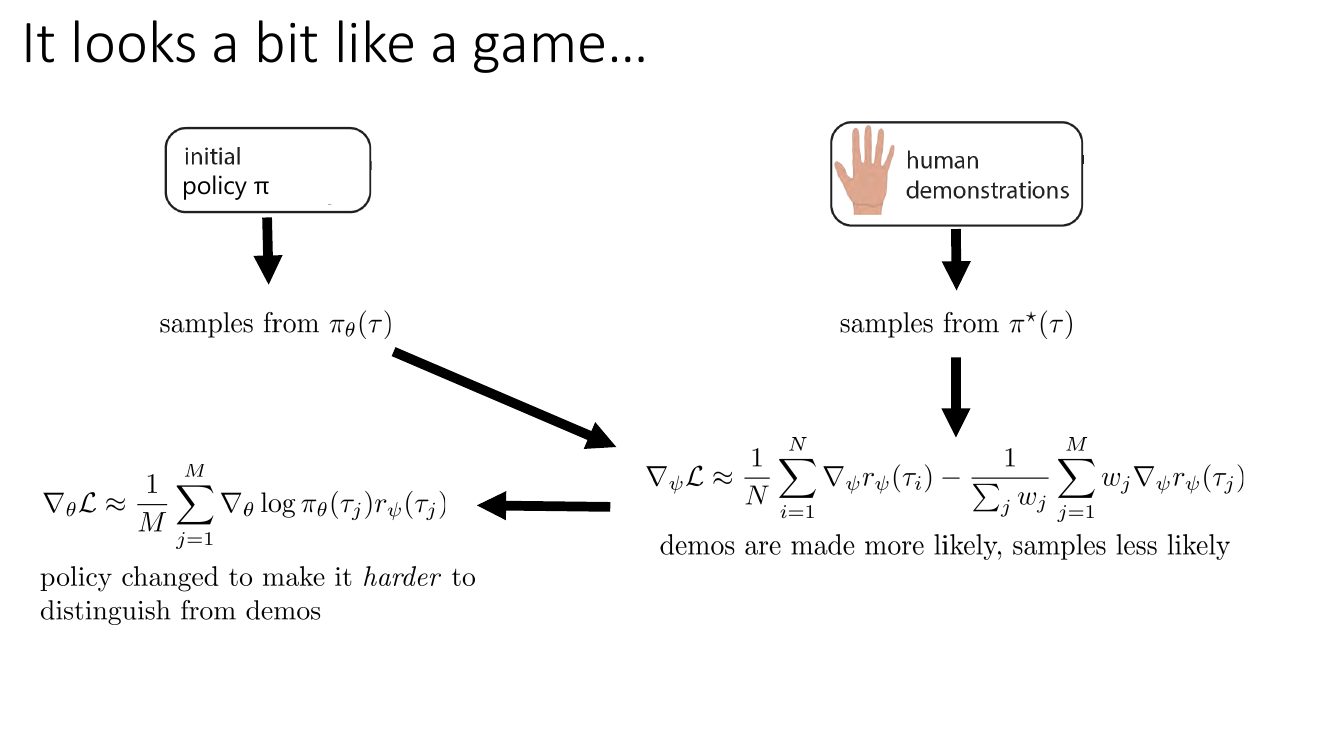
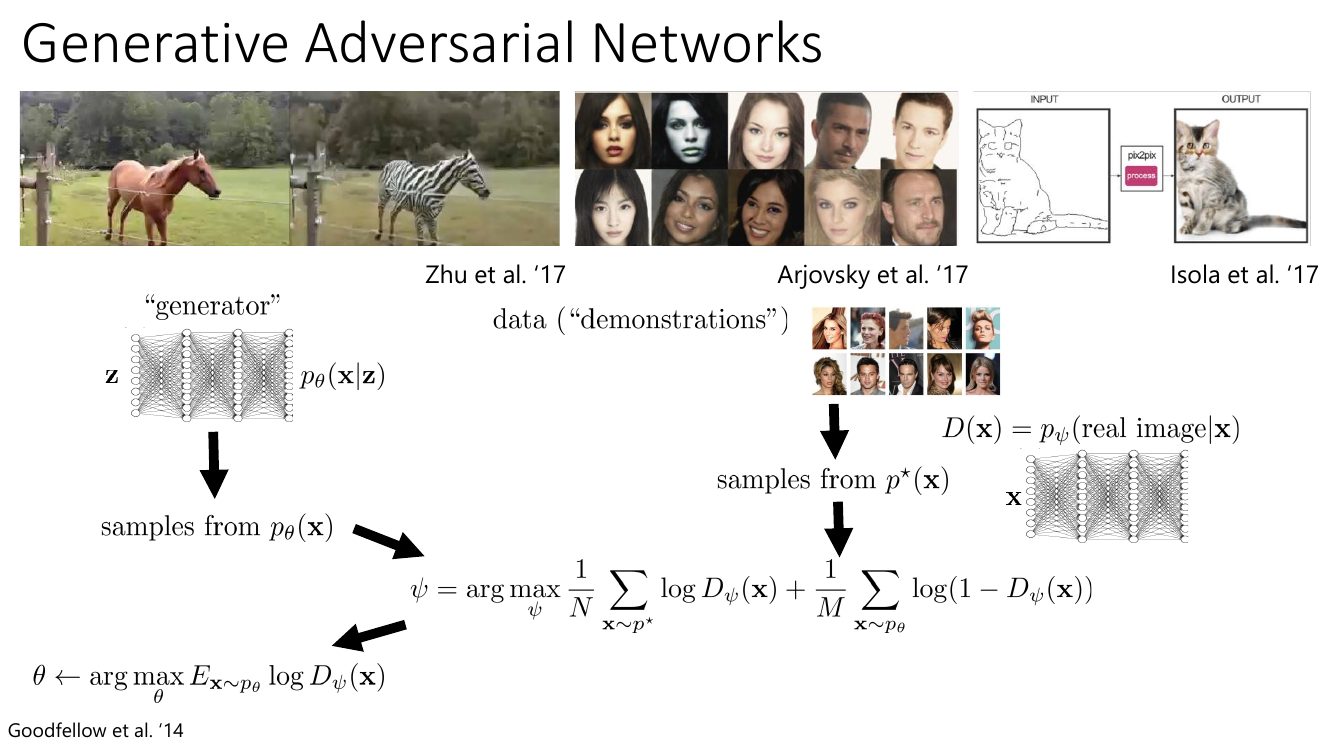
一个「生成器」努力让自己的样本像真数据,一个「判别器/奖励」努力把真假分开 —— 这不就是 GAN 吗。
最优判别器与 IRL 的精确对应
GAN 理论告诉我们,给定固定的生成器,最优判别器是
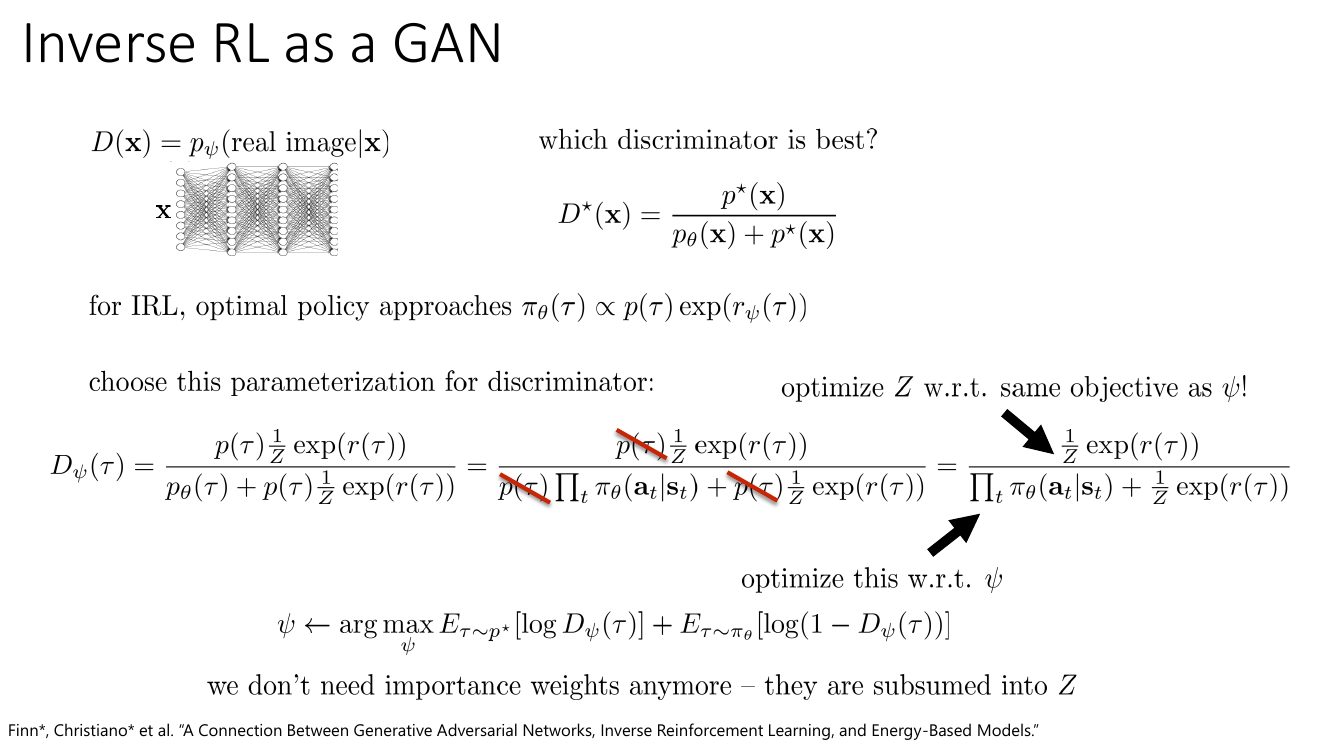
$$ D^\star(x)=\frac{p^\star(x)}{p_\theta(x)+p^\star(x)}. $$对 IRL 而言,最优策略应当趋于 $\pi_\theta(\tau)\propto p(\tau)\exp(r_\psi(\tau))$,也就是我们希望这两个分布最终重合。于是 Finn*、Christiano* 等人提出:不要用一个自由的神经网络当判别器,而是把判别器按上式的形状写死:
$$ D_\psi(\tau)=\frac{p(\tau)\frac{1}{Z}\exp(r_\psi(\tau))}{p_\theta(\tau)+p(\tau)\frac{1}{Z}\exp(r_\psi(\tau))} =\frac{\cancel{p(\tau)}\frac{1}{Z}\exp(r_\psi(\tau))}{\cancel{p(\tau)}\prod_t\pi_\theta(a_t|s_t)+\cancel{p(\tau)}\frac{1}{Z}\exp(r_\psi(\tau))} =\frac{\frac{1}{Z}\exp(r_\psi(\tau))}{\prod_t\pi_\theta(a_t|s_t)+\frac{1}{Z}\exp(r_\psi(\tau))} . $$动力学项再一次全部抵消。然后用标准的 GAN 判别器目标训练它:
$$ \psi\leftarrow\argmax_\psi\;\E_{\tau\sim p^\star}\big[\log D_\psi(\tau)\big]+\E_{\tau\sim\pi_\theta}\big[\log\big(1-D_\psi(\tau)\big)\big], $$并且把 $Z$ 也当成一个参数,用同一个目标去优化。这一步是整个方法的精妙之处:配分函数不再需要显式估计,也不再需要重要性权重 —— 它被吸收进了判别器的这个参数里,由判别损失自动校准到正确的量级。
能不能就用一个普通判别器?—— GAIL
可以,这就是 Ho & Ermon 的 GAIL(Generative Adversarial Imitation Learning):$D_\psi$ 是一个普通的二分类网络,然后直接把 $\log D_\psi(\tau)$ 当作奖励喂给策略梯度。
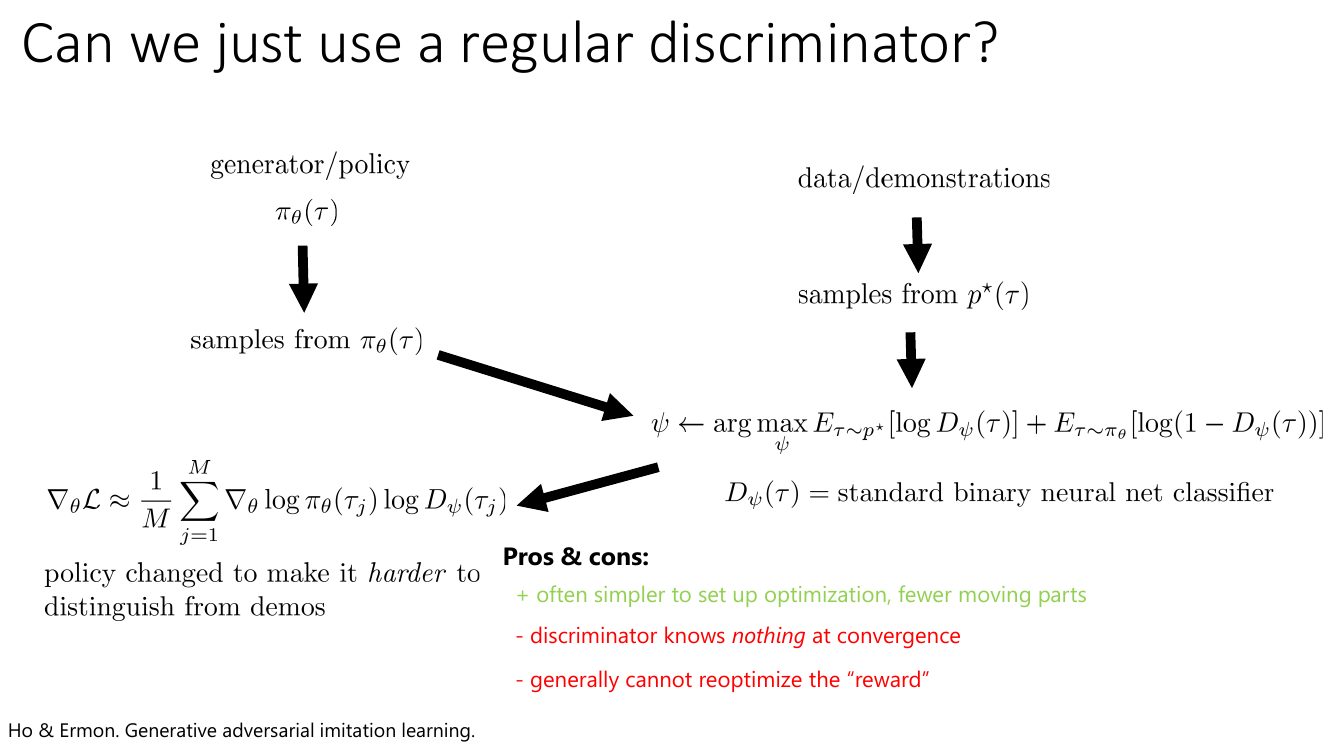
这两个缺点值得展开一句。如果你的目标只是模仿(在同一个环境里复现专家行为),GAIL 完全够用,而且更好调。如果你的目标是把奖励拿走用(迁移到新环境、新机器人、新初始状态分布),那就必须用结构化的 $D_\psi$,因为只有它里面那个 $r_\psi$ 才是一个真正意义上的奖励函数。后续工作 AIRL(Adversarial Inverse RL)进一步把 $r_\psi$ 分解成状态相关的部分和 shaping 部分,以获得对动力学变化鲁棒的奖励。
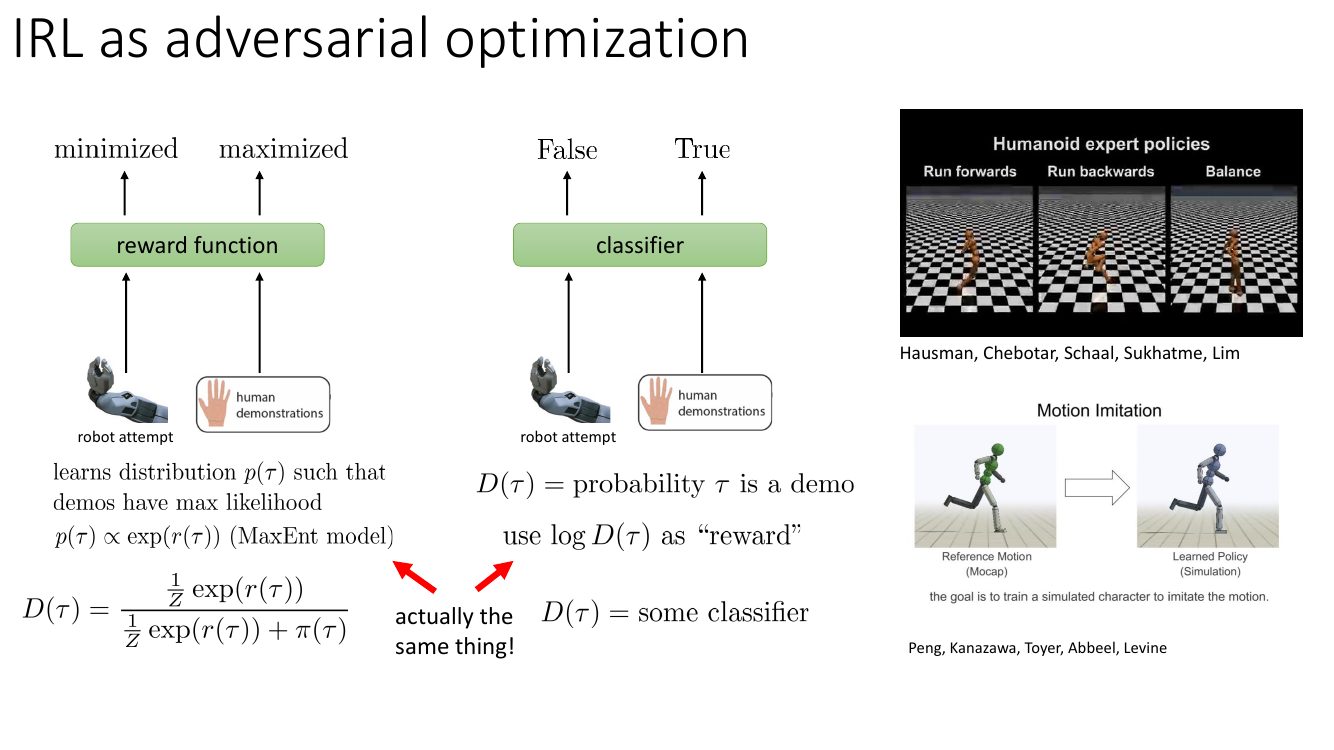
「学一个奖励函数」和「学一个判别器」在数学上是同一件事,区别只在于你给判别器施加了多少结构:完全自由 $\Rightarrow$ GAIL,形如 $\frac{e^{r}/Z}{e^{r}/Z+\pi}$ $\Rightarrow$ MaxEnt IRL。而这个特定形状之所以正确,来自本讲第 1 节那个模型 $p(\tau|\mathcal{O})\propto p(\tau)e^{\sum r}$。整条链条是:最优性变量 $\to$ 轨迹的指数族分布 $\to$ 最大似然的正负相位梯度 $\to$ 最优判别器公式 $\to$ GAN。
IRL 这条线在下一讲还会继续 —— 尤其是当「轨迹」变成「一段文本」、「演示」变成「人类偏好」的时候,这里的每一个公式都会以另一副面孔重新出现。
本讲小结
| 概念 | 公式 | 一句话 |
|---|---|---|
| 最优性变量 | $p(\mathcal{O}_t|s_t,a_t)=\exp(r(s_t,a_t))$ | 把「最优」变成可观测的随机变量 |
| 轨迹后验 | $p(\tau|\mathcal{O}_{1:T})\propto p(\tau)\exp(\sum_t r)$ | 回报每高 1,概率大 $e$ 倍 |
| 反向消息 | $\beta_t(s,a)=p(\mathcal{O}_t|s,a)\E_{s'}[\beta_{t+1}(s')]$ | 取对数就是 $Q$ |
| 前向消息 | $\alpha_t(s_t)=p(s_t|\mathcal{O}_{1:t-1})$ | $\alpha\beta$ 相乘 = 状态边缘,IRL 要用 |
| 朴素推断的 backup | $Q=r+\alpha\log\E_{s'}[e^{V/\alpha}]$ | 错:对运气也取 soft max(乐观偏差) |
| 变分族 | $q(\tau)=p(s_1)\prod_t p(s'|s,a)q(a_t|s_t)$ | 动力学钉死,只学动作分布 |
| ELBO | $\sum_t\E_q[r+\mathcal{H}(q(\cdot|s_t))]$ | 最大熵 RL 目标,动力学项精确抵消 |
| 自由能恒等式 | $\max_q\{\E_q[Q]+\alpha\mathcal{H}\}=\alpha\log\int e^{Q/\alpha}$ | 解为 $q\propto e^{Q/\alpha}$,证明用 KL 配项 |
| soft 值迭代 | $Q\!\leftarrow\!r+\gamma\E_{s'}[V]$,$V\!\leftarrow\!\alpha\log\!\int\! e^{Q/\alpha}$ | 只有动作是 soft 的;仍是 $\gamma$-压缩 |
| 偏差上界 | $0\le V_{\text{soft}}-V_{\text{hard}}\le\frac{\alpha\log|\mathcal{A}|}{1-\gamma}$ | $\alpha$ 越小越接近标准 RL |
| soft Q-learning | $y=r+\gamma\,\alpha\log\sum_{a'}e^{Q_{\bar\theta}(s',a')/\alpha}$ | 与 DQN 只差 logsumexp 换 max |
| SAC critic | $y=r+\gamma\E_{a'\sim\pi}[Q_{\bar\phi}-\alpha\log\pi]$ | 熵在 $\gamma$ 里面 = 熵进值函数 |
| SAC actor | $\min_\theta\E[\alpha\log\pi_\theta-\min(Q_1,Q_2)]$ | 向 $e^{Q/\alpha}$ 的反向 KL 投影 |
| 自动调温 | $\mathcal{L}(\alpha)=-\E[\alpha(\log\pi+\bar{\mathcal{H}})]$ | 熵约束的对偶变量,$\bar{\mathcal{H}}=-\dim(\mathcal{A})$ |
| KL 正则版 | $q^\star\propto\rho\,e^{Q/\alpha}$ | 动作先验非均匀 $\Rightarrow$ RLHF 的形式 |
| MaxEnt IRL 梯度 | $\E_{\pi^\star}[\nabla r_\psi]-\E_{p(\tau|\mathcal{O},\psi)}[\nabla r_\psi]$ | 正相位减负相位;负相位靠 max-ent RL 采样 |
| IS 权重 | $w_j=\exp(\sum_t r_\psi)/\prod_t\pi(a_t|s_t)$ | 动力学抵消,无需模型 |
| IRL as GAN | $D_\psi=\frac{e^{r_\psi}/Z}{\prod_t\pi_\theta+e^{r_\psi}/Z}$ | $Z$ 用同一目标学,取代重要性权重 |
要点清单
- 建模次优行为的正确方式不是「加噪声」,而是让轨迹分布 $\propto e^{\text{回报}}$。
- 「控制 = 推断」这句话只在限定变分族之后才成立;不限定就会得到乐观规划者。乐观偏差的根源是 $\log\E\exp\ge\E$,且在确定性动力学下消失。
- 最大熵目标里的熵不是人为正则,是 ELBO 自带的 $-\E_q[\log q]$。温度 $\alpha$ 就是奖励尺度的倒数。
- soft 与 hard 的唯一区别在对动作取 max 的方式;对下一状态永远是普通期望。
- $\pi\propto\exp(Q/\alpha)$ 是自由能恒等式的解;参数化策略只能做它的 KL 投影,这就是 SAC 的 actor 损失。
- SAC 之所以稳定:随机策略 + 熵进 target + 双 Q + 自动调温;之所以能 off-policy:$a'$ 和 $a$ 都是现采的,回放池只提供状态与转移。
- 把同一个模型反过来学 $r$,就是 MaxEnt IRL;把配分函数塞进判别器,就是 GAN。IRL 与对抗模仿学习是同一件事的两种参数化。
延伸阅读
理论框架
- Reinforcement Learning and Control as Probabilistic Inference: Tutorial and Review (Levine, 2018) — 本讲的完整版综述,前向/反向消息、变分推导、与各家算法的对应关系都在里面,强烈建议通读。
- Linearly-solvable Markov decision problems (Todorov, 2006/2007) — 最早发现「$\log$ 变换后 Bellman 方程变线性」的工作,本讲 soft max 的前身。
- Robot trajectory optimization using approximate inference (Toussaint, ICML 2009) — 把轨迹优化写成消息传递,是「控制即推断」在机器人上的早期落地。
- Modeling Purposeful Adaptive Behavior with the Principle of Maximum Causal Entropy (Ziebart, 2010 博士论文) — 讨论了随机动力学下「因果熵」为什么才是正确的量,正面回应本讲第 4 节的乐观问题。
最大熵 RL 算法
- Reinforcement Learning with Deep Energy-Based Policies (Haarnoja et al., 2017) — soft Q-learning 的原始论文,连续动作用 amortized SVGD 采样,多模态策略的可视化非常直观。
- Soft Actor-Critic (Haarnoja et al., 2018) — SAC v1,含 soft policy iteration 的收敛性证明。
- Soft Actor-Critic Algorithms and Applications (Haarnoja et al., 2018) — SAC v2,自动调温的约束优化推导就在这里,也是工程实现的事实标准。
- Equivalence Between Policy Gradients and Soft Q-Learning (Schulman et al., 2017) — 证明带熵的策略梯度与 soft Q-learning 在一定条件下等价,把第 7、8 节缝在一起。
- Bridging the Gap Between Value and Policy Based RL (Nachum et al., 2017) — PCL,从 soft 一致性方程出发同时训练策略与值函数。
- Maximum a Posteriori Policy Optimisation (Abdolmaleki et al., 2018) — 把控制即推断做成 EM:E 步求非参数的 $q\propto\pi e^{Q/\alpha}$,M 步做投影,与 SAC 是同一个恒等式的另一种用法。
- Maximum Entropy RL (Provably) Solves Some Robust RL Problems (Eysenbach & Levine, 2021) — 把第 10 节「更鲁棒」这句直觉变成定理。
逆强化学习与对抗模仿
- Algorithms for Inverse Reinforcement Learning (Ng & Russell, ICML 2000) — IRL 的开山之作,也是「问题欠定」这一诊断的出处。
- Maximum Entropy Inverse Reinforcement Learning (Ziebart et al., AAAI 2008) — 用最大熵解决欠定性,表格化 forward-backward 版本。
- Guided Cost Learning (Finn et al., 2016) — 神经网络奖励 + 重要性采样 + 「懒惰」策略优化,真实机器人上的 MaxEnt IRL。
- A Connection Between GANs, Inverse RL, and Energy-Based Models (Finn*, Christiano* et al., 2016) — 本讲第 12 节的来源,判别器的特殊参数化与 $Z$ 的处理。
- Generative Adversarial Imitation Learning (Ho & Ermon, 2016) — GAIL,用普通判别器换取优化上的简洁。
- Learning Robust Rewards with Adversarial Inverse RL (Fu et al., 2017) — AIRL,把奖励与 shaping 分离,得到可迁移的奖励。
- Multi-Modal Imitation Learning from Unstructured Demonstrations using GANs (Hausman et al., 2017) — 幻灯片右上角那个「前跑/后跑/平衡」humanoid 实验。
- Variational Discriminator Bottleneck (Peng et al., 2018) — 幻灯片右下角的动作模仿实验,用信息瓶颈稳定对抗训练。
- Generative Adversarial Networks (Goodfellow et al., 2014) — GAN 原文,最优判别器公式的出处。
通往下一讲
- Direct Preference Optimization (Rafailov et al., 2023) — RLHF 的最优策略 $\pi^\star\propto\pi_{\text{ref}}e^{r/\beta}$ 正是本讲第 6 节的 KL 正则公式;DPO 把它反解出奖励,与 IRL 的思路完全同构。