变分推断:隐变量模型、ELBO 与摊销推断
当一个概率模型里藏着看不见的变量,极大似然就算不动了。变分推断给出一个可优化的下界,这个下界是后面三讲(control as inference、软 Q 学习、基于模型的 RL)共同的数学地基。
0. 本讲导读
前十讲我们一直在做一件事:把强化学习问题写成一个目标函数 $J(\theta)=\E_{\tau\sim p_\theta(\tau)}[\sum_t r(s_t,a_t)]$,然后想办法算它的梯度、或者用动态规划逼近它的最优解。到 Lecture 10 为止,工具箱里已经有了策略梯度、自然梯度、信赖域、Q 学习、actor-critic。这些方法的共同点是:奖励函数 $r(s,a)$ 是给定的,我们只优化策略。
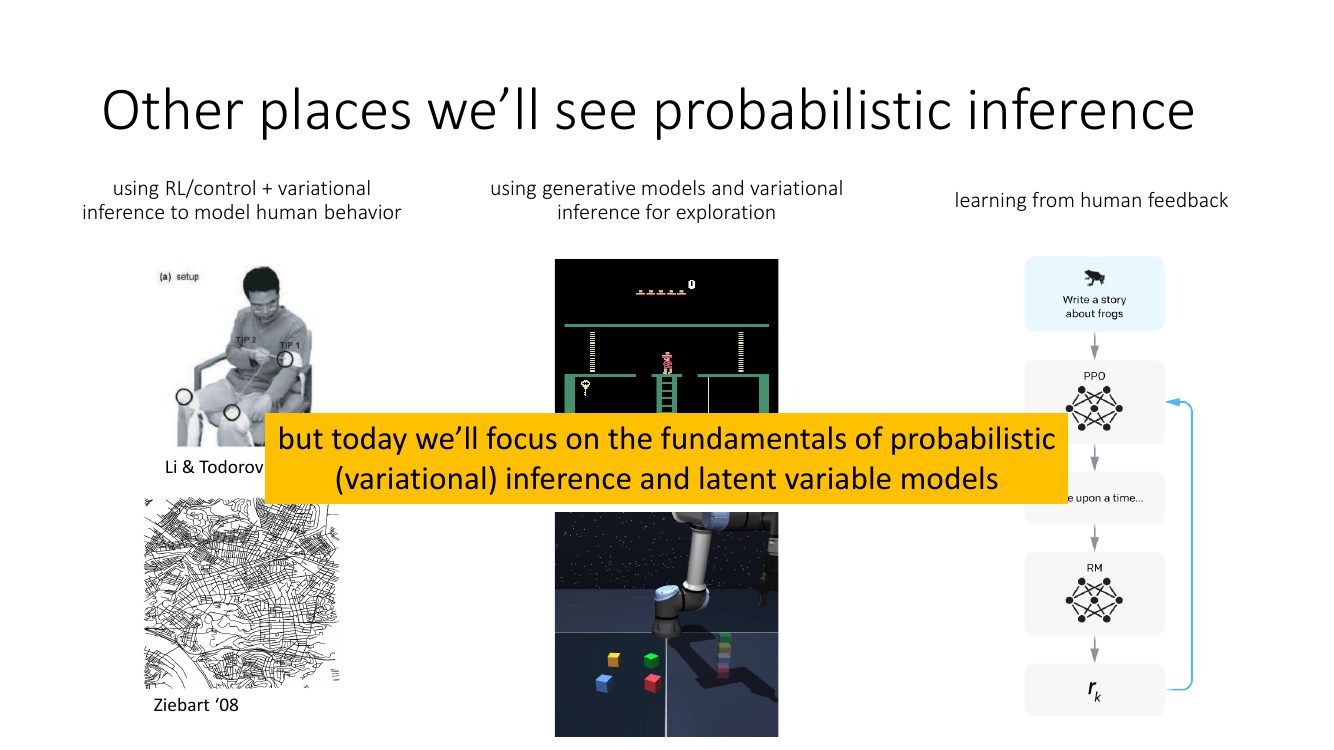
从本讲开始,课程转向一条完全不同的思路:把「做出最优决策」这件事本身,重写成一个概率推断(probabilistic inference)问题。这条线索会一路通向最大熵强化学习(maximum entropy RL)、软 Q 学习(soft Q-learning)、软演员-评论家(SAC)、逆强化学习(inverse RL),以及用生成模型做探索、用人类反馈做对齐(RLHF)。而所有这些的共同数学工具只有一个——变分推断(variational inference, VI)。
本讲不谈 RL。本讲只做一件事:把变分推断这套数学彻底讲清楚。具体路线是:
- 隐变量模型(latent variable model, LVM)是什么,为什么在模型里塞一个看不见的 $z$ 能极大提升表达力;
- 为什么隐变量模型没法直接做极大似然——罪魁祸首是 $\log p(x)=\log\int p(x|z)p(z)\,dz$ 这个「对数套积分」;
- 引入一个近似后验 $q_i(z)$,推出证据下界(evidence lower bound, ELBO) $\mathcal{L}_i(p,q_i)$。这个下界我们会用两种完全不同的方式各推一遍:Jensen 不等式,以及 $\log p(x)=\mathcal{L}(q)+\KL(q\|p(z|x))$ 的精确恒等式分解;
- 为了看懂 ELBO 里的熵项,补一段熵(entropy)与 KL 散度(KL divergence)的直觉;
- 用 ELBO 写出训练算法,然后发现它有个致命问题:参数量随数据集大小线性增长;
- 解决办法是摊销推断(amortized inference)——用一个神经网络 $q_\phi(z|x)$ 把「每个数据点一套变分参数」压缩成「一套共享权重」;
- 最后一块拼图是怎么求 $q$ 的梯度:重参数化技巧(reparameterization trick)与 score function / REINFORCE 估计的对比。这里会看到一个惊人的巧合——score function 估计器和我们在 Lecture 5 推的策略梯度是同一个公式。
把这些拼起来就得到变分自编码器(variational autoencoder, VAE)。最后我们会给出一个能跑通的最小 PyTorch 实现,并预告下一讲怎么把「最优性」当成一个观测变量塞进图模型里,从而把 RL 变成推断。
- 隐变量模型 $p(x)=\int p(x|z)p(z)dz$ 用「简单分布的连续混合」构造出任意复杂的分布,代价是 $\log p(x)$ 不再有闭式解。
- 对任意分布 $q(z)$(只要与 $p$ 同支撑)都有 $\log p(x)\;=\;\mathcal{L}(p,q)\;+\;\KL\!\big(q(z)\,\|\,p(z|x)\big)$,其中 $\mathcal{L}(p,q)=\E_{z\sim q}[\log p(x|z)+\log p(z)]+\mathcal{H}(q)$。
- 因为 $\KL\ge 0$,所以 $\mathcal{L}$ 是 $\log p(x)$ 的下界;又因为 $\log p(x)$ 与 $q$ 无关,所以对 $q$ 最大化 ELBO 等价于最小化 $\KL(q\|p(z|x))$——「优化下界」和「做近似推断」是同一件事。
- ELBO 里的熵项 $\mathcal{H}(q)$ 不是可有可无的正则,它是防止 $q$ 塌缩成一个点的关键;没有它,变分推断退化成「猜一个最可能的 $z$」。
- 摊销推断把 $O(N)$ 个变分参数换成一个网络 $q_\phi(z|x)$;重参数化技巧让这个网络可以直接反向传播,方差远小于 score function 估计器,但只适用于连续、可重参数化的 $z$。
1. 概率模型与隐变量模型
1.1 我们一直在拟合的三类分布
回顾一下这门课到目前为止拟合过的东西,其实都是概率模型:
- $p(x)$:无条件密度模型。给一堆数据点,学出它们的分布。比如把一团二维点云拟合成一个高斯椭圆。
- $p(y|x)$:条件模型。最典型的是回归——给定输入 $x$ 预测输出 $y$,通常假设 $p(y|x)=\mathcal{N}(f_\theta(x),\sigma^2)$,极大似然就退化成最小二乘。
- $\pi_\theta(a|s)$:策略。这就是一个条件模型,只不过输入叫状态 $s$、输出叫动作 $a$。前十讲里我们用一个卷积网络把图像观测 $o$ 映射成动作分布,本质上就是在拟合 $p(y|x)$。
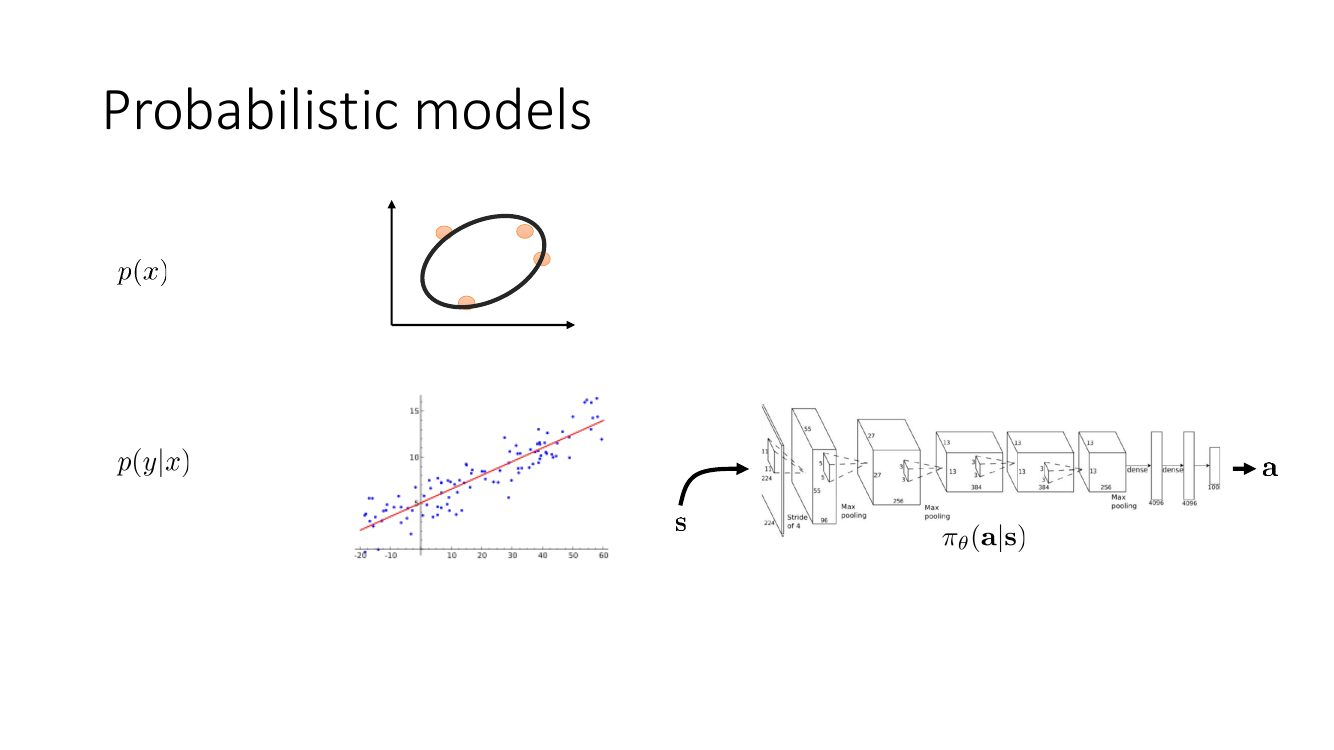
问题在于:这三类模型的表达力都被「分布族」卡死了。如果你假设 $p(y|x)$ 是一个高斯,那么对每个 $x$,$y$ 的分布就只能是单峰、对称、指数衰减的。真实世界不长这样。
1.2 一个具体的反例:树前的岔路
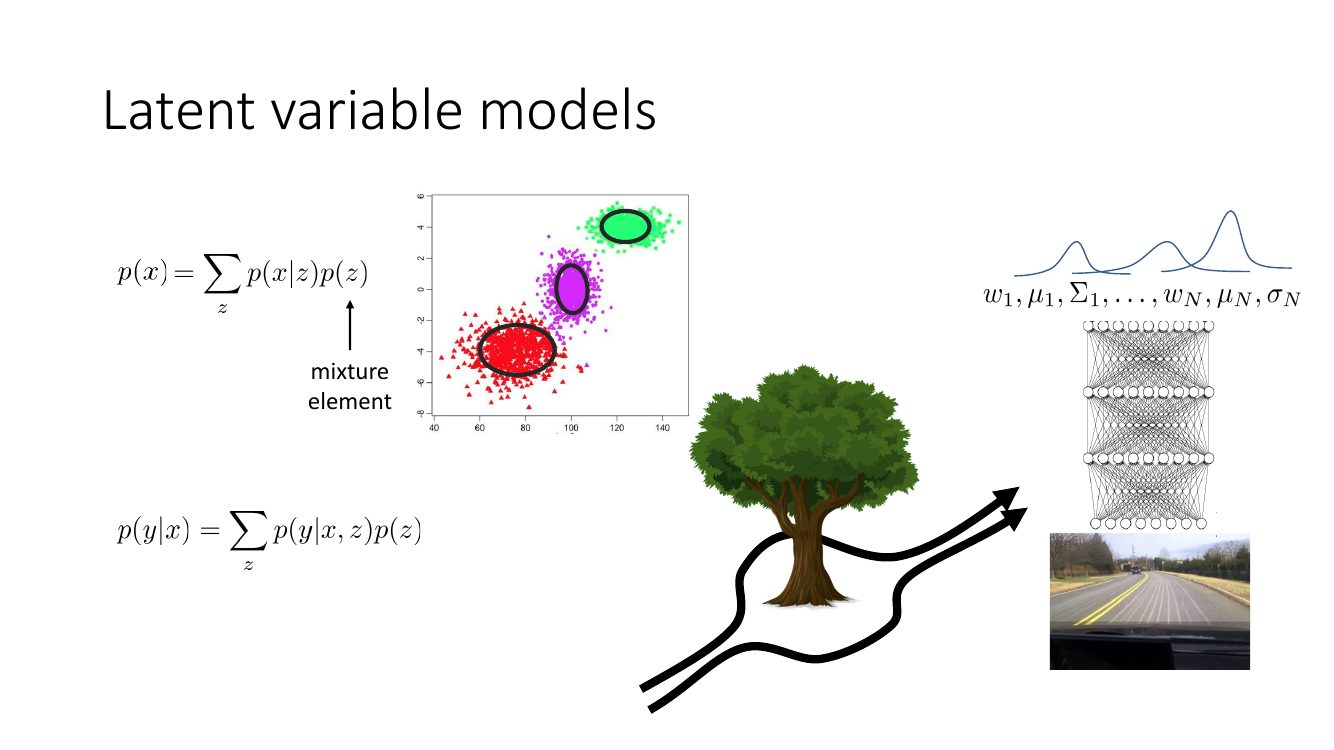
Levine 反复用的例子是:一辆自动驾驶车开到一棵树前面,人类司机的正确行为可能是向左绕,也可能是向右绕,唯独不能是直接撞上去。现在你收集了人类演示数据做行为克隆(behavioral cloning),数据里一半左绕一半右绕。如果策略是单峰高斯,极大似然会怎么做?
高斯的极大似然解就是数据的均值。左绕的转向角是 $-30°$,右绕是 $+30°$,均值是 $0°$——直接撞树。这不是训练不充分,这是模型族的表达力从根本上不够。任何单峰分布在这个问题上都会给出灾难性的答案。
「多模态问题可以靠加大网络解决」——不行。网络再大,只要输出头是一个高斯的 $(\mu,\sigma)$,它对任意输入的输出分布永远是单峰的。加大网络只能让 $\mu(x)$ 这个函数更复杂,不能让给定 $x$ 之后 $y$ 的分布变成双峰。要突破这一点必须换分布族——这正是隐变量模型的动机。
1.3 混合模型:最简单的隐变量模型
最古老的解法是混合模型(mixture model):引入一个离散的隐变量 $z\in\{1,\dots,K\}$ 表示「用哪个成分」,然后
$$ p(x)=\sum_z p(x|z)p(z),\qquad p(x|z=k)=\mathcal{N}(\mu_k,\Sigma_k),\quad p(z=k)=w_k . $$这里 $z$ 就是混合成分编号(mixture element)。$p(z)$ 是一个 $K$ 类的类别分布,权重 $w_1,\dots,w_K$ 满足 $\sum_k w_k=1$。虽然每个成分 $p(x|z)$ 都是简单的高斯,但它们的加权和可以是任意形状——三个高斯就能拟合出三团分离的点云。
对应到条件模型,就是混合密度网络(mixture density network, MDN):
$$ p(y|x)=\sum_z p(y|x,z)p(z), $$让神经网络吃进 $x$(比如那张有树的路面图像),输出 $K$ 组高斯参数 $w_1,\mu_1,\Sigma_1,\dots,w_N,\mu_N,\sigma_N$。这样在树前面,网络可以输出两个权重各 0.5 的成分,一个中心在 $-30°$、一个在 $+30°$——两条绕行路线都被正确表示,而中间的 $0°$ 概率极低。
1.4 从离散 $z$ 到连续 $z$:一般的隐变量模型
混合模型有个明显的缺陷:成分数 $K$ 要手工指定,而且参数量随 $K$ 线性增长。如果真实分布有 1000 个模式,你就得输出 1000 组高斯参数。对高维数据(比如图像),模式的数量是天文数字。
解决办法是把离散的 $z$ 换成连续的 $z\in\R^d$,求和换成积分:
$$ p(x)=\int p(x|z)\,p(z)\,dz . $$这就是一般的隐变量模型。它的精妙之处在于:等号右边的两个分布都可以很简单。
- $p(z)$ 通常取标准正态 $\mathcal{N}(0,I)$——最简单的分布,没有任何可学参数。
- $p(x|z)$ 取条件高斯 $\mathcal{N}(\mu_{\text{nn}}(z),\sigma_{\text{nn}}(z))$,其中 $\mu_{\text{nn}},\sigma_{\text{nn}}$ 是神经网络的输出。给定某个具体的 $z$,$x$ 的分布是单峰高斯,这依然很简单。
但边缘分布 $p(x)$ 却可以极其复杂。直觉是:这相当于把无穷多个高斯按 $p(z)$ 的权重连续地叠加起来。当 $\mu_{\text{nn}}$ 是一个非线性网络时,$z$ 在隐空间里平滑移动,对应的 $\mu_{\text{nn}}(z)$ 在数据空间里可以跳来跳去,于是叠加出来的 $p(x)$ 可以有任意多个峰、任意的形状。
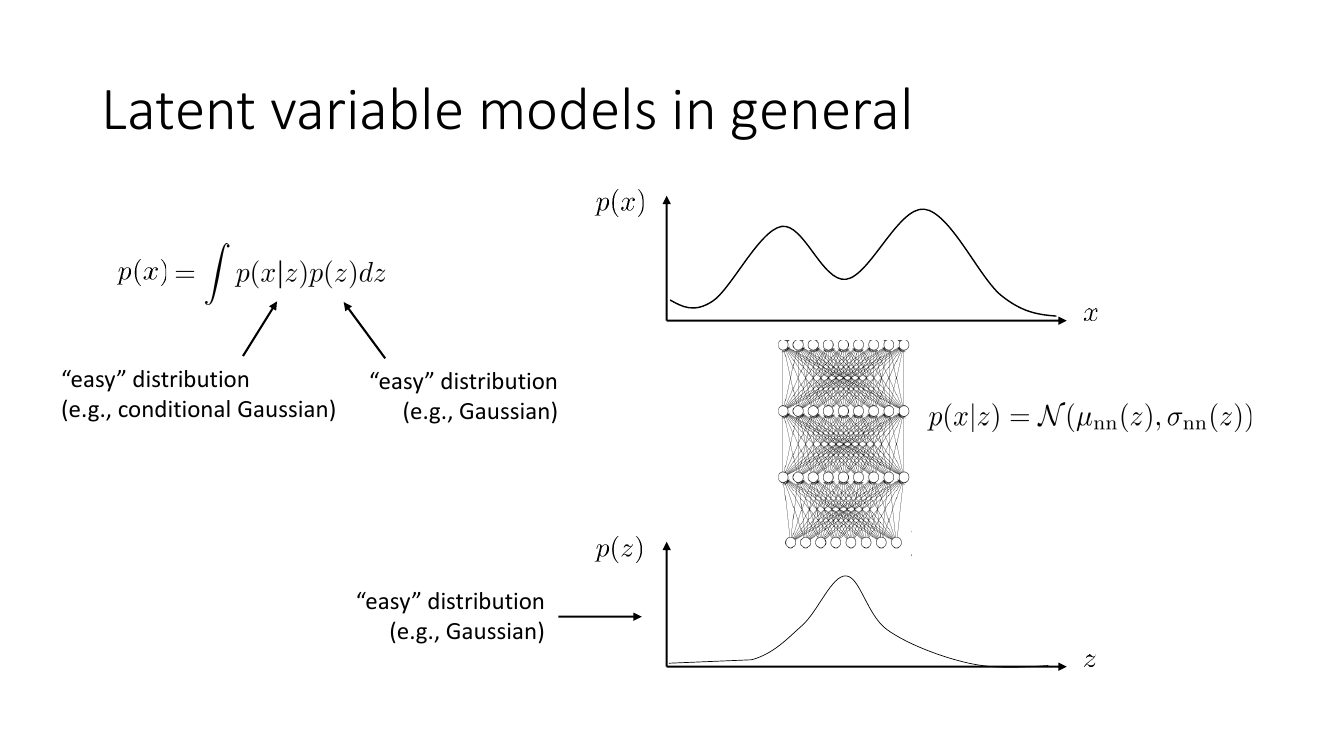
可以把隐变量模型理解成一个随机的生成程序:先掷一次骰子得到 $z\sim\mathcal{N}(0,I)$,再把 $z$ 喂进一个确定性网络得到分布参数,最后从这个简单分布里采一个 $x$。整个程序每一步都简单,但组合出来的 $x$ 的分布可以任意复杂——就像一个只有几行代码的伪随机数生成器可以产生看似毫无规律的序列。所谓「表达力」,来自于非线性 $\times$ 边缘化,而不是来自于让某一步的分布本身变复杂。
值得强调的是,$z$ 之所以叫「隐(latent)」变量,是因为它在数据里从来没被观测到。数据集只有 $\mathcal{D}=\{x_1,\dots,x_N\}$,没有配套的 $z_i$。如果每个 $x_i$ 都附带一个已知的 $z_i$(比如你知道每个点属于哪一团),那这就是一个普通的有监督问题,直接极大似然 $\log p(x_i,z_i)=\log p(x_i|z_i)+\log p(z_i)$ 就完了,一点难度都没有。全部的困难都来自 $z$ 不可见。
2. 隐变量模型在强化学习中的位置
在开始推数学之前,先把「为什么 RL 课要花一整讲讲 VAE 的数学」说清楚。隐变量模型在这门课里至少出现在四个地方。
2.1 多模态策略
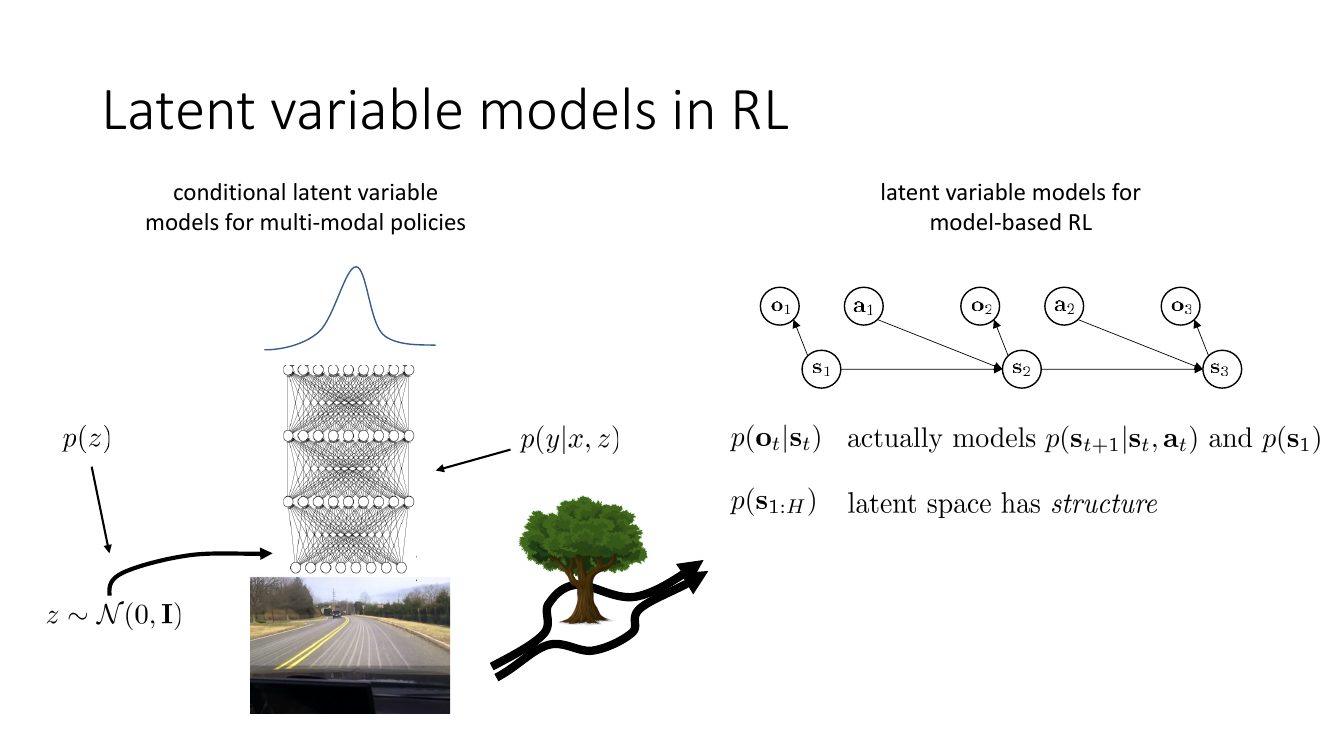
第一个就是上一节的树前岔路。把策略写成条件隐变量模型:
$$ \pi_\theta(a|s)=\int \pi_\theta(a|s,z)\,p(z)\,dz,\qquad z\sim\mathcal{N}(0,I). $$具体做法是:把噪声 $z$ 和状态 $s$ 一起送进策略网络,网络输出一个条件高斯 $\pi_\theta(a|s,z)$。对同一个 $s$,采不同的 $z$ 就能得到不同的动作模式。这在模仿学习(imitation learning)里尤其重要——人类演示天然是多模态的,不同的人、甚至同一个人在不同时刻的做法都不一样。
2.2 基于模型 RL 中的状态空间模型
第二个场景更本质。在部分可观测(partially observed)的环境里,我们看到的是观测 $o_t$(比如一帧图像),而真正满足马尔可夫性的状态 $s_t$ 是看不见的。要学一个环境模型,就得处理这个图模型:
$$ p(o_{1:T},s_{1:T}|a_{1:T})=p(s_1)\prod_{t}p(s_{t+1}|s_t,a_t)\,p(o_t|s_t). $$这里 $s_{1:T}$ 整条状态序列都是隐变量。注意这个隐空间和 VAE 里那个各向同性的 $z$ 不同——它是有结构的:$s_{t+1}$ 只依赖 $s_t$ 和 $a_t$,构成一条马尔可夫链。要训练这样的模型,我们需要推断后验 $p(s_{1:T}|o_{1:T},a_{1:T})$,这正是变分推断的活儿。这条线索会在基于模型的 RL 那几讲里展开。
2.3 探索与人类行为建模
第三,探索(exploration)。一类重要的探索方法是「新颖性驱动」:对已访问状态拟合一个密度模型 $p(s)$,把 $-\log p(s)$ 或者某种信息增益当作内在奖励,鼓励智能体去密度低的地方。要在高维图像上做这件事,密度模型就得是隐变量模型,训练它就得用变分推断。
第四,人类行为建模与逆强化学习。人不是完美的最优控制器,但也不是随机的。把「人在近似地最优化某个未知奖励」写成一个概率图模型,然后从演示数据里推断奖励——这就是 Ziebart 2008 的最大熵逆 RL。它的推断步骤本质上是一个变分推断问题。
RL 里凡是出现「我看不到但我需要它」的量——多模态策略里的模式编号、POMDP 里的真实状态、逆 RL 里的奖励函数、control as inference 里的最优性变量——都是隐变量。掌握变分推断,就等于拿到了处理这一整类问题的通用钥匙。
3. 训练的困难:对数套积分
3.1 极大似然为什么算不动
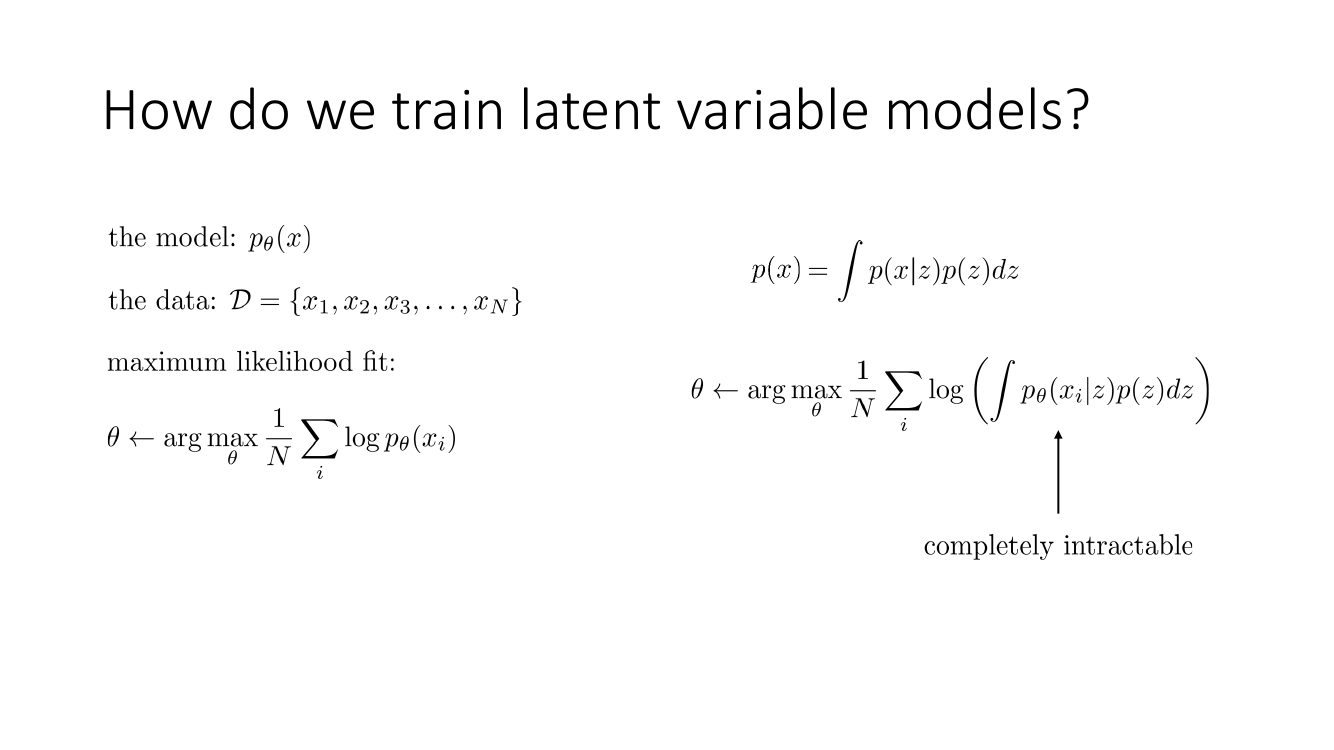
标准的模型拟合流程是极大似然(maximum likelihood):
$$ \theta\leftarrow\argmax_\theta\frac{1}{N}\sum_i\log p_\theta(x_i). $$对于普通模型(比如一个高斯、一个自回归模型),$\log p_\theta(x_i)$ 有闭式表达,直接反向传播即可。但对隐变量模型,把 $p_\theta(x_i)=\int p_\theta(x_i|z)p(z)dz$ 代进去:
$$ \theta\leftarrow\argmax_\theta\frac{1}{N}\sum_i\log\left(\int p_\theta(x_i|z)\,p(z)\,dz\right). $$这个式子 Levine 在 slides 上直接标了四个字:completely intractable。为什么?
3.2 三层困难,逐层拆解
第一层:积分本身没有解析解。 当 $p_\theta(x|z)=\mathcal{N}(\mu_{\text{nn}}(z),\sigma_{\text{nn}}(z))$ 里的 $\mu_{\text{nn}}$ 是一个多层非线性网络时,$\int\mathcal{N}(x;\mu_{\text{nn}}(z),\cdot)\mathcal{N}(z;0,I)dz$ 不属于任何已知的分布族,写不出闭式。
第二层:蒙特卡洛估计会失效。 你可能会想:积分不就是期望吗,采样估计不就行了?
$$ p_\theta(x_i)=\E_{z\sim p(z)}[p_\theta(x_i|z)]\approx\frac{1}{M}\sum_{j=1}^{M}p_\theta(x_i|z_j),\quad z_j\sim\mathcal{N}(0,I). $$这在数学上是无偏的,但在实践中方差大到没法用。原因是:在高维空间里,从先验 $p(z)$ 随机采的 $z_j$ 几乎必然与 $x_i$ 毫不相干,于是 $p_\theta(x_i|z_j)$ 几乎全是 $0$(准确说是 $e^{-\text{很大的数}}$)。只有极少数「碰巧对上」的 $z_j$ 贡献了整个积分的绝大部分质量。
举个量化的例子:设 $x$ 是 $784$ 维的 MNIST 图像,$p_\theta(x|z)=\mathcal{N}(\mu_{\text{nn}}(z),I)$。那么 $\log p_\theta(x|z)=-\frac12\|x-\mu_{\text{nn}}(z)\|^2+\text{const}$。一个随机的 $z$ 解码出来的图像和目标图像的像素级距离平方轻松达到几十上百,于是 $p_\theta(x|z)\sim e^{-50}$;而「正确的」$z$ 可能给出 $e^{-5}$。两者相差 $e^{45}\approx 10^{19}$ 倍。要让蒙特卡洛估计有意义,你需要采到那些概率质量集中的 $z$,而它们在 $p(z)$ 下的占比可能只有 $10^{-15}$。用先验采样做估计,等于在中国随机拨号码找一个特定的人。
第三层:还有个 $\log$ 在外面。 即使你的积分估计 $\hat{p}$ 是 $p$ 的无偏估计,$\log\hat{p}$ 也不是 $\log p$ 的无偏估计——由 Jensen 不等式,$\E[\log\hat p]\le\log\E[\hat p]=\log p$。它系统性地偏低。这个偏差恰恰是后面 ELBO 的来源,我们会看到它其实是个特性而不是 bug。
3.3 换个目标:期望对数似然
Levine 的思路是:既然 $\log$ 套 $\int$ 这个结构本身就是麻烦的根源,那我们干脆换一个目标函数——用期望对数似然(expected log-likelihood):
$$ \theta\leftarrow\argmax_\theta\frac{1}{N}\sum_i\E_{z\sim p(z|x_i)}\big[\log p_\theta(x_i,z)\big]. $$注意这个式子的结构变了:$\log$ 跑到了期望里面,而且里面是联合分布 $p_\theta(x_i,z)=p_\theta(x_i|z)p(z)$,它是完全可以解析计算的(两个简单分布的对数之和)。期望外面用蒙特卡洛,$\log$ 里面用闭式,问题一下就顺了。
但这里有个关键的选择:期望是对哪个分布取的? 答案是 $z\sim p(z|x_i)$,即后验分布,而不是先验 $p(z)$。
直觉是这样的:如果我们知道每个 $x_i$ 对应的正确 $z_i$,那问题就是有监督的,直接最大化 $\log p_\theta(x_i,z_i)$ 即可。我们不知道,那退而求其次——猜一个给定 $x_i$ 时最可能的 $z$,然后假装它是对的。但「最可能的 $z$」有很多种可能,硬取一个点会丢失不确定性信息,所以正确的做法是对整个后验分布 $p(z|x_i)$ 取期望,让每个候选 $z$ 按它的后验概率加权。
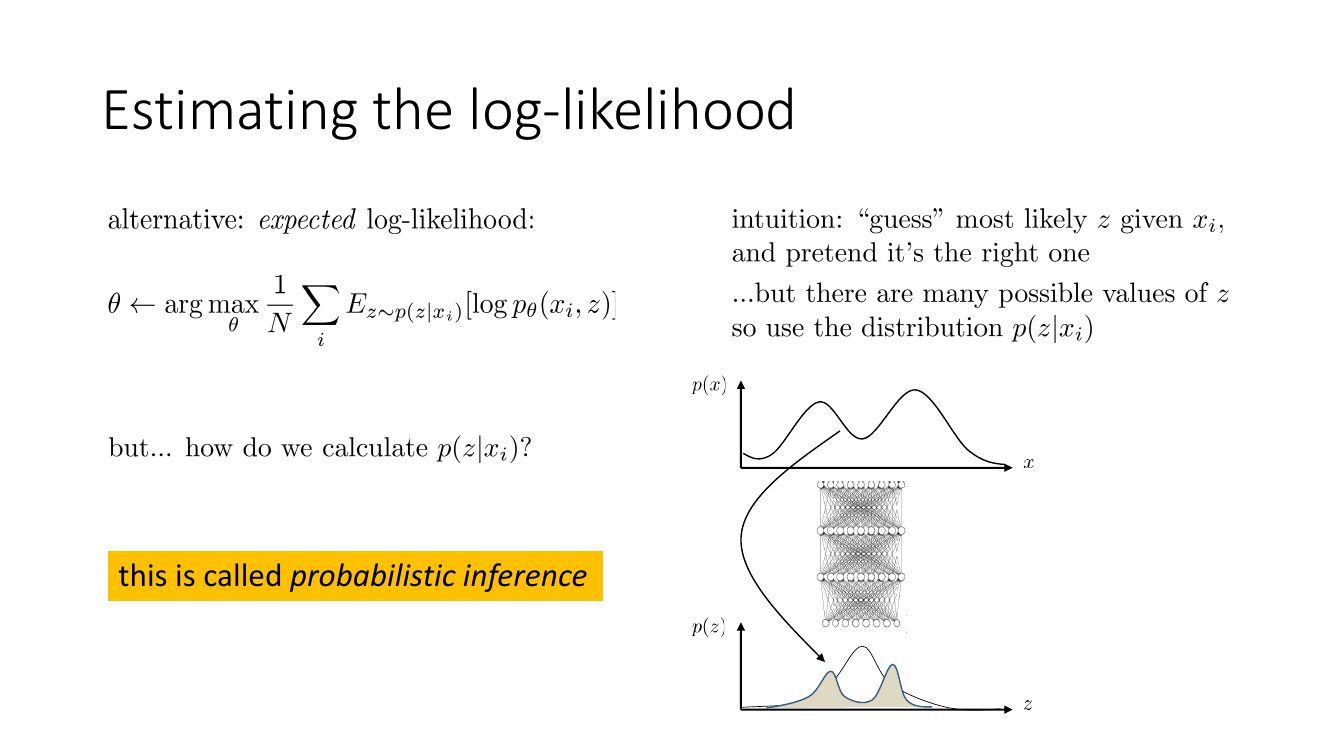
我们并没有真的解决问题,只是把问题换了个形式:原来卡在「算不出 $\int p(x|z)p(z)dz$」,现在卡在「算不出 $p(z|x_i)$」。由贝叶斯公式 $p(z|x_i)=\frac{p(x_i|z)p(z)}{p(x_i)}$,分母正是那个算不动的积分——两个难题其实是同一个难题。这不是白忙一场:新形式里我们只需要一个近似的 $p(z|x_i)$,而近似一个分布比精确算一个积分容易得多。这就是变分推断的切入点。
4. 变分近似与 ELBO:Jensen 不等式推导
4.1 「不正确但极其方便」的一步
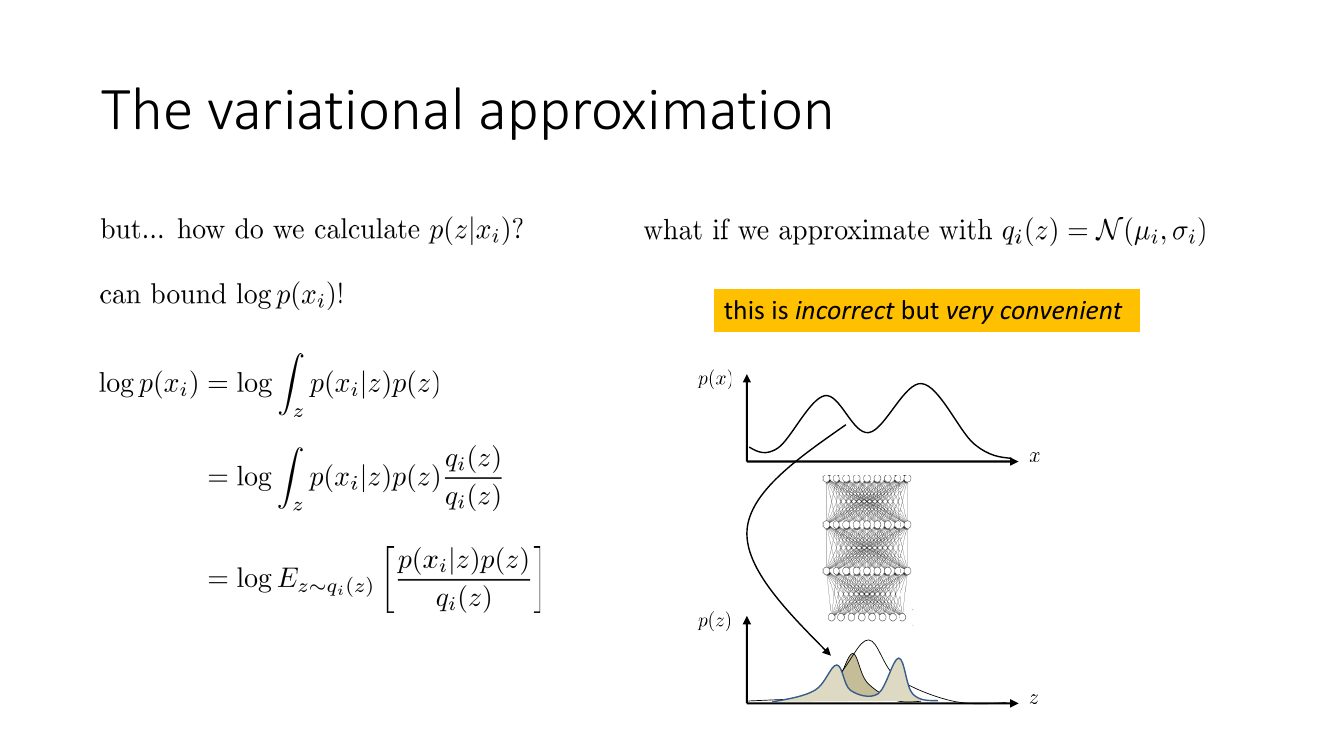
既然精确的后验 $p(z|x_i)$ 算不出来,那就硬造一个近似。最粗暴的做法是:对每一个数据点 $x_i$,引入一个属于它自己的高斯
$$ q_i(z)=\mathcal{N}(\mu_i,\sigma_i), $$参数 $(\mu_i,\sigma_i)$ 是可学习的。Levine 在 slides 上对这一步的评价一针见血:「this is incorrect but very convenient」——真实后验几乎肯定不是高斯(它可能是多峰的、偏斜的),所以这是错的;但高斯的期望、熵、KL 都有闭式,而且可以采样、可以求导,所以它极其方便。
这个「明知不对但先用着」的姿态贯穿整个变分推断。$q$ 所属的分布族叫变分族(variational family),族越大近似越准、优化越难,这是一个纯粹的工程权衡。
4.2 恒等变形:乘一个 1
推导从 $\log p(x_i)$ 出发,第一步是乘以 $\frac{q_i(z)}{q_i(z)}=1$——这个技巧和 Lecture 5 里策略梯度的 log-derivative trick、Lecture 9 里 off-policy 的重要性采样是同一个套路:在积分里插入一个恒等因子,把「对难采样分布的积分」变成「对易采样分布的期望」。
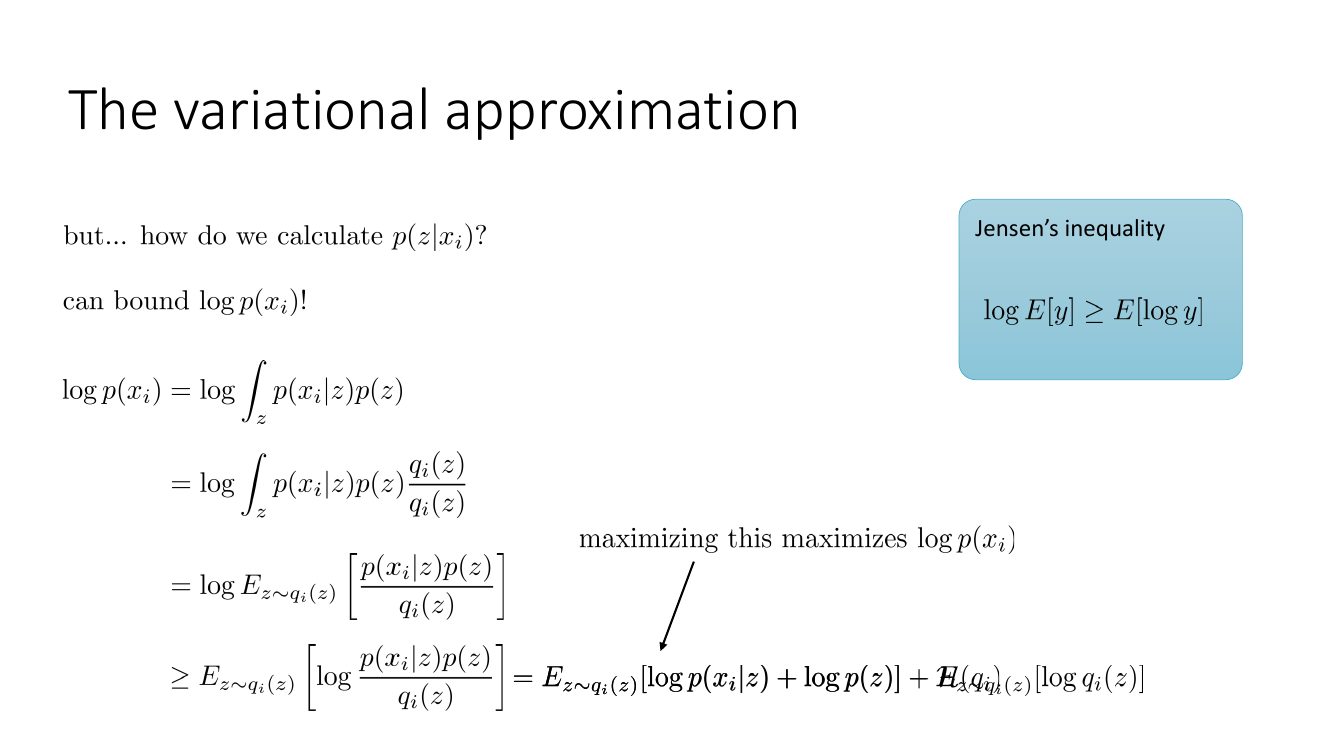
$$ \log p(x_i)=\log\int_z p(x_i|z)p(z)\,dz $$ $$ =\log\int_z p(x_i|z)p(z)\frac{q_i(z)}{q_i(z)}\,dz $$ $$ =\log\,\E_{z\sim q_i(z)}\!\left[\frac{p(x_i|z)p(z)}{q_i(z)}\right]. $$到这里还是完全精确的,没有任何近似。注意期望现在是对 $q_i$ 取的,而 $q_i$ 是我们自己选的高斯——想采多少样本采多少样本。唯一剩下的麻烦是那个 $\log$ 还在期望外面。
4.3 Jensen 不等式登场
Jensen 不等式说:对任意凹函数 $f$ 有 $f(\E[y])\ge\E[f(y)]$。$\log$ 是凹函数(二阶导 $-1/y^2<0$),所以
$$ \log\E[y]\ge\E[\log y]. $$为什么凹函数满足这个不等式?凹函数在任意点 $y_0$ 处都位于其切线下方:$f(y)\le f(y_0)+f'(y_0)(y-y_0)$。取 $y_0=\E[y]$ 并对两边取期望:
$$ \E[f(y)]\le f(\E[y])+f'(\E[y])\,\big(\E[y]-\E[y]\big)=f(\E[y]). $$括号里那项恰好是 $0$,不等式就出来了。对 $\log$ 而言,$\log(\E[y])-\E[\log y]$ 这个间隙有个名字,它衡量的是 $y$ 的「乘性离散程度」:$y$ 越集中(越接近常数),间隙越小;$y$ 完全是常数时间隙为 $0$。这个观察待会儿会告诉我们 ELBO 什么时候是紧的。
把 $y=\frac{p(x_i|z)p(z)}{q_i(z)}$ 代进去:
$$ \log p(x_i)=\log\,\E_{z\sim q_i}\!\left[\frac{p(x_i|z)p(z)}{q_i(z)}\right]\;\ge\;\E_{z\sim q_i}\!\left[\log\frac{p(x_i|z)p(z)}{q_i(z)}\right]. $$把右边的对数拆开:
$$ \E_{z\sim q_i}\big[\log p(x_i|z)+\log p(z)\big]-\E_{z\sim q_i}\big[\log q_i(z)\big]. $$最后一项的相反数正好是 $q_i$ 的熵 $\mathcal{H}(q_i)=-\E_{z\sim q_i}[\log q_i(z)]$。于是我们得到本讲最重要的那个式子:
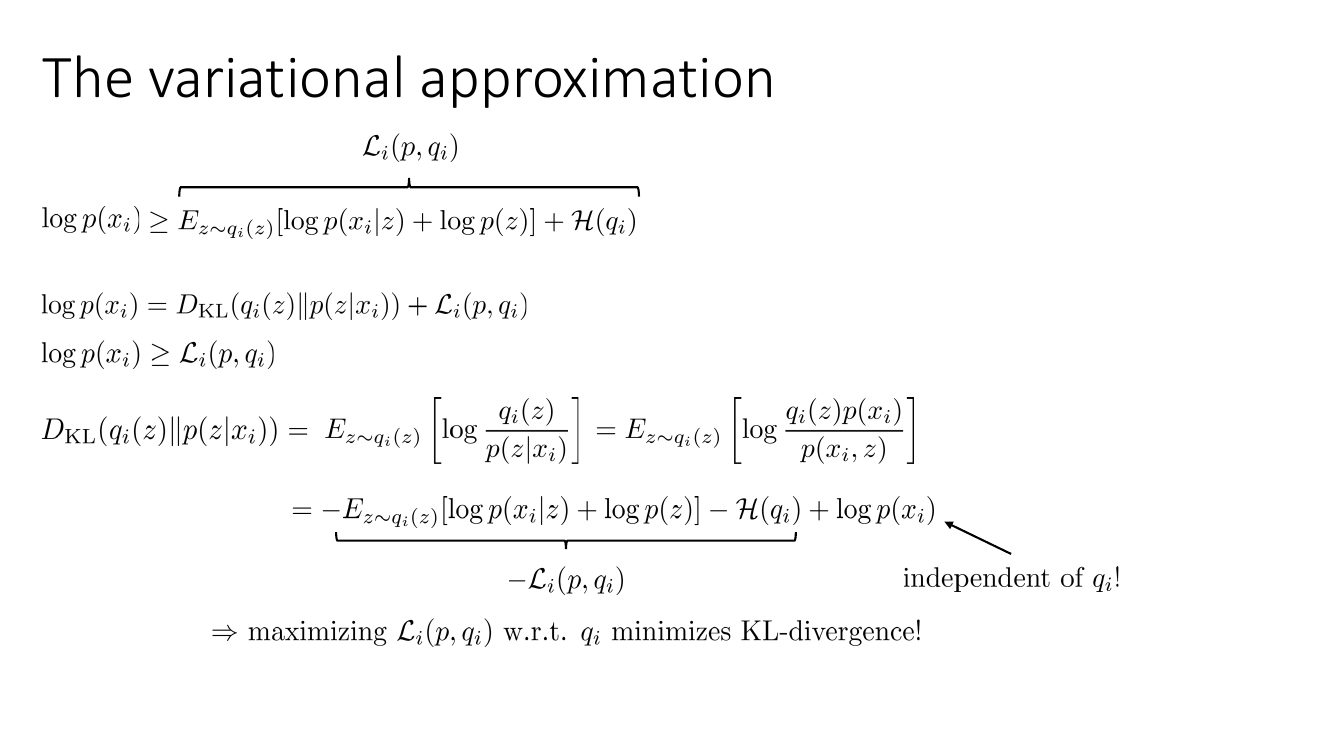
$$ \boxed{\;\log p(x_i)\;\ge\;\underbrace{\E_{z\sim q_i(z)}\big[\log p(x_i|z)+\log p(z)\big]+\mathcal{H}(q_i)}_{\textstyle \mathcal{L}_i(p,q_i)}\;} $$右边这个量叫证据下界(evidence lower bound, ELBO),记作 $\mathcal{L}_i(p,q_i)$。「证据(evidence)」是贝叶斯统计里对边缘似然 $p(x_i)$ 的叫法,所以名字直译就是「证据的下界」。
4.4 ELBO 每一项在说什么
把 ELBO 写成两块来读:
$$ \mathcal{L}_i=\underbrace{\E_{z\sim q_i}[\log p_\theta(x_i|z)]}_{\text{重构项}}+\underbrace{\E_{z\sim q_i}[\log p(z)]+\mathcal{H}(q_i)}_{-\KL(q_i\|p(z))} $$- 重构项 $\E_{q_i}[\log p_\theta(x_i|z)]$:从 $q_i$ 采一个 $z$,解码器把它变回 $x$ 的对数概率有多高。如果 $p_\theta(x|z)$ 是单位方差高斯,这一项就是 $-\frac12\|x_i-\mu_{\text{nn}}(z)\|^2$ 加常数——就是重构的平方误差取负。这解释了为什么 VAE 看起来像一个自编码器。
- 后两项合起来是 $-\KL(q_i\|p(z))$:因为 $\E_{q_i}[\log p(z)]+\mathcal{H}(q_i)=\E_{q_i}[\log p(z)]-\E_{q_i}[\log q_i(z)]=-\E_{q_i}\big[\log\frac{q_i}{p}\big]$。它是一个正则项,把每个数据点的近似后验往先验 $\mathcal{N}(0,I)$ 上拉。
这就是 VAE 损失函数的两项来源:重构误差 + KL 正则。它们不是拍脑袋凑出来的,而是从「对数似然的下界」严格推导出来的。
为什么「优化下界」是个合法策略?考虑一个类比:你想爬到山顶但看不见山的形状,只能摸到一个处处不高于地面的「垫子」。你把垫子撑起来,垫子会顶着地面往上抬——垫子抬到哪,地面至少有那么高。ELBO 就是这个垫子,而且它有个额外的好处:我们可以同时调整垫子的形状(优化 $q$)让它贴紧地面。下一节的恒等式分解会精确告诉我们「贴紧」意味着什么。
5. 插曲:熵与 KL 散度
ELBO 里那个 $\mathcal{H}(q_i)$ 看起来像个附赠品,实际上它是整个方法能工作的关键。这一节把熵和 KL 散度这两个量的直觉建起来——它们在后面的最大熵 RL 里还会以主角身份回归。
5.1 熵:随机性有多大
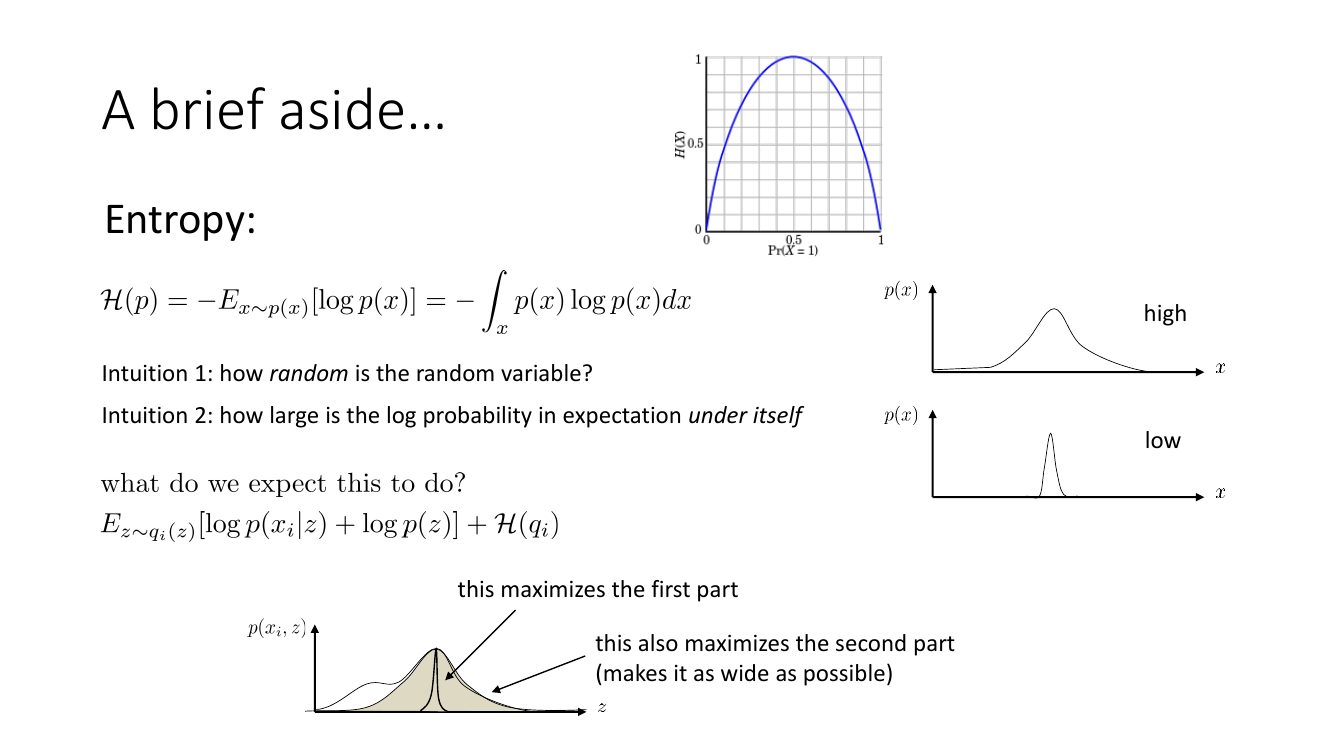
$$ \mathcal{H}(p)=-\E_{x\sim p(x)}[\log p(x)]=-\int_x p(x)\log p(x)\,dx. $$Levine 给了两个直觉:
直觉一:这个随机变量有多随机? 一个尖锐的分布(几乎确定取某个值)熵低;一个宽的分布熵高。对伯努利变量 $\Pr(X{=}1)=p$,熵 $\mathcal{H}=-p\log p-(1-p)\log(1-p)$ 是一条倒 U 形曲线:$p=0$ 或 $p=1$ 时熵为 $0$(毫无悬念),$p=0.5$ 时熵最大($\log 2\approx0.693$ nat,或 1 bit)。
直觉二:一个分布在它自己下的对数概率的期望有多大? 这个说法更实用。$\mathcal{H}(p)=-\E_{x\sim p}[\log p(x)]$——从 $p$ 采样,看采到的点的密度值。如果分布很尖,采到的点密度都很高,$\log p$ 大,取负号后熵就小。这个视角直接解释了下一段。
5.2 熵项在 ELBO 里到底防止了什么
做一个思想实验:如果把 ELBO 里的 $\mathcal{H}(q_i)$ 删掉会怎样? 剩下的目标是 $\E_{z\sim q_i}[\log p(x_i,z)]$,即「$q_i$ 下联合对数密度的平均值」。要最大化它,最优解是把 $q_i$ 塌缩成一个狄拉克函数 $\delta(z-z^*)$,其中 $z^*=\argmax_z\log p(x_i,z)$。也就是说,$q$ 会退化成一个点估计——最大后验(MAP)。
这正是 slides 那张图里「极窄尖峰」的情形。它有什么问题?
- 丢失不确定性:如果后验真的是双峰的(比如「左绕」和「右绕」两个解释同样说得通),点估计会任选一个,而模型永远学不到还有另一种可能。
- 下界变得极松:ELBO 与 $\log p(x_i)$ 之间的差距(下一节会看到就是 $\KL(q_i\|p(z|x_i))$)会变得巨大,我们优化的东西和真正想优化的东西相差十万八千里。
- 数值上退化:$\sigma_i\to0$ 时高斯的熵趋于 $-\infty$,梯度爆炸。
加上熵项之后,目标变成一个拉锯:第一项要求 $q_i$ 把质量放在 $p(x_i,z)$ 高的地方,第二项要求 $q_i$ 尽可能宽。平衡点恰好是「覆盖住 $p(x_i,z)$ 的主要质量、形状与之匹配」的那个分布——这正是我们想要的后验近似。
熵项是「保持不确定性」的力。没有它,变分推断退化成 MAP 点估计;有了它,$q$ 才真正在近似一个分布。这个「奖励高概率 + 奖励高熵」的双项结构会在最大熵 RL 里原封不动地重现:那时第一项变成期望奖励 $\E[r(s,a)]$,第二项变成策略熵 $\mathcal{H}(\pi(\cdot|s))$,得到的目标就是 SAC 的目标函数。结构完全同构。
5.3 KL 散度:两个分布差多远
$$ \KL(q\|p)=\E_{x\sim q(x)}\!\left[\log\frac{q(x)}{p(x)}\right]=\E_{x\sim q}[\log q(x)]-\E_{x\sim q}[\log p(x)]=-\E_{x\sim q}[\log p(x)]-\mathcal{H}(q). $$最右边那个形式最有启发性:KL 散度 = 交叉熵项 $-\E_q[\log p]$ 减去 $q$ 的熵。Levine 的两个直觉:
直觉一:两个分布有多不一样? 这是教科书说法。$\KL(q\|p)\ge0$,当且仅当 $q=p$(几乎处处)时取等号。注意它不对称:$\KL(q\|p)\ne\KL(p\|q)$,所以严格说它不是「距离」。
直觉二:一个分布在另一个分布下的期望对数概率有多小,再减去熵。 换句话说,最小化 $\KL(q\|p)$ = 最大化 $\E_{x\sim q}[\log p(x)] + \mathcal{H}(q)$——又是那个双项结构。
slides 上专门问了一句「why entropy?」,答案和上一节一模一样:只最大化 $\E_q[\log p]$ 会让 $q$ 塌缩成 $p$ 的众数处的尖峰;加上熵项,$q$ 才会展开去覆盖 $p$。这就是为什么 KL 散度的定义里天然带一个熵——它保证了「和 $p$ 一样」意味着形状和宽度都一样,而不只是峰位对上。
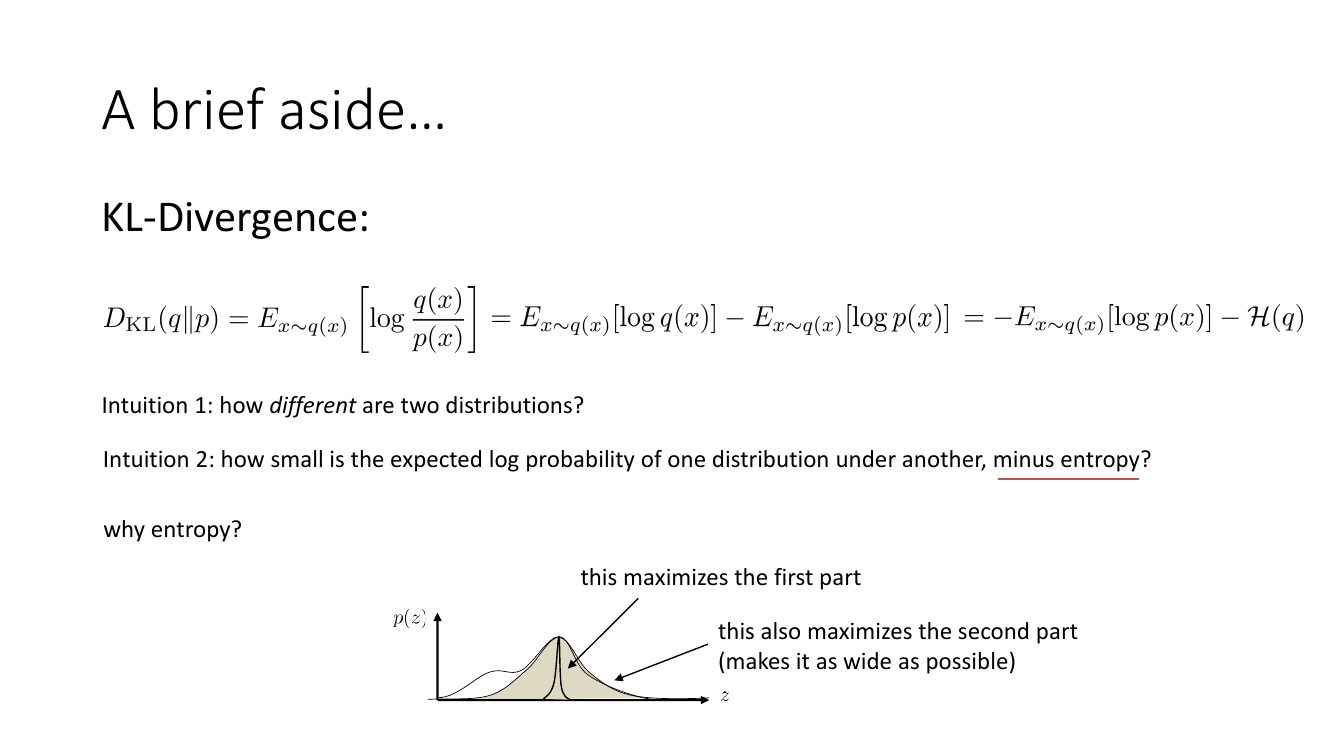
KL 的方向很重要。变分推断用的是 $\KL(q\|p)$(reverse KL,也叫 mode-seeking):因为期望是对 $q$ 取的,只要 $q$ 在某处为 $0$,那里 $p$ 多大都不受惩罚;反过来 $q$ 在 $p$ 为 $0$ 处有质量则惩罚无穷大。结果就是 $q$ 倾向于钻进 $p$ 的某一个峰里,而不是摊开覆盖所有峰。极大似然用的是 $\KL(p_{\text{data}}\|p_\theta)$(forward KL,mode-covering),$p_\theta$ 会努力覆盖数据的所有模式,哪怕在模式之间的空白处也放一些质量。用高斯 $q$ 近似双峰后验时,reverse KL 会选一个峰,forward KL 会跨在两峰之间——两者都「错」,但错的方式不同。
6. ELBO 的第二种推导:精确的恒等式分解
Jensen 推导告诉我们 $\mathcal{L}_i$ 是个下界,但没告诉我们下界有多松、什么时候紧、以及怎样的 $q_i$ 才算好。第二种推导直接回答这三个问题。这一次我们不用不等式,用精确的等式。
6.1 直接展开 $\KL(q_i\|p(z|x_i))$
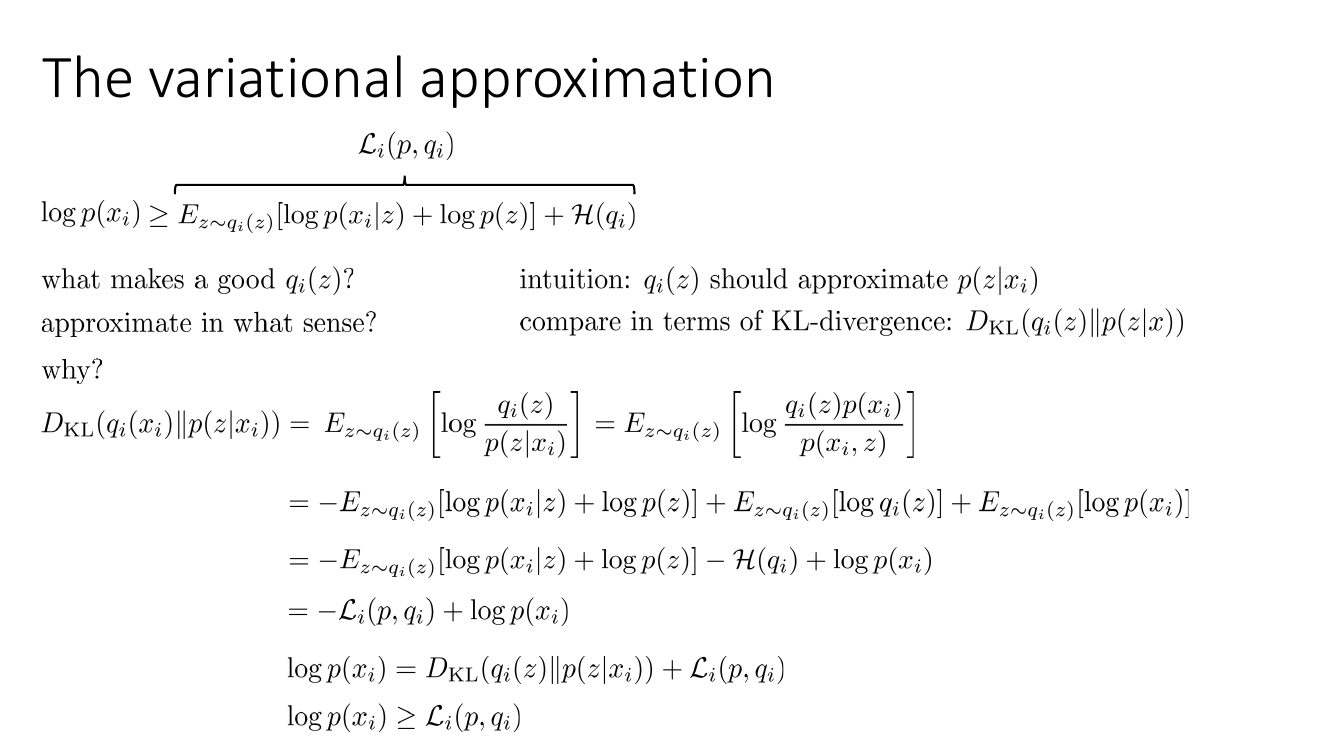
「什么样的 $q_i(z)$ 才是好的?」——直觉答案是「$q_i(z)$ 应该逼近真实后验 $p(z|x_i)$」。用什么衡量「逼近」?用 KL 散度。于是我们计算 $\KL\big(q_i(z)\,\|\,p(z|x_i)\big)$,看看会得到什么。
第一步,写出定义并用贝叶斯公式 $p(z|x_i)=\dfrac{p(x_i,z)}{p(x_i)}$ 替换分母:
$$ \KL\big(q_i\|p(z|x_i)\big)=\E_{z\sim q_i}\!\left[\log\frac{q_i(z)}{p(z|x_i)}\right]=\E_{z\sim q_i}\!\left[\log\frac{q_i(z)\,p(x_i)}{p(x_i,z)}\right]. $$第二步,把对数拆成三块(记住 $p(x_i,z)=p(x_i|z)p(z)$):
$$ =-\E_{z\sim q_i}\big[\log p(x_i|z)+\log p(z)\big]+\E_{z\sim q_i}\big[\log q_i(z)\big]+\E_{z\sim q_i}\big[\log p(x_i)\big]. $$第三步,识别中间那项:$\E_{q_i}[\log q_i(z)]=-\mathcal{H}(q_i)$。而最后一项里 $\log p(x_i)$ 根本不依赖 $z$,所以期望对它没有作用,直接脱掉:
$$ =-\E_{z\sim q_i}\big[\log p(x_i|z)+\log p(z)\big]-\mathcal{H}(q_i)+\log p(x_i). $$第四步,认出前两项之和恰好是 $-\mathcal{L}_i(p,q_i)$:
$$ \KL\big(q_i\|p(z|x_i)\big)=-\mathcal{L}_i(p,q_i)+\log p(x_i). $$移项,得到本讲的中心恒等式:
$$ \boxed{\;\log p(x_i)=\mathcal{L}_i(p,q_i)+\KL\big(q_i(z)\,\|\,p(z|x_i)\big)\;} $$请注意:这是一个精确的等式,对任意 $q_i$ 都成立,没有用到任何不等式或近似。由于 $\KL\ge0$,立刻得到 $\log p(x_i)\ge\mathcal{L}_i(p,q_i)$——Jensen 推导的结论作为推论掉了出来,而且我们额外知道了间隙的确切大小就是 $\KL(q_i\|p(z|x_i))$。
6.2 关键推论:最大化 ELBO ⟺ 最小化 KL
把恒等式再看一眼,盯住一个事实:$\log p(x_i)$ 完全不依赖 $q_i$。它只是数据在当前模型 $p_\theta$ 下的对数似然,$q_i$ 怎么变它都不动。
于是对 $q_i$ 而言,$\mathcal{L}_i$ 和 $\KL$ 是一个零和游戏:两者之和恒定,一个涨另一个必然等量地跌。所以
$$ \argmax_{q_i}\mathcal{L}_i(p,q_i)=\argmin_{q_i}\KL\big(q_i(z)\|p(z|x_i)\big). $$这个结论的分量怎么强调都不过分:
- 我们只需要写一个优化器。「让下界更紧」和「让近似后验更准」不是两件需要分别操心的事,它们是同一件事的两种说法。梯度上升 $\mathcal{L}_i$ 时,你免费得到了一个越来越好的后验近似。
- 下界什么时候是紧的? 当 $q_i(z)=p(z|x_i)$ 时 $\KL=0$,此时 $\mathcal{L}_i=\log p(x_i)$,下界精确成立。这也解释了 Jensen 那边的间隙:$y=\frac{p(x_i|z)p(z)}{q_i(z)}=\frac{p(x_i,z)}{q_i(z)}$,当 $q_i=p(z|x_i)$ 时 $y\equiv p(x_i)$ 是常数,而常数的 Jensen 间隙为零——两条推导在这里完美对上。
- 整个算法的合法性有了保证。我们同时对 $\theta$(推高 $\log p$)和对 $q_i$(缩小间隙)做上升,是一个坐标上升(coordinate ascent)过程。这正是 EM 算法(expectation-maximization)的现代表述:E 步优化 $q$、M 步优化 $\theta$。
6.3 一个具体数字例子
为了让恒等式不停留在符号层面,看一个能手算的例子。设隐变量是二值的:$z\in\{0,1\}$,先验 $p(z{=}1)=0.5$。设某个 $x_i$ 的似然是 $p(x_i|z{=}0)=0.02$、$p(x_i|z{=}1)=0.08$。那么
$$ p(x_i)=0.5\times0.02+0.5\times0.08=0.05,\quad \log p(x_i)\approx-3.00. $$真实后验是 $p(z{=}1|x_i)=\frac{0.5\times0.08}{0.05}=0.8$。现在取一个错误的 $q$:$q(z{=}1)=0.5$。计算 ELBO:
$$ \mathcal{L}=0.5\big(\log0.02+\log0.5\big)+0.5\big(\log0.08+\log0.5\big)+\mathcal{H}(q), $$其中 $\mathcal{H}(q)=\log 2\approx0.693$。第一项 $=0.5(-3.912-0.693)+0.5(-2.526-0.693)=0.5(-4.605)+0.5(-3.219)=-3.912$。加上熵:$\mathcal{L}=-3.912+0.693=-3.219$。
而 $\KL(q\|p(z|x_i))=0.5\log\frac{0.5}{0.2}+0.5\log\frac{0.5}{0.8}=0.5(0.916)+0.5(-0.470)=0.223$。验证恒等式:$\mathcal{L}+\KL=-3.219+0.223=-2.996\approx\log p(x_i)$。✓
如果换成正确的 $q(z{=}1)=0.8$:$\mathcal{H}(q)=-0.8\log0.8-0.2\log0.2=0.500$,第一项 $=0.2(-3.912-0.693)+0.8(-2.526-0.693)=-0.921-2.575=-3.496$,$\mathcal{L}=-3.496+0.500=-2.996=\log p(x_i)$,KL 为 $0$,下界精确成立。这个小例子把整套理论压缩到了两行算术里。
7. 用 ELBO 训练:算法与它的致命缺陷
7.1 把不可解的目标换成可解的目标
现在我们把原来那个划掉的目标
$$ \theta\leftarrow\argmax_\theta\frac{1}{N}\sum_i\log p_\theta(x_i)\qquad(\text{算不动}) $$替换成
$$ \theta\leftarrow\argmax_\theta\frac{1}{N}\sum_i\mathcal{L}_i(p,q_i). $$因为每个 $\mathcal{L}_i\le\log p_\theta(x_i)$,推高所有的 $\mathcal{L}_i$ 就是在推高对数似然的下界。同时对每个 $q_i$ 做最大化,把下界拉紧。
7.2 完整算法
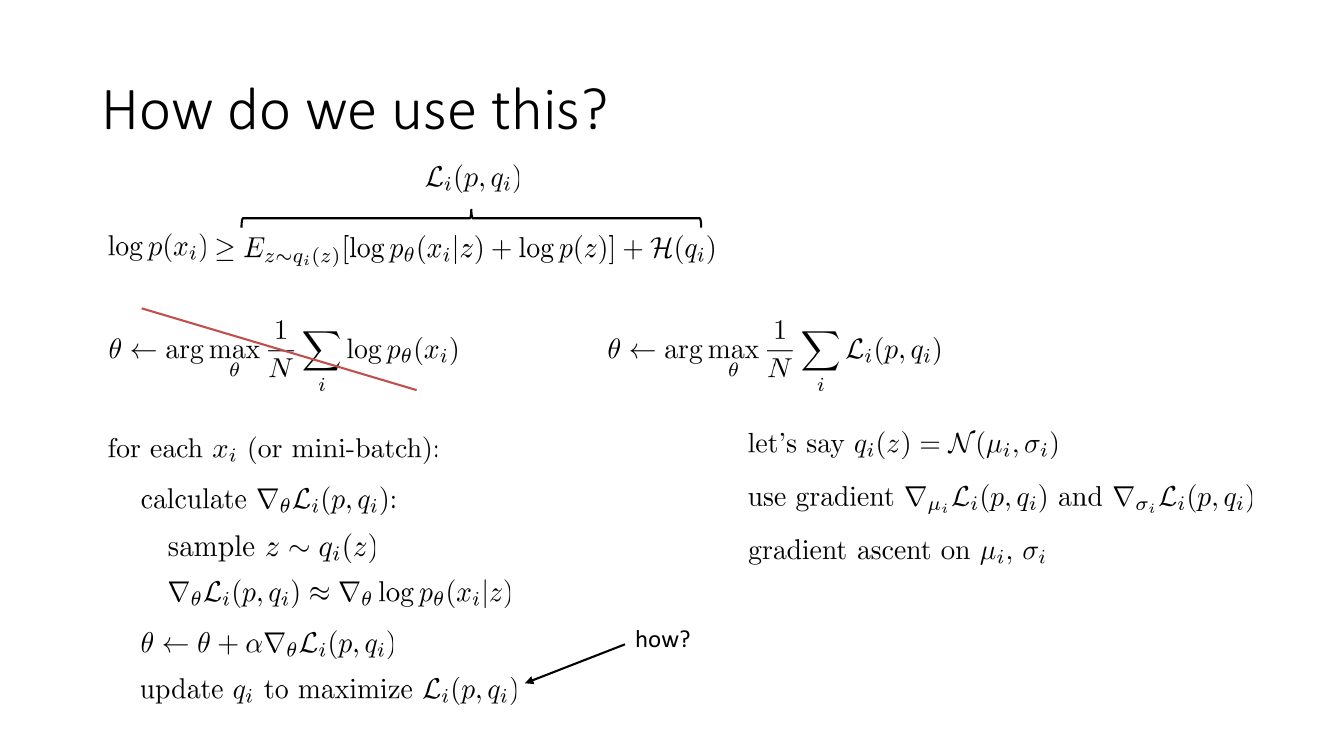
Levine 在 slides 上写的伪代码是:
for each x_i (or mini-batch):
    # ---- 1. 更新模型参数 theta ----
    calculate grad_theta L_i(p, q_i):
        sample z ~ q_i(z)
        grad_theta L_i(p,q_i) ≈ grad_theta log p_theta(x_i | z)
    theta <- theta + alpha * grad_theta L_i(p, q_i)

    # ---- 2. 更新变分参数 q_i ----
    update q_i to maximize L_i(p, q_i)     # <-- how?
第一步($\theta$ 的梯度)为什么这么简单? 回看 ELBO:
$$ \mathcal{L}_i=\E_{z\sim q_i}\big[\log p_\theta(x_i|z)+\log p(z)\big]+\mathcal{H}(q_i). $$对 $\theta$ 求梯度时,$\log p(z)$(固定先验)和 $\mathcal{H}(q_i)$(只依赖变分参数)都是常数,直接消失。而期望所依赖的分布 $q_i$ 不含 $\theta$,所以梯度可以直接穿进期望里:
$$ \nabla_\theta\mathcal{L}_i=\E_{z\sim q_i}\big[\nabla_\theta\log p_\theta(x_i|z)\big]\approx\nabla_\theta\log p_\theta(x_i|z),\quad z\sim q_i. $$单样本蒙特卡洛就够了——这就是伪代码里「sample $z\sim q_i(z)$,然后 $\nabla_\theta\mathcal{L}_i\approx\nabla_\theta\log p_\theta(x_i|z)$」的由来。注意这一步已经完全可以用 PyTorch 自动求导实现:采一个 $z$,前向解码,算 $\log p_\theta(x_i|z)$,`.backward()`。
第二步($q_i$ 的更新)就没这么轻松了。 如果 $q_i(z)=\mathcal{N}(\mu_i,\sigma_i)$,我们需要 $\nabla_{\mu_i}\mathcal{L}_i$ 和 $\nabla_{\sigma_i}\mathcal{L}_i$,然后对 $\mu_i,\sigma_i$ 做梯度上升。麻烦在于:期望所依赖的分布本身含有 $\mu_i,\sigma_i$,梯度不能直接穿进去。slides 上就在这一行旁边打了个大大的「how?」——这个问题留到第 9 节的重参数化技巧来回答。
7.3 致命缺陷:参数量随数据集线性增长
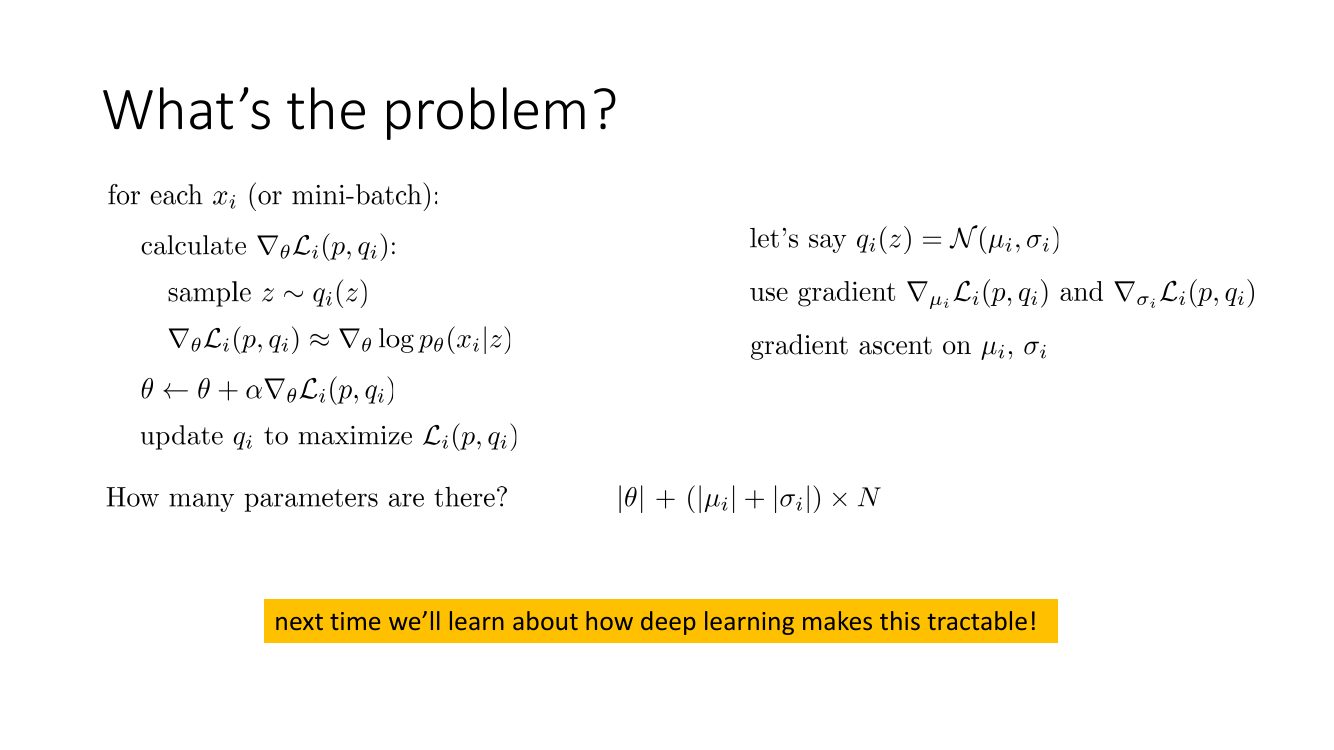
先不管 $q_i$ 的梯度怎么算,假设我们解决了。这个算法还有一个更结构性的问题,Levine 用一句话点破:「How many parameters are there?」
$$ |\theta|+\big(|\mu_i|+|\sigma_i|\big)\times N. $$模型参数 $\theta$ 是共享的,只有一份;但变分参数是每个数据点一套。如果隐空间是 $d=64$ 维、用对角高斯,每个数据点要存 $128$ 个数。对 CIFAR-10($N=5\times10^4$)这是 640 万个额外参数,尚可忍受;对 ImageNet($N=1.2\times10^6$)就是 $1.5$ 亿;对一个上亿条样本的数据集,变分参数会比模型本身大好几个数量级。
而且问题不止是存储:
- 每个 $\mu_i,\sigma_i$ 只被它自己那个数据点更新。数据点之间没有任何统计共享,每个 $q_i$ 都得从头优化到收敛,训练极慢。
- 没法处理新数据。来了一个没见过的 $x_{\text{new}}$,你没有对应的 $q_{\text{new}}$,必须现场跑一轮内层优化才能算它的 ELBO。这在测试时、在线学习、RL 的滚动数据流里完全不可接受。
- 和小批量随机梯度不兼容得很别扭。每次抽到一个 batch,你只能更新这个 batch 对应的那几套变分参数,其余的都停着。
这种「每个数据点一套变分参数」的做法在经典统计里叫平均场变分推断(mean-field VI),在数据量小、模型是共轭指数族(此时 $q$ 的更新有闭式解)的场景里工作得很好——LDA 主题模型就是这么训的。它不是错的,只是不 scale。深度学习时代的解法是下一节的摊销推断。
8. 摊销推断:用一个网络代替 N 套参数
8.1 核心想法
观察一件事:$\mu_i,\sigma_i$ 虽然形式上是自由参数,但它们其实是$x_i$ 的函数——最优的变分参数由 $x_i$ 唯一决定(就是让 $q_i$ 最接近 $p(z|x_i)$ 的那组参数)。既然是函数,为什么不直接学这个函数?
$$ q_i(z)=q_\phi(z|x_i)=\mathcal{N}\big(\mu_\phi(x_i),\,\sigma_\phi(x_i)\big). $$用一个神经网络 $\phi$ 吃进 $x_i$,吐出这一点的变分参数。参数量立刻变成
$$ |\theta|+|\phi|, $$与 $N$ 无关。这个技巧叫摊销推断(amortized inference)——「摊销」的意思是:推断的成本被摊到了所有数据点上共同分担,训练一次网络,之后对任何 $x$ 做推断都只要一次前向传播。
在 VAE 的语言里,$q_\phi(z|x)$ 叫编码器(encoder)或识别模型(recognition model),$p_\theta(x|z)$ 叫解码器(decoder)。
摊销推断的思想在深度学习里到处都是:与其为每个测试样本跑一遍优化,不如训练一个网络来预测优化的结果。类比一下:解方程 $Ax=b$ 可以每次跑一遍高斯消元(对应逐点优化 $q_i$),也可以事先算好 $A^{-1}$ 然后每次只做一次矩阵乘法(对应摊销)。前者每个样本都精确,后者一次投入、永久便宜。
8.2 代价:摊销间隙
天下没有免费的午餐。用一个共享网络去预测所有数据点的变分参数,必然不如逐点优化那么准。这个差距有个名字,叫摊销间隙(amortization gap):
$$ \underbrace{\log p_\theta(x_i)-\mathcal{L}_i(p,q_\phi)}_{\text{总间隙}}=\underbrace{\big[\log p_\theta(x_i)-\max_{q\in\mathcal{Q}}\mathcal{L}_i(p,q)\big]}_{\text{近似族间隙}}+\underbrace{\big[\max_{q\in\mathcal{Q}}\mathcal{L}_i(p,q)-\mathcal{L}_i(p,q_\phi)\big]}_{\text{摊销间隙}}. $$第一块是「高斯族装不下真实后验」造成的,第二块是「网络没能预测出族内最优参数」造成的。实践中大家接受这个代价,因为它换来的是 $O(1)$ 的推断成本和对新数据的泛化。
8.3 摊销之后的 ELBO
把 $q_\phi(z|x)$ 代回去,并把整个数据集的目标合起来写:
$$ \mathcal{L}(\theta,\phi)=\frac{1}{N}\sum_i\Big\{\E_{z\sim q_\phi(z|x_i)}\big[\log p_\theta(x_i|z)\big]-\KL\big(q_\phi(z|x_i)\,\|\,p(z)\big)\Big\}. $$现在我们要对 $\theta$ 和 $\phi$ 同时做梯度上升。$\theta$ 的部分上一节已经解决了。$\phi$ 的部分呢?$\phi$ 出现在期望的下标里,这是整讲最后一个技术障碍。
摊销推断把变分推断从「$N$ 个独立的优化问题」变成「一个函数逼近问题」。这一步是 VAE 相对于经典变分推断的最大工程贡献,也是它能在百万级数据集上训练的唯一原因。同一个思想在 RL 里的对应物是:与其对每个状态单独规划,不如训练一个策略网络直接输出规划的结果。
9. 怎么求 $q$ 的梯度:重参数化 vs. score function
问题的一般形式是:给定一个依赖参数 $\phi$ 的分布 $q_\phi$ 和一个函数 $f$,怎么估计
$$ \nabla_\phi\,\E_{z\sim q_\phi(z)}\big[f(z)\big]\;? $$难点在于 $\phi$ 藏在采样分布里,而不是(只)在被积函数里。梯度不能直接换进期望。有两条路。
9.1 路线 A:score function 估计器(REINFORCE)
把期望写成积分再求导:
用对数导数恒等式(log-derivative trick):$\nabla_\phi q_\phi(z)=q_\phi(z)\nabla_\phi\log q_\phi(z)$。这个恒等式来自链式法则 $\nabla_\phi\log q_\phi=\frac{\nabla_\phi q_\phi}{q_\phi}$,两边乘 $q_\phi$ 即得。代回去:
$$ =\int q_\phi(z)\,\nabla_\phi\log q_\phi(z)\,f(z)\,dz=\E_{z\sim q_\phi}\big[f(z)\,\nabla_\phi\log q_\phi(z)\big]. $$于是得到一个可以直接蒙特卡洛估计的表达式:
$$ \nabla_\phi\E_{q_\phi}[f(z)]\approx\frac{1}{M}\sum_{j=1}^{M}f(z_j)\,\nabla_\phi\log q_\phi(z_j),\quad z_j\sim q_\phi. $$停一下,仔细看这个式子。 把 $z$ 换成轨迹 $\tau$、$q_\phi$ 换成 $p_\theta(\tau)$、$f$ 换成回报 $r(\tau)$,就是
$$ \nabla_\theta J(\theta)=\E_{\tau\sim p_\theta(\tau)}\big[r(\tau)\nabla_\theta\log p_\theta(\tau)\big] $$——Lecture 5 的策略梯度定理,一字不差。这不是巧合:策略梯度要解决的问题(「参数在采样分布里,怎么求梯度」)和变分推断要解决的问题在数学上是同一个问题。这也解释了为什么这个估计器在 ML 界有三个名字:统计学叫 score function estimator(因为 $\nabla\log q$ 叫 score),RL 叫 REINFORCE(Williams 1992),图形学叫 likelihood ratio method。
它的优点是普适:只要能采样 $q_\phi$、能算 $\log q_\phi$ 的梯度就行。$f$ 可以不可导、可以是黑箱、$z$ 可以是离散的。
它的缺点是方差极大。原因和策略梯度完全一样:估计器里 $f(z_j)$ 是一个标量权重,它把整个 $\nabla_\phi\log q_\phi$ 向量整体放大或缩小,却不携带任何关于「$f$ 在 $z$ 附近往哪个方向增大」的信息。梯度信息只通过一个标量传递。RL 里对付它的所有招数——基线(baseline)、因果性(causality)、优势函数、控制变量——在变分推断里也照搬,那边叫 NVIL、VIMCO、MuProp。
9.2 路线 B:重参数化技巧
如果 $q_\phi$ 是高斯,我们有一个更好的选择。观察这个事实:
$$ z\sim\mathcal{N}(\mu_\phi(x),\sigma_\phi(x)^2)\quad\Longleftrightarrow\quad z=\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon,\;\;\epsilon\sim\mathcal{N}(0,I). $$也就是说,随机性可以从参数里剥离出来,装进一个与 $\phi$ 无关的辅助噪声 $\epsilon$。这样一来:
$$ \E_{z\sim q_\phi}[f(z)]=\E_{\epsilon\sim\mathcal{N}(0,I)}\big[f(\mu_\phi+\sigma_\phi\odot\epsilon)\big], $$期望的分布不再依赖 $\phi$ 了!梯度可以毫无障碍地穿进去:
$$ \nabla_\phi\E_{q_\phi}[f(z)]=\E_{\epsilon}\big[\nabla_\phi f(\mu_\phi+\sigma_\phi\odot\epsilon)\big]=\E_\epsilon\Big[\nabla_z f(z)\big|_{z=\mu_\phi+\sigma_\phi\epsilon}\cdot\big(\nabla_\phi\mu_\phi+\epsilon\,\nabla_\phi\sigma_\phi\big)\Big]. $$单样本估计就是:采一个 $\epsilon$,前向计算 $z=\mu_\phi+\sigma_\phi\epsilon$,然后直接 backprop。在 PyTorch 里这就是一行 z = mu + std * torch.randn_like(std)——完全不需要写任何特殊的梯度代码,自动求导会把梯度沿着 $\mu$ 和 $\sigma$ 送回去。
9.3 为什么重参数化的方差小得多
关键区别在于梯度信息的带宽:
- score function 估计器用的是 $f(z)\nabla_\phi\log q_\phi(z)$:只用到 $f$ 的函数值。它像是在黑暗中扔石头,靠「哪个方向扔出去回报高」来间接推断斜坡方向。
- 重参数化估计器用的是 $\nabla_z f(z)\cdot\frac{\partial z}{\partial\phi}$:直接用了 $f$ 的梯度。它像是拿着一张地形图,知道当前脚下每个方向的坡度。
粗略的量级比较:对 $d$ 维隐变量,score function 估计器的方差通常随 $d$ 线性甚至更快地增长(因为 $\nabla_\phi\log q_\phi$ 的每个分量都在贡献噪声,而权重 $f$ 只有一个),而重参数化估计器的方差往往几乎与 $d$ 无关。实践中在 VAE 上两者的梯度方差可以差两到三个数量级,直接决定了训练能不能收敛。这就是为什么 Kingma & Welling 2013 的论文标题里那个「Auto-Encoding Variational Bayes」能引爆整个领域——不是 ELBO 是新的(它 90 年代就有了),而是重参数化让它第一次能在深度网络上稳定训练。
| score function / REINFORCE | 重参数化 (reparameterization) | |
|---|---|---|
| 估计式 | $\E_q[f(z)\nabla_\phi\log q_\phi(z)]$ | $\E_\epsilon[\nabla_\phi f(g_\phi(\epsilon))]$ |
| 用到 $f$ 的什么 | 只用函数值 | 用梯度 $\nabla_z f$ |
| 要求 $f$ 可导 | 否 | 是 |
| 要求 $z$ 连续 | 否,离散照用 | 是(离散无法直接重参数化) |
| 要求 $q_\phi$ 可重参数化 | 否 | 是(高斯、均匀、Gumbel 等位置-尺度族可以) |
| 方差 | 大,常需基线/控制变量 | 小,单样本通常够用 |
| 实现复杂度 | 要手写 surrogate loss | 一行 mu + std * eps |
| RL 中的对应 | 策略梯度 / PPO / TRPO | DDPG、SAC 里对 actor 的梯度 |
9.4 离散隐变量怎么办
如果 $z$ 是离散的(比如混合模型里的成分编号、离散动作、VQ-VAE 的码本索引),重参数化直接用不了——从类别分布采样这个操作对参数不可导,采样结果在参数微小变化下要么不变要么整数跳变,导数处处为 $0$ 或不存在。可选的对策有四类:
- 退回 score function 估计器,配上强力的方差缩减(基线 $b$、多样本 leave-one-out 基线如 VIMCO)。这是最正统的做法。
- 精确求和。如果 $z$ 的取值只有 $K$ 个且 $K$ 不大(几十以内),直接把期望写成 $\sum_{k=1}^{K}q_\phi(k)f(k)$,这是关于 $\phi$ 完全可导的确定性表达式,零方差。混合密度网络就是这么训的。
- 连续松弛:Gumbel-Softmax / Concrete 分布。用 $\text{softmax}((\log\pi_k+g_k)/\tau)$ 代替 one-hot 采样($g_k$ 是 Gumbel 噪声),得到一个可导的近似。温度 $\tau\to0$ 时逼近真实的离散采样但方差变大,$\tau$ 大时偏差大但梯度稳。用偏差换方差。
- 直通估计器(straight-through):前向用硬采样,反向假装它是恒等映射。理论上不成立,实践中出奇地好用(VQ-VAE 用的就是这个)。
「重参数化总是比 REINFORCE 好」——不对,前提条件差别很大。重参数化要求 $f$ 对 $z$ 可导。在 RL 里,$f$ 通常是环境给的回报,环境是黑箱、不可导,所以策略梯度只能用 score function。反过来在 SAC 里,$f$ 被换成了可导的 Q 网络 $Q_\psi(s,a)$,于是 actor 的更新就可以用重参数化:$a=\tanh(\mu_\phi(s)+\sigma_\phi(s)\epsilon)$,梯度直接从 $Q$ 穿回策略。SAC 相对 PPO 的样本效率优势,有相当一部分就来自这个梯度估计器的切换。 这是本讲和 RL 最直接的一条连线。
10. 变分自编码器:把所有零件拼起来
10.1 完整的损失函数
把前面所有零件组装起来。模型是 $p_\theta(x|z)$ 加固定先验 $p(z)=\mathcal{N}(0,I)$;编码器是 $q_\phi(z|x)=\mathcal{N}(\mu_\phi(x),\diag(\sigma_\phi(x)^2))$;目标是最大化 ELBO,等价于最小化
$$ \mathcal{J}(\theta,\phi)=\underbrace{-\E_{\epsilon\sim\mathcal{N}(0,I)}\big[\log p_\theta\big(x\,|\,\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon\big)\big]}_{\text{重构损失}}+\underbrace{\KL\big(q_\phi(z|x)\,\|\,\mathcal{N}(0,I)\big)}_{\text{正则项}}. $$两项都能显式算出来:
重构项:若 $p_\theta(x|z)=\mathcal{N}(\hat{x}(z),I)$,则 $-\log p_\theta(x|z)=\frac12\|x-\hat x(z)\|^2+\text{const}$,就是 MSE;若 $x$ 是二值的、用伯努利解码器,则是二元交叉熵(BCE)。
KL 项:两个对角高斯之间的 KL 有闭式解,对 $d$ 维隐空间:
$$ \KL\big(\mathcal{N}(\mu,\diag(\sigma^2))\,\|\,\mathcal{N}(0,I)\big)=\frac12\sum_{j=1}^{d}\big(\mu_j^2+\sigma_j^2-\log\sigma_j^2-1\big). $$一维情形足够说明问题。$\KL(\mathcal{N}(\mu,\sigma^2)\|\mathcal{N}(0,1))=\E_{q}[\log q-\log p]$。代入密度:
$$ \log q(z)-\log p(z)=-\log\sigma-\frac{(z-\mu)^2}{2\sigma^2}+\frac{z^2}{2}. $$对 $z\sim q$ 取期望,用 $\E[(z-\mu)^2]=\sigma^2$ 和 $\E[z^2]=\mu^2+\sigma^2$:
$$ =-\log\sigma-\frac12+\frac{\mu^2+\sigma^2}{2}=\frac12\big(\mu^2+\sigma^2-\log\sigma^2-1\big). $$多维对角情形各维独立,直接求和。检验一下:$\mu=0,\sigma=1$ 时值为 $\frac12(0+1-0-1)=0$,✓。
10.2 最小 PyTorch 实现
import torch, torch.nn as nn, torch.nn.functional as F

class VAE(nn.Module):
    def __init__(self, x_dim=784, h=400, z_dim=20):
        super().__init__()
        # 编码器 q_phi(z|x):输出 mu 和 logvar(用 logvar 而非 sigma,保证正性且数值稳定)
        self.enc = nn.Sequential(nn.Linear(x_dim, h), nn.ReLU())
        self.fc_mu     = nn.Linear(h, z_dim)
        self.fc_logvar = nn.Linear(h, z_dim)
        # 解码器 p_theta(x|z):伯努利参数(MNIST 像素在 [0,1])
        self.dec = nn.Sequential(nn.Linear(z_dim, h), nn.ReLU(),
                                 nn.Linear(h, x_dim))

    def encode(self, x):
        hh = self.enc(x)
        return self.fc_mu(hh), self.fc_logvar(hh)

    def reparameterize(self, mu, logvar):
        # ---- 重参数化技巧:z = mu + sigma * eps,梯度可以穿过 mu 和 sigma ----
        std = torch.exp(0.5 * logvar)
        eps = torch.randn_like(std)          # eps 与 phi 无关,是外部噪声
        return mu + std * eps

    def forward(self, x):
        mu, logvar = self.encode(x)
        z = self.reparameterize(mu, logvar)
        x_logits = self.dec(z)               # 未过 sigmoid 的 logits
        return x_logits, mu, logvar

def elbo_loss(x_logits, x, mu, logvar):
    # 重构项:-E_q[log p(x|z)],伯努利解码器 => 二元交叉熵,按 batch 求和
    recon = F.binary_cross_entropy_with_logits(x_logits, x, reduction='sum')
    # KL 项:KL(N(mu, sigma^2) || N(0, I)) 的闭式解
    kld = 0.5 * torch.sum(mu.pow(2) + logvar.exp() - logvar - 1.0)
    return (recon + kld) / x.size(0)         # 返回每样本平均的负 ELBO

# ---- 训练循环 ----
model = VAE()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
for x, _ in dataloader:                      # x: (B, 784), 取值 [0,1]
    x_logits, mu, logvar = model(x)
    loss = elbo_loss(x_logits, x, mu, logvar)
    opt.zero_grad(); loss.backward(); opt.step()

# ---- 生成新样本:从先验采 z,解码 ----
with torch.no_grad():
    z = torch.randn(64, 20)                  # z ~ N(0, I)
    samples = torch.sigmoid(model.dec(z))    # (64, 784)
几个实现要点:
- 为什么输出
logvar而不是sigma? $\log\sigma^2$ 的取值范围是整条实轴,网络可以自由输出;而 $\sigma$ 必须为正,需要额外的 softplus/exp 约束。而且 KL 公式里正好用到 $\log\sigma^2$,省一次 log。 - 为什么单样本 $\epsilon$ 就够? 重参数化估计器的方差本来就小,而且 SGD 本身就在做批量平均——batch size 为 128 时,等效于用了 128 个不同 $(x,\epsilon)$ 对的平均。
reduction='sum'还是'mean'? 必须是sum(对像素维求和),因为 ELBO 是整个 $x$ 向量的对数似然。若对像素取平均,相当于把重构项除以 784,KL 项的相对权重被放大 784 倍,模型会立刻塌缩成「忽略 $z$、只输出平均图像」。这是 VAE 最常见的调试陷阱。- 后验塌缩(posterior collapse):当解码器太强(比如自回归解码器)时,模型发现最省事的做法是让 $q_\phi(z|x)\to p(z)$(KL 项归零),完全不用 $z$。常用对策是 KL 退火(训练初期给 KL 项乘一个从 0 升到 1 的系数)或 free bits(给每维 KL 设一个不惩罚的下限)。
10.3 条件 VAE
回到最开始那个树前岔路的问题。我们要的不是 $p(x)$,而是多模态的 $p(y|x)$。把条件 $x$ 加进模型的每一处即可:
$$ p_\theta(y|x)=\int p_\theta(y|x,z)\,p(z|x)\,dz,\qquad \mathcal{L}=\E_{q_\phi(z|x,y)}\big[\log p_\theta(y|x,z)\big]-\KL\big(q_\phi(z|x,y)\,\|\,p(z|x)\big). $$三处改动:编码器变成 $q_\phi(z|x,y)$(把 $x$ 和 $y$ 拼起来输入),解码器变成 $p_\theta(y|x,z)$(把 $x$ 和 $z$ 拼起来输入),先验可以保持 $\mathcal{N}(0,I)$,也可以做成条件先验 $p_\psi(z|x)$(另一个网络,表达力更强)。
class CVAE(nn.Module):
    def __init__(self, x_dim, y_dim, h=256, z_dim=8):
        super().__init__()
        self.enc = nn.Sequential(nn.Linear(x_dim + y_dim, h), nn.ReLU())
        self.fc_mu, self.fc_lv = nn.Linear(h, z_dim), nn.Linear(h, z_dim)
        self.dec = nn.Sequential(nn.Linear(x_dim + z_dim, h), nn.ReLU(),
                                 nn.Linear(h, y_dim))

    def forward(self, x, y):
        hh = self.enc(torch.cat([x, y], dim=-1))     # 编码器同时看到 x 和 y
        mu, lv = self.fc_mu(hh), self.fc_lv(hh)
        z = mu + torch.exp(0.5 * lv) * torch.randn_like(mu)
        y_hat = self.dec(torch.cat([x, z], dim=-1))  # 解码器看到 x 和 z
        return y_hat, mu, lv

    @torch.no_grad()
    def sample(self, x, n=1):
        # 测试时:只给 x,从先验采 z => 每个 z 给出一种可能的行为模式
        x_rep = x.repeat_interleave(n, dim=0)
        z = torch.randn(x_rep.size(0), self.fc_mu.out_features)
        return self.dec(torch.cat([x_rep, z], dim=-1))
训练完之后,对同一张「前方有树」的图像 $x$ 反复调用 sample,采不同的 $z$,就能得到一批不同的动作:有的左绕、有的右绕,没有一个是直接撞上去的均值动作。第 1 节提出的问题在这里被彻底解决。
注意训练和测试时编码器的不对称:训练时 $q_\phi(z|x,y)$ 能偷看答案 $y$,所以它能准确地推断「这条演示走的是哪个模式」;测试时没有 $y$,只能从先验 $p(z|x)$ 采。这个「训练时作弊、测试时靠先验」的结构是 CVAE 的核心,也是它和普通监督学习最不一样的地方。$z$ 承载的正是「$x$ 无法解释的那部分变化」——在模仿学习里,那就是演示者的个人风格和随机选择。
11. 接口预告:把最优性当成观测变量
最后一节把本讲和这门课的主线接上。下一讲的核心问题是:能不能把「智能体表现得最优」写成一个概率图模型里的观测事件,从而用变分推断来做 RL?
11.1 为什么要这么干
标准 RL 求的是 $\pi^*=\argmax_\pi\E[\sum_t r(s_t,a_t)]$——一个确定性的、唯一的最优解。但这个框架有两个说不通的地方:
- 它无法解释人类行为。人不是完美的最优控制器。给同一个人同一个任务做十次,轨迹十次都不一样,而且失败的方式有规律可循。要用最优控制去拟合人的行为数据,模型总是拟合不上——因为数据里的次优性(suboptimality)在模型里没有位置。
- 它给出的解不够鲁棒。一个只走最优路径的策略,一旦被扰动到分布外就完全不知道该干什么。而一个「知道多条差不多好的路」的策略要稳健得多。
11.2 构造:最优性变量
做法是给图模型的每一步加一个二值隐变量 $\mathcal{O}_t$,表示「第 $t$ 步的行为是最优的」这一事件,并定义
$$ p(\mathcal{O}_t=1\,|\,s_t,a_t)\;\propto\;\exp\big(r(s_t,a_t)\big). $$这个定义把奖励和概率连了起来:奖励越高,「这一步是最优的」的概率越大。指数形式不是随便选的——它是唯一能让后验推断的结果回到 Bellman 方程形式的选择。
然后我们问一个纯粹的推断问题:给定所有步都最优($\mathcal{O}_{1:T}=1$),轨迹的后验分布是什么?
$$ p(\tau\,|\,\mathcal{O}_{1:T}=1)\;\propto\;p(\tau)\exp\Big(\sum_t r(s_t,a_t)\Big). $$这个后验有个漂亮的性质:它不是只支持最优轨迹,而是给所有轨迹按回报的指数赋权。回报高的轨迹概率大,但次优的轨迹也有非零概率——这正好对应「人的行为大致最优但有随机性」。
11.3 变分推断在哪里进场
精确算这个后验依然做不到(分母是对所有轨迹积分)。于是我们套用本讲的全部机器:找一个变分分布 $q(\tau)$ 去近似它,最大化 ELBO。如果把 $q$ 参数化成「真实动力学 + 一个策略 $\pi(a_t|s_t)$」的形式,ELBO 展开后会变成
$$ \mathcal{L}=\sum_t\E_{(s_t,a_t)\sim q}\Big[r(s_t,a_t)+\mathcal{H}\big(\pi(\cdot|s_t)\big)\Big]. $$这就是最大熵强化学习的目标函数。 期望奖励项来自 ELBO 的第一部分,策略熵项就是本讲第 5 节反复强调的 $\mathcal{H}(q)$。第 5 节里那个「不加熵项 $q$ 就塌缩成点估计」的论证,在这里的对应物是「不加熵项策略就退化成确定性最优策略」。
顺着这条线往下推,把 ELBO 用动态规划的方式逐步优化,会得到软 Bellman 备份(soft Bellman backup):
$$ V(s_t)=\log\int\exp\big(Q(s_t,a_t)\big)da_t,\qquad Q(s_t,a_t)=r(s_t,a_t)+\E\big[V(s_{t+1})\big]. $$把标准 Bellman 方程里的 $\max$ 换成了 log-sum-exp(软最大)——这就是 soft Q-learning 和 SAC 的来源。而它们又直接依赖第 9 节的重参数化技巧来更新 actor。
本讲的三个零件,在后面三讲里各有一个精确的对应物:(1) ELBO 的「期望项 + 熵项」结构 $\to$ 最大熵 RL 的目标 $\sum_t\E[r]+\mathcal{H}(\pi)$;(2) 「最大化 ELBO $=$ 最小化 $\KL(q\|p)$」$\to$ 「学策略 $=$ 让轨迹分布逼近最优性后验」;(3) 重参数化 $\to$ SAC 的 actor 更新。如果本讲的数学没学扎实,后面会变成一堆记不住的公式;学扎实了,后面基本是本讲的机械应用。
本讲小结
一页速查
| 概念 | 公式 | 一句话 |
|---|---|---|
| 隐变量模型 | $p(x)=\int p(x|z)p(z)dz$ | 简单 × 简单,积分出复杂 |
| 困难 | $\log\int p_\theta(x|z)p(z)dz$ | 对数套积分,无闭式、蒙特卡洛方差爆炸 |
| 期望对数似然 | $\E_{z\sim p(z|x)}[\log p_\theta(x,z)]$ | 把 log 挪进期望,代价是要后验 |
| ELBO | $\mathcal{L}_i=\E_{q_i}[\log p(x_i|z)+\log p(z)]+\mathcal{H}(q_i)$ | 可优化的下界 |
| Jensen 推导 | $\log\E[y]\ge\E[\log y]$ | 乘 $q/q$,再把 log 挪进去 |
| 恒等式分解 | $\log p(x_i)=\mathcal{L}_i+\KL(q_i\|p(z|x_i))$ | 精确等式,间隙就是 KL |
| 关键推论 | $\argmax_{q}\mathcal{L}=\argmin_q\KL(q\|p(z|x))$ | 优化下界 $=$ 做近似推断 |
| 熵项的作用 | $\mathcal{H}(q)=-\E_q[\log q]$ | 防止 $q$ 塌缩成 MAP 点估计 |
| 摊销推断 | $q_\phi(z|x)$ 代替 $\{(\mu_i,\sigma_i)\}_{i=1}^N$ | 参数量从 $O(N)$ 降到 $O(1)$ |
| 重参数化 | $z=\mu_\phi+\sigma_\phi\odot\epsilon$ | 低方差,要求连续可导 |
| score function | $\E_q[f(z)\nabla_\phi\log q_\phi(z)]$ | 普适但高方差,=策略梯度 |
| VAE 损失 | 重构 $+\ \KL(q_\phi(z|x)\|\mathcal{N}(0,I))$ | 两项都有闭式,直接 backprop |
要点清单
- 隐变量提升表达力的机制是非线性映射 + 边缘化,不是让某一步的分布变复杂。混合模型是它的离散特例,参数随成分数线性增长;连续隐变量则不受这个限制。
- $\log p(x)=\log\int p(x|z)p(z)dz$ 之所以算不动,有三层原因:积分无闭式、从先验采样的蒙特卡洛估计方差爆炸(高维下 $10^{19}$ 量级的差异)、外层 $\log$ 让无偏估计变有偏。
- ELBO 有两种推导。Jensen 推导快,但看不出间隙是什么;恒等式推导多算三行,但直接给出 $\log p(x)=\mathcal{L}+\KL(q\|p(z|x))$,从而回答了「什么样的 $q$ 好」「下界何时紧」「为什么只需要一个优化器」。面试和考试都优先写第二种。
- $\log p(x_i)$ 与 $q_i$ 无关这一事实,是「最大化 ELBO ⟺ 最小化 KL」的全部依据。这一行是整讲的枢纽。
- 熵项不是正则化的装饰品。删掉它,变分推断退化成 MAP;保留它,$q$ 才会去覆盖后验的形状。这个「值 + 熵」的双项结构在最大熵 RL 里原样重现。
- 逐点变分参数的参数量是 $|\theta|+(|\mu_i|+|\sigma_i|)N$,不 scale。摊销推断用一个编码器网络换掉它,代价是引入摊销间隙。
- 两种梯度估计器的分水岭是「能否对 $z$ 求导」。重参数化用了 $\nabla_z f$,方差可以低两三个数量级;score function 只用 $f$ 的值,普适但需要基线等方差缩减手段。score function 估计器和策略梯度定理是同一个公式。
- 离散隐变量四种对策:REINFORCE + 基线、精确求和($K$ 小时零方差)、Gumbel-Softmax 松弛、直通估计器。
- VAE 实现的两个常见坑:重构损失必须对像素求和而非平均,否则 KL 权重被隐式放大导致塌缩;解码器过强会引发后验塌缩,需 KL 退火或 free bits。
- 条件 VAE 的训练/测试不对称(训练时编码器看得到 $y$,测试时只能从先验采 $z$)是它能表达多模态行为的关键,也是它用于多模态模仿学习的基础。
延伸阅读
变分推断与 VAE 的原始文献
- Auto-Encoding Variational Bayes (Kingma & Welling, 2013) — VAE 的原始论文。本讲第 8、9、10 节基本就是这篇的内容:摊销推断 + 重参数化 + 闭式 KL。必读,篇幅很短。
- Stochastic Backpropagation and Approximate Inference in Deep Generative Models (Rezende et al., 2014) — 与 VAE 同期独立提出重参数化的工作,对梯度估计器的分析更细致。
- Variational Inference: A Review for Statisticians (Blei et al., 2016) — 从统计学视角系统梳理变分推断,包含平均场、坐标上升、与 EM 的关系。想补经典背景看这篇。
- An Introduction to Variational Autoencoders (Kingma & Welling, 2019) — 作者自己写的教程版,比原论文详细得多,涵盖了后续六年的各种改进。
梯度估计器
- Neural Variational Inference and Learning in Belief Networks (Mnih & Gregor, 2014) — NVIL,离散隐变量下用 score function + 学出来的基线,是「策略梯度技巧搬到 VI」的典范。
- Categorical Reparameterization with Gumbel-Softmax (Jang et al., 2016) — 离散变量的连续松弛,第 9.4 节提到的方案三。
- The Concrete Distribution (Maddison et al., 2016) — 与上一篇同期独立提出的同一方法,理论推导更完整。
- Neural Discrete Representation Learning (van den Oord et al., 2017) — VQ-VAE,直通估计器的成功应用,现在是各类离散 token 生成模型的基础。
通向 RL 的接口
- Reinforcement Learning and Control as Probabilistic Inference: A Tutorial and Review (Levine, 2018) — 下一讲的官方教程。最优性变量、软 Bellman 方程、最大熵 RL 与变分推断的完整对应关系都在这里。
- Reinforcement Learning with Deep Energy-Based Policies (Haarnoja et al., 2017) — soft Q-learning,log-sum-exp 备份的第一个深度实现。
- Soft Actor-Critic (Haarnoja et al., 2018) — SAC。注意它的 actor 更新用的正是本讲第 9 节的重参数化技巧。
- Maximum Entropy Inverse Reinforcement Learning (Ziebart et al., 2008) — 最大熵逆 RL 的开山之作,slides 上引用的那张出租车轨迹图就出自这里。
隐变量模型在 RL 中的应用
- Learning Latent Dynamics for Planning from Pixels (Hafner et al., 2018) — PlaNet,第 2.2 节那个带结构隐空间的状态空间模型的代表作。
- VIME: Variational Information Maximizing Exploration (Houthooft et al., 2016) — 用变分推断量化信息增益作为探索奖励,对应 slides 上「探索」那一栏。
- Learning Complex Dexterous Manipulation (Rajeswaran et al., 2017) — 多模态演示数据下的模仿学习,条件隐变量策略的实际动机。