离线 RL 算法
上一讲说清楚了离线强化学习为什么难:分布偏移会让 Q 函数在没见过的动作上疯狂高估。这一讲把所有主流的补救方案——策略约束、保守值函数、隐式 Q-learning、悲观模型——的目标函数一条条推导出来,并回答一个工程问题:到底什么时候该用哪个。
0. 本讲导读
先把上一讲的结论浓缩成一句话:离线强化学习(offline RL)之所以困难,不是因为数据少,而是因为算法会主动去问数据没有回答过的反事实问题(counterfactual query)。Q-learning 的目标值里有一个 $\max_{a'} Q(s',a')$,这个 $\argmax$ 会精确地挑出「网络恰好高估得最厉害」的那个动作;在线 RL 里这没关系,因为下一步就去试一下、发现不好、把值压回去;离线 RL 里没有「下一步去试一下」,于是误差单向累积,Q 值在训练曲线上冲到 $10^{10}$ 量级,而真实回报一路下滑。
本讲统一使用如下记号:$s$ 表示状态(满足马尔可夫性),$a$ 表示动作,$r(s,a)$ 是奖励,$p(s'|s,a)$ 是转移,$\gamma$ 是折扣因子。数据集记作 $\mathcal{D}=\{(s_i,a_i,r_i,s_i')\}_{i=1}^{N}$,采集数据的策略叫行为策略(behavior policy) $\pi_\beta(a|s)$,我们从数据里估计出来的经验版本记作 $\hat\pi_\beta$。$\pi_\theta(a|s)$ 是我们要学的策略,$Q^\pi,V^\pi,A^\pi$ 分别是动作值、状态值和优势函数,$\hat Q_\phi$ 表示参数为 $\phi$ 的 Q 网络。「OOD 动作」指的是 out-of-distribution action,也就是 $\pi_\beta(a|s)$ 概率极低、数据里几乎没出现过的动作。
这一讲的所有算法都在做同一件事的两个部分:用基于值的方法(Q-learning 或 Q 函数 actor-critic),然后想办法修掉分布偏移。第二部分有三条互不相同的技术路线,本讲会把每一条都走到底。
- 策略约束:改 actor,让 $\pi_\theta$ 别离 $\pi_\beta$ 太远。最直接,但「离得近」这个度量选错了就会付出很大代价——分布匹配约束(KL)过严,支撑集约束(support constraint)才是理论上正确的,但难以可靠估计。
- 保守值函数(CQL):改 critic,在 Bellman 误差上加 $\alpha\left(\E_{a\sim\mu}[Q]-\E_{a\sim\hat\pi_\beta}[Q]\right)$。可以证明得到的 $\hat Q^\pi$ 在策略下的期望是真值的下界,惩罚强度正比于密度比 $\mu/\hat\pi_\beta$——恰好在数据没覆盖的地方最大。
- 隐式方法(IQL):干脆让整个算法从不在任何 OOD 动作上求值。用期望回归(expectile regression)让 $V(s)$ 逼近 $\max_{a\in\Omega(s)}Q(s,a)$,其中 $\Omega(s)$ 是数据支撑集,于是「支撑集约束」这个理想目标被以一种完全可微、完全不查询 OOD 动作的方式实现了。
- 基于模型的方法:模型在数据分布外的预测同样不可信,所以要么在奖励上减不确定性惩罚(MOPO),要么直接把模型 rollout 当成「假动作」用 CQL 压下去(COMBO)。
- 离线到在线:离线阶段要保守、在线阶段要乐观,这两件事内在冲突,至今没有一个算法能同时做好。一个「令人不安地有效」的基线是:不做任何离线预训练,直接在线 RL,但每个 batch 一半采自离线数据、一半采自在线 replay buffer。
1. 三条主线:约束策略、压低值、绕开 OOD
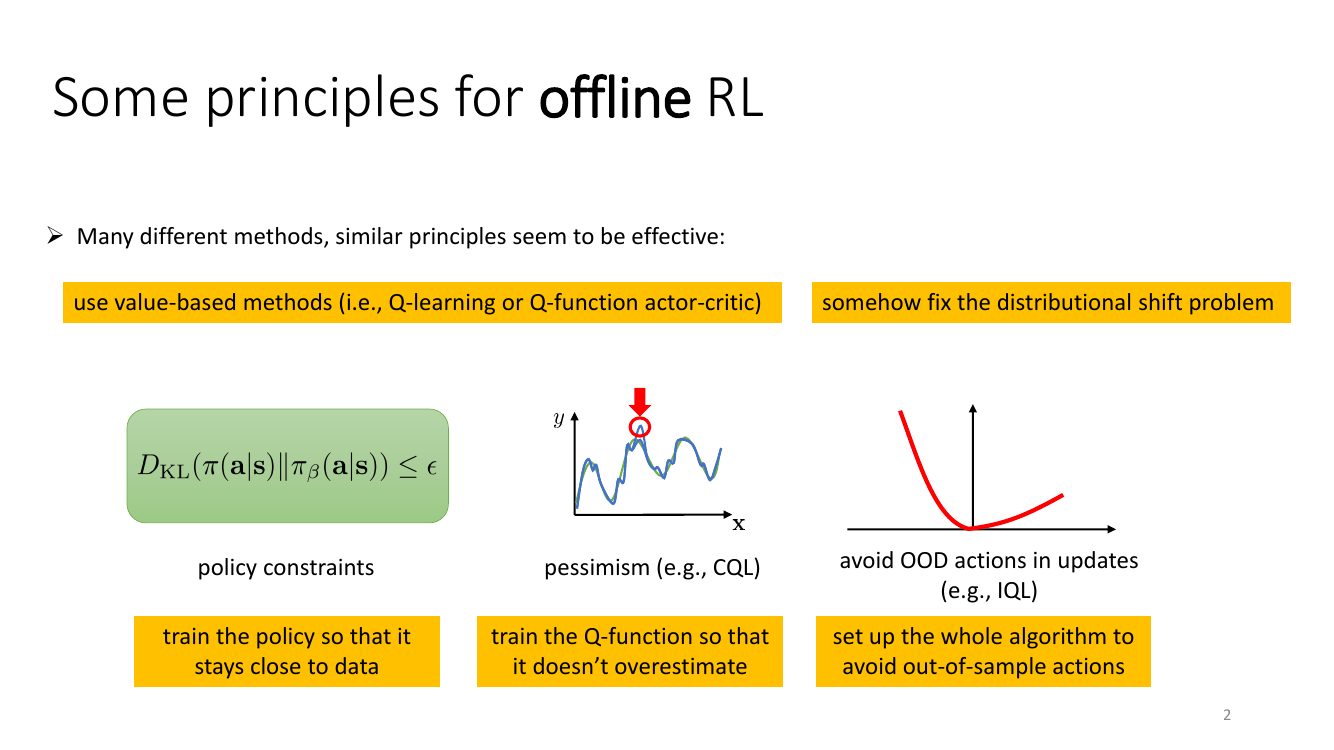
为什么一定要用基于值的方法?因为离线 RL 的核心价值来自上一讲说的「拼接」(stitching):数据里有 A→B 的片段和 B→C 的片段,我们希望学出 A→B→C 这条谁都没走过的完整轨迹。只有动态规划(Bellman 备份)能做到这一点——值函数通过 $s'$ 把两段轨迹的信息缝在一起。纯策略梯度类方法需要重要性采样修正整条轨迹的概率比,方差随时间步指数爆炸,在离线设定下基本没法用;而模仿学习类方法(哪怕加了回报条件)只能复现数据里已有的行为,无法拼接。所以「用基于值的方法」不是偏好,是必需。
三条主线的差别在于「在哪里动手」:
| 路线 | 动手位置 | 代表算法 | 核心机制 | 典型失败模式 |
|---|---|---|---|---|
| 策略约束 | actor 的目标函数 / 奖励函数 | BCQ、BEAR、BRAC、TD3+BC、AWAC | 限制 $\pi_\theta$ 与 $\pi_\beta$ 的散度,使 $Q(s',a')$ 的查询点落在可靠区域 | 约束太紧退化成行为克隆;太松则值函数照样发散;约束度量选错则两头不讨好 |
| 保守值函数 | critic 的损失函数 | CQL、COMBO、SAC-N/EDAC | 主动压低 OOD 动作上的 Q 值,使估计成为真值下界 | 过度悲观,值函数被压到远低于真实回报,在线微调时要花很久「重新标定」 |
| 避开 OOD 动作 | 整个算法的结构 | IQL、one-step RL、IDQL | 只在数据集里出现过的 $(s,a)$ 上求 $Q$,用期望回归代替 $\max$ | 改进幅度受限于数据支撑集;$\tau$ 太大时回归目标方差爆炸 |
把这三条路线想成对付一个爱吹牛的下属:策略约束是「你只准做你熟悉的事」,保守值函数是「你报上来的数字我一律打折,越是我没见过的项目打折越狠」,IQL 则是「我根本不问你没做过的项目的收益,只从你做过的项目里挑最好的那个来估算你的能力上限」。第三种最不伤和气,也最难被钻空子。
2. 策略约束:分布匹配还是支撑集匹配
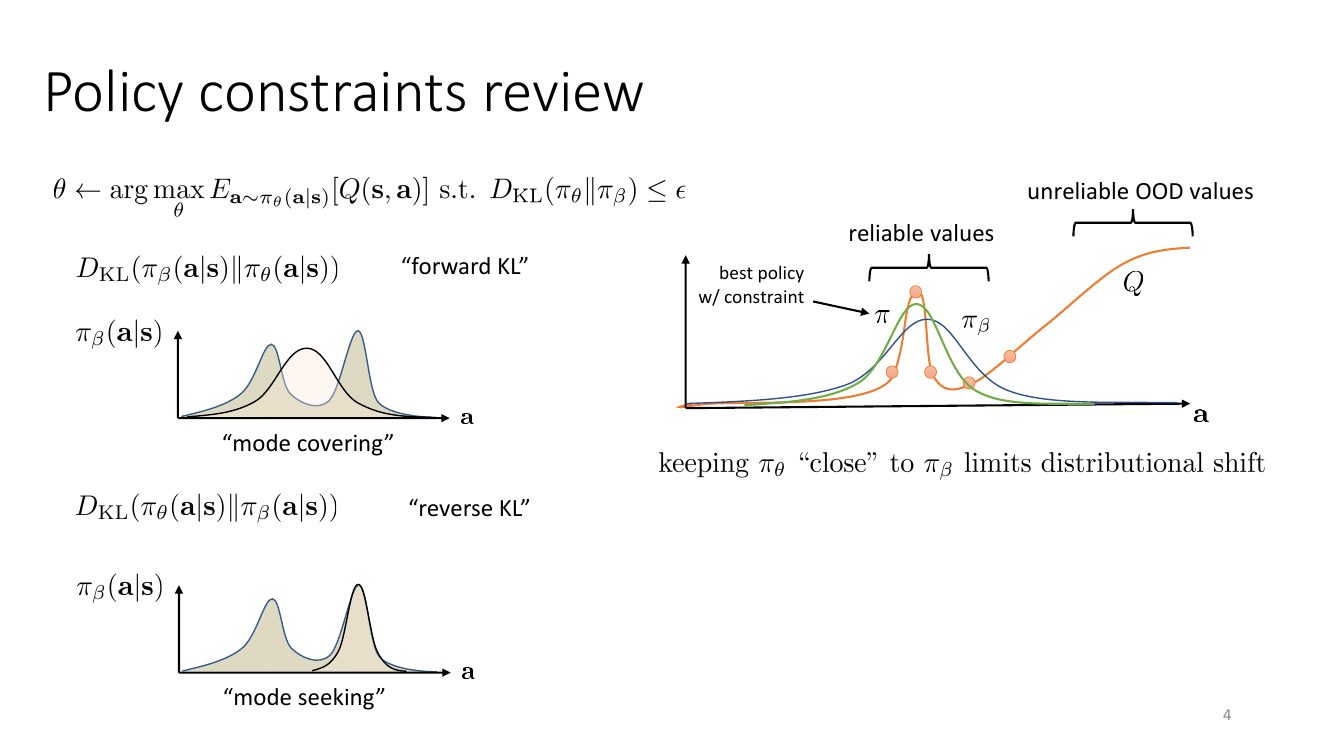
先把两个 KL 的展开式写清楚,后面所有目标函数都是从这两行里长出来的。反向 KL(reverse KL):
$$ D_{\mathrm{KL}}(\pi_\theta\|\pi_\beta)=\E_{a\sim\pi_\theta}\left[\log\pi_\theta(a|s)-\log\pi_\beta(a|s)\right] =-\E_{a\sim\pi_\theta}\left[\log\pi_\beta(a|s)\right]-\mathcal{H}\!\left(\pi_\theta(\cdot|s)\right) $$期望在 $\pi_\theta$ 下取,所以只要 $\pi_\theta$ 在某处概率为 0,那里的 $\pi_\beta$ 有多大都不受惩罚——这就是「模式寻找」的来源:$\pi_\theta$ 可以放心地丢掉 $\pi_\beta$ 的其它峰。反过来,只要 $\pi_\theta$ 在 $\pi_\beta\approx 0$ 处有质量,$-\log\pi_\beta\to+\infty$,惩罚无穷大。前向 KL(forward KL):
$$ D_{\mathrm{KL}}(\pi_\beta\|\pi_\theta)=\E_{a\sim\pi_\beta}\left[\log\pi_\beta(a|s)-\log\pi_\theta(a|s)\right] =-\E_{a\sim\pi_\beta}\left[\log\pi_\theta(a|s)\right]+\text{const} $$常数项 $-\mathcal{H}(\pi_\beta)$ 与 $\theta$ 无关。这个式子有一个巨大的工程优势:期望在 $\pi_\beta$ 下取,而我们手上正好有一堆 $\pi_\beta$ 的样本(就是数据集里的动作 $a_i$),所以它可以直接用 $-\frac{1}{N}\sum_i\log\pi_\theta(a_i|s_i)$ 无偏估计——这就是行为克隆的损失。代价是「模式覆盖」:$\pi_\theta$ 必须在 $\pi_\beta$ 有质量的每个地方都有质量,否则 $-\log\pi_\theta\to\infty$。如果数据里既有好行为也有坏行为,前向 KL 会强迫我们保留坏行为的那些模式。
Levine 反复强调:从「不要保留坏模式」的角度看,反向 KL 更符合我们的需求;但从「可估计性」的角度看,前向 KL 才是免费的。这个矛盾贯穿整个策略约束家族——凡是用反向 KL 的方法(BRAC 的一支、SAC+BC 的 1a 形式),都必须额外训练一个行为策略模型 $\hat\pi_\beta$,而这个模型本身的误差会被 $\log$ 放大。
分布匹配为什么本质上是错的
真正的问题在于:KL 约束要求的是分布匹配(distribution matching),而我们真正需要的只是支撑集匹配(support matching)。我们害怕的唯一一件事是「策略选了一个数据里没有的动作,导致 $Q$ 值不可信」。只要动作落在 $\pi_\beta$ 的支撑集里,$\pi_\theta$ 把多少概率质量放在上面,跟 $Q$ 值可不可信毫无关系。理想的约束应该写成:
$$ \pi_{\text{new}}=\argmax_{\pi}\ \E_{s\sim\mathcal{D}}\E_{a\sim\pi(\cdot|s)}\left[Q(s,a)\right] \quad\text{s.t.}\quad \pi(a|s)>0 \Rightarrow \pi_\beta(a|s)\ge\epsilon $$也就是 $\pi$ 的支撑集必须落在 $\Omega(s)=\{a:\pi_\beta(a|s)\ge\epsilon\}$ 之内,但在 $\Omega(s)$ 内部它想怎么分配都行。
一个两动作的数值例子就能看出分布匹配有多亏。设某状态下 $\pi_\beta=(0.99,\,0.01)$,而真实值是 $Q(s,a_1)=0$、$Q(s,a_2)=10$——数据里那个稀有动作恰好是好动作(这在人类演示数据里极其常见:偶尔的一次正确操作)。
支撑集约束下的最优策略是 $\pi=\delta(a=a_2)$,回报 10,而且完全合法,因为 $a_2$ 在数据里出现过 1% ,$Q(s,a_2)$ 是有样本支撑的可靠估计。
反向 KL 约束下呢?$D_{\mathrm{KL}}(\delta_{a_2}\|\pi_\beta)=\log\frac{1}{0.01}=4.605$。也就是说,只要我们设 $\epsilon\lt 4.6$(实践中 $\epsilon$ 常取 0.05~1),这个完全安全的最优策略就被判为违规。约束住的策略只能是 $\pi=(1-p,p)$ 且 $p\log\frac{p}{0.01}+(1-p)\log\frac{1-p}{0.99}\le\epsilon$;取 $\epsilon=0.5$ 时解得 $p\approx 0.13$,期望回报只有 $1.3$,不到最优的 $1/7$。
反过来的情形同样糟:若 $\pi_\beta$ 是一个宽的高斯而最优动作是它的中心,前向 KL 会强迫 $\pi_\theta$ 保持同样宽——把一堆平庸动作一起学下来。
所以结论是:支撑集约束才是对的,分布匹配约束是一个过强的代理。可惜从有限样本估计一个高维分布的支撑集是统计上非常困难的问题——$\epsilon$ 阈值怎么定?100 维动作空间里,$N=10^6$ 个样本连支撑集的边界都勾勒不出来。而且支撑集约束不是一个可微的目标函数。上一讲结尾 Levine 给这条路留下的判词就是「very hard to approximate tractably」。下面三个算法是三种不同程度的近似。
BCQ:用生成模型枚举「像数据的动作」
BCQ(Batch-Constrained deep Q-learning)的做法非常直白:既然要求动作在支撑集内,那就只从一个拟合了 $\pi_\beta$ 的生成模型里采样候选动作。具体地,先用数据集训练一个条件 VAE $G_\omega(\cdot|s)$ 来克隆行为策略,然后策略定义为
$$ \pi(s)=\argmax_{a_i+\xi_\phi(s,a_i,\Phi)}\ Q_\vartheta\big(s,\ a_i+\xi_\phi(s,a_i,\Phi)\big), \qquad \{a_i\}_{i=1}^{n}\sim G_\omega(\cdot|s) $$其中 $\xi_\phi$ 是一个输出被裁剪在 $[-\Phi,\Phi]$ 内的扰动网络(perturbation network),用确定性策略梯度训练来最大化 $Q$。这个设计的漂亮之处在于它是一个连续的插值:$\Phi=0,n=1$ 时就是纯行为克隆;$\Phi=a_{\max},n\to\infty$ 时就是普通的 Q-learning;中间的取值给出一族「批约束」程度不同的算法。此外 BCQ 的目标值用了一个偏保守的双 Q 混合 $\lambda\min(Q_1,Q_2)+(1-\lambda)\max(Q_1,Q_2)$,$\lambda$ 通常取 0.75。
缺点也明显:它依赖 VAE 的采样质量。VAE 如果模式塌缩,支撑集就被低估,算法退化成 BC;VAE 如果过度平滑(高维连续动作上很常见),支撑集被高估,OOD 动作又漏进来了。$n$ 通常要取到 10~100,每一步都要跑 $n$ 次前向传播,推理很贵。
BEAR:用 MMD 做支撑集匹配
BEAR(Bootstrapping Error Accumulation Reduction)把约束换成了最大均值差异(Maximum Mean Discrepancy, MMD):
$$ \pi=\argmax_{\pi}\ \E_{s\sim\mathcal{D}}\E_{a\sim\pi}\left[\hat Q(s,a)\right] \quad\text{s.t.}\quad \mathrm{MMD}^2\!\left(\pi(\cdot|s),\hat\pi_\beta(\cdot|s)\right)\le\epsilon $$MMD 的样本估计只需要两边各一批样本,不需要密度:
$$ \mathrm{MMD}^2(\{x_i\}_{i=1}^{n},\{y_j\}_{j=1}^{m}) =\frac{1}{n^2}\sum_{i,i'}k(x_i,x_{i'})-\frac{2}{nm}\sum_{i,j}k(x_i,y_j)+\frac{1}{m^2}\sum_{j,j'}k(y_j,y_{j'}) $$核 $k$ 常取拉普拉斯核 $k(x,y)=\exp(-\|x-y\|_1/\sigma)$ 或高斯核。BEAR 的关键论点是:当样本数 $n$ 很小(论文里用 4~10)时,样本 MMD 表现得更像支撑集散度而不是分布散度。直觉是这样的:MMD 的样本估计只能分辨「有没有样本落在这一带」这个量级的信息,分辨不出精细的密度差异;只要 $\pi$ 的样本都掉在 $\pi_\beta$ 的样本附近,交叉项 $\frac{2}{nm}\sum k(x_i,y_j)$ 就足够大,MMD 就足够小,至于 $\pi$ 内部怎么分配质量,前两项的差异在小样本下被噪声淹没了。这不是一个严格的定理,是一个经验性的近似——Levine 在课上对这类方法的评价是「方向对,但落地时非常依赖核宽 $\sigma$ 的调法」。
TD3+BC:把约束简化到只剩一行
与前两者相反,TD3+BC 走的是「简单到荒谬也能work」的路线。它在 TD3 的 actor 目标上直接加一项行为克隆的均方误差:
$$ \pi=\argmax_{\pi}\ \E_{(s,a)\sim\mathcal{D}}\left[\lambda\, Q(s,\pi(s))-\big(\pi(s)-a\big)^2\right], \qquad \lambda=\frac{\alpha}{\frac{1}{N}\sum_{i}\left|Q(s_i,a_i)\right|} $$注意两个细节。第一,对确定性策略 $\pi(s)$ 而言,$(\pi(s)-a)^2$ 恰好就是固定方差高斯策略的负对数似然,也就是前向 KL 的样本估计——所以 TD3+BC 属于上面那个 1b 分支。第二,$\lambda$ 的分母是当前 batch 上 $|Q|$ 的均值,这个归一化非常关键:不同任务、不同训练阶段 $Q$ 的量级差好几个数量级,如果 $\lambda$ 固定,那么 $\alpha$ 就得针对每个数据集重调;除以 $\overline{|Q|}$ 之后 $\alpha=2.5$ 这一个值在整个 D4RL locomotion 上都能用。此外还要对状态做标准化。这两个「工程 trick」贡献的性能,往往比约束形式本身的理论优劣还大。
| 方法 | 约束类型 | 需要显式 $\hat\pi_\beta$ 吗 | 约束的实现 | 主要弱点 |
|---|---|---|---|---|
| BCQ | 近似支撑集 | 需要(CVAE) | 候选动作只能来自生成模型 + 有界扰动 | 推理需 $n$ 次采样;受 VAE 质量支配 |
| BEAR | 近似支撑集 | 需要(采样即可) | 小样本 MMD 罚项 + 对偶上升调 $\lambda$ | 核宽敏感;MMD≈支撑集只是经验性的 |
| BRAC | 分布匹配(KL 等) | 需要 | 罚在 actor 目标或奖励里 | $\hat\pi_\beta$ 的误差被 $\log$ 放大 |
| TD3+BC | 分布匹配(前向 KL) | 不需要 | actor 目标里加一项 $-(\pi(s)-a)^2$ | 过强约束,无法丢弃数据里的坏模式 |
| AWAC / AWR | 隐式分布匹配 | 不需要 | 优势加权的最大似然 | critic 里仍然查询 OOD 动作 |
| IQL | 隐式支撑集 | 不需要 | 期望回归自动实现「支撑集内取 max」 | 改进上限受支撑集限制 |
3. 显式策略约束:改目标函数,还是改奖励
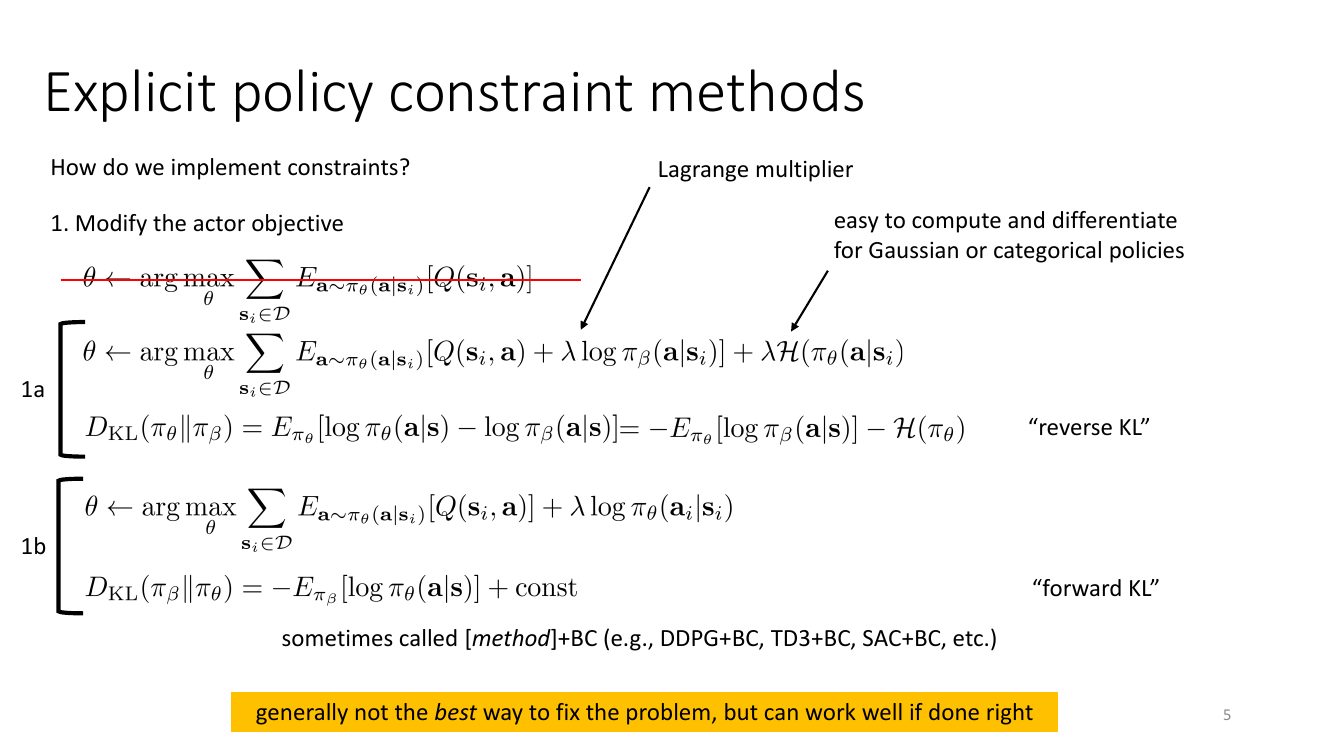
从约束优化到拉格朗日形式
原问题是
$$ \max_{\theta}\ \sum_{s_i\in\mathcal{D}}\E_{a\sim\pi_\theta(a|s_i)}\left[Q(s_i,a)\right] \quad\text{s.t.}\quad D_{\mathrm{KL}}\!\left(\pi_\theta(\cdot|s_i)\,\|\,\pi_\beta(\cdot|s_i)\right)\le\epsilon $$写出拉格朗日函数 $\mathcal{L}(\theta,\lambda)=\sum_i\E_{\pi_\theta}[Q]-\lambda\left(D_{\mathrm{KL}}(\pi_\theta\|\pi_\beta)-\epsilon\right)$,把上一节的反向 KL 展开式代进去,$\lambda\epsilon$ 与 $\theta$ 无关可以丢掉,得到 1a:
$$ \theta\leftarrow\argmax_{\theta}\ \sum_{s_i\in\mathcal{D}}\E_{a\sim\pi_\theta(a|s_i)}\left[Q(s_i,a)+\lambda\log\pi_\beta(a|s_i)\right]+\lambda\,\mathcal{H}\!\left(\pi_\theta(\cdot|s_i)\right) $$这个形式在实现上非常友好:如果 $\pi_\theta$ 是高斯或类别分布,$\mathcal{H}$ 有闭式解,$\E_{a\sim\pi_\theta}[\cdot]$ 用重参数化采样一两个动作就能求导。$\lambda$ 可以固定,也可以用对偶梯度上升自动调节:$\lambda\leftarrow\lambda+\eta\left(\widehat{D_{\mathrm{KL}}}-\epsilon\right)$,即 KL 超标就加大惩罚。但它需要 $\log\pi_\beta$,也就是必须先跑一遍行为克隆得到 $\hat\pi_\beta$。
如果换成前向 KL,$D_{\mathrm{KL}}(\pi_\beta\|\pi_\theta)=-\E_{a\sim\pi_\beta}[\log\pi_\theta(a|s)]+\text{const}$,而 $\pi_\beta$ 的样本就是数据里的 $a_i$,于是得到 1b:
$$ \theta\leftarrow\argmax_{\theta}\ \sum_{s_i\in\mathcal{D}}\E_{a\sim\pi_\theta(a|s_i)}\left[Q(s_i,a)\right]+\lambda\log\pi_\theta(a_i|s_i) $$这就是「[某算法]+BC」的通用配方。它完全不需要 $\hat\pi_\beta$,这是它在实践中大行其道的根本原因:少训一个网络,就少一个误差来源、少一堆超参数。
「1a 用反向 KL 所以模式寻找,1b 用前向 KL 所以模式覆盖,那当然选 1a。」——这个推理在数学上没错,但漏掉了误差来源。1a 里的 $\log\hat\pi_\beta(a|s)$ 是一个神经网络在自己没见过的动作上的外推值。当 $\pi_\theta$ 试探性地移到 OOD 区域时,我们希望 $\log\hat\pi_\beta\to-\infty$ 把它拉回来,但一个高斯输出头的 BC 模型在那里给出的可能是一个温和的有限值,甚至(如果 OOD 动作恰好落在拟合高斯的尾部中心线上)是一个偏高的值。于是约束在最需要它的地方失效。1b 虽然形式笨,但 $\log\pi_\theta(a_i|s_i)$ 是在真实数据点上求值的,没有外推。
方案二:把约束搬进奖励函数
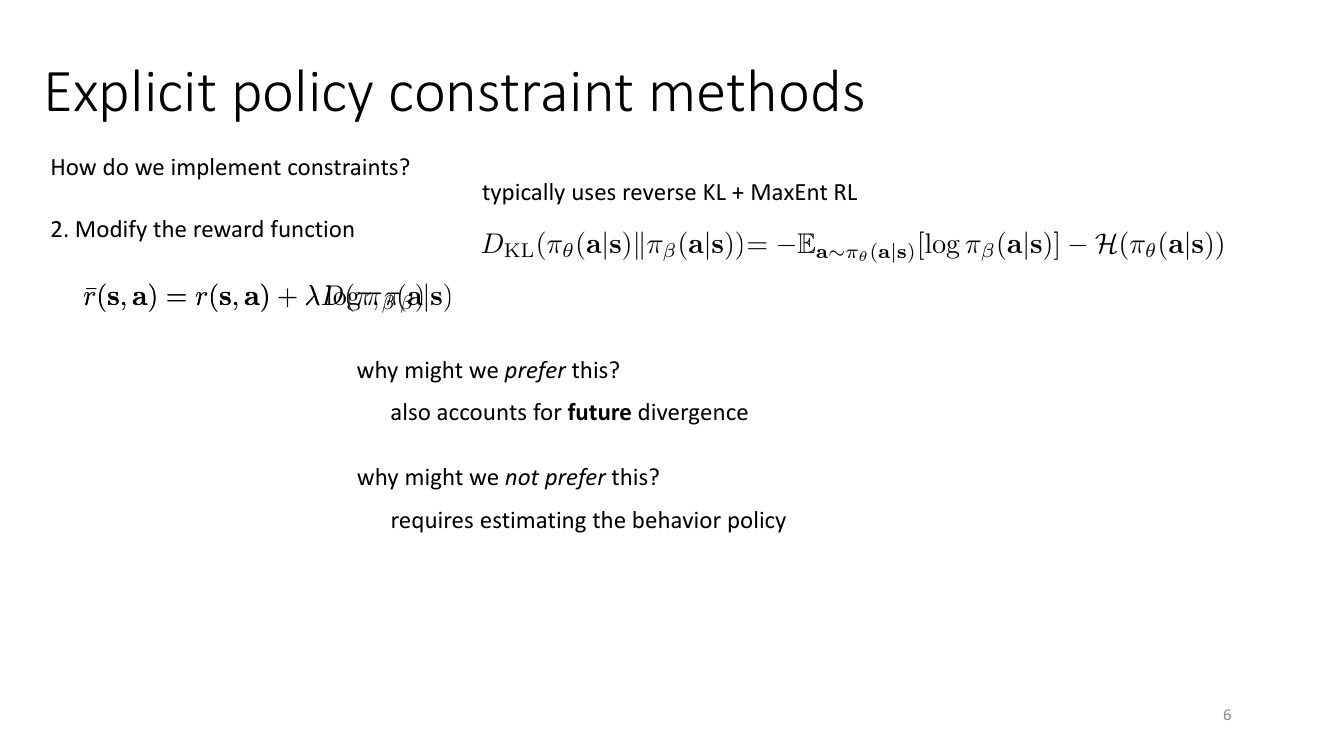
把 $-\lambda D_{\mathrm{KL}}$ 塞进奖励里之后,Bellman 备份会把这个惩罚沿轨迹传播:
$$ \bar r(s,a)=r(s,a)-\lambda\log\frac{\pi_\theta(a|s)}{\pi_\beta(a|s)} =r(s,a)+\lambda\log\pi_\beta(a|s)-\lambda\log\pi_\theta(a|s) $$在最大熵 RL 框架下,最后那项 $-\lambda\log\pi_\theta$ 正是熵奖励,框架自带,所以实现上只需要加 $\lambda\log\pi_\beta(a|s)$ 一项。这个改动的价值在于它约束的不再是单步散度,而是折扣累积散度:
$$ \bar J(\theta)=\E_{\pi_\theta}\left[\sum_t\gamma^t r(s_t,a_t)\right]-\lambda\,\E_{\pi_\theta}\left[\sum_t\gamma^t D_{\mathrm{KL}}\!\left(\pi_\theta(\cdot|s_t)\,\|\,\pi_\beta(\cdot|s_t)\right)\right] $$这解决了一个 1a/1b 都解决不了的问题:假设当前状态下所有动作都在支撑集内,但其中一个动作会把智能体带到一个数据从未覆盖的区域,在那里策略无论如何都得输出 OOD 动作。单步 KL 惩罚对这个动作毫无意见,而奖励版本会把未来的巨大 KL 折现回来,现在就把它压下去。代价是:$\log\pi_\beta$ 又回来了,必须训练 $\hat\pi_\beta$;而且惩罚被烘焙进了 Q 函数,想调 $\lambda$ 就得从头重训 critic,没法像 1b 那样只改 actor 的一个系数。
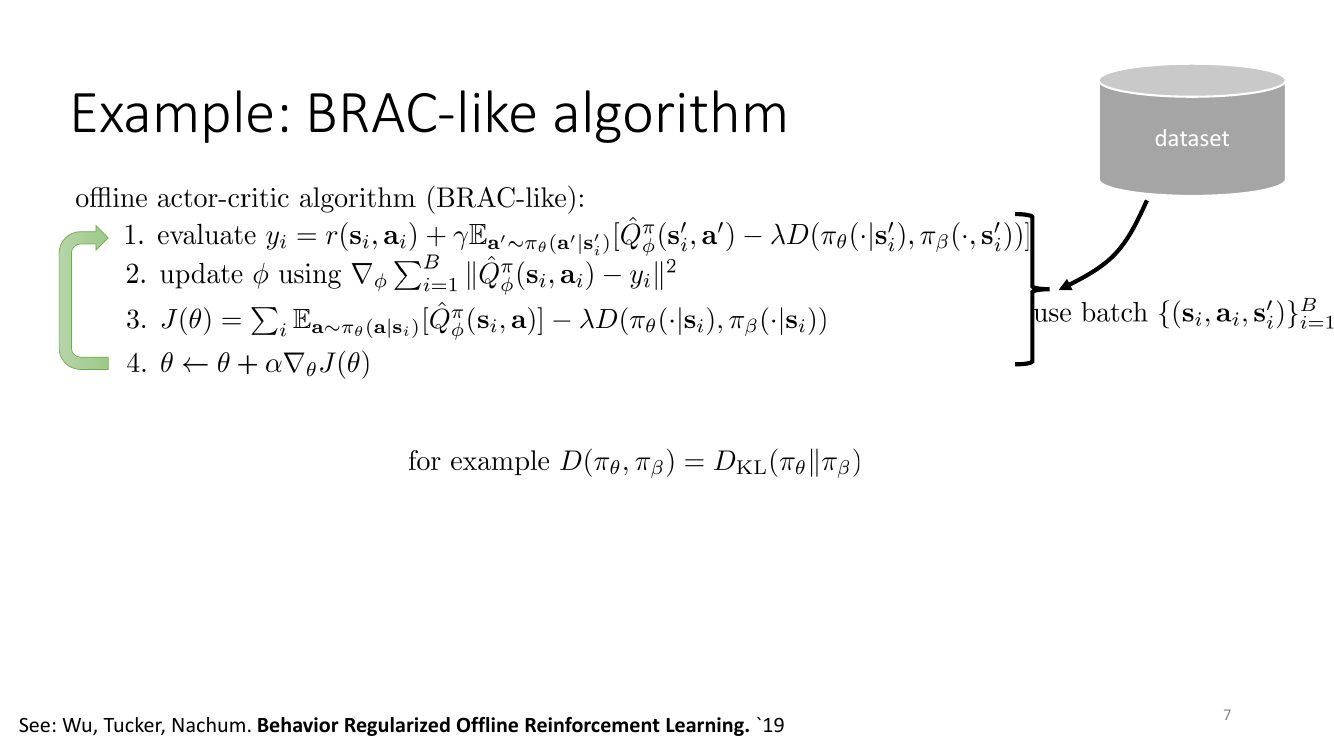
把 BRAC 的散度罚项全部去掉、只在 actor 目标里留一项 $\lambda\log\pi_\theta(a_i|s_i)$,就得到「AC+BC」风格的算法——目标值退化成普通的 $y_i=r+\gamma\E_{a'\sim\pi_\theta}[\hat Q_\phi(s_i',a')]$,actor 目标变成 $J(\theta)=\sum_i\E_{a\sim\pi_\theta}[\hat Q_\phi(s_i,a)]+\lambda\log\pi_\theta(a_i|s_i)$。TD3+BC 就是这个模板的一个具体实例。它的四行伪代码比 BRAC 少了两个散度项和一个 $\hat\pi_\beta$ 网络,这就是为什么它在 2021 年横空出世时让很多人尴尬:一个只多了一行代码的 TD3,在 D4RL locomotion 上打平甚至超过了精心设计的 BCQ/BEAR/BRAC。
不管哪种显式约束,都有一个共同的结构性缺陷:约束是加在 actor 上的,但错误是在 critic 里累积的。目标值 $y_i$ 里那个 $\E_{a'\sim\pi_\theta}[\hat Q_\phi(s',a')]$ 依然要在 $\pi_\theta$ 采出的动作上求值。约束只能保证这些动作「不太远」,不能保证它们在数据里出现过。$\lambda$ 稍微小一点,自举误差就开始滚雪球。这正是下面 CQL(直接修 critic)和 IQL(根本不查询 $a'$)两条路线的动机。
4. 隐式策略约束:AWR 与 AWAC
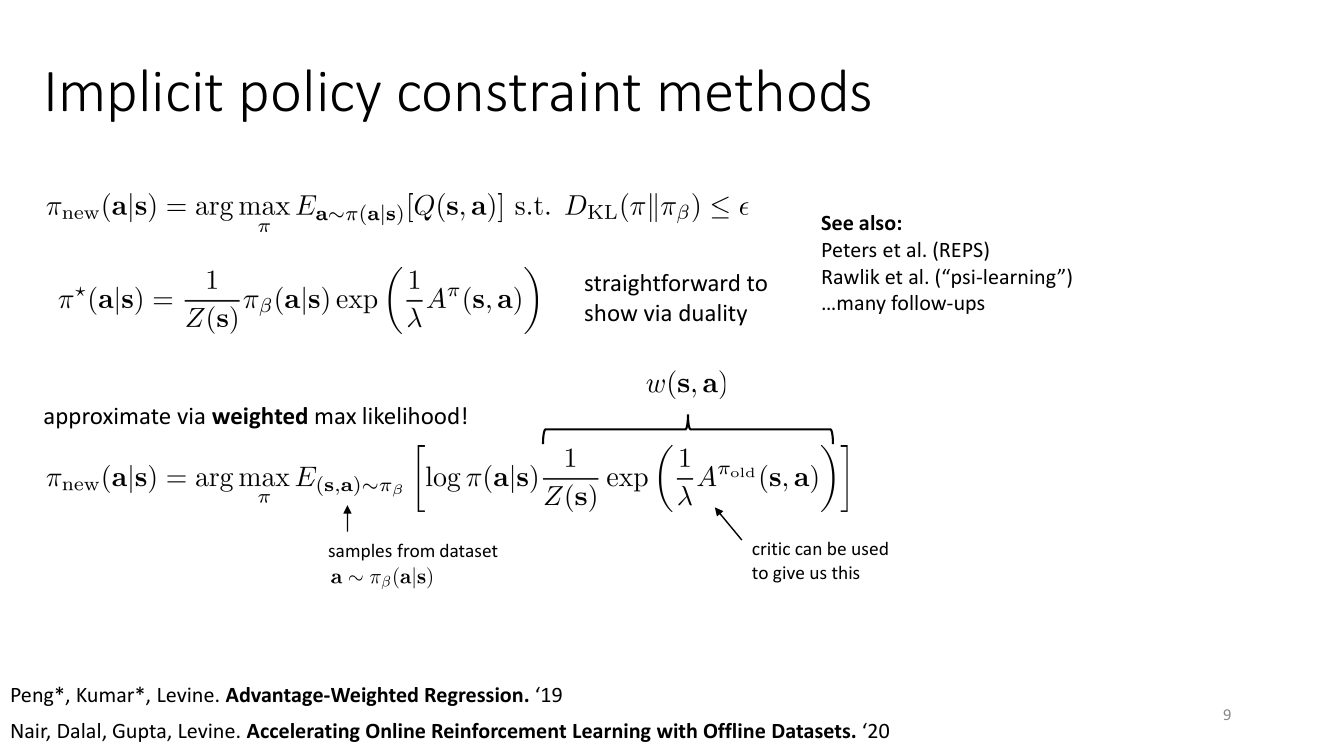
闭式解的完整推导
这是本讲最值得亲手推一遍的式子。固定某个状态 $s$,把 $\pi(\cdot|s)$ 当成一个待优化的概率分布(非参数),求解
$$ \max_{\pi}\ \int \pi(a|s)Q(s,a)\,da \quad\text{s.t.}\quad \int\pi(a|s)\log\frac{\pi(a|s)}{\pi_\beta(a|s)}da\le\epsilon,\quad \int\pi(a|s)\,da=1 $$拉格朗日函数($\lambda\ge 0$ 对应 KL 约束,$\nu$ 对应归一化约束):
$$ \mathcal{L}[\pi]=\int \pi Q\,da-\lambda\left(\int\pi\log\frac{\pi}{\pi_\beta}da-\epsilon\right)+\nu\left(\int\pi\,da-1\right) $$对 $\pi(a|s)$ 求变分导数(把 $\pi(a|s)$ 看成每个 $a$ 上的一个自变量):
$$ \frac{\partial\mathcal{L}}{\partial\pi(a|s)}=Q(s,a)-\lambda\left(\log\frac{\pi(a|s)}{\pi_\beta(a|s)}+1\right)+\nu=0 $$其中 $\frac{\partial}{\partial\pi}\left[\pi\log\frac{\pi}{\pi_\beta}\right]=\log\frac{\pi}{\pi_\beta}+1$。整理得
$$ \log\frac{\pi(a|s)}{\pi_\beta(a|s)}=\frac{1}{\lambda}Q(s,a)+\frac{\nu}{\lambda}-1 \quad\Longrightarrow\quad \pi^\star(a|s)=\pi_\beta(a|s)\exp\!\left(\frac{1}{\lambda}Q(s,a)\right)\cdot e^{\nu/\lambda-1} $$最后那个因子与 $a$ 无关,由归一化条件确定,记作 $1/Z(s)$,即 $Z(s)=\int\pi_\beta(a|s)\exp\!\left(\frac{1}{\lambda}Q(s,a)\right)da$。又因为 $V(s)$ 不依赖 $a$,$\exp\!\left(\frac{1}{\lambda}Q\right)=\exp\!\left(\frac{1}{\lambda}A\right)\cdot\exp\!\left(\frac{1}{\lambda}V\right)$,多出的因子同样被 $Z(s)$ 吸收。于是
$$ \boxed{\ \pi^\star(a|s)=\frac{1}{Z(s)}\pi_\beta(a|s)\exp\!\left(\frac{1}{\lambda}A^\pi(s,a)\right)\ } $$用 $A$ 而不是 $Q$ 在数值上重要得多:$Q$ 的绝对量级随任务和 $\gamma$ 剧烈变化($\gamma=0.99$ 时 $Q$ 轻松上千),$\exp(Q/\lambda)$ 会直接溢出;而 $A$ 以 0 为中心,量级可控。
这个解有一个非常好的性质:它的支撑集自动包含在 $\pi_\beta$ 的支撑集里。因为 $\pi^\star\propto\pi_\beta\cdot(\text{正数})$,只要 $\pi_\beta(a|s)=0$ 就有 $\pi^\star(a|s)=0$。也就是说,最优解从来不会跑到数据外面去,约束是「隐式」满足的——这就是「隐式策略约束」这个名字的来历。$\lambda\to 0$ 时它退化成在支撑集内取 $\argmax$(正是我们想要的支撑集约束最优解);$\lambda\to\infty$ 时它退化成 $\pi_\beta$(行为克隆)。
从闭式解到可训练的目标
$\pi^\star$ 是一个非参数分布,我们没法直接用它采样($Z(s)$ 是个积分)。所以要把它投影到参数化策略族上。选前向 KL 做投影:
$$ \theta\leftarrow\argmin_\theta\ \E_{s\sim\mathcal{D}}\left[D_{\mathrm{KL}}\!\left(\pi^\star(\cdot|s)\,\|\,\pi_\theta(\cdot|s)\right)\right] =\argmax_\theta\ \E_{s\sim\mathcal{D}}\,\E_{a\sim\pi^\star(\cdot|s)}\left[\log\pi_\theta(a|s)\right] $$问题是我们也没有 $\pi^\star$ 的样本。但我们有 $\pi_\beta$ 的样本,做一次重要性替换即可:
$$ \E_{a\sim\pi^\star}\left[\log\pi_\theta(a|s)\right] =\E_{a\sim\pi_\beta}\left[\frac{\pi^\star(a|s)}{\pi_\beta(a|s)}\log\pi_\theta(a|s)\right] =\E_{a\sim\pi_\beta}\left[\frac{1}{Z(s)}\exp\!\left(\frac{1}{\lambda}A^{\pi_{\text{old}}}(s,a)\right)\log\pi_\theta(a|s)\right] $$这一步是整个方法的枢纽:$\pi^\star$ 里的 $\pi_\beta$ 因子被重要性比的分母精确抵消了,剩下的权重里完全不含 $\pi_\beta$。所以我们既得到了以 $\pi_\beta$ 为基准的约束,又不需要训练任何行为策略模型。最终目标就是幻灯片上那一行:
$$ \pi_{\text{new}}=\argmax_\pi\ \E_{(s,a)\sim\pi_\beta}\left[\log\pi(a|s)\underbrace{\frac{1}{Z(s)}\exp\!\left(\frac{1}{\lambda}A^{\pi_{\text{old}}}(s,a)\right)}_{w(s,a)}\right] $$形式上它就是加权行为克隆:数据里回报高于平均的动作权重大,低于平均的权重小。这就是 AWR(Advantage-Weighted Regression)。注意重要性比在这里没有引起方差爆炸,因为它不是对整条轨迹的概率比连乘,只是单步动作上的一个有界(经裁剪后)标量权重。
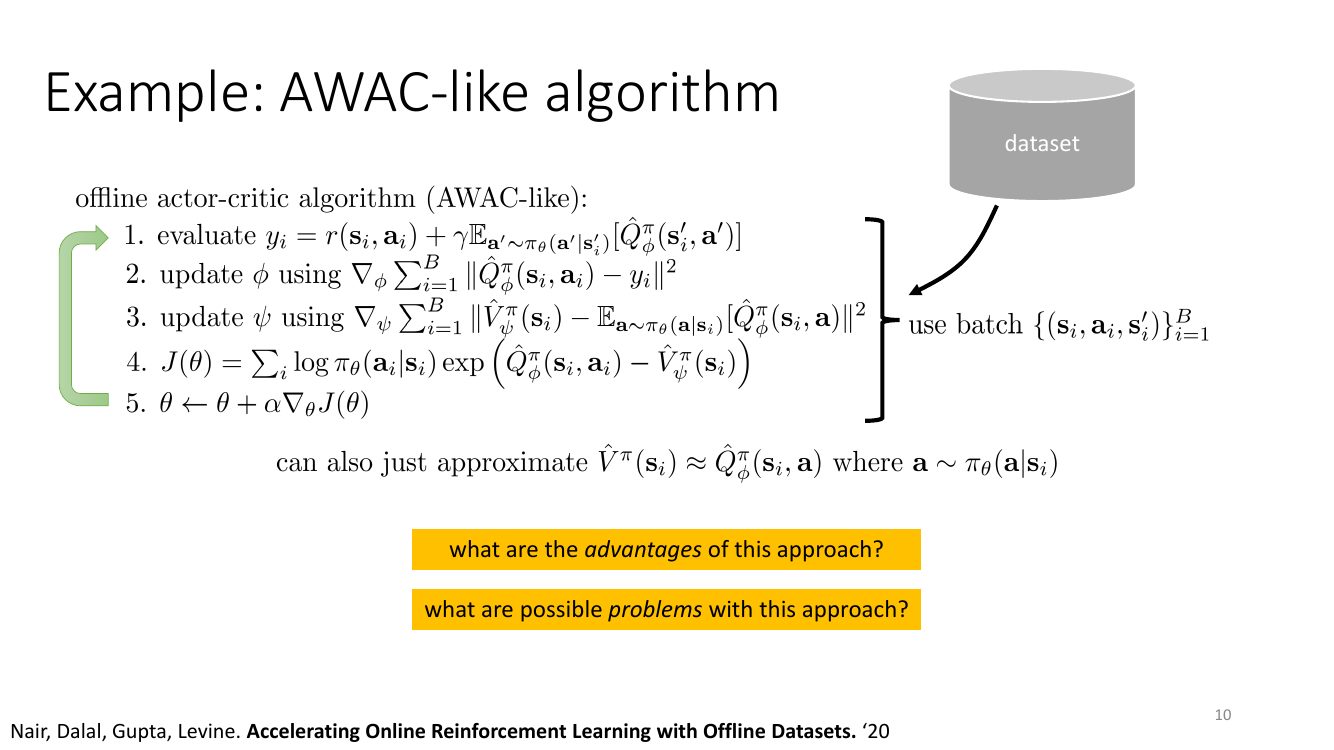
回答那两个黄框问题。优点:(1) actor 更新里出现的所有动作都是数据集里的 $a_i$,永远不在 OOD 动作上求 $\log\pi_\theta$ 或 $Q$,actor 侧完全安全;(2) 不需要 $\hat\pi_\beta$;(3) 失败模式温和——如果 critic 完全没学到东西,所有权重趋于相等,算法自动退化成行为克隆,不会崩到比数据更差;(4) 天然适合离线转在线,因为随着 buffer 里灌进在线数据,$\pi_\beta$ 自动向 $\pi_\theta$ 靠拢,约束自动放松。
问题:(1) 最要命的是第 1 步——目标值里 $\E_{a'\sim\pi_\theta}[\hat Q_\phi(s',a')]$ 仍然在查询 OOD 动作。actor 安全了,critic 没有。分布偏移的根子还在。(2) 指数权重会导致有效样本量塌缩:$\lambda$ 小的时候,256 个样本里可能只有三五个权重非零,梯度噪声极大;所以实现里通常要把 $\exp(\cdot)$ 裁剪到 100 以内。(3) $Z(s)$ 通常被忽略或用 batch 内归一化代替,这在不同状态优势尺度差异大时是有偏的。(4) 根本性的上限:这个目标只是在重新加权数据,它永远不会输出数据里没有的动作,改进幅度受限。极端情况就是「one-step RL」——只估一次 $Q^{\pi_\beta}$,只做一次 AWR 更新——在 D4RL locomotion 上出奇地强,但在需要长程拼接的 AntMaze 上完全失败,因为一步改进无法把多段轨迹缝起来。
5. 隐式 Q-learning(IQL):一次都不问 OOD 动作
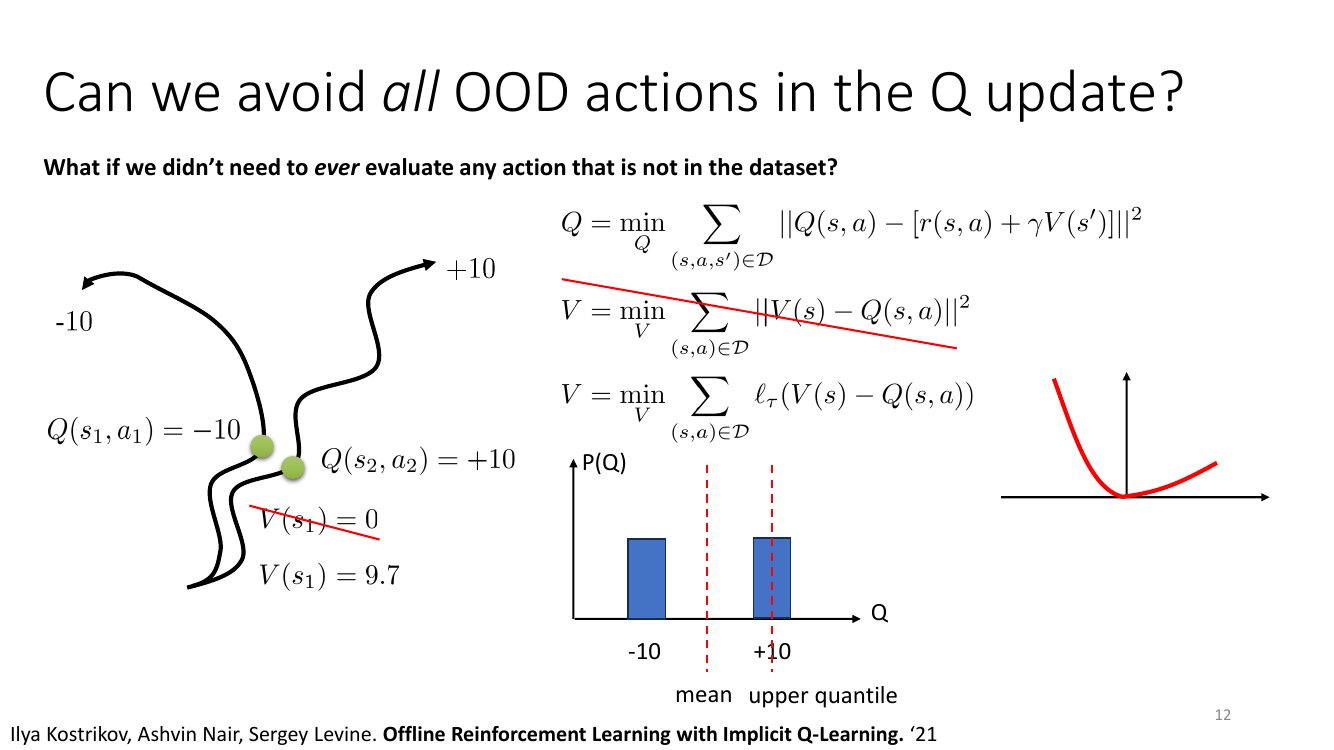
思路的起点很朴素:既然一切麻烦都来自「在没见过的动作上求 $Q$」,那能不能设计一个算法,从头到尾只在数据集里出现过的 $(s,a)$ 上调用 $Q$ 网络?
把 Q-learning 的备份拆成两半:
$$ Q(s,a)\leftarrow r(s,a)+\gamma V(s'),\qquad V(s)=\max_{a}Q(s,a) $$第一半完全没问题——$(s,a,s')$ 全都来自数据。麻烦全在第二半的 $\max_a$:它要在整个动作空间上搜索。如果我们能不通过枚举动作而算出 $V(s)$,问题就解决了。IQL 的答案是:把 $V$ 做成另一个神经网络,用数据集里的动作去回归它,但回归的不是均值,而是上分位。
期望回归(expectile regression)
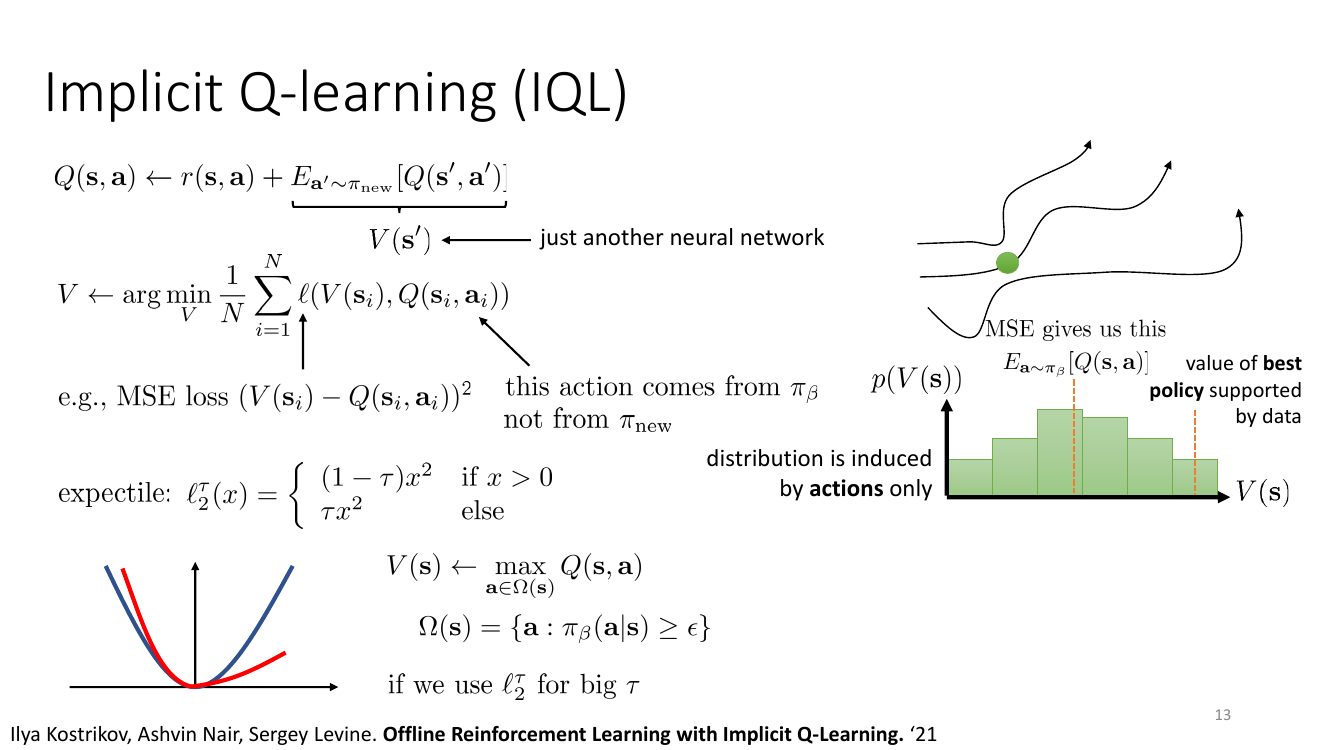
期望回归的损失函数写作(这里用 IQL 论文的记号,$u$ 是残差):
$$ L_2^\tau(u)=\left|\tau-\mathbf{1}(u\lt 0)\right|\cdot u^2,\qquad u=Q(s,a)-V(s) $$当 $u>0$(也就是 $V$ 低估了这个样本的 $Q$)时权重是 $\tau$;当 $u\lt 0$($V$ 高估)时权重是 $1-\tau$。取 $\tau>1/2$,低估被罚得更重,$V$ 就被推向分布的上端。幻灯片上写的是等价的另一种形式 $\ell_2^\tau(x)=(1-\tau)x^2$ if $x>0$ else $\tau x^2$,那里的 $x=V(s)-Q(s,a)=-u$,两者完全一致——符号约定是这里最容易搞混的地方,务必对齐。$\tau=1/2$ 时两个权重相等,退化为 MSE(差一个常数因子 $1/2$),回归到均值。
为什么大 $\tau$ 会逼近 $\max$?固定一个状态 $s$,令 $X$ 表示随机变量 $Q(s,a)$,$a\sim\pi_\beta(\cdot|s)$。我们求 $m^\star=\argmin_m\E\left[L_2^\tau(X-m)\right]$。一阶条件($L_2^\tau$ 在 $u=0$ 处可导,导数为 0,所以可以逐段求导后相加):
$$ \frac{d}{dm}\E\left[L_2^\tau(X-m)\right]=-2\tau\,\E\left[(X-m)_+\right]+2(1-\tau)\,\E\left[(m-X)_+\right]=0 $$即
$$ \tau\,\E\left[(X-m^\star)_+\right]=(1-\tau)\,\E\left[(m^\star-X)_+\right] $$这就是 $\tau$-expectile 的定义式。$\tau=1/2$ 时化为 $\E[X-m]=0$,即 $m=\E[X]$。当 $\tau\to 1$ 时右边系数 $(1-\tau)\to 0$,要维持等式,左边 $\E[(X-m)_+]$ 必须趋于 0,也就是 $m\to \operatorname{ess\,sup}X=\max_{a\in\Omega(s)}Q(s,a)$——在 $\pi_\beta$ 的支撑集上取最大值。注意「$\operatorname{ess\,sup}$」意味着概率为 0 的动作根本不参与,这正是我们在第 2 节苦苦追求却写不出可微形式的支撑集约束。
数值验证 1:幻灯片的两分支例子。$X$ 以各 $1/2$ 的概率取 $-10$ 和 $+10$。设 $-10\lt m\lt 10$,代入:$\tau\cdot\frac12(10-m)=(1-\tau)\cdot\frac12(m+10)$,解得 $m=20\tau-10$。$\tau=0.5$ 给出 $m=0$(划掉的那个答案),$\tau=0.985$ 给出 $m=9.7$(幻灯片上的答案)。
数值验证 2:设某状态下数据里有 6 个动作,对应 $Q$ 值均匀地取 $\{0,2,4,6,8,10\}$。均值是 5,最大值是 10。取 $\tau=0.9$,猜 $m\in[6,8]$:左边 $0.9\left[(8-m)+(10-m)\right]=0.9(18-2m)$,右边 $0.1\left[m+(m-2)+(m-4)+(m-6)\right]=0.1(4m-12)$,令两者相等得 $16.2-1.8m=0.4m-1.2$,$m=17.4/2.2\approx 7.91$,确实落在 $[6,8]$ 内,自洽。取 $\tau=0.99$,猜 $m\in[8,10]$:$0.99(10-m)=0.01(5m-20)$,得 $m\approx 9.71$。可以看到 $\tau$ 从 0.5 调到 0.99,$V$ 从 5 一路爬到 9.71,平滑地在「均值」和「最大值」之间插值。
期望回归把「在支撑集内取 $\max$」这个组合优化问题转化成了一个加权最小二乘问题。$\tau$ 就是「我们愿意有多贪心」的旋钮:$\tau=0.5$ 是策略评估(评估 $\pi_\beta$ 本身),$\tau\to 1$ 是支撑集内的最优控制。而且整个过程只在数据集的 $(s_i,a_i)$ 上调用 $Q$ 网络,一次 OOD 查询都没有。
为什么必须拆成 V 和 Q 两个网络
一个自然的问题是:既然要取上分位,为什么不直接对 TD 误差 $Q(s,a)-[r+\gamma\max\ldots]$ 做期望回归,非要多一个 $V$ 网络?答案在幻灯片右下角那句旁注:这个分布必须只由动作诱导。
回忆随机环境下 $Q^\pi(s,a)=r(s,a)+\gamma\,\E_{s'\sim p(\cdot|s,a)}[V^\pi(s')]$——对转移取的是期望,不是最大值。如果我们对包含 $s'$ 随机性的量取上分位,就会得到一个「风险偏好」的估计:算法会认为自己每次都能撞上最幸运的那个转移。这在有随机性的环境里是灾难性的高估,跟我们要治的病是同一种。IQL 的两网络结构把两种随机性干净地分开了:
- $V_\psi$ 用期望回归拟合 $Q_\phi(s,a)$,$a\sim\pi_\beta$ ——只对动作取上分位,这是我们想要的(策略改进)。
- $Q_\phi$ 用普通均方回归拟合 $r+\gamma V_\psi(s')$ ——对转移取均值,这也是我们想要的(正确的期望备份)。
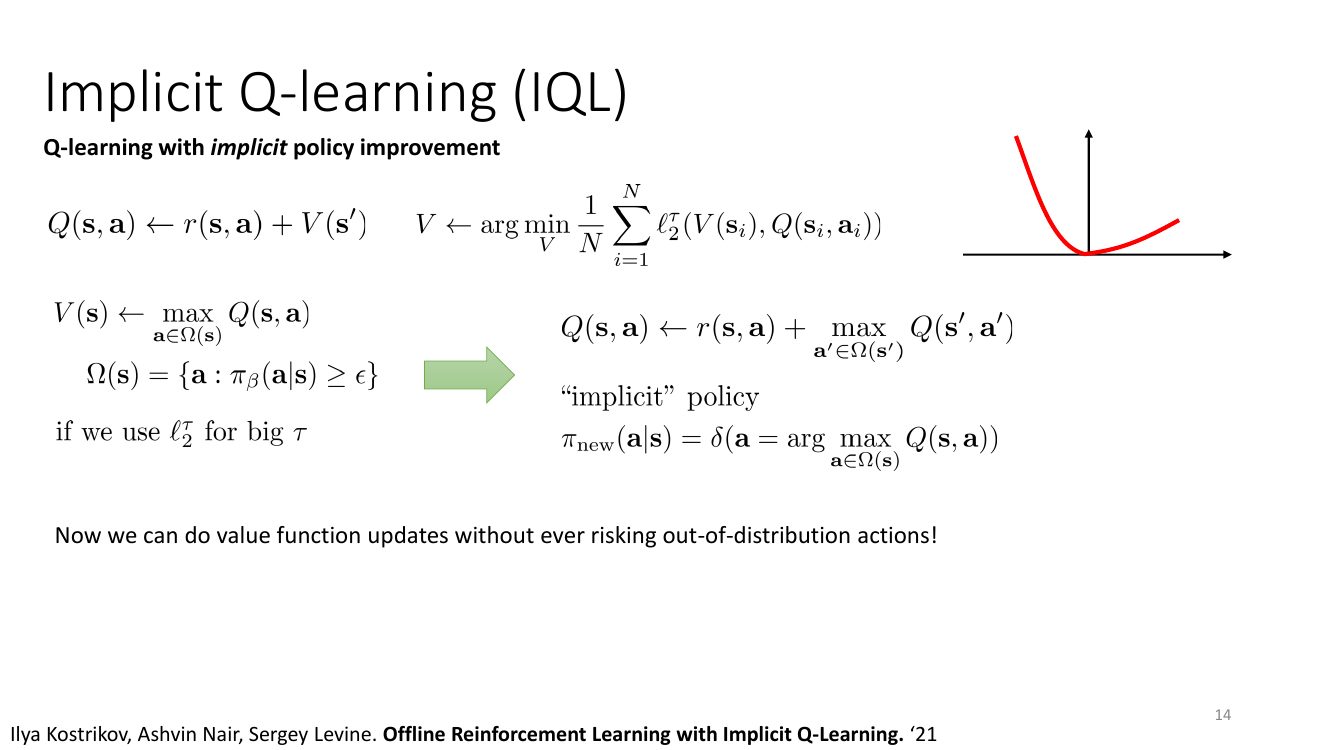
右边那个式子值得单独看一眼:$Q(s,a)\leftarrow r(s,a)+\max_{a'\in\Omega(s')}Q(s',a')$。这是一个Bellman 最优算子的支撑集约束版本。它跟标准 Bellman 最优算子一样是 $\gamma$-收缩的($\max$ 在一个固定集合上取仍然是非扩张的),所以有唯一不动点,就是「数据支撑集内的最优策略」的 Q 函数。这在理论上比策略约束类方法干净得多:策略约束的不动点依赖于 $\lambda$ 和散度的具体形式,而 IQL 的不动点有清晰的语义。
策略抽取与完整算法
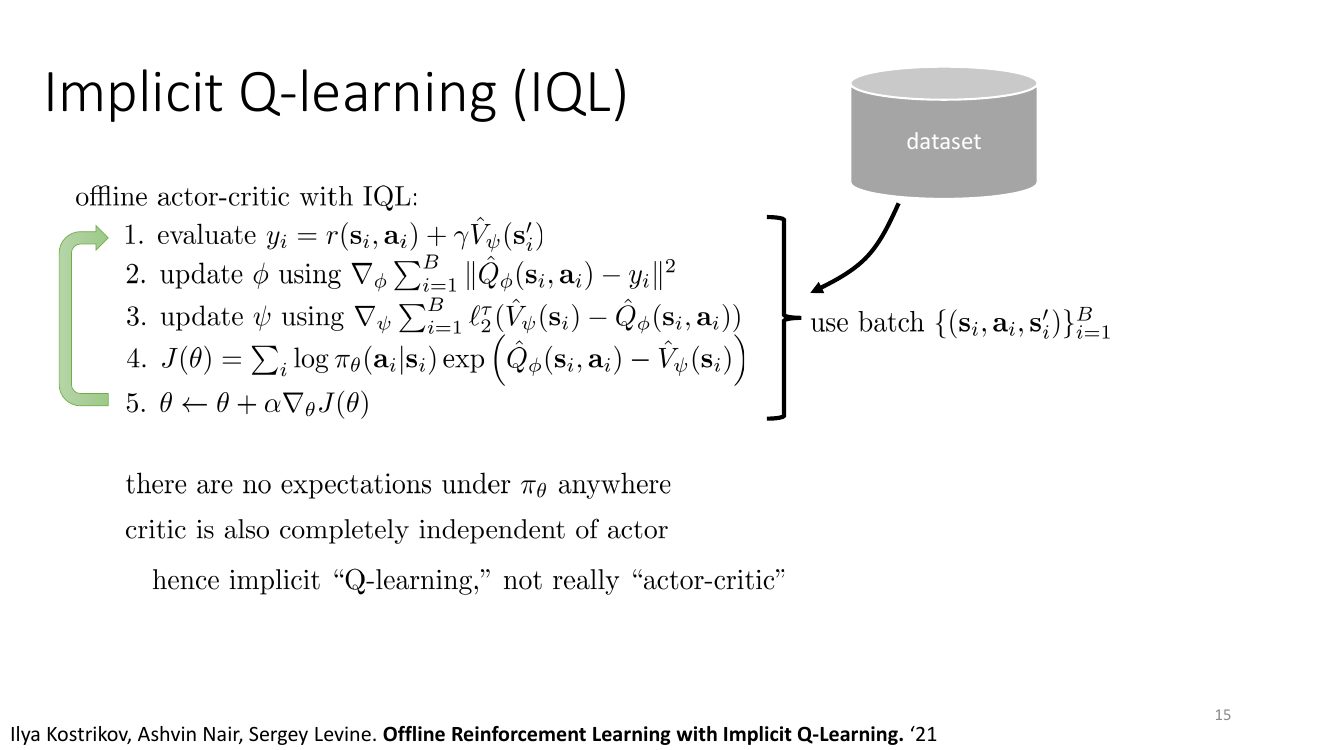
第 4 步就是第 4 节推出来的 AWR 权重,只不过优势用 $\hat Q_\phi(s_i,a_i)-\hat V_\psi(s_i)$ 现成算出来(实际实现里权重写成 $\exp(\beta\cdot A)$ 并裁剪到 100 以内,$\beta$ 是逆温度)。关键在于:第 1~3 步完全不依赖 $\theta$。你可以先把 critic 训到收敛,再抽取策略;也可以用同一个 critic 抽取好几个不同 $\beta$ 的策略去比。这种解耦在工程上极其舒服,也是 IQL 被广泛当作基线的原因之一。
import torch
import torch.nn.functional as F

def expectile_loss(diff, tau=0.7):
    """diff = Q(s,a) - V(s)。tau > 0.5 时,对 V 低估(diff > 0)罚得更重,
    于是 V 被推向 Q 在数据动作上的上分位,即 max_{a in supp(pi_beta)} Q(s,a)。"""
    weight = torch.where(diff > 0, tau, 1.0 - tau)
    return weight * diff.pow(2)


def iql_losses(q_net, q_targ, v_net, actor, batch,
               gamma=0.99, tau=0.7, beta=3.0, w_max=100.0):
    s, a, r, s2, done = batch          # 全部来自离线数据集

    # ---- 1) V 的期望回归:动作 a 来自数据,绝不采样新动作 ----
    with torch.no_grad():
        q1_t, q2_t = q_targ(s, a)
        q_sa = torch.min(q1_t, q2_t)   # 双 Q 取小,抑制残余高估
    v_s = v_net(s).squeeze(-1)
    v_loss = expectile_loss(q_sa - v_s, tau).mean()

    # ---- 2) Q 的普通均方回归:bootstrap 只用 V(s'),不含任何 max_a ----
    with torch.no_grad():
        y = r + gamma * (1.0 - done) * v_net(s2).squeeze(-1)
    q1, q2 = q_net(s, a)
    q_loss = F.mse_loss(q1, y) + F.mse_loss(q2, y)

    # ---- 3) 策略抽取:优势加权回归(AWR / AWAC 式)----
    with torch.no_grad():
        adv = q_sa - v_s                       # A(s,a) = Q(s,a) - V(s)
        w = torch.exp(beta * adv).clamp(max=w_max)   # 裁剪防止权重爆炸
    logp = actor.log_prob(s, a)                # 只在数据动作上求对数似然
    pi_loss = -(w * logp).mean()

    return v_loss, q_loss, pi_loss
把三个损失分别喂给三个优化器,再对 q_targ 做 Polyak 平均,就是完整的 IQL。整份代码里没有任何一处调用 actor.sample() 然后送进 q_net——这就是「从不查询 OOD 动作」的字面含义。
「$\tau$ 越大越好,直接取 0.999 逼近 max。」不行。$\tau\to 1$ 时,一阶条件里几乎所有权重都压在少数几个残差为正的样本上,有效样本量急剧下降,回归目标的方差爆炸;同时,如果某个状态在数据里只出现过一两次,那个「上分位」实际上就是「那一两个样本里最大的那个」,采样噪声会被当成真实的高值学进去,形成新的高估。实践中 $\tau$ 一般取 0.7(locomotion)到 0.9(AntMaze 这类需要强拼接的稀疏奖励任务)。这是一个真实的偏差-方差权衡,不是调不动的死参数。
6. 保守 Q-learning(CQL):把值函数压成下界
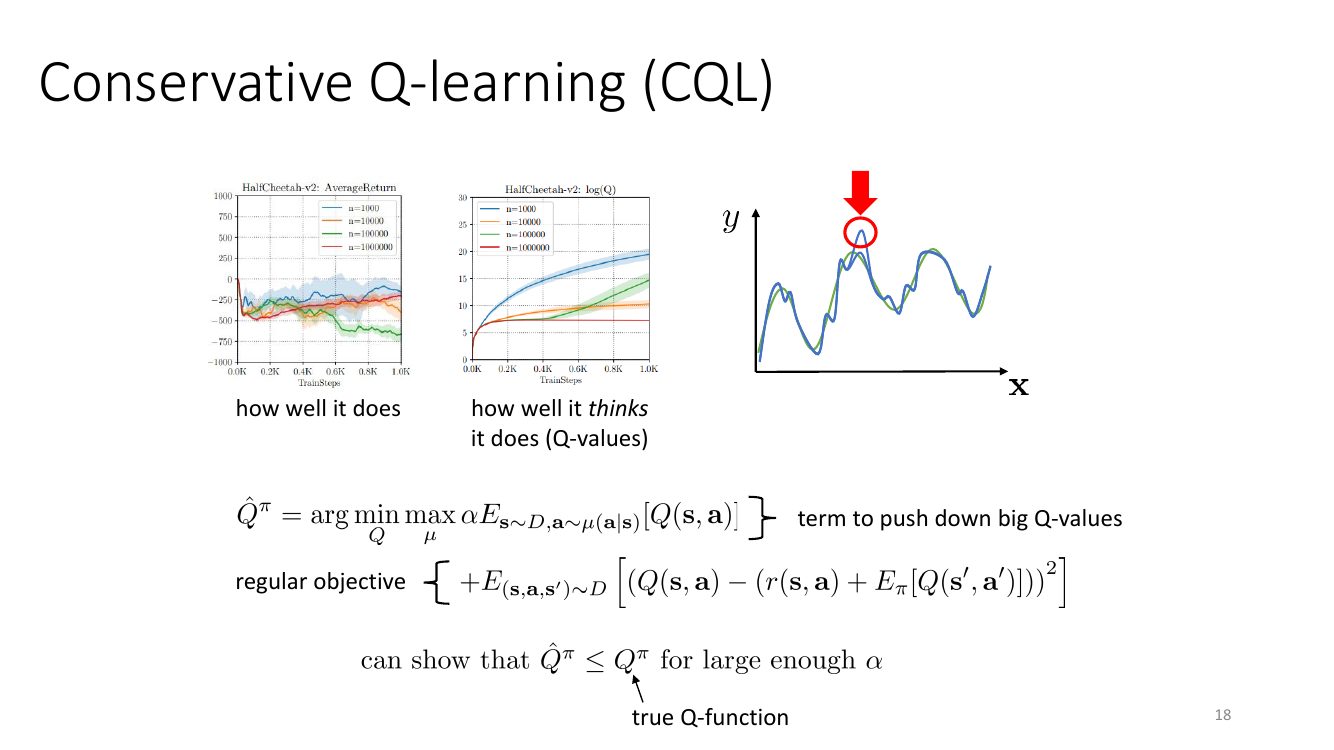
CQL 的思路和策略约束完全不同:不管策略往哪走,我先保证我的 Q 值不会高估。如果 $\hat Q^\pi\le Q^\pi$,那么策略在 $\hat Q$ 上做 $\argmax$ 最坏也只是选到一个「我不确定但也没吹牛」的动作,而不会被一个 $e^{20}$ 的幻觉带跑。
第一版:逐点下界
为了推导,先写成迭代形式(这样每一步都是一个凸的最小二乘 + 线性项问题):
$$ \hat Q^{k+1}=\argmin_Q\ \alpha\,\E_{s\sim\mathcal{D},\,a\sim\mu(a|s)}\left[Q(s,a)\right] +\frac{1}{2}\,\E_{(s,a)\sim\mathcal{D}}\left[\left(Q(s,a)-\hat{\mathcal{B}}^\pi\hat Q^{k}(s,a)\right)^2\right] $$其中 $\hat{\mathcal{B}}^\pi Q(s,a)=r(s,a)+\gamma\,\E_{a'\sim\pi}[Q(s',a')]$ 是经验 Bellman 算子。
在表格(tabular)设定下,$Q$ 的每个元素 $Q(s,a)$ 都是独立的自由变量,可以逐点求极值。记 $d(s)$ 为数据集的状态边缘分布,$\hat\pi_\beta(a|s)$ 为经验动作分布,则目标写成
$$ \sum_{s,a}\Big[\alpha\, d(s)\mu(a|s)\,Q(s,a)+\tfrac{1}{2}d(s)\hat\pi_\beta(a|s)\left(Q(s,a)-\hat{\mathcal{B}}^\pi\hat Q^k(s,a)\right)^2\Big] $$对 $Q(s,a)$ 求偏导并置零:
$$ \alpha\,d(s)\mu(a|s)+d(s)\hat\pi_\beta(a|s)\left(Q(s,a)-\hat{\mathcal{B}}^\pi\hat Q^k(s,a)\right)=0 $$两边除以 $d(s)\hat\pi_\beta(a|s)$(假设该状态-动作对在数据里出现过):
$$ \boxed{\ \hat Q^{k+1}(s,a)=\hat{\mathcal{B}}^\pi\hat Q^{k}(s,a)-\alpha\,\frac{\mu(a|s)}{\hat\pi_\beta(a|s)}\ } $$每一轮备份之后,都被减掉一个非负的量,而且这个量正比于密度比 $\mu/\hat\pi_\beta$。这个密度比就是 CQL 的灵魂:在数据密集的地方 $\hat\pi_\beta$ 大,惩罚小;在 $\hat\pi_\beta\to 0$ 的 OOD 区域,密度比爆炸,惩罚极大。惩罚强度自动与「我们有多不了解这里」成正比,这一点不需要任何显式的不确定性估计。
接着用归纳法。$\mathcal{B}^\pi$ 是单调算子($Q_1\le Q_2\Rightarrow\mathcal{B}^\pi Q_1\le\mathcal{B}^\pi Q_2$,因为它只含正系数的期望和加法)。设 $\hat Q^k\le Q^\pi$,则
$$ \hat Q^{k+1}=\mathcal{B}^\pi\hat Q^{k}-\alpha\frac{\mu}{\hat\pi_\beta}\le\mathcal{B}^\pi Q^\pi-\alpha\frac{\mu}{\hat\pi_\beta}=Q^\pi-\alpha\frac{\mu}{\hat\pi_\beta}\le Q^\pi $$初值取 $\hat Q^0\le Q^\pi$(例如全 0 且奖励非负)即可启动归纳。写成不动点的闭式:$\hat Q^\pi=Q^\pi-\alpha\left(I-\gamma P^\pi\right)^{-1}\frac{\mu}{\hat\pi_\beta}$,而 $(I-\gamma P^\pi)^{-1}=\sum_t\gamma^t (P^\pi)^t$ 的所有元素非负,所以差值确实非负。「$\alpha$ 足够大」这个条件是用来吃掉经验 Bellman 算子的采样误差的:真实情况下 $\hat{\mathcal{B}}^\pi\ne\mathcal{B}^\pi$,两者的差被集中不等式界成 $O(1/\sqrt{|\mathcal{D}(s,a)|})$,$\alpha$ 必须大过它。
第二版:更紧的下界
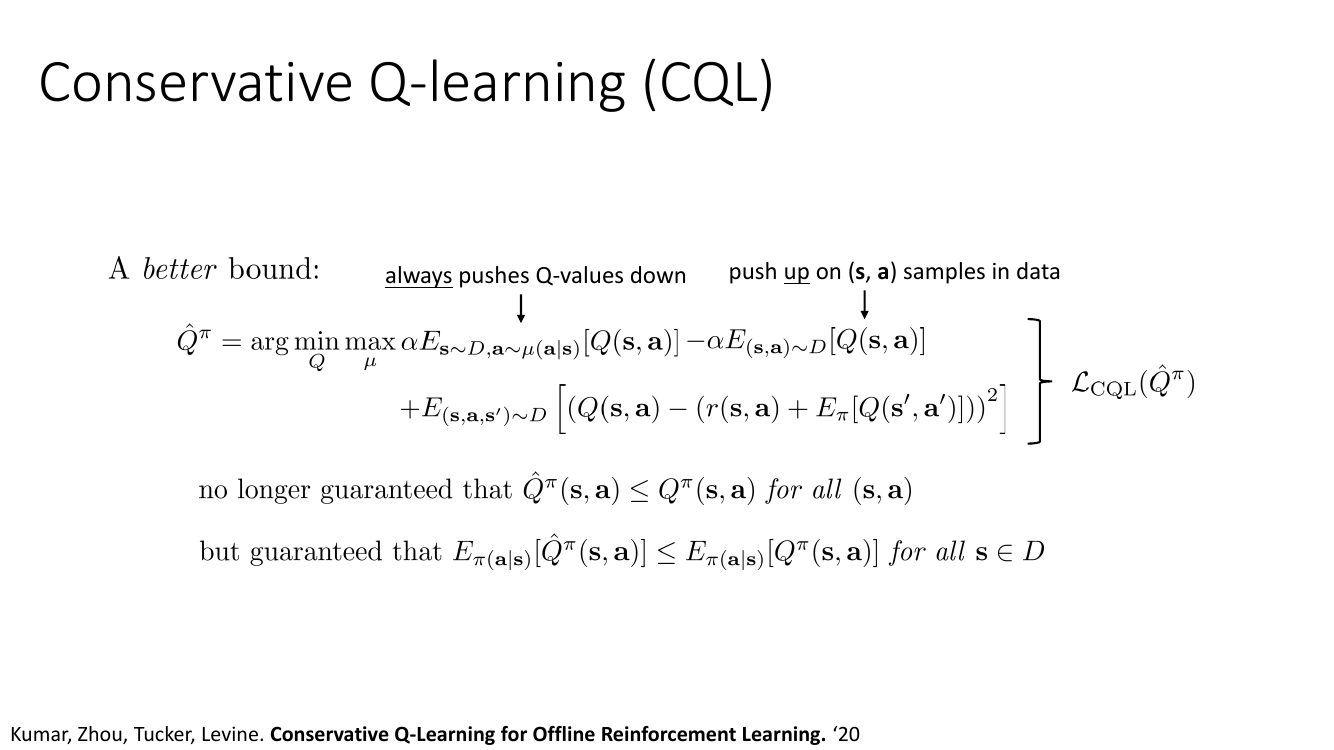
第一版有个明显缺点:它把所有的 Q 值都往下压,包括数据里那些我们非常有把握的 $(s,a)$。结果是整个值函数被系统性地压低一大截,虽然「安全」,但过度悲观会让策略改进的信号被噪声淹没。第二版加一项把数据内的动作抬回来:
$$ \hat Q^{k+1}=\argmin_Q\ \alpha\left(\E_{s\sim\mathcal{D},a\sim\mu(a|s)}\left[Q(s,a)\right]-\E_{(s,a)\sim\mathcal{D}}\left[Q(s,a)\right]\right) +\frac{1}{2}\,\E_{\mathcal{D}}\left[\left(Q-\hat{\mathcal{B}}^\pi\hat Q^{k}\right)^2\right] $$同样逐点求导。第二项相当于在 $(s,a)$ 处的线性系数上减去 $d(s)\hat\pi_\beta(a|s)$:
$$ \alpha\,d(s)\left(\mu(a|s)-\hat\pi_\beta(a|s)\right)+d(s)\hat\pi_\beta(a|s)\left(Q-\hat{\mathcal{B}}^\pi\hat Q^k\right)=0 $$ $$ \Longrightarrow\quad \hat Q^{k+1}(s,a)=\hat{\mathcal{B}}^\pi\hat Q^{k}(s,a)-\alpha\left(\frac{\mu(a|s)}{\hat\pi_\beta(a|s)}-1\right) $$现在修正项 $\frac{\mu}{\hat\pi_\beta}-1$ 可以是负的(在 $\mu\lt\hat\pi_\beta$ 的地方,即数据多而 $\mu$ 不关心的动作上),所以逐点下界不再成立。但我们真正关心的从来不是逐点值,而是策略的价值 $\E_{a\sim\pi}[Q(s,a)]$。取 $\mu=\pi$,对修正项在 $\pi$ 下求期望:
$$ \E_{a\sim\pi}\left[\frac{\pi(a|s)}{\hat\pi_\beta(a|s)}-1\right] =\sum_a\frac{\pi(a|s)^2}{\hat\pi_\beta(a|s)}-1 $$而卡方散度的定义是 $\chi^2(\pi\|\hat\pi_\beta)=\sum_a\frac{\left(\pi(a|s)-\hat\pi_\beta(a|s)\right)^2}{\hat\pi_\beta(a|s)}$。展开它:
$$ \sum_a\frac{\pi^2-2\pi\hat\pi_\beta+\hat\pi_\beta^2}{\hat\pi_\beta} =\sum_a\frac{\pi^2}{\hat\pi_\beta}-2\sum_a\pi+\sum_a\hat\pi_\beta =\sum_a\frac{\pi^2}{\hat\pi_\beta}-2+1 $$两式完全相同,于是
$$ \boxed{\ \E_{a\sim\pi}\left[\frac{\pi(a|s)}{\hat\pi_\beta(a|s)}-1\right]=\chi^2\!\left(\pi(\cdot|s)\,\|\,\hat\pi_\beta(\cdot|s)\right)\ \ge 0\ } $$等号当且仅当 $\pi=\hat\pi_\beta$ 时成立。把它代回不动点表达式,并注意 $(I-\gamma P^\pi)^{-1}$ 对应的是 $\pi$ 下的折扣访问分布,最终得到
$$ \E_{a\sim\pi(\cdot|s)}\left[\hat Q^\pi(s,a)\right]=\E_{a\sim\pi(\cdot|s)}\left[Q^\pi(s,a)\right]-\alpha\sum_{t}\gamma^t\,\E_{s_t}\left[\chi^2\!\left(\pi(\cdot|s_t)\|\hat\pi_\beta(\cdot|s_t)\right)\right]\ \le\ \E_{a\sim\pi(\cdot|s)}\left[Q^\pi(s,a)\right] $$这个界比第一版紧得多:惩罚量正比于策略偏离行为策略的卡方散度,$\pi$ 越贴近数据惩罚越小,贴合时甚至为零;而第一版无论如何都要减掉 $\alpha\,\E_\mu[\mu/\hat\pi_\beta]>0$。同时它保留了我们真正需要的性质——策略的价值不会被高估,这正是保证「策略改进不会被幻觉误导」所需要的全部条件。
内层 $\max_\mu$ 与 log-sum-exp
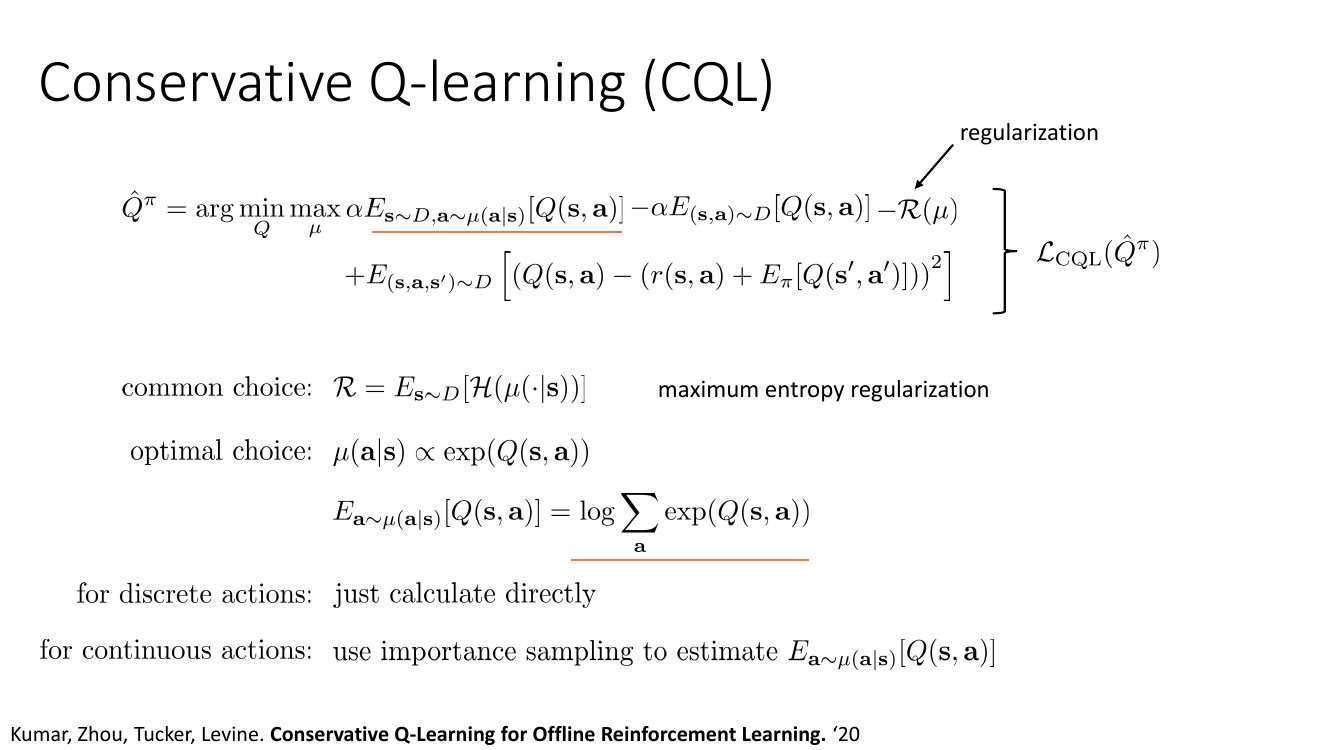
到目前为止 $\mu$ 一直没定。$\min_Q\max_\mu$ 中的内层最大化,如果 $\mu$ 完全自由,最优解就是把全部质量放在 $\argmax_a Q(s,a)$ 上——一个 delta 分布,不可导也不稳定。加一个熵正则就好了:
$$ \max_{\mu(\cdot|s)}\ \E_{a\sim\mu}\left[Q(s,a)\right]+\mathcal{H}\!\left(\mu(\cdot|s)\right) \quad\text{s.t.}\quad\sum_a\mu(a|s)=1 $$拉格朗日:$\sum_a\mu(a)Q(a)-\sum_a\mu(a)\log\mu(a)+\nu\left(\sum_a\mu(a)-1\right)$。对 $\mu(a)$ 求导置零:
$$ Q(a)-\log\mu(a)-1+\nu=0\quad\Longrightarrow\quad \mu^\star(a)=\frac{\exp Q(a)}{\sum_{a'}\exp Q(a')}=\softmax_a Q(s,a) $$代回目标值(记 $Z=\sum_a e^{Q(a)}$,则 $\log\mu^\star(a)=Q(a)-\log Z$):
$$ \sum_a\mu^\star(a)Q(a)-\sum_a\mu^\star(a)\left(Q(a)-\log Z\right)=\log Z=\log\sum_a\exp Q(s,a) $$所以内层最大化的取值恰好是 log-sum-exp——一个「软最大值」。它满足 $\max_a Q\le\log\sum_a\exp Q\le\max_a Q+\log|\mathcal{A}|$,所以它是 $\max$ 的一个上界,用它来做「压低」是比压 $\max$ 更保守一点的选择,符合我们的目的。
于是 CQL(H) 的最终损失是
$$ \mathcal{L}_{\mathrm{CQL}}(\phi)=\alpha\,\E_{s\sim\mathcal{D}}\left[\log\sum_{a}\exp Q_\phi(s,a)-\E_{a\sim\hat\pi_\beta(\cdot|s)}\left[Q_\phi(s,a)\right]\right] +\frac{1}{2}\,\E_{(s,a,s')\sim\mathcal{D}}\left[\left(Q_\phi-\hat{\mathcal{B}}^\pi\hat Q\right)^2\right] $$方括号里的东西有一个非常直观的解读:它是「软最大动作看起来有多好」减去「数据里的动作实际有多好」,也就是策略改进想要占的那个便宜有多大。CQL 直接把这个便宜罚掉。如果 $Q$ 在某个 OOD 动作上虚高,第一项就大,罚就重;如果 $Q$ 老老实实地在数据动作上最大,两项相消,罚接近 $\log|\mathcal{A}|$ 这个常数,没有额外压力。
离散动作直接算 logsumexp。连续动作没法枚举,用重要性采样:从若干个提议分布(均匀分布、当前策略在 $s$ 上的分布、当前策略在 $s'$ 上的分布)各采 $N$ 个动作,构造
用三个提议混合是官方实现的做法:均匀分布负责覆盖整个动作空间(这是「压低所有 OOD 动作」的主力),策略分布负责在当前最有可能被利用的区域加密采样。
import torch
import torch.nn.functional as F

def cql_critic_loss(q_net, q_targ, policy, batch, gamma=0.99,
                    alpha=5.0, n_sample=10, act_lim=1.0):
    s, a, r, s2, done = batch
    B, act_dim = a.shape

    # ---------- 1) 常规 TD 误差(双 Q 取小)----------
    with torch.no_grad():
        a2, _ = policy.sample(s2)
        tq1, tq2 = q_targ(s2, a2)
        y = r + gamma * (1.0 - done) * torch.min(tq1, tq2)
    q1, q2 = q_net(s, a)
    td_loss = F.mse_loss(q1, y) + F.mse_loss(q2, y)

    # ---------- 2) log-sum-exp 的重要性采样估计 ----------
    def rep(x):                                   # (B,d) -> (B*N,d)
        return x.unsqueeze(1).expand(-1, n_sample, -1).reshape(B * n_sample, -1)
    s_rep, s2_rep = rep(s), rep(s2)

    # 提议 1:动作空间上的均匀分布,log 密度是常数
    a_unif = torch.empty(B * n_sample, act_dim, device=a.device).uniform_(-act_lim, act_lim)
    logp_unif = -act_dim * torch.log(torch.tensor(2.0 * act_lim, device=a.device))
    # 提议 2/3:当前策略在 s 和 s' 上的分布
    a_cur, logp_cur = policy.sample(s_rep)
    a_nxt, logp_nxt = policy.sample(s2_rep)

    def cat_q(idx):
        """把三组 (Q - log q_prop) 拼成 (B, 3N),即 log(exp(Q)/q_prop)"""
        def qv(sx, ax):
            return q_net(sx, ax)[idx].view(B, n_sample)
        return torch.cat([
            qv(s_rep, a_unif) - logp_unif,
            qv(s_rep, a_cur)  - logp_cur.view(B, n_sample).detach(),
            qv(s_rep, a_nxt)  - logp_nxt.view(B, n_sample).detach(),
        ], dim=1)

    # logsumexp 再减去 log(3N):常数偏移,不影响梯度,但让数值更可读
    log3n = torch.log(torch.tensor(3.0 * n_sample, device=a.device))
    lse1 = torch.logsumexp(cat_q(0), dim=1) - log3n
    lse2 = torch.logsumexp(cat_q(1), dim=1) - log3n

    # ---------- 3) 保守项:压低软最大值,抬高数据里的 (s,a) ----------
    cql_gap = (lse1 - q1).mean() + (lse2 - q2).mean()

    return td_loss + alpha * cql_gap
算法的外层循环(幻灯片第 20 页)只有两步:1. 用 $\mathcal{L}_{\mathrm{CQL}}$ 在 $\mathcal{D}$ 上更新 $\hat Q^\pi$;2. 更新策略 $\pi$——离散动作时直接取贪心 $\pi(a|s)=\mathbf{1}\left[a=\argmax_a\hat Q(s,a)\right]$,连续动作时做 $\theta\leftarrow\theta+\alpha\nabla_\theta\sum_i\E_{a\sim\pi_\theta(a|s_i)}\left[\hat Q(s_i,a)\right]$(即普通的 DDPG/SAC 式 actor 更新,不需要任何额外的约束项——保守性全部由 critic 承担)。
CQL 的实践代价:每个 batch 要多做 $3N$(默认 $N=10$,即 30 倍 batch 大小)次 Q 网络前向,训练速度比 TD3+BC 慢好几倍。而且 $\alpha$ 非常敏感——太小则压不住高估,太大则整个 Q 函数被压平、策略学不到任何东西。为此有一个「Lagrange 版 CQL」:设定一个目标间隙 $\tau_{\text{gap}}$,让 $\alpha$ 自动做对偶上升 $\alpha\leftarrow\alpha+\eta\left(\widehat{\text{gap}}-\tau_{\text{gap}}\right)$。它把「调 $\alpha$」换成了「调 $\tau_{\text{gap}}$」,后者的量纲是 Q 值差,比 $\alpha$ 好理解一些,但并没有彻底消除敏感性。
7. 离线预训练 + 在线微调
离线 RL 最诱人的应用场景不是「只用离线数据」,而是用海量离线数据做预训练,再用少量在线交互做微调——就像 LLM 先做预训练再做后训练。理想图景是:机器人先从一个大规模的历史数据集里学出一个还不错的策略,部署到真实世界后只需要几百次尝试就能把成功率从 50% 拉到 95%,而且这几百次尝试是安全的(因为初始策略已经不错,不会做出危险动作)。
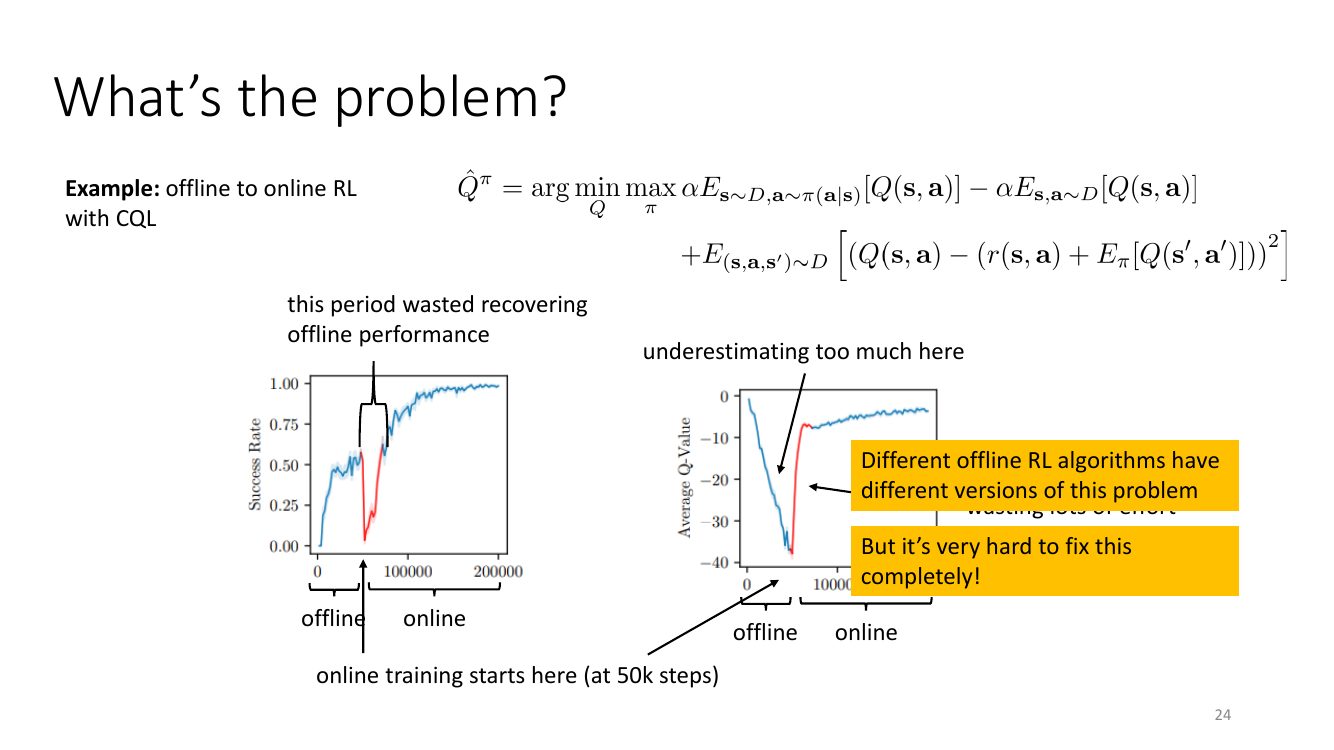
为什么会塌陷?根子在于 CQL 学到的 $\hat Q$ 是相对于离线数据分布校准的。$\alpha\left(\E_\mu[Q]-\E_{\hat\pi_\beta}[Q]\right)$ 这个惩罚的强度取决于 $\hat\pi_\beta$;在线数据一进 buffer,$\hat\pi_\beta$ 变了,惩罚的几何形状随之改变,值函数必须整体重新调整。更糟的是,被压到 $-40$ 的 Q 值和真实回报之间差了一个巨大的常数偏移,而策略改进只关心相对大小——问题是这个偏移在不同状态上并不一致(惩罚正比于该状态下的卡方散度),所以偏移本身就扭曲了策略。在线阶段的头几万步,梯度几乎全用来消除这个扭曲,而不是学新东西。
其它算法有各自版本的同一问题:TD3+BC 的 BC 项在在线阶段变成了枷锁(数据里的动作已经不如当前策略好了,还在往回拽);AWAC 和 IQL 比较温和(约束会随 buffer 更新自动放松),但改进速度慢——IQL 的策略被支撑集卡住,而在线阶段最需要的恰恰是走出支撑集去探索。
根本矛盾
幻灯片第 25 页把这个矛盾摆得很清楚:两个阶段的需求几乎处处相反。
| 离线阶段需要 | 在线阶段需要 | |
|---|---|---|
| 与 $\pi_\beta$ 的关系 | 贴近 $\pi_\beta$(不能冒险) | 尽可能超越 $\pi_\beta$(必须冒险) |
| 值函数的偏向 | 保守,$\hat Q^\pi\le Q^\pi$ | 乐观,$\hat Q^\pi\ge Q^\pi$(乐观是探索的引擎,见下一讲) |
| 数据使用方式 | 在同一批数据上做大量梯度步 | 尽快消化新数据、尽快学完 |
| 过拟合风险 | 高(数据固定),需要强正则 | 低(数据不断刷新),强正则反而拖慢学习 |
「保守」和「乐观」是同一个符号的两个方向,要一个算法同时做好这两件事,本质上是要它知道什么时候可以开始不保守——这需要一个可靠的不确定性估计,而这恰恰是深度网络最不擅长的事。Levine 的判断是:这很难彻底解决。(一个部分的补丁是 Cal-QL:把 CQL 的压低项改成 $\E_{a\sim\mu}\left[\max\left(Q(s,a),\ V^{\pi_\beta}(s)\right)\right]$,即只把 Q 压到「行为策略的价值」为止、不再往下压,从而保证值函数是校准的,在线切换时不需要漫长的重新标定。这不在本讲的幻灯片里,但正是针对上图那个坑设计的。)
一个令人不安地有效的基线:RLPD
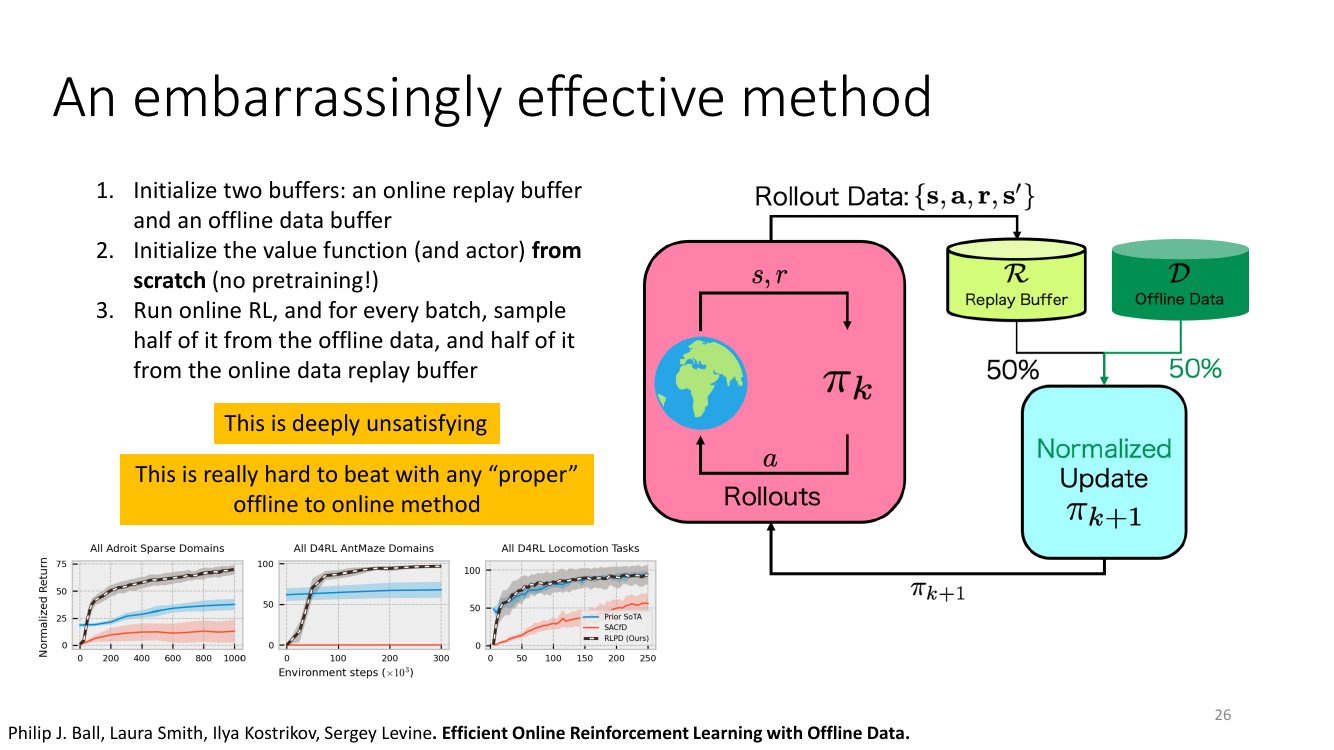
为什么这么简单的东西能work?三点:(1) 对称采样本身就是一个隐式的、自动衰减的约束——训练早期在线 buffer 很小,梯度实质上被离线数据主导,值函数被拉向数据分布;随着在线数据积累,离线数据的相对影响自然下降,不需要任何超参数调度。(2) 从零初始化避免了「继承一个已经被扭曲的值函数」——上图那个 $-40$ 的坑压根不会出现。(3) 「归一化更新」(normalized update)里的工程细节其实很关键:论文用了很高的 update-to-data 比(每收集一个转移就做多次梯度更新)、在 critic 里加 LayerNorm 抑制值的外推爆炸、以及一个较大的 Q 函数集成取随机子集的最小值。LayerNorm 这一条尤其重要:它把网络在远离数据处的输出限制在一个有界范围内,等于用架构而不是损失函数来实现悲观。
「RLPD 说明离线 RL 预训练没用。」不对。RLPD 说明的是:当你能做在线交互时,把离线数据当作 replay buffer 的一半来用,往往比先做一遍复杂的离线预训练再微调更划算。它并不适用于「在线交互极其昂贵或危险,必须一开始就有一个好策略」的场景——那种场景下你依然需要离线 RL 产出一个能直接部署的策略。两者回答的是不同的问题。
意外的主角:扩散与流匹配策略
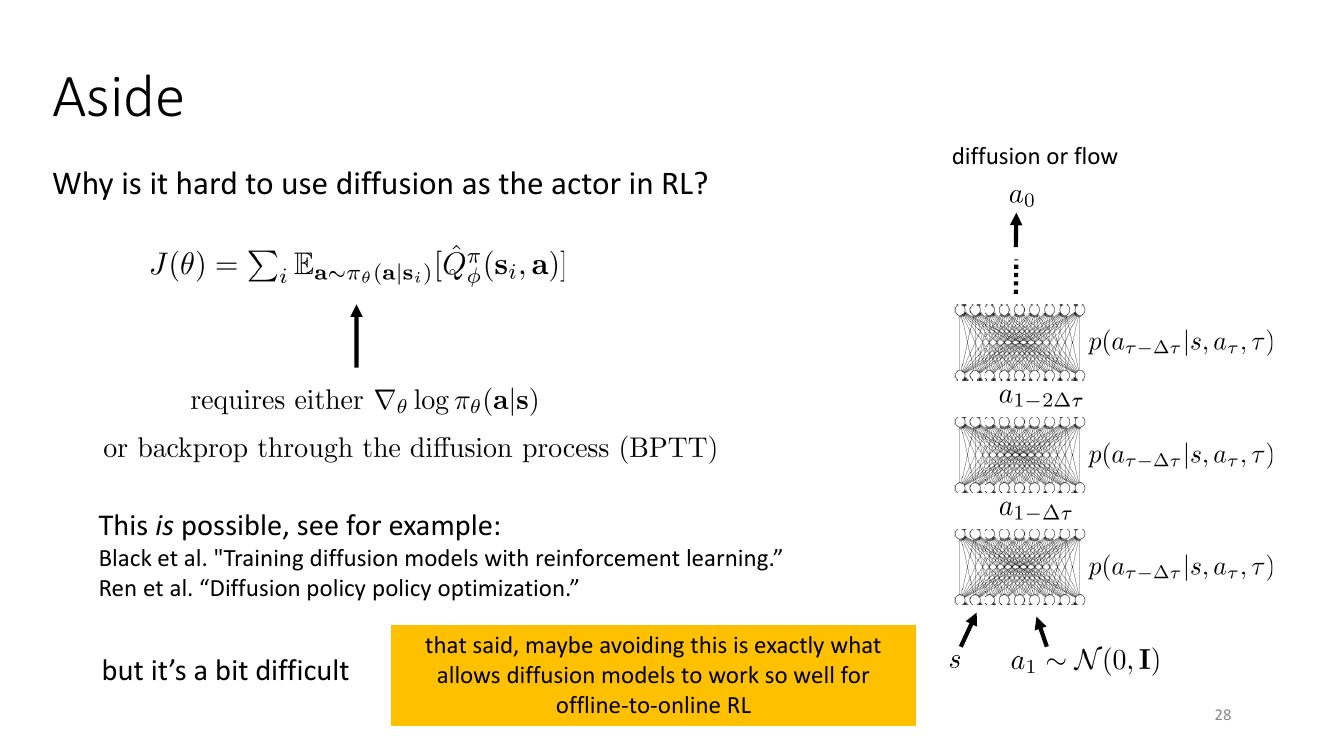
一个经验观察是:用扩散模型(diffusion model)或流匹配(flow matching)表示 actor 的算法,在离线到在线这个场景里表现明显更好。Levine 坦承不完全知道原因,并给出几个猜想:在线阶段最优策略往往是确定性的(不需要表示多个模式);离线阶段只要能抓住数据里最好的那个模式就够了;如果模型能表示多个模式,就更容易在离线阶段把所有模式都「记住」,然后在线阶段再押注其中最好的一个。而且——这一点很反直觉——下面这些方法里,扩散/流模型全都只用监督学习(行为克隆)训练,从来不用 RL 梯度去更新它。
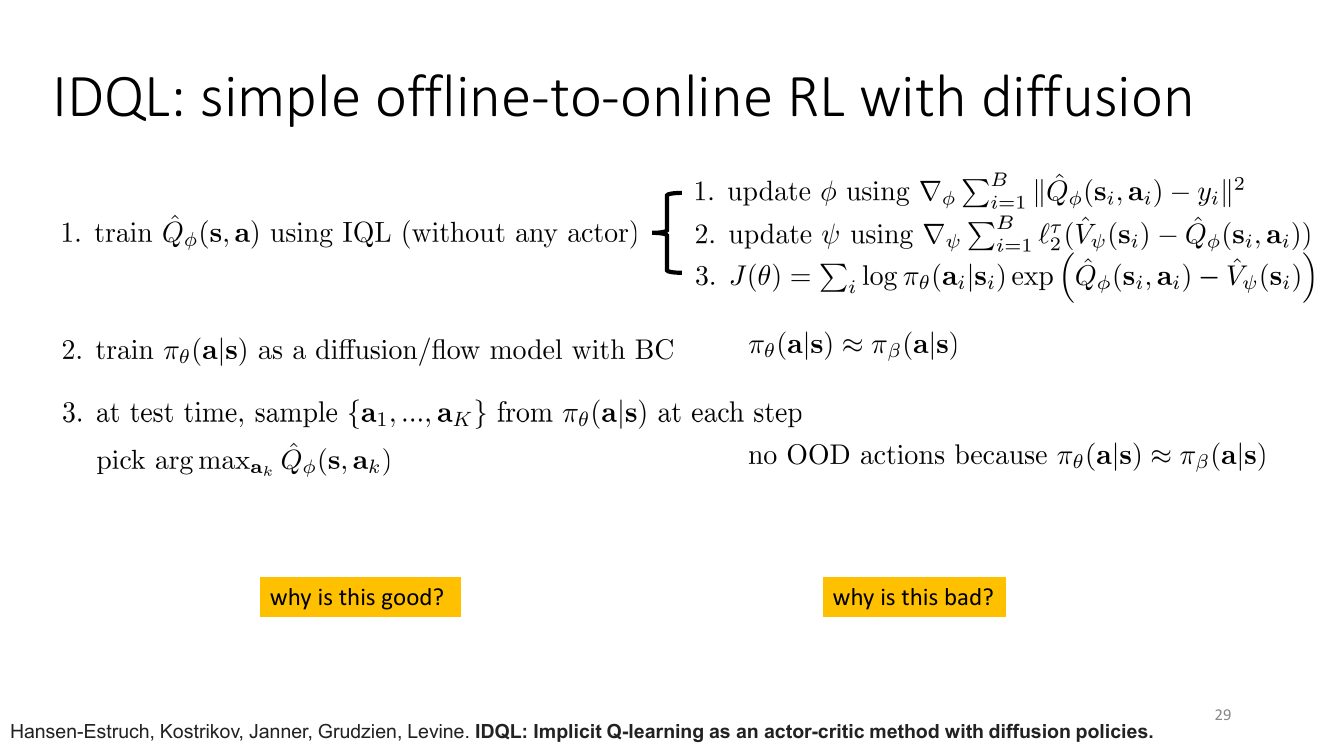
IDQL 好在哪:它把「策略改进」变成了一个纯粹的推理期重采样操作,完全不需要对扩散模型求任何 RL 梯度,训练过程就是「IQL 训 critic + BC 训扩散模型」两个独立的监督式任务,稳定得不能再稳定;而且由于候选动作全部来自行为策略的近似,支撑集约束是构造性满足的,比任何罚项都可靠。
坏在哪:(1) 每一步决策要跑 $K$ 次扩散采样(每次采样本身又是几十步去噪),推理成本高得吓人;(2) 改进幅度被 $K$ 死死卡住——从 $\pi_\beta$ 里采 $K$ 个样本再取最好的,大致相当于取到了 $\pi_\beta$ 下动作质量的前 $1/K$ 分位,$K=32$ 也不过是 3% 分位,若最优动作在 $\pi_\beta$ 下概率是 $10^{-4}$,你永远采不到;(3) 在 $K$ 个含噪 $Q$ 估计上取 $\max$ 会重新引入 max 的乐观偏差($\E[\max_k \hat Q_k]\ge\max_k\E[\hat Q_k]$),$K$ 越大偏差越大——这里存在一个不太舒服的权衡:$K$ 大了改进多但偏差也大。
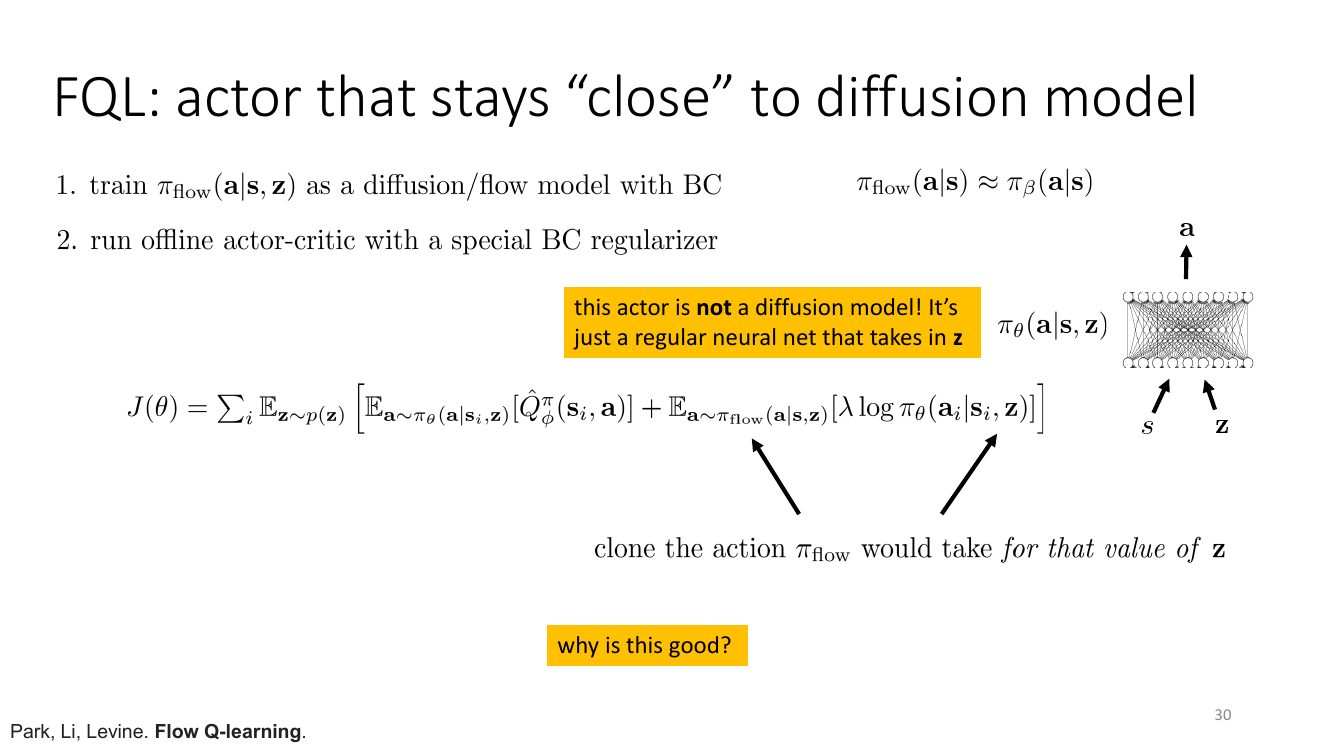
FQL 的巧妙之处在于 $z$ 的角色。流模型 $\pi_{\text{flow}}(a|s,z)$ 是一个从噪声 $z$ 到动作的确定性映射,不同的 $z$ 对应行为分布的不同模式。FQL 训练一个一步网络 $\pi_\theta(a|s,z)$ 去逐 $z$ 地模仿这个映射,同时最大化 $Q$。因为 BC 项是在每个 $z$ 上单独施加的,多模态结构被完整保留下来(每个 $z$ 守着自己的模式),而 $Q$ 项允许 actor 在每个模式内部朝高价值方向偏移一点。这既避免了 BPTT($\pi_\theta$ 是一步网络,$\nabla_\theta Q$ 直接流过去),又避免了「多模态被平均成一个模式之间的无效动作」这个行为克隆的经典病症。推理时只需一次前向,比 IDQL 快几十倍。
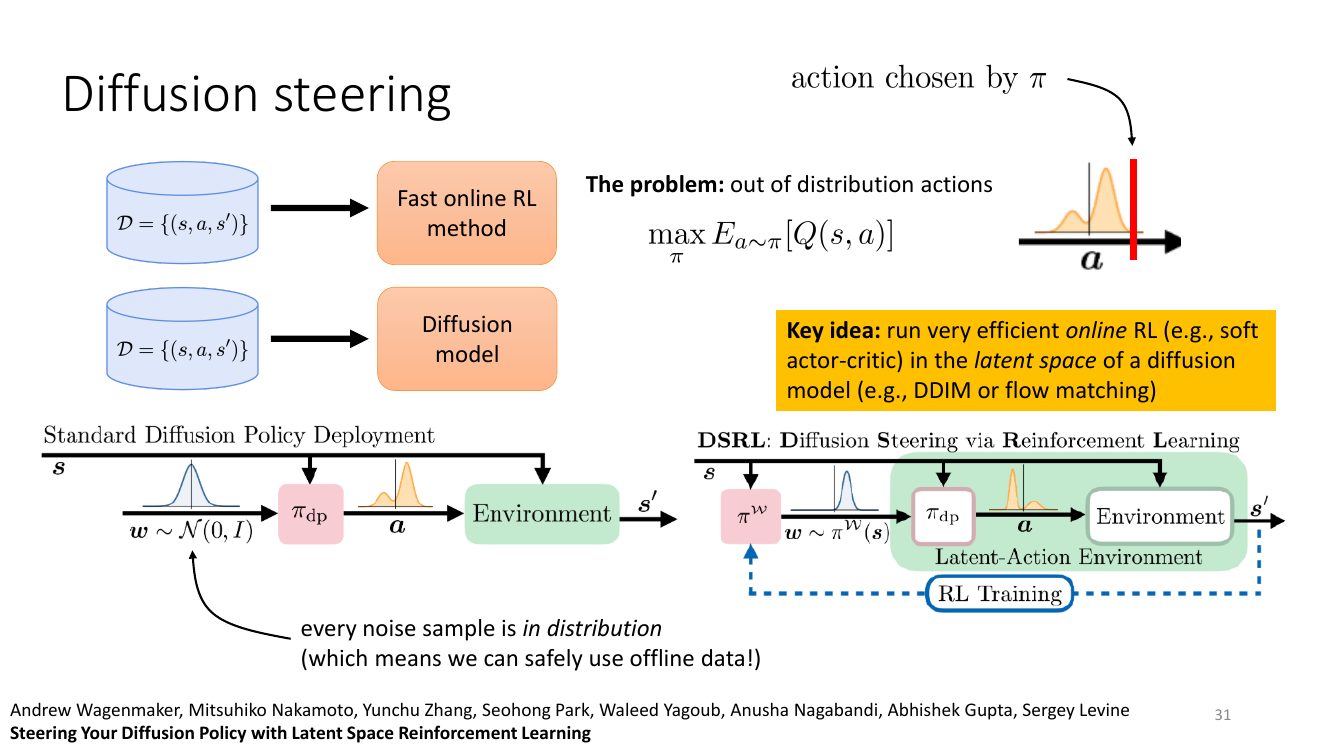
DSRL 是这条思路的极致:它把「不许输出 OOD 动作」这个约束编码进了动作空间的定义。RL 智能体的动作不再是机器人的关节力矩,而是扩散模型的输入噪声 $w$;无论 RL 把 $w$ 优化到哪里,经过冻结的扩散策略之后出来的都是一个「这个扩散策略会做的动作」,天然在支撑集内。于是约束消失了,我们可以直接用最激进、最高效的在线 RL 算法(SAC 之类),不需要任何保守项、不需要 BC 罚项、也不需要对扩散模型求梯度(它是环境的一部分)。代价是:策略的能力上限被冻结的扩散模型限定住了——它只能在扩散策略能生成的动作集合里做选择,如果那个集合本身不含好动作,RL 再聪明也没用。
8. 基于模型的离线 RL:MOPO 与 COMBO
基于模型的 RL(第 15、16 讲)在离线设定下会遇到一个结构完全相同的问题。标准流程是:用数据拟合 $\hat p(s_{t+1}|s_t,a_t)$,用模型做 rollout 优化策略 $\pi(a_t|s_t)$,再用新策略收集数据回来改进模型。离线设定把最后那个箭头砍掉了。于是策略会做一件模型学习者最怕的事:它专门去找模型出错的地方。模型在数据覆盖的区域拟合得很好,在没覆盖的地方是任意外推的;策略优化 $\E_{\hat p}[\sum\gamma^t r]$ 时,只要模型预测某条路径能通向天堂,策略就会走过去,而模型的这个预测毫无根据——从模型 rollout 出去几步之后,状态本身就已经是 OOD 的了,此后所有预测都无效。
这跟无模型情形是同一个病:$\argmax$ 作用在一个「在分布内准确、在分布外任意」的函数上,必然挑中分布外的错误。区别只在于载体——无模型方法里出错的是 $Q$,基于模型的方法里出错的是 $\hat p$,而且模型误差还会随 rollout 长度复合累积:第 1 步的小误差把你带到一个略微 OOD 的状态,第 2 步在那里的误差更大,几步之后就完全脱轨。这也是为什么离线 MBRL 普遍只做很短的 rollout($h=1\sim 5$)并从数据集里的真实状态出发(branched rollout)。
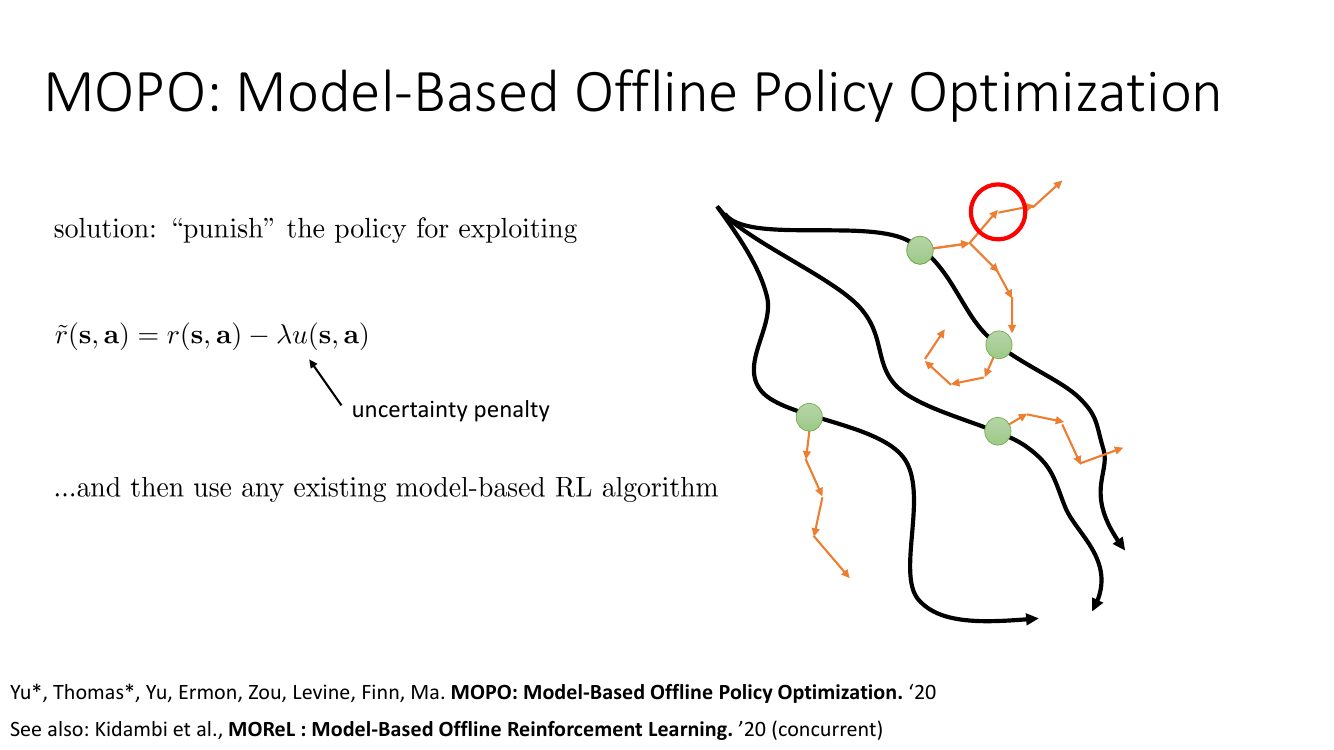
理论动机很干净。设 $\hat M$ 是学到的模型 MDP,$M$ 是真实 MDP。如果不确定性度量 $u(s,a)$ 满足 $u(s,a)\ge D_{\mathrm{TV}}\!\left(\hat p(\cdot|s,a),p(\cdot|s,a)\right)$(即它上界了模型的单步误差),那么在惩罚后的模型 MDP $\tilde M$ 里任何策略的价值都下界了它在真实 MDP 里的价值:
$$ \eta_{\tilde M}(\pi)\le\eta_{M}(\pi)\qquad\text{当}\quad \lambda\ge\frac{2\gamma\,r_{\max}}{1-\gamma} $$于是在 $\tilde M$ 里做策略优化就是在优化真实回报的一个下界——和 CQL 的哲学一模一样,只是悲观加在了奖励上而不是 $Q$ 上。实践中 $u$ 用模型集成的不一致度(ensemble disagreement)来估计:训练 $N$ 个(通常 5~7 个)高斯输出的动力学模型 $\hat p_i(s'|s,a)=\mathcal{N}\!\left(\mu_i(s,a),\Sigma_i(s,a)\right)$,取
$$ u(s,a)=\max_{i=1,\ldots,N}\left\|\Sigma_i(s,a)\right\|_{F} \qquad\text{或}\qquad u(s,a)=\max_{i,j}\left\|\mu_i(s,a)-\mu_j(s,a)\right\|_2 $$前者是「模型自己承认的不确定性」(aleatoric + 部分 epistemic),后者是「不同模型之间的分歧」(纯 epistemic)。同期的 MOReL 用了一个更硬的版本:设一个阈值,一旦不确定性超标就把智能体传送到一个吸收态并给 $-\kappa$ 的奖励——相当于在状态空间里画了一道「越界即死」的围栏,构造出一个悲观 MDP。
import torch

def mopo_penalized_reward(model_ensemble, s, a, lam=1.0, mode="max_std"):
    """model_ensemble(s, a) 返回每个成员预测的高斯参数 (mu, logstd),
    形状均为 (N, B, dim)。返回惩罚后的奖励与下一状态。"""
    mu, logstd = model_ensemble(s, a)          # (N, B, s_dim+1),最后一维是奖励
    std = logstd.exp()

    if mode == "max_std":                      # 各成员预测方差的最大 Frobenius 范数
        u = std.norm(dim=-1).max(dim=0).values          # (B,)
    else:                                      # 成员之间的最大两两分歧
        d = (mu.unsqueeze(0) - mu.unsqueeze(1)).norm(dim=-1)   # (N, N, B)
        u = d.flatten(0, 1).max(dim=0).values            # (B,)

    # 随机挑一个成员来采样下一状态,这样 rollout 能覆盖 epistemic 不确定性
    idx = torch.randint(0, mu.shape[0], (mu.shape[1],), device=s.device)
    pick = mu[idx, torch.arange(mu.shape[1])] + \
           std[idx, torch.arange(mu.shape[1])] * torch.randn_like(mu[0])

    s_next, r_hat = pick[:, :-1], pick[:, -1]
    return s_next, r_hat - lam * u             # 这就是 \tilde r = r - lambda * u
同样的「集成即悲观」思想在无模型一侧也有直接对应:SAC-N / EDAC 训练 $N$ 个 Q 函数并在目标值里取 $\min_{i=1..N}Q_i$。取 $N$ 个(近似独立的)估计的最小值,等价于取一个下置信界(lower confidence bound):若 $Q_i\sim\mathcal{N}(\bar Q,\sigma^2)$,则 $\E[\min_i Q_i]\approx\bar Q-c_N\sigma$,其中 $c_N$ 随 $N$ 缓慢增长($N=2$ 时约 0.56,$N=10$ 时约 1.54,$N=50$ 时约 2.25)。在数据覆盖好的地方各个 $Q_i$ 一致、$\sigma$ 小、惩罚小;在 OOD 动作上它们各自胡乱外推、$\sigma$ 大、惩罚大——又一次得到了「惩罚正比于不确定性」。有意思的是,把标准 SAC 的 $N$ 从 2 调到 10~500,不加任何其它离线 RL 技巧,在 D4RL 上就已经很有竞争力,这从侧面说明离线 RL 的核心困难确实就是「值的不确定性没被算进去」。
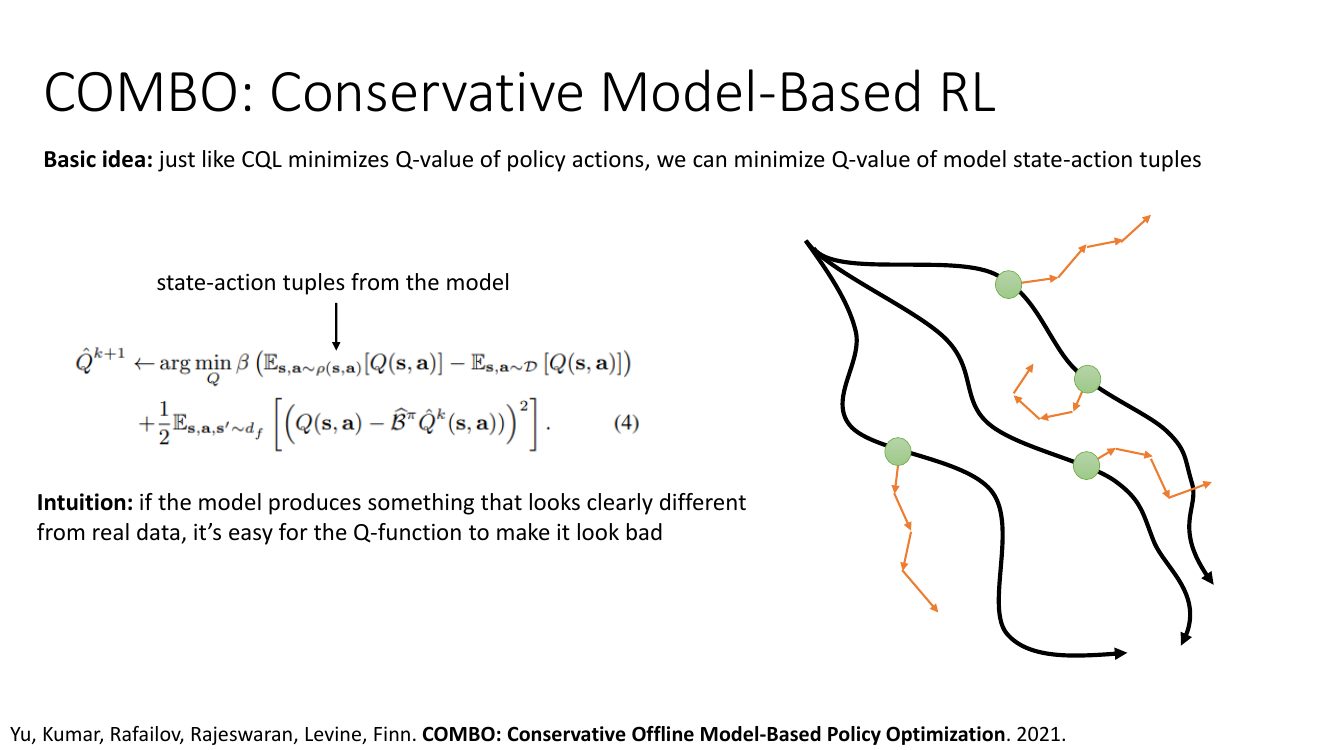
COMBO 的关键洞察是它绕开了不确定性估计。MOPO 需要一个可靠的 $u(s,a)$,但深度网络的不确定性量化出了名地不可靠(集成成员之间可能因为共享的归纳偏置而一致地错)。COMBO 把 CQL 的压低项从「策略采样的动作」换成「模型 rollout 出来的 $(s,a)$」,于是不需要任何显式的不确定性数值——可分辨性本身就充当了不确定性度量。这里的论证很像 GAN 的判别器:如果模型生成的状态看起来和真实数据明显不同(也就是它确实跑到了 OOD 区域),那么 Q 网络作为一个足够灵活的函数逼近器,就能轻易地在不影响真实数据点的前提下把这些点的值压低;反之,如果模型生成的状态与真实数据难以区分(说明模型在那里是可信的),Q 网络压不下去,也就不会被过度惩罚。惩罚强度自动跟着「模型输出与真实数据的可分辨程度」走。
另外,COMBO 给出的下界比 CQL 更紧:CQL 只在数据里出现过的 $(s,a)$ 上抬升,而 COMBO 的 Bellman 误差是在混合分布 $d_f$ 上算的,模型 rollout 提供了额外的、有一定可信度的「合成数据」,让值函数在数据附近的邻域里也能得到监督,从而不必把整个邻域一律压死。这就是「模型带来的泛化」在离线 RL 里的价值。
| 方法 | 悲观加在哪 | 需要显式不确定性估计吗 | 主要优点 | 主要弱点 |
|---|---|---|---|---|
| MOPO | 奖励 $\tilde r=r-\lambda u$ | 需要(集成方差/分歧) | 可套用任何现成 MBRL;理论清晰 | $u$ 的质量决定一切;$\lambda$ 难调 |
| MOReL | 构造悲观 MDP(越界即终止 $-\kappa$) | 需要(阈值判定) | 惩罚是硬的,不会被小数值抹平 | 阈值敏感;容易过早终止导致学不到东西 |
| COMBO | Q 函数(对模型样本做 CQL) | 不需要 | 免除不确定性量化;下界比 CQL 紧 | 继承 CQL 的 $\beta$ 敏感性与计算开销 |
| SAC-N / EDAC | Q 函数($\min_{i}Q_i$) | 隐式(集成即 LCB) | 实现极简,就是加大 $N$ | $N$ 可能要到数百,显存和算力开销大 |
9. 实践指南:怎么选、怎么调
D4RL 上的经验规律
D4RL 是离线 RL 的标准评测集,它的几个子任务考察的能力完全不同,理解这一点比记住排行榜数字有用得多。
| 任务族 | 数据特点 | 考察什么 | 经验规律 |
|---|---|---|---|
| Gym locomotion(halfcheetah / hopper / walker2d 的 random / medium / medium-replay / medium-expert / expert) | 稠密奖励,单一目标,数据覆盖较广 | 能否从中等水平数据里榨出更好的策略 | 约束类(TD3+BC)、CQL、IQL 差距不大;medium-expert 上偏 BC 的方法反而占优(数据里已有近乎最优的行为,别乱改就行);medium-replay 上需要一点拼接能力,CQL/IQL 更好;random 数据上所有方法都很弱,因为数据里根本没有好行为可挖 |
| AntMaze(umaze / medium / large,含 diverse / play 变体) | 稀疏奖励(到达目标才 +1),数据是大量互不相连的短路径 | 拼接能力——必须把不同轨迹的片段缝成一条通往目标的完整路径 | 纯 BC 和 TD3+BC 在大迷宫上基本归零;一步式方法(one-step RL)也失败;IQL 和 CQL 是这里的主力,IQL 在 antmaze-large 上尤其突出。这是区分「真离线 RL」和「花式行为克隆」的试金石 |
| Adroit(pen / door / hammer / relocate 的 human / cloned / expert) | 人类演示,数据极窄且高维(24~30 维动作) | 在极稀疏支撑集下的稳健性 | 约束必须很紧,稍一放松值函数就发散;BC 类基线出奇地强;CQL 需要较大的 $\alpha$ |
| Kitchen / FrankaKitchen | 多阶段长程任务,演示数据 | 长程信用分配 + 拼接 | IQL / CQL 明显优于 BC 类 |
如果你只记一条规律:数据里已经有近似最优行为时,越像行为克隆的方法越好;数据里只有零碎的次优片段、需要拼接时,越像动态规划的方法越好。 TD3+BC 在 medium-expert 上打平 CQL,同时在 AntMaze 上归零,这不是巧合,是这两类方法的本质差异。选算法之前先问自己:我这份数据是「已经有人做对过,只是混杂了噪声」,还是「没人做对过,但每一段都有人做对过一部分」。
超参数敏感度
| 算法 | 关键超参 | 常用默认值 | 敏感度 | 调法 |
|---|---|---|---|---|
| TD3+BC | $\alpha$(BC 权重,已被 $\overline{|Q|}$ 归一化) | $\alpha=2.5$;必须做状态标准化 | 低 | 几乎不用调,这是它最大的卖点 |
| CQL | $\alpha$(保守项权重)、采样数 $N$、是否用 Lagrange 版 | locomotion 约 $\alpha=5$;稀疏奖励任务常用 Lagrange 版并设目标间隙 | 高 | 先看 Q 值曲线:训练后期 Q 若持续上涨说明 $\alpha$ 太小;若 Q 被压到远负于任何可能回报说明太大。用 Lagrange 版把「调 $\alpha$」换成「调目标间隙」 |
| IQL | 期望 $\tau$、AWR 逆温度 $\beta$ | locomotion $\tau=0.7,\beta=3$;AntMaze $\tau=0.9,\beta=10$ | 中 | $\tau$ 控制「多贪心」,需要拼接就调大;$\beta$ 控制策略抽取的激进程度,调大会更接近贪心但有效样本变少 |
| AWAC | $\lambda$(温度)、权重裁剪上限 | $\lambda\approx 1$,裁剪到 100 | 中 | 观察权重的有效样本量($\left(\sum w\right)^2/\sum w^2$),塌到个位数就说明 $\lambda$ 太小 |
| BEAR | MMD 阈值 $\epsilon$、核宽 $\sigma$、样本数 $n$ | $n=4\sim 10$,拉普拉斯核 | 高 | 核宽与动作维度强耦合,换任务基本要重调 |
| MOPO | $\lambda$(惩罚系数)、rollout 长度 $h$ | $h=1\sim 5$,$\lambda$ 逐任务调 | 高 | $h$ 大了模型误差复合累积;$\lambda$ 与 $u$ 的量纲绑定,换不确定性度量就得重调 |
| RLPD | UTD 比、集成规模、是否用 LayerNorm | UTD 较高,critic 带 LayerNorm | 低(但 LayerNorm 必须有) | 去掉 LayerNorm 通常直接发散 |
离线 RL 有一个绕不开的元问题:你没法在离线状态下选超参数。所有上面这些「调法」都默认你能跑在线评估看回报,可一旦你能跑在线评估,你就已经不是纯离线设定了。真正的离线模型选择(offline model selection)至今是开放问题——离线策略评估(OPE)的方差太大,用它来排序不同超参的策略经常给出错误顺序。实践中的折中是:优先选超参数敏感度低的算法(这就是 TD3+BC 和 IQL 受欢迎的深层原因),并把 Q 值曲线的形状当作粗糙的诊断信号(Q 值发散 = 约束太松,Q 值被压到不可能的负数 = 太紧)。
选型决策
| 场景 | 推荐 | 理由 |
|---|---|---|
| 第一次做离线 RL,想要一个能跑通的基线 | IQL | 不查询 OOD 动作,训练稳定,超参就两个,critic 与 actor 解耦便于调试 |
| 数据接近专家水平,只想去掉噪声 | TD3+BC 或直接 BC | 约束越紧越好;复杂方法的额外自由度只会带来风险 |
| 稀疏奖励、需要长程拼接 | CQL 或 IQL($\tau$ 调大) | 只有真正的动态规划能缝合轨迹 |
| 离散动作(推荐系统、对话、游戏) | CQL | log-sum-exp 可以精确计算,不需要重要性采样,实现最干净 |
| 数据量极小但有个不错的模拟器/动力学先验 | COMBO 或 MOPO | 模型能提供数据外的泛化,样本效率更高 |
| 能做在线交互,只是想利用历史数据加速 | RLPD(对称采样) | 比「离线预训练再微调」更简单也更强 |
| 需要先离线拿到可部署策略,再少量在线微调 | IQL / Cal-QL,或 FQL / IDQL 这类流模型方法 | IQL 切换到在线时不塌陷;Cal-QL 专门修 CQL 的重标定问题 |
| 多模态演示数据(人类操作、多种解法) | FQL / IDQL / DSRL | 扩散或流模型能保留多个模式,避免高斯策略把两个模式平均成一个错误动作 |
本讲小结
把全讲压缩成一张速查表:
| 算法 | 核心目标函数(简写) | 约束/悲观的载体 | critic 会查 OOD 动作吗 |
|---|---|---|---|
| BC | $\max_\theta\sum_i\log\pi_\theta(a_i|s_i)$ | 无(不做 RL) | 无 critic |
| BCQ | 候选动作 $\sim$ CVAE,$\argmax_{a_i+\xi}Q$ | 生成模型的支撑集 | 否(候选来自生成模型) |
| BEAR | $\max_\pi\E_\pi[Q]$ s.t. $\mathrm{MMD}^2(\pi,\hat\pi_\beta)\le\epsilon$ | 小样本 MMD | 是(但被 MMD 约束) |
| BRAC | 目标值与 actor 目标里都减 $\lambda D(\pi_\theta,\pi_\beta)$ | 显式散度 + 奖励修改 | 是 |
| TD3+BC | $\max_\pi\E\left[\lambda Q(s,\pi(s))-(\pi(s)-a)^2\right]$ | 前向 KL(= BC 项) | 是 |
| AWR / AWAC | $\max_\theta\sum_i\log\pi_\theta(a_i|s_i)\exp\!\left(\tfrac{1}{\lambda}A(s_i,a_i)\right)$ | 隐式(闭式解的支撑集) | 是(这是它的软肋) |
| IQL | $\min_\psi\ell_2^\tau\!\left(V_\psi(s)-Q_\phi(s,a)\right)$ + 均方 TD + AWR 抽取 | 期望回归 $\Rightarrow$ 支撑集内取 max | 否 |
| CQL | $\alpha\left(\log\sum_a e^{Q}-\E_{\hat\pi_\beta}[Q]\right)$ + TD 误差 | Q 值下界(密度比惩罚) | 是(但被主动压低) |
| MOPO | $\tilde r=r-\lambda u(s,a)$,然后跑任意 MBRL | 模型集成的不确定性 | 是(在模型里) |
| COMBO | $\beta\left(\E_{\rho}[Q]-\E_{\mathcal{D}}[Q]\right)$ + 混合分布上的 TD | 对模型样本做 CQL | 是(但被压低) |
| RLPD | 普通在线 RL,batch 一半离线一半在线 | 对称采样 + LayerNorm + 大集成 | 是(有在线数据兜底) |
要点清单:
- 离线 RL 必须用基于值的方法,因为只有动态规划能做轨迹拼接;而基于值的方法必然要问反事实问题,于是必然要处理分布偏移。这是一个无法回避的取舍。
- 策略约束里,反向 KL 模式寻找但需要 $\hat\pi_\beta$,前向 KL 模式覆盖但只需数据里的动作。理论上最优的是支撑集约束,一个 $\pi_\beta=(0.99,0.01)$、$Q=(0,10)$ 的两动作例子就能显示 KL 约束会禁止一个完全安全的最优策略。
- 约束加在奖励上比加在 actor 目标上多一个好处:它约束的是折扣累积散度,能提前惩罚「现在合法但会把你逼进死角」的动作。代价是需要 $\hat\pi_\beta$,且 $\lambda$ 被烘焙进 Q 函数。
- AWR 的闭式解 $\pi^\star\propto\pi_\beta\exp(A/\lambda)$ 来自 KL 约束优化的拉格朗日条件;把它用前向 KL 投影到参数族并做重要性替换,$\pi_\beta$ 被精确抵消,得到「优势加权最大似然」——所以不需要行为策略模型。但它的 critic 依然查询 OOD 动作。
- IQL 用期望回归 $L_2^\tau(u)=\left|\tau-\mathbf{1}(u\lt 0)\right|u^2$ 把「支撑集内取 $\max$」变成加权最小二乘。一阶条件 $\tau\E[(X-m)_+]=(1-\tau)\E[(m-X)_+]$,$\tau\to1$ 时 $m\to\operatorname{ess\,sup}X$。必须用两个网络:$V$ 对动作取上分位、$Q$ 对转移取均值,否则会对环境随机性也变得乐观。
- CQL 的逐点解是 $\hat Q^{k+1}=\hat{\mathcal{B}}^\pi\hat Q^k-\alpha\frac{\mu}{\hat\pi_\beta}$,惩罚正比于密度比;加上抬升数据内动作的项之后,逐点下界变成期望下界,缺口恰好是卡方散度 $\chi^2(\pi\|\hat\pi_\beta)$。内层 $\max_\mu$ 加熵正则后闭式解是 $\softmax Q$,取值是 $\log\sum_a\exp Q$。
- 离线到在线的核心矛盾是「离线要保守、在线要乐观」。CQL 切换时会先崩再慢慢恢复。一个难以击败的基线是不预训练、50/50 对称采样的在线 RL。扩散/流模型的 actor(IDQL、FQL、DSRL)在这个场景经验上更好用,且它们都只用监督学习训练生成模型。
- 基于模型的离线 RL 面临同构的问题:策略会去利用模型误差。MOPO 在奖励上减不确定性惩罚(需要可靠的 $u$),COMBO 直接对模型样本做 CQL(不需要 $u$,用「可分辨性」代替)。无模型侧的对应物是 SAC-N/EDAC 的 $\min_i Q_i$,本质是一个下置信界。
- 选型的第一性问题不是「哪个算法最强」,而是「我的数据里有没有已经做对过的完整行为」。有 $\Rightarrow$ 偏 BC;没有但有碎片 $\Rightarrow$ 偏动态规划。
延伸阅读
综述与背景
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives on Open Problems (2020) — Levine、Kumar、Tucker、Fu 的综述,本讲两讲内容的完整展开版,想系统入门先读它。
- D4RL: Datasets for Deep Data-Driven Reinforcement Learning (2020) — 标准评测集,读它的动机部分能明白 AntMaze 为什么是拼接能力的试金石。
策略约束
- Off-Policy Deep Reinforcement Learning without Exploration (2018) — BCQ,第一个把「批约束」讲清楚的工作,生成模型 + 有界扰动的设计至今仍被沿用。
- Stabilizing Off-Policy Q-Learning via Bootstrapping Error Reduction (2019) — BEAR,「支撑集匹配优于分布匹配」这个论点的原始出处,MMD 那一节值得细读。
- Behavior Regularized Offline Reinforcement Learning (2019) — BRAC,把各种散度、加在哪里、怎么调 $\lambda$ 做了系统的消融,是这一类方法的「实验手册」。
- A Minimalist Approach to Offline Reinforcement Learning (2021) — TD3+BC,读它是为了体会「一行代码 + 两个归一化技巧」能走多远。
- Advantage-Weighted Regression (2019) — AWR,本讲第 4 节闭式解推导的来源。
- Accelerating Online Reinforcement Learning with Offline Datasets (2020) — AWAC,把 AWR 做成离线转在线的实用算法。
- Offline RL Without Off-Policy Evaluation (2021) — 「one-step RL」,论证了在很多 D4RL 任务上一步策略改进就够了,是理解「什么时候真的需要动态规划」的重要反面参照。
保守值函数与隐式方法
- Conservative Q-Learning for Offline Reinforcement Learning (2020) — CQL,本讲第 6 节所有推导的原文,附录里的定理证明比正文更值得读。
- Offline Reinforcement Learning with Implicit Q-Learning (2021) — IQL,期望回归那一节非常短,但把「只用样本内动作做最优备份」这件事讲得极清楚。
- Uncertainty-Based Offline RL with Diversified Q-Ensemble (2021) — SAC-N / EDAC,展示了「只是把 Q 集成调大」能有多强,是理解不确定性视角的最短路径。
基于模型的离线 RL
- MOPO: Model-Based Offline Policy Optimization (2020) — 不确定性惩罚的下界定理与实践实现。
- MOReL: Model-Based Offline Reinforcement Learning (2020) — 与 MOPO 同期,用「悲观 MDP + 越界终止」实现同样的目的,两篇对照读能看出硬约束与软惩罚的取舍。
- COMBO: Conservative Offline Model-Based Policy Optimization (2021) — 把 CQL 与模型结合,免除不确定性量化。
离线到在线与生成式 actor
- Efficient Online Reinforcement Learning with Offline Data (2023) — RLPD,那个「令人不安地有效」的对称采样基线,附录里的消融说明了 LayerNorm 和集成的必要性。
- Cal-QL: Calibrated Offline RL Pre-Training for Efficient Online Fine-Tuning (2023) — 直接针对本讲第 7 节那张「切换即塌陷」曲线设计的修正。
- IDQL: Implicit Q-Learning as an Actor-Critic Method with Diffusion Policies (2023) — IQL 的 critic + 扩散策略的重采样,理解「推理期策略改进」的最佳入口。
- Flow Q-Learning (2025) — FQL,用一步网络逐 $z$ 蒸馏流模型,兼顾多模态与可微性。
- Steering Your Diffusion Policy with Latent Space Reinforcement Learning (2025) — DSRL,把 RL 的动作空间换成扩散模型的隐噪声,让 OOD 问题从定义上消失。
- Training Diffusion Models with Reinforcement Learning (2023) — DDPO,如果确实需要用 RL 梯度直接训扩散模型,这是标准做法。
- Diffusion Policy Policy Optimization (2024) — DPPO,把扩散去噪链当成一个 MDP 来做策略梯度。