探索:Exploration
当奖励稀疏到几乎不存在时,智能体凭什么知道该往哪走?从多臂老虎机的三类最优策略,到深度 RL 里的伪计数、哈希计数与 RND。
0. 本讲导读
到这一讲为止,我们已经有了一整套能把奖励信号转成好策略的机器:策略梯度、Q 学习、actor-critic、基于模型的方法,以及上一讲的离线 RL。它们有一个共同的、从未被认真质疑过的前提——数据里已经出现过高奖励的行为。策略梯度需要采到几条比平均好的轨迹才能把概率往那边推;Q 学习需要缓冲区里存在一条通向高回报的转移链,Bellman 备份才能把价值一步步往回传;离线 RL 更是直接把「数据集覆盖了好行为」写进了假设。
本讲要处理的,正是这个前提不成立的时候该怎么办。如果一个游戏你随机按一万亿次按钮,屏幕上的分数始终是 0,那么无论用多好的优化器、多大的网络,梯度都恒等于零,学习根本无从开始。这就是探索问题(exploration problem)。
Levine 在这一讲里的组织方式非常典型:先说清楚问题为什么难、难在哪里,再退到一个理论上完全可解的最小模型——多臂老虎机(multi-armed bandit)——把「什么叫最优探索」讲透,得到三类可证明近最优的策略族;最后把这三类思想硬搬到大规模 MDP 上,看看在深度网络的世界里它们各自退化成了什么样的近似(并且坦率承认这些近似都是 hack)。
记号沿用全课程约定:$s_t$ 为状态(满足马尔可夫性),$o_t$ 为观测(可能部分可观测),$a_t$ 为动作,$\pi_\theta(a|s)$ 为策略,$r(s,a)$ 为奖励,$p(s'|s,a)$ 为转移,$\tau$ 为轨迹,$\gamma$ 为折扣。本讲新增:$N(s)$ 或 $N(a)$ 表示访问计数,$\mathcal{B}(\cdot)$ 表示探索 bonus 函数,$\hat\mu_a$ 表示动作 $a$ 的平均奖励估计。
- 探索与利用(exploration / exploitation)不是两个问题,而是同一个问题的两面:只有当「尝试新东西的潜在收益」被显式量化,取舍才有依据。
- 在多臂老虎机上,探索问题理论上是可解的,有三大类近最优策略:乐观探索(optimistic exploration,如 UCB)、后验采样(posterior sampling / Thompson sampling)、信息增益(information gain)。它们的 regret 都能做到 $O(\log H)$ 级别,而这已被证明是下界。
- 把 UCB 搬到 MDP 上,形式是给奖励加一个随访问次数衰减的 bonus:$r^+(s,a)=r(s,a)+\mathcal{B}(N(s))$。优点是可以插进任何 RL 算法,缺点是 bonus 权重要调。
- 在图像状态空间里「计数」本身没有意义(同一个状态永远不会出现第二次)。解法是拟合一个密度模型 $p_\theta(s)$,再用两个方程反解出伪计数(pseudo-count):$\hat N(s_i)=\hat n\, p_\theta(s_i)$,$\hat n=\frac{1-p_{\theta'}(s_i)}{p_{\theta'}(s_i)-p_\theta(s_i)}p_\theta(s_i)$。
- 密度模型的要求和主流生成模型正好相反:需要能输出密度,不需要能采样出好看的图。再往前一步,连密度都不需要——只要能判断「新不新」,于是有了 RND(random network distillation):用对随机固定网络的蒸馏误差当 bonus。
本讲与前后讲的关系:第 5–7 讲的策略梯度与 Q 学习给出的都是「给定数据怎么学」,本讲给出的是「怎么弄到有用的数据」;上一讲(离线 RL 算法)假定数据已经存在且覆盖良好,本讲恰好是它的对偶;下一讲(强化学习理论)会把这里只给了直觉的 regret 界、样本复杂度真正证一遍。
1. 探索问题到底难在哪
两个 Atari 游戏,天壤之别
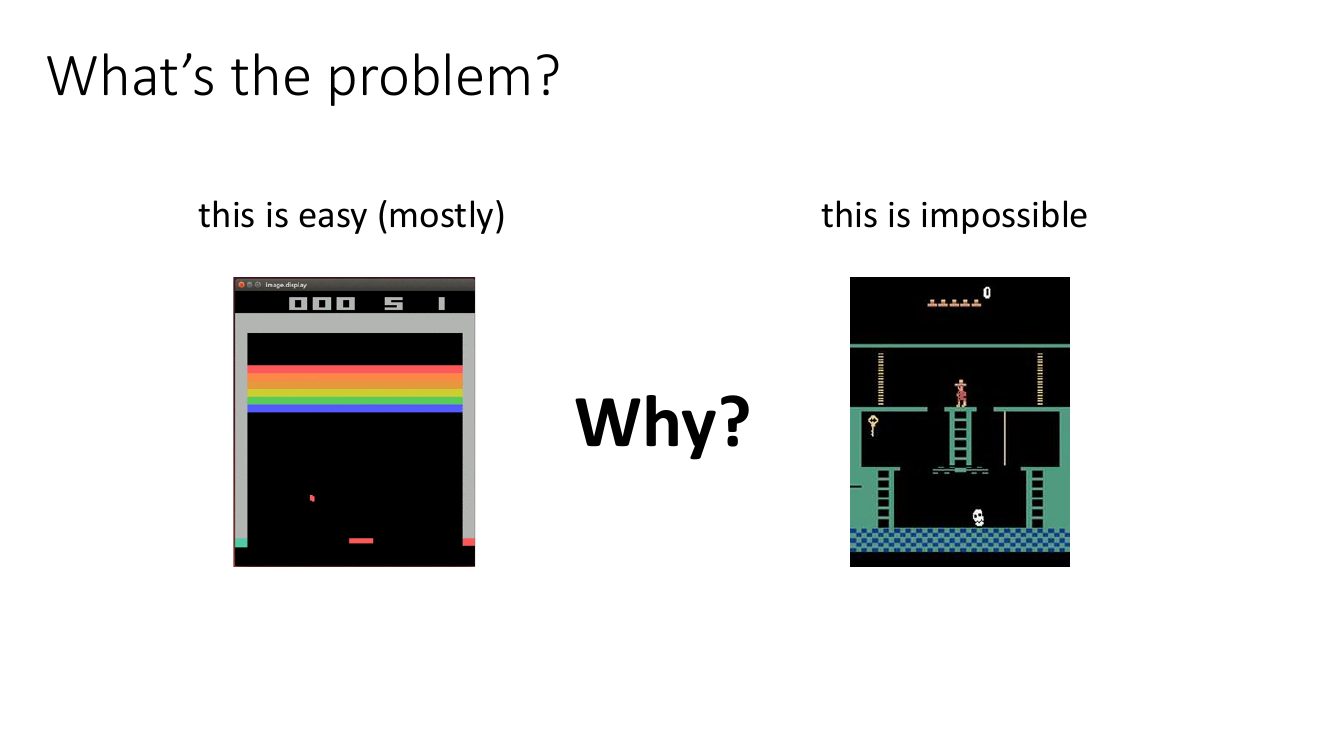
Breakout 为什么容易?因为随机策略就能拿到奖励。球在屏幕里乱飞,挡板随机左右移动,早晚会碰到球,碰到球就会打掉砖块,打掉砖块就加分。也就是说,$\pi_\text{random}$ 采样出来的轨迹里,回报的方差非零、均值非零,策略梯度立刻有信号:往「刚才那次接到球的动作序列」的方向推。学习曲线从第一帧起就是有斜率的。
Montezuma's Revenge 为什么不可能?这个游戏的奖励结构是:
- 拿到钥匙 = 有奖励;
- 用钥匙开门 = 有奖励;
- 被骷髅碰到 = 什么都没有(既不加分也不扣分,从奖励上看这件事「不存在」,算法完全无法判断它是好是坏);
- 通关本身与那些零星的加分事件只有很弱的相关性。
要拿到第一个奖励,智能体必须完成一段长达数十步的、每一步单独看都毫无回报的动作序列:爬下梯子 → 跳过缺口 → 避开来回移动的骷髅 → 再爬一段梯子 → 走到钥匙位置。随机策略走出这条序列的概率大致是 $(1/|\mathcal{A}|)^{L}$ 量级——$|\mathcal{A}|=18$、$L\approx 100$,这个数比宇宙中原子数的倒数还小。梯度恒为零,什么优化器都救不了。
我们人类觉得这游戏不难,是因为我们看得懂那些像素的语义:那个黄色的东西是「钥匙」,钥匙一般用来开门;那个白色的东西是「骷髅」,骷髅一般代表危险要躲开;梯子是用来爬的。这些先验不是从这个游戏里学来的,是从我们过去几十年的人生里迁移过来的。算法没有这些先验——对它来说钥匙只是一坨特定颜色的像素块,与背景没有本质区别。Levine 反复强调这一点:Montezuma 之所以对人容易,恰恰暴露了纯 RL 设定的信息劣势。
把自己代入算法的处境:Mao 纸牌游戏
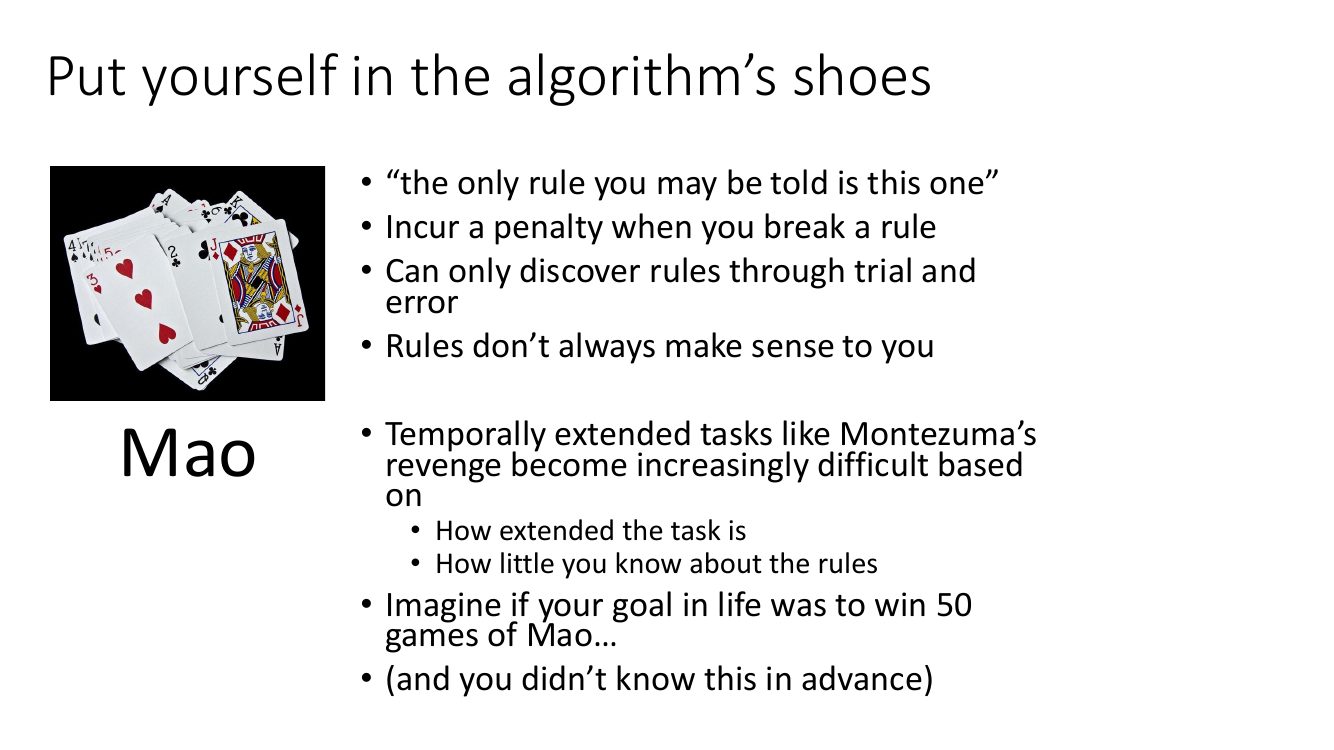
Mao 这个类比之所以精准,是因为它同时刻画了两个维度的难度:
- 任务在时间上有多延展(how extended the task is):要连赢多少局才算成功。赢一局你可能瞎撞得到,连赢 50 局就必须真正掌握规则。
- 你对规则知道得有多少(how little you know about the rules):先验越弱,需要试错的空间越大。
Levine 让大家想象:如果你人生的唯一目标是「赢 50 局 Mao」,而且你事先并不知道这个目标是什么,只知道有时候会挨罚——你会怎么做?这几乎就是 Montezuma's Revenge 对 DQN 的样子。
两个定义,其实是同一个问题
幻灯片给出了探索问题的两种表述:
- 表述 A(时间延展视角):智能体如何发现那些需要「一长串单独看毫无奖励的复杂行为」才能达成的高回报策略?
- 表述 B(取舍视角):智能体如何决定是去尝试新行为(希望发现更高奖励),还是继续做它目前已知最好的事?
Levine 明确指出:这两个其实是同一个问题。因为
- 利用(exploitation):做你已知会带来最高奖励的事;
- 探索(exploration):做你没做过的事,希望得到更高的奖励。
表述 A 是表述 B 在「需要连续做很多次探索决策」时的极端情形——每一步你都可以选择重复已知的、或者试点新的;只有连续几十步都选了「试点新的」并且方向恰好一致,才会撞上钥匙。所以时间延展让探索–利用的取舍在指数级放大。
课上还给了三个来自 D. Silver 讲义的经典例子,帮助把这个取舍从游戏搬到现实:
| 场景 | 利用(exploitation) | 探索(exploration) |
|---|---|---|
| 选餐厅 | 去你最喜欢的那家 | 试一家没去过的 |
| 在线广告投放 | 展示历史点击率最高的广告 | 随机展示一个不同的广告 |
| 石油钻探 | 在已知最好的位置继续钻 | 换一个新位置钻 |
这三个例子有个共同点:探索是有真实代价的(一顿难吃的饭、一次浪费的广告曝光、几百万美元的干井)。所以「多探索一点总没坏处」是错的,探索必须算账:只有当获得信息的期望价值超过当下损失的期望奖励时,才值得探索。这正是后面所有算法要形式化的东西。
2. 探索的可解性谱系
下一个自然的问题是:我们能不能推导出一个「最优」的探索策略? 这个问题一提出来就遇到麻烦——「最优」是什么意思?在标准 RL 里最优的定义很清楚(最大化期望回报),但探索涉及「我还不知道环境是什么」,最优性至少有两种不同的定义:
- regret(后悔值):与「事后诸葛亮」的最优策略相比,我总共少拿了多少奖励。这是频率派的定义。
- Bayes 最优(Bayes-optimal)策略:给定对环境的先验分布,最大化在这个先验下的期望回报。这是贝叶斯派的定义,它把「不确定性」本身当成状态的一部分。
两者不等价,但在很多情形下能得到相似的算法。下一讲会更正式地处理它们;本讲只需要知道 regret 就够了。
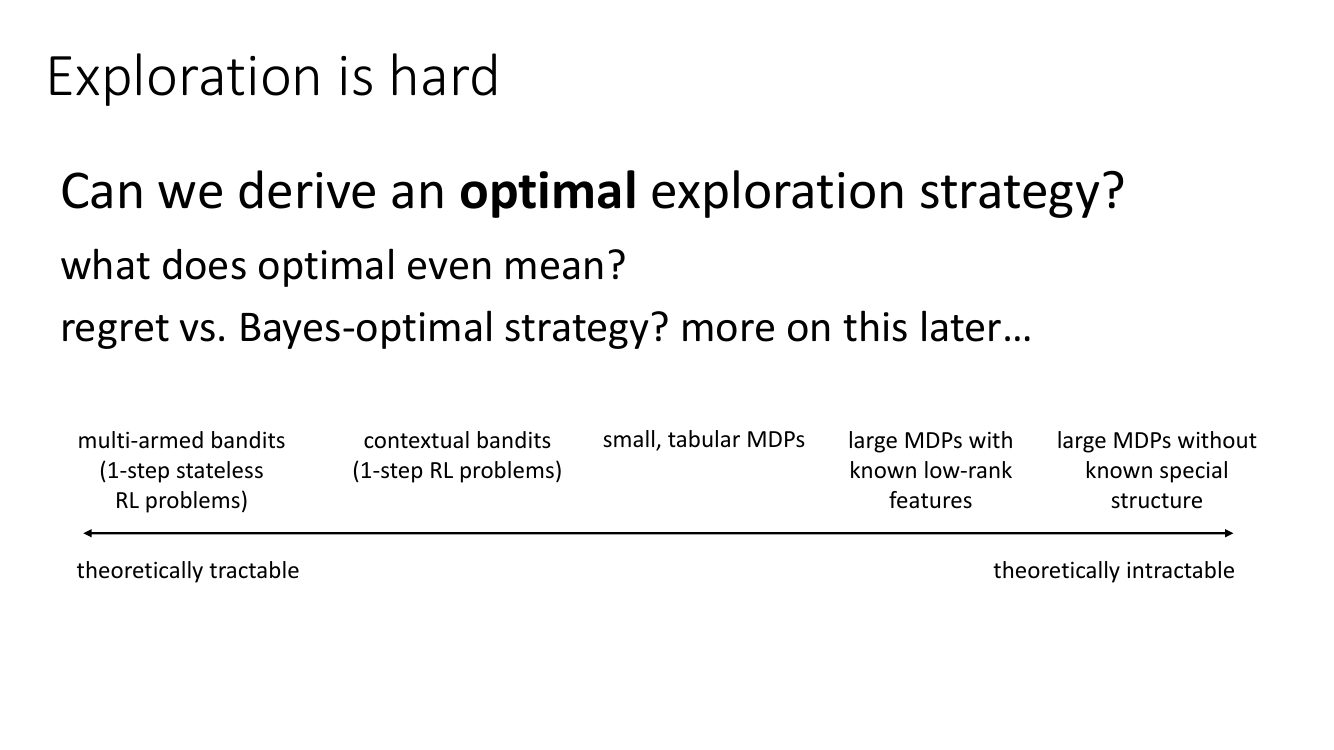
这条谱系值得逐档解释,因为它决定了每一类方法「理论保证到底还剩多少」:
- 多臂老虎机:只有一步,没有状态。动作空间有限,每个动作对应一个未知的奖励分布。这是探索问题的「果蝇」——足够简单到可以完全分析,又保留了探索–利用取舍的全部本质。
- 上下文老虎机(contextual bandits):每一步先看到一个上下文(相当于状态),再选动作,然后拿奖励,episode 就结束了。它是一步的 RL 问题:有状态但没有状态转移。
- 小规模表格型 MDP:有状态转移,但状态数少到可以为每个 $(s,a)$ 单独维护计数和不确定性。此时可以做「贝叶斯模型辨识」,显式计算信息的价值。
- 有已知低秩特征的大 MDP:状态空间巨大,但假设值函数在某组已知特征上线性,此时还能给出多项式样本复杂度的保证。
- 没有已知结构的大 MDP:Atari、机器人、真实世界。理论上不可解——存在下界说明必须指数级样本。
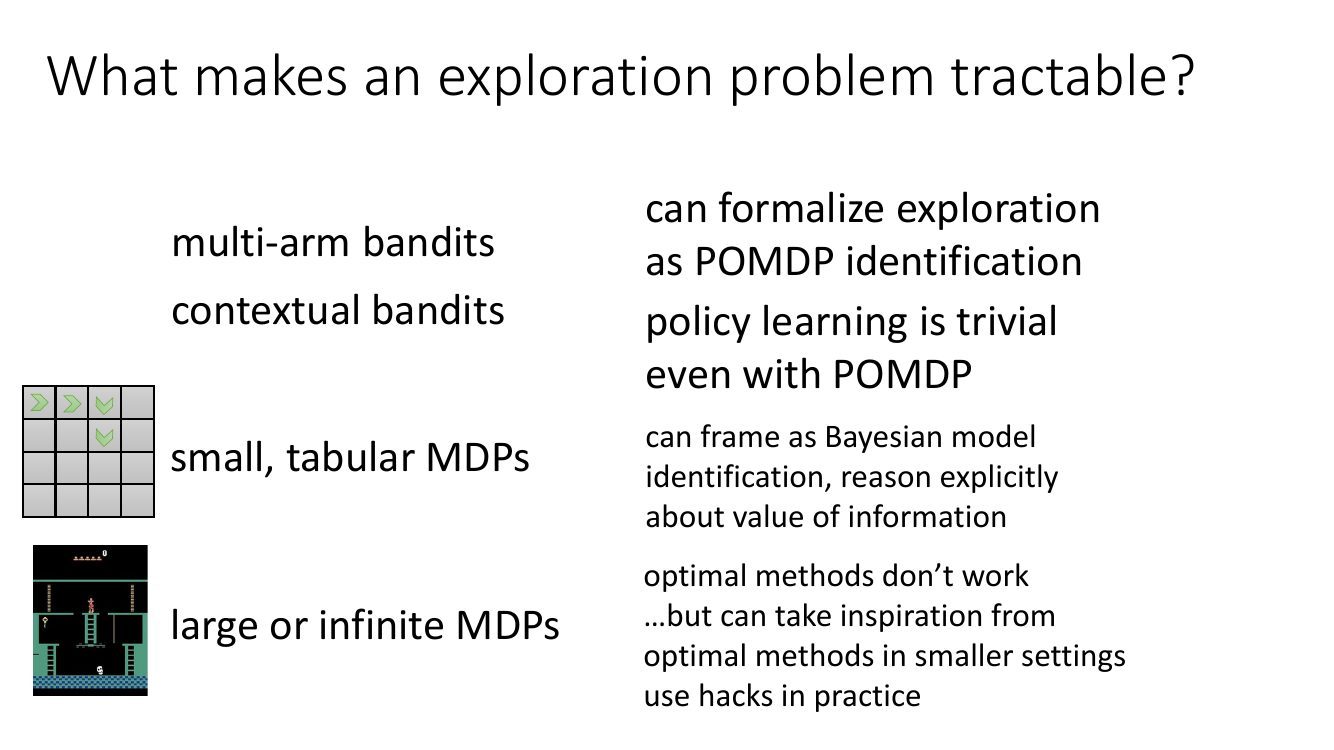
这张表是本讲的方法论纲领,请记住最后一行:在大规模 MDP 上,我们接下来讲的所有深度 RL 探索方法都没有理论保证,它们只是把小规模设定下的最优方法「照猫画虎」搬过来的启发式。 这不是这些方法不好,而是必须诚实地知道它们的地位——所以调参才这么重要,所以同一个 bonus 在这个任务上灵在那个任务上不灵。
3. 多臂老虎机:把探索问题写成数学
什么是老虎机
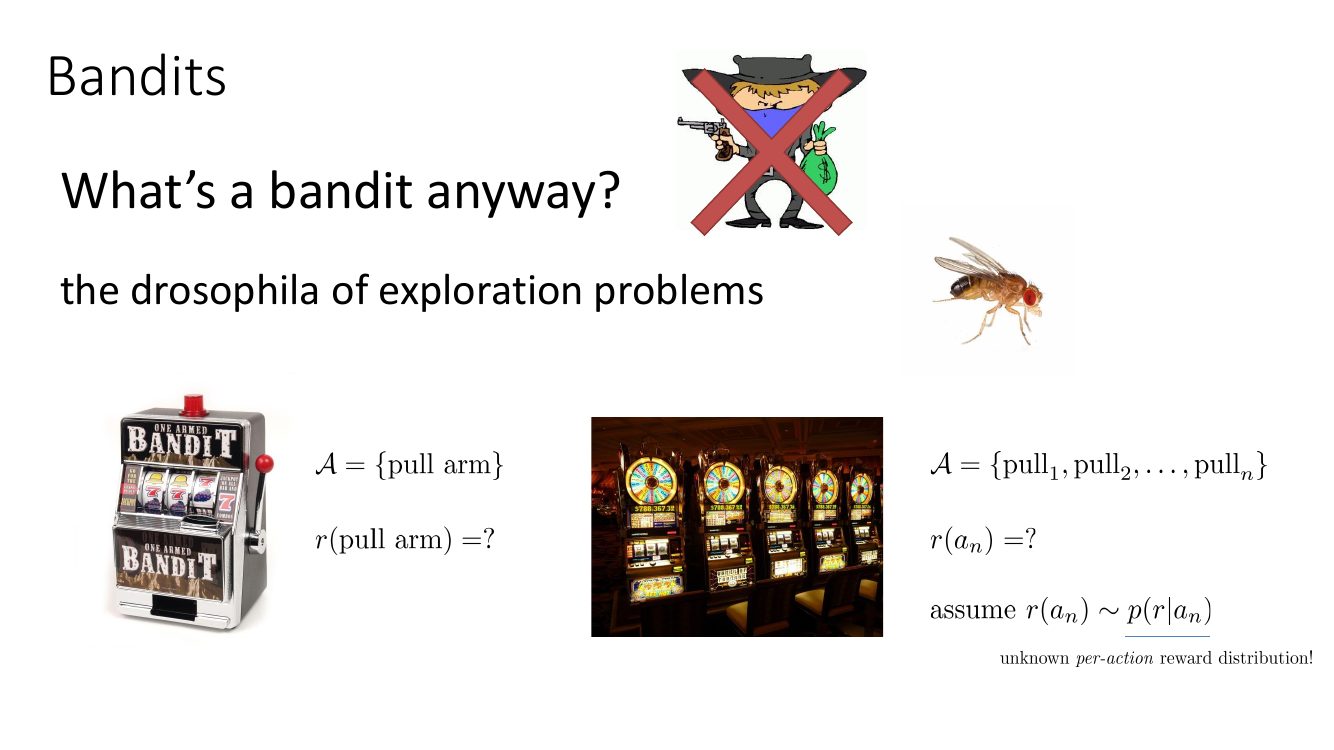
形式化地:假设 $r(a_i)\sim p_{\theta_i}(r_i)$,其中 $\theta_i$ 是刻画第 $i$ 个臂奖励分布的参数。一个最常用的具体化是伯努利老虎机:
$$ p(r_i = 1) = \theta_i, \qquad p(r_i = 0) = 1 - \theta_i $$也就是说拉第 $i$ 个臂,以概率 $\theta_i$ 得到 1 分,否则 0 分。参数向量 $\theta=[\theta_1,\dots,\theta_n]$ 从某个先验 $p(\theta)$ 中抽出,但对算法不可见——这才是问题的全部难点所在。如果 $\theta$ 已知,最优策略就是永远拉 $\argmax_i \theta_i$,一行代码解决。
老虎机其实是一个 POMDP
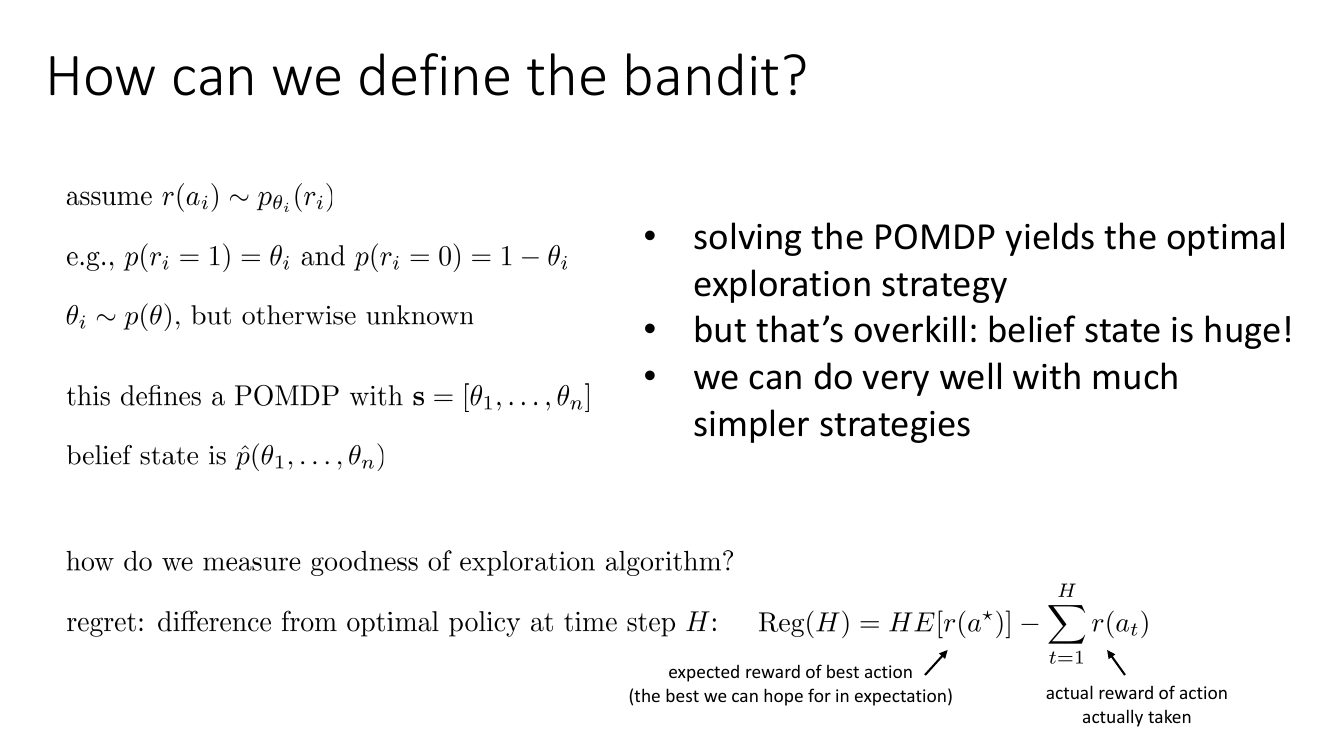
这个视角非常关键。把 $\theta$ 当成隐藏状态,那么老虎机就是一个特殊的 POMDP:
- 真实状态 $\mathbf{s}=[\theta_1,\dots,\theta_n]$,不随动作改变(转移是恒等映射);
- 观测就是每次拉杆得到的奖励 $r$;
- 信念状态(belief state)$\hat p(\theta_1,\dots,\theta_n)$ 是关于 $\theta$ 的后验,每拉一次杆就按 Bayes 规则更新一次。
在信念状态上,这个 POMDP 变成了一个完全可观测的 MDP(belief MDP),理论上用动态规划解它就得到真正最优的探索策略——它会自动权衡「这次拉杆能带来多少信息、这些信息在剩余回合里值多少奖励」。
但 Levine 立刻泼冷水:这是杀鸡用牛刀,而且刀太大握不住。信念状态是 $n$ 维连续分布空间中的一个点,belief MDP 的状态空间是无穷维的;即使是 $n=2$ 的伯努利老虎机,精确求解也已经很痛苦。好消息是——用简单得多的策略就能做得非常好(好到只差常数因子)。这就是接下来三节的内容。
regret:怎么衡量一个探索算法的好坏
幻灯片给出的定义是:在时间步 $H$ 处,相对最优策略的差距
$$ \mathrm{Reg}(H) = H\,\E[r(a^\star)] - \sum_{t=1}^{H} r(a_t) $$逐项解释:
- $a^\star = \argmax_a \E[r(a)]$ 是事后最优的那个臂(如果我们能看到 $\theta$ 的话会一直拉它)。$\E[r(a^\star)]$ 是它的期望奖励,也就是「我们在期望意义下所能希望的最好结果」的单步值。
- $H\,\E[r(a^\star)]$ 就是拉 $H$ 次最优臂的期望总回报——一个理想上界。
- $\sum_{t=1}^H r(a_t)$ 是算法实际选出的动作实际拿到的奖励之和。
两者之差就是「后悔」。注意 regret 是关于 $H$ 的函数,所以要看的是它的增长阶:
- 如果算法永远只利用(贪心,从不探索),它可能一开始就锁死在一个次优臂上,每步损失一个常数 $\Delta$,于是 $\mathrm{Reg}(H)=\Theta(H)$ ——线性 regret,最差的情形。
- 如果算法用固定 $\epsilon$ 的 $\epsilon$-greedy,那么有 $\epsilon$ 比例的步永远在瞎试,$\mathrm{Reg}(H)\ge \epsilon\,\Delta\,H\cdot\frac{n-1}{n}=\Theta(H)$,同样是线性的。这解释了为什么固定 $\epsilon$ 的 $\epsilon$-greedy 在理论上是「坏」算法,尽管它在 DQN 里够用(因为通常会做 $\epsilon$ 衰减)。
- 好算法能做到 $\mathrm{Reg}(H)=O(\log H)$。而 Lai & Robbins 的经典结果说明 $\Omega(\log H)$ 是下界——所以 $O(\log H)$ 已经是「和任何算法一样好」的意思。
$O(\log H)$ 的含义是:随着时间推移,犯错的频率趋于 0(因为 $\frac{d}{dH}\log H = 1/H \to 0$),但总错误次数仍然缓慢增长。换句话说,好的探索算法会「越来越少地探索,但永远不会完全停止探索」。这个性质在后面所有 bonus 方法里都会以「bonus 随计数衰减但不为零」的形式再次出现。
4. 策略一:乐观探索(UCB)
从贪心到乐观
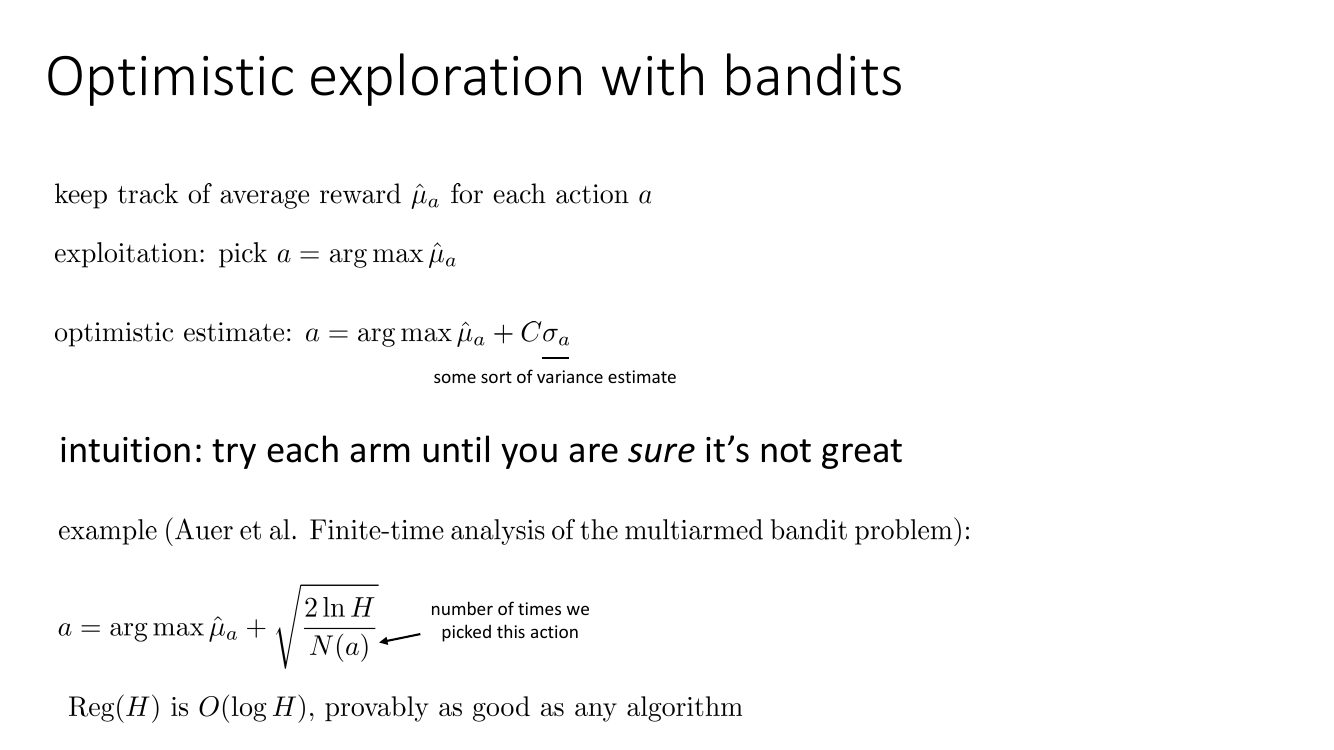
最朴素的做法是纯利用:记录每个臂的样本均值
$$ \hat\mu_a = \frac{1}{N(a)}\sum_{t:\,a_t=a} r_t ,\qquad a = \argmax_a \hat\mu_a $$这为什么不行?考虑一个两臂伯努利老虎机,$\theta_1=0.4$、$\theta_2=0.6$。假设第一次拉臂 1 运气好拿到 1 分($\hat\mu_1=1$),第一次拉臂 2 运气差拿到 0 分($\hat\mu_2=0$)。贪心算法从此永远只拉臂 1:$\hat\mu_1$ 会慢慢收敛到 0.4,但只要它一直大于 $\hat\mu_2=0$(臂 2 再也不会被采样,$\hat\mu_2$ 永远冻结在 0),臂 2 就永无翻身之日。这就是前面说的线性 regret:每步损失 $0.2$,$H$ 步损失 $0.2H$。
问题的根源是贪心把「估计值」当成了「真值」,完全忽略了 $\hat\mu_2=0$ 这个估计只来自 一个 样本,极不可靠。修正方式就是乐观:给每个臂的估计加上一个正比于其不确定性的项,
$$ a = \argmax_a\ \hat\mu_a + C\sigma_a $$$\sigma_a$ 是 $\hat\mu_a$ 的不确定性(标准误)。这条式子被称为「面对不确定性时保持乐观」(optimism in the face of uncertainty)。它的行为很好理解:一个臂只有在「均值确实低」并且「我们对这个低均值已经很确信」时才会被放弃。只试过一次的臂,$\sigma_a$ 很大,会被自动顶到前面去再试几次。
UCB 的具体形式
Auer 等人(Finite-time Analysis of the Multiarmed Bandit Problem, 2002)给出的经典选择是
$$ a = \argmax_a\ \hat\mu_a + \sqrt{\frac{2\ln H}{N(a)}} $$其中 $N(a)$ 是迄今为止选择动作 $a$ 的次数,$H$ 是总步数(或当前时刻 $t$)。结论是
$$ \mathrm{Reg}(H) = O(\log H) $$并且这已被证明「和任何算法一样好」(provably as good as any algorithm)——因为 $\Omega(\log H)$ 是下界。
bonus 项 $\sqrt{2\ln H/N(a)}$ 是从哪来的? 用 Hoeffding 不等式。设臂 $a$ 的奖励有界在 $[0,1]$,被拉了 $N(a)$ 次,样本均值 $\hat\mu_a$ 与真值 $\mu_a$ 满足
$$ \Pr\!\left(\ \mu_a \gt \hat\mu_a + u\ \right) \le \exp\!\big(-2N(a)u^2\big) $$我们希望这个「置信区间失效」的概率小到可以忽略,比如令右端等于 $H^{-4}$:
$$ \exp(-2N(a)u^2) = H^{-4} \;\Longrightarrow\; 2N(a)u^2 = 4\ln H \;\Longrightarrow\; u = \sqrt{\frac{2\ln H}{N(a)}} $$这正是 bonus。所以 $\hat\mu_a+u$ 是真实均值 $\mu_a$ 的一个高置信度上界——这就是名字「Upper Confidence Bound」的由来。$\ln H$ 出现在分子里,是因为要在 $H$ 步内做 $H$ 次判断,需要用联合界(union bound)把每次判断的失败概率压到 $1/H$ 量级以下。
$O(\log H)$ regret 的直觉论证。 关键量是次优臂 $a$ 的间隙 $\Delta_a = \mu_{a^\star}-\mu_a \gt 0$。整个 regret 可以写成
$$ \E[\mathrm{Reg}(H)] = \sum_{a \ne a^\star} \Delta_a\, \E[N_H(a)] $$即「每个次优臂的损失 × 它被拉的次数」。所以只要证明每个次优臂被拉的次数是 $O(\log H)$ 就够了。
什么时候 UCB 会(错误地)选择次优臂 $a$?必须满足
$$ \hat\mu_a + \sqrt{\frac{2\ln H}{N(a)}} \ \ge\ \hat\mu_{a^\star} + \sqrt{\frac{2\ln H}{N(a^\star)}} $$在「所有置信区间都有效」的高概率事件下,左边 $\le \mu_a + 2\sqrt{2\ln H/N(a)}$,右边 $\ge \mu_{a^\star}$。于是必有
$$ \mu_a + 2\sqrt{\frac{2\ln H}{N(a)}} \ge \mu_{a^\star} \quad\Longleftrightarrow\quad 2\sqrt{\frac{2\ln H}{N(a)}} \ge \Delta_a $$两边平方整理得
$$ N(a) \le \frac{8\ln H}{\Delta_a^{2}} $$也就是说:一旦次优臂 $a$ 被拉够了 $8\ln H/\Delta_a^2$ 次,它的置信上界就再也不可能超过最优臂,UCB 从此不会再选它。代回 regret 表达式:
$$ \E[\mathrm{Reg}(H)] \ \lesssim\ \sum_{a\ne a^\star}\frac{8\ln H}{\Delta_a} = O(\log H) $$这个式子还有一个漂亮的读法:越接近最优的臂($\Delta_a$ 越小)需要被试越多次才能排除,但每次试它的损失也越小,两者相乘后损失只随 $1/\Delta_a$ 增长。这就是「乐观」为什么高效——它把探索预算自动分配给了「难以区分」的臂。
UCB 的 bonus 并不需要恰好是 $\sqrt{2\ln H/N(a)}$。幻灯片上明确写着「lots of functions work, so long as they decrease with $N(a)$」——只要 bonus 随计数单调递减、且衰减速度不太快(保证每个臂被试的次数是无穷但增长缓慢),就能得到亚线性 regret。这一点非常重要:后面在深度 RL 里我们会毫无顾忌地换成 $1/\sqrt{N}$ 或 $1/N$,正是因为这个自由度是理论允许的。
最小实现
import numpy as np

def ucb_bandit(theta, H=10000, c=1.0):
    """theta: 每个臂的伯努利参数; 返回累积 regret 曲线"""
    n = len(theta)
    N     = np.zeros(n)          # 每个臂被拉的次数
    S     = np.zeros(n)          # 每个臂的累积奖励
    best  = theta.max()
    regret, cum = [], 0.0

    for t in range(1, H + 1):
        if (N == 0).any():                    # 先把每个臂各拉一次,避免除零
            a = int(np.argmin(N))
        else:
            mu_hat = S / N
            bonus  = c * np.sqrt(2.0 * np.log(t) / N)
            a      = int(np.argmax(mu_hat + bonus))

        r = float(np.random.rand() < theta[a]) # 拉杆,得到 0/1 奖励
        N[a] += 1
        S[a] += r
        cum  += best - theta[a]               # 期望意义下这一步的 regret
        regret.append(cum)
    return np.array(regret)

theta = np.array([0.3, 0.5, 0.55, 0.6])
reg   = ucb_bandit(theta, H=20000)
print(reg[-1])        # 典型量级:几十,而不是 0.05*20000=1000
把这段代码跑一下你会看到:累积 regret 曲线在对数坐标下接近直线,而 $\epsilon$-greedy(固定 $\epsilon$)的曲线是一条斜率恒定的直线。这就是 $O(\log H)$ 与 $\Theta(H)$ 的肉眼差别。
5. 策略二:后验采样 / Thompson sampling
第二类策略回到我们在第 3 节建立的 POMDP 视角。既然老虎机的「隐藏状态」是参数向量 $\theta=[\theta_1,\dots,\theta_n]$,而我们维护着它的后验 $\hat p(\theta_1,\dots,\theta_n)$,那么一个极其简单的想法是:
后验采样(posterior sampling),又称 Thompson sampling,每一步做三件事:
- 从当前后验中采一个模型:$\theta_1,\dots,\theta_n \sim \hat p(\theta_1,\dots,\theta_n)$;
- 假装这个采出来的模型就是真的,对它求最优动作:$a=\argmax_a \E_{\theta_a}[r(a)]$;
- 拉这个臂,观察奖励,用 Bayes 规则更新后验 $\hat p$。
为什么它有效
关键在于第 2 步的「假装」。注意我们并不是取后验的均值再贪心(那退化成纯利用),而是采样。采样带来两个性质:
- 不确定性大的臂更容易被选中。如果臂 $i$ 只被试过一次,它的后验很宽,采样出来的 $\theta_i$ 有相当概率是个很大的值,于是被选中。反之被试了一千次的臂后验很窄,采样值几乎就是真值。
- 被选中的概率恰好等于「它是最优臂」的后验概率。这是 Thompson sampling 最优雅的性质:$\Pr(\text{选}\ a) = \Pr(a = a^\star \mid \text{数据})$。这是一种「概率匹配」(probability matching)——你花在一个臂上的探索预算,正比于你相信它是最优的程度。
把 Thompson sampling 和 UCB 对照:UCB 是「对每个臂都用最乐观的估计」,Thompson 是「随机抽一个自洽的世界,然后在那个世界里当最优主义者」。UCB 的乐观是逐臂独立的,可能同时对所有臂乐观(这在 MDP 里会导致不自洽的价值函数);Thompson 采出来的是一个完整、自洽的模型,这个区别在搬到 MDP 上时会变得非常重要——因为在 MDP 里我们需要的是「连续多步都朝同一个假设去探索」,即所谓的深度探索(deep exploration)。
伯努利老虎机上的具体实现
对伯努利老虎机,取 Beta 分布作为共轭先验,后验更新是闭式的:先验 $\theta_i\sim\mathrm{Beta}(\alpha_i,\beta_i)$,观察到一次奖励 1 则 $\alpha_i \mathrel{+}= 1$,观察到 0 则 $\beta_i \mathrel{+}= 1$。整个算法只有几行:
import numpy as np

def thompson_bandit(theta, H=20000):
    n = len(theta)
    alpha = np.ones(n)      # Beta(1,1) = 均匀先验
    beta  = np.ones(n)
    best, cum, regret = theta.max(), 0.0, []

    for t in range(H):
        # 1) 从后验采一个「世界」
        sample = np.random.beta(alpha, beta)
        # 2) 在这个世界里贪心
        a = int(np.argmax(sample))
        # 3) 真实交互 + Bayes 更新
        r = float(np.random.rand() < theta[a])
        if r > 0.5: alpha[a] += 1
        else:       beta[a]  += 1
        cum += best - theta[a]
        regret.append(cum)
return np.array(regret)注意这里没有任何需要调的超参数——不像 UCB 有个 bonus 系数 $C$。这是 Thompson sampling 在实践中受欢迎的一大原因(工业界的 A/B 测试、广告投放系统大量使用它)。它的 regret 同样是 $O(\log H)$,而且实证上常常比 UCB 更好,因为 UCB 的置信界通常偏保守。
Thompson sampling 的困难全部集中在「怎么表示并采样后验」。伯努利老虎机上有共轭先验,一切都是闭式的;换成一个 500 万参数的 Q 网络,后验 $p(\theta\mid \mathcal{D})$ 就是一个 500 万维的、完全不可解的分布。第 11 节讲的 Bootstrapped DQN,本质上就是用「一组独立训练的 Q 头」去粗暴近似这个后验。
6. 策略三:信息增益
第三类策略最贴近「探索的本质是获取信息」这句话,直接把信息写进目标函数。
信息增益的定义
先回忆熵:随机变量 $z$ 的熵 $\mathcal{H}(\hat p(z)) = -\E_{z\sim\hat p}[\log \hat p(z)]$,度量我们对 $z$ 的不确定程度。现在假设我们关心某个未知量 $z$(例如老虎机的参数 $\theta$),并且要做一次动作、得到一个观测 $y$(例如奖励 $r$)。信息增益(information gain, IG)定义为
$$ \mathrm{IG}(z, y) = \E_{y}\Big[\ \mathcal{H}(\hat p(z)) - \mathcal{H}(\hat p(z \mid y))\ \Big] $$即「观测 $y$ 之前对 $z$ 的不确定性」减去「观测之后的不确定性」,对 $y$ 的分布取期望。这个量恒非负(信息不会让你更糊涂,至少在期望意义下不会),并且等于 $z$ 与 $y$ 的互信息。
在决策问题里,我们真正要问的是:如果我采取动作 $a$,能获得关于 $z$ 的多少信息? 于是写成条件形式
$$ \mathrm{IG}(z, y \mid a) = \E_{y \sim p(y|a)}\Big[\ \mathcal{H}(\hat p(z)) - \mathcal{H}(\hat p(z\mid y))\ \Big] $$这就是「做动作 $a$ 的信息价值」。
为什么信息增益能直接用来构造 bonus? 一个具体化的例子(Russo & Van Roy 的「information-directed sampling」):令 $z=\theta$(我们想搞清楚的未知参数),$y=r_a$(拉臂 $a$ 观测到的奖励)。定义两个量:
- $g(a) = \mathrm{IG}(\theta, r_a \mid a)$:拉臂 $a$ 得到的信息增益;
- $\Delta(a) = \E[r(a^\star)-r(a)]$:拉臂 $a$ 相对最优臂的期望损失(就是前面的间隙)。
然后选择
$$ a = \argmin_a\ \frac{\Delta(a)^2}{g(a)} $$这个准则的含义非常直白:分子是「这次探索的代价」,分母是「这次探索买到的信息」,我们要买单位信息最便宜的那个动作。平方是理论分析出来的最优指数(它使得 regret 界最紧)。当某个动作代价为零($\Delta=0$,它本来就是最优的)时比值为 0,会被优先选择;当某个动作已经没有信息可提供($g\to 0$)时比值趋于无穷,被排除。
三类策略的关系
把三类策略并排看,会发现它们其实是同一件事的三种不同「记账方式」:
| 策略 | 核心机制 | 需要维护什么 | 超参数 | 搬到深度 RL 的难点 |
|---|---|---|---|---|
| 乐观探索(UCB) | 把不确定性当成额外奖励,$\hat\mu_a+C\sigma_a$ | 每个动作的计数 $N(a)$ 与均值 $\hat\mu_a$ | bonus 系数 $C$(必须调) | 「计数」在连续 / 图像状态上没有意义 |
| 后验采样(Thompson) | 从后验采一个模型,再对它贪心 | 模型参数的后验 $\hat p(\theta)$ | 无(只有先验) | 神经网络参数的后验无法表示 |
| 信息增益 | 显式计算「每单位信息的代价」 | 后验 + 熵的可计算形式 | 代价/信息的权衡系数 | 熵与后验都要近似两次,误差叠加 |
Levine 的判断是:这三类在老虎机上都有严格保证、性能相近;但在深度 RL 里它们的「可近似程度」差异巨大。乐观探索最容易近似(只要能造出一个「novelty 分数」就行),所以工程上用得最多;后验采样次之(bootstrap 是个还算靠谱的近似);信息增益最难,近似误差最大,实际效果往往最不稳定。
7. 从老虎机搬到 MDP:计数探索与探索 bonus
核心改写
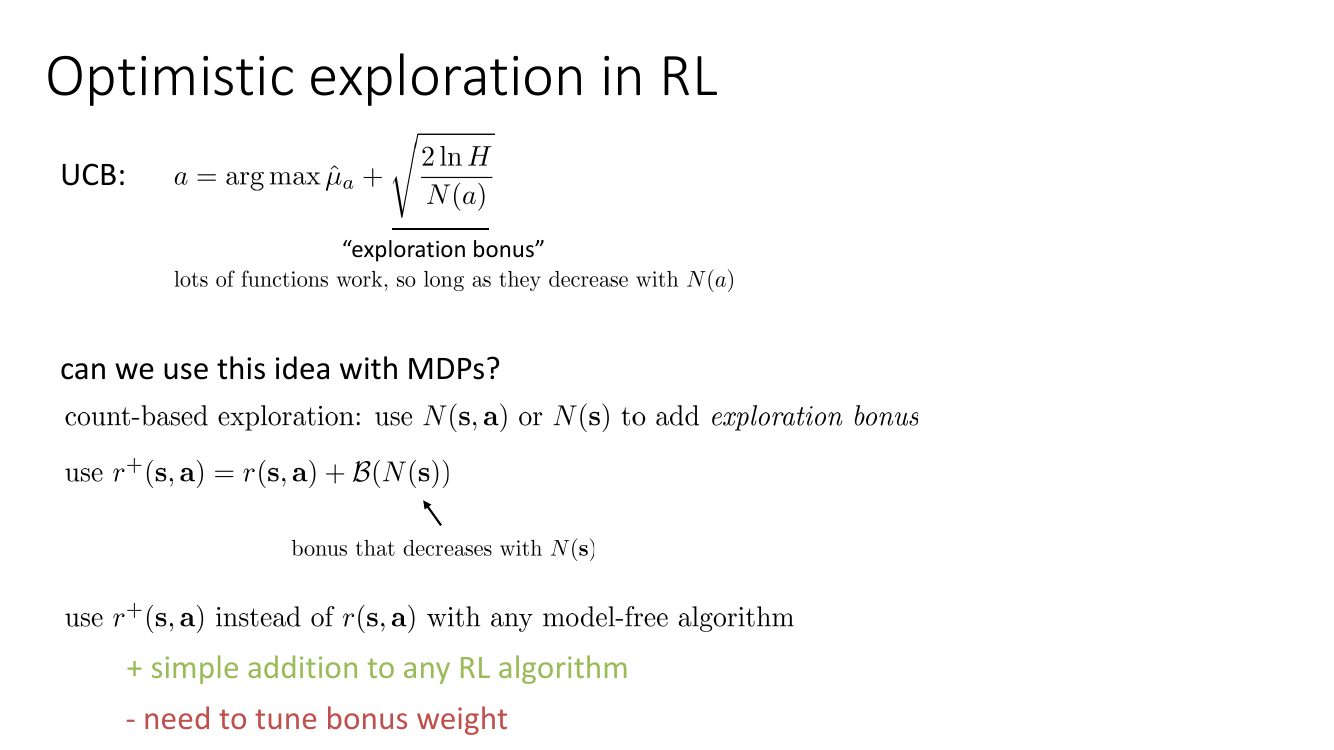
把 UCB 的思想搬到 MDP,只需要一步替换:老虎机里我们对每个动作计数,MDP 里我们对每个状态(或状态–动作对)计数。于是定义修改后的奖励
$$ r^+(s,a) = r(s,a) + \mathcal{B}\big(N(s)\big) $$其中 $\mathcal{B}$ 是任意随 $N(s)$ 单调递减的函数。然后——这是本讲最实用的一句话——把 $r^+$ 当成真实奖励,原封不动地喂给任何 model-free 算法(DQN、SAC、PPO 都行)。
这个方案的优缺点,Levine 用一绿一红两行字总结得很清楚:
- + 可以作为一个简单的加法插件接到任何 RL 算法上。不需要改网络结构、不需要改损失函数、不需要改采样流程,只在算 target 之前把 $r$ 换成 $r+\mathcal{B}$。这是它席卷工程实践的原因。
- - bonus 权重需要调。真实奖励 $r$ 的量级和 bonus 的量级必须匹配:bonus 太小则完全没效果,太大则智能体变成纯粹的「新奇物追逐者」,把真实任务奖励忘得一干二净(这就是著名的「noisy TV 问题」的近亲)。而理论给出的系数在深度网络下毫无意义,只能网格搜索。
该用哪种 bonus 函数
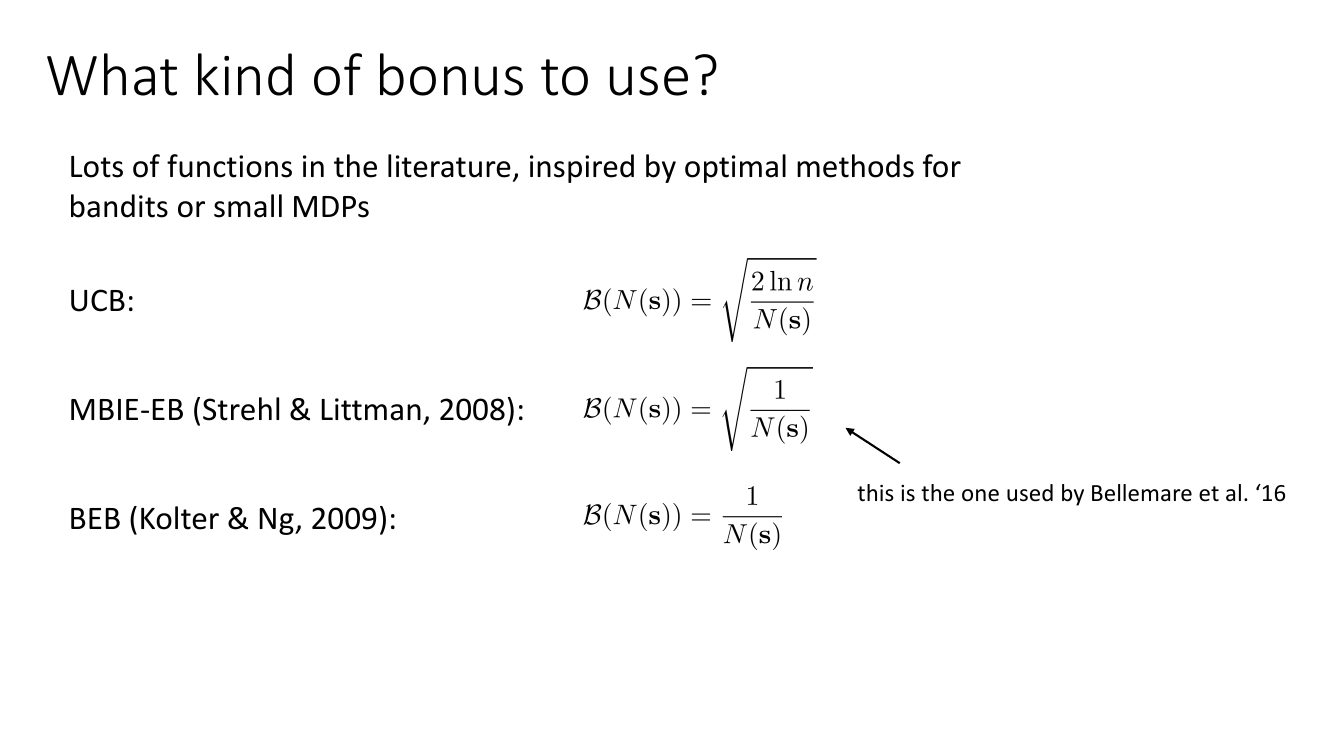
三种形式如下:
$$ \text{UCB:}\qquad \mathcal{B}(N(s)) = \sqrt{\frac{2\ln n}{N(s)}} $$ $$ \text{MBIE-EB (Strehl \& Littman, 2008):}\qquad \mathcal{B}(N(s)) = \sqrt{\frac{1}{N(s)}} $$ $$ \text{BEB (Kolter \& Ng, 2009):}\qquad \mathcal{B}(N(s)) = \frac{1}{N(s)} $$这里 $n$ 是总的访问步数(即 $\sum_s N(s)$)。三者的差别值得体会:
| bonus | 形式 | 衰减速度 | 理论出身 | 特点 |
|---|---|---|---|---|
| UCB | $\sqrt{2\ln n / N(s)}$ | $N^{-1/2}$,但分子随总步数缓慢增长 | 多臂老虎机的置信上界 | 随着训练变长,所有状态的 bonus 都会被 $\ln n$ 稍微抬高,鼓励持续探索 |
| MBIE-EB | $1/\sqrt{N(s)}$ | $N^{-1/2}$ | PAC-MDP 分析(frequentist) | 去掉了 $\ln n$,量级更稳定;Bellemare 等人 2016 的选择 |
| BEB | $1/N(s)$ | $N^{-1}$,快得多 | 贝叶斯探索加成(Bayesian) | 衰减快 → 更快收敛到利用;理论上给的是 Bayes 意义下的近最优而非 PAC 保证 |
为什么在小规模表格 MDP 上 $1/\sqrt{N}$ 是「对的」?因为 $N$ 个样本估计一个均值的标准误就是 $\sigma/\sqrt{N}$,而这个不确定性会通过 Bellman 备份传播到值函数上。$1/N$(BEB)衰减更快,对应的是「贝叶斯后验方差」而不是「频率派置信区间宽度」的直觉;它探索得更保守,但在有先验信息时收敛更快。在深度 RL 实践中,$1/\sqrt{\hat N}$ 是最常见的默认选择。
然而:什么叫「计数」?
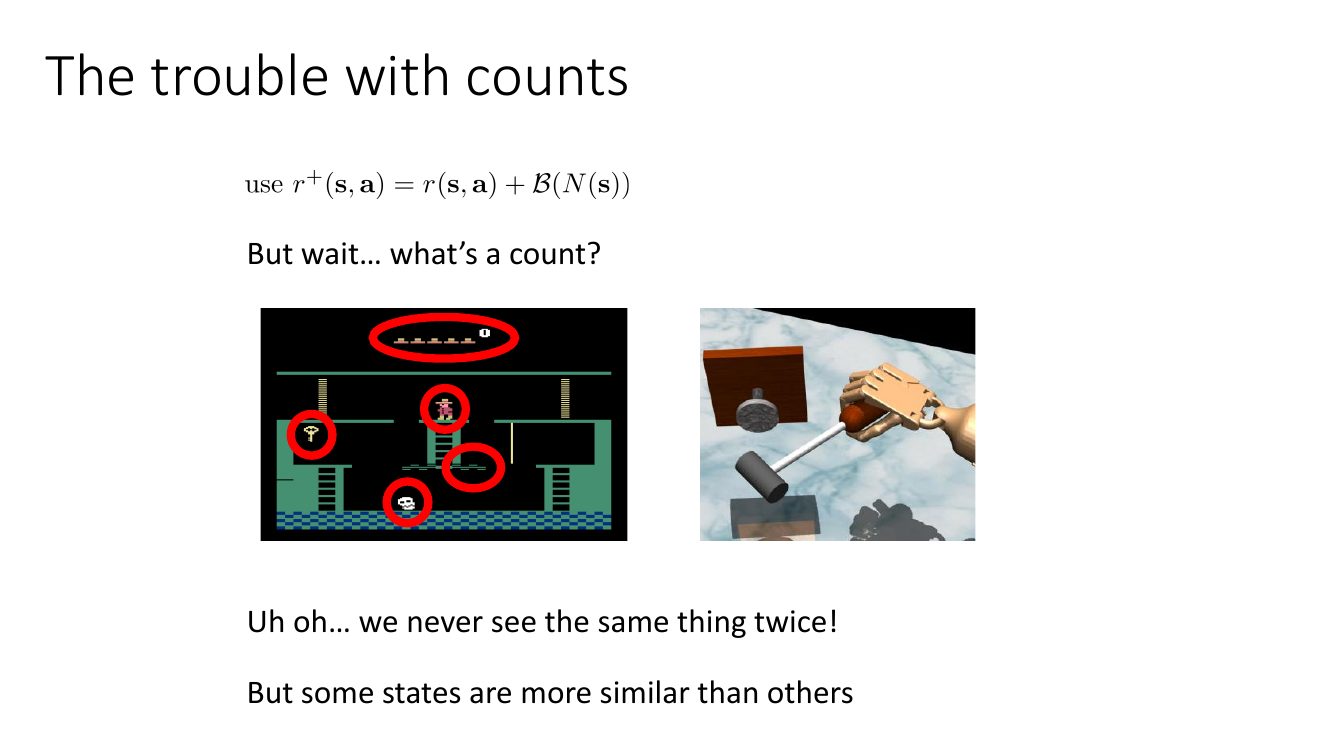
这是全讲的转折点。在表格型 MDP 里 $N(s)$ 是一个字典查表;在 Atari 里,状态是 $210\times160\times3$ 的像素,加上 4 帧堆叠,可能的状态数远超宇宙原子数。字面意义上的计数恒等于 1,毫无信息量。
但「永远不会重复」不等于「毫无结构」。图中红圈标出的那些语义元素——玩家位置、钥匙、骷髅、绳子——才是真正决定状态「新不新」的东西。两帧只差一个骷髅移动了 2 像素,本质上是同一个状态;两帧一个在第一个房间、一个在第二个房间,才是真正不同的状态。
所以问题转化为:如何定义一种「软计数」,让相似的状态互相贡献计数? 接下来三节给出三条不同的技术路线,它们的抽象程度依次递减、工程可用性依次递增。
8. 伪计数:用密度模型反推计数
思路:拟合一个生成模型
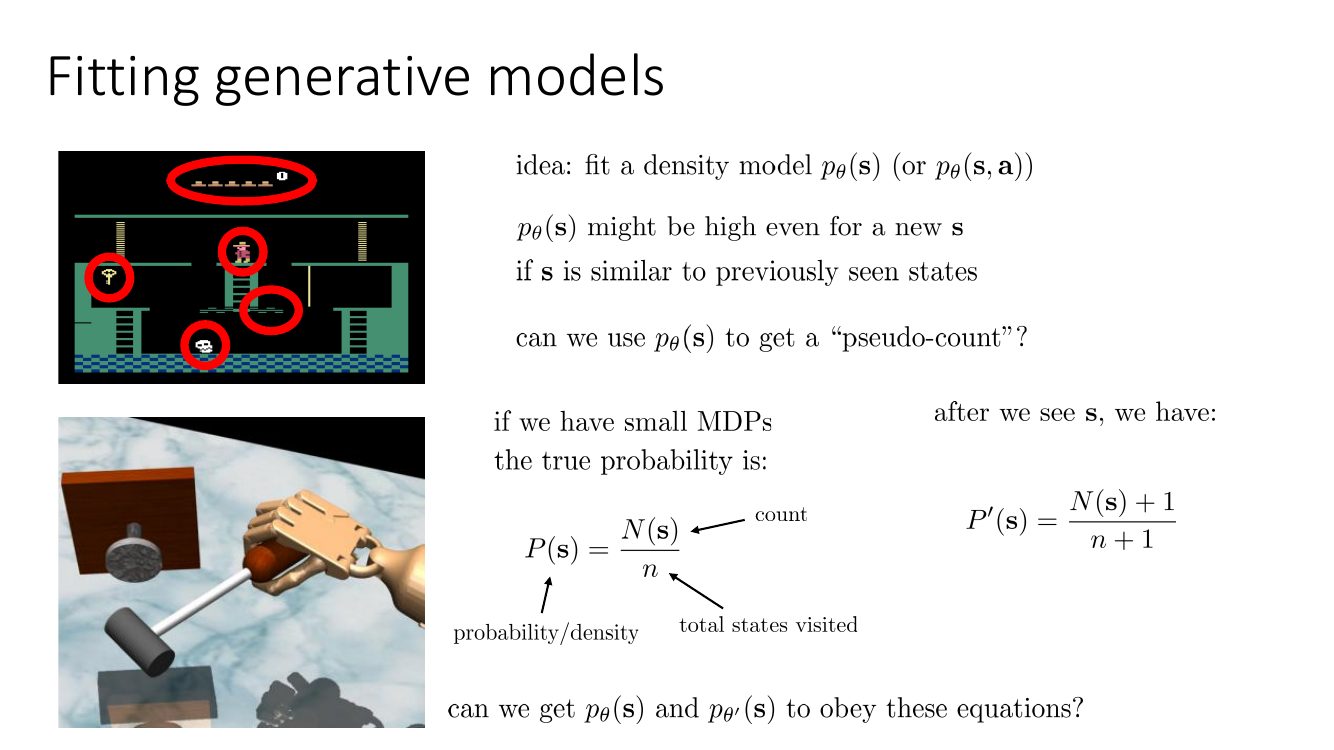
先把逻辑理顺:
- 在表格设定下,经验分布与计数之间有一一对应:$P(s)=N(s)/n$,其中 $n=\sum_{s'}N(s')$ 是访问过的状态总数。
- 因此「计数」并不是一个比「密度」更基本的东西——它们互为函数。既然在高维空间里计数崩溃了而密度还能估(因为密度模型可以泛化),那就反过来:先估密度,再从密度里解出计数。
- 但一个方程 $p_\theta(s)=\hat N(s)/\hat n$ 里有两个未知数 $\hat N(s)$ 和 $\hat n$,解不出来。所以还需要第二个方程——这就是为什么要引入「看到 $s$ 之后重新拟合的模型 $p_{\theta'}$」。
完整算法与反解公式
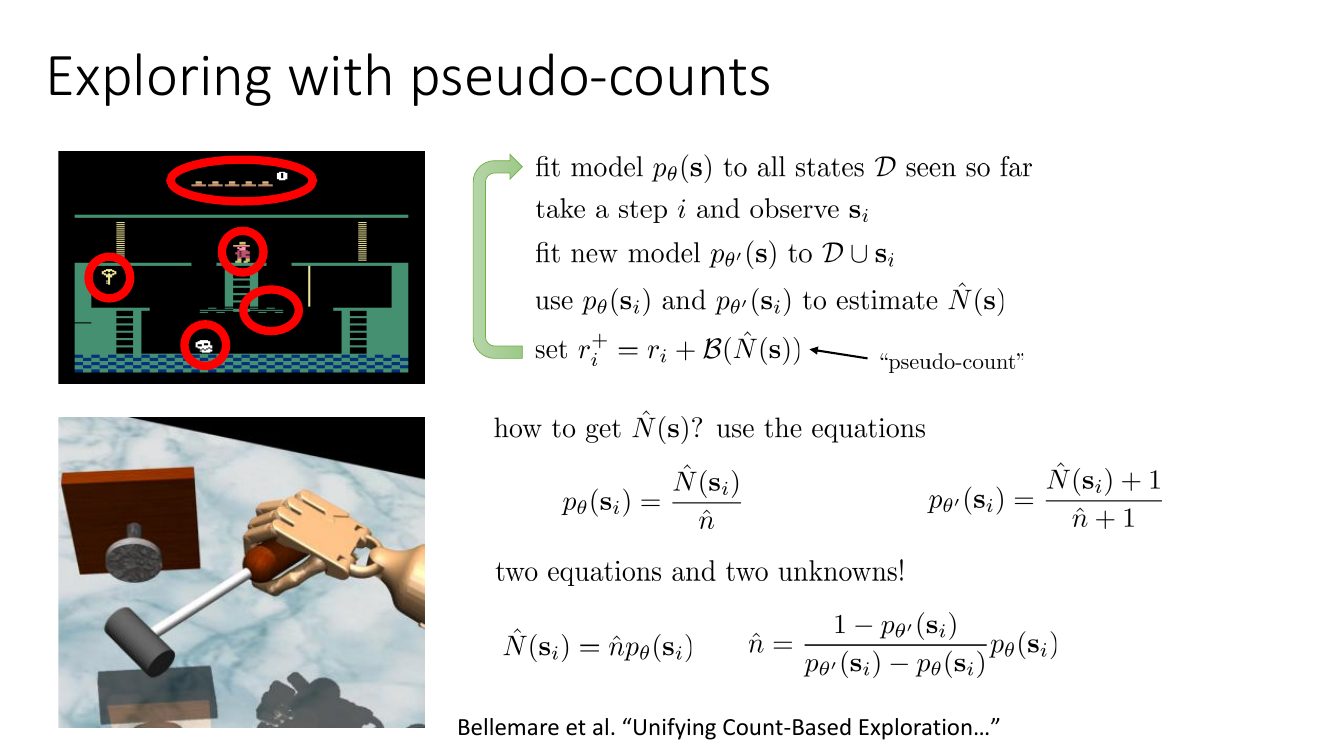
算法(每次迭代):
- 用迄今为止见过的所有状态 $\mathcal{D}$ 拟合模型 $p_\theta(s)$;
- 走一步 $i$,观察到新状态 $s_i$;
- 用 $\mathcal{D}\cup\{s_i\}$ 重新拟合一个模型 $p_{\theta'}(s)$;
- 用 $p_\theta(s_i)$ 和 $p_{\theta'}(s_i)$ 估计伪计数 $\hat N(s_i)$;
- 令 $r_i^+ = r_i + \mathcal{B}(\hat N(s_i))$,用 $r^+$ 更新策略 / Q 函数;回到第 1 步。
第 4 步怎么做?把表格情形的两条方程强行套用到模型输出上:
$$ p_\theta(s_i) = \frac{\hat N(s_i)}{\hat n}, \qquad p_{\theta'}(s_i) = \frac{\hat N(s_i) + 1}{\hat n + 1} $$「两个方程,两个未知数!」——于是可以解出来。
由第一式得 $\hat N(s_i) = \hat n\, p_\theta(s_i)$。代入第二式:
$$ p_{\theta'}(s_i) = \frac{\hat n\, p_\theta(s_i) + 1}{\hat n + 1} $$两边乘 $(\hat n+1)$:
$$ p_{\theta'}(s_i)\,\hat n + p_{\theta'}(s_i) = \hat n\, p_\theta(s_i) + 1 $$把含 $\hat n$ 的项移到一边:
$$ \hat n\big(p_{\theta'}(s_i) - p_\theta(s_i)\big) = 1 - p_{\theta'}(s_i) $$于是
$$ \hat n = \frac{1 - p_{\theta'}(s_i)}{p_{\theta'}(s_i) - p_\theta(s_i)} $$再代回 $\hat N(s_i)=\hat n\,p_\theta(s_i)$,得到幻灯片上的最终结果:
$$ \boxed{\ \hat N(s_i) = \hat n\, p_\theta(s_i), \qquad \hat n = \frac{1 - p_{\theta'}(s_i)}{p_{\theta'}(s_i) - p_\theta(s_i)}\, p_\theta(s_i)\ } $$(幻灯片上 $\hat n$ 的表达式末尾也乘了 $p_\theta(s_i)$,是因为它把两式合并写成了 $\hat N$ 的直接表达;两种写法在数值上等价,实现时只要保证 $\hat N=\hat n\,p_\theta$ 的一致性即可。)
这个公式在做什么?分母 $p_{\theta'}(s_i)-p_\theta(s_i)$ 是「多看了一次 $s_i$,模型对 $s_i$ 的信心提升了多少」。
- 如果 $s_i$ 是个全新的状态,多这一个样本会让 $p_{\theta'}(s_i)$ 比 $p_\theta(s_i)$ 大很多 → 分母大 → $\hat n$ 小 → $\hat N(s_i)$ 小 → bonus 大。✔
- 如果 $s_i$ 是个见过一万次的状态,多这一个样本几乎不改变模型,$p_{\theta'}\approx p_\theta$ → 分母趋于 0 → $\hat n$ 巨大 → $\hat N(s_i)$ 巨大 → bonus 趋于 0。✔
也就是说,伪计数度量的是「这个样本对模型的边际影响力」。这与「计数」的直觉完全吻合,而且天然带有泛化:一个从没见过、但与见过的状态很像的状态,模型早就把概率质量分给它了,所以它的边际影响力也小,伪计数自然就高。
效果
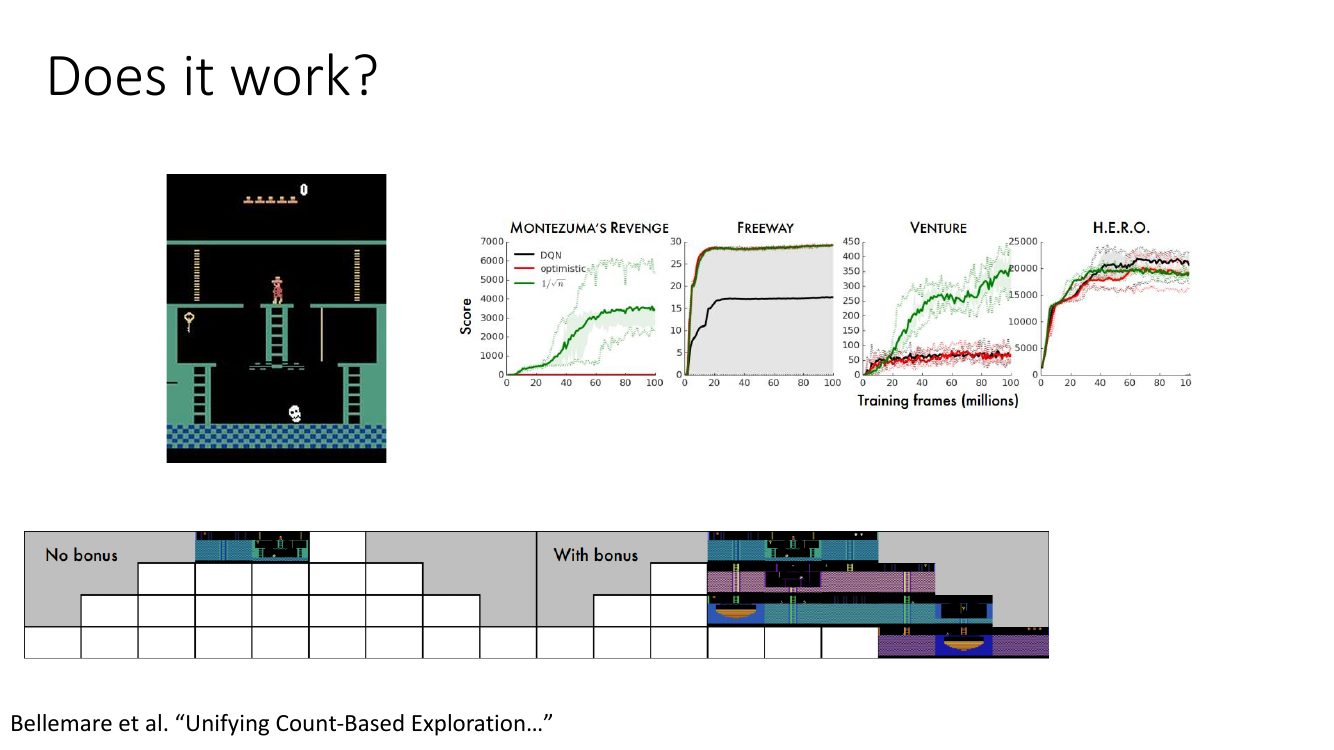
这张图要看的重点不是绝对分数,而是定性的转变:在 Montezuma 这类任务上,没有探索 bonus 时学习曲线是一条平坦的零线(梯度信号根本不存在),加上 bonus 后曲线终于有了斜率。同时注意 Freeway 和 H.E.R.O. 的对比:在奖励本来就不稀疏的游戏上,bonus 带来的提升有限甚至可能略有拖累——这印证了前面说的「bonus 权重必须调,加多了会挤占真实奖励」。
该用什么密度模型
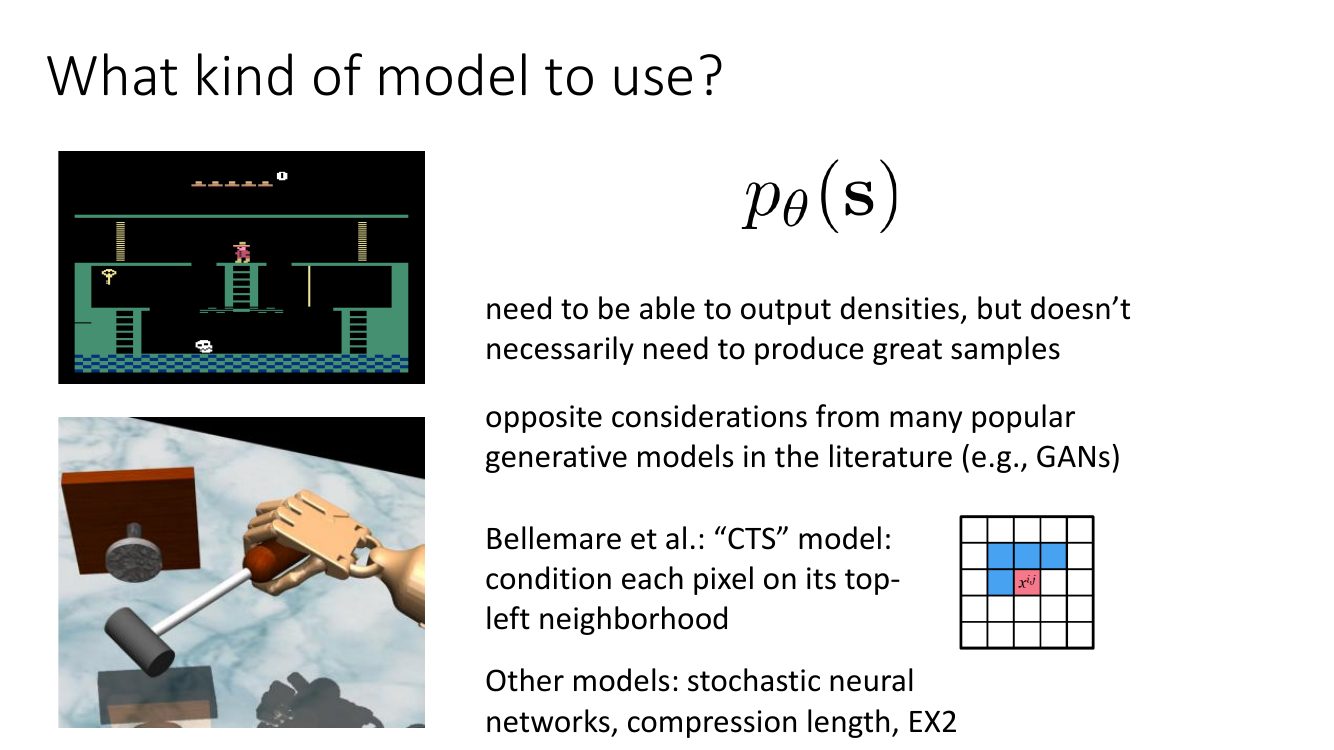
这是一条很有价值的工程判断。GAN 能生成惊艳的图像,但它压根不给你密度(判别器不是密度,生成器是隐式分布)——所以 GAN 在这里完全没用。反过来,一个像 CTS 这样简单到几乎「土」的自回归模型,采样出来的图像惨不忍睹,但它给出的 $\log p_\theta(s)$ 是良定义、可精确计算、且数值稳定的,这就够了。
可用的模型家族包括:
- CTS(Context Tree Switching):像素级自回归,每个像素条件在左上邻域。极快、无需梯度训练、天然支持在线增量更新(这对算法第 3 步「重新拟合」至关重要)。
- PixelCNN:Ostrovski 等人的后续工作用它替换 CTS,密度估计更准,Montezuma 上的成绩进一步提升。
- 随机神经网络 / 变分自编码器:给出的是 ELBO(密度下界)而非精确密度,但用作相对新颖度排序通常够用。
- 压缩长度:用压缩算法的编码长度 $\ell(s)$ 近似 $-\log p(s)$。这是 MDL 视角,非常粗糙但零训练成本。
算法第 3 步写的是「用 $\mathcal{D}\cup s_i$ 重新拟合一个新模型 $p_{\theta'}$」,读起来像是每一步都要从头训一个生成模型——那当然不可行。实现上是在线更新:CTS 这类模型对单个样本做一次增量更新只需要 $O(\text{像素数})$,$p_\theta$ 是更新前的输出、$p_{\theta'}$ 是更新后的输出,两次前向就够了。用神经网络时则是做一步梯度更新,不是重新训练。这也是为什么密度模型的「可增量更新性」比「样本质量」重要得多。
9. 哈希计数与 EX2:另外两条造计数的路
伪计数需要一个能算密度的生成模型,这在图像上仍然是个不小的负担。有没有更省事的办法?有两条。
哈希计数:把状态压成短码,再老老实实数
思路直白得可爱:既然「相同状态永不重现」是因为状态太高维,那就把状态压缩成一个短的离散码,然后在码上做真正的表格计数。这就是 Tang 等人 #Exploration: A Study of Count-Based Exploration for Deep RL(2016)的做法:
$$ \phi: \mathcal{S}\to\{0,1\}^k,\qquad N(s) \;\triangleq\; N\big(\phi(s)\big),\qquad \mathcal{B}(N(s)) = \frac{\beta}{\sqrt{N(\phi(s))}} $$$k$ 通常取 16~256 比特,于是最多有 $2^k$ 个「桶」,但实际被访问到的桶只有几万个,用一个哈希表存得下。关键在于 $\phi$ 怎么选:
- SimHash / 随机投影:$\phi(s)=\mathrm{sign}(A\,g(s))$,$A\in\R^{k\times d}$ 元素取自标准正态,$g(s)$ 是状态的某种特征(原始像素或降采样图)。这是局部敏感哈希(LSH):欧氏距离近的状态大概率哈希到同一个码,这正是我们要的「相似状态互相贡献计数」。
- 学出来的哈希:训练一个自编码器把状态压到 $k$ 维瓶颈层,瓶颈层加上噪声并二值化。这样哈希码携带的是语义相似性而非像素相似性,效果通常更好。
import numpy as np
from collections import defaultdict

class HashCounter:
    """SimHash 计数器:给状态一个 1/sqrt(N) 的探索 bonus"""
    def __init__(self, feat_dim, k=32, beta=0.05, seed=0):
        rng = np.random.RandomState(seed)
        self.A = rng.randn(k, feat_dim)     # 固定的随机投影矩阵
        self.table = defaultdict(int)
        self.beta = beta

    def _code(self, phi):                   # phi: (feat_dim,) 的状态特征
        bits = (self.A @ phi > 0).astype(np.uint8)
        return bits.tobytes()               # 当作哈希表的键

    def bonus(self, phi, update=True):
        key = self._code(phi)
        if update:
            self.table[key] += 1
        n = max(self.table[key], 1)
        return self.beta / np.sqrt(n)

# 用法:r_plus = r + counter.bonus(encoder(s))哈希计数的取舍很明确:$k$ 太小会把语义上完全不同的状态撞进同一个桶(bonus 过早消失),$k$ 太大则每个状态又各占一桶(回到 $N\equiv 1$ 的退化情形)。所以 $k$ 是一个必须调的关键超参数,它实际上在控制「相似度」的粒度。
EX2:用「可区分性」隐式估计密度
第三条路更巧妙,来自 Fu 等人的 EX2: Exploration with Exemplar Models(2017):不显式建模密度,而是训练一个分类器去判断「这个状态能不能和其他状态区分开」。
具体做法:对当前状态 $s$,训练一个二分类器 $D_s$ 区分「$s$ 本身」(正例)与「回放缓冲区里采出的其他状态」(负例)。如果 $s$ 很新颖,分类器很容易把它挑出来,判别概率接近 1;如果 $s$ 已经在缓冲区里出现过很多次,分类器无法区分,最优判别概率会趋于 $1/2$。可以证明最优判别器满足
$$ D_s(s) = \frac{p_{\delta}(s)}{p_{\delta}(s) + p_{\mathcal{D}}(s)} \;\Longrightarrow\; p_{\mathcal{D}}(s) = \frac{1 - D_s(s)}{D_s(s)}\cdot p_\delta(s) $$也就是说,判别器的输出可以反解出缓冲区分布的密度(这是与 GAN 相同的密度比技巧)。于是 bonus 可以直接写成 $\mathcal{B}=-\log p_{\mathcal{D}}(s)$ 或它的单调函数。EX2 的好处是完全避开了在像素上做显式密度估计——训练判别器比训练生成模型容易得多。
这三条路——伪计数、哈希计数、EX2——本质上在做同一件事:定义一个「相似度」,让相似的状态共享计数。区别只在相似度从哪里来:伪计数从生成模型的泛化能力里来,哈希计数从随机投影 / 自编码器的几何结构里来,EX2 从判别器的可分性里来。理解了这一点,你就能自己发明第四条路(例如用最近邻距离、用对比学习的表示空间等——事实上后来的 RE3、NGU 等方法正是这么做的)。
10. RND:连密度都不要了
从密度到误差
这一节是本讲逻辑链条最漂亮的一段。回顾一下需求是怎么一步步被削减的:
- 最初我们要的是计数 $N(s)$ —— 在高维空间不可行;
- 退而求其次要密度 $p_\theta(s)$,再反解伪计数 —— 需要训练生成模型,麻烦;
- 再退一步:其实我们只需要一个相对的新颖度排序,密度值准不准无所谓;
- 最后:任何一个「在见过的数据上小、在没见过的数据上大」的标量函数都可以当 bonus。
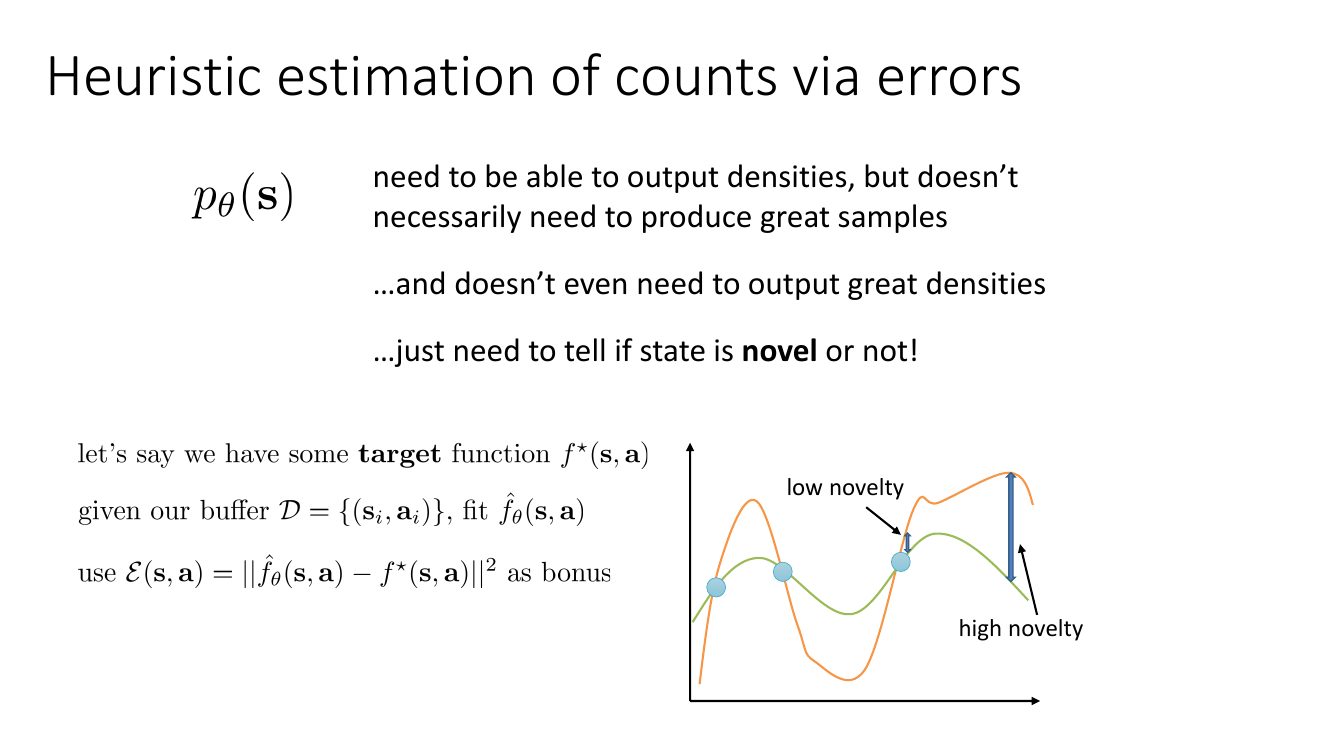
而「监督学习的泛化误差」天然就有这个性质!于是构造:任选一个 target 函数 $f^\star(s,a)$,用缓冲区数据做回归拟合出 $\hat f_\theta$,令
$$ \mathcal{E}(s,a) = \big\|\hat f_\theta(s,a) - f^\star(s,a)\big\|^2 $$作为 bonus。在训练数据附近,回归拟合得好,$\mathcal{E}$ 小;在数据稀疏的区域,网络只能靠外推,$\mathcal{E}$ 大。这就是我们要的新颖度信号。
target 该选什么
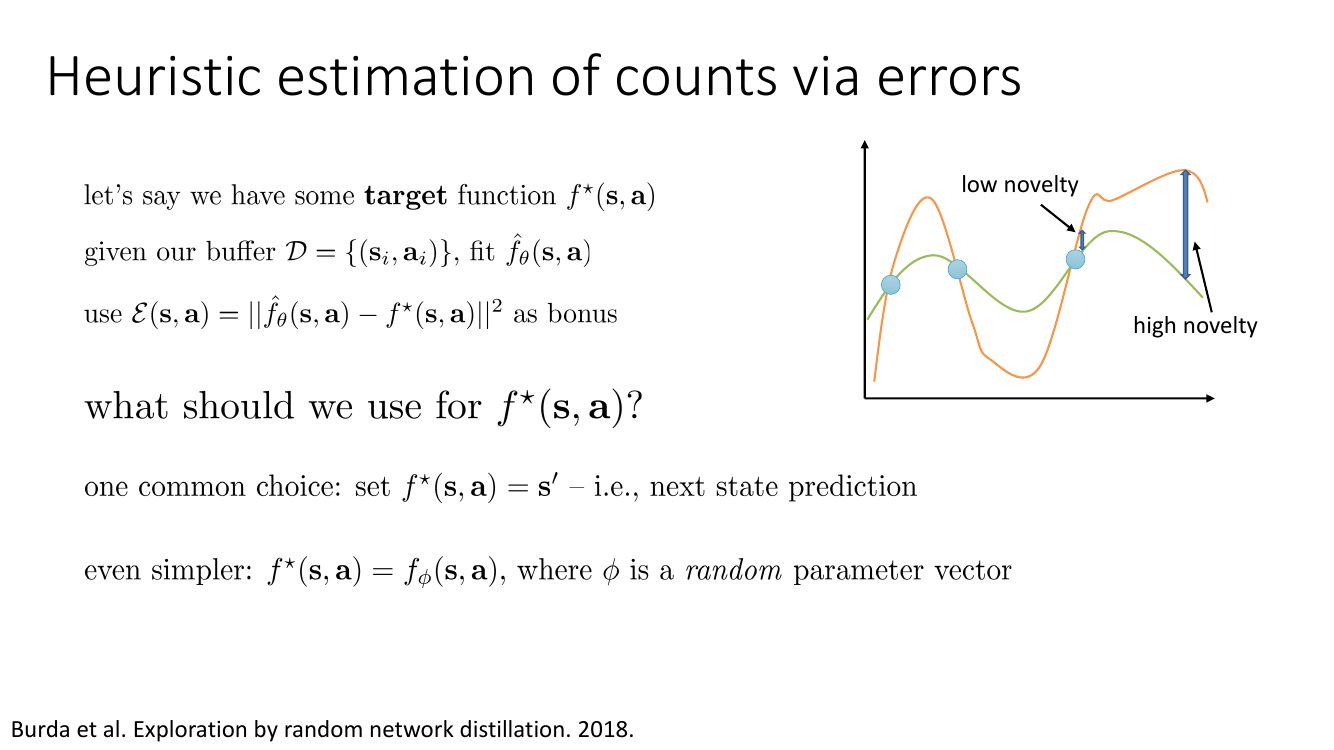
选择 A:预测下一个状态。 令 $f^\star(s,a)=s'$,那么 $\hat f_\theta$ 就是一个动力学模型,$\mathcal{E}$ 是它的预测误差。直觉很好:在你已经理解了动力学的区域,预测准,不需要探索;在你还预测不准的地方,说明还没学会,值得去。这就是所谓的 prediction-error bonus(Stadie 等人 2015;Pathak 等人的 ICM 也是同族)。
用预测误差当 bonus 有一个著名的失败模式:noisy-TV 问题。如果环境中存在本质随机的东西(一台播放雪花噪声的电视机、随风飘动的树叶、掷骰子),那么无论智能体观察多少次,下一状态都无法预测,$\mathcal{E}$ 永远居高不下。结果智能体会坐在电视机前不动,永远拿着最高的 bonus,再也不去探索真正的新区域。根因是预测误差混淆了两种不确定性:认知不确定性(epistemic,源于数据不足,可以通过探索消除)和偶然不确定性(aleatoric,源于环境本身随机,永远无法消除)。我们只想要前者。
选择 B:随机网络蒸馏(RND)。 Burda 等人(2018)的解法极其漂亮:令
$$ f^\star(s,a) = f_\phi(s,a),\qquad \phi \sim \text{随机初始化,之后永久冻结} $$也就是说 target 是一个随机初始化的、从不训练的神经网络的输出。它没有任何语义,只是一个固定的、复杂的确定性函数。然后训练 $\hat f_\theta$ 去回归它:
$$ \theta \leftarrow \argmin_\theta \sum_{(s_i,a_i)\in\mathcal{D}} \big\|\hat f_\theta(s_i,a_i) - f_\phi(s_i,a_i)\big\|^2, \qquad \mathcal{B}(s,a) = \big\|\hat f_\theta(s,a)-f_\phi(s,a)\big\|^2 $$为什么这样就解决了 noisy-TV?因为 $f_\phi$ 是关于 $s$ 的确定性函数,没有任何噪声可言。同一个雪花噪声画面输入两次,$f_\phi$ 输出完全相同,所以只要看过足够多次,$\hat f_\theta$ 就能记住它,误差降到 0。此时的误差纯粹反映「这个输入我见过多少次」,即认知不确定性——这正是我们想要的量。
RND 的整套逻辑可以概括为一句话:把「新颖度」重新定义为「一个随机固定函数在这个点上的蒸馏误差」。它同时具备三个优点:
- 不需要生成模型、不需要密度、不需要动力学模型,只需要两个前向和一个 MSE 损失;
- 对随机环境免疫(target 是确定性的);
- 误差随访问次数单调下降,天然具备「bonus 随计数衰减」的性质。
代价是:bonus 的绝对量级没有意义(依赖于随机网络的初始化尺度),必须做运行时归一化——RND 论文中对 bonus 做了运行均值/方差归一化,对观测也做了归一化。这在实现里是必须的细节,不是可选项。
最小实现
import torch, torch.nn as nn

class RND(nn.Module):
    def __init__(self, obs_dim, out_dim=128, hid=256):
        super().__init__()
        # target:随机初始化后冻结,永不训练
        self.target = nn.Sequential(
            nn.Linear(obs_dim, hid), nn.ReLU(), nn.Linear(hid, out_dim))
        for p in self.target.parameters():
            p.requires_grad_(False)
        # predictor:训练它去回归 target
        self.pred = nn.Sequential(
            nn.Linear(obs_dim, hid), nn.ReLU(),
            nn.Linear(hid, hid), nn.ReLU(), nn.Linear(hid, out_dim))
        self.register_buffer('rew_var', torch.ones(()))   # running variance

    def bonus(self, obs):
        """返回归一化后的探索 bonus(不回传梯度到策略)"""
        with torch.no_grad():
            e = (self.pred(obs) - self.target(obs)).pow(2).mean(dim=-1)
            self.rew_var.mul_(0.99).add_(0.01 * e.var().clamp(min=1e-8))
            return e / self.rew_var.sqrt()

    def loss(self, obs):
        """predictor 的训练损失:只在采到的数据上最小化"""
        return (self.pred(obs) - self.target(obs)).pow(2).mean()

# 训练循环里:
#   r_plus = r + beta * rnd.bonus(obs_next)
#   opt_rnd.zero_grad(); rnd.loss(obs_next).backward(); opt_rnd.step()
#   然后用 r_plus 跑你原本的 PPO / DQN 更新
三个实现要点:(1)target 网络的参数必须 requires_grad_(False),否则它会和 predictor 一起塌缩到 0,误差恒为 0;(2)predictor 一般比 target 更深更宽,保证它有能力拟合;(3)bonus 必须归一化,否则它与真实奖励的相对量级会在训练中漂移。RND 论文还建议把内在奖励作为非分幕(non-episodic)信号、用两个独立的价值头分别估计内在与外在回报,这样内在奖励不会因为「死亡结束 episode」而被截断——这个技巧对 Montezuma 上的成绩至关重要。
11. 后验采样在深度 RL:Bootstrapped DQN
第 5 节的 Thompson sampling 在老虎机上只有三行,搬到深度 RL 上的障碍是:我们要采样的「模型」是什么?直接对环境模型 $p(s'|s,a)$ 做后验太难了。Osband 等人的关键简化是:不对模型采样,而是直接对 Q 函数采样。
理由是:在老虎机里,「从后验采一个模型再贪心」等价于「从后验采一个 $\hat\mu$ 向量再取 argmax」。而在 MDP 里,$Q$ 函数就扮演 $\hat\mu$ 的角色。于是算法变成:
- 维护 Q 函数的某种「后验」$\hat p(Q)$;
- 每个 episode 开始时,从中采样一个 $Q\sim\hat p(Q)$;
- 在整个 episode 里都用这个 $Q$ 贪心地行动(不再加任何随机性);
- episode 结束后用新数据更新后验,回到第 2 步。
怎么表示 Q 函数的后验:bootstrap
神经网络参数的后验不可能显式表示,但统计学里有一个经典的、不需要任何分布假设的近似——自助法(bootstrap):给定数据集 $\mathcal{D}$($N$ 个样本),有放回地重采样出 $N$ 个样本得到 $\mathcal{D}_i$,在 $\mathcal{D}_i$ 上训练模型 $f_{\theta_i}$。重复 $K$ 次,得到的 $\{f_{\theta_1},\dots,f_{\theta_K}\}$ 就近似是模型后验的 $K$ 个样本。
直接实现代价太高($K$ 个完整的网络 + $K$ 份数据)。Bootstrapped DQN 的工程妥协是:
- 共享卷积主干,只分出 $K$ 个 Q 头(典型 $K=10$)。这样计算量只比普通 DQN 多一点点。
- 不做真正的有放回重采样,而是给每个转移随机生成一个 bootstrap mask $m\in\{0,1\}^K$(例如每一位以 0.5 或 1.0 的概率为 1),第 $i$ 个头只在 $m_i=1$ 的样本上更新。
- 头之间的差异主要来自不同的随机初始化加上不同的数据子集——实践中初始化的作用甚至比数据划分更大。
import torch, torch.nn as nn

class BootstrappedQ(nn.Module):
    def __init__(self, obs_dim, n_act, K=10, hid=256):
        super().__init__()
        self.K = K
        self.trunk = nn.Sequential(nn.Linear(obs_dim, hid), nn.ReLU())
        self.heads = nn.ModuleList([nn.Linear(hid, n_act) for _ in range(K)])

    def forward(self, obs, head=None):
        z = self.trunk(obs)
        if head is not None:                      # 单头:用于行动
            return self.heads[head](z)
        return torch.stack([h(z) for h in self.heads], dim=0)   # (K,B,A)

def run_episode(env, qnet, K):
    head = int(torch.randint(K, (1,)))            # ← 后验采样:一个 episode 固定一个头
    s, done = env.reset(), False
    while not done:
        a = int(qnet(torch.as_tensor(s).float()[None], head=head).argmax())
        s2, r, done, _ = env.step(a)
        mask = (torch.rand(K) < 0.5).float()      # bootstrap mask,存进 replay
        buffer.add(s, a, r, s2, done, mask)
        s = s2

# 更新时:每个头只在自己 mask=1 的样本上计 loss
#   td = q_all.gather(...) - target                  # (K,B)
#   loss = (mask.T * td.pow(2)).sum() / mask.sum()
为什么这比 $\epsilon$-greedy 强:深度探索
Bootstrapped DQN 的威力不在于它更随机,而在于它的随机性是「时间上一致」的。
- $\epsilon$-greedy 每一步独立地掷骰子。要走出一条长度 $L$ 的特定探索路径,概率约为 $(\epsilon/|\mathcal{A}|)^L$——指数级小。它做的是抖动(dithering),就像在原地随机游走,走不远。
- Bootstrapped DQN 在 episode 开头选定一个头,然后整局都坚持这个假设。如果这个头恰好「相信」左边那扇门后面有宝藏,它会一路坚定地走到那扇门去验证。这叫深度探索(deep exploration)。
用一个具体例子体会:一条 $L$ 个状态的链,只有最左端有小奖励、最右端有大奖励,起点在中间。$\epsilon$-greedy 需要 $\Theta(2^L)$ 步才能到达右端;Bootstrapped DQN 只需要 $O(L)$ 个 episode——因为总有某个头初始时高估右端,而它会坚持走过去。
Levine 对这类方法的评价是:它的最大优点是「没有 bonus 权重要调」——不像 UCB 系方法要平衡 $\mathcal{B}$ 与真实奖励的量级,bootstrap 方法在纯粹的 RL 目标上工作。缺点是它对「新颖度」的刻画比显式 bonus 弱得多:如果所有头都对某个未访问区域给出一致的(错误的)低估计,就没有任何机制能把智能体推过去。所以在 Montezuma 这种极端稀疏的任务上,bootstrap 通常打不过 RND;但在中等稀疏、需要长时序一致探索的任务上,它往往更稳、更省事。
12. 信息增益在深度 RL:VIME 与预测误差
三类方法的最后一类。第 6 节的 $\mathrm{IG}(z,y|a)$ 要落到深度 RL 上,首先要回答:我们想获取关于「什么」的信息? 有几种可能的选择:
| 要获取信息的对象 $z$ | 含义 | 问题 |
|---|---|---|
| 奖励函数 $r(s,a)$ | 搞清楚哪里有奖励 | 奖励太稀疏时信息量几乎为零,学不到东西 |
| 状态密度 $p(s)$ | 搞清楚状态空间长什么样 | 有点奇怪(这不是我们要学的东西),但确实是个合理的新颖度代理 |
| 动力学 $p(s'|s,a)$ | 搞清楚环境怎么运作 | 最合理:学会动力学是学会最优策略的必要条件 |
VIME:用变分推断近似动力学的信息增益
Houthooft 等人的 VIME(Variational Information Maximizing Exploration, 2016)选了第三条。设动力学模型的参数为 $\theta$,历史为 $h$,做一次转移观察到 $(s,a,s')$,则信息增益是
$$ \mathrm{IG}(s';\theta \mid s,a) \;=\; \KL\Big(\,p(\theta \mid h, s, a, s')\ \big\|\ p(\theta \mid h)\,\Big) $$读作:「看到这次转移之后,我对动力学参数的信念改变了多少」。改变得越多,说明这次转移越出乎意料、信息量越大 —— 于是把它当作 bonus。注意这和第 8 节伪计数的直觉是同源的(都是「这个样本的边际影响力」),只不过伪计数量的是对密度模型的影响,VIME 量的是对动力学模型的影响。
问题在于 $p(\theta|h)$ 对神经网络无法计算。VIME 用变分近似:设 $q_\phi(\theta)$ 是一个可处理的分布族(VIME 取独立高斯,即贝叶斯神经网络的均值场近似),通过最大化 ELBO 拟合后验:
$$ \phi = \argmax_\phi\ \Big\{\ \E_{\theta\sim q_\phi}\big[\log p(h\mid\theta)\big] - \KL\big(q_\phi(\theta)\,\|\,p(\theta)\big)\ \Big\} $$然后把 KL 里的两个后验都换成变分近似。记看到新转移之前的参数为 $\phi$、之后(做一步或几步梯度更新)的参数为 $\phi'$,bonus 就是
$$ \mathcal{B}(s,a,s') = \KL\big(q_{\phi'}(\theta)\ \|\ q_{\phi}(\theta)\big) $$对角高斯之间的 KL 有闭式解,逐维求和即可:
$$ \KL\big(\mathcal{N}(\mu_1,\sigma_1^2)\,\|\,\mathcal{N}(\mu_2,\sigma_2^2)\big) = \log\frac{\sigma_2}{\sigma_1} + \frac{\sigma_1^2 + (\mu_1-\mu_2)^2}{2\sigma_2^2} - \frac12 $$为了避免每一步都做完整的变分更新,VIME 进一步用二阶展开近似:$\KL \approx \frac12 \Delta\phi^\top H \Delta\phi$,其中 $H$ 是 KL 的 Hessian(即 Fisher 信息矩阵),而 $\Delta\phi$ 是一步梯度。对角高斯下 $H$ 是对角的,整个计算退化成逐参数的乘加,非常便宜。
为什么 KL 散度可以当 bonus?$\KL(q_{\phi'}\|q_\phi)$ 度量的是「这条数据让我改变了多少想法」。一个已经见过无数次的转移不会让贝叶斯神经网络的后验有任何移动,KL 趋于 0;一个从未见过的转移会显著收窄某些参数的后验,KL 很大。而且——这一点很关键——如果某个转移是本质随机的,贝叶斯后验在见过足够多次之后会稳定下来(它学会了「这里就是随机的」),KL 同样趋于 0。所以 VIME 在原理上也能免疫 noisy-TV,这是它相对朴素预测误差 bonus 的理论优势。
预测误差 bonus:信息增益的粗暴近似
如果嫌 VIME 太重,最粗糙的近似就是第 10 节讲的 prediction-error bonus:
$$ \mathcal{B}(s,a) = \big\|\hat f_\theta(s,a) - s'\big\|^2 $$它可以理解成「信息增益的一阶代理」:预测误差大的地方,往往就是模型还没学会、后验还会大幅移动的地方。但它把两种不确定性混在一起,于是有了 noisy-TV 问题;而 VIME 因为显式地建模了参数后验,原则上能区分开。代价是 VIME 要维护一个贝叶斯神经网络,实现复杂、训练慢、超参数敏感——这就是 Levine 说的「信息增益类方法近似误差最大、最难用」的具体体现。
此外还有一类思路是把 bonus 定义在模型集成的分歧上:训练 $K$ 个动力学模型 $\{\hat f_{\theta_1},\dots,\hat f_{\theta_K}\}$,用它们预测的方差
$$ \mathcal{B}(s,a) = \frac{1}{K}\sum_{i=1}^{K}\big\|\hat f_{\theta_i}(s,a) - \bar f(s,a)\big\|^2, \qquad \bar f = \frac1K\sum_i \hat f_{\theta_i} $$当作 bonus。这实际上是「用 bootstrap 近似后验 + 用后验方差近似信息增益」的组合,兼具实现简单和对随机性的鲁棒性(真随机的地方所有模型都会预测同一个均值,分歧为 0),是目前工程上性价比很高的一条路(Pathak 等人的 Disagreement、Plan2Explore 都属此类)。
13. 方法总览与实践要点
一张表看完所有方法
| 方法 | 所属家族 | bonus / 机制的具体形式 | 需要额外训练什么 | 关键超参数 | 对随机环境 |
|---|---|---|---|---|---|
| UCB(老虎机) | 乐观 | $\hat\mu_a+\sqrt{2\ln H/N(a)}$ | 无(只记计数与均值) | bonus 系数 $C$ | — |
| 表格计数 bonus | 乐观 | $r^+ = r + \beta/\sqrt{N(s)}$ | 无 | $\beta$ | 稳健 |
| 伪计数(Bellemare 2016) | 乐观 | $\hat N=\hat n\,p_\theta(s)$,$\hat n=\frac{1-p_{\theta'}}{p_{\theta'}-p_\theta}p_\theta$;再套 $1/\sqrt{\hat N}$ | 密度模型 CTS / PixelCNN | $\beta$、密度模型容量 | 较稳健 |
| 哈希计数(#Exploration) | 乐观 | $\beta/\sqrt{N(\phi(s))}$,$\phi$ 为 SimHash 或自编码器 | 可选:自编码器 | $\beta$、码长 $k$ | 稳健 |
| EX2 | 乐观 | 由判别器反解 $p_\mathcal{D}(s)$,$\mathcal{B}=-\log p_\mathcal{D}$ | 判别器(每状态一个/摊销) | $\beta$、负样本数 | 较稳健 |
| 预测误差 bonus | 乐观 / IG 代理 | $\|\hat f_\theta(s,a)-s'\|^2$ | 动力学模型 | $\beta$ | 失效(noisy TV) |
| RND(Burda 2018) | 乐观 | $\|\hat f_\theta(s)-f_\phi(s)\|^2$,$f_\phi$ 随机冻结 | 一个 predictor 网络 | $\beta$、归一化、内外双价值头 | 免疫 |
| Bootstrapped DQN | 后验采样 | 整局固定一个 Q 头贪心行动(无 bonus) | $K$ 个 Q 头 | $K$、mask 概率 | 稳健 |
| VIME | 信息增益 | $\KL(q_{\phi'}(\theta)\|q_\phi(\theta))$(动力学参数后验的移动量) | 贝叶斯神经网络动力学 | $\beta$、变分步长 | 原理上免疫 |
| 模型集成分歧 | 信息增益近似 | $\frac1K\sum_i\|\hat f_{\theta_i}-\bar f\|^2$ | $K$ 个动力学模型 | $\beta$、$K$ | 免疫 |
实践中怎么选
- 状态是低维向量、状态空间不大:直接离散化 + 表格计数 $\beta/\sqrt{N}$。别上复杂方法,简单的往往更好。
- 图像输入、极端稀疏奖励(Montezuma 级):RND 是当前性价比最高的基线,实现简单、超参数少、有公开可复现的结果。伪计数(PixelCNN 版)效果也好但工程量大得多。
- 需要长时序一致的探索(走廊 / 迷宫 / 需要连续几十步坚持同一假设):Bootstrapped DQN 或它的变体(加 prior 网络的 BootDQN+prior)。$\epsilon$-greedy 在这类问题上是彻底无效的。
- 基于模型的设定、要主动收集数据训练动力学:模型集成分歧(Disagreement / Plan2Explore)最自然,因为动力学模型本来就要训。
- 环境中有本质随机源(其他智能体、随机纹理、传感器噪声):避开裸的预测误差 bonus,用 RND 或集成分歧。
三个几乎所有人都会踩的实现坑:
- bonus 量级。真实奖励可能在 $[0,1]$ 或 $[-100,100]$,bonus 的原始量级完全无关。必须归一化(对 bonus 做 running std 归一化,或对外部奖励做 clip),然后再调 $\beta$。$\beta$ 通常要扫 3–4 个数量级。
- 内在奖励是非平稳的。同一个状态在训练早期 bonus 很大、后期很小。这意味着 $r^+$ 定义的 MDP 本身在变,Q 函数一直在追一个移动的目标。常见缓解手段是用两套价值头分别估计内在和外在回报,最后合成 $Q = Q_\text{ext} + \beta Q_\text{int}$。
- 内在奖励不该被 episode 边界截断。RND 论文明确指出内在奖励应当是 non-episodic 的(即死亡时不 bootstrap 为 0),否则智能体会学会「快点死掉以规避未来的低 bonus」这类病态行为。
「加了探索 bonus 就一定更好」是错的。在奖励本身不稀疏的任务上(第 8 节 Freeway / H.E.R.O. 的曲线已经暗示了这一点),bonus 是纯粹的干扰项:它把优化目标从「拿分」改成了「拿分 + 逛新地方」,后者会拖慢收敛甚至改变最优策略。探索方法应当在确认了奖励稀疏是瓶颈之后才引入。诊断方法很简单:看看随机策略下的回报方差——如果为零,才是探索问题;如果不为零,你的瓶颈可能在别处。
本讲小结
- 问题:稀疏奖励 + 需要长序列有意义行为 = 随机策略的梯度恒为零。Montezuma's Revenge 是标准反例;人之所以觉得它简单,是因为人有像素语义的先验,算法没有。
- 探索 vs 利用是同一个问题:探索 = 做没做过的事以期更高奖励;利用 = 做已知最好的事。取舍必须算账,因为探索有真实代价。
- 可解性谱系:多臂老虎机 → 上下文老虎机 → 小表格 MDP → 有低秩结构的大 MDP → 无结构大 MDP,从可解到不可解。深度 RL 在最右端,所有方法都是从左端「取灵感」的 hack。
- regret:$\mathrm{Reg}(H)=H\,\E[r(a^\star)]-\sum_{t=1}^H r(a_t)$。贪心与固定 $\epsilon$-greedy 是 $\Theta(H)$;好算法是 $O(\log H)$,而这正是下界。
- 三大类最优策略:
- 乐观探索 UCB:$a=\argmax_a \hat\mu_a+\sqrt{2\ln H/N(a)}$,bonus 由 Hoeffding 不等式导出;次优臂被拉次数 $\le 8\ln H/\Delta_a^2$,故 regret 为 $O(\log H)$。
- 后验采样 / Thompson:从 $\hat p(\theta)$ 采一个模型,假装它是真的然后贪心。无超参数,「概率匹配」。
- 信息增益:$\mathrm{IG}(z,y|a)=\E_y[\mathcal{H}(\hat p(z))-\mathcal{H}(\hat p(z|y))]$,按 $\argmin_a \Delta(a)^2/g(a)$ 买单位信息最便宜的动作。
- 搬到 MDP:$r^+(s,a)=r(s,a)+\mathcal{B}(N(s))$,任何随 $N$ 递减的 $\mathcal{B}$ 都行;常用 UCB $\sqrt{2\ln n/N}$、MBIE-EB $1/\sqrt{N}$、BEB $1/N$。优点是能插进任何算法,缺点是要调权重。
- 计数崩溃 → 伪计数:用密度模型 $p_\theta$ 与增量更新后的 $p_{\theta'}$ 联立 $p_\theta=\hat N/\hat n$、$p_{\theta'}=(\hat N+1)/(\hat n+1)$,解得 $\hat N=\hat n\,p_\theta$、$\hat n=\frac{1-p_{\theta'}}{p_{\theta'}-p_\theta}p_\theta$。伪计数度量的是样本对模型的边际影响力。
- 密度模型要求与 GAN 相反:要能算密度、能增量更新,不需要能生成好样本。CTS / PixelCNN 是典型选择。
- 需求的逐级削弱:计数 → 密度 → 相对新颖度 → 「任何在见过的数据上小、没见过的数据上大的函数」。终点是 RND:$\mathcal{B}=\|\hat f_\theta(s)-f_\phi(s)\|^2$,$f_\phi$ 随机冻结。因为 target 是确定性的,RND 免疫 noisy-TV。
- 后验采样的深度 RL 版:Bootstrapped DQN,$K$ 个 Q 头 + bootstrap mask,每局固定一个头贪心 → 时间上一致的深度探索,这是它相对 $\epsilon$-greedy 的本质优势。
- 信息增益的深度 RL 版:VIME 用贝叶斯神经网络动力学,bonus 取 $\KL(q_{\phi'}\|q_\phi)$;更轻的替代是模型集成的预测分歧。
延伸阅读
老虎机与理论基础
- Auer, Cesa-Bianchi, Fischer, Finite-time Analysis of the Multiarmed Bandit Problem (2002) — UCB1 的原始论文,本讲 $\sqrt{2\ln H/N(a)}$ 与 $O(\log H)$ regret 的来源,证明可读性很好。
- Lai & Robbins, Asymptotically Efficient Adaptive Allocation Rules (1985) — $\Omega(\log H)$ 下界,说明为什么 $O(\log H)$ 已经是「最优」。
- Bubeck & Cesa-Bianchi, Regret Analysis of Stochastic and Nonstochastic Multi-armed Bandit Problems (2012) — 老虎机领域最好的综述,UCB / Thompson / EXP3 一网打尽。
- Russo et al., A Tutorial on Thompson Sampling (2017) — Thompson sampling 的权威教程,含大量可复现的实验与代码。
- Russo & Van Roy, Learning to Optimize via Information-Directed Sampling (2014) — 第 6 节 $\argmin_a \Delta(a)^2/g(a)$ 准则的出处。
- Strehl & Littman, An Analysis of Model-Based Interval Estimation for MDPs (2008) — MBIE-EB 的 $1/\sqrt{N(s)}$ bonus;Kolter & Ng, Near-Bayesian Exploration in Polynomial Time (2009) — BEB 的 $1/N(s)$ bonus。
计数与伪计数
- Bellemare et al., Unifying Count-Based Exploration and Intrinsic Motivation (2016) — 本讲第 8 节的主线论文,伪计数反解公式与 Montezuma 的第一次实质突破都在这里。
- Ostrovski et al., Count-Based Exploration with Neural Density Models (2017) — 把 CTS 换成 PixelCNN,并讨论了密度模型「学习率」对伪计数的影响,是理解伪计数细节的最佳补充。
- Tang et al., #Exploration: A Study of Count-Based Exploration for Deep RL (2016) — 哈希计数(SimHash 与学出来的哈希),第 9 节的出处。
- Fu, Co-Reyes, Levine, EX2: Exploration with Exemplar Models (2017) — 用判别器隐式估计密度,避开显式生成模型。
预测误差与 RND
- Burda et al., Exploration by Random Network Distillation (2018) — 本讲第 10 节的主线论文,也是第一个在 Montezuma's Revenge 上超过人类平均水平的方法。附录里的归一化与双价值头细节必读。
- Stadie, Levine, Abbeel, Incentivizing Exploration in RL with Deep Predictive Models (2015) — 预测误差 bonus 的早期代表作。
- Pathak et al., Curiosity-driven Exploration by Self-supervised Prediction (2017) — ICM:在「逆动力学特征」空间里算预测误差,用特征学习来过滤掉与动作无关的噪声。
- Burda et al., Large-Scale Study of Curiosity-Driven Learning (2018) — 在 54 个环境上系统比较各种特征空间下的好奇心,noisy-TV 实验就出自这里。
后验采样与信息增益
- Osband et al., Deep Exploration via Bootstrapped DQN (2016) — 第 11 节的主线论文,「深度探索 vs 抖动」的论证非常值得读。
- Osband et al., Randomized Prior Functions for Deep RL (2018) — 给每个头加一个随机固定的 prior 网络,修正了纯 bootstrap 在无数据区域不确定性坍缩的缺陷。
- Houthooft et al., VIME: Variational Information Maximizing Exploration (2016) — 第 12 节的主线论文,贝叶斯神经网络 + KL bonus。
- Pathak, Gandhi, Gupta, Self-Supervised Exploration via Disagreement (2019) — 用模型集成的分歧当 bonus,简单且对随机性鲁棒。
- Sekar et al., Planning to Explore via Self-Supervised World Models (2020) — 在隐空间世界模型里做基于分歧的探索(Plan2Explore),把探索与基于模型的 RL 结合起来。
更进一步
- Badia et al., Never Give Up: Learning Directed Exploration Strategies (2020) 与 Agent57 (2020) — 把「分幕内新颖度(k 近邻)」与「跨幕新颖度(RND)」结合,并用元控制器自适应地选择探索强度,是这条线目前的集大成者。
- Ecoffet et al., Go-Explore (2019) — 另辟蹊径:显式记住「有希望的状态」并直接返回那里再探索,在 Montezuma 上把分数推到了远超此前所有方法的水平,值得作为「探索不一定要靠 bonus」的对照。