变分推断在 RL 中的应用
把变分下界变成一个能跑的算法:摊销推断与重参数化 → VAE、条件模型、状态空间模型 → 再把「控制」本身写成一次概率推断。
0. 本讲导读
上一讲我们推出了证据下界(Evidence Lower Bound, ELBO):对任意分布 $q_i(z)$,都有 $\log p(x_i) \ge \mathcal{L}_i(p, q_i)$,于是「最大化难算的 $\log p(x_i)$」被替换成「最大化好算的 $\mathcal{L}_i$」。 但那还只是一个数学恒等式,不是一个算法。真正落地时马上会撞上三个问题:
- $q_i$ 是每个数据点各配一份的分布,参数量随数据集线性增长,而且来了一个新样本还得重新跑一轮优化;
- 就算只优化一个 $q_i$,$\nabla_\phi \E_{z\sim q_\phi}[\cdot]$ 这个「对期望的分布本身求导」到底怎么估?
- 这套东西跟强化学习有什么关系?
本讲按三段回答。第一段把 $q_i$ 换成一张网络 $q_\phi(z|x)$——摊销变分推断(amortized variational inference), 并给出两种梯度估计器:策略梯度(score function / REINFORCE)与重参数化技巧(reparameterization trick), 逐条对比它们的适用范围与方差。第二段把这套工具组装成生成模型:VAE、条件 VAE、 以及把 VAE 铺到时间轴上得到的状态空间模型(state space model)——这正是后面 model-based RL 里 「从像素学潜动力学」的骨架;顺带说清 diffusion / flow matching 为什么可以看成一个层次化 VAE。 第三段换一个方向:不是「用变分推断做 RL 里的某个模块」,而是把整个最优控制问题本身 写成一个概率图模型上的推断问题——控制即推断(control as inference)。这一段会推出 soft 值迭代、 $\pi = \exp(A)$ 的玻尔兹曼策略、以及前向/后向消息相交产生的「橄榄球形」状态边缘分布。
- 摊销:用一张网络 $q_\phi(z|x)=\mathcal{N}(\mu_\phi(x),\sigma_\phi(x))$ 一次性拟合所有 $p(z|x_i)$, 参数量从 $|\theta| + (|\mu_i|+|\sigma_i|)\times N$ 降到 $|\theta|+|\phi|$,而且新样本一次前向就能推断。
- 两种梯度:策略梯度通用(离散、连续都行)但方差大;重参数化 $z=\mu_\phi(x)+\epsilon\sigma_\phi(x)$ 只适用于连续隐变量,但实现简单、方差低,单样本就够用。原因是它用了 $\partial r/\partial z$ 这个一阶信息, 而策略梯度只把 $r$ 当成一个标量权重。
- ELBO 的第二种写法:$\mathcal{L}_i=\E_{z\sim q_\phi(z|x_i)}[\log p_\theta(x_i|z)] - D_{\mathrm{KL}}(q_\phi(z|x_i)\,\|\,p(z))$, 重构项用重参数化采样估计,KL 项对高斯有解析式——这就是 VAE 的全部。
- 状态空间模型就是「$x=(o_1,\dots,o_T)$、$z=(z_1,\dots,z_T)$」的 VAE: 先验 $p(z)=p(z_1)\prod_t p(z_{t+1}|z_t,a_t)$ 是学出来的动力学, 解码器 $p_\theta(o|z)=\prod_t p(o_t|z_t)$ 是观测模型, 编码器 $q_\phi(z|o)=\prod_t q_\phi(z_t|o_{1:t})$ 就是 POMDP 里的信念状态。
- 控制即推断:引入二值最优性变量 $\mathcal{O}_t$,令 $p(\mathcal{O}_t|s_t,a_t)=\exp(r(s_t,a_t))$, 则 $p(\tau|\mathcal{O}_{1:T})\propto p(\tau)\exp\left(\sum_t r(s_t,a_t)\right)$。 在这个模型里做后向消息传递 = soft 值迭代($\max$ 换成 $\log\int\exp$), 算策略 = $\pi(a_t|s_t)=\beta_t(s_t,a_t)/\beta_t(s_t)=\exp(A_t(s_t,a_t))$。
- 一个必须记住的坑:随机动力学下后向递推给出 $Q_t=r+\log\E[\exp V_{t+1}]$, 这是「乐观转移」——智能体以为自己能操纵骰子。确定性动力学下才退化成正常的 $Q_t=r+V_{t+1}$。
1. 从变分下界到摊销推断
1.1 先把上一讲的下界重新摆一遍
设生成模型是 $p_\theta(x,z)=p_\theta(x|z)p(z)$,其中 $z$ 是隐变量(latent variable),$p(z)$ 通常取 $\mathcal{N}(0,I)$。 我们想做的是极大似然:$\theta \leftarrow \argmax_\theta \frac{1}{N}\sum_i \log p_\theta(x_i)$。 但 $\log p_\theta(x_i)=\log\int p_\theta(x_i|z)p(z)\,dz$ 里的积分对神经网络解码器是算不出来的。
引入任意分布 $q_i(z)$,用一次乘除再配 Jensen 不等式:
$$ \log p(x_i)=\log\int p_\theta(x_i|z)p(z)\,dz =\log \E_{z\sim q_i(z)}\!\left[\frac{p_\theta(x_i|z)p(z)}{q_i(z)}\right] \ \ge\ \E_{z\sim q_i(z)}\!\left[\log \frac{p_\theta(x_i|z)p(z)}{q_i(z)}\right] $$把最后一项拆开,就是幻灯片上那个写法:
$$ \log p(x_i)\ \ge\ \underbrace{\E_{z\sim q_i(z)}\big[\log p_\theta(x_i|z)+\log p(z)\big]+\mathcal{H}(q_i)}_{\mathcal{L}_i(p,q_i)} $$其中 $\mathcal{H}(q)=-\E_{z\sim q}[\log q(z)]$ 是熵。这个不等式松了多少?把差值算出来:
下界的间隙恰好是 $q_i$ 与真后验的 KL 散度:
$$ \begin{aligned} D_{\mathrm{KL}}\big(q_i(z)\,\|\,p(z|x_i)\big) &=\E_{z\sim q_i}\big[\log q_i(z)-\log p(z|x_i)\big]\\ &=\E_{z\sim q_i}\big[\log q_i(z)-\log p(x_i,z)\big]+\log p(x_i)\\ &=-\mathcal{L}_i(p,q_i)+\log p(x_i) \end{aligned} $$所以 $\log p(x_i)=\mathcal{L}_i+D_{\mathrm{KL}}(q_i\|p(z|x_i))$。关于 $q_i$ 最大化 $\mathcal{L}_i$,等价于让 $q_i$ 逼近真后验 $p(z|x_i)$。 这就是「$q_i(z)$ 应该近似 $p(z|x_i)$」这句直觉的严格来源,也是下一小节摊销的出发点。
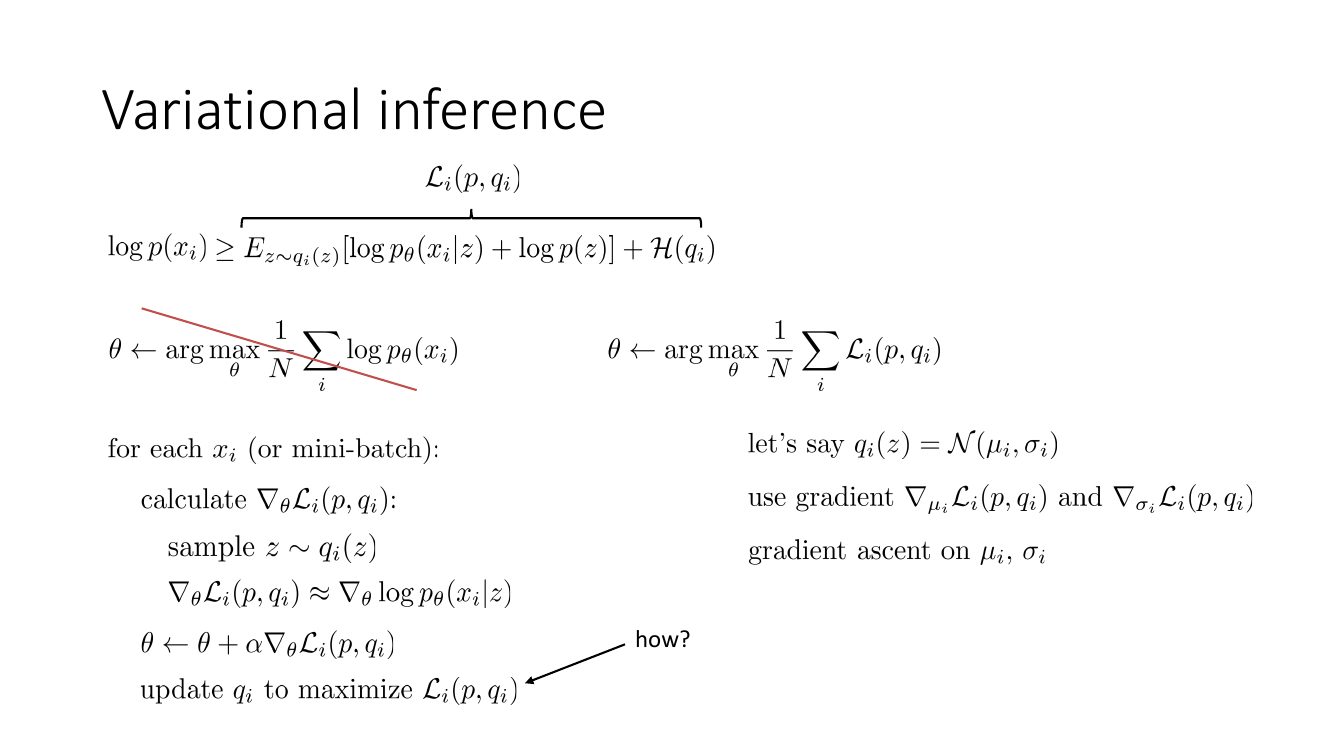
注意上图算法里对 $\theta$ 的梯度为什么可以只保留一项:$\mathcal{L}_i$ 中只有 $\log p_\theta(x_i|z)$ 含 $\theta$, $\log p(z)$ 和 $\mathcal{H}(q_i)$ 都与 $\theta$ 无关,而且期望的分布 $q_i(z)$ 也不含 $\theta$, 所以 $\nabla_\theta\mathcal{L}_i=\E_{z\sim q_i}[\nabla_\theta\log p_\theta(x_i|z)]\approx\nabla_\theta\log p_\theta(x_i|z)$,单样本无偏。 麻烦全在 $q_i$ 那一侧。
1.2 「每个样本一份 $q_i$」为什么不可行
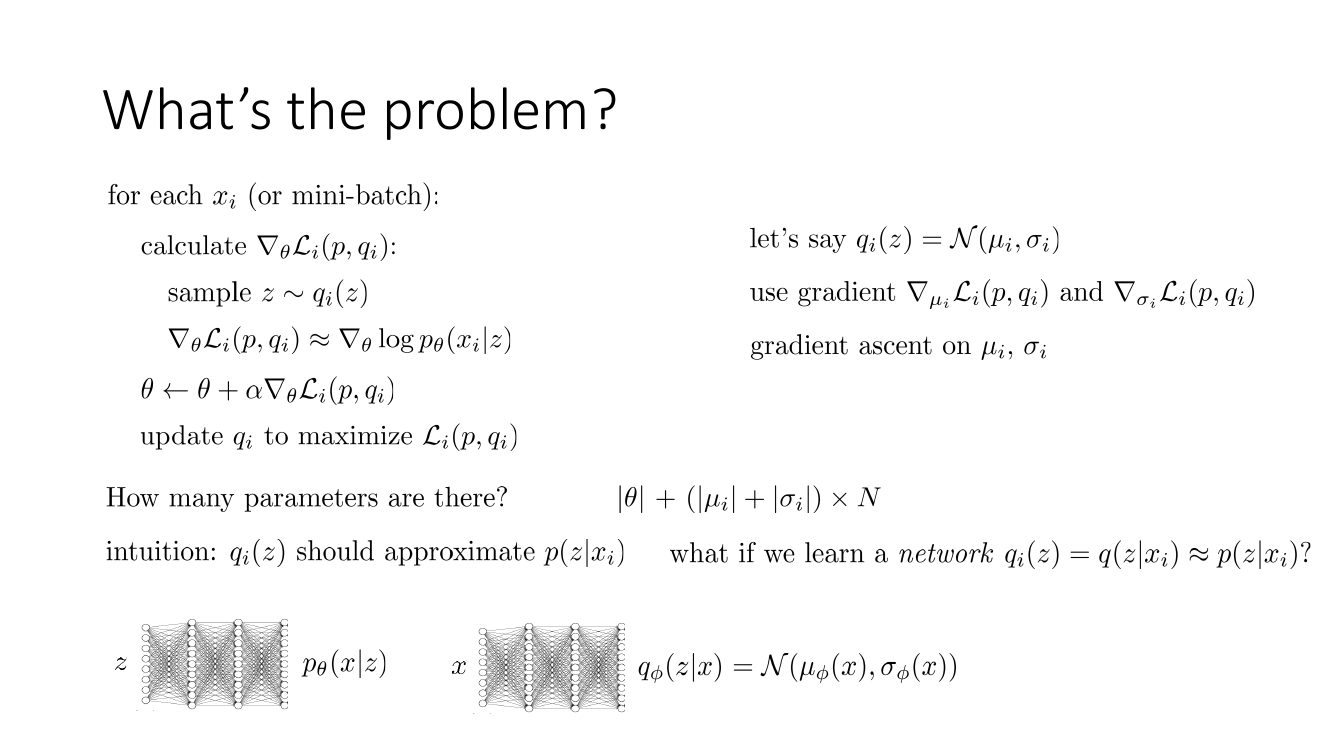
把这个参数量算算实数。假设数据集是 $N=10^6$ 张图,隐变量维度 $|z|=32$,那么每个样本要存 $\mu_i\in\R^{32}$ 和 $\sigma_i\in\R^{32}$, 一共 $10^6\times 64=6.4\times 10^7$ 个额外参数——已经和一个中等规模的解码器相当。更糟的是三件事:
- 每个参数只被一个数据点的梯度更新。$\mu_i$ 只出现在 $\mathcal{L}_i$ 里,跑完一个 epoch 它只被更新了一次(或几次), 统计效率极差;解码器 $\theta$ 却被 $N$ 个样本共同训练。二者的学习速度严重失配。
- 数据集变大就崩。参数量 $O(N)$ 意味着换个更大的数据集就得重新分配显存。
- 测试时无法推断。来了一个从没见过的 $x_{\text{new}}$,你没有对应的 $\mu_{\text{new}},\sigma_{\text{new}}$, 必须现场跑一个内层优化循环把它优化出来。对需要在线感知的机器人来说这是致命的。
「摊销」(amortize)这个词是会计术语:一笔大开销分摊到很多期。这里分摊的是推断的计算成本: 本来每个 $x_i$ 都要独立解一次优化问题(求 $\argmax_{q_i}\mathcal{L}_i$),现在把这些优化问题的解 用一张网络 $x\mapsto(\mu_\phi(x),\sigma_\phi(x))$ 拟合下来。训练时多花的力气是学这张网络, 换来的是测试时一次前向传播就能得到近似后验。代价是引入了摊销间隙(amortization gap)—— 网络的输出未必真是那个 $\argmax$,所以下界比逐样本优化时更松一点。实践中这点损失完全值得。
1.3 摊销后的算法长什么样
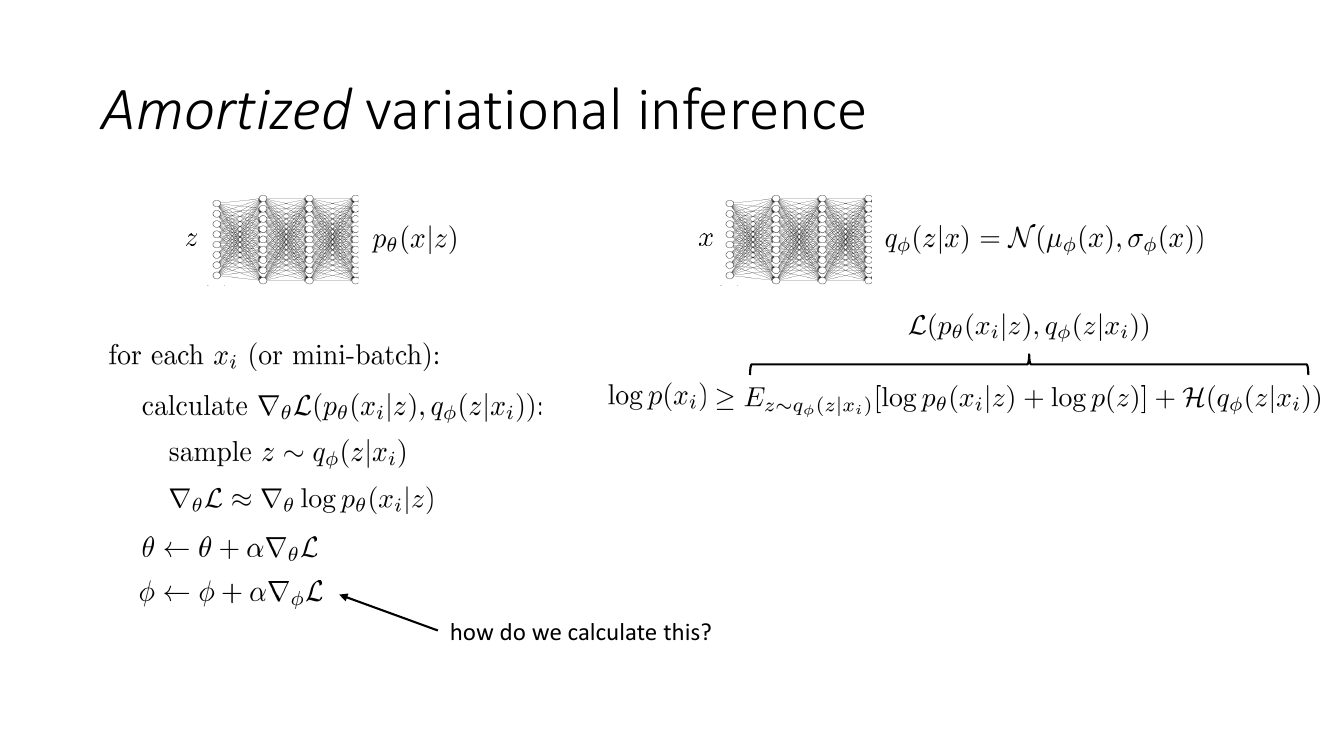
形式上只是把下标 $i$ 换成了下标 $\phi$,但含义变了:现在 $\phi$ 是所有样本共享的一组参数, 每个 mini-batch 的每个样本都在更新它。总参数量变成 $|\theta|+|\phi|$,与 $N$ 无关。
目标函数写全:
$$ \mathcal{L}(\theta,\phi)=\frac{1}{N}\sum_{i=1}^{N}\Big(\E_{z\sim q_\phi(z|x_i)}\big[\log p_\theta(x_i|z)+\log p(z)\big]+\mathcal{H}\big(q_\phi(z|x_i)\big)\Big) $$$\theta$ 的梯度还是老样子。真正新的是 $\nabla_\phi$:$\phi$ 同时出现在被积函数外面(期望所依赖的分布)和 熵项里面。熵项好办——高斯熵有闭式:
$$ \mathcal{H}\big(\mathcal{N}(\mu,\diag(\sigma^2))\big)=\frac{1}{2}\log\det\big(2\pi e\,\diag(\sigma^2)\big) =\frac{d}{2}\log(2\pi e)+\sum_{j=1}^{d}\log\sigma_j $$直接对 $\sigma_\phi(x)$ 求导即可,无需采样。难的是第一项 $J(\phi)=\E_{z\sim q_\phi(z|x_i)}[r(x_i,z)]$, 其中我们把 $$ r(x_i,z)\;\triangleq\;\log p_\theta(x_i|z)+\log p(z) $$ 记成一个「奖励」。这个记号不是巧合——它和 RL 里 $\E_{a\sim\pi_\phi(a|s)}[r(s,a)]$ 的形状一模一样: $x_i$ 对应状态 $s$,$z$ 对应动作 $a$,$q_\phi(z|x)$ 对应策略 $\pi_\phi(a|s)$。所以我们已经会算它了。
2. 两种梯度估计器:策略梯度 vs 重参数化
2.1 直接搬策略梯度
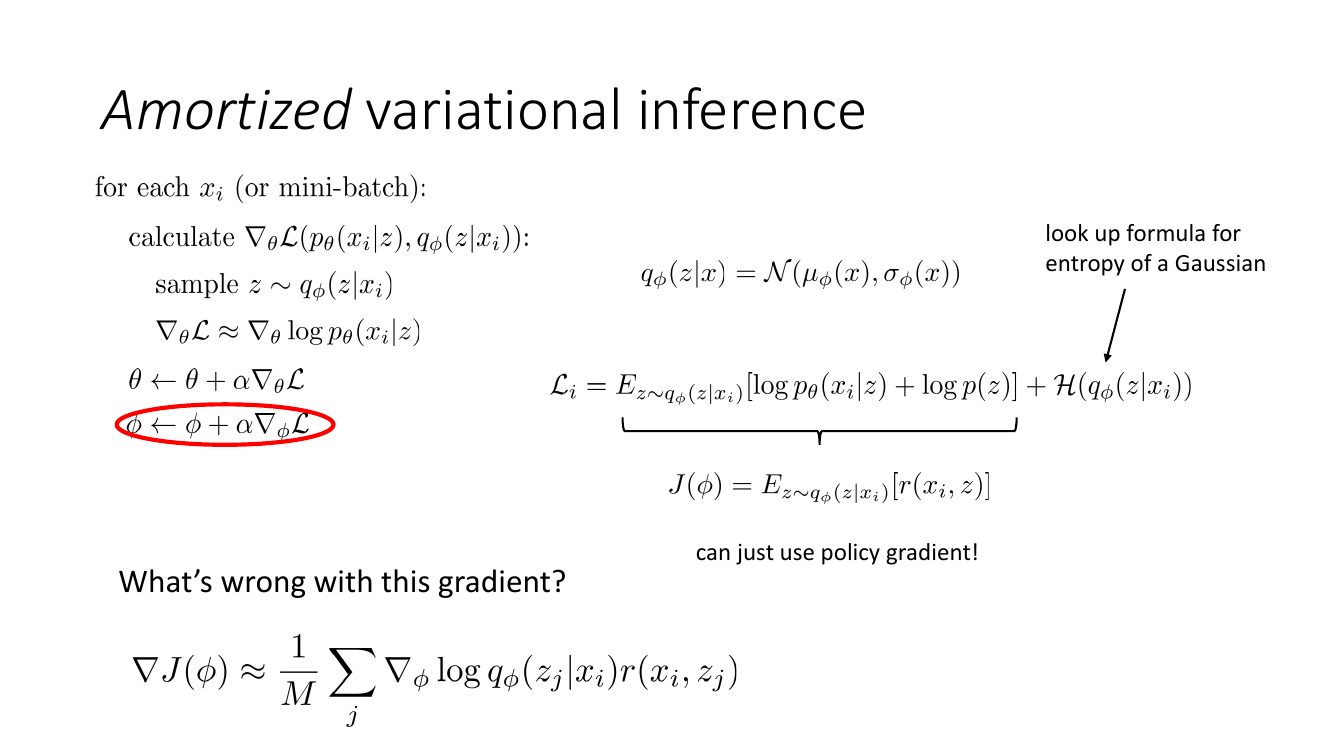
推导就是第 4 讲的 log-derivative trick,一步不落地写出来:
用 $M$ 个样本做蒙特卡洛:$\nabla_\phi J(\phi)\approx\frac{1}{M}\sum_j\nabla_\phi\log q_\phi(z_j|x_i)\,r(x_i,z_j)$,$z_j\sim q_\phi(z|x_i)$。
这个估计器是无偏的,而且对离散 $z$ 一样成立(把积分换成求和即可)。那「What's wrong」在哪?方差。
「无偏就够了」是错的。看这个估计器的结构:它把 $r(x_i,z_j)$ 当成一个标量权重去缩放方向 $\nabla_\phi\log q_\phi(z_j|x_i)$, 完全不知道「往哪个方向挪 $z$ 能让 $r$ 变大」。对图像 VAE,$r(x_i,z)=\log p_\theta(x_i|z)+\log p(z)$ 的量级可以是 $-10^3\sim-10^4$ nats (784 维伯努利像素的对数似然),而不同 $z_j$ 之间 $r$ 的相对差异可能只有几十 nats。 于是估计器 $\approx(-5000\pm 30)\times(\text{一个噪声方向})$:那个 $-5000$ 的公共部分完全是噪声放大器, 它对期望没有贡献(因为 $\E[\nabla_\phi\log q_\phi]=0$),但会把方差抬高好几个数量级。 这就是幻灯片上「High variance, requires multiple samples & small learning rates」的来源。 减去 baseline 能缓解常数部分,但缓解不了「只用到零阶信息」这一根本缺陷。
2.2 重参数化技巧
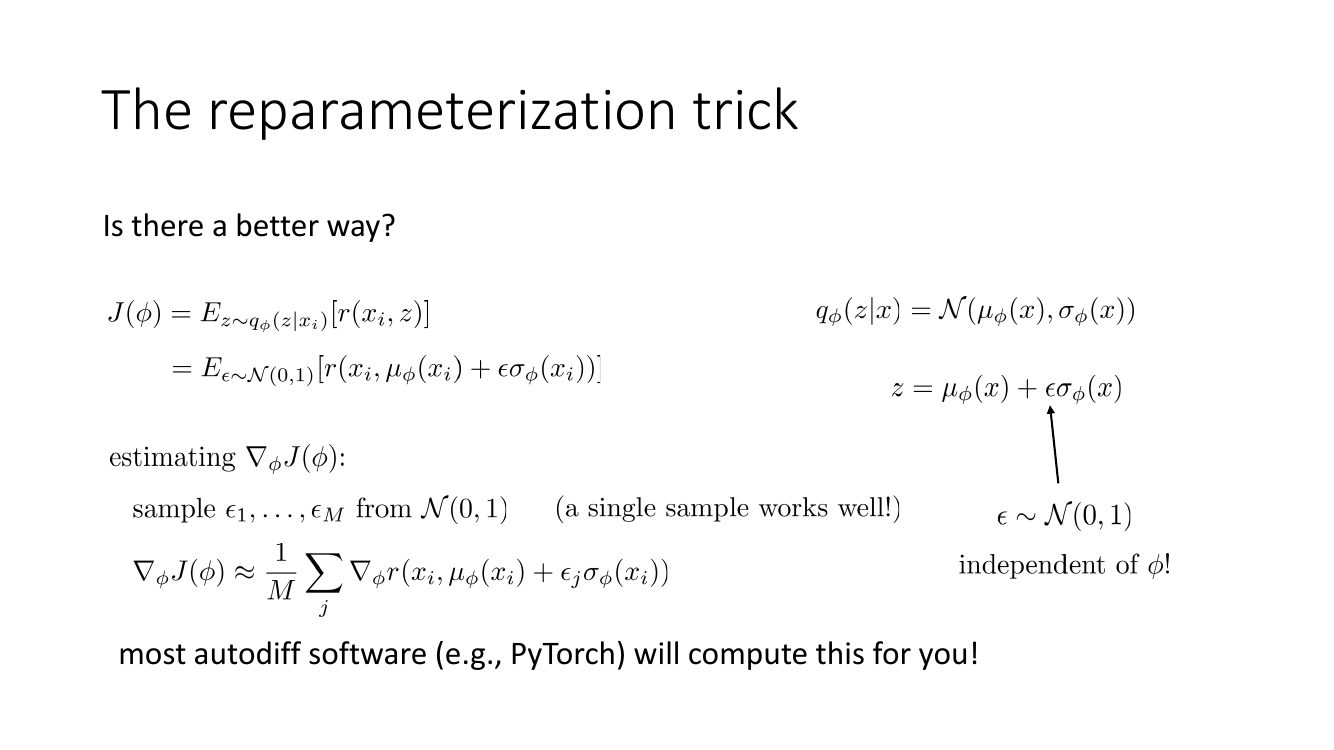
为什么可以换基?因为 $\mathcal{N}(\mu,\sigma^2)$ 是位置-尺度族(location-scale family): 若 $\epsilon\sim\mathcal{N}(0,1)$,则 $\mu+\sigma\epsilon\sim\mathcal{N}(\mu,\sigma^2)$。 于是对任意可测函数 $r$,$\E_{z\sim\mathcal{N}(\mu_\phi,\sigma_\phi^2)}[r(z)]=\E_{\epsilon\sim\mathcal{N}(0,1)}[r(\mu_\phi+\sigma_\phi\epsilon)]$。 这是恒等变形,不是近似。
换基之后,$\phi$ 只出现在被积函数里,普通链式法则就够了:
$$ \nabla_\phi\,r\big(x_i,\mu_\phi(x_i)+\epsilon\sigma_\phi(x_i)\big) =\underbrace{\frac{\partial r}{\partial z}}_{\text{一阶信息}} \left(\frac{\partial \mu_\phi(x_i)}{\partial \phi}+\epsilon\,\frac{\partial \sigma_\phi(x_i)}{\partial \phi}\right) $$关键差别一目了然:这里出现了 $\partial r/\partial z$。估计器知道把 $z$ 往哪挪能让 $r$ 变大, 而不是像策略梯度那样只知道「这次采到的 $z$ 好不好」。这种估计器叫路径导数(pathwise derivative)估计器。 $r$ 里那个 $-5000$ 的公共偏移量在求导后直接消失了——它是常数,导数为零。这就是低方差的根源。
打个比方:你要找山顶。策略梯度像是「随机往四周扔石头,记下每块石头落点的海拔,然后朝海拔高的方向平均地挪一点」—— 只用得到海拔数值。重参数化像是「站在原地摸一下脚下的坡度」——直接拿到梯度。 前者对任何地形都能用(哪怕海拔函数不可导、$z$ 是离散的),后者要求地形光滑可导, 但一旦能用,一次采样的信息量就顶前者几百次。
2.3 换个写法:重构项 + KL 项
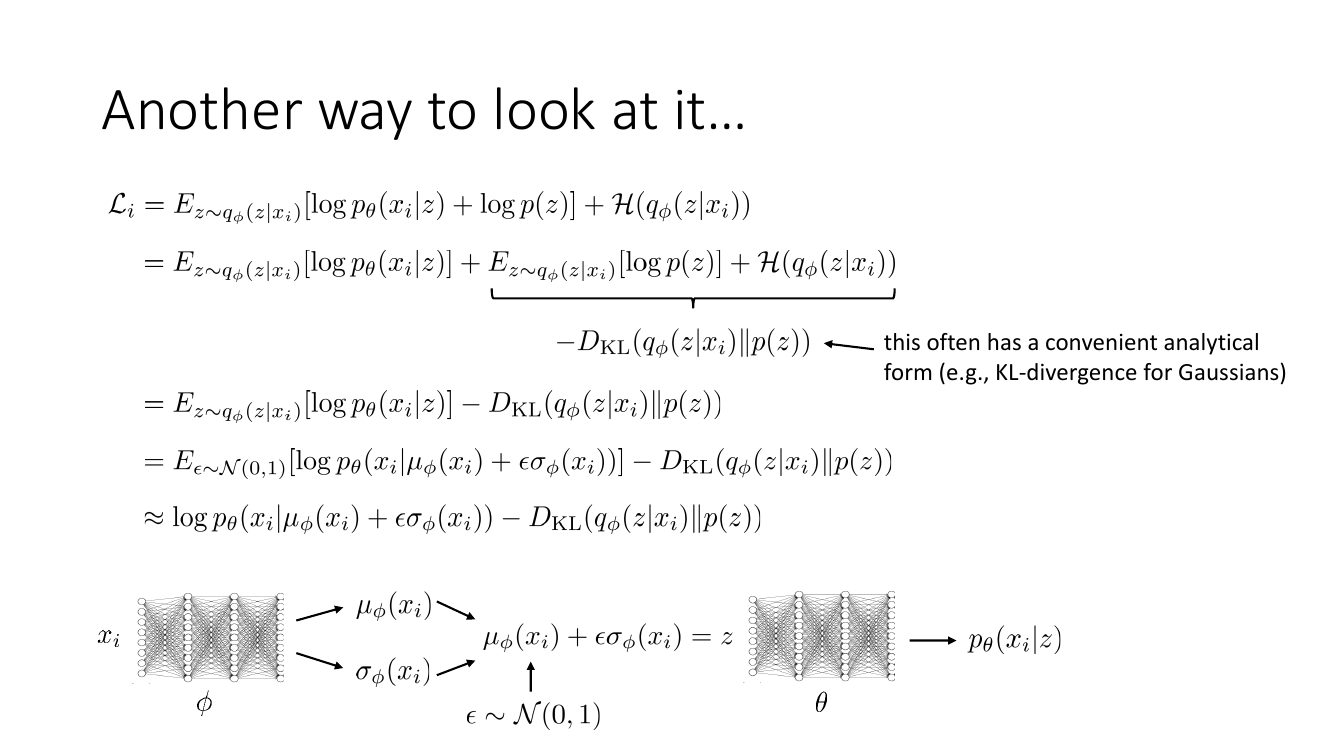
第一步的合并要看清楚:
$$ \begin{aligned} -D_{\mathrm{KL}}\big(q_\phi(z|x_i)\,\|\,p(z)\big) &=-\E_{z\sim q_\phi}\big[\log q_\phi(z|x_i)-\log p(z)\big]\\ &=\E_{z\sim q_\phi}\big[\log p(z)\big]+\big(-\E_{z\sim q_\phi}[\log q_\phi(z|x_i)]\big)\\ &=\E_{z\sim q_\phi}\big[\log p(z)\big]+\mathcal{H}\big(q_\phi(z|x_i)\big) \end{aligned} $$于是整条链条是:
$$ \begin{aligned} \mathcal{L}_i&=\E_{z\sim q_\phi(z|x_i)}\big[\log p_\theta(x_i|z)+\log p(z)\big]+\mathcal{H}\big(q_\phi(z|x_i)\big)\\ &=\E_{z\sim q_\phi(z|x_i)}\big[\log p_\theta(x_i|z)\big]-D_{\mathrm{KL}}\big(q_\phi(z|x_i)\,\|\,p(z)\big)\\ &=\E_{\epsilon\sim\mathcal{N}(0,1)}\big[\log p_\theta\big(x_i\,|\,\mu_\phi(x_i)+\epsilon\sigma_\phi(x_i)\big)\big]-D_{\mathrm{KL}}\big(q_\phi(z|x_i)\,\|\,p(z)\big)\\ &\approx\log p_\theta\big(x_i\,|\,\mu_\phi(x_i)+\epsilon\sigma_\phi(x_i)\big)-D_{\mathrm{KL}}\big(q_\phi(z|x_i)\,\|\,p(z)\big),\qquad \epsilon\sim\mathcal{N}(0,1) \end{aligned} $$这个写法在工程上比原写法优越,原因是方差进一步降低:KL 项从「用采样估的两项之差」变成了精确解析值, 只有重构项还带蒙特卡洛噪声。对 $q=\mathcal{N}(\mu,\diag(\sigma^2))$、$p=\mathcal{N}(0,I)$,逐维展开得到那个人人都会背的式子:
$$ D_{\mathrm{KL}}\big(\mathcal{N}(\mu,\diag(\sigma^2))\,\|\,\mathcal{N}(0,I)\big) =\frac{1}{2}\sum_{j=1}^{d}\Big(\sigma_j^2+\mu_j^2-1-\log\sigma_j^2\Big) $$两项的解释也很清楚:$\E_{q}[\log p_\theta(x_i|z)]$ 是重构(reconstruction)项,逼着 $z$ 保留足够信息把 $x_i$ 还原; $-D_{\mathrm{KL}}(q_\phi(z|x_i)\|p(z))$ 是正则项,逼着每个样本的后验都别离先验太远。两者拉锯: 重构项想让不同 $x_i$ 的 $z$ 互相分开、$\sigma$ 尽量小(信息多);KL 项想让它们全都缩回 $\mathcal{N}(0,I)$(信息少)。 最终得到的隐空间是被填满的、连续的——这正是采样能工作的前提,见 §3.2。
2.4 两种估计器的正面对比
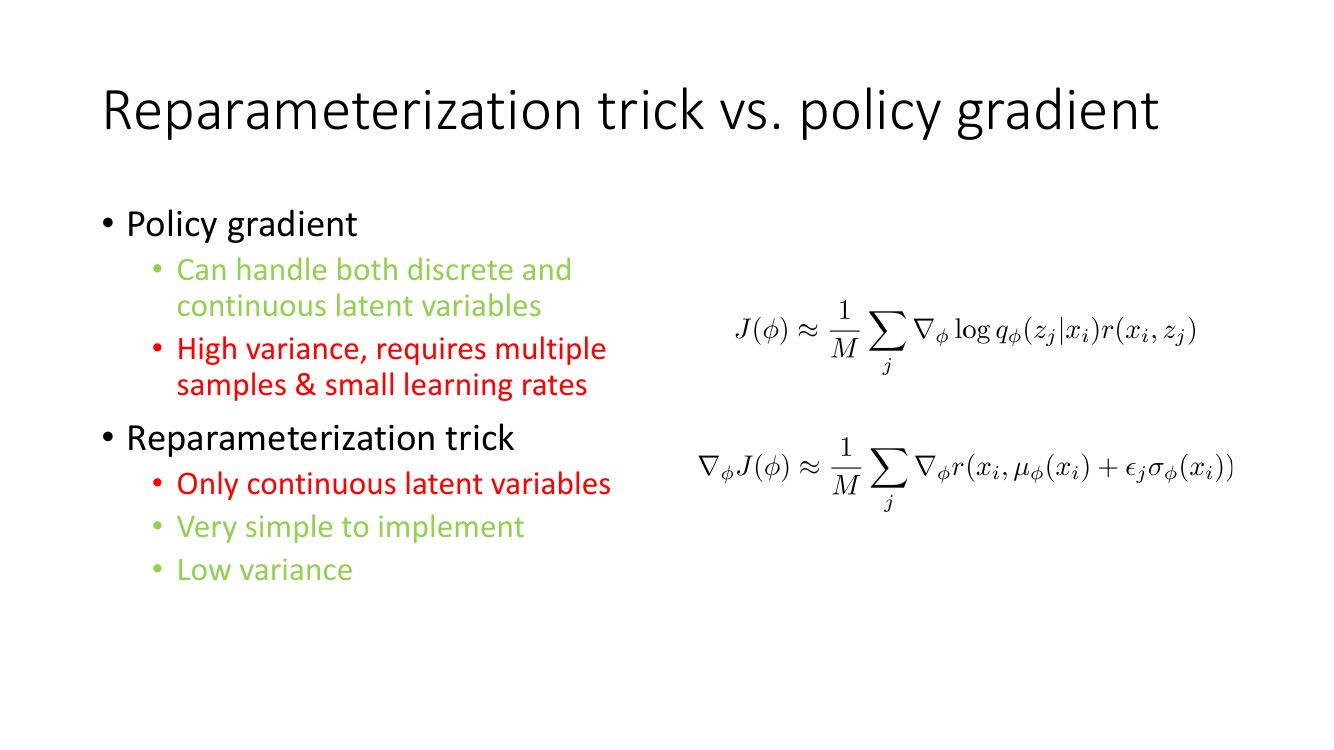
| 策略梯度 / score function(REINFORCE) | 重参数化 / pathwise derivative | |
|---|---|---|
| 估计式 | $\frac{1}{M}\sum_j\nabla_\phi\log q_\phi(z_j|x_i)\,r(x_i,z_j)$ | $\frac{1}{M}\sum_j\nabla_\phi r(x_i,\mu_\phi(x_i)+\epsilon_j\sigma_\phi(x_i))$ |
| 用到的信息 | 只有 $r$ 的值(零阶) | $\partial r/\partial z$(一阶) |
| 隐变量类型 | 离散、连续都行 | 只能连续(且 $q$ 需可重参数化) |
| 对 $r$ 的要求 | 可以是黑盒、不可导、甚至是环境反馈 | 必须对 $z$ 可导 |
| 方差 | 高,随 $|r|$ 量级增长;需要 baseline | 低,$r$ 的常数偏移自动消失 |
| 所需样本数 | 多;学习率要小 | 单样本通常就够 |
| 实现难度 | 要手写 surrogate、要处理 baseline | 写成 mu + eps * std,自动微分全包 |
| 在本课其它地方的化身 | REINFORCE、A2C、PPO 的策略梯度 | DDPG / SAC 里对 actor 的更新、模型预测里的 BPTT |
「只能连续」这条限制是真限制,不是懒得实现。离散 $z$ 上不存在一个把 $\phi$ 挪出采样分布的光滑变换, 因为离散采样对参数是分段常数的,导数处处为零。绕开的办法有两类: (1)用连续松弛,比如 Gumbel-Softmax / Concrete 分布,把 one-hot 换成 softmax 温度趋零的连续近似——代价是引入偏差; (2)老老实实用 score function,再堆各种方差缩减(baseline、控制变量、NVIL 之类)。 本课后面遇到离散动作时(例如 DQN 系)用的是完全不同的路子,不走这条。
2.5 最小实现:同一个下界的两种梯度
下面这段代码把两个估计器并排实现,用的是同一个编码器/解码器。跑起来你会看到:
elbo_reparam 的梯度范数稳定,elbo_score_function 的梯度范数在批与批之间跳好几个数量级。
import math
import torch, torch.nn as nn, torch.nn.functional as F

D_X, D_Z, H = 784, 16, 400

class Encoder(nn.Module):      # q_phi(z|x) = N(mu_phi(x), diag(sigma_phi(x)^2))
    def __init__(self):
        super().__init__()
        self.body = nn.Sequential(nn.Linear(D_X, H), nn.ReLU(),
                                  nn.Linear(H, H),   nn.ReLU())
        self.mu, self.logstd = nn.Linear(H, D_Z), nn.Linear(H, D_Z)
    def forward(self, x):
        h = self.body(x)
        return self.mu(h), self.logstd(h).clamp(-5.0, 2.0)   # clamp 防止 sigma 爆炸/塌缩

class Decoder(nn.Module):      # p_theta(x|z):伯努利像素,log p(x|z) 就是负 BCE
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(D_Z, H), nn.ReLU(),
                                 nn.Linear(H, H),   nn.ReLU(),
                                 nn.Linear(H, D_X))
    def forward(self, z):
        return self.net(z)                                    # 返回 logits

enc, dec = Encoder(), Decoder()
opt = torch.optim.Adam(list(enc.parameters()) + list(dec.parameters()), lr=1e-3)

def log_px_given_z(x, z):
    logits = dec(z)
    return -F.binary_cross_entropy_with_logits(logits, x, reduction='none').sum(-1)

# ---------- 写法 A:重参数化 + 解析 KL(就是 VAE) ----------
def elbo_reparam(x):
    mu, logstd = enc(x)
    std = logstd.exp()
    eps = torch.randn_like(std)          # eps 与 phi 无关,梯度可以直接穿过去
    z   = mu + eps * std                 # <-- 重参数化
    rec = log_px_given_z(x, z)
    kl  = 0.5 * (std.pow(2) + mu.pow(2) - 1.0 - 2.0 * logstd).sum(-1)   # 解析式
    return (rec - kl).mean()

# ---------- 写法 B:同一个下界,phi 的梯度改用 policy gradient ----------
def surrogate_score_function(x):
    """返回值本身不是 ELBO,但它对 (theta, phi) 的梯度 = REINFORCE 估计器。"""
    mu, logstd = enc(x)
    std = logstd.exp()
    with torch.no_grad():                        # 采样这一步不回传:这正是问题所在
        z = mu + torch.randn_like(std) * std
    # log q_phi(z|x),z 视作常数,梯度只经由 mu / logstd 流向 phi
    logq = (-0.5 * ((z - mu) / std).pow(2) - logstd
            - 0.5 * math.log(2 * math.pi)).sum(-1)
    rec  = log_px_given_z(x, z)                  # theta 的梯度从这里来
    r    = (rec - 0.5 * z.pow(2).sum(-1)).detach()   # r = log p(x|z) + log p(z),当常数
    ent  = (logstd + 0.5 * math.log(2 * math.pi * math.e)).sum(-1)  # 高斯熵,解析可导
    return (rec + logq * r + ent).mean()

def grad_norm(loss):
    opt.zero_grad(); loss.backward()
    g = torch.cat([p.grad.flatten() for p in enc.parameters()])
    return g.norm().item()

# 训练循环(用写法 A)
for x in dataloader:                     # x: [B, 784],取值 0/1
    loss = -elbo_reparam(x)
    opt.zero_grad(); loss.backward(); opt.step()
两点实现细节值得强调。第一,网络输出的是 logstd 而不是 std,
这样 std = logstd.exp() 天然为正,不需要额外约束;同时 KL 的解析式里 $\log\sigma_j^2=2\cdot\texttt{logstd}$ 直接可用。
第二,写法 B 里的 with torch.no_grad() 不是可选项——如果不 detach,PyTorch 会因为
z = mu + randn * std 而自动给你算出重参数化梯度,那就不是 score function 估计器了。
这也从侧面说明重参数化在现代框架里有多「免费」:你什么都不用做,它就发生了。
3. 变分自编码器与表示学习
3.1 VAE:把上一节的零件拼起来
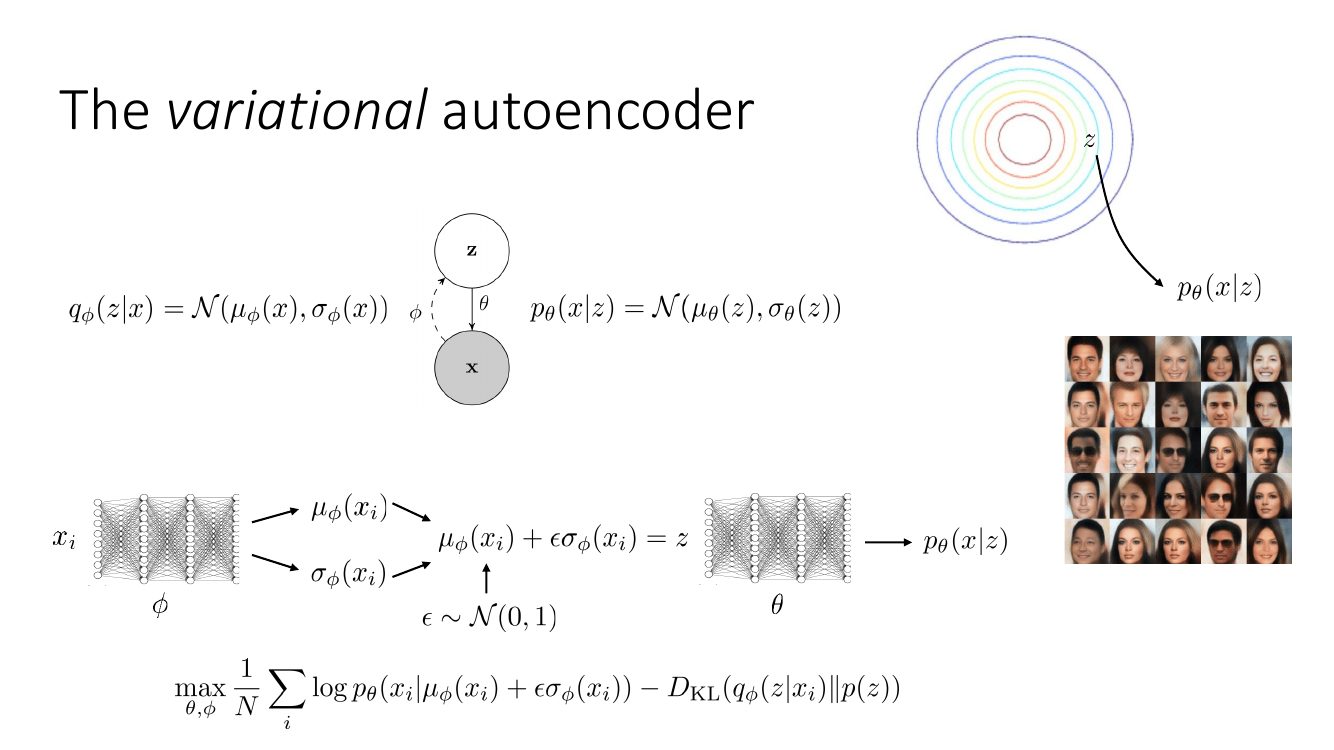
没有新东西了——VAE 就是「摊销变分推断 + 重参数化 + 解析 KL」这三件事的名字。 唯一值得单独说的是解码器分布的选择:
- $p_\theta(x|z)=\mathcal{N}(\mu_\theta(z),\sigma^2 I)$ 且 $\sigma$ 固定 $\Rightarrow$ $\log p_\theta(x|z)=-\frac{1}{2\sigma^2}\|x-\mu_\theta(z)\|^2+\text{const}$, 重构项退化成加权的 L2 损失。此时 $\sigma$ 起的作用是调节重构项与 KL 项的相对权重:$\sigma$ 越小,重构越被看重。
- $p_\theta(x|z)$ 取伯努利(二值图像)$\Rightarrow$ 重构项是二元交叉熵。
- 幻灯片上写的是 $\mathcal{N}(\mu_\theta(z),\sigma_\theta(z))$,即方差也由网络输出。这更灵活,但训练容易不稳: 网络会发现把 $\sigma_\theta$ 推到 0 能让某些点的对数似然趋于 $+\infty$。实践中要给 $\log\sigma_\theta$ 加 clamp。
3.2 用 VAE:为什么祖先采样能工作
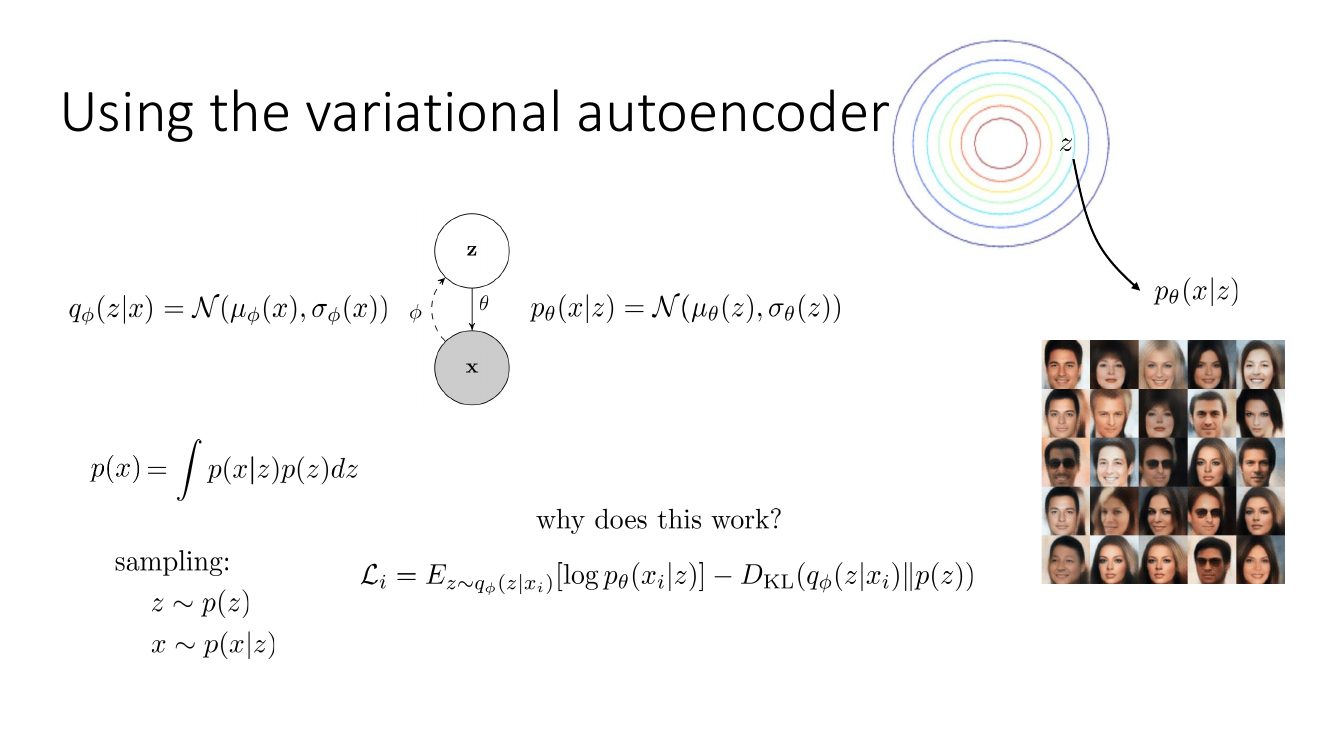
这一页的问题很值得认真答,因为它解释了 VAE 与普通自编码器的本质区别。
普通自编码器只优化重构。训练完之后,编码器把 $N$ 个训练样本映射到隐空间里 $N$ 个孤立的点, 点与点之间的区域解码器从没见过,随便取一个 $z$ 解出来大概率是垃圾——所以自编码器不是生成模型。
VAE 的 KL 项做了两件事:(1)它逼着每个样本的后验 $q_\phi(z|x_i)$ 有非零方差, 于是每个样本在隐空间占据的不是一个点而是一小团云,训练时解码器被迫在整团云上都能重构 $x_i$; (2)它逼着这些云的中心都靠近原点、尺度接近 1,于是所有云叠起来大致铺满 $\mathcal{N}(0,I)$, 相邻样本的云还会互相重叠。结果是隐空间被连续地填满了,从 $p(z)$ 里随便采一个点, 它几乎总落在某几团云的重叠区,解码出来是一个合理的(甚至是插值出来的新)样本。
更严格一点的说法:把所有样本的后验平均起来得到聚合后验(aggregate posterior) $\bar{q}(z)=\frac{1}{N}\sum_i q_\phi(z|x_i)$。可以证明
$$ \frac{1}{N}\sum_i D_{\mathrm{KL}}\big(q_\phi(z|x_i)\,\|\,p(z)\big) = D_{\mathrm{KL}}\big(\bar q(z)\,\|\,p(z)\big) + I_{\bar q}(x;z) $$其中 $I_{\bar q}(x;z)\ge 0$ 是数据与隐变量在联合分布 $\frac{1}{N}\sum_i\delta_{x_i}(x)q_\phi(z|x)$ 下的互信息。 所以 ELBO 里的 KL 惩罚同时压 $D_{\mathrm{KL}}(\bar q\|p)$(让聚合后验对齐先验,采样才有效) 和 $I(x;z)$(限制 $z$ 携带的信息量)。这两个作用的拉扯就是 VAE 的两大经典毛病: 「先验空洞」(prior hole,$\bar q$ 没铺满 $p$,采样落到空区)与「后验塌缩」(posterior collapse,$I(x;z)\to0$,$z$ 被忽略)。
后验塌缩是自己训 VAE 时最常撞的墙:如果解码器足够强(比如带自回归结构), 它可以完全不看 $z$ 也能把 $x$ 还原得不错,此时把 $q_\phi(z|x)$ 直接设成 $\mathcal{N}(0,I)$ 能让 KL 项归零、 而重构项几乎不掉——ELBO 反而更高。于是 $z$ 变成了纯噪声,编码器学了个寂寞。 标准对策:KL 退火(训练初期把 KL 的权重从 0 慢慢升到 1)、 free bits(每一维 KL 低于 $\lambda$ 纳特就不再惩罚,即 $\sum_j\max(\lambda, \mathrm{KL}_j)$)、 或者削弱解码器。后面的状态空间模型代码里就用了 free bits。
3.3 第一个 RL 用法:把 $z$ 当状态
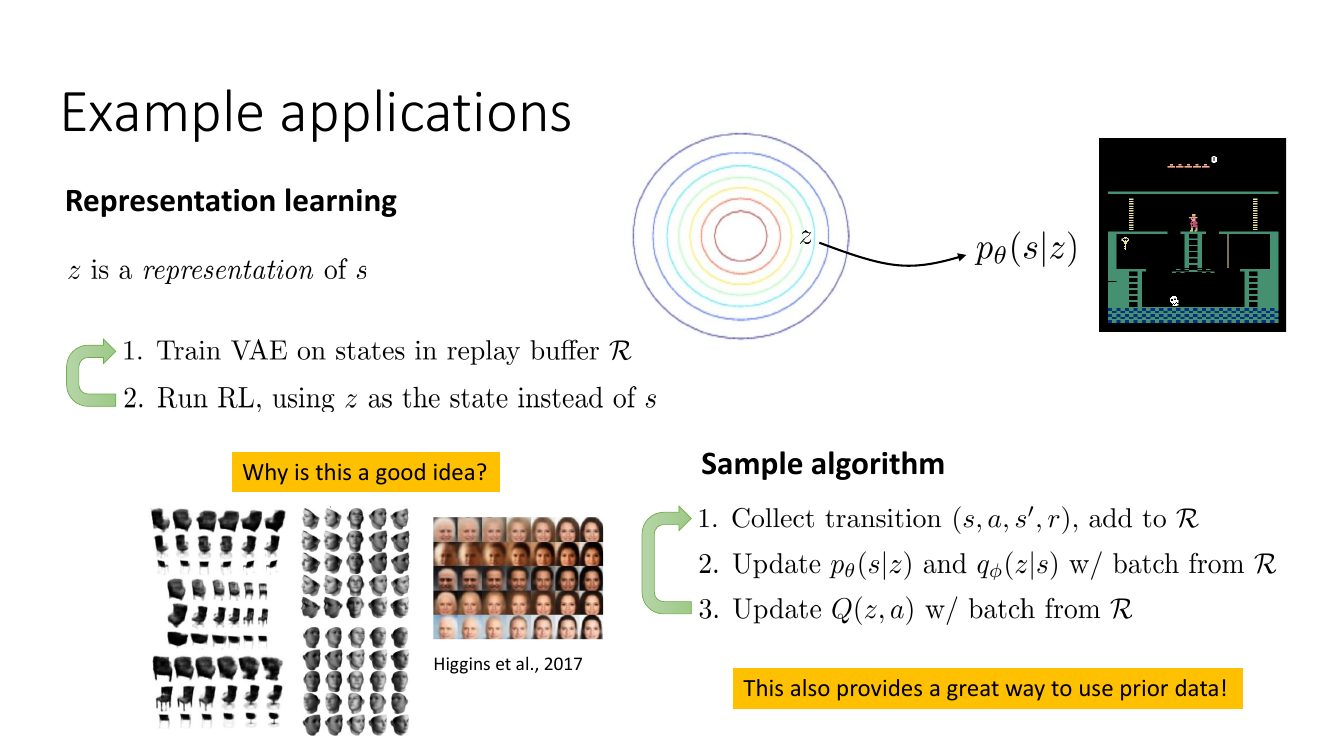
「Why is this a good idea?」这个问题 Levine 留给听众,答案至少有四条:
- 降维。$Q(s,a)$ 直接吃 $84\times84\times3$ 的像素,需要一个大 CNN,而这个 CNN 的唯一训练信号是 TD 误差——一个标量、而且在稀疏奖励任务里几乎全是零。换成 $Q(z,a)$ 且 $z\in\R^{32}$,值函数网络可以只是个小 MLP。
- 密集的无监督信号。重构损失对每个像素都有梯度,是极其密集的监督。它替 TD 误差把「视觉特征」这部分活干了。 这是「用自监督预训练替代端到端」在 RL 里的最早形态之一。
- 光滑性与泛化。VAE 的隐空间是连续的、局部线性的(KL 正则的副产品), 视觉上相似的状态在 $z$ 空间里也相近,值函数在其上更容易插值,样本效率更高。 左下那张图展示的正是这一点:沿单个隐维度移动,椅子的朝向 / 人脸的姿态连续且解耦地变化。
- 能用先验数据(黄框那句)。训 VAE 只需要 状态,不需要动作、不需要奖励、不需要是本任务的数据。 所以你可以拿一大堆无标注的视频、别的任务的 replay buffer 先把表示学好,再上任务。
这个方案有个众所周知的失效模式:重构目标按像素面积分配注意力,而任务重要性不按像素面积分配。 Montezuma's Revenge 里那把钥匙可能只有十几个像素,把它从 $z$ 里丢掉几乎不影响重构损失, 但丢掉之后 RL 就彻底做不了。同理,背景里飘动的云会占掉大量隐容量。 这就是为什么后来的方法要么给重构加任务相关的权重,要么干脆放弃重构, 改用对比学习 / 只预测奖励和值的目标(这条线索会在 model-based RL 那几讲里继续)。
4. 条件模型与多模态模仿学习
4.1 条件 VAE 的下界
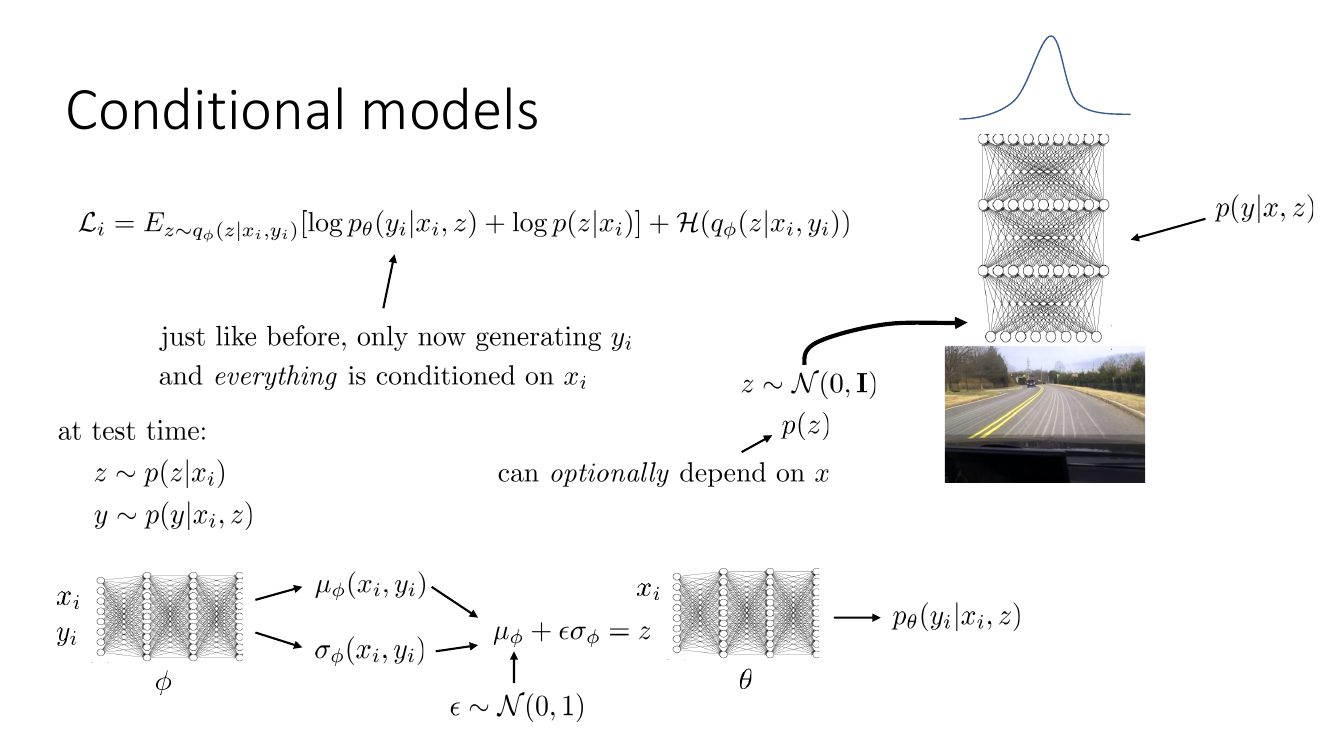
推导与无条件情形逐字对应,只要把每一处概率都加上 $|x_i$:
$$ \log p(y_i|x_i)\ \ge\ \E_{z\sim q_\phi(z|x_i,y_i)}\big[\log p_\theta(y_i|x_i,z)+\log p(z|x_i)\big]+\mathcal{H}\big(q_\phi(z|x_i,y_i)\big) $$同样可以合并成重构 + KL 的形式:
$$ \mathcal{L}_i=\E_{z\sim q_\phi(z|x_i,y_i)}\big[\log p_\theta(y_i|x_i,z)\big]-D_{\mathrm{KL}}\big(q_\phi(z|x_i,y_i)\,\|\,p(z|x_i)\big) $$两个容易搞错的地方:
- 编码器必须看到 $y_i$。$q_\phi(z|x_i,y_i)$ 近似的是后验 $p(z|x_i,y_i)$, 它的任务是「已知输入和这一条示范的输出,反推是哪个模式产生的」。如果只给 $x_i$,它根本没有信息去区分模式。
- 先验可以条件于 $x$,但解码时不能用 $y$。测试时你只有 $x$,所以采样必须走 $z\sim p(z|x_i)$。 $p(z|x)$ 若取成固定的 $\mathcal{N}(0,I)$ 最省事,KL 项也有解析式;若学一个 $p_\psi(z|x)$(Learning Latent Plans from Play 里叫 plan proposal,对应的 $q_\phi$ 叫 plan recognition),表达力更强,代价是 KL 变成两个学出来的高斯之间的 KL, 训练时要小心两边互相追着跑。
4.2 为什么模仿学习非要多模态不可
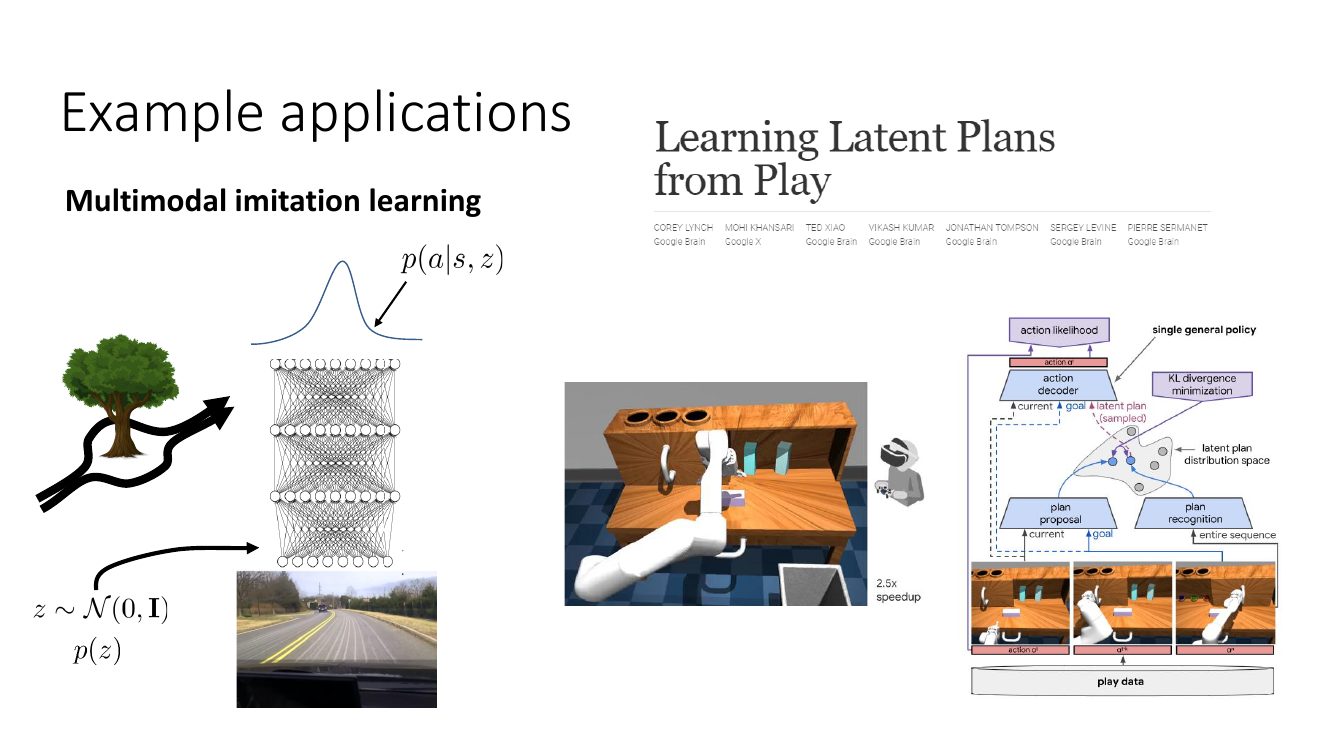
把这件事说透:设两个模式各占一半,动作是一维的转向角,左绕 $a=-1$、右绕 $a=+1$。 用一个高斯 $\mathcal{N}(\mu,\sigma^2)$ 做最大似然拟合,闭式解是 $\mu=0$、$\sigma=1$。 $\mu=0$ 就是「直行撞树」——而且这个策略的似然还挺高,因为它把两个模式都覆盖住了。 最大似然对多模态数据的这种「取平均」行为不是训练不充分,而是模型类本身表达不了。
加了隐变量之后,模型类变成了混合分布: $p(a|s)=\int p(a|s,z)p(z)\,dz$。虽然每个 $p(a|s,z)$ 还是单峰高斯,但对 $z$ 积分之后 可以逼近任意复杂的多峰分布(这就是无限混合高斯)。解码器要学的是「给定 $z$ 的这个取值,我该走哪条路」, 而 $z$ 扮演的是没被观测到的意图 / 风格变量:示范者当时打算左绕还是右绕,这个信息在数据里是缺失的, 所以它天然应该是隐变量。
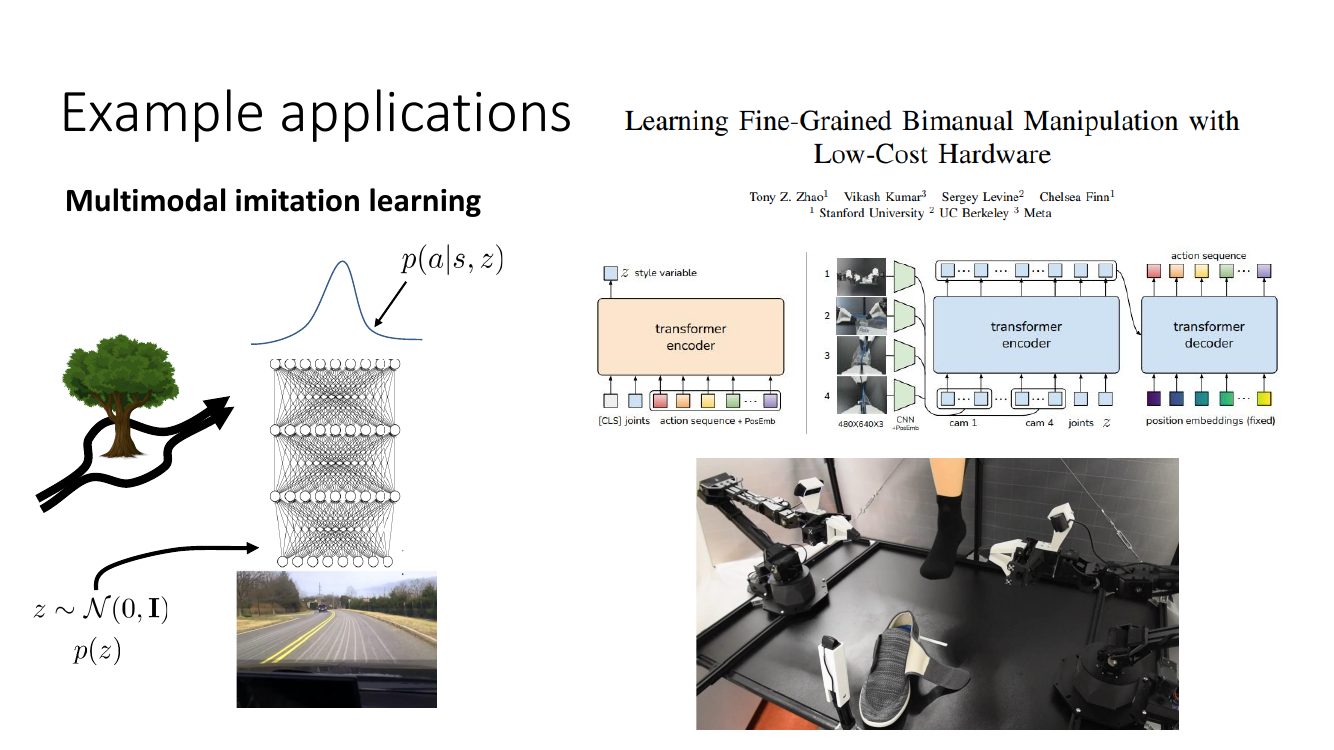
ACT 把两件事叠在一起,值得分开理解:
- 动作分块(action chunking):一次预测未来 $k$ 步动作而不是 1 步。这缓解的是模仿学习里的复合误差 和人类示范的时间抖动;从概率角度看,它把建模对象从 $p(a_t|s_t)$ 换成了 $p(a_{t:t+k}|s_t)$, 后者的多模态性更强(整段轨迹的模式比单步动作的模式更明显),所以更需要隐变量。
- CVAE 的隐变量 $z$:吸收「这次示范是哪种风格 / 哪个意图」的信息。训练时编码器能看到真实动作序列, 所以它能把「这一段属于哪个模式」编进 $z$,解码器于是不必在模式间平均。 推理时直接取 $z=0$(先验均值)或从 $\mathcal{N}(0,I)$ 采样。
4.3 最小实现:带隐变量的多模态 BC 策略
import torch, torch.nn as nn

D_S, D_A, D_Z, H = 32, 4, 8, 256

class LatentPolicy(nn.Module):
    """条件 VAE 形式的行为克隆策略:pi(a|s) = int p(a|s,z) p(z) dz"""
    def __init__(self):
        super().__init__()
        # q_phi(z | s, a):编码器必须看到动作,否则无法分辨模式
        self.enc = nn.Sequential(nn.Linear(D_S + D_A, H), nn.ReLU(),
                                 nn.Linear(H, 2 * D_Z))
        # p_theta(a | s, z):解码器只看 s 和 z
        self.dec = nn.Sequential(nn.Linear(D_S + D_Z, H), nn.ReLU(),
                                 nn.Linear(H, 2 * D_A))

    def loss(self, s, a, beta=1.0):
        mu, logstd = self.enc(torch.cat([s, a], -1)).chunk(2, -1)
        logstd = logstd.clamp(-5.0, 2.0)
        z = mu + torch.randn_like(mu) * logstd.exp()          # 重参数化
        a_mu, a_logstd = self.dec(torch.cat([s, z], -1)).chunk(2, -1)
        a_logstd = a_logstd.clamp(-5.0, 2.0)
        # 重构项:高斯对数似然
        rec = (-0.5 * ((a - a_mu) / a_logstd.exp()).pow(2) - a_logstd).sum(-1)
        # KL(q || N(0,I)) 解析式
        kl  = 0.5 * ((2 * logstd).exp() + mu.pow(2) - 1.0 - 2 * logstd).sum(-1)
        return (-rec + beta * kl).mean()                      # 最小化 -ELBO

    @torch.no_grad()
    def act(self, s, stochastic=True):
        z = torch.randn(s.shape[0], D_Z) if stochastic else torch.zeros(s.shape[0], D_Z)
        a_mu, a_logstd = self.dec(torch.cat([s, z], -1)).chunk(2, -1)
        return a_mu + (torch.randn_like(a_mu) * a_logstd.clamp(-5.0, 2.0).exp()
                       if stochastic else 0.0)
注意 act 里的两次随机:一次是采 $z$(选模式:左绕还是右绕),
一次是在选定模式内采动作(模式内的抖动)。这两级随机性的分工正是隐变量策略的价值所在。
如果只想要「确定地选一个模式」,把 $z$ 固定成 0 即可——ACT 在真机上就是这么做的。
$\beta$ 是 KL 权重($\beta$-VAE 的那个 $\beta$):$\beta$ 太大会后验塌缩、退回单峰策略;太小则 $z$ 会把动作原样记住,
而测试时你从先验采的 $z$ 与训练时的分布对不上,输出乱掉。
5. 与 diffusion / flow matching 的关系
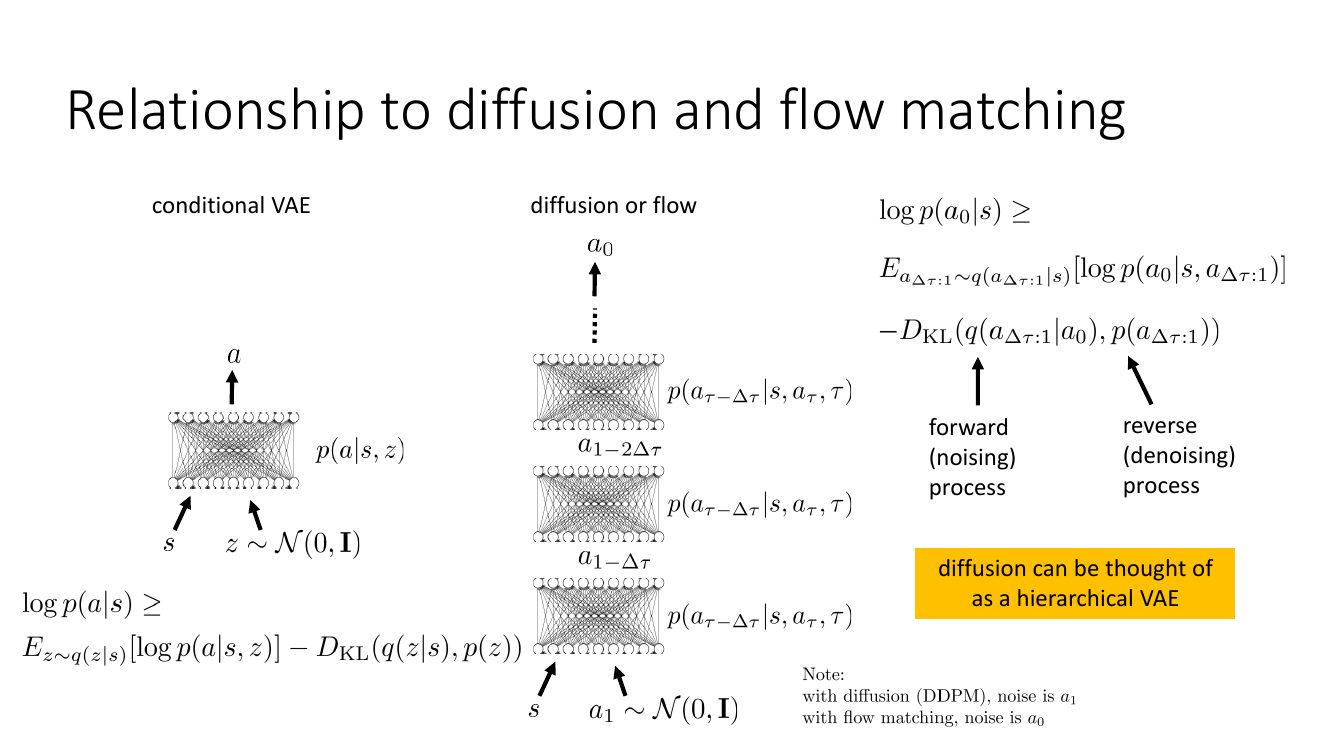
把这张图翻译成一句话:diffusion 就是隐变量为一整条加噪轨迹 $a_{\Delta\tau:1}$ 的条件 VAE, 而且它的编码器不用学。逐条对比:
| 条件 VAE | diffusion / flow matching | |
|---|---|---|
| 隐变量 | 一个低维 $z\in\R^{d_z}$ | 一串 $a_{\Delta\tau},a_{2\Delta\tau},\dots,a_1$,每个都与数据同维 |
| 编码器 $q$ | 学出来的 $q_\phi(z|s,a)$ | 手工指定且固定:$q(a_\tau|a_0)=\mathcal{N}(\sqrt{\bar\alpha_\tau}a_0,(1-\bar\alpha_\tau)I)$ |
| 解码器 $p$ | 一步 $p_\theta(a|s,z)$ | 多步 $p_\theta(a_{\tau-\Delta\tau}|s,a_\tau,\tau)$,共享参数 |
| KL 项 | $D_{\mathrm{KL}}(q_\phi(z|\cdot)\|p(z))$,需要学的两边 | 逐步 KL,两边都是已知方差的高斯 $\Rightarrow$ 化简成加权 $\|\epsilon-\epsilon_\theta\|^2$ |
| 后验塌缩 | 会发生($z$ 被忽略) | 不会:$q$ 固定,最终步 $a_1$ 一定是纯噪声 |
| 采样成本 | 一次前向 | $1/\Delta\tau$ 次前向(可用蒸馏 / ODE 求解器加速) |
| 表达多模态 | 受 $d_z$ 与解码器容量限制 | 非常强,实践中对机器人动作分布效果显著更好 |
diffusion 之所以训练比 VAE 稳,关键不在于网络更大,而在于它把「学一个好的 $q$」这个最难的部分删掉了: 前向加噪过程是解析给定的,于是 ELBO 里的每一个 KL 项都变成两个已知高斯之间的 KL,闭式可算、无需采样、无方差、 也不存在编码器与解码器互相追逐的不稳定。代价是隐变量维度爆炸($T$ 份与数据同维的噪声)和采样要跑 $T$ 步。 把这条思路用回策略上就是 Diffusion Policy:$p_\theta(a_{t:t+k}|s_t)$ 用去噪过程建模,天然多模态。
关于「层次化 VAE」这个说法:普通 VAE 是 $z\to x$ 两层;层次化 VAE 是 $z_L\to z_{L-1}\to\dots\to z_1\to x$, 每一层都是一个条件生成步,ELBO 里有 $L$ 个 KL 项。diffusion 正是这个结构, 只不过 $L$ 特别大(上千)、各层维度相同、且推断方向 $q$ 被写死。至于 flow matching, 它把离散的去噪步换成一个连续时间的常微分方程 $\frac{da_\tau}{d\tau}=v_\theta(a_\tau,\tau,s)$, 训练目标不再是显式的 ELBO 而是回归一个已知的条件速度场; 但「用一条固定的、把数据搅成噪声的路径来定义隐变量」这个骨架是一样的。 幻灯片右下那条注记提醒的是索引约定:DDPM 习惯 $\tau=1$ 是噪声、$\tau=0$ 是数据, flow matching 文献常反过来,读论文时别弄混。
6. 状态空间模型:把 VAE 铺到时间轴上
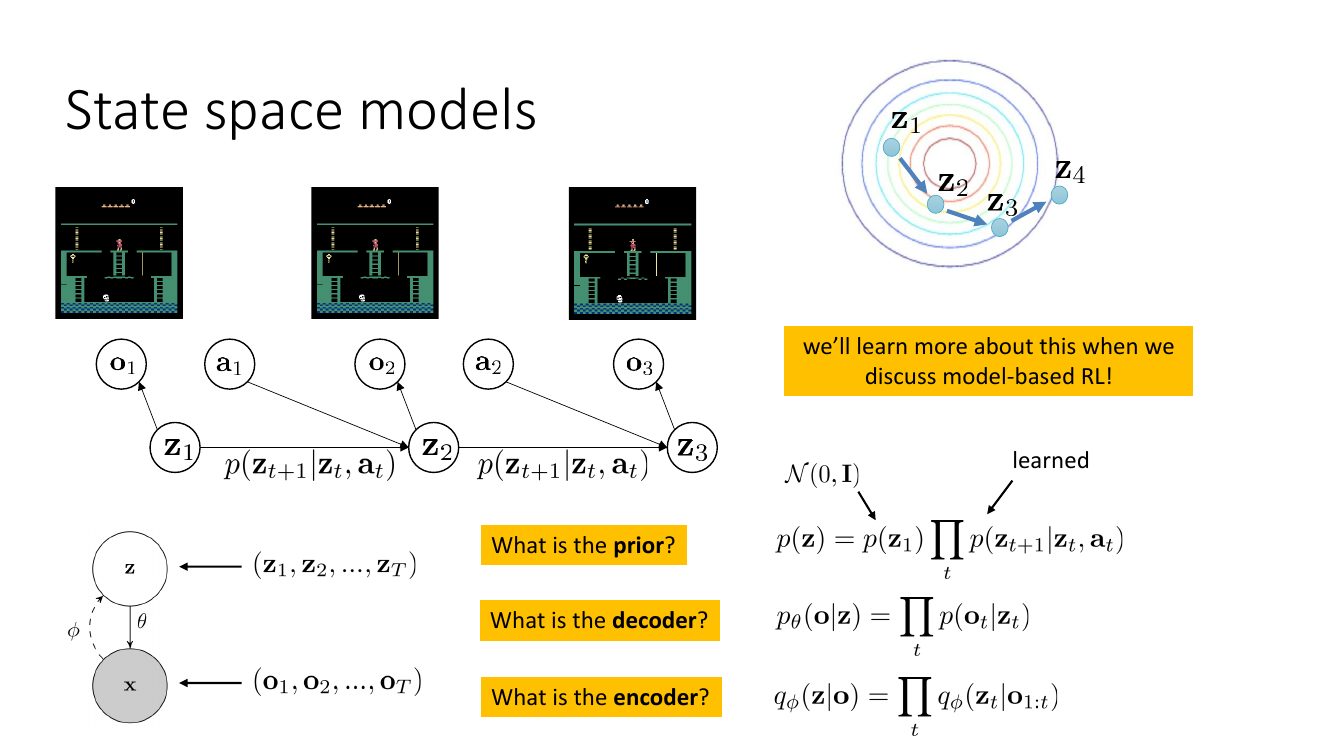
6.1 三个组件的角色
先统一记号。$o_t$ 是观测(可能只是环境的一部分,比如一帧图像),$z_t$ 是隐状态 (我们希望它满足马尔可夫性,扮演真正的 $s_t$),$a_t$ 是动作。整个模型是
$$ p_\theta(o_{1:T},z_{1:T}\mid a_{1:T-1}) =\underbrace{p(z_1)\prod_{t=1}^{T-1}p_\theta(z_{t+1}\mid z_t,a_t)}_{\text{先验 }p(z)}\ \cdot\ \underbrace{\prod_{t=1}^{T}p_\theta(o_t\mid z_t)}_{\text{解码器}} $$| VAE 里的角色 | 状态空间模型里是什么 | RL 里的意义 |
|---|---|---|
| 数据 $x$ | 整条观测序列 $(o_1,\dots,o_T)$ | 一段轨迹的像素流 |
| 隐变量 $z$ | 整条隐状态序列 $(z_1,\dots,z_T)$ | 紧凑的、马尔可夫的状态表示 |
| 先验 $p(z)$ | $p(z_1)\prod_t p_\theta(z_{t+1}|z_t,a_t)$,转移是学的 | 就是动力学模型!可以拿来做规划 |
| 解码器 $p_\theta(x|z)$ | $\prod_t p_\theta(o_t|z_t)$,逐帧独立 | 观测模型 / 渲染器;只在训练时用 |
| 编码器 $q_\phi(z|x)$ | $\prod_t q_\phi(z_t|o_{1:t})$ | 信念状态(belief state);控制时在线用 |
状态空间模型最漂亮的一点是:VAE 里那个「只是个正则项」的先验 $p(z)$,在这里就是我们真正想要的东西—— 一个可以用来做规划和想象的动力学模型 $p_\theta(z_{t+1}|z_t,a_t)$。 而编码器 $q_\phi(z_t|o_{1:t})$ 因为只依赖过去的观测,天然可以在线递归地跑, 它就是部分可观测环境里的信念状态。训练时它负责把像素压成状态, 部署时它负责实时估计当前状态,然后你在 $z$ 空间里规划、在 $z$ 空间里学 $Q$—— 解码器 $p_\theta(o_t|z_t)$ 在部署时甚至可以整个扔掉。
6.2 序列 ELBO 的完整推导
直接把 VAE 的下界套上去,然后利用两个乘积形式的因子分解拆开。
起点是通用 ELBO(为简洁省略对 $a$ 的条件):
$$ \mathcal{L}=\E_{z_{1:T}\sim q_\phi(z_{1:T}|o_{1:T})}\Big[\log p_\theta(o_{1:T},z_{1:T})-\log q_\phi(z_{1:T}|o_{1:T})\Big] $$代入三个因子分解:
$$ \mathcal{L}=\E_{q_\phi}\Big[\sum_{t=1}^{T}\log p_\theta(o_t|z_t)+\log p(z_1)+\sum_{t=1}^{T-1}\log p_\theta(z_{t+1}|z_t,a_t)-\sum_{t=1}^{T}\log q_\phi(z_t|o_{1:t})\Big] $$关键观察:给定 $o_{1:T}$,$q_\phi$ 下各个 $z_t$ 是相互独立的(因为 $q_\phi(z_t|o_{1:t})$ 不依赖别的 $z$)。 于是可以把 $\log q_\phi(z_1|o_1)$ 与 $\log p(z_1)$ 配对,把 $\log q_\phi(z_{t+1}|o_{1:t+1})$ 与 $\log p_\theta(z_{t+1}|z_t,a_t)$ 配对:
$$ \E_{q_\phi}\big[\log p(z_1)-\log q_\phi(z_1|o_1)\big]=-D_{\mathrm{KL}}\big(q_\phi(z_1|o_1)\,\|\,p(z_1)\big) $$ $$ \E_{q_\phi}\big[\log p_\theta(z_{t+1}|z_t,a_t)-\log q_\phi(z_{t+1}|o_{1:t+1})\big] =-\E_{z_t\sim q_\phi(z_t|o_{1:t})}\Big[D_{\mathrm{KL}}\big(q_\phi(z_{t+1}|o_{1:t+1})\,\|\,p_\theta(z_{t+1}|z_t,a_t)\big)\Big] $$第二式成立正是因为 $q_\phi(z_{t+1}|o_{1:t+1})$ 不含 $z_t$,所以对 $z_{t+1}$ 的内层期望可以单独提出来变成一个 KL。 合起来得到最终形式:
$$ \boxed{\ \mathcal{L}=\sum_{t=1}^{T}\E_{q_\phi}\big[\log p_\theta(o_t|z_t)\big] -D_{\mathrm{KL}}\big(q_\phi(z_1|o_1)\|p(z_1)\big) -\sum_{t=1}^{T-1}\E_{q_\phi}\Big[D_{\mathrm{KL}}\big(q_\phi(z_{t+1}|o_{1:t+1})\|p_\theta(z_{t+1}|z_t,a_t)\big)\Big]\ } $$这个式子每一项都有直白的含义:
- 第一项:$z_t$ 必须留住足够信息把 $o_t$ 画回来。防止 $z$ 退化成常数。
- 第三项:编码器在 $t+1$ 时刻推断出的状态,必须跟动力学从 $z_t$ 预测出来的一致。 这一项同时训练了两边:既逼动力学学准(不然预测不上编码器给的答案), 又逼编码器输出可预测的表示(不然 KL 罚不下去)。这是整个目标里最重要的一项, 也是「学出来的 $z$ 为什么会近似满足马尔可夫性」的原因。
- 第二项:起始状态对齐标准正态,只是个锚。
第三项那个 KL 在 model-based RL 文献里通常被叫做「KL balancing」的对象,因为它把两个学出来的分布往一起拉, 到底是「让先验去追后验」还是「让后验去迁就先验」会显著影响效果: 后验追先验会让表示变懒(丢信息以便好预测),先验追后验会让动力学疲于奔命。 实践中的做法是把这一项拆成两半,分别 stop-gradient 一侧,再用不同权重加起来。 这类细节在 PlaNet / Dreamer 系列里被反复调过。
6.3 编码器的因子分解:filtering、smoothing 还是单帧?
幻灯片给的是 $q_\phi(z|o)=\prod_t q_\phi(z_t|o_{1:t})$,这叫滤波(filtering)后验。但这不是唯一选择, 不同选择在「精度 / 计算量 / 能否在线用」之间取舍:
| 因子分解 | 名字 | 精度 | 能否在线运行 | 备注 |
|---|---|---|---|---|
| $q_\phi(z_{1:T}|o_{1:T})$ 不分解 | 完全后验 | 最高(真后验就长这样) | 否 | 要建模 $z_t$ 之间的相关性,参数最多、最难训 |
| $\prod_t q_\phi(z_t|z_{t-1},o_{1:T})$ | 平滑(smoothing) | 高 | 否(要看到未来) | 训练时最准,但控制时用不了 |
| $\prod_t q_\phi(z_t|o_{1:t})$ | 滤波(本讲用的) | 中 | 是(RNN 递归即可) | 与信念状态完全对应;训练与部署同一个模块 |
| $\prod_t q_\phi(z_t|o_t)$ | 单帧编码 | 低 | 是 | 只在观测几乎等于状态时够用;实现最简单 |
为什么滤波是甜点?因为你在控制时本来就只有 $o_{1:t}$。如果训练时用了平滑后验, 部署时就得再单独搞一个滤波器,两者不一致会掉性能。而滤波形式的 $q_\phi(z_t|o_{1:t})$ 用一个 RNN 实现: 维护隐藏态 $h_t=\mathrm{RNN}(h_{t-1},[\,\mathrm{enc}(o_t),a_{t-1}\,])$,然后 $q_\phi(z_t|o_{1:t})=\mathcal{N}(\mu_\phi(h_t),\sigma_\phi(h_t))$。 一次前向就能采出整条 $z_{1:T}$,重参数化照常穿过去。
还有一个容易忽略的点:$q_\phi(z_t|o_{1:t})$ 严格说应该写成 $q_\phi(z_t|o_{1:t},a_{1:t-1})$, 因为过去的动作显然影响当前状态的后验。幻灯片省掉了 $a$ 只是为了式子干净, 实现时务必把动作喂进编码器 RNN,否则在动作对状态影响大的任务上会明显变差。
6.4 最小实现:一个能跑的潜动力学模型
import torch, torch.nn as nn, torch.distributions as D

D_O, D_A, D_Z, H = 64, 4, 32, 256

def gauss(params, lo=-5.0, hi=2.0):
    mu, logstd = params.chunk(2, dim=-1)
    return D.Normal(mu, logstd.clamp(lo, hi).exp())

class LatentDynamics(nn.Module):
    def __init__(self):
        super().__init__()
        self.obs_enc = nn.Sequential(nn.Linear(D_O, H), nn.ReLU(), nn.Linear(H, H))
        self.rnn     = nn.GRUCell(H + D_A, H)                 # 把 o_{1:t}, a_{1:t-1} 累积进 h_t
        self.q_head  = nn.Linear(H, 2 * D_Z)                  # 编码器 q(z_t | o_{1:t})  <- 信念状态
        self.dyn     = nn.Sequential(nn.Linear(D_Z + D_A, H), nn.ReLU(),
                                     nn.Linear(H, 2 * D_Z))   # 先验 p(z_{t+1} | z_t, a_t) <- 动力学
        self.dec     = nn.Sequential(nn.Linear(D_Z, H), nn.ReLU(),
                                     nn.Linear(H, 2 * D_O))   # 解码器 p(o_t | z_t)

    def elbo(self, obs, act, free_nats=1.0):
        """obs: [B,T,D_O];act: [B,T,D_A],act[:,t] 是在 t 时刻采取的动作。"""
        B, T, _ = obs.shape
        h = obs.new_zeros(B, H)
        z_prev, a_prev = None, obs.new_zeros(B, D_A)
        rec_total = obs.new_zeros(B)
        kl_total  = obs.new_zeros(B)

        for t in range(T):
            # --- 编码器:把 o_t 和上一步动作并进 RNN,得到 q(z_t | o_{1:t}) ---
            h   = self.rnn(torch.cat([self.obs_enc(obs[:, t]), a_prev], dim=-1), h)
            q_t = gauss(self.q_head(h))
            z_t = q_t.rsample()                         # rsample = 重参数化采样

            # --- 解码器:重构 o_t ---
            rec_total = rec_total + gauss(self.dec(z_t)).log_prob(obs[:, t]).sum(-1)

            # --- 先验:t=0 用 N(0,I),之后用学出来的转移 ---
            if z_prev is None:
                p_t = D.Normal(torch.zeros_like(z_t), torch.ones_like(z_t))
            else:
                p_t = gauss(self.dyn(torch.cat([z_prev, a_prev], dim=-1)))

            kl_t = D.kl_divergence(q_t, p_t).sum(-1)
            kl_total = kl_total + kl_t.clamp(min=free_nats)   # free bits,防后验塌缩

            z_prev, a_prev = z_t, act[:, t]

        return (rec_total - kl_total).mean()

model = LatentDynamics()
opt   = torch.optim.Adam(model.parameters(), lr=3e-4)

for obs, act in dataloader:                      # obs:[B,T,D_O]  act:[B,T,D_A]
    loss = -model.elbo(obs, act)
    opt.zero_grad(); loss.backward()
    nn.utils.clip_grad_norm_(model.parameters(), 100.0)
    opt.step()

# ---- 部署:用编码器在线维护信念,然后只靠 dyn 在潜空间里“想象” ----
@torch.no_grad()
def imagine(model, h, a_seq):
    """h 由在线跑 RNN 得到(已吸收 o_{1:t});a_seq: [B,K,D_A] 是候选动作序列。"""
    z = gauss(model.q_head(h)).mean
    traj = []
    for k in range(a_seq.shape[1]):
        z = gauss(model.dyn(torch.cat([z, a_seq[:, k]], dim=-1))).mean
        traj.append(z)
    return torch.stack(traj, dim=1)              # [B,K,D_Z],喂给 reward 头或 Q 网络
几处工程要点:(1)rsample() 而不是 sample()——前者走重参数化、可回传梯度,
后者切断梯度,写错了模型会一动不动;(2)kl_t.clamp(min=free_nats) 就是 free bits,
让 KL 在低于 1 nat 时不再被压,给编码器留出携带信息的余地;
(3)clip_grad_norm_ 是必须的,序列模型的 BPTT 梯度尖峰很常见;
(4)imagine 里完全不需要解码器和真实观测——这就是「在潜空间里做规划」的含义,
把它接上 CEM / MPPI 就是 PlaNet,接上在潜空间里学的 actor-critic 就是 Dreamer。
7. 控制即推断:动机与概率图模型
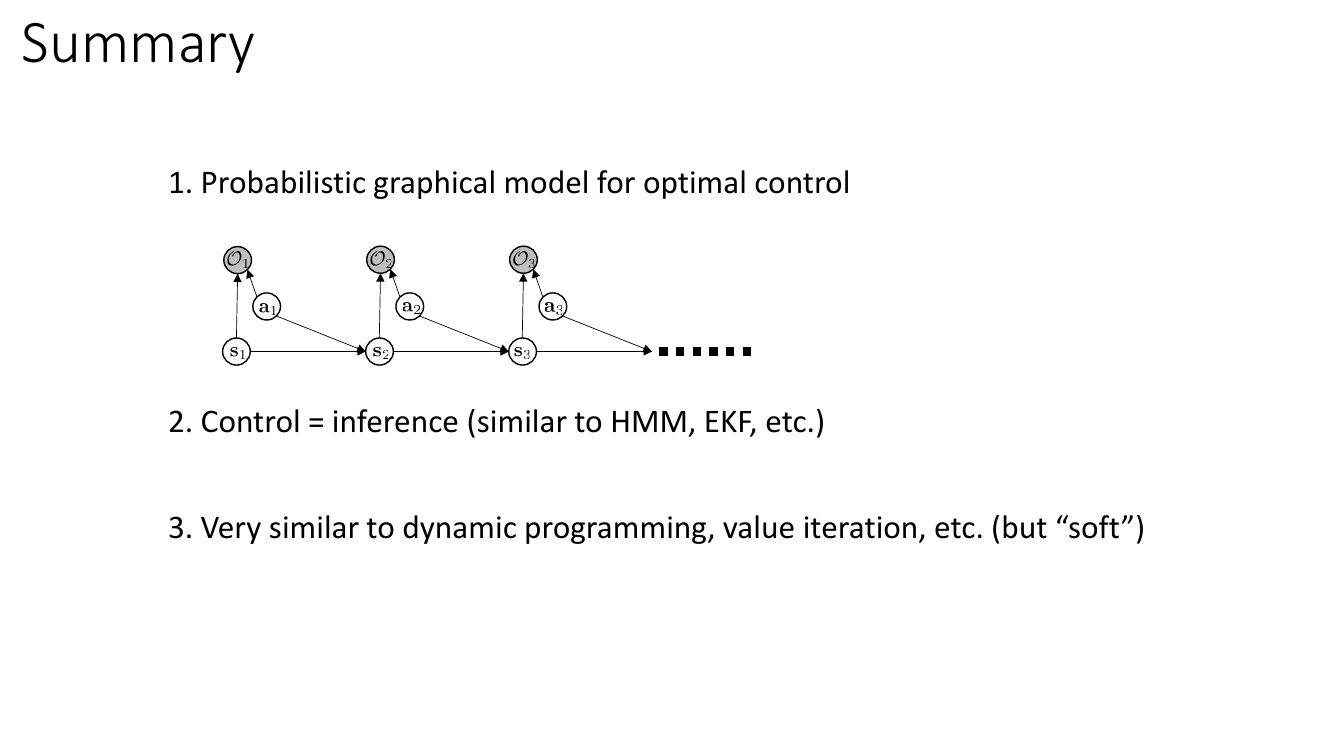
前面六节是「用变分推断做 RL 里的某个模块」。现在换一个更激进的问题: 能不能把最优控制问题本身,整个写成一次概率推断? 如果能,我们就可以把 HMM、卡尔曼滤波、消息传递这些成熟的推断算法直接搬过来解控制问题。
7.1 出发点:用最优控制解释人的行为
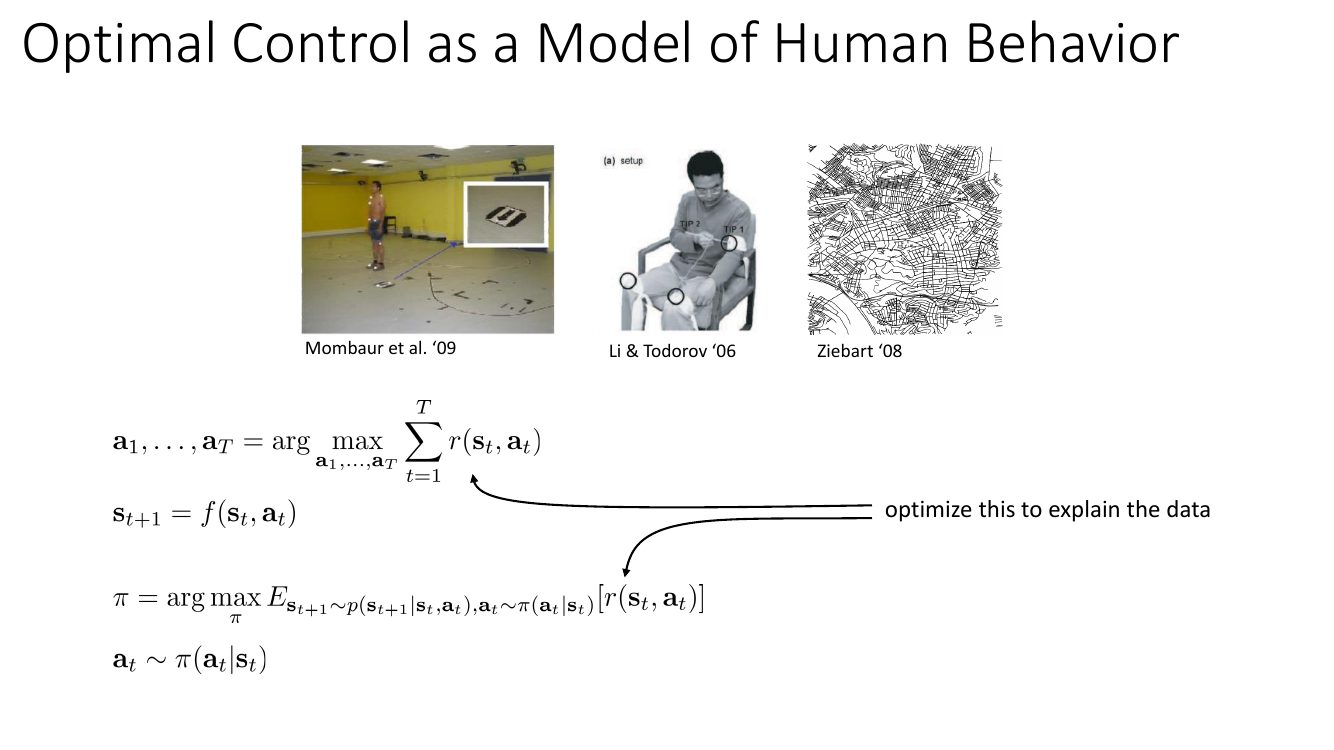
这一页的立场是:人和动物的行为看起来是在优化某个目标,所以我们可以假设他们是最优控制器, 然后去拟合那个让观测到的行为「最合理」的奖励函数 $r$。这就是逆强化学习(inverse RL)的基本设定。 但立刻就有一个大问题。
7.2 数据不是最优的
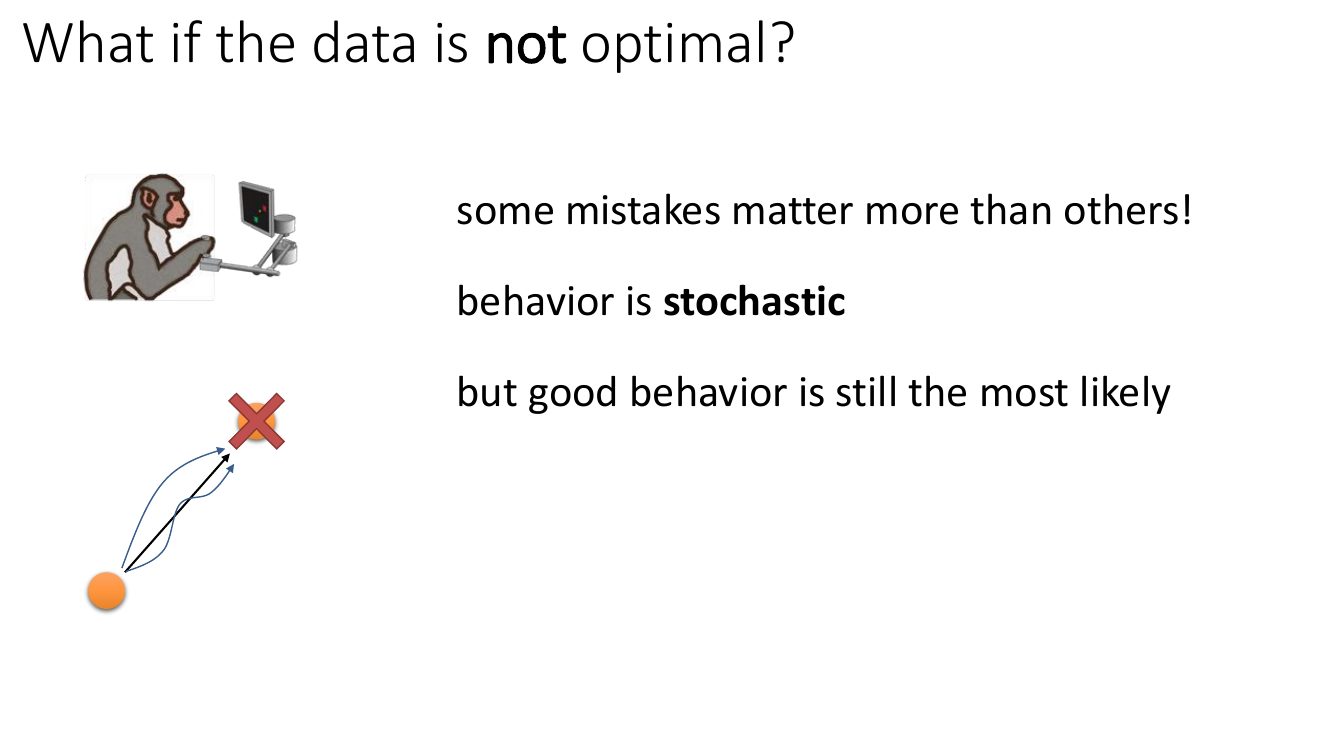
严格的 $\argmax$ 模型无法解释这张图。它给「最优轨迹」概率 1,给其余所有轨迹概率 0, 于是只要数据里出现任何一点偏差,模型的似然就是 $-\infty$。可现实是:
- 人的行为是随机的——同一个任务做十次,十条轨迹都不一样;
- 但这些随机不是均匀的:在路径中段绕一点弯几乎无所谓(反正最后能到),在终点抓偏 5 厘米就完全失败。 某些错误比另一些更要紧;
- 而且好行为依然是最可能的——不是唯一可能,是最可能。
我们需要的是一个模型,它给轨迹赋予的概率随奖励单调递增,好轨迹概率高、差轨迹概率低但非零, 而且这个「衰减速度」应该由奖励差距决定。
7.3 决策的概率图模型:最优性变量
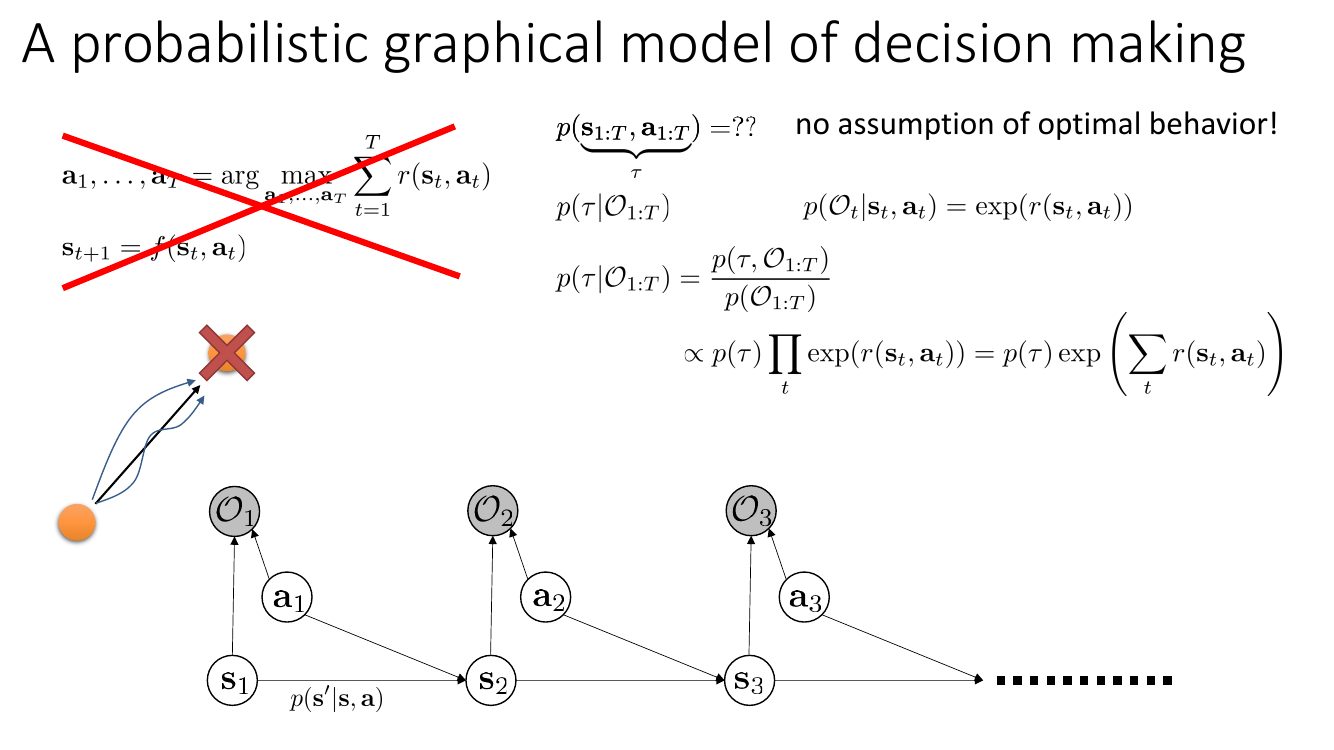
这个构造的巧妙之处:$\mathcal{O}_t\in\{0,1\}$ 是一个人造的二值变量,读作「第 $t$ 步的行为是最优的」。 它的取值我们永远设为 1 并当作已观测,于是「求最优行为」就变成了标准的推断问题 「已知 $\mathcal{O}_{1:T}=1$,问 $\tau$ 的后验是什么」。
先约定轨迹先验:$p(\tau)=p(s_1)\prod_{t}p(s_{t+1}|s_t,a_t)p(a_t|s_t)$, 其中 $p(a_t|s_t)$ 是动作先验(暂时设为均匀),注意它不是策略—— 它只描述「在不知道是否最优的前提下,动作长什么样」。然后:
$$ \begin{aligned} p(\tau\mid\mathcal{O}_{1:T})&=\frac{p(\tau,\mathcal{O}_{1:T})}{p(\mathcal{O}_{1:T})} =\frac{p(\tau)\,p(\mathcal{O}_{1:T}\mid\tau)}{p(\mathcal{O}_{1:T})}\\[2pt] &\propto p(\tau)\prod_{t=1}^{T}p(\mathcal{O}_t\mid s_t,a_t) \qquad(\mathcal{O}_t\text{ 之间给定 }\tau\text{ 条件独立})\\[2pt] &=p(\tau)\prod_{t=1}^{T}\exp\big(r(s_t,a_t)\big) = p(\tau)\exp\left(\sum_{t=1}^{T} r(s_t,a_t)\right) \end{aligned} $$现在检查它是否满足 §7.2 的三条要求。假设动力学是确定的,那么 $p(\tau)$ 在所有可行轨迹上是常数 (每条可行轨迹的转移概率都是 1,不可行的是 0),于是
$$ p(\tau\mid\mathcal{O}_{1:T})\ \propto\ \mathbf{1}[\tau\ \text{可行}]\cdot\exp\left(\sum_t r(s_t,a_t)\right) $$这是一个玻尔兹曼分布(Boltzmann distribution),能量就是负的总回报。三条要求全部满足:
用数字说话。设有三条轨迹,总回报分别是 $R_A=10$、$R_B=8$、$R_C=0$。后验概率比是
$p(A):p(B):p(C)=e^{10}:e^{8}:e^{0}=22026:2981:1$。
归一化后约为 $0.881:0.119:4\times10^{-5}$。也就是说:差一点点的 $B$(少 2 的回报)概率只降到 $A$ 的 $e^{-2}\approx13.5\%$,依然经常出现;差很多的 $C$(少 10)概率降到 $A$ 的 $e^{-10}\approx0.0045\%$, 基本不会被观察到。这就精确地实现了「行为是随机的,但某些错误比另一些更要紧,而好行为仍是最可能的」。 $\argmax$ 模型给出的是 $1:0:0$,无法解释真实数据;均匀随机给出的是 $1:1:1$,同样解释不了。
$p(\mathcal{O}_t|s_t,a_t)=\exp(r(s_t,a_t))$ 要求 $r\le 0$ 才是合法概率。这不是限制: 奖励整体平移一个常数不改变最优策略,也不改变后验 $p(\tau|\mathcal{O}_{1:T})$(常数被归一化吃掉)。 更常见的写法是直接说 $p(\mathcal{O}_t|s_t,a_t)\propto\exp(r(s_t,a_t))$,正比常数在归一化时消掉。 后面所有推导都只用到「正比」这一点。
7.4 这个模型为什么值得做
幻灯片列了三条理由,每条都对应本课后面的一整块内容:
| 理由 | 展开 |
|---|---|
| 能建模次优行为(对逆 RL 很重要) | 有了 $p(\tau|\mathcal{O}_{1:T})$,逆 RL 就是标准的极大似然:$\max_r\sum_i\log p_r(\tau_i|\mathcal{O}_{1:T})$。这正是最大熵逆强化学习(MaxEnt IRL)的出发点,Ziebart 2008 的工作。 |
| 能把推断算法搬来解控制/规划 | 后向消息 = 值迭代,前向消息 = 状态分布传播,变分推断 = 一整类新的 RL 算法(下一讲)。 |
| 解释了为什么随机行为可能更优 | 后验策略 $\pi=\exp(A)$ 天然带熵。这对探索(不会过早收敛到一个动作)和迁移(保留了所有近似同等好的解,换个环境后还有备选)都有实际好处。 |
7.5 推断 = 规划:三个要问的问题
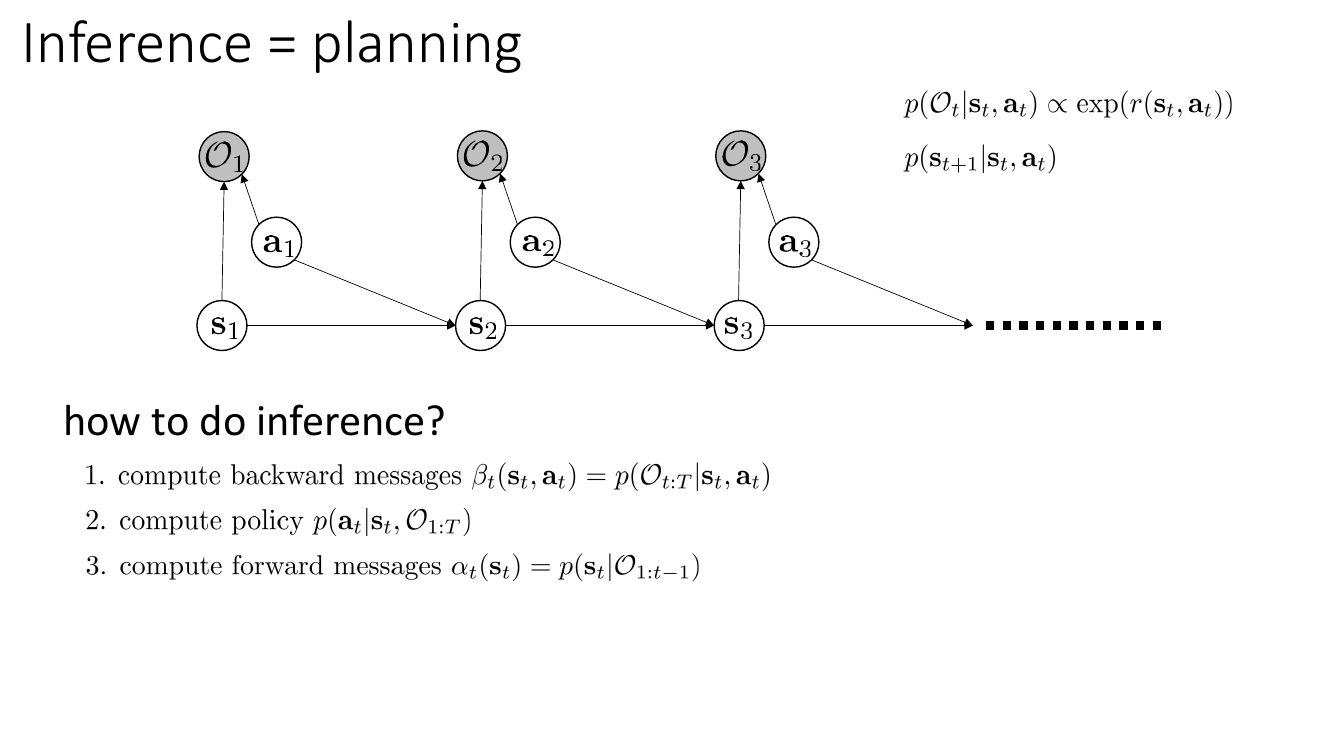
这三个量的含义值得先建立直觉:
- $\beta_t(s_t,a_t)=p(\mathcal{O}_{t:T}|s_t,a_t)$:在 $s_t$ 做了 $a_t$ 之后,从 $t$ 到 $T$ 全都最优的概率。 它只看未来,不看过去——所以它是「$Q$ 函数式」的量。
- $\pi(a_t|s_t)=p(a_t|s_t,\mathcal{O}_{1:T})$:已知全程最优,在 $s_t$ 时会做什么动作。这就是我们要的策略。
- $\alpha_t(s_t)=p(s_t|\mathcal{O}_{1:t-1})$:假设前 $t-1$ 步都最优,现在会在哪些状态。它只看过去。 两者相乘就得到完整的状态边缘 $p(s_t|\mathcal{O}_{1:T})$。
这个「后向消息 × 前向消息」的结构和 HMM 的前向-后向算法(forward-backward)、 卡尔曼滤波与平滑是完全同构的——这正是本讲最后一页要强调的「control = inference (similar to HMM, EKF, etc.)」。
8. 后向消息:soft 值迭代的由来
8.1 后向递推的推导
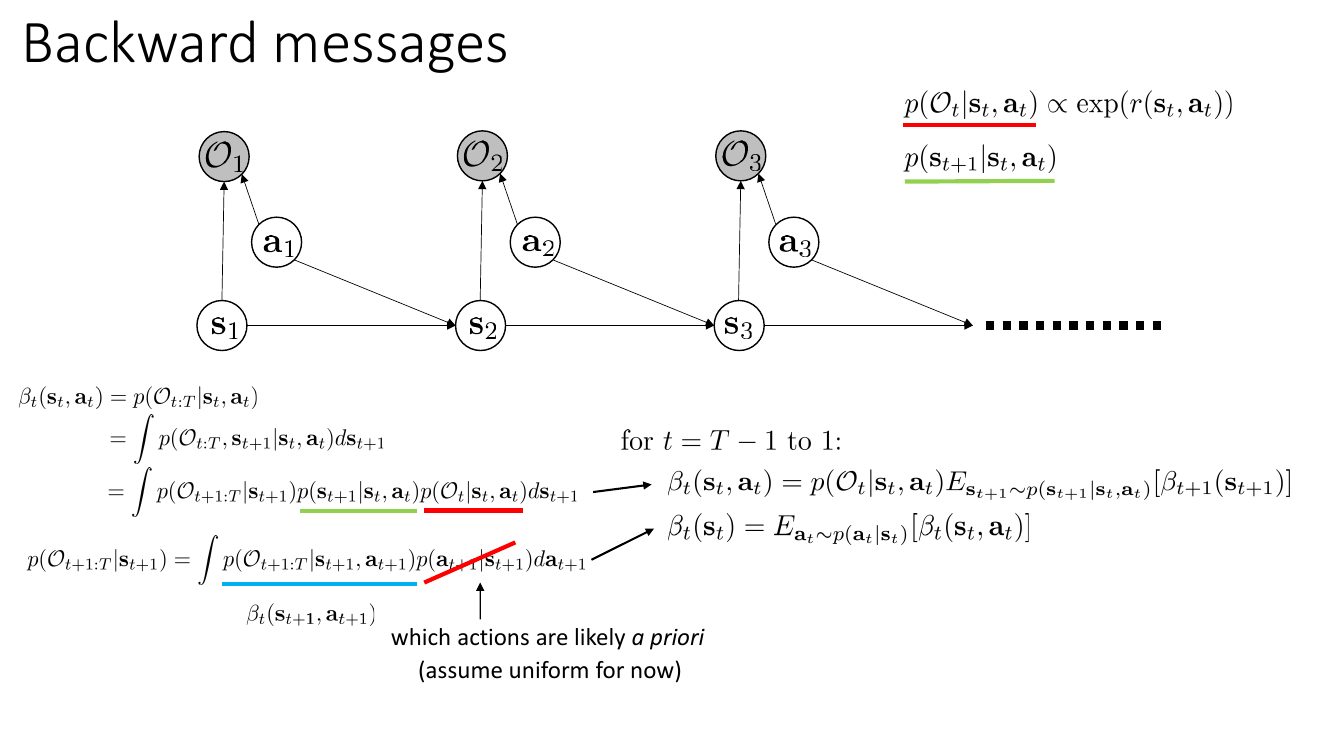
第一步:引入 $s_{t+1}$ 再积掉。
$$ \beta_t(s_t,a_t)=p(\mathcal{O}_{t:T}\mid s_t,a_t)=\int p(\mathcal{O}_{t:T},s_{t+1}\mid s_t,a_t)\,ds_{t+1} $$第二步:用图模型的条件独立性拆开被积项。给定 $s_{t+1}$,未来的最优性变量 $\mathcal{O}_{t+1:T}$ 与 $(s_t,a_t)$ 独立($s_{t+1}$ 把它们 d-分离了);而 $\mathcal{O}_t$ 只依赖 $(s_t,a_t)$:
$$ p(\mathcal{O}_{t:T},s_{t+1}\mid s_t,a_t)=\underbrace{p(\mathcal{O}_{t+1:T}\mid s_{t+1})}_{\triangleq\ \beta_{t+1}(s_{t+1})}\cdot \underbrace{p(s_{t+1}\mid s_t,a_t)}_{\text{转移}}\cdot \underbrace{p(\mathcal{O}_t\mid s_t,a_t)}_{\exp(r)} $$把与 $s_{t+1}$ 无关的因子提出积分号:
$$ \boxed{\ \beta_t(s_t,a_t)=p(\mathcal{O}_t\mid s_t,a_t)\ \E_{s_{t+1}\sim p(s_{t+1}\mid s_t,a_t)}\big[\beta_{t+1}(s_{t+1})\big]\ } $$第三步:把 $\beta_{t+1}(s_{t+1})=p(\mathcal{O}_{t+1:T}|s_{t+1})$ 也写成递推。对 $a_{t+1}$ 边缘化:
$$ p(\mathcal{O}_{t+1:T}\mid s_{t+1})=\int \underbrace{p(\mathcal{O}_{t+1:T}\mid s_{t+1},a_{t+1})}_{\beta_{t+1}(s_{t+1},a_{t+1})}\,p(a_{t+1}\mid s_{t+1})\,da_{t+1} $$即
$$ \boxed{\ \beta_t(s_t)=\E_{a_t\sim p(a_t\mid s_t)}\big[\beta_t(s_t,a_t)\big]\ } $$两式交替,从 $t=T$(边界 $\beta_T(s_T,a_T)=p(\mathcal{O}_T|s_T,a_T)$)倒推到 $t=1$。
第三步里的 $p(a_{t+1}|s_{t+1})$ 不是策略。它是图模型里动作节点的先验—— 在不知道 $\mathcal{O}$ 的情况下动作的分布。之所以要格外强调,是因为它长得跟策略一模一样, 但如果你把它当成策略代进去,整个推导就成了循环定义(策略是我们要求的东西,见 §10)。 幻灯片上把它用红笔划掉,就是在说「暂时假设它是均匀分布,于是它是常数,可以忽略」。 §9 会证明这个假设不损失一般性。
8.2 取对数:soft 值迭代现身
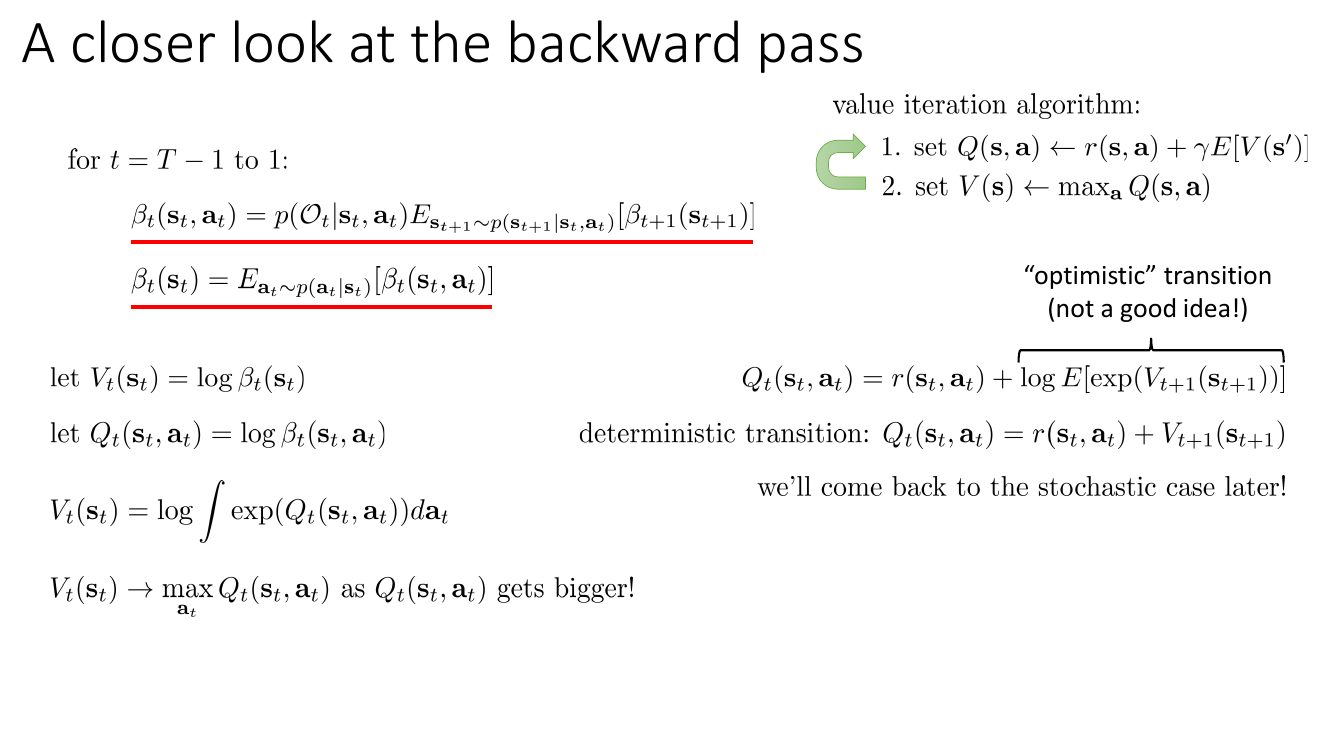
对两条递推取对数。第二条($\beta_t(s_t)=\int\beta_t(s_t,a_t)p(a_t|s_t)da_t$,均匀先验下 $p(a|s)$ 是常数)给出
$$ V_t(s_t)=\log\int \exp\big(Q_t(s_t,a_t)\big)\,da_t $$这就是 log-sum-exp,也叫 soft max(注意不是 softmax 函数,是「软化的 max」)。为什么它近似 $\max$?
记 $Q^\star=\max_a Q(s,a)$,离散动作时
$$ \log\sum_{a}e^{Q(s,a)}=Q^\star+\log\sum_a e^{Q(s,a)-Q^\star} $$右边第二项中至少有一个指数等于 1(取到最大值那个),其余都 $\le1$,所以
$$ Q^\star\ \le\ \log\sum_a e^{Q(s,a)}\ \le\ Q^\star+\log|\mathcal{A}| $$误差上界与 $Q$ 的绝对大小无关,只与动作数有关;而当 $Q^\star$ 与次优动作的差距拉大时, 误差趋于 0。具体地,$Q=(2,0)$ 时 $\mathrm{LSE}=2+\log(1+e^{-2})=2.127$(误差 0.127); $Q=(10,0)$ 时 $\mathrm{LSE}=10+\log(1+e^{-10})=10.0000454$(误差 $4.5\times10^{-5}$)。 这就是幻灯片上「$V_t(s_t)\to\max_{a_t}Q_t(s_t,a_t)$ as $Q_t$ gets bigger」的准确含义: 把奖励整体放大(等价于温度趋于 0),soft max 就收敛到 hard max。
第一条递推取对数(用 $p(\mathcal{O}_t|s_t,a_t)=\exp r$)给出
$$ Q_t(s_t,a_t)=r(s_t,a_t)+\log \E_{s_{t+1}\sim p(s_{t+1}|s_t,a_t)}\Big[\exp\big(V_{t+1}(s_{t+1})\big)\Big] $$和标准值迭代 $Q(s,a)\leftarrow r(s,a)+\gamma\E[V(s')]$ 并排一看,差别就两处: $\max_a$ 变成了 $\log\int\exp$,$\E_{s'}[V]$ 变成了 $\log\E_{s'}[\exp V]$。第一处是我们想要的(它带来了随机策略), 第二处是个大问题。
8.3 「乐观转移」:这个模型的真正缺陷
$\log\E_{s'}[\exp V(s')]\ \ge\ \E_{s'}[V(s')]$(Jensen 不等式,$\exp$ 是凸函数), 而且差距随 $V$ 在不同 $s'$ 上的方差急剧增大。这意味着 soft 后向传递系统性地高估了随机转移的价值。
具体数字:某动作有两个等概率结果,$V_{t+1}=0$ 和 $V_{t+1}=20$。真实期望价值是 $\frac{0+20}{2}=10$。 但 soft 版本算出来是
$\log\left(\tfrac12 e^{0}+\tfrac12 e^{20}\right)=20+\log\tfrac12+\log(1+e^{-20})\approx 20-0.693\approx 19.31$。
它几乎完全按最好的那个结果来估值。为什么会这样?因为我们在做的推断是 「给定全程最优,轨迹的后验是什么」——而「全程最优」这个条件会反过来影响我们对状态转移的信念: 既然结果最优,那当初那次抛硬币多半也抛出了好的一面。数学上没错,但作为控制算法这是灾难: 智能体会去买彩票,因为「在中奖的那个世界里」它确实最优。
Levine 在幻灯片上直接写了 “not a good idea!”,并给出两种目前可以接受的处理:
- 确定性动力学:此时 $\E_{s'}[\exp V]=\exp V(s_{t+1})$,$\log$ 与 $\exp$ 抵消,得到 $Q_t(s_t,a_t)=r(s_t,a_t)+V_{t+1}(s_{t+1})$——和标准 Bellman 备份完全一致。 所以在确定性环境里,control-as-inference 除了 $V$ 的 soft max 之外没有任何偏差。
- 随机动力学:留到下一讲用变分推断来修——办法是不去求精确后验 $p(\tau|\mathcal{O}_{1:T})$, 而是在一个约束了转移必须等于真实转移的分布族里做变分近似 $q(\tau)=p(s_1)\prod_t p(s_{t+1}|s_t,a_t)q(a_t|s_t)$。这样一来智能体就不能通过「改变对动力学的信念」来作弊, 只能改策略。最大化对应的 ELBO 得到的正是最大熵 RL 的目标 $\sum_t\E[r(s_t,a_t)+\mathcal{H}(q(a_t|s_t))]$,也就是 Soft Actor-Critic 的出发点。
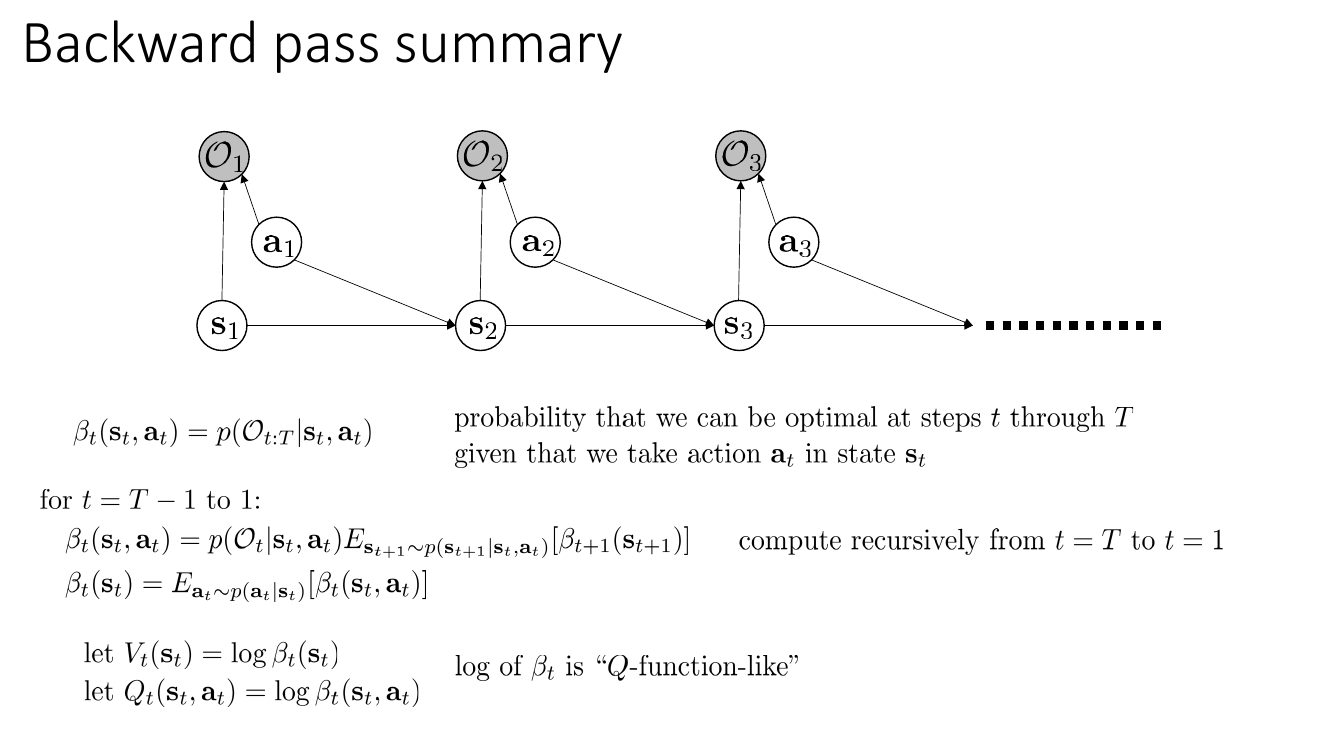
注意这里的语义是概率而不是回报:$\beta_t\in[0,1]$(在 $r\le0$ 的约定下), 它的对数才是我们熟悉的 $Q$。这解释了为什么值函数会以 $\log$ 的形式出现—— 「累加奖励」在概率空间里是「连乘 $\exp(r)$」,取对数就变回累加。
9. 动作先验:为什么可以放心假设均匀
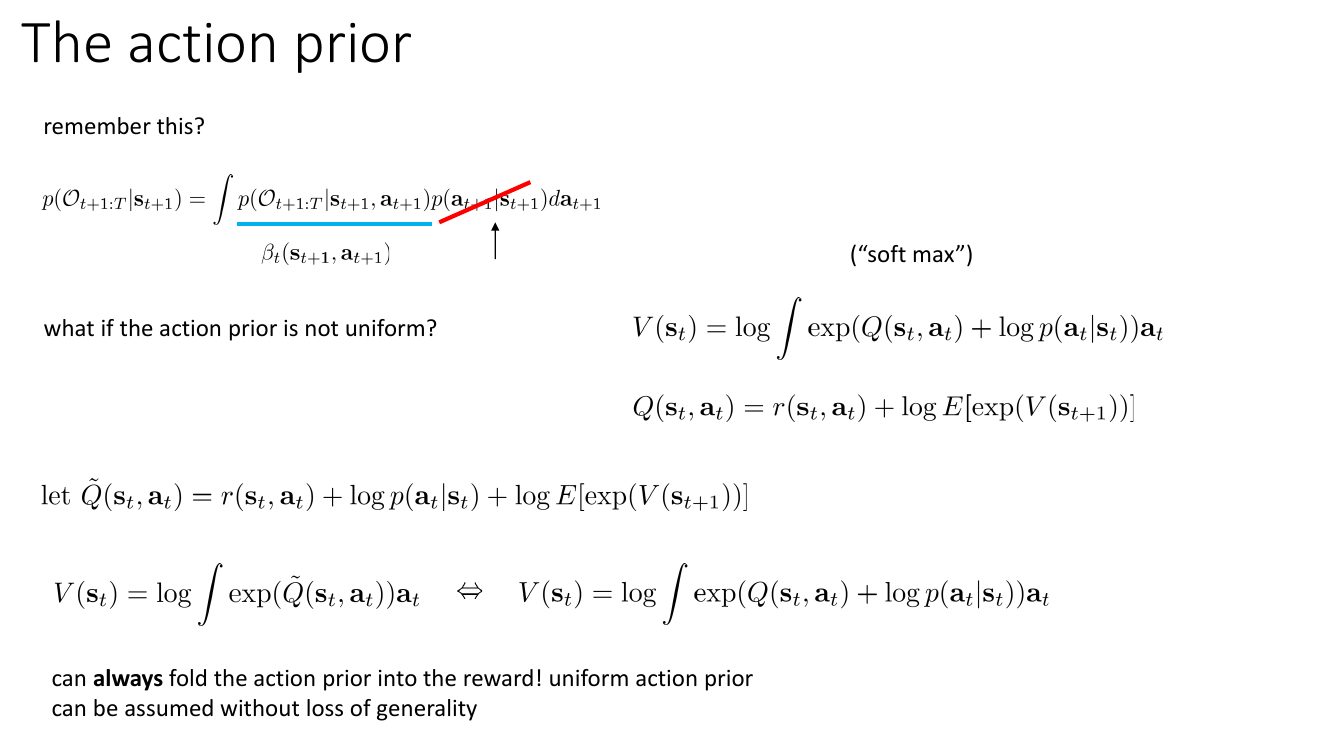
推导只有一行代数,但结论很有分量。带一般先验时,$V$ 的更新是
$$ V(s_t)=\log\int \exp\big(Q(s_t,a_t)\big)\,p(a_t|s_t)\,da_t=\log\int\exp\Big(Q(s_t,a_t)+\log p(a_t|s_t)\Big)\,da_t $$令 $\tilde{Q}(s_t,a_t)\triangleq Q(s_t,a_t)+\log p(a_t|s_t)=\underbrace{r(s_t,a_t)+\log p(a_t|s_t)}_{\tilde r(s_t,a_t)}+\log\E[\exp V(s_{t+1})]$, 则 $V(s_t)=\log\int\exp(\tilde Q(s_t,a_t))\,da_t$——形式与均匀先验时一模一样, 只是奖励换成了 $\tilde r=r+\log p(a|s)$。所以:任何带动作先验的问题,都等价于一个奖励被修改过、 动作先验为均匀的问题。
$\tilde r(s,a)=r(s,a)+\log p(a|s)$ 这个式子在现代 RL 里到处都是,只是换了名字:
- 把 $p(a|s)$ 取成某个参考策略 $\pi_{\text{ref}}$,则 $\log\pi_{\text{ref}}(a|s)$ 就是一个奖励塑形项, 最大化 $\sum_t\E[r+\log\pi_{\text{ref}}]$ 加上策略自身的熵,恰好等于 $\sum_t\E[r]-D_{\mathrm{KL}}(\pi\|\pi_{\text{ref}})$。 这就是 KL 正则 RL;语言模型的 RLHF 目标就长这样。
- 把 $p(a|s)$ 取成行为策略(数据里动作的分布),就得到 offline RL 里对分布外动作的惩罚。
- 取均匀先验时 $\log p(a|s)=\text{const}$,整体退化——这就是为什么本讲后面一律假设均匀,不失一般性。
10. 策略计算:$\pi=\exp(A)$
10.1 从后验中读出策略
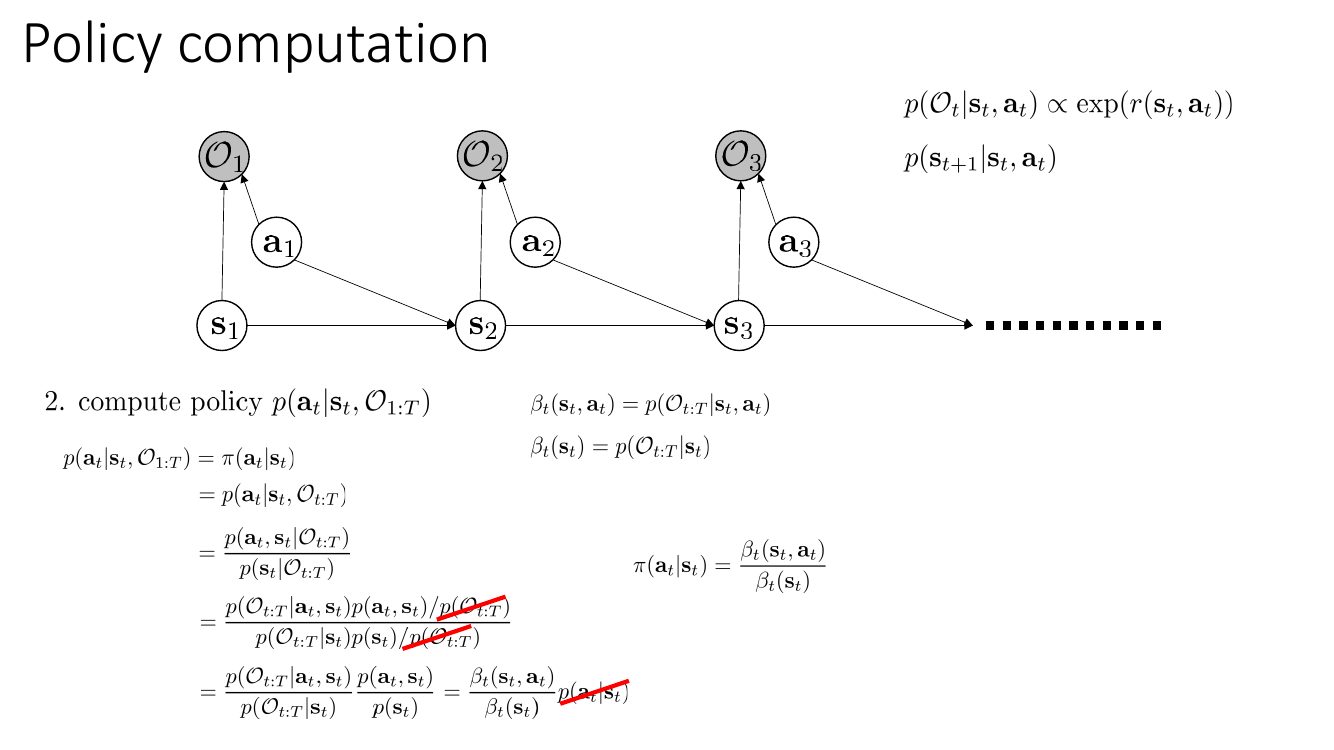
第一步:去掉过去的最优性变量。在图模型里,给定 $s_t$,节点 $a_t$ 与 $\mathcal{O}_{1:t-1}$ 被 d-分离 (从 $\mathcal{O}_{1:t-1}$ 到 $a_t$ 的所有路径都必须经过 $s_t$,而 $s_t$ 已被观测且是链上的中间节点),因此
$$ p(a_t\mid s_t,\mathcal{O}_{1:T})=p(a_t\mid s_t,\mathcal{O}_{t:T}) $$第二步:写成联合除边缘,然后两边同时用贝叶斯公式。
$$ \begin{aligned} p(a_t\mid s_t,\mathcal{O}_{t:T}) &=\frac{p(a_t,s_t\mid\mathcal{O}_{t:T})}{p(s_t\mid\mathcal{O}_{t:T})}\\[3pt] &=\frac{p(\mathcal{O}_{t:T}\mid a_t,s_t)\,p(a_t,s_t)\,/\,p(\mathcal{O}_{t:T})} {p(\mathcal{O}_{t:T}\mid s_t)\,p(s_t)\,/\,p(\mathcal{O}_{t:T})}\\[3pt] &=\frac{p(\mathcal{O}_{t:T}\mid a_t,s_t)}{p(\mathcal{O}_{t:T}\mid s_t)}\cdot\frac{p(a_t,s_t)}{p(s_t)} =\frac{\beta_t(s_t,a_t)}{\beta_t(s_t)}\,p(a_t\mid s_t) \end{aligned} $$其中 $p(\mathcal{O}_{t:T})$ 上下相消(这是幻灯片上第一处红叉)。均匀动作先验下 $p(a_t|s_t)$ 是常数 (这是第二处红叉,且由 §9 知不失一般性),于是
$$ \boxed{\ \pi(a_t\mid s_t)=\frac{\beta_t(s_t,a_t)}{\beta_t(s_t)}\ } $$这个式子有非常朴素的解释:分子是「做了 $a_t$ 之后全程最优的概率」, 分母是「在 $s_t$ 什么都还没决定时全程最优的概率」,比值就是这个动作对『还能最优』的相对贡献。 贡献大的动作被选中的概率高。
10.2 换成值函数写法
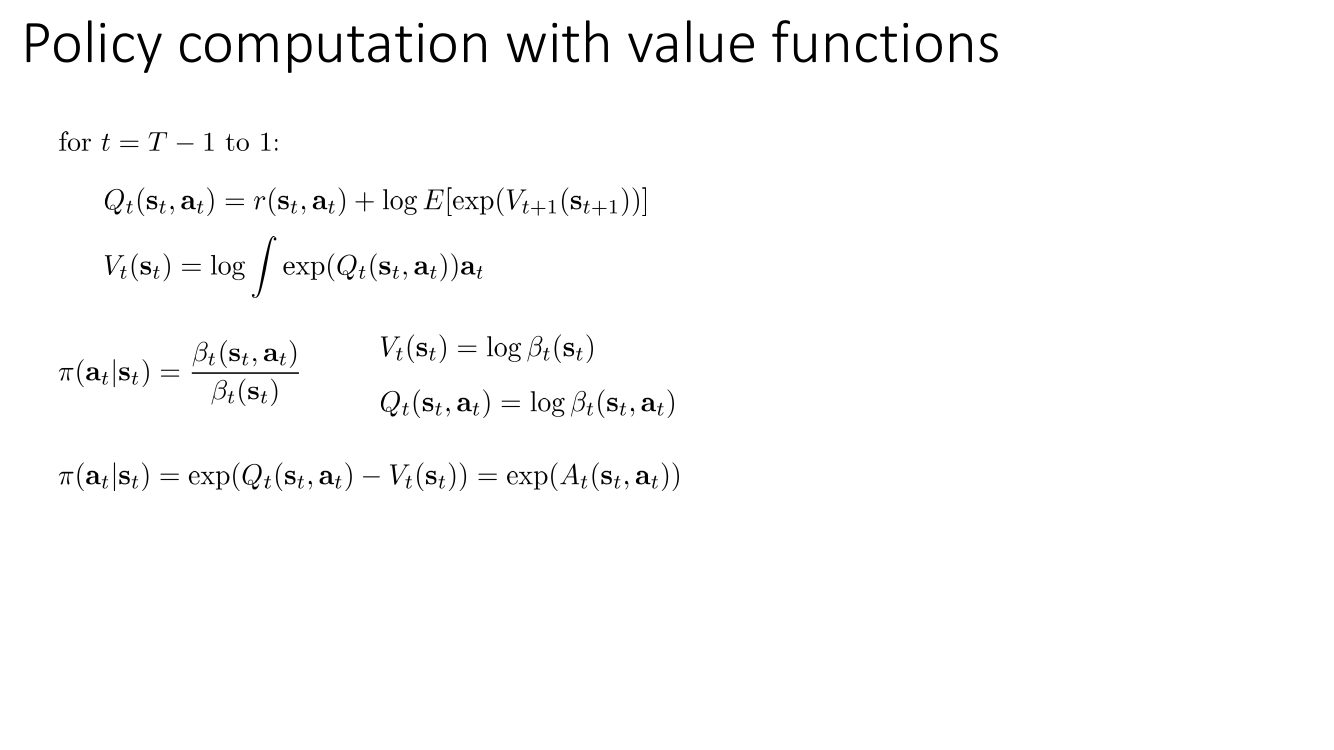
代换一步即可:$\beta_t(s_t,a_t)=\exp(Q_t)$、$\beta_t(s_t)=\exp(V_t)$,所以
$$ \pi(a_t\mid s_t)=\frac{\exp\big(Q_t(s_t,a_t)\big)}{\exp\big(V_t(s_t)\big)}=\exp\big(Q_t(s_t,a_t)-V_t(s_t)\big)=\exp\big(A_t(s_t,a_t)\big) $$顺带验证它自动归一化:$\int\exp(Q_t-V_t)da_t=e^{-V_t}\int e^{Q_t}da_t=e^{-V_t}\cdot e^{V_t}=1$。 这不是巧合——$V_t=\log\int\exp Q_t$ 这个 soft max 的定义恰恰就是那个归一化常数(配分函数)的对数。
$\pi(a|s)=\exp(A(s,a))$ 是 control-as-inference 的招牌结论。它把「优势函数」和「策略」 用一个 $\exp$ 直接绑在一起:两个动作的概率之比就是它们优势之差的指数, 优势差 1 就意味着概率差 $e\approx2.72$ 倍。离散动作下 $V_t=\log\sum_a\exp Q_t\ge\max_a Q_t\ge Q_t(s_t,a_t)$, 所以 $A_t\le0$、$\pi\le1$,是合法的概率。
10.3 温度:从贪心到均匀的一根旋钮
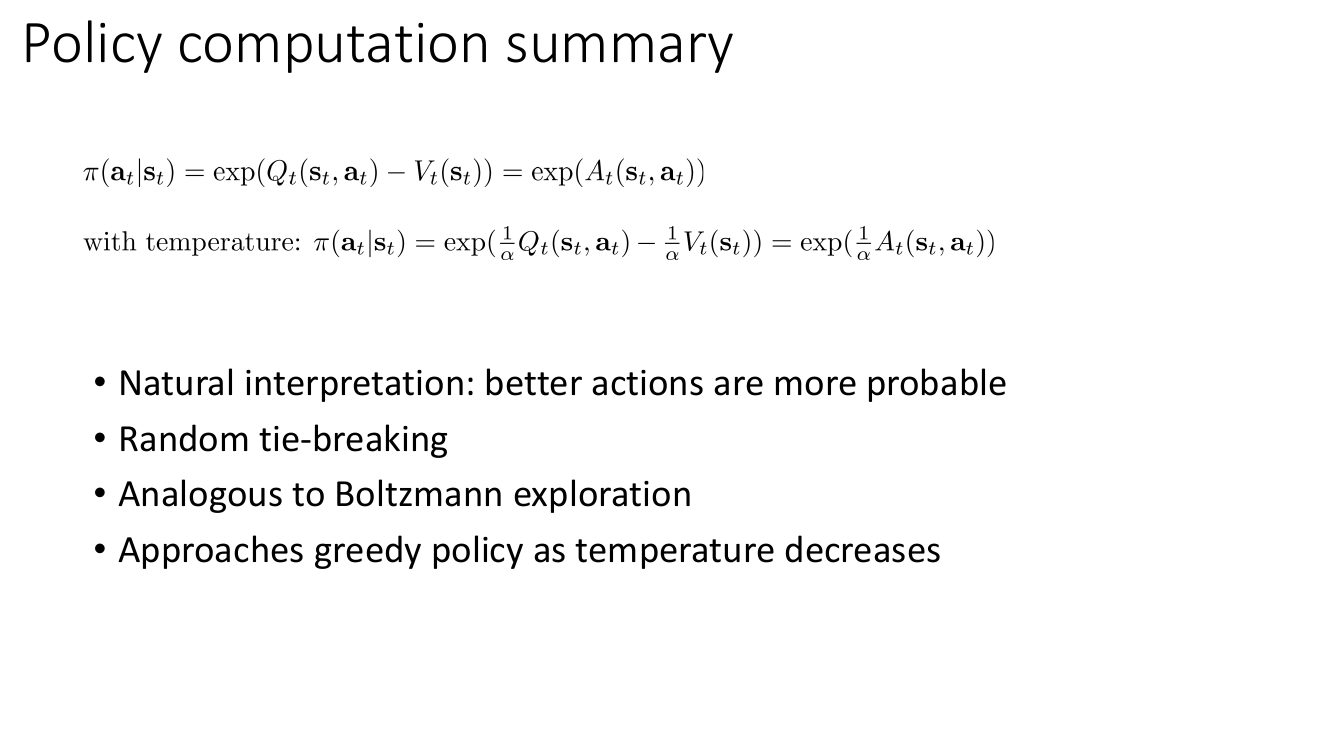
温度是从哪来的?把最优性变量的定义改成 $p(\mathcal{O}_t|s_t,a_t)=\exp\big(r(s_t,a_t)/\alpha\big)$, 所有推导原样成立,只是各处的 $r$ 换成 $r/\alpha$,于是 $Q,V$ 都被 $1/\alpha$ 缩放。 换句话说 $\alpha$ 就是「你认为示范者/智能体有多接近最优」的刻度。
| $\alpha$ | $Q/\alpha$(取 $Q=(2,1,-1)$) | $V/\alpha=\mathrm{LSE}$ | $\pi=\exp(A/\alpha)$ | 行为 |
|---|---|---|---|---|
| $10$ | $(0.2,\,0.1,\,-0.1)$ | $1.173$ | $(0.378,\,0.342,\,0.280)$ | 几乎均匀随机 |
| $1$ | $(2,\,1,\,-1)$ | $2.349$ | $(0.705,\,0.259,\,0.035)$ | 明显偏好最优,但保留备选 |
| $0.1$ | $(20,\,10,\,-10)$ | $20.000045$ | $(0.99995,\,4.5\!\times\!10^{-5},\,\approx0)$ | 几乎贪心 |
四条性质逐条对上:更好的动作概率更大($\exp$ 单调);随机打破平局 (两个 $Q$ 完全相等时各 50%,而 $\argmax$ 要靠实现细节任意挑一个); 与玻尔兹曼探索同构($\pi\propto\exp(Q/\alpha)$ 正是 Boltzmann / softmax 探索的公式, 只不过这里它是从推断里推出来的,而不是手工加的探索启发式); 温度降低趋于贪心(上表第三行)。
为什么随机策略在实践中可能更好而不只是「次优的妥协」?两个理由: (1)探索——它天然把概率质量分给所有近似同等好的动作,不会因为一次估计噪声就永久锁死在某个动作上; (2)迁移与鲁棒——如果一个任务有多条同样好的解法,$\argmax$ 策略只会记住一条, 环境稍微一变(那条路被堵了)就完全失效;而 $\exp(A)$ 策略把所有解法都保留了下来,还有备选。 Levine 反复强调的「stochastic behavior might be preferred」指的正是这件事。
10.4 最小实现:表格式 soft 值迭代
import numpy as np
from scipy.special import logsumexp

def soft_value_iteration(r, P, T, alpha=1.0):
    """r: [S,A] 奖励;P: [S,A,S] 转移概率;T: 时域长度;alpha: 温度。
    返回每个时刻的 Q、V 和策略 pi。"""
    S, A = r.shape
    V  = np.zeros((T + 1, S))          # V[T] = 0 作为边界条件
    Q  = np.zeros((T, S, A))
    logP = np.log(P + 1e-300)          # 防 log(0)
    for t in range(T - 1, -1, -1):
        # log E_{s'}[exp V_{t+1}(s')] = logsumexp_{s'}( log P(s'|s,a) + V_{t+1}(s') )
        soft_next = logsumexp(logP + V[t + 1][None, None, :], axis=2)   # [S,A]
        Q[t] = r / alpha + soft_next                 # <- “乐观”转移就藏在 soft_next 里
        V[t] = logsumexp(Q[t], axis=1)               # V_t(s) = log sum_a exp Q_t(s,a)
    pi = np.exp(Q - V[:T, :, None])                  # pi(a|s) = exp(Q - V) = exp(A)
    return Q, V[:T], pi

def hard_value_iteration(r, P, T, gamma=1.0):
    """对照组:标准(hard)有限时域值迭代。"""
    S, A = r.shape
    V = np.zeros((T + 1, S)); Q = np.zeros((T, S, A))
    for t in range(T - 1, -1, -1):
        Q[t] = r + gamma * P @ V[t + 1]              # E_{s'}[V],不是 log E[exp V]
        V[t] = Q[t].max(axis=1)
    return Q, V[:T]
把 alpha 从 1 调到 0.05 再跑 soft_value_iteration,你会看到 pi 逐渐变成 one-hot,
而 Q * alpha 收敛到 hard_value_iteration 的 Q——但只在确定性转移下。
在随机转移的 MDP 上,即使 $\alpha\to0$,soft_next 也会因为 $\log\E[\exp]$ 而收敛到
$\max_{s'}V(s')$ 而不是 $\E_{s'}[V(s')]$,两者的差就是 §8.3 那个乐观偏差。
自己造一个「有 1% 概率通向大奖」的动作跑一下,能非常直观地看到这个模型的病灶。
11. 前向消息与状态边缘分布
11.1 前向递推
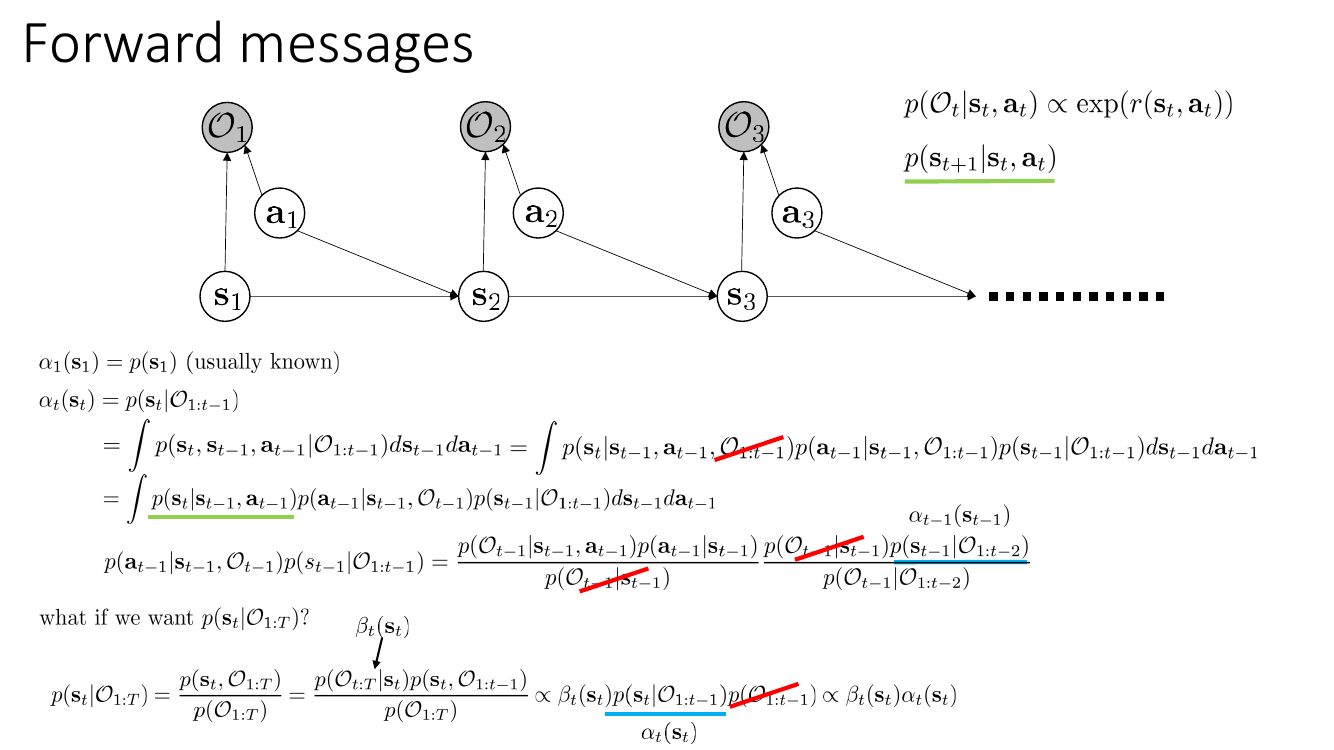
边界:$\alpha_1(s_1)=p(s_1)$(初始状态分布,通常已知)。递推:
$$ \begin{aligned} \alpha_t(s_t)&=p(s_t\mid\mathcal{O}_{1:t-1}) =\iint p(s_t,s_{t-1},a_{t-1}\mid\mathcal{O}_{1:t-1})\,ds_{t-1}\,da_{t-1}\\ &=\iint p(s_t\mid s_{t-1},a_{t-1})\;p(a_{t-1}\mid s_{t-1},\mathcal{O}_{1:t-1})\;p(s_{t-1}\mid\mathcal{O}_{1:t-1})\,ds_{t-1}\,da_{t-1} \end{aligned} $$第一个因子里的条件 $\mathcal{O}_{1:t-1}$ 被丢掉,用的是马尔可夫性:给定 $(s_{t-1},a_{t-1})$, $s_t$ 与之前的一切都独立。第二个因子进一步简化为 $p(a_{t-1}|s_{t-1},\mathcal{O}_{t-1})$ (给定 $s_{t-1}$,动作只与本步的最优性有关)。接着把后两个因子一起用贝叶斯展开:
$$ p(a_{t-1}\mid s_{t-1},\mathcal{O}_{t-1})\,p(s_{t-1}\mid\mathcal{O}_{1:t-1}) =\frac{p(\mathcal{O}_{t-1}\mid s_{t-1},a_{t-1})\,p(a_{t-1}\mid s_{t-1})}{p(\mathcal{O}_{t-1}\mid s_{t-1})} \cdot\frac{p(\mathcal{O}_{t-1}\mid s_{t-1})\,\overbrace{p(s_{t-1}\mid\mathcal{O}_{1:t-2})}^{\alpha_{t-1}(s_{t-1})}}{p(\mathcal{O}_{t-1}\mid\mathcal{O}_{1:t-2})} $$$p(\mathcal{O}_{t-1}|s_{t-1})$ 上下相消,分母 $p(\mathcal{O}_{t-1}|\mathcal{O}_{1:t-2})$ 与 $s_{t-1},a_{t-1}$ 无关、 只是归一化常数。于是
$$ \boxed{\ \alpha_t(s_t)\ \propto\ \iint p(s_t\mid s_{t-1},a_{t-1})\;\underbrace{p(\mathcal{O}_{t-1}\mid s_{t-1},a_{t-1})}_{\exp r}\;p(a_{t-1}\mid s_{t-1})\;\alpha_{t-1}(s_{t-1})\,ds_{t-1}\,da_{t-1}\ } $$前向递推里出现的动作分布是 $p(a_{t-1}|s_{t-1},\mathcal{O}_{t-1})\propto\exp(r(s_{t-1},a_{t-1}))\,p(a_{t-1}|s_{t-1})$, 它只条件于当前这一步的最优性,不是我们在 §10 求出的策略 $\pi(a|s)=\exp(A)$(那个条件于 $\mathcal{O}_{1:T}$)。 初学时很容易随手把 $\pi$ 代进去。要真正得到「在最优策略下访问状态的分布」, 正确做法是先用 $\pi$ 把 $\alpha$ 和 $\beta$ 都算出来,再用下面的乘积公式,而不是在前向递推里偷偷换分布。
11.2 两条消息相乘 = 状态边缘
最后一步是把两个方向的信息合起来:
$$ p(s_t\mid\mathcal{O}_{1:T})=\frac{p(s_t,\mathcal{O}_{1:T})}{p(\mathcal{O}_{1:T})} =\frac{\overbrace{p(\mathcal{O}_{t:T}\mid s_t)}^{\beta_t(s_t)}\ p(s_t,\mathcal{O}_{1:t-1})}{p(\mathcal{O}_{1:T})} \ \propto\ \beta_t(s_t)\,\underbrace{p(s_t\mid\mathcal{O}_{1:t-1})}_{\alpha_t(s_t)}\,p(\mathcal{O}_{1:t-1}) \ \propto\ \beta_t(s_t)\,\alpha_t(s_t) $$第一处用的是条件独立:给定 $s_t$,未来的最优性 $\mathcal{O}_{t:T}$ 与过去的 $\mathcal{O}_{1:t-1}$ 独立。 最后 $p(\mathcal{O}_{1:t-1})$ 与 $s_t$ 无关,作为常数丢掉。
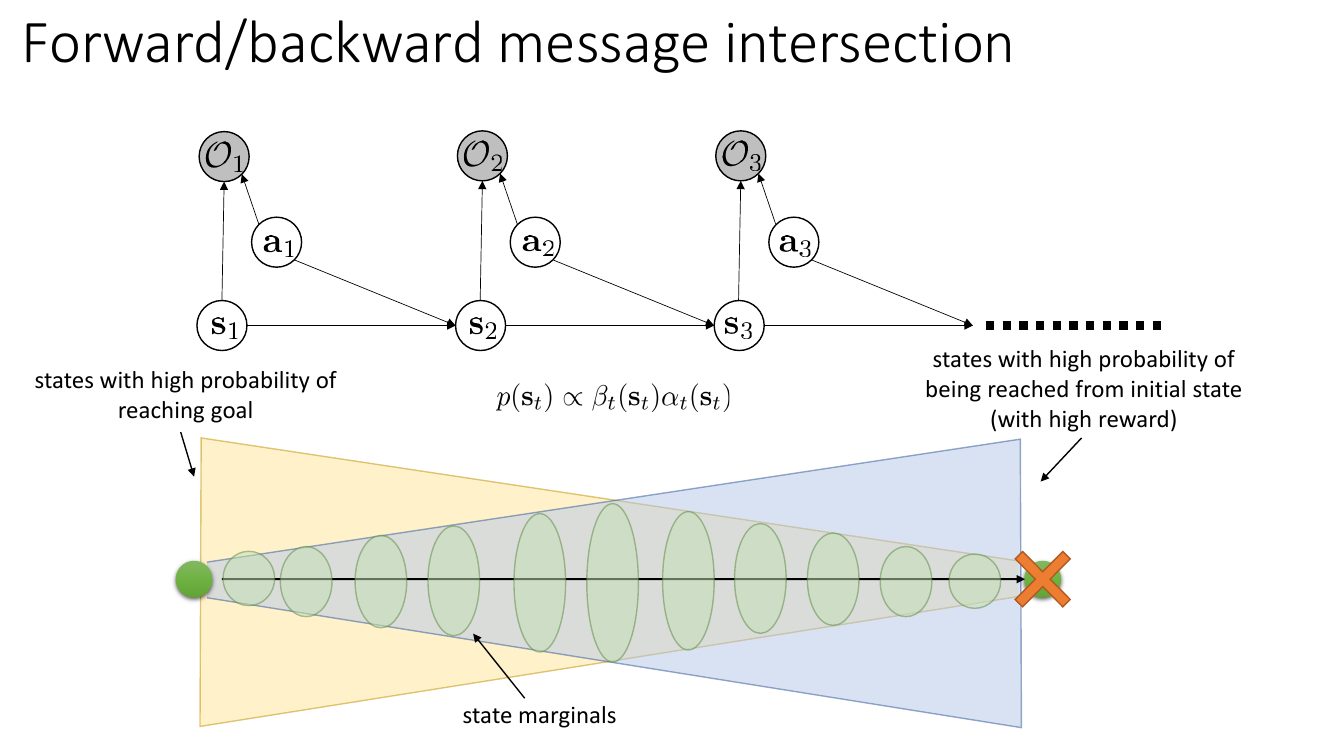
为什么是橄榄球(或者说梭形)?
- $\alpha_t(s_t)$ 只看过去:从一个确定的起点出发,随着时间推移,不确定性单调增长——一个向右张开的锥。
- $\beta_t(s_t)$ 只看未来:离终点越近,「还能救回来」的状态集合越小,越接近终点约束越紧——一个向左张开的锥。
- 二者相乘:起点附近被 $\alpha$ 卡死(你就在那儿),终点附近被 $\beta$ 卡死(必须能到目标), 中间没人管,所以方差最大。
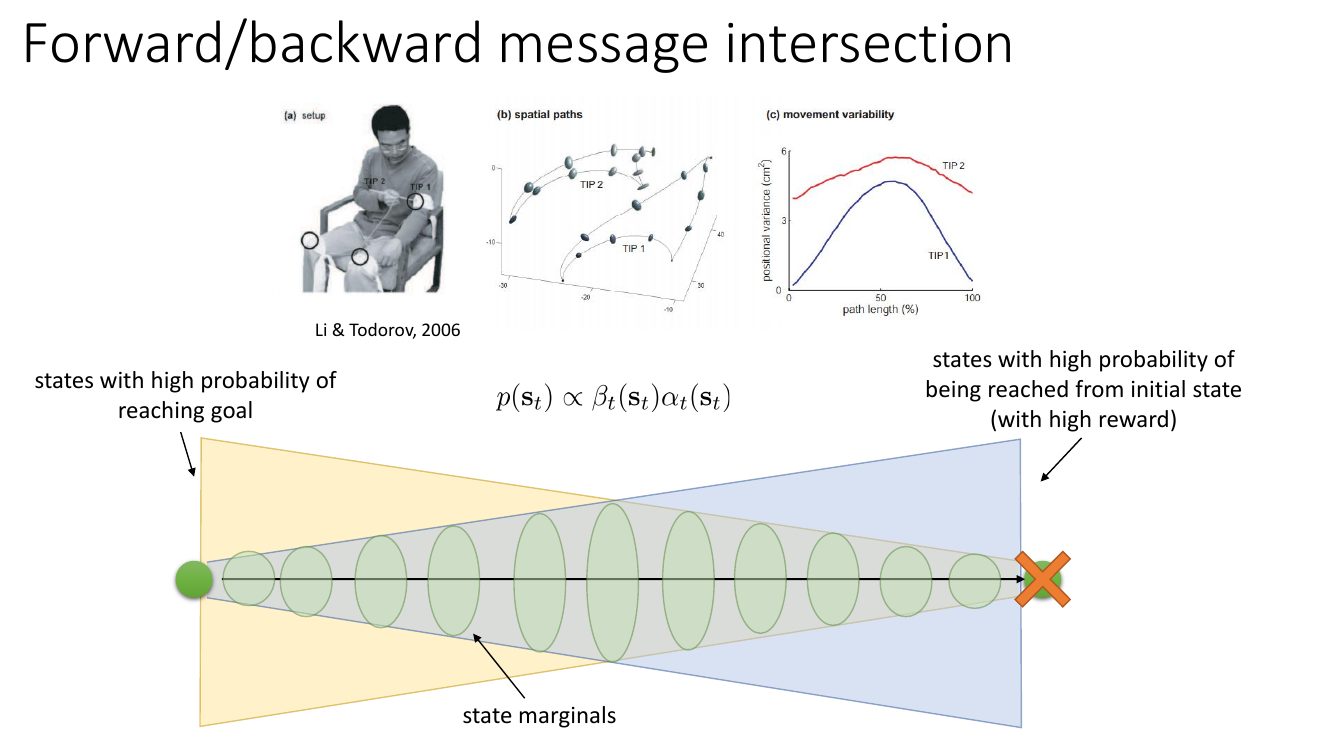
这是本讲最漂亮的一个「理论 → 实验」闭环。control-as-inference 模型预言: 真人做够物动作时,多次重复的轨迹方差应该在路径中段最大、在起点和终点最小。 Li & Todorov 2006 测出来的曲线正是这个形状。这条预言普通的 $\argmax$ 最优控制模型给不出来—— 它预测方差处处为零。而「最小化方差」的直觉模型会预测方差单调增长。 只有「给定全程最优的后验」这个框架才能同时解释「两端紧、中间松」: 终点紧是因为任务要求,起点紧是因为初始条件,中间松是因为怎么走都行,没必要精确—— 这正是 Todorov 提出的「最小干预原则」(minimum intervention principle)。
11.3 最小实现:前向消息与状态边缘
import numpy as np
from scipy.special import logsumexp

def forward_messages(p1, P, r, T):
    """alpha[t, s] = p(s_t | O_{1:t-1}),与 soft_value_iteration 用同一套 (P, r)。"""
    S, A = r.shape
    alpha = np.zeros((T, S))
    alpha[0] = p1                                        # alpha_1(s) = p(s_1)
    # p(a|s,O) 正比于 exp(r(s,a)) * p(a|s),均匀先验下就是对 a 做 softmax
    pa_given_sO = np.exp(r - logsumexp(r, axis=1, keepdims=True))     # [S,A]
    for t in range(1, T):
        # alpha_t(s') = sum_{s,a} P(s'|s,a) p(a|s,O) alpha_{t-1}(s)
        alpha[t] = np.einsum('s,sa,sax->x', alpha[t - 1], pa_given_sO, P)
        alpha[t] /= alpha[t].sum()                       # 归一化(前面推导里丢掉的常数)
    return alpha

def state_marginals(alpha, V):
    """p(s_t | O_{1:T}) 正比于 beta_t(s_t) * alpha_t(s_t),其中 beta_t(s) = exp(V_t(s))。"""
    m = alpha * np.exp(V - V.max(axis=1, keepdims=True))  # 减最大值防溢出
    return m / m.sum(axis=1, keepdims=True)

# 用法:先后向、再前向、最后相乘
Q, V, pi = soft_value_iteration(r, P, T, alpha=1.0)
al       = forward_messages(p1, P, r, T)
marg     = state_marginals(al, V)
# marg[t] 就是那串绿色椭圆;把 marg 的熵按 t 画出来,会看到中间高、两端低
ent = -(marg * np.log(marg + 1e-12)).sum(axis=1)
把最后那个 ent(每个时刻状态边缘分布的熵)画成曲线,就是 Li & Todorov 那条实验曲线的
理论对应物:起点熵接近 0(初始状态确定),终点熵很低(目标约束紧),中间最高。
本讲小结
速查表:本讲所有关键公式
| 名称 | 公式 | 要点 |
|---|---|---|
| ELBO | $\log p(x)\ge\E_{q}[\log p_\theta(x|z)+\log p(z)]+\mathcal{H}(q)$ | 间隙 $=D_{\mathrm{KL}}(q\|p(z|x))$ |
| ELBO(第二形式) | $\mathcal{L}=\E_{q_\phi}[\log p_\theta(x|z)]-D_{\mathrm{KL}}(q_\phi(z|x)\|p(z))$ | KL 解析可算,方差更低 |
| 高斯 KL | $\frac{1}{2}\sum_j(\sigma_j^2+\mu_j^2-1-\log\sigma_j^2)$ | 对 $\mathcal{N}(0,I)$ 先验 |
| 策略梯度估计器 | $\frac{1}{M}\sum_j\nabla_\phi\log q_\phi(z_j|x)\,r(x,z_j)$ | 通用;高方差 |
| 重参数化估计器 | $\frac{1}{M}\sum_j\nabla_\phi r(x,\mu_\phi(x)+\epsilon_j\sigma_\phi(x))$ | 只限连续;单样本够用 |
| 条件 ELBO | $\E_{q_\phi(z|x,y)}[\log p_\theta(y|x,z)]-D_{\mathrm{KL}}(q_\phi(z|x,y)\|p(z|x))$ | 编码器必须看 $y$ |
| SSM 先验/解码/编码 | $p(z_1)\prod p(z_{t+1}|z_t,a_t)$ / $\prod p(o_t|z_t)$ / $\prod q_\phi(z_t|o_{1:t})$ | 先验=动力学;编码器=信念状态 |
| SSM 的 ELBO | $\sum_t\E[\log p(o_t|z_t)]-\sum_t\E\big[D_{\mathrm{KL}}(q(z_{t+1}|o_{1:t+1})\|p(z_{t+1}|z_t,a_t))\big]$ | 第二项同时训动力学与表示 |
| 最优性变量 | $p(\mathcal{O}_t|s_t,a_t)=\exp(r(s_t,a_t))$ | 需 $r\le0$,或写成正比 |
| 轨迹后验 | $p(\tau|\mathcal{O}_{1:T})\propto p(\tau)\exp(\sum_t r(s_t,a_t))$ | 确定性动力学下 = 玻尔兹曼分布 |
| 后向消息 | $\beta_t(s_t,a_t)=p(\mathcal{O}_t|s_t,a_t)\E_{s'}[\beta_{t+1}(s')]$,$\beta_t(s_t)=\E_{a\sim p(a|s)}[\beta_t(s_t,a_t)]$ | $t=T$ 倒推到 1 |
| soft 值迭代 | $Q_t=r+\log\E[\exp V_{t+1}]$,$V_t=\log\int\exp Q_t\,da_t$ | $\max\to$ LSE;随机转移下有乐观偏差 |
| 动作先验 | $\tilde r=r+\log p(a|s)$ | 可折进奖励,均匀先验不失一般性 |
| 策略 | $\pi(a_t|s_t)=\frac{\beta_t(s_t,a_t)}{\beta_t(s_t)}=\exp(A_t(s_t,a_t))$ | 带温度:$\exp(A_t/\alpha)$ |
| 前向消息 | $\alpha_t(s_t)\propto\iint p(s_t|s',a')e^{r(s',a')}p(a'|s')\alpha_{t-1}(s')$ | $\alpha_1=p(s_1)$ |
| 状态边缘 | $p(s_t|\mathcal{O}_{1:T})\propto\alpha_t(s_t)\beta_t(s_t)$ | 两锥相交 = 橄榄球形 |
要点清单
- 摊销把逐样本变分参数换成一张编码器网络,参数量与数据量脱钩,测试时一次前向即可推断; 代价是引入摊销间隙。
- 重参数化之所以低方差,是因为它用了 $\partial r/\partial z$ 这个一阶信息, 而且 $r$ 的常数偏移会被求导消掉。策略梯度只用零阶信息,$r$ 的绝对量级会直接放大方差。 连续隐变量优先用重参数化,离散隐变量只能用策略梯度或连续松弛。
- VAE 能采样的原因是 KL 项让每个样本在隐空间占一团有体积的云、并把这些云拉向先验, 从而把隐空间连续地填满。这也带来两个孪生病症:先验空洞与后验塌缩。
- 隐变量策略是模仿学习处理多模态的标准手段:$p(a|s)=\int p(a|s,z)p(z)dz$, $z$ 承担「示范者当时的意图」这个缺失变量。不用它,最大似然会在模式之间取平均——直接撞树。
- diffusion 是编码器写死的层次化 VAE:省掉了学 $q$ 的全部麻烦,KL 项解析化, 代价是采样要跑很多步。
- 状态空间模型把 VAE 铺到时间轴:先验成了要学的动力学,编码器成了信念状态。 序列 ELBO 里那个逐步 KL 是核心——它同时训练动力学的准确性和表示的可预测性。 编码器用滤波形式 $q(z_t|o_{1:t})$ 是因为控制时只能看到过去。
- control as inference 用最优性变量把「求最优策略」变成「求后验」。 它自然地建模了次优行为、给出了随机策略的第一性解释、并把推断算法引入控制。
- 后向传递就是 soft 值迭代:$\max_a\to\log\int\exp$。 但 $\E_{s'}[V]\to\log\E_{s'}[\exp V]$ 是个 bug 不是 feature——它让智能体变成风险偏好者。 确定性动力学下没这个问题;随机动力学下要靠下一讲的变分近似来修。
- $\pi=\exp(A)$ 就是玻尔兹曼探索,只是这里它是推出来的而非手工加的。 温度 $\alpha$ 在贪心与均匀之间连续插值。
- 前向 × 后向 = 状态边缘,形状是两端窄中间宽的橄榄球, 与 Li & Todorov 2006 测到的人类运动方差曲线吻合。
本讲把 control-as-inference 的精确推断做完了,也暴露了它的致命伤(乐观转移)。 下一讲会把第一段的工具(变分推断)用到第三段的模型上: 在「转移必须是真实转移」的约束下做变分近似,得到最大熵 RL 的目标 $\sum_t\E\big[r(s_t,a_t)+\mathcal{H}(\pi(\cdot|s_t))\big]$, 并由此导出 soft Q-learning、soft actor-critic 这些真正能用的算法。
延伸阅读
变分推断与 VAE 的基础
- Auto-Encoding Variational Bayes (Kingma & Welling, 2013) — 本讲第一、二段的原始论文,摊销推断 + 重参数化的出处,短且好读,值得逐行推一遍。
- Stochastic Backpropagation and Approximate Inference in Deep Generative Models (Rezende et al., 2014) — 与上一篇同期独立提出同一套方法,对梯度估计器的讨论更细致。
- Neural Variational Inference and Learning in Belief Networks (Mnih & Gregor, 2014) — 离散隐变量只能用 score function 时,怎么做方差缩减;理解「为什么大家都想用重参数化」的反面教材。
- Categorical Reparameterization with Gumbel-Softmax (Jang et al., 2016) 与 The Concrete Distribution (Maddison et al., 2016) — 把重参数化推广到离散隐变量的两篇同期工作。
- Variational Inference with Normalizing Flows (Rezende & Mohamed, 2015) — 当对角高斯的 $q$ 表达力不够时怎么办:用可逆变换堆出更灵活的后验。
- β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework (Higgins et al., 2017) — 幻灯片里椅子与人脸那组隐维度遍历图的来源,也是「调大 KL 权重换解耦表示」这个做法的出处。
表示学习与隐变量策略
- Learning Latent Plans from Play (Lynch et al., 2019) — 幻灯片右侧那张框架图的论文:plan recognition = $q_\phi$,plan proposal = $p(z|x)$,一个条件 VAE 撑起一个通用策略。
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware (Zhao et al., 2023) — 即 ACT / ALOHA。CVAE + 动作分块 + transformer,是当前机器人模仿学习最常被复现的基线之一。
- Diffusion Policy (Chi et al., 2023) — 把第 5 节讲的 diffusion 直接当成策略的动作分布,多模态表达力显著强于 CVAE。
- Denoising Diffusion Probabilistic Models (Ho et al., 2020) — 把 diffusion 的变分下界化简成 $\|\epsilon-\epsilon_\theta\|^2$ 的关键一步,正好对应第 5 节那张表。
- Flow Matching for Generative Modeling (Lipman et al., 2022) — 连续时间版本,训练目标是回归条件速度场;理解 slides 上那条「DDPM 与 flow matching 时间轴方向相反」的注记。
状态空间模型 / 潜动力学
- Embed to Control (Watter et al., 2015) — 最早把「学一个隐空间使动力学在其中局部线性」这件事做通的工作,之后可以直接上 iLQR。
- Deep Kalman Filters (Krishnan et al., 2015) — 序列 VAE 里编码器因子分解(filtering / smoothing)的系统讨论。
- Learning Latent Dynamics for Planning from Pixels (Hafner et al., 2018) — 即 PlaNet。第 6 节代码的完整工业级版本,含 RSSM 的「确定性 + 随机」双通道设计。
- Dream to Control (Hafner et al., 2019) 与 Mastering Diverse Domains through World Models (Hafner et al., 2023) — Dreamer / DreamerV3:在学出来的隐空间里直接跑 actor-critic,是「imagine 函数」的终点形态。
- Stochastic Latent Actor-Critic (Lee et al., 2019) — 把本讲两半(潜状态模型 + 最大熵 RL)真正拼在一起的工作。
- SOLAR: Deep Structured Representations for Model-Based RL (Zhang et al., 2018) — 在隐空间里学线性高斯动力学,从而可以套用 LQR 类的高效控制器。
控制即推断
- Reinforcement Learning and Control as Probabilistic Inference: Tutorial and Review (Levine, 2018) — 本讲第三段的完整书面版,包括本讲略过的随机动力学变分修正、与最大熵 RL 的等价性证明。 如果只读一篇,读这篇。
- Maximum Entropy Inverse Reinforcement Learning (Ziebart et al., 2008) — $p(\tau)\propto\exp(\sum_t r)$ 这个模型在逆 RL 里的首次系统使用,幻灯片上出租车路线图的来源。
- An Iterative Optimal Control and Estimation Design for Nonlinear Stochastic Systems (Li & Todorov, 2006) — 橄榄球形状态边缘那条实验曲线的来源,也是「最小干预原则」的代表工作。
- Reinforcement Learning with Deep Energy-Based Policies (Haarnoja et al., 2017) — soft Q-learning:把本讲的 soft 值迭代变成能在连续动作、深度网络上跑的算法。
- Soft Actor-Critic (Haarnoja et al., 2018) — 下一讲的终点。最大熵目标 + actor-critic,目前连续控制上最稳的 off-policy 算法之一。