期中复习 2:Q-learning、变分推断、控制即推断、模型、离线 RL、探索与理论
把课程后半段的 Part 4–Part 10 串成一条线:每个算法解决什么分布偏移 / 方差 / 过估计问题,考点在哪,易错在哪。
0. 本讲导读
这是期中复习的下半场。上半场(Lecture 21)覆盖了 Part 1–Part 3:模仿学习、策略梯度、actor-critic。这一讲把剩下的七个板块一次性过完:
| Part | 主题 | 核心矛盾 | 本讲节次 |
|---|---|---|---|
| Part 4 | Q-learning | 没有转移模型时怎么做「max」;非线性逼近下为什么不收敛 | §1 §2 |
| Part 5 | 变分推断 / VAE | 后验 $p(z|x)$ 算不出来 → 用 $q$ 逼近 + ELBO | §3 |
| Part 6 | 控制即推断 / IRL | 把「最优」写成概率图模型里的观测变量 | §4 §5 |
| Part 7 | 基于模型的 RL | 模型误差被策略「对抗式」利用 → 不确定性感知 | §6 |
| Part 8 | 离线 RL | 分布偏移:$\pi_\theta \neq \pi_\beta$ 时 Q 值被高估 | §7 §8 §9 |
| Part 9 | 探索 | 把 bandit 的乐观主义搬到 MDP:计数与伪计数 | §10 |
| Part 10 | RL 理论 | Bellman 算子的收缩性、采样误差与逼近误差如何随 horizon 复合 | §11 |
复习课的组织方式和正课不同:Levine 会把每个板块最容易考的那一两张 slide 拎出来,然后在旁边写一个黄底问号——「why is this good? why is this bad?」「what is the prior / decoder / encoder?」「why is this suboptimal?」。这些问号就是考点。下面每一节都按同样的模式来:先还原题面与设定,再给完整解答与推导,最后标出易错点。
- 后半段课程的主线其实只有一个词:分布偏移(distributional shift)。Q-learning 的过估计、model-based RL 的模型被利用、离线 RL 的 OOD 动作、理论部分的 $\|\hat T Q - TQ\|_\infty$,全都是「训练分布 ≠ 使用分布」的不同面孔。
- 第二条主线是方差 vs 偏差:重要性采样比值爆炸 → 换成策略约束;蒙特卡洛回报方差大 → 换成 bootstrapping,但 bootstrapping 带来偏差与不收敛。
- 第三条主线是概率化重述:把控制问题写成图模型推断,就自然得到 soft value iteration、SAC、MaxEnt IRL、RLHF 这一整条支线。
- 理论部分给出的量化答案是:误差以 $\frac{1}{1-\gamma}$ 或 $\frac{\gamma}{(1-\gamma)^2}$ 的量级随 horizon 放大,样本量 $N$ 只能以 $1/\sqrt N$ 的速度压下去。这解释了为什么长 horizon 的深度 RL 这么难调。
1. Part 4 · 从策略迭代到 fitted Q-iteration
题 1.1:策略迭代的两步各是什么?表格式表示要多大?
题面:给一个 $4\times 4$ 的网格世界,16 个状态、每个状态 4 个动作。写出策略迭代(policy iteration)的两个步骤,并说明存下 $V^\pi$ 和转移张量 $\mathcal{T}$ 各需要多大空间。
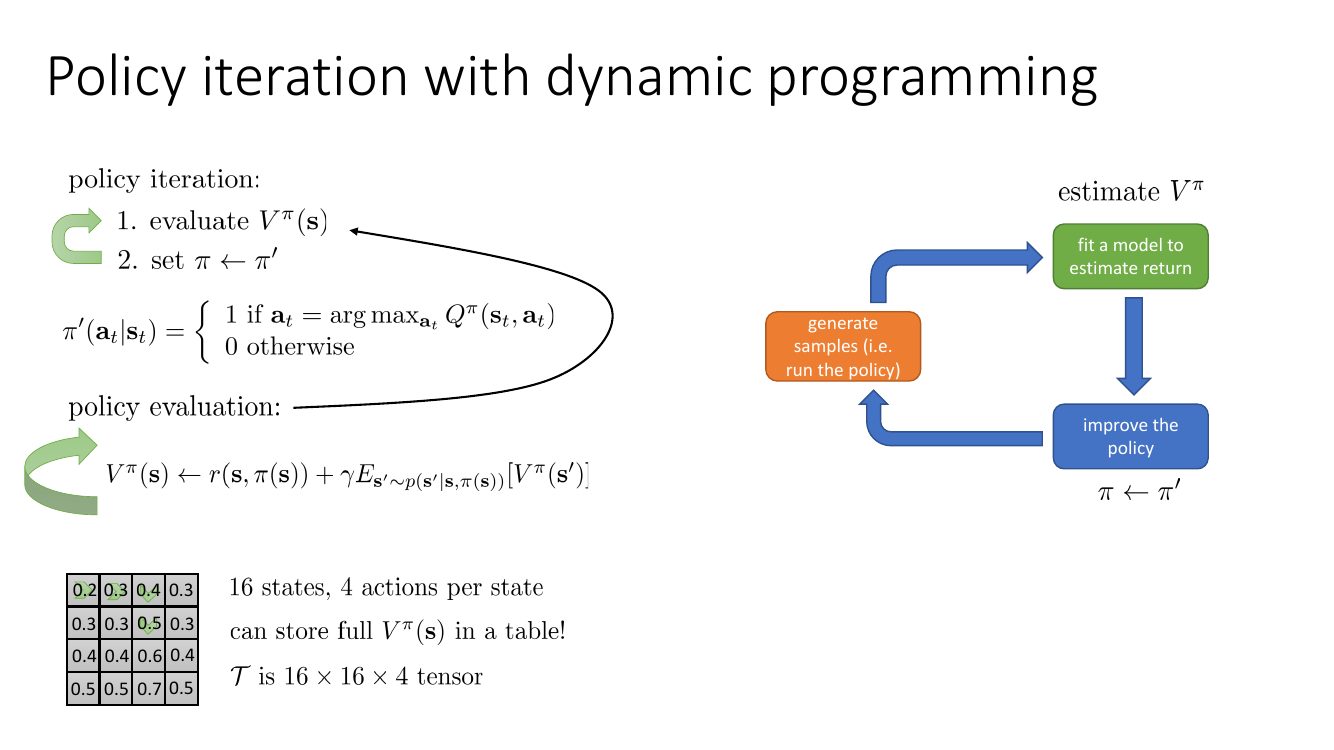
解答。策略迭代交替执行:
第 1 步,策略评估。反复应用
$$ V^\pi(\mathbf{s}) \leftarrow r(\mathbf{s}, \pi(\mathbf{s})) + \gamma\, \E_{\mathbf{s}' \sim p(\mathbf{s}'|\mathbf{s},\pi(\mathbf{s}))}\!\left[V^\pi(\mathbf{s}')\right] $$直到收敛(或只做几步,即 modified policy iteration)。这是一个线性方程组,$\gamma \lt 1$ 时解唯一。
第 2 步,策略改进。取
$$ \pi'(\mathbf{a}_t|\mathbf{s}_t) = \begin{cases} 1 & \text{if } \mathbf{a}_t = \argmax_{\mathbf{a}_t} Q^\pi(\mathbf{s}_t, \mathbf{a}_t)\\ 0 & \text{otherwise}\end{cases} $$其中 $Q^\pi(\mathbf{s},\mathbf{a}) = r(\mathbf{s},\mathbf{a}) + \gamma \E_{\mathbf{s}'}[V^\pi(\mathbf{s}')]$。空间开销:$V^\pi$ 是长度 16 的向量;$\mathcal{T}$ 是 $16 \times 16 \times 4 = 1024$ 个数($|\mathcal{S}| \times |\mathcal{S}| \times |\mathcal{A}|$)。考点:转移张量随状态数平方增长,这就是表格式方法只能处理玩具问题的根本原因。
题 1.2:为什么可以「跳过策略」直接算值?
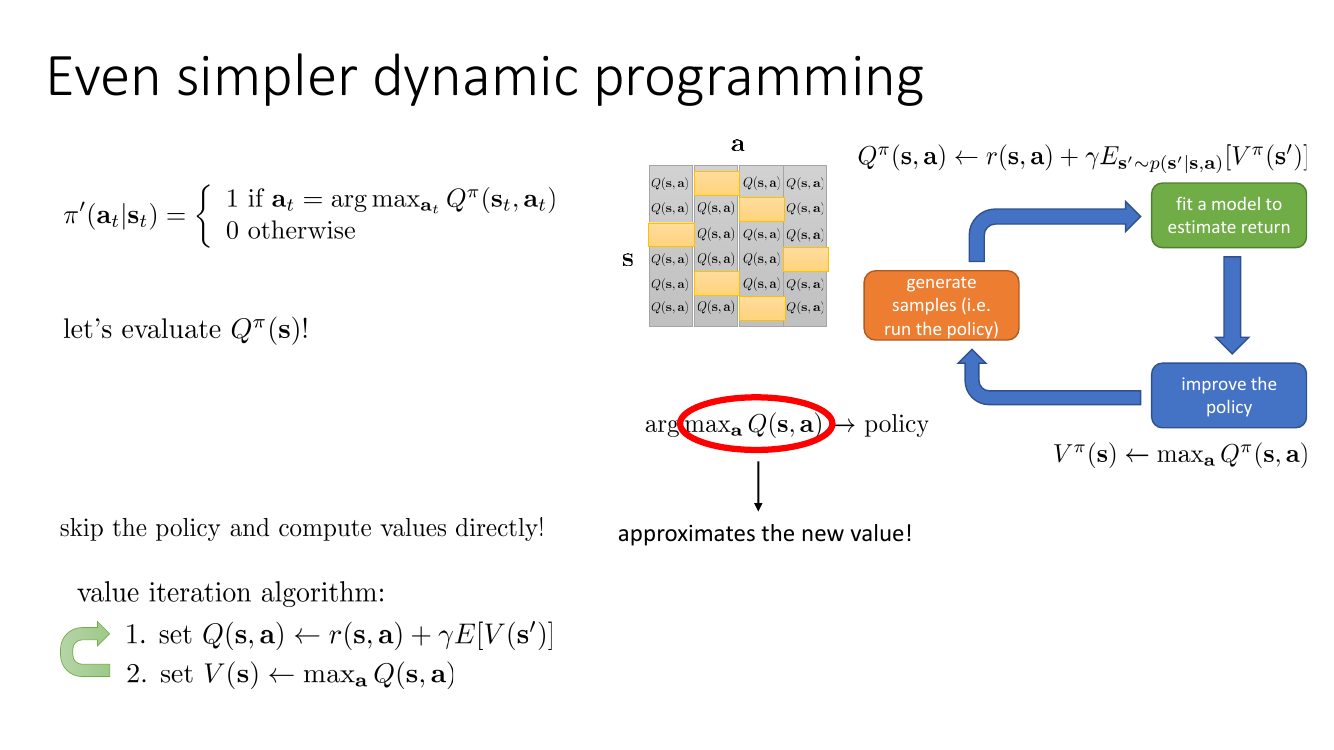
解答。策略改进得到的 $\pi'$ 在状态 $\mathbf{s}$ 处以概率 1 取 $\argmax_\mathbf{a} Q^\pi(\mathbf{s},\mathbf{a})$,因此
$$ V^{\pi'}(\mathbf{s}) \approx \max_{\mathbf{a}} Q^\pi(\mathbf{s},\mathbf{a}). $$既然新值可以直接由 $\max$ 得到,就没必要把策略显式写出来。值迭代算法只有两行:
$$ \text{1. } Q(\mathbf{s},\mathbf{a}) \leftarrow r(\mathbf{s},\mathbf{a}) + \gamma \E[V(\mathbf{s}')], \qquad \text{2. } V(\mathbf{s}) \leftarrow \max_\mathbf{a} Q(\mathbf{s},\mathbf{a}). $$题 1.3:不知道转移动力学时,为什么 fitted value iteration 用不了、而 fitted Q-iteration 可以?
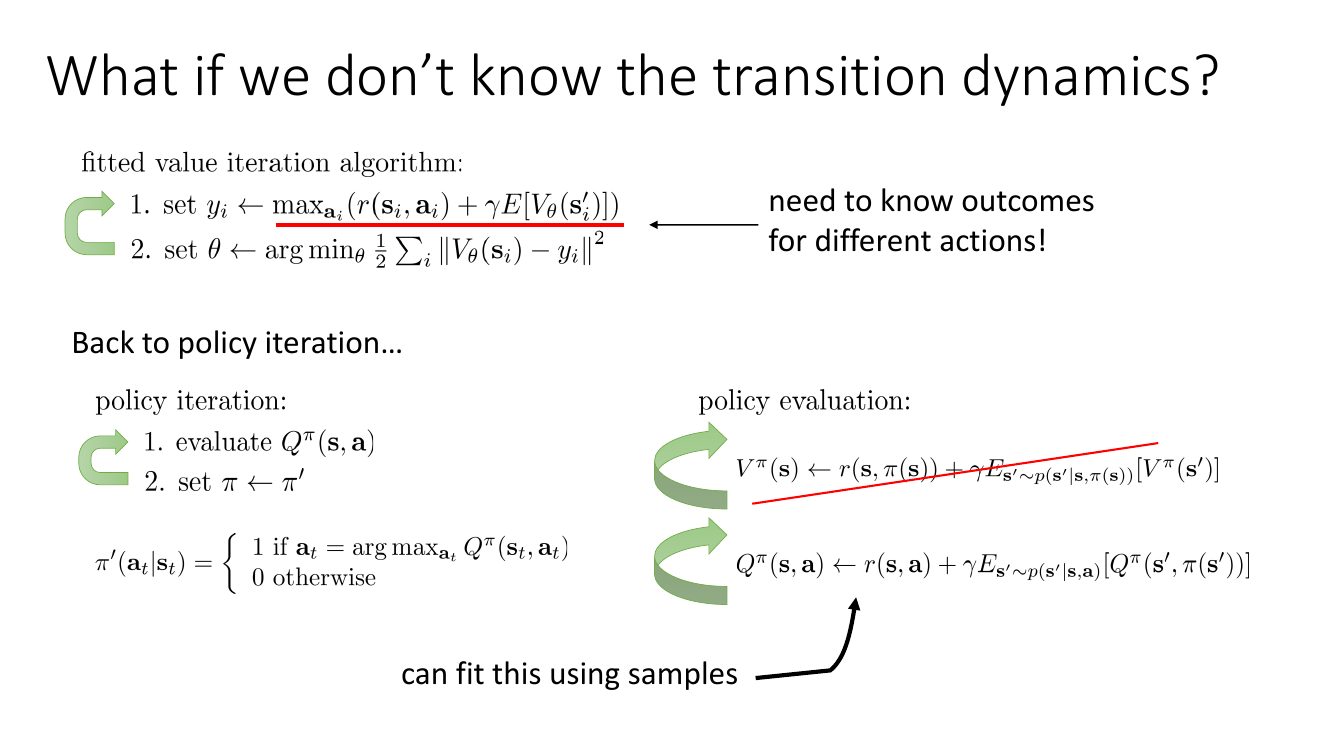
解答。关键区别在于「期望里条件了什么」。$V$ 的备份需要 $\E_{\mathbf{s}'\sim p(\mathbf{s}'|\mathbf{s},\pi(\mathbf{s}))}$——采样时用的动作是 $\pi(\mathbf{s})$,一旦策略变了,这个期望的采样分布就变了,必须重新与环境交互(或已知模型)。而 $Q$ 的备份需要 $\E_{\mathbf{s}'\sim p(\mathbf{s}'|\mathbf{s},\mathbf{a})}$——它条件在实际执行过的那个动作 $\mathbf{a}$ 上,所以数据集里的任意一条 $(\mathbf{s}_i,\mathbf{a}_i,\mathbf{s}_i')$ 都是这个期望的一个无偏样本,与产生数据的策略无关。这正是 Q 函数能 off-policy 的根源。
题 1.4:fitted Q-iteration 的完整算法与三条优缺点
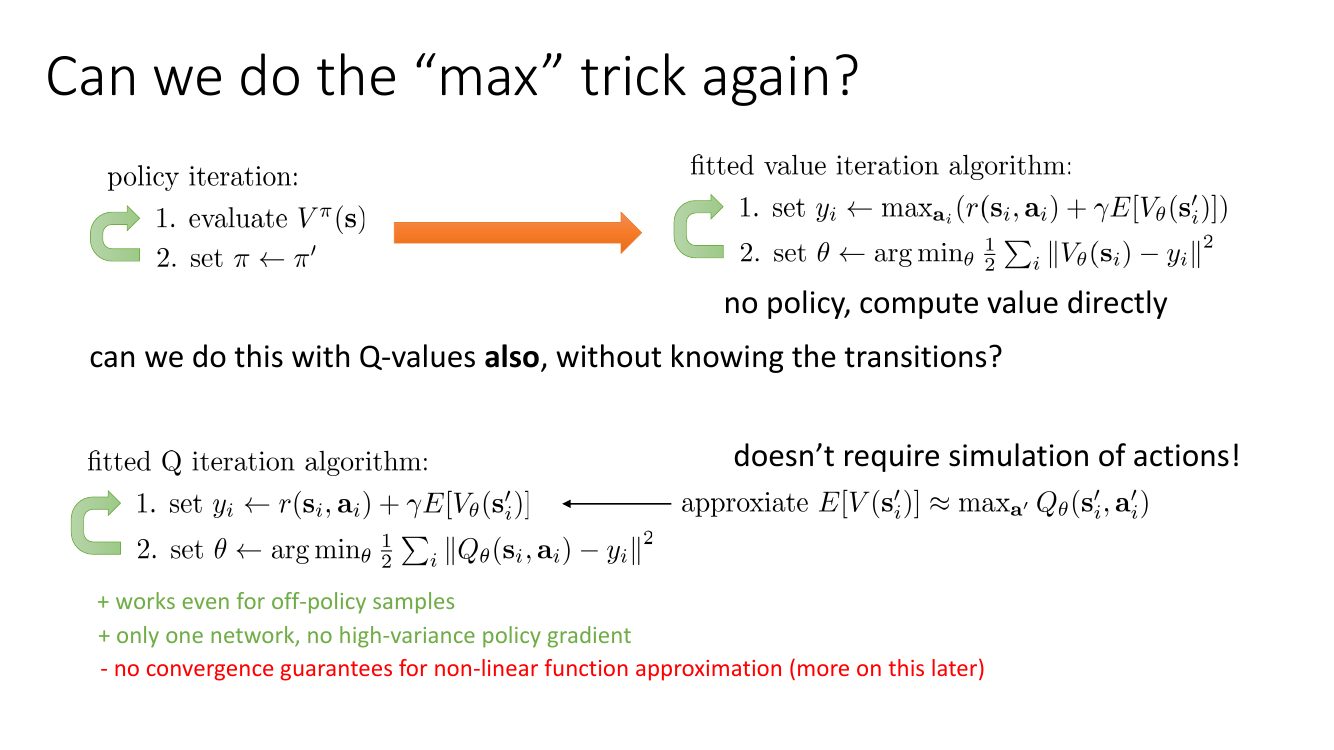
解答。fitted Q-iteration:
$$ \text{1. } y_i \leftarrow r(\mathbf{s}_i,\mathbf{a}_i) + \gamma \max_{\mathbf{a}'} Q_\theta(\mathbf{s}_i',\mathbf{a}'), \qquad \text{2. } \theta \leftarrow \argmin_\theta \tfrac12\sum_i \|Q_\theta(\mathbf{s}_i,\mathbf{a}_i) - y_i\|^2 . $$三条评价必须背下来:+ 对 off-policy 样本同样有效(因为期望条件在 $\mathbf{a}_i$ 上);+ 只需一个网络,没有高方差的策略梯度;− 非线性函数逼近下没有收敛性保证(§2 末尾解释原因)。
2. Part 4 · DQN、过估计与「为什么会发散」
题 2.1:写出经典 DQN,并说明 $N$、$K$ 两层循环各控制什么
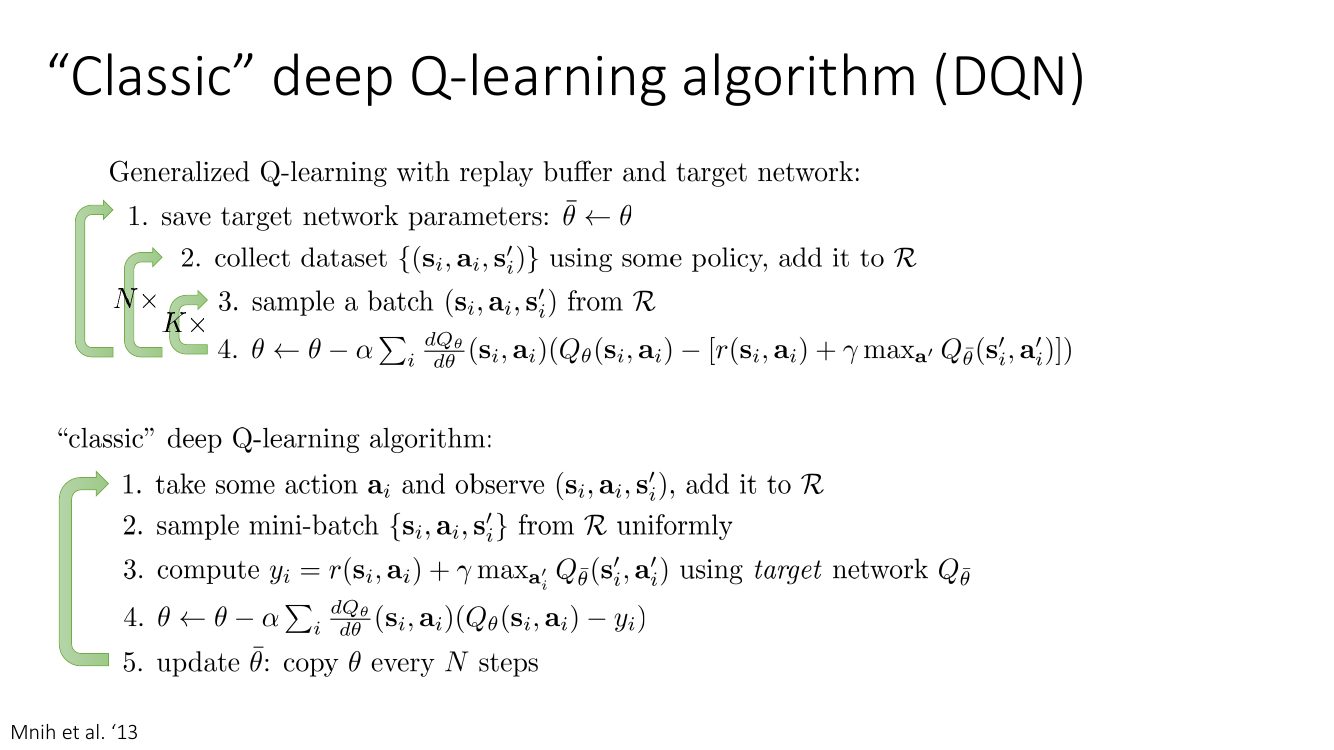
解答。广义 Q-learning 的梯度步是
$$ \theta \leftarrow \theta - \alpha \sum_i \frac{dQ_\theta}{d\theta}(\mathbf{s}_i,\mathbf{a}_i)\Big(Q_\theta(\mathbf{s}_i,\mathbf{a}_i) - \big[r(\mathbf{s}_i,\mathbf{a}_i) + \gamma \max_{\mathbf{a}'} Q_{\bar\theta}(\mathbf{s}_i',\mathbf{a}')\big]\Big). $$三个循环层次对应三个「时间尺度」:最外层(目标网络更新)最慢,保证回归目标 $y$ 在一段时间内是固定的、从而这一步真正是监督回归;$N$ 层控制数据收集与训练的比例(replay ratio);$K$ 层控制每批数据用几次梯度。易错点:注意 $\frac{dQ_\theta}{d\theta}$ 只对当前 Q 求导,目标里的 $Q_{\bar\theta}$ 被当成常数——这不是任何目标函数的真梯度,所以叫「半梯度」(semi-gradient),也是不收敛的伏笔之一。
题 2.2:Q-learning 的过估计从哪来?double Q 为什么能修
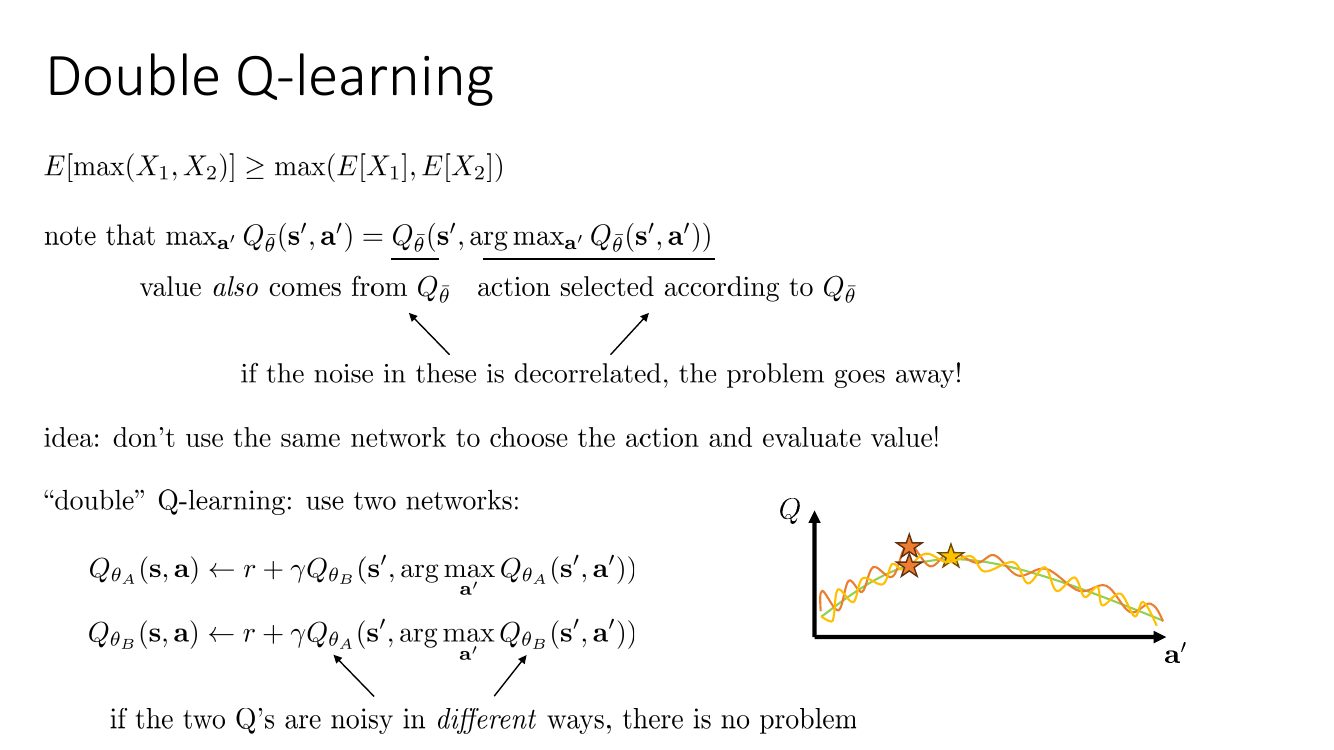
解答。设真实值为 $Q^\star$,网络估计 $Q = Q^\star + \varepsilon$,$\varepsilon$ 是零均值噪声。那么
$$ \E\left[\max_{\mathbf{a}} Q(\mathbf{s},\mathbf{a})\right] = \E\left[\max_\mathbf{a}\big(Q^\star(\mathbf{s},\mathbf{a}) + \varepsilon_\mathbf{a}\big)\right] \ \ge\ \max_\mathbf{a} Q^\star(\mathbf{s},\mathbf{a}), $$因为 max 是凸函数,Jensen 不等式给出系统性正偏差。动作越多、噪声越大,偏差越大;而 bootstrapping 会把这个正偏差一轮一轮传播、累积。
关键观察是把 max 改写为
$$ \max_{\mathbf{a}'} Q_{\bar\theta}(\mathbf{s}',\mathbf{a}') = Q_{\bar\theta}\big(\mathbf{s}',\ \argmax_{\mathbf{a}'} Q_{\bar\theta}(\mathbf{s}',\mathbf{a}')\big), $$「选动作」和「评估值」用的是同一个网络,所以噪声完全相关:只要某个动作的噪声碰巧偏大,它就既被选中、又被以那个偏大的值记账。double Q-learning 用两个网络交替:
$$ Q_{\theta_A}(\mathbf{s},\mathbf{a}) \leftarrow r + \gamma\, Q_{\theta_B}\big(\mathbf{s}', \argmax_{\mathbf{a}'} Q_{\theta_A}(\mathbf{s}',\mathbf{a}')\big),\qquad Q_{\theta_B}(\mathbf{s},\mathbf{a}) \leftarrow r + \gamma\, Q_{\theta_A}\big(\mathbf{s}', \argmax_{\mathbf{a}'} Q_{\theta_B}(\mathbf{s}',\mathbf{a}')\big). $$实践中的 DQN 用当前网络 $Q_\theta$ 选动作、目标网络 $Q_{\bar\theta}$ 取值,因为这两者「已经是两个网络了」。易错点:这只削弱、不能消除过估计——两个网络在同一份数据上训练,噪声并非真正独立。
题 2.3:DDPG 与 off-policy actor-critic 的区别;还学过哪些改进?
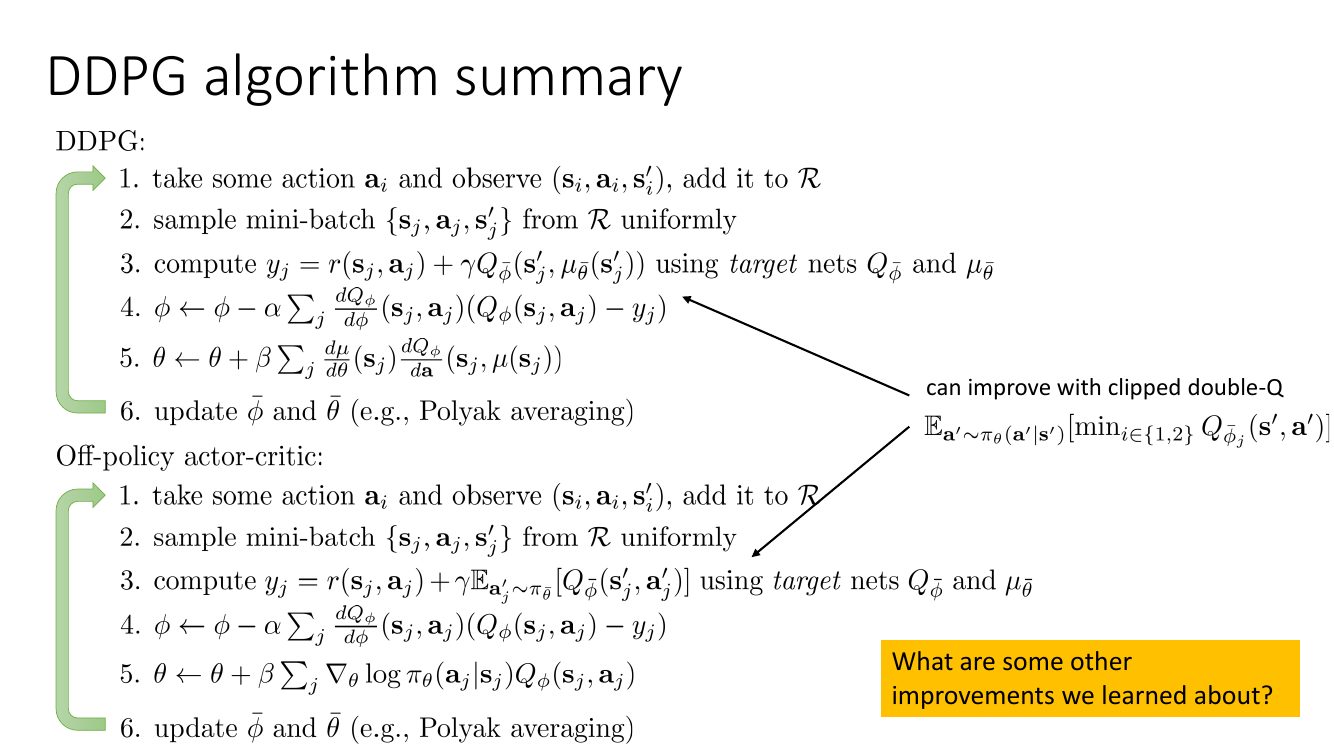
解答。连续动作空间没法穷举 $\max_{\mathbf{a}'}$,于是有两条路:(a) 训练一个确定性 actor $\mu_\theta(\mathbf{s}) \approx \argmax_\mathbf{a} Q_\phi(\mathbf{s},\mathbf{a})$,通过 $\theta \leftarrow \theta + \beta\sum_j \frac{d\mu}{d\theta}(\mathbf{s}_j)\frac{dQ_\phi}{d\mathbf{a}}(\mathbf{s}_j,\mu(\mathbf{s}_j))$ 沿 Q 的动作梯度爬坡,即 DDPG;(b) 用随机策略并对目标取期望,即 off-policy actor-critic(SAC 的骨架)。
Slide 上的黄框问「还有哪些改进」,标准答案清单:clipped double-Q(取两个 critic 的 min,进一步压过估计)、Polyak 平均的软目标更新 $\bar\phi \leftarrow \rho\bar\phi + (1-\rho)\phi$、多步回报(N-step return,降低 bootstrapping 偏差但引入 off-policy 偏差)、目标策略平滑(TD3 在目标动作上加噪声,防止 critic 出现尖锐虚假峰值)、优先经验回放、Q 值集成。
题 2.4:为什么表格值迭代收敛、fitted 值迭代不收敛?
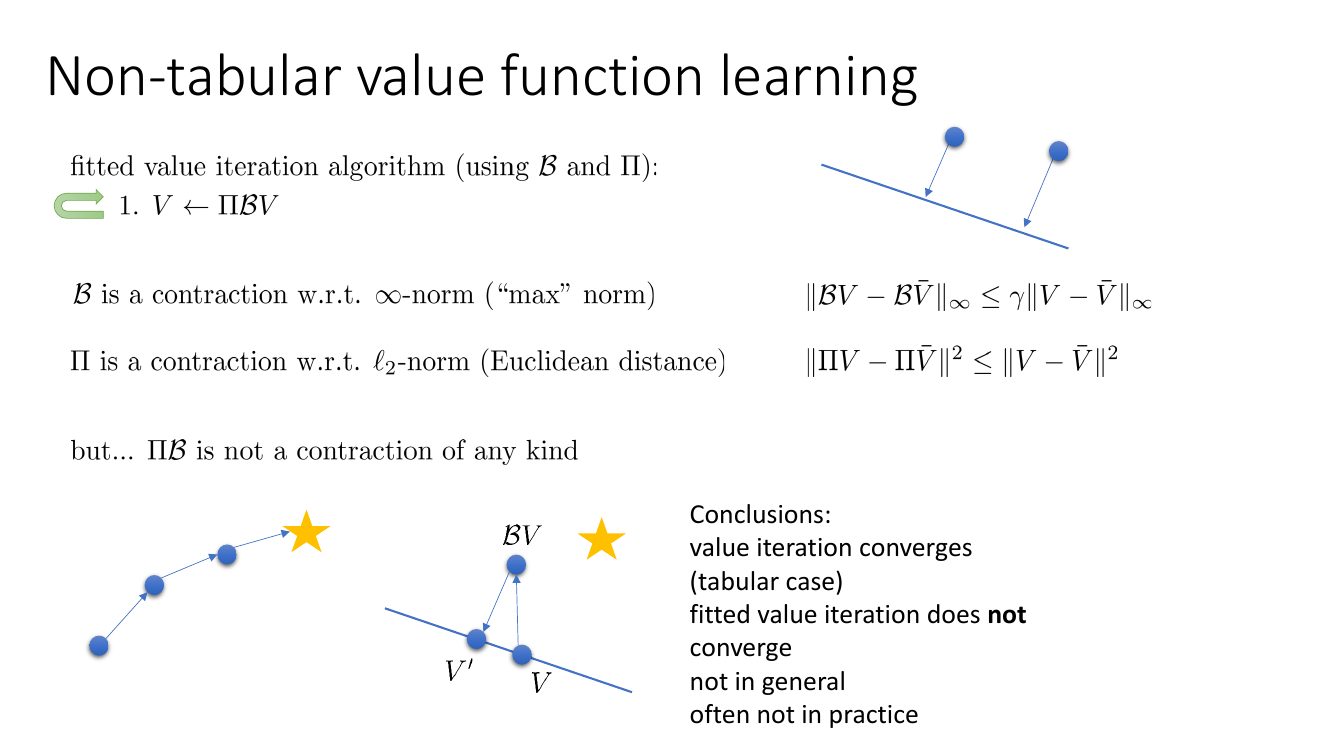
解答。两个事实:
$$ \|\mathcal{B}V - \mathcal{B}\bar V\|_\infty \le \gamma \|V - \bar V\|_\infty, \qquad \|\Pi V - \Pi \bar V\|^2 \le \|V - \bar V\|^2 . $$问题在于两个收缩用的是不同的范数:$\mathcal{B}$ 在 $\infty$-范数下收缩,$\Pi$ 在 $\ell_2$ 范数下非扩张。复合算子 $\Pi\mathcal{B}$ 在任何范数下都不是收缩,因此没有不动点定理可用。结论三行:值迭代在表格情形收敛;fitted 值迭代不收敛——一般情况下没有保证,实践中也经常真的发散。同样的论证适用于 fitted Q-iteration 和用了神经网络的 Q-learning。
| 对象 | 目标 $y$ | 要点 |
|---|---|---|
| Q-learning / DQN | $r + \gamma\max_{\mathbf{a}'}Q_{\bar\theta}(\mathbf{s}',\mathbf{a}')$ | max 造成过估计;半梯度 |
| Double DQN | $r + \gamma Q_{\bar\theta}(\mathbf{s}',\argmax_{\mathbf{a}'}Q_\theta(\mathbf{s}',\mathbf{a}'))$ | 选动作 / 取值解耦 |
| DDPG | $r + \gamma Q_{\bar\phi}(\mathbf{s}',\mu_{\bar\theta}(\mathbf{s}'))$ | 确定性 actor 代替 max |
| Clipped double-Q (TD3) | $r + \gamma \min_{i\in\{1,2\}} Q_{\bar\phi_i}(\mathbf{s}',\mathbf{a}')$ | 悲观化,压过估计 |
| SAC | $r + \gamma \E_{\mathbf{a}'\sim\pi_\theta}[Q_{\bar\phi}(\mathbf{s}',\mathbf{a}') - \beta\log\pi_\theta(\mathbf{a}'|\mathbf{s}')]$ | 见 §4,soft 备份 |
3. Part 5 · 变分推断、VAE 与状态空间模型
题 3.1:从 $\log p(x_i)$ 推出 ELBO(要求写出 Jensen 那一步)
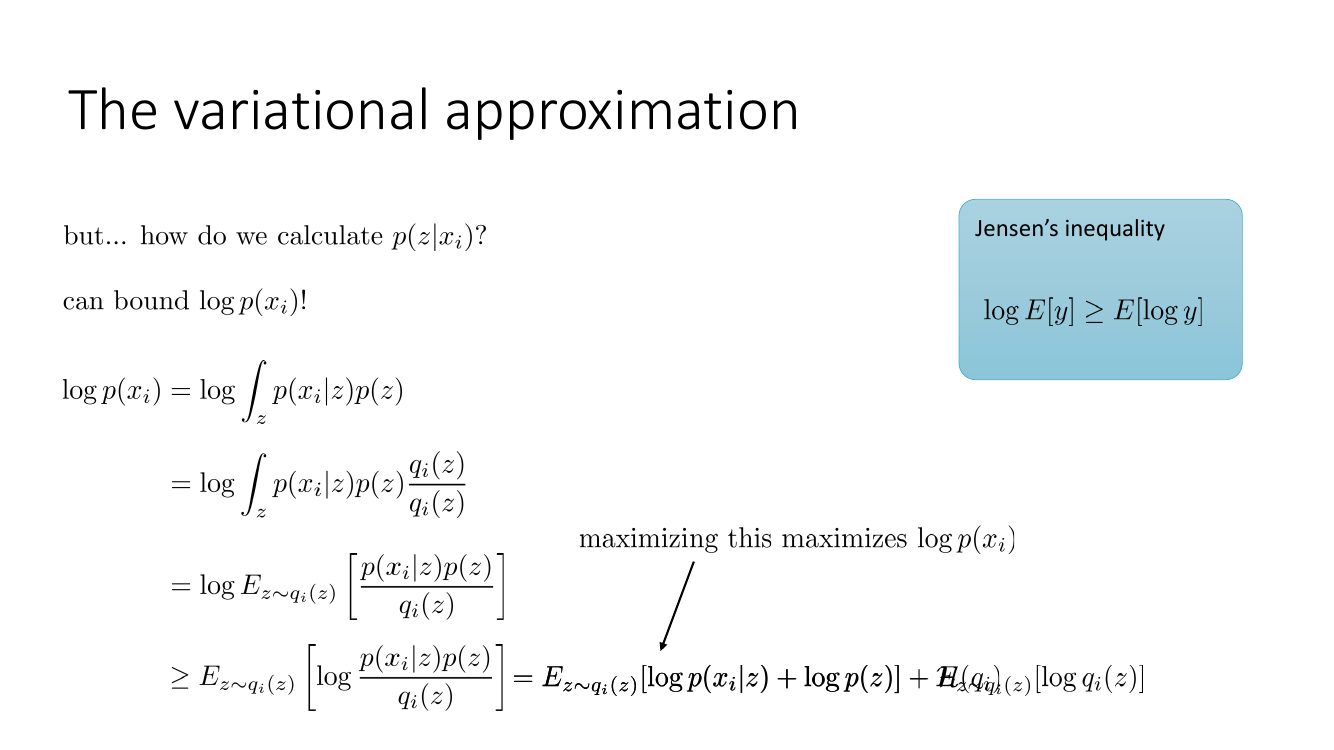
解答。设隐变量为 $z$,逐步写:
$$ \log p(x_i) = \log \int_z p(x_i|z)p(z)\,dz = \log \int_z p(x_i|z)p(z)\frac{q_i(z)}{q_i(z)}\,dz = \log \E_{z\sim q_i(z)}\!\left[\frac{p(x_i|z)p(z)}{q_i(z)}\right] $$用 Jensen($\log$ 是凹函数)把 $\log$ 换进去:
$$ \log p(x_i) \ \ge\ \E_{z\sim q_i(z)}\!\left[\log \frac{p(x_i|z)p(z)}{q_i(z)}\right] = \underbrace{\E_{z\sim q_i(z)}\big[\log p(x_i|z) + \log p(z)\big] + \mathcal{H}(q_i)}_{\mathcal{L}_i(p, q_i)} . $$这个 $\mathcal{L}_i$ 就是证据下界(ELBO, evidence lower bound)。易错点:熵项来自 $-\E_{q_i}[\log q_i(z)] = \mathcal{H}(q_i)$,别把符号写反;很多人把它记成 $+\E[\log q_i]$,结果整个优化方向就反了。
题 3.2:什么样的 $q_i$ 是好的?为什么最大化 ELBO 等价于最小化 KL?
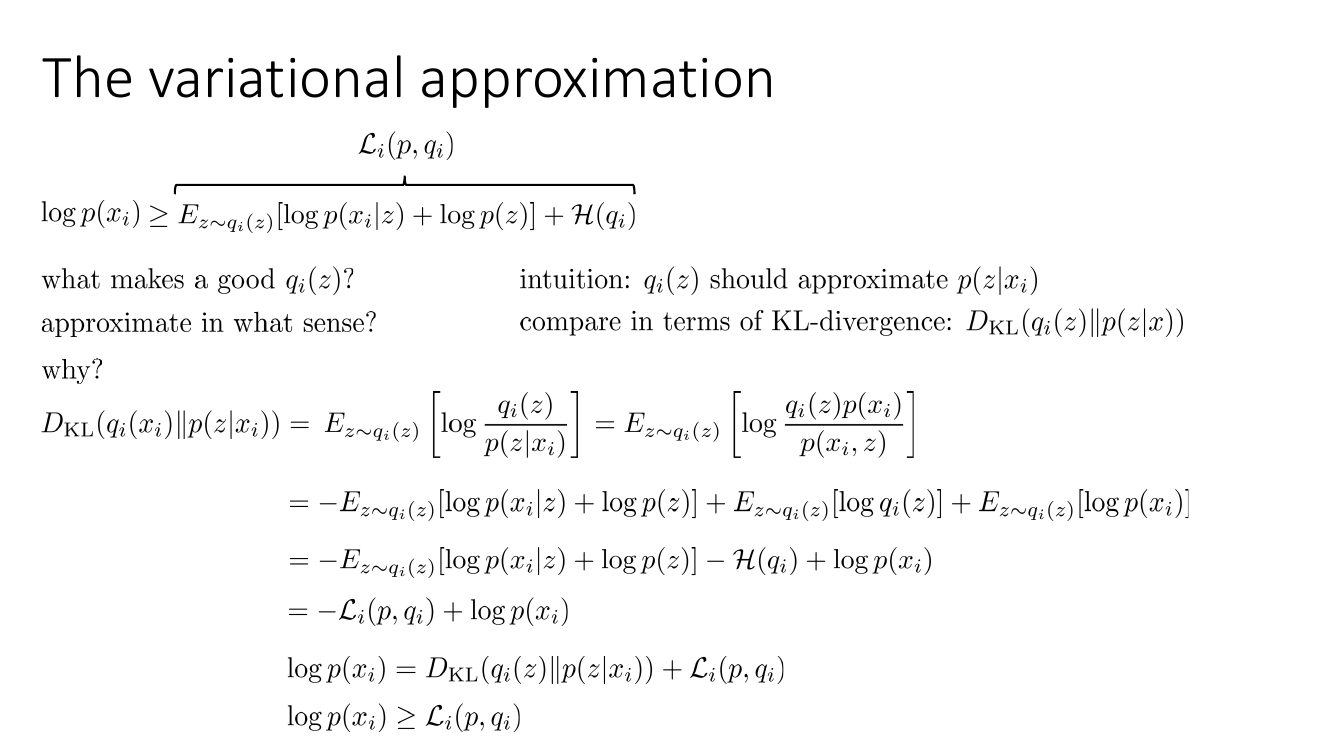
解答。直觉答案:$q_i(z)$ 应该逼近真实后验 $p(z|x_i)$,「逼近」的度量是 KL 散度。推导:
$$ \KL\big(q_i(z)\,\|\,p(z|x_i)\big) = \E_{z\sim q_i}\!\left[\log\frac{q_i(z)}{p(z|x_i)}\right] = \E_{z\sim q_i}\!\left[\log \frac{q_i(z)p(x_i)}{p(x_i,z)}\right] $$ $$ = -\E_{z\sim q_i}\big[\log p(x_i|z) + \log p(z)\big] - \mathcal{H}(q_i) + \log p(x_i) = -\mathcal{L}_i(p,q_i) + \log p(x_i). $$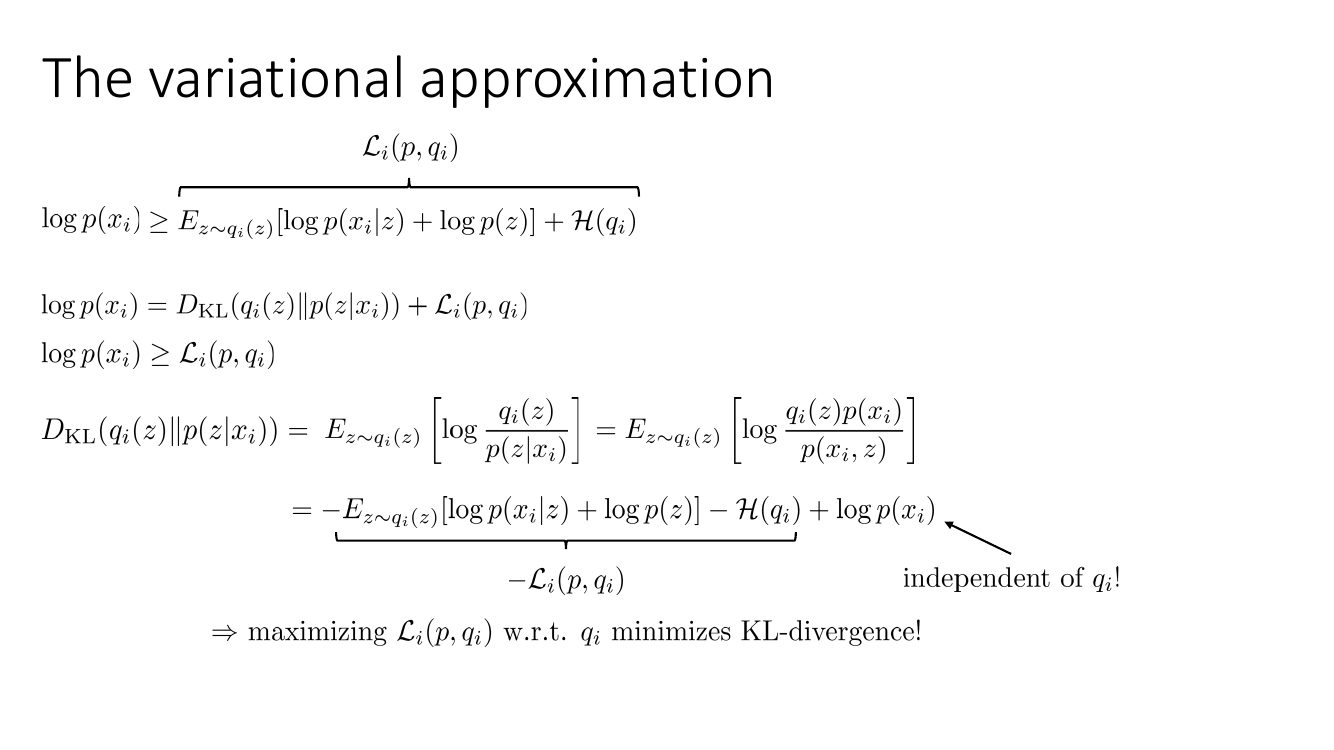
由于 $\log p(x_i)$ 不含 $q_i$,对 $q_i$ 最大化 $\mathcal{L}_i$ ⟺ 最小化 $\KL(q_i\|p(z|x_i))$;同时对 $p$ 最大化 $\mathcal{L}_i$ 就是在提升证据下界。考点:这里用的是反向 KL($q$ 在前),它有 mode-seeking 的性质,会让 $q$ 缩到后验的某一个峰上;这是 VAE 后验塌缩的一个来源。
题 3.3:amortized 变分推断怎么算 $\nabla_\phi \mathcal{L}$?
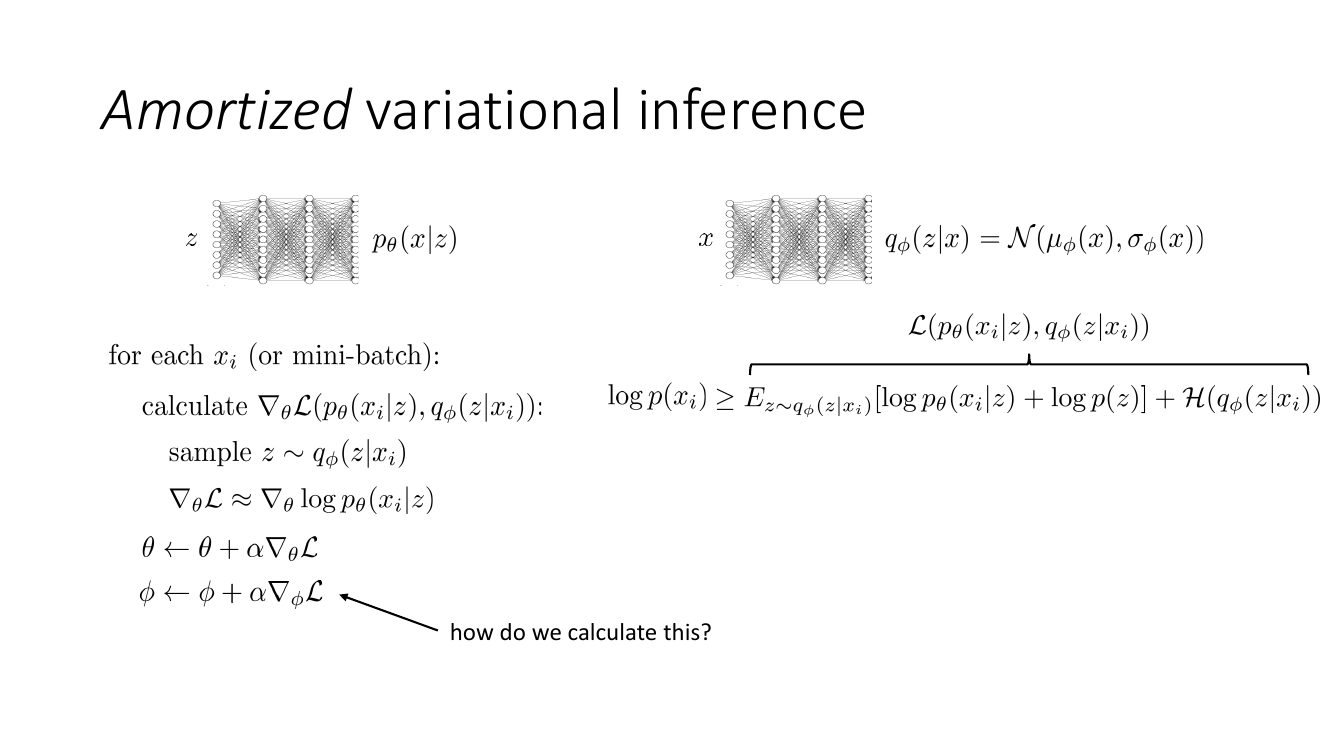
解答。难点在于采样分布本身依赖 $\phi$。两条路:(1) 用 score function / REINFORCE 估计器 $\nabla_\phi \E_{q_\phi}[f] = \E_{q_\phi}[f \nabla_\phi \log q_\phi]$——通用但方差大;(2) 重参数化技巧(reparameterization trick),对高斯 $q$ 写 $z = \mu_\phi(x_i) + \epsilon\,\sigma_\phi(x_i)$,$\epsilon \sim \mathcal{N}(0,1)$,随机性被挪到与 $\phi$ 无关的 $\epsilon$ 上,可以直接反向传播,方差小得多。
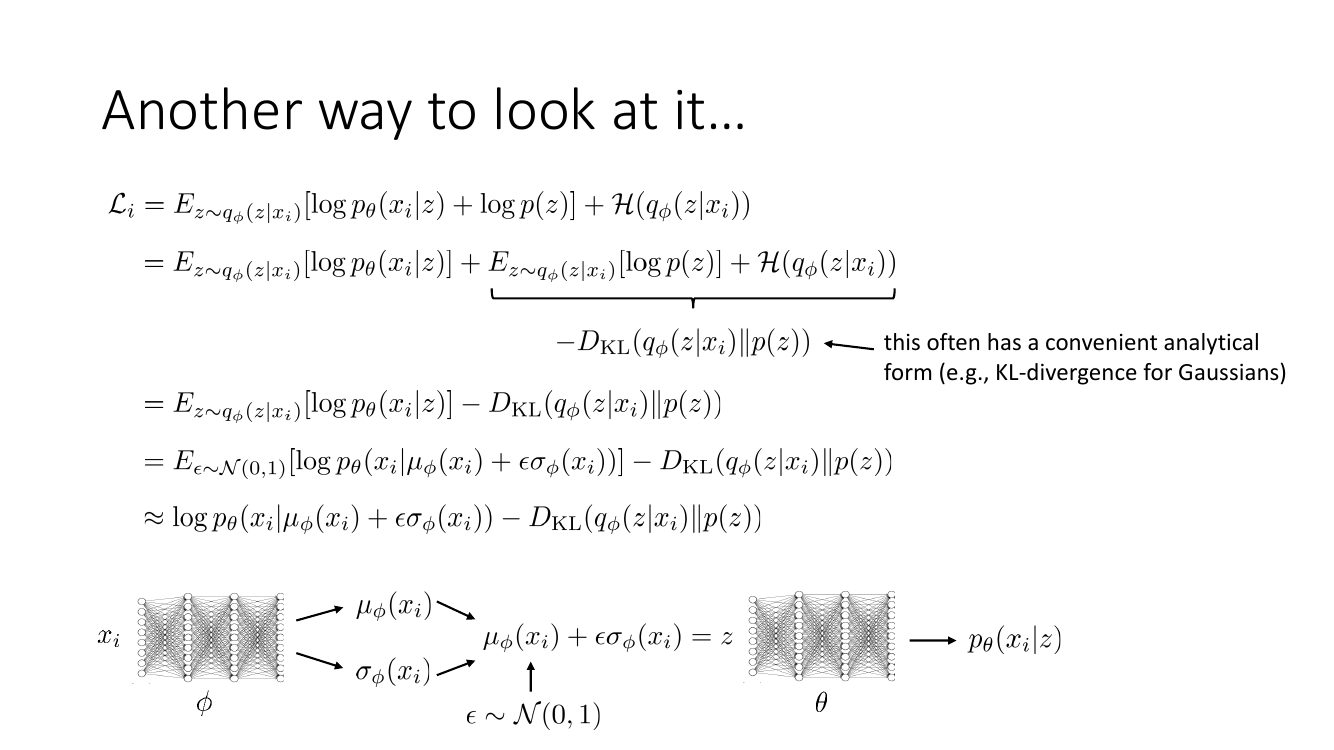
import torch, torch.nn as nn

class VAE(nn.Module):
    def __init__(self, xdim, zdim, h=256):
        super().__init__()
        self.enc = nn.Sequential(nn.Linear(xdim, h), nn.ReLU(), nn.Linear(h, 2 * zdim))
        self.dec = nn.Sequential(nn.Linear(zdim, h), nn.ReLU(), nn.Linear(h, xdim))
        self.zdim = zdim

    def elbo(self, x):
        mu, log_sigma = self.enc(x).chunk(2, dim=-1)
        log_sigma = log_sigma.clamp(-5, 2)
        eps = torch.randn_like(mu)
        z = mu + eps * log_sigma.exp()              # 重参数化:梯度可穿过
        recon = -((self.dec(z) - x) ** 2).sum(-1)   # 高斯似然(固定方差)
        # KL(N(mu,sigma) || N(0,I)) 的解析式
        kl = 0.5 * (mu ** 2 + (2 * log_sigma).exp() - 1 - 2 * log_sigma).sum(-1)
        return (recon - kl).mean()
题 3.4:条件模型、扩散与 VAE 的关系
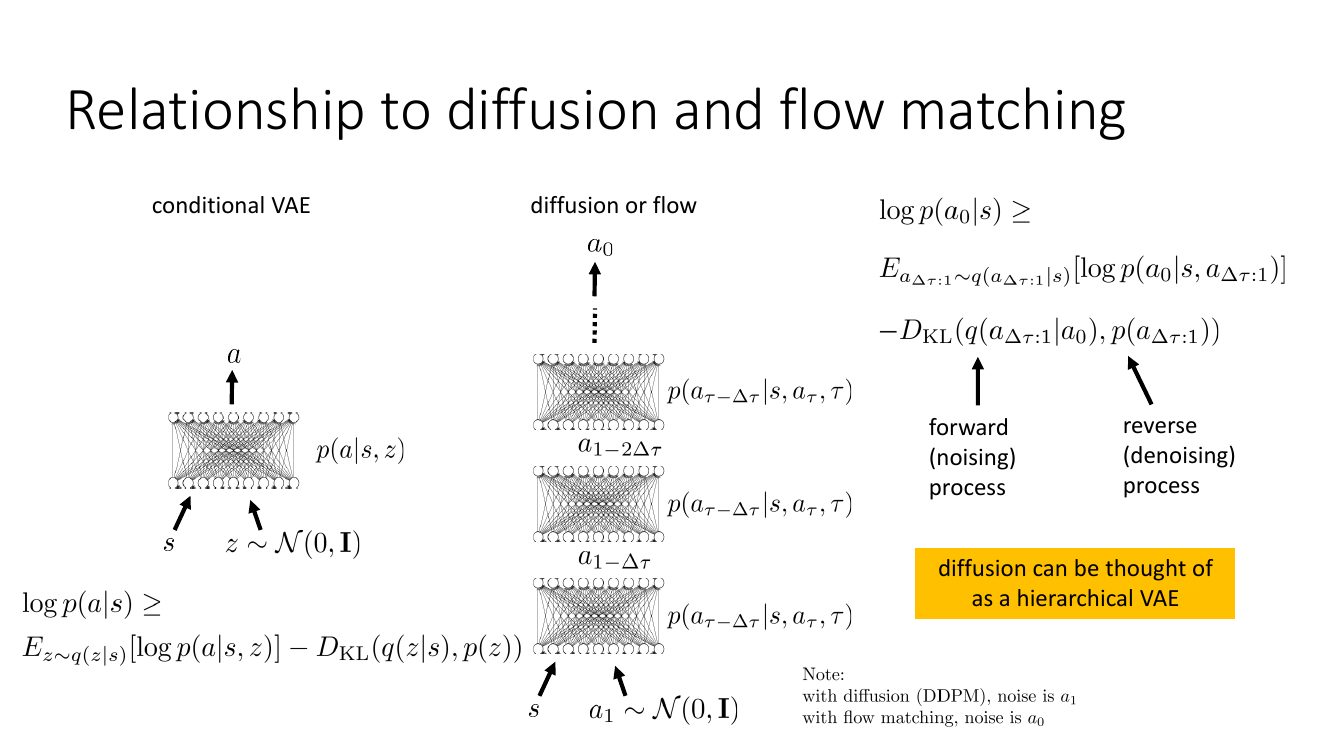
解答要点。条件模型只是把所有分布都条件在 $x_i$ 上:$\mathcal{L}_i = \E_{z\sim q_\phi(z|x_i,y_i)}[\log p_\theta(y_i|x_i,z) + \log p(z|x_i)] + \mathcal{H}(q_\phi(z|x_i,y_i))$,测试时先 $z\sim p(z|x_i)$ 再 $y \sim p(y|x_i,z)$。扩散模型的区别是:隐变量不是一个 $z$ 而是一整条加噪轨迹 $a_{\Delta\tau:1}$,且「编码器」$q$ 是固定的加噪过程(不学习),只学反向去噪。这就是为什么扩散训练稳定——没有编码器和解码器互相追逐的问题。
题 3.5(黄框三连):状态空间模型的 prior / decoder / encoder 各是什么?
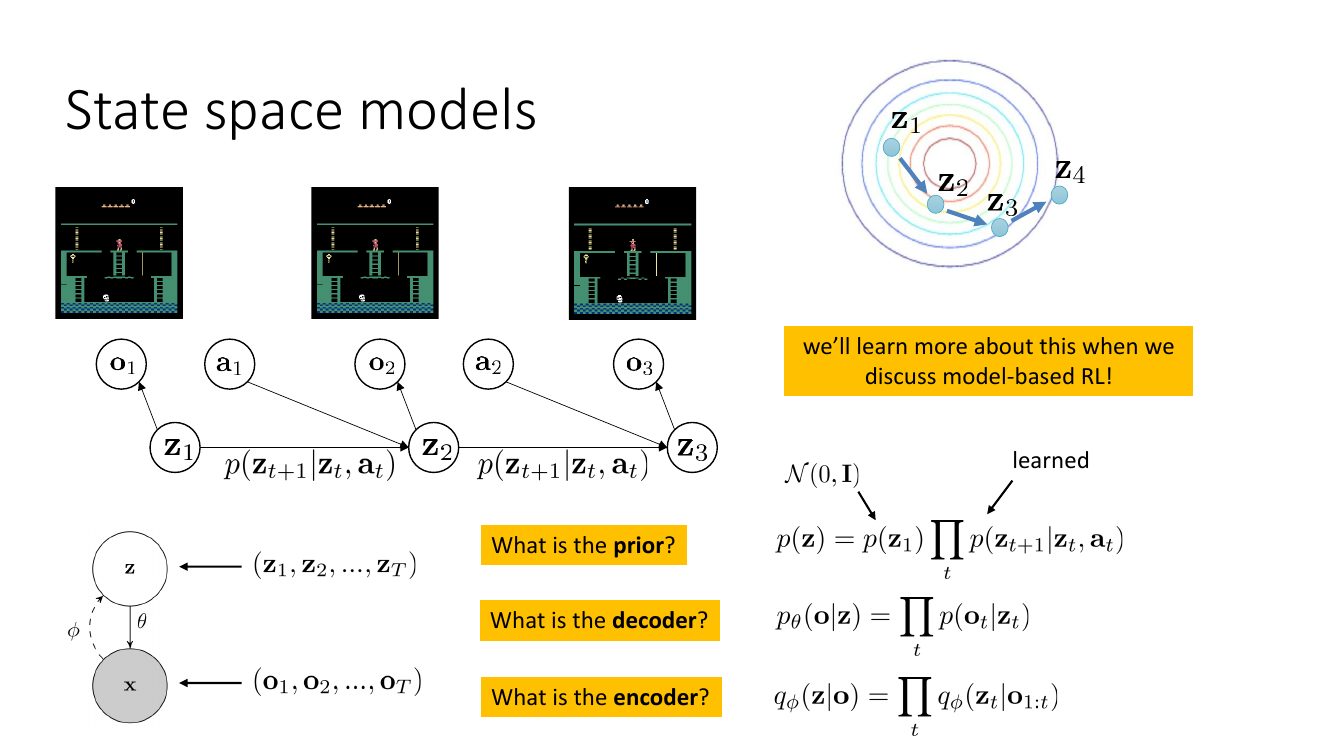
解答。把整条隐状态序列当作 $z$、整条观测序列当作 $x$:
$$ \underbrace{p(\mathbf{z}) = p(\mathbf{z}_1)\prod_t p(\mathbf{z}_{t+1}|\mathbf{z}_t,\mathbf{a}_t)}_{\text{prior:初始分布} + \text{学到的动力学}},\quad \underbrace{p_\theta(\mathbf{o}|\mathbf{z}) = \prod_t p(\mathbf{o}_t|\mathbf{z}_t)}_{\text{decoder:观测模型}},\quad \underbrace{q_\phi(\mathbf{z}|\mathbf{o}) = \prod_t q_\phi(\mathbf{z}_t|\mathbf{o}_{1:t})}_{\text{encoder:滤波式后验}} . $$易错点:这里的 prior 不是标准正态——只有 $p(\mathbf{z}_1)$ 是 $\mathcal{N}(0,\mathbf{I})$,后面的转移是要学的动力学模型。这正是「潜空间模型 = VAE + 动力学」的意思,也是 §6 潜空间 model-based RL 的基础。另一个易错点是 encoder 的条件:写成 $q_\phi(\mathbf{z}_t|\mathbf{o}_{1:t})$(滤波)而不是 $q_\phi(\mathbf{z}_t|\mathbf{o}_t)$,因为部分可观测时单帧不足以确定状态。
4. Part 6 · 控制即推断:从图模型到 soft actor-critic
题 4.1:写出决策的概率图模型,并解释「不假设最优行为」的含义
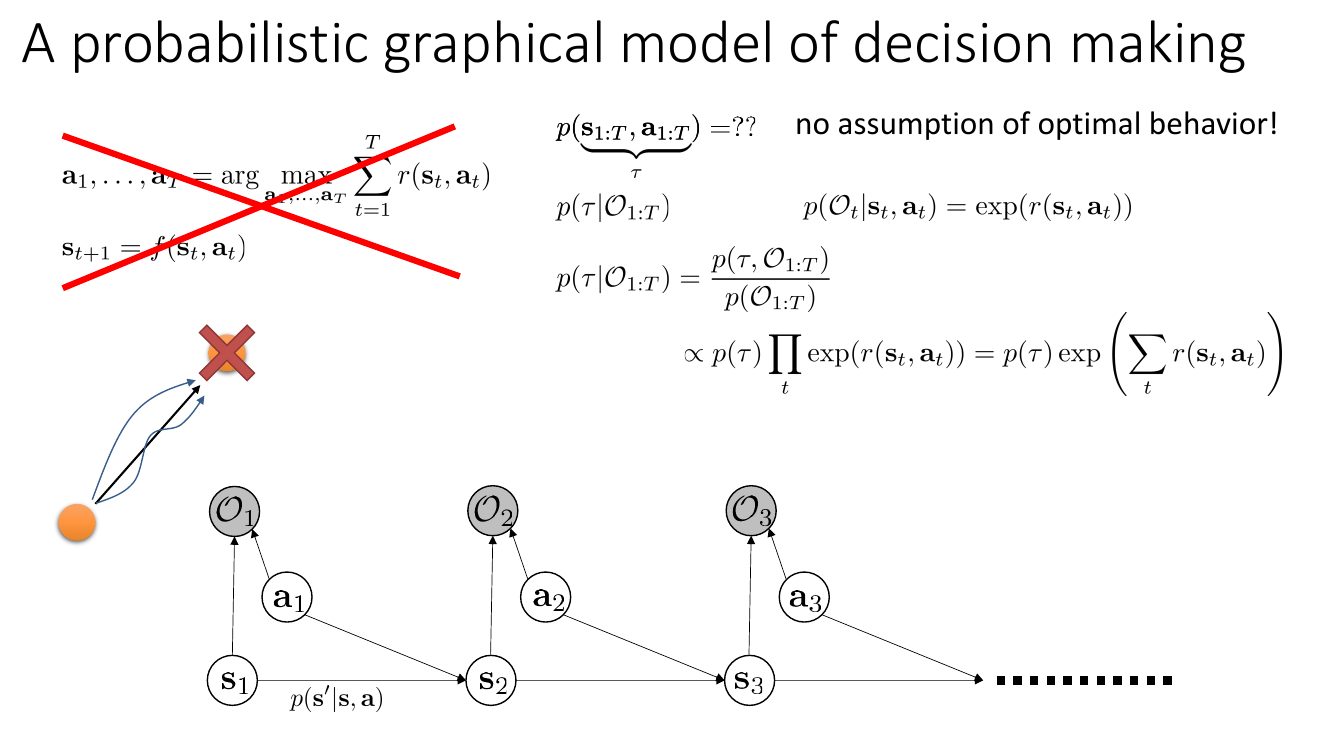
解答。先验轨迹分布 $p(\tau) = p(\mathbf{s}_1)\prod_t p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$ 里不含任何关于「好动作」的信息(动作先验通常取均匀)。所有的「想要高奖励」这件事都编码在观测 $\mathcal{O}_{1:T}=1$ 上:
$$ p(\tau|\mathcal{O}_{1:T}) = \frac{p(\tau,\mathcal{O}_{1:T})}{p(\mathcal{O}_{1:T})} \propto p(\tau)\prod_t \exp\big(r(\mathbf{s}_t,\mathbf{a}_t)\big) = p(\tau)\exp\Big(\sum_t r(\mathbf{s}_t,\mathbf{a}_t)\Big). $$「no assumption of optimal behavior」的意思是:模型本身不强制智能体最优,只是说「越优的轨迹越可能被观察到」,概率按指数加权。奖励差 1 的两条轨迹概率比是 $e$ 倍——次优行为仍有非零概率,这正是它能解释真实人类/动物数据的原因,也是 IRL 的建模基础。
题 4.2:推导后向消息 $\beta_t$ 的递推
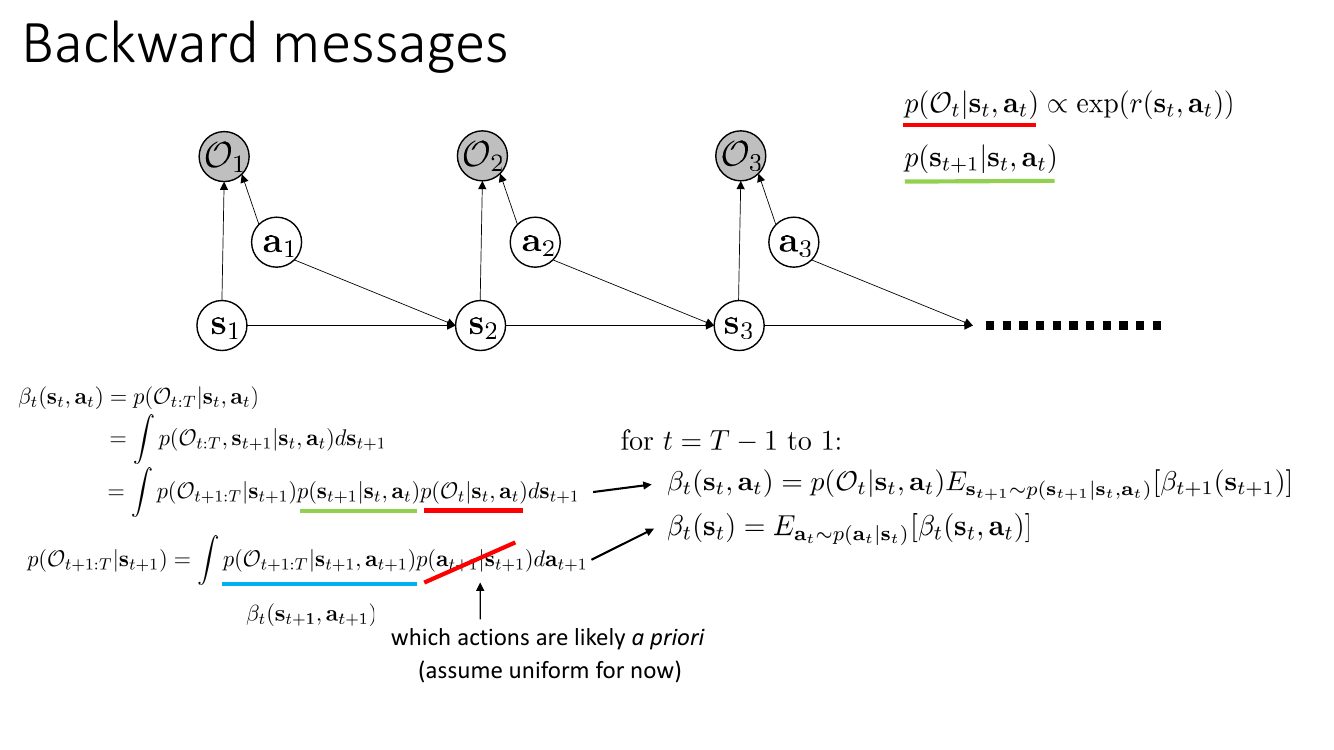
解答。从 $t=T-1$ 倒推到 $1$:
$$ \beta_t(\mathbf{s}_t,\mathbf{a}_t) = p(\mathcal{O}_t|\mathbf{s}_t,\mathbf{a}_t)\,\E_{\mathbf{s}_{t+1}\sim p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)}\big[\beta_{t+1}(\mathbf{s}_{t+1})\big],\qquad \beta_t(\mathbf{s}_t) = \E_{\mathbf{a}_t \sim p(\mathbf{a}_t|\mathbf{s}_t)}\big[\beta_t(\mathbf{s}_t,\mathbf{a}_t)\big]. $$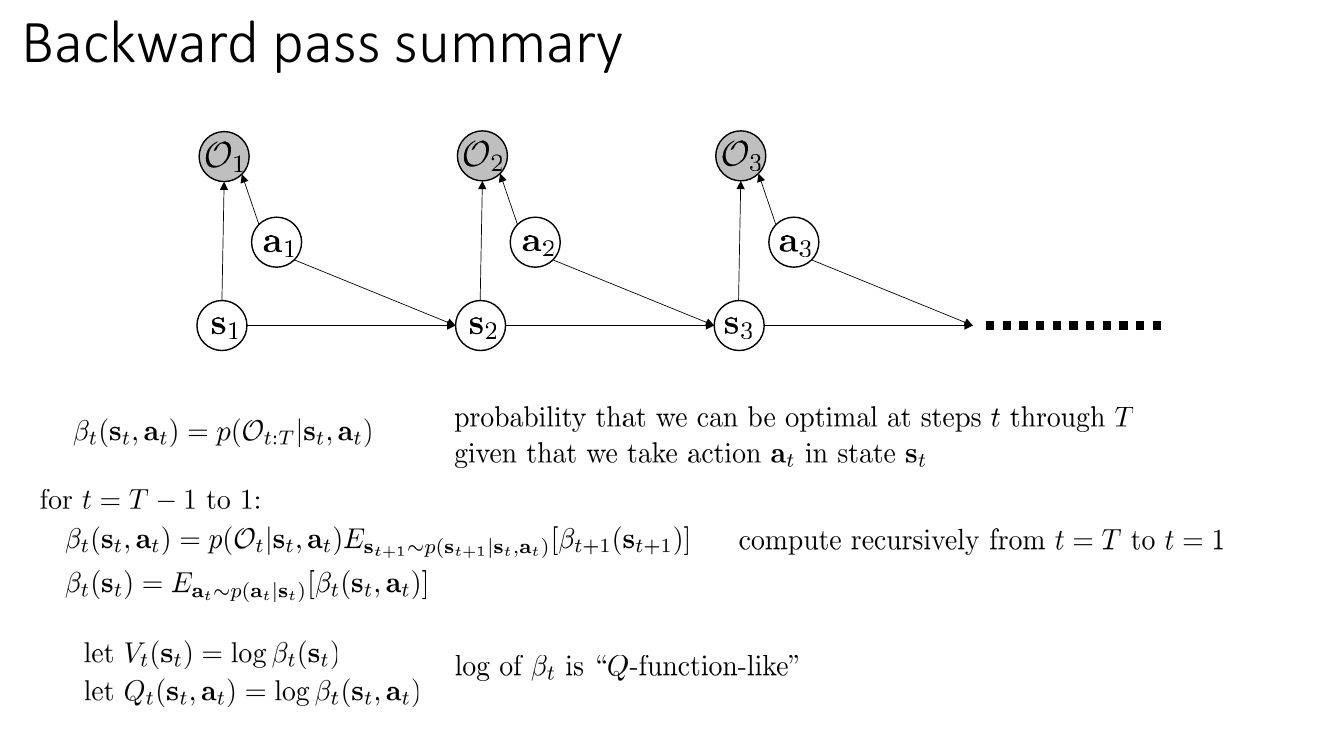
取对数后(动作先验均匀,常数吸收进去):
$$ Q_t(\mathbf{s}_t,\mathbf{a}_t) = r(\mathbf{s}_t,\mathbf{a}_t) + \log \E\big[\exp(V_{t+1}(\mathbf{s}_{t+1}))\big], \qquad V_t(\mathbf{s}_t) = \log \int \exp\big(Q_t(\mathbf{s}_t,\mathbf{a}_t)\big)\,d\mathbf{a}_t . $$第二式就是 soft max(log-sum-exp),当 $Q$ 值差距很大时 $\log\int e^{Q} \approx \max_\mathbf{a} Q$,退化为普通值迭代。
题 4.3:由 $\beta$ 计算策略,并说明它为什么是 $\exp(A)$
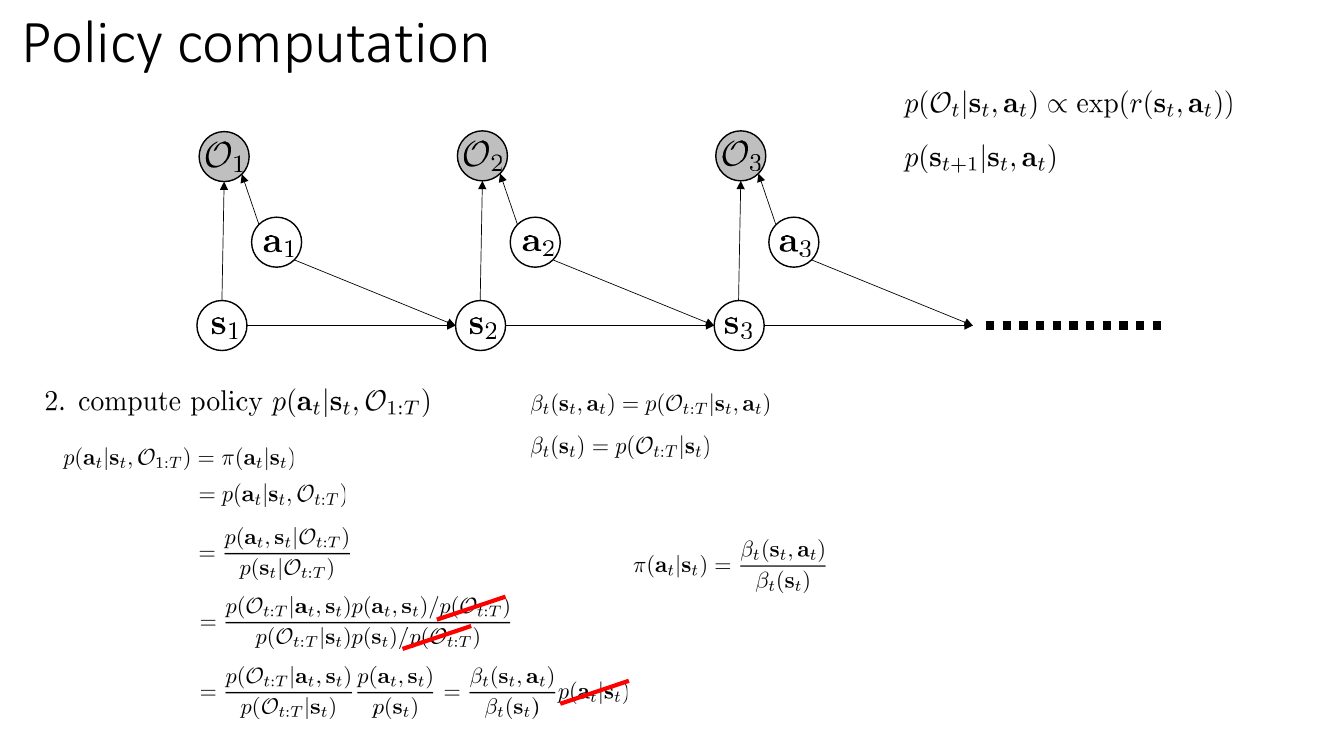
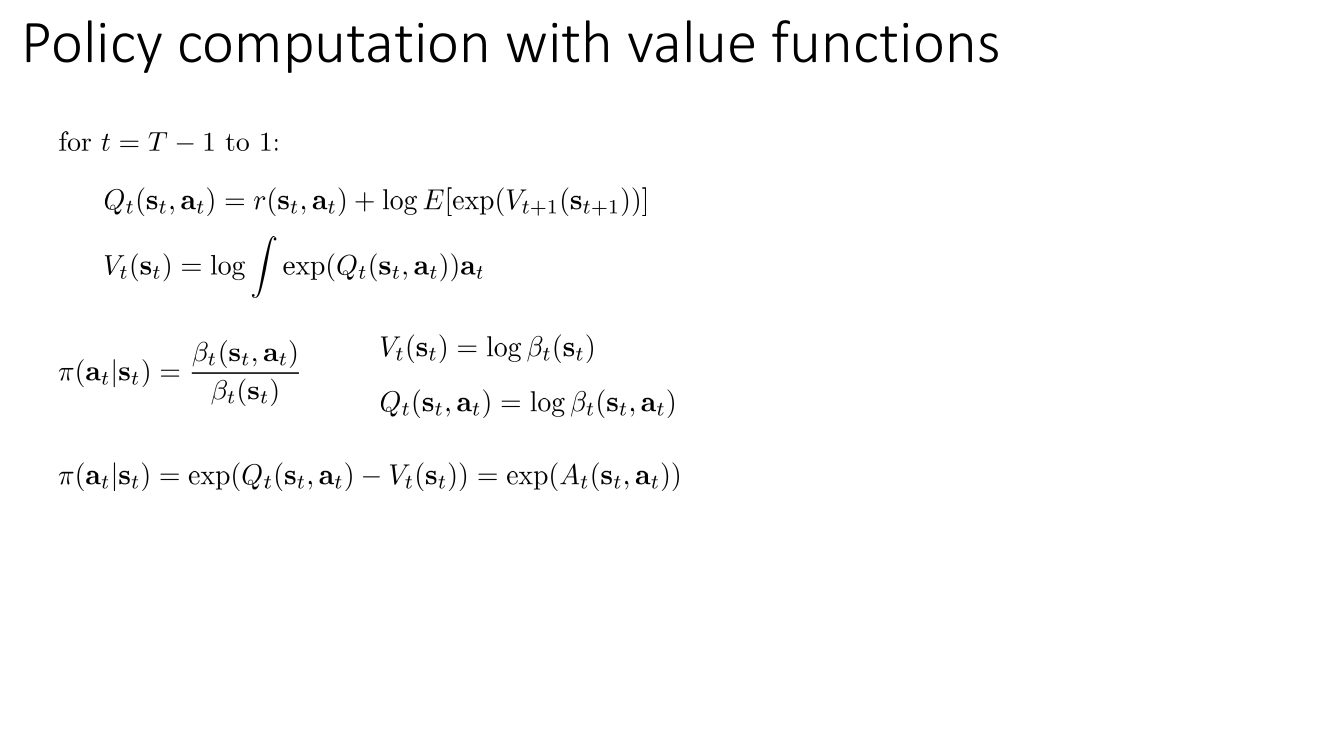
考点:优势为 0 的动作概率为 1 的「基准」,优势为 $-1$ 的动作概率降到 $1/e$。加上温度 $\beta$ 后是 $\pi \propto \exp(A/\beta)$,$\beta\to 0$ 时退化为确定性贪心策略。
题 4.4:变分版本——为什么要固定 $q$ 的动力学?推出「奖励 + 熵」目标
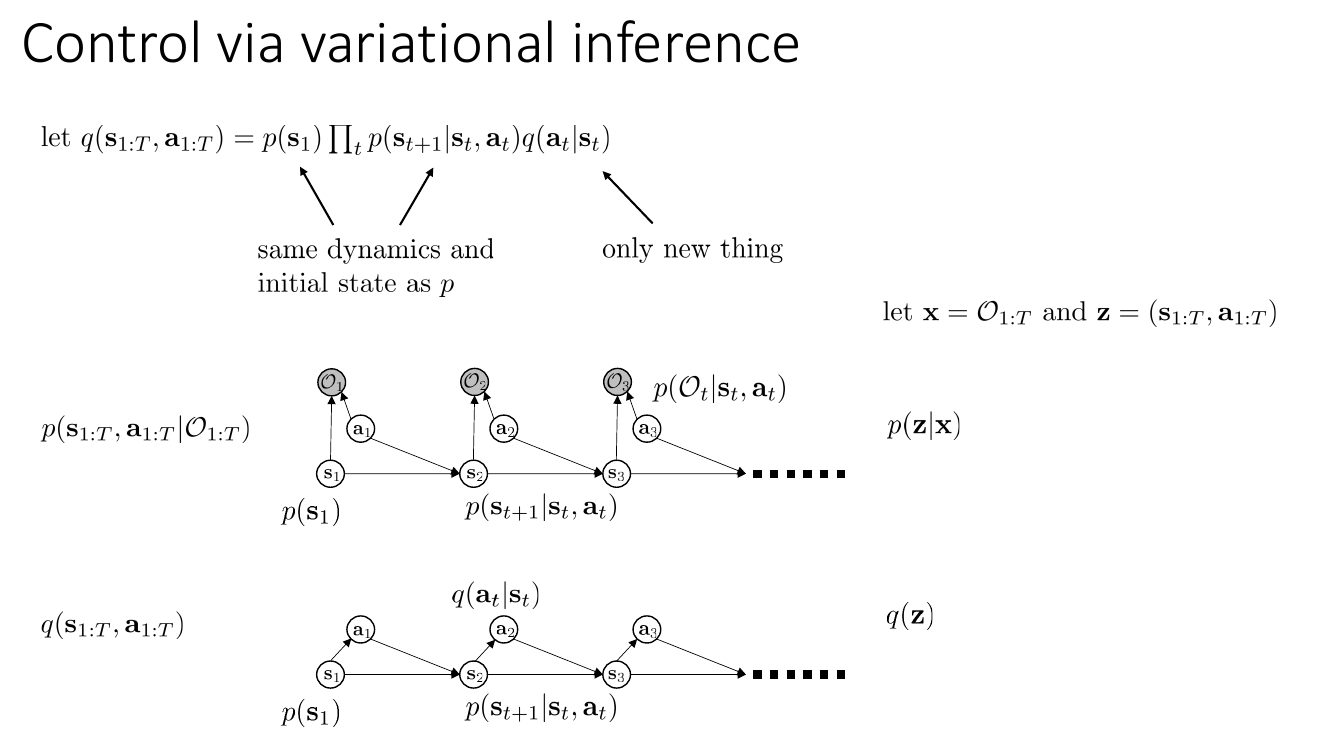
解答(第一问)。如果允许 $q$ 也改动力学,推断出来的「最优轨迹」会包含改变物理规律的成分——正是题 4.2 那个乐观偏差的来源。把 $q$ 的动力学钉死成真实动力学,就强制智能体只能通过选动作来提高奖励。
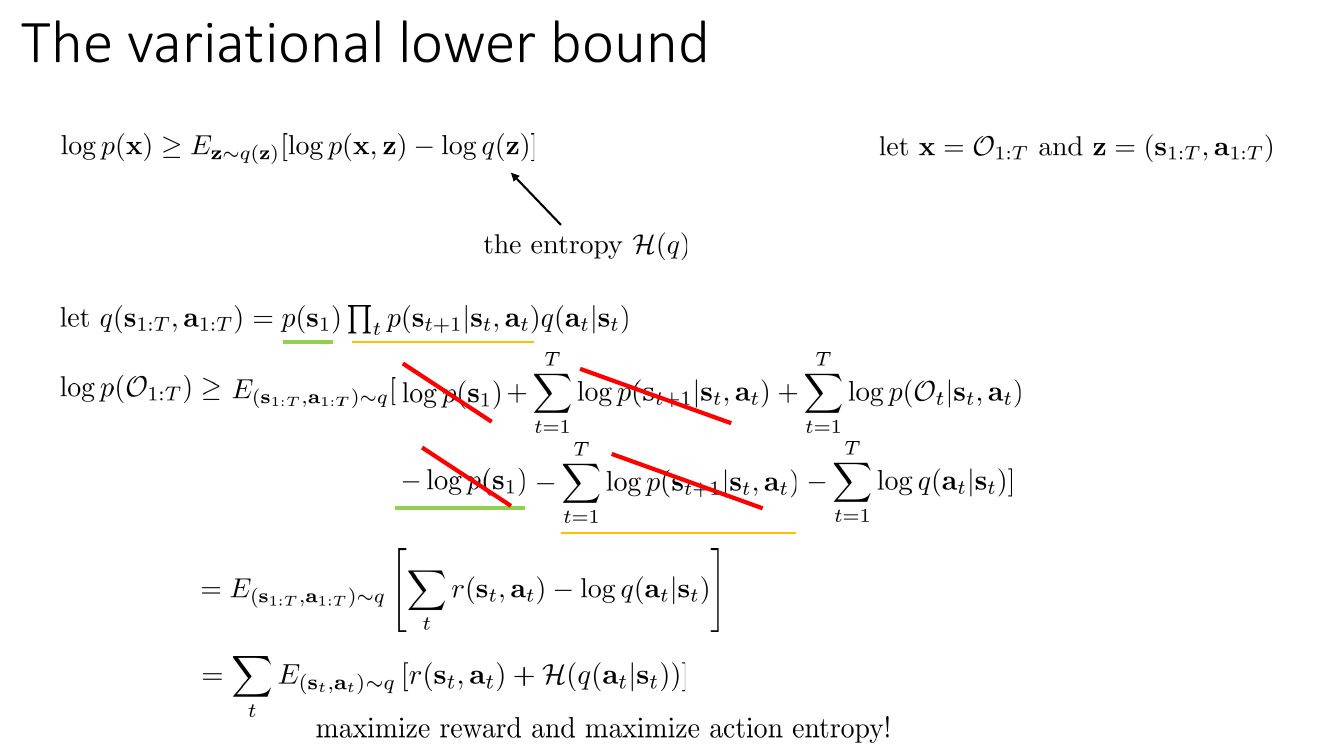
这就是最大熵强化学习(MaxEnt RL)的目标。相消的两项正是「$q$ 与 $p$ 共享动力学」的红利:如果不共享,$\sum_t[\log p(\mathbf{s}_{t+1}|\cdot) - \log q(\mathbf{s}_{t+1}|\cdot)]$ 会留下一个 KL 项,鼓励智能体去「幻想」有利的转移。
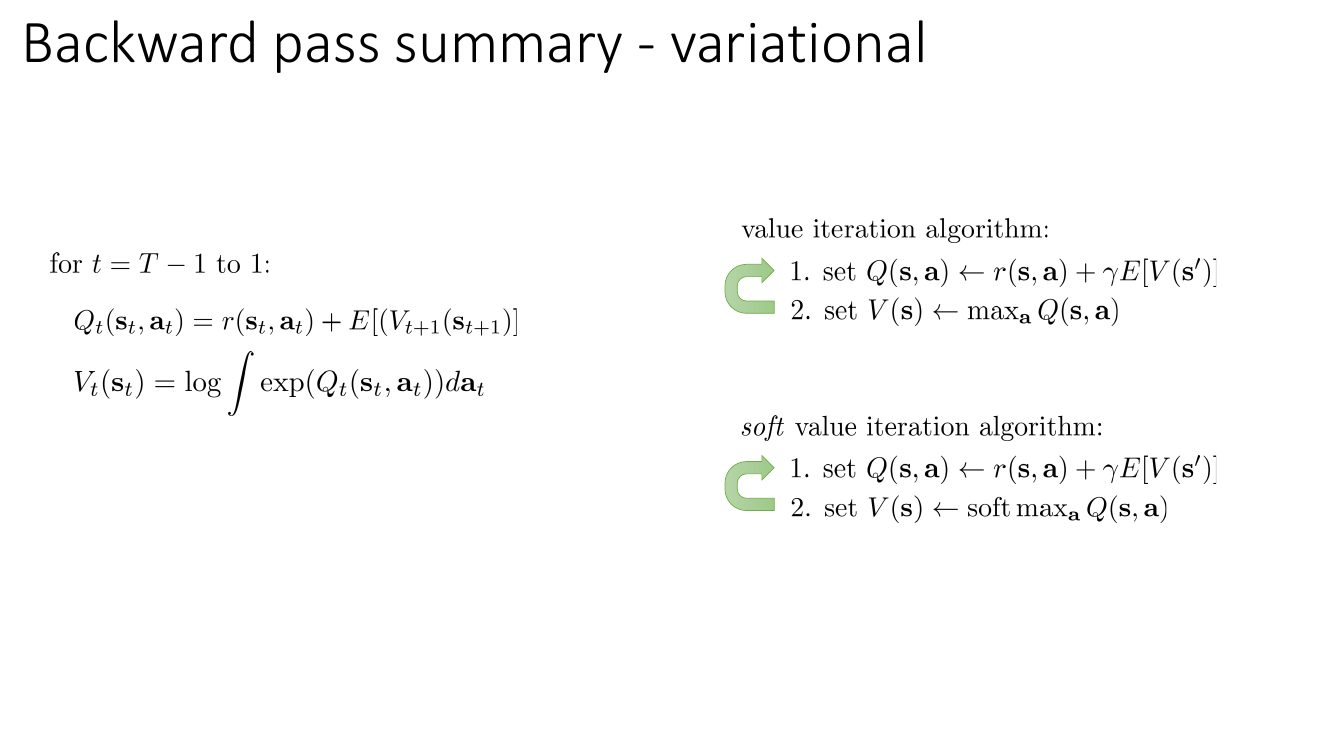
题 4.5:soft actor-critic 的四步;为什么要给熵加温度 $\beta$?
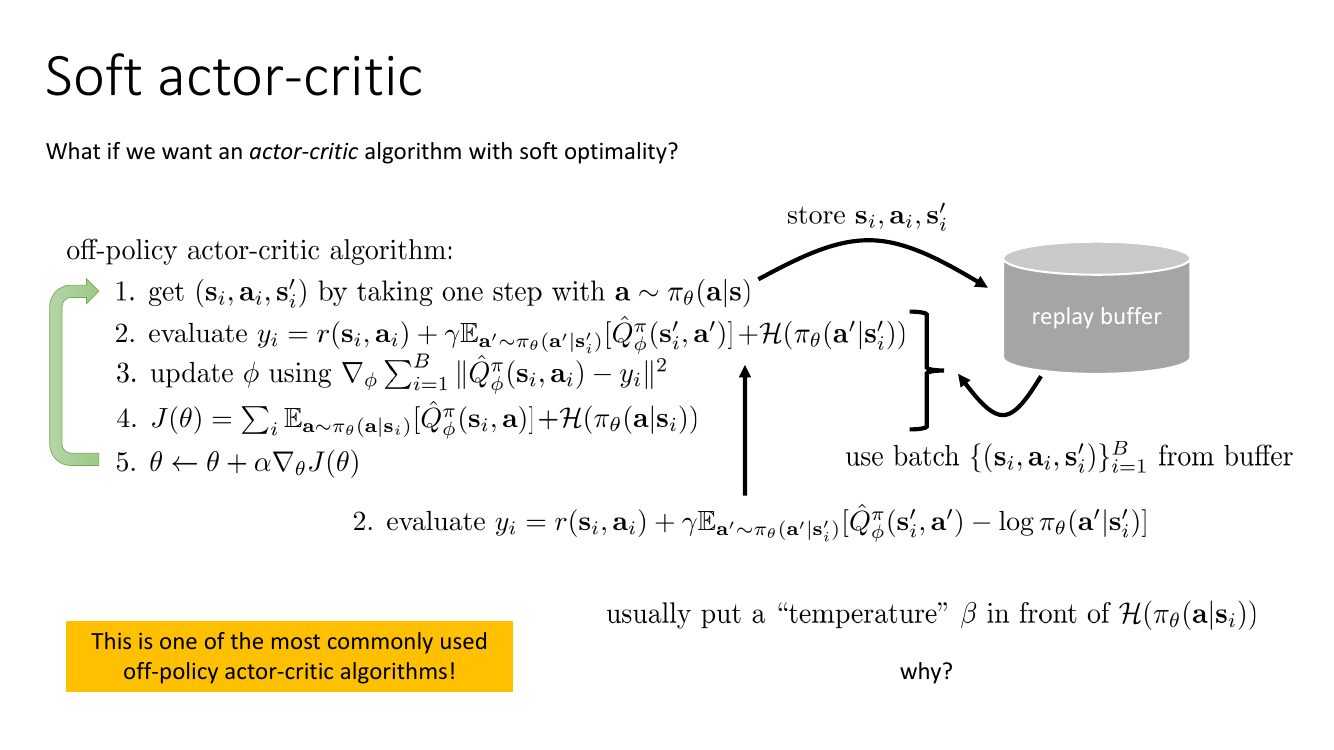
解答。温度 $\beta$ 的必要性有三层:(1) 量纲——奖励的尺度是任意的,$r$ 放大 10 倍等价于把熵项缩小 10 倍,所以熵的权重必须可调;(2) 退火——训练初期需要大熵探索,后期需要小熵以逼近真正的最优策略,$\beta$ 提供这个旋钮;(3) 自动调节——SAC 的实现把 $\beta$ 当作拉格朗日乘子,约束 $\E[-\log\pi] \ge \bar{\mathcal{H}}$,用对偶梯度自动调,省掉一个超参。
黄框问「为什么 SAC 是最常用的 off-policy actor-critic」:因为它同时拿到了三样东西——off-policy 的样本效率(回放池)、熵正则带来的探索与鲁棒性(不会过早坍缩到确定性策略)、以及 clipped double-Q 带来的稳定性。易错点:SAC 的 critic 学的是 soft Q 函数,目标里带 $-\log\pi$;如果照抄普通 TD 目标就会得到不一致的 actor 与 critic。
5. Part 6 续 · 逆强化学习与 RLHF
题 5.1:MaxEnt IRL 的最大似然目标;难点在哪
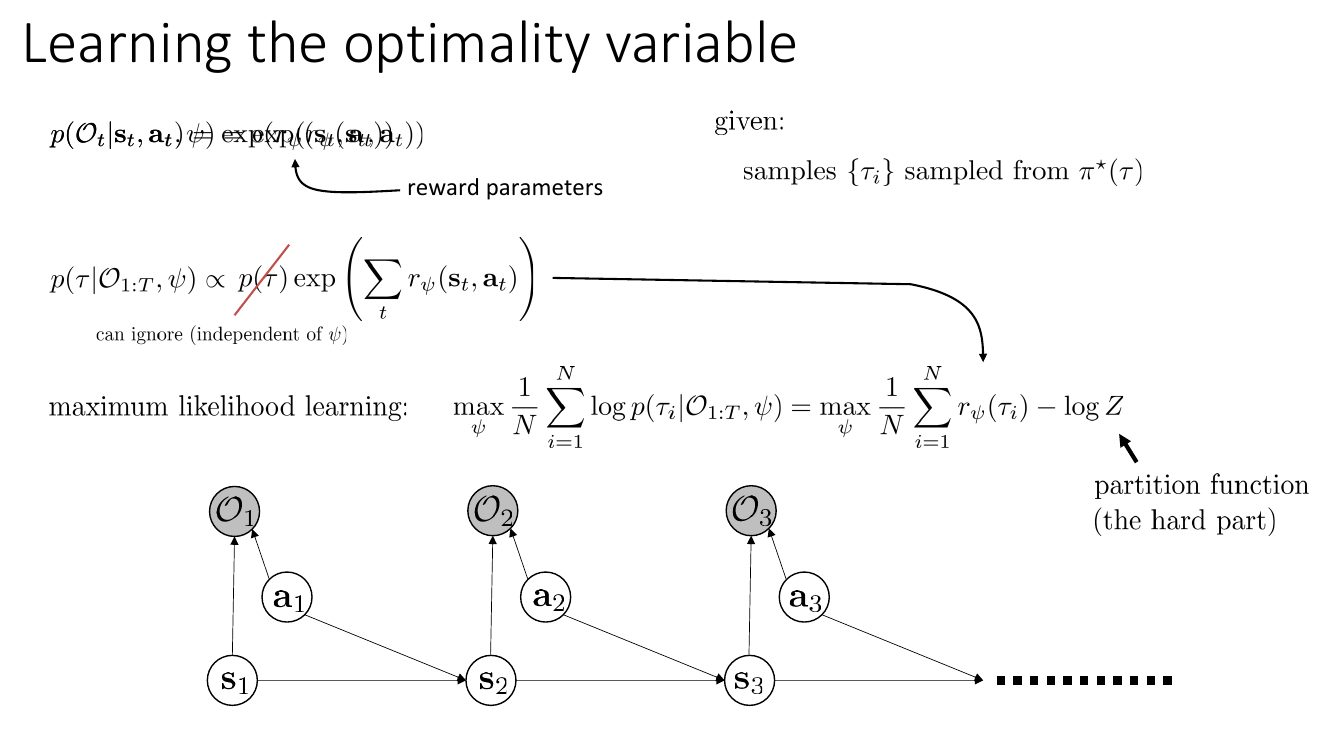
解答。目标函数是「专家轨迹的奖励尽量高,减去所有可能轨迹的 log 配分函数」:
$$ \max_\psi \frac1N \sum_{i=1}^N r_\psi(\tau_i) - \log Z, \qquad Z = \int p(\tau)\exp\big(r_\psi(\tau)\big)\,d\tau . $$难点是 $Z$——对所有轨迹积分,在连续高维空间里无法直接算。
题 5.2:推导 IRL 的梯度,并解释两项的物理意义
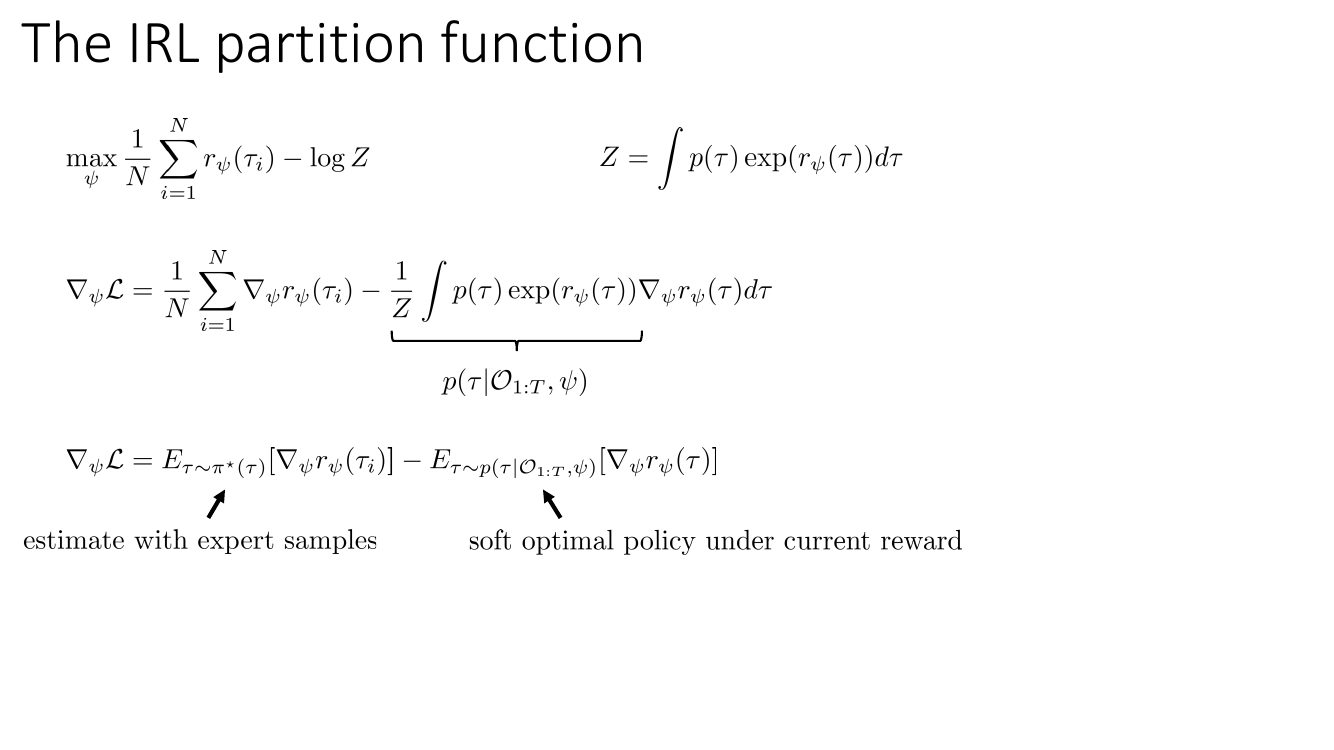
解答。
$$ \nabla_\psi \mathcal{L} = \frac1N\sum_{i=1}^N \nabla_\psi r_\psi(\tau_i) - \frac1Z\int p(\tau)\exp\big(r_\psi(\tau)\big)\nabla_\psi r_\psi(\tau)\,d\tau = \E_{\tau\sim\pi^\star(\tau)}\big[\nabla_\psi r_\psi(\tau)\big] - \E_{\tau\sim p(\tau|\mathcal{O}_{1:T},\psi)}\big[\nabla_\psi r_\psi(\tau)\big]. $$物理意义:抬高专家做过的事的奖励,压低当前策略爱做的事的奖励——这是能量模型(EBM)经典的「正相 − 负相」结构。两个期望相等时梯度为零,即当前软最优策略的行为分布与专家一致。易错点:第二项要求在每次奖励更新后重新求解一遍(软)RL 问题,这是 IRL 昂贵的根源;实践中用「部分优化」(只更新几步策略)来近似。
题 5.3:IRL 与 GAN 的等价——判别器该怎么参数化?
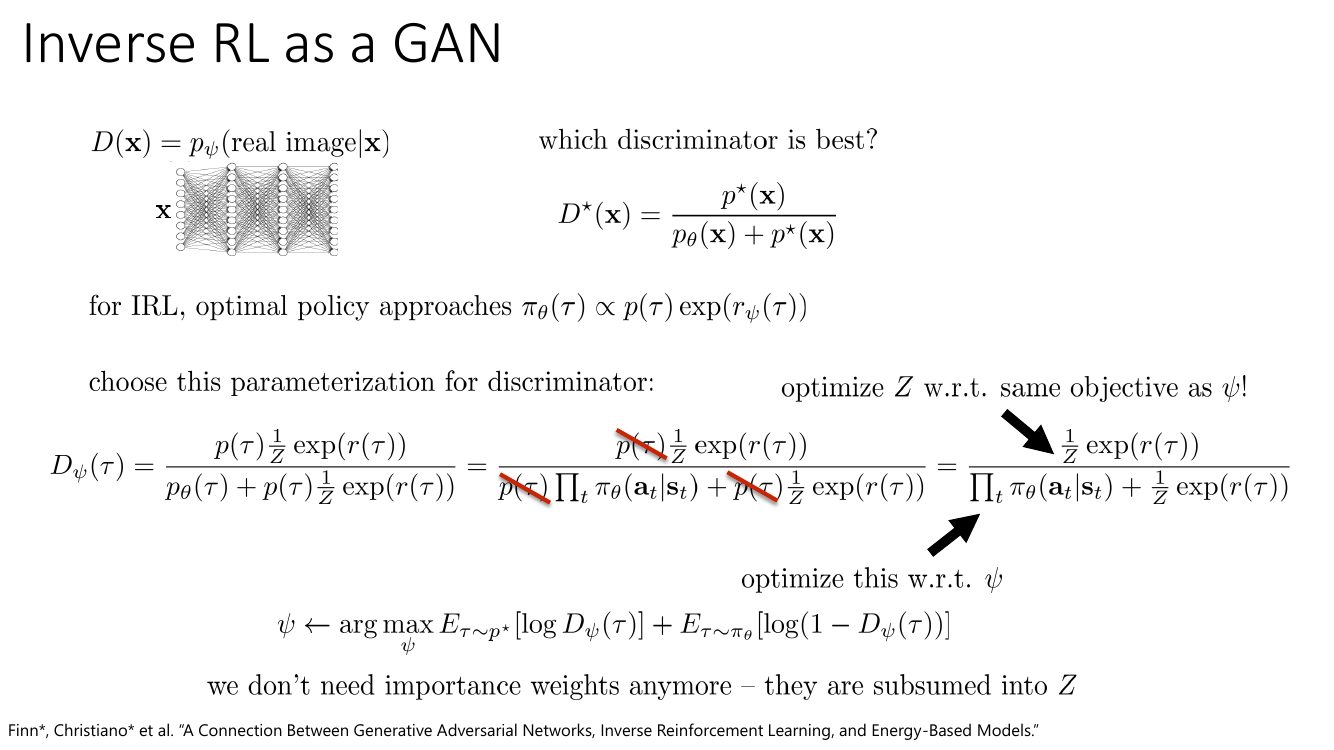
解答。判别器用上面这个特殊结构(而不是普通的黑箱二分类器),判别器的训练目标就是标准 GAN 的交叉熵:
$$ \psi \leftarrow \argmax_\psi\ \E_{\tau\sim p^\star}\big[\log D_\psi(\tau)\big] + \E_{\tau\sim\pi_\theta}\big[\log(1 - D_\psi(\tau))\big]. $$好处有两点:一是所有与 $\psi$ 无关的动力学项被约掉,判别器只依赖可学的奖励和已知的策略密度;二是原本需要用重要性权重 $\frac{\exp(r)}{\pi_\theta}$ 来修正「负相样本来自 $\pi_\theta$ 而不是软最优分布」的偏差,现在这个权重被 $Z$ 自动吸收了。
题 5.4:可以直接用普通判别器吗?三条利弊
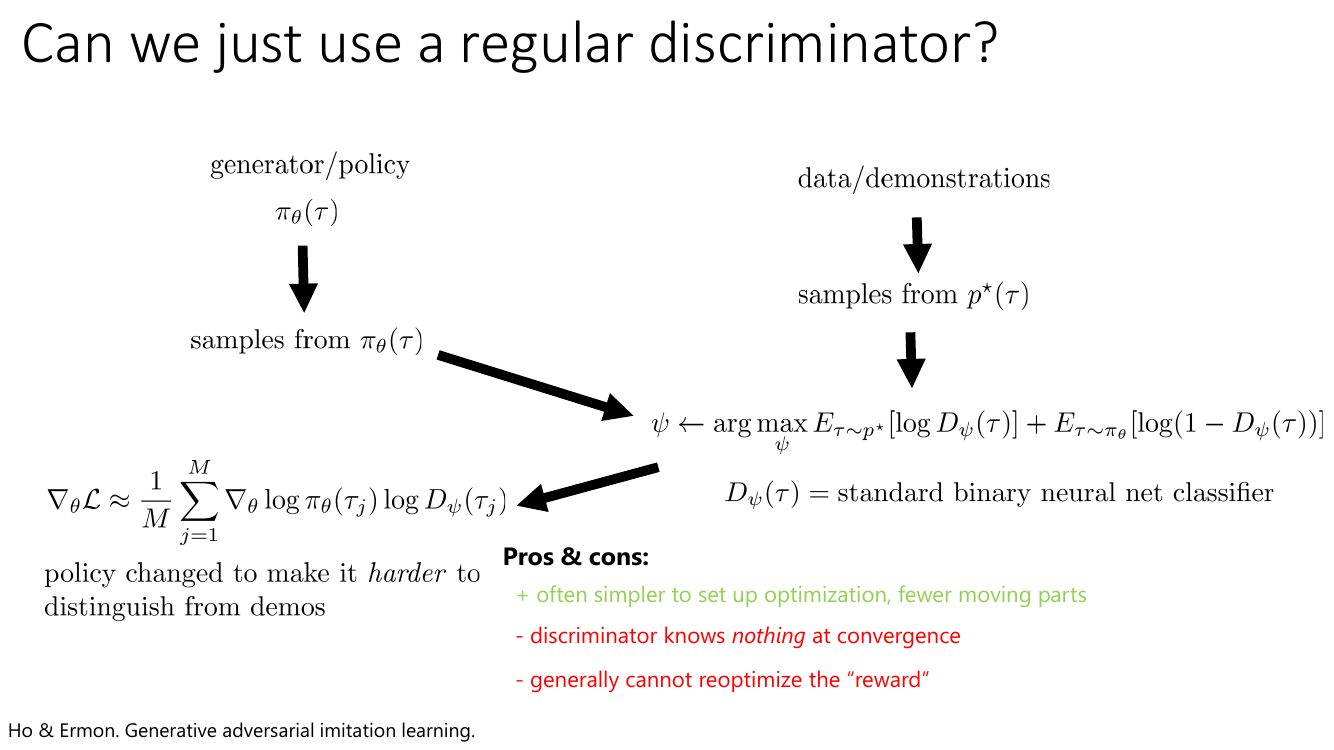
解答。$D_\psi$ 用普通二分类网络即可,这就是 GAIL(generative adversarial imitation learning)。+ 优化设置更简单、活动部件更少;− 收敛时判别器「什么都不知道」——当 $\pi_\theta = p^\star$ 时最优判别器恒等于 $1/2$,梯度里再也提取不出关于任务的信息;− 因此一般不能把学到的「奖励」拿去在新环境里重新优化。如果目的是学一个可迁移、可复用的奖励函数,就必须用题 5.3 的结构化判别器。
题 5.5:完整的 RLHF 算法;为什么第 3 步「看起来像逻辑回归」
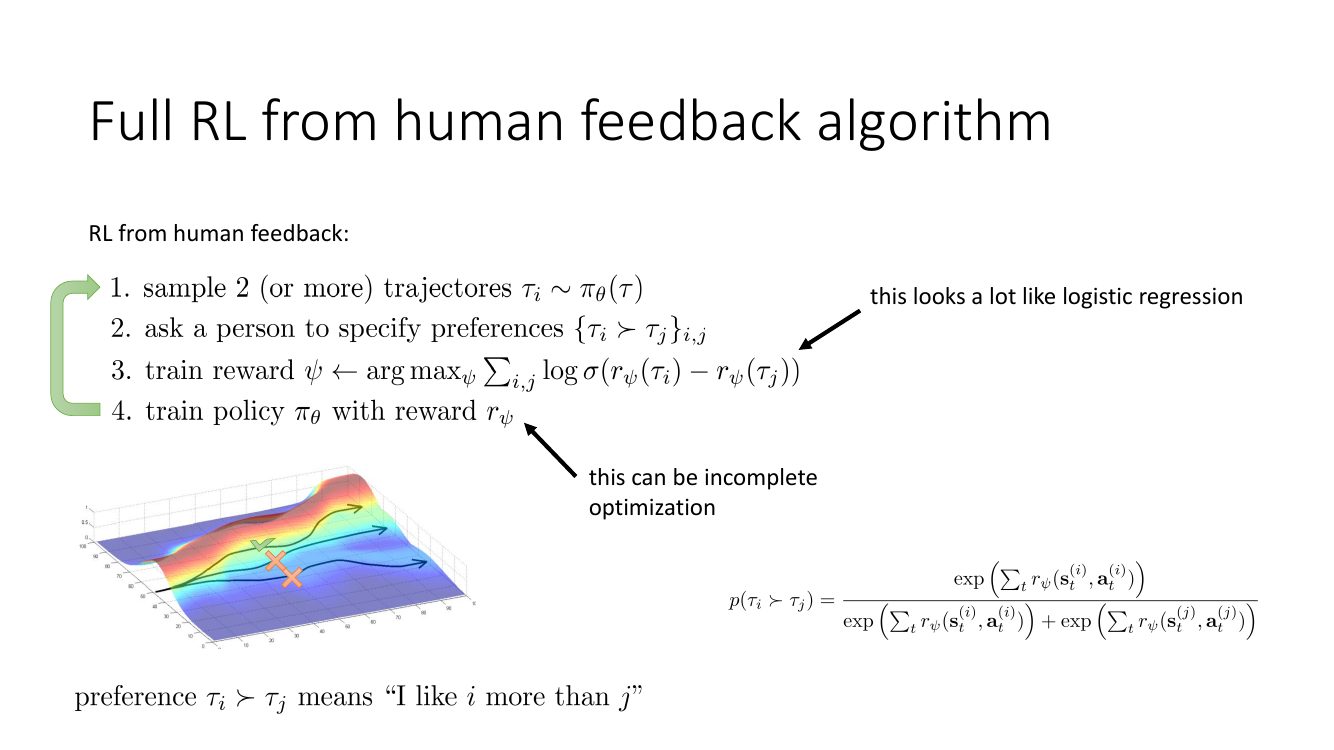
解答。Bradley–Terry 模型把两条轨迹的偏好概率写成回报差的 sigmoid:
$$ p(\tau_i \succ \tau_j) = \frac{\exp\!\big(\sum_t r_\psi(\tau_i)\big)}{\exp\!\big(\sum_t r_\psi(\tau_i)\big) + \exp\!\big(\sum_t r_\psi(\tau_j)\big)} = \sigma\big(r_\psi(\tau_i) - r_\psi(\tau_j)\big), $$取对数似然正好是逻辑回归的形式,其中「特征」是回报差。为什么不用 §5.2 的配分函数版本:偏好是成对比较,配分函数只对这两条轨迹求和,天然可算——这就是 RLHF 相比 MaxEnt IRL 的最大工程优势。
| 量 | 表达式 | 对应的经典 RL 概念 |
|---|---|---|
| 最优性似然 | $p(\mathcal{O}_t|\mathbf{s}_t,\mathbf{a}_t)=\exp r(\mathbf{s}_t,\mathbf{a}_t)$ | 奖励 |
| 后向消息 | $\beta_t(\mathbf{s},\mathbf{a}) = p(\mathcal{O}_{t:T}|\mathbf{s},\mathbf{a})$ | $\log\beta_t = Q_t$ |
| soft 值 | $V(\mathbf{s}) = \log\int \exp Q(\mathbf{s},\mathbf{a})\,d\mathbf{a}$ | $\max_\mathbf{a} Q$ 的平滑版 |
| soft 策略 | $\pi(\mathbf{a}|\mathbf{s}) = \exp(A(\mathbf{s},\mathbf{a}))$ | Boltzmann 策略 |
| 变分目标 | $\sum_t\E[r + \mathcal{H}(\pi)]$ | MaxEnt RL / SAC |
| IRL 梯度 | $\E_{\pi^\star}[\nabla r_\psi] - \E_{\text{soft opt}}[\nabla r_\psi]$ | EBM 正相 − 负相 |
| RLHF 奖励损失 | $-\sum \log\sigma(r_\psi(\tau_i)-r_\psi(\tau_j))$ | Bradley–Terry / 逻辑回归 |
6. Part 7 · 基于模型的 RL:分布偏移与不确定性
题 6.1:model-based RL 的分布偏移长什么样?两类解法是什么?
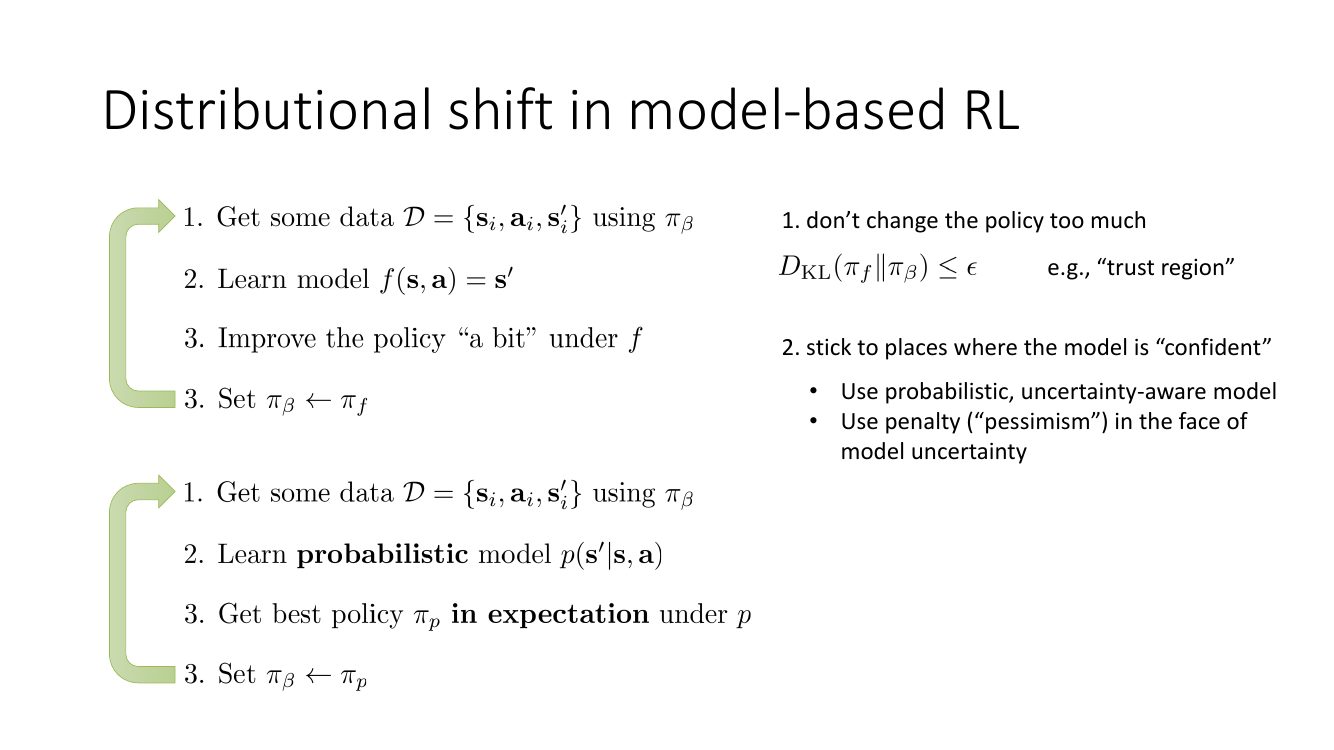
解答。模型是在 $\pi_\beta$ 的状态分布上拟合的,但策略优化会去最大化模型下的回报——优化器会主动搜索模型误差最大、看起来奖励最高的区域。这与对抗样本是同一现象:模型没错在平均意义上,而是错在被专门挑出来的那一小撮点上。两类解法:(1) 限制策略变化幅度(信赖域,让状态分布不要跑太远);(2) 只在模型「自信」的地方行动,用不确定性感知模型 + 悲观惩罚。
题 6.2(黄框):为什么输出熵不够?两类不确定性各是什么?
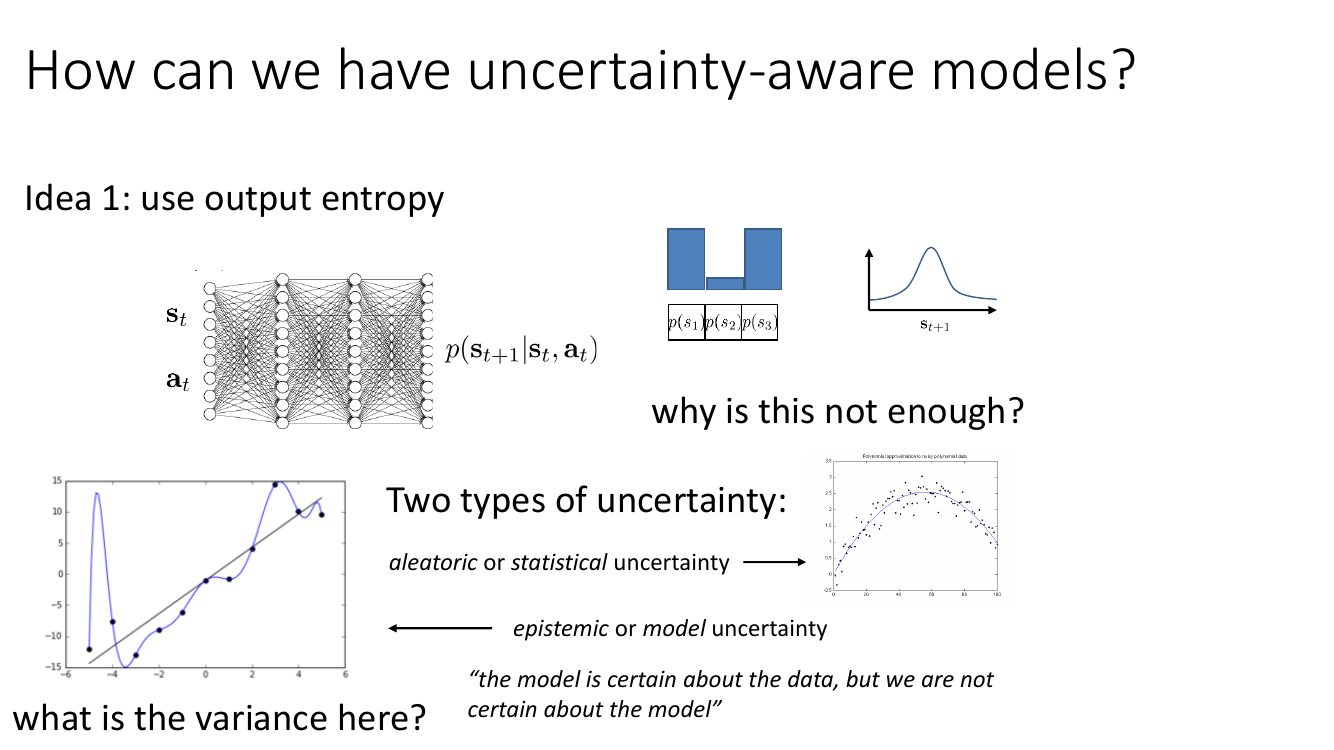
解答。网络的输出熵只刻画了 aleatoric 不确定性,即「给定这个模型,结果本身有多随机」。但过拟合的模型可以在没有数据的地方非常自信地给出错误预测——输出熵极低,实际误差极大。我们真正需要的是 epistemic 不确定性:$p(\theta|\mathcal{D})$ 的分散程度,也就是「模型对数据很确定,但我们对模型不确定」。左下角的问题「what is the variance here?」的答案:那条震荡曲线在数据点之间的方差看起来是 0(曲线穿过每个点),但换一组随机种子重训会得到完全不同的曲线,这个「模型间的方差」才是我们要的量。实践中的近似:bootstrap ensemble(训 $N$ 个模型,用它们预测的分歧当不确定性)。
题 6.3:如何用不确定性做规划?
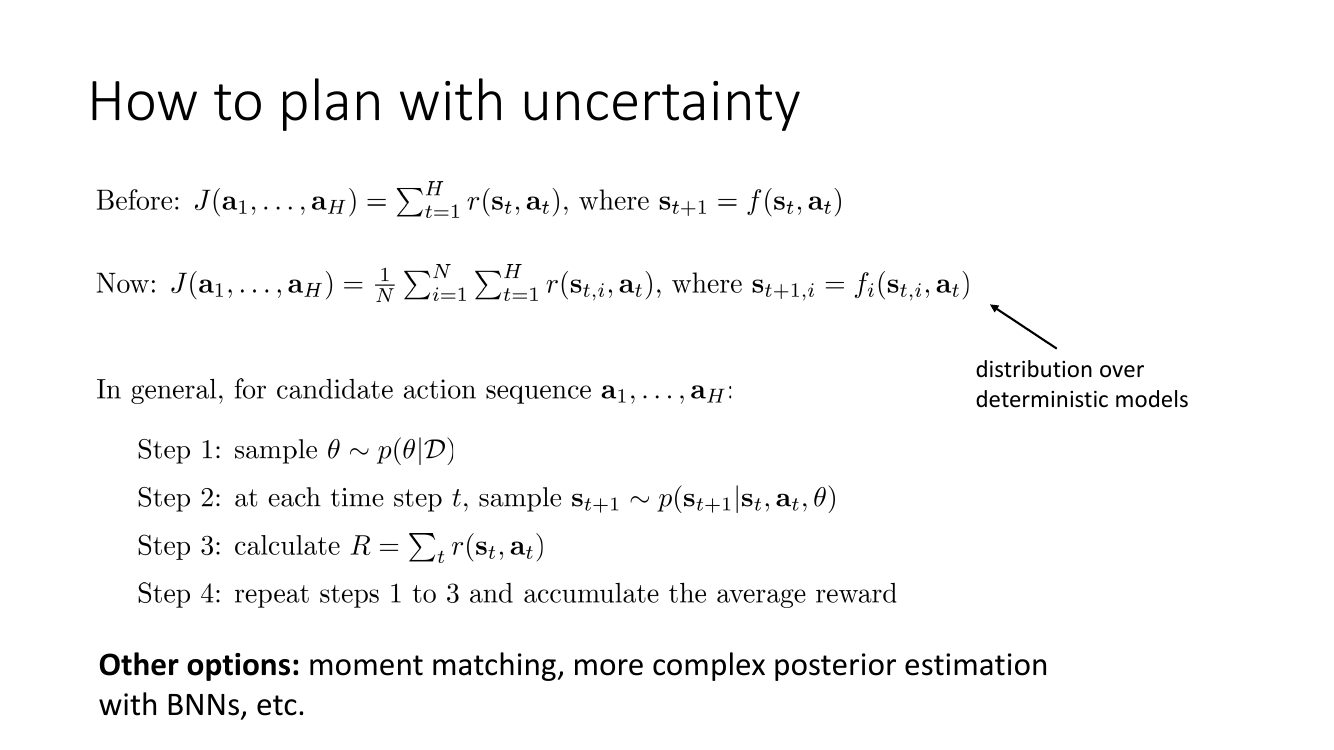
解答。对同一个候选动作序列,在每一个集成成员上都 rollout 一遍,取平均回报作为该序列的评分。关键在于:一条 rollout 全程用同一个 $\theta$(不要每步换模型),否则不确定性会被平均掉。这样一来,只有在所有模型都认为好的动作序列才会得高分——模型分歧大的区域自动被降权。其他做法:矩匹配(moment matching)、贝叶斯神经网络后验估计。
题 6.4(红字):随机开环控制为什么是次优的?
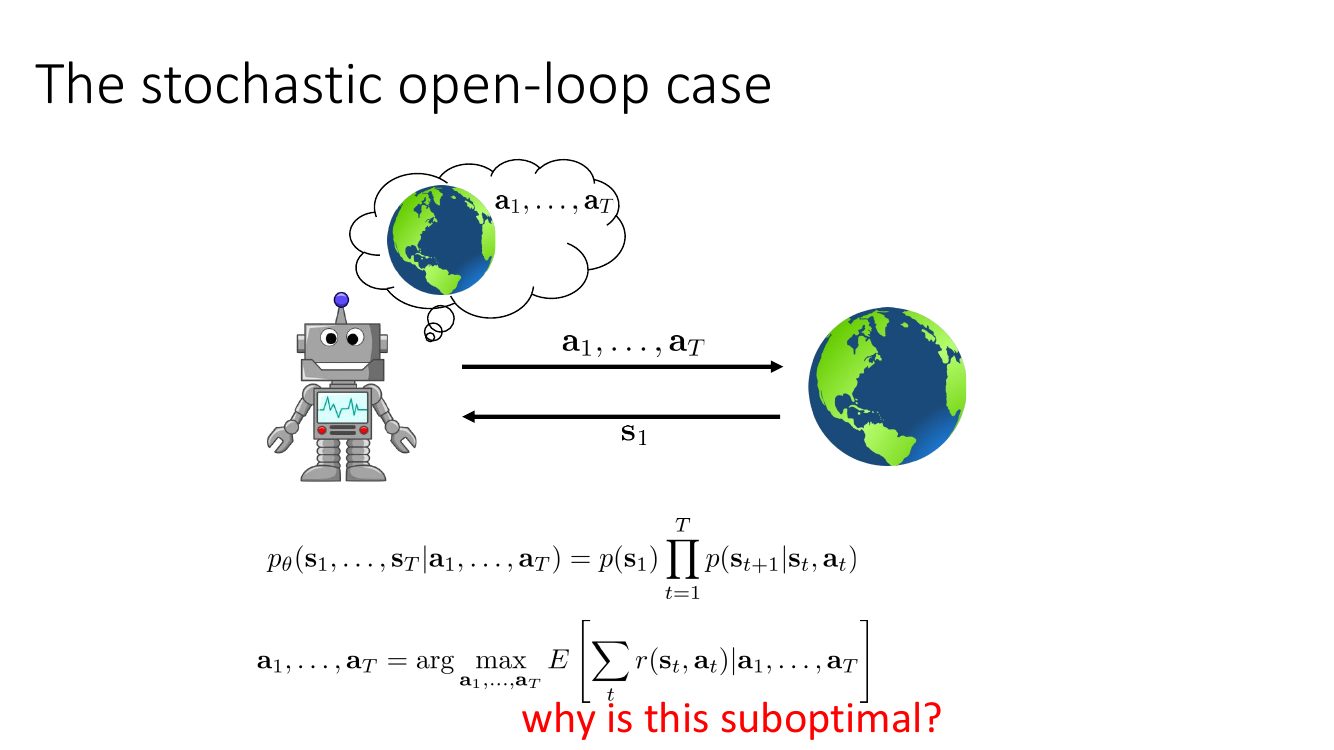
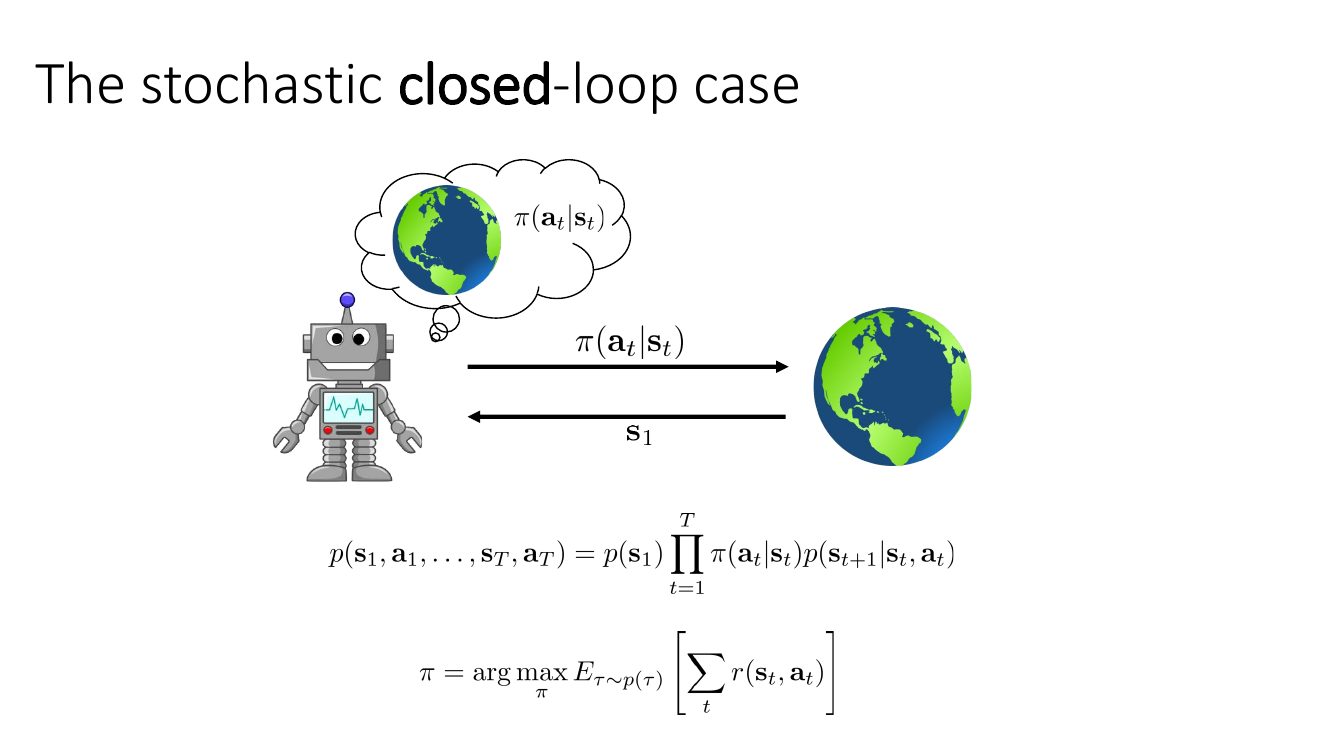
解答。因为它假设自己在未来不会获得任何新信息,从而必须选一串对所有可能的随机结果都还凑合的动作。而真实的最优解是闭环策略 $\pi(\mathbf{a}_t|\mathbf{s}_t)$:在 $t$ 时刻已经观测到 $\mathbf{s}_t$,可以据此调整。举个数值例子:走迷宫时前方有两扇门,随机一扇是通的(各 50%)。开环最优只能盲选一扇,期望成功率 0.5;闭环策略走到门口看一眼再选,成功率 1.0。易错点:开环解不仅期望回报低,还会系统性地表现得「过分保守」,因为它把「我将来会知道更多」这件事的价值算成了 0。
题 6.5:MBA / MVE / MBPO 这一类算法好在哪、坏在哪?
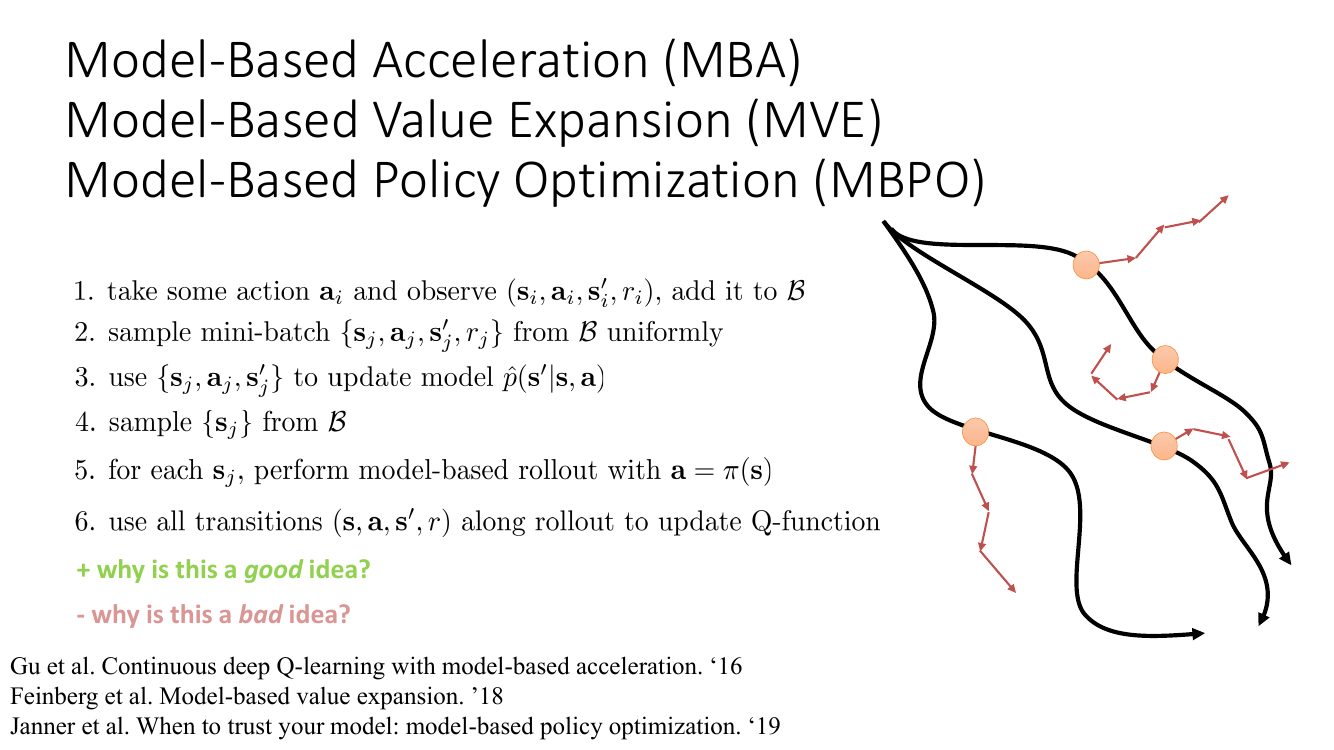
解答。好处:(a) 数据量放大——一条真实转移可以派生出几十条模型转移,样本效率大幅提升;(b) rollout 起点都在真实数据分布里,所以模型只需在真实状态的小邻域内准确,比从初始状态一路展开到 $T$ 要容易得多;(c) rollout 里的动作由当前策略产生,缓解了 Q 函数只见过 $\pi_\beta$ 动作的问题;(d) 短 rollout 让模型误差没有时间累积。
坏处:(a) 模型误差仍会污染 Q 函数——一旦 Q 学到了模型幻觉出的高回报状态,策略就会去追它;(b) 出现了两重分布偏移(模型的 + Q 的),互相放大;(c) rollout 长度 $k$ 是一个敏感超参:太短则收益有限,太长则误差爆炸;(d) 计算开销大。MBPO 的核心贡献正是给出「什么时候该信任模型」的分析,并给出随训练进度增长 $k$ 的调度。
题 6.6:潜空间模型的 prior / decoder / encoder(与题 3.5 的区别)
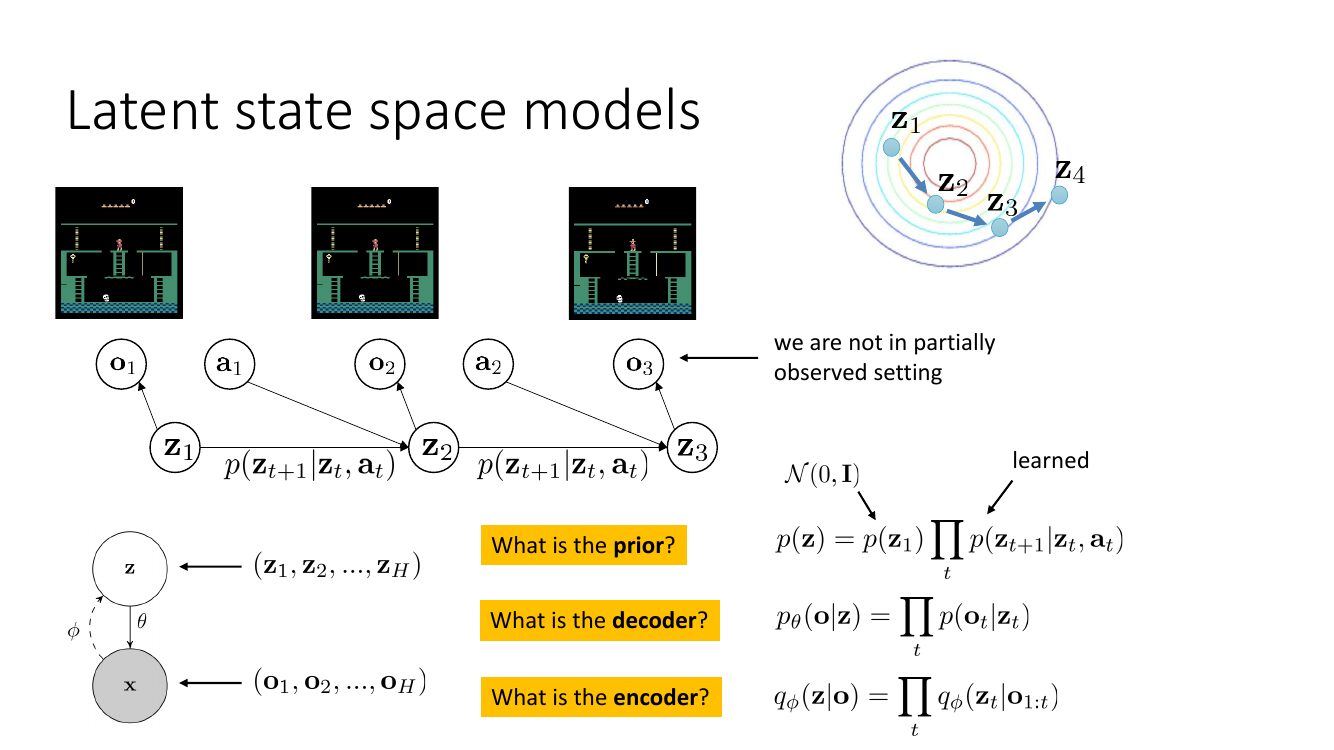
解答。形式完全相同:prior 是 $p(\mathbf{z}_1)\prod_t p(\mathbf{z}_{t+1}|\mathbf{z}_t,\mathbf{a}_t)$($\mathcal{N}(0,\mathbf{I})$ 初始 + 学到的隐动力学),decoder 是 $\prod_t p(\mathbf{o}_t|\mathbf{z}_t)$,encoder 是 $\prod_t q_\phi(\mathbf{z}_t|\mathbf{o}_{1:t})$。区别在用途:在 §3 里它是一个生成模型;在这里,$p(\mathbf{z}_{t+1}|\mathbf{z}_t,\mathbf{a}_t)$ 就是我们要用来做规划 / rollout 的动力学模型,图像重建只是为了给隐空间提供训练信号。考点:这是 Dreamer 系列方法的基本结构;训练时同时优化 ELBO(表示学习)和 RL 目标(在隐空间里做 actor-critic)。
7. Part 8 · 离线 RL:分布偏移出现在每一种算法的什么位置
题 7.1:on-policy / off-policy / offline 三种设定的区别
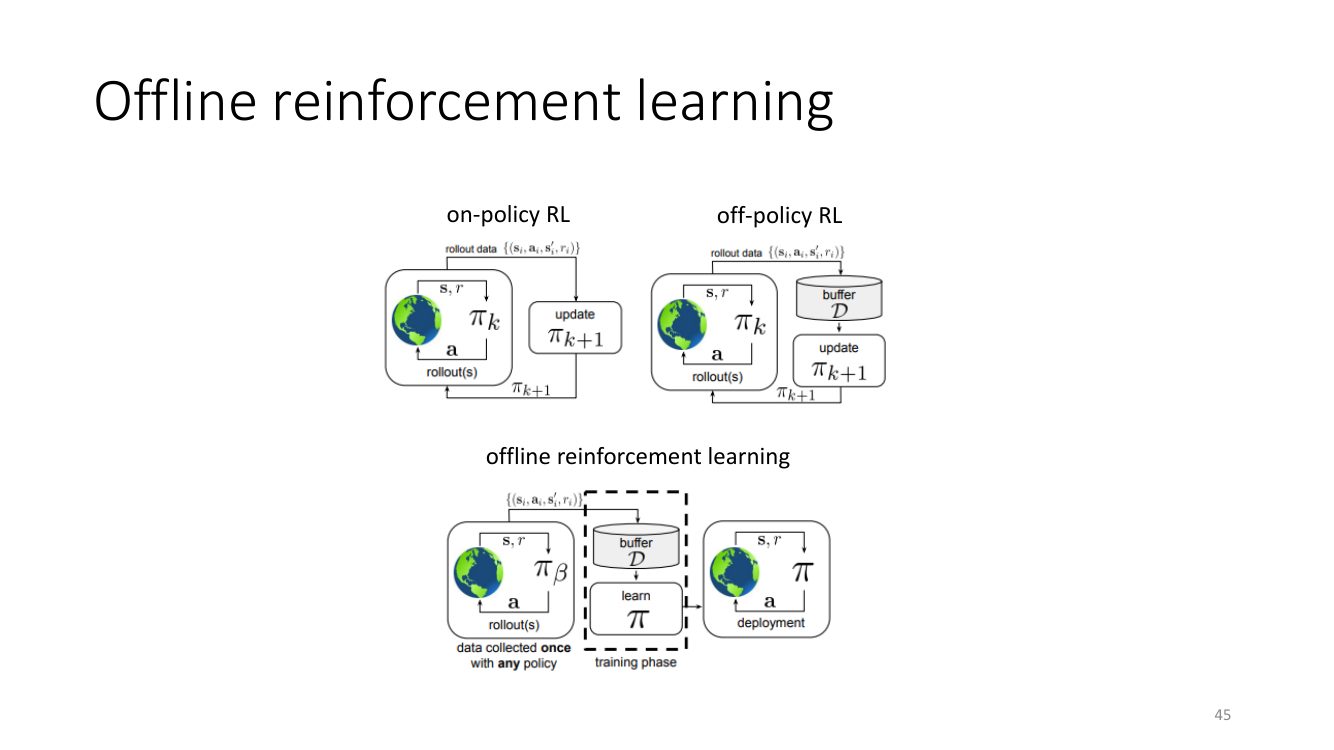
解答。关键差别只有一条:训练过程中能否继续采集数据来纠正自己的错误。on-policy 和 off-policy 都能,offline 不能。这一条差别导致离线 RL 的核心困难:算法会对数据里没有的动作做出乐观的反事实推断,而没有任何机会去验证这个推断是错的。
题 7.2:分布偏移在 Q-learning / actor-critic 里出现在哪两处?
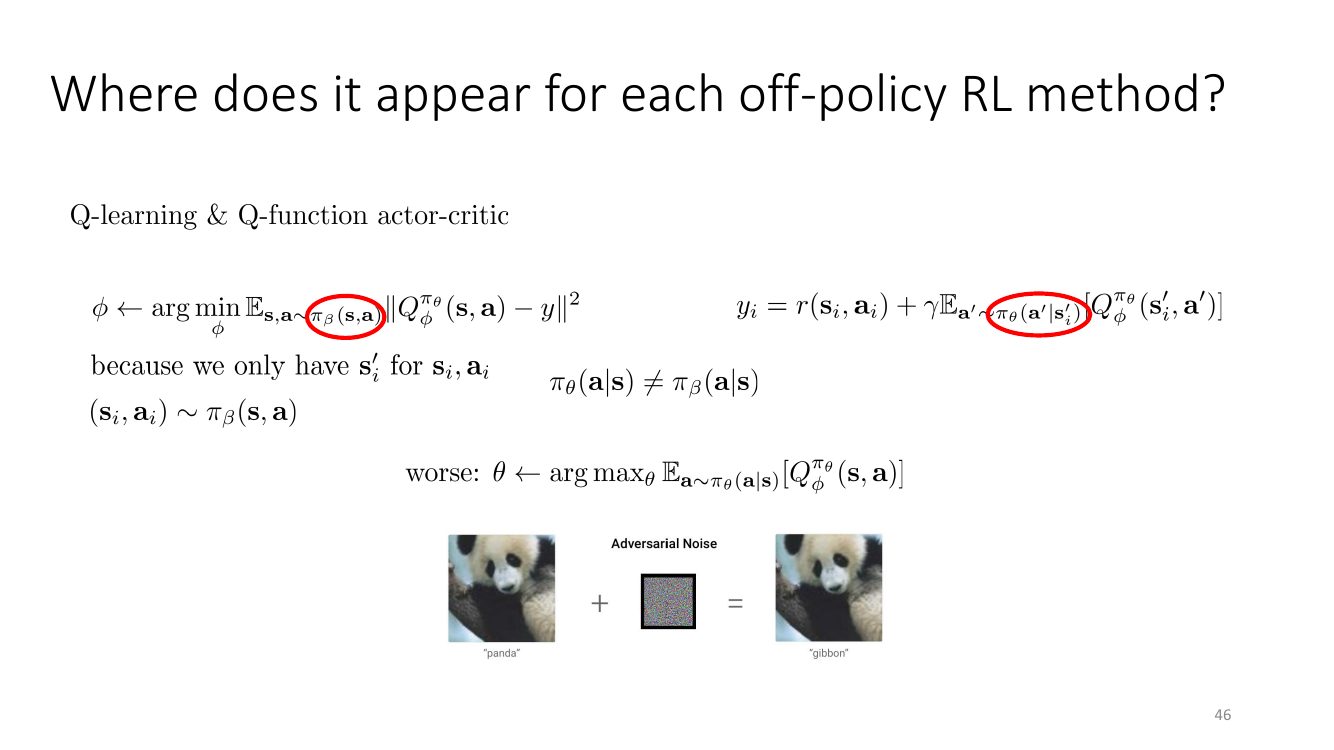
解答。两处:训练分布是 $\pi_\beta$(数据),评估分布是 $\pi_\theta$(新策略)。监督学习只保证在训练分布上误差小,$\pi_\theta\neq\pi_\beta$ 时 $Q_\phi$ 在新动作上的误差没有任何保证。而「worse」的那一行说明了更致命的问题:actor 不是随机地在 $Q$ 上查询,而是专门去找 $Q$ 最大的动作——它主动搜索 $Q$ 高估最严重的点。这与对抗样本完全同构:熊猫图片加上专门优化过的噪声就被判成长臂猿,误差不是随机的,是被优化器找出来的。
题 7.3:model-based RL 与 off-policy policy gradient 里的对应位置
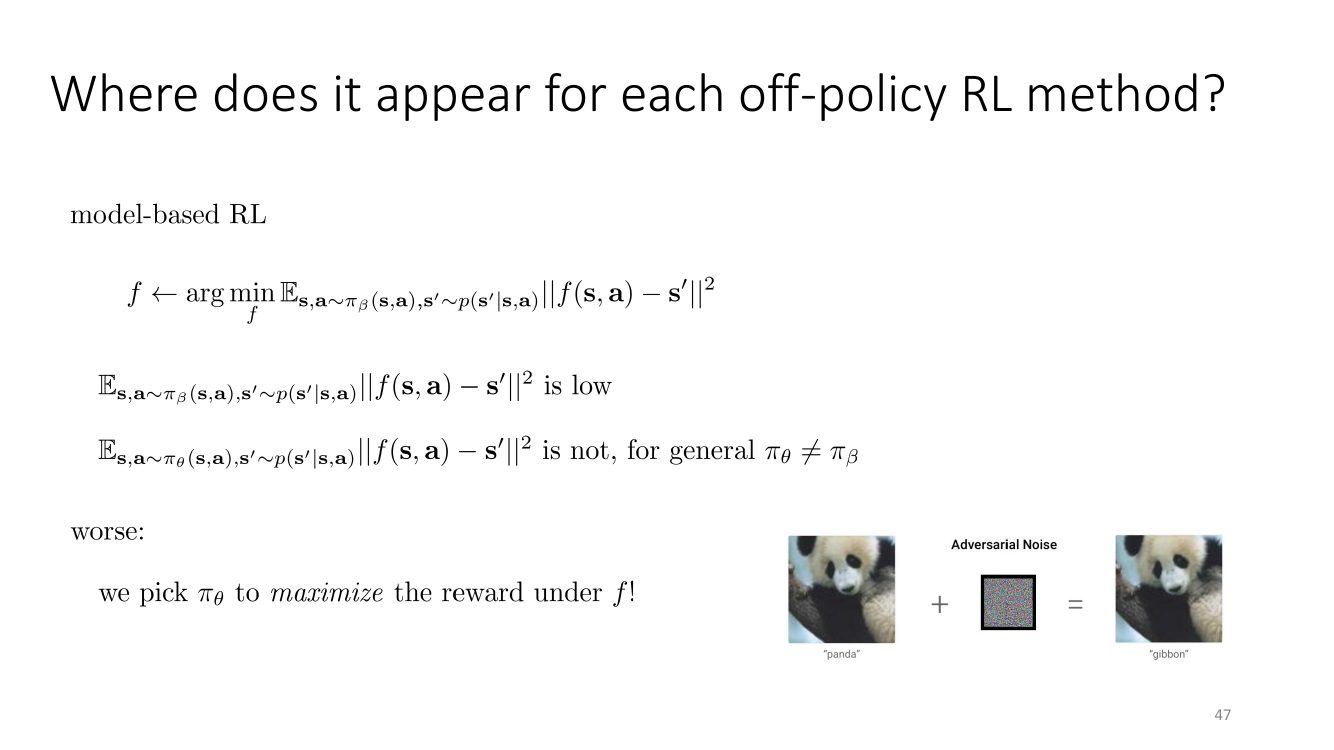
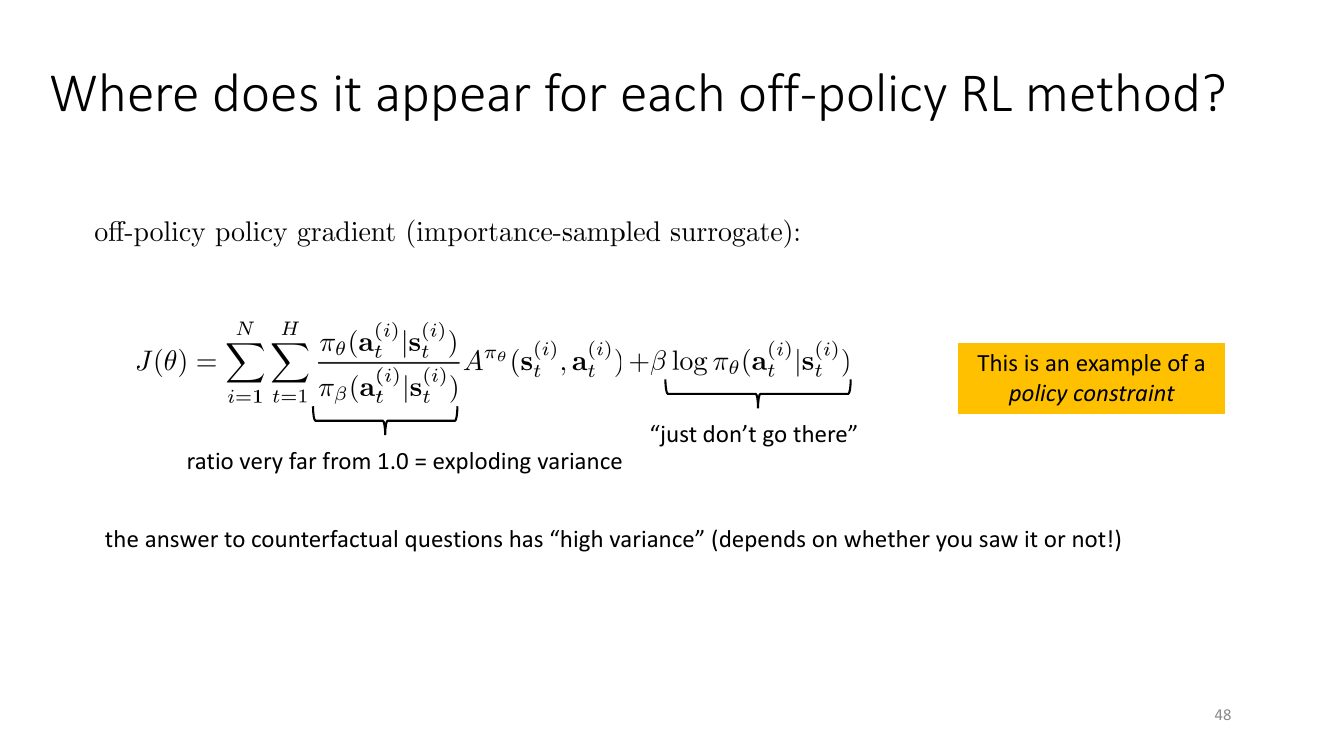
解答。model-based RL:模型误差在 $\pi_\beta$ 分布下低,在 $\pi_\theta$ 分布下不低,而策略优化又刻意去利用这个误差。off-policy policy gradient:重要性权重 $\prod_t \frac{\pi_\theta}{\pi_\beta}$ 在 $\pi_\theta$ 远离 $\pi_\beta$ 时方差指数爆炸。关键洞察:加一项 $\beta\log\pi_\theta(\mathbf{a}_t^{(i)}|\mathbf{s}_t^{(i)})$($\mathbf{a}^{(i)}$ 是数据里的动作,即行为克隆项),就是在告诉策略「别往那边走」——这已经是一个策略约束了。所以「重要性采样方差爆炸」与「策略约束」是同一个硬币的两面:要么忍受方差,要么限制偏移。
题 7.4:离线 RL 的三大原则
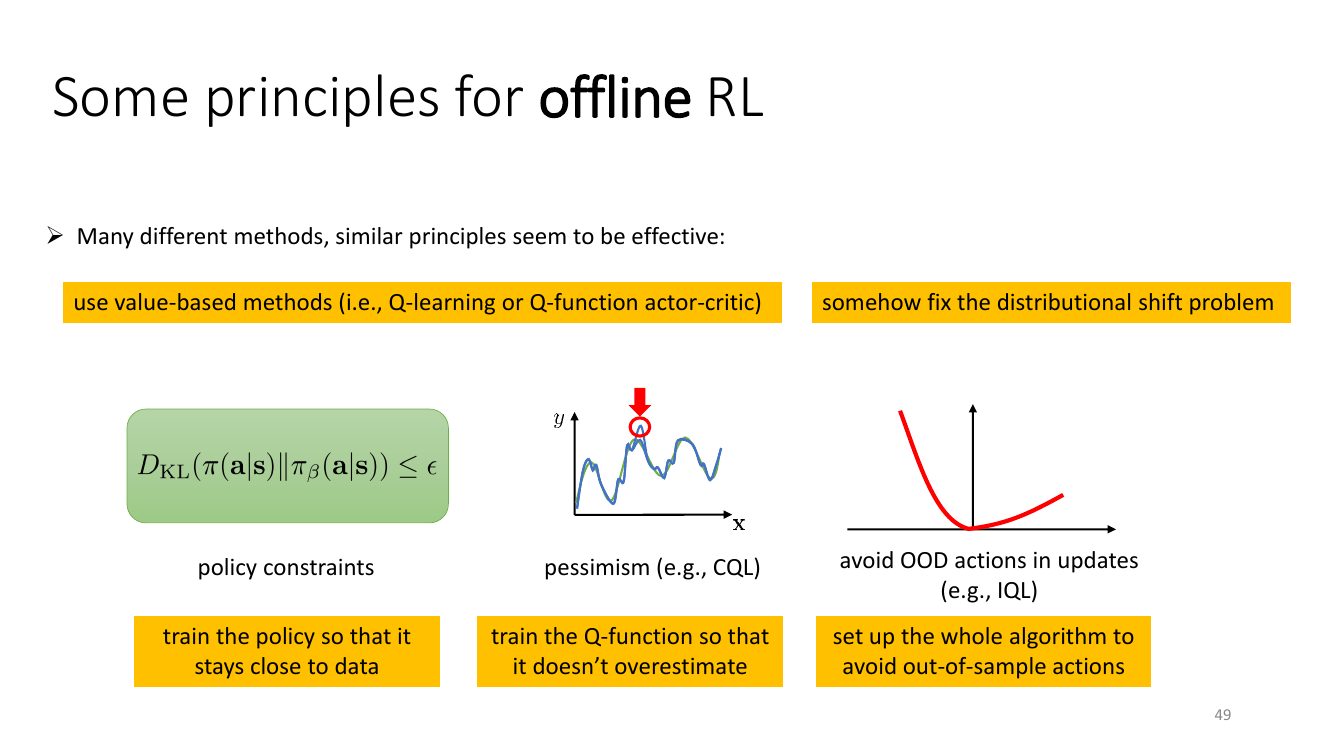
解答。为什么必须用基于值的方法?因为纯策略梯度在离线设定下需要重要性权重,方差不可控;而 Q 函数可以直接用数据里的 $(\mathbf{s},\mathbf{a},\mathbf{s}')$ 做 Bellman 备份,唯一的偏移只在目标里的 $\mathbf{a}'$ 那一处,容易定点治理。三条原则的差别在于「治哪一头」:
| 原则 | 改什么 | 代表算法 | 主要代价 |
|---|---|---|---|
| 策略约束 | actor 的目标 | BRAC, TD3+BC, AWAC | 过约束时无法超越行为策略;需要估计 $\pi_\beta$ |
| 悲观 / 保守 | critic 的目标 | CQL, MOPO | 低估过头,offline→online 时要长时间「恢复」 |
| 回避样本外动作 | 整个更新规则 | IQL | 只能做「数据内的最好」,改进幅度受限 |
8. Part 8 续 · 显式与隐式策略约束
题 8.1:两种把约束塞进 actor 目标的写法,分别对应哪个方向的 KL?
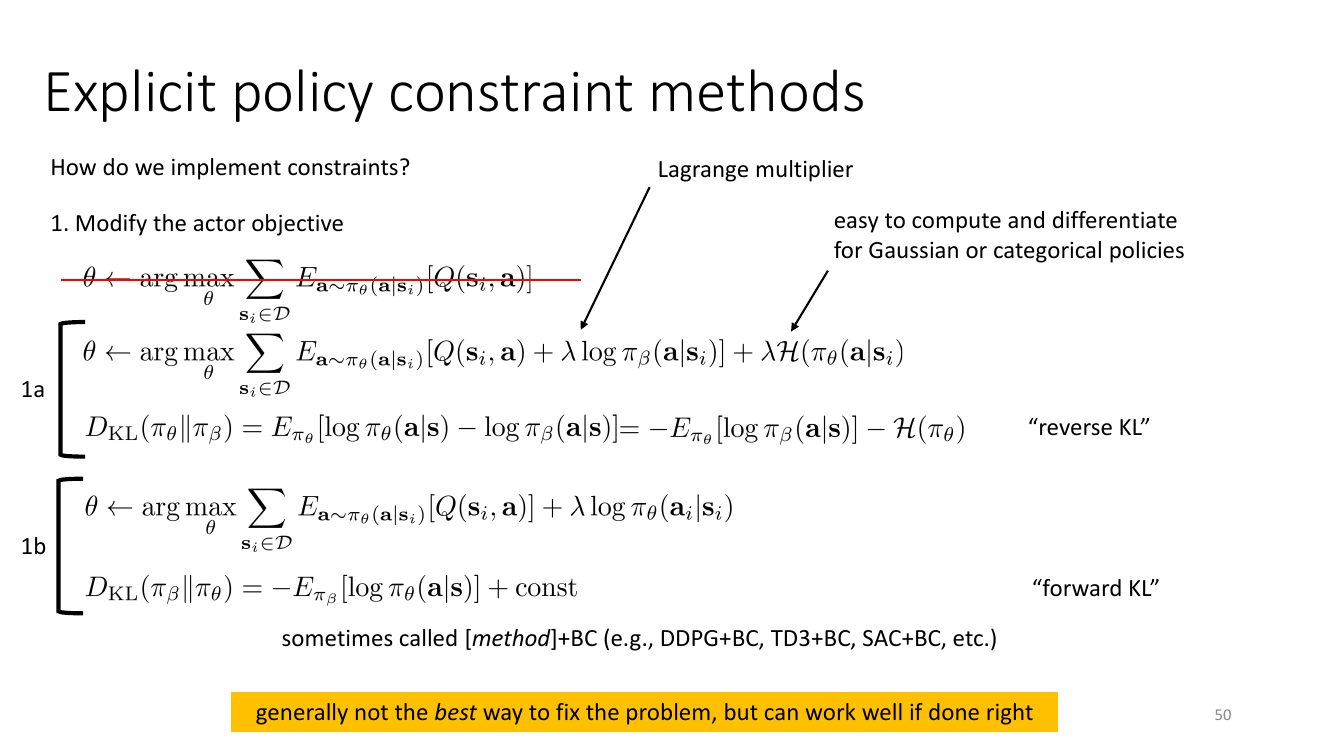
解答。先看 1a。反向 KL 展开:
$$ \KL(\pi_\theta\|\pi_\beta) = \E_{\pi_\theta}\big[\log\pi_\theta(\mathbf{a}|\mathbf{s}) - \log\pi_\beta(\mathbf{a}|\mathbf{s})\big] = -\E_{\pi_\theta}\big[\log\pi_\beta(\mathbf{a}|\mathbf{s})\big] - \mathcal{H}(\pi_\theta), $$所以在目标里加 $\lambda\E_{\pi_\theta}[\log\pi_\beta] + \lambda\mathcal{H}(\pi_\theta)$ 就等价于减去 $\lambda\KL(\pi_\theta\|\pi_\beta)$。代价:需要一个显式的行为策略模型 $\pi_\beta$(通常先用 BC 训一个),而 $\pi_\beta$ 的估计误差会直接注入约束。
再看 1b。前向 KL:$\KL(\pi_\beta\|\pi_\theta) = -\E_{\pi_\beta}[\log\pi_\theta(\mathbf{a}|\mathbf{s})] + \text{const}$,只需要数据样本就能估计——这就是加一项 $\lambda\log\pi_\theta(\mathbf{a}_i|\mathbf{s}_i)$ 的来历,也是 TD3+BC 那种「Q 项 + 行为克隆项」写法的理论依据。两者的性质差异:反向 KL 是 mode-seeking,策略会缩到行为分布的某一个峰上(对多模态数据可能只学到一种做法,但至少不会学出「峰间」的危险动作);前向 KL 是 mode-covering,策略会试图覆盖行为分布的全部支撑集,多模态数据下可能在两个峰的中间产生一个数据里根本不存在的动作。
题 8.2:BRAC 式与 AC+BC 式算法的差别在哪一行?
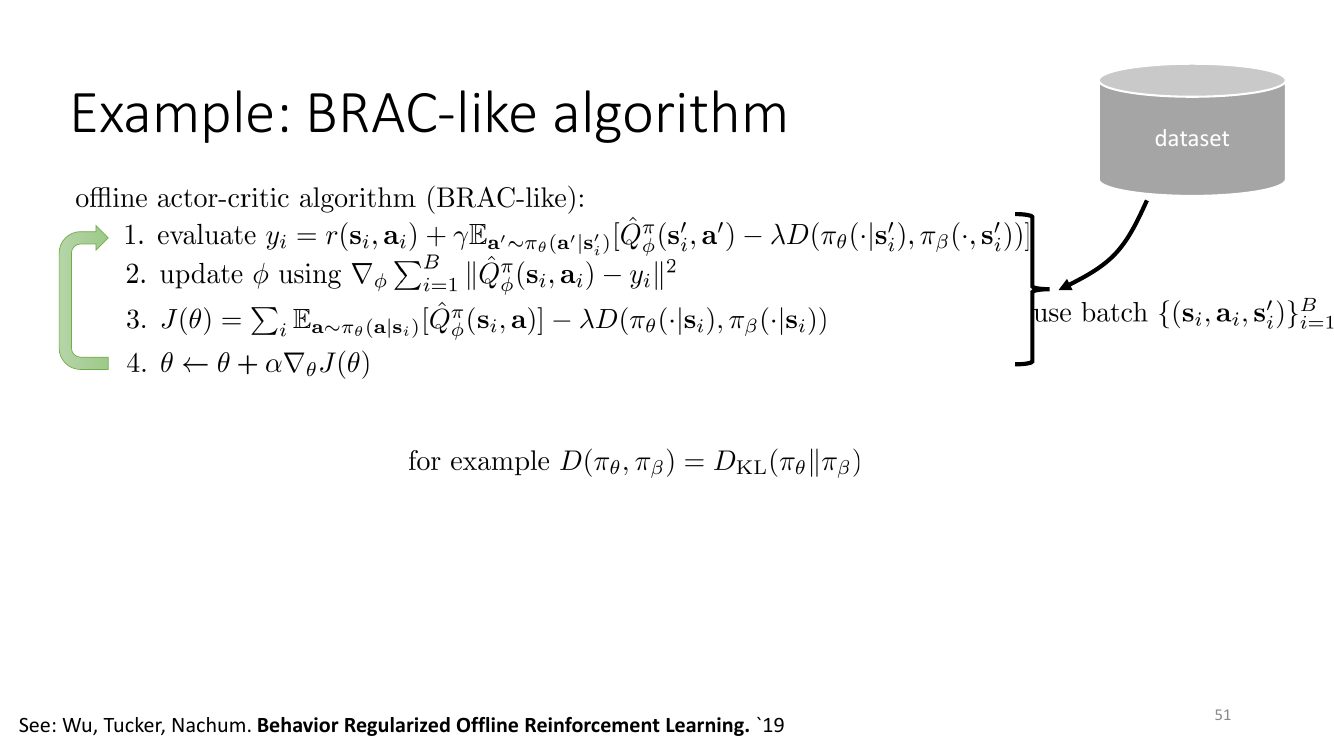
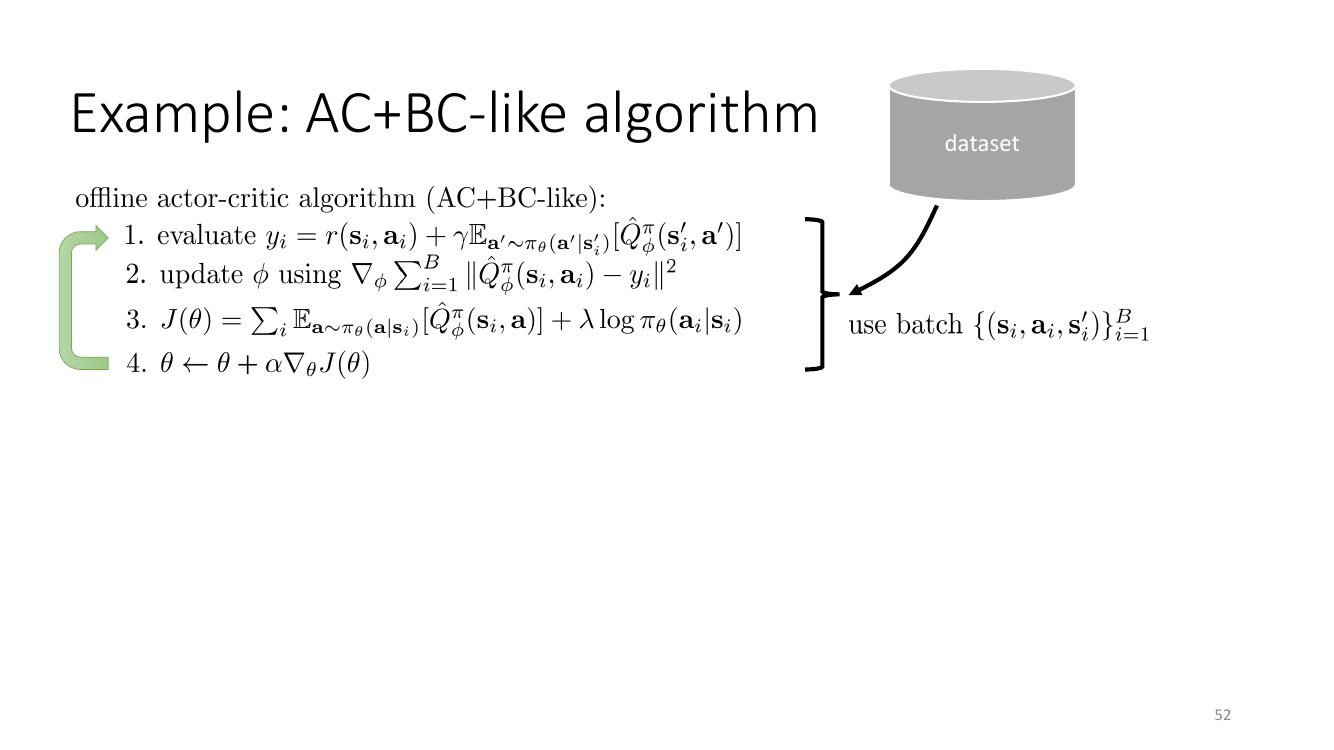
解答。差别在于惩罚是否进入 critic 的备份目标。BRAC 把 $-\lambda D$ 写进 $y_i$,等于修改了奖励函数($\tilde r = r - \lambda D$),因此 Q 学到的是「受约束 MDP」的值——惩罚会沿着时间反向传播,策略会提前避开那些将来不得不偏离数据的状态。AC+BC 只在 actor 上加 BC 项,Q 学的还是原 MDP 的值,约束只是「当下这一步别偏太远」,没有长期视野。考点:前者理论上更彻底,后者实现简单、超参更好调(TD3+BC 只有一个 $\lambda$,还常做归一化 $\lambda = \alpha/\overline{|Q|}$)。
题 8.3:隐式约束——带 KL 约束的策略改进的闭式解是什么?
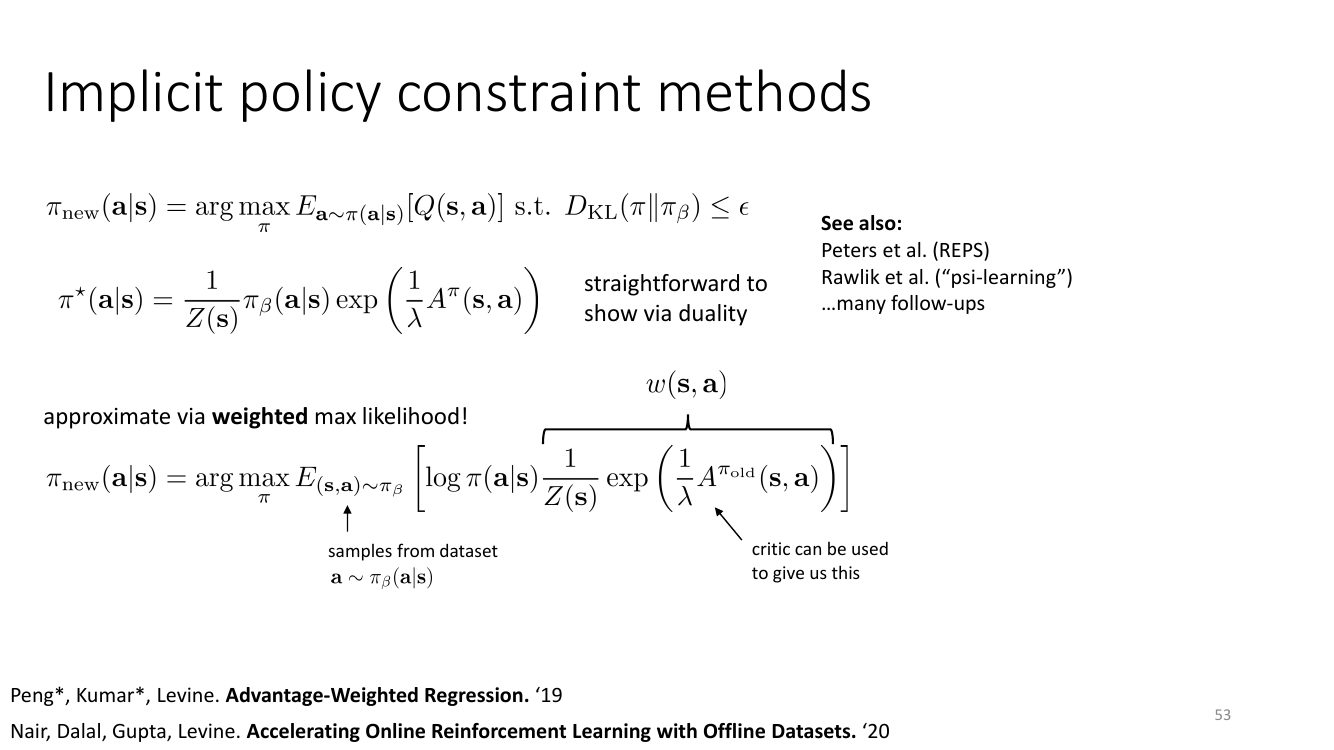
解答。用拉格朗日乘子 $\lambda$ 写出 $\E_\pi[Q] - \lambda(\KL(\pi\|\pi_\beta) - \epsilon)$,对 $\pi$ 变分求导并加上归一化约束,得到
$$ \pi^\star(\mathbf{a}|\mathbf{s}) = \frac{1}{Z(\mathbf{s})}\pi_\beta(\mathbf{a}|\mathbf{s})\exp\!\Big(\frac1\lambda A^\pi(\mathbf{s},\mathbf{a})\Big). $$「隐式」的含义:我们从来没有显式写出约束,约束是通过解的形式自动满足的——解里带着因子 $\pi_\beta$,所以数据里概率为 0 的动作,新策略的概率也是 0。实际做法是用加权行为克隆逼近它:从数据里采 $(\mathbf{s},\mathbf{a})$,用 $w = \exp(A/\lambda)$ 加权做最大似然。最大好处:整个流程只用到数据里的动作,$\pi_\beta$ 从来不需要被显式建模。
题 8.4(黄框二连):AWAC 的优点与可能的问题
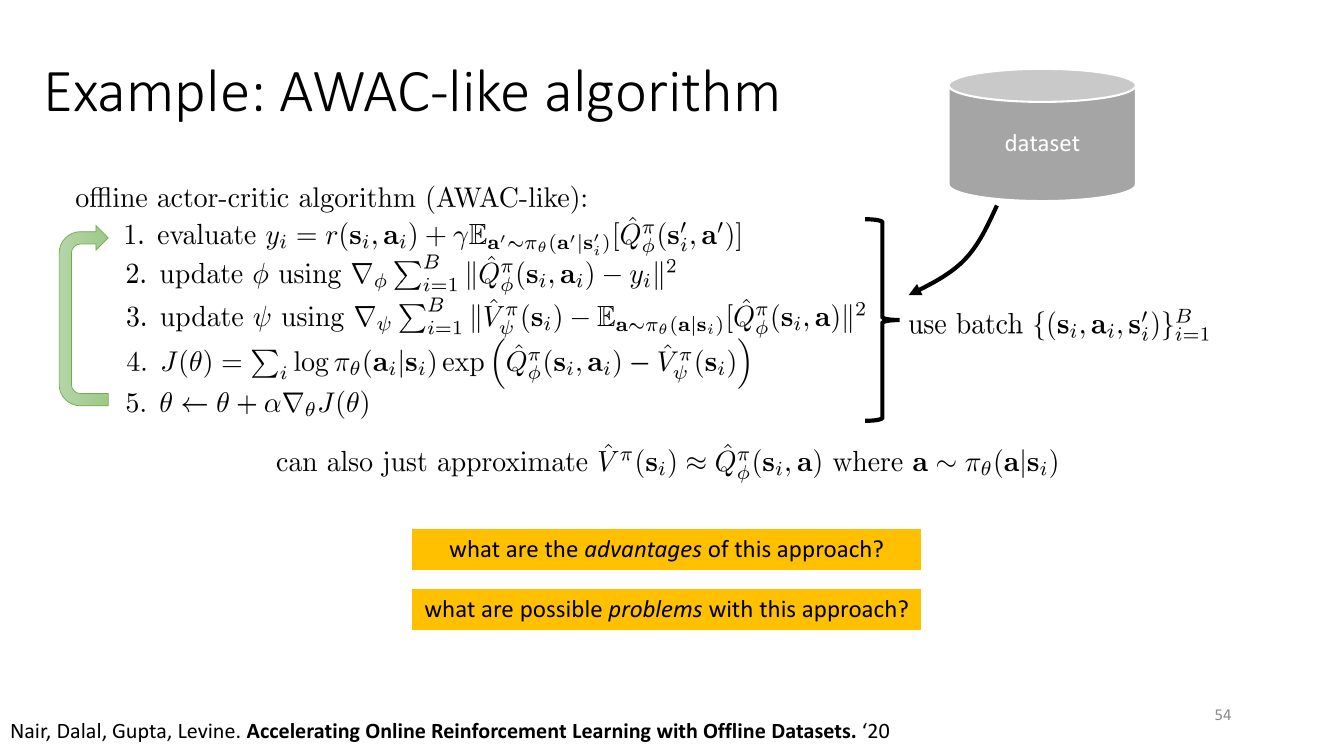
解答(优点)。(1) actor 更新只用数据里的动作 $\mathbf{a}_i$,不会在 OOD 动作上查询 $Q$;(2) 不需要显式的 $\pi_\beta$ 模型,避免了 BC 模型误差;(3) 权重 $\exp(A/\lambda)$ 恒非负,形式就是一个加权 BC,实现极简、数值稳定;(4) 天然支持 offline→online 微调(同一套目标,在线时数据分布自动更新)。
解答(问题)。(1) critic 的目标 $y_i$ 里仍然有 $\E_{\mathbf{a}'\sim\pi_\theta}$——只要 $\pi_\theta$ 偏离数据,这一处的 OOD 查询就还在,这是 AWAC 未彻底解决的漏洞(IQL 正是为堵这个洞而生);(2) 权重的指数会有极端值,需要裁剪,$\lambda$ 敏感;(3) 策略被约束在 $\pi_\beta$ 的支撑集里,如果数据质量差,改进上限低——它永远只能做「数据里的最好组合」;(4) 优势估计不准时权重就是噪声,退化成普通 BC。
9. Part 8 续 · IQL、CQL 与 offline-to-online
题 9.1:IQL 怎么做到「永远不查询 OOD 动作」?$\ell_2^\tau$ 是什么
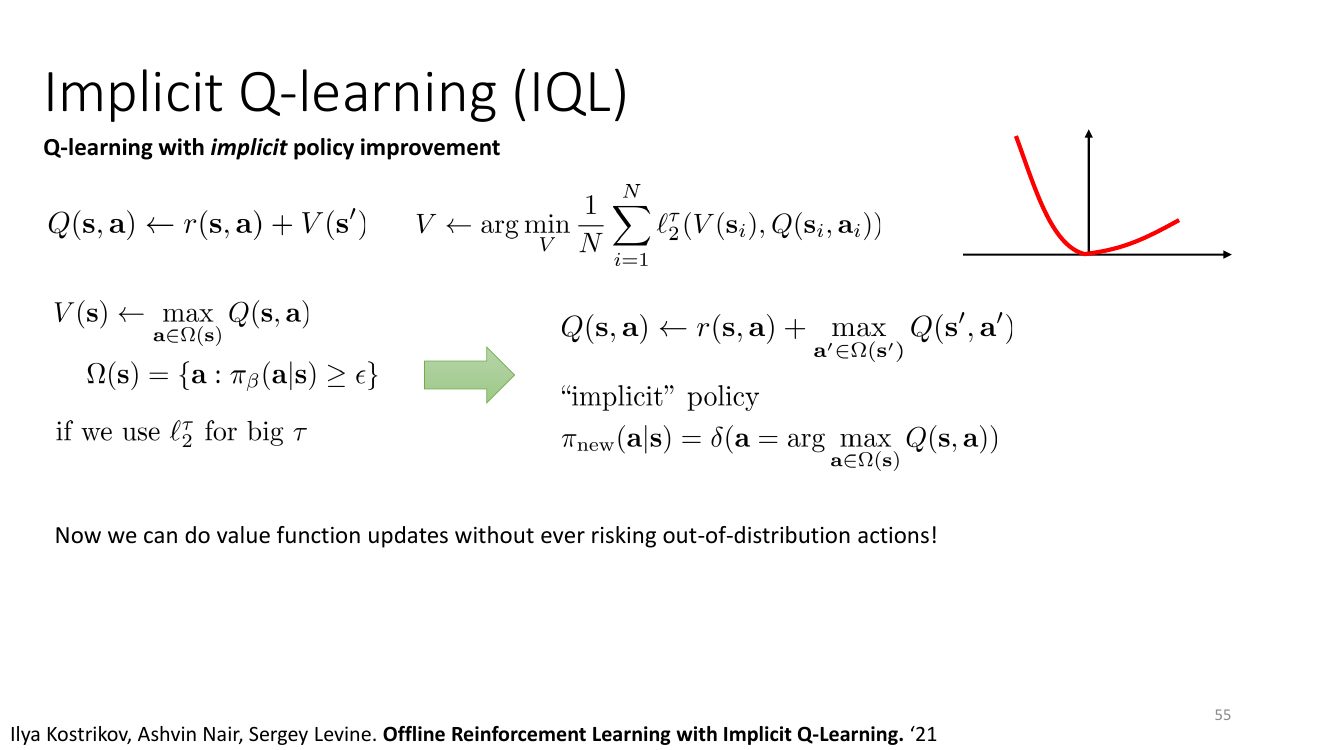
解答。普通 Q-learning 的目标是 $r + \gamma\max_{\mathbf{a}'}Q(\mathbf{s}',\mathbf{a}')$,这个 $\max$ 遍历所有动作,必然踩到 OOD。IQL 的想法是:既然数据集里对每个 $\mathbf{s}$ 只有若干个 $\mathbf{a}\sim\pi_\beta$,那么「在支撑集上取 max」就可以用对 $Q(\mathbf{s},\mathbf{a}), \mathbf{a}\sim\pi_\beta$ 的高分位数回归来实现。expectile 损失
$$ \ell_2^\tau(u) = |\tau - \mathbb{1}(u \lt 0)|\,u^2 $$在 $\tau=0.5$ 时退化成普通平方损失(回归均值),$\tau\to 1$ 时回归的是条件分布的上端——也就是 $\max_{\mathbf{a}\in\Omega(\mathbf{s})}Q(\mathbf{s},\mathbf{a})$ 的近似。
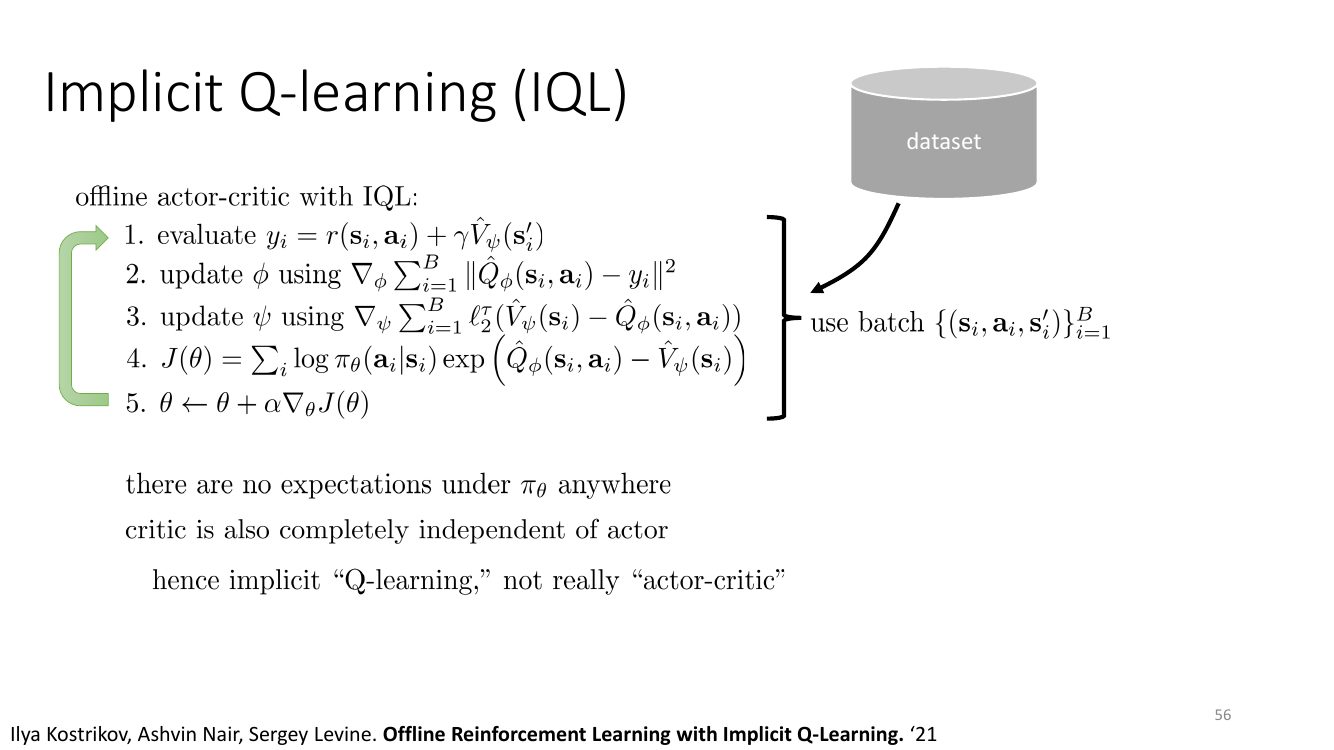
关键考点:IQL 中 critic 的训练完全不依赖 actor——可以先把 $Q,V$ 训到收敛,最后再抽取策略。这既是它稳定的原因,也是它的局限:策略改进只发生在「数据支撑集内」,$\tau$ 越大越激进(越接近真 max,也越接近 OOD 风险),$\tau$ 越小越保守($\tau=0.5$ 时退化为策略评估,等于纯 BC)。
题 9.2:CQL 的目标函数三项各起什么作用?它保证了什么、没保证什么
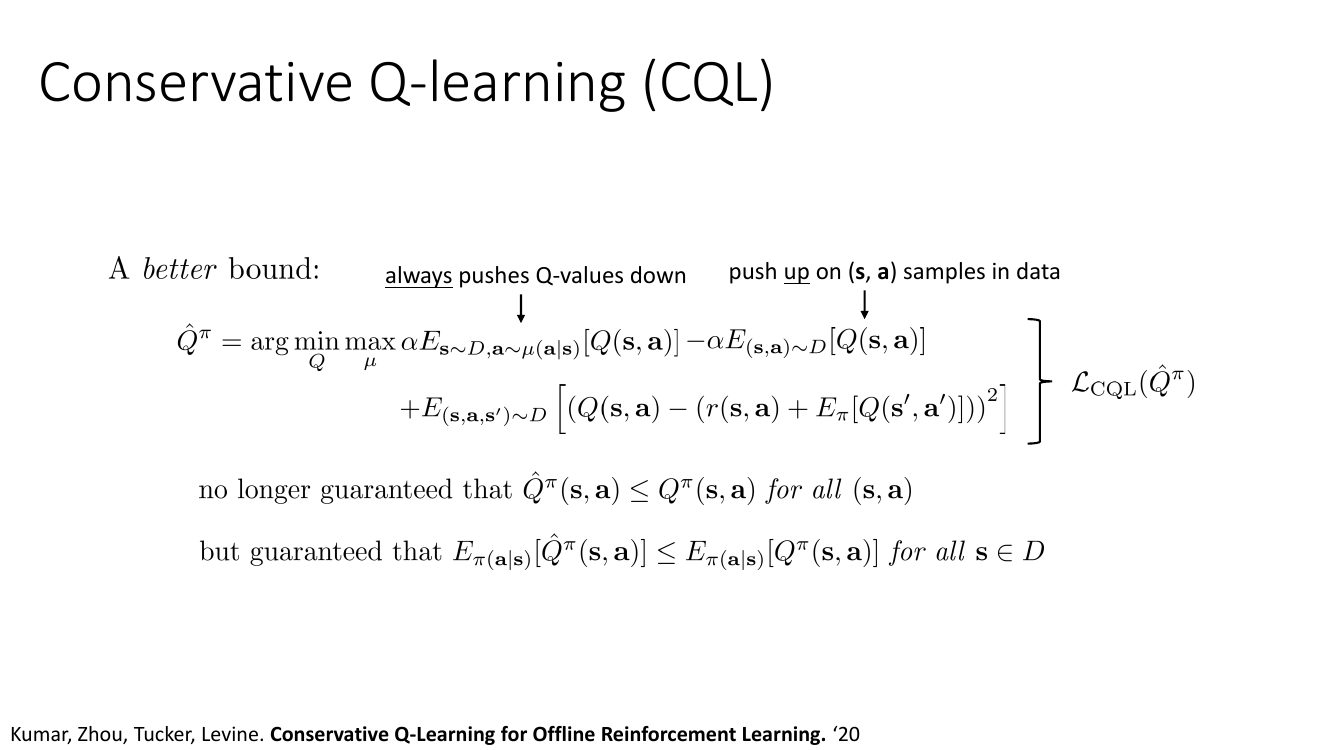
解答。三项分别是:压低项——对最坏情况的动作分布 $\mu$(内层 max 会把 $\mu$ 推向 $Q$ 最大的动作,实际实现里 $\mu\propto\exp Q$,于是这一项化为 $\log\sum_\mathbf{a}\exp Q(\mathbf{s},\mathbf{a})$)压低 $Q$;抬高项——把数据里真实出现过的 $(\mathbf{s},\mathbf{a})$ 的 $Q$ 抬回来;Bellman 项——普通的 TD 误差。前两项合起来的效果是「在数据分布之外压、在数据分布之内不动」,正好抵消了 max 造成的乐观偏差。
保证了什么:只加第一项时可以证明逐点下界 $\hat Q \le Q^\pi$,但那太保守;加上第二项(「a better bound」)后,逐点下界不再成立,取而代之的是期望意义的下界:对数据中出现的每个状态,$\E_{\pi}[\hat Q] \le \E_\pi[Q^\pi]$。这已经足够——策略改进只关心动作之间的相对大小和状态值的期望。$\alpha$ 控制保守程度,是 CQL 最关键的超参。
题 9.3:offline→online 微调为什么会掉性能?
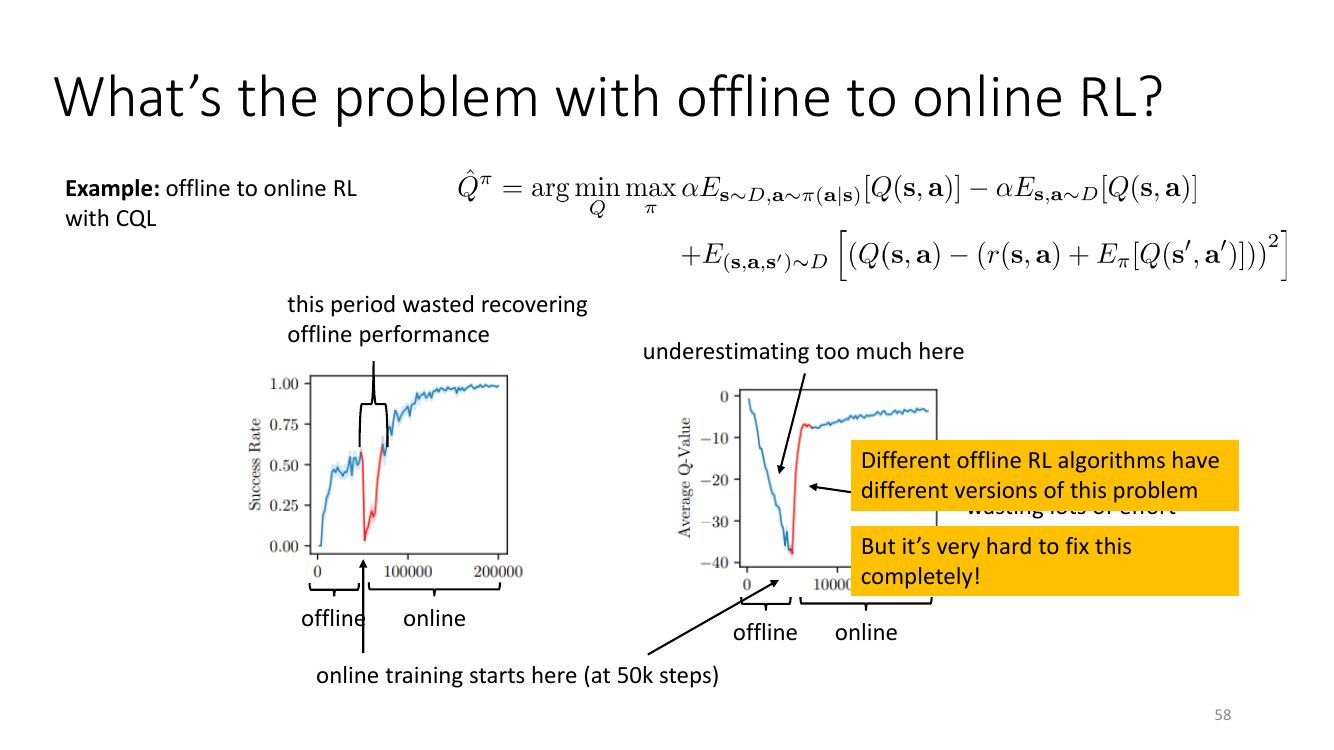
解答。保守训练让 Q 值被系统性压低(图中压到 $-40$,而真值接近 0)。切到在线后,新收集的数据不再需要那么强的保守约束,Q 函数必须重新校准整个值的尺度;在校准完成之前,$\argmax_\mathbf{a} Q$ 给出的动作是混乱的,策略性能因此崩塌。等价说法:离线阶段学到的 Q 只在相对排序上有意义,而在线 TD 更新需要它在绝对数值上正确。这个「重新校准期」就是浪费掉的样本。
题 9.4:IDQL 与 FQL——好在哪、坏在哪
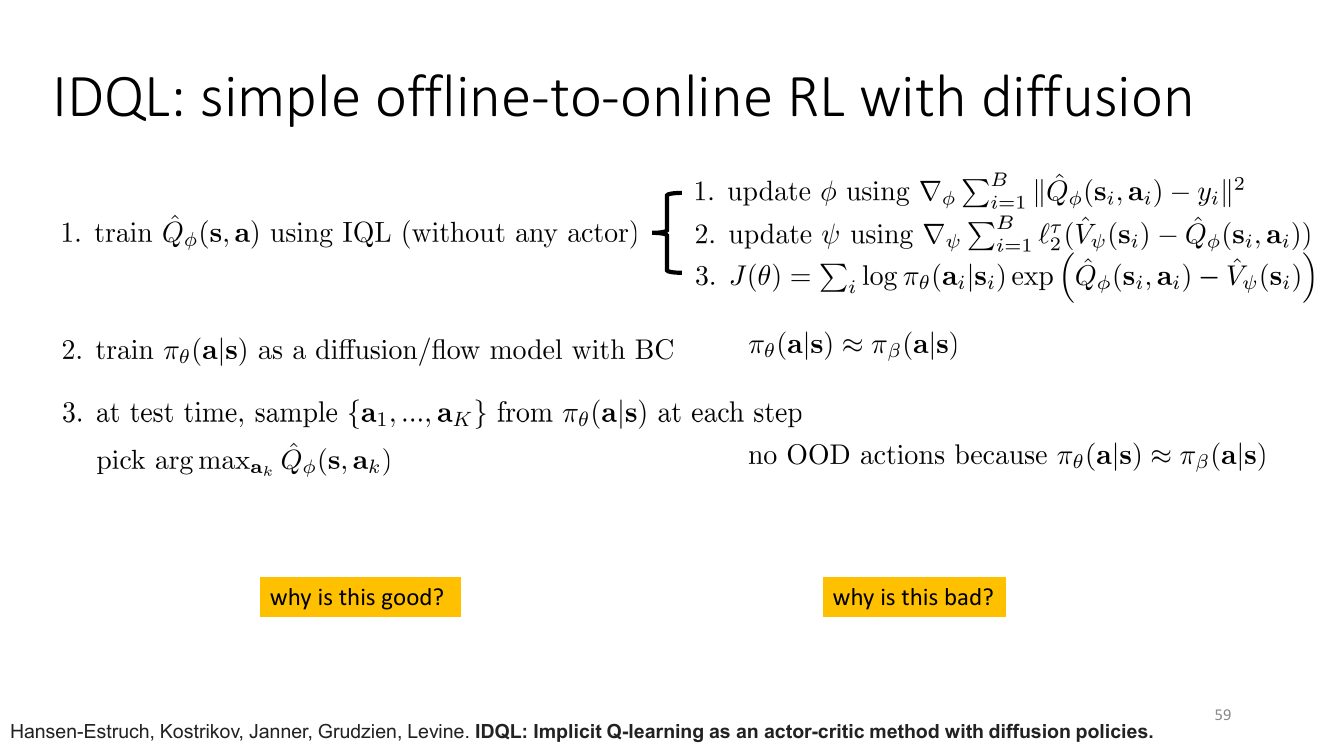
解答。好:策略改进完全通过「采样 + 重排序」实现,不需要任何梯度穿过 $Q$,因此不存在「actor 去攻击 critic」的问题;扩散模型能精确拟合多模态的行为分布(普通高斯策略做不到);离线与在线用同一套机制,切换时没有目标函数的突变,缓解了题 9.3 的塌陷。坏:测试时要采 $K$ 次扩散(每次几十步去噪),推理开销巨大;改进幅度受限于 $K$——只能在行为策略采出的 $K$ 个动作里挑最好的,$K$ 有限时离真正的 $\argmax$ 还很远;而且 $K$ 越大,挑到 $Q$ 高估点的概率也越高(重排序本身就是一次弱化的 max)。
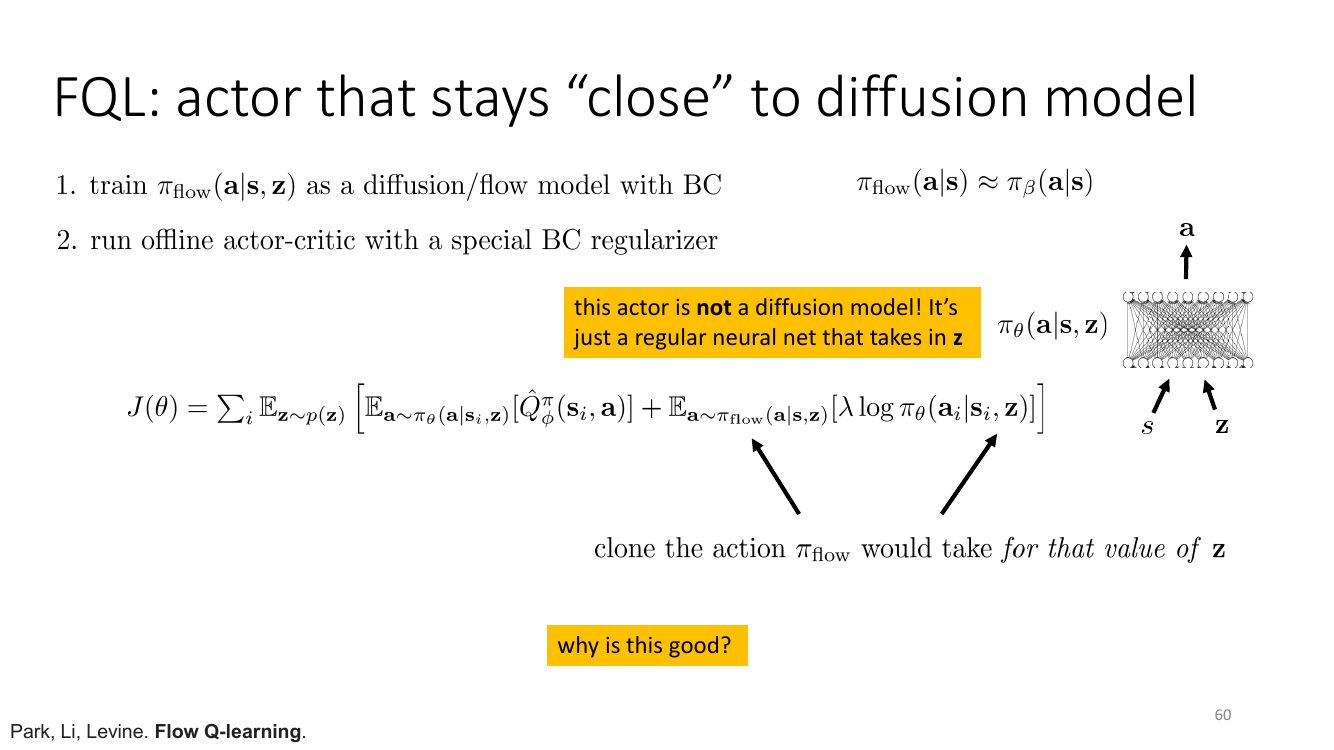
解答(why is this good?)。FQL 把「表达力」和「推理速度」解耦:流模型负责刻画复杂的多模态行为分布,但只在训练时用;actor 是一个一步网络 $\pi_\theta(\mathbf{a}|\mathbf{s},\mathbf{z})$,通过匹配「给定同一个噪声 $\mathbf{z}$ 时流模型的输出」被蒸馏成流模型的单步等价物,同时又被 $Q$ 项推向高价值动作。于是推理只需一次前向传播,且约束是逐 $\mathbf{z}$ 对齐的——比全局的 KL 约束更精细,不会把多模态压成单模态。
题 9.5:MOPO 把不确定性变成什么?
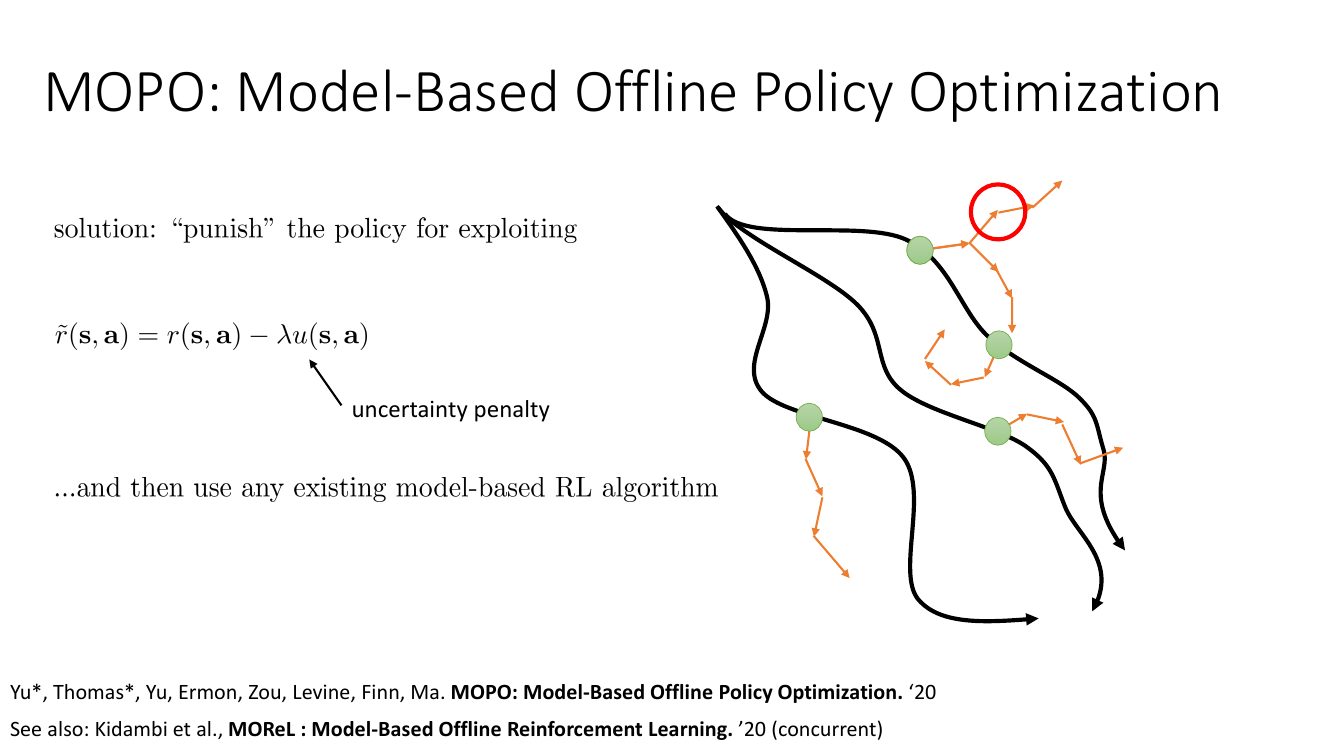
解答。MOPO 把「悲观主义」实现在奖励层面:$u(\mathbf{s},\mathbf{a})$ 一般取集成模型预测的最大标准差。理论上这给出真实回报的一个下界(离数据越远,惩罚越大,因此策略不会被幻觉吸引)。它与 CQL 的对偶关系值得记:CQL 在 Q 上做悲观,MOPO 在 $r$ 上做悲观;后者的好处是可以复用整套 model-based 机器,坏处是 $u$ 的标定($\lambda$)极难,且神经网络集成的方差并不是可靠的 epistemic 不确定性估计。MOReL 是同期的另一个版本,用「不确定就转到吸收态并给最小奖励」的硬阈值。
10. Part 9 · 探索:从 UCB 到伪计数与 RND
题 10.1:UCB 怎么搬到 MDP 上?
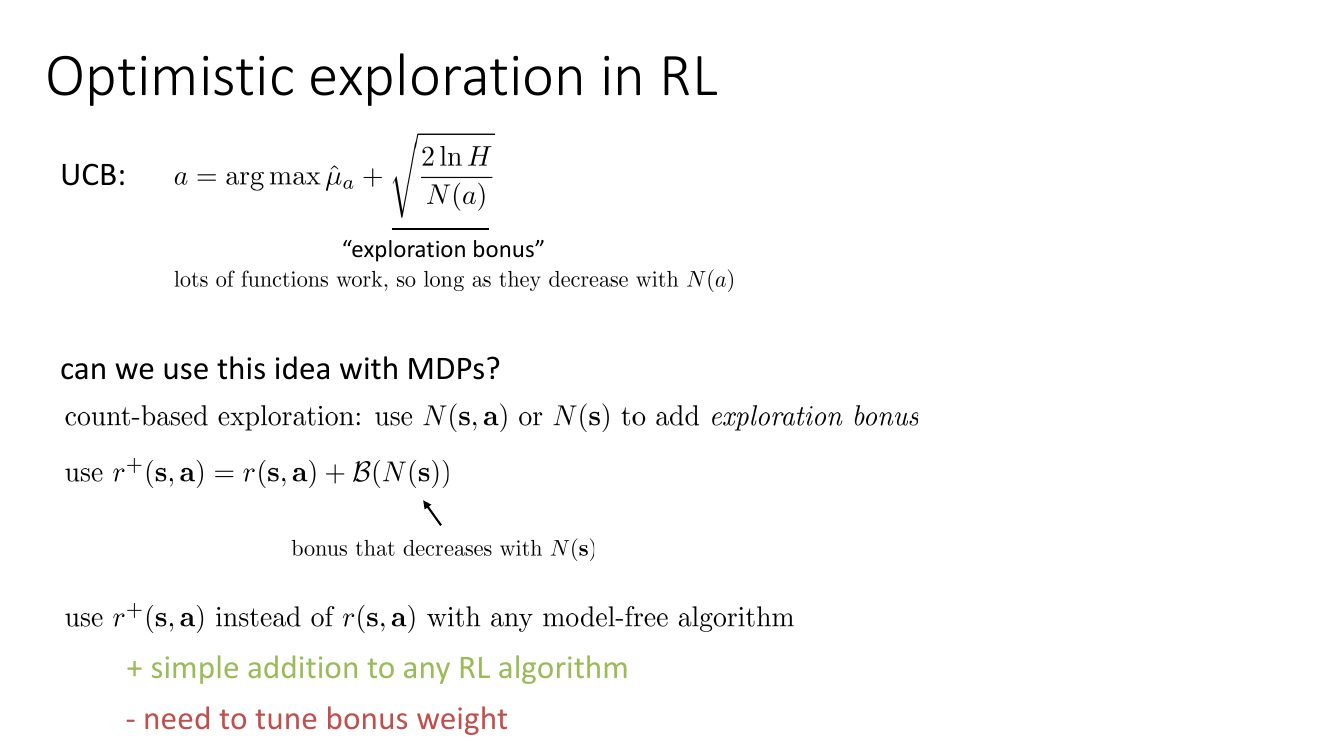
解答。UCB 的思想是「在不确定性面前保持乐观」:置信上界随访问次数下降,没试过的动作有很高的乐观加成,一旦试够了加成就消失。搬到 MDP 上只需把「臂的计数」换成「状态(或状态-动作)的计数」,并把 bonus 写进奖励:
$$ r^+(\mathbf{s},\mathbf{a}) = r(\mathbf{s},\mathbf{a}) + \mathcal{B}\big(N(\mathbf{s})\big),\qquad \mathcal{B} \text{ 随 } N \text{ 递减,例如 } \mathcal{B}(N)=\sqrt{\tfrac{2\ln n}{N}} \text{ 或 } \tfrac{1}{\sqrt N}. $$题 10.2:连续 / 高维状态里根本没有重复状态,怎么「计数」?
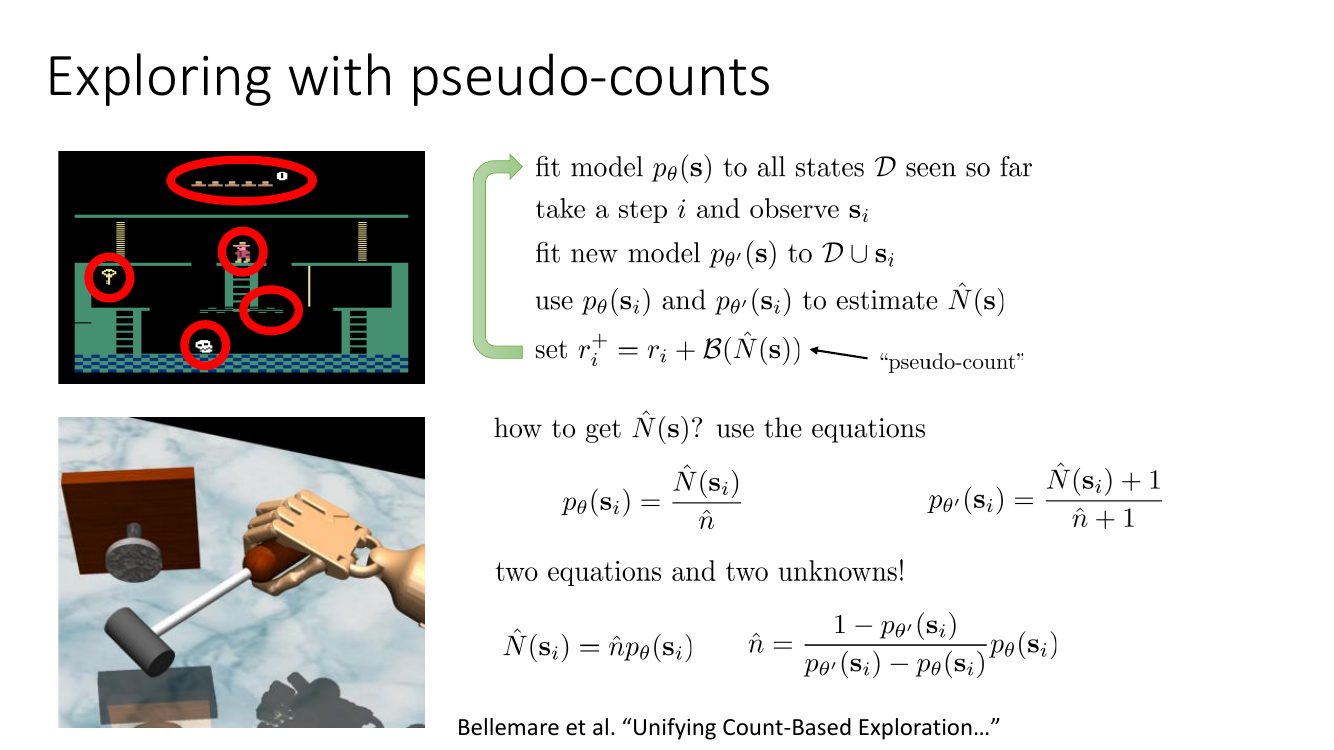
解答。关键技巧:不直接数,而是从密度模型的更新量反推计数。假设密度模型表现得像一个经验频率估计:
$$ p_\theta(\mathbf{s}_i) = \frac{\hat N(\mathbf{s}_i)}{\hat n}, \qquad p_{\theta'}(\mathbf{s}_i) = \frac{\hat N(\mathbf{s}_i) + 1}{\hat n + 1}. $$两个方程两个未知数($\hat N$ 和总数 $\hat n$),解得
$$ \hat N(\mathbf{s}_i) = \hat n\, p_\theta(\mathbf{s}_i), \qquad \hat n = \frac{1 - p_{\theta'}(\mathbf{s}_i)}{p_{\theta'}(\mathbf{s}_i) - p_\theta(\mathbf{s}_i)}\,p_\theta(\mathbf{s}_i). $$直觉:如果加一个样本后密度涨了很多($p_{\theta'} \gg p_\theta$),说明这个状态很新鲜,伪计数小、bonus 大;如果几乎没变,说明模型早就见过很多类似状态。易错点:这里的密度模型不需要生成好看的样本,只需要给出相对合理的密度值;实践中用 CTS、PixelCNN 或简单的哈希都行。
题 10.3:RND 用预测误差估计新颖度——目标函数该选什么?
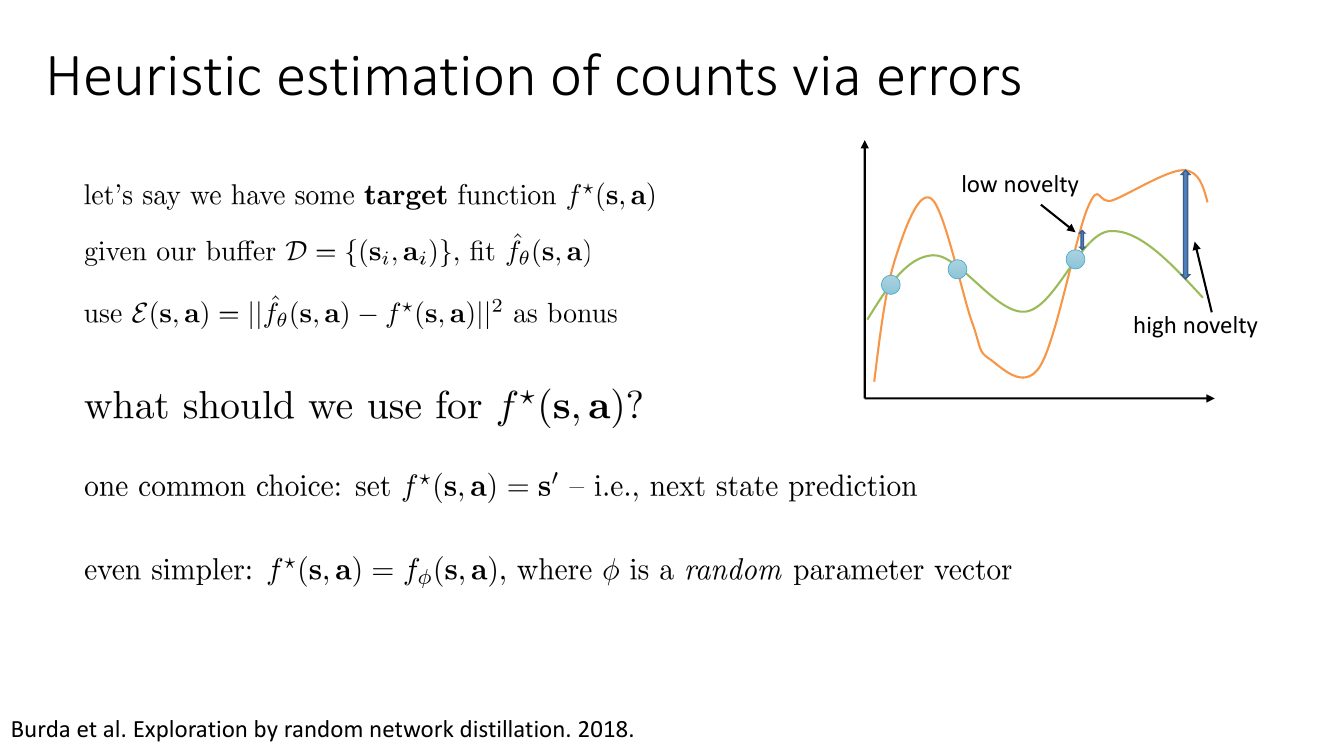
解答。「见得多的地方拟合得好,没见过的地方误差大」——预测误差本身就是新颖度的代理。$f^\star = \mathbf{s}'$ 的问题是:环境的随机性(aleatoric 噪声)会让误差永远降不下去,智能体会被「电视机噪声」永久吸引(noisy-TV problem)。用随机固定网络 $f_\phi$ 做目标就绕开了这个陷阱:目标是 $(\mathbf{s},\mathbf{a})$ 的一个确定性函数,不含任何环境噪声,因此误差纯粹反映「这个输入见过没有」,这就是 random network distillation(RND)。考点:RND 的 bonus 只依赖状态覆盖,不依赖环境是否随机——这是它相比前向动力学预测误差的决定性优势。
11. Part 10 · RL 理论:收缩性、采样误差与逼近误差
题 11.1:证明 Bellman 最优算子是 $\infty$-范数下的 $\gamma$-收缩
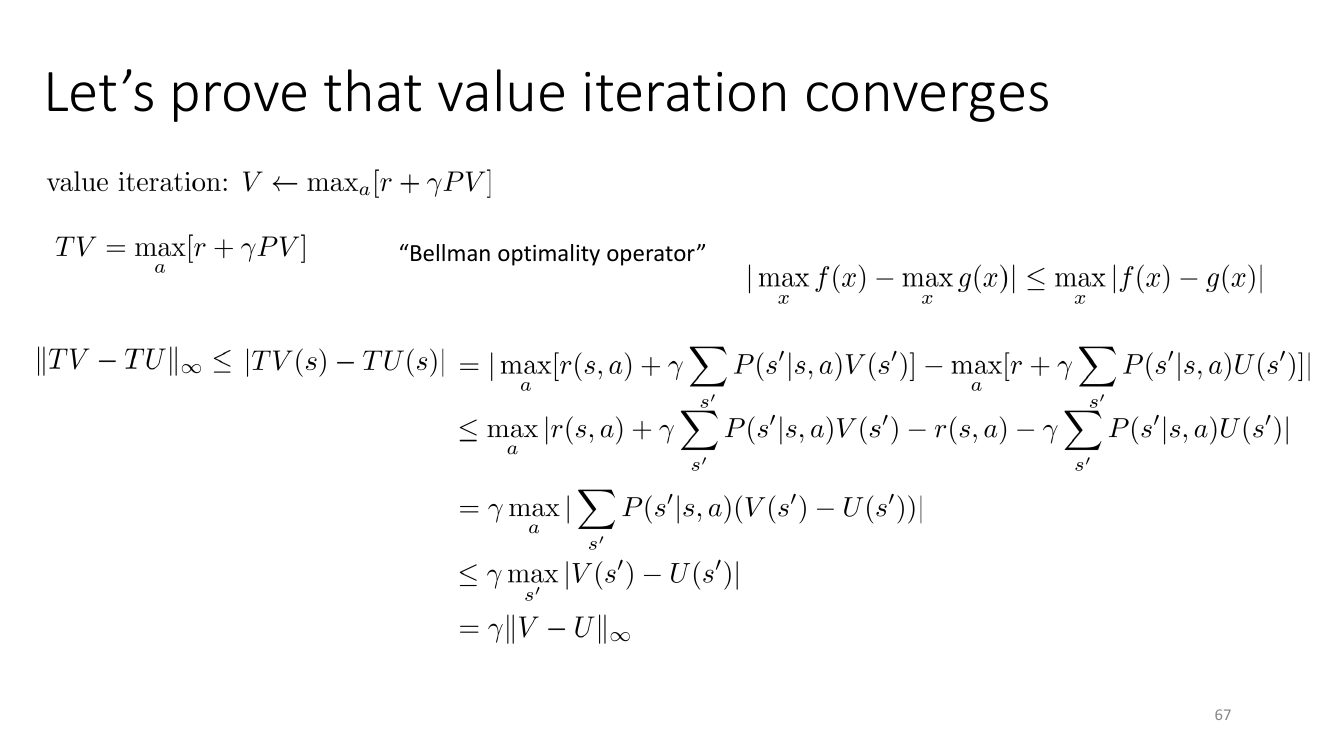
解答。设 $TV = \max_a[r + \gamma PV]$。取使 $|TV(s) - TU(s)|$ 最大的状态 $s$:
$$ \|TV - TU\|_\infty \le \Big|\max_a\big[r(s,a) + \gamma\sum_{s'}P(s'|s,a)V(s')\big] - \max_a\big[r(s,a) + \gamma\sum_{s'}P(s'|s,a)U(s')\big]\Big| $$ $$ \le \max_a\Big|r(s,a) + \gamma\sum_{s'}P(s'|s,a)V(s') - r(s,a) - \gamma\sum_{s'}P(s'|s,a)U(s')\Big| = \gamma\max_a\Big|\sum_{s'}P(s'|s,a)\big(V(s')-U(s')\big)\Big| $$ $$ \le \gamma\max_{s'}\big|V(s') - U(s')\big| = \gamma\|V - U\|_\infty . $$三个不等号分别用到:max 的差不超过差的 max;$r$ 相消;概率加权平均不超过逐点最大值($\sum_{s'}P(s'|s,a) = 1$)。由 Banach 不动点定理,$T$ 有唯一不动点 $V^\star$,且 $\|V_k - V^\star\|_\infty \le \gamma^k\|V_0-V^\star\|_\infty$——几何收敛。$\gamma=0.9$ 时每次迭代把误差压到 90%,要压到 1% 需要约 $\log 0.01/\log 0.9 \approx 44$ 次迭代;$\gamma=0.99$ 则需要约 458 次。这就是「有效视界 $\frac{1}{1-\gamma}$」的来历。
题 11.2:oracle exploration 下,用估计的 $\hat P$ 学到的 $\hat Q^\pi$ 有多准?
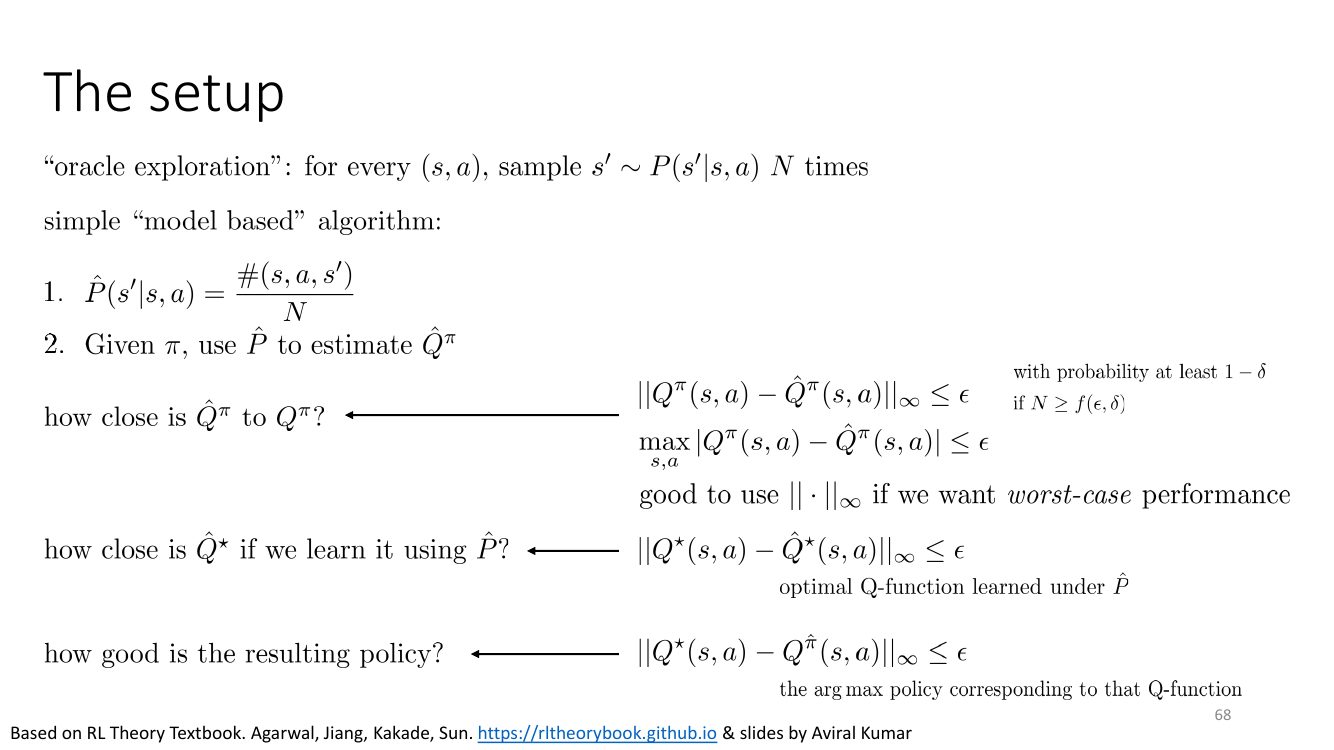
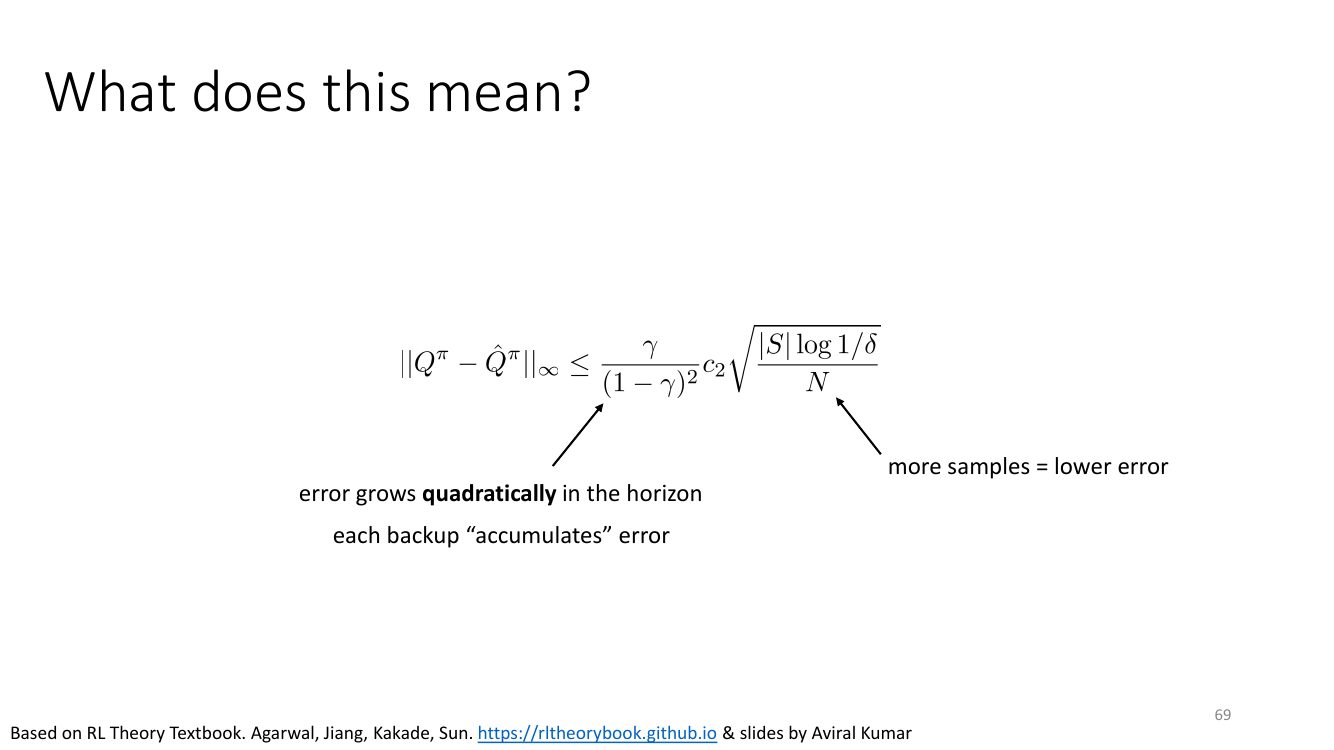
解答。结论是
$$ \|Q^\pi - \hat Q^\pi\|_\infty \le \frac{\gamma}{(1-\gamma)^2}\,c_2\sqrt{\frac{|S|\log(1/\delta)}{N}} . $$两个因子分别解读:$\sqrt{|S|\log(1/\delta)/N}$ 是标准的集中不等式(Hoeffding)给出的单步转移估计误差,样本量 $N$ 翻 4 倍误差减半;$\frac{\gamma}{(1-\gamma)^2}$ 是误差放大因子——一个 $\frac{1}{1-\gamma}$ 来自单条轨迹上 $\frac{1}{1-\gamma}$ 次备份的累积,另一个 $\frac{1}{1-\gamma}$ 来自 $Q$ 值本身的量级 $O(R_{\max}/(1-\gamma))$。数值感受:$\gamma=0.99$ 时 $\frac{\gamma}{(1-\gamma)^2}\approx 9900$,也就是说单步 1% 的转移估计误差可以放大成 99 的值误差。这就是长视界 RL 难的定量原因。
题 11.3:从 $\|Q^\pi-\hat Q^\pi\|_\infty\le\epsilon$ 推出策略的次优性界
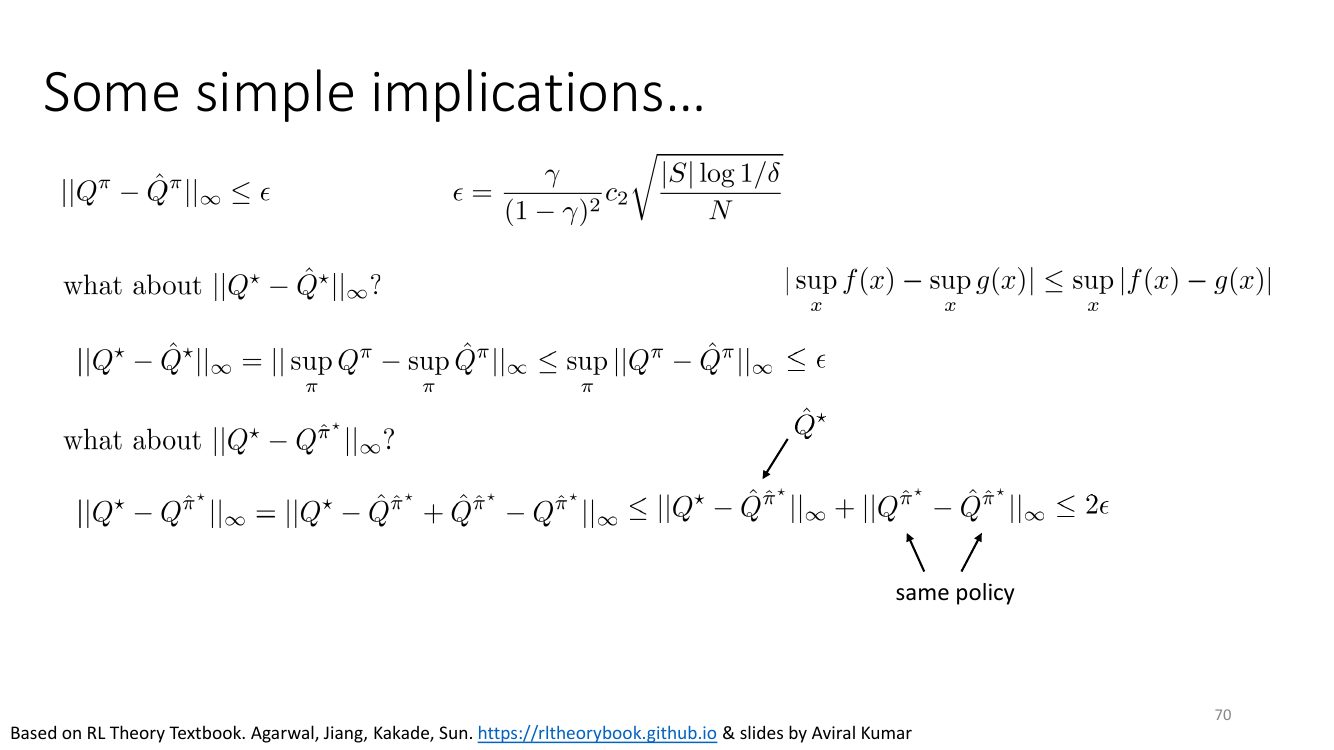
解答。技巧是「加一项减一项 + 三角不等式」。第一项 $\hat Q^{\hat\pi^\star} = \hat Q^\star$(因为 $\hat\pi^\star$ 就是 $\hat P$ 下的最优策略),所以由第一步得 $\le\epsilon$;第二项是同一个策略 $\hat\pi^\star$ 在真实模型与估计模型下的值之差,由题 11.2 的结论也 $\le\epsilon$。合计 $\le 2\epsilon$。考点:这个「2」很重要——它说明用估计模型算出的最优策略在真实环境里的次优性只比值估计误差差一个常数倍,而不是指数放大。
题 11.4:fitted Q-iteration 的误差从哪来?最终误差界是什么?
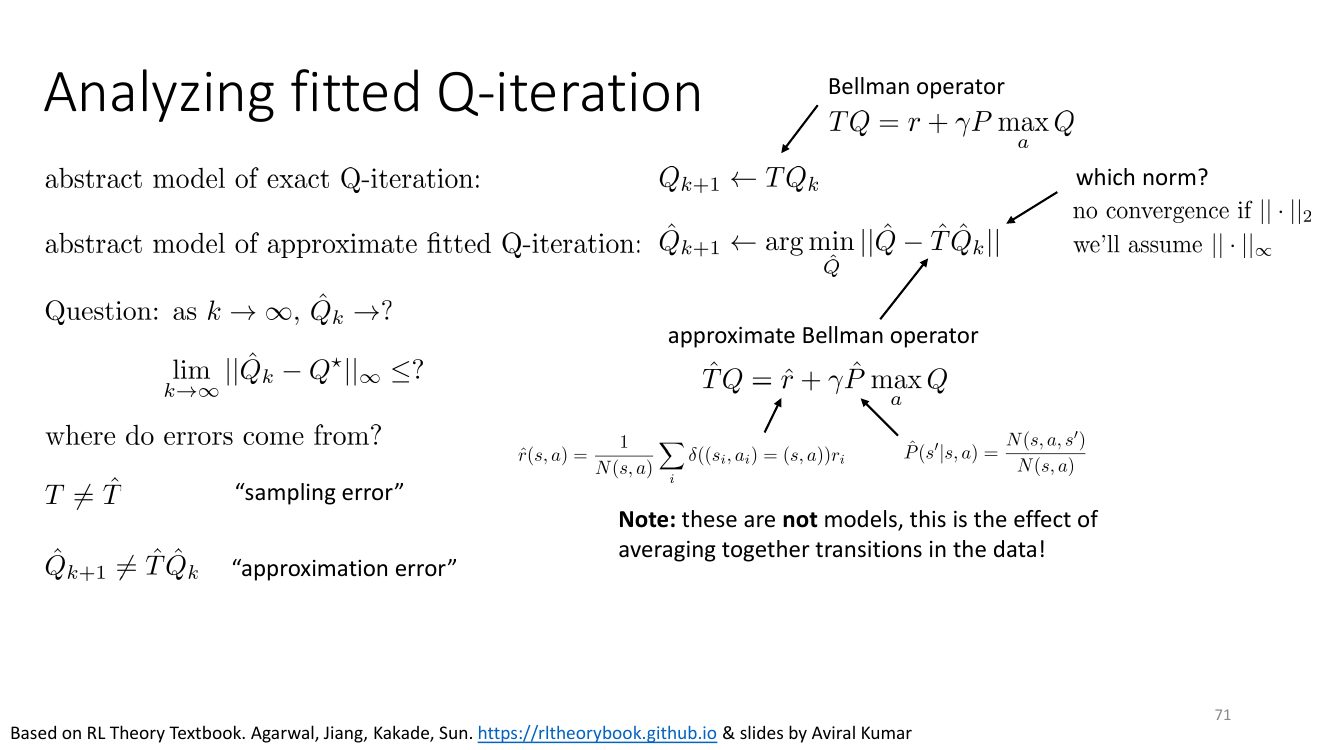
解答。误差有且仅有两个来源:采样误差——我们只有有限样本,用经验平均 $\hat T$ 代替真算子 $T$;逼近误差——神经网络容量有限 + 优化不彻底,回归的结果 $\hat Q_{k+1}$ 并不精确等于 $\hat T\hat Q_k$。特别要注意 slide 上那句加粗的话:即使算法叫「model-free」,只要你用数据的经验分布做备份,效果上就等价于在一个经验模型上做精确备份——这是理解「model-free 与 model-based 的误差同源」的关键。
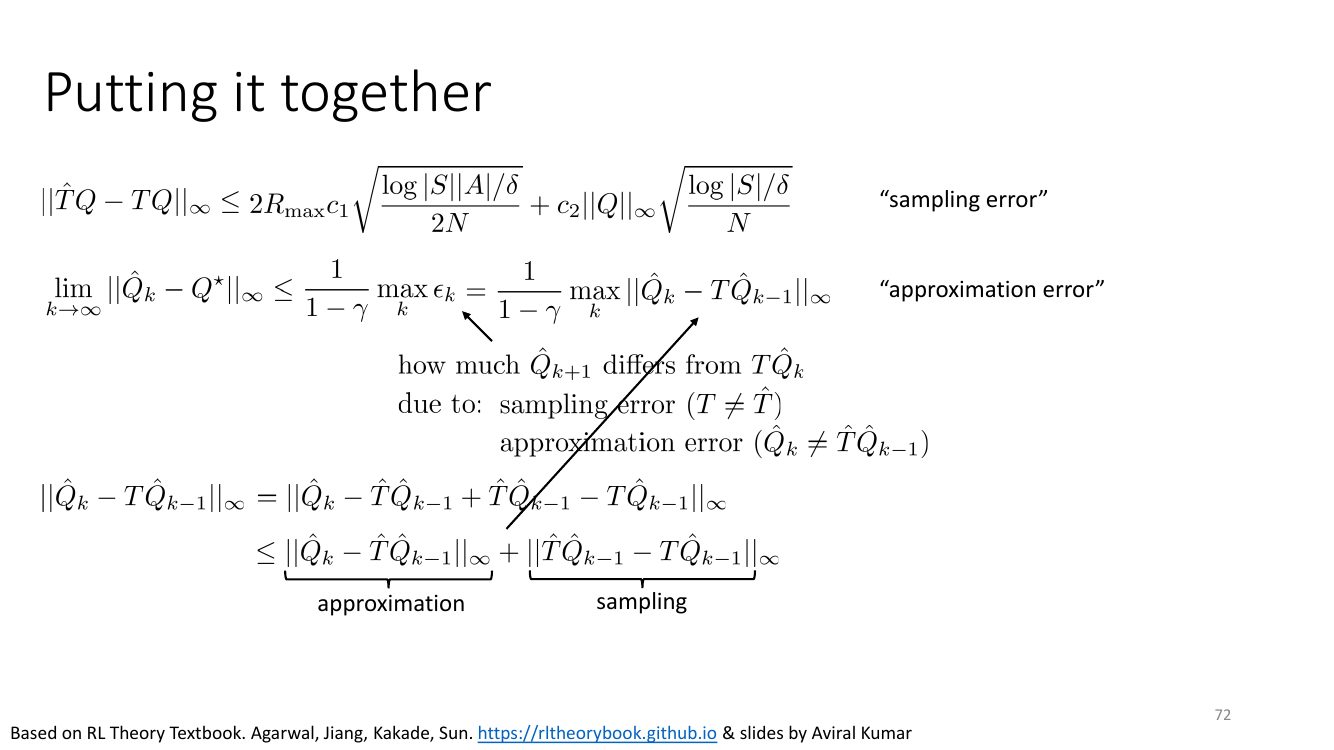
怎么读这个界。每一轮引入的误差 $\epsilon_k$ 不会无限累积(因为 $T$ 是收缩,旧误差按 $\gamma$ 衰减),但会被稳态放大 $\frac{1}{1-\gamma}$ 倍:几何级数 $\sum_k\gamma^k\epsilon = \frac{\epsilon}{1-\gamma}$。这是 fitted Q-iteration 最重要的定量结论。
题 11.5:这一切意味着什么?$\infty$-范数假设的问题在哪
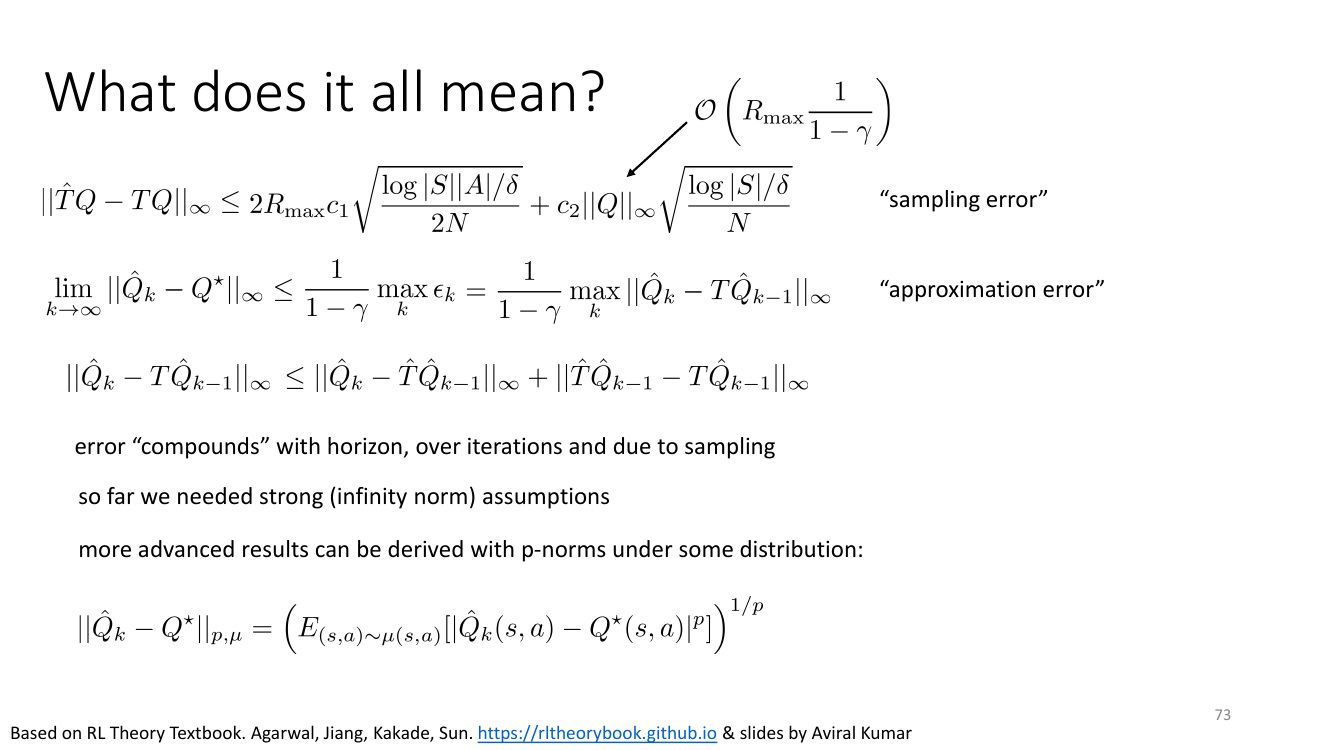
解答。三层含义:(1) 误差在三个维度上复合——单步 → 一轮备份($\times\frac{1}{1-\gamma}$)→ 多轮迭代(再 $\times\frac{1}{1-\gamma}$),加上采样误差本身就带 $\|Q\|_\infty = O(R_{\max}/(1-\gamma))$,于是总量级来到 $O(R_{\max}/(1-\gamma)^2)$ 甚至更高。(2) $\infty$-范数假设非常强:它要求逼近误差在每一个状态-动作对上都小,而深度网络只能保证在训练分布上平均误差小。(3) 因此现代理论转向在某个分布 $\mu$ 下的 $p$-范数,代价是要引入「集中系数」(concentrability coefficient)来刻画训练分布与目标分布的比值——这又回到了分布偏移,正好和 §7 的离线 RL 对上。
本讲小结
一页速查:七个板块的一句话核心
| 板块 | 一句话核心 | 最常考的式子 |
|---|---|---|
| Q-learning | Q 的备份条件在执行过的动作上,因此天然 off-policy;但 max 带来过估计,$\Pi\mathcal{B}$ 不是收缩 | $y = r+\gamma\max_{\mathbf{a}'}Q_{\bar\theta}(\mathbf{s}',\mathbf{a}')$ |
| 变分推断 | $\log p(x) = \KL(q\|p(z|x)) + \mathcal{L}(p,q)$;重参数化让梯度穿过采样 | $\mathcal{L} = \E_q[\log p(x|z)] - \KL(q(z|x)\|p(z))$ |
| 控制即推断 | 把「最优」当观测变量,后验推断自然给出 soft 值迭代与熵正则 | $\pi(\mathbf{a}|\mathbf{s}) = \exp(A(\mathbf{s},\mathbf{a}))$ |
| IRL / RLHF | 奖励学习 = 能量模型的正相减负相;偏好比较让配分函数变得可算 | $\E_{\pi^\star}[\nabla r_\psi] - \E_{\text{soft}}[\nabla r_\psi]$ |
| Model-based RL | 策略会对抗式地利用模型误差;解法是信赖域 + 不确定性感知(epistemic ≠ aleatoric) | $J=\frac1N\sum_i\sum_t r(\mathbf{s}_{t,i},\mathbf{a}_t)$ |
| Offline RL | 三条路:约束策略、悲观 critic、回避样本外动作 | $\pi^\star \propto \pi_\beta\exp(\tfrac1\lambda A)$ |
| Exploration | 乐观主义 + 计数;高维下用伪计数或随机网络蒸馏 | $r^+ = r + \mathcal{B}(N(\mathbf{s}))$ |
| RL 理论 | $T$ 是 $\gamma$-收缩;误差以 $\frac{1}{1-\gamma}$(乃至 $\frac{\gamma}{(1-\gamma)^2}$)放大,以 $\sqrt{1/N}$ 缩小 | $\lim_k\|\hat Q_k-Q^\star\|_\infty\le\frac{\max_k\epsilon_k}{1-\gamma}$ |
易错点总清单
- ELBO 里的熵项符号:$\mathcal{H}(q) = -\E_q[\log q]$,写反了整个优化方向就反了。
- 反向 KL($\KL(q\|p)$,mode-seeking)与前向 KL($\KL(p\|q)$,mode-covering):VAE、策略约束 1a/1b、AWR 里都出现过,方向弄错结论完全不同。
- 朴素 control-as-inference 的 $Q = r + \log\E[\exp V']$ 有乐观偏差;变分版是 $Q = r + \E[V']$,期望在外面。
- 状态空间模型的 prior 不是 $\mathcal{N}(0,\mathbf{I})$,只有 $p(\mathbf{z}_1)$ 是;encoder 的条件是 $\mathbf{o}_{1:t}$ 不是 $\mathbf{o}_t$。
- Double Q 只削弱不消除过估计;clipped double-Q 是取 min不是取平均。
- CQL 保证的是期望意义下界($\E_\pi[\hat Q]\le\E_\pi[Q^\pi]$),不是逐点下界。
- IQL 的 $\tau=0.5$ 退化为策略评估(≈ BC),$\tau\to1$ 才有策略改进;critic 不依赖 actor。
- AWAC 的 critic 目标里仍有 $\E_{\mathbf{a}'\sim\pi_\theta}$,OOD 漏洞没堵上——这正是 IQL 的动机。
- RND 用随机固定网络做目标是为了避开 noisy-TV;用下一状态预测则会被环境随机性永久吸引。
- $\mathcal{B}$ 在 $\infty$-范数收缩、$\Pi$ 在 $\ell_2$ 非扩张,范数不同,所以复合起来不是收缩。
复习清单(按讲次回查)
| 要点 | 回查 |
|---|---|
| MDP 定义、值函数、RL 算法的三框图 | Lecture 04 · 强化学习基础 |
| 策略梯度、因果性与 baseline 的方差分析 | Lecture 05 · 策略梯度 |
| Actor-critic、bootstrapping 的偏差-方差权衡、GAE | Lecture 06 · Actor-Critic |
| 策略迭代 / 值迭代 / fitted value & Q iteration、$\Pi\mathcal{B}$ 不收敛(§1 §2) | Lecture 07 · 基于值函数的 RL |
| DQN、目标网络、double Q、DDPG、clipped double-Q(§2) | Lecture 08 · 深度 Q 学习实践 |
| 重要性采样、off-policy 策略梯度与方差爆炸(§7.3) | Lecture 09 · Off-Policy 策略梯度 |
| 信赖域、KL 的二阶近似、TRPO / PPO(§6.1) | Lecture 10 · 进阶策略梯度 |
| ELBO、amortized VI、重参数化、VAE(§3.1–3.3) | Lecture 11 · 变分推断 |
| 条件模型、扩散 / 流匹配、状态空间模型(§3.4 §3.5) | Lecture 12 · 变分推断在 RL 中的应用 |
| 控制即推断、后向消息、soft 值迭代、SAC(§4) | Lecture 13 · 控制即变分推断 |
| MaxEnt IRL、IRL 即 GAN、GAIL、RLHF 与 Bradley–Terry(§5) | Lecture 14 · RL with Sequences & LLMs |
| 模型学习、开环 vs 闭环、不确定性感知模型(§6.1–6.4) | Lecture 15 · 基于模型的 RL |
| MBA / MVE / MBPO、潜空间模型(§6.5 §6.6) | Lecture 16 · 基于模型的 RL 算法 |
| 离线 RL 的问题诊断、三大原则(§7) | Lecture 17 · 离线强化学习 |
| 策略约束、AWAC、IQL、CQL、MOPO、offline→online(§8 §9) | Lecture 18 · 离线 RL 算法 |
| UCB、Thompson sampling、伪计数、RND(§10) | Lecture 19 · 探索 |
| 收缩性证明、样本复杂度、fitted Q-iteration 误差界(§11) | Lecture 20 · 强化学习理论 |
| 模仿学习、DAgger、策略梯度与 actor-critic 的复习题 | Lecture 21 · 期中复习(上) |
延伸阅读
Q-learning 与 off-policy actor-critic
- Playing Atari with Deep Reinforcement Learning (2013) — DQN 原始论文,回放池 + 目标网络的组合从这里开始。
- Deep Reinforcement Learning with Double Q-learning (2015) — 把 double Q 落到 DQN 上,题 2.2 的实践版本。
- Continuous control with deep reinforcement learning (2015) — DDPG。
- Addressing Function Approximation Error in Actor-Critic Methods (2018) — TD3,clipped double-Q 与目标策略平滑的出处。
- Soft Actor-Critic (2018) — §4.5 的算法;配套的 SAC Algorithms and Applications (2018) 讲了自动温度调节。
变分推断与生成模型
- Auto-Encoding Variational Bayes (2013) — VAE 与重参数化技巧,§3 的全部内容。
- Denoising Diffusion Probabilistic Models (2020) — 把扩散写成层次化 VAE 的下界,对应题 3.4。
- Flow Matching for Generative Modeling (2022) — 流匹配,FQL 里 actor 蒸馏的对象。
控制即推断、IRL 与 RLHF
- Reinforcement Learning and Control as Probabilistic Inference (2018) — Levine 本人写的教程综述,§4 的完整版。
- A Connection Between GANs, Inverse RL, and Energy-Based Models (2016) — 题 5.3 的判别器参数化。
- Generative Adversarial Imitation Learning (2016) — 题 5.4 的普通判别器版本。
- Deep Reinforcement Learning from Human Preferences (2017) — 题 5.5 的 RLHF 原型。
基于模型的 RL
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models (2018) — PETS,题 6.3 的集成 + 轨迹采样规划。
- When to Trust Your Model: Model-Based Policy Optimization (2019) — MBPO,题 6.5 的定量分析与 rollout 长度调度。
- Dream to Control: Learning Behaviors by Latent Imagination (2019) — 潜空间模型 + actor-critic,题 6.6 的代表作。
离线 RL
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives (2020) — §7 的完整版综述,考前最值得通读的一篇。
- Behavior Regularized Offline Reinforcement Learning (2019) — BRAC,题 8.2 的显式约束。
- Advantage-Weighted Regression (2019) 与 AWAC (2020) — 题 8.3、8.4 的隐式约束。
- Offline RL with Implicit Q-Learning (2021) — IQL 与 expectile 回归。
- Conservative Q-Learning (2020) — CQL 的界与实现。
- MOPO: Model-Based Offline Policy Optimization (2020) — 题 9.5 的不确定性惩罚。
- IDQL (2023) 与 Flow Q-Learning (2025) — 题 9.4 的两种扩散 / 流策略方案。
探索与理论
- Unifying Count-Based Exploration and Intrinsic Motivation (2016) — 题 10.2 的伪计数推导。
- Exploration by Random Network Distillation (2018) — 题 10.3 的 RND。
- Reinforcement Learning: Theory and Algorithms (Agarwal, Jiang, Kakade, Sun) — §11 的全部结论都出自这本书,免费在线。