行为的监督学习:行为克隆为什么会失败
把「学会开车」写成一个图像分类问题,只需要五分钟。但这五分钟里悄悄丢掉了监督学习最核心的 i.i.d. 假设——本讲把这个代价精确算成 $O(\epsilon H^2)$。
0. 本讲导读
上一讲我们讨论了「为什么要做深度强化学习」:为什么手工设计控制器在真实世界里不可扩展,为什么表示学习和决策制定必须放在同一个框架里解决。这一讲开始动真格——我们要造出本课程的第一个可运行的算法。
而这个算法出人意料地朴素:让人类演示一遍,然后用监督学习去拟合人类的动作。这就是行为克隆(behavioral cloning, BC),也叫模仿学习(imitation learning)最基础的形式。它甚至不需要奖励函数 $r(s,a)$,不需要价值函数,不需要与环境交互——一个标准的图像分类/回归训练脚本就能跑。
本讲真正的价值不在于「介绍 BC 这个算法」,而在于回答这样一串问题,它们构成了 Levine 讲课里典型的动机链条:
- 把控制问题写成监督学习,到底丢了什么? 监督学习的一切理论保证都建立在「训练和测试数据独立同分布(i.i.d.)」上。而在控制问题里,策略自己的输出会改变它下一步看到的输入。这个反馈回路一旦存在,i.i.d. 假设就彻底失效。
- 失效有多严重? 这是本讲的技术核心。我们会一步不漏地推出:如果策略在训练分布上犯错概率不超过 $\epsilon$,那么在长度为 $H$ 的任务上,期望犯错总数的最坏情况上界是 $O(\epsilon H^2)$ —— 注意是 $H$ 的二次方,而不是监督学习里天真预期的 $\epsilon H$。
- 那为什么现实中 BC 又经常能用? 1989 年的 ALVINN、2016 年 NVIDIA 的端到端自动驾驶、今天的机器人 VLA 模型,全都是行为克隆。理论说不行,实践说行,矛盾在哪?答案藏在「数据是怎么收集的」里。
- 怎么从根上修好它? DAgger(Dataset Aggregation) 的核心思想只有一句话:既然是 $p_{\text{data}}$ 和 $p_{\pi_\theta}$ 对不上,与其想办法让策略去迁就数据,不如让数据去迁就策略。
与后续课程的关系:下一讲会继续深挖模仿学习——DAgger 的工程变体、非马尔可夫策略(历史信息)带来的因果混淆(causal confusion)、以及人类演示天然的多模态性该怎么用扩散策略(diffusion policy)、动作分块(action chunking)之类的手段建模。再往后进入真正的强化学习时,你会发现本讲的分布漂移分析像幽灵一样反复出现:off-policy 修正、TRPO 的信任域、offline RL 的分布外动作,本质上都是同一个 $p_{\text{train}} \neq p_{\text{test}}$ 的问题在不同场景下的变形。
- BC 就是在演示数据上做最大似然:$\displaystyle\max_\theta \sum_{i}\sum_{t}\log \pi_\theta(a_t^{(i)}|o_t^{(i)})$。它是监督学习,不是强化学习。
- 控制问题打破了 i.i.d. 假设:策略的动作决定了它将来会遇到什么状态,因此误差会累积、会自我放大,而不是像监督学习那样独立地平均掉。
- 最坏情况下期望犯错次数是 $O(\epsilon H^2)$;直觉是「每一步都可能第一次跌出数据分布,一旦跌出去,剩下的 $H-t$ 步全废」,$\sum_t (H-t) \sim H^2/2$。
- $O(\epsilon H^2)$ 是最坏情况界,现实中往往没这么糟,因为真实系统通常可以从错误中恢复。但——「能恢复」不等于「BC 学得会恢复」,除非数据里就有恢复行为。
- 由此产生一个反直觉的悖论:演示数据里含有更多(小)错误和纠正,BC 的效果反而更好。完美无瑕的专家演示是糟糕的 BC 数据。
- NVIDIA 端到端驾驶能成功的关键不是网络,而是左中右三摄像头 + 人工修正转向角——这是在用数据增强人为合成「偏离车道后如何回正」的样本。
- DAgger 通过「跑策略 → 让专家给策略访问到的状态打标签 → 聚合进数据集 → 重训」的循环,使 $p_{\text{data}} \to p_{\pi_\theta}$,把误差界从 $O(\epsilon H^2)$ 降到 $O(\epsilon H)$。它的代价是需要一个随叫随到的交互式专家。
1. 记号:从 $p_\theta(y|x)$ 到 $\pi_\theta(a_t|o_t)$
先从一件你已经会的事情开始。给定一张车载前视摄像头拍到的图片 $\mathbf{x}$,我们想输出图中物体的类别 $y$(比如「car」)。标准做法是训练一个神经网络输出条件分布 $p_\theta(y|\mathbf{x})$,然后在带标注的数据集 $\{(\mathbf{x}^{(i)}, y^{(i)})\}_{i=1}^{N}$ 上做最大似然估计(maximum likelihood estimation, MLE):
$$ \theta^\star = \argmax_\theta \sum_{i=1}^{N} \log p_\theta(y^{(i)}|\mathbf{x}^{(i)}) $$这就是监督学习。交叉熵损失、Adam、数据增强、早停——整套工具链你都熟悉。
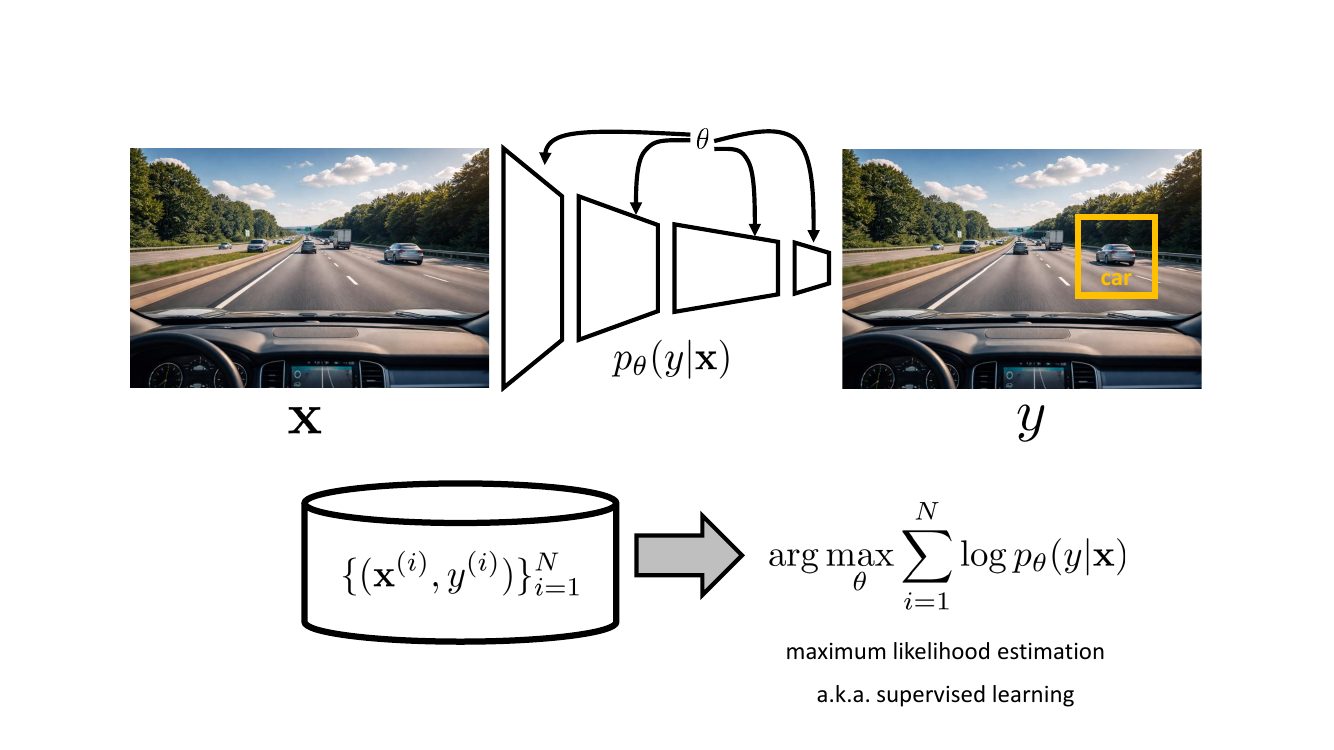
1.1 只改标签,不改结构
现在把这张图上的符号换掉,什么都不改:让输出 $y$ 不再是物体类别,而是此刻应该打多少方向盘、踩多深油门。于是同一个网络就成了一个「驾驶员」。
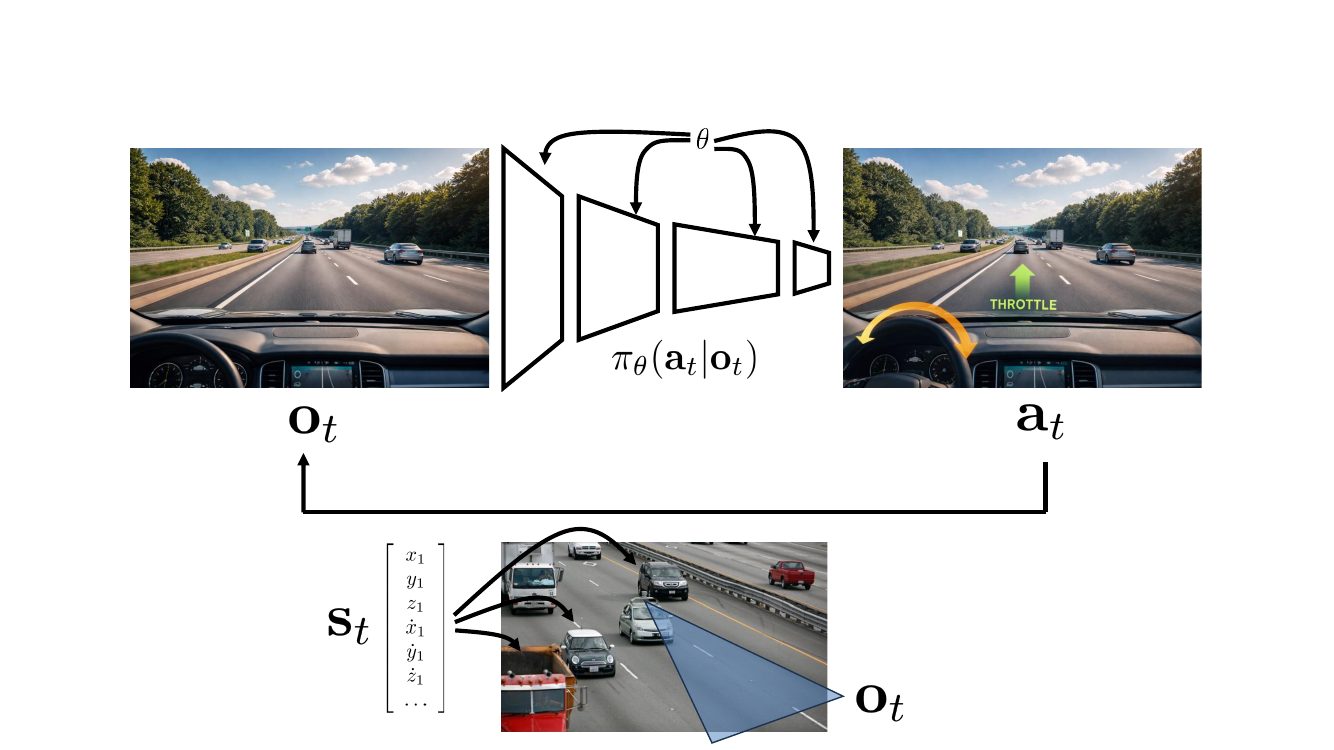
本课程通用的记号,从这里开始固定下来:
| 符号 | 名称 | 含义 |
|---|---|---|
| $\mathbf{s}_t$ | 状态(state) | 系统在 $t$ 时刻的完整物理描述,满足马尔可夫性 |
| $\mathbf{o}_t$ | 观测(observation) | 智能体实际看到的东西,由 $\mathbf{s}_t$ 生成,可能不足以还原 $\mathbf{s}_t$ |
| $\mathbf{a}_t$ | 动作(action) | $t$ 时刻输出的控制量,离散或连续 |
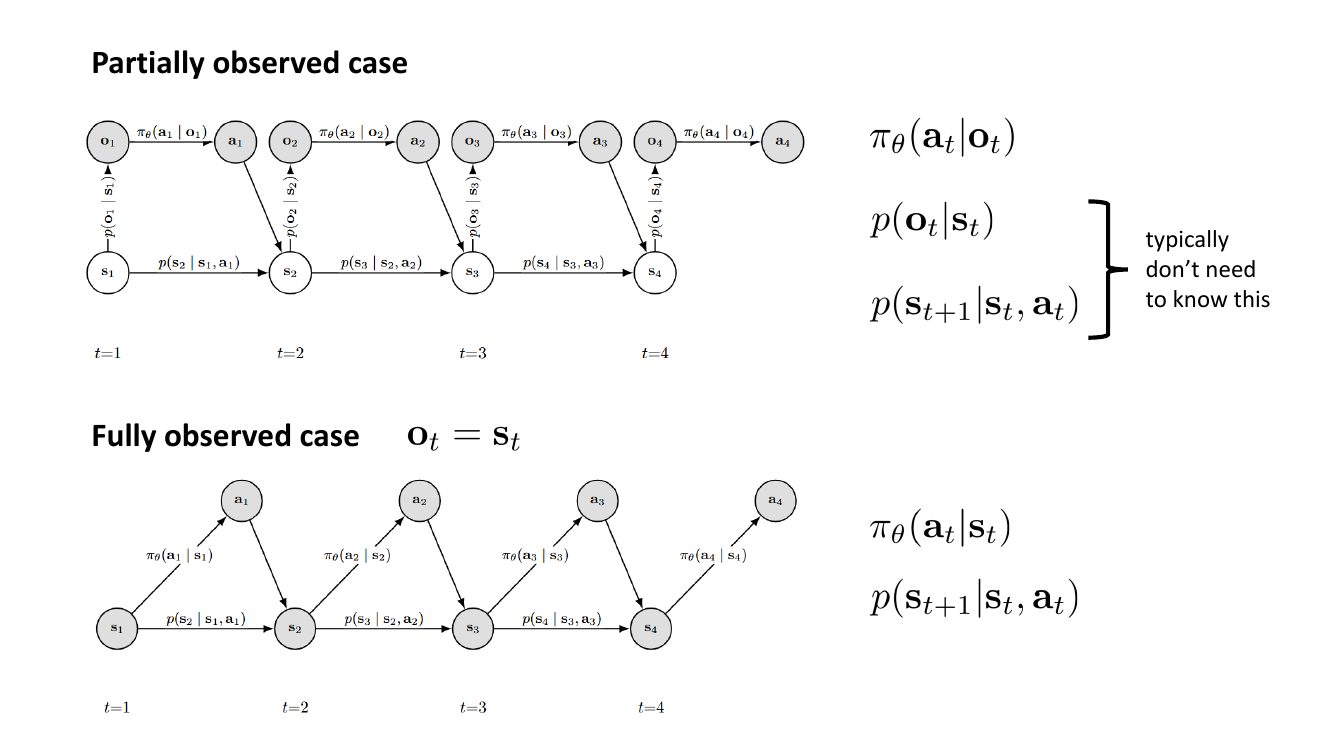
| $\pi_\theta(\mathbf{a}_t|\mathbf{o}_t)$ | 策略(policy) | 参数为 $\theta$ 的条件动作分布;完全可观测时写作 $\pi_\theta(\mathbf{a}_t|\mathbf{s}_t)$ |
| $p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$ | 转移概率(dynamics) | 环境的动力学,模仿学习中不需要知道 |
| $p(\mathbf{o}_t|\mathbf{s}_t)$ | 观测模型 | 状态如何生成观测,同样不需要知道 |
| $\tau$ | 轨迹(trajectory) | $(\mathbf{o}_1,\mathbf{a}_1,\ldots,\mathbf{o}_H,\mathbf{a}_H)$,$H$ 是时域(horizon) |
| $\pi^\star$ | 专家策略 | 产生演示数据的那个(通常是人类)策略 |
| $r(\mathbf{s},\mathbf{a}),\gamma,Q^\pi,V^\pi$ | 奖励、折扣、值函数 | 本讲用不到——BC 的迷人之处正在于此 |
1.2 状态与观测:马尔可夫性到底在说什么
$\mathbf{s}$ 和 $\mathbf{o}$ 的区别是本课程反复踩坑的地方,必须一次讲清。
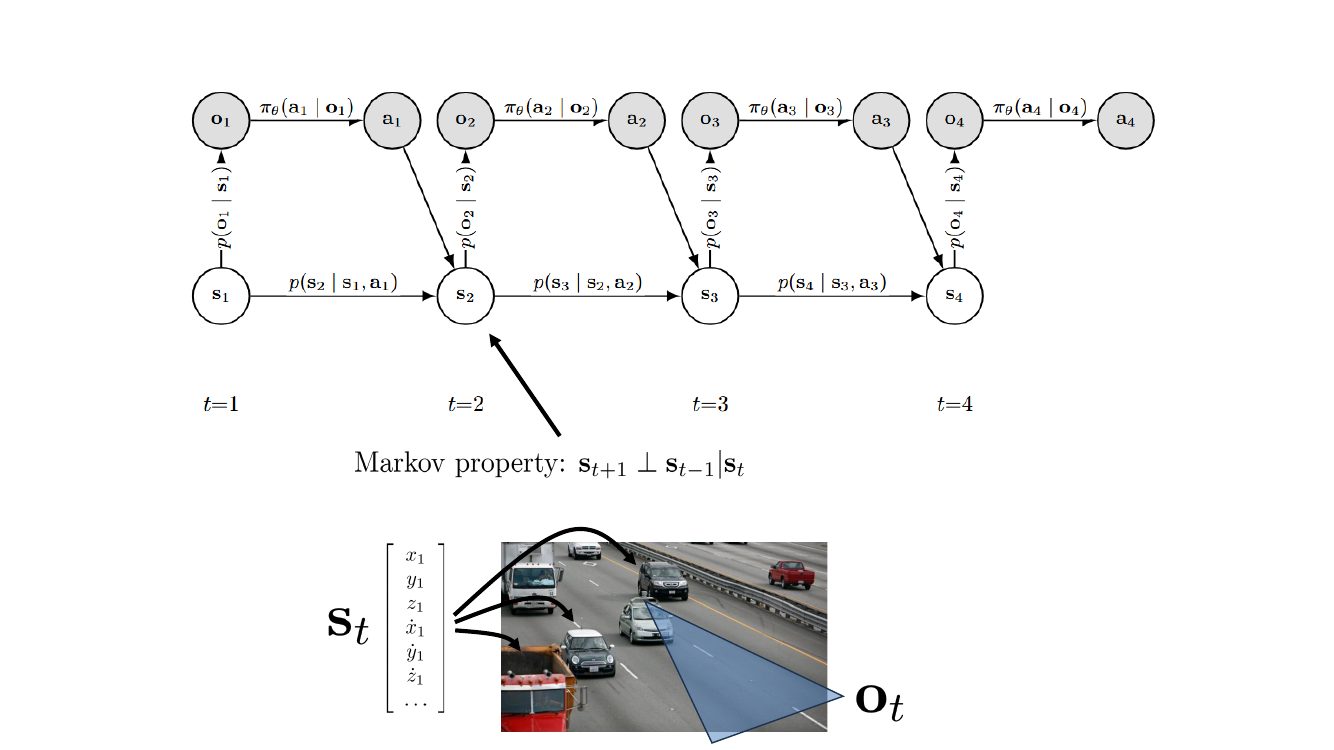
马尔可夫性(Markov property)说的是:给定当前状态 $\mathbf{s}_t$,未来 $\mathbf{s}_{t+1}$ 与过去 $\mathbf{s}_{t-1}$ 条件独立。用大白话讲:知道了现在,过去就再也提供不了任何额外信息。这是「状态」这个词的定义性质——如果一个量不满足它,它就不配叫状态。
而观测没有这个性质。看图里那辆被卡车挡住的小汽车:在 $\mathbf{s}_t$ 里它的坐标和速度都在,但 $\mathbf{o}_t$(一张图片)里它被完全遮挡了。此刻如果你只看 $\mathbf{o}_t$,你会以为右车道是空的;但如果你还记得 $\mathbf{o}_{t-1}$——那时它还没被挡住——你就知道那儿有辆车。过去的观测对预测未来是有用的,所以观测不满足马尔可夫性。
这一条有个非常实际的推论:如果策略只吃单帧观测 $\pi_\theta(\mathbf{a}_t|\mathbf{o}_t)$,那么在部分可观测的环境里,最优策略可能根本不在这个函数类里——不管你的网络多大、数据多多,你都学不到最优。想要理论上的最优性,要么保证 $\mathbf{o}_t = \mathbf{s}_t$(完全可观测),要么让策略吃整段历史 $\pi_\theta(\mathbf{a}_t|\mathbf{o}_{1:t})$。后者会带来自己的麻烦(因果混淆),下一讲细说。
1.3 演示数据与行为克隆的目标函数
数据从哪来?让一个人去开车,把他每一时刻看到的画面和他打的方向盘都记录下来。一次完整的记录叫一条演示轨迹(demonstration trajectory),数据集就是 $N$ 条这样的轨迹:
$$ \mathcal{D} = \Big\{ \big(\mathbf{o}_1^{(i)}, \mathbf{a}_1^{(i)}, \ldots, \mathbf{o}_H^{(i)}, \mathbf{a}_H^{(i)}\big) \Big\}_{i=1}^{N} $$然后——把它当成一堆 $(\mathbf{o},\mathbf{a})$ 的散装样本对,忘掉它们的时间顺序,直接跑最大似然:
$$ \theta^\star = \argmax_\theta \sum_{i=1}^{N} \sum_{t=1}^{H} \log \pi_\theta\big(\mathbf{a}_t^{(i)} \big| \mathbf{o}_t^{(i)}\big) $$这个式子就是行为克隆。请仔细体会「忘掉时间顺序」这五个字——它是本讲后面所有麻烦的源头。我们把一个序贯决策问题当成了 $N \times H$ 个互不相干的分类/回归问题来处理,等于默认了这些样本是 i.i.d. 的。它们当然不是。
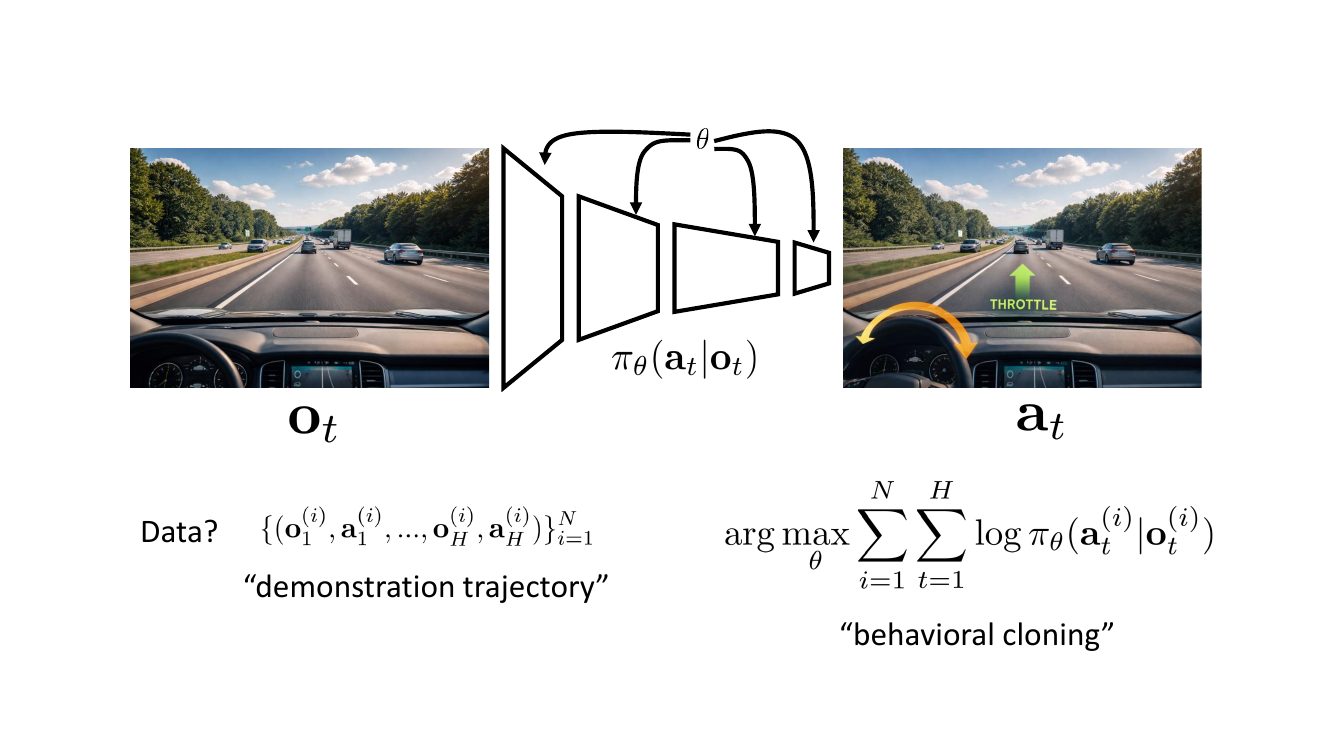
「BC 是强化学习的一种」——不是。BC 里没有奖励函数,没有探索,没有与环境的交互,也没有任何时序信用分配(credit assignment)。它是百分之百的监督学习,只不过被应用在了一个监督学习假设不成立的场景上。之所以把它放在深度 RL 课的第二讲,恰恰是为了让你看清:不做 RL 的代价是什么。
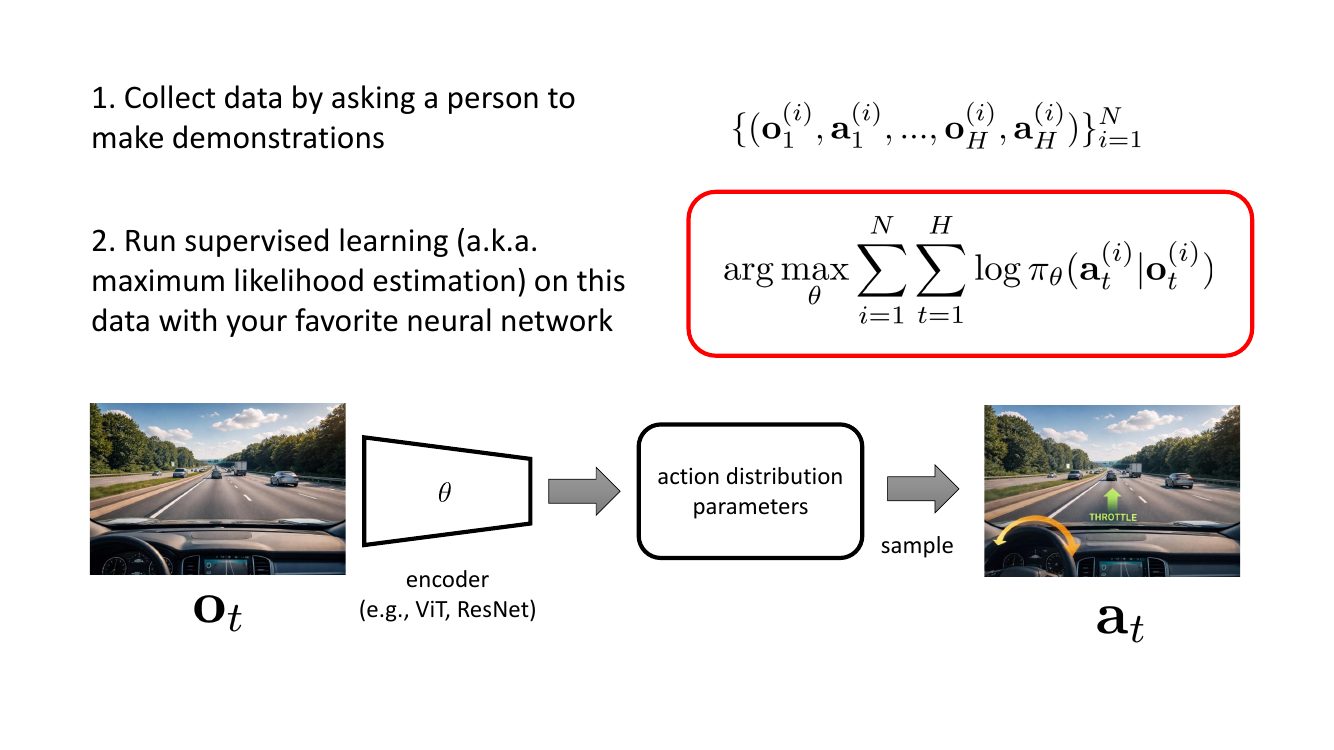
2. 行为克隆算法:完整的两步
算法本身简单到可以写在一张便签上:
- 收集数据:请一个人(或任何已有的好控制器)来做演示,记录 $\mathcal{D} = \{(\mathbf{o}_1^{(i)}, \mathbf{a}_1^{(i)}, \ldots, \mathbf{o}_H^{(i)}, \mathbf{a}_H^{(i)})\}_{i=1}^{N}$。
- 跑监督学习:用你最喜欢的神经网络,在这些数据上最大化 $\sum_{i}\sum_{t}\log \pi_\theta(\mathbf{a}_t^{(i)}|\mathbf{o}_t^{(i)})$。
2.1 历史插曲:1989 年的 ALVINN
这个想法一点都不新。1989 年,CMU 的 Dean Pomerleau 做了 ALVINN(Autonomous Land Vehicle In a Neural Network):一个只有 5 个隐藏单元、输入是 $30\times 32$ 灰度「视网膜」、输出 30 个转向方向单元的全连接网络,装在一辆改装军用卡车上,学人类司机开车。
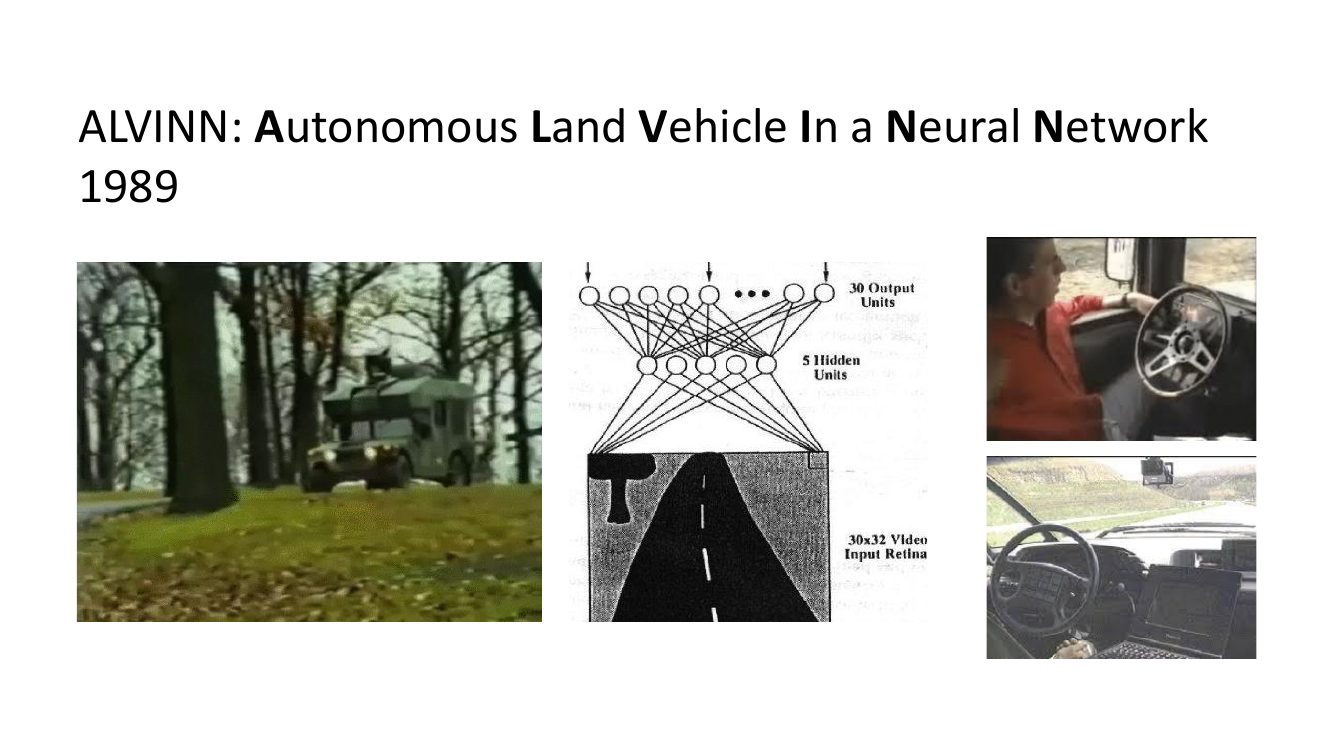
Levine 讲这段历史是有目的的:让你意识到 BC 的问题不是「模型不够大」。同样的范式在 5000 参数和 50 亿参数上都能跑,也都会遭遇同一个结构性缺陷。这个缺陷不在模型里,在问题的设定里。
2.2 动作分布怎么参数化
「输出一个分布」在具体实现上分两种情况。
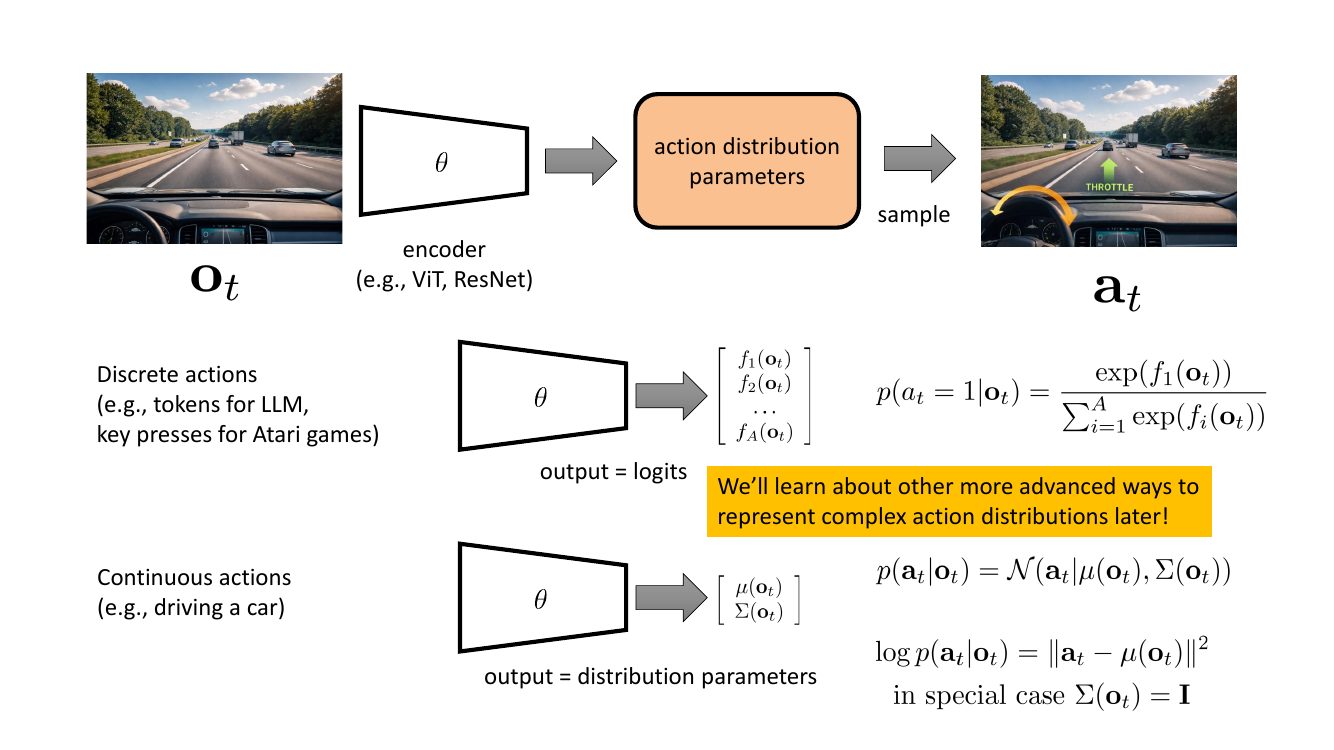
离散动作。网络输出 $A$ 维 logits 向量,用 softmax 转成概率:
$$ p(a_t = j \mid \mathbf{o}_t) = \frac{\exp\big(f_j(\mathbf{o}_t)\big)}{\sum_{i=1}^{A} \exp\big(f_i(\mathbf{o}_t)\big)} $$取对数似然就是标准的交叉熵损失。这跟做图像分类一模一样。顺便说一句:大语言模型的下一 token 预测,形式上就是一个离散动作空间上的行为克隆——观测是上文,动作是下一个 token,演示数据是人类写的文本。这个类比在本课后面讲 RLHF 时会再次出现。
连续动作。最简单的做法是输出一个多元高斯的参数:
$$ p(\mathbf{a}_t|\mathbf{o}_t) = \mathcal{N}\big(\mathbf{a}_t \,;\, \mu(\mathbf{o}_t), \Sigma(\mathbf{o}_t)\big) $$在 $\Sigma(\mathbf{o}_t) = \mathbf{I}$ 的特殊情况下,负对数似然退化为
$$ -\log p(\mathbf{a}_t|\mathbf{o}_t) = \tfrac{1}{2}\big\|\mathbf{a}_t - \mu(\mathbf{o}_t)\big\|^2 + \text{const} $$也就是普通的均方误差回归。这解释了为什么很多 BC 实现直接就是 MSE loss——它是「固定单位方差高斯 + 最大似然」的等价形式。
为什么非要输出分布,不能直接回归一个动作?两个理由。其一,训练目标的统一性:MLE 框架下离散和连续可以用同一套语言描述,后面接策略梯度时也能无缝衔接。其二,也是更重要的,人类演示天然是多模态的:面对路中间一棵树,绕左边和绕右边都对,MSE 回归会输出两者的平均值——直直撞上去。单峰高斯其实也躲不开这个问题(它的均值同样是平均值),所以才需要更强的分布族。这是下一讲的主线之一。
2.3 一份能跑的最小实现
下面是完整的 BC 训练循环(PyTorch),连续动作用对角高斯,离散动作只需把最后两行换成交叉熵。
import torch, torch.nn as nn

class GaussianPolicy(nn.Module):
    """pi_theta(a|o):观测 -> 对角高斯的 (mu, log_std)。"""
    def __init__(self, obs_dim, act_dim, hidden=256):
        super().__init__()
        self.trunk = nn.Sequential(
            nn.Linear(obs_dim, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
        )
        self.mu_head = nn.Linear(hidden, act_dim)
        # log_std 与观测无关(state-independent),是最常用的简化
        self.log_std = nn.Parameter(torch.zeros(act_dim))

    def dist(self, obs):
        h = self.trunk(obs)
        mu = self.mu_head(h)
        std = self.log_std.clamp(-5.0, 2.0).exp()
        return torch.distributions.Normal(mu, std)

    def log_prob(self, obs, act):
        # 各维度独立,log p(a|o) = sum_j log p(a_j|o)
        return self.dist(obs).log_prob(act).sum(dim=-1)

    @torch.no_grad()
    def act(self, obs, deterministic=False):
        d = self.dist(obs)
        return d.mean if deterministic else d.sample()


def behavior_cloning(obs_all, act_all, obs_dim, act_dim,
                     epochs=50, batch_size=256, lr=1e-3):
    """obs_all: (N*H, obs_dim)  act_all: (N*H, act_dim)
    注意这里把所有轨迹的所有时间步「打散」成了一个大池子,
    并且每个 epoch 都随机打乱 —— 这正是在假装样本是 i.i.d. 的。"""
    policy = GaussianPolicy(obs_dim, act_dim)
    opt = torch.optim.Adam(policy.parameters(), lr=lr)
    n = obs_all.shape[0]
    for ep in range(epochs):
        perm = torch.randperm(n)
        total = 0.0
        for i in range(0, n, batch_size):
            idx = perm[i:i + batch_size]
            o, a = obs_all[idx], act_all[idx]
            loss = -policy.log_prob(o, a).mean()   # 负对数似然
            opt.zero_grad(); loss.backward(); opt.step()
            total += loss.item() * len(idx)
        print(f"epoch {ep:3d}  NLL = {total / n:.4f}")
    return policy
请特别留意 behavior_cloning 里那句 torch.randperm(n)。它把所有轨迹、所有时间步的数据彻底打散重排——这是监督学习的标准操作,也正是我们主动抹掉时序结构、假装数据 i.i.d. 的那一行代码。整个第 4、5 节要付的账,就是从这里欠下的。
3. 它到底行不行?
3.1 不行
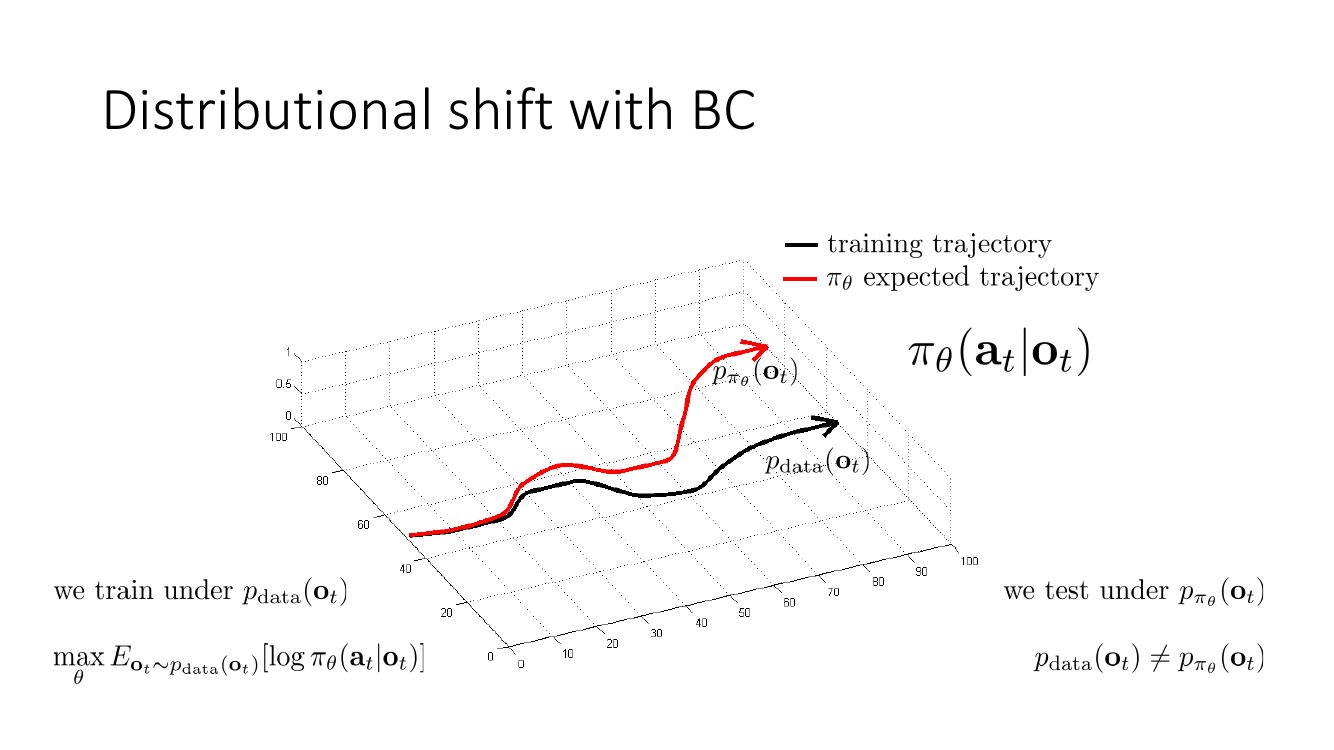
拿一个理想化的实验来看:训练数据是一条黑色轨迹,我们在上面做 BC,然后把学到的策略放回环境里跑,画出它的期望轨迹(红色)。
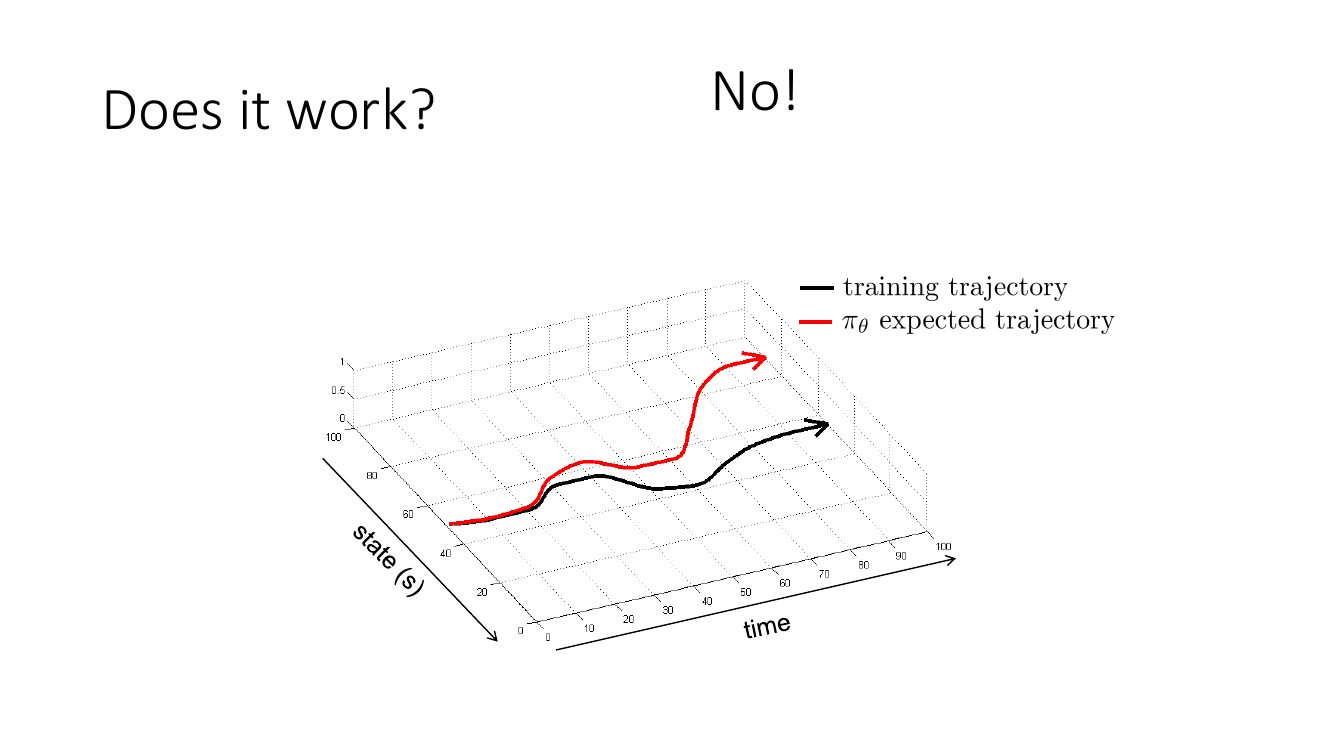
注意这张图里失败的模式:不是随机抖动,是单向发散。这跟监督学习中「测试误差比训练误差高一点」的图景完全不同。误差在这里不是被平均掉,而是被积分起来。
3.2 行
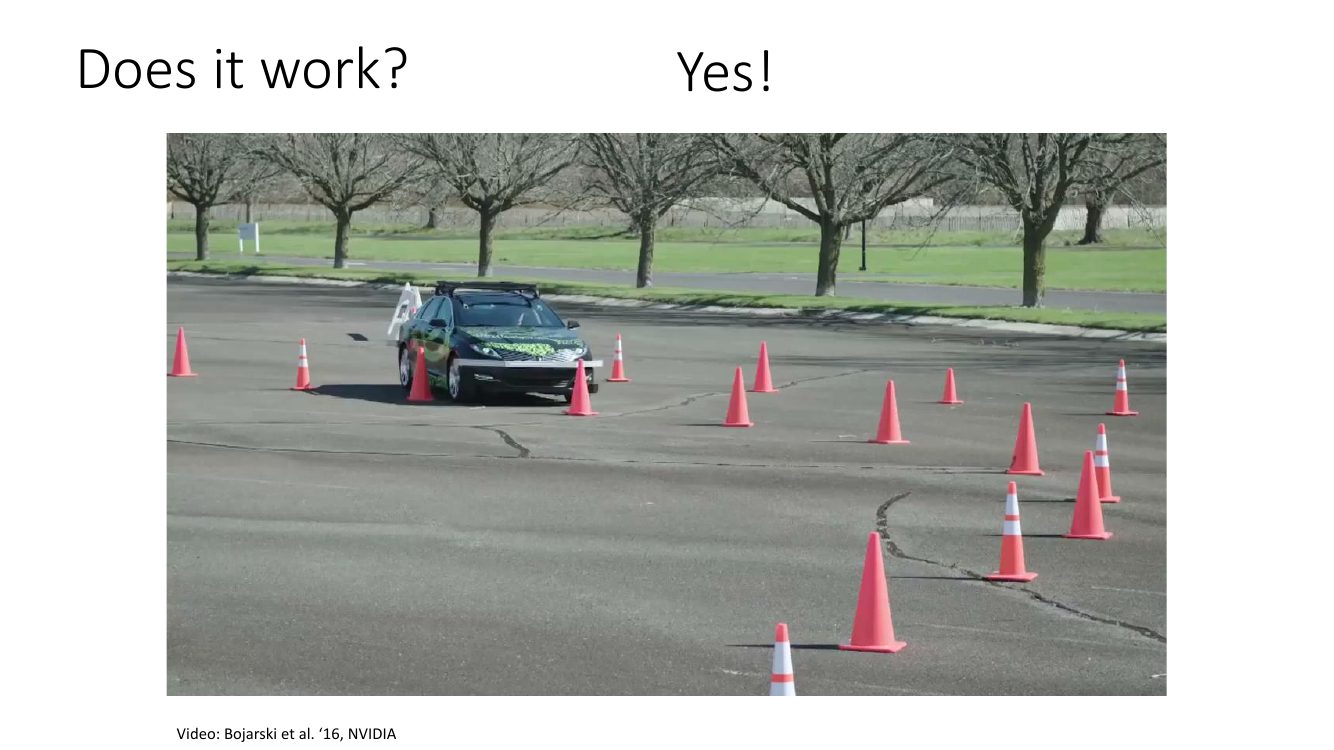
然后 Levine 立刻放了 2016 年 NVIDIA 的演示视频:一辆车在锥桶阵里稳稳地开,用的正是纯粹的端到端行为克隆(Bojarski 等人)。这构成了一个必须解释的矛盾。
3.3 为什么那个能行?
答案不在网络结构里,在数据采集装置里。
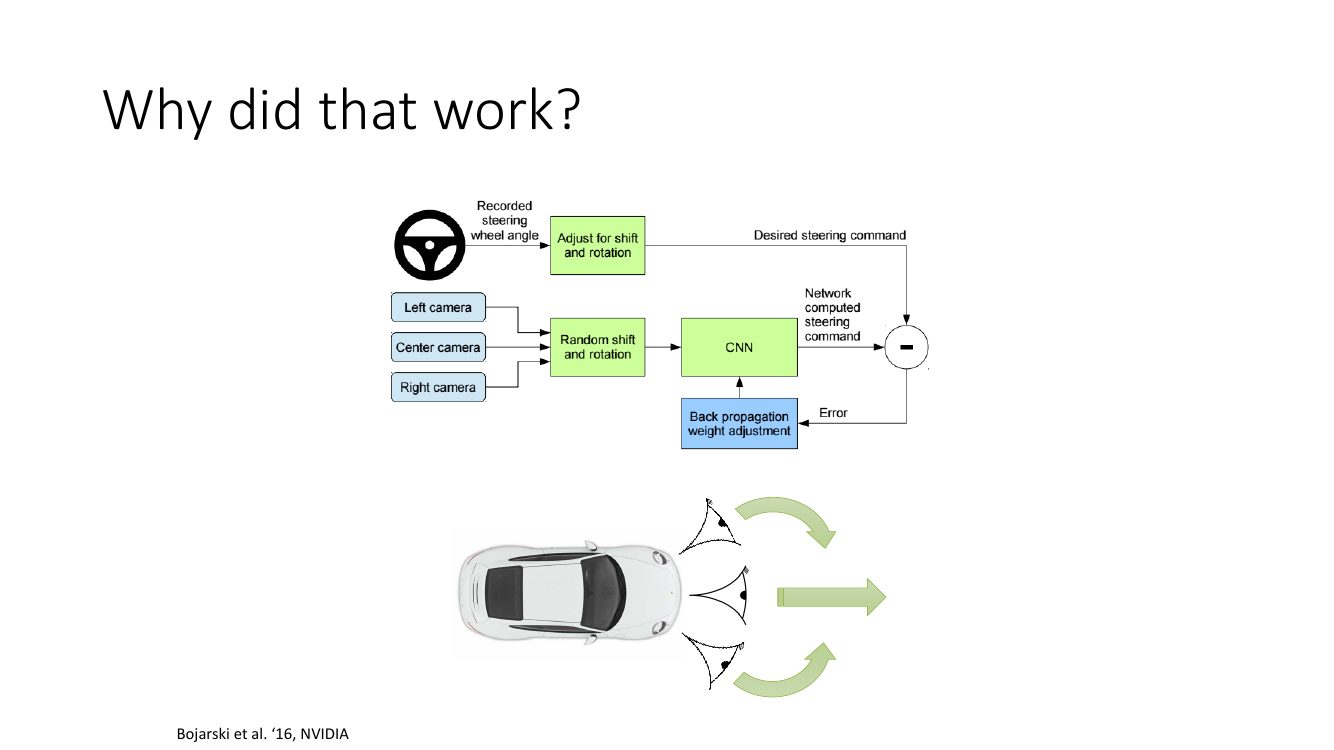
三摄像头技巧的本质,是用极低的成本人工合成了「偏离中心线之后如何回正」的训练样本。人类司机开得很好,所以真实数据里几乎没有「车快压线了」的状态;而左右摄像头恰恰模拟了车横向偏移之后的视角,配上的修正转向角则给出了正确的纠偏动作。换句话说:他们没有改算法,他们改了数据分布,把策略执行时可能遇到的「偏离态」提前塞进了训练集。这与本讲后面 DAgger 的思想完全一致,只是用一种廉价的、离线的方式近似实现。
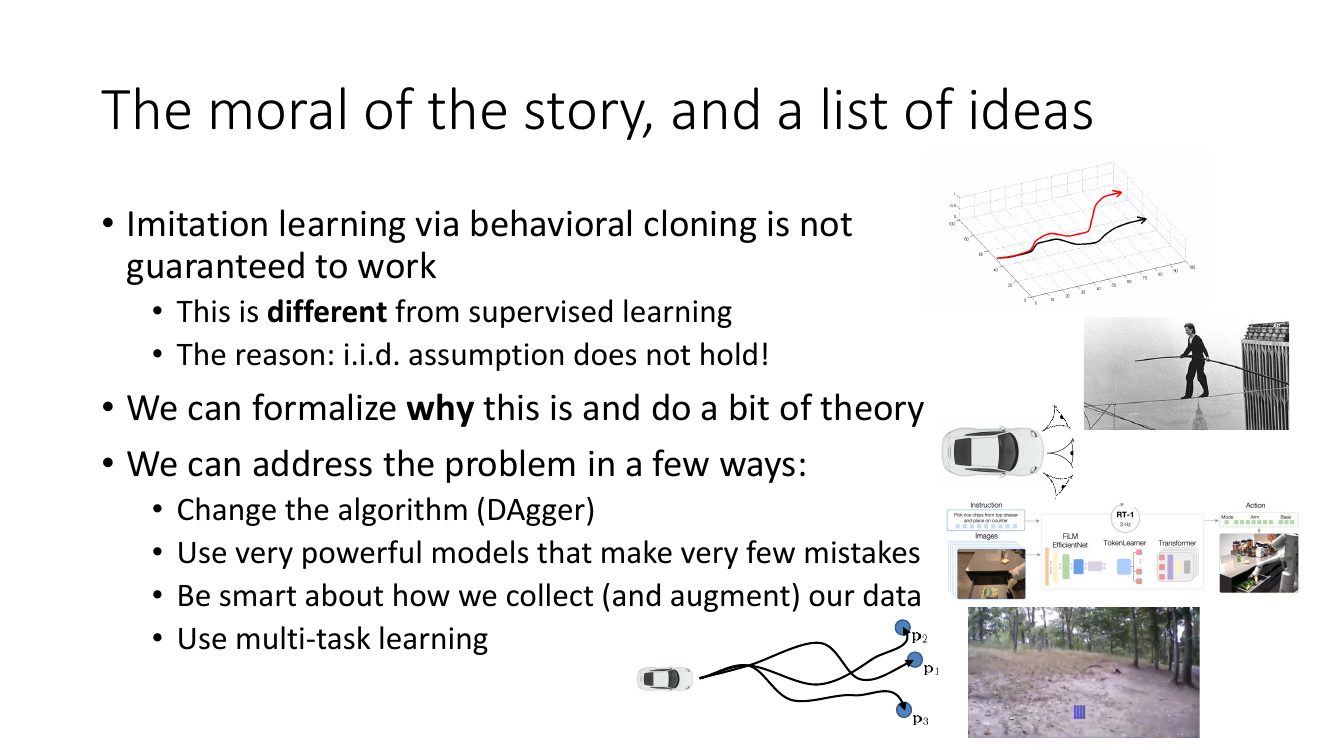
顺着这条线,可以给出一份「让 BC 变得可用」的想法清单(第 8 节会逐条展开):
4. 分布漂移:问题的名字
先给这个现象一个准确的名字。
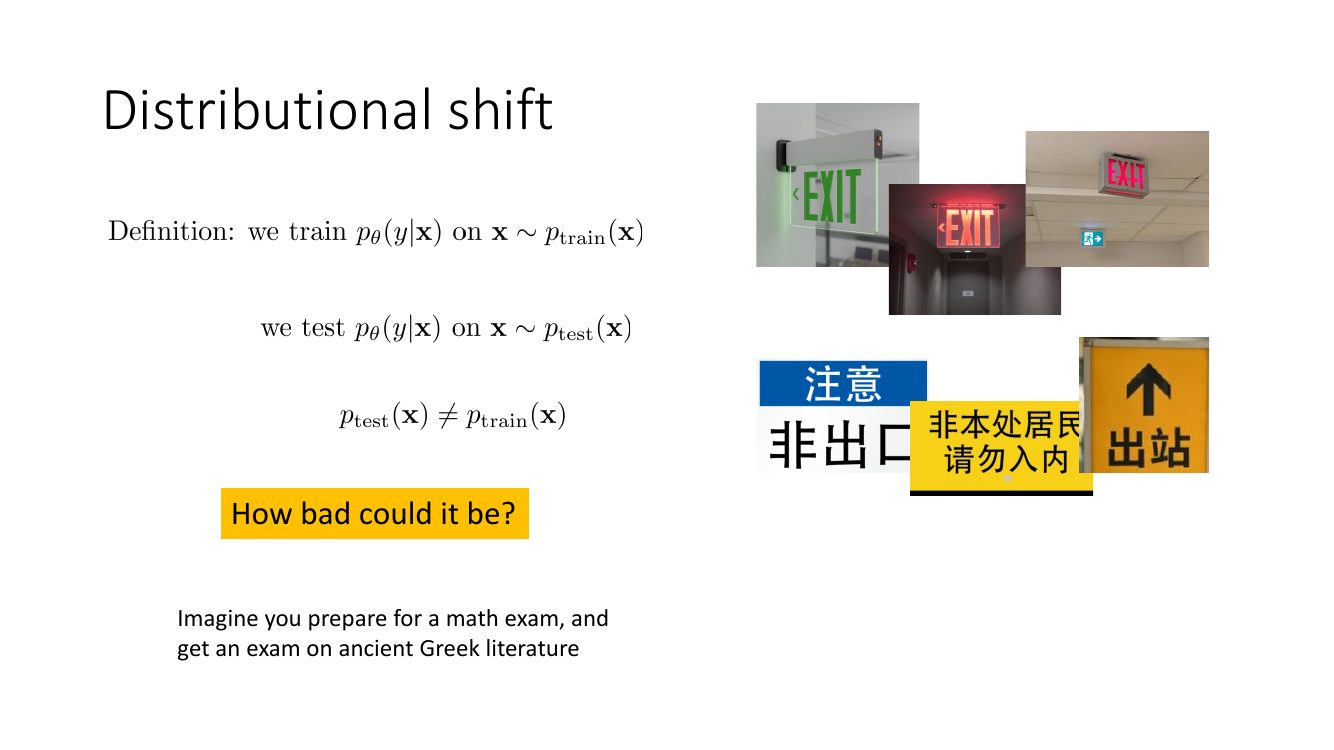
分布漂移在监督学习里也存在(跨域泛化、OOD 检测都在处理它),但那里它是一个外生的、偶然的麻烦:数据集收得不好、部署环境变了。而在控制问题里,它是内生的、必然的——
行为克隆的分布漂移是策略自己造成的。训练分布 $p_{\text{data}}(\mathbf{o}_t)$ 是由专家 $\pi^\star$ 与环境交互产生的状态分布;测试分布 $p_{\pi_\theta}(\mathbf{o}_t)$ 是由学到的策略 $\pi_\theta$ 与环境交互产生的状态分布。只要 $\pi_\theta \neq \pi^\star$(永远如此),这两个分布就必然不同。你无法通过「多收集点数据」来消除它,因为问题不在数据的量,而在数据的生成机制。
写成一行:我们优化的是
$$ \max_\theta\ \E_{\mathbf{o}_t \sim p_{\text{data}}(\mathbf{o}_t)}\big[\log \pi_\theta(\mathbf{a}_t|\mathbf{o}_t)\big] \qquad\text{但我们想要的是在}\ p_{\pi_\theta}(\mathbf{o}_t)\ \text{下表现好} $$而且 $p_{\text{data}}(\mathbf{o}_t) \neq p_{\pi_\theta}(\mathbf{o}_t)$。更糟的是,$p_{\pi_\theta}$ 依赖于 $\theta$,所以每次你更新参数,测试分布就跟着变——这是一个移动的靶子。
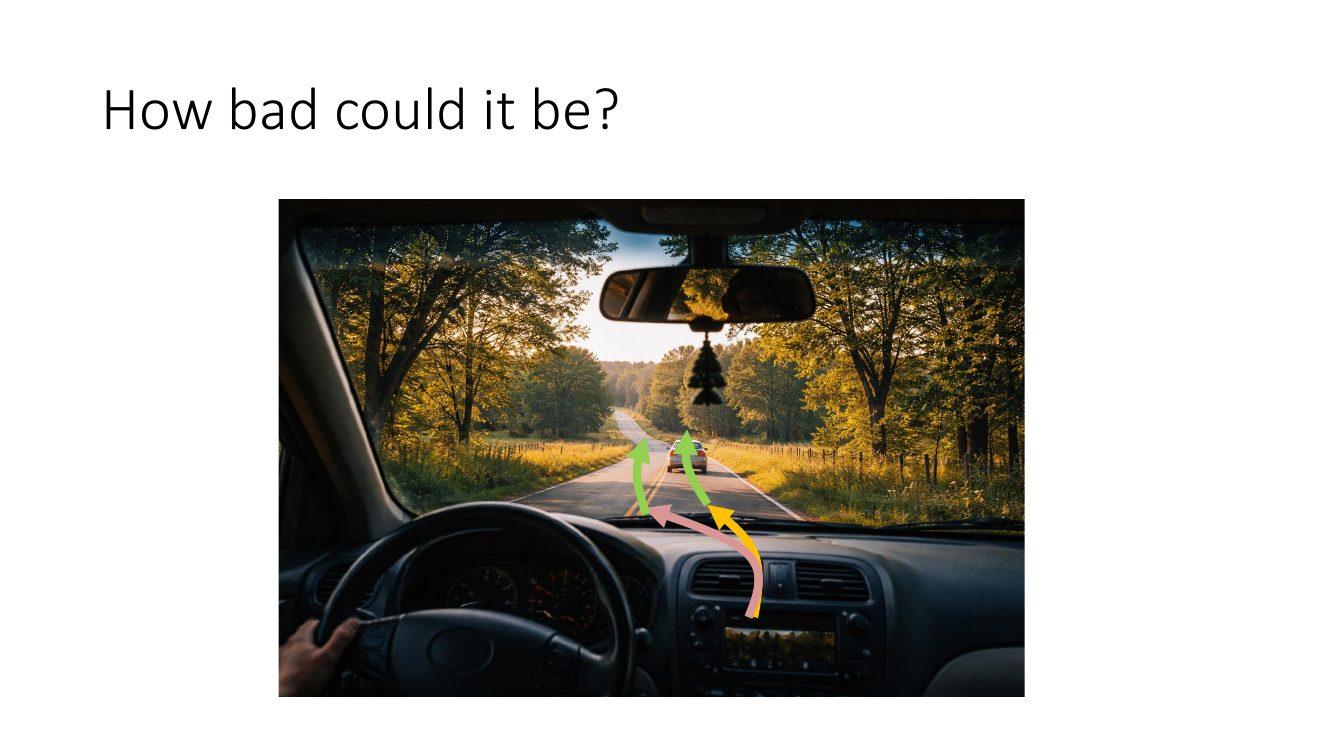
你训练一个开车策略。人类司机永远把车开在车道正中,所以数据里 99.9% 的画面都是「车在正中」。你的策略学得很好,在训练分布上犯错率只有 0.1%。上路后第 37 帧,它多打了 0.5 度方向盘,车偏离中线 5 厘米。这个「偏离 5 厘米」的画面在训练集里一次都没出现过,网络在这个输入上的输出没有任何保证——假设它又多打了 1 度。现在偏离 15 厘米,这个画面离训练分布更远了……第 200 帧的时候车已经在对向车道上,而这个画面对网络来说完全是「古希腊文学试卷」。
5. 到底能有多糟:$O(\epsilon H^2)$ 的完整推导
这一节是本讲的技术核心。我们要把上面的直觉变成一个定量的、可以讨论的界。
5.1 先说清楚理论能给什么、不能给什么
请把这段话记牢。下面推出的 $O(\epsilon H^2)$ 是最坏情况上界,不是对现实的预测。它的价值在于告诉你「误差随时域二次增长」这个标度关系,以及问题的结构性来源。第 6 节会专门讨论它有多悲观。
5.2 设定:代价函数与犯错概率
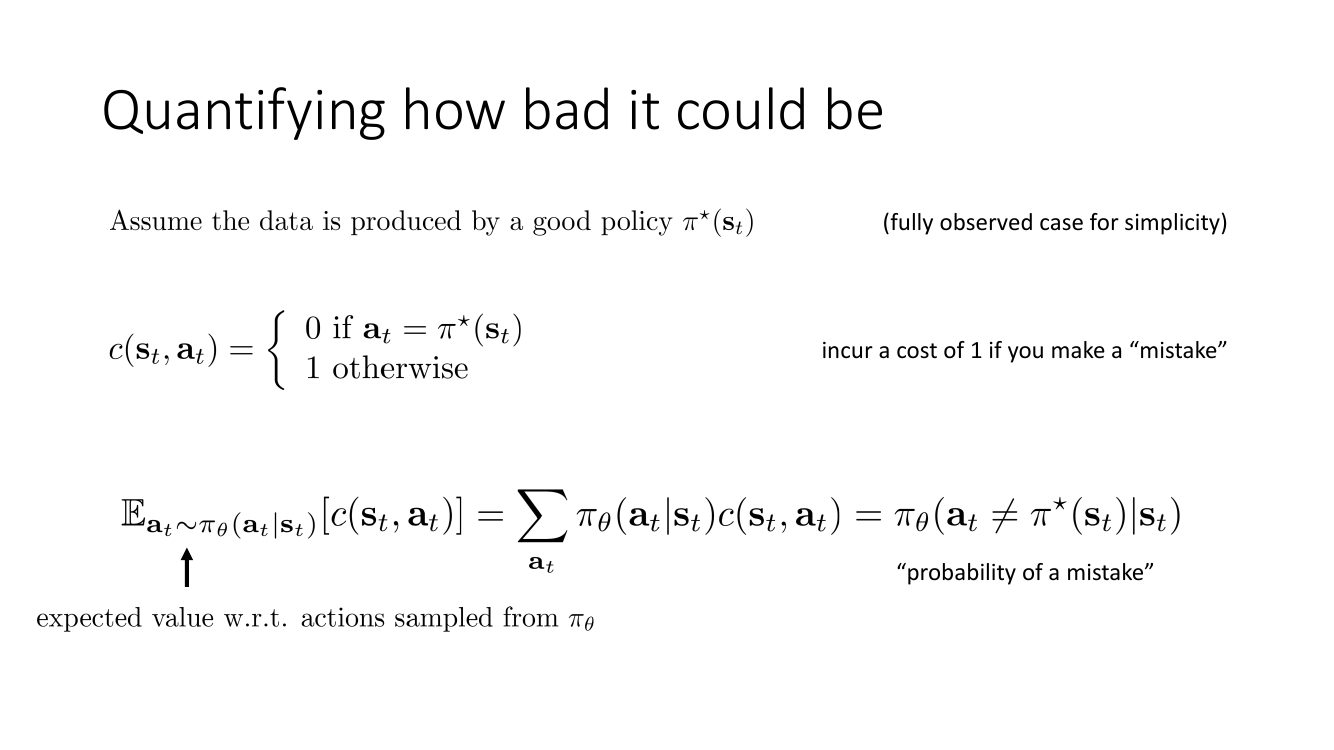
为简单起见,全部在完全可观测设定下讨论($\mathbf{o}_t = \mathbf{s}_t$)。假设数据由一个好策略 $\pi^\star(\mathbf{s}_t)$ 产生,它是确定性的:在状态 $\mathbf{s}$ 上,正确动作就是 $\pi^\star(\mathbf{s})$。定义 0-1 代价:
$$ c(\mathbf{s}_t,\mathbf{a}_t) = \begin{cases} 0 & \text{if } \mathbf{a}_t = \pi^\star(\mathbf{s}_t) \\ 1 & \text{otherwise} \end{cases} $$也就是说:每犯一次错,付出 1 单位代价。这是一个很粗糙的代价函数(它认为「稍微打偏一点」和「一头撞上去」一样糟),但正因为粗糙,它给出的界才是最坏情况的界。
把这一步写全:
$$ \E_{\mathbf{a}_t \sim \pi_\theta(\mathbf{a}_t|\mathbf{s}_t)}\big[c(\mathbf{s}_t,\mathbf{a}_t)\big] = \sum_{\mathbf{a}_t} \pi_\theta(\mathbf{a}_t|\mathbf{s}_t)\, c(\mathbf{s}_t,\mathbf{a}_t) = \sum_{\mathbf{a}_t \neq \pi^\star(\mathbf{s}_t)} \pi_\theta(\mathbf{a}_t|\mathbf{s}_t) = \pi_\theta\big(\mathbf{a}_t \neq \pi^\star(\mathbf{s}_t) \,\big|\, \mathbf{s}_t\big) $$5.3 我们要界定的量:期望犯错总数
整条轨迹上的总代价,就是把每个时刻的期望代价加起来。注意状态要从策略自己诱导的分布 $p_{\pi_\theta}(\mathbf{s}_t)$ 里采:
$$ J(\pi_\theta) \;=\; \sum_{t=1}^{H} \E_{\mathbf{s}_t \sim p_{\pi_\theta}(\mathbf{s}_t),\ \mathbf{a}_t \sim \pi_\theta(\mathbf{a}_t|\mathbf{s}_t)}\big[c(\mathbf{s}_t,\mathbf{a}_t)\big] $$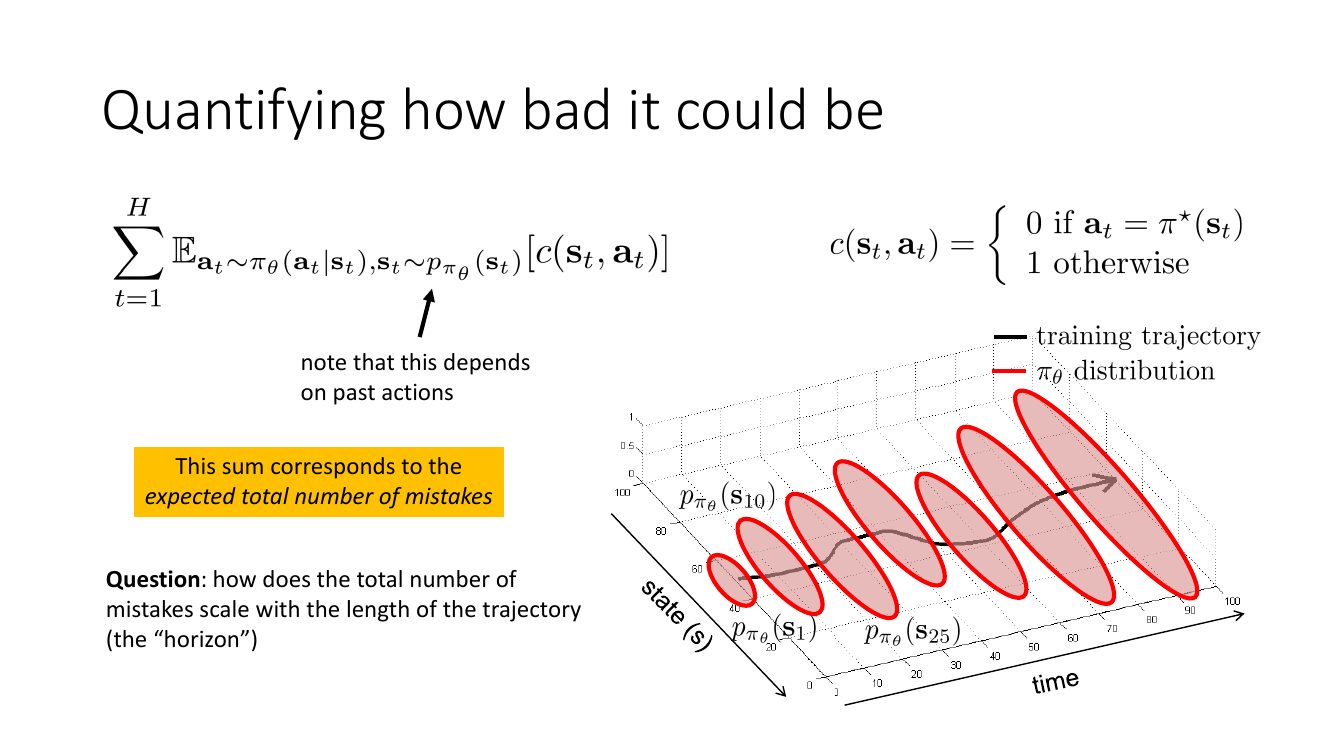
「训练误差 $\epsilon$,跑 $H$ 步,那期望犯错就是 $\epsilon H$ 呗。」——这个推理默认了每一步的状态都还在训练分布里。而事实是:第一次犯错就把你踢出了训练分布,从那以后 $\epsilon$ 这个数字对你不再有任何约束力。下面的推导就是在算这个「踢出去」的代价。
5.4 第一版:最坏情况的直观论证
先做一个更强、更不现实的假设,好把直觉建立起来:
$$ \pi_\theta\big(\mathbf{a} \neq \pi^\star(\mathbf{s}) \,\big|\, \mathbf{s}\big) \le \epsilon \qquad \text{对所有 } \mathbf{s} \in \mathcal{D}_{\text{train}} $$注意这里是「对训练集里的每一个状态,犯错概率都不超过 $\epsilon$」,这比「平均犯错概率不超过 $\epsilon$」强得多。即便如此,结论仍然很糟。
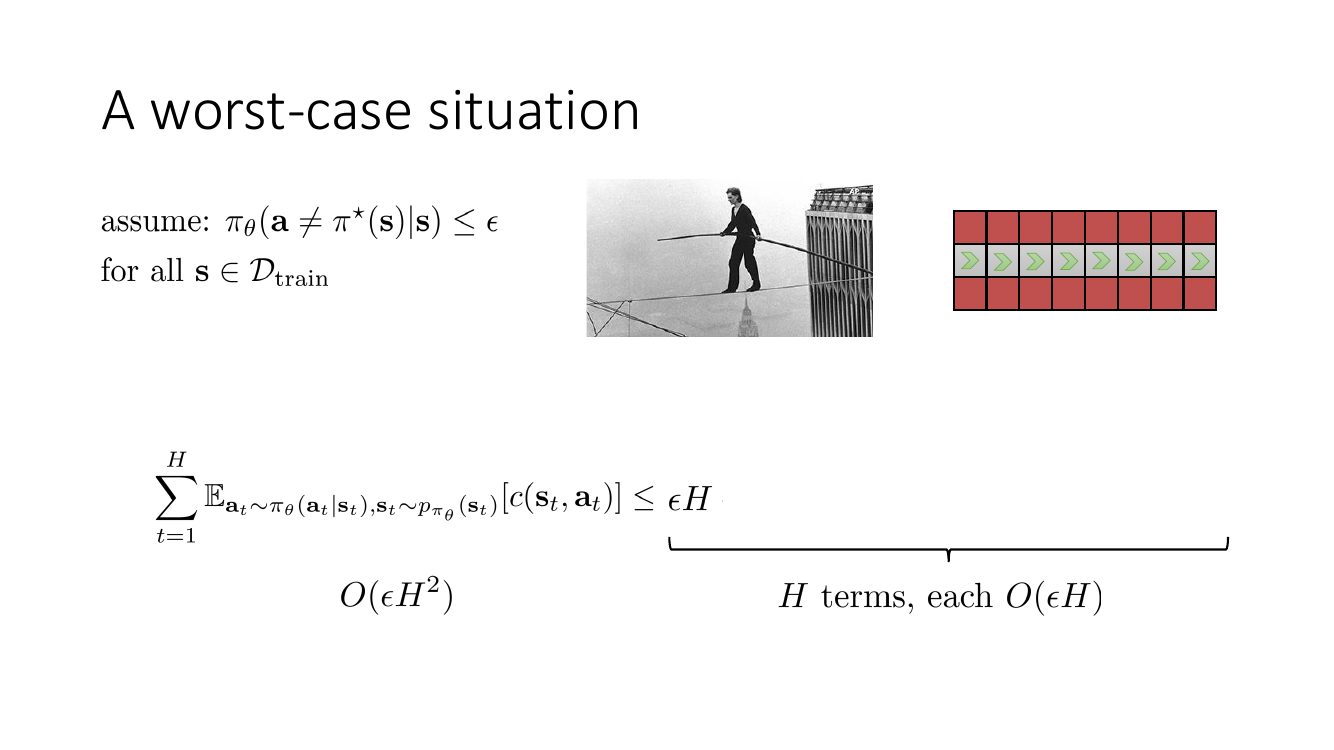
逐步展开这个论证。考虑第 $t$ 步:
- 如果前 $t-1$ 步一次都没犯错(概率至少 $(1-\epsilon)^{t-1}$),那么此刻你还在训练分布上,第 $t$ 步的犯错概率 $\le \epsilon$,而且往后的每一步依然受 $\epsilon$ 约束。
- 如果犯过至少一次错(概率 $\le 1-(1-\epsilon)^{t-1}$),你已经不在训练分布里了,最坏情况下剩下的每一步都犯错,代价为 1。
于是,「第一次犯错发生在第 $t$ 步」这个事件的概率大约是 $\epsilon$(乘上前面都没错的概率,$\le\epsilon$),而一旦在第 $t$ 步首次犯错,后续 $H-t$ 步全部作废,贡献代价 $H-t$。把所有可能的首错时刻加起来:
$$ \E[\text{总犯错数}] \;\lesssim\; \sum_{t=1}^{H} \epsilon \cdot (H - t) \;=\; \epsilon \cdot \frac{H(H-1)}{2} \;=\; O(\epsilon H^2) $$这就是幻灯片上「$H$ 个项,每项 $O(\epsilon H)$,合计 $O(\epsilon H^2)$」的含义。
两个 $H$ 来自两个不同的地方,把它们分开看就不神秘了。第一个 $H$:轨迹有 $H$ 步,每一步都是一次「可能第一次跌出分布」的机会。第二个 $H$:每一次跌出去,损失的不是 1 步,而是剩余的所有步,平均是 $H/2$ 步。机会数 $\times$ 每次机会的损失 $=H \times H/2$,再乘上每次跌出去的概率 $\epsilon$,就是 $\epsilon H^2/2$。
对比监督学习:那里也有 $H$ 个样本,每个样本犯错代价是 1,所以是 $\epsilon H$。差别只在于「一次错误的后果会不会波及未来」。
5.5 一个具体数值:为什么 99.9% 的准确率救不了你
假设你训练出一个非常好的驾驶策略,在训练分布上每一步的犯错概率只有 $\epsilon = 10^{-3}$(千分之一,按 10 Hz 控制频率算,相当于平均每 100 秒才失误一次,听起来相当靠谱)。
| 时域 $H$(步) | 监督学习式预期 $\epsilon H$ | 最坏情况界 $\epsilon H^2/2$ | 解读 |
|---|---|---|---|
| 10(1 秒) | 0.01 | 0.05 | 几乎察觉不到差别 |
| 100(10 秒) | 0.1 | 5 | 已经差 50 倍 |
| 1000(100 秒) | 1 | 500 | 界已经超过 $H$ 的一半,完全失去意义 |
| 10000(约 17 分钟) | 10 | $5\times 10^4$(截断为 $H$) | 界饱和:等价于「几乎每一步都错」 |
这张表说明三件事。第一,短时域任务上 BC 很好用——这解释了为什么「抓取一个物体」这类几秒钟的任务用 BC 效果不错。第二,长时域任务上界迅速退化到平凡(犯错数不可能超过 $H$,所以界一旦超过 $H$ 就没信息量了)。第三,也是最重要的:要想在 $H$ 变大时保持性能,$\epsilon$ 必须以 $1/H^2$ 的速度下降,而泛化误差通常只能随数据量 $N$ 以 $O(1/\sqrt{N})$ 或 $O(1/N)$ 下降。这就回答了幻灯片上的第二个问题:问题不会随着数据变多而自动消失,只会变得更贵。
6. 更一般的分析:用总变差距离做完整证明
上一节的假设「对训练集里每一个状态犯错概率都 $\le\epsilon$」太强了:真实的监督学习只能保证平均误差小。这一节把假设换成更弱、更现实的版本,重新做一遍推导——结论仍然是 $O(\epsilon H^2)$,而且这次是严格的。
6.1 更弱的假设
$$ \E_{\mathbf{s}_t \sim p_{\text{train}}(\mathbf{s}_t)}\Big[\pi_\theta\big(\mathbf{a}_t \neq \pi^\star(\mathbf{s}_t)\big|\mathbf{s}_t\big)\Big] \;\le\; \epsilon $$用话说:「如果我们从训练分布里采一个状态,策略不太可能犯错。」这正是监督学习的泛化保证所能给出的东西——它对个别的、罕见的困难状态不作任何承诺。
6.2 一个有用的分解
核心技巧是把策略诱导的状态分布 $p_{\pi_\theta}(\mathbf{s}_t)$ 按「到 $t$ 时刻为止有没有犯过错」分成两块:
$$ p_{\pi_\theta}(\mathbf{s}_t) \;=\; \underbrace{(1-\epsilon)^t}_{\text{一次都没犯错的概率}} p_{\text{train}}(\mathbf{s}_t) \;+\; \underbrace{\big(1-(1-\epsilon)^t\big)}_{\text{至少犯过一次错}} p_{\text{mistake}}(\mathbf{s}_t) $$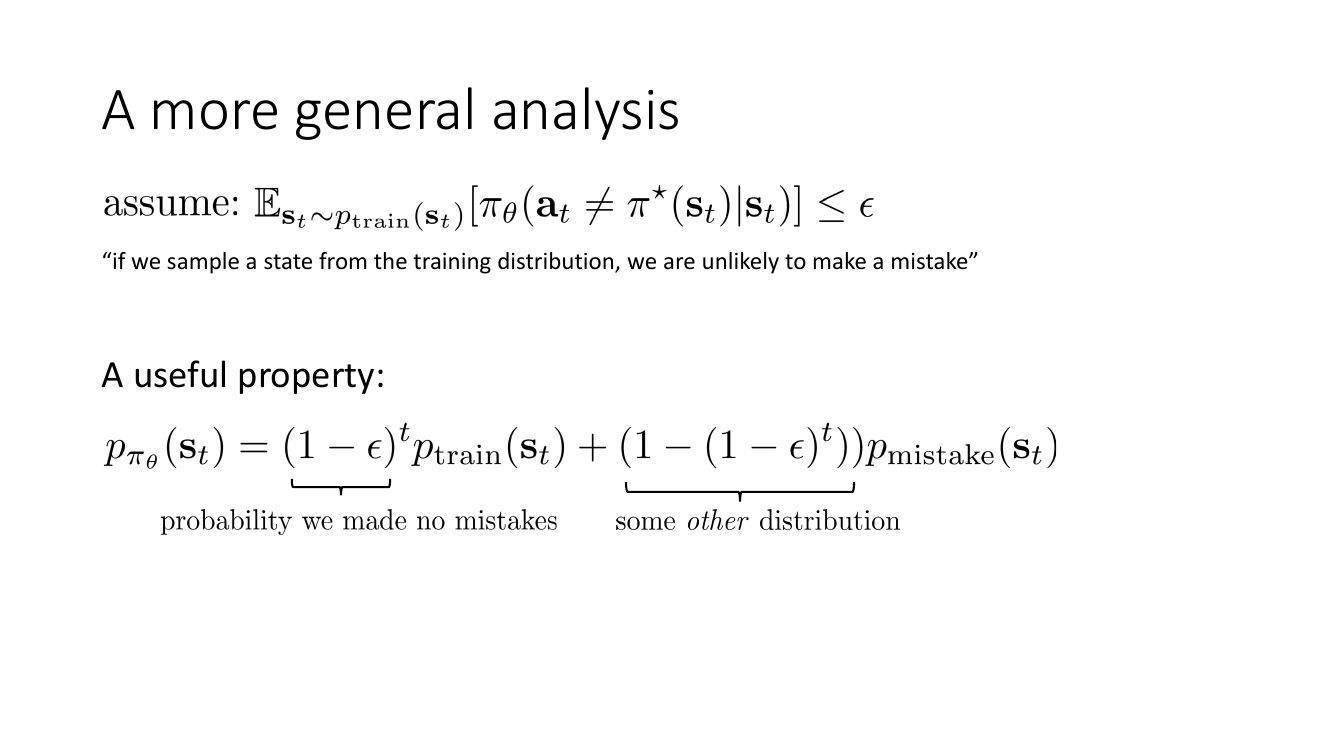
严格来说 $(1-\epsilon)^t$ 只是「没犯错概率」的一个下界(因为一旦离开训练分布,犯错率就不再受 $\epsilon$ 约束,可能更高),而 $p_{\text{mistake}}$ 是把所有其它情况打包进去的记号。这个分解是构造性的、略显粗糙的,但它足以支撑我们要的上界。Levine 在课上明确说这是「a bit of theory」,目的是拿到标度关系,不是写一篇理论论文。真正严谨的版本见 Ross & Bagnell 的 DAgger 论文。
6.3 两个分布差多远:总变差距离
引入总变差距离(total variation divergence):
$$ D_{\mathrm{TV}}(p,q) \;=\; \frac{1}{2}\sum_{x} \big|p(x) - q(x)\big| \;\le\; 1 $$「$\le 1$」是它最重要的性质:无论两个分布差得多离谱,TV 距离最多是 1(当两者支撑集完全不相交时取到)。这就是我们用来给 $p_{\text{mistake}}$ 兜底的工具。
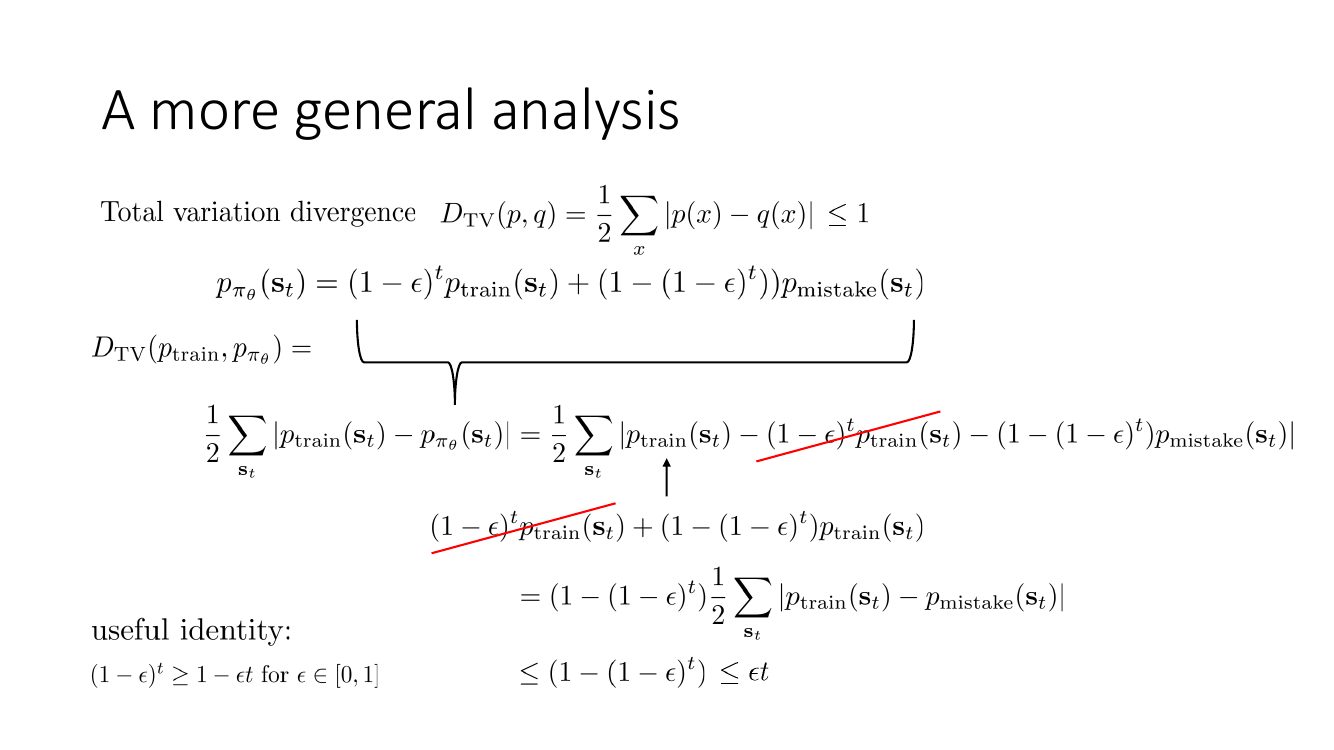
把这几步全部写出来。
第一步,按定义展开,并把 $p_{\pi_\theta}$ 用分解式代入:
$$ D_{\mathrm{TV}} = \frac{1}{2}\sum_{\mathbf{s}_t}\big|p_{\text{train}}(\mathbf{s}_t) - p_{\pi_\theta}(\mathbf{s}_t)\big| = \frac{1}{2}\sum_{\mathbf{s}_t}\Big|p_{\text{train}}(\mathbf{s}_t) - (1-\epsilon)^t p_{\text{train}}(\mathbf{s}_t) - \big(1-(1-\epsilon)^t\big)p_{\text{mistake}}(\mathbf{s}_t)\Big| $$第二步(配凑),注意到恒等式 $p_{\text{train}} = (1-\epsilon)^t p_{\text{train}} + \big(1-(1-\epsilon)^t\big)p_{\text{train}}$,把它代入上式最左边那一项,$(1-\epsilon)^t p_{\text{train}}$ 与后面的同类项抵消:
$$ = \frac{1}{2}\sum_{\mathbf{s}_t}\Big|\big(1-(1-\epsilon)^t\big)p_{\text{train}}(\mathbf{s}_t) - \big(1-(1-\epsilon)^t\big)p_{\text{mistake}}(\mathbf{s}_t)\Big| = \big(1-(1-\epsilon)^t\big)\cdot \frac{1}{2}\sum_{\mathbf{s}_t}\big|p_{\text{train}}(\mathbf{s}_t) - p_{\text{mistake}}(\mathbf{s}_t)\big| $$第三步,右边那个求和就是 $D_{\mathrm{TV}}(p_{\text{train}}, p_{\text{mistake}}) \le 1$,直接扔掉(这就是「不需要知道 $p_{\text{mistake}}$」的地方):
$$ \le\ 1-(1-\epsilon)^t $$第四步,用伯努利不等式 $(1-\epsilon)^t \ge 1 - \epsilon t$($\epsilon\in[0,1]$,对 $t\ge 1$ 的整数成立,可对 $t$ 归纳证明),得到 $1-(1-\epsilon)^t \le \epsilon t$:
$$ D_{\mathrm{TV}}(p_{\text{train}}, p_{\pi_\theta}) \;\le\; \epsilon t $$这个中间结论本身就很有信息量:策略的状态分布与训练分布的偏离,随时间线性增长,斜率是 $\epsilon$。$t$ 越大偏得越远,这是「误差累积」最直接的数学表述。
6.4 从分布距离到代价
现在回到我们真正关心的量——期望犯错总数。
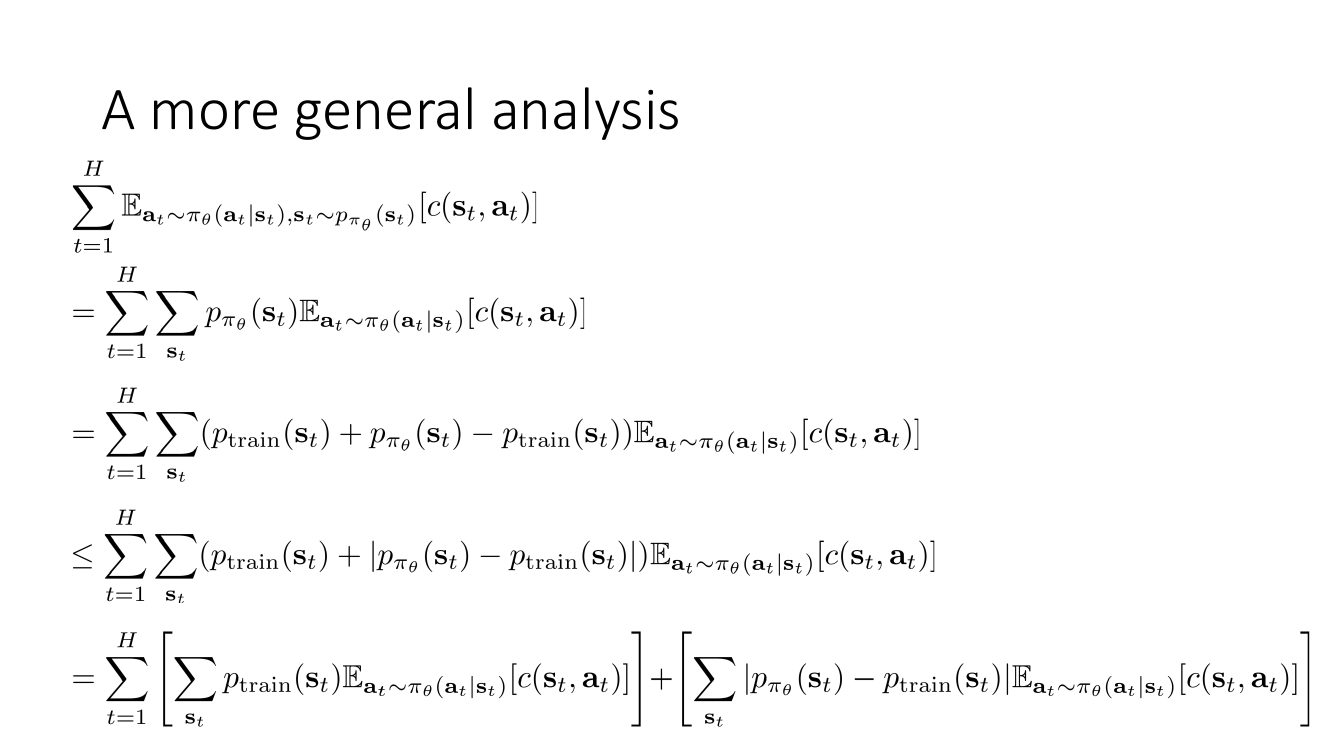
第一步,把对状态的期望写成求和:
$$ \sum_{t=1}^{H} \E_{\mathbf{s}_t \sim p_{\pi_\theta}(\mathbf{s}_t)}\Big[\E_{\mathbf{a}_t\sim\pi_\theta}\big[c(\mathbf{s}_t,\mathbf{a}_t)\big]\Big] = \sum_{t=1}^{H}\sum_{\mathbf{s}_t} p_{\pi_\theta}(\mathbf{s}_t)\,\E_{\mathbf{a}_t\sim\pi_\theta(\mathbf{a}_t|\mathbf{s}_t)}\big[c(\mathbf{s}_t,\mathbf{a}_t)\big] $$第二步,加减 $p_{\text{train}}(\mathbf{s}_t)$:
$$ = \sum_{t=1}^{H}\sum_{\mathbf{s}_t} \Big(p_{\text{train}}(\mathbf{s}_t) + p_{\pi_\theta}(\mathbf{s}_t) - p_{\text{train}}(\mathbf{s}_t)\Big)\,\E_{\mathbf{a}_t\sim\pi_\theta}\big[c\big] $$第三步,因为 $\E[c] \ge 0$,把差值放大成绝对值只会让式子变大:
$$ \le \sum_{t=1}^{H}\sum_{\mathbf{s}_t} \Big(p_{\text{train}}(\mathbf{s}_t) + \big|p_{\pi_\theta}(\mathbf{s}_t) - p_{\text{train}}(\mathbf{s}_t)\big|\Big)\,\E_{\mathbf{a}_t\sim\pi_\theta}\big[c\big] $$第四步,拆成两块:
$$ = \sum_{t=1}^{H}\left[\underbrace{\sum_{\mathbf{s}_t} p_{\text{train}}(\mathbf{s}_t)\E_{\mathbf{a}_t\sim\pi_\theta}[c]}_{(\mathrm{A})}\right] + \left[\underbrace{\sum_{\mathbf{s}_t}\big|p_{\pi_\theta}(\mathbf{s}_t) - p_{\text{train}}(\mathbf{s}_t)\big|\,\E_{\mathbf{a}_t\sim\pi_\theta}[c]}_{(\mathrm{B})}\right] $$第五步,界定 (A)。它恰好就是 $\E_{\mathbf{s}_t\sim p_{\text{train}}}\big[\pi_\theta(\mathbf{a}_t\neq\pi^\star(\mathbf{s}_t)|\mathbf{s}_t)\big]$,正是我们的假设,所以 $(\mathrm{A}) \le \epsilon$。
第六步,界定 (B)。把它拆成两个因子:$\E_{\mathbf{a}_t}[c] \le 1$(0-1 代价的上界),而剩下的求和 $\sum_{\mathbf{s}_t}|p_{\pi_\theta}-p_{\text{train}}| = 2D_{\mathrm{TV}}(p_{\pi_\theta},p_{\text{train}}) \le 2\epsilon t$(用上一小节的结论)。所以 $(\mathrm{B}) \le 2\epsilon t$。
第七步,合并求和。
$$ J(\pi_\theta) \;\le\; \sum_{t=1}^{H}\big(\epsilon + 2\epsilon t\big) \;=\; \epsilon H + 2\epsilon\cdot\frac{H(H+1)}{2} \;=\; \epsilon H^2 + 2\epsilon H \;=\; O(\epsilon H^2) $$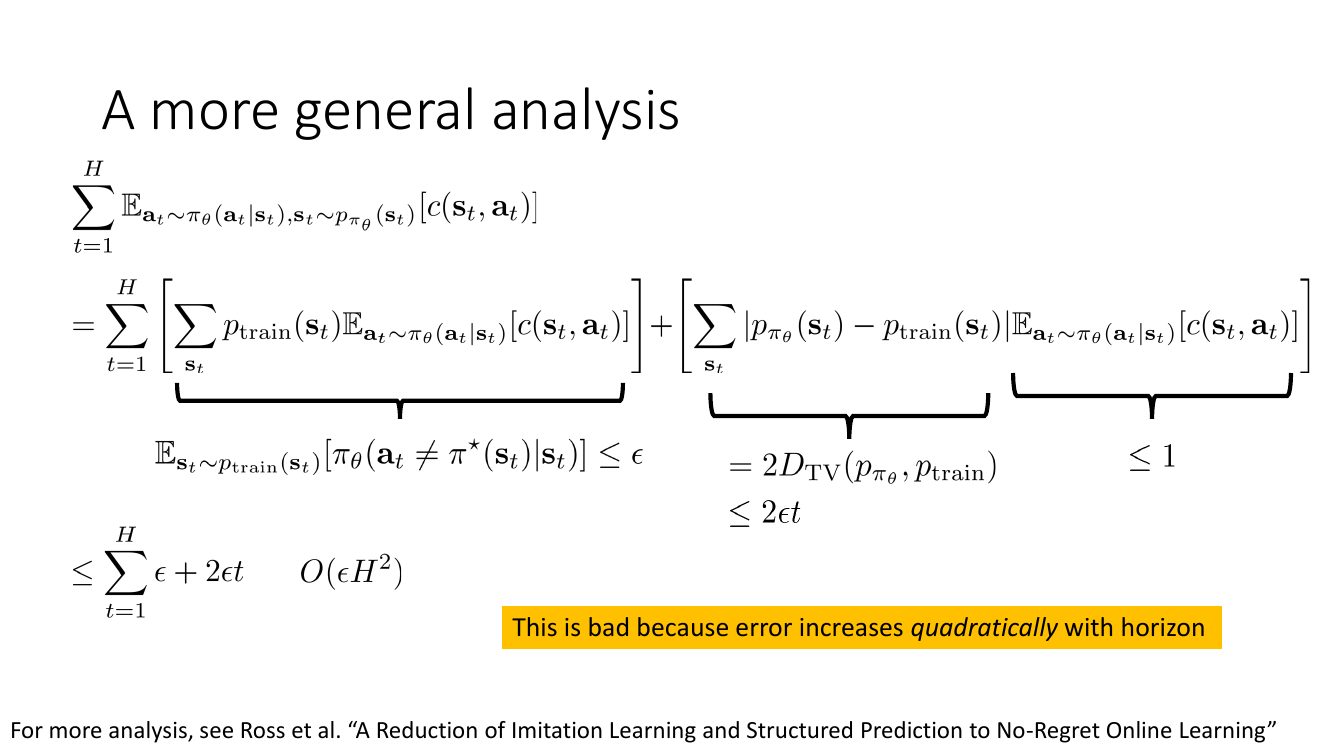
- 比监督学习更糟吗? 是。监督学习是 $O(\epsilon H)$($H$ 个独立样本各犯 $\epsilon$ 的错),模仿学习最坏是 $O(\epsilon H^2)$。多出来的那个 $H$ 完全来自「动作会改变未来的输入分布」。
- 数据变多问题会消失吗? 不会自动消失。更多数据只能压小 $\epsilon$,压不掉 $H^2$ 这个因子;要在时域翻倍时维持同样的性能,你需要 $\epsilon$ 降到 1/4,这在样本复杂度上是极其昂贵的。
- 某些控制问题更糟吗? 是。$H$ 越长、越是「一步错步步错」的窄通道型任务(走钢丝、精细装配),界越紧、现实也越接近最坏情况。
7. 这个界有多悲观?以及一个反直觉的悖论
拿到一个 $O(\epsilon H^2)$ 的界之后,正确的态度不是「所以 BC 没救了」,而是去问:这个最坏情况在现实中有多典型?
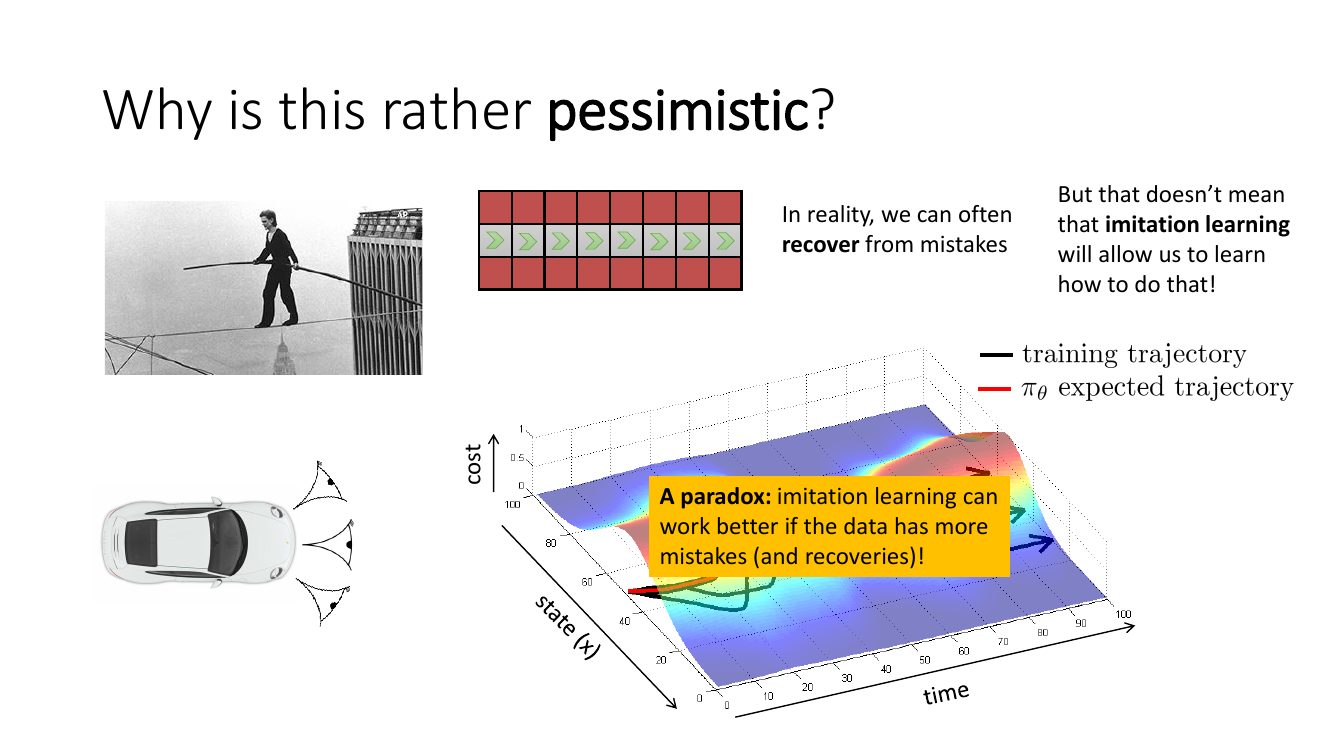
7.1 为什么最坏情况通常不会发生
$O(\epsilon H^2)$ 的推导里有一个隐含的最坏假设:一旦离开训练分布,就再也回不来($p_{\text{mistake}}$ 与 $p_{\text{train}}$ 完全不相交,TV 距离取到上界 1)。真实的物理系统很少这么残酷:
- 大多数控制问题有吸引子结构:车道保持任务里,即使方向盘打偏几度,路面几何和后续的正确动作也会把你拉回车道中心;机械臂的位置误差在下一步就能被纠正。
- 动力学往往是耗散的、稳定的:小扰动会衰减而不是放大。走钢丝之所以是最坏情况的完美隐喻,正因为它是罕见的不稳定系统。
- 状态分布的重叠往往并不小:车偏离 5 厘米时看到的画面,与在中心线上看到的画面在特征空间里非常接近,网络的泛化能力本身就提供了一定的鲁棒性。
7.2 但「能恢复」不等于「学得会恢复」
这是 Levine 特别强调的一点,也是许多人第一次读这套材料时漏掉的。系统物理上可以从偏离态恢复,与策略知道怎么恢复,是两件完全不同的事。而 BC 学不到恢复行为的原因非常直接:演示数据里没有恢复行为。
一个优秀的人类司机从不压线,所以数据集里 $p_{\text{train}}$ 的支撑集根本不包含「车已经压线」这个状态;网络在这个输入上的输出是纯粹的外插,没有任何监督信号约束过它。就算真实世界允许你打方向盘回正,策略也不知道这件事。
假设有两位司机来采数据:
司机 A:技术完美,全程车在正中,方向盘几乎不动。数据里 $\epsilon$ 可以训得极小,但状态分布是一根极细的线。
司机 B:技术一般,经常偏个十几厘米,然后打回来。数据里有噪声,训练误差 $\epsilon$ 更大,但状态分布是一条宽带,并且带上的每个偏离态都配着正确的纠偏动作。
用 B 的数据训出来的策略,在真机上几乎总是表现更好。为什么?因为 BC 的失败模式不是「动作精度不够」,而是「跌出分布后不知所措」。B 的数据把 $p_{\text{train}}$ 撑宽了,使得策略执行时的漂移仍然落在训练分布内;而且它示范了漂移之后该怎么办。用理论的语言说:牺牲一点 $\epsilon$,换取 $p_{\text{mistake}}$ 与 $p_{\text{train}}$ 的大幅重叠,从而让 $D_{\mathrm{TV}}$ 那一项不再随 $t$ 线性增长。
这个洞见有非常具体的工程后果,在今天的机器人数据采集里是常识:
- 主动注入噪声:让演示者在带噪声的遥操作下工作(或对专家动作加小扰动),迫使他不断做微观纠正,这些纠正就成了训练信号。DART(Laskey 等人,2017)就是把这个想法系统化的方法。
- 合成偏离态:NVIDIA 的三摄像头就是最经典的例子——不改变演示者的行为,而是用几何变换伪造偏离视角,再解析地推算出对应的修正动作。
- 不要过滤掉「不完美」的演示:直觉上你会想只保留最漂亮的那些轨迹,但对 BC 来说,含有小失误 + 纠正的轨迹是宝贵的,不该扔。
「既然噪声有好处,那我把动作标签随机扰动一下当数据增强就行了。」——不行。关键不在于动作噪声本身,而在于「偏离态 → 正确的纠偏动作」这个配对必须是真实的。给动作标签加噪声只会把正确标签变成错误标签,纯粹损害性能。正确的做法是让状态偏离(通过扰动执行、通过几何变换伪造观测),然后为偏离后的状态获取正确的标签。
8. DAgger:从根上修好分布漂移
8.1 换一个方向想
问题是 $p_{\text{data}}(\mathbf{o}_t) \neq p_{\pi_\theta}(\mathbf{o}_t)$。要修好它,可以从两端下手:
- 改 $p_{\pi_\theta}$:让策略尽量别偏离数据分布。这需要更强的模型、更好的表示、更多数据——本质上是在把 $\epsilon$ 往小里压。有用,但正如第 5 节算过的,代价随 $H$ 二次增长。
- 改 $p_{\text{data}}$:让训练数据来自策略自己会访问到的分布。这才是 DAgger 的思路。
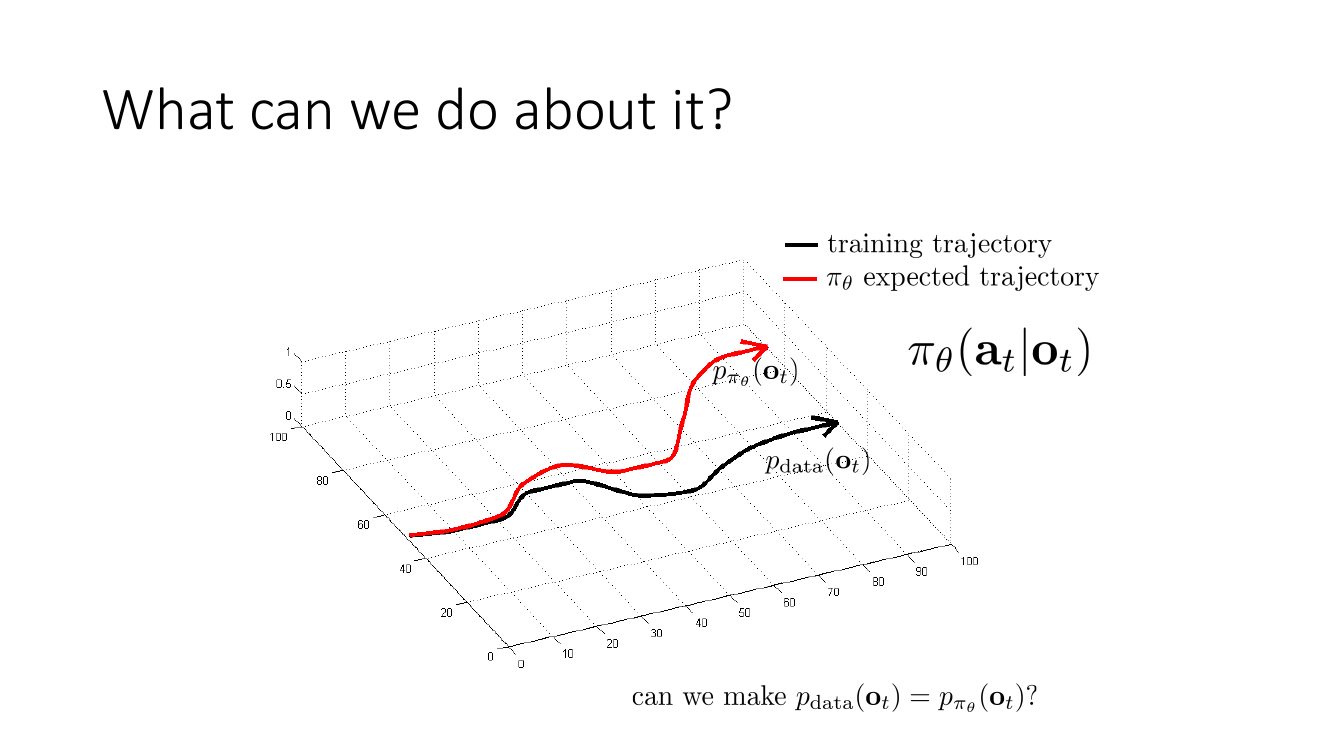
与其绞尽脑汁让 $p_{\pi_\theta}(\mathbf{o}_t)$ 变聪明,不如让 $p_{\text{data}}(\mathbf{o}_t)$ 变聪明——直接从 $p_{\pi_\theta}$ 里采数据。怎么采?把策略放到环境里跑就是了。唯一缺的是标签 $\mathbf{a}_t$:这些状态上正确的动作是什么?去问专家。
8.2 算法
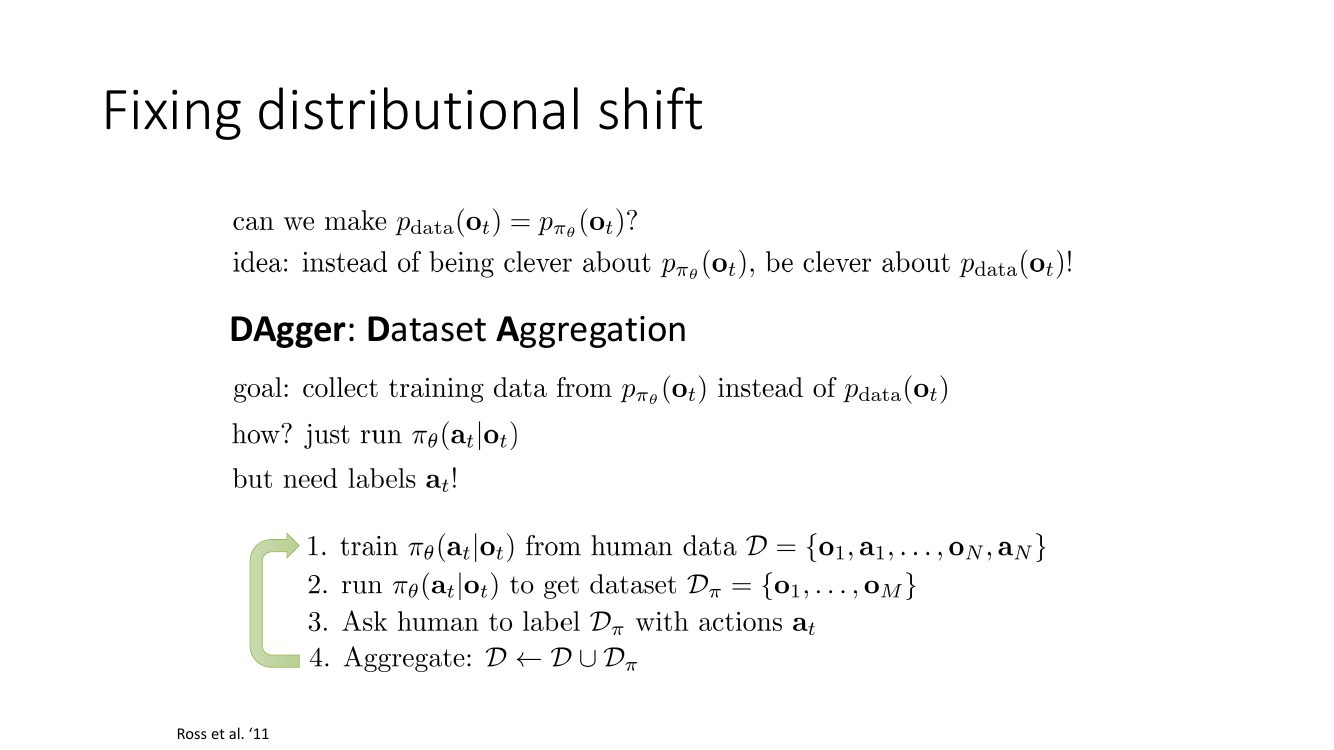
- 在人类数据 $\mathcal{D} = \{\mathbf{o}_1,\mathbf{a}_1,\ldots,\mathbf{o}_N,\mathbf{a}_N\}$ 上训练 $\pi_\theta(\mathbf{a}_t|\mathbf{o}_t)$;
- 运行 $\pi_\theta(\mathbf{a}_t|\mathbf{o}_t)$ 与环境交互,得到只有观测、没有标签的数据集 $\mathcal{D}_\pi = \{\mathbf{o}_1,\ldots,\mathbf{o}_M\}$;
- 请人类为 $\mathcal{D}_\pi$ 中的每个观测标注正确动作 $\mathbf{a}_t$;
- 聚合:$\mathcal{D} \leftarrow \mathcal{D} \cup \mathcal{D}_\pi$,回到第 1 步。
为什么这样就修好了?因为随着迭代进行,$\mathcal{D}$ 里越来越大的比例来自 $p_{\pi_\theta}$ 本身,训练分布逐步收敛到策略的执行分布。当 $p_{\text{data}} \to p_{\pi_\theta}$ 时,第 6 节推导里那个 $2D_{\mathrm{TV}} \le 2\epsilon t$ 的偏移项趋近于 0,只剩下主项 $\sum_t \epsilon = \epsilon H$。误差界从 $O(\epsilon H^2)$ 回到了监督学习的 $O(\epsilon H)$——这是 Ross 等人论文的核心定理(严格版本用 no-regret 在线学习的框架给出,且要求专家可查询的次数随迭代增长)。
回看第 6 节最后的拆分 $J(\pi_\theta) \le \sum_{t=1}^{H}\big[(\mathrm{A}) + (\mathrm{B})\big]$,其中 $(\mathrm{A})\le\epsilon$ 是「训练分布上的固有误差」,$(\mathrm{B})\le 2D_{\mathrm{TV}}(p_{\pi_\theta},p_{\text{train}})$ 是「分布偏移的额外代价」。BC 的问题在于 $(\mathrm{B})$ 随 $t$ 线性增长,求和后给出 $H^2$。而 DAgger 在收敛时满足 $p_{\text{train}} = p_{\pi_\theta}$,于是
$$ D_{\mathrm{TV}}(p_{\pi_\theta},p_{\text{train}}) = 0 \quad\Longrightarrow\quad J(\pi_\theta) \le \sum_{t=1}^{H}\epsilon = \epsilon H $$换句话说,DAgger 不是让策略变准了($\epsilon$ 没变),而是让「训练分布」和「测试分布」重新对齐,从而恢复了 i.i.d. 假设。这是它与「换个更大的模型」在性质上的根本区别。
8.3 DAgger 的真正麻烦:第 3 步
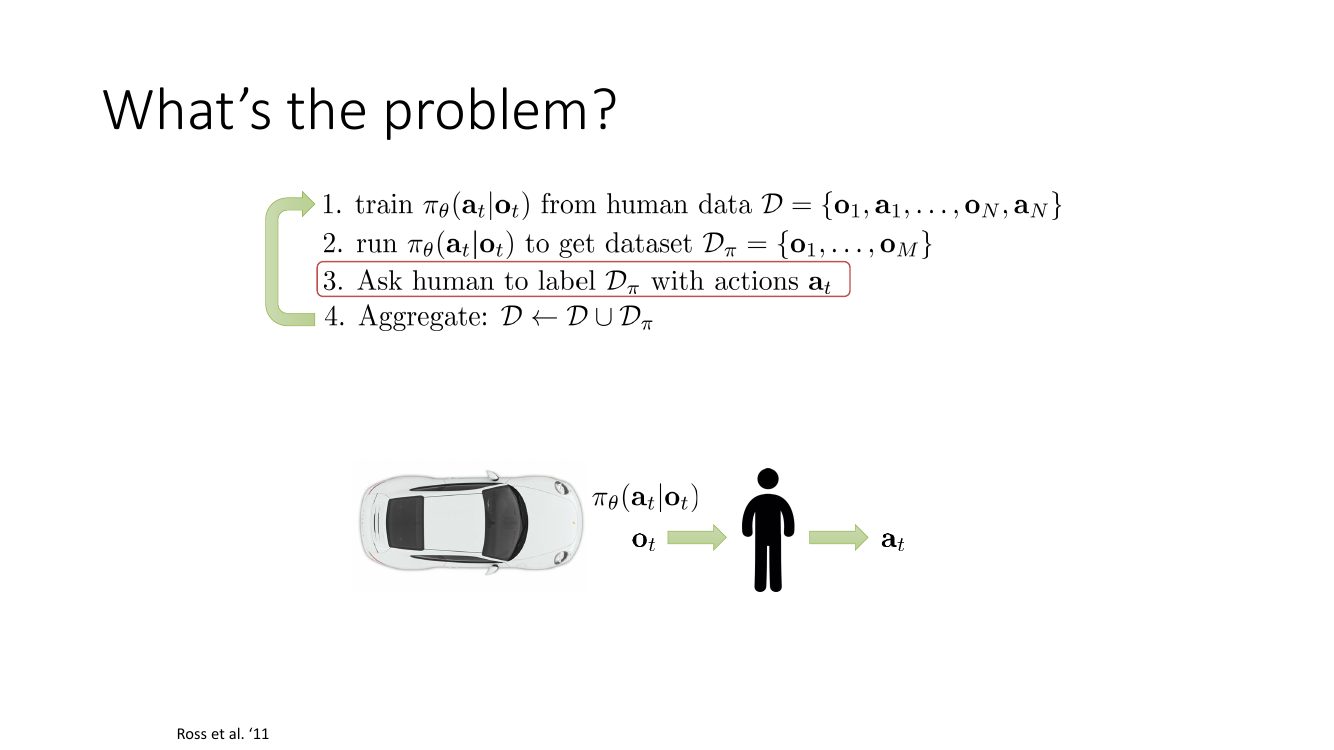
这一步在实践中有三个层面的困难:
| 困难 | 说明 | 后果 |
|---|---|---|
| 需要交互式专家 | 不能只用一批离线演示数据,专家必须在训练循环里随叫随到 | 大幅抬高数据成本;很多场景(历史数据、他人采集的数据集)根本无法应用 |
| 脱离情境标注很难 | 人类的控制能力是闭环、连续、有本体感觉的。给一张静态图片说「打 7.3 度方向盘」,人根本给不准 | 标签质量差,噪声大;对精细操作(机器人力控)几乎不可能标 |
| 要标的状态很危险/很怪 | DAgger 特意去采策略犯错后的状态——那可能是「车已经在对向车道」 | 真机上直接跑未训练好的策略有安全风险;早期迭代尤其危险 |
8.4 工程上更常用的变体:人类接管
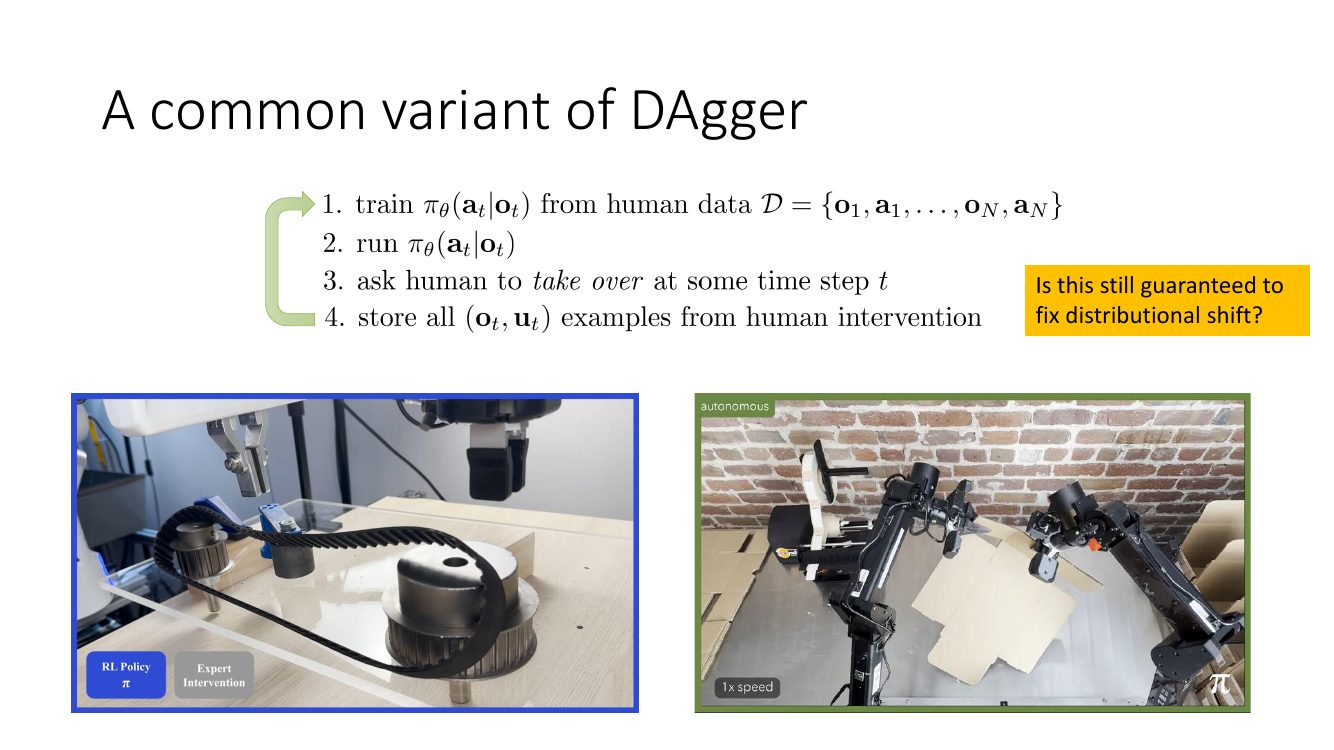
这个变体在人机工效上好太多:人类不需要对着截图猜,而是直接接过控制权继续开,标签是他在真实闭环情境下的自然操作,质量高得多。今天绝大多数机器人公司的数据飞轮就是这么转的。
严格来说——不完全保证。原始 DAgger 要求对策略访问到的每一个状态都获得专家标注,这样训练分布才真正等于 $p_{\pi_\theta}$。而接管变体只在人类觉得该干预的时刻之后才记录数据,于是:
- 数据集偏向「危险/困难状态 + 人类救场动作」,而策略正常运行时访问的大量普通状态没有新增标注,两个分布仍不相同;
- 人类什么时候接管带有很强的主观性,这引入了一个不受控的采样偏置;
- 接管瞬间往往伴随控制权切换的动力学不连续,那一段数据可能本身就有噪声。
但在工程上它通常仍然有效,因为它精确地补上了最需要补的那部分数据——策略即将失败的地方。这是理论保证与实用性之间一次典型的交换,Levine 把这个问题留给听众思考,本身就是在提醒你:算法的理论保证依赖于它的每一个前提条件,改了前提就得重新想。
8.5 DAgger 的最小实现
def dagger(env, expert, obs_dim, act_dim, n_iters=10, rollouts_per_iter=20):
    """expert(obs) -> 正确动作;在仿真里通常是一个已有的控制器,
    在真机上就是「请人类标注 / 接管」这一步。"""
    obs_buf, act_buf = [], []

    # 第 0 轮:纯 BC,用专家自己跑出来的数据
    for _ in range(rollouts_per_iter):
        o, done = env.reset(), False
        while not done:
            a = expert(o)                    # 专家演示
            obs_buf.append(o); act_buf.append(a)
            o, _, done, _ = env.step(a)      # 环境由专家动作驱动

    policy = None
    for it in range(n_iters):
        # 1. 在聚合后的数据集上重新训练(每轮从头训,避免早期数据的过拟合遗留)
        policy = behavior_cloning(torch.stack(obs_buf), torch.stack(act_buf),
                                  obs_dim, act_dim)

        # 2&3. 跑「学生」策略采状态,但标签来自专家 —— 这两行是 DAgger 的全部秘密
        for _ in range(rollouts_per_iter):
            o, done = env.reset(), False
            while not done:
                a_student = policy.act(o, deterministic=True)
                a_expert  = expert(o)        # 专家对学生访问到的状态给出正确动作
                obs_buf.append(o); act_buf.append(a_expert)
                o, _, done, _ = env.step(a_student)   # 注意:环境由「学生」驱动!
        # 4. 聚合已经在上面的 append 里完成了
        print(f"DAgger iter {it}: dataset size = {len(obs_buf)}")
return policy请对照两处细节。第一,内层循环里 env.step(a_student) 用的是学生的动作,而 act_buf.append(a_expert) 存的是专家的动作——状态由学生的分布产生,标签由专家提供,这一行错位就是 DAgger 的全部内容。第二,每轮都在聚合后的完整数据集上重训,而不是只用新数据微调;「Aggregation」这个名字就是从这里来的,它保证了策略不会在迭代中遗忘早期的好行为(对应 no-regret 在线学习里的 Follow-the-Leader)。
常见的实用变体还有 $\beta$-混合:第 $i$ 轮用 $\pi_i = \beta_i \pi^\star + (1-\beta_i)\pi_\theta$ 去采数据,$\beta_i$ 从 1 递减到 0。早期主要由专家驾驶(安全、状态不至于太离谱),后期完全交给学生。原论文推荐 $\beta_i$ 指数衰减,并证明只要 $\frac{1}{N}\sum_i \beta_i \to 0$,no-regret 保证依然成立。
9. 不改算法,怎么让 BC 好用
DAgger 需要交互式专家,这个前提在很多场景下无法满足(你手上只有一批别人采好的离线数据)。那么在不改算法的前提下,还有哪些手段?Levine 给出的清单有四条,逐条展开。
9.1 让模型强到几乎不犯错
既然界是 $O(\epsilon H^2)$,把 $\epsilon$ 压到足够小当然也管用。这条路线在今天的机器人基础模型(RT-1、RT-2、Octo、$\pi_0$ 一类)上被推到了极致:几十亿参数、上千小时的多机器人数据、强大的视觉语言预训练。
但要看清这条路的两个前提。其一,$\epsilon$ 必须以 $1/H^2$ 的速度下降才能维持性能,所以模型规模换来的收益是被时域平方稀释的;这解释了为什么大模型在「拿起杯子」这种几秒钟的任务上表现惊艳,在「整理整个厨房」这种几分钟的长程任务上仍然会崩。其二,拟合专家分布本身也很难——人类演示是多模态且非马尔可夫的,用单峰高斯去拟合会得到「两个正确动作的平均值」这种最糟的结果。这正是下一讲要用扩散策略、动作分块等手段解决的问题。
9.2 聪明地采集与增强数据
这是投入产出比最高的一条,也是第 3 节 NVIDIA 案例和第 7 节悖论的直接推论。核心目标只有一个:让 $p_{\text{train}}$ 覆盖策略执行时会漂到的区域,并在那些区域提供正确的纠偏标签。
| 手段 | 怎么做 | 为什么有效 |
|---|---|---|
| 多摄像头 | 装左/中/右三个相机,左相机图像配「右打一点」的标签,右相机配「左打一点」 | 零成本合成偏离视角 + 解析地推出正确纠正动作,直接把 $p_{\text{train}}$ 撑宽 |
| 几何增强 | 对图像做随机平移/旋转,并对动作标签做相应的修正 | 同上,但要求你知道「视角变换 ↔ 动作修正」的对应关系 |
| 注入噪声演示 | 在遥操作链路上加扰动,逼演示者不断做微观纠正(DART) | 真实的「偏离 → 纠正」配对,标签质量最高 |
| 刻意示范失败与恢复 | 让演示者故意把机器人放到别扭的位姿,再演示怎么救回来 | 直接补齐 $p_{\text{mistake}}$ 上的标签,是 DAgger 的离线近似 |
| 保留不完美轨迹 | 不要只挑最漂亮的演示训练 | 见第 7 节的悖论:小失误 + 纠正是宝贵信号 |
把图像增强(随机裁剪、颜色抖动)当作解决分布漂移的手段。普通的图像增强只提升观测层面的鲁棒性(对光照、纹理变化不敏感),完全没有触及状态层面的分布漂移。关键区别在于:三摄像头技巧同时修改了动作标签,而随机颜色抖动不会。凡是不改标签的增强,都不能生成新的「纠偏样本」。
9.3 历史信息与序列模型
回到第 1 节的部分可观测问题:若 $\mathbf{o}_t$ 不满足马尔可夫性,单帧策略 $\pi_\theta(\mathbf{a}_t|\mathbf{o}_t)$ 在原理上就学不到最优行为。自然的补救是让策略读入整段历史:
$$ \pi_\theta\big(\mathbf{a}_t \,\big|\, \mathbf{o}_1,\mathbf{o}_2,\ldots,\mathbf{o}_t\big) $$实现上有三种常见做法:帧堆叠(把最近 $k$ 帧沿通道维拼起来,DQN 打 Atari 就是这么干的,简单粗暴但只能看到固定长度的过去)、循环网络(LSTM/GRU 维护一个隐状态,理论上能记住任意长的历史)、以及今天的主流Transformer(把观测序列当 token 序列,用因果注意力,还能顺便处理语言指令)。
喂进历史会引入一个隐蔽而致命的新问题——因果混淆(causal confusion)。经典例子:车里有个刹车指示灯,司机踩刹车时它会亮。如果策略能看到当前帧的指示灯,它会学到「灯亮 → 刹车」这条相关性极强但因果方向完全颠倒的规则,而不去学「前方有行人 → 刹车」。更普遍地,历史里包含上一步自己的动作的痕迹,而演示数据中动作在时间上高度自相关,于是策略会退化成「重复上一个动作」的惯性预测器——在训练集上损失极低,一上线就完全不响应环境。
反直觉的结论:信息更多的策略,在 BC 下反而可能表现更差。下一讲会详细讨论这个现象及其缓解手段。
9.4 多任务学习
最后一条乍看很奇怪:同时学多个任务,每个任务反而学得更好。
设想训练一个导航策略。方案 A:只收集「从各处到达目标点 $\mathbf{p}_1$」的演示。方案 B:收集「到达 $\mathbf{p}_1$」「到达 $\mathbf{p}_2$」「到达 $\mathbf{p}_3$」……的演示,并把目标点作为条件输入,学一个目标条件策略(goal-conditioned policy)$\pi_\theta(\mathbf{a}_t|\mathbf{o}_t, \mathbf{g})$。
方案 B 更好,理由与第 7 节的悖论同源:去往 $\mathbf{p}_2$ 的轨迹会经过许多「对 $\mathbf{p}_1$ 任务来说属于偏离态」的状态。这些状态在方案 A 的数据里根本不存在,在方案 B 里却被别的任务顺带覆盖了。多任务数据以一种「免费」的方式把状态分布撑宽了——从 $\mathbf{p}_2$ 任务的演示里,策略学会了在那片区域该怎么动,这些知识可以迁移到 $\mathbf{p}_1$ 任务上偏离后的恢复。
这个思路还有一个更激进的版本:把任何一条轨迹的终点事后标记成「目标」,于是所有数据都变成成功的演示。这就是 hindsight relabeling / goal relabeling 的想法,本课后面讲 goal-conditioned RL 时会正式展开。
把这四条办法放在第 6 节的界 $J \le \sum_t [(\mathrm{A}) + (\mathrm{B})]$ 上看,它们的分工一目了然:
「更强的模型」压的是 $(\mathrm{A})$(训练分布上的固有误差 $\epsilon$);
「聪明的数据」「多任务」「DAgger」压的都是 $(\mathrm{B})$(分布偏移项 $D_{\mathrm{TV}}$)——只是手段不同:DAgger 用交互式专家精确对齐,数据增强用几何先验近似合成,多任务用别的任务的数据顺带覆盖。
「历史信息」则是在修正一个更基础的问题:当 $\mathbf{o}_t$ 不是状态时,$\epsilon$ 存在一个不可消除的下界,再多数据也压不下去。
理解了这个分类,你以后看到任何一篇「改进 BC」的论文,都能立刻定位它在攻哪一项。
本讲小结
一页速查:
| 概念 | 一句话 | 关键式子 |
|---|---|---|
| 状态 vs 观测 | $\mathbf{s}_t$ 满足马尔可夫性,$\mathbf{o}_t$ 一般不满足 | $\mathbf{s}_{t+1}\perp\mathbf{s}_{t-1}\mid\mathbf{s}_t$ |
| 行为克隆 | 把演示数据打散当 i.i.d. 样本做最大似然 | $\argmax_\theta\sum_i\sum_t\log\pi_\theta(\mathbf{a}_t^{(i)}|\mathbf{o}_t^{(i)})$ |
| 动作分布 | 离散用 softmax logits;连续用高斯,$\Sigma=\mathbf{I}$ 时退化为 MSE | $-\log p = \tfrac12\|\mathbf{a}_t-\mu(\mathbf{o}_t)\|^2 + C$ |
| 分布漂移 | 训练分布由专家产生,测试分布由学生产生,二者必然不同 | $p_{\text{data}}(\mathbf{o}_t)\neq p_{\pi_\theta}(\mathbf{o}_t)$ |
| 0-1 代价 | 动作与专家不一致就记 1 分 | $\E_{\mathbf{a}_t\sim\pi_\theta}[c] = \pi_\theta(\mathbf{a}_t\neq\pi^\star(\mathbf{s}_t)|\mathbf{s}_t)$ |
| 分布分解 | 按「有没有犯过错」把 $p_{\pi_\theta}$ 拆成两块 | $p_{\pi_\theta}=(1-\epsilon)^t p_{\text{train}} + (1-(1-\epsilon)^t)p_{\text{mistake}}$ |
| TV 界 | 分布偏离随时间线性增长 | $D_{\mathrm{TV}}(p_{\text{train}},p_{\pi_\theta})\le 1-(1-\epsilon)^t\le\epsilon t$ |
| BC 误差界 | 最坏情况随时域二次增长 | $J(\pi_\theta)\le\sum_{t=1}^{H}(\epsilon+2\epsilon t)=O(\epsilon H^2)$ |
| DAgger | 让数据去迁就策略:跑学生、专家标注、聚合、重训 | $p_{\text{train}}\to p_{\pi_\theta}\Rightarrow J\le\epsilon H$ |
| 恢复悖论 | 演示里有更多小错误 + 纠正,BC 反而更好 | 牺牲 $\epsilon$ 换 $D_{\mathrm{TV}}$ |
要点清单:
- 行为克隆不是强化学习,它是被用在了 i.i.d. 假设不成立的场景上的监督学习;它没有任何有效性保证。
- 失败的机制是误差累积:犯一个错就进入没见过的状态,在那里犯错概率不再受训练误差约束,于是发散。「犯错」与「跌出分布」在控制问题里是同一件事。
- 最坏情况上界 $O(\epsilon H^2)$,两个 $H$ 分别来自「有 $H$ 次跌出去的机会」和「每次跌出去平均损失 $H/2$ 步」。
- 推导的主线:0-1 代价 $\to$ 犯错概率 $\to$ 按是否犯错分解状态分布 $\to$ 用 TV 距离界定偏移($\le\epsilon t$)$\to$「主项 + 偏移项」拆分 $\to$ 求和得 $O(\epsilon H^2)$。这个「主项 + 分布偏移项」的套路后面会反复出现。
- 这是最坏情况界。现实中系统往往能从错误中恢复,所以 BC 常常能用;但系统能恢复 ≠ 策略学得会恢复,除非数据里有恢复行为。
- DAgger 是唯一从根上解决问题的方法(把界降回 $O(\epsilon H)$),代价是需要交互式专家;工程上常用「人类接管」变体,人机工效好但牺牲了部分理论保证。
- 不改算法的四条路:更强的模型(压 $\epsilon$)、更聪明的数据采集与增强(压 $D_{\mathrm{TV}}$)、历史/序列模型(应对部分可观测,但小心因果混淆)、多任务学习(用别的任务免费撑宽状态分布)。
- 下一讲继续:DAgger 的深入变体、非马尔可夫策略的因果混淆、以及人类演示多模态性的建模(混合密度、隐变量模型、扩散策略、自回归离散化)。
延伸阅读
本讲直接引用
- ALVINN: An Autonomous Land Vehicle in a Neural Network(Pomerleau, 1989)— 行为克隆的开山之作,5 个隐藏单元开真车。读它是为了看清 BC 的范式 35 年没变过。
- End to End Learning for Self-Driving Cars (Bojarski et al., 2016) — NVIDIA 的端到端驾驶。重点看第 4 节的数据采集:三摄像头 + 转向角修正才是它能跑起来的真正原因。
- A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning (Ross, Gordon & Bagnell, 2011) — DAgger 原论文,本讲 $O(\epsilon H^2)$ 与 $O(\epsilon H)$ 两个界的严格版本都在这里。定理 2.1 和 3.2 值得逐行读。
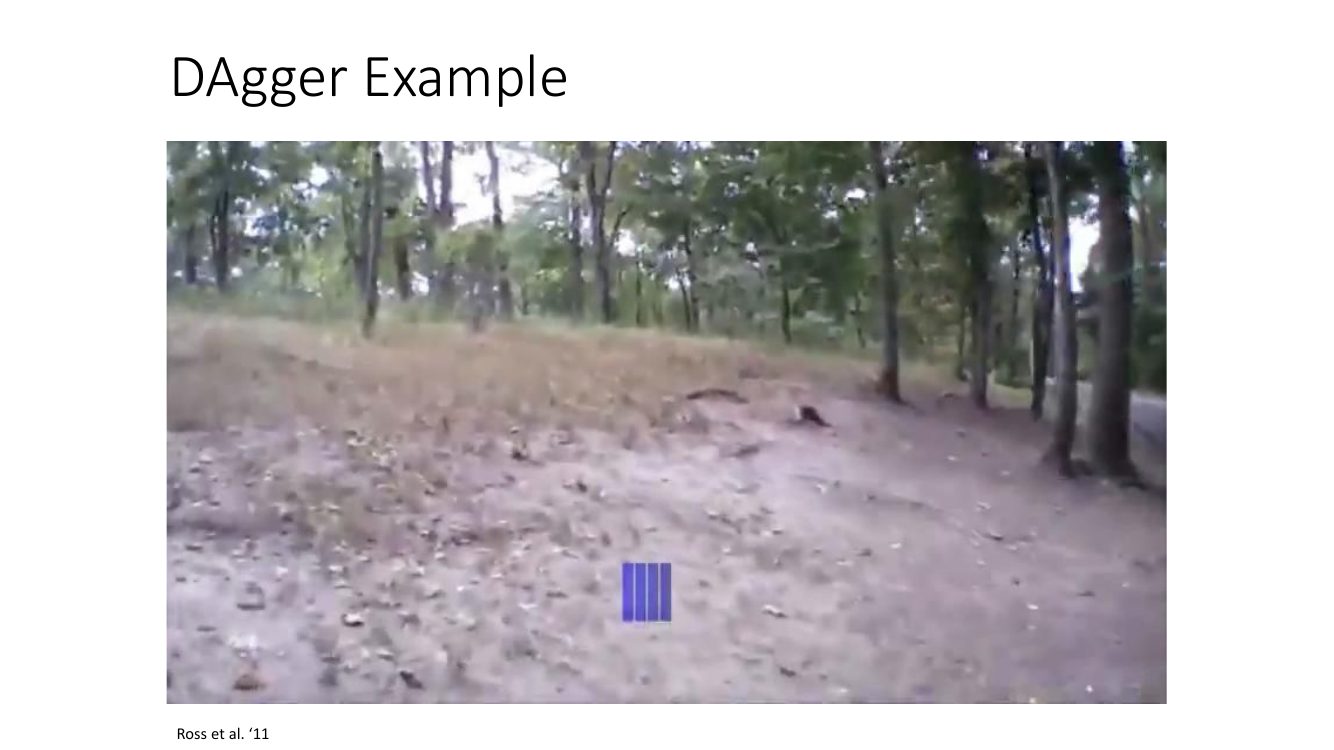
- Learning Monocular Reactive UAV Control in Cluttered Natural Environments (Ross et al., 2013) — 幻灯片里那段无人机穿林视频的出处,DAgger 在真实机器人上的完整案例。
让 BC 变得可用
- DART: Noise Injection for Robust Imitation Learning (Laskey et al., 2017) — 把「注入噪声让演示者做纠正」系统化,是第 7 节那个悖论最直接的算法化。
- HG-DAgger: Interactive Imitation Learning with Human Experts (Kelly et al., 2018) — 第 8.4 节「人类接管」变体的正式版本,讨论了它与原始 DAgger 在保证上的差异。
- Causal Confusion in Imitation Learning (de Haan, Jayaraman & Levine, 2019) — 「给策略更多信息反而更差」的系统研究,刹车指示灯的例子就出自这里。读完再回看 9.3 节会有新体会。
现代的 BC:大模型与多模态动作
- RT-1: Robotics Transformer for Real-World Control at Scale (Brohan et al., 2022) — 「用非常强的模型把 $\epsilon$ 压小」这条路线的代表作,也是幻灯片总结页里那张网络图的出处。
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion (Chi et al., 2023) — 用扩散模型表示多模态动作分布,直接针对 2.2 节末尾提到的「平均值撞树」问题。下一讲的主角之一。
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware (Zhao et al., 2023) — ACT / 动作分块(action chunking):一次预测一段动作序列,等价于把有效时域 $H$ 缩短,从误差累积的角度看非常自然。