行为的监督学习(下):非马尔可夫、多模态与目标条件 BC
上一讲证明了「即使完美拟合专家,误差也会随时间二次累积」。本讲面对一个更前置、也更现实的问题——我们连专家都拟合不了。
0. 本讲导读
上一讲的主线是分布漂移(distributional shift):行为克隆(behavioral cloning, BC)之所以不等价于监督学习,是因为训练数据来自专家的状态分布 $p_{\text{data}}(s)$,而测试时策略走在自己的状态分布 $p_{\pi_\theta}(s)$ 上,二者不匹配,误差会以 $O(\epsilon T^2)$ 的速度累积。那一讲给出的解药是 DAgger:与其想办法让 $p_{\pi_\theta}$ 靠近 $p_{\text{data}}$,不如把 $p_{\text{data}}$ 拉过来匹配 $p_{\pi_\theta}$,让人来标注策略自己访问到的状态。
但 DAgger 有个致命的实用障碍:让人对着策略跑出来的状态一帧帧标动作,既昂贵又反直觉(想象让人看着一段汽车行驶视频,逐帧写出方向盘角度)。所以上一讲结尾还留了另外三条路:用非常强的模型让错误率 $\epsilon$ 本身足够小、聪明地收集与增广数据、用多任务学习。本讲就是把这三条路彻底展开。
而展开之前必须先问一个更基本的问题——上一讲的整套理论有一个未言明的前提:假设我们能把专家拟合到训练误差 $\epsilon$ 很小。现实中这个前提经常直接崩掉。Levine 把「拟合不了专家」的原因归结为两条,本讲的前半部分就是逐条拆解它们:
- 非马尔可夫行为(non-Markovian behavior):人类演示者的动作往往不只取决于当前这一帧看到的东西,还取决于之前发生过什么。而我们写的策略 $\pi_\theta(a_t|o_t)$ 只看当前观测,它在数学上根本表达不出这种行为。
- 多模态行为(multimodal behavior):面对同一个状态,专家有好几种同样合理的做法(绕树左边或右边)。如果我们用单峰的高斯策略去拟合,它会去拟合这些模态的平均值——而平均值往往是最糟糕的动作(直接撞树)。
后半部分转向数据与任务结构:宽(broad)而差的数据 vs 窄(narrow)而好的数据该怎么取舍,为什么「预训练 + 后训练」这个语言模型里的范式在机器人上同样成立;以及目标条件模仿学习(goal-conditioned BC)——把「失败的轨迹」重新解释成「到达了别的目标的成功轨迹」,从而让几乎任何数据都变成可用的监督信号。最后我们诚实地面对模仿学习的天花板。
- 「拟合不了专家」有两大元凶:非马尔可夫行为与多模态行为。它们是模型表达力问题,与上一讲的分布漂移问题正交,必须分开诊断。
- 解决非马尔可夫性的办法是让策略读入历史 $\pi_\theta(a_t|o_1,\dots,o_t)$,实现上用共享权重的编码器 + 序列模型(Transformer / RNN)。但历史是一把双刃剑:它会放大因果混淆(causal confusion)——模型学到的是相关性而非因果性。
- 解决多模态的三条路线:混合高斯 / 隐变量模型(简单但维度受限或训练不稳)、自回归离散化(用链式法则把 $D$ 维联合分布拆成 $D$ 个一维 softmax,避免 $K^D$ 爆炸)、扩散 / 流匹配(当前机器人领域的事实标准)。
- 流匹配(flow matching)的训练目标简单到令人意外:采样 $\mathbf{a}_{t,\tau}=\tau \mathbf{a}_t+(1-\tau)\mathbf{a}_{t,0}$,回归目标速度 $\mathbf{a}_t-\mathbf{a}_{t,0}$,一个 MSE 就够了;采样时从噪声出发做欧拉积分。
- 动作分块(action chunking):一次预测未来 $K$ 步动作并开环执行,能显著缓解非马尔可夫性带来的抖动与「犹豫」,是实践中性价比极高的小技巧。
- 宽而差的数据教模型「见过世面」,窄而好的数据教模型「怎么做对」。二者结合(预训练 + 后训练)远胜任何单独一方——$\pi_0$ 的 10000 小时预训练 + 20 小时后训练就是这个范式的机器人版本。
- 目标条件 BC 把每条轨迹的终点当作它自己的目标标签,让失败数据变成有效监督。但它引入了第二处分布漂移:训练时的目标来自数据轨迹的终点,测试时的目标由用户任意指定。
- 模仿学习的根本局限:数据成本高、原则上无法超越专家、无法自主改进。这正是后续引入奖励函数和强化学习的动机。
1. 承上启下:两类完全不同的失败
先把上一讲的结论压缩成一句话再往前走。行为克隆做的事情是最大似然:
$$ \theta^\star=\argmax_\theta\ \E_{(o,a)\sim p_{\text{data}}}\big[\log\pi_\theta(a\mid o)\big] $$上一讲的定理说:若在训练分布上每一步犯错的概率不超过 $\epsilon$,即 $\pi_\theta(a\neq\pi^\star(s)\mid s)\le\epsilon$ 对所有 $s\sim p_{\text{data}}$ 成立,则整条长度为 $T$ 的轨迹上累积的额外代价是 $O(\epsilon T^2)$。DAgger 通过把数据分布改成 $p_{\pi_\theta}$,把这个界改进到 $O(\epsilon T)$。
请注意这句话里的条件状语:「若训练误差 $\epsilon$ 很小」。上一讲把它当作已知条件,本讲要质问它。在真实的人类演示数据上,$\epsilon$ 常常大得离谱,而且不是因为数据不够、网络不够大——是因为你写下的那个模型族 $\{\pi_\theta\}$ 里压根不存在一个能匹配专家的分布。这是逼近误差(approximation error),不是估计误差(estimation error),加数据、加参数都救不了。
诊断 BC 失败时先分清两件事。训练集上的动作预测就已经不准 → 表达力问题(本讲前半);训练集上拟合得很好,一放到环境里跑就越漂越远 → 分布漂移问题(上一讲)。两者的解法完全不同:前者要换模型/换分布族,后者要换数据收集方式。实践中它们经常同时存在,而且会互相放大——表达力不足导致的小误差会把策略推到没见过的状态,那里的误差更大。
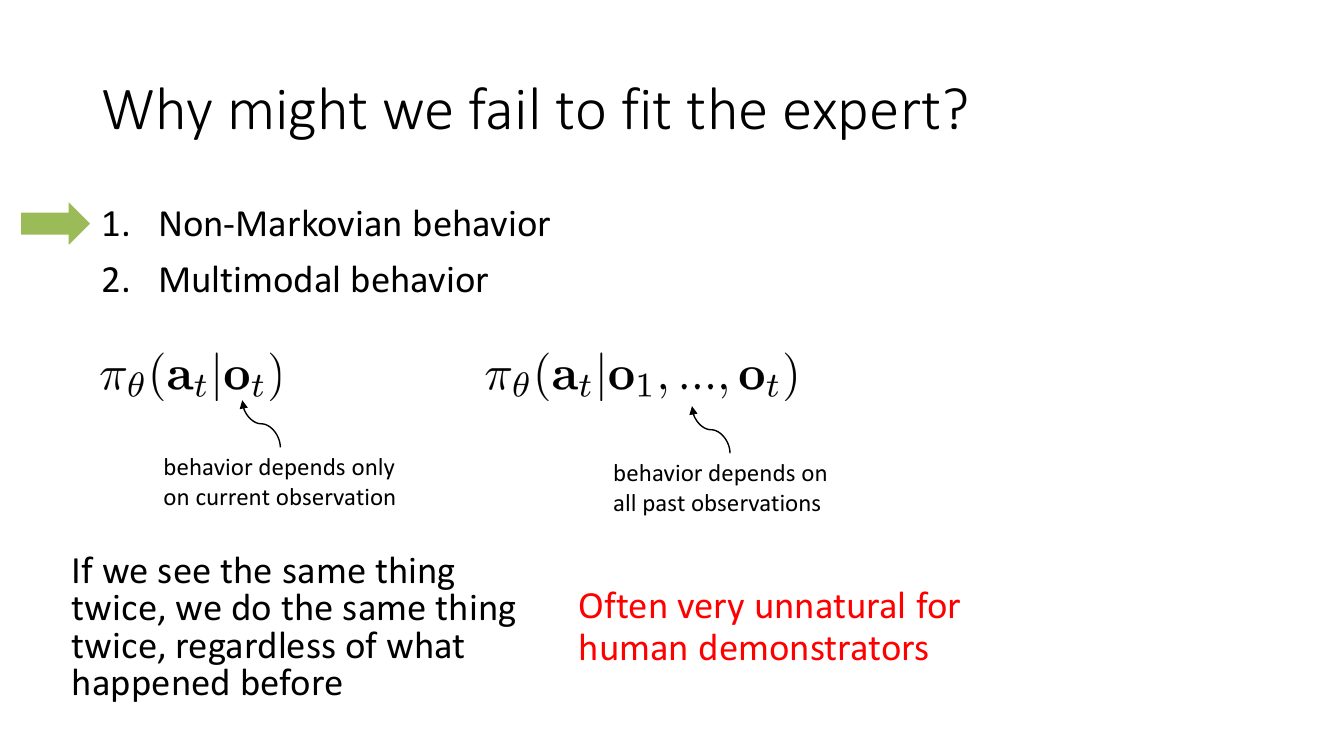
为什么说马尔可夫假设对人类不自然?举几个具体场景:
- 驾驶中的刹车:你已经踩了刹车,之后即便前方画面没变,你也会继续保持踩着,因为你「记得」自己在减速。一个只看当前帧的策略无法区分「刚开始刹车」和「已经刹了两秒」。
- 速度与加速度不可见:单张 RGB 图片里没有速度信息。人可以从连续几帧里感知运动,单帧策略不行。这是最典型的部分可观测(partially observed)情形:$o_t$ 不是马尔可夫状态 $s_t$。
- 任务阶段:折叠衣服时,同一个「衣服平铺在桌上」的画面,可能是「还没开始折」,也可能是「折完一半又展开检查」,对应完全不同的下一步动作。
- 人类的犹豫:演示者中途改主意、手抖、停顿一下——这些都写在历史里,不在当前帧里。
关键点在于:这些不是噪声,而是系统性的、可被历史解释的结构。如果模型看不到历史,这部分行为在它眼里就是不可约的随机性,最大似然只能用一个很宽的分布去覆盖它,训练损失下不去——$\epsilon$ 于是很大。反过来,如果我们给模型历史,它原则上能把这部分结构学出来。这就是下一节要做的事。
2. 用整段历史:从「堆帧」到序列模型
最朴素的做法:把过去所有帧拼在一起,一起喂给一个大卷积网络。
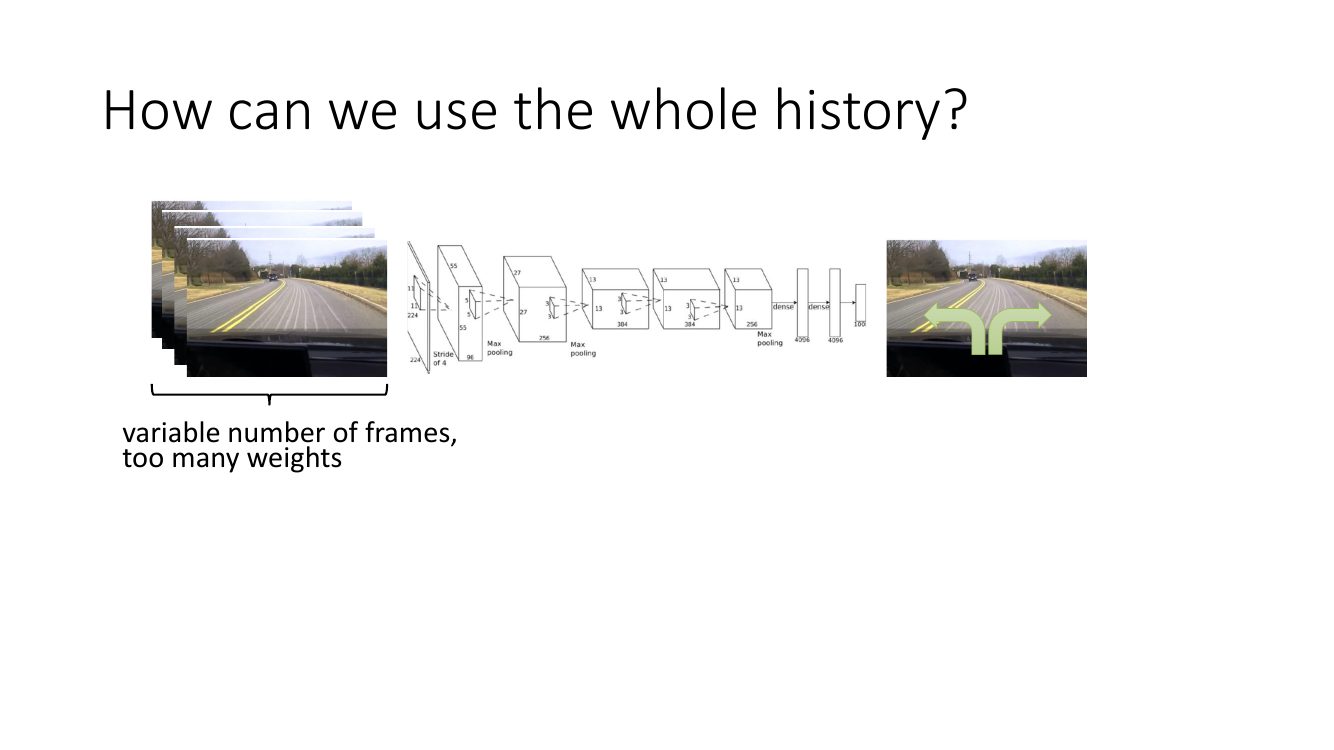
这个方案在两点上不可行。第一,可变长度:轨迹在推理时会越来越长,网络结构却是静态的。你可以截断成最近 $k$ 帧(frame stacking,这正是 DQN 玩 Atari 的做法:堆 4 帧),但这只是把非马尔可夫性推后了 $k$ 步,没有真正解决。第二,参数量:假设每帧是 $224\times224\times3$,第一层卷积有 96 个 $11\times11$ 的核,若堆 100 帧,输入通道从 3 变成 300,第一层参数从 $96\times11\times11\times3\approx3.5$ 万变成 $96\times11\times11\times300\approx350$ 万。更糟的是,每一帧的低层视觉特征(边缘、纹理)本质上是同一套东西,却被迫为每个时间位置各学一份,样本效率极低。
共享权重的编码器 + 序列模型
正确的做法是把「看懂一帧」和「整合时间」两件事解耦:
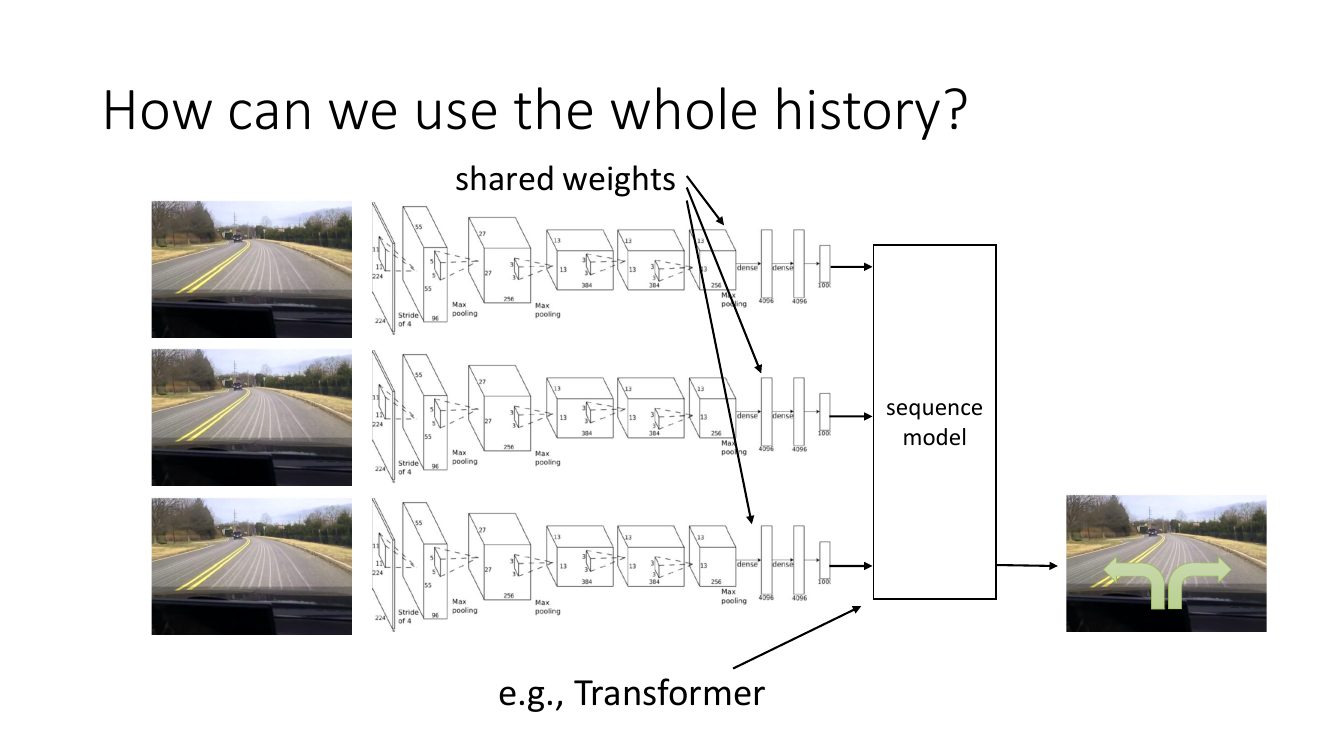
形式上,令 $z_i=\mathrm{Enc}_\phi(o_i)\in\R^{d}$ 是共享编码器的输出,序列模型给出隐藏表示 $h_t=\mathrm{Seq}_\psi(z_1,\dots,z_t)$,最后策略头输出分布:
$$ \pi_\theta(a_t\mid o_1,\dots,o_t)=\mathrm{Head}_\omega(a_t\mid h_t),\qquad \theta=(\phi,\psi,\omega) $$训练目标仍然是最大似然,只是现在每条演示轨迹是一个序列样本而不是一堆独立的 $(o,a)$ 对:
$$ \max_\theta\ \sum_{i=1}^{N}\sum_{t=1}^{T_i}\log\pi_\theta\big(a^{(i)}_t\mid o^{(i)}_1,\dots,o^{(i)}_t\big) $$用 Transformer 时要记得加因果掩码(causal mask):第 $t$ 个位置只能看到 $\le t$ 的帧,否则就泄漏了未来信息——训练时损失会很低,部署时直接崩溃。下面是一个可跑通的最小实现。
import torch, torch.nn as nn

class HistoryPolicy(nn.Module):
    """共享 CNN 编码器 + 因果 Transformer 的历史策略。
       输入 obs: (B, T, C, H, W),输出每个时刻的动作均值 (B, T, A)。"""
    def __init__(self, act_dim, d_model=256, n_layer=4, n_head=8, max_len=512):
        super().__init__()
        self.enc = nn.Sequential(                    # 逐帧共享的视觉编码器
            nn.Conv2d(3, 32, 8, 4), nn.ReLU(),
            nn.Conv2d(32, 64, 4, 2), nn.ReLU(),
            nn.Conv2d(64, 64, 3, 1), nn.ReLU(),
            nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(64, d_model))
        self.pos = nn.Parameter(torch.zeros(max_len, d_model))
        layer = nn.TransformerEncoderLayer(d_model, n_head, 4 * d_model,
                                           batch_first=True, norm_first=True)
        self.seq  = nn.TransformerEncoder(layer, n_layer)
        self.head = nn.Linear(d_model, act_dim)

    def forward(self, obs):
        B, T = obs.shape[:2]
        z = self.enc(obs.flatten(0, 1)).view(B, T, -1) + self.pos[:T]
        # 因果掩码:位置 t 只能看到 <= t 的帧,True 表示屏蔽
        mask = torch.triu(torch.ones(T, T, dtype=torch.bool, device=obs.device), 1)
        h = self.seq(z, mask=mask)
        return self.head(h)

# 训练:一次前向拿到整条轨迹上所有时刻的预测,损失一次性算完
policy = HistoryPolicy(act_dim=2)
obs = torch.randn(4, 16, 3, 64, 64)      # 4 条轨迹,各 16 帧
act = torch.randn(4, 16, 2)              # 专家动作
loss = ((policy(obs) - act) ** 2).mean() # 高斯策略 + 固定方差 = MSE
loss.backward()
推理时若每步都把全部历史重跑一遍,代价是 $O(T^2)$。实践中有两个标准做法:一是用 KV cache 增量解码(Transformer);二是只保留最近 $k$ 帧的滑动窗口。对机器人任务,$k$ 取 2 到 5 帧往往就够了——足以恢复速度信息与短期任务阶段,同时避免下一节要讲的历史副作用。$\pi_0$ 这类模型甚至只用 1~3 张当前图像,把「记忆」交给动作分块去承担。
3. 因果混淆:历史为什么可能帮倒忙
直觉上「给模型更多信息总不会更差」——在因果推断的意义上这是错的。Levine 在这里插入了一个非常重要的旁白。
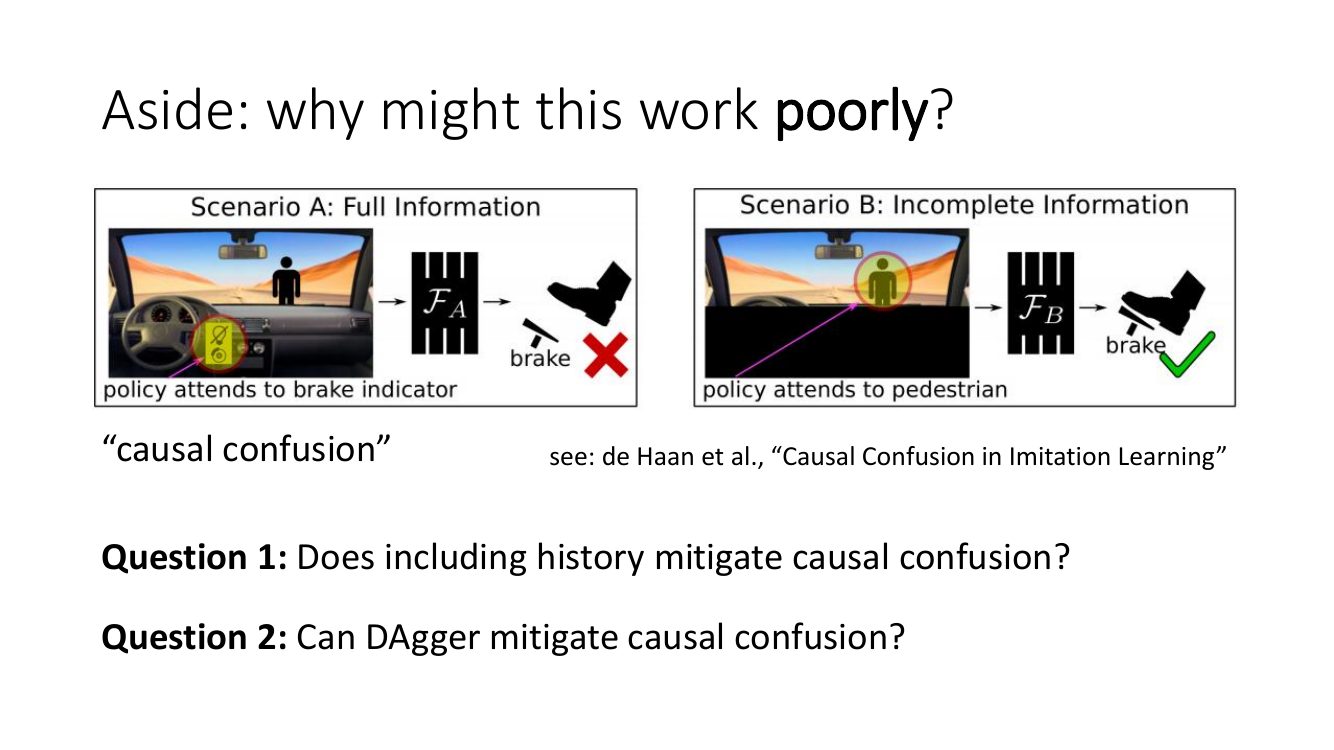
把它形式化一点。设专家的真实因果机制是「看到行人 $\Rightarrow$ 踩刹车 $\Rightarrow$ 刹车灯亮」。在演示数据里,刹车灯状态 $\ell_t$ 与专家动作 $a_t$ 高度相关(因为 $\ell_t$ 是 $a_{t-1}$ 的结果),而且这种相关性通常比「行人像素 $\Rightarrow$ 刹车」更容易被网络捕捉——前者是一个几像素的高对比度指示灯,后者需要真正的物体识别。最大似然并不区分因果与相关,它只挑最容易降低损失的特征。于是模型学到 $\pi_\theta(a_t|\ell_t)$,本质上是在复读自己上一步的动作。
更本质的问题是:这个错误的策略在训练分布上完全正确(专家数据里刹车灯确实完美预测了刹车),所以你从训练/验证损失上根本看不出来。只有真正把策略放到闭环里跑,问题才暴露。这也解释了为什么模仿学习必须做闭环评测,离线的动作 MSE 是极不可靠的指标。
「因果混淆 = 过拟合」是错的。过拟合是训练误差小、验证误差大;因果混淆是训练误差和验证误差都很小(数据是 i.i.d. 划分的,相关性在两边都成立),只有闭环执行时才失败。它的根源是训练分布与执行分布的因果结构不同,而不是样本不够。加数据只会让模型对错误特征更自信。
Levine 留的两道思考题
问题一:加入历史能缓解因果混淆吗?答案是——通常会加剧。前一时刻的动作 $a_{t-1}$(或它在画面里的痕迹,比如刹车灯、机械臂的位置变化)就在历史里明晃晃地摆着。给模型历史,等于把这个「泄漏因子」直接送到它嘴边。这类失败在机器人上有个俗名叫「copycat problem」或「惯性问题」:策略学会了「上一步在动就继续动,上一步停着就继续停」,于是一旦停下来就永远停在那里。这正是本讲反复强调的张力——历史既是解决非马尔可夫性的必需品,又是因果混淆的燃料。实践中的折中是:只给很短的历史窗口、对历史帧做强增广(随机裁剪、颜色抖动)、或者干脆遮掉那些已知会泄漏的区域(比如把仪表盘裁掉)。
问题二:DAgger 能缓解因果混淆吗?答案是——能,而且这是 DAgger 少见的额外好处。DAgger 让策略自己去跑,然后由专家在策略访问到的状态上标注。当那个只看刹车灯的策略跑起来时,它会遇到「有行人但刹车灯没亮」的状态;专家在这些状态上标注「刹车」,于是 $\ell_t$ 与 $a_t$ 的虚假相关性被打破了。换句话说,DAgger 通过主动干预(intervention)收集数据,天然具备一点因果发现的能力。这与因果推断中「随机实验优于观察数据」是同一个道理。
历史信息的取舍是一个真实的权衡,没有免费午餐:没有历史 → 非马尔可夫行为拟合不了,$\epsilon$ 大;有历史 → 因果混淆风险上升,离线指标好看但闭环崩溃。工程上的默认选择是「短历史 + 强数据增广 + 闭环评测」,并在可能的情况下用 DAgger 式的交互数据打破虚假相关。
4. 多模态行为:为什么单峰高斯策略必然撞树
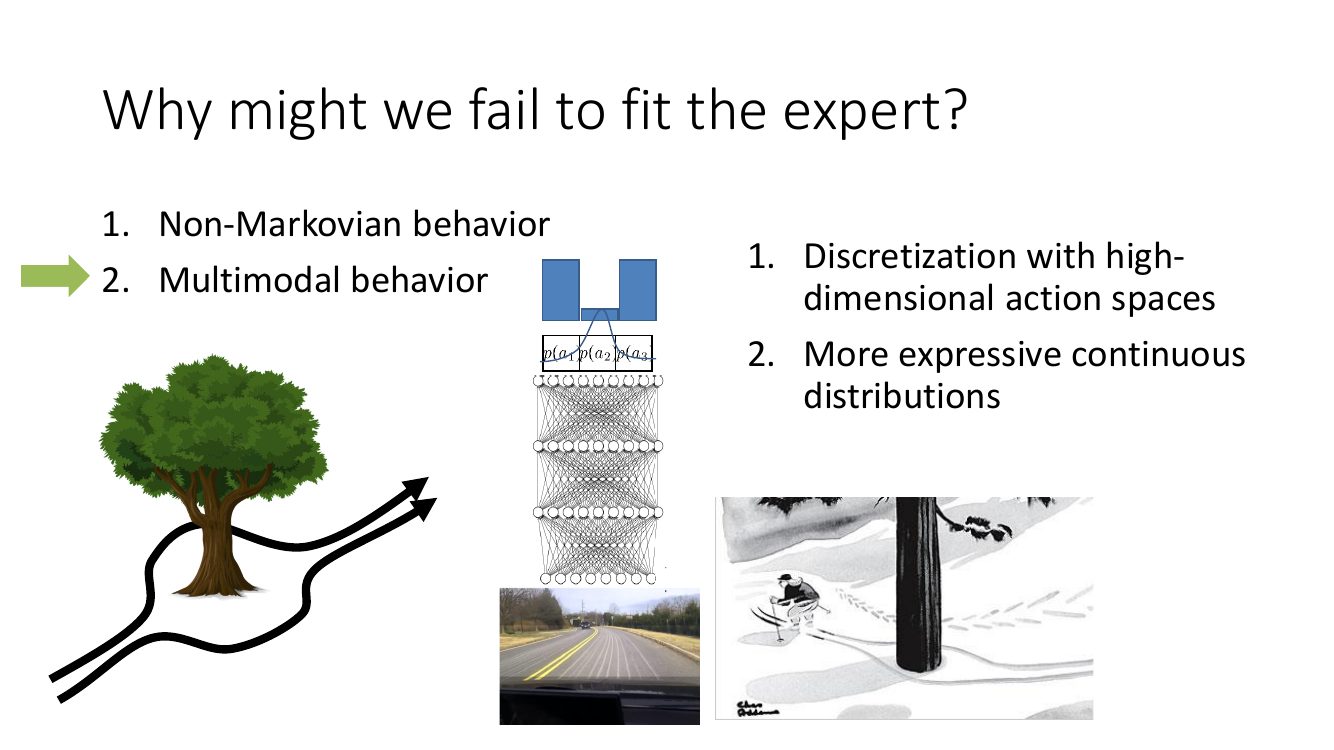
设动作是一维的转向角 $a\in\R$,负值向左、正值向右。专家数据里 $a\approx-1$ 和 $a\approx+1$ 各占一半。如果我们用最常见的单峰高斯策略:
$$ \pi_\theta(a\mid o)=\mathcal{N}\big(a;\ \mu_\theta(o),\ \sigma^2\big) $$最大似然会给出什么?把负对数似然写出来,对 $\mu$ 求导并令其为零:
$$ \mathcal{L}(\mu)=\frac{1}{2\sigma^2}\sum_{i=1}^{N}(a_i-\mu)^2+\text{const},\qquad \frac{\partial\mathcal{L}}{\partial\mu}=-\frac{1}{\sigma^2}\sum_i(a_i-\mu)=0 \ \Longrightarrow\ \mu^\star=\frac1N\sum_i a_i $$也就是样本均值。当数据是 $\{-1,+1\}$ 各半时,$\mu^\star=0$——直直地开向树。这不是训练不充分,而是最优解本身就是错的:在给定模型族里,$\mathcal{N}(0,\sigma^2)$ 确实是对这份数据的最大似然拟合。而学到的方差 $\sigma^{2\star}=\frac1N\sum_i(a_i-\mu^\star)^2=1$ 也毫无帮助——采样出来的动作会均匀散布在 $[-2,2]$,大部分时候仍然贴着树中心。
更一般地,最大似然等价于最小化 $\KL\big(p_{\text{data}}(a|o)\,\|\,\pi_\theta(a|o)\big)$ 在 $o\sim p_{\text{data}}$ 下的期望。注意 KL 的方向是 forward KL(数据在前):
$$ \KL(p\|\pi_\theta)=\int p(a)\log\frac{p(a)}{\pi_\theta(a)}\,da $$只要在某处 $p(a)>0$ 而 $\pi_\theta(a)\to0$,被积函数就发散。因此 forward KL 有强烈的 mode-covering(覆盖所有模态) 倾向:模型宁可把概率质量摊薄到所有模态之间,也不愿在任何一个模态上留下零概率。这就从原理上解释了为什么单峰模型会去「取平均」,而不是「挑一个模态」。反向 KL $\KL(\pi_\theta\|p)$ 才是 mode-seeking 的,但它在 BC 里不可用——我们只有 $p$ 的样本,算不出 $\pi_\theta$ 下的期望里需要的 $\log p$。
还要强调一个容易被忽略的点:多模态问题只在连续动作空间才严重。如果动作是离散的(比如 $\{左,直,右\}$ 三选一),策略头是一个 softmax,它天然可以输出 $(0.5,\ 0,\ 0.5)$ 这样的双峰分布——softmax 是完全通用的离散分布表示。所以 Atari 之类的离散控制任务几乎不受此困扰。困难来自「连续 + 高维」:机器人往往有 7 个关节甚至双臂 14 个自由度。
由此就得到了图右边那两条路线,它们也构成了后面三节的骨架:
| 路线 | 思路 | 核心难点 | 代表方法 |
|---|---|---|---|
| 离散化 | 把连续动作切成 $K$ 个 bin,退化成 softmax 分类 | $D$ 维动作需要 $K^D$ 个类别,指数爆炸 | 自回归离散化(§6) |
| 更强的连续分布 | 保持连续输出,但让分布族本身多峰 | 如何让随机噪声真正被模型「用起来」 | 混合高斯、VAE、归一化流、扩散/流匹配(§5、§7) |
5. 解法一:混合高斯与隐变量策略
5.1 混合密度网络(Mixture Density Network)
最直接的补救:既然一个高斯不够,就输出 $K$ 个。网络对每个观测 $o$ 吐出 $K$ 组参数 $\{w_k(o),\mu_k(o),\Sigma_k(o)\}_{k=1}^K$,其中混合权重经过 softmax 保证 $\sum_k w_k=1$:
$$ \pi_\theta(a\mid o)=\sum_{k=1}^{K}w_k(o)\,\mathcal{N}\big(a;\ \mu_k(o),\ \Sigma_k(o)\big) $$训练损失就是这个混合密度的负对数似然,注意 $\log$ 在求和外面,不能拆开:
$$ \mathcal{L}(\theta)=-\sum_{i}\log\left[\sum_{k=1}^{K}w_k(o_i)\,\mathcal{N}\big(a_i;\mu_k(o_i),\Sigma_k(o_i)\big)\right] $$采样分两步:先按 $w(o)$ 抽一个分量 $k$,再从 $\mathcal{N}(\mu_k,\Sigma_k)$ 抽动作。在绕树的例子里,理想解是 $w=(0.5,0.5)$、$\mu_1=-1$、$\mu_2=+1$、方差都很小——采样时随机挑一边绕过去,完全正确。
import torch, torch.nn as nn, torch.nn.functional as F

class MDNPolicy(nn.Module):
    def __init__(self, obs_dim, act_dim, K=5, hidden=256):
        super().__init__()
        self.K, self.A = K, act_dim
        self.trunk = nn.Sequential(nn.Linear(obs_dim, hidden), nn.ReLU(),
                                   nn.Linear(hidden, hidden), nn.ReLU())
        self.head = nn.Linear(hidden, K * (1 + 2 * act_dim))   # 权重 + 均值 + log 标准差

    def forward(self, obs):
        h = self.head(self.trunk(obs))
        logit, mu, log_std = torch.split(h, [self.K, self.K*self.A, self.K*self.A], -1)
        mu      = mu.view(*obs.shape[:-1], self.K, self.A)
        log_std = log_std.view(*obs.shape[:-1], self.K, self.A).clamp(-5, 2)
        return F.log_softmax(logit, -1), mu, log_std

    def nll(self, obs, act):
        logw, mu, log_std = self(obs)
        a = act.unsqueeze(-2)                                   # (..., 1, A) 广播到 K 个分量
        # 各分量的对角高斯 log 概率,对动作维求和
        comp = (-0.5 * ((a - mu) / log_std.exp()) ** 2 - log_std
                - 0.5 * torch.log(torch.tensor(2 * torch.pi))).sum(-1)
        return -torch.logsumexp(logw + comp, dim=-1).mean()     # log-sum-exp 保证数值稳定

    @torch.no_grad()
    def sample(self, obs):
        logw, mu, log_std = self(obs)
        k = torch.distributions.Categorical(logits=logw).sample()   # 先选分量
        idx = k.view(*k.shape, 1, 1).expand(*k.shape, 1, self.A)
        m, s = mu.gather(-2, idx).squeeze(-2), log_std.gather(-2, idx).squeeze(-2)
        return m + s.exp() * torch.randn_like(m)                    # 再从该分量采样
MDN 在低维动作空间(1~4 维)上非常好用,实现简单、训练稳定、可解释性强。它的问题是维度诅咒:真实的多模态结构可能是「每个关节的模态相互耦合」,例如双臂机器人有 $2^{7}$ 种协调模式,你需要的分量数会随维度指数增长。此外训练时常出现分量坍缩——所有 $\mu_k$ 挤到一起,退化成单个高斯;缓解手段包括对 $\log\sigma$ 设下界、用不同的初始化打散各分量、以及在损失里加一点熵正则。
5.2 隐变量策略:让噪声真正起作用
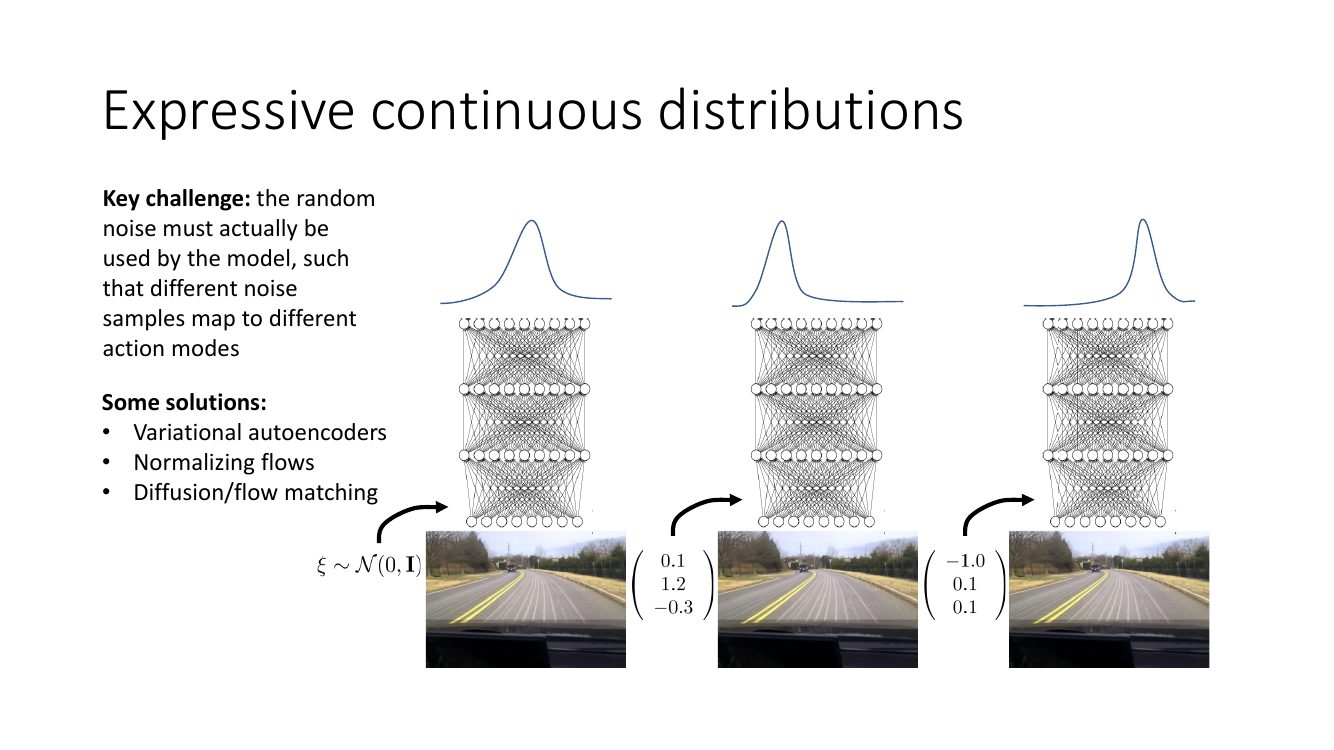
形式上这定义了一个隐变量模型(latent variable model):
$$ \pi_\theta(a\mid o)=\int \pi_\theta(a\mid o,\xi)\,p(\xi)\,d\xi,\qquad p(\xi)=\mathcal{N}(0,\mathbf{I}) $$只要 $\xi$ 的维度够、$\pi_\theta(a|o,\xi)$ 足够灵活,这个族原则上可以表示任意分布。但你没法直接对它做最大似然——这个积分算不出来。而且如果偷懒用「采一个 $\xi$、算一次 MSE」来训练,会发生一件事:网络学会彻底忽略 $\xi$。原因很简单,MSE 的最优解仍然是条件均值,噪声只会增加损失,梯度下降会把 $\xi$ 那一路的权重压到零。这就是图上那句红字的含义。
5.3 条件 VAE:用变分下界逼模型使用噪声
解决办法是引入一个后验编码器(encoder) $q_\phi(\xi\mid o,a)$:它看着真实动作 $a$,反推「是哪个噪声生成了它」。于是我们可以优化对数似然的证据下界(ELBO)。推导一步一步来:
对凹函数 $\log$ 用 Jensen 不等式 $\log\E[X]\ge\E[\log X]$:
$$ \log\pi_\theta(a|o)\ \ge\ \E_{q_\phi}\big[\log\pi_\theta(a|o,\xi)\big]-\KL\big(q_\phi(\xi|o,a)\,\|\,p(\xi)\big)\ \equiv\ \mathrm{ELBO} $$第一项是重构项:给定编码器推出的 $\xi$,解码器要能重建出真实动作——这就强迫 $\xi$ 携带区分模态的信息。第二项是 KL 正则项:把后验拉向标准正态,保证测试时直接从 $\mathcal{N}(0,\mathbf I)$ 采样也落在解码器见过的区域。两项之差恰好等于 $\log\pi_\theta(a|o)-\KL(q_\phi\|\pi_\theta(\xi|o,a))$,所以 ELBO 越紧,编码器越接近真实后验。
取 $q_\phi(\xi|o,a)=\mathcal{N}(\mu_\phi,\ \diag(\sigma_\phi^2))$,两个高斯之间的 KL 有闭式解:
$$ \KL\big(\mathcal{N}(\mu,\diag(\sigma^2))\,\|\,\mathcal{N}(0,\mathbf I)\big)=\frac12\sum_{j}\big(\mu_j^2+\sigma_j^2-\log\sigma_j^2-1\big) $$而重构项里对 $q_\phi$ 求期望时要对 $\phi$ 求导,用重参数化技巧(reparameterization trick):把随机性挪到与参数无关的 $\varepsilon$ 上,$\xi=\mu_\phi+\sigma_\phi\odot\varepsilon$,$\varepsilon\sim\mathcal{N}(0,\mathbf I)$,这样梯度就能穿过采样点。
class CVAEPolicy(nn.Module):
    """条件 VAE 策略:encoder q(xi|o,a) 只在训练时用,推理时从 N(0,I) 采样。"""
    def __init__(self, obs_dim, act_dim, zdim=8, h=256):
        super().__init__()
        self.zdim = zdim
        self.enc = nn.Sequential(nn.Linear(obs_dim + act_dim, h), nn.ReLU(),
                                 nn.Linear(h, 2 * zdim))          # 输出 mu 和 log_std
        self.dec = nn.Sequential(nn.Linear(obs_dim + zdim, h), nn.ReLU(),
                                 nn.Linear(h, h), nn.ReLU(), nn.Linear(h, act_dim))

    def elbo_loss(self, obs, act, beta=1.0):
        mu, log_std = self.enc(torch.cat([obs, act], -1)).chunk(2, -1)
        log_std = log_std.clamp(-5, 2)
        xi = mu + log_std.exp() * torch.randn_like(mu)             # 重参数化
        rec = ((self.dec(torch.cat([obs, xi], -1)) - act) ** 2).sum(-1)
        kl  = 0.5 * (mu ** 2 + (2 * log_std).exp() - 2 * log_std - 1).sum(-1)
        return (rec + beta * kl).mean()                            # 最小化 -ELBO

    @torch.no_grad()
    def sample(self, obs):                                         # 推理:丢掉 encoder
        xi = torch.randn(*obs.shape[:-1], self.zdim, device=obs.device)
        return self.dec(torch.cat([obs, xi], -1))
CVAE 最常见的失败是 posterior collapse(后验坍缩):KL 项被优化到 0,$q_\phi$ 退化成先验,解码器又一次忽略 $\xi$,模型变回单峰。症状是训练日志里 KL 迅速趋近 0 而重构损失卡住。常用对策:把 KL 系数 $\beta$ 从 0 缓慢升到 1(KL annealing)、给 KL 设一个下限(free bits)、或者减小 $\xi$ 的维度。这类调参的脆弱性正是扩散模型后来在机器人领域取代 VAE 的现实原因之一——不过 CVAE 依然活跃,ACT(Action Chunking with Transformers)用的就是它。
顺带一提图上提到的第三类:归一化流(normalizing flow)。它用一串可逆变换 $a=f_\theta(\xi;o)$ 把简单分布推成复杂分布,由变量替换公式得到精确的对数似然 $\log\pi_\theta(a|o)=\log p(\xi)-\log\left|\det\frac{\partial f_\theta}{\partial\xi}\right|$。优点是似然精确、采样一步到位;缺点是为了让雅可比行列式可算,网络结构必须受限(耦合层、自回归流等),表达力与工程复杂度都不占优,在机器人策略上用得相对少。
6. 解法二:自回归离散化
换一条完全不同的路:既然离散分布(softmax)天然可以多峰,那就把连续动作离散化。
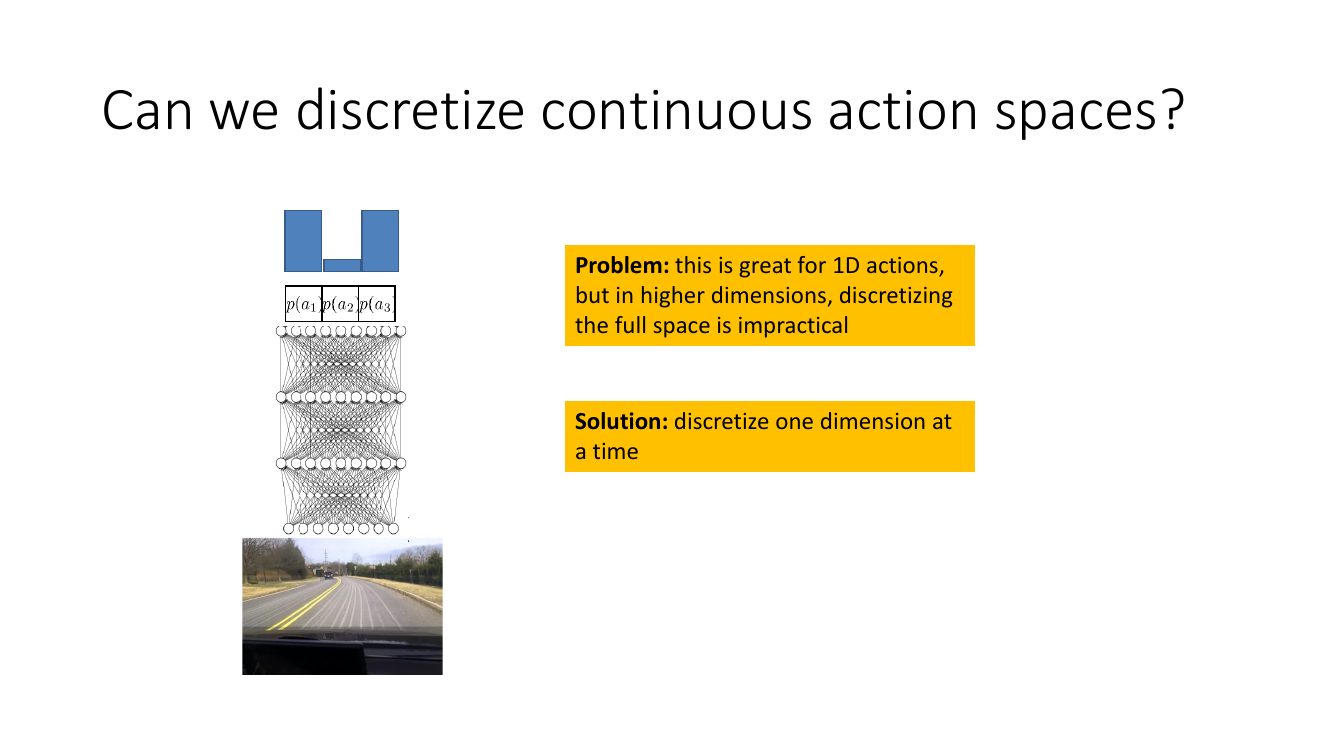
先算一笔账。设动作有 $D$ 维,每维切成 $K$ 个 bin。若对整个动作空间做联合离散化,类别数是 $K^D$。取 $K=256$(一个字节的分辨率)、$D=7$(单臂机器人),$256^7\approx7.2\times10^{16}$——softmax 层的输出维度比宇宙里的沙子还多。而且每个类别的样本数近乎为零,根本学不动。联合离散化在 $D\ge3$ 时就已经不现实了。
用链式法则拆开
解法是概率论里最基本的一招:任何联合分布都能按链式法则分解成一串条件分布。
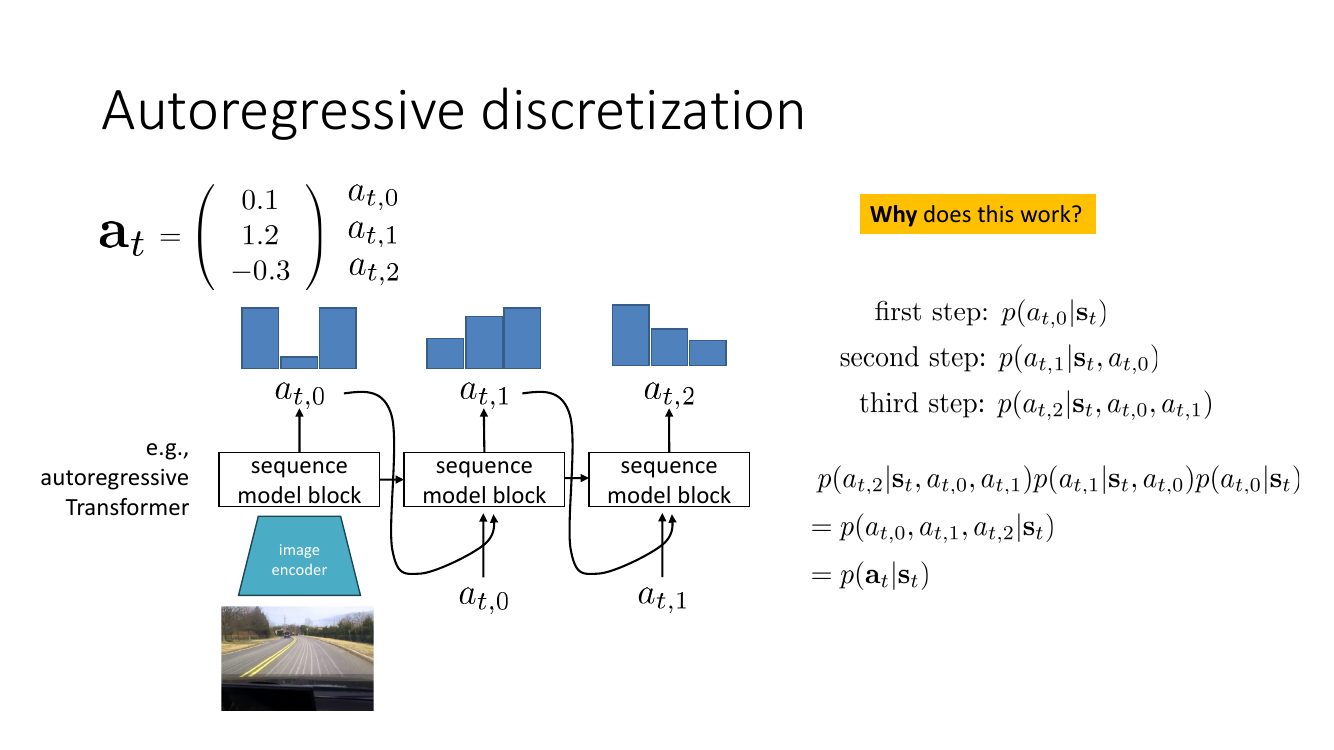
这个等式是恒等式,没有任何近似——所以自回归分解不损失任何表达力,只要每个条件分布本身足够灵活。代价从 $K^D$ 变成 $D\times K$:还是 $K=256$、$D=7$,总输出维度只有 $1792$。
为什么逐维离散化能表达模态之间的耦合?考虑二维动作,两个模态是 $(-1,-1)$ 和 $(+1,+1)$(对角线),而 $(-1,+1)$ 是非法的。若两维独立建模,边缘分布都是 $\pm1$ 各半,采样会以 25% 的概率给出非法的 $(-1,+1)$。自回归则不然:采出 $a_0=-1$ 后,第二个 softmax 看到这个条件,会把全部质量放在 $a_1=-1$ 上。条件化就是耦合。
训练与采样
训练完全并行,用 teacher forcing:把真实动作的各维一次性喂进去(配合因果掩码),一次前向就得到所有 $D$ 个位置的 logits,损失是 $D$ 个交叉熵之和。采样则必须串行 $D$ 步,这是它相对 MDN/扩散的主要开销(扩散虽然也要多步,但每步是整个动作向量并行的)。
import torch, torch.nn as nn, torch.nn.functional as F

K, D = 256, 7                      # 每维 256 个 bin,动作 7 维
LOW, HIGH = -1.0, 1.0

def to_bin(a):                     # 连续动作 -> 离散 token
    x = ((a - LOW) / (HIGH - LOW) * K).long()
    return x.clamp(0, K - 1)

def to_cont(idx):                  # token -> 连续动作(取 bin 中心)
    return LOW + (idx.float() + 0.5) / K * (HIGH - LOW)

class ARPolicy(nn.Module):
    def __init__(self, obs_dim, d=256, n_layer=4, n_head=8):
        super().__init__()
        self.obs_emb = nn.Linear(obs_dim, d)          # 观测作为序列第 0 个 token
        self.tok_emb = nn.Embedding(K, d)             # 已生成的动作维度
        self.pos     = nn.Parameter(torch.zeros(D + 1, d))
        layer = nn.TransformerEncoderLayer(d, n_head, 4 * d, batch_first=True,
                                           norm_first=True)
        self.tr   = nn.TransformerEncoder(layer, n_layer)
        self.head = nn.Linear(d, K)

    def logits(self, obs, tokens):                    # tokens: (B, L) 已知的前 L 维
        x = [self.obs_emb(obs).unsqueeze(1)]
        if tokens.shape[1] > 0:
            x.append(self.tok_emb(tokens))
        x = torch.cat(x, 1) + self.pos[:1 + tokens.shape[1]]
        L = x.shape[1]
        mask = torch.triu(torch.ones(L, L, dtype=torch.bool, device=x.device), 1)
        return self.head(self.tr(x, mask=mask))       # (B, L, K)

    def loss(self, obs, act):                         # teacher forcing,一次前向
        tok = to_bin(act)                             # (B, D)
        lg  = self.logits(obs, tok[:, :-1])           # 位置 i 预测第 i 维
        return F.cross_entropy(lg.reshape(-1, K), tok.reshape(-1))

    @torch.no_grad()
    def sample(self, obs, temp=1.0):                  # 串行 D 步
        tok = torch.zeros(obs.shape[0], 0, dtype=torch.long, device=obs.device)
        for _ in range(D):
            lg = self.logits(obs, tok)[:, -1] / temp
            nxt = torch.distributions.Categorical(logits=lg).sample().unsqueeze(1)
            tok = torch.cat([tok, nxt], 1)
        return to_cont(tok)
离散化会引入量化误差:bin 宽为 $(\text{HIGH}-\text{LOW})/K$,动作精度被截断在这个尺度上。对需要毫米级精度的操作任务,$K=256$ 的均匀分箱可能不够。常见改进:(1)用非均匀分箱(如 $\mu$-law 压缩,让零附近更密——大多数动作接近零);(2)在离散 bin 上再回归一个残差;(3)对动作序列先做 DCT/VQ 压缩再离散化($\pi_0$-FAST 走的就是这条路)。另外,采样温度 $T$ 是个重要旋钮:$T$ 太高会在模态之间乱跳,$T\to0$ 又退化成贪心、丢掉多模态性。
自回归离散化的另一个巨大优势是与语言模型的基础设施完全兼容。把动作 bin 当成 token,就可以直接复用预训练的 LLM/VLM 权重、tokenizer 之外的全部结构、以及成熟的推理加速手段。RT-2、OpenVLA 这一系「视觉-语言-动作模型」正是这么做的:把动作编码成文本 token,让 VLM 像输出句子一样输出动作。代价是每个动作要串行解码若干个 token,实时控制频率受限。
7. 解法三:扩散与流匹配策略
这是目前机器人模仿学习的事实标准。核心思想:不去显式写出 $\pi_\theta(a|o)$ 的概率密度,而是学一个「把噪声逐步变成动作」的过程。
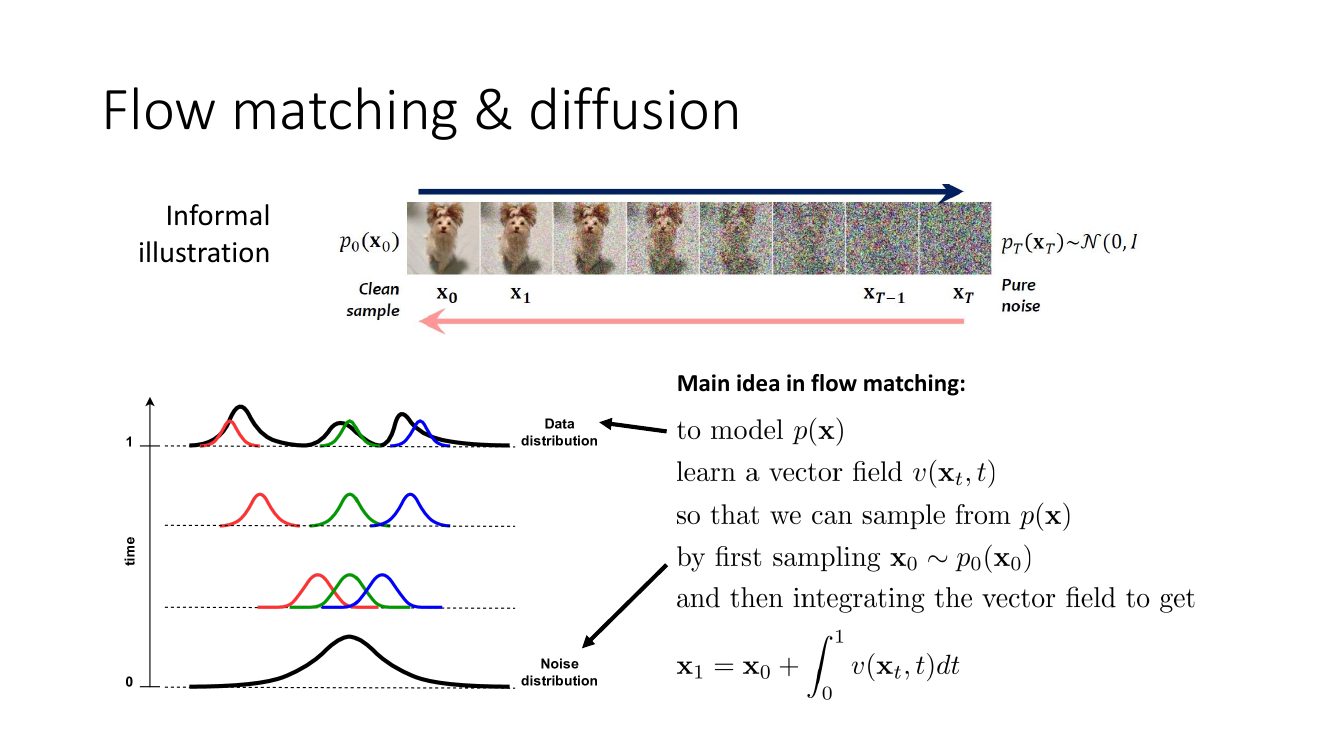
为什么这能解决多模态?回到 §5.2 的困境——普通网络会忽略噪声,因为「一步从噪声映射到动作」的监督信号(MSE)本身鼓励取平均。扩散/流匹配的巧妙之处在于:它把「取平均」这件事变成了正确的中间目标。每一步只学一个小的、局部的位移方向,而在噪声很大的地方取平均是对的(那时确实还不知道该去哪个模态);随着 $t$ 增大、$\mathbf{x}_t$ 逐渐落入某个模态的吸引域,向量场自然把它推向那个模态。模态选择是由初始噪声 $\mathbf{x}_0$ 决定的,而积分过程忠实地保持了这个选择。
7.1 流匹配:训练与采样
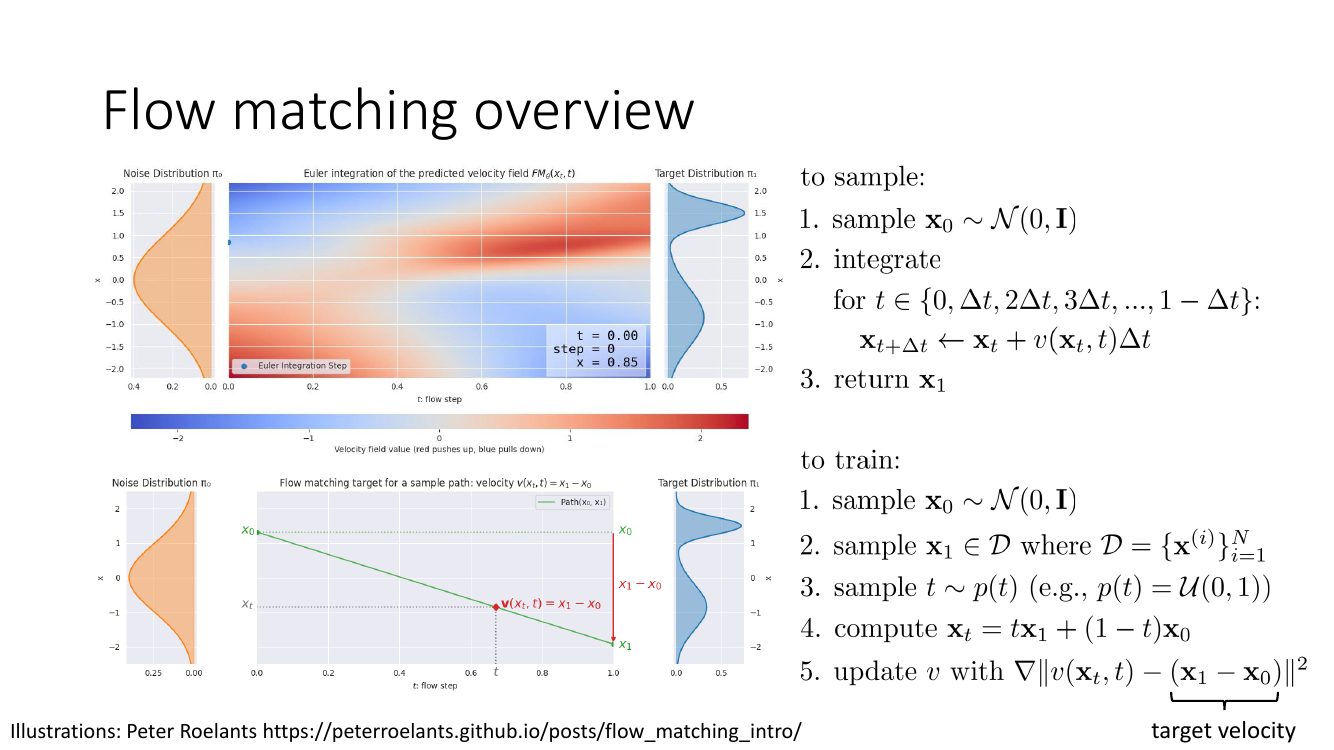
把图右边的伪代码逐条转写。采样:
- 采 $\mathbf{x}_0\sim\mathcal{N}(0,\mathbf I)$;
- 对 $t\in\{0,\Delta t,2\Delta t,\dots,1-\Delta t\}$ 做欧拉积分:$\mathbf{x}_{t+\Delta t}\leftarrow\mathbf{x}_t+v(\mathbf{x}_t,t)\,\Delta t$;
- 返回 $\mathbf{x}_1$。
训练:
- 采 $\mathbf{x}_0\sim\mathcal{N}(0,\mathbf I)$;
- 从数据集 $\mathcal{D}=\{\mathbf{x}^{(i)}\}_{i=1}^N$ 里采一个真实样本 $\mathbf{x}_1$;
- 采时间 $t\sim p(t)$,例如 $\mathcal{U}(0,1)$;
- 构造插值点 $\mathbf{x}_t=t\,\mathbf{x}_1+(1-t)\,\mathbf{x}_0$;
- 用 $\nabla\big\|v(\mathbf{x}_t,t)-\underbrace{(\mathbf{x}_1-\mathbf{x}_0)}_{\text{目标速度}}\big\|^2$ 更新 $v$。
训练目标看起来「太简单了」,值得解释为什么它是对的。我们真正想要的是边缘速度场 $v^\star(\mathbf{x},t)=\E[\mathbf{x}_1-\mathbf{x}_0\mid \mathbf{x}_t=\mathbf{x}]$,即所有穿过点 $\mathbf{x}$ 的直线路径的平均速度。它不可直接计算(要对所有配对求条件期望)。但注意一个通用事实:对任意随机变量,
$$ \argmin_{f}\ \E\big[\|f(\mathbf{x}_t,t)-Y\|^2\big]=\E[Y\mid \mathbf{x}_t,t] $$也就是说,用 MSE 回归一个带噪的目标,最优解自动是该目标的条件期望。所以直接回归单条路径的速度 $\mathbf{x}_1-\mathbf{x}_0$(一个高方差但无偏的目标),其最优解恰好就是我们要的 $v^\star$。这正是「条件流匹配(conditional flow matching)」的核心引理:一个可计算的逐样本目标,与不可计算的边缘目标,有相同的最优解和相同的梯度期望。同样的逻辑也支撑扩散模型里「回归噪声 $\epsilon$」的做法。
7.2 流匹配策略:把观测作为条件
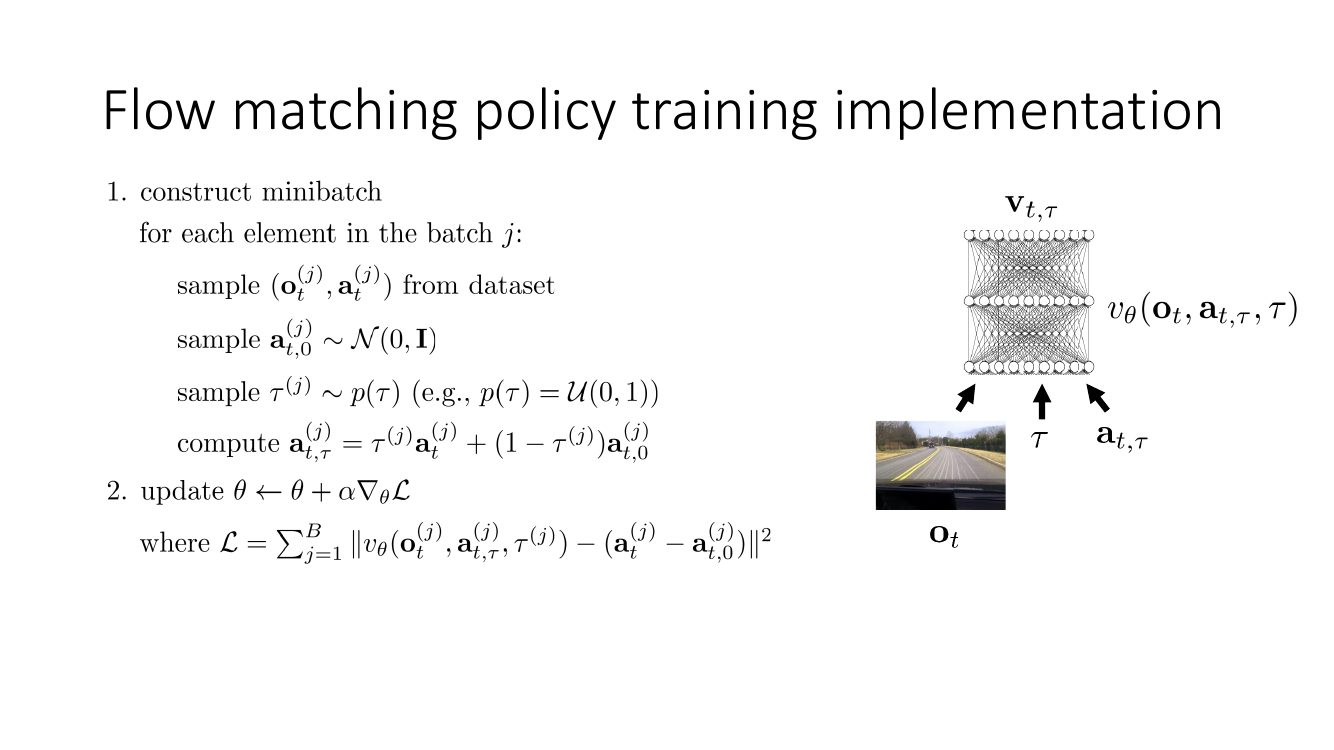
图上的算法逐字转写如下。对 minibatch 中每个元素 $j$:从数据集采 $(\mathbf{o}^{(j)}_t,\mathbf{a}^{(j)}_t)$;采噪声动作 $\mathbf{a}^{(j)}_{t,0}\sim\mathcal{N}(0,\mathbf I)$;采流时间 $\tau^{(j)}\sim p(\tau)$(如 $\mathcal{U}(0,1)$);构造插值 $\mathbf{a}^{(j)}_{t,\tau}=\tau^{(j)}\mathbf{a}^{(j)}_t+(1-\tau^{(j)})\mathbf{a}^{(j)}_{t,0}$。然后按下式更新 $\theta\leftarrow\theta+\alpha\nabla_\theta\mathcal{L}$(图上写的是加号,因为 $\mathcal{L}$ 被定义为要最小化的量,实现时取负梯度):
$$ \mathcal{L}=\sum_{j=1}^{B}\Big\|\,v_\theta\big(\mathbf{o}^{(j)}_t,\ \mathbf{a}^{(j)}_{t,\tau},\ \tau^{(j)}\big)-\big(\mathbf{a}^{(j)}_t-\mathbf{a}^{(j)}_{t,0}\big)\Big\|^2 $$import torch, torch.nn as nn
class FlowPolicy(nn.Module):
"""流匹配策略:v(o, a_noisy, tau) -> 速度。动作可以是一个 chunk,形状 (B, K*A)。"""
def __init__(self, obs_dim, act_dim, h=512):
super().__init__()
self.net = nn.Sequential(
nn.Linear(obs_dim + act_dim + 64, h), nn.SiLU(),
nn.Linear(h, h), nn.SiLU(),
nn.Linear(h, h), nn.SiLU(),
nn.Linear(h, act_dim))
self.act_dim = act_dim
@staticmethod
def time_emb(tau, dim=64): # 正弦时间编码,tau: (B, 1)
f = torch.exp(torch.linspace(0, 6, dim // 2, device=tau.device))
x = tau * f
return torch.cat([x.sin(), x.cos()], -1)
def v(self, obs, a_tau, tau):
return self.net(torch.cat([obs, a_tau, self.time_emb(tau)], -1))
def loss(self, obs, act): # act: (B, act_dim) 真实动作 a_1
a0 = torch.randn_like(act) # 噪声端 a_0
tau = torch.rand(act.shape[0], 1, device=act.device) # tau ~ U(0,1)
a_tau = tau * act + (1 - tau) * a0 # 线性插值
target = act - a0 # 目标速度(常向量)
return ((self.v(obs, a_tau, tau) - target) ** 2).sum(-1).mean()
@torch.no_grad()
def sample(self, obs, steps=10): # 欧拉积分 tau: 0 -> 1
a = torch.randn(obs.shape[0], self.act_dim, device=obs.device)
dt = 1.0 / steps
for i in range(steps):
tau = torch.full((obs.shape[0], 1), i * dt, device=obs.device)
a = a + self.v(obs, a, tau) * dt
return a
值得注意的细节:整段代码里没有任何一处显式地处理「多模态」,也没有 KL 项、没有混合权重、没有离散化。多模态是免费得来的——因为最终动作由初始噪声 $\mathbf{a}_{t,0}$ 决定,不同的 $\mathbf{a}_{t,0}$ 沿着不同的积分轨迹落到不同的模态。这正是 Levine 强调「噪声必须真的被用起来」那句话的圆满答案:在流匹配里,噪声是积分的起点,模型想忽略也忽略不了。
7.3 与 DDPM 式扩散的关系
扩散模型(DDPM)与流匹配是同一件事的两种参数化。DDPM 定义前向加噪 $\mathbf{x}_\tau=\sqrt{\bar\alpha_\tau}\,\mathbf{x}_1+\sqrt{1-\bar\alpha_\tau}\,\epsilon$,训练网络预测噪声:$\mathcal{L}=\E\|\epsilon_\theta(\mathbf{x}_\tau,\tau)-\epsilon\|^2$;采样时按 $\mathbf{x}_{\tau-1}=\frac{1}{\sqrt{\alpha_\tau}}\big(\mathbf{x}_\tau-\frac{1-\alpha_\tau}{\sqrt{1-\bar\alpha_\tau}}\epsilon_\theta\big)+\sigma_\tau z$ 逐步去噪。流匹配用线性插值路径与速度参数化,采样是确定性 ODE。实践差异:
| DDPM 式扩散 | 流匹配 / rectified flow | |
|---|---|---|
| 插值路径 | $\sqrt{\bar\alpha_\tau}\mathbf{x}_1+\sqrt{1-\bar\alpha_\tau}\epsilon$(余弦/线性 schedule) | $\tau\mathbf{x}_1+(1-\tau)\mathbf{x}_0$,直线 |
| 回归目标 | 噪声 $\epsilon$(或 $\mathbf{x}_1$、或 $v$) | 速度 $\mathbf{x}_1-\mathbf{x}_0$ |
| 采样 | SDE,随机;典型 50~100 步(DDIM 可降到 10~20) | ODE,确定性;直线路径使 5~10 步欧拉即可 |
| 超参数 | 需要设计 noise schedule $\bar\alpha_\tau$ | 几乎没有;只需选 $p(\tau)$ |
| 实时控制 | 步数多,机器人上需蒸馏加速 | 步数少,更适合高频控制 |
对机器人策略而言,采样步数直接决定控制频率,所以流匹配的「少步数」优势非常实在。$\pi_0$ 选择流匹配正是出于这个考虑。
8. 动作分块与三条路线的对比
8.1 Action chunking:一个便宜得离谱的技巧
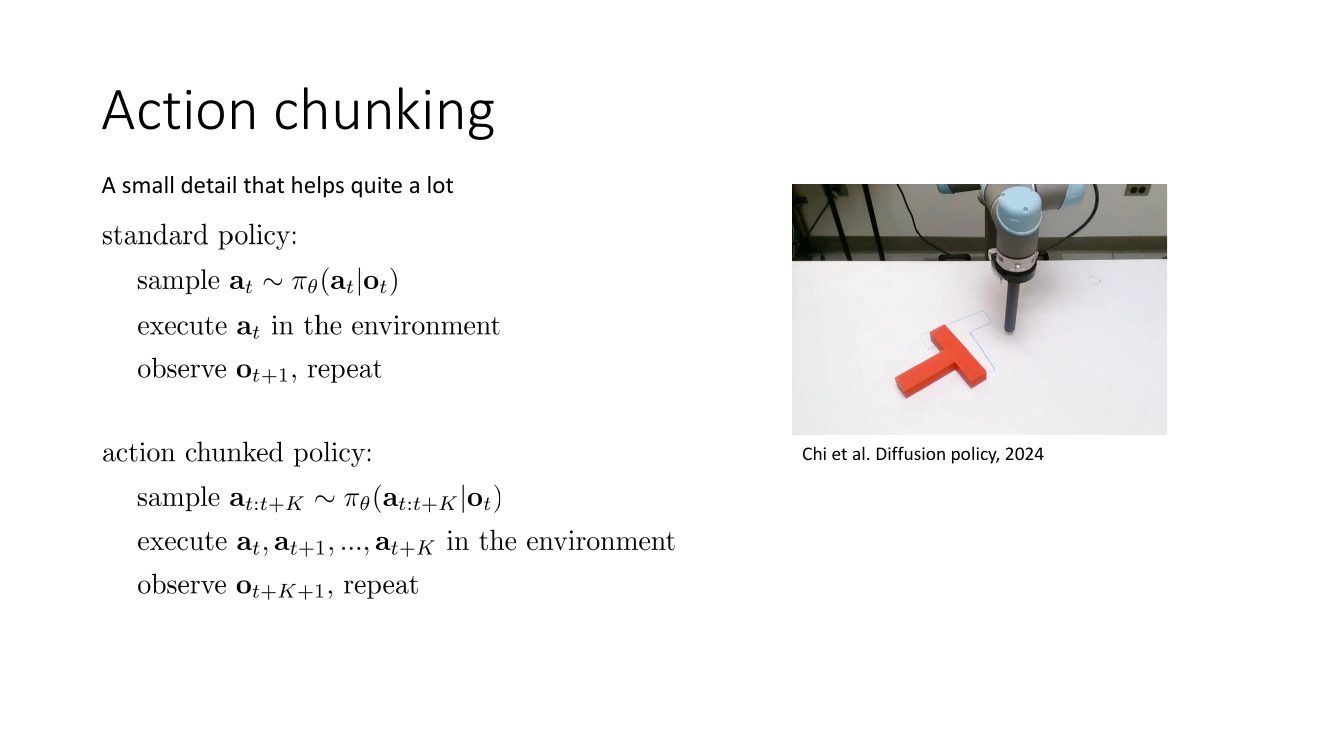
为什么一次输出未来 $K$ 步(典型 $K=8\sim50$)反而更好?有三个相互独立的理由,都很重要:
- 缓解非马尔可夫性带来的抖动。 回到 §4 的绕树例子。假设每一步都独立地从双峰分布里采样:第 1 步采到「左」,第 2 步采到「右」,第 3 步又「左」……策略在两个模态之间高频震荡,合成出来的轨迹是取平均的那条——直接撞树。这是「时间维度上的模态平均」,比单步的模态平均更隐蔽。而分块策略一次性采出整段一致的动作序列(模态选择在块级别做一次),从根本上消除了这种震荡。
- 抵消 copycat / 惯性问题。 单步策略容易学成「复读上一步动作」,在演示中的停顿处会永久卡住。分块把决策频率降低 $K$ 倍,也把这类局部相关性的影响削弱了。
- 误差累积的步数变少。 上一讲的 $O(\epsilon T^2)$ 里的 $T$ 是决策步数。分块后决策步数变成 $T/K$,理论上界改善为 $O(\epsilon (T/K)^2)$——当然块内的开环执行本身也有风险,这是一个权衡:$K$ 太大则对环境扰动失去反应能力。
实现上极其简单:把策略的动作维度从 $A$ 改成 $K\times A$,损失照旧。前面 FlowPolicy 的 act_dim 直接填 $K\cdot A$ 就是一个分块流匹配策略。实践中常用 temporal ensembling 做平滑:在每个时刻对所有覆盖到该时刻的历史块做指数加权平均,兼顾一致性与反应性。
8.2 案例:Diffusion Policy 与 $\pi_0$
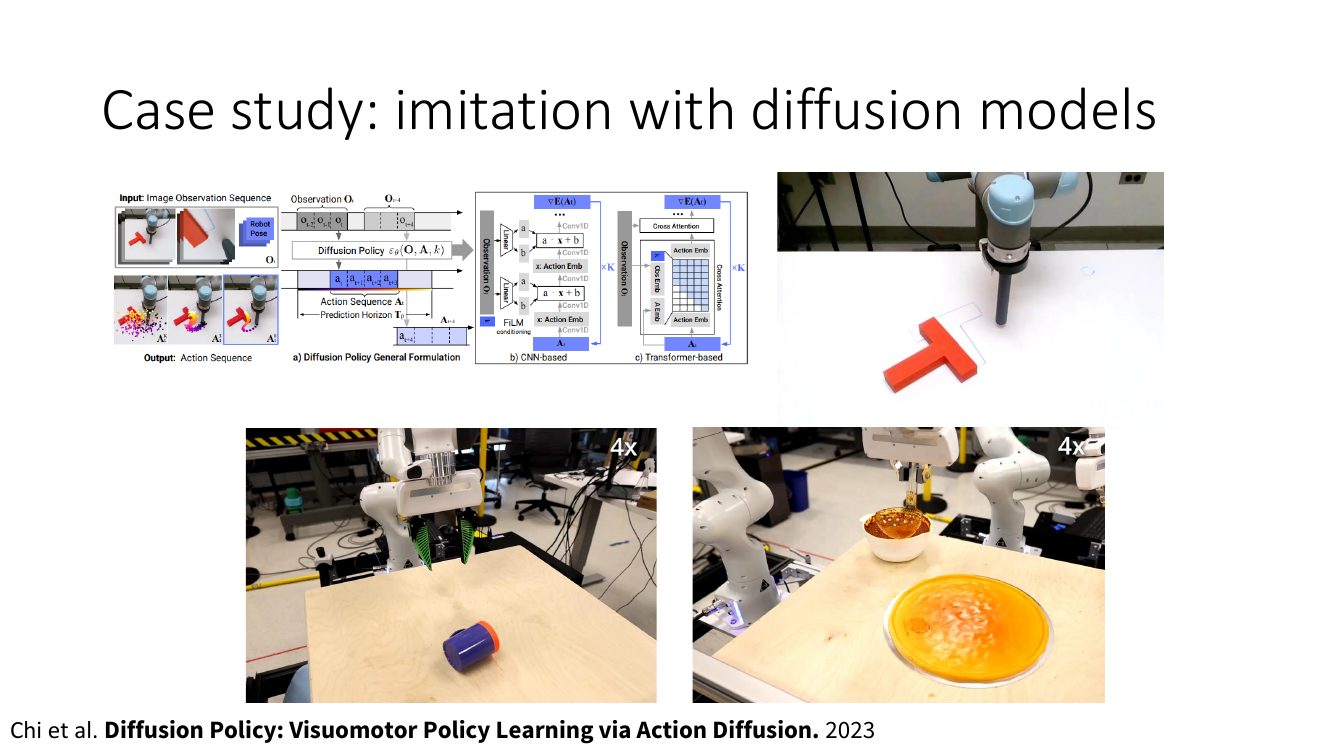
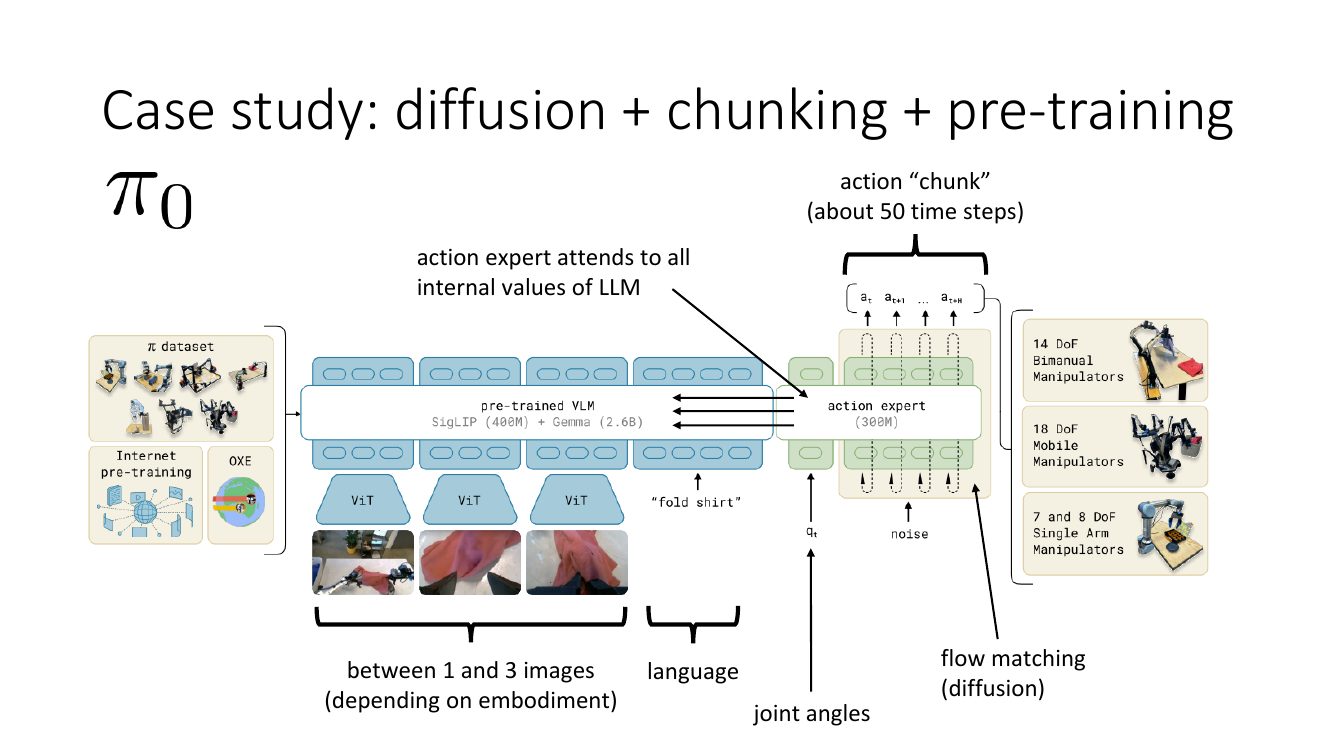
这张图值得多看两眼,因为它是本讲所有零件的合流:预训练 VLM(下一节的「宽数据」)、流匹配(§7 的多模态解法)、动作分块(§8.1)、语言条件(§10 的多任务/目标条件的自然语言版本)。架构上的一个精巧设计是「动作专家」与 VLM 共享注意力但使用独立权重:语言 token 走 VLM 的权重,动作 token 走动作专家的权重——这样既复用了 VLM 的语义知识,又不让连续动作的梯度破坏预训练表示。
8.3 三条路线怎么选
| 维度 | 混合高斯 / MDN | 隐变量(CVAE) | 自回归离散化 | 扩散 / 流匹配 |
|---|---|---|---|---|
| 训练目标 | 混合密度 NLL(精确似然) | ELBO(似然下界) | 逐维交叉熵(精确似然) | 速度/噪声 MSE(隐式似然) |
| 采样开销 | 1 次前向 | 1 次前向 | $D$(或 $K\cdot D$)次串行前向 | 5~100 次前向(各维并行) |
| 表达力 | 受 $K$ 限制,高维弱 | 中等,受后验坍缩影响 | 理论上无损,受量化精度限制 | 非常强,无模态数上限 |
| 训练稳定性 | 易分量坍缩,需正则 | 需调 $\beta$、KL annealing | 非常稳定(就是分类) | 非常稳定(就是回归) |
| 动作精度 | 连续,精确 | 连续,精确 | 受 bin 宽度限制 | 连续,精确 |
| 与 LLM/VLM 复用 | 差 | 差 | 极好(动作即 token) | 好(可作为独立动作头挂载) |
| 典型代表 | 早期 BC、离线 RL 的行为模型 | ACT、Learning Latent Plans from Play | RT-1/RT-2、OpenVLA | Diffusion Policy、$\pi_0$ |
如果动作维度低($\le3$)且只需要粗略的多模态,MDN 就够了,实现只要二十行。如果要接入预训练语言模型、需要一个统一的 token 接口,用自回归离散化。如果目标是高自由度机器人上最强的模仿性能,当前的默认答案是「流匹配 + 动作分块 + VLM 预训练」——这三者的组合就是 $\pi_0$。CVAE 处在一个尴尬位置:比 MDN 强但不如扩散稳,如今主要出现在需要单步采样的低延迟场景。
9. 数据的宽与窄:从「加噪声」到「预训练 + 后训练」
前面八节都在改模型。现在换个角度:假设模型已经足够强,我们还能通过改数据做什么?这一节回到上一讲留下的第三条路——「聪明地收集和增广数据」。
9.1 故意犯错,然后纠正
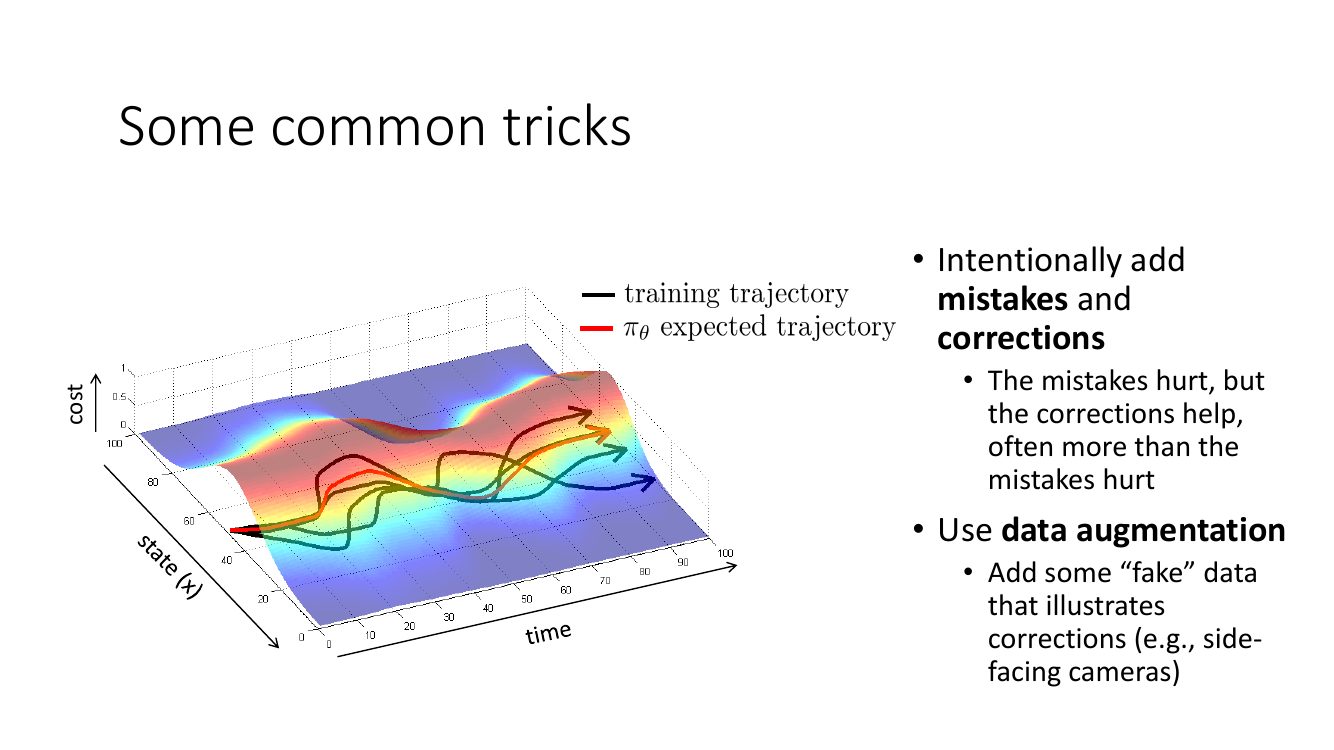
这个技巧初听是反直觉的:往干净的专家数据里掺入错误?但看上一讲的理论就清楚了。BC 失败的根源是策略偏离后进入了训练分布之外的状态,那里没有任何监督信号。如果演示者主动把车开偏一点再纠正回来,数据里就有了「偏离状态 → 纠正动作」的样本。数学上,这相当于人工地把 $p_{\text{data}}(s)$ 的支撑集扩大到覆盖 $p_{\pi_\theta}(s)$ 可能到达的区域——这是 DAgger 的「穷人版」,不需要交互式标注,只需要演示者在采集时刻意制造扰动。
代价当然存在:数据里有了次优动作,模型会以一定概率复现这些错误。所以 Levine 的措辞很谨慎——「错误有害,但纠正的收益往往大于错误的损害」。经验上的做法是把噪声控制在小幅度、且保证每个错误后面紧跟一段清晰的纠正。
数据增广是同一思路的自动化版本。最经典的例子是 NVIDIA 的端到端驾驶(Bojarski et al. 2016):车上装三个摄像头(左、中、右)。中间摄像头的图像配上真实转向角;左侧摄像头的图像被当作「车偏右了」的观测,标签是真实转向角 + 一个向左的修正量;右侧同理。这样一次采集就免费得到三倍数据,其中三分之二是模型自己永远不会主动产生的「偏离 + 纠正」样本。同类手段还有:对图像做随机裁剪/平移并相应调整动作标签、在仿真中对机器人施加随机扰动力后记录专家控制器的恢复动作。
9.2 宽而差 vs 窄而好
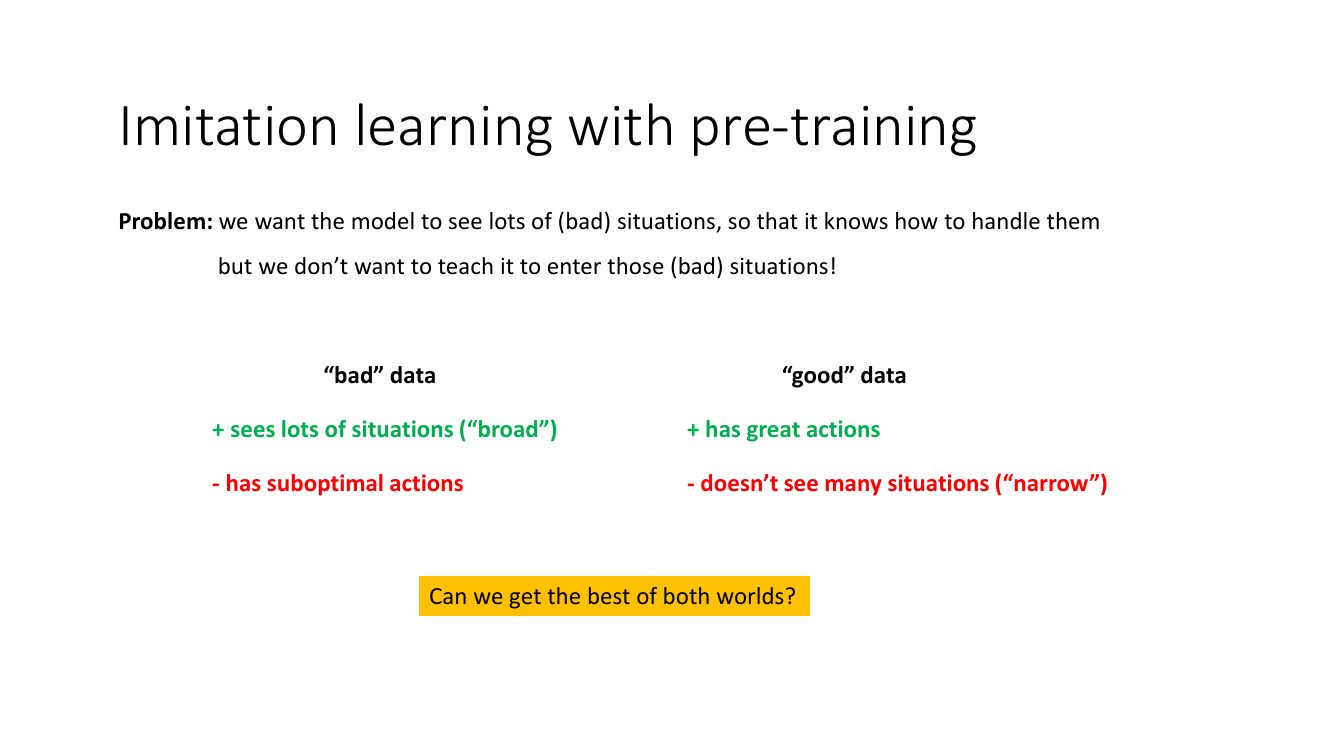
这个张力是模仿学习里最深刻的实践问题之一,值得慢慢体会。纯粹的高质量专家数据是窄的——专家几乎不犯错,所以数据里几乎没有「从错误中恢复」的样本;而这恰恰是策略最需要的知识。反过来,从各种来源搜刮来的杂乱数据(不同技能水平的操作员、遥操作时的失误、别的机器人本体、甚至互联网视频)是宽的——覆盖了大量奇怪的状态,但如果直接做 BC,模型会把「怎么把事情搞砸」也一并学去。
注意这里的困难与上一讲的分布漂移是同一个问题的两面:分布漂移之所以致命,正是因为数据窄;把数据变宽就直接缓解了漂移。所以「宽 vs 窄」不是一个新话题,而是把老问题从「算法侧」搬到了「数据侧」。
9.3 答案:预训练 + 后训练
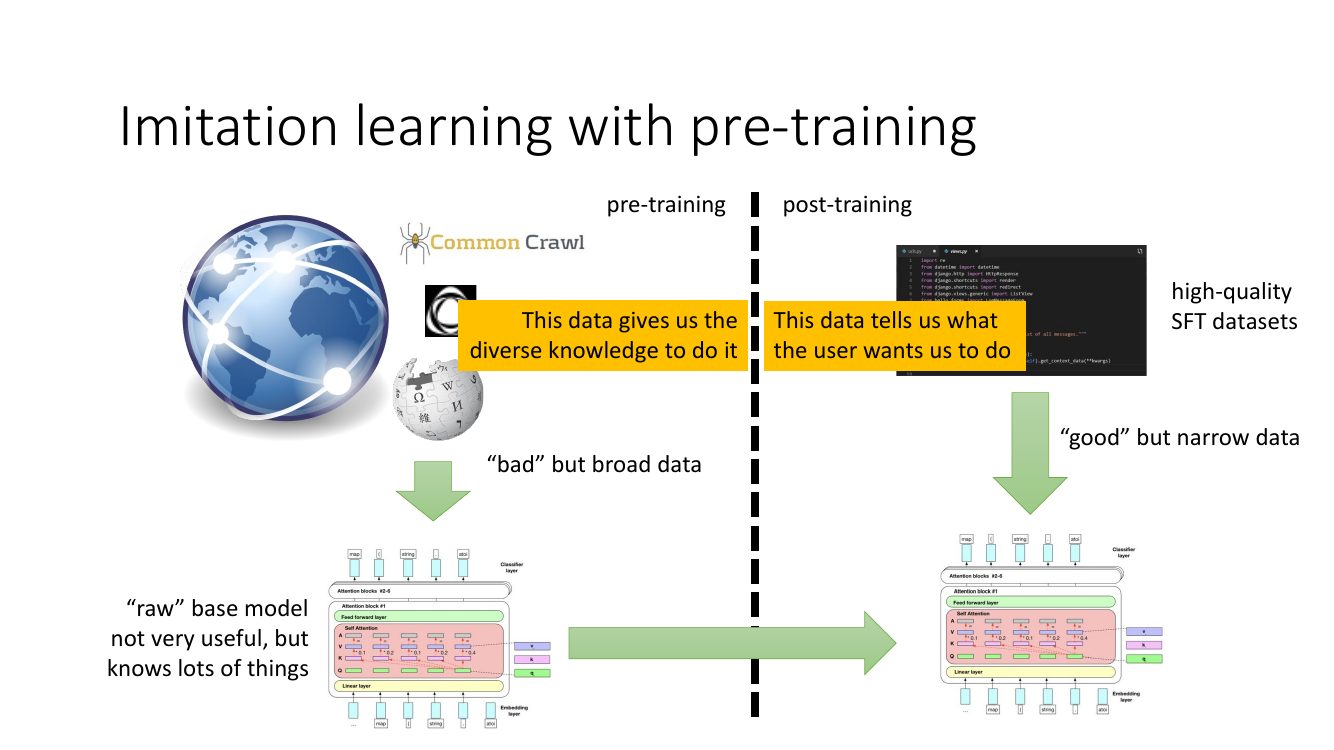
为什么这个分工有效?可以这样理解:预训练学的是「世界是什么样、可能发生什么」——一个关于观测空间和动力学的表示;后训练学的是「在这个世界里应该怎么行动」——一个关于策略的偏好。前者需要覆盖度,容忍噪声;后者需要精确性,容忍窄。用同一份数据同时满足两者是不可能的,分成两个阶段就都能满足。
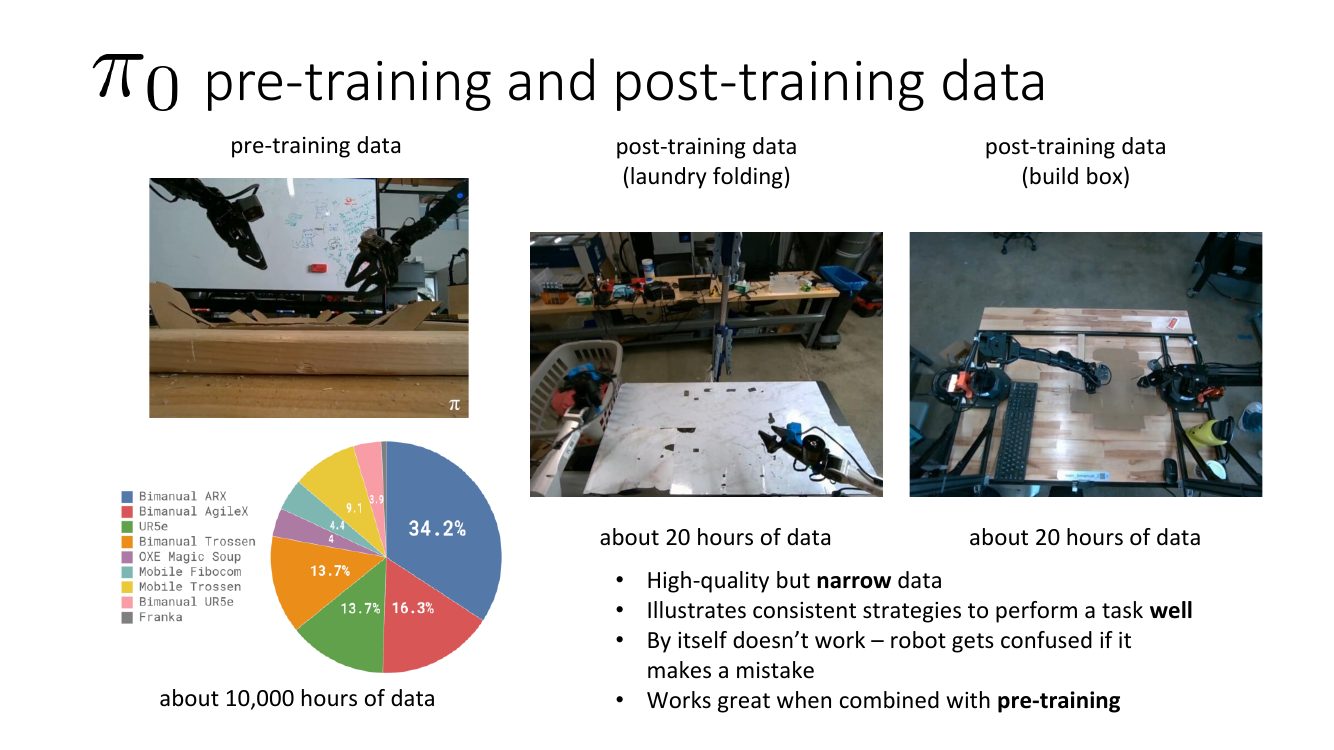
注意 10000 : 20 这个约 500 : 1 的比例。这与 LLM 的情况惊人一致(万亿 token 预训练 vs 十万条 SFT)。也请注意那句「单独用后训练数据不行——机器人一旦犯错就懵了」:这正是上一讲 $O(\epsilon T^2)$ 的实证版本。20 小时的完美演示训出来的策略,一旦偏离就无处可依;而预训练数据里有海量的「偏离状态」,模型至少知道那些状态长什么样、大致该往哪个方向恢复。
可以把预训练看成是在扩大 $p_{\text{data}}$ 的支撑集,后训练看成是在支撑集内塑造条件分布 $\pi(a|s)$ 的形状。上一讲的定理要求「在策略访问到的状态上误差小」;预训练保证这些状态在支撑集里(否则模型的输出完全无定义),后训练保证在这些状态上动作是好的。缺任何一半都不行。
10. 多任务学习与目标条件模仿
最后一条路线,也是本讲最反直觉的一条:学更多任务,反而更容易。
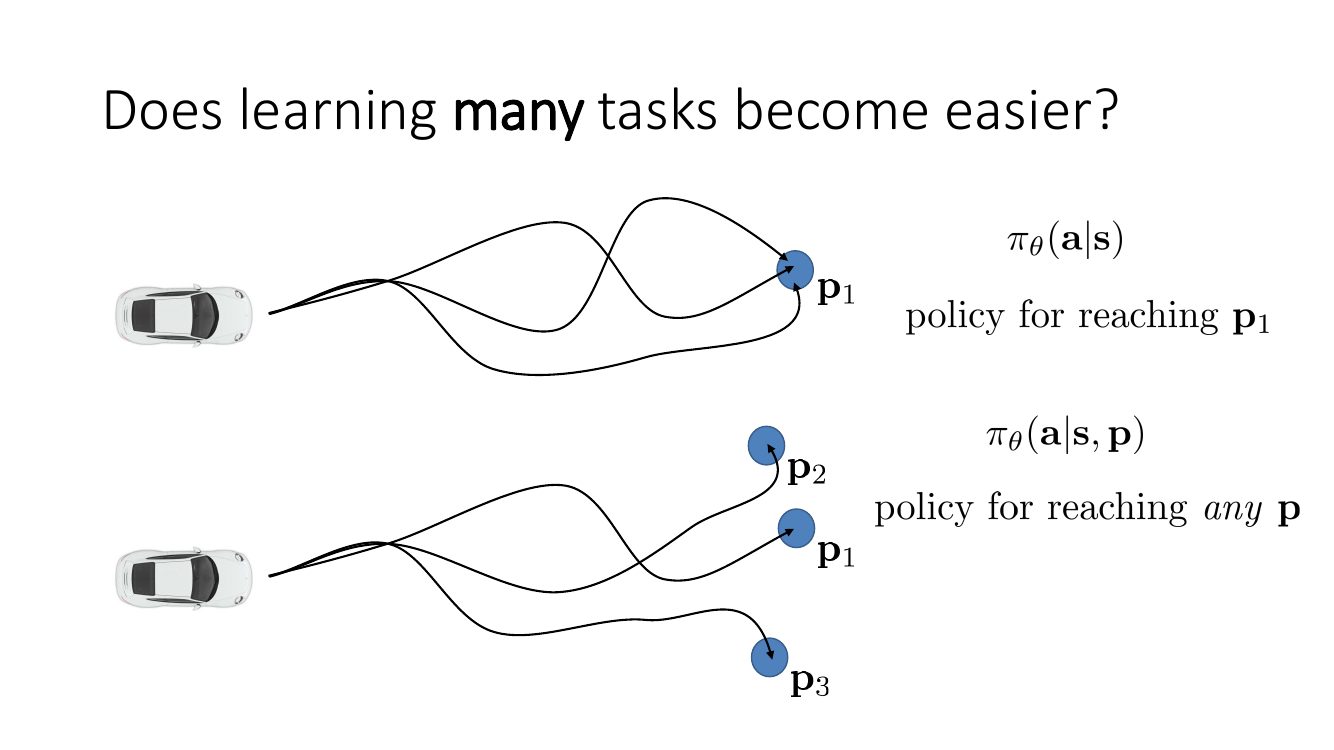
为什么更多任务能缓解分布漂移?三条互相加强的理由:
- 状态覆盖变宽。 通向不同目标的轨迹会经过不同的状态。合起来看,多任务数据集的 $p_{\text{data}}(s)$ 支撑集比任何单任务数据集都大得多。策略偏离到某处时,那里很可能是另一个任务的演示轨迹经过的地方——于是策略仍有可靠的监督。这与 §9 的「宽数据」是同一件事,只不过宽度来自任务多样性而非质量参差。
- 表示共享。 「怎么看懂一张路面图像」「怎么控制转向」这些底层能力在所有任务间是共通的,多任务训练相当于给编码器提供了 $N$ 倍的监督。
- 失败数据被回收。 这是最关键的一点,下面展开。
10.1 目标条件行为克隆
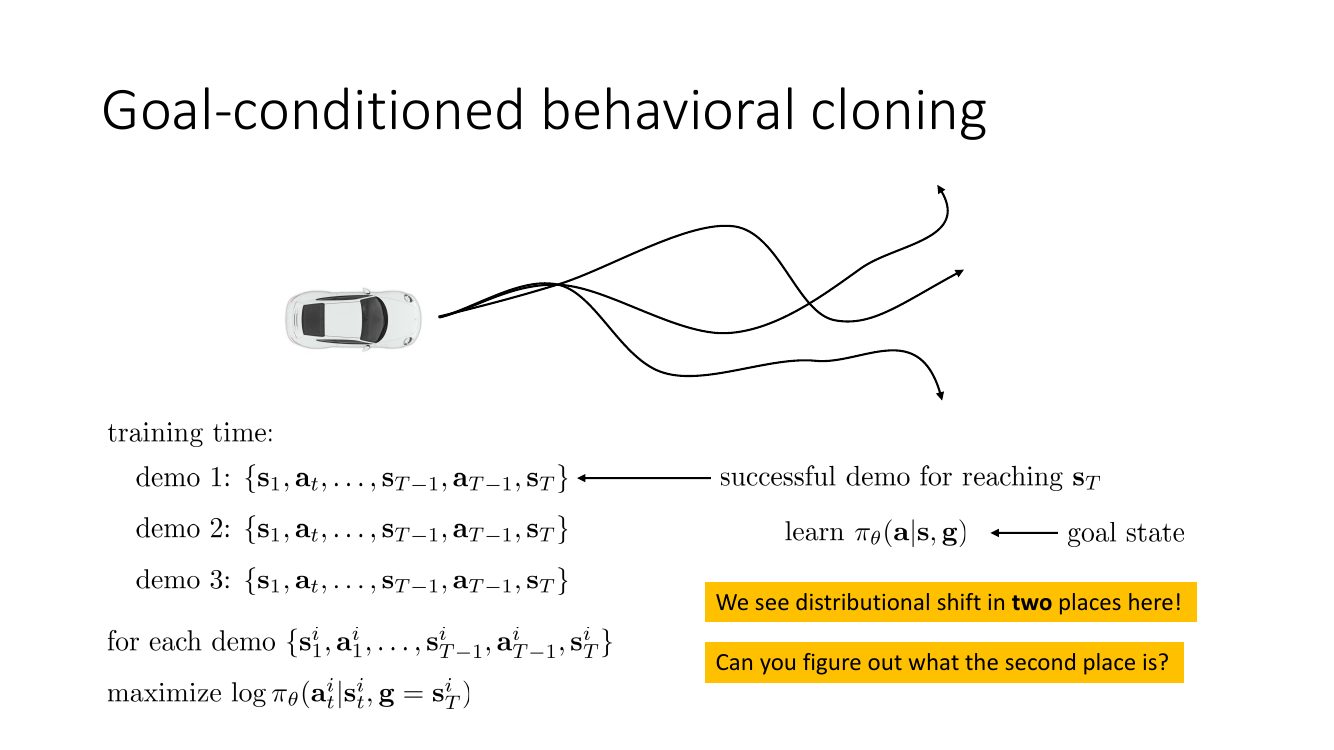
训练目标写出来只是给最大似然多加了一个条件变量:
$$ \max_\theta\ \sum_{i=1}^{N}\sum_{t=1}^{T_i-1}\log\pi_\theta\big(\mathbf{a}^i_t\ \big|\ \mathbf{s}^i_t,\ \mathbf{g}=\mathbf{s}^i_{T_i}\big) $$这个小改动的威力在于标签是免费的。以往我们需要「专家为任务 X 提供的成功演示」;现在任何一条轨迹,哪怕它是随机策略瞎跑出来的、哪怕它彻底搞砸了原定任务,只要我们把它的实际终点当作目标,它就是一条完美的成功演示。没有失败的轨迹,只有到达了别的目标的成功轨迹——这个「事后重标注(hindsight relabeling)」的思想在后面的强化学习部分还会反复出现。
两处分布漂移分别是什么?
第一处(老朋友):状态分布漂移。 训练时状态来自演示轨迹 $p_{\text{data}}(s)$,测试时来自策略自己 $p_{\pi_\theta}(s)$。这与上一讲完全相同,$O(\epsilon T^2)$ 照旧。
第二处(新增):目标分布漂移。 训练时的目标 $\mathbf{g}$ 不是任意的——它必然是某条数据轨迹的终点,即 $\mathbf{g}\sim p_{\text{data}}(\mathbf{s}_T)$,而且这个目标必然是从对应的起始状态可达的(因为那条轨迹真的到过)。测试时用户可以给出任意目标 $\mathbf{g}\sim p_{\text{test}}(\mathbf{g})$,它可能从当前状态根本到不了,也可能落在训练目标分布的低密度区。于是 $p_{\text{test}}(\mathbf{g})\neq p_{\text{data}}(\mathbf{g})$,策略在这些目标上没有任何训练信号。
更微妙的是:即使目标可达,条件分布也被扭曲了。数据里的 $(\mathbf{s}_t,\mathbf{g})$ 配对总是「$\mathbf{g}$ 恰好是从 $\mathbf{s}_t$ 出发在 $T-t$ 步内到达的那个点」,所以模型可能学成「预测数据里那条特定路径」而不是「找一条通往 $\mathbf{g}$ 的路」。缓解办法:训练时不只用轨迹终点,而是随机采样轨迹中任意未来时刻的状态 $\mathbf{g}=\mathbf{s}^i_k,\ k>t$ 作为目标,这样每条长度 $T$ 的轨迹能产出 $O(T^2)$ 个 $(\mathbf{s},\mathbf{a},\mathbf{g})$ 三元组,目标分布也宽得多。
import random, torch

def relabel_batch(trajs, batch_size, future_only=True):
    """事后重标注:从演示/rollout 中采样 (s, a, g) 三元组。
       trajs: list of dict(states=(T+1, S), actions=(T, A))"""
    S, A, G = [], [], []
    for _ in range(batch_size):
        tr = random.choice(trajs)
        T  = tr['actions'].shape[0]
        t  = random.randrange(T)
        # 目标从 t 之后的任意时刻采(含终点),而不是只用终点 —— 缓解目标分布漂移
        k  = random.randrange(t + 1, T + 1) if future_only else T
        S.append(tr['states'][t]); A.append(tr['actions'][t]); G.append(tr['states'][k])
    return torch.stack(S), torch.stack(A), torch.stack(G)

def gcbc_loss(policy, trajs, bs=256):
    s, a, g = relabel_batch(trajs, bs)
    return -policy.log_prob(a, torch.cat([s, g], -1)).mean()   # 目标直接拼进观测
10.2 案例:从 play data 学隐式计划
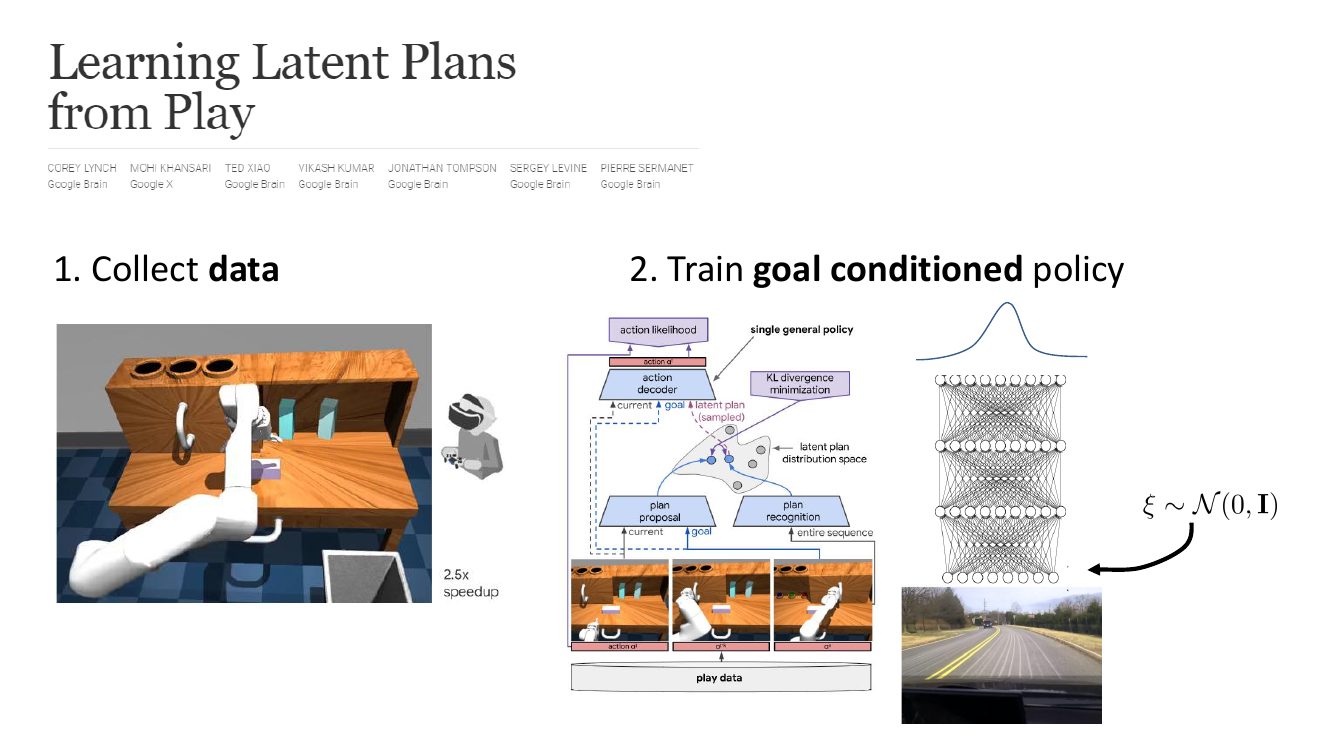
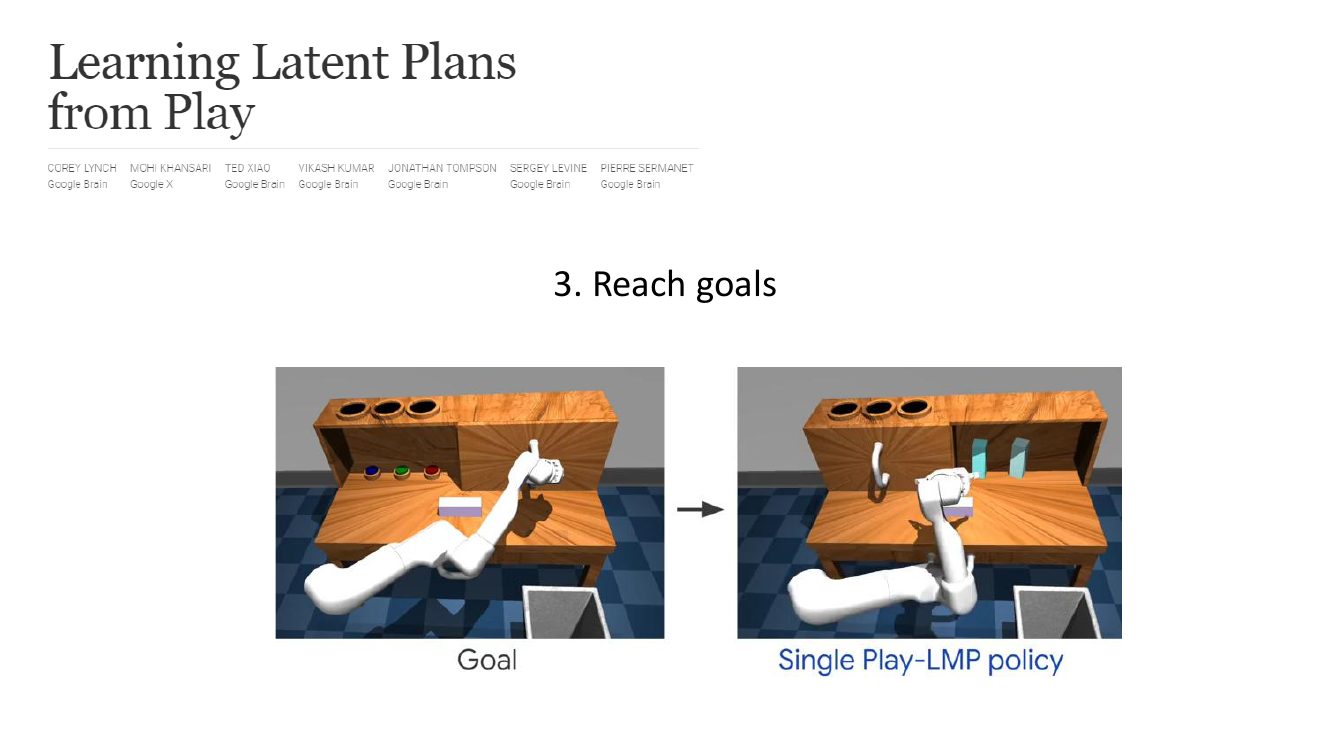
这个工作把本讲的两条主线缝在了一起:目标条件让无标签的 play data 变成有监督数据;隐变量(CVAE)处理「从 $\mathbf{s}$ 到 $\mathbf{g}$ 有多条路径」这个内在的多模态性。隐变量在这里有很自然的语义——它就是「打算走哪条路线」,论文称之为 latent plan。测试时给定一张目标图像,策略就能自主完成一串从未被显式标注过的操作。
10.3 超越模仿:迭代式自我改进
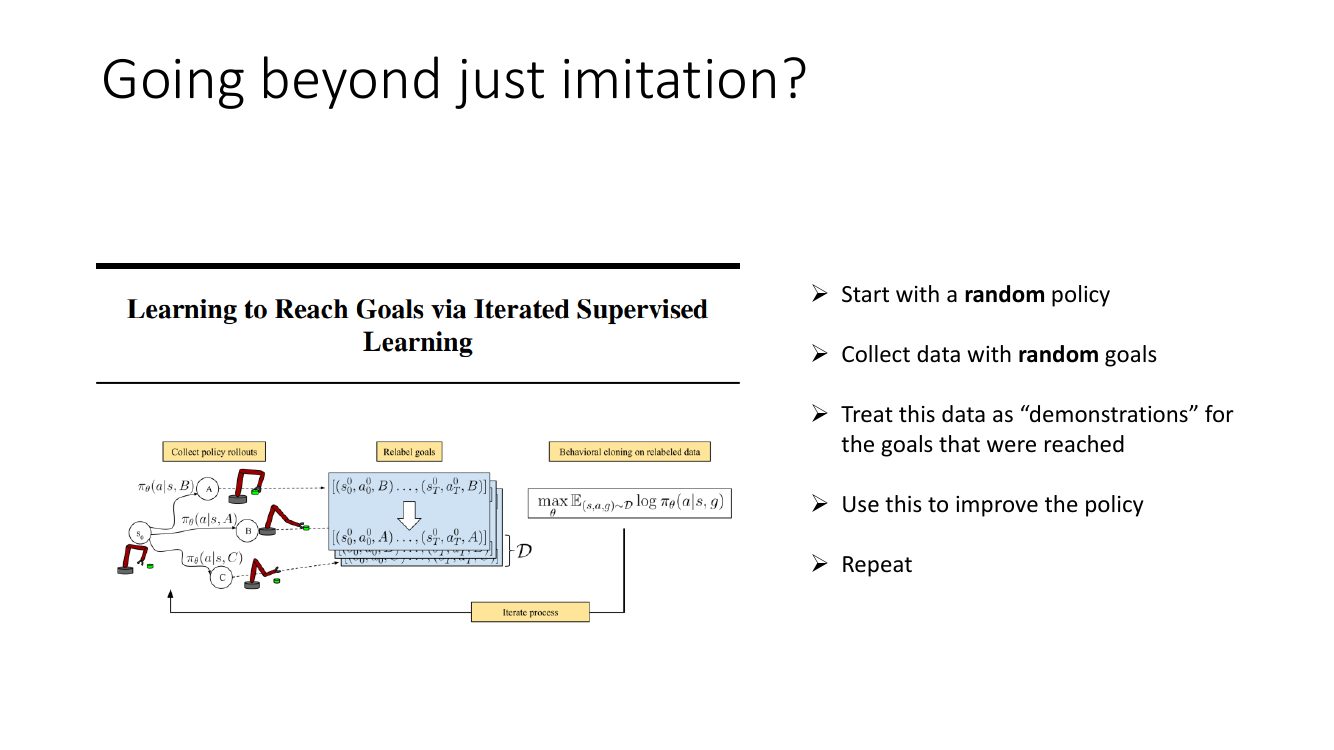
右侧的算法逐条是:从随机策略开始 → 用随机目标收集数据 → 把数据当作「它实际到达的那些目标」的演示 → 用这些数据改进策略 → 重复。为什么这样能变好,而不是原地打转?因为每一轮策略的能力都会小幅扩张:第 $k$ 轮策略能可靠到达的目标集合记作 $\mathcal{G}_k$,那么第 $k$ 轮收集的数据覆盖了 $\mathcal{G}_k$ 的一个邻域(随机性带来的探索),在这些数据上做 BC 会让 $\mathcal{G}_{k+1}\supseteq\mathcal{G}_k$。这是一个自举(bootstrapping)过程,不需要任何奖励函数或人类演示。
不过要诚实:这个方法的探索能力完全依赖策略自身的随机性,在需要长程精确探索的任务上会卡住;而且它优化的是「到达目标」这个特定形式的目标,不是任意奖励。它是「用监督学习的工具做一点点强化学习」的漂亮示范,但天花板明确。
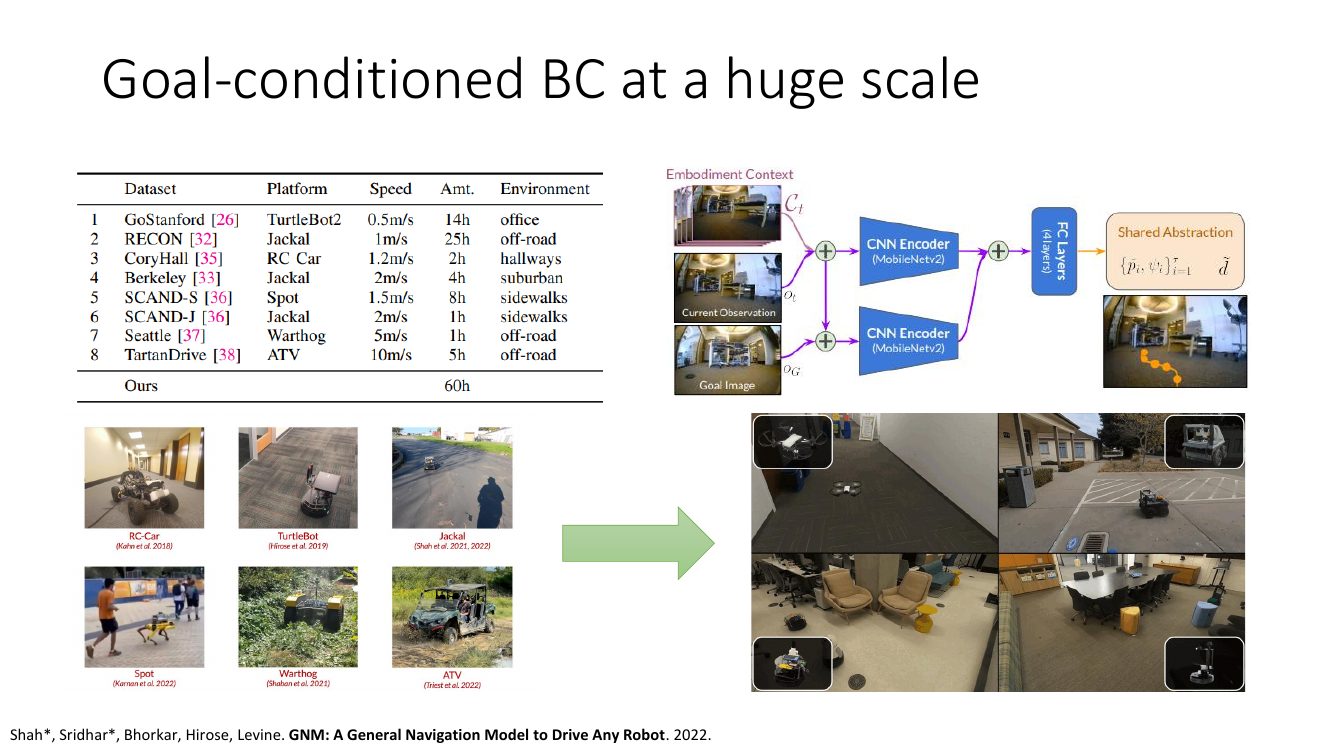
GNM 的核心洞见与 §9 完全一致:把 8 个各自太小、太窄的数据集合并成一个宽数据集,训出的单个策略在每个平台上都优于该平台上单独训练的策略。目标条件(用图像作为目标)在这里是让异构数据可以合并的「通用接口」——不同机器人的任务定义天差地别,但「到达这张图片所示的地方」是通用的。
11. 模仿学习的根本局限
本讲花了大量篇幅补救 BC,但必须清醒:这些补救全都在同一个范式内部——用监督学习去复制人给的动作。这个范式有三条无法通过工程手段绕过的边界。
11.1 数据必须由人提供,而人是有限的
BC 的性能与演示数据量强相关,而演示只能由人一条条采。$\pi_0$ 的 10000 小时预训练数据背后是成百上千个小时的遥操作工时;GNM 的 60 小时导航数据来自 8 个研究组多年的积累。对比一下:一个仿真环境里的 RL 智能体一晚上就能产生几百万步经验,而且完全自动。这个成本差异是量级性的,并且不随算力增长而改善——买更多 GPU 不会让人类演示变多。
更麻烦的是有些任务人根本没法演示:高维冗余机械手的精细协调、需要毫秒级反应的动态平衡、化学分子结构的设计。「人能做但没法通过遥操作接口传达」和「人根本做不到」是两个不同的障碍,BC 都跨不过去。
11.2 原则上无法超越专家
这是最根本的一条。BC 的目标函数是
$$ \theta^\star=\argmin_\theta\ \E_{s\sim p_{\text{data}}}\big[\KL\big(\pi^\star(\cdot|s)\ \|\ \pi_\theta(\cdot|s)\big)\big] $$它的最优解就是专家本身。哪怕数据无限、模型无限大、优化完美,你得到的也只是 $\pi_\theta=\pi^\star$。BC 的目标函数里根本没有出现「好」的概念——没有奖励、没有代价、没有任何告诉模型「这个动作比那个动作更优」的信号。它只知道「专家会这么做」。
这与人类学习形成鲜明对比:学生可以超过老师,因为学生除了模仿还会练习并观察结果。要让机器也能做到,就必须引入一个衡量结果好坏的量——奖励函数 $r(s,a)$。这正是下一讲的起点。
「数据里有好有坏,模型自然会学好的那部分」——不会。最大似然对数据里的每个样本一视同仁,坏动作与好动作以同等权重被拟合。除非你给它一个区分好坏的信号(奖励、偏好比较、成功/失败标签、或者像目标条件 BC 那样把「结果」变成条件变量),否则模型只会忠实地复制整个数据分布,包括其中的错误。这也是为什么 §9 的「预训练 + 后训练」必须分阶段而不能混在一起训:后训练阶段的窄而好的数据必须占据主导,才能把行为塑造到高质量的那个模态上。
11.3 无法自主改进,也无法处理演示者与执行者的差异
BC 是一次性的:训完就定型,部署后遇到新情况不会变好。DAgger 提供了一点交互能力,但仍需要人在环中标注。真正的自主改进要求智能体自己判断结果好坏——又回到奖励函数。
还有一个常被忽略的问题:形态与感知的不匹配。人演示时用的是自己的手眼,机器人有不同的关节限位、不同的摄像头位置、不同的延迟。哪怕完美复制了人的动作序列,在机器人身上也未必产生同样的效果。这类问题(correspondence problem)在跨本体学习、从人类视频学习中是核心难点。
目标条件 BC + 事后重标注(§10.3)是在这个范式内能走的最远的一步:它让智能体能从自己产生的数据里学习,不需要人。但它优化的仍然只是「到达状态」这一类目标,而且探索靠随机性驱动,效率很低。要系统地解决「怎么变得比数据更好」,必须换范式。
模仿学习的定位:它是把先验知识注入策略的最有效手段,但不是获得最优策略的手段。现代系统的典型形态是「模仿学习提供起点 + 强化学习提供改进」——这也解释了为什么本课先花两讲讲 BC,再用二十讲讲 RL:没有 BC 提供的良好初始化,很多 RL 问题的探索难度是无法接受的;没有 RL,BC 的性能天花板就是人。
本讲小结
一张速查表,按「问题 → 症状 → 解法」组织:
| 问题 | 症状 | 解法 | 代价 / 副作用 |
|---|---|---|---|
| 非马尔可夫行为 | 训练损失下不去;同一画面对应不同动作 | 历史输入 + 共享编码器 + 序列模型(Transformer/RNN) | 计算量上升;加剧因果混淆 |
| 因果混淆 | 训练/验证指标都很好,闭环执行崩溃 | 缩短历史窗口、遮挡泄漏区域、强增广、DAgger 式干预数据 | 可能丢掉真正有用的历史信息 |
| 多模态行为 | 策略输出各模态的平均值(撞树);轨迹抖动 | MDN / CVAE / 自回归离散化 / 扩散·流匹配 | 见 §8.3 对比表 |
| 时间维度上的模态平均 | 相邻时刻在不同模态间跳变 | 动作分块(一次输出 $K$ 步)+ temporal ensembling | 块内开环,对扰动反应变慢 |
| 数据太窄(分布漂移) | 一偏离演示轨迹就无从恢复 | 故意加错误+纠正、数据增广(侧摄像头)、宽数据预训练 | 次优动作被部分复现;需要两阶段训练 |
| 任务太少 / 数据无标签 | 可用监督数据太少 | 多任务学习、目标条件 BC、事后重标注 | 引入第二处分布漂移(目标分布) |
| 无法超越专家 | 性能天花板 = 演示者水平 | (本讲无解)引入奖励函数 → 强化学习 | 需要定义奖励,需要交互 |
必须记住的几个式子
- 历史策略:$\pi_\theta(a_t\mid o_1,\dots,o_t)$,用共享编码器 $z_i=\mathrm{Enc}(o_i)$ + 因果序列模型。
- 混合高斯:$\pi_\theta(a|o)=\sum_k w_k(o)\mathcal{N}(a;\mu_k(o),\Sigma_k(o))$,损失是 $-\log\sum_k$(用 logsumexp)。
- 隐变量策略的 ELBO:$\log\pi_\theta(a|o)\ge\E_{q_\phi}[\log\pi_\theta(a|o,\xi)]-\KL(q_\phi(\xi|o,a)\|p(\xi))$。
- 自回归分解:$p(\mathbf a|\mathbf s)=\prod_{d} p(a_d\mid \mathbf s,a_{<d})$,把 $K^D$ 降到 $D\times K$。
- 流匹配:训练 $\min_\theta\E\|v_\theta(\mathbf a_\tau,\tau,\mathbf o)-(\mathbf a_1-\mathbf a_0)\|^2$,其中 $\mathbf a_\tau=\tau\mathbf a_1+(1-\tau)\mathbf a_0$;采样 $\mathbf a\leftarrow\mathbf a+v_\theta\Delta\tau$。
- 目标条件 BC:$\max_\theta\sum_i\sum_t\log\pi_\theta(a^i_t\mid s^i_t,\ \mathbf g=s^i_{k}),\ k>t$。
Levine 的取舍判断
- 历史信息「能不加就不加」,$\pi_0$ 只用 1~3 张当前图像;先靠动作分块解决时间一致性,再考虑上历史。
- 连续高维动作上,扩散/流匹配 + 动作分块是当前最稳的默认选择;离散化路线的价值主要在于与 LLM 复用基础设施。
- 离线的动作 MSE 与验证损失不能作为策略质量的指标,必须闭环评测。因果混淆是这一点最好的反例。
- 数据配方比模型结构更重要:宽数据预训练 + 窄数据后训练的组合,收益通常大于换一个更花哨的策略头。
延伸阅读
非马尔可夫性与因果混淆
- Causal Confusion in Imitation Learning (de Haan, Jayaraman, Levine, 2019) — 本讲那张「刹车灯」图的出处,系统地论证了「信息更多反而更差」,并给出基于因果图搜索的缓解方案。理解 BC 为何在离线指标很好时闭环失败,必读。
- End to End Learning for Self-Driving Cars (Bojarski et al., 2016) — NVIDIA 的端到端驾驶,侧向摄像头数据增广的经典来源,也是 §9.1「合成纠正数据」的最佳范例。
多模态策略:隐变量与离散化
- Auto-Encoding Variational Bayes (Kingma & Welling, 2013) — VAE 与重参数化技巧的原始论文,§5.3 的全部数学都在这里。
- Mixture Density Networks (Bishop, 1994) — 混合高斯输出头的原始技术报告,一篇非常好读的短文。
- Density Estimation using Real NVP (Dinh et al., 2016) — 归一化流的代表作,理解「可逆变换 + 雅可比行列式」这条精确似然路线。
- RT-1: Robotics Transformer for Real-World Control at Scale (Brohan et al., 2022) — 大规模自回归离散化动作的代表,把每个动作维度离散成 256 个 bin 交给 Transformer。
- Behavior Transformers: Cloning k modes with one stone (Shafiullah et al., 2022) — 把动作聚类成若干「模态 token」再回归残差,是离散化与连续回归的一个巧妙混合。
扩散与流匹配策略
- Denoising Diffusion Probabilistic Models (Ho, Jain, Abbeel, 2020) — 扩散模型的现代起点,理解 §7.3 里的噪声预测参数化。
- Flow Matching for Generative Modeling (Lipman et al., 2022) — 流匹配的原始论文,§7.1 那个「回归条件速度即可得到边缘速度场」的引理出自这里。
- Diffusion Policy: Visuomotor Policy Learning via Action Diffusion (Chi et al., 2023) — 把扩散模型引入机器人操作的标志性工作,同时确立了「扩散 + 动作分块」的组合。
- Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware (Zhao et al., 2023) — ACT,用 CVAE + Transformer 做动作分块,是 CVAE 路线在机器人上最成功的实例。
- π0: A Vision-Language-Action Flow Model for General Robot Control (Black et al., 2024) — 本讲最后一张架构图的出处,把 VLM 预训练、流匹配动作专家、动作分块、宽/窄数据配方全部整合。
数据、多任务与目标条件
- Learning Latent Plans from Play (Lynch et al., 2019) — 用无标签的「玩耍」数据训练目标条件策略,隐变量恰好对应「打算走哪条路线」。
- Learning to Reach Goals via Iterated Supervised Learning (Ghosh et al., 2019) — GCSL,纯监督学习的自我改进循环,§10.3 的出处。
- Hindsight Experience Replay (Andrychowicz et al., 2017) — 事后重标注思想在 off-policy RL 中的版本,本讲结尾预告的内容。
- GNM: A General Navigation Model to Drive Any Robot (Shah, Sridhar et al., 2022) — 用图像目标作为通用接口,把 8 个异构机器人数据集合并训练单一导航策略。
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models (2023) — 迄今最大的跨本体机器人数据集合并工作,是 §9「宽数据」在机器人领域的基础设施。
- A Reduction of Imitation Learning to No-Regret Online Learning (Ross, Gordon, Bagnell, 2011) — DAgger 原始论文,回顾上一讲的理论以及本讲 §3 中「DAgger 能缓解因果混淆」的机制。