基于模型的强化学习
用监督学习拟合动力学,再在这个「学出来的模拟器」里规划——为什么这个看起来显然正确的想法一定会崩,以及不确定性估计凭什么是救命的那一步。
0. 本讲导读
到目前为止我们学的所有方法——策略梯度、actor-critic、Q-learning、以及第 14 讲把语言模型接进来的 RLVR—— 有一个共同点:它们从来不去了解世界是怎么运转的。它们只知道「我做了这个动作,最后拿到了这么多奖励」。 转移概率 $p(s_{t+1}|s_t,a_t)$ 始终躲在采样过程后面,从没有被显式写下来过。这类方法叫 无模型强化学习(model-free RL)。
但人显然不是这么学的。你伸手去推桌上的杯子之前,脑子里已经预演过杯子会往哪滑、会不会倒; 如果推错了,你也不需要真把水洒一地才知道那个动作不好。这种「先在脑子里跑一遍」的能力, 在 RL 里对应的就是模型(model):一个能回答「在状态 $s$ 做动作 $a$ 之后会发生什么」的函数。 如果我们手上有这个东西,很多问题会立刻变得简单——不需要真的在环境里试错, 可以在模型里想象出任意多的数据;甚至可以完全不学策略,直接用规划器(planner)在模型里搜出一条好轨迹。
本讲要问的核心问题只有一个:既然拟合 $p(s'|s,a)$ 只是一个再普通不过的监督学习问题, 我们为什么不干脆学一个模拟器,然后在里面跑 RL?Levine 用了整整一讲来说明:这个想法是对的, 但最朴素的实现方式必然失败,而且失败的原因和第 2 讲模仿学习里的 分布漂移(distributional shift)是同一个东西,只是换了一副面孔—— 这次漂移的不是策略看到的状态,而是模型被查询到的状态-动作对。
脉络分三段:第一段写下「学出来的模拟器」的朴素算法,并逐条拆解它为什么会失败 (分布漂移、模型设计的领域依赖、以及「有了模拟器不等于规划变容易」)。 第二段把分布漂移讲透:为什么把数据收集放进循环只能「勉强算是」修好了问题, 为什么优化器一定会去利用模型的错误(model exploitation),以及两条对策—— 信赖域(trust region)和不确定性感知(uncertainty-aware)模型。 第三段回答「不确定性到底怎么估」:输出熵为什么不够, 偶然不确定性(aleatoric)与认知不确定性(epistemic)的区别,贝叶斯神经网络, 以及工程上真正好用的 bootstrap 集成(bootstrap ensemble)。
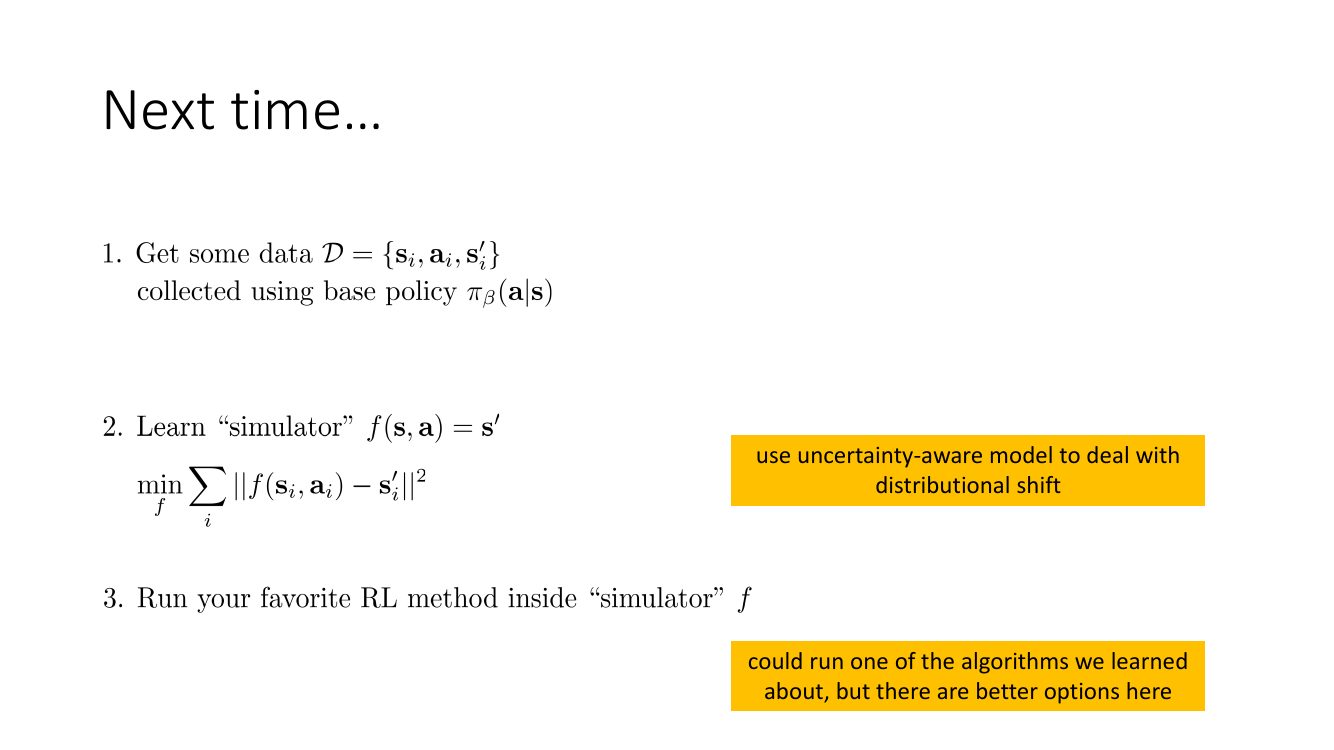
- 朴素做法(v0.5):用基础策略 $\pi_\beta$ 采数据 $\mathcal{D}=\{(s_i,a_i,s_i')\}$, 最小二乘拟合 $f(s,a)=s'$,然后在 $f$ 里跑你喜欢的 RL 或规划。它在经典控制里能用,在深度 RL 里通常直接崩。
- 崩的原因是分布漂移:模型只在 $p_{\pi_\beta}(s_t)$ 上准确,而优化出来的新策略 $\pi_f$ 会把系统带到 $p_{\pi_f}(s_t) \ne p_{\pi_\beta}(s_t)$ 的地方,那里模型的误差是不受控的。 而且这个漂移不是意外,是被优化目标主动追求的——哪里模型误差大且方向有利,规划器就往哪去。
- v1.0:把数据收集塞进循环(用 $\pi_f$ 再采数据、重训模型),像 DAgger 一样。有用,但只解决了一半。
- v1.5:每轮只把策略「改一点点」,不要一口气优化到最优。因为一口气优化必然会 落到模型误差最大的那个诱人尖峰上。
- v2.0(真正的解法):学概率模型 $p(s'|s,a)$ 并在期望意义下优化策略。 关键洞察是「高方差预测下的期望回报很低,即使均值一样」——不确定性自动产生了对危险区域的回避。
- 不确定性必须是认知不确定性:网络输出分布的熵(aleatoric)刻画的是数据本身的噪声, 过拟合的网络照样可以对着错误答案给出零方差的自信预测。我们要的是 $p(\theta|\mathcal{D})$ 的熵。
- bootstrap ensemble 基本够用:训 $N \lt 10$ 个模型,用 $p(\theta|\mathcal{D}) \approx \frac{1}{N}\sum_i \delta(\theta_i)$ 近似后验。 在深度学习里连有放回重采样都常常省掉——SGD 的随机性和随机初始化就足以让模型「够独立」。
1. 我们真的能学出一个「模拟器」吗
先把术语对齐。本讲的记号沿用全课:$s_t$ 是状态(满足马尔可夫性),$a_t$ 是动作, $o_t$ 是观测(可能只是状态的一部分),$r(s,a)$ 是奖励,$\pi_\theta(a|s)$ 是策略, $\tau=(s_1,a_1,\dots,s_T,a_T)$ 是轨迹。所谓模型,就是对转移分布的一个显式表示:
$$ \text{随机模型:}\; p_\phi(s_{t+1}\mid s_t,a_t) \qquad\qquad \text{确定性模型:}\; s_{t+1} = f_\phi(s_t,a_t) $$其中 $\phi$ 是模型参数(为了和策略参数 $\theta$ 区分开)。注意确定性模型是随机模型的特例 (退化成一个 $\delta$ 分布)。本讲前半段为了叙述简洁用 $f$,后半段讨论不确定性时必须换回 $p$。
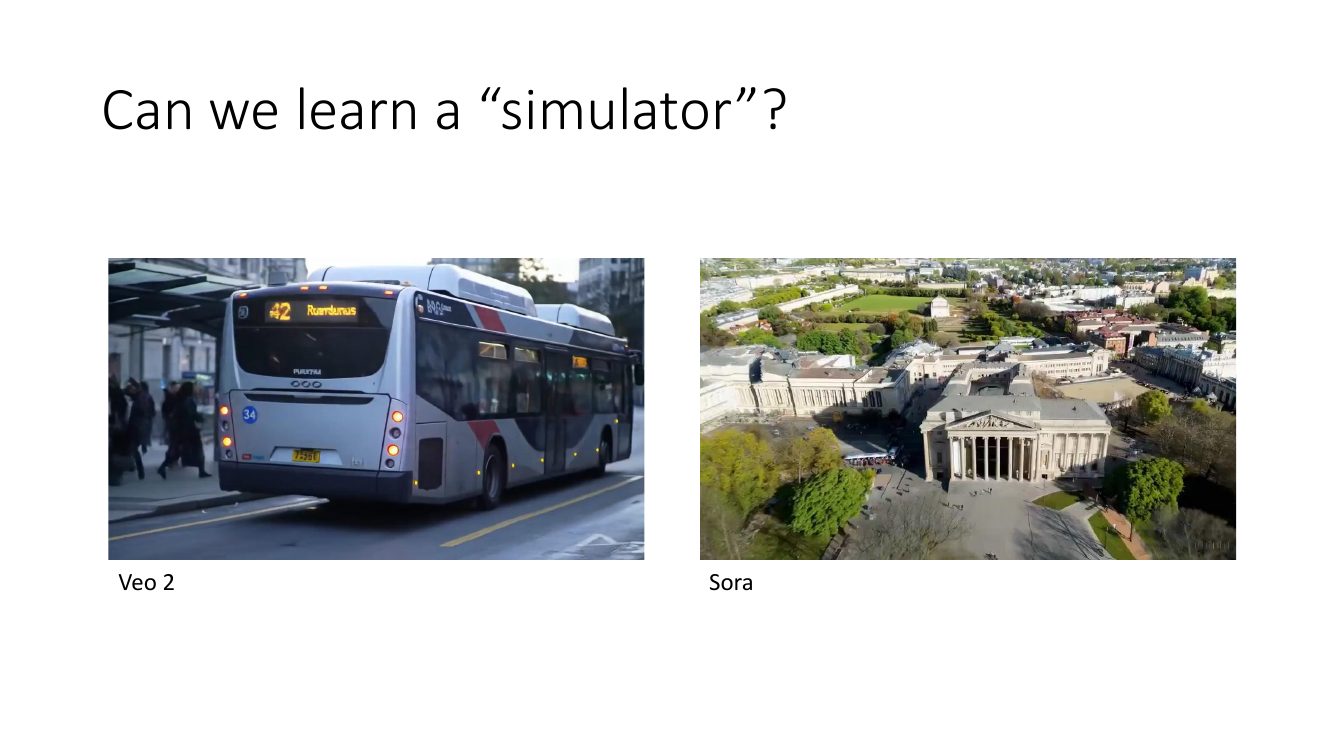
为什么想要模型:三个动机
动机一:样本效率。这是最直接的理由。model-free 方法的样本消耗量级大家已经很熟悉了: 在线策略梯度类方法要在真实环境里跑上百万甚至上亿步。而模型是用监督学习拟合的, 监督学习是我们最擅长、样本效率最高的一类学习。一旦有了模型, 后续的策略优化一步真实环境交互都不需要——全部在模型里进行。 换句话说,我们把「昂贵的真实交互」换成了「便宜的模型内交互」。
动机二:可以完全不用 RL。如果模型是可微的、或者动作空间不大, 我们可以直接用规划(planning)或轨迹优化(trajectory optimization) 求解,压根不需要学一个策略网络,也不需要处理 Bellman 误差、目标网络这些麻烦事。 这在机器人领域是主流做法:模型预测控制(Model Predictive Control, MPC)几十年来一直是工业标准。
动机三:模型可以复用。动力学 $p(s'|s,a)$ 是环境的属性,与奖励无关。 换一个任务(换 $r$),策略和值函数全部作废,但模型一字不改还能用。 这一点在多任务、目标条件(goal-conditioned)设定下价值极大。
model-free 方法把「世界怎么运转」和「我该怎么做」这两件事压缩进了同一个网络, 所以它必须靠海量试错才能把两件事一起学出来;model-based 方法把它们拆开: 世界怎么运转交给监督学习(便宜、稳定、可复用),我该怎么做交给规划或 RL(昂贵,但现在可以在想象里做)。 拆开的代价是:两个模块的误差会互相放大,而这正是本讲剩下部分的全部内容。
这不是新想法:系统辨识
「先辨识动力学,再基于辨识出的动力学做控制」在控制论里叫 系统辨识(system identification),比深度学习早了半个世纪。 经典做法是:假设动力学有已知的参数化形式(比如刚体动力学方程 $M(q)\ddot q + C(q,\dot q)\dot q + g(q) = \tau$,未知的只是质量、惯量、摩擦系数这几个数), 然后用少量数据把这几个物理参数拟合出来。这套东西非常好用: 未知量只有几个到几十个,数据需求极小,泛化极好——因为方程的结构本身已经编码了正确的归纳偏置。
深度学习版本的野心大得多:我们不假设任何结构,直接用一张大网络去拟合 $f_\phi: (s,a) \mapsto s'$。好处是通用,坏处是——网络在数据覆盖之外的行为毫无保证。 下一节我们就会看到,正是这个「毫无保证」,让朴素算法从根上垮掉。
2. 朴素算法:model-based RL v0.5
把上一节的想法写成算法,只有三行:
- 用某个基础策略 $\pi_\beta(a|s)$(比如均匀随机策略)与环境交互,收集数据 $\mathcal{D}=\{(s_i,a_i,s_i')\}$;
- 用监督学习拟合「模拟器」 $f_\phi(s,a)=s'$: $$\min_\phi \sum_i \left\| f_\phi(s_i,a_i) - s_i' \right\|^2$$
- 在这个模拟器 $f_\phi$ 里跑你最喜欢的 RL 方法(或规划算法),得到策略 $\pi_f$。
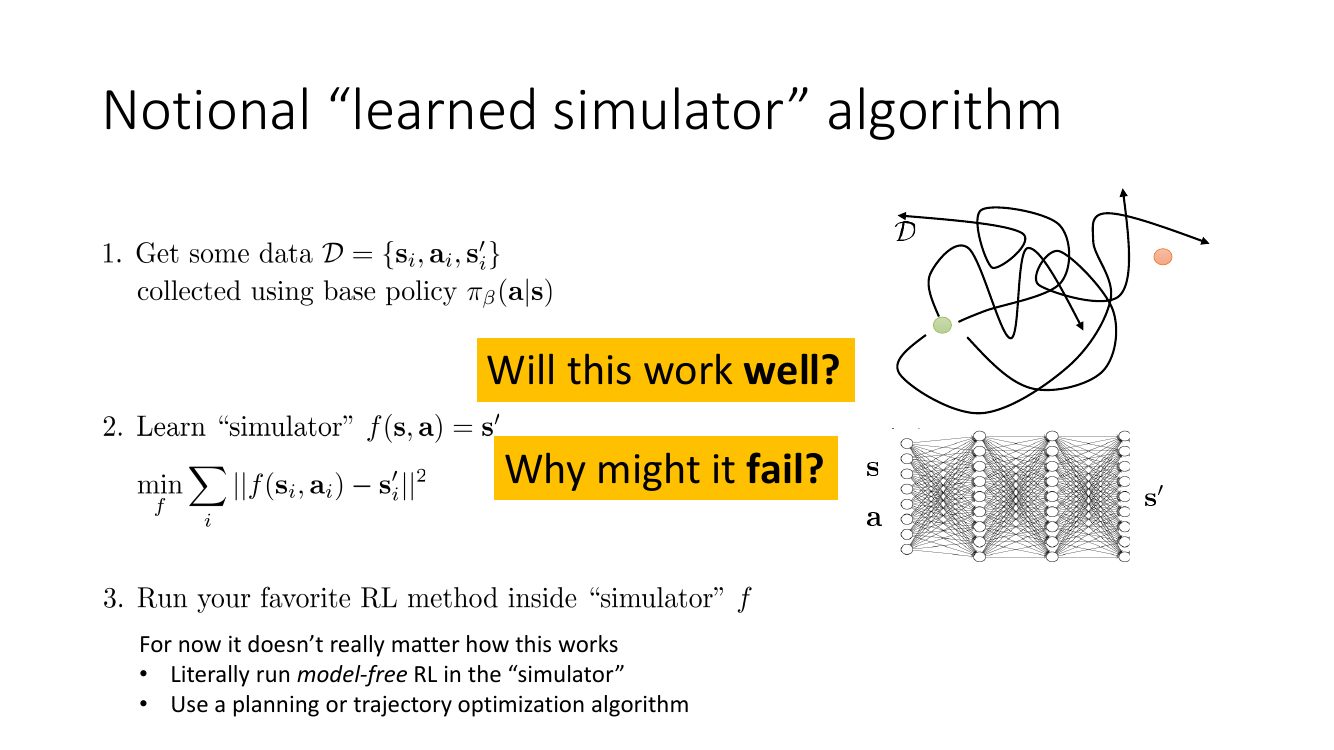
第二步的损失函数值得多说一句。写成 $\|f_\phi(s_i,a_i)-s_i'\|^2$, 等价于假设 $p(s'|s,a)=\mathcal{N}(f_\phi(s,a), \sigma^2 I)$ 且 $\sigma$ 固定, 再做极大似然:$-\log p = \frac{1}{2\sigma^2}\|f_\phi - s'\|^2 + \text{const}$。 也就是说,最小二乘等价于一个方差固定的高斯模型——它永远不会告诉你「我不确定」。 这个隐含假设会在第 7 节被彻底推翻。
实践中几乎没有人直接回归 $s'$,而是回归状态增量 $\Delta s = s'-s$,然后令 $\hat s' = s + f_\phi(s,a)$。原因很简单:在时间步长很小时 $s' \approx s$, 直接回归 $s'$ 时网络只要学一个恒等映射就能把 loss 压到很低, 而真正有用的信息(那个微小的变化量)被淹没在 $s$ 的量级里。举个数: 机器人关节角 $s \sim 1\,\text{rad}$,一个控制周期的变化 $\Delta s \sim 0.01\,\text{rad}$, 信噪比差了 100 倍。回归 $\Delta s$ 相当于给网络加了一个免费的残差连接。 另外输入输出都要做归一化(减均值除标准差),否则不同量纲的状态分量会主导 loss。
2.1 这个算法在什么情况下真的能用
先给它一句公道话:v0.5 不是完全没用。当以下条件成立时它工作得相当好:
- 动力学有已知的良好结构(如前述系统辨识的情形),待拟合的参数很少;
- 基础策略 $\pi_\beta$ 的数据已经覆盖了最优策略会去的那片状态空间;
- 状态维度低、动力学光滑。
典型的成功例子就是给机器人做重力补偿、给四旋翼辨识推力系数这类任务。 但只要环境稍微复杂一点、$\pi_\beta$ 稍微「不够好」一点,第二条就会破。而它一破,全盘皆输。
2.2 失败点一:分布漂移(这次漂移的是模型的输入分布)
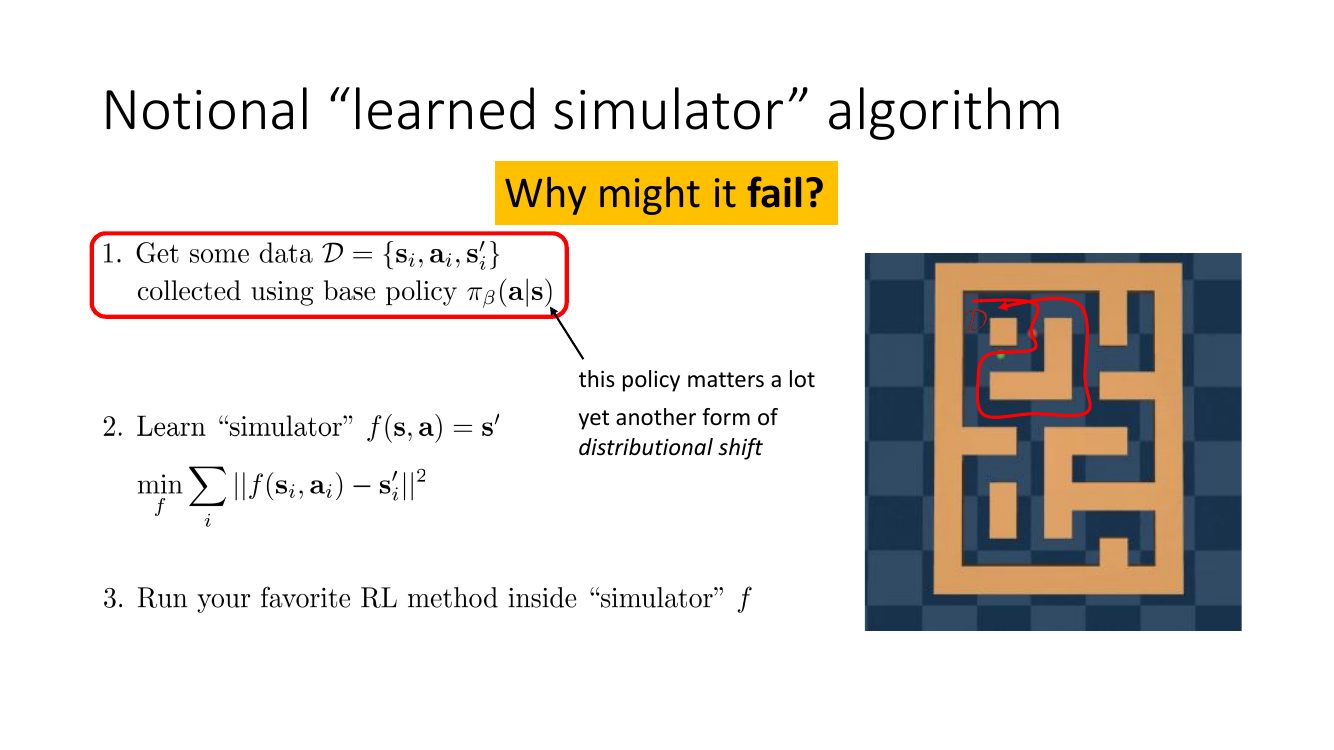
形式化地说:我们用监督学习拟合模型,得到的保证是训练分布下的期望误差小:
$$ \E_{(s,a)\sim p_{\pi_\beta}(s,a)}\Big[\big\|f_\phi(s,a)-f^\star(s,a)\big\|\Big] \le \epsilon $$但第 3 步的优化器要做的事情是:找一个 $\pi_f$ 最大化模型里的回报
$$ \pi_f = \argmax_\pi\; \E_{\tau \sim p_{f}^{\pi}(\tau)}\left[\sum_t r(s_t,a_t)\right] $$这里 $p_f^\pi$ 是「策略 $\pi$ 在模型 $f$ 里」诱导的轨迹分布。 优化器完全没有理由停留在 $p_{\pi_\beta}$ 覆盖的区域内。事实上恰恰相反: $\pi_\beta$ 是个笨策略,它去过的地方回报都不高;回报高的地方,按定义就是 $\pi_\beta$ 没去过的地方。 于是优化过程会系统性地、主动地把查询点推向模型没有数据的区域。 这比模仿学习里的漂移严重得多——在模仿学习里漂移是被动累积的误差; 在这里漂移是优化目标主动奖励的行为。
2.3 失败点二:模型的设计是领域相关的
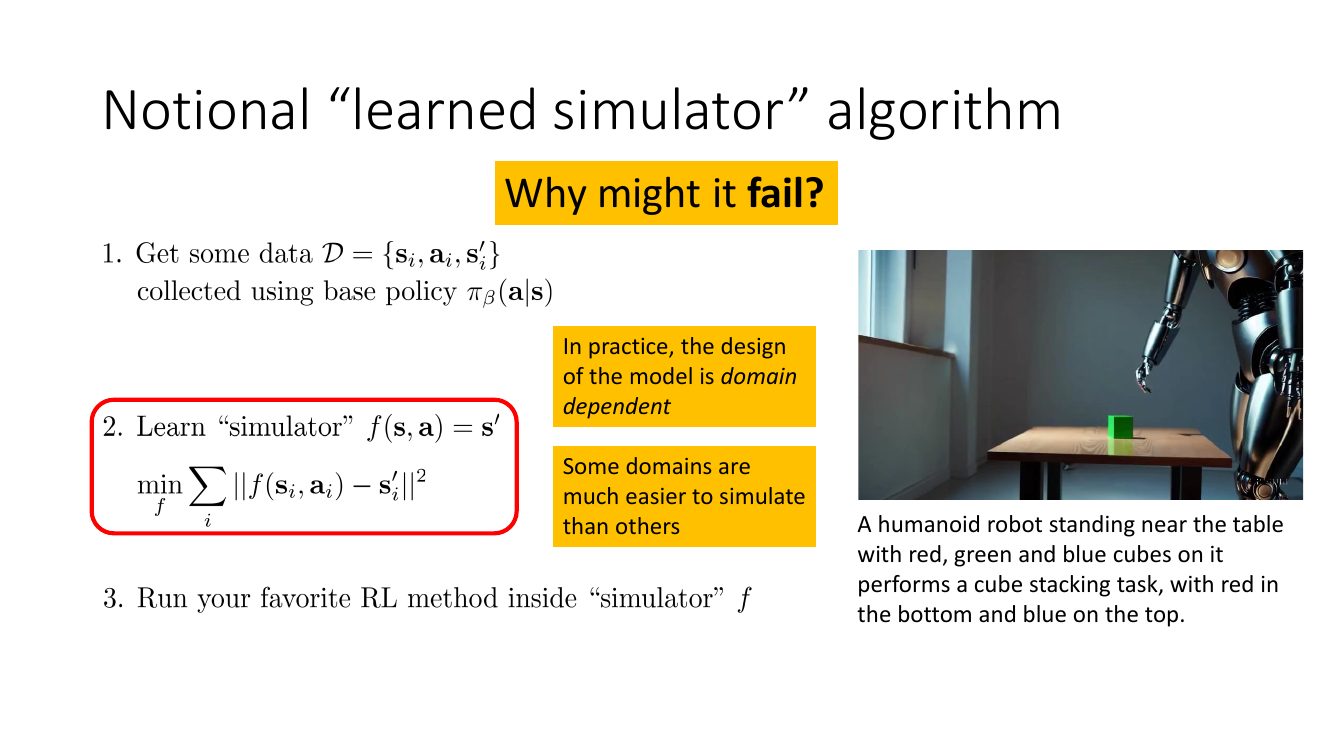
这条常常被忽略,但它是实践中最难的部分。「学一个模拟器」听起来是一个统一的问题, 实际上模型的状态表示、网络结构、训练目标全都高度依赖具体领域:
| 领域 | 状态表示 | 难点 |
|---|---|---|
| 低维机器人(关节角/速度) | 几十维向量 | 相对容易,MLP 就够;难在接触(contact)不连续 |
| 刚体操作(推、抓) | 物体位姿 + 机器人状态 | 接触动力学高度非线性,误差在碰撞瞬间爆炸 |
| 可变形物体 / 流体 | 粒子、网格、点云 | 状态维度极高,且不存在紧凑的马尔可夫状态 |
| 图像观测 | 像素 或 学出来的隐状态 | 需要同时学表示与动力学;长期预测会漂移、模糊 |
| 视频生成式世界模型 | 像素序列 | 物体会凭空出现/消失,物理不守恒;计算量巨大 |
2.4 失败点三:有了模拟器,规划也未必容易
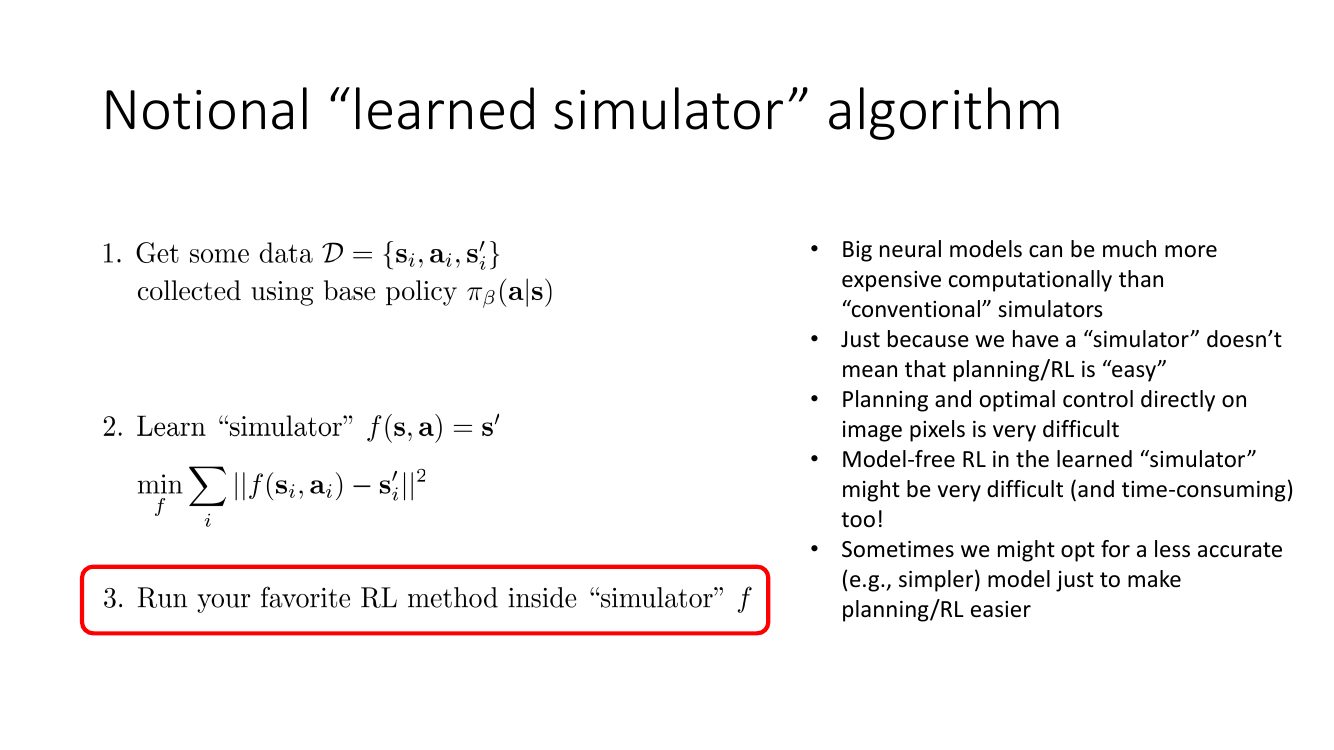
- 大神经模型可能比传统模拟器慢得多。一个物理引擎步进一次可能只要几微秒, 而一次视频扩散模型的前向要几百毫秒。如果规划需要几万次 rollout,学出来的模拟器反而是负担。
- 有了「模拟器」不代表规划/RL 就容易了。模拟器只是把环境交互变便宜了, 探索难、奖励稀疏、长时序信用分配这些问题一个都没消失。
- 直接在图像像素上做规划和最优控制极其困难。规划算法需要在状态空间里做优化, 而像素空间既高维又没有有用的度量结构——两张只差几个像素的图可能语义天差地别。
- 在学出来的模拟器里跑 model-free RL 也可能非常困难、非常慢。 你只是把「真实环境的样本复杂度」换成了「模型内 rollout 的计算复杂度」,后者未必更便宜。
- 有时我们会故意选一个不那么准确(更简单)的模型,只为了让规划变容易。 比如用线性模型换来 LQR 的闭式解,用低维隐状态换来 CEM 能在其中搜索。准确度和可规划性是一对权衡。
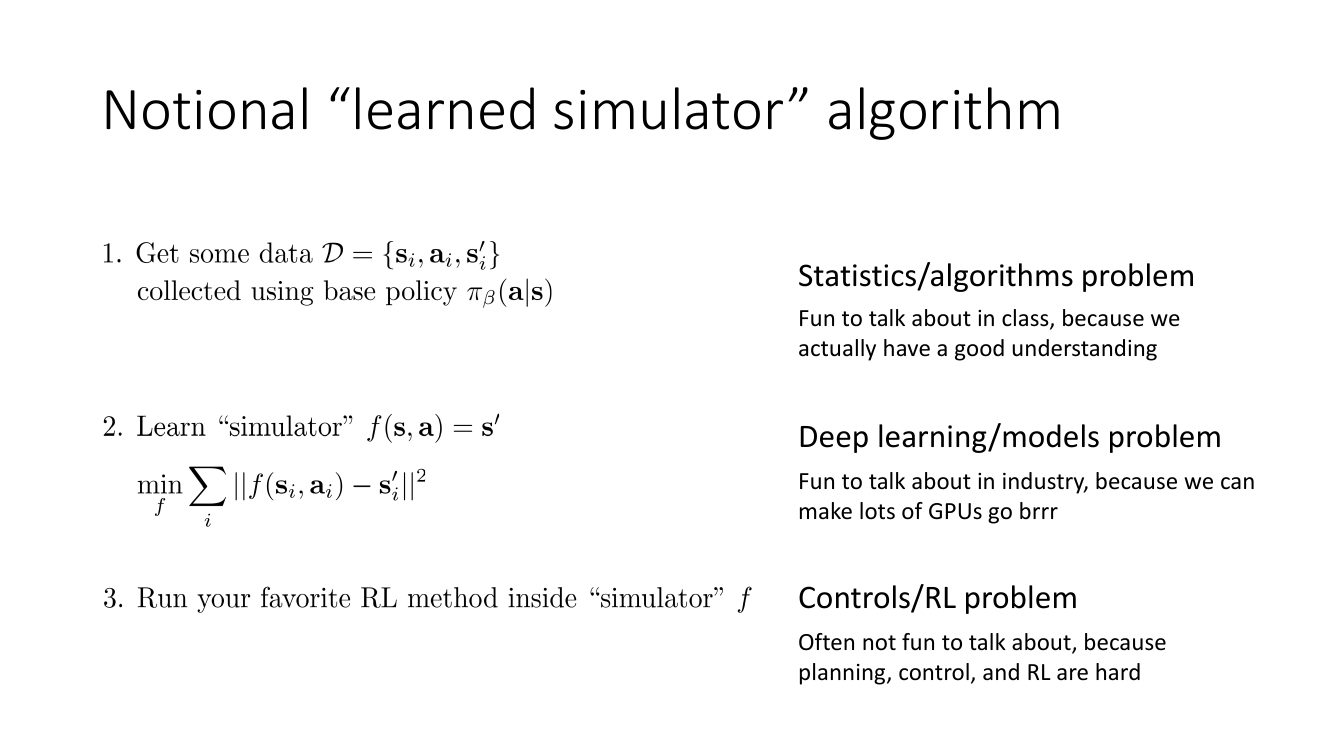
这三条失败点的性质完全不同。失败点二和三是工程与算力问题——它们会随着模型架构和算力的进步而缓解。 失败点一是根本性的统计问题:它不会因为你把网络变大、数据变多而消失, 因为它源于「优化目标本身在奖励你去模型不认识的地方」。所以本讲剩下的部分几乎全在处理它。
3. 分布漂移的数学:误差是怎么被放大的
幻灯片上这一段只有一张图和一句「yet another form of distributional shift」。 但既然这是全讲的病根,值得把量化的推导补全。我们要回答: 单步模型误差 $\epsilon$ 会在 $T$ 步的 rollout 里被放大成多大的回报误差?
设真实转移为 $p(s'|s,a)$,学到的模型为 $\hat p(s'|s,a)$。假设在某个分布 $\mu$ 覆盖的区域上, 两者的全变差(total variation)距离被 $\epsilon$ 控制:
$$ D_{TV}\big(p(\cdot|s,a),\, \hat p(\cdot|s,a)\big) \;=\; \tfrac12 \textstyle\sum_{s'} \big| p(s'|s,a) - \hat p(s'|s,a) \big| \;\le\; \epsilon $$固定一个策略 $\pi$,记 $p_t$ 与 $\hat p_t$ 分别为真实环境和模型中第 $t$ 步的状态分布($p_1=\hat p_1$)。 我们用归纳法证明 $D_{TV}(p_t, \hat p_t) \le (t-1)\epsilon$。
归纳步。把两条链的一步演化写出来,中间插入一个「用真实转移推进 $\hat p_t$」的桥接项:
$$ p_{t+1}(s') = \sum_{s,a} p_t(s)\pi(a|s)\,p(s'|s,a), \qquad \hat p_{t+1}(s') = \sum_{s,a} \hat p_t(s)\pi(a|s)\,\hat p(s'|s,a) $$ $$ \begin{aligned} 2D_{TV}(p_{t+1},\hat p_{t+1}) &= \sum_{s'}\Big| \sum_{s,a} p_t(s)\pi\,p(s'|s,a) - \sum_{s,a}\hat p_t(s)\pi\,\hat p(s'|s,a) \Big| \\ &\le \underbrace{\sum_{s'}\Big|\sum_{s,a}\big(p_t(s)-\hat p_t(s)\big)\pi\,p(s'|s,a)\Big|}_{\text{(A) 分布不同}} \;+\; \underbrace{\sum_{s'}\Big|\sum_{s,a}\hat p_t(s)\pi\big(p(s'|s,a)-\hat p(s'|s,a)\big)\Big|}_{\text{(B) 模型不同}} \end{aligned} $$(A) 项:转移核是一个非扩张(non-expansive)映射,把绝对值挪到里面得 $\le \sum_{s,a}|p_t(s)-\hat p_t(s)|\pi \sum_{s'} p(s'|s,a) = \sum_s |p_t(s)-\hat p_t(s)| = 2D_{TV}(p_t,\hat p_t)$。 (这一步是关键:转移只会「摊平」误差,不会放大它。)
(B) 项:同样把绝对值放进去,$\le \sum_{s,a}\hat p_t(s)\pi \sum_{s'}|p-\hat p| \le 2\epsilon$。
合起来 $D_{TV}(p_{t+1},\hat p_{t+1}) \le D_{TV}(p_t,\hat p_t) + \epsilon$,配合 $D_{TV}(p_1,\hat p_1)=0$ 得 $D_{TV}(p_t,\hat p_t)\le (t-1)\epsilon$。
回报的误差。设奖励有界 $|r|\le R_{\max}$,则任意分布下期望的差被 $2R_{\max}D_{TV}$ 控制,累加 $T$ 步:
$$ \big|J(\pi) - \hat J(\pi)\big| \;\le\; \sum_{t=1}^{T} 2R_{\max} D_{TV}(p_t,\hat p_t) \;\le\; 2R_{\max}\epsilon \sum_{t=1}^{T}(t-1) \;=\; R_{\max}\,\epsilon\, T(T-1) \;=\; O(\epsilon T^2) $$又是 $O(\epsilon T^2)$——和第 2 讲行为克隆的误差界完全同一个形状,这不是巧合: 两者都是「单步误差 $\epsilon$ + 误差改变了后续的状态分布 + 时间长度 $T$」的组合。 代入数字感受一下:单步 TV 误差 $\epsilon=0.01$(已经算相当准了),$T=200$,$R_{\max}=1$, 界给出 $\approx 0.01\times 200\times 199 \approx 398$,而这段轨迹的总回报本身最多也就 $200$。 界完全失效了。当然这是最坏情况的上界,但它准确地传达了一件事: 长时域 rollout 下,模型误差的放大是超线性的。这也解释了为什么后来的很多算法 (如 Dyna 类方法)宁可只用模型做很短的 rollout($k=1\sim5$ 步), 剩下的长期价值交给学到的值函数。
「模型的验证集 loss 已经很低了,所以模型很准。」——这句话只在 验证集和训练集同分布时成立。而 model-based RL 里, 真正被查询的 $(s,a)$ 分布是由规划器在训练之后决定的, 它按定义就不在你的验证集里。所以「验证 loss 低」和「规划出来的策略好」之间没有必然联系。 更糟的是,下一节会看到:规划器会主动去找验证集里没有的那些点。
3.1 版本 1.0:把数据收集塞进循环
既然问题是「$\pi_f$ 去的地方模型没数据」,最自然的修法就是:那就让 $\pi_f$ 去采点数据回来。 这就是 DAgger 的思路搬到模型上:
- 用 $\pi_\beta$ 收集数据 $\mathcal{D}=\{(s_i,a_i,s_i')\}$;
- 学模型 $f(s,a)=s'$;
- 在 $f$ 下学出最优策略 $\pi_f$;
- 令 $\pi_\beta \leftarrow \pi_f$,回到第 1 步(新数据追加进 $\mathcal{D}$)。
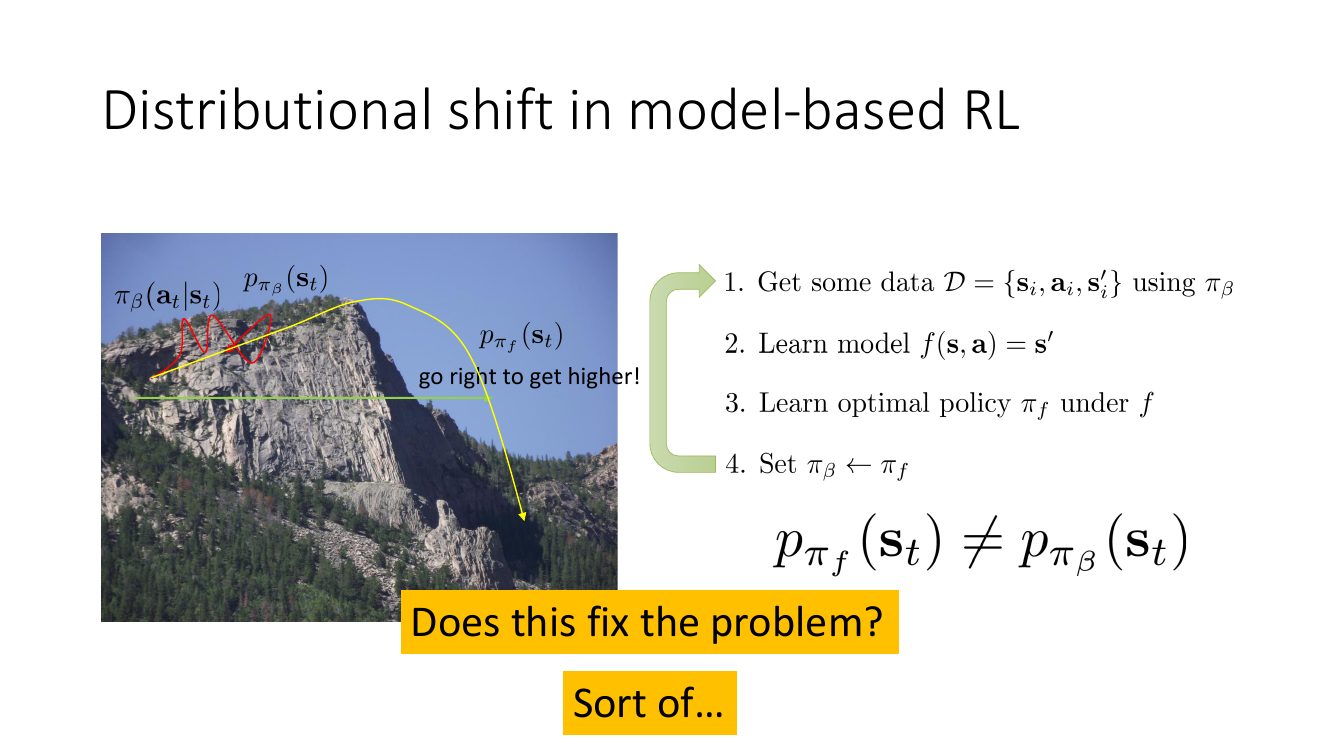
v1.0 确实有用,而且是所有实用 model-based RL 算法的基本骨架: 它保证了「策略去哪里,数据就补到哪里」,让模型在当前策略的分布上逐步变准。 从模拟引理的角度看,它是在把 $\epsilon$ 定义所依赖的那个分布 $\mu$ 不断拉向 $p_{\pi_f}$。
但为什么只是「sort of」?因为它是事后补救:策略必须先冲出悬崖、真的摔下去一次, 数据才会告诉模型「这里不能走」。在仿真里这只是浪费样本;在真实机器人上,这一次可能就是最后一次。 更麻烦的是下一节要讲的:即使你愿意付这个代价,第 3 步里的「学出最优策略」 这个要求本身就是有毒的。
4. 走多远?版本 1.5 与「模型被利用」
4.1 别一口气优化到最优
v1.0 的第 3 步写的是「学出最优策略 $\pi_f$」。想想这意味着什么: 优化器会在模型里搜索所有可能的策略,挑出模型认为回报最高的那个。 而模型在没有数据的区域可以给出任意离谱的预测。那么「模型认为回报最高的策略」 大概率就是「最会利用模型错误的策略」。
所以第一个修正是:别把策略优化到最优,只改进一点点。
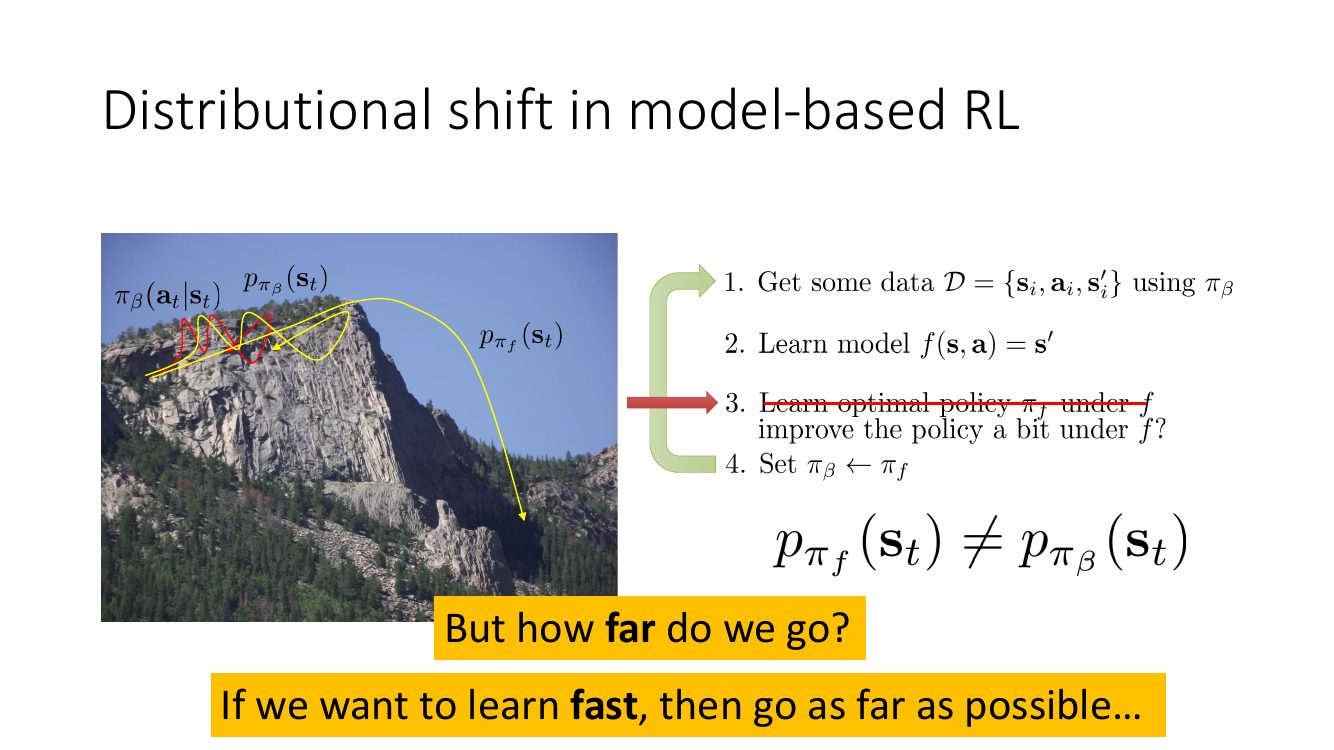
这个「走多远」的两难,和第 9–10 讲的信赖域问题在结构上一模一样: 那里我们要在「用旧数据的重要性采样估计有效」和「策略改进足够快」之间权衡; 这里我们要在「模型预测有效」和「策略改进足够快」之间权衡。数学形式也一样, 都归结为约束 $D_{\mathrm{KL}}(\pi_{\text{new}} \| \pi_{\text{old}}) \le \epsilon$。
- 用 $\pi_\beta$ 收集数据 $\mathcal{D}=\{(s_i,a_i,s_i')\}$;
- 学模型 $f(s,a)=s'$;
- 在 $f$ 下把策略改进「一点点」,得到 $\pi_f$;
- 令 $\pi_\beta \leftarrow \pi_f$,回到第 1 步。
与 v1.0 唯一的差别就是第 3 步的「一点点」。但正是这三个字,决定了算法是收敛还是发散。
4.2 问题比想象的更糟:优化器会主动挖出模型的错误
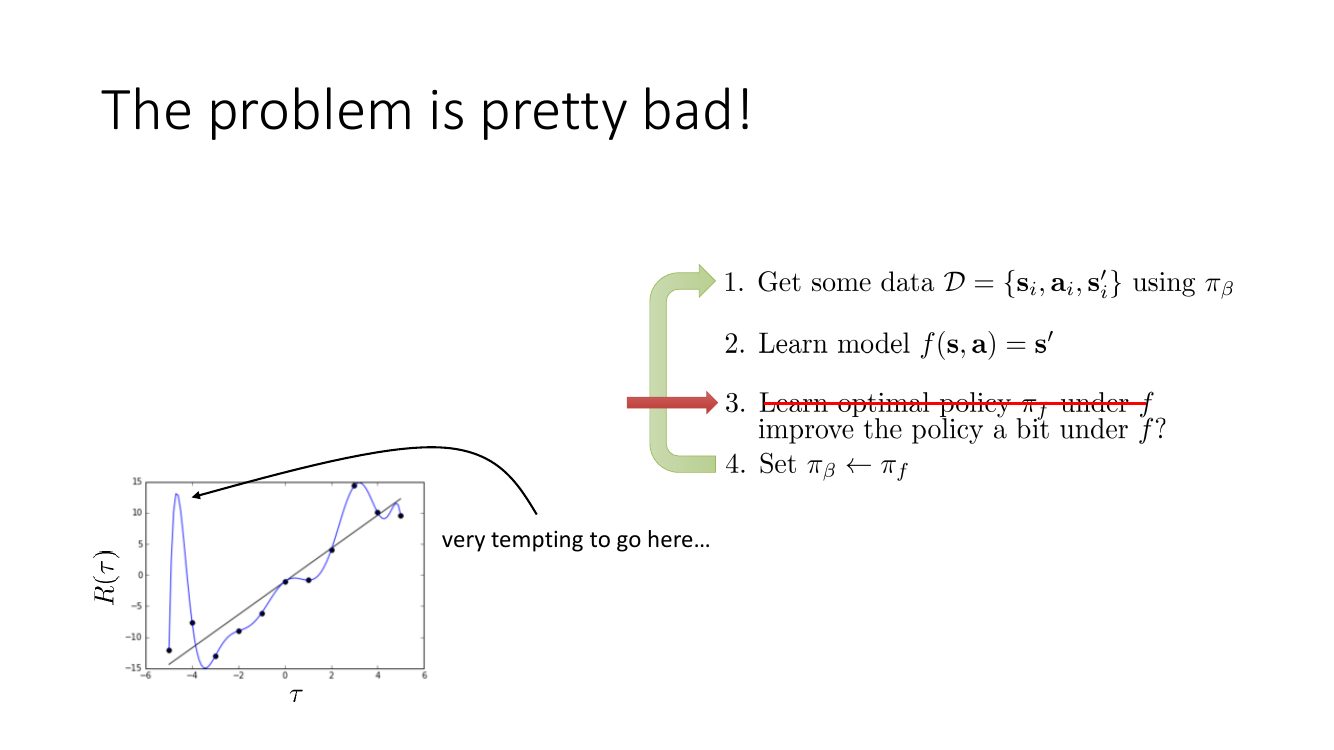
这张图值得停下来品一品。请注意:那个虚假尖峰之所以致命,恰恰因为它是尖峰。 如果模型误差是随机分布的、有正有负,那么大部分误差点根本不会被选中—— 优化器只会挑正向误差最大的那个点。也就是说, $\argmax$ 操作把「零均值的随机误差」系统性地转成了「正向偏差」。 这和第 8 讲 Q-learning 里的最大化偏差(maximization bias)是同一个数学现象。
设规划器要在 $K$ 条候选动作序列里挑最好的一条。为了把问题极端化,假设这 $K$ 条序列的 真实回报完全相同,都等于 $0$;模型对每条序列的回报估计带有独立同分布的误差 $\varepsilon_k \sim \mathcal{N}(0,\sigma^2)$,即 $\hat R_k = 0 + \varepsilon_k$。
规划器选出的是 $k^\star=\argmax_k \hat R_k$,它相信自己能拿到 $\max_k \varepsilon_k$, 而实际拿到的是 $0$。这个「期望落差」就是纯粹的模型利用量。由高斯极值统计:
$$ \E\Big[\max_{1\le k\le K}\varepsilon_k\Big] \;\approx\; \sigma\sqrt{2\ln K} $$(简单推导:$P(\max \le x) = \Phi(x/\sigma)^K$,取 $x$ 使 $1-\Phi(x/\sigma)\approx 1/K$, 用高斯尾部近似 $1-\Phi(u)\approx \phi(u)/u$ 解出 $u \approx \sqrt{2\ln K}$。)
代入数字:$\sigma=1$(模型对回报的估计有 1 个单位的噪声), $K=100$ 时偏差 $\approx 3.0$;$K=1000$ 时 $\approx 3.7$;$K=10^6$ 时 $\approx 5.3$。
这个结论极其反直觉但极其重要:搜索得越努力($K$ 越大),被模型骗得越惨。 而且偏差随 $\sqrt{\ln K}$ 增长,意味着你没法靠「多搜一点」来摆脱它—— 只能靠减小 $\sigma$(更准的模型)或者在优化目标里把 $\sigma$ 本身惩罚掉。 后者正是第 6 节要讲的做法。
「我的规划器很强,能在模型里找到回报 $500$ 的轨迹,说明这个方法有希望。」—— 恰恰相反。在 model-based RL 里,模型内的预测回报远高于真实回报,是最典型的失败信号。 调试时一定要同时画两条曲线:模型预测的回报和实际执行后的真实回报。 两条线之间的裂口(gap)就是模型被利用的程度。裂口越大,说明你的规划器越是在 「和自己的幻觉打交道」。
4.3 两条药方
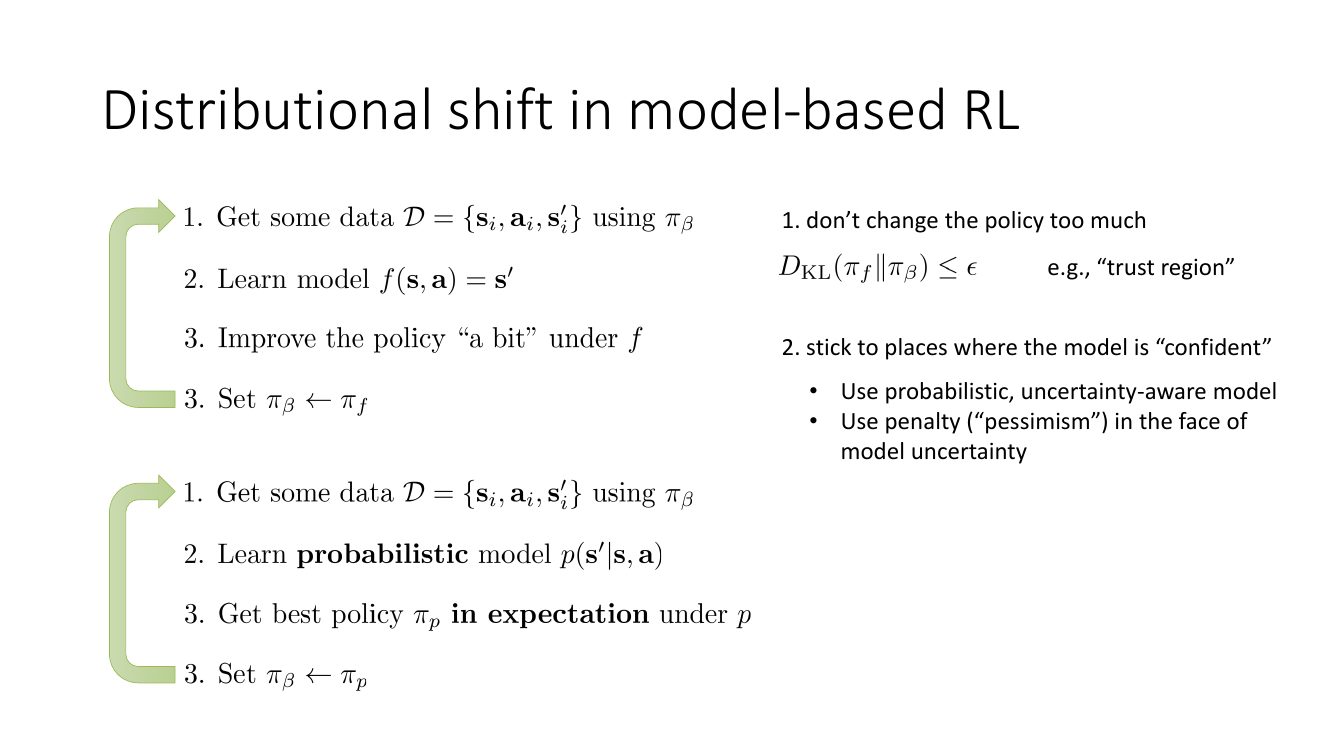
| 对策 1:信赖域 | 对策 2:不确定性感知 | |
|---|---|---|
| 约束什么 | 策略的变化量 $D_{\mathrm{KL}}(\pi_f\|\pi_\beta)\le\epsilon$ | 查询点落在模型有把握的区域 |
| 作用机制 | 间接:策略变化小 ⇒ 状态分布变化小 ⇒ 模型仍近似有效 | 直接:模型自己报告「这里我不知道」,优化目标据此打折 |
| 需要什么 | 能度量策略距离(随机策略、KL 可算) | 能估计认知不确定性的模型 |
| 局限 | $\epsilon$ 难调;改进速度被硬性限死;对纯规划器(无显式策略)不适用 | 不确定性估计本身很难;过度悲观会阻碍探索 |
| 本讲重点 | 已在第 9–10 讲讲透,这里只是复用 | 剩下三节全在讲这个 |
注意版本 2.0 的措辞变化:不是「在 $p$ 下最优」,而是「在 $p$ 下期望意义最优」 (best policy in expectation under $p$)。这个「期望」是对模型的不确定性取的, 而不只是对环境的随机性取的。下一节会说明,这个小小的措辞差别为什么能救命。
5. 不确定性估计凭什么能救命
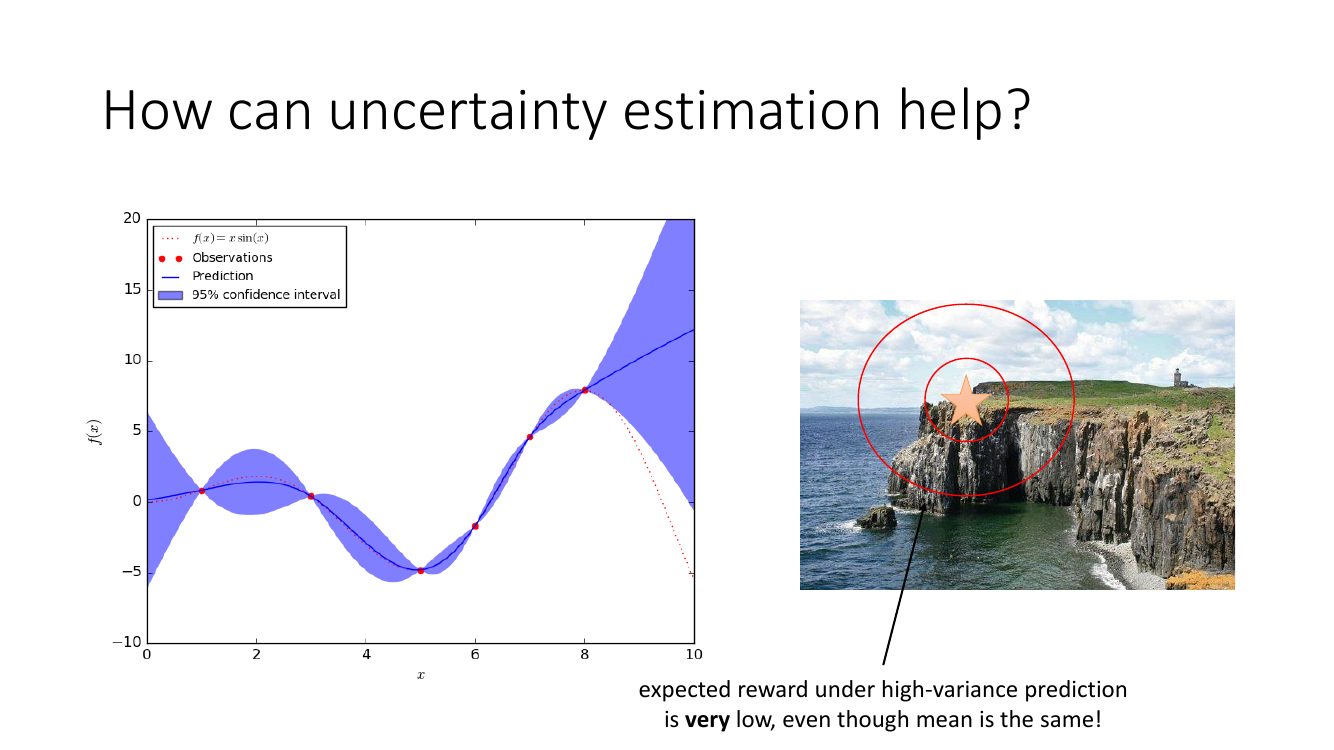
5.1 一个具体的数值例子
为什么「均值一样,方差不同,期望回报就不同」?因为回报函数是非线性的—— 准确地说,是不对称的:站在悬崖边一米处很安全,掉下去则是灾难。 用 Jensen 不等式的语言:对于凹的回报函数 $r$,$\E[r(s')] \le r(\E[s'])$, 方差越大,这个不等号越紧。
把悬崖简化成一维。设 $x$ 是「距悬崖边缘的水平位置」,$x \gt 0$ 表示还在崖顶的安全地带, $x \lt 0$ 表示已经越过边缘。奖励设成:
$$ r(x) = \begin{cases} +10 & x \ge 0 \quad (\text{到达崖顶的观景点}) \\ -100 & x \lt 0 \quad (\text{掉下去}) \end{cases} $$规划器考虑一个动作,两个模型对结果位置 $x'$ 的预测均值相同,都是 $\mu = 1$(离边缘 1 米):
- 模型 A(有数据,低方差):$x' \sim \mathcal{N}(1, 0.3^2)$。 越界概率 $P(x'\lt 0)=\Phi(-1/0.3)=\Phi(-3.33)\approx 0.0004$。 期望回报 $\approx 0.9996\times 10 + 0.0004\times(-100) = 9.96$。
- 模型 B(无数据,高方差):$x' \sim \mathcal{N}(1, 2.0^2)$。 越界概率 $P(x'\lt 0)=\Phi(-0.5)\approx 0.31$。 期望回报 $\approx 0.69\times 10 + 0.31\times(-100) = 6.9 - 31 = -24.1$。
均值完全相同,期望回报却从 $+9.96$ 掉到 $-24.1$。 如果我们只用均值预测(也就是确定性模型 $f(s,a)$),两种情况完全无法区分, 规划器会同样兴高采烈地执行这个动作。而只要把不确定性纳入期望, 规划器自动就会避开高方差的区域——不需要任何手工设计的惩罚项。
不确定性不是通过「加一个惩罚项 $-\lambda\sigma$」来起作用的(虽然也可以那么做)。 它起作用的方式更根本:在一个奖励非对称的世界里,方差本身就会拉低期望回报。 只要你的目标函数写成 $\E_{s'\sim p(s'|s,a)}[\cdot]$ 而不是对着均值算, 风险规避(risk aversion)就是免费附赠的。这也解释了为什么 v2.0 的第 3 步特意写成 「get best policy in expectation under $p$」。
5.2 这套逻辑的边界
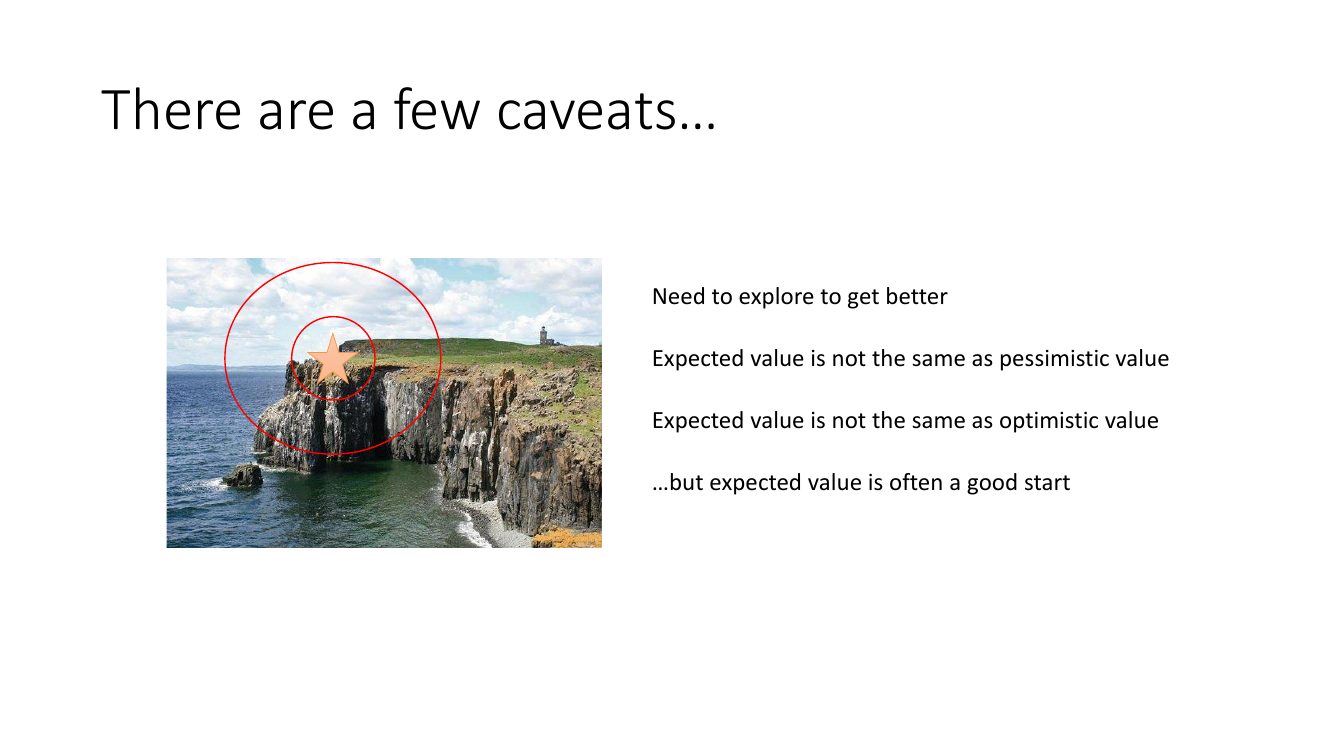
- 还是需要探索才能变好(need to explore to get better)。 如果永远只往「有把握」的地方走,模型永远不会在新区域获得数据,性能就卡死了。 不确定性回避和探索是方向相反的两股力:前者说「别去不熟的地方」,后者说「必须去不熟的地方」。 实际算法里的解法是把探索交给外层循环——v1.5 的「每轮采一点新数据」本身就在做小步探索; 更激进的做法(第 19–20 讲)会给不确定性一个正的奖励(乐观主义), 让智能体主动去消除不确定性。
- 期望值不等于悲观值。取期望是一个「风险中性」的操作。 如果任务真的不能容忍任何失败(真实机器人、医疗决策),你需要的是显式的悲观估计, 比如优化下分位数 $\text{CVaR}_\alpha$ 或者用 $\hat R - \lambda \sigma$ 这种带惩罚的目标。 期望值给的保护是被动的、强度由奖励的不对称性决定,你无法直接调节它。
- 期望值也不等于乐观值。反过来,如果你在做探索,想要的是 $\hat R + \lambda\sigma$(upper confidence bound),期望值同样给不了。
- ……但期望值通常是个不错的起点。这是 Levine 的实用主义判断: 悲观和乐观都需要额外的超参数 $\lambda$,调不好就会太保守或太激进; 而「按模型的不确定性取期望」是唯一一个没有额外超参数的选择, 并且在实践中(比如 PETS 这类算法)已经足以让 model-based RL 稳定工作。
为什么期望值这么「便宜」就能起效?因为它把模型的认知不确定性 伪装成了环境的随机性。规划器以为自己在处理一个「本来就有噪声的环境」, 于是自动采取了对噪声鲁棒的策略(比如离悬崖远一点走)。 它并不知道那个噪声其实是「我不知道」,但结果是一样的。
6. 两种不确定性:输出熵为什么不够
现在问题变成:怎么让神经网络告诉我们它有多不确定? 第一个想法几乎是条件反射式的:让网络输出一个分布而不是一个点。
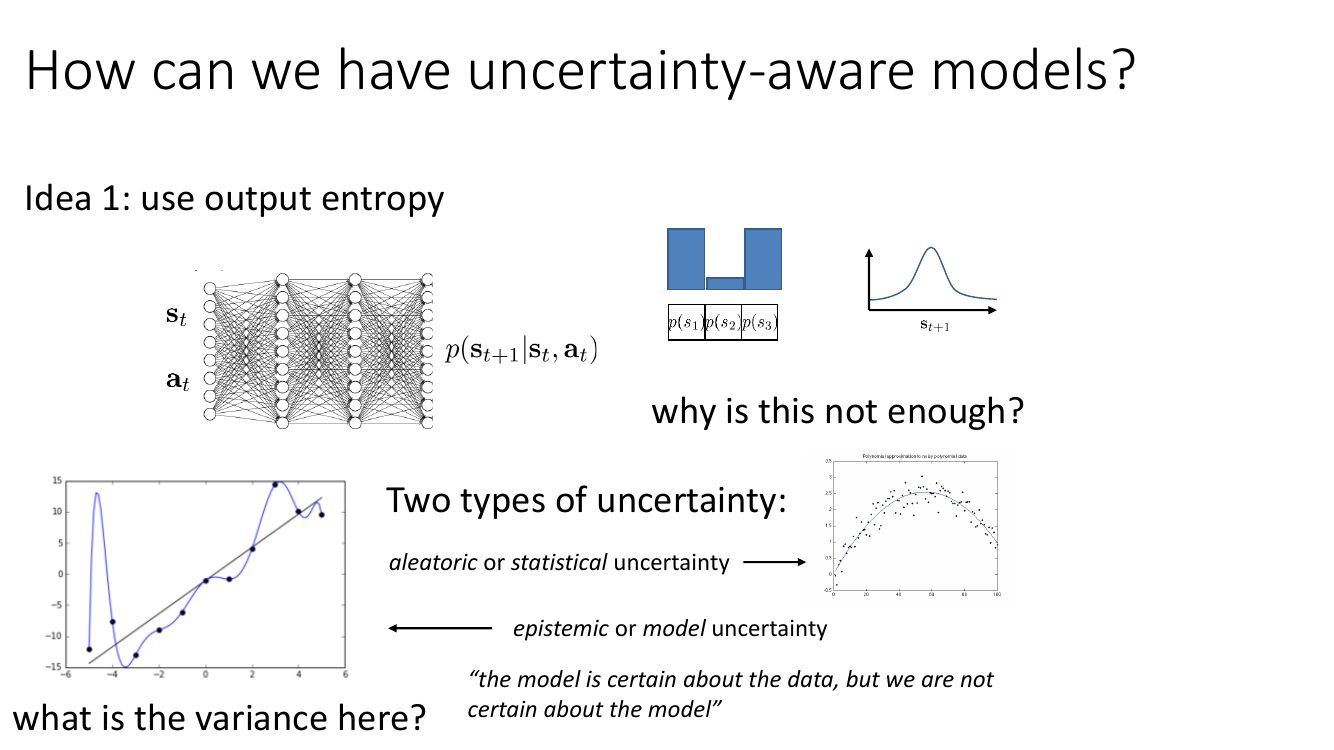
| 偶然不确定性 aleatoric(统计不确定性) | 认知不确定性 epistemic(模型不确定性) | |
|---|---|---|
| 来源 | 世界本身就是随机的:传感器噪声、掷骰子、未建模的扰动 | 数据不够,我们不知道哪个模型才对 |
| 数据变多会怎样 | 不会减少——它是数据生成过程的固有属性 | 会趋于零——数据够多时后验会集中 |
| 对应图 | 带噪抛物线:模型形状确定,但每个点上下抖动 | 过拟合多项式:数据点上完全吻合,点与点之间为所欲为 |
| 网络输出熵能捕捉吗 | 能(这正是它建模的东西) | 不能 |
| 在 model-based RL 里的作用 | 让规划考虑环境噪声,有用但不解决分布漂移 | 正是我们需要的:它标记出「模型没见过的地方」 |
Levine 给认知不确定性的那句定义值得背下来: 「模型对数据是确定的,但我们对模型是不确定的」 (the model is certain about the data, but we are not certain about the model)。
6.1 为什么输出熵抓不到认知不确定性
考虑最坏的情况:一张容量极大的网络,在小数据集上训练到完美过拟合。 它输出的 $p_\phi(s'|s,a)$ 在每个训练点上都是一个尖锐的、几乎零方差的分布—— 因为它确实把每个训练点都记住了,训练损失为零。现在拿一个训练集外的 $(s,a)$ 去问它, 网络会怎样?它会同样自信地给出一个尖锐分布,只不过均值可能完全是胡说。
问题的根源在于:网络输出的那个分布,建模的是「给定这组参数 $\phi$,$s'$ 有多随机」, 也就是 $p(s'|s,a,\phi)$ 中对 $s'$ 的随机性。它完全没有表达 $\phi$ 本身有多不可靠。 用一句话说:过拟合的网络输出熵低,但它恰恰是最不可信的网络。
把两种不确定性的关系写清楚。真正的预测分布应当对参数的后验积分:
$$ p(s'|s,a,\mathcal{D}) = \int p(s'|s,a,\phi)\, p(\phi|\mathcal{D})\, d\phi $$对它求方差,用全方差公式(以 $\phi\sim p(\phi|\mathcal{D})$ 为条件):
$$ \underbrace{\mathrm{Var}\big[s'\,\big|\,s,a,\mathcal{D}\big]}_{\text{总不确定性}} = \underbrace{\E_{\phi}\Big[\mathrm{Var}\big[s'\mid s,a,\phi\big]\Big]}_{\text{(I) aleatoric:各模型自报的方差之平均}} + \underbrace{\mathrm{Var}_{\phi}\Big[\E\big[s'\mid s,a,\phi\big]\Big]}_{\text{(II) epistemic:各模型均值之间的分歧}} $$这个分解把整节的内容浓缩成一行公式:
- (I) 是「每个模型自己说的方差」的平均。单个网络的输出熵只能给你这一项。
- (II) 是「不同的合理模型给出的均值彼此有多不一致」。 这一项只有在你手上有多个模型(或一个参数分布)时才算得出来。
过拟合网络的情形:(I) $\approx 0$(每个模型都很自信),但如果我们真的有多个模型, (II) 会在数据稀疏区域爆炸——因为每个模型都以完全不同的方式在数据点之间胡乱插值。 这正是下一节 bootstrap ensemble 的全部原理:训一堆模型,看它们吵不吵架。
「我的网络输出了 $\mu$ 和 $\sigma$,还用 NLL 训练,所以它是不确定性感知的。」—— 它只是 aleatoric 感知的。在分布外的输入上,这个 $\sigma$ 的行为完全没有保证: 它可能大,也可能小,甚至可能因为 $\sigma$ 头也在外推而给出一个荒谬的小值。 换句话说,你不能指望网络在没见过的地方诚实地说「我不知道」—— 「不知道」这件事本身,是学不出来的,必须从模型的多样性里算出来。
7. 想法 2:直接估计参数的后验
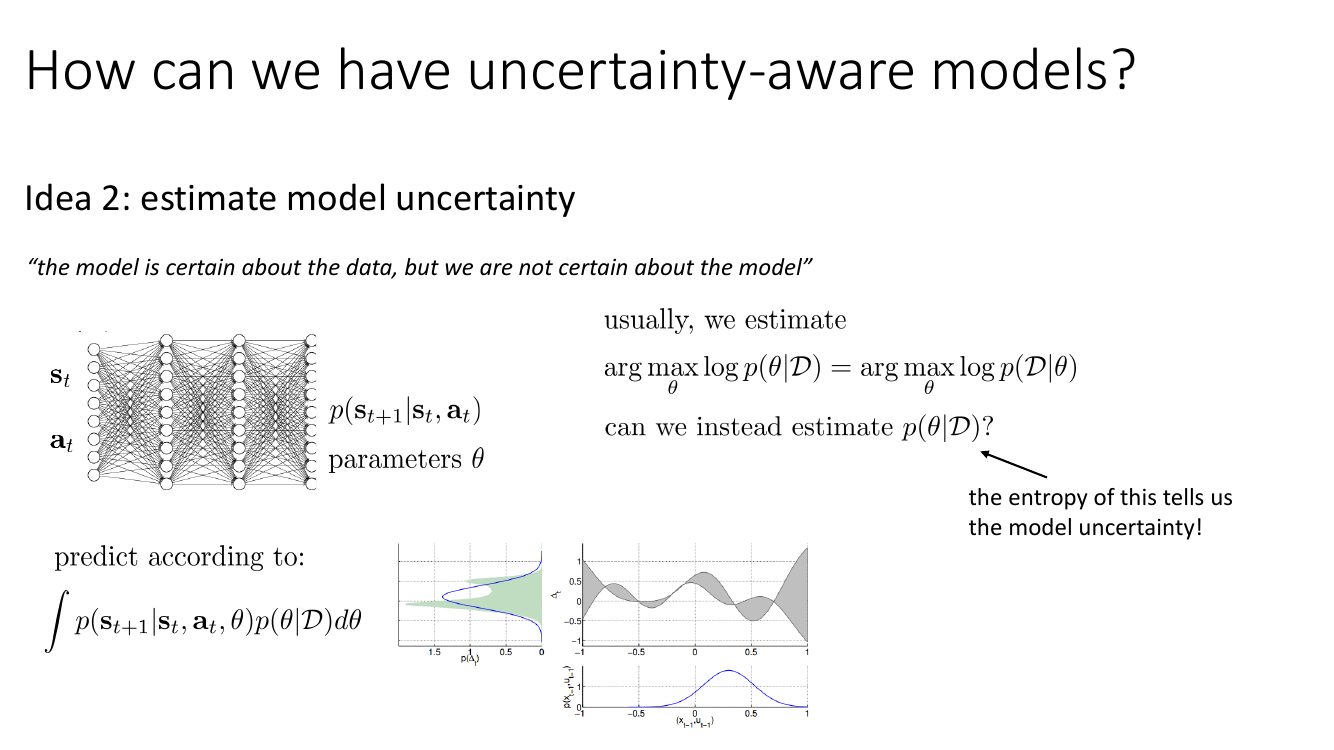
把这个思路写成公式。通常的训练是点估计:
$$ \theta^\star = \argmax_\theta \log p(\theta \mid \mathcal{D}) = \argmax_\theta \log p(\mathcal{D}\mid\theta) + \log p(\theta) $$我们改成保留整个后验,并在预测时把它积掉:
$$ p(s_{t+1}\mid s_t,a_t,\mathcal{D}) = \int p(s_{t+1}\mid s_t,a_t,\theta)\; p(\theta\mid\mathcal{D})\; d\theta $$(注意这里换用 $\theta$ 表示模型参数,与幻灯片一致。) $p(\theta|\mathcal{D})$ 的熵就是模型不确定性的度量:数据充分时后验集中、熵低; 数据不足时后验弥散、熵高。而且这个量与输入无关地刻画了参数层面的无知, 再通过上面的积分传播到每个具体的 $(s_t,a_t)$ 上—— 在数据覆盖的输入上不同 $\theta$ 给出的预测差不多(积分后仍然尖锐), 在没覆盖的输入上不同 $\theta$ 给出的预测天差地别(积分后被抹平成一个宽分布)。这正是我们想要的行为。
7.1 贝叶斯神经网络
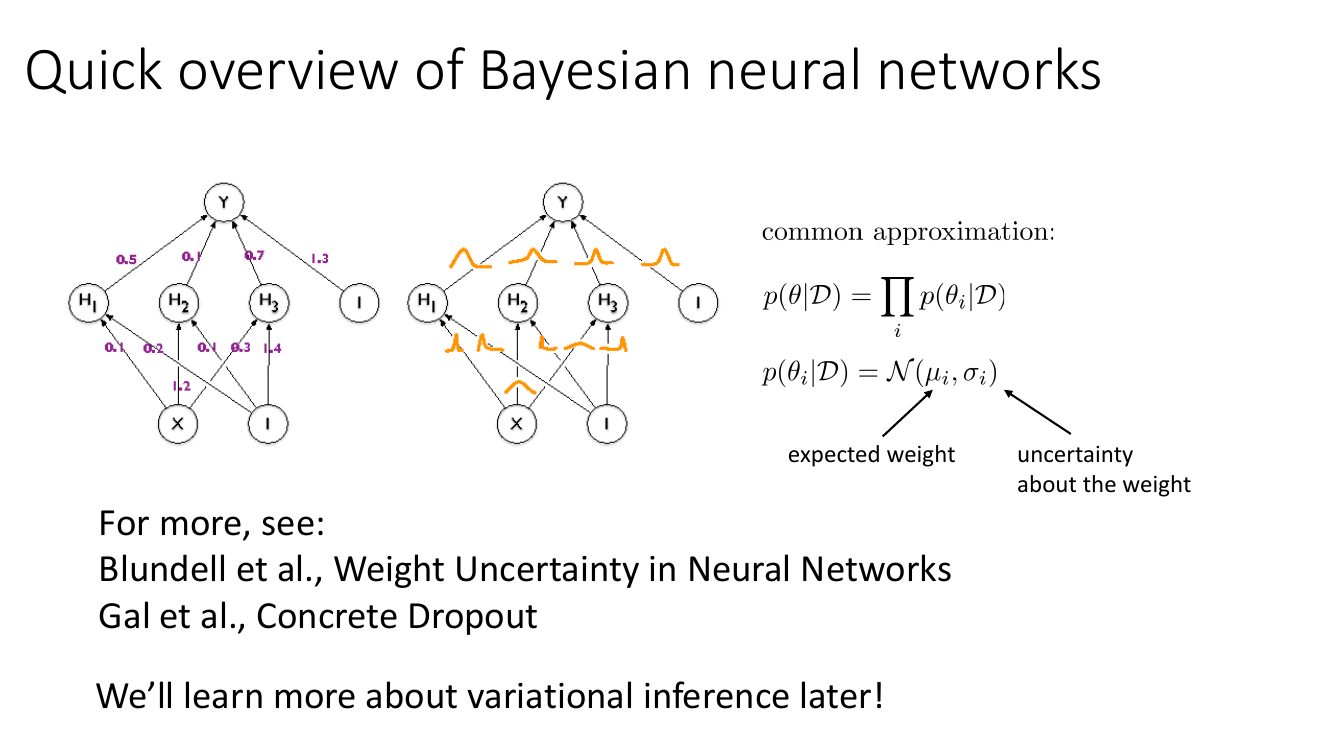
贝叶斯神经网络(Bayesian neural network, BNN)的想法是直接对 $p(\theta|\mathcal{D})$ 建模。 但 $\theta$ 动辄百万维,真实后验的形状复杂到无法表示,所以必须做近似。 最常见的近似是平均场(mean field):
$$ p(\theta\mid\mathcal{D}) \;\approx\; \prod_i p(\theta_i \mid \mathcal{D}), \qquad p(\theta_i\mid\mathcal{D}) = \mathcal{N}(\mu_i,\ \sigma_i) $$参数量正好翻倍:每个权重从 1 个数变成 2 个数(均值 + 标准差)。 训练方法是变分推断——最大化 ELBO,这套工具第 11–12 讲已经完整推过了: 把 $q(\theta)=\prod_i\mathcal{N}(\mu_i,\sigma_i)$ 当作变分分布, 用重参数化技巧 $\theta_i = \mu_i + \sigma_i\epsilon_i$($\epsilon_i\sim\mathcal{N}(0,1)$) 让梯度能穿过采样,目标是
$$ \max_{\mu,\sigma}\ \E_{\theta\sim q}\big[\log p(\mathcal{D}\mid\theta)\big] - D_{\mathrm{KL}}\big(q(\theta)\,\|\,p(\theta)\big) $$这就是 Blundell 等人的 Bayes by Backprop。另一条更省事的路线是把 dropout 解释成变分近似 (Gal 等人的 Concrete Dropout):训练时和推断时都开着 dropout,多次前向取样, 样本之间的分歧就是认知不确定性的估计。
「各权重后验独立」这个假设在神经网络里明显不成立——权重之间高度相关 (比如同一层内两个神经元交换位置得到完全等价的网络,这本身就说明后验有巨大的对称多峰结构)。 平均场高斯只能覆盖一个峰的一个椭球,因此往往低估不确定性。 这也是下一节的 bootstrap ensemble 在实践中常常反而更好用的原因: 不同的随机初始化会落到不同的峰里,多样性来得更真实。
8. Bootstrap 集成:工程上真正好用的那个
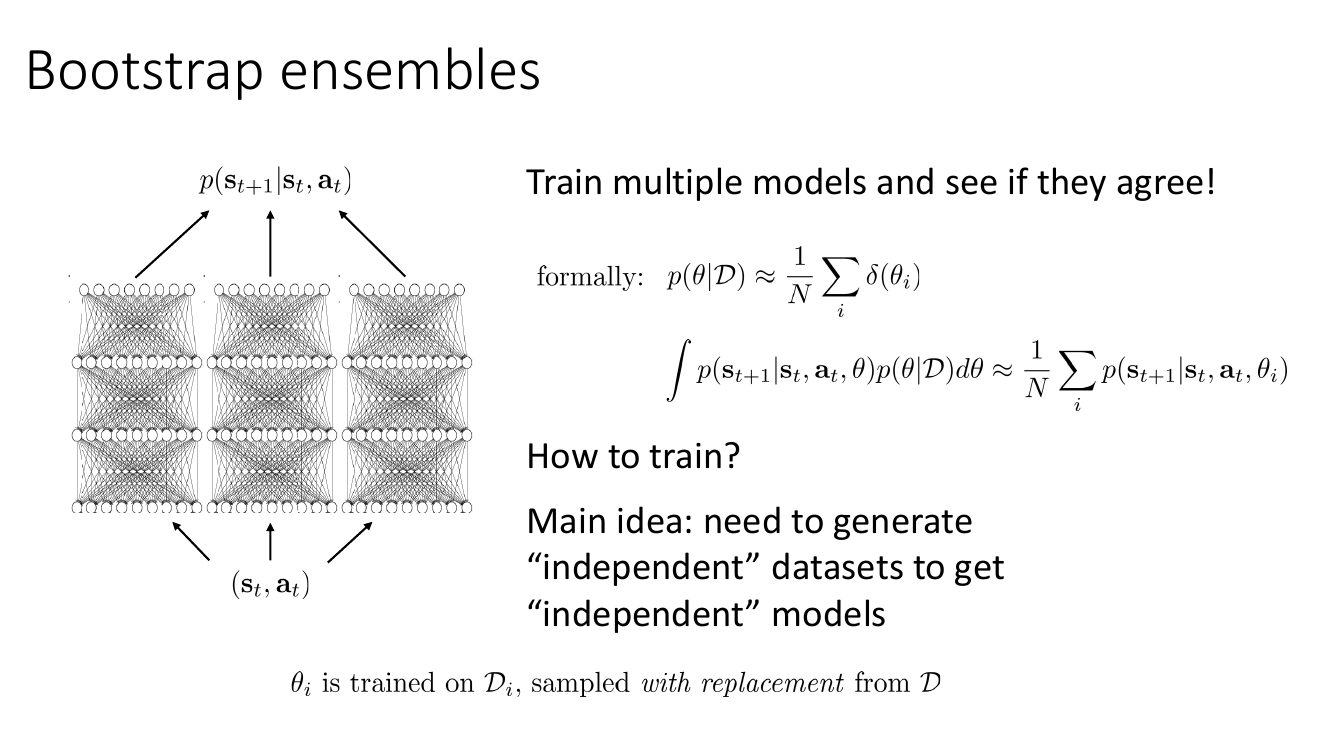
核心近似只有两行。第一行:用 $N$ 个 Dirac 分布的均匀混合来代替后验——
$$ p(\theta\mid\mathcal{D}) \;\approx\; \frac{1}{N}\sum_{i=1}^{N}\delta(\theta - \theta_i) $$第二行:把这个近似代入预测积分,$\delta$ 函数的筛选性质直接把积分变成求和——
$$ \int p(s_{t+1}\mid s_t,a_t,\theta)\,p(\theta\mid\mathcal{D})\,d\theta \;\approx\; \frac{1}{N}\sum_{i=1}^{N} p(s_{t+1}\mid s_t,a_t,\theta_i) $$也就是说,预测分布 = $N$ 个模型输出分布的等权混合。 如果每个 $p(\cdot|s,a,\theta_i)$ 是高斯 $\mathcal{N}(\mu_i,\Sigma_i)$, 那么这个混合分布的均值和方差正好复现第 6 节的全方差分解:
$$ \mu = \frac{1}{N}\sum_i \mu_i, \qquad \Sigma = \underbrace{\frac{1}{N}\sum_i \Sigma_i}_{\text{aleatoric}} \;+\; \underbrace{\frac{1}{N}\sum_i (\mu_i-\mu)(\mu_i-\mu)^{\!\top}}_{\text{epistemic:成员之间的分歧}} $$第二项就是「模型们吵架的程度」。在训练数据密集的地方,所有成员都被数据钉死在同一个答案上, 分歧接近零;在没有数据的地方,每个成员按自己随机初始化的偏好乱外推,分歧巨大。 这就是我们要的认知不确定性,而且它几乎不需要任何新数学。
8.1 为什么叫「bootstrap」,以及为什么实践中可以省掉它
统计学里的 bootstrap 是这样一个技巧:想知道一个估计量的抽样分布, 但只有一份数据集 $\mathcal{D}$(大小 $M$),那就从 $\mathcal{D}$ 里有放回地 再抽 $M$ 个样本组成 $\mathcal{D}_i$,重复 $N$ 次,在每个 $\mathcal{D}_i$ 上各算一次估计量。 这些估计量的分散程度就近似了真实的抽样分布。有放回采样使每个 $\mathcal{D}_i$ 大约只包含原数据集 $1-(1-1/M)^M \to 1-e^{-1}\approx 63.2\%$ 的不同样本, 剩下的位置由重复样本填充——正是这种差异制造了模型之间的独立性。
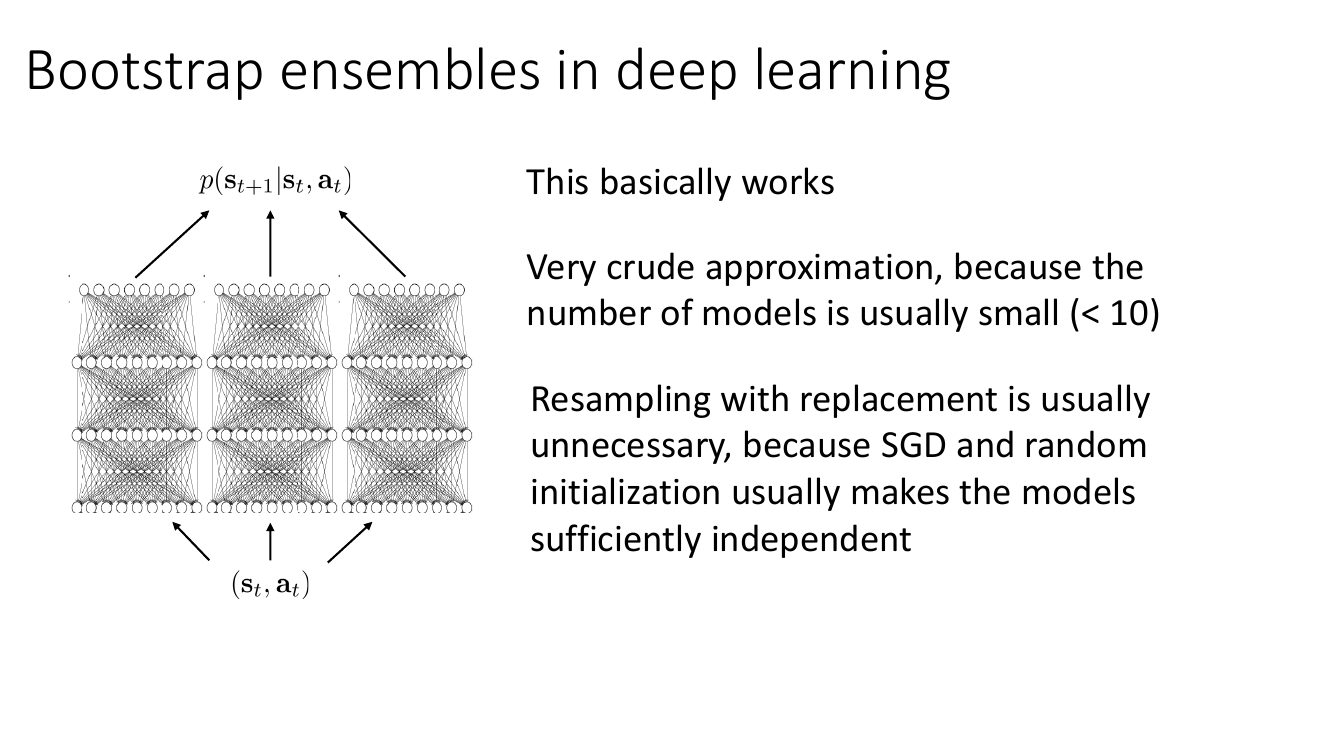
最后一条对工程实现是个好消息:你不需要维护 $N$ 份不同的数据集, 所有模型共享同一个 replay buffer,只是初始化不同、每步看到的 mini-batch 顺序不同。 这既省内存又省代码,而且经验上不确定性估计的质量并不比真 bootstrap 差。
用 5 个样本估计方差,标准误差本身就在 $\sigma/\sqrt{2(N-1)} \approx 0.35\sigma$ 的量级—— 也就是说,你对不确定性的估计,自己也有约 35% 的相对不确定性。 所以别指望用集成方差做精细的风险量化(比如「保证失败概率小于 0.1%」)。 它的正确用法是定性的:区分「大家都同意」和「大家吵翻了」这两种情形, 这个信号足够强,即使只有 5 个成员也不会搞错。
8.2 最小实现:概率动力学模型 + 集成
下面给出一份能跑通的实现。要点:预测 $\Delta s$、输入输出归一化、 每个成员输出高斯的均值与对数方差、用负对数似然(NLL)训练、 对 $\log\sigma^2$ 做软性上下界约束(PETS 的做法,防止方差跑飞)。
import torch, torch.nn as nn

class GaussianDynamics(nn.Module):
    """单个概率动力学模型:(s, a) -> N(mu_ds, sigma^2),预测状态增量 delta_s = s' - s"""
    def __init__(self, dim_s, dim_a, hidden=256):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(dim_s + dim_a, hidden), nn.SiLU(),
            nn.Linear(hidden, hidden),        nn.SiLU(),
            nn.Linear(hidden, 2 * dim_s),          # 前 dim_s 是均值,后 dim_s 是 log 方差
        )
        self.dim_s = dim_s
        # 可学习的方差软边界(PETS 的技巧):让 logvar 被平滑地夹在 [min, max] 内
        self.max_logvar = nn.Parameter(torch.full((dim_s,),  0.5))
        self.min_logvar = nn.Parameter(torch.full((dim_s,), -10.0))
        # 输入/输出归一化统计量(用数据集估计,不参与梯度)
        self.register_buffer('in_mu',  torch.zeros(dim_s + dim_a))
        self.register_buffer('in_std', torch.ones(dim_s + dim_a))
        self.register_buffer('ds_mu',  torch.zeros(dim_s))
        self.register_buffer('ds_std', torch.ones(dim_s))

    def fit_normalizer(self, s, a, ds):
        x = torch.cat([s, a], dim=-1)
        self.in_mu.copy_(x.mean(0));  self.in_std.copy_(x.std(0).clamp_min(1e-6))
        self.ds_mu.copy_(ds.mean(0)); self.ds_std.copy_(ds.std(0).clamp_min(1e-6))

    def forward(self, s, a):
        """返回归一化空间中的 (mu, logvar)"""
        x = (torch.cat([s, a], dim=-1) - self.in_mu) / self.in_std
        out = self.net(x)
        mu, logvar = out[..., :self.dim_s], out[..., self.dim_s:]
        # 软夹紧:超出边界时用 softplus 平滑衰减,梯度不会被截断成 0
        logvar = self.max_logvar - nn.functional.softplus(self.max_logvar - logvar)
        logvar = self.min_logvar + nn.functional.softplus(logvar - self.min_logvar)
        return mu, logvar

    def nll_loss(self, s, a, s_next):
        ds = ((s_next - s) - self.ds_mu) / self.ds_std      # 归一化后的目标增量
        mu, logvar = self(s, a)
        inv_var = torch.exp(-logvar)
        # 高斯 NLL(省略常数):0.5 * [ (y-mu)^2 / var + log var ]
        loss = 0.5 * ((mu - ds) ** 2 * inv_var + logvar).sum(-1).mean()
        # 让软边界本身也被轻微地往里拉,否则 max_logvar 会一直往上漂
        loss = loss + 0.01 * (self.max_logvar.sum() - self.min_logvar.sum())
        return loss

    @torch.no_grad()
    def predict(self, s, a, sample=True):
        """返回真实空间中的下一状态"""
        mu, logvar = self(s, a)
        ds = mu + torch.randn_like(mu) * torch.exp(0.5 * logvar) if sample else mu
        return s + ds * self.ds_std + self.ds_mu
class Ensemble(nn.Module):
    """N 个独立初始化的动力学模型。共享同一个数据集,靠随机初始化 + SGD 噪声制造多样性。"""
    def __init__(self, n_models, dim_s, dim_a, hidden=256):
        super().__init__()
        self.models = nn.ModuleList([GaussianDynamics(dim_s, dim_a, hidden)
                                     for _ in range(n_models)])

    def fit_normalizer(self, s, a, s_next):
        for m in self.models:
            m.fit_normalizer(s, a, s_next - s)

    def train_epoch(self, buf, opt, batch=256, steps=200, bootstrap=False):
        """buf: (S, A, S') 三个张量。bootstrap=True 时每个成员看有放回采样的子集。"""
        S, A, S2 = buf
        M = S.shape[0]
        for _ in range(steps):
            loss = 0.0
            for m in self.models:
                idx = torch.randint(0, M, (batch,))    # 有放回采样 == 天然的 bootstrap 批
                loss = loss + m.nll_loss(S[idx], A[idx], S2[idx])
            opt.zero_grad(); loss.backward()
            torch.nn.utils.clip_grad_norm_(self.parameters(), 10.0)
            opt.step()

    @torch.no_grad()
    def disagreement(self, s, a):
        """成员均值之间的方差 —— 认知不确定性的直接度量"""
        mus = torch.stack([m.predict(s, a, sample=False) for m in self.models])  # [N,B,dim_s]
        return mus.var(dim=0).mean(dim=-1)            # [B]
disagreement 这个函数就是全方差分解里的第 (II) 项:把随机性关掉
(sample=False,只取均值),看 $N$ 个成员的均值散得有多开。
你可以直接把它当作 exploration bonus 或者 pessimism penalty 用。
9. 把整条链接起来:不确定性感知的 MPC 循环
到这里,本讲的三个部分已经齐了:怎么收数据(v1.5 的循环)、 怎么训模型(概率模型 + 集成)、以及为什么要这么做(分布漂移与模型利用)。 剩下唯一的空缺是「第 3 步到底怎么用模型」——这是下一讲的主题, 但为了让代码能真正跑起来,这里先给出最简单也最常用的那个答案: 随机打靶(random shooting)+ 交叉熵方法(cross-entropy method, CEM)+ 模型预测控制(MPC)。
9.1 用采样做规划:从 random shooting 到 CEM
不学策略,直接在每个时刻现场求解一个有限时域的最优控制问题:
$$ a_{t:t+H-1}^\star \;=\; \argmax_{a_{t:t+H-1}}\; \E\left[\sum_{k=0}^{H-1} r(\hat s_{t+k}, a_{t+k})\right], \qquad \hat s_{t+k+1}\sim p(\cdot\mid \hat s_{t+k}, a_{t+k}) $$其中期望同时对环境随机性和模型不确定性取—— 后者正是第 5 节说的「in expectation under $p$」。这个优化问题在连续动作空间里非凸、 不可微(模型可能不可微,奖励也可能不可微),所以最省事的解法是纯采样:
- 随机打靶:从某个分布(比如均匀分布)里采 $K$ 条长度为 $H$ 的动作序列, 在模型里 rollout,选累计回报最高的那条。简单、无梯度、可并行; 缺点是 $K$ 需要随 $H\times\dim(a)$ 指数增长才能覆盖搜索空间。
- CEM:把随机打靶做成迭代的。用一个高斯 $\mathcal{N}(\mu,\sigma^2)$ 采 $K$ 条, 评估后取回报最高的 $E$ 条(精英,elites),用这 $E$ 条重新拟合 $\mu,\sigma$,重复几轮。 本质上是一个非常朴素的分布式进化策略——搜索分布逐步收缩到高回报区域。 经验上 $K\approx 200\sim 1000$、精英比例 $10\%$、迭代 $4\sim 6$ 轮就足够。
- MPC:不管规划出多长的序列,只执行第一个动作,然后在新的真实状态上重新规划。 这一步是整个方案能工作的关键:它把「模型误差在 $H$ 步内累积」的问题 用每一步都从真实状态重启的方式反复清零,等于给系统加了一个闭环反馈。 代价是计算量——每个控制周期都要跑一次完整的 CEM。
第 3 节的 $O(\epsilon T^2)$ 界告诉我们误差随时域超线性放大。MPC 把 $T$ 换成了规划时域 $H$ (通常 $10\sim 30$),并且每一步都用真实观测把状态重置回来, 于是误差累积被硬性截断在 $O(\epsilon H^2)$ 而不是 $O(\epsilon T^2)$。 $H=20, T=1000$ 时,这是 400 与 $10^6$ 的差别。
9.2 用集成做 rollout:轨迹采样
集成模型怎么参与 rollout?最直接的做法(PETS 论文里叫 TS1 / TS∞)是 粒子化:对每条候选动作序列,开 $P$ 个粒子并行 rollout, 每个粒子在每一步(TS1)或整条轨迹上固定(TS∞)随机选一个集成成员来推进。 然后把 $P$ 个粒子的回报取平均——这就是对 $p(\theta|\mathcal{D})$ 的蒙特卡洛积分。
为什么这样做能自动实现风险规避?回到悬崖的例子:在模型有把握的区域, 所有成员给出的下一状态几乎相同,$P$ 个粒子挤在一起,平均回报就等于那个确定的回报; 在模型没把握的区域,粒子们四散飞开,其中一部分落进了灾难区,把平均值狠狠拉低。 规划器于是自发地避开了它。
@torch.no_grad()
def cem_plan(ens, s0, reward_fn, dim_a, H=20, K=500, elites=50, iters=5,
             P=20, a_low=-1.0, a_high=1.0, mu_init=None):
    """
    ens      : Ensemble
    s0       : [dim_s] 当前真实状态
    reward_fn: (s, a) -> [B] 已知的奖励函数(model-based RL 通常假设奖励已知)
    P        : 每条候选序列的粒子数(对模型不确定性做蒙特卡洛积分)
    返回     : 规划出的第一个动作 [dim_a],以及可热启动下一轮的 mu
    """
    N = len(ens.models)
    mu = torch.zeros(H, dim_a) if mu_init is None else mu_init.clone()
    sigma = torch.full((H, dim_a), (a_high - a_low) / 2)

    for _ in range(iters):
        # 1) 从当前搜索分布采 K 条动作序列并裁剪到动作范围内
        acts = (mu + sigma * torch.randn(K, H, dim_a)).clamp(a_low, a_high)

        # 2) 每条序列开 P 个粒子,在集成模型里 rollout
        s = s0.expand(K * P, -1).contiguous()                 # [K*P, dim_s]
        ret = torch.zeros(K * P)
        for h in range(H):
            a = acts[:, h].repeat_interleave(P, dim=0)        # [K*P, dim_a]
            ret += reward_fn(s, a)
            # TS1:每个粒子在每一步独立地随机挑一个集成成员
            member = torch.randint(0, N, (K * P,))
            s_next = torch.empty_like(s)
            for i in range(N):
                m = member == i
                if m.any():
                    s_next[m] = ens.models[i].predict(s[m], a[m], sample=True)
            s = s_next

        # 3) 对粒子取平均 —— 这就是「in expectation under p」
        scores = ret.view(K, P).mean(dim=1)                   # [K]

        # 4) 取精英,重新拟合搜索分布
        top = scores.topk(elites).indices
        mu = acts[top].mean(dim=0)
        sigma = acts[top].std(dim=0).clamp_min(1e-3)

    # MPC:只返回第一个动作;把 mu 左移一格作为下一轮的热启动
    warm = torch.cat([mu[1:], torch.zeros(1, dim_a)], dim=0)
    return mu[0], warm
把 scores 那一行从 .mean(dim=1) 改成
ret.view(K,P).mean(1) - lam * ret.view(K,P).std(1),
就从「期望值」变成了「悲观值」——这正是第 5 节讨论的那个 $\lambda$ 超参数。
改成加号则是乐观值(用于探索)。三行代码里藏着三种完全不同的风险态度。
9.3 外层循环:完整的 model-based RL v1.5
def mbrl_loop(env, ens, reward_fn, dim_a, n_iters=30, steps_per_iter=200):
    opt = torch.optim.Adam(ens.parameters(), lr=1e-3, weight_decay=1e-5)
    S, A, S2 = [], [], []

    # --- 第 0 轮:用随机基础策略 pi_beta 收集种子数据 ---
    s = env.reset()
    for _ in range(1000):
        a = torch.empty(dim_a).uniform_(-1, 1)
        s2, _, done, _ = env.step(a.numpy())
        S.append(s); A.append(a); S2.append(s2)
        s = env.reset() if done else s2

    for it in range(n_iters):
        buf = (torch.as_tensor(S).float(),
               torch.as_tensor(A).float(),
               torch.as_tensor(S2).float())

        # --- 第 2 步:重训模型(每轮从头训比增量微调更稳) ---
        ens.fit_normalizer(*buf)
        ens.train_epoch(buf, opt, steps=1000)

        # --- 第 3 步 + 第 1 步合并:用 MPC 在真实环境里跑,同时收新数据 ---
        # 注意这天然就是 v1.5 的「只改进一点点」:策略隐含在规划器里,
        # 模型只变了一点,规划结果也就只变了一点,不存在「一口气优化到最优」的问题。
        s, warm, ep_ret = env.reset(), None, 0.0
        for _ in range(steps_per_iter):
            a, warm = cem_plan(ens, torch.as_tensor(s).float(), reward_fn,
                               dim_a, mu_init=warm)
            s2, r, done, _ = env.step(a.numpy())
            S.append(s); A.append(a); S2.append(s2)
            ep_ret += r
            s = env.reset() if done else s2
        print(f'iter {it}  真实回报 {ep_ret:.1f}  数据量 {len(S)}')
- 种子数据用随机策略 → v0.5 的第 1 步,也是分布漂移的源头。
- 循环里不断追加新数据、重训模型 → v1.0:把数据收集塞进循环, 让模型在当前策略访问的分布上变准。
- 用 MPC 而不是先学一个最优策略再执行 → v1.5: 模型只更新了一点,规划出来的行为也就只变了一点,「改进一点点」是自动满足的。 这也是为什么规划类 model-based RL 往往比「在模型里训策略」更稳。
- 粒子 rollout 后取平均 → v2.0:在概率模型下按期望优化, 高方差区域的期望回报自动被压低。
- 集成而不是单模型 → 认知不确定性只能从模型间的分歧里算出来。
本讲小结
四个版本的递进(一页速查)
| 版本 | 算法 | 修好了什么 | 还剩什么问题 |
|---|---|---|---|
| v0.5 | ① $\pi_\beta$ 采数据 ② 拟合 $f(s,a)=s'$ ③ 在 $f$ 里求最优策略 | 把 RL 问题变成了监督学习 + 规划,样本效率极高 | 模型只在 $p_{\pi_\beta}$ 上准;$\pi_f$ 会走到没数据的地方并崩掉 |
| v1.0 | 在 v0.5 外面套循环:④ $\pi_\beta\leftarrow\pi_f$,重新采数据、重训模型 | 策略去哪里,数据就补到哪里(DAgger 式的思路) | 是事后补救;必须先真的犯一次错。而且「求最优策略」这一步本身有毒 |
| v1.5 | 第 ③ 步改为「只把策略改进一点点」 | 限制了每轮的分布漂移量,避免一步跳进模型的虚假高峰 | 「一点点」是多少?走得慢学得慢,走得快就被模型骗 |
| v2.0 | ② 学概率模型 $p(s'|s,a)$;③ 求在 $p$ 下期望最优的 $\pi_p$ | 模型自己报告不确定性;高方差区域的期望回报被自动压低,无需手工惩罚 | 不确定性怎么估?必须是认知不确定性,输出熵不够用 |
要点清单
- 分布漂移在 model-based RL 里换了对象:模仿学习漂移的是策略的输入状态, 这里漂移的是模型被查询的 $(s,a)$。而且这次漂移是被优化目标主动奖励的,不是被动累积的。
- 模拟引理:单步 TV 误差 $\epsilon$ ⇒ 第 $t$ 步状态分布误差 $\le (t-1)\epsilon$ ⇒ 回报误差 $O(\epsilon T^2)$。这解释了为什么长时域 rollout 不可信,以及为什么 MPC(把 $T$ 换成 $H$)如此有效。
- 模型利用(model exploitation):在 $K$ 条候选里取 $\argmax$, 会把零均值的模型噪声系统性地转成约 $\sigma\sqrt{2\ln K}$ 的正向偏差。 搜索得越狠,被骗得越惨。调试时永远同时看「模型预测回报」与「真实回报」的裂口。
- 两条对策:信赖域(限制策略变化,$D_{\mathrm{KL}}(\pi_f\|\pi_\beta)\le\epsilon$) 与不确定性感知(待在模型有把握的地方)。前者第 9–10 讲已备好工具,后者是本讲重点。
- 不确定性为什么起效:奖励函数在危险边界附近是不对称的, 所以「均值相同、方差更大」的预测其期望回报更低。悬崖例子里 $\mathcal{N}(1,0.3^2)$ 给 $+9.96$,$\mathcal{N}(1,2^2)$ 给 $-24.1$。风险规避是免费附赠的。
- aleatoric vs epistemic:全方差分解 $\mathrm{Var}[s'] = \E_\theta[\mathrm{Var}[s'|\theta]] + \mathrm{Var}_\theta[\E[s'|\theta]]$。 单个网络的输出熵只给第一项;我们要的是第二项。 「模型对数据是确定的,但我们对模型是不确定的。」
- 估计 $p(\theta|\mathcal{D})$ 的两条路:贝叶斯神经网络(每个权重换成 $\mathcal{N}(\mu_i,\sigma_i)$,变分推断训练;平均场假设粗糙,倾向低估不确定性) 与 bootstrap 集成($p(\theta|\mathcal{D})\approx\frac1N\sum_i\delta(\theta_i)$, 预测变成 $N$ 个分布的等权混合)。
- 集成的工程结论:基本有效;$N\lt 10$ 是很粗糙的近似,只能定性用; 有放回重采样通常可以省掉,随机初始化 + SGD 噪声就够。
- 下一讲:在有了(不确定性感知的)模型之后,第 3 步该怎么做—— 专为学到的模型设计的规划与最优控制方法。
延伸阅读
不确定性估计
- Weight Uncertainty in Neural Networks (Blundell et al., 2015) —— 幻灯片直接点名的 Bayes by Backprop。把变分推断落到每个权重上, 读它可以搞清楚「权重的分布」在实现层面到底长什么样。
- Concrete Dropout (Gal et al., 2017) —— 另一条被点名的路线:把 dropout 率也变成可学习的,从而把 dropout 严格解释成变分近似。 工程上是「加最少代码拿到不确定性」的方案。
- Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles (Lakshminarayanan et al., 2017) —— 为「集成 + 高斯 NLL 输出头」这套组合提供了系统的实证支持, 也是本讲「重采样通常没必要」这一结论的主要出处。
- What Uncertainties Do We Need in Bayesian Deep Learning for Computer Vision? (Kendall & Gal, 2017) —— aleatoric / epistemic 这对区分最清晰的一篇论述,附有把两者分开建模的具体损失函数。
不确定性感知的 model-based RL
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models (Chua et al., 2018) —— 即 PETS,本讲所有思想的教科书式实现:概率集成 + 轨迹采样(TS1/TS∞)+ CEM + MPC。 本讲第 8–9 节的代码基本就是它的简化版。
- Neural Network Dynamics for Model-Based Deep RL with Model-Free Fine-Tuning (Nagabandi et al., 2018) —— 把「预测 $\Delta s$ + 随机打靶 MPC + 数据聚合」这套最朴素的组合做通的工作, 是理解 v1.5 循环的最佳入门读物。
- When to Trust Your Model: Model-Based Policy Optimization (Janner et al., 2019) —— MBPO。把「模型 rollout 只走 $k$ 步」这件事的理论依据写清楚了, 正是对本讲 $O(\epsilon T^2)$ 界的直接回应。
- MOPO: Model-based Offline Policy Optimization (Yu et al., 2020) —— 把「不确定性惩罚」写成显式的 $r - \lambda u(s,a)$, 是第 5 节讨论的「悲观值」在离线设定下的标准做法。
学出来的模拟器 / 世界模型
- World Models (Ha & Schmidhuber, 2018) —— 「在学到的模型里做梦训练策略」这个提法的来源,第 12 讲的状态空间模型在这里派上用场。
- Learning Latent Dynamics for Planning from Pixels (Hafner et al., 2018) —— PlaNet。回答本讲失败点三里的「像素上没法规划」:先学一个低维隐状态,再在隐空间里跑 CEM。
- Dream to Control: Learning Behaviors by Latent Imagination (Hafner et al., 2019) —— Dreamer。把隐空间里的规划换成隐空间里的 actor-critic,是「第 3 步该怎么做」的另一个主流答案。
- Genie: Generative Interactive Environments (Bruce et al., 2024) —— 开场那两张视频生成图所指向的方向:从无标注视频里学出可以用动作交互的生成式环境。
回顾
- 第 2 讲(模仿学习):分布漂移与 DAgger,本讲 v1.0 的直接来源,两者的 $O(\epsilon T^2)$ 界形状完全一致。
- 第 9–10 讲(高级策略梯度):信赖域与 KL 约束,本讲「对策 1」的全部工具。
- 第 11–12 讲(变分推断):贝叶斯神经网络的训练方法,以及从像素学隐动力学的模型骨架。