策略梯度:REINFORCE、方差削减与实现
强化学习的目标函数里藏着未知的环境转移,还要对采样过程求导——本讲把这个看似不可导的目标,变成一行可以交给 autograd 的加权最大似然。
0. 本讲导读
上一讲我们把强化学习的问题定义搭好了:马尔可夫决策过程(Markov Decision Process, MDP)、轨迹分布、目标函数,以及「采样 → 估计回报 → 改进策略」这个贯穿全课的三步循环。但那一讲只给出了骨架,没有给出任何一个真正能跑的算法。本讲是全课第一个完整的、端到端的深度强化学习算法:策略梯度(policy gradient),它的最基础形式叫 REINFORCE。
这一讲要正面回答四个问题,它们环环相扣,构成 Levine 讲课里典型的「这样不行 → 所以改成这样」的动机链条:
- 目标函数怎么求导? RL 的目标 $J(\theta)=\E_{\tau\sim p_\theta(\tau)}[r(\tau)]$ 里,参数 $\theta$ 不在被求期望的东西里面,而是在期望所依赖的分布里面。而且这个分布里含有我们根本不知道的环境转移 $p(s'|s,a)$。这怎么求导?
- 求出来的梯度长什么样? 它和监督学习里的最大似然(maximum likelihood)到底差在哪?为什么说策略梯度只是把「试错」这件事写成了公式?
- 为什么它这么难用? 策略梯度的估计量方差极大,大到你可能需要几百万条轨迹才能看出方向。方差从哪来?两个经典的削减手段——因果性(causality / reward-to-go)和基线(baseline)——各自砍掉了哪一部分方差?
- 怎么写成代码? 深度学习框架只会对「损失函数」做反向传播,而策略梯度不是任何损失函数的梯度。怎么骗过 autograd?
本讲和前后讲的关系是这样的:上一讲给了 RL 的问题定义与算法全景,本讲把其中「策略梯度」那一支落地;第 2 讲的行为克隆(behavior cloning)在这里会以一种新面目出现——策略梯度其实就是「按回报加权的行为克隆」;下一讲的 actor-critic 则是把本讲用蒙特卡洛单样本估计的 $\hat Q_{i,t}$ 换成一个学出来的值函数,从而把方差再砍一大截。可以说,读懂本讲的每一步推导,后面 TRPO、PPO、GAE、乃至 RLHF 里的 PPO 微调,全都是在这套骨架上加零件。
- 用 log-derivative trick($p\nabla\log p=\nabla p$)可以把「对分布求导」变成「在分布下求期望」,从而得到无偏的蒙特卡洛梯度估计。
- 展开 $\log p_\theta(\tau)$ 后,初始状态分布 $p(s_1)$ 和转移概率 $p(s_{t+1}|s_t,a_t)$ 都与 $\theta$ 无关,求梯度时直接消失。这是策略梯度成为 model-free 方法的根本原因。
- 最终形式 $\nabla_\theta J=\E\big[(\sum_t\nabla_\theta\log\pi_\theta(a_t|s_t))(\sum_t r(s_t,a_t))\big]$ 就是用回报加权的最大似然:好轨迹的 log 概率被推高,坏轨迹被压低。这正是「试错」的数学形式化。
- 推导中从未使用马尔可夫性,所以策略梯度可以原封不动地用在部分可观测(POMDP)设定下的 $\pi_\theta(a_t|o_t)$ 上。
- 它的致命弱点是方差极大。两个基本武器:reward-to-go(只用当前时刻之后的奖励,因为未来的动作影响不了过去的奖励)与 baseline(减去任意与动作无关的常数,期望无偏,方差可大幅下降)。
- 策略梯度天生是 on-policy 的,样本效率低。用重要性采样(importance sampling)改成 off-policy 会得到随时间步长指数爆炸的权重连乘,必须近似成 per-step 形式才可用——这就是 PPO 的雏形。
- 实现上用伪损失(pseudo-loss) $\tilde J=\frac1N\sum_i\sum_t\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\hat Q_t^{(i)}$ 交给自动微分。它的数值没有任何意义,只有梯度有意义。
1. 从 RL 目标到三步循环
记号约定
先把全课统一的记号钉死,后面所有推导都用它:$s_t$ 是 $t$ 时刻的状态(state),满足马尔可夫性;$o_t$ 是观测(observation),可能只是状态的一部分(部分可观测);$a_t$ 是动作(action);$\pi_\theta(a_t|s_t)$ 是由参数 $\theta$(比如神经网络权重)定义的策略(policy),它是一个条件概率分布;$r(s_t,a_t)$ 是奖励函数(reward);$p(s_{t+1}|s_t,a_t)$ 是转移概率(transition / dynamics);$\tau=(s_1,a_1,s_2,a_2,\dots,s_H,a_H)$ 是一条轨迹(trajectory),$H$ 是时间跨度(horizon)。本讲主要在有限跨度下讨论,暂时不引入折扣因子 $\gamma$。
把策略接到环境上,就得到轨迹的概率分布。这个式子是本讲一切推导的起点,务必逐项看清楚它由三部分组成:
$$ p_\theta(\tau)=p_\theta(s_1,a_1,\dots,s_H,a_H)=\underbrace{p(s_1)}_{\text{初始状态分布}}\prod_{t=1}^{H}\underbrace{\pi_\theta(a_t|s_t)}_{\text{我们控制的}}\underbrace{p(s_{t+1}|s_t,a_t)}_{\text{环境,未知}} $$三部分里只有中间那一项含 $\theta$。第一项和第三项属于环境,我们既不知道它们的解析形式,也无法对它们求导(想想真实机器人的物理接触动力学,或者一个只能通过 API 调用的模拟器)。整个策略梯度方法的技术核心,就是想办法让这两项在求导时自动消失。
强化学习的目标就是最大化轨迹回报的期望:
$$ \theta^\star=\argmax_\theta \underbrace{\E_{\tau\sim p_\theta(\tau)}\left[\sum_{t=1}^{H}r(s_t,a_t)\right]}_{J(\theta)} $$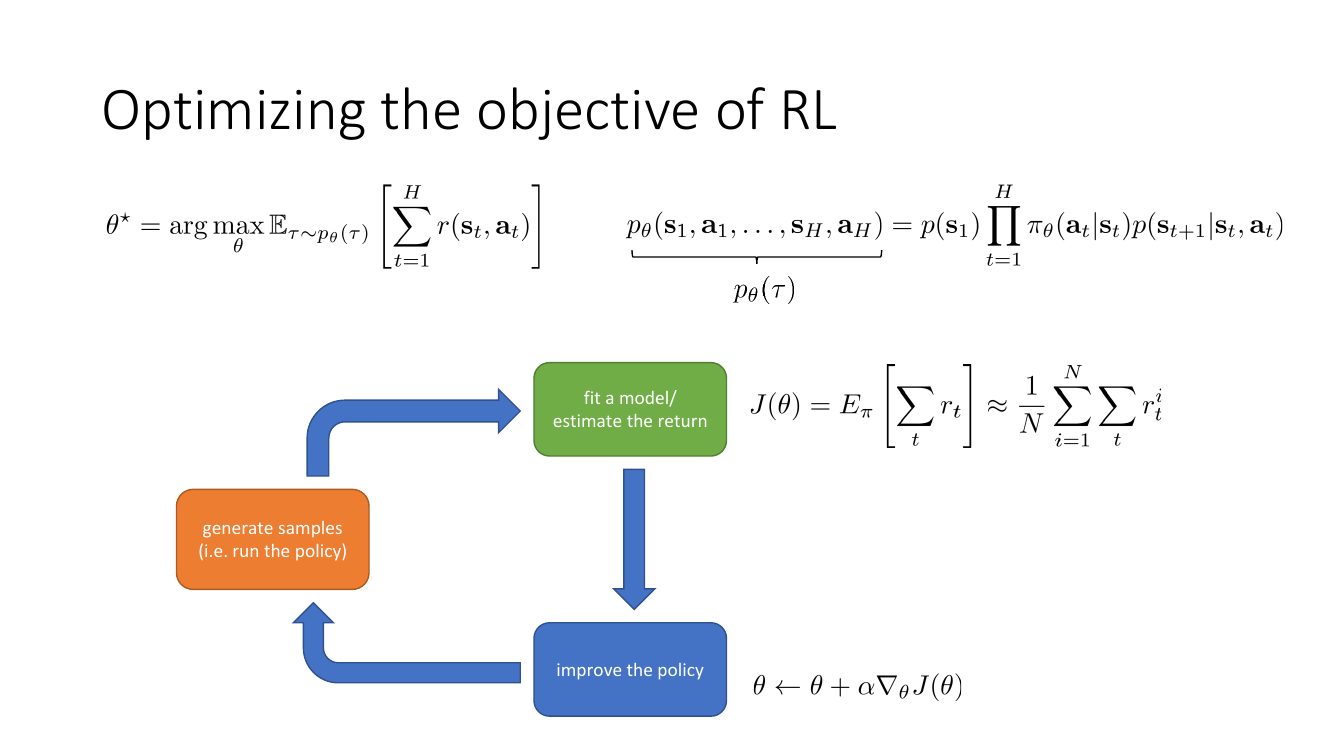
目标本身可以无偏估计,但梯度不能直接算
先看一个好消息:虽然 $J(\theta)$ 是对一个未知分布的期望,但我们可以无偏地估计它的值——只要真的把策略放到环境里跑 $N$ 次,把每条轨迹的奖励加起来求平均即可:
$$ J(\theta)=\E_{\tau\sim p_\theta(\tau)}\left[\sum_{t=1}^{H}r(s_t,a_t)\right]\approx\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H} r\!\left(s_t^{(i)},a_t^{(i)}\right) $$这里的关键在于:我们不需要知道 $p(s_1)$ 和 $p(s_{t+1}|s_t,a_t)$ 的表达式,只需要能从它们里面采样——而「跑一遍策略」正好就是从 $p_\theta(\tau)$ 里采样。这是 model-free 强化学习的第一层含义。
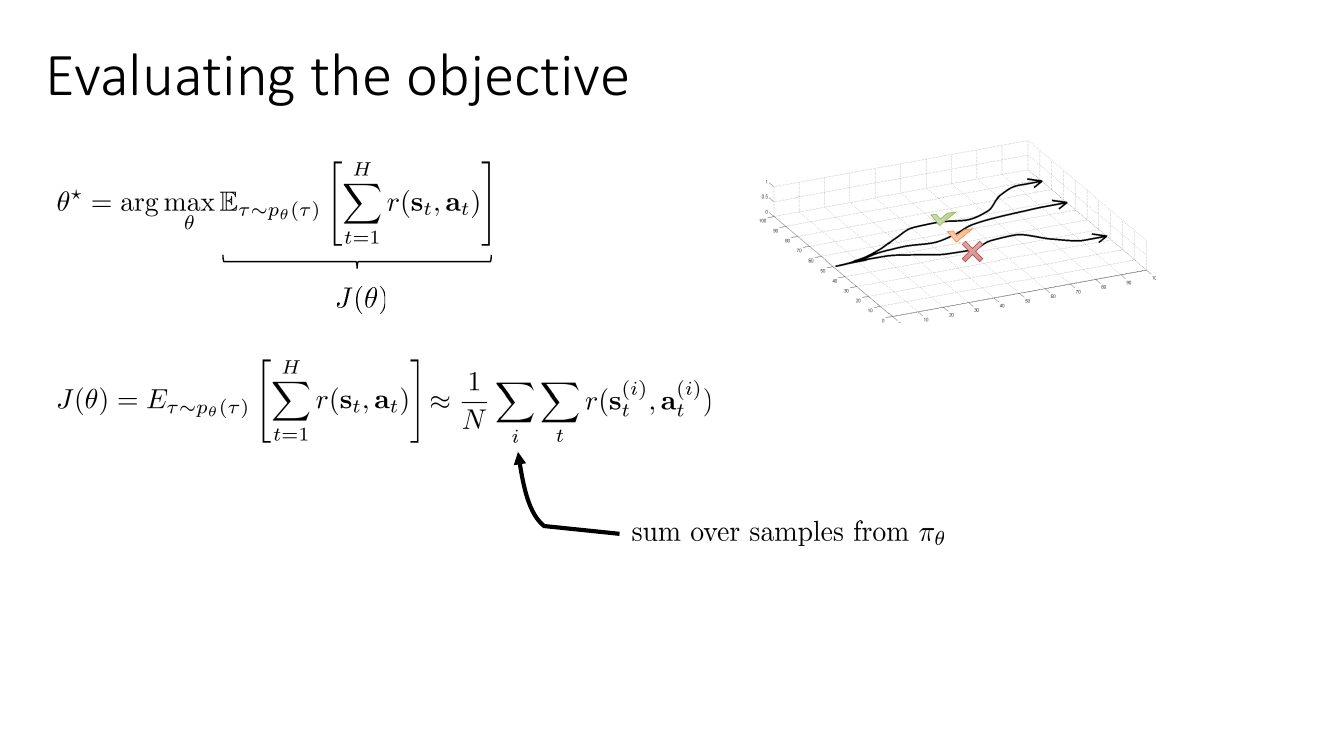
为什么不能像监督学习那样「写出 loss,然后 backward」?因为 $J(\theta)$ 的表达式里,$\theta$ 出现在期望的下标上,而不是在被积函数里。换句话说,$\theta$ 改变的是「我们在哪些轨迹上采样」,而不是「每条轨迹的得分」。而采样这个操作本身是不可导的:你没法对「掷了一次骰子」求梯度。更糟的是,$p_\theta(\tau)$ 里还乘着一堆我们既不知道形式、也无法反传的环境项。本讲接下来的第一步,就是用一个恒等式把「对分布求导」翻译成「在分布下求某个东西的期望」,这样蒙特卡洛就又能用了。
2. 直接对策略求导:REINFORCE 的完整推导
2.1 那个方便的恒等式:log-derivative trick
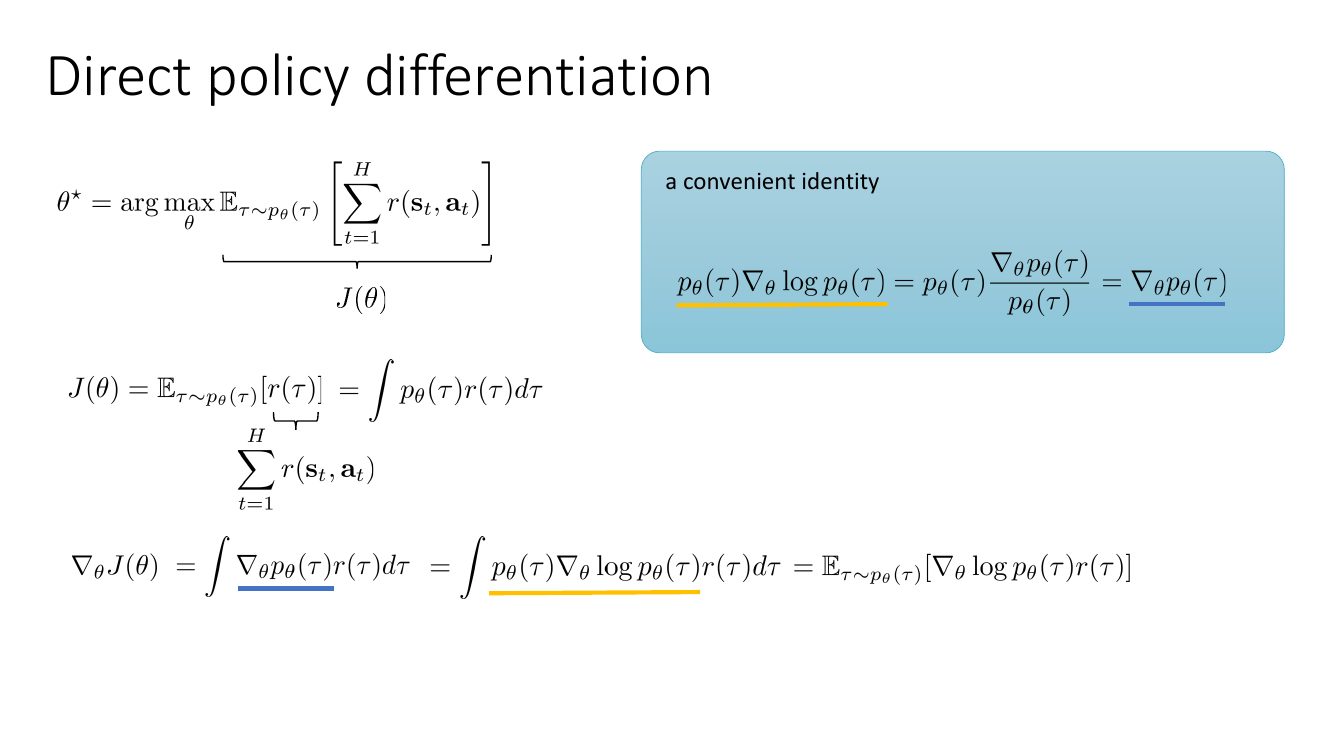
整个推导的机关只有一个恒等式,Levine 在 slides 上把它单独放在蓝框里,称为「a convenient identity」。对任意可微的概率密度 $p_\theta(\tau)$(只要 $p_\theta(\tau)\gt 0$):
$$ p_\theta(\tau)\,\nabla_\theta\log p_\theta(\tau)=p_\theta(\tau)\cdot\frac{\nabla_\theta p_\theta(\tau)}{p_\theta(\tau)}=\nabla_\theta p_\theta(\tau) $$中间一步只是链式法则 $\nabla\log f=\nabla f/f$。它看起来平淡无奇,但作用极大:等号左边是「密度 × 某个函数」,可以写成期望;等号右边是「密度的梯度」,不能写成期望。这个恒等式让我们在两种形式之间自由切换。
现在正式推导。把目标写成积分形式(记 $r(\tau)=\sum_{t=1}^H r(s_t,a_t)$ 为整条轨迹的回报):
$$ J(\theta)=\E_{\tau\sim p_\theta(\tau)}[r(\tau)]=\int p_\theta(\tau)\,r(\tau)\,d\tau $$对 $\theta$ 求梯度。注意 $r(\tau)$ 不含 $\theta$(奖励函数是环境给的,不随策略参数变),所以梯度只作用在 $p_\theta(\tau)$ 上:
$$ \nabla_\theta J(\theta)=\int \nabla_\theta p_\theta(\tau)\,r(\tau)\,d\tau $$这一步之后就卡住了:$\nabla_\theta p_\theta(\tau)$ 不是一个概率密度,我们没法从它里面采样,所以这个积分算不出来。用上面的恒等式反向替换 $\nabla_\theta p_\theta(\tau)=p_\theta(\tau)\nabla_\theta\log p_\theta(\tau)$:
$$ \nabla_\theta J(\theta)=\int p_\theta(\tau)\,\nabla_\theta\log p_\theta(\tau)\,r(\tau)\,d\tau=\E_{\tau\sim p_\theta(\tau)}\big[\nabla_\theta\log p_\theta(\tau)\,r(\tau)\big] $$现在积分又变回了「在 $p_\theta$ 下对某个量求期望」的形式——而从 $p_\theta$ 采样我们是会的(跑策略就行)。这一步是整个策略梯度方法的转折点。
2.2 关键一步:转移概率为什么会消掉
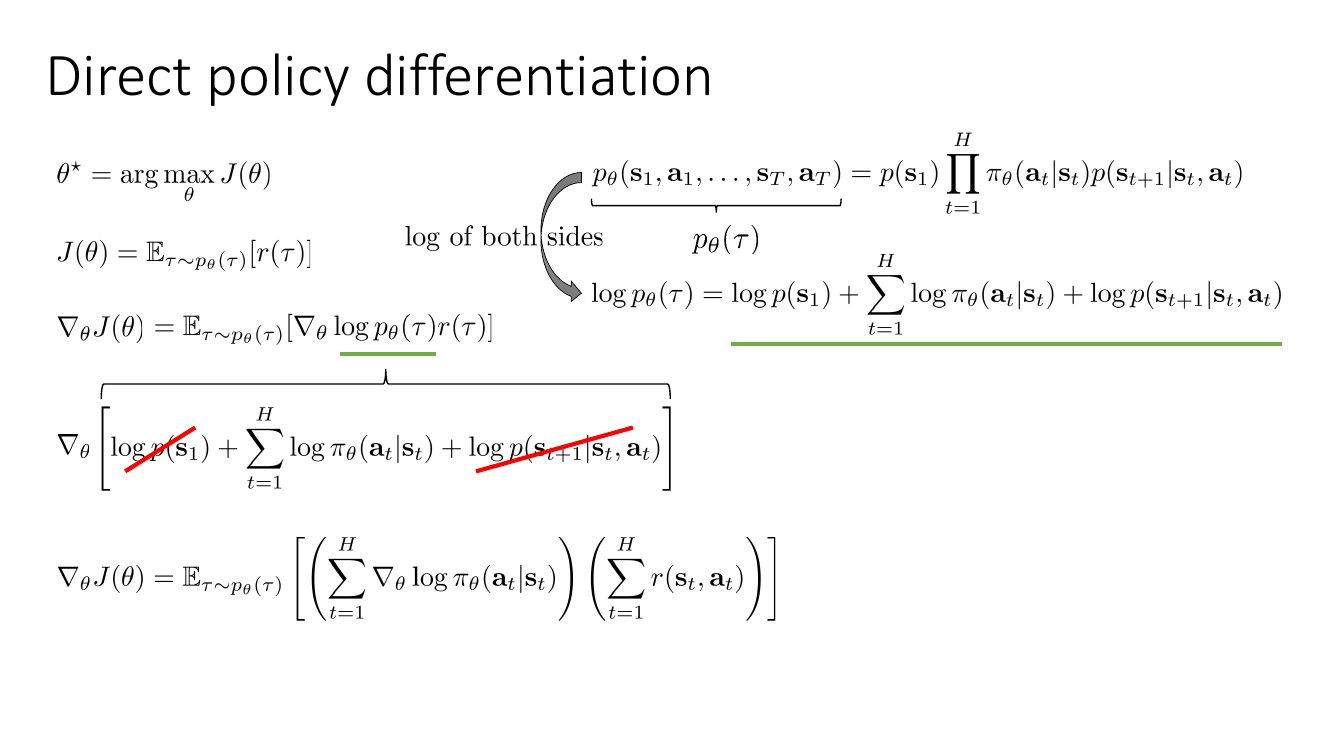
上面的结果里还有 $\nabla_\theta\log p_\theta(\tau)$,而 $p_\theta(\tau)$ 里含有未知的环境项。看起来问题只是被挪了个位置。但 log 把连乘变成了连加,这正是奇迹发生的地方。对轨迹分布两边取对数:
$$ \log p_\theta(\tau)=\log p(s_1)+\sum_{t=1}^{H}\log \pi_\theta(a_t|s_t)+\sum_{t=1}^{H}\log p(s_{t+1}|s_t,a_t) $$现在对 $\theta$ 求梯度,逐项检查:
- $\nabla_\theta\log p(s_1)=0$:初始状态分布由环境决定,跟策略参数毫无关系。这是一个不含 $\theta$ 的常数(对 $\theta$ 而言),梯度为零。
- $\nabla_\theta\log\pi_\theta(a_t|s_t)$:保留。这是唯一含 $\theta$ 的项,也是我们能用神经网络算出来的项。
- $\nabla_\theta\log p(s_{t+1}|s_t,a_t)=0$:这是关键。虽然我们访问到哪些 $(s_t,a_t)$ 对确实依赖于 $\theta$,但函数 $p(\cdot|\cdot,\cdot)$ 本身是环境的固有属性,它的函数形式不含 $\theta$。在这个式子里 $(s_t,a_t,s_{t+1})$ 是被求期望的随机变量的取值,是固定的自变量,不是 $\theta$ 的函数。所以对 $\theta$ 的偏导数是零。
这一点是初学者最容易糊涂的地方,值得多说一句。把期望写开:
$$ \nabla_\theta J(\theta)=\int p_\theta(\tau)\Big[\nabla_\theta\log p(s_1)+\sum_t\nabla_\theta\log\pi_\theta(a_t|s_t)+\sum_t\nabla_\theta\log p(s_{t+1}|s_t,a_t)\Big]r(\tau)\,d\tau $$$\theta$ 对轨迹分布的全部影响,已经被完整地打包进了外面那个 $p_\theta(\tau)$(也就是「我们从哪里采样」)。方括号内部是一个对固定轨迹 $\tau$ 求值的函数,此时 $\tau$ 是积分变量,与 $\theta$ 无关。因此 $\log p(s_1)$ 和 $\log p(s_{t+1}|s_t,a_t)$ 作为 $\theta$ 的函数就是常数,梯度为 $0$。剩下:
$$ \nabla_\theta J(\theta)=\E_{\tau\sim p_\theta(\tau)}\left[\left(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta(a_t|s_t)\right)\left(\sum_{t=1}^{H}r(s_t,a_t)\right)\right] $$右边这个式子里,没有任何一项需要知道环境:$\nabla_\theta\log\pi_\theta$ 是我们自己的网络的反向传播,$r(s_t,a_t)$ 是环境直接返回的标量。期望则用采样近似。这就是 model-free 的全部魔法。
2.3 蒙特卡洛估计与 REINFORCE 算法
期望仍然算不出解析解,但现在可以用采样近似了。跑 $N$ 条轨迹 $\{\tau^{(i)}\}_{i=1}^N$,得到:
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\left(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\right)\left(\sum_{t=1}^{H}r\!\left(s_t^{(i)},a_t^{(i)}\right)\right) $$然后做梯度上升(我们在最大化 $J$,不是最小化损失):$\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$。整个算法就三行,这就是 Williams 1992 年提出的 REINFORCE:
- 用当前策略 $\pi_\theta(a_t|s_t)$ 采样若干条轨迹 $\{\tau^{(i)}\}$(就是把策略放到环境里跑);
- 估计梯度 $\nabla_\theta J(\theta)\approx\sum_i\big(\sum_t\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\big)\big(\sum_t r(s_t^{(i)},a_t^{(i)})\big)$;
- 更新参数 $\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$,回到第 1 步。
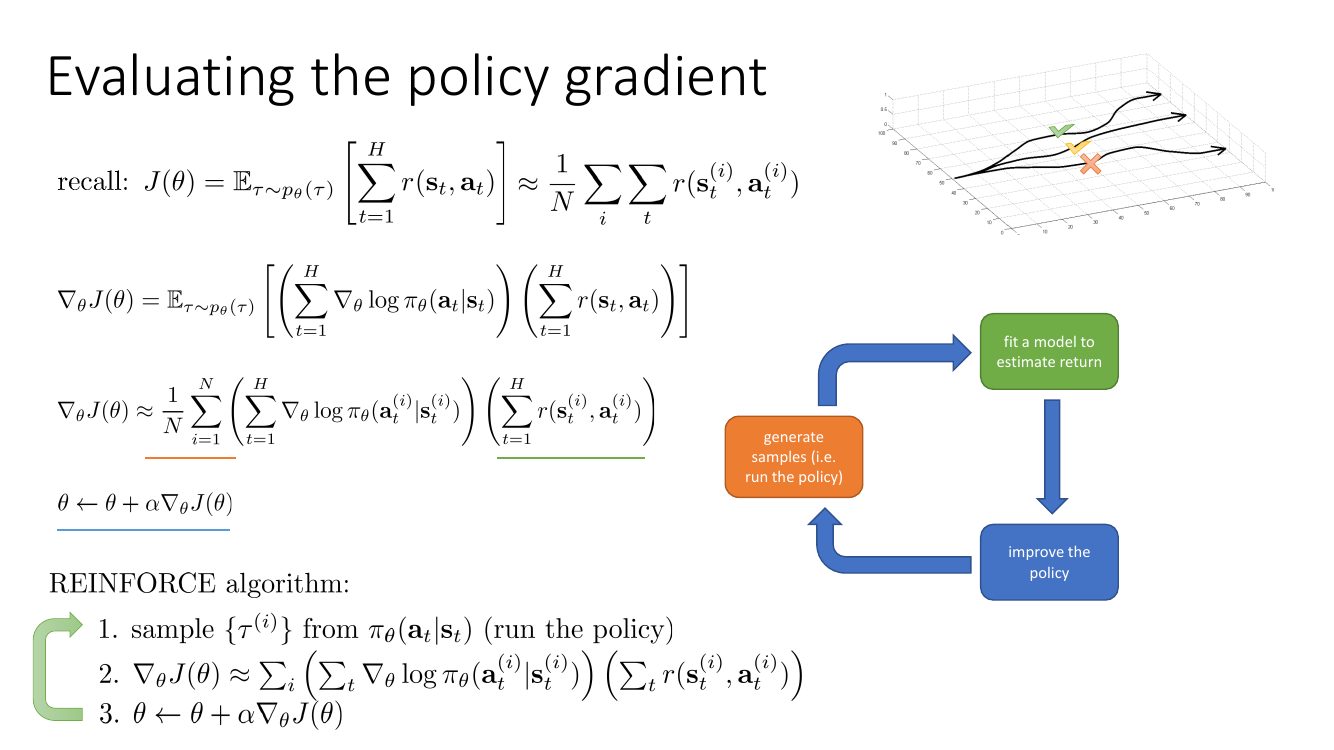
注意 REINFORCE 对奖励函数的要求有多低:$r(s,a)$ 不需要可微,不需要连续,甚至不需要有解析形式——它可以是「围棋赢了给 +1」,可以是人工打分,可以是另一个神经网络的输出(RLHF 里的奖励模型),也可以是一段黑箱代码的返回值。这跟监督学习形成鲜明对比:监督学习必须让 loss 对预测可微。策略梯度只要求策略对参数可微,对奖励什么要求都没有。这正是它能被用来优化「BLEU 分数」「用户点击率」「人类偏好」这些不可微目标的原因。
2.4 一个必须记住的性质:策略梯度是 on-policy 的
梯度表达式里的期望是 $\E_{\tau\sim p_\theta(\tau)}$,下标里的 $\theta$ 就是我们正在求梯度的那个 $\theta$。这意味着:每做完一次参数更新,之前收集的所有轨迹就全部作废了,因为它们来自旧策略 $p_{\theta_{\text{old}}}$,不再是当前 $p_\theta$ 的样本。
这个约束的代价非常昂贵。假设一次梯度更新需要 $N=1000$ 条轨迹,每条 $H=1000$ 步,那么一次更新就消耗 100 万个环境交互步;训练 1000 次更新就是 10 亿步。对模拟器来说勉强能忍,对真实机器人就是灾难。这是策略梯度类方法(相对 Q-learning 这类 off-policy 方法)最大的实用短板,也是第 8 节要处理的问题。
3. 理解策略梯度:一次加权的最大似然
3.1 $\nabla_\theta\log\pi_\theta(a|s)$ 到底是什么
推导做完了,但公式的含义还没说清。Levine 在这里停下来问了一句「what is this?」,指着 $\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})$ 这一项。
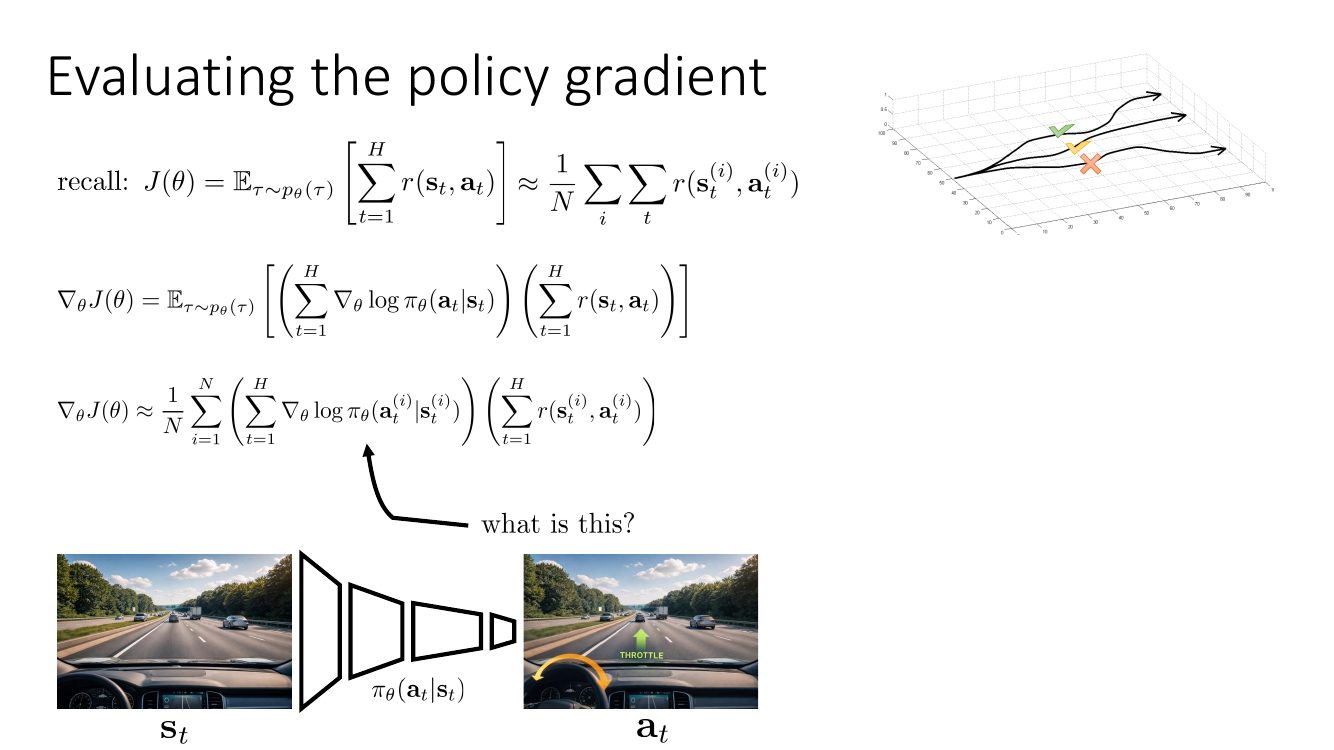
答案是:它就是监督学习的梯度。如果你手上有一批「专家演示」数据 $\{(s_t^{(i)},a_t^{(i)})\}$,想做行为克隆,你会最大化对数似然:
$$ J_{\mathrm{ML}}(\theta)=\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H}\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right),\qquad \nabla_\theta J_{\mathrm{ML}}(\theta)=\frac1N\sum_{i=1}^{N}\left(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\right) $$把它和策略梯度并排放:
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\left(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\right)\underbrace{\left(\sum_{t=1}^{H}r\!\left(s_t^{(i)},a_t^{(i)}\right)\right)}_{\text{唯一的差别}} $$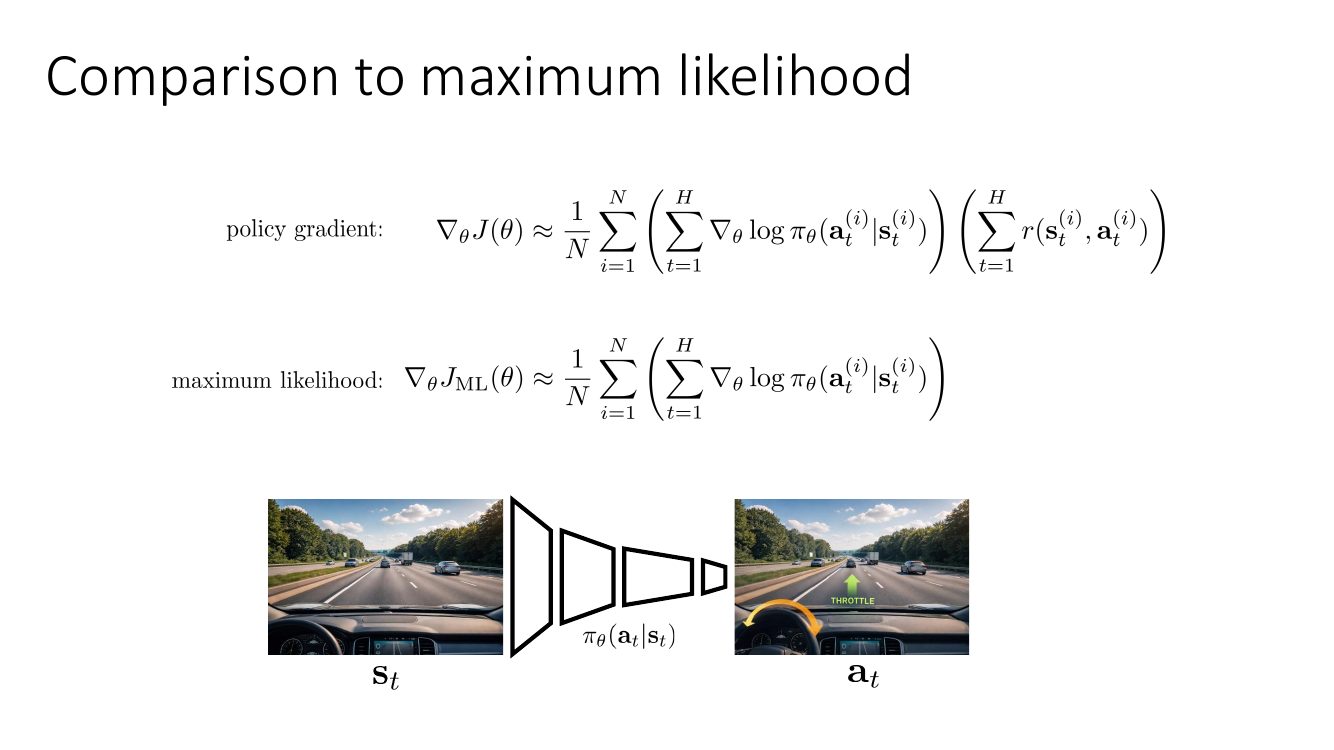
策略梯度 = 加权的最大似然。 行为克隆是「无条件地模仿数据里的每一个动作」;策略梯度是「模仿我自己产生的动作,但按它带来的回报加权」。回报高的轨迹权重是大正数,这条轨迹上每个动作的 log 概率都被推高;回报低(负)的轨迹权重是负数,这条轨迹上的动作会被压低。
一个特别干净的特例:若奖励是 $0/1$ 的成功信号,$r(\tau)\in\{0,1\}$,那么策略梯度严格等于「只在成功的轨迹上做行为克隆」——失败轨迹的权重是 0,直接被丢掉。这正是「筛选式模仿学习」「self-imitation」「拒绝采样微调(rejection sampling fine-tuning)」这一类方法的理论出处。
3.2 高斯策略:把公式落到具体网络上
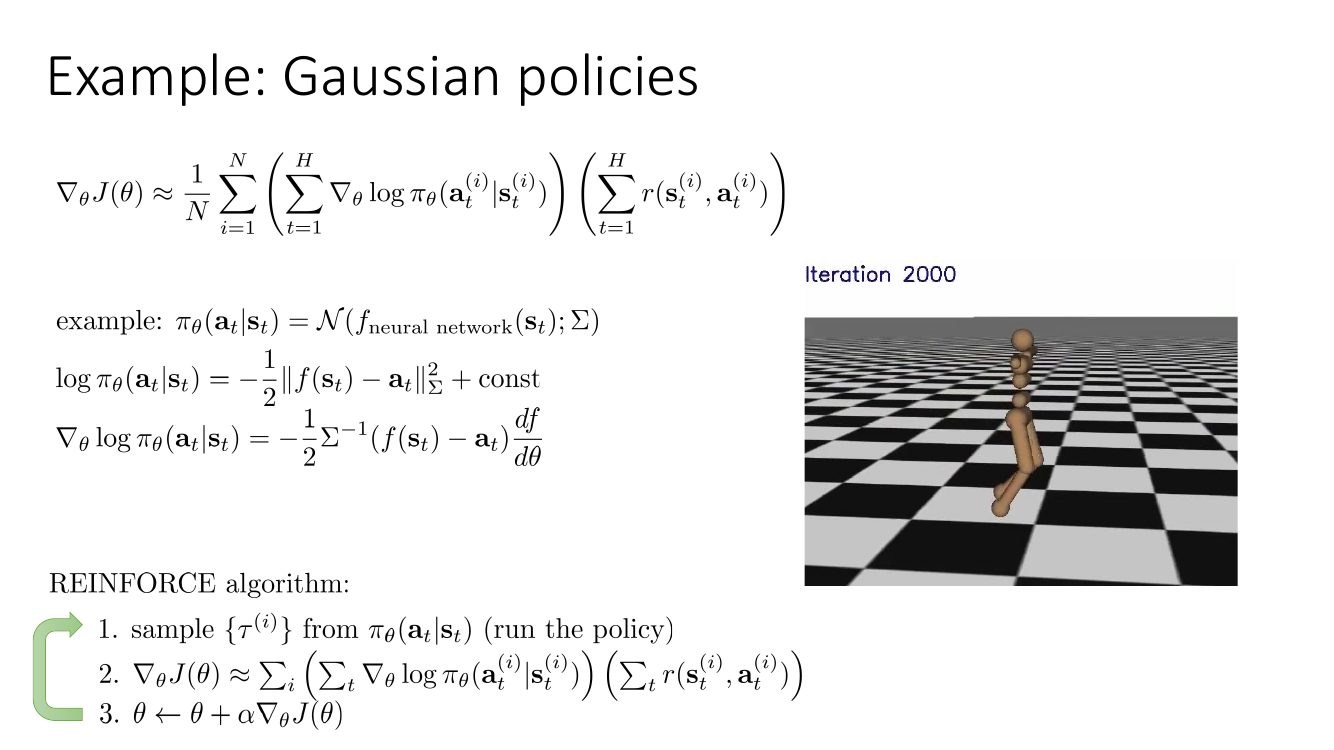
对连续动作(比如机器人关节力矩),最常用的策略是高斯策略(Gaussian policy):神经网络输出高斯分布的均值,协方差 $\Sigma$ 可以是固定的、可学习的常数,或者也由网络输出:
$$ \pi_\theta(a_t|s_t)=\mathcal N\big(f_{\text{neural network}}(s_t);\ \Sigma\big) $$它的对数概率是(记 $\|x\|_\Sigma^2=x^\top\Sigma^{-1}x$):
$$ \log\pi_\theta(a_t|s_t)=-\tfrac12\big\|f(s_t)-a_t\big\|_\Sigma^2+\text{const} $$常数项 $-\frac12\log\big((2\pi)^{d}|\Sigma|\big)$ 在 $\Sigma$ 固定时与 $\theta$ 无关,求梯度时消失。于是:
$$ \nabla_\theta\log\pi_\theta(a_t|s_t)=-\Sigma^{-1}\big(f(s_t)-a_t\big)\frac{df}{d\theta} $$看清楚这个式子:$-\frac12\|f(s)-a\|_\Sigma^2$ 就是负的加权平方误差。所以对高斯策略而言,最大似然=最小化 $f(s)$ 与数据中动作 $a$ 之间的马氏距离,就是最普通的回归。而策略梯度不过是在这个回归损失前面乘上回报权重。$\Sigma^{-1}$ 的作用是缩放:策略越确定($\Sigma$ 越小),同样大小的动作偏差会产生越大的梯度。
3.3 这就是「试错」的形式化
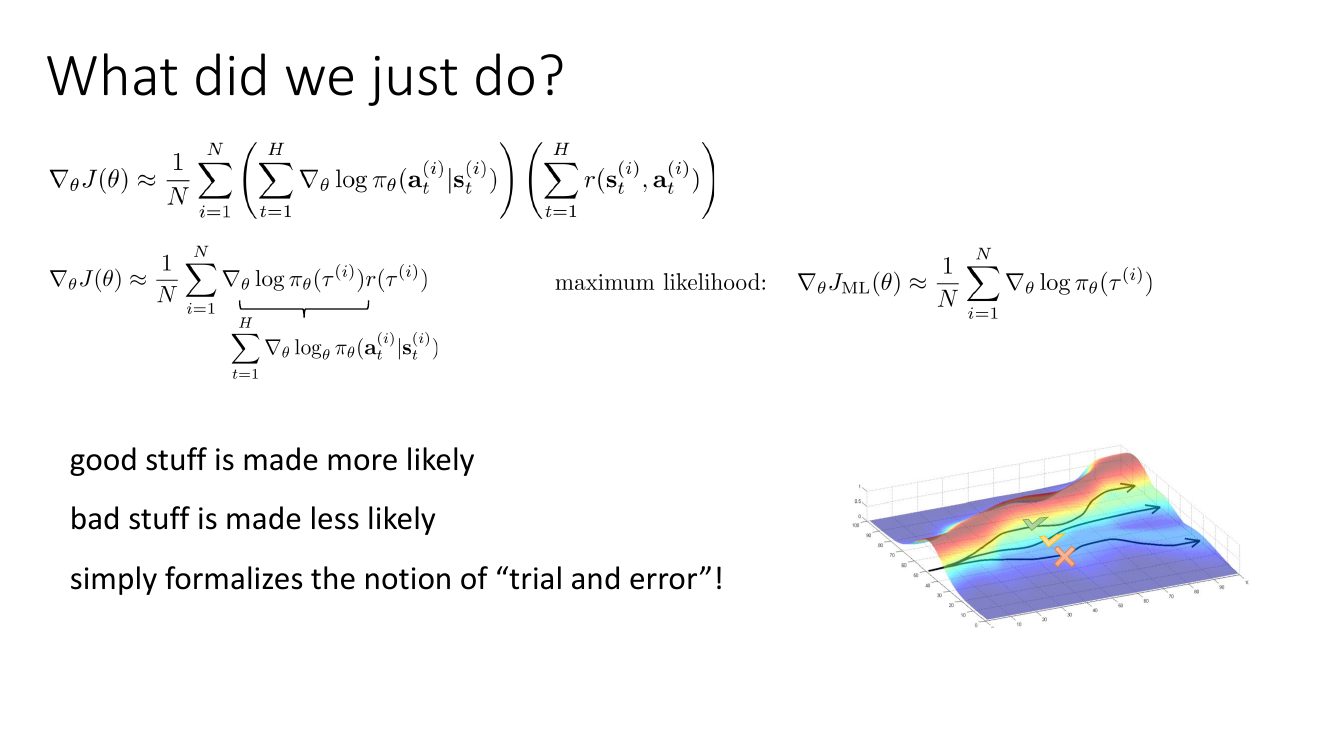
这三句话值得反复咀嚼。人类学骑车的过程是:随便试一下 → 摔了 → 下次别这么做;试对了 → 记住这个感觉。策略梯度做的就是这件事,只不过「记住」被实现为「提高该动作序列的对数似然」,「别这么做」被实现为「降低它」。强化学习的整个 trial-and-error 直觉,被完整压缩进了 $\nabla\log\pi\cdot r$ 这一个乘积里。
「$\nabla_\theta\log\pi_\theta(\tau)r(\tau)$ 看起来像某个损失函数的梯度,那这个损失函数是什么?」——没有这样的损失函数。 你可以写出 $\tilde J(\theta)=\frac1N\sum_i\log\pi_\theta(\tau^{(i)})r(\tau^{(i)})$,它对 $\theta$ 求导确实给出策略梯度,但这只在当前这一批样本、当前这个 $\theta$ 处成立:一旦 $\theta$ 变了,样本分布 $p_\theta$ 也变了,而 $\tilde J$ 里的样本还是旧的。所以 $\tilde J$ 的函数值毫无意义,它既不是 $J(\theta)$ 也不是它的下界,训练时盯着这个「loss」看是没有意义的(它经常上上下下甚至发散,而回报却在稳步上升)。第 9 节会详细讲这个「伪损失」怎么用。
4. 部分可观测:策略梯度不需要马尔可夫性
回头把第 2 节的推导再检查一遍,看看我们到底用了哪些假设。答案是:只用了「轨迹分布可以因式分解成 $p(s_1)\prod\pi_\theta(a_t|s_t)p(s_{t+1}|s_t,a_t)$,且后两类因子中只有策略含 $\theta$」这一条。 我们从来没有用到「$s_{t+1}$ 只依赖 $s_t,a_t$」这个马尔可夫性质本身来做任何化简——即便转移写成 $p(s_{t+1}|s_{1:t},a_{1:t})$,它照样不含 $\theta$,照样在取 log 求梯度时消失。
这带来一个非常实用的结论:如果智能体只能看到观测 $o_t$(比如机器人只有摄像头,看不到自己被遮挡的手臂位置),策略写成 $\pi_\theta(a_t|o_t)$,那么把公式里的 $s_t$ 换成 $o_t$ 就完事了,其他一个字都不用改:
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\left(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|o_t^{(i)}\right)\right)\left(\sum_{t=1}^{H}r\!\left(s_t^{(i)},a_t^{(i)}\right)\right) $$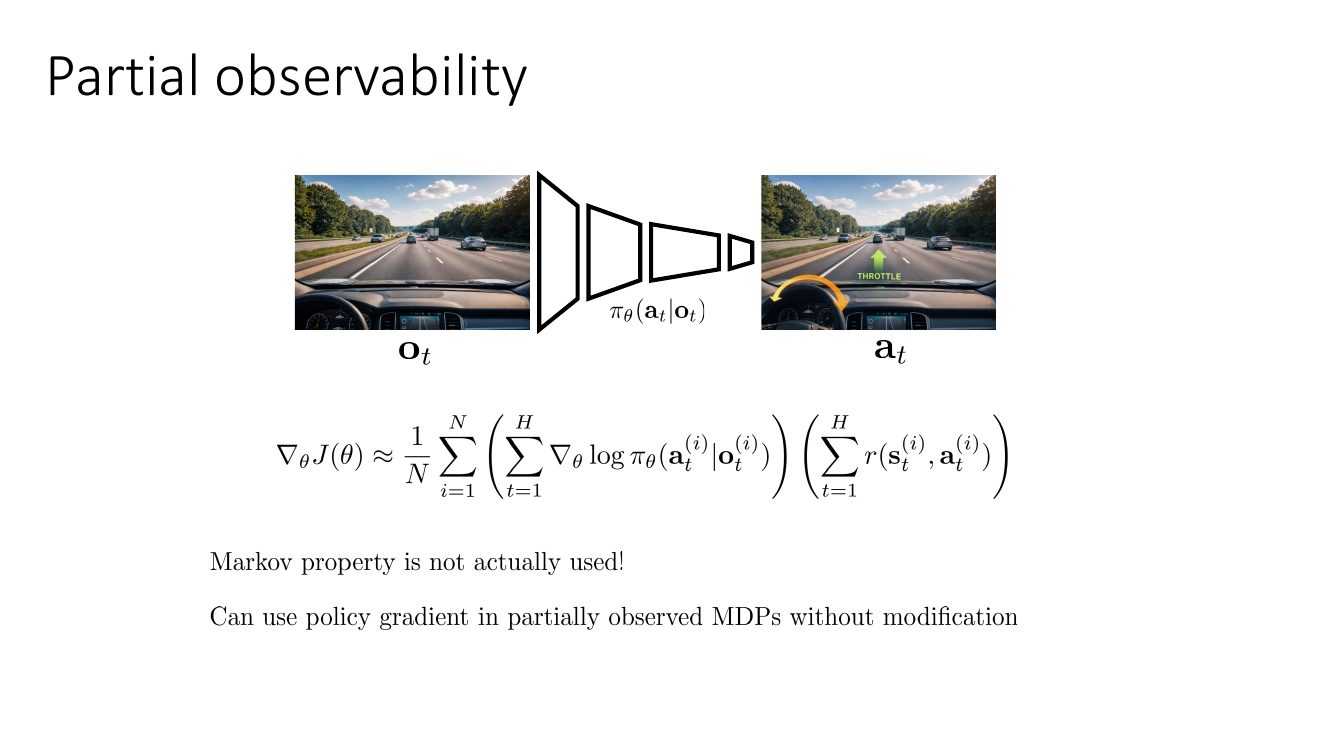
这条性质是策略梯度相对于值函数方法的一个结构性优势。Q-learning、值迭代这类方法的正确性完全建立在 Bellman 方程上,而 Bellman 方程 $Q(s,a)=r(s,a)+\gamma\E_{s'}[\max_{a'}Q(s',a')]$ 要求 $s$ 是马尔可夫的;在部分可观测下直接把 $s$ 换成 $o$,Bellman 备份就是错的(同一个 $o$ 可能对应完全不同的真实状态,其价值不同)。所以 POMDP 下的值函数方法通常需要显式引入信念状态或循环网络记忆,而策略梯度什么都不用做。
当然,这不意味着部分可观测是「免费」的:最优的马尔可夫策略在 POMDP 下可能根本不存在(可能需要随机策略甚至记忆),策略梯度只是保证「在你指定的 $\pi_\theta(a|o)$ 这个策略类里,它算出的梯度是正确的」。奖励仍然写作 $r(s_t,a_t)$——环境按真实状态发奖励,我们只是收到那个标量而已。
5. 策略梯度到底哪里不好:方差
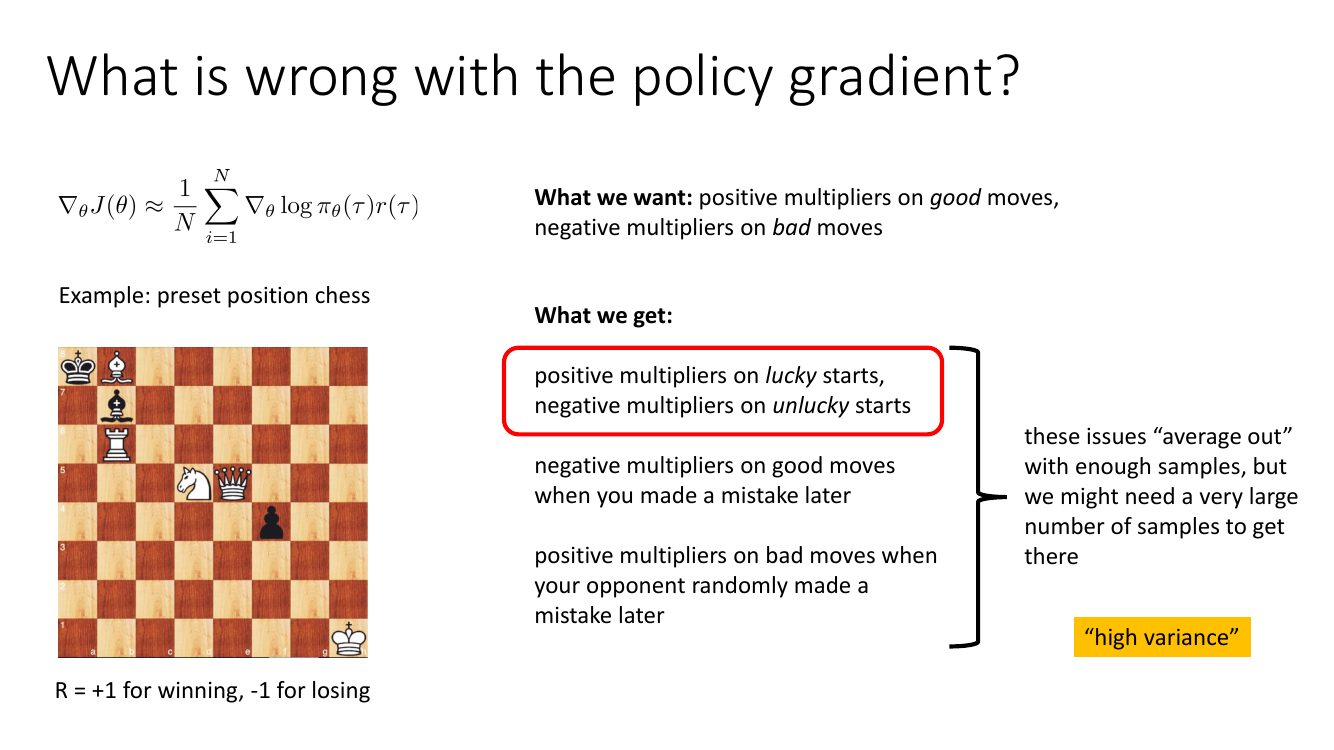
推导干净、无偏、不需要环境模型——听起来完美。但如果你真的照着 REINFORCE 写一遍代码去跑 CartPole,你会发现它训练得极慢、极不稳定,换个随机种子结果可能天差地别。原因只有一个:这个梯度估计量的方差极大。
5.1 一个残酷的例子:预设局面的国际象棋
Levine 用了一个很尖锐的例子。设想让智能体从一个随机预设的棋局开始下国际象棋,奖励只在终局给出:赢 $+1$,输 $-1$。策略梯度是
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\nabla_\theta\log\pi_\theta(\tau^{(i)})\,r(\tau^{(i)}) $$我们想要的是:好棋步得到正的乘数,坏棋步得到负的乘数。我们实际得到的是什么?
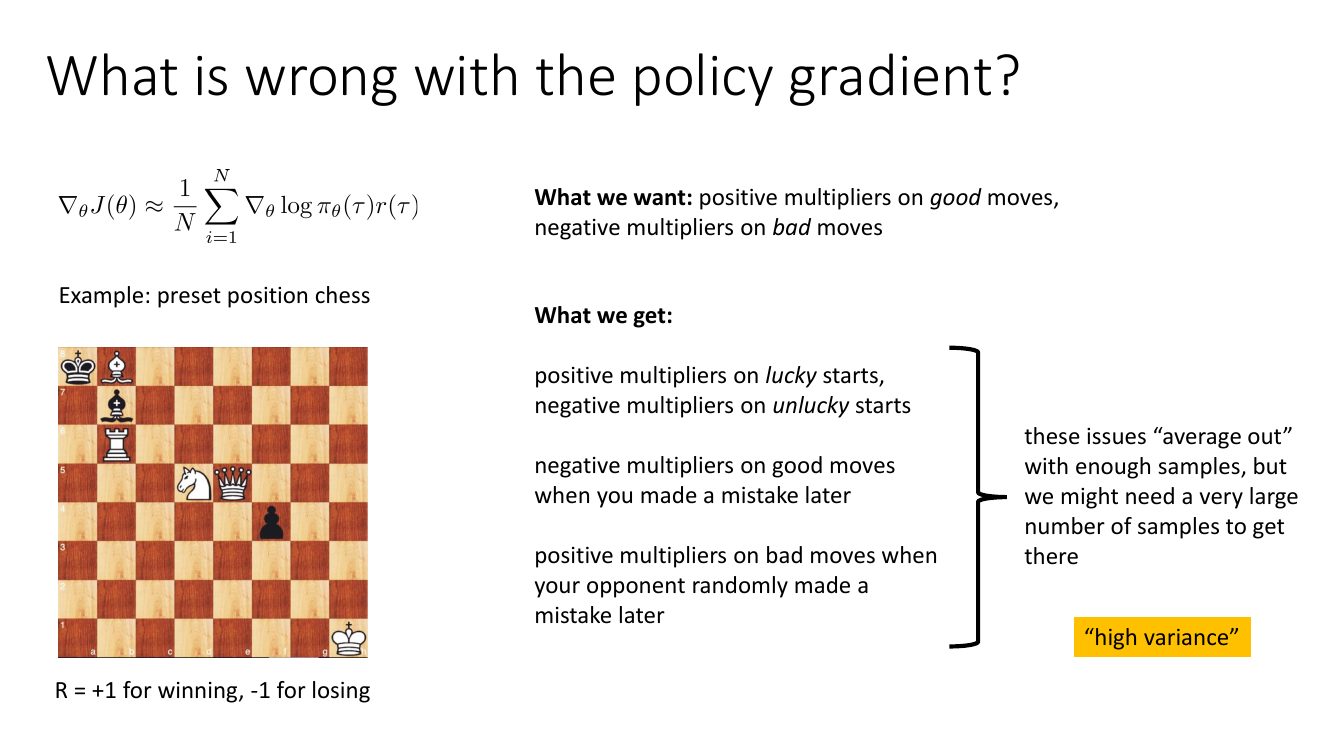
把三条落差拆开看,正好对应策略梯度方差的三个来源:
| 方差来源 | 在棋类例子里的表现 | 对应的解药 |
|---|---|---|
| 初始状态的运气 ($p(s_1)$ 的随机性) | 拿到必胜残局的对局回报高,拿到必败残局的回报低,跟策略好坏无关 | baseline(尤其是依赖状态的 baseline $V(s)$,下一讲) |
| 同一条轨迹上其他时刻动作的运气 | 第 5 步的好棋被第 40 步的昏招连坐;第 3 步的臭棋被第 30 步的妙手洗白 | reward-to-go(砍掉过去)+ 学出来的 critic(削减未来的噪声) |
| 环境/对手的随机性 ($p(s'|s,a)$ 的随机性) | 对手随机走错,让一步坏棋看起来很好 | 本质上只能靠更多样本,或者用 critic 把「期望值」学出来 |
5.2 方差有多大?一个可以手算的数值例子
抽象的「方差大」没有感觉,我们算一个具体的。考虑最简单的单步问题(一个 3 臂老虎机,$H=1$),三个动作,策略是 softmax,参数 $\theta=(\theta_1,\theta_2,\theta_3)=(0,0,0)$,于是 $\pi(a_j)=1/3$。softmax 策略的 score function 有个漂亮的闭式:
$$ \frac{\partial}{\partial\theta_j}\log\pi_\theta(a_i)=\mathbf 1[i=j]-\pi_\theta(a_j) $$所以采到动作 $a_1$ 时,梯度向量是 $g_1=(\tfrac23,-\tfrac13,-\tfrac13)$;采到 $a_2$ 是 $g_2=(-\tfrac13,\tfrac23,-\tfrac13)$;采到 $a_3$ 是 $g_3=(-\tfrac13,-\tfrac13,\tfrac23)$。
现在把奖励设成 $r(a_1)=1000$,$r(a_2)=1001$,$r(a_3)=999$。注意真正有意义的信息只有 $\pm1$ 的差别:$a_2$ 最好,$a_3$ 最差,那个 $1000$ 的公共部分完全是噪音级的常数偏移(想想「每步存活给 +1000 分」这种常见的奖励设计)。
真实梯度(三种动作各 $1/3$ 概率):
$$ \nabla_\theta J=\tfrac13\big(1000\,g_1+1001\,g_2+999\,g_3\big)=\big(0,\ \tfrac13,\ -\tfrac13\big) $$方向完全正确:提高 $a_2$ 的 logit,降低 $a_3$ 的。但单样本估计是什么样?
| 采到的动作 | 单样本梯度估计 $g\cdot r$ | 第 1 维数值 |
|---|---|---|
| $a_1$(概率 1/3) | $1000\cdot(\tfrac23,-\tfrac13,-\tfrac13)$ | $+666.7$ |
| $a_2$(概率 1/3) | $1001\cdot(-\tfrac13,\tfrac23,-\tfrac13)$ | $-333.7$ |
| $a_3$(概率 1/3) | $999\cdot(-\tfrac13,-\tfrac13,\tfrac23)$ | $-333.0$ |
第 1 维的真实梯度是 $0$,但单样本估计的取值是 $\{+666.7,-333.7,-333.0\}$,标准差约 $\sqrt{(666.7^2+333.7^2+333.0^2)/3}\approx 471$。信号是 $0.33$ 量级,噪声是 $471$ 量级,信噪比约 $1:1400$。 由于蒙特卡洛估计的标准差按 $1/\sqrt N$ 下降,要让噪声降到和信号同一量级,需要 $N\approx 1400^2\approx 2\times10^6$ 条样本——而这只是一个三选一的单步问题!这就是「high variance」的真实含义。
问题的根源在于 $\nabla_\theta\log\pi$ 的期望恒为零(下一节会证明),所以真正的梯度信号完全来自「不同动作的回报差异」,而每个单样本估计的大小却由「回报的绝对值」决定。当回报的绝对值远大于它们之间的差异时($1000$ vs $\pm1$),信噪比就崩了。
更让人不安的是:给所有奖励加一个常数 $c$,最优策略完全不变,真实梯度也完全不变(因为 $\E[\nabla\log\pi\cdot c]=0$),但梯度估计的方差会随 $c^2$ 增长。也就是说,一个在数学上完全无关紧要的奖励平移,能把算法从「能训练」变成「训不动」。这个观察直接导出了 baseline 这个解法。
6. 方差削减之一:因果性与 reward-to-go
回看基础形式:
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\left(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\right)\left(\sum_{t'=1}^{H}r\!\left(s_{t'}^{(i)},a_{t'}^{(i)}\right)\right) $$把括号展开,这是 $H\times H$ 个交叉项 $\nabla_\theta\log\pi_\theta(a_t|s_t)\cdot r(s_{t'},a_{t'})$ 的和。其中有一大批项在物理上就说不通:$t$ 时刻的动作乘以 $t'\lt t$ 时刻的奖励。今天做的决定不可能改变昨天已经拿到的奖励。这就是因果性(causality)。
6.1 严格证明:过去的奖励项期望为零
引理(score function 零均值):对任意固定的 $s$,
$$ \E_{a\sim\pi_\theta(\cdot|s)}\big[\nabla_\theta\log\pi_\theta(a|s)\big]=\int\pi_\theta(a|s)\frac{\nabla_\theta\pi_\theta(a|s)}{\pi_\theta(a|s)}\,da=\nabla_\theta\int\pi_\theta(a|s)\,da=\nabla_\theta 1=0 $$(用的还是同一个 log-derivative 恒等式,加上「概率积分为 1,与 $\theta$ 无关」。)
命题:对任意 $t'\lt t$,$\ \E_{\tau\sim p_\theta}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\,r(s_{t'},a_{t'})\big]=0$。
证明:把轨迹拆成「前缀」$\tau_{\lt t}=(s_1,a_1,\dots,s_{t-1},a_{t-1},s_t)$(包含 $s_t$ 但不含 $a_t$)与其余部分。由于 $t'\lt t$,奖励 $r(s_{t'},a_{t'})$ 是前缀的确定性函数。用全期望公式(塔性质)先对 $a_t$ 求条件期望:
$$ \E_{\tau}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\,r(s_{t'},a_{t'})\big] =\E_{\tau_{\lt t}}\Big[r(s_{t'},a_{t'})\cdot\underbrace{\E_{a_t\sim\pi_\theta(\cdot|s_t)}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\big]}_{=\,0\ \text{(引理)}}\Big]=0 $$注意这里为什么能把 $r(s_{t'},a_{t'})$ 提到内层期望外面:给定前缀之后它就是一个常数,而内层期望只对 $a_t$ 取。$\blacksquare$
于是我们可以把所有 $t'\lt t$ 的项直接删掉,而不改变期望——估计量依然无偏。删完之后,每个 $\nabla_\theta\log\pi_\theta(a_t|s_t)$ 的乘数从「整条轨迹的总回报」变成了「从 $t$ 开始到结束的回报」:
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\underbrace{\left(\sum_{t'=t}^{H}r\!\left(s_{t'}^{(i)},a_{t'}^{(i)}\right)\right)}_{\text{“reward to go” }\ \hat Q_t^{(i)}} $$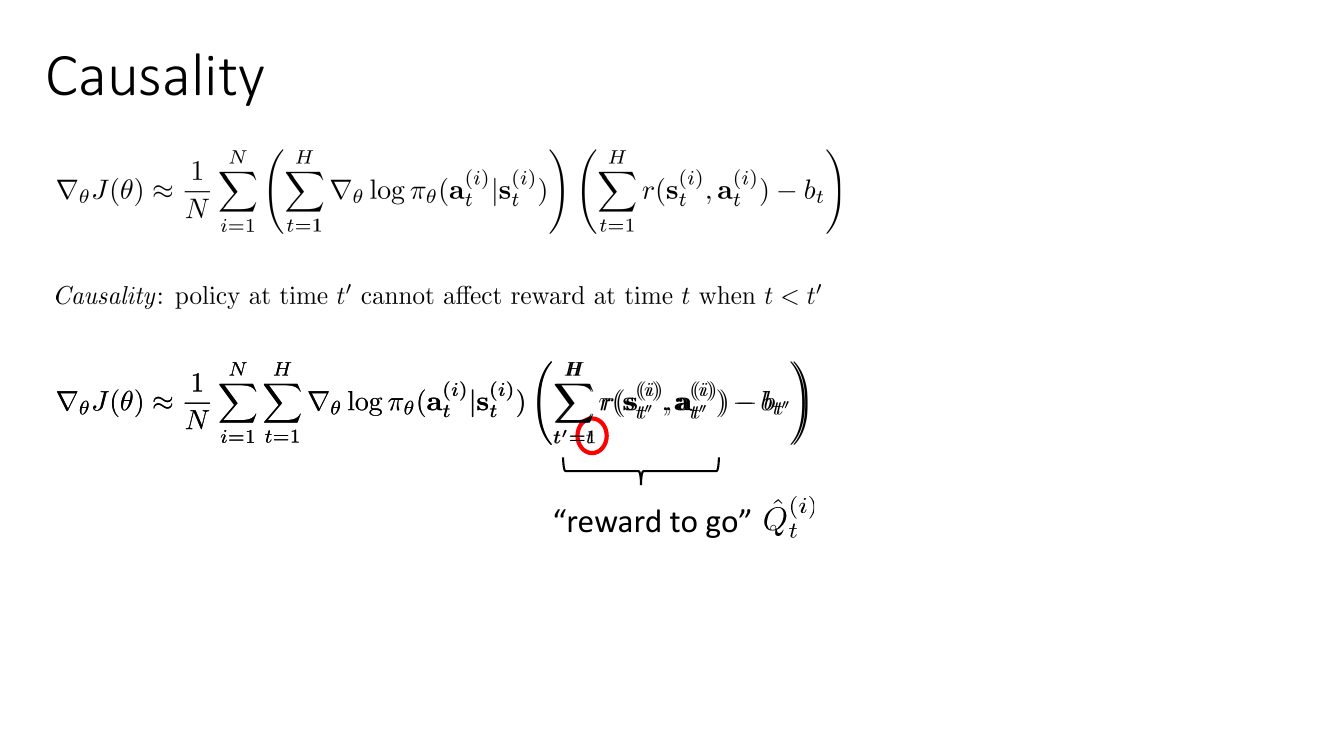
6.2 为什么方差会变小
把估计量写成 $X+Y$:$X$ 是保留下来的部分($t'\ge t$ 的交叉项之和),$Y$ 是被删掉的部分($t'\lt t$ 的交叉项之和),已证 $\E[Y]=0$。那么
$$ \mathrm{Var}(X+Y)=\mathrm{Var}(X)+\mathrm{Var}(Y)+2\,\mathrm{Cov}(X,Y) $$删掉 $Y$ 之后方差从 $\mathrm{Var}(X+Y)$ 变成 $\mathrm{Var}(X)$,所以只要 $\mathrm{Var}(Y)+2\mathrm{Cov}(X,Y)\gt 0$ 就是净赚。$Y$ 是纯噪声(均值为零、不携带任何梯度信号),而它与 $X$ 的相关性通常很弱,$\mathrm{Cov}(X,Y)\approx 0$,于是方差几乎必然下降 $\mathrm{Var}(Y)$ 那么多。(严格来说,如果 $Y$ 与 $X$ 强负相关,删掉它反而可能变差;但在实际的 MDP 里这种病态情形基本不出现,因此 reward-to-go 被当作「永远该做」的默认操作。)
再做个量级估计。设每步奖励是均值 $\mu$、标准差 $\sigma$ 的近似独立随机变量,$H=100$:
- 全轨迹回报 $\sum_{t'=1}^{100}r_{t'}$ 的标准差约为 $\sigma\sqrt{100}=10\sigma$;
- 从 $t=91$ 起的 reward-to-go 只含 10 项,标准差约为 $\sigma\sqrt{10}\approx3.2\sigma$——该项的方差降到原来的 $1/10$;
- 对所有 $t$ 平均,乘数的期望项数从 $H=100$ 降到 $(H+1)/2\approx50$,方差平均降为原来的一半左右。
如果奖励里含有一个由「初始状态运气」决定的、在整条轨迹上完全相同的成分,那它的方差贡献是 $O(H^2)$ 而不是 $O(H)$——这种成分 reward-to-go 是砍不掉的(它在每个 $t$ 之后依然存在),必须靠 baseline。
causality 在稀疏终局奖励下几乎没用。 上面的棋类例子里,奖励只在最后一步给出 $\pm1$,所以对每个 $t$,reward-to-go 都等于同一个 $\pm1$——什么也没砍掉。这解释了 slides 上「What is wrong with the policy gradient」那一页在讲完 causality 之后仍然把第一条(幸运/不幸的开局)单独红框圈出来:那一条只有 baseline 能治。所以两个技巧不是二选一,而是必须同时上。
顺带一提,$\hat Q_t^{(i)}=\sum_{t'=t}^{H}r(s_{t'}^{(i)},a_{t'}^{(i)})$ 这个记号不是随便取的:它正是真实的状态-动作值函数
$$ Q^\pi(s_t,a_t)=\E_{\tau\sim p_\theta(\cdot|s_t,a_t)}\left[\sum_{t'=t}^{H}r(s_{t'},a_{t'})\right] $$的一个单样本无偏估计。既然是单样本,方差自然大。下一讲 actor-critic 的全部动机就是:与其用一条轨迹的蒙特卡洛回报,不如训练一个神经网络去逼近 $Q^\pi$ 或 $V^\pi$,用它的输出替代 $\hat Q_t$——用一点点偏差换取巨大的方差削减。
7. 方差削减之二:baseline
7.1 想法与合法性
第 5 节的数值例子已经把动机摆出来了:奖励里那个 $+1000$ 的公共偏移毫无信息量,却贡献了几乎全部方差。自然的想法是把它减掉:
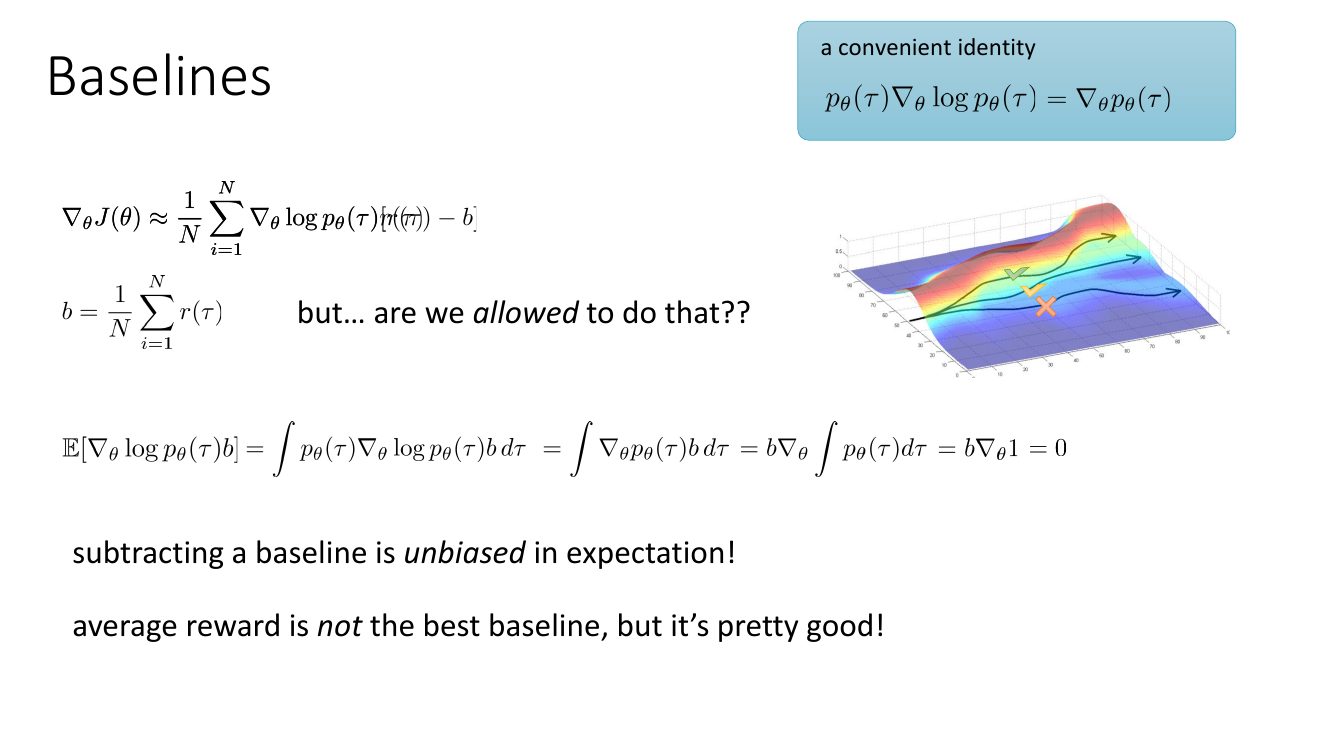
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\nabla_\theta\log p_\theta(\tau^{(i)})\big[r(\tau^{(i)})-b\big],\qquad b=\frac1N\sum_{i=1}^{N}r(\tau^{(i)}) $$直觉上非常合理:比平均水平好的轨迹被推高,比平均水平差的被压低。但 Levine 在 slides 上写了一句「but… are we allowed to do that??」——我们凭什么可以随便改动一个梯度估计量?
只要 $b$ 不依赖于轨迹 $\tau$(更一般地,不依赖于当前的动作),减去它对期望没有任何影响:
$$ \E_{\tau\sim p_\theta}\big[\nabla_\theta\log p_\theta(\tau)\,b\big] =\int p_\theta(\tau)\,\nabla_\theta\log p_\theta(\tau)\,b\;d\tau $$用 log-derivative 恒等式把 $p_\theta\nabla_\theta\log p_\theta$ 换成 $\nabla_\theta p_\theta$:
$$ =\int \nabla_\theta p_\theta(\tau)\,b\;d\tau = b\,\nabla_\theta\!\int p_\theta(\tau)\,d\tau = b\,\nabla_\theta 1 = 0 $$三步分别用了:恒等式、把常数 $b$ 和梯度算子提到积分外(交换积分与求导需要正则性条件,实际中恒成立)、概率密度归一化。因此
$$ \E\big[\nabla_\theta\log p_\theta(\tau)(r(\tau)-b)\big]=\E\big[\nabla_\theta\log p_\theta(\tau)\,r(\tau)\big]-0=\nabla_\theta J(\theta) $$期望完全不变,但方差可以差好几个数量级。$\blacksquare$
回到第 5 节的三臂例子,取 $b=1000$:三种情形的乘数变成 $0,+1,-1$,单样本梯度第 1 维的取值变成 $\{0,\,+0.333,\,-0.333\}$,标准差约 $0.27$,而真实梯度依然是 $(0,\frac13,-\frac13)$。标准差从 $471$ 降到 $0.27$,方差下降了约 $3\times10^6$ 倍,信噪比从 $1:1400$ 变成约 $1.2:1$。同一个算法、同一个无偏估计,只是减了个常数,样本需求量就从百万级降到个位数。
7.2 最优 baseline
既然任何与动作无关的 $b$ 都不引入偏差,那哪个 $b$ 让方差最小?把它当成一个一维优化问题解出来。记 $g(\tau)=\nabla_\theta\log p_\theta(\tau)$(先看某一个参数分量,所以 $g$ 是标量),估计量为 $g(\tau)(r(\tau)-b)$。
方差的定义:
$$ \mathrm{Var}=\E\big[g(\tau)^2(r(\tau)-b)^2\big]-\Big(\underbrace{\E\big[g(\tau)(r(\tau)-b)\big]}_{=\,\nabla_\theta J,\ \text{与}\,b\,\text{无关}}\Big)^{2} $$第二项因为无偏性而与 $b$ 无关,所以求导时它是常数,可以忽略。展开第一项:
$$ \E\big[g^2(r-b)^2\big]=\E\big[g^2r^2\big]-2b\,\E\big[g^2r\big]+b^2\,\E\big[g^2\big] $$这是关于 $b$ 的二次函数,且二次项系数 $\E[g^2]\gt 0$,所以有唯一极小值。对 $b$ 求导并令其为零:
$$ \frac{d\,\mathrm{Var}}{db}=-2\,\E\big[g^2r\big]+2b\,\E\big[g^2\big]=0 \quad\Longrightarrow\quad \boxed{\;b^\star=\frac{\E\big[g(\tau)^2\,r(\tau)\big]}{\E\big[g(\tau)^2\big]}\;} $$这就是 Levine 说的「average reward is not the best baseline」的确切含义:最优 baseline 不是回报的普通平均 $\E[r]$,而是用梯度模长平方 $g^2$ 加权的回报平均。$\blacksquare$
这个式子有很自然的解释:那些梯度幅度大的样本对最终估计的影响大,所以它们的回报在决定「基准线画在哪」时应该占更大权重。
但实践中几乎没人用 $b^\star$,原因有三,值得逐条说清楚:
- 它是逐参数分量的。 上面推导里 $g$ 是标量,即某一个参数的偏导。对 $\theta$ 的每一维都有不同的 $b^\star$。用第 5 节的三臂例子验算:第 1 维的 $g^2$ 是 $(\frac49,\frac19,\frac19)$,于是 $b^\star_1=\frac{(4/9)\cdot1000+(1/9)\cdot1001+(1/9)\cdot999}{4/9+1/9+1/9}=\frac{6000/9}{6/9}=1000.0$;第 2 维的 $g^2$ 是 $(\frac19,\frac49,\frac19)$,$b^\star_2=\frac{1000+4\cdot1001+999}{6}=1000.5$。两维的最优 baseline 不同。神经网络有上百万个参数,就得维护上百万个 baseline 统计量。
- 估计 $b^\star$ 本身有方差。 它需要估计 $\E[g^2r]$ 和 $\E[g^2]$ 两个二阶量,这些量的样本估计噪声很大,用一个噪声很大的 baseline 反而可能吃掉收益。
- 收益边际。 从「不减 baseline」到「减平均回报」是从 $10^6$ 倍方差降到 $1$ 倍的量级跃迁;从「平均回报」到「最优 baseline」通常只是几十个百分点的改善。上面例子中 $b^\star$ 和平均回报 $1000$ 只差 $0.5$。性价比完全不在一个层级。
所以标准做法是:用当前 batch 的平均回报(或按时间步的平均 reward-to-go $b_t$)作为 baseline。更进一步,用一个依赖状态的 baseline $b(s_t)\approx V^\pi(s_t)$——它仍然与动作无关,所以仍然无偏,但能把「初始状态运气」这种 reward-to-go 砍不掉的方差彻底消除。此时乘数变成
$$ \hat A_t=\hat Q_t-V^\pi(s_t)\approx A^\pi(s_t,a_t) $$也就是优势函数(advantage function):这个动作比该状态下的平均水平好多少。这正是下一讲 actor-critic 的入口。
「既然 $b$ 可以任意,那我用 $b(s_t,a_t)=Q(s_t,a_t)$ 岂不是方差为零?」——不行。 无偏性证明的关键一步是把 $b$ 提到对动作的积分外面:$\int\pi_\theta(a|s)\nabla_\theta\log\pi_\theta(a|s)\,b\,da=b\nabla_\theta\!\int\pi_\theta(a|s)da=0$。如果 $b$ 依赖 $a$,就提不出来,等式不成立,估计量变成有偏的。baseline 可以依赖状态、可以依赖时间步,但绝对不能依赖当前动作。(存在依赖动作的 baseline 方法,但必须额外加一个修正项来抵消引入的偏差;后续研究表明这类方法的实际收益远小于最初宣称的。)
7.3 把两个技巧合起来
最终的「vanilla policy gradient」长这样:
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\left(\underbrace{\sum_{t'=t}^{H}\gamma^{\,t'-t}r\!\left(s_{t'}^{(i)},a_{t'}^{(i)}\right)}_{\hat Q_t^{(i)}}-\;b_t\right) $$(这里顺手加上了折扣因子 $\gamma$,它在无限跨度任务中保证回报有界,同时也起到进一步削减方差的作用——远期奖励的权重被指数压低,而远期奖励恰恰是噪声最大的部分。$\gamma$ 的严格处理留到下一讲。)
| 乘数 $\hat A_t$ 的选择 | 是否无偏 | 方差 | 额外代价 |
|---|---|---|---|
| $\sum_{t'=1}^{H}r_{t'}$(全轨迹回报) | 无偏 | 极大 | 无 |
| $\sum_{t'=t}^{H}r_{t'}$(reward-to-go) | 无偏 | 大(约降一半,稀疏奖励下无改善) | 无 |
| $\hat Q_t-\bar b$(batch 平均常数) | 无偏 | 中(对奖励平移最有效) | 可忽略 |
| $\hat Q_t-b_t$(按时间步平均) | 无偏 | 中偏小 | 可忽略 |
| $\hat Q_t-V_\phi(s_t)$(学出来的 critic) | 无偏(若 $V$ 与动作无关) | 小 | 需训练一个值网络 → 下一讲 |
| $r_t+\gamma V_\phi(s_{t+1})-V_\phi(s_t)$(TD 残差) | 有偏($V_\phi$ 不准时) | 很小 | 下一讲 / GAE |
| $b^\star=\E[g^2r]/\E[g^2]$ | 无偏 | 理论最小 | 每个参数一份统计量,不实用 |
8. off-policy 策略梯度与重要性采样
8.1 动机:on-policy 太浪费
第 2.4 节已经点出:$\nabla_\theta J(\theta)=\E_{\tau\sim p_\theta(\tau)}[\cdots]$ 中的期望是对当前策略取的,所以每次参数更新后旧数据就作废。神经网络的梯度上升每步只能走很小一步,于是「采一大批样本 → 只走一小步 → 全部扔掉」,样本效率低得惊人。有没有办法在旧策略 $\pi_{\theta}$ 采的数据上,评估新策略 $\pi_{\theta'}$ 的梯度?
8.2 重要性采样恒等式
重要性采样(importance sampling, IS)是概率论里的老工具:想算 $\E_{x\sim p}[f(x)]$ 却只有 $q$ 的样本时,
$$ \E_{x\sim p}[f(x)]=\int p(x)f(x)dx=\int q(x)\frac{p(x)}{q(x)}f(x)dx=\E_{x\sim q}\left[\frac{p(x)}{q(x)}f(x)\right] $$只要 $q(x)\gt0$ 处处成立($p$ 的支撑被 $q$ 覆盖)。套到轨迹上:
$$ J(\theta')=\E_{\tau\sim p_{\theta}(\tau)}\left[\frac{p_{\theta'}(\tau)}{p_{\theta}(\tau)}\,r(\tau)\right] $$现在来看那个权重 $\frac{p_{\theta'}(\tau)}{p_{\theta}(\tau)}$。把两个轨迹分布都展开:
$$ \frac{p_{\theta'}(\tau)}{p_{\theta}(\tau)} =\frac{\cancel{p(s_1)}\prod_{t=1}^{H}\pi_{\theta'}(a_t|s_t)\,\cancel{p(s_{t+1}|s_t,a_t)}}{\cancel{p(s_1)}\prod_{t=1}^{H}\pi_{\theta}(a_t|s_t)\,\cancel{p(s_{t+1}|s_t,a_t)}} =\prod_{t=1}^{H}\frac{\pi_{\theta'}(a_t|s_t)}{\pi_{\theta}(a_t|s_t)} $$环境动力学又一次完整地约掉了。 这是本讲第二次看到同样的机制:因为分子分母共享同一个环境,环境项在比值里消失,在 log 里求导后消失。IS 权重只由策略决定,完全可计算。
对 $\theta'$ 求梯度(注意 $\nabla_{\theta'}p_{\theta'}(\tau)=p_{\theta'}(\tau)\nabla_{\theta'}\log p_{\theta'}(\tau)$,还是那个恒等式):
$$ \nabla_{\theta'}J(\theta')=\E_{\tau\sim p_{\theta}(\tau)}\left[\frac{p_{\theta'}(\tau)}{p_{\theta}(\tau)}\,\nabla_{\theta'}\log p_{\theta'}(\tau)\,r(\tau)\right] $$令 $\theta'=\theta$ 时权重变为 $1$,退化回原来的 on-policy 策略梯度——自洽。
8.3 为什么它会随 $H$ 指数爆炸
IS 在理论上无偏,但方差可以坏到无法使用。核心问题是权重是 $H$ 个比值的连乘。做个定量分析:假设各步的比值 $w_t=\pi_{\theta'}(a_t|s_t)/\pi_\theta(a_t|s_t)$ 近似独立,且满足 $\E[w_t]=1$(这是 IS 权重的固有性质)、$\mathrm{Var}(w_t)=\sigma^2$。那么连乘 $W=\prod_{t=1}^{H}w_t$ 的二阶矩为
$$ \E[W^2]=\prod_{t=1}^{H}\E[w_t^2]=\big(1+\sigma^2\big)^{H},\qquad \mathrm{Var}(W)=(1+\sigma^2)^H-1 $$方差随 $H$ 指数增长。 代具体数字:设新旧策略只有轻微差别,使得每步的比值以各 $1/2$ 概率取 $0.5$ 或 $1.5$(均值恰为 $1$,$\E[w^2]=1.25$,$\sigma^2=0.25$)。这已经是非常接近的两个策略了。取 $H=100$:
$$ \E[W^2]=1.25^{100}=e^{100\ln 1.25}=e^{22.3}\approx 4.9\times10^{9},\qquad \mathrm{std}(W)\approx 7\times10^{4} $$权重的标准差是其均值的 7 万倍。实际发生的现象是:绝大多数轨迹的权重被压到接近 $0$(因为 $\log W=\sum\log w_t$ 按大数定律趋向 $H\,\E[\log w]\lt 0$),而极个别轨迹拿到天文数字的权重。于是 $N$ 条样本里真正起作用的可能只有一条——这叫「有效样本量塌缩」。$H=1000$ 时更是彻底没救。
这里有个反直觉之处:$\E[W]=1$ 恒成立,但 $W$ 的中位数随 $H$ 指数趋于 $0$。也就是说你采 1000 条轨迹,可能 999 条的权重都是 $10^{-6}$ 量级,剩下 1 条是 $10^{3}$ 量级。这类估计量虽然无偏,但在任何实际样本量下都完全不可用。「无偏」和「有用」是两回事,这是整个 off-policy RL 反复出现的教训。
8.4 用因果性把连乘拆开,再砍掉一半
把 $\nabla_{\theta'}\log p_{\theta'}(\tau)=\sum_t\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t)$ 展开,并同时应用第 6 节的因果性(时刻 $t$ 的动作只影响 $t$ 及之后的奖励),可以把整体权重 $\prod_{t=1}^H w_t$ 按时间切成两段:
$$ \nabla_{\theta'}J(\theta')=\E_{\tau\sim p_\theta}\left[\sum_{t=1}^{H}\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t) \underbrace{\left(\prod_{t'=1}^{t}\frac{\pi_{\theta'}(a_{t'}|s_{t'})}{\pi_{\theta}(a_{t'}|s_{t'})}\right)}_{\text{(A) 到达 }s_t\text{ 的概率修正}} \left(\sum_{t''=t}^{H}r(s_{t''},a_{t''})\underbrace{\prod_{t'''=t+1}^{t''}\frac{\pi_{\theta'}(a_{t'''}|s_{t'''})}{\pi_{\theta}(a_{t'''}|s_{t'''})}}_{\text{(B) 未来奖励的概率修正}}\right)\right] $$两段的含义完全不同:
- (A) 修正的是「新策略有多大概率走到 $(s_t,a_t)$ 这个位置」——即状态访问分布的差异。
- (B) 修正的是「在 $(s_t,a_t)$ 之后,新策略能拿到多少未来奖励」。
关键观察:如果把 (B) 整段丢掉,得到的估计量虽然有偏,但可以证明它对应的是一个策略改进的下界(这是 TRPO 那一支理论的出发点,第 9 讲会展开)。丢掉 (B) 后:
$$ \nabla_{\theta'}J(\theta')\approx\E_{\tau\sim p_\theta}\left[\sum_{t=1}^{H}\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t)\left(\prod_{t'=1}^{t}\frac{\pi_{\theta'}(a_{t'}|s_{t'})}{\pi_{\theta}(a_{t'}|s_{t'})}\right)\hat Q_t\right] $$8.5 从连乘到 per-step 比值
剩下的 (A) 依然是个长度为 $t$ 的连乘,$t$ 大时照样爆炸。最后一步近似是把轨迹级的期望改写成状态-动作边缘分布上的期望。记 $p_{\theta'}(s_t)$ 为新策略在 $t$ 时刻的状态边缘分布,则
$$ \nabla_{\theta'}J(\theta')=\sum_{t=1}^{H}\E_{s_t\sim p_{\theta}(s_t)}\left[\frac{p_{\theta'}(s_t)}{p_{\theta}(s_t)}\E_{a_t\sim\pi_\theta(\cdot|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_{\theta}(a_t|s_t)}\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t)\,\hat Q_t\right]\right] $$其中的状态边缘比值 $p_{\theta'}(s_t)/p_{\theta}(s_t)$ 我们既算不出也估不准(它依赖环境动力学)。直接把它近似为 $1$,就得到实践中真正使用的 per-step 形式:
$$ \nabla_{\theta'}J(\theta')\approx\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H}\frac{\pi_{\theta'}\!\left(a_t^{(i)}|s_t^{(i)}\right)}{\pi_{\theta}\!\left(a_t^{(i)}|s_t^{(i)}\right)}\nabla_{\theta'}\log\pi_{\theta'}\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\hat A_t^{(i)} $$现在每个时刻只有一个比值,不再连乘,方差是可控的。代价是引入了偏差——这个近似只在 $\pi_{\theta'}$ 与 $\pi_\theta$ 足够接近时才靠谱。如何量化「足够接近」并强制它成立,就是 TRPO(KL 约束)和 PPO(比值裁剪)要解决的问题。 这也解释了为什么 PPO 的目标函数长成 $\min\big(\rho_t\hat A_t,\ \mathrm{clip}(\rho_t,1-\epsilon,1+\epsilon)\hat A_t\big)$ 的样子:$\rho_t$ 就是上面这个 per-step 比值,clip 就是在强行阻止新旧策略偏离太远。
# per-step importance sampling 的最小写法(PPO 目标的核心)
# logp_old: 采样时记录下的 log pi_theta(a|s),已 detach
# logp_new: 用当前参数重新前向算出的 log pi_theta'(a|s)
# adv:      优势估计,已 detach

ratio = torch.exp(logp_new - logp_old)          # rho_t,数值上比直接除法稳定
surr1 = ratio * adv
surr2 = torch.clamp(ratio, 1 - eps, 1 + eps) * adv   # eps 常取 0.2
loss  = -torch.min(surr1, surr2).mean()         # 取 min = 保守的下界

# 若不做 clip,就是纯 off-policy 策略梯度:loss = -(ratio * adv).mean()
# 一旦 theta' 跑远,ratio 会指数放大,梯度爆炸| on-policy 策略梯度 | 轨迹级 IS | per-step IS(PPO 式) | |
|---|---|---|---|
| 数据可否复用 | 不可,一步一扔 | 可 | 可(通常复用 4–10 个 epoch) |
| 是否无偏 | 无偏 | 无偏 | 有偏(丢掉了状态分布比值与未来权重) |
| 方差随 $H$ 的行为 | 约 $O(H^2)$ | $O\big((1+\sigma^2)^H\big)$ 指数爆炸 | 与 on-policy 同量级 |
| 需要额外约束吗 | 不需要 | 不需要(但没法用) | 需要:KL 惩罚或 ratio 裁剪 |
| 代表算法 | REINFORCE、vanilla PG、A2C | (理论工具) | TRPO、PPO、RLHF 微调 |
9. 用自动微分实现:伪损失
9.1 问题:框架只会对 loss 反向传播
手上的公式是
$$ \nabla_\theta J(\theta)\approx\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\hat Q_t^{(i)} $$如果照字面实现——对每个 $(i,t)$ 单独反传一次拿到梯度向量,再乘以标量 $\hat Q_t^{(i)}$,再求和——那就要做 $N\times H$ 次反向传播,而且要显式存下 $N\times H$ 个和网络参数一样大的梯度向量。对一个百万参数的网络、$N\times H=10^4$ 的 batch,这是 $10^{10}$ 个浮点数。Levine 在 slides 上的批注是「pretty inefficient to compute these explicitly!」
正确做法是构造一个标量函数,使它的梯度恰好等于策略梯度,然后让框架一次性反传。回忆最大似然:
$$ J_{\mathrm{ML}}(\theta)=\frac1N\sum_{i}\sum_{t}\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right) \quad\Longrightarrow\quad \nabla_\theta J_{\mathrm{ML}}(\theta)=\frac1N\sum_{i}\sum_{t}\nabla_\theta\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right) $$那么只要在每一项上乘一个被视作常数的权重 $\hat Q_t^{(i)}$,就得到伪损失(pseudo-loss):
$$ \tilde J(\theta)=\frac1N\sum_{i=1}^{N}\sum_{t=1}^{H}\log\pi_\theta\!\left(a_t^{(i)}\big|s_t^{(i)}\right)\hat Q_t^{(i)} \quad\Longrightarrow\quad \nabla_\theta\tilde J(\theta)=\nabla_\theta J(\theta) $$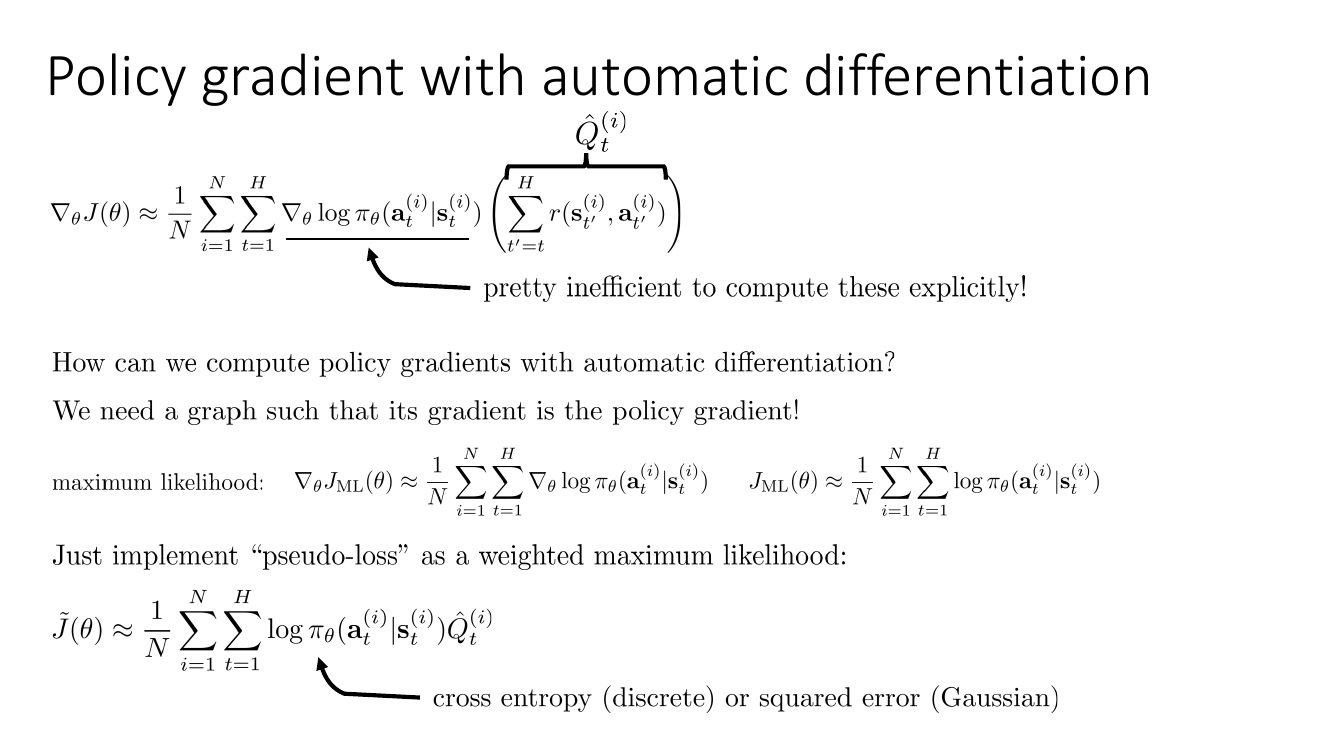
9.2 离散动作:加权交叉熵
先看最大似然版本。对离散动作,$\log\pi_\theta(a|s)$ 就是 softmax 输出的对数概率,而「负对数概率」正是交叉熵(cross entropy):
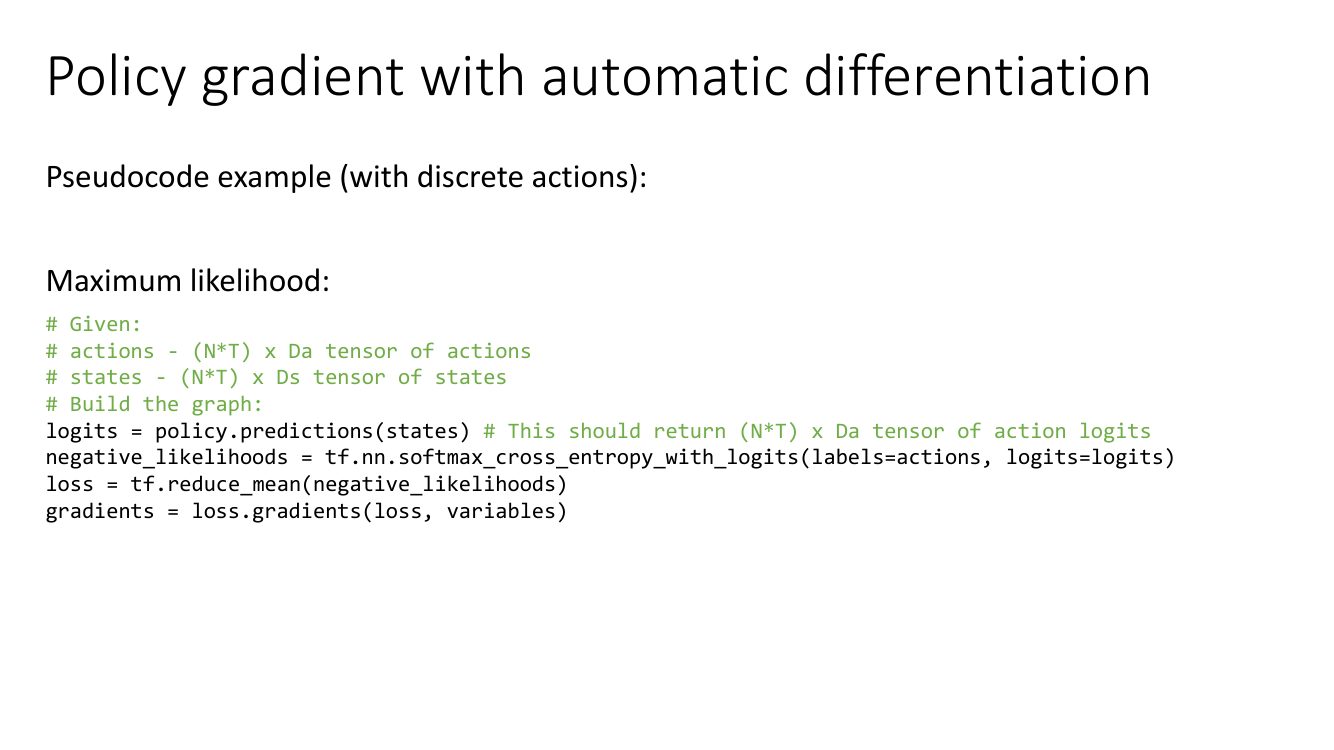
softmax_cross_entropy_with_logits 得到每个样本的负对数似然,取平均作为 loss,再求梯度。这就是一个标准的分类训练循环——注意此处 actions 扮演的是分类标签的角色。策略梯度版本只需要在取平均之前,把每个样本的负对数似然乘上它的 $\hat Q$:
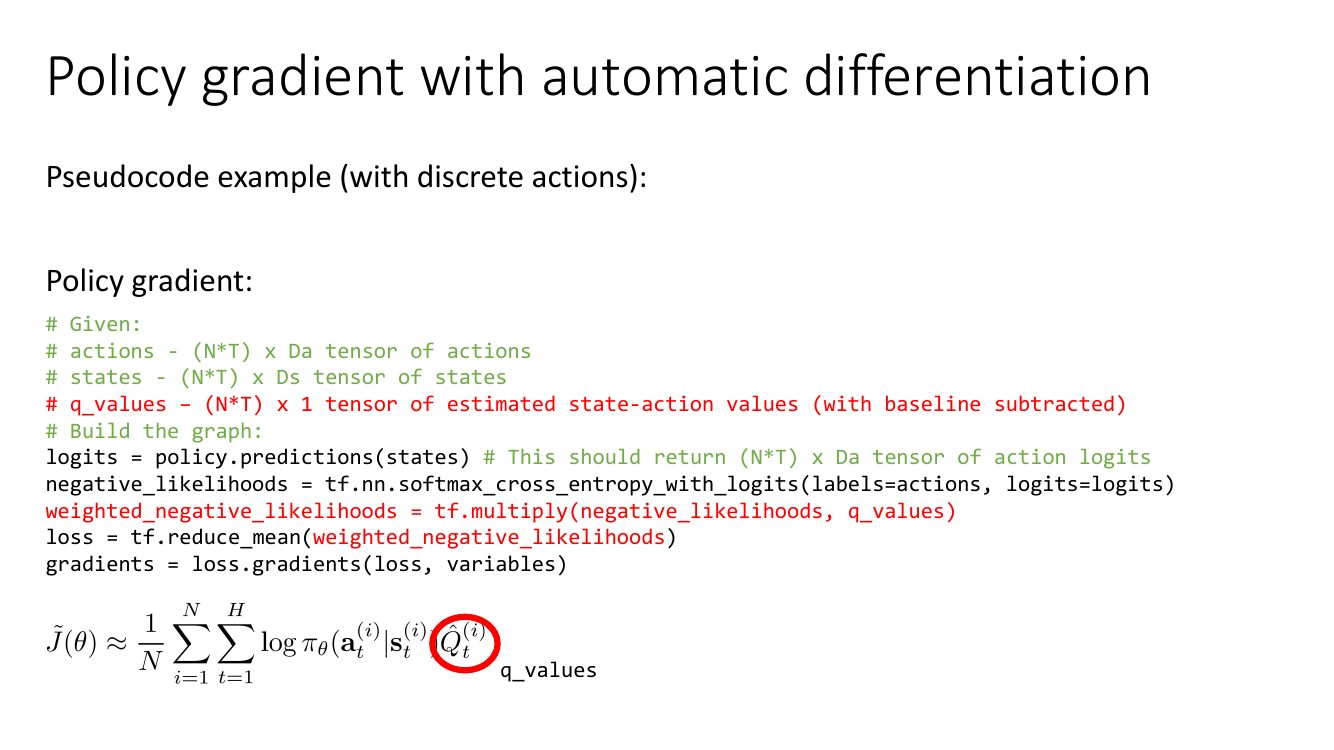
q_values(形状 (N*T) x 1 的状态-动作值估计,已经减过 baseline),多了一行 tf.multiply(negative_likelihoods, q_values),然后对加权后的量取平均。底部公式用红圈标出 $\hat Q_t^{(i)}$ 对应代码里的 q_values。从行为克隆改成策略梯度,只需要改两行代码——这再次印证了第 3 节「策略梯度 = 加权最大似然」的说法。- $\hat Q$ 必须 detach。 $\hat Q_t$ 在数学上是被当作常数的(推导里它来自采样得到的奖励)。如果你的 $\hat Q$ 是由某个网络算出来的(下一讲的 critic),一定要
.detach(),否则梯度会顺着 $\hat Q$ 流回去,得到的东西不再是策略梯度。 - 取平均前先乘权重。 必须用
reduction='none'拿到逐样本的对数似然,乘上权重之后再mean()。先 mean 再乘就完全错了。 - 符号。 我们要最大化 $\tilde J$,而框架的优化器是最小化,所以代码里的 loss 应该是 $-\tilde J$。
9.3 连续动作:加权平方误差
对高斯策略,$\log\pi_\theta(a|s)=-\frac12\|f_\theta(s)-a\|_\Sigma^2+\text{const}$,所以伪损失就是加权的平方误差回归:把每个样本的回归损失乘上 $\hat Q_t$。同样地,最大似然版本=普通回归=行为克隆,策略梯度版本=加权回归。
9.4 完整的 PyTorch 最小实现
下面是一份可以直接读懂的 vanilla policy gradient:带 reward-to-go、带 batch 平均 baseline、离散与连续两种策略都给出。
import math
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import gymnasium as gym


def mlp(sizes, act=nn.Tanh, out_act=nn.Identity):
    layers = []
    for i in range(len(sizes) - 1):
        layers.append(nn.Linear(sizes[i], sizes[i + 1]))
        layers.append(act() if i < len(sizes) - 2 else out_act())
    return nn.Sequential(*layers)


class CategoricalPolicy(nn.Module):
    """离散动作:网络输出 logits;log pi 用 -cross_entropy 直接拿到。"""

    def __init__(self, obs_dim, n_act, hidden=64):
        super().__init__()
        self.net = mlp([obs_dim, hidden, hidden, n_act])

    def log_prob(self, obs, act):
        # obs: (B, obs_dim) float32 ; act: (B,) int64
        logits = self.net(obs)                                   # (B, n_act)
        return -F.cross_entropy(logits, act, reduction='none')   # (B,) = log pi

    @torch.no_grad()
    def sample(self, obs):
        logits = self.net(obs.unsqueeze(0))
        return int(torch.distributions.Categorical(logits=logits).sample())


class GaussianPolicy(nn.Module):
    """连续动作:网络输出均值,log_std 为与状态无关的可训练参数(对角高斯)。"""

    def __init__(self, obs_dim, act_dim, hidden=64):
        super().__init__()
        self.mu_net = mlp([obs_dim, hidden, hidden, act_dim])
        self.log_std = nn.Parameter(-0.5 * torch.ones(act_dim))

    def log_prob(self, obs, act):
        # obs: (B, obs_dim) ; act: (B, act_dim)
        mu = self.mu_net(obs)
        std = self.log_std.exp()
        z = (act - mu) / std
        # -1/2 * ||f(s)-a||^2_Sigma + const,逐维求和
        return (-0.5 * z.pow(2) - self.log_std - 0.5 * math.log(2 * math.pi)).sum(-1)

    @torch.no_grad()
    def sample(self, obs):
        mu = self.mu_net(obs.unsqueeze(0))[0]
        return (mu + self.log_std.exp() * torch.randn_like(mu)).numpy()


def reward_to_go(rews, gamma=1.0):
    """把一条轨迹的即时奖励序列转成 reward-to-go:out[t] = sum_{t'>=t} gamma^(t'-t) r[t']"""
    out = np.zeros(len(rews), dtype=np.float32)
    running = 0.0
    for t in reversed(range(len(rews))):
        running = rews[t] + gamma * running
        out[t] = running
    return out


def train(env_name='CartPole-v1', epochs=100, batch_steps=5000, lr=1e-2, gamma=0.99):
    env = gym.make(env_name)
    obs_dim = env.observation_space.shape[0]
    pi = CategoricalPolicy(obs_dim, env.action_space.n)
    opt = torch.optim.Adam(pi.parameters(), lr=lr)

    for epoch in range(epochs):
        # ---------- 1. 采样:跑当前策略,凑够 batch_steps 个 transition ----------
        obs_buf, act_buf, q_buf, ep_rets = [], [], [], []
        obs, _ = env.reset()
        ep_obs, ep_act, ep_rew = [], [], []

        while True:
            o = torch.as_tensor(obs, dtype=torch.float32)
            a = pi.sample(o)
            nxt_obs, r, terminated, truncated, _ = env.step(a)

            ep_obs.append(obs); ep_act.append(a); ep_rew.append(r)
            obs = nxt_obs

            if terminated or truncated:
                # 一条轨迹结束才能算 reward-to-go
                q_buf.append(reward_to_go(ep_rew, gamma))
                obs_buf.extend(ep_obs); act_buf.extend(ep_act)
                ep_rets.append(sum(ep_rew))
                obs, _ = env.reset()
                ep_obs, ep_act, ep_rew = [], [], []
                if len(obs_buf) >= batch_steps:
                    break

        obs_t = torch.as_tensor(np.array(obs_buf), dtype=torch.float32)
        act_t = torch.as_tensor(np.array(act_buf), dtype=torch.int64)
        q_t   = torch.as_tensor(np.concatenate(q_buf), dtype=torch.float32)

        # ---------- 2. baseline:整批的平均 reward-to-go,再做标准化 ----------
        adv = q_t - q_t.mean()                 # 减 baseline:无偏,砍掉常数偏移带来的方差
        adv = adv / (adv.std() + 1e-8)         # 标准化:让梯度尺度与奖励量纲脱钩
        adv = adv.detach()                     # 绝不让梯度流回权重

        # ---------- 3. 伪损失,交给 autograd ----------
        logp = pi.log_prob(obs_t, act_t)       # (B,)
        loss = -(logp * adv).mean()            # 负号:优化器最小化,我们要最大化 J~

        opt.zero_grad()
        loss.backward()
        opt.step()

        print(f'epoch {epoch:3d} | avg return {np.mean(ep_rets):7.1f} '
              f'| episodes {len(ep_rets):3d} | pseudo-loss {loss.item():+.3f}')


if __name__ == '__main__':
train()不要盯着 pseudo-loss 的数值判断训练好坏。 打印出来你会看到它在 $0$ 附近随机跳动,甚至和回报的走势毫无关系。原因在第 3 节说过:$\tilde J(\theta)$ 只在采样时那个 $\theta$ 处的梯度有意义,它的函数值不是 $J(\theta)$、不是 $J$ 的下界、也不是任何有意义的量。事实上,由于 adv 被标准化成了零均值,$\tilde J$ 的期望值天然就在 $0$ 附近。唯一该监控的指标是平均回报(外加策略熵、KL 变化量、梯度范数这些诊断量)。
关于代码里的两个实践技巧再补充一句:
- 优势标准化(除以 batch 内标准差)严格说来引入了偏差,因为标准差是从同一批样本估出来的,与分子相关。但它的实际价值极大:它让梯度的尺度与奖励的量纲解耦,从而使同一个学习率能在「奖励范围是 $[0,1]$」和「奖励范围是 $[-1000,1000]$」的两个任务上都工作。几乎所有开源实现都开着它。
- 轨迹必须跑完再算 reward-to-go。代码里在
terminated or truncated时才调用reward_to_go,并且if len(obs_buf) >= batch_steps: break也只在轨迹边界检查,保证不会截断出半条轨迹。如果任务被truncated(到达时间上限而非真正终止)打断,严格做法是用一个值函数给尾部「bootstrap」一个估计值,否则会系统性低估长期回报——这属于下一讲的内容。
10. 实践中的策略梯度
10.1 「这不是监督学习」
这句话值得展开。监督学习里,一个 batch 的梯度和全数据集梯度的方向通常高度一致,你用 batch size 32 就能训练;即使梯度有噪声,噪声也常常起正则化作用。策略梯度完全不同:
- 梯度的信噪比可能远小于 1(第 5 节的例子里是 $1:1400$)。单个 batch 的梯度方向可能和真实梯度方向成钝角。
- 数据分布随参数移动。你不是在一个固定的数据集上做优化,而是在优化一个「其数据由自己产生」的目标。参数走错一步,下一批数据也跟着变差,可能引发不可逆的性能崩塌。
- 没有验证集可言。你无法「早停」,因为唯一的评价指标(回报)本身也是高方差的采样估计。
10.2 用大 batch
既然噪声是主要敌人,而蒙特卡洛误差按 $1/\sqrt N$ 下降,最直接的对策就是加大 batch。监督学习里 batch size 32–256 是常态,策略梯度里 5000–100000 个环境步是常态,某些大规模工作会用到百万级。这也是为什么策略梯度研究几乎都在模拟器里做:只有模拟器能并行开几千个环境实例来喂饱它。
值得注意的取舍是:给定固定的总交互预算,「大 batch × 少更新次数」和「小 batch × 多更新次数」哪个好?对策略梯度,答案通常偏向前者,因为小 batch 下的梯度方向可能根本是错的,多走几步只是在随机游走。
10.3 学习率为什么这么难调
Levine 说「Tweaking learning rates is very hard」,背后有个结构性的原因,值得先埋个伏笔:参数空间中一步固定大小的移动,在策略空间(分布空间)里可能对应天差地别的变化。
举个具体例子。设一维连续动作的高斯策略 $\pi_\theta(a|s)=\mathcal N(\theta_1 s,\ \sigma^2)$,$\sigma$ 也是可学习的。当 $\sigma$ 已经收缩到 $0.01$ 时,$\theta_1$ 变化 $0.1$ 会让动作分布几乎完全不重叠(KL 散度巨大);而当 $\sigma=10$ 时,同样的 $0.1$ 变化几乎什么都没改变。也就是说,同一个学习率在训练的不同阶段、在参数的不同分量上,其「实际效果」相差好几个数量级。 学习率太大 → 策略一步跳到一个糟糕区域,采集到的新数据全是垃圾,无法恢复;太小 → 训练慢到不可接受。
Adam 这类自适应方法能部分缓解(它按每个参数的历史梯度幅度自动缩放步长),所以 Levine 说「can be OK-ish」——够用但不够好。真正的解法是不在参数空间而在分布空间度量步长:用 KL 散度约束每次更新,这就是自然策略梯度(natural policy gradient)、TRPO、PPO 的思路,第 9 讲会详细讲。
- 回报不动? 先确认 baseline 减了、reward-to-go 用了、优势做了标准化。这三样任缺其一都可能让训练看起来「完全没在学」。
- 训到一半崩掉? 大概率是学习率太大,或者策略熵塌缩到 0(策略变得确定性,不再探索)。可以打印策略熵;必要时加一个熵正则项 $+\beta\,\mathcal H(\pi_\theta(\cdot|s))$。
- 方差诊断。 打印梯度范数在 batch 内的波动、优势的标准差。如果优势的标准差远大于其均值的绝对值,说明你正处在低信噪比区间,该加大 batch。
- 先验证实现正确性。 在一个 $H=1$ 的老虎机或 $H$ 很小的玩具环境上跑,那里可以解析地算出真实梯度,用来核对你的实现。
- 随机种子。 策略梯度对种子极其敏感,报结果时必须跑多个种子并给出区间;单种子的曲线基本没有说服力。
本讲小结
把整讲压缩成一条推理链:
- 目标 $J(\theta)=\E_{\tau\sim p_\theta(\tau)}[r(\tau)]$ 中 $\theta$ 在分布里,不能直接反传。
- 用 log-derivative trick $\nabla p=p\nabla\log p$,把「对分布求导」翻译成「在分布下求期望」。
- 展开 $\log p_\theta(\tau)$,$p(s_1)$ 与 $p(s_{t+1}|s_t,a_t)$ 不含 $\theta$,梯度为零,环境彻底消失 → model-free。
- 得到 REINFORCE,本质是按回报加权的最大似然,即「试错」的形式化。
- 推导没用马尔可夫性 → 部分可观测下可直接用 $\pi_\theta(a|o)$。
- 它方差极大 → 用 reward-to-go(砍掉期望为零的过去奖励项)和 baseline(减去与动作无关的量,期望不变)压方差。
- 它是 on-policy 的 → 用 importance sampling 可以复用旧数据,但轨迹级权重连乘随 $H$ 指数爆炸,必须近似成 per-step 比值(→ PPO)。
- 实现上构造伪损失 $\tilde J=\frac1N\sum\log\pi_\theta\cdot\hat A$ 交给 autograd;离散=加权交叉熵,连续=加权平方误差。
- 实践上:大 batch、学习率难调、只看回报不看 loss。
一页速查表
| 概念 | 公式 | 一句话 |
|---|---|---|
| 轨迹分布 | $p_\theta(\tau)=p(s_1)\prod_t\pi_\theta(a_t|s_t)p(s_{t+1}|s_t,a_t)$ | 只有中间一项含 $\theta$ |
| log-derivative | $p_\theta\nabla_\theta\log p_\theta=\nabla_\theta p_\theta$ | 本讲唯一的技术机关,用了三次 |
| score 零均值 | $\E_{a\sim\pi_\theta}[\nabla_\theta\log\pi_\theta(a|s)]=0$ | causality 与 baseline 无偏性的共同基础 |
| 策略梯度 | $\nabla_\theta J=\E\big[\sum_t\nabla_\theta\log\pi_\theta(a_t|s_t)\,\hat A_t\big]$ | 加权最大似然 |
| reward-to-go | $\hat Q_t=\sum_{t'\ge t}\gamma^{t'-t}r_{t'}$ | 未来的动作影响不了过去的奖励 |
| baseline 无偏 | $\E[\nabla_\theta\log p_\theta(\tau)\,b]=b\nabla_\theta 1=0$ | $b$ 可依赖 $s$、$t$,绝不能依赖 $a$ |
| 最优 baseline | $b^\star=\E[g^2r]/\E[g^2]$ | 梯度模长加权的平均回报;实践用普通平均 |
| IS 权重 | $\frac{p_{\theta'}(\tau)}{p_\theta(\tau)}=\prod_t\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}$ | 环境再次约掉;但方差 $\propto(1+\sigma^2)^H$ |
| 伪损失 | $\tilde J=\frac1N\sum_i\sum_t\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\hat A_t^{(i)}$ | 只有梯度有意义,数值无意义 |
留给下一讲的三个悬念
- $\hat Q_t$ 是 $Q^\pi(s_t,a_t)$ 的单样本估计,方差仍然很大。能不能训练一个网络去逼近它?→ actor-critic。
- 最好的 baseline 是依赖状态的 $V^\pi(s_t)$,此时乘数变成优势函数 $A^\pi(s_t,a_t)$。怎么学 $V^\pi$?用蒙特卡洛还是自举(bootstrapping)?偏差与方差怎么权衡?→ actor-critic + GAE。
- 学习率难调的根源是「参数空间的距离 ≠ 策略空间的距离」。怎么在分布空间里定义步长?→ 自然梯度、TRPO、PPO。
延伸阅读
经典原始文献
- Williams, "Simple statistical gradient-following algorithms for connectionist reinforcement learning" (1992) — REINFORCE 的原始论文,本讲第 2 节推导的出处;里面也已经讨论了 baseline。
- Sutton, McAllester, Singh & Mansour, "Policy Gradient Methods for Reinforcement Learning with Function Approximation" (2000) — 策略梯度定理的现代形式,把 REINFORCE 推广到带函数逼近的值函数(即 actor-critic 的理论基础),是理解下一讲的最佳前置阅读。
- Baxter & Bartlett, "Infinite-Horizon Policy-Gradient Estimation" (2001) — GPOMDP 算法,系统分析了 causality/reward-to-go 与折扣因子对偏差-方差的影响。
- Kakade, "A Natural Policy Gradient" (2001) — 第 10.3 节埋的伏笔:把步长定义在分布空间而非参数空间,TRPO 的直接前身。
- Peters & Schaal, "Reinforcement learning of motor skills with policy gradients" (2008) — 从机器人控制视角总结策略梯度的各种变体与实践经验,对理解「为什么高斯策略这么常用」很有帮助。
方差削减与现代算法
- High-Dimensional Continuous Control Using Generalized Advantage Estimation (GAE, 2015) — 把本讲的 baseline 思路推到极致:用 $\lambda$ 在「纯蒙特卡洛(无偏高方差)」和「纯自举(有偏低方差)」之间连续插值,是当今几乎所有 PPO 实现的标配。
- Trust Region Policy Optimization (TRPO, 2015) — 第 8 节丢掉的那两项近似究竟带来多少误差?TRPO 给出了严格的界,并用 KL 约束控制它。
- Proximal Policy Optimization (PPO, 2017) — 把 TRPO 的约束换成 per-step 比值裁剪,正是第 8.5 节代码片段的来源;目前工业界(含 RLHF)的默认算法。
- Q-Prop: Sample-Efficient Policy Gradient with An Off-Policy Critic (2016) — 尝试用依赖动作的控制变量(加修正项保持无偏)进一步降方差。
- The Mirage of Action-Dependent Baselines in Reinforcement Learning (2018) — 对上一条这类方法的严肃复核,结论是收益大多来自实现细节而非理论机制。读它是为了学会怎样怀疑一个「方差削减」的宣称。
实证与实现
- Benchmarking Deep Reinforcement Learning for Continuous Control (2016) — 系统比较了 REINFORCE、TRPO 等在连续控制任务上的表现,可以看到 vanilla 策略梯度到底有多慢。
- Deep Reinforcement Learning that Matters (2017) — 论证了策略梯度方法对随机种子、超参数、代码实现的极端敏感性,是第 10.3 节调试清单里「必须多种子」那条的实证依据。
- What Matters In On-Policy Reinforcement Learning? A Large-Scale Empirical Study (2020) — 对优势标准化、初始化、学习率等几十个实现细节做了大规模消融,是把本讲代码调到「真能跑」的实用手册。