多任务与分层强化学习
把「很多任务」压进一个 MDP:上下文策略、目标条件 RL 与后见重标注、继承表示、options 与目标下发型分层,以及把元学习看成 POMDP 推断。
0. 本讲导读
到目前为止,这门课里的每一个算法——策略梯度、actor-critic、Q-learning、基于模型的规划、 离线 RL——都默认了一件事:有一个固定的奖励函数 $r(s,a)$,我们要把它最大化。 可是现实里几乎没有「一个任务」这种东西。一个家用机器人要会开抽屉、会倒水、会叠衣服; 一个语言模型 agent 要会订机票、会写代码、会查资料。逐个任务从零跑一遍 RL, 既要为每个任务手写一个奖励函数,又要为每个任务重新烧掉几百万步交互,显然不可行。
另一边,监督学习那边已经给出了答案:通才模型(generalist model)。 不再为分割、分类、描述、问答各训一个模型,而是训一个通用的基础模型, 再靠微调(finetuning)或提示(prompting)得到你要的那个模型。 之所以能这样,核心是多任务学习(multi-task learning):同时在很多任务上训练, 让每个单独任务所需的数据量大幅下降。这一讲就是问:RL 能不能也这么干?
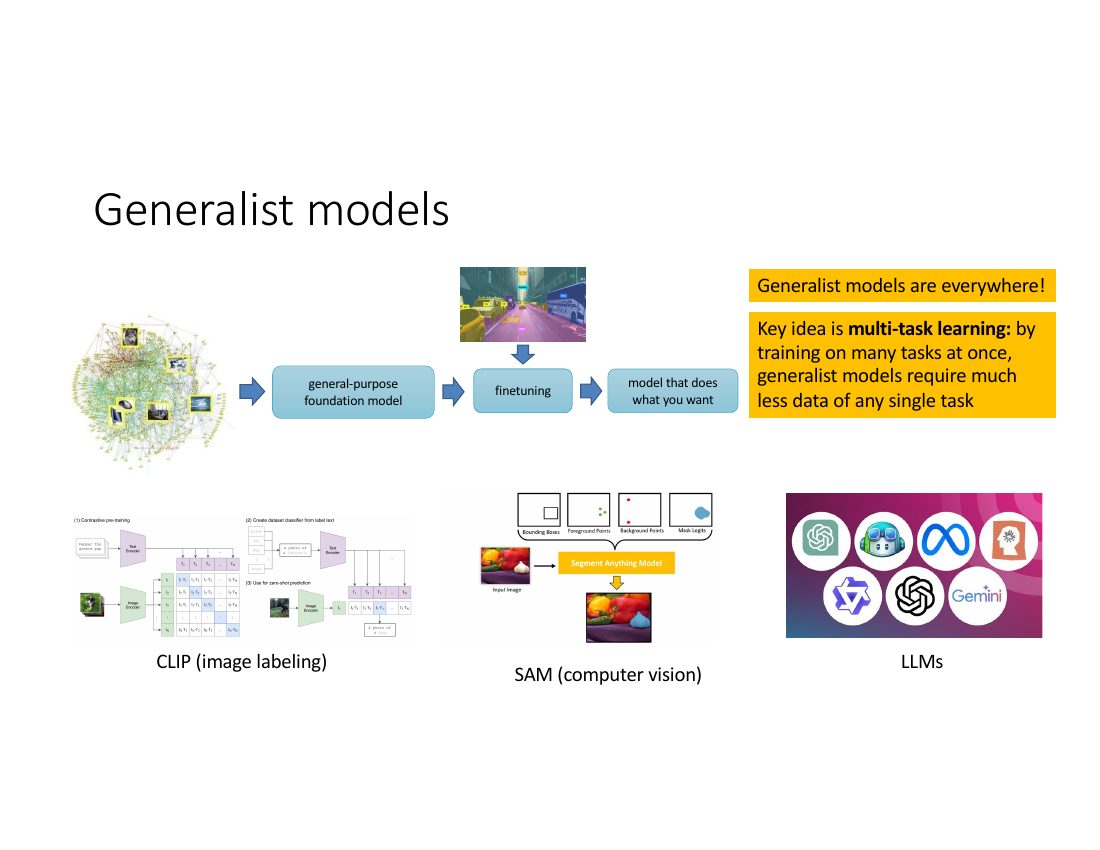
本讲会沿着一条相当清晰的逻辑链走下来。首先我们会发现,多任务 RL 在形式上根本不是新问题—— 把任务上下文 $\omega$ 塞进状态里,多任务 RL 就退化成一个更大的单任务 MDP 上的普通 RL。 但形式上不难不等于实际上不难:任务之间会互相干扰,简单任务学得快、 把策略拽向自己那一侧,反而把困难任务卡在平台期。于是需要课程(curriculum) 和重标注(relabeling)两类对策。重标注在目标条件 RL 里有一个特别漂亮的形式, 就是 HER(hindsight experience replay,后见经验回放): 一条没有到达指定目标的轨迹,对它实际到达的那个状态而言是成功的, 于是原本极度稀疏的奖励被变密。
接着我们会发现目标条件值函数其实是一个「到达难度」的度量, 满足类似三角不等式的性质,可以拿来做规划;再往前一步就是 继承表示 (successor representation)——一个介于无模型与有模型之间的对象, 它把「未来会去哪些状态」和「那些状态值多少钱」解耦,于是奖励一换就能立刻重算值函数。 连续状态下继承表示退化成分类问题,这就是 C-learning。
后半程转向分层 RL(hierarchical RL):经典的 options 框架 $\mathbf{o} = (\mathcal{I}_\mathbf{o}, \pi_\mathbf{o}, \beta_\mathbf{o})$ 与半马尔可夫决策过程, 为什么它能压缩有效时间跨度、也为什么端到端学 option 常常把好处抵消掉; 然后是更实用的做法——把 option 直接看成一个多任务策略,高层下发的不是「第几号 option」 而是技能编号 $z$、目标状态 $\mathbf{g}$、甚至一段自然语言 $\ell$。 最后是元强化学习(meta-RL):把「学习算法本身」当成要学的东西, 黑箱 RNN 做法、梯度型做法,以及一个统一的视角—— 元学习就是在一个把任务身份藏起来的 POMDP 里做推断。
- 多任务 RL 形式上等价于联合 MDP 上的单任务 RL:把上下文 $\omega$ 拼进状态、用 $r_\omega$ 当奖励即可。难点全在优化,不在定义。
- 多任务比单任务更难而不是更容易的主要原因是任务干扰(ray interference):简单任务先学会并占据策略,困难任务的梯度信号被压住,出现长平台期。监督学习里这个现象弱得多。
- 重标注是多任务 RL 独有的免费午餐:同一批转移 $(s,a,s')$ 可以配上任意上下文重新算奖励,等价于数据量翻好几倍。它必须配 off-policy 算法。
- 目标条件值函数 $V(\mathbf{s},\mathbf{g})$ 在稀疏奖励 $r=-\delta(\mathbf{s}\neq\mathbf{g})$、$\gamma=1$ 下就是「从 $\mathbf{s}$ 到 $\mathbf{g}$ 的期望步数」的负数,满足 $V(\mathbf{s},\mathbf{g}) \le V(\mathbf{s},\mathbf{w}) + V(\mathbf{w},\mathbf{g})$ 式的三角不等式,可直接用于子目标规划。
- 继承表示 $\mu^\pi(\mathbf{s})$ 是「策略未来状态占用分布」,满足贝尔曼方程;有了它,$V^\pi = \mu^\pi{}^{T}\vec r$,换奖励只需重算一个内积。继承特征 $\psi^\pi$ 把它压到低维,是迁移的实用形式,但只保证一步策略提升,不给最优解。
- 分层的真正收益是把高层 Q 函数的有效时间跨度从 $T$ 降到 $T/k$,同时让探索以「技能」为单位而不是以「原子动作」为单位。代价是下层策略在训练中不断变化,高层面对的是一个非平稳环境。
- 元 RL 的目标是 $\theta^\star = \argmax_\theta \sum_i \E_{\pi_{\phi_i}(\tau)}[R(\tau)]$,$\phi_i = f_\theta(\mathcal{M}_i)$。最简单的实现就是「训一个 RNN 策略、且跨 episode 不重置隐状态」——它会自动学会探索,因为探索是最大化整段 meta-episode 回报的最优行为。
- 把任务身份 $z$ 当成隐状态,元 RL 就是一个 POMDP $\tilde{\mathcal{M}}$,其中 $\tilde s = (s,z)$、$\tilde o = s$。解这个 POMDP 等价于元学习;带记忆的策略(即 in-context learning)只是解它的最简单办法之一。
1. 我们为什么想要多任务 RL
动机一:效率——一起学比分开学快
先把最朴素的动机说清楚。假设你有 5 个机器人任务:开烤箱、往烧杯里倒液体、 从桌上收拾瓶子、叠衣服、遛狗。传统做法是跑 5 次独立的 RL,每次从随机初始化开始。 多任务做法是让这 5 个任务共享同一个网络(同一套卷积特征、同一套动力学理解), 于是「怎么看懂一张桌面图像」「手臂怎么运动不会自己打结」这类知识只需要学一遍。
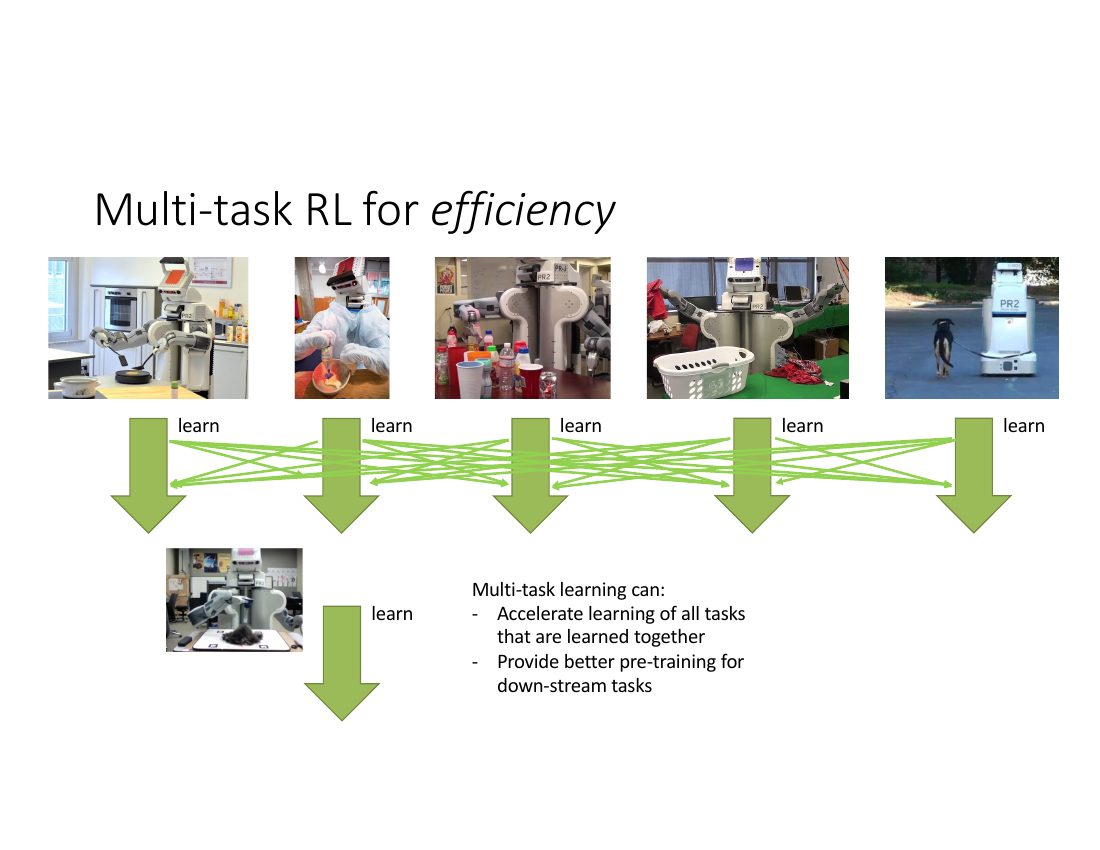
数量级上感受一下:如果单个任务需要 $N$ 步交互,其中 $\alpha N$ 步是花在学习共享结构上、 $(1-\alpha)N$ 步花在学习任务特有的部分,那么 $K$ 个任务独立学要 $KN$ 步, 理想的多任务学习只要 $\alpha N + K(1-\alpha)N$ 步。当 $\alpha = 0.9$、$K=10$ 时, 这是 $10N$ 对 $1.9N$,五倍多的差距。这就是「通才模型需要的单任务数据少得多」的定量含义。 当然,这是理想情况——第 3 节我们会看到 RL 里的现实往往相反。
动机二:迁移——先验结构让难题变简单
第二个动机更深刻,也更能说明 RL 的痛点。看两个 Atari 游戏:Breakout(打砖块) 对深度 RL 来说基本是解决了的;而 Montezuma's Revenge(蒙特祖玛的复仇)长期是无法攻克的。 两者的观测都是 210×160 的像素,动作空间都是十几个离散动作,为什么差别这么大?
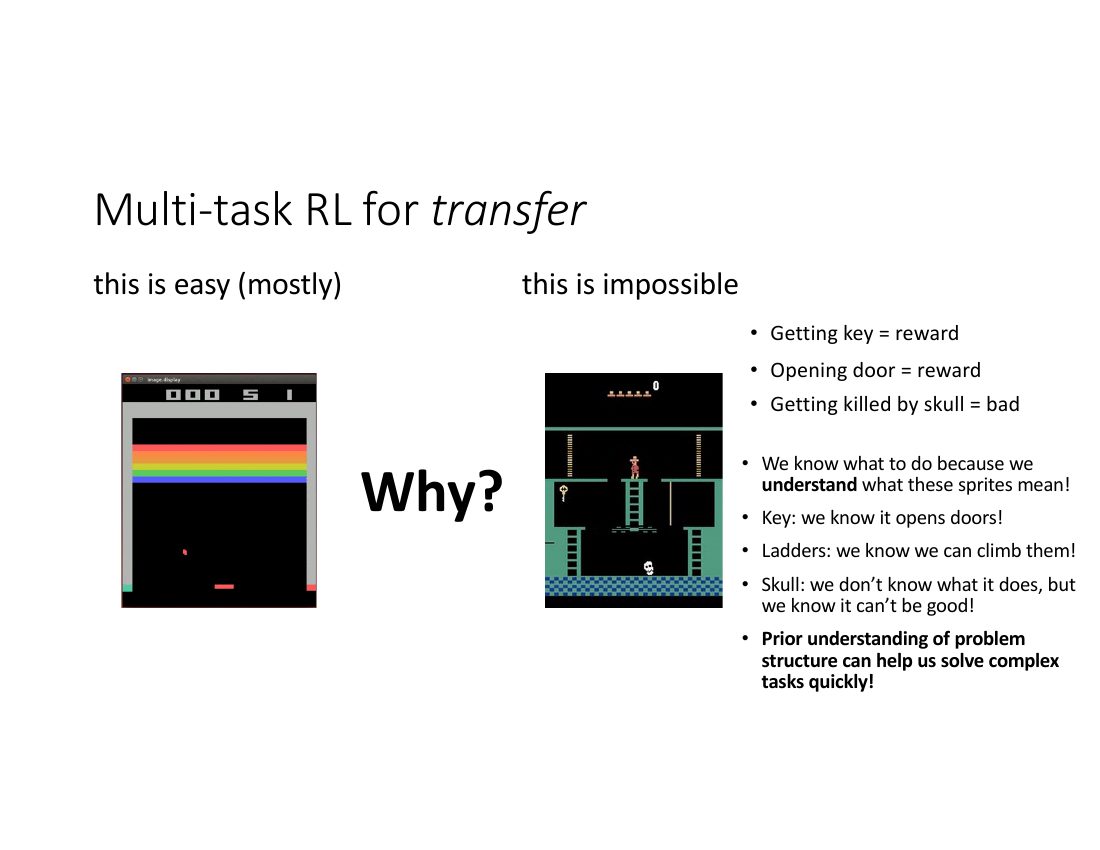
Levine 在这里的论点是:人类之所以能几分钟上手蒙特祖玛,靠的完全不是探索效率高, 而是已经解过成千上万个「先验任务」——见过钥匙、见过梯子、有过被尖锐物体伤害的经验。 所以真正该问的不是「怎么设计一个更好的探索奖励」,而是「先前解决的任务里, 知识到底以什么形式被存了下来,又怎么复用」。
知识可以存在四个地方,每一处对应一类迁移方法:
- Q 函数:告诉你哪些状态/动作是好的。迁移它 ≈ 迁移价值判断。继承特征(第 7 节)就是这条路。
- 策略:告诉你哪些动作可能有用——注意还有一层信息是「哪些动作永远没用」, 这本身就大幅剪枝了搜索空间。分层 RL 里的 option / 技能(第 9、10 节)走的是这条路。
- 模型:世界的物理规律。物理不随任务改变,所以模型是最「可迁移」的对象,这是基于模型 RL 的核心卖点。
- 特征 / 隐状态:一个好的表示。这条最接近监督学习里的预训练,也是目前实践中最靠谱的。
2. 多任务 RL 的形式化:上下文策略与联合 MDP
把任务写进目标函数
先固定记号。普通 RL 的目标是
$$ \theta \leftarrow \argmax_\theta \E_{\tau \sim \pi_\theta(\tau)}\big[r(\tau)\big], \qquad r(\tau) = \sum_{t=1}^{H} r(s_t, a_t). $$多任务 RL 引入一个任务上下文(task context) $\omega$, 它服从某个任务分布 $p(\omega)$。策略和奖励都以它为条件:
$$ \theta \leftarrow \argmax_\theta \E_{\omega \sim p(\omega)}\Big[\E_{\tau \sim \pi_\theta(\tau|\omega)}\big[r_\omega(\tau)\big]\Big], \qquad r_\omega(\tau) = \sum_{t=1}^{H} r_\omega(s_t, a_t), $$其中条件轨迹分布为
$$ \pi_\theta(\tau|\omega) = p(s_1)\prod_{t=1}^{H} \pi_\theta(a_t | s_t, \omega)\, p(s_{t+1}|s_t, a_t). $$注意三处细节:(i)转移 $p(s_{t+1}|s_t,a_t)$ 不依赖 $\omega$—— 这是最常见的设定(同一个物理世界,不同的任务目标),但不是必须的; (ii)$\omega$ 在一条轨迹里是固定的,第一步采样一次之后就不变; (iii)奖励 $r_\omega$ 依赖 $\omega$,这才是任务之间真正的区别所在。
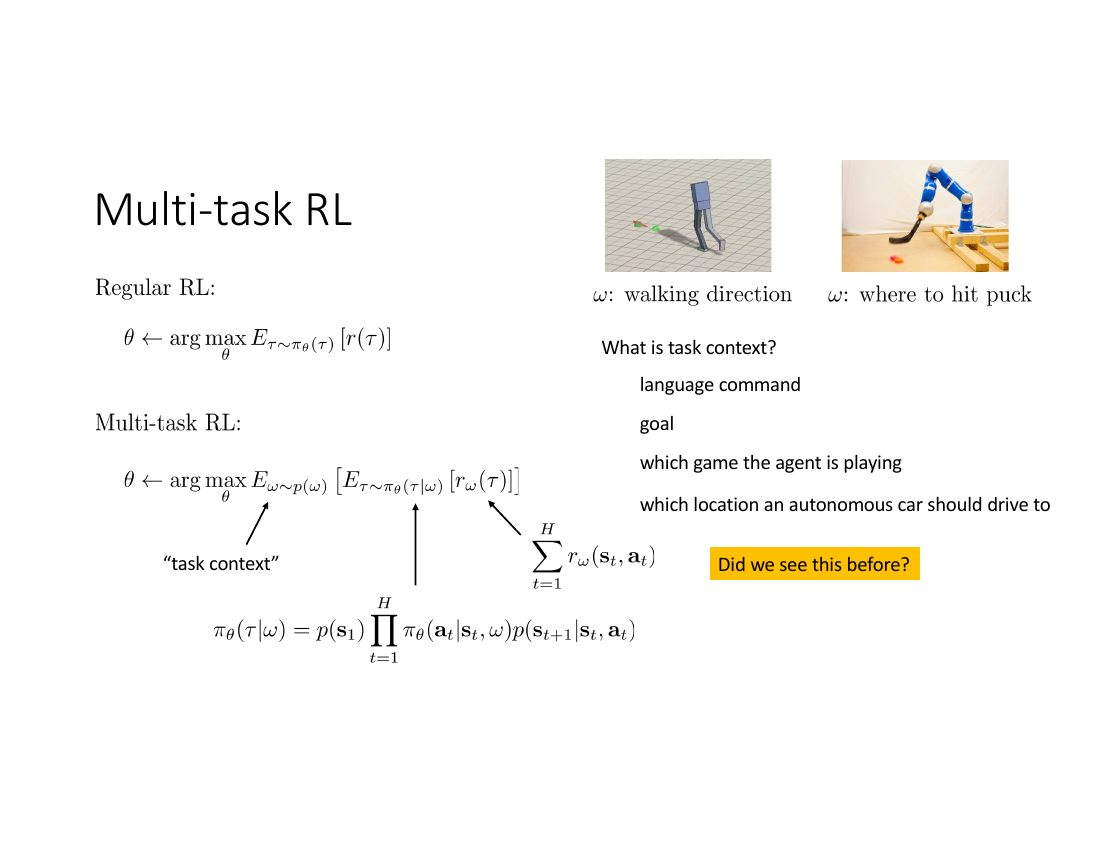
上下文 $\omega$ 的形态在实践中差别很大,值得单独列个表,因为它决定了后面能用哪些技巧:
| 上下文形态 | 例子 | 奖励怎么来 | 能否重标注 |
|---|---|---|---|
| 离散任务 ID | 「第 7 号任务」、玩哪个 Atari 游戏 | 每个任务手写一个 $r_\omega$ | 难(需要能对任意轨迹算所有任务的奖励) |
| 目标状态 $\mathbf{g}$ | 把手臂末端移到坐标 $\mathbf{g}$ | 自动:$r=-\delta(\mathbf{s}\neq\mathbf{g})$ 或 $-\|\mathbf{s}-\mathbf{g}\|$ | 非常容易(HER) |
| 连续参数 | 行走速度 0.7 m/s、冰球落点 | 参数化的奖励族 | 容易(可解析算任意 $\omega$ 的奖励) |
| 自然语言 $\ell$ | 「把红色积木放到蓝色盘子上」 | 需要一个语言条件奖励模型或人工标注 | 可以(用 VLM 事后描述轨迹做了什么) |
关键洞察:这根本不是一个新问题
现在问一个尖锐的问题:多任务 RL 跟普通 RL 本质上有区别吗? Levine 的答案就一个字:没有。
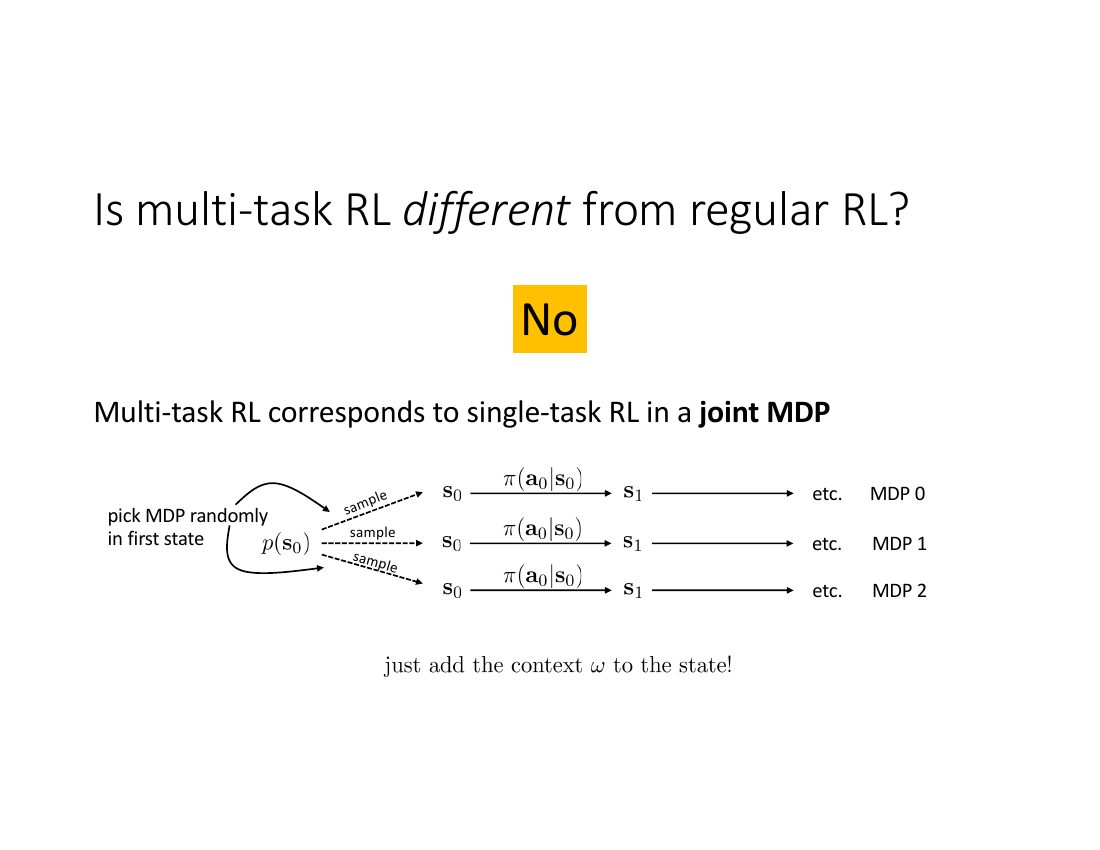
形式化地说,给定任务族 $\{\mathcal{M}_\omega\}$,其中 $\mathcal{M}_\omega = (\mathcal{S}, \mathcal{A}, p, r_\omega)$, 定义联合 MDP $\bar{\mathcal{M}} = (\bar{\mathcal{S}}, \mathcal{A}, \bar p, \bar r)$:
$$ \bar{\mathcal{S}} = \mathcal{S}\times\Omega, \quad \bar s = (s,\omega), \quad \bar p\big((s',\omega')\,\big|\,(s,\omega),a\big) = p(s'|s,a)\,\delta(\omega'=\omega), \quad \bar r\big((s,\omega),a\big) = r_\omega(s,a), $$初始分布 $\bar p_0(s,\omega) = p_0(s)p(\omega)$。第二项里的 $\delta(\omega'=\omega)$ 是全部的机关所在: 上下文一旦采定就再也不变,所以它是状态里一个「冻结」的分量。 在 $\bar{\mathcal{M}}$ 上跑普通 RL,其目标函数展开后逐字等于上面的多任务目标。 $\bar{\mathcal{M}}$ 依然满足马尔可夫性(因为 $\omega$ 被显式放进了状态), 所以 Q-learning 的收缩性、策略梯度的无偏性等等一切结论原样成立。
落到代码上,改动少到有点好笑:
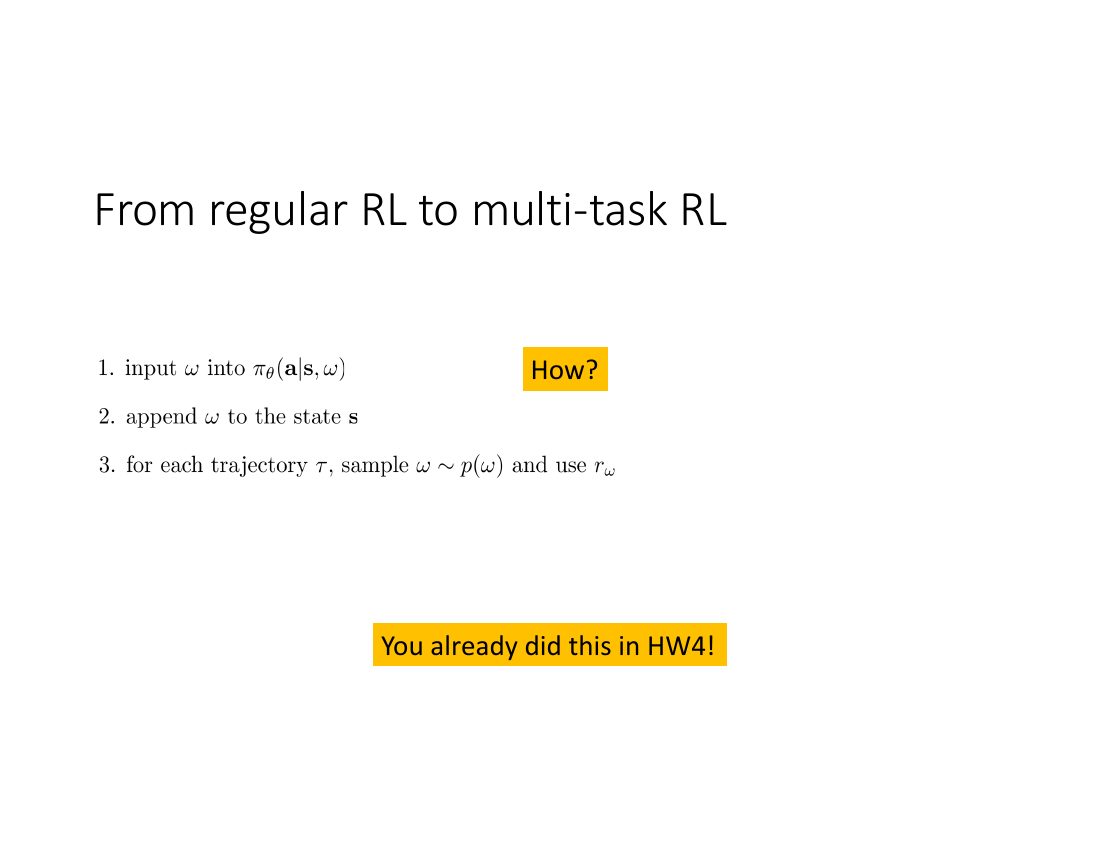
class ContextualPolicy(nn.Module):
    """多任务策略:只是把 omega 拼进输入而已。"""
    def __init__(self, obs_dim, ctx_dim, act_dim, hidden=256):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(obs_dim + ctx_dim, hidden), nn.ReLU(),
            nn.Linear(hidden, hidden), nn.ReLU(),
            nn.Linear(hidden, 2 * act_dim),          # 高斯策略的 mean 和 log_std
        )
        self.act_dim = act_dim

    def forward(self, obs, ctx):
        x = torch.cat([obs, ctx], dim=-1)            # <-- 全部的改动就在这一行
        mean, log_std = self.net(x).chunk(2, dim=-1)
        return mean, log_std.clamp(-5.0, 2.0)

def rollout(env, policy, ctx_sampler, reward_fn, horizon):
    omega = ctx_sampler()                            # 每条轨迹采一次,之后冻结
    s, traj = env.reset(), []
    for _ in range(horizon):
        mean, log_std = policy(s, omega)
        a = mean + log_std.exp() * torch.randn_like(mean)
        s2, _, done, _ = env.step(a)                 # 环境自带的奖励丢掉不要
        r = reward_fn(s, a, s2, omega)               # 用 r_omega 现算
        traj.append((s, a, r, s2, omega))
        s = s2
        if done: break
return traj「形式上等价」是一句关于问题定义的话,不是一句关于难度的话。 联合 MDP $\bar{\mathcal{M}}$ 的状态空间比任何单个 $\mathcal{M}_\omega$ 都大, 最优值函数 $V^\star(s,\omega)$ 要在整个 $\mathcal{S}\times\Omega$ 上拟合, 探索也要覆盖所有任务。所以正确的说法是:多任务 RL 没有新的理论障碍, 但有全部的优化障碍,而且更严重。下一节就讲这个。
3. 为什么多任务 RL 反而更难
Ray interference:RL 特有的病
直觉上「一起学更多任务」应该更容易——数据更多、共享结构更多。 监督学习里这个直觉大体成立;但在 RL 里,经常反过来。原因是 RL 有一个监督学习没有的反馈回路: 策略决定数据分布。
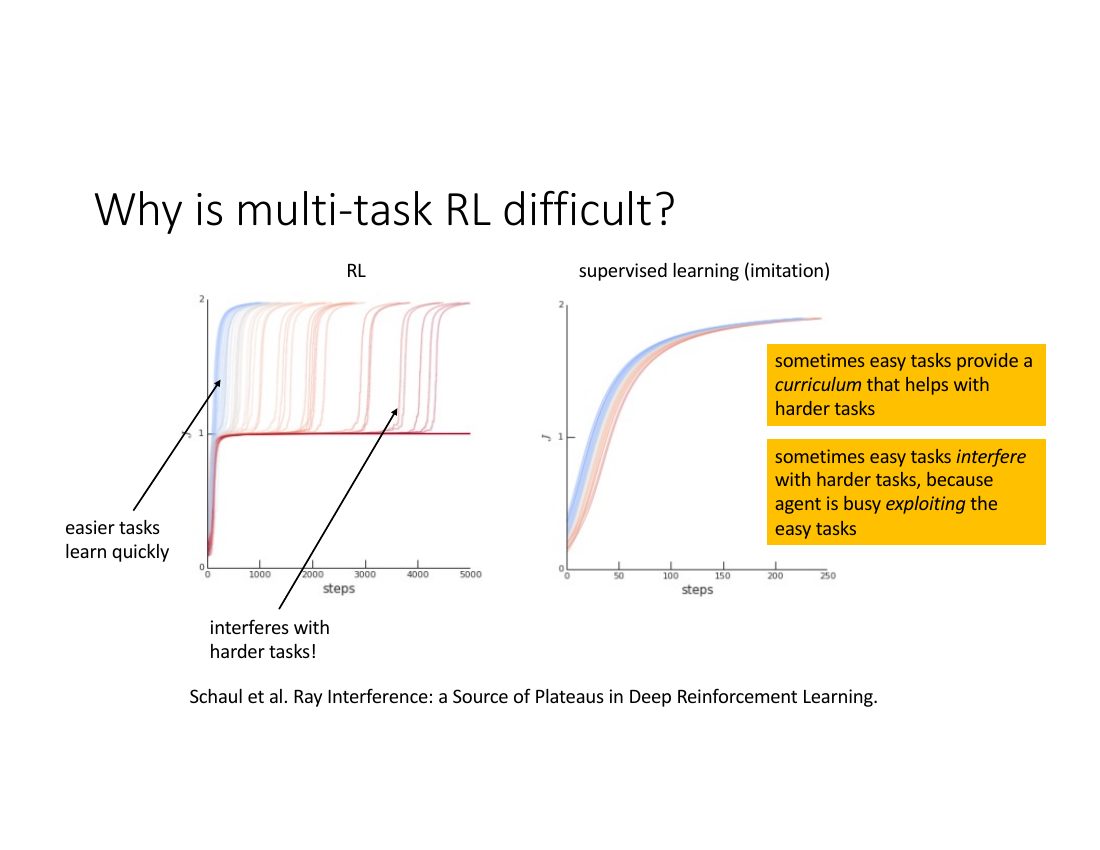
机制说细一点。设任务 $A$ 简单、任务 $B$ 困难,共享参数 $\theta$。训练早期:
- $A$ 的奖励信号强,梯度 $\nabla_\theta J_A$ 幅值大;$B$ 几乎从没成功过,$\nabla_\theta J_B \approx 0$。
- 于是 $\theta$ 被拽向「专精 $A$」的方向。
- 专精 $A$ 意味着策略在 $A$ 上变得确定性(熵下降)。而策略是共享的—— 在 $B$ 的状态里,它也倾向于输出 $A$ 里那套动作。
- 结果:$B$ 的探索被扼杀,$\nabla_\theta J_B$ 继续保持 $\approx 0$。正反馈闭环形成,平台期出现。
- 只有当 $A$ 完全饱和(梯度归零)之后,$B$ 的微弱信号才有机会主导更新,于是曲线突然跳起。这就是那些阶梯。
注意第 3、4 步在监督学习里是不存在的:监督学习中 $B$ 的标签一直在那儿, 不管策略变成什么样,$\nabla_\theta \mathcal{L}_B$ 都不会消失。 RL 里梯度信号本身依赖于当前策略产生的数据,这才是差别的根源。
看到多任务学习曲线出现长平台,第一反应常常是「网络容量不够,任务之间在抢参数」。 容量确实可能是问题之一,但 ray interference 说明即使容量无限、 即使任务之间在表示上完全不冲突,光靠「简单任务先饱和、把探索熵吃掉」这一条机制, 平台期就会出现。所以对策不是无脑加宽网络,而是要管住数据分布: 课程、重标注、以及对每个任务分别维持足够的探索(比如按任务分开的熵系数或 $\epsilon$)。
对策一:课程(curriculum)
既然简单任务的存在既可能帮忙也可能添乱,就不要让它们随机地互相碰撞,而是安排顺序。 课程学习的思路是:先在简单任务上学到有用的东西(能用的特征、能用的基本动作), 再逐步把任务分布 $p(\omega)$ 的质量往困难任务上挪。实践中的常见形式包括 按成功率自动调难度(比如始终把任务采样集中在当前成功率约 50% 的那一档)、 从近距离目标逐步扩展到远距离目标、以及从短 horizon 逐步加长。
对策二:重标注(relabeling)——多任务 RL 独有的免费午餐
这是本讲第一个真正的「技术」。观察:一条转移 $(s_i, a_i, s_i')$ 是由物理决定的, 跟你当初想做哪个任务毫无关系。既然奖励是 $r_\omega(s,a)$—— 一个我们自己写的、可以对任意 $\omega$ 求值的函数——那么同一条转移可以被贴上 任意多个上下文标签,每个标签配一个不同的奖励。数据一下子被放大了 $|\Omega|$ 倍。
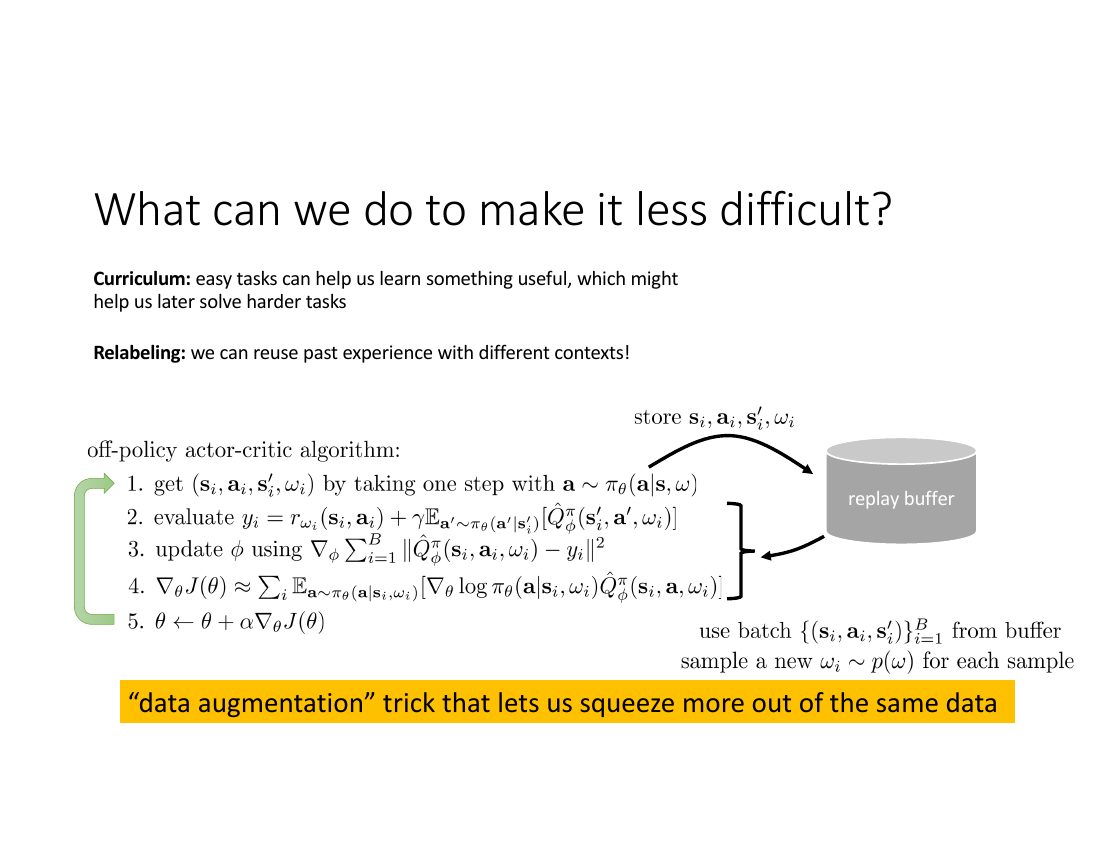
用公式写清楚:对于回放池里的一条转移 $(s,a,s')$, 无论它当初是在哪个 $\omega_{\text{old}}$ 下采集的,我们都可以构造训练目标
$$ y(\omega_{\text{new}}) = r_{\omega_{\text{new}}}(s,a) + \gamma\, \hat Q_\phi\big(s', \pi_\theta(s',\omega_{\text{new}}), \omega_{\text{new}}\big), $$并用 $\|\hat Q_\phi(s,a,\omega_{\text{new}}) - y(\omega_{\text{new}})\|^2$ 做回归。 这一步完全不需要重新与环境交互。
重标注之后,数据 $(s,a,s')$ 是在旧上下文 $\omega_{\text{old}}$ 下、 由旧策略 $\pi_{\theta_{\text{old}}}(\cdot|s,\omega_{\text{old}})$ 产生的, 而我们要评估的是 $\pi_\theta(\cdot|s,\omega_{\text{new}})$。这两个策略几乎必然不同, 所以数据严格地是 off-policy 的——而且不是「稍微旧一点」那种 off-policy, 是行为策略在做完全不同的任务那种。用 REINFORCE / 普通策略梯度会直接偏掉, 用重要性采样则权重 $\prod_t \pi_\theta(a_t|s_t,\omega_{\text{new}})/\pi_{\theta_{\text{old}}}(a_t|s_t,\omega_{\text{old}})$ 会以 $T$ 的指数速度爆炸。所以重标注实际上只能跟 Q-learning / off-policy actor-critic 这类 「基于贝尔曼回溯、不显式依赖行为策略」的方法组合。这也是为什么本讲后面所有算法都是 off-policy 的。
4. 目标条件 RL 与后见重标注(HER)
目标就是一种特殊的上下文
多任务 RL 里最重要的一个特例:让上下文 $\omega$ 就是一个目标状态 $\mathbf{g}$, 即 $\omega = \mathbf{g} \in \mathcal{S}$。任务变成「从当前状态走到 $\mathbf{g}$」, 策略写成 $\pi_\theta(\mathbf{a}|\mathbf{s},\mathbf{g})$,读作 「能到达任意 $\mathbf{g}$ 的策略」。这就是目标条件 RL (goal-conditioned RL)。
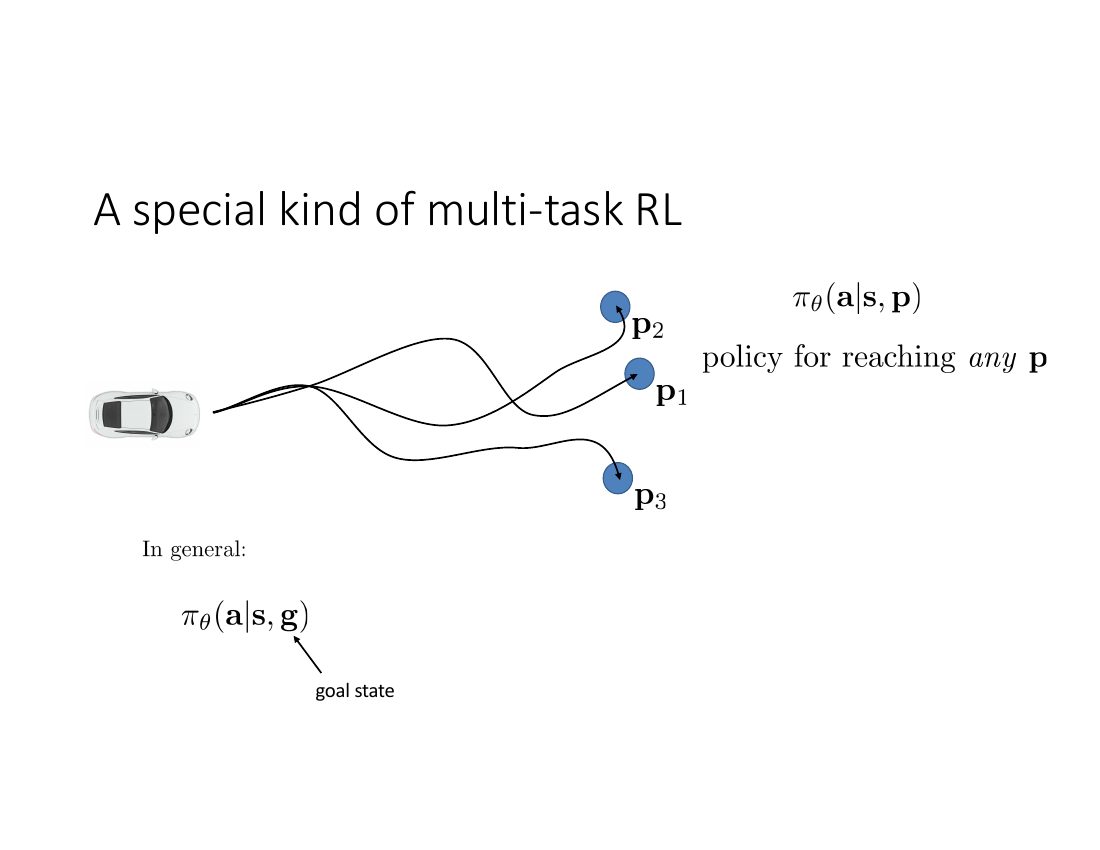
为什么这个特例值得单独拿出来讲?因为它把「奖励从哪来」这个 RL 里最脏的工程问题自动化了。 目标条件奖励有几种标准写法:
$$ r(\mathbf{s},\mathbf{a},\mathbf{g}) = \delta(\mathbf{s}=\mathbf{g}), \qquad r(\mathbf{s},\mathbf{a},\mathbf{g}) = \delta\big(\|\mathbf{s}-\mathbf{g}\| \le \varepsilon\big), \qquad r(\mathbf{s},\mathbf{a},\mathbf{g}) = -\delta(\mathbf{s}\neq\mathbf{g}). $$第一种是「到达即得 1 分」;第二种放宽为 $\varepsilon$-邻域(连续状态下必须这么做, 因为精确相等是零测事件);第三种是「没到就扣 1 分」,等价于最小化到达步数—— 第 5 节会看到它有极漂亮的几何解释。三种都不需要人写任何任务特定的东西。
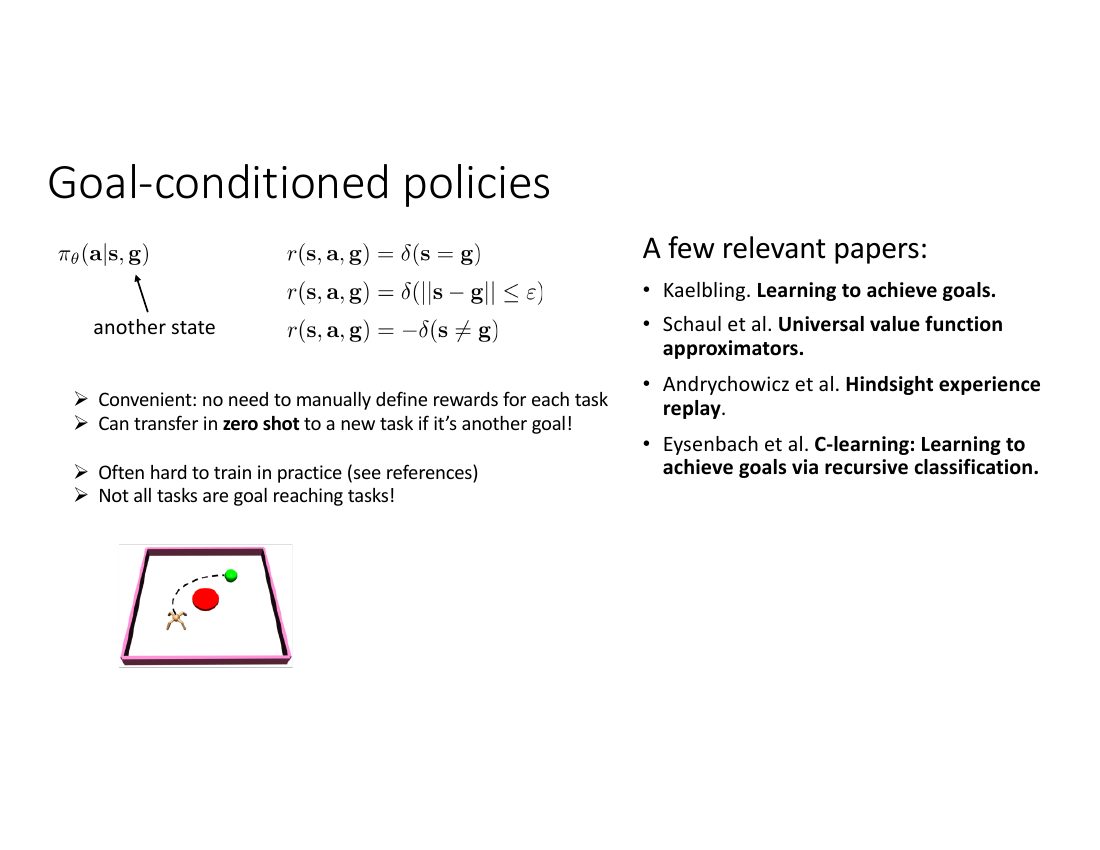
「目标条件 RL 免去了奖励设计」这句话经常被过度解读。它免掉的是奖励函数的形状设计, 但你还是得回答两个问题:(1)什么算「状态」?如果 $\mathbf{s}$ 是原始像素, 那 $\|\mathbf{s}-\mathbf{g}\|\le\varepsilon$ 在像素空间里几乎没有意义(背景稍微一变距离就爆了), 所以实际上你需要一个好的表示或一个学到的距离;(2)目标从哪来? 训练时 $p(\mathbf{g})$ 怎么选,直接决定了课程难度。这两个问题恰恰是上一讲 「无监督探索与技能学习」在解决的东西——目标条件 RL 和自动目标生成天然是一对。
HER:失败的轨迹对别的目标是成功的
现在面对稀疏奖励的死结。用 $r = \delta(\|\mathbf{s}-\mathbf{g}\|\le\varepsilon)$, 在训练早期策略基本是随机的,它永远到不了指定的 $\mathbf{g}$, 所以每条轨迹的回报都是 0,$\hat Q$ 的回归目标全是 0,什么都学不到。 这正是蒙特祖玛困境的一个干净版本。
解药是一个几乎有点狡猾的观察:
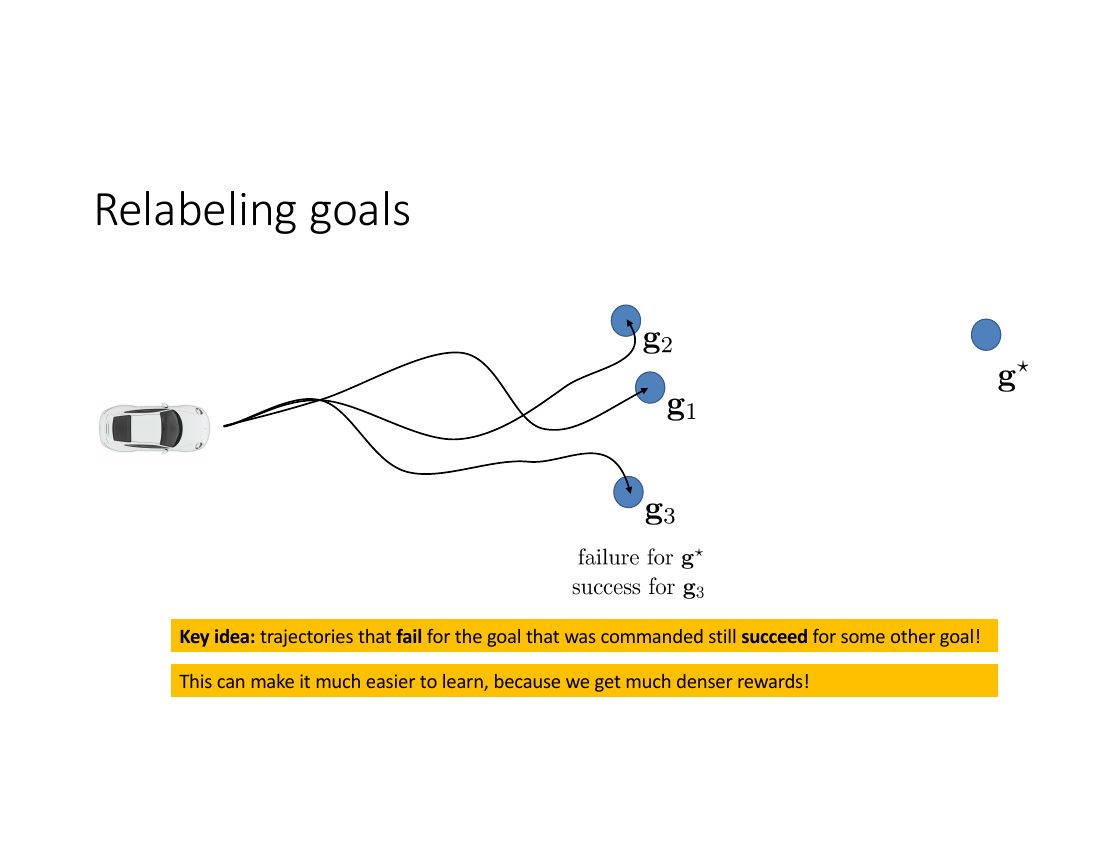
这就是 HER(hindsight experience replay,后见经验回放), Andrychowicz 等人 2017 年提出。名字里的 "hindsight" 就是「事后诸葛亮」: 事后回头看,把当初实际到达的状态追认为目标。
设状态空间大小 $|\mathcal{S}|=N$,随机策略跑 $T$ 步。对一个固定的目标 $\mathbf{g}$, 轨迹能碰到它的概率约为 $T/N$($T \ll N$ 时)。所以采 $M$ 条轨迹, 非零奖励样本的期望条数约为 $MT/N$。当 $N = 10^6$、$T=50$、$M=1000$ 时, 这个数是 $0.05$——意思是平均要跑两万条轨迹才见到一次成功。学不动是必然的。
启用 HER 后:对每条轨迹,把它实际访问过的某个状态 $\mathbf{s}_{t'}$ 追认为目标, 那么在时刻 $t'$ 处的转移必定得到奖励 1。所以非零奖励样本数变成 $\Theta(M)$——从 $0.05$ 变成 $1000$,提高了四个数量级。代价是这些奖励对应的是 「我们自己选的目标」而不是「用户关心的目标」,所以还需要混入真实目标的样本 (下面的 50/50 策略),否则学到的东西可能与真实目标分布错配。
完整算法
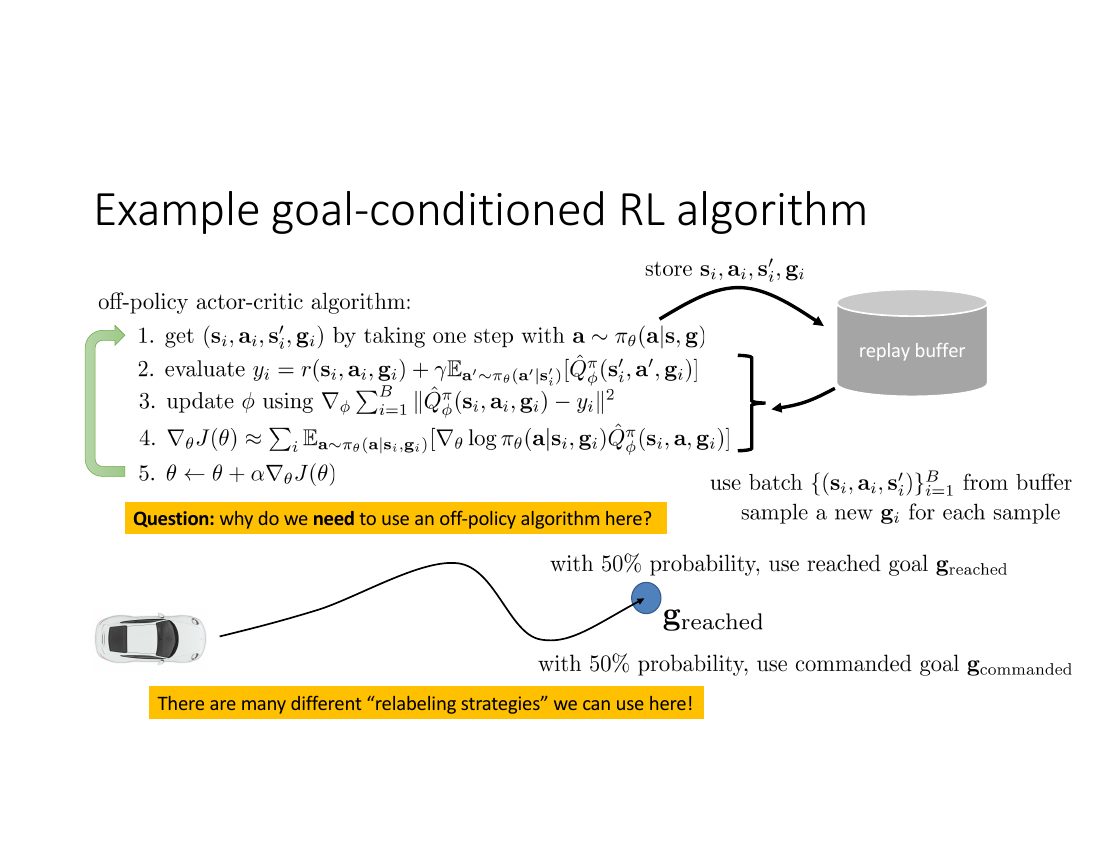
常见的重标注策略(HER 原文称为 relabeling strategies):
| 策略 | 新目标怎么选 | 特点 |
|---|---|---|
final | 整条轨迹的最后一个状态 $\mathbf{s}_T$ | 最简单;只在轨迹末尾造出成功样本,信息量有限 |
future | 对时刻 $t$ 的转移,从 $\{\mathbf{s}_{t+1},\dots,\mathbf{s}_T\}$ 里均匀采一个 | 实践中最常用、效果最好;天然形成「由近及远」的课程 |
episode | 从同一条轨迹的任意时刻采(可以在 $t$ 之前) | 会产生「向后走」的错误监督,通常不如 future |
random | 从整个回放池里随机采一个状态 | 覆盖广但绝大多数是失败样本,退化回稀疏奖励 |
| 50/50 混合 | 一半用 $\mathbf{g}_{\text{reached}}$,一半保留 $\mathbf{g}_{\text{commanded}}$ | 课上给的版本;保证既有密集信号又不丢失真实任务分布 |
def her_relabel(batch, traj_index, strategy="future", p_relabel=0.5):
    """对一批转移做 HER 重标注。batch 里每条是 (s, a, s2, g, t, traj_id)。"""
    out = []
    for (s, a, s2, g, t, tid) in batch:
        if random.random() < p_relabel:
            traj = traj_index[tid]                       # 该转移所属的完整轨迹
            if strategy == "final":
                g_new = traj[-1].s2
            elif strategy == "future":
                k = random.randint(t, len(traj) - 1)     # 只从「未来」采,保证可达
                g_new = traj[k].s2
            else:
                raise ValueError(strategy)
        else:
            g_new = g                                    # 保留原始指令目标
        r_new = float(np.linalg.norm(s2 - g_new) <= EPS) # 奖励现算,不查表
        done  = r_new > 0.5                              # 到达即终止
        out.append((s, a, s2, g_new, r_new, done))
return out三个实现要点:(1)奖励是现场算的而不是从回放池读的——
这是重标注能成立的根本前提,你必须有一个可对任意 $(\mathbf{s},\mathbf{g})$ 求值的 $r$;
(2)future 只从 $t$ 之后采样,因为「未来到过的状态」才是可达的,
从 $t$ 之前采会教出错误的可达性;(3)重标注后 done 也要跟着改,
否则 bootstrap 会把「已经到达」的状态继续往后回溯,值函数会被高估。
5. 一点几何:目标条件值函数就是一个距离
取那个「没到就扣 1 分」的奖励 $r(\mathbf{s},\mathbf{a},\mathbf{g}) = -\delta(\mathbf{s}\neq\mathbf{g})$, 令 $\gamma = 1$,并规定 episode 在 $\mathbf{s}=\mathbf{g}$ 时结束。 写出这个设定下的贝尔曼方程:
$$ V(\mathbf{s},\mathbf{g}) = -\delta(\mathbf{s}\neq\mathbf{g}) + \E_{\mathbf{s}'}\big[V(\mathbf{s}',\mathbf{g})\big]\,\delta(\mathbf{s}\neq\mathbf{g}). $$两个 $\delta(\mathbf{s}\neq\mathbf{g})$ 的角色不同:第一个是即时奖励; 第二个是「只有还没到达才继续 bootstrap」,也就是终止条件。分情况展开:
$$ V(\mathbf{s},\mathbf{g}) = \begin{cases} -1 + \E_{\mathbf{s}'}\big[V(\mathbf{s}',\mathbf{g})\big], & \mathbf{s} \neq \mathbf{g},\\[2pt] 0, & \mathbf{s} = \mathbf{g}. \end{cases} $$这个递推式的含义一眼可见:$-V(\mathbf{s},\mathbf{g})$ 就是从 $\mathbf{s}$ 出发 到达 $\mathbf{g}$ 所需的期望步数。每走一步扣 1,到了就停。
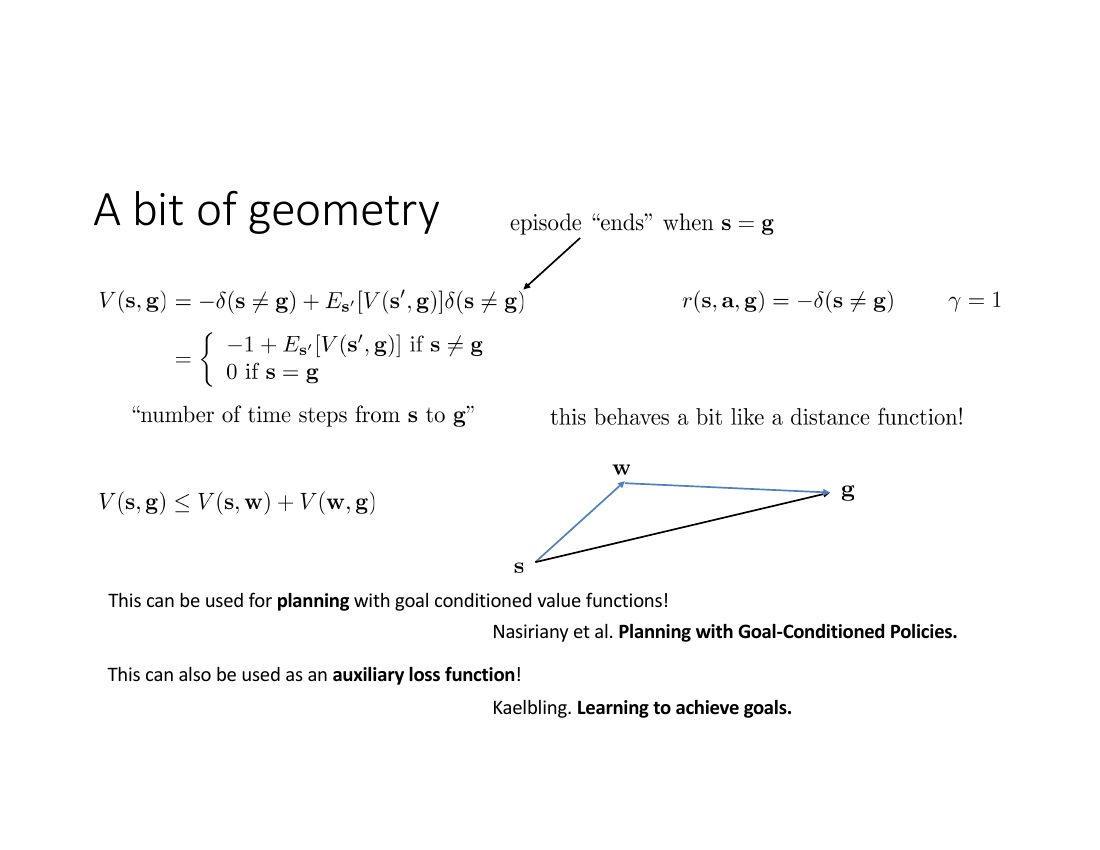
注意 $V \le 0$,所以「$V$ 更大」= 「距离更近」= 更好。断言:
$$ V(\mathbf{s},\mathbf{g}) \;\ge\; V(\mathbf{s},\mathbf{w}) + V(\mathbf{w},\mathbf{g}) \quad\Longleftrightarrow\quad d(\mathbf{s},\mathbf{g}) \;\le\; d(\mathbf{s},\mathbf{w}) + d(\mathbf{w},\mathbf{g}), $$其中 $d = -V$ 是期望步数。证明是构造性的:考虑一个次优策略—— 先按最优策略走到 $\mathbf{w}$(期望 $d(\mathbf{s},\mathbf{w})$ 步),再按最优策略从 $\mathbf{w}$ 走到 $\mathbf{g}$ (期望 $d(\mathbf{w},\mathbf{g})$ 步)。它到达 $\mathbf{g}$ 的期望步数恰是两者之和。 而 $d(\mathbf{s},\mathbf{g})$ 是所有策略里的最小值,所以不会更大。证毕。
课上幻灯片写的是 $V(\mathbf{s},\mathbf{g}) \le V(\mathbf{s},\mathbf{w}) + V(\mathbf{w},\mathbf{g})$, 那是把 $V$ 当作代价(正的距离)来写的口径;两种写法说的是同一件事, 关键是记住语义:绕道不会更快。
要小心的是:$d$ 一般不是度量,因为它通常不对称—— 从山顶滑到山脚 3 步,从山脚爬到山顶可能要 300 步。所以只有三角不等式和 $d(\mathbf{s},\mathbf{s})=0$ 成立, 称它「拟度量(quasimetric)」更准确。这一点在实现里很要紧: 如果你用一个对称的网络结构(比如 $\|f(\mathbf{s})-f(\mathbf{g})\|$)去拟合 $V$, 就硬性地引入了错误的归纳偏置。
两个直接的用途:
- 规划:想从 $\mathbf{s}$ 到很远的 $\mathbf{g}$,而目标条件策略只在近距离上可靠。 那就在中间搜一串子目标 $\mathbf{w}_1,\dots,\mathbf{w}_K$,最大化 $\sum_k V(\mathbf{w}_{k-1}, \mathbf{w}_k)$(令 $\mathbf{w}_0=\mathbf{s}$、$\mathbf{w}_{K+1}=\mathbf{g}$), 再让低层策略逐段执行。这正是 Nasiriany 等人的做法,也直接通向第 10 节的分层 RL: 所谓「高层下发目标」就是在做这个搜索,只不过用 RL 学出来而不是在线搜。
- 辅助损失:把三角不等式当成一个可微的约束项加进 critic 的损失里, $\mathcal{L}_{\text{tri}} = \E_{\mathbf{s},\mathbf{w},\mathbf{g}}\big[\max\big(0,\; V(\mathbf{s},\mathbf{w}) + V(\mathbf{w},\mathbf{g}) - V(\mathbf{s},\mathbf{g})\big)^2\big]$, 可以在没有额外数据的情况下把值函数正则化到一致。
6. 继承表示:介于无模型与有模型之间
第 5 节末尾那句「$V(\mathbf{s},\mathbf{g})$ 告诉我们到达各个状态有多容易」值得追问一句: 如果一个函数能告诉你「从这里出发未来会去到哪些状态」,那它是不是某种模型?
模型到底需要预测什么?
Levine 用一个非常漂亮的推导切入。回到 RL 的基本循环:采样 → 拟合模型估计回报 → 改进策略。 问:为了「评估一个策略」,模型最少需要预测什么? (能评估就能改进——这是策略迭代的全部内容。)
从策略的目标出发,$J(\pi) = \E_{s\sim p(s_1)}[V^\pi(s_1)]$,而
$$ V^\pi(s_t) = \sum_{t'=t}^{\infty}\gamma^{t'-t}\,\E_{p(s_{t'}|s_t)}\big[r(s_{t'})\big]. $$(这里为了简洁只写状态相关的奖励 $r(s)$;动作相关的 $r(s,a)$ 完全同理,只是多带一个 $a$。) 接下来是关键的一步——把求和顺序换掉:
$$ V^\pi(s_t) = \sum_{t'=t}^{\infty}\gamma^{t'-t}\sum_{\mathbf{s}} p(s_{t'}=\mathbf{s}|s_t)\, r(\mathbf{s}) = \sum_{\mathbf{s}} \underbrace{\left(\sum_{t'=t}^{\infty}\gamma^{t'-t} p(s_{t'}=\mathbf{s}|s_t)\right)}_{\text{与奖励无关}} r(\mathbf{s}). $$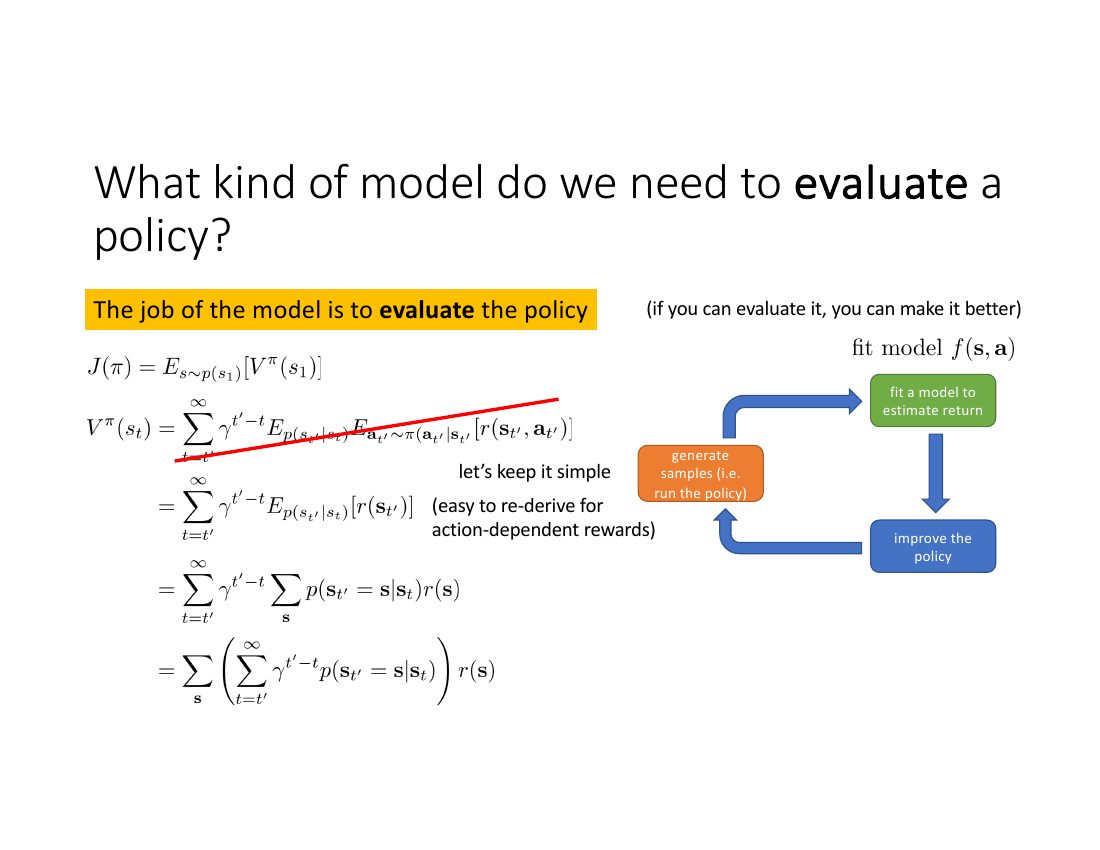
括号里的东西就是全部的答案。给它归一化一下(乘 $1-\gamma$,让它成为一个概率分布), 定义未来状态占用分布(future state occupancy):
$$ p_\pi(\mathbf{s}_{\text{future}} = \mathbf{s}\,|\,s_t) = (1-\gamma)\sum_{t'=t}^{\infty}\gamma^{t'-t}\,p(s_{t'}=\mathbf{s}|s_t). $$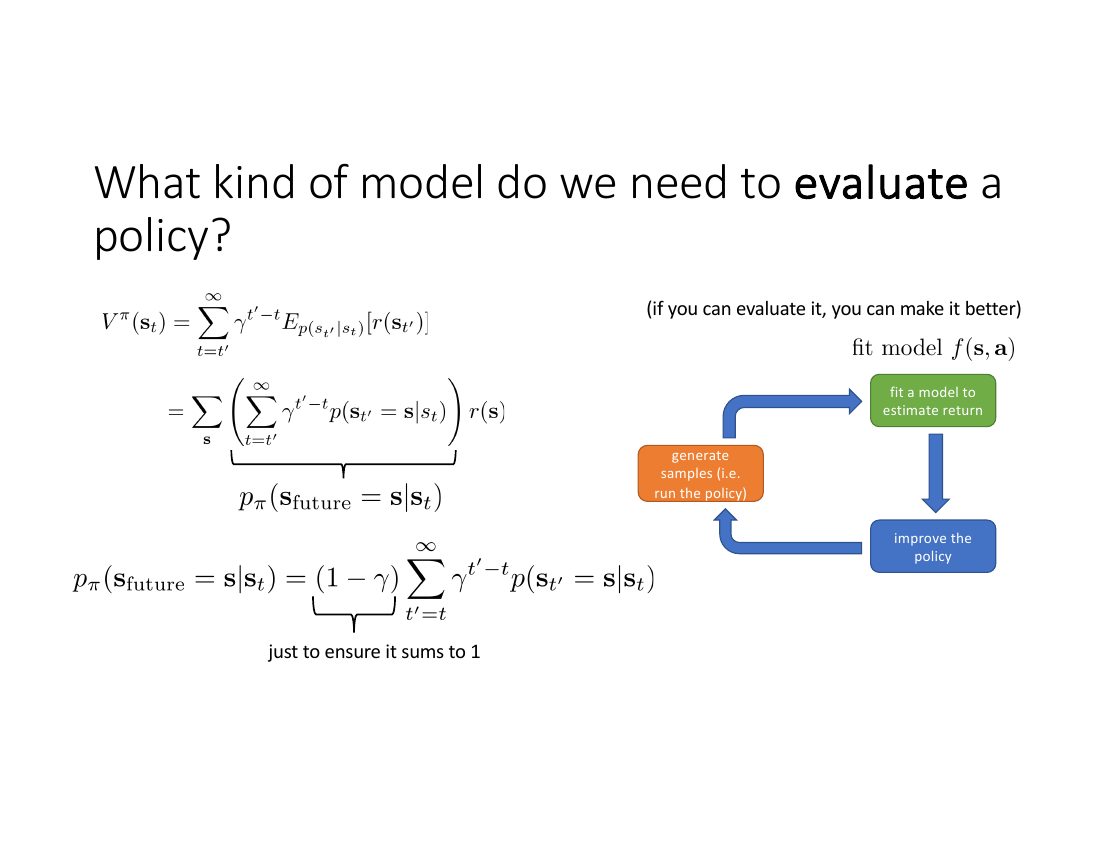
继承表示的定义与贝尔曼方程
把它写成向量形式:设状态空间有 $N$ 个状态,定义 $\mu^\pi(s_t) \in \mathbb{R}^N$, 第 $i$ 个分量是 $\mu_i^\pi(s_t) = p_\pi(\mathbf{s}_{\text{future}} = i\,|\,s_t)$。 于是值函数变成一个内积:
$$ V^\pi(s_t) = \frac{1}{1-\gamma}\sum_{\mathbf{s}} p_\pi(\mathbf{s}_{\text{future}}=\mathbf{s}|s_t)\,r(\mathbf{s}) = \frac{1}{1-\gamma}\,\mu^\pi(s_t)^{T}\vec{r}. $$$\mu^\pi$ 就是 Dayan 1993 年提出的继承表示(successor representation, SR)。
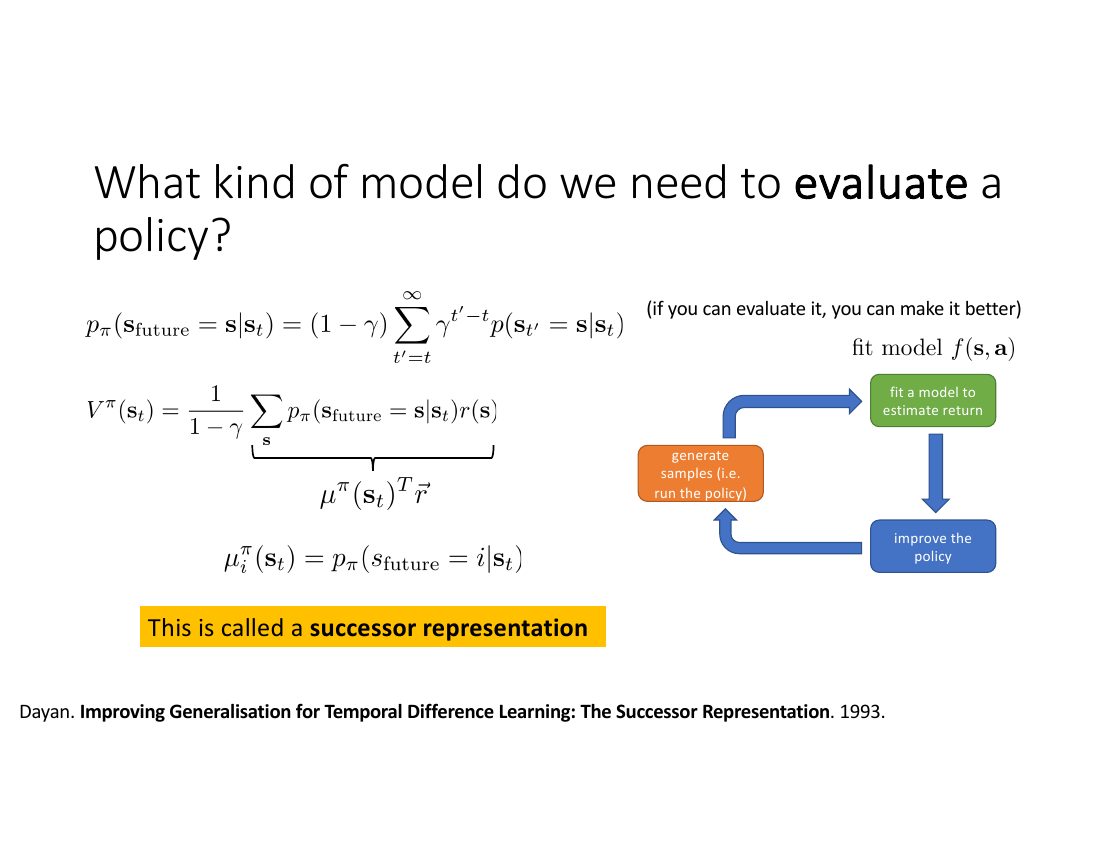
$V^\pi = \frac{1}{1-\gamma}\mu^\pi{}^{T}\vec r$ 这个式子把值函数因式分解成了两部分: $\mu^\pi$ 只依赖动力学和策略,$\vec r$ 只依赖任务。 于是——换一个奖励函数,只要重算一个内积就能得到新的值函数,不需要任何新的 RL。 这正是多任务迁移最想要的东西。它也解释了 SR 的定位:它比无模型方法多存了「未来会去哪」的信息, 又比完整的动力学模型少存了「一步一步怎么走」的细节——介于无模型与有模型之间。
那 $\mu^\pi$ 怎么学?好消息是它满足一个贝尔曼方程。把定义里的求和拆出第一项:
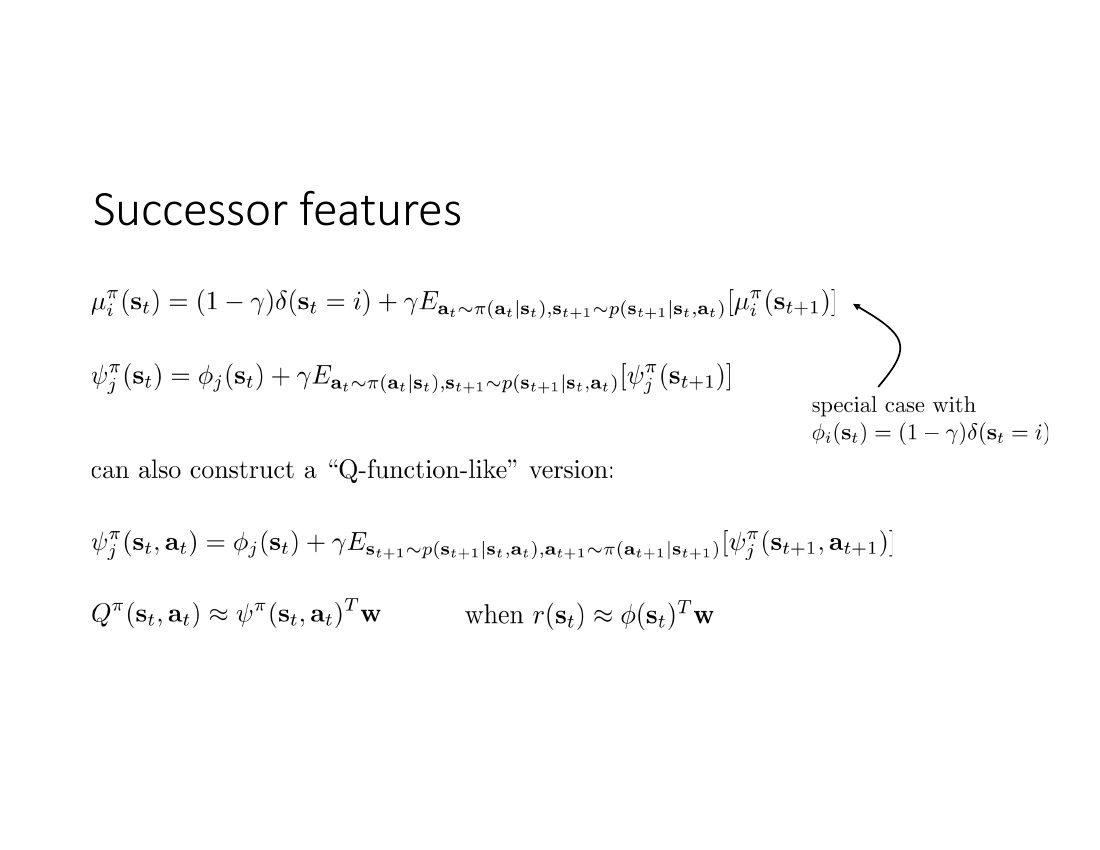
$$ \mu_i^\pi(s_t) = (1-\gamma)\,\delta(s_t = i) + \gamma\,\E_{a_t\sim\pi(a_t|s_t),\,s_{t+1}\sim p(s_{t+1}|s_t,a_t)}\big[\mu_i^\pi(s_{t+1})\big]. $$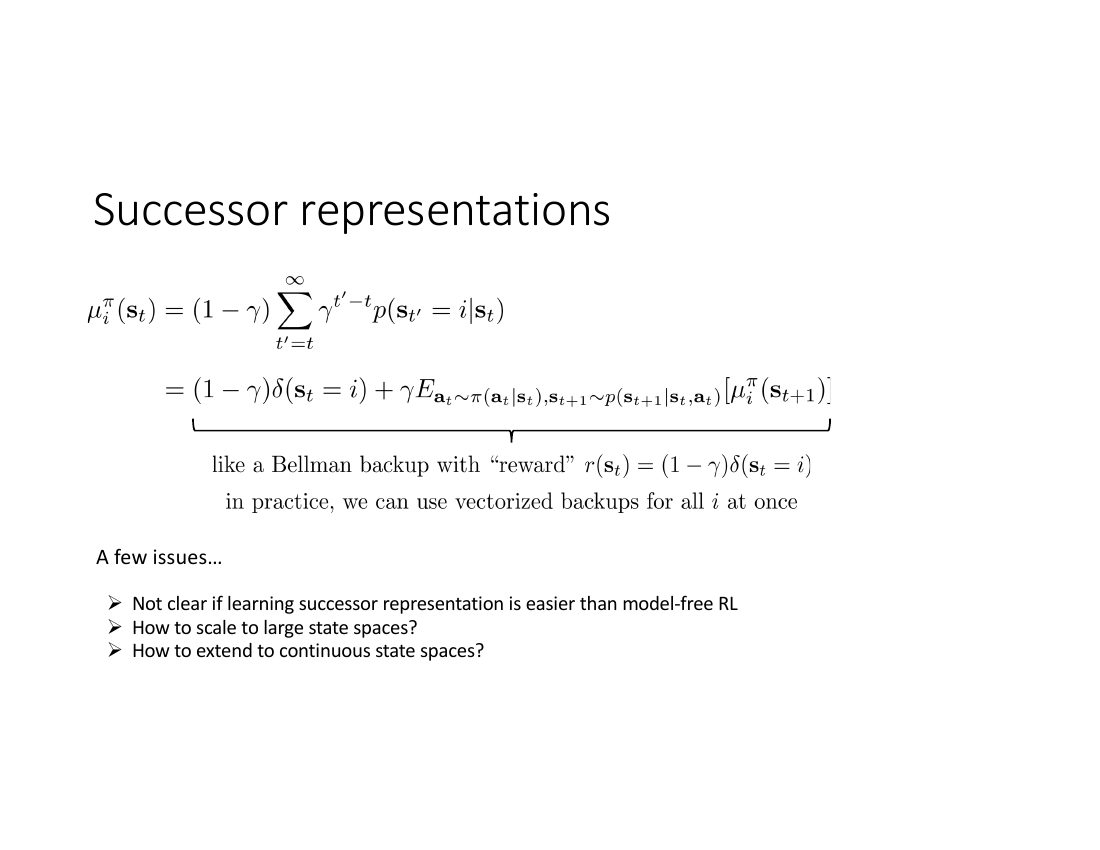
把 $\delta(s_t=i)$ 理解成「第 $i$ 个 one-hot 奖励」,那么学 $\mu^\pi$ 就等于同时解 $N$ 个 RL 问题, 每个的奖励是一个 one-hot 向量。这就是为什么第一个问题很尖锐:如果 $N$ 很大, 这比解一个 RL 问题贵得多。第 7 节的继承特征就是为了解决它。
7. 继承特征:把 SR 压到低维,用于迁移
SR 的致命伤是维度:$\mu^\pi(s) \in \mathbb{R}^{|\mathcal{S}|}$。 解法很自然——既然值函数只需要 $\mu^{T}\vec r$ 这一个内积, 而奖励通常在一个低维特征空间里就能表达,那就在特征空间里做 SR。
设有 $D$ 个特征函数 $\phi_j: \mathcal{S}\to\mathbb{R}$,$j=1,\dots,D$,$D \ll |\mathcal{S}|$。 定义继承特征(successor features, SF):
$$ \psi_j^\pi(s_t) = \sum_{\mathbf{s}} \mu_{\mathbf{s}}^\pi(s_t)\,\phi_j(\mathbf{s}) = \mu^\pi(s_t)^{T}\vec\phi_j, $$即「未来会遇到的特征值的(折扣)期望」。它同样满足贝尔曼方程, 而且这次是直接对 $\psi$ 做备份,完全不需要经过 $\mu$:
$$ \psi_j^\pi(s_t) = \phi_j(s_t) + \gamma\,\E_{a_t\sim\pi,\,s_{t+1}\sim p}\big[\psi_j^\pi(s_{t+1})\big]. $$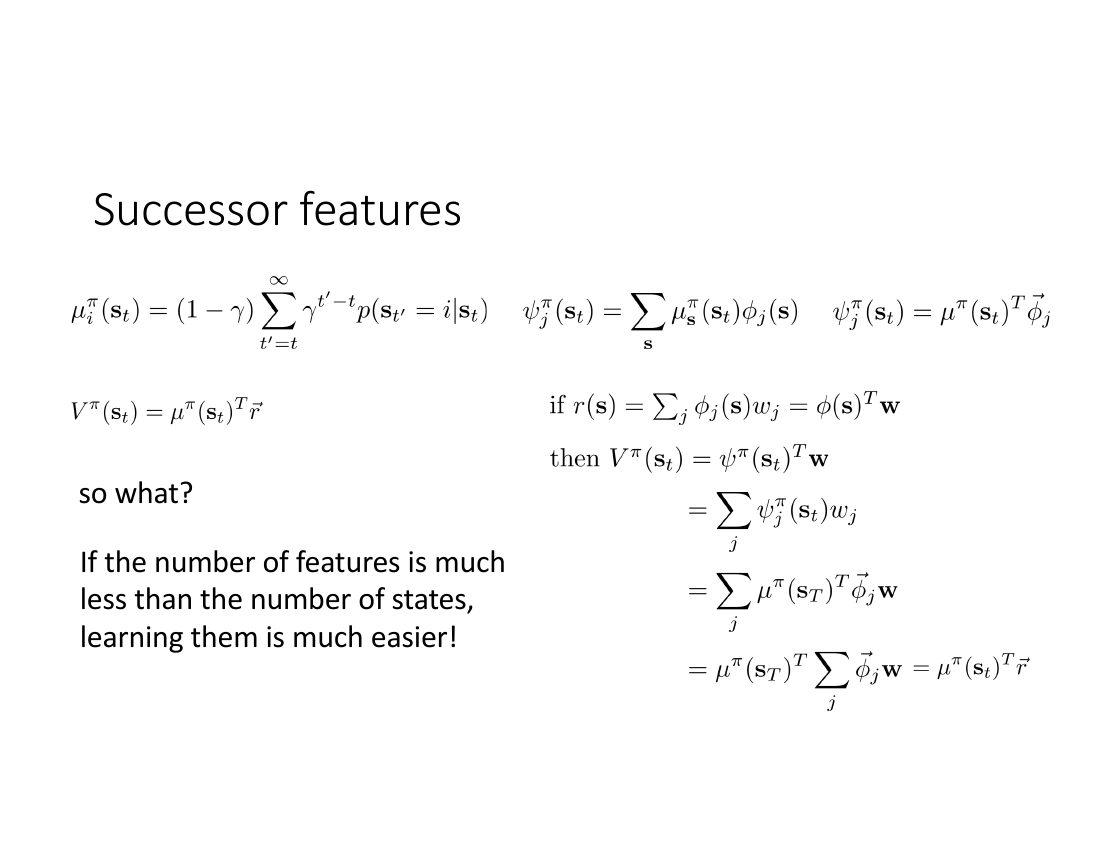
假设奖励在特征上线性:$r(\mathbf{s}) = \phi(\mathbf{s})^T\mathbf{w}$。那么
$$ V^\pi(s_t) = \mu^\pi(s_t)^{T}\vec r = \sum_{\mathbf{s}}\mu^\pi_{\mathbf{s}}(s_t)\,\phi(\mathbf{s})^{T}\mathbf{w} = \Big(\sum_{\mathbf{s}}\mu^\pi_{\mathbf{s}}(s_t)\phi(\mathbf{s})\Big)^{T}\mathbf{w} = \psi^\pi(s_t)^{T}\mathbf{w}. $$注意 SR 是 SF 的特例:取 $\phi_i(\mathbf{s}) = (1-\gamma)\delta(\mathbf{s}=i)$, 即 one-hot 特征,$\psi$ 就退化回 $\mu$。也就是说 SR 是「特征 = 状态本身」的 SF。
同理可以构造 Q 函数版本的继承特征——把动作也带上:
$$ \psi_j^\pi(s_t,a_t) = \phi_j(s_t) + \gamma\,\E_{s_{t+1}\sim p(\cdot|s_t,a_t),\,a_{t+1}\sim\pi(\cdot|s_{t+1})}\big[\psi_j^\pi(s_{t+1},a_{t+1})\big], $$于是 $Q^\pi(s_t,a_t) \approx \psi^\pi(s_t,a_t)^{T}\mathbf{w}$。注意这是 SARSA 式的备份 ($a_{t+1}$ 采自 $\pi$ 而不是取 max),因为 SF 评估的是给定策略 $\pi$ 的占用, 而不是最优策略的。
用法一:快速恢复一个 Q 函数
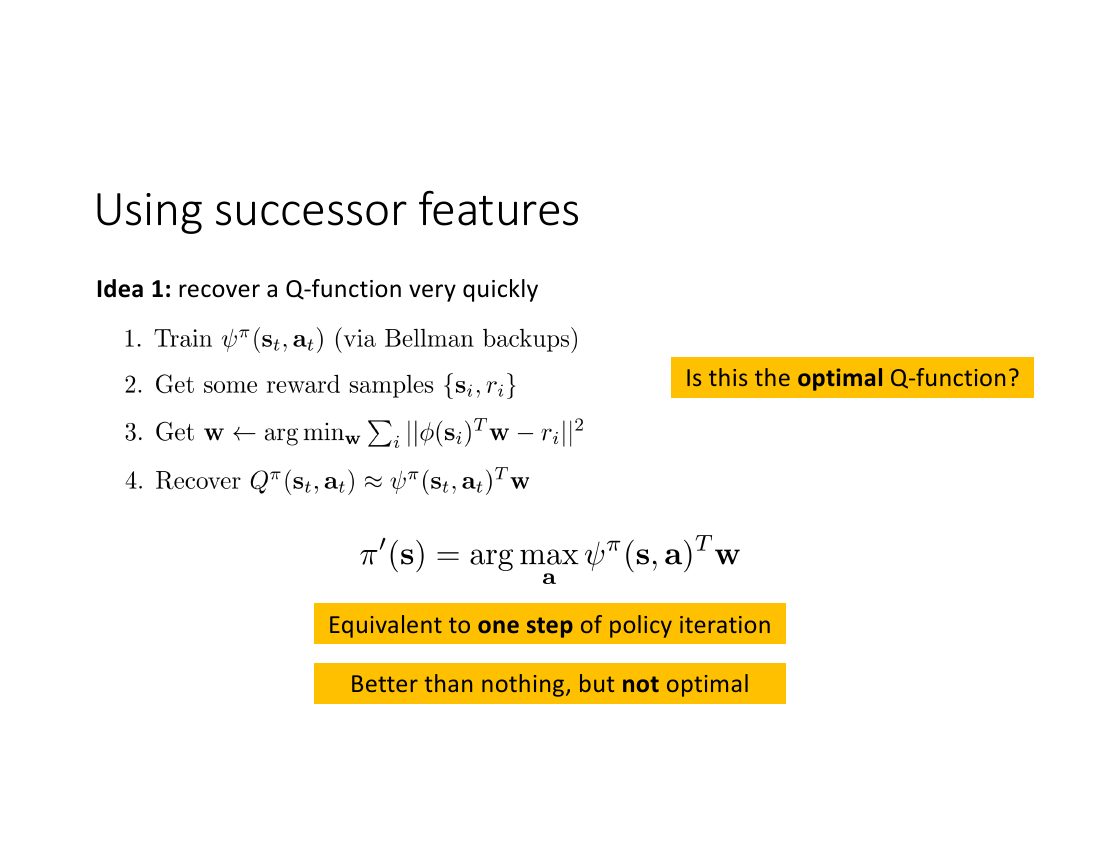
为什么只是一步策略迭代?因为 $\psi^\pi$ 是关于策略 $\pi$ 的占用度量。 换了新奖励 $\mathbf{w}$ 后算出的 $Q^\pi(\cdot,\cdot)^{}$ 是「继续用旧策略 $\pi$ 能拿多少新奖励」, 对它取 argmax 得到的 $\pi'$ 确实满足 $V^{\pi'} \ge V^\pi$(策略提升定理), 但 $\pi'$ 的占用度量已经变了,$\psi^\pi$ 不再适用,要继续提升就得重新学 $\psi^{\pi'}$。 所以你只免费拿到一次提升。这是继承特征最重要的局限,务必记住。
用法二:一次恢复很多 Q 函数(GPI)
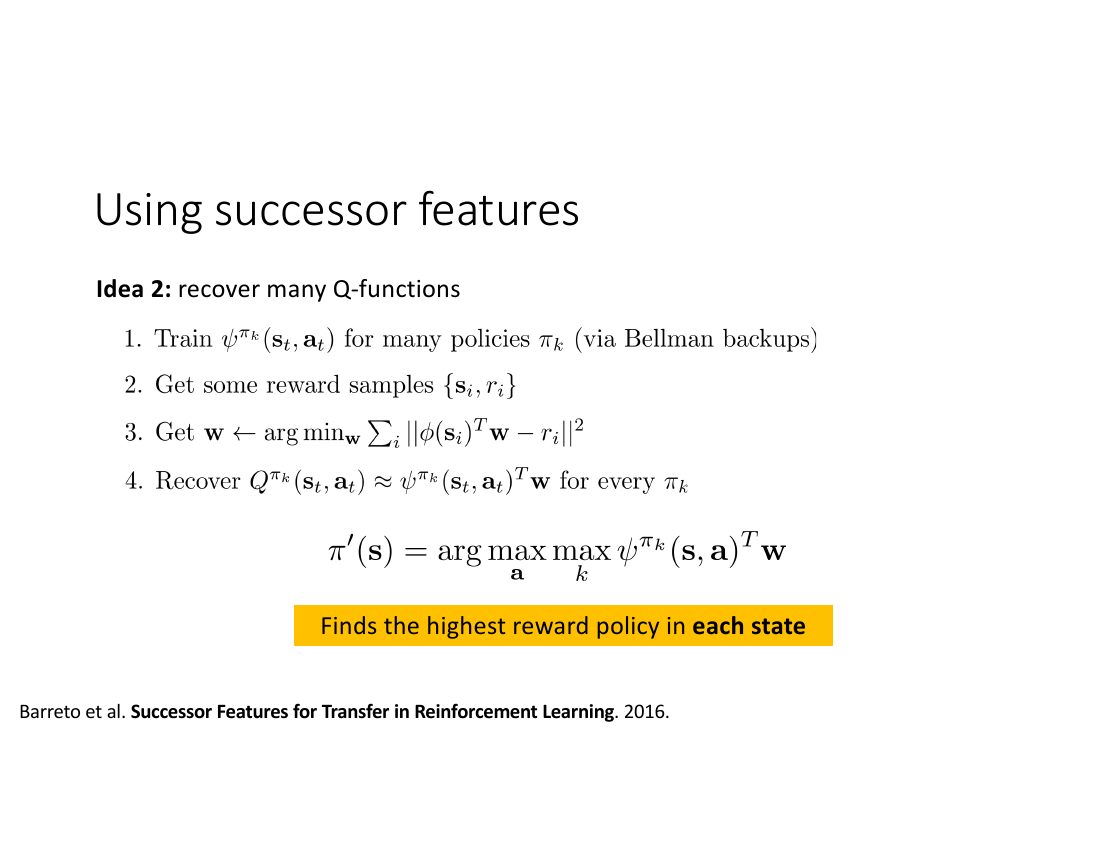
GPI 的保证是:新策略 $\pi'$ 满足 $V^{\pi'}(\mathbf{s}) \ge \max_k V^{\pi_k}(\mathbf{s})$ 对所有 $\mathbf{s}$ 成立。 直觉是:在每个状态你都从 $K$ 个候选里挑了当下最好的那个的建议, 所以你至少不比任何一个候选差。$K$ 越大、策略库越多样,这个下界越强。 这也把继承特征变成了一种技能库:预训一批策略 + 它们的 $\psi$, 新任务来了只需拟合一个 $D$ 维向量 $\mathbf{w}$(可能只要几十个奖励样本), 就能零样本组合出一个不错的策略。
- 线性奖励假设不成立:$r \approx \phi^T\mathbf{w}$ 是硬前提。如果新任务的奖励在 $\phi$ 张成的空间之外, $\mathbf{w}$ 怎么拟合都不对,恢复出来的 $Q$ 是错的。特征 $\phi$ 从哪来是个悬而未决的问题—— 手工设计不 scalable,学出来的又不保证能张成未来的奖励。
- 只有一步提升:如上所述。别指望 SF 直接给你最优策略。
- $\psi$ 本身不好学:它是 $D$ 个值函数的联合回归,误差会在 $D$ 个维度上各自累积; 而且 $\phi$ 的尺度不一致时,某些维度会主导损失。实践中常需要对 $\phi$ 做归一化。
8. 连续状态下的继承表示:C-Learning
回到第 6 节遗留的第三个问题。SR 的贝尔曼方程里有 $(1-\gamma)\delta(s_t=i)$ 这一项, 在连续状态空间里,任何采样出来的状态与任何指定的 $i$ 精确相等的概率是 0, 所以这一项恒为零,整个备份退化成 $\mu \leftarrow \gamma\E[\mu]$,收敛到全零。SR 直接失效。
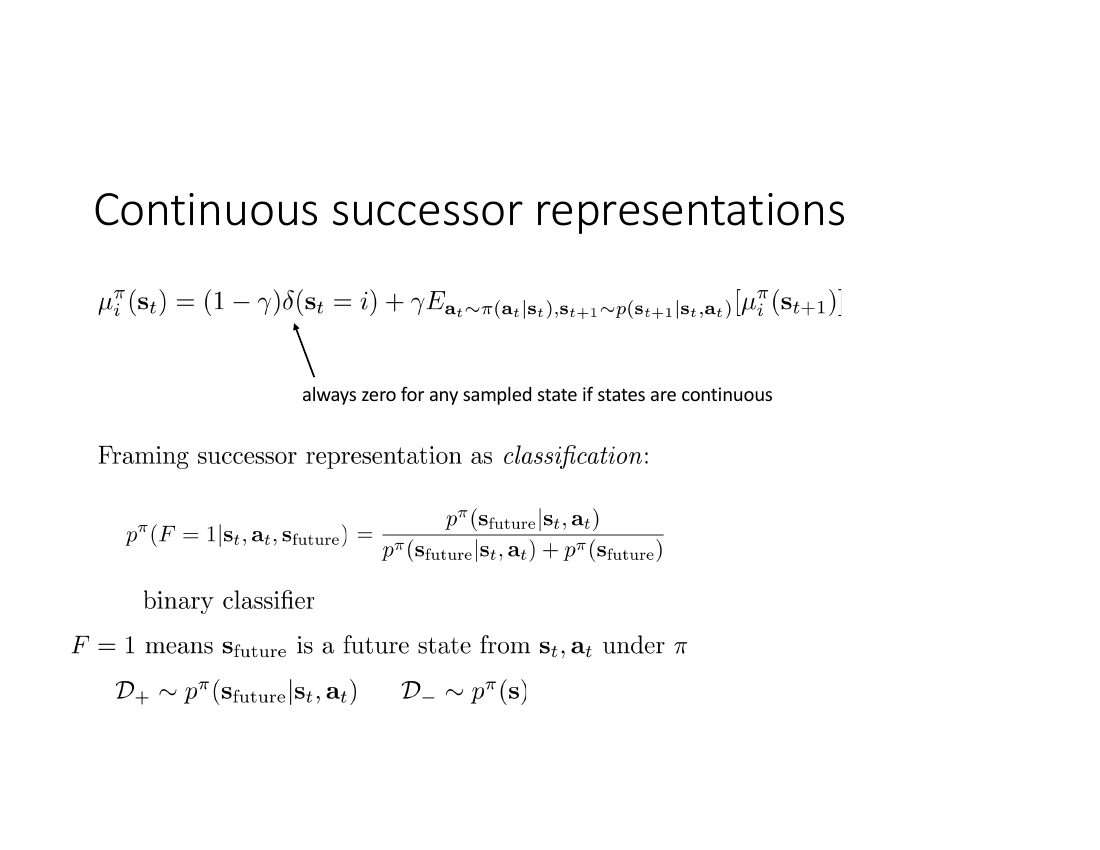
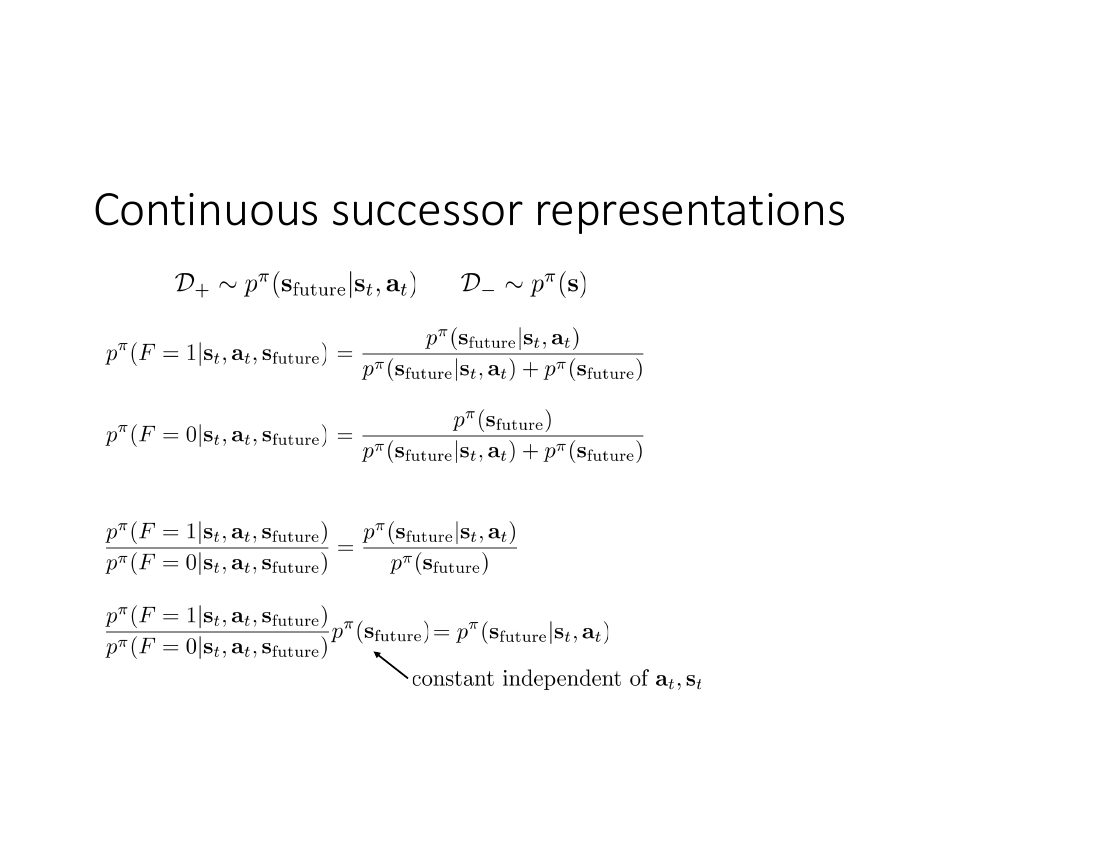
思路是用判别代替生成:不去直接估计密度 $p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,\mathbf{a}_t)$, 而是训练一个分类器去区分「真未来」和「随机状态」。假设正负样本各占一半, 贝叶斯最优分类器为
$$ p^\pi(F=1|\mathbf{s}_t,\mathbf{a}_t,\mathbf{s}_{\text{future}}) = \frac{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,\mathbf{a}_t)}{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,\mathbf{a}_t) + p^\pi(\mathbf{s}_{\text{future}})}. $$写出 $F=0$ 的情形:
$$ p^\pi(F=0|\mathbf{s}_t,\mathbf{a}_t,\mathbf{s}_{\text{future}}) = \frac{p^\pi(\mathbf{s}_{\text{future}})}{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,\mathbf{a}_t) + p^\pi(\mathbf{s}_{\text{future}})}. $$两式相除,分母整个抵消:
$$ \frac{p^\pi(F=1|\mathbf{s}_t,\mathbf{a}_t,\mathbf{s}_{\text{future}})}{p^\pi(F=0|\mathbf{s}_t,\mathbf{a}_t,\mathbf{s}_{\text{future}})} = \frac{p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,\mathbf{a}_t)}{p^\pi(\mathbf{s}_{\text{future}})}. $$于是
$$ \underbrace{\frac{p^\pi(F=1|\cdot)}{p^\pi(F=0|\cdot)}}_{\text{分类器的 odds}}\;\cdot\; \underbrace{p^\pi(\mathbf{s}_{\text{future}})}_{\text{与 }\mathbf{s}_t,\mathbf{a}_t\text{ 无关的常数}} = p^\pi(\mathbf{s}_{\text{future}}|\mathbf{s}_t,\mathbf{a}_t). $$这就是全部的魔法:分类器的 odds 与我们想要的连续版继承表示只差一个与 $(\mathbf{s}_t,\mathbf{a}_t)$ 无关的常数。 既然做决策时只比较不同的 $\mathbf{a}_t$,这个常数直接约掉了—— 所以我们永远不需要知道它。分类比密度估计容易得多,这就是它的价值。
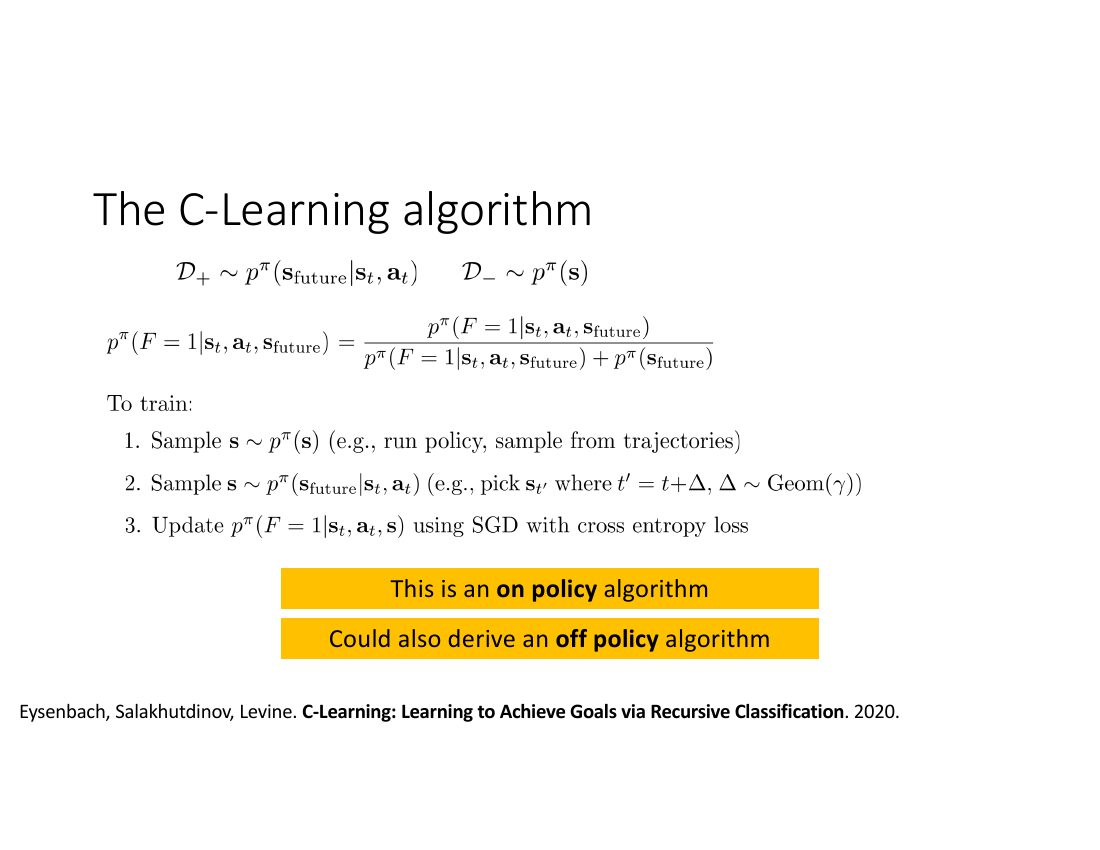
第 2 步那个几何分布是关键的实现细节,值得展开:我们想采
$p_\pi(\mathbf{s}_{\text{future}}=\mathbf{s}|s_t) = (1-\gamma)\sum_{t'\ge t}\gamma^{t'-t}p(s_{t'}=\mathbf{s}|s_t)$,
这正好是「先从几何分布 $\Delta\sim\mathrm{Geom}(\gamma)$ 采一个时间间隔,
再取轨迹上 $t+\Delta$ 时刻的状态」的边缘分布。$\Pr[\Delta=k] = (1-\gamma)\gamma^{k}$,
期望间隔 $\gamma/(1-\gamma)$——$\gamma=0.99$ 时约 99 步。所以 numpy 里就是
delta = np.random.geometric(1 - gamma) - 1。
def c_learning_step(classifier, opt, traj_batch, gamma, all_states):
    """C-Learning 的一步:正样本来自几何分布采的未来状态,负样本来自边缘分布。"""
    s, a, s_pos, s_neg = [], [], [], []
    for traj in traj_batch:
        t = random.randrange(len(traj))
        delta = np.random.geometric(1.0 - gamma) - 1        # Geom(gamma),从 0 开始
        t_future = min(t + delta, len(traj) - 1)
        s.append(traj[t].s); a.append(traj[t].a)
        s_pos.append(traj[t_future].s)                      # F = 1
        s_neg.append(all_states[random.randrange(len(all_states))])   # F = 0

    s, a = torch.as_tensor(s), torch.as_tensor(a)
    logit_pos = classifier(s, a, torch.as_tensor(s_pos))    # 输出 logit,不过 sigmoid
    logit_neg = classifier(s, a, torch.as_tensor(s_neg))
    loss = (F.binary_cross_entropy_with_logits(logit_pos, torch.ones_like(logit_pos))
          + F.binary_cross_entropy_with_logits(logit_neg, torch.zeros_like(logit_neg)))
    opt.zero_grad(); loss.backward(); opt.step()
    return loss.item()

def goal_conditioned_q(classifier, s, a, g):
    """分类器的 logit 就是 log-odds,等于 log p(g|s,a) + const —— 直接当 Q 用。"""
return classifier(s, a, g) # argmax_a 时那个 const 会被约掉HER 说:把「实际到达的状态」当成目标,就有了正样本。 C-learning 说:把「实际到达的状态」当成正类、随机状态当成负类,训一个分类器。 两者用的是完全相同的数据信号,区别在于 HER 把它塞进了标准的 Q-learning 回归, 而 C-learning 把它写成了一个有明确概率语义(密度比估计)的对比学习问题。 后者的好处是不再需要人为设定 $\varepsilon$-邻域这种超参, 而且分类损失的梯度性质通常比稀疏 0/1 回归好得多。
9. 分层 RL(一):options 与半马尔可夫决策过程
option 的定义
换一个角度看多任务。人类做复杂任务时不是一步一步想「肌肉该收缩多少」, 而是在「泡咖啡」「走到厨房」这种层次上思考。 把这种「时间上被抽象的动作」形式化,就是 Sutton、Precup、Singh 1999 年的 options 框架。一个 option 是一个三元组:
$$ \mathbf{o} = \big(\mathcal{I}_\mathbf{o},\ \pi_\mathbf{o},\ \beta_\mathbf{o}\big), $$- $\mathcal{I}_\mathbf{o} \subseteq \mathcal{S}$ 是启动集(initiation set): 只有当 $s \in \mathcal{I}_\mathbf{o}$ 时这个 option 才能被调用。 (比如「开门」这个 option 只有在门前才有意义。)
- $\pi_\mathbf{o}(a|s)$ 是 option 策略:就是一个普通的策略,负责在 option 激活期间选原子动作。
- $\beta_\mathbf{o}(s) \in [0,1]$ 是终止条件(termination): 在状态 $s$ 处以概率 $\beta_\mathbf{o}(s)$ 结束这个 option,把控制权交还给高层。
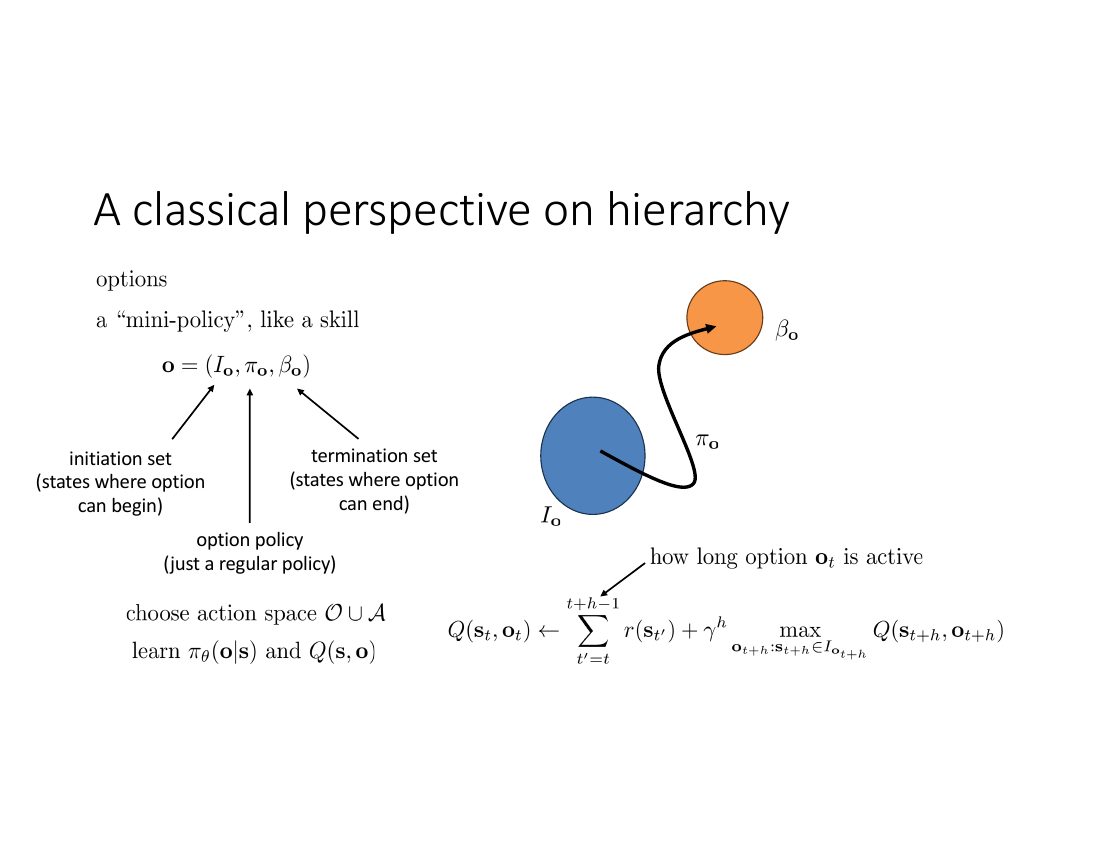
普通 MDP 的贝尔曼备份跨越一个时间步:$Q(s,a) = r(s,a) + \gamma\max_{a'}Q(s',a')$。 option 的备份跨越 $h$ 步,而且 $h$ 本身是随机的—— 它由 $\beta_\mathbf{o}$ 和轨迹共同决定。这就是「半马尔可夫决策过程 (semi-Markov decision process, SMDP)」的定义:决策点之间的时间间隔是随机变量。 所以备份写成
$$ Q(\mathbf{s}_t,\mathbf{o}_t) \;\leftarrow\; \underbrace{\sum_{t'=t}^{t+h-1} \gamma^{t'-t} r(\mathbf{s}_{t'})}_{\text{option 执行期间累积的奖励}} \;+\; \gamma^{h}\max_{\mathbf{o}':\,\mathbf{s}_{t+h}\in\mathcal{I}_{\mathbf{o}'}} Q(\mathbf{s}_{t+h},\mathbf{o}'). $$两处细节:(i)折扣因子是 $\gamma^h$ 而不是 $\gamma$——跳过了 $h$ 步就要折 $h$ 次; (ii)外层 max 只在那些在 $\mathbf{s}_{t+h}$ 处合法的 option 上取, 这正是启动集 $\mathcal{I}$ 的作用。可以证明这个备份算子在 $\gamma^h \le \gamma \lt 1$ 下依然是压缩映射, 所以 Q 迭代的收敛性照旧成立——option 没有破坏任何理论保证。
为什么这是个好主意
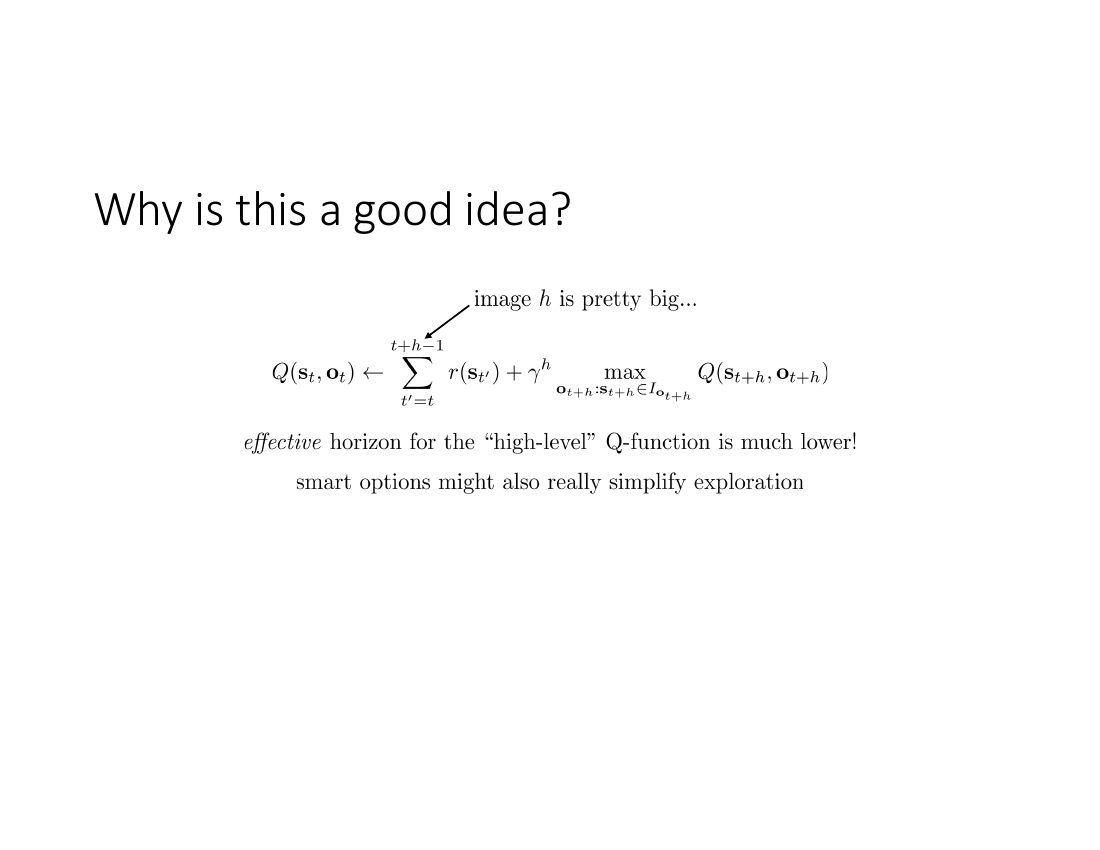
把这两点量化一下,就能明白分层为什么诱人:
| 指标 | 扁平(flat)RL | 分层(option 平均长 $h$ 步) |
|---|---|---|
| 高层决策次数 | $T$ | $T/h$ |
| 值函数误差的传播因子 | $\frac{1}{1-\gamma}$ | $\frac{1}{1-\gamma^{h}}$($\gamma=0.99,h=10$ 时约 $10.5$ 对 $100$) |
| 随机探索到达 $d$ 步外某状态的概率 | $\sim |\mathcal{A}|^{-d}$ | $\sim |\mathcal{O}|^{-d/h}$ |
| 需要的信用分配跨度 | $T$ 步反向传播 | $T/h$ 步 |
第三行尤其触目惊心:$|\mathcal{A}|=4$、$d=100$ 时,扁平随机探索命中概率是 $4^{-100}\approx 10^{-60}$; 若有 $|\mathcal{O}|=4$ 个各能走 $h=10$ 步的 option,概率变成 $4^{-10}\approx 10^{-6}$。 这是 54 个数量级的差距。蒙特祖玛之所以难,正是因为它需要 $d$ 很大的定向探索。
为什么这是个坏主意
Option-critic 给出了端到端学 option 的完整梯度。定义 option 内策略 $\pi_{\omega,\theta}(a|s)$、 终止函数 $\beta_{\omega,\vartheta}(s)$、以及 option 层的 $Q_\Omega(s,\omega)$。 引入两个辅助量:
$$ Q_U(s,\omega,a) = r(s,a) + \gamma\,\E_{s'}\big[U(\omega, s')\big], \qquad U(\omega, s') = \big(1-\beta_{\omega,\vartheta}(s')\big) Q_\Omega(s',\omega) + \beta_{\omega,\vartheta}(s')\, V_\Omega(s'). $$$U$ 的含义是「刚到 $s'$、当前 option 还是 $\omega$ 时的价值」—— 以概率 $1-\beta$ 继续用 $\omega$,以概率 $\beta$ 终止并由高层重选。于是两条梯度:
$$ \frac{\partial Q_\Omega(s,\omega)}{\partial\theta} = \E\Big[\frac{\partial\log\pi_{\omega,\theta}(a|s)}{\partial\theta}\,Q_U(s,\omega,a)\Big] \quad\text{(option 内策略梯度)}, $$ $$ \frac{\partial U(\omega,s')}{\partial\vartheta} = -\,\frac{\partial\beta_{\omega,\vartheta}(s')}{\partial\vartheta}\,A_\Omega(s',\omega), \qquad A_\Omega(s',\omega) = Q_\Omega(s',\omega) - V_\Omega(s') \quad\text{(终止梯度)}. $$看终止梯度的符号:要减小损失就要沿负梯度走,即当优势 $A_\Omega(s',\omega) \lt 0$ (当前 option 不如平均水平)时增大 $\beta$、尽早终止;反之减小 $\beta$。听起来合理。 但训练到中后期,$Q_\Omega$ 逐渐收敛后 $A_\Omega \to 0$,终止梯度随之消失, $\beta$ 的取值几乎不受约束。实践中观察到两种退化解:
- $\beta \to 1$:每一步都终止。这时 option 只持续 1 步, 半 MDP 退化回普通 MDP,$h=1$,分层的全部好处消失,只剩下多余的参数。 这是最常见的失败模式,也正是 Levine 说的「端到端学 option 可能抵消好处」。
- $\beta \to 0$ 且只用一个 option:高层永远选同一个 option, 整个系统退化成一个扁平策略。
常见对策是加正则:对 $\beta$ 加一个终止惩罚(deliberation cost), 即每次终止扣一点奖励,逼迫 option 至少持续若干步;或者干脆固定 $h$ (每 $k$ 步强制换一次),这就是第 10 节所有实用方法的做法。
10. 分层 RL(二):把 option 当成多任务策略
丢掉 $\mathcal{I}$ 和 $\beta$,只留策略
Levine 在这里做了一个非常实用主义的简化。既然 $\mathcal{I}_\mathbf{o}$ 和 $\beta_\mathbf{o}$ 又难学又容易退化, 那就把它们扔掉:启动集设为全空间(任何 option 在任何状态都能启动), 终止条件设为固定周期(每 $k$ 步换一次)。剩下的 $\pi_\mathbf{o}(a|s)$ 是什么? 如果把 option 的编号写成一个变量,它就是
$$ \pi(\mathbf{a}|\mathbf{s},\mathbf{o}) \quad\text{或}\quad \pi(\mathbf{a}|\mathbf{s},\mathbf{z}) \qquad\Longrightarrow\qquad \textbf{option 就是一个多任务策略!} $$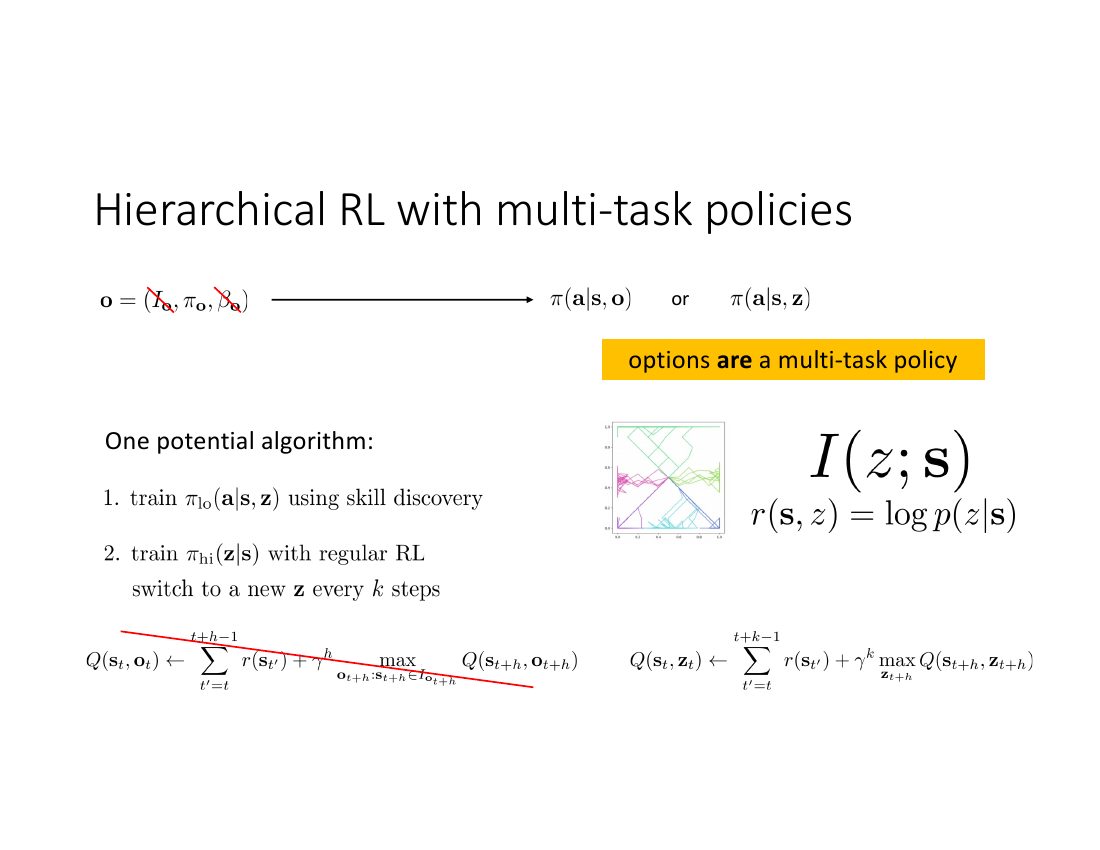
这个视角非常有力:它把分层 RL 直接还原成了本讲前半部分的多任务 RL。 低层是一个上下文策略,上下文 $\mathbf{z}$ 由高层下发;高层是一个动作空间为 $\mathcal{Z}$ 的普通 RL 问题,只不过它的「一步」等于环境里的 $k$ 步。前面所有多任务技巧 (重标注、目标条件、HER)立刻可以用在低层上。
目标下发型分层:HIRO / feudal
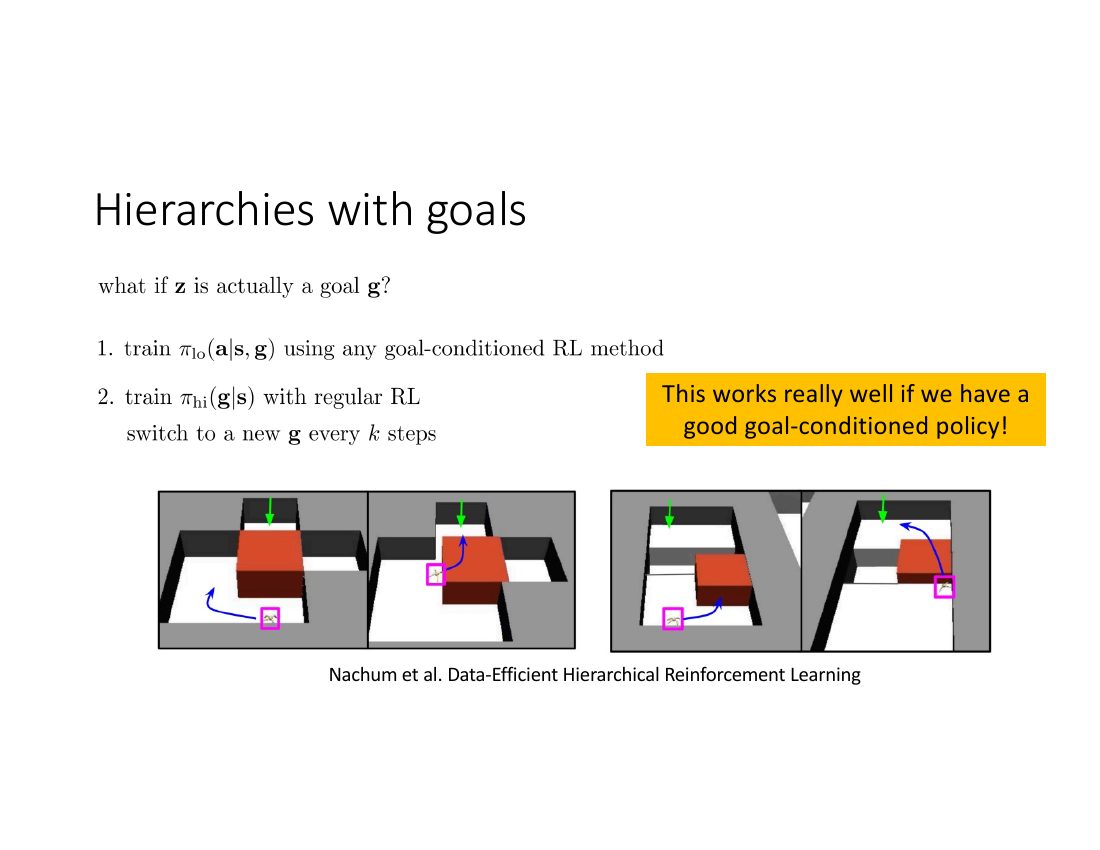
这一族方法有两个经典成员,值得对比:
| FeUdal / FuN(Vezhnevets 等 2017) | HIRO(Nachum 等 2018) | |
|---|---|---|
| 高层输出 | 潜空间里的方向 $g_t$(单位向量) | 状态空间里的相对位移 $\mathbf{g}_t$($s_t + \mathbf{g}_t$ 是要到的位置) |
| 低层奖励 | 内在奖励 $r^{\text{lo}}_t = \frac{1}{c}\sum_{i=1}^{c}\cos\big(s_t - s_{t-i},\, g_{t-i}\big)$ | $r^{\text{lo}}_t = -\|s_t + \mathbf{g}_t - s_{t+1}\|_2$ |
| 算法类型 | on-policy(A3C 式) | off-policy(TD3 式),样本效率高一个数量级 |
| 对非平稳的处理 | 用「方向」而非「绝对目标」,对低层变化不敏感 | off-policy 目标重标注(见下) |
高层的转移函数是「下发 $\mathbf{g}$ 之后 $k$ 步会到哪」, 而这完全取决于当前的低层策略 $\pi_{\text{lo}}$。 低层还在训练、每一轮都在变,于是高层面对的是一个不断变化的 MDP—— 它昨天学到的「下发 $\mathbf{g}=(3,0)$ 会走到 $(3,0)$」今天可能不成立了。 更糟的是,高层回放池里的旧样本 $(\mathbf{s},\mathbf{g},\sum r,\mathbf{s}')$ 是在老版本低层下产生的,直接拿来做 off-policy 训练会引入系统性偏差。
HIRO 的解法叫 off-policy 目标重标注:取出旧样本时, 不用当初下发的 $\mathbf{g}$,而是重新搜一个 $\tilde{\mathbf{g}}$,使得当前的低层策略 最有可能产生已经观测到的那串动作:
$$ \tilde{\mathbf{g}} = \argmax_{\mathbf{g}} \sum_{t'=t}^{t+k-1}\log \pi_{\text{lo}}\big(a_{t'}\,\big|\,s_{t'},\, \mathbf{g}\big). $$实现上只需在 $\mathbf{g}$ 的邻域里采 8~10 个候选(包括原始 $\mathbf{g}$ 和 「实际位移 $s_{t+k}-s_t$」这两个显然的候选),算 log-likelihood 取最大即可。 注意它与 HER 的血缘:都是事后修改上下文标签,让旧数据在新语义下重新变成有效监督。
语言作为分层接口
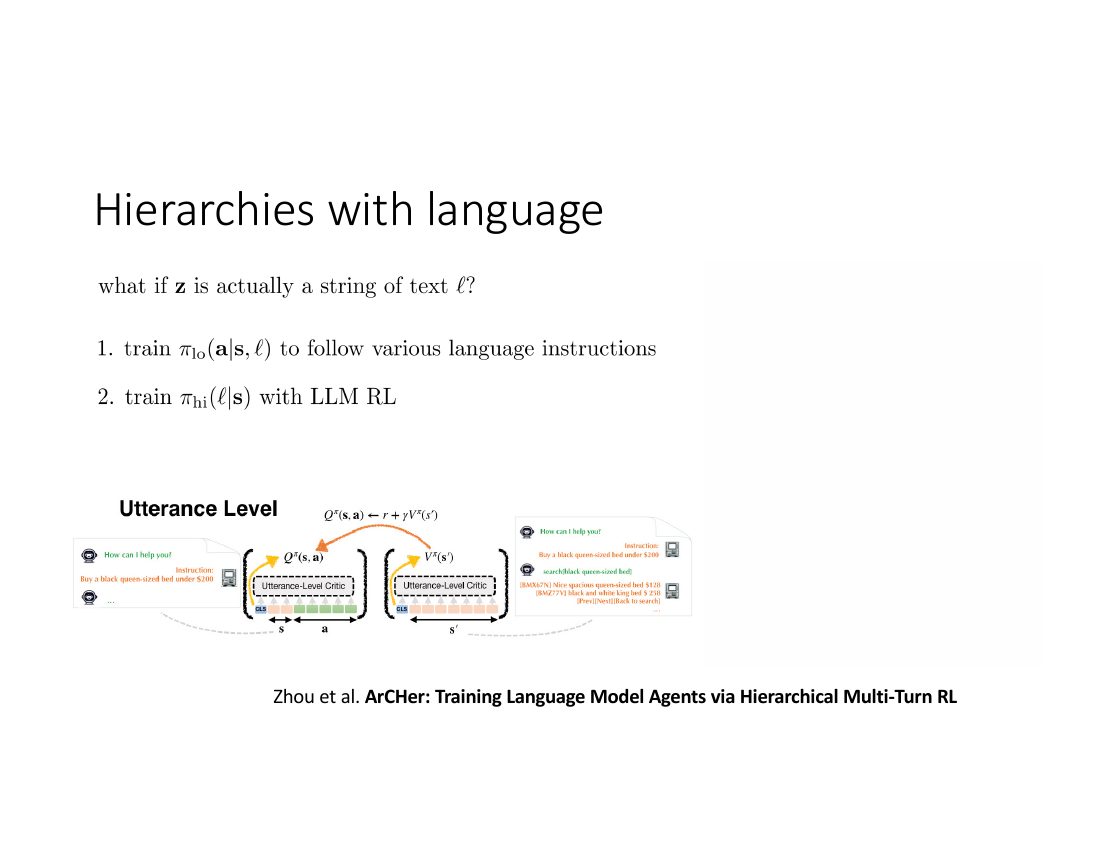
为什么语言是特别好的分层接口?三个原因: (1)它是组合式的,天然能表达「先 A 再 B」这类结构; (2)互联网上有海量的「语言—行为」配对数据,低层策略可以从中预训练, 不需要从零做技能发现;(3)它可解释——你能直接读出高层在想什么, 这在调试分层系统时价值巨大(HIRO 里的 $\mathbf{g}$ 至少还能画出来, DIAYN 里的 $\mathbf{z}$ 就是一串没有语义的数字)。 代价是 $\ell$ 的动作空间是离散且组合爆炸的,高层 RL 本身就变成了一个 LLM 训练问题。
11. 元学习与元强化学习
本讲最后一块拼图。前面讲的迁移都是「把知识从旧任务搬到新任务」, 但搬运的方式是我们人工规定的(共享参数、共享特征、共享技能)。 元学习(meta-learning)问一个更激进的问题: 能不能把「怎么快速学一个新任务」这件事本身学出来?
先看监督学习版本
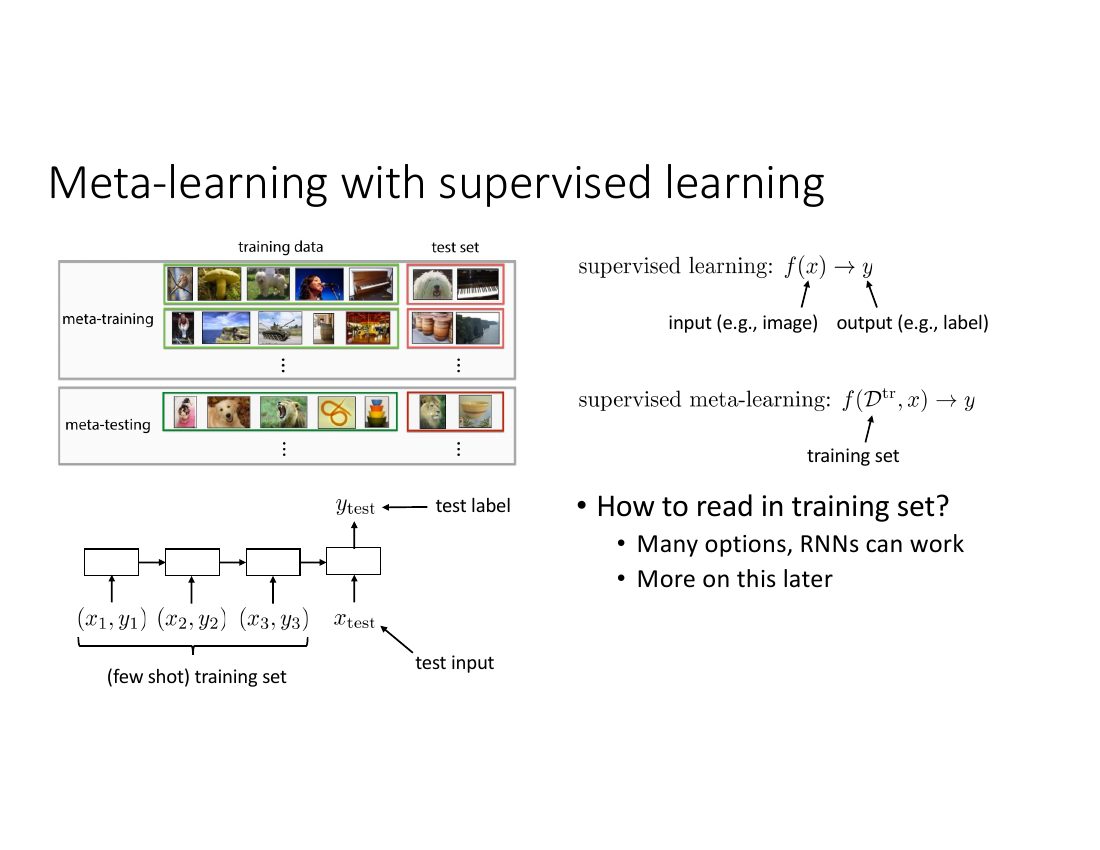
把两者的目标函数并排写出来,差别一目了然:
$$ \underbrace{\theta^\star = \argmin_\theta \mathcal{L}\big(\theta, \mathcal{D}^{\text{tr}}\big) = f_{\text{learn}}(\mathcal{D}^{\text{tr}})}_{\text{普通学习}} \qquad\qquad \underbrace{\theta^\star = \argmin_\theta \sum_{i=1}^{n}\mathcal{L}\big(\phi_i, \mathcal{D}_i^{\text{ts}}\big),\ \ \phi_i = f_\theta(\mathcal{D}_i^{\text{tr}})}_{\text{元学习}} $$读法:普通学习产出一组参数 $\theta^\star$;元学习产出一个函数 $f_\theta$, 这个函数吃进一个任务的训练集、吐出该任务专用的参数 $\phi_i$。 外层优化的是「$f_\theta$ 产出的 $\phi_i$ 在没见过的测试集上表现好不好」。 换句话说,$\theta$ 编码的是学习算法,$\phi_i$ 才是被学到的东西。
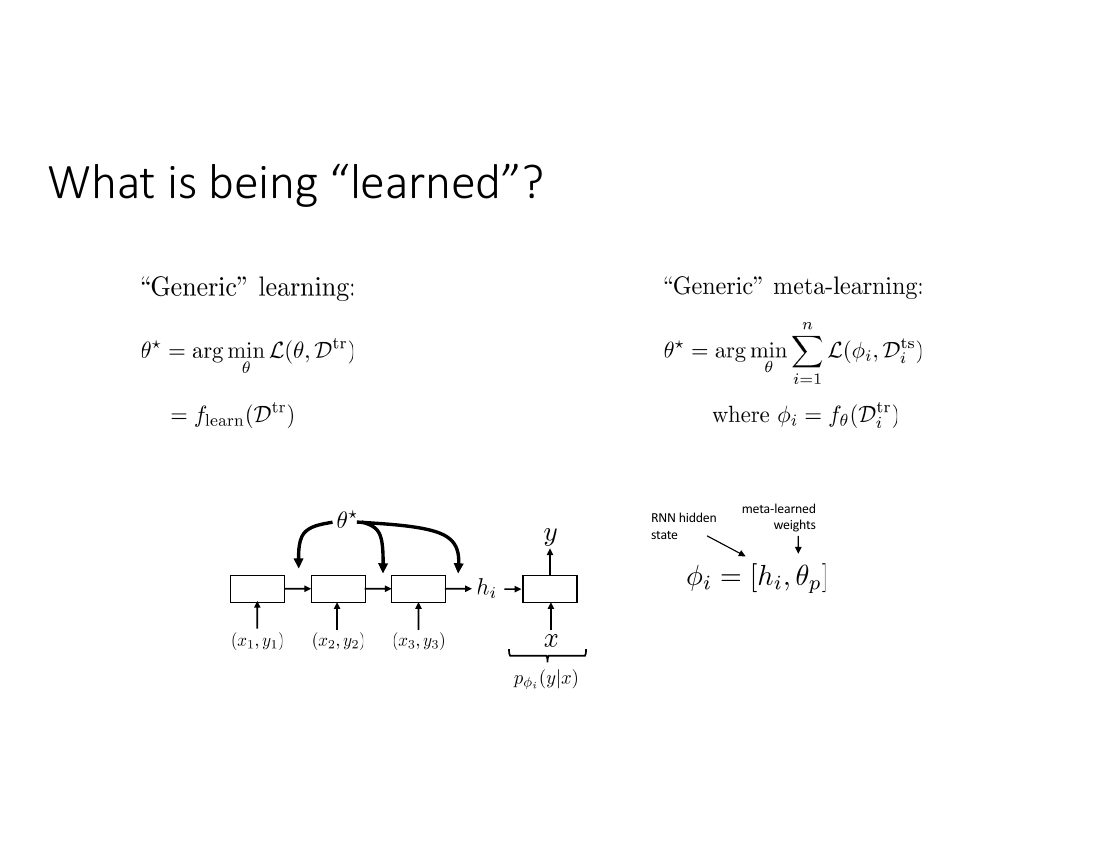
「把训练集拼成一个序列喂给 RNN / Transformer,让它在前向传播里完成学习」—— 这正是今天 LLM 的少样本提示(few-shot prompting)在做的事。 所谓「模型在上下文里学会了新任务」,形式上就是 $\phi_i = f_\theta(\mathcal{D}_i^{\text{tr}})$ 被一次前向传播实现了。区别只在于 LLM 的 $f_\theta$ 是在海量自然语料上隐式元训练出来的, 而这里我们是显式地按元学习目标训练它。
元 RL 的问题定义
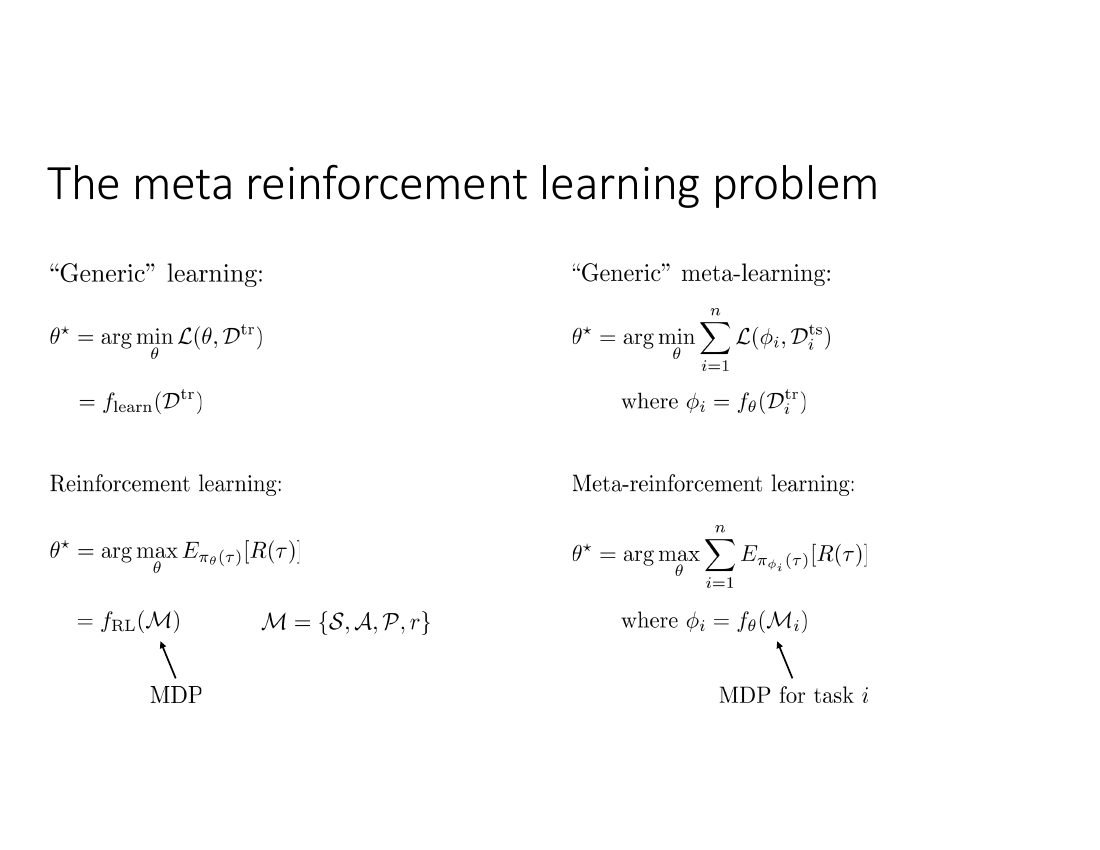
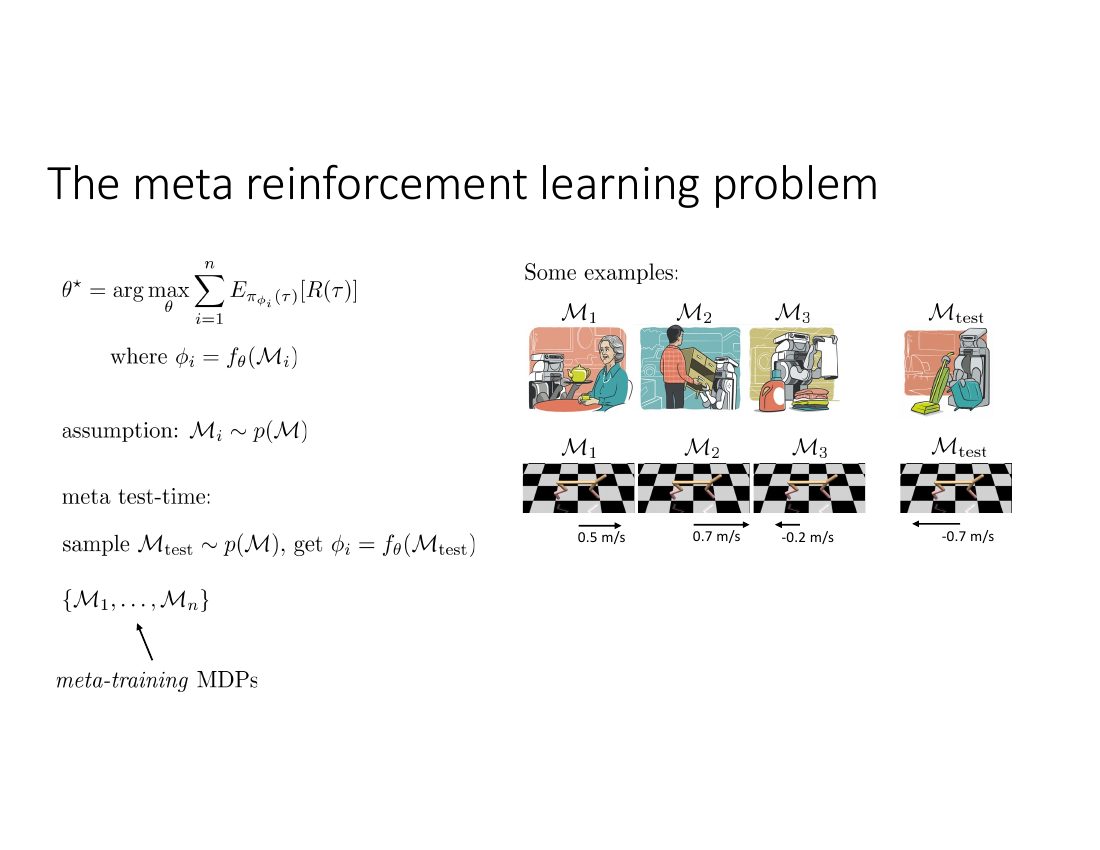
元 RL 与多任务 RL 的关系
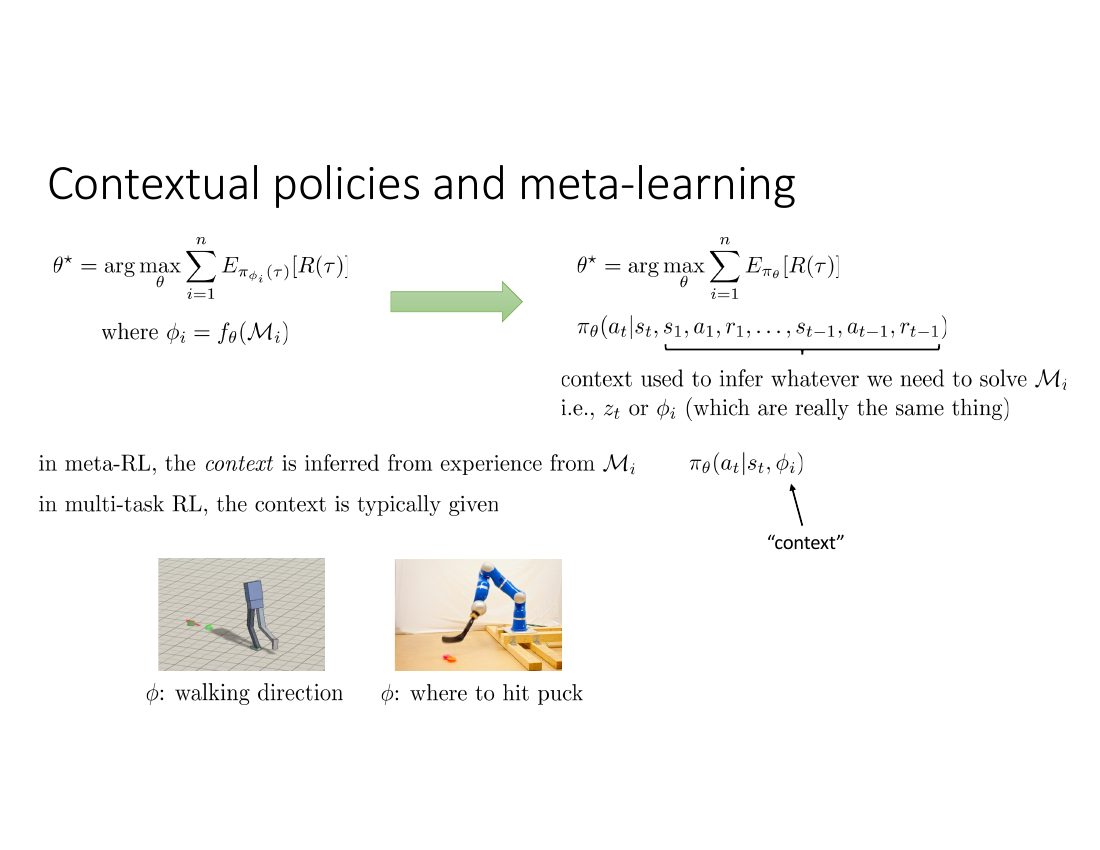
- 多任务 RL:$\pi_\theta(a|s,\omega)$,$\omega$ 告诉你要做什么任务。
- 元 RL:$\pi_\theta(a|s,\phi)$,$\phi$ 要你自己从交互里推断出来—— 所以策略必须先做实验、再解题。
- 零样本泛化:既不给 $\omega$ 也不让你试探,直接要求做对。最难,通常也不现实。
由此可见元 RL 比多任务 RL 多了一件事:它必须学会探索。 这不是可选项——如果不通过试探把 $\phi$ 认出来,策略根本不知道该优化什么。
做法一:黑箱元 RL(RNN 策略)
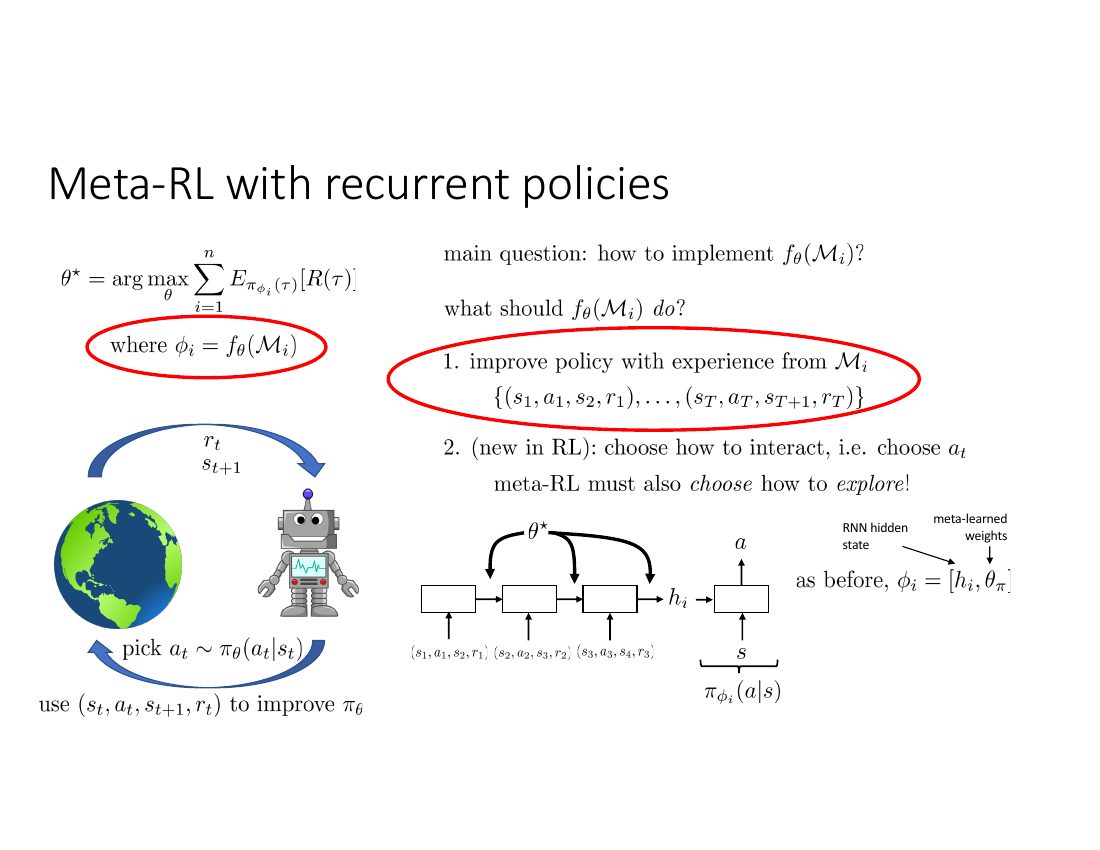
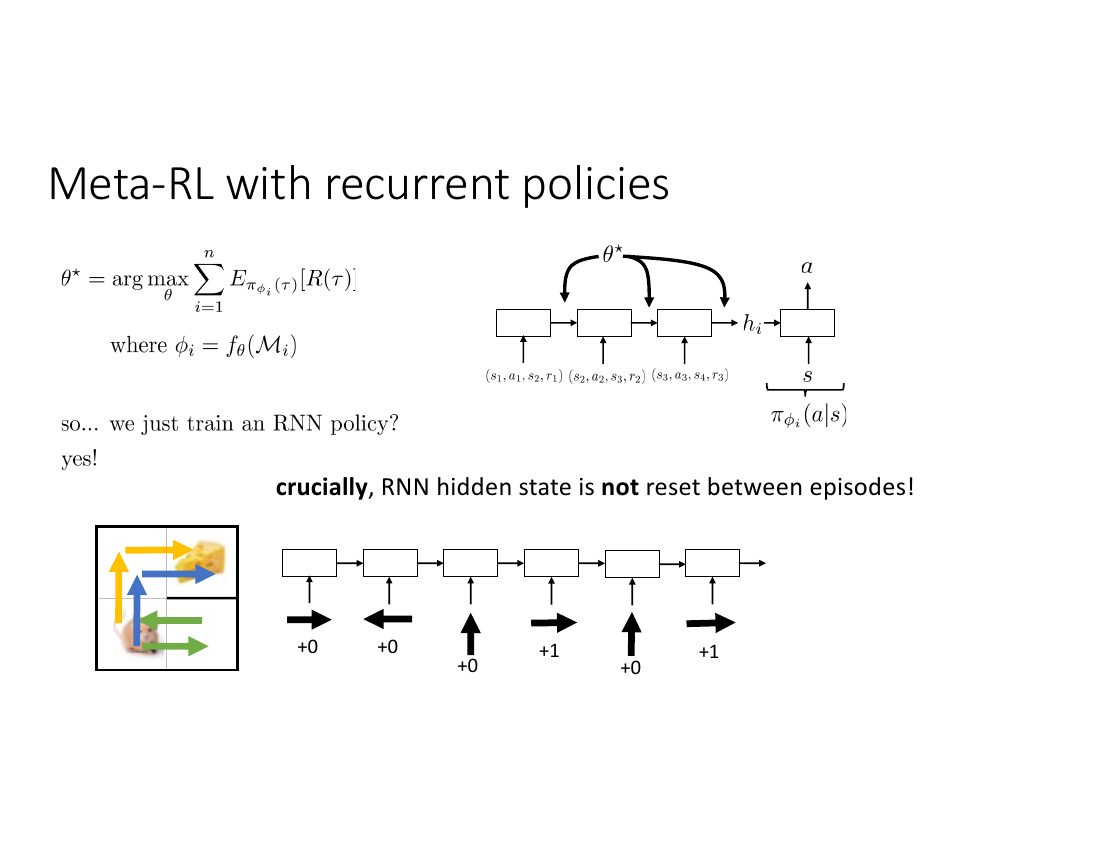
既然 $\phi_i = f_\theta(\mathcal{M}_i)$ 要从交互经验里推断,最直接的实现就是让 RNN 来读经验。
为什么 RNN 策略会自己学会探索
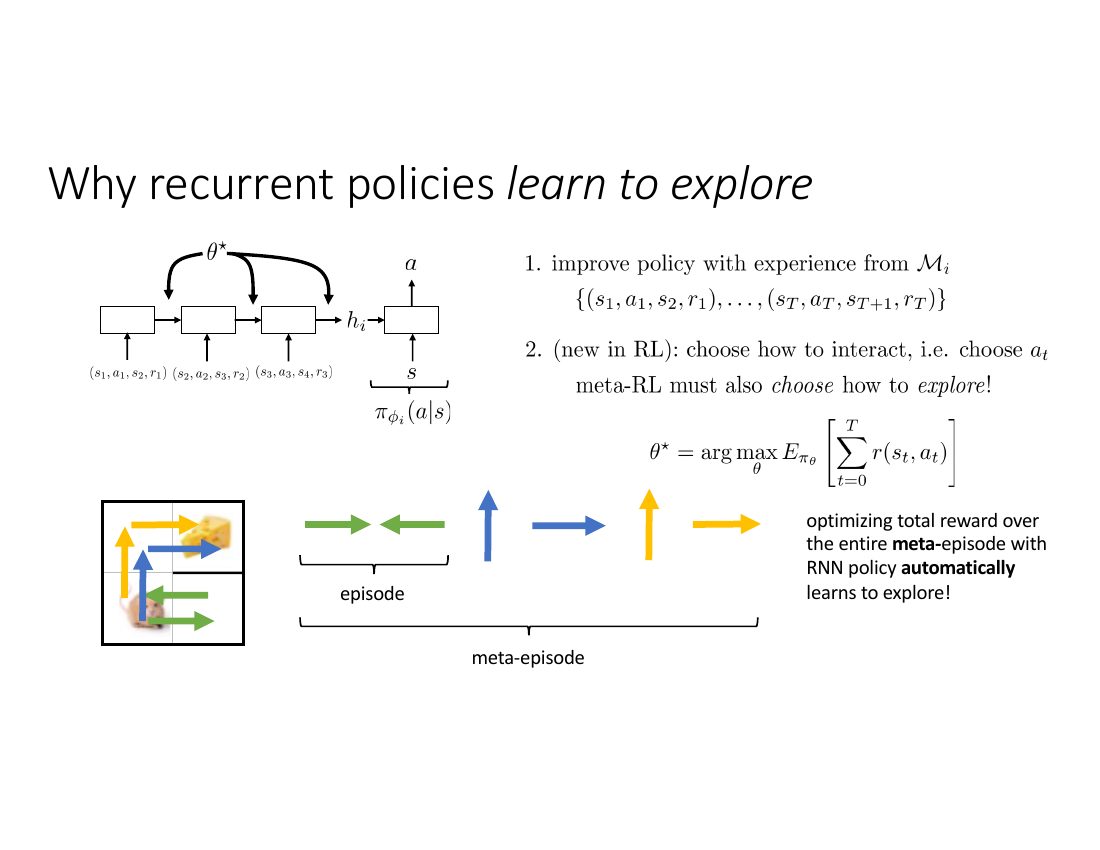
设 meta-episode 包含 $K$ 个 episode,每个长 $L$。总回报
$$ J(\theta) = \E\Big[\sum_{k=1}^{K}\sum_{t=1}^{L} r\big(s^{(k)}_t, a^{(k)}_t\big)\Big]. $$假设任务身份 $z$ 未知,先验为 $p(z)$。考虑一个极端例子:迷宫里奶酪等概率藏在 $M$ 个位置之一, 找到得 1 分。若智能体不探索,每次随机猜一个位置,期望回报 $= K/M$。 若智能体第一个 episode 花 $L$ 步系统性搜索确定奶酪位置(假设 $L$ 够大能搜完), 之后 $K-1$ 个 episode 每次都直奔目标,期望回报 $\approx (K-1)\cdot 1$。 当 $K$ 较大(比如 $K=10$、$M=4$)时,后者是 $9$,前者是 $2.5$—— 探索严格更优,所以最大化 $J(\theta)$ 的策略必然探索。
这就是黑箱元 RL 最迷人的地方:我们没有写任何探索奖励、 没有 $\epsilon$-greedy、没有好奇心项。探索是目标函数的最优解, 不是外挂的启发式。前提只有一个:隐状态跨 episode 保留, 使得「这个 episode 的探索成果」能被后面的 episode 用上—— 否则探索的收益无法回收,梯度就不会推向探索。
- meta-overfitting:如果 meta-training 的任务只有几十个, RNN 会直接记住每个任务而不是学会推断。表现是训练任务上完美、新任务上崩溃。 对策是任务分布要足够宽、足够连续(比如猎豹速度是连续采样的而不是三个固定值)。
- 信用分配跨度太长:meta-episode 长度是 $K\times L$, 可能是几千步。策略梯度在这个跨度上的方差极大,是黑箱元 RL 最实际的训练瓶颈。
- 不探索的局部最优:如果初始策略从没在任何任务上拿到过奖励, 「探索有收益」这件事本身就学不到,梯度是零,卡死。所以任务分布里最好包含一些容易的任务。
做法二:梯度型元 RL(MAML 风格)
黑箱做法把 $f_\theta$ 完全交给神经网络。另一条路是规定 $f_\theta$ 就是「做几步梯度上升」, 只把初始参数 $\theta$ 元学习出来。这就是 MAML(model-agnostic meta-learning)的思路, 在 RL 里写成:
$$ \phi_i = f_\theta(\mathcal{M}_i) = \theta + \alpha\,\nabla_\theta J_{\mathcal{M}_i}(\theta), \qquad \theta^\star = \argmax_\theta \sum_{i=1}^{n} J_{\mathcal{M}_i}\big(\phi_i\big), $$其中 $J_{\mathcal{M}_i}(\theta) = \E_{\tau\sim\pi_\theta}[R(\tau)]$ 用任务 $i$ 上采的一批轨迹估计。 展开外层梯度会出现二阶项:
$$ \nabla_\theta \sum_i J_{\mathcal{M}_i}(\phi_i) = \sum_i \big(I + \alpha\,\nabla^2_\theta J_{\mathcal{M}_i}(\theta)\big)\,\nabla_{\phi}J_{\mathcal{M}_i}(\phi)\big|_{\phi=\phi_i}. $$三点评价:(1)它的归纳偏置很强——保证了「只要梯度上升能解这个任务, 元学到的初始化就能在几步内解它」,外推性通常比 RNN 好; (2)代价是需要二阶导,实现麻烦、方差大, 而且 RL 的策略梯度本身就带高方差,二阶估计更糟(常用一阶近似 FOMAML 绕过); (3)在元 RL 里它的探索能力较弱:内层的一步梯度用的是 $\pi_\theta$ 采的数据, 而 $\pi_\theta$ 没有被显式激励去做信息收集,容易只学到「一个中庸的初始策略」。
统一视角:元 RL 就是 POMDP 推断
最后 Levine 给出一个把所有做法统一起来的视角。先复习 POMDP:
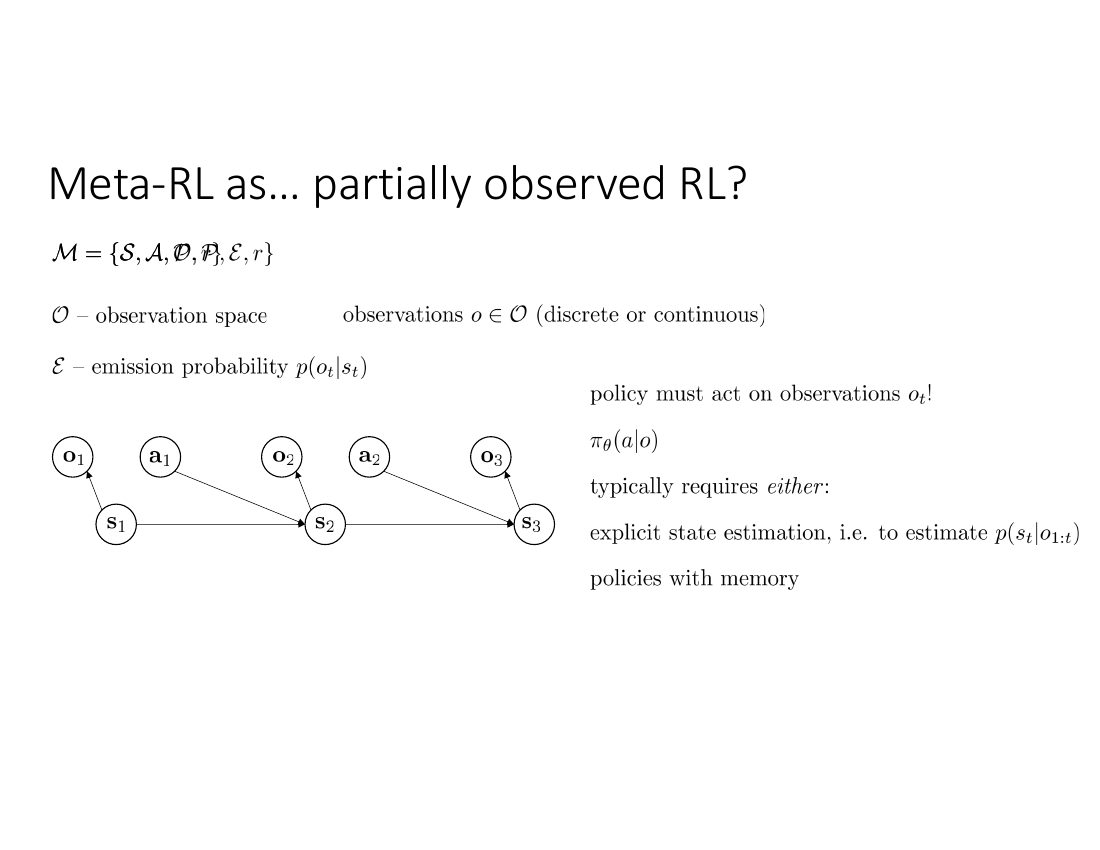
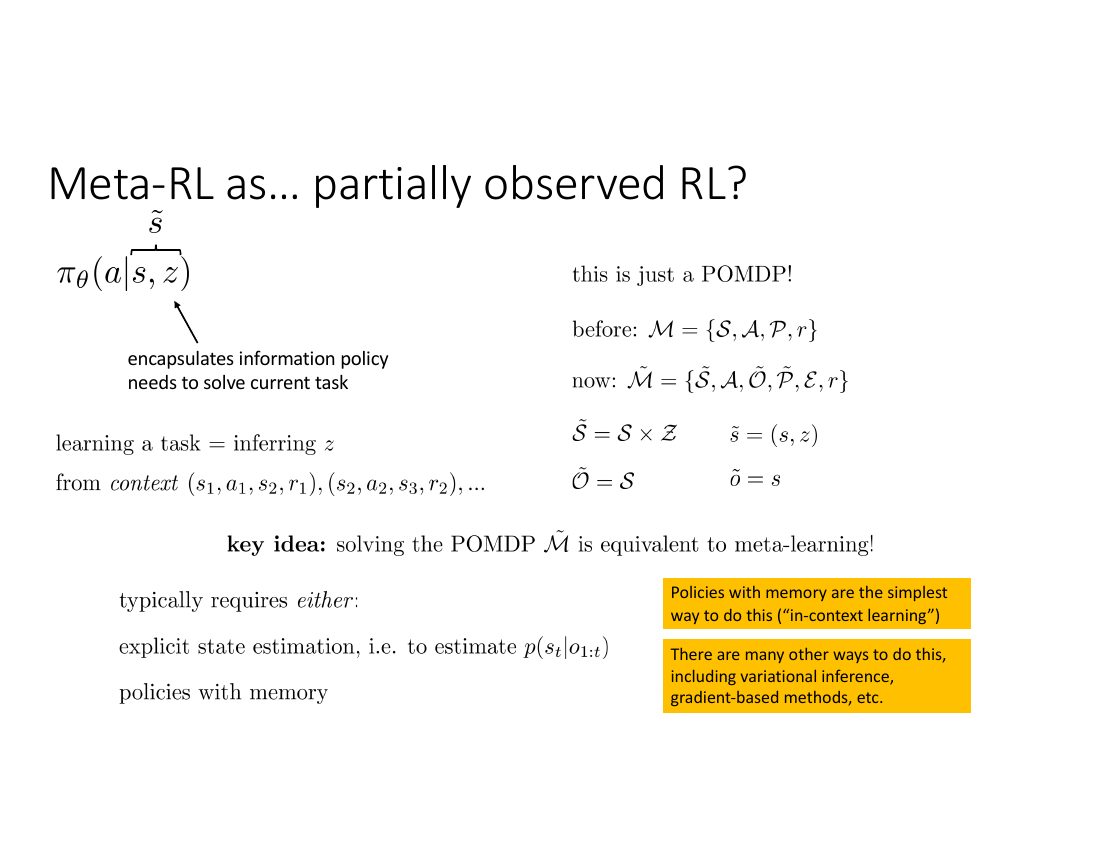
这个视角的威力在于它解释了前面所有做法为什么是同一件事:
| 做法 | 怎么处理隐变量 $z$ | 探索从哪来 | 典型失败模式 |
|---|---|---|---|
| RNN 黑箱(RL$^2$) | 隐式:$z$ 就是 RNN 隐状态 $h_t$,不做显式推断 | 目标函数自动导出 | meta-overfitting;长跨度信用分配 |
| MAML 梯度型 | 隐式:$z$ 被编码进「适配后的参数 $\phi_i$」 | 弱,需要额外机制(如 MAESN 的可学噪声) | 二阶梯度方差大;探索不足 |
| 变分推断型(PEARL / VariBAD) | 显式:学一个后验编码器 $q_\psi(z|\text{context})$,从中采样 | 后验采样(posterior sampling)自然导出定向探索 | 后验坍缩;需要假设 $z$ 的维度和先验 |
| 「就用一个大 Transformer」 | 隐式,在超长上下文里 | 同 RNN | 算力;上下文长度 |
如果我们维护一个关于任务身份的后验 $q(z|\text{context})$, 就可以做后验采样(Thompson sampling):每个 episode 从后验里采一个 $z$, 然后假装它是真的、按最优策略行动。这自动产生了「不确定性大的时候尝试多样行为、 不确定性小的时候稳定利用」的行为,而且这种探索是定向的(deep exploration), 比 $\epsilon$-greedy 的随机抖动强得多。PEARL 就是这么做的。 代价是你必须显式假设 $z$ 的结构(维度、先验),而 RNN 做法不需要。 这是「结构化假设 → 更好的样本效率 / 更差的通用性」这一 RL 永恒权衡的又一个实例。
本讲小结
一页速查表
| 方法 | 解决什么问题 | 目标函数 / 核心式子 | 失败模式 |
|---|---|---|---|
| 上下文策略 (多任务 RL) |
不想为每个任务单独训一个策略 | $\argmax_\theta \E_{\omega\sim p(\omega)}\E_{\tau\sim\pi_\theta(\tau|\omega)}[r_\omega(\tau)]$;实现上就是把 $\omega$ 拼进状态 | ray interference:简单任务先饱和、吃掉探索熵,困难任务卡在平台期 |
| 重标注 | 多任务数据利用率低 | 对回放池里的 $(s,a,s')$ 重采 $\omega_{\text{new}}$,用 $r_{\omega_{\text{new}}}$ 现算目标 $y$ | 必须配 off-policy 算法;重标注分布与真实任务分布错配 |
| HER | 目标条件 RL 里稀疏奖励几乎永远为 0 | 以概率 $p$ 把目标换成实际到达的 $\mathbf{g}_{\text{reached}}$(future 策略最好用) | 只教「你已经会做的事」;对真正没探索到的区域仍然无能为力 |
| 目标条件值函数 | 需要一个可迁移的「到达难度」度量 | $V(\mathbf{s},\mathbf{g}) = -1 + \E_{\mathbf{s}'}[V(\mathbf{s}',\mathbf{g})]$($\mathbf{s}\neq\mathbf{g}$);满足三角不等式 | 它是拟度量(不对称);用对称网络结构拟合会引入错误偏置 |
| 继承表示 SR | 换奖励就要重训一遍 RL | $\mu_i^\pi(s) = (1-\gamma)\delta(s=i)+\gamma\E[\mu_i^\pi(s')]$,$V^\pi = \frac{1}{1-\gamma}\mu^{\pi T}\vec r$ | 维度 $=|\mathcal{S}|$;连续状态下 $\delta$ 恒为 0,完全失效 |
| 继承特征 SF | SR 维度爆炸 | $\psi_j^\pi(s)=\phi_j(s)+\gamma\E[\psi_j^\pi(s')]$,$Q^\pi \approx \psi^{\pi T}\mathbf{w}$;GPI:$\argmax_a\max_k \psi^{\pi_k}(s,a)^T\mathbf{w}$ | 依赖线性奖励假设 $r=\phi^T\mathbf{w}$;只保证一步策略提升;$\phi$ 从哪来无解 |
| C-Learning | 连续状态下的 SR | 训分类器 $p^\pi(F{=}1|s,a,s_{\text{future}})$,其 odds $\propto p^\pi(s_{\text{future}}|s,a)$;正样本用 $\Delta\sim\mathrm{Geom}(\gamma)$ 采 | 基础版是 on-policy;分类器在高维状态上容易被表面特征欺骗 |
| Options / SMDP | 长时间跨度的信用分配与探索 | $\mathbf{o}=(\mathcal{I}_\mathbf{o},\pi_\mathbf{o},\beta_\mathbf{o})$;$Q(s,\mathbf{o})\leftarrow\sum_{t'=t}^{t+h-1}r+\gamma^h\max_{\mathbf{o}'}Q(s_{t+h},\mathbf{o}')$ | 三元组从哪来;option-critic 端到端训练常退化成 $\beta\to1$($h=1$,好处归零) |
| 技能 / 目标型分层 | option 太难学 | 低层 $\pi_{\text{lo}}(a|s,\mathbf{z})$ 或 $\pi_{\text{lo}}(a|s,\mathbf{g})$,高层 $\pi_{\text{hi}}$ 每 $k$ 步下发一次;$Q(s,\mathbf{z})\leftarrow\sum_{t'}^{t+k-1}r+\gamma^k\max Q$ | 低层在变 ⇒ 高层面对非平稳 MDP;HIRO 用目标重标注 $\argmax_\mathbf{g}\sum\log\pi_{\text{lo}}(a_{t'}|s_{t'},\mathbf{g})$ 修正 |
| 黑箱元 RL | 任务身份未知,必须边试边学 | $\argmax_\theta\sum_i\E_{\pi_{\phi_i}}[R(\tau)]$,$\phi_i=[h_i,\theta_\pi]$;隐状态跨 episode 不重置 | meta-overfitting;meta-episode 太长导致梯度方差爆炸;零奖励起步时卡死 |
| 梯度型元 RL | 想要更强的外推能力 | $\phi_i=\theta+\alpha\nabla_\theta J_{\mathcal{M}_i}(\theta)$,外层再对 $\theta$ 求导(含二阶项) | 二阶梯度方差大;内层用 $\pi_\theta$ 采样,探索能力弱 |
| POMDP 推断视角 | 统一解释所有元 RL 做法 | $\tilde s=(s,z)$,$\tilde o=s$;解 $\tilde{\mathcal{M}}$ 等价于元学习;显式做法学 $q_\psi(z|\text{context})$ | 后验坍缩;需假设 $z$ 的维度与先验 |
要点清单
- 多任务 RL 不是新问题:把上下文塞进状态就变回单任务 RL。所以不要去找新的理论, 要去找优化技巧。
- RL 的多任务比监督学习的多任务难,根源是数据分布由策略决定—— 这条因果链贯穿整门课(探索、离线 RL 的分布偏移、模仿学习的复合误差都是它的变体)。
- 重标注是本讲最实用的一招,也是最容易被低估的一招。 只要你的奖励函数是可对任意上下文求值的解析函数,你就在浪费 $|\Omega|$ 倍的数据。
- 目标条件值函数 → 距离 → 三角不等式 → 子目标规划 → 分层 RL,这条链是本讲的骨架: 「高层下发目标、低层执行」不是拍脑袋的架构,而是目标条件值函数几何性质的直接推论。
- 继承表示是「值函数分解成 动力学 × 奖励」的唯一干净方式。理解 $V^\pi = \mu^{\pi T}\vec r$ 之后再回头看基于模型 RL 和无模型 RL 的分野,会清楚很多。
- 分层的好处(有效跨度 $T\to T/k$、探索以技能为单位)是真的, 但只有当低层是预先训好并冻结或缓慢变化时才拿得到。端到端一起训基本上等于放弃这些好处。
- 元 RL 最重要的一句话:探索不是外挂,是最大化 meta-episode 回报的最优解。 只要隐状态跨 episode 保留、目标函数覆盖整段 meta-episode,探索行为会自己长出来。
- 元学习 = 在把任务身份藏起来的 POMDP 里做推断。这句话把 in-context learning、 MAML、PEARL 全部纳入同一个框架,也解释了为什么今天的 LLM agent 会「在上下文里学会新任务」。
延伸阅读
多任务与目标条件 RL
- Hindsight Experience Replay (Andrychowicz et al., 2017) —
HER 原论文。读它的 relabeling strategy 消融实验,能直观看到
future为什么最好。 - Universal Value Function Approximators (Schaul et al., ICML 2015) — 第一次系统地把 $V(s,g)$ 当成一个可泛化的函数逼近器来训,目标条件 RL 的奠基工作。
- Learning to Achieve Goals (Kaelbling, 1993) — 课上提到的最早期工作,三角不等式作为辅助损失的想法就出自这里。
- C-Learning: Learning to Achieve Goals via Recursive Classification (Eysenbach et al., 2020) — 把连续状态下的继承表示写成递归分类,是第 8 节的完整版(含 off-policy 推导)。
- Learning to Reach Goals via Iterated Supervised Learning (Ghosh et al., 2019) — GCSL:把 HER 推到极致,完全丢掉值函数,只用「重标注 + 行为克隆」迭代,简单得惊人。
- Ray Interference: a Source of Plateaus in Deep RL (Schaul et al., 2019) — 第 3 节那张学习曲线图的出处,给出了任务干扰的最小化数学模型。
- Gradient Surgery for Multi-Task Learning (Yu et al., 2020) — PCGrad:当两个任务的梯度夹角为钝角时,把冲突分量投影掉。对付任务干扰的直接手术方案。
- Meta-World (Yu et al., 2019) — 50 个机械臂任务的标准基准,多任务 RL 与元 RL 论文几乎都在上面报结果。
继承表示与继承特征
- Improving Generalisation for Temporal Difference Learning: The Successor Representation (Dayan, 1993) — 原始论文,只有十几页,推导比现代复述干净得多,强烈建议读原文。
- Successor Features for Transfer in Reinforcement Learning (Barreto et al., 2016) — 第 7 节两个「用法」的出处,含 GPI 的完整定理与界。
- Planning with Goal-Conditioned Policies (Nasiriany et al., 2019) — 用目标条件值函数在潜空间里搜子目标序列,把第 5 节的三角不等式变成一个真的规划器。
分层强化学习
- Between MDPs and semi-MDPs: A Framework for Temporal Abstraction in Reinforcement Learning (Sutton, Precup & Singh, 1999) — options 框架的原始论文,SMDP 备份的收敛性证明在这里。
- The Option-Critic Architecture (Bacon et al., 2016) — 端到端学 option 的完整梯度推导;也建议顺便看它后续关于 $\beta\to1$ 退化和 deliberation cost 的讨论。
- FeUdal Networks for Hierarchical Reinforcement Learning (Vezhnevets et al., 2017) — manager 输出潜空间方向、worker 用余弦相似度作为内在奖励,是「目标下发型」分层的经典形态。
- Data-Efficient Hierarchical Reinforcement Learning (Nachum et al., 2018) — HIRO:第 10 节的主角,off-policy 目标重标注是对付分层非平稳性最实用的技巧。
- Diversity is All You Need (Eysenbach et al., 2018) — 上一讲的无监督技能发现,正是第 10 节里训练低层 $\pi_{\text{lo}}(a|s,z)$ 的标准做法。
- ArCHer: Training Language Model Agents via Hierarchical Multi-Turn RL (Zhou et al., 2024) — 把「一句话 = 一个高层动作、一个 token = 一个低层动作」写成分层 RL,是 LLM agent 时代的分层实践。
元学习与元 RL
- RL$^2$: Fast Reinforcement Learning via Slow Reinforcement Learning (Duan et al., 2016) — 黑箱 RNN 元 RL 的代表作,第 11 节那套「隐状态跨 episode 不重置」就是它。
- Learning to Reinforcement Learn (Wang et al., 2016) — 与 RL$^2$ 同期的独立工作,还讨论了它与前额叶皮层的神经科学对应。
- Model-Agnostic Meta-Learning (Finn et al., 2017) — MAML 原论文,第 11 节梯度型元学习的目标函数出自这里。
- PEARL: Efficient Off-Policy Meta-RL via Probabilistic Context Variables (Rakelly et al., 2019) — 显式学后验 $q(z|\text{context})$ + 后验采样探索,是「POMDP 推断视角」最干净的落地。
- VariBAD: A Very Good Method for Bayes-Adaptive Deep RL via Meta-Learning (Zintgraf et al., 2019) — 把元 RL 明确写成 Bayes-adaptive MDP(BAMDP),并用变分推断近似 belief,理论上最完整的一篇。