序列与大语言模型上的强化学习
奖励从哪里来?把一段文本生成写成 MDP 之后,PPO、GRPO、RLHF、RLVR 到底在优化什么;以及当状态不可观测时,哪些算法还能用。
0. 本讲导读
这一讲是整门课里离当下工业实践最近的一讲。它由五个部分拼成,而这五个部分之间有一条非常清晰的暗线:奖励函数不是天上掉下来的。
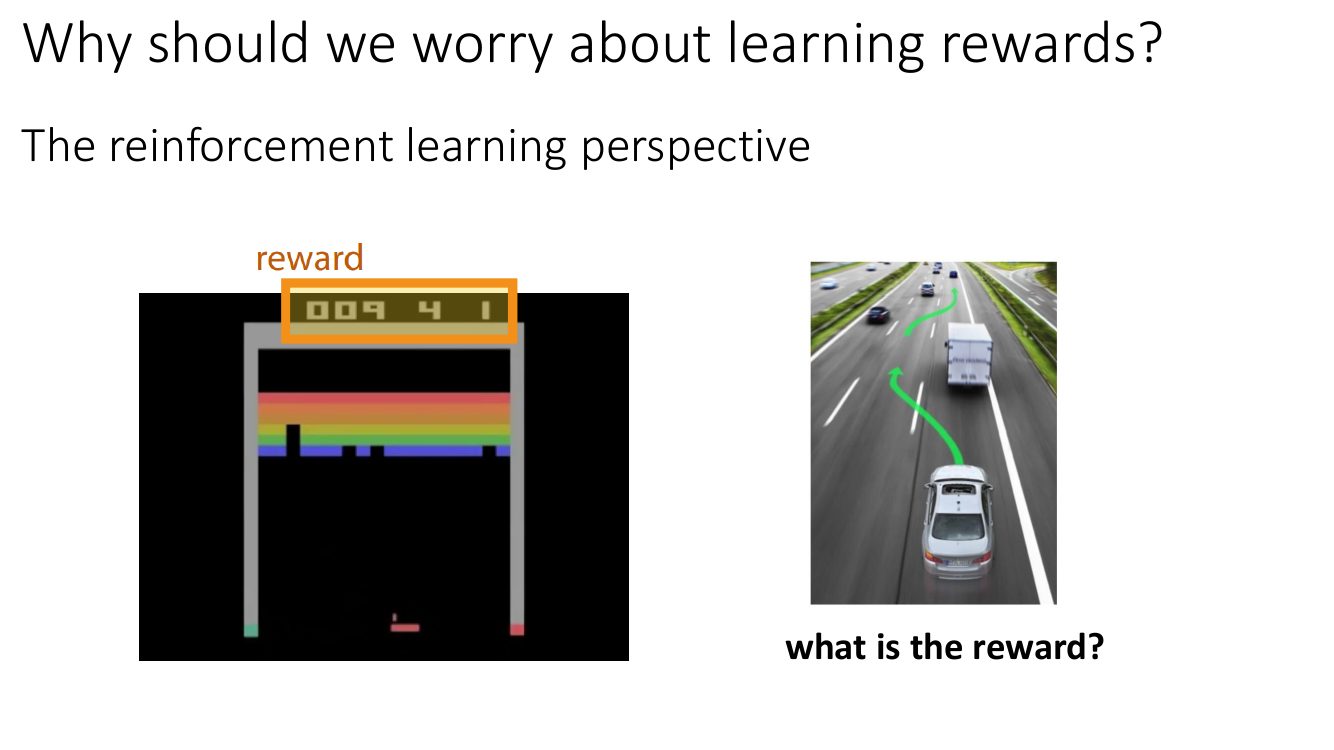
前面十几讲我们默认奖励 $r(s,a)$ 是已知的:Atari 游戏的屏幕上写着分数,MuJoCo 的仿真器直接给你前进速度。但只要走出仿真器一步,问题就变了——一辆车在高速公路上变道,什么叫「奖励」?变道快是好事还是坏事?超车激进一点算加分还是扣分?没有人能写下这个函数。于是有两条路:
- 逆强化学习(Inverse Reinforcement Learning, IRL):从人类的演示轨迹里把奖励反解出来。这是本讲第 1、2 节,它直接建立在上一讲「控制即推断」的最优性变量 $\mathcal O_t$ 之上,最后会发现 IRL 和 GAN 在数学上是同一件事。
- 从人类偏好里学奖励:不要求人演示(太贵),只要求人在两个候选之间选一个。这条路走到今天就是 RLHF,就是 ChatGPT。这是本讲第 8 节。
中间的第 3–7 节回答另一个问题:语言模型的 MDP 到底是什么?一段 token 序列既可以看成「一个动作」(一步 bandit),也可以看成「一串动作」(token 级 MDP)。这两种视角在只有末端奖励时是等价的,但一旦引入价值函数基线和中间奖励,第二种视角才说得通。想明白这件事之后,PPO、GRPO 在 LLM 上的所有实现细节都会变成三个可选项的组合:选一个基线(1)、选一个正则化器(2)、选或者学一个奖励(3)。
第 9 节是可验证奖励(RLVR)与推理模型:当奖励不再来自一个可能被欺骗的神经网络,而来自一个数学答案检查器或者单元测试时,RL 的行为会发生什么变化。第 10 节(原讲的 bonus part)回到理论:部分可观测。这看似与 LLM 无关,其实是同一件事的另一面——多轮对话、工具调用、智能体,本质上都是 POMDP,而 Transformer 的上下文窗口就是教科书里说的「历史状态」。
- 最大熵 IRL 的梯度是一个对比式的表达式:在专家轨迹上抬高奖励,在当前策略的软最优轨迹上压低奖励。困难全在配分函数 $Z$ 上,解法是用一个 max-ent RL 的策略去做采样估计,再用重要性采样修正「没优化到底」带来的偏差。
- 把生成器当策略、把判别器当奖励,IRL 就是 GAN。GAIL 用普通判别器(简单但收敛时判别器一无所知、奖励不可复用),AIRL 把判别器写成 $D=\frac{\frac1Z e^{r}}{\frac1Z e^{r}+\pi}$(复杂但学到真正的奖励)。
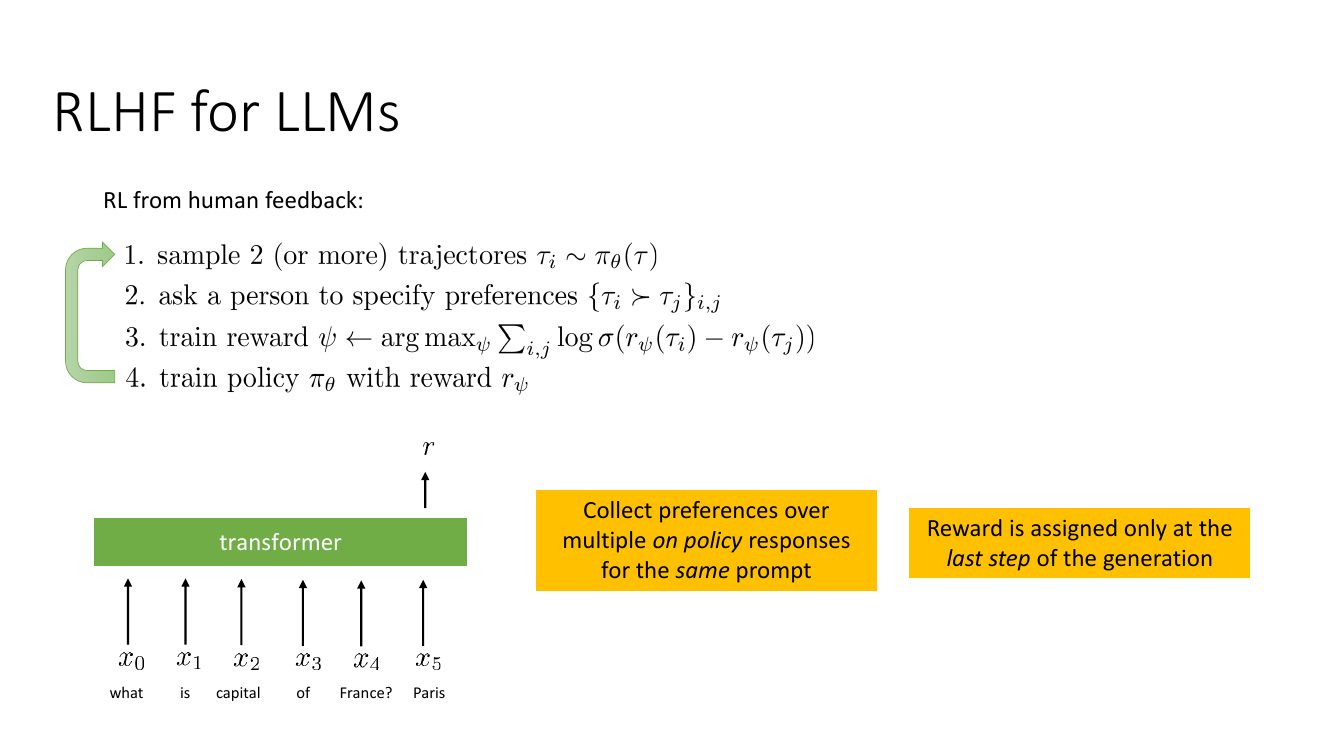
- LLM 的 RL 有两种等价建模:一步 bandit(状态=prompt,动作=整段补全)和 token 级 MDP(状态=前缀,动作=下一个 token,转移是确定性拼接)。奖励通常只在最后一个 token 给出。
- 实践中一律用重要性加权(PPO 式)估计器而不是纯 REINFORCE,原因很现实:从 LLM 采样极贵,必须让同一批样本喂多次梯度步。
- 基线有两种选法:训一个价值函数 + GAE(要多一个和策略同样大的 critic),或者对同一个 prompt 采 $K$ 个回答、用组内均值当基线——后者就是 GRPO。
- 参考模型 KL 惩罚 $\bar r = r - \beta \KL(\pi_\theta\|\pi_{\text{ref}})$ 有两个作用:保证输出还是人话,以及防止策略去「利用」不完美的奖励模型(reward hacking)。它同时是 DPO 推导的起点。
- Bradley–Terry 模型把「$\tau_i$ 比 $\tau_j$ 好」写成 $\log\sigma(r_\psi(\tau_i)-r_\psi(\tau_j))$,训练奖励模型就是一次逻辑回归。奖励只在差值意义下可辨识。
- 值函数方法在没有马尔可夫性时会坏掉;策略梯度不会。学一个隐状态空间模型,或者干脆把整段历史丢给序列模型,是两条通用出路。
1. 为什么要学奖励:最大熵逆强化学习
先把动机说透。强化学习的标准设定是「给定 $r(s,a)$,找 $\pi$」。Breakout 里屏幕顶端那串数字就是奖励,写代码读出来即可。但换成「在高速公路上开车」这类任务,你能写出的所有候选奖励都是错的:写「速度越快越好」会得到一个疯子;写「和前车距离越大越好」会得到一个永远不敢并线的司机;手工调权重的多目标奖励在真实分布下总能找到你没想到的漏洞。
从最优性变量出发
上一讲我们引入了最优性变量 $\mathcal O_t$,并令
$$ p(\mathcal O_t\mid s_t,a_t)=\exp\big(r_\psi(s_t,a_t)\big), $$其中 $\psi$ 是奖励函数的参数(不是策略参数 $\theta$)。在这个概率图模型下,给定「全程都最优」这个条件,轨迹的后验是
$$ p(\tau\mid \mathcal O_{1:T},\psi)\;\propto\; p(\tau)\exp\!\Big(\sum_t r_\psi(s_t,a_t)\Big), $$其中 $p(\tau)=p(s_1)\prod_t p(s_{t+1}|s_t,a_t)$ 是只由动力学决定的先验,与 $\psi$ 无关,所以在对 $\psi$ 求导时可以整体划掉(幻灯片上就是那一道红杠)。
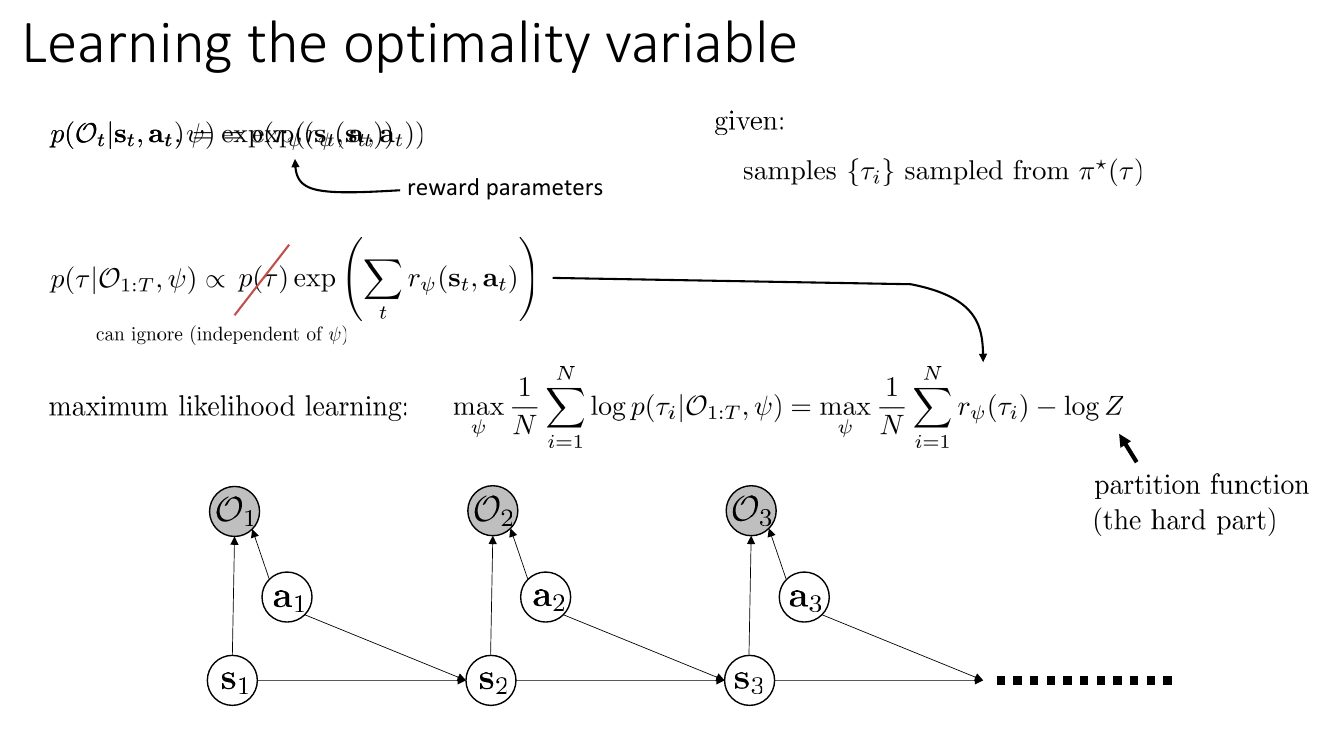
现在假设我们手上有一批专家演示 $\{\tau_i\}_{i=1}^N\sim\pi^\star(\tau)$。做最大似然学习:
$$ \max_\psi \frac1N\sum_{i=1}^N \log p(\tau_i\mid\mathcal O_{1:T},\psi) =\max_\psi \frac1N\sum_{i=1}^N r_\psi(\tau_i)-\log Z, $$这里 $r_\psi(\tau)\triangleq\sum_t r_\psi(s_t,a_t)$,而
$$ Z=\int p(\tau)\exp\big(r_\psi(\tau)\big)\,d\tau . $$配分函数的梯度
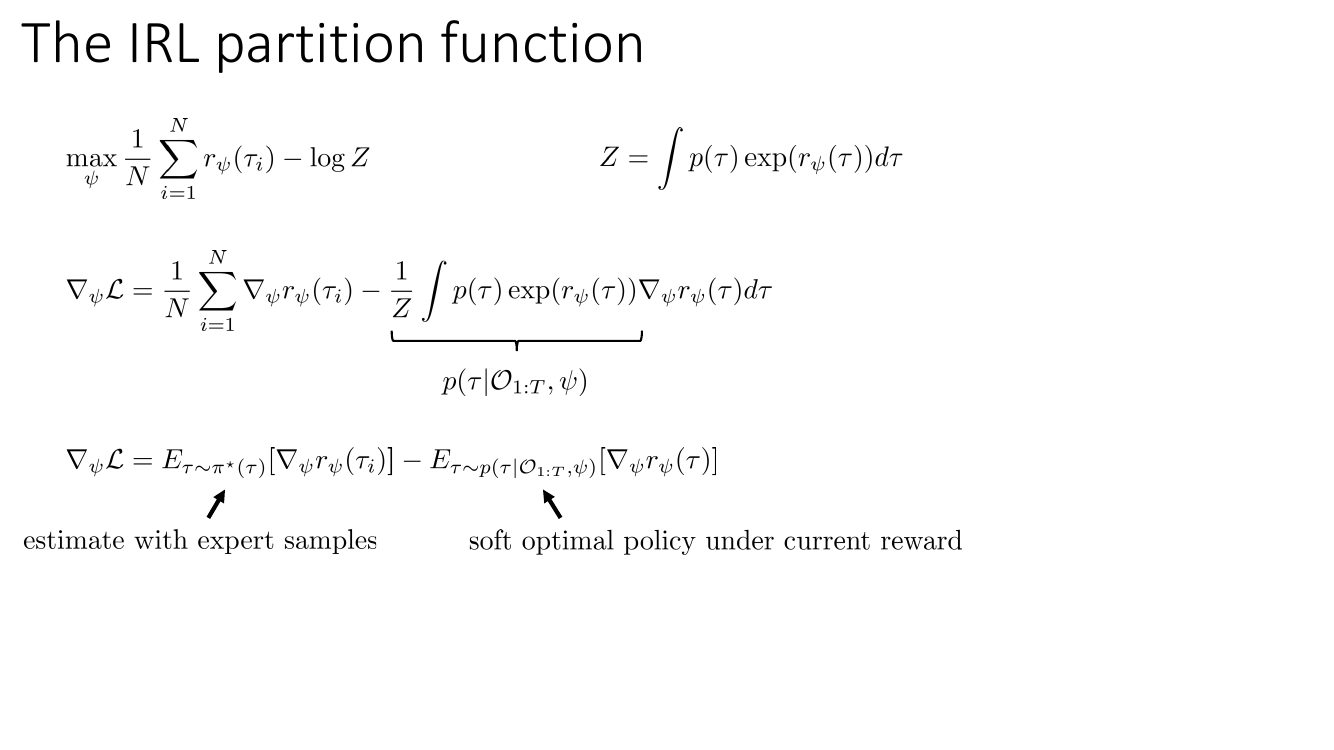
一步步来。对 $\psi$ 求导:
$$ \nabla_\psi\mathcal L=\frac1N\sum_{i=1}^N\nabla_\psi r_\psi(\tau_i)\;-\;\nabla_\psi\log Z . $$第二项展开:$\nabla_\psi \log Z=\frac{1}{Z}\nabla_\psi Z$,而
$$ \nabla_\psi Z=\int p(\tau)\exp\big(r_\psi(\tau)\big)\nabla_\psi r_\psi(\tau)\,d\tau , $$因为 $\nabla_\psi \exp(r_\psi)=\exp(r_\psi)\nabla_\psi r_\psi$。于是
$$ \nabla_\psi\log Z=\int \underbrace{\frac{p(\tau)\exp(r_\psi(\tau))}{Z}}_{=\;p(\tau\mid\mathcal O_{1:T},\psi)}\nabla_\psi r_\psi(\tau)\,d\tau =\E_{\tau\sim p(\tau|\mathcal O_{1:T},\psi)}\big[\nabla_\psi r_\psi(\tau)\big]. $$合起来就是本节最重要的一个式子:
$$ \nabla_\psi\mathcal L=\E_{\tau\sim\pi^\star(\tau)}\big[\nabla_\psi r_\psi(\tau)\big]-\E_{\tau\sim p(\tau|\mathcal O_{1:T},\psi)}\big[\nabla_\psi r_\psi(\tau)\big]. $$左边这项用专家样本估计,直接对演示数据求平均即可。右边这项要从「当前奖励函数下的软最优策略」里采样——这就麻烦了,因为要知道这个分布,你得先解一遍 RL 问题。
「懒惰」的策略优化与重要性采样
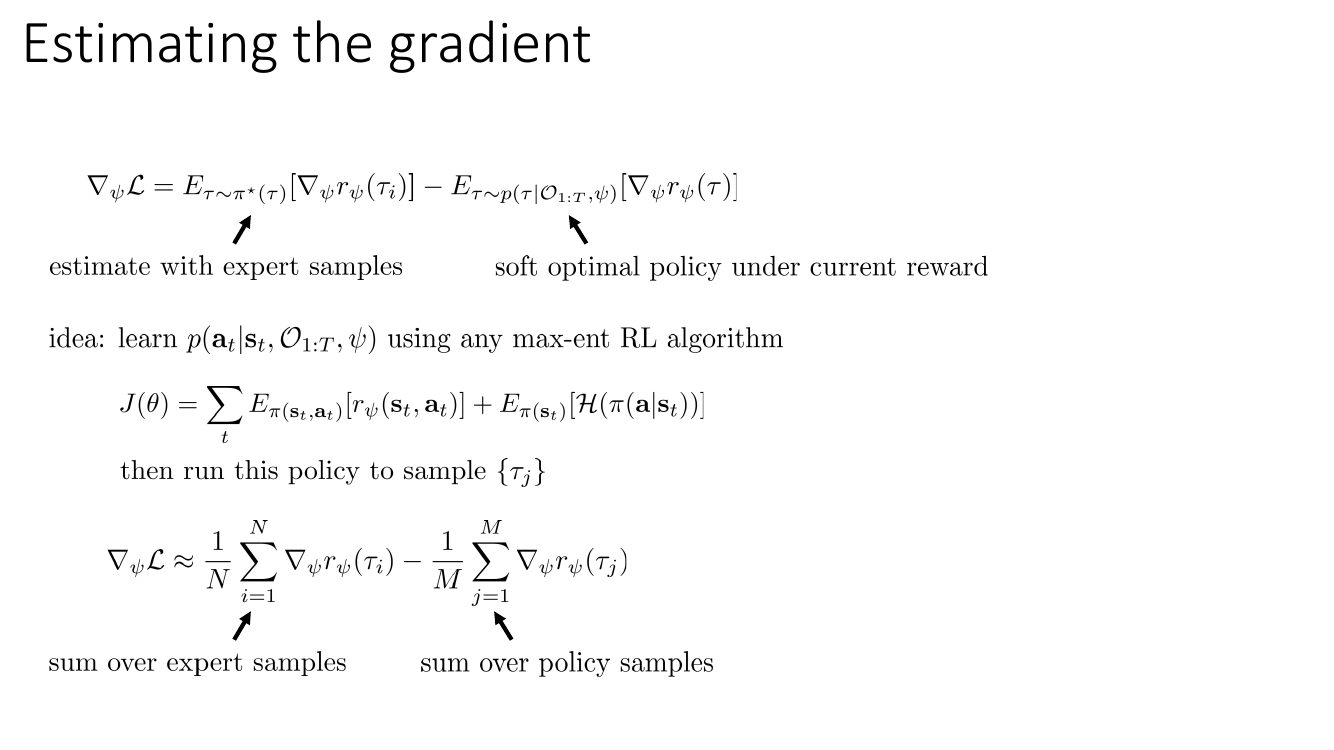
问题来了:每更新一次奖励,就要把 RL 从头解一遍,代价高得离谱。自然的想法是——别解到底,只改进一点点。Levine 在幻灯片上直接把 “learn” 划掉,换成 “improve (a little)”。
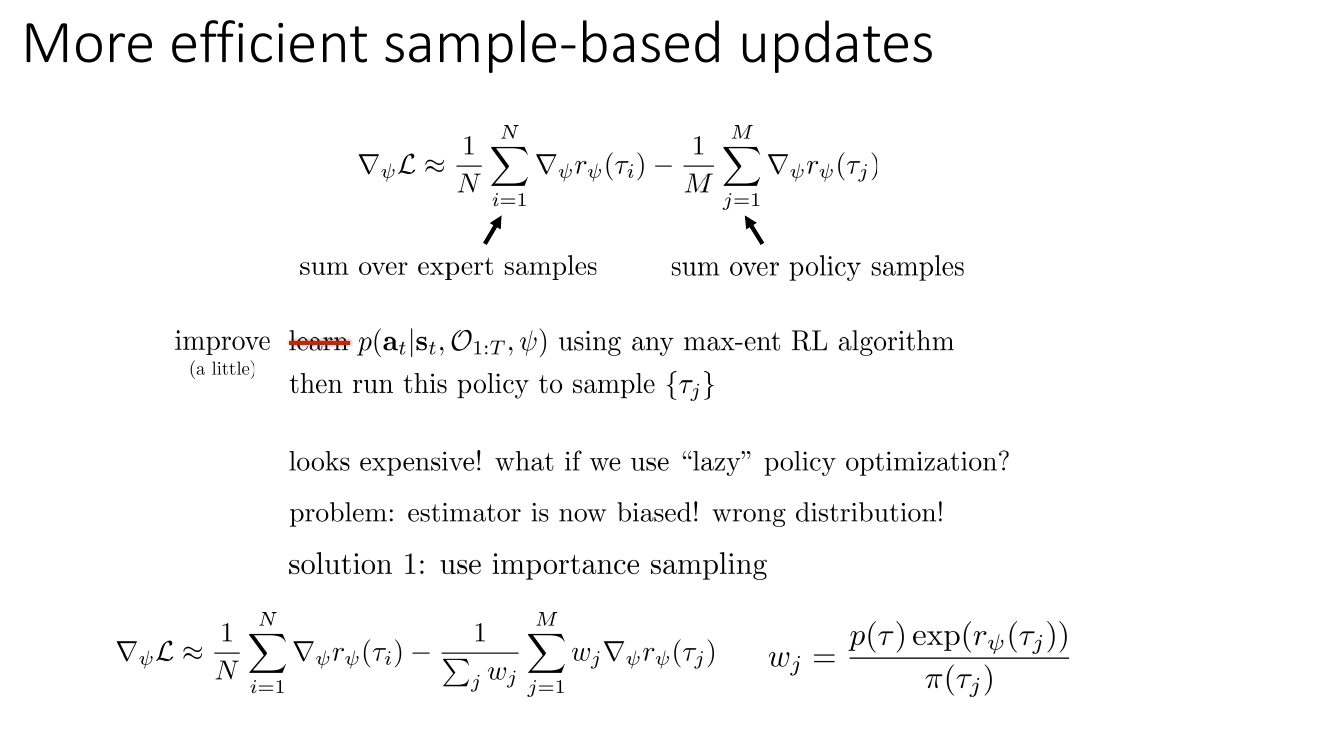
代价是估计器变成有偏的——我们在用错误的分布去估计第二个期望。修正方式是重要性采样:
$$ \nabla_\psi\mathcal L\approx\frac1N\sum_{i=1}^N\nabla_\psi r_\psi(\tau_i)-\frac{1}{\sum_j w_j}\sum_{j=1}^M w_j\,\nabla_\psi r_\psi(\tau_j), \qquad w_j=\frac{p(\tau_j)\exp\big(r_\psi(\tau_j)\big)}{\pi(\tau_j)} . $$这里用的是自归一化重要性采样(分母 $\sum_j w_j$ 而不是 $M$),因为 $Z$ 未知,权重只知道到一个常数倍——自归一化恰好把这个常数消掉。
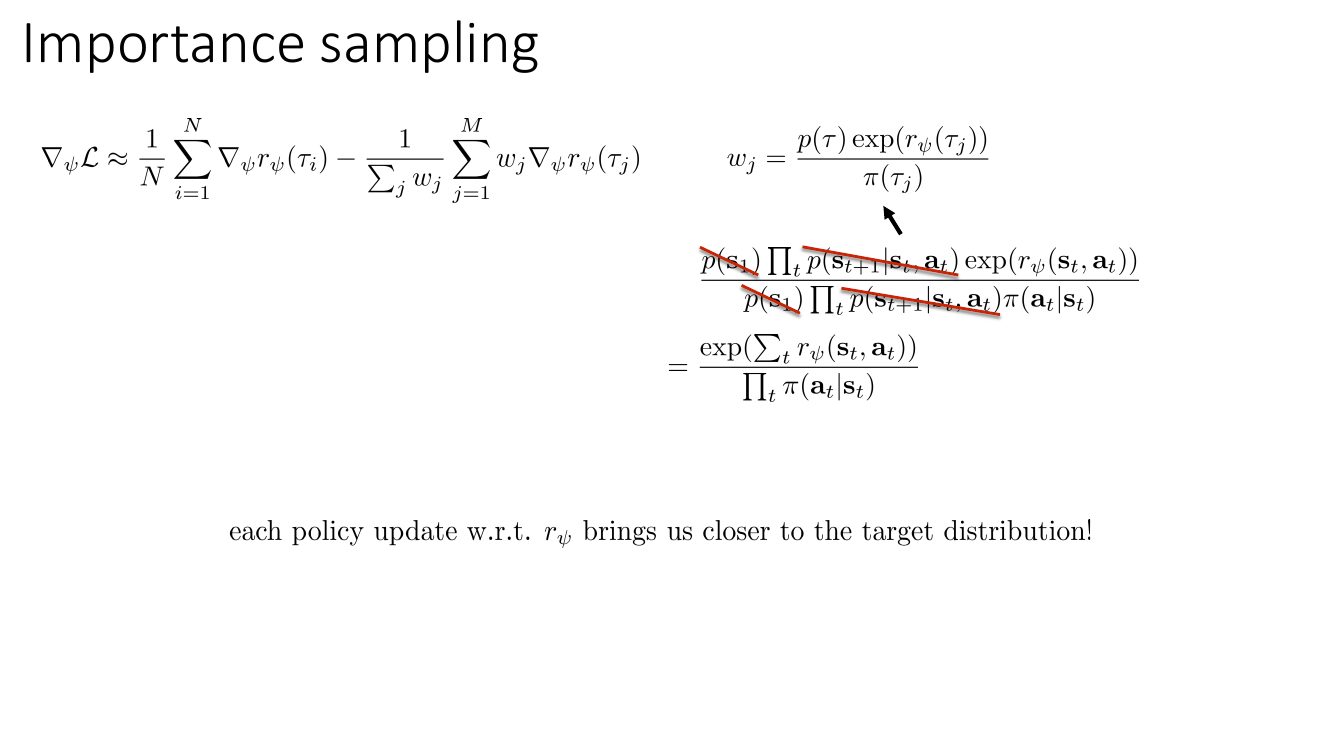
展开写:
$$ w_j=\frac{\overbrace{p(s_1)\textstyle\prod_t p(s_{t+1}|s_t,a_t)}^{\text{相消}}\exp\big(\sum_t r_\psi(s_t,a_t)\big)}{\underbrace{p(s_1)\textstyle\prod_t p(s_{t+1}|s_t,a_t)}_{\text{相消}}\prod_t\pi(a_t|s_t)} =\frac{\exp\big(\sum_t r_\psi(s_t,a_t)\big)}{\prod_t\pi(a_t|s_t)} . $$动力学项在分子分母里完全一致,直接约掉。这是本课反复出现的一个技巧(策略梯度里也用过):只要分子分母是同一个 MDP 下的两个策略,环境动力学永远消失。于是 $w_j$ 只需要奖励值和策略的动作概率,两者都是我们能算的。
这个算法就是 Guided Cost Learning:外层更新奖励,内层只跑几步策略改进,两者交替。它有一个很好的性质——每次奖励更新后,采样策略离目标分布更近一点,重要性权重的方差也就更小一点。
import torch, torch.nn as nn

class RewardNet(nn.Module):
    """r_psi(s, a) -> 标量,逐时间步"""
    def __init__(self, dim_s, dim_a, h=256):
        super().__init__()
        self.f = nn.Sequential(nn.Linear(dim_s + dim_a, h), nn.ReLU(),
                               nn.Linear(h, h), nn.ReLU(), nn.Linear(h, 1))
    def forward(self, s, a):                 # s: (B,T,ds)  a: (B,T,da)
        return self.f(torch.cat([s, a], -1)).squeeze(-1)   # (B,T)

def irl_reward_loss(rnet, expert, policy, logp_policy):
    """
    expert : (s_e, a_e)   专家演示批
    policy : (s_p, a_p)   当前(懒惰优化后)策略的采样批
    logp_policy: (M,T)    这些动作在采样策略下的 log pi(a_t|s_t)
    返回需要 *最小化* 的损失 = -L
    """
    s_e, a_e = expert
    s_p, a_p = policy

    r_e = rnet(s_e, a_e).sum(dim=1)                  # (N,) 专家轨迹总奖励
    r_p = rnet(s_p, a_p).sum(dim=1)                  # (M,) 策略轨迹总奖励

    # log w_j = sum_t r_psi - sum_t log pi ;只差一个与 j 无关的常数 -log Z
    log_w = (r_p - logp_policy.sum(dim=1)).detach()  # detach: 权重不回传梯度
    w = torch.softmax(log_w, dim=0)                  # 自归一化,等价于 w_j / sum_j w_j

    # L = mean(r_expert) - log Z ;负相用自归一化重要性采样估计
    loss = -(r_e.mean() - (w * r_p).sum())
    return loss
注意代码里两个细节:其一,log_w 用 softmax 归一化,这正好实现了自归一化并且数值稳定(等价于减去 $\max_j \log w_j$);其二,权重必须 detach,因为它只是重要性采样的修正系数,不是目标的一部分——如果让它回传,梯度就不再是我们推出来的那个表达式了。
2. IRL 就是 GAN:对抗式的奖励学习
把上一节的两条更新并排放在一起看,会发现一件很有意思的事。
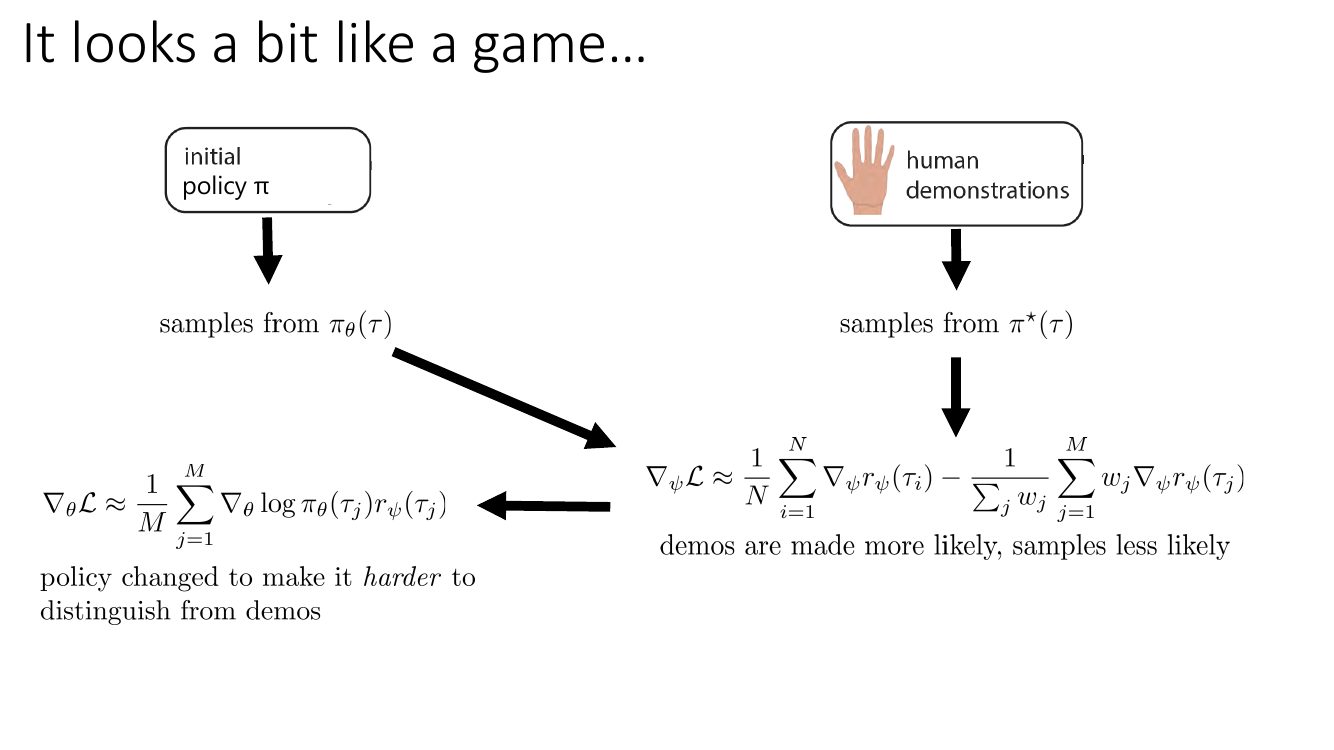
- 奖励侧:$\nabla_\psi\mathcal L\approx\frac1N\sum_i\nabla_\psi r_\psi(\tau_i)-\frac{1}{\sum_j w_j}\sum_j w_j\nabla_\psi r_\psi(\tau_j)$,即抬高演示、压低样本。
- 策略侧:$\nabla_\theta\mathcal L\approx\frac1M\sum_j\nabla_\theta\log\pi_\theta(\tau_j)\,r_\psi(\tau_j)$,即让自己产生的轨迹在当前奖励下得分更高,也就是更像演示。
一个网络负责把两类样本分开,另一个网络负责让它分不开——这就是生成对抗网络(Generative Adversarial Network, GAN)。
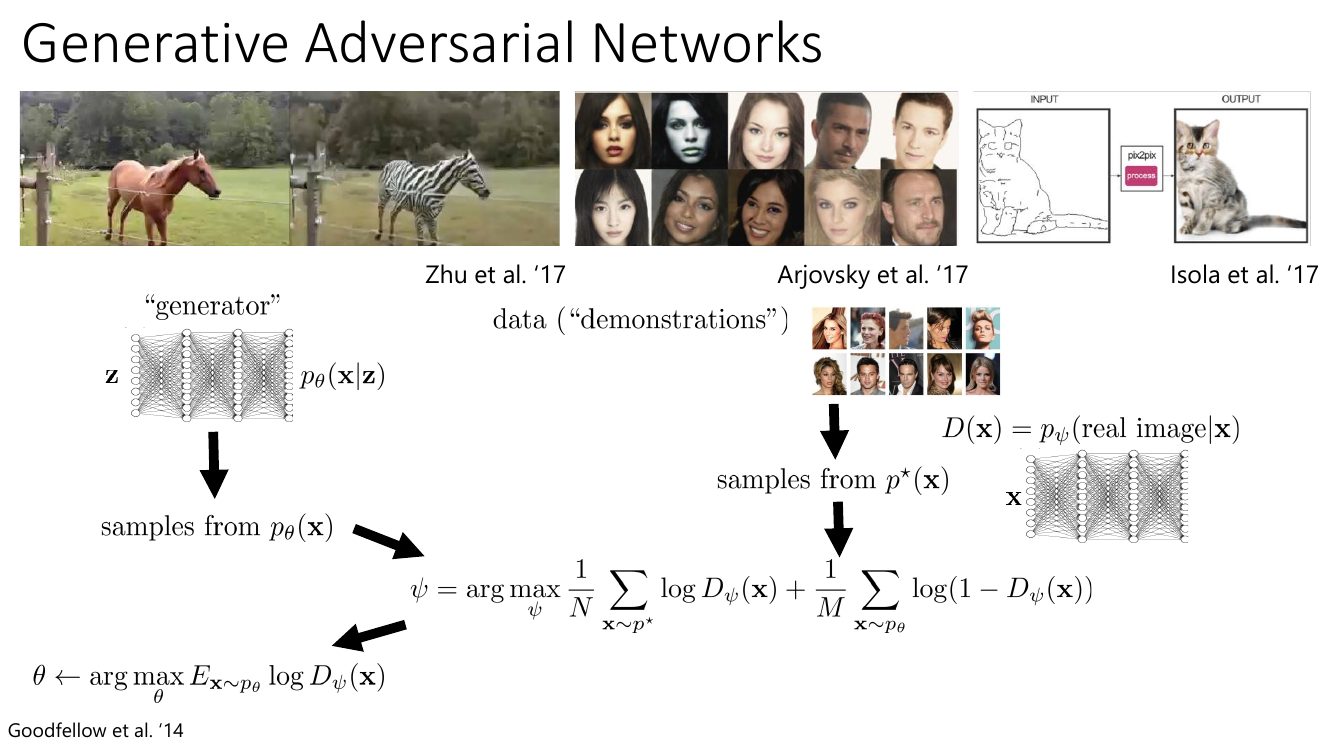
能不能直接用一个普通判别器?
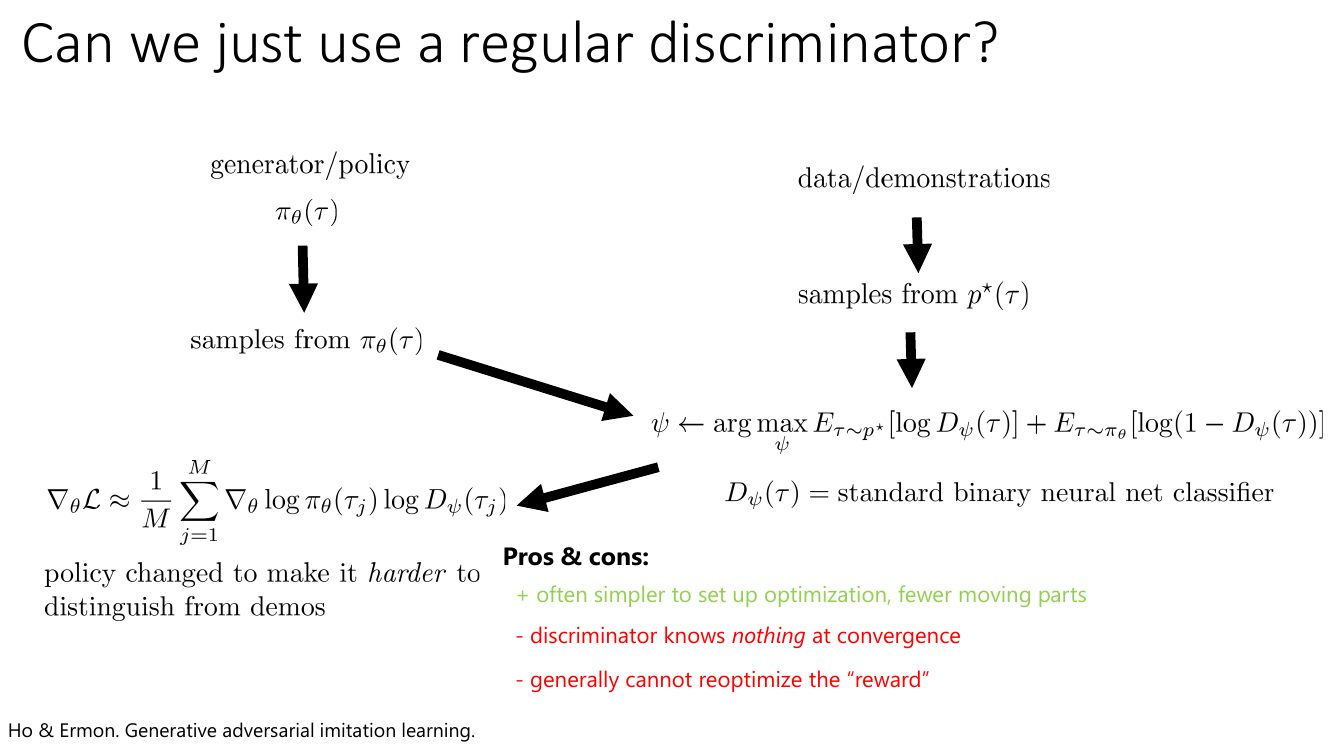
「无法重新优化奖励」是什么意思?假设你在平地上学会了模仿人走路,现在想把学到的奖励搬到有台阶的地形上重新跑 RL。GAIL 的判别器学到的是「这条轨迹看起来像不像专家数据」,它把状态分布本身编码进去了,换个地形立刻失效;而且在收敛点它输出恒等于 $\frac12$,梯度信息为零。相比之下,如果学到的是真正的 $r(s,a)$(比如「躯干保持直立、质心前移」),换地形照样能用。
AIRL:把 MaxEnt 模型塞进判别器
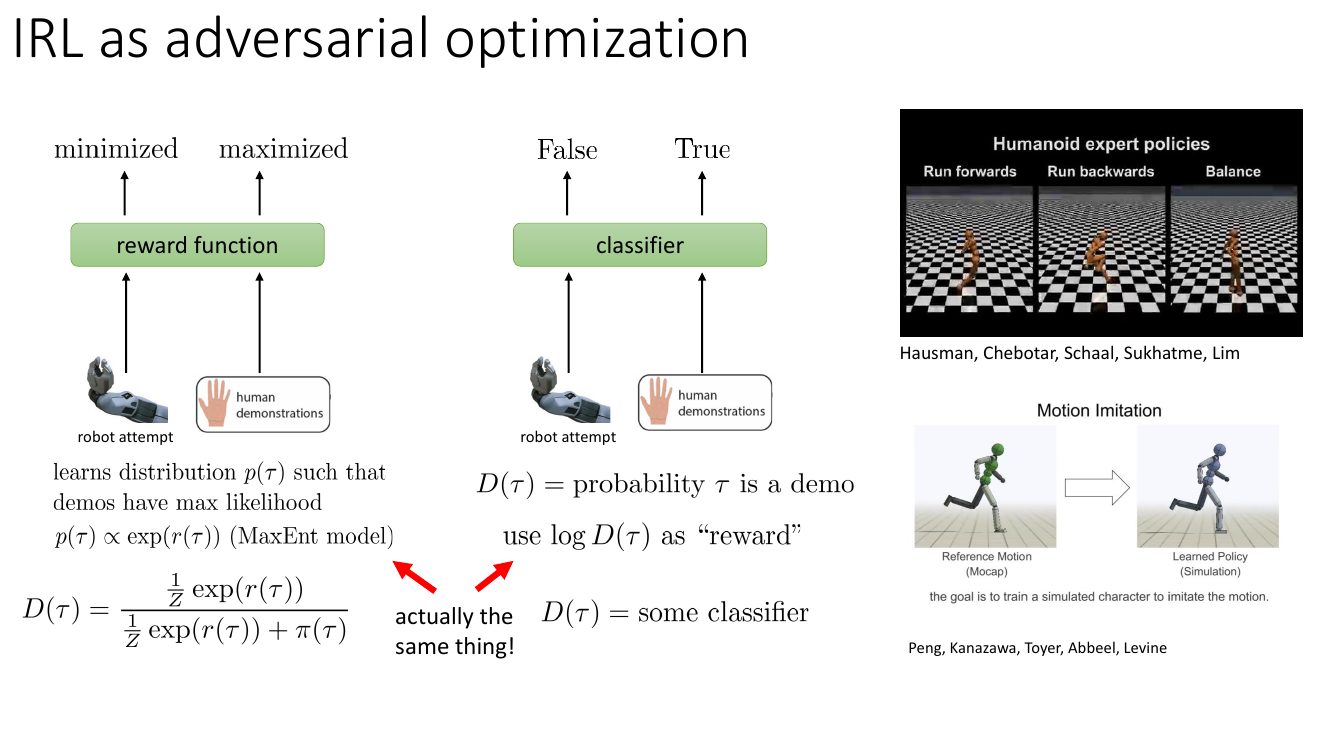
把上面那个最优判别器公式 $D^\star=\frac{p^\star}{p^\star+p_\theta}$ 拿过来,令「真实分布」$p^\star(\tau)=\frac1Z\exp(r_\psi(\tau))$(最大熵模型),「生成分布」就是策略 $\pi(\tau)$,于是
$$ D_\psi(\tau)=\frac{\frac1Z\exp\big(r_\psi(\tau)\big)}{\frac1Z\exp\big(r_\psi(\tau)\big)+\pi(\tau)} . $$这是一个结构化的判别器:它不是任意的神经网络,而是被强行写成上面这个形式,里面显式含着一个可解释的 $r_\psi$。用普通的二分类交叉熵去训练它,等价于我们第 1 节推的那个最大似然 IRL;但因为形式被约束住了,收敛时 $D\equiv\frac12$ 意味着 $\pi(\tau)=\frac1Z\exp(r_\psi(\tau))$,也就是策略恰好是当前奖励下的软最优策略——而 $r_\psi$ 本身依然是一个有意义、可迁移的奖励函数。这条路线就是 AIRL。
| 方法 | 判别器/奖励形式 | 优点 | 缺点 |
|---|---|---|---|
| Guided Cost Learning | 显式 $r_\psi$ + 重要性采样估计 $Z$ | 直接对应最大似然,奖励可迁移 | 需要精心处理重要性权重方差 |
| GAIL | 任意二分类 $D_\psi(\tau)$,奖励 $=\log D_\psi$ | 实现简单、稳定、活动部件少 | 收敛时 $D=\frac12$,奖励不可复用 |
| AIRL | $D=\dfrac{\frac1Z e^{r_\psi}}{\frac1Z e^{r_\psi}+\pi}$ | 学到可迁移的 $r_\psi$,等价于 MaxEnt IRL | 需要策略的显式概率,训练更敏感 |
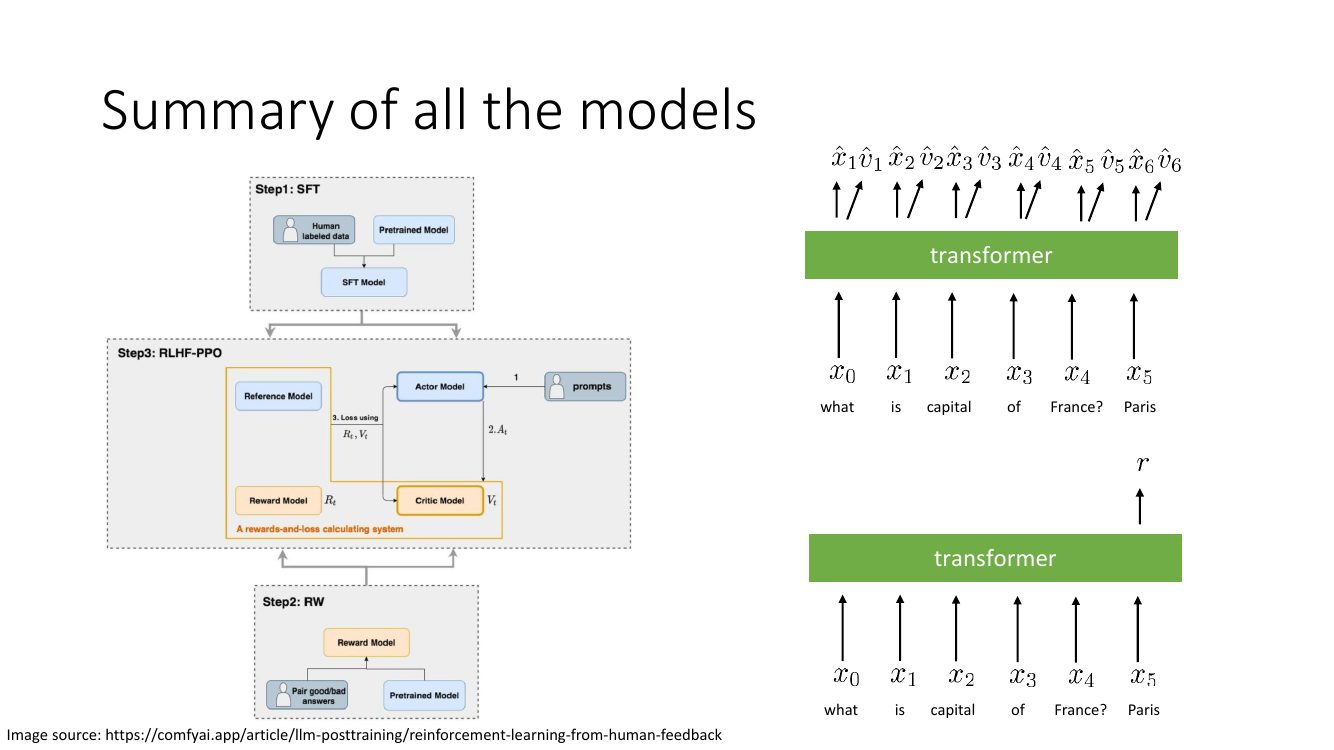
这一节的意义不只在于模仿学习。「一个网络给分、另一个网络优化这个分数」正是接下来 RLHF 的骨架:奖励模型(reward model)扮演判别器,LLM 策略扮演生成器。区别只在于奖励模型是用人类偏好而不是真假分类训练出来的,而且训练通常不是完全对抗式地交替到底。
3. 把语言模型写成 RL 问题:MDP 到底是什么
换赛道。语言模型平时是用监督学习训练的:给定前 $t$ 个 token,预测第 $t+1$ 个,最小化交叉熵。这件事的目标非常明确——拟合数据分布。
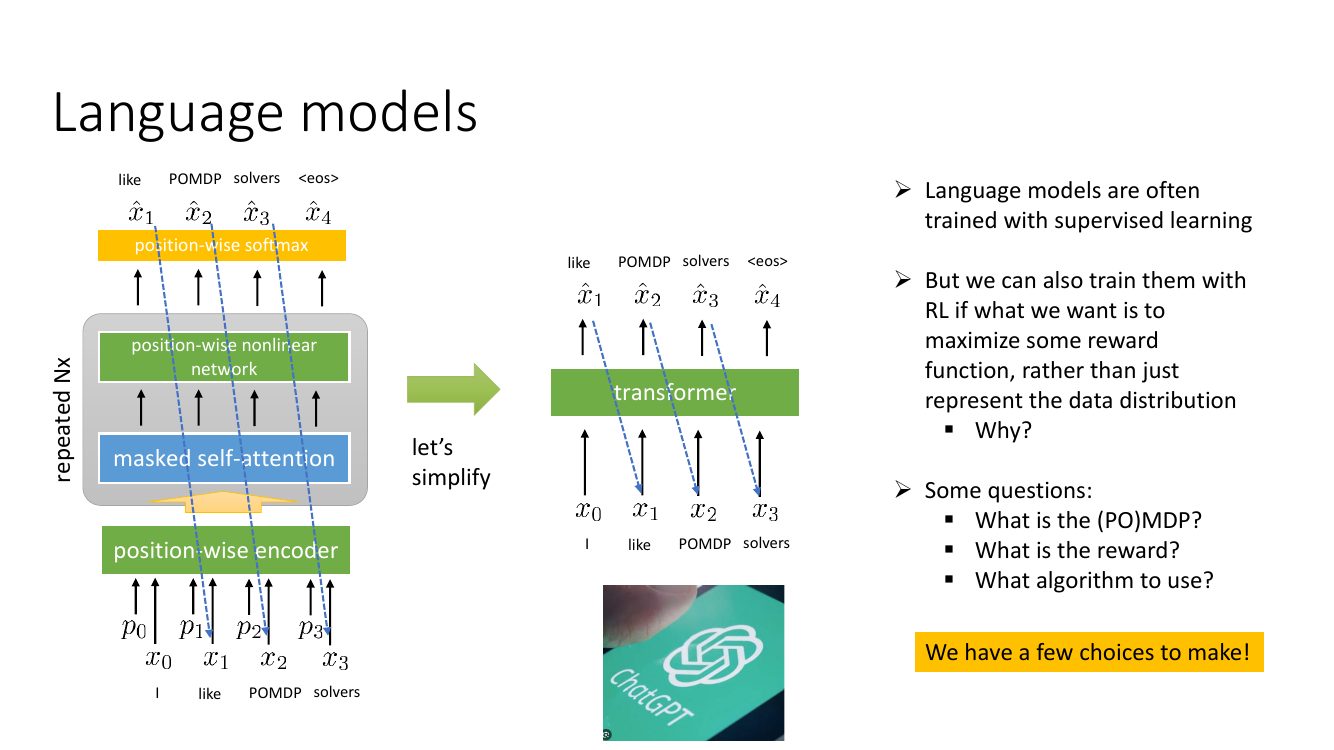
关键的观察是:如果我们想要的不是「复现数据分布」,而是「最大化某个奖励函数」,那就必须用 RL。为什么会想要后者?因为互联网文本的分布里包含大量我们不想要的东西:错误、有害内容、冗长、拒绝回答;而我们想要的东西(比如「解对这道数学题」)在数据里的频率并不高。监督学习没有办法说「这个回答比那个回答好」,它只会说「这个 token 出现的概率应该是多少」。
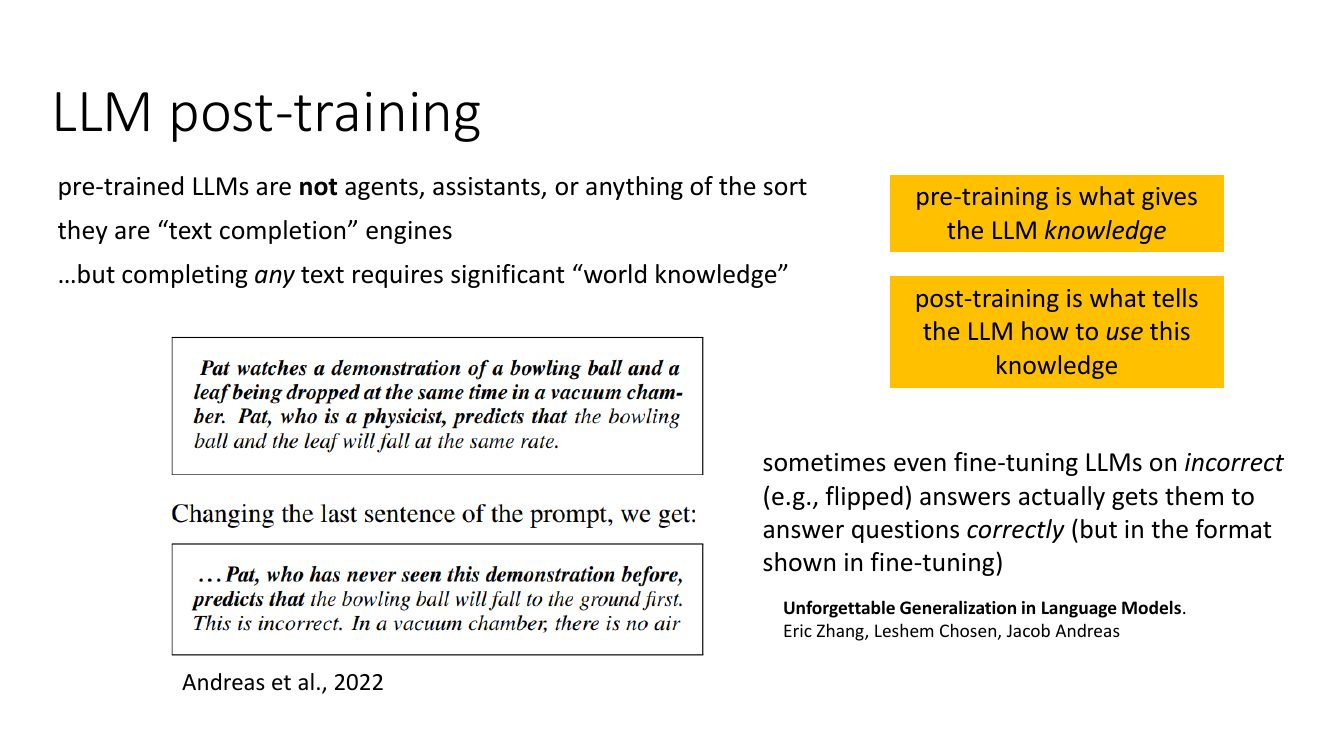
预训练与后训练
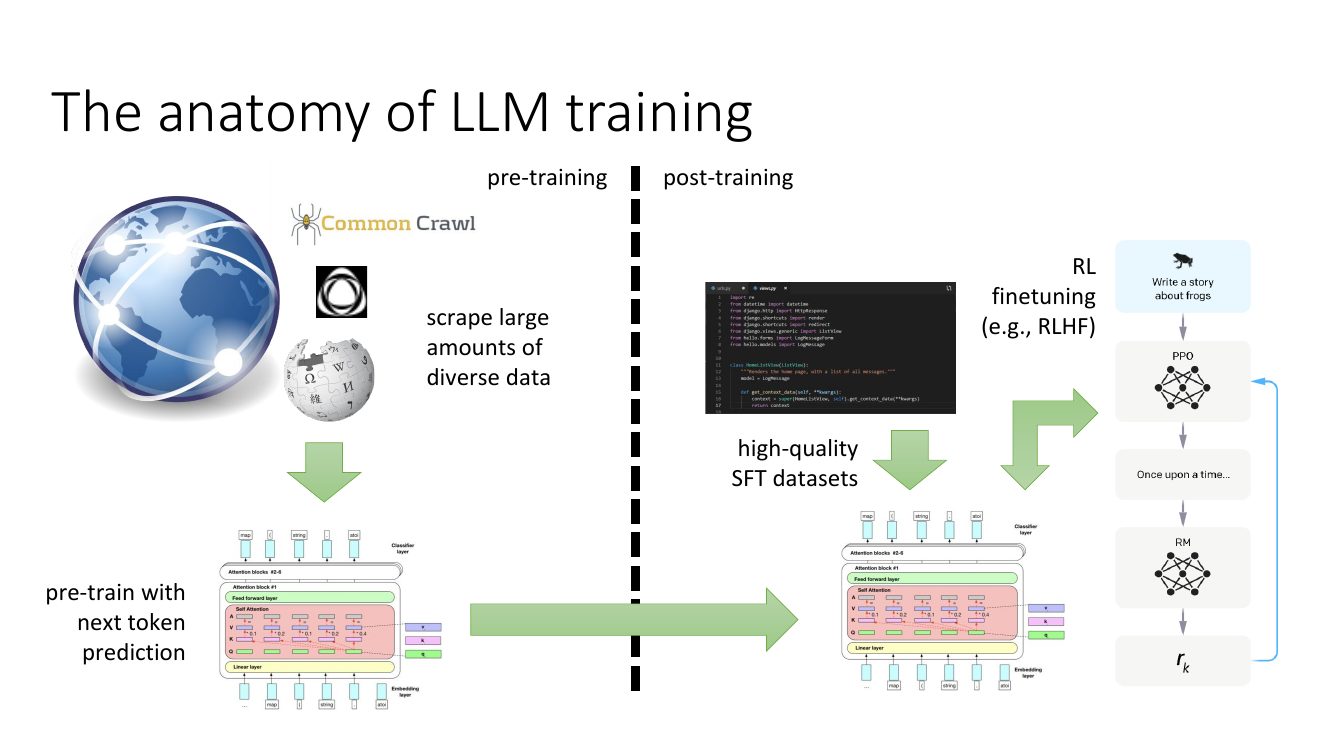
指令微调不够用
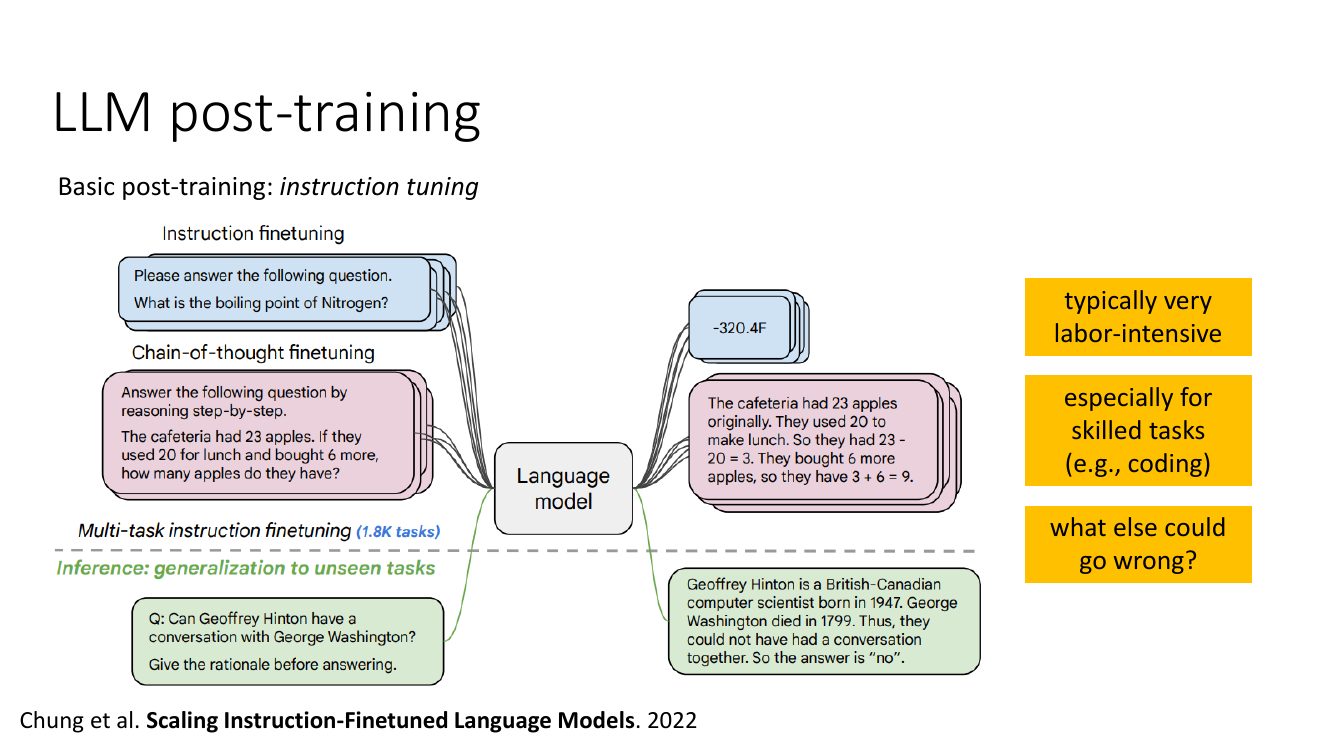
「什么别的地方可能出问题」的答案,其实就是本课第 2 讲讲模仿学习时的老问题,只是换了个场景:
- 指令微调是行为克隆。它继承了行为克隆的一切毛病:分布漂移(模型自己生成的前缀会逐渐偏离训练分布,误差累积),以及无法超越示范者。你雇的标注员写不出比自己水平更高的代码,模型就学不到更高水平。
- 它会教模型撒谎。如果微调数据里有一条「珠峰高 8848 米」而模型内部并不「知道」这个事实,你教给它的其实是「遇到这类问题就自信地报一个数字」——这是幻觉(hallucination)的一个直接来源。RL 不同:如果奖励惩罚错误答案,模型会学到「不确定时就说不确定」。
- 它无法表达偏好强度。监督学习只能说「这是正确输出」,说不了「A 比 B 好一点点」。而人类对「什么是好回答」的判断天然是比较式的。
MDP 建模的第一种选择:一步 bandit
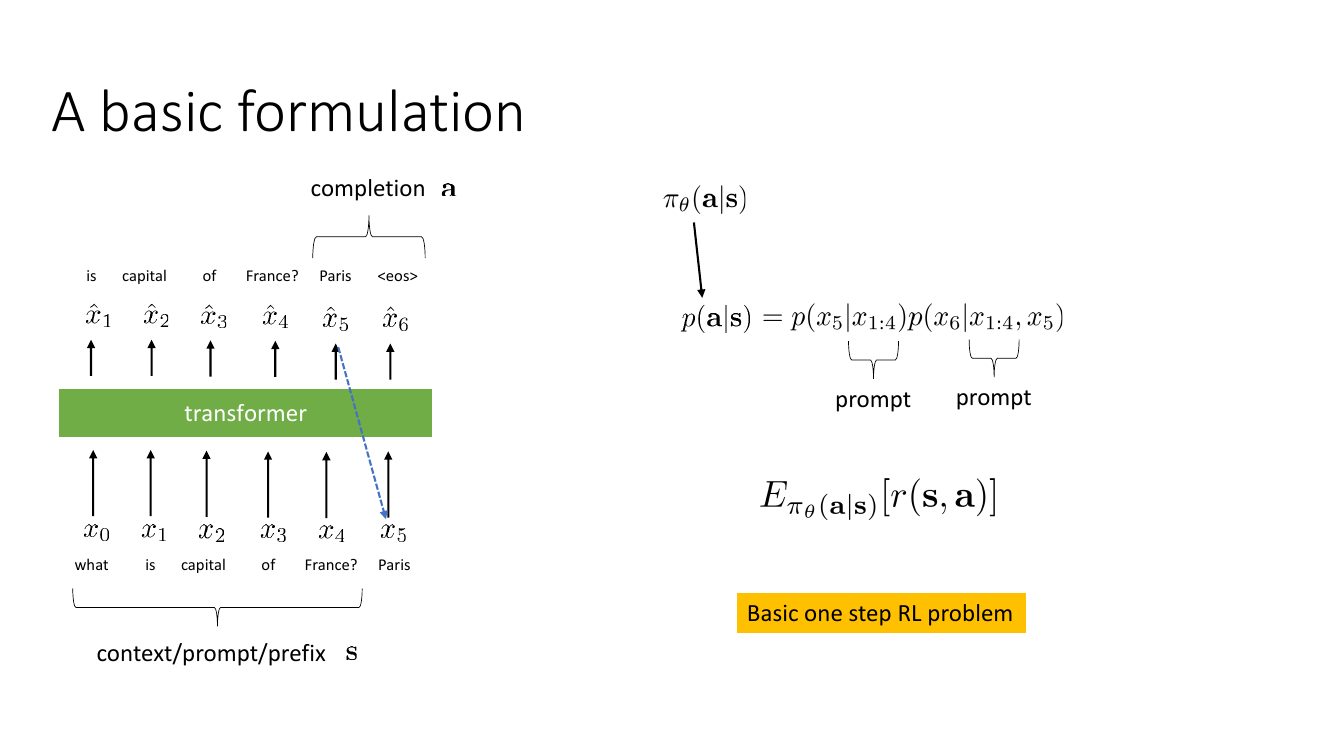
这是最省事的建模:整段补全就是一个动作。$\pi_\theta(\mathbf a|\mathbf s)$ 虽然是自回归分解出来的,但在 RL 眼里它就是一个(巨大离散空间上的)动作分布。目标
$$ J(\theta)=\E_{\mathbf s\sim\mathcal D}\,\E_{\mathbf a\sim\pi_\theta(\mathbf a|\mathbf s)}\big[r(\mathbf s,\mathbf a)\big]. $$没有转移、没有折扣、没有 Bellman 方程。你可能会觉得「这也太简单了,还叫 RL 吗」——但正因为简单,它的分析是干净的:不存在长期信用分配问题,唯一的困难是动作空间大到离谱($|V|^{H}$,词表 15 万、长度 1000 的话是 $150000^{1000}$)以及只有一个末端标量反馈。
MDP 建模的第二种选择:token 级 MDP
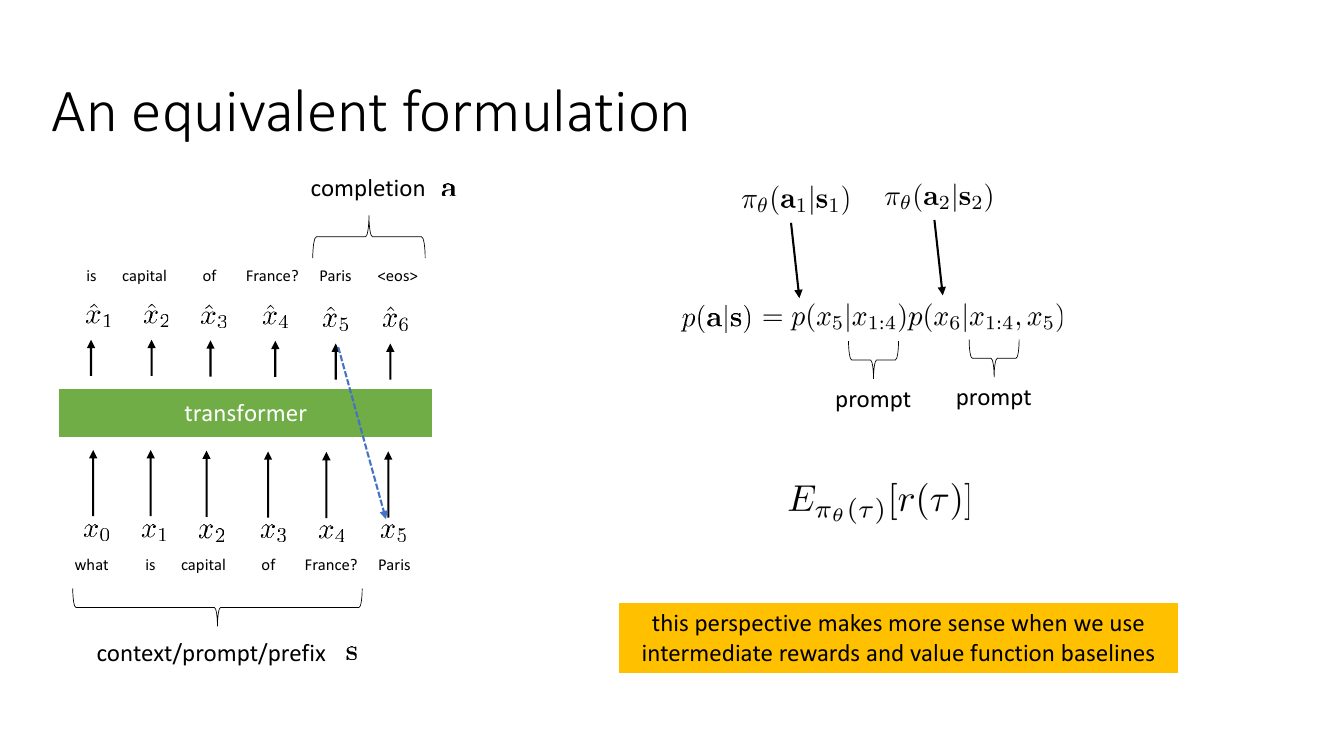
在 token 级 MDP 里:
| MDP 元素 | 在 LLM 中对应什么 |
|---|---|
| 状态 $s_t$ | 当前完整前缀 $(x_0,\dots,x_{t-1})$,即 prompt 加上已生成的 token |
| 动作 $a_t$ | 下一个 token $x_t$,动作空间 = 词表(约 $10^5$ 个离散动作) |
| 转移 $p(s_{t+1}|s_t,a_t)$ | 确定性:把 $a_t$ 拼到 $s_t$ 后面,概率为 1 |
| 奖励 $r(s_t,a_t)$ | 通常全为 0,只在生成 <eos> 的那一步给出 RM 分数或验证器 0/1 |
| 终止 | 采样到 <eos>,或达到最大长度截断 |
| 折扣 $\gamma$ | 实践中几乎总是取 $\gamma=1$(回合长度有限,且早晚生成没有优劣之分) |
| 初始状态分布 | prompt 数据集 $\mathcal D$ |
两种建模的目标函数在数学上完全一样:因为转移是确定性的、奖励只在末端给出,所以 $\E_{\pi_\theta(\tau)}[r(\tau)]=\E_{\pi_\theta(\mathbf a|\mathbf s)}[r(\mathbf s,\mathbf a)]$。而且它们的 REINFORCE 梯度也完全一样,因为
$$ \nabla_\theta\log\pi_\theta(\mathbf a|\mathbf s)=\sum_{t}\nabla_\theta\log\pi_\theta(a_t|s_t). $$那为什么还要区分?因为一旦你想加基线或者中间奖励,两者就不同了。bandit 视角只允许一个与 $\mathbf s$ 有关的标量基线;token 视角允许每个位置有自己的 $\hat V(s_t)$,从而给每个 token 分配不同的优势值。这就是「信用分配」——在 5000 个 token 的思维链里,究竟是哪几步导致了最终答对?
但注意:多轮场景下这个论断失效。当模型调用工具、检索、或者与真实用户交互时,环境返回的 token 不是策略生成的,转移变成真正随机的,而且是部分可观测的。这时候我们就回到了标准 RL 的困难区间(见第 10 节)。
4. LLM 上的策略梯度:从 REINFORCE 到 PPO 循环
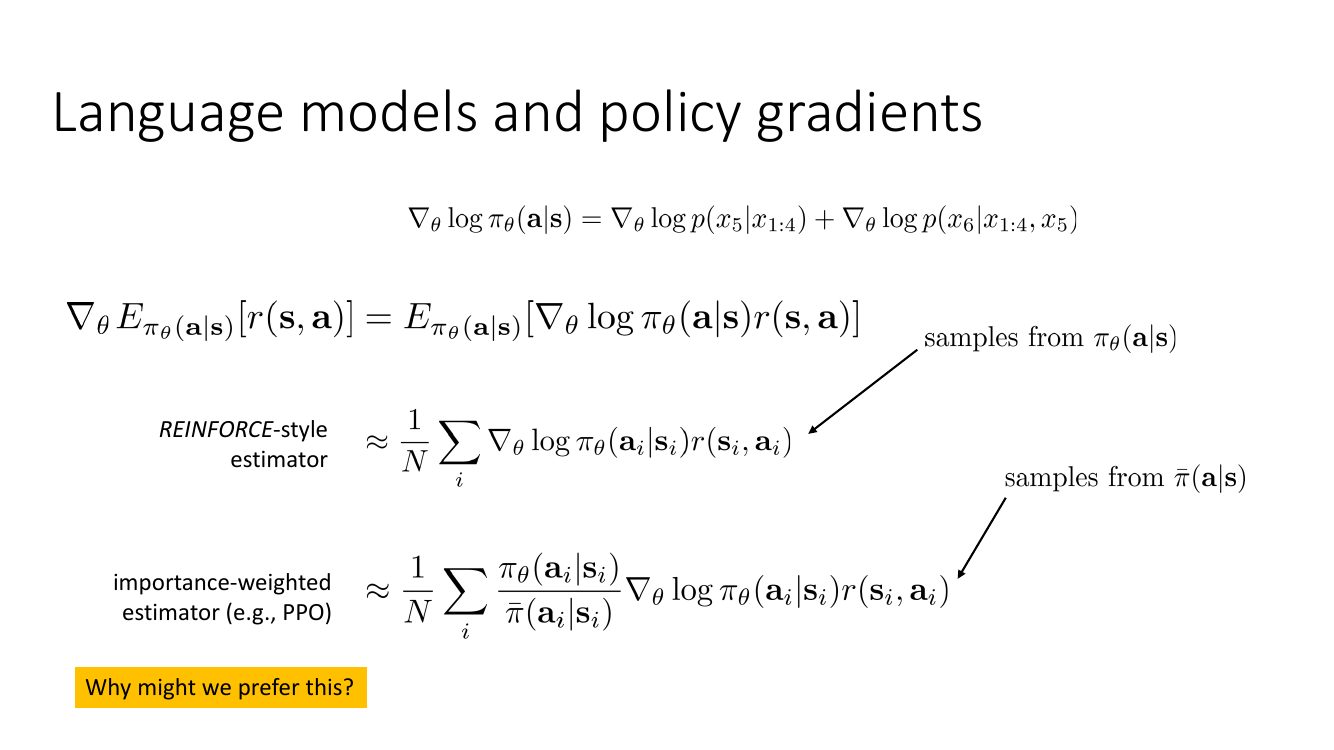
先把 log-derivative trick 在这个场景重写一遍(这一步值得写全,因为它解释了「为什么 RL 微调在代码上看起来就像加权的交叉熵」):
$$ \nabla_\theta \E_{\pi_\theta(\mathbf a|\mathbf s)}\big[r(\mathbf s,\mathbf a)\big] =\nabla_\theta\sum_{\mathbf a}\pi_\theta(\mathbf a|\mathbf s)r(\mathbf s,\mathbf a) =\sum_{\mathbf a}\pi_\theta(\mathbf a|\mathbf s)\nabla_\theta\log\pi_\theta(\mathbf a|\mathbf s)\,r(\mathbf s,\mathbf a), $$用到 $\nabla_\theta\pi_\theta=\pi_\theta\nabla_\theta\log\pi_\theta$。写成期望并用样本近似:
$$ \approx\frac1N\sum_{i}\nabla_\theta\log\pi_\theta(\mathbf a_i|\mathbf s_i)\,r(\mathbf s_i,\mathbf a_i) =\frac1N\sum_i\Big(\sum_t\nabla_\theta\log\pi_\theta(a_{i,t}|s_{i,t})\Big)r(\mathbf s_i,\mathbf a_i). $$括号里那个东西,就是标准语言模型训练里的交叉熵梯度(只不过标签换成了模型自己采出来的 token)。所以 REINFORCE 微调 = 用奖励加权的自我监督微调:奖励为正就把这条序列的概率往上推,为负就往下压。
为什么必须用重要性加权
重要性加权版本:
$$ \nabla_\theta \E_{\pi_\theta}\big[r\big]\approx\frac1N\sum_i\frac{\pi_\theta(\mathbf a_i|\mathbf s_i)}{\bar\pi(\mathbf a_i|\mathbf s_i)}\nabla_\theta\log\pi_\theta(\mathbf a_i|\mathbf s_i)\,r(\mathbf s_i,\mathbf a_i),\qquad \mathbf a_i\sim\bar\pi . $$这是无偏的,因为 $\E_{\bar\pi}[\frac{\pi_\theta}{\bar\pi}f]=\E_{\pi_\theta}[f]$。它带来的自由是:样本可以来自一个旧策略。为什么这件事在 LLM 上如此关键?
- 采样极贵。生成 1000 个 token 要做 1000 次前向(自回归,无法并行),而一次梯度步只是一次前向 + 一次反向。工程上采样通常还跑在独立的推理引擎(vLLM/SGLang)上,权重同步本身就有开销。如果每做一次梯度更新就要重新采一批数据,GPU 利用率会低得不能看。
- 批量要足够大才能降方差。末端稀疏奖励的梯度方差极大,一批往往要几百上千条序列。这么大的一批只喂一次梯度就扔掉,太浪费。
- 异步/流水线训练。允许 $\bar\pi\ne\pi_\theta$ 之后,采样器和训练器可以并行跑,采样器用的是稍旧的权重。这在现代 RLHF 框架里是标配。
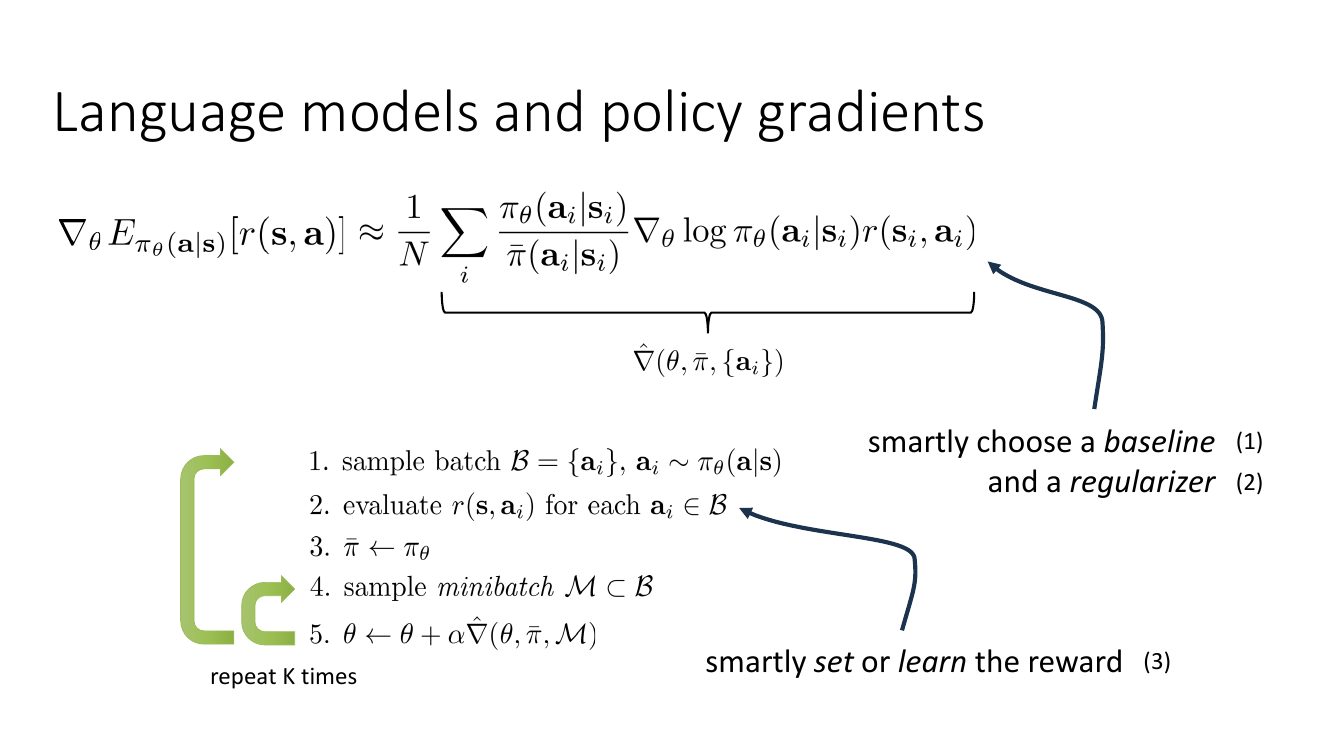
注意步骤 3 的位置:$\bar\pi$ 是本轮采样时的策略。在内层 $K$ 次小批更新中 $\theta$ 一直在变,而 $\bar\pi$ 冻结不动,所以比值 $\frac{\pi_\theta}{\bar\pi}$ 从 1 开始逐渐偏离。$K$ 越大,样本复用率越高,但分布偏移也越严重。这正是 PPO 的 clip 要解决的问题。
实现上的标准做法是把比值下放到 token 级:对每个 $t$ 单独算 $\rho_t=\frac{\pi_\theta(a_t|s_t)}{\bar\pi(a_t|s_t)}$ 并 clip。这在数学上不再是精确的序列级重要性采样,而是「近似 on-policy + 信任域」的启发式——但它能跑,序列级的不能。
import torch, torch.nn.functional as F

def sequence_logprobs(model, input_ids, attention_mask, prompt_len):
    """
    返回每个「生成 token」的 log pi(a_t | s_t)。
    input_ids: (B, L) = [prompt tokens | completion tokens]
    prompt_len: (B,)  每条样本 prompt 的长度
    """
    logits = model(input_ids=input_ids, attention_mask=attention_mask).logits  # (B,L,V)
    # 位置 t 的 logits 预测位置 t+1 的 token,因此错位对齐
    logits = logits[:, :-1, :]                       # (B, L-1, V)
    targets = input_ids[:, 1:]                       # (B, L-1)
    logp = torch.log_softmax(logits.float(), dim=-1)
    token_logp = logp.gather(-1, targets.unsqueeze(-1)).squeeze(-1)   # (B, L-1)

    # 只保留 completion 部分:prompt 里的 token 不是策略做出的动作
    idx = torch.arange(token_logp.size(1), device=token_logp.device)
    gen_mask = (idx.unsqueeze(0) >= (prompt_len - 1).unsqueeze(1)).float()
    gen_mask = gen_mask * attention_mask[:, 1:].float()
    return token_logp, gen_mask                       # (B,L-1), (B,L-1)


def reinforce_loss(token_logp, gen_mask, reward):
    """最朴素的 REINFORCE:奖励加权的负对数似然。reward: (B,)"""
    seq_logp = (token_logp * gen_mask).sum(dim=1)     # log pi(a|s)
    return -(seq_logp * reward.detach()).mean()
这段代码里 gen_mask 是最容易写错、也最要紧的地方:prompt 里的 token 不是策略选的动作,它们的 log-prob 不能进入策略梯度,否则你等于在用奖励去调整模型对用户输入的建模概率——毫无意义,而且会显著损害模型。多轮/工具场景下同理,工具返回的 token 也必须被 mask 掉。
5. 设计选择(1):基线——价值函数 + GAE 还是组内归一化
先说为什么非要基线不可。假设奖励是验证器给的 $r\in\{0,1\}$,某个 prompt 上模型的正确率是 80%。不加基线的 REINFORCE 梯度是
$$ \frac1N\sum_i \nabla_\theta\log\pi_\theta(\mathbf a_i|\mathbf s)\cdot r_i . $$$r_i=0$ 的样本贡献零梯度——也就是说,模型答错的那 20% 完全没有被惩罚,算法只是在把答对的 80% 往上推。这不仅浪费了一半信息,还会让所有采样过的序列概率都上升(其余序列被 softmax 挤下去),训练信号极其低效。加上基线 $b=0.8$ 之后,答对的优势是 $+0.2$、答错的是 $-0.8$,一推一压,才是我们想要的对比信号。
回忆本课第 5 讲的结论:任何只依赖状态、不依赖动作的基线都不引入偏差,因为
$$ \E_{a\sim\pi_\theta(\cdot|s)}\big[\nabla_\theta\log\pi_\theta(a|s)\,b(s)\big]=b(s)\sum_a\nabla_\theta\pi_\theta(a|s)=b(s)\,\nabla_\theta\!\!\underbrace{\sum_a\pi_\theta(a|s)}_{=1}=0 . $$做法 A:价值函数基线 + GAE
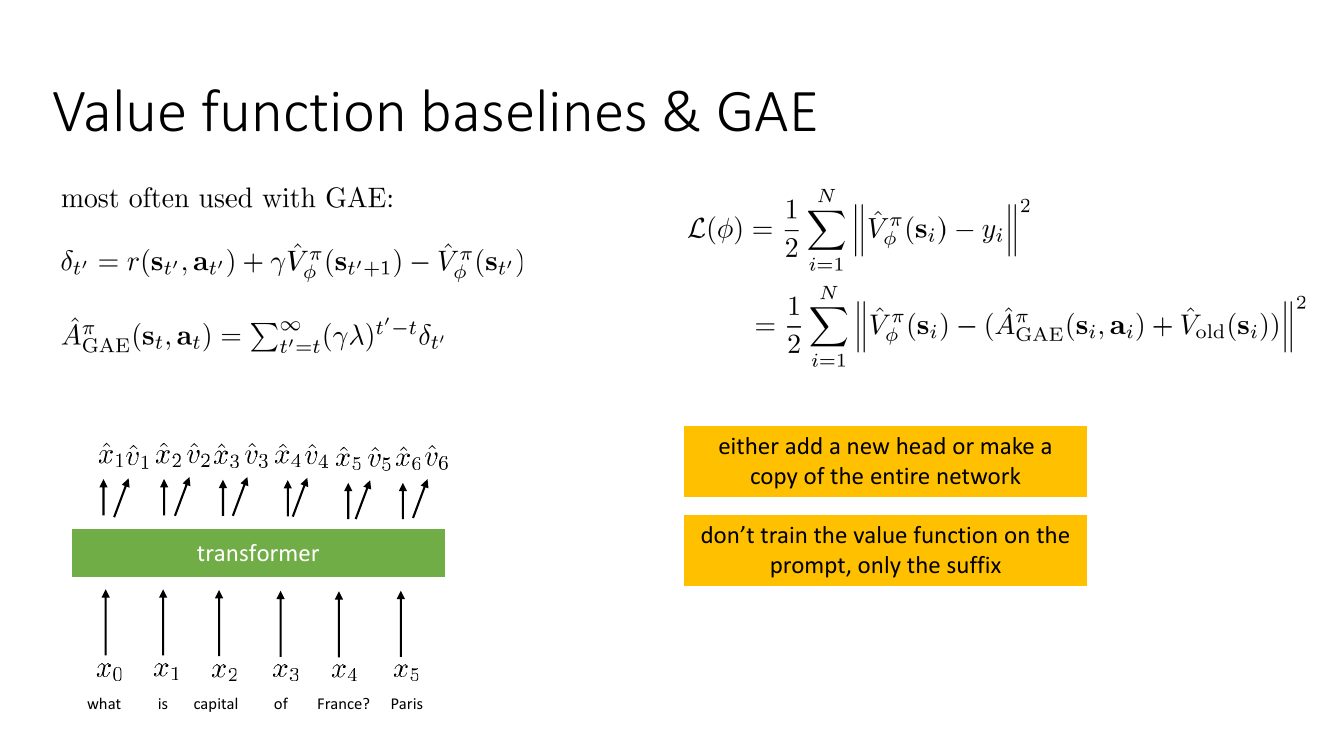
GAE(Generalized Advantage Estimation)在这里的作用和标准 RL 一样:用 $\lambda$ 在「低方差高偏差的单步 TD($\lambda=0$)」和「高方差无偏的蒙特卡洛回报($\lambda=1$)」之间插值。在 LLM 里因为奖励只在末端,$\gamma=1,\lambda=1$ 时 $\hat A_t$ 就退化成 $r_{\text{end}}-\hat V(s_t)$;取 $\lambda\lt 1$ 会让远处的奖励信号衰减,实践中大多数实现干脆取 $\gamma=\lambda=1$。
为什么「不要在 prompt 上训价值函数」?因为 prompt 位置上的 $s_t$ 并不是策略做决策的状态——那里没有动作,也就没有对应的优势要算。在那些位置上做回归只是在消耗网络容量、并把梯度污染进共享的 transformer 主干。
代价也要算清楚。用 GAE 就意味着你要维护一个和策略同等规模的 critic(哪怕只是加个头,反向传播也要走整个主干)。加上策略、参考模型、奖励模型,显存里同时有 四个大模型。
做法 B:GRPO——不用价值函数的基线
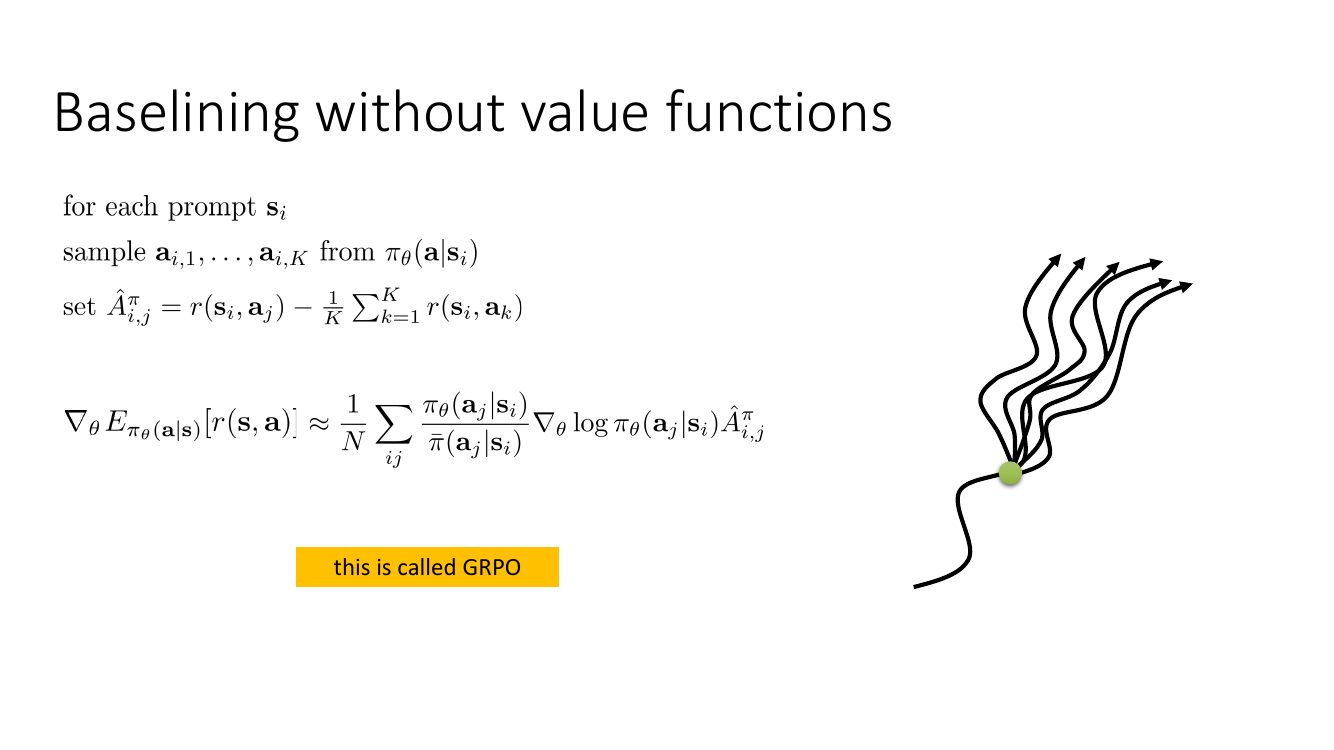
思路极其朴素:既然基线只要「依赖状态、不依赖动作」就无偏,那我干脆再多采几个样本,用它们的平均奖励当基线。这在普通 RL 里做不到(你无法把环境重置到同一个状态采多次),但在 LLM 里可以——prompt 就是状态,想采多少次采多少次。
标准差归一化:它的作用与它的偏差
幻灯片上写的是纯均值基线,而 DeepSeekMath 原始论文里的 GRPO 还多除了一个组内标准差:
$$ \hat A_{i,j}=\frac{r(\mathbf s_i,\mathbf a_j)-\operatorname{mean}\big(\{r(\mathbf s_i,\mathbf a_k)\}_{k=1}^K\big)}{\operatorname{std}\big(\{r(\mathbf s_i,\mathbf a_k)\}_{k=1}^K\big)} . $$好处很直观:不同 prompt 的奖励尺度天然不同(还记得第 8 节会讲的——BT 模型下奖励只在差值意义上可辨识,跨 prompt 的绝对值毫无可比性),除以标准差相当于给每个 prompt 做自适应的步长归一化,让梯度尺度统一。
- 难度偏差。对二元奖励,若组内正确率为 $p$,则 $\operatorname{std}=\sqrt{p(1-p)}$。$p=0.5$ 时 std 最大(0.5),$p=0.9$ 时 std 只有 0.3,$p=0.99$ 时只有 0.1。除以它意味着极简单和极困难的 prompt 被放大了 5–10 倍权重,而这些恰恰是信息量最少的样本。更糟的是 $p\in\{0,1\}$ 时 std $=0$,整组优势全为 0,这一整批采样白算——大规模训练里这类「全对/全错组」的比例可以很高。
- 长度偏差。GRPO 的目标里对每条回答的 token 做 $\frac{1}{|\mathbf a_i|}$ 平均。当 $\hat A\lt 0$ 时,回答越长,每个 token 分到的惩罚越小;于是「写得又长又错」比「写得短而错」损失更小,模型被隐式鼓励在做不对的题上啰嗦下去。这是 Dr. GRPO 那条工作指出的核心问题,修法是把 $\frac{1}{|\mathbf a_i|}$ 换成一个与样本无关的常数(比如固定的最大长度)。
| PPO + 价值函数 + GAE | GRPO / RLOO(组内基线) | |
|---|---|---|
| 显存中的模型数 | 4(策略、参考、奖励模型、critic) | 3(策略、参考、奖励模型/验证器) |
| 每个 prompt 的采样数 | 1 条即可 | 必须 $K$ 条(典型 $K=4\sim64$) |
| 信用分配粒度 | 逐 token 的 $\hat A_t$,可利用中间奖励 | 整条序列共享一个 $\hat A$ |
| 基线偏差来源 | critic 拟合误差(尤其训练早期极不准) | 组内样本有限带来的估计噪声;std 归一化的难度/长度偏差 |
| 额外计算 | critic 的前反向 | $K$ 倍的采样开销 |
| 适用场景 | 密集/过程奖励、长 horizon、多轮 | 末端稀疏奖励、单轮、可验证任务 |
Levine 的判断是:这两者不是「谁更先进」的关系,而是把方差换成计算的两种不同方式。critic 用参数化拟合去省采样;GRPO 用多采样去省参数。在末端 0/1 奖励、单轮生成的场景里,critic 要拟合的其实就是「这个 prompt 的正确率」,一个用 $K$ 个样本直接估的均值往往比一个训练不稳的神经网络更准,所以 GRPO 赢;但在多轮、有中间奖励、需要区分「哪一步走错了」的场景里,没有 critic 就没有细粒度信用分配。
6. 设计选择(2):参考模型 KL 正则化
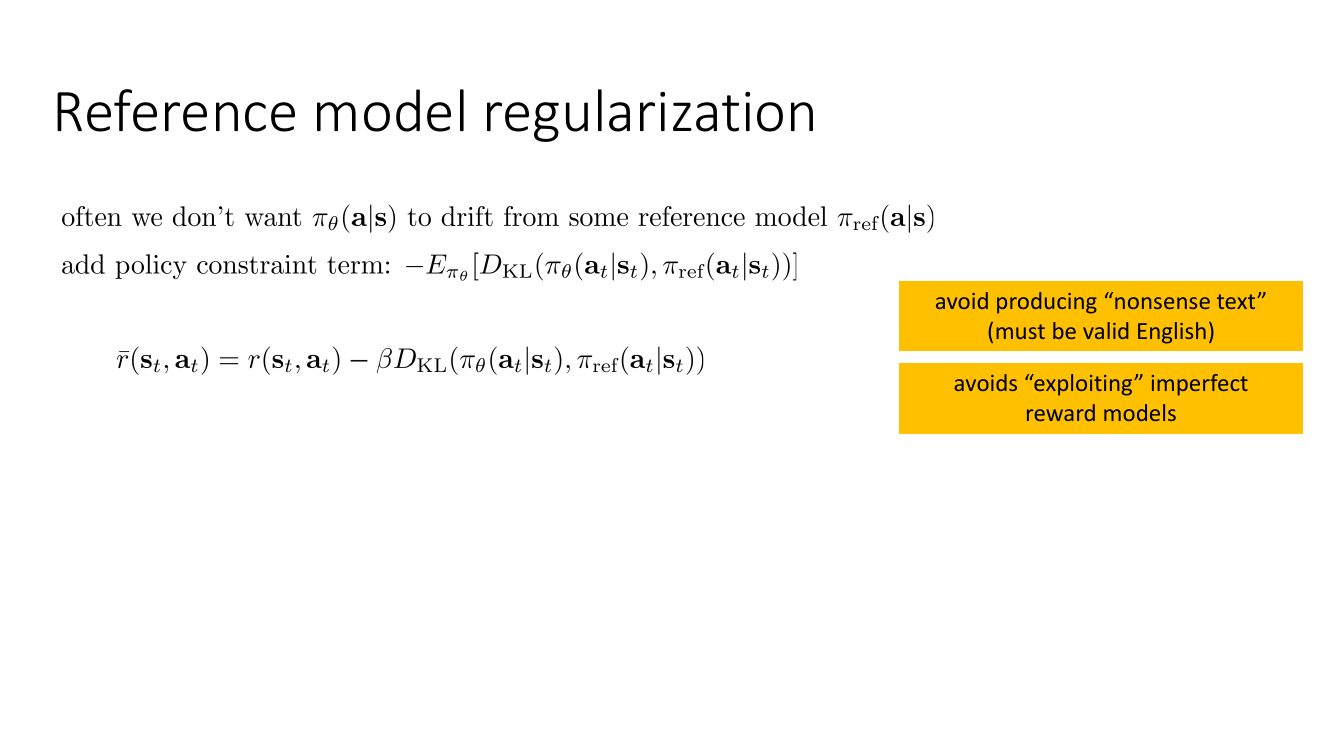
第二条理由值得展开,它是整个 RLHF 体系里最脆弱的一环。
而 RL 是什么?RL 是一个专门用来寻找函数最大值的优化器。你给它一个有漏洞的函数,它会以惊人的效率找到漏洞。经典现象:策略发现连着输出一串特定的标点或者某个罕见 token 能让 RM 打出高分,于是输出退化成一堆乱码;或者发现 RM 偏爱长回答,于是把每个回答都灌水到 2000 词。这就是奖励黑客(reward hacking),本质是 Goodhart 定律:一旦某个度量成为目标,它就不再是好的度量。
KL 惩罚的作用就是:把策略锁在奖励模型还可信的那片区域里。$\beta$ 是「相信奖励模型多少」的旋钮。
把 KL 项吸收进奖励之后,优化的实际目标是
$$ J(\theta)=\E_{\mathbf s\sim\mathcal D}\Big[\E_{\mathbf a\sim\pi_\theta}\big[r(\mathbf s,\mathbf a)\big]-\beta\,\KL\big(\pi_\theta(\cdot|\mathbf s)\,\|\,\pi_{\text{ref}}(\cdot|\mathbf s)\big)\Big]. $$这个目标有一个闭式最优解,我们在第 8 节推导 DPO 时会用到它;它也正是上一讲「控制即推断」里那个软最优策略在 $\pi_{\text{ref}}$ 不均匀时的推广。
KL 的三种估计方式
实现上有若干变体,差别不小:
| 估计器 | 表达式(记 $u=\log\pi_{\text{ref}}(a_t|s_t)-\log\pi_\theta(a_t|s_t)$) | 性质 |
|---|---|---|
| 解析全 KL | $\sum_{v\in V}\pi_\theta(v|s_t)\log\frac{\pi_\theta(v|s_t)}{\pi_{\text{ref}}(v|s_t)}$ | 无方差,但要对整个词表求和,显存开销大 |
| k1(朴素) | $-u$ | 无偏,但方差大且可正可负 |
| k3(常用) | $\exp(u)-u-1$ | 无偏、恒非负、方差显著更低,GRPO 论文采用 |
k3 的无偏性来自 $\E_{\pi_\theta}[\exp(u)]=\E_{\pi_\theta}\big[\frac{\pi_{\text{ref}}}{\pi_\theta}\big]=1$,所以 $\E[\exp(u)-u-1]=1+\KL-1=\KL$。而 $\exp(u)-u-1\ge0$ 对任意实数 $u$ 成立($e^x\ge1+x$),因此它逐样本就非负,不会像 k1 那样出现「负 KL」的诡异日志。
另外,RLVR 场景下很多工作直接取 $\beta=0$:验证器给的奖励不是一个可被攻破的神经网络,而且 KL 会明显限制模型探索长思维链的能力(模型必须大幅偏离 SFT 分布才能学会「等一下,让我再检查一遍」这类行为)。
7. 拼起来:LLM 版 PPO 与 GRPO 的完整算法
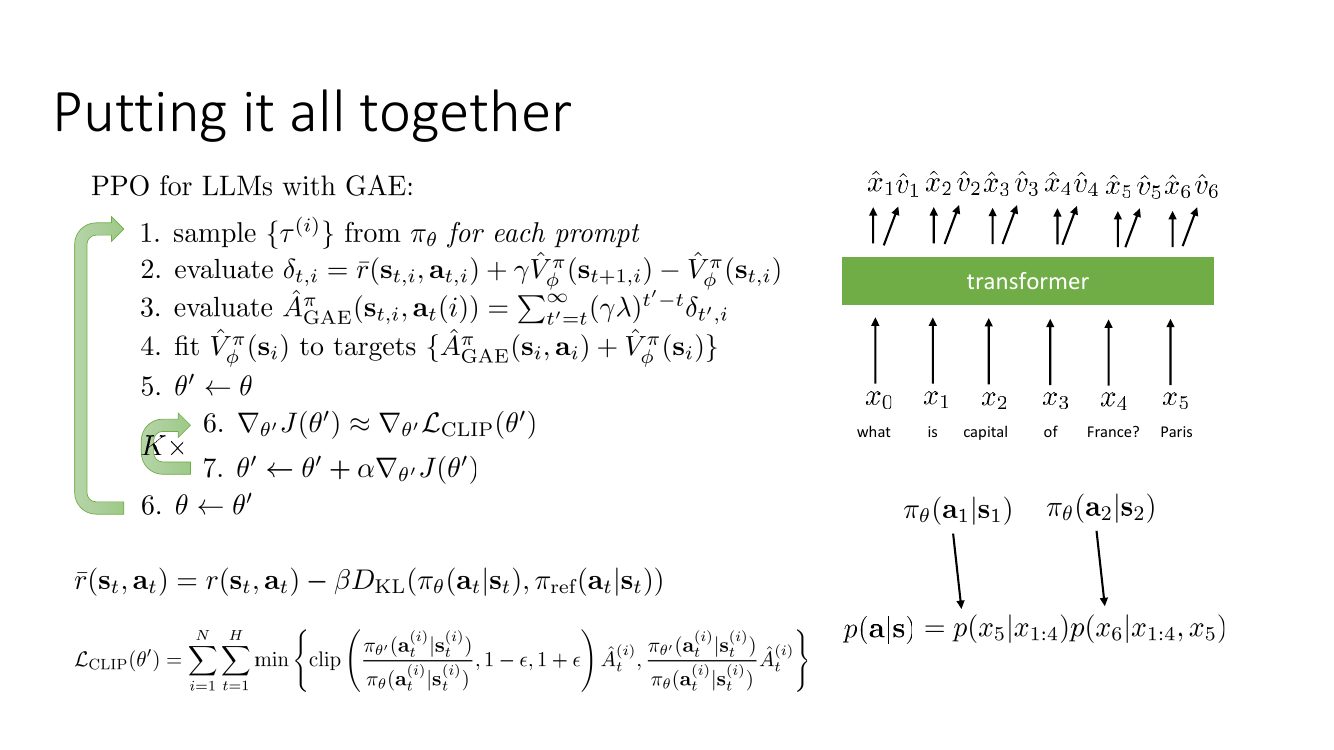
逐条抄下来:
- 对每个 prompt,从 $\pi_\theta$ 采样若干轨迹 $\{\tau^{(i)}\}$;
- 计算 $\delta_{t,i}=\bar r(s_{t,i},a_{t,i})+\gamma\hat V^\pi_\phi(s_{t+1,i})-\hat V^\pi_\phi(s_{t,i})$;
- 计算 $\hat A^\pi_{\text{GAE}}(s_{t,i},a_{t,i})=\sum_{t'=t}^{\infty}(\gamma\lambda)^{t'-t}\delta_{t',i}$;
- 把 $\hat V^\pi_\phi$ 回归到目标 $\{\hat A^\pi_{\text{GAE}}(s_i,a_i)+\hat V^\pi_\phi(s_i)\}$;
- $\theta'\leftarrow\theta$;
- (重复 $K$ 次)$\nabla_{\theta'}J(\theta')\approx\nabla_{\theta'}\mathcal L_{\text{CLIP}}(\theta')$;
- (重复 $K$ 次)$\theta'\leftarrow\theta'+\alpha\nabla_{\theta'}J(\theta')$;
- $\theta\leftarrow\theta'$。
其中
$$ \bar r(s_t,a_t)=r(s_t,a_t)-\beta D_{\mathrm{KL}}\big(\pi_\theta(a_t|s_t),\pi_{\text{ref}}(a_t|s_t)\big), $$ $$ \mathcal L_{\text{CLIP}}(\theta')=\sum_{i=1}^{N}\sum_{t=1}^{H}\min\left\{\operatorname{clip}\!\left(\frac{\pi_{\theta'}(a^{(i)}_t|s^{(i)}_t)}{\pi_{\theta}(a^{(i)}_t|s^{(i)}_t)},1-\epsilon,1+\epsilon\right)\hat A^{(i)}_t,\;\;\frac{\pi_{\theta'}(a^{(i)}_t|s^{(i)}_t)}{\pi_{\theta}(a^{(i)}_t|s^{(i)}_t)}\hat A^{(i)}_t\right\}. $$- $\hat A\gt 0$(这个动作比平均好,想提高它的概率):$\min$ 的效果是当 $\rho\gt1+\epsilon$ 时目标被截断成常数 $(1+\epsilon)\hat A$,梯度归零。不允许把好动作的概率无限往上推。
- $\hat A\lt 0$(想压低它):当 $\rho\lt1-\epsilon$ 时目标被截断成 $(1-\epsilon)\hat A$,梯度归零。不允许把坏动作压得太狠。
GRPO 的完整目标函数
把第 5 节的组内优势和第 6 节的 KL 装进同一个 clip 框架,就得到 GRPO 的标准形式。设一个 prompt $q$ 采出一组 $G$ 个回答 $\{o_i\}$:
$$ \mathcal J_{\text{GRPO}}(\theta)=\E\left[\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|o_i|}\sum_{t=1}^{|o_i|}\min\Big(\rho_{i,t}\hat A_i,\;\operatorname{clip}(\rho_{i,t},1-\epsilon,1+\epsilon)\hat A_i\Big)-\beta\,\hat D_{\mathrm{KL}}\big[\pi_\theta\,\|\,\pi_{\text{ref}}\big]\right], $$ $$ \rho_{i,t}=\frac{\pi_\theta(o_{i,t}\mid q,o_{i,\lt t})}{\pi_{\theta_{\text{old}}}(o_{i,t}\mid q,o_{i,\lt t})},\qquad \hat A_i=\frac{r_i-\operatorname{mean}(\{r_1,\dots,r_G\})}{\operatorname{std}(\{r_1,\dots,r_G\})}. $$和 PPO 比,差别只有三处:优势不来自 critic 而来自组内归一化;同一条回答的所有 token 共享同一个 $\hat A_i$;KL 作为独立损失项而非塞进奖励。
import torch

def grpo_loss(policy_logp, old_logp, ref_logp, gen_mask, rewards,
              group_size, beta=0.04, eps=0.2, use_std=True):
    """
    policy_logp / old_logp / ref_logp : (B, L) 逐 token 的 log 概率,B = n_prompt * group_size
    gen_mask : (B, L)  1 表示该位置是策略生成的 token
    rewards  : (B,)    每条回答的标量奖励(验证器或奖励模型给的)
    """
    B = rewards.size(0)
    r = rewards.view(-1, group_size)                       # (n_prompt, G)
    adv = r - r.mean(dim=1, keepdim=True)                  # 组内减均值 —— 幻灯片上的版本
    if use_std:
        adv = adv / (r.std(dim=1, keepdim=True) + 1e-6)    # 原论文的 std 归一化
    adv = adv.view(B, 1)                                   # 整条回答共享一个优势

    ratio = torch.exp(policy_logp - old_logp)              # token 级重要性比
    unclipped = ratio * adv
    clipped   = torch.clamp(ratio, 1 - eps, 1 + eps) * adv
    pg = torch.min(unclipped, clipped)                     # 悲观下界

    # k3 KL 估计:exp(u) - u - 1,其中 u = log pi_ref - log pi_theta,恒非负
    u  = ref_logp - policy_logp
    kl = torch.exp(u) - u - 1.0

    per_token = -(pg - beta * kl)                          # 要最小化的损失
    # 每条回答内部按 token 数平均(注意:这一步正是长度偏差的来源)
    per_seq = (per_token * gen_mask).sum(dim=1) / gen_mask.sum(dim=1).clamp(min=1)
    return per_seq.mean()
def gae_advantages(rewards, values, gen_mask, gamma=1.0, lam=1.0):
    """
    PPO 路线:逐 token 的 GAE。
    rewards : (B, L) 逐 token 奖励(通常只有最后一个生成位置非零,
                     再叠加逐 token 的 -beta * KL 惩罚)
    values  : (B, L) critic 输出 V(s_t)
    """
    B, L = rewards.shape
    adv = torch.zeros_like(rewards)
    last = torch.zeros(B, device=rewards.device)
    for t in reversed(range(L)):
        v_next = values[:, t + 1] if t + 1 < L else torch.zeros(B, device=rewards.device)
        delta = rewards[:, t] + gamma * v_next - values[:, t]
        last = delta + gamma * lam * last
        adv[:, t] = last
    returns = adv + values                    # critic 的回归目标 = A_GAE + V_old
    adv = adv * gen_mask
    # 全批次白化,进一步降方差(PPO 实现中的标准技巧)
    m = adv.sum() / gen_mask.sum()
    v = ((adv - m) ** 2 * gen_mask).sum() / gen_mask.sum()
    adv = (adv - m) / (v.sqrt() + 1e-8) * gen_mask
    return adv.detach(), returns.detach()
关于 gae_advantages 里的循环方向:必须从后往前,因为 $\hat A_t=\delta_t+\gamma\lambda\hat A_{t+1}$ 是一个反向递推。这个恒等式的验证很直接——把定义 $\hat A_t=\sum_{t'\ge t}(\gamma\lambda)^{t'-t}\delta_{t'}$ 拆出第一项即可。
8. 设计选择(3a):从人类偏好学奖励——Bradley–Terry 与 RLHF
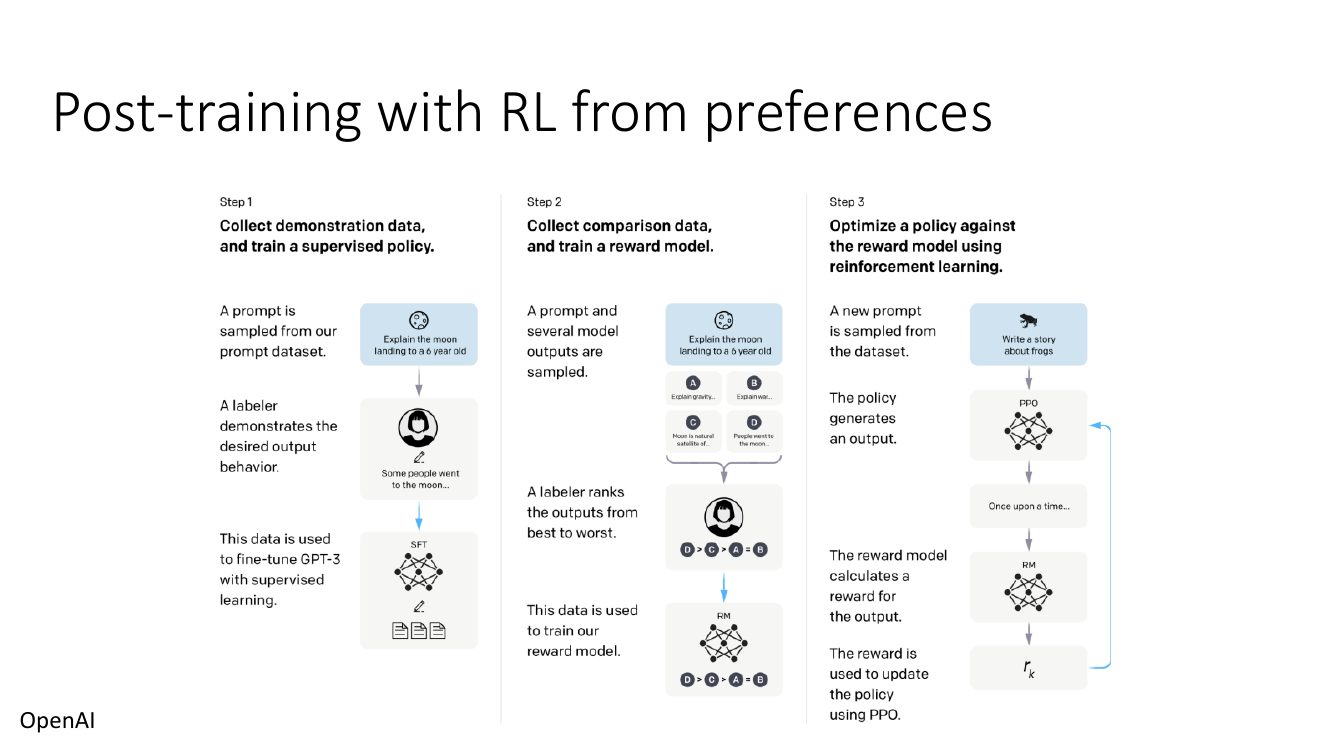
回到那个循环里第 2 步的问号:$r(\mathbf s,\mathbf a_i)$ 从哪儿来?第 1 节的 IRL 路线要求人类演示;但对「什么是好的助手回答」这件事,演示太贵了(要人写出完美答案),而且人写的答案未必比模型采样出来的好。更便宜的信号是比较。
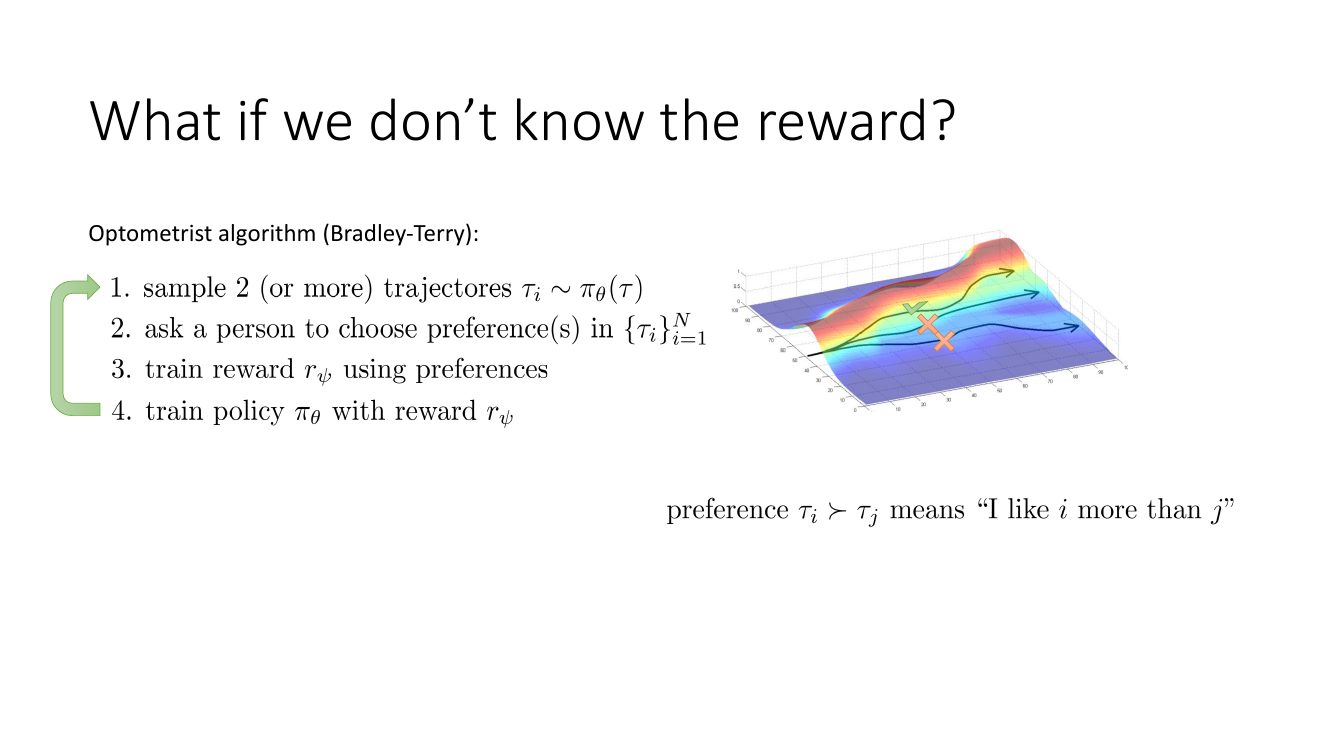
人类给的是序关系,不是数值。要把序关系变成可微的损失,需要一个概率模型——这就是 Bradley–Terry。
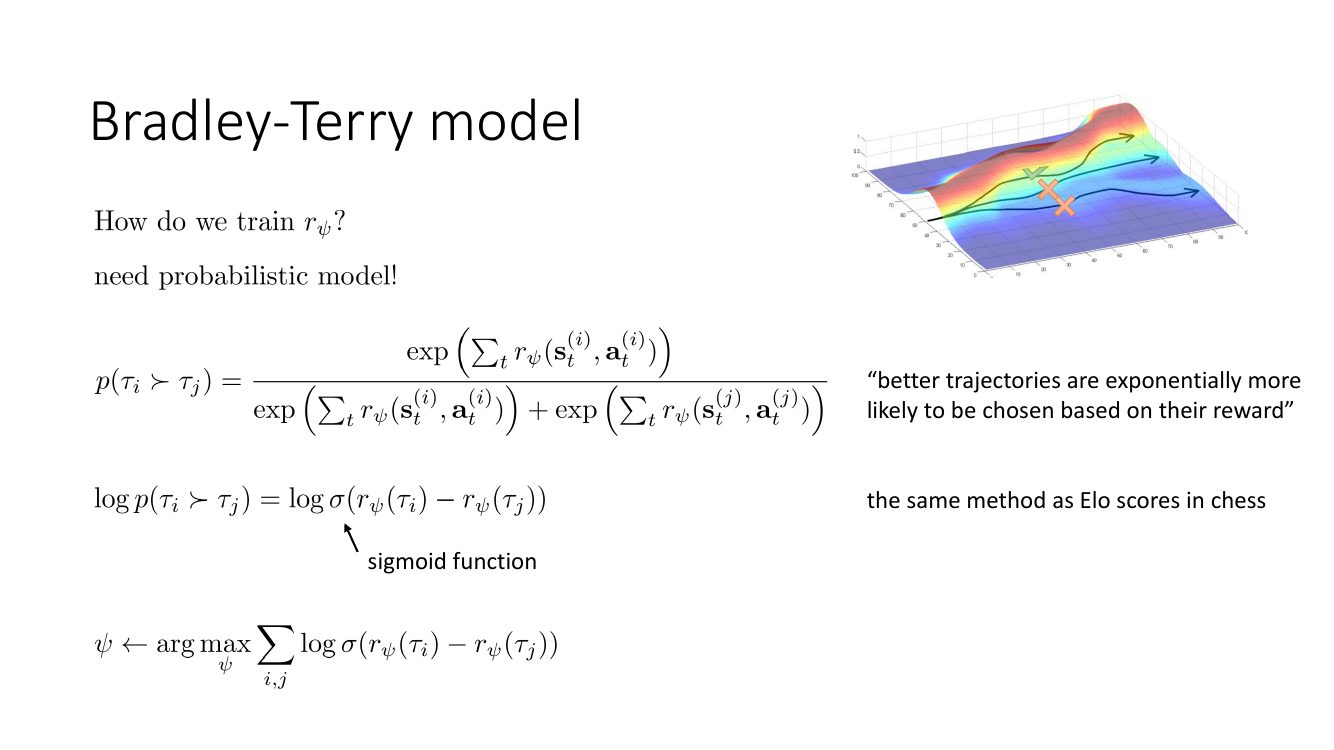
梯度也很有解释力: $$ \nabla_\psi\mathcal L=-\sum \sigma\big(r_\psi(\tau_l)-r_\psi(\tau_w)\big)\big(\nabla_\psi r_\psi(\tau_w)-\nabla_\psi r_\psi(\tau_l)\big), $$ 权重 $\sigma(r_l-r_w)$ 正是「模型当前有多不同意人类」——已经排对的样本权重趋近 0,排错的样本权重趋近 1。这是自动的难例挖掘。
这条性质有两个直接后果:(a) 你不能拿 RM 分数在不同题目之间排序、也不能拿它当绝对的质量指标;(b) 策略梯度里必须用依赖 prompt 的基线把这个未知常数消掉——这正好又一次论证了 GRPO 组内基线的合理性。
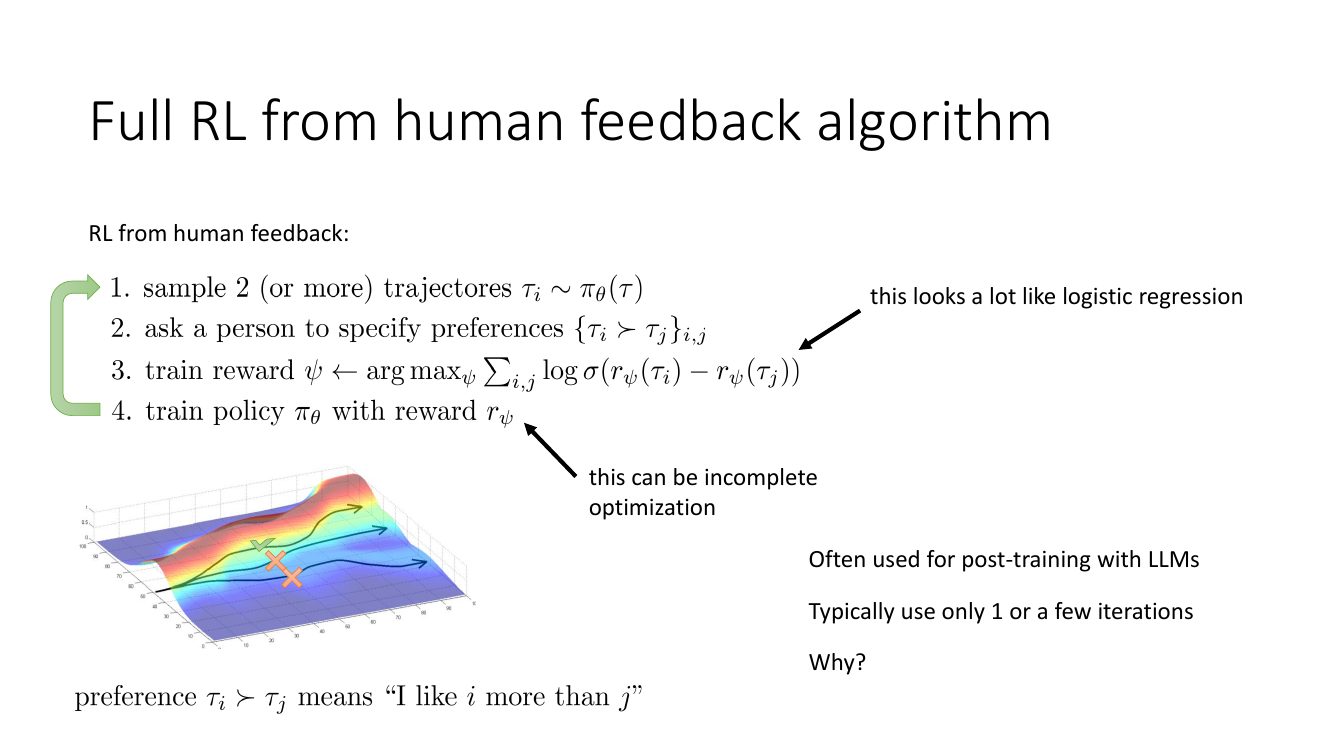
「为什么只做一两轮」这个问题,答案有三层:
- 人在环里,循环转不快。第 2 步要真人标注,一轮就是几周和几十万美元。相比之下经典的偏好式 RL(比如 Christiano 等人的 MuJoCo 实验)可以让人在训练过程中持续标注几百次,因为每次只要看两段几秒的视频。
- 奖励模型的有效期很短。RM 是在 $\pi_{\text{ref}}$ 附近的回答上训的。策略一旦被优化得偏离,RM 立刻进入外推区、开始被攻破。要继续优化,就必须重新采样、重新标注——也就是重新转一圈循环。所以「1 轮 RLHF + 强 KL 约束」和「多轮 RLHF + 弱 KL 约束」是同一件事的两种预算分配。
- 第 4 步本来就不需要解到底。幻灯片明确写了 “this can be incomplete optimization”,这与第 1 节 IRL 里的「懒惰策略优化」是同一个思想:外层的奖励在变,内层没必要收敛。
import torch, torch.nn as nn, torch.nn.functional as F

class RewardModel(nn.Module):
    """Bradley-Terry 奖励模型:transformer 主干 + 标量头,读最后一个非 padding 位置"""
    def __init__(self, backbone, hidden):
        super().__init__()
        self.backbone = backbone
        self.v_head = nn.Linear(hidden, 1, bias=False)

    def forward(self, input_ids, attention_mask):
        h = self.backbone(input_ids=input_ids,
                          attention_mask=attention_mask).last_hidden_state  # (B,L,H)
        scores = self.v_head(h).squeeze(-1)                                 # (B,L)
        last = attention_mask.sum(dim=1) - 1                                # 最后一个真实 token
        return scores.gather(1, last.unsqueeze(1)).squeeze(1)               # (B,)

def bt_loss(rm, chosen_ids, chosen_mask, rejected_ids, rejected_mask, margin=0.0):
    r_w = rm(chosen_ids, chosen_mask)        # 人类偏好的回答
    r_l = rm(rejected_ids, rejected_mask)    # 被拒绝的回答
    # -log sigma(r_w - r_l),等价于 softplus(-(r_w - r_l)),数值更稳
    loss = F.softplus(-(r_w - r_l - margin)).mean()
    acc  = (r_w > r_l).float().mean()        # 偏好准确率,最重要的监控指标
    return loss, acc
补充:DPO——把 RL 那一步消掉
这一部分不在幻灯片上,但它是理解上述框架的绝佳练习:只要把第 6 节那个 KL 正则化目标的闭式解反解出来,整个 RL 循环可以被一个监督损失替代。
这正是上一讲「控制即推断」里那个 $\pi\propto\exp(Q/\alpha)$ 的形式,只是先验从均匀分布换成了 $\pi_{\text{ref}}$。
于是我们可以直接对策略做最大似然,不需要先学一个 RM 再跑 RL: $$ \mathcal L_{\text{DPO}}(\theta)=-\E_{(\mathbf s,\mathbf a_w,\mathbf a_l)\sim\mathcal D}\left[\log\sigma\Big(\beta\log\frac{\pi_\theta(\mathbf a_w|\mathbf s)}{\pi_{\text{ref}}(\mathbf a_w|\mathbf s)}-\beta\log\frac{\pi_\theta(\mathbf a_l|\mathbf s)}{\pi_{\text{ref}}(\mathbf a_l|\mathbf s)}\Big)\right]. $$
它的梯度同样有清晰的解释:
$$ \nabla_\theta\mathcal L_{\text{DPO}}=-\beta\,\E\Big[\underbrace{\sigma\big(\hat r_\theta(\mathbf a_l)-\hat r_\theta(\mathbf a_w)\big)}_{\text{隐式 RM 现在错得有多离谱}}\big(\nabla_\theta\log\pi_\theta(\mathbf a_w|\mathbf s)-\nabla_\theta\log\pi_\theta(\mathbf a_l|\mathbf s)\big)\Big], $$其中 $\hat r_\theta(\mathbf a)=\beta\log\frac{\pi_\theta(\mathbf a|\mathbf s)}{\pi_{\text{ref}}(\mathbf a|\mathbf s)}$。抬高胜者、压低败者,权重是当前模型的「排错程度」。
import torch.nn.functional as F

def dpo_loss(pi_logp_w, pi_logp_l, ref_logp_w, ref_logp_l, beta=0.1):
    """
    四个输入都是整条回答的 log 概率(对 completion token 求和,(B,) 形状)。
    pi_*  来自正在训练的策略;ref_* 来自冻结的参考模型(可预先算好缓存)。
    """
    logits = beta * ((pi_logp_w - ref_logp_w) - (pi_logp_l - ref_logp_l))
    loss = F.softplus(-logits).mean()           # = -log sigmoid(logits)
    with torch.no_grad():
        implicit_acc = (logits > 0).float().mean()
        margin = logits.mean() / beta
    return loss, implicit_acc, margin
| RLHF(RM + PPO) | DPO | GRPO + 验证器 | |
|---|---|---|---|
| 需要在线采样 | 是 | 否(离线偏好数据集) | 是(每 prompt 采 $K$ 条) |
| 训练中的模型数 | 4 | 2(策略 + 参考,参考可缓存) | 2–3 |
| 奖励形式 | 显式神经网络 RM | 隐式,$\beta\log\frac{\pi_\theta}{\pi_{\text{ref}}}$ | 规则/程序,$r\in\{0,1\}$ |
| 能否超出偏好数据分布 | 能(策略自己探索) | 不能(只能在给定的 $\mathbf a_w,\mathbf a_l$ 上做对比) | 能 |
| 主要失效模式 | reward hacking、训练不稳 | 分布外似然坍塌:$\pi(\mathbf a_w)$ 和 $\pi(\mathbf a_l)$ 可能一起下降,只要差值拉大 | 验证器漏洞、全对/全错组 |
| 实现复杂度 | 高 | 低(就是一个损失函数) | 中 |
DPO 的那个失效模式值得记住:损失只关心 $\log\pi_\theta(\mathbf a_w)-\log\pi_\theta(\mathbf a_l)$ 这个差,完全不管两者的绝对值。实践中经常观察到 chosen 和 rejected 的对数似然双双下降,概率质量跑到了两者之外的第三类文本上。缓解办法包括加一个 SFT 正则项、或者用在线/迭代式 DPO(每轮用当前策略重新采样并重新标注)——后者其实又转回了 RLHF 的循环。
9. 设计选择(3b):可验证奖励、过程奖励与推理模型
人类偏好不是唯一的奖励来源。对一大类任务,我们知道正确答案:数学题有标准答案,代码有单元测试,形式化证明有检查器。这时候奖励可以由程序给出,不需要神经网络。
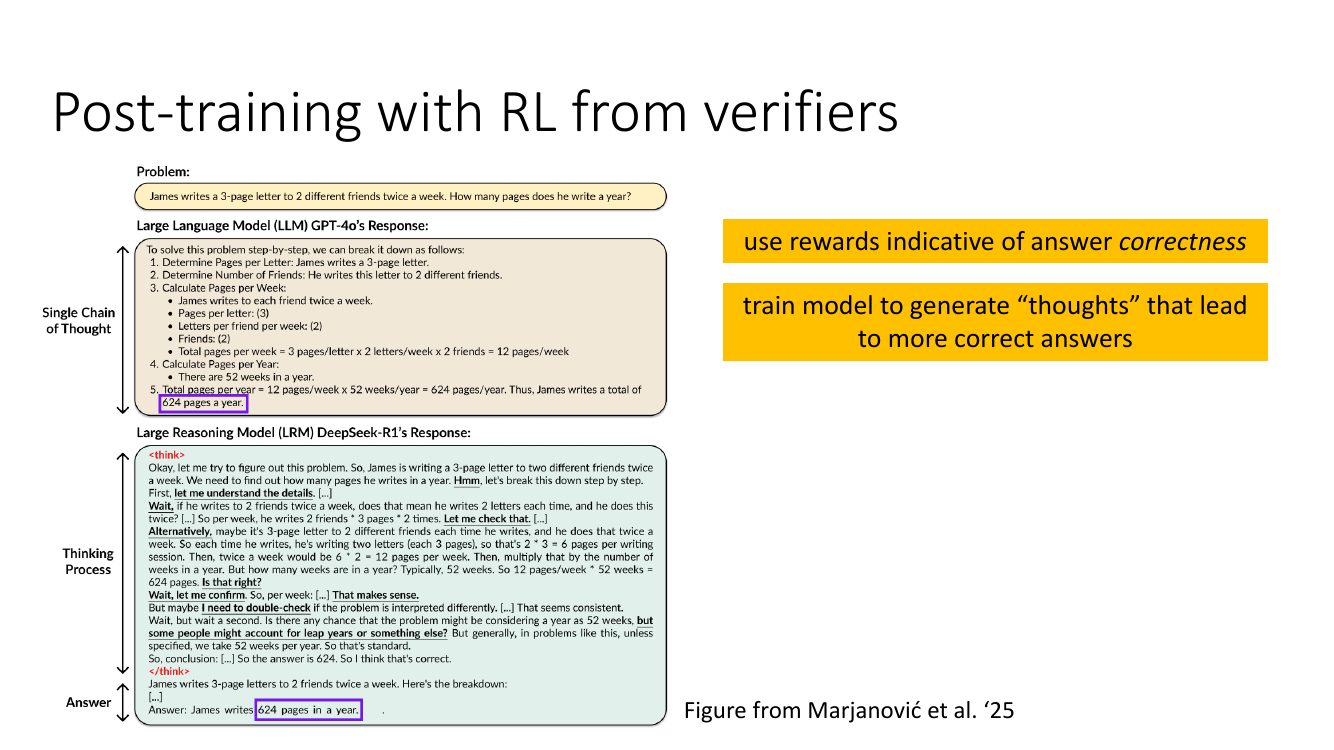
<think> 包起来的思考过程,里面充满「Hmm, 让我先理解一下细节」「Wait, 让我检查一下」「Alternatively, 也许……」「But wait a second. 有没有可能考虑闰年?」这类自我怀疑与回溯,最后才输出答案。右侧两个黄框是方法论:使用能指示答案正确性的奖励;训练模型生成能导向更多正确答案的「思考」。这就是 RLVR(RL with Verifiable Rewards)。它在 RL 的框架里其实非常经典,但有一个特别漂亮的性质:
于是模型自发地学出了各种提高成功率的策略:把问题拆解、列举多种解法、算完之后回头验算、发现矛盾就推倒重来。这些行为没有一条是被人类示范教出来的——用监督学习你根本不知道该往标签里写什么。这正是 RL 相对于模仿学习的根本优势:它优化的是结果,不是过程。典型的副产品是回答长度在训练中持续增长,因为「多想一会」确实能提高正确率。
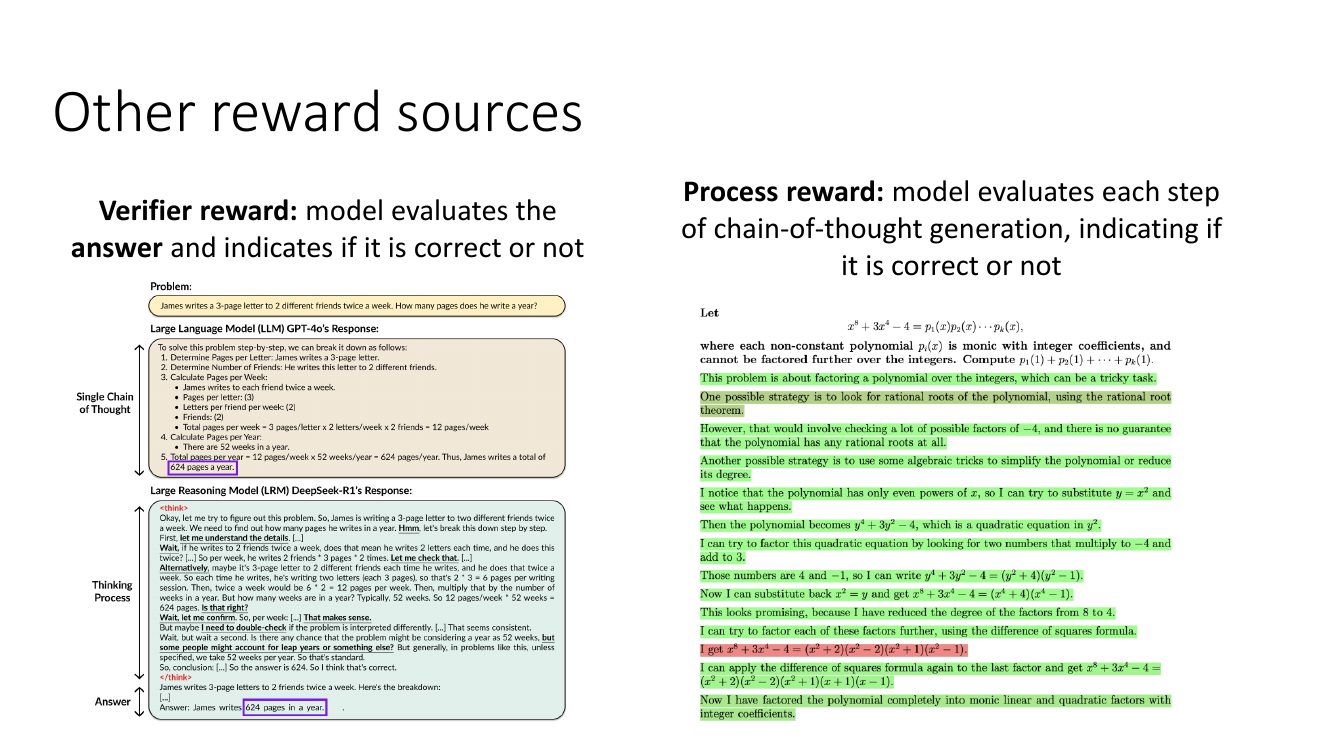
| 奖励来源 | 信号形式 | 优点 | 代价与风险 |
|---|---|---|---|
| 人类偏好 RM | 末端标量,同 prompt 内可比 | 适用于开放式任务(写作、对话、安全) | 标注贵;RM 可被攻破;只在 $\pi_{\text{ref}}$ 附近可信 |
| 验证器(ORM / 规则) | 末端 $\{0,1\}$ | 不可(轻易)被攻破,可无限量生成 | 只适用于有标准答案的领域;信号极稀疏,长 horizon 信用分配困难 |
| 过程奖励模型 PRM | 每一步一个标量 | 稠密信号,信用分配精细;也可用于推理时搜索 | 步骤级标注极贵(或需大量 MC rollout 估计);PRM 本身也会被攻破 |
| LLM-as-judge | 末端标量或偏好 | 便宜、可扩展、适用范围广 | 继承评判模型的偏见(偏爱长文、偏爱自己风格) |
信用分配:稀疏奖励在长序列上的老问题
一条 8000 token 的思维链,最后得到 $r=1$。在 GRPO 里,这 8000 个 token 全部拿到同一个优势值 $\hat A$。这意味着:那句真正解决问题的关键推导,和中间那句无关紧要的「Hmm, let me think」,被同等强化。这就是稀疏奖励下的信用分配问题,只不过在 LLM 上表现为「哪些 token 值得被强化」。
现有的三条缓解路线:
- 过程奖励:给中间步骤打分,把稀疏奖励变稠密。代价是需要 PRM,而 PRM 又是一个可被攻破的神经网络。
- 价值函数 / GAE:让 critic 学出「从这个前缀出发的成功率」,$\hat A_t = r + \gamma\hat V(s_{t+1})-\hat V(s_t)$ 自动给出「这一步让成功率上升了多少」。理论最优,但 critic 在超长序列上极难训好。
- 大数定律:干脆不做细粒度信用分配,靠海量样本让噪声平均掉。GRPO 在实践中基本走这条路——这也是为什么它需要非常大的批量。
奖励黑客:RL 会找到你留下的每一个漏洞
- 答案格式匹配漏洞:奖励用字符串匹配判分,模型学会在回答里把所有可能的答案都列一遍,总有一个能匹配上。
- 测试用例攻击:代码任务里模型不去实现功能,而是
if input == "test1": return 3地硬编码测试用例;或者直接改写测试文件、捕获异常让测试「通过」。 - 验证器本身的 bug:数值比较用了
==、正则写漏了一个分支、超时被判成成功。 - 语言退化:$\beta=0$ 时思维链常会变成人类无法阅读的中英混杂缩写串——因为奖励从不检查思考过程的可读性。DeepSeek-R1 就为此额外加了语言一致性奖励。
多轮、工具与智能体:困难在哪里
前面所有讨论都假设「一个 prompt → 一段回答 → 一个奖励」。真实的智能体不是这样:它要调用搜索、执行代码、读取返回结果、再决定下一步。这时会同时出现三个新问题:
- 转移不再确定。环境返回的 token(搜索结果、报错信息、用户的下一句话)不由策略决定。因此必须把这些位置从策略梯度里 mask 掉——否则你是在用奖励去调整模型对环境输出的预测概率。
- horizon 暴涨。一个 10 轮的智能体轨迹可能有 10 万 token,末端一个 0/1 奖励。这已经远超 GRPO 的舒适区,也是过程奖励和分层方法重新变得重要的原因。
- 部分可观测。环境的真实状态(数据库内容、用户的真实意图、代码库的完整结构)从来没有被完整观测到,模型只看到一串观测。这就把我们带到了本讲的最后一部分。
10. 附加篇:部分可观测与序列模型
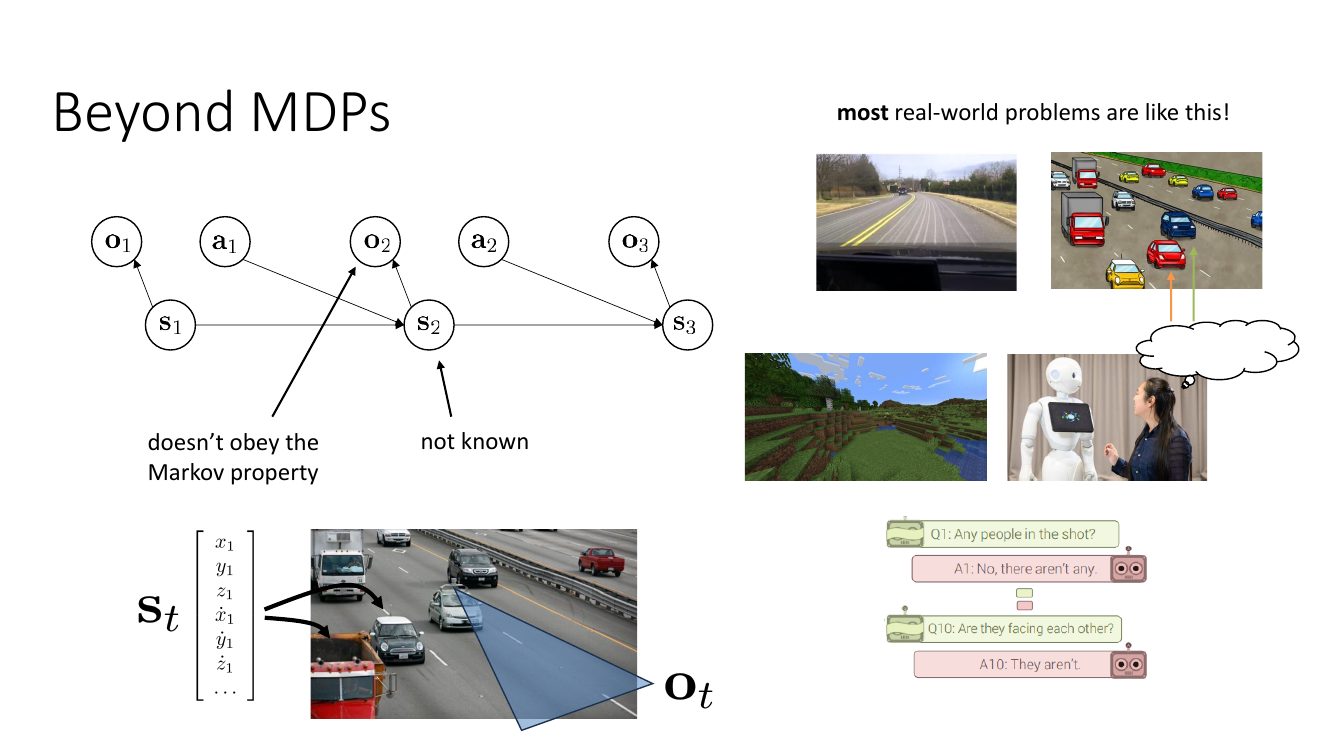
为什么 LLM 这一讲要谈 POMDP?因为多轮对话正是标准的 POMDP:用户心里真正想要什么(真实状态)你看不到,你只看到他打出来的字(观测)。而更根本的原因在最后会揭晓——LLM 处理这个问题的方式,恰好就是教科书里的标准答案之一。
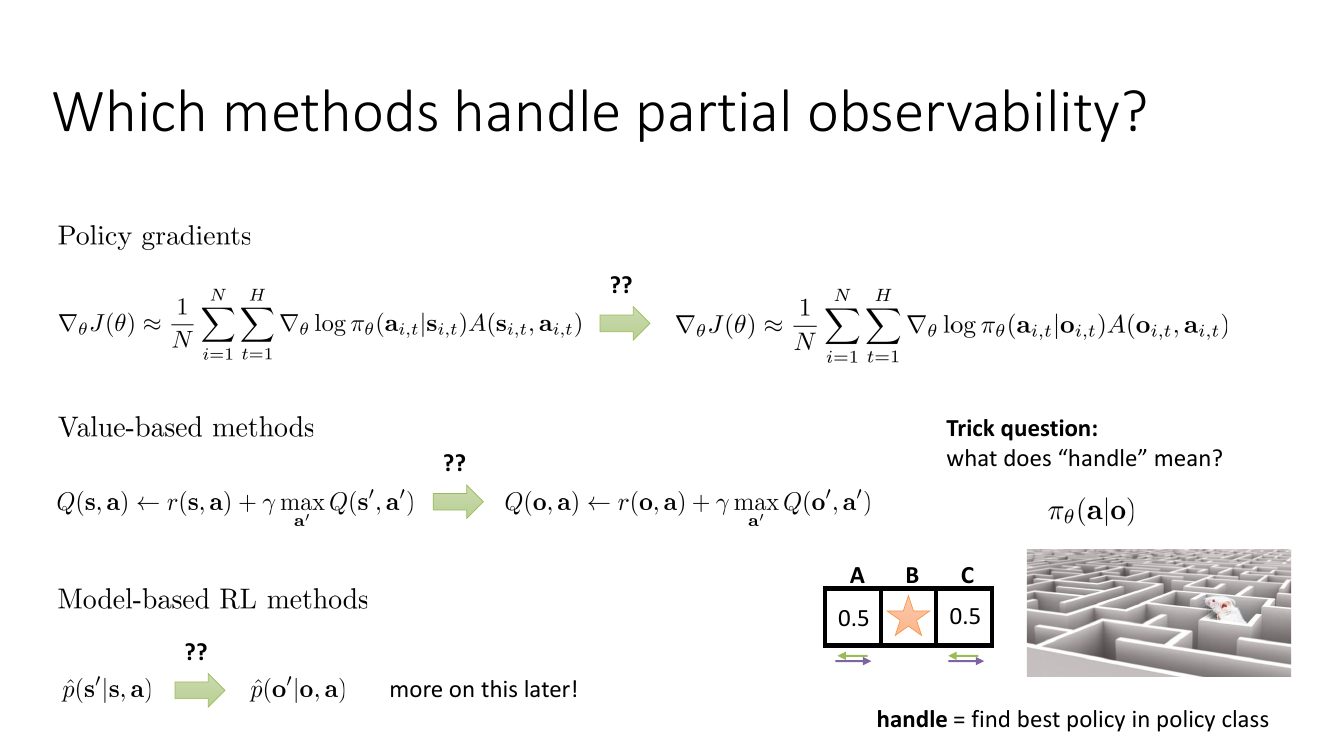
POMDP 有多古怪
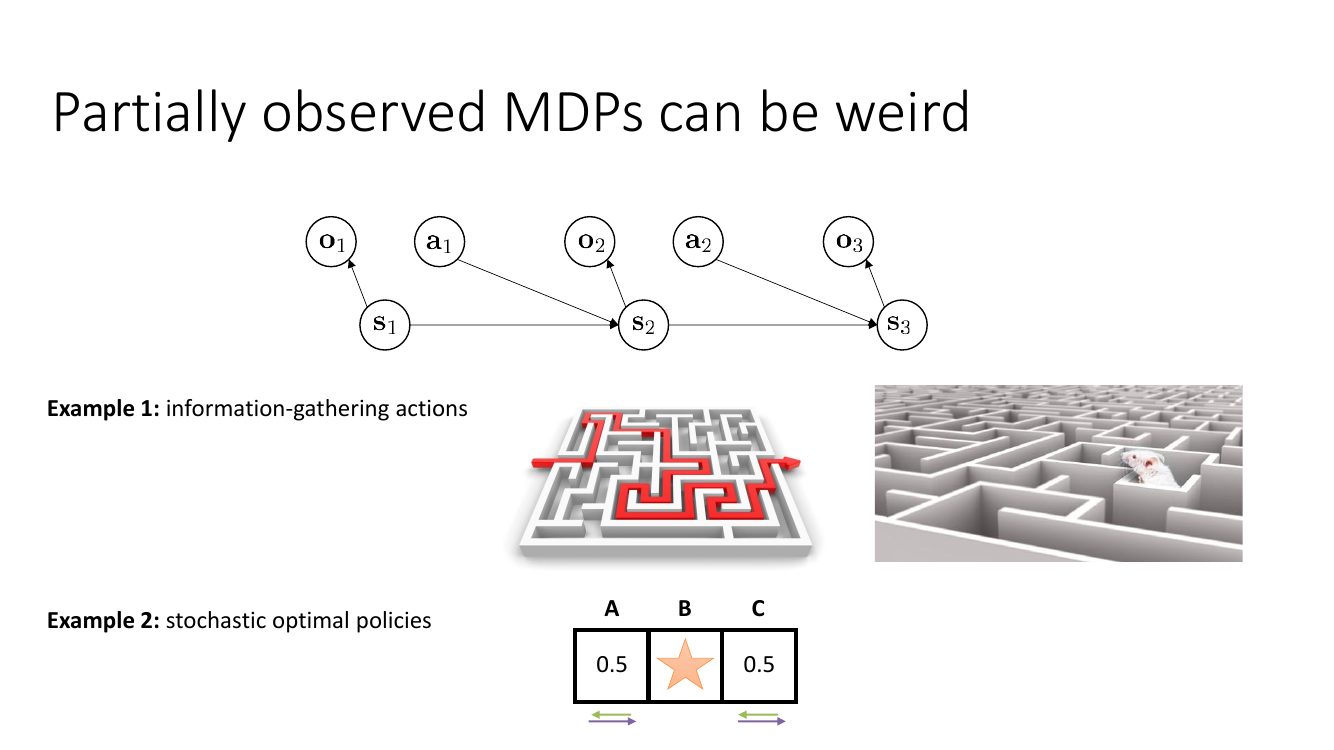
· 若总是向右,则从 A 出发能到 B,从 C 出发会永远走开;
· 若总是向左,情况正好相反。
两种确定性策略都有一半的初始状态永远到不了目标。而「左右各 0.5」的随机策略,从 A 或 C 出发都会做随机游走,期望几步之内必然踏进 B。
结论:在部分可观测环境下,最优的无记忆策略可能是随机的。这直接摧毁了 MDP 理论里「总存在确定性最优策略」这条基本定理。
策略梯度:基本没问题
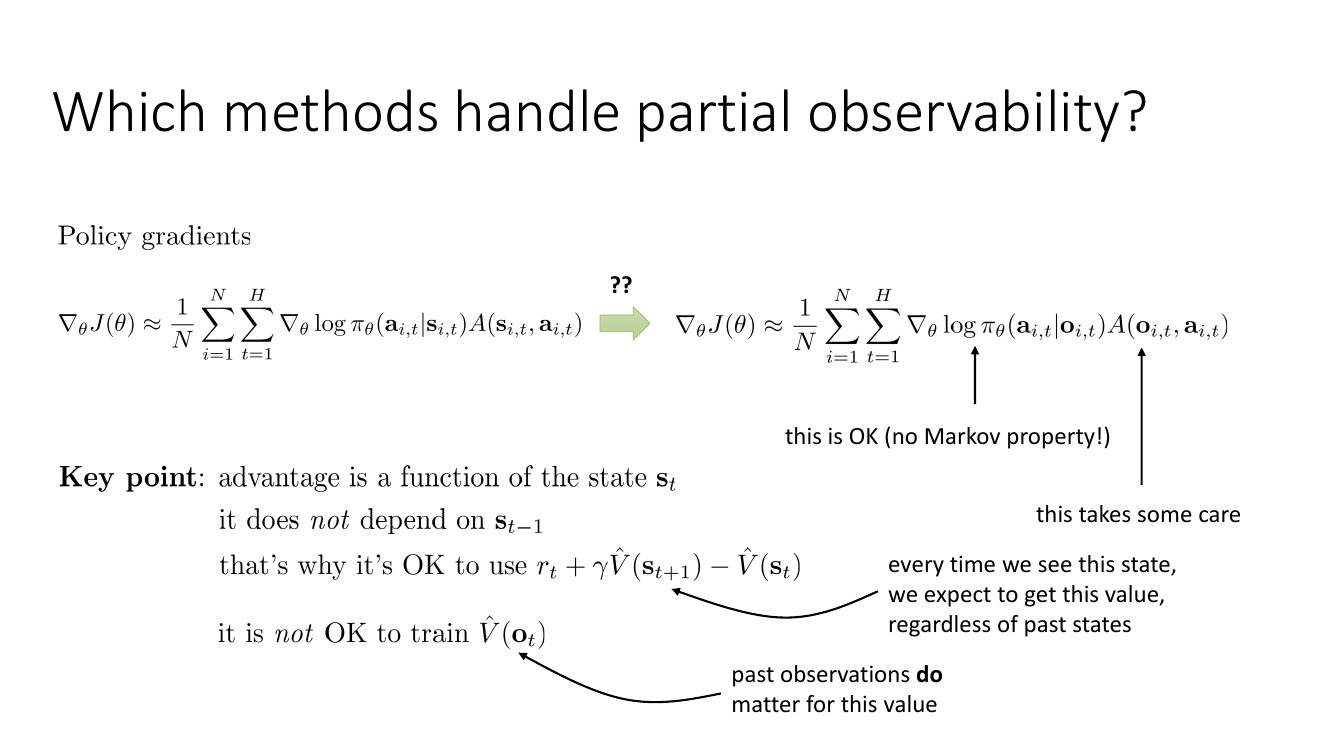
为什么 $\log\pi_\theta(a_t|o_t)$ 那一侧完全没问题?回忆策略梯度的推导:
$$ \nabla_\theta J(\theta)=\E_{\tau\sim p_\theta(\tau)}\left[\Big(\sum_t\nabla_\theta\log\pi_\theta(a_t|o_t)\Big)\Big(\sum_t r(o_t,a_t)\Big)\right]. $$这个式子的推导只用到了两件事:轨迹分布可以分解成 $p(\tau)=p(o_1)\prod_t\pi_\theta(a_t|o_t)p(o_{t+1}|o_{1:t},a_{1:t})$,以及 $\nabla\log$ 技巧。整个过程从未使用马尔可夫性——环境的转移可以任意依赖全部历史,那些项在求 $\nabla_\theta$ 时照样被消掉,因为它们不含 $\theta$。所以 REINFORCE 直接可用。
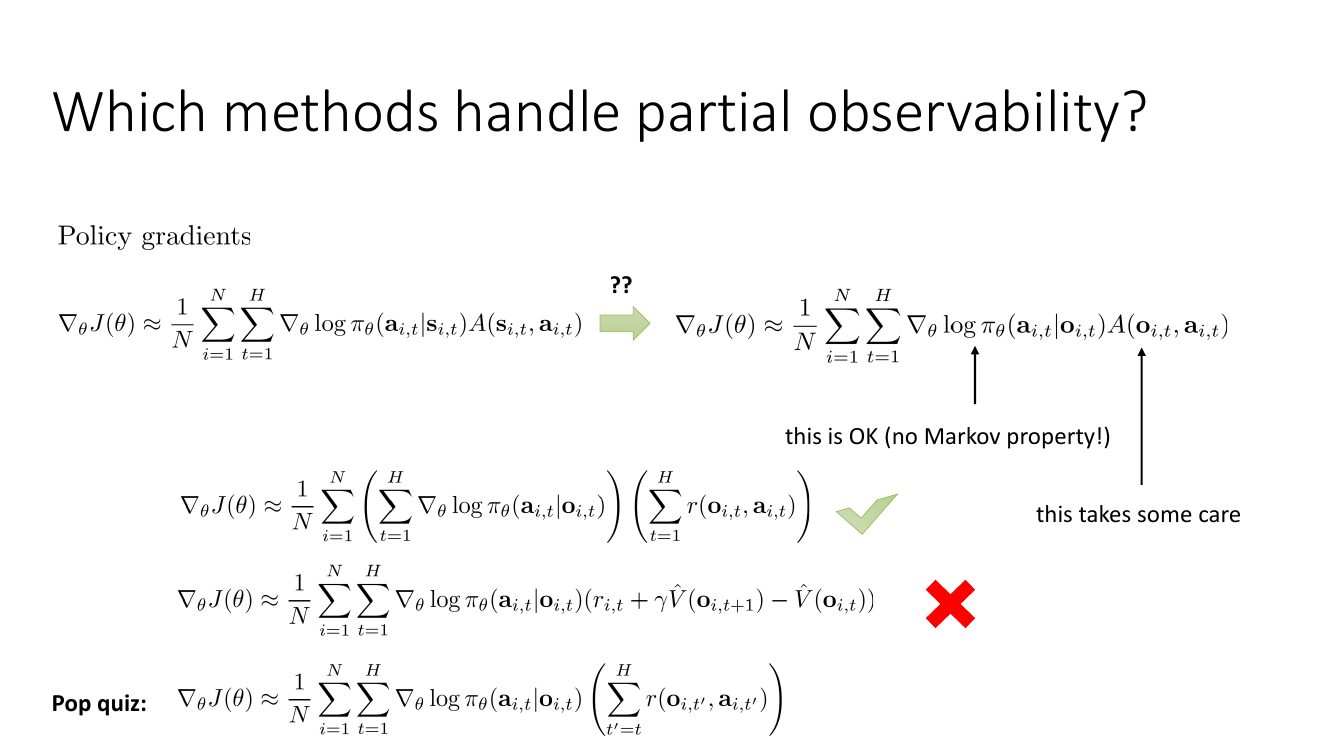
同理,任何不依赖动作的基线 $b$(包括依赖整段历史的 $b(o_{1:t})$)也是合法的。真正不合法的只有一件事:用自举(bootstrapping),也就是用 $\hat V(o_{t+1})$ 去替代未来回报——因为 $\hat V(o)$ 这个函数本身就不存在良好定义。
值函数方法:坏掉了
两个独立的失效机制,都要说清楚:
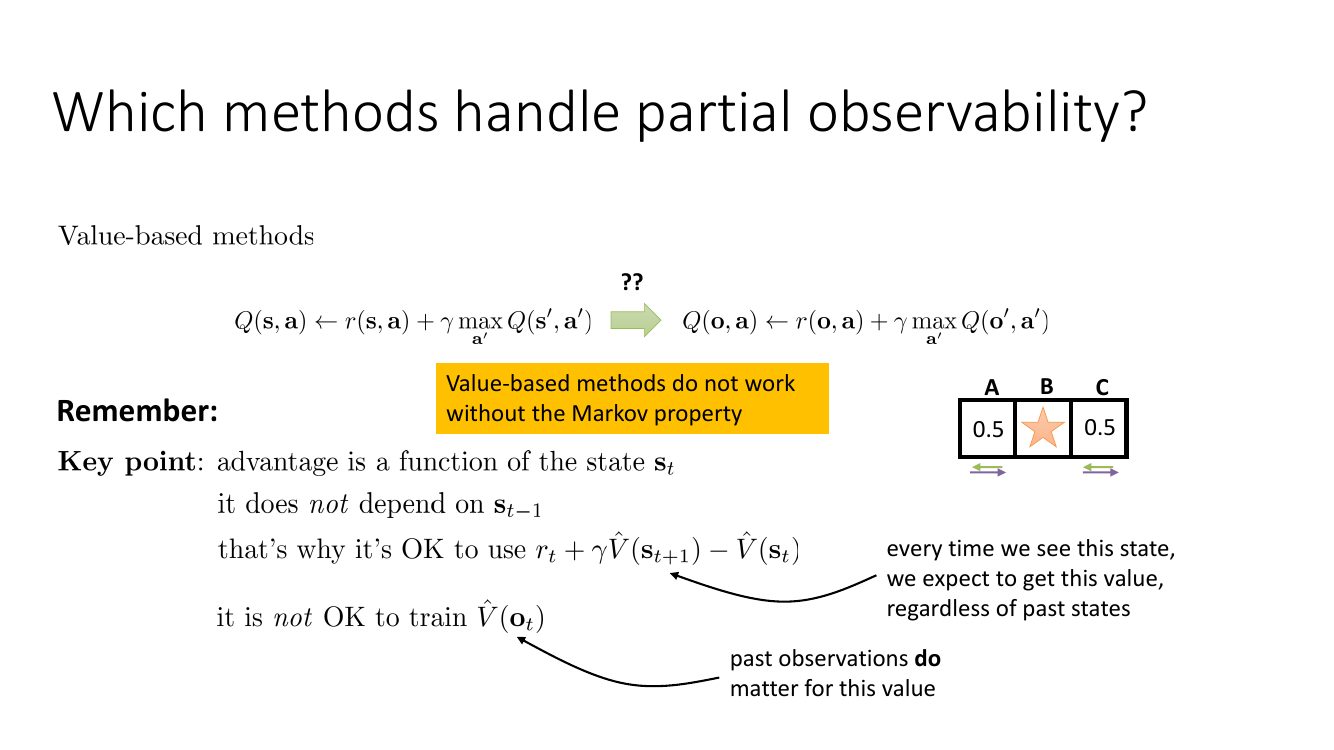
- 自举的前提不成立。$Q(o,a)\leftarrow r(o,a)+\gamma\max_{a'}Q(o',a')$ 这个更新隐含假设:$o'$ 完全概括了未来。但在 POMDP 里,「从观测 $o$ 出发的期望回报」根本不是一个良定义的量——它取决于你是怎么走到这里的。在 A/B/C 例子里,$Q$ 表被迫给 A 和 C 存同一个数字,而这个数字是两者的某种平均,对哪一个都不对。而且这个错误会通过自举不断传播和放大:错的目标训出更错的 $Q$。
- 贪心策略必然是确定性的。$\pi(a|o)=\argmax_a Q(o,a)$ 永远给出确定性策略,而我们刚证明了在这个环境里最优无记忆策略必须是随机的。所以即使 $Q$ 学对了,导出的策略也是坏的。
这条结论的实际影响很大:它意味着 Q-learning、SAC、DDPG 这些采样效率最高的算法,在部分可观测下都不能直接用 $o$ 替换 $s$。而采样效率最低的 REINFORCE 反而没事。「能处理 POMDP」和「采样高效」在这里是矛盾的。
基于模型的方法:更糟
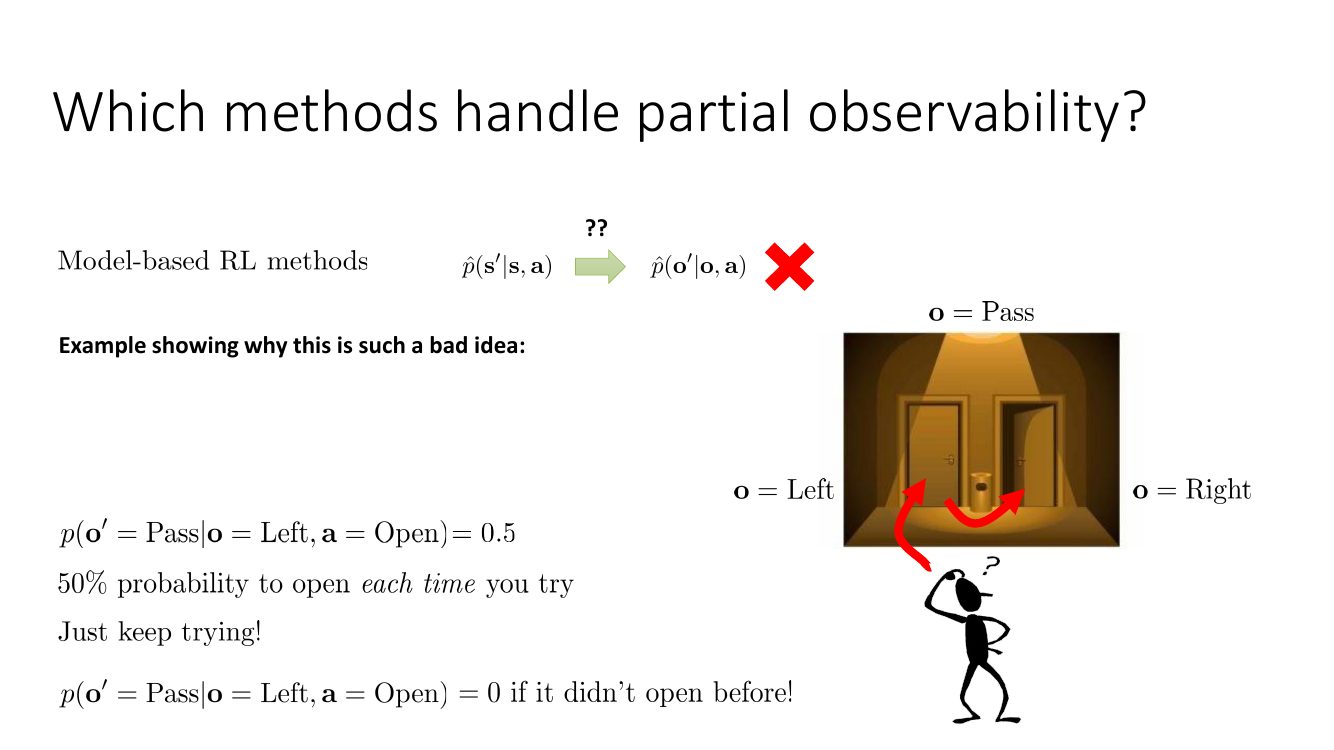
这个例子的深刻之处在于:学到的模型 $\hat p(o'|o,a)$ 边缘分布是对的(在所有门中确实有一半能开),但条件于历史的分布是错的。而规划器恰恰要反复展开这个模型,于是把「50% 的机会」错误地当成了每次独立重抽——产生了一种系统性的、无法通过多采样修复的乐观偏差。这类「模型自欺」在基于模型的 RL 里是致命的,因为规划器会主动去搜索模型认为好、实际上不存在的路径。
出路一:学一个马尔可夫的隐状态空间
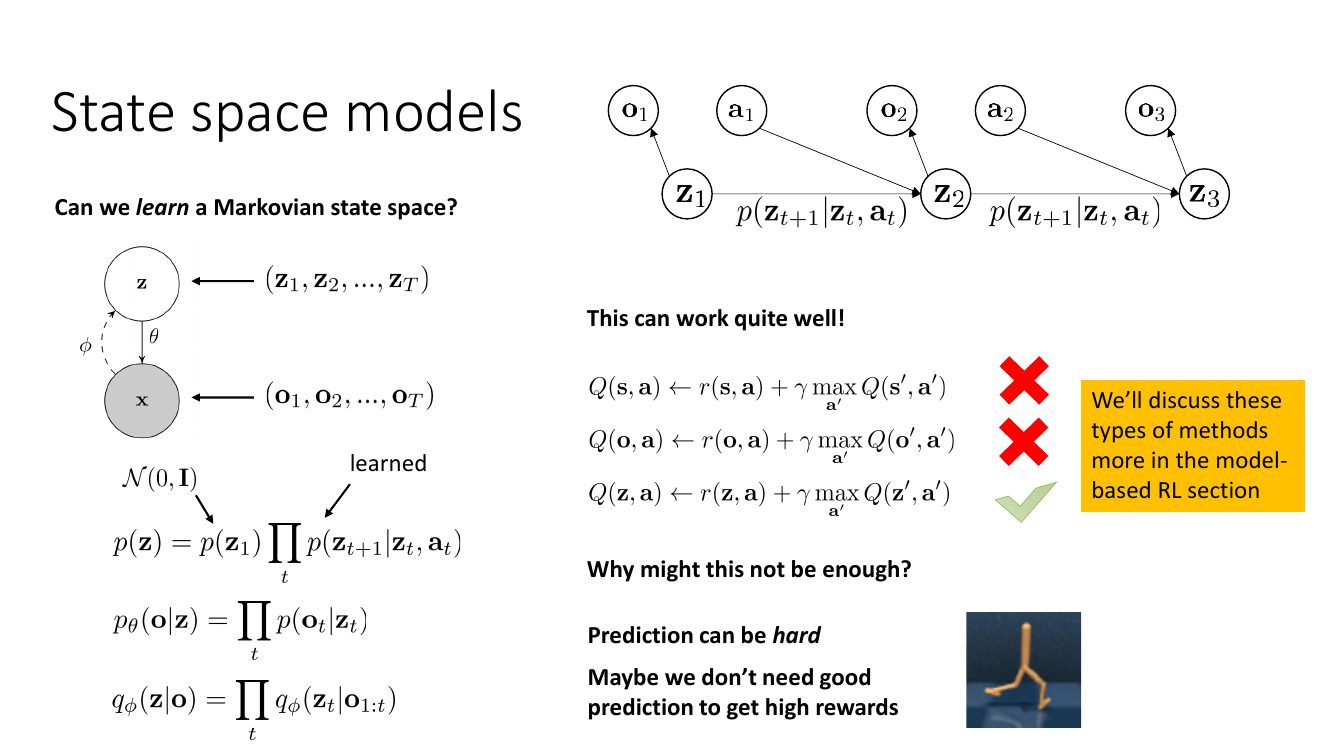
这是一个变分自编码器式的做法:用 ELBO 同时学生成模型和编码器,把「压缩历史」这件事交给 $q_\phi$。学出来的 $\mathbf z_t$ 按构造满足马尔可夫性,于是所有值函数方法立刻恢复可用。Dreamer、SLAC、PlaNet 这一系工作走的都是这条路,在图像输入的控制任务上效果相当好。
Levine 提出的保留意见也很关键:要重建观测就意味着模型必须学会渲染整幅图像,而画面里大部分像素(背景纹理、飘动的树叶)对决策毫无价值。你可能耗尽全部模型容量去预测无关细节,反而丢掉了那个决定成败的小物体。「也许我们并不需要好的预测就能拿到高奖励」——这个思路会在基于模型的 RL 那部分继续展开。
出路二:历史状态
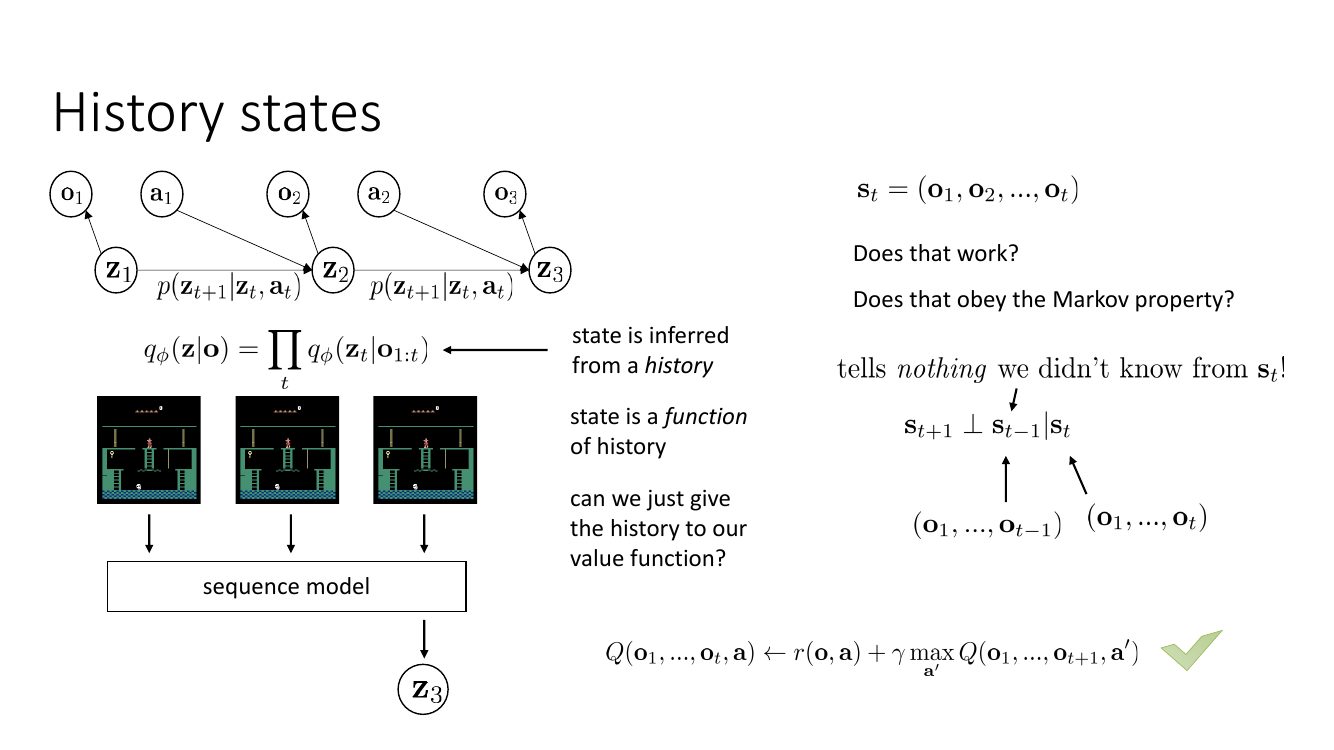
代价是状态空间随 $t$ 无界增长——但这只是表示上的困难,不是理论上的困难。而处理「把一个变长序列压成定长表示」正是序列模型最擅长的事。
import torch, torch.nn as nn

class RecurrentQ(nn.Module):
    """历史状态 Q 网络:序列模型把 o_{1:t} 压成隐状态,再输出各动作的 Q"""
    def __init__(self, obs_dim, n_act, hid=256):
        super().__init__()
        self.enc  = nn.Sequential(nn.Linear(obs_dim, hid), nn.ReLU())
        self.core = nn.GRU(hid, hid, batch_first=True)   # 也可换成 Transformer
        self.head = nn.Linear(hid, n_act)

    def forward(self, obs_seq, h0=None):                 # obs_seq: (B,T,obs_dim)
        z, hT = self.core(self.enc(obs_seq), h0)         # z: (B,T,hid) —— z_t 编码 o_{1:t}
        return self.head(z), hT                          # (B,T,n_act)

def recurrent_dqn_loss(q_net, tgt_net, obs_seq, act_seq, rew_seq, done_seq,
                       gamma=0.99, burn_in=8):
    """
    在整段序列上做 Q-learning。关键点:
      1) 必须按「整条轨迹」而非「打散的转移」采样,否则隐状态无从谈起;
      2) burn_in:前若干步只用来预热隐状态、不计损失,缓解隐状态陈旧问题。
    """
    q_all, _ = q_net(obs_seq)                                   # (B,T,A)
    with torch.no_grad():
        q_tgt_all, _ = tgt_net(obs_seq)
        next_max = q_tgt_all[:, 1:].max(dim=-1).values           # (B,T-1)
        y = rew_seq[:, :-1] + gamma * (1 - done_seq[:, :-1]) * next_max
    q_sa = q_all[:, :-1].gather(-1, act_seq[:, :-1].unsqueeze(-1)).squeeze(-1)
    td = (q_sa - y) ** 2
    return td[:, burn_in:].mean()
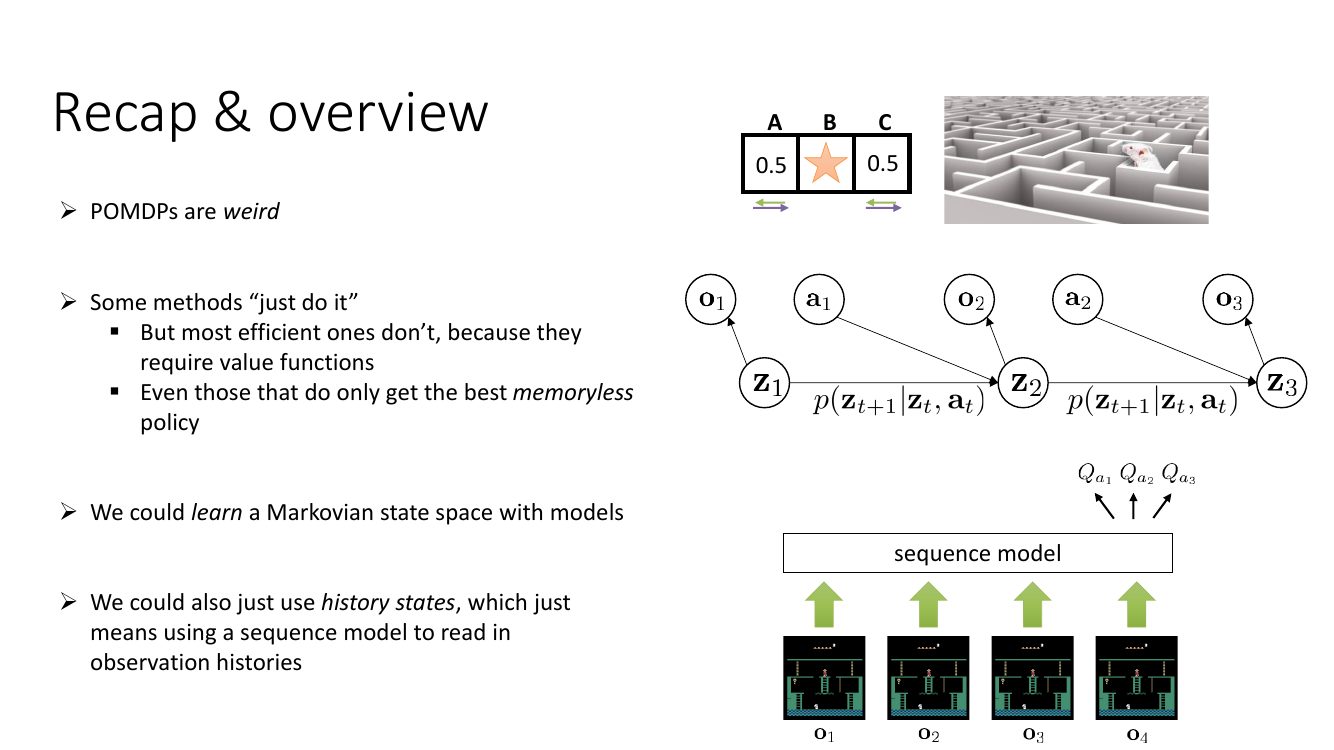
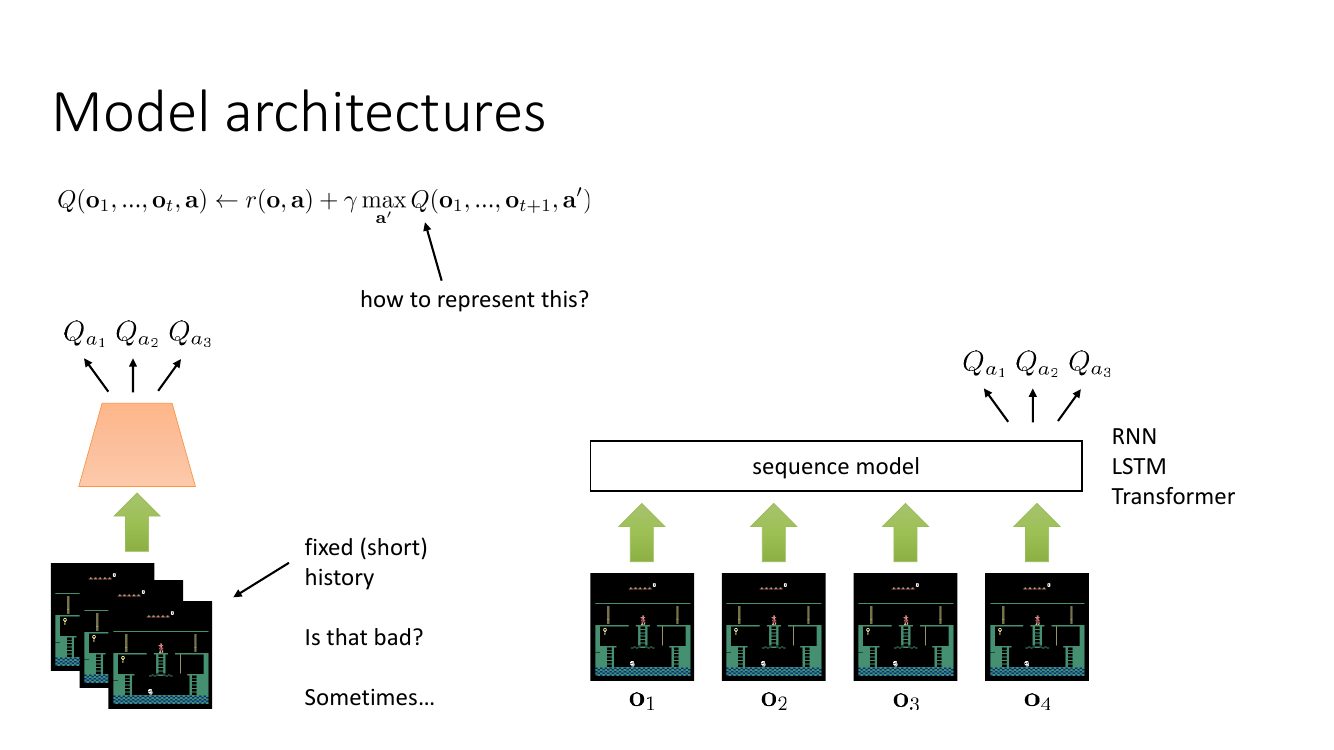
这解释了两件事:为什么在 LLM 上做 RL 时,策略梯度类方法(PPO、GRPO)一统天下,而 Q-learning 类方法几乎无人使用——因为上下文历史下的 $Q$ 自举极难稳定;也解释了为什么「上下文长度」对智能体如此关键——它直接决定了这个历史状态能容纳多少信息,超出窗口的部分就退化成了 p-50 左边那个「固定短历史」的方案。
本讲小结
一页速查
| 主题 | 关键式子 | 一句话 |
|---|---|---|
| MaxEnt IRL | $\nabla_\psi\mathcal L=\E_{\pi^\star}[\nabla_\psi r_\psi]-\E_{p(\tau|\mathcal O,\psi)}[\nabla_\psi r_\psi]$ | 抬专家、压策略;难点是配分函数 |
| 重要性权重 | $w_j=\dfrac{\exp(\sum_t r_\psi)}{\prod_t\pi(a_t|s_t)}$ | 动力学项相消,不需要知道环境模型 |
| AIRL 判别器 | $D=\dfrac{\frac1Z e^{r_\psi}}{\frac1Z e^{r_\psi}+\pi}$ | IRL 就是结构化的 GAN |
| LLM 的 bandit 视角 | $\E_{\pi_\theta(\mathbf a|\mathbf s)}[r(\mathbf s,\mathbf a)]$ | 状态=prompt,动作=整段补全 |
| LLM 的 token 视角 | $\E_{\pi_\theta(\tau)}[r(\tau)]$,转移确定性拼接 | 要用价值基线/中间奖励时才必须 |
| 序列 log 概率分解 | $\nabla_\theta\log\pi_\theta(\mathbf a|\mathbf s)=\sum_t\nabla_\theta\log\pi_\theta(a_t|s_t)$ | RL 微调 = 奖励加权的交叉熵 |
| 重要性加权估计器 | $\frac1N\sum_i\frac{\pi_\theta}{\bar\pi}\nabla_\theta\log\pi_\theta\,r$ | 为了让贵重的样本被复用 $K$ 次 |
| GAE | $\hat A_t=\sum_{t'\ge t}(\gamma\lambda)^{t'-t}\delta_{t'}$ | 偏差-方差旋钮;critic 别在 prompt 上训 |
| GRPO 优势 | $\hat A_{i,j}=\frac{r_j-\operatorname{mean}(r)}{\operatorname{std}(r)}$ | 用组内均值当基线,扔掉 critic |
| 组内基线的偏差 | $\E[\hat A_j|\mathbf a_j]=\frac{K-1}{K}(r_j-\bar r)$ | 只差一个常数缩放;RLOO 严格无偏 |
| KL 正则化奖励 | $\bar r=r-\beta\KL(\pi_\theta\|\pi_{\text{ref}})$ | 保住人话 + 防止 reward hacking |
| k3 KL 估计 | $e^{u}-u-1,\;u=\log\pi_{\text{ref}}-\log\pi_\theta$ | 无偏、恒非负、低方差 |
| PPO clip | $\min\{\operatorname{clip}(\rho,1\pm\epsilon)\hat A,\;\rho\hat A\}$ | 悲观下界;比值必须逐 token 算 |
| Bradley–Terry | $\log p(\tau_i\succ\tau_j)=\log\sigma(r_\psi(\tau_i)-r_\psi(\tau_j))$ | 偏好学习 = 逻辑回归;只有差值可辨识 |
| KL 正则的最优策略 | $\pi^\star\propto\pi_{\text{ref}}\exp(r/\beta)$ | 控制即推断的直接推论,也是 DPO 的起点 |
| DPO | $-\log\sigma\big(\beta\log\frac{\pi_\theta(\mathbf a_w)}{\pi_{\text{ref}}(\mathbf a_w)}-\beta\log\frac{\pi_\theta(\mathbf a_l)}{\pi_{\text{ref}}(\mathbf a_l)}\big)$ | 把 RM + RL 折叠成一个监督损失,$Z(\mathbf s)$ 抵消 |
| POMDP 里的策略梯度 | $\nabla_\theta J\approx\frac1N\sum_i(\sum_t\nabla\log\pi_\theta(a|o))(\sum_t r)$ | 合法,推导从未用过马尔可夫性 |
| POMDP 里的值函数 | $Q(o,a)\leftarrow r+\gamma\max Q(o',a')$ | 不合法:自举前提破裂 + 强制确定性策略 |
| 历史状态 | $\mathbf s_t=(\mathbf o_1,\dots,\mathbf o_t)$ | 天然马尔可夫;序列模型来表示它 |
要点清单
- 奖励是设计问题,不是给定条件。本讲给出三条获取奖励的路:从演示反推(IRL)、从偏好学习(BT/RLHF)、从程序验证(RLVR)。它们的适用范围互不重叠:IRL 适合可演示的控制任务,偏好适合开放式生成,验证器适合有客观答案的推理。
- MaxEnt IRL 与 GAN 是同一个东西。「一个网络给分、另一个网络优化这个分数」这个结构,从 GAIL/AIRL 一路延续到 RLHF——奖励模型就是判别器,LLM 就是生成器。
- LLM 上的 RL 全部是策略梯度的变体。REINFORCE → 加重要性权重(为了复用样本)→ 加 clip(为了不跑太远)→ 加基线(为了降方差)→ 加 KL(为了不被奖励模型骗)。每一步都对应本课前半程学过的一个概念。
- PPO 与 GRPO 的差别只是基线的来源。critic 用参数拟合换采样,组内平均用采样换参数。选哪个取决于奖励是稀疏末端的还是稠密中间的、任务是单轮的还是多轮的。
- std 归一化不是免费的。它带来难度偏差(简单/困难 prompt 被过度放大、全对全错组零梯度)和长度偏差(长的错误回答受罚更轻)。知道这些偏差从哪来,比记住公式重要。
- Bradley–Terry 的不可辨识性是一条贯穿全篇的线索。它解释了为什么 RM 分数不能跨 prompt 比较、为什么需要 per-prompt 基线、以及为什么 DPO 推导里 $Z(\mathbf s)$ 会消失。
- RL 优化的是结果不是过程,因此才能让模型自己发明出回溯、验算这类没人教过的推理行为——也因此才会去攻击你验证器里的每一个漏洞。这是同一枚硬币的两面。
- 部分可观测下,采样效率和适用性是矛盾的。最笨的 REINFORCE 直接可用,最高效的值函数方法直接坏掉。出路是学隐状态空间(有模型)或用历史状态(序列模型)——而 LLM 智能体就是后者的极致实现。
延伸阅读
逆强化学习与对抗式模仿
- Maximum Entropy Inverse Reinforcement Learning (Ziebart et al., 2008) — 本讲第 1 节全部推导的源头,先读它再读后面所有 IRL 论文。
- Guided Cost Learning (2016) — 把 MaxEnt IRL 扩展到深度网络与未知动力学,重要性采样修正「懒惰策略优化」的原始出处。
- Generative Adversarial Networks (2014) — 第 2 节所有类比的另一端;重点看最优判别器 $D^\star=\frac{p^\star}{p^\star+p_\theta}$ 那一节。
- Generative Adversarial Imitation Learning (2016) — GAIL,用普通判别器做模仿;理解「简单但奖励不可复用」这个权衡。
- Learning Robust Rewards with Adversarial Inverse RL (2018) — AIRL,把判别器结构化成含显式奖励的形式,学到可迁移的 $r_\psi$。
RLHF 与偏好学习
- Deep Reinforcement Learning from Human Preferences (2017) — Bradley–Terry + RL 的开创性工作,在 MuJoCo/Atari 上验证,读它能看清「人在环」的完整循环。
- Fine-Tuning Language Models from Human Preferences (2019) — 第一次把上面的框架搬到语言模型,KL 惩罚的动机在这里讲得最清楚。
- Learning to Summarize from Human Feedback (2020) — 摘要任务上的 RLHF,附录里有大量关于 RM 过优化的实证观察。
- Training Language Models to Follow Instructions with Human Feedback (2022) — InstructGPT,本讲第 3 节那张三步流程图的出处,ChatGPT 的直接前身。
- Direct Preference Optimization (2023) — DPO 原论文;第 8 节那两段推导的完整版本在它的第 4 节。
- Scaling Laws for Reward Model Overoptimization (2022) — 用实验刻画「RM 分数上升但真实质量下降」的拐点如何随 RM 规模和 KL 预算变化,理解 reward hacking 的必读。
LLM 上的 RL 算法
- Proximal Policy Optimization (2017) — clip 目标的出处;配合 GAE (2015) 一起读,这两篇构成第 7 节的全部技术基础。
- DeepSeekMath: GRPO (2024) — GRPO 的原始定义,包括 std 归一化和 k3 KL 估计器。
- Back to Basics: Revisiting REINFORCE-Style Optimization for RLHF (2024) — RLOO;论证在 LLM 场景下 PPO 的很多机制是多余的,留一法基线足够。
- DeepSeek-R1 (2025) — 大规模 RLVR 的完整报告:纯 RL 如何诱发长思维链、语言混杂问题及其修补。
- Understanding R1-Zero-Like Training: A Critical Perspective (2025) — 即 Dr. GRPO,系统分析 std 归一化与长度归一化引入的偏差,第 5 节那个警告框的来源。
- Let's Verify Step by Step (2023) — 过程奖励模型(PRM)与结果奖励模型(ORM)的系统对比,第 9 节右图的背景。
后训练与模型行为
- Scaling Instruction-Finetuned Language Models (2022) — FLAN 系列,本讲第 3 节那张指令微调图的出处。
- Language Models as Agent Models (Andreas, 2022) — 「LLM 是在模拟说话人」这个视角,解释了保龄球那个例子为什么会随前缀改变而改变。
- Unforgettable Generalization in Language Models (Zhang, Chosen, Andreas) — 用翻转标签微调反而答对的现象,支撑「后训练主要在诱发已有能力」这个论断。
部分可观测
- Deep Recurrent Q-Learning for Partially Observable MDPs (2015) — DRQN,把 LSTM 装进 DQN,第 10 节那段循环 Q 网络代码的对应工作。
- Dream to Control: Learning Behaviors by Latent Imagination (2020) — Dreamer,学隐状态空间模型再在其中做 RL,「出路一」的代表作。
- Stochastic Latent Actor-Critic (2019) — 把隐状态推断与 actor-critic 结合,直接对应 p-48 那张图的形式化。
- Decision Transformer (2021) — 把 RL 当序列建模问题,「历史状态 + 序列模型」这条路线的另一个极端。