Actor-Critic:用学出来的值函数给策略梯度降方差
策略梯度里那个「reward-to-go」只是一次采样的粗糙估计。把它换成一个神经网络拟合的值函数,方差立刻塌下来——代价是引入偏差。本讲就是这场偏差-方差交易的完整说明书。
0. 本讲导读
上一讲我们推出了策略梯度(policy gradient)的最终形式,并用因果性(causality)把它化简成了「reward-to-go」加权的对数似然梯度:
$$ \nabla_\theta J(\theta) \approx \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H} \nabla_\theta \log \pi_\theta(a_t^{(i)}|s_t^{(i)})\,\hat Q_t^{(i)}, \qquad \hat Q_t^{(i)} = \sum_{t'=t}^{H} r(s_{t'}^{(i)}, a_{t'}^{(i)}). $$这个式子是无偏的,但它的方差大到令人绝望。原因藏在 $\hat Q_t^{(i)}$ 这一项里:它是「在状态 $s_t^{(i)}$ 下采取动作 $a_t^{(i)}$ 之后能拿到多少总回报」这个期望值的单样本估计。一条轨迹就是一次抽样,而未来几十上百步的随机性(策略的随机采样、环境转移的随机性)全都压缩进了这一个数字里。同一个 $(s_t,a_t)$,这次跑出来 $+100$,下次可能跑出来 $-30$,梯度方向就跟着乱抖。
本讲的核心思想只有一句话:与其用一条轨迹的单样本回报,不如训练一个神经网络去拟合这个期望,再把拟合值代进策略梯度里。 拟合出来的那个值函数网络就叫 critic(评论家),被它指导的策略网络就叫 actor(演员)。actor 负责做动作,critic 负责打分——这就是 actor-critic 这个名字的来历。
围绕这一句话,本讲要展开的问题链条是:
- 拟合谁? 我们可以拟合 $Q^\pi$、$V^\pi$ 或 $A^\pi$。哪一个进策略梯度方差最低?哪一个最容易学?(结论:用 $A^\pi$ 进梯度,但只学 $V^\pi$。)
- 怎么学? 拟合 $V^\pi$ 这件事叫策略评估(policy evaluation)。监督标签从哪来?蒙特卡洛回报(无偏、方差大)还是自举目标 $r+\gamma \hat V_\phi(s')$(有偏、方差小)?
- 无限长的任务怎么办? $H\to\infty$ 时 $V^\pi$ 会发散,于是引入折扣因子 $\gamma$。而 $\gamma$ 放在策略梯度的哪个位置,会得到两个不一样的梯度——几乎所有人都在用「错的那个」,为什么?
- 算法怎么组织? 批量(batch)版本 vs 在线(online)版本;在线版本为什么必须靠并行 worker 才能跑起来;actor 和 critic 该共享网络还是各用一个。
- 能不能既降方差又不引入偏差? 能——把 critic 只当 baseline 用。这条路通向 n-step return 和 GAE(generalized advantage estimation),用一个旋钮 $\lambda$ 连续调节偏差与方差。
- 能不能用 replay buffer 变成 off-policy? 能,但天真的做法是错的。修正它需要把 critic 从 $V$ 换成 $Q$,再加上重参数化技巧——终点就是 SAC。
与前后讲的关系:上一讲(策略梯度)给了 actor 的更新公式,本讲给它配一个 critic;下一讲(基于值的 RL)会把这件事推到极端——干脆不要 actor,只学一个 $Q$,用 $\argmax_a Q(s,a)$ 当策略。可以说 actor-critic 正好坐在纯策略梯度和纯值函数方法的中间,理解了它,两边都通了。本讲还会第一次完整推导 GAE,它是 PPO 实现里的标配部件,也是作业 2 的必做项。
- 策略梯度权重的「理想值」是真实的 $Q^\pi(s_t,a_t)$;减去只依赖状态的 baseline $V^\pi(s_t)$ 得到优势函数(advantage) $A^\pi=Q^\pi-V^\pi$,它是方差最低且仍然无偏的选择。
- 由 $Q^\pi(s_t,a_t)=r(s_t,a_t)+\gamma\,\E_{s_{t+1}}[V^\pi(s_{t+1})]$,只要有 $V^\pi$ 就能用单样本拼出 $A^\pi\approx r+\gamma \hat V_\phi(s')-\hat V_\phi(s)$。所以只拟合 $V^\pi$ 一个网络就够了——它输入维度最低、最好学。
- 拟合 $V^\pi$ 的目标有两种:蒙特卡洛 $y_t=\sum_{t'\ge t} r_{t'}$(无偏、高方差)与自举 $y_t = r_t+\gamma\hat V_\phi(s_{t+1})$(有偏、低方差)。后者复用了函数逼近器的泛化能力,实践中通常更好。
- $\gamma$ 有两种解释:数学上是给 MDP 加一个概率 $1-\gamma$ 的死亡状态;实践上是一个方差削减旋钮。把 $\gamma$ 放在不同位置会得到 option 1 / option 2 两个不同梯度,理论上正确的是带 $\gamma^{t-1}$ 前缀的 option 2,但大家用的是 option 1。
- 把 critic 只当 baseline(而不是替换整个回报)可以保持完全无偏:因为 $\E_{a\sim\pi}[\nabla_\theta\log\pi_\theta(a|s)\,b(s)]=0$ 对任意只依赖 $s$ 的 $b$ 成立。
- n-step return 在「前 n 步用真实奖励、n 步之后交给 critic」处切一刀;GAE 干脆在所有 n 处都切,按 $\lambda^{n-1}$ 指数加权,化简后得到极其简洁的 $\hat A^{\text{GAE}}_t=\sum_{l\ge 0}(\gamma\lambda)^l\delta_{t+l}$,其中 $\delta_t = r_t+\gamma\hat V_\phi(s_{t+1})-\hat V_\phi(s_t)$。
- 直接给在线 actor-critic 加 replay buffer 会两处出错:$V^\pi$ 的自举目标用了旧策略的动作,且 $\log\pi_\theta$ 前面乘的动作不是当前策略会选的。修法是改学 $Q_\phi(s,a)$、并从当前策略重新采样动作。
1. 从单样本 reward-to-go 到期望:Q、V、A 三个值函数
1.1 回顾:REINFORCE 里那个刺眼的单样本回报
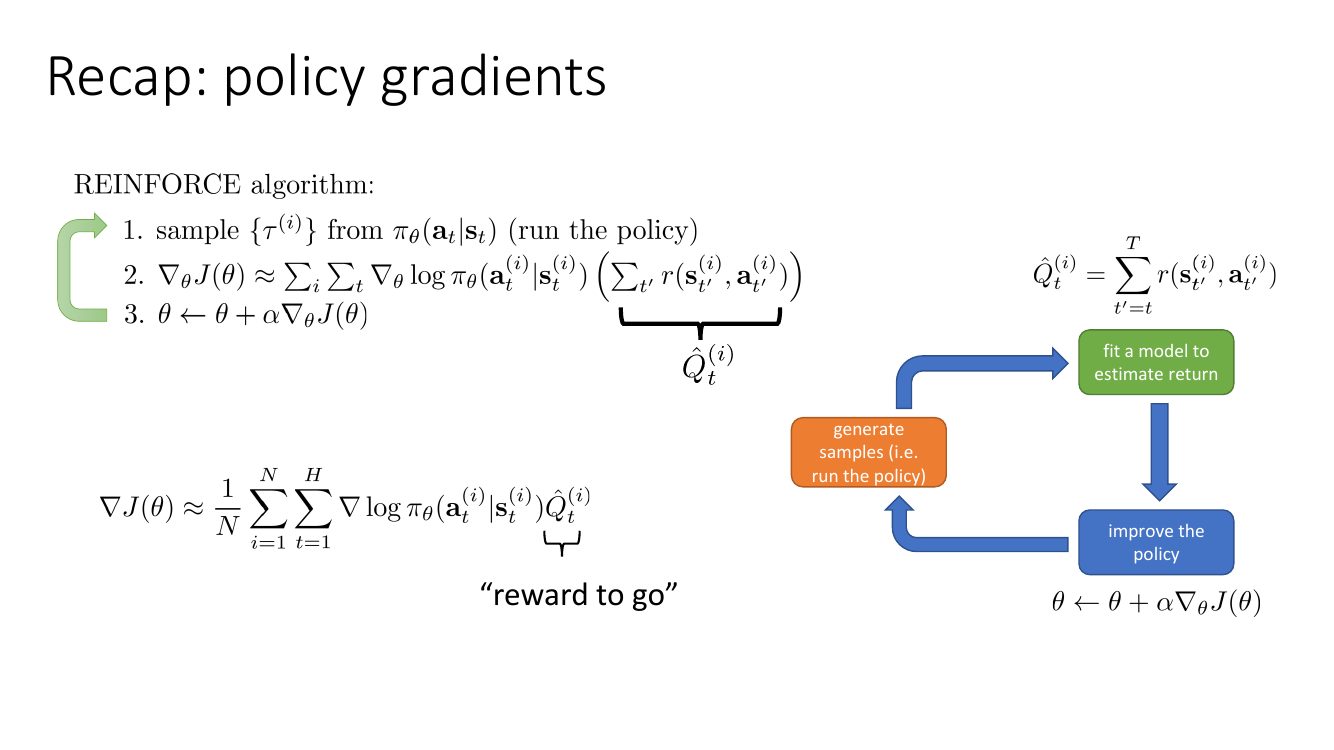
先统一记号:$s_t$ 是状态(满足马尔可夫性),$a_t$ 是动作,$\pi_\theta(a|s)$ 是参数为 $\theta$ 的策略,$r(s,a)$ 是奖励,$p(s'|s,a)$ 是环境转移,$H$ 是回合长度(horizon),$\tau=(s_1,a_1,\dots,s_H,a_H)$ 是轨迹,$\gamma$ 是折扣因子。上标 $(i)$ 表示第 $i$ 条采样轨迹。
REINFORCE 的完整算法是:
- 从 $\pi_\theta(a_t|s_t)$ 采样 $N$ 条轨迹 $\{\tau^{(i)}\}$(就是跑策略);
- 计算 $\nabla_\theta J(\theta)\approx \frac1N\sum_i\sum_t \nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\,\hat Q_t^{(i)}$,其中 $\hat Q_t^{(i)}=\sum_{t'=t}^{H} r(s_{t'}^{(i)},a_{t'}^{(i)})$;
- $\theta \leftarrow \theta + \alpha\nabla_\theta J(\theta)$。
关键在于理解 $\hat Q_t^{(i)}$ 到底代表什么。它想表达的意思是:「如果我在状态 $s_t^{(i)}$ 采取动作 $a_t^{(i)}$,之后预期能拿到多少总奖励?」 但一条轨迹只能给出这个问题的一个样本。真正的答案应该是对所有可能的未来求期望:
$$ Q^\pi(s_t,a_t) = \sum_{t'=t}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\,\big|\,s_t,a_t\big]. $$这就是状态-动作值函数(state-action value function),也叫 Q 函数:真实的期望 reward-to-go。
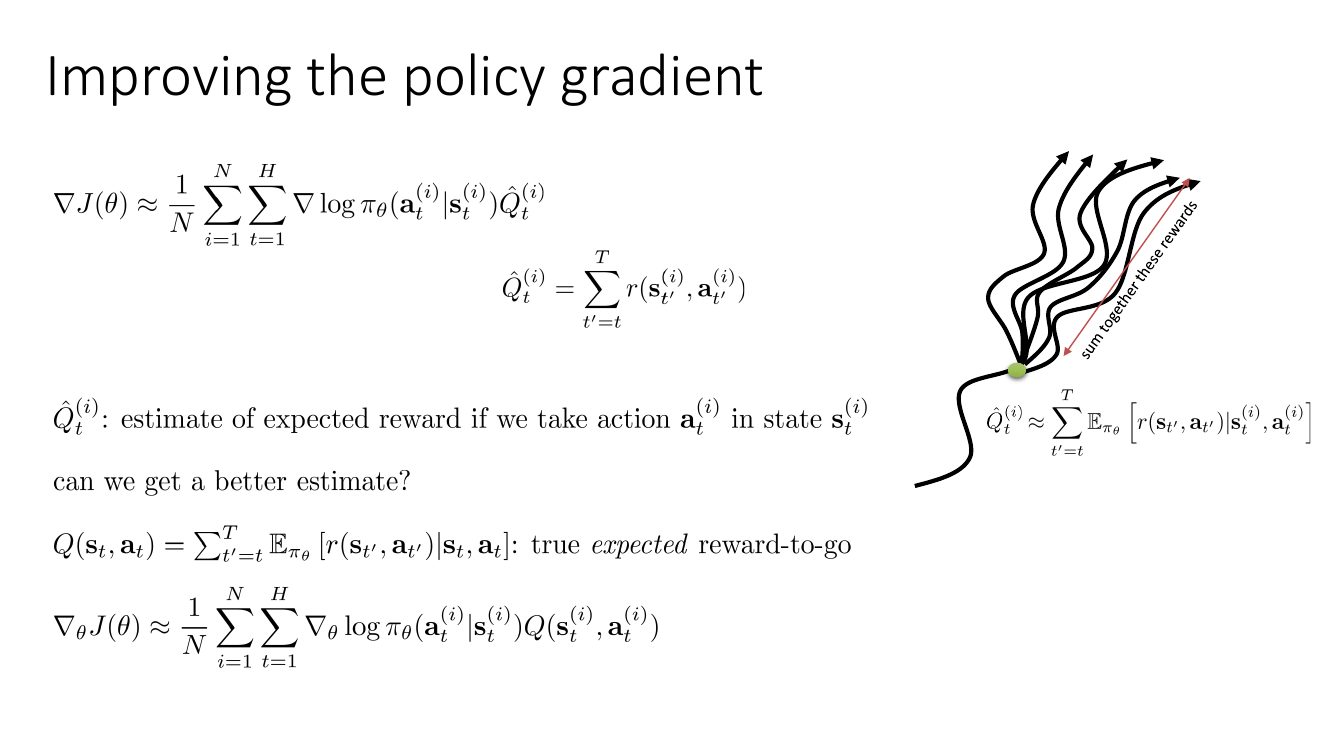
把单样本换成真实期望,策略梯度变成
$$ \nabla_\theta J(\theta) \approx \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\,Q^\pi(s_t^{(i)},a_t^{(i)}). $$这一步没有改变梯度的期望值——因为 $\hat Q_t^{(i)}$ 本来就是 $Q^\pi(s_t,a_t)$ 的无偏估计,把一个无偏估计换成它自己的期望,外层期望不变。改变的只有方差:我们把「未来所有随机性」这一坨方差从估计量里彻底抹掉了,只剩下「当前状态-动作对本身是随机采的」这一层方差。这是免费的午餐——如果我们真的知道 $Q^\pi$ 的话。本讲剩下的篇幅就是在讨论:不知道 $Q^\pi$ 时,用一个近似的 $\hat Q$ 代替,要付出什么代价。
1.2 baseline 应该取什么:状态值函数出场
上一讲已经证明:给策略梯度的权重减去任意一个与动作无关的 baseline $b$,梯度期望不变。当时我们用的是最简单的 $b=\frac1N\sum_i r(\tau^{(i)})$,即「平均回报」。现在有了 $Q^\pi$,一个更好的 baseline 呼之欲出。
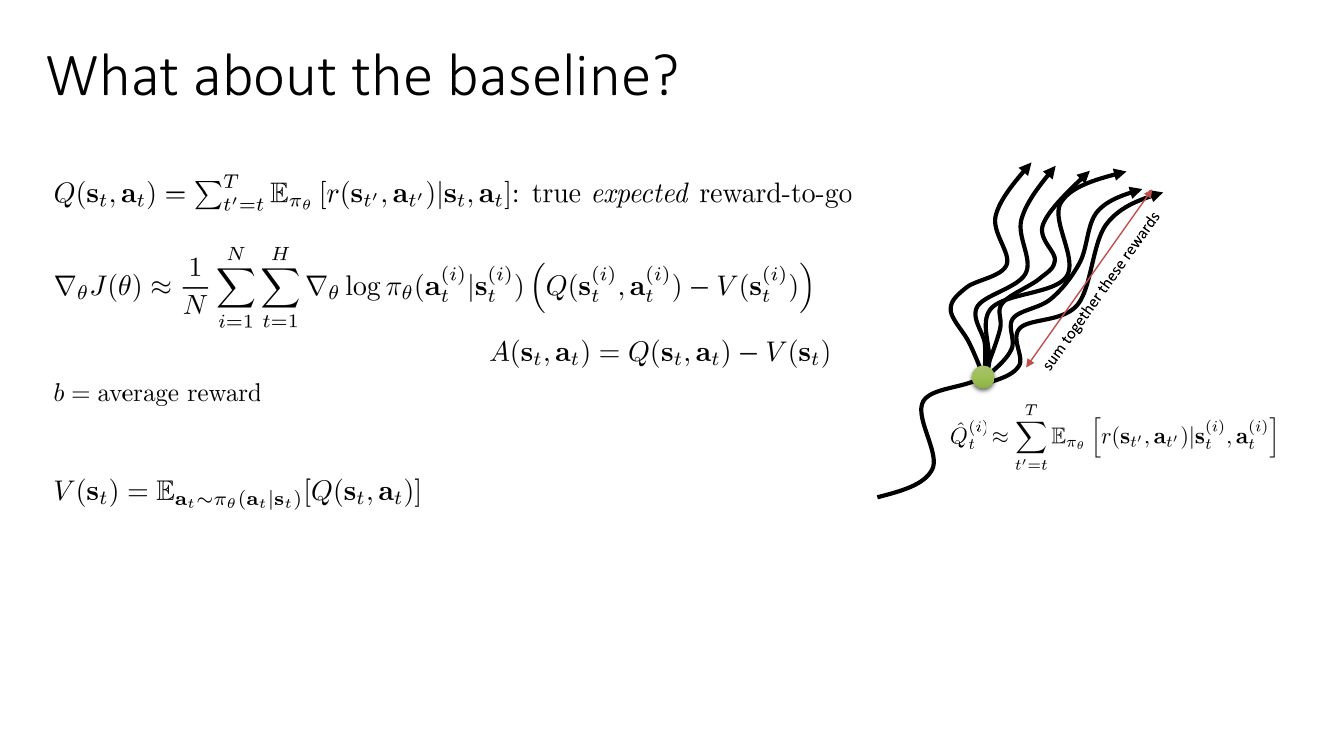
定义状态值函数(state value function)
$$ V^\pi(s_t)=\E_{a_t\sim\pi_\theta(a_t|s_t)}\big[Q^\pi(s_t,a_t)\big], $$即「从状态 $s_t$ 出发,按当前策略行动,期望能拿多少总奖励」。它与 $Q^\pi$ 的差值就是优势函数(advantage function):
$$ A^\pi(s_t,a_t)=Q^\pi(s_t,a_t)-V^\pi(s_t). $$$A^\pi$ 的语义是「$a_t$ 比在 $s_t$ 处随便按策略抽一个动作好多少」。它有一个非常漂亮的性质:在当前策略下的期望恒为零,$\E_{a\sim\pi}[A^\pi(s,a)]=0$。这意味着在任何状态下,总有一半左右(按概率加权)的动作优势为正、一半为负,梯度会均匀地「推好的、压坏的」。
为什么这是好事?考虑一个所有奖励都是正数的环境(比如每步 $+1$ 的生存奖励)。用原始 reward-to-go 时,所有动作的权重都是正的,策略梯度会同时推高所有采样到的动作的概率——只是推的力度不同。由于概率必须归一化,最终效果是相对的,能学,但梯度里混进了大量与「哪个动作更好」无关的公共分量,这部分纯粹是噪声放大器。减去 $V^\pi$ 之后,公共分量被扣掉了,剩下的每一个数字都直接回答「这个动作值不值得强化」。
严格来说不是。上一讲推过,使梯度方差最小的 baseline 是「用梯度模长平方加权的期望回报」
$$ b^\star = \frac{\E\big[\|\nabla_\theta\log\pi_\theta(\tau)\|^2\, r(\tau)\big]}{\E\big[\|\nabla_\theta\log\pi_\theta(\tau)\|^2\big]}, $$而 $V^\pi$ 相当于把权重 $\|\nabla_\theta\log\pi_\theta\|^2$ 换成常数 1 之后的结果。但 $b^\star$ 需要额外估计梯度模长的二阶统计量,每个参数分量还各有一个最优值,实现麻烦、本身估计噪声大。Levine 的判断很直接:$V^\pi$ 在实践中已经几乎抓住了全部收益,而且它有清晰的语义(「这个状态的平均水平」),还能被一个神经网络高效地共享学习。所以后面所有算法都用 $V^\pi$。
1.3 三个函数,学哪一个?
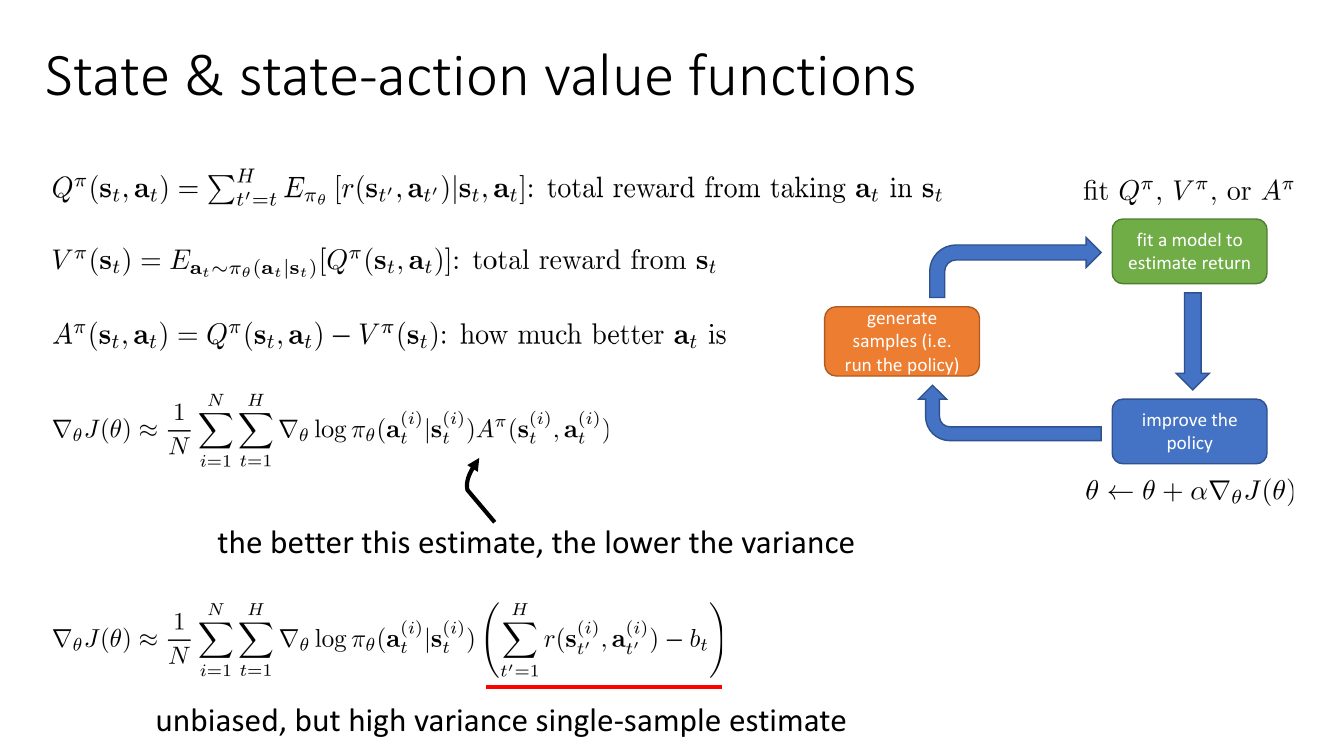
于是策略梯度的最终形态是
$$ \nabla_\theta J(\theta)\approx \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\,A^\pi(s_t^{(i)},a_t^{(i)}). $$注意这里的核心权衡:$A^\pi$ 估计得越准,梯度方差越低。注意是「方差」而不是「偏差」——如果我们的 $\hat A$ 有系统性误差,梯度就是有偏的,可能收敛到错误的地方。这与纯策略梯度形成鲜明对比:后者的 $\hat A$(单样本回报减常数 baseline)永远无偏,但方差大到需要海量样本。本讲从这里开始,就一直在这条偏差-方差的钢丝上走。
| 用作梯度权重的量 | 是否无偏 | 方差 | 需要学什么 |
|---|---|---|---|
| $\sum_{t'\ge t} r_{t'}$(reward-to-go) | 无偏 | 极高 | 什么都不用学 |
| $\sum_{t'\ge t} r_{t'} - b$(常数 baseline) | 无偏 | 高 | 一个标量 |
| $\sum_{t'\ge t} r_{t'} - \hat V_\phi(s_t)$ | 无偏 | 中 | $V^\pi$ |
| $r_t + \gamma\hat V_\phi(s_{t+1}) - \hat V_\phi(s_t)$(actor-critic) | 有偏(critic 不完美时) | 低 | $V^\pi$ |
| 真实 $A^\pi(s_t,a_t)$ | 无偏 | 最低 | 不可得 |
接下来的问题是:$Q^\pi$、$V^\pi$、$A^\pi$ 这三个函数,我们到底该用神经网络去拟合哪一个?答案在下一节。
2. 只拟合状态值函数就够了
2.1 fit what to what?
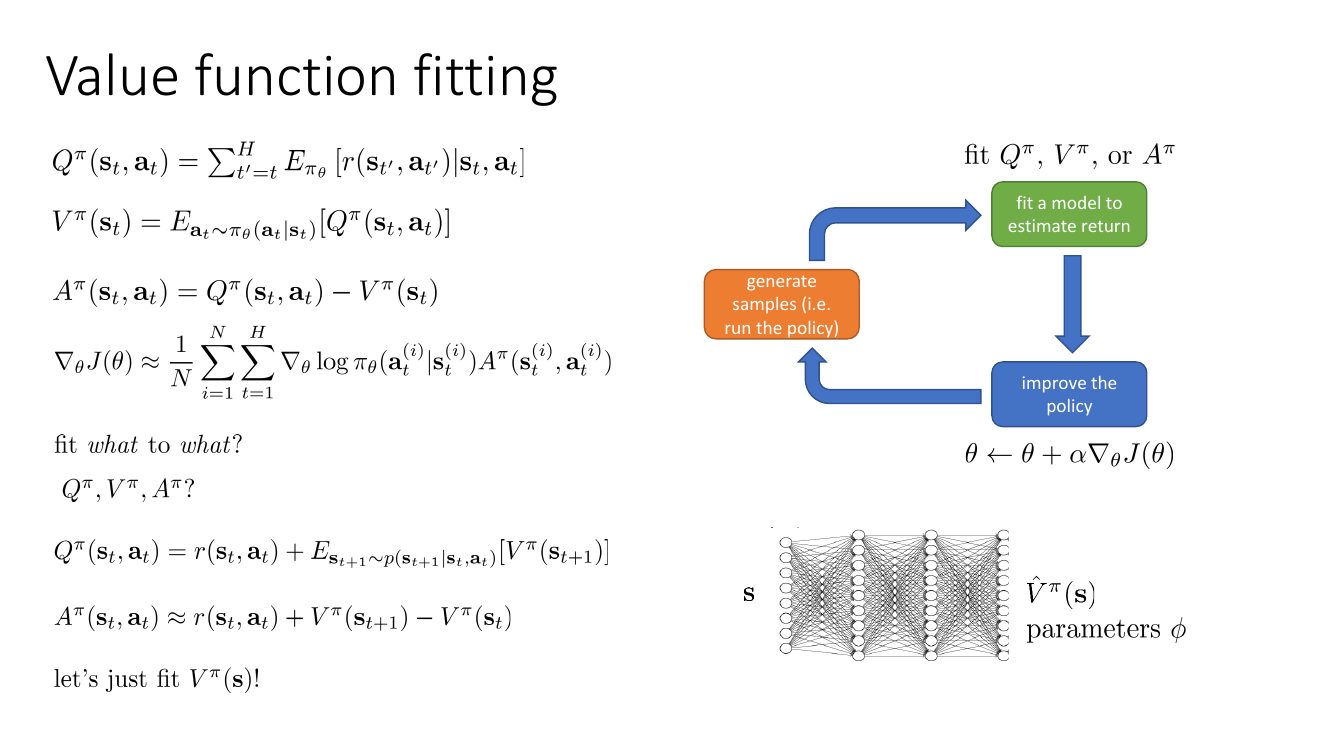
三个候选里,$Q^\pi$ 和 $A^\pi$ 都是 $(s,a)$ 的二元函数,而 $V^\pi$ 只是 $s$ 的一元函数。输入维度更低意味着更少的样本就能学好,这是选 $V^\pi$ 的第一个理由。第二个理由更本质:有了 $V^\pi$,另外两个都能拼出来。
由 Q 函数的定义与马尔可夫性,把第一步的奖励从求和里拿出来:
$$ Q^\pi(s_t,a_t)=r(s_t,a_t)+\sum_{t'=t+1}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\,\big|\,s_t,a_t\big] = r(s_t,a_t)+\E_{s_{t+1}\sim p(s_{t+1}|s_t,a_t)}\big[V^\pi(s_{t+1})\big]. $$这一步用到了:给定 $s_{t+1}$ 之后,后续的期望回报只依赖 $s_{t+1}$(马尔可夫性),也就是 $V^\pi(s_{t+1})$ 的定义。注意 $r(s_t,a_t)$ 是确定的(已知 $s_t,a_t$),不需要期望。
代入优势函数:
$$ A^\pi(s_t,a_t)=r(s_t,a_t)+\E_{s_{t+1}}\big[V^\pi(s_{t+1})\big]-V^\pi(s_t) \;\approx\; r(s_t,a_t)+V^\pi(s_{t+1})-V^\pi(s_t). $$最后那个 $\approx$ 是把对 $s_{t+1}$ 的期望换成了实际采样到的那一个 $s_{t+1}$。这是一次单样本近似,会引入方差——但请注意它和之前那个单样本 reward-to-go 的量级差别:之前是把整条未来轨迹压成一个样本,现在只把一步转移压成一个样本,后面所有步的随机性都被 $V^\pi$ 平滑掉了。这就是方差骤降的来源。
如果环境转移是确定性的(很多机器人仿真环境近似如此),那么这个 $\approx$ 直接变成等号,一点误差都没有。如果转移随机性很强(比如带风的导航、纸牌游戏的发牌),这一项就会贡献可观的方差——但仍然远小于蒙特卡洛。
2.2 策略评估:值函数的监督标签从哪来
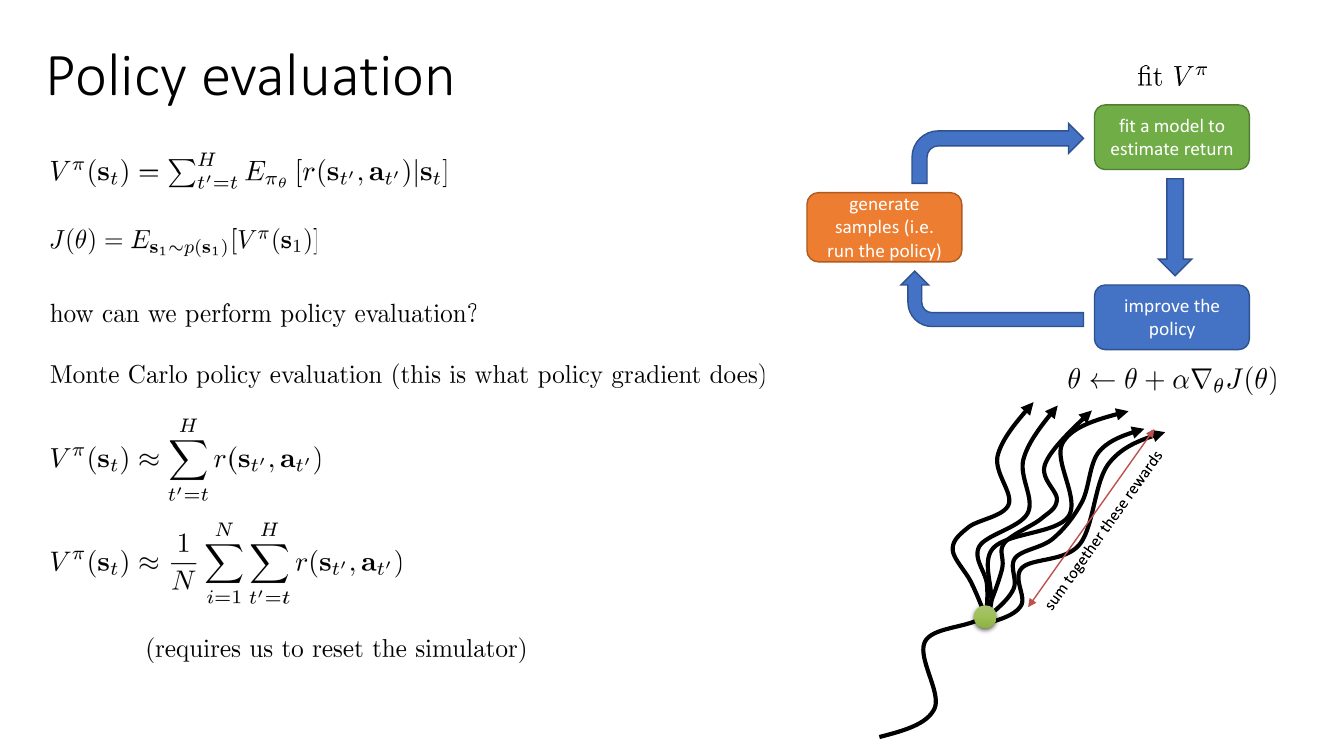
策略评估(policy evaluation)指的就是「给定策略 $\pi$,算出它的 $V^\pi$」,不涉及任何策略改进。它和 RL 目标的关系是
$$ J(\theta)=\E_{s_1\sim p(s_1)}\big[V^\pi(s_1)\big], $$即目标函数就是初始状态的值在初始状态分布下的平均。
最朴素的做法是蒙特卡洛策略评估(Monte Carlo policy evaluation):
$$ V^\pi(s_t)\approx \sum_{t'=t}^{H} r(s_{t'},a_{t'}) \qquad\text{(单条轨迹)} $$或者更好的
$$ V^\pi(s_t)\approx \frac{1}{N}\sum_{i=1}^{N}\sum_{t'=t}^{H} r(s_{t'}^{(i)},a_{t'}^{(i)}) \qquad\text{(从 } s_t \text{ 重启 } N \text{ 次)}. $$第二式方差更小,但它要求能把模拟器重置到任意指定状态并从那里重跑多次。真实机器人做不到,大多数标准 gym 环境也做不到(只能 reset 到初始分布)。所以实践中我们只有第一式——每个状态只有一条样本轨迹。这正是纯策略梯度在做的事。
2.3 函数逼近让单样本也够用
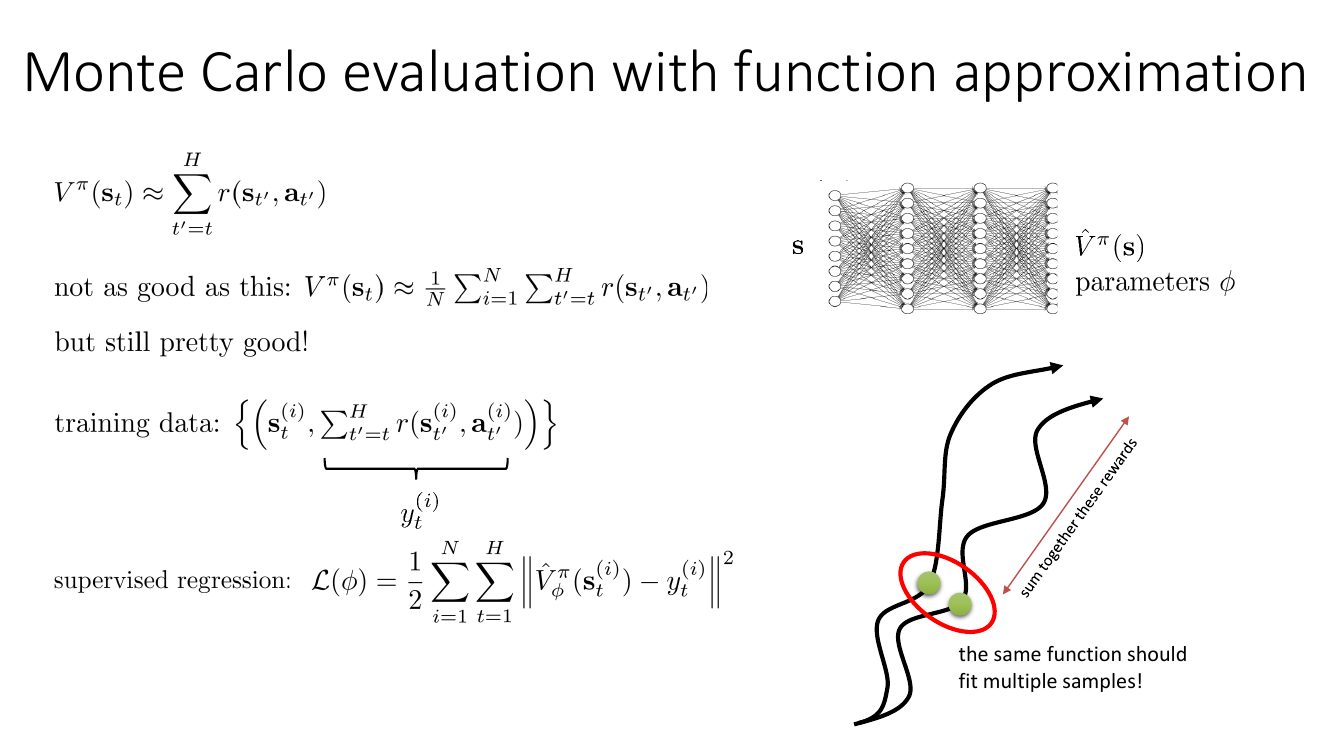
虽然每个状态只有一条样本,但如果我们用神经网络 $\hat V^\pi_\phi$ 去拟合,情况会好很多。构造训练集
$$ \mathcal{D}=\Big\{\Big(s_t^{(i)},\ \underbrace{\textstyle\sum_{t'=t}^{H} r(s_{t'}^{(i)},a_{t'}^{(i)})}_{y_t^{(i)}}\Big)\Big\}, $$然后做最普通的监督回归:
$$ \mathcal{L}(\phi)=\frac{1}{2}\sum_{i=1}^{N}\sum_{t=1}^{H}\big\|\hat V^\pi_\phi(s_t^{(i)})-y_t^{(i)}\big\|^2 . $$关键洞察在于:神经网络是连续、光滑的函数。当两个状态 $s$ 和 $s'$ 很接近时,网络给它们的输出也接近,于是它们各自的单样本标签会被隐式地平均。相当于免费获得了「从同一状态重启多次」的效果——只不过是近似的、基于泛化的。Levine 的原话是「not as good as this(指真正的多次重启平均),but still pretty good!」。
2.4 自举(bootstrapping):把 critic 自己当标签
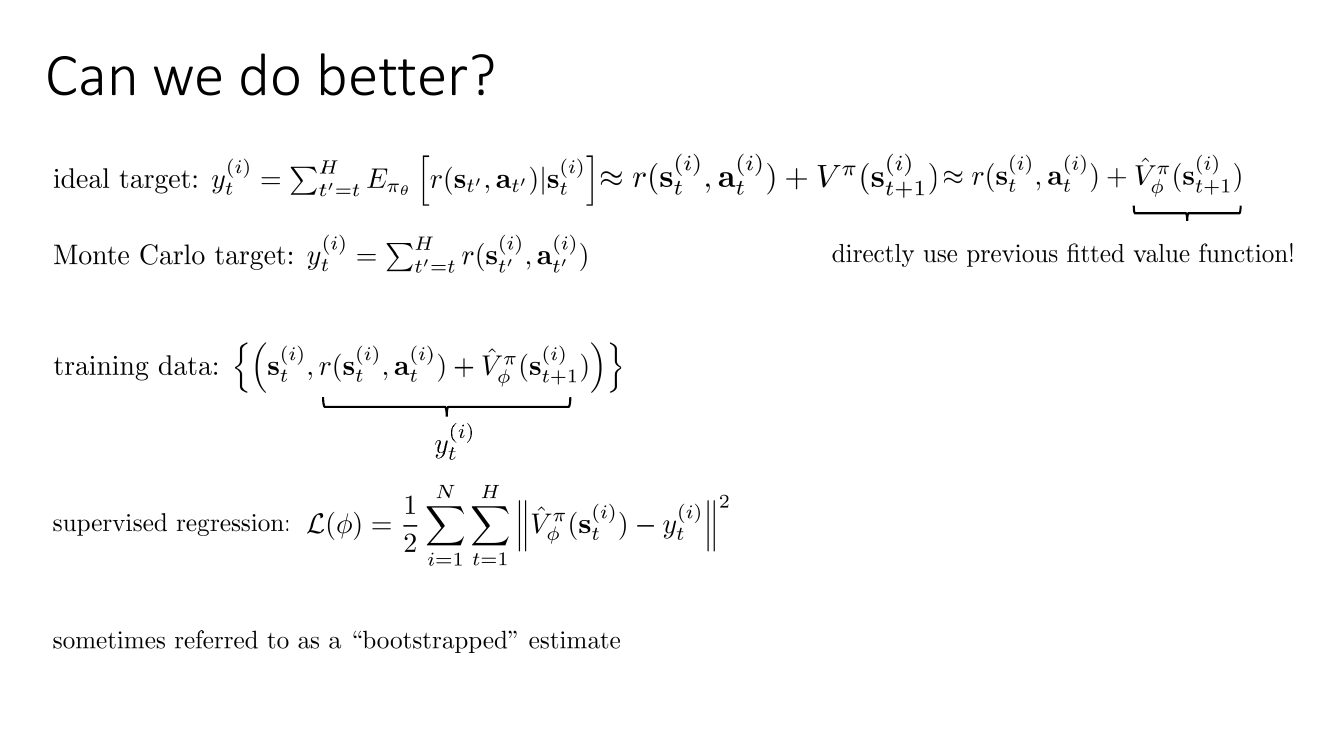
蒙特卡洛标签 $y_t=\sum_{t'\ge t} r_{t'}$ 是无偏的,但它把未来 $H-t$ 步的所有随机性都塞进了一个标签里,方差随剩余步数增长。有没有方差更小的标签?
回到理想目标的定义并做一次一步展开:
$$ y_t^{(i)}=\sum_{t'=t}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\,\big|\,s_t^{(i)}\big] \;\approx\; r(s_t^{(i)},a_t^{(i)})+V^\pi(s_{t+1}^{(i)}) \;\approx\; r(s_t^{(i)},a_t^{(i)})+\hat V^\pi_\phi(s_{t+1}^{(i)}). $$第一个 $\approx$ 只是把一步的期望换成采样(同样是低方差的单步近似);第二个 $\approx$ 是关键:我们把 $V^\pi$ 替换成了自己当前的估计 $\hat V^\pi_\phi$。这就是「自举」——用自己的估计去构造自己的训练标签,像揪着自己的鞋带把自己拎起来。
训练集变成
$$ \mathcal{D}=\Big\{\Big(s_t^{(i)},\ r(s_t^{(i)},a_t^{(i)})+\hat V^\pi_\phi(s_{t+1}^{(i)})\Big)\Big\}, $$损失函数一模一样。实现上要注意:标签里的 $\hat V^\pi_\phi(s_{t+1})$ 必须被当成常数(PyTorch 里 .detach()),不能让梯度穿过去,否则优化的就不是回归问题了。
设真实值为 $V^\pi(s_t)$,剩余步数为 $k=H-t$,每步奖励的方差为 $\sigma_r^2$(简化起见假设各步独立)。
- 蒙特卡洛目标:$\E[y_t]=V^\pi(s_t)$,零偏差;方差约 $\mathrm{Var}(y_t)\approx k\sigma_r^2$,随剩余步数线性增长。$H=1000$ 时这个数字是 $H=10$ 时的 100 倍。
- 自举目标:$\E[y_t]=r_t+\E[\hat V_\phi(s_{t+1})]$。若 $\hat V_\phi$ 有系统误差 $\varepsilon$,标签就带上 $\varepsilon$ 的偏差,并且这个偏差会沿着自举链条向前传播($s_t$ 的标签错了会让 $s_{t-1}$ 的标签也错);但方差只有 $\sigma_r^2+\mathrm{Var}(\hat V_\phi(s_{t+1}))$,与 $k$ 无关。
直觉上:蒙特卡洛是「实测但只测一次」,自举是「测一步 + 查表」。查的表可能是错的,但至少每次查出来的结果稳定。深度 RL 里 $H$ 通常几百到几千,$k\sigma_r^2$ 大得离谱,所以自举几乎总是赢。第 6 节的 GAE 会告诉我们如何在两者之间连续插值。
2.5 两个历史性的例子
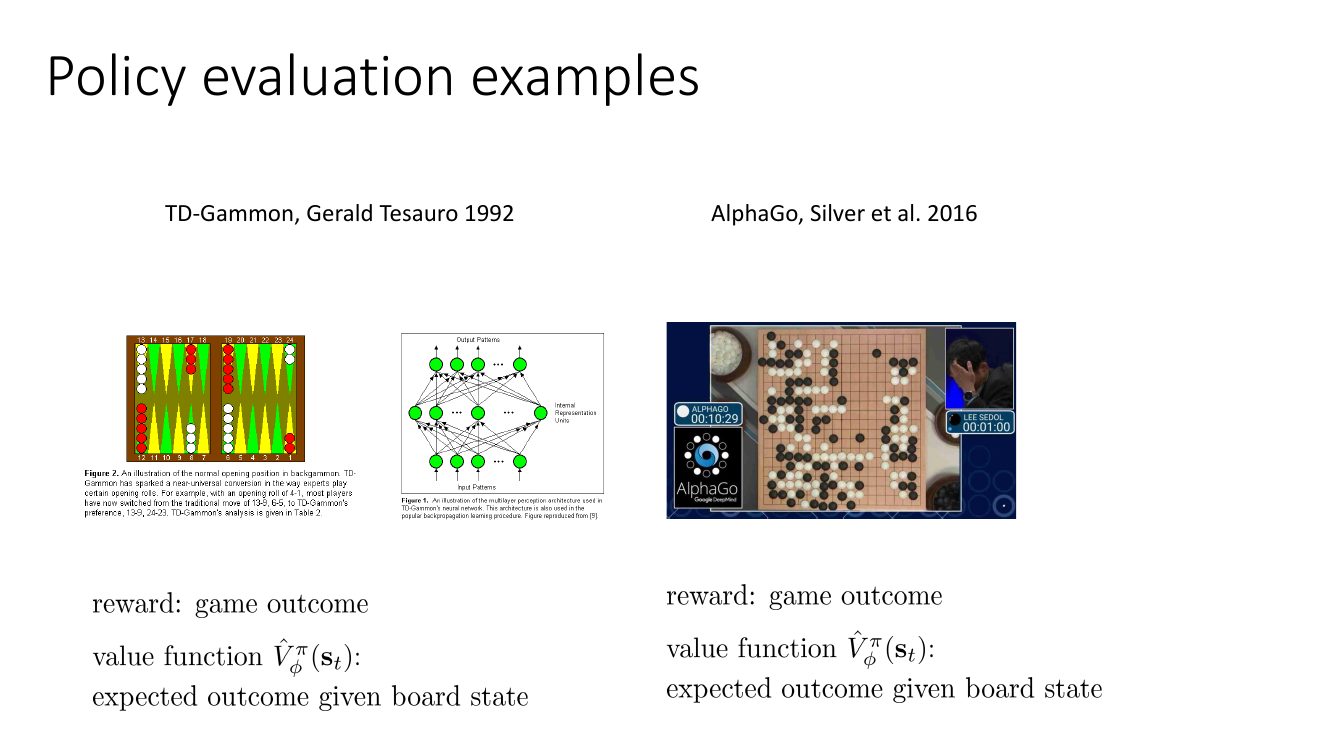
这两个例子的共同点值得强调:奖励只在回合结束时出现(赢 $+1$ / 输 $-1$),中间几十上百步全是 $0$。如果只用蒙特卡洛,每个局面的标签就是最终输赢,噪声极大;而值函数网络学到的是「这个局面的胜率」,它把终局信号沿着自举链条一路回传,同时用泛化能力在相似局面之间共享信息。这正是 2.3 和 2.4 两节说的机制在真实系统里的体现。
3. 折扣因子 γ:它到底是什么,该放在哪里
3.1 无限长任务会让值函数发散
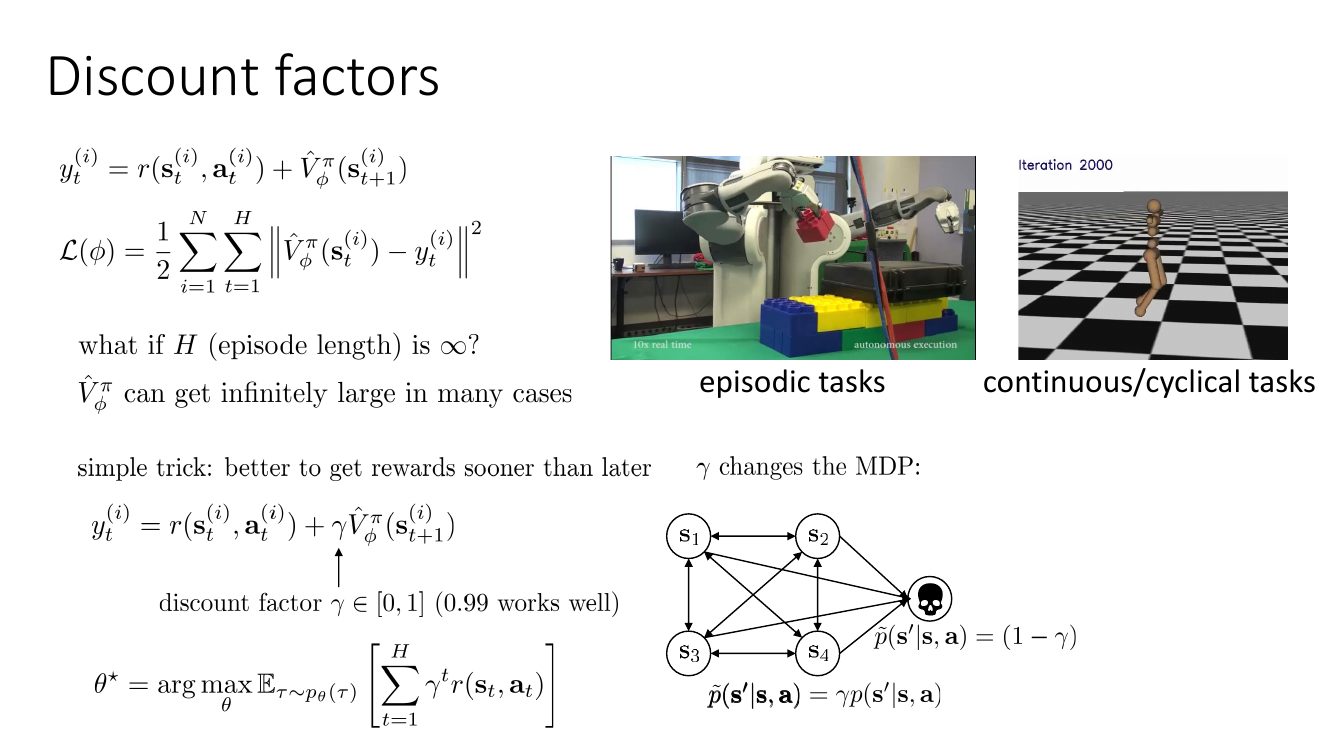
到目前为止我们都假设回合长度 $H$ 有限。但很多任务本质上是连续/循环型(continuous / cyclical)的:让机器人一直跑下去、让服务器一直调度请求。此时 $H=\infty$,如果每步奖励都是正的,$V^\pi(s)=\sum_{t=1}^{\infty} r_t$ 就是 $+\infty$,网络要去拟合一个发散的目标,训练必然崩掉。
标准解法是折扣因子(discount factor) $\gamma\in[0,1]$。自举目标改成
$$ y_t^{(i)}=r(s_t^{(i)},a_t^{(i)})+\gamma\,\hat V^\pi_\phi(s_{t+1}^{(i)}), $$对应的优化目标变成
$$ \theta^\star=\argmax_\theta\ \E_{\tau\sim p_\theta(\tau)}\Big[\sum_{t=1}^{H}\gamma^{t}r(s_t,a_t)\Big]. $$只要奖励有界 $|r|\le R_{\max}$,$|V^\pi|\le R_{\max}/(1-\gamma)$ 就是有限的。$\gamma=0.99$ 时上界是 $100R_{\max}$,完全在网络能表达的范围内。CS285 里 $\gamma=0.99$ 是几乎所有连续控制任务的默认值。
3.2 折扣因子的两种解释
给原 MDP 增加一个吸收态 $s_\dagger$(幻灯片里画成骷髅头),定义新的转移
$$ \tilde p(s'|s,a)=\gamma\, p(s'|s,a)\quad (s'\ne s_\dagger),\qquad \tilde p(s_\dagger|s,a)=1-\gamma . $$验证归一化:$\sum_{s'\ne s_\dagger}\gamma p(s'|s,a)+(1-\gamma)=\gamma+1-\gamma=1$,合法。进入 $s_\dagger$ 后永远留在那里且奖励恒为 $0$。那么在新 MDP 上的无折扣期望回报,恰好等于原 MDP 上的 $\gamma$-折扣期望回报:因为「活到第 $t$ 步」的概率正好是 $\gamma^{t-1}$。
所以 $\gamma$ 的语义是「每一步都有 $1-\gamma$ 的概率世界末日」。这也解释了为什么它叫「better to get rewards sooner than later」:既然随时可能死,当然要先拿现钱。$\gamma=0.99$ 对应的「期望寿命」是 $1/(1-\gamma)=100$ 步——这也是一个很有用的心算:$\gamma$ 决定了值函数关心多远的未来,有效视界约为 $\frac{1}{1-\gamma}$ 步。$\gamma=0.9$ 只看 10 步,$\gamma=0.999$ 看 1000 步。
即使任务本身是有限长的、$V^\pi$ 根本不会发散,人们照样会加 $\gamma$。原因是:遥远未来的奖励与当前这个动作的因果关联通常很弱,但它们贡献的方差却一点不少。用 $\gamma$ 把它们指数衰减掉,等于砍掉了「信噪比最差的那部分信号」。代价是偏差——如果任务真的需要 200 步之后才有回报,$\gamma=0.99$ 会把它压到 $0.99^{200}\approx 0.13$,几乎看不见了。所以 $\gamma$ 的选择本质上是「有效视界 vs 方差」的权衡,而不只是数值稳定性问题。
3.3 γ 放在策略梯度的哪里:option 1 vs option 2
这是本讲最容易被跳过、但概念上最微妙的一点。我们已经知道 $\gamma$ 怎么进值函数了,那它怎么进策略梯度?有两种自然的写法,而它们不相等。
写法 A(option 1):先写出无折扣的 causality 形式,再把 reward-to-go 换成折扣 reward-to-go:
$$ \nabla_\theta J(\theta)\approx \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)}) \Big(\sum_{t'=t}^{H}\gamma^{\,t'-t}\,r(s_{t'}^{(i)},a_{t'}^{(i)})\Big). $$注意折扣的指数是 $t'-t$:每个时间步都以「自己所在的时刻」为原点重新开始打折。
写法 B(option 2):从折扣目标 $J(\theta)=\E[\sum_t \gamma^{t-1}r_t]$ 出发,老老实实推策略梯度。上一讲的推导给出
$$ \nabla_\theta J(\theta)\approx\frac{1}{N}\sum_{i=1}^{N}\Big(\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\Big)\Big(\sum_{t'=1}^{H}\gamma^{\,t'-1}r(s_{t'}^{(i)},a_{t'}^{(i)})\Big), $$再用因果性去掉 $t'\lt t$ 的项,并把 $\gamma^{t'-1}$ 拆成 $\gamma^{t-1}\cdot\gamma^{t'-t}$:
$$ \nabla_\theta J(\theta)\approx\frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\ \gamma^{\,t-1}\,\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)}) \Big(\sum_{t'=t}^{H}\gamma^{\,t'-t}r(s_{t'}^{(i)},a_{t'}^{(i)})\Big). $$与写法 A 相比,多了一个前置因子 $\gamma^{t-1}$。
option 2 是「$\gamma$-折扣目标函数」的数学上正确的梯度。它说的是:第 100 步的那个动作,即使它在局部看起来非常关键,对目标函数的贡献也只有第 1 步动作的 $\gamma^{99}$ 倍。换句话说,option 2 认为「越晚做的决策越不重要」,因为按解释一,你多半已经死在半路上了。
option 1 没有这个前置因子,它对所有时间步一视同仁。它不是 $\gamma$-折扣目标的梯度。那它是什么的梯度?粗略地说,它对应的是平均奖励(average reward)目标的梯度的一个近似——每个时刻都被同等看待,$\gamma$ 只在「估计当前时刻的 reward-to-go」时起作用,纯粹作为一个降方差手段。Philip Thomas 在 2014 年的论文《Bias in Natural Actor-Critic Algorithms》里详细分析了这件事:几乎所有实现(包括 A3C、PPO、SAC)用的都是 option 1,因此从「折扣目标」的角度看它们全都是有偏的。
为什么大家还是用 option 1? 因为 option 2 在实践中很糟糕:$\gamma^{t-1}$ 会让 $t$ 较大的样本的梯度指数级衰减到零。$\gamma=0.99$、$t=1000$ 时前置因子是 $\gamma^{999}\approx 4\times 10^{-5}$,等于把回合后半段的所有数据统统扔掉。我们通常真的希望机器人在第 1000 步也走得好,而不是「反正它大概率活不到那时候」。所以:我们真正想优化的是平均奖励式的目标,$\gamma$ 只是我们借来降方差的工具,option 1 恰好匹配这个意图。
「既然 option 2 才是对的,那我的实现是不是错了?」——不是。要意识到这是一个有意为之的取舍:我们放弃了「优化折扣目标」这个理论保证,换来了「所有时间步的数据都能用」这个实际收益。写作业时如果你在代码里写了 discount ** t 作为 log-prob 的前置系数,反而会发现学不动。标准实现(包括 CS285 作业 2 的参考答案)都是 option 1。
3.4 从「时变」到「时不变」:为什么可以只写转移三元组
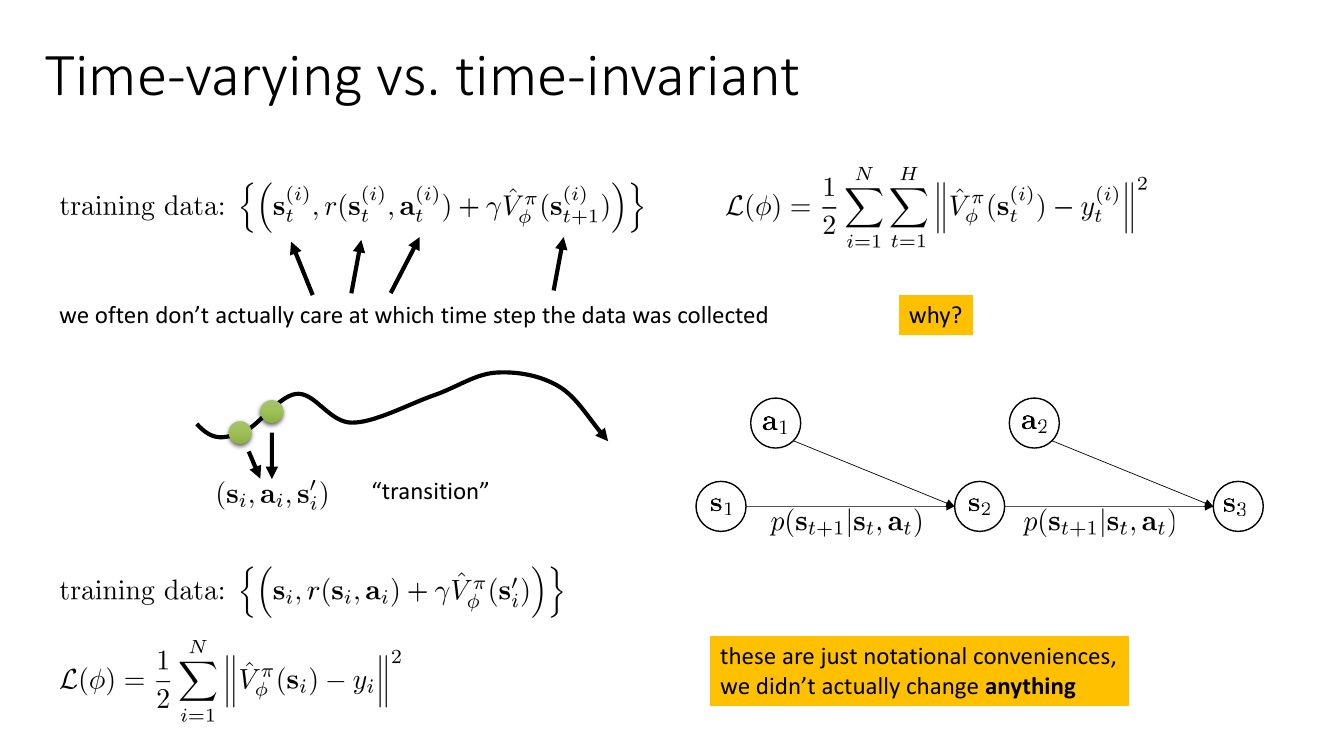
这一小节表面上只是换记号,实际影响很大。原来我们写 $s_t^{(i)}$,需要同时记住「第几条轨迹、第几步」。但在时齐(time-invariant / stationary)的无限视界 MDP 中:
- 转移 $p(s'|s,a)$ 不随 $t$ 变化;
- 折扣目标 $\sum_{t'\ge t}\gamma^{t'-t}r_{t'}$ 从任何时刻看都长得一样;
- 因此 $V^\pi(s)$ 只是 $s$ 的函数,与 $t$ 无关。
于是我们可以把所有轨迹拆散成一堆独立的转移(transition) $(s_i,a_i,s_i')$,训练集写成
$$ \mathcal{D}=\big\{\big(s_i,\ r(s_i,a_i)+\gamma\hat V^\pi_\phi(s_i')\big)\big\}_{i=1}^{N}, \qquad \mathcal{L}(\phi)=\frac{1}{2}\sum_{i=1}^{N}\big\|\hat V^\pi_\phi(s_i)-y_i\big\|^2 . $$这个记号的转变是后面所有内容的前提:只有把数据看成「一袋转移」而不是「一批轨迹」,replay buffer、mini-batch 随机梯度、异步并行采样这些工程手段才有意义。 反之,如果任务是有限视界且策略/值函数依赖时间(比如「第 10 步必须抓住杯子」),就必须保留 $t$,此时 $V$ 要写成 $V(s,t)$,或者把 $t$ 作为观测的一部分喂进网络。
4. 基本的 actor-critic 算法:批量版与在线版
4.1 批量 actor-critic
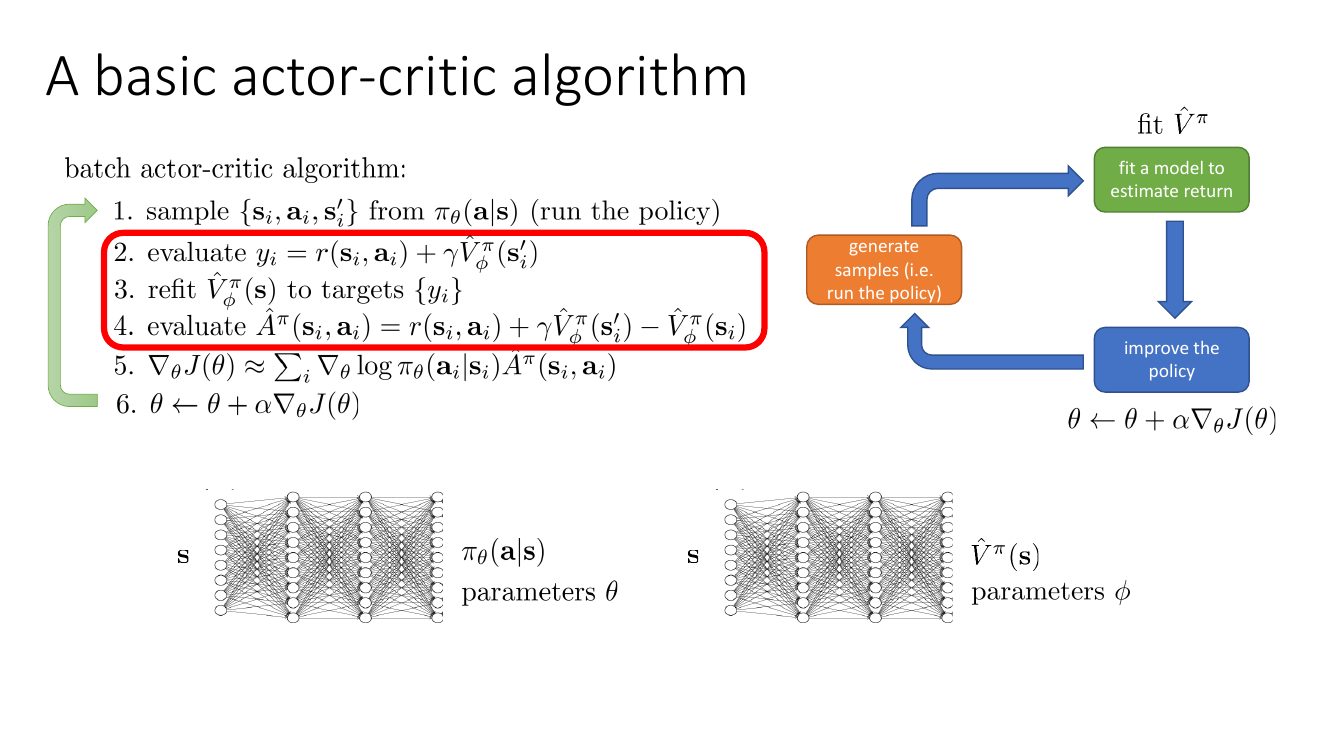
把前三节的结论装配起来,就得到批量 actor-critic 算法(batch actor-critic):
- 用当前策略 $\pi_\theta(a|s)$ 采样一批转移 $\{(s_i,a_i,r_i,s_i')\}$(通常是若干条完整轨迹拆散得到);
- 计算自举目标 $y_i = r(s_i,a_i)+\gamma\hat V^\pi_\phi(s_i')$;
- 把 $\hat V^\pi_\phi(s)$ 回归到目标 $\{y_i\}$,即最小化 $\sum_i\|\hat V^\pi_\phi(s_i)-y_i\|^2$;
- 计算优势 $\hat A^\pi(s_i,a_i)=r(s_i,a_i)+\gamma\hat V^\pi_\phi(s_i')-\hat V^\pi_\phi(s_i)$;
- $\nabla_\theta J(\theta)\approx\sum_i \nabla_\theta\log\pi_\theta(a_i|s_i)\,\hat A^\pi(s_i,a_i)$;
- $\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$,回到第 1 步。
几点必须讲清楚的细节:
- 第 2 步和第 4 步里的 $\hat V^\pi_\phi$ 用的是哪一版参数? 第 2 步用的是更新前的 $\phi$(老的 critic 给出目标),第 4 步一般用更新后的 $\phi$(新 critic 给出更准的优势)。这个细节在实现里很容易搞混,但影响不大。
- 第 3 步做几次梯度下降? 可以只做一次(此时更像在线 TD),也可以做几十次直到收敛(此时更像「拟合值迭代」)。做太多次会过拟合到旧目标上,做太少 critic 跟不上 actor。常见做法是每轮做几到几十次 mini-batch 更新。
- 终止状态的处理:如果 $s_i'$ 是回合结束(terminal),必须令 $y_i=r_i$,即把 $\gamma\hat V^\pi_\phi(s_i')$ 强制置零。忘了这一点是最常见的 bug 之一:网络会认为「死了以后还能继续拿奖励」,学出来的策略会主动求死或主动求生(取决于奖励符号)。注意要区分「真正终止」和「因为时间上限被截断(time limit)」,后者理论上仍应自举。
- on-policy 性质:第 1 步的样本必须来自当前的 $\pi_\theta$。一旦 $\theta$ 更新,之前的样本就作废了,因为 $V^\pi$ 是对特定策略 $\pi$ 定义的。这是 actor-critic 样本效率低的根源,第 7 节会试图修补它。
4.2 在线 actor-critic:只有一条转移怎么办
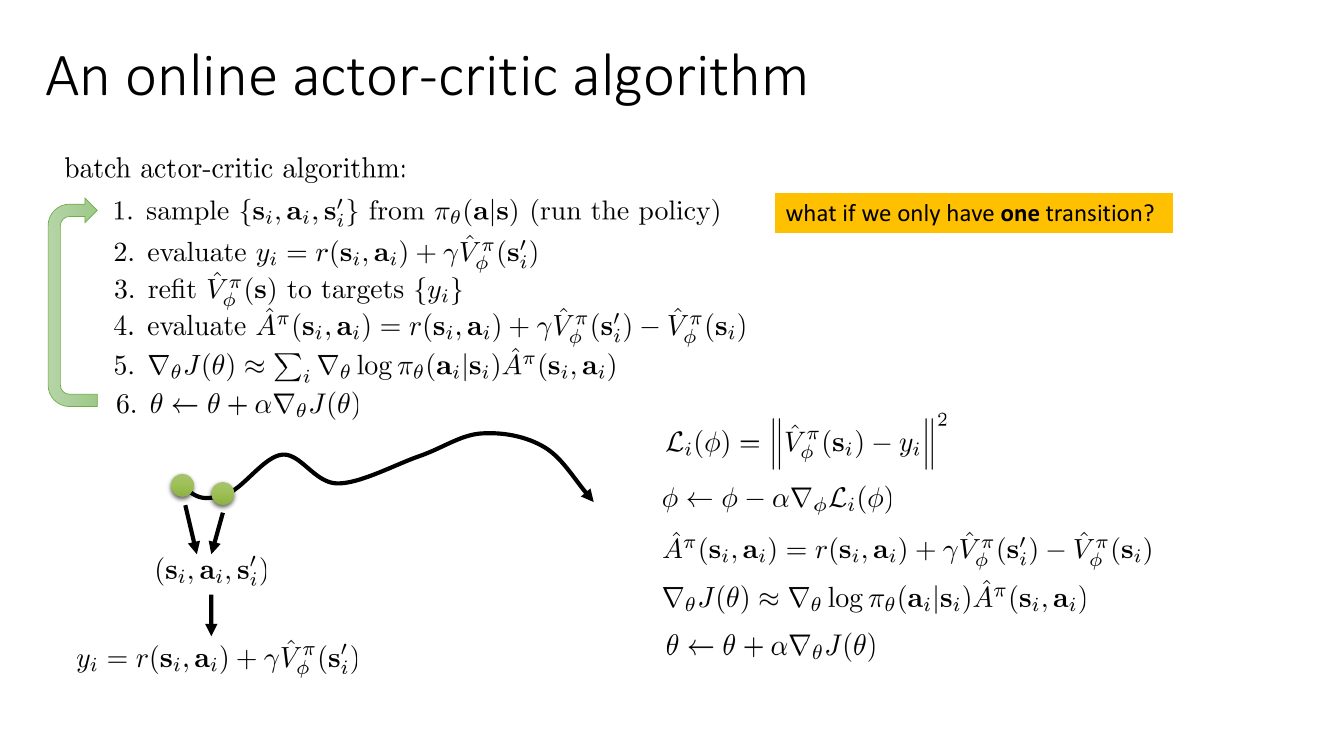
批量版本要求先攒够一批数据。但既然我们已经把数据看成「一袋转移」,理论上每走一步就能更新一次。这就是在线 actor-critic(online actor-critic):
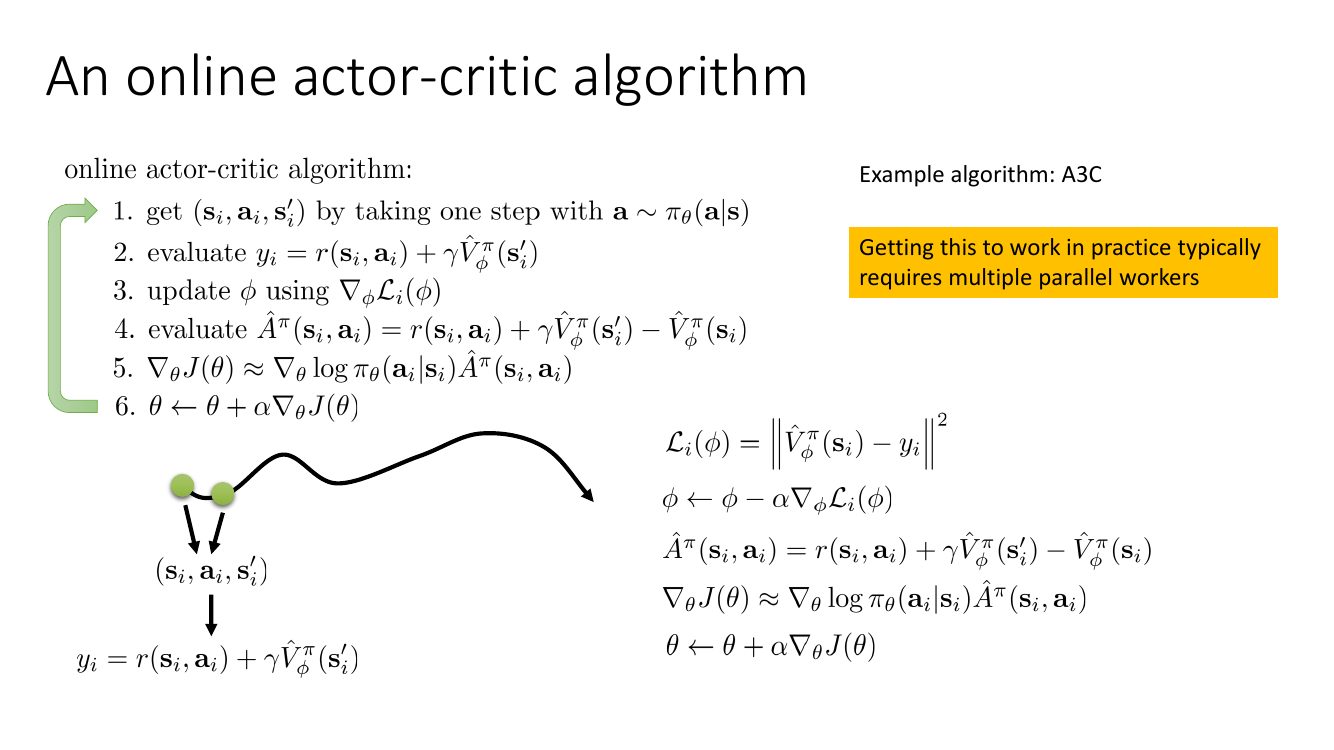
- 用 $a\sim\pi_\theta(a|s)$ 走一步,得到 $(s_i,a_i,r_i,s_i')$;
- $y_i = r(s_i,a_i)+\gamma\hat V^\pi_\phi(s_i')$;
- 用 $\nabla_\phi\mathcal{L}_i(\phi)$ 更新 $\phi$,其中 $\mathcal{L}_i(\phi)=\|\hat V^\pi_\phi(s_i)-y_i\|^2$;
- $\hat A^\pi(s_i,a_i)=r(s_i,a_i)+\gamma\hat V^\pi_\phi(s_i')-\hat V^\pi_\phi(s_i)$;
- $\nabla_\theta J(\theta)\approx\nabla_\theta\log\pi_\theta(a_i|s_i)\,\hat A^\pi(s_i,a_i)$;
- $\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$。
用 batch size $=1$ 做深度学习,本身就是灾难:梯度噪声极大,BatchNorm 之类的组件直接失效。更糟的是 RL 特有的问题——连续采到的转移高度相关。$s_1,s_2,s_3,\dots$ 是同一条轨迹上相邻的状态,它们几乎一样。用它们逐个做 SGD,等于反复用几乎相同的样本更新网络,网络会剧烈地过拟合到当前这一小段轨迹上,然后在下一段轨迹上被推向另一个方向。这叫「样本相关性」问题,在 Q-learning 那一讲会再次以完整形态出现。
4.3 并行化:同步 vs 异步
解决办法是并行化:同时跑 $K$ 个环境实例,每步收集 $K$ 条互不相关的转移,凑成一个 batch 再更新。这样既保持了「在线」(每步一更新),又拿到了 i.i.d. 程度足够好的 mini-batch。
| 同步并行(synchronized) | 异步并行(asynchronous) | |
|---|---|---|
| 做法 | $K$ 个 worker 各走一步,全部等齐,汇总梯度后统一更新参数,再把新参数广播回去 | 每个 worker 自己走、自己算梯度,随时把梯度推给参数服务器;参数服务器立即更新并返回最新参数 |
| 数据是否严格 on-policy | 是 | 否——worker 用的参数可能已经落后几步(stale gradients) |
| 吞吐 | 受最慢 worker 拖累(straggler 问题) | 高,无需等待 |
| 代表算法 | A2C(Advantage Actor-Critic) | A3C(Asynchronous Advantage Actor-Critic) |
| 实践评价 | 实现简单、复现性好;GPU 时代通常更快 | 历史上很重要;理论上不完全正确,但实践中「基本没事」 |
Levine 对异步版本的评价值得记下来:从理论上讲,异步 worker 用的是稍旧的策略产生数据,所以严格来说已经 off-policy 了,这是个「错误」;但只要参数变化不大(学习率小、更新频繁),这个偏差在实践中可以忽略。这是深度 RL 里非常典型的态度——大量方法在理论上是不严格的,但工程上有效。后来的研究(如 OpenAI 的 A2C 实现)发现同步版本在同等计算量下往往更好且更容易调试,所以现在同步并行是主流。
4.4 网络架构:两个网络还是一个网络
幻灯片上画的是两个独立的网络(一个吐 $\pi_\theta(a|s)$,一个吐 $\hat V^\pi_\phi(s)$)。但在图像输入的任务里,两个网络都要从像素里提取特征,这份工作重复了两遍。于是有两种设计:
| 双网络(separate) | 共享主干(shared trunk / two-head) | |
|---|---|---|
| 结构 | actor 与 critic 各一套完整参数 | 共享卷积/编码器,顶部分出策略头与值函数头 |
| 优点 | 简单、稳定;两个损失互不干扰,学习率可以分别调 | 特征共享、样本效率高;像素输入时省一半算力 |
| 缺点 | 无特征共享,图像任务下浪费严重 | 两个梯度在共享层相互干扰,值函数的回归梯度量级往往远大于策略梯度,容易「压垮」策略学习 |
| 常见对策 | — | 给两个损失加权:$\mathcal{L}=\mathcal{L}_{\text{actor}}+c_v\mathcal{L}_{\text{critic}}$,$c_v$ 常取 $0.5$;或对回报做标准化 |
| 适用 | 低维状态输入(MuJoCo 之类) | 高维像素输入(Atari、A3C 原论文的设定) |
共享主干时如果不加权直接把两个 loss 相加,训练常常表现为「critic 学得飞快,actor 完全不动」。原因是值函数回归的损失尺度由奖励量级决定(可能是几百),而策略梯度项的尺度由 $\log\pi$ 和优势决定(通常是个位数)。诊断方法:分别打印两个 loss 的梯度范数。修法:调 $c_v$、对优势做标准化(见 §6.4)、或干脆改用双网络。
5. critic 当 baseline:要方差还是要无偏
5.1 要让它在实践中真正好用,还缺什么
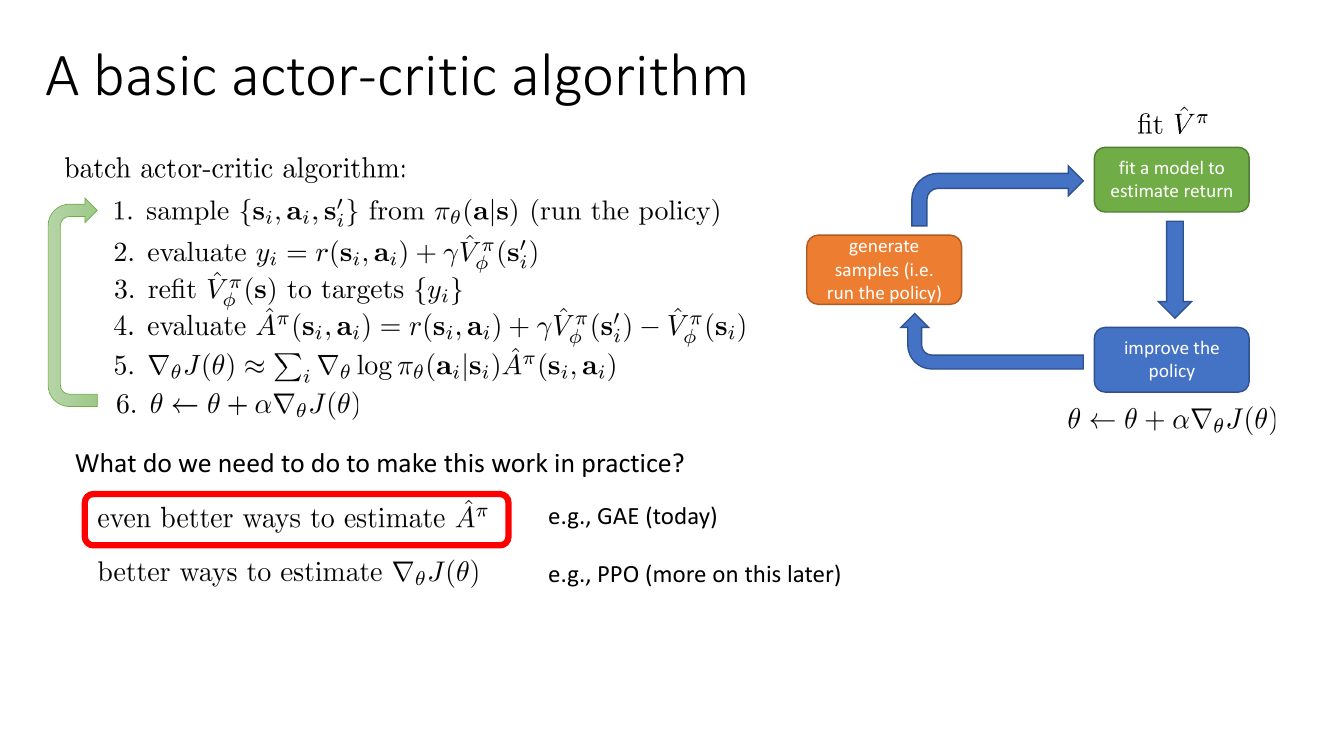
把 §4 的算法直接实现出来,在简单任务上能跑,但在稍难的任务上通常表现平庸。要让它变成「真正能用的策略梯度」,需要两方面的改进:
- 更好的 $\hat A^\pi$ 估计——本讲剩余部分(n-step、GAE);
- 更好的 $\nabla_\theta J(\theta)$ 估计——即在同一批数据上做多次策略更新而不崩掉,这是 PPO 的内容,留到后面的讲次。
5.2 三种估计量的偏差-方差谱
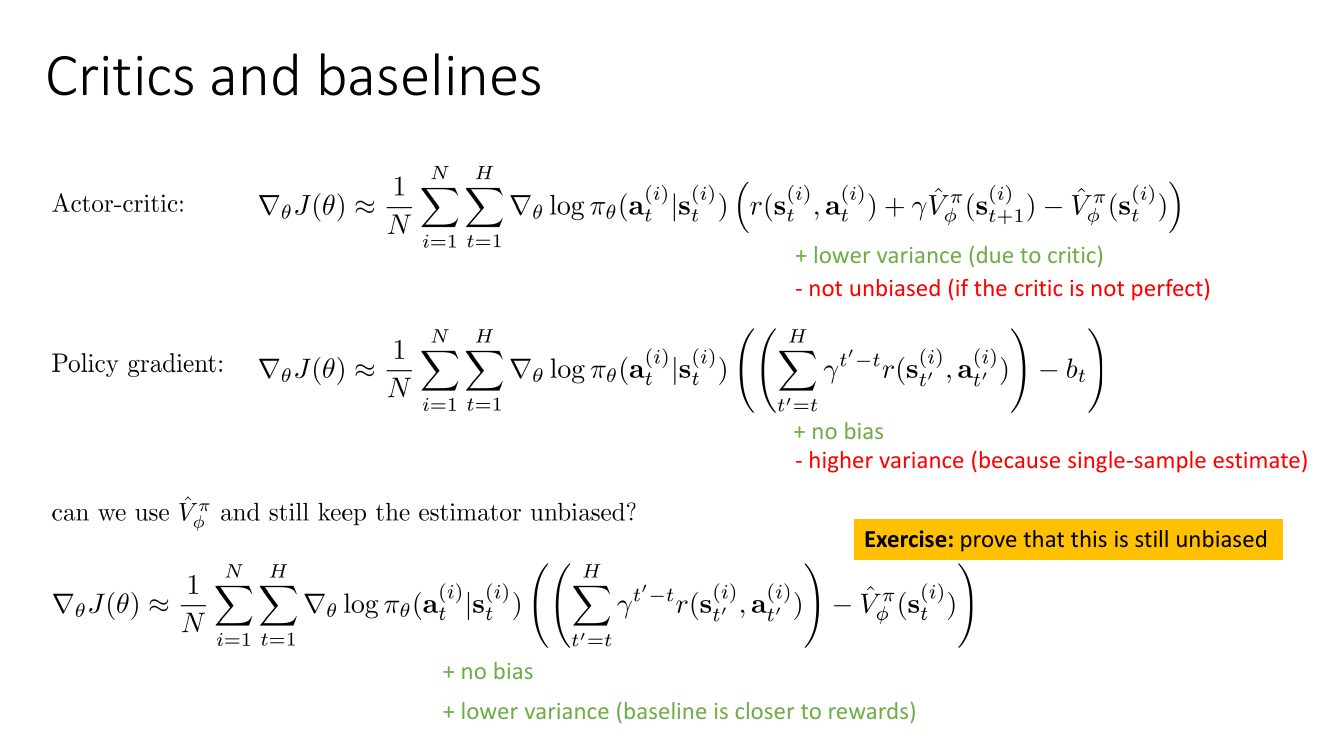
写在一起看得更清楚。记 $g_t = \nabla_\theta\log\pi_\theta(a_t|s_t)$:
| 名称 | 权重 | 偏差 | 方差 |
|---|---|---|---|
| Actor-critic | $r(s_t,a_t)+\gamma\hat V^\pi_\phi(s_{t+1})-\hat V^\pi_\phi(s_t)$ | 有(critic 不完美时) | 低 |
| Policy gradient(常数 baseline) | $\big(\sum_{t'=t}^{H}\gamma^{t'-t}r(s_{t'},a_{t'})\big)-b_t$ | 无 | 高 |
| PG + 状态相关 baseline | $\big(\sum_{t'=t}^{H}\gamma^{t'-t}r(s_{t'},a_{t'})\big)-\hat V^\pi_\phi(s_t)$ | 无 | 中(baseline 更贴近回报) |
第三行是个非常有意思的位置:它用了 critic,却没有引入任何偏差。原因是 critic 只出现在 baseline 的位置,而 baseline 的无偏性对任意只依赖状态的函数都成立——哪怕这个函数学得一塌糊涂。学得越准,方差降得越多;学得不准,最多是白干,绝不会把梯度带偏。这是一个「只赚不赔」的用法。
5.3 证明:状态相关的 baseline 不引入偏差
要证的是:对任意只依赖状态的函数 $b(s_t)$(可以是 $\hat V^\pi_\phi$,也可以是任何别的东西,只要不依赖 $a_t$),有
$$ \E_{\tau\sim p_\theta(\tau)}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\,b(s_t)\big]=0 . $$第一步:先对 $a_t$ 求条件期望。 用全期望公式,把对整条轨迹的期望拆成「先对 $s_t$,再对 $a_t$,再对其余部分」。由于被求期望的量只依赖 $(s_t,a_t)$,其余部分积掉后剩下
$$ \E_{\tau}\big[g_t\, b(s_t)\big] =\E_{s_t\sim p_\theta(s_t)}\Big[\ \E_{a_t\sim\pi_\theta(a_t|s_t)}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\big]\cdot b(s_t)\Big]. $$这里把 $b(s_t)$ 提到内层期望外面是合法的——正因为它不依赖 $a_t$。这一步就是整个证明的全部要害。
第二步:内层期望恒为零。 用 log-derivative 恒等式 $\pi\nabla\log\pi=\nabla\pi$ 反向走一遍:
$$ \E_{a_t\sim\pi_\theta}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)\big] =\int \pi_\theta(a_t|s_t)\,\nabla_\theta\log\pi_\theta(a_t|s_t)\,\mathrm{d}a_t =\int \nabla_\theta \pi_\theta(a_t|s_t)\,\mathrm{d}a_t . $$交换积分与求导(对神经网络这类光滑参数化是允许的),
$$ =\nabla_\theta\int \pi_\theta(a_t|s_t)\,\mathrm{d}a_t=\nabla_\theta 1 = 0 . $$第三步:合并。 内层为 $0$,整体就是 $0$。$\square$
值得注意的是,这个证明只用到了「$b$ 与 $a_t$ 无关」。它没有要求 $b$ 是常数、没有要求 $b$ 准确、也没有要求 $b$ 与 $\theta$ 无关(只要 $b$ 是用其他数据估计出来的、与当前这个 $a_t$ 样本独立即可——实践中我们从同一批数据里拟合 $\hat V_\phi$,严格说会带来一点点相关性,但影响极小,大家都这么干)。
反过来也说明了为什么 actor-critic 那一行是有偏的:那里 $\hat V^\pi_\phi(s_{t+1})$ 出现在被减数的位置上,它替换的是「未来的真实回报」,而这一项本来就依赖于 $a_t$($a_t$ 决定了会到哪个 $s_{t+1}$)。$\hat V^\pi_\phi$ 一旦有误差,这个误差就直接进入梯度的期望,无法被抵消。
考虑一个奖励全为正的环境,某状态下三个动作的 reward-to-go 分别是 $98,100,102$。不减 baseline 时,三个动作的梯度权重都是接近 $100$ 的大正数,梯度向量 $\sum_a g_a\cdot 100$ 主要由「$100$ 这个公共分量乘以随机采到哪个动作」决定,信号($\pm 2$ 的差异)淹没在噪声里。减去 $\hat V\approx 100$ 之后,权重变成 $-2,0,+2$,梯度的量级降了 50 倍,而方向信息完全保留。这就是为什么「baseline 越贴近真实回报,方差越低」——它扣掉的正是那个不携带信息的公共分量。
6. n-step return 与 GAE:把偏差-方差变成一个旋钮
6.1 在哪里「切一刀」
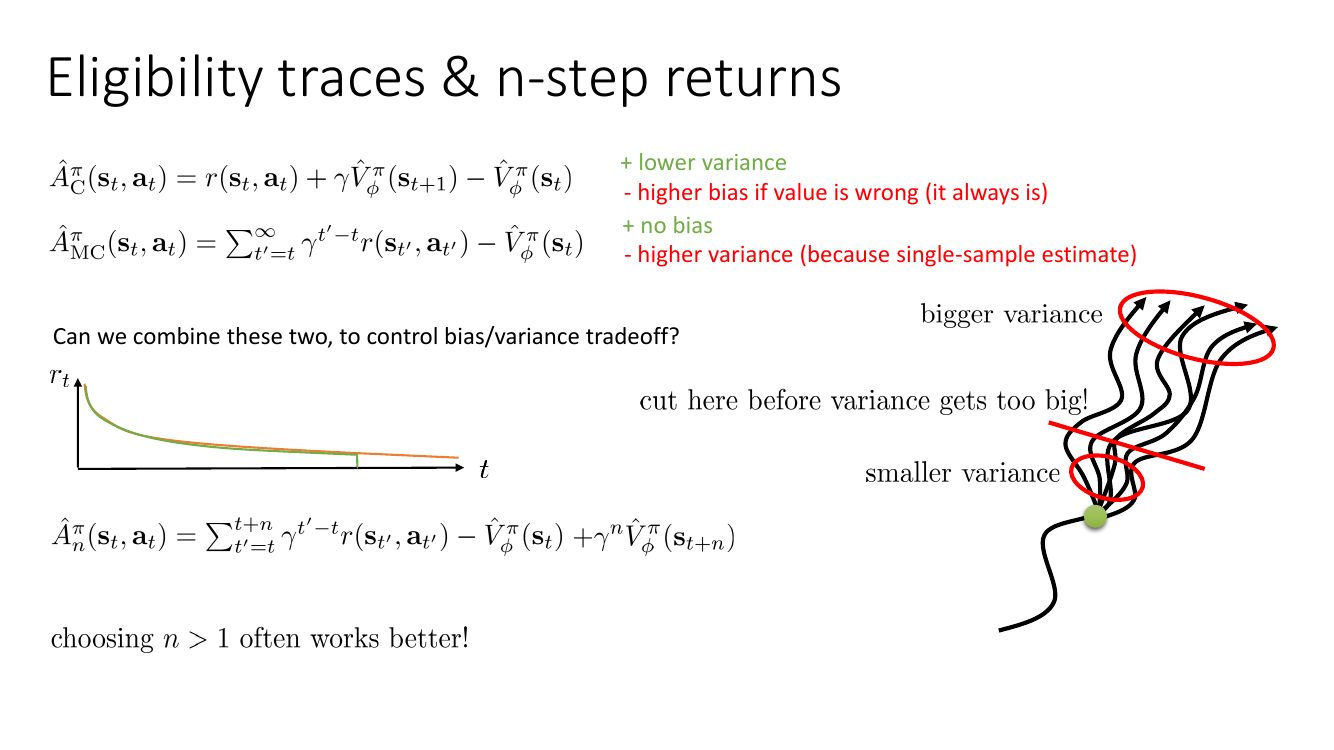
把两个极端写在一起:
$$ \hat A^\pi_{\mathrm{C}}(s_t,a_t)=r(s_t,a_t)+\gamma\hat V^\pi_\phi(s_{t+1})-\hat V^\pi_\phi(s_t), $$ $$ \hat A^\pi_{\mathrm{MC}}(s_t,a_t)=\sum_{t'=t}^{\infty}\gamma^{\,t'-t}r(s_{t'},a_{t'})-\hat V^\pi_\phi(s_t). $$第一个只信任一步真实奖励,之后全部交给 critic;第二个信任全部真实奖励,critic 只当 baseline。自然的折中是:信任前 $n$ 步真实奖励,第 $n$ 步之后交给 critic。这就是 n-step return 优势:
$$ \hat A^\pi_n(s_t,a_t)=\sum_{t'=t}^{t+n-1}\gamma^{\,t'-t}r(s_{t'},a_{t'})\ +\ \gamma^{\,n}\hat V^\pi_\phi(s_{t+n})\ -\ \hat V^\pi_\phi(s_t). $$三项的含义依次是:前 $n$ 步的真实折扣奖励、第 $n$ 步之后的估计值(打 $\gamma^n$ 的折扣)、以及作为 baseline 的当前值。令 $n=1$ 退化为 $\hat A^\pi_{\mathrm{C}}$,令 $n\to\infty$ 退化为 $\hat A^\pi_{\mathrm{MC}}$。
右图的轨迹束在近处很紧、在远处发散,这是因为随机性是累积的:走一步的不确定性小,走一百步的不确定性大。所以「用真实样本」在近处几乎不花方差代价,在远处代价高昂。反过来,critic 的偏差在近处影响小(只占一步权重),在远处影响大——但远处的一切都被 $\gamma^n$ 压缩了。综合起来,最优的切点在中间某处。经验上 $n$ 取 $5\sim 20$ 对大多数任务都不错。注意 $\gamma^n$ 这个因子同时压制了 critic 偏差和 critic 方差的贡献,所以 $n$ 稍大一点是相当安全的。
6.2 GAE:不用选 n,全都要
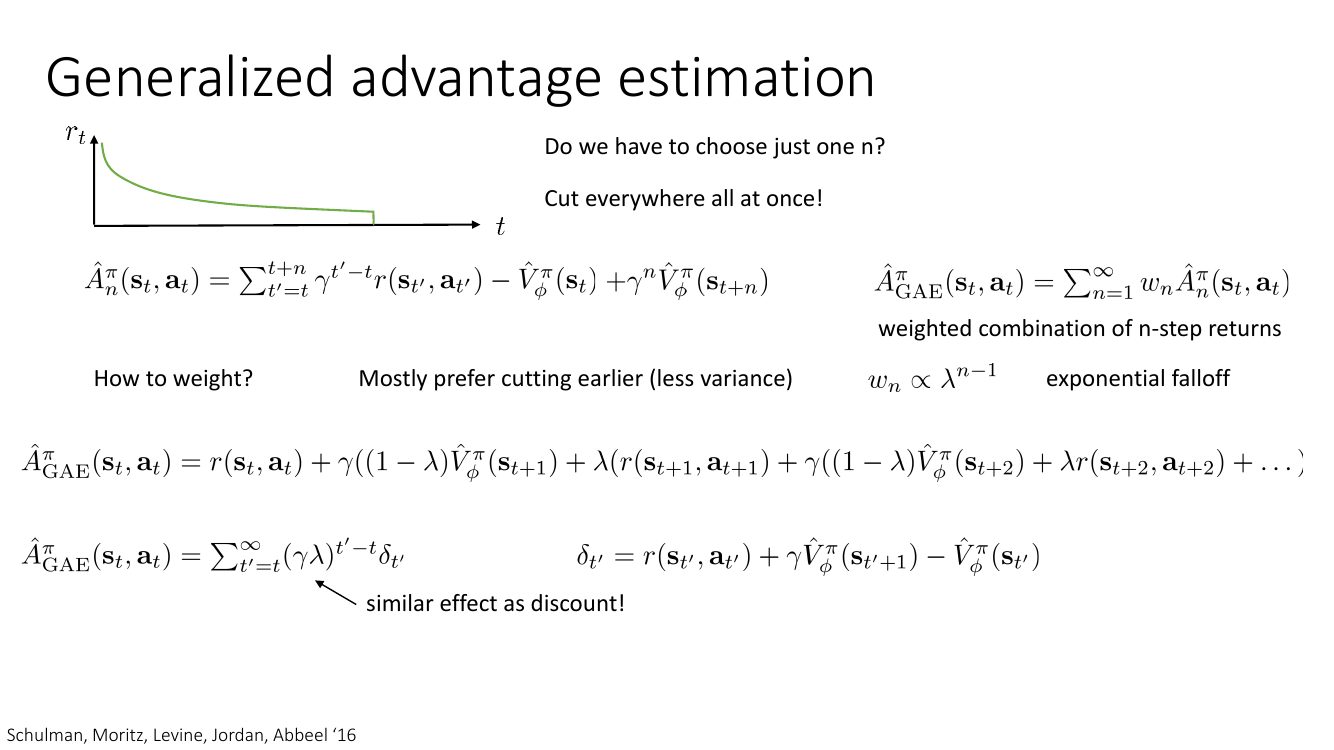
选 $n$ 是个超参数搜索问题,而且不同状态的最优 $n$ 未必一样。广义优势估计(Generalized Advantage Estimation, GAE)的想法是干脆不选:把所有 $n$ 的 n-step 优势加权平均起来。
$$ \hat A^\pi_{\mathrm{GAE}}(s_t,a_t)=\sum_{n=1}^{\infty}w_n\,\hat A^\pi_n(s_t,a_t),\qquad \sum_n w_n=1 . $$权重怎么选?既然「早点切」方差更小,那就让权重随 $n$ 指数衰减:
$$ w_n\propto \lambda^{\,n-1},\qquad \lambda\in[0,1] . $$归一化系数是 $(1-\lambda)$,即 $w_n=(1-\lambda)\lambda^{n-1}$(几何分布)。$\lambda=0$ 时只保留 $n=1$(纯 critic);$\lambda\to 1$ 时权重趋于均匀并把质量推向大 $n$(纯蒙特卡洛)。
6.3 化简:为什么会得到 TD 误差的指数加权和
第一步:把 n-step 优势写成 TD 误差之和。 定义单步 TD 误差(temporal difference error)
$$ \delta_{t}=r(s_{t},a_{t})+\gamma\hat V^\pi_\phi(s_{t+1})-\hat V^\pi_\phi(s_{t}). $$断言:$\hat A^\pi_n(s_t,a_t)=\sum_{l=0}^{n-1}\gamma^{\,l}\delta_{t+l}$。验证方法是把右边展开,看中间项如何抵消(望远镜求和):
$$ \begin{aligned} \sum_{l=0}^{n-1}\gamma^{l}\delta_{t+l} &=\sum_{l=0}^{n-1}\gamma^{l}\Big(r_{t+l}+\gamma\hat V_\phi(s_{t+l+1})-\hat V_\phi(s_{t+l})\Big)\\ &=\sum_{l=0}^{n-1}\gamma^{l}r_{t+l} +\sum_{l=0}^{n-1}\gamma^{l+1}\hat V_\phi(s_{t+l+1}) -\sum_{l=0}^{n-1}\gamma^{l}\hat V_\phi(s_{t+l}). \end{aligned} $$后两个和式里,第二个和的第 $l$ 项 $\gamma^{l+1}\hat V_\phi(s_{t+l+1})$ 与第三个和的第 $l+1$ 项 $\gamma^{l+1}\hat V_\phi(s_{t+l+1})$ 完全相同,逐项抵消。只剩下第二个和的最后一项 $\gamma^{n}\hat V_\phi(s_{t+n})$ 和第三个和的第一项 $-\hat V_\phi(s_t)$。于是
$$ \sum_{l=0}^{n-1}\gamma^{l}\delta_{t+l}=\sum_{l=0}^{n-1}\gamma^{l}r_{t+l}+\gamma^{n}\hat V_\phi(s_{t+n})-\hat V_\phi(s_t)=\hat A^\pi_n(s_t,a_t).\ \checkmark $$第二步:代入加权和并交换求和次序。
$$ \hat A^\pi_{\mathrm{GAE}}=\sum_{n=1}^{\infty}(1-\lambda)\lambda^{\,n-1}\sum_{l=0}^{n-1}\gamma^{l}\delta_{t+l} =(1-\lambda)\sum_{l=0}^{\infty}\gamma^{l}\delta_{t+l}\sum_{n=l+1}^{\infty}\lambda^{\,n-1}. $$(交换次序时注意约束是 $l\le n-1$,即 $n\ge l+1$。)
第三步:算内层几何级数。
$$ \sum_{n=l+1}^{\infty}\lambda^{\,n-1}=\lambda^{l}+\lambda^{l+1}+\cdots=\frac{\lambda^{l}}{1-\lambda}. $$第四步:合并。 $(1-\lambda)$ 与 $\frac{1}{1-\lambda}$ 抵消:
$$ \boxed{\ \hat A^\pi_{\mathrm{GAE}}(s_t,a_t)=\sum_{l=0}^{\infty}(\gamma\lambda)^{l}\,\delta_{t+l} =\sum_{t'=t}^{\infty}(\gamma\lambda)^{\,t'-t}\,\delta_{t'}\ } $$整个「所有 n-step 的指数加权组合」塌缩成了一行:TD 误差按 $\gamma\lambda$ 指数加权求和。$\square$
这个结果有几个值得反复品味的地方:
- $\lambda$ 和 $\gamma$ 在公式里以乘积 $\gamma\lambda$ 出现,所以幻灯片上那句「similar effect as discount!」是字面意义上的:调小 $\lambda$ 与调小 $\gamma$ 对优势估计的影响形式完全一样,都是缩短有效视界、降低方差、引入偏差。区别在于 $\gamma$ 同时改变了我们优化的目标(它出现在 $\delta$ 的定义里、也定义了 $V^\pi$ 是什么),而 $\lambda$ 只影响估计量,不改变目标。所以 $\lambda$ 是一个更「干净」的方差旋钮:可以放心把 $\gamma$ 设成 $0.99$ 来定义任务,再用 $\lambda=0.95$ 单独控制估计噪声。
- $\lambda=0$:只剩 $l=0$ 项,$\hat A=\delta_t$,就是最基本的 actor-critic(最低方差、最大偏差)。$\lambda=1$:$\hat A=\sum_l\gamma^l\delta_{t+l}$,望远镜全部抵消后正好是 $\sum_{t'\ge t}\gamma^{t'-t}r_{t'}-\hat V_\phi(s_t)$,即蒙特卡洛优势(无偏、最大方差)。
- 常用取值是 $\lambda\in[0.9,0.99]$,其中 $0.95$ 是最常见的默认值(PPO 原论文用的就是 $\gamma=0.99,\lambda=0.95$)。以 $\gamma\lambda=0.99\times0.95\approx0.94$ 计,有效视界约 $1/(1-0.94)\approx 17$ 步——和 §6.1 里 n-step 的经验值 $5\sim 20$ 完全吻合。
- 计算极其便宜:从轨迹末尾往前做一次线性扫描即可,$\hat A_t = \delta_t+\gamma\lambda\hat A_{t+1}$。这个递推式直接由上面的求和形式得到。
6.4 用 GAE 的策略梯度算法与优势标准化
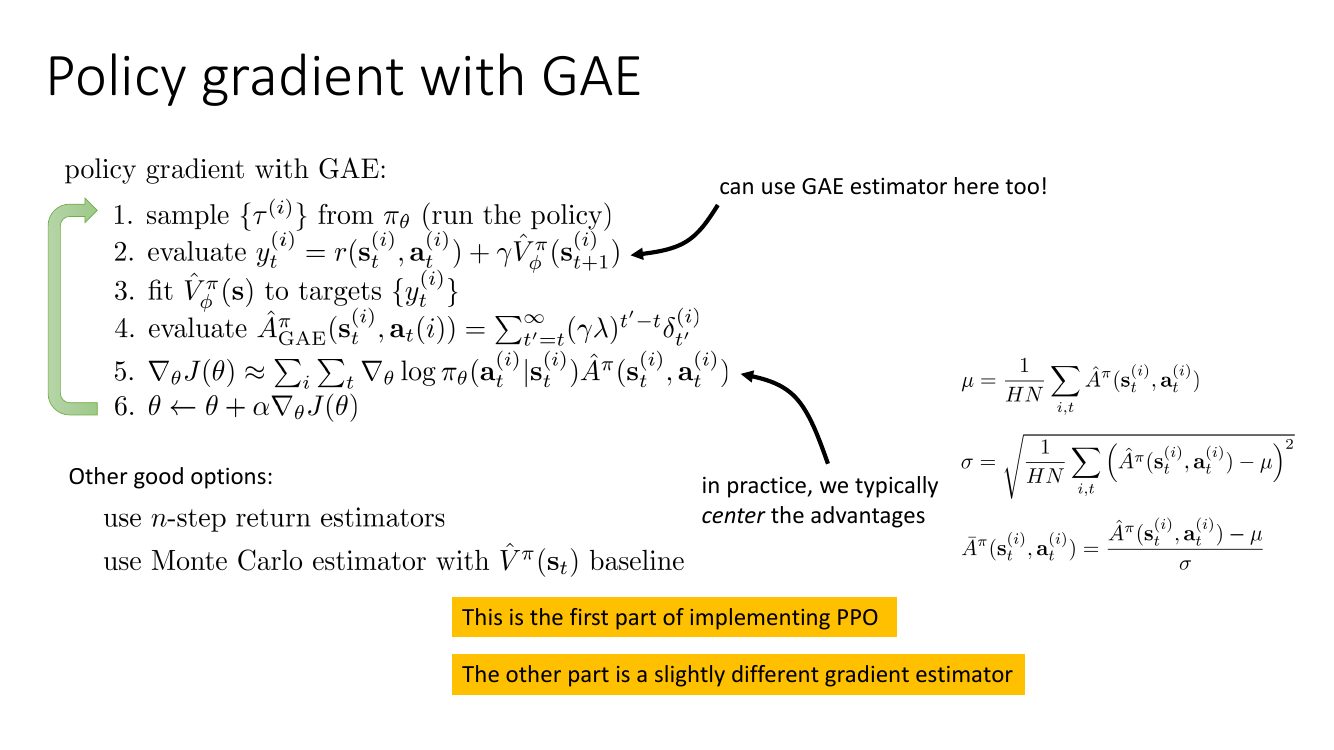
完整算法:
- 用 $\pi_\theta$ 采样一批轨迹 $\{\tau^{(i)}\}$;
- 算值函数回归目标 $y_t^{(i)}=r(s_t^{(i)},a_t^{(i)})+\gamma\hat V^\pi_\phi(s_{t+1}^{(i)})$(也可以用 $\lambda$-return 作为目标,即 $\hat V_\phi(s_t)+\hat A^{\mathrm{GAE}}_t$);
- 把 $\hat V^\pi_\phi$ 拟合到 $\{y_t^{(i)}\}$;
- 算 $\hat A^\pi_{\mathrm{GAE}}(s_t^{(i)},a_t^{(i)})=\sum_{t'\ge t}(\gamma\lambda)^{t'-t}\delta_{t'}^{(i)}$;
- $\nabla_\theta J(\theta)\approx\sum_i\sum_t\nabla_\theta\log\pi_\theta(a_t^{(i)}|s_t^{(i)})\,\bar A(s_t^{(i)},a_t^{(i)})$;
- $\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$。
第 5 步用的是标准化后的优势:
$$ \mu=\frac{1}{HN}\sum_{i,t}\hat A^\pi(s_t^{(i)},a_t^{(i)}),\qquad \sigma=\sqrt{\frac{1}{HN}\sum_{i,t}\big(\hat A^\pi(s_t^{(i)},a_t^{(i)})-\mu\big)^2}, $$ $$ \bar A^\pi(s_t^{(i)},a_t^{(i)})=\frac{\hat A^\pi(s_t^{(i)},a_t^{(i)})-\mu}{\sigma}. $$减去 $\mu$ 是一个(近似的)常数 baseline,理论上无偏;除以 $\sigma$ 严格来说改变了梯度的大小(相当于自适应地缩放学习率),但不改变方向。这在实践中是必备操作:它让同一套超参数能跨越奖励量级差好几个数量级的任务,也让训练早期(优势尺度大)和后期(优势尺度小)的有效步长保持一致。
做到这一步,你已经写出了 PPO 的一半。PPO = 「GAE 优势估计 + 优势标准化」 + 「重要性采样比与裁剪目标,允许在同一批数据上做多轮更新」。前一半是本讲内容,后一半留给后面的讲次。这也说明为什么本讲的标题里 Levine 写着「policy gradient that actually works」。
7. Off-policy actor-critic:给它接上 replay buffer
7.1 天真的做法为什么是错的
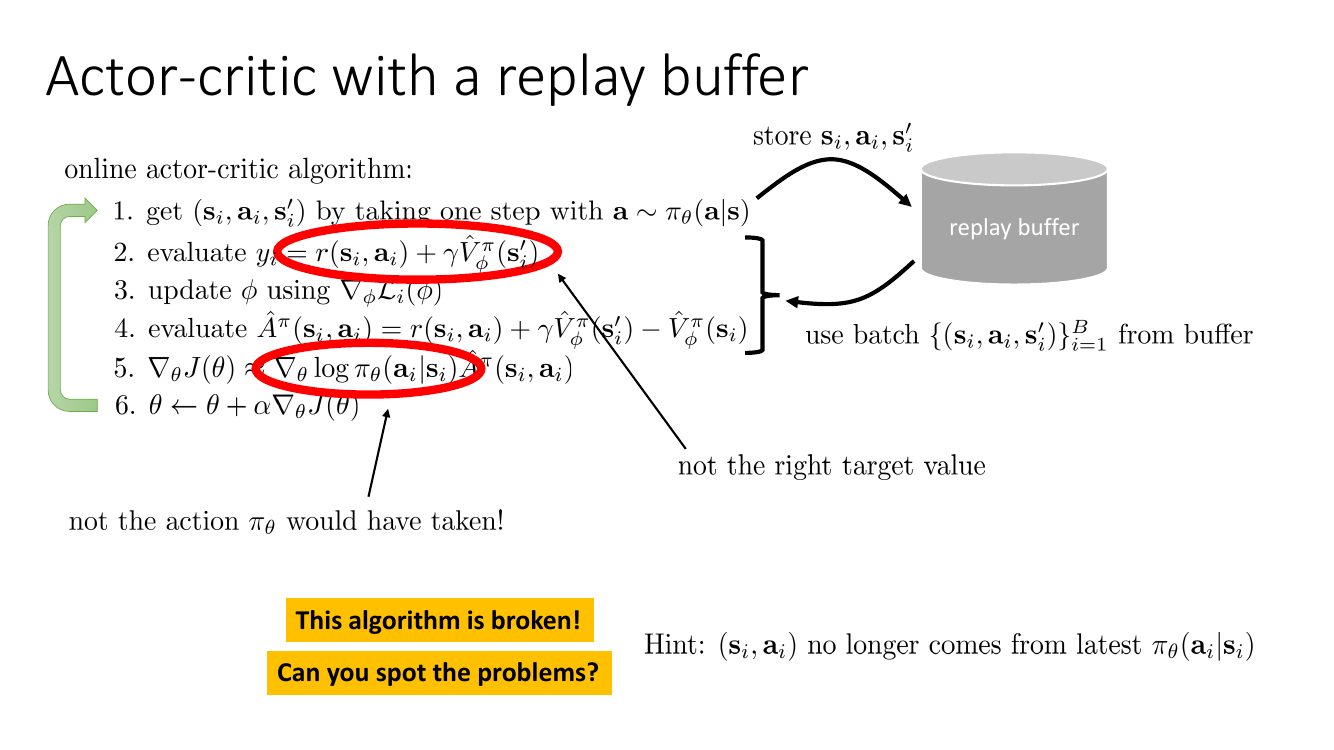
在线 actor-critic 的样本效率极低:每条转移只用一次就扔掉。深度学习的本能反应是加一个 replay buffer(经验回放池):把走过的转移都存起来,每次训练从池子里随机抽一个 batch。这既解决了「batch size 只有 1」的问题,也解决了「连续样本高度相关」的问题,还能把每条数据反复利用。
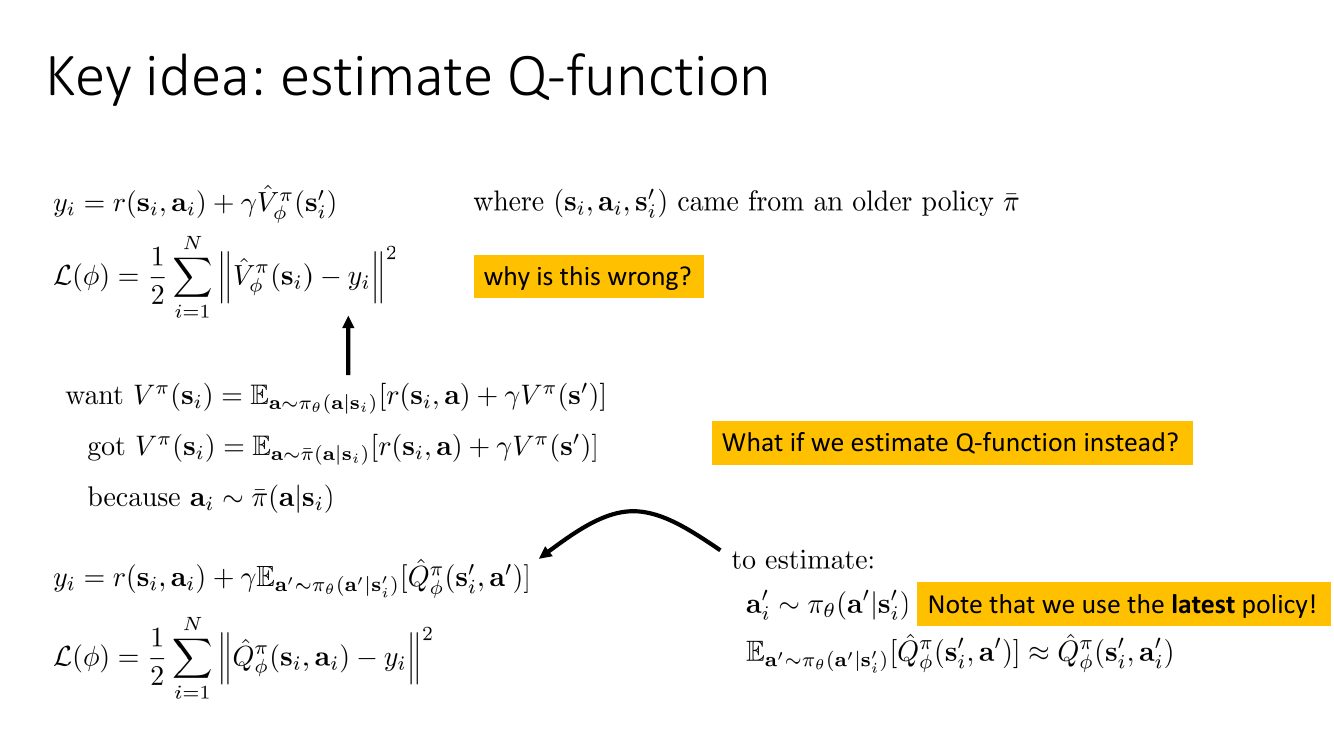
但直接这么做是错的,而且错在两个不同的地方。设 buffer 里的数据来自某个较旧的策略 $\bar\pi$:
- critic 的目标错了。 我们想学的是 $V^\pi$,即当前策略的值函数,它满足 $V^\pi(s)=\E_{a\sim\pi_\theta(a|s)}\big[r(s,a)+\gamma V^\pi(s')\big]$。但 buffer 里的 $a_i$ 是 $\bar\pi$ 采的,用它算出来的目标对应的是 $\E_{a\sim\bar\pi(a|s)}[r(s,a)+\gamma V^\pi(s')]$——这是旧策略的值函数,不是我们要的。
- actor 的梯度错了。 策略梯度公式 $\E_{a\sim\pi_\theta}[\nabla_\theta\log\pi_\theta(a|s)\hat A(s,a)]$ 要求动作从当前策略采样。buffer 里的 $a_i$ 不是当前策略会选的动作,这个期望的采样分布不对。
7.2 第一处修补:把 critic 从 V 换成 Q
第一个错误的根源是:$V^\pi(s)$ 的定义里,「第一步的动作」是由策略决定的,所以数据里的动作必须来自当前策略。而 $Q^\pi(s,a)$ 的定义里,第一步的动作是作为输入给定的:
$$ Q^\pi(s,a)=r(s,a)+\gamma\,\E_{s'\sim p(s'|s,a)}\big[V^\pi(s')\big] = r(s,a)+\gamma\,\E_{s'}\Big[\E_{a'\sim\pi_\theta(a'|s')}\big[Q^\pi(s',a')\big]\Big]. $$这个式子里对 $(s,a)$ 没有任何分布假设——它对任意 $(s,a)$ 都成立。所以 buffer 里的 $(s_i,a_i,s_i')$ 无论来自哪个策略都能用:$s_i'$ 是环境按 $p(s'|s_i,a_i)$ 给的,这与策略无关。唯一需要来自当前策略的是 $a'$——而它我们可以自己现场采,因为采样动作不需要与环境交互,只要跑一次策略网络的前向:
$$ a_i'\sim\pi_\theta(a'|s_i'),\qquad y_i=r(s_i,a_i)+\gamma\,\hat Q^\pi_\phi(s_i',a_i'),\qquad \mathcal{L}(\phi)=\frac{1}{2}\sum_i\big\|\hat Q^\pi_\phi(s_i,a_i)-y_i\big\|^2 . $$这就是「用最新策略」的含义:$a_i'$ 永远由当前的 $\pi_\theta$ 产生,所以学出来的是当前策略的 $Q^\pi$,而不是旧策略的。代价是 critic 的输入从 $s$ 变成了 $(s,a)$,学起来更难一些——这是为拿到 off-policy 能力付的学费。
7.3 第二处修补:actor 用的动作要重新采
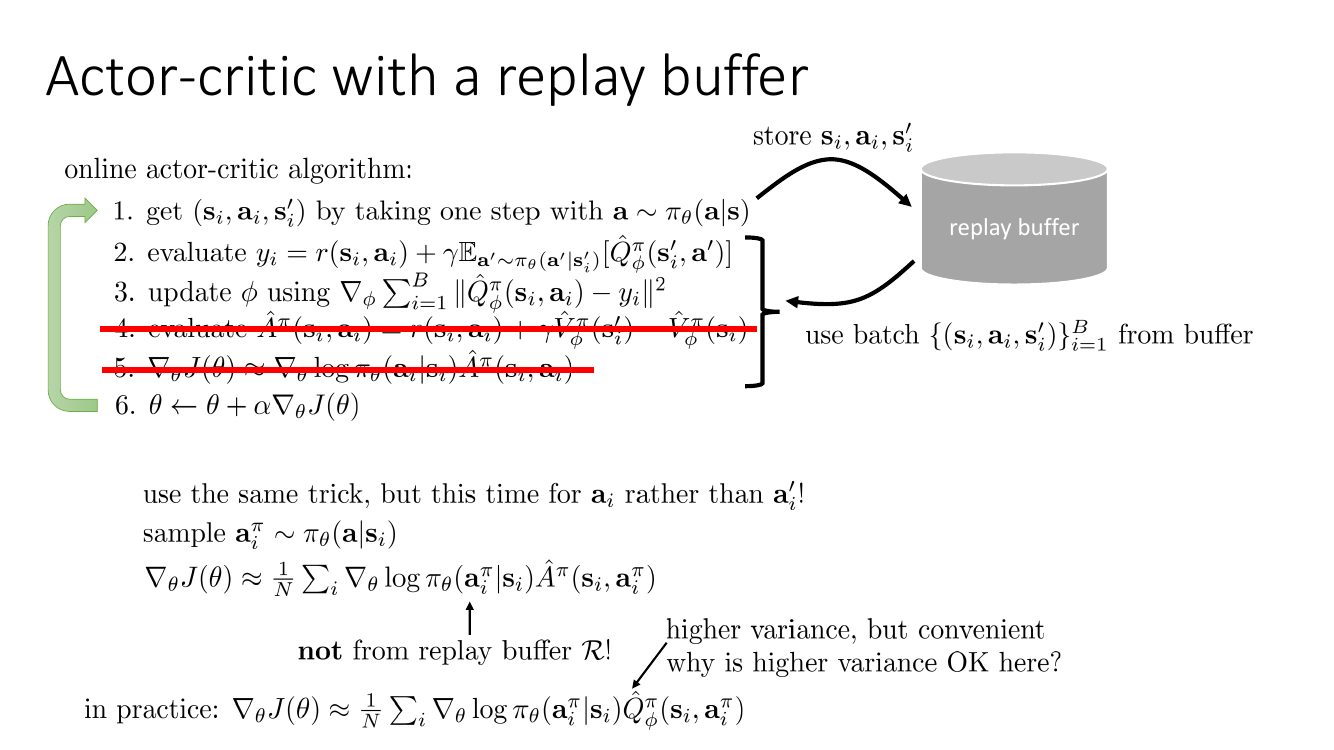
同样的技巧用在 actor 侧:既然采样动作不需要与环境交互,那就对 buffer 里的每个状态 $s_i$,重新从当前策略采一个动作 $a_i^\pi\sim\pi_\theta(a|s_i)$,然后
$$ \nabla_\theta J(\theta)\approx\frac{1}{N}\sum_i\nabla_\theta\log\pi_\theta(a_i^\pi|s_i)\,\hat Q^\pi_\phi(s_i,a_i^\pi). $$注意这里直接用了 $\hat Q^\pi_\phi$ 而不是优势 $\hat Q-\hat V$。这确实方差更高(没有减 baseline),但方便——我们只有 $Q$ 网络,没有 $V$ 网络。幻灯片留下的问题「为什么这里高方差是可以接受的?」答案是:因为我们可以对同一个 $s_i$ 采任意多个动作而不花任何环境交互成本。想降方差就多采几个 $a^\pi$ 求平均,或者用 $\hat V_\phi(s_i)\approx\frac{1}{M}\sum_{m}\hat Q_\phi(s_i,a^{\pi,m}_i)$ 现算一个 baseline。在 on-policy 情形下你做不到这一点(每个动作都必须真的执行),但 off-policy + Q 函数让「重复采样动作」变成了免费操作。
7.4 剩下那个改不掉的问题:状态分布
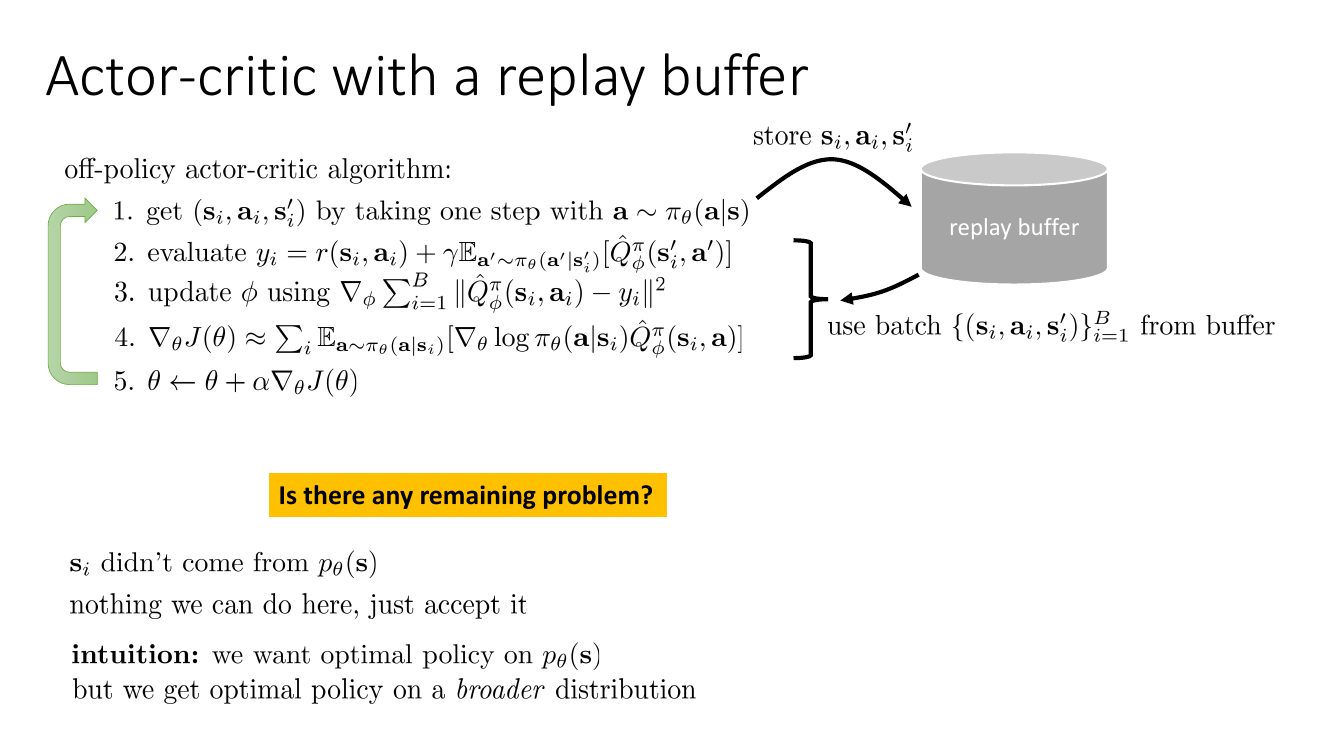
修完两处之后还有第三个偏差:$s_i$ 不来自当前策略的状态分布 $p_\theta(s)$。我们能重新采动作,却不能重新采状态——状态是环境交互的产物,要想按 $p_\theta(s)$ 采状态就必须用当前策略真的跑一遍,那 replay buffer 就白搭了。
Levine 对此的态度很干脆:「nothing we can do here, just accept it」。并给出一个安慰性的直觉:我们本来想要「在 $p_\theta(s)$ 上表现最优的策略」,现在得到的是「在一个更宽的状态分布(历史上所有策略访问过的状态的混合)上表现最优的策略」。这个策略在我们真正关心的那部分状态上通常也不差——只是我们浪费了一些容量去优化那些当前策略根本不会去的地方。在后面的离线 RL 讲次里会看到,当这个分布偏移变得极端时(数据全部来自完全不同的策略),它会从「可以接受」变成「致命」。
7.5 重参数化技巧:绕开对数概率
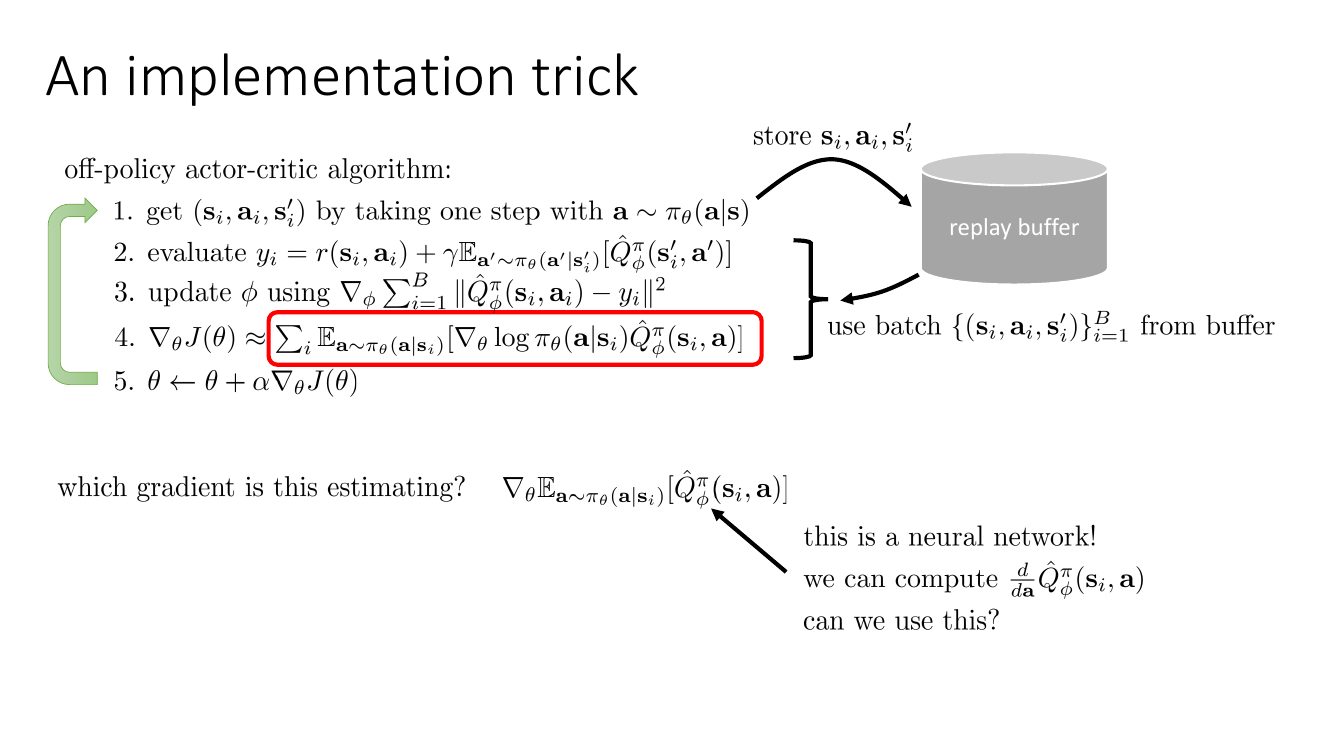
先看清楚我们在优化什么。第 4 步的梯度
$$ \sum_i\E_{a\sim\pi_\theta(a|s_i)}\big[\nabla_\theta\log\pi_\theta(a|s_i)\,\hat Q^\pi_\phi(s_i,a)\big] =\sum_i\nabla_\theta\,\E_{a\sim\pi_\theta(a|s_i)}\big[\hat Q^\pi_\phi(s_i,a)\big], $$目标就是「让策略在每个状态下选出 Q 值高的动作」。这是一个很朴素的目标。而 log-derivative(也叫 REINFORCE / score function)估计量只是计算这个梯度的一种方法——它把 $\hat Q_\phi$ 当成一个黑箱,只用它的取值。可是 $\hat Q_\phi$ 明明是一个可微的神经网络,我们完全可以对它的输入 $a$ 求导!
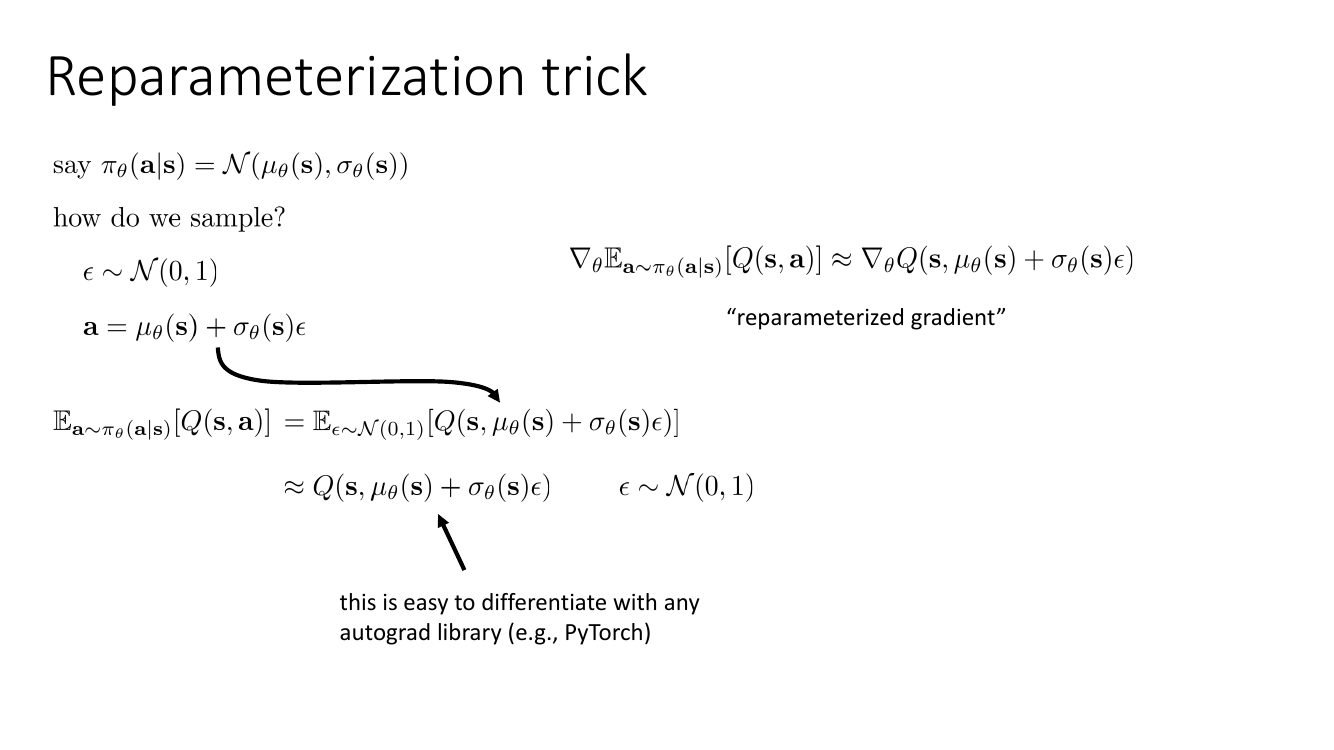
重参数化技巧(reparameterization trick)的关键观察:高斯采样可以拆成「确定性变换 + 与参数无关的噪声」。设 $\pi_\theta(a|s)=\mathcal{N}(\mu_\theta(s),\sigma_\theta(s))$,则
$$ \epsilon\sim\mathcal{N}(0,1),\qquad a=\mu_\theta(s)+\sigma_\theta(s)\,\epsilon $$与直接从 $\pi_\theta$ 采样等价。因此
$$ \E_{a\sim\pi_\theta(a|s)}\big[Q(s,a)\big] =\E_{\epsilon\sim\mathcal{N}(0,1)}\big[Q\big(s,\mu_\theta(s)+\sigma_\theta(s)\epsilon\big)\big] \approx Q\big(s,\mu_\theta(s)+\sigma_\theta(s)\epsilon\big), $$而右边这个式子里 $\theta$ 出现在可微函数的内部,autograd 直接就能求导:
$$ \nabla_\theta\,\E_{a\sim\pi_\theta(a|s)}\big[Q(s,a)\big]\approx\nabla_\theta\,Q\big(s,\mu_\theta(s)+\sigma_\theta(s)\epsilon\big) =\frac{\partial Q}{\partial a}\Big(\frac{\partial\mu_\theta}{\partial\theta}+\epsilon\frac{\partial\sigma_\theta}{\partial\theta}\Big). $$score function 估计量只知道「这个动作得了 8 分」,它靠比较不同随机动作的分数来推断该往哪走——本质上是零阶(数值差分式)的搜索。重参数化梯度知道「往这个方向挪动动作,分数会上升」,它直接读取了 $Q$ 网络关于动作的一阶导数信息。低维连续动作空间下方差可以低一两个数量级。代价是:它要求动作空间连续且策略可重参数化(高斯可以,离散分类分布不行),并且需要 $Q$ 对 $a$ 可导——所以离散动作的 RL 用不了它。
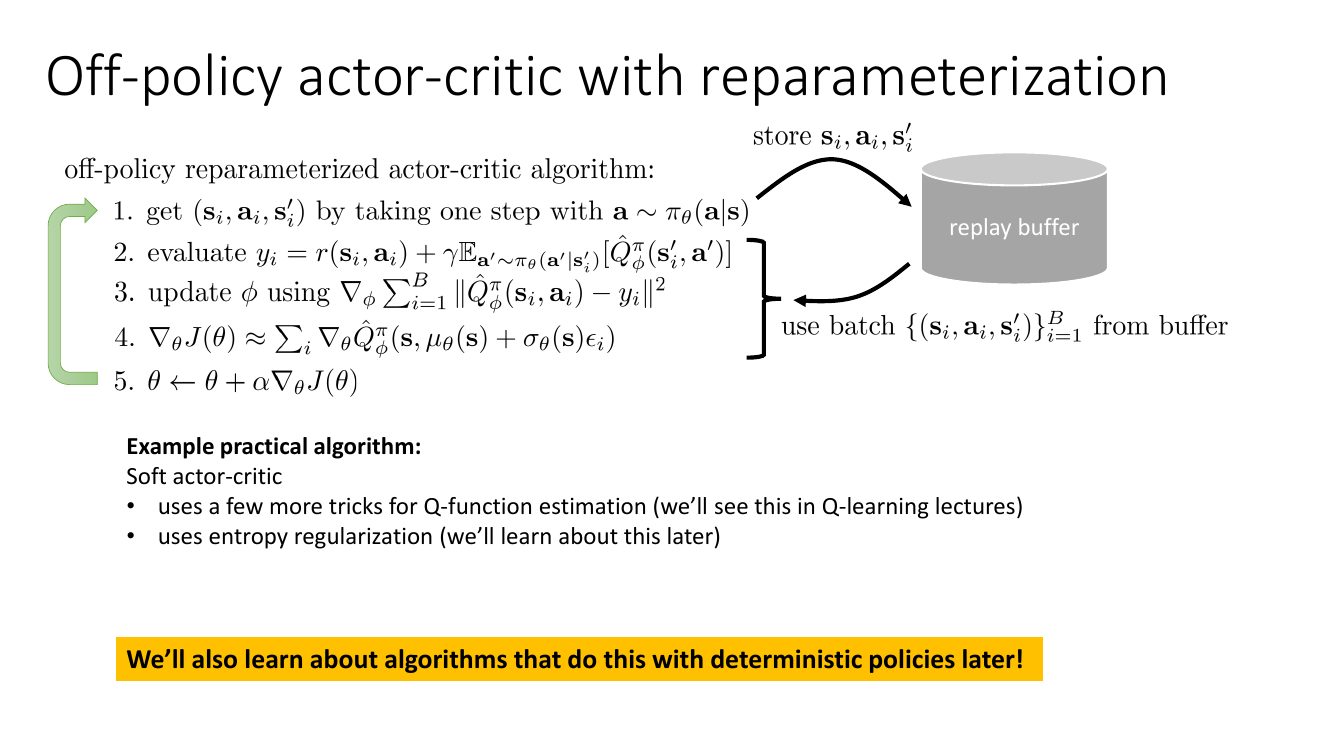
把所有修补装配起来,得到带重参数化的 off-policy actor-critic:
- 用 $a\sim\pi_\theta(a|s)$ 走一步,把 $(s_i,a_i,r_i,s_i')$ 存入 replay buffer $\mathcal{R}$;
- 从 $\mathcal{R}$ 抽一个 batch,采 $a_i'\sim\pi_\theta(a'|s_i')$,算目标 $y_i=r(s_i,a_i)+\gamma\hat Q^\pi_\phi(s_i',a_i')$;
- 用 $\nabla_\phi\sum_i\|\hat Q^\pi_\phi(s_i,a_i)-y_i\|^2$ 更新 $\phi$;
- 采 $\epsilon_i\sim\mathcal{N}(0,1)$,用 $\nabla_\theta\sum_i \hat Q^\pi_\phi\big(s_i,\mu_\theta(s_i)+\sigma_\theta(s_i)\epsilon_i\big)$ 更新 $\theta$;
- 回到第 1 步。
| On-policy AC(§4–6) | Off-policy AC(§7) | |
|---|---|---|
| critic 学什么 | $V^\pi(s)$ | $Q^\pi(s,a)$ |
| 数据来源 | 当前策略刚采的一批 | replay buffer(历史所有策略) |
| 优势估计 | 可用 n-step / GAE | 只能用 1 步自举(多步会引入 off-policy 偏差) |
| actor 梯度 | $\nabla\log\pi\cdot\hat A$ | $\nabla\log\pi\cdot\hat Q$ 或重参数化梯度 |
| 样本效率 | 低(每条数据用一次) | 高(反复利用) |
| 稳定性 | 较好 | 较差(自举 + off-policy + 函数逼近的「致命三角」) |
| 代表算法 | A2C / A3C / PPO | SAC / DDPG / TD3 |
8. 实现细节与最小可跑代码
8.1 一份 on-policy actor-critic + GAE 的最小实现
下面这段代码把 §4 的算法框、§6 的 GAE 递推和 §6.4 的优势标准化全部串起来。它是可以真正跑通的逻辑(配一个 Gym 连续控制环境即可),只是省略了日志、评估、随机种子等工程外壳。
import torch
import torch.nn as nn


class Actor(nn.Module):
    """高斯策略 pi(a|s) = N(mu_theta(s), diag(exp(log_std)))。
    log_std 做成与状态无关的全局参数,这是连续控制里最常用的做法。"""

    def __init__(self, obs_dim, act_dim, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(obs_dim, hidden), nn.Tanh(),
            nn.Linear(hidden, hidden), nn.Tanh(),
            nn.Linear(hidden, act_dim),
        )
        self.log_std = nn.Parameter(torch.zeros(act_dim))

    def dist(self, obs):
        mu = self.net(obs)
        return torch.distributions.Normal(mu, self.log_std.exp())


class Critic(nn.Module):
    """V_phi(s):输入状态,输出一个标量。"""

    def __init__(self, obs_dim, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(obs_dim, hidden), nn.Tanh(),
            nn.Linear(hidden, hidden), nn.Tanh(),
            nn.Linear(hidden, 1),
        )

    def forward(self, obs):
        return self.net(obs).squeeze(-1)


def compute_gae(rewards, values, dones, last_value, gamma=0.99, lam=0.95):
    """GAE 的反向递推:A_t = delta_t + gamma * lam * A_{t+1}。

    rewards, values, dones : 形状 (T,) 的一维张量
    last_value             : V_phi(s_T),即这一段 rollout 之后的自举值
    返回 (advantages, returns),returns 用作 critic 的回归目标。
    """
    T = rewards.shape[0]
    adv = torch.zeros(T)
    running = torch.zeros(())
    for t in reversed(range(T)):
        next_value = last_value if t == T - 1 else values[t + 1]
        nonterminal = 1.0 - dones[t]                      # 终止状态不自举
        delta = rewards[t] + gamma * next_value * nonterminal - values[t]
        running = delta + gamma * lam * nonterminal * running
        adv[t] = running
    returns = adv + values          # lambda-return = A^GAE + V(s)
    return adv, returns


def update(actor, critic, opt_a, opt_c, obs, act, adv, ret, n_critic_steps=8):
    # --- actor:伪损失,只有梯度有意义,数值本身没有意义 ---
    adv = (adv - adv.mean()) / (adv.std() + 1e-8)         # 优势标准化
    logp = actor.dist(obs).log_prob(act).sum(dim=-1)      # 各维独立,log 概率相加
    actor_loss = -(logp * adv).mean()                    # 取负号是因为要做梯度上升
    opt_a.zero_grad()
    actor_loss.backward()
    nn.utils.clip_grad_norm_(actor.parameters(), 0.5)    # 梯度裁剪,防单批数据把策略打飞
    opt_a.step()

    # --- critic:普通的平方误差回归,目标已 detach ---
    for _ in range(n_critic_steps):
        critic_loss = ((critic(obs) - ret) ** 2).mean()
        opt_c.zero_grad()
        critic_loss.backward()
        opt_c.step()
配套的采样与主循环(以 Gym 接口为例):
def collect_rollout(env, actor, critic, n_steps=2048):
    obs_buf, act_buf, rew_buf, done_buf, val_buf = [], [], [], [], []
    obs, _ = env.reset()
    for _ in range(n_steps):
        obs_t = torch.as_tensor(obs, dtype=torch.float32)
        with torch.no_grad():
            dist = actor.dist(obs_t)
            action = dist.sample()
            value = critic(obs_t)
        nxt, rew, terminated, truncated, _ = env.step(action.numpy())

        obs_buf.append(obs_t)
        act_buf.append(action)
        rew_buf.append(float(rew))
        val_buf.append(value)
        # 注意:只有"真正终止"才算 done;因超时被截断时仍应自举
        done_buf.append(float(terminated))

        obs = nxt
        if terminated or truncated:
            obs, _ = env.reset()

    with torch.no_grad():
        last_value = critic(torch.as_tensor(obs, dtype=torch.float32))
    return (torch.stack(obs_buf), torch.stack(act_buf),
            torch.tensor(rew_buf), torch.tensor(done_buf),
            torch.stack(val_buf), last_value)


env = ...                                    # 任一连续动作环境
actor = Actor(obs_dim, act_dim)
critic = Critic(obs_dim)
opt_a = torch.optim.Adam(actor.parameters(), lr=3e-4)
opt_c = torch.optim.Adam(critic.parameters(), lr=1e-3)

for itr in range(1000):
    obs, act, rew, done, val, last_v = collect_rollout(env, actor, critic)
    adv, ret = compute_gae(rew, val, done, last_v, gamma=0.99, lam=0.95)
    update(actor, critic, opt_a, opt_c, obs, act, adv.detach(), ret.detach())
8.2 off-policy 版本的 actor 更新(重参数化)
§7.5 的重参数化梯度写成代码只有几行,关键是不要 detach 动作——梯度必须能从 $Q$ 网络穿过动作回到策略参数:
def reparam_actor_loss(actor, q_net, obs):
    """off-policy actor 更新:直接最大化 Q(s, a(theta))。"""
    dist = actor.dist(obs)
    action = dist.rsample()        # rsample 而不是 sample:保留计算图(重参数化)
    q_value = q_net(obs, action)   # 梯度经由 action 传回 mu_theta / sigma_theta
    return -q_value.mean()


def q_target(q_net, actor, rew, next_obs, done, gamma=0.99):
    """critic 目标:动作 a' 一定要用最新策略现采,而不是 buffer 里的动作。"""
    with torch.no_grad():
        next_action = actor.dist(next_obs).sample()
        next_q = q_net(next_obs, next_action)
        return rew + gamma * (1.0 - done) * next_q
把 sample() 写成 rsample() 是这段代码里唯一但也是最关键的区别:前者切断梯度(只能配 score function 估计量用),后者保留 $a=\mu_\theta+\sigma_\theta\epsilon$ 这条计算路径,让 autograd 自动算出重参数化梯度。
8.3 实现清单:最容易踩的坑
| 坑 | 症状 | 正确做法 |
|---|---|---|
| 忘记 detach 值函数目标 | critic loss 迅速降到 0,但策略毫无长进 | 目标 $y$ 一律 .detach() 或在 torch.no_grad() 下计算 |
| 终止状态仍然自举 | 值函数在回合末尾发散或塌陷;策略学会「自杀」或「拖时间」 | $y_i=r_i+\gamma(1-\text{done}_i)\hat V_\phi(s_i')$;区分「真终止」与「超时截断」 |
| 把优势也算进反传图 | 梯度含有 $\nabla_\theta \hat A$ 项,公式变味 | on-policy 版本里 advantage 必须 detach |
| 没做优势标准化 | 换个奖励量级就要重调学习率 | 每批数据减均值除标准差(分母加 $10^{-8}$) |
| 共享主干但不加权 loss | critic 收敛、actor 不动 | $\mathcal{L}=\mathcal{L}_a+c_v\mathcal{L}_c$,$c_v\approx0.5$;或改用双网络 |
| critic 学习率与 actor 相同 | critic 跟不上,优势估计常年不准 | critic 学习率通常取 actor 的 $2\sim 10$ 倍,或每轮多做几次 critic 更新 |
| on-policy 数据复用多轮 | 训练初期上升然后突然崩掉 | 朴素策略梯度只能用一次;要复用请上 PPO 的裁剪目标 |
| batch size 太小 | 曲线剧烈震荡、不可复现 | 并行环境凑大 batch,$2048\sim 16384$ 步是常见量级 |
| 观测未标准化 | 网络输入尺度差几个数量级,训练极慢 | 用运行时均值/方差做 observation normalization |
actor-critic 出问题时,先单独验证 critic:固定策略不更新,只训 critic,看它能否把 $\hat V_\phi(s)$ 拟合到与蒙特卡洛回报接近(可以画 $\hat V_\phi(s_t)$ 与实际 reward-to-go 的散点图,理想情况沿对角线分布)。critic 都学不好的话,调 actor 是没有意义的——因为你的优势估计全是噪声,actor 只是在随机游走。这个「先分模块验证」的习惯在整个深度 RL 里都非常值钱。
本讲小结
一句话:把策略梯度里那个单样本的 reward-to-go 换成学出来的值函数,用可控的偏差换取巨大的方差削减,这就是 actor-critic。
| 概念 | 公式 | 一句话 |
|---|---|---|
| Q 函数 | $Q^\pi(s_t,a_t)=\sum_{t'\ge t}\E_\pi[r_{t'}|s_t,a_t]$ | 期望 reward-to-go |
| V 函数 | $V^\pi(s_t)=\E_{a\sim\pi}[Q^\pi(s_t,a)]$ | 状态的平均水平 |
| 优势 | $A^\pi=Q^\pi-V^\pi$ | 这个动作比平均好多少 |
| Q 由 V 拼出 | $Q^\pi(s,a)=r(s,a)+\gamma\E_{s'}[V^\pi(s')]$ | 所以只学 $V^\pi$ 就够 |
| 蒙特卡洛目标 | $y_t=\sum_{t'\ge t}\gamma^{t'-t}r_{t'}$ | 无偏、方差随视界线性增长 |
| 自举目标 | $y_t=r_t+\gamma\hat V_\phi(s_{t+1})$ | 有偏、方差与视界无关 |
| TD 误差 | $\delta_t=r_t+\gamma\hat V_\phi(s_{t+1})-\hat V_\phi(s_t)$ | 1-step 优势估计 |
| n-step 优势 | $\hat A_n=\sum_{l=0}^{n-1}\gamma^l\delta_{t+l}$ | 在方差爆炸前切一刀 |
| GAE | $\hat A^{\mathrm{GAE}}_t=\sum_{l\ge0}(\gamma\lambda)^l\delta_{t+l}$ | 所有 n 的指数加权组合,$\lambda$ 是偏差-方差旋钮 |
| baseline 无偏性 | $\E_{a\sim\pi}[\nabla_\theta\log\pi_\theta(a|s)b(s)]=0$ | 只要 $b$ 不依赖 $a$,随便怎么烂都不引偏差 |
| 折扣的 MDP 解释 | $\tilde p(s_\dagger|s,a)=1-\gamma$ | 每步 $1-\gamma$ 概率世界末日,有效视界 $\frac{1}{1-\gamma}$ |
| off-policy 修补 | $y_i=r_i+\gamma\hat Q_\phi(s_i',a_i')$,$a_i'\sim\pi_\theta$ | 学 $Q$ 而非 $V$,动作现采 |
| 重参数化梯度 | $\nabla_\theta Q(s,\mu_\theta(s)+\sigma_\theta(s)\epsilon)$ | 利用 $Q$ 对动作的导数,方差远低于 score function |
要点清单:
- 方差的根源是「用一条轨迹估计一个期望」。critic 的全部价值在于把这个期望估出来。
- 只学 $V^\pi$(输入维度最低),$Q^\pi$ 和 $A^\pi$ 都能由它和一步转移拼出来。
- 自举 vs 蒙特卡洛 = 偏差 vs 方差。深度 RL 里视界长,自举几乎总是赢。
- $\gamma$ 既是数学上的死亡概率,也是实践中的方差旋钮;$\gamma$ 放在 $\log\pi$ 前面(option 2)才是折扣目标的真梯度,但大家都用 option 1,因为我们其实想要的是无折扣/平均奖励目标。
- 在线 actor-critic 必须并行化才能跑;同步(A2C)比异步(A3C)更简单也通常更好。
- critic 放在 baseline 位置 → 完全无偏;放在「替换未来回报」的位置 → 有偏但低方差。GAE 用 $\lambda$ 在两者之间连续插值。
- GAE 的推导核心是「n-step 优势 = 前 n 个 TD 误差的折扣和」这个望远镜恒等式。
- 加 replay buffer 需要三处审视:critic 目标(换 $Q$ + 现采 $a'$)、actor 动作(现采 $a^\pi$)、状态分布(无解,接受它)。
- 写完 §6 的算法你就有了 PPO 的一半;写完 §7 你就到了 SAC 的门口。
延伸阅读
核心论文
- High-Dimensional Continuous Control Using Generalized Advantage Estimation (Schulman, Moritz, Levine, Jordan, Abbeel, 2015) — GAE 的原始论文,本讲第 6 节的完整来源。除了 $\hat A^{\mathrm{GAE}}$ 的推导,还给出了「$\gamma$ 与 $\lambda$ 分别控制什么」的实验对比,值得亲自看那几张曲线。
- Asynchronous Methods for Deep Reinforcement Learning (Mnih et al., 2016) — A3C 原论文。异步并行 worker 的具体做法、共享主干网络的架构、以及为什么在当年不用 GPU 也能训 Atari。
- Proximal Policy Optimization Algorithms (Schulman et al., 2017) — PPO。本讲的 GAE + 优势标准化就是它的一半,另一半是裁剪的重要性采样目标。今天绝大多数 on-policy 实现(包括 RLHF)都是它。
- Soft Actor-Critic (Haarnoja et al., 2018) — 第 7 节那条 off-policy 路线的终点:replay buffer + $Q$ 函数 + 重参数化梯度 + 熵正则化,连续控制上的默认强基线。
- Continuous Control with Deep Reinforcement Learning (Lillicrap et al., 2015) — DDPG,用确定性策略做同样的事($\sigma\to 0$ 的极限),第 7 节结尾预告的那类算法。
偏差、方差与折扣的理论
- Bias in Natural Actor-Critic Algorithms (Philip Thomas, 2014) — 严格分析了「option 1 少了 $\gamma^{t-1}$」造成的偏差,是理解 §3.3 的必读文献。
- Learning to Predict by the Methods of Temporal Differences (Sutton, 1988) — TD($\lambda$) 与资格迹(eligibility traces)的源头,GAE 本质上是它在优势估计上的对应物。
- Q-Prop (Gu et al., 2016) — 把 on-policy 无偏梯度与 off-policy critic 结合,用 critic 的一阶泰勒展开做控制变量(control variate),是「既要无偏又要低方差」这条思路的代表。
- Sample Efficient Actor-Critic with Experience Replay / ACER (Wang et al., 2016) — 用截断重要性采样 + Retrace 修正让多步回报也能 off-policy 使用,正好补上 §7 表格里「off-policy 只能 1 步自举」那一格。
历史与实践
- Temporal Difference Learning and TD-Gammon (Tesauro, 1992/1995) — 第 2.5 节那个例子的原文,第一个证明神经网络 + 自举可以在真实任务上达到人类水平的系统。
- Mastering the Game of Go with Deep Neural Networks and Tree Search (Silver et al., 2016) — AlphaGo,值函数网络在稀疏终局奖励下的大规模应用。
- What Matters In On-Policy Reinforcement Learning? (Andrychowicz et al., 2020) — 对 on-policy actor-critic 的几十个实现细节做了大规模消融实验,§8.3 那张坑表里的很多结论都能在这里找到定量证据。