探索与技能学习:没有奖励函数时该学什么
把「探索」写成一个信息论目标:状态边缘熵 $\mathcal{H}(\pi(s))$ 量化覆盖,互信息 $\mathcal{I}(z;s)$ 量化控制力。由此得到 DIAYN、目标条件 RL、Skew-Fit 与 Go-Explore 这一整条无监督预训练路线。
0. 本讲导读
到目前为止,本课程里的每一个算法都以「给定奖励函数 $r(s,a)$」为前提。策略梯度在最大化 $\E_{\tau\sim p_\theta(\tau)}[\sum_t r(s_t,a_t)]$,Q-learning 在拟合 $r + \gamma\max_{a'}Q(s',a')$, model-based 方法在用模型做 $r$ 的规划。奖励是整个体系的输入。本讲要问一个更根本的问题:
如果根本没有奖励函数呢?智能体在环境里可以自由动,但没人告诉它什么算好、什么算坏。 它应该学什么?这不是一个哲学问题,而是一个非常实际的工程问题——三个场景都会逼你面对它:
- 稀疏奖励下的探索:奖励函数虽然存在,但在你第一次拿到非零奖励之前,它等价于「没有奖励」。 Montezuma's Revenge 里,你要先爬下梯子、躲过骷髅、拿到钥匙、再走回去开门,才有第一个 $+100$。 在这之前,任何以 $r$ 为驱动的算法梯度都恒为零。你需要一个不依赖 $r$ 的行为生成机制把智能体推到远处。
- 无监督预训练:机器人在实验室里放着,未来的任务是什么还不知道。它现在应该练什么, 才能在任务揭晓时最快学会?这是「预训练—微调」范式在 RL 里的对应物。
- 分层 RL 的底座:如果我们想要一个高层控制器去调用「向前走」「抓起东西」这类子技能, 这些子技能得先从哪来?手工设计代价太高,最好能自己长出来。
本讲的核心主张是:「学什么」这个问题可以被写成一个信息论目标,而且这些目标可以被机械地 转成标准 RL 里的奖励函数,交给 SAC/PPO 之类的现成算法去优化。整讲分三段:
第一段(§2–§4)是信息论工具箱:熵 $\mathcal{H}$、互信息 $\mathcal{I}$、以及本讲反复要用的 变分下界——因为所有互信息目标里都藏着一个算不出来的后验 $p(z|s)$, 必须用一个网络 $q_\phi(z|s)$ 去逼近它,这正是第 11 讲 ELBO 那套推导在新场景下的复用。 然后我们定义两个量:状态边缘熵 $\mathcal{H}(\pi(s))$ 量化「覆盖」, empowerment $\mathcal{I}(a_t;s_{t+1})$ 量化「控制力」。
第二段(§5–§6)是技能发现:引入一个技能变量 $z$,策略变成 $\pi(a|s,z)$, 用互信息 $\mathcal{I}(z;s)$ 当目标。这就是 DIAYN(Diversity is All You Need): 把 $\mathcal{I}(z;s)=\mathcal{H}(z)-\mathcal{H}(z|s)$ 一拆,前一项靠均匀先验拉满, 后一项就变成一个判别器 $q_\phi(z|s)$,而它的对数似然 $\log q_\phi(z|s)$ 直接就是给策略的奖励。 一个「猜技能编号的分类器」竟然成了内在奖励,这是本讲最漂亮的一步。我们还会讲 DIAYN 的失效模式, 以及 DADS 用 $\mathcal{I}(s';z|s)$ 修正它。
第三段(§7–§10)把 $z$ 换成目标 $g$:技能变量取值在状态空间里,就得到目标条件 RL。 判别器退化成距离度量,MI 目标 $\mathcal{I}(g;s)=\mathcal{H}(g)-\mathcal{H}(g|s)$ 的两项分别对应 「提出多样的目标」和「可靠地到达目标」。到达那一项由 HER(hindsight relabeling)高效解决, 而提目标那一项才是真正有意思的地方——Skew-Fit 用一个带权重的极大似然让目标分布的熵单调上升, 形成自动扩张的课程。最后看 Go-Explore 和 HOMER 这两条不走 MI 路线的做法。
- 熵量化覆盖:无监督探索的目标可以写成 $\max_\pi \mathcal{H}(p_\pi(s))$。 它的「奖励」是 $-\log p_\pi(s)$,即越少去的地方奖励越高——这正是 count-based bonus 的连续版本, 但奖励随策略变化,因此本质上是一个两玩家博弈而不是标准 MDP。
- 互信息量化可区分性:$\mathcal{I}(z;s)=\mathcal{H}(z)-\mathcal{H}(z|s)$。 第一项要求「技能编号本身要多样」(用均匀先验直接拉满),第二项要求「看到状态就能反推出是哪个技能」。 两项合起来 = 不同技能必须去不同的状态区域。
- 变分下界是通用扳手:$-\mathcal{H}(z|s)=\E[\log p(z|s)]\ge \E[\log q_\phi(z|s)]$, 间隙恰为 $\E_s[\KL(p(z|s)\,\|\,q_\phi(z|s))]$。于是「最大化互信息」变成 「训练一个判别器 + 把判别器的对数似然当奖励做 RL」,两者交替上升。
- DIAYN 的奖励:$r(s,z)=\log q_\phi(z|s)-\log p(z)$,配合最大熵 RL 即可。 它的天花板是 $\mathcal{H}(z)=\log N$——用 $N$ 个离散技能时互信息最多 $\log N$ 奈特, 这意味着把状态空间一个小角落分成 $N$ 块就能拿满分,这是它最主要的失效模式。
- Skew-Fit 的关键结果:对采样自 $p_\psi$ 的数据做权重为 $w(g)=p_\psi(g)^\alpha$ 的加权 MLE, 拟合出的新分布 $\propto p_\psi^{1+\alpha}$;当 $\alpha\in[-1,0)$ 时熵严格上升, 反复迭代收敛到支撑集上的均匀分布。目标分布自动扩张。
- HER 之所以合法:转移 $p(s'|s,a)$ 与目标 $g$ 无关,而奖励 $r(s,a,g)$ 是解析已知的, 所以任何一条轨迹都可以被事后重标注成任意目标的有效 off-policy 数据。代价是目标分布被拉向 「已经能到的地方」,与扩张覆盖的诉求相冲突。
1. 回到起点:为什么 Breakout 简单而 Montezuma's Revenge 不可能
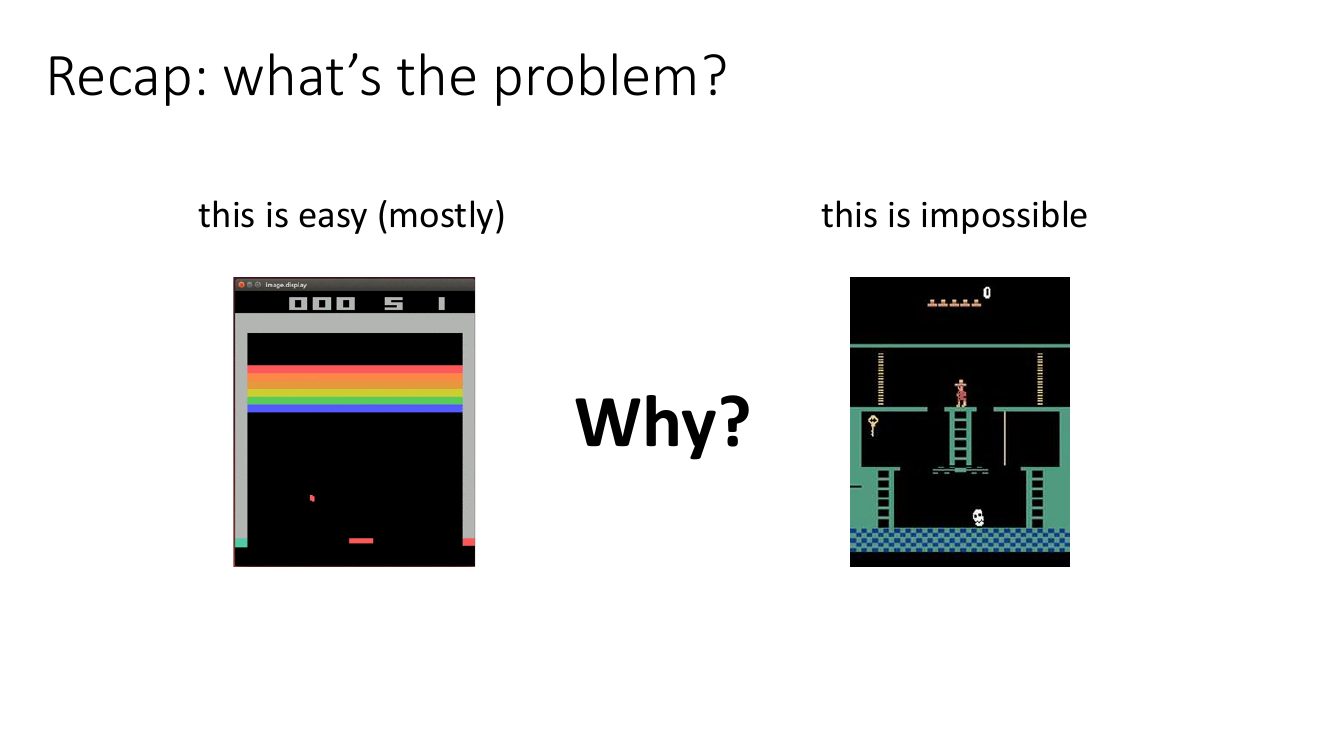
这张对比图是理解本讲动机的起点。左边 Breakout:随机乱动挡板,几十步内就会撞到球,球撞到砖块就加分。 奖励信号在随机策略下就是非零的,于是 $\nabla_\theta J(\theta)$ 从第一批数据起就有信息, 策略梯度或 Q-learning 可以沿着它一路爬上去。右边 Montezuma's Revenge:你必须先下梯子、跨过转动的骷髅、 拿到左边的钥匙、再原路返回去开门,才拿到第一个正奖励。这条动作序列长达上百步, 每一步随机策略走对的概率大约是 $1/|\mathcal{A}|$(Atari 是 18 个动作)。 就算保守地假设只有 30 个「关键决策点」是不能错的,随机撞对的概率也是 $18^{-30}\approx 10^{-38}$。 这个数字的含义很直白:你永远看不到第一个非零奖励,所有基于 $r$ 的梯度恒等于零, 算法在数学上没有任何可优化的东西。
人类玩家第一次玩 Montezuma's Revenge 也不知道规则,但他们不是从零开始的: 屏幕上那个东西看起来像钥匙,钥匙通常用来开门;骷髅看起来危险,梯子是用来爬的。 这些是从现实世界迁移过来的语义先验。有研究把游戏贴图换成无意义的色块后测试人类, 人类的通关效率会大幅下降到接近随机搜索——说明「探索难」在很大程度上是「没有先验」。 本讲的路线是:既然拿不到语义先验,那就退而求其次,让智能体系统性地、无遗漏地 把行为空间扫一遍,用覆盖率代替语义。
前面讲探索时,我们的做法是给奖励加一个探索奖金(exploration bonus): $\tilde r(s,a)=r(s,a)+\mathcal{B}(N(s))$,其中 $N(s)$ 是访问计数或伪计数,$\mathcal{B}$ 单调递减, 比如 $\mathcal{B}=c/\sqrt{N(s)}$。这类方法的共同结构是「主奖励 + 内在奖励」。 本讲要走得更极端:把 $r$ 整个拿掉,只剩内在奖励,看看能学出什么。
没有奖励函数时,我们到底想要什么
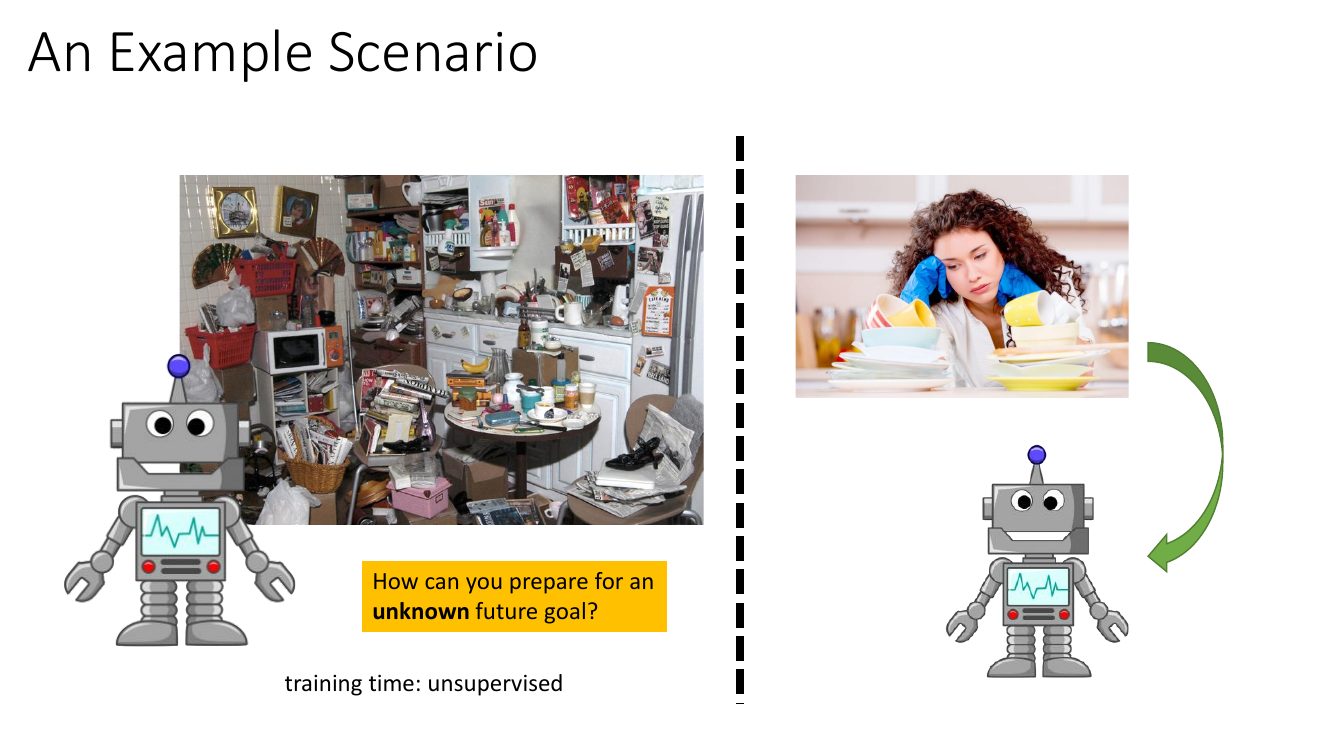
这张图定义了本讲的问题设定,叫做无监督 RL(unsupervised RL)或 两阶段范式(pretrain-then-finetune):
- 阶段一(无监督预训练):智能体在环境 $M=\{\mathcal{S},\mathcal{A},p\}$ 里自由交互, $M$ 里没有 $r$。它可以随便收集数据、训练任何模型、学任何策略。这个阶段可以很长。
- 阶段二(任务揭晓):给定一个奖励函数 $r$(或一个目标状态 $g$),要求以尽可能少的 额外交互学会最大化 $\sum_t r(s_t,a_t)$。
评价标准是阶段二的样本效率。这就把「阶段一该干什么」变成一个可以定义的优化问题: 阶段一应该获取那些对任意可能的 $r$ 都有用的东西。注意这里的「任意」—— 因为你不知道 $r$ 是什么,本质上要对抗一个最坏情况的任务分布。这个 minimax 视角 会在 §4 给出「为什么是熵最大化」的答案。
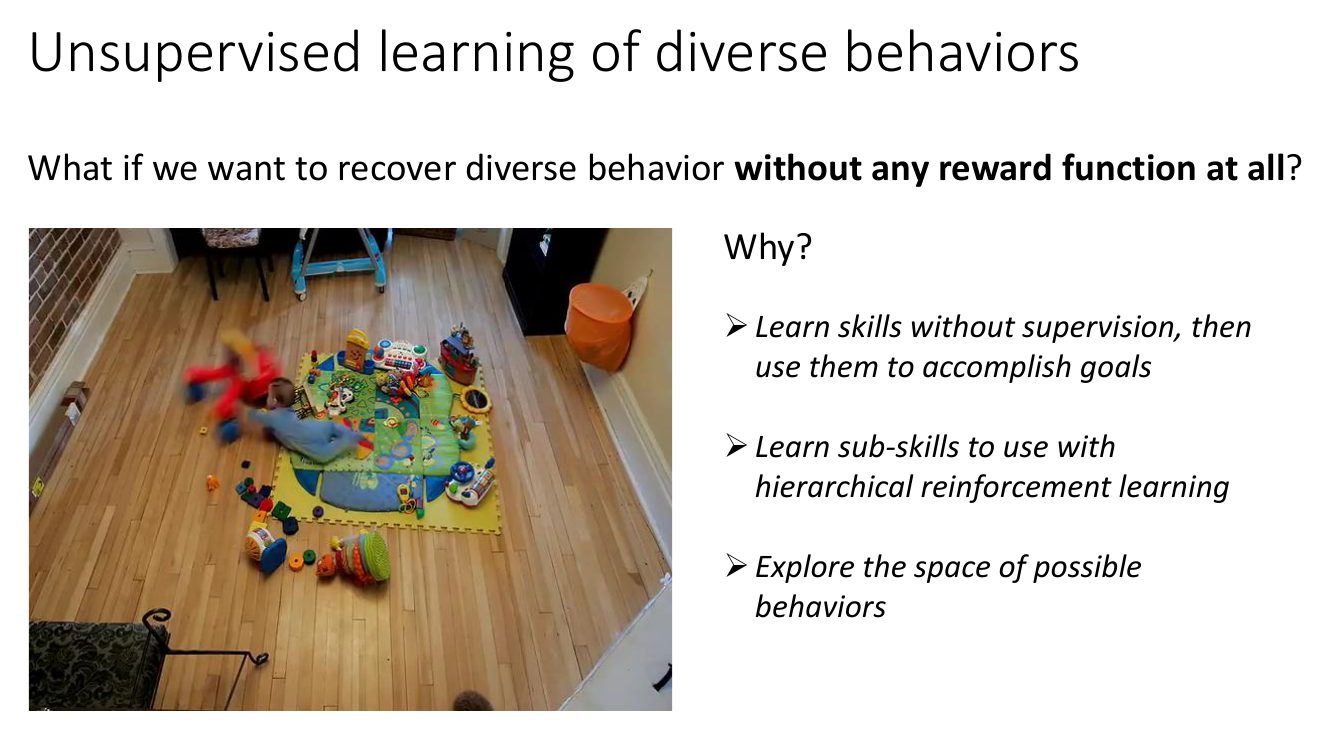
三个动机对应三种用法,也对应本讲后面的三块内容。第一条是「技能 → 目标」: 学一组参数化的技能 $\pi(a|s,z)$,任务来了以后只需要在 $z$ 空间里搜索($z$ 如果是离散的 $N$ 个, 穷举 $N$ 次即可),比在原始动作空间里重新学一遍便宜好几个数量级。第二条是「技能 → 分层 RL」: 高层策略 $\pi^{\text{hi}}(z|s)$ 每 $k$ 步输出一个 $z$,低层策略 $\pi(a|s,z)$ 执行—— 这把决策的时间尺度拉长了 $k$ 倍,等价于把折扣视野缩短,探索和信用分配都变容易(这是下一讲的主题)。 第三条最接近「探索」的本义:把行为空间扫一遍,本身就是在给稀疏奖励任务铺路。
「多样的行为」和「多样的目标」不是同一件事,这个区分贯穿全讲。 到达不同的目标状态是一类行为,但不是全部:「原地转圈」「保持平衡不倒」「以恒定速度奔跑」 这些行为都不能被「到达某个状态 $g$」刻画——它们的特征在于状态的轨迹形态, 而不是终点。所以本讲先讲更一般的技能($z$ 是抽象编号),再讲它的特例目标条件 RL($z=g$ 是状态)。
2. 信息论工具箱:熵、互信息与变分下界
本讲所有目标函数都由两个量搭起来,先把它们的定义和要用到的恒等式一次性理清楚。
2.1 熵
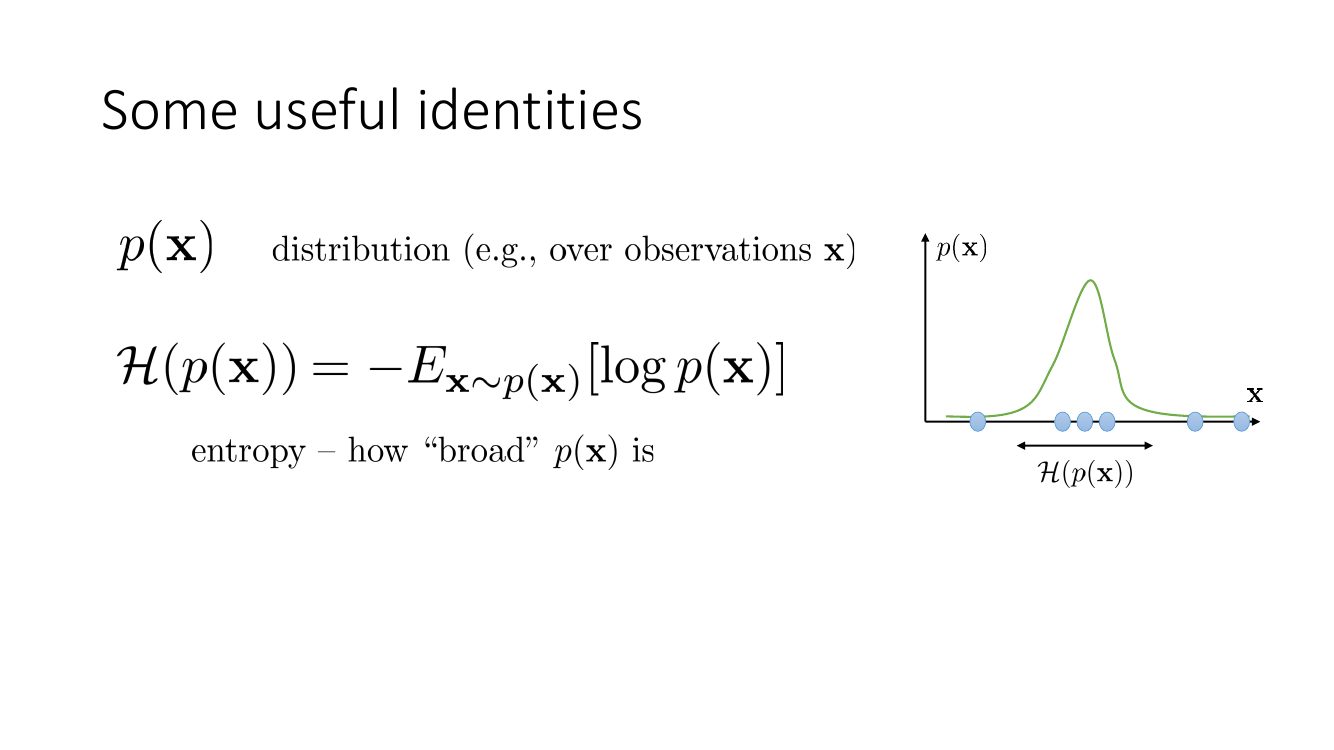
对分布 $p(x)$($x$ 可以是观测、状态、技能编号),熵定义为
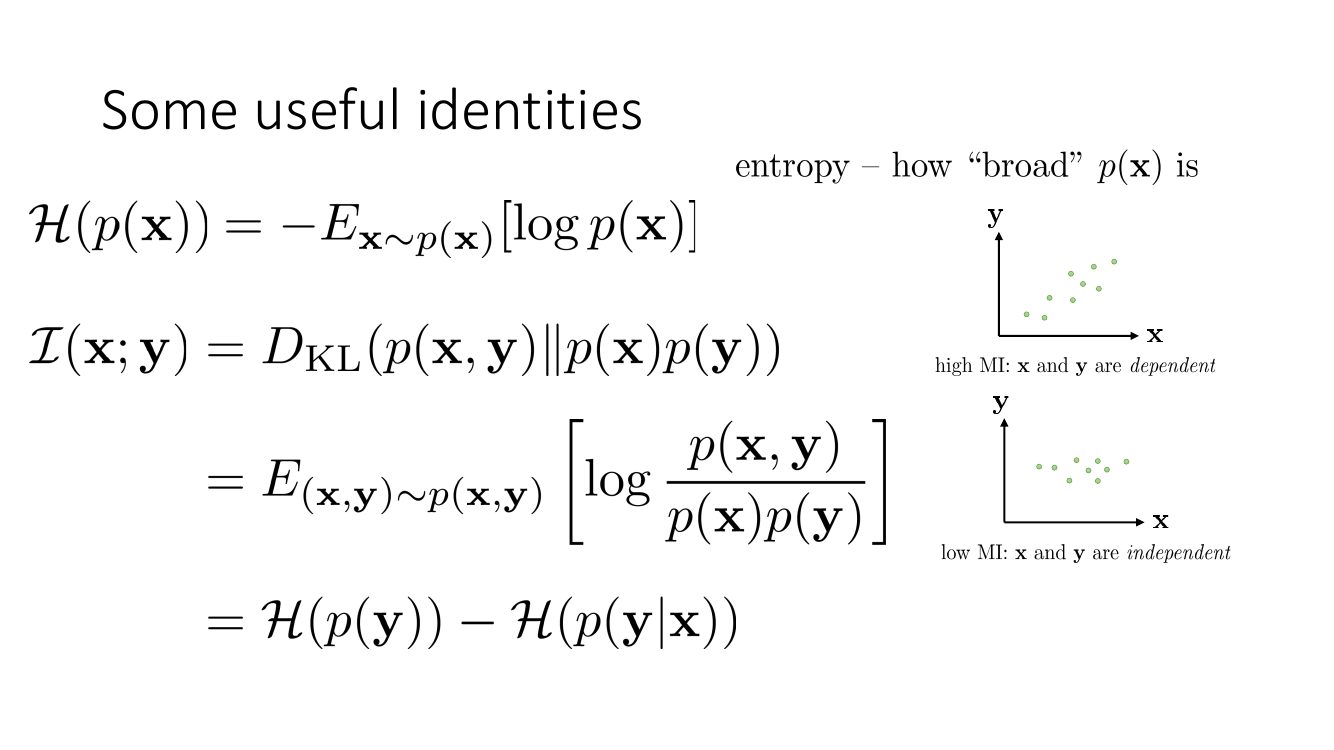
$$ \mathcal{H}(p(x)) = -\E_{x\sim p(x)}\left[\log p(x)\right] = -\int p(x)\log p(x)\,dx . $$两个必须记住的性质:
- 有限支撑集上,均匀分布熵最大。若 $x$ 取 $N$ 个值,则 $\mathcal{H}\le\log N$, 等号当且仅当 $p$ 均匀。证明用 Jensen: $\mathcal{H}(p)=\E[\log\frac{1}{p(x)}]\le\log\E[\frac{1}{p(x)}]=\log\sum_x p(x)\frac{1}{p(x)}=\log N$。 这个上界后面会变成 DIAYN 的天花板。
- 熵是「意外程度」的期望。$-\log p(x)$ 叫 $x$ 的自信息(surprisal): 概率 $10^{-3}$ 的事件发生时 surprisal 是 $6.9$ 奈特,概率 $0.5$ 的只有 $0.69$。 所以「最大化熵」= 「让自己经常感到意外」。把 $x$ 换成状态,这就是探索。
2.2 互信息与它的三种写法
$$ \mathcal{I}(x;y) \;=\; \KL\big(p(x,y)\,\|\,p(x)p(y)\big) \;=\; \E_{(x,y)\sim p(x,y)}\!\left[\log\frac{p(x,y)}{p(x)p(y)}\right] \;=\; \mathcal{H}(p(y)) - \mathcal{H}(p(y|x)) . $$第一个等号是定义:MI 衡量「联合分布离独立有多远」。因为 KL 非负,所以 $\mathcal{I}\ge 0$, 且 $=0$ 当且仅当 $x\perp y$。第二个等号只是把 KL 写成期望。第三个等号需要一步推导, 它是本讲用得最多的形式,我们把它写全:
约定条件熵 $\mathcal{H}(p(y|x)) \triangleq -\E_{(x,y)\sim p(x,y)}[\log p(y|x)]$ (注意期望是对联合分布取的,所以它是一个标量而不是 $x$ 的函数)。于是
$$ \begin{aligned} \mathcal{I}(x;y) &= \E_{p(x,y)}\!\left[\log\frac{p(x,y)}{p(x)p(y)}\right] = \E_{p(x,y)}\!\left[\log\frac{p(y|x)\,p(x)}{p(x)\,p(y)}\right] \\[2pt] &= \E_{p(x,y)}\!\left[\log p(y|x)\right] - \E_{p(x,y)}\!\left[\log p(y)\right] \\[2pt] &= -\mathcal{H}(p(y|x)) \;-\; \E_{p(y)}\!\left[\log p(y)\right] \;=\; \mathcal{H}(p(y)) - \mathcal{H}(p(y|x)). \end{aligned} $$第三行第二项用了「联合分布对 $x$ 边缘化后就是 $p(y)$」。由对称性同样有 $\mathcal{I}(x;y)=\mathcal{H}(p(x))-\mathcal{H}(p(x|y))$,用哪一边取决于哪一边好算。
读法:$\mathcal{I}(x;y)$ = 「$y$ 本身的不确定性」减去「已知 $x$ 后 $y$ 剩下的不确定性」 = 知道 $x$ 能替你消掉多少关于 $y$ 的不确定性。 这个读法是后面所有目标函数的解释模板:把 $x$ 换成技能编号 $z$、$y$ 换成状态 $s$, $\mathcal{I}(z;s)$ 就是「知道你现在处于哪个状态,能多大程度上确定你在执行哪个技能」。
2.3 变分下界:本讲的通用扳手
问题来了:$\mathcal{H}(p(z|s))$ 里的 $p(z|s)$ 是后验—— 它由策略 $\pi(a|s,z)$、先验 $p(z)$ 和环境动力学共同诱导,我们既写不出它的解析式, 也没法直接采样。这和第 11 讲里「$p(z|x)$ 算不出来」是同一个困难,解法也一样: 拿一个带参数的网络 $q_\phi(z|s)$ 去逼近它,然后证明这样只会低估目标(得到下界), 不会高估。
对任意分布 $q_\phi(z|s)$,考虑真实后验与它的 KL:
$$ \E_{s\sim p(s)}\Big[\KL\big(p(z|s)\,\|\,q_\phi(z|s)\big)\Big] = \E_{p(s,z)}\left[\log p(z|s)\right] - \E_{p(s,z)}\left[\log q_\phi(z|s)\right] \;\ge\; 0 . $$移项即得
$$ \E_{p(s,z)}\left[\log p(z|s)\right] \;\ge\; \E_{p(s,z)}\left[\log q_\phi(z|s)\right], \qquad\text{即}\qquad -\mathcal{H}(p(z|s)) \;\ge\; \E_{p(s,z)}\left[\log q_\phi(z|s)\right]. $$代回互信息的熵差形式:
$$ \boxed{\;\mathcal{I}(z;s) \;=\; \mathcal{H}(p(z)) - \mathcal{H}(p(z|s)) \;\ge\; \mathcal{H}(p(z)) + \E_{p(s,z)}\left[\log q_\phi(z|s)\right]\;} $$间隙(gap)恰好是 $\E_{s}[\KL(p(z|s)\|q_\phi(z|s))]$:判别器学得越准,界越紧; 学到完美时($q_\phi=p(z|s)$)界变成等号。
这个界的工程意义极大,值得单独强调:右端只包含可以采样估计的量。 $\mathcal{H}(p(z))$ 是我们自己选的先验,通常直接取均匀分布,是个已知常数; $\E[\log q_\phi(z|s)]$ 只要有 $(s,z)$ 配对样本就能算——而这些样本正是执行 $\pi(a|s,z)$ 时自然产生的。 于是最大化互信息变成了一个漂亮的交替上升过程:
- 对 $\phi$ 上升:固定策略产生的数据,做 $\max_\phi \E[\log q_\phi(z|s)]$, 这就是一个普通的监督分类/回归问题(输入状态、标签技能编号)。
- 对 $\pi$ 上升:固定 $q_\phi$,注意到 $\E_{p(s,z)}[\log q_\phi(z|s)]$ 关于策略就是「以 $\log q_\phi(z|s)$ 为奖励的期望回报」,于是用任意标准 RL 算法优化。
两步都在抬同一个下界,所以下界单调不降(在每步都精确求解的理想情况下)。 这个「判别器给奖励、策略去骗判别器往更可分的地方走」的结构,是本讲后半段所有算法的骨架。
不要以为「$q_\phi$ 是判别器,所以这是 GAN」。GAN 里生成器和判别器是对抗的 (一个要骗过另一个),而这里策略和判别器是合作的:策略主动去访问那些让判别器更容易猜对的状态。 两者优化的是同一个目标 $\E[\log q_\phi(z|s)]$,都在把它变大。 真正的对抗成分出现在另一处——§4 的状态熵最大化里,密度模型和策略确实是零和的。
3. RL 里的两个信息论量:覆盖与控制力
3.1 状态边缘分布与它的熵
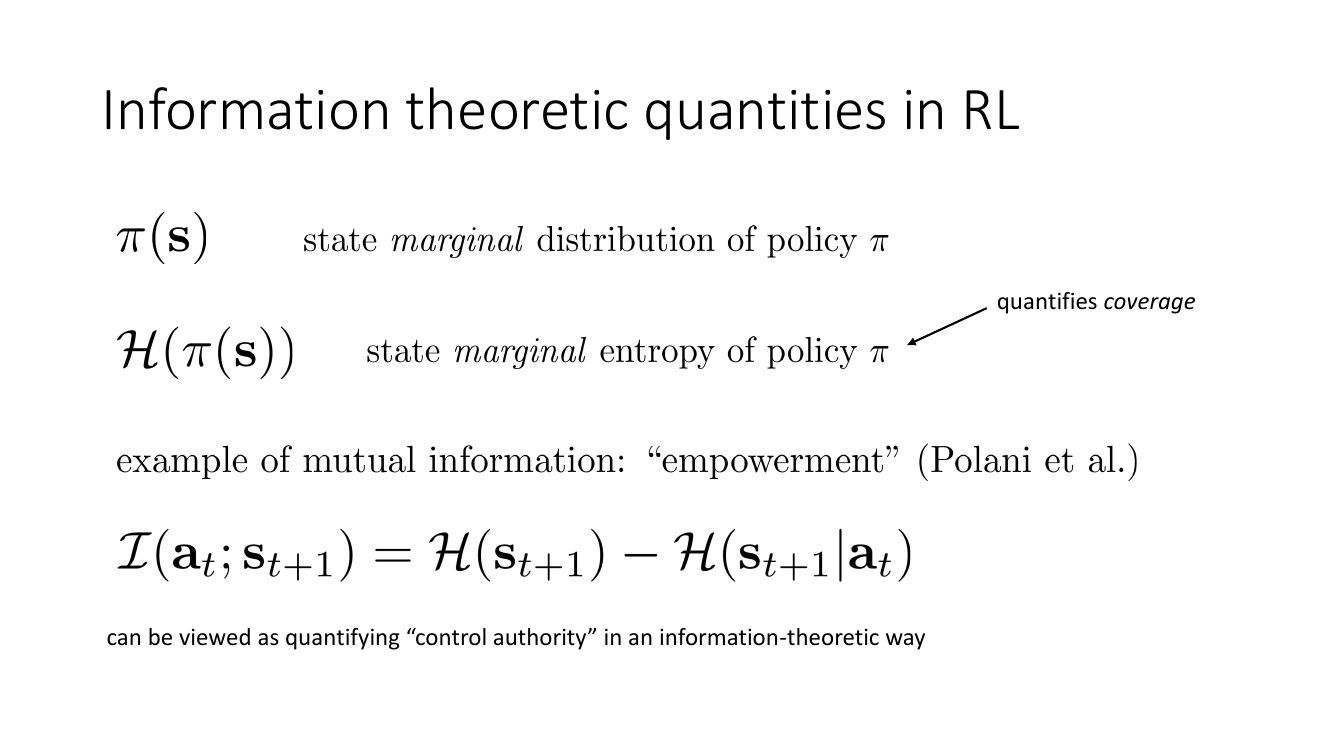
先把记号定死。策略 $\pi_\theta(a|s)$ 与环境 $p(s'|s,a)$ 一起诱导一个轨迹分布 $p_\theta(\tau)$, 把时间边缘化掉得到状态边缘分布(state marginal distribution):
$$ \pi(s) \;\triangleq\; p_\theta(s) \;=\; \frac{1}{T}\sum_{t=1}^{T} p_\theta(s_t=s) \qquad\text{(或折扣版 } (1-\gamma)\sum_t \gamma^{t}p_\theta(s_t=s)\text{)}. $$它回答的问题是:「如果我在一个随机时刻按下暂停键,看到状态 $s$ 的概率是多少?」 注意这里的 $s$ 是状态(满足马尔可夫性),实际中往往只有观测 $o$, 密度模型只能建在 $o$ 或某个学到的表征上,这个近似后面会成为一个真实的痛点。
那么 $\mathcal{H}(\pi(s))$ 就是「这个策略去过的地方有多广」:
- 一个只会站着不动的策略,$\pi(s)$ 是个尖峰,熵接近 $-\infty$(连续情形)或 $0$(离散情形)。
- 一个能均匀地跑遍整个地图的策略,$\pi(s)$ 接近均匀,熵接近 $\log|\mathcal{S}|$。
- 注意熵和「随机」不是一回事:$\pi$ 本身可以是确定性的,只要它的轨迹走遍全图, $\pi(s)$ 的熵照样很大。反过来,一个每步随机抖动但被困在角落的策略,动作熵大而状态熵小。 我们要的是后者的反面——这正是最大熵 RL(对 $\mathcal{H}(\pi(a|s))$ 求最大) 和状态熵最大化的根本区别。
3.2 Empowerment:控制力的信息论度量
第二个量把互信息用在了动作和下一个状态之间:
$$ \mathcal{I}(a_t;s_{t+1}) \;=\; \mathcal{H}(s_{t+1}) - \mathcal{H}(s_{t+1}|a_t). $$用 §2.2 的读法:知道我采取了哪个动作,能多大程度上确定下一个状态。 要让它大,需要两件事同时成立:
- $\mathcal{H}(s_{t+1})$ 大——我的动作整体上能导致很多种不同的后继状态;
- $\mathcal{H}(s_{t+1}|a_t)$ 小——给定一个具体动作,结果是可预测的,不是随机的。
这两条正好排除了两种「假控制」。只满足第 2 条不满足第 1 条:你站在墙角,无论按什么键都不动—— 结果完全可预测,但你没有任何影响力。只满足第 1 条不满足第 2 条:你在一台老虎机前, 每次拉杆结果都不同但完全随机——变化很大,但那不是你造成的。 Empowerment 只在「变化多 且 由你决定」时才高,所以它被解读为 控制权(control authority)。
想象你站在一个悬崖边和站在一间大房子中央。悬崖边:一步走错就掉下去,之后所有动作都无所谓了—— 未来状态的分布被环境接管,$\mathcal{H}(s_{t+1}|a_t)$ 相对 $\mathcal{H}(s_{t+1})$ 没小多少。 房子中央:往任意方向走都能到不同的地方,且走哪儿由你决定——empowerment 高。 所以「最大化 empowerment」会自发地产生「保持自己处于选项最多的位置」这种行为, 不需要任何人告诉它「不要掉下悬崖」。这是内在动机文献里一个经典结果。
更一般地,可以把单步换成 $K$ 步动作序列 $\mathbf{a}_{t:t+K}$,得到 $K$-step empowerment $\mathcal{I}(\mathbf{a}_{t:t+K};s_{t+K})$,它度量的是「我在 $K$ 步的时间尺度上能把世界带到多少种状态」。 这个量在实践中很难直接估——同样要走变分路线:引入一个「反向」网络 $q_\phi(\mathbf{a}|s_t,s_{t+K})$(给定起点和终点,猜我用了哪串动作),得到
$$ \mathcal{I}(\mathbf{a};s_{t+K}) \;\ge\; \mathcal{H}(p(\mathbf{a}|s_t)) + \E\big[\log q_\phi(\mathbf{a}\mid s_t,s_{t+K})\big]. $$形式和 §2.3 完全一样,只是把 $z$ 换成了动作序列。把 $z$ 换成什么,就得到不同的算法—— 这是理解本讲后半段的钥匙:
| 互信息目标 | 变分网络 $q_\phi$ 的语义 | 得到的算法 | 学出什么 |
|---|---|---|---|
| $\mathcal{I}(a_t;s_{t+1})$ | 给定 $(s_t,s_{t+1})$ 猜 $a_t$ | Empowerment (Polani et al.) | 停留在可控性高的状态 |
| $\mathcal{I}(z;s)$ | 给定 $s$ 猜技能编号 $z$ | DIAYN / VIC | 去不同状态区域的一组技能 |
| $\mathcal{I}(s';z\mid s)$ | 给定 $(s,z)$ 预测 $s'$(技能动力学) | DADS | 行为可预测且互不相同的技能 + 可规划的模型 |
| $\mathcal{I}(g;s)$ | 给定 $s$ 猜目标 $g$(退化为距离) | 目标条件 RL / RIG / Skew-Fit | 能到达任意目标的策略 + 扩张的目标分布 |
| $\mathcal{H}(\pi(s))$(无 $z$) | 状态密度模型 $p_\psi(s)$ | SMM / MaxEnt 探索 | 覆盖整个状态空间的策略 |
4. 状态覆盖最大化:以 $\mathcal{H}(\pi(s))$ 为目标的探索
先把最简单的那个目标做透:不引入技能变量,直接要求策略把状态空间铺满。
$$ \max_{\pi}\;\; \mathcal{H}\big(p_\pi(s)\big) \;=\; \max_\pi\; -\E_{s\sim p_\pi(s)}\big[\log p_\pi(s)\big]. $$4.1 为什么是熵?一个 minimax 论证
凭什么说「铺满状态空间」是对未知任务的最优准备?给一个可以说清楚的论证。 假设阶段二的任务是「到达某个目标状态 $g$」,而 $g$ 由一个我们不知道的分布 $p^\ast(g)$ 抽出, 甚至由一个对手挑选。如果我们的预训练策略的状态边缘是 $p_\pi(s)$, 那么用它随机撞的方式去撞到 $g$,期望需要的轨迹条数大约是 $1/p_\pi(g)$, 对应的对数代价约为 $-\log p_\pi(g)$。于是对手会挑我们最少去的那个 $g$,我们的最坏情况代价是
$$ \max_{g}\;\big[-\log p_\pi(g)\big] \;=\; -\log \min_g p_\pi(g). $$要让这个最坏值最小,就要把 $\min_g p_\pi(g)$ 抬到最大——在概率和为 1 的约束下, 这恰恰意味着把概率均匀地摊开,也就是最大化 $\mathcal{H}(p_\pi(s))$。 如果对手不是完全对抗而是从 $p^\ast$ 抽,期望代价是 $\E_{g\sim p^\ast}[-\log p_\pi(g)]$, 即交叉熵,最小化它等价于最小化 $\KL(p^\ast\|p_\pi)$。所以更一般的目标是 状态边缘匹配(State Marginal Matching, SMM):
$$ \min_\pi \; \KL\big(p_\pi(s)\,\|\,p^\ast(s)\big) = \min_\pi\Big\{ -\mathcal{H}(p_\pi(s)) - \E_{s\sim p_\pi}\big[\log p^\ast(s)\big] \Big\}. $$当 $p^\ast$ 取均匀分布时 $\log p^\ast(s)$ 是常数,上式退化成纯熵最大化。 当你对任务有一点先验(比如「机器人应该多在桌面附近活动」),就把它编码进 $p^\ast$。
4.2 难点:奖励依赖于策略自己
把熵展开成「期望某个东西」的形式:
$$ \mathcal{H}(p_\pi(s)) = \E_{s\sim p_\pi(s)}\big[\underbrace{-\log p_\pi(s)}_{\text{“奖励”}}\big]. $$形式上这就是一个 RL 目标,奖励是 $r(s)=-\log p_\pi(s)$:去得越少的地方,奖励越高。 但这里有个致命的循环——奖励函数里含有 $\pi$ 自己。这不是标准 MDP: 策略一改,奖励就变;奖励一变,最优策略又变。天真地做「拟合密度 → 用 $-\log p_\psi$ 当奖励跑 RL → 重新拟合密度」 会发生什么?策略跑到低密度区 A,密度模型学会 A 现在密度高了,于是奖励把策略推去 B, 密度模型跟着更新,奖励又把策略推回 A……策略在各个区域之间来回震荡,永不收敛。
SMM 的正确框架是一个零和博弈。定义
$$ \min_{p_\psi}\max_{\pi}\; \E_{s\sim p_\pi(s)}\big[\log p^\ast(s) - \log p_\psi(s)\big]. $$玩家一是策略 $\pi$(要去 $p_\psi$ 认为不可能的地方),玩家二是密度模型 $p_\psi$ (要把 $\pi$ 去过的地方的密度调高)。内层对 $\pi$ 的最大化就是一次标准 RL; 外层对 $p_\psi$ 的最小化,在给定 $\pi$ 时的解是 $p_\psi = p_\pi$(因为 $\max_{p_\psi}\E_{p_\pi}[\log p_\psi]$ 的解是 $p_\pi$ 本身,即 MLE), 代回去外层目标就变成 $-\KL(p_\pi\|p^\ast)$ 加常数,与原问题一致。
关键结论:这个博弈的纳什均衡通常是混合策略—— 不存在单个确定性策略能让状态分布均匀,只有一组策略的混合可以。 因此用虚拟对弈(fictitious play)求解时,最终该输出的是历次迭代策略的均匀混合 $\pi^{\text{mix}} = \text{Uniform}\{\pi_1,\dots,\pi_K\}$,而不是最后一次的 $\pi_K$。 最后一次迭代的策略恰恰是最糟的选择之一:它专门去当时密度最低的那一小块地方。
「跑一个 novelty bonus,收敛后拿最后的策略」是实践中最常见的错误。 最后的策略被训练成「专去当前最冷门的地方」,它的状态分布本身可能极其集中。 正确做法是保留一个策略池(或保留整个 replay buffer),并从中均匀混合地采样行为。 这条经验对所有「奖励依赖当前数据分布」的内在动机方法都成立。
4.3 三种把 $-\log p_\pi(s)$ 变成可计算奖励的办法
(a)参数化密度模型。训练一个 VAE / 流模型 / autoregressive 模型 $p_\psi(s)$ 去拟合 replay buffer 里的状态,奖励取 $r(s)=-\log p_\psi(s)$。优点是通用; 缺点是高维图像上的似然值极不可靠(似然被低层纹理统计主宰,与语义新颖性关系微弱)。
(b)计数 / 伪计数。如果状态离散或能被离散化,令 $p_\psi(s)=N(s)/n$,则
$$ r(s) = -\log p_\psi(s) = \log n - \log N(s). $$这就严格地把状态熵最大化和 count-based bonus 联系了起来: 两者只差奖金函数的形状($-\log N$ 对 $N^{-1/2}$)和一个与状态无关的常数 $\log n$。 它们的动机也不同:UCB 型的 $c/\sqrt{N(s)}$ 来自「不确定性的置信上界」, 而 $-\log N(s)$ 来自「覆盖率」。实践中前者衰减更快($N$ 从 1 到 100, $N^{-1/2}$ 掉 10 倍,$-\log N$ 只从 0 掉到 $-4.6$),所以熵目标更「执着」地 要求把所有状态访问次数拉平,而 UCB 型 bonus 更快地放弃已探索区域。
(c)非参数的 $k$ 近邻熵估计。这是目前最实用的一条路,避开了显式密度建模。 Kozachenko–Leonenko 估计器给出:对从 $p$ 中独立采的 $n$ 个点 $\{s_i\}$, 在 $d$ 维空间里
$$ \hat{\mathcal{H}}(p) \;\approx\; \frac{d}{n}\sum_{i=1}^{n}\log \big\|s_i - s_i^{k\text{-NN}}\big\| + \text{const}, $$其中 $s_i^{k\text{-NN}}$ 是 $s_i$ 在这批样本中的第 $k$ 近邻。直觉极简单: 点越稀疏,到最近邻的距离越大,熵越大。于是内在奖励可以直接取
$$ r(s_i) = \log\Big(1 + \big\|\,\phi(s_i)-\phi(s_i^{k\text{-NN}})\,\big\|\Big), $$$\phi$ 是一个学到的表征(对比学习或随机编码器都可以)。这类方法(APT、RE3 等)的好处是: 没有密度模型要训、天然适配连续空间、且奖励只依赖 batch 内的相对距离,数值稳定。 坏处是它衡量的是表征空间的熵,$\phi$ 选得不好就前功尽弃。
import torch

def knn_entropy_reward(z, k=5, eps=1e-6):
    """z: (N, d) 一个 batch 的状态表征,返回每个样本的内在奖励。
    奖励 = log(1 + 到第 k 近邻的距离),是 Kozachenko-Leonenko 熵估计的逐点项。"""
    # 两两欧氏距离,(N, N)
    d = torch.cdist(z, z, p=2)
    # 把自身距离置为 +inf,避免选到自己
    d = d + torch.eye(d.shape[0], device=z.device) * 1e9
    # 每行最小的 k 个距离;取第 k 个(也可以取 k 个的均值,更平滑)
    knn_d, _ = torch.topk(d, k=k, dim=1, largest=False)
    r = torch.log(1.0 + knn_d[:, -1] + eps)
    # 常见做法:用 batch 内均值归一化,避免奖励尺度随训练漂移
    return r / (r.mean().detach() + eps)
所有基于「新颖性」的内在奖励都有一个共同的死穴:噪声电视问题(noisy TV problem)。 如果环境里有一个不可控的随机源(一台播放雪花的电视、风吹动的树叶、传感器噪声), 那么盯着它看就能源源不断地产生「从未见过的状态」,$-\log p_\psi(s)$ 永远很高。 智能体会心满意足地坐在电视机前看一辈子雪花。状态熵最大化对此没有免疫力—— 这也是 §6 里 DADS 那种「要求技能的效果可预测」的目标之所以重要的原因: 可预测性把纯随机的变化排除掉了。
5. 技能发现:DIAYN 与互信息目标的完整推导
5.1 问题设定与直觉
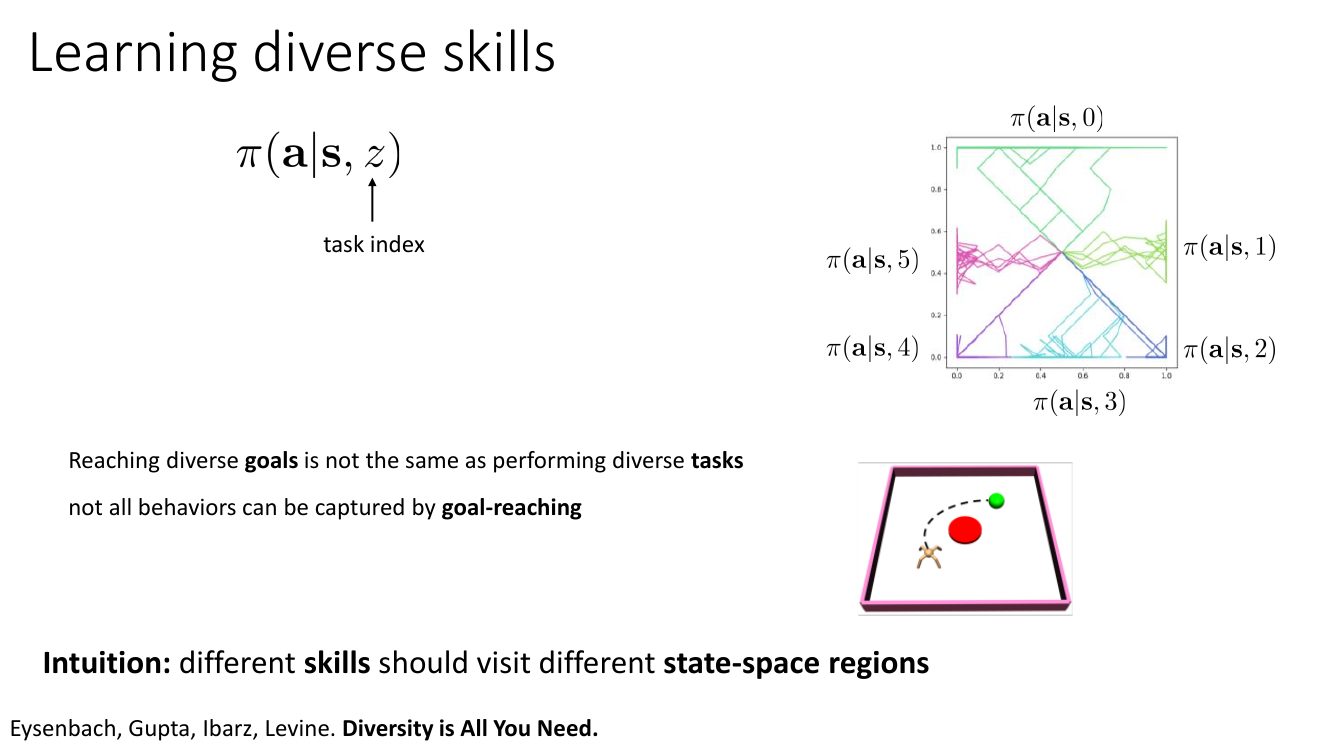
引入一个技能变量(skill / latent / option) $z$,从一个我们自己指定的先验 $p(z)$ 采样, 在整条轨迹的开头采一次、然后保持不变。策略变成 $\pi_\theta(a|s,z)$。 不同的 $z$ 值就代表不同的技能。现在的问题是:用什么目标函数,才能让这些技能既多样又有意义?
第一个想到的可能是「让不同 $z$ 的动作分布不一样」,即最大化 $\mathcal{I}(a;z|s)$。 这是错的,而且错得很有教益:动作层面的差异可以是完全无意义的抖动—— 技能 0 让第一个关节多抖 0.01 弧度、技能 1 让第二个关节多抖 0.01 弧度, 判别器能分得清清楚楚,而机器人在宏观上什么都没做。差异必须体现在状态上,而不是动作上。 这就是幻灯片上那句直觉的来源:
不同的技能应该访问状态空间的不同区域。 形式化:最大化状态与技能之间的互信息 $\mathcal{I}(z;s)$。
5.2 从直觉到奖励函数
照搬 §2.3 的变分下界,令 $z$ 是技能、$s$ 是状态:
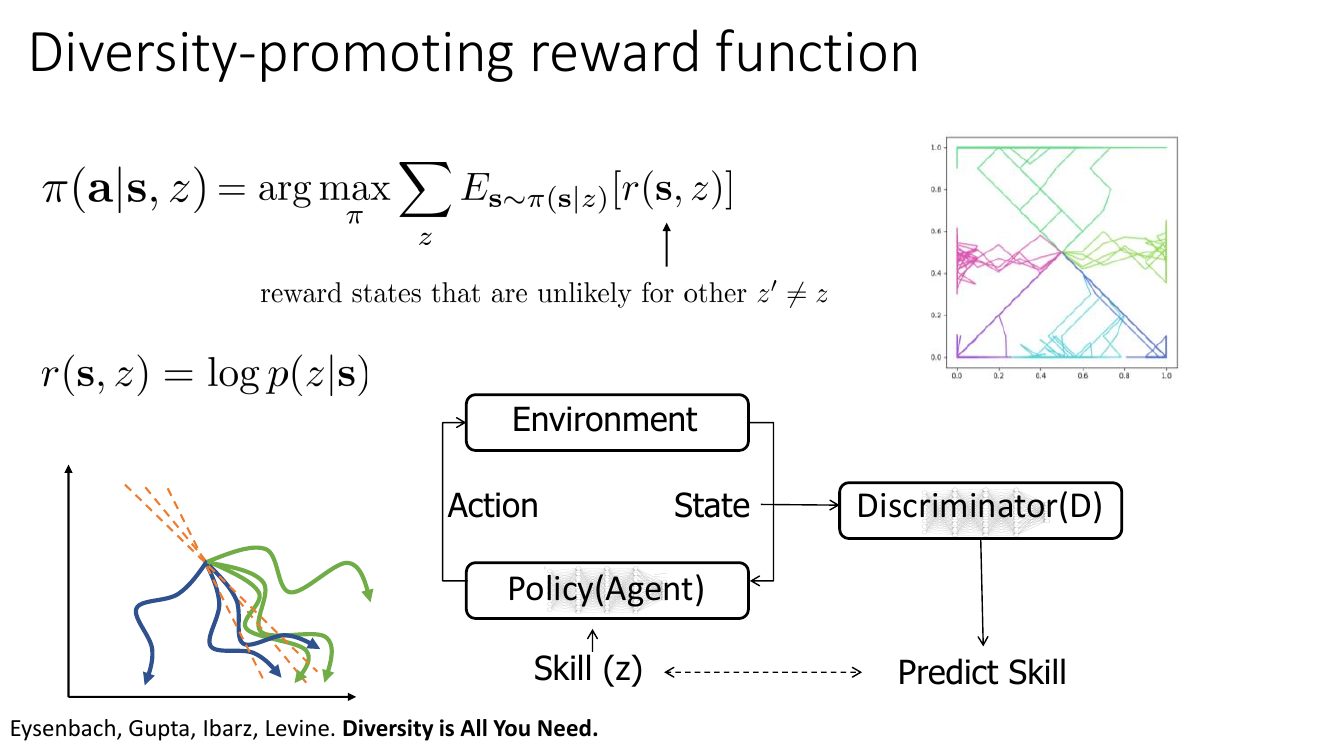
$$ \mathcal{I}(z;s) = \mathcal{H}(p(z)) - \mathcal{H}(p(z|s)) \;\ge\; \mathcal{H}(p(z)) + \E_{z\sim p(z),\,s\sim \pi(s|z)}\big[\log q_\phi(z|s)\big]. $$两项分别怎么处理,幻灯片上那两个箭头说得很清楚:
- $\mathcal{H}(z)$ 通过取均匀先验 $p(z)$ 直接拉满。 这一项完全由我们控制,不需要学:$z$ 取 $N$ 个离散值时令 $p(z)=1/N$, 则 $\mathcal{H}(z)=\log N$ 已是最大值。所以它在优化中是常数,梯度为零。 (如果反过来让 $p(z)$ 也可学,就会退化——模型会把概率全压到最容易区分的那一个 $z$ 上, 熵掉到 0,互信息也跟着掉到 0。所以「固定为均匀」不是偷懒,是必要的。)
- $\mathcal{H}(z|s)$ 通过最大化 $\log q_\phi(z|s)$ 来最小化。 这一项才是要学的,而它天然地就是一个奖励函数。
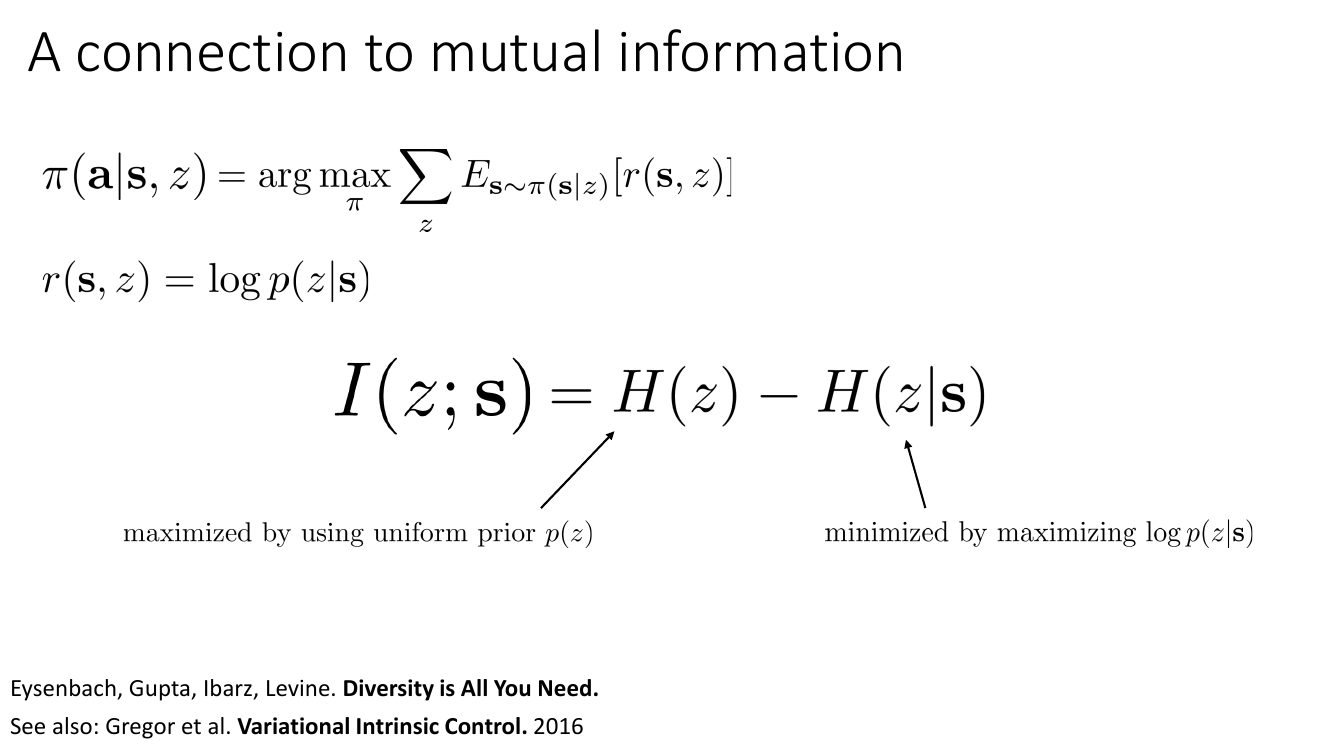
论文里的目标其实比 $\mathcal{I}(z;s)$ 多两项,值得推一遍因为每一项都有明确用意:
$$ \mathcal{F}(\theta) \;\triangleq\; \mathcal{I}(s;z) \;+\; \mathcal{H}(a|s) \;-\; \mathcal{I}(a;z|s). $$三项的动机:第一项要「不同技能去不同状态」;第二项要「动作尽量随机」(最大熵正则); 第三项要「不要靠动作去区分技能」——正是 §5.1 说的那个陷阱,这里被显式地惩罚掉了。 现在展开。用 $\mathcal{I}(x;y)=\mathcal{H}(y)-\mathcal{H}(y|x)$ 展开第一、三项:
$$ \begin{aligned} \mathcal{F}(\theta) &= \big[\mathcal{H}(z)-\mathcal{H}(z|s)\big] + \mathcal{H}(a|s) - \big[\mathcal{H}(a|s)-\mathcal{H}(a|s,z)\big] \\[2pt] &= \mathcal{H}(z) - \mathcal{H}(z|s) + \mathcal{H}(a|s,z). \end{aligned} $$$\mathcal{H}(a|s)$ 被整项消掉了,剩下的第三项是「给定状态和技能后动作仍然要随机」, 这正是 SAC 里的最大熵项。再对 $-\mathcal{H}(z|s)$ 用变分下界:
$$ \mathcal{F}(\theta) \;\ge\; \mathcal{H}(z) + \E_{z,s}\big[\log q_\phi(z|s)\big] + \mathcal{H}(a|s,z). $$把它整理成「SAC 目标 + 内在奖励」的形式,得到最终的奖励定义:
$$ \boxed{\; r_z(s,a) \;=\; \log q_\phi(z\mid s) \;-\; \log p(z) \;} $$减去 $\log p(z)$ 是为了让奖励有个自然的基线:如果判别器完全猜不出来($q_\phi(z|s)=p(z)=1/N$), 奖励恰好为 0;比瞎猜好,奖励为正;比瞎猜还差,奖励为负。因为 $p(z)$ 是均匀常数, 这一项不影响梯度,但对数值稳定性和调参感受帮助很大。
5.3 算法与实现
把上面的推导落成一个循环,就是完整的 DIAYN:
- 采一个技能 $z\sim p(z)$(均匀);
- 用 $\pi_\theta(a|s,z)$ 跑一整条轨迹,把 $(s_t,a_t,s_{t+1},z)$ 存进 replay buffer;
- 用 buffer 里的 $(s,z)$ 对做监督分类,梯度上升 $\nabla_\phi \log q_\phi(z|s)$;
- 用 $r_z(s,a)=\log q_\phi(z|s)-\log p(z)$ 作为奖励,跑一步 SAC 更新 $\theta$;
- 回到 1。
import torch, torch.nn as nn, torch.nn.functional as F

N_SKILLS = 50
disc = nn.Sequential(nn.Linear(obs_dim, 256), nn.ReLU(),
                     nn.Linear(256, 256), nn.ReLU(),
                     nn.Linear(256, N_SKILLS))          # q_phi(z|s) 的 logits
disc_opt = torch.optim.Adam(disc.parameters(), lr=3e-4)
log_pz = -torch.log(torch.tensor(float(N_SKILLS)))       # 均匀先验,log p(z) = -log N

def diayn_step(batch):
    s, a, s_next, z = batch['obs'], batch['act'], batch['next_obs'], batch['skill']

    # --- 1. 判别器:一个普通的交叉熵分类问题(输入状态,标签技能编号) ---
    logits = disc(s_next)                                # 用 s' 更常见:奖励评价的是"动作的后果"
    disc_loss = F.cross_entropy(logits, z)
    disc_opt.zero_grad(); disc_loss.backward(); disc_opt.step()

    # --- 2. 内在奖励 r = log q(z|s') - log p(z),注意 detach,不要把 RL 梯度传回判别器 ---
    with torch.no_grad():
        logq = F.log_softmax(disc(s_next), dim=-1)       # (B, N_SKILLS)
        r_int = logq.gather(1, z.view(-1, 1)).squeeze(1) - log_pz

    # --- 3. 用 (s,z) 拼接后的"增广状态"跑标准 SAC;alpha 项负责 H(a|s,z) ---
    z_onehot = F.one_hot(z, N_SKILLS).float()
    sac.update(obs=torch.cat([s, z_onehot], -1),
               next_obs=torch.cat([s_next, z_onehot], -1),
               act=a, rew=r_int, done=batch['done'])
    return disc_loss.item(), r_int.mean().item()
几个实现细节值得点出来。第一,判别器的输入用 $s'$ 还是 $s$?用 $s'$(下一状态)更符合 「奖励动作的后果」这个语义,也是原实现的做法。第二,奖励必须 detach: 策略不应该通过「让判别器变笨」来作弊,二者是合作而非对抗,梯度不能互串。 第三,$z$ 用 one-hot 拼接到观测上是最简单的条件化方式;连续 $z$ 则用高斯先验并直接拼接, 判别器换成输出高斯参数的网络,$\log q_\phi(z|s)$ 变成高斯对数密度。 第四,SAC 的温度 $\alpha$ 直接对应目标里的 $\mathcal{H}(a|s,z)$ 项, $\alpha$ 太大技能会互相糊掉,太小则每个技能塌成确定性轨迹。
5.4 为什么这个目标真的会产生「多样」行为
把奖励 $r(s,z)=\log q_\phi(z|s)$ 的行为分析一遍,能看清背后的博弈:
- 假设两个技能 $z_1,z_2$ 的状态分布重叠。在重叠区,判别器最好也只能给出 $q_\phi(z_1|s)\approx q_\phi(z_2|s)\approx 1/2$, 于是双方奖励都只有 $\log(1/2)=-0.69$(加上基线后为 $\log N - 0.69$)。
- 只要 $z_1$ 稍微往一个 $z_2$ 不去的方向偏一点,判别器就会学到这个偏差, $q_\phi(z_1|s)$ 上升,奖励上升。于是策略被激励着继续偏。
- 这个正反馈一直持续到各技能的状态分布互不相交、判别器能给出接近 1 的置信度为止, 此时奖励达到上限 $\log 1 = 0$(加基线后 $\log N$)。
换句话说,$\log q_\phi(z|s)$ 是一个「排他性」奖励: 奖励那些「别的技能不会去」的状态。幻灯片上那句 "reward states that are unlikely for other $z'\neq z$" 说的就是这件事。左下角那张示意图里,蓝色和绿色两簇轨迹被橙色虚线(判别器的决策边界)分开, 两簇都在往远离边界的方向拉伸——这是这个奖励的几何画面。
$\mathcal{I}(z;s)\le \mathcal{H}(z)=\log N$。取 $N=50$,上界是 $\log 50\approx 3.9$ 奈特。 这意味着:只要能把状态空间切成 50 个可区分的块,目标就被完全拉满了, 不管这 50 块加起来占整个状态空间的 1% 还是 100%。 一个 Ant 机器人只要学会朝 50 个不同方向各挪动 5 厘米,判别器就能 100% 分对, 互信息已经到顶,再往远处走一点好处也没有。这是 DIAYN 最主要的失效模式, 我们在 §6 里处理它。
6. DIAYN 的失效模式与它的变体:VIC、DADS
6.1 三个失效模式
(1)互信息饱和 → 技能不需要「走远」。上一节末尾已经说了:目标被 $\log N$ 封顶, 且这个上界在状态空间的任意小邻域里都可以达到。实践中的表现是: Ant 学出来的技能常常是「朝 $N$ 个方向各走一小步然后站住」,而不是「朝 $N$ 个方向一直跑」。 缓解办法有:把 $z$ 做成连续的($\mathcal{H}(z)$ 不再有有限上界)、 在奖励里额外加状态熵项、或者干脆改目标(下面的 DADS)。
(2)静态技能偏好。目标 $\mathcal{I}(z;s)$ 里的 $s$ 是状态边缘, 不区分「一直待在某个状态」和「反复经过某个状态」。所以最省力的解是: 每个技能冲到自己那块地方然后不动了。因为静止状态最好判别(判别器看到那个固定的 $s$ 就能 100% 确定是哪个 $z$),而且不动比动更容易维持。 结果是学到一堆「姿势」而不是「运动」。这对下游任务很不利—— 分层 RL 想要的是「向前走」这种可以持续执行的技能,不是「保持某个姿势」。
(3)判别在错误的空间里进行。如果状态是图像,判别器可能靠背景里的一个像素、 一个时钟读数、一个随机噪点就把技能分开了,而机器人本体什么都没做。 这是「噪声电视」在技能学习里的版本。实践中通常需要人为限定判别器只看 状态的一个子集(比如只看质心 $x,y$ 坐标),而这已经是偷偷注入监督信息了—— 这是这类方法一个诚实的批评点。
「DIAYN 学出的技能一定覆盖状态空间」——不成立。$\mathcal{I}(z;s)$ 只要求可区分, 不要求覆盖。可区分性是关于分布之间「不重叠」的性质, 把 $N$ 个 delta 函数放在原点附近的 $N$ 个不同点上,重叠为 0,互信息拉满,覆盖率却几乎为 0。 如果你真正想要的是覆盖,就要显式地把 $\mathcal{H}(s)$ 写进目标里: $\mathcal{I}(z;s)=\mathcal{H}(s)-\mathcal{H}(s|z)$,这个反向分解把覆盖项 $\mathcal{H}(s)$ 摆到了明面上——但它需要一个状态密度模型才能优化,这正是 §4 的技术。 两种分解在数学上等价,在近似下却给出完全不同的算法,这是本讲一个反复出现的教训。
6.2 VIC:把「起点」也考虑进来
DIAYN 的前身是 Variational Intrinsic Control(Gregor et al., 2016), 它优化的是 $\mathcal{I}(z;s_T|s_0)$——技能编号与终止状态之间的互信息,条件在初始状态上。 形式上:
$$ \mathcal{I}(z;s_T\mid s_0) \;\ge\; \mathcal{H}(p(z|s_0)) + \E\big[\log q_\phi(z\mid s_0,s_T)\big]. $$与 DIAYN 的三点差别:(a)只看终止状态而不是整条轨迹的状态边缘, 所以技能被定义为「从哪走到哪」,中间过程不管;(b)先验 $p(z|s_0)$ 依赖初始状态且可学, 这允许在不同起点上有不同数量的可用技能,但也带来了「熵坍缩」的风险 (DIAYN 正是靠把先验固定成均匀分布解决了这个问题); (c)判别器 $q_\phi(z|s_0,s_T)$ 同时看起点和终点。 VIC 更接近 empowerment 的原始形式,DIAYN 则是把它简化到「只看状态边缘、先验固定」的版本, 稳定性大幅提升,这是它更流行的原因。
6.3 DADS:要求技能的效果可预测
Dynamics-Aware Discovery of Skills(DADS)换了一个互信息:
$$ \mathcal{I}(s';z\mid s) \;=\; \mathcal{H}(s'\mid s) - \mathcal{H}(s'\mid s,z). $$逐项读:第一项要求在给定当前状态时,各技能造成的下一状态整体上要多样; 第二项要求给定当前状态和技能后,下一状态是可预测的。 两项合起来正是 §3.2 empowerment 的语义,只不过控制量从原始动作换成了抽象技能。
用变分近似。这次要近似的不是后验 $p(z|s)$,而是技能动力学 $p(s'|s,z)$, 用一个网络 $q_\phi(s'|s,z)$:
$$ -\mathcal{H}(s'|s,z) = \E\big[\log p(s'|s,z)\big] \;\ge\; \E\big[\log q_\phi(s'|s,z)\big]. $$而 $\mathcal{H}(s'|s)$ 需要边缘分布 $p(s'|s)=\int p(s'|s,z)p(z)\,dz$,用 $L$ 个先验采样近似:
$$ p(s'|s) \;\approx\; \frac{1}{L}\sum_{i=1}^{L} q_\phi\big(s'\mid s, z_i\big), \qquad z_i\sim p(z). $$把两者拼起来,逐样本的内在奖励是
$$ \boxed{\;r(s,z,s') \;=\; \log \frac{q_\phi(s'\mid s,z)}{\frac{1}{L}\sum_{i=1}^{L} q_\phi(s'\mid s,z_i)}\;} $$分子说「我这个技能对 $s'$ 的预测要准」,分母说「别的技能预测不出这个 $s'$」。 比值大 = 这个转移是我这个技能特有且可靠的效果。
DADS 相对 DIAYN 有两个实质好处。第一,它排斥不可控的随机性: 分子 $\log q_\phi(s'|s,z)$ 要求可预测,所以盯着噪声电视看不会得高分—— 这是对「噪声电视问题」的一个真正的结构性修复,而不是打补丁。 第二,也是更重要的:它顺手学出了一个以技能为动作的动力学模型 $q_\phi(s'|s,z)$。 到了下游任务阶段,你不需要再跑 RL,直接在 $z$ 空间里做 model-predictive control:
def plan_with_skills(s0, reward_fn, q_dyn, horizon=10, n_samples=200, n_elite=20, iters=4):
    """在技能空间里做 CEM 规划:用学到的技能动力学 q_dyn(s'|s,z) 想象未来。
    这是 DADS 的 zero-shot 用法——下游任务不需要任何环境交互就能出解。"""
    mu  = torch.zeros(horizon, z_dim)          # 技能序列的高斯提议分布
    std = torch.ones(horizon, z_dim)
    for _ in range(iters):
        Z = mu + std * torch.randn(n_samples, horizon, z_dim)   # (M, H, dz)
        s = s0.expand(n_samples, -1)
        ret = torch.zeros(n_samples)
        for h in range(horizon):
            s = q_dyn(s, Z[:, h])              # 一步技能动力学(每个技能持续若干环境步)
            ret = ret + reward_fn(s)           # 下游任务奖励,只需要能对状态求值
        elite = Z[ret.topk(n_elite).indices]   # 取回报最高的一批
        mu, std = elite.mean(0), elite.std(0) + 1e-3
    return mu[0]                               # 执行第一个技能,然后重规划
这也解释了为什么 DADS 的技能倾向于是「运动」而不是「姿势」: 一个静止的技能,它的 $s'\approx s$ 与所有其它静止技能的预测高度重叠,分母很大,奖励很低。 要拿高分,技能必须造成与众不同且稳定重复的状态变化——正是我们想要的那种技能。
| DIAYN | VIC | DADS | |
|---|---|---|---|
| 目标 | $\mathcal{I}(z;s)$ | $\mathcal{I}(z;s_T\mid s_0)$ | $\mathcal{I}(s';z\mid s)$ |
| 变分网络 | 判别器 $q_\phi(z\mid s)$ | 判别器 $q_\phi(z\mid s_0,s_T)$ | 技能动力学 $q_\phi(s'\mid s,z)$ |
| 先验 $p(z)$ | 固定均匀 | 可学 $p(z\mid s_0)$ | 固定(常用高斯) |
| 抗随机干扰 | 差(噪声电视可拿高分) | 差 | 好(要求可预测) |
| 倾向于 | 静态可区分姿势 | 不同终点 | 持续的、可重复的运动 |
| 下游用法 | 在 $z$ 上搜索 / 分层 RL | 分层 RL | 在 $z$ 上做 MPC(零样本) |
7. 把 $z$ 换成目标 $g$:目标条件 RL
7.1 一个小改动带来的大简化
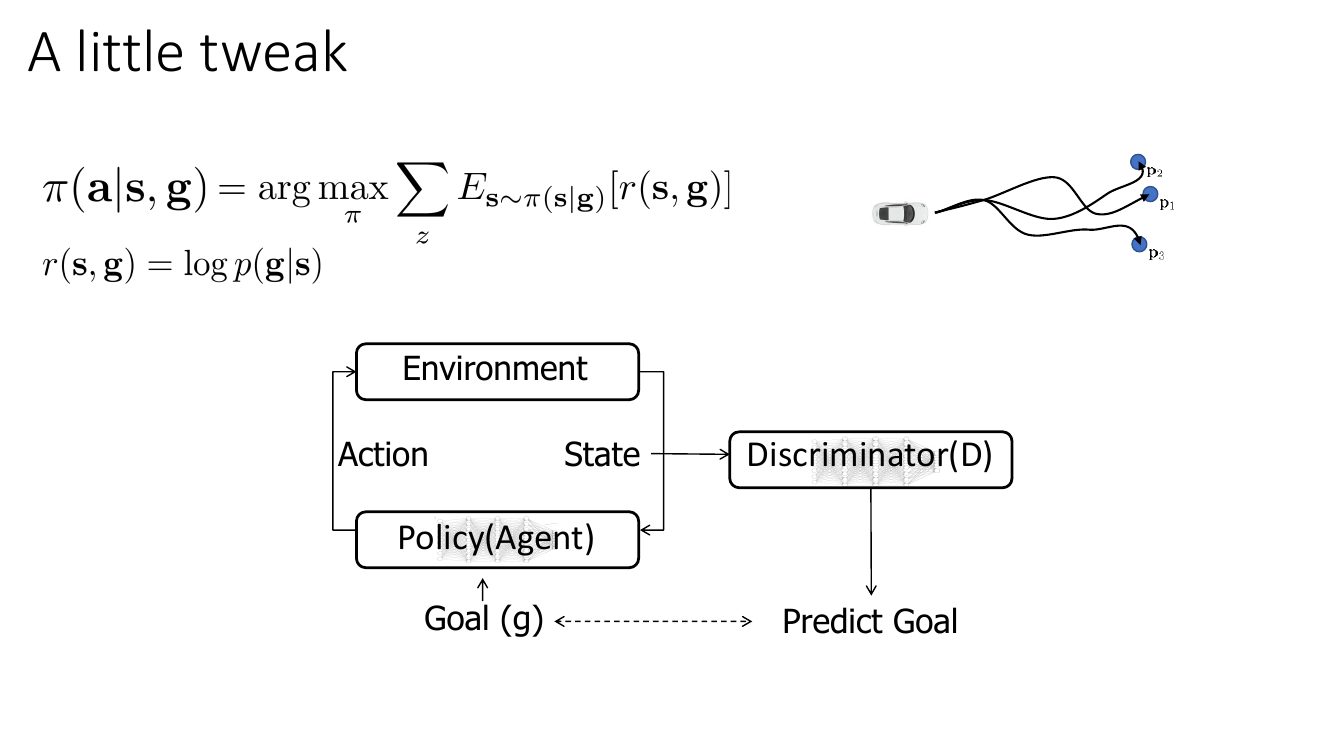
把 $z$ 替换成 $\mathbf{g}\in\mathcal{S}$,一切照抄:
$$ \pi(a|s,\mathbf{g}) = \argmax_\pi \sum_{\mathbf{g}} \E_{s\sim\pi(s|\mathbf{g})}\big[r(s,\mathbf{g})\big], \qquad r(s,\mathbf{g}) = \log p(\mathbf{g}\mid s). $$为什么这个替换是重大简化?因为 $\mathbf{g}$ 和 $s$ 同构,判别器就不用学了。 $p(\mathbf{g}|s)$ 想表达的是「看到状态 $s$,我猜你的目标是 $\mathbf{g}$」—— 而最自然的答案就是「$\mathbf{g}$ 大概就是 $s$ 本身」。于是可以直接手写:
$$ p(\mathbf{g}\mid s) \propto \exp\left(-\tfrac{1}{2\sigma^2}\|s-\mathbf{g}\|^2\right) \;\;\Longrightarrow\;\; r(s,\mathbf{g}) = -\tfrac{1}{2\sigma^2}\|s-\mathbf{g}\|^2 + \text{const}. $$一个高斯「判别器」直接给出了负平方距离奖励。幻灯片上也列了实践中更常用的两种:
$$ r(s,\mathbf{g}) = \delta(s=\mathbf{g}), \qquad\qquad r(s,\mathbf{g}) = \delta\big(\|s-\mathbf{g}\|\le \epsilon\big). $$即稀疏的 0/1 奖励:到了给 1,没到给 0。看起来这是在自找麻烦(稀疏奖励很难学), 但实践中它常常比负距离更好用,原因有二:(a)负距离奖励会诱导策略在 「离目标近但过不去」的地方磨蹭(比如隔着一堵墙贴着墙站), 因为它在局部确实让距离变小了——这是典型的奖励塑形陷阱; (b)稀疏奖励下的 $Q^\pi(s,a,\mathbf{g})$ 有明确的语义(近似「到达概率」或 $\gamma^{\text{到达步数}}$), 数值范围有界,训练更稳。而稀疏奖励难学这个问题,恰好被下面的 HER 化解掉了。
7.2 两项的分工
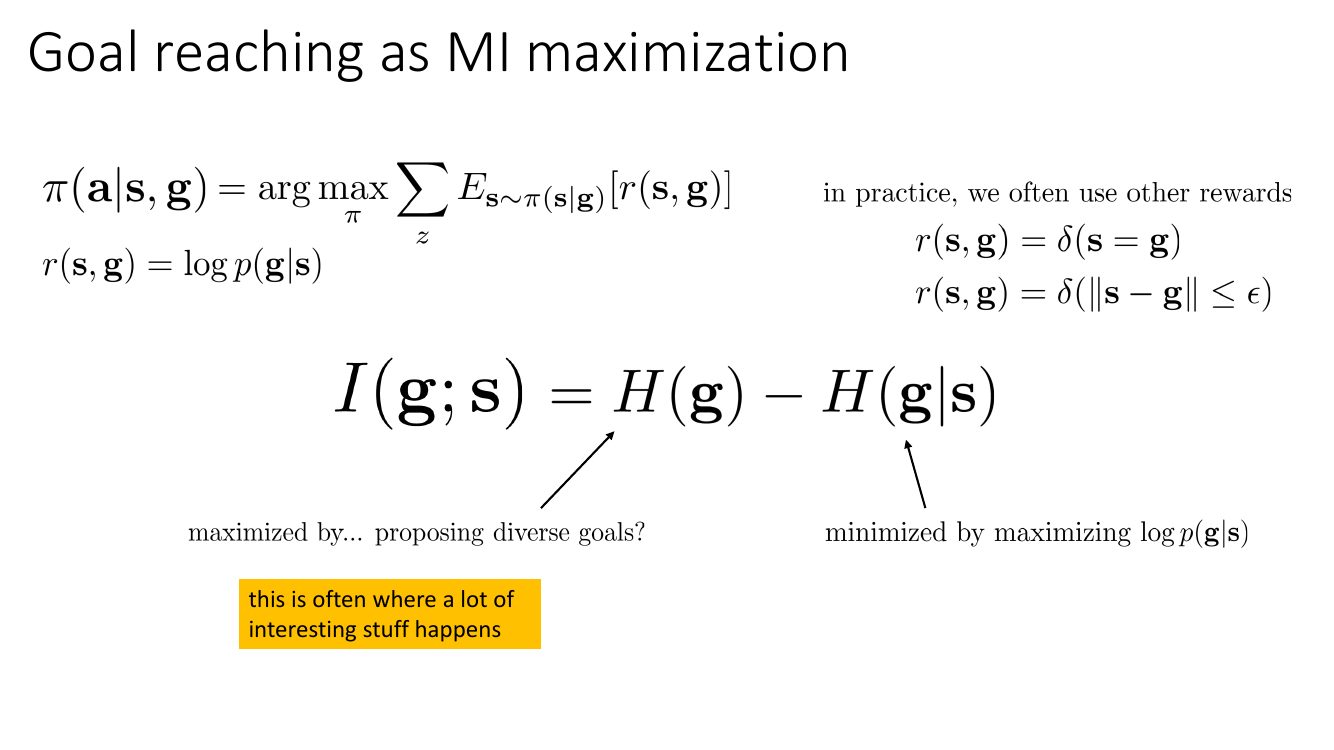
$$ \mathcal{I}(\mathbf{g};s) = \underbrace{\mathcal{H}(\mathbf{g})}_{\text{提出多样的目标}} - \underbrace{\mathcal{H}(\mathbf{g}\mid s)}_{\text{可靠地到达目标}} . $$和 DIAYN 对照着看,差别就在第一项:
- DIAYN 里 $\mathcal{H}(z)$ 是免费的——$z$ 是个抽象编号,取均匀先验就拉满了。
- 目标条件 RL 里 $\mathcal{H}(\mathbf{g})$ 一点也不免费——$\mathbf{g}$ 活在状态空间里, 你不能对一个 100 万维的图像空间取「均匀分布」,那采出来全是雪花噪声,没有任何一个是可达状态。 目标必须从可达状态的流形上采,而这个流形你一开始并不知道, 只能从「已经去过的状态」里估计。于是就有了鸡生蛋问题: 只有见过的状态才能当目标,只有当目标才会被反复去, 分布怎么才能扩张出去?
如果我们简单地「从 replay buffer 里随机挑一个访问过的状态当目标」, 那 $\mathbf{g}\sim p_\pi(s)$,此时 $\mathcal{H}(\mathbf{g})=\mathcal{H}(p_\pi(s))$—— 第一项精确地退化成了 §4 的状态边缘熵。整讲的两条线在这里合流了: 提出多样目标 = 最大化状态覆盖。而 §4 已经告诉我们这件事不平凡。
7.3 HER:把失败的轨迹变成成功的数据
先解决第二项——如何高效地训练 $\pi(a|s,\mathbf{g})$。稀疏奖励 $\delta(\|s-\mathbf{g}\|\le\epsilon)$ 下,早期策略几乎从不成功,$Q$ 学习拿到的全是 $r=0$ 的转移,学不动。 Hindsight Experience Replay(HER)的解法是一句话:你没到达 $\mathbf{g}$, 但你到达了别的地方——那就假装那里才是你的目标。
目标条件 MDP 的转移核是 $p(s'|s,a)$,它不依赖 $\mathbf{g}$—— 目标只出现在策略的输入和奖励函数里,环境根本不知道你想去哪。因此对任意 $\mathbf{g}'$, 一条实际发生的转移 $(s,a,s')$ 都是「以 $\mathbf{g}'$ 为目标的那个 MDP」中一个合法的转移样本。 再加上奖励函数 $r(s,a,\mathbf{g}')=\delta(\|s'-\mathbf{g}'\|\le\epsilon)$ 是解析已知的 (不需要环境返回,我们自己就能算),于是重标注后的四元组
$$ \big(s,\;a,\;s',\;\mathbf{g}',\;r(s,a,\mathbf{g}')\big) $$是目标 $\mathbf{g}'$ 下完全无偏的 off-policy 数据,可以直接喂给 Q-learning 的 Bellman 备份:
$$ Q(s,a,\mathbf{g}') \leftarrow r(s,a,\mathbf{g}') + \gamma\max_{a'}Q(s',a',\mathbf{g}'). $$唯一的前提是算法本身是 off-policy 的(DQN/DDPG/SAC 都可以): 因为数据是用 $\pi(\cdot|\cdot,\mathbf{g})$ 而不是 $\pi(\cdot|\cdot,\mathbf{g}')$ 采的, 行为策略与目标策略不一致。策略梯度类方法不能这么用(除非做重要性加权,而那会方差爆炸)。
效果是立竿见影的:如果把 $\mathbf{g}'$ 取成轨迹里实际到达的某个未来状态, 那这条轨迹在重标注后一定成功,$r=1$ 的正样本比例从 0% 直接跳到 100%。 稀疏奖励的「找不到信号」问题被彻底消解。
import numpy as np

def her_relabel(traj, reward_fn, k=4, strategy='future'):
    """traj: [(s, a, s', g), ...] 一条用目标 g 采的轨迹。
    返回原始转移 + k 倍的重标注转移。'future' 策略:只从 t 之后的状态里挑新目标,
    保证 g' 在时间上确实可达(挑 t 之前的状态会教出错误的可达性)。"""
    T, out = len(traj), []
    for t, (s, a, s2, g) in enumerate(traj):
        out.append((s, a, s2, g, reward_fn(s2, g)))          # 原始(几乎总是 r=0)
        if t == T - 1:
            continue
        for idx in np.random.randint(t + 1, T, size=k):      # 从未来采 k 个新目标
            g2 = traj[idx][2]                                # 用那一步实际到达的 s'
            out.append((s, a, s2, g2, reward_fn(s2, g2)))    # 重标注(其中至少一条 r=1)
    return out

def reward_fn(s, g, eps=0.05):
    return float(np.linalg.norm(s - g) <= eps)               # 稀疏 0/1 奖励,解析可算
几个要点。第一,为什么必须用 'future' 而不是整条轨迹随机挑: 如果把 $t$ 时刻之前的状态当目标,你在教网络「从 $s_t$ 出发,做 $a_t$,能到达一个我其实是从那儿来的地方」, 在不可逆的环境里这是错误的可达性信号。第二,重标注比例 $k$ 是个关键超参: $k$ 太大,buffer 里几乎全是「事后成功」的样本,策略会学成「预测我本来就要去哪」而不是「去我被要求去的地方」; 典型取 $k=4$,即约 80% 的样本是重标注的。第三,HER 也可以理解成一种自动课程: 早期策略乱走,重标注出来的目标都很近很容易;策略变强后走得远,重标注的目标自动变远。 课程难度自动跟随能力——这是 HER 除了解决稀疏奖励之外的第二个红利。
HER 让训练目标分布变成了「策略实际到达的状态分布」,即 $\mathbf{g}'\sim p_\pi(s)$。这意味着策略只在它已经会去的地方接受训练。 从 $\mathcal{I}(\mathbf{g};s)$ 的角度看:HER 把第二项 $\mathcal{H}(\mathbf{g}|s)$ 压得很低, 却完全没有推动第一项 $\mathcal{H}(\mathbf{g})$,甚至有反作用—— 它把学习资源全部投给了容易的目标。 纯 HER 的系统会稳定地精通一个小区域然后停止扩张。这正是 Skew-Fit 要修的东西。
7.4 RIG:在图像上怎么做
如果状态是图像,「目标状态」就是一张目标图片,而 $\|s-\mathbf{g}\|$ 在像素空间里毫无意义 (平移几个像素就会让距离巨大,而语义上完全等价)。RIG(Reinforcement Learning with Imagined Goals) 的做法分三步:
- 用无监督采集的图像训练一个 VAE(正是第 11 讲的内容),得到编码器 $q_\lambda(z|o)$ 和先验 $p(z)=\mathcal{N}(0,I)$;
- 目标从潜空间的先验采样:$z_g\sim p(z)$,再解码成一张「想象出来的目标图片」。 这解决了「怎么在图像空间提目标」的问题——不在像素空间提,在潜空间提;
- 奖励用潜空间距离 $r=-\|z_s - z_g\|$,策略是 $\pi(a|z_s,z_g)$, 并在潜空间做 HER 重标注。
潜空间距离比像素距离好得多,因为 VAE 的隐变量近似捕捉了场景中物体的位置等低维因素。 但它也继承了 VAE 的所有毛病:对无关的视觉变化敏感、对小物体不敏感。 更重要的是,从 $\mathcal{N}(0,I)$ 采出来的 $z_g$ 未必对应任何真实可达的场景—— 这就把我们推到了下一节的问题:目标分布本身应该怎么学、怎么扩张?
8. 自动课程:Skew-Fit 与熵单调上升的目标分布
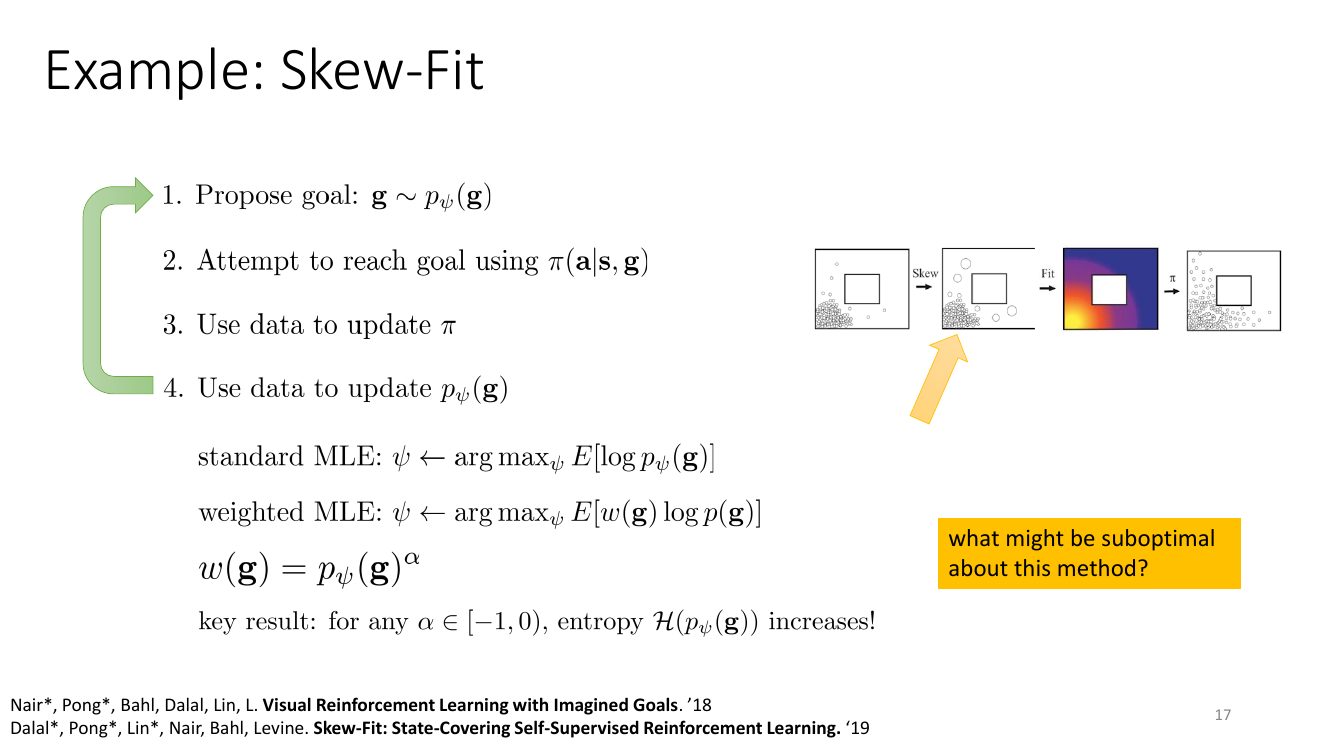
8.1 算法
Skew-Fit 的循环是:
- 提出目标:$\mathbf{g}\sim p_\psi(\mathbf{g})$($p_\psi$ 是一个生成模型,比如 VAE);
- 尝试到达:用 $\pi(a|s,\mathbf{g})$ 跑一条轨迹;
- 更新策略:用这批数据 + HER 重标注做 off-policy RL;
- 更新目标分布:用这批数据(实际访问到的状态)更新 $p_\psi$。
如果第 4 步用标准 MLE $\psi\leftarrow\argmax_\psi \E[\log p_\psi(\mathbf{g})]$, 会发生什么?$p_\psi$ 会收敛到策略的状态边缘分布 $p_\pi(s)$, 然后目标就都从策略已经常去的地方采,策略去那些地方更多,$p_\psi$ 更集中…… 正反馈坍缩:分布越来越尖,探索停止。这就是 §7.4 结尾说的鸡生蛋问题。
Skew-Fit 的修正只有一行:把 MLE 换成加权 MLE,权重是当前密度的 $\alpha$ 次幂:
$$ \psi \leftarrow \argmax_\psi\; \E_{\mathbf{g}\sim \text{data}}\big[\,w(\mathbf{g})\log p_\psi(\mathbf{g})\,\big], \qquad w(\mathbf{g}) = p_\psi(\mathbf{g})^{\alpha},\qquad \alpha\in[-1,0). $$$\alpha$ 是负的,所以当前密度越低的样本,权重越大。稀有状态被放大,常见状态被压低。 幻灯片右侧第二格图里那些「变大的圆圈」画的就是这件事。
8.2 关键结果:熵严格上升
设当前分布是 $p_t \triangleq p_{\psi_t}$,而数据(即策略访问到的状态)近似服从 $p_t$。 加权 MLE 的目标是
$$ \E_{\mathbf{g}\sim p_t}\big[p_t(\mathbf{g})^{\alpha}\log p_\psi(\mathbf{g})\big] = \int p_t(\mathbf{g})^{1+\alpha}\log p_\psi(\mathbf{g})\,d\mathbf{g} = Z\cdot \E_{\mathbf{g}\sim \tilde p}\big[\log p_\psi(\mathbf{g})\big], $$其中 $\tilde p(\mathbf{g}) \triangleq p_t(\mathbf{g})^{1+\alpha}/Z$,$Z=\int p_t^{1+\alpha}$。 也就是说,加权 MLE 恰好是对分布 $\tilde p$ 做的普通 MLE。 在模型容量无限的理想情况下,MLE 的解就是被拟合的分布本身,于是
$$ \boxed{\;p_{t+1} \;\propto\; p_t^{\,1+\alpha},\qquad \beta\triangleq 1+\alpha\in[0,1).\;} $$这是一次温度大于 1 的退火(tempering):把密度开根号($\beta=1/2$)会把 「$0.9$ 和 $0.01$」拉近成「$0.95$ 和 $0.1$」,分布被压平。$\alpha=-1$ 时 $\beta=0$, 一步就得到支撑集上的均匀分布。
要证:$\beta\in[0,1)$ 时 $\mathcal{H}(p^\beta/Z) \ge \mathcal{H}(p)$。 把 $q_\beta(x)=p(x)^\beta/Z(\beta)$ 看成一个单参数指数族: 自然参数是 $\beta$,充分统计量是 $T(x)=\log p(x)$, $\log Z(\beta)=\log\int e^{\beta T(x)}dx$ 是对数配分函数。指数族的两个标准恒等式:
$$ \frac{d\log Z}{d\beta} = \E_{q_\beta}[T], \qquad \frac{d^2 \log Z}{d\beta^2} = \mathrm{Var}_{q_\beta}[T] \;\ge\; 0 . $$(第一个由 $\frac{d}{d\beta}\log\int e^{\beta T}=\frac{\int T e^{\beta T}}{\int e^{\beta T}}=\E_{q_\beta}[T]$ 得到; 第二个再求一次导即可。)现在写出熵:
$$ \mathcal{H}(q_\beta) = -\E_{q_\beta}\big[\log q_\beta\big] = -\E_{q_\beta}\big[\beta T - \log Z(\beta)\big] = -\beta\,\E_{q_\beta}[T] + \log Z(\beta). $$对 $\beta$ 求导,注意 $\frac{d}{d\beta}\E_{q_\beta}[T]=\mathrm{Var}_{q_\beta}[T]$:
$$ \frac{d\mathcal{H}(q_\beta)}{d\beta} = -\E_{q_\beta}[T] - \beta\,\mathrm{Var}_{q_\beta}[T] + \underbrace{\E_{q_\beta}[T]}_{=\,d\log Z/d\beta} = -\,\beta\,\mathrm{Var}_{q_\beta}\big[\log p\big] \;\le\; 0 . $$所以熵是 $\beta$ 的单调不增函数。因为 $\beta=1$ 对应 $q_1=p$, 而我们用的是 $\beta<1$,故 $\mathcal{H}(q_\beta)\ge\mathcal{H}(p)$, 等号仅当 $\mathrm{Var}[\log p]=0$,即 $p$ 已经在支撑集上均匀。这就是幻灯片上那句 "for any $\alpha\in[-1,0)$, entropy $\mathcal{H}(p_\psi(\mathbf{g}))$ increases!" 的完整证明。
反复迭代 $p_{t+1}\propto p_t^{\beta}$,得 $p_t \propto p_0^{\beta^t}$, 而 $\beta^t\to 0$,故 $p_t$ 收敛到 $p_0$ 支撑集上的均匀分布。目标分布自动扩张, 而且有收敛性保证——这在深度 RL 里是罕见的干净结果。
import torch

def skewfit_update(vae, states, alpha=-0.5, n_steps=100):
    """对访问过的状态做 Skew-Fit 加权 MLE,等价于拟合 p^(1+alpha)。
    实现上有两种等价做法:(a) 逐样本加权损失;(b) 按权重重采样后做普通 MLE。
    这里用 (b),数值更稳,也直接兼容任何现成的生成模型训练代码。"""
    with torch.no_grad():
        logp = vae.log_prob(states)              # 当前模型对每个状态的对数密度(VAE 用 ELBO 近似)
        logw = alpha * logp                      # log w = alpha * log p,alpha < 0 => 稀有样本权重大
        logw = logw - logw.max()                 # 数值稳定
        w = torch.exp(logw)
        w = w / w.sum()

    for _ in range(n_steps):
        # 按 w 有放回地重采样一个 batch —— 等价于从 p^(1+alpha)/Z 中采样
        idx = torch.multinomial(w, num_samples=256, replacement=True)
        loss = -vae.elbo(states[idx]).mean()     # 在重采样数据上做普通 MLE
        vae.opt.zero_grad(); loss.backward(); vae.opt.step()

def propose_goal(vae):
    z = torch.randn(1, vae.z_dim)                # 从潜先验采样
    return vae.decode(z)                          # 解码成一张"想象的目标图片"
8.3 「这个方法可能有什么不足?」
幻灯片上那个黄色问号是留给听众的。几个诚实的答案:
- 它在错误的空间里追求均匀。Skew-Fit 最大化的是观测(或 VAE 潜空间)的熵, 不是任务相关空间的熵。房间里多一盏会闪烁的灯,就会产生大量视觉上不同、行为上毫无意义的状态, 均匀覆盖它们纯属浪费。这是「噪声电视」的又一次现身。
- 「均匀」不等于「有用」。覆盖率对所有状态一视同仁, 但从下游任务角度看,某些状态(比如「手里握着杯子」)的价值远高于另一些(「机器人躺在地上的第 731 种姿势」)。 minimax 论证只有在「对手真的会挑最坏目标」时才是对的;现实任务分布远没有那么对抗。
- 目标只能从见过的东西里插值出来。$p_\psi$ 是拟合已访问状态的生成模型, 它采出来的目标必然在数据流形附近。所以扩张是局部的、渐进的, 一次只能往外推一小圈;如果通往新区域需要一段很长且没有中间状态的行为序列 (Montezuma 那种「必须先拿钥匙」),Skew-Fit 一样过不去。
- 没有「学习进展」的概念。它给所有稀有目标同等的权重, 无论那个目标是「稍微努力一下就能到」还是「物理上根本不可能」。 把一半的交互预算花在不可达的目标上是常见现象。 基于学习进展 / 中等难度(比如挑成功率约 50% 的目标)的课程方法在这点上更聪明, 但缺少 Skew-Fit 这样干净的理论保证。
- 密度估计本身不可靠。整个证明建立在「$p_\psi$ 准确反映当前状态分布」之上。 高维图像上的 VAE 似然是出了名的不靠谱,$\alpha$ 次幂又会把估计误差放大 ($\alpha=-1$ 时误差直接取倒数)。实践中 $\alpha$ 要取得温和一些(如 $-0.5$), 本质上是在「扩张速度」和「被密度估计误差带跑偏」之间折中。
9. 不走互信息路线的探索:Go-Explore 与 HOMER
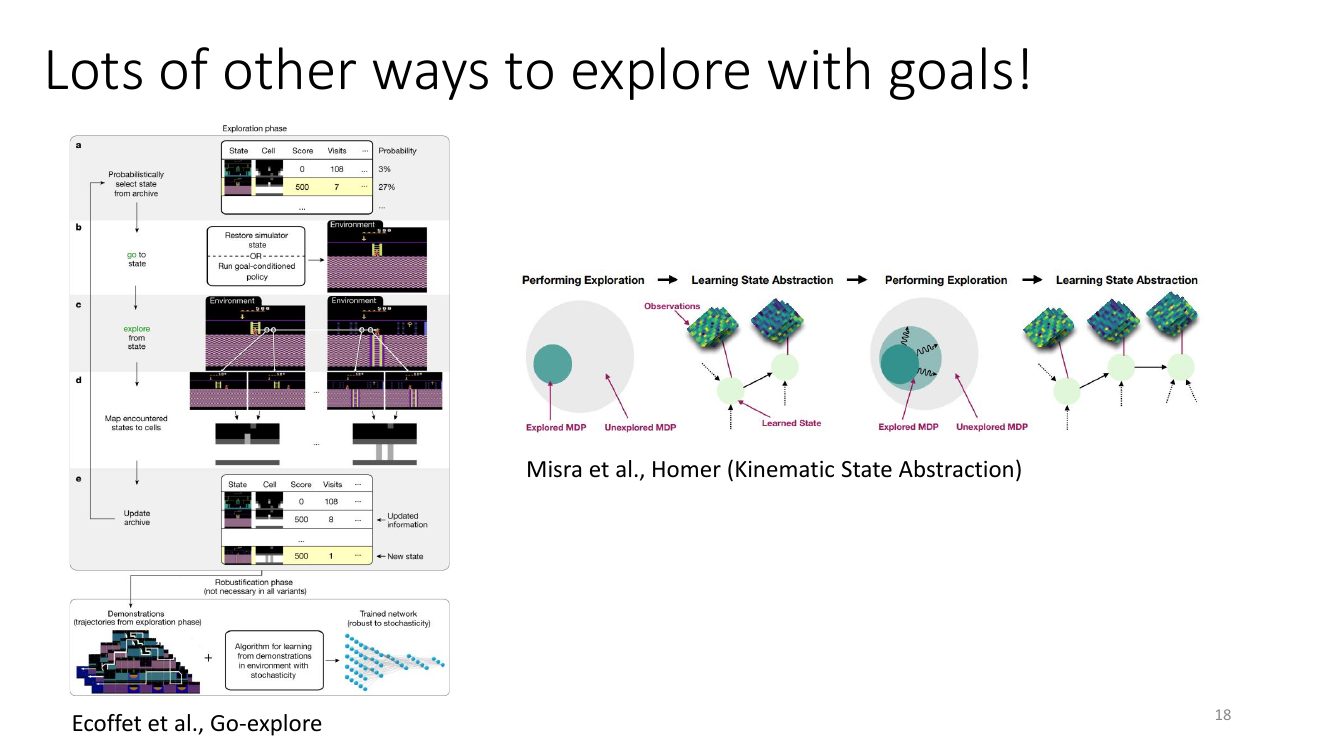
9.1 Go-Explore:先回去,再探索
Go-Explore 的出发点是对内在动机方法的一个尖锐批评。它指出这类方法有两个结构性缺陷:
- 脱离(detachment):内在奖励是随访问次数衰减的。当智能体探索完区域 A 的边缘、 奖励被消耗殆尽后,它会转向区域 B。但等它在 B 那边耗完,A 的边缘早已被遗忘—— 策略不再知道怎么回到 A 的前沿,那片有希望的边界就此被抛弃。
- 脱轨(derailment):即使还记得某个有希望的状态,要回到那里需要执行一长串精确动作。 而探索算法为了探索必然带随机性($\epsilon$-greedy、熵正则), 这些随机扰动会在返回途中把你踢下轨道。想去的地方越远,成功返回的概率指数级衰减。
Go-Explore 的解法直白得近乎粗暴:把「返回」和「探索」彻底分开。
- 档案(archive):把状态离散化成 cell(早期版本用降采样的画面, 后期用学到的表征),每个 cell 记录代表状态、最高分、访问次数。
- Select:按概率挑一个 cell,偏好访问次数少 / 最近发现 / 得分高的。 图中表格里那一行「500 分、访问 7 次 → 27% 概率」画的就是这件事—— 访问 108 次的只有 3% 概率,访问 7 次的有 27%。
- Go:确定性地回到那个状态。在模拟器里可以直接恢复存档(这是它最受争议的地方, 但也是它效果惊人的原因);无法存档时就训练一个目标条件策略去到达它—— 目标条件 RL 在这里变成了 Go-Explore 的一个部件。
- Explore:从那里开始随机动若干步。
- Update:新状态映射到 cell,若是新 cell 或更优轨迹,就更新档案。
- Robustify(可选):探索阶段产出的是一串开环动作序列,在随机环境里不可靠。 把这些轨迹当演示,用模仿学习 / backward algorithm 训练一个闭环策略。
这套方法在 Montezuma's Revenge 上把分数从此前方法的几千推到了几万乃至通关, 在 Pitfall 上首次拿到正分。它的哲学立场和本讲前半段正相反: 不去设计一个漂亮的内在奖励让单一策略自发探索,而是承认探索本质上是一个搜索问题, 显式地维护一个前沿集合并用「记忆 + 确定性返回」来对抗遗忘。 Levine 把它列在这里,是提醒你信息论目标不是唯一的答案。
设某个前沿状态需要 100 步精确动作才能到达,每步以 $\epsilon=0.05$ 的概率随机化。 一个带探索噪声的策略成功返回的概率上界约为 $(1-\epsilon)^{100}\approx 0.6\%$。 也就是说,即使策略「知道怎么走」,平均也要试 170 次才能回到前沿一次, 探索预算几乎全部消耗在往返路上。Go-Explore 把返回阶段的随机性设为 0, 这个 170 倍的浪费直接消失。这个简单的量级估计解释了它的大部分性能优势。
9.2 HOMER:把探索和表征学习交织起来
HOMER(Misra et al., "Kinematic State Abstraction and Provably Efficient Rich-Observation RL") 研究的是 block MDP 设定:真实状态数量少(记为 $|\mathcal{S}|$), 但观测是高维富信息的(图像),且观测到状态的映射是确定的多对一。 在这个设定下可以要求可证明的样本复杂度。它的循环是(对应图右侧的四格):
- Perform Exploration:用当前已有的一组「策略覆盖(policy cover)」去到达第 $h$ 层的各个抽象状态, 把「已探索 MDP」(深色圆)向外推一圈;
- Learn State Abstraction:用收集的数据训练一个对比式二分类器—— 给定 $(o_h, a_h, o_{h+1})$,判断这三元组是真实转移还是从边缘分布里拼出来的假样本。 分类器中间的信息瓶颈层被迫编码出「运动学上等价」的抽象状态: 两个观测被映射到同一个抽象状态,当且仅当它们对未来是等价的;
- 用新学到的抽象状态定义第 $h+1$ 层的目标,训练新的目标条件策略加入策略覆盖,回到 1。
它和本讲前半段的关系是:同样用「到达目标」驱动探索,但目标不是从生成模型里采的图片, 而是学出来的离散抽象状态;而且它逐层(by horizon)推进,保证第 $h$ 层完全覆盖后再做第 $h+1$ 层, 从而给出 PAC 保证。代价是设定很强(block MDP、有限抽象状态、确定性发射), 在真实机器人上很难直接套用。但它给出的教训是普适的: 探索和表征学习必须一起做——好的抽象让探索变简单,广的探索让抽象学得准。
| 方法 | 探索的驱动力 | 如何对抗遗忘 | 理论保证 | 典型适用场景 |
|---|---|---|---|---|
| Count / novelty bonus | $-\log N(s)$ 内在奖励 | 无(靠策略自己记) | 表格情形有 | 中等规模、奖励较稀疏 |
| SMM / MaxEnt 探索 | $\mathcal{H}(p_\pi(s))$ | 保留策略混合 | 博弈均衡 | 连续控制预训练 |
| DIAYN / DADS | $\mathcal{I}(z;s)$、$\mathcal{I}(s';z|s)$ | 技能被 $z$ 索引,不会互相覆盖 | 变分下界单调 | 技能库、分层 RL |
| Skew-Fit | 目标分布熵上升 | 目标由生成模型记住 | 收敛到均匀 | 视觉目标到达 |
| Go-Explore | 档案里的稀有 cell | 显式档案 + 确定性返回 | 无 | 可存档模拟器、极端稀疏奖励 |
| HOMER | 逐层的策略覆盖 | 策略覆盖集合被保留 | PAC(block MDP) | 理论分析、结构化环境 |
10. 从无监督预训练到下游任务
预训练完了,任务来了,怎么接上?根据预训练产出的东西不同,有四条接法。
10.1 在技能空间里搜索
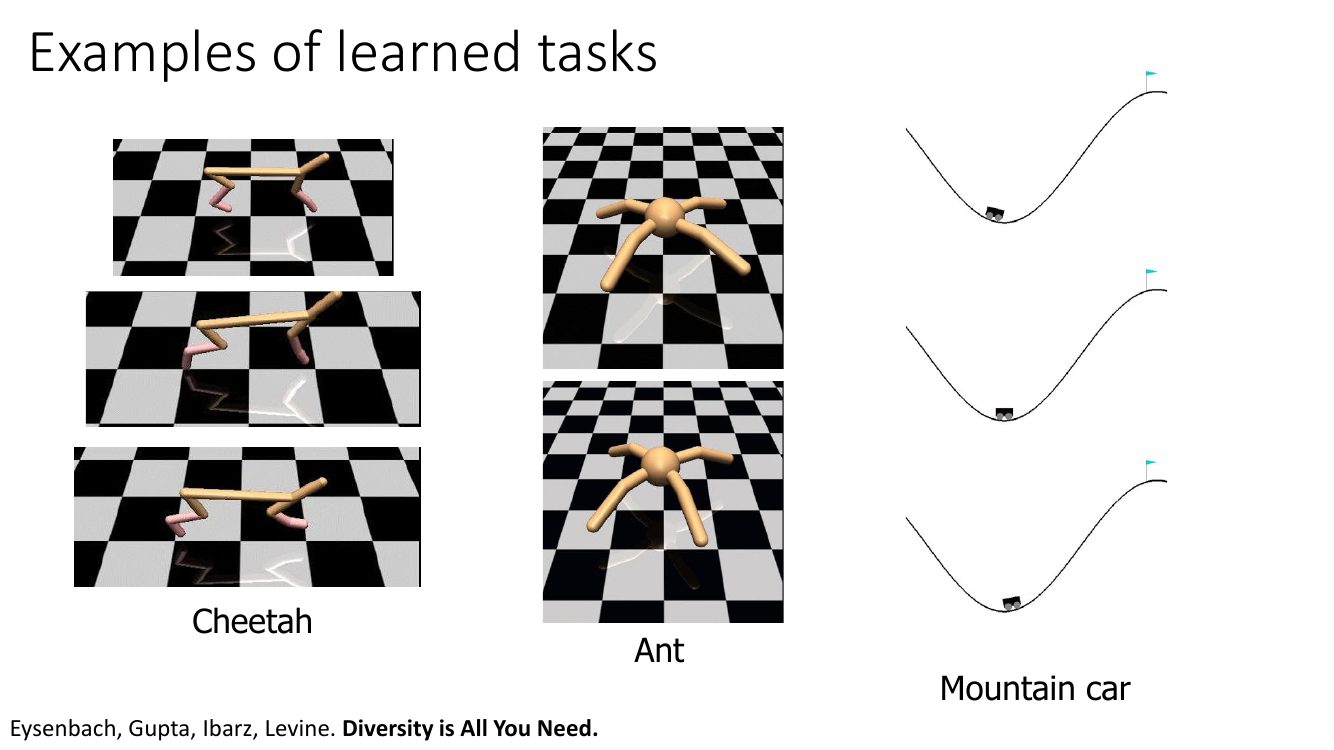
如果预训练产出的是 $\pi(a|s,z)$ 和一组离散技能 $z\in\{1,\dots,N\}$, 最简单的用法是穷举:对每个 $z$ 跑几条轨迹,算一下真实任务回报 $\sum_t r(s_t,a_t)$, 挑最好的那个。计算量是 $N$ 条轨迹($N=50$ 时是 50 条), 而从零开始学一个连续控制任务动辄要 $10^5\sim10^6$ 条。 DIAYN 论文里 Mountain Car、Cheetah 这些任务上,直接挑技能就已经能拿到相当可观的分数—— 因为「爬到山顶」「向前跑」这类行为本身就是判别器最喜欢的可区分行为, 无监督阶段已经把它们发现了。若 $z$ 是连续的,就用 CEM 之类的黑盒优化在 $z$ 空间里搜。
10.2 分层:学一个高层策略去调度技能
更强的用法是固定低层 $\pi(a|s,z)$,学一个高层策略 $\pi^{\text{hi}}(z|s)$, 每 $k$ 步(比如 $k=20$)输出一个技能,低层执行 $k$ 步。这样做的三个好处:
- 动作空间变小:高层的动作是 $N$ 个离散技能,而不是 8 维连续力矩;
- 时间尺度变粗:一个长度 1000 的 episode 在高层只有 50 步决策, 折扣 $\gamma$ 的有效视野缩短 $k$ 倍,信用分配容易得多;
- 探索变好:高层的随机探索是「随机切换技能」, 每次切换都造成宏观上有意义的行为变化,比在原始动作上加噪声有效得多。
代价是低层被冻住了:如果无监督阶段没学出任务需要的那个技能,高层再怎么组合也变不出来。 这是下一讲分层 RL 要处理的核心张力。
10.3 微调:把预训练策略当初始化
把 $\pi(a|s,z)$ 的权重(丢掉 $z$ 输入或固定一个 $z$)当作任务策略的初始化, 然后用真实奖励继续跑 SAC。此外,无监督阶段积累的 replay buffer 本身就是宝贵资产: 可以用它预训练动力学模型、表征编码器,或者直接混进微调阶段的 buffer 里 (这时就变成了 offline-to-online RL 的问题)。
10.4 目标条件策略直接当通用求解器
如果预训练产出的是 $\pi(a|s,\mathbf{g})$(Skew-Fit / RIG 路线), 而下游任务恰好是「到达某个状态」,那就零样本可用:把任务的目标状态喂进去即可。 如果下游任务是一般的奖励函数 $r$,可以先找出 $r$ 的高值状态作为 $\mathbf{g}$,再用目标条件策略去到那儿。
Unsupervised RL Benchmark(URLB)这类统一评测给出的图景比论文单独报告的要冷静得多: 在同一预训练预算下,不同类别方法的下游表现差异很大且高度依赖任务, 基于「能力/技能」的方法(DIAYN 一类)在很多下游任务上并不优于 基于「数据覆盖」的方法(状态熵最大化一类),有时甚至不如从零开始训练。 原因回到 §6.1:$\mathcal{I}(z;s)$ 的天花板 $\log N$ 让技能没有动力覆盖全空间, 而覆盖才是下游任务真正需要的东西。这是一个诚实的现状: 本讲的目标函数在数学上都很漂亮,但「哪个目标真的能带来下游收益」远未有定论。
本讲小结
一句话:没有奖励函数时,用信息论量代替它——熵度量覆盖,互信息度量可区分性 / 控制力;两者都可以通过变分下界转化成一个「训一个辅助网络、把它的对数似然当奖励」的标准 RL 循环。
公式速查
| 名称 | 公式 | 作用 |
|---|---|---|
| 熵 | $\mathcal{H}(p(x))=-\E_{x\sim p}[\log p(x)]$ | 度量分布有多宽;有限支撑下 $\le\log N$ |
| 互信息(三写法) | $\mathcal{I}(x;y)=\KL(p(x,y)\|p(x)p(y))=\E[\log\frac{p(x,y)}{p(x)p(y)}]=\mathcal{H}(y)-\mathcal{H}(y|x)$ | 知道 $x$ 能消掉多少关于 $y$ 的不确定性 |
| 变分下界 | $\mathcal{I}(z;s)\ge \mathcal{H}(z)+\E[\log q_\phi(z|s)]$,间隙 $=\E_s[\KL(p(z|s)\|q_\phi)]$ | 把 MI 变成「分类器 + RL」 |
| 状态边缘熵 | $\mathcal{H}(p_\pi(s))=\E_{p_\pi}[-\log p_\pi(s)]$ | 探索目标;奖励 $=-\log p_\pi(s)$,含策略自身 → 两玩家博弈 |
| SMM | $\min_\pi \KL(p_\pi(s)\|p^\ast(s))$ | 熵最大化的带先验推广;输出应是策略混合 |
| Empowerment | $\mathcal{I}(a_t;s_{t+1})=\mathcal{H}(s_{t+1})-\mathcal{H}(s_{t+1}|a_t)$ | 控制权:变化多 且 由我决定 |
| DIAYN 目标 | $\mathcal{F}=\mathcal{I}(s;z)+\mathcal{H}(a|s)-\mathcal{I}(a;z|s)=\mathcal{H}(z)-\mathcal{H}(z|s)+\mathcal{H}(a|s,z)$ | 技能多样、动作随机、不靠动作区分技能 |
| DIAYN 奖励 | $r_z(s,a)=\log q_\phi(z|s)-\log p(z)$ | 判别器猜对得正分,配 SAC 使用 |
| DADS 奖励 | $r=\log\frac{q_\phi(s'|s,z)}{\frac1L\sum_i q_\phi(s'|s,z_i)}$ | 效果独特且可预测;顺带得到可规划的模型 |
| 目标条件 MI | $\mathcal{I}(\mathbf{g};s)=\mathcal{H}(\mathbf{g})-\mathcal{H}(\mathbf{g}|s)$ | 提多样目标 + 可靠到达 |
| Skew-Fit | $w(\mathbf{g})=p_\psi(\mathbf{g})^\alpha,\ \alpha\in[-1,0)\Rightarrow p_{t+1}\propto p_t^{1+\alpha}$ | $\frac{d\mathcal{H}(q_\beta)}{d\beta}=-\beta\mathrm{Var}[\log p]\le 0$ ⇒ 熵严格上升 |
要点清单
- 探索难的本质不是感知,而是「随机策略撞不到奖励」+「没有语义先验」。 把语义换成覆盖率,是本讲的整体策略。
- 互信息目标的模板:$\mathcal{I}(A;B)=\mathcal{H}(B)-\mathcal{H}(B|A)$, 挑一项用「我们自己指定的先验」拉满,另一项用变分网络逼近后当奖励。 把 $(A,B)$ 换成不同的东西,就得到 empowerment / DIAYN / DADS / 目标条件 RL。
- 同一个量的两种分解会给出完全不同的算法: $\mathcal{I}(z;s)=\mathcal{H}(z)-\mathcal{H}(z|s)$(DIAYN,只需分类器,但不保证覆盖) vs. $\mathcal{H}(s)-\mathcal{H}(s|z)$(需要状态密度模型,但覆盖项在明面上)。 数学等价 ≠ 近似后等价,这是深度 RL 里反复出现的现象。
- 可区分 ≠ 覆盖:$N$ 个离散技能的互信息上界是 $\log N$, 在状态空间的任意小角落里就能拿满。这是 DIAYN 类方法最主要的局限。
- 可预测性是抗噪的关键:纯新颖性目标会被「噪声电视」骗, 而 DADS 那种要求「技能的后果可预测」的目标有结构性免疫力。
- 奖励依赖数据分布时不要取最后一次的策略,要取历次策略的混合—— 这条经验对所有 novelty bonus 方法都成立。
- HER 合法的根本原因是「转移与目标无关 + 奖励解析可算」, 所以它只能用在 off-policy 算法上;它顺带提供了自动课程,但把目标分布拉向已能到达的区域。
- Skew-Fit 修的正是 HER 的这个偏向:加权 MLE = 对 $p^{1+\alpha}$ 做普通 MLE = 温度退火, 熵单调上升并收敛到均匀。
- Go-Explore 提醒我们:探索也可以不写成一个内在奖励,而写成一个显式的搜索 + 记忆问题; 「先确定性地回到前沿,再开始随机探索」这个拆分带来的收益可以是量级级别的。
- 现状是谦逊的:统一评测下,无监督 RL 预训练的下游收益远没有监督预训练在 NLP/CV 里那么确定, 「该最大化哪个目标」仍是开放问题。
延伸阅读
技能发现(互信息路线)
- Diversity is All You Need: Learning Skills without a Reward Function (2018) — 本讲第二段的原始论文。读第 3 节的目标推导和附录里 $\mathcal{H}(a|s)$ 被消掉的那步; 实验部分关于「用学到的技能做分层 RL 和模仿学习」的用法值得看。
- Variational Intrinsic Control (2016) — DIAYN 的前身,用 $\mathcal{I}(z;s_T|s_0)$。对比它和 DIAYN 能看清「可学先验 vs 固定均匀先验」 这个看似次要的选择为什么决定了稳定性。
- Dynamics-Aware Unsupervised Discovery of Skills (2019) — DADS。把 MI 换成 $\mathcal{I}(s';z|s)$,同时学出可用于 MPC 的技能动力学模型, 是本讲里唯一支持零样本规划的方法。
- Variational Information Maximisation for Intrinsically Motivated RL (2015) — Mohamed & Rezende,把 empowerment 的变分下界系统化的工作,是所有后续方法的技术源头。
状态覆盖与探索
- Efficient Exploration via State Marginal Matching (2019) — SMM。给出「两玩家博弈」的正确框架,以及「应该输出策略混合而不是最后一个策略」这个重要结论。
- Provably Efficient Maximum Entropy Exploration (2018) — MaxEnt 探索的理论版本,给出在表格 MDP 下最大化状态熵的可证明高效算法(frank-wolfe 型)。
- Behavior From the Void: Unsupervised Active Pre-Training (2021) — APT,用 $k$-NN 粒子熵估计器做内在奖励,§4.3(c) 那个奖励公式的出处,实现简单效果稳。
- Unifying Count-Based Exploration and Intrinsic Motivation (2016) — 伪计数的经典工作,读它可以看清 $-\log p(s)$ 与 $N(s)^{-1/2}$ 这两类 bonus 的关系。
目标条件 RL 与自动课程
- Hindsight Experience Replay (2017) — HER 原文。重点看 §4 的「future / final / episode / random」四种重标注策略的消融, 以及为什么必须配 off-policy 算法。
- Visual Reinforcement Learning with Imagined Goals (2018) — RIG。用 VAE 在潜空间里提目标、算奖励、做 HER,是把目标条件 RL 搬到图像上的标准配方。
- Skew-Fit: State-Covering Self-Supervised Reinforcement Learning (2019) — §8 的原文。定理 1(熵单调上升)和它的证明结构值得完整读一遍,是本讲最干净的理论结果。
- Automatic Goal Generation for Reinforcement Learning Agents (2017) — GoalGAN,用 GAN 生成「中等难度」的目标(成功率在 10%–90% 之间), 代表另一条课程思路:按学习进展而不是按稀有度选目标。
其它探索路线
- Go-Explore: a New Approach for Hard-Exploration Problems (2019) — 档案 + 确定性返回 + 鲁棒化。对「detachment / derailment」的诊断即使不用它的算法也很有价值。
- Kinematic State Abstraction and Provably Efficient Rich-Observation RL (2019) — HOMER。在 block MDP 下把探索和表征学习交织起来并给出 PAC 保证。
- URLB: Unsupervised Reinforcement Learning Benchmark (2021) — 统一评测。看完本讲所有方法后读它,会对「哪类目标真的有用」形成更冷静的判断。
与前面几讲的连接
- 第 11 讲 · 变分推断 — 本讲每一个「$\ge$」号都来自那一讲的同一个技巧:引入 $q_\phi$, 用 $\KL(p\|q_\phi)\ge0$ 换出一个可计算的下界,间隙就是那个 KL。 DIAYN 的判别器和 VAE 的编码器在数学上是同一个东西。
- 第 12 讲 · 变分推断在 RL 中的应用 — 那里的最大熵 RL / soft Q-learning 正是 DIAYN 里 $\mathcal{H}(a|s,z)$ 那一项的实现(SAC)。