进阶策略梯度:信赖域、自然梯度、TRPO 与 PPO
把策略梯度重新解释成「软化的策略迭代」,从性能差分引理一路推到 TRPO 和 PPO 的损失函数。
0. 本讲导读
上一讲我们推导了 off-policy 策略梯度:手里只有旧策略 $\pi_\theta$ 采的样本,却想更新到新参数 $\theta'$,于是用重要性采样(importance sampling, IS)把期望搬过去。但那个推导的最后,我们干了两件在数学上说不清楚的事——把两个碍事的因子直接划掉了。这一讲就是专门回来还这笔债的:那两个「划掉」到底在什么条件下是合法的?
答案会把我们带到一条非常漂亮的逻辑链:
- 先证性能差分引理(performance difference lemma):两个策略的回报之差,等于新策略的轨迹分布下、旧策略的优势函数之和。这一步把「策略梯度」重新解释成了「策略迭代」。
- 用 IS 把动作上的期望换成旧策略的期望——这就解释了第一个「划掉」:用旧策略的优势 $A^{\pi_\theta}$ 是完全正确的,不需要 $A^{\pi_{\theta'}}$。
- 但状态分布 $p_{\theta'}(s_t)$ 还是新策略的,换不掉。于是证有界分布漂移引理:只要两个策略在动作层面足够接近(总变差 $\le\epsilon$),状态边缘分布的差就被 $\epsilon t$ 控制住。这解释了第二个「划掉」。
- 把总变差换成 KL 散度(Pinsker 不等式),得到一个带 KL 约束的优化问题——这就是「信赖域」的原型。
- 解这个带约束问题的两条路:拉格朗日对偶(→ PPO)和二阶近似 + 自然梯度(→ TRPO)。
这一讲是全课理论密度最高的一讲。它的价值不在于让你会调 PPO 的超参数(那反而是最容易的部分),而在于让你明白:为什么可以拿同一批样本对策略连做十几步梯度更新而不崩——这件事在 REINFORCE 的框架里是完全说不通的,只有在「策略迭代」的框架里才讲得清楚。
- 性能差分引理:$J(\theta')-J(\theta)=\E_{\tau\sim p_{\theta'}(\tau)}\big[\sum_t \gamma^t A^{\pi_\theta}(s_t,a_t)\big]$。想改进策略,只需在新策略的分布下最大化旧策略的优势。
- 动作上的分布不匹配用 IS 精确修正;状态上的分布不匹配无法修正,只能限制策略变化幅度把误差压住:$D_{\mathrm{TV}}(\pi_{\theta'},\pi_\theta)\le\epsilon\Rightarrow \frac12\sum_{s_t}|p_{\theta'}(s_t)-p_\theta(s_t)|\le\epsilon t$。
- 由 Pinsker 不等式 $D_{\mathrm{TV}}\le\sqrt{\tfrac12 D_{\mathrm{KL}}}$,把约束写成 KL 形式;KL 只需对旧策略的样本求期望即可估计,这是它比 TV 好用的根本原因。
- PPO:把 KL 约束当作惩罚项,用对偶梯度下降调 $\beta$;实践中的 clip 形式是它的一个廉价启发式近似。
- TRPO:目标一阶展开 + KL 二阶展开,得到自然梯度 $\theta'=\theta+\alpha F^{-1}\nabla_\theta J$,步长 $\alpha=\sqrt{2\epsilon/(\nabla_\theta J^\top F^{-1}\nabla_\theta J)}$,用共轭梯度避免显式求逆。
- 一句话:策略梯度 = 步长受 KL 约束的软化版策略迭代。约束半径 $\epsilon\to\infty$ 是贪心策略迭代,$\epsilon\to 0$ 是普通梯度上升,TRPO/PPO 在中间。
1. 我们究竟偷了哪两个懒
先把上一讲的结论摆回桌面。目标是 $\theta^\star=\argmax_\theta J(\theta)$,其中 $J(\theta)=\E_{\tau\sim p_\theta(\tau)}[r(\tau)]$。我们想用 $\pi_\theta$ 采的样本来估计 $\nabla_{\theta'}J(\theta')$,于是对整条轨迹做重要性采样:
$$ \nabla_{\theta'}J(\theta')=\E_{\tau\sim p_\theta(\tau)}\left[\frac{p_{\theta'}(\tau)}{p_\theta(\tau)}\nabla_{\theta'}\log \pi_{\theta'}(\tau)\, r(\tau)\right] $$轨迹概率 $p_\theta(\tau)=p(s_1)\prod_t \pi_\theta(a_t|s_t)p(s_{t+1}|s_t,a_t)$ 里的初始分布和转移概率在比值中约掉,只剩策略项,于是
$$ \nabla_{\theta'}J(\theta')=\E_{\tau\sim p_\theta(\tau)}\left[\left(\prod_{t=1}^{H}\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}\right)\left(\sum_{t=1}^{H}\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t)\right)\left(\sum_{t=1}^{H} r(s_t,a_t)\right)\right] $$再利用因果性(causality,$t$ 时刻的动作不影响 $t$ 之前的奖励)把连乘拆开重排,得到
$$ \nabla_{\theta'}J(\theta')=\E_{\tau\sim p_\theta(\tau)}\left[\sum_{t=1}^{H}\underbrace{\left(\prod_{t'=1}^{t}\frac{\pi_{\theta'}(a_{t'}|s_{t'})}{\pi_\theta(a_{t'}|s_{t'})}\right)}_{\text{到 }t\text{ 为止的权重}}\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t)\left(\sum_{t'=t}^{H}r(s_{t'},a_{t'})\underbrace{\left(\prod_{t''=t}^{t'}\frac{\pi_{\theta'}(a_{t''}|s_{t''})}{\pi_\theta(a_{t''}|s_{t''})}\right)}_{\text{未来奖励的权重}}\right)\right] $$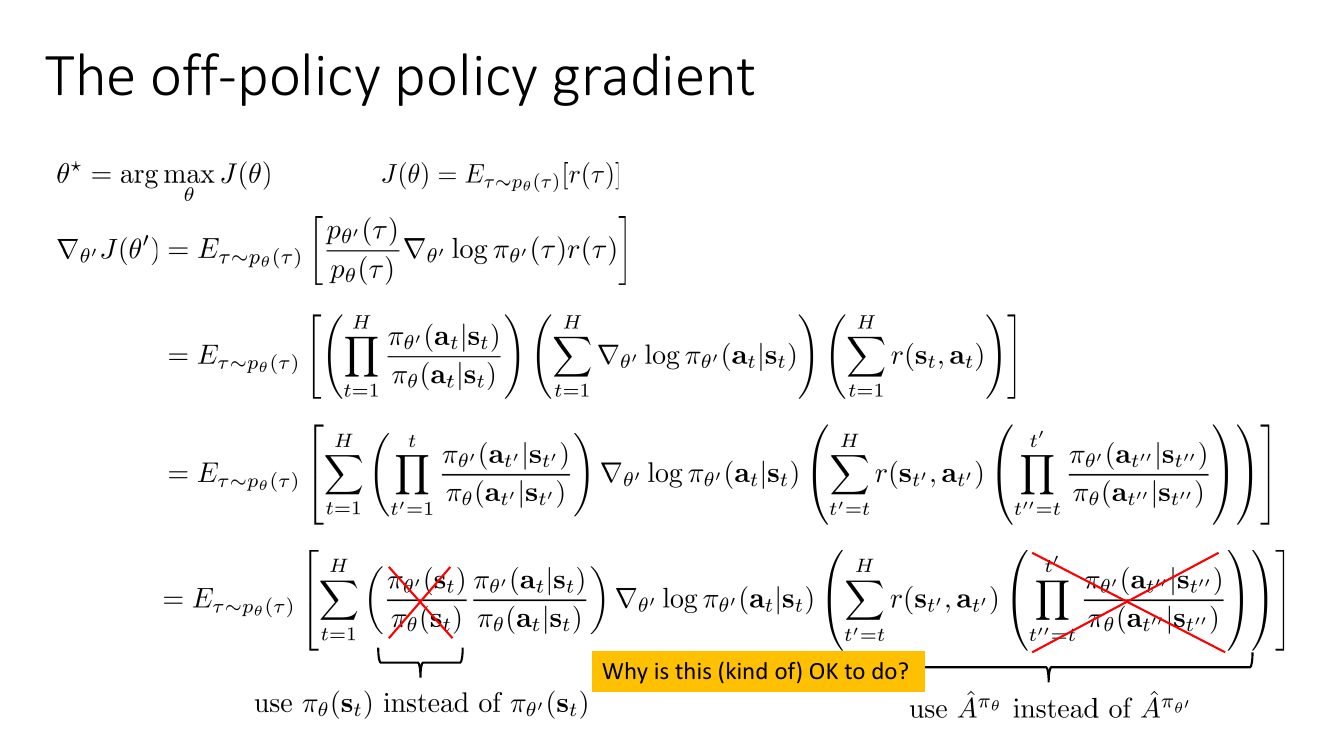
问题在于:那两串连乘会随时间指数增长或衰减。$H=100$、每步比值平均偏离 1 只有 1% 的话,连乘的方差就已经不可控了——这是上一讲反复强调的 IS 方差爆炸。于是实践中我们做了两件事:
| 偷的懒 | 数学上做了什么 | 直观代价 | 本讲的辩护 |
|---|---|---|---|
| Hack 1:用 $\hat A^{\pi_\theta}$ 而不是 $\hat A^{\pi_{\theta'}}$ | 把 $t$ 之后的那串 IS 连乘整个划掉 | 优势函数算的是旧策略的,不是我们要更新到的那个策略的 | 完全合法,性能差分引理给出精确等式(第 2、3 节) |
| Hack 2:用 $p_\theta(s_t)$ 而不是 $p_{\theta'}(s_t)$ | 把 $\pi_{\theta'}(s_t)/\pi_\theta(s_t)$ 这个状态边缘比值划掉 | 访问到的状态分布是旧策略造成的 | 近似合法,只要策略变化不大,误差被 $O(\epsilon t)$ 控制(第 4、5 节) |
把这两笔账算清楚,我们就会得到一个带约束的优化问题,而 TRPO 和 PPO 不过是解这个问题的两种不同数值方法。这也是本讲议程的全部内容:为什么可以用错的优势、为什么可以用错的状态分布、这会催生什么算法、我们平时用的算法和它是什么关系、还能推出什么别的算法、以及这告诉我们该怎么用策略梯度。
2. 策略梯度其实是策略迭代:性能差分引理
先看一眼算法解剖图
把 actor-critic 风格的策略梯度写成三个盒子的循环:跑策略采样 → 拟合模型估计回报(也就是估 $\hat A^\pi$)→ 改进策略($\theta\leftarrow\theta+\alpha\nabla_\theta J$)。
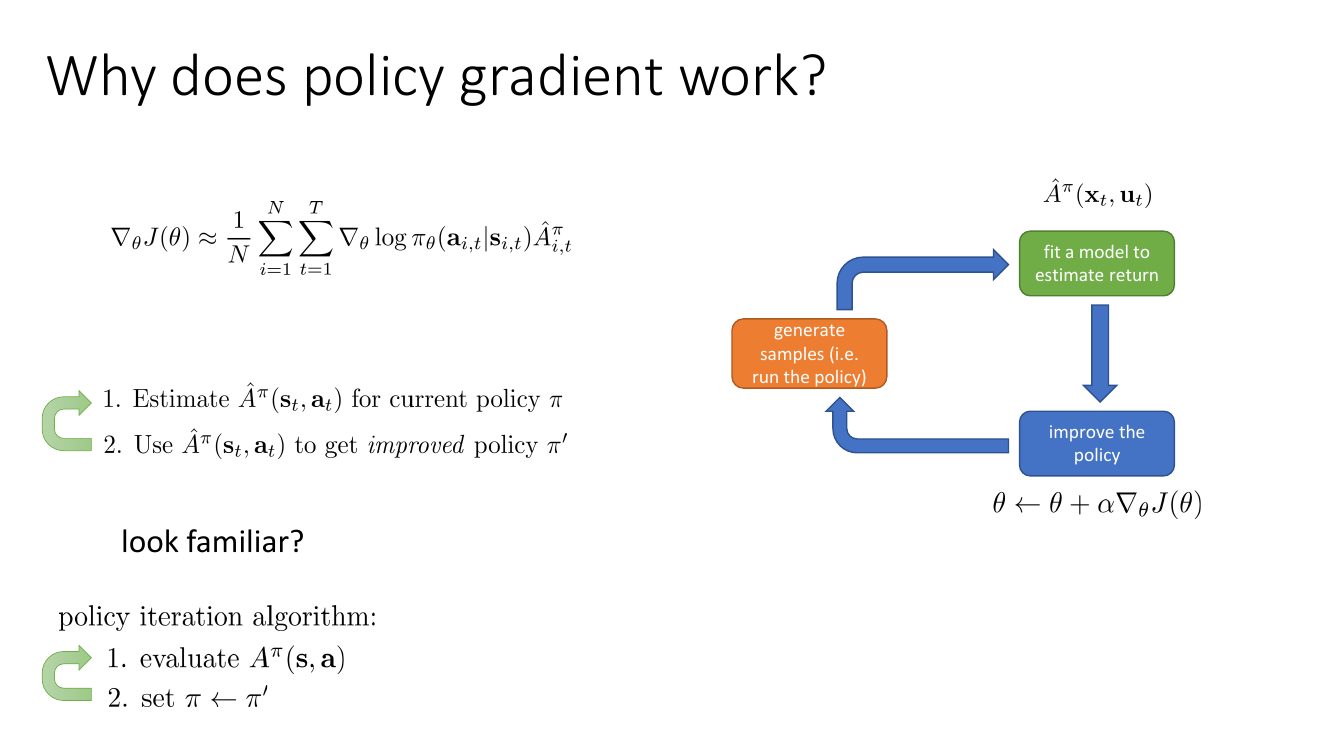
这个观察是本讲的出发点。策略梯度是策略迭代的「软化」版本:策略迭代是硬性地跳到贪心策略,策略梯度是往贪心方向挪一点点。如果这个类比成立,那么策略迭代的理论(尤其是「用 $A^\pi$ 就能保证改进」这条)就应该能借过来用。下面就把这个类比变成一个精确的等式。
性能差分引理的完整证明
记折扣回报目标为
$$ J(\theta)=\E_{\tau\sim p_\theta(\tau)}\left[\sum_t\gamma^t r(s_t,a_t)\right] $$断言(performance difference lemma):对任意两个参数 $\theta,\theta'$,
$$ J(\theta')-J(\theta)=\E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_t \gamma^t A^{\pi_\theta}(s_t,a_t)\right] $$注意这个式子的非对称性:期望取在 $\theta'$ 的轨迹分布下,但优势函数是 $\theta$ 的。这正是它有用的地方。下面一步步证。
第一步:把 $J(\theta)$ 写成 $V^{\pi_\theta}$ 在初始分布下的期望。根据 $V^\pi$ 的定义,
$$ J(\theta)=\E_{s_0\sim p(s_0)}\left[V^{\pi_\theta}(s_0)\right] \quad\Longrightarrow\quad J(\theta')-J(\theta)=J(\theta')-\E_{s_0\sim p(s_0)}\left[V^{\pi_\theta}(s_0)\right] $$第二步:把 $s_0$ 的期望换成 $\theta'$ 轨迹的期望。关键观察:初始状态分布 $p(s_0)$ 是环境给定的,与策略无关。所以从 $p_{\theta'}(\tau)$ 里取出的 $s_0$,其边缘分布正是 $p(s_0)$:
$$ J(\theta')-J(\theta)=J(\theta')-\E_{\tau\sim p_{\theta'}(\tau)}\left[V^{\pi_\theta}(s_0)\right] $$这一步是整个证明的枢纽——它让我们可以把「旧策略的价值函数」塞进「新策略的轨迹期望」里。
第三步:把 $V^{\pi_\theta}(s_0)$ 写成一个望远镜(telescoping)级数。对任意一条轨迹,
$$ V^{\pi_\theta}(s_0)=\sum_{t=0}^{\infty}\gamma^t V^{\pi_\theta}(s_t)-\sum_{t=1}^{\infty}\gamma^t V^{\pi_\theta}(s_t) $$这是显然的恒等式(后一项是前一项少了 $t=0$ 那一项)。于是
$$ J(\theta')-J(\theta)=J(\theta')-\E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_{t=0}^{\infty}\gamma^t V^{\pi_\theta}(s_t)-\sum_{t=1}^{\infty}\gamma^t V^{\pi_\theta}(s_t)\right] $$第四步:对第二个求和换指标。令 $t\to t+1$:$\sum_{t=1}^\infty\gamma^t V^{\pi_\theta}(s_t)=\sum_{t=0}^{\infty}\gamma^{t+1}V^{\pi_\theta}(s_{t+1})$。代回并把负号分配进去:
$$ J(\theta')-J(\theta)=J(\theta')+\E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_{t=0}^{\infty}\gamma^t\big(\gamma V^{\pi_\theta}(s_{t+1})-V^{\pi_\theta}(s_t)\big)\right] $$第五步:把 $J(\theta')$ 展开成它自己的定义。$J(\theta')=\E_{\tau\sim p_{\theta'}(\tau)}[\sum_t\gamma^t r(s_t,a_t)]$,两个期望都在 $p_{\theta'}$ 下,可以合并:
$$ J(\theta')-J(\theta)=\E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_{t=0}^{\infty}\gamma^t\big(r(s_t,a_t)+\gamma V^{\pi_\theta}(s_{t+1})-V^{\pi_\theta}(s_t)\big)\right] $$第六步:认出括号里就是优势函数。回忆 $A^{\pi}(s_t,a_t)=Q^\pi(s_t,a_t)-V^\pi(s_t)$,而 $Q^{\pi}(s_t,a_t)=r(s_t,a_t)+\gamma\E_{s_{t+1}\sim p(\cdot|s_t,a_t)}[V^\pi(s_{t+1})]$。在 $p_{\theta'}$ 的轨迹里,给定 $(s_t,a_t)$ 之后 $s_{t+1}$ 的条件分布就是环境转移 $p(s_{t+1}|s_t,a_t)$,与策略无关——所以对轨迹取期望时,$\gamma V^{\pi_\theta}(s_{t+1})$ 这一项自动完成了对 $s_{t+1}$ 的积分。因此
$$ J(\theta')-J(\theta)=\E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_{t=0}^{\infty}\gamma^t A^{\pi_\theta}(s_t,a_t)\right]\qquad\blacksquare $$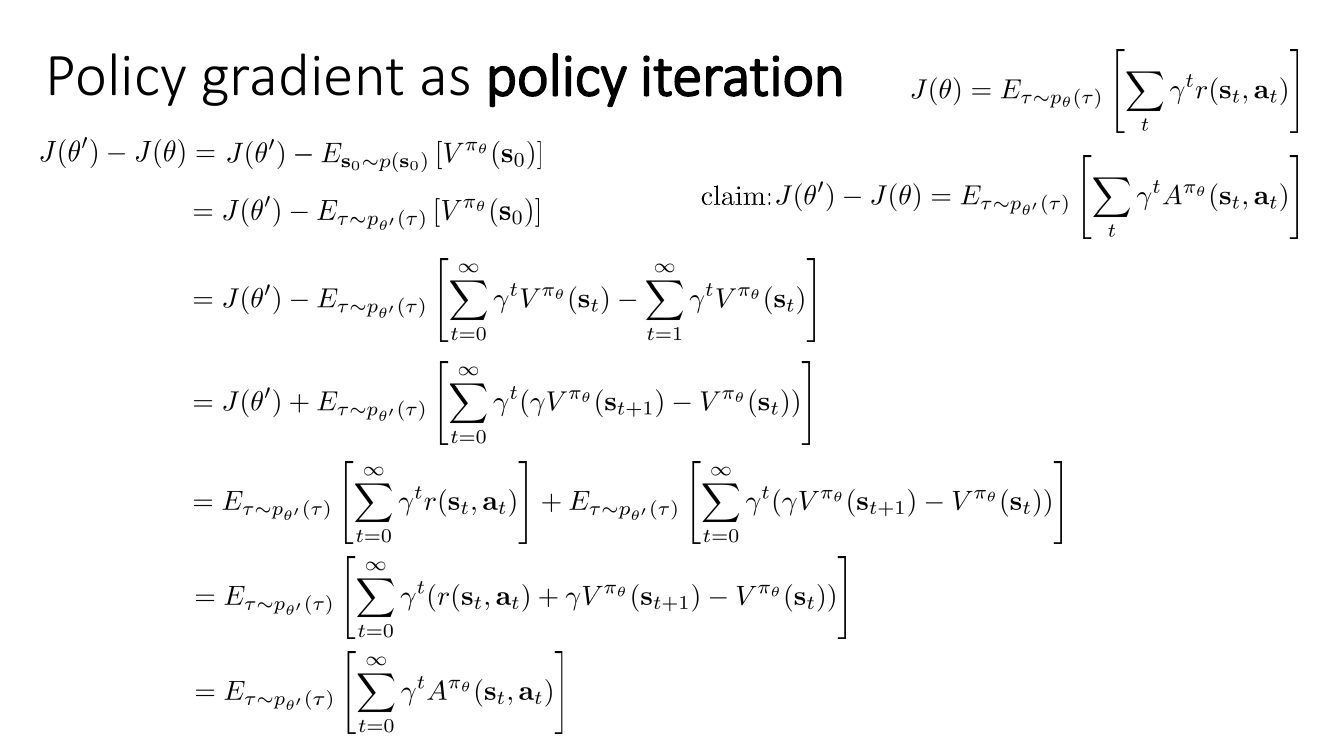
换个角度看这个引理:想知道新策略比旧策略好多少,就让新策略去跑,然后在它走过的每一步上问「按旧策略的评价标准,我这一步走得比旧策略的平均水平好多少」,把这些「每步的超额收益」按 $\gamma^t$ 加权求和。
这跟金融里算超额收益是一个套路:$A^{\pi_\theta}(s,a)$ 就是旧策略给出的「基准线」,新策略每一步相对基准线的偏离累加起来,恰好等于总收益的差。这也解释了为什么 $\E_{a\sim\pi_\theta}[A^{\pi_\theta}(s,a)]=0$:旧策略相对自己的基准,超额收益当然是零。所以如果新策略等于旧策略,右边整个为零,等式自洽。
这个引理最重要的推论是:「最大化 $J(\theta')$」和「最大化 $\E_{p_{\theta'}}[\sum_t\gamma^tA^{\pi_\theta}]$」是同一件事(因为 $J(\theta)$ 是与 $\theta'$ 无关的常数)。而后者只需要旧策略的优势函数——我们手上正好有。这就是策略迭代那个「用 $A^\pi$ 来改进 $\pi$」的严格版本。
3. 重要性采样改写:第一个「划掉」是合法的
性能差分引理右边的期望有两层:轨迹分布 $p_{\theta'}$ 决定了状态怎么访问,策略 $\pi_{\theta'}$ 决定了在每个状态选什么动作。把它按时间步拆开、并把状态和动作的期望分离:
$$ \E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_t\gamma^t A^{\pi_\theta}(s_t,a_t)\right] =\sum_t \E_{s_t\sim p_{\theta'}(s_t)}\Big[\E_{a_t\sim\pi_{\theta'}(a_t|s_t)}\big[\gamma^t A^{\pi_\theta}(s_t,a_t)\big]\Big] $$这里 $p_{\theta'}(s_t)$ 是新策略在 $t$ 时刻的状态边缘分布(state marginal)。现在对内层的动作期望做重要性采样:
$$ \E_{a_t\sim\pi_{\theta'}(a_t|s_t)}\big[f(a_t)\big] =\E_{a_t\sim\pi_{\theta}(a_t|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}f(a_t)\right] $$于是
$$ J(\theta')-J(\theta)=\sum_t \E_{s_t\sim p_{\theta'}(s_t)}\left[\E_{a_t\sim\pi_\theta(a_t|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}\gamma^t A^{\pi_\theta}(s_t,a_t)\right]\right] $$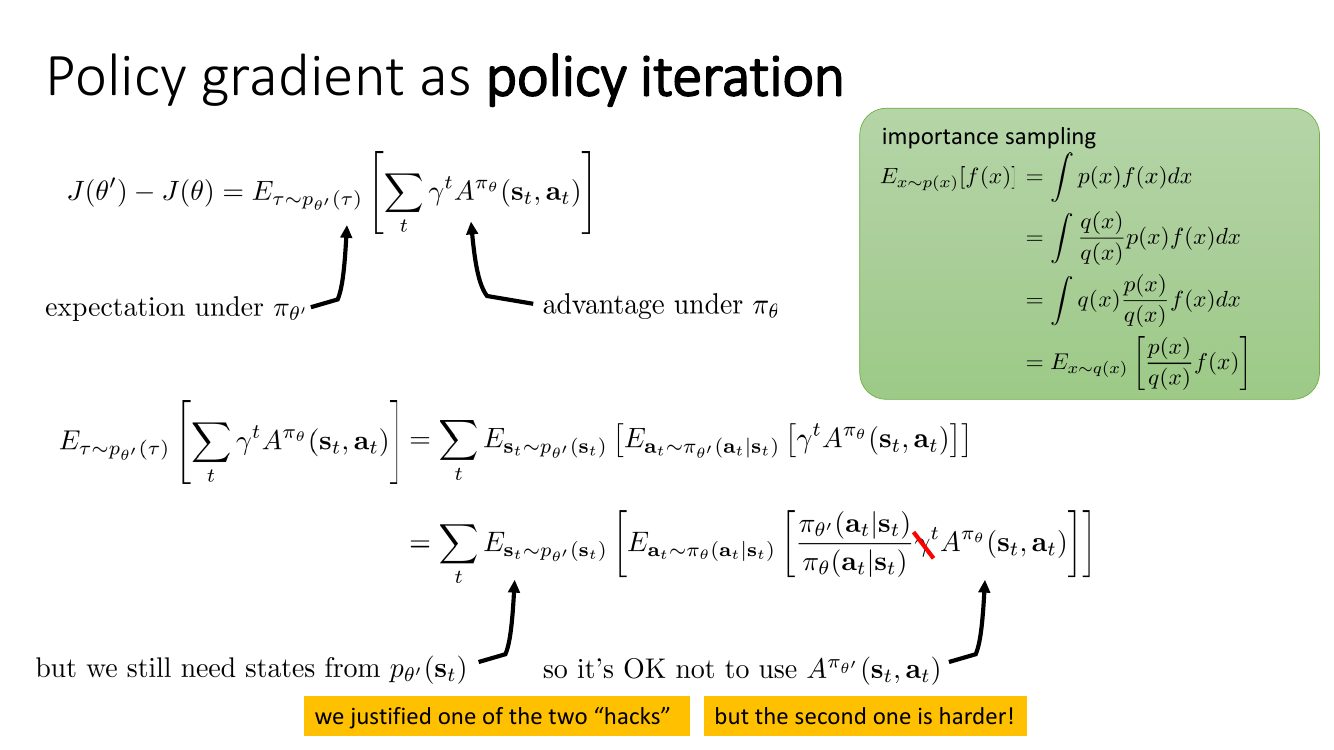
到这里,第一个 hack 被彻底洗白了:使用旧策略的优势函数 $A^{\pi_\theta}$ 根本不是近似,而是性能差分引理给出的精确结论。之前 off-policy 推导里那一大串「$t$ 之后的 IS 连乘」之所以能划掉,是因为它本来就不该在那里——正确的写法从一开始就只需要单步的 IS 比值 $\pi_{\theta'}(a_t|s_t)/\pi_\theta(a_t|s_t)$。
「既然 $A^{\pi_\theta}$ 是对的,那我可以拿旧样本无限次更新策略了?」不行。合法的只是优势函数的角标;外层的状态分布仍然是 $p_{\theta'}$,$\theta'$ 走得越远,用 $p_\theta$ 代替它的误差越大。另外别忘了 $A^{\pi_\theta}$ 本身是用有限样本估的,$\theta'$ 走远之后 IS 比值 $\pi_{\theta'}/\pi_\theta$ 会变大,估计量的方差也随之增长。这两件事共同决定了「一批样本能榨多少次更新」。
剩下的那个问题:状态分布
我们真正想优化的是
$$ \bar A(\theta')\;\triangleq\;\sum_t \E_{s_t\sim p_{\theta}(s_t)}\left[\E_{a_t\sim\pi_\theta(a_t|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)} A^{\pi_\theta}(s_t,a_t)\right]\right] $$注意外层已经换成了 $p_\theta(s_t)$——这个量完全可以用旧样本估计,因为状态来自旧策略的 rollout,动作也来自旧策略,唯一含 $\theta'$ 的地方是那个可微的比值。它就是所谓的代理目标(surrogate objective)。
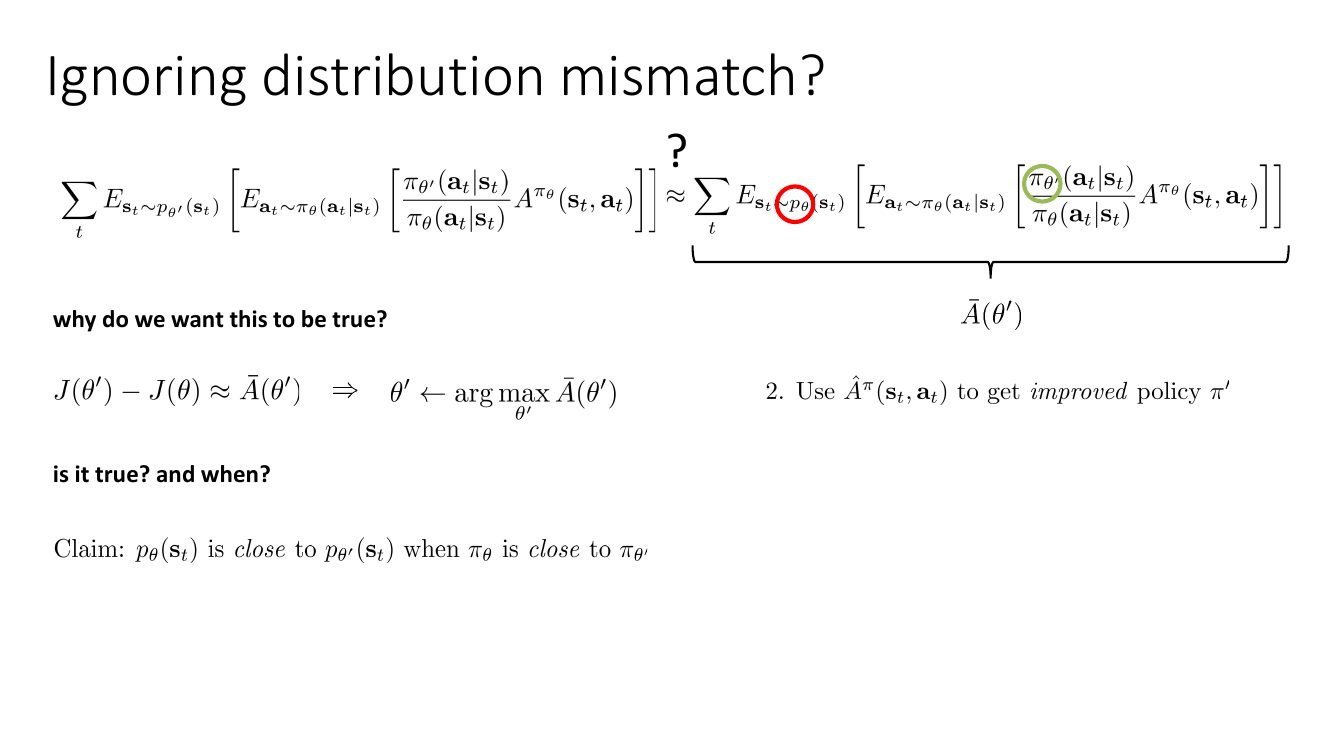
于是整讲剩下的部分就归结为一个问题:$p_\theta(s_t)$ 和 $p_{\theta'}(s_t)$ 到底差多远?这个差能不能被「策略变化幅度」控制住?
4. 有界分布漂移:状态分布会跑多远
我们要证的命题是:如果 $\pi_{\theta'}$ 与 $\pi_\theta$ 在每个状态上的动作分布都很接近,那么它们在时刻 $t$ 的状态边缘分布也接近,而且误差最多线性增长。
先约定「接近」的度量。两个离散分布 $p,q$ 的总变差距离(total variation distance, TV)定义为
$$ D_{\mathrm{TV}}(p,q)=\frac12\sum_x |p(x)-q(x)|=\max_{A}\,\big|p(A)-q(A)\big| $$它取值在 $[0,1]$:0 表示两个分布完全一样,1 表示支撑集不交。第二个等号(TV 等于「任意事件上概率差的最大值」)是 TV 距离最有用的刻画,后面会反复用到。
4.1 先看最简单的情形:旧策略是确定性的
设 $\pi_\theta$ 是确定性策略 $a_t=\pi_\theta(s_t)$。定义 $\pi_{\theta'}$ 与之「接近」为:在任意状态上,新策略选到「非旧策略动作」的概率不超过 $\epsilon$:
$$ \pi_{\theta'}\big(a_t\neq\pi_\theta(s_t)\,\big|\,s_t\big)\le \epsilon\qquad \forall s_t $$现在做一个想象实验:让 $\pi_{\theta'}$ 从 $s_0$ 开始跑。在每一步,它要么选了跟旧策略一样的动作(概率 $\ge 1-\epsilon$),要么「犯了个错」。如果它前 $t$ 步一次错都没犯,那么它走过的轨迹和旧策略走过的轨迹在分布上完全一样,此时 $s_t\sim p_\theta(s_t)$。一旦犯过错,之后的状态分布就变成某个我们控制不了的其他分布 $p_{\text{mistake}}(s_t)$。把这两种情况按概率合并:
$$ p_{\theta'}(s_t)=\underbrace{(1-\epsilon)^t}_{\text{前 }t\text{ 步没犯错的概率}}p_\theta(s_t)+\Big(1-(1-\epsilon)^t\Big)\underbrace{p_{\text{mistake}}(s_t)}_{\text{某个别的分布}} $$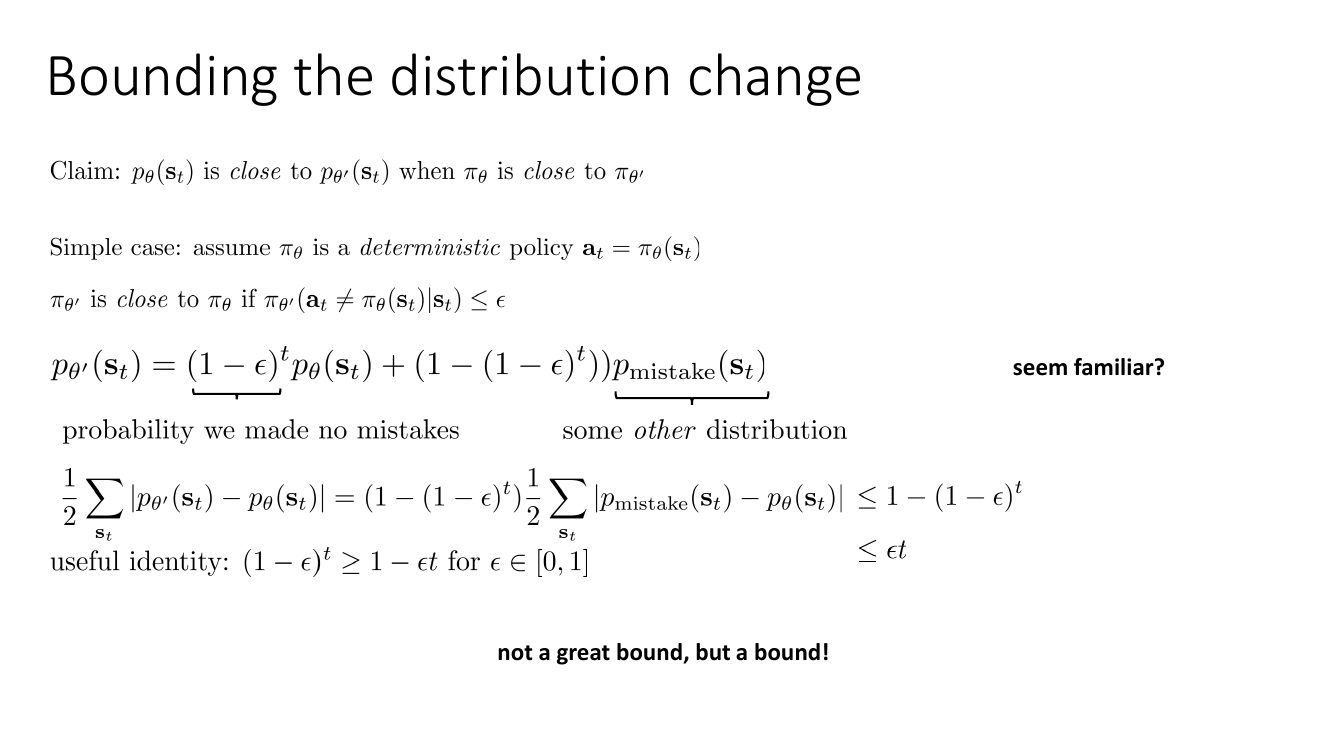
从混合分解出发。令 $\lambda_t=1-(1-\epsilon)^t$,则
$$ p_{\theta'}(s_t)-p_\theta(s_t)=(1-\lambda_t)p_\theta(s_t)+\lambda_t p_{\text{mistake}}(s_t)-p_\theta(s_t)=\lambda_t\big(p_{\text{mistake}}(s_t)-p_\theta(s_t)\big) $$两边取绝对值求和再除以 2:
$$ \frac12\sum_{s_t}\big|p_{\theta'}(s_t)-p_\theta(s_t)\big|=\lambda_t\cdot\underbrace{\frac12\sum_{s_t}\big|p_{\text{mistake}}(s_t)-p_\theta(s_t)\big|}_{\text{这是一个 TV 距离,}\le 1}\le\lambda_t=1-(1-\epsilon)^t $$最后用伯努利不等式 $(1-\epsilon)^t\ge 1-\epsilon t$(对 $\epsilon\in[0,1]$、整数 $t\ge0$ 成立,可对 $t$ 归纳:$(1-\epsilon)^{t+1}\ge(1-\epsilon t)(1-\epsilon)=1-\epsilon(t+1)+\epsilon^2 t\ge 1-\epsilon(t+1)$),得
$$ \boxed{\;\frac12\sum_{s_t}\big|p_{\theta'}(s_t)-p_\theta(s_t)\big|\le \epsilon t\;} $$用「不带 $\frac12$」的写法就是 $\sum_{s_t}|p_{\theta'}(s_t)-p_\theta(s_t)|\le 2\epsilon t$——两种约定在文献里都常见,后面用到哪个会明确标出。
4.2 一般情形:耦合(coupling)论证
现实中 $\pi_\theta$ 当然不是确定性的(不然连探索都没有)。一般情形下,「接近」的定义改成对每个状态的 TV 距离设上限:
$$ \frac12\sum_{a_t}\big|\pi_{\theta'}(a_t|s_t)-\pi_\theta(a_t|s_t)\big|=D_{\mathrm{TV}}\big(\pi_{\theta'}(\cdot|s_t),\pi_\theta(\cdot|s_t)\big)\le\epsilon\qquad\forall s_t $$怎么把这个条件规约到 4.1 的「犯错概率」图景?靠下面这条引理。
引理:若 $D_{\mathrm{TV}}(p_X,p_Y)\le\epsilon$,则存在一个定义在 $(x,y)$ 上的联合分布 $p(x,y)$,其边缘分别是 $p(x)=p_X(x)$、$p(y)=p_Y(y)$,且 $p(x=y)\ge 1-\epsilon$。
构造(最大耦合 maximal coupling)。记 $m(x)=\min(p_X(x),p_Y(x))$,$M=\sum_x m(x)$。注意
$$ M=\sum_x\min(p_X,p_Y)=\sum_x\frac{p_X+p_Y-|p_X-p_Y|}{2}=1-\frac12\sum_x|p_X-p_Y|=1-D_{\mathrm{TV}}(p_X,p_Y)\ge 1-\epsilon $$(用到了 $\min(a,b)=\frac{a+b-|a-b|}2$。)定义两个「残差」分布
$$ r_X(x)=\frac{p_X(x)-m(x)}{1-M},\qquad r_Y(y)=\frac{p_Y(y)-m(y)}{1-M} $$它们都非负、都归一(分子求和都等于 $1-M$)。现在这样造联合分布:以概率 $M$,抽 $x\sim m/M$ 并令 $y=x$;以概率 $1-M$,独立地抽 $x\sim r_X$、$y\sim r_Y$。验证边缘:$p(x)=M\cdot\frac{m(x)}{M}+(1-M)r_X(x)=m(x)+p_X(x)-m(x)=p_X(x)$,$y$ 同理。而 $p(x=y)\ge M\ge 1-\epsilon$。$\blacksquare$
怎么用:把这个耦合逐状态地应用到策略上。想象我们同时模拟两条轨迹,一条由 $\pi_\theta$ 驱动、一条由 $\pi_{\theta'}$ 驱动,共用同一个初始状态和同一份环境随机数。在每个时刻,只要两条轨迹当前状态相同(都是 $s_t$),我们就用最大耦合联合地抽出 $(a_t,a_t')$:以至少 $1-\epsilon$ 的概率 $a_t=a_t'$,此时两条轨迹继续同步;否则它们「分叉」,之后就不管了。
设 $E_t$ 表示「前 $t$ 步从未分叉」,则 $P(E_t)\ge(1-\epsilon)^t$,且在 $E_t$ 上有 $s_t=s_t'$。用 TV 距离的耦合不等式(对任意耦合,$D_{\mathrm{TV}}(p_X,p_Y)\le P(X\neq Y)$,因为对任意事件 $A$,$|P(X\in A)-P(Y\in A)|=|\E[\mathbb 1_{X\in A}-\mathbb 1_{Y\in A}]|\le P(X\neq Y)$):
$$ D_{\mathrm{TV}}\big(p_{\theta'}(s_t),p_\theta(s_t)\big)\le P(s_t\neq s_t')\le 1-P(E_t)\le 1-(1-\epsilon)^t\le \epsilon t $$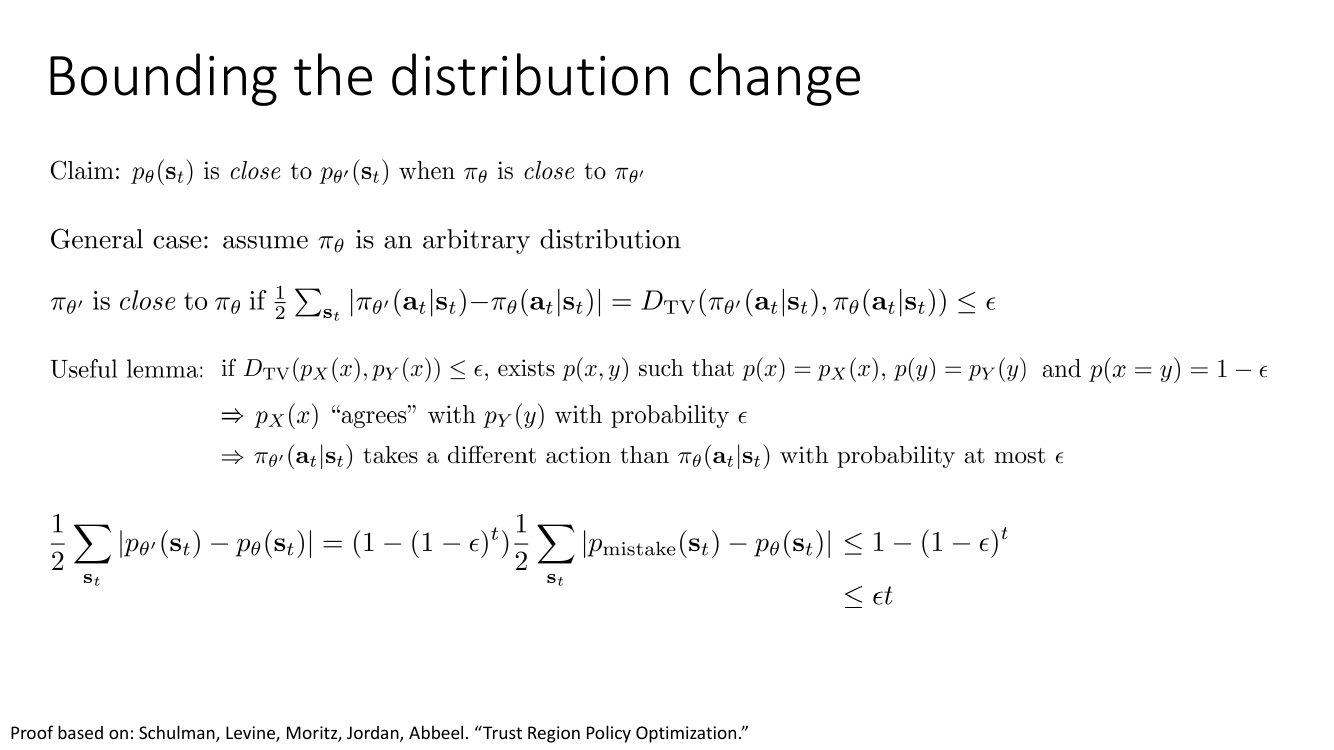
耦合的精髓是:与其比较两个分布的「形状差异」,不如把它们放在同一个概率空间里,让它们尽量长得一样,然后只数「它们不一样的概率」。TV 距离恰好等于「最好的耦合下,两者不相等的最小概率」。所以「两个策略的 TV 距离 $\le\epsilon$」可以被物理地翻译成:只要你愿意,就能让这两个策略以 $1-\epsilon$ 的概率做出完全相同的动作。剩下的论证就跟第 2 讲讲模仿学习时「每步以 $\epsilon$ 概率犯错」的分析一模一样了。
4.3 这个界有多紧?一个可以自己跑的数值例子
造一条长度为 12 的链:状态 $0,1,\dots,11$,动作有「留在原地」和「前进一格」。$\pi_\theta$ 是确定性的「永远留在原地」,所以 $p_\theta(s_t)$ 恒为集中在状态 0 的点质量。$\pi_{\theta'}$ 以 $\epsilon=0.05$ 的概率「前进」。此时 $p_{\theta'}(s_t=0)=(1-\epsilon)^t$,于是 TV 距离精确等于 $1-(1-\epsilon)^t$——正好落在我们那条链式不等式的中间一环上。
import numpy as np

L, T, eps = 12, 40, 0.05

def rollout_marginals(p_go):
    """p_go: 每步选择「前进」的概率。返回形状 (T+1, L) 的状态边缘分布序列。"""
    p = np.zeros(L); p[0] = 1.0
    out = [p.copy()]
    for _ in range(T):
        nxt = np.zeros(L)
        for s in range(L):
            nxt[s]              += p[s] * (1 - p_go)   # 留在原地
            nxt[min(s + 1, L-1)] += p[s] * p_go        # 前进(末端吸收)
        p = nxt
        out.append(p.copy())
    return np.array(out)

P_old = rollout_marginals(0.0)    # pi_theta :确定性「留在原地」
P_new = rollout_marginals(eps)    # pi_theta':以 eps 概率「前进」

for t in [1, 5, 10, 20, 40]:
    tv = 0.5 * np.abs(P_new[t] - P_old[t]).sum()
print(f"t={t:3d} TV={tv:.4f} 1-(1-eps)^t={1-(1-eps)**t:.4f} eps*t={eps*t:.4f}")| $t$ | 真实 TV $=1-(1-\epsilon)^t$ | 线性界 $\epsilon t$ | 结论 |
|---|---|---|---|
| 1 | 0.0500 | 0.05 | 完全紧 |
| 5 | 0.2262 | 0.25 | 仍然很紧 |
| 10 | 0.4013 | 0.50 | 开始松 |
| 20 | 0.6415 | 1.00 | 界已经等于 TV 的最大可能值 |
| 40 | 0.8715 | 2.00 | 界完全失效($\gt 1$,毫无信息量) |
这张表说明了一件极其重要的事:$\epsilon$ 必须随有效时域一起缩小。当 $\epsilon t\gtrsim 1$ 时,这条界退化成「TV 距离不超过 1」的废话。有效时域是 $H$(有限时域)或 $\frac{1}{1-\gamma}$(折扣情形)时,我们需要 $\epsilon\ll 1/H$ 或 $\epsilon\ll 1-\gamma$ 才能保证误差可控。这就是为什么 TRPO 的 KL 半径默认取到 $0.01$ 这么小的量级——而不是因为谁拍了脑袋。
5. 从分布界到目标函数界:最大化一个下界
知道了状态分布差多远,还要把它翻译成「目标函数差多远」。这一步是一个通用的小结论:分布变一点,任何有界函数的期望也只变一点。
设 $f$ 是任意函数,$p_\theta,p_{\theta'}$ 是两个分布。逐项估计:
$$ \E_{p_{\theta'}(s_t)}\big[f(s_t)\big]=\sum_{s_t}p_{\theta'}(s_t)f(s_t) =\sum_{s_t}p_\theta(s_t)f(s_t)+\sum_{s_t}\big(p_{\theta'}(s_t)-p_\theta(s_t)\big)f(s_t) $$第二项的绝对值不超过 $\sum_{s_t}|p_{\theta'}(s_t)-p_\theta(s_t)|\cdot\max_{s}|f(s)|$,因此
$$ \E_{p_{\theta'}(s_t)}\big[f(s_t)\big]\ \ge\ \E_{p_\theta(s_t)}\big[f(s_t)\big]-\sum_{s_t}\big|p_{\theta'}(s_t)-p_\theta(s_t)\big|\max_{s}\big|f(s)\big| \ \ge\ \E_{p_\theta(s_t)}\big[f(s_t)\big]-2\epsilon t\max_{s}\big|f(s)\big| $$最后一步用了第 4 节的 $\sum_{s_t}|p_{\theta'}-p_\theta|\le 2\epsilon t$。
把 $f(s_t)=\E_{a_t\sim\pi_\theta(a_t|s_t)}\big[\tfrac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}A^{\pi_\theta}(s_t,a_t)\big]$ 代进去,对 $t$ 求和:
$$ \underbrace{\sum_t \E_{s_t\sim p_{\theta'}(s_t)}\left[\E_{a_t\sim\pi_\theta}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}A^{\pi_\theta}(s_t,a_t)\right]\right]}_{=\,J(\theta')-J(\theta)\ \text{(性能差分引理,精确)}} \;\ge\; \underbrace{\sum_t \E_{s_t\sim p_{\theta}(s_t)}\left[\E_{a_t\sim\pi_\theta}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}A^{\pi_\theta}(s_t,a_t)\right]\right]}_{=\,\bar A(\theta')\ \text{(可用旧样本估计)}} -\sum_t 2\epsilon t\,C $$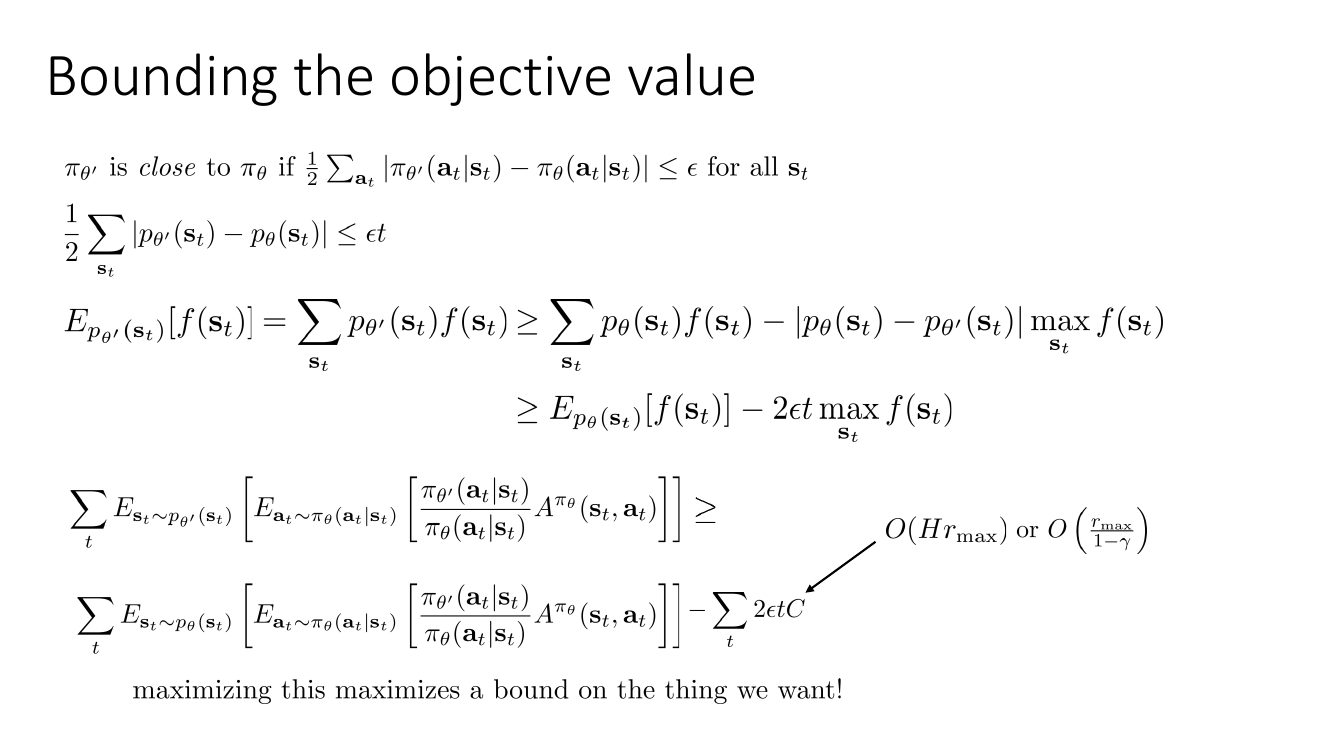
为什么「最大化下界」就够了:MM 原理
这套结构叫 minorize-maximization(MM):我们构造了一个函数 $L(\theta')=\bar A(\theta')-\text{penalty}(\theta')$,它满足两条性质:
- 下界性:对所有满足约束的 $\theta'$,$J(\theta')-J(\theta)\ge L(\theta')$;
- 在当前点紧:$\theta'=\theta$ 时 $\bar A(\theta)=0$(因为 IS 比值为 1 且 $\E_{a\sim\pi_\theta}[A^{\pi_\theta}]=0$),此时策略没变,$\epsilon$ 可取 0,惩罚项也为 0,所以 $L(\theta)=0=J(\theta)-J(\theta)$。
有了这两条,只要我们找到 $\theta'$ 使 $L(\theta')\gt L(\theta)=0$,就自动有 $J(\theta')-J(\theta)\ge L(\theta')\gt 0$——单调改进。这跟 EM 算法、变分推断里的 ELBO 是同一个套路,也是 CPI(conservative policy iteration)和 TRPO 论文的理论骨架。
如果按幻灯片上取 $C=\max_s|f(s)|=O(Hr_{\max})$,惩罚项是 $\sum_t 2\epsilon tC=O(\epsilon H^2C)$,关于 $\epsilon$ 是线性的;而增益 $\bar A(\theta')$ 也是 $O(\epsilon)$ 量级。两者同阶,「$\epsilon$ 足够小就一定改进」严格来说站不住脚。
修补方法是把 $f$ 的界估得更细。注意 $\E_{a\sim\pi_\theta}[A^{\pi_\theta}(s,a)]=0$,所以
$$ f(s_t)=\sum_{a}\pi_{\theta'}(a|s_t)A^{\pi_\theta}(s_t,a)=\sum_a\big(\pi_{\theta'}(a|s_t)-\pi_\theta(a|s_t)\big)A^{\pi_\theta}(s_t,a) $$于是 $|f(s_t)|\le \|\pi_{\theta'}-\pi_\theta\|_1\max_a|A^{\pi_\theta}|=2D_{\mathrm{TV}}\max_a|A|\le 2\epsilon\max_a|A|$。代回去,惩罚项变成 $O(\epsilon^2H^2\max|A|)$,是 $\epsilon$ 的二次函数,而增益最大可达 $O(\epsilon H\max|A|)$,是一次的。这时「取 $\epsilon\lesssim 1/H$ 就保证改进」才真正成立。这正是 Kakade & Langford (2002) 与 TRPO 论文里做的事情。Levine 在课上用粗糙版本是为了让推导一眼看得懂,理解时要知道精细版本长什么样。
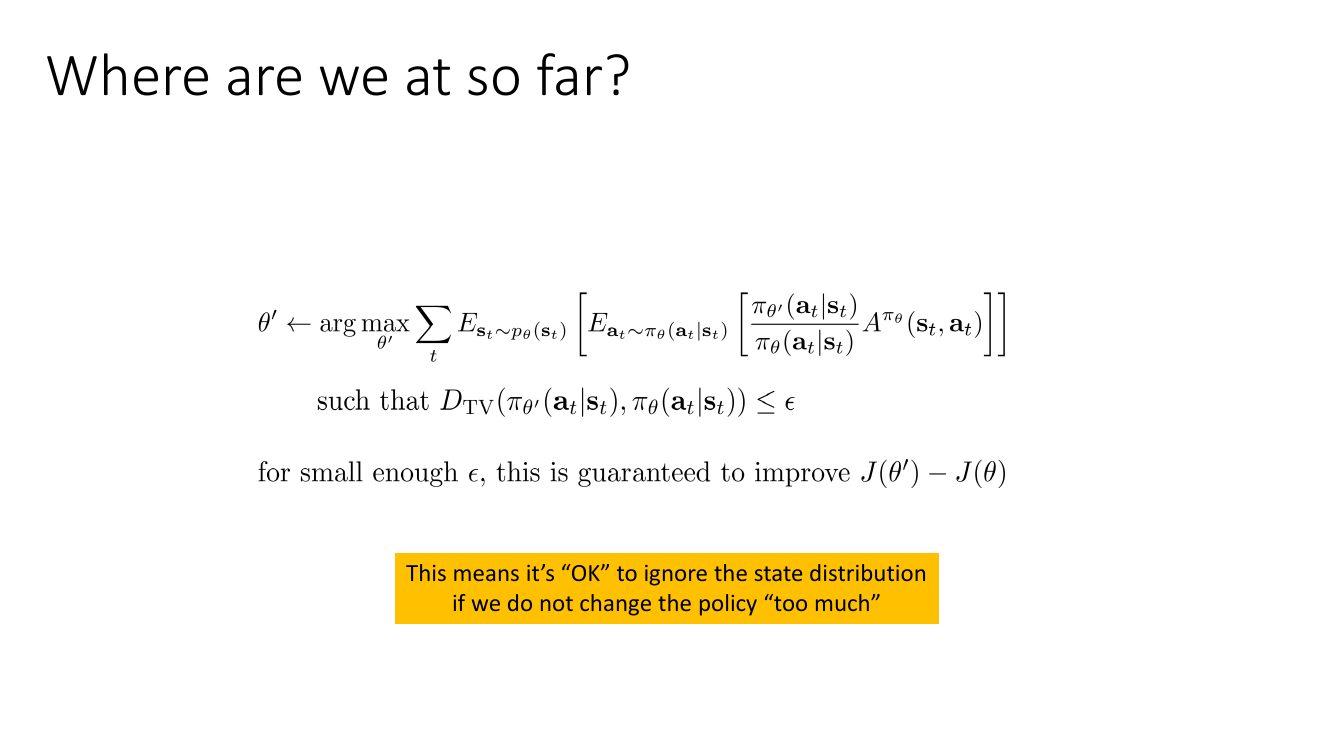
顺便,这也回答了「为什么可以拿同一批样本对策略连做 K 步梯度更新」:因为我们优化的从来不是那个只在 $\theta$ 处成立的一阶展开,而是一个在整个信赖域内都有效的下界。只要每步更新都留在信赖域里,多走几步就是在把下界推得更高,而不是在做无效外推。这是普通 REINFORCE 视角完全给不出的解释。
6. 从 TV 到 KL:一个更好用的约束
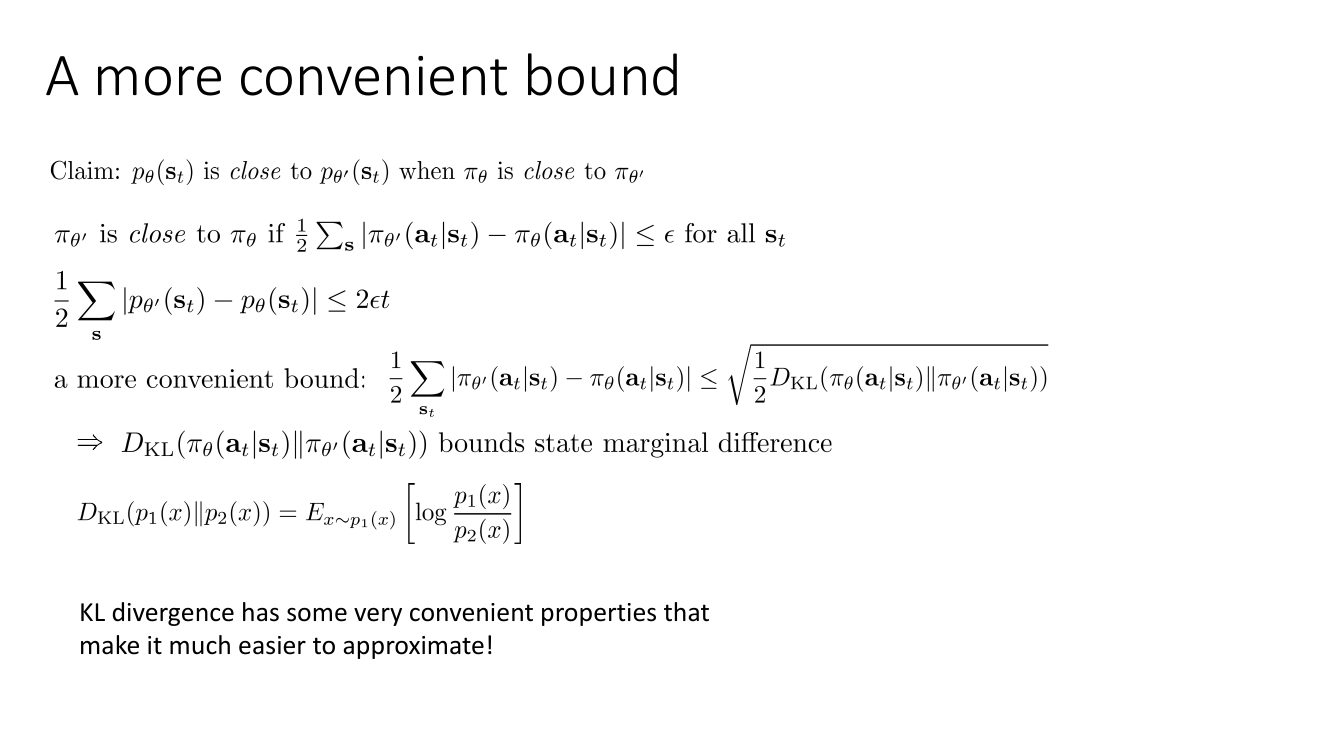
上一节得到的约束是 $D_{\mathrm{TV}}(\pi_{\theta'}(\cdot|s_t),\pi_\theta(\cdot|s_t))\le\epsilon$。理论上没问题,工程上是灾难:TV 距离要对所有动作求和取绝对值,连续动作空间下是个积分,而且绝对值不可微、对神经网络参数没有好用的梯度。我们需要一个「更方便的界」。
6.1 Pinsker 不等式
把 TV 换成 KL 散度(Kullback–Leibler divergence):
$$ D_{\mathrm{KL}}(p_1\|p_2)=\E_{x\sim p_1(x)}\left[\log\frac{p_1(x)}{p_2(x)}\right] $$Pinsker 不等式给出两者的关系:
$$ \frac12\sum_{a_t}\big|\pi_{\theta'}(a_t|s_t)-\pi_\theta(a_t|s_t)\big|\;\le\;\sqrt{\tfrac12 D_{\mathrm{KL}}\big(\pi_\theta(a_t|s_t)\,\|\,\pi_{\theta'}(a_t|s_t)\big)} $$也就是 $D_{\mathrm{TV}}\le\sqrt{\frac12 D_{\mathrm{KL}}}$。方向很关键:KL 小 $\Rightarrow$ TV 小,所以只要我们约束住 KL,第 4、5 节的所有结论就自动成立(把 $\epsilon$ 换成 $\sqrt{\epsilon_{\mathrm{KL}}/2}$ 即可)。反过来不成立——TV 小并不能保证 KL 小(KL 对「新策略在旧策略有支撑的地方概率趋于 0」这种情形会爆到无穷),但这正是我们想要的保守方向。
6.2 KL 为什么好用:它退化成了对数似然
这是本讲最容易被忽略、但实践中最关键的一个小观察。把 KL 用旧策略的样本近似:
$$ D_{\mathrm{KL}}\big(\pi_\theta(a_t|s_t)\,\|\,\pi_{\theta'}(a_t|s_t)\big)\approx\sum_i \Big[\underbrace{\log\pi_\theta\big(a_t^{(i)}\big|s_t^{(i)}\big)}_{\text{与 }\theta'\text{ 无关,是常数}}-\log\pi_{\theta'}\big(a_t^{(i)}\big|s_t^{(i)}\big)\Big],\qquad \big(s_t^{(i)},a_t^{(i)}\big)\sim\pi_\theta $$第一项完全不含优化变量 $\theta'$,求梯度时直接消失。于是
$$ \text{最小化 } D_{\mathrm{KL}}(\pi_\theta\|\pi_{\theta'}) \text{ 关于 }\theta' \quad\Longleftrightarrow\quad \text{最大化旧策略样本的对数似然 }\sum_i\log\pi_{\theta'}\big(a_t^{(i)}\big|s_t^{(i)}\big) $$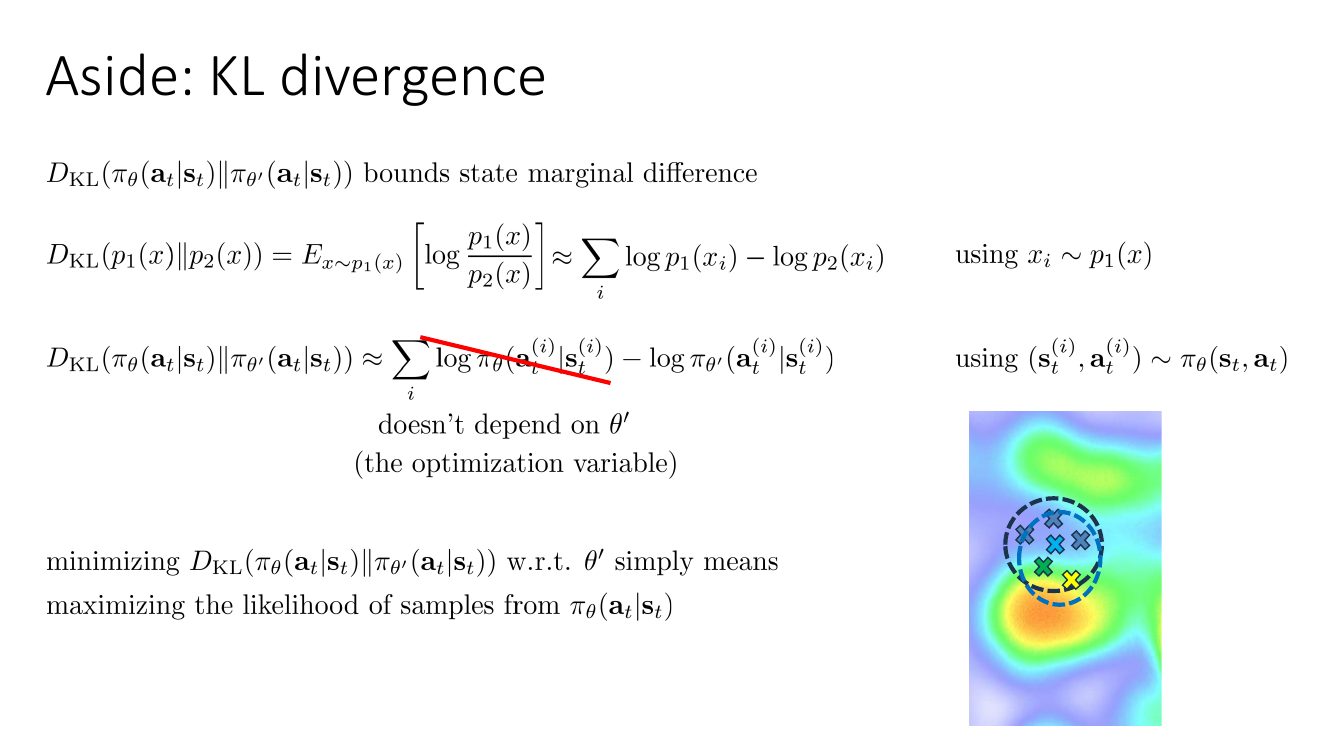
KL 惩罚项在实现上就是一个「别忘了你原来会做什么」的行为克隆损失。代理目标 $\bar A(\theta')$ 说「往优势高的动作上使劲」,KL 惩罚说「但别离采样策略太远,否则那张优势地形图在你脚下就不准了」。两者的拉扯就是信赖域方法的全部内容。
这个「样本 = 地形图的有效区域」的图像也解释了 TRPO/PPO 那张彩色示意图:我们只在采样点附近对目标函数有可信的估计,跨出这个圈就是在对一张没数据支撑的地图做外推。
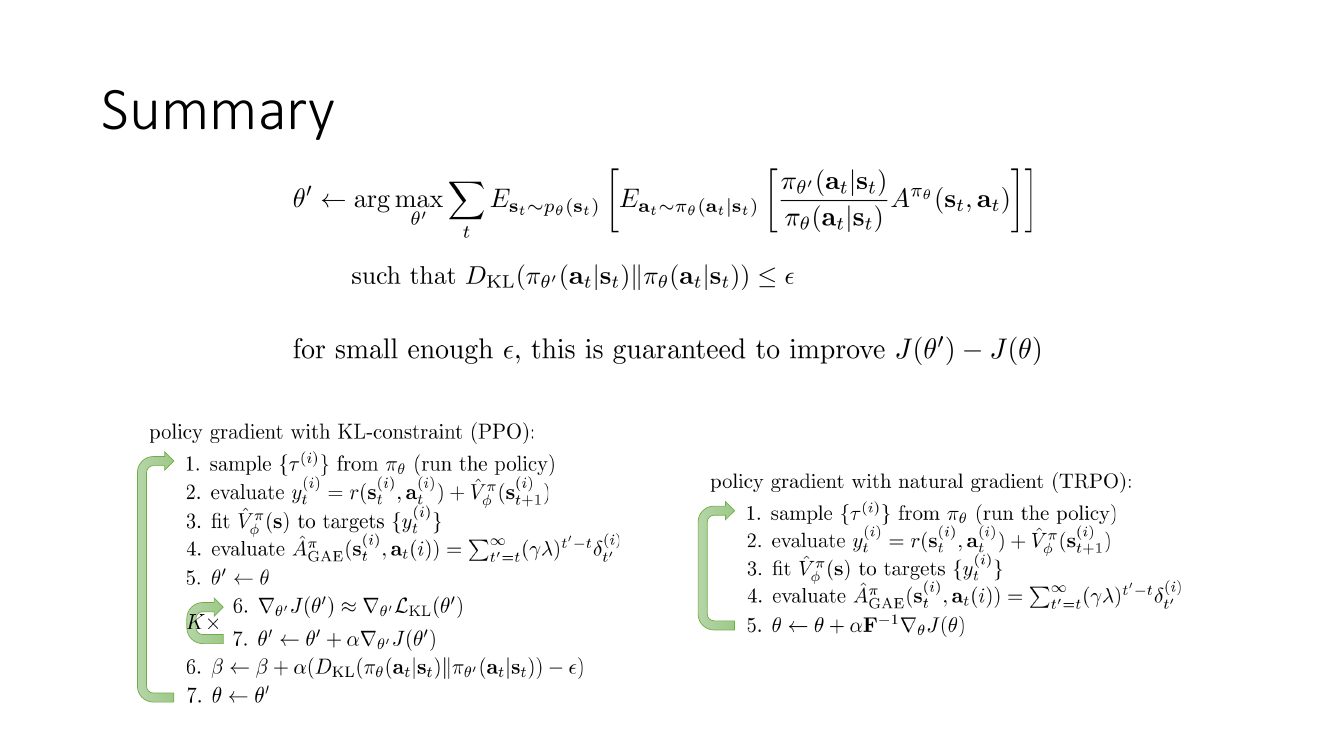
于是本讲第一阶段的成果可以完整写下来了:
$$ \theta'\leftarrow\argmax_{\theta'}\ \sum_t \E_{s_t\sim p_\theta(s_t)}\left[\E_{a_t\sim\pi_\theta(a_t|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}A^{\pi_\theta}(s_t,a_t)\right]\right] \quad\text{s.t.}\quad D_{\mathrm{KL}}\big(\pi_\theta(a_t|s_t)\,\|\,\pi_{\theta'}(a_t|s_t)\big)\le\epsilon $$「对足够小的 $\epsilon$,这保证 $J(\theta')-J(\theta)$ 上升。」剩下的两节讲两种解法。
| 总变差 $D_{\mathrm{TV}}$ | KL 散度 $D_{\mathrm{KL}}$ | |
|---|---|---|
| 定义 | $\frac12\sum_a|p-q|$ | $\E_{p}[\log p-\log q]$ |
| 取值范围 | $[0,1]$,有界 | $[0,\infty]$,可爆炸 |
| 对称性 | 对称,是真正的度量 | 不对称,不满足三角不等式 |
| 样本估计 | 难(绝对值 + 需要两个密度的差) | 易(退化成对数似然) |
| 可微性 | 绝对值处不可微 | 处处光滑 |
| 二阶结构 | 无好用的二次近似 | Hessian = Fisher 信息矩阵(第 9 节) |
| 两者关系 | Pinsker:$D_{\mathrm{TV}}\le\sqrt{\tfrac12 D_{\mathrm{KL}}}$,所以约束 KL 是更保守(更安全)的做法 | |
7. 施加约束之一:对偶梯度下降与 PPO
7.1 拉格朗日对偶
带约束的问题最直接的处理是引入拉格朗日乘子 $\beta\ge 0$,构造
$$ \mathcal L(\theta',\beta)=\sum_t \E_{s_t\sim p_\theta(s_t)}\left[\E_{a_t\sim\pi_\theta(a_t|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}A^{\pi_\theta}(s_t,a_t)\right]\right]-\beta\Big(D_{\mathrm{KL}}\big(\pi_\theta(a_t|s_t)\|\pi_{\theta'}(a_t|s_t)\big)-\epsilon\Big) $$然后做对偶梯度下降(dual gradient descent):
- 关于 $\theta'$ 最大化 $\mathcal L(\theta',\beta)$;
- $\beta\leftarrow\beta+\alpha\big(D_{\mathrm{KL}}(\pi_\theta\|\pi_{\theta'})-\epsilon\big)$。
第 2 步的直觉一目了然:如果 KL 超标了(约束被违反),就调高惩罚系数 $\beta$;如果 KL 还很小(约束有余量),就调低 $\beta$,让优化器放开手脚。这是一个自动调节的「弹簧」。
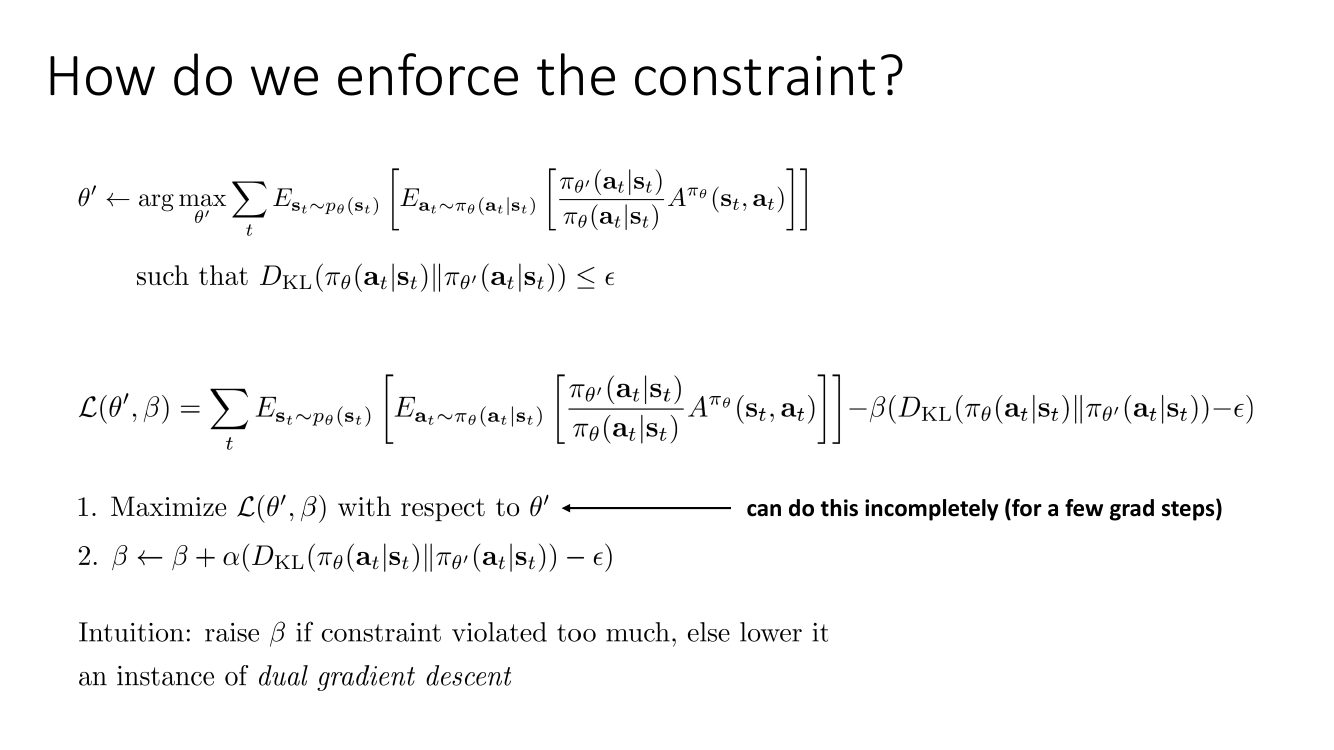
严格的对偶梯度下降要求内层精确求解 $\max_{\theta'}\mathcal L(\theta',\beta)$,才能保证外层的 $\beta$ 更新是在对偶函数上做梯度。实践中我们只跑几步 SGD 就切换到 $\beta$ 的更新——这在理论上叫「不精确的对偶上升」,收敛性保证会弱化。但它在深度 RL 里工作得很好,原因是:内层每多跑一步,$\theta'$ 就离 $\theta$ 更远一点,KL 也随之增大,外层的 $\beta$ 反馈回路仍然是负反馈。真正会出事的是内层跑得太狠、一批数据上做了几十次更新导致 KL 冲到 $\epsilon$ 的十几倍,此时下界早已失效。所以现代实现几乎都会加一个 KL 早停。
7.2 用样本写出可以直接反向传播的损失
把 $\mathcal L$ 的两项都换成采样估计。第一项是标准的 IS 代理目标;第二项利用 6.2 的观察,$-\beta D_{\mathrm{KL}}(\pi_\theta\|\pi_{\theta'})=\beta\,\E_{\pi_\theta}[\log\pi_{\theta'}]+\text{const}$:
$$ \mathcal L(\theta',\beta)\approx\sum_{i=1}^{N}\sum_{t=1}^{H}\underbrace{\frac{\pi_{\theta'}\big(a_t^{(i)}\big|s_t^{(i)}\big)}{\pi_\theta\big(a_t^{(i)}\big|s_t^{(i)}\big)}A^{\pi_\theta}\big(s_t^{(i)},a_t^{(i)}\big)}_{\text{重要性采样代理目标}}+\underbrace{\beta\log\pi_{\theta'}\big(a_t^{(i)}\big|s_t^{(i)}\big)}_{\text{离开样本的惩罚}}+\text{const} $$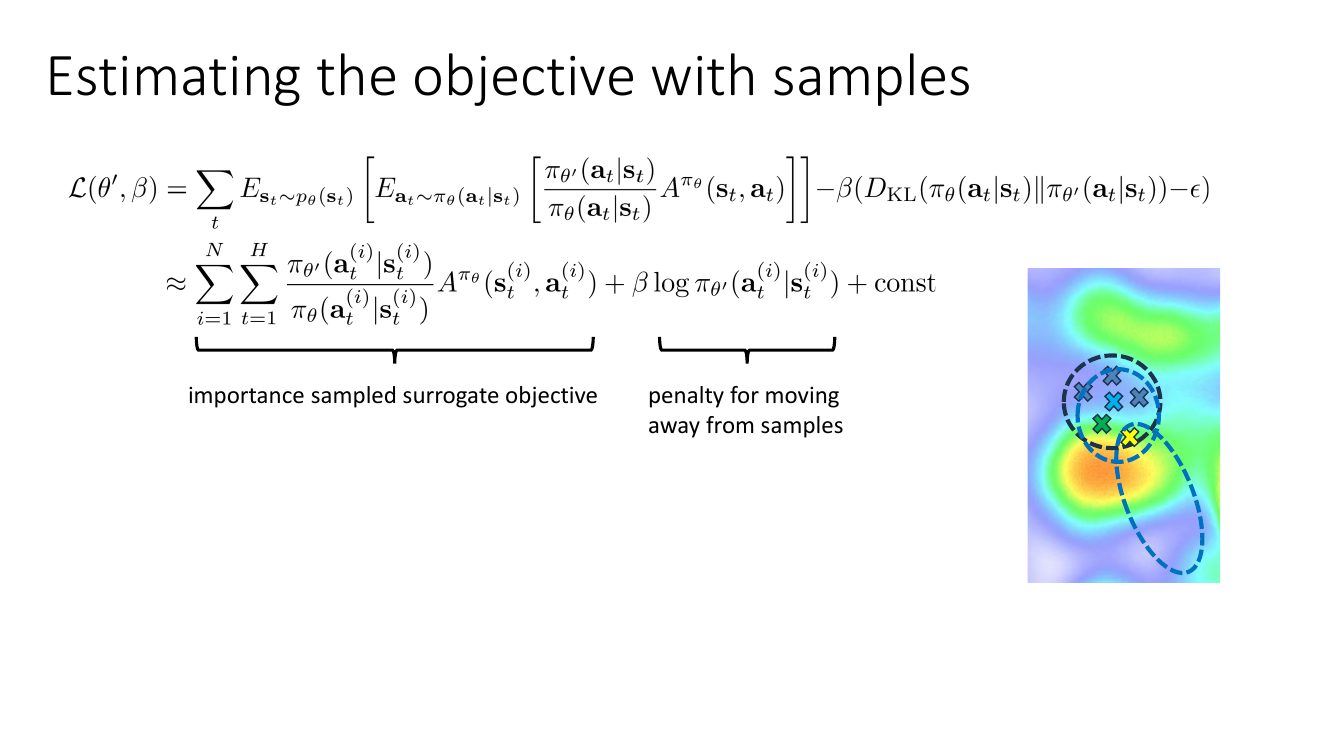
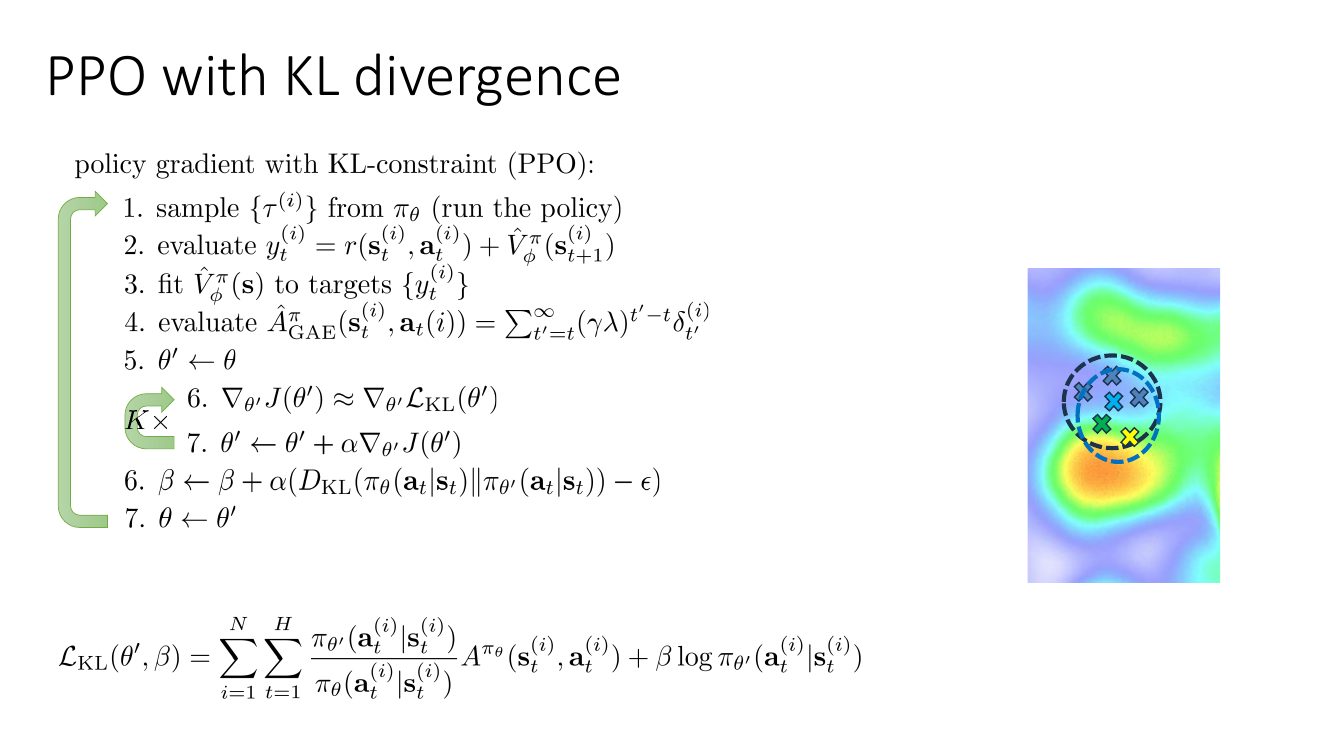
7.3 PPO with KL penalty 的完整算法
逐条读一遍:
- 采样 $\{\tau^{(i)}\}\sim\pi_\theta$(跑策略)。
- 算价值目标 $y_t^{(i)}=r(s_t^{(i)},a_t^{(i)})+\hat V^\pi_\phi(s_{t+1}^{(i)})$。
- 拟合 critic:把 $\hat V^\pi_\phi(s)$ 回归到 $\{y_t^{(i)}\}$。
- 算优势:用 GAE,$\hat A^\pi_{\mathrm{GAE}}(s_t,a_t)=\sum_{t'=t}^{\infty}(\gamma\lambda)^{t'-t}\delta_{t'}$,其中 $\delta_{t'}=r_{t'}+\gamma\hat V_\phi(s_{t'+1})-\hat V_\phi(s_{t'})$。这里的 $\lambda$ 就是第 6 讲讲过的偏差-方差权衡旋钮。
- 令 $\theta'\leftarrow\theta$,此时所有 IS 比值都等于 1。
- –7. 内层循环 $K$ 次:$\nabla_{\theta'}J(\theta')\approx\nabla_{\theta'}\mathcal L_{\mathrm{KL}}(\theta')$,$\theta'\leftarrow\theta'+\alpha\nabla_{\theta'}J(\theta')$。
- 更新对偶变量:$\beta\leftarrow\beta+\alpha\big(D_{\mathrm{KL}}(\pi_\theta\|\pi_{\theta'})-\epsilon\big)$。
- 提交:$\theta\leftarrow\theta'$,回到第 1 步。
注意第 5 步的重要性:$\pi_\theta$ 在整个内层循环中被冻结成「行为策略」,所有 $\log\pi_\theta(a^{(i)}_t|s^{(i)}_t)$ 在采样时算好并 detach。内层每走一步,比值就偏离 1 一点,代理目标的可信度就降一点,$\beta$ 项的拉力就强一点。
PPO 论文里的 adaptive-KL 版本用的是一个更简单的乘性规则,效果类似:如果 $\hat d=\hat\E[D_{\mathrm{KL}}]\lt \epsilon/1.5$ 就 $\beta\leftarrow\beta/2$;如果 $\hat d\gt 1.5\epsilon$ 就 $\beta\leftarrow 2\beta$。它本质上是对偶梯度下降在对数尺度上的离散化。
8. PPO 的 clip 形式:为什么剪裁能近似信赖域
上一节的 KL 惩罚版本需要维护一个额外的对偶变量 $\beta$,还要每轮估计一次 KL。PPO 论文提出了一个更粗暴但极其好用的替代:把 IS 比值直接剪裁(clip)掉。这就是今天绝大多数人口中的「PPO」。
8.1 clipped surrogate objective
记 IS 比值
$$ r_t(\theta')=\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)},\qquad r_t(\theta)=1 $$未剪裁的代理目标是 $L^{\mathrm{IS}}(\theta')=\hat\E_t\big[r_t(\theta')\hat A_t\big]$。PPO 的目标是
$$ L^{\mathrm{CLIP}}(\theta')=\hat\E_t\Big[\min\Big(r_t(\theta')\hat A_t,\ \operatorname{clip}\big(r_t(\theta'),\,1-\varepsilon,\,1+\varepsilon\big)\hat A_t\Big)\Big] $$其中 $\varepsilon$ 是剪裁半径(典型值 0.2),$\operatorname{clip}(x,l,u)=\max(l,\min(u,x))$。注意这里的 $\varepsilon$ 和信赖域半径 $\epsilon$ 不是一回事,但扮演相同角色。
把 $\hat A_t$ 的符号分开讨论。记 $L_t=\min\big(r\hat A,\operatorname{clip}(r,1-\varepsilon,1+\varepsilon)\hat A\big)$。
情形一:$\hat A_t\gt 0$(这个动作比平均好,想提高它的概率)。由于 $\hat A\gt0$,乘法保序,$\min$ 直接作用在 $r$ 上:$L_t=\hat A_t\cdot\min\big(r,\operatorname{clip}(r,1-\varepsilon,1+\varepsilon)\big)=\hat A_t\cdot\min(r,1+\varepsilon)$。
- $r\le 1+\varepsilon$:$L_t=r\hat A_t$,梯度正常,继续推高 $r$。
- $r\gt 1+\varepsilon$:$L_t=(1+\varepsilon)\hat A_t$ 是常数,$\partial L_t/\partial\theta'=0$。再推高概率没有任何收益。
情形二:$\hat A_t\lt 0$(这个动作比平均差,想降低它的概率)。此时乘 $\hat A$ 反序,$\min$ 选的是 $r$ 更大的那一支:$L_t=\hat A_t\cdot\max\big(r,\operatorname{clip}(r,1-\varepsilon,1+\varepsilon)\big)=\hat A_t\cdot\max(r,1-\varepsilon)$。
- $r\ge 1-\varepsilon$:$L_t=r\hat A_t$,梯度正常,继续压低 $r$。
- $r\lt 1-\varepsilon$:$L_t=(1-\varepsilon)\hat A_t$ 是常数,梯度为 0。再压低概率没有任何收益。
关键的第三点:这个 $\min$ 是单向的。假设 $\hat A_t\gt0$ 而某次更新把 $r$ 推到了 $1.5$(远超 $1+\varepsilon=1.2$),此时梯度为 0,$r$ 不会被主动拉回来;但如果 $\hat A_t\gt 0$ 且 $r$ 掉到了 $0.5$($\lt 1-\varepsilon$),$\operatorname{clip}(r)=0.8\gt r$,于是 $\min$ 取的是未剪裁的 $r\hat A$,梯度依然存在,把 $r$ 往上拉。也就是说:剪裁只掐掉「越界方向上继续获利」的动机,不掐掉「回到界内」的动力。这就是为什么写的是 $\min$ 而不是直接用 $\operatorname{clip}(r)\hat A$——后者在越界后梯度恒为 0,一旦被别的样本推出界就永远回不来。
| $\hat A_t$ 符号 | $r_t$ 区间 | 目标取值 | 梯度 | 解读 |
|---|---|---|---|---|
| $+$ | $r\lt 1-\varepsilon$ | $r\hat A$ | 推高 $r$ | 没到界内,正常优化 |
| $+$ | $1-\varepsilon\le r\le 1+\varepsilon$ | $r\hat A$ | 推高 $r$ | 信赖域内,正常优化 |
| $+$ | $r\gt 1+\varepsilon$ | $(1+\varepsilon)\hat A$ | 0 | 已越界,停止获利 |
| $-$ | $r\lt 1-\varepsilon$ | $(1-\varepsilon)\hat A$ | 0 | 已越界,停止获利 |
| $-$ | $1-\varepsilon\le r\le 1+\varepsilon$ | $r\hat A$ | 压低 $r$ | 信赖域内,正常优化 |
| $-$ | $r\gt 1+\varepsilon$ | $r\hat A$ | 压低 $r$ | 越界但方向是回来,保留梯度 |
8.2 为什么这算「近似信赖域」
三条理由:
- 它是 $L^{\mathrm{IS}}$ 的悲观下界。$\min$ 保证 $L^{\mathrm{CLIP}}\le L^{\mathrm{IS}}$,而且在 $\theta'=\theta$($r\equiv1$)处两者相等、一阶导也相等。所以 clip 版本同样具有第 5 节讲的 MM 结构:优化一个在当前点紧的下界。
- 它把「比值偏离 1」这个量直接钉住。回忆 $D_{\mathrm{KL}}(\pi_\theta\|\pi_{\theta'})=\E_{\pi_\theta}[-\log r]$,且当 $r\approx1$ 时 $-\log r\approx (1-r)+\frac12(1-r)^2$。所以「$|r-1|\le\varepsilon$」和「KL 很小」在一阶意义上是等价的条件——clip 是在逐样本地施加一个信赖域,而 KL 约束是在期望意义上施加。
- 它让「多跑几个 epoch」变得安全。随着内层 epoch 数增加,越来越多样本的 $r$ 跑出剪裁区间、贡献零梯度,有效批量自动缩小,更新自然减速。这是一个内建的、免费的刹车。
剪裁只作用在采到的那些 $(s_t,a_t)$ 上。神经网络在没采到的动作、没访问过的状态上完全可以任意乱动——KL 是对整个动作分布的积分,逐样本剪裁管不住它。此外,剪裁只让越界样本的梯度为 0,并没有把它们拉回来;若一次更新中大量样本同时越界,$\theta'$ 可能已经跳得很远。
所以工业级实现几乎都会补上一个近似 KL 早停:每个 epoch 结束时用 $\widehat{\mathrm{KL}}=\hat\E_t[\log\pi_\theta-\log\pi_{\theta'}]$ 或数值上更稳的 $\hat\E_t[(r-1)-\log r]$(恒非负,方差更低)估一下,超过阈值(常见 $0.015\sim0.03$)就提前跳出内层循环。Levine 在课上强调的那句「PPO with clipping is a heuristic approximation to PPO with KL」正是这个意思——clip 是启发式,KL 才是理论上的那个东西。
8.3 一个可运行的最小 PPO 实现
import torch, torch.nn as nn, torch.nn.functional as F

def ppo_update(policy, value, opt_pi, opt_v, batch,
               clip_eps=0.2, epochs=10, minibatch=64,
               ent_coef=0.0, target_kl=0.02, max_grad_norm=0.5):
    """batch = (obs, act, logp_old, adv, ret),全部已 detach。
       policy(obs) 返回一个 torch.distributions.Distribution。"""
    obs, act, logp_old, adv, ret = batch
    # 优势归一化:等价于按批自适应地调步长,是 PPO 最有效的实现细节之一
    adv = (adv - adv.mean()) / (adv.std() + 1e-8)
    n = obs.shape[0]

    for ep in range(epochs):
        perm = torch.randperm(n)
        for i in range(0, n, minibatch):
            j = perm[i:i + minibatch]
            dist  = policy(obs[j])
            logp  = dist.log_prob(act[j]).sum(-1)
            ratio = torch.exp(logp - logp_old[j])            # r_t(theta')

            unclipped = ratio * adv[j]
            clipped   = torch.clamp(ratio, 1 - clip_eps, 1 + clip_eps) * adv[j]
            pi_loss   = -torch.min(unclipped, clipped).mean()  # 取 min 再取负 = 最大化下界
            ent       = dist.entropy().sum(-1).mean()
            loss      = pi_loss - ent_coef * ent

            opt_pi.zero_grad(); loss.backward()
            nn.utils.clip_grad_norm_(policy.parameters(), max_grad_norm)
            opt_pi.step()

            v_loss = F.mse_loss(value(obs[j]).squeeze(-1), ret[j])
            opt_v.zero_grad(); v_loss.backward()
            nn.utils.clip_grad_norm_(value.parameters(), max_grad_norm)
            opt_v.step()

        # 每个 epoch 后检查近似 KL:clip 不保证 KL 有界,必须显式早停
        with torch.no_grad():
            logp_new = policy(obs).log_prob(act).sum(-1)
            log_r    = logp_new - logp_old
            approx_kl = ((torch.exp(log_r) - 1) - log_r).mean()   # 恒 >= 0 的低方差估计
        if approx_kl > 1.5 * target_kl:
            print(f"early stop at epoch {ep}, approx_kl={approx_kl:.4f}")
            break
几个值得注意的实现细节,它们对最终性能的影响常常大于算法本身:
- 优势归一化:$\hat A\leftarrow(\hat A-\text{mean})/\text{std}$。它让梯度尺度与奖励尺度解耦,相当于一个自适应步长。
- $\log\pi_\theta$ 必须在采样时算好,不能事后用「当前网络」重算——否则 $r$ 恒为 1,整个信赖域机制失效。
- 近似 KL 用 $\hat\E[(r-1)-\log r]$ 而不是 $\hat\E[-\log r]$:后者是无偏的但可正可负、方差大;前者同样无偏(因为 $\E_{\pi_\theta}[r-1]=0$)却恒非负,实践中读数稳定得多。
- 价值函数的裁剪(对 $\hat V$ 也做一次类似 clip)在一些实现里存在,但多数消融研究显示它可有可无。
9. 施加约束之二:自然梯度、Fisher 信息矩阵与 TRPO
回到那个带约束的问题。上一条路是「把约束变成惩罚」,这一条路是「把目标线性化、把约束二次化,然后解析地求解」。
9.1 把目标一阶展开
由于 $\epsilon$ 很小,$\theta'$ 只会离 $\theta$ 很近,那就干脆把 $\bar A(\theta')$ 在 $\theta$ 处做一阶泰勒展开(线性化):
$$ \theta'\leftarrow\argmax_{\theta'}\ \nabla_\theta\bar A(\theta)^\top(\theta'-\theta)\qquad\text{s.t.}\quad D_{\mathrm{KL}}\big(\pi_{\theta'}\|\pi_\theta\big)\le\epsilon $$(常数项 $\bar A(\theta)=0$ 略去。)现在关键问题是:$\nabla_\theta\bar A(\theta)$ 是什么?
对 $\bar A(\theta')$ 求关于 $\theta'$ 的梯度。只有 IS 比值的分子含 $\theta'$,用 $\nabla_{\theta'}\pi_{\theta'}=\pi_{\theta'}\nabla_{\theta'}\log\pi_{\theta'}$(log-derivative trick):
$$ \nabla_{\theta'}\bar A(\theta')=\sum_t \E_{s_t\sim p_\theta(s_t)}\left[\E_{a_t\sim\pi_\theta(a_t|s_t)}\left[\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)}\nabla_{\theta'}\log\pi_{\theta'}(a_t|s_t)A^{\pi_\theta}(s_t,a_t)\right]\right] $$现在代入 $\theta'=\theta$,比值变成 1,整项化简为
$$ \nabla_{\theta}\bar A(\theta)=\sum_t \E_{s_t\sim p_\theta(s_t)}\Big[\E_{a_t\sim\pi_\theta(a_t|s_t)}\big[\nabla_\theta\log\pi_\theta(a_t|s_t)A^{\pi_\theta}(s_t,a_t)\big]\Big]=\nabla_\theta J(\theta) $$这恰好就是普通的策略梯度。$\blacksquare$
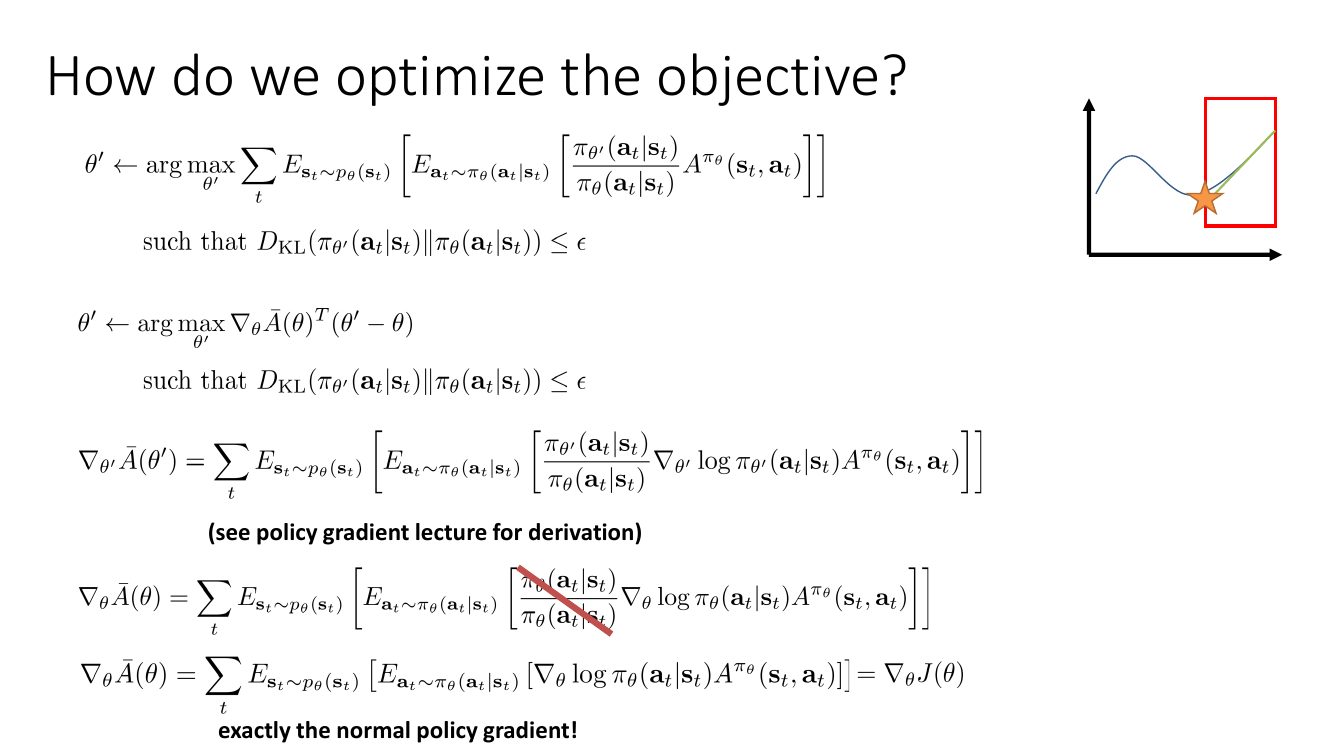
这是一个漂亮的结论:我们平时算的策略梯度,正是这个「策略迭代式代理目标」的一阶信息。所以从策略迭代出发和从策略梯度出发,在一阶层面殊途同归。
9.2 但普通梯度上升解的不是这个问题
既然梯度一样,那直接做 $\theta\leftarrow\theta+\alpha\nabla_\theta J(\theta)$ 不就完了?不行。问题出在约束上。
考虑一个简单的带约束线性规划:$\max_{\theta'}g^\top(\theta'-\theta)$ 且 $\|\theta'-\theta\|^2\le\epsilon$,其中 $g=\nabla_\theta J(\theta)$。令 $d=\theta'-\theta$。由 Cauchy–Schwarz,$g^\top d\le\|g\|\|d\|\le\|g\|\sqrt\epsilon$,等号当且仅当 $d$ 与 $g$ 同向且模长取满。于是
$$ \theta'=\theta+\sqrt{\frac{\epsilon}{\|\nabla_\theta J(\theta)\|^2}}\nabla_\theta J(\theta) $$这正是固定步长的梯度上升(步长 $\alpha=\sqrt\epsilon/\|g\|$)。
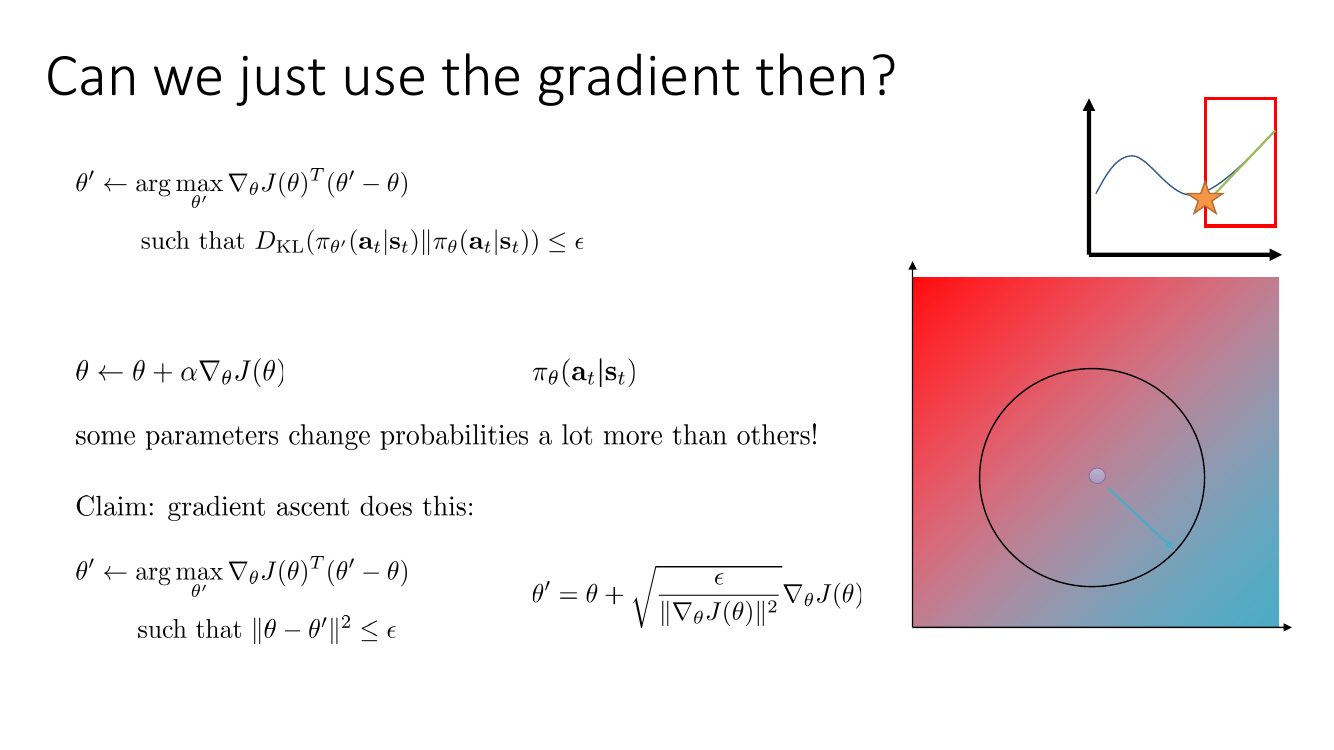
问题的本质是:参数空间的距离不等于策略空间的距离。把高斯策略 $\pi_\theta(a|s)=\mathcal N(\mu_k(s),\sigma^2)$ 的 $\sigma$ 从 1 改到 0.9,策略几乎没变;从 0.01 改到 0.001,策略天翻地覆——两者在参数空间里的位移相差 100 倍,但对分布的影响正好相反。用欧氏球当信赖域,等于用错误的尺子量距离。
9.3 KL 的二阶展开:Fisher 信息矩阵
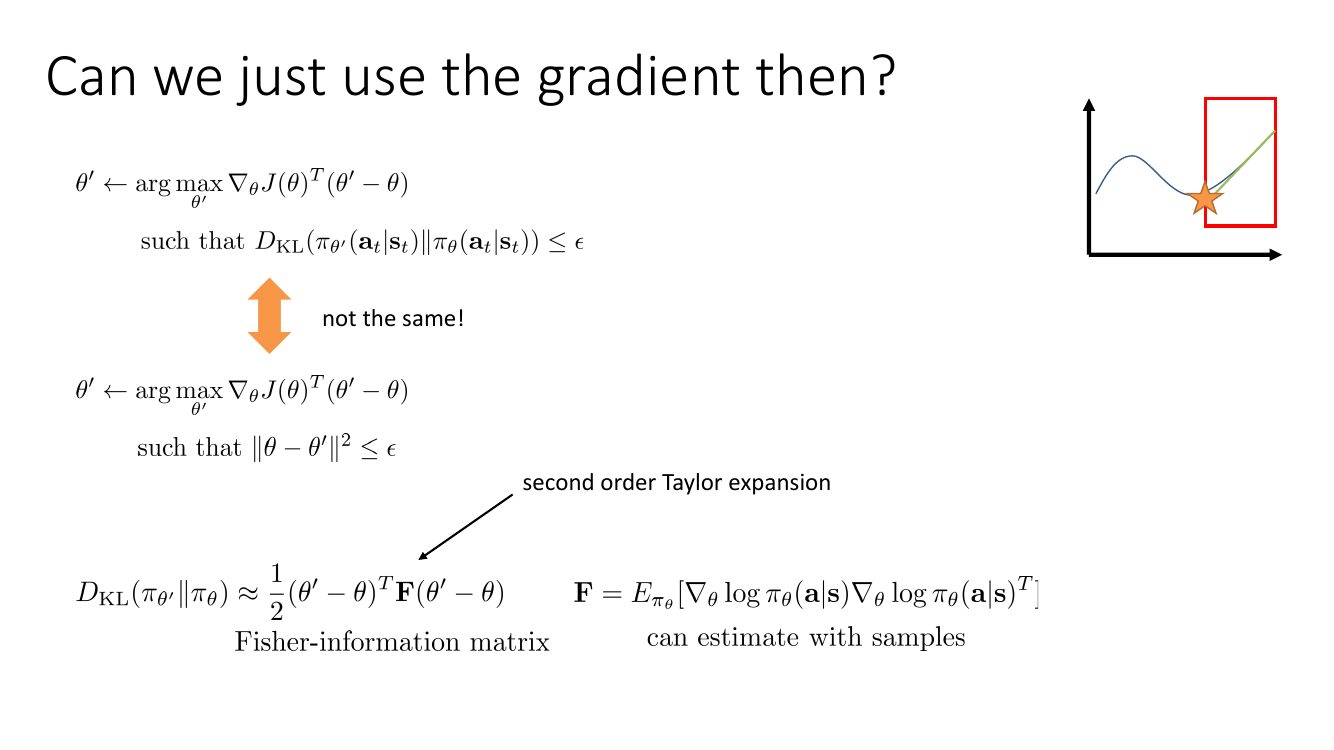
把 $g(\theta')=D_{\mathrm{KL}}\big(\pi_\theta(\cdot|s)\,\|\,\pi_{\theta'}(\cdot|s)\big)$ 看成 $\theta'$ 的函数,在 $\theta'=\theta$ 处展开。
零阶项:$g(\theta)=D_{\mathrm{KL}}(\pi_\theta\|\pi_\theta)=0$。
一阶项:$g(\theta')=\E_{\pi_\theta}[\log\pi_\theta]-\E_{\pi_\theta}[\log\pi_{\theta'}]$,只有第二项含 $\theta'$,
$$ \nabla_{\theta'}g(\theta')=-\E_{a\sim\pi_\theta}\big[\nabla_{\theta'}\log\pi_{\theta'}(a|s)\big] \quad\Longrightarrow\quad \nabla_{\theta'}g\big|_{\theta'=\theta}=-\E_{a\sim\pi_\theta}\big[\nabla_\theta\log\pi_\theta(a|s)\big]=0 $$最后一步用了 score function 的期望为零:$\E_{\pi}[\nabla\log\pi]=\sum_a\pi\frac{\nabla\pi}{\pi}=\nabla\sum_a\pi=\nabla 1=0$。这解释了为什么必须展到二阶——一阶项恒为零,KL 在 $\theta$ 处是「平的」,所有信息都在 Hessian 里。
二阶项:
$$ \nabla^2_{\theta'}g\big|_{\theta'=\theta}=-\E_{a\sim\pi_\theta}\big[\nabla^2_\theta\log\pi_\theta(a|s)\big] $$现在证明这个量等于 score 的外积期望。对任意概率密度 $p_\theta$:
$$ \nabla^2\log p_\theta=\nabla\left(\frac{\nabla p_\theta}{p_\theta}\right)=\frac{\nabla^2 p_\theta}{p_\theta}-\frac{\nabla p_\theta\nabla p_\theta^\top}{p_\theta^2}=\frac{\nabla^2p_\theta}{p_\theta}-\nabla\log p_\theta\,\nabla\log p_\theta^\top $$对 $p_\theta$ 取期望,第一项 $\E\big[\frac{\nabla^2p_\theta}{p_\theta}\big]=\sum_a\nabla^2p_\theta=\nabla^2\sum_a p_\theta=\nabla^21=0$。于是
$$ \E_{p_\theta}\big[\nabla^2\log p_\theta\big]=-\E_{p_\theta}\big[\nabla\log p_\theta\nabla\log p_\theta^\top\big]=-\mathbf F $$代回得 $\nabla^2_{\theta'}g|_{\theta'=\theta}=\mathbf F$。因此
$$ D_{\mathrm{KL}}\big(\pi_\theta\|\pi_{\theta'}\big)\approx\frac12(\theta'-\theta)^\top\mathbf F(\theta'-\theta),\qquad \mathbf F=\E_{\pi_\theta}\Big[\nabla_\theta\log\pi_\theta(a|s)\,\nabla_\theta\log\pi_\theta(a|s)^\top\Big] $$顺带一提:反方向 $D_{\mathrm{KL}}(\pi_{\theta'}\|\pi_\theta)$ 关于 $\theta'$ 的二阶展开也是同一个 $\mathbf F$——KL 在局部是对称的,两个方向只在三阶项才开始分道扬镳。所以幻灯片上写哪个方向都不影响结论。
$\mathbf F$ 定义了参数空间上的一个局部度量:$\|d\|_{\mathbf F}^2=d^\top\mathbf F d$ 衡量的不是「参数走了多远」,而是「策略变了多少」。$\mathbf F$ 在某个方向上特征值大,说明那个方向的参数一动策略就大变,就该走小步;特征值小则相反。用 $\mathbf F$ 做度量,得到的是黎曼流形上的最速上升方向,而且这个方向不依赖参数化方式——你把网络的某一层乘以 100、下一层除以 100,普通梯度会完全变样,自然梯度不变。这就是 Amari 提出「自然梯度」时的核心论点。
9.4 解出自然梯度和它的步长
问题:$\max_d\ g^\top d$ 且 $\frac12 d^\top\mathbf Fd\le\epsilon$,其中 $g=\nabla_\theta J(\theta)$、$d=\theta'-\theta$、$\mathbf F\succ0$。
目标线性、约束是凸的椭球,最优解必在边界上。写拉格朗日函数
$$ \mathcal L(d,\lambda)=g^\top d-\lambda\left(\frac12 d^\top\mathbf Fd-\epsilon\right) $$对 $d$ 求导置零:$g-\lambda\mathbf Fd=0\Rightarrow d=\frac1\lambda\mathbf F^{-1}g$。代入激活的约束 $\frac12d^\top\mathbf Fd=\epsilon$:
$$ \frac{1}{2\lambda^2}\,g^\top \mathbf F^{-1}\mathbf F\,\mathbf F^{-1}g=\frac{1}{2\lambda^2}g^\top\mathbf F^{-1}g=\epsilon \quad\Longrightarrow\quad \lambda=\sqrt{\frac{g^\top\mathbf F^{-1}g}{2\epsilon}} $$于是
$$ \boxed{\;\theta'=\theta+\alpha\,\mathbf F^{-1}\nabla_\theta J(\theta),\qquad \alpha=\sqrt{\frac{2\epsilon}{\nabla_\theta J(\theta)^\top\mathbf F^{-1}\nabla_\theta J(\theta)}}\;} $$$\mathbf F^{-1}\nabla_\theta J$ 就叫自然梯度(natural gradient)。
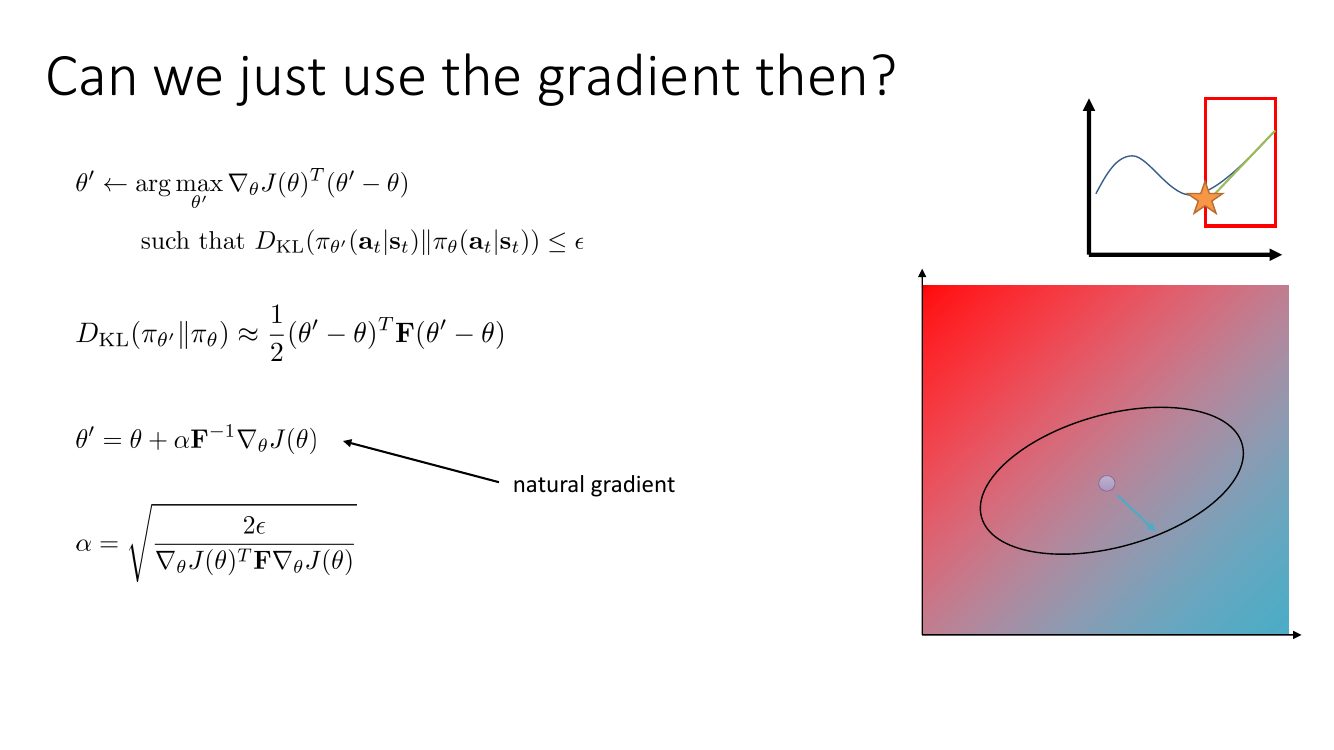
幻灯片上把步长写成了 $\alpha=\sqrt{2\epsilon/(\nabla J^\top\mathbf F\nabla J)}$,这是一个流传已久的笔误。正确的是 $\mathbf F^{-1}$:这一点从「代入检验」就能看出来——把 $d=\alpha\mathbf F^{-1}g$ 代入约束,$\frac12 d^\top\mathbf Fd=\frac{\alpha^2}{2}g^\top\mathbf F^{-1}g$,令它等于 $\epsilon$ 才解出 $\alpha=\sqrt{2\epsilon/(g^\top\mathbf F^{-1}g)}$。TRPO 论文里写的也是这个形式。实现上不必单独算这个量:设 $x=\mathbf F^{-1}g$(共轭梯度的解),则 $g^\top\mathbf F^{-1}g=x^\top\mathbf Fx$,而 $\mathbf Fx$ 本来就要算一次,顺手就得到了。
9.5 这在实践中真的是个问题吗?
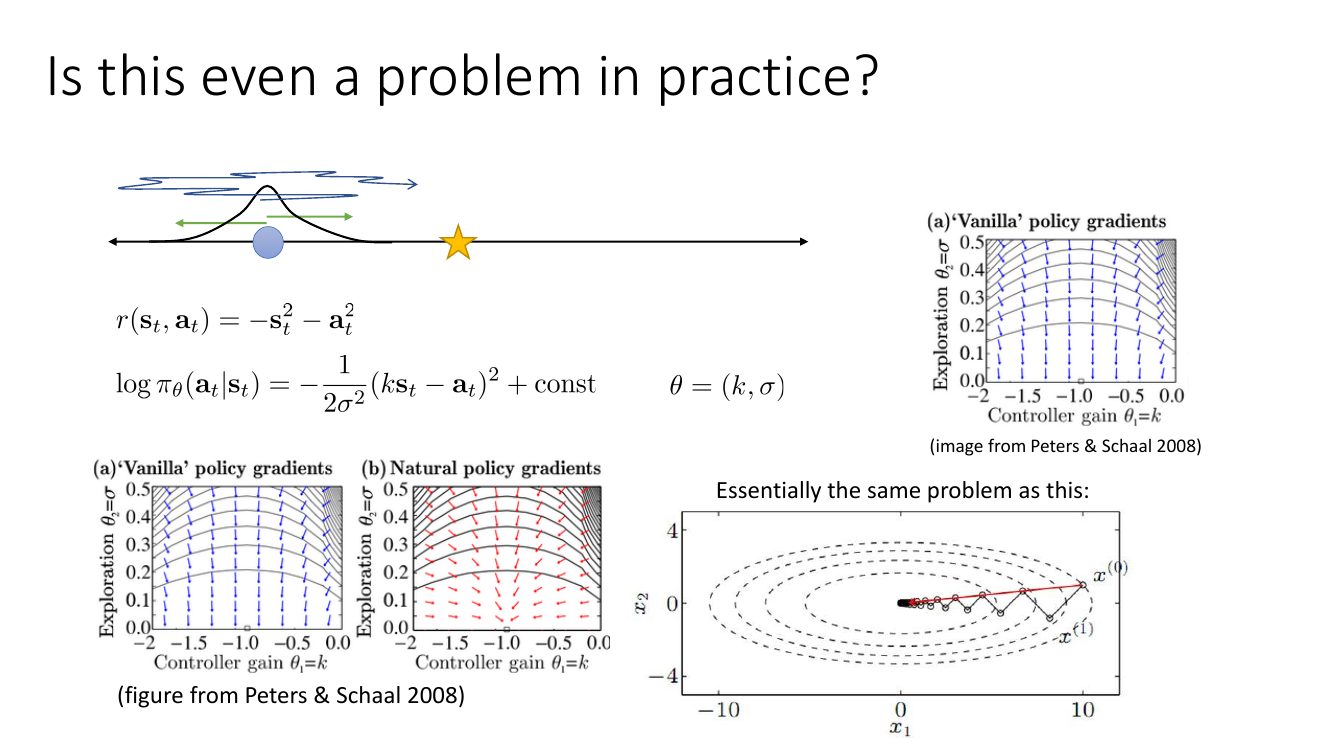
为什么普通梯度会拼命压 $\sigma$?做一下计算。设 $a=ks+\sigma z$、$z\sim\mathcal N(0,1)$,则
$$ \nabla_k\log\pi_\theta=\frac{(a-ks)s}{\sigma^2}=\frac{zs}{\sigma},\qquad \nabla_\sigma\log\pi_\theta=\frac{(a-ks)^2}{\sigma^3}-\frac1\sigma=\frac{z^2-1}{\sigma} $$两个分量都以 $1/\sigma$ 的速度放大,但 $k$ 方向还额外乘了一个 $s$——当策略已经把状态控制在原点附近时 $\E[s^2]$ 很小,$k$ 方向的梯度就被压得很扁。结果是:优化器先把探索杀死,然后因为没有探索,$k$ 再也学不动了。这是策略梯度里最典型的「过早收敛」失效模式。
Fisher 矩阵正好修好这件事:$\mathbf F_{kk}=\E[s^2]/\sigma^2$、$\mathbf F_{\sigma\sigma}=2/\sigma^2$,$\mathbf F^{-1}$ 把两个方向各自的 $1/\sigma^2$ 尺度和 $\E[s^2]$ 因子都除掉,恢复了两者的平衡。数值上感受一下:$\sigma$ 从 1 降到 0.1,梯度模长会放大约 10 倍;如果你的学习率是在 $\sigma=1$ 时调好的,到 $\sigma=0.1$ 时这一步就迈大了 10 倍——要么发散,要么反过来在 $\sigma$ 大时爬得像蜗牛。没有任何一个固定的标量学习率能同时伺候好这两种情形,这正是需要 $\mathbf F^{-1}$ 这个矩阵型预条件子的原因。
9.6 TRPO:共轭梯度 + 线搜索
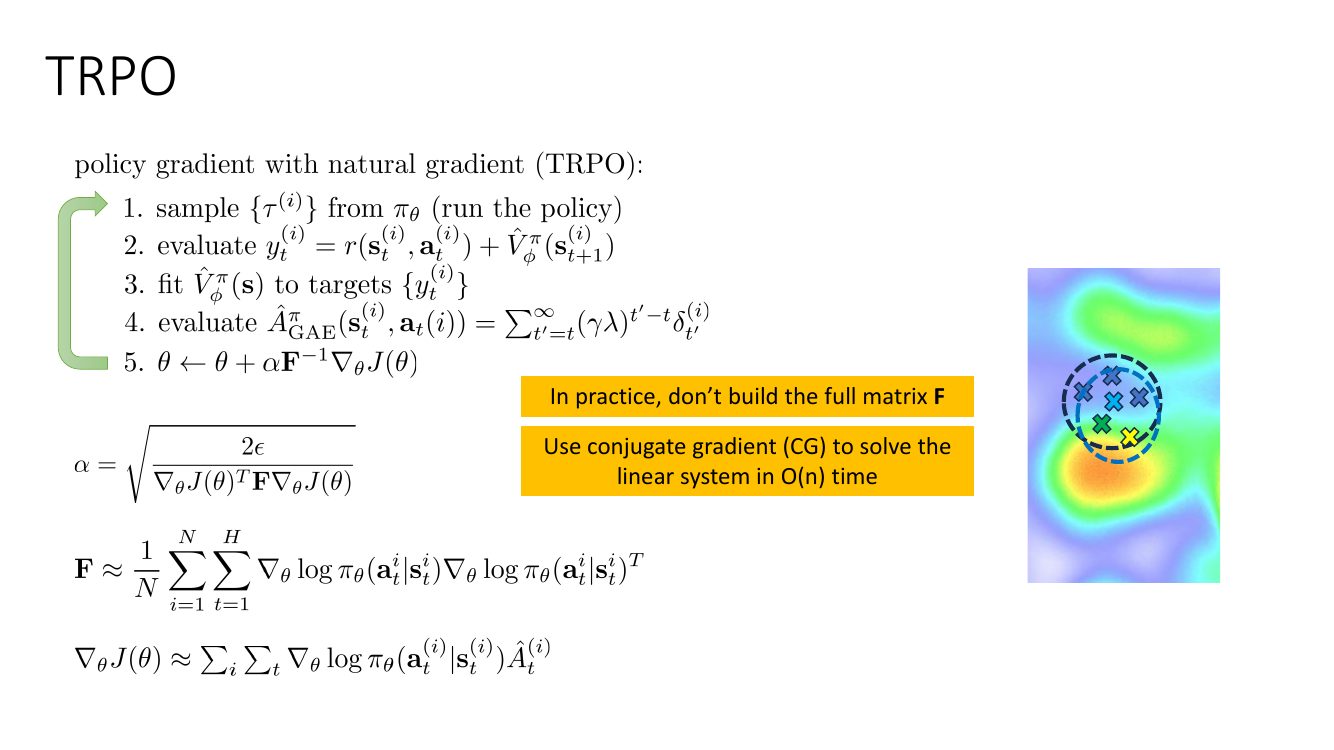
自然梯度的公式看起来很美,但 $\mathbf F$ 是 $n\times n$ 的,$n$ 是网络参数量(百万级)。显式构造要 $O(n^2)$ 内存、求逆要 $O(n^3)$ 时间,完全不可行。TRPO 的工程贡献就是绕开这两件事。
两个关键技巧:
技巧一:把「求 $\mathbf F^{-1}g$」变成「解线性方程组 $\mathbf Fx=g$」,用共轭梯度法(conjugate gradient, CG)。CG 只需要能计算「矩阵乘向量」$\mathbf Fv$,不需要矩阵本身;对 $n$ 维正定系统理论上 $n$ 步收敛,实践中 10 步左右就足够(因为 $\mathbf F$ 的谱通常集中)。
技巧二:Fisher-向量积(Fisher-vector product)用二次反向传播算。因为 $\mathbf F$ 是 KL 的 Hessian,
$$ \mathbf Fv=\nabla_\theta\Big(\big(\nabla_\theta \bar D_{\mathrm{KL}}\big)^\top v\Big) $$先对平均 KL 求一次梯度得到向量 $\nabla\bar D_{\mathrm{KL}}$(保留计算图),与 $v$ 做内积得到标量,再对这个标量求一次梯度——就得到了 $\mathbf Fv$,代价只有两次反向传播,内存 $O(n)$。
技巧三:线搜索(line search)兜底。二阶近似是近似,$\alpha$ 算出来的那一步可能真的把 KL 撑爆、或者代理目标反而变差。TRPO 用回溯线搜索:依次尝试 $\theta+\eta^j\cdot\alpha x$($\eta=0.5$ 或 $0.8$,$j=0,1,2,\dots$),接受第一个同时满足「真实 KL $\le\epsilon$」和「代理目标确实提高了」的候选;全部失败就原地不动。这一步把 TRPO 从「近似方法」变成了「有硬约束保证的方法」。
import torch

def flat_grad(y, params, retain=False, create=False):
    g = torch.autograd.grad(y, params, retain_graph=retain, create_graph=create)
    return torch.cat([gi.reshape(-1) for gi in g])

def set_flat_params(module, flat):
    i = 0
    for p in module.parameters():
        k = p.numel()
        p.data.copy_(flat[i:i + k].view_as(p))
        i += k

def mean_kl(policy, obs, old_mean, old_std):
    """KL(pi_old || pi_theta),old_* 是 detach 过的旧分布参数。
       它在 theta = theta_old 处取值 0、梯度 0,Hessian 恰为 Fisher 矩阵。"""
    dist = policy(obs)
    old  = torch.distributions.Normal(old_mean, old_std)
    return torch.distributions.kl_divergence(old, dist).sum(-1).mean()

def fisher_vector_product(policy, obs, old_mean, old_std, v, damping=0.1):
    """只用两次反向传播算 F @ v,从不显式构造 F。damping 保证正定与数值稳定。"""
    params = list(policy.parameters())
    kl = mean_kl(policy, obs, old_mean, old_std)
    g  = flat_grad(kl, params, retain=True, create=True)
    gv = (g * v).sum()
    hv = flat_grad(gv, params, retain=True)
    return hv.detach() + damping * v

def conjugate_gradient(Av, b, iters=10, tol=1e-10):
    """解 A x = b,A 只以「乘向量」的形式给出。"""
    x = torch.zeros_like(b)
    r = b.clone()
    p = b.clone()
    rr = r @ r
    for _ in range(iters):
        Ap = Av(p)
        alpha = rr / (p @ Ap + 1e-12)
        x = x + alpha * p
        r = r - alpha * Ap
        rr_new = r @ r
        if rr_new < tol:
            break
        p = r + (rr_new / rr) * p
        rr = rr_new
    return x

def trpo_step(policy, obs, act, logp_old, adv, old_mean, old_std,
              max_kl=0.01, backtracks=10, accept_ratio=0.1):
    params = list(policy.parameters())

    def surrogate():
        logp = policy(obs).log_prob(act).sum(-1)
        return (torch.exp(logp - logp_old) * adv).mean()

    L_old = surrogate()
    g = flat_grad(L_old, params, retain=True).detach()          # 策略梯度

    Av = lambda v: fisher_vector_product(policy, obs, old_mean, old_std, v)
    x  = conjugate_gradient(Av, g)                              # x = F^{-1} g
    xFx = (x * Av(x)).sum()                                     # = g^T F^{-1} g
    step = torch.sqrt(2 * max_kl / (xFx + 1e-12)) * x           # alpha * F^{-1} g

    old_flat = torch.cat([p.data.reshape(-1) for p in params])
    expected = (g @ step).item()                                # 一阶预测的提升量
    for j in range(backtracks):                                 # 回溯线搜索
        frac = 0.5 ** j
        set_flat_params(policy, old_flat + frac * step)
        with torch.no_grad():
            kl   = mean_kl(policy, obs, old_mean, old_std).item()
            gain = surrogate().item() - L_old.item()
        if kl <= max_kl and gain > accept_ratio * frac * expected:
            return True, kl, gain
    set_flat_params(policy, old_flat)                           # 全部失败则回退
    return False, 0.0, 0.0
注意 damping:实际的 $\hat{\mathbf F}$ 由有限样本估出,很可能奇异或病态;加上 $\delta\mathbf I$(典型 $\delta=0.1$)既保证 CG 收敛,也相当于在自然梯度和普通梯度之间插值——$\delta\to\infty$ 时 $(\mathbf F+\delta\mathbf I)^{-1}g\propto g$ 就退化成普通梯度。
10. 镜像下降视角、TRPO vs PPO 与实践指南
10.1 一个统一视角:镜像下降
把本讲的核心更新写成「近端(proximal)」形式:
$$ \pi_{k+1}=\argmax_{\pi}\ \left\{\ \E_{s\sim d^{\pi_k}}\E_{a\sim\pi(\cdot|s)}\big[A^{\pi_k}(s,a)\big]-\frac{1}{\eta}\,\E_{s\sim d^{\pi_k}}\Big[D_{\mathrm{KL}}\big(\pi(\cdot|s)\,\|\,\pi_k(\cdot|s)\big)\Big]\right\} $$这就是镜像下降(mirror descent)的标准形式:线性项 + Bregman 散度型的近端项。取负熵作为镜像映射时,Bregman 散度正是 KL。这个视角一下子把三个东西串起来了:
固定一个状态 $s$,在概率单纯形上求解 $\max_{\pi(\cdot|s)}\sum_a\pi(a|s)A^{\pi_k}(s,a)-\frac1\eta\sum_a\pi(a|s)\log\frac{\pi(a|s)}{\pi_k(a|s)}$,带归一化约束 $\sum_a\pi=1$。写拉格朗日函数并对 $\pi(a|s)$ 求导:
$$ A^{\pi_k}(s,a)-\frac1\eta\left(\log\frac{\pi(a|s)}{\pi_k(a|s)}+1\right)-\mu=0 \quad\Longrightarrow\quad \pi(a|s)\ \propto\ \pi_k(a|s)\exp\big(\eta A^{\pi_k}(s,a)\big) $$这是一个指数加权(乘性权重)更新。看它的两个极限:
- $\eta\to\infty$(信赖域半径 $\epsilon\to\infty$):指数把最大优势的动作放大到无穷,$\pi_{k+1}$ 退化成 $\argmax_a A^{\pi_k}(s,a)$ 的确定性策略——这就是贪心策略迭代。
- $\eta\to 0$($\epsilon\to0$):$\exp(\eta A)\approx1+\eta A$,$\pi_{k+1}\approx\pi_k(1+\eta(A-\bar A))$,是沿优势方向的一个无穷小扰动——这就是策略梯度。
策略迭代和策略梯度不是两种算法,而是同一族算法的两个端点,参数就是信赖域半径 $\epsilon$(或步长 $\eta$):
贪心策略迭代($\epsilon=\infty$) ← TRPO / PPO($\epsilon$ 适中) → 普通策略梯度($\epsilon\to0$)
而自然梯度就是在参数化策略上、用 KL 的二阶近似实现这个镜像下降步的具体数值方法。这也解释了它为什么与参数化无关:镜像下降定义在策略空间(分布空间)上,与你用什么网络表示它无关。
顺带一提,这个指数加权形式 $\pi\propto\pi_k e^{\eta A}$ 也正是后面几讲要讲的「RL as inference / 最大熵 RL」里的软策略改进公式,以及离线 RL 中 AWR / AWAC 那一类「优势加权回归」的来源。同一个公式在这门课里会反复出现。
10.2 TRPO vs PPO:一大步还是许多小步
| TRPO | PPO(clip) | |
|---|---|---|
| 约束的施加方式 | 硬约束 + 线搜索验证,每轮 KL 有保证 | 逐样本剪裁 + 近似 KL 早停,无硬保证 |
| 每批数据的更新次数 | 1 次(一大步) | K 个 epoch × 多个 minibatch(许多小步) |
| 用到的信息阶数 | 二阶(Fisher) | 一阶(Adam) |
| 单次更新代价 | 高:10 次 CG × 2 次反传 + 最多 10 次线搜索 | 低:普通 SGD |
| 与网络结构的兼容性 | 差:共享参数的 actor-critic、RNN、dropout / batchnorm 都会破坏 Fisher 的估计 | 好:任意结构,只要能求梯度 |
| 实现难度 | 高(CG、Fisher-向量积、扁平化参数、线搜索) | 低(约 20 行) |
| 分布式扩展 | 较难(CG 要多次全局同步) | 容易(数据并行) |
| 超参数敏感度 | 低($\epsilon$ 几乎不用调) | 较高(clip 半径、epoch 数、学习率相互耦合) |
| 今天的地位 | 理论参照物、强基线 | 事实标准(含 RLHF、机器人、游戏) |
Levine 在课上没有给出一边倒的结论,而是把它抛成一个开放问题。可以这样理解这个取舍:TRPO 花很大代价把「一步」这件事做到最好——它确定性地在椭球边界上找最优点,然后验证。PPO 承认自己每一步都不精确,但它走得便宜,可以走很多步,靠一个粗糙的护栏防止跑飞。在深度网络 + 大批量样本 + Adam 的现实条件下,后者的工程优势压倒了前者的理论优雅。但要记住:PPO 之所以能工作,靠的仍然是本讲这套信赖域理论;把 clip 半径开到 10,或者把 epoch 数调到 100,PPO 就会崩得和普通 REINFORCE 一样彻底。
10.3 实践中的超参数
| 算法 | 超参数 | 常见默认值 | 怎么调 |
|---|---|---|---|
| PPO | clip 半径 $\varepsilon$ | 0.2(范围 0.1–0.3) | 训练不稳就调小;样本效率太低可试 0.3 |
| 内层 epoch 数 $K$ | 3–10 | 与 clip 半径、批量大小强耦合;连续控制常用 10,Atari 常用 3–4 | |
| GAE $\lambda$ | 0.95 | 价值函数准就调大(更低偏差),不准就调小(更低方差) | |
| 折扣 $\gamma$ | 0.99 | 任务时域长就调大;注意有效时域 $\approx\frac{1}{1-\gamma}$ | |
| 学习率(Adam) | $3\times10^{-4}$ | 常配线性退火到 0 | |
| 目标 KL(早停) | 0.01–0.03 | 触发得太频繁说明学习率或 epoch 数过大 | |
| 熵系数 | 0(连续)/ 0.01(离散) | 离散动作容易过早确定化,需要熵奖励撑住探索 | |
| TRPO | KL 半径 $\epsilon$ | 0.01 | 几乎不用调,这是 TRPO 最大的优点 |
| CG 迭代数 | 10 | 再多收益很小 | |
| damping $\delta$ | 0.1 | CG 不收敛或步长异常大就调大 | |
| 线搜索回溯 | 系数 0.5–0.8,最多 10 次 | 频繁全部失败说明二阶近似不成立,需减小 $\epsilon$ |
还有几条不写在论文里但极其重要的经验:
- 优势归一化几乎是必须的。它让 clip 半径和学习率的含义在不同奖励尺度的任务间保持一致。
- 观测归一化(running mean/std)对连续控制任务的影响常常超过算法选择本身。
- 批量要大。信赖域的整套理论建立在「$\bar A(\theta')$ 和 KL 都被准确估计」的前提上。批量太小时,估计噪声会让 clip 和早停都失效。连续控制常见批量是每次更新 2048–8192 步。
- 监控三个数:近似 KL、clip 触发比例、解释方差(explained variance of $\hat V$)。KL 突然跳高说明步子迈大了;clip 比例接近 1 说明策略在撞墙;解释方差接近 0 说明 critic 没学到东西,此时优势估计全是噪声,再好的信赖域也救不了。
- $A^{\pi_\theta}$ 是估出来的,不是真的。所有推导都假设我们有精确的优势函数。critic 有偏差时,「最大化下界」保证的是「最大化一个有偏下界」,单调改进无从谈起。
- $\epsilon t$ 那条界在长时域下是废话。第 4.3 节的表已经说明了这一点。深度 RL 常见的 $H=1000$ 意味着理论上需要 $\epsilon\sim10^{-3}$,而实际用的 clip 半径对应的 TV 大得多。理论只是在指方向,不是在给保证。
- Fisher 矩阵是用同一批样本估的。参数量远大于样本量时,$\hat{\mathbf F}$ 严重秩亏,$\hat{\mathbf F}^{-1}$ 在零空间上的行为完全由 damping 决定。
- $\gamma^t$ 那个权重在实现中普遍被丢掉。严格的折扣目标要求在状态分布上也带 $\gamma^t$,几乎没有实现这么做。这是一个已知的、大家默契忽略的不一致。
Levine 的态度值得学:这些理论的价值不在于它们提供的保证(在深度网络下大多失效),而在于它们告诉你算法为什么长成这个样子、以及当它崩掉时该往哪个方向找原因。
本讲小结
| 问题 | 答案 | 依据 |
|---|---|---|
| 为什么可以用旧策略的优势 $A^{\pi_\theta}$? | 这是精确的,不是近似 | 性能差分引理 $J(\theta')-J(\theta)=\E_{p_{\theta'}}[\sum_t\gamma^tA^{\pi_\theta}]$ |
| 为什么可以用旧策略的状态分布 $p_\theta(s_t)$? | 近似成立,前提是策略变化不大 | 耦合论证:$D_{\mathrm{TV}}(\pi_{\theta'},\pi_\theta)\le\epsilon\Rightarrow D_{\mathrm{TV}}(p_{\theta'}(s_t),p_\theta(s_t))\le\epsilon t$ |
| 这个误差怎么影响目标? | 目标被一个可计算的量减去 $\sum_t 2\epsilon tC$ 所下界 | 期望扰动界 + MM 原理(下界在 $\theta'=\theta$ 处紧) |
| 为什么用 KL 而不是 TV? | KL 可用样本估、光滑、Hessian 是 Fisher | Pinsker $D_{\mathrm{TV}}\le\sqrt{\tfrac12D_{\mathrm{KL}}}$;$-\beta D_{\mathrm{KL}}$ 退化成对数似然 |
| 怎么解带约束的问题(法一)? | 拉格朗日 + 对偶梯度下降 → PPO-KL | $\beta\leftarrow\beta+\alpha(D_{\mathrm{KL}}-\epsilon)$,内层可以只跑几步 |
| clip 是怎么回事? | 逐样本的启发式信赖域,是 PPO-KL 的廉价近似 | $\min$ 掐掉越界方向的梯度、保留回归方向的梯度 |
| 怎么解带约束的问题(法二)? | 目标一阶 + KL 二阶 → 自然梯度 / TRPO | $\theta'=\theta+\alpha\mathbf F^{-1}\nabla J$,$\alpha=\sqrt{2\epsilon/(\nabla J^\top\mathbf F^{-1}\nabla J)}$ |
| 为什么不用普通梯度? | 欧氏球不是策略空间的正确形状 | Peters & Schaal 的例子:普通梯度只会压 $\sigma$,杀死探索 |
| $\mathbf F$ 太大怎么办? | CG 解 $\mathbf Fx=g$ + 二次反传算 $\mathbf Fv$ + 线搜索兜底 | $O(n)$ 内存,约 10 次 CG 迭代 |
| 这一切的统一图景? | 策略梯度 = KL 约束下的软化策略迭代 | 镜像下降:$\pi_{k+1}\propto\pi_k e^{\eta A^{\pi_k}}$,$\eta\to\infty$ 是策略迭代,$\eta\to0$ 是策略梯度 |
要记住的三个公式:
$$ J(\theta')-J(\theta)=\E_{\tau\sim p_{\theta'}(\tau)}\left[\sum_t\gamma^tA^{\pi_\theta}(s_t,a_t)\right] $$ $$ L^{\mathrm{CLIP}}(\theta')=\hat\E_t\Big[\min\Big(r_t(\theta')\hat A_t,\ \operatorname{clip}\big(r_t(\theta'),1-\varepsilon,1+\varepsilon\big)\hat A_t\Big)\Big],\qquad r_t(\theta')=\frac{\pi_{\theta'}(a_t|s_t)}{\pi_\theta(a_t|s_t)} $$ $$ \theta'=\theta+\sqrt{\frac{2\epsilon}{\nabla_\theta J^\top\mathbf F^{-1}\nabla_\theta J}}\ \mathbf F^{-1}\nabla_\theta J,\qquad \mathbf F=\E_{\pi_\theta}\big[\nabla_\theta\log\pi_\theta\,\nabla_\theta\log\pi_\theta^\top\big] $$延伸阅读
本讲的直接来源
- Trust Region Policy Optimization (Schulman et al., 2015) — 本讲第 4、5、9 节的证明都出自这篇。附录里有 $\epsilon t$ 那条界的完整版本,以及为什么最终实现里把「每个状态的最大 KL」换成了「平均 KL」。
- Proximal Policy Optimization Algorithms (Schulman et al., 2017) — clip 与 adaptive-KL 两个版本都在这里,包括那张著名的「单个样本上目标函数随比值变化」的分段折线图。
- Approximately Optimal Approximate Reinforcement Learning (Kakade & Langford, ICML 2002) — CPI,性能差分引理与「保守策略改进」的源头。TRPO 的理论骨架是它的推广。
- A Natural Policy Gradient (Kakade, NeurIPS 2001) — 第一次把 Fisher 度量引入策略梯度。
- Natural Gradient Works Efficiently in Learning (Amari, Neural Computation 1998) — 自然梯度的原始论文,讲清楚了「参数化无关」这件事。
- Natural Actor-Critic (Peters & Schaal, Neurocomputing 2008) — 第 9.5 节那两张向量场图的出处。
补齐推导所需的工具
- High-Dimensional Continuous Control Using Generalized Advantage Estimation (Schulman et al., 2015) — TRPO/PPO 伪代码第 4 步用的 GAE 就来自这里,讲 $\lambda$ 如何在偏差与方差之间取舍。
- A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning (Ross et al., 2011) — DAgger。第 4 节那句 "seem familiar?" 指的就是它的分布漂移分析,两者的数学结构完全一样。
后续与变体
- ACKTR: Scalable trust-region method using Kronecker-factored approximation (Wu et al., 2017) — 用 K-FAC 近似 Fisher 矩阵,把自然梯度做到大网络上可用。
- Constrained Policy Optimization (Achiam et al., 2017) — 把 TRPO 的信赖域机制推广到「同时满足安全约束」的场景,本讲的下界技巧在这里被完整复用。
- Mirror Descent Policy Optimization (Tomar et al., 2020) — 把第 10.1 节的镜像下降视角做成一个显式算法,说明 TRPO/PPO 都是它的特例。
实践、消融与踩坑
- Implementation Matters in Deep Policy Gradients: A Case Study on PPO and TRPO (Engstrom et al., 2020) — 结论令人不适但必须读:PPO 相对 TRPO 的性能优势,很大一部分来自优势归一化、观测归一化、学习率退火这些「代码层面的细节」,而非 clip 本身。
- What Matters In On-Policy Reinforcement Learning? A Large-Scale Empirical Study (Andrychowicz et al., 2020) — 数万次实验的超参数消融,第 10.3 节那张表的经验依据。
- The 37 Implementation Details of Proximal Policy Optimization (Huang et al., ICLR Blog Track 2022) — 逐条对照原始实现的清单,自己写 PPO 前值得通读一遍。
- Training language models to follow instructions with human feedback (Ouyang et al., 2022) — RLHF 里的 PPO 用法。注意它在奖励里额外加了一项对参考模型的 KL 惩罚——那是另一个层面的 KL(防止偏离预训练模型),和本讲的信赖域 KL(防止偏离采样策略)是两回事,初学时极易混淆。