基于模型的强化学习算法
动力学模型已经学到手了——接下来到底怎么用它?规划、把梯度反传进策略、还是让它给无模型算法造数据。
0. 本讲导读
上一讲我们建立了「学一个模拟器」这件事的基本框架:从环境里收集转移数据 $\mathcal{D}=\{(\mathbf{s}_i,\mathbf{a}_i,\mathbf{s}_i')\}$,用监督学习拟合一个动力学模型(dynamics model)$f(\mathbf{s},\mathbf{a})=\mathbf{s}'$ 或者概率形式 $p_\phi(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$,然后「在这个模拟器里跑你喜欢的 RL 算法」。上一讲也已经指出这条路上的两块大石头:分布漂移(distributional shift)——策略一旦被优化,就会跑到模型没见过的状态去;以及模型不确定性(model uncertainty)——我们需要贝叶斯神经网络或 bootstrap 集成来知道「模型自己也不知道」的地方在哪。
这一讲把那个含糊的第三步「run your favorite RL method inside the simulator」拆开,认真回答:拿到模型之后到底怎么做决策。整讲分三大块:
- Part 1 · 用模型做规划(planning):完全不要策略,直接在模型里搜索一串动作。从确定性开环问题出发,讲清楚开环 / 闭环的区别、随机打靶法(random shooting)与交叉熵方法(CEM)、模型预测控制(MPC),以及怎么在集成模型的不确定性下做规划。
- Part 2 · 用模型学策略(policy learning):把梯度直接反传穿过模型进策略参数(pathwise 梯度),它为什么在长时域下会炸;改用策略梯度为什么更稳;再到长 rollout 的 $\mathcal{O}(\epsilon H^2)$ 误差诅咒,以及 Dyna 风格的「短分支 rollout + off-policy RL」解法(MBA / MVE / MBPO)。
- Part 3 · 模型怎么表示(representing the model):当观测是图像时,直接在像素上建模和规划都很痛苦,于是引入潜在状态空间模型(latent state space model):观测模型 + 动力学模型 + 奖励模型 + 编码器联合训练,最后长成 SLAC / Dreamer 这样的算法。
下一讲会转向离线强化学习(offline RL)。你会发现那里的核心矛盾——「值函数在没见过的动作上过高估计,策略去利用这个错误」——和本讲里的 model exploitation 是同一个病的两种表现,只不过一个发生在动力学模型上,一个发生在值函数上。带着这个对应关系读,两讲会互相点亮。
全讲统一记号:$\mathbf{s}_t$ 是状态(满足马尔可夫性),$\mathbf{o}_t$ 是观测(可能只是状态的部分信息),$\mathbf{a}_t$ 是动作,$r(\mathbf{s}_t,\mathbf{a}_t)$ 是奖励,$\pi_\theta(\mathbf{a}|\mathbf{s})$ 是策略,$p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$ 是真实转移,$\hat p_\phi$ 或 $f_\phi$ 是学到的模型,$\tau$ 是轨迹,$\gamma$ 是折扣,$H$ 是规划时域(planning horizon),$T$ 是任务时域。
- 规划 ≠ 学策略。规划是在当前状态下现场解一个优化问题,输出一串动作;学策略是离线把决策函数固化到网络参数里。前者不需要训练、天然能利用模型的即时信息,但只能做开环、维度上限极低。
- 开环规划在随机环境下必然次优,因为它在看到未来状态之前就把所有动作都定死了。修复方法有两条:要么学闭环策略,要么每一步重新规划(MPC)——后者才是模型基 RL 在真实机器人上真正管用的原因。
- 规划器是模型误差的对手(adversary)。$\argmax$ 会主动去找模型高估奖励的地方,所以必须用不确定性感知的模型。用 bootstrap 集成时,正确做法是对回报取平均 $J=\frac1N\sum_i\sum_t r(\mathbf{s}_{t,i},\mathbf{a}_t)$,而不是对预测取平均——两者差别巨大。
- 把梯度反传穿过 $H$ 步模型会乘上 $H$ 个雅可比矩阵,数值上等价于训练一个没有门控机制的 RNN,梯度非爆即消;用策略梯度在模型里做「无模型优化」反而更稳。
- 长 rollout 的误差以 $\mathcal{O}(\epsilon H^2)$ 累积。解法是 Dyna 风格:从真实 replay buffer 里取状态作起点,只做极短(哪怕 1 步)的分支 rollout,把生成的转移喂给 off-policy 的无模型算法。这就是 MBPO 的骨架,也是目前最实用的模型基 RL 配方。
- 图像输入时不要在像素上建模型。学一个潜在空间 $\mathbf{s}_t$,同时训练观测模型 $p(\mathbf{o}_t|\mathbf{s}_t)$、动力学 $p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$、奖励模型 $p(r_t|\mathbf{s}_t)$ 与编码器 $q_\psi(\mathbf{s}_t|\mathbf{o}_t)$,目标函数就是这个隐变量模型的 ELBO。
1. 路线图:模型基 RL 的版本进化史
Levine 讲模型基 RL 有一套经典的「版本号」讲法:从一个显然会失败的朴素算法出发,每次只补一个洞,一路升级到真正能用的算法。这条动机链条本身就是本讲最值钱的东西,我们先把它整个铺开,后面各节再逐个填细节。
版本 0.5:收集 → 拟合 → 规划
最朴素的写法只有三步,没有任何循环:
model-based RL version 0.5:
  1. 用基准策略 pi_0(a|s)(例如均匀随机策略)收集数据 D = {(s, a, s')_i}
  2. 学动力学模型 f(s,a),最小化 sum_i || f(s_i,a_i) - s'_i ||^2
3. 用 f(s,a) 规划出动作序列,执行它这套东西在系统辨识(system identification)里其实很有用:如果你已经知道动力学的参数化形式(比如机器人的连杆长度、质量、摩擦系数未知,但方程形式已知),用随机激励采一批数据、拟合几个参数、然后用最优控制求解,是几十年来的标准做法。它失败的地方在于:$\pi_0$ 采出来的状态分布 $p_{\pi_0}(\mathbf{s})$,和你规划出来的策略访问的状态分布 $p_{\pi_f}(\mathbf{s})$ 完全不是一回事。
这就是上一讲反复强调的分布漂移。给一个具体图景:你在一片山地上随机游走采数据,模型在你走过的低矮区域拟合得很好;但奖励是「海拔越高越好」,于是规划器发现「一直往右走海拔就一直涨」,因为在训练数据的边缘处模型的外推恰好是一条上升直线。你照做,实际上右边是悬崖。模型在数据分布内几乎完美,在数据分布外错得离谱,而规划器专门往数据分布外跑——因为那里才有模型幻想出来的高奖励。
版本 1.0:把执行时的数据收回来(DAgger 式修补)
模仿学习那一讲教过一个思路:既然训练分布和测试分布不一致,那就把测试分布也变成训练分布。DAgger 是让专家来标注策略访问过的状态;这里更简单——环境本身就是「专家」,我们执行完计划后自然会观测到真实的 $\mathbf{s}'$,直接把它加回数据集就行,不需要任何人工标注。
model-based RL version 1.0:
  1. 用基准策略 pi_0(a|s) 收集数据 D = {(s, a, s')_i}
  2. 学动力学模型 f(s,a),最小化 sum_i || f(s_i,a_i) - s'_i ||^2
  3. 用 f(s,a) 规划动作序列
  4. 执行这些动作,把真实观测到的 (s, a, s') 追加进 D
     —— 回到第 2 步
循环 2→3→4→2 就是 DAgger 的模型基版本。它确实让训练分布逐步逼近了策略访问的分布,但还留着一个致命问题:第 3 步规划出的是一整条长度 $H$ 的开环动作序列,第 4 步要把它全部执行完才回头更新模型。如果模型在第 3 步就把你带到了悬崖,你会在收集到「悬崖是坏的」这条数据之前先摔下去。
版本 1.5:MPC —— 只执行第一个动作,然后重新规划
model-based RL version 1.5:
  1. 用基准策略 pi_0(a|s) 收集数据 D = {(s, a, s')_i}
  2. 学动力学模型 f(s,a)
  3. 用 f(s,a) 规划动作序列 a_1 ... a_H
  4. 只执行第一个动作 a_1,观测到真实的 s'(这就是 MPC)
  5. 把 (s, a_1, s') 追加进 D
—— 回到第 3 步(每 N 步回到第 2 步重训模型)注意这里出现了两层循环:内层 3→4→5→3 是每个时间步都重新规划一次,外层每 N 步才重新训练一次模型。这个「重规划」的动作看起来只是工程上的小改动,实际上一石二鸟:(a)它把开环规划变成了事实上的闭环控制,因为每一步的规划都基于刚刚真实观测到的状态;(b)模型只需要在一步之内是对的,因为一步之后我们就会用真实状态把累积误差清零。代价是计算量——每个控制周期都要现场解一次优化问题。
版本 2.0:把梯度反传进策略
MPC 每步都要重规划,在高频控制(比如 1 kHz 的力矩控制)下算不过来;而且规划器只能做开环,处理不了「等看到结果再决定」这类需求。于是自然的下一步是:既然模型是可微的神经网络,那就把 $H$ 步 rollout 的总奖励对策略参数 $\theta$ 求导,直接训练一个闭环策略 $\pi_\theta(\mathbf{a}|\mathbf{s})$。
model-based RL version 2.0:
  1. 用基准策略 pi_0(a|s) 收集数据 D = {(s, a, s')_i}
  2. 学动力学模型 f(s,a)
  3. 通过 f(s,a) 把梯度反传进策略 pi_theta(a|s),优化 sum_t r(s_t, a_t)
  4. 运行 pi_theta(a|s),把访问到的 (s, a, s') 追加进 D
     —— 回到第 2 步
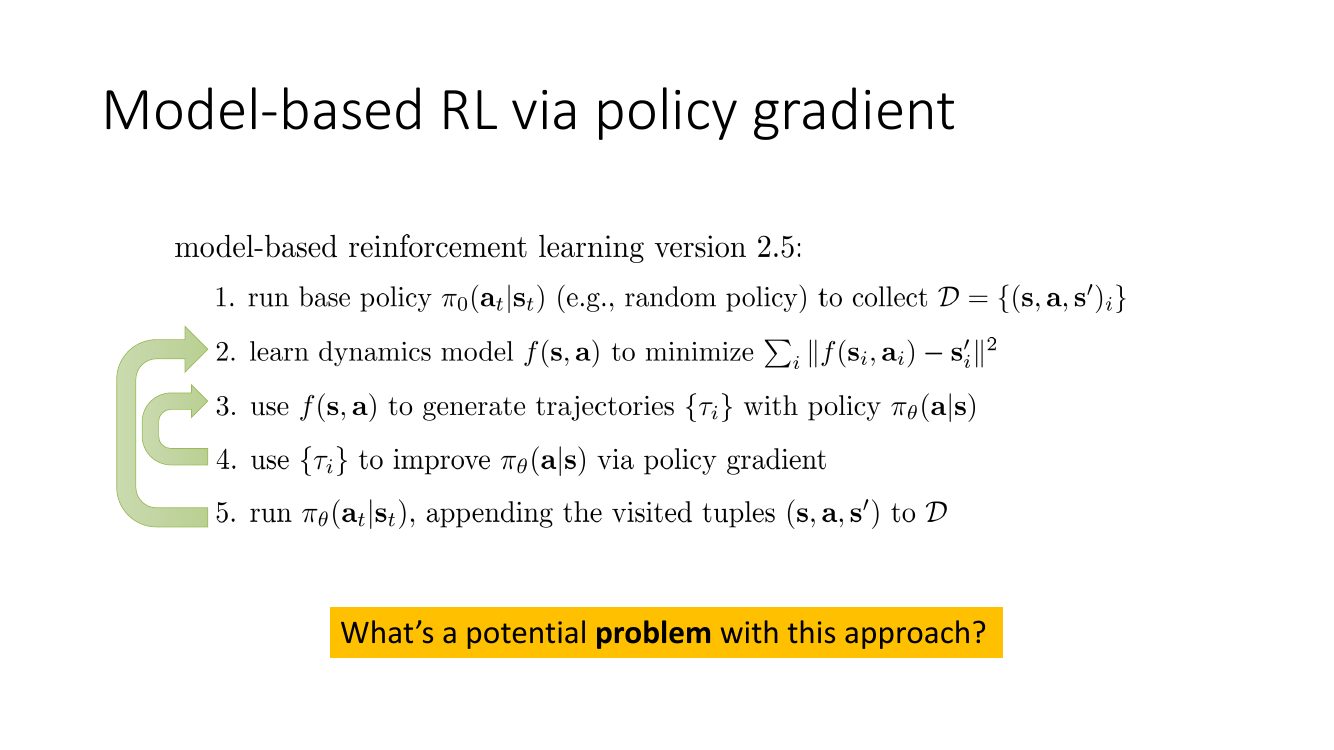
这一版才是「真正的模型基策略学习」。它的问题在第 8 节展开:反传穿过 $H$ 步模型意味着连乘 $H$ 个雅可比矩阵,数值性质和训练一个没有 LSTM 门控的深层 RNN 一样糟。
版本 2.5 与 3.0:本讲新增的两级
本讲在 2.0 之上又加了两级。版本 2.5 把第 3 步的「反传」换成「在模型里跑策略梯度」——把学到的模型当成一个廉价模拟器,用 REINFORCE / PPO 这类无模型算法去优化策略,从而避开雅可比连乘。版本 3.0 再解决 2.5 遗留的长 rollout 误差累积问题:不从初始状态出发做长 rollout,而是从真实 replay buffer 里随机取状态作起点,只做极短的分支 rollout,再用 off-policy 算法同时消化真实数据和模型数据。
| 版本 | 怎么用模型 | 闭环? | 抗分布漂移手段 | 主要弱点 |
|---|---|---|---|---|
| 0.5 | 规划一次 | 否 | 无 | 分布漂移直接致命 |
| 1.0 | 规划 + 回收数据 | 否 | DAgger 式数据回收 | 执行整条计划才更新,容易先摔死 |
| 1.5 | MPC:每步重规划 | 是(事实上) | 数据回收 + 每步纠偏 | 在线计算量大;只能开环规划 |
| 2.0 | 反传穿过模型学策略 | 是 | 数据回收 | 雅可比连乘导致梯度爆炸/消失 |
| 2.5 | 模型内跑策略梯度 | 是 | 数据回收 | 长 rollout 误差 $\mathcal{O}(\epsilon H^2)$ |
| 3.0 | 短分支 rollout + off-policy RL | 是 | 短 rollout + 真假数据混训 | 模型数据的状态分布仍有偏 |
把这条进化线一句话总结:每一级升级,都是在缩短「我们信任模型的时长」。0.5 版信任模型整整 $H$ 步且永不修正;1.0 版信任 $H$ 步但会事后补数据;1.5 版只信任 1 步;3.0 版索性只让模型往前走 1~5 步。模型基 RL 的全部工程智慧,几乎都可以归结为「别让模型自己走太远」。
2. 确定性情形:开环规划的数学形式
先把最干净的情形写清楚:动力学是确定性的,$\mathbf{s}_{t+1}=f(\mathbf{s}_t,\mathbf{a}_t)$,初始状态 $\mathbf{s}_1$ 已知。此时「决策」这件事退化成一个纯粹的确定性优化问题:
$$ \mathbf{a}_1,\dots,\mathbf{a}_T=\argmax_{\mathbf{a}_1,\dots,\mathbf{a}_T}\sum_{t=1}^{T}r(\mathbf{s}_t,\mathbf{a}_t)\quad\text{s.t.}\quad \mathbf{s}_{t+1}=f(\mathbf{s}_t,\mathbf{a}_t) $$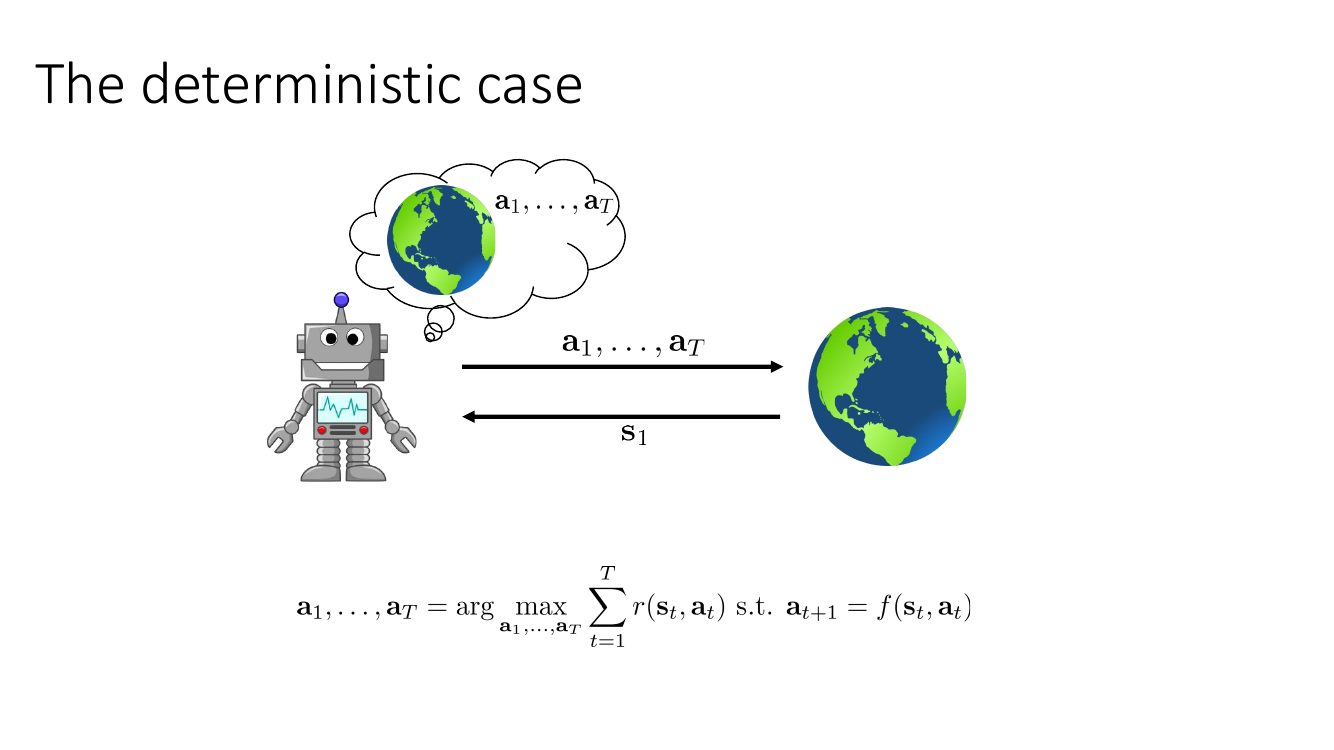
三点值得注意。
第一,这里没有策略。输出是一串具体的动作向量,不是一个函数。这就是「规划(planning)」与「学策略(policy learning)」的本质分界:规划的解只对这一个初始状态有效,换个 $\mathbf{s}_1$ 要重解一遍;策略的解对所有状态都有效,但需要训练。
第二,约束可以被消掉。把 $\mathbf{s}_{t+1}=f(\mathbf{s}_t,\mathbf{a}_t)$ 递归代入,$\mathbf{s}_t$ 就是 $\mathbf{s}_1,\mathbf{a}_1,\dots,\mathbf{a}_{t-1}$ 的确定性函数,于是目标变成只关于动作序列的无约束函数:
$$ J(\mathbf{a}_1,\dots,\mathbf{a}_T)=r(\mathbf{s}_1,\mathbf{a}_1)+r\big(f(\mathbf{s}_1,\mathbf{a}_1),\mathbf{a}_2\big)+r\Big(f\big(f(\mathbf{s}_1,\mathbf{a}_1),\mathbf{a}_2\big),\mathbf{a}_3\Big)+\cdots $$这种「把状态全部用动作表达掉」的写法叫 shooting 形式(打靶法),下一节的 random shooting、CEM 都建立在它之上。它的好处是变量少(只有动作)、无约束;坏处是数值上极其病态——$\mathbf{a}_1$ 的微小改变会经过 $T-1$ 层 $f$ 的复合放大到 $\mathbf{s}_T$,而 $\mathbf{a}_T$ 只影响最后一项。这正是后面梯度方法会炸掉的根源。(与之相对的 collocation 形式把 $\mathbf{s}_t$ 也当作优化变量、把动力学作为等式约束,条件数好得多,但要上带约束优化求解器。)
第三,这个问题在真实的深度 RL 场景里通常是非凸的。$f$ 是神经网络,$r$ 可能有稀疏项,$J$ 的地形坑坑洼洼。所以我们不会指望梯度下降找到全局最优,而是接受「找到一个够好的局部解」。这也是为什么本讲花大力气讲无梯度的随机优化。
「确定性动力学 ⇒ 开环最优」这个论断只在初始状态已知且模型完全正确时成立。真实情况下模型有误差、执行有噪声,即使物理系统本身是确定性的,开环执行照样会漂掉。所以后面即使是确定性模型,我们也照样用 MPC 重规划。
3. 随机动力学:开环为什么必然次优
现在把 $f$ 换成随机转移 $p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$。给定一串动作,轨迹分布是
$$ p_\theta(\mathbf{s}_1,\dots,\mathbf{s}_T\mid \mathbf{a}_1,\dots,\mathbf{a}_T)=p(\mathbf{s}_1)\prod_{t=1}^{T}p(\mathbf{s}_{t+1}\mid\mathbf{s}_t,\mathbf{a}_t) $$开环规划要解的问题变成:
$$ \mathbf{a}_1,\dots,\mathbf{a}_T=\argmax_{\mathbf{a}_1,\dots,\mathbf{a}_T}\ \E\left[\sum_t r(\mathbf{s}_t,\mathbf{a}_t)\ \Big|\ \mathbf{a}_1,\dots,\mathbf{a}_T\right] $$Levine 在这里问了一句:这为什么是次优的?答案藏在条件里——期望是在给定整串动作的条件下取的,也就是说,$\mathbf{a}_5$ 必须在还没看到 $\mathbf{s}_2,\mathbf{s}_3,\mathbf{s}_4$ 的时候就定死。而最优决策显然应该依赖于中途观测到的状态。
Levine 的考试比喻
他讲课时用的例子很传神:明天你要参加一场考试,考题可能是数学题也可能是化学题,各 50%。闭环的情形是:你明天到考场,看到题目再作答——你只要两门都会,就能拿满分。开环的情形是:今天就要把答案写好交上去,明天直接照抄。你只能赌一门,期望得分立刻腰斩。注意这里两种情形的「能力」完全一样,差的只是信息何时到达。
一个可以算出来的两步 MDP
把上面的比喻写成数字。设 $t=1$ 时只有一个状态 $\mathbf{s}_1$ 和一个无关紧要的动作;转移到 $t=2$ 时,以概率 $0.5$ 进入 $\mathbf{s}_2^A$(数学题),以概率 $0.5$ 进入 $\mathbf{s}_2^B$(化学题),且与动作无关。第二步有两个动作 $\alpha,\beta$:
| $a_2=\alpha$ | $a_2=\beta$ | |
|---|---|---|
| $\mathbf{s}_2^A$(概率 0.5) | $r=10$ | $r=0$ |
| $\mathbf{s}_2^B$(概率 0.5) | $r=0$ | $r=10$ |
开环最优:$\mathbf{a}_2$ 只能是常数。选 $\alpha$ 得 $0.5\times10+0.5\times0=5$;选 $\beta$ 同理得 $5$。开环最优值 $J^{\text{open}}=5$。
闭环最优:$\pi(\mathbf{a}_2|\mathbf{s}_2)$ 可以在 $\mathbf{s}_2^A$ 选 $\alpha$、在 $\mathbf{s}_2^B$ 选 $\beta$,得 $0.5\times10+0.5\times10=10$。闭环最优值 $J^{\text{closed}}=10$。
整整差了 2 倍,而且这个差距完全来自「决策时能不能看到状态」,跟模型准不准毫无关系。把这个结构串联 $T$ 步,差距会随 $T$ 指数级放大。
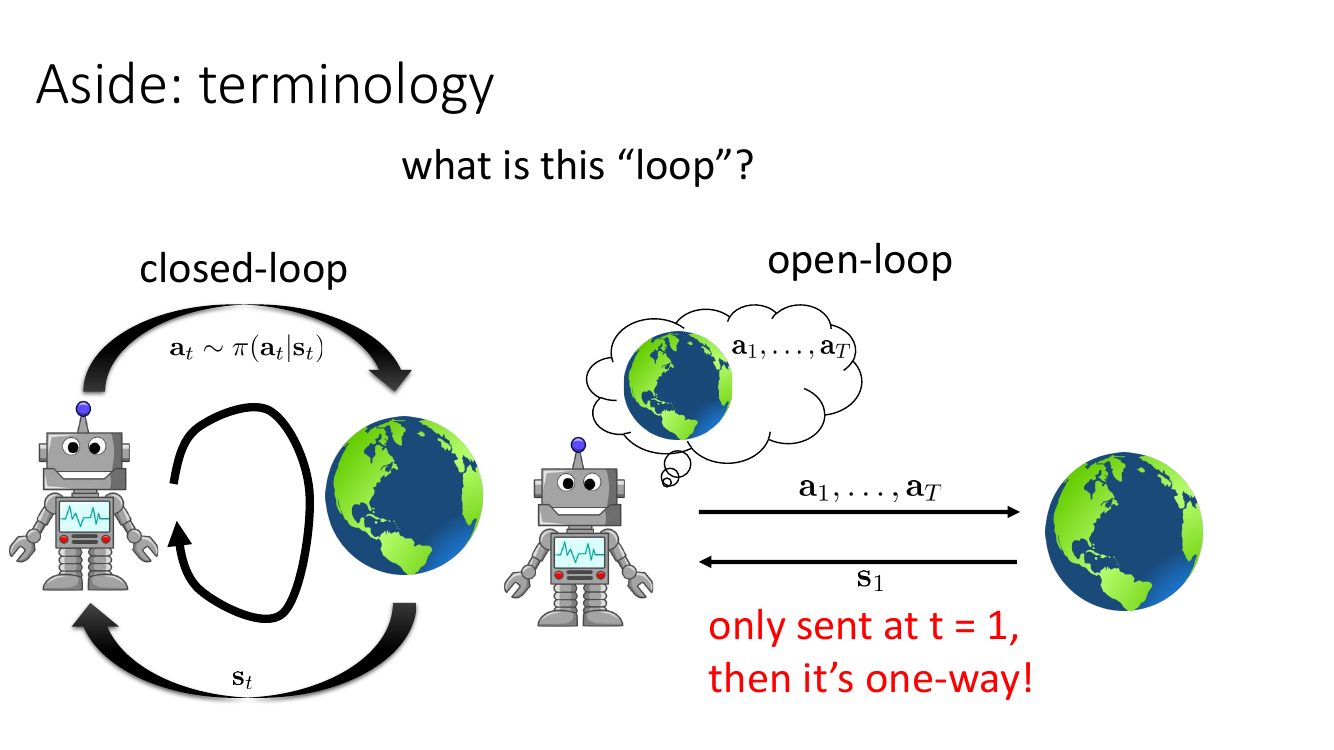
闭环情形下我们优化的是策略而不是动作序列,轨迹分布里多了 $\pi$ 这一项:
$$ p(\mathbf{s}_1,\mathbf{a}_1,\dots,\mathbf{s}_T,\mathbf{a}_T)=p(\mathbf{s}_1)\prod_{t=1}^{T}\pi(\mathbf{a}_t|\mathbf{s}_t)\,p(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t),\qquad \pi=\argmax_{\pi}\ \E_{\tau\sim p(\tau)}\left[\sum_t r(\mathbf{s}_t,\mathbf{a}_t)\right] $$| 开环规划 | 闭环策略 | |
|---|---|---|
| 决策对象 | 动作序列 $\mathbf{a}_{1:T}$ | 函数 $\pi(\mathbf{a}|\mathbf{s})$ |
| 随机环境下 | 严格次优 | 可达最优 |
| 是否需要训练 | 否,现场求解 | 是,离线优化参数 |
| 换初始状态 | 要重解 | 直接复用 |
| 典型方法 | random shooting、CEM、LQR、MCTS | 策略梯度、Q 学习、actor-critic |
| 与模型误差的关系 | 误差沿 $H$ 步累积 | 误差在训练时被平均掉一部分 |
那既然闭环这么好,为什么本讲 Part 1 还要花这么多篇幅讲开环?两个理由:一是开环规划不需要任何训练,模型一更新立刻就能用,这在数据极少的真实机器人场景里价值巨大;二是配上 MPC 重规划之后,开环规划在实践中就变成了闭环控制——每一步的开环解都基于最新的真实状态。这是第 5 节的主题。
把开环规划想成「闭眼睛把整套动作背下来再做」,闭环策略想成「睁着眼睛边看边做」。MPC 则是一个折中的怪招:每睁一次眼,就重新闭眼把剩下的动作背一遍,但只做第一个。虽然每次规划都是「闭眼」的,但因为睁眼极其频繁,整体行为几乎与闭环无异。
4. 随机优化:random shooting 与 CEM
现在把规划问题彻底抽象掉。不管你是确定性开环、随机开环还是别的什么,最后都归结为:找一个向量 $\mathbf{A}=(\mathbf{a}_1,\dots,\mathbf{a}_H)$ 使某个黑箱函数最大。
$$ \mathbf{A}=\argmax_{\mathbf{A}}J(\mathbf{A}) $$Levine 特意在 $J$ 底下标了一句「don't care what this is」——我们只需要能求值(在模型里 rollout 一遍算总奖励),完全不需要梯度。这一节的方法全是无梯度的。
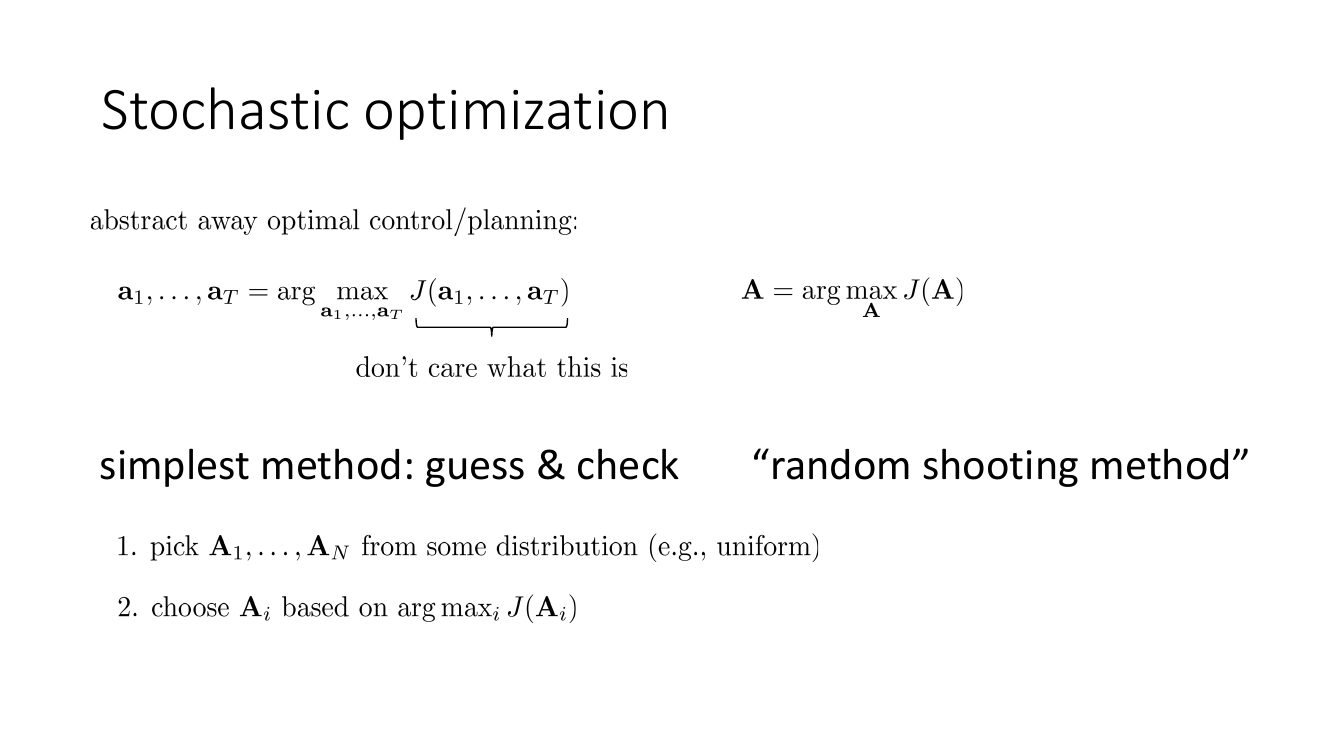
random shooting 能有多差?算一算
假设「足够好的动作序列」在采样分布下占的概率质量是 $p$。采 $N$ 个独立样本至少命中一次的概率是 $1-(1-p)^N$。要达到 $90\%$ 的命中率,需要
$$ N\ \ge\ \frac{\log 0.1}{\log(1-p)}\ \approx\ \frac{2.30}{p}\quad (p\ \text{很小时}) $$若 $p=10^{-3}$,$N\approx 2300$,还能接受。问题在于 $p$ 随维度指数衰减:假设动作序列有 $d$ 个标量分量,每个分量都必须落在自己取值范围的某个 $10\%$ 区间里才算「好」,那么 $p=0.1^{d}$。$d=4$ 时 $p=10^{-4}$,$N\approx2.3\times10^4$,勉强可行;$d=10$ 时 $p=10^{-10}$,$N\approx2.3\times10^{10}$,彻底没戏。
而动作序列的维度是 $d=\dim(\mathbf{a})\times H$。一个 6 自由度机械臂、规划时域 $H=30$,就是 $d=180$。这就是「非常苛刻的维度上限」的来历——纯随机打靶实际能对付的通常只有几十维,也就是低维动作 + 短时域。
CEM:把采样分布也一起优化
random shooting 的浪费之处是:它采完一轮就丢掉了所有信息,下一轮还从同一个均匀分布采。交叉熵方法(cross-entropy method, CEM)的想法是把采样分布 $p(\mathbf{A})$ 本身迭代地往好区域挪。
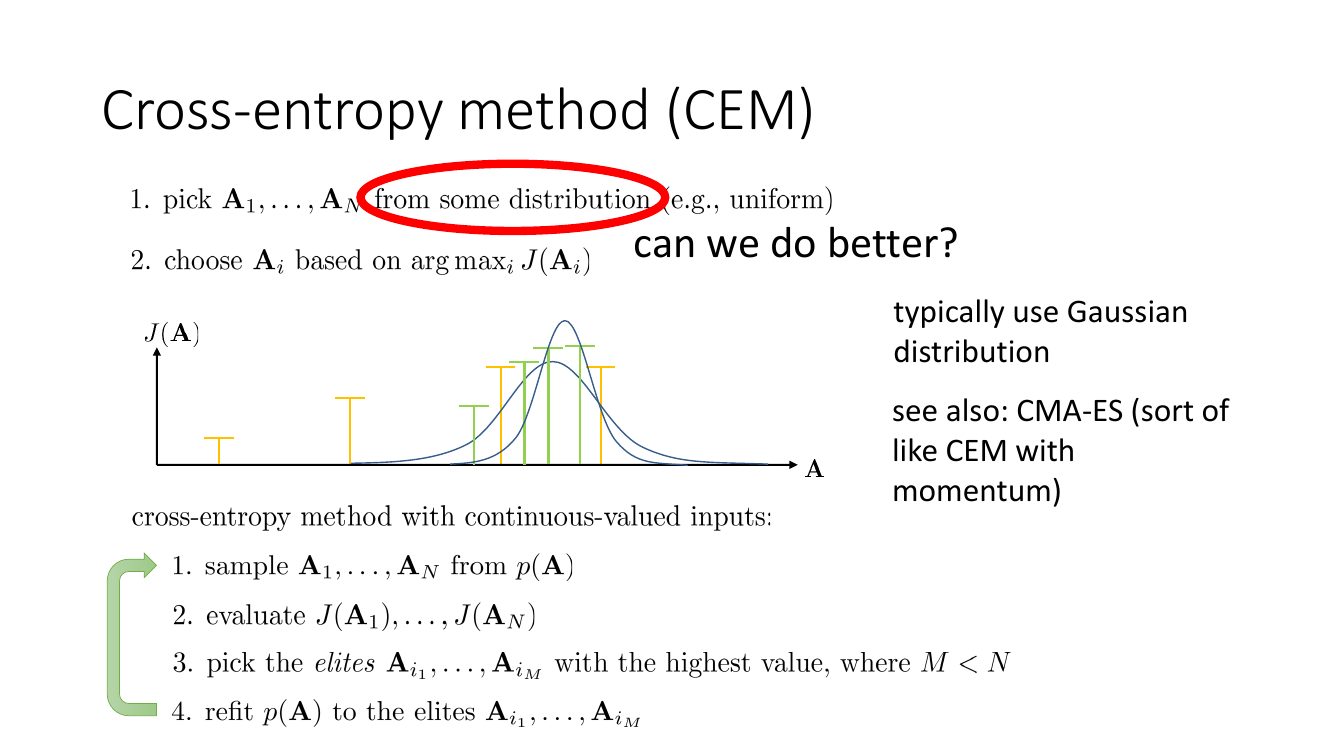
连续动作下的 CEM 就四步,反复迭代:
cross-entropy method (continuous):
  1. 从 p(A) 采样 A_1, ..., A_N
  2. 求值 J(A_1), ..., J(A_N)
  3. 取值最高的 M 个精英 A_{i_1}, ..., A_{i_M}   (M < N)
  4. 用这 M 个精英重新拟合 p(A),回到第 1 步
「重新拟合」在高斯情形下就是求精英的样本均值和样本(对角)方差:
$$ \mu\leftarrow\frac{1}{M}\sum_{j=1}^{M}\mathbf{A}_{i_j},\qquad \sigma^2\leftarrow\frac{1}{M}\sum_{j=1}^{M}(\mathbf{A}_{i_j}-\mu)^2 $$为什么这个算法叫「交叉熵」?CEM 原本是从稀有事件估计推出来的。设想我们想让采样分布 $p$ 尽量贴近「最优解附近」的目标分布 $q^\ast(\mathbf{A})\propto \mathbb{1}[J(\mathbf{A})\ge\gamma_k]$($\gamma_k$ 是第 $k$ 轮精英的阈值,也就是第 $M$ 名的分数)。用交叉熵(等价于 KL 散度)作为距离:
$$ \min_{p}\ \KL\big(q^\ast\,\|\,p\big)=\min_p\ \E_{q^\ast}[\log q^\ast]-\E_{q^\ast}[\log p(\mathbf{A})] \ \Longleftrightarrow\ \max_p\ \E_{q^\ast}\big[\log p(\mathbf{A})\big] $$第一项与 $p$ 无关可丢掉。用从上一轮 $p$ 采出的、且满足 $J\ge\gamma_k$ 的样本(正是那 $M$ 个精英)做蒙特卡洛近似,就得到 $\max_p\frac{1}{M}\sum_j\log p(\mathbf{A}_{i_j})$——这正是在精英集合上做极大似然估计。对高斯而言,MLE 的闭式解就是样本均值和样本方差。所以第 4 步「refit to elites」并不是随手的启发式,而是一个 KL 最小化步骤。
典型超参:$N=200\sim1000$ 条候选,$M$ 取 $N$ 的 $10\%$,迭代 $3\sim8$ 轮。CEM 相比 random shooting 的提升是实打实的,但它没有改变维度上限的本质——只是把可行维度从十几维推到几十维。原因很简单:对角高斯无法表达动作维度之间的相关性,而好的轨迹恰恰高度相关(比如「先加速再刹车」)。CMA-ES 通过维护完整协方差矩阵和演化路径(相当于动量)部分缓解了这一点,代价是 $\mathcal{O}(d^2)$ 的存储和 $\mathcal{O}(d^3)$ 的分解。
| 规划方法 | 需要梯度 | 动作空间 | 典型可行维度 | 并行友好 | 备注 |
|---|---|---|---|---|---|
| random shooting | 否 | 连续/离散 | ~十几维 | 极好 | 三行代码,可作 baseline |
| CEM | 否 | 连续 | ~几十维 | 极好 | 模型基 RL 的默认选择 |
| CMA-ES | 否 | 连续 | ~上百维 | 好 | 带协方差与动量的 CEM |
| MCTS | 否 | 离散为主 | — | 中等 | 树搜索,AlphaGo/MuZero 的骨架 |
| LQR / iLQR / DDP | 是(需一二阶导) | 连续 | 很高 | 差(串行) | 轨迹优化,要求动力学光滑 |
| RRT 等运动规划 | 否 | 连续 | 高 | 中等 | 擅长几何约束、避障 |
随机优化类方法(random shooting / CEM)的账很好算:优点——① 并行化后极快,$N$ 条候选可以在 GPU 上一个 batch 全推完,$N=1000$、$H=30$ 也不过是 30 次前向;② 极其简单,没有梯度、没有二阶导、对 $f$ 和 $r$ 的形式毫无要求,甚至可以是不可微的仿真器。缺点——① 维度上限苛刻;② 只能做开环规划。这两条缺点分别由 MPC(第 5 节)和策略学习(第 8 节起)来补。
5. MPC:用重规划把开环变成闭环
模型预测控制(model predictive control, MPC)是本讲最重要的一个工程思想,可惜它简单到经常被低估。它只做一件事:规划长度 $H$ 的动作序列,但只执行第一个,然后在新观测到的状态上从头再规划一次。
MPC 控制循环(版本 1.5 的第 3~5 步):
  while True:
      A = plan(model, s_now, horizon=H)     # 用 CEM 解一次开环问题
      a = A[0]                              # 只取第一个动作
      s_next, r = env.step(a)               # 在真实世界里执行一步
      D.append((s_now, a, s_next))          # 回收真实数据
      s_now = s_next
      每 N 步: model.fit(D)                  # 重训模型
为什么这么小的改动能起这么大作用?分三层看。
第一层:它把开环变成了事实上的闭环。回顾第 3 节那个两步 MDP:开环之所以只能拿 5 分,是因为 $\mathbf{a}_2$ 必须在看到 $\mathbf{s}_2$ 之前定死。MPC 里 $\mathbf{a}_2$ 是在真正到达 $\mathbf{s}_2$ 之后、基于 $\mathbf{s}_2$ 重新规划出来的,所以能拿满 10 分。虽然每一次调用规划器解的都是开环问题,但由于 $\mathbf{a}_2$ 实际使用的那一版是以 $\mathbf{s}_2$ 为初始状态求出来的,整体行为等价于一个(计算量很大的)闭环策略 $\pi_{\text{MPC}}(\mathbf{a}|\mathbf{s})=\big[\text{plan}(\mathbf{s})\big]_1$。
第二层:它把模型误差的累积窗口压到了一步。假设模型每步引入的状态误差量级是 $\epsilon$。开环执行 $H$ 步,末端误差是 $\mathcal{O}(\epsilon H)$ 甚至更糟(第 9 节细算)。MPC 每步都用真实状态把预测误差清零重置,所以实际执行轨迹上的误差始终是 $\mathcal{O}(\epsilon)$ 量级。代价是规划出来的「后 $H-1$ 步」永远不会被真的执行,它们只起「让第一步的选择考虑到长远后果」的作用——所以后面几步不准也无所谓。
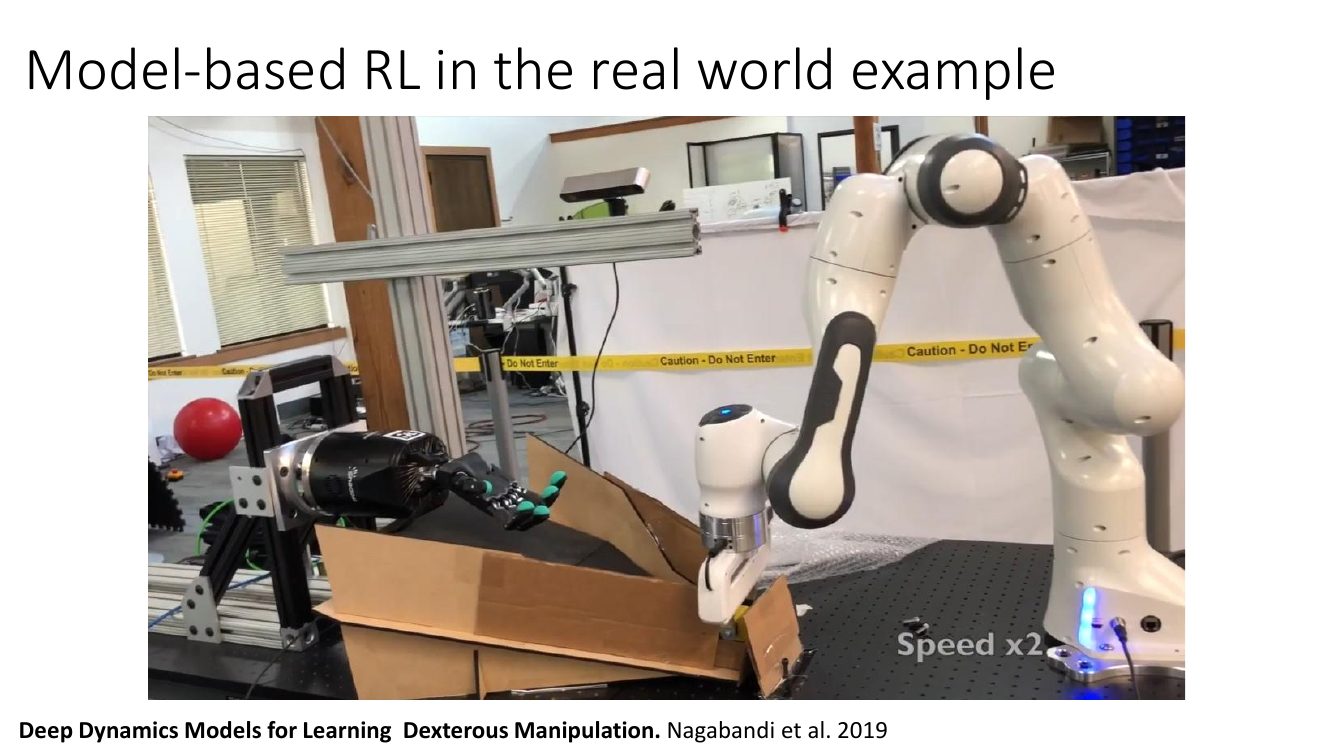
第三层:它让「差模型」变得可用。这是 Levine 反复强调的实践观察:模型基 RL 在真实机器人上能工作,很大程度上不是因为模型学得多好,而是因为 MPC 极其宽容。一个只在一步预测上靠谱的模型,配上每步重规划,就足以完成相当复杂的操作任务。
三个必须知道的工程细节
(1)热启动(warm start)。每步都从零开始跑 CEM 太浪费。标准做法是把上一步规划出的 $\mu=(\mathbf{a}_1,\dots,\mathbf{a}_H)$ 左移一格,末尾补零或补随机值,作为这一步 CEM 的初始均值。因为相邻两步的最优计划高度相似,热启动往往能把 CEM 迭代轮数从 8 轮降到 2~3 轮。
(2)规划时域 $H$ 的取舍。$H$ 太短会短视(比如为了避免立刻的负奖励而错过后面的大奖励);$H$ 太长则(a)搜索维度 $\dim(\mathbf{a})\times H$ 线性增长,CEM 效率崩塌;(b)模型在深处的预测已经完全不可信,规划器会去优化纯噪声。实践中 $H$ 通常取 $10\sim30$ 步。一个更好的做法是用学到的值函数截断:$J=\sum_{t=1}^{H}\gamma^{t-1}r(\mathbf{s}_t,\mathbf{a}_t)+\gamma^{H}V(\mathbf{s}_{H+1})$,让值函数负责 $H$ 步之后的一切。这是 TD-MPC、MuZero 这类方法的核心结构,也是把 Part 1(规划)和 Part 2(学策略)缝在一起的最自然接口。
(3)奖励函数从哪来。规划需要能对任意 $(\mathbf{s},\mathbf{a})$ 求 $r$。很多机器人任务的奖励是我们自己写的解析函数(比如「手指尖到目标点的距离」),这时直接调用即可;否则就得像第 11 节那样额外学一个奖励模型 $\hat r_\phi(\mathbf{s},\mathbf{a})$,这时奖励模型的误差也会被规划器利用。
MPC 不是万能药。它无法处理需要长期承诺的任务:如果最优行为要求「先花 50 步搭一个梯子,才能拿到墙后面的东西」,而你的规划时域只有 20 步,那么在时域内搭梯子只有代价没有收益,MPC 永远不会开始搭。这类问题必须靠值函数(把长期收益压缩进 $V$)或分层结构来解决。另外,MPC 的在线计算量是硬约束——每个控制周期要跑 $N\times H$ 次模型前向,1 kHz 的控制回路基本不可能。
6. 在模型不确定性下规划:集成与期望回报
规划器是模型误差的对手
先把问题说透。假设我们训练好了模型 $\hat f$,然后拿它去解 $\max_\mathbf{A}\hat J(\mathbf{A})$。写出真实回报和模型回报的关系:
$$ \hat J(\mathbf{A})=J(\mathbf{A})+\underbrace{\big[\hat J(\mathbf{A})-J(\mathbf{A})\big]}_{\text{模型误差}\ \delta(\mathbf{A})} $$规划器求的是 $\argmax_\mathbf{A}\big[J(\mathbf{A})+\delta(\mathbf{A})\big]$。即便 $\delta$ 在数据分布下均值为零、方差不大,$\argmax$ 也会系统性地偏向 $\delta$ 取大正值的那些 $\mathbf{A}$。这就是「优化者的诅咒(optimizer's curse)」,在模型基 RL 里叫 model exploitation(模型利用/模型套利)。
数值感受一下这个偏差有多大:设有 $N$ 个候选动作序列,真实回报都相等($J\equiv 0$),模型误差 $\delta_i\sim\mathcal{N}(0,\sigma^2)$ 独立。则 $\E[\max_i\delta_i]\approx\sigma\sqrt{2\ln N}$。取 $\sigma=1$、$N=1000$,期望的「幻觉收益」约为 $3.7$;$N=10^6$ 时约为 $5.3$。你搜索得越狠,被模型骗得越惨——这是模型基 RL 里最反直觉、也最重要的一条定律。它意味着单纯提升规划器的优化能力,反而可能让性能下降。
两种不确定性,只有一种有用
上一讲区分过两类不确定性,这里再压缩复述一遍,因为它直接决定了本节的算法设计。
| 偶然不确定性 aleatoric / statistical | 认知不确定性 epistemic / model | |
|---|---|---|
| 来源 | 环境本身随机(掷骰子、传感器噪声) | 数据不够,我们不知道该信哪个模型 |
| 数学位置 | $p(\mathbf{s}'|\mathbf{s},\mathbf{a},\theta)$ 的熵 | $p(\theta|\mathcal{D})$ 的熵 |
| 数据变多会 | 不变 | 趋于零 |
| 能否防 model exploitation | 不能 | 能 |
为什么「输出熵」(网络直接吐出的高斯方差)不够?因为在数据分布之外,网络对自己的错误答案非常自信:它会以很小的方差预测一个完全离谱的下一状态。这正是「模型对数据很确定,但我们对模型不确定」这句话的含义。要捕捉后者,我们必须表达 $p(\theta|\mathcal{D})$。
做法一:贝叶斯神经网络
把每个权重看成随机变量,用变分推断近似后验。最常见的平均场近似把后验分解成各权重独立的高斯:
$$ p(\theta\mid\mathcal{D})\ \approx\ \prod_i \mathcal{N}\big(\mu_i,\ \sigma_i^2\big) $$其中 $\mu_i$ 是权重的期望值、$\sigma_i$ 刻画我们对这个权重有多不确定。训练时用重参数化技巧采样权重、优化 ELBO(Blundell et al. 的 Bayes-by-Backprop;Concrete Dropout 则用可学习的 dropout 率隐式实现类似效果)。理论上漂亮,实践中调参痛苦、方差估计偏保守,而且平均场假设忽略了权重之间的强相关性。
做法二:bootstrap 集成(实践中的胜者)
用 $N$ 个独立训练的模型 $\theta_1,\dots,\theta_N$ 构成一个粒子近似:
$$ p(\theta\mid\mathcal{D})\ \approx\ \frac{1}{N}\sum_{i=1}^{N}\delta(\theta-\theta_i) \quad\Longrightarrow\quad \int p(\mathbf{s}'|\mathbf{s},\mathbf{a},\theta)\,p(\theta|\mathcal{D})\,d\theta\ \approx\ \frac{1}{N}\sum_{i=1}^{N}p(\mathbf{s}'|\mathbf{s},\mathbf{a},\theta_i) $$关键是让这 $N$ 个模型「独立」。经典 bootstrap 的做法是从 $\mathcal{D}$ 有放回地重采样 $N$ 个数据集 $\mathcal{D}_i$(每个大小仍为 $|\mathcal{D}|$,平均包含约 $63.2\%$ 的不重复样本)分别训练。深度学习里有两个实用观察:
- 模型个数通常很小($N\lt 10$,常见 $5\sim7$),所以这是对后验非常粗糙的近似;但它对 model exploitation 的抑制作用已经够用。
- 有放回重采样常常不是必需的——随机初始化 + SGD 的随机性(不同的 minibatch 顺序)已经让不同成员足够不同。省掉重采样还能让每个成员用上全部数据。
用集成做规划:对回报取平均,不是对预测取平均
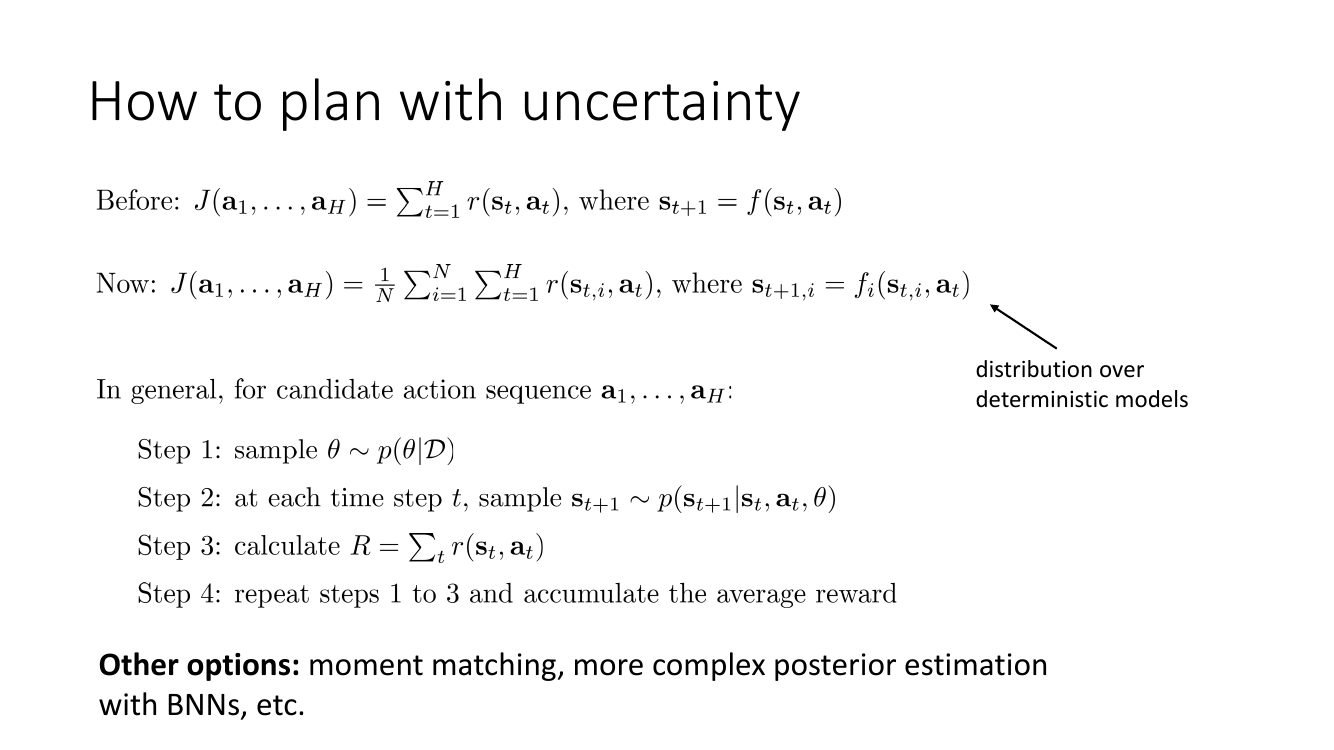
写清楚这个式子:对每个候选动作序列 $\mathbf{a}_1,\dots,\mathbf{a}_H$,
$$ J(\mathbf{a}_1,\dots,\mathbf{a}_H)=\frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}r(\mathbf{s}_{t,i},\mathbf{a}_t), \qquad \mathbf{s}_{t+1,i}=f_i(\mathbf{s}_{t,i},\mathbf{a}_t),\quad \mathbf{s}_{1,i}=\mathbf{s}_1 $$更一般地(后验不是集成、模型不是确定性时):
对每个候选动作序列 a_1, ..., a_H:
  Step 1: 采一个模型  theta ~ p(theta | D)
  Step 2: 逐步采下一状态  s_{t+1} ~ p(s_{t+1} | s_t, a_t, theta)
  Step 3: 算这条轨迹的回报  R = sum_t r(s_t, a_t)
Step 4: 重复 Step 1~3 多次,取回报的平均值作为 J必须先在每个模型里 rollout 出完整轨迹、算出回报,最后再平均回报;绝不能先把各模型的预测平均成一个「平均状态」再算奖励。数学上就是 $\frac1N\sum_i r(f_i(\mathbf{s},\mathbf{a}))\ \ne\ r\!\left(\frac1N\sum_i f_i(\mathbf{s},\mathbf{a})\right)$。
数值例子:状态是一维标量,奖励 $r(s)=1-s^2$(在 $s=0$ 最好)。模型 A 预测 $s'=+1$,模型 B 预测 $s'=-1$。先平均预测:$\bar s'=0$,$r=1$——看起来是完美动作。先算奖励再平均:$\frac12\big[r(1)+r(-1)\big]=\frac12(0+0)=0$——如实反映「两个模型严重分歧,这个动作的期望结果并不好」。前者会让规划器一头扎进模型分歧最大的区域,正是我们最想避免的。
为什么期望回报能抑制 model exploitation
直觉是这样的:在数据分布内,各成员的预测几乎一致,平均后与单模型无异;在数据分布外,各成员的外推方向天差地别,于是它们的轨迹会散开到状态空间的各处。只要奖励函数不是到处都高(真实任务里高奖励区域总是很窄的),散开的轨迹里绝大多数会落在低奖励区,平均回报自然被拉低。模型分歧大的地方,期望回报自动变低——这是一个「免费」的悲观正则化项,不需要我们手写任何惩罚。
用上一讲的图景说:一个高方差的预测,其期望奖励远低于同均值的低方差预测。假设奖励在状态上呈钟形 $r(s)=\exp(-s^2/2)$,模型预测 $s'\sim\mathcal N(0,\sigma^2)$,则 $\E[r]=\frac{1}{\sqrt{1+\sigma^2}}$:$\sigma=0$ 时为 $1$,$\sigma=1$ 时降到 $0.71$,$\sigma=3$ 时只剩 $0.32$。均值完全没变,仅仅因为不确定性大,期望回报就掉了三分之二。
Levine 明确列了几条 caveat:期望值 $\ne$ 悲观值,也 $\ne$ 乐观值。真正的悲观(用于离线 RL)应该取 $\min_i$ 或 $\text{mean}-\lambda\cdot\text{std}$;真正的乐观(用于探索)应该取 $\max_i$ 或 $\text{mean}+\lambda\cdot\text{std}$——而且我们确实需要探索才能把模型变好,一味悲观会卡在原地。期望值只是一个「通常不错的起点」,它足以防止最灾难性的模型套利,同时不会过度扼杀探索。真要精调,就在 $J$ 里显式加上 $-\lambda\cdot\mathrm{std}_i\big[\sum_t r(\mathbf{s}_{t,i},\mathbf{a}_t)\big]$ 这样的分歧惩罚项。
另外,除了采样近似还有 矩匹配(moment matching):不采轨迹,而是把每步的状态分布用高斯近似,解析地传播均值和协方差(PILCO 用高斯过程做的就是这件事)。它方差更小、无需大量采样,但只在分布近似高斯时才准,遇到多峰(比如「物体可能倒向左边也可能倒向右边」)就会失效。
7. 最小实现:概率集成动力学模型 + CEM-MPC
把前六节的东西拼成一份能跑的代码。三个部件:单个高斯动力学网络(捕捉偶然不确定性)、集成(捕捉认知不确定性)、CEM 规划器 + MPC 循环。
(1)单个概率动力学模型
两个细节值得强调:预测状态增量 $\Delta\mathbf{s}$ 而不是 $\mathbf{s}'$ 本身(因为相邻状态通常很接近,直接预测 $\mathbf{s}'$ 会让网络把力气全花在学恒等映射上);用高斯负对数似然而不是 MSE(这样网络能表达「这一步我不太确定」)。
import torch, torch.nn as nn, torch.nn.functional as F, numpy as np

class GaussianDynamics(nn.Module):
    """预测 p(s' | s, a) = N(s + mu(s,a), diag(exp(logvar(s,a))))"""
    def __init__(self, ds, da, hidden=256):
        super().__init__()
        self.ds = ds
        self.net = nn.Sequential(
            nn.Linear(ds + da, hidden), nn.SiLU(),
            nn.Linear(hidden, hidden),  nn.SiLU(),
            nn.Linear(hidden, 2 * ds))
        # 可学习的 logvar 上下界(PETS 的做法),防止方差塌到 0 或爆炸
        self.max_logvar = nn.Parameter(torch.full((ds,),  0.5))
        self.min_logvar = nn.Parameter(torch.full((ds,), -10.0))

    def forward(self, s, a):
        out = self.net(torch.cat([s, a], dim=-1))
        delta, logvar = out[..., :self.ds], out[..., self.ds:]
        # 软裁剪:保证 min_logvar < logvar < max_logvar 且处处可导
        logvar = self.max_logvar - F.softplus(self.max_logvar - logvar)
        logvar = self.min_logvar + F.softplus(logvar - self.min_logvar)
        return s + delta, logvar

    def nll(self, s, a, s_next):
        mu, logvar = self(s, a)
        inv_var = torch.exp(-logvar)
        # 高斯 NLL(去掉常数项):((mu-y)^2 / var + log var)
        loss = ((mu - s_next) ** 2 * inv_var + logvar).mean()
        # 轻微惩罚,把上下界拉紧
        return loss + 0.01 * (self.max_logvar.sum() - self.min_logvar.sum())
(2)bootstrap 集成
class Ensemble(nn.Module):
    def __init__(self, n_models, ds, da):
        super().__init__()
        self.members = nn.ModuleList([GaussianDynamics(ds, da)
                                      for _ in range(n_models)])
        self.n = n_models

    def fit(self, S, A, S2, epochs=40, bs=256, lr=1e-3, bootstrap=True):
        N = S.shape[0]
        for m in self.members:
            opt = torch.optim.Adam(m.parameters(), lr=lr)
            # 每个成员用一份自己的(有放回重采样的)数据集
            idx = torch.randint(0, N, (N,)) if bootstrap else torch.arange(N)
            for _ in range(epochs):
                perm = idx[torch.randperm(N)]
                for k in range(0, N, bs):
                    b = perm[k:k + bs]
                    loss = m.nll(S[b], A[b], S2[b])
                    opt.zero_grad(); loss.backward(); opt.step()

    @torch.no_grad()
    def step(self, s, a, member):
        """在第 member 个模型里往前走一步(采样,而非取均值)"""
        mu, logvar = self.members[member](s, a)
        return mu + torch.randn_like(mu) * torch.exp(0.5 * logvar)
(3)CEM 规划器:对回报取平均
注意内层的双重循环——外层遍历集成成员、内层遍历时间步,每个成员维护自己那份 $N$ 条候选轨迹的状态;奖励在成员内累加,最后才除以成员数。这就是第 6 节强调的「先算回报再平均」。
@torch.no_grad()
def cem_plan(model, s0, reward_fn, a_dim, H=15, N=400, n_elite=40,
             iters=5, a_low=-1.0, a_high=1.0, mu_init=None):
    dev = s0.device
    mu  = torch.zeros(H, a_dim, device=dev) if mu_init is None else mu_init.clone()
    std = torch.full((H, a_dim), 0.5 * (a_high - a_low), device=dev)

    for _ in range(iters):
        # 1) 从当前高斯采 N 条候选动作序列
        A = (mu + std * torch.randn(N, H, a_dim, device=dev)).clamp(a_low, a_high)

        # 2) 每条候选在每个集成成员里各推演一遍,回报累加后取平均
        J = torch.zeros(N, device=dev)
        for m in range(model.n):
            s = s0.unsqueeze(0).expand(N, -1).contiguous()
            for t in range(H):
                J = J + reward_fn(s, A[:, t])
                s = model.step(s, A[:, t], m)
        J = J / model.n

        # 3) 取精英,重拟合高斯(即在精英集上做 MLE)
        elite = A[J.topk(n_elite).indices]
        mu, std = elite.mean(dim=0), elite.std(dim=0) + 1e-6

    return mu          # mu[0] 是本步要执行的动作
(4)MPC 主循环(版本 1.5)
def mbrl_loop(env, model, reward_fn, a_dim, total_steps=20000, refit_every=1000):
    S, A, S2 = [], [], []
    # 第 1 步:随机策略采一批种子数据
    s = env.reset()
    for _ in range(1000):
        a = env.action_space.sample()
        s2, _, done, _ = env.step(a)
        S.append(s); A.append(a); S2.append(s2)
        s = env.reset() if done else s2
    to_t = lambda x: torch.as_tensor(np.array(x), dtype=torch.float32)
    model.fit(to_t(S), to_t(A), to_t(S2))

    s, warm = env.reset(), None
    for step in range(total_steps):
        plan = cem_plan(model, to_t(s), reward_fn, a_dim, mu_init=warm)
        a = plan[0].cpu().numpy()
        s2, r, done, _ = env.step(a)               # 只执行第一个动作
        S.append(s); A.append(a); S2.append(s2)    # 回收真实转移
        # 热启动:把计划左移一格,末尾补零,作为下一步 CEM 的初值
        warm = torch.cat([plan[1:], torch.zeros(1, a_dim)], dim=0)
        s, warm = (env.reset(), None) if done else (s2, warm)
        if (step + 1) % refit_every == 0:          # 每 N 步重训模型
            model.fit(to_t(S), to_t(A), to_t(S2))
这份代码就是 PETS(Chua et al. 2018)的骨架。真正跑起来还需要补的东西:状态/动作的输入归一化(对模型精度影响极大)、若奖励未知则再训一个 $\hat r_\phi$、以及把成员内层循环向量化成一次 batched 前向(把 $N$ 条候选 $\times$ $N_{\text{model}}$ 个成员合并成一个大 batch,GPU 上能快一个数量级)。
model.step 里为什么要采样而不是直接返回均值?两个原因:一是这样才如实反映了偶然不确定性(环境本身的随机性);二是均值传播在多步之后会系统性地偏向「分布的中心」,让轨迹显得比实际更平滑、更可控,规划器于是高估自己的控制能力。PETS 还有一个更细的技巧叫 TS∞(trajectory sampling):让同一条候选轨迹在整个 $H$ 步里始终使用同一个集成成员(正如上面的代码),而不是每步重新抽一个成员——后者会把认知不确定性错误地当成偶然噪声给「平均掉」。
8. 用模型学策略:pathwise 梯度 vs 策略梯度
Part 2 换一条路:不再每步现场规划,而是把模型当作可微(或可采样)的模拟器,训练一个闭环策略 $\pi_\theta(\mathbf{a}_t|\mathbf{s}_t)$。目标就是第 3 节写过的闭环目标:
$$ \theta^\star=\argmax_\theta\ \E_{\tau\sim p_\theta(\tau)}\left[\sum_t r(\mathbf{s}_t,\mathbf{a}_t)\right],\qquad p_\theta(\tau)=p(\mathbf{s}_1)\prod_{t}\pi_\theta(\mathbf{a}_t|\mathbf{s}_t)\,\hat p_\phi(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t) $$唯一的区别是转移用的是学到的 $\hat p_\phi$。这样一来,采样几乎免费——不用碰真实机器人,在 GPU 上想采多少条采多少条。剩下的问题只有一个:怎么对 $\theta$ 求梯度?有两个截然不同的答案。
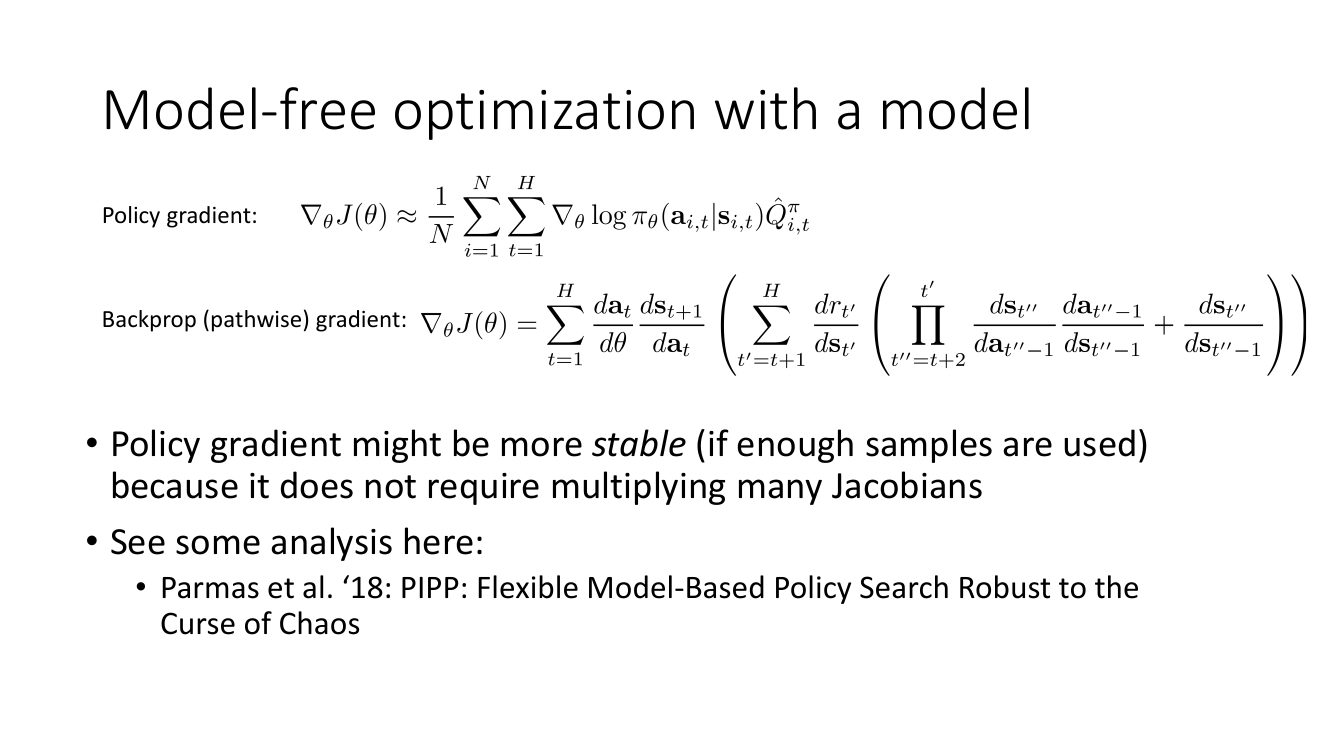
做法一:pathwise(反传)梯度 —— 版本 2.0
如果 $\hat f_\phi$、$r$、$\pi_\theta$ 全都可微(策略的随机性用重参数化技巧处理,$\mathbf{a}_t=\pi_\theta(\mathbf{s}_t,\xi_t)$,$\xi_t$ 是与 $\theta$ 无关的噪声),那整条 rollout 就是一个巨大的可微计算图,直接 loss.backward() 即可。展开写出来是:
逐项解释这个式子怎么来的。$\theta$ 影响 $J$ 的路径是:$\theta\to\mathbf{a}_t\to\mathbf{s}_{t+1}\to(\mathbf{a}_{t+1},\mathbf{s}_{t+2})\to\cdots\to r_{t'}$。
- 最外层 $\sum_{t=1}^{H}$:$\theta$ 在每个时间步都产生一次动作,每次都是一条独立的影响路径,梯度全部相加。
- $\frac{d\mathbf{a}_t}{d\theta}\frac{d\mathbf{s}_{t+1}}{d\mathbf{a}_t}$:参数先影响动作,动作再影响下一状态。这里的第二项就是动力学模型的雅可比。
- 中间的 $\sum_{t'=t+1}^{H}\frac{dr_{t'}}{d\mathbf{s}_{t'}}$:状态被扰动后,会影响它之后所有时刻的奖励,所以对未来所有 $t'$ 求和。
- 最内层的连乘 $\prod_{t''=t+2}^{t'}$:这是「扰动从 $\mathbf{s}_{t+1}$ 传播到 $\mathbf{s}_{t'}$」的转移矩阵。每传播一步有两条通路并联:直接通过动力学 $\frac{d\mathbf{s}_{t''}}{d\mathbf{s}_{t''-1}}$(状态本身的自然演化),以及绕道策略 $\frac{d\mathbf{s}_{t''}}{d\mathbf{a}_{t''-1}}\frac{d\mathbf{a}_{t''-1}}{d\mathbf{s}_{t''-1}}$(状态变了 → 策略选的动作变了 → 下一状态变了)。两条并联所以相加,然后逐步相乘。
换句话说,把每步的「闭环雅可比」记作 $\mathbf{M}_{t}=\frac{\partial \mathbf{s}_{t+1}}{\partial\mathbf{s}_{t}}+\frac{\partial\mathbf{s}_{t+1}}{\partial\mathbf{a}_{t}}\frac{\partial\mathbf{a}_{t}}{\partial\mathbf{s}_{t}}$,则梯度里出现的是 $\mathbf{M}_{t'-1}\mathbf{M}_{t'-2}\cdots\mathbf{M}_{t+1}$ 这样的矩阵连乘。
为什么这个梯度会炸
矩阵连乘的病理和训练 RNN 时的梯度爆炸/消失一模一样。设 $\mathbf{M}_t$ 的谱半径大致是 $\lambda$,则 $H$ 步之后梯度的量级是 $\lambda^{H}$:
| $\lambda$(每步闭环增益) | $H=20$ | $H=50$ | $H=100$ |
|---|---|---|---|
| $1.1$(轻微不稳定) | $6.7$ | $1.2\times10^{2}$ | $1.4\times10^{4}$ |
| $1.3$ | $1.9\times10^{2}$ | $5.0\times10^{5}$ | $2.5\times10^{11}$ |
| $0.9$(收敛系统) | $0.12$ | $5.2\times10^{-3}$ | $2.7\times10^{-5}$ |
更糟的是,$\lambda$ 通常在轨迹的不同段落取不同值:接触发生的瞬间(脚落地、手指碰到物体)雅可比会突然变得巨大甚至不连续,而在自由飞行段几乎是 $1$。所以梯度既爆炸又消失,还在同一条轨迹里混着来。这就是 Parmas et al. 说的「混沌的诅咒(curse of chaos)」——真实物理系统对初值敏感,$\frac{d\mathbf{s}_{t'}}{d\mathbf{s}_{t}}$ 本身就随 $t'-t$ 指数发散。
「这不就是 BPTT 吗?RNN 里我们用 LSTM/GRU 和梯度裁剪就解决了。」——不行。RNN 的转移矩阵是我们自己的参数,可以设计门控结构、可以正交初始化、可以约束谱范数。而这里的 $\mathbf{M}_t$ 是物理系统(或拟合它的模型)强加给我们的,我们没有任何设计自由度:真实的倒立摆就是不稳定的,$\lambda$ 就是大于 1。梯度裁剪能防止数值溢出,但裁剪后的方向已经不是真实梯度方向了。这也是为什么 Levine 说「如果样本够多,策略梯度可能更稳定」——注意他用的是「可能」,这不是定理,是经验判断。
做法二:在模型里跑策略梯度 —— 版本 2.5
既然连乘雅可比是病根,那就用完全不需要模型雅可比的估计量。策略梯度(似然比 / REINFORCE 估计量)正是如此:
$$ \nabla_\theta J(\theta)\approx\frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\nabla_\theta\log\pi_\theta(\mathbf{a}_{i,t}|\mathbf{s}_{i,t})\,\hat Q^{\pi}_{i,t} $$这里唯一的求导对象是 $\log\pi_\theta$,模型只负责产生样本——它甚至可以是不可微的、离散的、带 if-else 的。$\hat Q^\pi_{i,t}=\sum_{t'\ge t}\gamma^{t'-t}r_{i,t'}$ 只是一堆数字,不参与求导。于是就有了:
| pathwise(反传)梯度 | 策略梯度(似然比) | |
|---|---|---|
| 是否需要 $\hat f$ 可微 | 需要 | 不需要(只需能采样) |
| 梯度的偏差 | 无偏(对模型而言) | 无偏(对模型而言) |
| 方差 | 通常较低…… | 较高,需要大 $N$ 压方差 |
| 数值稳定性 | 差:$H$ 个雅可比连乘 | 好:不含雅可比连乘 |
| 对时域 $H$ 的敏感度 | 指数级恶化 | 方差随 $H$ 大致线性/平方增长 |
| 对不连续动力学(接触) | 崩溃 | 照常工作 |
| 样本效率(在模型内) | 高 | 低,但模型采样便宜 |
「方差通常较低」那一栏之所以打省略号,是因为这是低维光滑问题上的经验;一旦系统混沌,pathwise 梯度的方差反而会爆掉——Parmas et al. 的 PIPP 正是分析并混合这两种估计量的工作。
一个记忆点:pathwise 梯度问「如果我把动作往这个方向挪一点点,回报会怎么变」;策略梯度问「哪些采出来的动作恰好回报高,就提高它们的概率」。前者需要精确知道系统的局部导数结构(模型必须在导数层面也准确,这比在值层面准确难得多);后者只需要模型在分布层面大致对。学到的神经网络动力学模型往往预测值还行、导数却噪声很大,这是策略梯度在模型里更稳的一个实际原因。
9. 长 rollout 的诅咒与短 rollout 方案
版本 2.5 遗留的问题是:第 ③ 步「用 $f$ 生成轨迹」到底要生成多长?如果按任务时域 $T$ 生成完整轨迹,模型误差会一路累积。
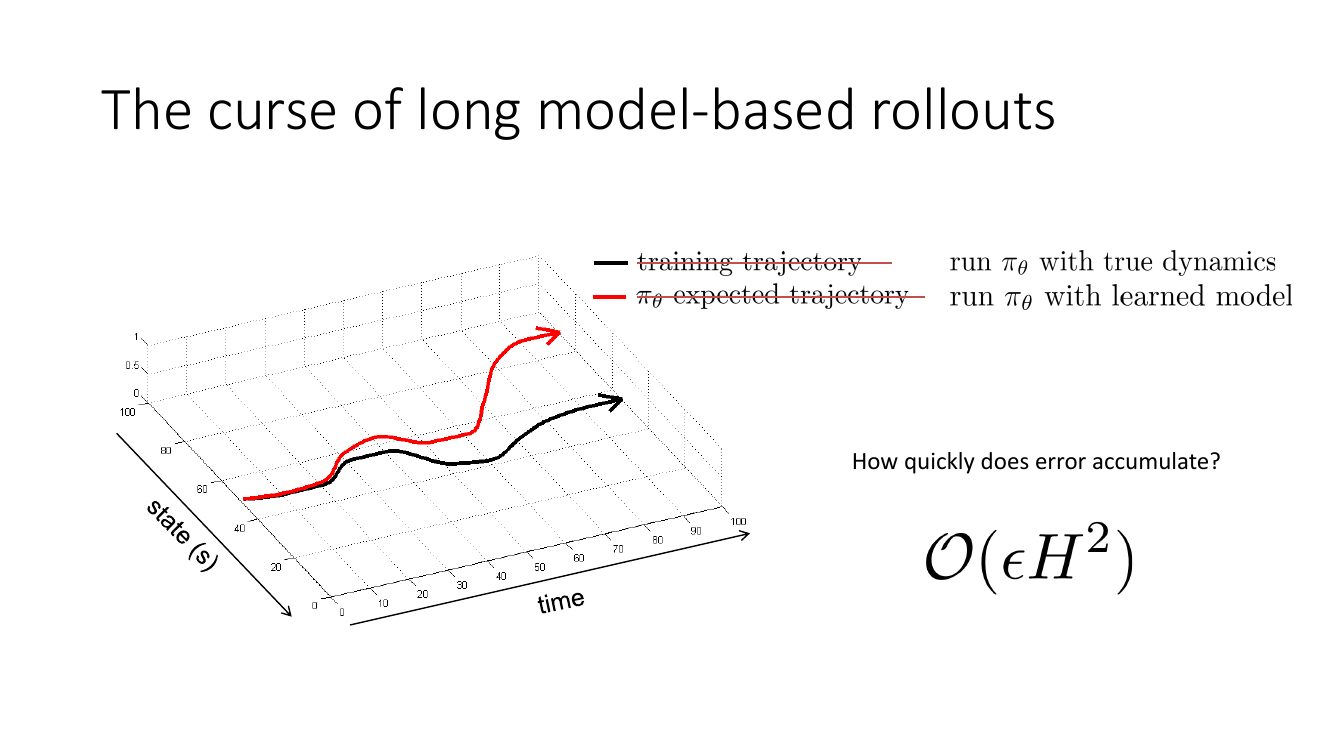
$\mathcal{O}(\epsilon H^2)$ 是怎么来的?这与模仿学习那一讲里 behavior cloning 的 $\mathcal{O}(\epsilon T^2)$ 分析完全同构,只是「犯错的人」从策略换成了模型。
设模型的一步预测误差用总变差距离刻画:对数据分布覆盖到的任意 $(\mathbf{s},\mathbf{a})$,
$$ D_{\mathrm{TV}}\big(\hat p_\phi(\cdot|\mathbf{s},\mathbf{a}),\ p(\cdot|\mathbf{s},\mathbf{a})\big)\le\epsilon $$第一步:分布误差随时间线性增长。记 $p_t$ 和 $\hat p_t$ 分别是真实动力学和模型在 $t$ 时刻的状态分布,起点相同 $p_1=\hat p_1$。用「一步耦合」论证:$\hat p_{t+1}$ 与 $p_{t+1}$ 的差异有两个来源——(a) 输入分布本来就不同($\hat p_t$ vs $p_t$),(b) 即使输入相同,转移核也差 $\epsilon$。由三角不等式与 TV 距离在马尔可夫核下的非扩张性:
$$ D_{\mathrm{TV}}(\hat p_{t+1},p_{t+1})\ \le\ D_{\mathrm{TV}}(\hat p_t,p_t)+\epsilon \quad\Longrightarrow\quad D_{\mathrm{TV}}(\hat p_t,p_t)\le (t-1)\epsilon $$第二步:把分布误差换算成回报误差。设奖励有界 $|r|\le R_{\max}$。对任意有界函数,期望之差不超过 $2R_{\max}$ 乘以 TV 距离:
$$ \Big|\E_{\hat p_t}[r]-\E_{p_t}[r]\Big|\ \le\ 2R_{\max}\,D_{\mathrm{TV}}(\hat p_t,p_t)\ \le\ 2R_{\max}(t-1)\epsilon $$第三步:对时间求和。
$$ \big|\hat J-J\big|\ \le\ \sum_{t=1}^{H}2R_{\max}(t-1)\epsilon\ =\ 2R_{\max}\epsilon\cdot\frac{H(H-1)}{2}\ =\ \mathcal{O}(\epsilon H^2) $$数值感受:$\epsilon=0.01$(每步 1% 的分布误差,已经算相当好的模型了)、$R_{\max}=1$。$H=10$ 时误差界约 $0.9$;$H=100$ 时约 $99$——已经远超整条轨迹能拿到的总奖励 $H\cdot R_{\max}=100$,界完全失效(意味着模型内的回报估计毫无意义)。而 $H=1$ 时界是 $0$,$H=5$ 时只有 $0.2$。这就是「短 rollout」三个字的全部理由。
顺带一提,这还是乐观的估计。如果动力学有 Lipschitz 常数 $L\gt 1$(混沌系统),误差是 $\epsilon\frac{L^{H}-1}{L-1}$,即指数级而非平方级。
三种 rollout 方案的取舍
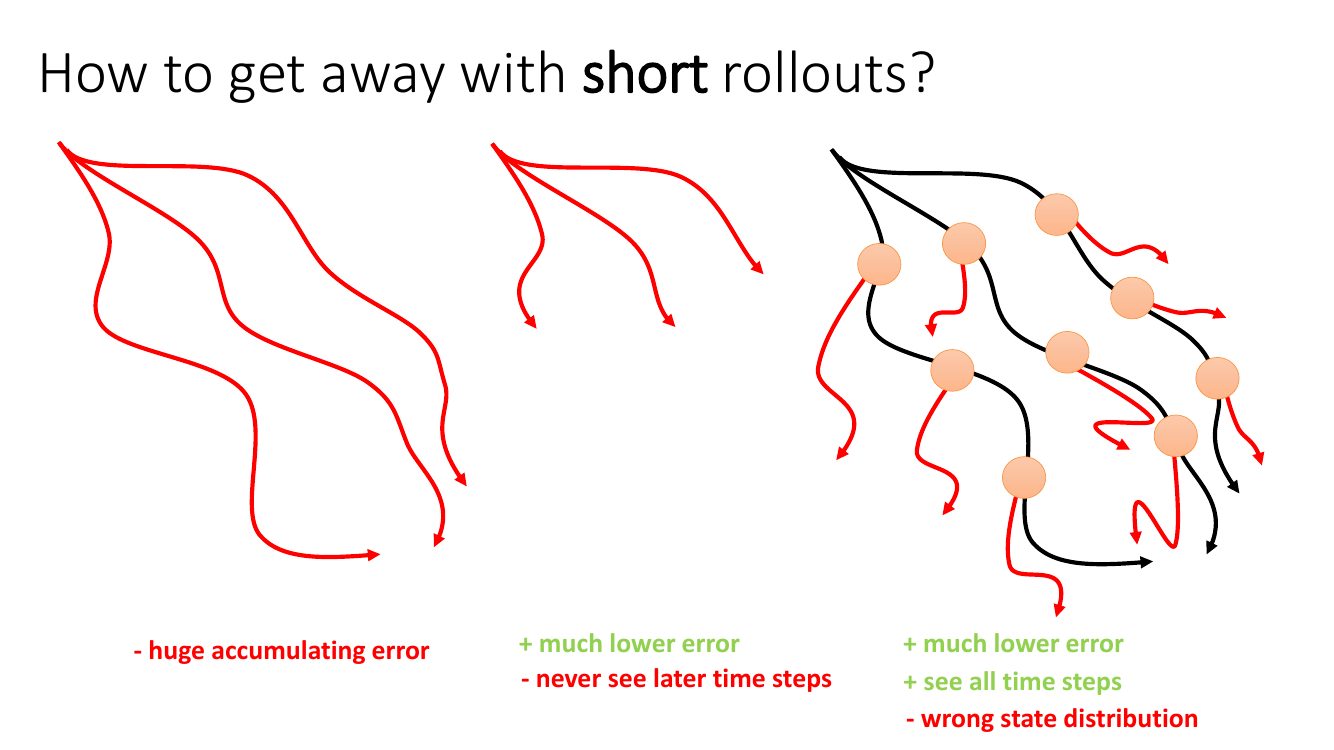
| 方案 | rollout 起点 | 长度 | 模型误差 | 覆盖后期状态 | 状态分布 |
|---|---|---|---|---|---|
| 长 rollout | 初始状态 $\mathbf{s}_1$ | $T$(完整) | $\mathcal{O}(\epsilon T^2)$ 极大 | 覆盖(但全是幻觉) | 正确(若模型准) |
| 短 rollout | 初始状态 $\mathbf{s}_1$ | $k$ 很小 | $\mathcal{O}(\epsilon k^2)$ 很小 | 不覆盖 | 正确但只有开头 |
| 分支 rollout | buffer 中任意真实状态 | $k$ 很小 | $\mathcal{O}(\epsilon k^2)$ 很小 | 覆盖 | 有偏(是旧策略的分布) |
第三种方案的「状态分布是错的」具体指什么?我们从 buffer 里采起点,而 buffer 里的状态是历史上各个旧策略访问过的状态,不是当前 $\pi_\theta$ 的稳态分布 $d^{\pi_\theta}$。所以我们实际在优化的是一个 off-policy 的目标。这也正是为什么第 4 步必须用off-policy 的无模型算法(Q 学习、SAC 之类)而不是 on-policy 的策略梯度——策略梯度要求样本来自当前策略,而这里显然不是。
把这三点合起来就是版本 3.0:
model-based RL version 3.0:
  1. 用基准策略 pi_0(a|s) 收集数据 D = {(s, a, s')_i}
  2. 学动力学模型 f(s,a),最小化 sum_i || f(s_i,a_i) - s'_i ||^2
  3. 从 D 里挑一批状态 s_i,用 f(s,a) 从它们出发做【短】rollout
  4. 用【真实数据和模型数据一起】,以【off-policy RL】改进 pi_theta(a|s)
  5. 运行 pi_theta(a|s),把访问到的 (s, a, s') 追加进 D
—— 内层回到第 3 步,外层回到第 2 步版本 3.0 用三个改动同时解决了三个问题:短 rollout 压住 $\mathcal{O}(\epsilon H^2)$ 的误差累积;从 buffer 采起点保证策略能见到所有阶段的状态;用 off-policy 算法容忍由此带来的状态分布偏差,并顺便让真实数据和模型数据可以混在一起训练。这三件事缺一不可,去掉任何一件整个方案都不成立。
10. Dyna 风格:用模型给无模型算法造数据
版本 3.0 的思想其实是 Sutton 在 1990 年就提出的 Dyna 架构的现代重述。Dyna 的一句话概括:每和真实环境交互一步,就在脑子里(模型里)多做 $K$ 步「想象中的」更新。
原始 Dyna
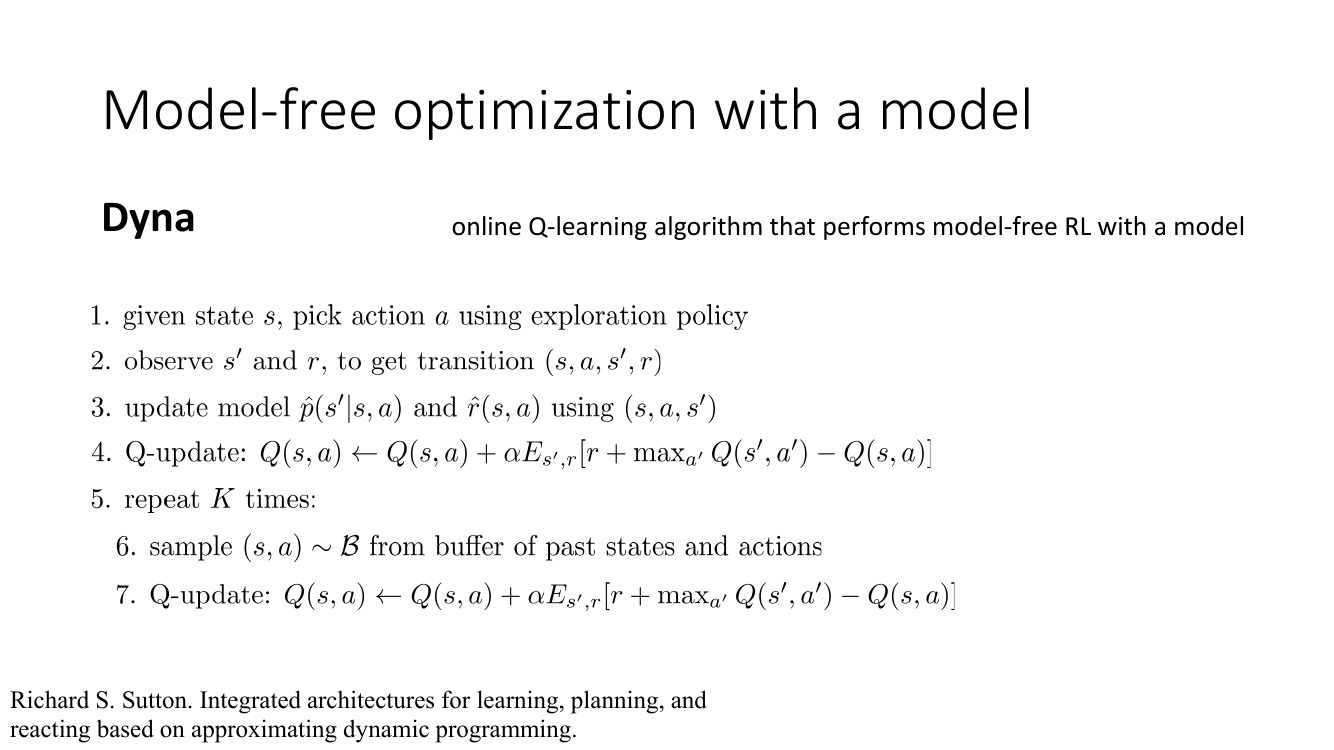
这里有两个设计值得细看。
第一,第 ⑥ 步从 $\mathcal{B}$ 采样,而不是从模型里自由漫游。$\mathcal{B}$ 是「过去真的访问过的 $(s,a)$」,所以每次模型内更新的起点都是真实的。这正是上一节说的「从 buffer 采起点」。
第二,rollout 只有一步。第 ⑦ 步用模型采一个 $s'$ 就立刻做 Q 更新,不继续往下走。按上一节的分析,$k=1$ 时误差界正比于 $\epsilon\cdot 1^2$,几乎不受模型误差累积影响。那这样还有什么价值?价值在于 Q 值的信息传播:真实交互每步只能更新一个 $(s,a)$ 的 Q 值,而模型内的 $K$ 次更新可以把奖励信息迅速沿着状态空间反向扩散。在经典的 Dyna-Maze 实验里,加上 $K=50$ 次规划更新能把找到最优路径所需的真实回合数减少一个数量级以上。
一般化的 Dyna 风格配方
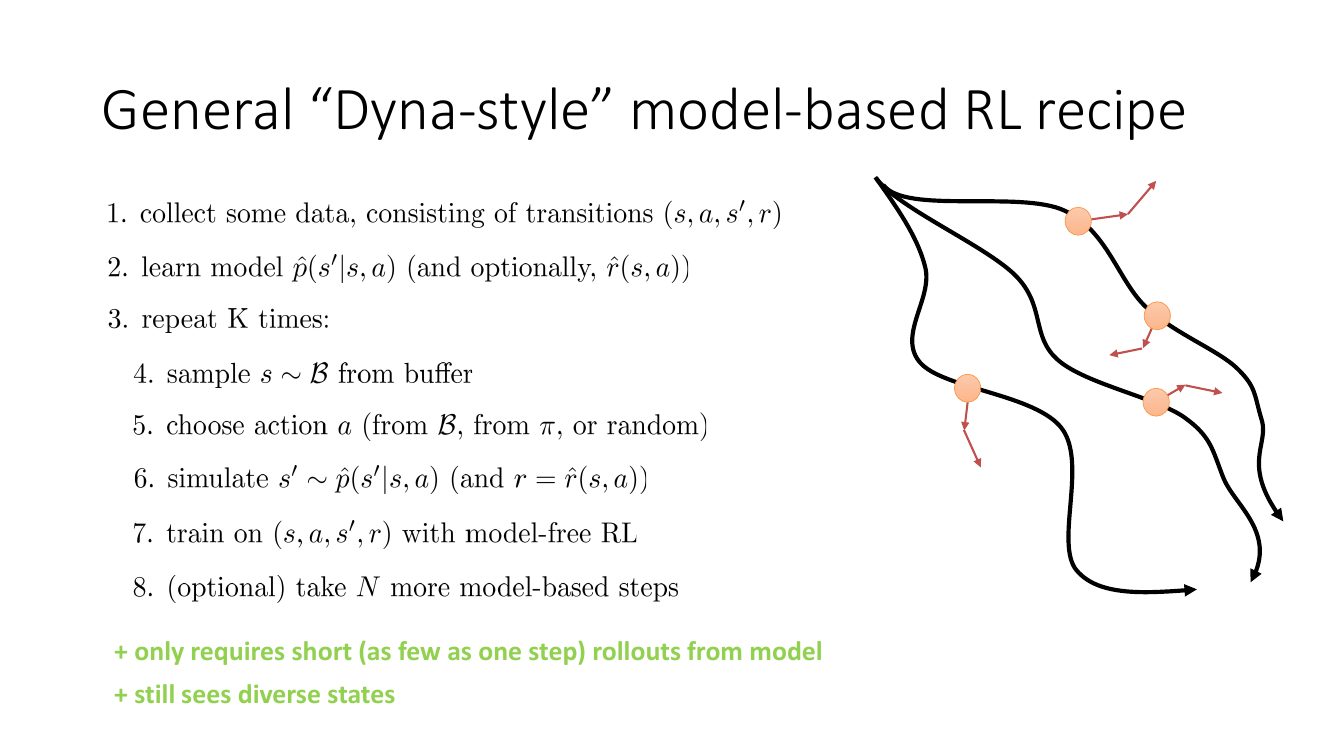
第 ⑤ 步「动作从哪来」是一个被低估的设计维度:
| 动作来源 | 效果 | 适合的下游算法 |
|---|---|---|
| 从 $\mathcal{B}$ 取(历史动作) | 完全 off-policy,最保守,模型只做「重放」 | Q 学习 |
| 从当前策略 $\pi_\theta$ 采 | on-policy 的动作分布,能评估当前策略的价值 | SAC / actor-critic(MBPO 的选择) |
| 纯随机 | 覆盖面最广,但很多动作毫无意义,样本浪费 | 探索阶段 |
模型加速的 off-policy RL:完整的系统图
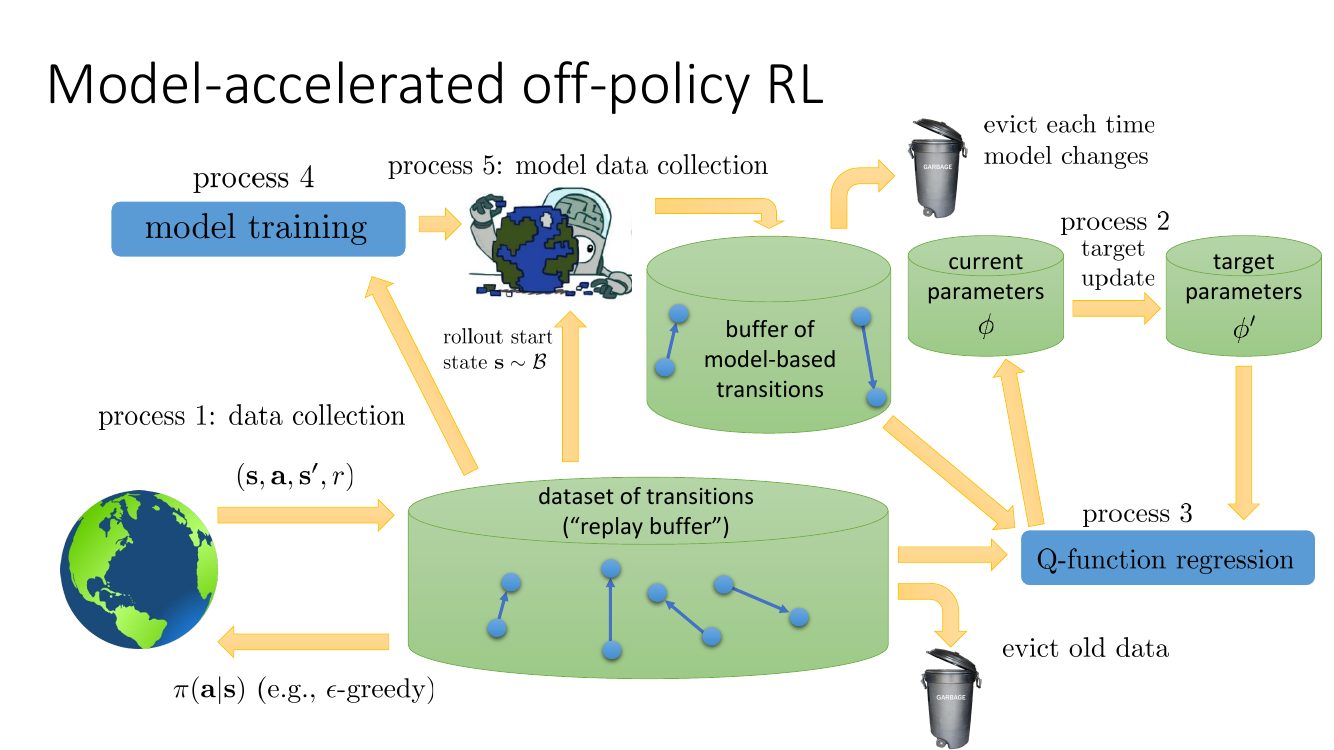
两个 buffer 分开是关键工程设计:真实数据是「事实」,可以长期保留;模型数据是「意见」,随模型更新而失效,必须及时清空。实践中通常还会控制两者在每个 batch 里的比例(例如 $5\%$ 真实 + $95\%$ 模型,或者反过来),这个比例是最重要的超参之一。
MBA / MVE / MBPO
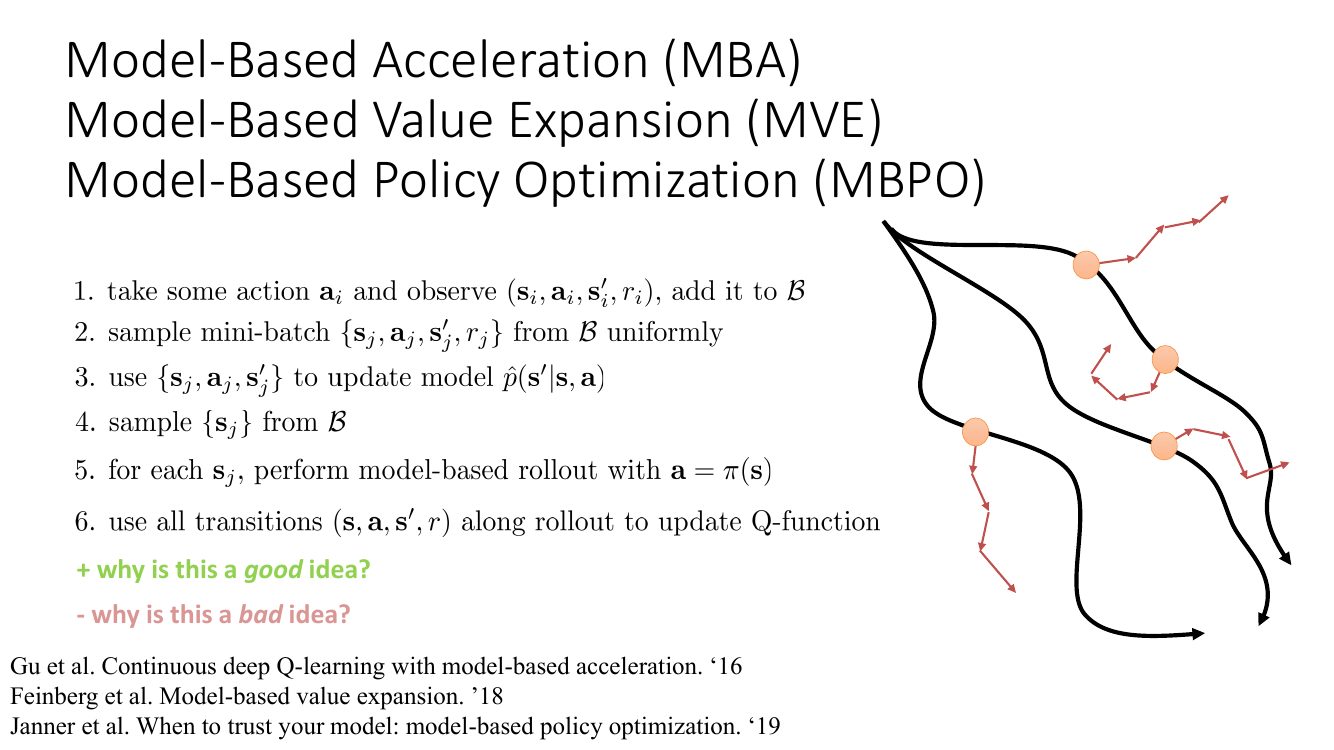
为什么是好主意:(a)样本效率暴涨——每条真实转移可以「繁殖」出几十上百条模型转移供 Q 函数消化,在 MuJoCo 连续控制基准上,这类方法达到 SAC 同等性能所需的真实交互步数常常能少一个数量级;(b)起点来自真实 buffer,状态覆盖有保证;(c)rollout 很短,误差可控。
为什么是坏主意:(a)Q 函数会被模型误差污染,而且这个污染会通过 Bellman 自举不断循环放大——错误的 $Q(\mathbf{s}',\mathbf{a}')$ 被用作目标去训练 $Q(\mathbf{s},\mathbf{a})$,一轮轮传播;(b)策略又会去 $\argmax$ 这个被污染的 Q,重演 model exploitation,只不过这次被利用的是值函数里的模型误差;(c)计算量大——每个真实步要跑几百次模型前向和几十次梯度更新,wall-clock 时间可能比纯无模型方法还长(虽然真实样本少得多)。
三者的区别
MBA(Gu et al. 2016, Continuous Deep Q-learning with Model-based Acceleration):最直接的 Dyna——把模型生成的转移加进 replay buffer 喂给 Q 学习(他们用的是 NAF)。
MVE(Feinberg et al. 2018, Model-Based Value Expansion):不是造数据,而是改造 Bellman 目标。标准的一步目标是 $y=r_0+\gamma Q_{\phi'}(\mathbf{s}_1,\mathbf{a}_1)$;MVE 用模型往前展开 $k$ 步再接上 Q:
$$ y^{(k)}=\sum_{t=0}^{k-1}\gamma^{t}\hat r(\hat{\mathbf{s}}_t,\hat{\mathbf{a}}_t)+\gamma^{k}Q_{\phi'}(\hat{\mathbf{s}}_k,\hat{\mathbf{a}}_k), \qquad \hat{\mathbf{s}}_{t+1}\sim\hat p_\phi(\cdot|\hat{\mathbf{s}}_t,\hat{\mathbf{a}}_t),\ \hat{\mathbf{a}}_t\sim\pi_\theta(\cdot|\hat{\mathbf{s}}_t) $$这样做的收益是降低目标的偏差:$k$ 步真实(模型)奖励替代了 $k$ 步的自举,Q 的估计误差被 $\gamma^k$ 压缩。代价是引入了 $k$ 步模型误差。$k$ 就是在「自举偏差」和「模型偏差」之间的旋钮。后续的 STEVE 进一步用集成的不确定性对不同 $k$ 的目标做加权平均,让算法自动决定该信任模型多少步。
MBPO(Janner et al. 2019, When to Trust Your Model):本节最完整的方案,也是当前的实用基线。它的三个决定性选择是:概率集成模型(第 6 节那套)、从真实 buffer 出发的 $k$ 步分支 rollout、SAC 作为底层 off-policy 优化器,且真实数据与模型数据按固定比例混合采样。论文的理论部分给出形如
$$ \eta[\pi]\ \ge\ \hat\eta[\pi]-\underbrace{C(\epsilon_m,\epsilon_\pi,k)}_{\text{随}\ \epsilon_m\ \text{和}\ k\ \text{增大}} $$的下界:$\hat\eta$ 是模型内估计的回报,$\epsilon_m$ 是模型的泛化误差,$\epsilon_\pi$ 度量当前策略与数据收集策略的差距。这个界告诉我们,只要模型误差足够小、rollout 长度 $k$ 足够短,模型内的改进就能保证真实回报的改进。
rollout 长度 $k$ 的取舍是 MBPO 的灵魂。$k$ 增大:好处是模型数据能覆盖到离 buffer 更远的状态(对当前策略更 on-policy),Q 学习的目标偏差更小;坏处是误差按 $\mathcal{O}(\epsilon k^2)$(甚至指数)累积。$k$ 减小到极限 $k=1$ 时,模型只做「一步外推」,几乎不会出错,但生成的状态几乎全在 buffer 分布内,价值有限。实践中 $k$ 通常小到 $1$,最多也就几步;有的实现会随训练进行(模型变准)从 $1$ 逐步增大。请记住:模型基 RL 里的默认答案是「非常短」,长 rollout 需要额外理由才能被采用。
分支 rollout 的最小实现
@torch.no_grad()
def branched_rollouts(model, real_buf, model_buf, policy, reward_fn,
                      k=1, B=100000):
    """MBPO 的核心:从真实 buffer 采起点,用模型走 k 步,产物存进模型 buffer。"""
    s = real_buf.sample_states(B)                    # (B, ds) 全是真实状态
    for _ in range(k):
        a = policy.sample(s)                         # 用【当前】策略选动作
        # 每条轨迹随机挑一个集成成员,整段 rollout 用同一个成员
        m = int(torch.randint(0, model.n, (1,)))
        s2 = model.step(s, a, m)
        r  = reward_fn(s, a)                         # 或用学到的奖励模型
        model_buf.add(s, a, r, s2)                   # 存进【模型】buffer
        s = s2                                       # 从新状态继续分支

def mbpo_epoch(env, model, policy, real_buf, model_buf,
               k=1, n_env_steps=1000, grad_steps_per_step=20, p_real=0.05):
    for _ in range(n_env_steps):
        # (1) 真实环境走一步
        real_buf.add(*env_step(env, policy))
        # (2) 重训模型(实践中每隔几百步做一次即可)
        model.fit(*real_buf.all())
        # (3) 清空旧的模型数据,重新生成分支 rollout
        model_buf.clear()
        branched_rollouts(model, real_buf, model_buf, policy, reward_fn, k=k)
        # (4) 用混合 batch 做多次 SAC 更新
        for _ in range(grad_steps_per_step):
            n_real = int(p_real * BATCH)
            batch = concat(real_buf.sample(n_real),
                           model_buf.sample(BATCH - n_real))
            sac_update(policy, batch)
注意 grad_steps_per_step=20:每走一步真实环境,做 20 次梯度更新。这个「更新-数据比(update-to-data ratio, UTD)」正是模型基方法能把样本效率提上去的直接机制——模型提供了足够多的(伪)数据,让我们敢于在每条真实数据上榨取更多梯度步而不至于立刻过拟合。
11. 高维观测:潜在空间模型
Part 3 回头处理一件之前一直被跳过的事:模型的输入输出到底是什么。前面所有讨论都默认我们有低维的马尔可夫状态 $\mathbf{s}_t$(关节角、速度、物体位姿)。可现实里我们常常只有 $64\times64\times3$ 的图像 $\mathbf{o}_t$。直接在像素上学 $\hat p(\mathbf{o}_{t+1}|\mathbf{o}_t,\mathbf{a}_t)$ 有三重困难:
- 维度太高:$12288$ 维的输出,模型容量和训练开销都很吓人。
- 观测不是状态:单帧图像不含速度信息,也可能有遮挡——$\mathbf{o}_t$ 不满足马尔可夫性,$p(\mathbf{o}_{t+1}|\mathbf{o}_t,\mathbf{a}_t)$ 这个式子本身就不成立。
- 规划在像素上做不了:CEM 在像素空间里没有意义,奖励函数也很难定义在像素上。
解法是引入一个低维的潜在状态(latent state) $\mathbf{s}_t$(有些文献写作 $\mathbf{z}_t$),让动力学发生在潜在空间,图像只是它的一个「渲染」。
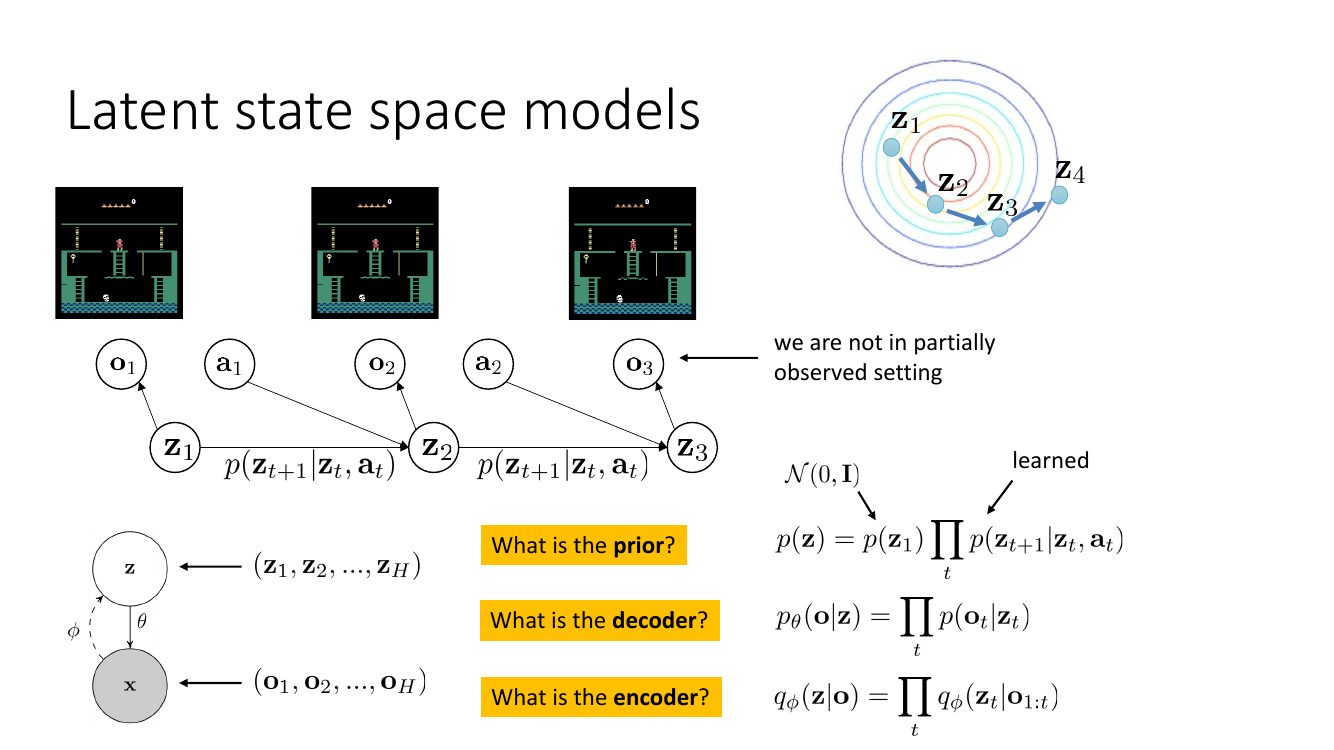
三个组件的对应关系值得反复品味:普通 VAE 的先验是固定的 $\mathcal{N}(0,\mathbf{I})$,而这里的先验是一个带动作输入的时序模型——它就是我们要的动力学模型。换句话说,学动力学模型这件事,被表述成了「学一个序列 VAE 的先验」。解码器就是一个反卷积网络,把 $\mathbf{z}_t$ 画成图像;编码器可以是逐帧 CNN,也可以是吃整段历史的 LSTM/Transformer——写成 $q_\phi(\mathbf{z}_t|\mathbf{o}_{1:t})$ 时它就是一个滤波后验(filtering posterior),能从多帧里恢复出速度这类单帧看不到的信息。
三个要学的模型
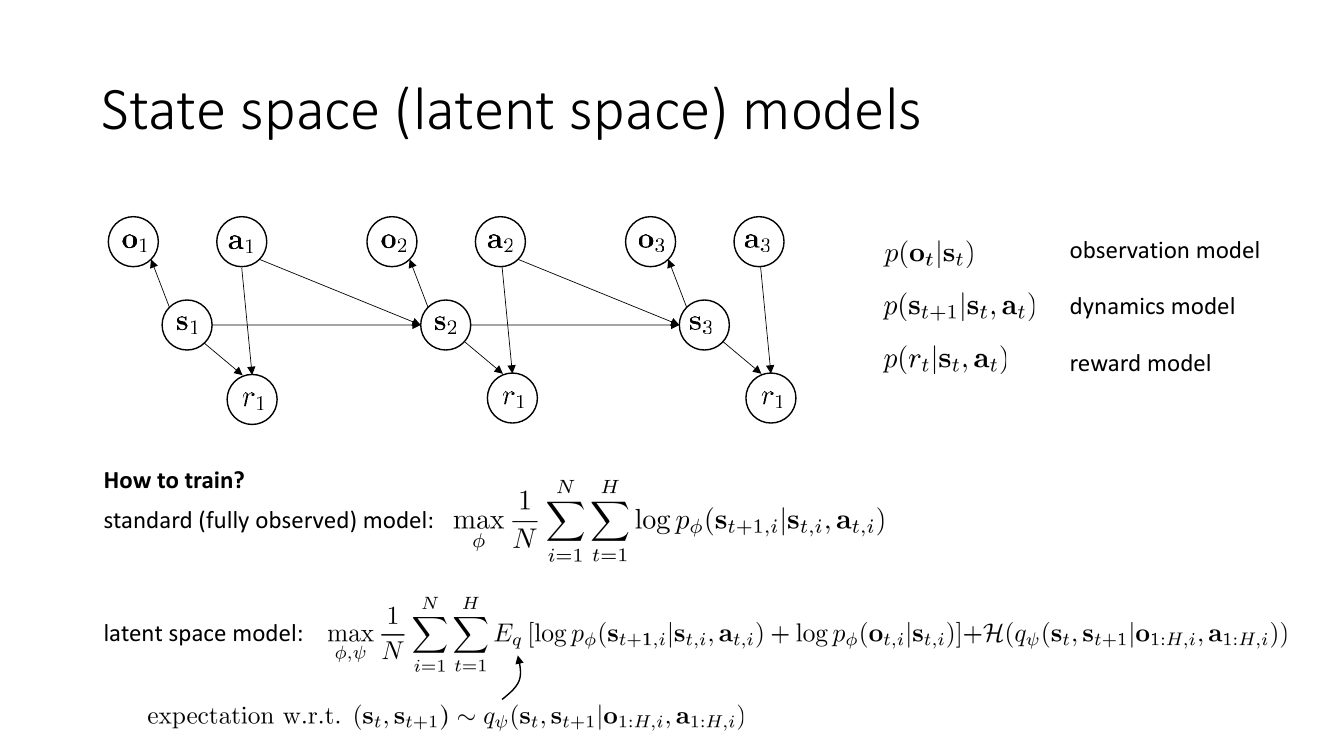
全可观测时目标简单得几乎不用想:
$$ \max_\phi\ \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\log p_\phi(\mathbf{s}_{t+1,i}\mid\mathbf{s}_{t,i},\mathbf{a}_{t,i}) $$潜在空间时 $\mathbf{s}_t$ 是未知的,我们只能对某个近似后验 $q_\psi$ 取期望:
$$ \max_{\phi,\psi}\ \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H} \E_{q}\Big[\log p_\phi(\mathbf{s}_{t+1,i}|\mathbf{s}_{t,i},\mathbf{a}_{t,i})+\log p_\phi(\mathbf{o}_{t,i}|\mathbf{s}_{t,i})\Big] +\mathcal{H}\big(q_\psi(\mathbf{s}_t,\mathbf{s}_{t+1}\mid \mathbf{o}_{1:H,i},\mathbf{a}_{1:H,i})\big) $$期望是对 $(\mathbf{s}_t,\mathbf{s}_{t+1})\sim q_\psi(\mathbf{s}_t,\mathbf{s}_{t+1}|\mathbf{o}_{1:H,i},\mathbf{a}_{1:H,i})$ 取的。
这个式子不是拍脑袋写的,它就是证据下界(ELBO)。从观测序列的对数似然出发(为简洁省去下标 $i$,并把 $\mathbf{a}_{1:H}$ 视为给定的条件):
$$ \log p_\phi(\mathbf{o}_{1:H}\mid\mathbf{a}_{1:H})=\log\int p_\phi(\mathbf{o}_{1:H},\mathbf{s}_{1:H}\mid\mathbf{a}_{1:H})\,d\mathbf{s}_{1:H} $$乘除一个任意的 $q_\psi(\mathbf{s}_{1:H}|\mathbf{o}_{1:H},\mathbf{a}_{1:H})$,再用 Jensen 不等式($\log$ 是凹函数)把 $\log$ 换到期望里面:
$$ =\log\E_{q_\psi}\!\left[\frac{p_\phi(\mathbf{o}_{1:H},\mathbf{s}_{1:H}|\mathbf{a}_{1:H})}{q_\psi(\mathbf{s}_{1:H}|\mathbf{o}_{1:H},\mathbf{a}_{1:H})}\right] \ \ge\ \E_{q_\psi}\big[\log p_\phi(\mathbf{o}_{1:H},\mathbf{s}_{1:H}|\mathbf{a}_{1:H})\big]-\E_{q_\psi}\big[\log q_\psi\big] $$第二项按定义就是熵 $\mathcal{H}(q_\psi)$。第一项按图模型的因子分解展开:
$$ \log p_\phi(\mathbf{o}_{1:H},\mathbf{s}_{1:H}|\mathbf{a}_{1:H})=\sum_{t}\log p_\phi(\mathbf{o}_t|\mathbf{s}_t)+\sum_{t}\log p_\phi(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)+\log p(\mathbf{s}_1) $$代回去,忽略与参数无关的 $\log p(\mathbf{s}_1)$,就得到
$$ \text{ELBO}=\sum_{t=1}^{H}\E_{q_\psi}\Big[\log p_\phi(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)+\log p_\phi(\mathbf{o}_t|\mathbf{s}_t)\Big]+\mathcal{H}(q_\psi) $$与幻灯片上的式子完全一致。三项各司其职:第一项逼着潜在空间里的动力学要可预测(这是我们真正想要的模型);第二项逼着潜在状态要保留足够信息重建出图像(防止 $\mathbf{s}_t$ 塌缩成常数——那样动力学项会完美但毫无用处);熵项防止后验塌缩成一个点,保持不确定性的表达能力。注意由于每一项只涉及 $(\mathbf{s}_t,\mathbf{s}_{t+1})$,我们其实只需要成对的边缘后验 $q_\psi(\mathbf{s}_t,\mathbf{s}_{t+1}|\cdot)$,不需要整条链的联合后验——这正是幻灯片写成那个形式的原因。
后验(编码器)怎么选
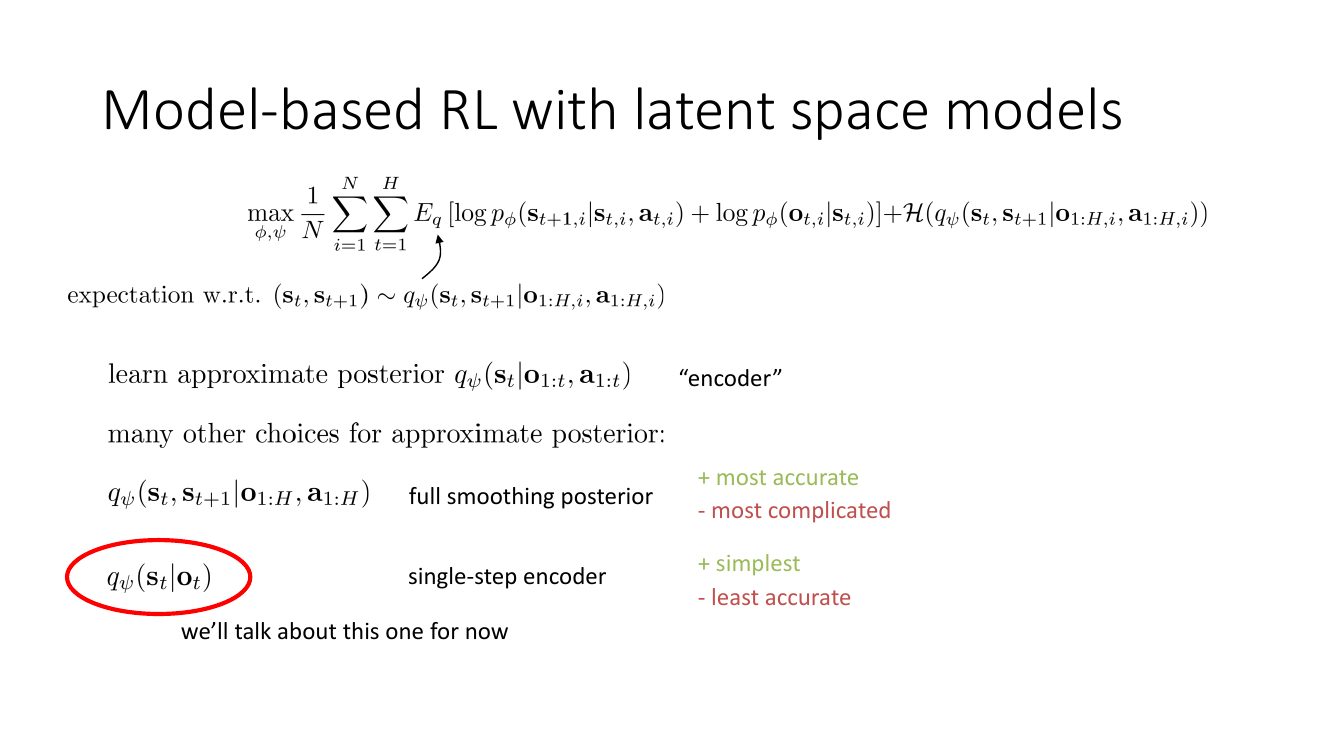
| 后验形式 | 用到的信息 | 准确度 | 实现复杂度 | 能否在线用 |
|---|---|---|---|---|
| $q_\psi(\mathbf{s}_t|\mathbf{o}_t)$ 单步 | 当前一帧 | 最低 | 最低(一个 CNN) | 可以 |
| $q_\psi(\mathbf{s}_t|\mathbf{o}_{1:t},\mathbf{a}_{1:t})$ 滤波 | 过去全部 | 中 | 中(RNN/Transformer) | 可以 |
| $q_\psi(\mathbf{s}_t|\mathbf{o}_{1:H},\mathbf{a}_{1:H})$ 平滑 | 过去 + 未来 | 最高 | 最高(双向序列模型) | 只能离线训练用 |
取单步编码器时,目标简化成(期望改为对 $\mathbf{s}_t\sim q(\mathbf{s}_t|\mathbf{o}_t)$、$\mathbf{s}_{t+1}\sim q(\mathbf{s}_{t+1}|\mathbf{o}_{t+1})$ 取):
$$ \max_{\phi,\psi}\ \frac{1}{N}\sum_{i}\sum_{t}\E_{q}\Big[\log p_\phi(\mathbf{s}_{t+1,i}|\mathbf{s}_{t,i},\mathbf{a}_{t,i})+\log p_\phi(\mathbf{o}_{t,i}|\mathbf{s}_{t,i})\Big]+\mathcal{H}\big(q(\mathbf{s}_t|\mathbf{o}_t)\big) $$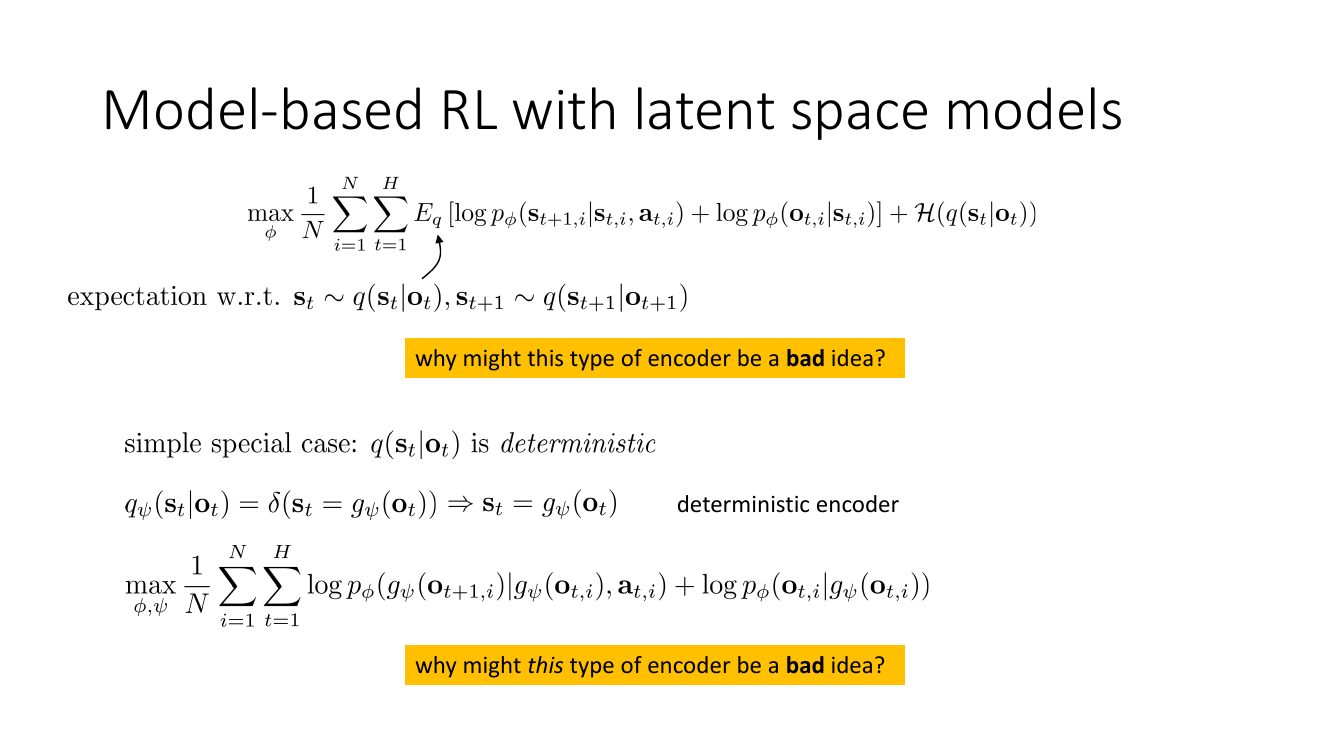
确定性编码器下的目标是:
$$ \max_{\phi,\psi}\ \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\log p_\phi\big(g_\psi(\mathbf{o}_{t+1,i})\,\big|\,g_\psi(\mathbf{o}_{t,i}),\mathbf{a}_{t,i}\big)+\log p_\phi\big(\mathbf{o}_{t,i}\,\big|\,g_\psi(\mathbf{o}_{t,i})\big) $$两个「为什么可能是坏主意」的答案。
(1)单步编码器 $q(\mathbf{s}_t|\mathbf{o}_t)$ 的问题:一帧图像通常不足以确定状态。速度、角速度从静止的一帧里根本读不出来;被遮挡的物体位置也读不出来。此时真实后验 $p(\mathbf{s}_t|\mathbf{o}_{1:t})$ 会显著窄于 $p(\mathbf{s}_t|\mathbf{o}_t)$,用后者做变分族相当于人为丢掉了历史信息,ELBO 的间隙很大,学到的「潜在动力学」被迫去建模那些其实可以从历史推断出来的不确定性,预测因此变得模糊。常见的粗暴补丁是把最近 $k$ 帧堆叠成一个「观测」,但那只是把滤波后验硬编码成固定窗口。
(2)确定性编码器的问题:它彻底放弃了表达状态不确定性的能力。$\delta$ 分布的微分熵是 $-\infty$,熵项被丢掉之后,目标里就没有任何东西阻止编码器把不同的真实状态映射到同一个 $\mathbf{s}$(信息塌缩),也没有任何机制让模型说出「这一帧我看不清」。在观测几乎完全决定状态的任务(比如固定视角、无遮挡、动作缓慢)里它工作得很好,也确实是最容易实现的版本;一旦有真正的部分可观测性,实践中的主流方法都会换成随机编码器或更复杂的滤波/平滑后验。
加上奖励模型,得到完整目标
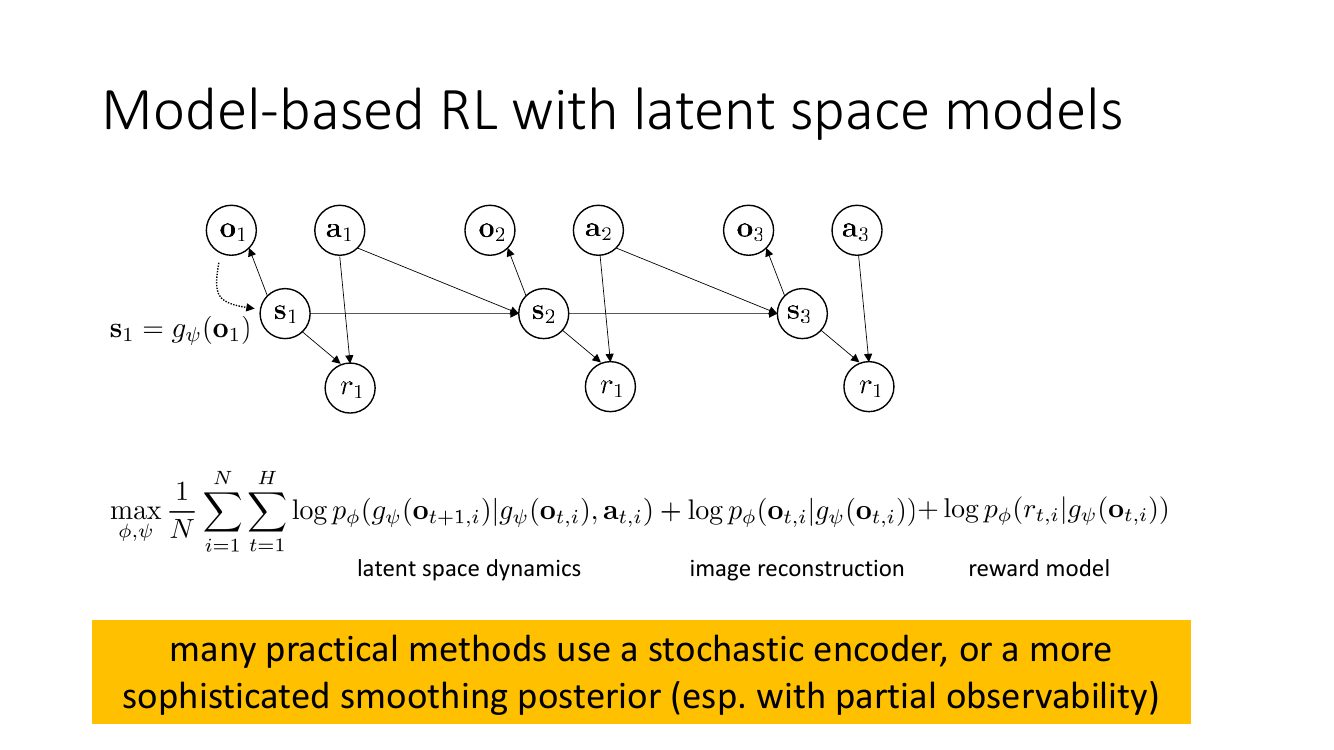
奖励模型不可或缺:规划器必须能对模型幻想出来的潜在状态求奖励,而我们手上没有那些状态对应的真实奖励值。
装进 MPC 循环
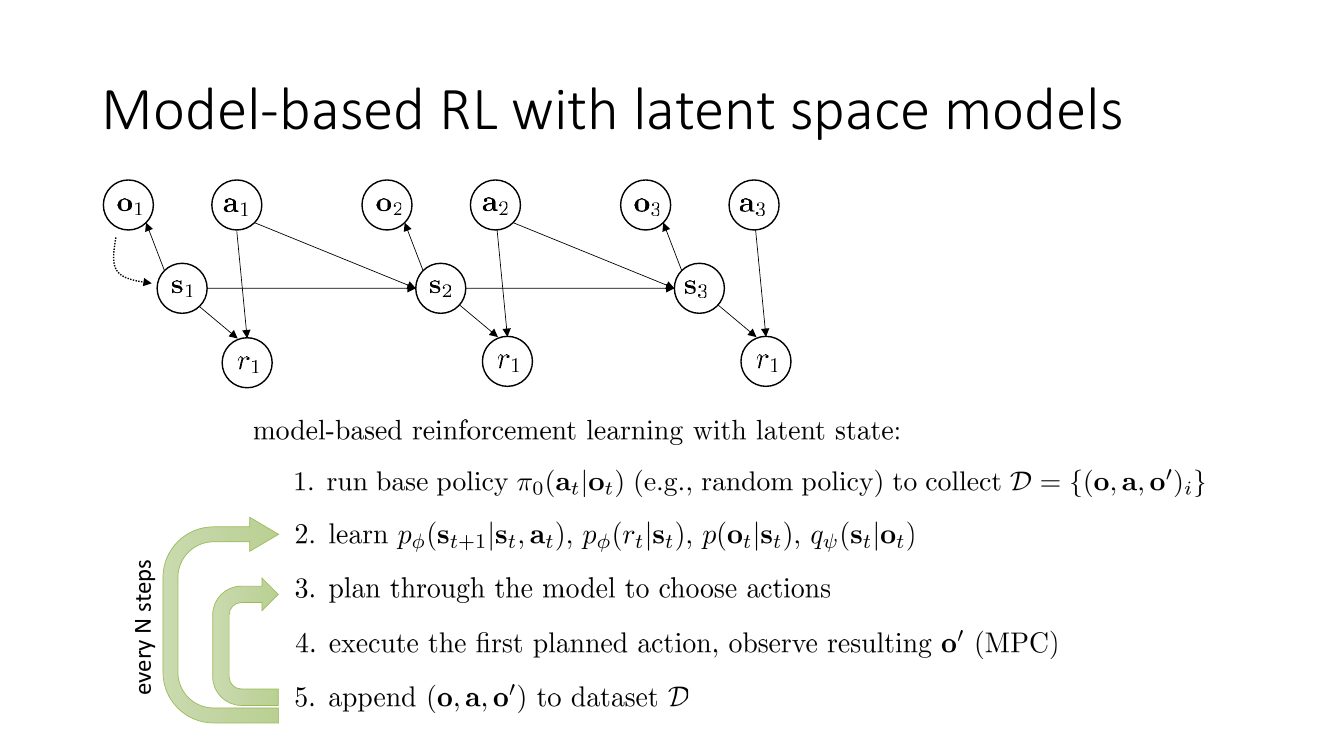
关键在第 ③ 步:规划整个发生在低维潜在空间里。CEM 采样的是动作序列,rollout 用的是 $p_\phi(\mathbf{s}_{t+1}|\mathbf{s}_t,\mathbf{a}_t)$,奖励用的是 $p_\phi(r_t|\mathbf{s}_t)$——从头到尾都不需要解码出图像。解码器只在训练时起作用(提供重建损失这个学习信号),推理时可以完全不用。这就把第 4 节说的「维度上限」问题绕过去了:动作维度不变,状态维度从 $12288$ 降到几十。PlaNet 就是这个算法的一个完整实现。
图像重建损失有个众所周知的毛病:它按像素面积分配注意力,而不是按任务相关性。画面里那面占了半屏的墙比那个 5 像素的小球贡献大得多的重建损失,于是潜在状态会优先编码墙的纹理,而把决定成败的小球位置当成噪声丢掉。缓解手段包括:加大奖励模型损失的权重、用对比学习目标替代重建、或者干脆彻底丢掉重建项只保留「动力学 + 奖励 + 值函数」的一致性(TD-MPC 一类的做法)。这不是本讲的内容,但在实践中往往是成败的分水岭。
12. 表征学习 + actor-critic:把三条线合起来
最后一步升级:MPC 每步重规划太贵,而且第 5 节说过它处理不了长期承诺。既然我们已经有了一个能把图像编码成低维状态的编码器 $q_\psi$,为什么不直接在这个潜在空间里跑一个标准的 actor-critic?
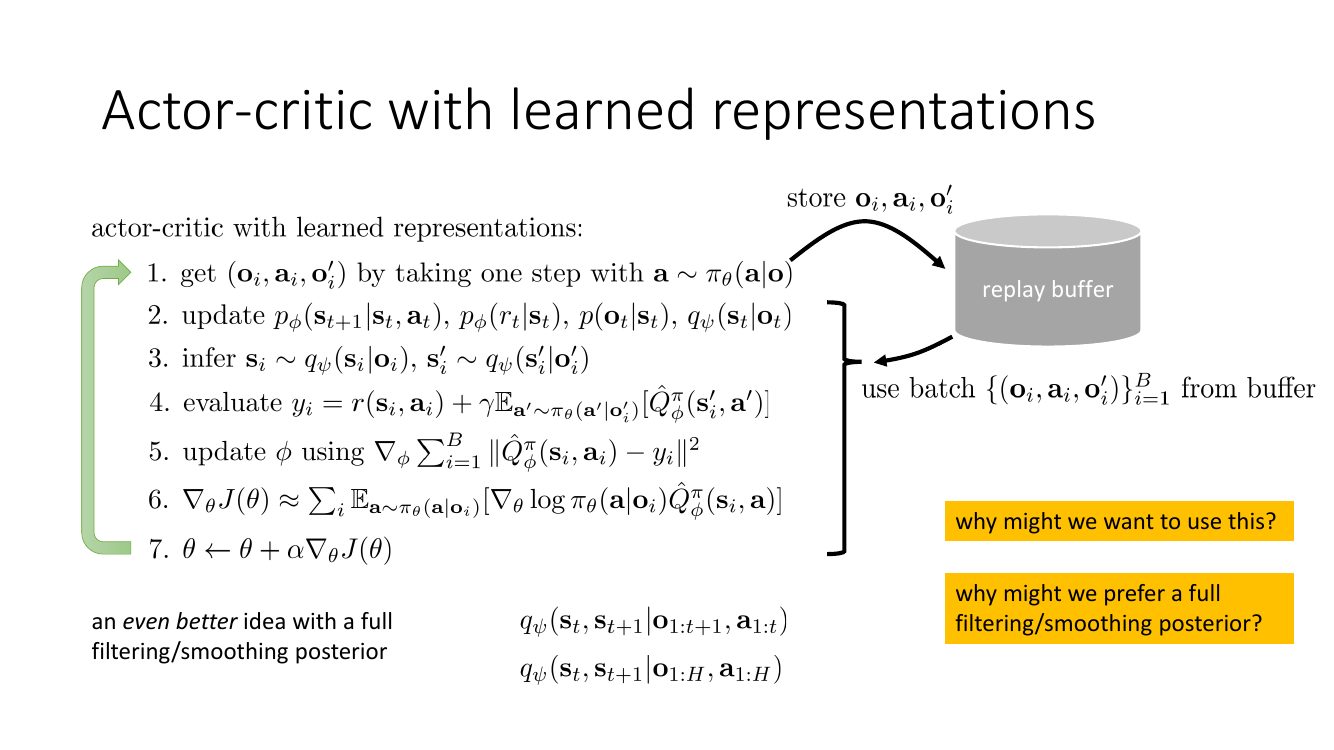
为什么我们会想用这个?注意这个算法里模型根本没有被用来生成数据——第 ④⑤⑥ 步用的全是真实转移。模型(准确说是表征学习目标)唯一的作用是给编码器提供一个额外的、密集的训练信号。从像素直接学 Q 函数时,唯一的学习信号是稀疏的奖励,卷积编码器要靠这点信号从零学出视觉表征,极其低效;而「预测下一帧、预测奖励、预测潜在动力学」这些自监督任务提供的梯度密集得多。这就是表征学习作为辅助任务的思路,也是本节标题里「learned representations」的含义。
为什么偏好完整的滤波/平滑后验?因为 Q 函数和策略都定义在 $\mathbf{s}$ 上,$\mathbf{s}$ 必须是马尔可夫的才能让 Bellman 方程成立。如果 $\mathbf{s}_i$ 只来自单帧 $\mathbf{o}_i$,那它可能不含速度,$Q(\mathbf{s},\mathbf{a})$ 就是在一个非马尔可夫的表征上做自举,收敛性质完全没有保证。用 $q_\psi(\mathbf{s}_t,\mathbf{s}_{t+1}|\mathbf{o}_{1:t+1},\mathbf{a}_{1:t})$ 这类滤波后验,$\mathbf{s}_t$ 汇总了整段历史,才更接近真正的马尔可夫状态。
最后一步:把 Dyna 加回来
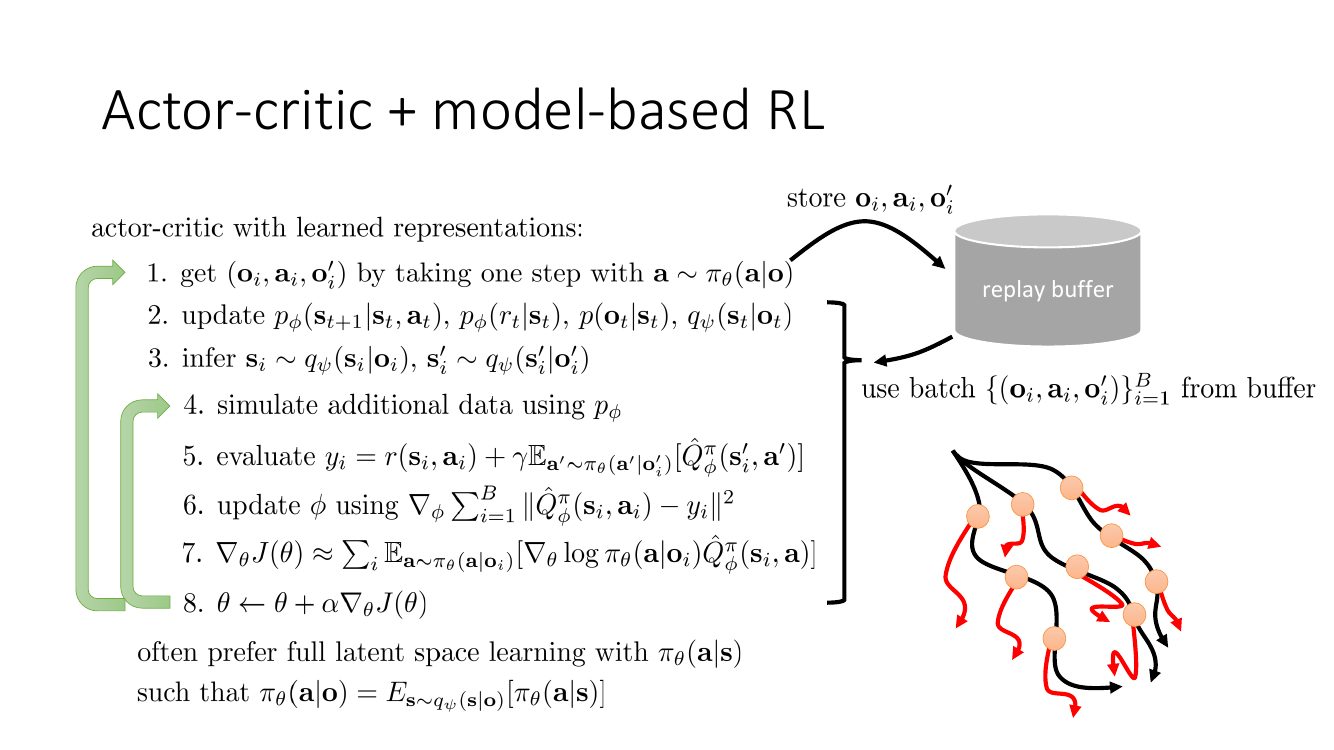
这一步把本讲的三条线全部合流了:Part 3 的潜在空间模型提供了低维马尔可夫表征,Part 2 的 Dyna 风格短 rollout 在这个表征里生成廉价数据,无模型 actor-critic 消化这些数据。Dreamer 系列正是这个结构的完整工程实现——它在潜在空间里做长达十几步的「想象」rollout,并用 pathwise 梯度(因为潜在动力学是自己学的、可微且被正则化得相当光滑,第 8 节的雅可比问题在这里没那么致命)反传训练演员。
$\pi_\theta(\mathbf{a}|\mathbf{o})=\E_{\mathbf{s}\sim q_\psi(\mathbf{s}|\mathbf{o})}[\pi_\theta(\mathbf{a}|\mathbf{s})]$ 这个式子也值得多看一眼:它说策略本质上只依赖潜在状态,面对观测时只需先编码、再决策。好处是策略和模型共享同一套表征,模型内的想象 rollout 里策略可以直接作用于 $\mathbf{s}$,不需要每步都解码出图像再编码回去——那样会慢得离谱,也会引入解码器的误差。
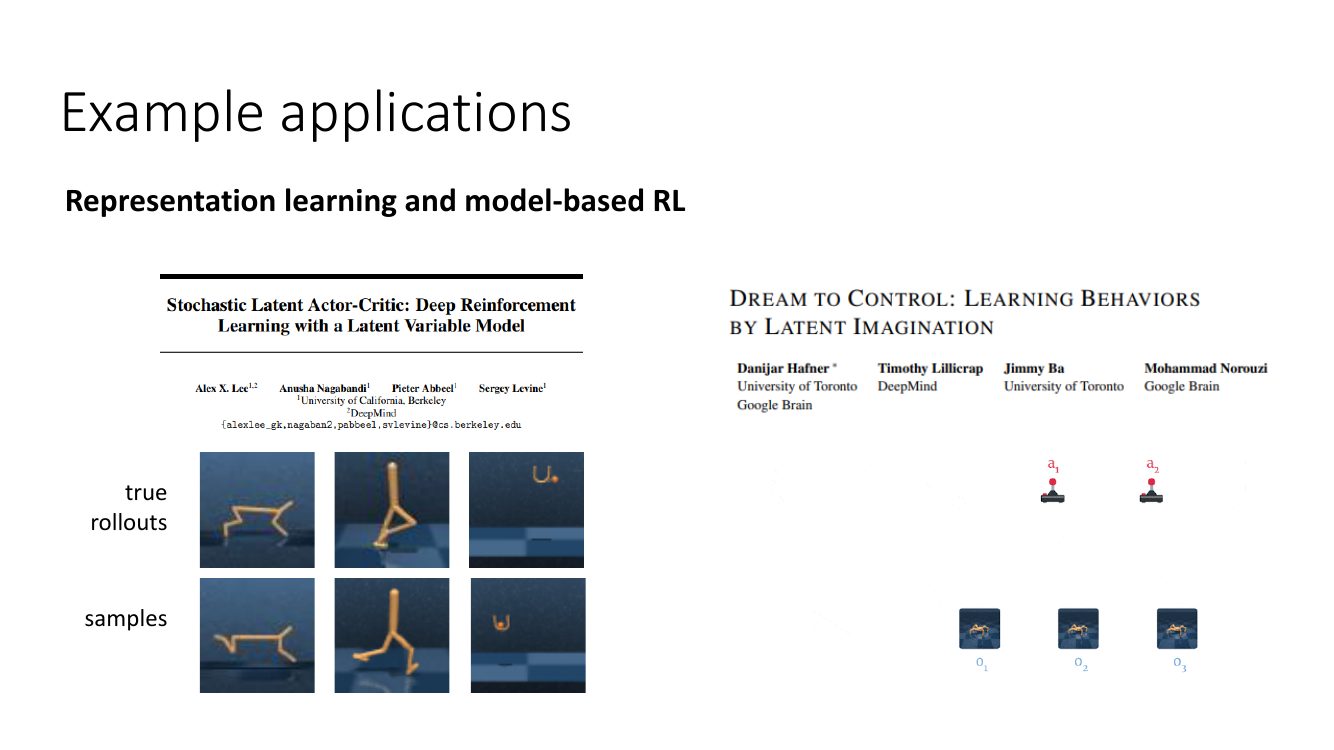
从像素做模型基 RL 的现代配方基本定型为四件事:(1)用序列 VAE 学一个低维潜在状态空间,同时训练观测、动力学、奖励三个头;(2)编码器至少是滤波级别的(RNN 或多帧堆叠),保证潜在状态近似马尔可夫;(3)在潜在空间里做短的想象 rollout,训练 actor-critic 或做 MPC;(4)永远保留一部分真实数据参与训练,并持续用新数据更新模型。SLAC、PlaNet、Dreamer、TD-MPC 都是这个模板的不同实例,差别只在于第 (3) 步用规划还是用 actor-critic、以及第 (1) 步要不要保留重建损失。
本讲小结
一页速查表:
| 问题 | 症状 | 解法 | 出现在 |
|---|---|---|---|
| 分布漂移 | 规划器把你带到模型没见过的状态 | 执行后回收数据(版本 1.0) | 第 1 节 |
| 整条计划才更新一次 | 模型骗你走向悬崖,来不及纠正 | MPC 每步重规划(版本 1.5) | 第 5 节 |
| 随机环境下开环次优 | 动作在看到状态前就定死 | 闭环策略,或 MPC 近似闭环 | 第 3 节 |
| 规划维度上限 | random shooting 命中概率 $q^{d}$ 指数衰减 | CEM / CMA-ES;短时域 + 值函数截断 | 第 4、5 节 |
| model exploitation | $\argmax$ 专挑模型高估的地方,$\E[\max\delta]\approx\sigma\sqrt{2\ln N}$ | 集成 + 对回报取平均 | 第 6 节 |
| 反传梯度爆炸/消失 | $H$ 个雅可比连乘,$\lambda^{H}$ | 改用策略梯度(版本 2.5) | 第 8 节 |
| 长 rollout 误差累积 | $\mathcal{O}(\epsilon H^2)$,混沌时指数 | 短分支 rollout + off-policy RL(版本 3.0) | 第 9、10 节 |
| Q 被模型误差污染 | 自举把错误循环放大 | 短 $k$、真假数据混合、集成不确定性加权(STEVE) | 第 10 节 |
| 图像观测 | 像素高维、非马尔可夫、无法规划 | 潜在空间模型(ELBO:动力学 + 重建 + 奖励 + 熵) | 第 11 节 |
| 稀疏奖励下表征学不出来 | 卷积编码器缺少学习信号 | 模型学习作为辅助任务喂给 actor-critic | 第 12 节 |
要点清单
- 规划 vs 学策略:规划是现场解优化问题、输出动作序列、不需训练但只能开环且维度受限;学策略是离线固化决策函数、闭环、可扩展但需要训练且会被模型误差腐蚀。MPC 是二者之间最实用的桥。
- 开环在随机环境下严格次优,两步 MDP 的例子里差了整整一倍;根源是「决策时看不到状态」,与模型准不准无关。
- random shooting 是三行代码的强 baseline;CEM 只是把采样分布也一起优化,其「重拟合精英」这一步等价于最小化 $\KL(q^\ast\|p)$,即在精英集上做 MLE。
- 不确定性只有认知不确定性有用。输出熵(偶然不确定性)在数据分布外会给出「自信的错误答案」。bootstrap 集成用 $p(\theta|\mathcal{D})\approx\frac1N\sum_i\delta(\theta-\theta_i)$ 做粒子近似,$N\lt 10$ 就够,随机初始化 + SGD 通常已经提供了足够的多样性。
- 永远先 rollout 再平均回报:$\frac1N\sum_i r(f_i(\mathbf{s},\mathbf{a}))\ne r(\frac1N\sum_i f_i(\mathbf{s},\mathbf{a}))$。反例:$r(s)=1-s^2$,两个模型分别预测 $\pm1$,平均预测给 $1$ 分,平均回报给 $0$ 分。
- 期望值不是悲观值也不是乐观值,但通常是个不错的起点;真要做离线 RL 就得显式加分歧惩罚,要做探索就得反过来加分歧奖励。
- pathwise 梯度 vs 策略梯度:前者需要模型在导数层面准确、且要连乘 $H$ 个雅可比;后者只需要模型在分布层面大致对、不含连乘。样本够多时后者往往更稳。
- $\mathcal{O}(\epsilon H^2)$ 的三步推导:一步 TV 误差 $\epsilon$ → 分布误差线性累积 $(t-1)\epsilon$ → 回报误差按 $2R_{\max}$ 换算并对 $t$ 求和。$\epsilon=0.01$、$H=100$ 时界已完全失效。
- Dyna 的三个要件:从真实 buffer 采起点、只走极短 rollout、用 off-policy 算法容忍状态分布偏差。MBPO 是它的现代实现(概率集成 + $k$ 步分支 + SAC);MVE 换了个角度,把模型用在 Bellman 目标的 $k$ 步展开上。
- 潜在空间模型 = 序列 VAE,其中先验就是我们要的动力学。目标是 ELBO:潜在动力学项 + 图像重建项 + 奖励项 + 后验熵。单步编码器最简单但丢历史信息;确定性编码器最好实现但无法表达状态不确定性。
- 规划发生在潜在空间,解码器只在训练时用;这样维度上限的问题被绕开了。
- 模型学习可以只作为表征学习的辅助任务(不生成任何数据),也可以进一步用来生成想象数据;SLAC / Dreamer / PlaNet / TD-MPC 是这条线的代表。
延伸阅读
规划与不确定性感知模型
- Deep Reinforcement Learning in a Handful of Trials using Probabilistic Dynamics Models (PETS, 2018) — 第 6、7 节代码的原型:概率集成 + CEM/MPC,并提出 TS∞ 这种「整段 rollout 固定同一个集成成员」的采样方案,是理解偶然/认知不确定性区别的最佳实操参考。
- Neural Network Dynamics for Model-Based Deep RL with Model-Free Fine-Tuning (2017) — 最干净的「学模型 + random shooting MPC」基线,并展示了用模型基结果初始化无模型算法的组合拳。
- Deep Dynamics Models for Learning Dexterous Manipulation (2019) — 本讲那个真实机器人例子的原论文,展示了这套方法在多指灵巧手上的可行性,值得看它对数据量和实时性约束的讨论。
- PILCO: A Model-Based and Data-Efficient Approach to Policy Search (Deisenroth & Rasmussen, 2011) — 用高斯过程 + 矩匹配做解析的不确定性传播,是「moment matching」路线的代表作,样本效率至今仍是标杆(代价是只能用于低维系统)。
- Weight Uncertainty in Neural Networks (Bayes by Backprop, 2015) — 贝叶斯神经网络路线的入门文献,理解 $p(\theta|\mathcal{D})\approx\prod_i\mathcal{N}(\mu_i,\sigma_i^2)$ 是怎么训出来的。
- Concrete Dropout (2017) — 用可学习的 dropout 率隐式地给出认知不确定性,工程上比完整 BNN 好落地得多。
用模型学策略、Dyna 与短 rollout
- Integrated Architectures for Learning, Planning, and Reacting Based on Approximating Dynamic Programming (Sutton, 1990) — Dyna 的原始论文,第 10 节整节的思想源头,短得可以一小时读完。
- Continuous Deep Q-Learning with Model-based Acceleration (MBA, 2016) — 把 Dyna 搬到连续控制的早期尝试,同时提出了 NAF 这个把 Q 学习用于连续动作的巧妙参数化。
- Model-Based Value Estimation for Efficient Model-Free RL (MVE, 2018) — 不生成数据,而是用模型把 Bellman 目标展开 $k$ 步,是「自举偏差 vs 模型偏差」权衡的最清晰案例。
- When to Trust Your Model: Model-Based Policy Optimization (MBPO, 2019) — 本讲版本 3.0 的标准答案。理论部分给出了 rollout 长度 $k$ 与模型误差的显式权衡界,实验部分给出了「$k$ 应该非常短」的经验证据。
- PIPP: Flexible Model-Based Policy Search Robust to the Curse of Chaos (Parmas et al., 2018) — 第 8 节「为什么反传梯度会炸」的正式分析,并给出混合 pathwise 与似然比估计量的方案。
- Aggressive Driving with Model Predictive Path Integral Control (Williams et al., 2016) — MPPI 的原始工作,是 CEM 之外另一种在真实机器人上广泛使用的采样式 MPC 求解器。
潜在空间模型与从像素学习
- Learning Latent Dynamics for Planning from Pixels (PlaNet, 2018) — 第 11 节那套算法(潜在空间模型 + 潜在空间 CEM-MPC)的完整实现,提出的 RSSM 结构(确定性 + 随机分量并存)几乎成了后续所有工作的默认骨架。
- Stochastic Latent Actor-Critic (SLAC, 2019) — 第 12 节「表征学习 + actor-critic」的代表作,模型不生成数据、只作为表征学习的辅助目标,是理解那条黄框问题「为什么我们会想用这个」的最佳材料。
- Dream to Control: Learning Behaviors by Latent Imagination (Dreamer, 2019) — 在潜在空间里做想象 rollout 并用 pathwise 梯度训练演员,把 Part 2 和 Part 3 完全合流。
- Mastering Diverse Domains through World Models (DreamerV3, 2023) — 同一套配方经过大量归一化技巧的打磨后,用一组固定超参跨越几十个差异极大的任务域,是「世界模型是否已经实用」这个问题的当前答案。
- Temporal Difference Learning for Model Predictive Control (TD-MPC, 2022) — 丢掉图像重建、只保留「动力学 + 奖励 + 值函数」的一致性目标,同时用短时域 MPC 加值函数截断,是第 5 节末尾那个「用 $V$ 截断规划时域」思想的完整实现。
- Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model (MuZero, 2019) — 离散动作下的对应物:学一个只需支持「预测奖励、值和策略」的抽象潜在模型,配 MCTS 做规划,完全不重建观测。