强化学习基础:MDP、目标函数与算法全景
这一讲不教任何一个具体算法,却是全课最重要的一讲——它把「强化学习」这四个字翻译成一个精确的数学问题,并给出后面二十讲的索引地图。
0. 本讲导读
前三讲我们一直在做模仿学习(imitation learning):给定人类专家演示 $\{(s_t^{(i)},a_t^{(i)})\}$,用最大似然把策略拟合出来,再用 DAgger 之类的手段修补分布漂移。整条路线的前提是——你手上有足够好的演示数据。可现实里这个前提经常不成立:没人能演示怎么控制一座电网,没人能演示怎么让四足机器人在冰面上跑,更没人能演示如何在围棋上超越人类。一旦没有演示,「模仿谁」这个问题就没有答案了。
本讲要做的事是换一个问题定义:不再要求「模仿某个人」,而是要求「让某个标量指标尽可能大」。这个指标就是奖励函数(reward function) $r(s,a)$。一旦有了它,学习的目标就从「像专家」变成了「拿高分」,而这正是强化学习(reinforcement learning, RL)的全部内容。
这一讲的结构可以概括成五个递进的问题:
- 问题长什么样? 从马尔可夫链(Markov chain)出发,加上动作和奖励得到 MDP,再加上观测得到 POMDP。这三个定义会一直用到第 25 讲。
- 目标是什么? $\theta^\star=\argmax_\theta \E_{\tau\sim p_\theta(\tau)}\left[\sum_t r(s_t,a_t)\right]$。这个式子有两种等价写法:有限步(finite horizon)用状态-动作边缘分布 $p_\theta(s_t,a_t)$,无限步(infinite horizon)用平稳分布 $\bar\mu$。后者要用到「平稳分布是转移算子特征值为 1 的特征向量」这个线性代数事实。
- 为什么是期望? 因为奖励本身可以极度不光滑(掉下悬崖 $-1$,没掉 $+1$),但期望关于策略参数是光滑的。这是所有基于梯度的 RL 方法能成立的根本原因。
- 怎么处理这些嵌套期望? 引入 $Q^\pi(s,a)$ 和 $V^\pi(s)$——它们把「从此刻起往后所有的期望」打包成一个数,于是策略改进变成了一件局部的、可操作的事。
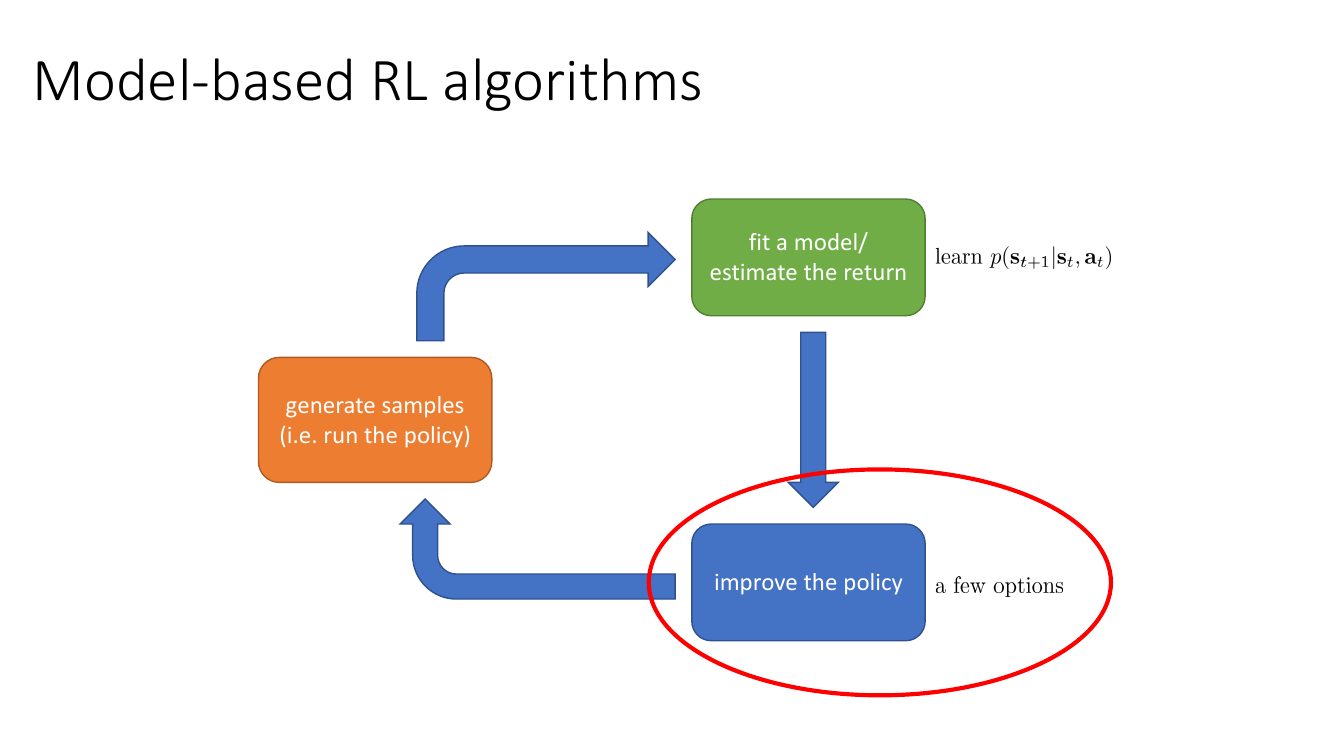
- 有哪些做法? 策略梯度、值函数方法、actor-critic、model-based,四大类算法都装在同一个「生成样本 → 拟合模型/估计回报 → 改进策略」的三步循环里,差别只在于第二、三步各自做什么。它们在采样效率、稳定性、适用假设上有截然不同的取舍。
- RL 问题 = $\mathcal{M}=\{\mathcal{S},\mathcal{A},\mathcal{T},r\}$ + 一个参数化策略 $\pi_\theta(a|s)$,目标是最大化期望累积奖励。
- 策略 $\pi_\theta$ 和转移 $\mathcal{T}$ 合起来把 MDP 变成一条关于 $(s_t,a_t)$ 增广状态的马尔可夫链,转移算子记作 $\mathcal{T}_\theta$;于是目标可写成 $\sum_t \mu_t^\top \vec r$,其中 $\mu_{t+1}=\mathcal{T}_\theta\mu_t$。
- 无限步时目标取时间平均,$\mu_t\to\bar\mu$ 满足 $\mathcal{T}_\theta\bar\mu=\bar\mu$,即 $(\mathcal{T}_\theta-I)\bar\mu=0$,$\bar\mu$ 是特征值 1 的特征向量。
- $Q^\pi(s_t,a_t)=\sum_{t'=t}^{H}\E_{\pi}[r(s_{t'},a_{t'})|s_t,a_t]$,$V^\pi(s_t)=\E_{a_t\sim\pi}[Q^\pi(s_t,a_t)]$,而 $\E_{s_1\sim p(s_1)}[V^\pi(s_1)]$ 就是 RL 目标本身。
- 所有 RL 算法都是同一个三步循环的不同实例;是否 off-policy 是决定采样效率的最重要单一因素,但采样效率 ≠ 墙钟时间(wall clock time)。
1. 从模仿学习到强化学习:奖励函数登场
先把上一讲的终点接上。模仿学习的训练目标是一个纯粹的监督学习问题:
$$ \argmax_\theta \sum_{i=1}^{N}\sum_{t=1}^{H} \log \pi_\theta\!\left(a_t^{(i)} \mid s_t^{(i)}\right) $$这里 $\pi_\theta(a_t|s_t)$ 是一个神经网络,输入状态 $s_t$(比如车载摄像头图像),输出动作 $a_t$(方向盘转角、油门)上的一个概率分布,$\theta$ 是网络权重;$N$ 条演示轨迹、每条 $H$ 步。这个目标里完全没有出现环境——它只是在拟合数据集里的条件分布。
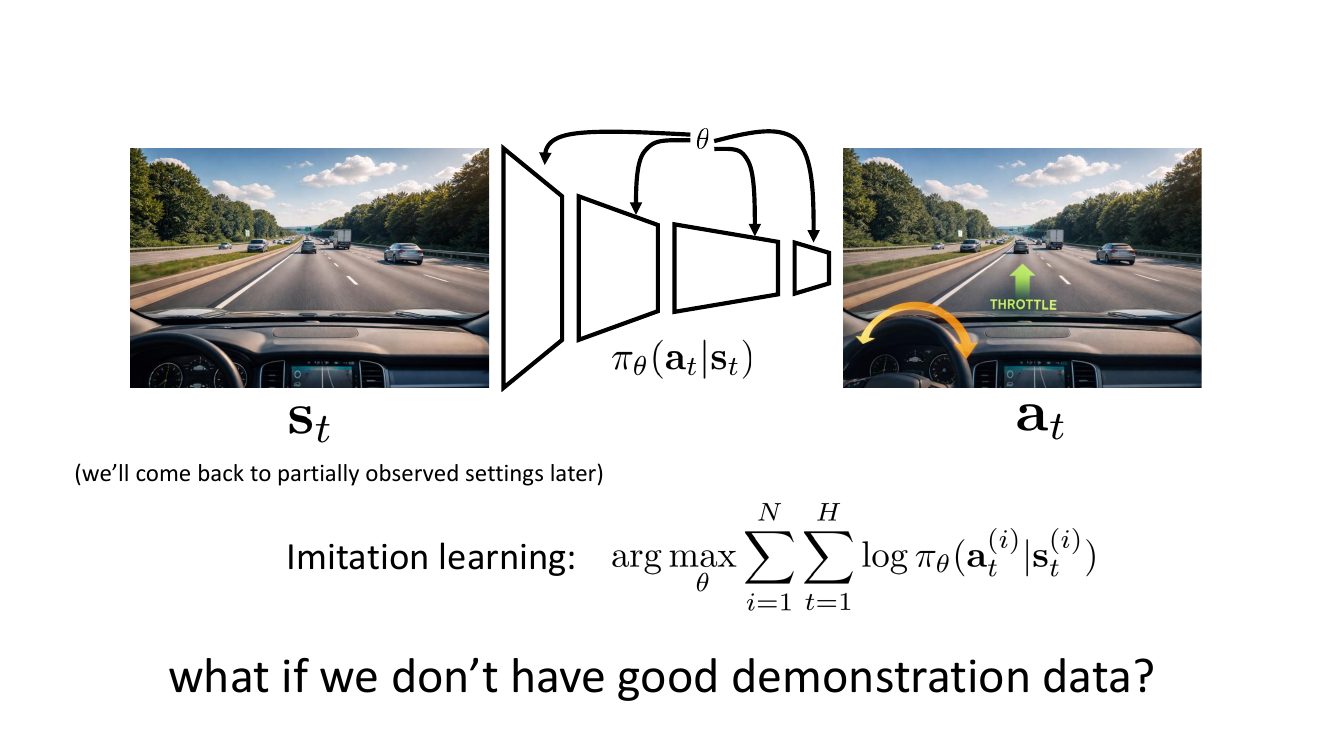
没有演示数据时,我们需要另一种方式告诉智能体「什么算好」。最直接的办法是给出一个函数,对任意状态-动作对打分:
$$ r:\mathcal{S}\times\mathcal{A}\to\R,\qquad r(s,a)\ \text{告诉我们哪些状态和动作更好} $$Levine 用开车做例子:车稳稳地在路上开是高奖励,撞到别的车是低奖励。看起来很简单,但立刻有一个关键的、贯穿整个 RL 的观察:
只优化当下这一步的奖励是完全没用的。等到你「马上要撞上别人」的那一刻,$r$ 才变成很低,可这时候方向盘已经救不回来了——by the time you're about to hit someone, it's too late。真正需要优化的是长期奖励:从现在起,未来所有时刻奖励之和的期望。
这句话是 RL 与监督学习最本质的分野。监督学习里每个样本的损失是独立的、当下就能算清的;RL 里当下这一步动作的「好坏」取决于它把你带到什么状态、以及在那个状态上你还能拿多少分。这种时序信用分配(temporal credit assignment)问题,正是后面所有值函数、Bellman 方程、TD 学习存在的理由。
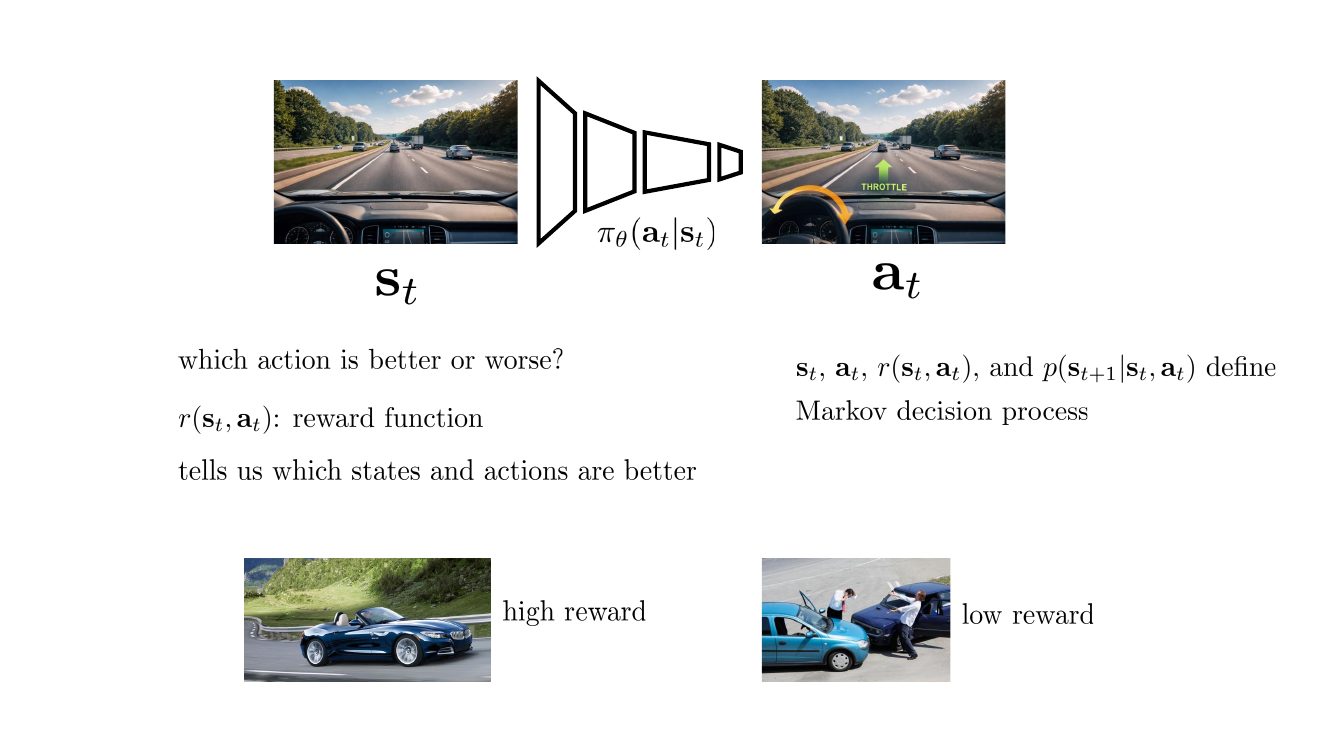
「奖励函数是给定的」这个假设在本讲成立,但它其实是深度 RL 落地时最大的痛点之一。真实任务里写出一个既能表达意图、又不会被智能体钻空子(reward hacking)的 $r$ 极其困难。后面的课程会讲两条出路:逆强化学习(inverse RL)——从演示里把 $r$ 反推出来;以及基于人类偏好的奖励建模。本讲暂且把 $r$ 当成上帝给的。
2. 马尔可夫链、MDP 与 POMDP
2.1 最基础的模型:马尔可夫链
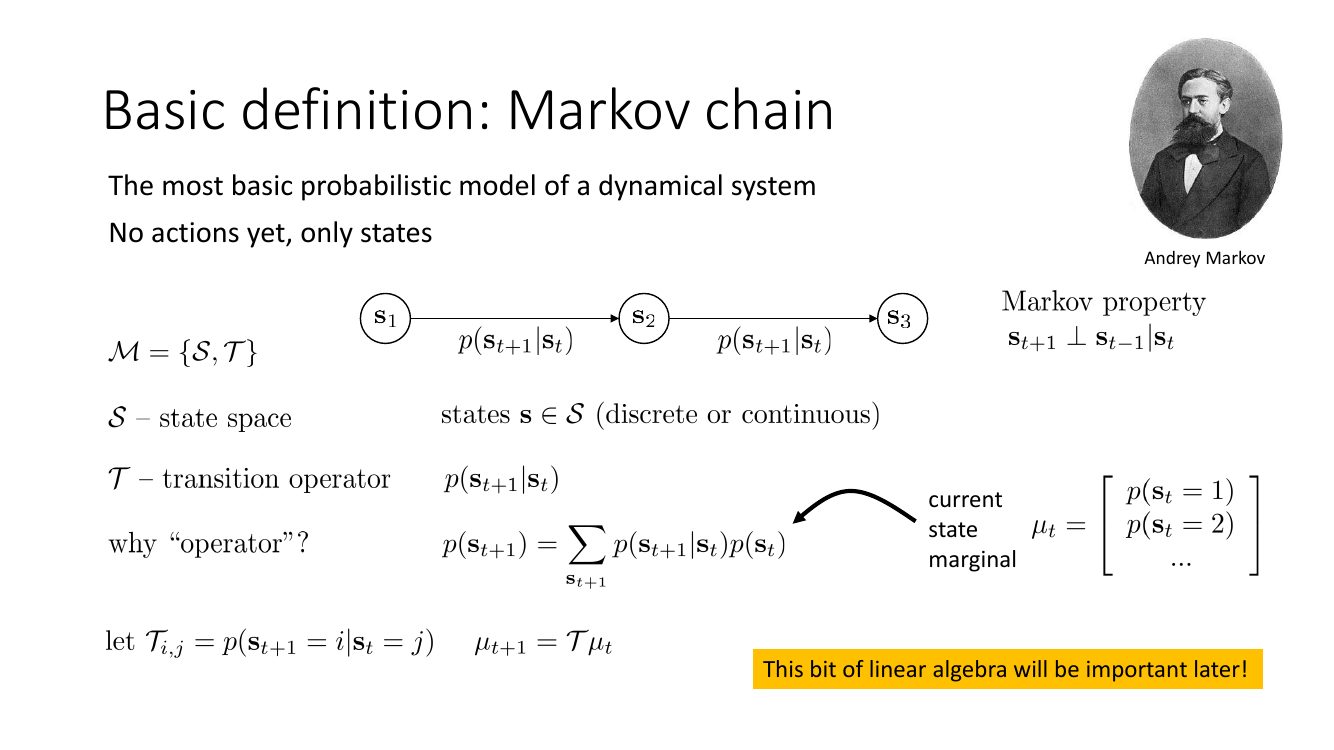
先把动作和奖励都扔掉,只看一个随机演化的动力系统。马尔可夫链定义为一个二元组
$$ \mathcal{M}=\{\mathcal{S},\mathcal{T}\} $$其中 $\mathcal{S}$ 是状态空间(state space),状态 $s\in\mathcal{S}$ 可以是离散的(比如 $\{1,2,\dots,n\}$)也可以是连续的(比如 $\R^d$);$\mathcal{T}$ 是转移算子(transition operator),也就是条件概率 $p(s_{t+1}|s_t)$。
「马尔可夫性(Markov property)」这个词的精确含义是条件独立:
$$ s_{t+1}\perp s_{t-1}\mid s_t $$读作「给定当前状态 $s_t$,下一个状态 $s_{t+1}$ 与过去的状态 $s_{t-1}$ 条件独立」。直觉上就是:当前状态包含了预测未来所需的全部信息,历史是多余的。 这不是对世界的描述,而是对「状态」这个词的定义——如果某个量不满足这条性质,它就不配叫状态。
2.2 为什么叫「算子」
这是学生常问的一个问题:$p(s_{t+1}|s_t)$ 明明是个条件概率,为什么要叫「算子」?答案在于我们关心的其实不是单条轨迹,而是分布的演化。边缘化掉 $s_t$:
$$ p(s_{t+1})=\sum_{s_t} p(s_{t+1}\mid s_t)\,p(s_t) $$把 $p(s_t)$ 看成一个概率向量(状态数为 $n$ 时它是 $n$ 维的、非负的、和为 1 的向量),记作
$$ \mu_t=\begin{bmatrix} p(s_t=1)\\ p(s_t=2)\\ \vdots \end{bmatrix},\qquad \mathcal{T}_{i,j}=p(s_{t+1}=i\mid s_t=j) $$那么上面那个求和恰好就是矩阵乘向量:
$$ \mu_{t+1}=\mathcal{T}\mu_t $$所以 $\mathcal{T}$ 是一个作用在「分布空间」上的线性算子。这个线性性质极其重要:虽然每条轨迹的演化是随机的、非线性的,但分布的演化永远是线性的。它意味着 $\mu_t=\mathcal{T}^{t-1}\mu_1$,也意味着我们可以用特征值/特征向量这套工具来分析长期行为。
举个两状态的具体例子。设 $\mathcal{S}=\{\text{晴},\text{雨}\}$,$\mathcal{T}=\begin{bmatrix}0.9 & 0.5\\ 0.1 & 0.5\end{bmatrix}$(列是「今天」,行是「明天」:晴天后 90% 还是晴,雨天后 50% 转晴)。若今天必定是晴,$\mu_1=[1,0]^\top$,则 $\mu_2=[0.9,0.1]^\top$,$\mu_3=[0.86,0.14]^\top$,$\mu_4=[0.844,0.156]^\top$……很快收敛到 $\bar\mu=[5/6,1/6]^\top\approx[0.833,0.167]^\top$。验证一下:$0.9\times\frac56+0.5\times\frac16=\frac{0.75+0.0833}{1}=0.8333$ ✓。这个 $\bar\mu$ 就是平稳分布,也就是 $\mathcal{T}$ 特征值为 1 的特征向量。第 4 节会正式用到它。
2.3 加上动作:马尔可夫决策过程
马尔可夫链里没有「选择」,系统自己演化,我们只能围观。把动作加进去,就得到了 Bellman 在 1950 年代形式化的马尔可夫决策过程(Markov Decision Process, MDP):
$$ \mathcal{M}=\{\mathcal{S},\mathcal{A},\mathcal{T},r\} $$- $\mathcal{S}$:状态空间,$s\in\mathcal{S}$;
- $\mathcal{A}$:动作空间(action space),$a\in\mathcal{A}$,同样可离散可连续;
- $\mathcal{T}$:转移算子,现在是 $p(s_{t+1}|s_t,a_t)$——注意它现在依赖于动作,所以严格说它是一个三阶张量 $\mathcal{T}_{i,j,k}=p(s_{t+1}=i|s_t=j,a_t=k)$;
- $r:\mathcal{S}\times\mathcal{A}\to\R$:奖励函数。
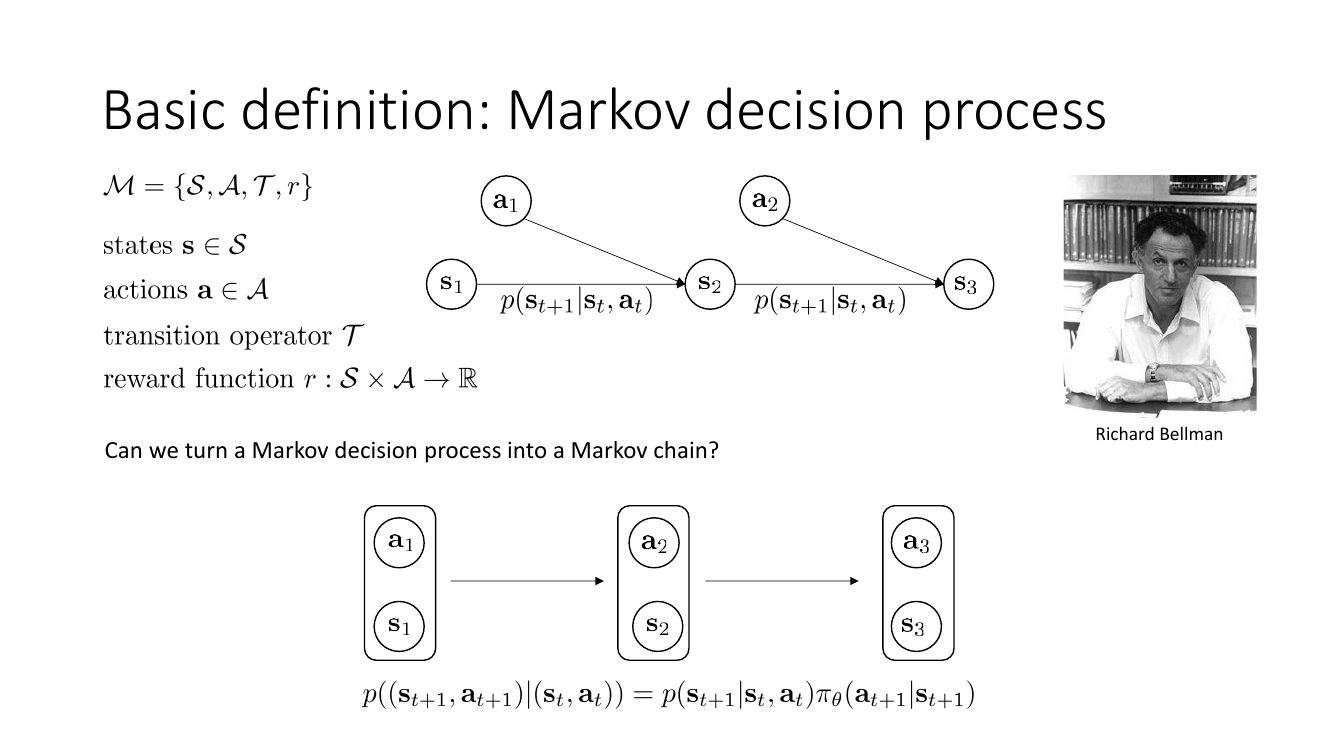
MDP 本身不是马尔可夫链,因为动作还没确定。但一旦固定一个策略 $\pi_\theta(a|s)$,MDP 就退化成一条关于增广状态 $(s,a)$ 的马尔可夫链,其转移算子为
$$ \mathcal{T}_{\theta}:\quad p\big((s_{t+1},a_{t+1})\mid (s_t,a_t)\big)=p(s_{t+1}\mid s_t,a_t)\,\pi_\theta(a_{t+1}\mid s_{t+1}) $$这一步转换是本讲后面所有线性代数推导的基础:它让我们可以把「策略的好坏」写成一个矩阵幂级数作用在初始分布上再和奖励向量做内积。
2.4 加上观测:部分可观测 MDP
现实中智能体往往看不到真实状态。摄像头拍到的是像素,不是「前车的速度和距离」。这就是部分可观测马尔可夫决策过程(Partially Observed Markov Decision Process, POMDP),它是一个六元组:
$$ \mathcal{M}=\{\mathcal{S},\mathcal{A},\mathcal{O},\mathcal{T},\mathcal{E},r\} $$新增的两样东西是:观测空间(observation space) $\mathcal{O}$,观测 $o\in\mathcal{O}$;以及发射算子(emission operator) $\mathcal{E}$,即 $p(o_t|s_t)$。注意奖励函数仍然定义在真实状态上,$r:\mathcal{S}\times\mathcal{A}\to\R$。
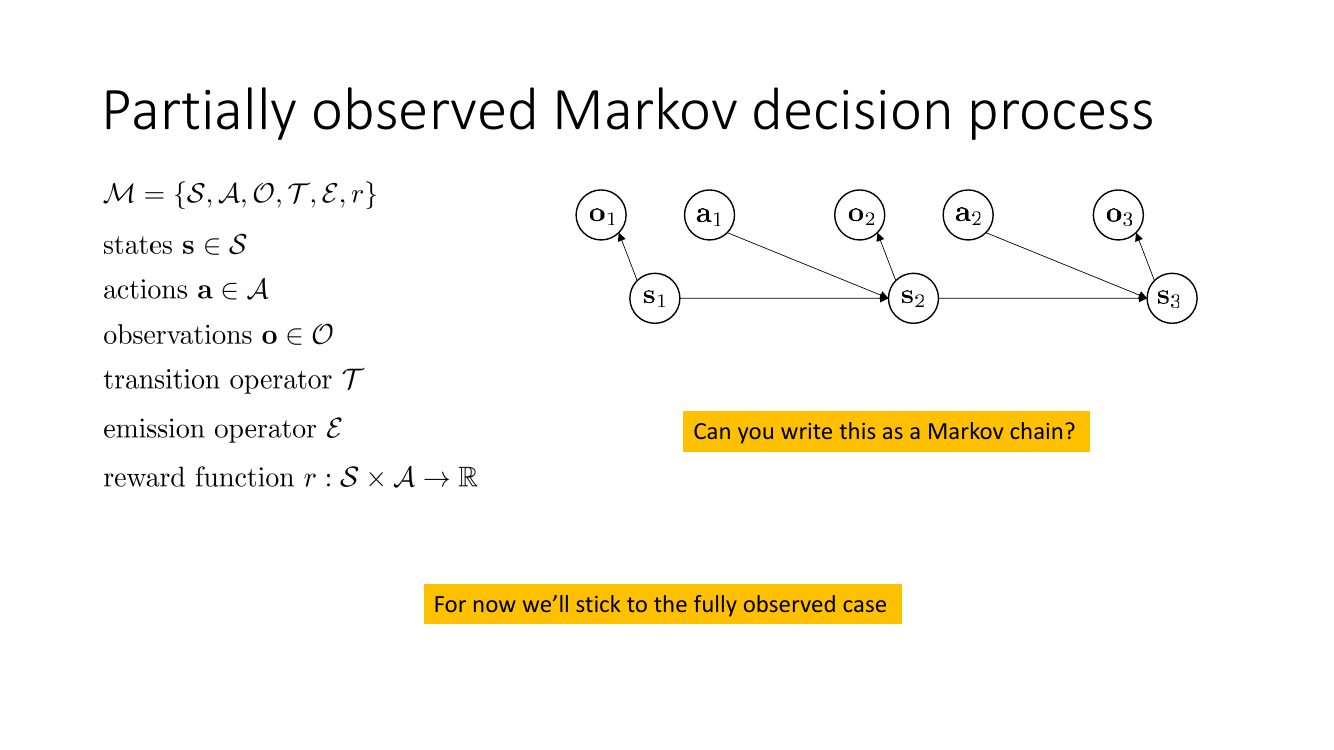
幻灯片上的提问「能把它写成马尔可夫链吗?」值得认真回答,因为答案揭示了 POMDP 为什么难:
观测层面不行。 若只看 $o_1,o_2,\dots$,则 $o_{t+1}\not\perp o_{t-1}\mid o_t$。举个极端例子:状态是机器人的位置,观测是一张有遮挡的图片。看到 $o_t$ 是一堵白墙,你不知道自己在哪;但如果你还记得 $o_{t-1}$ 是走廊尽头,你就能定位。历史含有信息 ⟹ 马尔可夫性破坏。
信念状态层面可以。 定义信念状态(belief state) $b_t = p(s_t\mid o_{1:t},a_{1:t-1})$,它是 $\mathcal{S}$ 上的一个概率分布。由贝叶斯滤波,$b_{t+1}$ 只由 $b_t,a_t,o_{t+1}$ 决定:
$$ b_{t+1}(s')\ \propto\ p(o_{t+1}\mid s')\sum_{s} p(s'\mid s,a_t)\,b_t(s) $$所以 $(b_t)$ 构成一条马尔可夫链,POMDP 等价于一个定义在信念空间上的 MDP。代价是:信念空间是原状态空间上的概率单纯形,即使 $|\mathcal{S}|=10$,信念状态也是一个 9 维连续向量;$|\mathcal{S}|$ 一大就彻底不可解。
Levine 的实际建议是:先把全部精力放在完全可观测的情形上。深度 RL 实践中处理部分可观测的常见做法不是精确的信念状态,而是「把最近 $k$ 帧堆叠起来当状态」(DQN 在 Atari 上叠 4 帧就是这么干的),或者用一个循环网络/Transformer 把历史压成隐藏向量。这些都是信念状态的粗糙近似,但工程上够用。第 20 讲左右会专门回来讲这件事。
很多教材把 $s$ 和 $o$ 混着写,在完全可观测时这没问题($o_t=s_t$)。但要记住:凡是本课写 $\pi_\theta(a_t|s_t)$ 的地方,都隐含假设了马尔可夫性成立;写 $\pi_\theta(a_t|o_t)$ 时则不然。后面讲策略梯度时会看到,很多算法(比如策略梯度)即使把 $s$ 换成 $o$ 也仍然有效,因为它们的推导没用到马尔可夫性;而值函数类方法(Q-learning、TD)严重依赖马尔可夫性,换成 $o$ 就会出问题。这个区别在第 5 讲末尾会再强调一次。
3. 轨迹分布与 RL 的目标函数
3.1 策略与环境闭环产生的分布
把神经网络策略 $\pi_\theta(a|s)$ 和环境 $p(s'|s,a)$ 接成闭环:状态进网络,网络出动作,动作交给世界,世界返回新状态。反复 $H$ 步,就得到一条轨迹(trajectory) $\tau=(s_1,a_1,s_2,a_2,\dots,s_H,a_H)$。这条轨迹是随机的,它服从的分布叫轨迹分布(trajectory distribution):
$$ p_\theta(\tau)=p_\theta(s_1,a_1,\dots,s_H,a_H)=p(s_1)\prod_{t=1}^{H}\pi_\theta(a_t\mid s_t)\,p(s_{t+1}\mid s_t,a_t) $$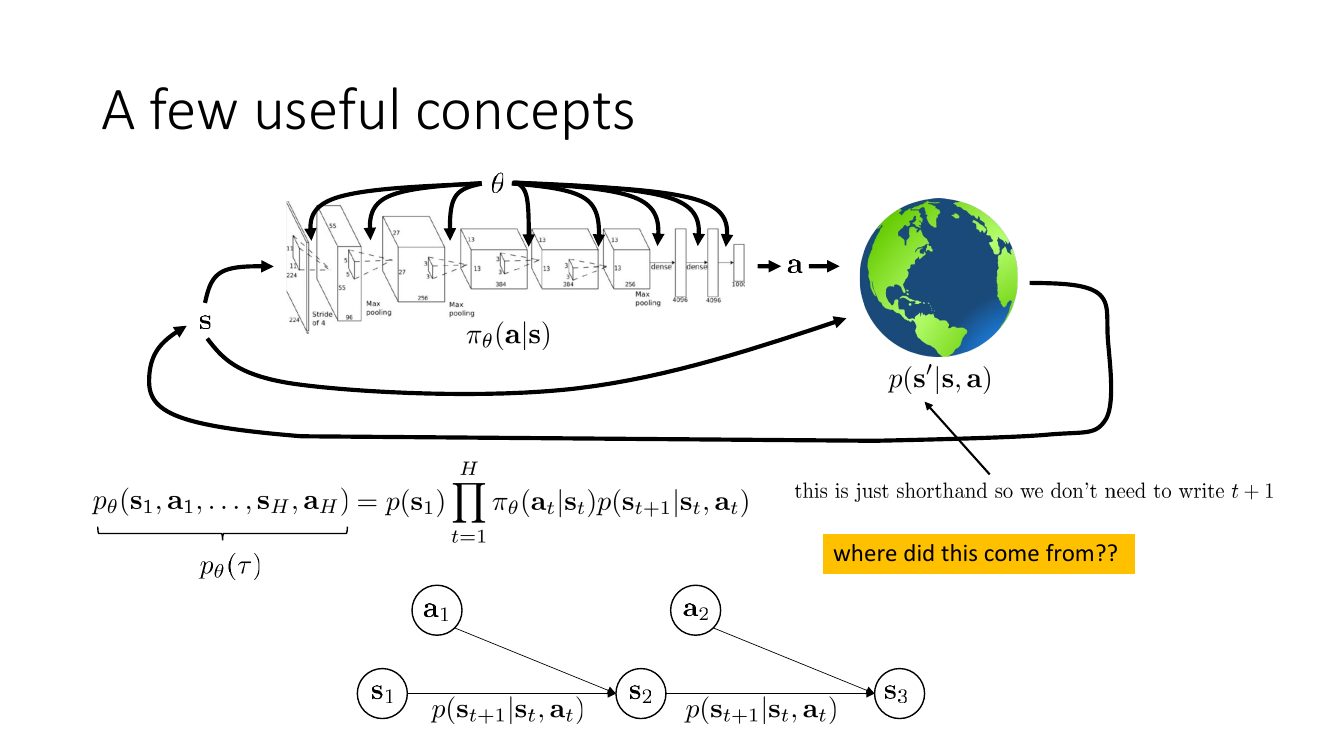
幻灯片上问「这个式子是哪来的?」。它就是概率链式法则 + 两条条件独立假设。链式法则给出
$$ p(s_1,a_1,s_2,a_2,\dots)=p(s_1)\,p(a_1|s_1)\,p(s_2|s_1,a_1)\,p(a_2|s_1,a_1,s_2)\,p(s_3|s_1,a_1,s_2,a_2)\cdots $$这一步是恒等式,任何联合分布都能这么写。然后代入两条假设:
- 策略是马尔可夫的且平稳的:$p(a_t|s_{1:t},a_{1:t-1})=\pi_\theta(a_t|s_t)$,即选动作只看当前状态,且各时刻用同一套参数 $\theta$;
- 环境是马尔可夫的:$p(s_{t+1}|s_{1:t},a_{1:t})=p(s_{t+1}|s_t,a_t)$。
代进去就得到了那个连乘。注意下标 $\theta$ 只出现在 $\pi$ 上——环境的 $p(s_1)$ 和 $p(s_{t+1}|s_t,a_t)$ 与我们的参数无关,这一点在第 5 讲推导策略梯度时会成为关键(它们求导后消失)。
3.2 状态边缘分布
有时候我们只关心「第 $t$ 步时智能体在哪」,而不关心它是怎么走过来的。这就是状态边缘分布(state marginal) $p_\theta(s_t)$,把轨迹分布里其余变量全部积掉:
$$ p_\theta(s_t)=\sum_{a_{1:H},\,s_{1:t-1},\,s_{t+1:H}} p(s_1)\prod_{t'=1}^{t-1}\pi_\theta(a_{t'}|s_{t'})\,p(s_{t'+1}|s_{t'},a_{t'}) $$幻灯片上做了一步化简:由于 $t$ 之后的变量在被积掉之后概率之和为 1,它们对 $p_\theta(s_t)$ 没有贡献,于是可以直接砍掉:
$$ p_\theta(s_t)=\sum_{a_{1:t-1},\,s_{1:t-1}} p(s_1)\prod_{t'=1}^{t-1}\pi_\theta(a_{t'}|s_{t'})\,p(s_{t'+1}|s_{t'},a_{t'}) $$这个「未来不影响现在」的因果性质看似平凡,但它是后面 reward-to-go 技巧的同一个数学事实的另一面。
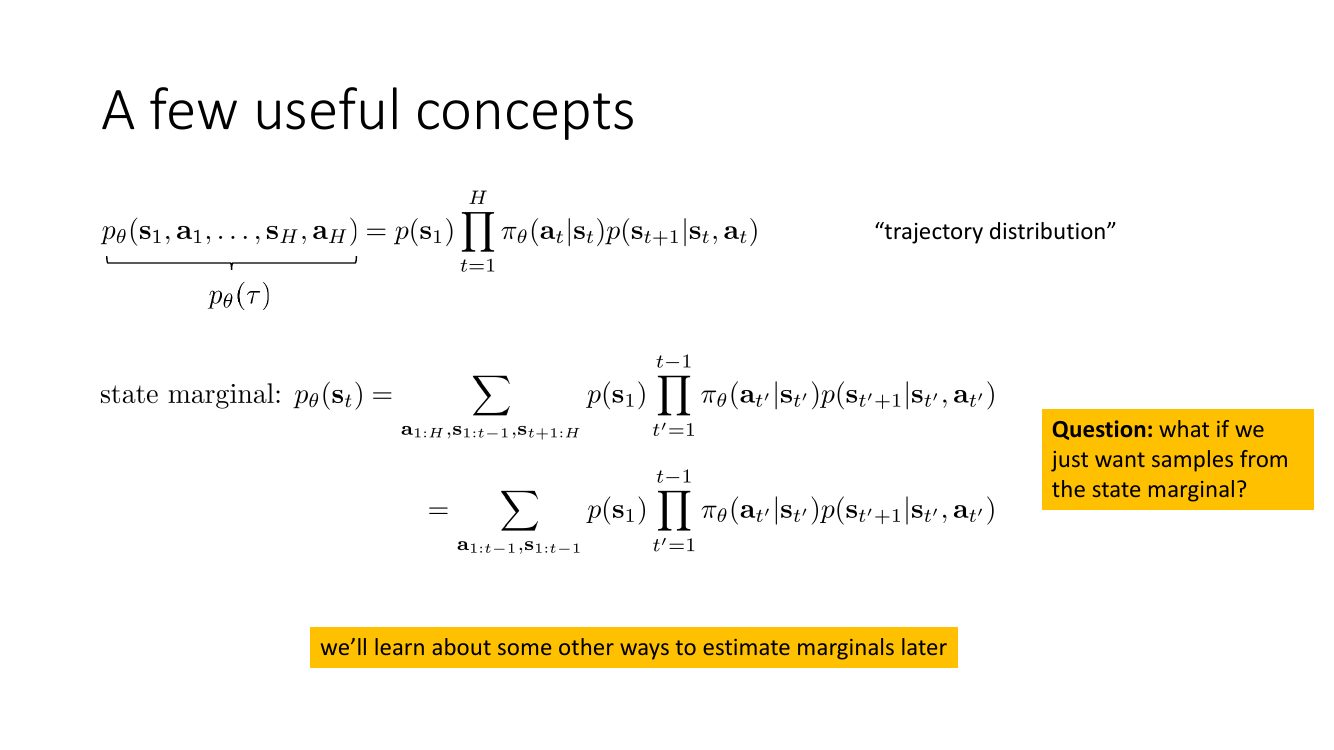
那个提问的答案是:直接跑策略,跑到第 $t$ 步,把 $s_t$ 记下来就行了。 你完全不需要显式计算那个巨大的求和。这就是蒙特卡洛方法的全部精髓——采样比求和容易得多。整个 RL 领域几乎所有算法都建立在这个观察之上:我们从来不去算那些高维积分,我们只是运行策略、收集样本、用样本均值近似期望。至于那些既不想跑完整策略、又想估计边缘分布的场合(比如离线 RL 里估计状态分布偏移),课程后面会讲一些别的估计手段。
3.3 目标函数
现在可以写出强化学习的目标了。我们要找一组参数 $\theta$,使得按 $p_\theta(\tau)$ 采样出来的轨迹,其累积奖励的期望最大:
$$ \theta^\star=\argmax_\theta\ \E_{\tau\sim p_\theta(\tau)}\!\left[\sum_{t=1}^{H} r(s_t,a_t)\right] $$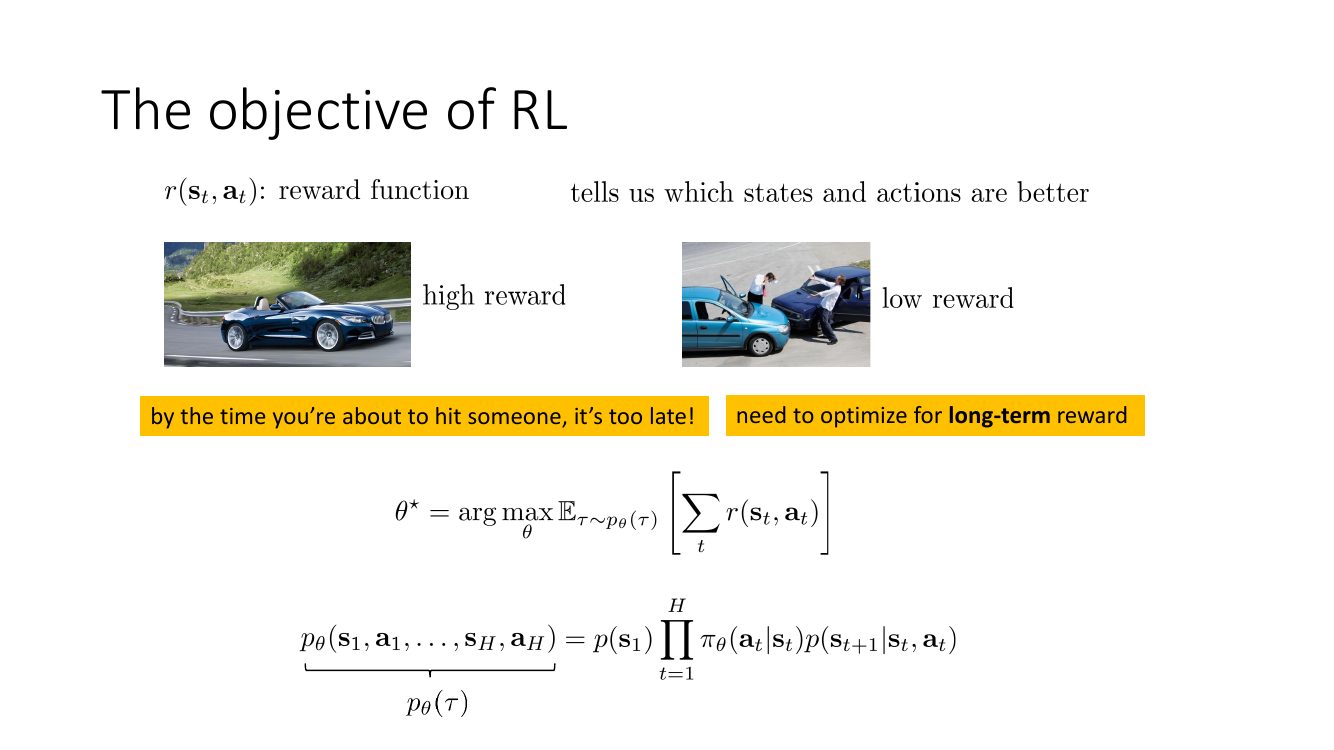
把这个式子拆开来看,有三处值得注意:
- $\theta$ 在哪? 不在被求期望的函数 $\sum_t r(s_t,a_t)$ 里——奖励函数是环境给的,跟 $\theta$ 无关;$\theta$ 在分布 $p_\theta(\tau)$ 里。所以这不是一个普通的「$\min_\theta f_\theta(x)$」型优化,求导需要特殊技巧(log-derivative trick),这是下一讲的主题。
- 期望里有未知量。 $p_\theta(\tau)$ 含有环境转移 $p(s_{t+1}|s_t,a_t)$,我们通常不知道它的解析形式。但我们能从中采样(跑策略就行)。「可采样但不可求值」是 RL 与一般随机优化的核心差异。
- 求和上限 $H$。 $H$ 有限叫 finite-horizon(episodic,回合制),比如一局游戏;$H=\infty$ 叫 infinite-horizon(continuing,持续任务),比如控制一座工厂。两者的目标写法不同,下一节专门处理。
初学者常把 RL 目标理解成「找到一条最好的轨迹」。不是的。目标是找到一个策略,使其产生的轨迹分布的期望回报最高。在随机环境里,即使是最优策略也可能撞上一条倒霉轨迹;反过来,一个糟糕的策略也可能撞大运。评价策略的唯一标准是期望,不是某一次运行的结果。下一节会说明,这个「只看期望」的选择不仅是统计上的合理,更是让优化成为可能的技术前提。
4. 目标的两种写法:状态-动作边缘与平稳分布
4.1 有限步:换成状态-动作边缘的求和
目标里的期望是对整条轨迹取的,这看起来很吓人(轨迹空间的维度是 $H$ 乘以状态动作维度)。但因为被求期望的量是各时刻奖励之和,我们可以用期望的线性性把它拆开:
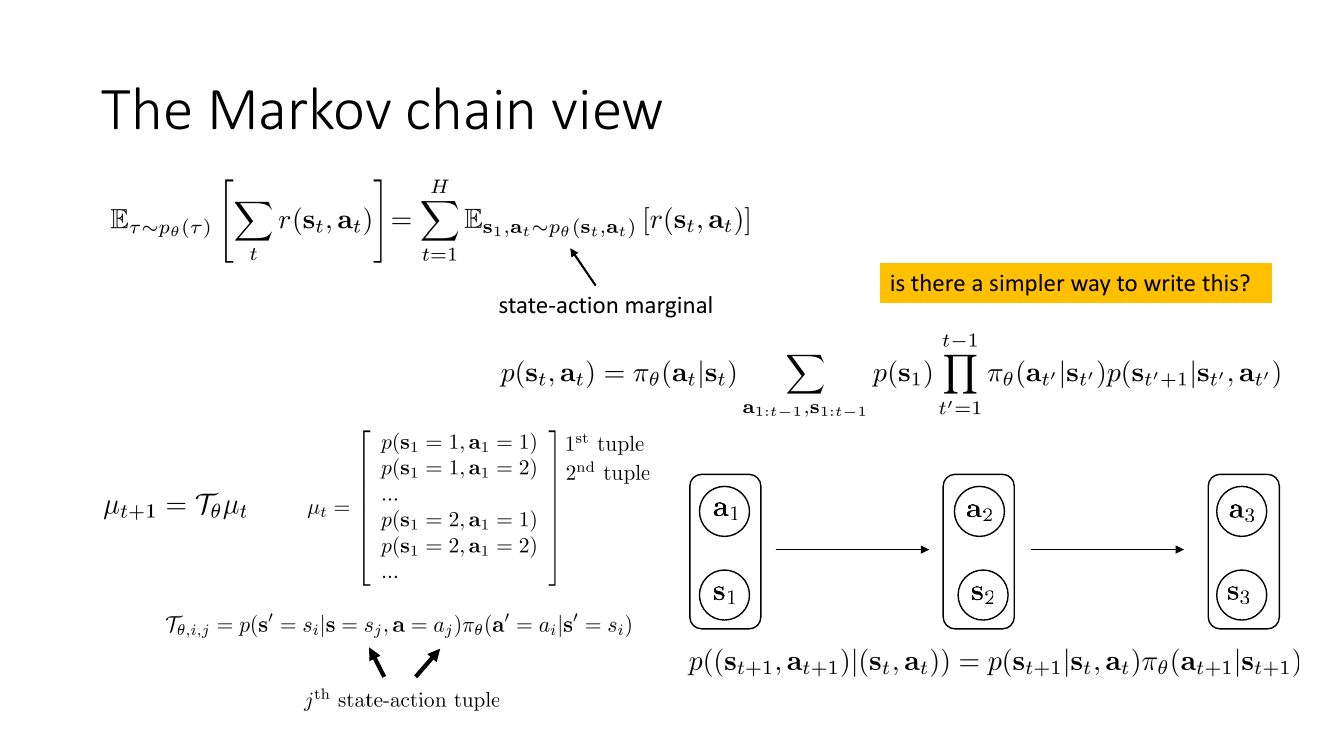
$$ \E_{\tau\sim p_\theta(\tau)}\!\left[\sum_{t=1}^{H} r(s_t,a_t)\right] =\sum_{t=1}^{H}\E_{\tau\sim p_\theta(\tau)}\big[r(s_t,a_t)\big] =\sum_{t=1}^{H}\E_{(s_t,a_t)\sim p_\theta(s_t,a_t)}\big[r(s_t,a_t)\big] $$第二个等号成立,是因为 $r(s_t,a_t)$ 只依赖于轨迹中的第 $t$ 个状态-动作对,其余变量可以直接边缘化掉。这里的 $p_\theta(s_t,a_t)$ 叫状态-动作边缘(state-action marginal):
$$ p_\theta(s_t,a_t)=\pi_\theta(a_t\mid s_t)\sum_{a_{1:t-1},\,s_{1:t-1}} p(s_1)\prod_{t'=1}^{t-1}\pi_\theta(a_{t'}|s_{t'})\,p(s_{t'+1}|s_{t'},a_{t'}) $$也就是上一节的状态边缘再乘上当前策略。这一步的意义是把「对 $H$ 步联合分布求期望」变成了「对 $H$ 个二维边缘分别求期望再相加」——维度从 $O(H\cdot d)$ 降到了 $O(d)$。
4.2 全部写成线性代数
既然增广链的边缘演化是线性的,整个目标就能写成纯粹的矩阵表达式。设状态动作对共 $m$ 个,定义奖励向量 $\vec r\in\R^m$,其第 $i$ 个分量是 $r(s_i,a_i)$。则
$$ \begin{aligned} \sum_{t=1}^{H}\E_{(s_t,a_t)\sim p_\theta}\big[r(s_t,a_t)\big] &=\sum_{t=1}^{H}\sum_{s_t,a_t} p_\theta(s_t,a_t)\,r(s_t,a_t)\\[2pt] &=\sum_{t=1}^{H}\sum_{i} \mu_{t,i}\,\vec r_i\\[2pt] &=\sum_{t=1}^{H}\mu_t^\top \vec r\\[2pt] &=\left[\sum_{t=1}^{H}\mathcal{T}_\theta^{\,t-1}\mu_1\right]^{\!\top}\vec r \end{aligned} $$最后一步用了 $\mu_t=\mathcal{T}_\theta^{\,t-1}\mu_1$,即从初始分布 $\mu_1$ 出发反复作用转移矩阵。
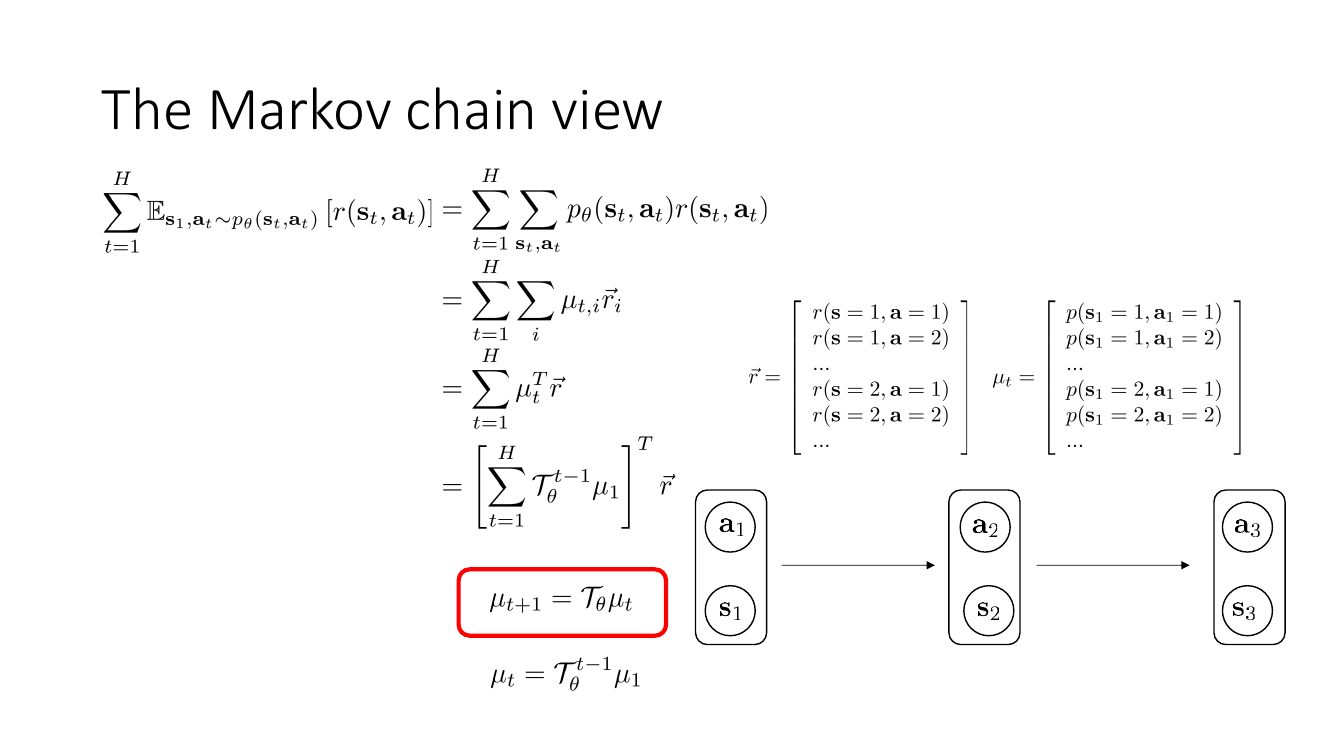
这套矩阵写法只在离散且有限的状态动作空间下字面成立——$\mathcal{T}_\theta$ 是 $m\times m$ 矩阵,$m=|\mathcal{S}||\mathcal{A}|$,在 Atari 上这个数比宇宙原子数还多,绝不可能显式写出来。Levine 明确说了:我们在实际算法里几乎从不显式求解这些东西。 它的价值是理论分析:许多 RL 的收敛性证明、离线 RL 的分布偏移界、以及后面会讲的「策略改进定理」,都是在这个线性代数框架下写出来的。对连续空间,把矩阵换成积分算子,结论形式基本不变。
4.3 无限步:平稳分布登场
如果 $H=\infty$,上面那个和就发散了(每步拿 $+1$,累积奖励是 $\infty$)。有两种标准修补方式,本讲用的是平均奖励(average reward):除以 $H$ 再取极限。
$$ \lim_{H\to\infty}\frac{1}{H}\sum_{t=1}^{H}\E_{(s_t,a_t)\sim p_\theta(s_t,a_t)}\big[r(s_t,a_t)\big] $$(另一种是引入折扣因子(discount factor) $\gamma\in(0,1)$,用 $\sum_t\gamma^{t-1}r_t$,这个下一讲会详细讲。)
这个极限存在吗?关键问题是:$p_\theta(s_t,a_t)$ 随 $t\to\infty$ 会收敛到某个固定分布吗?如果会,记这个极限分布为 $\bar\mu$,那么按 Cesàro 均值,时间平均也收敛到同一个东西,于是
$$ \lim_{H\to\infty}\frac{1}{H}\sum_{t=1}^{H}\E_{p_\theta(s_t,a_t)}[r] \;=\; \E_{(s,a)\sim\bar\mu}\big[r(s,a)\big]\;=\;\bar\mu^\top \vec r $$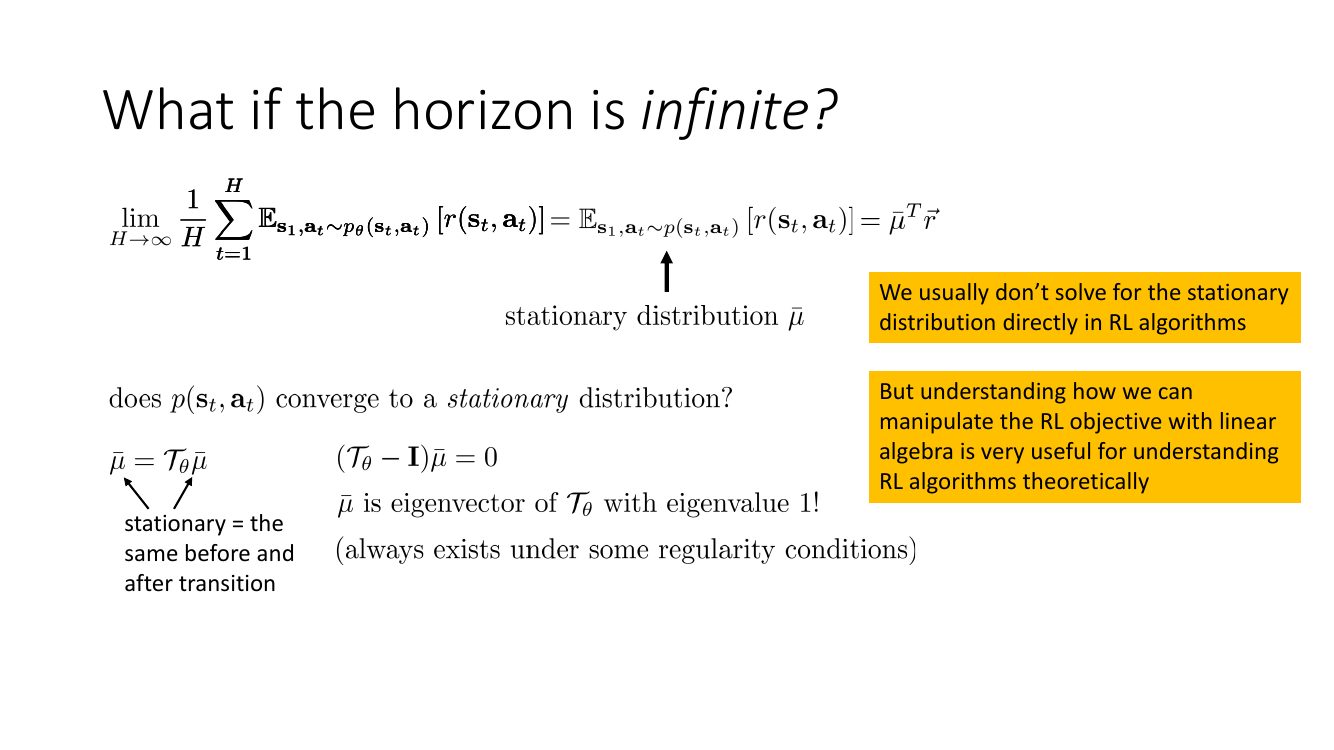
为什么平稳分布是特征值 1 的特征向量,而且一定存在?
「平稳」的定义是:作用一次转移之后分布不变,
$$ \bar\mu=\mathcal{T}_\theta\bar\mu\quad\Longleftrightarrow\quad(\mathcal{T}_\theta-I)\bar\mu=0 $$这正是「$\bar\mu$ 属于 $\mathcal{T}_\theta$ 的特征值 $\lambda=1$ 的特征空间」的定义。
存在性来自 $\mathcal{T}_\theta$ 是列随机矩阵(每一列非负、和为 1)。注意 $\mathbf{1}^\top\mathcal{T}_\theta=\mathbf{1}^\top$,所以 $\mathbf 1$ 是 $\mathcal{T}_\theta^\top$ 的特征值为 1 的(左)特征向量;而矩阵与其转置有相同的特征值集合,故 $\mathcal{T}_\theta$ 也有特征值 1,对应的右特征向量就是 $\bar\mu$。由 Perron–Frobenius 定理,若链是不可约(irreducible)且非周期(aperiodic)的(即幻灯片上说的「某些正则性条件」,ergodicity),则特征值 1 是单重的、模最大的,对应特征向量可取为各分量严格为正、和为 1 的概率向量,且对任意初始分布都有 $\mathcal{T}_\theta^{\,t}\mu_1\to\bar\mu$。
收敛速度由第二大特征值的模 $|\lambda_2|$(谱隙 spectral gap)决定:$\|\mu_t-\bar\mu\|=O(|\lambda_2|^{t})$。回到 2.2 节的天气例子,$\mathcal{T}$ 的特征值是 $1$ 和 $0.4$,所以误差每步缩小到 $0.4$ 倍——第 4 步偏差就只有 $0.4^3\approx 0.064$,和我们算出来的数吻合($0.844$ vs $0.833$,差 $0.011$,因为初始偏差本身只有 $1/6$)。谱隙小 = 混合慢 = RL 需要更长的轨迹才能看清策略的真实好坏,这在实践中表现为「探索难、需要更大的 horizon」。
不可约 + 非周期这两个条件不是走过场。举反例:一个只有两个状态、每步必然在两者之间来回跳的链,$\mathcal{T}=\begin{bmatrix}0&1\\1&0\end{bmatrix}$,特征值是 $\pm 1$。$\mu_t$ 永远在 $[1,0]^\top$ 和 $[0,1]^\top$ 之间震荡,不收敛;但时间平均仍然收敛到 $[0.5,0.5]^\top$,这也正是为什么无限步目标写成时间平均而不是 $\lim_t \mu_t$ 的原因之一。另外,如果 MDP 有吸收态(比如游戏结束),链是可约的,平稳分布不唯一——它取决于你从哪出发。这类任务应该用有限步或折扣形式来建模。
5. 为什么强化学习永远在谈期望
把两种情形并排放在一起,就是 RL 目标的最终形态:
$$ \underbrace{\theta^\star=\argmax_\theta\ \E_{(s,a)\sim p_\theta(s,a)}\big[r(s,a)\big]}_{\text{无限步(infinite horizon)}} \qquad \underbrace{\theta^\star=\argmax_\theta\ \sum_{t=1}^{H}\E_{(s_t,a_t)\sim p_\theta(s_t,a_t)}\big[r(s_t,a_t)\big]}_{\text{有限步(finite horizon)}} $$两个式子的共同点是:被优化的都是期望,而不是任何一次具体的结果。 这不只是「统计上更稳健」这么轻描淡写的理由。Levine 在这里给了一个非常漂亮的例子,说明期望是让整个优化问题有意义的前提。
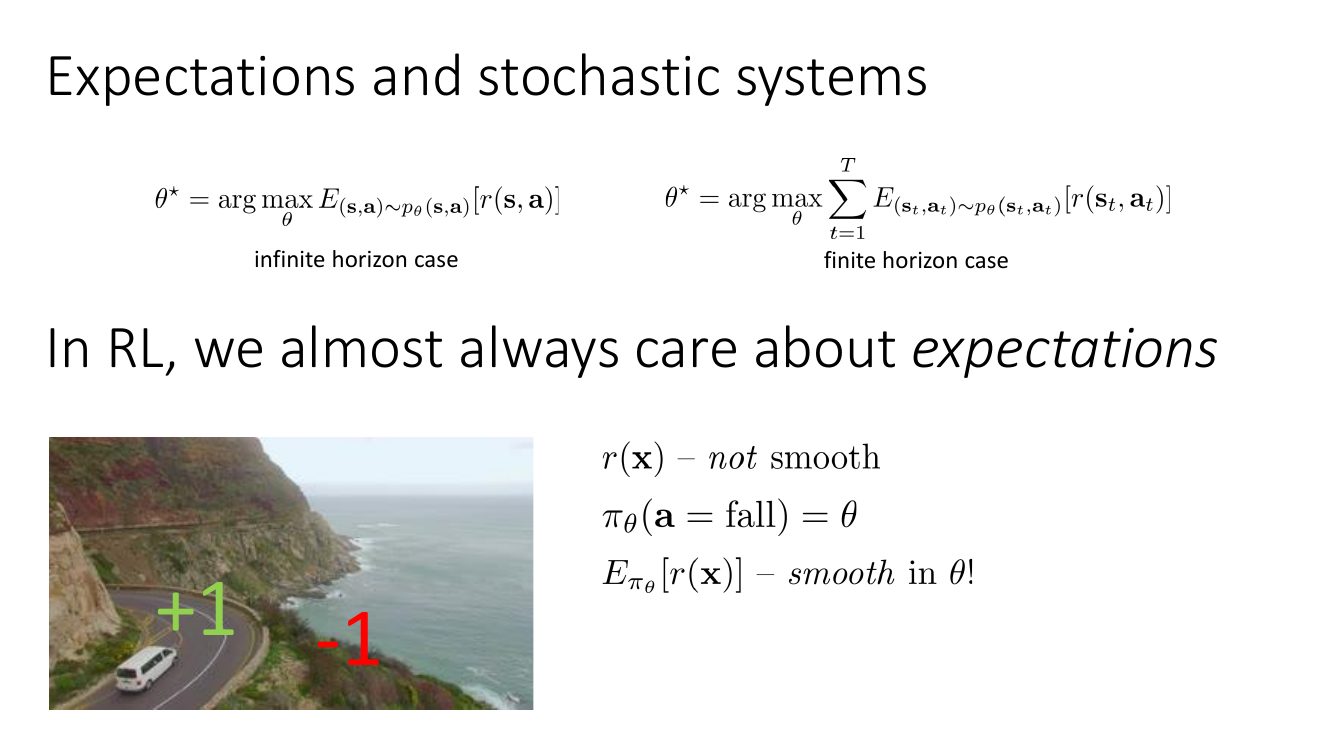
把这个例子算干净。设车的横向位置为 $x$,奖励是一个阶跃函数:
$$ r(x)=\begin{cases}+1,& x \text{ 在路面上}\\ -1,& x \text{ 已经越过悬崖边}\end{cases} $$这个 $r$ 关于 $x$ 既不连续也不可导,在悬崖边处导数不存在(或者说处处为 0 加一个 Dirac 冲激)。如果我们直接对「某一次的结果」做梯度上升,梯度要么是 0(离边缘远时,微调方向盘不改变结果),要么是无穷(正好在边缘上)。这样的目标根本没法用梯度方法优化。
现在引入随机策略。设策略以概率 $\theta$ 输出「掉下去」的动作,以概率 $1-\theta$ 输出「留在路上」:
$$ \pi_\theta(a=\text{fall})=\theta $$那么期望奖励是
$$ \E_{\pi_\theta}\big[r(x)\big]=\theta\cdot(-1)+(1-\theta)\cdot(+1)=1-2\theta $$这是一个关于 $\theta$ 的光滑(这里是线性)函数,导数恒为 $-2$。梯度信息明确地告诉你:把 $\theta$ 调小。奖励本身的不连续性被期望「抹平」了。
期望运算把一个关于随机变量的、可能极度不光滑的函数,变成了一个关于分布参数的光滑函数。这是所有基于梯度的强化学习方法(策略梯度、actor-critic、乃至用 RL 微调语言模型)能够工作的根本原因——也解释了为什么 RL 里的策略通常是随机的:随机性不只是为了探索,它还是让目标可导的技术手段。
5.1 这个观察的三个推论
推论一:RL 能处理不可微的奖励。 这是 RL 相对于「直接对目标做反向传播」的最大优势。奖励可以是「游戏是否获胜」(0/1)、「代码是否通过单元测试」(0/1)、「人类标注员是否更喜欢这个回答」(离散偏好)。这些量对模型参数没有梯度,但它们的期望有。用 RL 微调大语言模型(RLHF)之所以成立,用的正是这一条。
推论二:光滑性来自分布,不是来自奖励。 所以需要 $\pi_\theta$ 对 $\theta$ 可微,且是真正的分布(不能是确定性的 $\delta$ 函数)。如果策略是确定性的 $a=f_\theta(s)$,期望就退化成 $r(f_\theta(s))$,不光滑性又回来了。这就是为什么策略梯度类方法要求随机策略;而确定性策略梯度(DPG/DDPG)必须另辟蹊径——它借助 $Q$ 函数的可微性,把 $\nabla_\theta Q(s,f_\theta(s))$ 拿来当梯度,这已经不是同一套推导了。
推论三:期望也带来了新麻烦。 我们能优化期望,但我们无法直接计算期望——只能用有限个样本去估计它。这就引出了整个 RL 领域的核心矛盾:偏差-方差权衡。用 $N$ 条轨迹估计期望,标准误差是 $O(1/\sqrt N)$;而回报的方差随 horizon $H$ 增长(大致是 $O(H^2)$ 量级,因为回报是 $H$ 项之和)。这意味着长任务上策略梯度的信噪比会非常糟糕,第 5、6 讲会花大量篇幅对付它。
还有一个常被忽略的实践意义:期望目标意味着我们对风险是中性的。一个「90% 概率拿 0 分、10% 概率拿 100 分」的策略,和一个「100% 拿 10 分」的策略,在标准 RL 目标下完全等价。这在自动驾驶、医疗这类场景里显然不合适——你不会接受 1% 概率撞车换取平均速度更快。处理这类需求需要风险敏感 RL(优化 CVaR、方差惩罚等),本课不涉及,但值得记住标准公式里藏着这个假设。
6. RL 算法的解剖:一个贯穿全课的三步循环
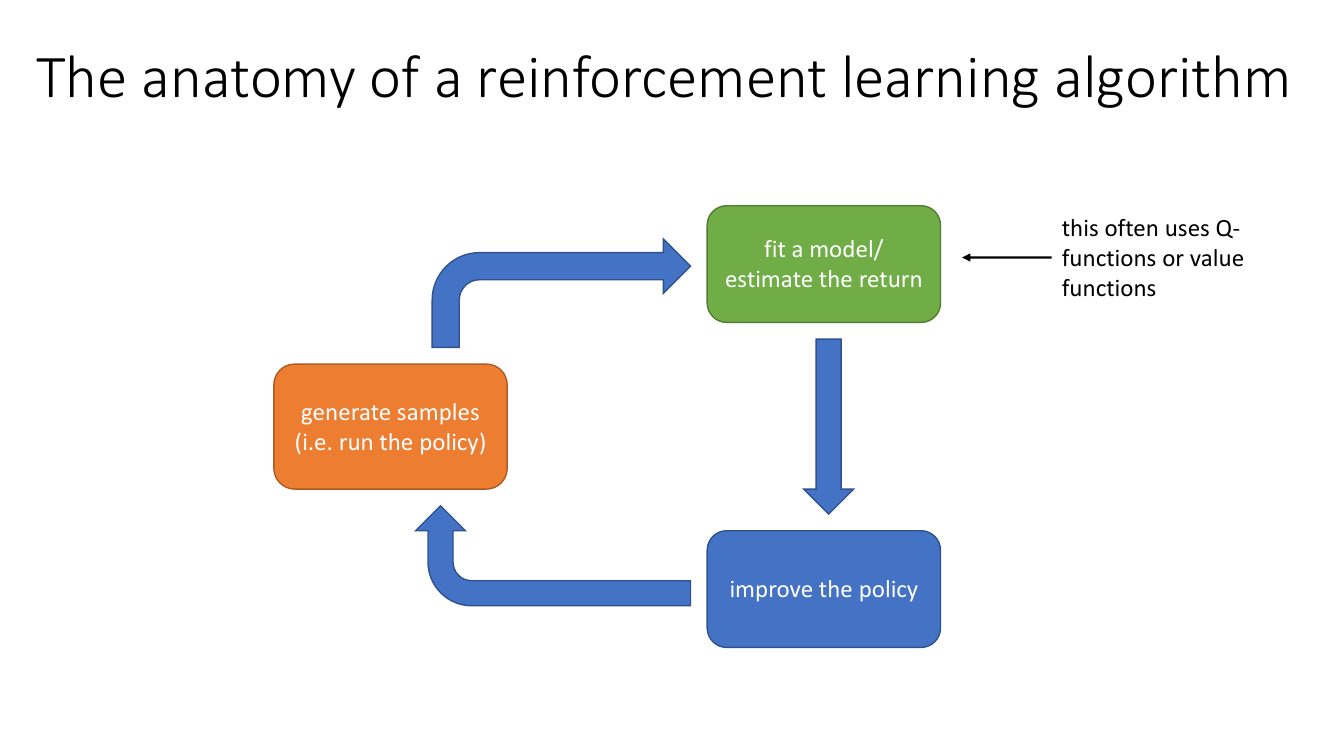
接下来是本讲最有「地图」价值的部分。Levine 给出一个抽象框架,本课后面二十讲的每一个算法都能塞进这个框架里:
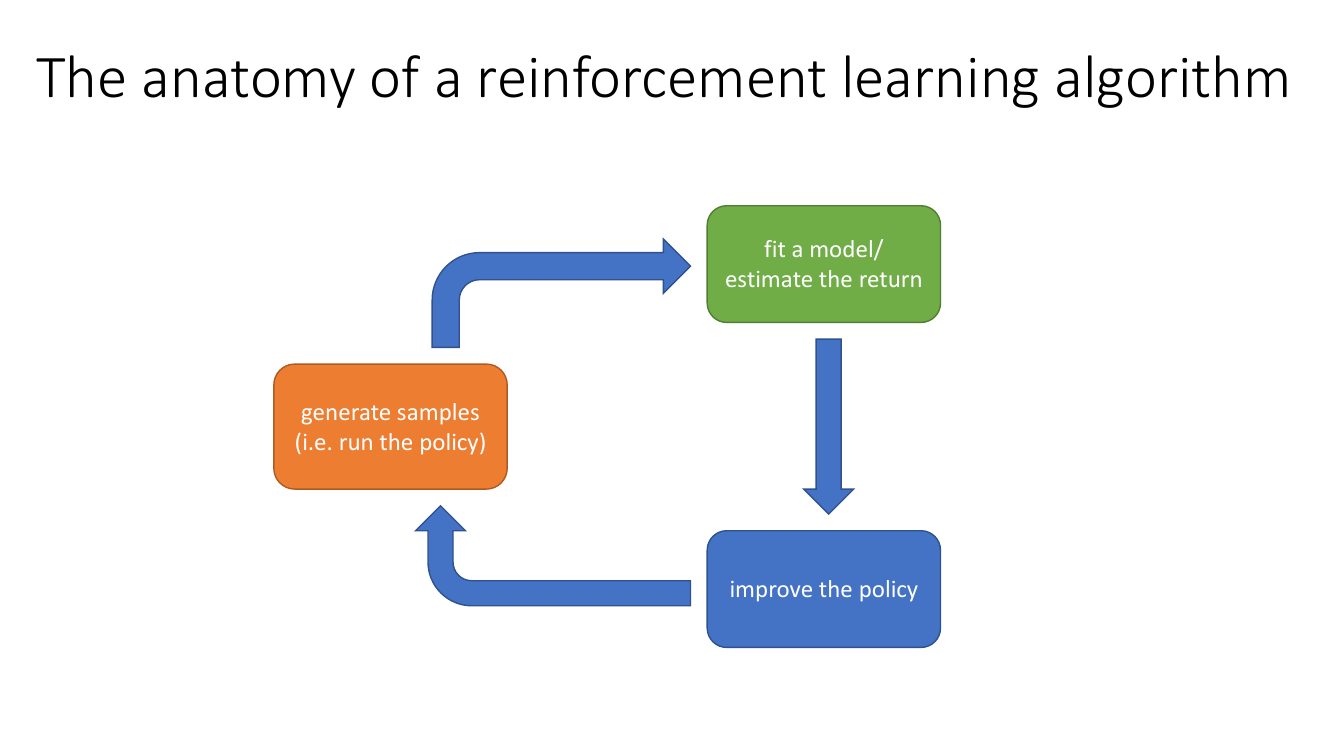
三个框各自可以填不同的东西,填法的组合就构成了不同的算法族。先看两个具体实例。
6.1 实例一:最朴素的策略梯度
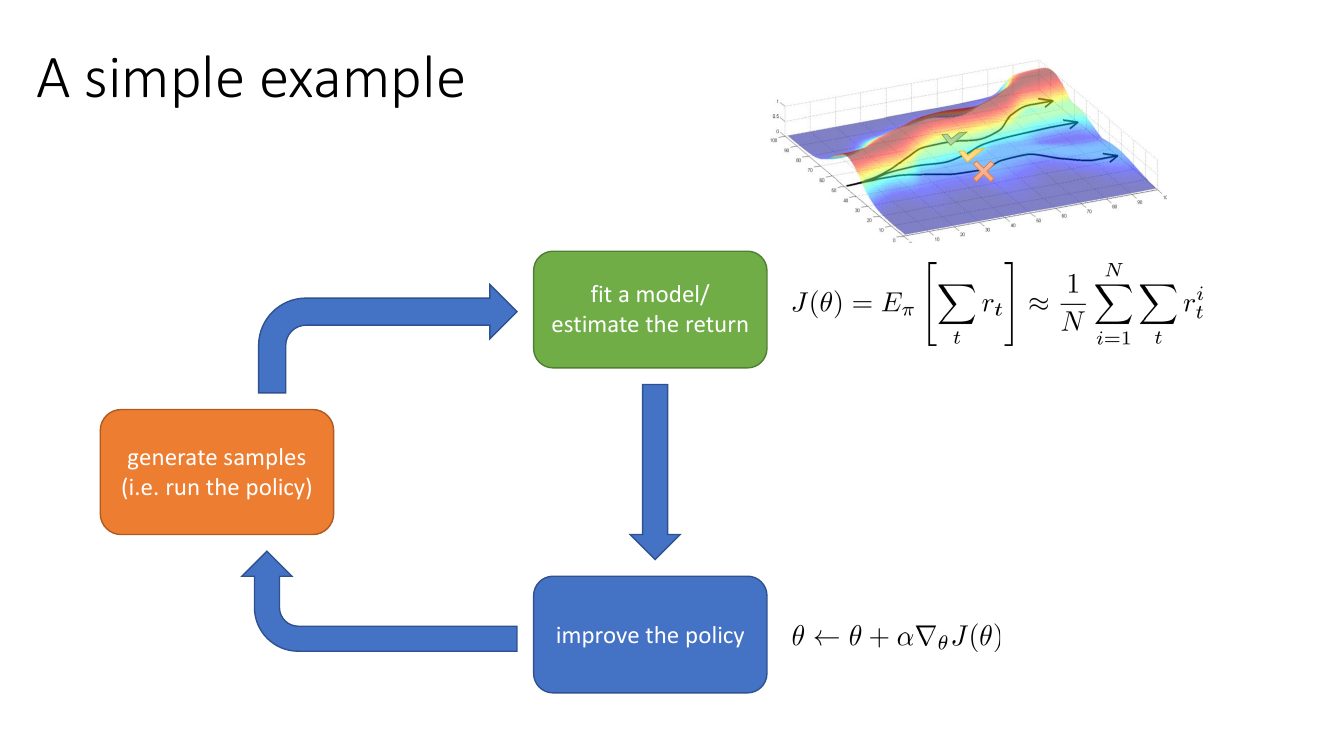
这里的 $J(\theta)$ 就是第 3 节写的目标函数。绿色框的「拟合模型」在这个实例里退化成了「算个平均数」——一行代码。真正的难点在蓝色框:$\nabla_\theta J(\theta)$ 怎么算?前面说过,$\theta$ 藏在分布里,而且分布里有未知的环境转移。这个问题的答案(log-derivative trick)就是下一讲的全部内容。
6.2 实例二:靠反向传播做 RL
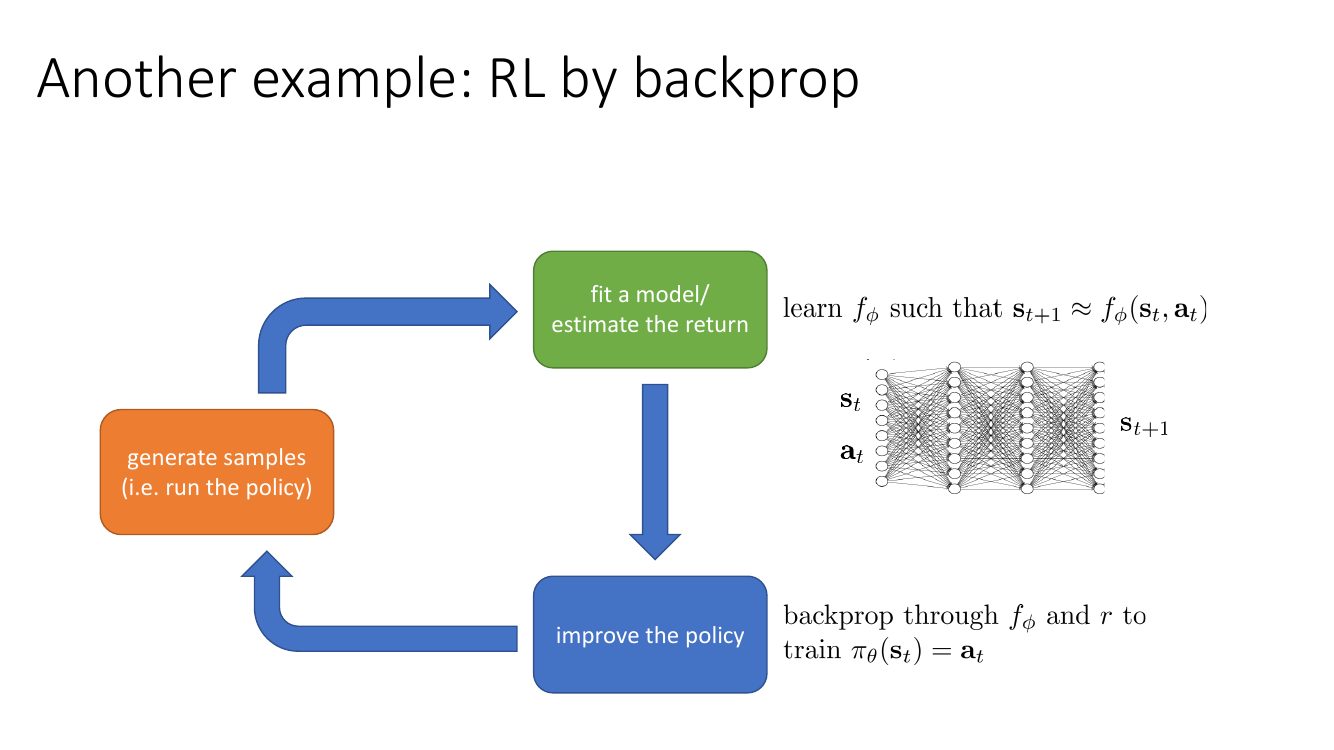
这个思路值得展开一下,因为它揭示了 model-based RL 的本质。如果我们知道 $f_\phi$ 和 $r$,且两者都可微,那么整条轨迹就是一个巨大的可微计算图:
$$ s_1\xrightarrow{\pi_\theta} a_1\xrightarrow{f_\phi} s_2\xrightarrow{\pi_\theta}a_2\xrightarrow{f_\phi}s_3\to\cdots $$总回报 $\sum_t r(s_t,a_t)$ 是这个图的输出,对 $\theta$ 求导就是标准的时序反向传播(BPTT)。这在概念上极其简洁——RL 变成了一个普通的深度学习问题。但实践中它非常脆弱,原因和训练很深的 RNN 一样:梯度沿时间维度连乘,会指数爆炸或消失;而且模型误差也会沿时间累积,策略很容易学会「利用模型的错误」(在真实世界不成立的作弊路径)。第 10–12 讲会专门讲怎么把它做对。
6.3 哪一步贵?
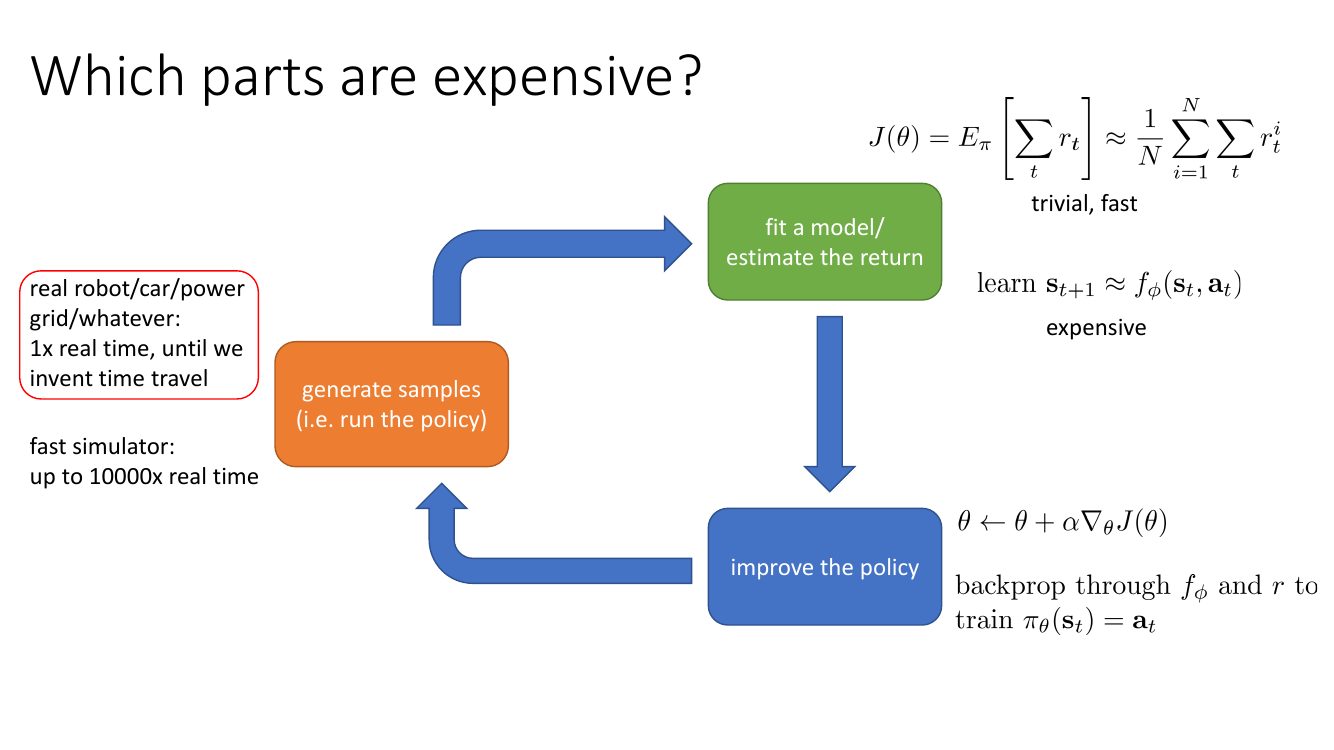
哪一步是瓶颈,完全取决于你的场景,而这决定了你该选哪类算法。
- 真机器人、真车、真电网、真用户:采样贵到离谱。此时应该不惜一切代价省样本——用 model-based 或 off-policy 方法,哪怕它们每步计算量大 100 倍。
- MuJoCo、Atari、围棋自对弈这类快仿真:采样几乎免费。此时简单、稳定、易调的 on-policy 方法(PPO)反而更省你的时间。
这正是第 9 节要讲的「采样效率 ≠ 墙钟时间」的前身。
6.4 把骨架写成代码
为了让这个循环不停留在框图层面,下面给出一个能真正跑起来的骨架。它把三步循环显式地写出来,绿色框和蓝色框留成可替换的函数——后面每一讲学到新算法,本质上都只是替换这两个函数。
import numpy as np
import torch, torch.nn as nn

class GaussianPolicy(nn.Module):
    """连续动作的高斯策略: a ~ N(mu_theta(s), exp(log_std)^2)"""
    def __init__(self, obs_dim, act_dim, hidden=64):
        super().__init__()
        self.mu = nn.Sequential(
            nn.Linear(obs_dim, hidden), nn.Tanh(),
            nn.Linear(hidden, hidden), nn.Tanh(),
            nn.Linear(hidden, act_dim))
        self.log_std = nn.Parameter(torch.zeros(act_dim))

    def dist(self, obs):
        return torch.distributions.Normal(self.mu(obs), self.log_std.exp())

    def act(self, obs_np):
        with torch.no_grad():
            a = self.dist(torch.as_tensor(obs_np, dtype=torch.float32)).sample()
        return a.numpy()


# ---------- 橙色框:生成样本(跑策略) ----------
def collect_trajectories(env, policy, n_traj, max_len):
    batch = []
    for _ in range(n_traj):
        obs, _ = env.reset()
        obs_l, act_l, rew_l = [], [], []
        for _t in range(max_len):
            a = policy.act(obs)
            nxt, r, term, trunc, _ = env.step(a)
            obs_l.append(obs); act_l.append(a); rew_l.append(r)
            obs = nxt
            if term or trunc:
                break
        batch.append(dict(obs=np.array(obs_l, dtype=np.float32),
                          act=np.array(act_l, dtype=np.float32),
                          rew=np.array(rew_l, dtype=np.float32)))
    return batch


# ---------- 绿色框:估计回报 / 拟合模型 ----------
def estimate_return(batch):
    """最朴素的填法:J(theta) 的蒙特卡洛估计 = 各轨迹总回报的平均"""
    return float(np.mean([traj["rew"].sum() for traj in batch]))


# ---------- 蓝色框:改进策略 ----------
def improve_policy(policy, optimizer, batch):
    """占位:具体形式由算法决定(第 5 讲填入策略梯度)"""
    raise NotImplementedError


# ---------- 三步循环 ----------
def rl_loop(env, policy, n_iters=200, n_traj=32, max_len=1000, lr=1e-3):
    optimizer = torch.optim.Adam(policy.parameters(), lr=lr)
    for it in range(n_iters):
        batch = collect_trajectories(env, policy, n_traj, max_len)   # 橙
        J_hat = estimate_return(batch)                               # 绿
        improve_policy(policy, optimizer, batch)                     # 蓝
        print(f"iter {it:4d}  avg return = {J_hat:8.2f}")
注意 estimate_return 目前只是打印用的诊断量,并没有参与梯度计算——因为 J_hat 是一个 Python 浮点数,早就和计算图断开了。「怎样构造一个其梯度恰好等于 $\nabla_\theta J(\theta)$ 的损失函数」是下一讲要解决的核心工程问题。
7. 值函数与 Q 函数:把嵌套期望打包
7.1 动机:期望套期望套期望
把 RL 目标按时间展开写成条件期望的嵌套形式:
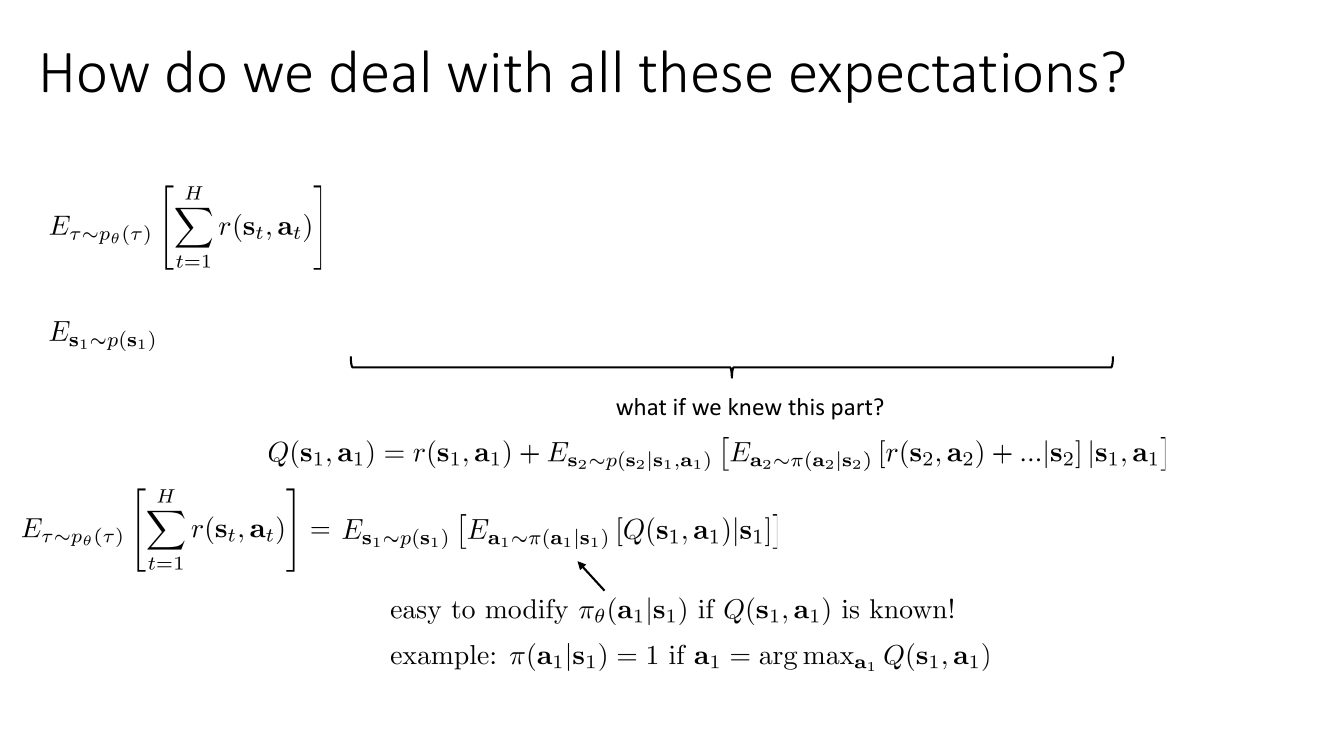
$$ \E_{\tau\sim p_\theta(\tau)}\!\left[\sum_{t=1}^{H}r(s_t,a_t)\right] =\E_{s_1\sim p(s_1)}\Big[\E_{a_1\sim\pi(a_1|s_1)}\big[r(s_1,a_1)+\E_{s_2\sim p(s_2|s_1,a_1)}\big[\E_{a_2\sim\pi(a_2|s_2)}[\,\cdots\,]\big]\big]\Big] $$这是一个深度为 $2H$ 的期望嵌套:状态期望、动作期望、状态期望、动作期望……交替出现。直接对付它没有希望。但仔细看会发现一个结构:最外层的 $s_1$ 和 $a_1$ 之后的那一大坨,只依赖于 $(s_1,a_1)$。如果我们能给这一大坨起个名字、并且知道它的值,问题就一下子简单了。
7.2 定义
Q 函数(Q-function / action-value function):在状态 $s_t$ 采取动作 $a_t$,其后一直遵循策略 $\pi$ 所能获得的期望累积奖励。
$$ Q^\pi(s_t,a_t)=\sum_{t'=t}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\,\big|\,s_t,a_t\big] $$值函数(value function / state-value function):在状态 $s_t$,遵循策略 $\pi$ 所能获得的期望累积奖励。
$$ V^\pi(s_t)=\sum_{t'=t}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\,\big|\,s_t\big] $$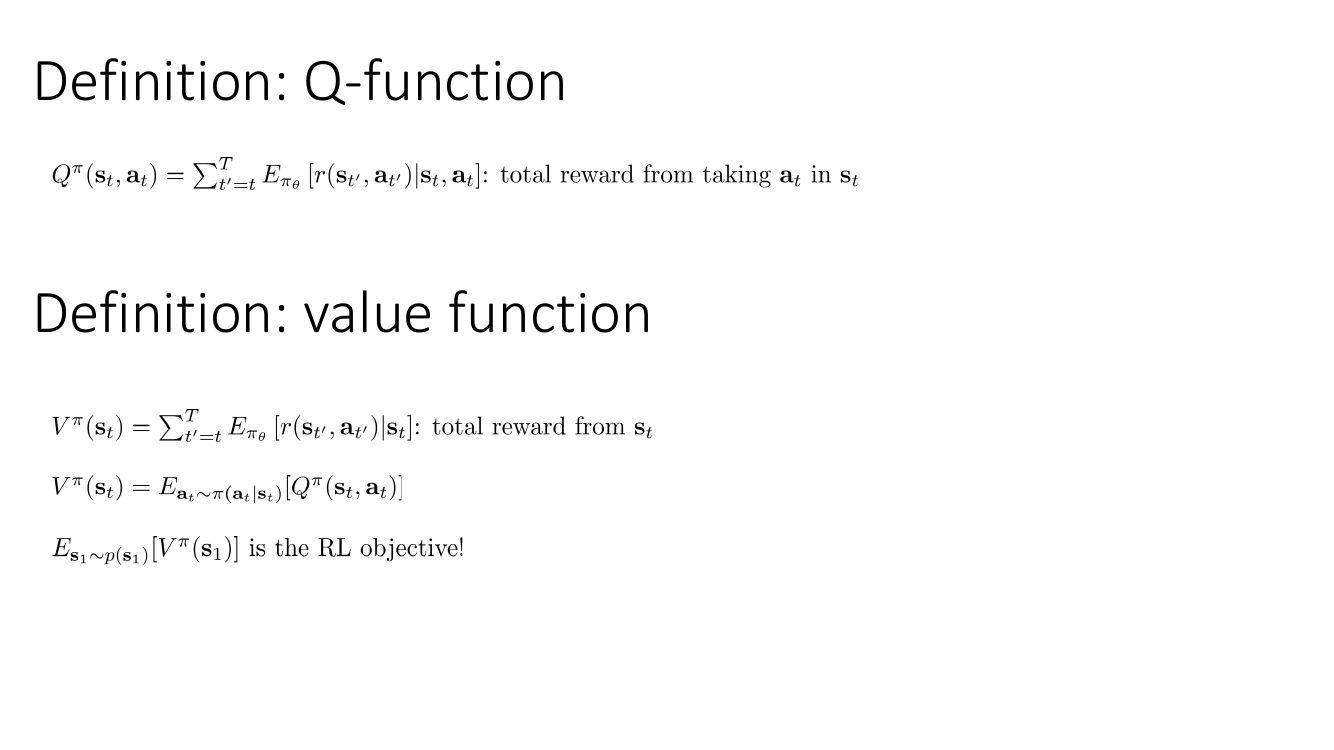
两者的关系一目了然——$V$ 就是 $Q$ 关于策略的动作期望:
$$ V^\pi(s_t)=\E_{a_t\sim\pi(a_t|s_t)}\big[Q^\pi(s_t,a_t)\big] $$而 RL 目标本身就是 $V^\pi$ 在初始状态分布下的期望:
$$ \E_{\tau\sim p_\theta(\tau)}\!\left[\sum_t r(s_t,a_t)\right]=\E_{s_1\sim p(s_1)}\big[V^\pi(s_1)\big] $$还有一个同样重要的关系是Bellman 一致性方程,它把 $Q$ 用「一步奖励 + 下一步的 $V$」表达出来。从定义出发拆开第一项:
$$ \begin{aligned} Q^\pi(s_t,a_t)&=r(s_t,a_t)+\sum_{t'=t+1}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\mid s_t,a_t\big]\\[2pt] &=r(s_t,a_t)+\E_{s_{t+1}\sim p(\cdot|s_t,a_t)}\left[\sum_{t'=t+1}^{H}\E_{\pi_\theta}\big[r(s_{t'},a_{t'})\mid s_{t+1}\big]\right]\\[2pt] &=r(s_t,a_t)+\E_{s_{t+1}\sim p(\cdot|s_t,a_t)}\big[V^\pi(s_{t+1})\big] \end{aligned} $$第二个等号用了全期望公式(对 $s_{t+1}$ 做条件化),第三个等号用了马尔可夫性——给定 $s_{t+1}$,未来与 $(s_t,a_t)$ 无关,所以内层期望正好是 $V^\pi(s_{t+1})$ 的定义。把 $V^\pi(s)=\E_{a\sim\pi}[Q^\pi(s,a)]$ 代进去还可得
$$ Q^\pi(s_t,a_t)=r(s_t,a_t)+\E_{s_{t+1}}\Big[\E_{a_{t+1}\sim\pi}\big[Q^\pi(s_{t+1},a_{t+1})\big]\Big] $$这个递推关系是第 6 讲 actor-critic、第 7–8 讲 Q-learning 的全部基础:它把「估计一个长期量」变成了「让一个函数满足一个一步的自洽条件」。
7.3 用它们改进策略的两个思路
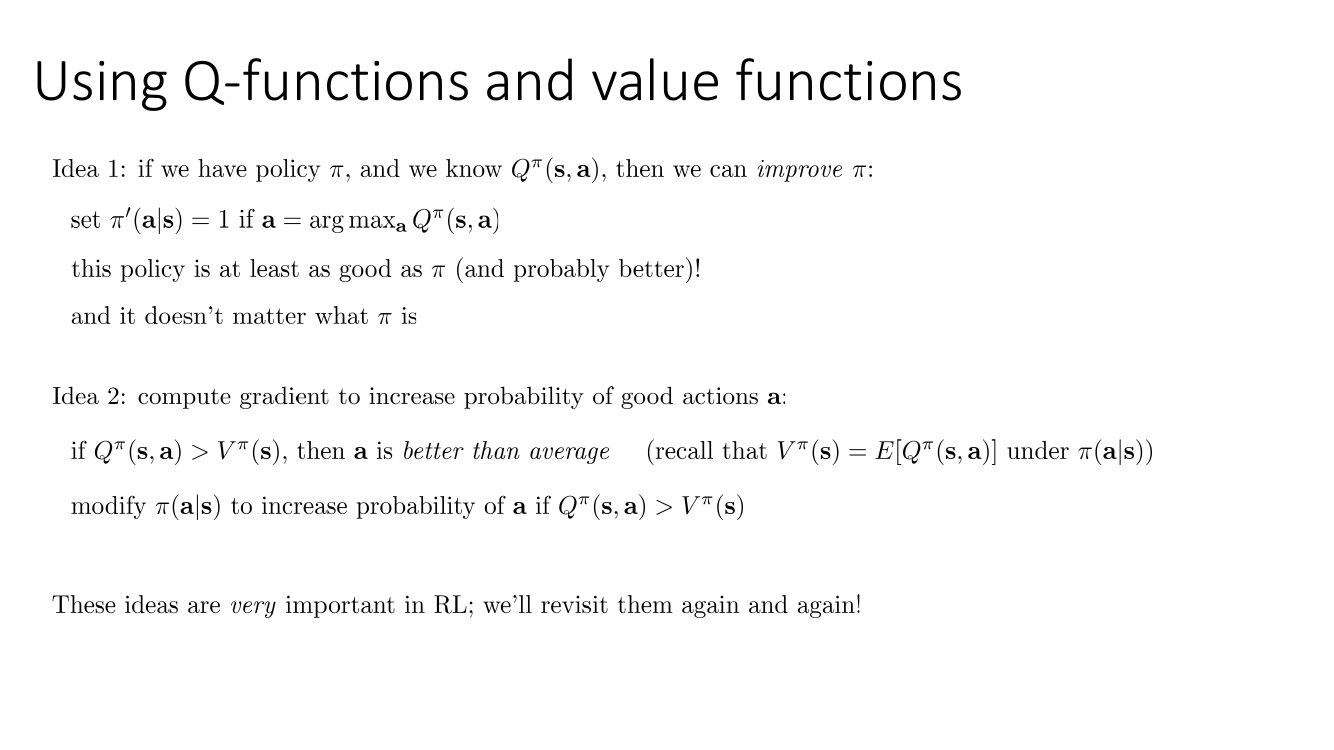
思路 1(策略改进 / policy improvement)。 若已有策略 $\pi$ 且知道 $Q^\pi(s,a)$,定义新策略
$$ \pi'(a\mid s)=\begin{cases}1,& a=\argmax_{a'} Q^\pi(s,a')\\ 0,&\text{否则}\end{cases} $$则 $\pi'$ 至少不比 $\pi$ 差,通常更好。而且——这是最妙的地方——$\pi$ 是什么根本不重要。哪怕 $\pi$ 是一个随机乱动的策略,只要你能算出它的 $Q^\pi$,按上式贪心就一定能得到一个更好的策略。反复「评估 → 贪心」就是策略迭代(policy iteration)。
为什么 $\pi'$ 一定不比 $\pi$ 差? 这就是经典的策略改进定理。首先由 $\pi'$ 的贪心定义,对任意 $s$:
$$ \E_{a\sim\pi'(\cdot|s)}\big[Q^\pi(s,a)\big]=\max_a Q^\pi(s,a)\ \ge\ \E_{a\sim\pi(\cdot|s)}\big[Q^\pi(s,a)\big]=V^\pi(s) $$(最大值一定不小于任何加权平均。)然后反复代入 Bellman 方程展开:
$$ \begin{aligned} V^\pi(s_t)&\le \E_{a_t\sim\pi'}\big[Q^\pi(s_t,a_t)\big] = \E_{a_t\sim\pi'}\Big[r(s_t,a_t)+\E_{s_{t+1}}\big[V^\pi(s_{t+1})\big]\Big]\\[2pt] &\le \E_{a_t\sim\pi'}\Big[r(s_t,a_t)+\E_{s_{t+1}}\big[\E_{a_{t+1}\sim\pi'}[Q^\pi(s_{t+1},a_{t+1})]\big]\Big]\\[2pt] &\le\ \cdots\ \le\ \E_{\pi'}\left[\sum_{t'=t}^{H}r(s_{t'},a_{t'})\,\Big|\,s_t\right]=V^{\pi'}(s_t) \end{aligned} $$每一步都在把「后面用 $\pi$」替换成「后面用 $\pi'$」,而每次替换都不减小值。递推到底就得到 $V^{\pi}(s)\le V^{\pi'}(s)$ 对所有 $s$ 成立。
思路 2(提高优势动作的概率)。 注意 $V^\pi(s)=\E_{a\sim\pi}[Q^\pi(s,a)]$ 说明 $V^\pi(s)$ 是 $Q^\pi(s,\cdot)$ 在当前策略下的平均值。于是:
$$ Q^\pi(s,a)\ \gt\ V^\pi(s)\quad\Longrightarrow\quad a\ \text{比当前策略的平均水平更好} $$那就修改 $\pi(a|s)$,提高这些动作的概率。这个差值太重要了,以至于它有自己的名字——优势函数(advantage function):
$$ A^\pi(s,a)=Q^\pi(s,a)-V^\pi(s) $$由定义立刻有 $\E_{a\sim\pi}[A^\pi(s,a)]=0$:在当前策略下,优势的平均值为零。这正是我们想要的「相对好坏」度量——它消除了状态本身好坏带来的偏移。第 6 讲会证明,把策略梯度里的回报换成 $A^\pi$ 能大幅降低方差,而这就是 actor-critic 的由来。
为什么优势比 Q 值本身更有用?想象一个状态 $s$,所有动作的 $Q$ 值都在 $1000$ 附近:$Q(s,a_1)=1002$,$Q(s,a_2)=998$。如果直接用 $Q$ 当权重去调整动作概率,两个动作的权重几乎一样,梯度信号被巨大的公共偏移淹没了。减掉 $V^\pi(s)=1000$ 之后,优势变成 $+2$ 和 $-2$,方向立刻清晰。基线(baseline)的全部意义就在这里:它不改变梯度的期望,却极大地降低了方差。
8. RL 算法全景:四大类
目标只有一个:
$$ \theta^\star=\argmax_\theta\ \E_{\tau\sim p_\theta(\tau)}\!\left[\sum_t r(s_t,a_t)\right] $$但通往它的路有四条。
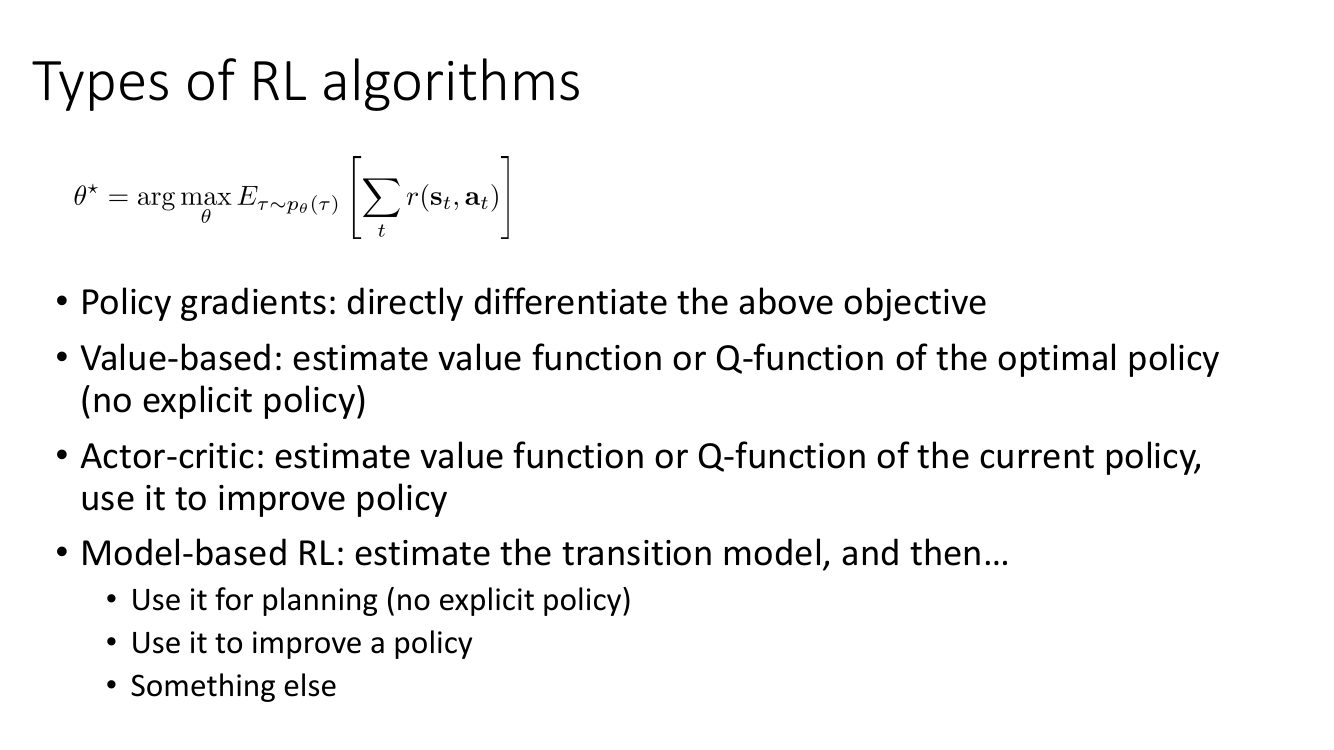
| 类别 | 绿色框做什么 | 蓝色框做什么 | 有显式策略吗 | 代表算法 |
|---|---|---|---|---|
| 策略梯度 policy gradient | 算回报 $R_\tau=\sum_t r(s_t,a_t)$ | $\theta\leftarrow\theta+\alpha\nabla_\theta\E\left[\sum_t r\right]$ | 有 | REINFORCE、NPG、TRPO、PPO |
| 值函数方法 value-based | 拟合 $V(s)$ 或 $Q(s,a)$(最优策略的) | 令 $\pi(s)=\argmax_a Q(s,a)$(不训练网络) | 无 | Q-learning、DQN、fitted value iteration |
| Actor-critic | 拟合当前策略的 $V^\pi$ 或 $Q^\pi$ | $\theta\leftarrow\theta+\alpha\nabla_\theta\E[Q(s_t,a_t)]$ | 有 | A3C、SAC、DDPG、TD3 |
| Model-based | 拟合转移模型 $p(s_{t+1}\mid s_t,a_t)$ | 规划 / 反传 / 学值函数(三选一) | 不一定 | Dyna、MBPO、MuZero、iLQR |
8.1 Model-based RL
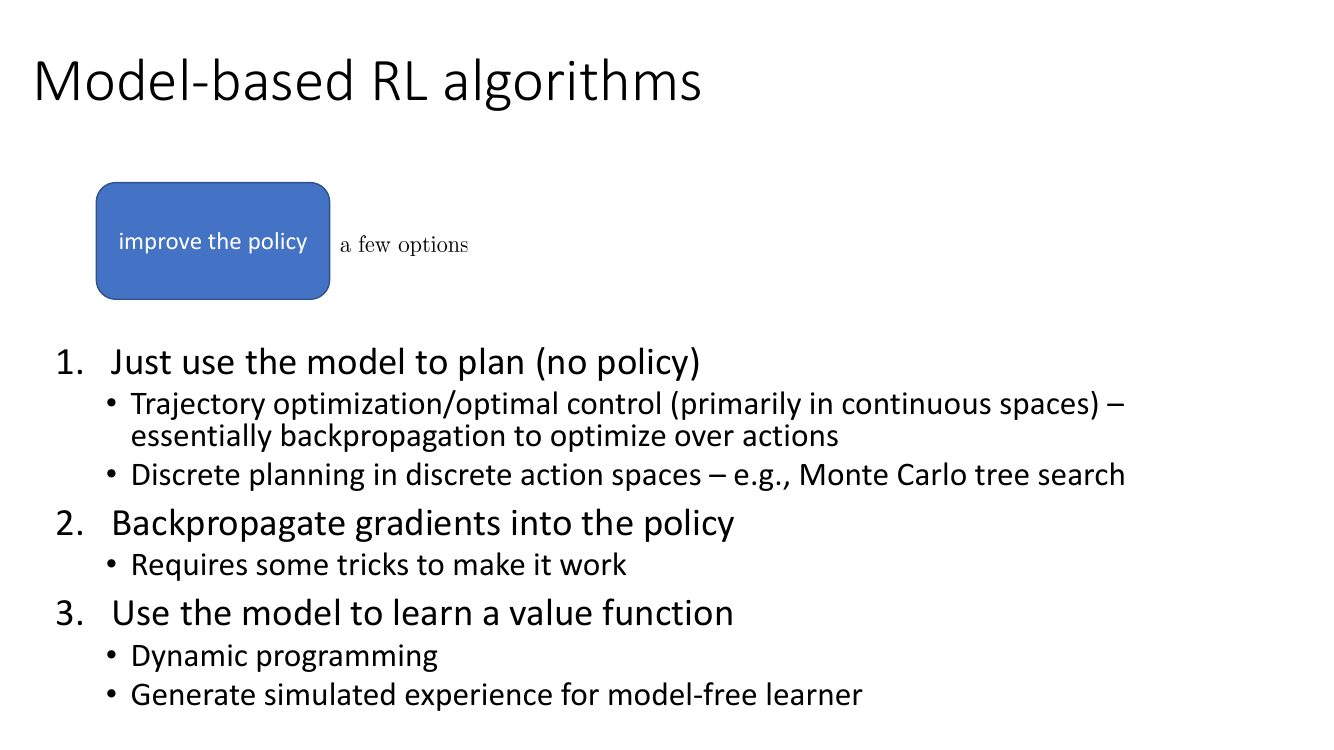
- 只用模型做规划,根本不要策略。 连续动作空间用轨迹优化 / 最优控制(trajectory optimization / optimal control)——本质上就是对动作序列做反向传播,代表方法是 iLQR、MPC、CEM;离散动作空间用离散规划,比如蒙特卡洛树搜索(MCTS),AlphaGo/MuZero 用的就是它。
- 把梯度反传到策略里。 就是 6.2 节讲的那条路,「需要一些技巧才能跑通」(Levine 原话)——主要是对付 BPTT 的梯度爆炸/消失和模型误差累积。
- 用模型学一个值函数。 若模型已知,可以直接做动态规划(dynamic programming)解 Bellman 方程;或者用模型生成模拟经验喂给一个 model-free 学习器——这就是 Dyna 的思想,现代版本是 MBPO。
8.2 值函数方法
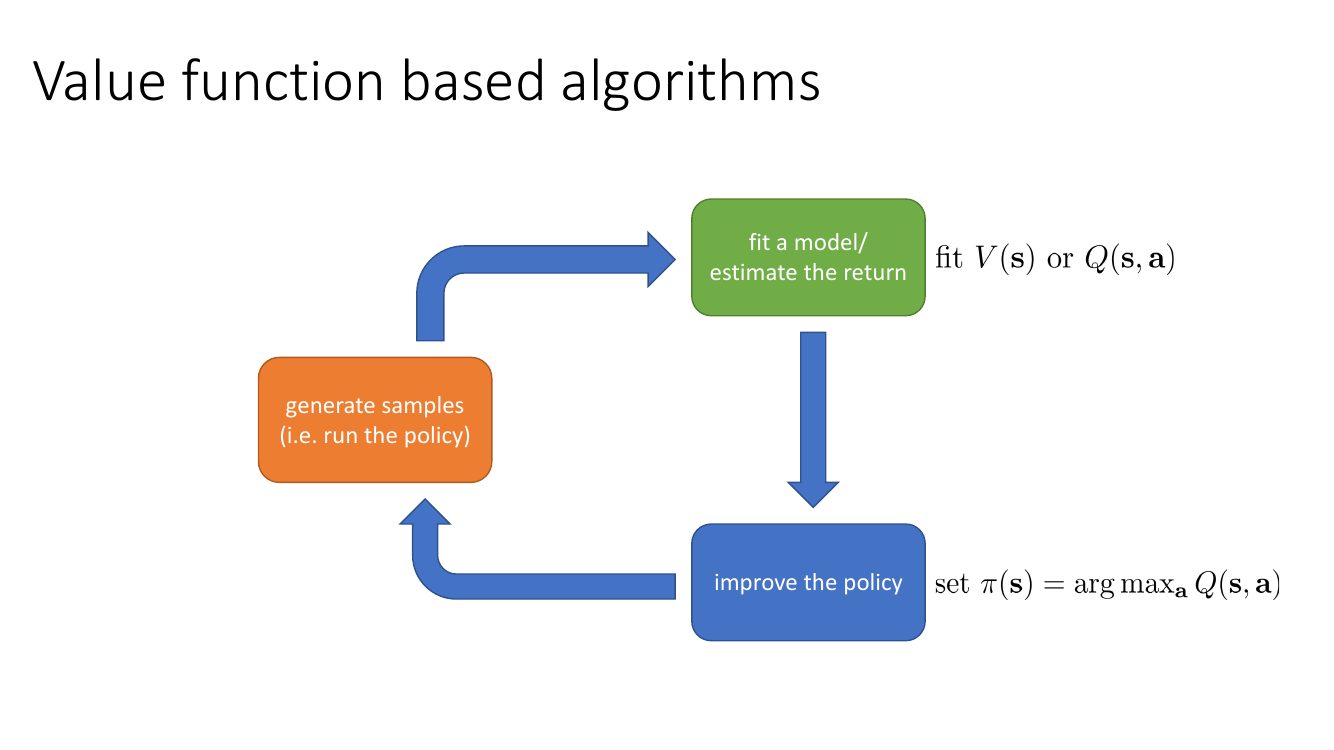
这是思路 1 的直接落地。它的巨大优势在于 off-policy:$Q^\star$(最优 $Q$)满足的 Bellman 最优方程
$$ Q^\star(s,a)=r(s,a)+\E_{s'\sim p(\cdot|s,a)}\Big[\max_{a'}Q^\star(s',a')\Big] $$右边的期望只对环境转移取,完全不涉及采样用的策略。这意味着任何来源的 $(s,a,r,s')$ 四元组都能用来拟合 $Q^\star$——去年收集的数据、别人的数据、随机策略的数据统统可以。这就是经验回放(replay buffer)能存在的理论依据,也是 Q-learning 类方法样本效率高的根源。代价是稳定性:在深度网络下,Bellman 误差最小化不保证收敛(第 9 节详述);而且 $\max_{a'}$ 在连续动作空间里本身就是个难题。
8.3 直接策略梯度
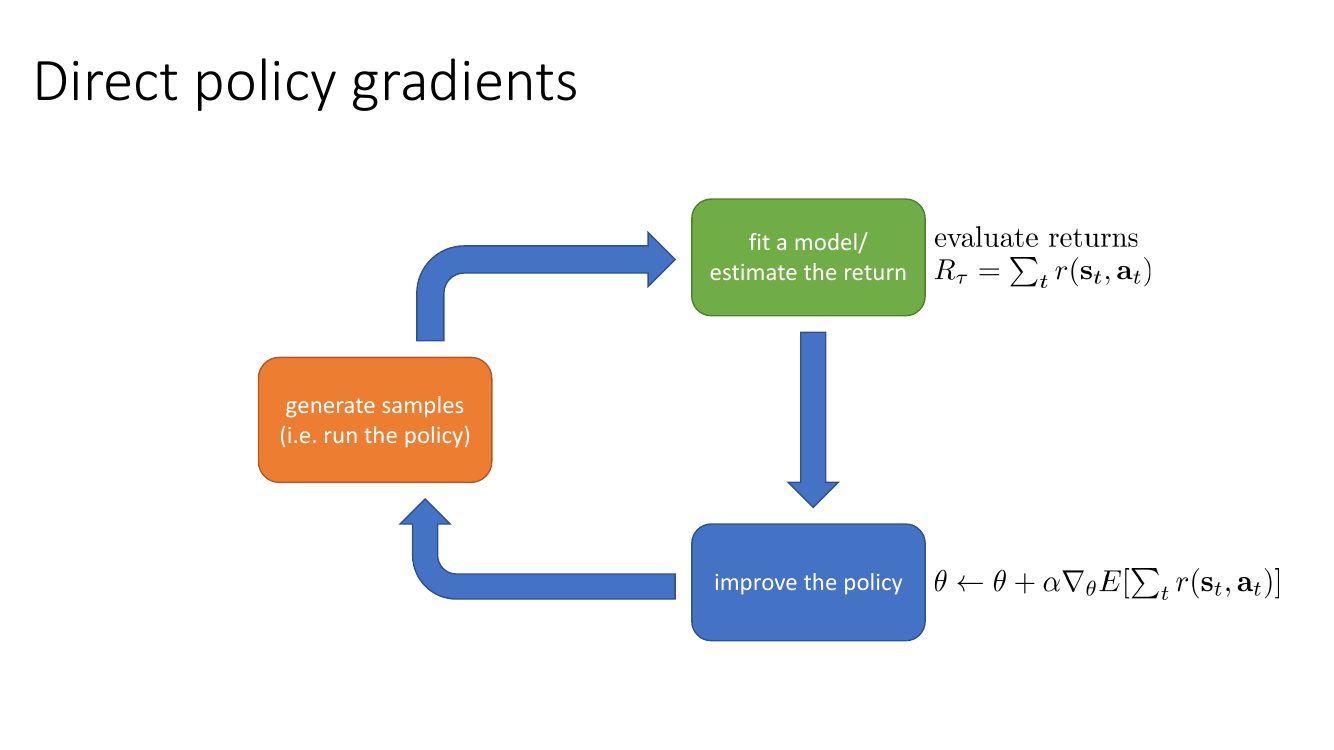
这类方法的定位很特殊:它是唯一真正在对我们关心的目标做梯度上升的方法。这带来了最好的理论保证(在合适的学习率下必然收敛到局部最优),但也带来了最差的样本效率——因为一旦策略更新了,之前的样本就来自旧策略,严格来说不能再用了(on-policy)。
8.4 Actor-critic:把两者缝在一起
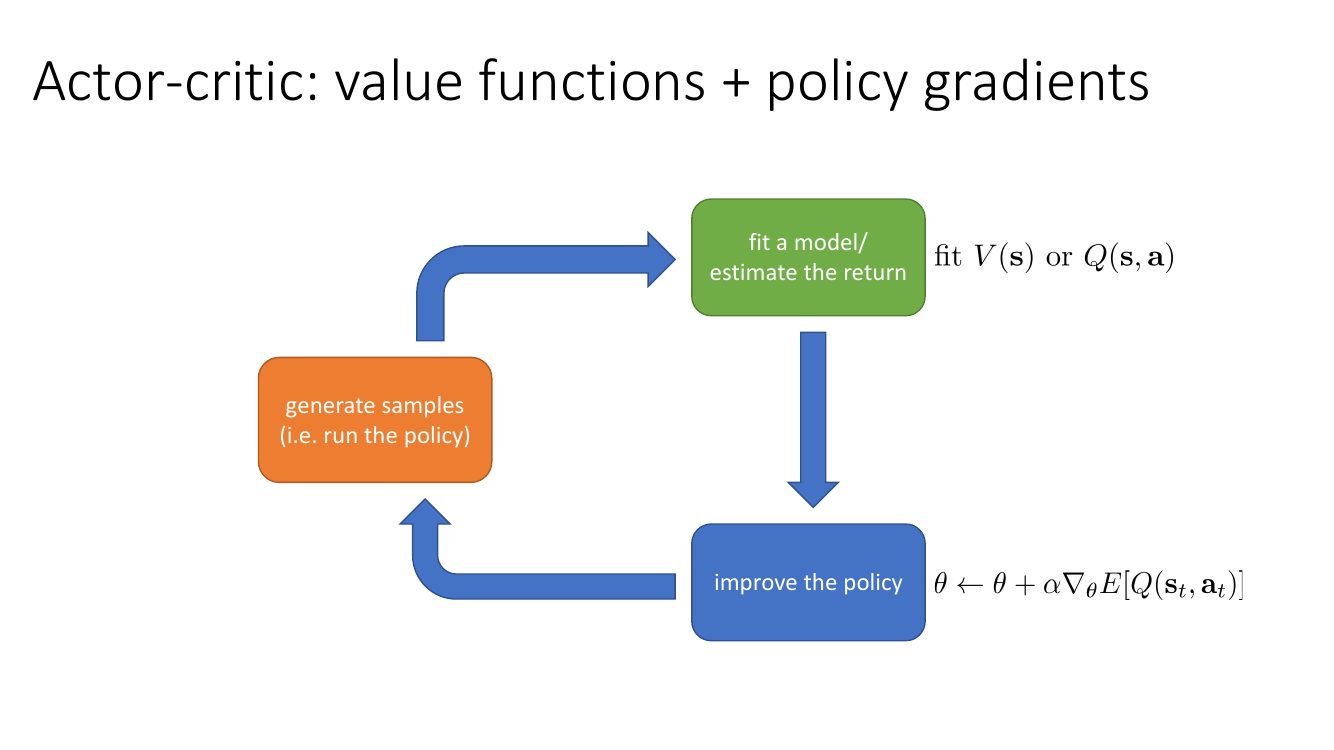
直觉是这样的:策略梯度的方差主要来自「用一条采样轨迹的总回报去估计期望回报」。而 critic 是一个学出来的、平滑的函数逼近器,它把很多条轨迹的信息压缩进去了,用它替代单条采样回报能大幅降低方差——代价是引入了偏差(critic 拟合得不准)。Actor-critic 就是这条偏差-方差谱线上的一族方法:纯策略梯度是「零偏差、高方差」的一端,纯值函数方法是「高偏差、低方差」的另一端。第 6 讲会精确刻画这条谱线($n$-step return、GAE)。
「Actor-critic 就是 policy gradient 加个 baseline」——不完全对。加 baseline(用 $V$ 减掉一个与动作无关的量)本身不引入偏差,纯粹降方差,那还是策略梯度。而 actor-critic 是用 critic 替换掉了回报估计本身(比如用 $r_t+V(s_{t+1})$ 代替 $\sum_{t'\ge t}r_{t'}$),这一步引入了 bootstrapping,是有偏的。两者的界限就在于:你有没有用 critic 去替代「未来奖励之和」这个采样量。
9. 权衡:为什么 RL 算法这么多
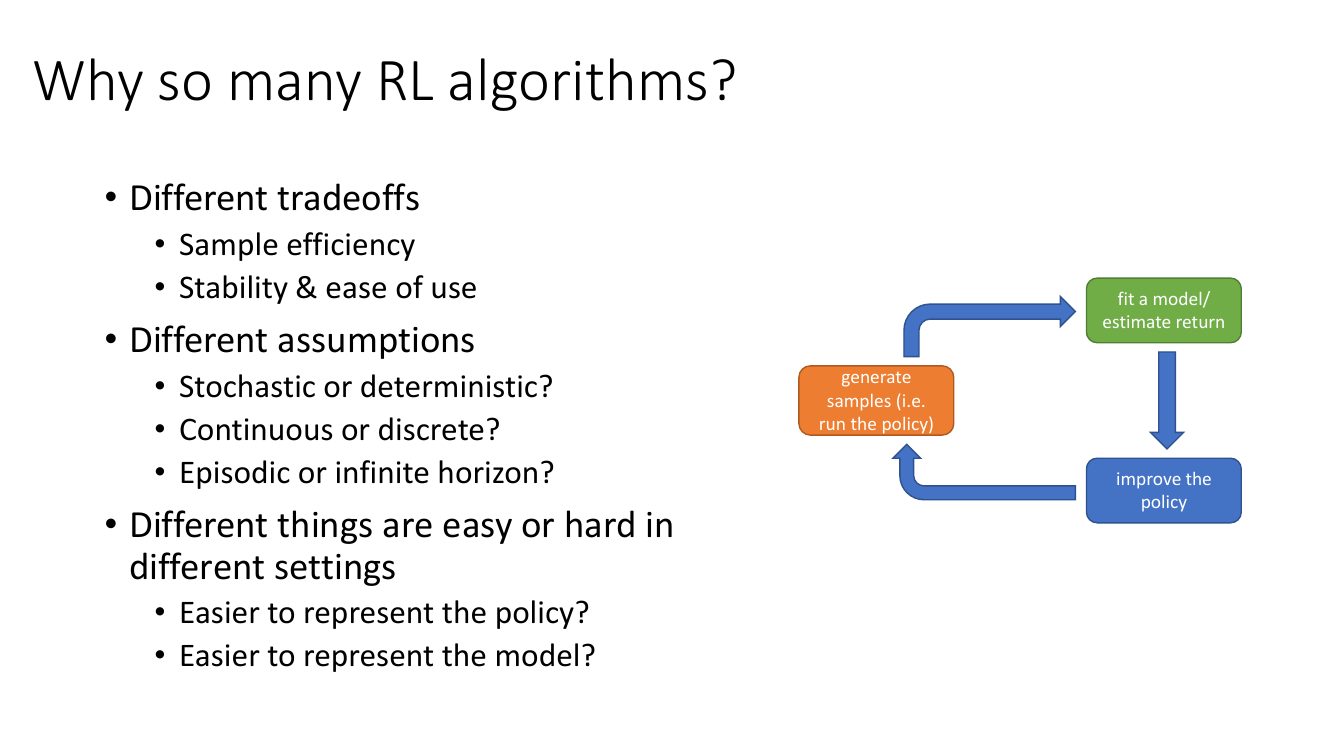
如果只有一个算法在所有维度上都最好,这门课就不用上二十讲了。现实是每一类方法都在某个维度上做了牺牲。下面逐个维度拆开。
9.1 采样效率与 on-policy / off-policy
采样效率(sample efficiency)的定义是:要得到一个足够好的策略,需要在环境里交互多少步?
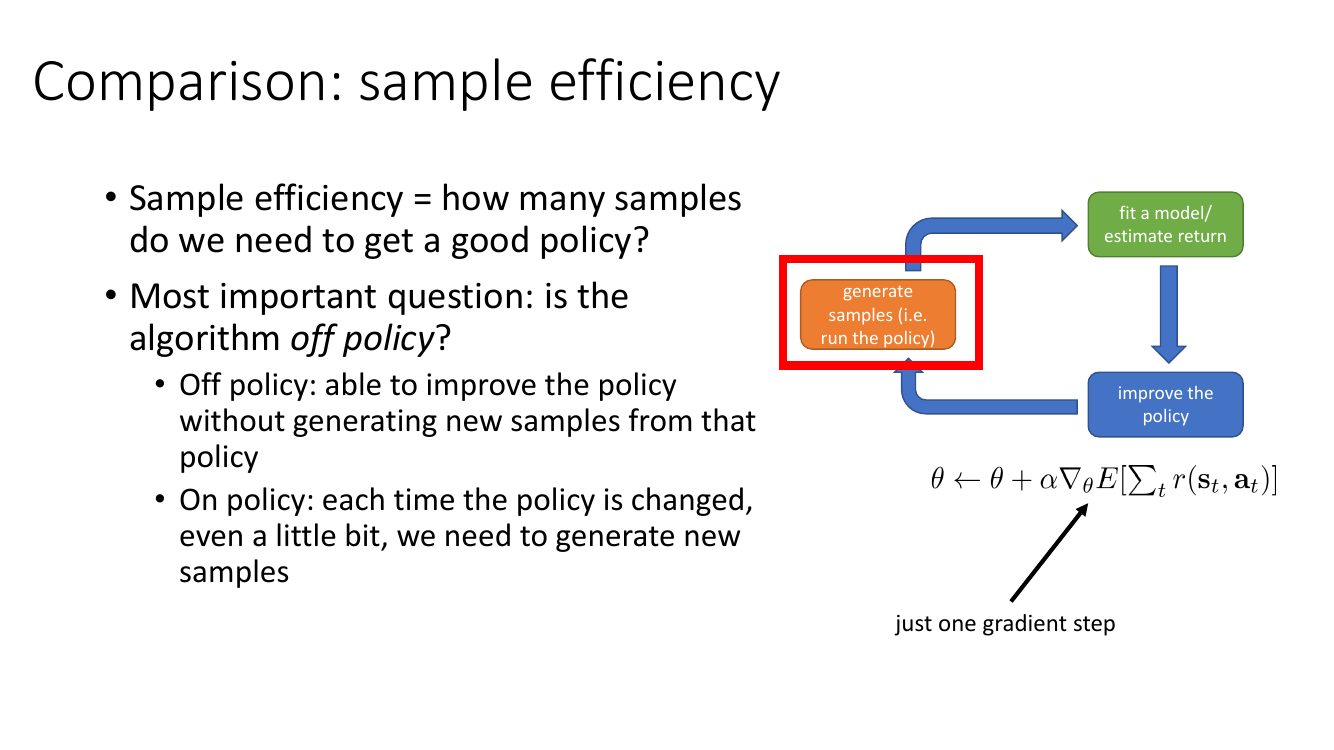
为什么策略梯度必须 on-policy?因为它的梯度是
$$ \nabla_\theta J(\theta)=\E_{\tau\sim p_\theta(\tau)}\big[\cdots\big] $$期望是对 $p_\theta(\tau)$ 取的,下标 $\theta$ 是当前参数。用旧策略 $\theta_{\text{old}}$ 的样本去估计这个期望,得到的是 $\nabla J$ 在 $\theta_{\text{old}}$ 处的值,不是在 $\theta$ 处的值——这是有偏的。而 Q-learning 的目标 $Q^\star$ 满足的方程里根本没有出现策略分布,所以任何数据都能用。「目标里的期望是不是对当前策略取的」,就是 on-policy 与 off-policy 的分水岭。
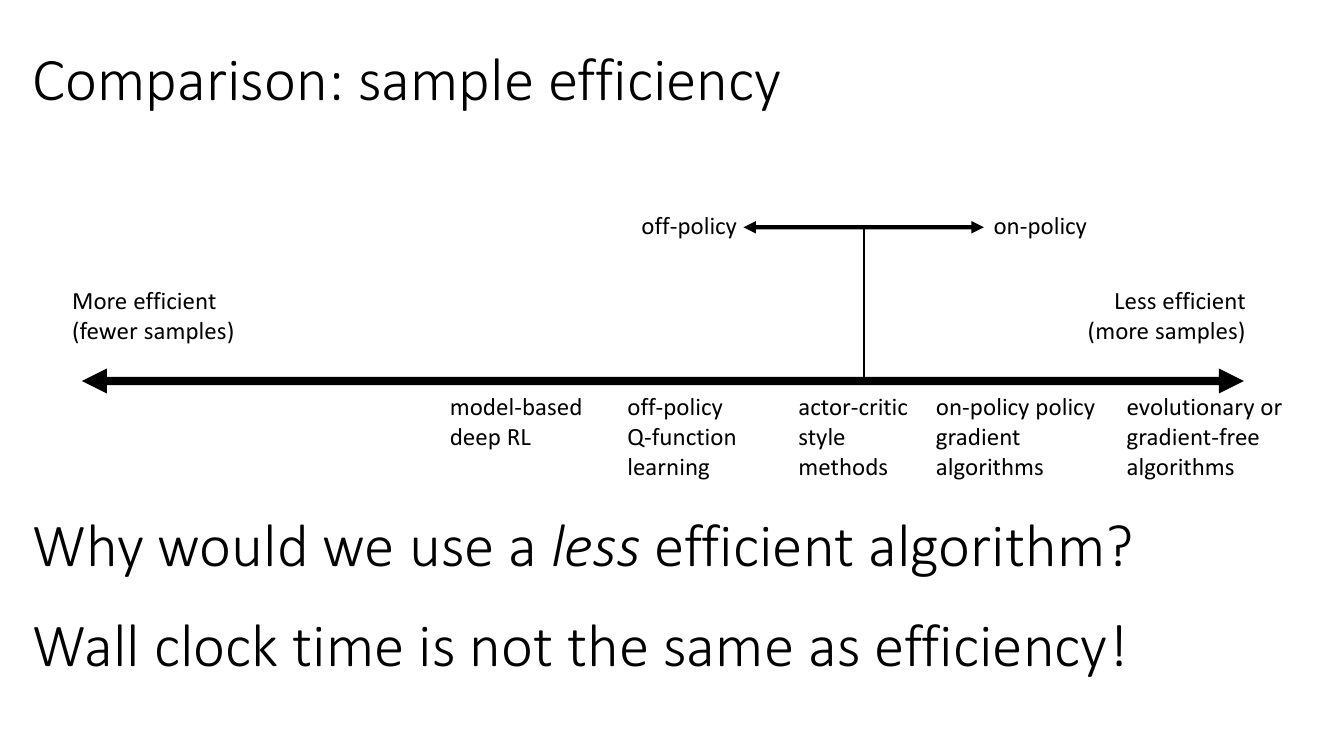
| 算法族 | on/off-policy | 相对样本量 | 为什么省 / 为什么费 |
|---|---|---|---|
| Model-based deep RL (Dyna、MBPO、MuZero) | off-policy | 最少 | 每个转移样本都用于监督式地训练动力学模型,信息利用率最高;训好模型后可以在「想象」里无限采样 |
| Off-policy Q 函数学习 (DQN、SAC 的 critic) | off-policy | 少 | Bellman 最优方程与行为策略无关,replay buffer 里的老数据可以反复使用 |
| Actor-critic | 两者都有 | 中等 | critic 可以 off-policy 复用数据,但 actor 的策略梯度部分通常需要较新的数据 |
| On-policy 策略梯度 (REINFORCE、TRPO、PPO) | on-policy | 多 | 每次更新后数据作废;PPO 靠重要性采样 + 裁剪把一批数据用几个 epoch,属于近似 on-policy |
| 进化 / 无梯度算法 (CEM、CMA-ES、ES) | on-policy | 最多 | 完全不利用轨迹的时序结构,只把「整个策略 → 一个标量分数」当黑箱来搜索,丢掉了每一步的信息 |
幻灯片最后两句必须重读:「为什么还要用效率低的算法?」「墙钟时间不等于采样效率!」
采样效率衡量的是「需要多少环境交互」,但你真正在意的往往是「需要多少小时才能得到结果」。进化算法虽然要 100 倍的样本,但它完全并行、每步计算极廉价、几乎没有超参数需要调——在一个能开 10000 个并行仿真实例的集群上,它可能比 model-based 方法更快出结果。反过来,MBPO 在 MuJoCo 上样本效率是 SAC 的十几倍,但单步计算慢一个数量级,在快仿真里墙钟时间未必占优。只有当采样本身昂贵(真实机器人、真实用户)时,采样效率才等价于总耗时。
9.2 稳定性与收敛性
Levine 在这里问了一个初看很怪的问题:「这怎么会成为一个问题?」 监督学习里我们从来不担心「算法会不会收敛」——梯度下降就是梯度下降,学习率够小就单调下降。但 RL 里:
| 方法 | 它实际在做什么优化 | 收敛吗 | 收敛到什么 |
|---|---|---|---|
| Q-learning / 值函数拟合 | 不是梯度下降,是不动点迭代(fixed point iteration) | 表格情形收敛;非线性函数逼近下没有保证 | 好的情况下最小化 Bellman 误差;坏的情况下什么都不优化,甚至发散 |
| Model-based RL | 最小化模型的拟合误差(监督学习) | 模型训练会收敛 | 收敛到一个好模型 —— 但好模型不等于好策略 |
| 策略梯度 | 真真正正的梯度上升,对象就是 $J(\theta)$ 本身 | 标准 SGD 保证(局部最优) | $J$ 的局部极大 —— 但往往是效率最低的 |
为什么 Q-learning 不是梯度下降? 它的更新长这样:
$$ \phi\leftarrow\phi-\alpha\,\nabla_\phi\big(Q_\phi(s,a)-y\big)^2,\qquad y=r+\max_{a'}Q_{\phi}(s',a') $$看起来像在最小化平方误差,但目标 $y$ 自己也依赖 $\phi$,而我们在求导时假装它不依赖(这叫「半梯度 semi-gradient」,实现上就是对 $y$ 做 detach())。所以这个更新不是任何一个固定损失函数的梯度。它真正在做的是迭代 Bellman 算子 $\mathcal{B}$:$Q\leftarrow \Pi\mathcal{B}Q$,其中 $\Pi$ 是往函数类上的投影。$\mathcal{B}$ 在 $\ell_\infty$ 范数下是 $\gamma$-收缩的,$\Pi$ 在 $\ell_2$ 下是非扩张的——两个在不同范数下的良性算子复合起来,可以不是收缩。这就是著名的「致命三要素(deadly triad):函数逼近 + bootstrapping + off-policy 数据」,三者同时出现时 Q-learning 可以发散。第 8 讲会给出具体的发散例子。
Model-based 的问题则更微妙:模型训练是标准监督学习,一定收敛;但你的模型是按「预测下一状态的均方误差」训的,不是按「用它规划出来的策略好不好」训的。一个在训练分布上误差很小的模型,可能在策略优化推向的新区域里错得离谱,而优化器恰恰会主动去寻找那些「模型预测收益很高但其实是幻觉」的区域。这叫 model exploitation,是 model-based RL 最核心的难题。
这里有一个残酷的对偶:唯一有可靠收敛保证的方法(策略梯度)恰恰是样本效率最差的;样本效率最好的方法(model-based、off-policy Q)恰恰是最容易崩的。 这个张力贯穿整门课,也解释了为什么工业界大量使用 PPO——它不是最优的,但它是最不容易莫名其妙炸掉的。
9.3 假设与表示难度
| 假设维度 | 谁需要它 | 违反了会怎样 |
|---|---|---|
| 完全可观测(状态满足马尔可夫性) | 值函数方法、model-based 强依赖 | Bellman 方程失效;策略梯度相对更鲁棒,因为其推导未用马尔可夫性 |
| 连续 vs 离散动作 | Q-learning 需要 $\max_a Q$,离散才好算 | 连续动作下 $\max_a$ 需要内层优化(DDPG 用一个 actor 网络近似它) |
| 回合制 vs 无限时长 | 纯策略梯度、model-based 常假设有限 horizon | 无限时长要用折扣或平均奖励形式(见第 4 节) |
| 确定性 vs 随机环境 | 一些轨迹优化方法假设确定性 | 随机环境下开环规划严重次优,需要 MPC 反复重规划 |
| 策略易表示 vs 模型易表示 | 决定选 model-free 还是 model-based | 例:叠积木的物理模型极难学,但「抓起来放上去」的策略很简单;反之,围棋的规则(模型)是已知且精确的,但最优策略极其复杂 |
最后这一行值得多说一句,因为它是选型时最实用的判据。Levine 举的例子是:想象一个装满水的杯子被打翻——模拟液体流动(模型)极难,但「别碰倒杯子」(策略)极简单。反过来,在围棋里模型完全已知且精确(就是规则),而最优策略复杂到人类几千年都没穷尽。所以围棋适合用 MCTS + 模型,而灵巧操作更适合直接学策略。先问自己「这个任务里,是策略更简单还是动力学更简单」,答案往往直接决定了该走哪条技术路线。
10. 具体算法清单与两个例子
把上面的分类落到具体名字上,就得到了本课后半程的目录。
| 类别 | 算法 | 一句话 | 大致在第几讲 |
|---|---|---|---|
| 值函数方法 | Q-learning / DQN | 用神经网络拟合 $Q^\star$,配 replay buffer 和 target network | 7–8 |
| 时序差分学习(TD learning) | 用 bootstrapping 而非完整回报来更新值估计 | 6–7 | |
| 拟合值迭代(fitted value iteration) | 把动态规划的值迭代搬到函数逼近上 | 7 | |
| 策略梯度方法 | REINFORCE | 最基础的策略梯度,log-derivative trick 的直接产物 | 5 |
| 自然策略梯度(natural policy gradient) | 用 Fisher 信息矩阵做预条件,梯度方向对参数化不敏感 | 9 | |
| PPO | 用裁剪的重要性比值近似信赖域约束,工业界默认选择 | 9 | |
| Actor-critic | A3C | 异步并行的优势 actor-critic | 6 |
| SAC(soft actor-critic) | 最大熵框架下的 off-policy actor-critic,连续控制的强基线 | 6 / 19 | |
| Model-based | Dyna(及 MBPO 等 Dyna 类方法) | 用学到的模型生成想象数据,喂给 model-free 学习器 | 11–12 |
| MuZero | 学一个「只需支持规划」的隐空间模型 + MCTS | 11–12 |
10.1 例子一:用 Q 函数玩 Atari
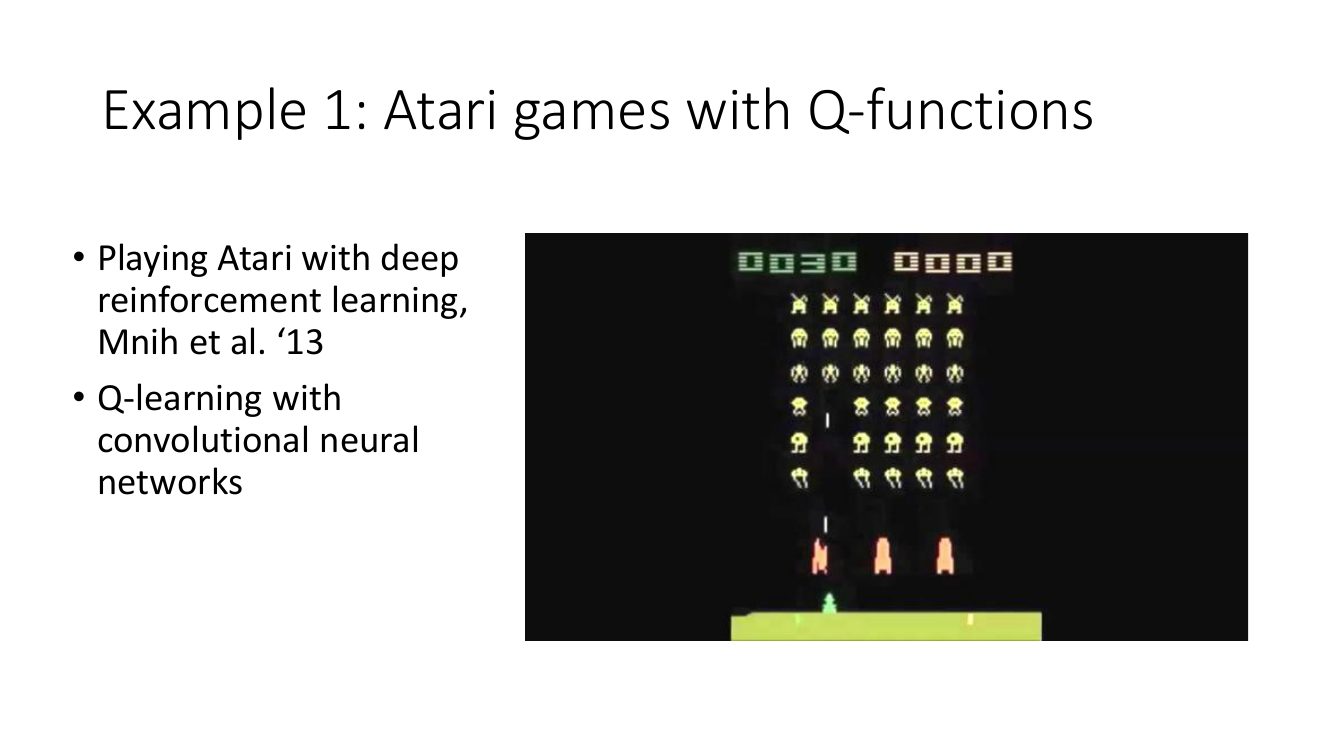
这个工作(Mnih et al., 2013)之所以成为深度 RL 的引爆点,是因为它第一次证明:同一套超参数、同一个网络结构,不做任何针对单个游戏的调整,就能在几十个 Atari 游戏上达到甚至超过人类水平。它把「函数逼近 + Q-learning」这个理论上不保证收敛的组合,用两个工程技巧(experience replay 打破样本相关性,target network 稳定回归目标)掰成了能用的东西。
10.2 例子二:用策略梯度学走路
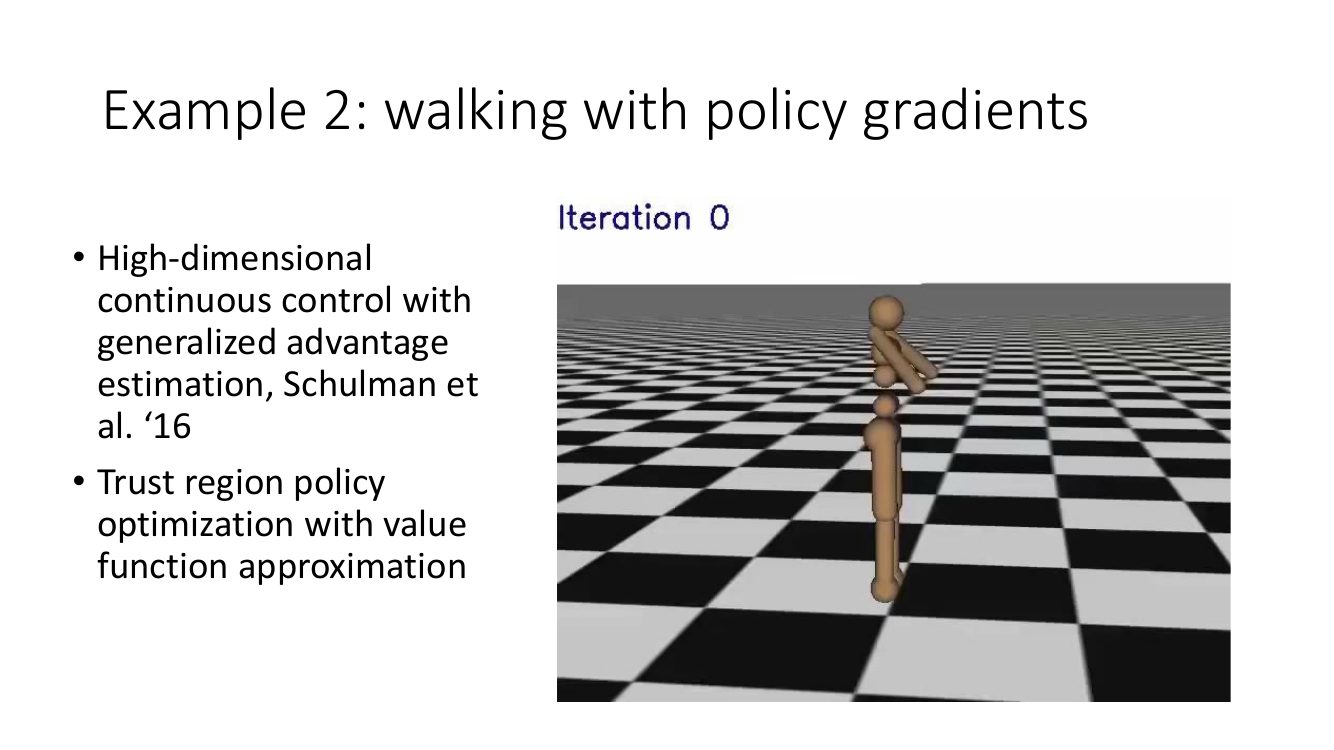
把两个例子并排看,四大分类的选型逻辑就清楚了:离散动作 + 像素输入 + 便宜仿真 → 值函数方法;连续高维动作 + 需要稳定训练 → 策略梯度 / actor-critic。而如果场景换成真实机器人、样本以「小时」计,那就该考虑 model-based 了。
本讲小结
速查表:本讲定义的所有记号
| 记号 | 名称 | 定义 / 含义 |
|---|---|---|
| $s_t\in\mathcal{S}$ | 状态 | 满足马尔可夫性:给定 $s_t$,未来与过去独立 |
| $a_t\in\mathcal{A}$ | 动作 | 智能体的输出,可离散可连续 |
| $o_t\in\mathcal{O}$ | 观测 | 由 $p(o_t|s_t)$ 生成;观测序列一般不马尔可夫 |
| $\pi_\theta(a|s)$ | 策略 | 参数为 $\theta$ 的条件分布,本课主要是神经网络 |
| $p(s'|s,a)$、$\mathcal{T}$ | 转移 / 转移算子 | 环境动力学;作为算子它线性地作用在分布上 |
| $r(s,a)$ | 奖励函数 | $\mathcal{S}\times\mathcal{A}\to\R$,本讲假设已知 |
| $\tau$ | 轨迹 | $(s_1,a_1,\dots,s_H,a_H)$ |
| $p_\theta(\tau)$ | 轨迹分布 | $p(s_1)\prod_t \pi_\theta(a_t|s_t)p(s_{t+1}|s_t,a_t)$ |
| $p_\theta(s_t)$、$p_\theta(s_t,a_t)$ | 状态 / 状态-动作边缘 | 轨迹分布对其余变量的边缘化 |
| $\mu_t$、$\mathcal{T}_\theta$ | 边缘向量 / 增广链转移矩阵 | $\mu_{t+1}=\mathcal{T}_\theta\mu_t$,$\mu_t=\mathcal{T}_\theta^{t-1}\mu_1$ |
| $\bar\mu$ | 平稳分布 | $\mathcal{T}_\theta\bar\mu=\bar\mu$,即特征值 1 的特征向量 |
| $Q^\pi(s_t,a_t)$ | Q 函数 | $\sum_{t'\ge t}\E_\pi[r(s_{t'},a_{t'})|s_t,a_t]$ |
| $V^\pi(s_t)$ | 值函数 | $\E_{a_t\sim\pi}[Q^\pi(s_t,a_t)]$;$\E_{s_1}[V^\pi(s_1)]$ 即 RL 目标 |
| $A^\pi(s,a)$ | 优势函数 | $Q^\pi(s,a)-V^\pi(s)$,满足 $\E_{a\sim\pi}[A^\pi]=0$ |
要点清单
- 三个模型层级:Markov chain $\{\mathcal S,\mathcal T\}$ → MDP $\{\mathcal S,\mathcal A,\mathcal T,r\}$ → POMDP $\{\mathcal S,\mathcal A,\mathcal O,\mathcal T,\mathcal E,r\}$。固定策略后 MDP 退化为增广状态 $(s,a)$ 上的马尔可夫链。
- 目标的三种等价写法:轨迹期望 $\E_{\tau\sim p_\theta(\tau)}\left[\sum_t r\right]$;边缘求和 $\sum_t\E_{p_\theta(s_t,a_t)}[r]$;线性代数 $\left[\sum_t\mathcal{T}_\theta^{t-1}\mu_1\right]^\top\vec r$。无限步时取时间平均,等于 $\bar\mu^\top\vec r$。
- 平稳分布的论证:平稳 ⟺ $(\mathcal{T}_\theta-I)\bar\mu=0$ ⟺ $\bar\mu$ 是特征值 1 的特征向量;在遍历性条件下存在唯一,且收敛速度由谱隙决定。
- 期望是可优化的前提:奖励可以是阶跃函数(掉崖 $-1$ / 不掉 $+1$),但 $\E_{\pi_\theta}[r]=1-2\theta$ 关于 $\theta$ 光滑。这是所有梯度型 RL 方法成立的根基,也是 RL 能处理不可微奖励(游戏胜负、人类偏好)的原因。
- 三步循环:生成样本 → 拟合模型 / 估计回报 → 改进策略。四大算法族只是这三个框的不同填法。
- $Q$ 与 $V$ 的两个用法:贪心改进(通向 Q-learning,改进定理保证不变差);提高优势为正的动作的概率(通向策略梯度 / actor-critic)。
- 核心权衡:off-policy ⟹ 样本效率高;策略梯度是唯一真正做梯度上升的方法,稳定但费样本;值函数方法是不动点迭代,非线性下无收敛保证;model-based 模型一定收敛,但好模型 ≠ 好策略。采样效率 ≠ 墙钟时间。
- 选型判据:采样贵不贵?动作连续还是离散?策略好表示还是模型好表示?这三问基本决定了技术路线。
如果这一讲只能记住一句话:强化学习就是在「由策略诱导出的轨迹分布」上做期望最大化,而所有算法的差别,都在于它们如何绕开「无法直接计算这个期望及其梯度」这个障碍。 策略梯度用采样直接估计梯度;值函数方法用 Bellman 递推把长期期望拆成一步;model-based 干脆把环境学下来自己算。后面每学一个新算法,都可以回来问一句:它在三步循环里填的是什么?它付出了什么代价?
延伸阅读
本讲直接提到的论文
- Playing Atari with Deep Reinforcement Learning (Mnih et al., 2013) — 深度 RL 的引爆点,值函数方法的范例;读它主要是看 replay buffer 和 target network 这两个让 Q-learning 稳定下来的工程技巧。
- High-Dimensional Continuous Control Using Generalized Advantage Estimation (Schulman et al., 2016) — 连续控制的策略梯度范例;GAE 是「偏差-方差谱线」最清晰的技术表达,第 6 讲会详细推。
- Trust Region Policy Optimization (Schulman et al., 2015) — 上一篇里用的策略优化方法,第 9 讲的主角。
四大算法族的入口论文
- Proximal Policy Optimization Algorithms (Schulman et al., 2017) — 如果只读一篇策略梯度的论文,读这篇;它是当前工业界(含 RLHF)事实上的默认算法。
- Soft Actor-Critic (Haarnoja et al., 2018) — off-policy actor-critic 的代表,连续控制上样本效率与稳定性兼顾得最好的方法之一。
- When to Trust Your Model: Model-Based Policy Optimization (Janner et al., 2019) — MBPO,现代 Dyna 类方法;正面处理了「模型误差如何限制想象 rollout 长度」这个问题。
- Mastering Atari, Go, Chess and Shogi by Planning with a Learned Model (Schrittwieser et al., 2019) — MuZero,把「学模型」重新定义为「学一个足以支持规划的隐表示」。
打基础的教材与综述
- Sutton & Barto, Reinforcement Learning: An Introduction(第 2 版,2018,作者官网免费)— 第 3 章讲 MDP 与值函数,第 4 章讲动态规划与策略改进定理,正好覆盖本讲第 2、4、7 节的内容,且推导更细。
- Puterman, Markov Decision Processes: Discrete Stochastic Dynamic Programming(1994)— 想把平稳分布、遍历性、平均奖励准则这些理论细节搞扎实,看这本;本讲第 4 节的正则性条件在这里有完整处理。
- An Introduction to Deep Reinforcement Learning (François-Lavet et al., 2018) — 一篇结构清晰的综述,可以当作本讲「算法全景图」的文字版扩写。
关于部分可观测
- Kaelbling, Littman & Cassandra, Planning and Acting in Partially Observable Stochastic Domains(1998)— POMDP 与信念状态的经典综述,本讲第 2.4 节的完整版。
- Deep Recurrent Q-Learning for Partially Observable MDPs (Hausknecht & Stone, 2015) — 用 LSTM 代替帧堆叠来近似信念状态,是深度 RL 处理 POMDP 最直接的做法。