离线强化学习
只给你一堆别人收集好的数据、一次环境交互都不许做,还要学出比数据里任何一条轨迹都好的策略——这件事为什么可能,又为什么把标准 RL 算法直接搬过来一定会崩。
0. 本讲导读
到目前为止,本课程里的每一个算法——策略梯度、Q-learning、actor-critic、基于模型的方法——都默认了一件事:你可以随时和环境交互。哪怕是所谓的「离策略(off-policy)」算法,比如 DQN 和 SAC,它们的 replay buffer 里装的也是自己刚刚跑出来的数据;只要当前策略想试一个新动作,下一轮采样它就会去试,试完就知道好不好。
这一讲要把这个假设彻底拿掉。离线强化学习(offline RL,也叫 batch RL、fully off-policy RL)的设定是:给你一个固定的数据集 $\mathcal{D}$,它由某个(或某些)行为策略(behavior policy) $\pi_\beta$ 事先采集好;你在整个训练过程中一次都不能与环境交互;训练结束后策略 $\pi_\theta$ 被部署一次,用最终表现打分。
这个设定听上去像是给自己找麻烦,但它其实是把 RL 推向真实世界的关键一环。机器人、自动驾驶、医疗决策、推荐系统、对话系统——这些领域的共同点是在线试错要么很贵,要么很危险,要么根本不合法,但历史数据往往堆积如山。同时,理解离线 RL 会反过来极大加深你对 RL 本身的理解:本讲揭示的「$\max$ 算子系统性地放大函数逼近误差」这一机制,其实在所有 Q-learning 类算法里都存在,只是在线交互一直在偷偷帮你打补丁,你没注意到而已。
本讲分三部分展开。第一部分回答「什么是离线 RL、它凭什么可能比数据更好」,核心概念是拼接(stitching)。第二部分是全讲的技术核心:分布偏移(distributional shift)为什么在离线设定下从一个小麻烦变成致命伤,以及它在 Q-learning、model-based RL、importance sampling 三类方法里分别长什么样。第三部分给出第一类解法——策略约束(policy constraint)——的第一性原理推导,并讨论应该用哪种散度度量。更完整的算法家族(CQL、IQL、悲观模型法等)留到下一讲。
- 离线 RL 的价值不在于「模仿数据里最好的那条轨迹」,而在于拼接:把不同轨迹的好片段重组成一条全新的、比数据集中任何一条轨迹都好的路径。这是它区别于模仿学习的本质。
- 离线 RL 的根本困难是反事实查询(counterfactual query):策略想做一个数据里没出现过的动作,而你无法通过实验去验证它好不好。
- Bellman 目标里的 $\max_{a'} Q(s',a')$ 或 $\E_{a'\sim\pi_\theta}[Q(s',a')]$ 是一个对抗性查询:它专门去找 $Q$ 值最高的动作,而函数逼近误差最大的地方恰恰最容易被选中,于是 $\max$ 系统性地挑出被高估的分布外(OOD)动作。
- 在线 RL 中,这种高估会因为「试一下发现没那么好」而被自动纠正;离线 RL 中没有这个纠正通道,误差通过 Bellman 备份反复自我强化,形成没有负反馈的正反馈循环,$Q$ 值可以涨到几个数量级之外。
- 因此直接把 SAC/DQN 跑在固定数据集上会失败,而且会出现反直觉现象:数据越多,有时反而越差——因为更大的数据集覆盖了更大的状态空间,也就给了 $\max$ 更多可供高估的「陌生角落」。
- 解法的共同思路只有一个:不要去查询你无法信任的地方。具体形态有四种——策略约束、保守(悲观)值函数、不确定性估计、以及保守的模型方法。
1. 三种数据流范式:on-policy、off-policy、offline
先把三种设定的数据流画清楚,因为它们的差别只体现在「谁采的数据、还能不能再采」这两个问题上,但后果天差地别。
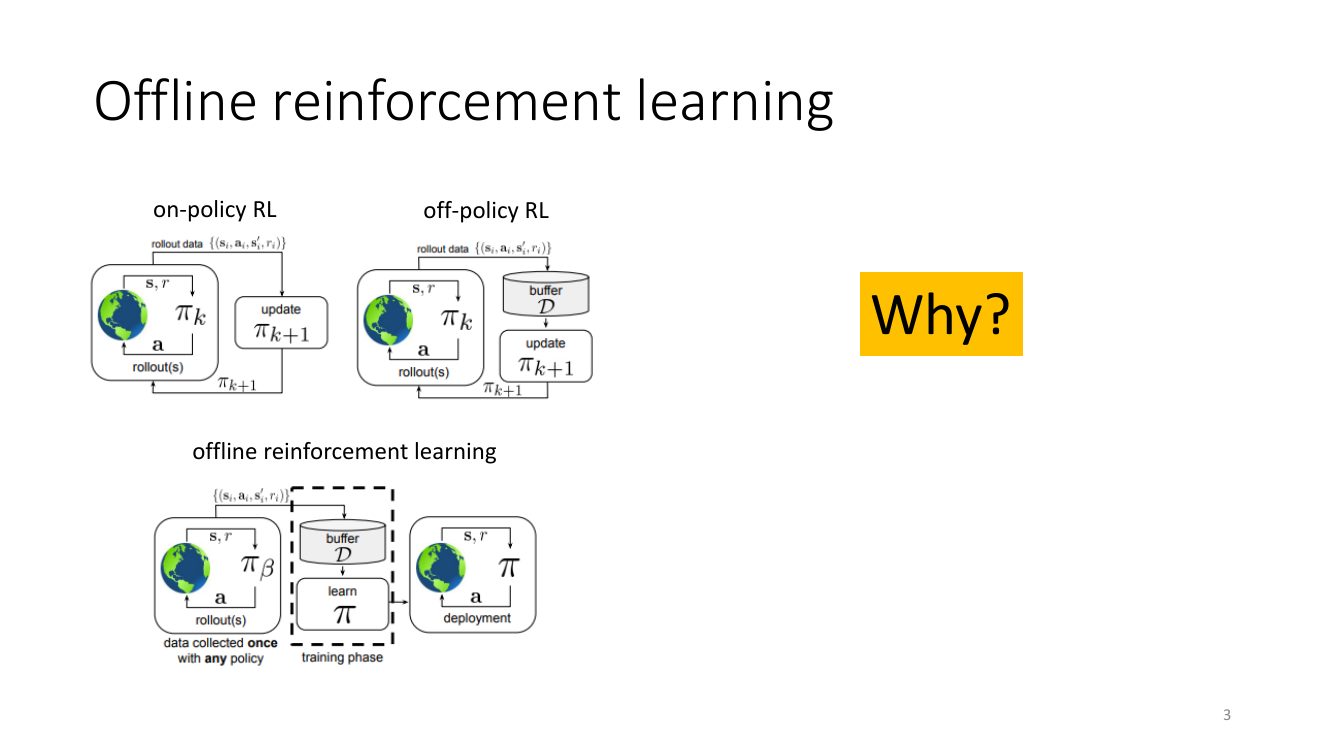
形式化定义
离线 RL 的数据集写作
$$ \mathcal{D} = \{(s_i, a_i, s_i', r_i)\}_{i=1}^{N},\qquad s \sim p_\beta(s),\quad a \sim \pi_\beta(a\mid s),\quad s' \sim p(s'\mid s,a) $$这里 $s$ 是状态(假设满足马尔可夫性),$a$ 是动作,$r(s,a)$ 是奖励,$p(s'\mid s,a)$ 是环境的真实转移。$\pi_\beta$ 就是行为策略,$p_\beta(s)$ 是它诱导出的状态边缘分布。有两点必须强调:
- $\pi_\beta$ 通常是未知的。 数据可能来自人类操作员、来自一个写死的控制器、来自若干个不同版本的旧策略,甚至是这些的混合。你手上只有样本,没有那个条件分布的解析形式。很多算法需要显式估计 $\hat\pi_\beta$,这本身就是一个误差来源。
- 转移 $s'$ 只在数据里出现过的 $(s_i,a_i)$ 上有。 这一句是后面所有推导的支点:你想问「如果在 $s_i$ 做另一个动作 $\tilde a$ 会怎样」,数据集里没有答案。
而我们的优化目标仍然是标准的 RL 目标——注意期望是在新策略 $\pi_\theta$ 下取的:
$$ \max_\theta \sum_{t=0}^{H} \E_{s_t,a_t \sim \pi_\theta}\big[\gamma^t\, r(s_t,a_t)\big] $$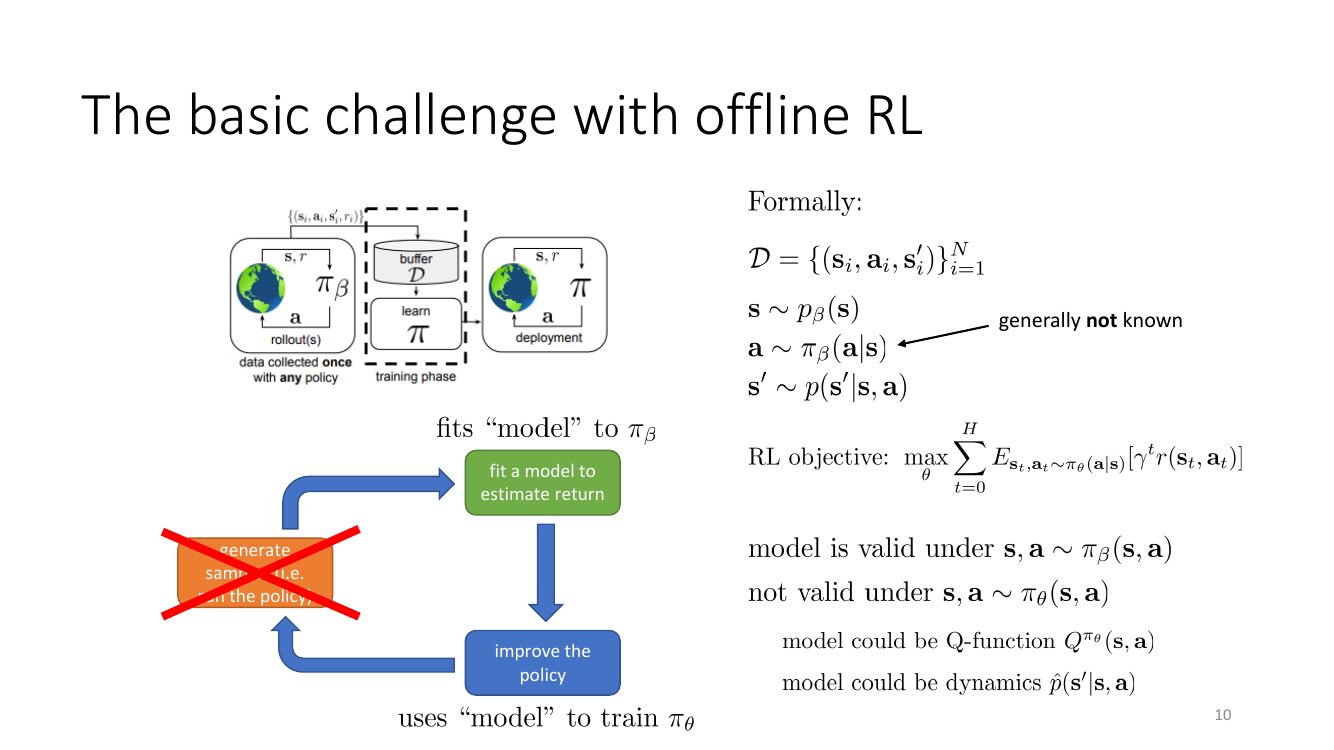
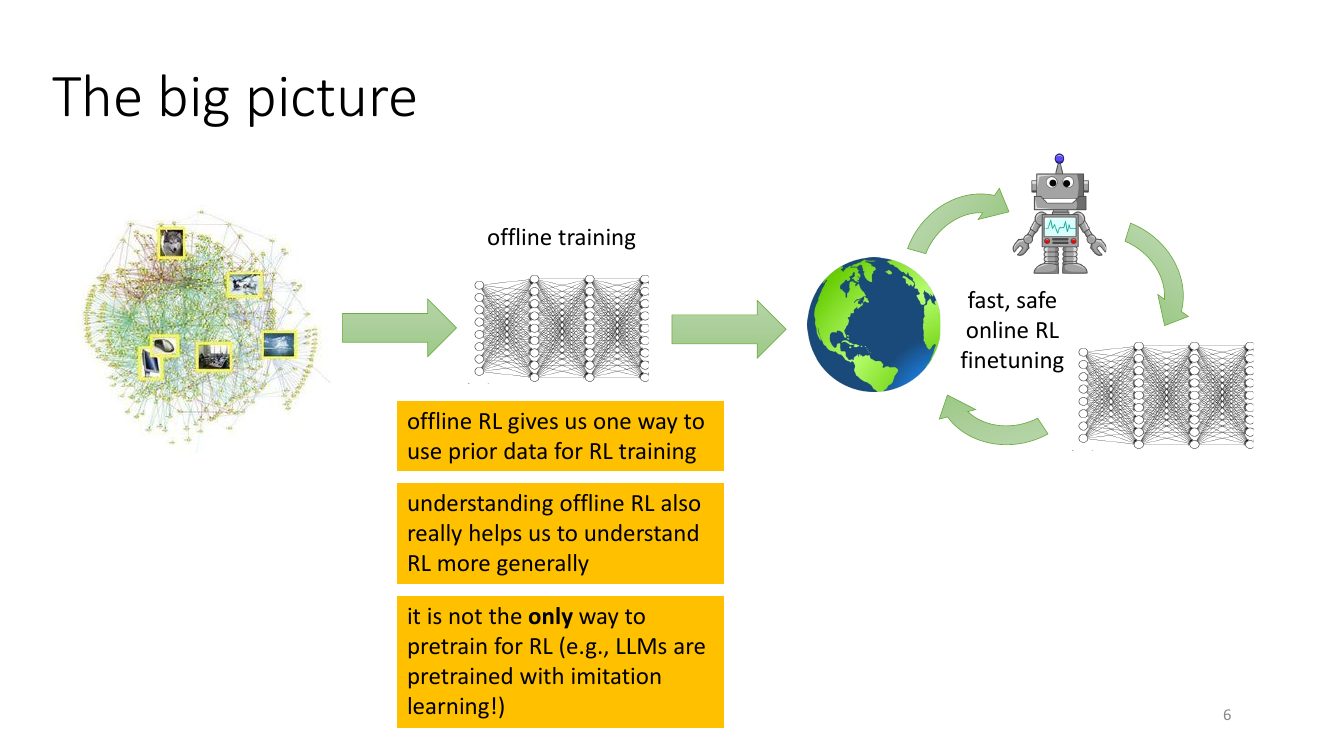
off-policy RL 和 offline RL 的区别,不是「数据新不新」,而是「错了以后有没有机会知道自己错了」。DQN 的 replay buffer 里也全是旧策略的数据,但只要它对某个动作产生了错误的乐观估计,它下一轮就会去做那个动作,环境会立刻用一个低奖励把它打回来。离线 RL 把这条纠错回路剪断了,剩下的就是一个纯粹的、无人监督的外推问题。
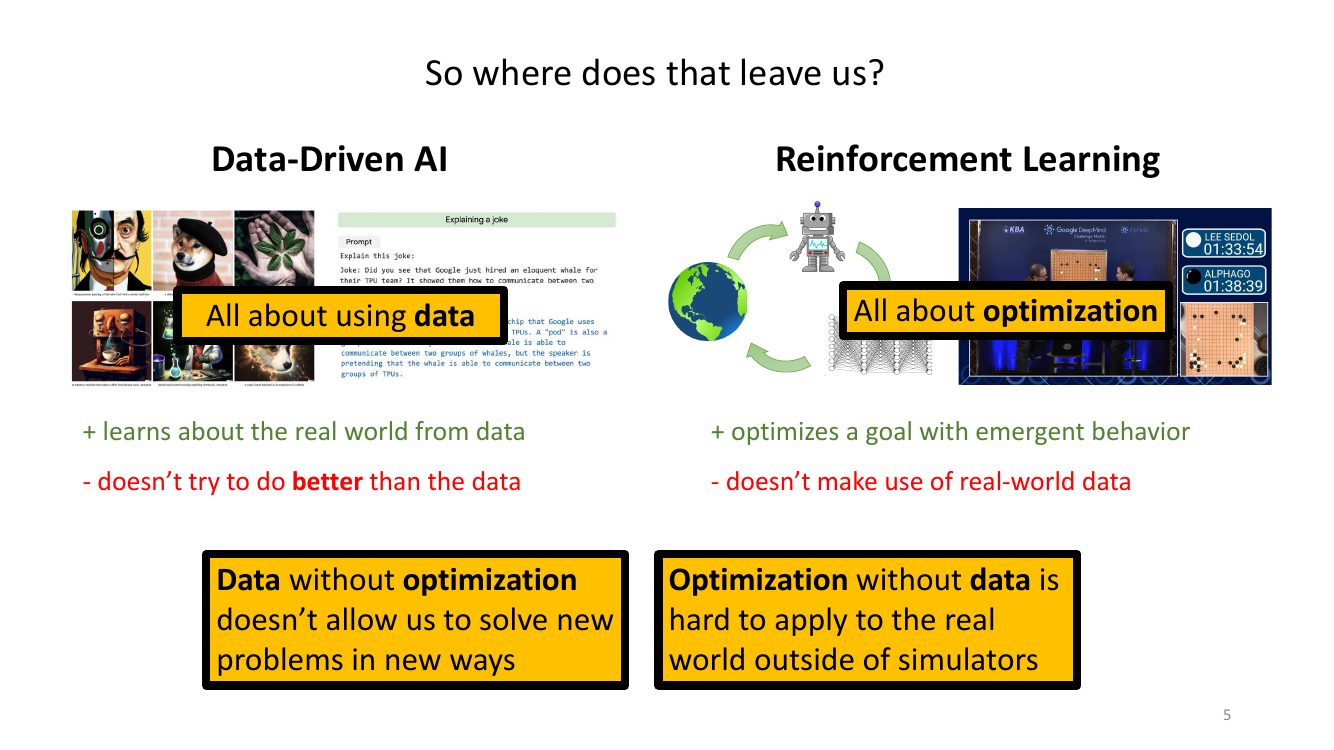
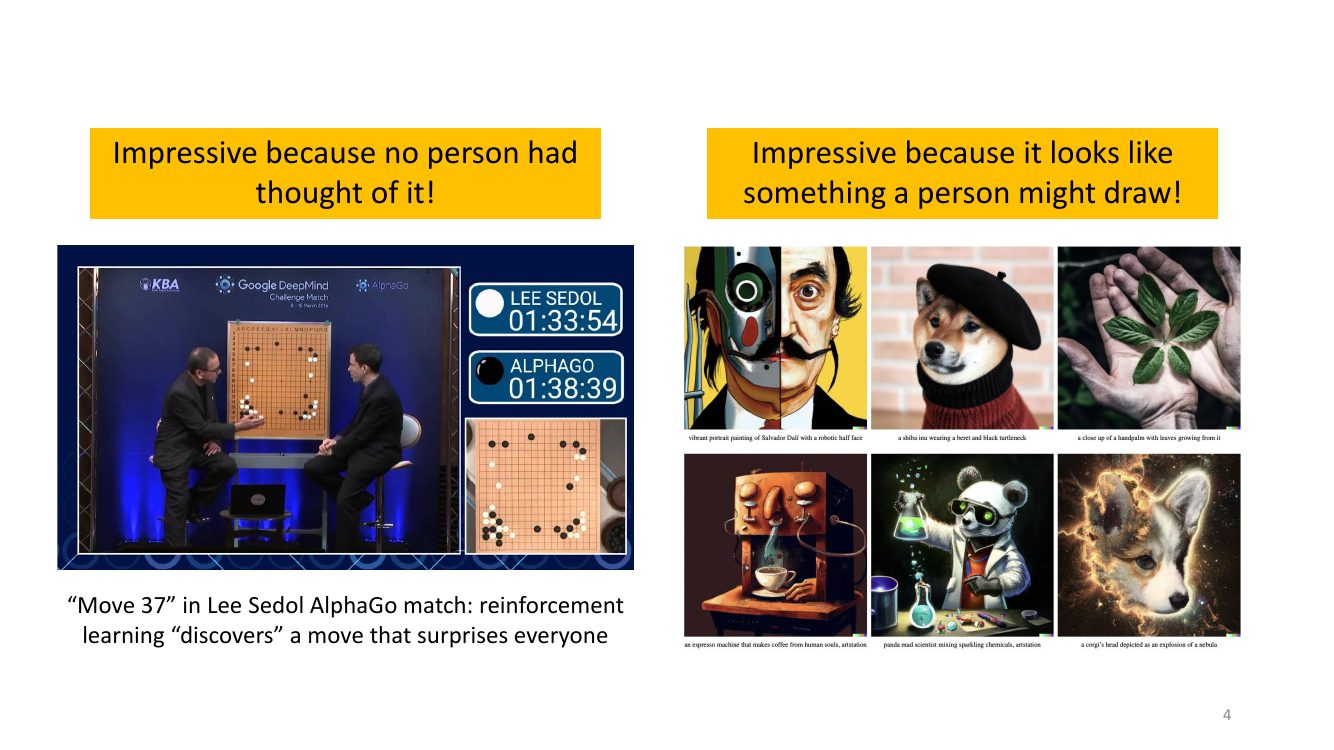
为什么值得关心:数据驱动 AI 与 RL 的互补
| on-policy RL | off-policy RL(DQN/SAC) | offline RL | |
|---|---|---|---|
| 训练时能否交互 | 能,且必须用当前策略采 | 能,可复用旧数据 | 完全不能 |
| 数据来源 | $\pi_\theta$ 自己 | $\pi_\theta$ 的历史版本 | 未知的 $\pi_\beta$(人 / 旧系统 / 混合) |
| 估计错误能否被纠正 | 立刻 | 下一轮采样时 | 永远不能 |
| 典型样本效率瓶颈 | 交互次数 | 交互次数 | 数据覆盖度 + 外推可靠性 |
| 主要失败模式 | 方差大、收敛慢 | 轻度高估、不稳定 | 灾难性高估、发散 |
2. 离线 RL 凭什么能比数据更好:拼接
这是初学者最容易误解的一点。听到「只用固定数据集学策略」,第一反应往往是:那不就是模仿学习吗?最好也就学成数据里最好的那个水平。不对。离线 RL 的目标恰恰是超过数据集里最好的轨迹。它靠三件事做到这一点:
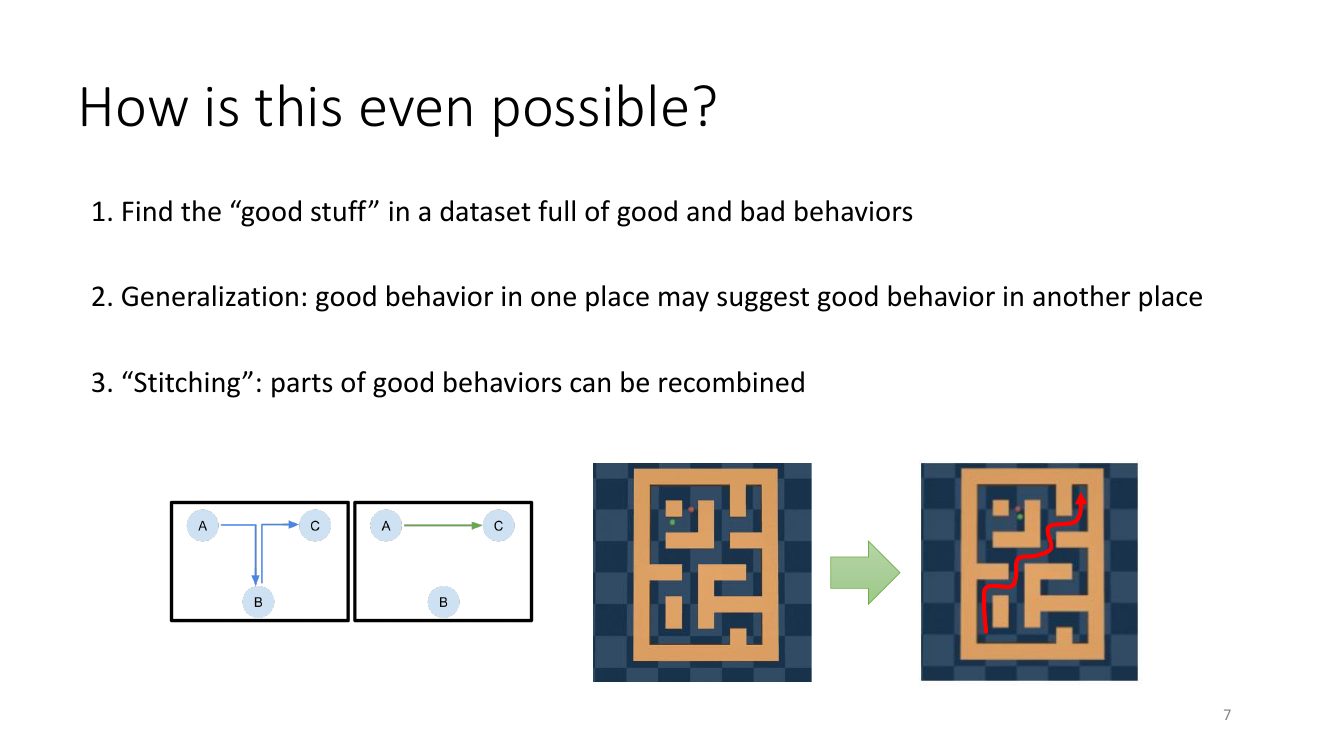
2.1 一个可以手算的拼接例子
为了把「拼接」讲透,我们造一个最小的确定性 MDP。四个状态 $\{A, B, C, G\}$,$G$ 是目标。可用转移与奖励:
| 转移 | 奖励 | 出现在哪条轨迹里 |
|---|---|---|
| $A \to B$ | $0$ | 轨迹 1 |
| $B \to G$ | $0$ | 轨迹 1(然后停在 $G$,什么也没拿到) |
| $A \to C$ | $-1$(绕远) | 轨迹 2 |
| $C \to G$ | $+10$ | 轨迹 2 |
| $B \to C$ | $0$ | 轨迹 3(一条短片段,只有 $B\to C$,此后数据就断了) |
数据集里只有这三条轨迹。取 $\gamma=0.9$,先算一算数据里最好的完整轨迹值多少:轨迹 2 是 $A\to C\to G$,回报 $= -1 + 0.9\times 10 = 8.0$;轨迹 1 是 $A\to B\to G$,回报 $=0$。所以模仿学习最好也就学到 $8.0$(还得假设它精准地只模仿轨迹 2,实际上行为克隆会把轨迹 1 和 3 也一并学进去,期望回报还要更低)。
现在做 Q-learning 的 Bellman 备份。数据里有 $(C,\to G)$ 这个转移,于是
$$ Q(C, \to G) = 10 + \gamma \cdot 0 = 10 $$数据里有 $(B, \to C)$ 这个转移,于是
$$ Q(B, \to C) = 0 + \gamma \max_{a'} Q(C, a') = 0.9 \times 10 = 9.0 $$数据里有 $(A, \to B)$ 这个转移,于是
$$ Q(A, \to B) = 0 + \gamma \max_{a'} Q(B, a') = 0.9 \times 9.0 = 8.1 $$$8.1 > 8.0$。贪心策略于是选择 $A \to B \to C \to G$——这条轨迹在数据集里根本不存在。它是由三条不同轨迹的片段拼出来的:$A\to B$ 来自轨迹 1,$B \to C$ 来自轨迹 3,$C\to G$ 来自轨迹 2。这就是 stitching。
拼接之所以「免费」,是因为马尔可夫性 + 动态规划。Bellman 备份只需要 $(s,a,r,s')$ 这一个四元组就能把价值信息从 $s'$ 传回 $s$,它完全不关心这个四元组当初属于哪条轨迹、后面接的是什么。所以只要「$A\to B$」和「$B\to\cdots\to G$ 的好办法」分别在数据的不同角落出现过,值迭代就会自动把它们焊在一起。反过来,任何基于完整轨迹回报的方法(行为克隆、回报加权的模仿、朴素的 reward-to-go 回归)都做不到这件事,因为它们看不见「$B$ 这个状态在另一条轨迹里其实很有前途」。
2.2 宏观拼接与微观拼接
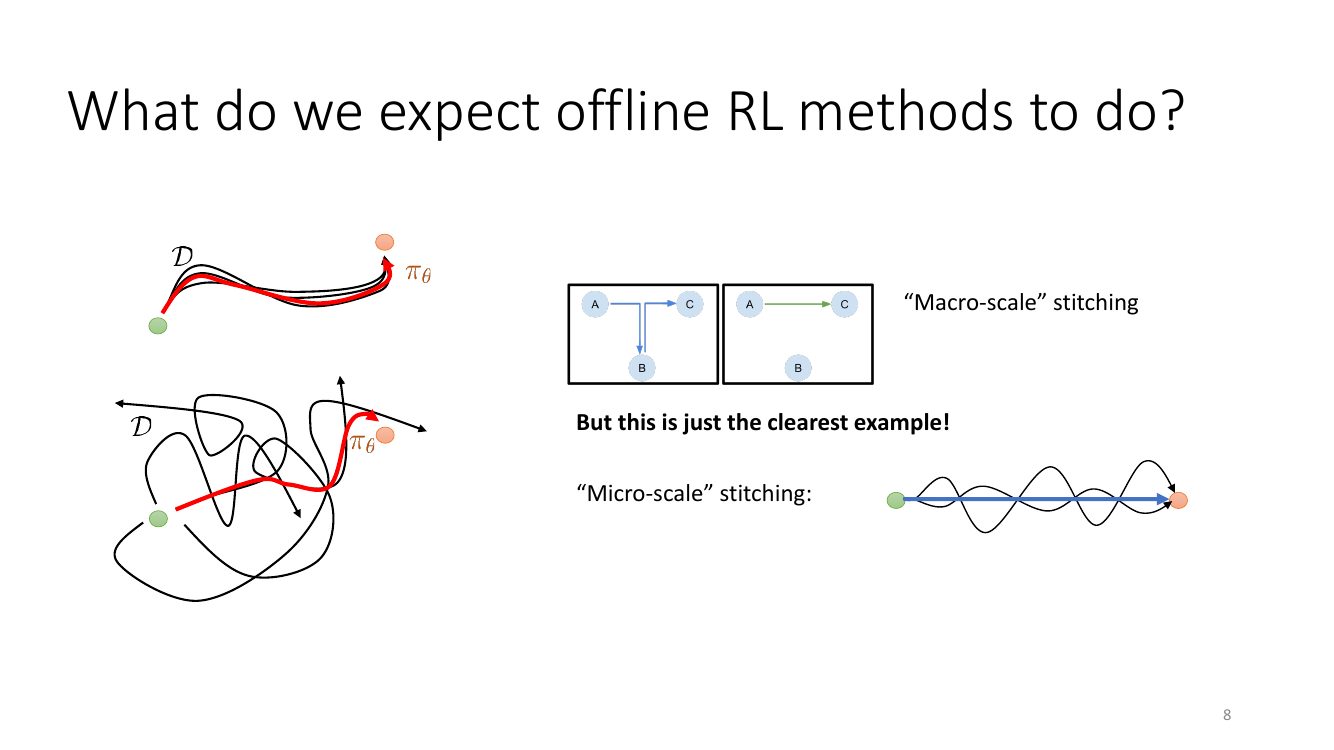
微观拼接解释了一个常见的实验现象:即使数据集里没有任何一条成功轨迹,离线 RL 有时也能学出成功的策略。因为「成功」可以由大量各自失败的轨迹的局部片段组装而成。这也是离线 RL 相对于「筛选出高回报轨迹再做行为克隆」(即 filtered BC / %BC 这类基线)的真正优势所在——后者的天花板严格等于数据集里最好轨迹的水平,前者没有这个天花板。
拼接不是无条件的。它要求数据在状态空间上有足够的重叠:上面的例子之所以能拼,是因为状态 $B$ 同时出现在轨迹 1 的中段和轨迹 3 的开头。如果数据集里每条轨迹都走在完全不相交的状态区域,动态规划就没有「焊点」可用,离线 RL 会退化成加权模仿学习。数据集的覆盖度(coverage)因此是离线 RL 里最重要的、也最容易被忽略的超参数——它不在代码里,在数据收集流程里。
3. 核心困难:反事实查询与分布偏移
拼接是好消息。现在讲坏消息,而且这个坏消息大到足以让所有标准算法直接失效。
3.1 反事实查询:offline RL 的原罪
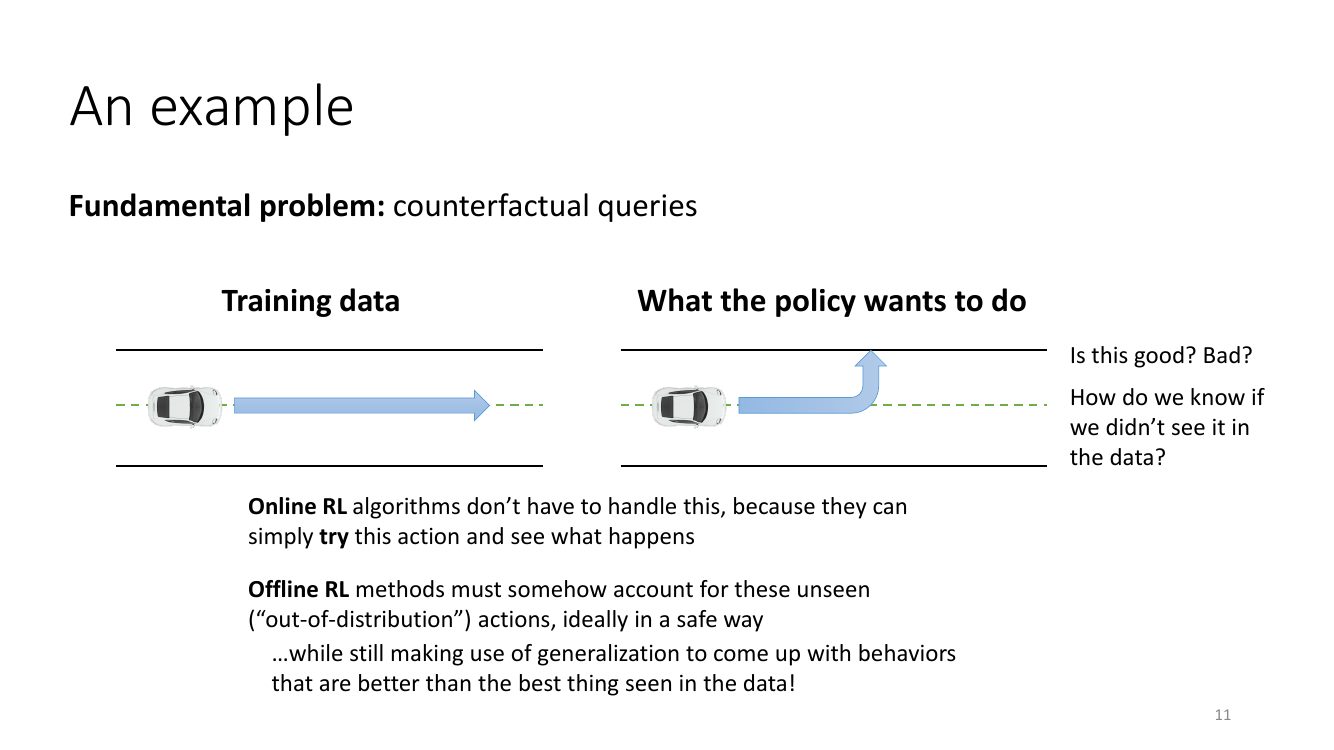
请注意这里的两难:
- 如果完全不允许 OOD 动作 → 退化成模仿学习,第 2 节讲的拼接和「超越数据」全部失效。
- 如果放任 OOD 动作 → 下面会看到,$Q$ 函数会在这些动作上编出天文数字,策略会追着幻觉走。
整个离线 RL 领域,本质上就是在这条钢丝上找平衡点。
3.2 复习分布偏移:它到底能有多糟
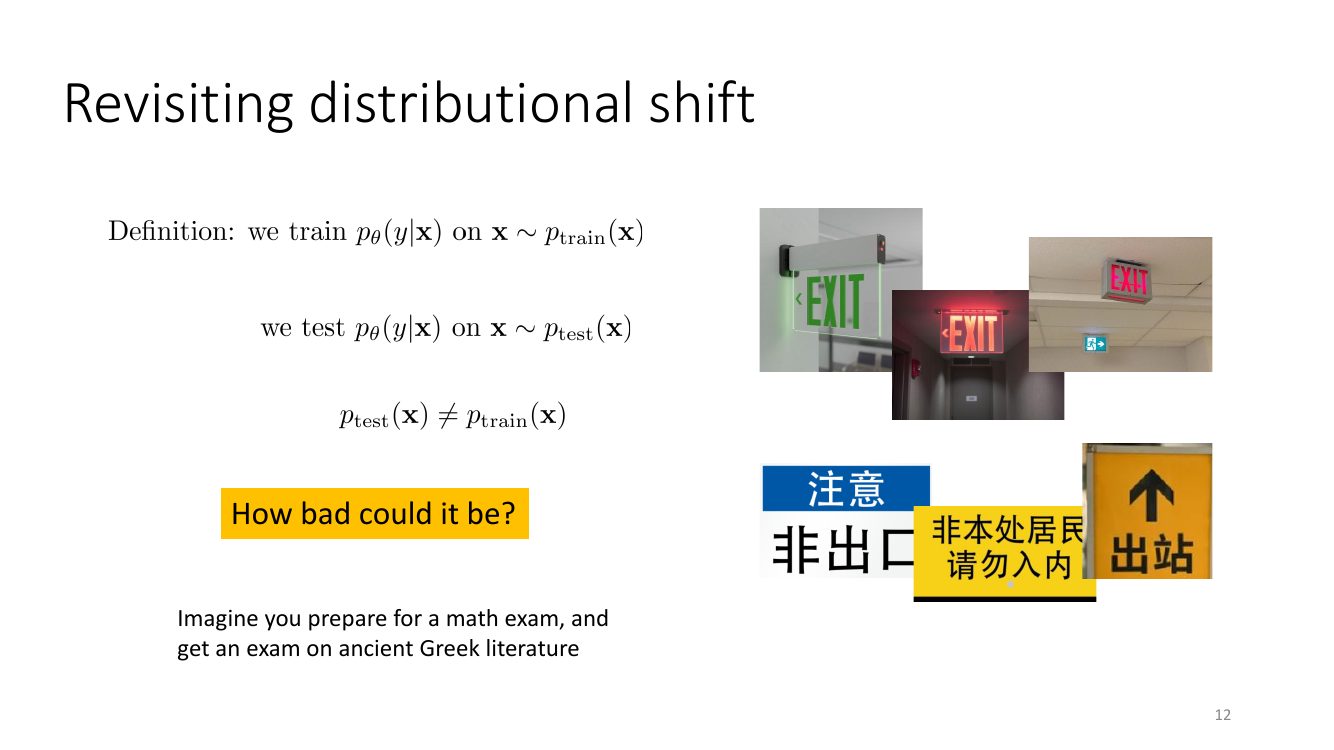
但你可能会说:分布偏移在监督学习里天天发生,深度网络的泛化能力其实很强,通常不是大问题。这话对,但离线 RL 里的分布偏移有一个致命的额外性质,下一小节就是要点出这个性质。
3.3 从 ERM 说起:$\argmax$ 是一个对抗性查询
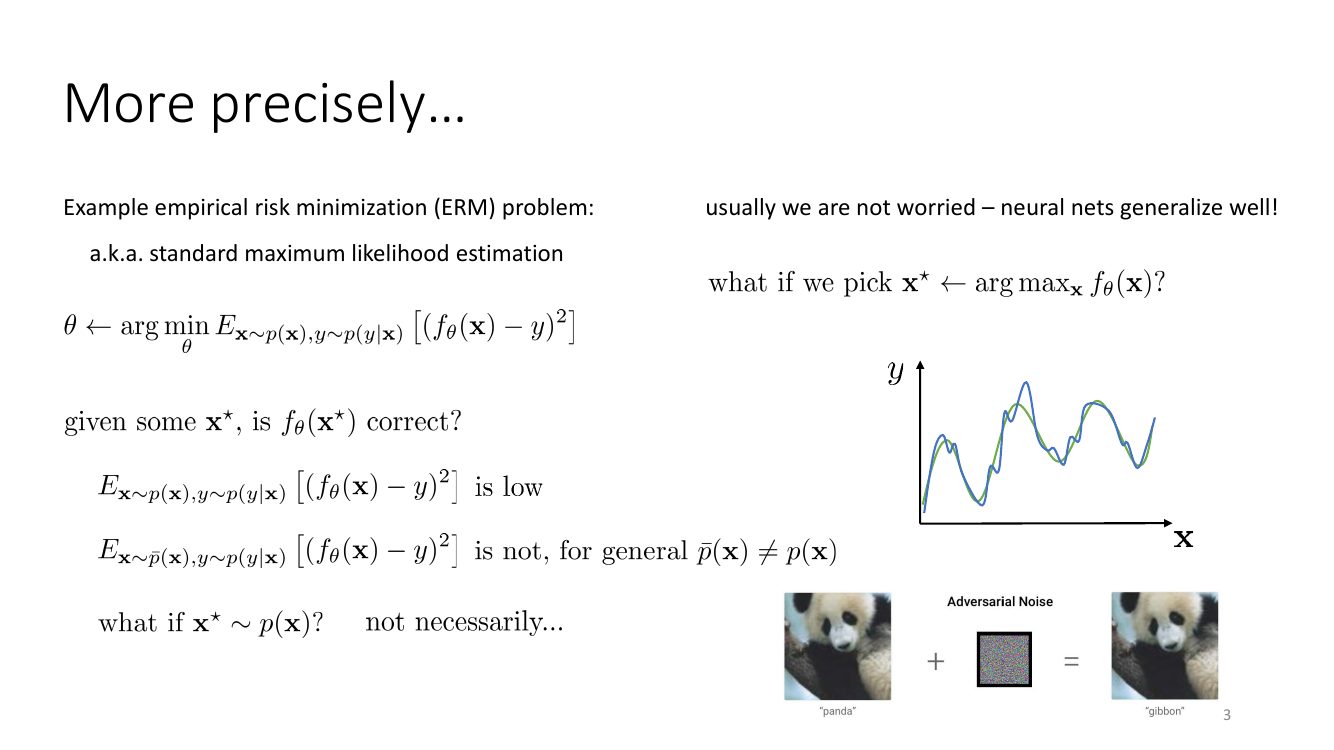
把这一页的逻辑写全。我们通过最小化平方误差来拟合 $f_\theta$:
$$ \theta \leftarrow \argmin_\theta\; \E_{x\sim p(x),\, y\sim p(y\mid x)}\big[(f_\theta(x)-y)^2\big] $$训练完成后我们知道两件事:
$$ \E_{x\sim p(x),\,y\sim p(y\mid x)}\big[(f_\theta(x)-y)^2\big]\;\text{很小} $$但对于一般的另一个分布 $\bar p(x)\neq p(x)$:
$$ \E_{x\sim \bar p(x),\,y\sim p(y\mid x)}\big[(f_\theta(x)-y)^2\big]\;\text{未必小} $$这是第一层问题——分布偏移。现在关键的第二层:就算 $x^\star \sim p(x)$(也就是查询点来自训练分布本身),$f_\theta(x^\star)$ 也未必对。为什么?因为「期望误差小」只保证了平均意义上对,不排除在个别点上有很大误差。而如果我们取
$$ x^\star \leftarrow \argmax_x f_\theta(x) $$这个选择就和误差的符号相关了。把逼近误差写成 $f_\theta(x) = f^\ast(x) + \epsilon(x)$,其中 $f^\ast$ 是真值、$\epsilon$ 是误差。那么
$$ \argmax_x f_\theta(x) = \argmax_x \big[f^\ast(x)+\epsilon(x)\big] $$$\argmax$ 同时在最大化真值和误差。在 $f^\ast$ 比较平坦的区域,谁的 $\epsilon$ 最大谁就被选中。于是
$$ \E\Big[f_\theta\big(\argmax_x f_\theta(x)\big) - f^\ast\big(\argmax_x f_\theta(x)\big)\Big] \;>\; 0 $$即使 $\E_x[\epsilon(x)]=0$,这个量也严格为正。这就是最大化偏差(maximization bias)——你在第 8 讲的 double Q-learning 那里已经见过它。$\argmax$ 不是一个中立的查询,它是一个专挑模型弱点的对抗性查询。
「只要我的 $Q$ 网络在训练集上的 Bellman 误差很低,学出来的策略就应该不错。」错。 低 Bellman 误差是在 $\pi_\beta$ 的分布下测得的平均量,而策略提取用的是 $\argmax_a Q(s,a)$——一个专门去找那个分布下误差最正的点的算子。这两者之间没有任何蕴含关系。实践中你会看到:训练曲线上的 TD loss 一路下降到很小,同时 $Q$ 值涨到 $10^6$、真实回报却在地板上。TD loss 小和策略好,在离线 RL 里几乎是两件不相干的事。
4. 分布偏移藏在每一类离策略算法的哪里
上一节的结论是抽象的。这一节把它落到具体算法上——你会发现每一类离策略方法都有一处「在 $\pi_\theta$ 下查询用 $\pi_\beta$ 数据训出来的模型」的地方,而那一处就是它的死穴。
4.1 Q-learning 与 Q 函数 actor-critic
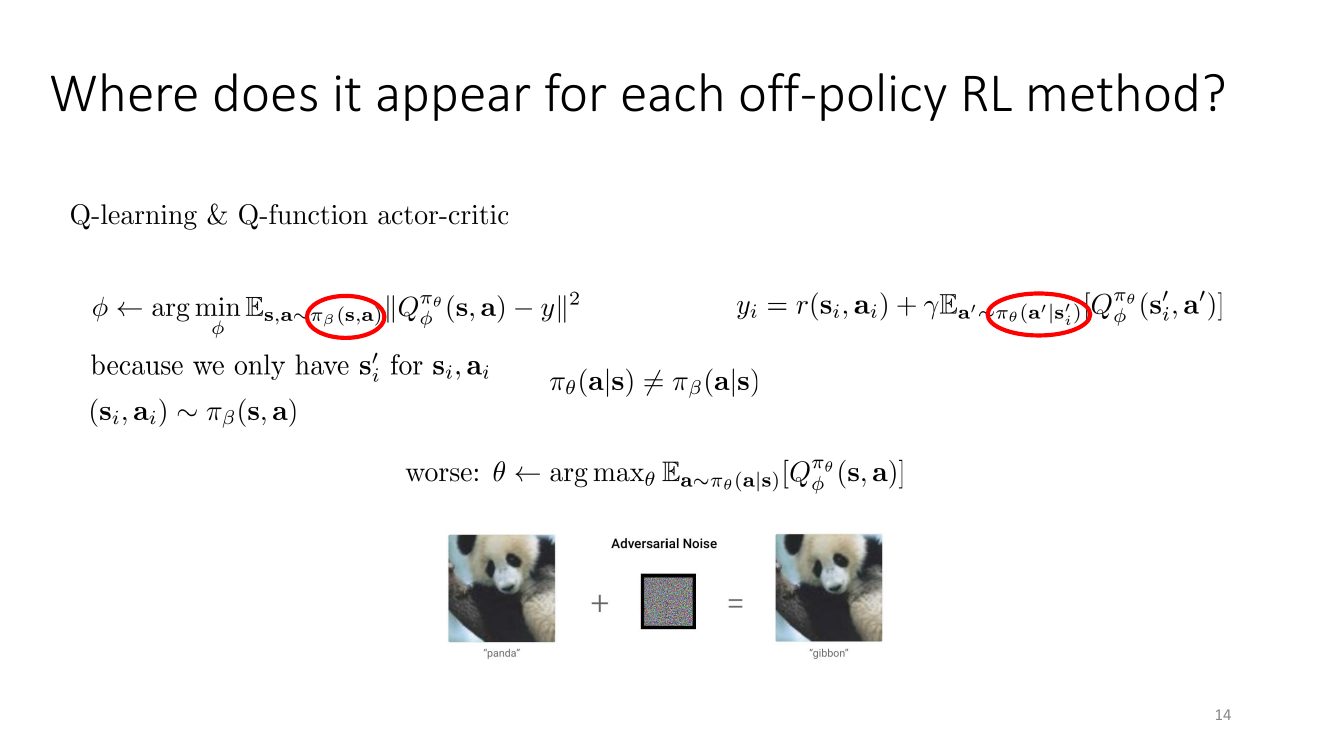
把它拆成两句人话:
- 回归的输入分布是 $\pi_\beta$。 $Q_\phi$ 只在数据里出现过的 $(s,a)$ 附近被约束过,别处纯属外推。
- 目标里的期望却是在 $\pi_\theta$ 下取的,而 $\pi_\theta$ 是被训练成去最大化 $Q_\phi$ 的。 换句话说,我们让一个优化器去 $\pi_\beta$ 覆盖不到的地方,主动搜索 $Q_\phi$ 最离谱的高估点,然后把这个高估点的值当作回归目标写回去。
第 2 点是全讲最重要的一句话。它不只是「用了错误的估计」,而是「把错误的估计固化成监督信号」。下一节会看到这个循环如何指数级放大误差。
4.2 基于模型的 RL
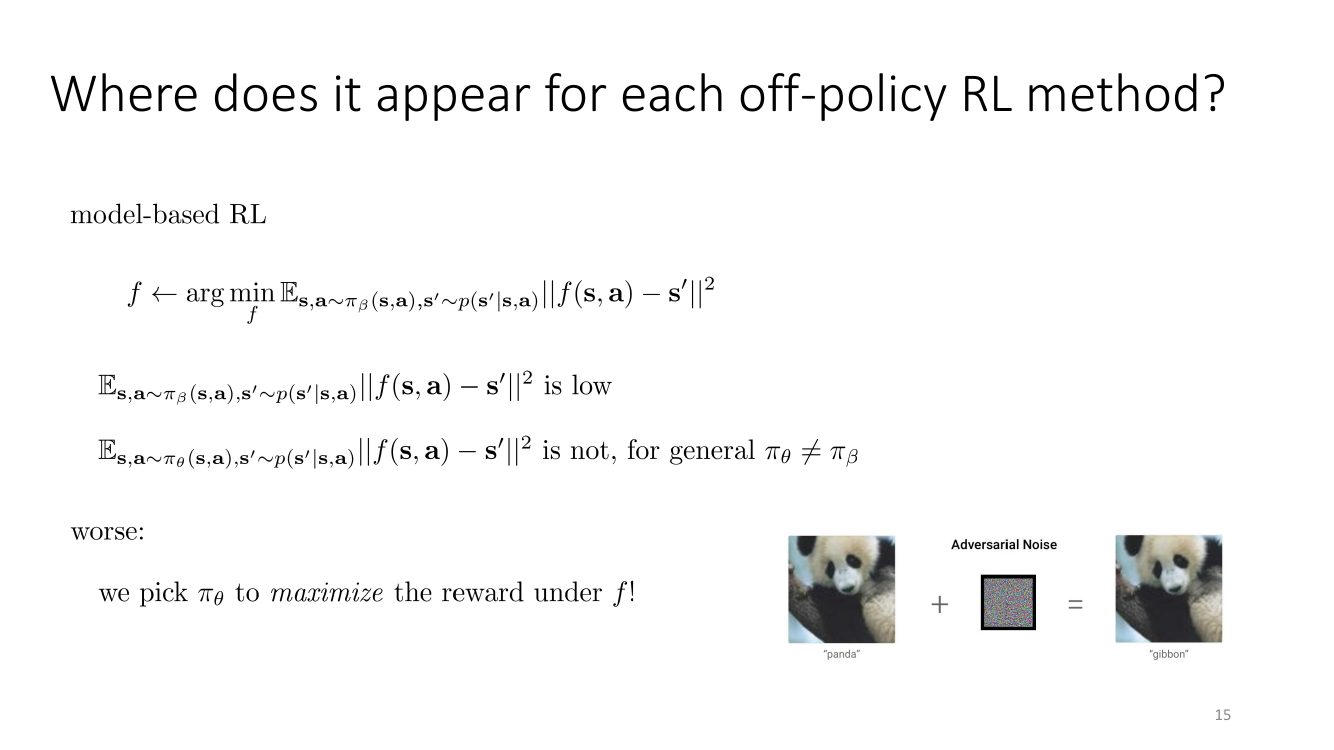
这里有一个统一的说法:凡是「先拟合一个模型,再针对这个模型做优化」的方法,优化器都会变成模型的对抗攻击者。 $Q$ 函数如此,动力学模型如此,学出来的奖励模型(RLHF 里的 reward model hacking)也是如此。在线交互的作用,就是不断把攻击成功的样本抓回来打上「其实没这么好」的标签。离线设定拿掉了这个防守方,攻击方就无人制衡。
4.3 离策略策略梯度与重要性采样
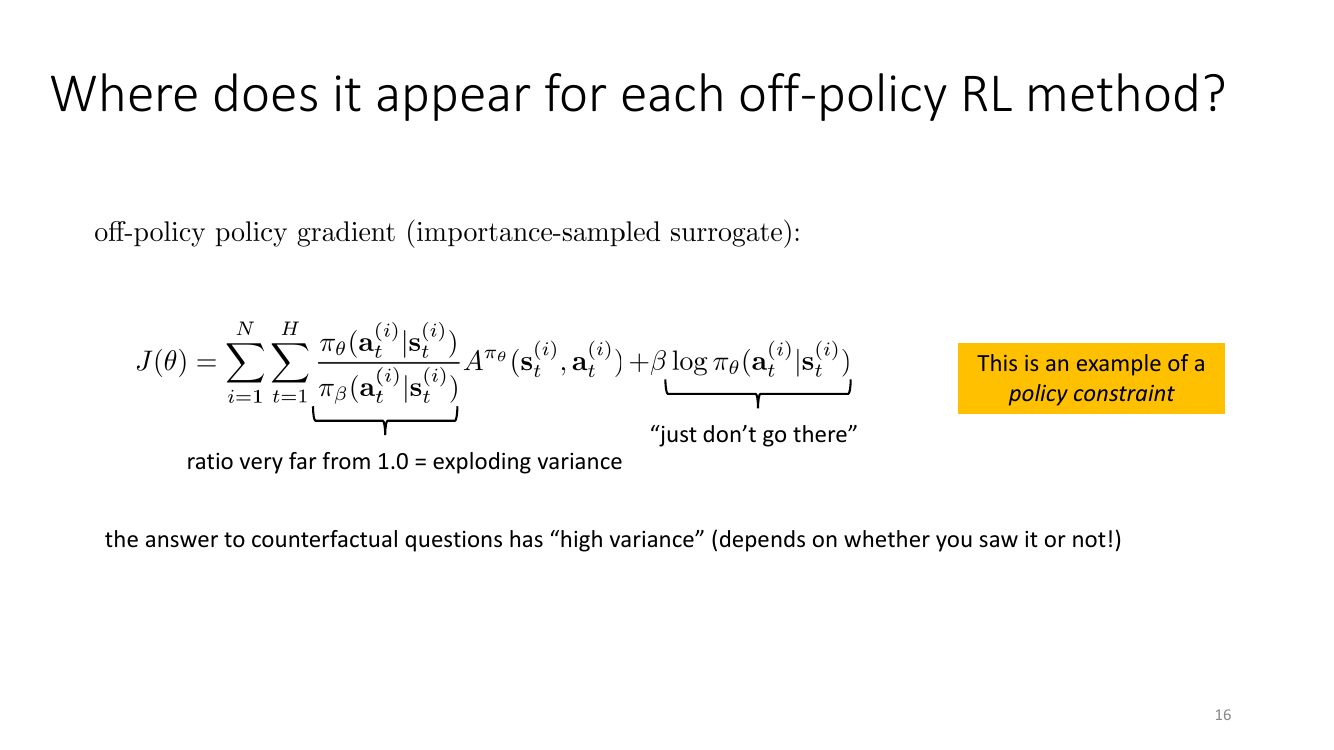
为什么 IS 的方差会爆炸?做一个最简单的量化。设在每个时间步上重要性权重 $w_t = \pi_\theta(a_t\mid s_t)/\pi_\beta(a_t\mid s_t)$,整条长度为 $H$ 的轨迹的权重是乘积
$$ w_{1:H} = \prod_{t=1}^{H} \frac{\pi_\theta(a_t\mid s_t)}{\pi_\beta(a_t\mid s_t)} $$无偏性没问题:$\E_{\pi_\beta}[w_{1:H}]=1$。但方差呢?假设各步权重近似独立同分布,$\E[w_t]=1$、$\mathrm{Var}(w_t)=\sigma^2$,那么 $\E[w_t^2]=1+\sigma^2$,于是
$$ \E\big[w_{1:H}^2\big]=\prod_{t=1}^{H}\E[w_t^2]=(1+\sigma^2)^H \quad\Longrightarrow\quad \mathrm{Var}(w_{1:H}) = (1+\sigma^2)^H - 1 $$方差随时间步指数增长。 代个数:即使 $\sigma^2 = 0.1$(两个策略已经相当接近了),$H=100$ 时 $\mathrm{Var} \approx 1.1^{100}-1 \approx 1.4\times 10^{4}$;标准差约 118,而被估量的均值是 1。要把标准误压到 $0.1$,你需要约 $118^2/0.1^2 \approx 1.4\times 10^{6}$ 条轨迹。$H=1000$ 时这个数字变成 $10^{41}$ 量级——比宇宙里的原子还多。
这里还藏着一个更本质的问题:权重的分布是极端右偏的。绝大多数样本的 $w_{1:H}\approx 0$,估计量的全部质量集中在极少数几个巨大权重的样本上,这被称为「有效样本量塌缩」。你可以用
$$ n_{\text{eff}} = \frac{\big(\sum_i w^{(i)}\big)^2}{\sum_i (w^{(i)})^2} $$来诊断:$n_{\text{eff}}$ 常常只有个位数,哪怕你有一百万条轨迹。
更糟的是,如果某个 $a_t$ 满足 $\pi_\beta(a_t\mid s_t)\approx 0$ 而 $\pi_\theta(a_t\mid s_t)>0$,权重直接趋于无穷——这恰恰就是 OOD 动作。所以「IS 方差爆炸」和「$Q$ 值高估」并不是两个独立的毛病,它们是同一个病在两种估计器上的两副面孔:你在问一个数据无法回答的问题。区别只在于,IS 的估计器至少诚实地把这份无知报告成了巨大的方差,而 $Q$ 网络会用一个平滑的外推掩盖这份无知,给你一个自信满满的错误数字。从这个角度说,基于 $Q$ 的方法更危险。
| 方法类别 | 在 $\pi_\beta$ 上训练的对象 | 在 $\pi_\theta$ 上查询的地方 | 失败表现 |
|---|---|---|---|
| Q-learning / Q-函数 actor-critic | $Q_\phi(s,a)$ | 目标里的 $\E_{a'\sim\pi_\theta}$、策略提取的 $\argmax$ | $Q$ 值发散、回报归零 |
| 基于模型的 RL | $\hat p(s'\mid s,a)$ 或 $f(s,a)$ | 规划 / 想象 rollout 中的动作 | 规划器攻击模型幻觉 |
| IS 版策略梯度 | —(直接估计 $J(\theta)$) | 重要性权重 $\pi_\theta/\pi_\beta$ | 方差指数爆炸、$n_{\text{eff}}$ 塌缩 |
| 行为克隆(作为对照) | $\pi_\theta(a\mid s)$ | 无(不查询反事实) | 不会崩,但也永远超不过数据 |
最后一行值得玩味:行为克隆之所以在离线设定下稳如老狗,正是因为它放弃了反事实推理。 稳定性和「超越数据的能力」在这里是一对此消彼长的量,所有离线 RL 算法都是在这条轴上选一个点。
5. 没有负反馈的正反馈:误差如何自我放大
现在把 4.1 节的两句话接成一个闭环,看看误差是怎么滚雪球的。这是本讲最需要「讲透」的一段。
5.1 一步一步写出误差递推
记真值为 $Q^\ast$,网络估计为 $Q_\phi$,定义误差 $\Delta(s,a) = Q_\phi(s,a) - Q^\ast(s,a)$。Bellman 备份一轮之后,在数据点 $(s,a)$ 上我们把 $Q_\phi$ 回归到
$$ y(s,a) = r(s,a) + \gamma\,\max_{a'} Q_\phi(s',a') $$而真值满足 $Q^\ast(s,a)=r(s,a)+\gamma\max_{a'}Q^\ast(s',a')$。两式相减:
$$ y(s,a) - Q^\ast(s,a) = \gamma\Big[\max_{a'}Q_\phi(s',a') - \max_{a'}Q^\ast(s',a')\Big] $$关键在于如何界定右边那个方括号。在在线设定下,我们通常用「$\max$ 是 1-Lipschitz」的性质得到
$$ \Big|\max_{a'}Q_\phi(s',a')-\max_{a'}Q^\ast(s',a')\Big| \le \max_{a'}\big|\Delta(s',a')\big| $$再配合「$\gamma \lt 1$ 是收缩」,得到 $\|\Delta\|_\infty \le \frac{\gamma}{1-\gamma}\epsilon$ 这样的界,其中 $\epsilon$ 是单步逼近误差。这看起来很安慰。但这个界有一个隐含前提:$\epsilon$ 是在所有 $(s',a')$ 上都成立的一致误差界。
离线设定下这个前提破产了。数据只覆盖 $\pi_\beta$ 的支撑集,我们只能保证
$$ \big|\Delta(s,a)\big| \le \epsilon_{\text{in}}\quad \text{当 } (s,a)\in\mathrm{supp}(\pi_\beta) $$而在支撑集之外,$\Delta$ 是无界的——网络在那里想输出什么就输出什么。于是
$$ \max_{a'}Q_\phi(s',a') \;\ge\; \max_{a'\in\text{OOD}} Q_\phi(s',a') \;=\; Q^\ast(s',a'_{\text{ood}}) + \Delta(s',a'_{\text{ood}}) $$而 $\Delta(s',a'_{\text{ood}})$ 可以任意大。把它记作 $\delta_{\text{ood}} > 0$,那么这一轮备份把误差写回了数据点:
$$ \Delta_{k+1}(s,a) \approx \gamma\big(\delta_{\text{ood}} + \Delta_k(\cdot)\big) $$下一轮,这个被抬高的 $Q_\phi(s,a)$ 又会通过网络的平滑性抬高它周围(包括更多 OOD 点)的估计,$\argmax$ 再从新的、更高的 OOD 峰上取值……于是递推变成
$$ \Delta_{k+1} \approx \gamma\,\Delta_k + \delta_{\text{ood},k},\qquad \delta_{\text{ood},k}\ \text{随}\ \Delta_k\ \text{增大而增大} $$只要 $\delta_{\text{ood},k}$ 随 $\Delta_k$ 增长得比 $(1/\gamma - 1)\Delta_k$ 快,这个递推就是发散的。$\gamma=0.99$ 时 $(1/\gamma-1)\approx 0.0101$——门槛低得可怜。这就是为什么实践中 $Q$ 值不是「略微偏高」,而是冲到 $10^6$、$10^{10}$。
在线 RL 里同样存在 $\delta_{\text{ood}}$,但它有一个天然的天花板:一旦策略去做那个被高估的动作,环境返回的真实 $r$ 和 $s'$ 就会把这一处的 $Q$ 拉回地面。高估本身就是采集纠错数据的信号——这甚至是「乐观面对不确定性」这类探索策略的理论基础。离线设定下,高估依然会驱动策略往那边走,但环境不会回话,于是乐观变成了纯粹的幻觉,而且是自我强化的幻觉。用一句话概括:在线 RL 的 $\max$ 是探索,离线 RL 的 $\max$ 是自欺。
5.2 泛化误差不再被修正
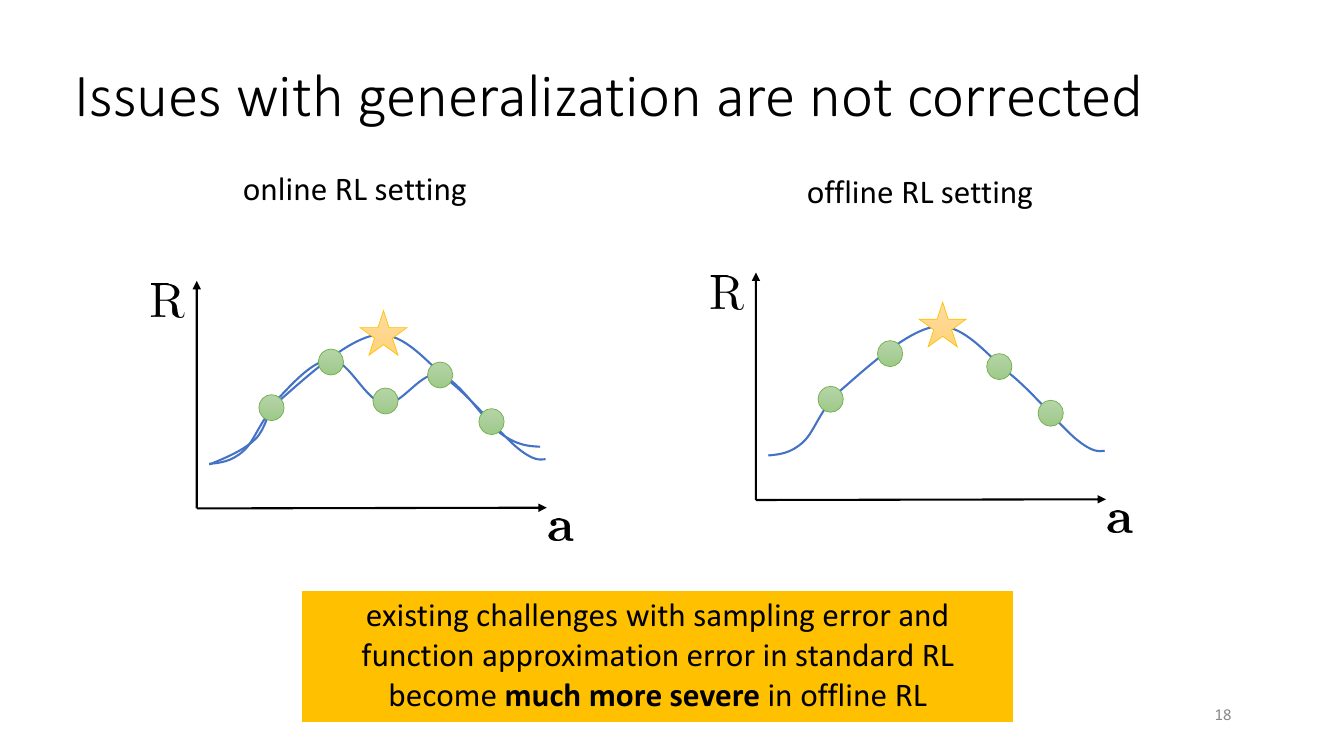
5.3 实证:SAC 直接跑离线数据会怎样
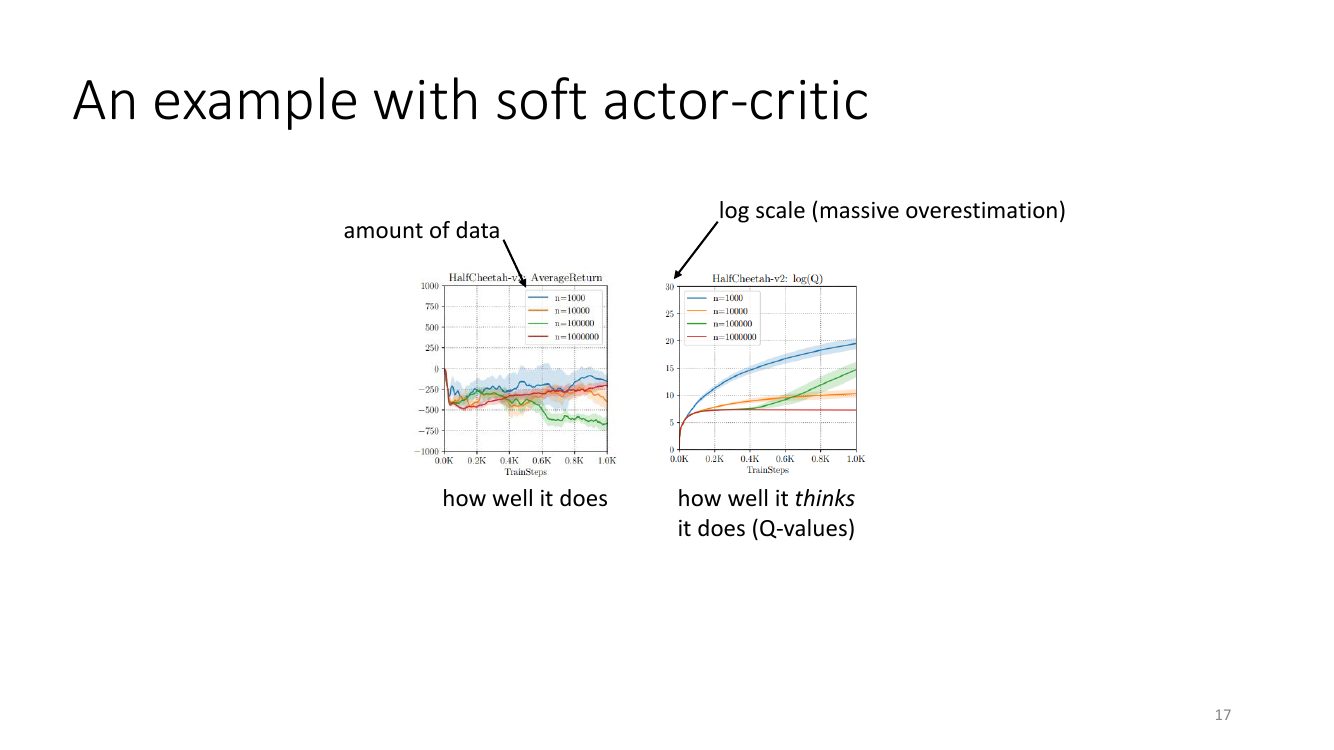
这张图还有一个值得反复咀嚼的细节:不同数据量的曲线并没有呈现「数据越多越好」的单调关系。 在右图里,最小的数据集 $n=1000$(蓝线)反而对应最猛烈的 $Q$ 值爆炸;而在左图里,几条曲线的真实回报互有高低,$n=10^5$(绿线)在后期甚至掉到了最下面。这种「更多数据反而更差」的反直觉现象在离线 RL 文献里被反复报告,原因有两层:
- 更大的数据集通常覆盖更广的状态空间。 更广的状态空间意味着更多「网络见过一点点、但见得不够」的边缘地带,也就给了 $\argmax$ 更多可以钻的空子。数据量增加带来的收益(每个点估得更准)会被状态空间扩张带来的损失(更多可被攻击的角落)抵消甚至反超。
- 更大的数据集常常来自更多样的行为策略。 $\pi_\beta$ 越「宽」,动作分布越平坦,任意给定动作的密度 $\pi_\beta(a\mid s)$ 反而越低,反事实查询的可靠性并没有随之提升。
不要把这条现象过度推广成「离线 RL 里数据越多越坏」。正确的表述是:在没有任何分布偏移矫正的朴素算法上,增加数据量不保证性能提升;一旦用上下一讲的保守类方法,数据量与性能之间通常会恢复成正相关。这个现象的意义在于它是一个诊断信号:如果你发现自己的离线 RL 实验「加数据没用甚至变差」,八成不是数据不够,而是分布偏移没处理好。
6. 离线策略评估与重要性采样的方差
在讲怎么学之前,先看一个更基础也更谦虚的问题:离线策略评估(off-policy evaluation, OPE)——只给数据集 $\mathcal{D}$ 和一个候选策略 $\pi_\theta$,估计它的回报 $J(\pi_\theta)$,不要求学习。这个问题在实际中极其重要(你总得知道该不该把新策略上线),而它的困难度已经足以说明离线 RL 的全部麻烦。
6.1 朴素的轨迹级 IS
设数据集里有 $N$ 条完整轨迹 $\tau^{(i)}=(s_1^{(i)},a_1^{(i)},r_1^{(i)},\dots)$,由 $\pi_\beta$ 采集。轨迹分布为
$$ p_\pi(\tau) = p(s_1)\prod_{t=1}^{H}\pi(a_t\mid s_t)\,p(s_{t+1}\mid s_t,a_t) $$做比值时,初始分布 $p(s_1)$ 和转移 $p(s_{t+1}\mid s_t,a_t)$ 完全消掉(它们与策略无关),这正是 IS 在 RL 里可用的原因:
$$ \frac{p_{\pi_\theta}(\tau)}{p_{\pi_\beta}(\tau)}=\prod_{t=1}^{H}\frac{\pi_\theta(a_t\mid s_t)}{\pi_\beta(a_t\mid s_t)} \;\equiv\; w_{1:H} $$于是得到无偏估计
$$ \hat J_{\text{IS}} = \frac{1}{N}\sum_{i=1}^{N} w^{(i)}_{1:H}\sum_{t=1}^{H}\gamma^{t-1} r_t^{(i)} $$6.2 三个改进:per-decision、self-normalized、doubly robust
(1) 逐决策 IS(per-decision IS)。 利用因果性:时刻 $t$ 的奖励只受 $t$ 之前动作的影响,所以不需要乘上未来的权重。
$$ \hat J_{\text{PDIS}} = \frac{1}{N}\sum_{i=1}^{N}\sum_{t=1}^{H}\gamma^{t-1}\,w^{(i)}_{1:t}\;r_t^{(i)}, \qquad w^{(i)}_{1:t}=\prod_{t'=1}^{t}\frac{\pi_\theta(a_{t'}^{(i)}\mid s_{t'}^{(i)})}{\pi_\beta(a_{t'}^{(i)}\mid s_{t'}^{(i)})} $$仍然无偏,但方差小得多——早期的奖励只需要承受很短的权重乘积。这与第 5 讲策略梯度里的 reward-to-go 技巧是同一个「因果性省方差」的思想。
(2) 自归一化 IS(weighted / self-normalized IS)。 把 $\frac{1}{N}$ 换成 $\frac{1}{\sum_i w^{(i)}}$:
$$ \hat J_{\text{WIS}} = \frac{\sum_{i} w^{(i)}_{1:H} R^{(i)}}{\sum_{i} w^{(i)}_{1:H}} $$它有偏但一致($N\to\infty$ 时收敛到真值),方差大幅下降,而且有界性很好:估计值必然落在数据中实际观测到的回报范围内,不会像 $\hat J_{\text{IS}}$ 那样被一条巨权重轨迹拉到天上去。实践中几乎总是用它。
(3) 双重稳健(doubly robust, DR)。 引入一个学出来的值函数 $\hat V,\hat Q$ 作为控制变量:
$$ \hat J_{\text{DR}} = \frac{1}{N}\sum_i \sum_t \gamma^{t-1}\Big[ w^{(i)}_{1:t}\big(r_t^{(i)} - \hat Q(s_t^{(i)},a_t^{(i)})\big) + w^{(i)}_{1:t-1}\,\E_{a\sim\pi_\theta}\big[\hat Q(s_t^{(i)},a)\big]\Big] $$名字里的「双重」指:只要 $\hat Q$ 准确或者 $\hat\pi_\beta$ 准确(二者有其一),估计就是无偏的。直觉是把大部分信号交给低方差的 $\hat Q$,只用 IS 去修正 $\hat Q$ 的残差 $r - \hat Q$,残差小则权重乘上去的方差也小。
import numpy as np

def ope_estimators(trajs, pi_theta_logp, pi_beta_logp, gamma=0.99):
    """trajs: list of dicts with keys 'states','actions','rewards' (numpy arrays).
    pi_*_logp(states, actions) -> per-step log prob, shape (T,).
    Returns naive IS, per-decision IS, and weighted IS estimates."""
    is_terms, pdis_terms, w_full = [], [], []
    for tr in trajs:
        s, a, r = tr['states'], tr['actions'], tr['rewards']
        T = len(r)
        logratio = pi_theta_logp(s, a) - pi_beta_logp(s, a)   # (T,)
        # 累积对数权重 -> 数值上远比直接连乘稳定
        cum_logw = np.cumsum(logratio)                        # w_{1:t}
        w_t = np.exp(np.clip(cum_logw, -30.0, 30.0))          # 截断防溢出
        disc = gamma ** np.arange(T)

        R = np.sum(disc * r)                 # 折扣回报
        w_T = w_t[-1]
        is_terms.append(w_T * R)             # 轨迹级 IS
        pdis_terms.append(np.sum(disc * w_t * r))  # 逐决策 IS
        w_full.append(w_T)

    is_terms = np.array(is_terms); w_full = np.array(w_full)
    n_eff = w_full.sum() ** 2 / np.sum(w_full ** 2)   # 有效样本量诊断
    # is_terms[i] = w[i] * R[i],所以 sum(is_terms)/sum(w) 正是自归一化 IS
    wis = is_terms.sum() / w_full.sum() if w_full.sum() > 0 else 0.0
    return {
        'IS':   is_terms.mean(),
        'PDIS': np.mean(pdis_terms),
        'WIS':  float(wis),
        'n_eff': n_eff,          # 若 n_eff << N,说明该估计不可信
        'N': len(trajs),
    }
「我用 IS 做了离线评估,估出来 $J(\pi_\theta)=850$,比行为策略的 $600$ 高,所以新策略更好。」先看 $n_{\text{eff}}$。 如果 $N=10^5$ 而 $n_{\text{eff}}=3$,那个 $850$ 实际上是三条轨迹说了算,置信区间宽到毫无意义。更隐蔽的陷阱是:把 IS 估计当作优化目标去训练 $\pi_\theta$ 时,优化器会主动去找那些能把巨大权重压到高回报轨迹上的参数——又是一次「优化器攻击估计器」。这正是幻灯片上写的那句话:反事实问题的答案具有高方差,因为它取决于你到底见没见过。
6.3 从「方差爆炸」到「策略约束」的第一次现身
回头看第 4.3 节那个 IS 版策略梯度目标:
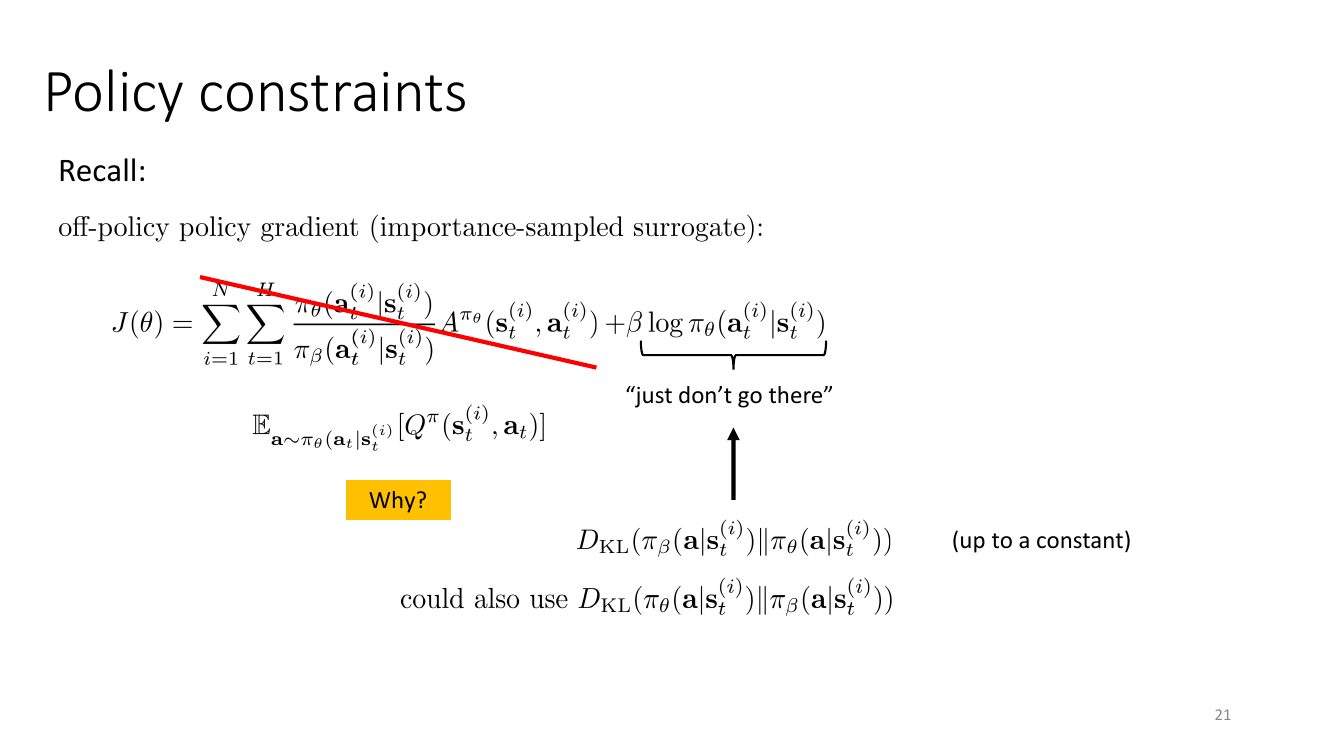
$$ J(\theta) = \sum_{i}\sum_{t} \frac{\pi_\theta(a_t^{(i)}\mid s_t^{(i)})}{\pi_\beta(a_t^{(i)}\mid s_t^{(i)})}A^{\pi_\theta}(s_t^{(i)},a_t^{(i)}) \;+\;\beta \log \pi_\theta(a_t^{(i)}\mid s_t^{(i)}) $$第二项 $\beta\log\pi_\theta(a_t^{(i)}\mid s_t^{(i)})$ 在幻灯片上被标注为「就别往那儿去」,并被明确称为策略约束的一个例子。它是什么?把它在数据上求和并取平均,就是
$$ \frac{1}{NH}\sum_{i,t}\log\pi_\theta(a_t^{(i)}\mid s_t^{(i)}) \;\approx\; \E_{s,a\sim\pi_\beta}\big[\log\pi_\theta(a\mid s)\big] $$也就是行为克隆的对数似然,等价于(差一个与 $\theta$ 无关的常数)负的前向 KL:
$$ D_{\mathrm{KL}}\big(\pi_\beta(a\mid s)\,\|\,\pi_\theta(a\mid s)\big) = -\E_{a\sim\pi_\beta}\big[\log\pi_\theta(a\mid s)\big] - \mathcal{H}(\pi_\beta) $$所以那一项在做的事是:把 $\pi_\theta$ 往 $\pi_\beta$ 上拉,从而让重要性比值不至于离 1 太远,方差不至于爆炸。 这就是本讲第三部分的主角。注意它是自然涌现的,不是硬塞进去的——控制分布偏移和控制估计方差是同一件事。
7. 解法总览:四类思路,一个共同原则
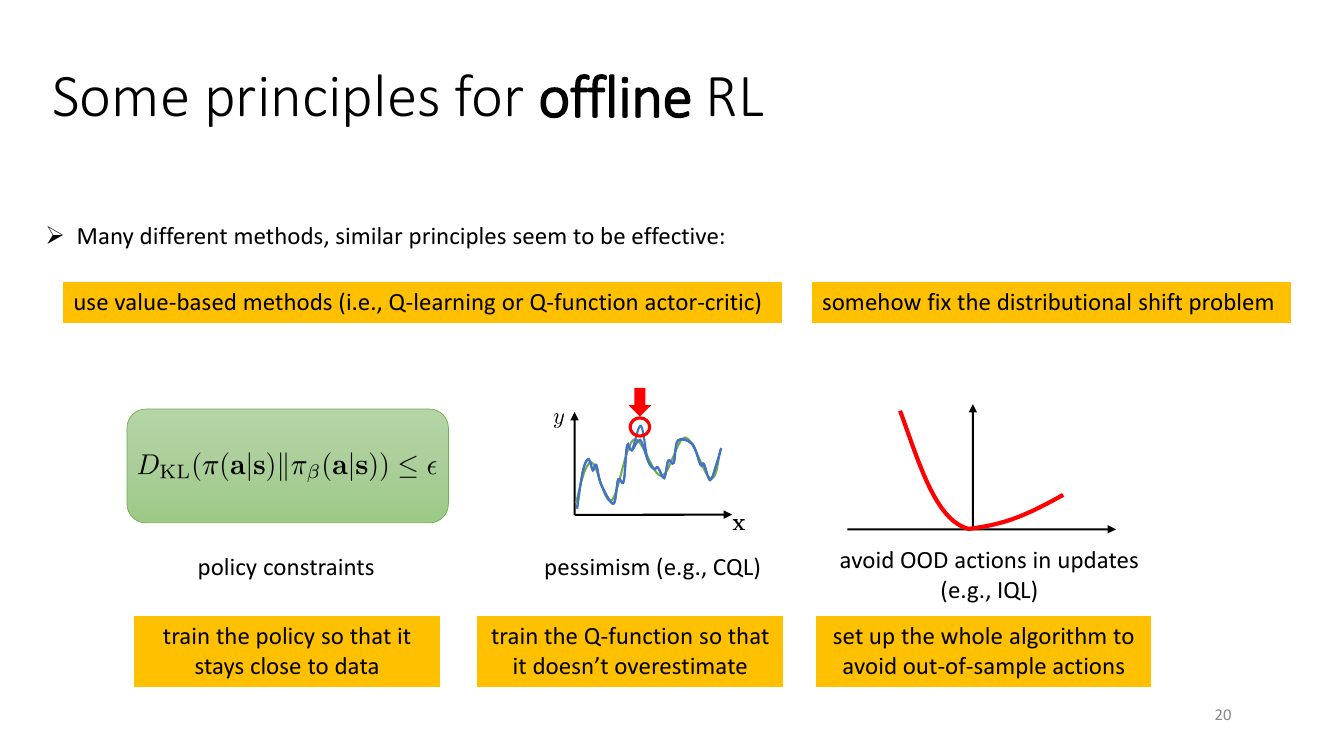
三条路线的分工可以这样理解——它们干预的是同一个式子的不同位置:
$$ \underbrace{\phi \leftarrow \argmin_\phi \E_{s,a\sim\pi_\beta}\Big[\big(Q_\phi(s,a) - r - \gamma\,\underbrace{\E_{a'\sim\pi_\theta}[Q_{\bar\phi}(s',a')]}_{\text{③ 这里改}}\big)^2\Big]}_{\text{② 这里加惩罚项}} ,\qquad \underbrace{\pi_\theta \leftarrow \argmax_\theta \E[Q_\phi]}_{\text{① 这里加约束}} $$| 思路 | 干预位置 | 做法一句话 | 代表方法 | 优点 / 代价 |
|---|---|---|---|---|
| 策略约束 | ① 策略优化 | 要求 $\pi_\theta$ 与 $\pi_\beta$ 足够接近 | BCQ、BEAR、AWAC、TD3+BC | 概念最直接;但需要估计 $\pi_\beta$,且约束太紧会直接退化成模仿 |
| 保守 / 悲观值函数 | ② critic 损失 | 额外压低 OOD 动作上的 $Q$,使估计成为真值的下界 | CQL | 不必显式建模 $\pi_\beta$;但保守度超参很敏感 |
| 避免 OOD 查询 | ③ 目标构造 | 只用数据集里出现过的动作做备份(期望回归 / 分位数回归) | IQL | 实现简单、极稳定;牺牲了一部分「向数据外泛化」的能力 |
| 不确定性估计 | ②③ | 用集成 / 贝叶斯后验度量 $Q$ 的可信度,按不确定性打折 | 集成 Q 网络、UWAC 类 | 原理最漂亮;但深度网络的不确定性估计本身就不可靠 |
| 保守的基于模型方法 | 模型 rollout | 在想象 rollout 中按模型不确定度扣奖励、限制 rollout 长度 | MOPO、MOReL、COMBO | 能用模型做数据增广;但继承了模型误差的所有问题 |
五种做法可以浓缩成同一句话:不要相信、也不要去查询你没有数据支撑的地方。 区别只在于「不相信」这件事被实现在了策略上(约束)、值函数上(悲观)、目标构造上(避免采样)、还是显式的不确定度上。理解了这一点,下一讲那些看起来五花八门的目标函数会立刻变得可以互相翻译。
为什么必须用基于值的方法?
幻灯片顶上那句「use value-based methods」不是随口一提。回顾第 2 节:拼接的能力完全来自 Bellman 备份能把价值信息跨轨迹传播。如果你用 Monte Carlo 回报(比如 return-conditioned BC、Decision Transformer 那一路),你的算法只能看到「这条轨迹整体拿了多少分」,永远学不会「$B$ 这个状态其实可以通向高分」。因此:
- 能拼接的算法必须做动态规划($Q$-learning / actor-critic);
- 而动态规划的 $\max$ 恰恰是分布偏移最致命的入口。
这个张力是离线 RL 的结构性宿命:你想要的能力和你害怕的失效模式,来自同一个算子。 所以所有方法都不是「删掉 $\max$」,而是「给 $\max$ 加个笼子」。
8. 策略约束:从第一性原理推出来
8.1 目标函数的两种等价写法
把上图形式化。策略约束方法的标准形式是一个带约束的优化问题:
$$ \pi_\theta \leftarrow \argmax_{\pi} \;\E_{s\sim \mathcal{D}}\Big[\E_{a\sim\pi(a\mid s)}\big[Q^{\pi}(s,a)\big]\Big] \quad \text{s.t.}\quad D\big(\pi(\cdot\mid s),\,\pi_\beta(\cdot\mid s)\big)\le \epsilon $$用拉格朗日乘子转成无约束的惩罚形式:
$$ \pi_\theta \leftarrow \argmax_{\pi}\;\E_{s\sim\mathcal{D}}\Big[\E_{a\sim\pi}\big[Q^\pi(s,a)\big] - \lambda\, D\big(\pi(\cdot\mid s),\pi_\beta(\cdot\mid s)\big)\Big] $$当 $D$ 取反向 KL 时,还有第三种更漂亮的写法:把惩罚吸收进奖励。因为
$$ D_{\mathrm{KL}}(\pi\,\|\,\pi_\beta) = \E_{a\sim\pi}\big[\log\pi(a\mid s) - \log\pi_\beta(a\mid s)\big] = -\E_{a\sim\pi}\big[\log\pi_\beta(a\mid s)\big] - \mathcal{H}\big(\pi(\cdot\mid s)\big) $$所以带反向 KL 惩罚的目标等价于
$$ \max_\pi\;\E_{a\sim\pi}\big[\underbrace{Q^\pi(s,a) + \lambda\log\pi_\beta(a\mid s)}_{\text{修改后的“奖励”}}\big] + \lambda\,\mathcal{H}\big(\pi(\cdot\mid s)\big) $$右边正是最大熵 RL(第 14 讲)的目标,只是把奖励改成了 $r(s,a) + \lambda\log\pi_\beta(a\mid s)$。这个观察非常有用:你可以把任何一个 MaxEnt RL 算法(比如 SAC)直接改造成策略约束的离线算法,只需要在奖励里加一项「行为策略对数似然」。 幻灯片上那句 "just add $\log\pi_\beta$ to $r$" 说的就是这件事。
8.2 为什么这样就能修好问题
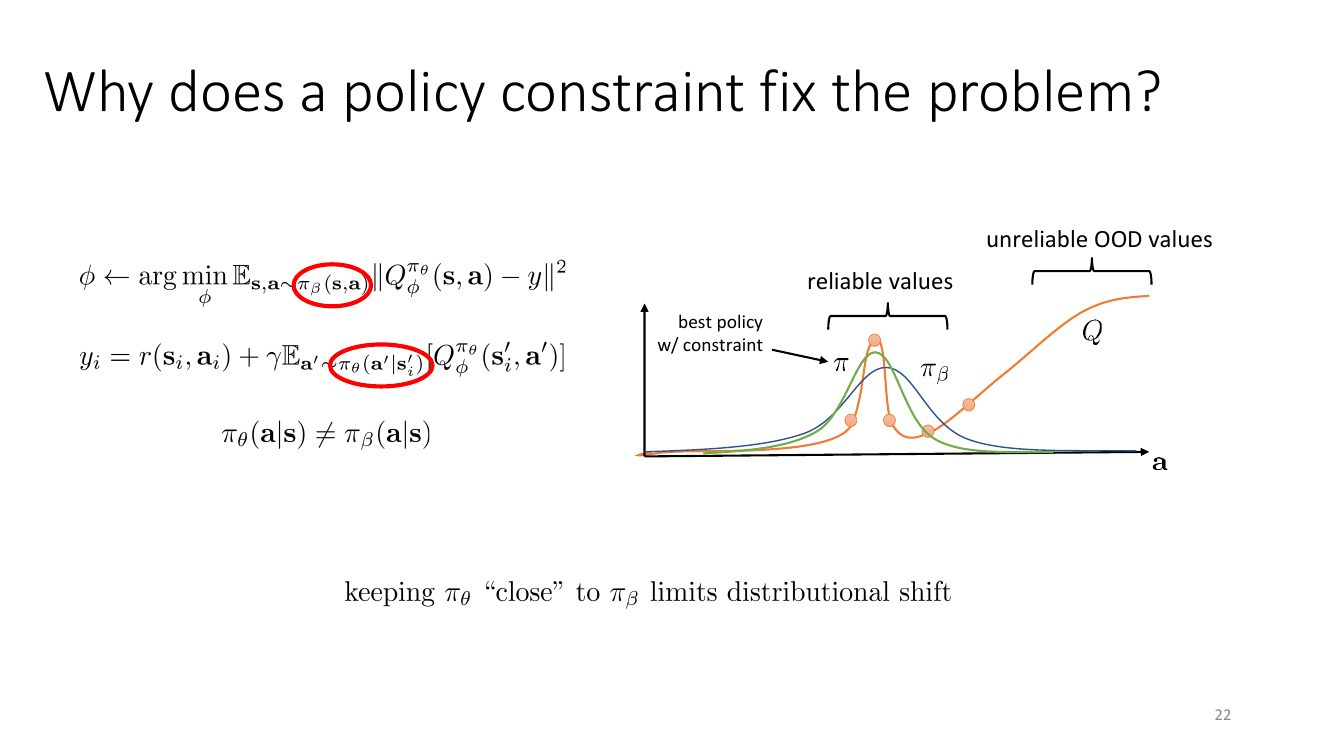
把作用机理说得再细一点,约束同时买到了两样东西:
- 切断了第 5 节的正反馈循环。 Bellman 目标里的 $\E_{a'\sim\pi_\theta}[Q(s',a')]$ 现在只会在 $\pi_\beta$ 支撑集附近取值,$\delta_{\text{ood}}$ 被压到 $\epsilon_{\text{in}}$ 的量级,递推 $\Delta_{k+1}=\gamma\Delta_k + \epsilon_{\text{in}}$ 重新变成收缩,收敛到 $\frac{\epsilon_{\text{in}}}{1-\gamma}$ 的有界误差。
- 保留了拼接能力。 这一点常被忽视但至关重要:约束限制的是每个状态上的动作分布,而不是整条轨迹。策略在 $s_1$ 处可以选轨迹 1 里出现过的动作,在 $s_2$ 处选轨迹 3 里出现过的动作——每一步都「在数据分布内」,组合起来却是数据里从未有过的轨迹。第 2 节那个 $A\to B\to C\to G$ 的例子完全落在约束之内。
约束是逐状态施加的,不是对状态分布施加的。这意味着策略约束方法只解决了动作分布偏移,没有解决状态分布偏移:一旦部署,$\pi_\theta$ 会走到 $p_\beta(s)$ 之外的状态去,那里的一切保证都失效。这是所有离线 RL 方法(包括下一讲的 CQL、IQL)共有的软肋,理论分析里通常靠「集中性系数(concentrability coefficient)」这类假设一笔带过,实践中则表现为「训练指标很好、部署几十步后就跑飞」。
「约束越紧越安全,那我把 $\lambda$ 调到很大不就行了?」$\lambda\to\infty$ 时目标退化成纯粹的 $\max_\pi \E_{a\sim\pi_\beta}[\log\pi(a\mid s)]$,也就是行为克隆——你确实不会崩,但也彻底放弃了离线 RL 的全部价值。$\lambda$(或 $\epsilon$)是离线 RL 里最需要调、也最难调的超参:太松则 $Q$ 爆炸,太紧则退化成 BC,而你没有在线环境可以用来做这个超参搜索——这本身就是离线 RL 最实际的工程痛点之一。
import torch, torch.nn.functional as F

def actor_loss_with_kl_constraint(q_net, actor, beh_actor, states,
                                  lam=1.0, n_samples=4):
    """反向 KL 版策略约束:max E_{a~pi}[Q] - lam * KL(pi || pi_beta)
    actor / beh_actor 返回 torch.distributions 对象(如 Normal + tanh)。"""
    dist = actor(states)
    # rsample 走重参数化,梯度能穿过采样进入 actor
    a = dist.rsample((n_samples,))                    # (K, B, act_dim)
    logp_pi = dist.log_prob(a).sum(-1)                # (K, B)

    with torch.no_grad():
        beh = beh_actor(states)                       # 事先用 BC 拟合好的 pi_beta
    logp_beta = beh.log_prob(a).sum(-1)               # (K, B)

    s_rep = states.unsqueeze(0).expand(n_samples, *states.shape)
    q = q_net(s_rep.reshape(-1, states.shape[-1]),
              a.reshape(-1, a.shape[-1])).view(n_samples, -1)

    kl = (logp_pi - logp_beta).mean(0)                # 反向 KL 的单样本估计
    return -(q.mean(0) - lam * kl).mean()             # 取负号变成待最小化的 loss


def critic_loss(q_net, q_targ, actor, batch, gamma=0.99, n_samples=4):
    """Bellman 目标里的 a' 从「被约束过的」策略采,从而不查询 OOD 动作。"""
    s, a, r, s2, done = batch
    with torch.no_grad():
        d2 = actor(s2)
        a2 = d2.sample((n_samples,))                  # (K, B, act_dim)
        s2_rep = s2.unsqueeze(0).expand(n_samples, *s2.shape)
        q2 = q_targ(s2_rep.reshape(-1, s2.shape[-1]),
                    a2.reshape(-1, a2.shape[-1])).view(n_samples, -1)
        # 用 min 而不是 max:对多次采样取悲观估计,进一步抑制高估
        y = r + gamma * (1.0 - done) * q2.min(dim=0).values
    return F.mse_loss(q_net(s, a), y)
注意 critic_loss 里那个 q2.min(...):即使加了策略约束,对多个采样动作取 min 而非 mean 仍然是实践中的标配技巧——它是「悲观」思想的一个廉价近似,和第 8 讲的 clipped double Q-learning 属于同一族。这也说明真实系统里几种思路是叠加使用的,而不是二选一。
9. 用哪一种约束?前向 KL、反向 KL 与支撑集约束
上一节把约束写成了抽象的 $D(\pi_\theta,\pi_\beta)$。具体该选什么?这个选择比想象中重要,而且它的影响远超离线 RL——RLHF 里 PPO 的 KL 惩罚、变分推断里 ELBO 的方向,都是同一个问题。
9.1 两个方向的 KL 各自在优化什么
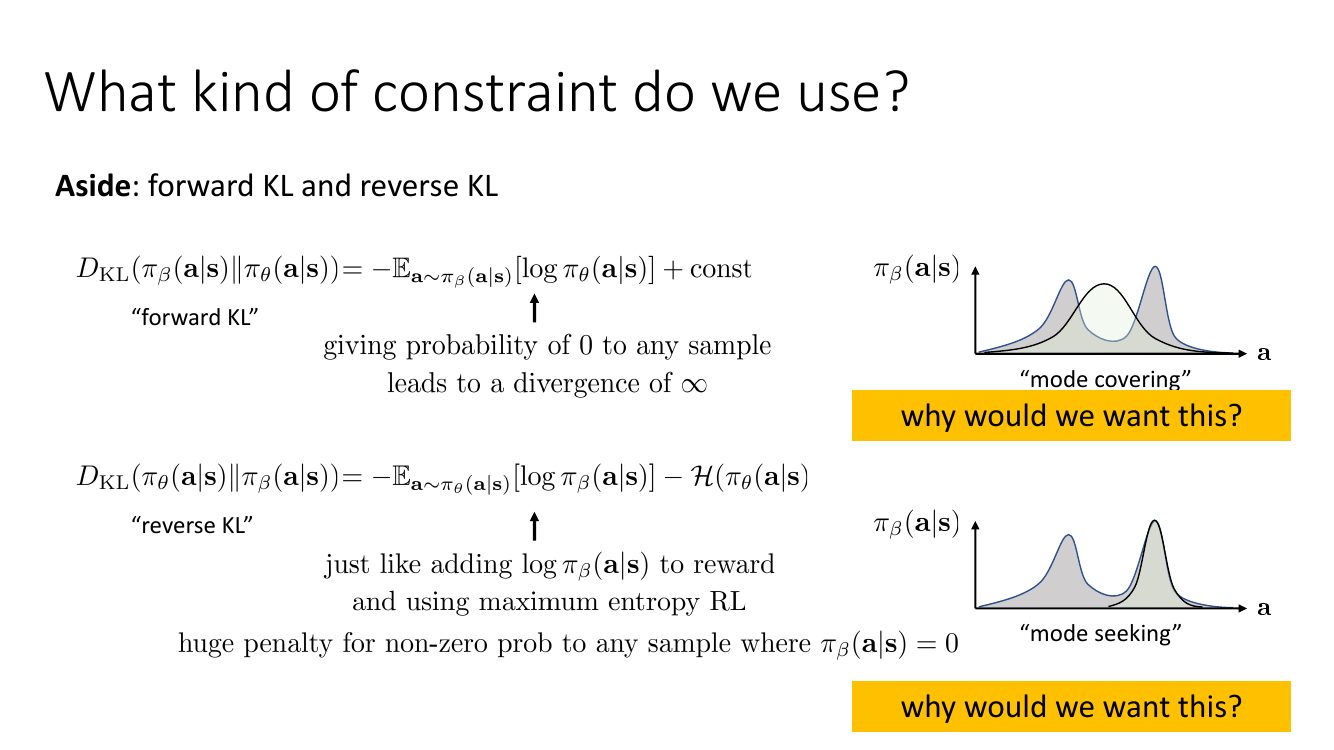
把两个方向都展开成对 $\theta$ 的优化问题,就能看出行为差异的来源。
前向 KL:
$$ D_{\mathrm{KL}}(\pi_\beta\|\pi_\theta)=\E_{a\sim\pi_\beta}\Big[\log\frac{\pi_\beta(a\mid s)}{\pi_\theta(a\mid s)}\Big] = -\E_{a\sim\pi_\beta}\big[\log\pi_\theta(a\mid s)\big] - \mathcal{H}(\pi_\beta) $$第二项与 $\theta$ 无关。所以最小化前向 KL $\equiv$ 最大化数据的对数似然 $\equiv$ 行为克隆。这解释了为什么它可以只用 $\pi_\beta$ 的样本算出来,不需要知道 $\pi_\beta$ 的密度。惩罚项 $-\log\pi_\theta(a)$ 在 $\pi_\theta(a)\to 0$ 时趋于 $+\infty$,而这个 $a$ 是从 $\pi_\beta$ 采的——于是凡是数据里出现过的动作,$\pi_\theta$ 都不敢给 0 概率,这就是 mode covering。
反向 KL:
$$ D_{\mathrm{KL}}(\pi_\theta\|\pi_\beta)=\E_{a\sim\pi_\theta}\Big[\log\frac{\pi_\theta(a\mid s)}{\pi_\beta(a\mid s)}\Big] = -\E_{a\sim\pi_\theta}\big[\log\pi_\beta(a\mid s)\big] - \mathcal{H}(\pi_\theta) $$现在 $\theta$ 出现在采样分布里,需要重参数化或 score-function 估计器才能求梯度;而且被积函数含 $\log\pi_\beta$,必须有 $\pi_\beta$ 的显式密度估计(通常先跑一个 BC / VAE / 扩散模型去拟合 $\hat\pi_\beta$,这本身就是误差来源)。惩罚项在 $\pi_\beta(a)\to 0$ 且 $\pi_\theta(a)>0$ 时爆炸——所以 $\pi_\theta$ 会躲开 $\pi_\beta$ 的零概率区,但完全不必覆盖 $\pi_\beta$ 的全部质量。加上 $-\mathcal{H}(\pi_\theta)$ 这一项在鼓励 $\pi_\theta$ 尽量分散,最终结果就是「在 $\pi_\beta$ 支撑集内部找一个(尽量宽的)模态」。
9.2 什么时候该用哪个
| 前向 KL $D_{\mathrm{KL}}(\pi_\beta\|\pi_\theta)$ | 反向 KL $D_{\mathrm{KL}}(\pi_\theta\|\pi_\beta)$ | |
|---|---|---|
| 期望在谁下取 | $\pi_\beta$(数据) | $\pi_\theta$(当前策略) |
| 需要 $\pi_\beta$ 的密度吗 | 不需要,只要样本 | 需要,得先拟合 $\hat\pi_\beta$ |
| 梯度怎么算 | 直接最大似然,最简单 | 重参数化 / REINFORCE |
| 几何行为 | mode covering(摊平、罩住全部) | mode seeking(收缩到一个峰) |
| 被迫保留低奖励模态? | 是——数据里的坏行为也得留概率 | 否——可以彻底抛弃差的模态 |
| 典型用武之地 | LLM / RLHF 的 KL 惩罚、PPO | 离线 RL 的策略约束 |
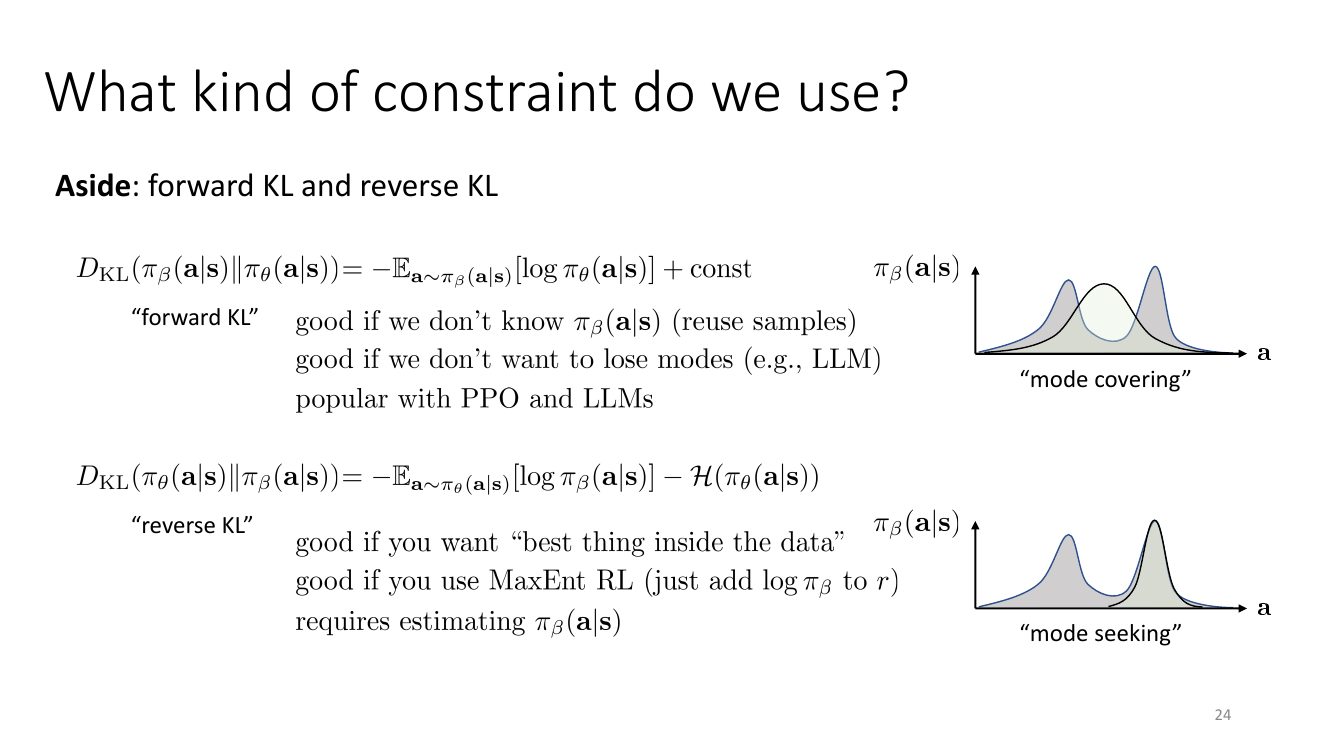
为什么离线 RL 更偏爱反向 KL?因为数据集本来就是好坏混杂的。前向 KL 会强迫 $\pi_\theta$ 给数据里的每一种行为都留下概率质量,包括那些回报很低的模态——这与「找出数据里的好东西」的目标直接冲突。而 LLM 的 RLHF 场景恰好相反:预训练分布代表的是「语言的合法性」,你不希望优化过程把整片语言空间坍缩掉,mode covering 反而是想要的性质。同一个数学工具,在两个场景下的取舍完全相反,这是很好的一课。
9.3 理想的约束:支撑集约束
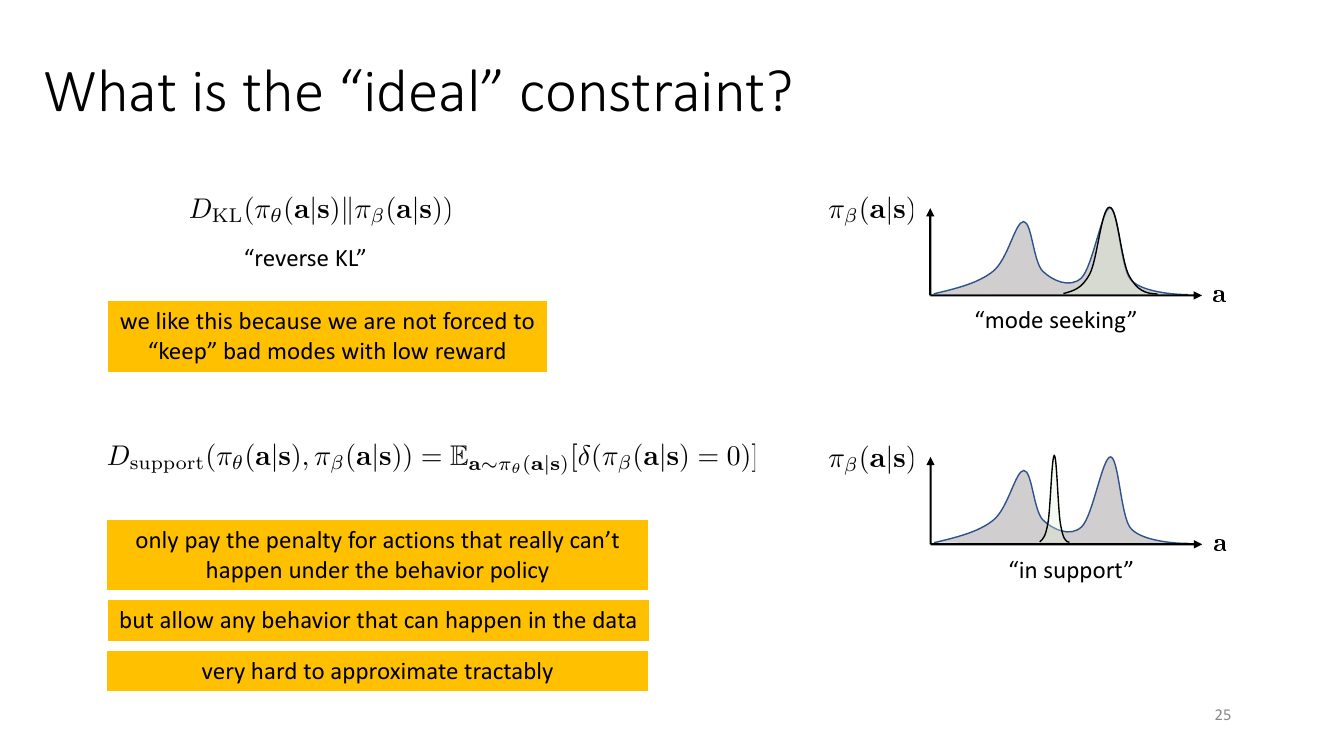
为什么这才是「理想」?比较三种约束对同一个策略的态度:
| $\pi_\theta$ 的形态 | 前向 KL | 反向 KL | 支撑集约束 |
|---|---|---|---|
| 放质量在 $\pi_\beta$ 覆盖不到的动作上 | 不直接惩罚(不安全) | 重罚 ✔ | 重罚 ✔ |
| 丢掉 $\pi_\beta$ 的某个低回报模态 | 重罚 ✘(不合理) | 允许 ✔ | 允许 ✔ |
| 在 $\pi_\beta$ 支撑集内变成很尖的确定性策略 | 重罚 ✘ | 仍会惩罚 ✘($-\mathcal{H}$ 项 + 与 $\pi_\beta$ 形状不符) | 完全不罚 ✔ |
第三行是反向 KL 唯一的短板:假设 $\pi_\beta$ 在某个状态是个宽高斯,而真正的最优动作是这个高斯正中央的一个点。反向 KL 依然会因为「你比 $\pi_\beta$ 尖太多了」而给你一份惩罚($D_{\mathrm{KL}}$ 在 $\pi_\theta$ 收缩成 delta 时是发散的),逼着你保留一些不必要的随机性。支撑集约束不会——它只关心「在不在里面」,不关心「形状像不像」。
那为什么大家不都用它?看它的定义式:$\delta(\pi_\beta(a\mid s)=0)$ 是一个指示函数,它处处梯度为零、且需要精确判断某个动作的密度是否严格为 0。在连续动作空间里用有限样本判断「支撑集边界在哪」,是一个极其病态的统计问题——这就是幻灯片最后一句「very hard to approximate tractably」的含义。实践中的替代品包括:用最大平均差异(MMD)近似支撑集距离(BEAR 的做法)、用条件 VAE 生成候选动作再做小幅扰动(BCQ 的做法)、或者干脆绕开约束改用保守值函数(CQL)与样本内备份(IQL)——这些正是下一讲的主题。
约束的选择是一个「限制多严」的谱:前向 KL(最严,等于 BC)→ 反向 KL(次之,允许挑模态但仍限制形状)→ 支撑集约束(最松,只禁止真正不可能的动作)。越往右,保留的「超越数据」的空间越大,但估计难度越高。你在实际项目里选哪一个,取决于你的数据有多干净、$\pi_\beta$ 有多好估、以及你对失败的容忍度。
本讲小结
一页速查
| 问题 | 答案 |
|---|---|
| 离线 RL 的设定是什么 | 固定数据集 $\mathcal{D}=\{(s_i,a_i,s_i',r_i)\}$ 由未知的 $\pi_\beta$ 采集;训练期间零环境交互;训练完部署一次 |
| 它和 off-policy RL 的区别 | 不是「数据新旧」,而是有没有纠错回路 |
| 它凭什么超过数据 | 筛选好行为 + 泛化 + 拼接(跨轨迹重组片段,靠 Bellman 备份实现) |
| 拼接的两种尺度 | 宏观(整段行为重组,A→B→C)与微观(每步挑一小段位移,串成新轨迹) |
| 根本困难 | 反事实查询:问一个数据里没发生过的动作会怎样,而无法做实验验证 |
| 为什么 $\max$ 特别危险 | $\argmax_a Q_\phi(s,a)=\argmax_a[Q^\ast+\epsilon]$,它同时在最大化误差,是对模型的对抗查询 |
| 误差如何放大 | OOD 高估被写进 Bellman 目标 → 抬高邻域 → 下一轮 $\max$ 取到更高的假峰;递推 $\Delta_{k+1}=\gamma\Delta_k+\delta_{\text{ood},k}$ 发散 |
| 在线 RL 为什么没事 | 试一下就会被真实回报打脸;高估在线上是探索信号,离线是自欺 |
| 直接跑 SAC 会怎样 | 真实回报趴在地板上,同时 $Q$ 值在对数坐标上涨到 $10^{13}$ 量级 |
| 为什么加数据反而更差 | 更大的数据集覆盖更广,也给 $\argmax$ 提供了更多「见得不够」的角落可钻 |
| IS 类 OPE 的问题 | $\mathrm{Var}(w_{1:H})=(1+\sigma^2)^H-1$ 随时间步指数爆炸;诊断看 $n_{\text{eff}}$ |
| 解法的共同原则 | 不要查询没有数据支撑的地方 |
| 四类解法 | 策略约束(改策略)、悲观值函数 CQL(改 critic 损失)、避免 OOD 备份 IQL(改目标构造)、不确定性 / 保守模型 |
| 策略约束等价形式 | 反向 KL 惩罚 $\equiv$ 把 $r$ 换成 $r+\lambda\log\pi_\beta$ 再做最大熵 RL |
| 用哪种约束 | 前向 KL = mode covering,不需 $\pi_\beta$ 密度,适合 LLM;反向 KL = mode seeking,需要 $\hat\pi_\beta$,适合离线 RL;支撑集约束最理想但难以近似 |
| 未解决的问题 | 约束只管住动作分布偏移,状态分布偏移在部署时依然存在 |
需要牢牢记住的三句话
- 离线 RL 想要的能力和它害怕的失效模式来自同一个算子。 动态规划的 $\max$ 既是拼接的引擎,也是高估的放大器。所有方法都不是删掉它,而是给它加笼子。
- 低 Bellman 误差 ≠ 好策略。 前者是 $\pi_\beta$ 分布下的平均量,后者取决于 $\argmax$ 挑中的那个点。离线 RL 里必须放弃「看 TD loss 判断训练是否正常」的习惯,改看 $Q$ 值的绝对量级。
- 稳定性与「超越数据」是一对此消彼长的量。 行为克隆在光谱的最稳定一端(也最平庸),无约束 Q-learning 在最激进一端(也最容易爆炸)。所有离线 RL 算法都是在这条轴上选一个点,超参 $\lambda$ 就是那个刻度。
下一讲预告
本讲只给出了策略约束的原理框架,还留下一堆没答的问题:如果我不想估计 $\pi_\beta$ 呢?如果我想直接让 $Q$ 函数自己变保守呢?有没有办法完全不查询样本外动作?下一讲会把 CQL 的保守 $Q$ 目标、IQL 的期望回归与隐式最大化、AWAC/AWR 的加权回归形式、以及 MOPO/COMBO 这类保守模型方法的目标函数逐条推导出来,并给出「什么数据该用什么方法」的工程判断。
延伸阅读
综述与教程(先读这两篇)
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives on Open Problems (2020) — Levine 等人写的离线 RL 权威综述,本讲的内容基本可以看作它前四节的浓缩版;想把分布偏移的形式化分析补全,直接看这一篇。
- Diagnosing Bottlenecks in Deep Q-learning Algorithms (2019) — 系统拆解 Q-learning 里采样误差、函数逼近误差、分布偏移各自贡献了多少,第 5 节那个「误差不被纠正」的论断在这里有实证支撑。
分布偏移与高估的诊断
- Off-Policy Deep Reinforcement Learning without Exploration (2019) — BCQ 原始论文,第一次清楚地把「外推误差(extrapolation error)」命名并量化,并给出「标准离策略算法在固定数据集上失败」的实验,本讲第 5.3 节的现象源头之一。
- Stabilizing Off-Policy Q-Learning via Bootstrapping Error Reduction (2019) — BEAR,提出用 MMD 做支撑集约束的近似,正是第 9.3 节说的「难以近似」的一种可行妥协。
- Deep Reinforcement Learning with Double Q-learning (2015) — 最大化偏差的经典处理,读它可以看清第 3.3 节的 $\argmax$ 偏差在在线设定下是什么量级,从而对比出离线设定放大了多少。
策略约束类方法
- Behavior Regularized Offline Reinforcement Learning (2019) — 把各种策略约束(KL、MMD、Wasserstein,惩罚形式 vs 硬约束)放进一个统一框架做对照实验,是选约束时最实用的参考。
- AWAC: Accelerating Online Reinforcement Learning with Offline Datasets (2020) — 把策略约束写成优势加权回归的闭式解,训练极稳定,且天然支持「离线预训练 + 在线微调」这条第 1 节图里的路径。
- A Minimalist Approach to Offline Reinforcement Learning (2021) — TD3+BC,在 TD3 的 actor loss 上直接加一项行为克隆(即前向 KL),二十行改动打平复杂方法,是「简单基线的力量」的最佳案例。
下一讲会展开的方法
- Conservative Q-Learning for Offline Reinforcement Learning (2020) — CQL,第 7 节表格里「悲观值函数」那一行的代表作,把「让 $Q$ 成为真值的下界」写成一个可以加进任意 critic 损失的正则项。
- Offline Reinforcement Learning with Implicit Q-Learning (2021) — IQL,用期望分位数回归实现「样本内最大化」,全程不查询任何数据集外的动作。
- MOPO: Model-based Offline Policy Optimization (2020) — 把模型不确定度直接从奖励里扣掉,第 4.2 节那个「规划器攻击模型幻觉」的对症解法。
离线策略评估
- Doubly Robust Off-policy Value Evaluation for Reinforcement Learning (2015) — 第 6.2 节 DR 估计量的原始推导与方差分析。
- Data-Efficient Off-Policy Policy Evaluation for Reinforcement Learning (2016) — 把 per-decision IS、WIS 与 DR 融合成 MAGIC 估计量,是实际做 OPE 时的实用参考。
基准数据集
- D4RL: Datasets for Deep Data-Driven Reinforcement Learning (2020) — 离线 RL 的标准评测集。它专门设计了考察拼接能力的任务(如
antmaze、maze2d的 diverse/play 数据集),在这些任务上行为克隆几乎必然失败,是验证第 2 节论断的最佳试验场。