导论:为什么是深度强化学习
数据让机器理解世界,优化让机器超越数据。本讲说明这两件事为什么必须放在一起,以及整门课要沿着哪条路把它们拼起来。
0. 本讲导读
这是全课的第一讲,它不教任何算法,但它决定了你读后面 24 讲时脑子里挂着的是什么问题。Levine 在这一讲里做的事情,本质上是把「强化学习(Reinforcement Learning, RL)」这个词从两个完全不同的角度各定义一遍,然后论证这两个定义指向同一件事:
- 作为数学形式化:RL 是「基于学习的决策」的一套数学语言——一个智能体(agent)反复地观察、行动、接受奖励,目标是最大化累计奖励。这个定义很窄,就是一堆符号。
- 作为方法论:RL 是「从经验中学习决策与控制」的一条路线。这个定义很宽,宽到把模仿学习、逆强化学习、基于模型的规划、离线 RL、大语言模型的后训练全都装了进去。
本讲要回答的核心问题只有一个:为什么在有了如此强大的监督学习(supervised learning)之后,我们还需要强化学习? Levine 的答案可以浓缩成一句他在 slides 上用黄框标出来的话:「数据没有优化,就无法用新的方式解决新的问题;优化没有数据,就很难走出模拟器应用到真实世界。」(Data without optimization doesn't allow us to solve new problems in new ways;Optimization without data is hard to apply to the real world outside of simulators.)这两句话是全课的思想主轴,后面每一个算法都可以放回这两句话里定位。
本讲与后续讲次的关系:这是一张地图。第 2 讲开始进入模仿学习(imitation learning),那是「先绕开 RL、只用监督学习做决策」的尝试,你会看到它在哪里失效;第 4 讲给出马尔可夫决策过程(MDP)的严格定义与算法全景;第 5 讲之后才真正开始一个个算法。读完本讲,你应该能说清楚策略梯度、值函数方法、model-based、offline RL、探索、LLM 的 RL 后训练这六大块各自在解决什么问题、彼此怎么衔接——这正是本讲最后一节要给你的东西。
- 监督学习假设数据独立同分布(i.i.d.)且有已知的正确答案;RL 两条假设都不成立:你自己的动作决定了下一步会看到什么数据,而且没人告诉你正确动作是什么,只有一个奖励信号。
- RL 的接口是:每一步输入状态 $s_t$、输出动作 $a_t$,数据是轨迹 $(s_1,a_1,r_1,\dots,s_T,a_T,r_T)$,目标是学一个策略 $\pi_\theta: s_t \mapsto a_t$ 使 $\sum_t r_t$ 最大。没有 $(x_i,y_i)$,只有你自己作出来的数据。
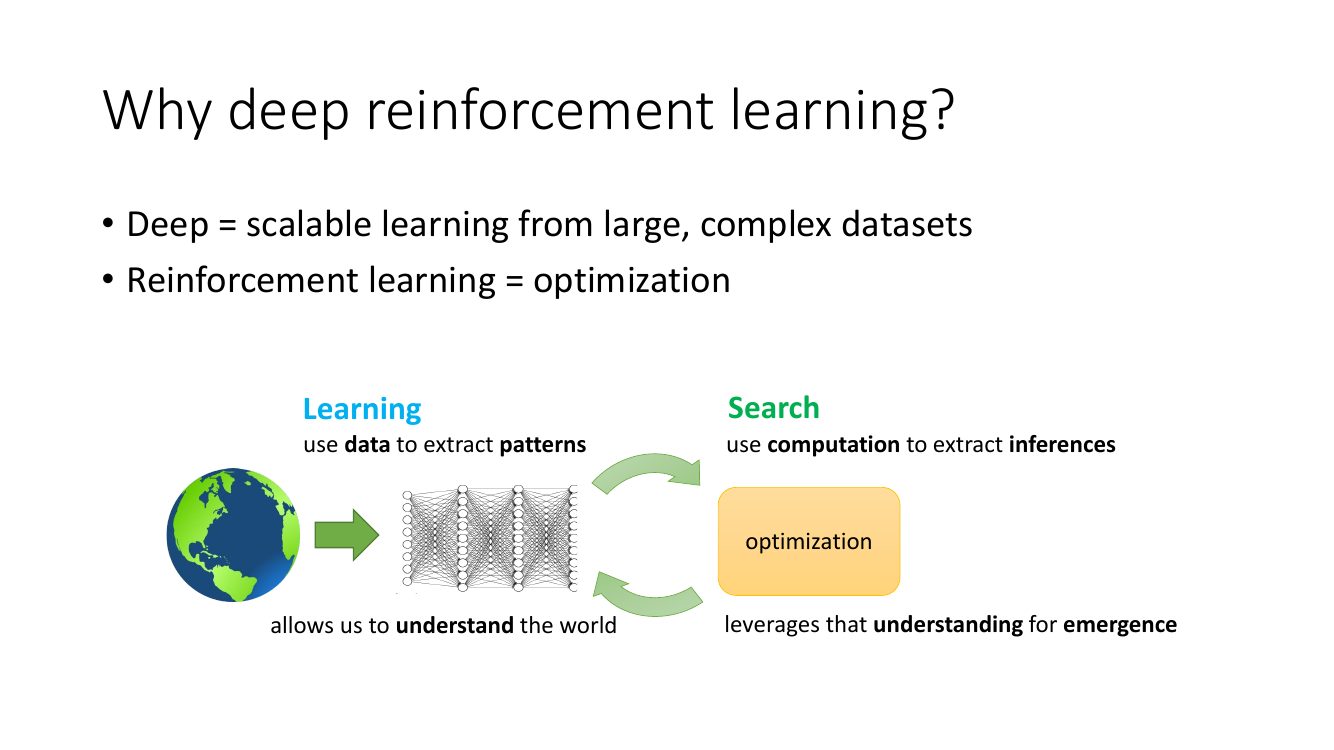
- 「深度」提供处理复杂高维输入的表示能力(learning:用数据抽取模式),「强化学习」提供目标导向的优化能力(search:用计算抽取推论)。Sutton 的「苦涩的教训」说的正是这两者才可无限扩展。
- RL 的独特价值在于它可以超越数据:监督学习最好也只是逼近数据分布,而 RL 的目标是最大化奖励,因此能产生 AlphaGo「第 37 手」那种没有任何人想到过的解法。
- 近年被称为「AI 进展」的东西——RLHF 对齐的聊天模型、会长思维链的推理模型、端到端的机器人策略、图像生成模型的偏好微调——底层几乎都是同一套 RL 机器套在不同的奖励上。
- 奖励从哪来是一个真问题。当奖励难以人工指定时,可以从人类示范里模仿,或用逆强化学习(inverse RL)把奖励反推出来,或用人类偏好训练一个奖励模型——这三条路本课都会讲。
1. 从一个具体问题开始:让机器人把杂物箱里的东西捡起来
Levine 没有一上来就写公式,而是摆了一个具体的工程问题:桌上有一个装满各种杂物的箱子(object bin),机械臂上方有一个单目 RGB 相机,机械臂是 7 自由度的,末端是一个二指夹爪。任务是:看一眼图像,决定把夹爪伸到哪个位置 $(x,y,z)$ 去闭合,才能真的抓起东西。
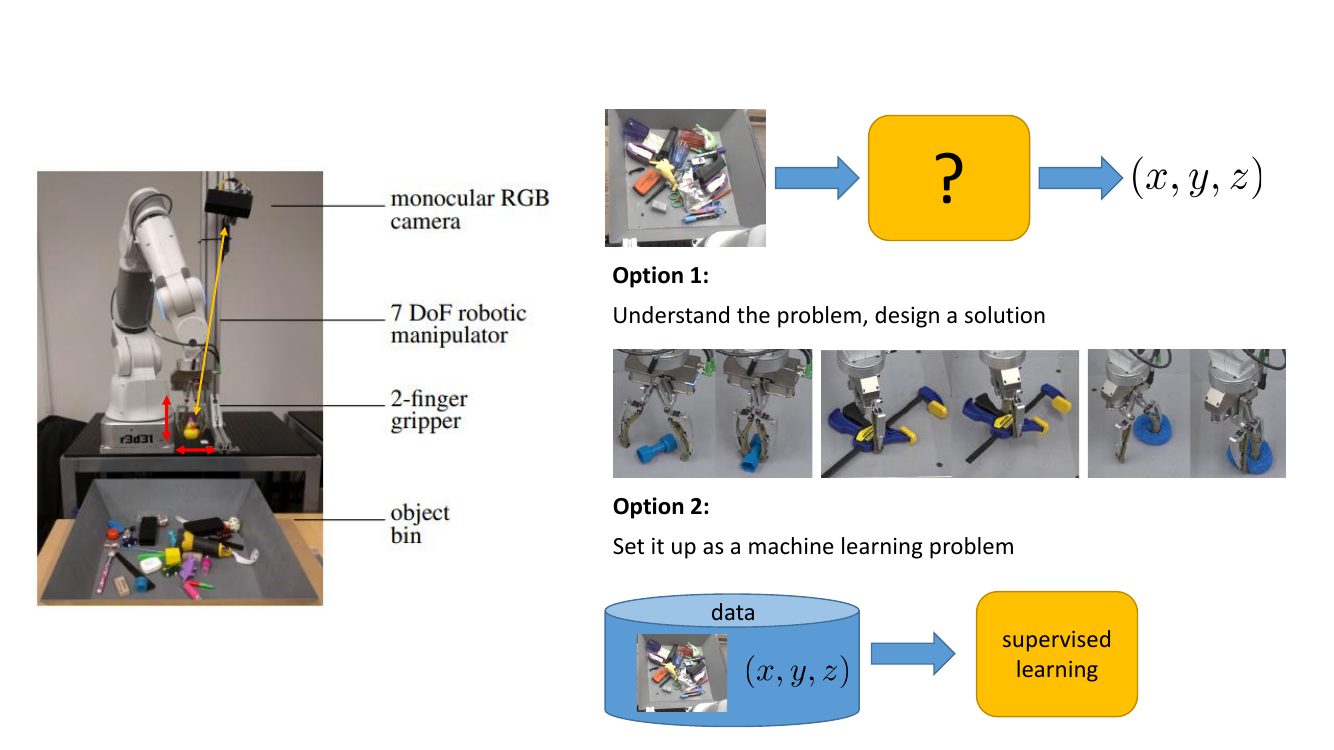
Option 1:理解问题,然后设计一个解
这是经典机器人学与计算机视觉的做法。你会把问题拆成若干模块:先做物体检测与分割,再估计每个物体的 6 自由度位姿,接着用几何学计算「力封闭」(force closure)条件下的可行抓取点,最后做运动规划把夹爪送过去。每一个模块都有几十年的文献,每一个模块单独看都很漂亮。
问题在于:这一整条流水线是你以为的解题方式,不是真正管用的解题方式。当箱子里是一根柔软的电线、一团渔网、一只半透明的塑料袋时,「6 自由度位姿」这个概念本身就不成立——它根本没有一个刚体位姿。你的模块化假设在这里悄无声息地崩塌,而系统只会告诉你「抓取失败」,不会告诉你是哪一层假设错了。
Option 2:把它设成一个机器学习问题
那就换一条路:收集数据集 $\mathcal{D}=\{(\mathbf{x}_i, y_i)\}$,其中 $\mathbf{x}_i$ 是相机图像,$y_i$ 是一个好的抓取坐标 $(x,y,z)$,然后训练 $f_\theta(\mathbf{x}_i)\approx y_i$。这是标准的监督学习,我们非常擅长做这件事。
但这里有一个致命的循环论证:那些标注 $y_i$ 从哪儿来? 让人一张一张标注「这堆乱七八糟的东西里最好的抓取点在哪」,既昂贵又不可靠——人自己也不知道对一根软管而言哪个抓取点最稳,人给出的标注只是人的猜测,而人的猜测正是 Option 1 已经失败过的那个东西。更糟的是,人手和二指夹爪的运动学完全不同,人认为好抓的地方对这个夹爪未必好抓。
「只要数据够多,监督学习什么都能做」——这句话在感知任务上大致成立(图像分类的标签是客观的、人人可标的),但在决策任务上会立刻碰壁:决策问题的「正确答案」往往依赖于执行者的身体、依赖于环境的动力学,人类标注者压根不掌握这些信息。这正是本课存在的理由。
让机器人自己制造标注
破局的办法是:让机器人自己试。 它随便挑一个 $(x,y,z)$ 去抓,抓完之后传感器能自动判断成功还是失败(比如夹爪闭合后测宽度、或者抬起来看物体还在不在)。于是我们免费得到了一条数据:$\big(\text{图像}, (x,y,z), \{\text{success}, \text{failure}\}\big)$。注意这条数据的形状和监督学习的 $(\mathbf{x},y)$ 已经不一样了——它多了一个「我采取的动作」,而标签变成了「这个动作的好坏」,而不是「正确动作是什么」。
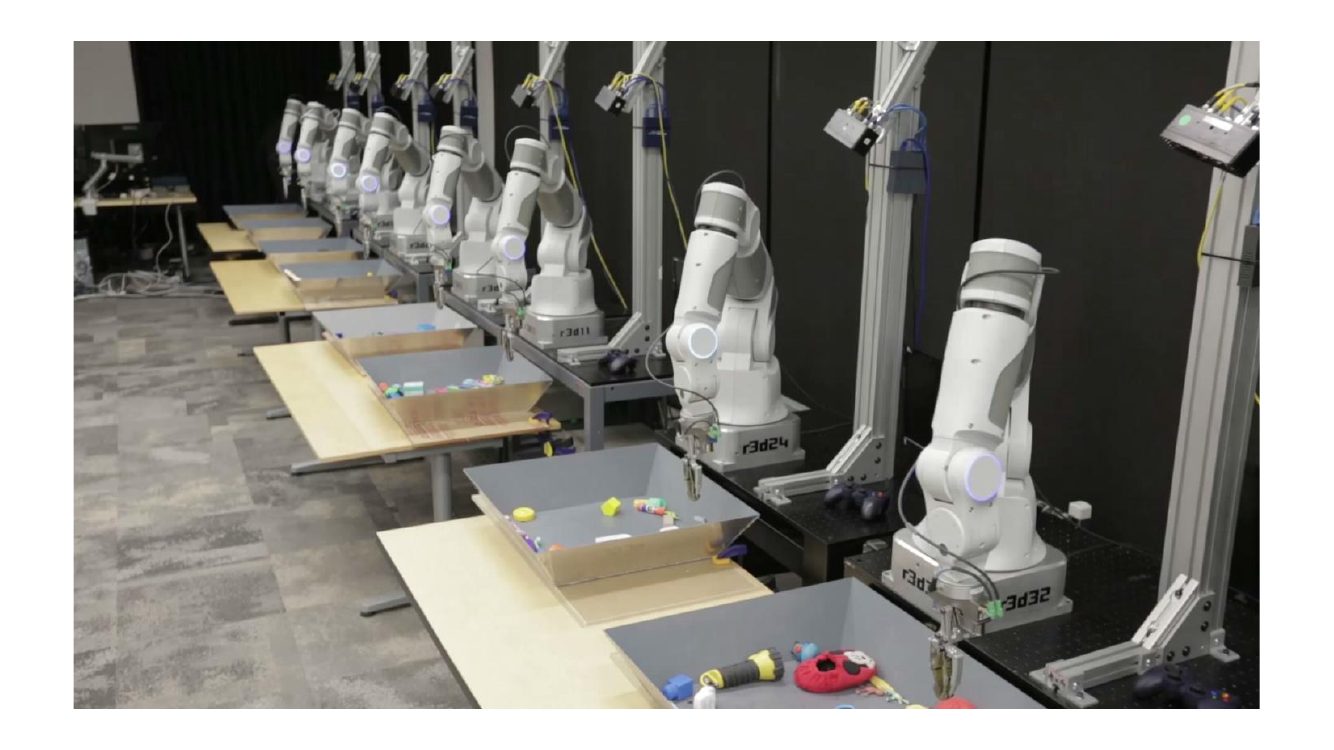
更关键的一步在后面:拿到这批「动作 + 成败」的数据后,我们用它改进策略,然后用改进后的策略再去采数据。新策略会去尝试它认为更有希望的抓取点,于是采到的数据分布也变了——它更集中在「接近成功」的区域,从而让下一轮学习更有效。这个闭环就是强化学习。
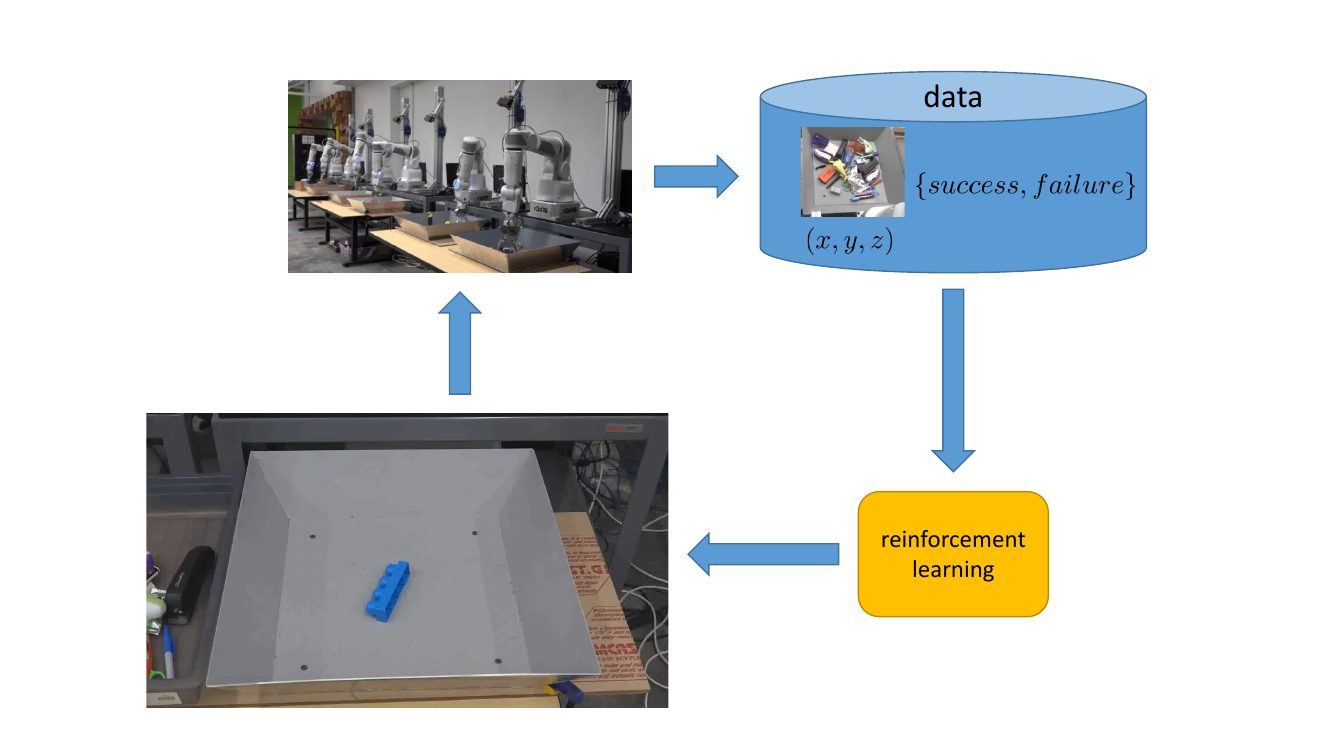
请把这张闭环图记牢。它有三个环节,而本课后面几乎每一个算法都可以被放进这三个环节里:(1)用当前策略产生样本;(2)用样本估计某个东西(回报、值函数、环境模型);(3)用估计出的东西改进策略。 不同算法的区别只在于第(2)步估计的是什么、第(3)步怎么改进。第 4 讲会把这个「三步循环」正式化成本课的通用算法骨架。
Option 1 是「我来告诉你怎么做」,Option 2 的监督版是「我来告诉你做什么是对的」,而 RL 是「我只告诉你做完之后有多好,你自己去找怎么做」。信息量一路递减,但适用范围一路递增。 这是一个非常普遍的权衡:你给系统的先验越少,它需要的数据和计算就越多,但它能解决的问题也越出乎你的意料。
2. 什么是强化学习:两个定义与一套记号
Levine 给了强化学习两个并列的定义,它们的抽象层级完全不同,但缺一不可:
- 强化学习是一套「基于学习的决策」的数学形式化(mathematical formalism for learning-based decision making)。这是狭义的 RL:马尔可夫决策过程、贝尔曼方程、策略梯度定理,一套自洽的符号系统。
- 强化学习是一种「从经验中学习决策与控制」的方法(approach for learning decision making and control from experience)。这是广义的 RL:任何「试→看结果→改」的学习范式都算,哪怕它的具体算法长得完全不像 Q-learning。
本课两个定义都要。前者给你严密性——没有它你分不清一个算法是不是无偏的、会不会收敛;后者给你视野——没有它你会以为 RL 只能玩 Atari。
2.1 与监督学习的两条根本差异
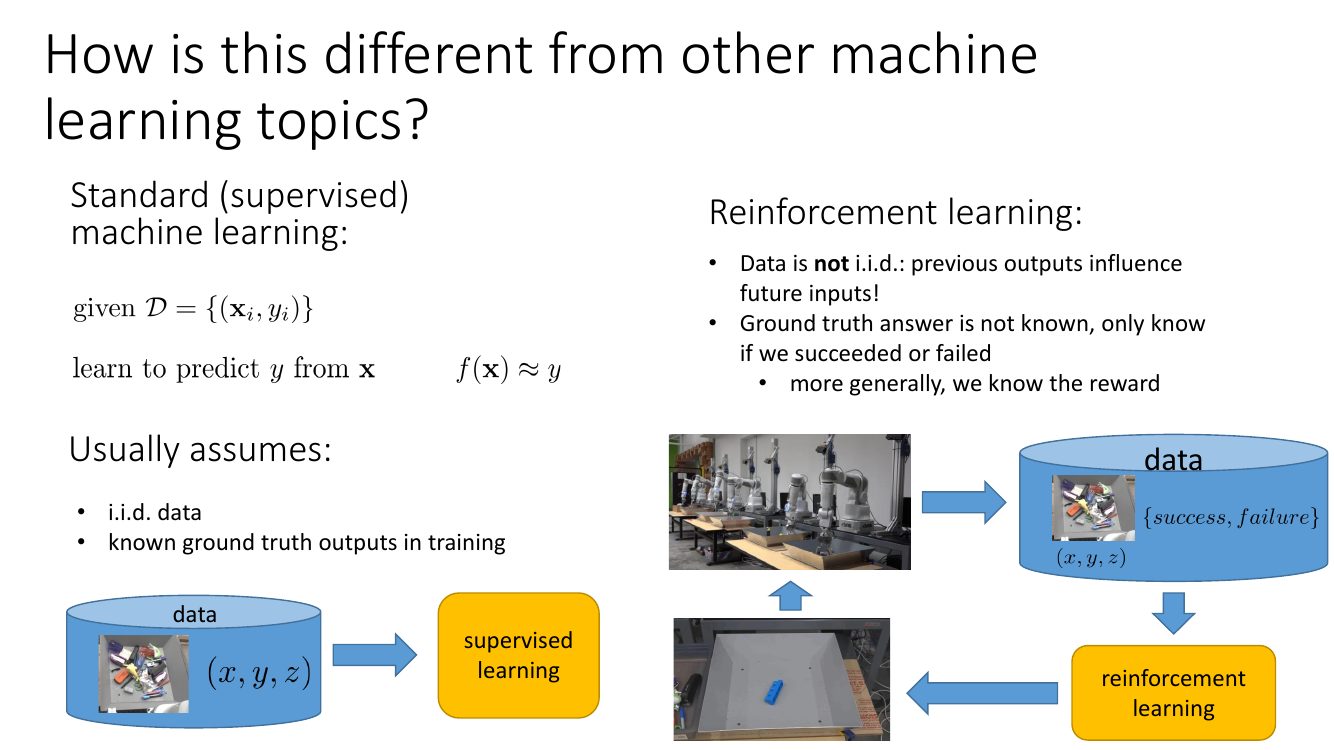
差异一:数据不是独立同分布的(data is not i.i.d.)。 这句话的完整含义是「previous outputs influence future inputs」——你上一时刻输出的动作,决定了下一时刻你会看到什么状态。这不只是一个技术性的统计假设被违反,它带来的是根本性的后果:
- 训练集和测试集的分布由你自己的模型决定。模型一改,分布就变,昨天在验证集上的评估今天就失效了。第 2 讲的行为克隆(behavior cloning)会因为这个性质出现著名的分布偏移(distributional shift)问题,误差随时间步数二次方累积。
- 「泛化」的含义变了。监督学习问「在同分布的新样本上表现如何」,RL 得问「在我自己的新策略诱导出的新分布上表现如何」。
- 探索(exploration)成为必需品。如果你的策略从来不去某个区域,你就永远拿不到那个区域的数据,也就永远不知道那里是不是更好。监督学习没有这个问题——数据集是别人给你的,你什么都能看见。
差异二:不知道正确答案,只知道奖励。 监督学习的每条样本自带一个「应该输出什么」的完整指示,梯度方向是明确的;RL 只有一个标量 $r$ 告诉你「你刚才那一串动作的总体效果是好是坏」。这带来两个经典难题:
- 信用分配(credit assignment):一盘棋下了 200 手,最后输了。到底是哪一手错了?奖励只有一个数,却要分摊到 200 个决策上。
- 方差:因为只能通过采样「猜」哪些动作是好的,梯度估计的噪声非常大。第 5 讲的一半篇幅都在处理这件事。
2.2 形式化:接口与目标
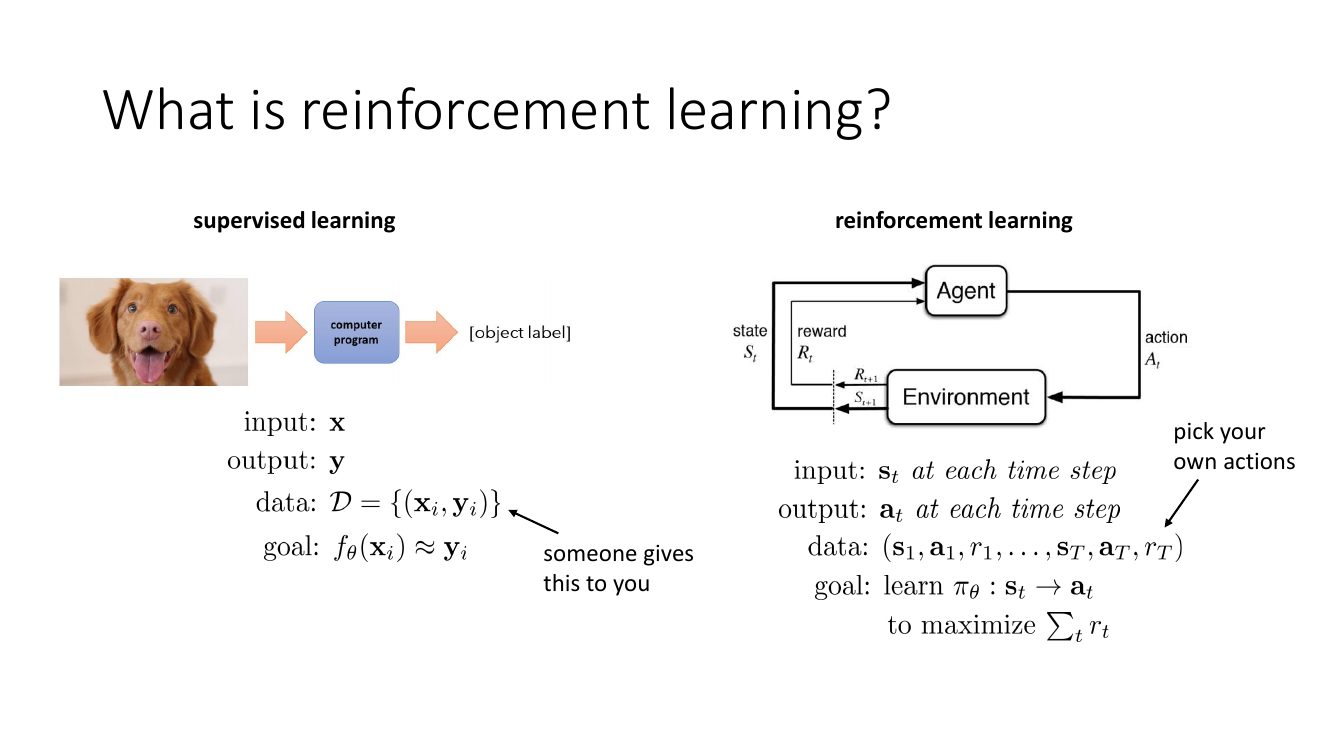
把记号一次性钉死,全课通用(第 4 讲会更严格地重述):
| 符号 | 名称 | 含义与注意点 |
|---|---|---|
| $s_t$ | 状态(state) | 时刻 $t$ 环境的完整描述,满足马尔可夫性:给定 $s_t$ 和 $a_t$,未来与过去无关。 |
| $o_t$ | 观测(observation) | 智能体实际看到的东西,可能只是 $s_t$ 的一部分。相机图像是 $o_t$,被遮挡物体的位置属于 $s_t$ 但不在 $o_t$ 里。 |
| $a_t$ | 动作(action) | 可以是离散的(上下左右、下一个 token)或连续的(关节力矩)。 |
| $\pi_\theta(a_t|s_t)$ | 策略(policy) | 由参数 $\theta$(神经网络权重)定义的条件概率分布。部分可观测时写作 $\pi_\theta(a_t|o_t)$。 |
| $r(s,a)$ | 奖励(reward) | 标量。不需要可微、不需要连续,可以是「赢棋 +1」这种黑箱。 |
| $p(s_{t+1}|s_t,a_t)$ | 转移概率(transition) | 环境的动力学。model-free 方法从不显式使用它,model-based 方法要把它学出来。 |
| $\tau$ | 轨迹(trajectory) | $\tau=(s_1,a_1,\dots,s_T,a_T)$,一次完整的交互序列,也叫 episode / rollout。 |
| $\gamma$ | 折扣因子(discount) | $\gamma\in[0,1)$,让无限长任务的回报有限,也表达「近期奖励更值钱」。 |
于是 RL 的目标函数可以写成:策略 $\pi_\theta$ 与环境交互诱导出一个轨迹分布
$$ p_\theta(\tau) = p(s_1)\prod_{t=1}^{T} \pi_\theta(a_t|s_t)\, p(s_{t+1}|s_t,a_t), $$我们要最大化的是这个分布下的期望累计奖励:
$$ \theta^\star = \argmax_\theta\; J(\theta),\qquad J(\theta)=\E_{\tau\sim p_\theta(\tau)}\left[\sum_{t=1}^{T} r(s_t,a_t)\right]. $$请注意这个式子的两个「不方便」之处,它们是后面十几讲所有技术困难的源头:第一,$\theta$ 不在被求期望的函数里,而在期望所依赖的分布里——这不是标准的可微优化;第二,$p_\theta(\tau)$ 里含有我们不知道的 $p(s_{t+1}|s_t,a_t)$——我们连这个分布长什么样都写不出来,更别说对它积分。第 5 讲的第一件事就是用 log-derivative trick 同时干掉这两个麻烦。
务必从一开始就区分 $s_t$ 与 $o_t$。很多入门材料把它们混着用,代价是你之后会读不懂「为什么 Q-learning 需要马尔可夫性而策略梯度不需要」「为什么部分可观测环境要用 RNN 或历史堆叠」。本讲的抓取例子里,相机图像是 $o_t$;如果箱子里一个物体被另一个挡住了,图像就不足以确定环境的真实状态,此时策略只能写成 $\pi_\theta(a_t|o_t)$,理论上最优策略甚至可能需要依赖整段历史 $o_{1:t}$。
2.3 这套接口适用的范围有多广
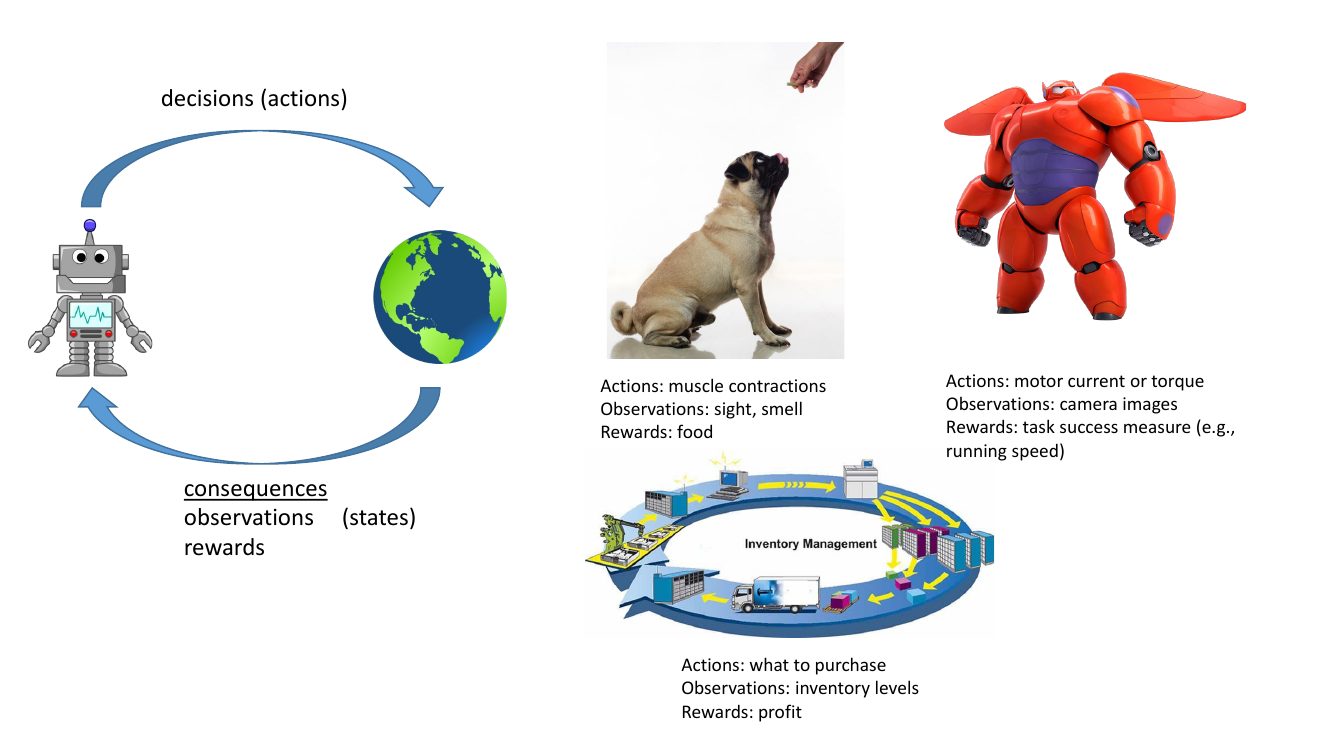
值得注意的是最后那个库存管理的例子:它既不是游戏也不是机器人,没有物理身体,没有图像输入,但它同样是一个序贯决策问题——今天多进的货会影响明天的仓储成本和缺货风险,「之前的输出影响之后的输入」原封不动地成立。凡是满足这个特征的问题,都在 RL 的射程之内:广告投放、推荐系统的长期留存、数据中心冷却、交通信号配时、临床用药方案、编译器优化、乃至大语言模型怎么组织一段推理。
3. 深度让强化学习变了什么
强化学习不是新东西。行为主义心理学里的操作性条件反射(Skinner 的鸽子实验)、控制论里的最优控制、演化算法、随机优化——这些都是「用试错优化行为」的古典形态,最早可以追溯到上世纪中叶。那么,为什么 2013 年之后才突然出现「深度强化学习」这个词?
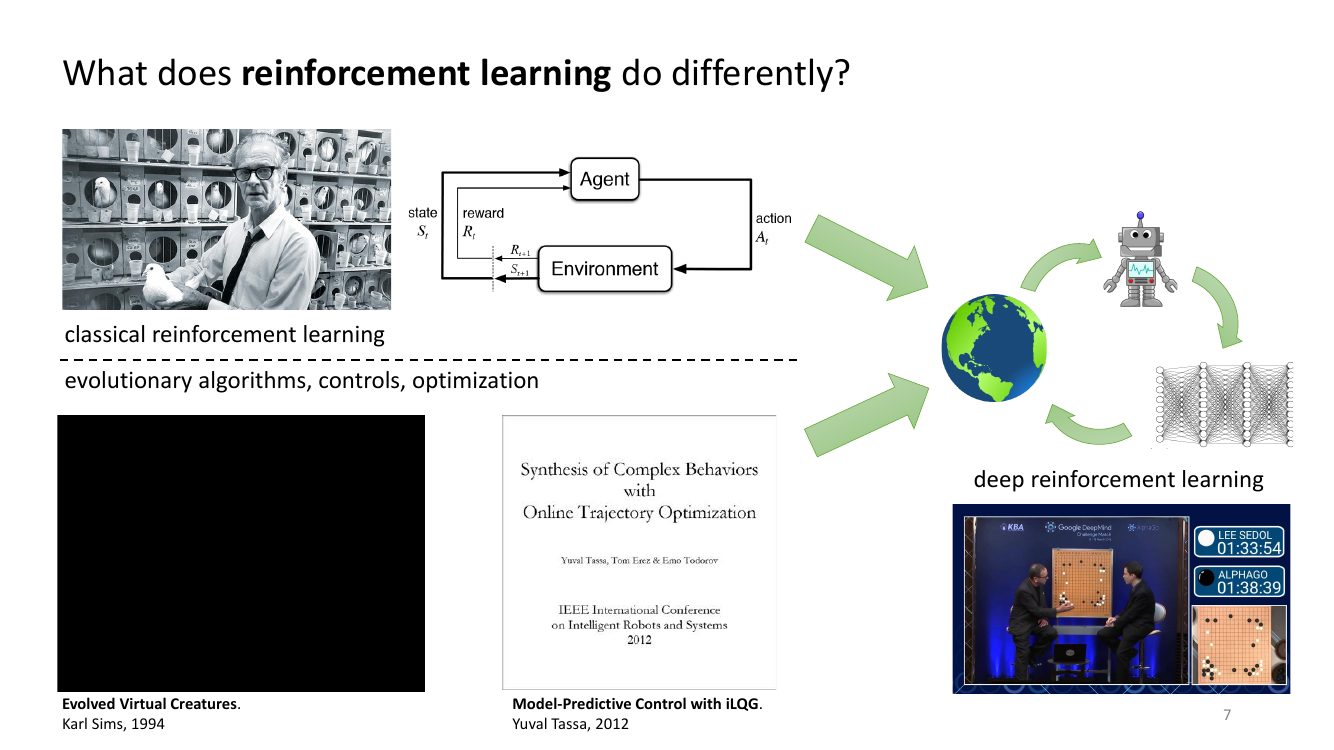
左右两边的差别不在「有没有试错优化」,而在试错优化作用在什么样的表示上。看看左边那两个经典工作的隐含前提:
- Evolved Virtual Creatures:状态是关节角度这类低维向量,控制器是一个小的有向图网络,演化算法在参数空间里搜索。它不可能接受一张 $128\times128$ 的图像作为输入——参数空间会立刻爆炸,而演化算法本质上是零阶方法,维度一高就没法用。
- iLQG 模型预测控制:它要求你已经知道系统的动力学方程 $s_{t+1}=f(s_t,a_t)$,而且这个 $f$ 要足够光滑、能求一阶二阶导。在模拟器里你确实知道;在真实世界里,一根软管被夹爪推一下会怎么变形,你写不出方程。
「深度」补上的恰恰是这两个洞:深度网络是一个可以吃下原始高维感知输入(图像、点云、文本)、并且端到端可微的函数逼近器。 于是,同一套试错优化的思想,可以被搬到「输入是相机像素、输出是电机力矩」的场景上,中间不需要人手工设计任何特征、任何位姿估计、任何状态机。这就是端到端(end-to-end)学习在决策问题上的含义。
端到端在这里有一个比「省掉中间模块」更深刻的含义:中间表示是为最终目标服务而被优化出来的,而不是被人预先规定的。 手工流水线里,位姿估计模块的目标是「位姿估计得准」,但位姿估计得准并不等于抓得稳——这两个目标之间存在错配(objective mismatch)。端到端训练让所有中间层都直接为「抓得稳」这个唯一目标而调整,从而消除了错配。代价是:你失去了模块化的可解释性与可调试性,而且需要多得多的数据。
3.1 它能做到什么程度:从行走到端咖啡
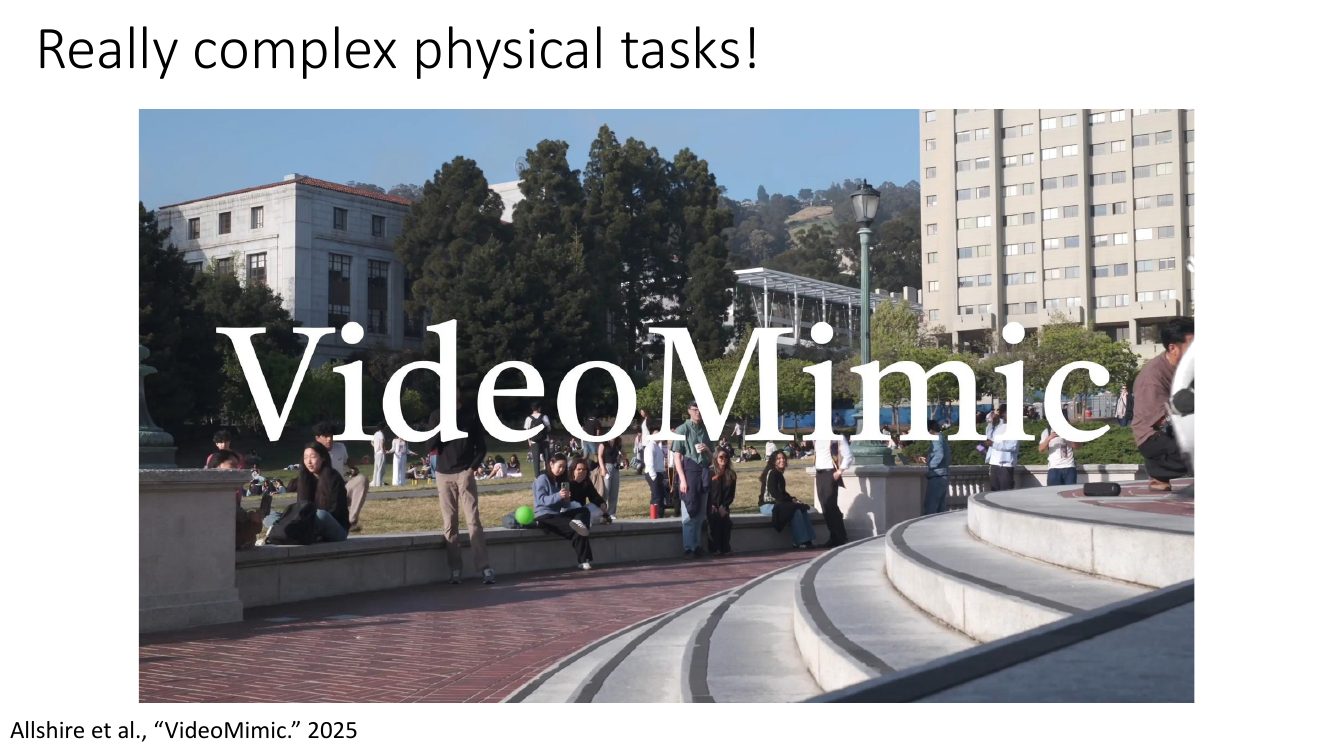
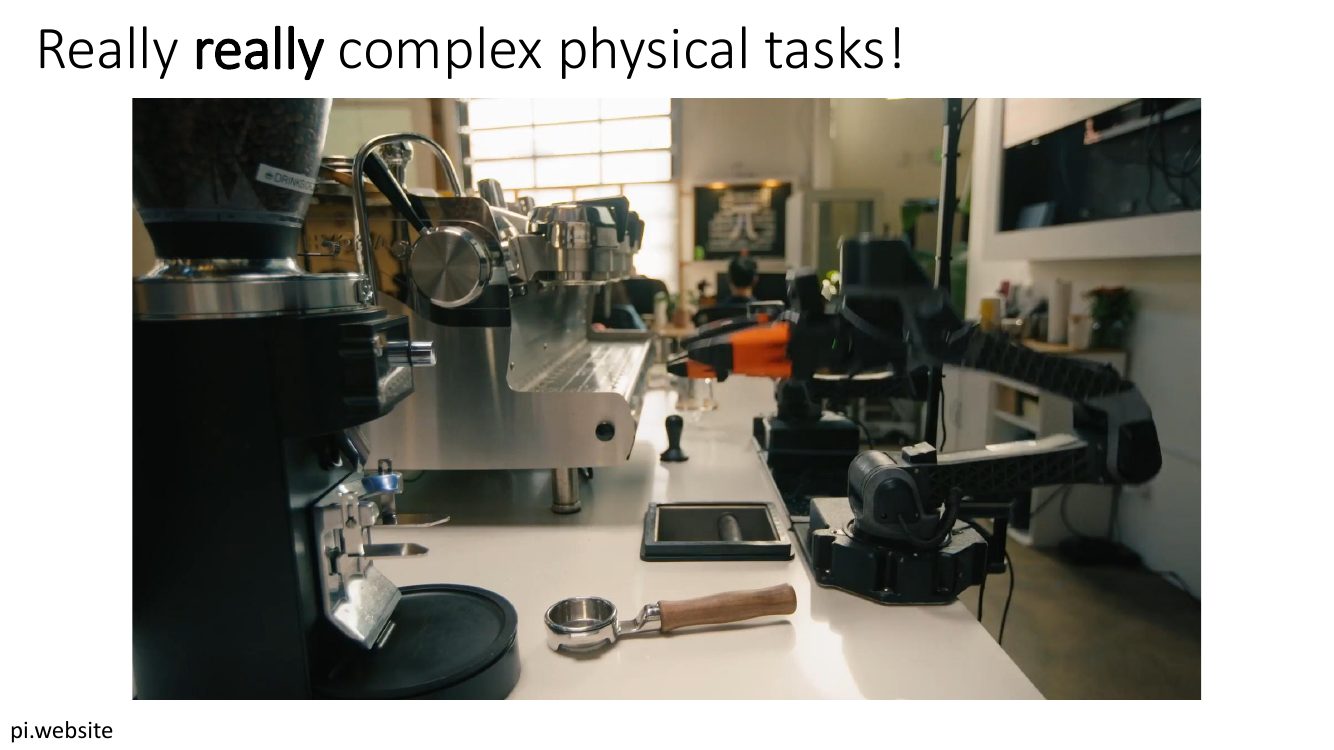
3.2 不只是游戏和机器人
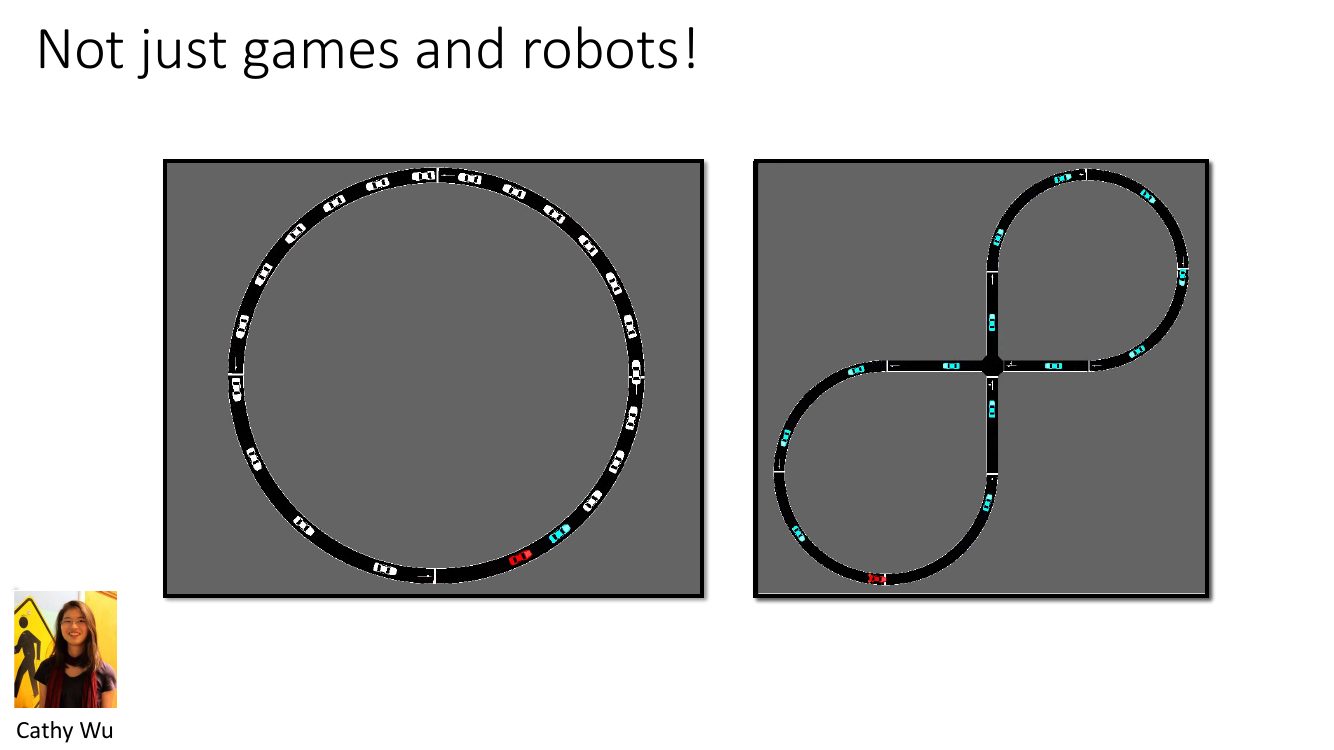
再加上库存管理、芯片布局、数据中心调度这些例子,可以看到 RL 的适用条件其实非常朴素,只有三条:(1)你的问题是序贯的,当前决策会影响未来;(2)你有一个能衡量好坏的标量信号;(3)你有一个能反复试错的地方(真实系统、模拟器、或者一批历史数据)。 第三条往往是实践中最卡人的一条,也正是「离线强化学习」这一整个分支存在的理由。
4. 近年的 AI 进展与 RL 的关系
Levine 在讲完机器人之后问了一个更大的问题:这几年我们说的「AI 进展」到底是什么?
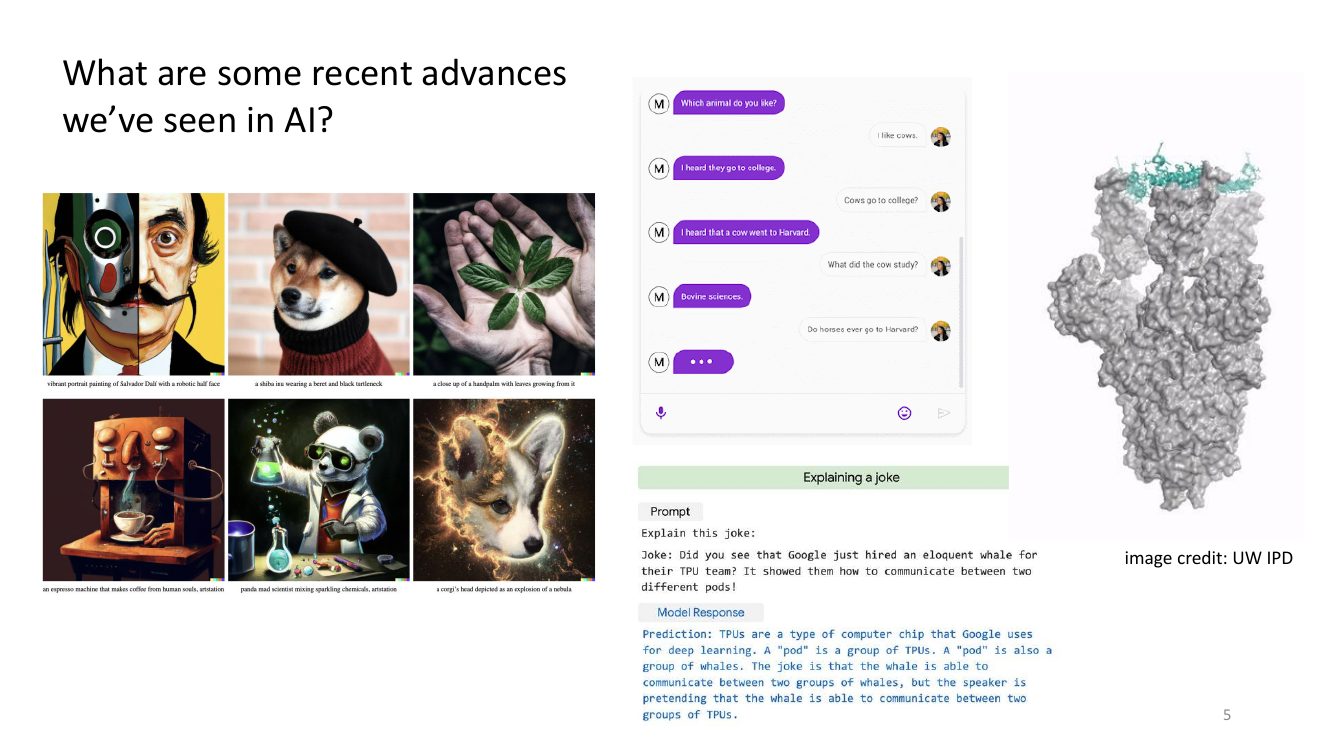
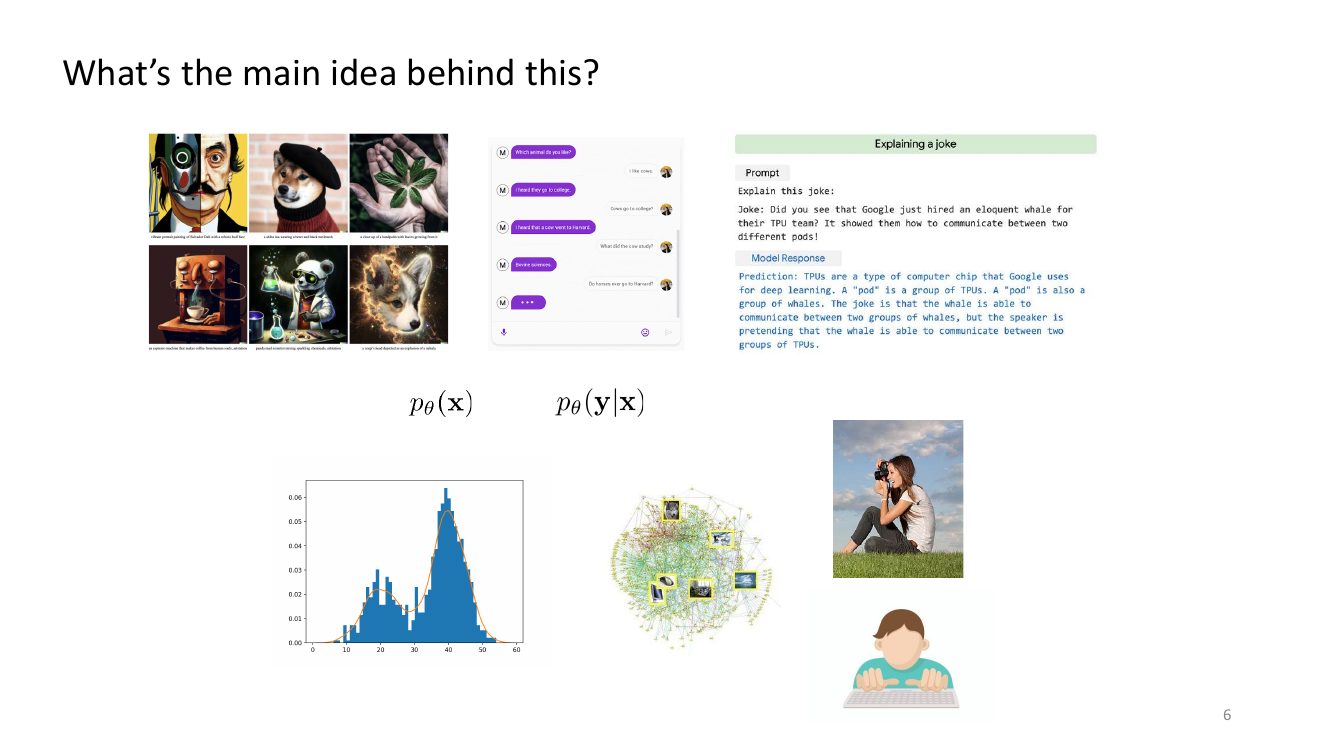
把话说得再直白一点:现代 AI 的主流范式是数据驱动(data-driven)的。它的运作方式是最大似然——收集人类产生的海量数据,最大化 $\sum_i \log p_\theta(\mathbf{x}_i)$ 或 $\sum_i \log p_\theta(\mathbf{y}_i|\mathbf{x}_i)$。这个范式的威力毋庸置疑,它是这一切能力的来源。但它有一个结构性的天花板,我们在下一节展开。
4.1 RLHF:把 RL 装到语言模型上
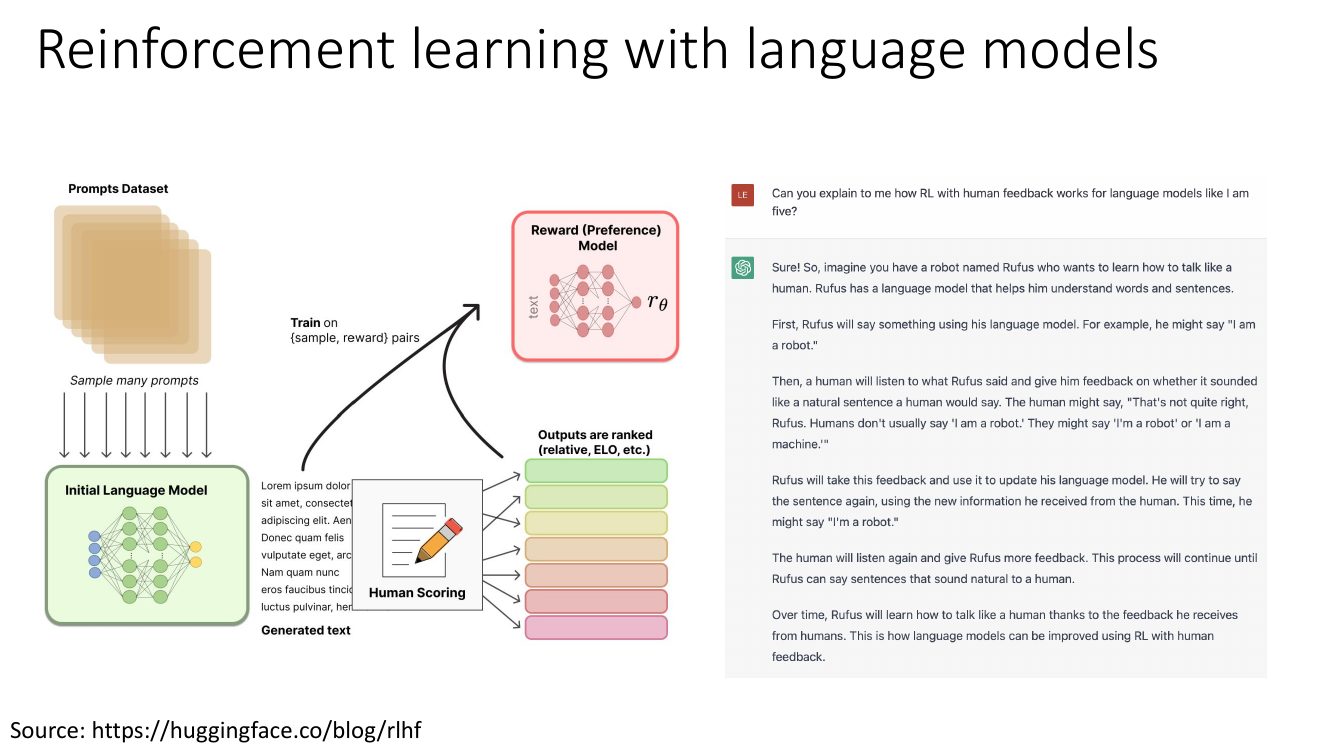
RLHF 是理解「RL 在今天为什么重要」的最好切入点,因为它把前面讲的每一个概念都对应上了:
| RL 概念 | 在 RLHF 中的对应 |
|---|---|
| 状态 $s_t$ | prompt 加上已经生成的前 $t-1$ 个 token |
| 动作 $a_t$ | 下一个 token(离散动作,动作空间大小 = 词表大小,约 $10^5$) |
| 策略 $\pi_\theta(a_t|s_t)$ | 语言模型本身——它天然就是一个条件分布,这是巧合般的契合 |
| 转移 $p(s_{t+1}|s_t,a_t)$ | 确定性且已知:把新 token 拼到序列后面即可,没有环境随机性 |
| 奖励 $r$ | 整段回复生成完后,由奖励模型给出的一个标量;中间步骤奖励为 0 |
| 轨迹 $\tau$ | 一段完整的回复 |
为什么非得用 RL,而不是直接监督微调?因为我们没有「正确回复」的标注,只有「A 比 B 好」的比较。这正是本讲第 2 节讲的第二条差异:不知道 ground truth,只知道奖励。人类在比较两个回复时是可靠的,在从零写出「最佳回复」时是不可靠且昂贵的——这与前面抓取例子里「人不知道软管的最佳抓取点」是完全同构的困境。
值得单独强调的一点:语言模型的 RL 有一个别处没有的奢侈条件——转移函数是已知且确定的。你不需要探索环境动力学,环境就是字符串拼接。这让 LLM 上的 RL 在技术上比机器人上的 RL 简单一大截,同时也让「奖励模型准不准」成为唯一真正的瓶颈。近年的推理模型(reasoning models)走得更远:干脆用可验证的奖励(数学题答案对不对、代码单元测试过不过)替代人类偏好模型,从而彻底消除奖励模型被「钻空子」(reward hacking)的风险,代价是只能用于有客观验证器的领域。这条线索本课在最后几讲会专门展开。
4.2 图像生成、芯片设计:同一台机器换个奖励
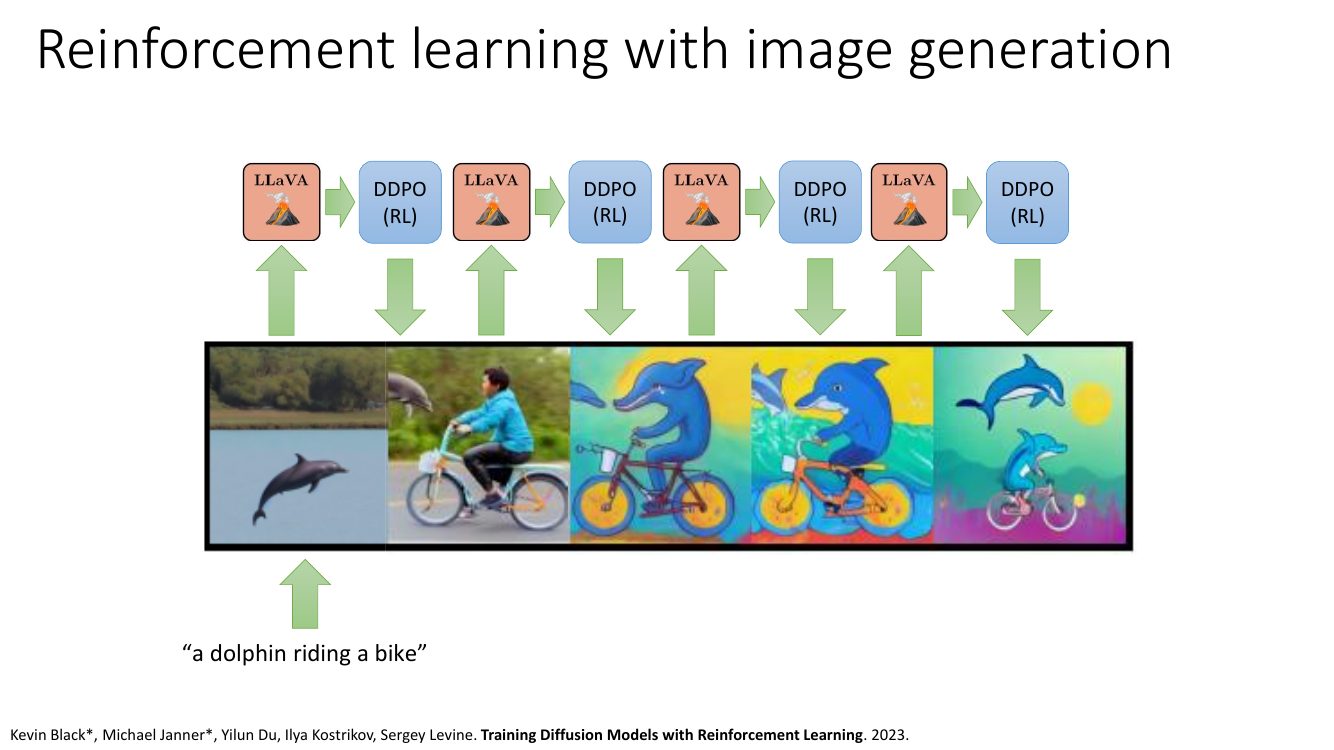
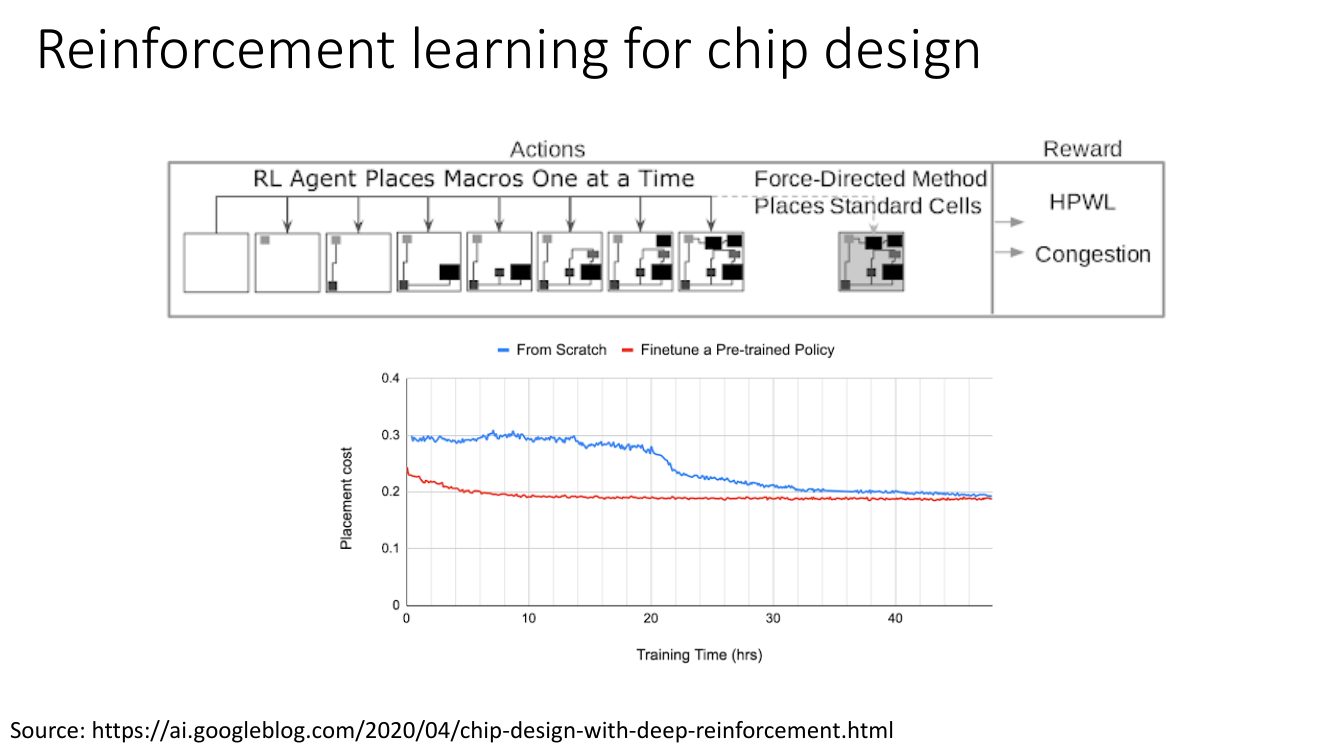
把这几个例子并排看,会发现一个统一的模式:底层的 RL 算法几乎是同一套,变的只是「什么算状态、什么算动作、奖励谁来给」。 这就是形式化的回报——一旦你把问题翻译成 $(s,a,r)$ 的语言,整个算法工具箱立刻可用。本课教的正是这个工具箱,而不是某个具体应用。
5. 为什么要学强化学习:数据与优化的分工
如果数据驱动的最大似然已经能造出会写代码、会画画、会预测蛋白质结构的模型,我们为什么还要费劲学 RL?这一节是 Levine 给出的正面论证,也是本讲思想密度最高的部分。
5.1 数据驱动 AI 的天花板:它不试图比数据更好
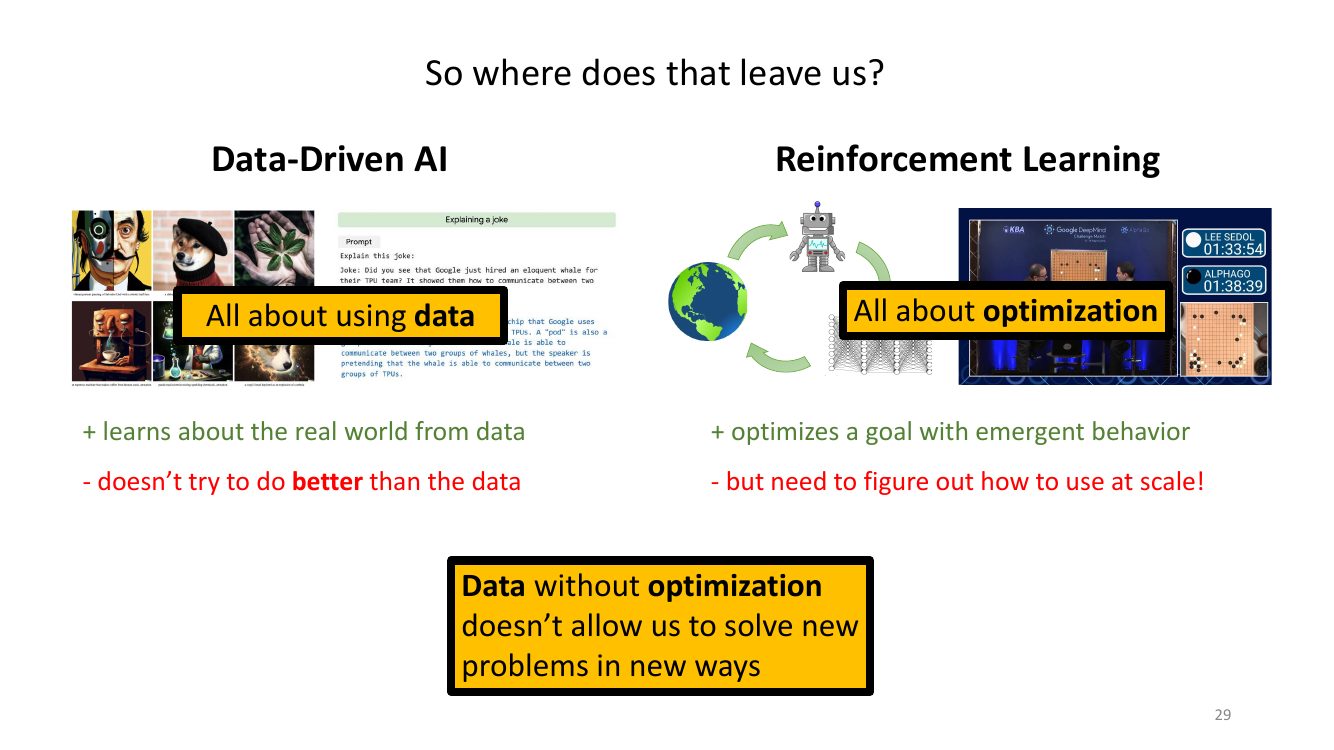
「不试图比数据更好」这句话值得掰开讲。最大似然训练的目标是让模型分布 $p_\theta$ 逼近数据分布 $p_{\text{data}}$:
$$ \max_\theta\; \E_{\mathbf{x}\sim p_{\text{data}}}[\log p_\theta(\mathbf{x})] \;\Longleftrightarrow\; \min_\theta\; \KL\big(p_{\text{data}}\,\|\,p_\theta\big). $$这个优化问题的最优解就是 $p_\theta = p_{\text{data}}$。也就是说,一个训练得完美的生成模型,其行为的上限恰好是「和数据一模一样」。它可以在数据的支撑集内部做插值组合(这已经很有用,「戴贝雷帽的柴犬」就是柴犬和贝雷帽的组合),但它没有任何机制去超越数据里出现过的质量水平。如果所有训练数据里的围棋棋谱都是人类下的,那么纯靠模仿人类棋谱的模型,棋力的天花板就是人类最强水平。
而 RL 的目标函数根本不是「像数据」,是 $\max_\theta \E[\sum_t r]$。它不关心某个行为在数据里出现过没有,只关心它的奖励高不高。这一字之差带来的是完全不同的行为上限。
5.2 RL 能发现新解法
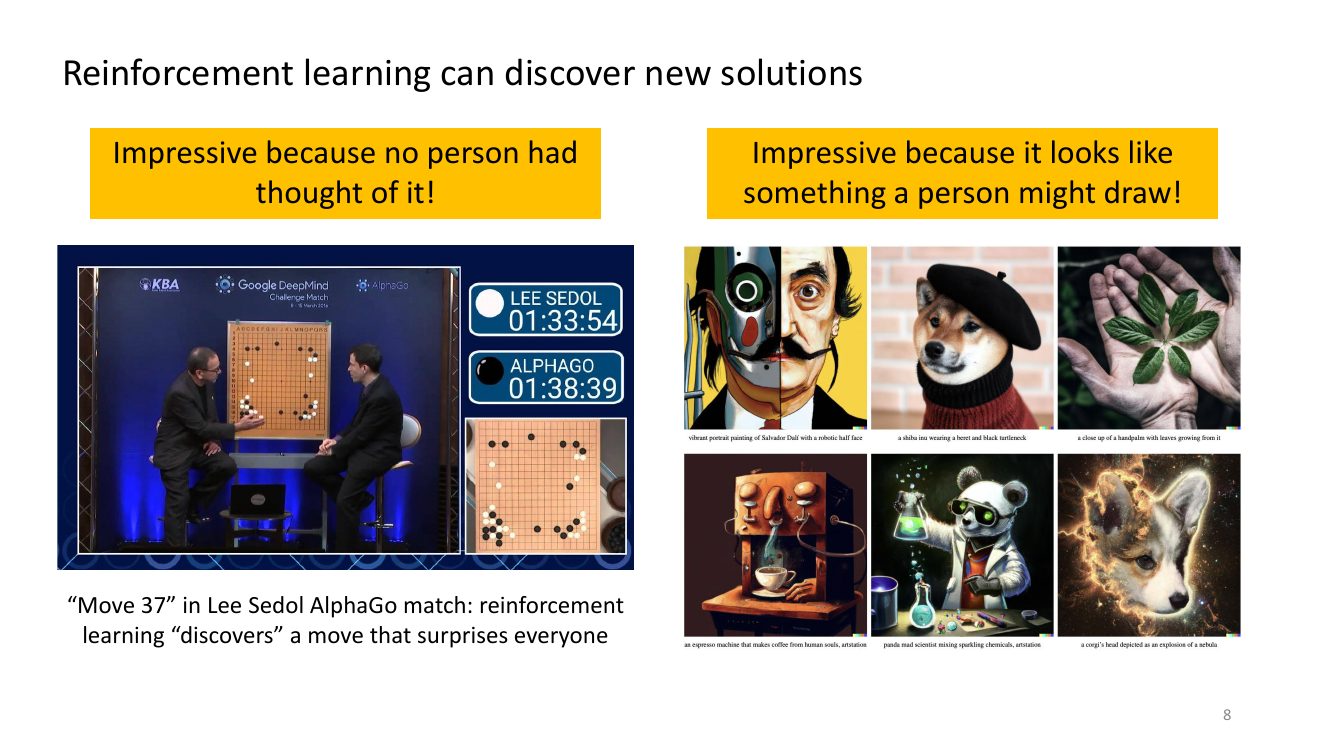
为什么 RL 能产生第 37 手?把它放回目标函数里看:AlphaGo 的策略在自我对弈中被优化的目标是「赢棋概率」,而不是「像人类棋手」。在搜索的过程中,某些人类棋谱里从未出现、因而在纯监督模型下概率接近零的着法,只要它们在自对弈中带来更高的胜率,就会被系统性地提升概率。优化过程会主动往数据分布之外走,只要外面的奖励更高。
可以用一句话概括这一节:模仿学习的上界是示范者,强化学习的上界是奖励函数。 如果你的奖励函数写对了,RL 可以远远超过任何人类示范;如果你的奖励函数写错了,RL 会以你意想不到的方式钻空子(比如赛艇游戏里不去终点、绕着圈刷补给分)。这个「双刃」性质会贯穿全课:能力越强的优化器,对目标设定错误的惩罚就越严厉。
5.3 苦涩的教训,以及它被误读的那一半
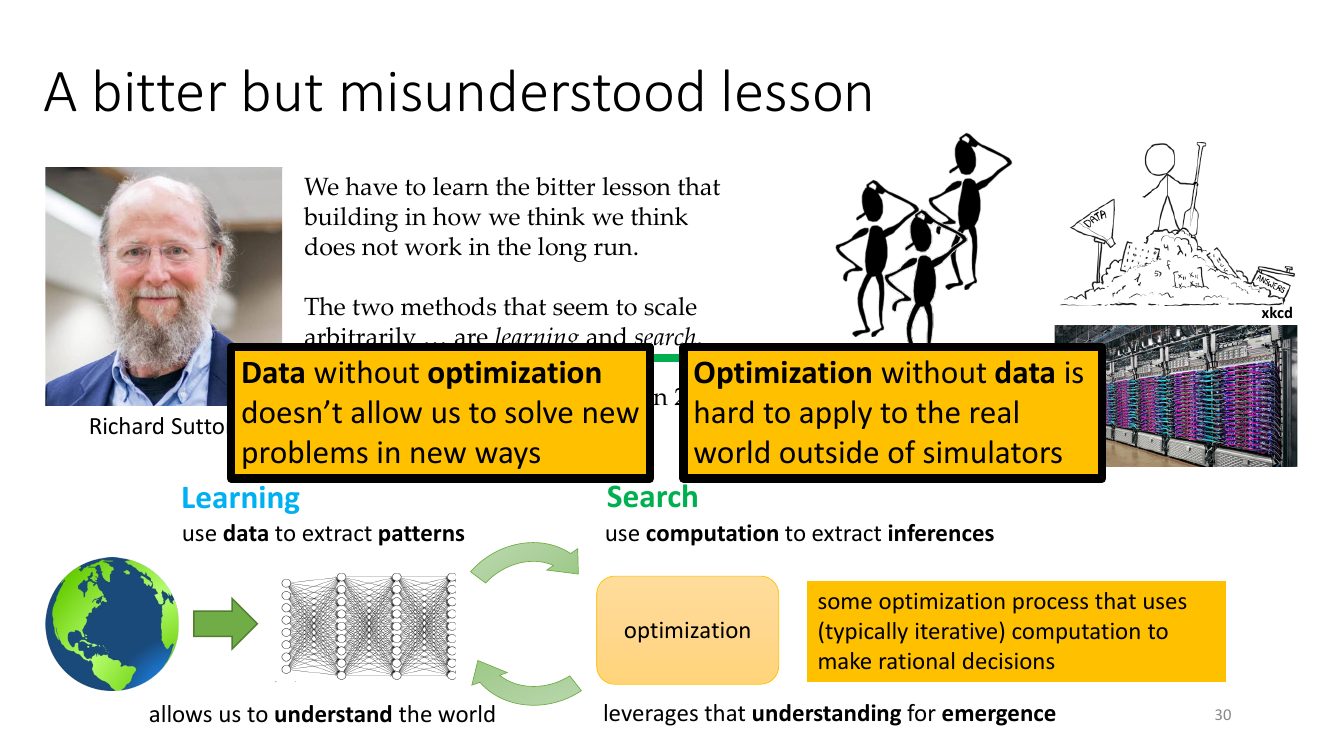
Levine 说这个教训「被误解了」(misunderstood),指的是很多人把《苦涩的教训》读成了「只要堆数据和算力就行」。但 Sutton 的原文明确写的是两种方法:learning 和 search。过去几年整个领域的注意力几乎全部押在 learning 上,search 这一半被忽略了。而这两半是互补的,谁也替代不了谁:
| Learning(学习) | Search / Optimization(搜索与优化) | |
|---|---|---|
| 做什么 | 用数据抽取模式 | 用计算抽取推论 |
| 给我们什么 | 理解世界的能力 | 把理解转化为涌现行为的能力 |
| 典型形态 | 最大似然、监督学习、自监督预训练 | 树搜索、轨迹优化、策略梯度、值迭代 |
| 单独使用时的短板 | 不会比数据更好;无法解决数据里没有的新问题 | 只在有精确模型的地方好用(模拟器、棋盘),难以应对真实世界的复杂性 |
| 代表性失败模式 | 模仿了人类的错误与偏见,性能被示范者封顶 | 在模拟器里表现完美,搬到真机上立刻失效(sim-to-real gap) |
右边那个黄框——「优化没有数据,很难走出模拟器」——同样重要,而且是很多 RL 入门者的盲区。纯优化方法(比如 iLQG、蒙特卡洛树搜索)需要一个精确的环境模型才能工作。在围棋里,规则就是完美模型,所以搜索所向披靡;在真实厨房里,你没有模型,任何基于模型的纯搜索都会因模型误差被放大而崩溃。只有把「从数据里学出对世界的理解」和「在这个理解上做优化」结合起来,才能既走出模拟器又超越数据。 这就是「深度」加「强化学习」的完整含义。
6. 一点哲学:智能、决策与单一算法
这一节在讲义里被标为「A bit of philosophy」,但它不是闲笔。它回答的是「本课的野心边界在哪」,也解释了为什么 Levine 认为 RL 而不是监督学习才是通往通用智能的框架。
6.1 我们到底为什么需要机器学习
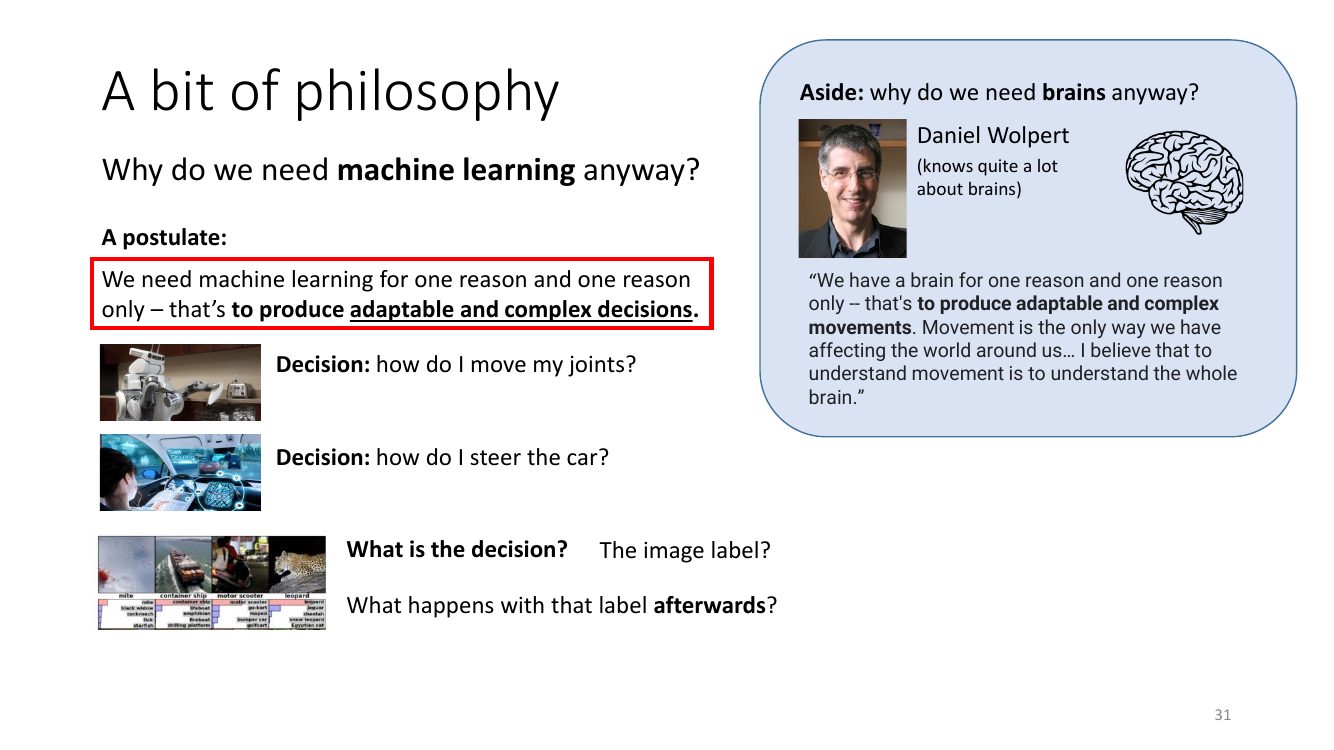
这个论证的力量在第三个例子上。图像分类看起来是一个纯感知任务,没有决策。但反问一句「这个标签之后被拿去做什么了」,就会发现标签从来不是终点:它要么被人看到并影响人的行为,要么被下游系统用于某个决定。如果一个预测永远不影响任何行动,那么它的正确与否在物理世界里没有任何后果。 按这个视角,感知任务其实是决策任务的一个退化特例——只有一步、且动作不影响未来状态的决策问题。
把这句话反过来读更有价值:既然一切机器学习最终服务于决策,那么直接对「决策的好坏」进行优化,就比先优化一个替代指标(分类精度)再指望它有利于决策,要更直接。 这就是前面说的「目标错配」问题在哲学层面的版本。RL 之所以是一个更根本的框架,是因为它的目标函数写的就是我们真正关心的东西。
这不意味着监督学习没用或者应该被替代。相反,本讲的整个论点是二者互补:感知的表示要靠大规模监督/自监督学习来得到(这是 learning 那一半),决策要靠 RL 来优化(这是 search 那一半)。实践中最成功的系统几乎都是「大规模预训练 + RL 微调」的组合——RLHF 就是最典型的例子:没有预训练语言模型,RLHF 无从谈起;没有 RLHF,预训练模型不会成为一个有用的助手。
6.2 智能的基础是学习
Levine 给出的替代思路是「学习是智能的基础」,论证只有四步:
- 有些事情我们所有人都会做,比如走路——这些可能是天生的、写死在基因里的。
- 有些事情只能靠学,比如开车。人类基因里不可能预装开车能力,因为汽车出现才一百多年。
- 我们能学会的东西种类极其繁多,而且包括非常困难的东西(微积分、下围棋、做同声传译)。
- 因此,我们的学习机制大概率已经强大到足以实现我们所说的一切「智能」。虽然如此,把少数极其重要的部分「硬编码」进去可能仍然很方便。
第 4 条最后那半句很重要,它是 Levine 的分寸感:他没有说「一切都必须学」。真实系统里硬编码一些东西(比如机器人的低层安全约束、语言模型的分词器、卷积网络的平移等变性)往往是划算的。争论的焦点不是「要不要有先验」,而是「先验应该放在多低的层次上」。
6.3 是一个算法,还是一堆算法?
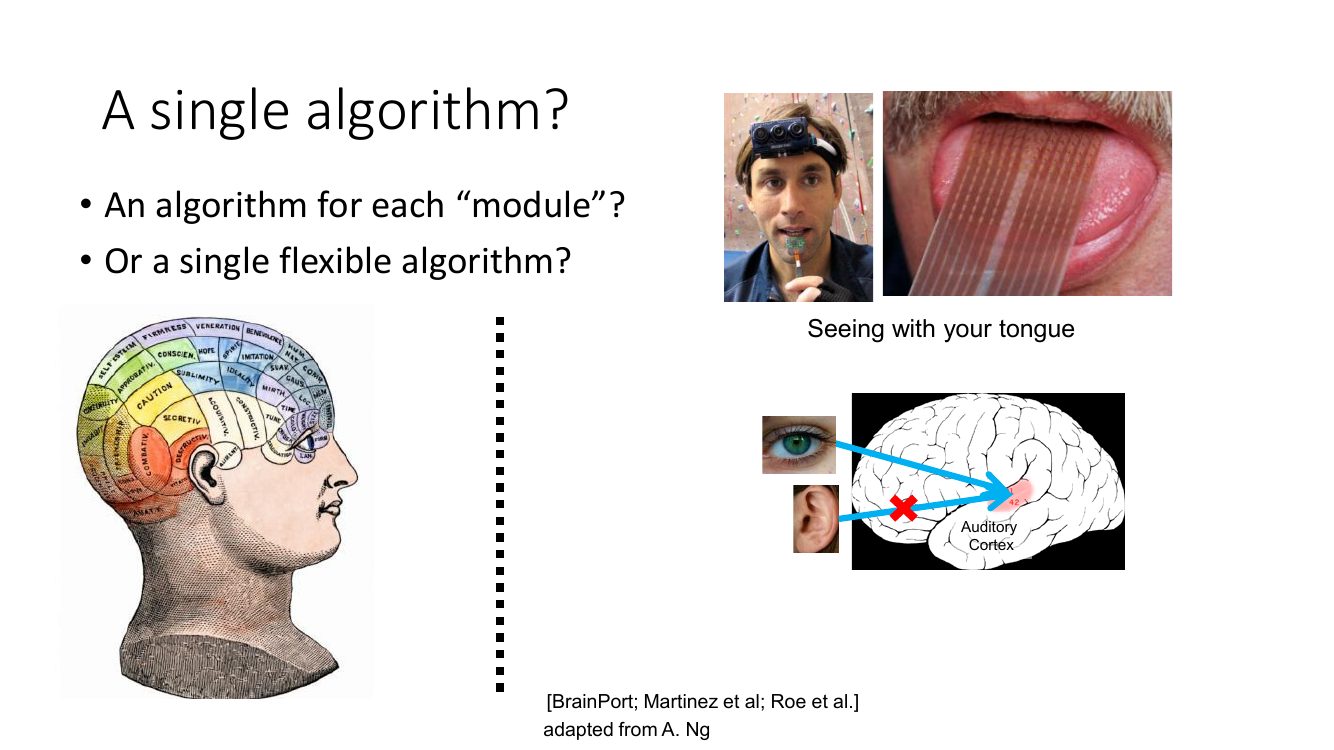
如果这个假说成立,那么造智能机器的正确做法就不是写几十个模块,而是找到那一个足够灵活的学习算法。那么这个算法必须具备什么能力?
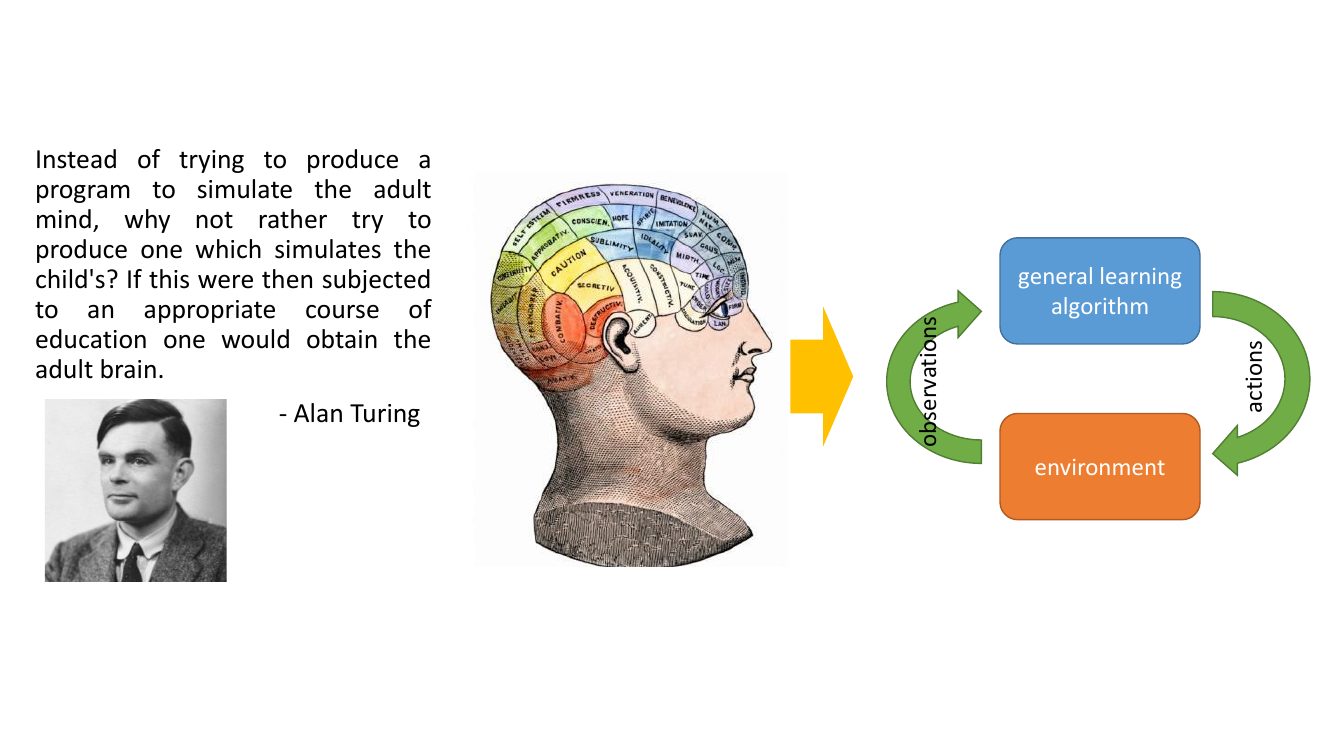
本讲哲学部分的落点:「智能 = 在与环境的交互中,通过一个通用学习算法,从丰富感知里选出复杂动作。」 这句话逐词对应着本课的技术内容——「与环境交互」是 MDP 与轨迹分布,「通用学习算法」是本课要教的那套算法工具箱,「丰富感知」是深度网络,「选出复杂动作」是策略优化。当你在后面某一讲里陷入某个推导细节时,回来看这句话,你就知道那个细节是在为什么服务。
7. 奖励从哪里来
到这里,RL 的框架看上去很美:给我一个奖励函数,我给你一个最优策略。但奖励函数本身从哪儿来?这是本课最诚实、也最容易被入门材料略过的问题。Levine 在导论里把它作为一个开放问题抛出来,后面用好几讲来回答。
7.1 三种情形
| 情形 | 例子 | 难点 | 本课的应对 |
|---|---|---|---|
| 奖励天然存在 | 游戏得分、围棋胜负、数学题答案是否正确、代码是否通过测试 | 几乎没有;这是最理想的设定 | 直接跑标准 RL;推理模型的 RLVR 走的就是这条路 |
| 奖励能写但很稀疏 | 机器人「把杯子放进柜子」——只有最后成功那一刻给 +1 | 随机探索几乎永远碰不到那个 +1,梯度长期为零 | 探索算法(第 13–14 讲)、奖励塑形、分层 RL、从示范中引导 |
| 奖励写不出来 | 「倒一杯好咖啡」「回答得有帮助且无害」「开得像个老司机」 | 目标是人类的隐含偏好,任何手写公式都会被钻空子 | 模仿学习、逆强化学习、从人类偏好学奖励模型(RLHF) |
7.2 模仿学习:绕开奖励,直接学行为
最简单的办法是不学奖励,直接学人的行为。收集一批专家示范 $\mathcal{D}=\{(s_i, a_i)\}$,然后用监督学习拟合 $\pi_\theta(a|s)$——这叫行为克隆(behavior cloning),是下一讲的主题。它把决策问题彻底还原成了监督学习,简单到几乎不需要新知识。
但它有一个致命弱点,而这个弱点恰恰是本讲第 2 节讲的「数据不是 i.i.d.」的直接后果:训练时的状态分布来自专家,测试时的状态分布来自你自己的策略。 只要你的策略有一点点误差,你就会漂到专家从没去过的状态,而在那些状态上你的策略没有受过训练,误差会更大,于是漂得更远——误差随时间步数累积。下一讲会证明,在最坏情况下这个累积误差是 $O(\epsilon T^2)$ 量级的($\epsilon$ 是每步的错误率,$T$ 是时间步数),并给出 DAgger 等应对方案。
7.3 逆强化学习:从行为反推奖励
更聪明的办法是:假设专家的行为是某个未知奖励函数下的(近似)最优解,那我们可以反过来把这个奖励函数解出来。这就是逆强化学习(inverse reinforcement learning, IRL):
- 正向 RL:已知 $r(s,a)$ → 求 $\pi^\star$。
- 逆向 RL:已知一批来自 $\pi^\star$ 的轨迹 → 求 $r(s,a)$。
为什么要多绕这一圈,而不直接克隆行为?因为奖励函数比策略更「可迁移」,也更紧凑。「尽快到达目的地且不撞车」这个奖励,在任何城市、任何车型上都成立;而「在这个路口应该怎么打方向」这个策略,换个路口就失效了。学到奖励之后,你可以在新环境里重新跑 RL,得到该环境下的最优策略——这是行为克隆做不到的。
IRL 的根本困难是问题本身是欠定的(ill-posed):同一批轨迹可以由无穷多个不同的奖励函数解释,其中包括平凡的 $r\equiv 0$(此时任何策略都最优,观测到的行为当然也「最优」)。解决办法是加正则或加原理性的假设,最常用的是最大熵假设:认为专家不是完全最优,而是以正比于 $\exp(r)$ 的概率选择行为,从而在所有能解释数据的奖励中挑出使行为分布熵最大的那个。本课在后期会专门讲这条线,同时会指出 RLHF 里的奖励模型训练在数学上与 IRL 高度同源——都是「从人类行为/偏好里反推目标」。
「有了奖励函数,RL 就是纯粹的数学问题了」——恰恰相反,奖励设计是 RL 实践中最容易出错、也最难调试的一环。一个常见的失败是给机器人「越接近目标物体奖励越高」的塑形奖励,结果机器人学会了把手悬在物体旁边不停抖动来刷分。奖励越是「代理指标」而非真实目标,被钻空子的概率就越高。这就是为什么可验证奖励(数学答案、单元测试)在近年的推理模型里如此受青睐——它们没有代理误差。
8. 这门课的地图:七大板块及其关系
本讲最后要给你的是一张地图。整门课的所有算法都可以放进同一个骨架里——就是第 1 节那张闭环图的正式版本:
# 全课通用的 RL 算法骨架。所有算法的差别只在第 2、3 步的实现。
def rl_loop(env, policy, n_iters=1000, n_traj=32):
    for it in range(n_iters):
        # ---- 步骤 1:用当前策略与环境交互,产生样本 ----
        batch = []
        for _ in range(n_traj):
            s, done, traj = env.reset(), False, []
            while not done:
                a = policy.act(s)              # a ~ pi_theta(a|s)
                s_next, r, done = env.step(a)
                traj.append((s, a, r, s_next))
                s = s_next
            batch.append(traj)

        # ---- 步骤 2:拟合某个东西来估计「回报」 ----
        #   策略梯度      -> 直接把奖励加起来,不拟合任何东西
        #   actor-critic  -> 拟合 V(s) 或 Q(s,a)
        #   Q-learning    -> 拟合 Q(s,a),用贝尔曼目标做回归
        #   model-based   -> 拟合环境模型 p(s'|s,a)
        estimates = fit_something(batch)

        # ---- 步骤 3:用估计出的东西改进策略 ----
        #   策略梯度      -> theta <- theta + alpha * grad J
        #   Q-learning    -> 策略隐式地定义为 argmax_a Q(s,a),无显式更新
        #   model-based   -> 在学到的模型上做规划 / 反向传播
        policy = improve(policy, estimates)
    return policy
下面按这个骨架把七大板块串起来。请特别注意每一块被上一块的什么缺陷逼出来——这条动机链条比算法本身更值得记。
板块一:模仿学习(第 2 讲)
解决什么:在完全不碰 RL 机器的前提下,用监督学习做决策。为什么先讲它:它是最简单的基线,而且它的失败方式(分布偏移)恰好暴露了「决策问题为什么不是监督学习」,是进入 RL 最自然的入口。它的缺陷:性能被示范者封顶,且需要昂贵的人类数据。
板块二:问题定义与算法全景(第 4 讲)
解决什么:把 MDP、轨迹分布、目标函数、值函数 $V^\pi, Q^\pi, A^\pi$ 一次性定义清楚,并给出上面那个三步骨架。为什么重要:后面每一讲都在往这个骨架里填零件,没有这一讲你会觉得算法之间毫无联系。
板块三:策略梯度(第 5–6、11–12 讲)
解决什么:直接对 $J(\theta)$ 求梯度并做上升。核心技巧是 log-derivative trick,把「对分布求导」变成「在分布下求期望」,从而绕过未知的转移概率。它的缺陷:方差极大、必须 on-policy(每次更新后旧数据全部作废),样本效率低。后续修补:baseline 与 reward-to-go 降方差 → actor-critic 用学到的值函数替代蒙特卡洛回报 → 自然梯度 / TRPO / PPO 控制每步更新的步长,避免策略崩溃。
板块四:值函数方法(第 7–8 讲)
解决什么:跳过显式的策略参数化,只学 $Q(s,a)$,策略隐式地定义为 $\pi(s)=\argmax_a Q(s,a)$。为什么需要它:它天然是 off-policy 的——旧数据可以反复使用,样本效率比策略梯度高一到两个数量级,这对真实机器人至关重要。它的缺陷:深度网络下的 Q-learning 没有收敛保证(「致命三要素」:函数逼近 + 自举 + off-policy),会高估、会发散;连续动作空间下 $\argmax_a$ 本身就很难算。
板块五:基于模型的方法(第 9–10 讲)
解决什么:把环境动力学 $p(s'|s,a)$ 学出来,然后在模型里做规划或生成想象数据。为什么需要它:样本效率再上一个台阶——真实交互只用来学模型,策略优化在模型里免费进行。它的缺陷:模型误差会被策略优化主动放大(优化器会专门去找模型预测错误但看起来奖励很高的地方),并且长时程滚动预测的误差是复利累积的。
板块六:探索与离线 RL(第 13–16 讲)
探索解决什么:当奖励极其稀疏时,随机动作永远碰不到奖励,学习无从开始。需要有原理的探索策略——乐观初始化、计数/伪计数奖励、后验采样、信息增益。离线 RL 解决什么:现实中很多场景(医疗、自动驾驶、推荐)你根本不能让一个未训练好的策略上线试错。离线 RL 要求只用一批固定的历史数据学出比数据里的行为更好的策略。它的核心困难是分布偏移下的价值高估:对数据里没出现过的动作,$Q$ 网络的外推是不可信的,而 $\argmax$ 恰恰专挑这些被高估的动作。应对手段是各种形式的保守化约束。
板块七:RL 与大模型(课程后段)
解决什么:把 RL 用在语言模型上——RLHF 做对齐,可验证奖励做推理能力。它为什么与经典 RL 不同:转移是确定且已知的,轨迹很短(几千 token),但动作空间巨大、奖励只在末尾给出、而且初始策略已经非常强(来自预训练)。这些特点使得实践中的算法选择与经典机器人 RL 相当不同。它为什么与经典 RL 相同:策略梯度、baseline、KL 约束、奖励高估——每一个概念都原封不动地出现,只是换了名字。
把七大板块按「用了多少关于环境的信息」排成一条谱系会更清楚:模仿学习完全不用奖励,只用示范;策略梯度只用奖励,不用转移;值函数方法用奖励 + 贝尔曼结构(隐式利用了马尔可夫性);model-based 把转移也显式学出来。越往右,用到的结构越多、样本效率越高,但假设越强、失效方式越隐蔽。 这条谱系是你在实际项目里选算法时的第一张决策表。
本课还会花时间讲一些「元」问题,它们不属于任何单一板块,但决定了你的 RL 项目会不会成功:为什么深度 RL 的实验难以复现、超参数敏感到什么程度、如何设计一个能诊断问题的评估协议、什么时候你根本不该用 RL(答案是:如果你的问题不是序贯的,或者你已经有很好的监督标注,就别用)。这些内容在论文里几乎看不到,只能在课堂上听到。
9. 课程信息与自学建议
9.1 原课程的组织方式
| 项目 | 说明 |
|---|---|
| 先修 | 需要修过 CS182 / CS189 / CS289 / CS281A / CS282 或等价课程;作业要用 PyTorch 训练神经网络 |
| 讲座 | 录像发在 bCourses 的 Media Gallery,也有 YouTube 播放列表;每讲配一个小测(占 10%),一周内完成,可做两次取高分 |
| 讨论班 | 助教组织,复习讲座内容,不讲新材料 |
| 作业 | 5 次编程作业,占 50%,每次约两周;课程明确要求不要用 AI 编程工具 |
| 考试 | 第 12 周,占 20%,有模拟题 |
| 期末项目 | 编程项目,占 20%,有若干选题方向 |
Levine 特别提到「每次作业都应该让每个人都有可能拿满分」——这句话的潜台词是:作业的难度不在于智力上的巧思,而在于实现的正确性与调试的耐心。深度 RL 的代码有一个恶劣的性质:写错了通常不报错,只是学不出来,而「学不出来」和「超参没调好」在现象上无法区分。所以作业的真正训练目标是让你养成「先用最小规模、最简单环境验证每一个组件」的习惯。
9.2 给自学者的建议
- 动手是唯一的路。 光看推导,你会觉得策略梯度就是一个公式;亲手在 CartPole 上跑一遍,你才会知道它有多不稳定、方差有多大、为什么大家都要加 baseline。建议按讲次配套实现:第 2 讲写行为克隆 + DAgger,第 5 讲写 REINFORCE,第 6 讲写 A2C,第 7–8 讲写 DQN,第 9–10 讲写一个简单的 model-based 方法。
- 先在最小环境上验证。 用离散动作、低维状态的经典控制任务(CartPole、MountainCar、FrozenLake)作为单元测试。如果你的算法在 CartPole 上学不会,去调 Atari 是浪费生命。
- 跑多个随机种子。 深度 RL 的方差之大,以至于单个种子的曲线基本没有信息量。至少 3–5 个种子,画中位数与四分位区间。
- 把「三步骨架」当索引。 每读到一个新算法,先问:它在第 2 步估计什么?第 3 步怎么改进策略?它是 on-policy 还是 off-policy?这三个问题回答完,算法的骨架就抓住了,剩下的都是细节。
- 不要跳过推导。 RL 的公式不是装饰。策略梯度里那个「转移概率的梯度为零」的消去、baseline 的无偏性证明、贝尔曼算子的压缩性,这些恰恰是理解「为什么某个技巧管用」的唯一途径。
本讲小结
- 问题的起点:像「从杂物箱里抓东西」这样的决策任务,手工设计(Option 1)会被真实世界的多样性击穿,纯监督学习(Option 2)会卡在「没人知道正确答案」上。出路是让系统自己试、自己产生带奖励标注的数据,再用这些数据改进策略——这个闭环就是 RL。
- RL 的两条根本特征:数据不是 i.i.d.(自己的动作决定下一步看到什么),且没有 ground truth(只有奖励)。由此派生出分布偏移、信用分配、探索、高方差这四个贯穿全课的技术难题。
- 形式化接口:状态 $s_t$(马尔可夫)/观测 $o_t$(可能部分可观测)、动作 $a_t$、策略 $\pi_\theta(a_t|s_t)$、奖励 $r(s,a)$、转移 $p(s'|s,a)$、轨迹 $\tau$、目标 $J(\theta)=\E_{\tau\sim p_\theta}[\sum_t r]$。两个技术麻烦:$\theta$ 在分布里而不在被积函数里;$p_\theta(\tau)$ 含未知的转移。
- 「深度」的作用:提供能吃下原始高维感知、端到端可微的函数逼近器,让试错优化不再局限于低维状态与已知模型,同时消除模块化流水线里的目标错配。
- 「强化学习」的作用:提供超越数据的能力。最大似然的最优解是「和数据一样」,而 RL 的最优解是「奖励最高」——AlphaGo 第 37 手、Breakout 挖隧道都是后者的产物。
- 苦涩教训的完整版:可无限扩展的方法有两种,learning 和 search,缺一不可。数据没有优化,无法用新方式解决新问题;优化没有数据,走不出模拟器。
- 哲学落点:机器学习的最终目的是产生适应性的复杂决策;智能的基础可能是单一的、灵活的学习算法;这个算法必须能解释丰富感知(deep)并选择复杂动作(RL)。
- 奖励的来源:天然存在(游戏、可验证任务)/稀疏难探索/写不出来。第三种情形靠模仿学习、逆强化学习、人类偏好奖励模型来处理,三者都会在课程中出现。
- 课程地图:模仿学习 → 问题定义 → 策略梯度 → 值函数方法 → model-based → 探索与离线 RL → 大模型上的 RL。每一块都由上一块的缺陷逼出来,样本效率沿这条链递增,而假设强度与失效隐蔽性同样递增。
监督学习教机器模仿世界,强化学习教机器改变世界;深度提供前者的规模,RL 提供后者的方向,两者闭环起来才是这门课要讲的东西。
延伸阅读
思想与背景
- The Bitter Lesson (Sutton, 2019) — 本讲第 5 节的直接来源。请特别注意它讲的是两种可扩展方法(learning 与 search),而不是只有堆数据。
- Computing Machinery and Intelligence (Turing, 1950) — 本讲最后一页的引文出处,「与其模拟成年人心智,不如模拟孩童心智」是学习型 AI 最早的纲领性表述。
- Reinforcement Learning: An Introduction (Sutton & Barto, 2nd ed., 2018) — 经典教材,本课的表格型 RL 基础部分(值迭代、TD、Q-learning)可与之对读;网上有作者免费提供的电子版。
本讲提到的具体工作
- Playing Atari with Deep Reinforcement Learning (Mnih et al., 2013) — DQN,本讲 Breakout「挖隧道」那个涌现行为的来源,也是「深度强化学习」这个词进入主流的起点。
- Learning to Walk in Minutes Using Massively Parallel Deep RL (Rudin et al., 2021) — 大规模并行仿真训练四足运动策略,与本讲「端到端运动与局部导航」同一研究线。
- Deep Reinforcement Learning from Human Preferences (Christiano et al., 2017) — RLHF 的奠基工作:用成对比较训练奖励模型,再用 RL 优化它。
- Training Language Models to Follow Instructions with Human Feedback (Ouyang et al., 2022) — InstructGPT,把 RLHF 用到大规模语言模型上的完整配方,本讲那张 RLHF 流程图的现实版本。
- Training Diffusion Models with Reinforcement Learning (Black, Janner, Du, Kostrikov, Levine, 2023) — DDPO,本讲「骑自行车的海豚」那一页;示范了如何把生成过程转成 MDP 并优化不可微目标。
- Chip Placement with Deep Reinforcement Learning (Mirhoseini et al., 2020) — 芯片布局那一页的原始工作,含预训练策略微调 vs 从零训练的对比曲线。
- Flow: Architecture and Benchmarking for RL in Traffic Control (Wu et al., 2017) — 用少量自动驾驶车消解幽灵堵车的交通流实验平台。
- Evolved Virtual Creatures (Karl Sims, 1994) — 用演化算法优化虚拟生物的形态与控制器,「经典 RL / 优化」一支的代表作,视频至今值得一看。
- Synthesis of Complex Behaviors with Online Trajectory Optimization (Tassa, Erez, Todorov, 2012) — iLQG 模型预测控制,展示了「有精确模型时纯优化能做到什么」,也反衬出模型未知时的困境。
接下来该读什么
- A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning (Ross et al., 2011) — DAgger,下一讲的核心内容,也是分布偏移问题的标准答案。
- Offline Reinforcement Learning: Tutorial, Review, and Perspectives (Levine et al., 2020) — 讲师本人写的离线 RL 综述,对应课程地图里的板块六,读它可以提前理解「为什么数据 + 优化的结合这么难」。