附录 B · 不只是「文风」
对「RLHF 只是学会了讨好人的文风、没有真正提升能力」这个流传最广的批评,作者的完整反驳——以及承认它在什么条件下确实成立。
0. 本章导读
如果你在 2023 到 2024 年读过任何一条关于 RLHF 的怀疑论,大概率是这一句的某个变体:
RLHF 只是风格迁移(style transfer)。它改变的是模型怎么说,不是模型知道什么、能做什么。真正的能力全在预训练里,后训练只是刷了一层漆。
这个说法有一个学术上的强版本,叫肤浅对齐假说(Superficial Alignment Hypothesis),出自 LIMA 那篇论文:知识与能力在预训练阶段就已经全部习得,对齐要做的只是从模型已有的分布里挑一个格式和语气;因此只需要一千条精心挑选的样本就够了。这个假说本身是个很有价值的科学猜想,但它在传播中被简化成了一句轻蔑的判词——「肤浅」「化妆品」「不重要」。
这个批评之所以有杀伤力,不是因为它凭空捏造。相反,它在当时有大量真实弹药:满屏的「As an AI language model…」、拒绝回答「怎么 kill 一个 Linux 进程」、动辄两千字的车轱辘话、在 AlpacaEval 上号称击败 GPT-4 但没人真的用的 7B 模型。这些都是第 14 章讲的过优化(over-optimization)的症状。也就是说:「只是风格」这个叙事,是过优化在公共舆论层面的投影。
这份附录要做的事情有两件,而且两件都必须做,缺一个就不诚实:
- 反驳:说清楚为什么「风格 vs 能力」这个二分法本身就是错的——呈现方式与信息内容不可分割;格式、长度、markdown 排版本身就产生可测量的可用性收益;而做得好的偏好训练在数学、代码、指令跟随这些客观、不看脸的指标上同样有提升。
- 承认:说清楚这个批评在什么条件下是对的——当优化压力越过某个点,模型确实会退化成一个只会排版和堆字数的东西,并且以牺牲数学、代码能力为代价。这不是理论担忧,是被 Qwen、Tülu 等多个团队白纸黑字记录过的现象。
贯穿全文有一个术语要先立住:chattiness(本文译作「话痨度」,但下文多数时候直接用英文)。它不只是「回答变长」,而是一整簇被 RLHF 系统性放大的表层特征:回答长度、大量使用 markdown、加粗小标题、编号列表、emoji、开场白与总结段。当人们说「RLHF 只带来了风格变化」时,他们指的基本就是这一簇东西。
- 「风格 vs 能力」是假二分。信息的组织方式就是信息的一部分——同样的事实,先给定义再分点列出,和糊成一堵散文墙,对使用者的价值差着数量级。重述已有内容的书能成为畅销书(《人类简史》),靠的正是这件事。
- 偏好训练可靠地拉高 LLM-as-a-judge 类聊天评测(AlpacaEval、MT-Bench),但这些收益不按比例迁移到 Arena 和真实使用。这个落差是所有争议的技术根源。
- 长度是古德哈特定律最爱的那根轴:它是回报最高的表层特征,可以被单调推高、不需要任何真实能力。泛滥到 AlpacaEval 和 WildBench 都不得不加线性长度校正。
- 批评成立的条件很具体:在反馈循环里跑偏好方法、或者喂过量偏好数据时,模型会用数学和代码能力去换聊天分数。Qwen 2023 技术报告的原话:「DPO 带来了人类偏好评估上的提升,却导致了 benchmark 评估上的退化。」
- 批评被驳倒的证据也很具体:Tülu 3 配方里 DPO 阶段既提升 chattiness,也在数学、代码、指令跟随上超过 SFT checkpoint;Olmo 3、SmolLM 3 报告了同样的全谱系提升。
- 实用诊断法则:怀疑一个提升是不是纯文风,就把长度控制住再比一次。长度归一化后收益消失大半,你买到的就是 chattiness。
1. 这个批评的来历,以及它为什么这么难反驳
三层含义,杀伤力各不相同
「只是风格迁移」这句话在传播中至少混合了三个不同的主张,强度递减:
| 层次 | 主张 | 是否成立 |
|---|---|---|
| 强 | RLHF 无法提升任何能力,能力全部由预训练决定 | 假——被开源配方的实测数字反驳(见第 6 节) |
| 中 | RLHF 实际上主要在改变呈现方式,能力提升是次要的 | 视情况——取决于配方;纯偏好训练确实以格式改动为主,RLVR 就完全不是 |
| 弱 | 呈现方式的改变不重要,所以 RLHF 不重要 | 假——这是价值判断错误,不是事实错误(见第 3 节) |
争论之所以持续了两年多,是因为参与者经常在这三层之间滑动:批评者用强版本立论,被数据反驳后退到中版本,再被反驳后退到弱版本——而弱版本其实是一个可以直接正面回答的问题。所以下面的讨论会把这三层分开处理。
肤浅对齐假说:最强的学术版本
把这个批评讲得最清楚、也最值得认真对待的,是 LIMA 提出的肤浅对齐假说(Superficial Alignment Hypothesis)。它的原始表述大意是:模型的知识和能力几乎完全在预训练阶段习得,对齐只是教会模型在与用户交互时应该使用哪一种子分布的格式。LIMA 的实证支撑是:只用 1000 条精心人工挑选的高质量样本做 SFT,就能得到一个在人类评价上相当有竞争力的助手。
这个假说的贡献是真实的:它正确地指出了后训练阶段的数据效率极高这一现象,也正确地指出了「学新知识」和「学怎么把已有知识拿出来」是两件不同的事。放在第 4 章(指令微调)的语境里,它解释了为什么 SFT 只需要几万条数据就能把一个 base 模型变成能用的助手——你不是在往里灌知识,你是在选择一个行为模式。
为什么这个批评当年有大量弹药
如果 2023 年的 RLHF 模型全都又好用又聪明,这个批评根本不会流行起来。事实是它确实有大量现成的例证,而且每一条都是第 14 章意义上的过优化症状:
- 套话:「As an AI language model, I…」「Certainly! Here's a comprehensive overview…」——这些短语在偏好数据里被系统性地正向标注过,于是被 RL 放大成了口头禅。
- 过度拒答:2023 年被玩成 meme 的经典失败是模型拒绝回答「怎么 kill 一个 Linux 进程」,理由是「我不能提供伤害或摧毁任何生命形式的指导」。
- 谄媚:自我怀疑、过度道歉、无条件同意用户。这条线一直延伸到 2025 年 4 月 GPT-4o 那次著名的谄媚事故。
- 灌水:重复、对冲、把一件事换三种说法说三遍,用长度换取评分。
这些现象有一个共同结构:它们全都是表层特征,全都能被奖励模型识别为「好」,而且全都不需要任何真实能力。一个把这些特征推到极致的模型,在 LLM 裁判评测上会很好看,在真实使用中会很难受。批评者看到的正是这种模型,他们的判断在当时并不冤枉。
还有一个被忽略的事实
批评之所以长期存在,第二个原因是很多人没有注意到做得好的 RLHF 会实打实地拉高主流评测分数。最直接的例子是 Llama 3 Instruct:它在 Arena 上排得极高,而业界普遍接受的解释是它的人格更讨喜——比同期模型更简洁、更机灵。注意这里的因果方向:不是「因为它能力强所以排名高」,也不是「因为它刷榜所以排名高」,而是它把同样的能力包装得更好用,于是在人类盲测里赢了。
这就把问题推到了本附录真正的核心:如果排名反映的是真实的人类偏好,而人类偏好里包含了对呈现方式的偏好,那么把呈现方式做好,本身算不算「提升」?
2. 对照实验:同一个 base,SFT 版 vs DPO 版
讨论「偏好训练到底改了什么」,最有效的办法不是看平均分,而是把同一个 base 模型的 SFT checkpoint 和 DPO checkpoint 对同一个 prompt 的回答并排放。变量被控制得很干净:同一个预训练权重、同一批 SFT 数据,唯一的差别是最后那一步长度受控的 DPO。
下面用的是 Tülu 3 家族的 70B 模型,prompt 就是本书最合适的那个:What is reinforcement learning from human feedback?
SFT 版本(Llama 3.1 Tülu 3 70B SFT)
原始回答是四段纯散文,没有任何标题和列表。结构大致是:
[第 1 段] 定义 + 反馈可以有哪些形式(二元奖励、标量奖励、动作间偏好、
         演示、自然语言指令、对行为的纠正)
[第 2 段] 动机:传统 RL 里奖励函数难写,容易导致 reward shaping 和 reward hacking
[第 3 段] 人类反馈如何缓解这些问题:实时反馈、按任务复杂度调整、
         随 agent 进展更新反馈
[第 4 段] 挑战:获取成本高、主观且不一致、扩展性、如何高效整合进算法;
以及应用领域(机器人、游戏、假肢控制、NLP)信息是完整的,逻辑也是顺的。问题在于:你必须从头读到尾才知道第 4 段里有「挑战」这一块。想快速找到「有哪些反馈形式」,你得在第一段的长句里用眼睛扫。
DPO 版本(Llama 3.1 Tülu 3 70B DPO)
同一个问题,偏好训练之后的输出骨架变成了这样:
[开头 2 段] 定义 + 与传统 RL 的对比(纯散文,和 SFT 版基本同质)

In contrast, in reinforcement learning from human feedback:

1. **Human Input:**        ...
2. **Feedback Loop:**      ...
3. **Reward Shaping:**     ...
4. **Preference-based RL:** ...
5. **Inverse Reinforcement Learning (IRL):** ...

**Applications:**
- **Robotics:** ...
- **Game playing:** ...
- **Language and content generation:** ...
- **Recommendation systems:** ...

**Challenges:**
1. **Scalability:**   ...
2. **Bias and Noise:** ...
3. **Alignment:**     ...
4. **Safety and Misuse:** ...

[收尾 1 段] 研究者正在做什么来缓解这些挑战
逐项对照:到底改了什么
| 维度 | SFT 版 | DPO 版 | 这算「风格」还是「能力」? |
|---|---|---|---|
| 核心事实 | 齐全 | 齐全,且多了 IRL 这一条 | 信息量基本持平 |
| 结构 | 4 段散文 | 定义 → 编号机制 → 应用清单 → 挑战清单 | 可用性的实质变化 |
| 可扫读性 | 必须线性读 | 加粗小标题充当索引,可跳读 | 可用性的实质变化 |
| 定义位置 | 混在第一段中部 | 第一句就给 | 信息组织,非纯装饰 |
| 长度 | 约 350 词 | 约 600 词 | chattiness 的典型表现 |
本书配了一个完整的对照库:rlhfbook.com/library,里面是三组 SFT → DPO 模型对(Tülu 3 70B、OLMo 2 32B、OLMo 2 7B)在 16 个共享 prompt 上的输出。翻十几组之后你会发现规律非常稳定:
- SFT 的答案倾向于一整堵散文墙。
- DPO 的答案保留同样的事实,但重新组织:先定义,再小标题,再编号列表。更好读、更好用,内容没丢。
3. 风格切不开能力:呈现方式就是信息的一部分
先处理价值判断:风格「不重要」吗
「只是风格」这句话里,真正做工的其实是那个「只是」。它预设了一个价值排序:内容 > 形式,形式是可有可无的装饰。但这个排序在人类知识生产的历史里根本站不住。
风格是一个永不枯竭的人类价值来源。这就是为什么重述已有内容的书可以成为畅销书——《人类简史》里几乎没有一条尤瓦尔·赫拉利原创的史实,它的全部价值在于组织方式和叙述方式。教科书、综述论文、优秀的技术博客,全都是同一类产品:把已经存在的信息重新组织,使它变得可获取。风格与信息「是什么」是交织在一起的,不是可以剥离的外衣。
所以,即便退一万步承认「RLHF 只带来风格变化」,正确的结论也不是「所以 RLHF 不重要」,而是「所以我们低估了风格」。如果 RLHF 让语言模型单纯地更好用、更有趣,那就是交付了价值,与 benchmark 分数无关。
再处理事实判断:风格能被剥离吗
这里有一个可以直接检验的推论。如果风格真的是一层可分离的漆,那么应该存在一个纯格式后处理器:给它 SFT 模型的散文输出,它输出 DPO 模型那种带小标题和编号的版本,且不改变任何事实。
问题是,这个后处理器长什么样?它必须能判断:
- 哪几个句子讲的是同一件事,应该合并为同一个要点;
- 哪些点是并列关系,哪些是从属关系(层级);
- 「应用」和「挑战」应该分成两个块,而不是混在一起;
- 定义句应该提到最前面。
这是一次完整的篇章级结构化推理。能做这件事的东西本身就是一个有能力的语言模型。换句话说:「把风格剥离出来」这个操作所需要的能力,恰恰就是偏好训练在模型内部装进去的那个能力。说它「只是风格」,等于说编译器「只是把代码换了种写法」。
把模型的输出看成 $y = (c, s)$,$c$ 是命题内容,$s$ 是呈现结构。「肤浅假说」的强版本主张后训练只改变条件分布 $p(s\mid c)$,不改变 $p(c\mid x)$。
但这个分解本身是不成立的:自回归模型是逐 token 生成的,结构决策在内容决策之前发生并约束后者。当模型在第 3 个 token 处决定输出 1. **Human Input:** 时,它已经承诺了「接下来要列举若干个并列机制」,这个承诺反过来决定了它后面会检索出哪些内容。经验上也确实如此:要求模型「一步步想」或者「先列提纲」会改变它答对的概率——这在推理模型上是整个范式的基础(见 第 7 章)。$c$ 和 $s$ 不是可交换的两个因子。
格式带来的可用性收益是可测量的
「排版有用」不是审美主张,它有硬指标:
| 格式手段 | 它实际解决什么问题 | 可测量的收益 |
|---|---|---|
| 加粗小标题 | 长回答无法扫读 | 用户定位所需信息的时间 |
| 编号列表 | 并列项在散文里边界模糊 | 用户漏读某一项的比例 |
| 代码块围栏 | 代码与说明混在一起无法复制 | 能否直接粘贴运行;能否被程序解析 |
把最终答案放进固定标记(如 \boxed{}) | 答案埋在推理里,自动评测抓不到 | 直接决定评测分数能不能拿到 |
| 结构化输出 / JSON | 下游程序无法消费自由文本 | 工具调用成功率 |
最后两行值得多说一句,因为它们把「风格是装饰」这个观点彻底击穿。在可验证奖励(RLVR,见第 7 章)的训练里,模型必须把最终答案放在一个约定的位置,否则再正确的推理也拿不到奖励——格式在这里就是能力的必要条件。在 agent 与工具调用场景里更极端:一个 JSON 少一个引号,整条工具调用链就断了。后训练教给模型的「格式」,在 2025 年之后是系统能不能跑起来的开关,不是好不好看的问题。
校准:一个骑在「风格」与「能力」边界上的例子
还有一类被归为风格的东西是语气强度:模型说「答案是 42」还是「我不太确定,但可能是 42」。表面上这是措辞,实质上它编码了模型对自身不确定性的估计——也就是校准(calibration)。
这条边界上发生的事情两个方向都有:偏好数据如果偏爱自信的表述,RLHF 会把模型推向过度自信,让语气与真实置信度脱钩,这是能力的损失;反过来,如果标注鼓励在真正不确定时说不确定,那么同样是「改语气」,改出来的是可靠性的提升。同一个旋钮,方向决定它是伤害还是提升。这也是为什么把 RLHF 笼统地评价为「改风格」既无法证伪也没有信息量——真正该问的是:它把哪些表层特征往哪个方向推了。
4. chattiness 的平衡:哪些评测好刷,哪些不好刷
整场争论的技术根源可以压缩成一句话:偏好训练在某一类评测上给出巨大且可复现的提升,而这个提升不按比例迁移到另一类评测和真实使用上。
评测的「可刷度」谱系
| 评测 | 裁判是谁 | 对 chattiness 的敏感度 | 刷起来有多容易 |
|---|---|---|---|
| AlpacaEval | LLM 裁判,对固定基线比胜率 | 极高 | 很容易:加长 + 排版即可涨点 |
| MT-Bench | LLM 裁判打 1–10 分 | 高 | 容易 |
| Arena(LMArena) | 真人盲测投票,ELO | 中——真人也偏好长而完整的答案 | 难,但不是不可能(见下一节 Llama 4) |
| GSM8K / MATH | 答案精确匹配 | 无 | 刷不动(除非污染训练集) |
| HumanEval / MBPP | 单元测试执行 | 无 | 刷不动 |
| IFEval | 程序化校验指令是否被遵守 | 无(但考的正是格式服从) | 刷不动 |
这张表就是本附录的操作核心。「RLHF 只提升了文风」这个命题,可以被翻译成一个可证伪的陈述:它只在表格上半部分涨分,下半部分不涨甚至掉分。于是问题从哲学争论变成了一次实验。
2023 年秋天:DPO vs PPO 之争的真正议题
2023 年秋,关于 DPO(直接偏好优化)与 PPO 等基于 RL 的偏好微调方法孰优孰劣的争论达到顶峰。表面上讨论的是算法,实际的争议中心正是聊天评测与真实性能之间的平衡:一方拿着 AlpacaEval 上漂亮的胜率,另一方问「那你的 GSM8K 掉了多少?」(这场争论的技术细节见第 8 章,以及 Ivison 等人 2024 年的《Unpacking DPO and PPO》——那是少数把变量控制干净的对照研究。)
关键的技术事实是:DPO 和 PPO 都可以被用在反馈循环里、或者被喂过量的偏好数据,从而以严重损害数学、代码等任务为代价,换取聊天性能。这不是算法的缺陷,是优化压力的必然结果——你给它一个只奖励聊天质量的目标,它就会把其它能力当作可牺牲的资源。
被反复引用的那句坦白
阿里在 2023 年的 Qwen 技术报告里留下了这个权衡最早也最直白的公开记录:
我们用大量数据做了预训练,并用监督微调和直接偏好优化做了后训练。然而,DPO 带来了人类偏好评估上的提升,却导致了 benchmark 评估上的退化。
这句话之所以重要,是因为它出自一个没有动机自曝其短的团队的技术报告。同样的现象在早期对齐实验里被反复观察到,只是很少有人写进论文——大多数论文只报告涨了的那一半。
做对了的样子:Starling Beta
2024 年 3 月的 Starling Beta 是这个权衡处理得好的早期样本。它的设置很干净:从另一个组织训练的聊天模型 OpenChat 出发,训练完全聚焦在 k-wise 奖励模型训练 + PPO 优化上,结果在 Arena 上上升了 10 位。
它的平均回复长度也增加了——但增加的方式确实帮到了人类评分者。这就是「长度增加」与「长度膨胀」的分界:前者携带了额外信息,后者只是把同一件事说三遍。光看长度变化这一个数字,你区分不出这两种情况;必须看长度归一化之后收益还剩多少。
现代做法:把权衡挪到 checkpoint 选择这一层
今天的成熟团队处理这个问题的方式,不是找一个「不会损害数学能力的偏好算法」,而是承认权衡存在,然后在 checkpoint 层面显式做选择。Olmo 3 的报告明确记录了这个决定:模型经历了大量聊天训练,但作者最终选择了数学、代码、推理分数更高的 checkpoint,而不是 LLM-as-a-judge 聊天基准上分数最高的那个。
5. 长度:古德哈特最爱的那根轴
为什么 RLHF 会让回答变长
这个问题的答案朴素得有点扫兴:因为人真的更喜欢长答案。
Arena 这类真人盲测评测反复显示,模型的普通用户在与简短回答对比时,往往更偏好更长、更完整的答案——长答案读起来更周全、更有帮助,甚至更可信,尤其是在评价者只花几秒钟扫一眼的情况下。这不代表每个用户的偏好,但模型是被训练去匹配大量标注员的平均偏好的,所以 RLHF 倾向于让模型变啰嗦。
把这条因果链完整写出来:
| 环节 | 发生了什么 |
|---|---|
| 1. 标注 | 标注员在时间压力下评比两个回答,长的那个平均更常被选中 |
| 2. 偏好数据 | 数据集里「chosen 比 rejected 长」的比例显著大于 50% |
| 3. 奖励模型 | 长度是最容易计算、泛化最稳定的特征,RM 优先学它 |
| 4. RL / DPO | 策略发现「加长」能单调提升奖励,且成本极低 |
| 5. 评测 | LLM 裁判同样偏好长答案,于是分数确认了这条路线 |
第 3 步是关键。回到第 5 章关于奖励模型是「有损压缩器」的讨论:RM 要从每条只含 1 bit 的比较里提取信号,它会优先抓住那些在标注员之间高度一致的粗粒度特征。长度恰好是这类特征的极端:它零歧义、零成本地可计算,而且与人类偏好有真实(虽然弱)的正相关。于是 RM 学到的偏好函数里,长度这一项的系数被系统性高估。
把奖励模型学到的分数近似分解为「内容项 + 长度项」:
$$ r_\theta(x,y) \;\approx\; r_{\text{content}}(x,y) \;+\; \alpha\,\ell(y), \qquad \alpha > 0 $$其中 $\ell(y)$ 是回复 token 数。RL 的目标是 $\E_{y\sim\pi_\theta}[r_\theta(x,y)] - \beta\,\KL(\pi_\theta\|\pi_{\text{ref}})$。
关键在于两项的边际成本结构完全不同:提升 $r_{\text{content}}$ 需要模型真的把内容做对,这在参数空间里是一个困难的、非单调的方向;而提升 $\ell(y)$ 只需要把 EOS 的概率往下压一点,是一个低维、单调、随处可达的方向。只要 $\alpha>0$,即使很小,策略梯度也会持续在这个方向上收集奖励,直到 KL 惩罚 $\beta$ 把它拉住为止。
推论有三条:(a) 长度膨胀的严重程度大致由 $\alpha/\beta$ 决定;(b) 减小 KL 系数 $\beta$ 一定会让回答变长;(c) 直接在奖励里减去一个长度惩罚 $r' = r_\theta - \lambda\,\ell(y)$ 是有效的,代价是 $\lambda$ 变成又一个要调的超参,而且调过头模型会变得过于简略。
被长度刷穿的排行榜
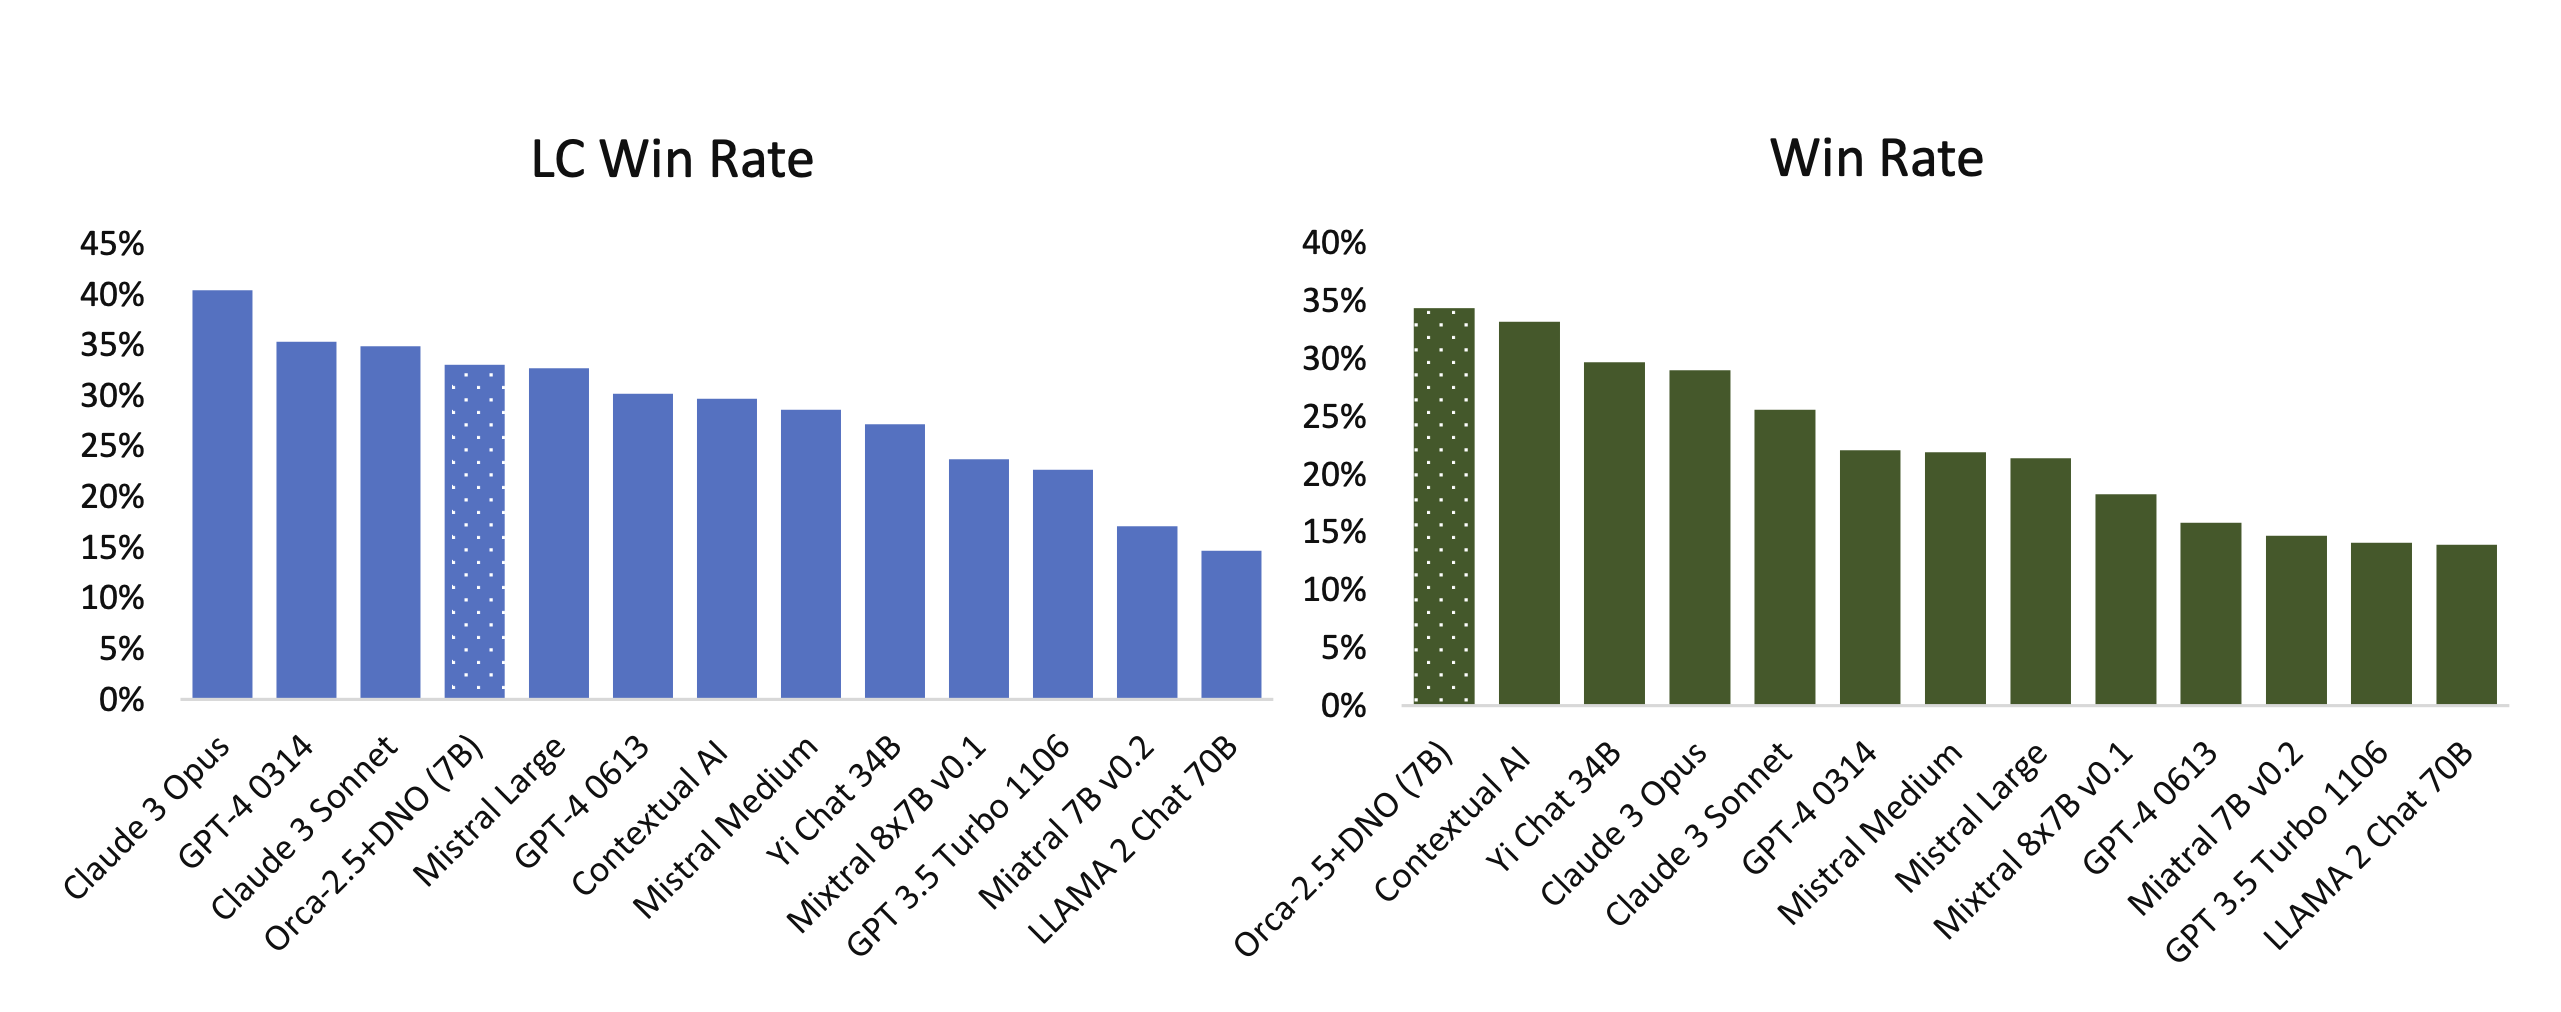
判断标准其实很简单:这些论文如果放出了权重,模型在公开使用中并不流行——因为它们在一般使用下不够稳健。它们被调到了狭窄的测试集上,面对它们声称击败的那些大得多的前沿模型,真实场景里根本撑不住。这类「洞见有价值、结果被过度包装」的工作大量存在,恰恰让 RLHF 更难被理解。
长度偏置泛滥到什么程度?AlpacaEval 和 WildBench 两个评测系统都内置了线性长度校正机制。这个补丁修的正是「靠加长来打败 GPT-4」的激励结构,让更短、更有用的模型也有机会赢。
自己动手做长度诊断
你不需要等评测方给你校正版本。下面这段代码是最小可用的长度去偏诊断:对一批成对的裁判判决,拟合一个只含「模型身份」和「长度差」的逻辑回归,然后看把长度差置零后胜率变成多少。
import numpy as np
from sklearn.linear_model import LogisticRegression

# wins[i] = 1 表示候选模型在第 i 个 prompt 上赢了基线
# len_a[i], len_b[i] 是候选/基线回答的 token 数
delta = np.log(len_a) - np.log(len_b)      # 用 log 长度差,尺度更稳
X = np.stack([np.ones_like(delta), delta], axis=1)

clf = LogisticRegression(fit_intercept=False).fit(X, wins)
b_model, b_len = clf.coef_[0]

raw_wr = wins.mean()
# 反事实:把长度差置零,只保留模型身份项
lc_wr  = 1.0 / (1.0 + np.exp(-b_model))

print(f"原始胜率      {raw_wr:.3f}")
print(f"长度控制胜率  {lc_wr:.3f}")
print(f"长度系数      {b_len:.3f}  (>0 说明裁判确实偏爱长回答)")
print(f"收益中被长度解释的比例  {1 - (lc_wr - .5) / (raw_wr - .5):.1%}")
用法:在 SFT checkpoint 和 DPO checkpoint 上各跑一次。如果 lc_wr 相比 raw_wr 塌回到 0.5 附近,那次训练买到的基本就是 chattiness。这也是判断一个新方法是否值得跟进的最快过滤器。
2025 年 4 月 Meta 发布 Llama 4,头条是 Maverick 以 ELO 1417 拿下 Chatbot Arena 第 2 名——脚注写着这是「一个实验性的 chat 版本」。榜单上那个模型不是发布出来的那个模型:它是一个针对 Arena 投票者调过的变体,回答长、塞满 emoji、无止境地热情。同一个名字,在 LMArena 上和在其它所有 API 供应商那里行为差别巨大。发布版的 Maverick 是个还行的模型、语气也正常;当真正的模型后来被排名时,落到了榜单相当靠后的位置,LMArena 随后修改了政策。
这件事的教训不是「某家公司作弊」,而是:一旦某个评测成为足够重要的目标,就一定会出现专门针对它优化的模型变体。这是古德哈特定律作用在组织而不是梯度上的版本——而且它证明了即便是真人盲测的 Arena,也是可以被 chattiness 定向优化的。
6. 批评在什么条件下是对的
一份只做辩护的附录没有价值。下面把「RLHF 退化成纯文风」这件事的触发条件尽量列全——这些条件同时也是一张检查清单:如果你的项目命中了其中几条,那么批评者说的就是你。
触发条件清单
| 条件 | 为什么会导致退化 | 缓解方向 |
|---|---|---|
| 在反馈循环里跑偏好方法(用模型自己的输出反复生成偏好数据再训) | 模型自身的表层偏好被逐轮放大,几轮之后数据里只剩格式差异 | 每轮换 judge、混入人类数据、限制轮数 |
| 偏好数据量相对能力过量 | 信号早已被榨干,后续 step 全部用于挖掘 RM 的漏洞 | 按 dev 集早停,而不是按数据跑完 |
| RM 训练数据自带强长度偏置且未纠正 | $\alpha$ 大,策略只需加长即可涨分 | 长度平衡采样、长度惩罚、长度去偏的 RM |
| KL 系数 $\beta$ 过小或没有 KL 约束 | 策略可以任意远离参考模型,直奔 RM 的极值点 | 调大 $\beta$(见第 15 章) |
| 只用 LLM-as-a-judge 分数做 checkpoint 选择 | 选择准则本身就偏爱 chattiness,等于把过优化选出来 | 把 GSM8K/HumanEval/IFEval 放进选择准则 |
| 模型较小 | 可利用的真实能力少,涨分的最短路径几乎必然是表层特征 | 降低对小模型「聊天分数超越大模型」的期待 |
| 不做长度控制就宣布胜利 | 看不见问题就以为没有问题 | 第 5 节的那段诊断代码 |
退化的曲线形状
这件事在训练曲线上不是突变,是渐变加交叉。典型的 DPO 或 PPO 运行会呈现这样一组曲线:
- 训练奖励 / 隐式奖励间隔:单调上升,从头涨到尾——所以它对判断何时该停毫无用处。
- LLM 裁判聊天分数:先快速上升,然后缓慢上升或走平。
- 平均回复长度:几乎与训练奖励同步单调上升。
- GSM8K / HumanEval:先小幅上升或持平,某个点之后开始下降。
关键是那个交叉点通常出现在聊天分数还在涨的时候。如果你的 checkpoint 选择只看聊天分数,你必然会选到交叉点之后的模型——不是因为你不小心,而是因为你的选择准则就是这么定义的。这与第 14 章里 Gao 等人的过优化缩放律是同一个形状:代理指标持续上升,真实指标见顶回落。
算法层面的补丁
除了早停和 checkpoint 选择,还有一类做法是直接把长度写进目标函数。最直接的是在奖励里减一个与长度成正比的惩罚:
$$ r'(x,y) \;=\; r_\theta(x,y) \;-\; \lambda\,\ell(y) $$在 DPO 上的对应物是 R-DPO(Disentangling Length from Quality in DPO):在 DPO 损失里给 chosen 和 rejected 各加一个正比于自身长度的正则项,使得「更长」这一件事本身不再能降低损失。本附录开头那个 Tülu 3 的对照例子,用的就是长度受控的 DPO(length-controlled DPO)——这也是为什么它的 DPO 版虽然变长了,但没有长到荒谬。
# 长度惩罚版的序列级奖励(可直接接在第 6 章的 PPO/GRPO 优势计算前)
# lam 的量级:让 lam * 平均长度 大约等于奖励标准差的 10%~30%
def length_penalized_reward(reward, resp_len, lam=0.0):
    # reward:   [B]  奖励模型给出的序列级分数
    # resp_len: [B]  每条 completion 的 token 数(不含 prompt)
    return reward - lam * resp_len.float()

# 更稳的做法:先在 batch 内做长度分组标准化,避免 lam 随任务尺度漂移
def length_debiased_reward(reward, resp_len, n_bins=4):
    order = resp_len.argsort()
    out = reward.clone()
    for chunk in order.chunk(n_bins):          # 按长度分成 n_bins 组
        r = reward[chunk]
        out[chunk] = (r - r.mean()) / (r.std() + 1e-6)
return out # 组内比较,长度不再是可利用维度把结论说清楚
所以,「RLHF 只是文风」这个批评在下面这个精确的意义上是对的:
当偏好训练被推过过优化的拐点,模型确实会以牺牲数学、代码等客观能力为代价,换取排版、长度和语气上的表层收益;此时它在 LLM 裁判评测上的提升基本可以被长度和格式完全解释。
而它不对的地方在于:这描述的是一种失败模式,不是这项技术的本质。下一节给出反面证据。
7. 反证:做对了的偏好训练确实提升真能力
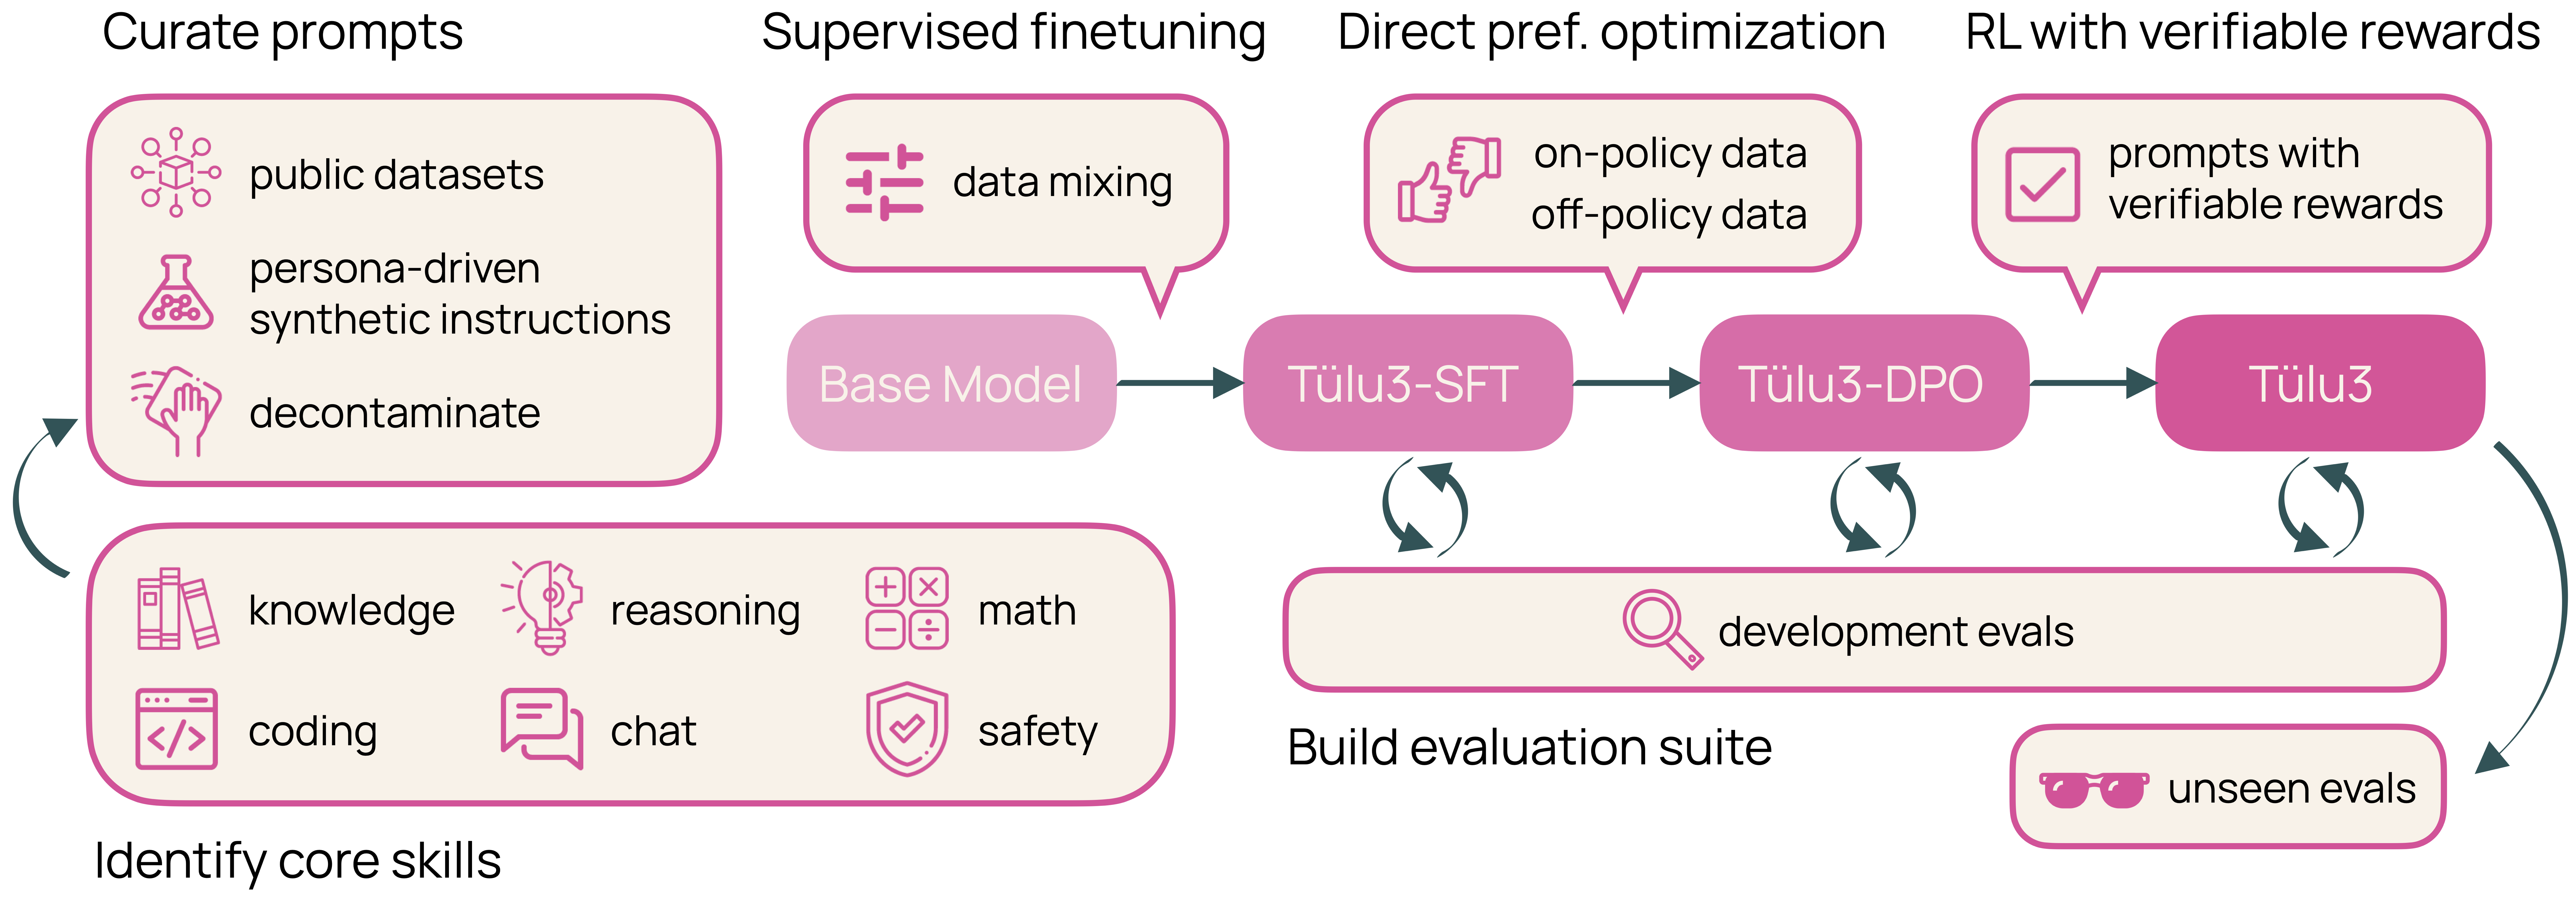
「只是风格」这个批评是被认真做的开源模型用数字逐步驳倒的——虽然只是部分驳倒。之所以是开源模型完成了这件事,原因很简单:只有它们同时公开了 SFT checkpoint、偏好训练后的 checkpoint,以及两者在同一套完整评测上的分数。闭源模型的技术报告只给最终数字,你无法把偏好训练这一步单独摘出来看。
三份独立的报告说了同一件事
| 配方 | 偏好训练阶段 | 报告的效果 |
|---|---|---|
| Tülu 3(2024) | 长度受控 DPO,位于 SFT 与 RLVR 之间 | chattiness 提升,同时数学、代码、指令跟随超过 SFT checkpoint |
| Olmo 3(2025) | 大规模聊天训练 + DPO | 报告了同类的全谱系提升;并显式按数学/代码/推理分数而非聊天分数选 checkpoint |
| SmolLM 3(2025) | DPO | 同样报告 RLHF 阶段带来跨评测套件的广谱提升 |
三个不同机构、不同规模、不同数据的配方,报告了同一个方向的结论。这在实证上足以否定强版本的肤浅对齐假说:偏好训练不是只在改格式,它在不吃排版的客观指标上也有正贡献。
为什么偏好训练能提升客观能力
这件事需要一个机制解释,否则容易被当成运气。至少有三条通路:
- 偏好数据里含有正确性信号。当两个回答一对一错时,标注员(或 LLM 裁判)绝大多数时候会选对的那个。于是「chosen vs rejected」这个 1 bit 里,除了风格差异,还打包了一部分正确性差异。RM 学到的方向因此不是纯格式的。
- on-policy 采样 + 排序本质上是拒绝采样的软化版。从当前策略采样若干条、按偏好排序、然后把概率质量往排前面的挪——这与第 9 章的拒绝采样在做同一件事,只是拒绝采样用硬阈值,偏好方法用梯度。而拒绝采样对能力的提升从来没有人质疑过。
- 指令跟随本身就是一项能力。IFEval 这类基准考的是「用户说了『用三段话回答』你有没有照做」,它是程序化校验的,刷不动。偏好训练在这上面的提升是纯增益——而这项能力恰好长得最像「风格」。这大概是整场争论里最反讽的一点:被指为「只是风格」的那部分改变,正是能被客观测量为能力提升的那部分。
把前面所有材料收成一条:风格与能力不是两个可以分开测量的量,而是同一个训练过程在不同评测上的投影。
- 在 AlpacaEval 上,这个过程的投影几乎全是风格——所以那里的分数不可尽信。
- 在 IFEval 上,同一个过程的投影是「服从指令的能力」——而它刷不动。
- 在 GSM8K 上,投影可能是正的(正确性信号 + 拒绝采样效应)也可能是负的(过优化),取决于你停在曲线的哪一点。
因此,「RLHF 是不是只是风格」这个问题没有唯一答案;有答案的问题是:你这次训练,在哪些指标上涨了、在哪些上掉了、长度控制之后还剩多少。
时代已经把这个问题改写了
还有一件事让这场争论在今天听起来有点陈旧:现代后训练的重心早就不只是偏好训练了。
在第 7 章讲的可验证奖励强化学习(RLVR)范式里,RL 阶段直接对着答案对不对、单元测试过不过优化。这里没有奖励模型可言,没有 LLM 裁判可以讨好,长度和 emoji 拿不到任何奖励——DeepSeek-R1 这类模型在数学和代码上的巨大提升,来自的正是这种 RL。说「RLHF 只改风格」,在 2023 年是一个关于偏好训练边界的合理怀疑;放在 2026 年,它连讨论对象都找错了。
本章小结
| 命题 | 结论 | 证据 |
|---|---|---|
| RLHF 只改风格不改能力 | 部分对,但作为整体判断是错的 | Tülu 3 / Olmo 3 / SmolLM 3 的 DPO 阶段在数学、代码、IF 上同步提升 |
| 风格是「肤浅的」 | 错——呈现方式承载真实的使用价值 | 同一 base 的 SFT vs DPO 对照;Llama 3 Instruct 的 Arena 排名被归因于人格 |
| 聊天评测的提升 = 能力提升 | 错——AlpacaEval/MT-Bench 极易被 chattiness 刷 | DNO、Self-Rewarding 的「7B 击败 GPT-4」无人采用 |
| 偏好训练一定损害数学/代码 | 错——但在循环里跑或数据过量时确实会 | Qwen 2023 报告的退化 vs Tülu 3 的同步提升 |
| 长度增加 = 灌水 | 不一定——要看增量是否携带信息 | Starling Beta:长度增加且 Arena 上升 10 位 |
一页速查:区分「真提升」与「纯文风」
- 先做长度控制。用 length-controlled AlpacaEval,或者自己做长度分桶配对比较。收益消失大半 ⇒ chattiness。
- 看不看脸的指标。GSM8K/MATH、HumanEval/MBPP、IFEval——这些不靠 LLM 裁判、不吃排版。DPO 之后这些不掉甚至涨,才叫真提升。
- 做格式剥离对照。把回答的 markdown 结构去掉再送裁判,看分数掉多少。掉得越多,说明分数越依赖排版。
- 看有没有人真的在用。榜单第一但模型权重下载后没人留下来,是最强的负面信号。
- checkpoint 选择要显式表态。你是按聊天分数选,还是按数学/代码分数选?Olmo 3 选了后者,并把这个决定写进了报告。
该记住的一句话
RLHF 的恶名是靠风格上的失败挣来的——过优化产出的那些油腻、冗长、谄媚的输出,确实配得上「只是风格」这个评价。但同样的工具,小心使用、配上正确的评测和 checkpoint 选择,现在是现代后训练的核心。把「RLHF 只是风格」当成 2026 年的技术判断,是拿 2023 年的失败案例当结论。
延伸阅读
「只是风格」这个论点本身
- LIMA: Less Is More for Alignment (2023) — 肤浅对齐假说的出处。读它是为了理解这个批评最强的学术版本长什么样,而不是它的网络简化版。
- Tülu 3 (2024) — 本附录对照例子的来源模型;同时是「DPO 阶段同步提升数学/代码/IF」这一反证的主要出处。
- Olmo 3 (2025) — 明确记录了「按数学/代码/推理分数而不是 LLM-judge 聊天分数选 checkpoint」的决定,是本附录的现代实践样本。
- SmolLM 3 (2025) — 另一个报告 RLHF 阶段全谱系提升的开放配方。
长度偏置与评测被刷
- A Long Way To Go: Investigating Length Correlations in RLHF (2023) — 系统量化 RLHF 收益中有多少可以用长度解释,是「先控长度再看收益」这条法则的实证基础。
- Length-Controlled AlpacaEval (2024) — 长度校正的具体做法;做任何 LLM-as-a-judge 流水线都应该先读这篇。
- Disentangling Length from Quality in Direct Preference Optimization (ACL Findings 2024) — R-DPO,把长度惩罚直接写进 DPO 目标,是「在算法层面而不是评测层面修长度」的代表作。
- Direct Nash Optimization (2024) — 本附录那张图的出处。方法本身正经,值得读的是它如何示范了评测被过优化时的样子。
- Self-Rewarding Language Models (2024) — 同类问题的另一个案例:想法重要,分数不可尽信。
做对了的样子
- Starling-7B: Improving Helpfulness and Harmlessness with RLAIF (COLM 2024) — k-wise 奖励模型 + PPO,Arena 上升 10 位、长度增加但增加得有用。「长度增加」和「长度膨胀」的分界线样本。
- Unpacking DPO and PPO: Disentangling Best Practices for Learning from Preference Feedback (NeurIPS 2024) — DPO/PPO 之争的可信实证对照,本附录「聊天分数与真实性能的平衡」一节的技术依据。
- Qwen Technical Report (2023) — 那句被反复引用的坦白就在这里,是这个权衡最早的公开记录之一。
- The Llama 3 Herd of Models (2024) — Instruct 版本的 Arena 表现被广泛归因于人格与简洁,是「风格即价值」的正面案例。
- rlhfbook.com/library — 本书配套的对照补全库:三组 SFT → DPO 模型对、16 个共享 prompt,自己翻一遍比读十篇论文更能建立直觉。