正则化
怎么让优化器把奖励榨干,又不至于把上一阶段辛苦训出来的通用模型给毁掉。
0. 本章导读
第 14 章是病理学:奖励模型是真实人类偏好的代理,优化器只要跑得够久,一定会找到那个「奖励很高但人类看了想吐」的角落——回复越写越长、满屏 emoji、中英文乱切、推理过程写得头头是道但答案离谱、或者干脆开始输出重复的特殊字符。这就是过优化(over-optimization)。
第 15 章是药理学:既然优化器一定会往那边跑,我们手上有哪些工具能把它拽住?本章把这些工具从最核心的一件(到参考策略的 KL 惩罚)铺开到最外围的一圈(预训练梯度混合、margin loss、熵正则、权重平均),并且——这是本章真正值钱的地方——告诉你哪些是必需品,哪些只是某篇论文为了让实验跑通而临时搭的脚手架,下一代模型出来就被拆掉了。
但本章不止讲「显式加什么惩罚项」。它还有一条更深的线索:优化器本身就有形状。SFT 的损失函数在数学上恰好等价于最小化一个前向 KL(forward KL),而带 KL 惩罚的 RL 目标恰好等价于最小化一个反向 KL(reverse KL)。这两个方向的数值行为完全不同——一个求覆盖(mass-covering),一个求聚焦(mode-seeking)——而这个差异直接解释了 2025–2026 年后训练社区最重要的一批实证结论:SFT 会记忆并遗忘,RL 会泛化并保留。也就是说,on-policy 的 RL 自带一层隐式正则化,就算你把 $\beta$ 设成 0、把参考模型从显存里删掉,它依然比 SFT 更不容易破坏模型原有的能力。
本章要回答的具体问题:
- KL 惩罚到底加在奖励里还是损失里?两种写法的梯度一样吗?
- 实践中的 KL 是估计出来的。$k_1 / k_2 / k_3$ 三种估计器分别是什么、偏差和方差怎么权衡、为什么现在的开源实现清一色默认 $k_3$。
- 系数 $\beta$(有时写作 $\lambda_{\text{KL}}$)的量级怎么定?为什么最早的 RLHF 论文用的是一个反馈控制器而不是常数?为什么现在又转回常数了?
- 参考模型该选谁、要不要中途更新、它在工程上要付出多少显存和算力?
- KL 之外还有什么:预训练梯度混合、DPO+NLL、Llama 2 的 margin loss、熵正则、权重平均 / model soup。
- 2026 年发生了什么变化:为什么前沿的 agentic 配方在删掉 KL 惩罚,同时又在别的地方加回约束。
- RLHF 的标准奖励是 $r = r_\theta - \lambda_{\text{KL}}\, \mathcal{D}_{\text{KL}}(\pi_{\text{RL}} \Vert \pi_{\text{ref}})$。这个 KL 是反向 KL:从正在训练的策略采样,用参考模型打分。它惩罚「模型在参考模型认为不可能的地方放了概率质量」。
- 「KL 距离」是行话,指花掉了多少优化预算。KL 不是真正的距离度量(不对称、不满足三角不等式),但作为「模型改了多少」的单一数字极其好用——训练时必须盯着这条曲线,KL 突然爆炸基本等于有 bug。
- KL 实践中总是被估计。$k_1 = -\log r$ 无偏但方差大且可能为负;$k_2 = \tfrac{1}{2}(\log r)^2$ 恒非负、方差小但有偏;$k_3 = (r - 1) - \log r$ 既无偏又恒非负,是当前开源实现的默认选择(
_src/code/policy_gradients/loss.py的kl_estimator: kl3)。 - 加在奖励里(进 GAE / advantage)和加在损失里(直接加一项 $\beta \cdot \hat{k}$)是两种不同的实现,梯度不等价。现代 GRPO 类实现几乎都走「加在损失里」这条路。
- 量级参考:open-instruct 的 GRPO 用静态
beta = 0.05;最早的 RLHF 论文用目标 KL + 比例控制器($K_\beta = 0.1$,误差 clip 到 $\pm 0.2$)动态调节。DPO 的 $\beta$ 是另一回事(隐式 KL,典型 0.01–0.1,见第 8 章)。 - SFT ⟺ 最小化前向 KL(mass-covering,被数据拉着走);带惩罚的 RL ⟺ 最小化到「奖励倾斜后的参考策略」$\pi_\star \propto \pi_{\text{ref}} \exp(r/\beta)$ 的反向 KL(mode-seeking,只在自己已有概率质量的地方动)。
- 隐式正则化是真的:即使 $\beta = 0$,on-policy 采样本身就把 RL 偏向了「KL 漂移最小」的那批高奖励解。遗忘量与 KL 漂移的相关性达到 $R^2 = 0.96$,而消融实验显示这个差异完全由 on-policy 数据解释,负梯度没有可辨识的贡献。
- Lambert 的判断:KL 之外的正则化手段绝大多数是脚手架——为了让某一代配方跑稳而加,下一代就被简化掉了。看到论文里一堆花哨的正则项,先假设它是那一版实验的拐杖,不要照抄。
1. 病与药:为什么必须约束「别离参考策略太远」
优化器不会自己停下来
回顾一下 RLHF 那个循环在干什么:从 prompt 集合里采一批 $x$,用当前策略 $\pi_\theta$ 生成回复 $y$,用奖励模型 $r_\theta$ 给 $(x, y)$ 打分,然后做策略梯度更新,让高分回复的概率上升。这个循环唯一的目标函数是
$$ J(\theta) = \E_{x\sim\mathcal{D},\, y\sim\pi_\theta(\cdot\mid x)}\big[r_\theta(y\mid x)\big] $$问题在于 $r_\theta$ 不是真实的人类偏好,它只是一个在有限偏好数据上拟合出来的代理(proxy)。真实偏好和代理在训练数据分布附近是吻合的,但一旦策略跑到分布外,代理的行为就完全没有保证了——它可能给一段乱码打出 8 分,因为它从没见过乱码,只见过「长的、格式漂亮的回复分数高」,而那段乱码恰好长且有 markdown 标题。
于是发生的事情是可预测的:优化器忠实地执行你写下的目标,一路爬到代理奖励的最高点,而那个点在真实偏好上可能比起点还差。第 14 章已经把这条曲线画出来了——代理奖励单调上升,真实奖励先升后降,两条线在某个 KL 预算处分道扬镳。
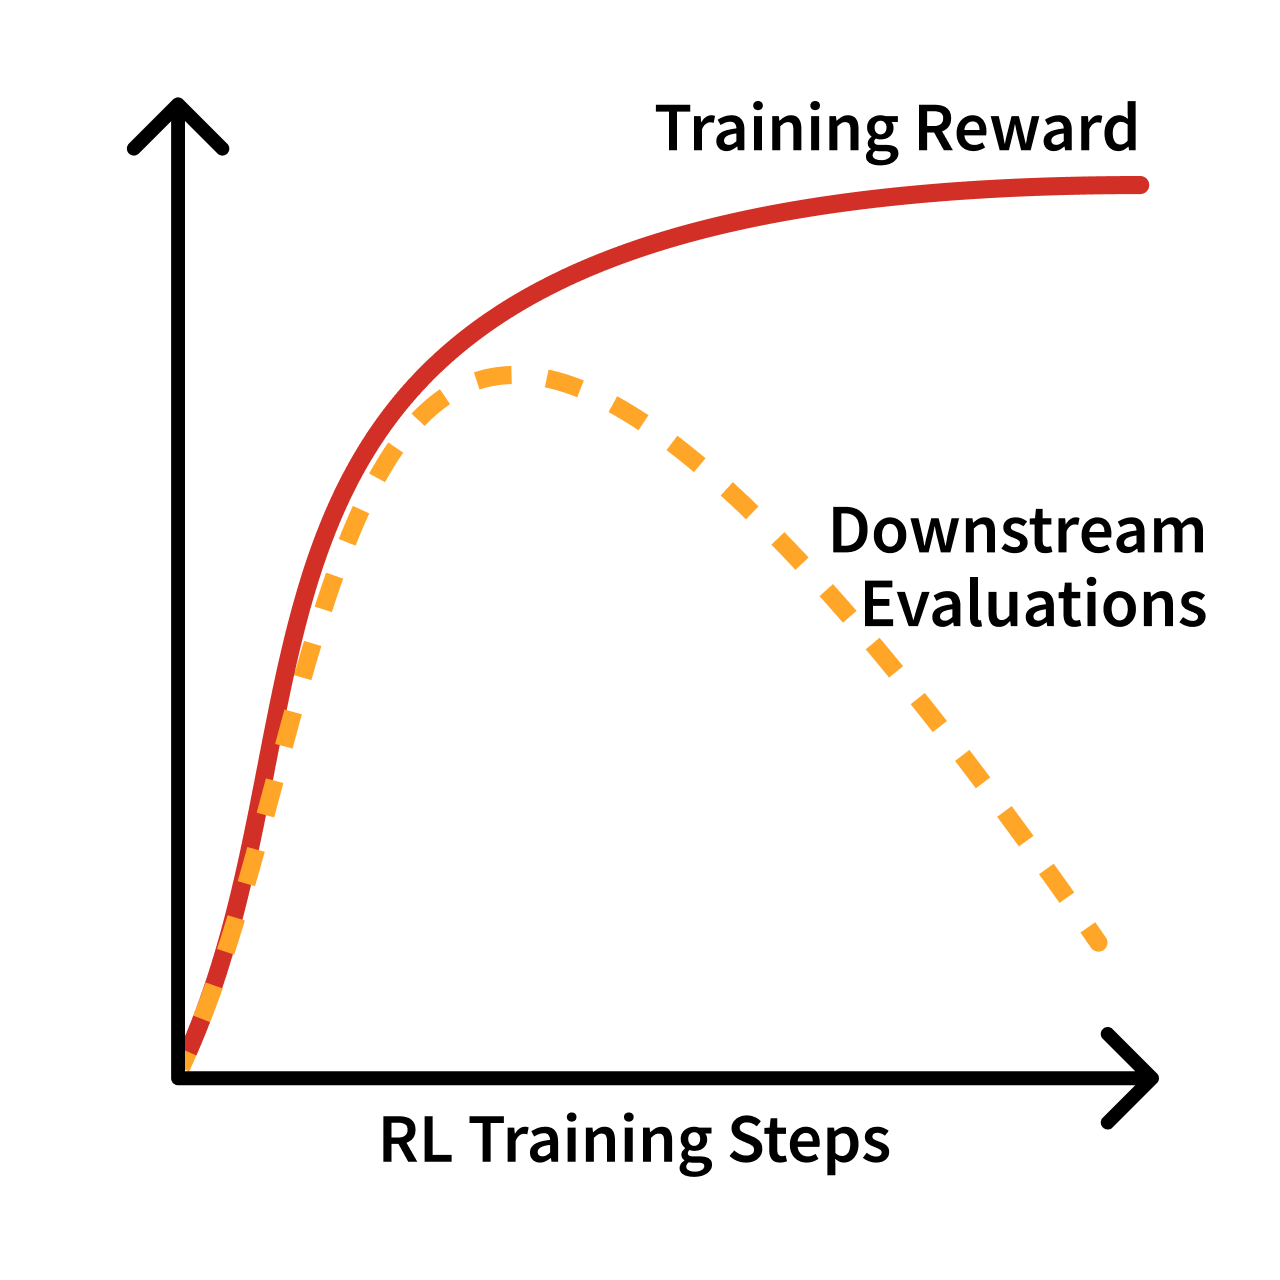
过优化在文本上长什么样
原文列了几种典型的「优化脱轨」形态——这些是你在曲线之外、真正去读 rollout 样本时会看到的东西:输出彻底不成句(大段重复、特殊字符堆积)、语言漂移(中途切换语种)、形似而神非的推理(步骤读起来完全通顺、格式规范,但答案错得离谱——这是最危险的一种,因为它能骗过格式类奖励和相当一部分人类标注员)、以及长度膨胀(几乎所有 RLHF 配方的默认失败模式,也是最好检测的一个)。
这些现象的共同点是:模型跑到了一个参考策略几乎不会生成的文本区域。所以最直接的药方也就呼之欲出了——在奖励里减掉一项,直接度量「你现在生成的东西,参考模型觉得有多离谱」。
通用形式
本章所有方法都可以套进同一个模板:
$$ r = r_\theta - \lambda \, r_{\text{reg.}} $$其中 $r_\theta$ 是任务信号(奖励模型打分,或者 RLVR 里的可验证奖励),$r_{\text{reg.}}$ 是「你离原来的自己有多远」的某种度量,$\lambda \ge 0$ 是价格。截至 2026 年,绝大多数实现里这个 $r_{\text{reg.}}$ 就是到参考策略的 KL 散度:
$$ r = r_\theta - \lambda_{\text{KL}} \, \mathcal{D}_{\text{KL}}\!\left( \pi_{\text{RL}}(y\mid x) \,\Vert\, \pi_{\text{ref}}(y\mid x) \right) $$符号约定(本章统一遵守):$x$ 是 prompt,$y$ 是完整的 completion(不是单个 token)。$\pi_{\text{RL}} = \pi_\theta$ 是正在训练的策略,$\pi_{\text{ref}}$ 是冻结的参考模型——通常就是 RL 开始前的那个 SFT checkpoint。$\lambda_{\text{KL}}$ 在大部分代码库和论文里被写成 $\beta$,本章后面也主要用 $\beta$。
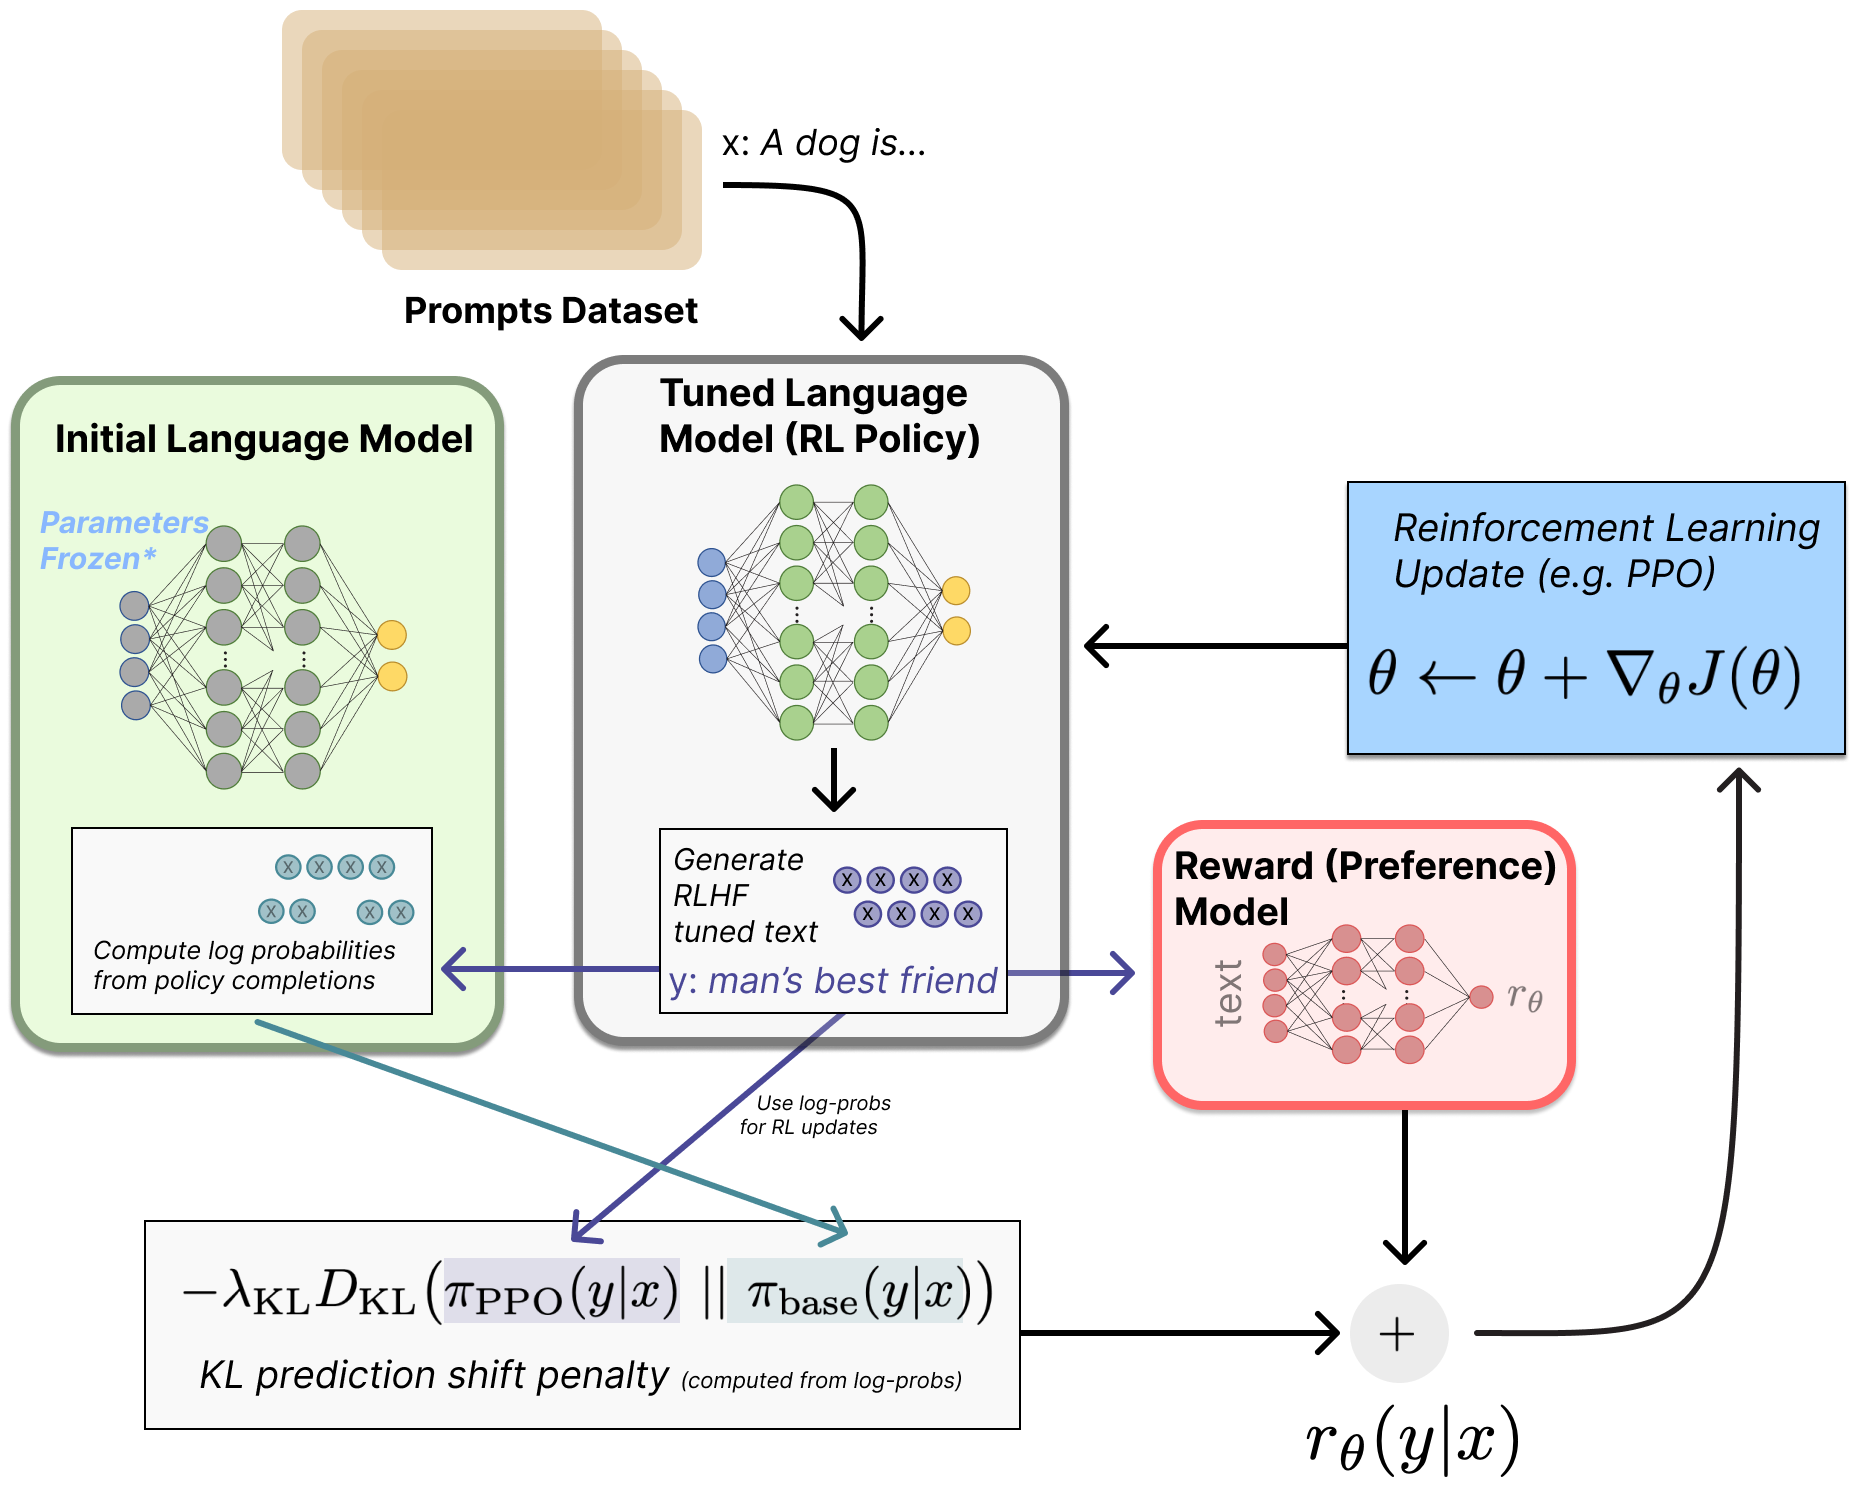
RLVR 也有正则化,但最佳实践不同
把奖励模型换成可验证的检查函数(数学答案对不对、代码单测过不过),RL 循环本身一模一样,但正则化的实践发生了明显分化。推理模型(在工具使用普及之前)常常直接把 KL 惩罚删掉——因为可验证奖励是不可 hack 的(答案对就是对),过优化的压力小得多,而 KL 惩罚会实打实地拖慢学习速度、压低最终分数。你会在开源 RLVR 配方里反复看到 beta: 0.0。
但随着大规模工具使用的到来,正则化又回来了——只是瞄准的东西变了:不再是「离参考模型的漂移」,而是「离采样分布的漂移」。这是本章第 9 节的主题。
2. KL 惩罚的机制:方向、采样、逐 token 展开
定义与两个方向
离散分布上的 KL 散度定义为
$$ \mathcal{D}_{\text{KL}}(P \Vert Q) = \sum_{z \in \mathcal{Z}} P(z) \log\frac{P(z)}{Q(z)} $$这里 $z$ 是样本空间 $\mathcal{Z}$ 上的一个通用随机变量(不是 prompt——这是原文特意提醒的一处符号复用)。在 RLHF 里,两个分布分别是当前策略和参考策略。谁放左边、谁放右边,是一个有实质后果的选择。
| 反向 KL(RLHF 的标准选择) | 前向 KL | |
|---|---|---|
| 写法 | $\mathcal{D}_{\text{KL}}(\pi_\theta \Vert \pi_{\text{ref}})$ | $\mathcal{D}_{\text{KL}}(\pi_{\text{ref}} \Vert \pi_\theta)$ |
| 从谁采样 | 从正在训练的策略 $\pi_\theta$ 采样 | 从参考模型(或数据集)采样 |
| 惩罚什么 | 新模型在参考模型认为不可能的地方放了概率质量 | 新模型在参考模型认为很可能的地方没有放概率质量 |
| 行为倾向 | mode-seeking(聚焦) | mass-covering(覆盖) |
| 典型用途 | RLHF 的 KL 惩罚、on-policy 蒸馏 | 蒸馏 / 行为克隆 / SFT、部分 RL 算法内部的信赖域计算 |
选反向 KL 的工程理由非常朴素:你手上现成就有从 $\pi_\theta$ 采出来的样本。RL 的每一步本来就要生成 rollout,这些 rollout 就是从 $\pi_\theta$ 采的。要算前向 KL,你得额外从参考模型采一批样本,等于每步多跑一次生成,代价直接翻倍。反向 KL 让 KL 惩罚变成一次几乎免费的搭车。
行为上的理由同样重要:过优化的失败模式是「模型跑进了参考模型的低概率区」,而反向 KL 正好在这种情况下爆炸——$\pi_\theta(y)$ 大而 $\pi_{\text{ref}}(y)$ 接近 0,$\log \frac{\pi_\theta}{\pi_{\text{ref}}}$ 巨大,惩罚项立刻把它拉回来。前向 KL 在这种情况下反而看不见问题(因为它按 $\pi_{\text{ref}}$ 的质量加权,而参考模型在那个乱码区的质量本来就是 0)。
从求和到期望:蒙特卡洛形式
定义式里的求和是对整个样本空间做的。对语言模型来说,$\mathcal{Z}$ 是所有可能的 completion 的集合——大小是 $|V|^T$,天文数字,不可能枚举。但只要你能从 $P$ 采样,求和就可以变期望:
$$ \mathcal{D}_{\text{KL}}(P \Vert Q) = \E_{z\sim P}\big[\log P(z) - \log Q(z)\big] $$这一步是整个实现的关键。它把一个需要枚举词表的量,变成了「拿采出来的那个序列,在两个模型下各算一遍 log 概率,相减」。而 log 概率本来就是语言模型训练里到处都是的东西——你算交叉熵损失时算的就是它。
把 $P = \pi_\theta$、$Q = \pi_{\text{ref}}$ 代入。对一条完整的 completion $y = (y_1, \dots, y_T)$,自回归模型给出
$$ \log \pi_\theta(y \mid x) = \sum_{t=1}^{T} \log \pi_\theta(y_t \mid x, y_{<t}) $$所以序列级的 log 比值就是逐 token log 比值的和:
$$ \log\frac{\pi_\theta(y\mid x)}{\pi_{\text{ref}}(y\mid x)} = \sum_{t=1}^{T}\Big[\log \pi_\theta(y_t \mid x, y_{<t}) - \log \pi_{\text{ref}}(y_t \mid x, y_{<t})\Big] $$用一条采样序列估计整个 KL,就是取上式作为 $\mathcal{D}_{\text{KL}}$ 的一次单样本估计。它是无偏的——期望等于真值——但方差不小,因为单条序列的 log 比值可正可负、量级随长度线性增长。第 3 节要讲的 $k_2/k_3$ 就是在解决这个方差问题。
注意 shape:如果 batch 是 $B$ 条序列、每条最多 $T$ 个 token,那么 logprobs 和 ref_logprobs 都是 $(B, T)$ 的张量(已经 gather 过、只保留实际生成的那个 token 的 log 概率),而不是 $(B, T, |V|)$。这是 KL 惩罚在显存上还算便宜的原因之一。
参考实现
下面这段是把原文的实现示例展开并加了注释的版本。注意 generate 和 forward 的分工:前者自回归地逐 token 采样出序列,后者对已有序列做一次并行前向拿到每个位置的 logits——不采样,只打分。
# --- Step 1: 从当前策略采样一条完整序列(自回归,慢)
generated_tokens = model.generate(inputs)          # (B, T_prompt + T_gen)

# --- Step 2: 对同一序列各跑一次前向(并行,快)
#   注意切掉最后一个 token:位置 t 的 logits 预测的是位置 t+1 的 token
logits     = model.forward(generated_tokens[:, :-1]).logits      # (B, L-1, |V|)
ref_logits = ref_model.forward(generated_tokens[:, :-1]).logits  # (B, L-1, |V|)

# --- Step 3: logits -> log 概率(在词表维度上做 log_softmax)
logprobs     = F.log_softmax(logits,     dim=-1)   # (B, L-1, |V|)
ref_logprobs = F.log_softmax(ref_logits, dim=-1)

# --- Step 4: 只取「实际生成的那个 token」的 log 概率
targets = generated_tokens[:, 1:].unsqueeze(-1)                  # (B, L-1, 1)
token_logprobs     = logprobs.gather(-1,     targets).squeeze(-1)  # (B, L-1)
ref_token_logprobs = ref_logprobs.gather(-1, targets).squeeze(-1)  # (B, L-1)

# --- Step 5: 序列级 log 概率之差 = KL 的单样本估计(即后面的 k1)
seq_logprob     = token_logprobs.sum(dim=-1)       # (B,)
ref_seq_logprob = ref_token_logprobs.sum(dim=-1)   # (B,)
kl_approx = seq_logprob - ref_seq_logprob          # (B,)

# 对比:F.kl_div 算的是「对整个词表求和」的精确 KL,不是采样估计
kl_full = F.kl_div(ref_logprobs, logprobs, reduction='batchmean')最后两行的对比值得强调。kl_approx 只用了实际采出来的那条路径;kl_full 在每个位置上对整个词表求和,算的是逐 token 的精确 KL。后者更准,但要保留 $(B, L, |V|)$ 的完整 log 概率张量——在 $|V| \approx 1.5\times10^5$、$L \approx 4096$ 的现代设置下,光这一个中间量就是几十 GB,通常不可行。所以生产实现几乎清一色用采样估计。
一段被遗忘的前史
KL 控制不是 LLM 时代的发明。早在 2017 年,Sequence Tutor(Jaques et al., 2017)就把「用 KL 约束把 RL 微调拴在预训练的序列模型上」用在了音乐生成上;2020 年的 Human-centric Dialog Training via Offline RL(Jaques et al., 2020)把它带到了对话智能体。这些工作比 InstructGPT 早了好几年,核心动机一模一样:预训练模型的语言能力是宝贵的,RL 微调很容易把它毁掉,所以给它套一根皮带。
3. 三种 KL 估计器:k1 / k2 / k3
上一节最后那个 kl_approx = seq_logprob - ref_seq_logprob 能用,但它是三个可选估计器里最差的那个。这一节讲清楚为什么,以及为什么现在的开源实现清一色默认第三个。这套东西出自 John Schulman 的一篇短博客(Approximating KL Divergence),是任何要动 KL 惩罚的人都该读一遍的行业常识。
统一记号
沿用 Schulman 的写法:我们要估计 $\mathcal{D}_{\text{KL}}(p \Vert q)$,样本从 $p$ 采出来。定义比值
$$ \rho \;=\; \frac{q(z)}{p(z)}, \qquad z \sim p $$在 RLHF 的语境下,$p = \pi_\theta$(我们采样的策略),$q = \pi_{\text{ref}}$(参考模型),所以
$$ \log \rho \;=\; \log \pi_{\text{ref}}(y_t\mid \cdot) - \log \pi_\theta(y_t\mid \cdot) $$这是一个逐 token 的标量,shape 为 $(B, T)$。三个估计器都是 $\log\rho$ 的函数:
$$ k_1 = -\log \rho, \qquad k_2 = \tfrac{1}{2}(\log \rho)^2, \qquad k_3 = (\rho - 1) - \log \rho $$各自的性质
$k_1 = -\log\rho$。这就是上一节代码里的 seq_logprob - ref_seq_logprob。它无偏——按定义 $\E_{z\sim p}[-\log\rho] = \E_p[\log\frac{p}{q}] = \mathcal{D}_{\text{KL}}(p\Vert q)$,一行就完事。缺点有两个:方差极大,以及单样本可以是负数。后者尤其烦人:KL 在数学上恒非负,但你的 $k_1$ 估计值在某个 token 上完全可能是 $-0.4$,因为策略在那个 token 上恰好比参考模型更不自信。一个可能为负的「惩罚项」意味着优化器有时会因为「离参考模型更远」而获得奖励,这在梯度上是纯噪声。
$k_2 = \tfrac{1}{2}(\log\rho)^2$。平方保证了恒非负,而且平方项对小偏差不敏感、对大偏差敏感——方差小很多。代价是有偏。它的来历是:$\mathcal{D}_{\text{KL}}$ 在两个分布接近时的二阶近似正好是 $\tfrac12 \E[(\log\rho)^2]$(Fisher 信息度规),所以当模型没跑远时它非常准,跑远了就开始偏。
$k_3 = (\rho - 1) - \log\rho$。这个是「两全其美」的那个。
无偏性:关键在于 $\E_{z\sim p}[\rho] = \E_{z\sim p}\!\left[\frac{q(z)}{p(z)}\right] = \sum_z p(z)\frac{q(z)}{p(z)} = \sum_z q(z) = 1$。所以
$$ \E_p[k_3] = \underbrace{\E_p[\rho - 1]}_{= 1 - 1 = 0} + \E_p[-\log\rho] = \mathcal{D}_{\text{KL}}(p\Vert q) $$也就是说,$k_3$ 就是 $k_1$ 加上了一个期望为零的控制变量(control variate)$\rho - 1$。这是方差缩减的标准技巧:加一个不改变期望、但与被估量负相关的项,把噪声抵消掉。
非负性:对任意 $\rho > 0$ 都有 $\log \rho \le \rho - 1$($\log$ 是凹函数,$y = \rho - 1$ 是它在 $\rho=1$ 处的切线)。移项即得 $k_3 = (\rho-1) - \log\rho \ge 0$,等号仅在 $\rho = 1$ 时成立。所以 $k_3$ 逐 token 都非负,不只是期望非负。
一个具体的数值对比
拿两个 5 元词表上的分布做例子:策略 $p = (0.40, 0.25, 0.20, 0.10, 0.05)$,参考 $q = (0.30, 0.30, 0.20, 0.15, 0.05)$。真值 $\mathcal{D}_{\text{KL}}(p\Vert q) = 0.02895$。因为支撑集有限,三个估计器的期望和标准差可以精确算出来:
| 估计器 | 期望 | 偏差 | 标准差 | 标准差 / 真值 | 单样本最小值 |
|---|---|---|---|---|---|
| $k_1 = -\log\rho$ | 0.028946 | 0(无偏) | 0.2388 | 8.25 | $-0.405$ |
| $k_2 = \tfrac12(\log\rho)^2$ | 0.028927 | $-1.8\times10^{-5}$ | 0.0244 | 0.84 | $0$ |
| $k_3 = (\rho-1)-\log\rho$ | 0.028946 | 0(无偏) | 0.0265 | 0.92 | $0$ |
这张表把结论摆得很清楚:$k_1$ 的单样本噪声是真值的 8 倍多——你要平均几百个样本才能把这个数字看清楚,而且中间会出现负值。$k_2$ 和 $k_3$ 的噪声都降到了真值量级以下,差了将近一个数量级。$k_2$ 有一点点偏(这里只有 0.06%,两个分布很近时确实可以忽略),$k_3$ 干脆连偏都没有。所以选 $k_3$ 是几乎没有代价的免费午餐。
参考实现
下面改写自 _src/code/policy_gradients/loss.py。原文件把 log_ratio 定义为 $\log\pi_\theta - \log\pi_{\text{ref}}$(也就是 $-\log\rho$),这里为了和上面的推导对齐,显式写成 Schulman 记号:
import torch

def approx_kl(logp, logp_ref, mask, estimator="k3"):
    """逐 token 的 KL(pi_theta || pi_ref) 估计。
    logp, logp_ref: (B, T)  实际生成 token 在两个模型下的 log 概率
    mask:           (B, T)  1 = 该位置是模型生成的 token,0 = prompt / padding
    返回:           (B, T)
    改写自 _src/code/policy_gradients/loss.py 的 approx_kl1/2/3
    """
    # Schulman 记号: log_rho = log q - log p = log pi_ref - log pi_theta
    log_rho = logp_ref - logp

    if estimator == "k1":                       # 无偏,高方差,可为负
        kl = -log_rho
    elif estimator == "k2":                     # 有偏,低方差,恒 >= 0
        kl = 0.5 * log_rho.pow(2)
    elif estimator == "k3":                     # 无偏 + 恒 >= 0(默认)
        kl = log_rho.exp() - 1 - log_rho
    else:
        raise ValueError(estimator)

    return kl * mask


def masked_mean(t, mask, dim=-1, eps=1e-8):
    """只在 mask=1 的位置上求平均(照抄 loss.py)"""
return (t * mask).sum(dim) / mask.sum(dim).clamp_min(eps)这是 KL 惩罚实现里最高频的 bug,而且它不会崩,只会让训练悄悄变坏。因为 $\log\rho$ 和 $-\log\rho$ 都是形状相同的张量,代码跑得通,loss 有数,只是符号反了——本该把模型拉回参考模型的项,变成了推着模型往外跑。
两条几乎零成本的自检:
- $k_3$ 必须逐元素非负。加一行
assert (kl >= -1e-6).all(),符号反了立刻炸。 - 训练开始时 KL 必须≈0 然后单调爬升。第 0 步 $\pi_\theta$ 和 $\pi_{\text{ref}}$ 是同一份权重,KL 应该精确是 0(浮点误差量级)。如果它一开始就不是 0,说明你的 policy 和 ref 的前向路径不一致(chat template、attention mask、dtype、或者 dropout 忘了关)。如果它是负的并且越来越负,符号反了。
另外注意 $k_3$ 里有个 exp。当策略和参考模型差得很远时 $\log\rho$ 可能是很大的正数,exp 会溢出。在长序列 + 无 KL 约束跑飞的场景下,你会先看到 KL 变成 inf 再看到 loss 变 nan。这其实是个有用的警报器。
序列级还是 token 级?
还有一个容易忽略的自由度:算完逐 token 的 $k$ 之后,怎么聚合。三种常见做法——
- 逐 token 求和($\sum_t k_t$):得到序列级的 KL,量纲上和「整条 completion 的 log 概率差」一致。长回复的 KL 天然更大,所以它隐含地惩罚长度。
- 逐 token 求均值(
masked_mean,loss.py 的做法):每条序列贡献相同权重,与长度解耦。 - 全 batch token 级均值(先求和再除以 batch 内总 token 数,DAPO 风格):长序列的每个 token 权重相同。
这三种选择会改变 $\beta$ 的有效量级,差异可以到几十倍。所以跨代码库照抄 $\beta$ 是没有意义的——必须先确认对方的聚合方式和你一样。这也是下一节要展开的话题之一。
4. 加在奖励里,还是加在损失里?
这是一个在论文里几乎从不明说、但在代码里必须二选一的问题。原始公式写的是 $r = r_\theta - \beta\,\mathcal{D}_{\text{KL}}$——KL 被减在奖励上。但打开 2025 年之后的任何一个 GRPO 实现,你会看到 KL 是作为损失的一项直接加上去的。这两者不等价。
写法 A:把 KL 塞进奖励
这是 InstructGPT / 经典 PPO-RLHF 的做法。每个 token 位置 $t$ 都有一个奖励:
$$ \tilde r_t = \underbrace{\mathbb{1}[t = T]\cdot r_\theta(x, y)}_{\text{只在最后一个 token 给}} \;-\; \beta\, k_t $$其中 $k_t$ 是第 3 节那个逐 token 的 KL 估计。注意奖励模型只在序列结束时给一个标量分数(稀疏奖励),而 KL 惩罚是逐 token 稠密的。这个 $\tilde r_t$ 序列随后被送进 GAE 算优势:
$$ \hat A_t = \sum_{l=0}^{T-t-1}(\gamma\lambda_{\text{GAE}})^{l}\,\delta_{t+l},\qquad \delta_t = \tilde r_t + \gamma V(s_{t+1}) - V(s_t) $$KL 惩罚在这里的效果是会向前传播的:位置 $t$ 上的一次大 KL,通过 GAE 的折扣求和,会压低 $t$ 之前所有位置的优势。直觉上这是对的——「你在第 300 个 token 上写出了参考模型绝不会说的话」这件事,应该让导致它的前 299 个 token 也一起负责。
写法 B:把 KL 加进损失
这是 GRPO 及其后继者的做法,也是 _src/code/policy_gradients/loss.py 里的写法:
# 摘自 _src/code/policy_gradients/loss.py 的 GRPOLoss.forward
ratio = (log_probs - experience.log_probs_old).exp()
unclipped = ratio * experience.advantages
clipped   = ratio.clamp(1 - clip_eps_lo, 1 + clip_eps_hi) * experience.advantages
policy_loss = -torch.min(unclipped, clipped)

if self.beta:                                   # beta = 0 时整块跳过
    kl_loss = get_approx_kl(self.kl_estimator, log_probs,
                            experience.log_probs_ref, experience.action_mask)
else:
    kl_loss = torch.tensor(0.0, device=log_probs.device)

loss = policy_loss + self.beta * kl_loss
loss = masked_mean(loss, mask=experience.action_mask, dim=-1).mean(dim=0)
这里的 advantages 是纯任务奖励算出来的(GRPO 里是组内标准化的奖励),KL 完全不参与优势计算,只是在最后作为一个独立的正则项加到损失上。
写法 B 的 KL 项对参数的梯度是直接的:
$$ \nabla_\theta\,\beta\,\E\big[k_3\big] = \beta\,\E_{y\sim\pi_\theta}\Big[\big(1 - \rho\big)\,\nabla_\theta \log \pi_\theta(y_t\mid\cdot)\Big]\Big|_{\rho = \pi_{\text{ref}}/\pi_\theta} $$(用 $\nabla_\theta \log\rho = -\nabla_\theta\log\pi_\theta$ 和链式法则;$\rho$ 本身也依赖 $\theta$。)这是一个只作用在当前 token 的力:$\rho < 1$(策略比参考更自信)时系数为正,损失上升,把该 token 的概率压回去。
写法 A 的 KL 项经过 GAE 之后,梯度里带上了 $\gamma\lambda_{\text{GAE}}$ 的折扣求和,还要穿过 value function 的估计误差。它作用在整条前缀上,但也因此继承了 value function 的所有噪声。
还有一个微妙但重要的差别:写法 A 里 KL 惩罚被 PPO 的 clip 保护着(因为它进了优势,而优势要乘 clip 过的 ratio);写法 B 里 KL 项不受 clip 约束,是一个每步都足额生效的力。这让写法 B 的 $\beta$ 在数值上更「实在」,也更好调。
该选哪个
| A:加在奖励里 | B:加在损失里 | |
|---|---|---|
| 典型算法 | PPO-RLHF(InstructGPT、TRL 早期 PPOTrainer) | GRPO、GSPO、CISPO、SAPO、RLOO(open-instruct、大多数现代库) |
| 需要 value function | 是(KL 要经过 GAE) | 否 |
| 惩罚的作用范围 | 向前传播到整条前缀 | 只作用在产生偏差的那个 token |
| 是否被 clip 保护 | 是 | 否 |
| $\beta$ 的可解释性 | 差(被 GAE 和 value 缩放搅在一起) | 好(直接是「1 nat 的 KL 值多少 loss」) |
| 关掉的代价 | 要改奖励拼装逻辑 | 一行 beta = 0,连参考模型的前向都省了 |
现代实现倒向 B 有两个原因。一是 GRPO 这一系根本没有 value function,写法 A 的载体消失了。二是 B 让 $\beta = 0$ 变成一个真正免费的开关——注意上面代码里 if self.beta: 那个判断,$\beta = 0$ 时连 get_approx_kl 都不调用。再往上一层,如果整个配方都不用 KL,你可以直接不加载参考模型,省下一整份权重的显存和每步一次的前向。对 70B+ 的模型来说这不是小钱。
两个常见优化:(1) 参考模型是冻结的,所以
ref_logprobs 可以在 rollout 阶段一次性算完存进 buffer(loss.py 里的 experience.log_probs_ref 就是这么来的),而不是在每个 PPO inner epoch 里重算;(2) 如果 rollout 引擎(vLLM/SGLang)和参考模型是同一份权重,理论上可以复用采样时顺带返回的 logprob——但要小心,推理引擎和训练框架的 logprob 常常对不齐(不同的 kernel、不同的数值精度),这个不一致本身就是第 10 节的主题。
5. 系数 β 怎么定:从反馈控制器回到常数
一开始它不是常数
把 LLM 拉进 RLHF 的第一篇论文(Fine-Tuning Language Models from Human Preferences, Ziegler et al., 2019)并没有固定 $\beta$。它做的事情更有工程味道:先定一个目标 KL($\text{KL}_{\text{target}}$),然后用一个反馈控制器去追这个目标。
$$ e_t = \operatorname{clip}\!\left(\frac{\mathcal{D}_{\text{KL}}(\pi_t, \pi_{\text{ref}}) - \text{KL}_{\text{target}}}{\text{KL}_{\text{target}}},\; -0.2,\; 0.2\right), \qquad \beta_{t+1} = \beta_t\big(1 + K_\beta\, e_t\big) $$逐项拆解:
- $e_t$ 是相对误差——当前 KL 超出目标的比例。用相对量而不是绝对量,是为了让控制器在不同 KL 量级下行为一致。
clip到 $\pm 0.2$:单步最多认为「超了 20%」或「低了 20%」,防止某一步的 KL 尖峰把 $\beta$ 直接打飞。- $\beta$ 的更新是乘性的($\beta \leftarrow \beta(1 + K_\beta e)$),作者称之为「对数空间的比例控制器」。乘性更新的好处是 $\beta$ 恒为正,且在数量级之间平滑移动——$\beta$ 从 0.01 调到 0.1 和从 1 调到 10 是同一件事。
- $K_\beta = 0.1$ 是增益。KL 超标 20%($e = 0.2$),$\beta$ 单步涨 2%。这是一个刻意调得很慢的控制器——它要跟踪的是趋势,不是噪声。
这个设计的实际价值在讲座里被点了出来:不同随机种子的 run 会落在同一个 KL 预算上,实验因此可比。这是一个被严重低估的好处。如果你固定 $\beta$,不同 seed / 不同数据混合的 run 会跑出完全不同的 KL 距离,你根本不知道 A 比 B 好是因为方法好还是因为它单纯跑得更远。固定 KL 预算之后,比较才有意义。
这个想法比 RLHF 老:PPO 原论文本身就有一个自适应 KL 惩罚的变体(KL 超过目标 1.5 倍就把 $\beta$ 翻倍,低于目标 1.5 分之一就减半);受约束 RL 领域后来把这个框架讲得更明确,直接上了 PID 控制器(Responsive Safety in RL by PID Lagrangian Methods, Stooke et al., 2020)——比例项管当前误差,积分项消除稳态偏差,微分项抑制超调。这不是巧合:「在满足约束的前提下最大化奖励」是拉格朗日对偶问题,而 $\beta$ 就是那个拉格朗日乘子,乘子的更新天然是一个控制问题。
现代实践:静态小 $\beta$,或者干脆是 0
钟摆又摆了回来。TRL 的 AdaptiveKLController 在现代重写里被删掉了;open-instruct 今天用的是一个静态的 beta = 0.05,直接加在损失里(第 4 节的写法 B)。而在大量 RLVR 推理配方里,$\beta$ 干脆是 0——本仓库 _src/code/policy_gradients/configs/ 下的 GRPO、GSPO、CISPO、SAPO、DAPO、RLOO 配置全部默认 beta: 0.0。
为什么会这样?
- 可验证奖励难以 hack。数学答案对就是对,代码单测过就是过。过优化的压力从「奖励模型被骗」变成了「格式坍缩 / 语言漂移」,而这类问题用别的手段(格式奖励、语言一致性检查、长度惩罚)更直接。
- KL 惩罚要花钱买。它拖慢学习,压低最终分数。当过优化不是主要矛盾时,这笔钱就白花了。
- 自适应控制器多了两个超参($\text{KL}_{\text{target}}$ 和 $K_\beta$),而且引入了训练动力学上的耦合。当大家发现「静态小 $\beta$ 已经够用」之后,简化就发生了。
另一个真实的取舍来自 TMax(终端 agent 配方):团队实测发现一个小的 KL 能减轻坍缩的严重程度,但会降低奖励——最终配方选了 $\beta = 0$。这句话值得反复读:正则化不是免费的,它是一笔在「稳定性」和「性能」之间的交易,而交易是否划算取决于你的失败模式有多致命。
数量级速查
| 场景 | 典型 $\beta$ | 备注 |
|---|---|---|
| PPO-RLHF(奖励模型,2022–2024 配方) | 目标 KL 驱动的动态 $\beta$,或 0.01–0.1 量级的静态值 | KL 加在奖励里;控制器 $K_\beta = 0.1$,误差 clip $\pm0.2$ |
| GRPO / open-instruct(有 KL 时) | 0.05 | 静态,加在损失里,$k_3$ 估计器 |
| RLVR 推理配方 | 0.0 | 大多数现代开源配置的默认值 |
| Agentic / 工具使用配方(2026) | 0.0,且常常连参考模型都不加载 | 约束改到采样分布上,见第 10 节 |
| DPO 系(第 8 章) | 0.01–0.1 | 完全是另一回事,见下方警告 |
调 $\beta$ 的实操流程
如果你确实需要一个非零的 $\beta$,一个可操作的做法是:
- 先跑 $\beta = 0$,把 KL 曲线记下来。你需要知道「不加约束时这个任务会跑多远」这个基线。
- 确定你的 KL 预算。看 $\beta = 0$ 那条 run 在什么 KL 值附近开始出现质量退化(读 rollout 样本,别只看奖励),把这个值的一半左右定为目标。
- 用「KL 项占 loss 的比例」反推 $\beta$。希望 KL 惩罚在训练中期贡献大约 5–20% 的总损失量级。已知目标 KL 和 policy loss 的量级,$\beta$ 就基本被定死了,不需要网格搜索一个数量级。
- 确认聚合方式。第 3 节末尾提过:序列级求和 vs token 级均值,会让同一个 $\beta$ 的有效强度差几十倍。从别的代码库抄 $\beta$ 之前,先对齐这一点。
6. 参考模型:选谁、要不要更新、代价是多少
KL 惩罚里有两个自由度,$\beta$ 只是其中一个。另一个是 $\pi_{\text{ref}}$ 本身——它在论文里通常被一句「the SFT checkpoint」带过,但这个选择实际影响很大。
参考模型在约束什么
原文给的直觉很朴素:你正在训练的这个模型有一种「风格」,而你希望留在那种风格附近。注意这句话里的「风格」不是修辞——参考模型约束的确实主要是分布层面的东西:句长、句式、markdown 使用习惯、拒答倾向、语言选择、特殊 token 的使用频率。它不太约束「知识对不对」(那是奖励信号的活儿),但它非常有效地约束「话说得像不像人话」。
这解释了参考模型选谁的第一原则:选那个你满意其行为分布的 checkpoint。
| 参考模型选择 | 什么时候用 | 后果 |
|---|---|---|
| SFT checkpoint(最常见) | 标准 RLHF:SFT → RM → RL | 约束模型保持 SFT 建立的对话格式与语气。$\pi_{\text{ref}} = \pi_{\text{init}}$,训练第 0 步 KL 精确为 0 |
| 上一轮 RL checkpoint | 多轮迭代式 RLHF(收集新偏好数据 → 再训一轮) | 每轮只约束「相对上一轮别跑太远」,允许总体漂移累积到很远。这是让模型在多轮里持续进步的必要条件 |
| base(预训练)模型 | R1-Zero 风格,直接对 base 做 RLVR | 约束极弱(base 模型的分布很宽),实践中这类配方多半直接把 $\beta$ 设成 0 |
| 不设参考模型 | $\beta = 0$ 的 RLVR / agentic 配方 | 省一份权重和每步一次前向;靠隐式正则化(第 8 节)和采样分布约束(第 10 节)兜底 |
静态 vs 移动的参考模型
标准做法是冻结:$\pi_{\text{ref}}$ 从头到尾是同一份权重。这带来一个必然的动力学——随着训练进行,KL 单调(或近似单调)增长,惩罚项越来越大,最终把奖励的增益抵消掉,训练自然停在某个平衡点。这个平衡点就是你的 KL 预算。
另一种做法是周期性更新参考模型:每 $N$ 步把当前策略拷贝成新的 $\pi_{\text{ref}}$。这时 KL 惩罚变成了一个「信赖域」——它只约束每段区间内的变化速度,不约束总位移。
假设参考模型每 $N$ 步刷新一次,每段内策略移动了 $\epsilon$ 的 KL。经过 $M$ 段之后,总位移不是 $M\epsilon$——KL 不满足三角不等式,无法这样累加。但有一个直觉上正确的图景:静态参考模型给的是一个以起点为球心的球,模型被困在球内;移动参考模型给的是每步步长的上限,模型可以沿着任意路径走到任意远,只是不能瞬移。
这两种约束对付的是不同的失败模式。静态球对付的是「模型总体上离人类语言太远了」;步长上限对付的是「单次更新太大导致优化崩掉」。PPO 的 clip 本质上属于后者(它约束的是 $\pi_\theta$ 与 rollout 时的 $\pi_{\text{old}}$ 的比值,而 $\pi_{\text{old}}$ 每个 batch 都在移动)。
所以一个完整的现代 RL 训练里其实同时有两层约束:clip / trust region 管步长(永远开着),KL-to-ref 管总位移(可以关掉)。把它们混为一谈是常见的理解错误。
参考模型的工程细节
几个在实现时必须处理的点:
- ref logprob 在 rollout 阶段就算好。参考模型是冻结的,同一批数据的
ref_logprobs不会变。所以标准做法是在生成完 rollout、构造Experiencebuffer 时就把它算完存进去(loss.py里experience.log_probs_ref的来源),而不是在每个 inner epoch 的 loss 计算里重复前向。PPO 类算法一批数据要走 2–4 个 inner epoch,这一优化能省下 2–4 倍的参考模型算力。 - dropout 必须关。参考模型永远是
eval()模式。策略模型在训练时如果开着 dropout,同一个序列在 policy 和 ref 下的 logprob 会有随机差异,直接污染 KL。现代 LLM 训练一般不开 dropout,但混合精度、attention kernel 的选择(FlashAttention vs SDPA)同样会引入不一致——第 0 步 KL 不为 0 就是这个问题的体检指标。 - 参考模型可以放在别的设备 / 用低精度。它不需要梯度和优化器状态,只需要一次前向。常见做法包括:把它 offload 到 CPU 分片、和 rollout 引擎共用一份权重、或者用 int8/fp8 加载。用低精度要谨慎——KL 是两个大数相减得到的小数,参考模型的精度损失会被放大。
- LoRA 的特殊便利。如果策略是在参考模型上加 LoRA 训的,那么「参考模型」就是关掉 adapter 的同一个模型。不需要第二份权重,只需要两次前向(一次开 adapter、一次关)。这是显存受限时非常实用的技巧。
DPO 系里的参考模型
直接对齐算法(Direct Alignment Algorithms, DAA)也要参考模型,但它出现在损失函数的定义里而不是作为一个可加的惩罚项:
$$ \mathcal{L}_{\text{DPO}} = -\log\sigma\!\left(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\text{ref}}(y_w\mid x)} - \beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\text{ref}}(y_l\mid x)}\right) $$因为 DPO 是完全 off-policy 的(数据是固定的偏好对),$\pi_{\text{ref}}$ 在这些数据上的 logprob 可以在训练开始前一次性预计算并缓存,训练时连参考模型都不用加载。这是 DPO 相比 PPO 在工程上便宜得多的原因之一。
7. 优化的形状:RL 是反向 KL,SFT 是前向 KL
前面六节讲的都是你主动加上去的惩罚:一个带系数的项,可以调大调小,可以关掉。这一节讲的是另一件事——优化器本身的形状。事实证明,SFT 和 RL 这两个我们天天用的目标函数,在数学上恰好就是 KL 散度的两个方向。而「方向」这件事,完全由样本从哪来决定。
SFT 就是前向 KL
设数据分布为 $\pi_\star$(在 SFT 语境下就是训练集里那些人写/模型写的 completion 的分布),我们训练的策略是 $\pi_\theta$。前向 KL 的定义是:
$$ \mathcal{D}_{\text{KL}}(\pi_\star \Vert \pi_\theta) = \E_{(x,y)\sim\mathcal{D}}\big[\log\pi_\star(y\mid x) - \log\pi_\theta(y\mid x)\big] $$把期望拆成两项:
$$ = \underbrace{\E_{(x,y)\sim\mathcal{D}}\big[\log\pi_\star(y\mid x)\big]}_{=\,-H(\pi_\star),\ \text{与}\ \theta\ \text{无关}} \;-\; \E_{(x,y)\sim\mathcal{D}}\big[\log\pi_\theta(y\mid x)\big] $$第一项只依赖数据分布,是它的负熵,对 $\theta$ 是常数。第二项加个负号就是负对数似然,也就是标准的 SFT 交叉熵损失。于是
$$ \mathcal{D}_{\text{KL}}(\pi_\star \Vert \pi_\theta) = \underbrace{-H(\pi_\star)}_{\text{const}} + \mathcal{L}_{\text{SFT}}(\theta) \;\propto\; \mathcal{L}_{\text{SFT}}(\theta) $$常数不影响梯度也不影响最小值点,所以最小化 SFT 损失,字面意义上就是最小化到数据分布的前向 KL。这不是类比,是恒等式。
带惩罚的 RL 就是反向 KL
从我们的 RL 训练器实际优化的那个目标出发:
$$ \max_\pi\; \mathcal{J}_{\text{RL}}(\theta) = \E_{x\sim\mathcal{D},\, y\sim\pi(\cdot\mid x)}\big[r(x,y)\big] - \beta\,\mathcal{D}_{\text{KL}}\big(\pi(\cdot\mid x)\,\Vert\,\pi_{\text{ref}}(\cdot\mid x)\big) $$除以 $-\beta$ 把最大化变成最小化,并把两项并进一个期望:
$$ = \min_\pi\; \E_{x\sim\mathcal{D},\, y\sim\pi(\cdot\mid x)}\left[\log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)} - \frac{1}{\beta}r(x,y)\right] $$引入配分函数 $Z(x) = \sum_y \pi_{\text{ref}}(y\mid x)\exp\!\big(\tfrac{1}{\beta}r(x,y)\big)$,加一项减一项 $\log Z(x)$,括号里的东西就变成了一个完整的 KL:
$$ = \min_\pi\; \E_{x\sim\mathcal{D}}\left[\mathcal{D}_{\text{KL}}\!\left(\pi(\cdot\mid x)\;\middle\Vert\;\tfrac{1}{Z(x)}\pi_{\text{ref}}(\cdot\mid x)\exp\!\big(\tfrac{1}{\beta}r(x,y)\big)\right) - \log Z(x)\right] $$$\log Z(x)$ 不依赖 $\pi$,而 KL 非负且仅在两分布相等时为零。所以最优策略有闭式解:
$$ \pi_\star(y\mid x) = \frac{1}{Z(x)}\,\pi_{\text{ref}}(y\mid x)\,\exp\!\left(\frac{1}{\beta}r(x,y)\right) $$这个式子读者应该已经见过:它就是第 8 章 DPO 推导的起点。DPO 做的事情是把它反解成 $r = \beta\log\frac{\pi_\star}{\pi_{\text{ref}}} + \beta\log Z(x)$,然后代进 Bradley-Terry 损失里让 $Z(x)$ 消掉。同一个式子,两种用法。
把 $\log\pi_\star(y\mid x) = \log\pi_{\text{ref}}(y\mid x) - \log Z(x) + \tfrac{1}{\beta}r(x,y)$ 代进 $\mathcal{D}_{\text{KL}}(\pi_\theta\Vert\pi_\star)$:
$$ \begin{aligned} \mathcal{D}_{\text{KL}}(\pi_\theta \Vert \pi_\star) &= \E_{x\sim\mathcal{D},\,y\sim\pi_\theta}\big[\log\pi_\theta(y\mid x) - \log\pi_\star(y\mid x)\big] \\[2pt] &= \E_{x,\,y\sim\pi_\theta}\Big[\log\pi_\theta - \log\pi_{\text{ref}} + \log Z(x) - \tfrac{1}{\beta}r(x,y)\Big] \\[2pt] &= -\tfrac{1}{\beta}\E_{x,y}\big[r(x,y)\big] + \mathcal{D}_{\text{KL}}\big(\pi_\theta \Vert \pi_{\text{ref}}\big) + \underbrace{\log Z(x)}_{\text{const}} \\[2pt] &\propto -\tfrac{1}{\beta}\,\mathcal{J}_{\text{RL}}(\theta) \end{aligned} $$于是
$$ \boxed{\;\max_\theta\,\mathcal{J}_{\text{RL}}(\theta) \iff \min_\theta\,\mathcal{D}_{\text{KL}}(\pi_\theta\Vert\pi_\star)\;} $$注意这个结论的强度:带 KL 惩罚的 RL 不只是「用到了一个反向 KL」,它整个目标函数就是一个反向 KL,指向那个奖励倾斜后的参考策略。
成立条件要说清楚:这个等价性需要 KL 惩罚在优化目标里($\beta > 0$)。$\beta = 0$ 的 RLVR 配方不满足这个等式——但正如第 8 节要讲的,on-policy 采样本身仍然把 RL 偏向了 KL 最小的解。
两个方向的数值行为
| 前向 KL $\mathcal{D}_{\text{KL}}(\pi_\star\Vert\pi_\theta)$ = SFT | 反向 KL $\mathcal{D}_{\text{KL}}(\pi_\theta\Vert\pi_\star)$ = RL | |
|---|---|---|
| 样本来自 | 目标(固定数据集 / 教师模型) | 策略自己 |
| on/off-policy | off-policy | on-policy |
| 什么时候损失爆炸 | 目标有质量而 $\pi_\theta\to 0$ 的地方,$\log\frac{\pi_\star}{\pi_\theta}\to\infty$ | $\pi_\theta$ 有质量而 $\pi_\star\to 0$ 的地方 |
| 行为 | mass-covering:必须摊开去覆盖目标的每一个模态 | mode-seeking:可以只占住一个高奖励模态,无视其余 |
| $\pi_\theta \approx 0$ 的区域 | 贡献巨大损失 | 几乎不贡献损失(被自己的概率加权掉了) |
反向 KL 的 mode-seeking 来自一个很简单的事实:期望是按 $\pi_\theta$ 自己的概率加权的。$\pi_\theta(y\mid x)\approx 0$ 的区域,无论 $\pi_\star$ 在那里有多少质量,对损失的贡献都接近 0。模型「看不见」自己不会生成的东西。而前向 KL 的期望按 $\pi_\star$ 加权,模型在目标有质量的地方必须跟上,否则损失发散。
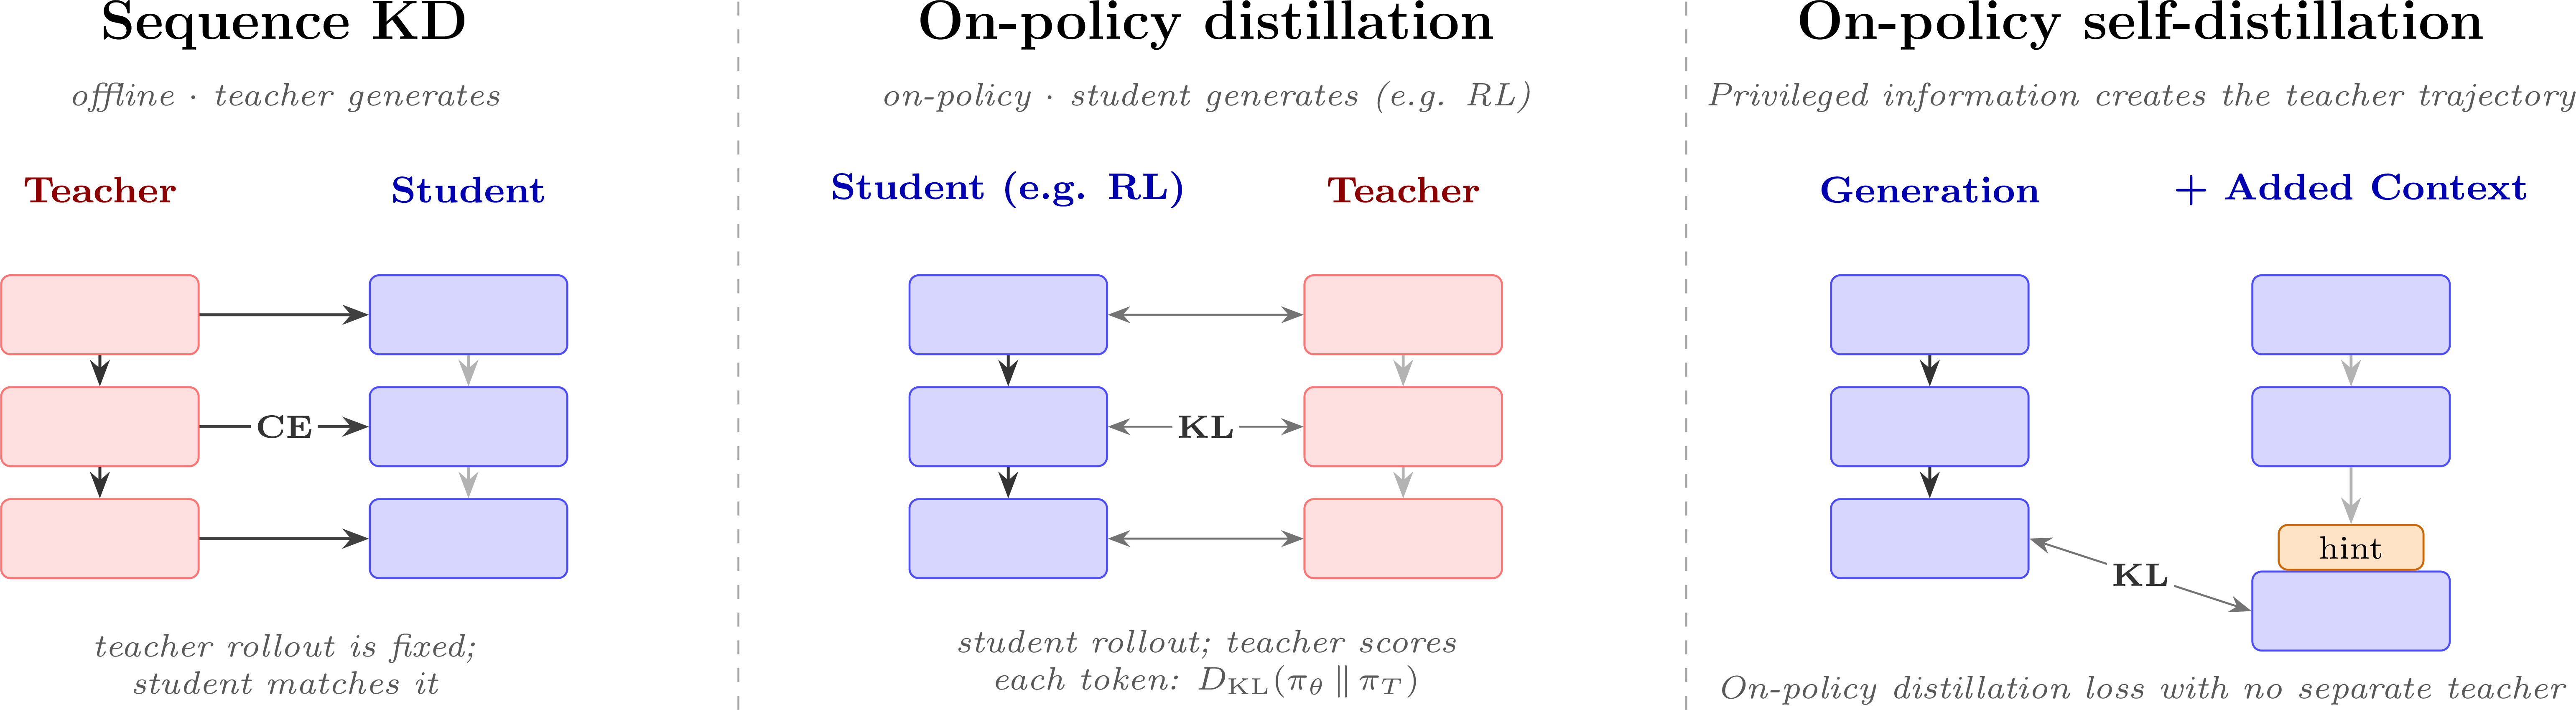
8. 隐式正则化:为什么 RL 忘得比 SFT 少
前面所有内容讲的都是显式正则化——KL 惩罚、预训练梯度、margin loss,都是你手动写进目标函数的东西。但 2025–2026 年积累起来的一批实证工作揭示了另一件事:基于 RL 的后训练自带一层隐式正则化。这层保护来自 on-policy 优化的结构本身,不依赖任何显式工具——没有 KL 惩罚、没有 replay buffer,它照样在。
SFT 记忆,RL 泛化
后训练社区一个核心问题是:在单个任务上训练时,模型学到的是一条可迁移的规则,还是只是背下了训练分布的表面模式?SFT Memorizes, RL Generalizes(Chu et al., 2025)用一个受控实验直接回答了这个问题:把后训练方法(SFT vs RL)当成唯一变量,看分布外(out-of-distribution, OOD)泛化怎么变。
两个环境都内建了「规则变体」,训练用一套规则,评测换另一套:
- GeneralPoints:给四张扑克牌,用 $+ - \times \div$ 组合出目标数(默认 24)。OOD 测试换的是花牌计分规则——训练时 J/Q/K 都算 10,评测时 J=11、Q=12、K=13。
- V-IRL:真实城市街景的视觉导航,模型按语言指令沿路线行进、识别沿途地标。OOD 把动作空间从绝对方向(north、east)切成相对方向(left、right)。
结果在所有任务变体上一致:随着训练算力增加,RL 的 OOD 性能持续上升,SFT 的 OOD 性能持续下降——尽管 SFT 的分布内性能在涨。分化的幅度大得吓人:在纯语言输入的 V-IRL 上,OOD 逐步准确率从 80.8% 出发,RL 提升到 91.8%,SFT 崩塌到 1.3%。
1.3% 这个数字值得停下来想一想。它不是「没学会新规则」——没学会的话应该退回到基础模型的水平(80.8%)。它是把基础模型原本就有的空间推理能力给毁了:模型退化成了一张从指令短语到绝对方向的查找表,一旦指令换成相对方向,查找表整个失效。
为什么方向决定了遗忘:多模态才是关键
Retaining by Doing(Chen et al., 2025)问的是互补的问题:顺序训练多个任务时,模型还记得原来会的东西吗?答案是 RL 在目标任务上收益相当或更高,同时遗忘显著更少。而解释就是第 7 节那两个 KL 方向。
先说一个直觉上应该成立但实际是错的推理:前向 KL 是 mass-covering 的,所以 SFT 应该保住目标分布的所有模态、保留旧知识;反向 KL 是 mode-seeking 的,所以 RL 应该坍缩到一个高奖励模态、把别的都丢掉。因此 SFT 该忘得少。
但事实恰好相反。问题出在那个推理默认策略是单模态的。预训练 LLM 里装着无数个模态。
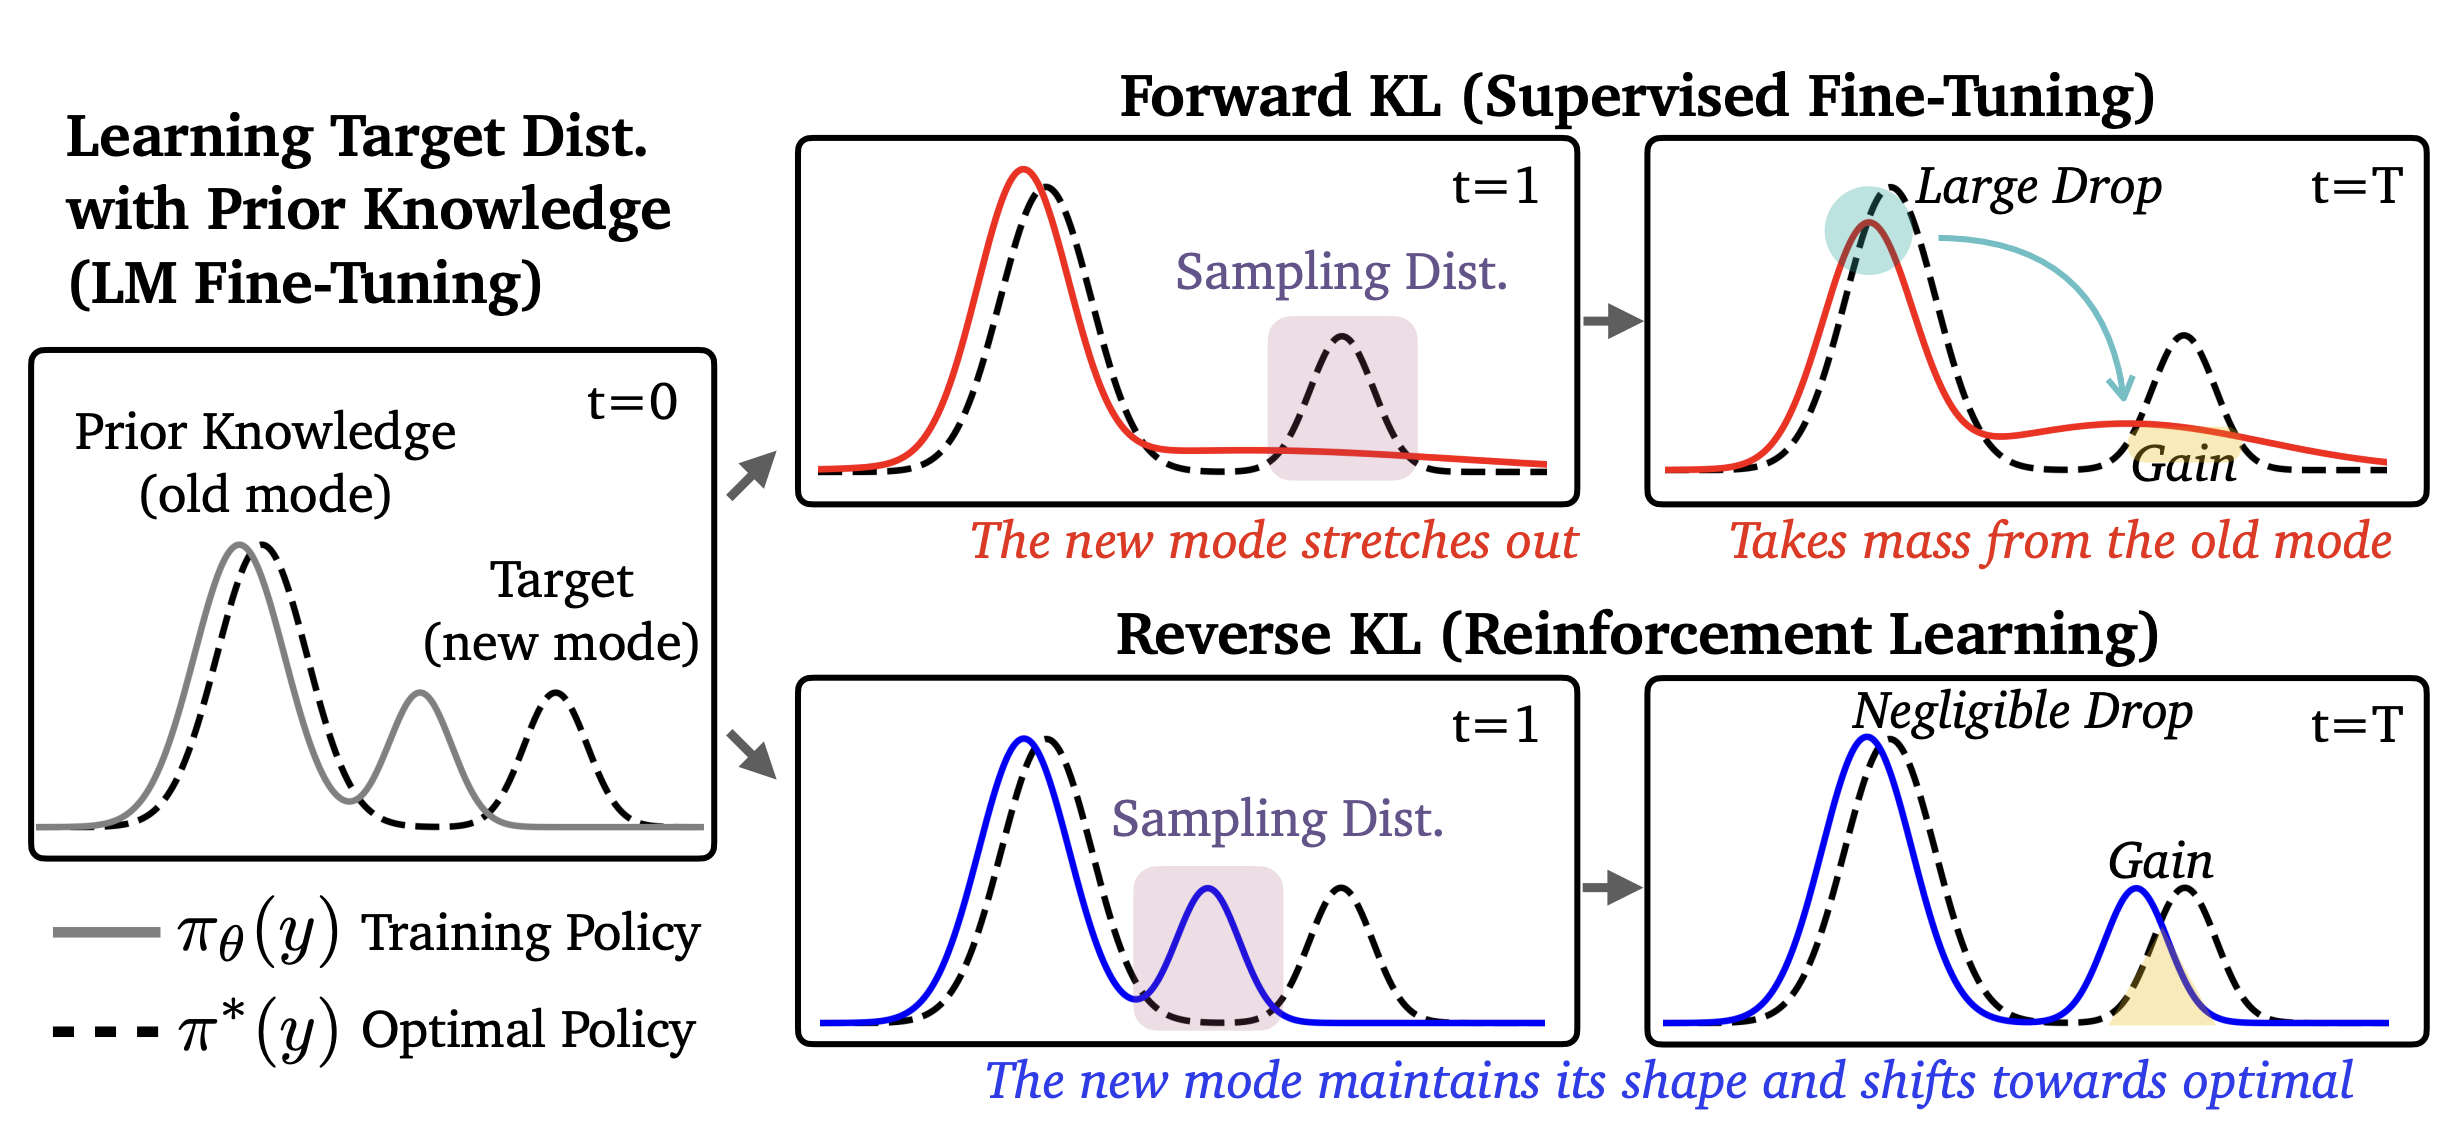
把这个图翻译成两句话:
- SFT(前向 KL):样本来自目标 $\pi_\star$——一个固定的人写数据集。对每条样本我们问:我的模型给这个分配了多少概率?模型从不生成任何东西,它只学着模仿。mass-covering 的压力迫使策略把概率质量重新摊开,从而破坏已有知识。
- RL(反向 KL):样本来自策略自己。对模型生成的每条 completion 我们问:它离奖励最优策略有多近?因为模型只在自己的生成结果上训练,更新被局限在它已经放了概率质量的地方——奖励信号告诉它这批生成里哪些该加强,概率往 $\pi_\star$ 挪,分布的其余部分纹丝不动。
RL's Razor:on-policy 采样本身就是正则化
RL's Razor(Shenfeld, Pari & Agrawal, 2026)从另一个角度给出了互补的解释。它的出发点是:对任何一个新任务,都存在很多个能拿到高分的策略。那么优化器会挑哪一个?论断是:
在新任务的众多高奖励解中,RL 这类 on-policy 方法内在地偏向那些在 KL 意义上离原策略最近的解。
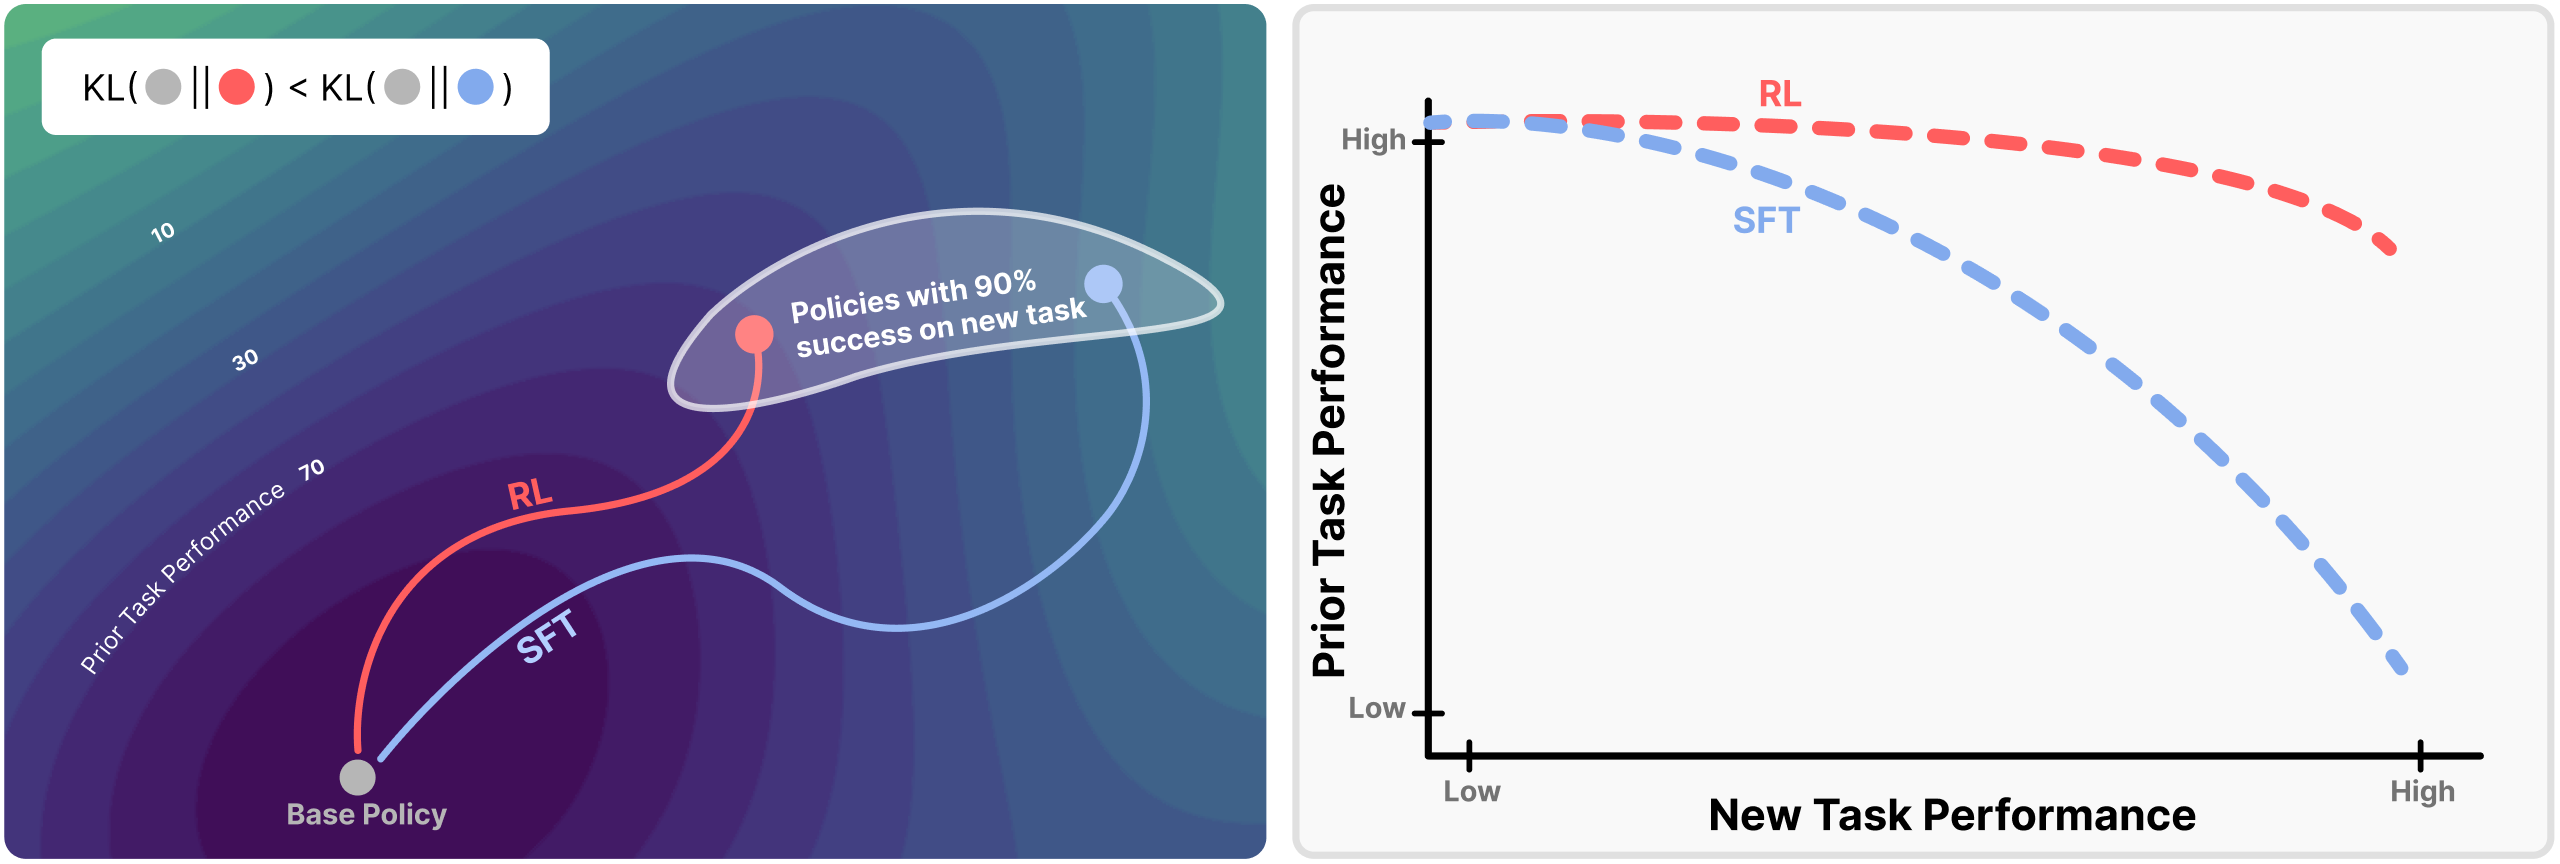
作者的核心实证结果是一个惊人简洁的关系:
$$ \text{遗忘量} \approx f\!\left(\E_{x\sim\tau}\Big[\mathcal{D}_{\text{KL}}\big(\pi_0(\cdot\mid x)\,\Vert\,\pi(\cdot\mid x)\big)\Big]\right) $$横跨多种 RL 和 SFT 的训练变体,遗忘量与「训练后策略 $\pi$ 相对初始策略 $\pi_0$ 的 KL 漂移」强相关,$R^2 = 0.96$。
令人意外的地方在 KL 是在新任务的输入分布上量的,不是在旧任务的留出数据上。你只需要拿新任务的 prompt,跑一遍两个模型,算个 KL,就能预测模型在完全没见过的旧任务上会掉多少分。这在实践上是一个非常便宜的仪表:
到底是哪个因素在起作用?
RL 和 SFT 差别很多,作者做了一个漂亮的消融,沿两条轴拆解:
- 数据是 on-policy 还是 offline——样本是模型自己生成的,还是外部给定的。
- 目标里有没有负梯度——RL 在样本得分低于基线时会有把概率推离该输出的梯度;SFT 只有正向强化(只在正确演示上提升概率)。
结论非常干净:on-policy vs offline 完全解释了泛化性能的差异,负梯度没有可辨识的影响。
为什么?on-policy 方法采样的是模型已经赋予了不可忽略概率的输出,所以每一步更新天然被约束在当前分布附近——你没法对一个自己永远不会生成的东西做梯度更新。而 SFT 训练在一个固定的外部分布上,这个分布可以离模型当前的输出任意远,每一步梯度都在把模型往那个遥远的目标拽,完全不管模型自己「相信」什么。
实践含义只有一句:能 on-policy 就 on-policy。即便 $\beta = 0$、参考模型根本没加载,你也已经拿到了一层免费的正则化——这正好解释了第 5 节那个观察:$\beta=0$ 的 GRPO run,KL 曲线自己就稳住了。
9. KL 之外:其余的正则化工具箱
后训练文献里,不少领先模型在自己的配方里塞了别的正则化手段。原文对这些内容的定位说得很坦率:它们是为了展示「领先模型是怎么把自己的配方调稳的」,而不是「这些工具在任何配方里都该用」。读这一节的正确姿势是当作案例集,而不是清单。
所以看到一篇论文的目标函数里挂着三四个正则项时,默认假设应该是:它们是那一版配方的拐杖,不是普适的原理。照抄这些项到你自己的设置里,大概率只是引入了三四个你不知道怎么调的超参。先跑最简单的版本,出了具体的问题再针对性加。
预训练梯度混合(InstructGPT)
另一种看待正则化的角度:你想约束的可能不是「离某个模型不要太远」,而是「离某个数据集不要太远」。InstructGPT 就是这么干的,动机原话是「为了修复在公开 NLP 数据集上的性能回退」。
把第 1 节的通用形式 $r = r_\theta - \lambda\, r_{\text{reg.}}$ 写成一个要最大化的目标函数(对 RL 策略采样、prompt $x$ 取自 RLHF 数据集、completion $y$ 由策略生成):
$$ J(\theta) = \E_{(x,y)\sim\mathcal{D}_{\pi_{\text{RL},\theta}}}\big[r_\theta(y\mid x) - \lambda\, r_{\text{reg.}}\big] $$然后加上一项:在预训练语料(或者别的什么语料)上采一批文档,给标准自回归下一 token 预测的对数似然一个正的权重:
$$ J(\theta) = \E_{(x,y)\sim\mathcal{D}_{\pi_{\text{RL},\theta}}}\big[r_\theta(y\mid x) - \lambda\, r_{\text{reg.}}\big] \;+\; \gamma\,\E_{x\sim\mathcal{D}_{\text{pretrain}}}\big[\log \pi_{\text{RL},\theta}(x)\big] $$第二项就是预训练损失,只不过符号翻过来当作要最大化的奖励。$\gamma$ 控制它的权重。这个配方在实现上意味着:每个训练步除了 RL 的 batch,还要额外过一个预训练 batch,做一次普通的语言建模前向反向。这也是它在 InstructGPT 论文里被叫作 PPO-ptx 的原因。
值得注意的是这个手段的方向:它是一个前向 KL 式的约束(样本来自固定数据集),加在一个反向 KL 的优化里。它想解决的问题——「RL 之后模型在传统 NLP 基准上掉分」——正是第 8 节讲的遗忘问题。而第 8 节告诉我们,这个问题的更深层原因其实是 SFT 阶段就埋下的,用更多前向 KL 去补,属于用同一类药治同一类病。这个手段在后续几代模型里基本消失了,可以作为「脚手架」的典型案例。
DPO 里混一项 NLL
Iterative Reasoning Preference Optimization(Pang et al., 2024)提出在 DPO 损失里加一个负对数似然项来平衡优化:
$$ \mathcal{L}_{\text{DPO+NLL}} = \mathcal{L}_{\text{DPO}}(c_i^w, y_i^w, c_i^l, y_i^l \mid x_i) + \alpha\,\mathcal{L}_{\text{NLL}}(c_i^w, y_i^w\mid x_i) $$展开:
$$ = -\log\sigma\!\left(\beta\log\frac{P_\theta(c_i^w, y_i^w\mid x_i)}{P_{\text{ref.}}(c_i^w, y_i^w\mid x_i)} - \beta\log\frac{P_\theta(c_i^l, y_i^l\mid x_i)}{P_{\text{ref.}}(c_i^l, y_i^l\mid x_i)}\right) - \alpha\,\frac{\log P_\theta(c_i^w, y_i^w\mid x_i)}{|c_i^w| + |y_i^w|} $$符号:$P_\theta$ 是可训练策略,$P_{\text{ref.}}$ 是冻结的参考模型(通常就是 SFT checkpoint),$(c_i^w, y_i^w)$ 和 $(c_i^l, y_i^l)$ 分别是 prompt $x_i$ 下的胜出与落败 completion($c$ 是推理链,$y$ 是最终答案)。
两项的分工:第一项是标准 DPO 的 logistic 损失,用对数似然比之差 $\log\frac{P_\theta}{P_{\text{ref.}}}$ 拉开胜负样本的间距,$\beta$ 控制这个偏好信号能把模型从参考模型拽多远。第二项是对胜出 completion 的长度归一化 NLL 惩罚,权重 $\alpha$,作用是让被偏好的文本在绝对语言建模意义上保持高似然,而不只是相对落败样本更好。
同样的修改也可以套到奖励模型训练上(DPO 损失和 BT 损失结构相同),用来约束 RM 保持生成合理文本的能力。
奖励模型的 margin loss(Llama 2)
RLHF 栈的其他部分,「控制优化」这件事定义得远没有 RL 阶段清楚。大多数奖励模型除了标准的对比损失之外没有任何正则化。直接对齐算法则把 KL 正则塞进了 $\beta$ 里(第 8 章)。
Llama 2 给奖励模型训练提出了一个 margin loss:
$$ \mathcal{L}(\theta) = -\log\Big(\sigma\big(r_\theta(y_c\mid x) - r_\theta(y_r\mid x) - m(y_c, y_r)\big)\Big) $$$m(y_c, y_r)$ 是两个数据点之间的间距,来自两位标注员评分之差的数值化。实现方式是让标注员在数值量表上打分,或者用量化的排序方法比如 Likert 量表(第 10 章讲偏好数据时的那套量表)。
直觉:不是所有偏好对都一样确信。「A 明显好过 B」和「A 略微好过 B」在标准 BT 损失里贡献的梯度是一样的,模型被迫把两者都推到同样的分差。加了 margin 之后,标注员标「明显更好」的对,模型必须把分差拉到 $m$ 以上才算达标;标「差不多」的对,$m\approx 0$,稍微拉开就够了。这既减少了在噪声标注上的过拟合,也让奖励模型的输出尺度更有意义。
margin 这个思路在直接对齐文献里被用得很重:Reward-weighted DPO;RPO(Reward-aware Preference Optimization, Nemotron-4 340B, 2024)把奖励模型分数整合进 DPO 式的更新规则;REBEL(Reinforcement Learning via Regressing Relative Rewards, 2024)用回归损失的形式做奖励差值加权。
熵正则
经典 RL 里的标配(A3C、SAC 里的 entropy bonus):在目标里加一项策略熵,鼓励模型保持随机性、不要过早坍缩到确定性策略。
$$ J(\theta) = \E\big[r(x,y)\big] + \alpha_H \cdot H\big(\pi_\theta(\cdot\mid x, y_{<t})\big) $$在 LLM 的 RL 里,这个东西的地位很微妙。熵坍缩确实是真实且高频的失败模式:训着训着,模型对每个位置都极度自信,采样温度 1.0 生成出来的还是几乎一样的东西;group 内 rollout 全都一模一样,GRPO 的组内优势全变成 0,梯度归零,训练卡死。所以监控 token 级熵是 RLVR 训练的标准操作。
但直接加 entropy bonus 作为解药口碑并不好——它是一个无差别的力,会同时抬高「该确定的地方」(闭合括号、固定格式串)和「该多样的地方」(推理路径选择)的熵,容易把输出搞得更不连贯。社区更常见的替代手段是从别处入手:clip-higher(DAPO 那样放宽 clip 上界,让低概率 token 有机会被抬起来)、动态采样(丢掉组内全对或全错的 prompt)、提高采样温度、以及在数据侧保证难度分布合理。
权重平均与模型融合(model soup)
最后一类工具在形式上和前面完全不同:它不改目标函数,而是在参数空间里做平均,$\theta_{\text{merged}} = \sum_i w_i \theta_i$($\sum_i w_i = 1$)。最简单的形式就是把若干 checkpoint 的权重直接算术平均。RLHF 语境下的三种典型用法:沿训练轨迹平均(平均后的模型必然落在各 checkpoint 之间,KL 漂移小于最远的那个);把 RL 模型和参考模型插值,$\theta = (1-\alpha)\theta_{\text{ref}} + \alpha\theta_{\text{RL}}$,给你一个训练后的旋钮,在「对齐程度」和「通用能力保留」之间连续调节而不需重训;融合领域专家(数学、代码、对话分别 RL 后合并)。
本书在附录 C里把模型融合列为「创造强模型的关键工具之一」,评价是「一个强大且简单的工具,但如何为后续融合而准备一个模型,还没有清晰的最佳实践」(参见 What Matters for Model Merging at Scale?, 2024)。这个评价很准确:它在最终配方里几乎总能挤出一点收益,但属于炼丹术而非理论。
10. 2026:约束的锚点从「参考模型」移到「采样分布」
本章到这里为止讲的都是参考模型锚定的正则化:一个固定的 $\pi_{\text{ref}}$,一个反向 KL,一个系数 $\beta$。但 2026 年前沿的 agentic 配方正在做一件看起来矛盾的事——一边把 KL 惩罚彻底删掉,一边在别的地方加回更强的约束。理解这个转向是本章的收尾。
KL 惩罚正在消失
证据是明确的:
- GLM-5 直接把它移除了,理由是「为了加速 RL 的提升」。
- Kimi 也不用:K2 → K3 的配方里既没有 KL 惩罚,也根本没有参考策略。
- TMax(终端 agent 配方)把这笔账算给你看了:一个小的 KL 能减轻坍缩的严重程度,但会降低奖励,最终配方选 $\beta = 0$。
为什么工具使用逼着大家改
三个技术原因叠在一起:
- 20 多轮的轨迹。一条 agentic rollout 不是「prompt → 一段回复」,而是「模型说一句 → 调工具 → 拿到结果 → 再说一句」循环二十几次。序列长度上万 token,而且中间大量 token 是工具返回的内容——那些 token 不是模型生成的,对它们算 KL 毫无意义,得小心地 mask 掉。轨迹越长,逐 token KL 的累积噪声越大,惩罚项的信噪比越差。
- 异步 / partial rollout。为了让 GPU 不空转,现代训练框架允许 rollout 和训练异步进行:这批数据是用几步之前的权重采的,甚至一条轨迹的前半段和后半段用的是不同版本的权重。此时「策略」和「采样器」已经不是同一个东西了。
- 训练引擎与推理引擎的数值不一致。rollout 用 vLLM / SGLang 生成,训练用 FSDP/Megatron 打分。同一份权重、同一条序列,两边算出来的 logprob就是不一样——不同的 kernel、不同的 batching、不同的数值精度累积。这个差异本身就构成一个 off-policy 的 gap。
结果是:真正致命的漂移不再是「离初始模型多远」,而是「训练时看到的分布,离采样时的分布多远」。TMax 的观测很具体——不稳定性在超过 10 个 assistant 轮次之后开始增加,5 轮以下则完全不出现。这不是一个「模型跑得太远」的问题,这是一个「重要性采样比值算不准」的问题。
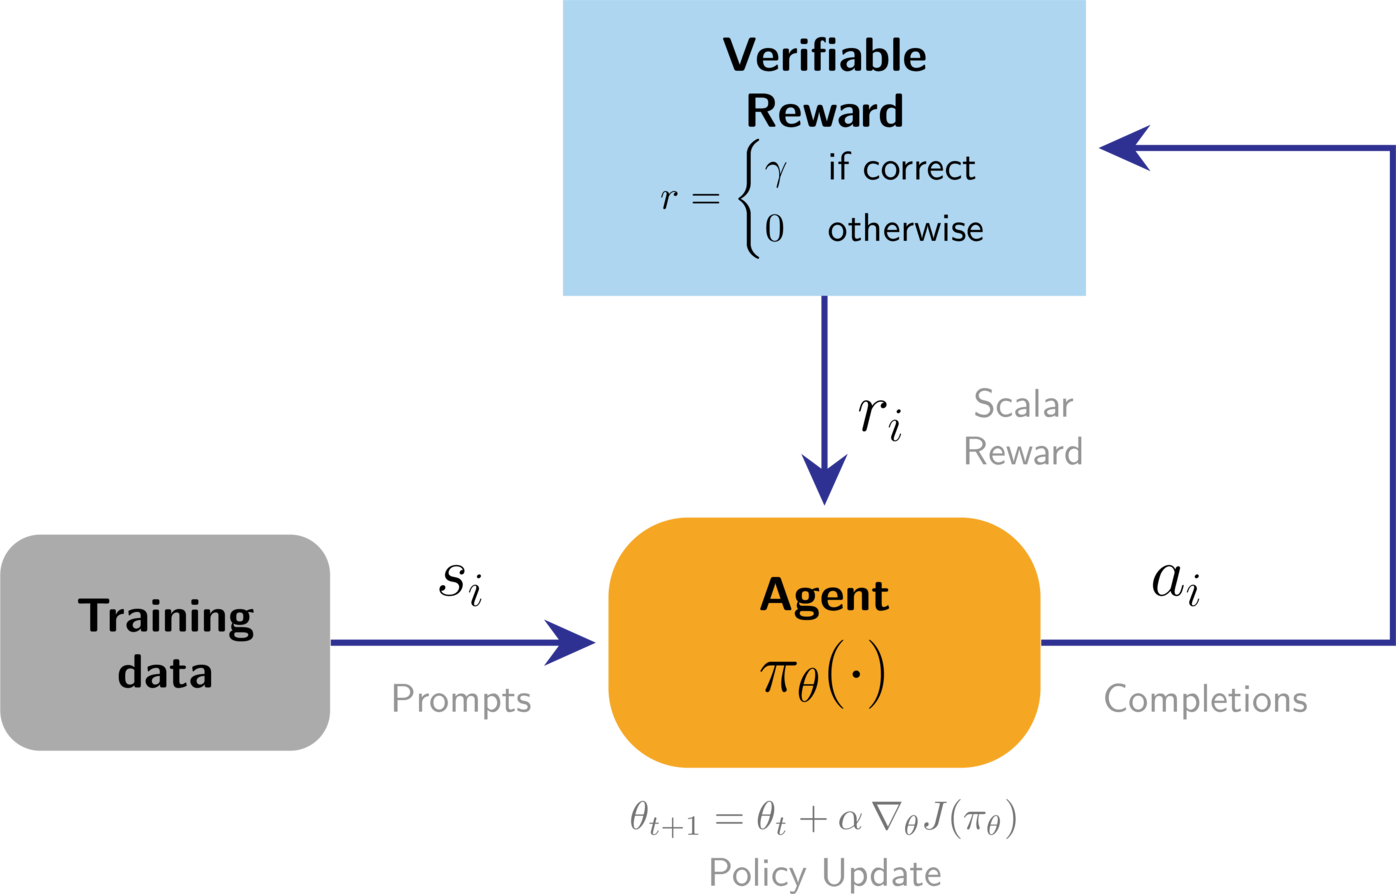
新的约束长什么样:mask,而不是 clip
PPO 的逐 token 比值 $\rho_t = \frac{\pi_\theta(y_t)}{\pi_{\text{old}}(y_t)}$ 本来就是「训练策略与采样策略之间散度」的一个单样本、高噪声估计(注意这和第 3 节 $k_1$ 方差大的原因是同一个)。当 $\pi_{\text{old}}(y_t)$ 很小时,这个比值会剧烈爆炸——不是因为策略真的变了那么多,而是因为分母是个接近 0 的数。
DPPO(Divergence Proximal Policy Optimization, Qi et al., 2026)的做法是:不再用逐 token 比值做 clip,而是直接估计 rollout 策略与训练策略之间的散度(用二值 total variation),然后按这个散度屏蔽(mask)token。同一时期 GLM 的 IcePop、Kimi 的 log-ratio 区间做的是同一件事:把有问题的 token 的梯度直接置零,而不是把它们的贡献裁到边界值。
| 本章前 9 节的 KL 惩罚 | 2026 的采样分布约束 | |
|---|---|---|
| 锚点 | 固定的参考模型 $\pi_{\text{ref}}$(训练前的 checkpoint) | 产生这批 rollout 的采样策略 $\pi_{\text{old}}$(每步都在移动) |
| 约束什么 | 总位移:模型离出发点多远 | 单步保真度:训练梯度是否对应真实采到的分布 |
| 形式 | 目标函数里的一个惩罚项 | 每次更新上的一个信赖域 |
| 失效表现 | 输出退化、乱码、语言漂移 | 训练发散、loss 尖峰、梯度爆炸 |
| 典型实现 | $\beta \cdot k_3(\pi_\theta, \pi_{\text{ref}})$ | DPPO 的 TV 散度 mask、IcePop、log-ratio 区间 mask |
- 信赖域 / clip / mask(PPO 的 $\epsilon$、DPPO 的 TV mask):约束每次更新的步长,锚在采样策略上。这一层永远开着——关掉它训练直接发散。它是数值稳定性问题。
- KL-to-ref 惩罚(本章的 $\beta$):约束训练全程的总位移,锚在一个固定的参考模型上。这一层可以关掉,而且 2026 年的很多配方确实关掉了。它是行为退化问题。
所以本章真正要教的不是「$\beta$ 该设多少」,而是怎么想正则化这件事:先确定你的失败模式是什么(读 rollout,不要只看曲线),再找那个直接针对该失败模式的约束。抄一个别人的 $\beta$ 而不知道它在防什么,等于给一个没病的人吃药。
本章小结
速查表:KL 惩罚的每个自由度
| 自由度 | 选项 | 默认建议 |
|---|---|---|
| KL 方向 | 反向 $\mathcal{D}_{\text{KL}}(\pi_\theta\Vert\pi_{\text{ref}})$ / 前向 | 反向——样本免费(rollout 本来就有),且正好惩罚「跑进参考模型的低概率区」 |
| 估计器 | $k_1 = -\log\rho$ / $k_2 = \tfrac12(\log\rho)^2$ / $k_3 = \rho - 1 - \log\rho$ | $k_3$——无偏 + 逐元素非负 + 低方差,没有代价 |
| 加在哪 | 奖励里(进 GAE)/ 损失里 | 损失里——梯度更直接,$\beta=0$ 时可完全跳过参考模型 |
| 聚合方式 | 序列求和 / 序列内均值 / batch token 均值 | 与你的 policy loss 的聚合方式保持一致;跨库照抄 $\beta$ 前必须先对齐这一项 |
| $\beta$ 取值 | 静态常数 / 目标 KL + 控制器 / 0 | RLHF-with-RM:$0.01$–$0.1$(open-instruct 用 0.05);RLVR / agentic:先试 0 |
| 参考模型 | SFT ckpt / 上一轮 RL ckpt / base / 无 | 标准 RLHF 用 SFT ckpt;多轮迭代用上一轮;$\beta=0$ 时不加载 |
要点清单
- 14 章是病,15 章是药。过优化的规律是「跑了多远」的函数而非「训了多少步」,所以 KL 被当成一笔可以计价的优化预算。
- KL 不是距离(不对称、不满足三角不等式),它是「用为 $Q$ 定制的编码去编 $P$ 的数据」的额外码长。行话里叫「KL 距离」是因为它作为「模型改了多少」的单一数字非常好用。
- KL 永远是估计出来的:精确 KL 要对整个词表求和,$(B,L,|V|)$ 的张量在现代规模下装不下。三个估计器里 $k_3$ 是免费的最优解——在本章那个数值例子里,$k_1$ 的单样本标准差是真值的 8.25 倍,$k_3$ 只有 0.92 倍,而两者同样无偏。
- 符号搞反是最高频的 bug,而且不会崩。两条自检:$k_3$ 逐元素 $\ge 0$;第 0 步 KL 精确为 0 然后单调爬升。
- $\beta$ 最初是控制器不是常数:目标 KL + 对数空间比例控制器($K_\beta = 0.1$,误差 clip $\pm0.2$),好处是不同 seed 的 run 落在同一 KL 预算上、实验可比。现代实践回到静态小 $\beta$,或者干脆 0。
- DPO 的 $\beta$ 和 RL 的 $\beta$ 不是一回事:前者是隐式奖励定义里的温度(不能设 0),后者是显式惩罚项的价格(可以设 0)。但方向一致:$\beta$ 小 = 允许跑得远。
- SFT ⟺ 最小化前向 KL 到数据分布(恒等式,不是类比);带惩罚的 RL ⟺ 最小化反向 KL 到奖励倾斜的参考策略 $\pi_\star \propto \pi_{\text{ref}}\exp(r/\beta)$——同一个 $\pi_\star$ 也是 DPO 推导的起点。
- 方向由「样本从哪来」决定:数据来 → 前向 → mass-covering;模型自己来 → 反向 → mode-seeking。这条轴同时统一了 SFT、蒸馏、RL 三件事。
- 隐式正则化是真实且可测的。SFT 在 V-IRL 上把 OOD 准确率从 80.8% 打到 1.3%(毁掉了基础模型已有的空间推理),RL 把它提到 91.8%。遗忘量与 KL 漂移的相关性 $R^2 = 0.96$,且这个 KL 在新任务数据上就能测——一个极其便宜的遗忘预警仪表。
- 消融结论:on-policy 数据完全解释了 RL 与 SFT 的泛化差异,负梯度没有可辨识贡献。所以「能 on-policy 就 on-policy」,即使 $\beta = 0$ 也已经拿到一层免费正则化。
- KL 之外的手段绝大多数是脚手架:预训练梯度混合(InstructGPT PPO-ptx)、DPO+NLL、Llama 2 的 margin loss、熵正则、权重平均。它们各自解决一个具体配方里的具体问题,下一代往往就被简化掉了。看到一堆正则项,先假设是拐杖。
- 2026 的转向:GLM-5 删掉 KL 惩罚以加速 RL,Kimi K2→K3 连参考策略都没有,TMax 实测「小 KL 减轻坍缩但降低奖励」后选了 $\beta=0$。约束的锚点从参考模型移到了采样分布(DPPO 的 TV mask、IcePop、log-ratio 区间)。
- 两层约束不要混淆:clip / mask 管每步步长(锚在采样策略,永远开着,管数值稳定);KL-to-ref 管全程总位移(锚在固定参考模型,可以关掉,管行为退化)。
动手实验
本章没有独立的作业目录,但 homework/hw3-pg(策略梯度)的实验框架可以直接用来观察 KL 惩罚的行为——正则化的所有旋钮都在 _src/code/policy_gradients/ 里。
实验一:$\beta$ 扫描,看 KL 预算与奖励的权衡
基线配置 policy_gradients/configs/grpo.yaml 默认是 beta: 0.0、kl_estimator: kl3。复制三份,把 beta 分别设成 0.0 / 0.01 / 0.05 / 0.2:
# 参照 _src/code/CLAUDE.md 的运行方式
uv run python -m policy_gradients.train --config policy_gradients/configs/grpo.yaml
要盯的指标:
- KL 曲线 vs 奖励曲线。$\beta = 0$ 时 KL 应该持续爬升然后在某个区间游走;$\beta$ 越大,KL 越早进入平台,同时最终奖励越低。这条权衡曲线就是本章的全部内容的实验版本。
- 第 0 步的 KL 必须是 0(浮点误差量级)。不是 0 就说明 policy 和 ref 的前向路径不一致,先修这个再谈别的。
- 生成样本本身。$\beta = 0$ 且训练足够久时,去读 rollout——你会看到格式坍缩、重复、或者输出退化成固定模板。这是过优化的直接证据,而且它通常在奖励曲线还在涨的时候就已经发生了。
实验二:三个估计器的方差对比
把 kl_estimator 在 kl1 / kl2 / kl3 之间切换,固定 $\beta$ 和随机种子,把每步的 KL 值记录下来(不只是均值,还要记 batch 内的标准差)。你应该能重现第 3 节表格的定性结论:$k_1$ 的 batch 内标准差远大于另外两个,而且会出现负值;$k_2$ 和 $k_3$ 的均值在训练早期几乎重合、在 KL 变大之后开始分离($k_2$ 偏低)。
加一行断言 assert (kl >= -1e-6).all() 到 approx_kl3 里,然后故意把 log_probs 和 log_probs_ref 调换位置,感受一下符号 bug 是多么安静地通过了所有类型检查。
实验三:测量 KL 漂移作为遗忘的代理指标
这个复现的是第 8 节 RL's Razor 的实操建议,用 homework/hw1-sft 的 SFT 流程做对照:
- 在一个窄领域数据集上分别做 SFT 和 GRPO,训到目标任务性能相同(这一点很关键,不然比较没有意义)。
- 用新任务的 prompt,测量微调后模型与初始模型之间的 KL 漂移。
- 在一个完全无关的留出任务上评测两个模型,看掉了多少分。
预期观察:在目标任务性能匹配的前提下,SFT 的 KL 漂移显著大于 RL,而留出任务的掉分幅度与 KL 漂移正相关。小规模下噪声会比较大,但趋势应该看得出来。
延伸阅读
KL 控制的源头
- Sequence Tutor: Conservative Fine-Tuning of Sequence Generation Models with KL-control (2017) — LLM 之前就有 KL 控制。读它是为了看清这个技巧的动机与语言模型无关:任何「用 RL 微调一个宝贵的生成模型」的场景都需要它。
- Human-centric Dialog Training via Offline Reinforcement Learning (2020) — 把 KL 控制带到对话智能体,确立了它作为微调预训练模型的核心技术的地位。
- Fine-Tuning Language Models from Human Preferences (2019) — 第一篇 LLM + RLHF。本章第 5 节那个自适应 $\beta$ 控制器就出自这里,原始代码至今可读。
- Approximating KL Divergence (Schulman, 博客) — $k_1/k_2/k_3$ 的出处。全文不到两千字,是「碰 KL 惩罚的人必读」级别的行业常识。
正则化的具体配方
- InstructGPT: Training Language Models to Follow Instructions with Human Feedback (2022) — PPO-ptx 的预训练梯度混合项在这里,动机原话是「修复公开 NLP 数据集上的性能回退」。
- Llama 2: Open Foundation and Fine-Tuned Chat Models (2023) — 奖励模型的 margin loss,以及把标注员的 Likert 评分差转成 margin 的具体做法。
- Iterative Reasoning Preference Optimization (2024) — DPO+NLL。理解「DPO 只约束比值,所以两边概率会一起掉」这个问题的标准修补方案。
- Nemotron-4 340B Technical Report (2024) — RPO:把奖励模型分数直接整合进 DPO 式更新规则的 reward-aware 变体。
- REBEL: Reinforcement Learning via Regressing Relative Rewards (2024) — 用回归损失做奖励差值加权,margin 思路的另一种代数形式。
- Proximal Policy Optimization Algorithms (2017) — 原论文里的 adaptive KL penalty 变体(超目标 1.5 倍则 $\beta$ 翻倍),是控制器思路的更早版本。
- Responsive Safety in RL by PID Lagrangian Methods (2020) — 把「惩罚系数就是拉格朗日乘子,乘子更新就是控制问题」这个框架讲透,读完会觉得 $\beta$ 调参不再是玄学。
- What Matters for Model Merging at Scale? (2024) — 权重平均 / model soup 在规模上的系统研究,本书附录 C 引用的那篇。
隐式正则化:RL 为什么忘得少
- SFT Memorizes, RL Generalizes (2025) — 受控实验,把后训练方法当唯一变量。V-IRL 上 80.8% → 91.8%(RL)vs 80.8% → 1.3%(SFT)这组数字值得记住。
- Retaining by Doing: The Role of On-Policy Data in Mitigating Forgetting (2025) — 用前向/反向 KL 解释遗忘。核心洞察是「多模态分布上,mass-covering 反而更具破坏性」,颠覆了单模态直觉。
- RL's Razor: Why Online Reinforcement Learning Forgets Less (2026) — $R^2 = 0.96$ 的遗忘-KL 关系,以及「on-policy 数据完全解释差异、负梯度无影响」的消融。第 8 节那个便宜的遗忘预警指标就来自这里。
2026 的转向:约束采样分布
- Rethinking the Trust Region in LLM Reinforcement Learning (DPPO, 2026) — 用直接估计的散度 mask token,替代 PPO 的逐 token 比值 clip。读它能理解「比值是散度的高噪声单样本估计」这个视角。
- TMax: A Simple Recipe for Terminal Agents (2026) — 少见地把「加 KL 减轻坍缩但降低奖励」这笔账明确写出来的工作,也给出了「不稳定性随 assistant 轮次增长」的具体观测。
- GLM-5: From Vibe Coding to Agentic Engineering (2026) — 明确移除 KL 惩罚「以加速 RL 提升」,同时引入 IcePop 做梯度屏蔽。转向的完整案例。
- Kimi K3: Open Frontier Intelligence (2026) — 配方里既无 KL 惩罚也无参考策略,走得最彻底的一家。
相关章节
- 第 14 章 · 过优化 — 本章的问题定义在那里。不读那一章,本章的所有工具都不知道在防什么。
- 第 8 章 · 直接对齐 — $\pi_\star \propto \pi_{\text{ref}}\exp(r/\beta)$ 这个式子在那里被反解成 DPO 损失。同一个推导,两种用法。
- 第 7 章 · 推理与蒸馏 — 前向/反向 KL 在蒸馏语境下的第一次出场,「为什么反向 KL 更好」这个问题在那里被留到了本章。
- 第 6 章 · 策略梯度 — PPO 的 clip、GRPO 的组内优势、GAE,本章第 4 节讨论 KL 加在哪里时的全部背景。