拒绝采样
生成一堆候选、用奖励模型挑出最好的那些、再拿去做一次 SFT——最简单的策略改进算法,也是工业界用得最多、却几乎没人正经写下来的那个。
0. 本章导读
假设你已经有了两样东西:一个跑完指令微调的模型(第 4 章),和一个能给回复打分的奖励模型(Reward Model, RM,第 5 章)。现在你想让模型变好一点。最直接的想法是什么?
不是 PPO。是这个:让模型对每个 prompt 生成 10 个回复,用 RM 给这 10 个打分,把分最高的那个留下来,然后拿这批「优等生回复」再做一次 SFT。
这就是拒绝采样(Rejection Sampling, RS)。它荒谬地简单——没有策略梯度,没有重要性采样比,没有价值函数,没有 KL 惩罚项,没有在线 rollout 循环。三个阶段(生成、打分、微调)之间完全解耦,每一段都可以独立跑、独立缓存、独立重试。损失函数就是第 4 章那个交叉熵,一个字都不用改。
而它在工业界的普及程度和它在文献里的存在感严重不成比例。WebGPT 用它、Anthropic 的 Helpful & Harmless 助手用它、OpenAI 的过程奖励模型论文用它、Llama 2 Chat 把它作为每一轮迭代的主力方法(PPO 只在最后一轮上)、Llama 3 的整个后训练管线以它为骨架。但如果你去找「拒绝采样怎么做」的标准参考文献,你会发现没有。它是一个人人都在用、人人都默认对方知道怎么做、却没有一篇论文把它讲清楚的方法。
本章之所以被放在核心优化方法的最后(在 PPO、GRPO、DPO 之后),是因为 RS 在管线里的位置本身就是流动的:你可以在 IFT 之后做、可以在 RL 之后做、甚至可以在 RLVR 之后做。它不是一个「阶段」,而是一个可以随时插进去的工具。
本章要回答的问题:
- 这个名字从统计学借来时,借对了什么、借错了什么?
- 选择策略怎么定:每个 prompt 取 top-1,还是全局取 top-K?两者的偏置分别在哪?
- $N$(每个 prompt 采多少个)取多大?收益怎么衰减?代价是什么?
- 为什么可以对 best-of-N 采样谈「KL 距离」——它明明没改模型?
- RS 和 RL 到底什么关系?(答案:它是最简单的策略改进算法,是把 REINFORCE 的连续权重换成 0/1 硬门限)
- 什么时候 RS 就够了,什么时候必须上 PPO?
全章约定:$x$ 表示 prompt,$y$ 表示回复(completion)。这是语言模型文献的惯例——方法作用在完整的「prompt-回复」对上,而不是单个 token 上。
- RS = 过滤式监督学习:生成 $N$ 个候选 → RM 打分 → 留最好的 → 用标准 SFT 损失训练。整条链路是离线的、可缓存的、可并行的。
- 它是最简单的策略改进算法:REINFORCE 把每条样本按 advantage 加权,RS 把权重硬压成 0 或 1。所以它一定不如 PPO 高效,但也一定不会像 PPO 那样炸掉。
- 两种选择策略各有偏置:每 prompt top-1 保证 prompt 覆盖率但受限于「每题只能学一条」;全局 top-K 追求绝对质量但会把训练数据集中到「RM 打分高的容易题」上,甚至让一部分 prompt 完全没有代表。Bradley-Terry 奖励只有组内差值有意义,所以跨 prompt 比绝对分数在原理上就是可疑的。
- $N$ 的典型取值是 10–30,温度 0.7–1.0。$N$ 太小则选择噪声大(选出来的可能只是随机波动),$N$ 太大则收益按 $\log N$ 衰减而过优化风险线性上升。
- best-of-N 相对基础策略的 KL 有解析近似 $\KL \approx \log N - \frac{N-1}{N}$:$N{=}8$ 约 1.2 nats,$N{=}64$ 约 3.2 nats。$N$ 从 8 涨到 64(算力 8 倍)只换来约 2 nats 的额外 KL 预算——这就是 BoN 的性价比曲线。
- 工业界喜欢它的真正原因不是效果,是基础设施:生成用推理引擎、打分用另一个进程、训练用普通 SFT 脚本,三者不需要同时在显存里,不需要权重同步,不需要在线 rollout。一个 SFT 集群就能跑。
- 做 RS 实验必须配随机对照组:同样的采样预算、同样的数据量,只是把「按 RM 选」换成「随机选」。没有这个对照,你无法区分收益来自「RM 选得准」还是单纯来自「多采样 + 再训一轮」。
1. 名字从哪来:统计学的拒绝采样,借对了什么
「拒绝采样」这个名字不是 RLHF 发明的,它来自计算统计学(可追溯到 Gilks & Wild 1992 的自适应拒绝采样)。理解原版能帮你看清 LM 版本继承了什么、又悄悄丢掉了什么——后者恰恰是本章大部分实践困难的来源。
原版:从难采的分布里采样
问题设定是这样的:你想从一个目标分布 $p(z)$ 里采样,但你只能算出它的未归一化密度 $\tilde p(z)$(归一化常数 $Z=\int \tilde p$ 算不动),也没有直接的采样器。经典拒绝采样的做法是:
- 找一个容易采样的提议分布(proposal distribution) $q(z)$,以及一个常数 $M$,使得对所有 $z$ 都有 $\tilde p(z) \le M\, q(z)$($Mq$ 是 $\tilde p$ 的一个"包络")。
- 从 $q$ 里采一个 $z$。
- 再采一个 $u \sim \text{Uniform}(0,1)$。若 $u \le \dfrac{\tilde p(z)}{M q(z)}$ 就接受这个样本,否则拒绝,重来。
这个算法有一个漂亮的性质:被接受的样本严格服从 $p$,完全无偏。代价是效率——接受率是 $Z/M$,包络越松($M$ 越大)浪费越多。
LM 版:三个对应关系
Lambert 给出的类比是这样的:
| 统计学的拒绝采样 | 语言模型的拒绝采样 |
|---|---|
| 目标分布 $p(z)$(难采) | 「对某个 prompt 的高质量回复」的分布 |
| 提议分布 $q(z)$(好采) | 当前策略 $\pi_\theta(\cdot\mid x)$——生成一次就是采一次 |
| 接受/拒绝的判据 $\tilde p / (Mq)$ | 奖励模型 $\mathcal{R}(y\mid x)$ 的打分排序 |
类比成立的部分很直观:我们确实无法直接从「好回复分布」里采样(如果能,就不需要后训练了),我们确实只能从当前模型里采、再用一个启发式判据去筛。
- 没有 $M$,也没有随机接受判定。实践里的做法是「排序取 top-1」,这是一个确定性的 argmax,而不是以概率 $\tilde p/(Mq)$ 接受。argmax 得到的分布是 best-of-$N$ 分布,不是任何一个良定义的目标分布。
- 目标分布 $p$ 根本没有被显式写下来。我们只有一个 RM,而 RM 是人类偏好的代理,本身带噪、带偏(长度偏好、格式偏好、谄媚倾向)。「向 RM 的高分区收缩」和「向真实高质量回复收缩」不是一回事——这正是第 14 章过优化的主题。
- 拒绝掉的样本被彻底丢弃,且信息没有被利用。统计学版本里被拒的样本本来就该被丢(它们是为了修正 $q$ 与 $p$ 的形状差异);而 RS 里被拒的低分回复其实包含了宝贵的负向信息——DPO(第 8 章)和策略梯度(第 6 章)都会用到它,RS 不用。这是 RS 样本效率低的直接原因。
为什么这个方法长期没有正式引用
值得单独说一句这段学术史,因为它本身就是一个关于「工业界与论文界脱节」的典型案例。
2021–2023 年间,RS 反复出现在最重要的 RLHF 论文里,但每次都是作为管线里一个不加解释的步骤:WebGPT 用「best-of-$n$ 重排序」作为 RL 的对照;Anthropic 的 HH 论文用它做迭代式的数据生成;OpenAI 的过程奖励模型论文用 PRM 做 best-of-$N$ 打分;Llama 2 Chat 明确写了「我们的 RLHF 有 5 轮拒绝采样微调,只有最后一轮加了 PPO」。这些论文没有一篇的标题或主体贡献是「拒绝采样」,它只是别人做正事时顺手用的工具。
直到后来才有工作把它形式化:RAFT(Reward rAnked FineTuning)把这套流程写成了一个有名字的算法并推广到多模态;RSO(Statistical Rejection Sampling Optimization)则从统计视角说明了拒绝采样与其他偏好学习目标之间的关系——它指出,如果你想从数据里近似出最优策略 $\pi^*$ 的样本(而不只是当前策略的高分样本),你需要一个真正带接受概率的拒绝采样步骤,而不是简单的 argmax。
2. 四个阶段:流程、记号与算力记账
整套流程分四步,第 0 步是准备工作。
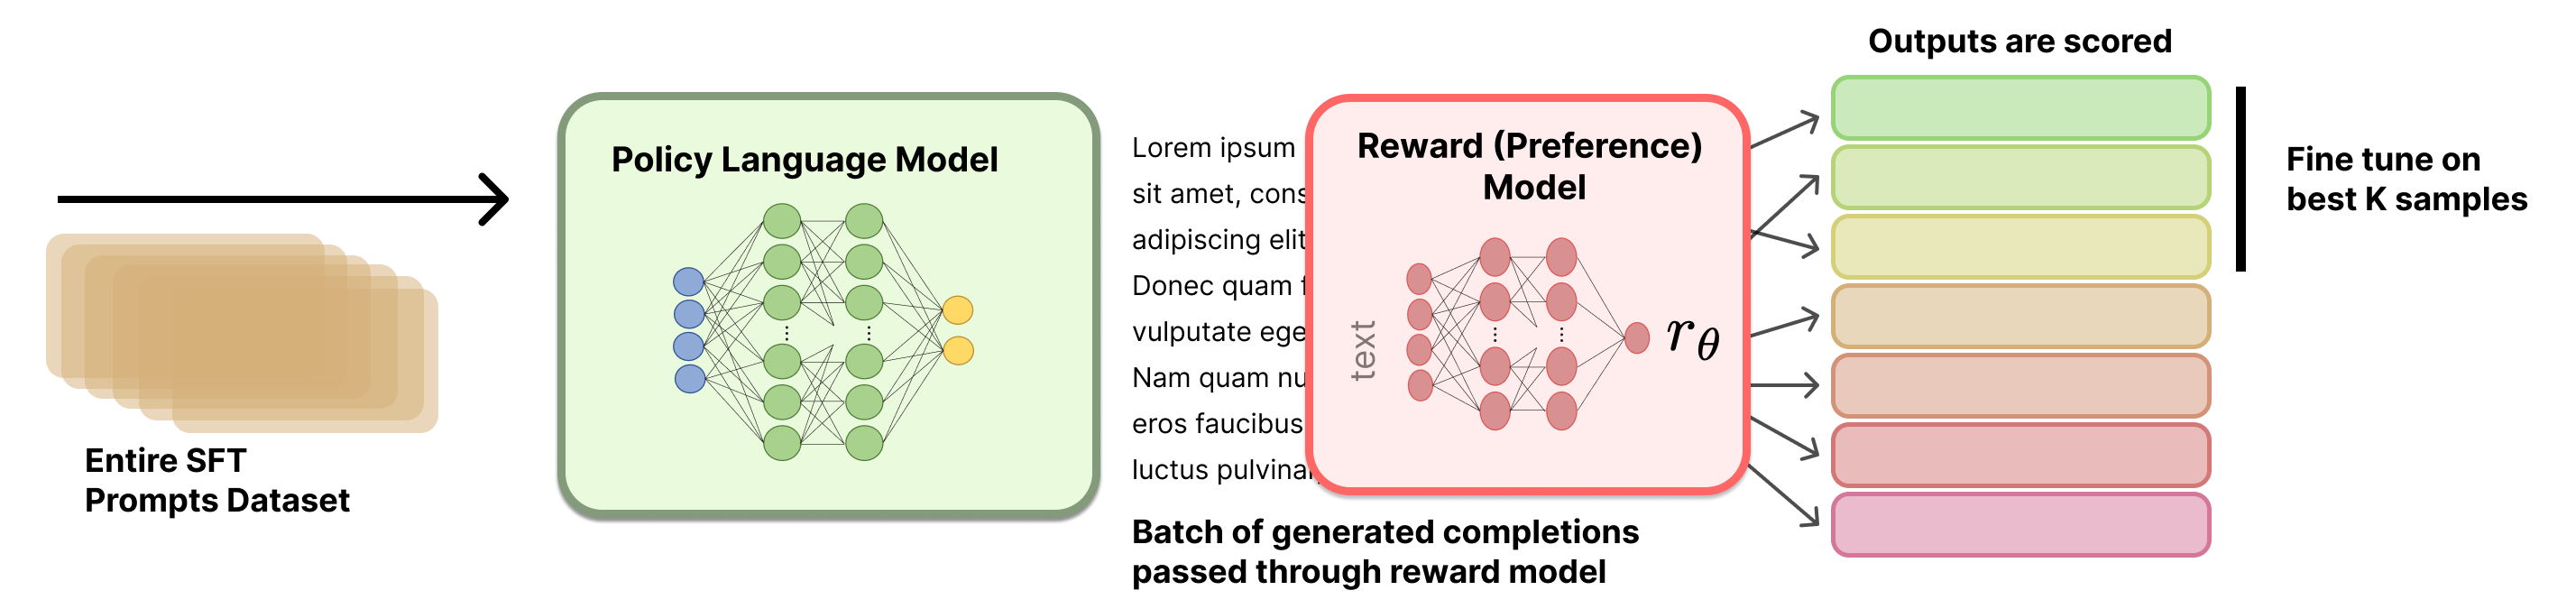
第 0 步:选 prompt,选奖励模型
这一步文献里写得最少,实际影响却最大。
prompt 从哪来?最省事的做法是把 SFT 阶段的 prompt 全部复用一遍。这能跑通,但有明显的过拟合风险:模型已经在这些 prompt 上被训过一轮,再在自己对这些 prompt 的生成上训一次,等于在同一片分布上反复压实,多样性会掉。更好的做法是留一部分新 prompt,或者从下游任务分布里重新采。第 4 章讲过的预算量级在这里同样适用:SFT 约 100 万条 prompt,偏好微调约 100 万条(与 SFT 部分重叠是有用的),RL 微调 1–10 万条。RS 处在「偏好微调」这一档。
RM 从哪来?必须先有一个训好的奖励模型(第 5 章)。这个 RM 的质量直接决定 RS 的上限——RS 本身没有任何纠错机制,RM 说好就是好。如果 RM 有长度偏好,RS 就会训出更长的回复;如果 RM 偏爱 markdown 列表,RS 就会训出满屏列表。这不是 bug,这就是这个算法在做的事。
第 1 步:生成候选
把 $M$ 个 prompt 写成一个向量:
$$ X = [x_1, x_2, \ldots, x_M] $$对每个 prompt $x_i$ 生成 $N$ 个回复,得到一个 $M \times N$ 的矩阵:
$$ Y = \begin{bmatrix} y_{1,1} & y_{1,2} & \cdots & y_{1,N} \\ y_{2,1} & y_{2,2} & \cdots & y_{2,N} \\ \vdots & \vdots & \ddots & \vdots \\ y_{M,1} & y_{M,2} & \cdots & y_{M,N} \end{bmatrix} $$其中 $y_{i,j}$ 是第 $i$ 个 prompt 的第 $j$ 个回复。第 $i$ 行是同一个 prompt 的 $N$ 个候选(这一行内部是可比的,因为条件相同);第 $j$ 列是所有 prompt 的第 $j$ 次采样(列没有任何意义,采样是 i.i.d. 的,第 3 列和第 7 列没区别)。记住行有意义、列没意义这件事,第 3 节讲选择策略时会用到。
这里的关键超参是采样温度必须大于 0。$N$ 个完全相同的贪心解码结果毫无用处——RS 吃的是多样性。实践中温度取 0.7–1.0,通常还配 top-p(0.9–0.95)或 top-k。参考实现里用的是 temperature 0.8 / top-p 0.95 / top-k 20。
第 2 步:打分
把所有 $M\times N$ 个「prompt-回复」对过一遍 RM,得到同形状的奖励矩阵:
$$ R = \begin{bmatrix} r_{1,1} & r_{1,2} & \cdots & r_{1,N} \\ r_{2,1} & r_{2,2} & \cdots & r_{2,N} \\ \vdots & \vdots & \ddots & \vdots \\ r_{M,1} & r_{M,2} & \cdots & r_{M,N} \end{bmatrix}, \qquad r_{i,j} = \mathcal{R}(y_{i,j} \mid x_i) $$每个 $r_{i,j}$ 是一个标量。注意 shape:$Y$ 和 $R$ 逐元素对应,$R$ 是 $M\times N$ 的实数矩阵,取值范围取决于 RM 的训练方式——Bradley-Terry RM 输出的是无界实数(典型范围大致 $[-10, 10]$,但没有任何保证),ORM 输出的是 $[0,1]$ 的概率。不同 RM 的分数尺度完全不可比,换 RM 就要重新校准所有阈值。
然后定义一个选择函数 $S$,它吃 $R$,吐出「要保留哪些格子」。这是整章唯一有设计空间的地方,下一节专门讲。
第 3 步:在选中的数据上做 SFT
拿选出来的 $(x, y)$ 对,用和第 4 章完全一样的指令微调损失训练当前 checkpoint:
$$ \mathcal{L}(\theta) = -\sum_{t} \log \pi_\theta(y_t \mid x, y_{<t}) $$prompt 部分 mask 掉,只在回复 token 上算 loss。没有任何新东西。
原文诚实地承认:这一步的具体训练细节从来没有被公开过。大概率与初始 IFT 阶段的设置不同(更低的学习率、更少的 epoch),但没有论文写清楚。参考实现用的是 lr $5\times10^{-6}$、2 个 epoch,比典型 SFT 保守一档。
- 生成:$10^6$ 条回复 × 512 token = $5\times10^8$ 个生成 token。这是整个流程最贵的一段,也是唯一无法用 batch 并行完全摊平的(自回归解码)。用 vLLM 这类推理引擎,8B 模型在 8×H100 上大约每秒几千 token/卡,量级是几十 GPU 小时。
- 打分:$10^6$ 次 RM 前向,每次约 700 token(prompt + 回复)。前向不是解码,整条序列一次算完,可以打满 batch。量级比生成小一个数量级以上。
- 训练:只有 $M = 10^5$ 条样本(每 prompt 取 1 条),2 个 epoch。这是三段里最便宜的——和一次小规模 SFT 没有区别。
一个容易被忽视的工程细节:按长度排序
做 RM 的批量推理时,把 tokenize 之后的序列按长度排序再切 batch,这样每个 batch 内部长度接近,padding token 大幅减少。用一点点实现复杂度换吞吐,几乎是白拿的收益。参考实现里就是这么做的:
# 改写自 _src/code/rejection_sampling/preprocess.py::score_rollouts
# 关键思想:先把所有 (prompt, completion) 对 tokenize 成扁平列表,
# 按长度排序后再切 batch,最后把分数写回原来的 (i, j) 位置。

flat = []
for i, prompt in enumerate(prompts):
    for j, completion in enumerate(completions[i]):
        chat_str = build_scoring_chat(prompt, completion, rm_tokenizer)
        ids = rm_tokenizer.encode(chat_str, add_special_tokens=False)
        flat.append((i, j, ids))

flat.sort(key=lambda item: len(item[2]))          # <- 这一行就是全部的技巧

rewards = [[0.0] * N for _ in prompts]
for start in range(0, len(flat), score_batch_size):
    batch = flat[start : start + score_batch_size]
    max_len = max(len(ids) for _, _, ids in batch)

    # 左填充:让最后一个 hidden state 永远落在最右端,
    # 这样不管序列多长,取 [:, -1] 都能拿到 EOS 位置的表示。
    input_ids = torch.full((len(batch), max_len), pad_id, dtype=torch.long)
    attention_mask = torch.zeros((len(batch), max_len), dtype=torch.long)
    for row, (_, _, ids) in enumerate(batch):
        input_ids[row, max_len - len(ids):] = torch.tensor(ids)
        attention_mask[row, max_len - len(ids):] = 1

    with torch.no_grad():
        scores = rm(input_ids=input_ids.to(rm.device),
                    attention_mask=attention_mask.to(rm.device)).logits[:, 0]

    for (i, j, _), s in zip(batch, scores.float().cpu().tolist()):
        rewards[i][j] = s                          # 写回原始 (i, j) 坐标
注意这里用的是左填充(left padding)而不是右填充。因为 Bradley-Terry RM 的分数取自序列最后一个非 padding token 的隐状态;左填充让「最后一个真实 token」永远在下标 $-1$,索引逻辑就不用再算长度了。生成阶段也是左填充,理由类似(让所有 prompt 的末尾对齐,这样 generate 才能正确接着往下写)。
3. 选择策略:每 prompt 取 top-1,还是全局取 top-K
拿到 $M\times N$ 的奖励矩阵 $R$ 之后,怎么决定训哪些?这是 RS 里唯一真正的设计决策,其余部分都是标准组件。原书给了两种基本策略,它们的差别远比看上去大。
策略一:每 prompt 取最优(top per prompt)
对每一行独立取 argmax:
$$ S(R) = \left[\argmax_{j} r_{1,j},\ \argmax_{j} r_{2,j},\ \ldots,\ \argmax_{j} r_{M,j}\right] $$$S$ 返回一个长度为 $M$ 的列索引向量,第 $i$ 个元素是第 $i$ 行最大值所在的列号。然后按这些索引取出回复:
$$ Y_{\text{chosen}} = \left[y_{1,S(R)_1},\ y_{2,S(R)_2},\ \ldots,\ y_{M,S(R)_M}\right] $$结果:恰好 $M$ 条训练样本,每个 prompt 一条,无一遗漏。
策略二:全局取前 K 对(top overall pairs)
先把矩阵按行主序拉平成一个长度 $MN$ 的向量:
$$ R_{\text{flat}} = [r_{1,1}, \ldots, r_{1,N},\ r_{2,1}, \ldots, r_{2,N},\ \ldots,\ r_{M,1}, \ldots, r_{M,N}] $$然后取全局最高的 $K$ 个:
$$ S_K(R_{\text{flat}}) = \text{argsort}(R_{\text{flat}})[-K:] $$其中 $\text{argsort}$ 返回升序排序对应的索引,取最后 $K$ 个就是最大的 $K$ 个。要把扁平索引 $k$(从 0 开始)还原回 $(i,j)$:
$$ i = \left\lfloor k / N \right\rfloor + 1, \qquad j = (k \bmod N) + 1 $$结果:恰好 $K$ 条样本,但每个 prompt 贡献几条完全不受控——可能 0 条,也可能 5 条。
把例子完整走一遍
5 个 prompt、每个 4 个回复:
$$ R = \begin{bmatrix} 0.7 & 0.3 & 0.5 & 0.2 \\ 0.4 & 0.8 & 0.6 & 0.5 \\ 0.9 & 0.3 & 0.4 & 0.7 \\ 0.2 & 0.5 & 0.8 & 0.6 \\ 0.5 & 0.4 & 0.3 & 0.6 \end{bmatrix} $$按行取最优,每行的最大值加粗:
$$ R = \begin{bmatrix} \mathbf{0.7} & 0.3 & 0.5 & 0.2 \\ 0.4 & \mathbf{0.8} & 0.6 & 0.5 \\ \mathbf{0.9} & 0.3 & 0.4 & 0.7 \\ 0.2 & 0.5 & \mathbf{0.8} & 0.6 \\ 0.5 & 0.4 & 0.3 & \mathbf{0.6} \end{bmatrix} \qquad S(R) = [1,\ 2,\ 1,\ 3,\ 4] $$即:prompt 1 选回复 1(0.7)、prompt 2 选回复 2(0.8)、prompt 3 选回复 1(0.9)、prompt 4 选回复 3(0.8)、prompt 5 选回复 4(0.6)。五个 prompt 每个都有代表。
全局取前 5。先拉平:
$$ R_{\text{flat}} = [0.7,\ 0.3,\ 0.5,\ 0.2,\ 0.4,\ 0.8,\ 0.6,\ 0.5,\ 0.9,\ 0.3,\ 0.4,\ 0.7,\ 0.2,\ 0.5,\ 0.8,\ 0.6,\ 0.5,\ 0.4,\ 0.3,\ 0.6] $$最高的 5 个值对应的扁平索引是:
$$ S_5(R_{\text{flat}}) = [8,\ 5,\ 14,\ 0,\ 11] $$按 $i=\lfloor k/4\rfloor+1,\ j=(k\bmod 4)+1$ 还原:
| 扁平索引 $k$ | $(i, j)$ | 奖励 | 说明 |
|---|---|---|---|
| 8 | prompt 3, 回复 1 | 0.9 | 全局最高 |
| 5 | prompt 2, 回复 2 | 0.8 | |
| 14 | prompt 4, 回复 3 | 0.8 | |
| 0 | prompt 1, 回复 1 | 0.7 | |
| 11 | prompt 3, 回复 4 | 0.7 | prompt 3 的第二条 |
结果对比一目了然:prompt 3 贡献了两条训练样本,而 prompt 5 一条都没有。prompt 5 的最好回复只有 0.6 分,全局排不进前 5,于是它在这一轮训练里完全消失了。
两种偏置,各选一种毒药
但每 prompt top-1 也不是免费的。它的问题是:无论这个 prompt 的最佳回复有多烂,你都会训它。如果某个 prompt 的 4 个回复分数是 $[-2.1, -2.3, -2.0, -2.5]$(全是垃圾),top-1 依然会把那条 $-2.0$ 的塞进训练集。你等于在教模型「这样答是对的」,而它其实不对。这是一个隐蔽的退化通道。
所以「prompt 3 的 0.7 分比 prompt 5 的 0.6 分好」这个判断,可能只是因为 prompt 3 这一行整体偏移量更高,而不是因为那条回复真的更好。行内的比较(top per prompt)是 RM 被训练去做的事;跨行的比较(top-K overall)不是。这是全局 top-K 更值得警惕的深层原因。
更多变体
| 策略 | 输出规模 | prompt 覆盖 | 主要偏置 / 适用场景 |
|---|---|---|---|
| 每 prompt top-1 | $M$ 条 | 100% | 最标准的做法。全覆盖,但会训进「全体候选都很烂」的那些行。 |
| 每 prompt top-$k$($k>1$) | $kM$ 条 | 100% | 数据量放大 $k$ 倍,但同一 prompt 的多条回复高度相关,实际信息增量远小于 $k$ 倍。$k=2,3$ 常见。 |
| 全局 top-K | $K$ 条 | 部分 | 追求绝对质量。会把数据集中到容易题上,且依赖跨 prompt 分数可比这个可疑假设。 |
| 全局阈值过滤($r > \tau$) | 不定 | 部分 | 比 top-K 更直白,但 $\tau$ 的取值完全依赖 RM 的尺度,换 RM 就要重调。且数据量不可预测,训练调度难安排。 |
| 组内归一化后再全局选 | 可控 | 可调 | 先对每行做 $\tilde r_{i,j} = (r_{i,j} - \mu_i)/\sigma_i$,再全局比。这就把「跨 prompt 不可比」的问题按 GRPO 的思路修掉了——本质是在算组内 advantage。原书没提,但这是把两种策略的优点合起来的自然做法。 |
| top-1 + 质量下限 | $\le M$ 条 | 部分 | 取每行最优,但若最优值低于绝对阈值就整行丢弃。堵住「全烂也训」的漏洞,代价是难题被跳过。 |
最小可读实现
参考实现里的选择策略只有几行,但结构值得注意:每个基于奖励的策略都配了一个同预算的随机对照。这一点在第 8 节会展开讲,先看代码。
# 改写自 _src/code/rejection_sampling/selection.py
# records 里每条形如:
#   {"question": str, "completions": [str, ...], "rewards": [float, ...]}

def select_top_per_prompt(records):
    """每行 argmax:输出 M 条,每个 prompt 恰好一条。"""
    pairs = []
    for rec in records:
        if not rec["completions"]:
            continue
        best = max(range(len(rec["rewards"])), key=lambda j: rec["rewards"][j])
        pairs.append((rec["question"], rec["completions"][best]))
    return pairs


def select_top_k_overall(records, k):
    """把 M x N 全部拉平,按奖励降序取前 k 条。"""
    flat = [
        (float(reward), rec["question"], completion)
        for rec in records
        for completion, reward in zip(rec["completions"], rec["rewards"])
    ]
    flat.sort(key=lambda item: item[0], reverse=True)
    return [(q, c) for _, q, c in flat[:k]]


# ---- 以下两个是「同预算随机对照」,不看奖励,只掷骰子 ----

def select_random_per_prompt(records, seed):
    """对照 top_per_prompt:每行随机取一条。数据量、prompt 覆盖率完全一致。"""
    rng = random.Random(seed)
    pairs = []
    for rec in records:
        if not rec["completions"]:
            continue
        pick = rng.randrange(len(rec["completions"]))
        pairs.append((rec["question"], rec["completions"][pick]))
    return pairs


def select_random_k_overall(records, k, seed):
    """对照 top_k_overall:从扁平池里均匀抽 k 条。样本预算完全一致。"""
    rng = random.Random(seed)
    flat = [(rec["question"], c) for rec in records for c in rec["completions"]]
    return rng.sample(flat, min(k, len(flat)))
注意这四个函数成对出现:top_per_prompt ↔ random_per_prompt(都输出 $M$ 条、都是全 prompt 覆盖),top_k_overall ↔ random_k_overall(都输出 $K$ 条、都从扁平池取)。每一对里唯一的差别就是「用不用奖励」。这个设计不是为了好看,它是让实验结论可解释的唯一办法。
4. $N$ 取多大:收益曲线、KL 代价、以及「可判定比例」
原书给的经验区间是 10 到 30 或更多,并附一句警告:「$N$ 太小会让训练有偏且/或有噪声。」这句话值得拆开讲,因为它同时说了两件不同的事。
为什么 $N$ 太小会「有噪声」
RM 的打分是有噪声的。把它建模成「真实质量 + 噪声」:$r_{i,j} = q_{i,j} + \epsilon_{i,j}$。当你在 $N$ 个候选里取 argmax 时,你选中的是质量高的还是噪声大的?答案取决于两者的方差之比。
如果 $N$ 个候选的真实质量差异很小(比如模型对这个 prompt 答得都差不多),而 RM 噪声不小,那么 argmax 基本就是在选 $\epsilon$ 最大的那一个——你训练的是「RM 最容易被骗的那种回复」。这是过优化的微观机制:不是模型学坏了,是选择函数把噪声当信号放大了。
$N$ 更大时情况会好些吗?两个相反的效应:一方面候选池里真正的好回复出现概率上升(信号变强),另一方面 $\max_j \epsilon_{i,j}$ 也随 $N$ 增大(噪声也变强)。对高斯噪声,$N$ 个样本最大值的期望大约按 $\sigma\sqrt{2\ln N}$ 增长——增长很慢,但不停。所以 $N$ 与效果的关系是一条先升后降的曲线,峰值位置取决于 RM 的质量。这正是 Gao、Schulman、Hilton 那篇过优化 scaling law 论文的核心图形(第 14 章会详细讲)。
为什么 $N$ 太小会「有偏」
这是另一件事。$N=2$ 时,你选出来的「最优」有 50% 的概率就是随机的那一个(如果 RM 完全没信号)。更重要的是:$N$ 太小的时候,你根本没有给模型机会展示它的上限。模型对某个 prompt 有 20% 概率答对,$N=2$ 时你有 64% 的概率一个对的都采不到,那么这个 prompt 上的 RS 训练不但没帮助,还在强化错误答案。
| $p$ | $N{=}1$ | $N{=}4$ | $N{=}8$ | $N{=}16$ | $N{=}32$ |
|---|---|---|---|---|---|
| 0.05 | 5% | 19% | 34% | 56% | 81% |
| 0.20 | 20% | 59% | 83% | 97% | 99.9% |
| 0.50 | 50% | 94% | 99.6% | >99.9% | >99.9% |
KL 代价:best-of-$N$ 走了多远
这里有一个非常有用的量化工具。虽然 best-of-$N$ 采样不改变模型权重,但它确实定义了一个新的分布——「从 $\pi$ 采 $N$ 次取最优」这个过程本身就是一个策略,记作 $\pi_{\text{BoN}}$。既然是分布,就可以问它离原策略 $\pi$ 有多远。
答案有一个漂亮的解析形式:
$$ \KL\!\left(\pi_{\text{BoN}} \,\|\, \pi\right) \;\approx\; \log N - \frac{N-1}{N} $$代入数值:
| $N$ | $\log N$ | $\KL \approx \log N - \frac{N-1}{N}$(nats) | 生成算力 |
|---|---|---|---|
| 2 | 0.69 | 0.19 | 2× |
| 4 | 1.39 | 0.64 | 4× |
| 8 | 2.08 | 1.20 | 8× |
| 16 | 2.77 | 1.83 | 16× |
| 32 | 3.47 | 2.50 | 32× |
| 64 | 4.16 | 3.18 | 64× |
| 256 | 5.55 | 4.55 | 256× |
这也解释了为什么 BoN 是一个「诚实的 baseline」:把 PPO 的效果和 BoN 的效果画在同一张「KL vs. 奖励」的图上,你就能看出 PPO 有没有真的比「暴力多采几次」学到更多东西。这是 RLHF 论文里的标准诊断,也是原书强调「BoN 与 PPO 的比较在某些语境下仍然有效」的确切含义。
更实用的诊断:可判定比例(decidable fraction)
参考实现里有一个诊断量非常值得学,原书没提但它抓住了 RS 实践里最关键的现实:
把每个 prompt 分成三类:$N$ 个回复全对、全错、以及有对有错(可判定)。只有第三类 prompt 上,选择策略才可能起作用。
# 改写自 _src/code/rejection_sampling/diagnostics.py
def decidable_fraction(df):
    """df 每行是一个 (prompt, completion) 对,含 correct 布尔列。"""
    n_prompts   = df["prompt_idx"].nunique()
    per_prompt  = df.groupby("prompt_idx")["correct"]
    all_correct = int((per_prompt.sum() == per_prompt.size()).sum())
    none_correct= int((per_prompt.sum() == 0).sum())
    decidable   = n_prompts - all_correct - none_correct
    return decidable / n_prompts        # 选择策略「有机会起作用」的比例
为什么这个数字要命:如果 decidable_fraction 是 0.15,那么你精心设计的选择策略最多只能影响 15% 的训练样本,剩下 85% 里,用 argmax 和用随机骰子选出来的东西在正确性上没有区别。这时候即便 RM 完美,RS 相对随机基线的提升也只有个位数百分点——天花板是数据侧的,不是 RM 侧的。
这解释了一个常见的困惑:为什么在 GSM8K 这类模型已经很强的数据集上跑 RS,常常看不到明显收益?因为大部分题目模型 8 次全对,选谁都一样。参考实现在 1000 条 GSM8K 训练切片上的观察正是如此:top_k_overall 略胜其随机对照,而 top_per_prompt 与 random_per_prompt 基本打平——README 明确提醒把这种小差距当作切片噪声,而不是稳定的排序结论。
- 奖励直方图:把「正确回复」和「错误回复」的奖励分布画在一起。如果两个峰重叠严重,RM 在这个任务上没有分辨力,RS 不会有效果。
- 行内命中率:在可判定的 prompt 上,$\argmax$ 选中正确回复的比例 vs. 随机选中的比例。这个 gap 就是 RM 在这批数据上的净信号强度。
- best-of-$N$ 扫描:$N=1\ldots K$ 时「top-$N$ 里至少有一条正确」的比例,同时画出「随机 $N$ 条里至少有一条正确」的对照。两条曲线的间距随 $N$ 的变化,直接告诉你 $N$ 该取多大。
diagnostics.py 就是干这三件事的,跑一次只需要已经缓存好的 rollout,不需要任何训练。
5. Best-of-N:把微调那一步删掉会发生什么
best-of-N(BoN)采样是 RS 的近亲:完全相同的「生成 + 打分」流程,但不做最后的微调。生成 $N$ 个、挑最好的一个直接返回给用户,仅此而已。
| 拒绝采样(RS) | best-of-N(BoN) | |
|---|---|---|
| 生成 $N$ 个候选 | ✓ | ✓ |
| RM 打分排序 | ✓ | ✓ |
| 在选中样本上微调 | ✓ | ✗ |
| 模型权重是否改变 | 改变 | 不变 |
| 算力花在哪 | 训练时(一次性) | 推理时(每次查询都要付) |
| 部署后的成本 | 与原模型相同 | $N$ 倍延迟或 $N$ 倍并发成本 |
这张表的最后两行是关键。RS 和 BoN 得到的是同一种「改进」,区别只在于你什么时候付这笔算力账。RS 把 $N$ 倍算力花在训练期,之后每次推理都是普通的一次生成;BoN 不训练,但从此每一次用户查询都要跑 $N$ 次。
这也解释了 BoN 在产品里的位置:聊天产品的「Pro 档」「深度思考」这类功能,本质上就是花更多推理算力去换一个更好的答案,BoN(以及它的变体:多次采样后投票、多次采样后用另一个模型评判)是其中最简单的一种。
单个 prompt 时,两种选择准则是同一件事
原书特意证明了一件小事,值得跟着走一遍,因为它澄清了记号。设只有一个 prompt、$N$ 个回复,奖励是一个向量:
$$ R = [r_1, r_2, \ldots, r_N] $$「每 prompt 取最优」就是
$$ S(R) = \argmax_{j \in [1,N]} r_j $$而「全局 top-$K$」在 $K=1$ 时是 $\text{argsort}(R)[-1:]$,也就是最大值的索引——和 argmax 完全一样。$M=1, K=1$ 时两种策略退化为同一个东西,这就是通常说的 best-of-$N$。第 3 节里两种策略的分歧只有在 $M>1$ 时才出现,而它来源于「跨 prompt 怎么比」这个问题——单 prompt 时这个问题根本不存在。
为什么可以拿 BoN 和 PPO 比
原书这里有一句容易被略过但很重要的话:「BoN 并不修改底层模型,它是一种采样技术。正因如此,把 BoN 和 PPO 这类在线训练方法作比较,在某些语境下仍然是有效的——比如你依然可以测量 BoN 采样相对任何其他策略的 KL 距离。」
把这句话展开:一个「对齐方法」到底该被怎么评价?只看最终奖励是不够的,因为你总可以把奖励刷得很高(代价是模型完全崩坏)。公平的比较必须是「在同等偏离基础模型的程度下,谁拿到的真实质量更高」。而「偏离程度」的标准度量就是 $\KL(\pi \| \pi_{\text{ref}})$。
关键在于:BoN 虽然不改权重,但它确实定义了一个分布(第 4 节已经算出它的 KL 是 $\log N - \frac{N-1}{N}$)。所以 BoN 可以和 PPO、DPO 一起画在同一张「x 轴 = KL、y 轴 = 真实奖励或人类评分」的图上。这张图是 RLHF 评估的标准形式:
- 如果 PPO 的曲线在 BoN 曲线上方,说明梯度优化确实学到了 BoN 靠暴力采样学不到的东西。
- 如果两条曲线重合,说明你的 PPO 实现基本等价于「多采几次挑好的」——这时候不如直接用 BoN,省掉全部工程复杂度。
- 如果 PPO 曲线在 BoN 下方,你的 PPO 训崩了。
从 BoN 回到 RS:蒸馏视角
把两者放在一起看,还有一个更统一的解释:
BoN 定义了一个比 $\pi$ 更好的策略 $\pi_{\text{BoN}}$,但这个策略只存在于推理流程里,不在权重里。RS 就是把 $\pi_{\text{BoN}}$ 蒸馏回权重的过程。
这个视角能一次性解释很多现象:
- 为什么 RS 用的是 SFT 损失?因为蒸馏就是在 teacher 的样本上做最大似然。这里的 teacher 是 $\pi_{\text{BoN}}$,而它的样本恰好就是「$N$ 选 1」的那些回复。这是 on-policy 蒸馏的一个特例——teacher 和 student 来自同一个模型。
- 为什么 RS 的效果上限被 $N$ 卡住?因为 student 最多学到 teacher 那么好,而 teacher 的能力上限就是 $\log N - \frac{N-1}{N}$ 那点 KL 预算。
- 为什么要迭代做?蒸馏完一轮之后,新的 $\pi$ 比原来强了,在新 $\pi$ 上再做一次 BoN 又能得到一个更强的 teacher。这就是 Llama 2 Chat 那种「5 轮拒绝采样微调」的逻辑:每一轮的 KL 位移都很小很安全,但可以叠加。
- 为什么 RS 天然稳定?因为每一轮的目标策略 $\pi_{\text{BoN}}$ 都离当前策略只有约 1–2 nats——KL 约束是被 $N$ 隐式施加的,不需要显式的惩罚项。这一点在下一节还会再展开。
顺着这个视角还有一条完整的研究线:既然 RS 是在蒸馏 BoN 分布,能不能设计一个损失函数直接让策略逼近 $\pi_{\text{BoN}}$,而不走「采样 + argmax + 最大似然」这条粗糙路径?BOND(Best-of-N Distillation)就是这个方向的代表工作。
6. 和 RL 的关系:最简单的策略改进算法
讲座里 Lambert 对 RS 的定位是一句话:「没有策略梯度,没有在线 RL——就是过滤后的监督学习。」但这句话只说对了一半。RS 确实没用策略梯度的机器,可它在做的事和策略梯度是同一件事,只是用了一个粗糙得多的近似。把这层关系讲清楚,是理解「什么时候 RS 够用、什么时候必须上 PPO」的前提。
从 REINFORCE 看 RS
回忆第 6 章的策略梯度目标:最大化期望奖励
$$ J(\theta) = \E_{x\sim\mathcal{D},\, y\sim\pi_\theta(\cdot\mid x)}\big[r(x,y)\big] $$REINFORCE 的梯度估计是
$$ \nabla_\theta J(\theta) = \E_{x\sim\mathcal{D},\, y\sim\pi_\theta(\cdot\mid x)}\big[\,r(x,y)\,\nabla_\theta \log \pi_\theta(y\mid x)\,\big] $$读这个式子要注意三件事:期望对 $(x,y)$ 取;$y$ 必须从当前策略 $\pi_\theta$ 采样(这是 on-policy 的要求);梯度只作用在 $\log \pi_\theta$ 上,$r$ 是一个不参与求导的标量权重。
现在看 RS 在做什么。RS 的训练损失是选中样本上的负对数似然,它的梯度是:
$$ \nabla_\theta \mathcal{L}_{\text{RS}} = -\E_{x\sim\mathcal{D},\, y\sim\pi_{\theta_{\text{old}}}(\cdot\mid x)}\big[\,w(x,y)\,\nabla_\theta \log \pi_\theta(y\mid x)\,\big], \qquad w(x,y) = \mathbb{1}\!\left[y \in Y_{\text{chosen}}\right] $$两个式子的形状一模一样。差别只有两处:
| REINFORCE | 拒绝采样 | |
|---|---|---|
| 样本权重 | 连续的 $r(x,y)$(或减去 baseline 后的 advantage) | 硬门限 $\{0, 1\}$:入选得 1,落选得 0 |
| 采样分布 | $\pi_\theta$,每步更新后重新采样 | $\pi_{\theta_{\text{old}}}$,整批数据一次采完、多个 epoch 复用 |
| 负样本 | 负 advantage 的样本会被推低概率 | 落选样本权重为 0,什么也不做 |
| 重要性采样修正 | PPO 里有 $\pi_\theta/\pi_{\theta_{\text{old}}}$ 比值 + clip | 无 |
和 GRPO 的距离,比想象中近
GRPO(第 6 章)的核心是:对同一个 prompt 采一组 $N$ 个回复,用组内均值做 baseline 算 advantage:
$$ A_{i,j} = \frac{r_{i,j} - \mu_i}{\sigma_i}, \qquad \mu_i = \frac{1}{N}\sum_j r_{i,j} $$然后按 $A_{i,j}$ 加权做策略梯度。把这个式子和 RS 并排看:
- 数据结构完全相同:都是 $M\times N$ 的「一 prompt 多回复」矩阵。GRPO 的「组」就是 RS 的「行」。
- 都在做组内相对比较,都因此绕开了「跨 prompt 奖励尺度不可比」的问题(第 3 节那个坑)。
- 差别在于权重函数:GRPO 用连续的标准化 advantage,RS 用 $\mathbb{1}[j = \argmax_j r_{i,j}]$。
换句话说,RS ≈ 一个只保留最大正 advantage、把其余全部置零的单步 GRPO。第 3 节表格里提到的「组内归一化后再全局选」那个变体,其实就是在往 GRPO 的方向走了半步。这条连线很有用:它意味着你在 RS 上积累的直觉($N$ 该多大、行内比较为什么重要、覆盖率为什么是天花板)几乎可以原封不动地搬到 GRPO 上。
隐式的 KL 约束
PPO 版 RLHF 的目标里有一个显式的 KL 惩罚:
$$ J(\pi) = \E\big[r_\theta(x,y)\big] - \beta\, \KL\!\left(\pi \,\|\, \pi_{\text{ref}}\right) $$这一项存在的理由是:不加约束地最大化一个学出来的奖励,模型会跑到 RM 的分布外区域去薅高分,产出人类根本不认可的东西。$\beta$ 要调,调不好就是过优化或者学不动。
RS 里没有这一项,但约束依然存在——只是被隐藏在采样过程里。逻辑很直接:
- 训练数据全部由当前策略自己生成,所以每一条训练样本的概率 $\pi_\theta(y\mid x)$ 本来就不低(它刚刚才被采出来)。
- 模型不可能被推向它「完全不会生成」的区域——那些区域根本不会出现在候选池里。
- 这一轮的目标策略是 $\pi_{\text{BoN}}$,而第 4 节算过它离当前策略只有约 $\log N - \frac{N-1}{N}$ nats。$N$ 就是隐式的 $\beta$:$N$ 越大,允许的位移越大。
迭代式拒绝采样:把小步叠成大步
既然每一轮只能走一小步,那就多走几轮。这正是 Llama 2 Chat 的做法:整个 RLHF 流程是 5 轮拒绝采样微调,只有最后一轮才换成 PPO。每一轮的模式是:
- 用当前模型生成候选 → RM 打分 → 挑最优 → SFT,得到新模型;
- 顺便收集新的偏好数据(新模型的输出送去人工标注)→ 更新 RM;
- 回到第 1 步。
这里有一个重要细节:RM 也要跟着一起更新。如果不更新,第 3 轮的模型输出对于第 1 轮训的 RM 来说已经是分布外的了——RM 对它没见过的分布打分不可靠,过优化会立刻出现。这条经验在开源复现里被反复验证,也是「迭代式 RLHF」(iterative RLHF)与「一次性 RLHF」的核心区别。
另一个变体是异构模型生成:候选池不只来自待训练的模型,也来自其他更强的模型。这时 RS 就滑向了蒸馏——你在教模型模仿一个它自己产生不出来的分布。原书对此的态度很克制:「最佳实践尚未确立。」需要注意的是这会破坏上面那个「隐式 KL 约束」的论证——来自别的模型的样本,在当前策略下的概率可以任意低,位移不再有 $\log N$ 的上界。
7. 工程账:为什么工业界离不开它,以及什么时候它就够了
超参数清单
原书说这些超参「非常直观」,确实如此,但每一个背后都有一句话要说:
| 超参 | 典型取值 | 为什么 |
|---|---|---|
| 采样温度 | 0.7 – 1.0 | 必须 > 0。温度是多样性的旋钮,多样性是 RS 的燃料。太低(<0.5)$N$ 个样本趋同,选择无意义;太高(>1.2)候选质量整体下滑,argmax 也救不回来。 |
| top-p / top-k | top-p 0.9–0.95;top-k 20–50 | 配合温度用,砍掉长尾里的胡言乱语。参考实现用 top-p 0.95 + top-k 20。 |
| 每 prompt 候选数 $N$ | 10 – 30 或更多 | 成功的实现都在这个区间。太少则「训练有偏且/或有噪声」(第 4 节)。教学用的参考实现为了省算力用了 8,属于偏低端。 |
| 最大生成长度 | 与任务匹配 | 截断的回复在 RM 眼里通常分很低(缺 EOS),会污染选择。参考实现用 512。 |
| SFT 学习率 | 比初始 IFT 低一档 | 原书直言「没有公开的明确训练细节」。参考实现用 $5\times10^{-6}$,比典型 SFT 的 $1\text{–}2\times10^{-5}$ 保守。理由:数据是模型自己生成的,分布很窄,学快了立刻多样性坍缩。 |
| epoch 数 | 1 – 2 | 同上。数据量本来就只有 $M$ 条,多训就是过拟合。 |
| RM 推理 batch | 按长度排序后尽量打满 | 见第 2 节的代码。纯前向,比生成便宜得多,别在这里省。 |
为什么工业界喜欢它:一笔基础设施的账
如果只看算法效率,RS 打不过 PPO。但工业界的选择函数里,算法效率只是一个分量。把在线 RL 和 RS 的系统需求并排列出来,差距会非常刺眼:
| 系统需求 | 在线 RL(PPO / GRPO) | 拒绝采样 |
|---|---|---|
| 显存里同时要放几份权重 | 策略 + 参考 + 奖励 + 价值(PPO)= 最多 4 份 | 任意时刻只需 1 份(三阶段串行) |
| 训练进程与推理引擎的关系 | 必须共存,每步之后要同步权重到 vLLM | 完全解耦,可以是两个不相干的作业 |
| 作业失败的代价 | 整条 RL 曲线作废,从 checkpoint 重跑 | rollout 缓存还在,重跑只损失最后一段 |
| 并行方式 | 需要 rollout / 训练的分布式协调,落后者拖慢全局 | 生成阶段可以无限水平扩展,prompt 之间零依赖 |
| 能否用抢占式 / 空闲算力 | 基本不能(长时有状态) | 能——生成是无状态批处理,被抢占了重跑那几条就行 |
| 需要的团队技能 | 会调 RL:KL 系数、GAE $\lambda$、clip 范围、优势归一化… | 会跑 SFT 就行 |
| 调试难度 | 崩了要在几十个耦合的指标里找原因 | 三段各自可单独检查(生成对不对?打分合理吗?训练 loss 正常吗?) |
这也解释了为什么 RS 在 2022–2023 年那么流行:那时候几乎没有团队有能跑通的 PPO 基础设施。而 RS 你今天下午就能跑起来。
什么时候 RS 就够了
把上面所有分析收敛成一张决策表:
| 场景 | 建议 | 理由 |
|---|---|---|
| 刚有一个 RM,想快速验证「这个 RM 有没有用」 | RS(或纯 BoN 诊断) | 不训练就能出结论。RM 分不开好坏回复,后面上什么算法都白搭。 |
| 目标是风格 / 格式 / 语气对齐 | RS 通常就够 | 这类目标的改进方向在模型已有分布内,$N=10$ 就能采到好样本,不需要长距离的策略位移。 |
| 目标是安全 / 拒答行为 | RS 够,且更可控 | 你能直接检查被选中的样本长什么样。PPO 训出来的行为是黑箱。 |
| 模型对目标任务的成功率已经在 10%–50% | RS 很有效 | 可判定比例高,覆盖率曲线在最陡的位置。 |
| 成功率 < 1%(采不到正样本)或 > 95%(可判定比例≈0) | RS 无效 | 前者 $N=30$ 也捞不到好样本;后者选谁都一样(GSM8K 上常见)。 |
| 需要把能力推到模型当前分布之外(长链推理、复杂工具使用) | 必须上 RL | 需要的 KL 位移远超 $\log N$ 能提供的量级。这也是推理模型时代 RLVR 取代 RS 成为主力的原因。 |
| 有可验证的奖励(数学答案、单测通过)且算力充足 | 直接上 GRPO | 有确定性验证器时,RM 噪声这个 RS 最大的软肋消失了,RL 的样本效率优势可以充分兑现。 |
| 团队没有在线 RL 基础设施,deadline 在两周内 | RS | 见上一张表。 |
还没被解决的问题
原书和讲座都明确列了开放问题,这些不是「留给读者的练习」,是这个领域真实的空白:多阶段管线里 RS 该放在哪、放几次?要不要混入其他模型的生成(「最佳实践尚未确立」)?prompt 该怎么选(复用 SFT prompt 会过拟合,换新的又要重做数据)?RS 阶段的 SFT 超参该怎么定(公开信息为零)?
这个判断值得认真对待,因为它把矛头从 RS 指向了 RM。RS 的代码就是
argmax 加一个 SFT 循环,没有任何可以藏私的地方——真正难复现的是那个能在自己模型的on-policy 输出上准确排序的奖励模型。学术界的 RM 大多是在公开偏好数据(分布外)上训的,拿去给自家模型的 rollout 打分,分辨力会显著下降。而工业界的 RM 是在自家模型每一轮的输出上不断重新标注、重新训练的。这个「RM 与策略共同演化」的闭环,才是 RS 真正的门槛。
本章小结
一句话速查
| 问题 | 答案 |
|---|---|
| RS 是什么 | 生成 $N$ 个候选 → RM 打分 → 留最好的 → 用标准 SFT 损失训练。四个阶段,全部离线。 |
| 损失函数 | 和第 4 章的指令微调一模一样的交叉熵,prompt 部分 mask 掉。 |
| 名字的由来 | 计算统计学:从简单分布采样 + 启发式接受/拒绝,近似复杂目标分布。但 LM 版丢掉了随机接受判定和无偏性。 |
| 两种选择策略 | 每 prompt top-1(覆盖率 100%,但会训进「全烂」的行);全局 top-K(追求绝对质量,但会集中到容易题,且依赖跨 prompt 分数可比这个可疑假设)。 |
| $N$ 取多大 | 10–30 或更多。温度 0.7–1.0。$N$ 太小则选择噪声主导,太大则收益按 $\log N$ 衰减、过优化风险上升。 |
| BoN 的 KL | $\KL \approx \log N - \frac{N-1}{N}$。$N{=}8$ 约 1.2 nats,$N{=}64$ 约 3.2 nats。算力线性涨,优化强度对数涨。 |
| RS vs. BoN | 同一套生成 + 打分,BoN 不做微调。RS 把算力花在训练期,BoN 每次查询都要付 $N$ 倍。 |
| RS vs. REINFORCE | 形状相同,RS 把连续的 advantage 权重量化成 $\{0,1\}$,且用离线数据。丢掉了负样本和奖励幅度信息。 |
| RS vs. GRPO | 数据结构完全相同($M\times N$ 分组)。RS ≈ 只保留最大正 advantage、其余置零的单步 GRPO。 |
| KL 约束在哪 | 没有显式惩罚项。数据全部来自当前策略 + BoN 的 $\log N$ 上界 = 隐式 KL 约束,$N$ 就是 $\beta$。 |
| 为什么工业界爱用 | 三段完全解耦:可缓存、可并行、可抢占、失败代价小、不需要在线 RL 基础设施、会跑 SFT 就会跑。 |
| 什么时候不够用 | 模型成功率 <1%(采不到正样本)或 >95%(可判定比例≈0);需要把能力推到当前分布之外时必须上 RL。 |
| 真正的门槛 | 不是 RS 本身(就是 argmax + SFT),而是那个能在自家模型 on-policy 输出上准确排序的 RM。 |
要点清单
- 行有意义、列没意义:$M\times N$ 矩阵里同一行的候选共享 prompt 因而可比,同一列只是第几次采样,毫无关系。所有靠谱的选择策略都应该建立在行内比较之上。
- Bradley-Terry 损失只约束同 prompt 内的分数差,每行的绝对偏移量是自由的。跨 prompt 比较绝对分数是在使用一个 RM 从未被训练去提供的能力。
- RS 不能创造模型做不到的能力,只能把它偶尔做到的行为固化下来。覆盖率 $1-(1-p)^N$ 是硬天花板。
- 「可判定比例」(有对有错的 prompt 占比)决定了选择策略的作用空间。这个数字低时,再好的 RM 也提升不了多少。
- 迭代做 RS 时,RM 必须跟着一起更新,否则新模型的输出对旧 RM 是分布外的。
- RS 处在核心优化方法的末尾不是因为它高级,而是因为它没有固定位置——IFT 后、RL 后、RLVR 后都能插一刀。
- 它被广泛使用(WebGPT、Anthropic HH、Llama 2/3、过程奖励模型论文)却长期没有正式参考文献,是「工业实践跑在论文前面」的典型样本。
动手实验
作业目录:homework/hw5-rs/,参考实现在 _src/code/rejection_sampling/。任务是 GSM8K:用 Qwen/Qwen3-1.7B 生成解题过程,用 nvidia/AceMath-7B-RM 打分,选一个子集做 SFT,最后在测试集上量 exact-match 准确率。
为什么必须有随机对照组
这是本次作业最重要的一条,重要到值得单独占一节。
假设你跑了 top_per_prompt,准确率从 52% 涨到了 56%。你能得出什么结论?
你想说的是「奖励模型选出了更好的回复,所以模型变好了」。但这个结论下不来,因为至少还有三个解释同样成立:
- 只是多训了一轮 SFT。你在模型自己生成的数据上又训了 2 个 epoch。这是自蒸馏,它本身就能提升表现(收敛到自身的高概率模式、减少采样方差、强化格式一致性),和 RM 一点关系都没有。
- 只是多采样了。从 8 个候选里挑一个再训,哪怕是随机挑,也等价于「在模型输出的一个更宽的样本上做训练」。数据分布已经变了。
- 只是格式被强化了。被选中的回复恰好都以某种格式结尾,模型学会了这个格式,评测脚本的答案抽取正则因此匹配率更高。这在 GSM8K 上特别常见,而它和「推理能力」毫无关系。
- 同一批 rollout:候选池完全相同(参考实现用哈希缓存强制保证这一点,四个配置共享同一份
rollouts/<hash>.jsonl)。 - 同样的训练样本数:
random_per_prompt输出 $M$ 条,和top_per_prompt一样;random_k_overall输出 $K$ 条,和top_k_overall一样。 - 同样的结构:per-prompt 版本都是全 prompt 覆盖,overall 版本都从扁平池取。
- 同样的训练超参、同样的随机种子。
max(rewards) 换成了 rng.randrange(len(completions))。
于是:「$\text{top}$ 的准确率 − $\text{random}$ 的准确率」才是 RM 的净贡献。而「$\text{random}$ 的准确率 − 原始模型的准确率」告诉你「多采样 + 再训一轮」本身值多少分——这个值往往不小,这正是没有对照组时最容易被误读成 RM 效果的那部分。
跑法
第一步:把 rollout 缓存建起来(只需一次)。
cd _src/code/
uv run python -m rejection_sampling.preprocess \
    --config rejection_sampling/configs/top_per_prompt.yaml
这一步做完 Stage 1(生成)和 Stage 2(打分),把结果写成 JSONL,每行一个 prompt:
{"question": "...", "answer": "72",
 "completions": ["...", "..."], "rewards": [0.71, 0.33, ...]}
四个配置的生成/打分参数刻意设成完全一致,所以它们哈希到同一个缓存文件,后续三次训练直接命中缓存。这不只是省时间——它是保证「候选池相同」这个对照前提的机制。跑完注意看它打印的 decidable_fraction。
第二步:跑四个配置,成对读结果。
uv run python -m rejection_sampling.train \
    --config rejection_sampling/configs/top_per_prompt.yaml
uv run python -m rejection_sampling.train \
    --config rejection_sampling/configs/random_per_prompt.yaml
uv run python -m rejection_sampling.train \
    --config rejection_sampling/configs/top_k_overall.yaml
uv run python -m rejection_sampling.train \
    --config rejection_sampling/configs/random_k_overall.yaml
读结果的方式是成对的:top_per_prompt 对 random_per_prompt,top_k_overall 对 random_k_overall。把日志放到 homework/hw5-rs/logs/,建议记一张表:
| 配置 | 训练样本数 | test_accuracy | 相对随机对照的 gap |
|---|---|---|---|
| 基线(不训练) | 0 | — | — |
random_per_prompt | $M$ | — | (基准) |
top_per_prompt | $M$ | — | ← RM 的净贡献 |
random_k_overall | $K$ | — | (基准) |
top_k_overall | $K$ | — | ← RM 的净贡献 |
top_k_overall 胜过它的随机对照,而 top_per_prompt 与 random_per_prompt 基本打平。README 明确提醒:把这种小差距当作切片噪声,不要当成稳定的策略排序。
这个「负结果」本身就是最有价值的教学点:它演示了 decidable_fraction 低时会发生什么。1.7B 的 Qwen3 在 GSM8K 上已经相当强,大量 prompt 是 8 次全对,选谁都一样。如果你的
top 跑不赢它的随机基线,正确的结论不是「RS 没用」,而是「在这个切片上,RM 或候选池没有提供有用的信号」——然后你应该回去看诊断图,而不是继续调训练超参。
先跑诊断,再跑训练
uv run python -m rejection_sampling.diagnostics \
    --cache rejection_sampling/output/rollouts/<hash>.jsonl \
    --out-dir rejection_sampling/output/diagnostics
它输出三张图 + 一段 markdown 汇总,正好对应第 4 节讲的三个诊断:
- 奖励直方图(正确 vs. 错误回复)——两个分布的均值 gap 就是 RM 的原始分辨力。gap 接近 0 就别往下跑了。
- 行内命中率——在可判定的 prompt 上,$\argmax(\text{reward})$ 选中正确回复的比例,以及随机基线的比例。这是在训练之前就能拿到的「RM 净贡献」估计,比跑完整个训练便宜几百倍。
- best-of-$N$ 扫描——$N=1\ldots 8$ 时「top-$N$ 里至少一条正确」vs.「随机 $N$ 条里至少一条正确」。两条线的间距如果很快饱和,说明再加 $N$ 也没用。
建议自己加的实验
- 扫 $N$ 和温度。复制一份 config,改
num_completions_per_prompt(4 / 8 / 16)和temperature(0.6 / 0.8 / 1.0)。注意每改一个都会让缓存哈希变化、必须重新生成,先算好算力预算。观察目标:候选池变大是否真的让「最好的那条」变好?还是只让 RM 有更多机会被噪声骗到? - 扫
selection.top_k。在top_k_overall里改 $K$。顺便统计:$K$ 取多少时,有多少 prompt 完全没有代表?这是第 3 节那个偏置的实测版本。 - 换一个更弱的策略模型。把
model_name换成更小的 instruct 模型,同时调小max_train_samples。这既省算力,又能回答一个关键问题:RS 是在「拯救糟糕的生成」,还是只是在「一堆本来就还行的答案里挑挑拣拣」?弱模型上 decidable_fraction 会显著升高,如果 RM 有真信号,gap 应该也跟着变大。 - 做组内归一化。先对每行做 $\tilde r_{i,j}=(r_{i,j}-\mu_i)/\sigma_i$ 再全局取 top-$K$。如果这个变体明显好过原始的
top_k_overall,就实证了「跨 prompt 奖励尺度不可比」确实是个真问题——顺便也把你推到了 GRPO 的门口。 - 迭代两轮。用第一轮 RS 训出的模型重新生成候选、重新打分、再训一次。观察第二轮的增益是不是明显小于第一轮(应该是),以及 decidable_fraction 怎么变化(应该下降——模型变强了,全对的行变多了)。这是第 6 节「迭代式 RS」的最小演示,也能让你亲眼看到为什么 RM 需要跟着一起更新。
延伸阅读
把拒绝采样当作核心组件的经典工作
- WebGPT: Browser-assisted question-answering with human feedback (2021) — 最早把 best-of-$n$ 重排序当作 RL 之外的独立手段系统汇报的工作,也是「BoN 作为 baseline」这个传统的起点。
- Training a Helpful and Harmless Assistant with RLHF (2022) — Anthropic 的 HH 论文,迭代式「生成 → 标注 → 更新 RM → 再训」闭环的原始描述,第 6 节讲的「RM 要跟着一起更新」出自这条线。
- Llama 2: Open Foundation and Fine-Tuned Chat Models (2023) — 本章最该精读的一篇。它明确写了「5 轮拒绝采样微调 + 最后一轮 PPO」,是迄今关于 RS 在真实大规模管线里怎么用的最详细公开记录。
- Let's Verify Step by Step (2023) — 过程奖励模型(PRM)论文,用 PRM 做 best-of-$N$ 打分,说明「打分器」不一定是 Bradley-Terry RM。
- Training Verifiers to Solve Math Word Problems (2021) — GSM8K 与 ORM 的原始论文,用验证器给多个候选打分再选最优,是 RS 在可验证任务上的雏形。
把它形式化的工作
- RAFT: Reward rAnked FineTuning for Generative Foundation Model Alignment (2023) — 第一次给这套流程起了名字、写成算法,并推广到文本之外的模态。想引用 RS 时引这篇。
- RSO: Statistical Rejection Sampling Improves Preference Optimization (2023) — 从统计视角说明 RS 与 DPO、SLiC 等偏好学习目标的关系,指出要真正逼近最优策略需要带接受概率的拒绝采样而不是 argmax。理解「LM 版 RS 丢了什么」就看这篇。
- Theoretical Guarantees on the Best-of-n Alignment Policy (2024) — 指出 $\log n - \frac{n-1}{n}$ 在一般情形下是 KL 的上界而非等式,并给出更紧的估计。用这个公式做工程决策前值得读一眼它的前提。
- BOND: Aligning LLMs with Best-of-N Distillation (2024) — 直接设计损失函数把 $\pi_{\text{BoN}}$ 蒸馏进权重,而不走「采样 + argmax + 最大似然」这条粗糙路径。第 5 节那个「RS = BoN 蒸馏」视角的正式化。
$N$ 该多大、代价是什么
- Scaling Laws for Reward Model Overoptimization (2022) — 把 BoN 和 RL 放在同一张「KL vs. 真实奖励」的图上,是本章第 4、5 节所有 KL 论证的实证基础。第 14 章会详细讲。
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling (2024) — 覆盖率随 $N$ 增长的系统研究,回答「多采样到底能买到多少」。
- Learning to Summarize from Human Feedback (2020) — $\log n - \frac{n-1}{n}$ 这个公式在 RLHF 语境下的早期出处(见附录),也是「BoN 与 PPO 画在同一张 KL 图上」这一做法的源头。
- Scaling LLM Test-Time Compute Optimally (2024) — BoN 只是推理时算力的一种花法,这篇比较了它与其他方式(修订、搜索)的性价比。
相邻方法与上下文
- Tülu 3: Pushing Frontiers in Open Language Model Post-Training (2024) — 完整开源后训练配方,各阶段 prompt 预算的数字出处;可以对照看现代管线里 RS 被什么取代了。
- STaR: Bootstrapping Reasoning With Reasoning (2022) — 在可验证任务上用正确解做 SFT 再迭代,本质是把 RM 换成确定性验证器的 RS,也是推理模型时代 RLVR 的思想前身。
- Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs (2024) — 论证 RLHF 里 PPO 的很多复杂机件并非必需,读它能理解第 6 节「RS 是 REINFORCE 的量化版」这条谱系的另一端。