附录 C · 实践问题
从算力预算、显存核算、超参搜索到故障定位——真正动手跑后训练时会踩的坑,以及每一个坑的症状、成因和排查顺序。
0. 这一页怎么用
全书前面十七章讲的是方法为什么这样设计。这一页讲的是方法跑起来会怎么坏。
原书这一节写得很短,作者自己在开头就声明了:「这是一份经验清单,不是一篇连贯的叙述。」它覆盖四件事——后训练的算力成本、评测方差、训练方差、如何识别一个坏掉的训练任务。这份精读把它扩成了一份排障手册:在原书四条经验的骨架上,补进配套代码库 code/ 里那些真实跑过、调过、失败过的配置和数字,以及课程问答里学员反复问到的实现细节。
这么做的理由是:后训练里最消耗时间的从来不是推导,是那些「代码没报错但模型学不动」的下午。你会遇到 loss 一条水平线、reward 曲线漂亮上升但采样出来全是乱码、KL 在第 40 步突然指数爆炸、生成长度一路涨到 512 token 上限、或者最经典的——同一份代码同一个 seed,昨天能跑今天 OOM。这些症状每一个背后都有两三种典型成因,而排查顺序是有优劣的。这一页就是把这些顺序写下来。
结构上分成三段:
- 第 1–4 节是「跑之前要算的账」——算力预算、rollout 与训练如何分离、显存怎么核算、超参数该往哪个方向调。这四件事在敲下第一条命令之前想清楚,能省掉后面一半的排障。
- 第 5–6 节是「跑起来之后怎么读曲线」——训练方差和评测方差的区别(这是原书最有价值的一节),以及十几种常见故障的症状 → 成因 → 定位方法。
- 第 7–8 节是「怎么让下一次更容易」——日志该记什么指标,以及如何用一套静态评测集分辨「配方不够好」和「东西是坏的」。
本页大量引用 _src/code/ 里的真实配置文件。这些配置不是论文附录里抄来的,是作者在 DGX Spark 上一轮轮调出来能给出「有代表性的学习曲线」的值——对自学者来说,一个确实跑通过的起点比一个理论上最优的区间有用得多。
- 配方开发的算力是最终训练的 10–100 倍。 Tülu 3 在 7B 规模上跑了「数以千计」的实验才定下配方。你看到的技术报告里那条训练曲线,是幸存者。
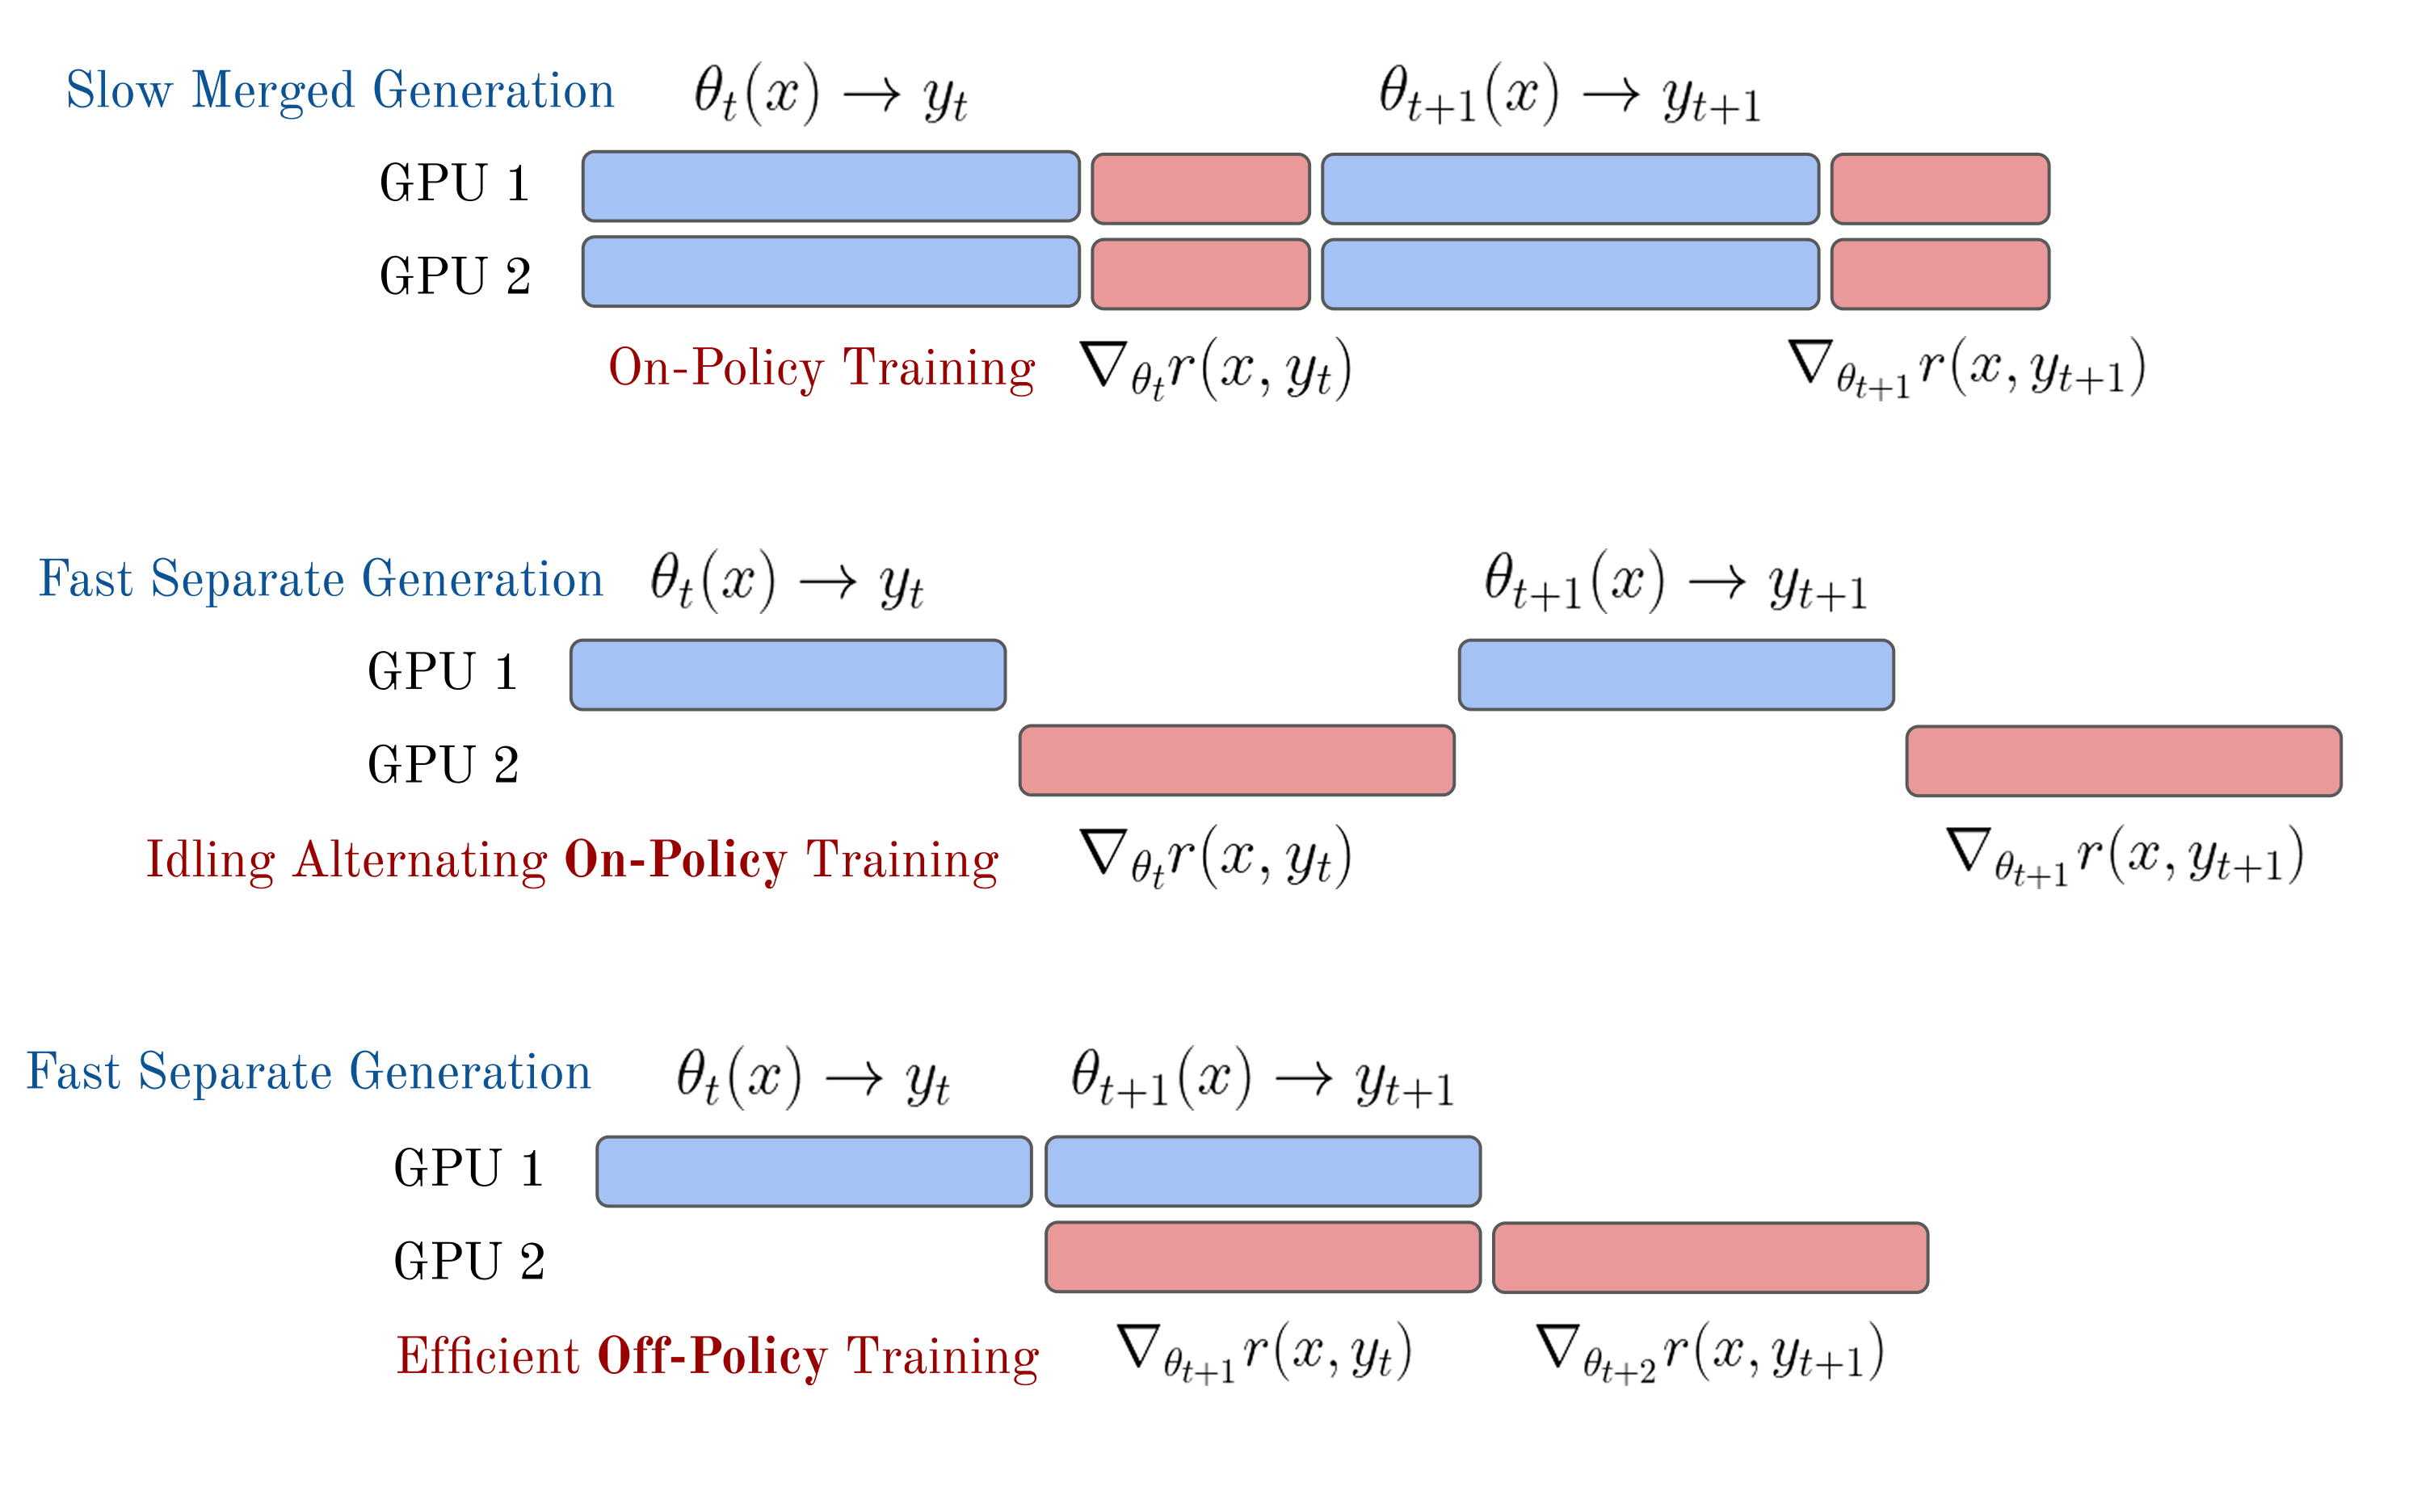
- RL 的瓶颈在生成不在梯度。 所以现代 RL 框架把 rollout(actor,跑 vLLM)和训练(learner,跑 FSDP)拆到不同 GPU 上异步执行。代价是数据不再严格 on-policy,需要重要性采样修正——包括同一份权重在两套后端上算出的 logprob 都不一样这种「隐性 off-policy」。
- 静态显存 ≈ 参数量 × 12 字节(bf16 权重 2 + bf16 梯度 2 + AdamW 的 fp32 一阶/二阶矩 8)。0.6B 模型全参数微调静态就要 7.1 GB,在只有 6.9 GB 可用的卡上必定 OOM——这不是玄学,是能提前算出来的。DPO 还要多驻留一份 reference 权重。
- 调参顺序:学习率 → 有效 batch → 算法专有系数 → seed。 学习率的影响远大于其它一切;先在宽区间扫 10 个点定量级,再在窄区间精调。奖励模型的学习率比 SFT/DPO 高一个数量级(5e-5 vs 5e-6),因为它有一个随机初始化的标量头。
- 评测噪声和训练噪声要分开治。 评测噪声可以靠重复评测抹平(Olmo 3 实测 GPQA 标准差 1.48,MMLU 只有 0.22);训练噪声只能靠多跑几个 seed 去「捞」正向离群点。
- 最可靠的「东西坏了」信号:知识型评测(MMLU 这类)掉 10–20 分。 这类指标本来就不该被后训练撬动,它一掉说明流水线某处是烂的,不是配方不够好。
1. 算力账:你看到的那条曲线是幸存者
两种成本,差一到两个数量级
问「训一个后训练模型要多少算力」,得先区分是在问哪一种成本。
第一种是配方开发成本。这是最大的一块,也是技术报告里从来不写的一块。为了做出 Tülu 3,团队在 7B 规模上跑了数以千计的实验和评测,才最终确定了那份配方。你在论文里看到的「我们用了 SFT + DPO + RLVR 三阶段,学习率 5e-6」,是从上千次尝试里筛出来的一条路径,不是第一次就试对的。
第二种是应用配方的成本。配方定下来之后,把它完整、严谨地跑一遍:多个 seed、每个阶段的学习率扫描、充分的 checkpoint 评测、加上必然会遇到的工程故障。这一块容易测量,因此技术报告里通常只报这一块。
配方开发的算力开销,轻松就是最终几次训练的 10 倍到 100 倍。当你自己动手时,请按这个比例给自己留预算——如果你只有跑三次训练的算力,那你能做的是复现别人的配方,不是开发一个新配方。
一个有具体数字的例子:Olmo 3 Think 32B
Olmo 3 的技术报告给了后训练成本的详细拆解,这在公开报告里非常少见。原文值得逐条对照读:
后训练遵循一种不同的操作模式:每个阶段要跑多次,扫学习率和其它超参数。后训练——尤其是 RL——的理论还不成熟,所以我们必须跑多个实验来找到给定基座模型下的最优超参。
后训练期间,checkpoint 评测消耗的算力占比更大,部分原因是推理模型在核心基准上的生成非常长。SFT 阶段我们扫了四个候选学习率,每个占 256 张 GPU,并行跑 36 小时;之后大约 12 小时用于评测、模型合并和 checkpoint 确认,合计约两天。DPO 训练每次更快(一次完整的学习率扫描约 18 小时 × 64 张 GPU),但实际上因为集群不稳定拖了好几天。最初的 Olmo 3 Think 32B 的最终 RL 训练跨越约 5 天,其中至少有一天的训练时间因稳定性问题损失掉了。首发之后,我们又在 224 张 GPU 上继续跑了 21 天最好的那次 RL 训练,才产出 Olmo 3.1 Think 32B。
几个值得注意的细节:
- 「扫了四个候选学习率」出现在 SFT 阶段。不是 RL,是 SFT。学习率扫描是每个阶段都要做的事,不是 RL 专利。
- 评测占了 12 小时,和 36 小时的训练同一个量级。推理模型在 AIME、LiveCodeBench 这类基准上一道题要生成上万 token,评测本身就是一次大规模推理任务。第 5 节会讲到,为了压噪声还要重复评测 10 次——成本再翻十倍。
- 「至少有一天的训练时间因稳定性问题损失掉了」。这是 5 天里的 20%。大规模 RL 训练崩掉、需要从 checkpoint 恢复,是常态不是意外。
- 21 天 × 224 GPU 换来一个版本号从 3.0 到 3.1。这条最能说明 RL 扩展的性质:成本主要花在时间上,而不是总算力上。你没法用 10 倍的 GPU 把 21 天压成 2 天,因为 RL 是串行的——每一批 rollout 都依赖上一步更新后的权重。
随着「扩展 RL 算力」成为标准做法,这套成本结构还会再变一次。Olmo 3 最初的 32B Think 后训练只用了两周,而为了发布改进版,团队又追加了三周半的 RLVR 训练。后训练正在从「几天的微调」变成「几周的持续训练」——这对个人和小团队意味着,你在 RL 上能投入的不再是算力,而是耐心和调度可靠性。
换算到自学者的尺度
上面的数字对单卡玩家没有直接意义,但比例关系有。配套代码库给出的参考点更贴地气:
| 实验 | 模型 / 数据 | 规模 | 参考耗时 |
|---|---|---|---|
| SFT(第 4 章) | OLMo-2-1B base / No Robots 9.5K 条 | 3 epoch,有效 batch 32 | 单张 24GB 卡数小时 |
| Bradley-Terry RM(第 5 章) | Qwen3-0.6B-Base / UltraFeedback 5K 对 | 2 epoch,有效 batch 16 | 单卡一两小时 |
| DPO(第 8 章) | OLMo-2-1B-SFT / UltraFeedback 6.4K 对 | 3 epoch ≈ 300 步 | 单卡数小时 |
| GRPO(第 6 章) | Qwen3-1.7B / spell_backward | 每步 4 prompt × 8 rollout | 单卡十几小时 |
| SDPO 自蒸馏(第 12 章) | Qwen3-1.7B / spell_backward | 200 步,每步 16 prompt × 8 rollout | 单张 24GB 卡 < 20 小时 |
| 拒绝采样全流程(第 9 章) | Qwen3-1.7B + AceMath-7B-RM / GSM8K 1K 训练 | 每 prompt 8 条 rollout,再 SFT 2 epoch | 生成+打分是大头,可缓存复用 |
注意最后一行的设计:拒绝采样把「生成 rollout」和「用 reward 打分」两个昂贵阶段的结果按参数哈希缓存到 output/rollouts/<hash>.jsonl,只要生成/打分参数不变,四种不同的选择策略就共享同一份缓存,选择本身几乎不花钱。这是个通用技巧:把流水线里昂贵且确定性的阶段和廉价且要反复试的阶段切开,前者缓存,后者随便扫。
缓存键必须覆盖所有会改变输出的参数。参考实现把 reward 模型、策略模型、数据切片、采样参数、seed、每 prompt 生成条数、max_new_tokens 全部哈希进去。漏掉任何一个,你就会在某次改参数后拿到静默的旧结果——这类 bug 不会报错,只会让你的实验结论完全错误。
2. 训练基础设施:为什么 rollout 必须和训练分开
问题出在哪:一个 GPU 干两件性质完全不同的事
先看最朴素的 RL 训练循环(参考实现 policy_gradients/train.py 就是这个形态):
while True:
    # 阶段 A:生成。自回归采样,每步只算一个 token,显存带宽受限,算力空转
    rollouts = policy.generate(prompts, max_new_tokens=512)
    rewards  = env.score(rollouts)

    # 阶段 B:训练。整段序列一次前向 + 反向,算力打满
    loss = policy_gradient_loss(policy, rollouts, rewards)
loss.backward(); optimizer.step()这两个阶段对硬件的要求是相反的。生成是自回归的:一次只能吐一个 token,每个 token 都要把整个模型的权重从显存搬到计算单元一遍,GPU 的算力单元大部分时间在等数据——这是典型的 memory-bound。训练是一次性对整批序列做前向反向,矩阵乘法密集,是 compute-bound。用同一套代码、同一个 GPU 顺序跑这两件事,意味着阶段 A 时算力闲置,阶段 B 时显存带宽闲置。
更糟的是长尾。同一个 batch 里,一道题的答案可能 50 个 token 就结束,另一道题要生成 512 个(推理模型上是 10K 到 100K+)。同步执行时,整批必须等最慢的那条生成完,绝大部分分配的算力在空转。
标准解法:actor / learner 分离 + Ray + vLLM
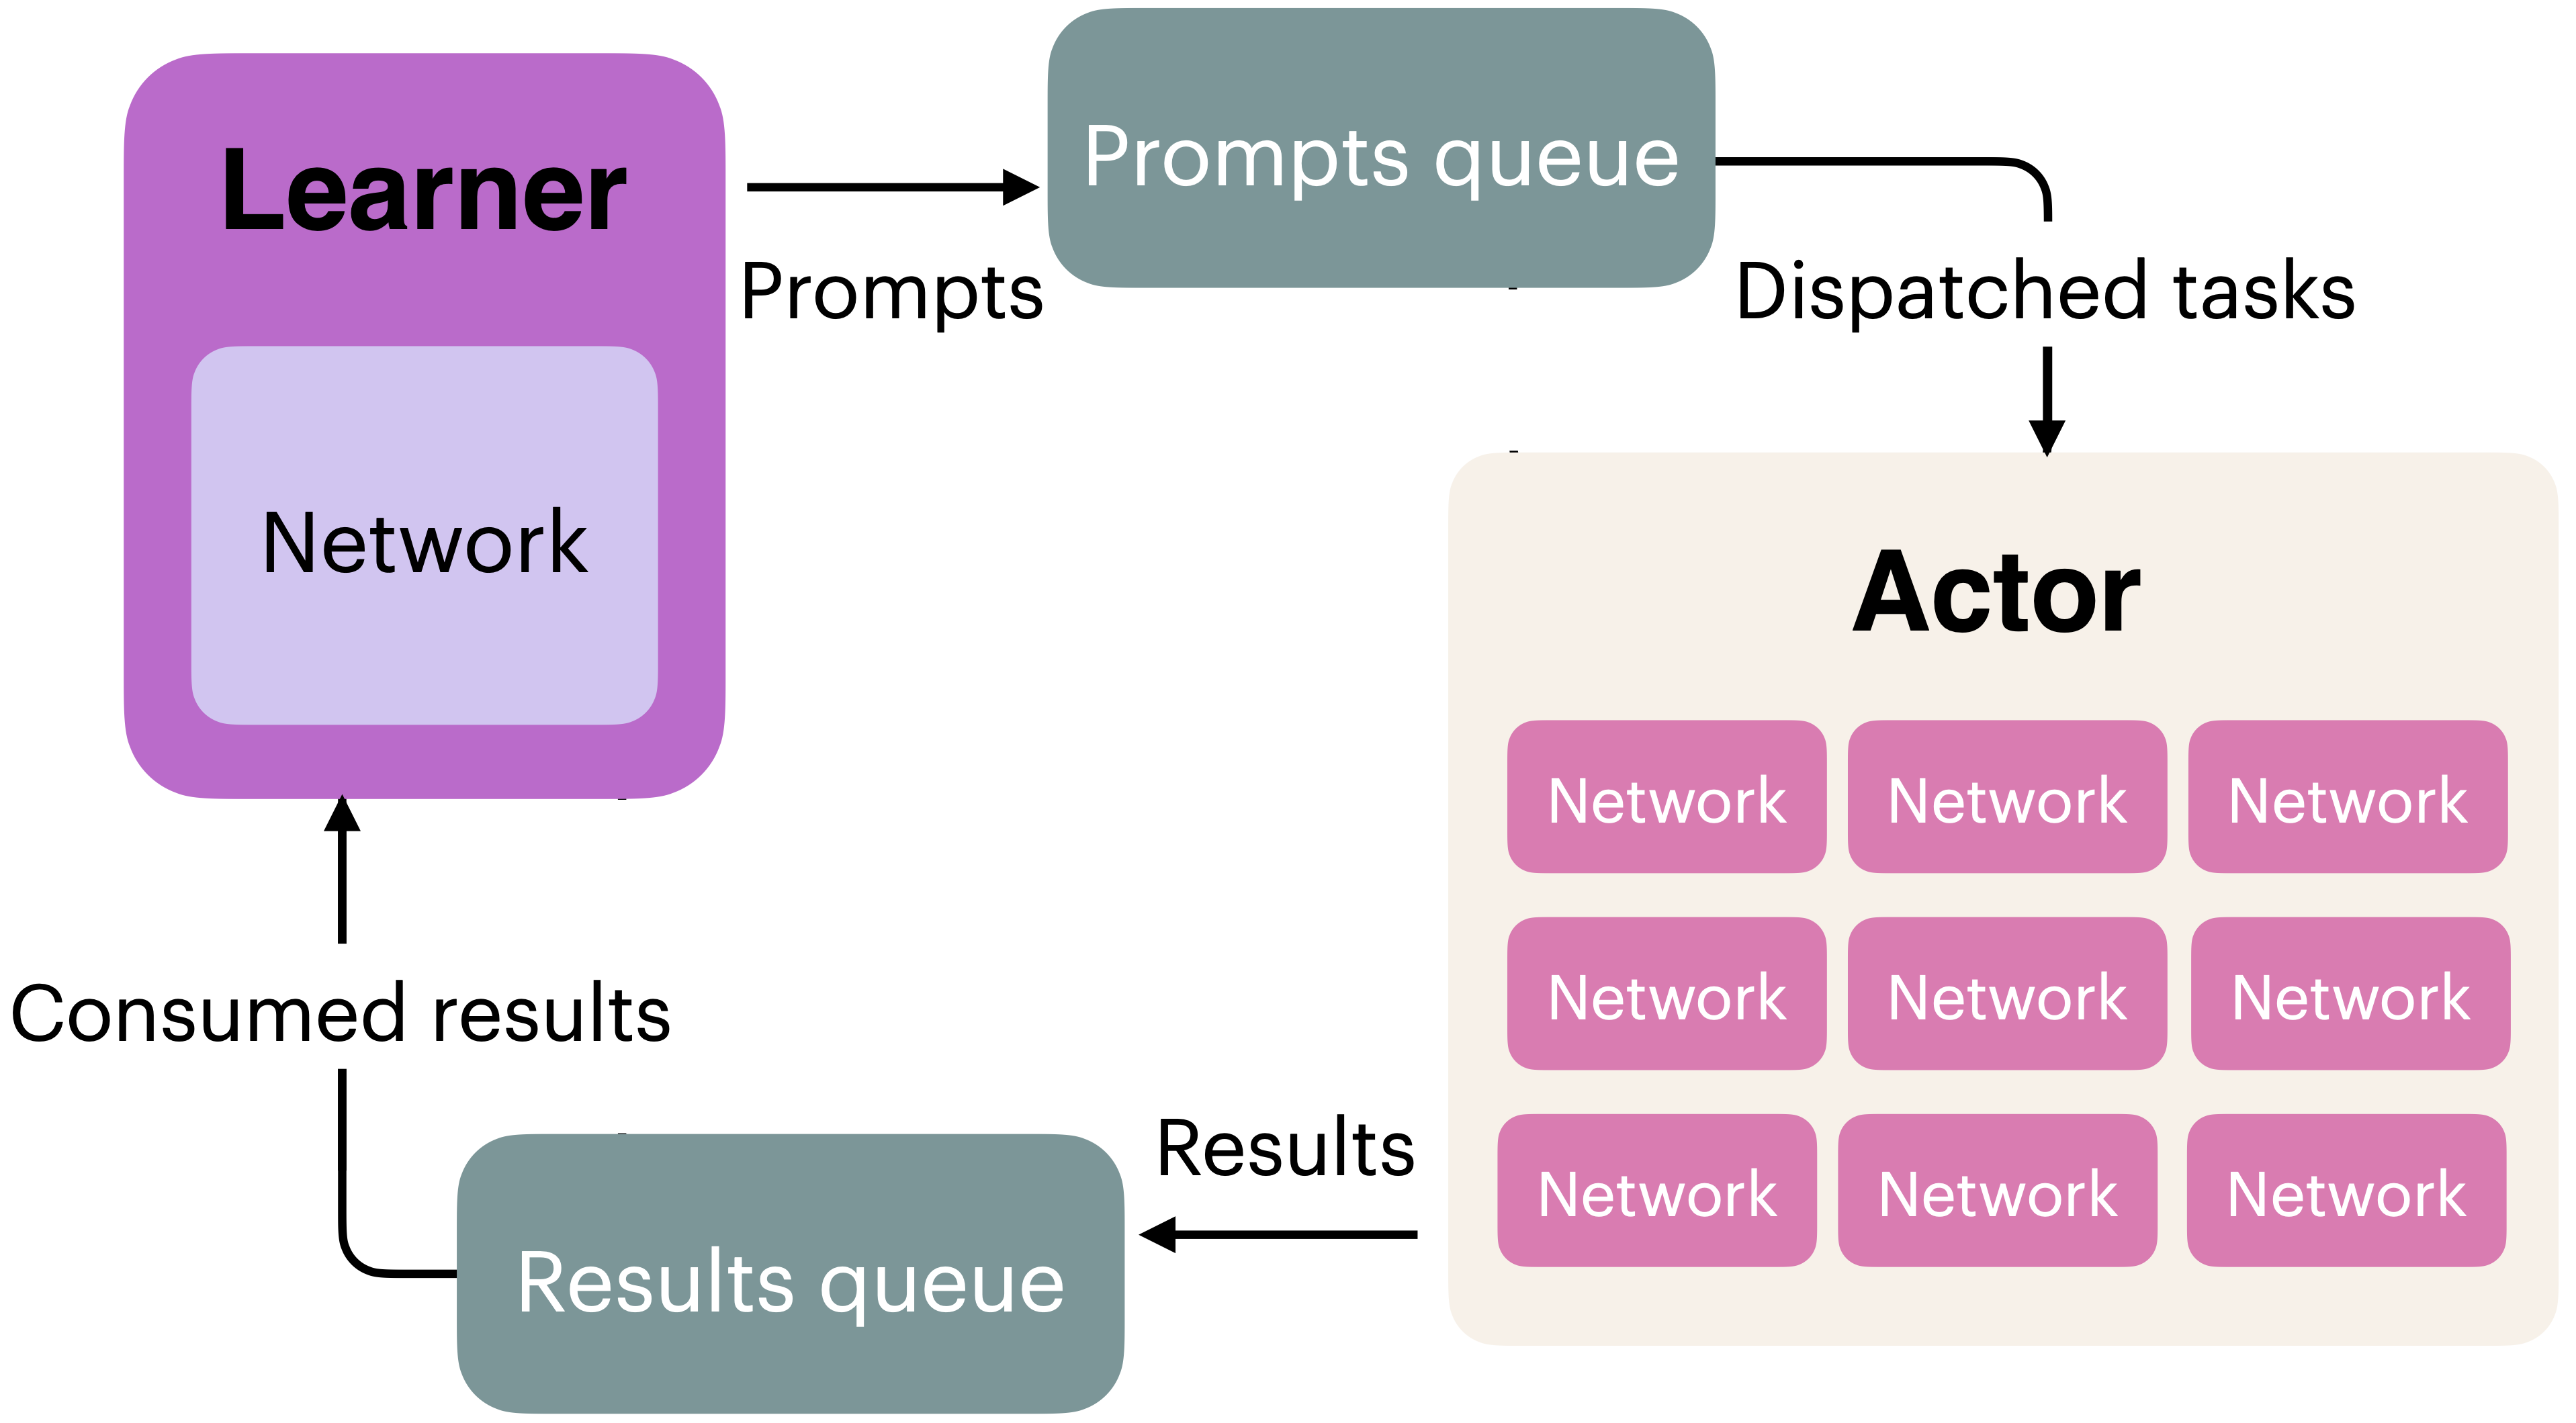
现代开源 RL 框架(veRL、OpenRLHF、TRL、SkyRL、Open Instruct、AReaL 等)的做法高度一致:
- Actor GPU:只做推理,跑 vLLM 或 SGLang 这类专用推理引擎。它们有连续批处理(continuous batching)、PagedAttention 的 KV cache 管理、专门优化的采样 kernel,吞吐比直接用 HuggingFace
generate()高一个数量级。 - Learner GPU:只做梯度更新,跑 FSDP 或 DeepSpeed / Megatron。
- 中间用 Ray 之类的分布式进程管理库,维护两个队列:一个把生成好的 rollout 送给 learner,一个把更新后的权重同步回 actor。
异步的代价:数据不再 on-policy
策略梯度的推导要求样本严格来自当前策略 $\pi_\theta$。异步系统里这个前提被打破了,而且是两个独立的来源——这是很多人只注意到第一个的地方。
来源一:策略漂移。一批 rollout 上要做多次梯度步,或者 actor 上的权重比 learner 落后若干步。修正方式是 PPO/GRPO 里那个重要性比值:
$$ \rho_t^{\text{policy}} = \frac{\pi_\theta(a_t \mid s_t)}{\pi_{\theta_{\text{old}}}(a_t \mid s_t)} $$这里 $\pi_\theta(\cdot\mid s_t)$ 是词表维的,形状 [B, T, V];在采样到的 token 上 gather 之后是 [B, T];所以 $\rho_t$ 是逐 token 的标量,整个 rollout 的比值张量形状就是 [B, T]。这是课程问答里被问到的一个高频困惑,写成代码最清楚:
# logprobs over vocab: [B, T, V]
old_logps_all = old_policy.log_softmax(logits_old, dim=-1)
new_logps_all = policy.log_softmax(logits_new, dim=-1)

actions = input_ids[:, 1:]          # 采样到的 token id: [B, T]

# 只 gather 采样到的那些 token 的概率: [B, T]
old_logps = old_logps_all.gather(-1, actions.unsqueeze(-1)).squeeze(-1)
new_logps = new_logps_all.gather(-1, actions.unsqueeze(-1)).squeeze(-1)

rho = torch.exp(new_logps - old_logps) # 逐 token 的重要性比值: [B, T]来源二(更隐蔽):后端数值差异。即使 actor 和 learner 持有完全相同的参数 $\theta$,它们算出的 logprob 也不一样。vLLM 用的 kernel、精度、并行策略跟 FSDP 完全不同,浮点误差在几千个 token 上累积,足以让同一条序列的 logprob 差出可观的量。这就是 Yao 等人那篇 Your Efficient RL Framework Secretly Brings You Off-Policy RL Training 的核心观察:你以为在做 on-policy RL,框架偷偷把它变成了 off-policy。
把「同一份参数在两套系统上」显式区分开,定义 learner/sampler 比值及其截断形式:
$$ \rho_t^{\text{learner}} = \frac{\pi_\theta^{\text{learner}}(a_t \mid s, a_{<t})}{\pi_\theta^{\text{sampler}}(a_t \mid s, a_{<t})}, \qquad \tilde{\rho}_t^{\text{learner}} = \min\!\big(\rho_t^{\text{learner}},\; C\big) $$这叫截断重要性采样(Truncated Importance Sampling, TIS)。注意它和 PPO 的裁剪不同:PPO 是双边裁剪,把比值约束在 $1$ 附近;TIS 是单边上限,比值可以自由地掉到 1 以下,但不允许超过 $C$。理由是,异常放大的权重会让梯度方差炸掉,而异常缩小的权重只是让样本贡献变小,无害。用小量偏差换有界方差。
实现上 TIS 就是乘在逐 token 策略梯度损失上的一个 detach 权重:
# Shape: (B*G, L)
C = 2.0   # Open Instruct 用的就是 2

logratio = learner_logprobs - sampler_logprobs
logratio = logratio.clamp(-10.0, 10.0)          # 只为 exp 前的数值安全
tis_weight = torch.exp(logratio).clamp(max=C)   # 单边截断

per_token_pg_loss = per_token_pg_loss * tis_weight.detach()
$[-10, 10]$ 那个 clamp 纯粹是防 exp 溢出,真正的 TIS 是 clamp(max=C) 这一步。这个修正在 veRL、TRL、OpenRLHF、SkyRL、OAT、Open Instruct 里都已经是标配,而且推理链越长越重要——每个 token 的微小数值差异会沿着几千步累积。
「$\rho$ 在第 0 个梯度步应该等于 1.0。」——在单机同步实现里是的,但在 actor/learner 分离的框架里不是。如果你的框架直接拿 sampler 算的 logprob 当 $\pi_{\theta_{\text{old}}}$,那么策略比值从第一步起就偏离 1,PPO 的裁剪窗口相当于开在一个错位的中心上。严谨的实现会在 learner 上重算旧 logprob,让策略比值只反映纯粹的策略漂移,把后端差异交给 TIS 单独处理。调试时先打印第 0 步的 rho.mean() 和 rho.std(),它是判断你落在哪种实现里的最快方法。
另一个减少空转的招:序列级 packing
针对长度长尾,除了异步还有第二个解法:把一个 batch 里较短的样本堆叠起来,配合精心设计的 attention mask,让模型可以在同一块显存里继续 rollout,同时把长度归一化更均匀地分摊到 batch 内部。这在推理模型训练里几乎是必备的。
分布式 RL 基建的完整复杂度超出本书范围——原书作者的原话是「它会引发很多其它微妙的问题,拖慢训练或造成不稳定」。对自学者的实际建议是:不要自己造 actor/learner 框架。先在单卡同步实现上把算法理解透(这正是 policy_gradients/ 模块的定位),需要规模时直接用 veRL 或 Open Instruct。
3. 显存核算:先算,再跑
静态部分:一个能背下来的公式
全参数微调时,训练开始前就必须常驻显存的东西有四样。按 bf16 混合精度 + AdamW 的标准配置:
| 成分 | 精度 | 字节 / 参数 | 能不能省 |
|---|---|---|---|
| 模型权重 | bf16 | 2 | 不能(除非 LoRA / 量化) |
| 梯度 | bf16 | 2 | 不能(可以梯度累积摊平,但显存峰值不变) |
| AdamW 一阶矩 $m$ | fp32 | 4 | 能——换 8-bit 优化器或 SGD/Adafactor |
| AdamW 二阶矩 $v$ | fp32 | 4 | 同上 |
| 合计 | 12 | ||
所以:
$$ M_{\text{static}} \approx N_{\text{params}} \times 12\ \text{bytes} \;\approx\; 12\ \text{GB per 1B params} $$如果框架还额外保留一份 fp32 主权重(很多混合精度实现会),再加 4 字节/参数,变成 16。这个数记住了,你在敲命令之前 30 秒就能判断一个配置有没有希望。
本项目的实测环境:2× RTX 5080,每卡 16 GB,其中约 8 GB 被其它进程占着,实际可用约 6.9 GB。跑 Qwen3-0.6B(约 5.96 亿参数)全参数微调:
- bf16 权重:$0.596\times10^9 \times 2 = \mathbf{1.19\ GB}$
- bf16 梯度:$0.596\times10^9 \times 2 = \mathbf{1.19\ GB}$
- AdamW 的 $m$、$v$(fp32):$0.596\times10^9 \times 8 = \mathbf{4.77\ GB}$
- 静态合计 ≈ 7.15 GB
7.15 > 6.9。还没开始算激活值就已经不够了——这个 OOM 是纸上就能算出来的,不需要跑一次才知道。0.6B 这种「小模型」在只剩 7 GB 的卡上全参数微调,本来就不成立。
可行的补救按代价从小到大:① 换 8-bit AdamW($m,v$ 从 8 字节降到 2 字节,静态从 7.15 降到 3.6 GB);② 换 LoRA(只训低秩适配器,优化器状态按适配器参数量算,通常降到几百 MB);③ 换更小的模型;④ 腾出那 8 GB。
动态部分:激活值,以及 batch 的真实含义
静态之外是激活值——前向过程中为反向传播保留的中间张量。它大致正比于
$$ \text{batch} \times \text{seq\_len} \times \text{hidden\_size} \times \text{n\_layers} $$这是唯一你能通过配置直接控制的一项,也是几乎所有「跑到一半才 OOM」的来源。三个关键点:
第一,梯度检查点(gradient checkpointing)能砍掉 30–40% 显存,代价是多一次前向计算(约 20–30% 的速度损失)。配套代码库的所有配置默认打开它。在显存吃紧时这永远是第一个该开的开关。
第二,「batch size」这个词在配置里有三个不同含义,混淆它们会让你算错显存:
| 名字 | 配置字段(示例) | 决定什么 |
|---|---|---|
| 微批 / micro-batch | batch_size、train_batch_size | 显存峰值。一次前向反向实际塞进 GPU 的序列数。 |
| 累积步数 | gradient_accumulation_steps、batch_acc | 不影响显存,只影响多少个微批合成一次 optimizer.step()。 |
| 有效批 / effective batch | 前两者相乘 | 优化行为。梯度噪声、学习率的合适量级都由它决定。 |
DPO 配置里 batch_size: 8 + gradient_accumulation_steps: 8 = 有效批 64;SFT 配置是 4 × 8 = 32;奖励模型是 2 × 8 = 16。显存不够时降微批、同步升累积步数,优化行为不变而显存下降——这是最安全的一个调整。
第三,OOM 通常发生在数据集里最长的那条样本上。如果你跑到第 800 步才炸,八成不是显存算错了,是这一批里撞上了一条超长序列。设 max_length 硬上限,或者按长度排序分桶。参考实现的截断策略也值得抄:超长时从左边(prompt 侧)截,因为 loss 只算在 response token 上,保住 response 比保住 prompt 重要。
不同任务的显存倍率
同样的模型,不同训练目标的显存需求差得很多:
| 训练类型 | 常驻模型份数 | 每个「样本」的前向次数 | 相对 SFT 的显存 |
|---|---|---|---|
| SFT | 1(policy) | 1 | 1×(基准) |
| Bradley-Terry RM | 1(backbone + 标量头) | 2(chosen + rejected) | 约 1×,但激活翻倍 |
| DPO / IPO / KTO / APO | 2(policy + reference) | 4(2 模型 × chosen/rejected) | 明显更高 |
| SimPO / ORPO | 1(无 reference) | 2 | 约等于 RM |
GRPO / RLOO(beta: 0.0) | 1 | 1 训练 + N rollout 生成 | 训练侧同 SFT,生成侧另算 KV cache |
| PPO | 3–4(policy + value + reference [+ RM]) | 多 | 最高 |
DPO 需要同时驻留 policy 和 reference 两份权重,因此同规模下它的显存需求明显高于 SFT 和 RM。好消息是 reference 不需要梯度和优化器状态,只多 2 字节/参数(0.6B 模型 +1.19 GB);坏消息是它要多跑一遍前向,激活值也跟着翻倍——而且 DPO 的一个「样本」本来就是 chosen + rejected 两条序列。所以 batch_size: 8 的 DPO,实际同时在算 8×2×2 = 32 条序列的前向。
省法:reference 模型的 logprob 在整个训练中是固定不变的(reference 不更新),所以可以预先把整个数据集的 reference logprob 算好缓存下来,训练时完全不加载 reference 模型。这正是参考实现列在 TODO 里的优化,Ai2 的 open-instruct dpo_tune_cache.py 是可抄的样板。SimPO 和 ORPO 干脆从算法层面去掉了 reference,这也是它们的一个实际卖点。
参考实现的实测数字
公式给的是量级,下面是配套代码库在真实硬件上量出来的峰值,两个都该看:
| 任务 | 模型 | 设置 | 实测显存 |
|---|---|---|---|
| SFT | OLMo-2-1B | batch 4 / len 2048,bf16 + 检查点 | 约 14–18 GB |
| SFT | OLMo-2-1B | batch 8 / len 2048 | 约 22–24 GB |
| SFT | OLMo-2-1B | batch 4 / len 4096 | 约 22–24 GB |
| 策略梯度 | Qwen3-1.7B | 单卡 GRPO | 约 16 GB |
| 奖励模型 | Qwen3-0.6B / 1.7B | — | 约 8–16 GB / 16–20 GB |
| DPO(1B / 3B) | — | 开梯度检查点 | 约 8–10 GB / 15–20 GB |
注意 batch 8 / len 2048 和 batch 4 / len 4096 给出同一个数字——激活值对这两者是乘性的,这条经验可以直接拿来做换算。
显存算对了还可能跑不起来。本项目在 RTX 5080(Blackwell,计算能力 sm_120)上踩到的坑:PyTorch 官方 cu126 轮子不包含 sm_120 的 kernel,装上去能 import torch、能 torch.cuda.is_available() 返回 True,但一做实际计算就报
RuntimeError: CUDA error: no kernel image is available for execution on the device解法是装 cu128 或更高的轮子。这类报错的特征是「环境检查全过、一算就炸」,遇到时第一时间用 torch.cuda.get_device_capability() 查你的算力号,再对照 torch.cuda.get_arch_list() 看当前轮子编译了哪些架构——两者对不上就是这个问题。
同一类问题还有 Flash Attention:它在 ARM64 / Blackwell 上没有预编译轮子,CUDA 13 也需要源码编译(很痛苦)。参考实现的处理方式值得学——默认关闭,自动回退到 PyTorch SDPA,所有示例不依赖它。在 DGX Spark 这类机器上 SDPA 反而更快,因为有原生 cuDNN 优化。
4. 超参数:实际取值范围与调参顺序
先把配套代码库的真实配置摆出来
这些不是论文里抄的推荐值,是作者调到「能给出有代表性学习曲线」之后写进 YAML 的值。对起步而言,一个确实跑通过的配置比一个理论最优区间有用得多。
| 阶段 | 模型 / 数据 | 学习率 | 有效 batch | 轮数 / 步数 | 其它关键项 |
|---|---|---|---|---|---|
| SFT | OLMo-2-1B base / No Robots | 5e-6 | 4×8 = 32 | 3 epoch | warmup 0.1,clip 1.0,len 2048 |
| Bradley-Terry RM | Qwen3-0.6B-Base / UltraFeedback 5K | 5e-5 | 2×8 = 16 | 2 epoch | len 512,验证集 10%,每 25 步验证 |
| DPO | OLMo-2-1B-SFT / UltraFeedback 6.4K | 5e-6 | 8×8 = 64 | 3 epoch ≈ 300 步 | $\beta=0.1$,len 2048 |
| SimPO | 同上,12.8K | 8e-7 | 8×8 = 64 | 3 epoch ≈ 600 步 | $\beta=2.0$,$\gamma=0.5$,无 reference |
| GRPO | Qwen3-1.7B / spell_backward | 5e-6 | 2×4,每步 4 prompt × 8 rollout | 数据 3000 题 | $\varepsilon=0.2/0.2$,$\beta=0.0$,temp 0.6 |
| DAPO | 同上 | 5e-6 | 同 GRPO | 同上 | $\varepsilon_{\text{hi}}=0.28$,超长惩罚 l_cache 128 / l_max 512 |
| PPO | 同上 | 5e-6 | 2×4,每步 16 prompt × 1 rollout | 数据 10000 题 | $\gamma=1.0$,$\lambda=0.98$,$c_{\text{vf}}=0.5$,值裁剪 0.4 |
| SDPO 自蒸馏 | Qwen3-1.7B / spell_backward | 1e-6(恒定,无 warmup) | 每步 16 prompt × 8 rollout | 200 步 | top-K KL 的 $K=20$ |
| 拒绝采样 SFT | Qwen3-1.7B / GSM8K 1K | 5e-6 | 2×4 = 8 | 2 epoch | 生成 temp 0.8,每题 8 条;评测 temp 0.0 |
几处值得停下来看的地方:
奖励模型的学习率是 5e-5,比 SFT/DPO 高整整一个数量级。原因是 RM 顶上挂了一个随机初始化的 nn.Linear(hidden, 1) 标量头,它需要大步子才能从随机状态收敛;而且 RM 不需要保住生成能力,「跑偏」对它没有代价。SFT 和 DPO 则是在一个已经能说话的模型上做微调,大步子会直接毁掉语言能力。
GRPO 的 beta: 0.0——KL 惩罚默认是关闭的。这不是笔误,是 RLVR 时代的普遍做法:当奖励来自可验证的正确性而不是一个可以被钻空子的奖励模型时,「防止模型跑偏」的必要性大大下降,而 KL 惩罚会实打实地拖慢学习。DAPO 论文干脆把 KL 项整个去掉了。但如果你的奖励来自训练出来的 RM,请把 $\beta$ 打开(第 14 章的过优化就是不打开的后果)。
$\gamma = 1.0$ 在所有 RLHF 实现里都是 1.0。标准 RL 里折扣因子是核心超参,用来平衡短期和长期回报;但在 RLHF 里,奖励评价的是整段回复的质量,把靠前的 token 折扣掉没有任何原理上的依据。(等到 agentic RL 成熟,模型真的在做多步工具调用时,折扣可能重新变得有意义。)
DPO 系列的 $\beta$ 完全不可跨算法比较。这是最容易翻车的一处:
| 算法 | $\beta$ 常用范围 | 学习率 | 需要 reference | logprob 用法 |
|---|---|---|---|---|
| DPO | 0.1–0.5 | 5e-6 | 是 | 序列求和 |
| DPO-Norm | 2.0–5.0 | 5e-6 ~ 1e-6 | 是 | 逐 token 平均 |
| IPO | 0.1 | 5e-6 | 是 | 序列求和 |
| SimPO | 2.0–2.5 | 8e-7 ~ 1e-6 | 否 | 逐 token 平均 |
| ORPO | 0.1 | 1e-6 | 否 | 逐 token 平均 |
| APO-Zero / Down | 0.1 | 5e-6 | 是 | 序列求和 |
DPO-Norm 的 $\beta$ 是 DPO 的 20–50 倍,原因很简单:它用逐 token 平均的 log-ratio,数值比求和小一两个数量级,所以要用更大的 $\beta$ 把它乘回可用范围。如果你只是从命令行传 --loss dpo_norm 而没有改 --beta,你会拿到 DPO 的默认值 0.1,训练看起来在跑但基本没有信号。用配置文件,别用裸 CLI 覆盖。
参考实现的原话:「DPO 需要非常低的学习率(1e-7 到 5e-6),更高的学习率会导致发散。」SimPO 官方仓库说得更狠:「较大的学习率(比如 1e-5)会显著降低性能,导致模型产出语无伦次的句子或完全重复的回复。」
这条和第 6 节的排障直接相关:如果你的 DPO 训完之后模型开始复读,先怀疑学习率,而不是数据。
调参顺序
把上面的表格当起点之后,往哪个方向调?Olmo 3 团队和参考实现给出的顺序高度一致:
- 学习率,永远第一。作者的具体建议是:拿到一个新基座模型时,先在很宽的区间上跑 10 个学习率把最优量级定下来,然后在更窄的最优窗口里重跑。先定量级(1e-7 / 1e-6 / 1e-5 差三个数量级),再定系数。这一步的收益远大于后面所有步骤之和。
- 有效 batch / 微批切分。SDPO 在困难任务上的调参笔记里,这一项被明确标成「最大的杠杆」:把 mini batch 从「整轮一次」改成 2 个 prompt 一组,意味着每轮 rollout 换来 16 次优化器步而不是 1 次。同样的采样预算,梯度更新次数差 16 倍。
- 算法专有系数。DPO 的 $\beta$、GRPO 的裁剪范围、PPO 的 $\lambda$ 和值损失权重、SDPO 的 top-K。这些通常在一个不错的区间里比较平坦,不值得先扫。
- 采样参数。temperature、top-p、rollout 条数。注意 训练用的采样器不要拿去做评测——SDPO 的调参表把这条单列出来:训练用 temperature 1.0 不加 top-k/top-p(保证探索),评测按模型卡的推荐设置。
- 随机种子。见下一节——这不是「调参」,是在同一个配置上多采样几次。
SDPO 在比 spell_backward 难得多的任务上(通过 veRL 的 fork 跑)经常出现「reward 一条水平线」或者「涨一阵然后发散」。团队总结出的稳定配置里,有几条是跨算法通用的经验:
- 最大生成长度设够(8192)。被截断的生成会被判为失败,这会污染奖励信号——模型明明在正确的路上,只是没写完。
- 学习率恒定 1e-6,不加 schedule。RL 阶段的 warmup/decay 收益不明显,还多一个变量。
- 梯度裁剪 1.0。原话是「梯度尖峰是必然的」——不是要不要裁的问题。
- weight decay 0.01,AdamW。不需要花哨的优化器。
- 教师用学生的 EMA($\alpha = 0.01$),不用冻结的教师。
- 重要性采样截断 2.0(教师侧和 rollout 侧都是)。又是那个 $C=2$。
SDPO 里教师会看到同组里一个正确的兄弟 rollout 作为示范。一个看起来很合理的优化是「挑最短的那条正确回答」——结果直接让训练崩溃:学生学到的是「把答案压短」,而不是「把题做对」。正确做法是在正确的里面随机挑一条。
同理,要过滤掉那些「最终答对但中途反复回溯、输出了好几个 <answer> 块」的样本——拿它们当监督信号,等于在教模型死循环。更彻底的做法是把 </answer> 设成 stop sequence,让 rollout 从源头上不可能产出第二个。
这条经验的一般形式是:任何用「选最优」构造监督信号的流水线,都要先问一句「这个选择标准和真正的目标之间有没有捷径」。拒绝采样、best-of-N、self-distillation 全都适用。
5. 方差管理:随机种子、评测噪声与可复现性
这是原书这一节里最有价值的部分,核心是一个区分:评测噪声和训练噪声性质完全不同,治法也完全不同。
评测噪声:可以靠重复抹平
推理模型必须用 temperature > 0 采样才能拿到最好的成绩,而只要在采样,输出就有方差。不同基准的稳定性差异极大——取决于题目难度的方差、题库大小、被测模型本身的脆弱程度。
Olmo 3 团队实测了各个基准的标准差(对 14 个模型各跑 3 次,先算每个模型的方差,再按基准平均):
| 类别 | 基准 | 标准差 |
|---|---|---|
| 高方差 | GPQA | 1.48 |
| AlpacaEval 3 | 1.24 | |
| IFEval | 0.88 | |
| 稳定 | ZebraLogic | 0.56 |
| Omega | 0.56 | |
| AIME 24 (Avg@32) | 0.54 | |
| HumanEvalPlus | 0.46 | |
| AgiEval | 0.43 | |
| BigBenchHard | 0.39 | |
| 非常稳定 | LiveCodeBench (Avg@10) | 0.29 |
| MBPPPlus | 0.27 | |
| MATH | 0.25 | |
| MMLU | 0.22 | |
| PopQA | 0.16 |
这张表该怎么用?把「你观察到的提升」和对应基准的标准差比一比。如果你在 GPQA 上涨了 1.2 分,那还在一倍标准差之内,什么都没证明;如果你在 MMLU 上涨了 1.2 分,那是 5 倍标准差,值得当真。「涨了一分」这句话在不同基准上的含义差了将近十倍。
表里 LiveCodeBench 标着 Avg@10、AIME 24 标着 Avg@32——它们本来都是高方差基准(题少),但因为又吵又便宜,重复跑 10 次 / 32 次取平均,就从高方差区搬到了非常稳定区。理论上每个基准都能这么做,但成本会爆炸——所以这是一个明确的取舍:先算「这个基准的方差 × 我要检测的效应量」,再决定重复几次值得。
评测方差还有些不那么显然的来源:batch size、vLLM 里的 tensor parallel 设置(比如基线用 TP=2)、以及长生成在不同基建上的数值细节。这和第 2 节讲的 sampler/learner 数值差异是同一件事的两副面孔。因此报告评测结果时,推理配置必须和被比较的基线完全一致——否则你测的是基建差异不是模型差异。
训练噪声:只能靠多跑几次去「捞」
更难对付的是训练侧的不确定性。区别在于:
- 评测噪声是对称的——多测几次就收敛到真值,噪声被均匀地压掉。
- 训练噪声是可以利用的——模型只训练一次,所以一个正向的离群点就是白赚的。你的目标不是消除训练方差,而是多采样几个点,然后挑最好的那个。
这里有个微妙的陷阱:你挑出来的那个「最好的」,可能只是评测噪声给的运气,而不是模型真的更好。所以实践中训练团队做三件事:
- 每个最终模型都扫核心优化参数(学习率、batch size)。见上一节的顺序。
- 在最好的几个设置上跑多个 seed。原书的措辞很明确:「随机种子对最终模型有实质性影响,值得为它花算力。」这句话在论文里几乎从来看不到,但它是真的。
- 模型合并(model merging)。合并已经是做出强模型的关键工具之一——可以合并同一份数据上的不同 checkpoint,也可以合并针对不同领域训练的专用模型。作者的补充判断是:合并被公认是简单有效的工具,但「怎么为后续合并做准备」还没有清晰的最佳实践。
可复现性:seed 能保证什么,不能保证什么
配套代码库的每个配置都写了 seed: 42(奖励模型是 123)。但要清楚它到底固定了什么:
| 能固定 | 不能固定 |
|---|---|
| 数据打乱顺序、数据切片的采样 | 不同 GPU 型号 / CUDA 版本上的浮点累加顺序 |
| 参数初始化(包括 RM 的标量头) | cuDNN / SDPA / FlashAttention 的非确定性 kernel |
| dropout mask | 不同 batch size 或并行策略下的归约顺序 |
| 生成时的采样(同一推理后端内) | vLLM 与 HF generate() 之间的数值差异 |
| 拒绝采样里随机对照组的选择 | 异步 RL 里 rollout 到达 learner 的顺序 |
换句话说,seed 保证的是「同一台机器同一份代码同一个配置能重跑出同样的结果」,不保证跨硬件、跨框架版本可复现。这不是工程做得不够好,是浮点运算不满足结合律的直接后果。分布式 RL 里更是彻底放弃了——rollout 的到达顺序本身就不确定。
参考实现的工作流里明确要求,每次实验都记下来:完整命令、模型、数据切片、seed、改动的配置项、最终指标、W&B 链接。这七项是让一次实验在三周后还能被解读的最小集合。
加两条自己的经验:① 把 torch.__version__、CUDA 版本、GPU 型号也记上(见第 3 节的 sm_120 事故——环境本身就是变量);② 用配置文件而不是 CLI 覆盖来跑正式实验,这样配置文件本身就是记录。
参考实现里有一个诚实到少见的例子。拒绝采样模块设计了四个配置:两种基于 reward 的选择策略,各配一个同预算的随机对照。结果是 top_k_overall 赢了它的随机基线,而 top_per_prompt 和它的随机对照基本打平。README 的原话是:「把这些小差距当作切片噪声,而不是稳定的排序。」
在 1K 训练 / 200 测试的 GSM8K 切片上,这个态度是对的。能忍住不把一次运行的小幅领先写成结论,是后训练实验里最难也最重要的自律。而那个「同预算随机对照」的设计本身,是这整个代码库里最值得抄的一个方法论——每一个用 reward 做选择的地方,都配一个不用 reward、其它完全相同的对照组,才能知道 reward 模型到底有没有在起作用。
6. 排障手册:症状 → 成因 → 定位
下面按症状组织。每一条的结构是:你看到什么 → 最可能的几个原因(按概率排序)→ 用什么命令/指标确认。
症状 A:loss 是一条水平线,或者根本不降
按下面的顺序查,前两条能解决大多数情况:
- 标签全被 mask 掉了。SFT 的标准做法是把 prompt 部分的 label 设成
-100(IGNORE_INDEX),只在 assistant token 上算 loss。如果 chat template 渲染出来的边界和你切 label 的逻辑对不上,可能整条序列都是-100,loss 恒等于某个常数。
确认方法:打印一个 batch 的(labels != -100).sum()。它应该是几十到几百,不是 0,也不该等于整个序列长度。 - chat template 不匹配。base 模型的 tokenizer 通常没有
chat_template。参考实现的处理方式是从对应的 SFT 版本「借」一份过来:chat_template_source: allenai/OLMo-2-0425-1B-SFT。如果你自己拼字符串,很容易和模型将来推理时用的格式对不上。
确认方法:把渲染后的一条完整样本原样打印出来,逐字符看特殊 token 对不对。 - 学习率低了一两个数量级。参见上一节——尤其是给 RM 用了 SFT 的 5e-6(应该是 5e-5)。
- loss 的量级本来就不该和别的算法比。IPO 用的是到目标 margin $1/(2\beta)$ 的平方误差,$\beta=0.1$ 时目标是 5.0,所以早期 loss 在 10–25 之间,而 DPO 是 0.5–0.7。这不是 bug,IPO 的 loss 值和梯度范数跟 DPO 没有可比性。看
accuracy和margins,别看 loss 绝对值。
症状 B:reward 曲线漂亮上涨,但采样出来的生成崩了
这是 RLHF 最经典的失败,第 14 章过优化讲的就是它。奖励模型是一个学出来的、可以被反复试探的环境,策略找到了它的漏洞。
定位的唯一可靠方法是看生成本身。参考实现在每个模块里都做了「训练中定期采样并打印」,SFT 的 README 里那句话说得很直接:「信息量最大的信号是循环内的采样面板」——不是 loss 曲线。
sample_every: 50          # 每 50 个优化器步采一次
sample_max_tokens: 128
sample_temperature: 0.7
sample_prompt_strategy: round_robin   # 在固定 prompt 池里轮换
用固定的 prompt 池(而不是每次随机抽)非常关键:只有 prompt 不变,你才能把 step 100 和 step 650 的输出并排比较。SFT 模块的那个例子很有代表性——step 100 时模型答完「Paris」还继续自问自答「What is the capital of Germany?」,到 step 650 才学会输出一句话然后打出 <|endoftext|> 停下。
reward 涨、生成崩,还有一种更平凡的可能:reward 模型和策略的 tokenizer / 格式不一致,导致 RM 打的分和它训练时见到的输入分布对不上。在接 RM 之前,先手动喂几条已知好/坏的回复,确认分数排序符合预期(参考实现的 skip_demo: false 就是干这个的)。
症状 C:KL 爆炸
KL 相对参考策略在某一步之后指数上升,通常伴随生成质量崩塌。可能原因:
- 学习率太高——第一嫌疑人,尤其在 DPO 系列上。
- $\beta$ 太小或者是 0——检查你的奖励是不是可验证的。可验证奖励关掉 KL 没问题,RM 奖励关掉 KL 就是在裸奔。
- KL 估计器用错了。配置里的
kl_estimator: kl3不是随便写的。KL 在实践中从来不是精确计算,而是从采样 token 上估计的,$k_1$、$k_2$、$k_3$ 三种估计器的方差和正定性不同。$k_1 = -\log\rho$ 是无偏的但方差大、还可能取负;$k_3 = \rho - 1 - \log\rho$ 无偏、方差低、且恒非负。Schulman 那篇 KL 近似的笔记是这一块的必读材料。
如果你看到 KL 曲线在零附近来回穿,说明你在用 $k_1$——换 $k_3$,曲线立刻变得可读。
KL 散度不是距离。它不对称($\KL(P\|Q)\neq\KL(Q\|P)$),也不满足三角不等式,所以不是度量。后训练团队口语里说「KL 距离」是「模型偏离了多少」的简写,但公式上它是
$$ \KL(P\|Q) = H(P,Q) - H(P) \ge 0 $$即用为 $Q$ 设计的编码去编码来自 $P$ 的数据所付出的额外编码代价。理解成「代价」而不是「距离」,在推 reverse KL / forward KL 的区别时会少犯很多错。
症状 D:生成越来越长,一路撞到 max_new_tokens
三个常见来源:
- 奖励模型有长度偏好。人类标注天然偏好更长的回复,RM 把这个偏置学了进去,策略就往长里写。这是 AlpacaEval 要做长度控制的原因。
- 算法本身的长度偏置。GRPO 里按序列长度归一化的方式会引入长度偏差,Dr. GRPO 的主要贡献就是把长度和难度这两个偏差去掉。
- 截断被当成失败在惩罚,但惩罚方式不对。DAPO 引入了「超长惩罚」,配置里是
l_cache: 128/l_max: 512——在接近上限的最后 128 个 token 里施加软惩罚,而不是在超出后一刀切判零分。
定位:把「平均生成长度」和「截断率」记进日志,和 reward 画在同一张图上。如果 reward 和长度同步上升,基本可以确诊。
SDPO 的调参笔记专门强调过这条——被截断的生成会被读成「答错」,于是本来走在正确路上、只是没写完的样本被打成负例,示范池被饿死。这在推理任务上尤其致命。宁可把 max_new_tokens 设大到浪费一些算力,也不要让截断率超过百分之几。
症状 E:生成变空、立刻 EOS,或者疯狂复读
- 熵坍塌:策略过度确定化,采样分布退化成一个尖峰。查策略熵这条曲线——它应该缓慢下降,如果断崖式掉到接近 0,训练已经废了。
- DPO/SimPO 学习率太高:症状就是「语无伦次或完全重复」。见第 4 节。
- 监督信号本身在奖励「短」:见第 4 节那个「挑最短示范导致崩溃」的例子。
症状 F:GRPO 训练在跑但没有任何梯度信号
GRPO 的优势是组内标准化的:$\hat A_i = (r_i - \bar r)/\sigma_r$。如果一个 prompt 的 8 条 rollout 全对或者全错,组内 reward 完全一致,优势整组为零,这个 prompt 对梯度贡献为零。当数据太简单或太难时,可能大部分 prompt 都是这样,训练表面在跑实际什么都没学。
定位:日志里记「组内 reward 的标准差」和「优势非零的 prompt 占比」。参考实现建议观察的正是「组里有没有对比度(whether groups contain contrast)」。
解法:DAPO 的动态采样——丢掉全对/全错的组,继续采样直到凑够有对比度的 batch。或者调整任务难度(spell_backward 的 min_word_len / max_word_len 就是干这个的)。
症状 G:DPO 的 chosen 和 rejected 的 logprob 一起往下掉
这不是 bug。DPO 优化的是两者之差,绝对值一起下降是它的已知行为(第 8 章讲过位移效应)。要看的指标是:
accuracy:隐式奖励排序正确的比例,应该从 0.5 稳步上升;margins:$\beta[(\log\pi_\theta^c - \log\pi_{\text{ref}}^c) - (\log\pi_\theta^r - \log\pi_{\text{ref}}^r)]$,应该稳步扩大。
如果 accuracy 上去了但下游评测反而变差,那可能是「两个都往下掉」掉得太多——这时候 APO-Down 或者更大的 $\beta$ 是对症的。APO 的两个变体正是为了消除 DPO 在「往哪个方向推」上的模糊性:数据比模型好用 APO-Zero(chosen 往上、rejected 往下),模型比数据好用 APO-Down(两个都往下,rejected 掉得更多)。
症状 H:ORPO 的 log_odds_ratio 数值极大、训练不稳
这是参考实现真实修过的 bug,很有教育意义:ORPO 原来用序列求和的 logprob,长回复上求和会变成绝对值很大的负数,让 log-odds 项在数值上极端,直接压过 SFT 项。修法是改成逐 token 平均(与 TRL 的 ORPO 行为一致),并在 log1mexp 之前把 policy logprob 钳制到 < 0 以避免边界数值问题。
DPO 家族里凡是「训练不稳、数值爆炸」的问题,八成出在 logprob 是求和还是平均。求和的量级正比于序列长度(几百到几千),平均的量级在 $[-10, 0]$ 附近。$\beta$ 必须和你选的那种量级匹配(这也是为什么 DPO 用 0.1 而 SimPO/DPO-Norm 用 2.0)。看到新的 DAA 变体,第一件事就是确认它用的是哪种。
症状 I:跑到中途才 OOM
见第 3 节。九成是撞上了数据集里的长尾样本。设 max_length、按长度分桶、或者降微批升累积步数。另外注意 RL 的显存峰值出现在生成阶段的 KV cache,不是训练阶段——rollout 条数 × 生成长度直接决定它。
症状 J:环境检查全过,一算就报 kernel 错误
见第 3 节的 sm_120 案例。torch.cuda.get_device_capability() 对照 torch.cuda.get_arch_list(),两秒定位。
7. 日志该记什么
上一节的每一条排障,前提都是「你记了对应的指标」。事后补记是不可能的——训练已经跑完了。所以这一节反过来组织:为了能诊断上面那些症状,日志里必须有什么。
所有阶段都要记的四项
| 指标 | 为什么 | 健康的样子 |
|---|---|---|
loss | 基本信号 | 下降;但注意跨算法不可比(IPO vs DPO) |
grad_norm | 不稳定的最早预警 | 早期波动、之后趋稳;尖峰通常对应 batch 里更长/更难的样本 |
learning_rate | 确认 schedule 真的生效了 | warmup 段线性上升,之后按设定衰减 |
hours_elapsed / epoch | 横轴。步数不能跨配置比较,时间和 epoch 可以 | — |
参考实现在每个模块里都记了 hours——这一项很容易被忽略,但当你要比较「同样 6 小时预算下 GRPO 和 RLOO 谁更划算」时,横轴是步数会得出完全错误的结论(不同算法一步的成本差好几倍)。
按阶段的专有指标
| 阶段 | 必记 | 用来诊断 |
|---|---|---|
| SFT | 循环内生成样本(固定 prompt 池)、有效 label token 数 | 症状 A(label 全 mask)、base→assistant 转变有没有发生 |
| 奖励模型 | train/loss、val/loss、val/accuracy、chosen−rejected 的 reward margin | 过拟合(val 开始上翘就该停)、RM 有没有真的在学排序 |
| DPO 系列 | accuracy、margins、chosen_rewards、rejected_rewards、生成样本 | 症状 G(两个一起掉)、症状 E(复读) |
| 策略梯度 | 各分项奖励(avg_correctness / avg_format / avg_binary)、组内 reward 标准差、策略熵、裁剪触发比例、KL、生成长度、截断率 | 症状 B/C/D/F 全套 |
| PPO 专有 | 值函数损失、解释方差(explained variance)、优势的均值与标准差 | critic 学没学到东西——解释方差贴近 0 说明值函数没用 |
| 自蒸馏(SDPO) | avg_reward、loss(top-K KL)、grad_norm、skipped | skipped 是这个算法特有的关键指标:整组都没答对的 prompt 会被跳过,跳过率太高说明任务对当前模型太难 |
| 拒绝采样 | test_accuracy,以及配对的随机对照的同一指标 | reward 模型到底有没有在起作用 |
参考实现的策略梯度模块把奖励拆成 correctness、format、binary 三项分别记录,代码上就是把 reward 字典的每个 key 自动展开:
reward_log = {f"avg_{key}": avg(key) for key in replay_buffer.buffer[0].rewards.keys()}
wandb.log({**reward_log, "hours": (time.time() - start_time) / 3600})
这个习惯的价值在于:当总 reward 上涨时,你能立刻看出是「真的答对更多了」还是「只是格式分刷满了」。只记总 reward,等于把症状 B 的诊断能力扔掉。任何时候你的奖励是多项加权和,就把每一项单独记下来。
指标之外:记生成,记配置
生成样本比任何标量都重要。参考实现把它做成了 W&B table,带完整元信息(prompt id、采样设置、token 上限),并支持三种 prompt 池策略:
| 策略 | 行为 | 什么时候用 |
|---|---|---|
fixed | 每次都用同一批 prompt | 要严格对比不同 step 的变化 |
round_robin | 在 16 条的池子里轮换 | 默认选择——既有覆盖度又能纵向比较 |
random | 每次随机抽 | 只想大致看看,不做纵向对比 |
关于 W&B 本身,几条实用的:设 WANDB_MODE=disabled 或配置里 wandb_project: null 可以整个关掉(做本地烟雾测试时用);把项目设为 Public 之后曲线、配置、指标都能免登录查看,这是分享实验结果最省事的方式。
参考实现的开发规范里写得很直白:长训练命令必须放到后台跑,并且挂一个监控持续检查,不要留一个「静默的后台任务」而不确认日志、W&B 或指标真的在动。前台跑会在产出有用指标之前就超时(对用编程助手驱动实验的人尤其如此)。
还有一条硬性纪律:一次只跑一个训练任务,除非你已经确认显存够。并行跑几个很容易把整机 OOM 掉——而且是在两个任务都跑了几小时之后。
8. 识别坏掉的训练任务
两种「不好」,要花的时间完全不同
训模型时有一个直觉必须尽早建立起来:区分「配方不够好」和「东西是坏的」。
- 配方不够好:当前的数据、算法、超参组合就是达不到你想要的效果。这是科学问题,值得花时间——你的大部分时间应该花在这里。
- 东西是坏的:搭新流水线的时候,某个方法压根就是断的。label mask 错位、chat template 不匹配、reward 模型接反了、优势符号写反了。这是工程问题,不值得花时间,但很容易伪装成前者,让你对着一个根本跑不通的东西调三天超参。
最可靠的信号:稳定评测的崩塌
作者给的方法非常朴素但极其有效:在一套基本静态的评测集上评很多个模型,久而久之你会形成直觉——知道哪些测试是后训练干预很难撬动的(通常是知识密集型的,比如 MMLU)。
然后:
当后训练流水线里有东西非常、非常坏的时候,这些本来极其稳定的评测会在一次训练里掉 10 到 20 分。原书作者的评价是:「这是搭建工具链时最有用的信号之一。」
这条为什么好用,值得掰开说:
- 它有极高的信噪比。回看第 5 节那张表,MMLU 的标准差是 0.22。掉 10 分是 45 倍标准差。这不可能是噪声,也不可能是「配方不够好」——后训练本来就不该动这类知识指标。
- 它是流水线级的健康检查,不是算法级的。不管你在跑 SFT、DPO 还是 RLVR,MMLU 崩了都意味着模型的基础能力被破坏了,而不是某个损失函数的系数调错了。
- 它便宜。MMLU 是选择题,不用长生成,评一次很快。作为每个 checkpoint 的哨兵指标,成本可以忽略。
实践建议:选 2–3 个已知稳定的评测当哨兵(知识型选择题 + 一个代码或数学的稳定基准),每个 checkpoint 都评,只看有没有断崖。真正想优化的目标指标另外评。
新流水线的冒烟测试顺序
把上面的思路落成一个可执行的检查表,从最便宜的检查开始:
| # | 检查 | 成本 | 能排除什么 |
|---|---|---|---|
| 1 | 用最小规模跑通一遍(--max_samples 1000 之类) | 分钟级 | 依赖、路径、显存、张量形状 |
| 2 | 打印一条完整渲染后的训练样本 + (labels != -100).sum() | 秒级 | 症状 A:template / mask 错位 |
| 3 | step 0 就采样生成一次 | 秒级 | 模型加载对不对、tokenizer 对不对 |
| 4 | 手动喂几条已知好/坏的回复给 RM,看分数排序 | 秒级 | reward 接反、格式不匹配 |
| 5 | RL 上打印第 0 步的 rho.mean() / rho.std() | 秒级 | sampler/learner 数值错位(第 2 节) |
| 6 | 跑一个短 run,评哨兵指标(MMLU 等) | 十几分钟 | 流水线是不是在破坏基础能力 |
| 7 | 和同预算的随机 / 无干预对照跑一遍 | 一倍成本 | 你的干预到底有没有效果 |
第 7 项是最容易被跳过、也最不该跳过的。拒绝采样模块的四配置设计就是这个思路的完整示范:top_per_prompt 对 random_per_prompt,top_k_overall 对 random_k_overall,两两之间训练对数完全相同、结构完全相同,唯一的差别是选择用了 reward 还是抛硬币。有了对照,「RM 到底知不知道哪条回复更好」才成为一个可以被回答的问题。
一份可以照抄的实验工作流
参考实验库的规范写得很清楚,这里翻成通用版本:
- 动手之前先读模块 README 和配置文件。大部分「怎么跑」的问题在里面已经答过。
- 从能看到信号的最小命令开始——砍样本数、砍 epoch、复制一份小的 YAML。先确认学习信号可见,再放大。
- 长训练放后台 + 挂监控,持续检查到出现第一批指标或第一次失败为止。
- 一次一个训练任务,除非显存已确认充足。
- 一次只改一个变量。README 的原话是「confirm that the learning signal is visible, then sweep one variable at a time」。
- 记下完整命令、模型、数据切片、seed、改动的配置、最终指标、W&B 链接。
- 如果一次失败改变了未来的工作方式,把它写进文档,让下一个人(包括三个月后的自己)能找到。
被问到「有没有编程作业」时,作者的建议很具体:从第 8 章的 DPO 或第 4 章的 SFT 开始——这两个都是离线的,不需要 reward 模型服务,也不需要 rollout 循环。等你把「数据怎么进来、loss 怎么算、曲线怎么读」这条链路走通了,再上策略梯度那套需要生成-打分-更新三段循环的东西。
推荐的第一批扫描也很朴素:SFT 固定配置只变 lr(5e-6 vs 1e-5)、num_epochs 或 max_samples;策略梯度只变 num_rollouts、temperature、format_weight、数据规模;DPO 固定数据集,横向比 dpo.yaml / ipo.yaml / dpo_norm.yaml,而且要通过 margins 和 accuracy 去读 IPO,不要看它的 loss 绝对值。
代码库对状态的标注非常诚实,值得学:奖励模型模块整体标了「实验性 / 训练曲线可能很吵、超参尚未优化」;direct alignment 里 DPO/IPO/KTO/APO 标「已验证」,而 SimPO 和 ORPO 标的是「噪声大,需要调试」,并且附了带日期的实验流水账。
这对读者的意义是:如果你跑 SimPO 得到一条难看的曲线,那可能不是你的问题。先去看模块 README 的状态标注,再决定要不要在自己身上找原因——这一步能省下的时间,往往以天计。
本章小结
跑之前先算的三笔账
| 账 | 算法 | 红线 |
|---|---|---|
| 算力 | 配方开发 = 最终训练 × 10~100 | 只有跑三次的预算 ⇒ 复现别人的配方,不要开发新配方 |
| 显存(静态) | 参数量 × 12 字节(bf16 权重 2 + bf16 梯度 2 + AdamW 矩 8) | 算出来超过可用显存就一定 OOM,不必试 |
| 显存(动态) | ∝ 微批 × 序列长 × hidden × 层数 | 降微批 + 升累积步数,优化行为不变而显存下降 |
超参速查
完整表格见第 4 节。三条能背下来的:奖励模型的学习率(5e-5)比 SFT/DPO(5e-6)高一个数量级,因为它有随机初始化的标量头;DPO 系列的 $\beta$ 取决于 logprob 是求和(0.1)还是逐 token 平均(2.0),跨算法照抄必错;$\gamma$ 恒为 1.0,RLHF 里折扣没有原理依据。
排障速查
| 症状 | 先查这个 | 确认命令 / 指标 |
|---|---|---|
| loss 水平线 | label 全被 mask / chat template 不匹配 | (labels != -100).sum();打印渲染后的样本 |
| loss 数值离谱地大 | IPO 的目标 margin 是 $1/(2\beta)$,本来就大 | 改看 accuracy / margins |
| reward 涨、生成崩 | 过优化 / RM 格式不匹配 | 循环内固定 prompt 池的生成样本 |
| KL 爆炸 | 学习率过高 / $\beta$ 为 0 / KL 估计器用了 $k_1$ | 换 kl_estimator: kl3;KL 应恒非负 |
| 生成越来越长 | RM 长度偏好 / 算法长度偏差 / 截断惩罚设计 | 把平均长度、截断率和 reward 画在同一张图 |
| 生成变空 / 复读 | 熵坍塌 / 学习率过高 / 监督信号奖励「短」 | 策略熵曲线 |
| GRPO 无梯度信号 | 组内 rollout 全对或全错,优势恒零 | 组内 reward 标准差、优势非零占比 |
| DPO 两个 logprob 一起掉 | 不是 bug,是位移效应 | 看 accuracy 和 margins 的走向 |
| ORPO 数值爆炸 | logprob 用了求和而不是平均 | 检查是 .sum() 还是 / num_tokens |
| $\rho$ 在第 0 步不等于 1 | sampler/learner 后端数值差异 | 打印 rho.mean();上 TIS($C=2$) |
| 跑到中途 OOM | 数据集里的长尾样本 | 设 max_length;按长度分桶 |
| 一算就报 no kernel image | PyTorch 轮子没编译你的计算能力 | get_device_capability() vs get_arch_list() |
| MMLU 掉 10–20 分 | 流水线某处是坏的,不是配方不够好 | 停下来查工程,别调超参 |
方差的两种治法
- 评测噪声——对称、可抹平。重复评测取平均(AIME 用 Avg@32、LiveCodeBench 用 Avg@10 就是这么把高方差基准搬进稳定区的)。判断一个提升真不真,拿它和该基准的标准差比:GPQA 是 1.48,MMLU 只有 0.22。
- 训练噪声——不对称、可利用。模型只训一次,所以正向离群点是白赚的。做法是扫学习率 → 在最好的几个设置上跑多个 seed → 考虑模型合并。但要警惕自己挑出来的「最好」只是评测运气。
- seed 保证的是同机同码同配置可重跑,不保证跨硬件、跨框架版本、跨并行策略可复现。这是浮点不满足结合律的直接结果,不是工程缺陷。
五条最容易被跳过、也最不该跳过的纪律
- 每一个用 reward 做选择的地方,都配一个同预算的随机对照。
- 循环内定期采样生成,用固定的 prompt 池——它比任何标量都更早暴露问题。
- 奖励是加权和的话,每一项单独记,否则你分不清「答对了」和「格式分刷满了」。
- 一次只改一个变量;长训练放后台并挂监控;一次只跑一个任务。
- 把命令、seed、数据切片、改动项、最终指标、环境版本记全——三周后你只会剩下这些。
动手实验
这一页的内容不适合单独做实验,它是配套作业全部六个实验的共用底座。建议的用法是:
| 作业 | 先回来读这里的哪一节 |
|---|---|
| HW1 · SFT | 第 3 节(显存核算)、第 6 节症状 A、第 7 节的循环内采样 |
| HW2 · 奖励模型 | 第 4 节(RM 为什么用 5e-5)、第 7 节的 val/loss 早停 |
| HW3 · 策略梯度 | 第 2 节(rollout 与训练分离)、第 6 节症状 B/C/D/F 全套 |
| HW4 · DPO | 第 3 节的 DPO 显存陷阱、第 4 节的 $\beta$ 对照表、第 6 节症状 G/H |
| HW5 · 拒绝采样 | 第 1 节的缓存设计、第 5 节和第 8 节的「同预算随机对照」 |
| HW6 · 自蒸馏 | 第 4 节的困难任务稳定配置、第 7 节的 skipped 指标 |
另外有两个可以在任何一次训练上顺手做的小实验,收益很高:
- 验证显存公式。跑任意一个训练,用
torch.cuda.max_memory_allocated()记峰值,和「参数量 × 12 字节 + 激活估计」对一遍。对上了,你以后就能在敲命令之前判断可行性;对不上,去查是优化器实现、梯度检查点还是分配器缓存造成的差异——这个过程本身就是最好的显存课。 - 做一次 seed 消融。拿同一份配置,只改
seed(42 / 123 / 2024)各跑一遍,把最终指标的极差和你正在追求的提升幅度比一比。这个实验极其便宜,但它会永久改变你读别人论文里「+0.8 分」时的态度。
延伸阅读
成本、方差与工程实录
- Olmo 3 (2025) — 本页评测方差表和 GPU-小时拆解的来源。少见的把「集群不稳定损失了一天训练时间」写进技术报告的诚实文档。
- Tülu 3: Pushing Frontiers in Open Language Model Post-Training (2024) — 「数千次 7B 实验才定下配方」的出处;也是完整后训练配方公开程度最高的报告之一。
- The Art of Scaling Reinforcement Learning Compute for LLMs (2025) — RL 算力扩展的系统性研究,理解「为什么成本主要花在时间上」。
- What Matters for Model Merging at Scale? (2024) — 模型合并的实证研究,本页第 5 节提到的「合并有效但最佳实践未定」的依据。
训练基础设施与异步
- Asynchronous RLHF: Faster and More Efficient Off-Policy RL for Language Models (ICLR 2025) — 同步 vs 异步那张对比图的出处,异步 RLHF 最系统的一篇。
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training (2025) — 「同一份权重在 vLLM 和 FSDP 上算出不同 logprob」的经验分析。跑异步 RL 之前必读。
- AReaL: A Large-Scale Asynchronous RL System for Language Reasoning (2025) — 完全异步 RL 系统的工程细节。
- LlamaRL: A Distributed Asynchronous RL Framework (2025) — Meta 的分布式异步 RL 框架,另一条工程路线。
- INTELLECT-2: Reasoning Model Trained Through Globally Decentralized RL (2025) — 把权重同步间隔拉到极致,跨数据中心训 RL 的极端案例。
- Ionides, Truncated Importance Sampling (Journal of Computational and Graphical Statistics, 2008) — TIS 的原始统计学出处,理解「小偏差换有界方差」这笔交易。
算法层面的实践坑
- Schulman, Approximating KL Divergence — $k_1/k_2/k_3$ 三种 KL 估计器的对比。任何要动 KL 惩罚的人都该读,篇幅很短。
- DAPO: An Open-Source LLM RL System at Scale (2025) — Clip-Higher、动态采样、token 级损失、超长惩罚——本页症状 D 和 F 的解法几乎都出自这里。
- Understanding R1-Zero-Like Training: A Critical Perspective (Dr. GRPO, 2025) — 指出并修正 GRPO 的长度偏差和难度偏差,症状 D 的算法侧根因。
- Group Sequence Policy Optimization (2025) — 把重要性比值推回序列级;也讨论了「旧 logprob 该在哪一侧重算」这个基建问题。
- SimPO: Simple Preference Optimization with a Reference-Free Reward (2024) — 长度归一化 + 去掉 reference 模型;官方仓库那句「大学习率会让模型语无伦次」是症状 E 的直接证据。
- ORPO: Monolithic Preference Optimization without Reference Model (2024) — 症状 H 的算法背景,理解 log-odds 项为什么对 logprob 尺度敏感。
- Anchored Preference Optimization (APO, 2024) — 明确「数据比模型好」和「模型比数据好」两种情形该往哪个方向推,症状 G 的对症解法。
可以直接抄的开源实现
- rlhf-book/code — 本页所有配置数字的来源。每个模块的 README 都标了「已验证 / 需要调试」的状态,这种诚实标注本身就值得学。
- Ai2 open-instruct — Tülu / Olmo 的生产级流水线。
dpo_tune_cache.py是 reference logprob 缓存的样板;TIS 的 $C=2$ 也出自这里。 - HuggingFace TRL — 覆盖最全的 DAA 与 RL trainer 实现,读它主要是为了对齐「大家默认怎么写」。
- veRL — 目前最主流的大规模异步 RL 框架,第 2 节讲的 actor/learner + Ray + vLLM 那套的参考实现。
- vLLM — rollout 侧的事实标准推理引擎;连续批处理和 PagedAttention 是它比
generate()快一个数量级的原因。