直接对齐算法
不训奖励模型、不跑 RL 循环,用一个可微的损失函数直接解开 KL 正则的 RLHF 目标——DPO 的推导、坑,以及它和在线 RL 的真实差距。
0. 本章导读
到这一章为止,本书讲的 RLHF 流程都是三段式:收集偏好数据 → 训一个奖励模型(Reward Model, RM)→ 用 RL(PPO/GRPO)在 KL 约束下最大化这个 RM 的打分。这套流程能work,但工程代价惊人:显存里要同时装策略模型、参考模型、奖励模型、价值模型四份权重;训练循环里要在线生成 rollout;调不好的超参数从 KL 系数一路排到 GAE 的 $\lambda$。2023 年春天,绝大多数开源团队根本跑不通这个流程,所谓的「aligned model」基本都只是 SFT。
直接对齐算法(Direct Alignment Algorithms, DAAs)把这件事彻底简化了。它的主张非常激进:你根本不需要那个奖励模型,也不需要 RL。同样一批偏好数据 $(x, y_c, y_r)$,同样那个带 KL 正则的 RLHF 目标,可以被改写成一个直接对策略参数 $\theta$ 可微的、形状像交叉熵一样朴素的损失函数。写出来只有四行 PyTorch。
其中最著名的当然是 直接偏好优化(Direct Preference Optimization, DPO),论文副标题就把结论说尽了:Your Language Model is Secretly a Reward Model——你的语言模型本来就是一个奖励模型,只是你没意识到。这句话不是修辞,是可以用四步代数严格证明的等价性,本章第 2、3 节会把每一步都写出来。这是全书最漂亮的一段数学:从一个带约束的优化问题出发,闭式解出最优策略,反解出隐式奖励,代进 Bradley-Terry,那个看似无法计算的配分函数 $Z(x)$ 恰好在相除时被消掉,剩下一个 logsigmoid。
但本章的价值不止于推导。DPO 从 2023 年 5 月发布,到 2023 年秋天 Zephyr-$\beta$、Tülu 2 把它跑通(关键发现是:学习率要低到反常识的程度),再到 Llama 3 Instruct、Nemotron-4 340B、Tülu 3 大规模采用,这段历史里积累了大量「论文不会写但你一定会踩」的经验:隐式奖励的 margin 在涨但 chosen 的概率在跌是怎么回事、$\beta$ 到底该怎么选、参考模型能不能省、为什么长度归一化几乎总是有帮助、以及最要紧的那个问题——DPO 和在线 RL 的差距到底来自算法,还是来自数据是不是 on-policy。
在全书中的位置:本章是第 6 章(策略梯度)的对照组,用的是第 5 章(奖励建模)里同一个 Bradley-Terry 模型和同一批数据,但完全绕开了 RM 的显式训练。第 9 章的拒绝采样是另一种「不用 RL 的 RLHF」,和本章可以对照着看。
- DPO 不是「另一种优化器」,它是 RLHF 目标的解析解。给定数据集和 $\beta$,它直接朝那个最优策略走,而不像 RL 那样根据当前 batch 一步步爬。
- 推导的四步:① KL 正则目标 → 闭式最优策略 $\pi^*=\frac{1}{Z(x)}\pi_{\text{ref}}e^{r/\beta}$;② 反解 $r^*=\beta\log\frac{\pi^*}{\pi_{\text{ref}}}+\beta\log Z$;③ 代入 Bradley-Terry,$Z(x)$ 约掉;④ 取负对数似然 = DPO 损失。
- DPO 的梯度 = 「错得多离谱」的权重 $\sigma(r_\theta(y_r)-r_\theta(y_c))$ 乘以 「抬 chosen、压 rejected」的梯度差,再乘 $\beta$。
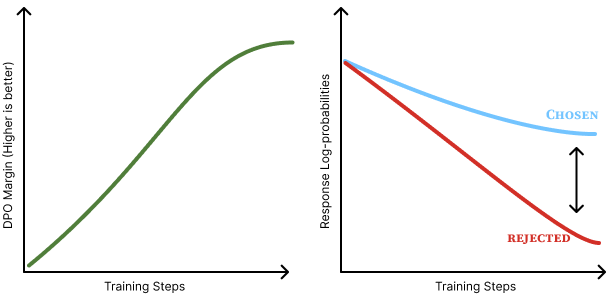
- 损失只管 margin,不管绝对值——所以模型常常把 chosen 和 rejected 的概率一起压低(只是 rejected 压得更狠)。这叫 likelihood displacement,是 DPO 最著名的隐藏坑。
- 变体(IPO/cDPO/ORPO/SimPO/KTO/APO)几乎都是一行改动:换损失形状、去掉 $\pi_{\text{ref}}$、加长度归一化、加 margin。但换算法带来的差异,通常远小于换数据带来的差异。
- Lambert 的判断:DPO 是通向「好模型」的路,不是通向「最好模型」的路。在蒸馏味重、教师模型杂的配方里(如 Olmo)它很好用;有工程资源的实验室大多会选峰值更高的在线 RL。
- DPO 的学习率必须非常低($1\times10^{-7}$ 到 $5\times10^{-6}$),高一个数量级就会发散。这是 2023 年秋天社区花了几个月才摸出来的经验。
1. DPO 在做什么:把两个阶段压成一个损失
先看结论
整章的数学最终落在两个式子上。第一个是 RLHF 目标的闭式最优策略:
$$ \pi^{*}(y\mid x) = \frac{1}{Z(x)}\,\pi_{\text{ref}}(y\mid x)\exp\!\Big(\tfrac{1}{\beta}\, r(x,y)\Big) $$第二个是你真正拿去训练的 DPO 损失:
$$ \mathcal{L}_{\text{DPO}}(\pi_\theta; \pi_{\text{ref}}) = -\E_{(x,y_c,y_r)\sim\mathcal{D}}\left[ \log \sigma\left( \beta \log \frac{\pi_{\theta}(y_c \mid x)}{\pi_{\text{ref}}(y_c \mid x)} - \beta \log \frac{\pi_{\theta}(y_r \mid x)}{\pi_{\text{ref}}(y_r \mid x)} \right) \right] $$符号先对齐清楚,后面全章通用:
| 符号 | 含义 | 形状 / 量纲 |
|---|---|---|
| $x$ | prompt(完整的用户输入,已过 chat template) | token 序列 |
| $y_c,\ y_r$ | chosen / rejected 两条完整回复(下标 c = chosen, r = rejected) | token 序列 |
| $\pi_\theta(y\mid x)$ | 被训练的策略给整条回复的概率,实际计算的是 $\log\pi_\theta(y\mid x)=\sum_t \log\pi_\theta(y_t\mid x,y_{<t})$ | 标量(每条样本一个数) |
| $\pi_{\text{ref}}$ | 参考模型,通常就是 SFT 后的那个 checkpoint,训练全程冻结 | — |
| $\beta$ | KL 正则强度。大 → 贴住参考模型;小 → 允许跑远、容易过优化 | 无量纲,典型 0.1(求和 logprob) |
| $\sigma(z)$ | sigmoid,$1/(1+e^{-z})$ | $(0,1)$ |
| $Z(x)$ | 配分函数,对所有可能的回复 $y$ 求和——完全不可计算,但推导中会被消掉 | 标量 |
注意 $\log\pi_\theta(y\mid x)$ 是整条序列 token 对数概率之和,一条 500 token 的回复,这个数通常在 $-1000$ 到 $-200$ 之间。而损失里进入 sigmoid 的是两个差值的差值,量级要小得多——这是后面理解 $\beta$ 取值和长度偏置的关键。
损失在直觉上做什么
把 sigmoid 里那一坨拆成两块看:
- $\beta \log \frac{\pi_{\theta}(y_c \mid x)}{\pi_{\text{ref}}(y_c \mid x)}$:策略相对参考模型,把 chosen 的概率提高了多少(取对数)。
- $\beta \log \frac{\pi_{\theta}(y_r \mid x)}{\pi_{\text{ref}}(y_r \mid x)}$:同一个量,但对 rejected。
两者相减,当 chosen 的提升幅度超过 rejected 的提升幅度时,sigmoid 的输入为正,$-\log\sigma(\cdot)$ 变小,损失下降。所以 DPO 干的事情用一句话概括就是:拉大 chosen 与 rejected 之间「相对参考模型的对数概率差」。
关键在于「相对参考模型」这四个字。如果没有 $\pi_{\text{ref}}$ 做分母,模型可以靠把所有长回复的概率整体压低来作弊;有了它,被优化的是变化量而不是绝对概率。这个分母不是工程 trick,它是从 KL 正则里直接推出来的——这正是下一节要做的事。
隐式奖励:奖励模型藏在策略里
DPO 的核心洞察是,那两块 $\beta\log\frac{\pi_\theta}{\pi_{\text{ref}}}$ 本身就是一个奖励函数:
$$ r_\theta(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)} $$代进去,DPO 损失就变成了 $-\E[\log\sigma(r_\theta(x,y_c) - r_\theta(x,y_r))]$——这正是第 5 章训练 Bradley-Terry 奖励模型的损失函数,一字不差。区别只在于:第 5 章里 $r_\phi$ 是一个带线性头的独立网络,这里 $r_\theta$ 是从策略的对数概率比里读出来的。
与 RL 的一个根本差别:KL 是静态的
PPO 每一步都基于新鲜采样的 batch 算一个 KL 惩罚,实际到达的 KL 距离是训练动力学的产物,很多实现还要挂一个自适应 KL 控制器来把它拽回目标值。DPO 不是这样:因为生成不是在线的,它对给定数据集直接朝 $\beta$ 所对应的那个最优解迈步。$\beta$ 定下来,理论上的终点就定下来了。
这带来一个实践上的好处:$\beta$ 比 PPO 的 KL 系数好调得多,语义也更清楚。但也带来一个限制:这个「最优解」只是给定这批数据的最优解。数据覆盖不到的地方,DPO 给不出任何有意义的行为——这是第 9 节要展开的、DAA 性能天花板的根源。
2. 推导(一):解出 KL 正则 RLHF 目标的最优策略
推导分两大部分。第一部分(本节):证明那个带 KL 约束的 RLHF 目标存在闭式最优解。第二部分(下一节):把这个解反过来用,从成对偏好数据里学出它。
起点:本书从第 3 章用到现在的目标函数
$$ \max_{\pi}\ \E_{x \sim \mathcal{D}}\,\E_{y \sim \pi(y\mid x)}\big[r(x, y)\big] - \beta\, \mathcal{D}_{\text{KL}}\big(\pi(y\mid x)\,\|\,\pi_{\text{ref}}(y\mid x)\big) $$读法:对数据集里的每个 prompt $x$,从当前策略 $\pi$ 采样回复 $y$,希望奖励高;同时不希望 $\pi$ 离 $\pi_{\text{ref}}$ 太远。注意这里的双重期望只作用于奖励项——KL 项是一个解析表达式,不需要采样。
第 1 步:把 KL 折进期望里
KL 散度的定义是 $\mathcal{D}_{\text{KL}}(\pi\|\pi_{\text{ref}}) = \E_{y\sim\pi}\big[\log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)}\big]$。注意它的采样分布也是 $\pi$,和奖励项完全一样。既然两项共享同一个期望,就可以合并:
$$ \max_{\pi}\ \E_{x \sim \mathcal{D}}\,\E_{y \sim \pi(y\mid x)}\left[r(x,y)-\beta\log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)}\right] $$第 2 步:翻成最小化,并除以 $\beta$
拆成两项,整体乘 $-1$ 把 $\max$ 变 $\min$:
$$ = \min_{\pi}\left(-\E_{x}\E_{y \sim \pi}\big[r(x,y)\big] + \beta\,\E_{x}\E_{y \sim \pi}\left[\log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)}\right]\right) $$再除以 $\beta$(正数,不改变 $\argmin$)并重新合并:
$$ = \min_{\pi}\ \E_{x \sim \mathcal{D}}\,\E_{y \sim \pi(y\mid x)}\left[ \log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)} - \frac{1}{\beta}r(x,y) \right] $$第 3 步:看出这几乎是一个 KL 散度
用 $\frac{1}{\beta}r = \log e^{r/\beta}$ 把第二项塞进对数里:
$$ = \min_{\pi}\ \E_{x}\,\E_{y \sim \pi}\left[ \log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)\,e^{\,r(x,y)/\beta}} \right] $$这一步是整段推导的转折点。分母 $\pi_{\text{ref}}(y\mid x)\,e^{r(x,y)/\beta}$ 的含义非常直白:被奖励重新加权过的参考模型——每条回复的概率被乘上 $e^{r/\beta}$,奖励越高乘得越多,$\beta$ 控制这个重加权有多激进。$\beta\to\infty$ 时 $e^{r/\beta}\to 1$,分母退化成 $\pi_{\text{ref}}$;$\beta\to 0$ 时重加权无限尖锐,只剩最高奖励的那条回复。
而 $\E_{y\sim\pi}\big[\log\frac{\pi}{q}\big]$ 的形状恰好就是 $\mathcal{D}_{\text{KL}}(\pi\|q)$。如果分母真是一个概率分布 $q$,那这个 $\min_\pi$ 就有精确的闭式解:Gibbs 不等式告诉我们 KL $\ge 0$,且当且仅当 $\pi = q$ 时取 0。也就是说,最小化的答案就是「分母里那个东西」。
第 4 步:引入配分函数 $Z(x)$ 把分母归一化
问题在于分母不是概率分布——把 $\pi_{\text{ref}}(y\mid x)e^{r(x,y)/\beta}$ 对所有 $y$ 求和不等于 1。所以我们造一个归一化常数,即配分函数(partition function):
$$ Z(x) = \sum_y \pi_{\text{ref}}(y\mid x)\exp\left(\frac{1}{\beta}r(x,y)\right) $$有了 $Z(x)$,令 $q(y\mid x) = \frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)e^{r(x,y)/\beta}$,它就是一个合法分布了。现在把 $Z$ 塞进目标函数。从第 2 步的形式出发,加一个恒等于零的 $\log Z(x)-\log Z(x)$:
$$ \log\frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)} - \frac{1}{\beta}r(x,y) + \log Z(x) - \log Z(x) $$把前两项和第一个 $\log Z$ 归到一组:
$$ = \left( \log \frac{\pi(y\mid x)}{\pi_{\text{ref}}(y\mid x)} + \log Z(x) \right) - \log Z(x) - \frac{1}{\beta}r(x,y) $$用 $\log a + \log b = \log(ab)$,把 $Z(x)$ 挪到分母(变成 $\frac{1}{Z(x)}$ 乘 $\pi_{\text{ref}}$):
$$ = \log \frac{\pi(y\mid x)}{\frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)} - \log Z(x) - \frac{1}{\beta}r(x,y) $$再把 $\frac{1}{\beta}r$ 展开成 $\log e^{r/\beta}$ 一并塞进分母,整体目标变成:
$$ \min_{\pi}\ \E_{x\sim\mathcal{D}} \left[ \E_{y\sim\pi(y\mid x)}\left[\log\frac{\pi(y\mid x)}{\frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)\exp\left(\frac{1}{\beta}r(x,y)\right)} \right] - \log Z(x)\right] $$$\log Z(x)$ 不依赖 $y$,所以可以从内层期望里提出来(上式已经提好了)。
第 5 步:Gibbs 不等式一锤定音
内层期望现在是一个货真价实的 KL 散度:
$$ \min_{\pi}\ \E_{x\sim\mathcal{D}}\left[\mathcal{D}_{\text{KL}} \left(\pi(y\mid x) \,\middle\|\, \frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)\exp\left(\frac{1}{\beta}r(x,y)\right) \right) - \log Z(x)\right] $$$\log Z(x)$ 与 $\pi$ 无关,是常数,扔掉。剩下的只有 KL 项。Gibbs 不等式:KL $\ge 0$,等号当且仅当两个分布相同。于是最优策略直接读出来:
3. 推导(二):反解隐式奖励,代进 Bradley-Terry
第 6 步:把最优策略反解成奖励
上一节得到 $\pi^*(y\mid x) = \frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)\exp(\frac{1}{\beta}r^*(x,y))$。现在我们要的是反方向:给定策略,奖励是什么。两边取对数:
$$ \log \pi^*(y\mid x) = \log \left( \frac{1}{Z(x)}\pi_{\text{ref}}(y\mid x)\exp\left(\frac{1}{\beta}r^*(x,y)\right) \right) $$用 $\log(abc) = \log a + \log b + \log c$ 展开右边:
$$ \log \pi^*(y\mid x) = -\log Z(x) + \log \pi_{\text{ref}}(y\mid x) + \frac{1}{\beta}r^*(x,y) $$移项,把 $r^*$ 孤立出来:
$$ \frac{1}{\beta}r^*(x,y) = \log \pi^*(y\mid x) - \log \pi_{\text{ref}}(y\mid x) + \log Z(x) $$两边乘 $\beta$,把前两项合成一个对数比:
那个碍事的 $\beta\log Z(x)$ 还在。但注意它只依赖 $x$,不依赖 $y$——同一个 prompt 下的所有回复共享同一个偏移。这个观察是下一步的全部。
第 7 步:代入 Bradley-Terry,$Z(x)$ 消失
回忆第 5 章的 Bradley-Terry 偏好模型:两条回复谁更好的概率,是它们奖励的 softmax。
$$ p^*(y_1 \succ y_2 \mid x) = \frac{\exp\left(r^*(x,y_1)\right)}{\exp\left(r^*(x,y_1)\right) + \exp\left(r^*(x, y_2)\right)} $$把隐式奖励代进去:
$$ p^*(y_1 \succ y_2 \mid x) = \frac{\exp\left(\beta \log \frac{\pi^*(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} + \beta \log Z(x)\right)} {\exp\left(\beta \log \frac{\pi^*(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} + \beta \log Z(x)\right) + \exp\left(\beta \log \frac{\pi^*(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)} + \beta \log Z(x)\right)} $$用 $e^{a+b} = e^a e^b$,分子分母的每一项都带一个公因子 $e^{\beta\log Z(x)} = Z(x)^\beta$。约掉:
$$ p^*(y_1 \succ y_2 \mid x) = \frac{\exp\left(\beta \log \frac{\pi^*(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)}\right)} {\exp\left(\beta \log \frac{\pi^*(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)}\right) + \exp\left(\beta \log \frac{\pi^*(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)}\right)} $$第 8 步:整理成 sigmoid
记 $\Delta_i = \beta \log \frac{\pi^*(y_i\mid x)}{\pi_{\text{ref}}(y_i\mid x)}$,上式就是 $\frac{e^{\Delta_1}}{e^{\Delta_1}+e^{\Delta_2}}$。分子分母同乘 $e^{-\Delta_1}$:
$$ p^*(y_1 \succ y_2 \mid x) = \frac{1}{1 + e^{\,\Delta_2 - \Delta_1}} $$对照 $\sigma(z) = \frac{1}{1+e^{-z}}$,得到:
$$ p^*(y_1 \succ y_2 \mid x) = \sigma\left(\beta \log \frac{\pi^*(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} - \beta \log \frac{\pi^*(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)}\right) $$第 9 步:取负对数似然
剩下的就是标准的最大似然估计。我们手上的数据是「人(或 AI)判定 $y_c \succ y_r$」,最大化这些观测的似然 = 最小化负对数似然。把待优化的 $\pi_\theta$ 换掉 $\pi^*$:
$$ \begin{aligned} \mathcal{L}_{\text{DPO}}(\pi_{\theta}; \pi_{\text{ref}}) &= -\E_{(x,y_c,y_r)\sim\mathcal{D}}\left[ \log p(y_c \succ y_r \mid x) \right] \\[6pt] &= -\E_{(x,y_c,y_r)\sim\mathcal{D}}\left[ \log \sigma\left(\beta \log \frac{\pi_{\theta}(y_c\mid x)}{\pi_{\text{ref}}(y_c\mid x)} - \beta \log \frac{\pi_{\theta}(y_r\mid x)}{\pi_{\text{ref}}(y_r\mid x)}\right)\right] \end{aligned} $$推导闭环。没有奖励模型、没有采样、没有 RL 循环,只有一个对 $\theta$ 直接可微的函数。
全景回顾
| 步骤 | 结果 | 用到的工具 |
|---|---|---|
| 目标 | $\max_\pi \E[r] - \beta\,\mathcal{D}_{\text{KL}}(\pi\|\pi_{\text{ref}})$ | 第 3 章的 RLHF 目标 |
| ① 最优策略 | $\pi^*=\frac{1}{Z(x)}\pi_{\text{ref}}e^{r/\beta}$ | 合并期望 + 配分函数 + Gibbs 不等式 |
| ② 隐式奖励 | $r^*=\beta\log\frac{\pi^*}{\pi_{\text{ref}}}+\beta\log Z$ | 取对数、移项 |
| ③ 偏好概率 | $p^*=\sigma(r^*(y_1)-r^*(y_2))$,$Z$ 约掉 | Bradley-Terry + 只看差值 |
| ④ 损失 | $-\log\sigma(\beta\log\frac{\pi_\theta(y_c)}{\pi_{\text{ref}}(y_c)}-\beta\log\frac{\pi_\theta(y_r)}{\pi_{\text{ref}}(y_r)})$ | 负对数似然 |
原论文还给出了 Plackett-Luce 模型(多于两条回复的排序)下的对应推导,但实践中几乎没人用——成对比较依然是偏好数据的主流形式。
4. 梯度长什么样:它到底在更新什么
损失函数只告诉你「优化目标是什么」,梯度才告诉你「每一步参数实际怎么动」。DPO 的梯度形式非常干净,而且它直接解释了后面所有的坑。
逐步求导
令 $u = \beta \log \frac{\pi_{\theta}(y_c\mid x)}{\pi_{\text{ref}}(y_c\mid x)} - \beta \log \frac{\pi_{\theta}(y_r\mid x)}{\pi_{\text{ref}}(y_r\mid x)}$,即 sigmoid 里那一坨。损失是 $-\E[\log\sigma(u)]$。链式法则第一层:
$$ \nabla_{\theta}\mathcal{L}_{\text{DPO}} = -\,\E_{(x, y_c, y_r)\sim \mathcal{D}}\left[\frac{\sigma'(u)}{\sigma(u)}\,\nabla_{\theta}u\right] $$用 sigmoid 的导数恒等式 $\sigma'(u) = \sigma(u)(1-\sigma(u))$,$\sigma(u)$ 上下约掉:
$$ \nabla_{\theta}\mathcal{L}_{\text{DPO}} = -\,\E\Big[\big(1-\sigma(u)\big)\,\nabla_{\theta}u\Big] = -\,\E\Big[\sigma(-u)\,\nabla_{\theta}u\Big] $$(第二个等号用了反射恒等式 $1-\sigma(u)=\sigma(-u)$。)再求 $\nabla_\theta u$:$\pi_{\text{ref}}$ 是冻结的,$\log\pi_{\text{ref}}$ 对 $\theta$ 的梯度为 0,两项直接掉光:
$$ \nabla_{\theta} u = \beta\big[\nabla_{\theta}\log\pi_{\theta}(y_c\mid x) - \nabla_{\theta}\log\pi_{\theta}(y_r\mid x)\big] $$合起来:
三个部件各干什么
- 权重 $w\in(0,1)$:自适应的「难例挖掘」。$w$ 是「模型认为 rejected 比 chosen 好」的概率。当模型已经排对了($r_\theta(y_c) \gg r_\theta(y_r)$),$w\to 0$,这条样本几乎不产生梯度;当模型排反了,$w\to 1$,梯度打满。所以 DPO 会自动把算力集中在还没学会的样本上。训练后期看到 loss 平掉,往往不是「学不动了」,而是大部分样本的 $w$ 已经趋近 0。
- 括号里的梯度差:抬 chosen、压 rejected。$\nabla_\theta\log\pi_\theta(y_c\mid x)$ 是标准的最大似然梯度(和 SFT 一模一样),前面的负号和外层负号抵消后是「增大 chosen 概率」;$-\nabla_\theta\log\pi_\theta(y_r\mid x)$ 则是反向的 SFT 梯度——unlikelihood training,把 rejected 的概率往下推。
- $\beta$:整体步长与 KL 权衡。它同时缩放整个梯度。$\beta$ 大,一次更新走得远,但也更容易偏离 $\pi_{\text{ref}}$。
token 级别发生了什么
虽然损失写在序列级,但 $\log\pi_\theta(y\mid x)=\sum_t\log\pi_\theta(y_t\mid x,y_{<t})$ 是逐 token 求和的,所以梯度也会逐 token 分摊。每个 token 拿到的梯度大小和方向,取决于它对整条序列的对数概率贡献了多少。这意味着优化器天然会去调整那些「最能改变整体偏好 margin」的 token——在实践中,通常就是 chosen 和 rejected 分岔的那几个关键位置。这是 DPO 相比「整条序列给一个标量奖励」的 RL 方法的一个隐性优势:credit assignment 是免费的、稠密的,不需要价值网络。
最小实现
把上面的数学翻成代码,核心只有五行。改写自参考实现 _src/code/direct_alignment/loss.py 中的 DPOLoss:
import torch.nn.functional as F

def dpo_loss(policy_chosen_logps, policy_rejected_logps,
             ref_chosen_logps, ref_rejected_logps, beta=0.1):
    """四个输入都是 shape (batch,) 的整条序列 log-prob 之和。"""
    # 隐式奖励的「未乘 beta」版本:策略相对参考模型的位移
    chosen_logratios   = policy_chosen_logps   - ref_chosen_logps
    rejected_logratios = policy_rejected_logps - ref_rejected_logps

    # sigmoid 内部的 u / beta;为正表示策略更偏向 chosen
    logits = chosen_logratios - rejected_logratios

    losses = -F.logsigmoid(beta * logits)          # DPO 损失

    # 下面几个只用于监控,detach 掉不参与反传
    chosen_rewards   = beta * chosen_logratios.detach()
    rejected_rewards = beta * rejected_logratios.detach()
    metrics = {
        "chosen_rewards":   chosen_rewards.mean().item(),
        "rejected_rewards": rejected_rewards.mean().item(),
        "margins":  (chosen_rewards - rejected_rewards).mean().item(),
        "accuracy": (chosen_rewards > rejected_rewards).float().mean().item(),
    }
    return losses.mean(), metrics
而 policy_chosen_logps 这些量的来源同样朴素——一次前向、一次 log_softmax、一次 gather:
def compute_logprobs(logits, labels, mask, average_log_prob=False):
    """logits: (B, T, V)  labels: (B, T)  mask: (B, T),1 表示是回复 token"""
    logits = logits[:, :-1, :]      # 自回归错位:用 0..t-1 预测 t
    labels = labels[:, 1:]
    mask   = mask[:, 1:]

    log_probs = F.log_softmax(logits, dim=-1)                       # (B, T-1, V)
    per_token = torch.gather(log_probs, -1, labels.unsqueeze(-1)).squeeze(-1)
    per_token = per_token * mask    # prompt 与 padding 位置不计入

    if average_log_prob:            # SimPO / DPO-Norm:按长度取平均
        return per_token.sum(-1) / mask.sum(-1).clamp(min=1)
    return per_token.sum(-1)        # 标准 DPO:整条序列求和
注意 mask 用的是 response mask 而不是 attention mask:只有回复部分的 token 进入 $\log\pi(y\mid x)$,prompt 部分不算——这与第 4 章 SFT 的 loss masking 完全一致。搞错这一点,$\beta$ 的有效尺度会随 prompt 长度乱漂。
5. 隐藏的坑:概率位移(likelihood displacement)
现象:margin 在涨,chosen 的概率却在跌
第一次跑 DPO 的人几乎都会被这个现象吓一跳:训练曲线上 margins 稳稳上升、accuracy 从 50% 爬到 70%,一切看起来都对;但如果你顺手把 policy_chosen_logps 也记下来,会发现它在往下走。模型正在降低「好回复」的概率。
原因在第 4 节已经埋好了:DPO 的损失只依赖 margin,不依赖两个对数概率的绝对值。要减小损失,模型有无穷多条路:
| 路径 | chosen 概率 | rejected 概率 | 损失 | 是我们想要的吗 |
|---|---|---|---|---|
| A | ↑↑ | ↓ | 下降 | 是 |
| B | ↑ | ↑(更慢) | 下降 | 可以接受 |
| C | ↓ | ↓↓(更快) | 下降 | 不是——但实际最常发生 |
实测中,路径 C 极其常见:chosen 和 rejected 的概率一起下降,只是 rejected 降得更多。
为什么会这样:概率质量守恒
这里的关键在于,语言模型在每个位置输出的是一个归一化分布。把 rejected 的概率压下去,被释放的概率质量不会凭空消失,它会流向其他所有 token。理想情况下应该流向 chosen,但 chosen 和 rejected 往往共享大量前缀和相似措辞——压 rejected 的梯度会顺带压到 chosen 的公共部分。于是概率质量流向了第三方:那些既不在 chosen 也不在 rejected 里、模型本来就有一定倾向的输出。
相关研究把这个现象命名为 likelihood displacement(概率位移 / 非预期失配),并指出它可能抬高「未被数据覆盖的行为」的概率——包括一些你完全不想要的行为。极端情况下,一个本意是让模型「更安全」的偏好数据集,反而可能把概率推向既非 chosen 也非 rejected 的第三种、更糟的回复上。这也是 DPO 训练偶尔出现「莫名其妙的重复、莫名其妙的语气漂移」的一个解释。
怎么缓解
| 做法 | 机制 | 代价 |
|---|---|---|
加一项 chosen 上的 SFT 损失(loss = dpo + λ·NLL(y_c)) | 直接给 chosen 一个「必须往上抬」的锚,最常见的工程做法 | 多一个 $\lambda$ 要调;$\lambda$ 太大退化成 SFT |
| Cal-DPO | 校准优化过程,让隐式奖励的尺度可比,抑制单纯压低概率的解 | 改动优化过程,需重新调参 |
| AlphaPO | 修改奖励的形状(reward shape),改变梯度对绝对概率的敏感度 | 多一个形状超参 |
| APO-Zero / APO-Down | 把 chosen 与 rejected 的奖励分别锚定,显式指定各自该升还是该降 | 需要判断「模型强于还是弱于偏好数据」 |
| 换成在线 / 半在线数据 | 让 rejected 来自当前模型自己的分布,压它就是在压模型真实会输出的东西 | 需要生成基础设施,退回半个 RL 循环 |
APO:把「该往哪边动」写进损失
APO(Anchored Preference Optimization)这条思路值得单独说一句,因为它把问题的本质点破了:DPO 对「概率该往哪个方向动」是欠定的(underspecified),而正确答案取决于模型和数据的相对强弱。
- 如果偏好数据里的 chosen 比模型自己生成的更好(弱模型学强数据),应该抬高 chosen 概率 → 用 APO-Zero。
- 如果 chosen 还不如模型自己能写的(强模型学弱数据),抬高 chosen 反而是在拉低模型,此时应该两个都压、rejected 压得更多 → 用 APO-Down。
参考实现里两者都很短(loss.py 的 APOZeroLoss / APODownLoss),核心差别只在损失怎么组合两个 sigmoid:
# chosen_logratios   = beta * (policy_chosen_logps   - ref_chosen_logps)
# rejected_logratios = beta * (policy_rejected_logps - ref_rejected_logps)

# APO-Zero:chosen 奖励要涨(第一项越大损失越小),rejected 奖励要跌
apo_zero_loss = -F.sigmoid(chosen_logratios) + F.sigmoid(rejected_logratios)

# APO-Down:chosen 奖励要跌(第一项),但 margin 要涨(第二项)
apo_down_loss = F.sigmoid(chosen_logratios) - F.sigmoid(chosen_logratios - rejected_logratios)
APO 不是纸面方法:HuggingFace 的 SmolLM3 后训练配方就用 APO 替代了 DPO。当你的 SFT 模型已经相当强、而偏好数据来自更弱的标注源时,这个替换很值得一试。
6. 变体家族:每个都只改了一件事
2023 年底到 2024 年,DPO 的变体像雨后春笋一样冒出来,多到有人做了专门的综述(RainbowPO、《The Differences Between Direct Alignment Algorithms are a Blur》)。好消息是:它们几乎都是一行改动,而且改的位置高度集中在四个地方。先建立这个分类框架,再看具体算法就不会晕。
| 改动位置 | 问题 | 代表算法 |
|---|---|---|
| ① 损失的形状(sigmoid → 别的) | Bradley-Terry 假设太强、对噪声标签过拟合 | IPO、cDPO、AlphaPO |
| ② 去掉参考模型 | 显存翻倍、工程复杂 | ORPO、SimPO |
| ③ 长度归一化与 margin 项 | 长度偏置、margin 无下界 | SimPO、DPO-Norm、ODPO |
| ④ 改变数据形态或权重 | 成对数据难收集、每对权重相同不合理 | KTO、REBEL、ODPO、Online DPO |
IPO:把分类问题换成回归问题
DPO 的一个理论批评是:Bradley-Terry 把「偏好」建模成无界的奖励差,只要标签是确定的($p=1$),最优解就是把 margin 推到无穷大。有限数据下,这直接导致过拟合——模型会记住训练对,而不是学到偏好的一般规律。
IPO(Identity Preference Optimization)的做法是把偏好概率的非线性映射从 $\log\frac{q}{1-q}$ 换成恒等映射(名字里的 Identity 就是这个意思),结果损失从「最大化 margin」变成「回归到一个目标 margin」:
$$ \mathcal{L}_{\text{IPO}} = \E_{(x,y_c,y_r)}\left[\left(\log\frac{\pi_\theta(y_c\mid x)\,\pi_{\text{ref}}(y_r\mid x)}{\pi_\theta(y_r\mid x)\,\pi_{\text{ref}}(y_c\mid x)} - \frac{1}{2\beta}\right)^2\right] $$代码上就是把 -F.logsigmoid(beta * logits) 换成 (logits - 1/(2*beta))**2:
# 来自 _src/code/direct_alignment/loss.py 的 IPOLoss
logits = chosen_logratios - rejected_logratios   # 与 DPO 完全相同
target_margin = 1.0 / (2.0 * self.beta)          # beta=0.1 → 目标 margin = 5.0
losses = (logits - target_margin) ** 2 # 平方误差,而不是 logsigmoidlogits 接近 0,损失就是 $5^2=25$ 左右——比 DPO 的 0.5~0.7 大两个数量级。不要因为 IPO 的 loss 数字大就以为它在发散。判断 IPO 是否正常,要看 accuracy 和 margins 的走势,而不是 loss 的绝对值。同理,IPO 的梯度范数也不能直接和 DPO 比。
cDPO:假设标签有噪声
更朴素的抗噪路线是 conservative DPO:假设有 $\varepsilon$ 比例的偏好标签是翻转的,于是把硬标签 $[1, 0]$ 软化成 $[1-\varepsilon, \varepsilon]$。实现上就是 label smoothing:
# cDPO = DPOLoss(beta=beta, label_smoothing=0.1)
losses = (-F.logsigmoid( beta * logits) * (1 - eps)
          -F.logsigmoid(-beta * logits) * eps)
效果是给 margin 加了一个软上界:当 margin 大到一定程度,第二项开始反向拉,防止无限制推大。合成偏好数据(比如 GPT-4 打的标签)通常有 10%~20% 的噪声,$\varepsilon=0.1$ 是个合理起点。
ORPO:把偏好项直接缝进 SFT 损失
ORPO(Odds Ratio Preference Optimization)的目标是彻底去掉参考模型,从而把显存需求砍掉一份权重,甚至允许直接从 base 模型开始一步到位。它的损失是 SFT 损失加上一个基于几率比(odds ratio)的偏好项:
$$ \mathcal{L}_{\text{ORPO}} = \mathcal{L}_{\text{SFT}}(y_c) - \lambda\,\E\left[\log \sigma\left(\log \frac{\text{odds}_\theta(y_c\mid x)}{\text{odds}_\theta(y_r\mid x)}\right)\right],\qquad \text{odds}_\theta(y) = \frac{\pi_\theta(y\mid x)}{1-\pi_\theta(y\mid x)} $$为什么用几率比而不是概率比?因为 $\frac{p}{1-p}$ 只需要 $\pi_\theta$ 一个模型就能算,不需要任何参考量做分母——参考模型的作用(提供一个基准)被 $1-p$ 顶替了。而前面的 SFT 项则同时扮演了「把 chosen 概率抬上去」的锚,天然规避了第 5 节的位移问题。
Lambert 的说法是:ORPO 最好看作「受 DPO 启发」而不是「DPO 的衍生物」——它并不是从 KL 正则目标推出来的。
SimPO:长度归一化 + 目标 margin,也不要参考模型
$$ \mathcal{L}_{\text{SimPO}} = -\E\left[\log \sigma\left(\frac{\beta}{|y_c|}\log \pi_\theta(y_c\mid x) - \frac{\beta}{|y_r|}\log \pi_\theta(y_r\mid x) - \gamma\right)\right] $$两处改动:(1) 用平均 token 对数概率替代求和($\frac{1}{|y|}$),这样长度不再直接放大 log-prob;(2) 减去一个目标 margin $\gamma$,要求 chosen 必须超出 rejected 一个固定量才算学会。参考模型被完全去掉——SimPO 主张长度归一化后的平均 log-prob 本身就是一个够用的隐式奖励。
DPO-Norm:只拿 SimPO 的一半
参考实现里还有一个折中方案 dpo_norm:保留参考模型和标准 DPO 损失,但 policy 和 reference 两边的序列 log-prob 都改成按 token 取平均。这样既拿到了长度归一化的好处,又没丢掉参考模型的校正,也不引入 $\gamma$。Liquid AI 的 LFM2 就用了 length-normalized DPO。这是四个变体里最容易「白捡收益」的一个。
KTO:连成对数据都不要了
KTO(Kahneman-Tversky Optimization)从行为经济学的前景理论出发,主张你只需要知道一条回复是「好」还是「坏」,不需要成对比较。这在工程上意义重大——线上产品收集到的往往是点赞/点踩这种单条二元反馈,凑成对本身就很贵。
代价是要引入一个「参考点」KL 来替代第 3 节里被消掉的 $\beta\log Z(x)$:
# 来自 _src/code/direct_alignment/loss.py 的 KTOLoss(简化版)
KL = kl_logratios.mean().detach().clamp(min=0)      # 参考点,从无关样本估计
chosen_losses   = 1 - F.sigmoid(beta * (chosen_logratios - KL))    # 好的:要高于参考点
rejected_losses = 1 - F.sigmoid(beta * (KL - rejected_logratios))  # 坏的:要低于参考点
loss = desirable_weight * chosen_losses.mean() + undesirable_weight * rejected_losses.mean()
两个权重不对称(论文建议 undesirable 约 1.33 倍)——这正是前景理论里「损失厌恶」的体现:人对坏事的反应强于对同等好事的反应。
横向对比表
| 算法 | 相对 DPO 改了什么 | 解决什么问题 | 要参考模型 | 典型 $\beta$ / 学习率 |
|---|---|---|---|---|
| DPO | 基准:$-\log\sigma(\beta\,\Delta)$,序列 log-prob 求和 | — | 是 | 0.1–0.5 / 5e-6 |
| cDPO | label smoothing $\varepsilon$ | 偏好标签有噪声 | 是 | 同 DPO,$\varepsilon\approx0.1$ |
| IPO | $\log\sigma$ → 平方误差,回归到目标 margin $\frac{1}{2\beta}$ | margin 无界导致的过拟合 | 是 | 0.1 / 5e-6 |
| ODPO | margin 要求超过一个随偏好强度变化的 offset | 不该把所有偏好对同等对待 | 是 | 需额外的强度标注 |
| ORPO | SFT 损失 + 几率比项,无 $\pi_{\text{ref}}$ | 省一份显存;可从 base 一步到位 | 否 | 0.1 / 1e-6 |
| SimPO | 平均 log-prob + 目标 margin $\gamma$,无 $\pi_{\text{ref}}$ | 长度偏置 + 省显存 | 否 | 2.0–2.5 / 8e-7 |
| DPO-Norm | 只加长度归一化,其余同 DPO | 长度偏置 | 是 | 2.0–5.0 / 5e-6–1e-6 |
| KTO | 逐条打分 + 参考点 KL + 非对称权重 | 成对数据难收集 | 是 | 0.1 / 5e-6 |
| APO-Zero / Down | 分别锚定 chosen / rejected 的奖励方向 | 概率位移方向欠定 | 是 | 0.1 / 5e-6 |
| REBEL | 引入奖励模型给出的数值 margin | 二元标签丢失了偏好强度 | 是(且要 RM) | — |
| Online DPO / D2PO | 训练中现采样、现打标 | 数据不是 on-policy | 是 | 需生成 + RM |
7. β、参考模型与长度偏置:把 DPO 真正跑对
$\beta$:唯一必须认真调的超参数
$\beta$ 在推导里的身份很清楚——它就是 RLHF 目标里 KL 项的系数。从 $\pi^*=\frac{1}{Z}\pi_{\text{ref}}e^{r/\beta}$ 可以直接读出它的作用:
- $\beta$ 大(比如 0.5):$e^{r/\beta}$ 的重加权很温和,最优策略贴着 $\pi_{\text{ref}}$。模型几乎不动,安全但也学不到什么。
- $\beta$ 小(比如 0.01):重加权极端尖锐,最优策略允许离 $\pi_{\text{ref}}$ 很远。学得多,但过优化风险高——第 14 章会展开这个话题。
因为 DPO 的 KL 是静态的($\beta$ 一定,理论终点就定了),$\beta$ 比 PPO 的 KL 系数好调:你不需要担心训练动力学把实际 KL 带到别处去。但最优的 $\beta$ 依赖于模型和数据,没有万能值。经验起点:序列 log-prob 求和的标准 DPO 用 $\beta=0.1$;换成长度归一化(平均 log-prob)后,logits 的量级小了一到两个数量级,$\beta$ 要相应放大到 2.0 左右。
--beta 是 DPO 的 0.1,如果你只把 --loss 改成 dpo_norm 而不改 $\beta$,有效的偏好信号会弱到几乎学不动。SimPO 的官方仓库也有类似警告,只是方向相反——学习率给大了(比如 1e-5)会让模型输出不连贯的句子或完全重复的内容。这两类失败都不会报错,只会安静地浪费你几个小时。
学习率:低到反常识
DPO 最著名的实践经验是:学习率必须非常低,通常在 $1\times10^{-7}$ 到 $5\times10^{-6}$ 之间,比 SFT 低约一个数量级。2023 年夏天很多复现失败,根因就是照搬了 SFT 的学习率。为什么?因为 DPO 的梯度里含有一项反向的最大似然梯度(压 rejected),这一项没有任何「下界」——SFT 的交叉熵至少受概率归一化约束,而把某条序列的概率往 0 推可以无限进行下去。学习率稍大,模型就会一头栽进「什么都不敢说」的退化解。
参考实现里的一组可直接照抄的配置(configs/dpo.yaml,OLMo-2-1B-SFT + UltraFeedback):
| 参数 | 值 | 说明 |
|---|---|---|
model_name | allenai/OLMo-2-0425-1B-SFT | 必须从 SFT 模型开始,不是 base |
beta | 0.1 | 求和 log-prob 的标准取值 |
learning_rate | 5e-6 | 1B 模型可以稍高;更大模型要降到 1e-6 甚至 5e-7 |
batch_size × grad_accum | 8 × 8 = 64 | 有效 batch 64 对偏好;DPO 常用 32–128 |
max_length | 2048 | prompt + 回复的总长;超长从左侧截断以保住回复 |
num_epochs | 3 | 6400 条样本 ÷ 64 × 3 ≈ 300 个优化步 |
warmup_ratio / max_grad_norm | 0.1 / 1.0 | 10% warmup 后线性衰减 |
注意这个规模有多小:300 个优化步、6400 条偏好对就足以在 1B 模型上看到清楚的信号。这正是 DPO 门槛低的直接体现——同规模的 PPO 实验要贵一个数量级。
参考模型该选谁
标准答案:$\pi_{\text{ref}}$ = 训练起点的那个 SFT checkpoint,即 $\pi_\theta$ 的初始值。这有两个理由:一是推导里 $\pi_{\text{ref}}$ 定义了 KL 约束的中心,选别的模型意味着你在约束模型靠近一个它从未去过的地方;二是训练开始时 $\log\frac{\pi_\theta}{\pi_{\text{ref}}}=0$,隐式奖励从 0 出发,margins 曲线的解读非常干净。
几个变体值得知道:
- 多轮迭代 DPO:第二轮把 $\pi_{\text{ref}}$ 换成第一轮的产物,相当于把 KL 球心搬过去,允许模型走得更远。
- 无参考模型(ORPO/SimPO):省一份显存,但失去了「相对位移」的语义,对 log-prob 的绝对尺度变得敏感——这也是为什么这两个方法出了名地难调。
- 不要用 base 模型当参考:偏好数据是在 SFT 模型的格式和分布上采的,用 base 当参考会让对数比里混入大量与偏好无关的格式差异。
省显存的关键技巧:缓存参考模型的 log-prob
朴素实现会在每个 batch 里同时前向 policy 和 reference 两个模型——显存直接翻倍,GPU 时间也多花一份。但 $\pi_{\text{ref}}$ 是冻结的,同一条数据的 log-prob 永远不变。所以正确做法是:训练开始前把整个数据集在参考模型上跑一遍,把 ref_chosen_logps / ref_rejected_logps 存成两列浮点数(每条样本 8 字节),然后把参考模型从显存里卸掉。
dpo_tune_cache.py 就是这么做的。本书的教学实现为了代码可读性没有做这个缓存(README 里把它列为待贡献项),但任何认真的生产运行都应该做。注意前提:数据顺序、tokenization、response mask 必须与训练时逐位一致,否则缓存的 log-prob 会对错样本。
长度偏置:为什么长度归一化几乎总是有用
$\log\pi_\theta(y\mid x)$ 是 token 对数概率之和,每个 token 贡献一个负数,所以回复越长,log-prob 越负。500 token 的回复和 100 token 的回复,log-prob 可能差好几百。这带来两个问题:
- 损失尺度随长度漂移。同样是「隐式奖励差 10%」,长回复对上的 logits 数值远大于短回复对,等于给长样本加了隐性的高权重。
- 偏好数据本身就有长度偏置。GPT-4 这类打分模型已知偏爱长回复(这是 AlpacaEval 要做长度控制的原因),而且偏爱和自己风格相似的输出。于是数据集里 chosen 系统性地比 rejected 长,DPO 就会学到「写长一点」这个和质量无关的捷径。两个偏置叠加,训出来的模型往往话变多了但没变好。
缓解手段就是把序列 log-prob 除以 token 数——compute_logprobs(..., average_log_prob=True) 那一行。SimPO 和 DPO-Norm 都这么做,代价是 $\beta$ 要相应调大。另一条互补的路径是在数据侧动手:构造偏好对时控制 chosen / rejected 的长度分布,或者干脆用长度控制的评测(如 length-controlled AlpacaEval)来验收,避免自欺欺人。
8. 数据:合成偏好、on-policy 与 Delta Learning
算法讲完了,但按 Lambert 反复强调的顺序,数据才是主角。今天几乎所有用 DAA 训练的模型,用的都不是人类偏好,而是AI 偏好:让一个前沿模型(GPT-4 类)在多个候选回复里挑赢家。这类数据的构建方法学仍在演化,但有三条已经比较确定的经验。
公开数据集的谱系
| 数据集 | 年份 | 关键做法 |
|---|---|---|
| UltraFeedback | 2023 | 第一个有影响力的开源合成偏好集,用 GPT-4 在多模型候选上打多维度分。DPO 时代的起点数据集 |
| Tülu 3 preference mix | 2024 | 扩展 UltraFeedback 方法学,并明确要求部分候选来自被微调的模型自身(on-policy) |
| SmolLM 3 / Olmo 3 (Dolci Pref) | 2025 | 转向 Delta Learning:chosen 来自 Qwen3-32B、rejected 来自 Qwen3-0.6B,两个团队独立想到同一招 |
本章参考实现的默认数据集是 argilla/ultrafeedback-binarized-preferences-cleaned(约 6 万条清洗过的偏好对),格式就是最朴素的 prompt / chosen / rejected 三列。
经验一:数据要「有点 on-policy」
Tülu 3 及其同期工作(2024 年 11 月前后)给出的结论是:合成的成对偏好数据需要在某种意义上是 on-policy 的——即候选池里要有一部分回复由你正要微调的那个模型生成(同时混入更大的模型池)。
原因回到损失的性质:DPO 是对比式的,比 SFT 更间接。SFT 直接告诉模型「照着这句写」,而 DPO 只说「A 比 B 好」。如果 A 和 B 都来自与你的模型完全无关的分布,那么「压低 B 的概率」这个操作,压的是你的模型本来就不会生成的东西——梯度用在了模型概率质量几乎为零的区域,收益微乎其微。让候选来自模型自己,才能保证优化作用在模型真正会输出的 token 空间里。
经验二:Delta Learning——差距比出身更重要
2025 年 Olmo 3 和 SmolLM 3 的经验给出了一个部分相反的观点:Delta Learning 假说主张,真正驱动学习的是 chosen 与 rejected 之间的质量差(delta),而不是它们具体来自哪个模型。极端做法就是那个反直觉的配对:chosen = Qwen3-32B 的输出,rejected = Qwen3-0.6B 的输出——两个模型都跟被训练的模型无关,但差距足够清晰稳定。
这两条经验并不完全矛盾,但张力是真实的,说明这个问题还没有定论。实践上的读法:如果你有能力用自己的模型采样,就混一部分进去;如果没有,构造一个「强模型 vs 弱模型」的稳定 delta 也能工作得不错,而且工程上简单得多(不需要在数据构建阶段挂着你的模型做推理)。
经验三:注意评判模型自带的偏见
用前沿模型当裁判,就会继承它的偏好。两个已被记录的偏见:
- 长度偏置:GPT-4 类模型偏爱长回复(第 7 节已讲)。
- 自我偏好:LLM 评判者会识别并偏爱自己的生成结果。
后果是:数据集里「chosen」那一栏更可能来自 OpenAI 模型或风格与之相近的强模型。你训出来的模型于是不只是「更好」,还会「更像 GPT-4」。如果你的目标就是蒸馏,这没问题;如果你在追求某种独特风格或本地化能力,这就是需要在数据构建阶段主动对抗的东西。第 12 章会详细讨论合成数据与 LLM-as-a-judge 的这类问题。
这些方法最终怎么改变模型的输出
把前面几节串起来,做一个高层总结:绝大多数 DAA 都在拉大 chosen 与 rejected 的概率 margin;这通常意味着两者的概率同时下降,只是 rejected 降得更多;序列里的每个 token 会根据「它对整体 margin 贡献了多少」拿到不同大小和方向的梯度,从而让优化器自动识别出哪些 token 真正决定了偏好结果。这就是 DAA 的全部作用机制——没有价值函数,没有优势估计,credit assignment 完全由 log-prob 的可加性提供。
9. DAA vs 在线 RL:真正的分水岭是数据,不是算法
争论的表面形式与实际形式
2023–2024 年那场「DPO 还是 PPO」的争论,表面上的问题是:要对齐语言模型,我们真的需要价值函数、策略梯度这一整套 RL 机制吗?像所有这样提问的问题一样,它过于简化了。两种方法都成熟可用,真正值得说清楚的是差异从哪来、性能天花板差在哪。
多份对照研究(Ivison 等《Unpacking DPO and PPO》、Xu 等《Is DPO Superior to PPO for LLM Alignment?》、Tajwar 等关于 on-policy 数据角色的工作)结论一致:在控制数据的前提下,基于策略梯度的方法确实优于 DPO 及其变体。但差距是「一线之隔」(a hair behind),不是数量级。
差距的来源:off-policy vs on-policy
把两者的数据流并排看,差别就一目了然:
| DPO / DAA(离线) | PPO / GRPO(在线) | |
|---|---|---|
| 训练信号来源 | 固定数据集里、由其他模型或更早的模型生成的回复 | 训练过程中由当前策略新采样的回复 |
| 需要奖励模型 | 否(隐式奖励) | 是(或可验证奖励) |
| 显存中的模型数 | 2(policy + ref,缓存后可降到 1) | 最多 4(policy + ref + reward + value) |
| KL 约束 | 静态:由 $\beta$ 一次性决定终点 | 动态:每步基于新 batch,甚至可用自适应控制器 |
| 能探索新区域 | 否——只能在数据集覆盖范围内重排概率 | 是——可以发现数据里没有的行为 |
| 迭代速度 | 快,改数据后几小时出结果 | 慢,还要维护生成基础设施 |
| 性能天花板 | 受数据集覆盖度限制,略低 | 更高 |
核心那一行是「训练信号来源」。DPO 优化的是「在数据集覆盖的区域里,把概率重新排列成最优」;它无法为数据里没出现过的行为生成任何信号。而在线方法每一步都从当前策略采样,模型走到哪里,反馈就跟到哪里——包括第 5 节里那些「被腾出的概率质量流向的第三方行为」,在线方法能立刻发现并修正,离线 DPO 则完全看不见。
为什么 DAA 依然被大量使用
即便有这个性能差,DAA 仍然出现在领先模型的配方里,理由是简单性本身就是一种能力。它提供了一个受控环境,让你可以对训练数据和各种配置做快速迭代;而既然数据往往比算法重要得多,那么用 DPO 迭代十次数据,很可能胜过用 PPO 迭代两次。
2025–2026 年 DPO 的实际位置
如果 DPO 这么好用,为什么前沿模型的技术报告里越来越少提到它?这是讲座里作者自问的一个问题,他给出的观察和判断如下:
| 模型 / 时间 | 怎么用 DPO |
|---|---|
| SmolLM 3(2025.07)/ Olmo 3(2025.11) | SFT 之后在推理轨迹上做 DPO,用一个简单流水线提升性能 |
| NVIDIA Nemotron 3(2025.12) | Mixed Preference Optimization:DPO + Binary Classifier Optimization 合成一个离线阶段,数据由生成式奖励模型打分 |
| Liquid AI LFM2(2025.11) | 在半在线数据上做长度归一化 DPO,之后再接一遍 RLVR |
- DPO 在「杂乱、蒸馏味重」的配方里特别好用——比如 Olmo 这种分布更尖锐、训练数据来自很多不同教师模型的场景。
- DPO 在别的场景也仍然有效,只是大多数实验室有工程资源去做峰值更高的事情。
- 一句话总结:DPO 是通向一个「好模型 / 扎实模型」的路径,但不是通向「最好模型」的路径。而且在越干净的训练配方里,DPO 能起的作用越小。
- 长期看,随着推理模型主要靠 RL 训练,行业会持续往 RL 基础设施上投入,这会进一步巩固在线方法相对 DAA 的优势。
你该怎么选
| 场景 | 建议 |
|---|---|
| 刚入门 / 想理解偏好学习 | DPO。没有 RM 服务、没有 rollout 循环,是唯一能在单卡上完整跑通的入口 |
| 有一批现成的静态偏好数据 | DPO / DPO-Norm。离线数据用在线方法是浪费 |
| 有生成基础设施 + 可靠 RM | 在线方法(PPO / GRPO),或至少用 Online DPO 半在线化 |
| 任务有可验证答案(数学、代码) | RLVR(第 7、14 章),偏好学习不是主战场 |
| 显存紧张、连参考模型都装不下 | ORPO / SimPO,但准备好花时间调学习率 |
| 只有单条「好/坏」二元反馈 | KTO |
本章小结
推导速查
$$ \begin{aligned} \textbf{目标} \;&:\; \max_{\pi}\, \E\big[r(x,y)\big] - \beta\, \mathcal{D}_{\text{KL}}(\pi \,\|\, \pi_{\text{ref}}) \\[4pt] \Rightarrow\ \textbf{最优策略} \;&:\; \pi^{*}(y\mid x) = \tfrac{1}{Z(x)}\,\pi_{\text{ref}}(y\mid x)\exp\!\big(\tfrac{1}{\beta} r(x,y)\big) \\[4pt] \Rightarrow\ \textbf{隐式奖励} \;&:\; r^{*}(x,y) = \beta \log \tfrac{\pi^{*}(y\mid x)}{\pi_{\text{ref}}(y\mid x)} + \beta \log Z(x) \\[4pt] \Rightarrow\ \textbf{Bradley-Terry} \;&:\; p^{*}(y_1 \succ y_2) = \sigma\!\big(r^{*}(x,y_1) - r^{*}(x,y_2)\big)\quad (Z \text{ 约掉}) \\[4pt] \Rightarrow\ \textbf{DPO 损失} \;&:\; -\log \sigma\!\big(\beta \log \tfrac{\pi_{\theta}(y_c)}{\pi_{\text{ref}}(y_c)} - \beta \log \tfrac{\pi_{\theta}(y_r)}{\pi_{\text{ref}}(y_r)}\big) \end{aligned} $$那个奖励模型从来不必被真的建出来——它一直藏在策略里。
要点清单
- DPO 是 RLHF 目标的解析解,不是一种新优化器。给定数据和 $\beta$,它直接迈向那个最优策略;RL 则是根据每个 batch 逐步爬。因此 DPO 的 KL 距离是静态的。
- $Z(x)$ 之所以能消失,是因为 Bradley-Terry 只看奖励的差。这也解释了为什么 DPO 必须建立在成对比较之上,以及 KTO 为什么要另外引入参考点。
- 梯度 = 权重 × 梯度差。权重 $w=\sigma(r_\theta(y_r)-r_\theta(y_c))$ 在模型排错时接近 1、排对时接近 0,自带难例挖掘;括号里是「抬 chosen + 压 rejected」。
- 损失只管 margin。后果是 chosen 与 rejected 的概率常常一起下降(likelihood displacement),被腾出的概率质量流向数据未覆盖的行为。缓解:加 chosen 的 SFT 项、Cal-DPO、AlphaPO、APO、或者用在线数据。
- 变体只改四件事:损失形状(IPO/cDPO)、去掉参考模型(ORPO/SimPO)、长度归一化与 margin(SimPO/DPO-Norm/ODPO)、数据形态与权重(KTO/REBEL/Online DPO)。
- 超参数底线:学习率 $1\times10^{-7}$–$5\times10^{-6}$(比 SFT 低一个数量级);求和 log-prob 时 $\beta=0.1$,改成平均 log-prob 后 $\beta\approx2.0$;有效 batch 32–128 对;1B 模型 6400 条数据 / 300 步就能看到信号。
- 参考模型选训练起点的 SFT checkpoint;把它的 log-prob 预先缓存下来可省 50% 峰值显存。
- 数据 > 算法。先跑通标准 DPO,把力气花在数据上:混入 on-policy 候选,或构造稳定的强/弱 delta;同时警惕评判模型的长度偏置和自我偏好。
- DPO 与在线 RL 的差距来自 on-policy,不是来自 RL 机制本身。DPO 是通向「好模型」的路,不是通向「最好模型」的路。
一眼看懂训练指标
| 指标 | 定义 | 健康的样子 | 异常信号 |
|---|---|---|---|
loss | $-\log\sigma(\beta\cdot\text{logits})$ 的均值 | 从 $\log 2\approx0.693$ 缓慢下降 | 掉到接近 0 = 过拟合;上升 = 学习率太高 |
accuracy | 隐式奖励排对的比例 | 50% → 65–80% | 始终 50% = 没在学;瞬间到 99% = 数据泄漏或过拟合 |
margins | chosen_rewards - rejected_rewards | 稳定上升 | 爆炸式增长 = $\beta$ 或学习率过大 |
chosen_rewards | $\beta(\log\pi_\theta(y_c)-\log\pi_{\text{ref}}(y_c))$ | 从 0 出发,理想是略升或持平 | 持续大幅为负 = 典型的 likelihood displacement |
rejected_rewards | 同上,对 rejected | 下降 | 暴跌到很负的值 = 模型在「什么都不敢说」 |
动手实验
本章的作业在 homework/hw4-dpo/,参考实现在 code/direct_alignment/。这是全书最容易上手的实验:完全离线,不需要奖励模型服务,也不需要 rollout 循环,一张消费级显卡(1B 模型约 8–10 GB)就能跑。
该盯哪些指标
每一步训练都会打出四个数,请把它们一起看,只看 loss 会漏掉最重要的现象:
accuracy—— 隐式奖励把 chosen 排在 rejected 前面的比例。这是唯一跨算法可比的指标(IPO 的 loss 和 DPO 差两个数量级,但 accuracy 可以直接比)。margins——chosen_rewards - rejected_rewards。它应该单调上升;上升太快说明学习率或 $\beta$ 过大。chosen_rewards与rejected_rewards—— 必须分开看。margin 上升可以来自「chosen 升 + rejected 降」,也可以来自「两个都降、rejected 降得更多」。后者就是第 5 节的 likelihood displacement,只看 margin 永远发现不了。
再加一个定性检查:训练脚本会定期在固定 prompt 池上生成样本(sample_every)。最核心的 sanity check 是:margin 往正确方向走的同时,生成的样本不能坍缩(不能变成重复、空洞或不连贯的文本)。
建议的实验顺序
先跑一个小规模 DPO。
cd code/
uv run python -m direct_alignment.train --loss dpo --max_samples 1000
观察
accuracy是否从 50% 起步往上走,chosen_rewards是否在往下漂。这一步的目的是把流程跑通并亲眼看到位移现象。对比 DPO / IPO / 长度归一化 DPO。
uv run python -m direct_alignment.train --config direct_alignment/configs/dpo.yaml
uv run python -m direct_alignment.train --config direct_alignment/configs/ipo.yaml
uv run python -m direct_alignment.train --config direct_alignment/configs/dpo_norm.yaml
重点比较 margin 的尺度和对学习率的敏感度。注意 IPO 的 loss 与 DPO 不在同一数值尺度上(目标 margin $\frac{1}{2\beta}=5.0$),必须通过
accuracy和 margin 走势来判断,别被 loss 的绝对值误导。小心地试无参考模型的变体。
uv run python -m direct_alignment.train --config direct_alignment/configs/simpo.yaml
uv run python -m direct_alignment.train --config direct_alignment/configs/orpo.yaml
这两个对 log-prob 的尺度和学习率极其敏感,正因为如此,它们是很好的调试练习。参考实现里 SimPO 用 lr=8e-7、ORPO 用 lr=1e-6,都明显低于 DPO。务必检查训练中打出的生成样本:ORPO 常见的失败模式是
or_loss相对sft_loss贡献可忽略,于是 margin 几乎不动(「稳定但学不到东西」);SimPO 则容易在学习率稍大时输出重复文本。这两个损失在参考实现里仍被标记为「需要进一步验证」,把它们调出信号本身就是一个有价值的练习。改数据,而不是改损失。把损失固定成 DPO,改变
--max_samples、--max_length或整个偏好数据集。如果这些改动带来的差异大于在各种 DPO 类目标之间切换带来的差异,那你就亲手验证了本章反复强调的那条经验:数据通常压倒算法上的小差别。(进阶)自己实现参考 log-prob 缓存。训练前把整个数据集在 $\pi_{\text{ref}}$ 上跑一遍存下来,然后释放参考模型。用
nvidia-smi对比峰值显存,应该能看到约 50% 的下降。这是参考实现里明确列出的待贡献项之一。
延伸阅读
核心方法
- DPO: Direct Preference Optimization — Your Language Model is Secretly a Reward Model (2023) — 本章全部推导的来源,附录里还有 Plackett-Luce 版本和理论分析,值得逐行读。
- SLiC-HF: Sequence Likelihood Calibration with Human Feedback (2023) — 技术上第一个现代直接对齐算法,比 DPO 还早,但没火起来。对照读它能理解「一个方法被采纳」有多少非技术因素。
- Zephyr: Direct Distillation of LM Alignment (2023) — 第一个把 DPO 大规模跑通的开源模型,「学习率要极低」这条经验的出处。
变体家族
- IPO: A General Theoretical Paradigm to Understand Learning from Human Preferences (2023) — 从理论上指出 Bradley-Terry + 确定性标签必然导致 margin 无界,是理解 DPO 过拟合的最佳材料。
- ORPO: Reference-free Monolithic Preference Optimization with Odds Ratio (2024) — 去掉参考模型的代表作,把 SFT 与偏好优化合成一步。
- SimPO: Simple Preference Optimization with a Reference-Free Reward (2024) — 长度归一化 + 目标 margin,本章 DPO-Norm 的思想来源。
- KTO: Model Alignment as Prospect Theoretic Optimization (2024) — 从成对偏好走向单条二元反馈,产品侧收集到的数据形态更接近它。
- APO: Anchored Preference Optimization and Contrastive Revisions (2024) — 点破了「DPO 对概率往哪走是欠定的」,SmolLM3 用它替代了 DPO。
- BCO: Binary Classifier Optimization for LLM Alignment (2024) — 另一条二元反馈路线,Nemotron 3 的 Mixed Preference Optimization 里与 DPO 同时使用。
- Cal-DPO: Calibrated Direct Preference Optimization (NeurIPS 2024) — 通过校准优化过程缓解概率位移。
- AlphaPO: Reward Shape Matters for LLM Alignment (ICML 2025) — 从奖励形状入手做同一件事,与 Cal-DPO 对照读。
- REBEL: Reinforcement Learning via Regressing Relative Rewards (NeurIPS 2024) — 引入奖励模型给出的数值 margin,弥补二元标签丢失的偏好强度。
- DNO: Direct Nash Optimization (2024) — 从博弈论视角处理不满足 Bradley-Terry 的一般偏好(与第 10 章呼应)。
DPO 的失效模式
- Unintentional Unalignment: Likelihood Displacement in DPO (ICLR 2025) — 概率位移的系统研究,指出它可能把概率推向未被数据覆盖的、甚至更糟的行为。
- Learning Dynamics of LLM Finetuning (ICLR 2025) — 从学习动力学角度解释同一现象,两篇一起读会清楚很多。
- Length-Controlled AlpacaEval (2024) — 长度偏置为什么必须在评测层面处理,做偏好数据前应该先读。
- LLM Evaluators Recognize and Favor Their Own Generations (NeurIPS 2024) — 用前沿模型当裁判时的自我偏好,合成偏好数据的隐性污染源。
离线 vs 在线之争
- Unpacking DPO and PPO: Disentangling Best Practices for Learning from Preference Feedback (NeurIPS 2024) — 控制数据的对照实验,本章「PPO 略胜一线」的主要证据。
- Is DPO Superior to PPO for LLM Alignment? A Comprehensive Study (ICML 2024) — 同一问题的另一组独立实验。
- Preference Fine-Tuning of LLMs Should Leverage Suboptimal, On-Policy Data (ICML 2024) — 直指要害:关键变量是 on-policy,不是 RL 机制。
- Online DPO: Direct Language Model Alignment from Online AI Feedback (2024) — 把 DPO 在线化的最直接做法。
- D2PO: Discriminator-Guided DPO with Response Evaluation Models (2024) — 用奖励模型在训练中重新打标,构造新鲜偏好对。
- The Differences Between Direct Alignment Algorithms are a Blur (2025) — 系统对比各 DAA,结论是差异远小于论文宣称。
- RainbowPO: A Unified Framework for Combining Improvements in Preference Optimization (ICLR 2025) — 把各种改进拆成正交组件逐一消融,变体选择的实用参考。
数据与模型配方
- UltraFeedback: Boosting Language Models with High-quality Feedback (2023) — 第一个有影响力的开源合成偏好集,本章参考实现的默认数据。
- Tülu 3: Pushing Frontiers in Open Language Model Post-Training (2024) — 「偏好数据要有一部分 on-policy」这条经验的出处,也是最完整的开源后训练文档。
- The Delta Learning Hypothesis: Preference Tuning on Weak Data can Yield Strong Gains (COLM 2025) — 与上一条形成张力:重要的是差距,不是出身。
- Olmo 3 (2025) — 在推理轨迹上做 DPO 的完整配方,以及 Delta Learning 的实际应用。
- SmolLM3 (2025) — 用 APO 替代 DPO 的后训练配方。
- Nemotron-4 340B Technical Report (2024) — 大规模模型使用 DPO 变体的公开记录。
参考实现
- eric-mitchell/direct-preference-optimization — DPO 原作者的实现,
trainers.py里的损失部分与本章代码一致。 - TRL DPOTrainer — 工业界最常用的实现,一个类里塞了十几种 loss_type,是变体对照的活字典。
- Ai2 open-instruct —
dpo_tune_cache.py展示了参考模型 log-prob 缓存的正确做法。