指令微调
把一个只会「续写文本」的预训练模型,改造成一个会「回答问题并且知道什么时候闭嘴」的助手。
0. 本章导读
把一个刚跑完预训练的模型拉出来,喂给它「法国的首都是哪里?」,它极有可能回你一句「德国的首都是哪里?意大利的首都是哪里?……」然后一路续写到上下文窗口耗尽。这不是模型「不知道」答案——它对巴黎的知识早就在参数里了——而是它不知道自己该扮演谁。预训练目标只教会了它一件事:给定前缀,续写最可能的下文。而互联网上「法国的首都是哪里?」这句话后面,跟着的往往是另一道题,而不是答案。
指令微调(Instruction Fine-Tuning, IFT),在实践中也几乎总是被叫作监督微调(Supervised Fine-Tuning, SFT),就是修复这个错配的那一步。它的技术含量看上去低得可疑:损失函数和预训练完全一样(自回归交叉熵),优化器一样,模型结构一样。变的只有两件事——数据长什么样,以及损失在哪些 token 上算。但正是这两件事决定了后训练全流程能不能跑起来:偏好数据要在这个格式上采样、奖励模型要在这个格式上打分、RL 的 rollout 要在这个格式上生成。格式定错了,后面每一步都跟着错。
所以本章的重心不是「SFT 是监督学习」这句废话,而是那些让 SFT 真正跑通或者悄悄跑坏的实现细节:
- chat template——把
[{"role": ..., "content": ...}]这样一个模型无关的对话对象,渲染成模型真正看到的那串扁平 token;以及这个渲染过程里埋着的特殊 token、EOS、多轮拼接的坑。 - loss masking——为什么只在 assistant 的 token 上算 loss,prompt 上算了会怎样,多轮对话该 mask 到什么程度。
- base → assistant 的相变——训练前几百步里到底发生了什么,为什么 loss 曲线会先陡降后拖平。
- 数据的配比与质量——1 万条人写数据 vs 100 万条合成数据,作者本人在 Tülu / OLMo 上的取舍。
- 超参数的实际取值范围——学习率、batch size、epoch 数,以及为什么它们和预训练差一到两个数量级。
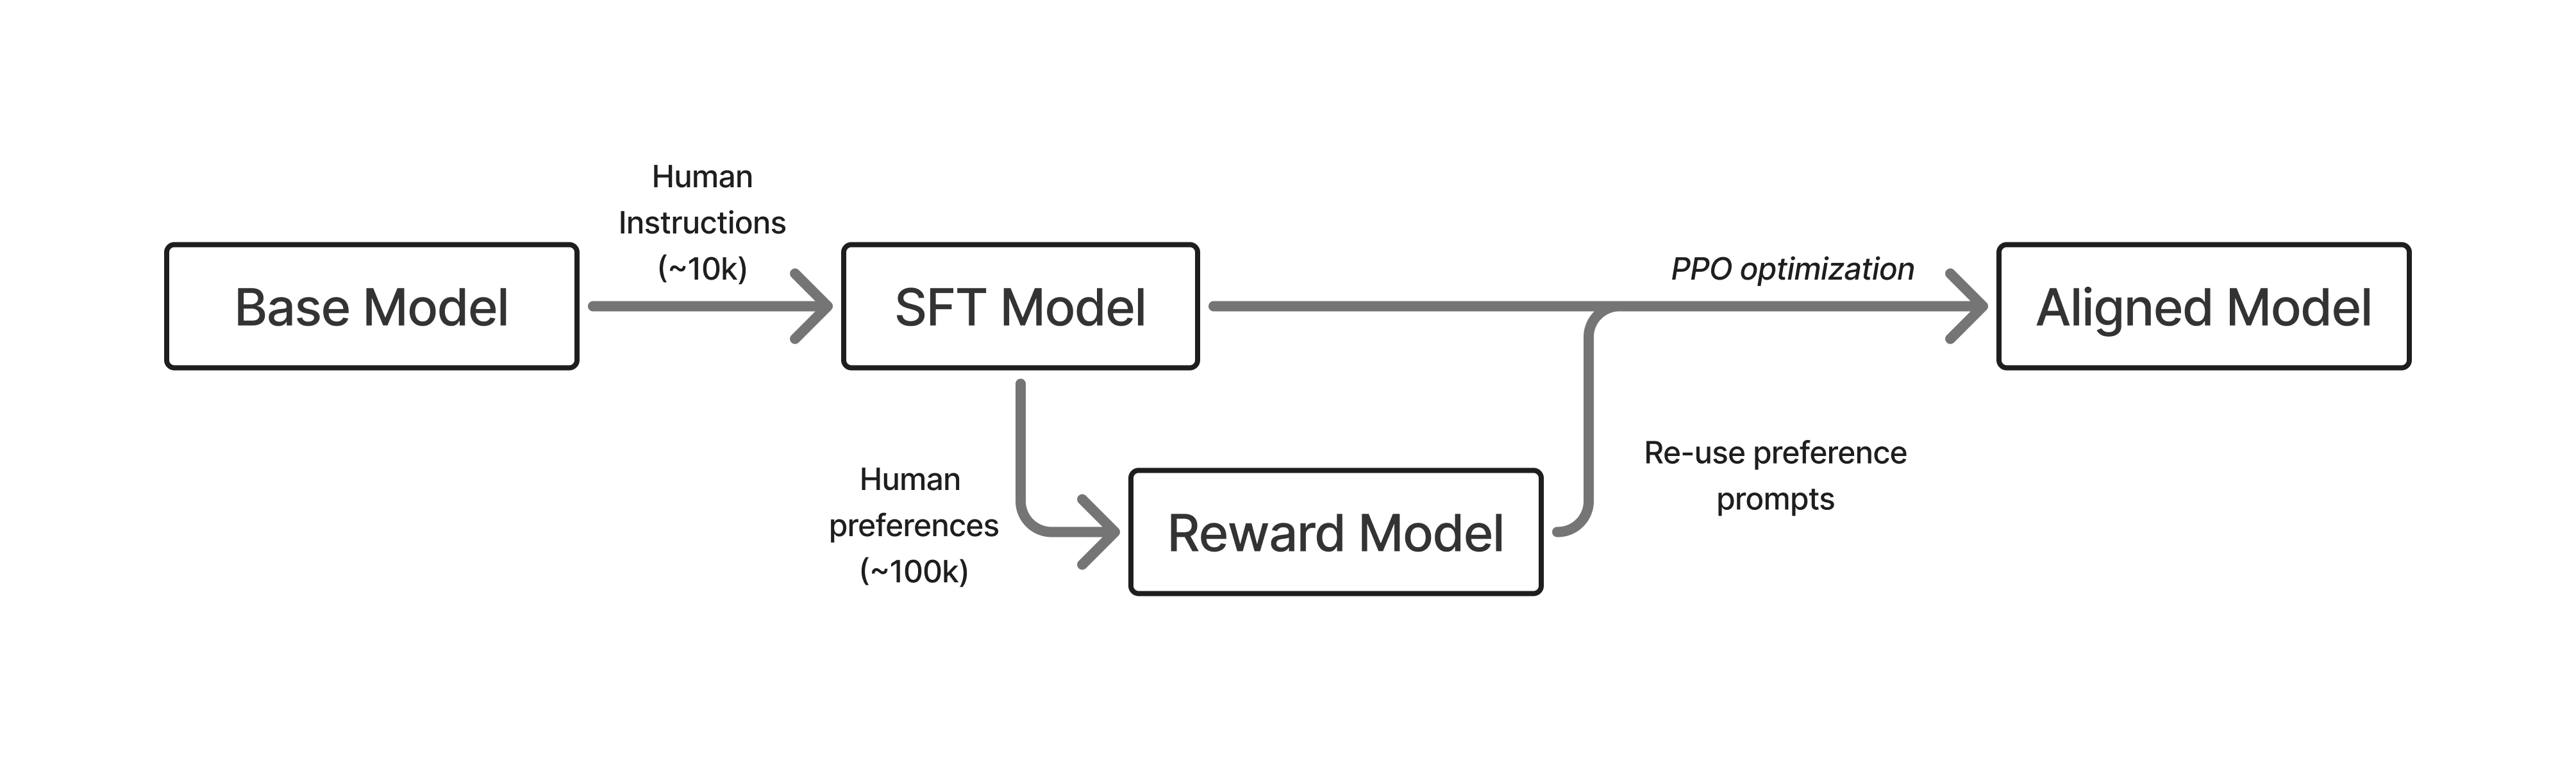
本章在全书中的位置很清楚:它是第 3 章那张后训练全景图里的第一格。第 5 章的奖励模型要用 SFT 模型来生成待比较的回复,第 9 章的拒绝采样直接复用 SFT 的损失函数,第 6 章的策略梯度把 SFT 模型当作初始策略 $\pi_{\text{init}}$ 和参考策略 $\pi_{\text{ref}}$。没有一个能用的 SFT 模型,后面全都是空中楼阁。
- SFT 的损失函数与预训练完全相同,区别只在数据格式(chat template)和 label 掩码(prompt masking)。理解这两点就理解了 SFT 的 90%。
- chat template 的本质是一个存在 tokenizer 配置里的 Jinja 字符串,把角色化的消息列表压平成 token 序列。训练用的模板和推理用的模板必须逐字节一致,这是最高频的线上事故来源。
- 只在 assistant token 上算 loss:模型要学的是怎么答,不是怎么问。prompt 部分的 label 置为
-100。 - 数据质量 > 数据数量。约 100 万条 prompt 足以训出一个适合做后续 RLHF 的模型,再往上收益迅速衰减;窄域对齐任务 1 万条高质量样本就能出效果。
- 典型超参:学习率比预训练低 1–2 个数量级($1\times10^{-5}$ 到 $8\times10^{-5}$),global batch 约 256 条 prompt,2–3 个 epoch,10% 步数 warmup 后线性衰减。
- Lambert 的判断:任何后训练项目都应该先看看纯 IFT 能走多远。它不酷、不发论文,但大量有实际影响力的专用模型只做了 IFT。
1. 从续写机到助手:IFT 要解决什么
base 模型的默认行为是「模式延续」
预训练模型的训练目标是最大化语料上的对数似然:
$$ \mathcal{L}_{\text{pretrain}}(\theta) = -\E_{x\sim\mathcal{D}}\left[\sum_{t=1}^{T} \log \pi_\theta(x_t \mid x_{<t})\right] $$这里 $x$ 是一段从网络语料里切出来的文本,$x_t$ 是第 $t$ 个 token,$\pi_\theta(\cdot\mid x_{<t})$ 是在词表 $V$ 上的分布(一个长度 $|V|$ 的概率向量,通常 $|V|$ 在 $5\times10^4$ 到 $2\times10^5$ 量级)。注意这个目标里没有任何「角色」的概念:模型只知道「前面是这些 token,后面最可能是什么 token」。
于是给它 <bos> The capital of the United States is,它会续写 Washington, D.C.——因为这是语料里最常见的续写。但给它「What is the capital of France?」,它续写什么就取决于训练语料里问句后面通常跟什么了。在爬下来的网页里,一个问句后面跟着的常常是另一个问句(习题册、FAQ 列表、测验页面),所以模型会输出「What is the capital of Germany? What is the capital of Italy?…」。它在做的事情,从它自己的目标函数看,完全正确。
两条研究线的汇合
指令微调不是某一篇论文突然发明的,是两条独立的线撞在一起的结果。
第一条线:把所有 NLP 任务统一成「文本进、文本出」。在 2020 年前后,NLP 的标准做法还是给每个任务配一个专用的分类头 / 抽取头,微调一个 BERT 出来。T5(Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, 2020)把翻译、摘要、分类、问答全部改写成序列到序列的形式——输入是一段带任务前缀的文本,输出也是文本。这一步的意义在于:一旦所有任务共享同一种接口,你就可以把几十上百个数据集直接混在一起训一个模型。沿着这条线,FLAN(Finetuned Language Models Are Zero-Shot Learners)、T0(Multitask Prompted Training Enables Zero-Shot Task Generalization)、Natural Instructions(Cross-Task Generalization via Natural Language Crowdsourcing Instructions)相继把「任务前缀」升级成了自然语言写的指令,并且发现:在足够多样的指令上训练后,模型在没见过的任务上也能零样本工作。
第二条线:规模化 + 上下文学习。GPT-3(Language Models are Few-Shot Learners, 2020)展示了另一条路——不改参数,只在 prompt 里塞几个示例(in-context learning),一个模型就能干很多任务。但这条路的可靠性有明显天花板:效果对示例的选择、顺序、格式极其敏感。
两条线合流的结论是:单模型多任务的泛化确实存在,但显式地在「指令-回复」样本上训练一遍,会让这种泛化可靠得多。ChatGPT 发布之后,这套配方被开源社区迅速复现——Alpaca、OpenAssistant、Tülu 等工作把 SFT 从「大厂内部工序」变成了一个笔记本上就能跑的开源流程。
为什么这一章值得单独讲
纯从算法看,SFT 没什么可讲的——它就是监督学习,交叉熵,反向传播。作者在原文里也直说了:指令微调在别处已经被讲烂了,本章只聚焦「对 RLHF 从业者最要紧的实践细节:训练数据是怎么组织和格式化的」。
这个取舍是对的,原因在于格式是有传染性的。你在 SFT 阶段选定的 chat template,会成为后面所有阶段的通用语:
| 后续阶段 | 如何依赖 SFT 阶段定下的格式 |
|---|---|
| 偏好数据采集 | 标注员看到的两个回复,必须由 SFT 模型在同一模板下采样得到,否则偏好信号里混进了格式差异 |
| 奖励模型训练 | RM 输入的是渲染后的完整对话文本;模板变了,RM 的打分分布就漂了 |
| DPO / 直接对齐 | 需要计算 $\pi_\theta$ 与 $\pi_{\text{ref}}$ 在同一序列上的 logprob,两者必须共享 tokenization |
| 在线 RL(PPO/GRPO) | rollout 用推理引擎(vLLM/SGLang)生成,训练用 HF transformers 打分——两边的模板渲染必须逐字节一致,否则 logprob 对不上,重要性采样比值失控 |
| 评测 | 几乎所有 chat 类评测都用 apply_chat_template 构造输入 |
2. Chat template:模型眼里的对话长什么样
两层表示:对话对象 vs 渲染文本
后训练数据在磁盘上几乎总是以模型无关的形式存储——一个消息列表:
messages = [
    {"role": "system",    "content": "You are a friendly chatbot who always responds in the style of a pirate"},
    {"role": "user",      "content": "How many helicopters can a human eat in one sitting?"},
    {"role": "assistant", "content": "Arrr, none, matey!"},
]这种表示的好处是可以在不同模型之间搬运。但模型本身看不见字典和列表,它只吃一维的 token 序列。把前者变成后者的那个函数,就是 chat template(对话模板)。在开源生态里,它是一段 Jinja 代码,存在 tokenizer 的配置文件里(tokenizer_config.json 的 chat_template 字段,或者独立的 chat_template.jinja),通过 tokenizer.apply_chat_template(messages) 调用。
三个标准角色:
| 角色 | 内容 | 关键约定 |
|---|---|---|
system | 系统提示(system prompt):人格设定、约束、当前日期时间、行为补丁 | 只允许出现在对话最开头,且通常对最终用户不可见 |
user | 使用者的输入 | 训练时被 mask,不计入 loss |
assistant | 模型自己的回复 | 唯一计入 loss 的部分 |
现代模型在这三个之外还会加:tool / function(工具返回值)、思维链通道(reasoning / analysis)、以及各种引用与结构化输出标记。但骨架不变。
拆解一个模板
下面是书里给的 ChatML 风格模板,逐块看它在干什么:
{% if messages[0]['role'] == 'system' %}
    {# 首条是 system:把它当成特殊的第 0 轮,用 offset 把后面的
       user/assistant 交替校验对齐 #}
    {% set offset = 1 %}
{% else %}
    {% set offset = 0 %}
{% endif %}

{# 发射 BOS(各家模型不同) #}
{{ bos_token }}

{% for message in messages %}
    {# 强制角色交替:(system), user, assistant, user, assistant, ...
       布尔比较「这条是不是 user」与「按下标算这一位该不该是 user」 #}
    {% if (message['role'] == 'user') != (loop.index0 % 2 == offset) %}
        {{ raise_exception('Conversation roles must alternate user/assistant/...') }}
    {% endif %}

    {# 每条消息包一层特殊 token:
       <|im_start|>角色\n  +  内容(去首尾空白)  +  <|im_end|>\n #}
    {{ '<|im_start|>' + message['role'] + '\n' + message['content'] | trim + '<|im_end|>\n' }}
{% endfor %}

{# 推理时追加一个空的 assistant 头,提示模型「从这里开始生成」 #}
{% if add_generation_prompt %}
    {{ '<|im_start|>assistant\n' }}
{% endif %}
三个设计点值得单独指出:
(1)角色交替校验。模板会主动抛异常拒绝 user, user, assistant 这种序列。这不是洁癖:模型在训练时从没见过连续两条 user,推理时喂给它会落到分布外。数据清洗阶段合并连续同角色消息,是常规操作。
(2)add_generation_prompt 这个开关。它是整个模板里最容易被搞错的参数,而且它区分了两种完全不同的用法:
| 场景 | add_generation_prompt | 渲染结果结尾 |
|---|---|---|
| 推理(要模型生成) | True | …<|im_start|>assistant\n(悬空,等模型接) |
| 训练(完整对话已知) | False | …<|im_end|>\n(闭合) |
后面构造 loss mask 时,我们恰恰要同时用到这两种渲染——一次 True 拿到 prompt 长度,一次 False 拿到完整序列,两者相减就是要计 loss 的区间。
(3)| trim 这个不起眼的过滤器。它会剥掉 content 的首尾空白。看起来无害,但它意味着渲染不是可逆的:如果你的数据里 assistant 回复以换行开头,训练时被 trim 掉了,模型就永远学不到「以换行开头」这个行为。更麻烦的是,这类差异会在训练/推理链路的不同实现之间产生几个 token 的偏移。
渲染出来的样子
用上面的模板 + add_generation_prompt=True 渲染,模型实际收到的是这样一串扁平文本(再由 tokenizer 转成 id):
<|im_start|>system
You are a friendly chatbot who always responds in the style of a pirate<|im_end|>
<|im_start|>user
How many helicopters can a human eat in one sitting?<|im_end|>
<|im_start|>assistant
注意最后两个 token 是 <|im_start|>assistant——这就是模型知道「轮到我说话了」的全部机制。它会一直生成,直到吐出 <|im_end|>,推理框架看到这个 token 就停止解码,把中间的内容切出来当作回复返回。
多轮:朴素地往下拼
<|im_start|>system
You are a friendly chatbot who always responds in the style of a pirate<|im_end|>
<|im_start|>user
How many helicopters can a human eat in one sitting?<|im_end|>
<|im_start|>assistant
Oh just 6.<|im_end|>
<|im_start|>user
Are you sure about that?<|im_end|>
<|im_start|>assistant
整段历史被压进同一条 token 序列,模型通过 attention 看到全部上文。这里没有任何「记忆机制」或「状态」——所谓多轮对话,在模型侧就是一次比一次更长的单次前向。这也解释了为什么长对话会线性变贵,以及为什么 KV cache 是推理侧的核心优化。
各家模板对照
上面的 ChatML 源自 OpenAI 早期的 Chat Markup Language。现在 OpenAI 等厂商用的是分层指令体系:用户能配 system message,但在它之上还有更高优先级、可能不向用户暴露的指令(见 The Instruction Hierarchy, 2024)。开源侧模板则五花八门,但结构同构:
| 模型族 | 轮次标记 | 结束 token | 备注 |
|---|---|---|---|
| ChatML / Qwen | <|im_start|>role\n | <|im_end|> | 目前事实上的通用格式 |
| Zephyr | <|system|> / <|user|> / <|assistant|> | </s> | 复用 Llama 系的 </s> |
| Tülu / OLMo-2 | <|user|> / <|assistant|> | <|endoftext|> | BOS/EOS/UNK 共用一个 token,见下节 |
| Llama-3 | <|start_header_id|>role<|end_header_id|> | <|eot_id|> | BOS 是独立的 <|begin_of_text|> |
| gpt-oss(Harmony) | <|start|>assistant<|channel|>…<|message|> | <|return|> / <|call|> | 不用 Jinja,Rust 渲染器 + 通道概念 |
最后一行值得展开。OpenAI 在开源 gpt-oss 时一并放出了 Harmony 格式,把回复拆成三条通道:analysis(内部推理,不给用户看)、commentary(工具调用)、final(面向用户的答复):
<|start|>assistant<|channel|>analysis<|message|>I need to check the weather...<|end|>
<|start|>assistant<|channel|>commentary to=functions.get_weather
<|constrain|>json<|message|>{"location":"SF"}<|call|>
<|start|>assistant<|channel|>final<|message|>It's 65°F and sunny in SF.<|return|>
动机很实际:Jinja 处理工具调用非常吃力(JSON 转义、边界歧义、嵌套结构),推理模型 + 工具调用让模板复杂度爆炸。Harmony 把复杂度从「一个模板字符串」搬进「一个专门的库」,并用 render_conversation_for_completion / render_conversation_for_training 两个函数替代了 add_generation_prompt 这个布尔开关——这个 API 设计恰好承认了上文说的那件事:训练渲染和推理渲染本来就是两回事。
3. 特殊 token、EOS 与模板的五个坑
这一节是纯工程内容,但踩过的人都知道它值多少调试时间。所有坑的根源只有一句话:模板操作的是字符串,模型消费的是 token id,两者之间的映射不是一一对应的。
坑一:角色标记未必是特殊 token
看到 <|user|> 这样的写法,很自然会以为它是词表里一个独立的 token。但这取决于模型族。参考实现用的 OLMo-2 就是反例——它的词表里只有两个特殊 token:<|endoftext|>(id 100257)和 <|pad|>。<|user|> / <|assistant|> / <|system|> 全都是普通 BPE 片段,被切成 <、|、user、|、> 这样五六个 token。
这有两个直接后果。第一,base 模型(SFT 之前)把它们当作普通文本,于是会生成出 <|admin|>、<|assistant|>> 这类似是而非的东西——因为它只是在续写一个「尖括号竖线开头」的模式。第二,你没法靠 stop token 来切分角色,必须靠字符串匹配,而字符串匹配对空白极其敏感。
相比之下 Llama-3 和 Qwen 把角色标记做成了真正的特殊 token(<|start_header_id|>、<|im_start|>),代价是词表要预留位置,好处是切分鲁棒、且这些 token 的 embedding 是可训练的专用向量。两种做法都在用,写数据处理代码前先 print(tokenizer.special_tokens_map) 确认一遍。
坑二:BOS 和 EOS 可能是同一个 token
OLMo-2 把 <|endoftext|> 同时用作 BOS、EOS 和 UNK。于是一条渲染完的对话长这样:
<|endoftext|><|user|>\nhi\n<|assistant|>\nhello<|endoftext|>
^^^^^^^^^^^^                                  ^^^^^^^^^^^^
  BOS(对话开始)                              EOS(assistant 轮结束)
同一个 token id 在序列首尾承担了完全相反的语义。模型靠上下文消歧:开头、后面跟着 <|user|>,是「开始」;在 assistant 内容之后,是「停止」。这在训练里是能学会的,但它会让你的调试输出很迷惑——第一次看到生成结果开头也有 <|endoftext|> 时不要以为是 bug。
apply_chat_template 里的 {{ bos_token }} 会加一次 BOS,而如果你随后又把渲染结果丢进 tokenizer(text),很多 tokenizer 默认 add_special_tokens=True 会再加一次。结果就是序列开头出现两个 BOS。这个错误不会报错、不会崩溃,只会让模型的表现莫名其妙地差一点。安全做法:要么用 apply_chat_template(..., tokenize=True) 一步到位(参考实现的做法),要么在二次编码时显式传 add_special_tokens=False。
坑三:pad token 缺失
base 模型的 tokenizer 常常没有 pad_token——预训练用的是定长打包,压根不需要 padding。而 SFT 一定要 padding(每条样本长度不同)。常见的应急做法是 tokenizer.pad_token = tokenizer.eos_token,参考实现里就是这么写的:
# _src/code/instruction_tuning/utils.py — load_model()
if tokenizer.pad_token is None:
tokenizer.pad_token = tokenizer.eos_token这样做是安全的,但前提是你把 padding 位置的 label 设成 -100,并且 attention_mask 置 0。否则模型会在一堆填充位上被训练去预测 EOS,学出「无脑早停」的病态行为。参考实现两件事都做了——它在 collate 时同时填 pad_token_id(进 input_ids)、0(进 attention_mask)和 -100(进 labels)。
坑四:base 模型根本没有模板
纯 base 模型的 tokenizer 通常 chat_template is None。你得从某处「借」一个。参考实现的做法是从官方 SFT 版本的 tokenizer 上把模板搬过来:
# _src/code/instruction_tuning/utils.py — load_model()
# base tokenizer 没有 chat_template,从 allenai/OLMo-2-0425-1B-SFT 借一个
if tokenizer.chat_template is None and cfg.chat_template_source:
    donor = AutoTokenizer.from_pretrained(cfg.chat_template_source)
    if donor.chat_template is None:
        raise ValueError(f"{cfg.chat_template_source} has no chat_template.")
    tokenizer.chat_template = donor.chat_template
这个「借模板」的动作看着 hack,实际上是有意义的设计选择:它保证你训出来的模型和官方 SFT 模型说同一种格式,因而可以直接复用官方的评测脚本、推理配置和后续对齐数据。自己发明一套模板当然也行,但你就得自己维护整条链路的一致性。
坑五:训练渲染 ≠ 推理渲染
这是最贵的一个坑,因为它在训练日志上完全看不出来——loss 曲线漂亮,评测分数莫名偏低。典型成因:
| 不一致来源 | 症状 | 排查方法 |
|---|---|---|
训练时忘了 add_generation_prompt=False | 序列里多一段悬空的 assistant 头 | 把一条训练样本 decode 出来肉眼看 |
| 推理框架(vLLM/SGLang)用了自己内置的模板 | 与 HF 渲染差几个空白 token | 两边都 tokenize=False 渲染同一条消息,逐字符 diff |
| system prompt 训练时没有、推理时有 | 模型对系统提示不敏感或行为异常 | 统计训练集中带 system 的比例 |
| 重复加 BOS | 轻微但持续的性能损失 | 打印 input_ids[:5] |
末尾换行 / | trim 行为差异 | 生成开头多余空行、停不下来 | repr() 打印渲染结果 |
repr() 打印,逐字符看。不要看 print() 的结果——它会把换行渲染掉,而换行恰恰是最常出问题的地方。参考实现在训练循环里每 50 步打印一次带特殊 token 的完整生成(skip_special_tokens=False),就是为了让这层信息始终可见:
full_text = tokenizer.decode(out[0], skip_special_tokens=False)4. Loss masking:模型到底在学什么
目标函数:形式不变,作用域变了
SFT 的损失和预训练是同一个自回归交叉熵,唯一的区别是求和范围。设一条渲染完的对话被 token 化成 $y = (y_1, \dots, y_T)$,定义一个掩码 $m_t \in \{0,1\}$ 表示第 $t$ 个位置是否计入损失,则:
$$ \mathcal{L}_{\text{SFT}}(\theta) = -\E_{y \sim \mathcal{D}}\left[\frac{\sum_{t=1}^{T} m_t \log \pi_\theta(y_t \mid y_{<t})}{\sum_{t=1}^{T} m_t}\right] $$逐项确认含义:$\pi_\theta(y_t \mid y_{<t})$ 是模型在位置 $t$ 给真实 token $y_t$ 的概率,取自一个形状为 (T, |V|) 的 logits 张量做 softmax 后的对应元素;$m_t = 1$ 当且仅当 $y_t$ 属于某条 assistant 回复(含其结束 token);分母是归一化项,把损失变成「每个受训 token 的平均负对数似然」。
预训练的写法是同一个式子取 $m_t \equiv 1$。整个 SFT 的算法内容就到此为止了——剩下的全是数据工程。
关键点在于:即使位置 $t$ 被 mask($m_t=0$),它依然出现在后续位置的条件 $y_{<t'}$ 里。也就是说,user 的 token 仍然被完整地喂进前向、仍然参与 attention、仍然影响 assistant token 的预测——它们只是不产生梯度信号「让模型更会生成 user 的话」。Mask 掉的是「被预测的资格」,不是「作为上下文的资格」。这是初学者最容易搞混的一点。
为什么要 mask prompt
如果不 mask 会怎样?模型会同时学两件事:怎么回答,以及怎么提问。后者带来三个具体问题:
- 梯度预算被稀释。在很多数据集里 prompt 占了序列的一大部分(尤其是带长 system prompt、长文档的样本)。不 mask 意味着大部分梯度花在了你根本不关心的分布上。
- 学到「自问自答」的行为。模型见多了「回答完之后接着出现一个新问题」的模式,推理时就更容易在答完之后自己续一个
<|user|>再自己答——这正是动手实验里 step 100 左右能观察到的现象。 - 污染人格。模型会吸收用户消息的语气和风格分布。用户 prompt 里常见的祈使句、错别字、粗鲁语气,你不会希望它们进到助手的输出分布里。
作者在原文里的表述很直白:completion 才是模型真正学的东西。这句话有一个重要推论——SFT 数据的质量投入应该压倒性地押在回复上,prompt 只需要「分布对」,不需要「写得好」。这也是为什么合成数据流程通常是「人写少量种子 prompt → LM 扩写出更多 prompt → 强 LM 生成回复」:prompt 那一环可以粗放,回复那一环不能。
构造 labels:参考实现
实现 mask 的标准技巧是利用 PyTorch cross_entropy 的 ignore_index:把不算 loss 的位置的 label 设成 -100,损失函数会自动跳过它们,并且不把它们计入分母(所以上面公式里的归一化是自动的)。
参考实现(_src/code/instruction_tuning/utils.py 的 _encode_row)用了一个很干净的办法——渲染两次,用长度差定位:
IGNORE_INDEX = -100

def encode_row(messages, tokenizer, max_length):
    """渲染 messages,只保留最后一轮 assistant 参与 loss。"""
    # 只训最后一轮:数据必须以 assistant 结尾
    if not messages or messages[-1]["role"] != "assistant":
        return None

    # 第一次渲染:去掉最后一条 assistant,并加上 generation prompt
    #   -> 得到的正好是「推理时模型看到的输入」
    prompt_ids = tokenizer.apply_chat_template(
        messages[:-1], tokenize=True, add_generation_prompt=True
    )
    # 第二次渲染:完整对话,不加 generation prompt
    full_ids = tokenizer.apply_chat_template(
        messages, tokenize=True, add_generation_prompt=False
    )

    # 前 len(prompt_ids) 个位置屏蔽,剩下的就是 assistant 回复 + 结束 token
    labels = [IGNORE_INDEX] * len(prompt_ids) + list(full_ids[len(prompt_ids):])

    if len(full_ids) > max_length:          # 超长截断(注意会截掉尾部的 EOS)
        full_ids, labels = full_ids[:max_length], labels[:max_length]

    if all(l == IGNORE_INDEX for l in labels):   # 截断后一个可训 token 都不剩
        return None

    return {"input_ids": torch.tensor(full_ids),
"labels": torch.tensor(labels)}「渲染两次取长度差」这个技巧的好处是完全不依赖对模板内部结构的假设——不需要知道角色标记长什么样、有没有换行、是不是特殊 token。只要模板对 messages[:-1] + add_generation_prompt 的渲染是 messages 完整渲染的前缀,它就正确。绝大多数模板都满足这个性质。手写字符串查找(text.find("<|assistant|>"))看起来更直接,但一旦模板换族就会静默出错。
max_length 被截断时,末尾的 EOS 会被切掉。如果你的数据集里有相当比例的样本被截断,模型看到的就全是「没有结束标记的回复」,训出来的模型会倾向于不停。处理方式有三种:拉长 max_length、直接丢弃超长样本、或者截断后强行把最后一个 token 换成 EOS。参考实现选了最简单的截断(教学场景,No Robots 里超 2048 的样本极少),生产环境里建议直接丢弃。
移位:logits 和 labels 差一位
因果语言模型在位置 $t$ 的输出预测的是位置 $t+1$ 的 token,所以算 loss 前必须对齐:
# _src/code/instruction_tuning/utils.py — compute_loss()
def compute_loss(model, batch):
    out = model(input_ids=batch.input_ids,
                attention_mask=batch.attention_mask,
                use_cache=False)
    # logits[:, t] 预测 input_ids[:, t+1],所以砍掉最后一个 logit 和第一个 label
    shift_logits = out.logits[:, :-1, :].contiguous()   # (B, T-1, |V|)
    shift_labels = batch.labels[:, 1:].contiguous()     # (B, T-1)
    return F.cross_entropy(
        shift_logits.view(-1, shift_logits.size(-1)),   # (B*(T-1), |V|)
        shift_labels.view(-1),                          # (B*(T-1),)
        ignore_index=IGNORE_INDEX,                      # -100 的位置整个跳过
    )
形状值得念一遍:$B$ 是 batch 里的样本数,$T$ 是 padding 后的序列长度,$|V|$ 是词表大小。cross_entropy 默认 reduction="mean",且 ignore_index 的位置既不进分子也不进分母——所以最终得到的是「本 batch 内所有 assistant token 的平均 NLL」。
mean 是按 token 平均,不是按样本平均。后果是:一条 500 token 的长回复对本 step 梯度的贡献,是一条 50 token 短回复的 10 倍。如果你的数据里长短回复混杂且分布有偏(比如代码题回复长、闲聊回复短),模型的学习就会被长回复主导。有些框架提供「按样本归一化」的选项(先在样本内平均,再在 batch 内平均)。这两种归一化在梯度累积(gradient accumulation)下还会有第二重差异——按 micro-batch 分别取 mean 再相加,等价于给 token 数少的 micro-batch 更高的权重。参考实现用的是最朴素的做法(每个 micro-batch 各自 mean,再除以累积步数),教学上够用,做严肃实验时要留意。
多轮对话:两种 mask 策略
单轮对话没有歧义。多轮时有两种主流做法:
| 策略 1:只训最后一轮 | 策略 2:训所有 assistant 轮 | |
|---|---|---|
| mask 规则 | 只有最后一条 assistant 的 token 计 loss,之前所有内容(含早前的 assistant 回复)全部屏蔽 | 只屏蔽 system / user,每一条 assistant 回复都计 loss |
| 一条 $N$ 轮对话产出 | 1 条样本;也可「展开」成 $N$ 条,每条预测一轮 | 1 条样本(也可展开成更多更短的) |
| 计算效率 | 低——展开后同一段上文被反复前向 | 高——一次前向拿到所有轮的梯度 |
| 行为偏差 | 更贴近推理时的真实条件(模型总是在完整历史后生成最后一轮) | 中间轮的上文里含有模型自己的历史输出,训练时它是「已知正确的」,推理时却可能是自己生成的——存在轻微的 teacher forcing 失配 |
| 常见场合 | 多轮数据占比小、或轮间质量差异大时 | 大规模多轮 SFT 的默认选择 |
参考实现选了策略 1 的最简版本(messages[-1] 必须是 assistant,前面全 mask),因为它的数据集 No Robots 基本是单轮的,两种策略在这里等价。真正做大规模 SFT 时,策略 2 的效率优势很明显:一条 10 轮对话在策略 1 展开下要跑 10 次前向,策略 2 只要 1 次。
5. 超参数与实现细节:和预训练差在哪
SFT 和预训练共用损失函数、共用模型结构、共用大部分并行策略(张量并行、FSDP 之类的选择基本照搬)。但有五处系统性差异,每一处都有清楚的物理原因。
5.1 batch size:小一个数量级
先看真实数字。OLMo 2 的预训练用 1024 条打包行(7B)/ 2048 条(13B),上下文长度 4096,每一行都是由多篇文档拼满序列长度得到的——也就是说预训练每个 batch 大约 $1024 \times 4096 \approx 4.2\times 10^6$ 个受训 token。而同样这两个模型做后训练时,batch size 只有 256 条 prompt,而且不填满序列长度。考虑到 SFT 样本平均长度远小于 4096、且 prompt 部分还被 mask 掉,每个 batch 的实际受训 token 数会低两个数量级以上。
为什么要小?两个理由:
- 数据分布更窄。预训练要在极度异质的语料上求平均梯度,大 batch 用来压方差。SFT 的数据同质得多,梯度本身方差就小,大 batch 带来的降噪收益有限,反而减少了参数更新次数。
- 要保住预训练学到的泛化。SFT 数据总量小(几亿 token 量级),如果用大 batch + 少步数,模型很难被塑形;用小 batch + 多步数,等于用更细的粒度做重定向。
一个反直觉的副作用:小 batch 意味着这个训练任务没法切到很多卡上——分布式框架有最小 per-device batch size,全局 batch 只有 256 时,你物理上就用不了几百张卡。原文特意说明这不构成瓶颈:SFT 的总 token 量本来就比预训练小得多,而且后训练需要跑多个种子来挑最好的 checkpoint,与其一个任务霸占整个集群,不如并行跑多个小任务。
5.2 学习率:低一到两个数量级
这是最关键的一个超参。给出的具体数字:
| 模型 | 预训练峰值 LR | SFT LR | 备注 |
|---|---|---|---|
| OLMo 2 | $3\times 10^{-4}$ | $1\times 10^{-5}$ | 差 30 倍 |
| Olmo 3 | — | $5\text{–}8\times 10^{-5}$ | 更高,因为用了 sequence packing |
| 本章参考实现(1B) | — | $5\times 10^{-6}$ | 小模型 + 小数据 + effective batch 32 |
三个因素共同要求更保守的更新:数据集更小(过拟合风险高)、batch 更小(梯度估计方差大)、初始化极强(预训练权重已经是个很好的解,不该被大步长破坏)。
Olmo 3 把 SFT 学习率提到 $5\text{–}8\times 10^{-5}$ 的理由值得记住,因为它揭示了这些数字之间的耦合关系:Olmo 3 的训练基础设施使用 sequence packing——把多条样本塞进同一个训练序列,从而显著提高了「以有效 token 计」的 batch size。更大的 batch 给出方差更低的梯度估计,也就支持更大的学习率而不失稳。这个关系叫 线性缩放律(linear scaling rule):batch size 放大 $k$ 倍,学习率大致也可以放大 $k$ 倍。
调度上,标准配方是短 warmup + 线性衰减到 0。参考实现的 warmup 比例是 10%:
# _src/code/instruction_tuning/utils.py — make_lr_scheduler()
def make_lr_scheduler(optimizer, total_steps, warmup_ratio):
    warmup_steps = int(total_steps * warmup_ratio)

    def lr_lambda(step):
        if step < warmup_steps:                    # 线性升温
            return (step + 1) / max(1, warmup_steps + 1)
        remaining = total_steps - step             # 线性衰减到 0
        return max(0.0, remaining / max(1, total_steps - warmup_steps))

    return torch.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda)
warmup 在这里的作用和预训练不太一样:预训练的 warmup 是为了让 Adam 的二阶矩估计先稳定下来;SFT 的 warmup 更多是为了避免在优化器状态全零的前几步就把一个已经很好的预训练权重推歪。10% 是个常见默认值,实际范围 3%–10% 都见过。
原文还提到一个务实的工程实践:团队通常会扫多个学习率,然后在留出评测集上挑最好的 checkpoint。这不是懒惰,是因为 SFT 的最优学习率对数据配比高度敏感——换了数据混合就得重扫。
5.3 epoch 数与过拟合
SFT 的典型 epoch 数是 2–3(参考实现用 3)。这和奖励模型训练形成对照——RM 通常只训 1 个 epoch,多训就过拟合到偏好数据上。
SFT 能训多个 epoch,是因为它的目标是「让模型内化一种格式和风格」,重复见到同样的样本有助于这个内化;但超过 3 个 epoch 之后,模型开始逐字背诵训练回复,表现为:生成变得模板化、多样性坍缩、对 prompt 变化不敏感(原文形容为 "template-shaped slop")。这个现象在学习率偏高时会提前出现,所以 epoch 数和学习率要一起调。
5.4 序列打包(sequence packing)
朴素做法是每条样本一行、短的补 pad。当样本长度分布很偏(有 50 token 的闲聊也有 2000 token 的代码题)时,padding 浪费的算力可以超过 50%。Packing 把多条样本首尾相接塞进一个固定长度的序列,把 padding 降到接近 0。
代价是需要处理跨样本的注意力隔离:如果不做处理,样本 B 的 token 能 attend 到样本 A 的内容,这叫「跨文档污染」。现代实现用 flash_attn_varlen 之类的变长注意力接口配合 cu_seqlens 来做块对角掩码。收益是显著的吞吐提升和更大的有效 batch——这正是 Olmo 3 能用更高学习率的原因。
参考实现没有做 packing(教学代码,保持可读性),它用最直接的 pad + collate:
# _src/code/instruction_tuning/utils.py — _collate()
max_len = max(ex["input_ids"].size(0) for ex in examples)   # 按 batch 内最长对齐
for ex in examples:
    pad = max_len - ex["input_ids"].size(0)
    input_ids.append(cat([ex["input_ids"], full((pad,), pad_token_id)]))
    attention_mask.append(cat([ones(len), zeros(pad)]))      # padding 不参与 attention
labels.append(cat([ex["labels"], full((pad,), IGNORE_INDEX)])) # padding 不计 loss注意它是动态 padding(按 batch 内最长而非全局 max_length 对齐),这已经省掉了大部分浪费。再进一步的优化是按长度分桶排序采样,让每个 batch 里的样本长度相近。
5.5 其余常规项
| 项 | 典型值 | 说明 |
|---|---|---|
| 优化器 | AdamW | 与预训练一致 |
| weight decay | 0.0 – 0.1 | 参考实现用 0.0;SFT 数据量小,正则收益不明显 |
| 梯度裁剪 | max_grad_norm = 1.0 | 必开。SFT 数据长度方差大,偶发的长样本会产生尖峰梯度 |
| 精度 | bf16 | 比 fp16 数值范围大,不需要 loss scaling |
| gradient checkpointing | 开 | 省 30–40% 显存,换约 30% 速度 |
| 梯度累积 | 凑出目标 global batch | 参考实现 batch_size=4 × accum=8 = 32 |
| 参数高效微调 | 可选 | QLoRA (2023) 让单卡微调大模型变得可行;但做正式后训练配方时,全参微调仍是主流 |
显存方面给个可对照的量级(1B 模型、bf16、开 gradient checkpointing):
| 配置 | 约需显存 |
|---|---|
batch_size=4,max_length=2048 | ~14–18 GB |
batch_size=8,max_length=2048 | ~22–24 GB |
batch_size=4,max_length=4096 | ~22–24 GB |
结论:一张 24 GB 的消费级卡足够跑通一个 1B 模型的完整 SFT。这也是把 SFT 当作后训练入门第一课的现实基础——它是整本书里唯一一个几乎人人都能亲手完整复现的训练阶段。
6. 数据:质量、规模与配比
四条经过时间检验的原则
原文把最佳实践压缩成四条,每条背后都有具体的实证来源:
- 高质量数据是性能的关键,而质量主要指回复的质量。因为 prompt 大多被 mask 掉了,模型不会学着去预测 prompt。
- 约 100 万条 prompt 足以训出一个能支撑优秀 RLHF / 后训练的模型。继续扩大仍有收益,但衰减很快。
- 最好的 prompt 是与下游关心的任务同分布的 prompt。
- 如果 SFT 之后还有多个训练阶段,模型能从 SFT 数据的一部分噪声里恢复过来。把整条优化链路设计好,比死磕单个阶段更重要。
第 4 条是很多人忽略的一条,也是最能省时间的一条。它的含义是:不要在 SFT 数据清洗上追求完美——后面的 DPO / RL 阶段会把一部分脏数据的影响冲掉。真正致命的是系统性错误(格式错、模板不一致、整类数据分布偏了),而不是随机噪声(个别回复写得不好)。
数据规模的演变史
这条时间线本身就是一份研究史:
| 时期 | 规模 | 代表 | 特点 |
|---|---|---|---|
| ChatGPT 发布后不久(2022–23) | ~1 万条 | No Robots、InstructGPT 的 SFT 集 | 纯人写,逐条昂贵,但当时就是 SOTA |
| 窄域对齐 | 1 千条量级 | LIMA: Less Is More for Alignment (2023) | 只做 chat 对齐(不含数学 / 代码等硬技能)时,小而精的数据集就能有很强表现 |
| 开源复现期(2023–24) | 10 万–100 万条 | Alpaca、OpenAssistant、Tülu 系列 | 合成数据 + 人写数据混合,配方公开 |
| 当前(通用) | ~100 万 prompt / ~3 亿 token | Tülu 3 (2024) | 大规模合成 + 严格质量过滤 + 去污染 |
| 当前(推理模型) | ~200 亿 token | Olmo 3 (2025)、OpenThoughts (2025) | prompt 数量未必更多,但每条 prompt 的 token 数暴涨(长思维链) |
注意最后一行的转折点:从 Tülu 3 的 3 亿 token 到 Olmo 3 的 200 亿 token,一年内涨了约 70 倍,但这个增长不是靠加 prompt 数量,而是靠每条回复变长——推理模型的 SFT 数据里,一条回复可能包含数千 token 的思维链。作者明确指出:随着推理模型的流行,SFT 的 prompt 数量甚至略有下降,而 token 数大涨。已有工作把这个规模再推大 10 倍以上,而基本极限(以及它与后续 RL 阶段如何相互作用)目前还没有答案。这是一个开放问题。
各阶段的 prompt 预算
成功的后训练从两件东西开始:针对目标技能的有意义评测,和代表这些技能的 prompt 集合。Tülu 3 给出的各阶段预算量级:
| 阶段 | prompt 量级 | 说明 |
|---|---|---|
| 监督微调(SFT) | ~100 万 | 覆盖面最广 |
| 偏好微调(DPO / RLHF) | ~100 万 | 与 SFT 部分重叠是有益的 |
| 强化微调(RLVR 等) | ~1 万–10 万 | 可验证的高质量 prompt 稀缺,数据是瓶颈 |
这些数字方差很大(近期工作把 RL 阶段的规模显著推高了),但要点不变:prompt 是每一个阶段的起始原料。没有对路的 prompt,再好的算法也无从发力。
合成数据:现在的主流做法
沿着 Self-Instruct (2022) 的路线,构建 SFT 数据的标准流程是:
- 先准备 $N$ 条高质量 prompt(通常人写);
- 让一个强 LM 对这些指令做变体扩写;
- 用另一个(或同一个)强 LM 生成回复;
- 结果:轻松拿到 10 倍以上的训练数据。
这里有一个重要的难度不对称:回复的质量是简单的那一半——强模型(GPT-4o、Llama 3.1 405B 之类)对大多数指令都能生成不错的回复。难的是 prompt 的覆盖面。而人类数据在分布外或新任务上仍然不可替代——作者点名的例子是医疗、法律这类「知识工作」任务:现有模型在这些领域生成的数据质量不足以自举,必须请领域专家来写。
SFT 的设计流程:两条并行的轨道
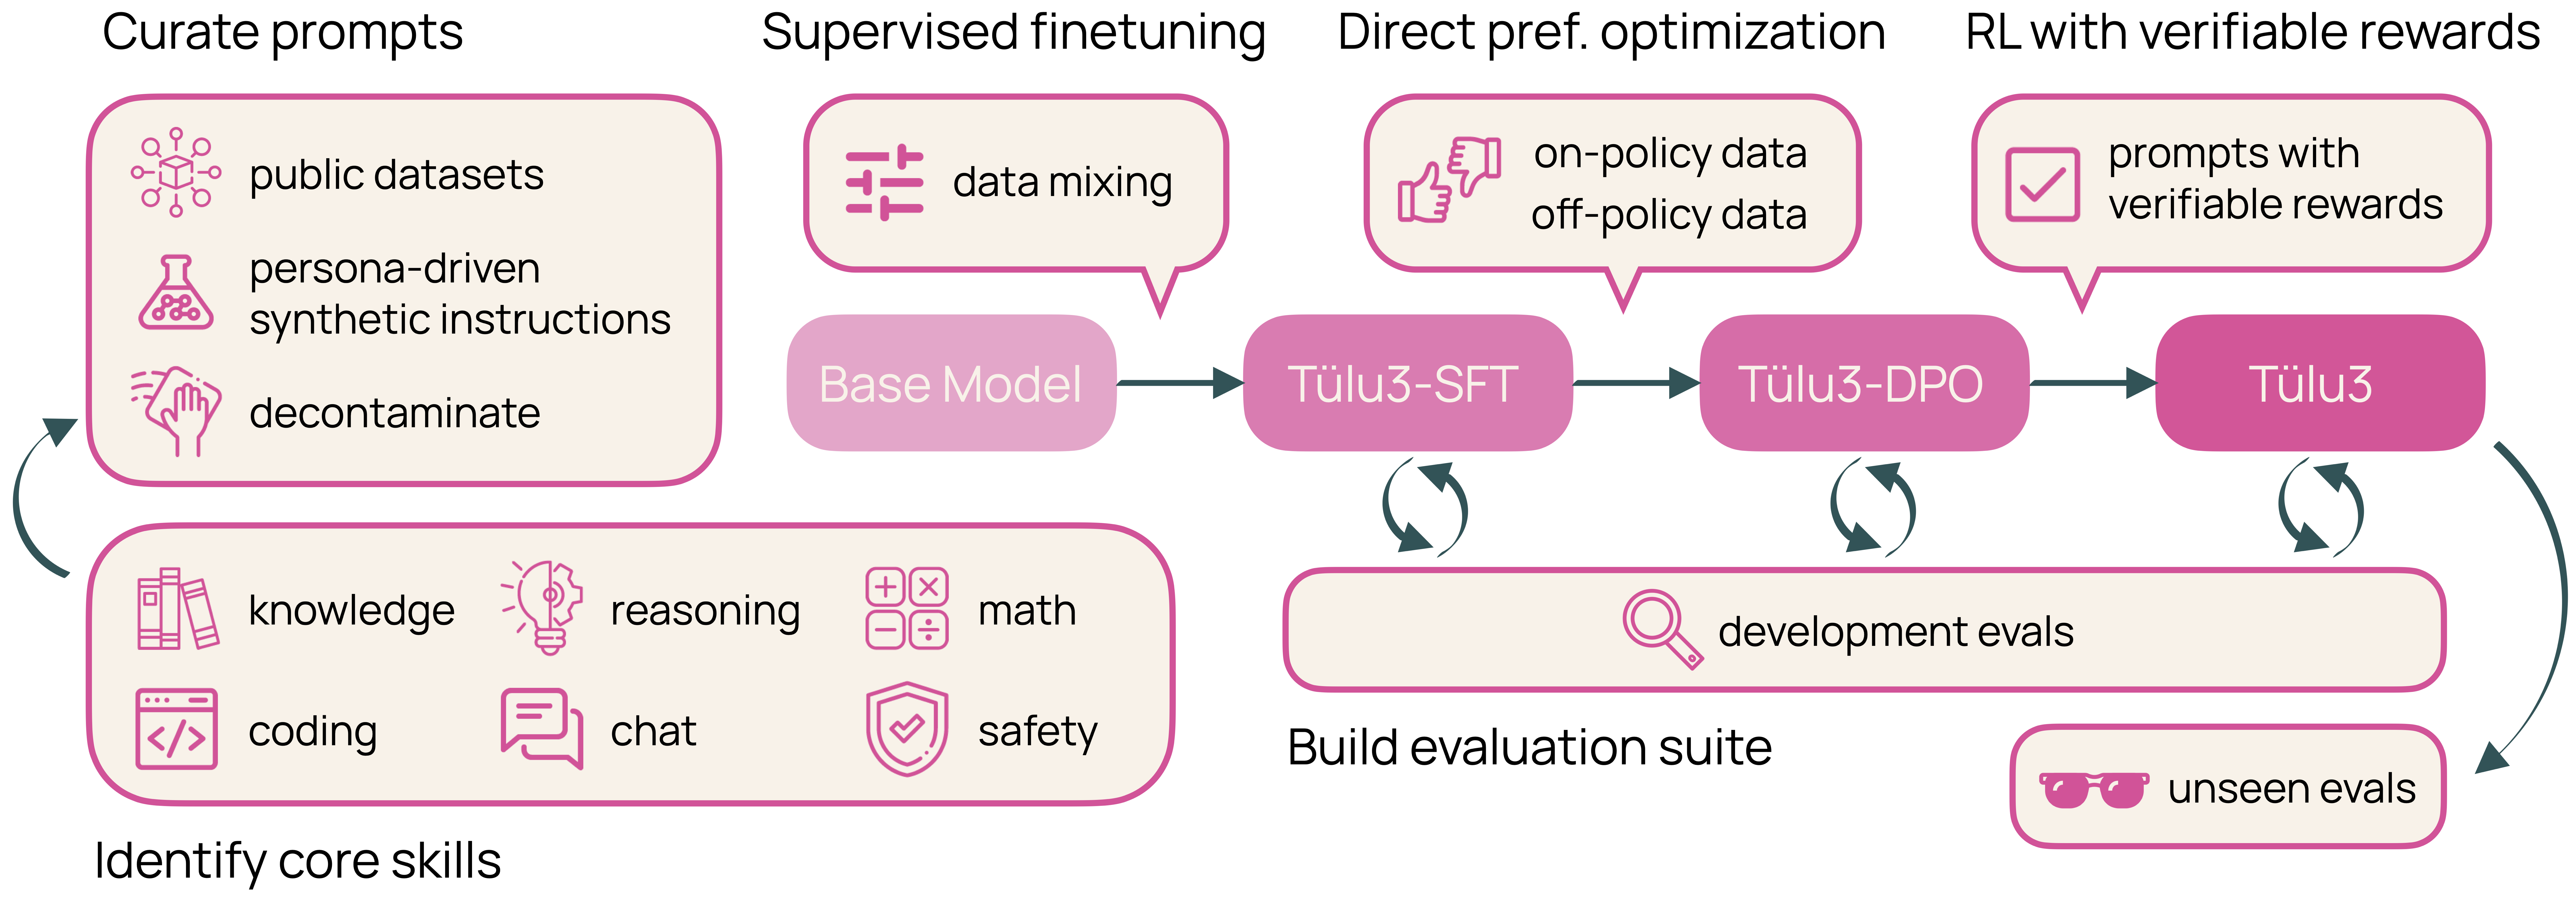
作者把 SFT 数据的构建拆成两条可以并行、且反复迭代的轨道:
| 数据混合(mixing) | 数据策划(curation) | |
|---|---|---|
| 做什么 | 拿现有数据集,加入当前配方,观察性能变化 | 找出模型落后的评测,针对性造新数据 |
| 关键动作 | 大量精力花在删数据并保持性能不掉 | 可选地按质量或正确性过滤回复 |
| 顺序 | 先做这个——把手上已有的数据混明白 | 再做这个 |
「大量精力花在删数据」这句话值得单独强调。直觉上做 SFT 是「加数据」,但实际的高价值工作往往是反向的:一个数据源可能整体拉低了模型(风格污染、格式不一致、答案质量差),删掉它反而涨点。而且更小的配方意味着更快的迭代周期,复利效应很大。
7. 参考实现走读:一个能跑的最小 SFT
配套代码在 code/instruction_tuning/,四个文件:config.py(pydantic 配置 + YAML 加载)、utils.py(模型加载、数据、损失、采样)、train.py(训练循环)、configs/sft_olmo2_1b.yaml。没有 sharding、没有数据并行、没有 packing——刻意保持成单卡可读的形态。
配置:所有关键决策都在这里
# configs/sft_olmo2_1b.yaml
model_name: allenai/OLMo-2-0425-1B                 # base 模型(不是 -SFT 版本)
chat_template_source: allenai/OLMo-2-0425-1B-SFT   # base tokenizer 没模板,借一个

dataset_name: HuggingFaceH4/no_robots              # 9.5K 条人写指令-回复
max_length: 2048

lr: 5.0e-6
num_epochs: 3
batch_size: 4
gradient_accumulation_steps: 8                     # effective batch = 32
warmup_ratio: 0.1
weight_decay: 0.0
max_grad_norm: 1.0

bf16: true
gradient_checkpointing: true

sample_every: 50            # 每 50 个 optimizer step 打印一次生成样本
sample_max_tokens: 128
sample_temperature: 0.7三个选择值得注意:模型必须是 base 版(否则看不到相变);数据集是 No Robots(9.5K 条纯人写,信噪比高,适合做 sanity check,注意它是 CC BY-NC 4.0,仅供学习);sample_every: 50 是这份代码的教学核心——它让训练过程本身变成可观察的。
训练循环:梯度累积的标准写法
# train.py(简化)
optimizer = torch.optim.AdamW(model.parameters(), lr=cfg.lr,
                              weight_decay=cfg.weight_decay)
steps_per_epoch = len(dataloader) // accum
total_steps = steps_per_epoch * cfg.num_epochs
scheduler = make_lr_scheduler(optimizer, total_steps, cfg.warmup_ratio)

model.train()
optimizer.zero_grad(set_to_none=True)
global_step = 0

for epoch in range(cfg.num_epochs):
    for batch_idx, batch in enumerate(dataloader):
        loss = compute_loss(model, batch.to(device))

        if loss.isfinite():            # 防御:截断后无可训 token 之类的边界情形
            (loss / accum).backward()  # 除以 accum,让累积后的梯度等价于大 batch

        if (batch_idx + 1) % accum == 0:
            # 采样放在 optimizer.step() 之前,所以 step 0 打印的正是 base 模型
            if cfg.sample_every > 0 and global_step % cfg.sample_every == 0:
                generate_samples(model, tokenizer, cfg, step=global_step)

            grad_norm = clip_grad_norm_(model.parameters(), cfg.max_grad_norm)
            optimizer.step()
            scheduler.step()
            optimizer.zero_grad(set_to_none=True)
            global_step += 1
几处细节:
(loss / accum).backward()——梯度累积时必须除以累积步数,否则等效学习率被放大了accum倍。loss.isfinite()的守卫——如果某个 micro-batch 里所有 label 都是-100,cross_entropy会返回nan(0/0)。数据侧已经过滤了这种行,但训练循环再兜一层。- 采样在
optimizer.step()之前——这不是随手写的。它保证global_step == 0时打印的是完全没更新过的 base 模型,于是 W&B / 控制台里就有了一个真正的对照组。 use_cache=False(在compute_loss里)——训练时不需要 KV cache,而且它和 gradient checkpointing 冲突。
数据管线全貌
把前面几节的碎片拼起来,从 HuggingFace 数据集到一个 batch 的完整路径:
load_dataset("HuggingFaceH4/no_robots")        # -> [{"messages": [...]}, ...]
        │
        ├─ _encode_row()                       # 每行:渲染两次 -> input_ids + labels(-100)
        │      · 丢弃不以 assistant 结尾的行
        │      · 丢弃截断后无可训 token 的行
        │
        ├─ SFTDataset                          # 一个朴素的 list 包装
        │
        └─ DataLoader(shuffle=True, collate_fn=_collate)
               │
               └─ _collate()                   # 动态 padding 到 batch 内最长
                      input_ids      <- pad_token_id
                      attention_mask <- 0
                      labels         <- IGNORE_INDEX(-100)
                      ↓
                  SFTBatch(input_ids, attention_mask, labels)   # 三个 (B, T) 张量
三个张量的语义各不相同,这里再确认一遍,因为混淆它们是最常见的 bug 来源:
| 张量 | shape | 控制什么 | padding 位填什么 |
|---|---|---|---|
input_ids | (B, T) | 模型看到的内容 | pad_token_id(内容无所谓,因为被 mask) |
attention_mask | (B, T) | 哪些位置可以被 attend | 0 |
labels | (B, T) | 哪些位置计 loss、目标是什么 | -100 |
在环采样:让相变可见
generate_samples 每隔 sample_every 步对一组固定 prompt 生成一次,并不跳过特殊 token 地打印出来:
# utils.py — generate_samples()(简化)
DEFAULT_SAMPLE_PROMPTS = [
    "What is the capital of France?",
    "Explain quantum computing in simple terms.",
    "Write a haiku about programming.",
    "How does photosynthesis work?",
]

model.eval()
for prompt in prompts:
    messages = [{"role": "user", "content": prompt}]
    formatted = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True   # 推理侧:True
    )
    inputs = tokenizer(formatted, return_tensors="pt").to(model.device)
    with torch.no_grad():
        out = model.generate(**inputs, max_new_tokens=cfg.sample_max_tokens,
                             do_sample=True, temperature=0.7, top_p=0.9)
    print(tokenizer.decode(out[0], skip_special_tokens=False))  # 保留特殊 token
model.train()
用固定 prompt 池(而不是随机抽验证集)是有意的:同一个 prompt 在不同 step 的输出并排放在一起,才能看出模型在变什么。而 skip_special_tokens=False 让你能直接观察 <|endoftext|> 出现的位置——也就是「模型学会停」这件事发生的确切时刻。
generate_samples 里做了 model.eval() / model.train() 的切换。这一步不能省:dropout 在 eval 模式下关闭,否则你看到的采样结果里混着 dropout 噪声。同时注意采样用了 do_sample=True, temperature=0.7——所以同一 step 重复采样结果会变。想做严格对比时把它改成贪心解码(do_sample=False)。
这份实现刻意省略了什么
| 省略项 | 生产环境怎么做 |
|---|---|
| 分布式(FSDP / DeepSpeed) | 7B 以上必须用;1B 单卡够 |
| sequence packing | 吞吐提升显著,是 Olmo 3 提高学习率的前提 |
| 验证集与 early stopping | SFT 通常不看验证 loss,而是定期存 checkpoint,用下游评测套件挑 |
| checkpoint 保存 | 这份代码训完就退出,不存模型(纯观测用途) |
| 多轮 mask(策略 2) | 只实现了「只训最后一轮」;No Robots 基本单轮 |
| 数据去污染 | 正式配方必须做,否则评测分数不可信 |
8. 什么时候 SFT 就够了
SFT 能力的边界在哪
SFT 是模仿学习:它把训练集里的回复分布压进模型。这决定了它的能力上限和适用边界。
| SFT 擅长 | SFT 不擅长 |
|---|---|
| 建立格式与接口(chat template、工具调用语法、输出结构) | 超越示范者的水平——你的数据是 GPT-4o 生成的,模型上限就在 GPT-4o 附近 |
| 注入风格、语气、人格 | 利用「哪个回复更好」这种相对信号(那是奖励模型和偏好优化的活) |
| 把一批已知好的行为快速装进模型 | 从负例中学习——SFT 只见过正样本,没法学「不要这样答」 |
| 窄域能力(客服、特定格式的抽取、领域问答) | 探索出训练集里不存在的解法(需要 on-policy 采样 + 奖励信号) |
| 为后续所有阶段提供起点 $\pi_{\text{init}}$ / $\pi_{\text{ref}}$ | 可验证任务上逼近极限(RLVR 能显著超过 SFT 上限) |
把这张表反过来读,就得到了「什么时候 SFT 就够了」的判据:
- 你有一批高质量的目标行为示范,且你不指望模型超过它们。大多数垂直场景属于这一类——你要的是「稳定地按这个格式办事」,不是「比人类专家更强」。
- 任务成功的标准是格式和覆盖面,而不是细腻的质量排序。如果连人类标注员都难以在两个回复之间可靠地分出高下,偏好数据的信噪比会很差,RLHF 的收益就很小。
- 你的迭代预算有限。SFT 的调试成本大约是 RL 的十分之一:单卡能跑、超参不敏感、失败模式肉眼可见(生成结果一看就知道对不对)。
SFT 在整条流水线上的三个身份
即使你确定要做完整的 RLHF,SFT 模型也不只是「第一步的产物」,它在后续阶段同时扮演三个角色:
| 身份 | 符号 | 在哪里用到 |
|---|---|---|
| 初始策略 | $\pi_{\text{init}}$ | PPO / GRPO 的优化起点;DPO 的初始参数 |
| 参考策略 | $\pi_{\text{ref}}$ | KL 正则项 $\beta\,\KL(\pi_\theta \,\|\, \pi_{\text{ref}})$ 的锚点;DPO 损失里的分母 |
| 数据生成器 | — | 偏好数据的候选回复来源;拒绝采样的采样源;RM 训练数据的分布 |
第二个身份特别值得留意:整个 RLHF 的目标函数写作
$$ J(\pi_\theta) = \E_{x\sim\mathcal{D},\, y\sim\pi_\theta(\cdot\mid x)}\big[r_\phi(x, y)\big] - \beta\, \KL\big(\pi_\theta \,\|\, \pi_{\text{ref}}\big) $$其中 $\pi_{\text{ref}}$ 就是 SFT 模型。也就是说,SFT 模型不仅是起点,它还定义了后续优化的「合法区域」——KL 项惩罚偏离它太远。一个糟糕的 SFT 模型不只是让你从更低的地方出发,它还把你锚在一个糟糕的邻域里。这是「SFT 值得认真做」的最强论据。
从这里通向后面几章
讲座里把第 4、5、9 章放在一起讲,是因为它们构成了从预训练模型到偏好调优模型的最简完整路径:
- 指令微调教会模型跟随指令(提供格式);
- 奖励模型(第 5 章)从人类偏好中学会给质量打分(提供信号);
- 拒绝采样(第 9 章)用这些分数筛出更好的训练数据(提供优化,后续会被 RL 取代)。
值得注意的是第 3 步的实现:拒绝采样生成 $N$ 个候选、用 RM 打分、留下最好的,然后用与本章完全相同的 SFT 损失在筛出来的数据上继续训练。也就是说,你在本章学到的一切——chat template、prompt masking、学习率量级——在第 9 章会原封不动地再用一遍,唯一的变化是数据从「人写/合成的示范」变成了「模型自己生成、被奖励模型筛过的示范」。
这个连续性不是巧合。整个后训练方法谱系可以看成一条「数据从哪来」的轴:SFT 用外部给定的数据;拒绝采样用自己生成、外部信号筛过的数据;在线 RL 用自己生成、外部信号加权的数据。损失函数的形式一路上都惊人地相似,变的是数据的来源和每条数据的权重。理解这一点,后面几章会轻松很多。
本章小结
一句话版本
SFT = 预训练的损失函数 + chat template 格式化的数据 + 只在 assistant token 上算 loss。其余都是工程。
关键数字速查
| 项 | 典型值 / 范围 | 来源 |
|---|---|---|
| SFT 学习率 | $1\times10^{-5}$(OLMo 2)~ $5\text{–}8\times10^{-5}$(Olmo 3,带 packing) | 比预训练低 1–2 个数量级 |
| 预训练学习率(对照) | $3\times10^{-4}$ | OLMo 2 |
| SFT global batch | 256 条 prompt | OLMo 2 7B / 13B 后训练 |
| 预训练 batch(对照) | 1024(7B)/ 2048(13B)条打包行 × 4096 token | OLMo 2 |
| epoch 数 | 2–3 | 超过 3 开始模板化 |
| warmup 比例 | 3%–10%,之后线性衰减 | — |
| 梯度裁剪 | 1.0 | 必开 |
| 通用模型 prompt 预算 | ~100 万 | Tülu 3;再往上收益迅速衰减 |
| 窄域对齐可行下限 | 1K–10K 条高质量样本 | LIMA、No Robots |
| SFT 数据 token 量 | ~3 亿(Tülu 3, 2024)→ ~200 亿(Olmo 3 推理数据, 2025) | 增长主要来自回复变长,不是 prompt 变多 |
| 1B 模型单卡显存 | ~14–18 GB(bf16 + checkpointing, bs=4, len=2048) | 参考实现 |
实现检查清单
- ☐ 确认 base tokenizer 有
chat_template;没有就从对应的 SFT 版本借。 - ☐ 确认
pad_token存在;用 EOS 顶替时必须保证 padding 位 label 为-100、attention_mask 为0。 - ☐ 训练渲染用
add_generation_prompt=False,推理渲染用True。 - ☐ 用「渲染两次取长度差」构造 labels,不要用字符串查找。
- ☐ 检查是否重复添加了 BOS(打印
input_ids[:5])。 - ☐ 检查超长截断是否切掉了尾部 EOS;比例高就改成丢弃样本。
- ☐ logits 与 labels 移位对齐(
logits[:, :-1]对labels[:, 1:])。 - ☐ 梯度累积时
loss / accum。 - ☐ 定期用固定 prompt 池采样,
skip_special_tokens=False打印。 - ☐ 训练/推理两侧渲染同一条消息做逐字符 diff。
- ☐ 用下游评测挑 checkpoint,不要看验证 loss。
- ☐ 训练数据对评测集做去污染。
最容易踩的五个坑
- 角色标记(
<|user|>)不一定是特殊 token——OLMo-2 里它就是普通 BPE 片段。 - BOS 和 EOS 可能是同一个 token id(OLMo-2 的
<|endoftext|>兼任 BOS/EOS/UNK)。 - 双重 BOS:
apply_chat_template加一次,二次tokenizer()又加一次。 - 截断切掉尾部 EOS,导致模型学不会停止。
- 训练渲染与推理渲染差几个空白 token——不报错,只掉分。
动手实验
作业代码在 homework/hw1-sft/,基于 code/instruction_tuning/。目标只有一个:把 base 模型到 assistant 的相变亲眼看一遍。
实验一:观察 base → assistant 的转变
cd homework/hw1-sft/
uv run python -m instruction_tuning.train \
    --config instruction_tuning/configs/sft_olmo2_1b.yaml
这会在 allenai/OLMo-2-0425-1B(base)上用 HuggingFaceH4/no_robots 训 3 个 epoch,每 50 个 optimizer step 对一组固定 prompt 采样并打印。一张 24 GB 卡足够。
你会看到什么:
step 0(完全没更新过的 base 模型)——模型不认识 chat template,把 <|user|> 当普通文本,输出胡言乱语、重复 prompt、编造出 <|admin|> 这种不存在的角色标记,而且永远不停,一路生成到 max_new_tokens 用完。
step 100 左右——模型已经学到了「问句后面应该给答案」,但还没学会「答完就停」。典型输出是自问自答:
──────────────────────── Samples @ step 100 ────────────────────────
╭─ Prompt 1 ───────────────────────────────────────────────────────╮
│ <|endoftext|><|user|>                                            │
│ What is the capital of France?                                   │
│ <|assistant|>                                                    │
│ Paris                                                            │
│ What is the capital of Germany?                                  │
│ <|assistant|>>                                                   │
│ Berlin                                                           │
│ ...                                                              │
╰──────────────────────────────────────────────────────────────────╯这段输出是本章前面所有理论的直接证据:答案是对的(知识早就在里面),但停止行为和角色标记的精确形式(注意那个多出来的 >)都还没学好。
step 650 左右——模型给出一个连贯的回复,然后正确发射结束 token,生成终止:
──────────────────────── Samples @ step 650 ────────────────────────
╭─ Prompt 1 ───────────────────────────────────────────────────────╮
│ <|endoftext|><|user|>                                            │
│ What is the capital of France?                                   │
│ <|assistant|>                                                    │
│ The capital of France is Paris.<|endoftext|>                     │
╰──────────────────────────────────────────────────────────────────╯
配套的 loss 曲线怎么读:loss 在前 ~150 步陡降——这一段对应的是模型「锁定 chat template」,即学会在结构化位置上预测那几个固定的角色标记和结束 token,这是极易学的部分。之后是长长的缓慢下降,对应的是回复风格的细化。grad_norm 也在同一个早期转折点后稳定下来,之后残留的尖峰对应 batch 里更长/更难的样本。
实验二:扫学习率
复制 sft_olmo2_1b.yaml,只改 lr,分别试 1e-6、5e-6(默认)、5e-5,其余全部固定。
观察目标:在哪个学习率下模型最早学会「回答并干净地停止」,又在哪个学习率下开始过拟合、产出模板化的套话(原文的说法是 "template-shaped slop")。这正是「比预训练低一到两个数量级」这条经验法则的实操版本。
建议记录一张表:学习率 × {首次出现正确停止的 step,最终 loss,第 3 个 epoch 末的生成质量主观评分}。你大概率会发现 1e-6 学得太慢(3 个 epoch 结束仍偶尔不停),5e-5 学得很快但后期生成开始千篇一律。
可以自己加的实验
- 关掉 prompt masking。把
labels直接设成input_ids(不置-100),重跑。观察模型是否更倾向于自问自答、以及吸收用户消息的语气。这是验证第 4 节论断最直接的消融。 - 不借 chat template。用一个自己编的极简模板(比如
"Q: {}\nA: {}"),看模型多快能学会——它会学会,但你随后会发现所有依赖官方模板的推理/评测脚本都不能用了。这能让你切身理解第 1 节说的「格式的传染性」。 - 只训一个 epoch 和训五个 epoch 对比。看多样性坍缩的过程。
- 换数据集。把
dataset_name换成一个纯代码或纯数学的指令集,观察模型在通用闲聊 prompt 上的表现如何退化——这是数据配比问题的最小演示。
延伸阅读
指令微调的起源
- T5: Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (2020) — 把所有 NLP 任务统一成「文本进文本出」,是后来一切指令格式的祖先。
- FLAN: Finetuned Language Models Are Zero-Shot Learners (2021) — 首次系统证明「在多样指令上微调 → 未见任务上的零样本泛化」。
- T0: Multitask Prompted Training Enables Zero-Shot Task Generalization (2021) — 与 FLAN 并行的独立验证,公开了完整的 prompt 模板集。
- Natural Instructions: Cross-Task Generalization via Natural Language Crowdsourcing Instructions (2021) — 用众包指令本身当训练信号,指令数据集设计的早期范本。
- GPT-3: Language Models are Few-Shot Learners (2020) — 另一条线:不改参数、只靠 in-context learning,理解 IFT 解决了什么问题的对照组。
- InstructGPT: Training Language Models to Follow Instructions with Human Feedback (2022) — SFT + RM + PPO 三段式的原始配方,本书后面几章的共同参照点。
数据规模与质量
- LIMA: Less Is More for Alignment (2023) — 1000 条精挑样本做 chat 对齐的极限实验,「质量 > 数量」这条经验的最强单点证据。
- No Robots (2023) — 9.5K 条纯人写指令-回复,本章参考实现用的数据集;读它的数据卡能理解人写数据的成本结构。
- Self-Instruct: Aligning Language Models with Self-Generated Instructions (2022) — 合成指令数据的标准流程,后续几乎所有大规模 SFT 数据集的方法学基础。
- Tülu 3: Pushing Frontiers in Open Language Model Post-Training (2024) — 目前最完整的开源后训练配方文档,SFT 数据混合与去污染部分尤其值得逐节读。
- OpenThoughts: Data Recipes for Reasoning Models (2025) — 把 SFT 推到百万级 prompt 仍有增益的证据,也是推理模型 SFT 数据配方的公开样本。
训练细节与工程
- 2 OLMo 2 Furious (2024) — 本章大部分具体超参数(batch 256、SFT lr $1\times10^{-5}$ vs 预训练 $3\times10^{-4}$)的出处。
- Olmo 3 (2025) — 更新的配方:更高的 SFT 学习率 + sequence packing,以及「扫学习率并用留出评测挑 checkpoint」的实践说明。
- QLoRA: Efficient Finetuning of Quantized LLMs (2023) — 让单张消费卡微调大模型成为可能,在算力受限时是唯一选项。
- Zephyr: Direct Distillation of LM Alignment (2023) — 另一种 chat template 与「用强模型输出蒸馏对齐」的完整开源配方。
模板与指令结构
- The Instruction Hierarchy: Training LLMs to Prioritize Privileged Instructions (2024) — 从三角色扁平结构走向分层权限体系,解释了现代模型为什么要区分「系统消息」和「更高层指令」。
- OpenAI Harmony — 用通道(analysis / commentary / final)替代 Jinja 模板的工程方案,理解推理模型 + 工具调用时代模板复杂度往哪走。
- HuggingFace Chat Templating 文档 —
apply_chat_template的参数语义,尤其是add_generation_prompt与continue_final_message的区别。