奖励建模
把「哪个回复更好」这种说不清楚的人类判断,压缩成一个可以被梯度下降优化的标量函数。
0. 本章导读
标准强化学习里有一个东西是白送的:环境的奖励函数。你让机械臂把方块推到目标点,距离小于 2 厘米就 +1;你玩 Atari,游戏分数直接就是 reward。RL 算法的全部工作是在给定奖励下找最优策略,奖励本身不需要学。
语言模型没有这个便利。「写一封得体的辞职信」的好坏没有传感器能测量,没有游戏引擎能判分。你唯一能拿到的,是人类看完两个回复之后说的一句「我更喜欢左边那个」。奖励建模就是把这种成对的、相对的、带噪声的人类判断,拟合成一个能对任意 (prompt, 回复) 打出实数分的函数 $r_\theta(x,y)$。拟合出来之后,它就顶替了 RL 里那个本该由环境提供的奖励函数——区别在于,这个「环境」是我们自己学出来的,因此也是可以被策略钻空子的(这是第 14 章过优化的伏笔)。
这一步的神奇之处值得多说一句:偏好数据里每一条样本只携带 1 bit 信息(左边好还是右边好),但把几万到几十万条这样的 1 bit 喂给一个几十亿参数的网络,它居然能泛化出「什么叫有帮助」「什么叫诚实」这种连人自己都定义不清的概念。这是现代深度学习的表示能力又一次超出直觉的例子。
本章要讲清楚的是这么几件事:
- Bradley-Terry 模型的完整推导——从 1952 年的成对比较模型出发,一步不跳地推到 $-\log\sigma(r_c - r_r)$ 这个损失,并说明为什么它本质上就是二分类的交叉熵。
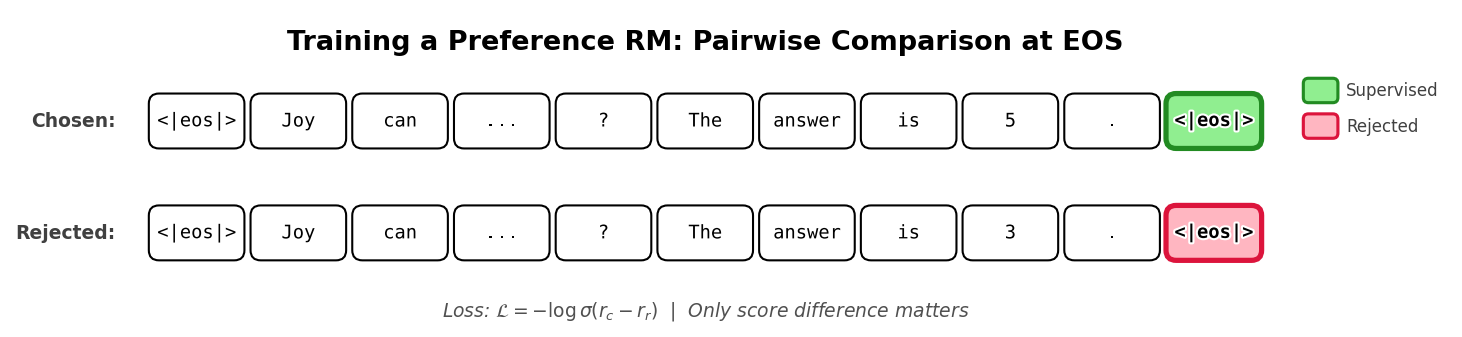
- 架构——「奖励模型」不是一个新网络,它就是一个语言模型头换成了一个输出维度为 1 的线性层,在最后一个非 padding token 的隐状态上取分。
- 三种监督粒度——序列级(Bradley-Terry RM)、结果级(Outcome Reward Model, ORM)、过程级(Process Reward Model, PRM),以及它们与价值函数的边界在哪。
- 生成式奖励模型——直接 prompt 一个强模型来当裁判(LLM-as-a-judge),什么时候够用、什么时候不够。
- 评测与局限——RewardBench 之后 RM 评测的爆发,以及作者本人对这些基准的保留意见:RM 基准上的准确率和它在下游 RLHF 里的实际效用,相关性没有想象中强。
本章在全书里的位置:第 4 章的 SFT 模型是偏好数据的采样源,也是奖励模型的初始化权重;本章训出的 $r_\theta$ 会成为第 6 章策略梯度的优化目标、第 9 章拒绝采样的打分器。而第 8 章的 DPO 之所以能省掉这一步,恰恰是因为它把本章推导出的 Bradley-Terry 损失和策略的 log-ratio 直接接在了一起——理解了本章,DPO 那个「看起来像变魔术」的推导就只剩代数。
- Bradley-Terry 模型假设每个回复有一个潜在强度 $p_i>0$,偏好概率是 $p_i/(p_i+p_j)$。令 $p_i=e^{r_i}$ 后偏好概率变成 $\sigma(r_i-r_j)$,只有分数之差有意义——奖励模型的绝对数值没有物理含义。
- 最大化偏好似然 ⇒ 最小化 $-\log\sigma(r_\theta(y_c\mid x)-r_\theta(y_r\mid x))$。这就是一个把「分数差」当 logit 的二分类交叉熵,代码只有一行
-F.logsigmoid(r_c - r_r).mean()。 - 架构上,RM = 因果语言模型 + 一个
nn.Linear(hidden_size, 1),取最后一个非 padding token(通常是 EOS)的隐状态打分。工程难点几乎全在数据加载和分布式,不在损失函数。 - 训练惯例:只训 1 个 epoch(RM 极易过拟合偏好数据)。参考实现用 Qwen3-0.6B-Base + UltraFeedback,有效 batch 16、lr $5\times10^{-5}$、10% warmup + 线性衰减。
- 三种监督粒度:RM 问「整个回答有多好」(EOS 处一个标量);ORM 问「这个回答对不对」(每个 completion token 一个正确性概率);PRM 问「每一步推理站得住吗」(只在步骤边界打分,三分类)。价值函数问的是「从这里往后还能拿多少奖励」,架构像 ORM,语义完全不同。
- Lambert 的判断:奖励建模是 RLHF 里相对最欠开发的一块;生成式 RM 在 RM 基准上普遍落后于训练出来的 RM,但在实际流水线里被大量使用——存在明显的「评测-效用错配」。
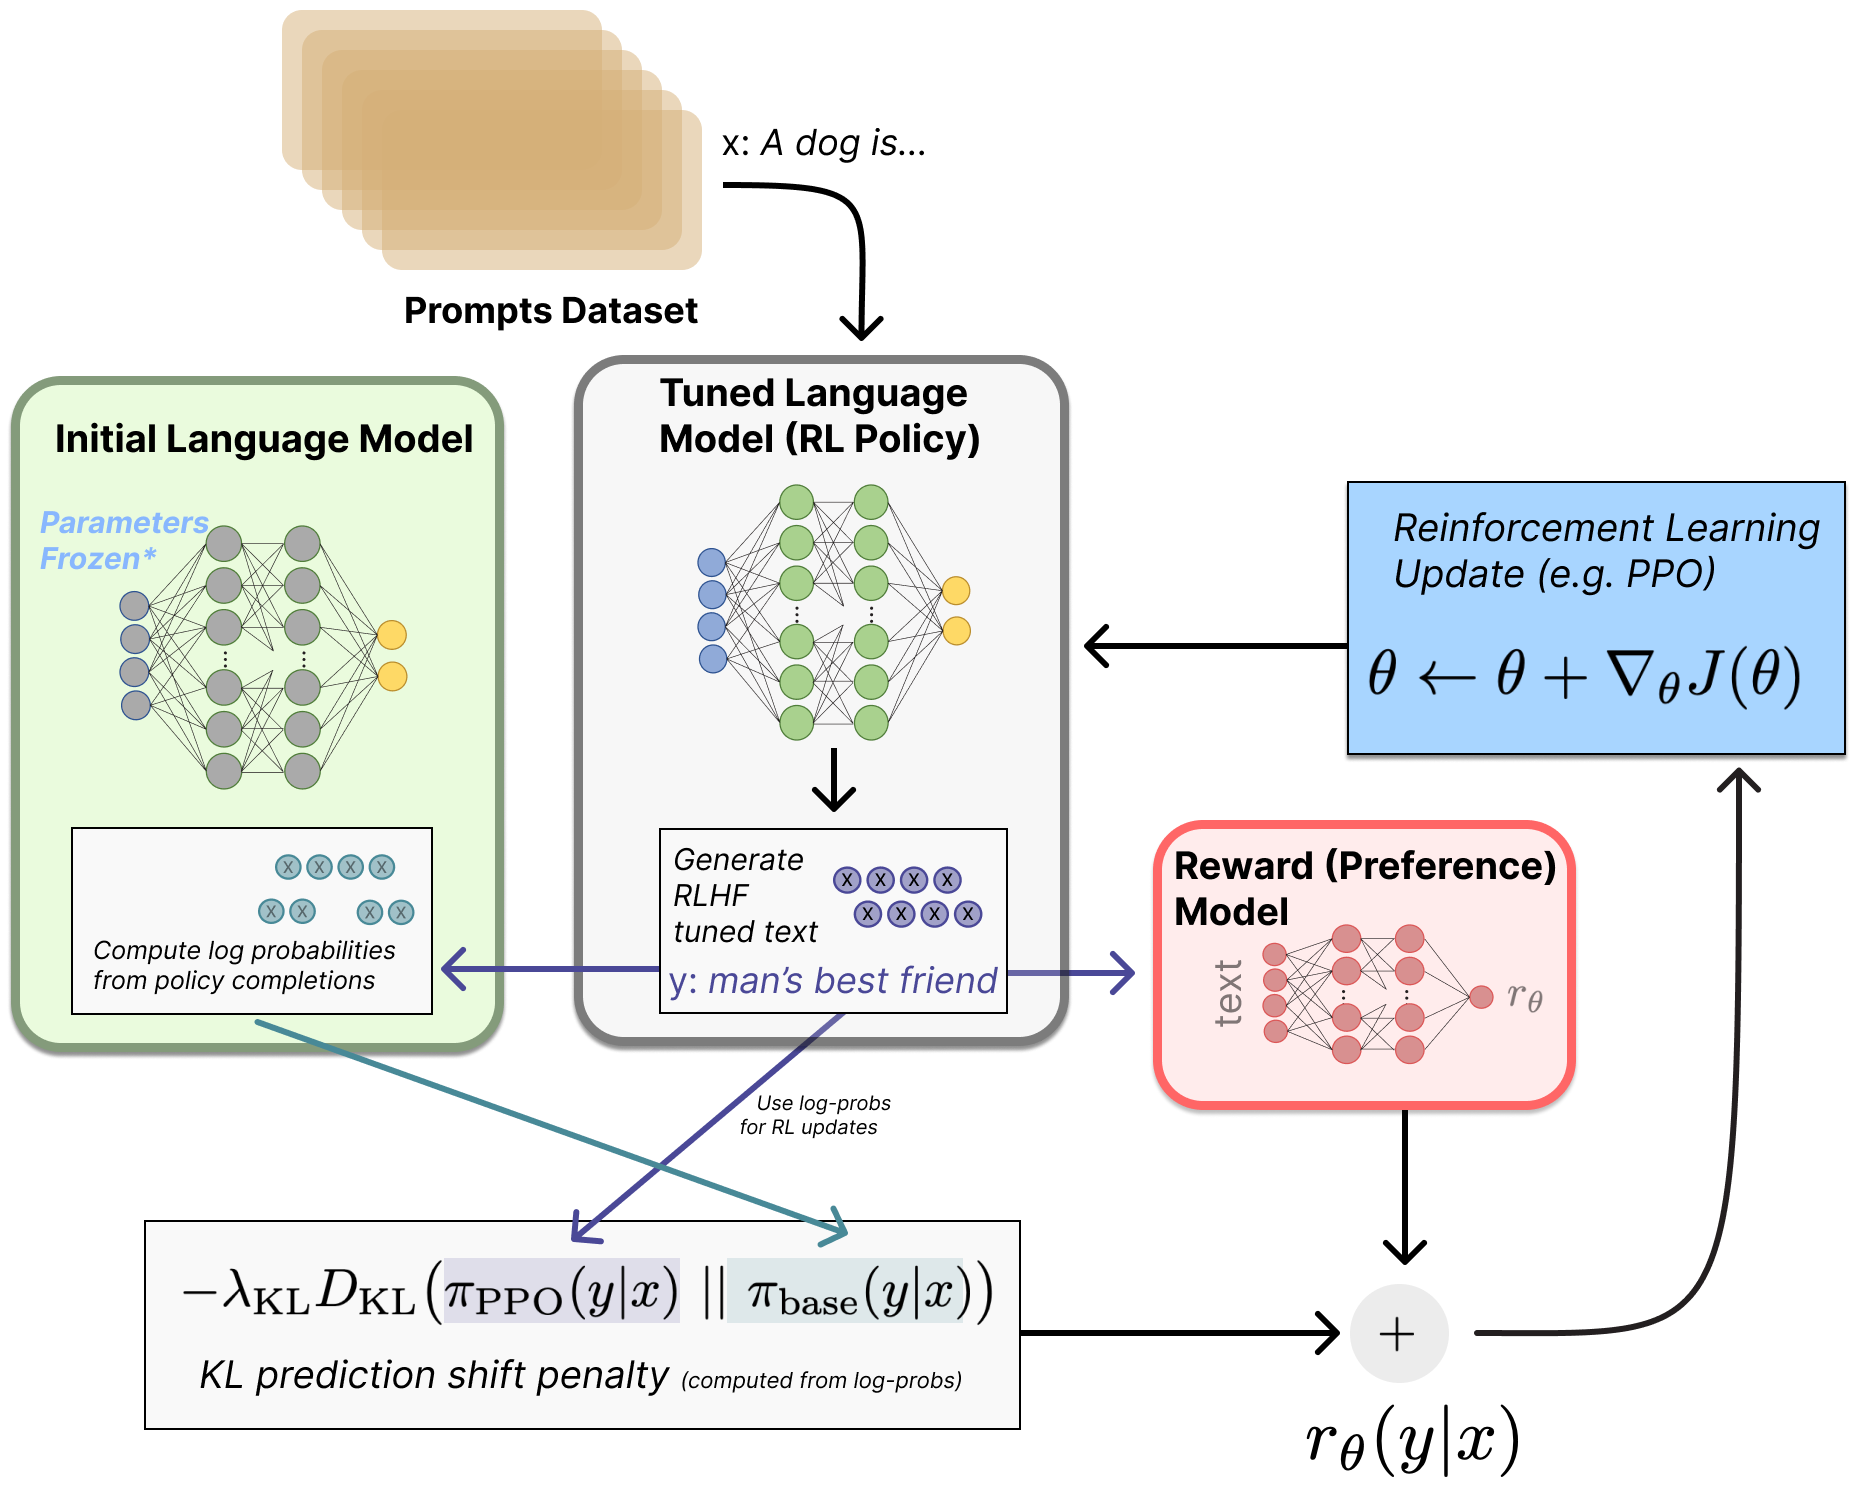
1. 奖励模型是被「学出来的环境」
它在 RL 的图里坐在哪个位置
先把强化学习的标准问题写出来。一个马尔可夫决策过程(Markov Decision Process, MDP)由五元组 $(\mathcal{S},\mathcal{A},P,r,\gamma)$ 给定:状态空间、动作空间、转移动力学 $P(s_{t+1}\mid s_t,a_t)$、奖励函数 $r(s_t,a_t)$、折扣因子 $\gamma$。目标是最大化轨迹上的累计回报:
$$ J(\pi) = \E_{\tau\sim\pi}\left[\sum_{t=0}^{T}\gamma^t\, r(s_t,a_t)\right] $$这里 $r$ 是环境给的,是问题定义的一部分。RLHF 把这一格挖空了,换成一个学出来的 $r_\theta$:
$$ J(\pi) = \E_{x\sim\mathcal{D},\,y\sim\pi_\theta(\cdot\mid x)}\big[r_\theta(x,y)\big] - \beta\,\KL\!\left(\pi_\theta \,\|\, \pi_{\text{ref}}\right) $$逐项对照一下差别,这张对照表基本决定了后面所有章节的形态:
| 成分 | 经典 RL | RLHF |
|---|---|---|
| 状态 | 环境返回的 $s_t$ | prompt $x$ + 已生成的前缀 $y_{<t}$ |
| 动作 | $a_t\in\mathcal{A}$ | 词表上的一个 token |
| 转移 | 随机的 $P(s_{t+1}\mid s_t,a_t)$ | 确定的——拼接一个 token,没有环境随机性 |
| 奖励 | 环境给定,每步都有 | 学出来的 $r_\theta$,只在序列结束时给一次(bandit 式) |
| 正则 | 无 | 对参考策略的 KL 惩罚,防止跑偏 |
「奖励只在结束时给一次」这一点非常重要,它是本章绝大多数设计的根源:Bradley-Terry 奖励模型就是一个序列级打分器,只在 EOS 位置输出一个数。后面 ORM 和 PRM 想解决的,正是这个信号太稀疏、无法定位「哪一步错了」的问题。
为什么是「学」奖励,而不是「写」奖励
用奖励模型当环境奖励的代理,在 RL 研究里有很长的历史 (Sutton & Barto, 2018)。它现代形式的提出,来自把价值对齐当研究问题的一条线 (Scalable agent alignment via reward modeling, 2018)。与之最接近的邻居是逆强化学习(Inverse Reinforcement Learning, IRL)——给定一批行为轨迹,反推出这个智能体在优化什么奖励函数 (Ng & Russell, 2000)。问题陈述几乎一样,但实现方式和关注点差得太远,实践中被当成两个独立领域。
那为什么不干脆手写一个奖励函数?因为你写不出来。试着为「有帮助」写一个规则:回复长度?那模型会写小作文。包含关键词?那模型会堆砌关键词。语法正确率?那模型会输出正确但空洞的句子。任何你能写下来的规则,都会被优化过程精确地找到它与真实意图的缝隙。而人类「看一眼就知道哪个更好」的能力恰恰不依赖任何显式规则,奖励建模做的就是把这种隐式判断蒸馏进网络参数。
本章的符号约定
全章用 $x$ 表示 prompt,$y$ 表示 completion(回复)。这是语言模型文献的习惯,因为这些方法操作的对象是完整的 prompt-completion 对,而不是单个 token。当需要区分成对数据时,用 $y_c$(chosen,人类选中的)和 $y_r$(rejected,被拒的)。奖励模型写作 $r_\theta(y\mid x)$ 或 $r_\theta(x,y)$,两种写法在文献里都常见,含义相同:给定 prompt 时这个回复的分数。
最常见的那一类奖励模型,就是本章的主角——Bradley-Terry 奖励模型。它预测的不是「这段文本有多好」的绝对质量,而是「这段文本在成对比较中被选中的相对可能性」。这个区别在解释 RM 输出值时非常关键,下一节推导完就会明白为什么。
2. Bradley-Terry:从偏好概率到损失函数
第 0 步:一个 1952 年的统计模型
Bradley-Terry 模型 (Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons, Biometrika 1952)回答的是这样一个问题:有一堆物品,你只能观察到「谁赢谁」的成对比较结果(比如棋手对局、口味测试),如何给每个物品估计一个强度分?
它的假设只有一条:每个物品 $i$ 有一个潜在强度 $p_i>0$,观察到的偏好是这些强度的带噪反映,具体来说,比较 $i$ 与 $j$ 时评判者选 $i$ 的概率是
$$ P(i > j) = \frac{p_i}{p_i + p_j} $$这个式子的直觉像分蛋糕:两个物品把「被选中」的概率按强度成比例瓜分。若 $p_i = p_j$,概率是 0.5;若 $p_i = 3p_j$,概率是 0.75。
第 1 步:重参数化到无界分数
问题在于 $p_i>0$ 这个约束对神经网络不友好——网络最后一层线性输出天然是全实数域的。所以做一个标准的重参数化 $p_i = e^{r_i}$,其中 $r_i\in\R$ 无约束。代入:
$$ P(i > j) = \frac{e^{r_i}}{e^{r_i} + e^{r_j}} $$分子分母同除 $e^{r_i}$:
$$ P(i>j) = \frac{1}{1 + e^{r_j - r_i}} = \frac{1}{1+e^{-(r_i-r_j)}} = \sigma(r_i - r_j) $$其中 $\sigma(z)=\frac{1}{1+e^{-z}}$ 是 logistic(sigmoid)函数。偏好概率只依赖分数之差。
另一个常被忽略的点:只有差被约束,尺度却没有被约束。如果把所有 $r$ 乘以 2,偏好概率会变得更极端(更接近 0 或 1)。所以模型在训练中不仅在学「谁比谁好」的顺序,也在学「有多确信」,而后者容易被过拟合——这正是 RM 只训 1 个 epoch 的原因之一。
第 2 步:把它接到语言模型上
要训一个奖励模型,就得把语言模型改造成一个输出标量的模型:在最后一层隐状态上接一个小的线性头(下一节讲细节)。给定 prompt $x$ 和两个采样出的回复 $y_1,y_2$,用 $r_\theta$ 分别打分,写成条件形式 $r_\theta(y_i\mid x)$。于是模型认为 $y_1$ 优于 $y_2$ 的概率是:
$$ P(y_1 > y_2 \mid x) = \frac{\exp\left(r_\theta(y_1\mid x)\right)}{\exp\left(r_\theta(y_1\mid x)\right) + \exp\left(r_\theta(y_2\mid x)\right)} $$把人类选中的记为 $y_c$、被拒的记为 $y_r$。我们希望模型给 $y_c$ 的分更高,也就是希望 $P(y_c>y_r\mid x)$ 尽可能大。
第 3 步:化成 sigmoid 形式(每步写出来)
第 4 步:极大似然 → 负对数似然损失
有了每条样本的似然,参数估计就是在整个偏好数据集 $D$ 上做极大似然。由于 $\log$ 单调递增,最大化对数似然等价于最小化负对数似然:
$$ \begin{aligned} \theta^* &= \argmax_\theta\ \E_{(x,y_c,y_r)\sim D}\left[\log P(y_c > y_r\mid x)\right] \\[4pt] &= \argmin_\theta\ \E_{(x,y_c,y_r)\sim D}\left[-\log\sigma\big(r_\theta(y_c\mid x) - r_\theta(y_r\mid x)\big)\right] \end{aligned} $$去掉期望符号,单条样本的损失就是 InstructGPT (Ouyang et al., 2022)等工作里写的形式:
$$ \mathcal{L}(\theta) = -\log\left(\sigma\big(r_\theta(y_c\mid x) - r_\theta(y_r\mid x)\big)\right) $$第 5 步:等价的第二种写法
文献里还有另一种同样常见的写法(如 Anthropic 的 A General Language Assistant as a Laboratory for Alignment, 2021),用 softplus 函数 $\log(1+e^z)$ 表达:
$$ \mathcal{L}(\theta) = \log\left(1 + e^{\,r_\theta(y_r\mid x) - r_\theta(y_c\mid x)}\right) $$两者完全等价。令 $\Delta = r_\theta(y_c\mid x) - r_\theta(y_r\mid x)$(这个量叫 reward margin,后面会反复出现),则
$$ -\log\sigma(\Delta) = -\log\frac{1}{1+e^{-\Delta}} = \log\left(1+e^{-\Delta}\right) = \log\left(1+e^{\,r_\theta(y_r\mid x)-r_\theta(y_c\mid x)}\right) $$看到哪种写法都别慌,它们是同一个东西。实现上永远用 F.logsigmoid 或 F.softplus,不要自己写 torch.log(1 + torch.exp(...))——后者在 $\Delta$ 很负时会数值溢出。
它其实就是二分类交叉熵
把 $\Delta$ 看成一个 logit,把「chosen 确实更好」看成标签 $y=1$,二元交叉熵 $-[y\log\sigma(\Delta) + (1-y)\log(1-\sigma(\Delta))]$ 在 $y=1$ 时就退化成 $-\log\sigma(\Delta)$。奖励模型训练在数学上就是一个二分类器:它在学「判断哪一边被人类选中」。这个视角解释了为什么 RM 的核心评测指标是准确率(在留出的偏好对上,$r_c > r_r$ 的比例),也解释了为什么它的天花板受限于标注者之间的一致率——如果两个人类看同一对回复只有 70% 时候意见相同,那 RM 在这份数据上的准确率也就大致封顶在 70% 附近。
梯度长什么样:一个额外的推导
这个式子有很强的可解释性。系数 $\sigma(-\Delta)\in(0,1)$ 是模型当前判错的概率:
| margin $\Delta$ | $\sigma(\Delta)$(判对的概率) | 单条损失 $-\log\sigma(\Delta)$ | 梯度系数 $\sigma(-\Delta)$ |
|---|---|---|---|
| $-3$(判反了,且很自信) | 0.047 | 3.05 | 0.95(强更新) |
| $0$(完全没区分) | 0.500 | 0.69 | 0.50 |
| $+1$ | 0.731 | 0.31 | 0.27 |
| $+3$(判对且自信) | 0.953 | 0.048 | 0.047(几乎不更新) |
| $+6$ | 0.9975 | 0.0025 | 0.0025(梯度饱和) |
所以这个损失自带难例挖掘:已经分得很开的样本对贡献的梯度指数级衰减,训练算力自动集中到模型还判不准的样本上。同时它也解释了训练曲线的典型形状——loss 从 $\log 2\approx0.693$(完全随机时的值)开始下降,margin 从 0 附近往正方向爬;一旦大部分样本的 margin 超过 3~4,loss 就趋于平坦,继续训只会让模型在少数噪声样本上死磕,这就是过拟合的开始。$\log 2 = 0.693$ 是这条曲线的「随机基线」,训练时第一眼要看的就是 loss 有没有稳稳低于它。
3. 架构:语言模型 + 一个标量头
默认做法
「奖励模型」听起来像一个新模型族,其实它就是一个语言模型换了个输出头。开源工具里最常见的抽象是 Transformers 的 AutoModelForSequenceClassification:在语言模型主干后面接一个小的线性层,对一条 prompt-completion 序列输出一个标量。推理时,这个标量表示的是「这段文本被选为 chosen 的相对可能性」,是一个 logit,不是概率、也不是「质量分」。
关键的实现选择是在哪个位置取隐状态。语言模型对长度为 $L$ 的序列输出的最后一层隐状态形状是 (batch, L, hidden_size),而我们只要一个数。标准做法是取最后一个非 padding token(通常就是 EOS)的隐状态向量,形状 (batch, hidden_size),再过线性层压成 (batch,)。
为什么是最后一个 token?因为在因果注意力(causal attention)下,只有最后一个位置能看到整条序列——第 $t$ 个位置的隐状态只编码了 $y_{\le t}$。取中间任何位置都会丢掉后半段信息。也存在别的做法(比如对所有 token 的隐状态做池化、或直接从 embedding 层接线性层),但在开源工具链里都不常见。
最小可读实现
下面这段改写自参考实现 _src/code/reward_models/base.py 与 train_preference_rm.py,去掉了 wandb、bf16 加载、config 解析等噪声,只保留结构:
import torch
import torch.nn as nn
import torch.nn.functional as F

class BradleyTerryRewardModel(nn.Module):
    """LM 主干 + 标量头。改写自 reward_models/base.py 的 BaseRewardModel
    与 train_preference_rm.py 的 PreferenceRewardModel。"""

    def __init__(self, base_lm):
        super().__init__()
        self.lm = base_lm                                   # 例如 AutoModelForCausalLM
        self.head = nn.Linear(self.lm.config.hidden_size, 1)

    def get_reward(self, input_ids, attention_mask):
        """input_ids:      (batch, L)   prompt + completion 拼在一起
           attention_mask: (batch, L)   真实 token 为 1,padding 为 0
           返回:            (batch,)     每条序列一个标量分数"""
        out = self.lm(
            input_ids=input_ids,
            attention_mask=attention_mask,
            output_hidden_states=True,
            return_dict=True,
        )
        hidden = out.hidden_states[-1]                      # (batch, L, hidden_size)

        # 每条序列最后一个非 padding token 的下标
        lengths = attention_mask.sum(dim=1) - 1             # (batch,)
        batch_idx = torch.arange(hidden.size(0), device=hidden.device)
        last_hidden = hidden[batch_idx, lengths]            # (batch, hidden_size)

        return self.head(last_hidden).squeeze(-1)           # (batch,)

    def forward(self, chosen_ids, chosen_mask, rejected_ids, rejected_mask):
        r_chosen   = self.get_reward(chosen_ids, chosen_mask)     # (batch,)
        r_rejected = self.get_reward(rejected_ids, rejected_mask) # (batch,)
        loss = -F.logsigmoid(r_chosen - r_rejected).mean()        # 标量
        return loss, r_chosen, r_rejected
请注意 shape 的流转:(batch, L, H) → 高级索引取出 (batch, H) → 线性层 (batch, 1) → squeeze 成 (batch,)。整个前向里唯一有技巧的一行是 hidden[batch_idx, lengths]——它用两个一维索引张量做「按行取不同列」的高级索引,等价于 [hidden[i, lengths[i]] for i in range(batch)],但完全向量化。
而损失,正如上一节推导的,就是一行:
loss = -F.logsigmoid(rewards_chosen - rewards_rejected).mean()
四个容易出事的实现细节
一、padding 方向与 mask。上面的 lengths = attention_mask.sum(dim=1) - 1 隐含假设是右侧 padding(真实 token 在前,pad 在后)。如果你的 collator 用的是左侧 padding(推理引擎常见),这行代码会取到错误的位置,模型照样能训、loss 照样会降,但学出来的东西是错的。这类 bug 不报错,只让指标莫名其妙地差。
二、pad_token 未设置。很多 base 模型的 tokenizer 没有 pad_token。参考实现的处理是直接复用 EOS:
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
这在配合 attention_mask 时是安全的,但要确保 mask 确实把 pad 位置置了 0,否则 EOS 和 pad 混淆会直接毁掉「取最后一个真实 token」的逻辑。
三、头的初始化与 dtype。参考实现把主干以 bfloat16 加载,然后显式把新建的线性头也转成 bfloat16(self.head.to(torch.bfloat16)),避免 dtype 不匹配的报错。另外注意这个头是随机初始化的:训练最开始时 $r_c$ 和 $r_r$ 都是接近 0 的随机数,margin 在 0 附近,loss 从 $\log 2\approx 0.693$ 起步。
四、只训 1 个 epoch。这是原文点名的实践惯例:训练奖励模型时最常见的做法是只训一个 epoch,以避免过拟合。原因在第 2 节的梯度分析里已经埋好了——一旦大部分样本的 margin 拉开,剩下的梯度全来自模型判不准的样本,而这些样本里有相当比例本身就是标注噪声(两个回复质量本来就接近,标注员随手选了一个)。第二个 epoch 基本就是在死记这些噪声。
reward_models/configs/preference_rm.yaml)用了 2 个 epoch,README 里明确解释了原因:在一个 5k 对的小规模扫参里,2 个 epoch 给出的验证曲线更干净。但同时提醒使用者盯住第二个 epoch 的 val/loss 和 val/accuracy,一旦退化就降回 1。这是一个很好的例子说明「最佳实践」的适用范围:小模型 + 小数据时,1 epoch 可能连收敛都没到;生产规模的偏好数据集上,1 epoch 才是稳妥选择。
4. 训练实操:数据管线、超参与该盯什么指标
数据长什么样
偏好数据集的一条样本是 (prompt, chosen, rejected)。参考实现默认用 argilla/ultrafeedback-binarized-preferences-cleaned——UltraFeedback 的二值化清洗版。「二值化」(binarized)这个词很关键:原始 UltraFeedback 里每个 prompt 有 4 个来自不同模型的回复,每个回复带一组 GPT-4 打的 1–10 分细粒度评分(helpfulness、honesty、instruction-following、truthfulness)。二值化就是把这些丰富的分数压缩成一个「谁赢」的二元标签——取最高分的当 chosen,随机(或取最低分)挑一个当 rejected。
这个压缩是有代价的:5 分对 1 分和 5 分对 4 分,在二值化后变成了同一条样本。第 5 节讲的 margin loss 就是想把这部分信息捞回来。
数据处理的核心是把 chosen 和 rejected 各自渲染成完整对话文本再 tokenize——注意 RM 看到的是「prompt + 回复」拼在一起的整段,不是只看回复:
# 改写自 reward_models/train_preference_rm.py 的 build_preference_dataset

def encode_pair(tokenizer, prompt, chosen, rejected, max_length=512):
    chosen_msgs = [{"role": "user", "content": prompt},
                   {"role": "assistant", "content": chosen}]
    rejected_msgs = [{"role": "user", "content": prompt},
                     {"role": "assistant", "content": rejected}]

    # 有 chat template 就用它渲染;没有就退化成 "role: content" 的朴素拼接
    enc = lambda m: tokenizer.apply_chat_template(
        m, tokenize=True, add_generation_prompt=False,
        max_length=max_length, truncation=True, return_dict=True,
    )
    c, r = enc(chosen_msgs), enc(rejected_msgs)
    return {
        "chosen_ids":   c["input_ids"],   "chosen_mask":   c["attention_mask"],
        "rejected_ids": r["input_ids"],   "rejected_mask": r["attention_mask"],
    }
collate 时把四个字段分别 pad 到 batch 内最长长度:*_ids 用 pad_token_id 填,*_mask 用 0 填。这里有一个容易忽略的点:chosen 和 rejected 的长度通常不同,pad 到各自的最大长度即可,两边不需要对齐。
truncation=True 配上 max_length=512 看起来很无害,但它会把长回复的尾部(包括 EOS)切掉。而我们的打分位置正是「最后一个非 padding token」——截断后这个位置变成了句子中间的某个 token,分数的语义就变了。更糟的是,截断会系统性地作用于长回复,而长回复在偏好数据里更常是 chosen,于是引入一个和标签相关的偏差。生产实践中 RM 的 max_length 通常要覆盖数据集 95%+ 的样本长度(chat 场景 2048–4096 起步),参考实现的 512 只是为了让小卡跑得动。
训练循环与超参
训练循环本身没有任何特殊之处:AdamW + 梯度累积 + warmup 后线性衰减。参考实现的默认值(reward_models/configs/preference_rm.yaml,作者说明是「小规模扫参选出的干净教学基线,不是普适最优」):
| 超参 | 参考实现取值 | 说明 |
|---|---|---|
| 基座模型 | Qwen3-0.6B-Base | 0.6B 全参微调约需 4–6 GB 显存 |
| 数据量 | 5000 对(默认) | 教学规模;生产 RM 通常 $10^5$–$10^6$ 对 |
| batch size | 2 × 梯度累积 8 = 有效 16 | 每步实际前向 32 条序列(chosen+rejected) |
| 学习率 | $5\times10^{-5}$ | 比 SFT 略高,因为新头是随机初始化的 |
| 调度 | 10% warmup + 线性衰减 | get_linear_schedule_with_warmup |
| epoch | 2(生产惯例是 1) | 见上一节的说明 |
| 验证集 | 10% 留出,每 25 个 optimizer step 评一次 | RM 过拟合很快,中途评估必须有 |
| 精度 | bf16 + autocast | 主干和头都用 bfloat16 |
规模上给个参照:生产级的偏好数据集量级在 10 万到 100 万对(讲座里给的偏好微调 prompt 预算约 100 万条,与 SFT 部分重叠是有益的)。RM 的基座通常和策略模型同规模或更小;InstructGPT 用 6B RM 对齐 175B 策略是一个经典配置——RM 不需要和策略一样大,因为「判断好坏」比「生成」容易。
盯什么指标
参考实现记录了五个量,它们对应五种不同的诊断:
| 指标 | 含义 | 健康的样子 |
|---|---|---|
train/loss | $-\log\sigma(\Delta)$ 的平均 | 从 0.693 起,稳步下降到 0.4–0.6 |
train/accuracy | $\mathbb{1}[r_c > r_r]$ 的比例 | 从 0.5 起,爬到 0.65–0.75(取决于数据噪声) |
train/reward_margin | $\E[r_c - r_r]$ | 单调上升——最直观的「模型在学东西」的证据 |
train/r_chosen_mean / r_rejected_mean | 两边分数的绝对水平 | 会一起漂移(平移不变性!),只看差 |
val/accuracy | 留出集上的准确率 | 训练准确率涨而它不涨 = 开始过拟合,该停了 |
reward margin 是这一章最值得盯的一条曲线。它从 0 附近起步(随机初始化的头对两条序列给出几乎相同的分),随训练单调上升。它上升得太慢说明学习率太低或数据信号太弱;上升得过快过高(比如几百步就冲到 5 以上)通常意味着模型抓到了某个捷径特征——最常见的就是长度。一个诊断技巧:随机打乱一部分样本的 chosen/rejected 标签,如果 margin 仍然照涨,说明模型学的是格式而不是内容。
一个务实的成本账
RM 训练的成本结构和 SFT 有个明确差别:同样的有效 batch size,RM 每步要跑两次前向(chosen + rejected),显存峰值也因为要同时持有两条序列的激活而更高。实践中的常见做法是把两条序列拼进同一个 batch 维度一次前向(cat([chosen, rejected], dim=0)),这样只需一次 kernel 调度,但显存占用不变。此外,因为 RM 只训 1 个 epoch,总的 GPU 时通常还是显著低于 SFT。
5. Bradley-Terry 的三种变体
原文对这一节的定位很坦白:奖励建模是 RLHF 里相对欠开发的一块。传统的奖励建模损失在很多有影响力的工作里被改过,但这些改法没有沉淀成单一的最佳实践。下面三个变体都出现在重要论文里,也都没有成为默认选项——了解它们的价值在于理解「标准损失丢掉了什么信息」。
变体一:偏好边界损失(Preference Margin Loss)
问题来自第 4 节说的二值化。当标注员给的是 Likert 量表评分(有序类别评分,如 1–5 分表示偏好强度)时,把「5 分 vs 1 分」和「5 分 vs 4 分」压成同一条二元样本,明显浪费了信息。Llama 2 (Touvron et al., 2023)提出在 sigmoid 里减去一个边界项 $m(y_c,y_r)$:
$$ \mathcal{L}(\theta) = -\log\left(\sigma\big(r_\theta(y_c\mid x) - r_\theta(y_r\mid x) - m(y_c,y_r)\big)\right) $$比如 chosen 打 5 分、rejected 打 2 分,则 $m = 5-2 = 3$。这一项做的事情很直白:把「判对」的门槛从 $\Delta>0$ 提高到 $\Delta>m$。回到第 2 节的梯度分析,此时梯度系数变成 $\sigma(-(\Delta-m))$——即使模型已经让 $\Delta=2$,只要 $m=3$,梯度系数仍有 $\sigma(1)=0.73$,模型会被继续推着拉大差距。反过来,对于 $m$ 很小的样本对(两个回复本来就差不多),门槛低,模型很快就「够了」,不会被逼着在噪声上硬分。
这个思路和 SVM 的 hinge margin、以及后来 SimPO 的 $\gamma$ 项是同源的。
变体二:同一 prompt 多个比较的平衡
InstructGPT (Ouyang et al., 2022)的标注流程是:对每个 prompt 采样 $K=4$ 到 $9$ 个回复,让标注员做完整排序。一个 $K$ 元排序可以拆出 $\binom{K}{2}$ 个成对比较——$K=9$ 时就是 36 对。
朴素做法是把这 36 对当成 36 条独立样本打散进数据集。这会出两个问题:
- 它们高度相关(共享同一个 prompt、同一批回复),打散后同一个 prompt 会在很多个 batch 里反复出现,模型对这个 prompt 严重过拟合。
- 采样多的 prompt 会主导损失:$K=9$ 的 prompt 贡献 36 条损失,$K=4$ 的只贡献 6 条,前者的权重是后者的 6 倍——而这只是标注流程的副产物,不代表它更重要。
InstructGPT 的解法是对每个 prompt 的比较做加权平均,并且在实现上把同一 prompt 的全部 $\binom{K}{2}$ 对放进同一个 batch,让每个 prompt 只贡献一次分组更新:
$$ \mathcal{L}(\theta) = -\frac{1}{\binom{K}{2}}\,\E_{(x,y_c,y_r)\sim D}\left[\log\sigma\big(r_\theta(y_c\mid x) - r_\theta(y_r\mid x)\big)\right] $$还有一个纯工程的好处顺带被拿到了:同一 prompt 的 $K$ 个回复只需要各自前向一次,而不是每对都重新算——$K=9$ 时前向次数从 72 降到 9。
变体三:K-wise 损失(Plackett-Luce)
既然标注员给的是完整排序,为什么要拆成成对?Plackett-Luce 模型直接对整个排列建模。Starling 7B / 34B (Zhu et al., COLM 2024)用的就是这一套,理论化的表述来自 Principled Reinforcement Learning with Human Feedback from Pairwise or K-wise Comparisons (2023)。
设定:给定 prompt(论文里写作状态 $s^i$),采样 $K$ 个回复(动作)$(a_0^i,\dots,a_{K-1}^i)$,标注员给出一个排列 $\sigma^i:[K]\mapsto[K]$,其中 $\sigma^i(0)$ 是最偏好的。这个完整排序的概率是:
$$ P(\sigma^i\mid s^i, a_0^i,\dots,a_{K-1}^i) = \prod_{k=0}^{K-1}\frac{\exp\left(r_\theta(s^i, a^i_{\sigma^i(k)})\right)}{\sum_{j=k}^{K-1}\exp\left(r_\theta(s^i, a^i_{\sigma^i(j)})\right)} $$用哪种损失,训完之后模型的用法完全一样:输入 prompt + 回复,输出一个标量。这些变体只影响训练时如何利用标注信息的结构。
小结:这三个变体分别捞回了什么
| 变体 | 捞回的信息 | 代价 / 现状 |
|---|---|---|
| Margin loss(Llama 2) | 偏好的强度(Likert 分差) | 需要评分而非纯排序;Llama 3 已弃用 |
| $\binom{K}{2}$ 加权(InstructGPT) | 同 prompt 内比较的相关性 | 需要改 sampler 让同 prompt 同 batch;这一条最值得默认采纳 |
| K-wise / Plackett-Luce(Starling) | 完整排序的全局结构 | 需要完整排序标注(贵);实现比 BT 复杂 |
6. 结果奖励模型(ORM):逐 token 的正确性预测
为什么需要另一类模型
Bradley-Terry 奖励模型适合偏好调优——「哪个回复更得体」这类没有客观答案的问题。但在数学、代码这类推理密集的任务上,情况不一样:答案的对错是可验证的。这时候硬要凑成对偏好数据(找一个对的、一个错的,标成 chosen/rejected)虽然可行,但浪费了一个更强的信号——你不需要比较,你直接知道标签。
结果奖励模型(Outcome Reward Model, ORM)就是为这个场景设计的,最早出现在 GSM8K 那篇论文 (Training Verifiers to Solve Math Word Problems, 2021),原文把它叫做 verifier(验证器)。作者的原话值得逐句拆:
我们用一个联合目标训练验证器:模型除了原本的语言建模目标外,还要学会把一个模型补全标注为正确或错误。
架构上,这意味着我们的验证器就是语言模型,外加一个按 token 输出预测的小标量头。
我们把这个标量头实现为作用在语言模型最终 unembedding 层输出 logits 上的单个偏置参数和单个增益参数。
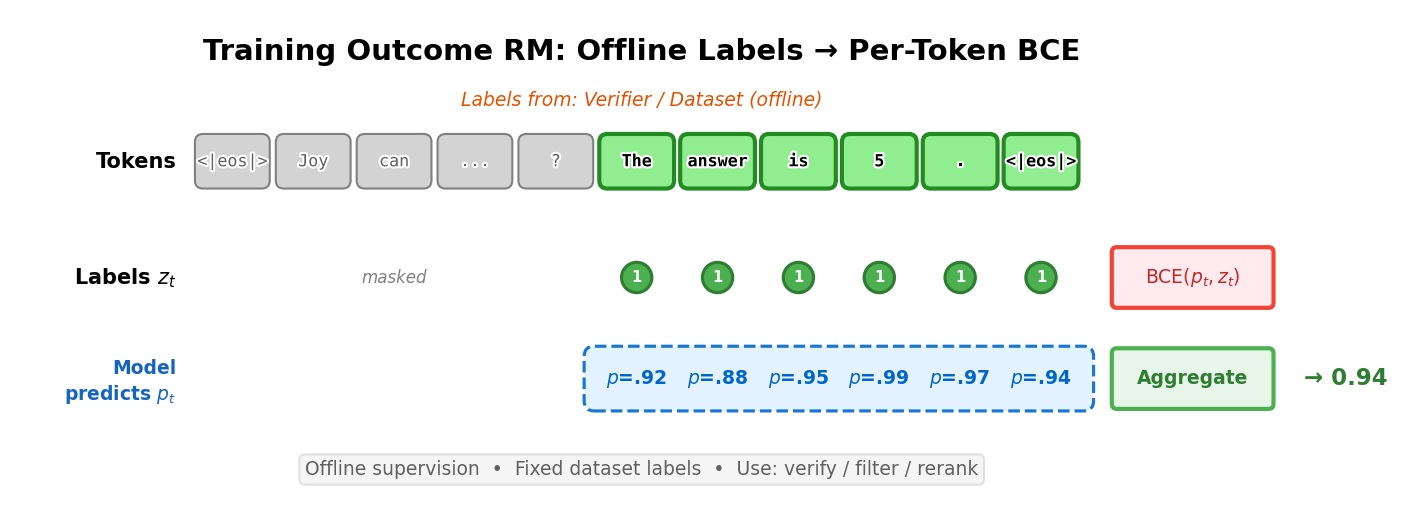
翻译成实现语言:它是一个每个 token 都预测两类(1 = 正确,0 = 错误)的语言建模式的头,而不是传统 RM 那种「整条序列输出一个 logit」的分类头。
损失函数
形式上(按 Exploring the Limit of Outcome Reward for Learning Mathematical Reasoning, 2025 的写法)就是逐 token 的二元交叉熵:
$$ \mathcal{L}_{\text{CE}}(\theta) = -\E_{(s,r)\sim\mathcal{D}}\big[r\log p_\theta(s) + (1-r)\log(1-p_\theta(s))\big] $$其中 $r\in\{0,1\}$ 是这条回复整体的正确性标签(1 = 这道题答对了),$p_\theta(s)$ 是模型预测的正确概率。
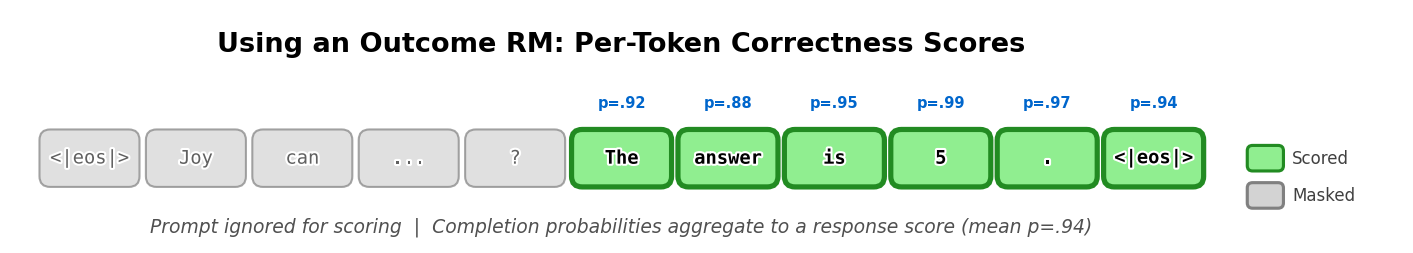
关键在于标签是怎么铺开的:这个序列级的标签会被复制到每一个 completion token 上,而 prompt token 用 -100 掩掉不参与损失。也就是说,如果一条 200 token 的解答最终答对了,那么这 200 个 token 每一个的目标都是「1」。
最小实现
改写自 _src/code/reward_models/train_orm.py:
class OutcomeRewardModel(nn.Module):
    def __init__(self, base_lm):
        super().__init__()
        self.lm = base_lm
        self.head = nn.Linear(self.lm.config.hidden_size, 1)

    def forward(self, input_ids, attention_mask, labels=None):
        """labels 与 token 对齐: prompt 位置为 -100,
           每个 completion token 重复该条序列的结果标签 (1=正确, 0=错误)"""
        hidden = self.lm(input_ids=input_ids, attention_mask=attention_mask,
                         output_hidden_states=True, return_dict=True).hidden_states[-1]
        logits = self.head(hidden).squeeze(-1)      # (batch, seq_len) 每个 token 一个 logit

        if labels is None:                          # 纯推理
            return None, logits

        mask = labels != -100                       # 只在 completion token 上算
        loss = F.binary_cross_entropy_with_logits(
            logits[mask], labels[mask].float()
        )
        return loss, logits
和 BT 模型对照,差别只有一处:线性头作用在哪些位置上。
| Bradley-Terry RM | ORM | |
|---|---|---|
| 取隐状态 | hidden[batch_idx, lengths] → (batch, H) | hidden 全部 → (batch, L, H) |
| 头输出 | (batch,) 一个标量 | (batch, L) 每 token 一个 logit |
| 最小训练输入 | 两条回复(一对) | 一条回复 + 一个标签 |
| 损失 | $-\log\sigma(r_c-r_r)$,依赖差 | 逐 token BCE,依赖绝对标签 |
数据侧同样简单——参考实现从 GSM8K 造正负例:正例是数据集里的标准解答(label=1),负例是把标准答案的数字加一个随机偏移后拼上去(label=0)。打包函数就是把 prompt token 标 -100、completion token 全标成结果:
# 改写自 train_orm.py 的 pack_example
prompt_ids     = tokenizer(prompt, add_special_tokens=False)["input_ids"]
completion_ids = tokenizer(completion + tokenizer.eos_token,
                           add_special_tokens=False)["input_ids"]
input_ids = prompt_ids + completion_ids
labels    = [-100] * len(prompt_ids) + [label] * len(completion_ids)
术语的混乱:ORM 这个词被用滥了
原文专门花篇幅澄清了一件事,讲座里也单独一页在讲,因为读文献时极易踩坑:
如果你用「正确 / 错误」构造成对数据,训一个 Bradley-Terry 模型,那不是 ORM。你只是把「正确性」当成了偏好信号来用,模型仍然是序列级对比损失、EOS 处输出一个标量——它属于第 2 节那一类。文献里相当一部分关于 ORM 的混乱都源自这里。
| 用「对/错」对训的 BT 模型 | 真正的 ORM(Cobbe et al.) | |
|---|---|---|
| 最小训练输入 | 两条回复(一对) | 一条回复 + 一个标签 |
| 输出 | EOS 处一个标量 | 每 token 一个概率 |
| 损失 | $-\log\sigma(r_c - r_{ic})$ | 逐 token 二元交叉熵 |
| 头作用位置 | 最后一个 token | 每一个 token |
另外,《Let's Verify Step by Step》(Lightman et al., 2023)里用的也是同类 ORM,但去掉了联合的语言建模损失,只保留「预测最终答案是否正确」的逐 token 交叉熵。由于缺少统一实现,ORM 这个术语在不同论文里的所指并不一致:有的严格沿用 Cobbe et al. 的定义,有的把任何「训来预测回复是否正确的验证器」都叫 ORM。读论文时务必看它的损失函数长什么样,而不是看它自称什么。
7. 过程奖励模型(PRM):在推理步骤的边界上打分
动机:结果对了不代表过程对了
ORM 的盲点在上一节图注里已经点了:一条解答如果最终数字碰对了,但中间第 3 步的代数变形是错的,ORM 会把这条轨迹的每个 token 都标成「正确」。模型学到的是「看起来像会答对的样子」,而不是「推理站得住」。在数学推理里这个问题很严重——大模型有相当比例的题是靠错误推理蒙对答案的。
过程奖励模型(Process Reward Model, PRM,早期叫 process-supervised reward model)把监督粒度提到中间:在思维链的每一个推理步骤结束处打一个分。三种粒度并排看就很清楚了:
| 模型 | 打分位置 | 目标来自 |
|---|---|---|
| Bradley-Terry RM | 只有 EOS 一个位置 | 整条回复的偏好比较 |
| ORM | 每一个 completion token | 整条回复的最终正确性(广播) |
| PRM | 只有步骤边界(如换行符) | 该步骤本身是否正确 |
损失函数
按《Let's Verify Step by Step》(Lightman et al., 2023),二值标注的 PRM 用逐步交叉熵优化:
$$ \mathcal{L}_{\text{PRM}}(\theta) = -\E_{(x,s)\sim\mathcal{D}}\left[\sum_{i=1}^{K} y_{s_i}\log r_\theta(s_i\mid x, s_{<i}) + (1-y_{s_i})\log\left(1 - r_\theta(s_i\mid x, s_{<i})\right)\right] $$符号含义:$s$ 是一条采样出的思维链,含 $K$ 个被标注的步骤;$y_{s_i}\in\{0,1\}$ 表示第 $i$ 步是否正确;$r_\theta(s_i\mid x,s_{<i})$ 是模型在看过 prompt 和前面所有步骤的条件下,预测第 $i$ 步有效的概率。注意条件里的 $s_{<i}$:PRM 是因果的,它对第 $i$ 步的判断只依赖前文,这让它可以在解码过程中在线使用(边生成边打分,剪掉低分分支)。
实践中 PRM 常用三分类而非二分类,标签是 $-1$(错误)/ $0$(中性)/ $+1$(正确)。「中性」这一类很重要——很多步骤既没错也没推进(重述题干、无关的展开),强行二分会引入噪声。原文强调:这些标签对应的是「这一步本身对不对」,而不是「模型是否走在正确的路上」,这两件事经常不一致(一步正确的计算可能走在一条注定失败的路上)。
数据长什么样:标签只落在分隔符上
PRM 的实现难点全在数据打包。核心技巧是:在每个步骤后面插一个分隔 token,然后只给这个分隔 token 打标签,其余全部 -100。HuggingFace TRL (Transformer Reinforcement Learning)里的做法非常直白:
# TRL 的 PRM 数据打包:给每个 completion 追加分隔符,标签只落在最后一个 token
separator_ids = tokenizer.encode(step_separator, add_special_tokens=False)
completions_ids = [completion + separator_ids for completion in completions_ids]

labels = [[-100] * (len(completion) - 1) + [label]
          for completion, label in zip(completions_ids, labels)]
参考实现 _src/code/reward_models/train_prm.py 用的是 PRM800K 数据集,分隔符定义为 "\n<step>\n",逻辑一样:
# 改写自 train_prm.py 的 build_prm_dataset
STEP_SEPARATOR = "\n<step>\n"
PRM_CLASS_VALUES = [-1, 0, 1]                      # 三类:错误 / 中性 / 正确
PRM_CLASS_TO_IDX = {v: i for i, v in enumerate(PRM_CLASS_VALUES)}

input_ids  = list(prompt_ids)
label_ids  = [-100] * len(prompt_ids)              # prompt 全掩掉

for step_text, lbl in zip(chunk_steps, chunk_labels):
    encoded = tokenizer(step_text.strip() + STEP_SEPARATOR,
                        add_special_tokens=False)["input_ids"]
    input_ids.extend(encoded)

    step_labels = [-100] * len(encoded)
    step_labels[-1] = PRM_CLASS_TO_IDX[int(lbl)]   # 只标该步最后一个 token
    label_ids.extend(step_labels)
模型侧就是把头的输出维度从 1 改成 3,损失从 BCE 换成多分类交叉熵:
class ProcessRewardModel(nn.Module):
    def __init__(self, base_lm, num_classes=3):
        super().__init__()
        self.lm = base_lm
        self.head = nn.Linear(self.lm.config.hidden_size, num_classes)

    def forward(self, input_ids, attention_mask=None, labels=None):
        hidden = self.lm(input_ids=input_ids, attention_mask=attention_mask,
                         output_hidden_states=True, return_dict=True).hidden_states[-1]
        logits = self.head(hidden)                 # (batch, seq_len, 3)

        if labels is None:
            return None, logits

        mask = labels != -100                      # 只有步骤边界参与
        loss = F.cross_entropy(logits[mask], labels[mask])
        return loss, logits
把三段损失代码并排放,三类模型的关系就一目了然了——骨架完全相同,区别只在「头输出几维」和「mask 选中哪些位置」:
# BT RM  : 一个位置(EOS)、1 维输出、成对对比
loss = -F.logsigmoid(r_chosen - r_rejected).mean()

# ORM    : 全部 completion token、1 维输出、二元标签
loss = F.binary_cross_entropy_with_logits(logits[mask], labels[mask].float())

# PRM    : 仅步骤边界 token、3 维输出、三分类标签
loss = F.cross_entropy(logits[mask], labels[mask])
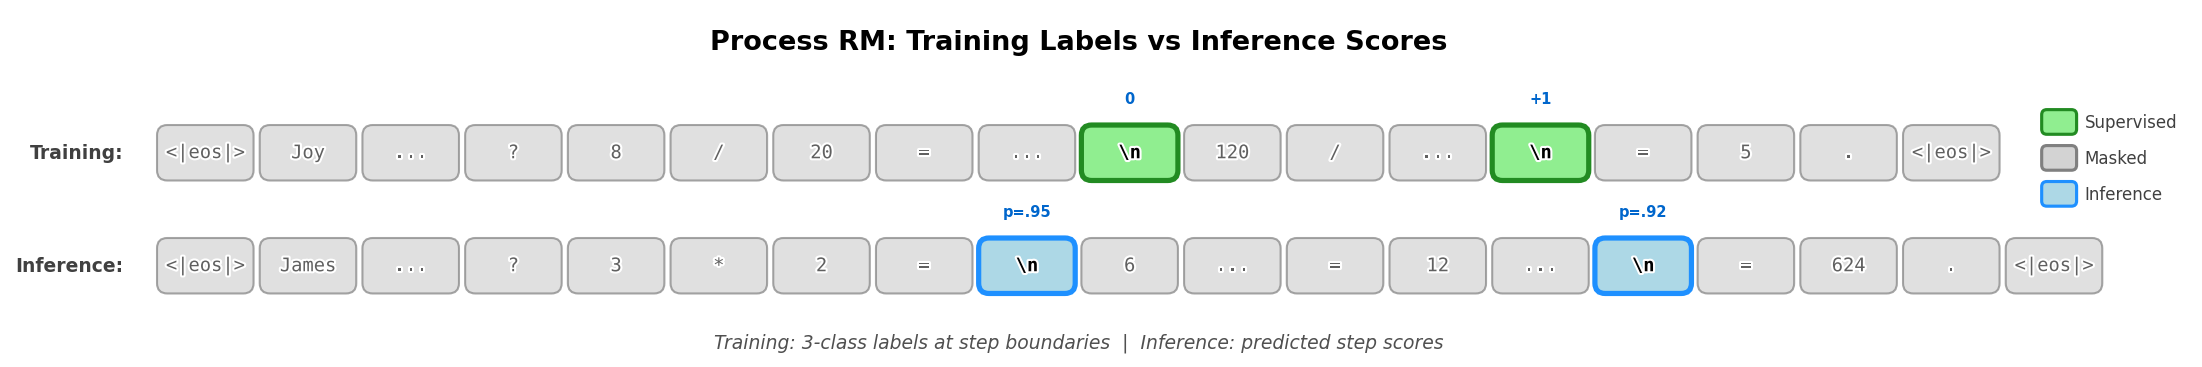
推理时 PRM 的用法比 BT RM 丰富:既可以给完整思维链打分(对步骤分做聚合:均值、最小值 fail-fast、或加权偏向后期步骤),也可以在搜索/解码过程中在线剪枝——生成一步、打一分、分低就回退换一条路。后者是 PRM 相对 ORM 的核心优势,也是它在测试时扩展(test-time scaling)里被大量使用的原因。
8. 四类模型的对比:RM / ORM / PRM / 价值函数
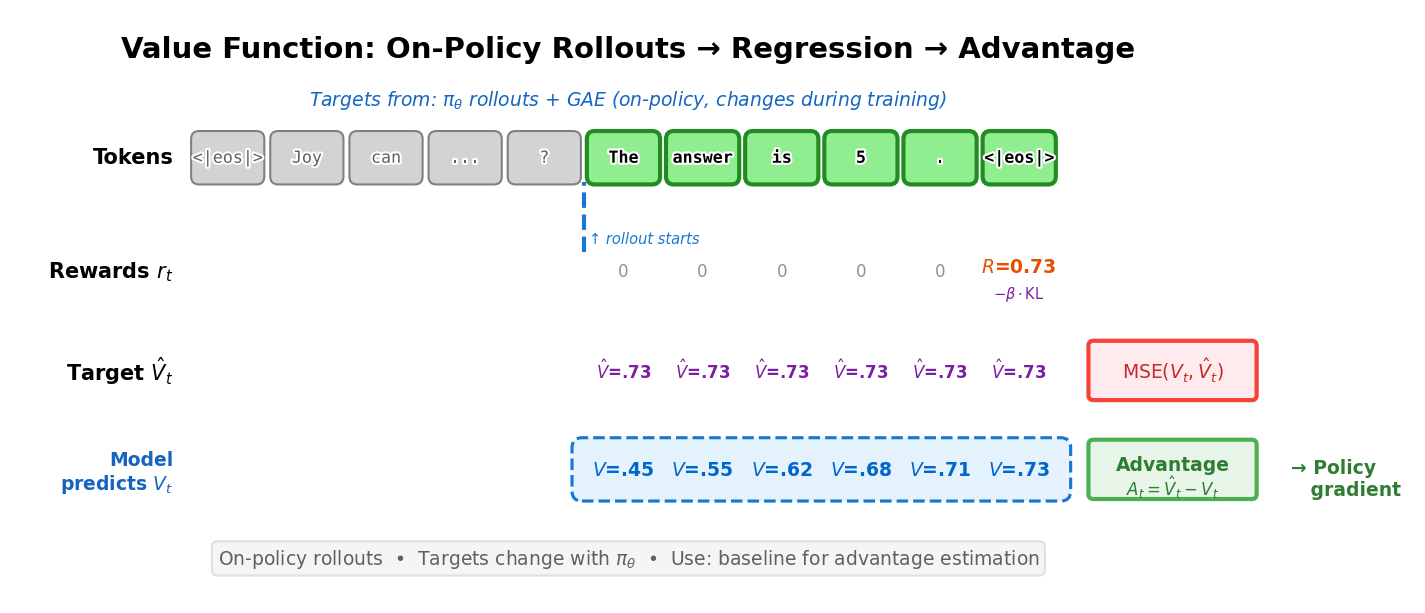
把价值函数也拉进来对比,是因为它和 ORM 长得几乎一模一样——同样是逐 token 输出的标量头——但语义完全不同,而这个混淆在实际项目里非常常见。
总览表
| 模型类别 | 预测什么 | 怎么训 | LM 上的结构 |
|---|---|---|---|
| 奖励模型(RM) | 序列级质量分 $r_\theta(x,y)$ | 成对(或 N 元)比较的对比损失 | EOS / 末 token 隐状态上的线性头 |
| 结果奖励模型(ORM) | 逐 token 的「答案是否正确」概率 | 带结果标签的样本(可验证域的成功/失败) | 逐 token 的二元交叉熵头;标签重复整条结果 |
| 过程奖励模型(PRM) | 每个推理步骤结束处的分数 | 中间反馈 / 逐步标注 | 逐 token 头,只在步骤边界预测(-1/0/1) |
| 价值函数 | 当前状态下的期望剩余回报 | 对序列上每个位置做回归 | 逐 token 输出的标量回归头 |
用一句话概括各自在问什么:
- RM:「这整个回答有多好?」→ 一个标量
- ORM:「哪些部分看起来是对的?」→ 逐 token 的正确性
- PRM:「这些推理步骤站得住吗?」→ 逐步骤的分数
- 价值函数:「从这里往后还剩多少奖励?」→ RL 优势估计的基线
边界没那么清楚:三个必须注意的灰色地带
一、价值函数在语言模型里通常 $\gamma = 1$。无论是偏好调优还是推理训练,折扣因子几乎都取 1(因为序列长度有限,且没有「越早拿到奖励越好」的语义)。这让价值函数在数值上更接近一个结果奖励模型——但训练损失仍然不同。
二、PRM 可以用 rollout 来监督。从某个中间状态出发多次采样到底,用最终正确率当作这一步的标签。这混合了过程与结果两种思想,但判定标准只看损失:如果损失用的是逐推理步骤的标签,就叫 PRM。
三、用「对/错」成对数据训的 BT 模型不是 ORM。这一条第 6 节已经详述,这里再强调一次,因为它是文献混乱的主要来源。它仍然是序列级对比损失,属于第一类。
ORM vs. 价值函数:同样的架构,不同的语义
这是本节最值得仔细区分的一对。它们的头架构可以完全一样(nn.Linear(hidden_size, 1) 作用在每个 token 上),但差别在预测什么和目标从哪来:
| ORM | 价值函数 | |
|---|---|---|
| 预测量 | 即时的、token 局部的量:$p(\text{correct}_t)$ 或 $r_t$ | 期望剩余回报 $V(s_t)=\E\left[\sum_{k\ge t}\gamma^{k-t} r_k \mid s_t\right]$ |
| 目标来源 | 离线标签(验证器或数据集标注的对/错) | 当前策略的 on-policy rollout 算出来的回报 |
| 是否随训练变化 | 不变——标签是固定的 | 会变——策略一更新,$V^{\pi_\theta}$ 的目标就变了 |
| 用途 | 验证、过滤、重排 | 算优势 $A_t = \hat R_t - V_t$,作为策略梯度的基线 |
用一个具体例子把关系钉死:假设定义稠密 token 奖励 $r_t = \mathbb{1}[\text{该 token 正确}]$,并取 $\gamma=1$。那么 ORM 学的是 $r_t$(或 $p(r_t=1)$),而价值头学的是剩余之和 $\sum_{k\ge t} r_k$。两者可以共享同一个基座、同样的头维度,但语义和监督流水线完全不同:ORM 从固定标签离线训练,价值函数在策略更新过程中在线训练。(理论上价值函数也可以 off-policy 训练,但这在语言建模里还没有成为成熟做法。)
推理时的用法差异
训完之后怎么用,四类模型也不一样,尤其是聚合方式这个常被忽略的环节:
| 模型 | 输入 | 输出 | 典型用途 | 聚合 |
|---|---|---|---|---|
| BT RM | $x$ + 候选回复 $y$ | 单个标量 $r_\theta(x,y)$ | 对 $k$ 个候选重排取 top-1(best-of-N);RLHF 的终局奖励 | 不需要 |
| ORM | $x$ + 完整回复 $y$ | completion 上逐 token 概率 $p_t$ | 给完成的候选打分、过滤 | 均值 / 最小值(尾部风险)/ $\prod_t p_t$(等价于 $\sum_t\log p_t$)/ 最后 $m$ 个 token 均值 / 任一 $p_t<\tau$ 就标记 |
| PRM | $x$ + 带步骤边界的推理轨迹 | 步骤边界处的分数(三分类 logits) | 给完整思维链打分;或在搜索/解码中剪掉低分分支 | 按步骤(不是 token)聚合:均值 / 最小值(fail-fast)/ 偏重后期步骤的加权和 |
| 价值函数 | $x$ + 当前前缀 $y_{\le t}$(即状态) | 每个位置的 $V_t$ | RL 训练中算逐 token 优势 $A_t = \hat R_t - V_t$ | 一般取最后一个生成 token 的 $V$;语义不是「正确概率」 |
9. 生成式奖励模型(LLM-as-a-judge)
为什么会出现这条路线
训一个奖励模型需要偏好数据,而偏好数据贵——找人标注一对回复的成本在几美元量级,几十万对就是七位数的预算。于是很自然地有人问:既然我们已经有了很强的语言模型,为什么不直接让它当裁判?给它一段评判说明、一个 prompt、两个回复,让它输出「哪个更好」,就像给人类标注员的指引一样。
这条路线的奠基工作是 MT-Bench / Chatbot Arena 那篇 (Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, 2023)。它用的 prompt 已经成了事实标准模板:
[System]
Please act as an impartial judge and evaluate the quality of the responses provided by
two AI assistants to the user question displayed below.
You should choose the assistant that follows the user's instructions and answers the
user's question better.
Your evaluation should consider factors such as the helpfulness, relevance, accuracy,
depth, creativity, and level of detail of their responses.
Begin your evaluation by comparing the two responses and provide a short explanation.
Avoid any position biases and ensure that the order in which the responses were
presented does not influence your decision.
Do not allow the length of the responses to influence your evaluation.
Do not favor certain names of the assistants.
Be as objective as possible.
After providing your explanation, output your final verdict by strictly following this
format: "[[A]]" if assistant A is better, "[[B]]" if assistant B is better, and "[[C]]"
for a tie.
[User Question]
{question}
[The Start of Assistant A's Answer]
{answer_a}
[The End of Assistant A's Answer]
[The Start of Assistant B's Answer]
{answer_b}
[The End of Assistant B's Answer]
这段 prompt 值得逐行读,因为它的每一条约束都是在堵一个已知的失效模式:
| prompt 里的这句话 | 在防什么 |
|---|---|
| Avoid any position biases… | 位置偏置:模型系统性地偏爱 A 位或 B 位。实践中要靠交换顺序跑两遍才能真正消除,光靠 prompt 说不管用 |
| Do not allow the length… to influence | 长度偏置:LLM 裁判比人类还偏爱长回复;AlpacaEval 后来专门出了长度控制版本来纠偏 |
| Do not favor certain names | 身份偏置:模型倾向于给自己家族的输出更高分(self-preference) |
| Begin your evaluation by comparing… provide a short explanation | 强制先说理由再下结论——把判决放在推理之后,质量明显更好(本质是 CoT) |
| strictly following this format: "[[A]]"… | 让结果可正则解析;双方括号是为了避免和正文里的 A/B 混淆 |
另一个提高稳健性的常用小技巧:把采样温度设成 0,减少评分的方差。同一对回复评两次得到不同结论,是 LLM-as-a-judge 流水线最烦人的问题之一。
它催生了一整个评测生态
LLM-as-a-judge 在评测上的有效性,直接催生了一批 chat 评测基准:AlpacaEval(长度控制版)、Arena-Hard、WildBench 等。随后很多人开始用 LLM 裁判代替奖励模型来生产和使用偏好数据——这就是 RLAIF(Reinforcement Learning from AI Feedback)的技术基础,第 12 章会详细讲。
围绕「生成式奖励模型」也长出了一个独立的研究方向:
- Generative Reward Models (2024) — 把 RM 显式定义成一个生成式模型
- Generative Verifiers: Reward Modeling as Next-Token Prediction — 把验证问题重写成下一 token 预测,从而复用全部 LM 训练基建
- Critique-out-Loud Reward Models (2024) — 先生成一段批评文本再打分,用推理换准确率
- Prometheus (2023) — 专门训练成裁判的模型,而不是拿通用模型来 prompt
怎么理解这个矛盾?两条都是真的,只是衡量维度不同:在「预测人类会选哪个」这个指标上,专门训练的 BT RM 更准;但在「能不能今天就把流水线跑起来、能不能给出可读的判决理由、能不能改一句 prompt 就换一个评判维度」这些工程维度上,LLM 裁判压倒性地方便。对于大多数没有偏好标注预算的团队,LLM-as-a-judge 是唯一现实的起点;而如果你的目标是把 RL 推到极限,就绕不开训一个真正的 RM。
什么时候不该用 LLM 裁判
补充几条实践经验,它们是上面那个「错配」的具体表现:
- 裁判模型比被评模型弱时不要用。一个 7B 裁判评 GPT-4 级别的输出,得到的基本是噪声——它无法识别自己写不出来的好回答。
- 需要高吞吐打分时不要用。RL 训练里每一步 rollout 都要打分,BT RM 一次前向就出结果,而 LLM 裁判要生成几百 token 的理由。成本差一到两个数量级。
- 被评对象和裁判同源时要警惕。self-preference 偏置会让评估结果系统性偏高。
- 可验证的任务不要用。数学题有标准答案、代码有单元测试,用规则验证器(第 7 章的 RLVR)既便宜又准,让 LLM 去「判断」这道题做对没有纯属浪费。
10. 奖励模型的评测:基准爆炸与它的局限
RewardBench 与这个领域的起点
奖励建模的学术文献基本是在 2024 年才立住的,而早期的绝大部分进展集中在建立基准和识别行为模式上,而不是改进训练方法。第一个 RM 基准是 RewardBench (2024)——作者本人是第一作者,他在讲座里的原话是「我很高兴帮助启动了这个领域」。
RewardBench 的评测方式很朴素:准备一批 (prompt, chosen, rejected) 三元组,其中偏好方向是有客观依据的(不是靠众包投票,而是靠已知的正确性、已知的安全策略等),然后看 RM 给出 $r_c > r_r$ 的比例。它的价值主要在于提供了共同的测试基建:在它之前,每篇论文报告的 RM 准确率各测各的,完全无法横向比较。
之后 RM 评测迅速扩张成一个和通用后训练模型评测类似的生态,大致分两类:一类测在有已知正确答案的领域上的预测准确率,一类更像「氛围评测」——用 LLM-as-a-judge 打分,或者看 RM 分数与其他基准的相关性。
| 类别 | 代表基准 |
|---|---|
| 纯文本(通用 chat / 偏好) | RewardBench、RewardBench 2、RMB、RM-Bench、Preference Proxy Evaluations |
| 专项文本(数学等) | M-RewardBench(多语言)、RAG-RewardBench(检索增强)、reWordBench(对错别字的鲁棒性)、RewardMATH、AceMath-RewardBench |
| 过程奖励模型 | PRMBench、ProcessBench,以及视觉版的 VisualProcessBench、ViLBench |
| 智能体 | Agent-RewardBench、CUARewardBench |
| 多模态 | MJ-Bench、Multimodal RewardBench、VL RewardBench、VLRMBench |
基准的根本局限
这里是本章最需要保持清醒的地方。RM 基准测的是「在留出的偏好对上排序准确率」,而我们真正关心的是「用这个 RM 做 RLHF,最终策略好不好」。这两件事的相关性远没有想象中强,已经有专门的工作在质疑这一点——标题就写在脸上:Rethinking Reward Model Evaluation: Are We Barking up the Wrong Tree?(ICLR 2025)。
- 分布错配。基准里的 chosen/rejected 是别人的模型生成的;而 RL 训练时 RM 要打分的是你自己的策略在训练中途生成的东西,那是一个完全不同的分布,而且还在不断漂移。RM 在前者上准,不代表在后者上准。
- 准确率不看幅度。基准只统计「排序对不对」,不管 margin 有多大。但 RL 优化的是数值:一个把所有正确答案打成 0.51、错误答案打成 0.49 的 RM,准确率 100%,但给策略的梯度信号极弱;反过来,一个在少数样本上给出巨大错误分数的 RM,准确率也许只掉 1%,却足以让 RL 整个跑偏。
- 没测「可被利用性」。基准不会去找 RM 的对抗样本,而 RL 策略会——它的全部工作就是找出 RM 打分最高的输出。RM 的最坏情况行为比平均情况行为更决定 RLHF 的成败,而基准只测平均情况。
- 风格捷径。RM-Bench 这类工作专门构造「内容一样但风格不同」的对照,就是因为很多 RM 实际上学的是格式(有没有分点、有没有 markdown、长不长),而不是内容质量。
奖励模型什么时候不管用
把讲座和全书的判断汇总,有几种情形下训一个 BT 奖励模型不是好选择:
- 任务是可验证的。数学答案、代码单测、格式约束——直接用规则验证器,信号既准确又不可被欺骗。这是 RLVR(第 7 章)取代 RM 的场景,也是 2024–2025 年推理模型爆发的技术前提。用 RM 去近似一个你本来就能精确计算的东西,纯属自找过优化。
- 没有足够的偏好数据。RM 是数据饥渴的,几千对训出来的模型准确率通常只比随机好一点点。这种情况下 LLM-as-a-judge 或直接对齐方法(DPO,第 8 章)更现实。
- 需要高度专业的判断。医疗、法律、前沿科研——标注员自己都判断不了的领域,RM 学到的只会是表面特征。这也是讲座里提到人类数据仍然不可替代的那类「知识工作」任务。
- 优化压力很大而 KL 约束很松。RM 是代理目标,优化得越狠,代理与真实目标的偏差就越致命。第 14 章的过优化曲线就是在量化这件事。
这句话的分量在于它出自一个亲手做过 RewardBench、Tülu、OLMo 的人。它的实际含义是:本章写下的所有公式和代码你都能在一天内跑通,但要训出一个在真实 RLHF 流水线里好用的 RM,公开信息是不完整的。数据配比、去重策略、长度去偏、多任务混合的比例——这些没有写在论文里,也没有沉淀成开源默认值。所以如果你的 RM 训出来指标漂亮但 RL 效果不好,这不是你一个人的问题。
训练方法这一侧的进展
相比基准的爆发,RM 训练方法的进展要慢得多,值得关注的几条线:多目标 / 属性条件的 RM(Interpretable Preferences via Multi-Objective Reward Modeling and Mixture-of-Experts,EMNLP 2024)把「有帮助」「安全」「简洁」拆成多个可解释维度而不是压成一个标量;HelpSteer2 (2024) 和 HelpSteer2-Preference 提供了高质量的开源人类标注数据;Nemotron-4 340B (2024) 给出了 RM 的规模化实验;Llama 2 的技术报告则是关于 RM 训练细节最完整的公开文档之一;OffsetBias(EMNLP 2024)专门做数据去偏。
本章小结
一句话速查
| 概念 | 核心公式 / 一行代码 | 要点 |
|---|---|---|
| Bradley-Terry 偏好模型 | $P(i>j)=\dfrac{p_i}{p_i+p_j}=\sigma(r_i-r_j)$ | 只有分数之差有意义;绝对值可任意平移 |
| RM 损失 | -F.logsigmoid(r_c - r_r).mean() | 等价于 $\log(1+e^{r_r-r_c})$;本质是二分类交叉熵 |
| 梯度系数 | $\partial\mathcal{L}/\partial\Delta = -\sigma(-\Delta)$ | 自带难例挖掘;margin 越大梯度越小 |
| 随机基线 | $\log 2 \approx 0.693$ | loss 稳不到这个值以下就说明没学到 |
| RM 架构 | nn.Linear(hidden_size, 1) @ 末 token | 因果注意力下只有最后一个位置看得到全序列 |
| margin loss(Llama 2) | $-\log\sigma(\Delta - m(y_c,y_r))$ | 用 Likert 分差抬高判对门槛;Llama 3 已弃用 |
| K 比较平衡(InstructGPT) | $-\frac{1}{\binom{K}{2}}\E[\log\sigma(\Delta)]$ | 同 prompt 的比较放同一 batch,防过拟合 |
| K-wise(Plackett-Luce) | $\prod_k \text{softmax}$ over 未选中集合 | $K=2$ 时退化为 Bradley-Terry |
| ORM | F.binary_cross_entropy_with_logits(logits[mask], labels[mask]) | 结果标签广播到每个 completion token |
| PRM | F.cross_entropy(logits[mask], labels[mask]) | 3 类标签只落在步骤分隔符 token 上 |
要点清单
- 奖励模型填的是标准 RL 里「环境」那一格,区别是它由我们从人类偏好学出来,因此可以被策略钻空子。
- Bradley-Terry 的推导链条:潜在强度 $p_i$ → 重参数化 $p_i=e^{r_i}$ → 偏好概率 $\sigma(r_i-r_j)$ → 极大似然 → $-\log\sigma(r_c-r_r)$。$\log$ 必须取在求平均之前。
- RM 的输出是相对的、无量纲的 logit,跨模型不可比,在 RL 里通常要做 batch 内标准化。
- 三类模型骨架完全相同,差别只在头输出几维和mask 选中哪些位置:RM 是 EOS 一处 / 1 维;ORM 是全部 completion token / 1 维;PRM 是步骤边界 / 3 维。
- 价值函数看起来像 ORM,但预测的是期望剩余回报,目标来自 on-policy rollout 而非离线标签,且随策略更新而漂移。
- 用「对/错」构造成对数据训的 BT 模型不是 ORM,它仍然是序列级对比模型。这是文献里最常见的术语混淆。
- RM 训练只训 1 个 epoch是标准做法;工程难度几乎全在数据管线,不在损失函数。
- 训练时最该盯的曲线是 reward margin(应稳步上升)和 val/accuracy(涨不动了就该停)。准确率 0.65–0.75 是正常范围,因为人类标注一致率本身就在这个量级。
- LLM-as-a-judge 在 RM 基准上落后于训练出来的 RM,但便宜且灵活,存在明显的评测-效用错配。用它时必须交换顺序去位置偏置、温度设 0 降方差。
- RM 基准上的准确率不等于下游 RLHF 效用:基准测平均情况,RL 会去找最坏情况。可验证的任务应该用规则验证器而不是 RM。
动手实验
作业代码在 homework/hw2-rm/,基于 code/reward_models/。三个实验分别对应本章的三种监督粒度。跑之前先在 code/ 目录 uv sync,一次只跑一个任务。
实验一:训一个 Bradley-Terry 偏好奖励模型
cd homework/hw2-rm/
uv run python -m reward_models.train_preference_rm --samples 2000 --epochs 1
这会在 Qwen/Qwen3-0.6B-Base 上,用 UltraFeedback 的 2000 对偏好数据训一轮。默认有效 batch 16、lr $5\times10^{-5}$、10% 数据留出做验证、每 25 个 optimizer step 评一次。一张 8 GB 卡够用。
你会看到什么。最核心的观测量是 train/reward_margin 和 val/reward_margin——即 $\E[r_c - r_r]$:
- 第 0 步:线性头是随机初始化的,它对 chosen 和 rejected 两条序列给出的分数几乎相同,所以 margin 在 0 附近(可能是个很小的正数或负数),准确率约 0.5,loss 约 0.693($=\log 2$)。这三个数同时出现,就说明起点是对的。
- 前几十步:margin 快速离开 0 向正方向走,loss 掉到 0.6 以下,准确率爬过 0.55。这一段学的基本是最粗的信号——回复的长度、是否分点、有没有明显的胡说八道。
- 中后段:margin 继续爬升但斜率变缓(回忆第 2 节:梯度系数 $\sigma(-\Delta)$ 随 margin 增大而指数衰减,曲线变缓是数学上的必然,不是学不动了)。准确率进入 0.65–0.75 的平台。
- 过拟合的样子:
train/accuracy继续涨而val/accuracy掉头向下,同时val/loss抬头。这通常在第二个 epoch 出现——这就是「RM 只训 1 个 epoch」这条惯例的实验证据。
还要注意 train/r_chosen_mean 和 train/r_rejected_mean 这两条曲线:它们可能一起往上飘或一起往下飘,甚至两条都是负数。这不是 bug,是第 2 节说的平移不变性——损失只约束差,不约束绝对水平。只看 margin。
训练结束后脚本会跑一个 demo:对同一个 prompt「Explain quantum computing in simple terms.」分别打分一个好回答和一个敷衍回答,打印两个分数并判断模型是否偏好前者。这是最直观的「它到底学到没有」的检查。
建议的消融。改 --samples(500 / 2000 / 5000)看信号什么时候从噪声里浮出来;改 --lr($1\times10^{-5}$ / $5\times10^{-5}$ / $2\times10^{-4}$)看 margin 曲线什么时候变得不稳定;改 --model-id 换到 1.7B 看容量的影响。另一个很有信息量的实验:随机翻转 20% 样本的 chosen/rejected 标签,观察准确率的天花板如何被数据噪声压低——这是理解「为什么 RM 准确率上不了 90%」的最快方式。
实验二:对比结果监督与过程监督
uv run python -m reward_models.train_orm --samples 400 --epochs 2
uv run python -m reward_models.train_prm --samples 500 --epochs 2
ORM 用 GSM8K(正例是标准解答,负例是把答案数字改错后的版本),PRM 用 PRM800K(人工逐步标注的数学推理轨迹)。
要对比的是「训完之后各自能打什么分」:ORM 应该能区分最终答案对与错的两条完整解答——但它对中间某一步错、结论碰巧对的解答区分不了,因为它的训练标签里根本没有这个信息。PRM 则应该能在中间步骤上给出有区分度的分数,你可以拿一条推理轨迹,把某一步故意改错,看 PRM 在那一步的三分类输出有没有变化。这就是第 6、7 两节讲的「序列级 / 结果级 / 过程级」监督差异的实操版本。
顺带观察一下两者的有效监督密度:打印一下每个 batch 里 (labels != -100).sum(),ORM 是几百(整个 completion),PRM 只有个位数到十几个(只有步骤边界)。同样的样本数下,PRM 的梯度信噪比要差得多,这解释了为什么 PRM 更难训、也更依赖大规模标注。
实验三:加一个小的留出评测
原书在建议实验里点名了一个值得做的贡献:给 reward_models/ 写一个 50–200 条样本的留出评测,报告准确率或偏好对的排序正确率,不需要完整训练就能跑。做这个的意义在于:调超参时你需要一个几秒钟就能给出反馈的信号,而不是每次都等一轮完整训练。实现上就是把验证逻辑(evaluate_preference_rm)抽出来,接受一个已保存的 checkpoint 和一个固定的评测集。这也是理解第 10 节「基准怎么建」最快的方式——你会立刻发现:评测集里放什么样的 chosen/rejected 对,直接决定了你的 RM 看起来有多好。
延伸阅读
奠基工作
- Bradley & Terry, Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons (Biometrika, 1952) — 本章全部数学的源头,1952 年的统计学论文,读它能理解这个模型原本是为什么问题设计的。
- Scalable Agent Alignment via Reward Modeling: A Research Direction (2018) — 把奖励建模明确提为价值对齐的研究方向,现代 RM 概念的出处。
- Ng & Russell, Algorithms for Inverse Reinforcement Learning (ICML 2000) — 从行为反推奖励函数的经典问题,和 RM 是同一个问题陈述的两种发展路径。
- InstructGPT: Training Language Models to Follow Instructions with Human Feedback (2022) — RM 损失的标准写法、$\binom{K}{2}$ 比较平衡的出处,本书的共同参照点。
- A General Language Assistant as a Laboratory for Alignment (2021) — softplus 形式损失的出处,也是 Anthropic 早期 RLHF 方法论的完整记录。
训练技巧与变体
- Llama 2: Open Foundation and Fine-Tuned Chat Models (2023) — margin loss 的出处,也是关于 RM 训练细节(数据配比、多 RM 分工)最详实的公开技术报告之一。
- Principled RLHF from Pairwise or K-wise Comparisons (2023) — K-wise / Plackett-Luce 损失的理论化表述,想搞清楚「为什么 $K=2$ 时退化为 BT」就读它。
- Starling-7B: Improving Helpfulness and Harmlessness with RLAIF (COLM 2024) — K-wise 损失的实际使用者,早期高质量开源 RM 的代表。
- HelpSteer2 (2024) — 高质量开源人类偏好标注数据集,附带完整的标注规范,理解「好的偏好数据长什么样」。
- Nemotron-4 340B Technical Report (2024) — 包含 RM 的规模化实验,公开报告里少见的 RM scaling 证据。
ORM / PRM 与推理
- Training Verifiers to Solve Math Word Problems (GSM8K, 2021) — ORM 的原始定义,读那段关于「按 token 输出的标量头」的描述是消除术语混乱的最短路径。
- Let's Verify Step by Step (2023) — PRM 的奠基论文,同时给出了 PRM800K 数据集;「过程监督优于结果监督」的最强单点证据。
- Exploring the Limit of Outcome Reward for Learning Mathematical Reasoning (2025) — 本章 ORM 损失的形式化写法出处,也是结果监督能推多远的近期实证。
- ProcessBench: Identifying Process Errors in Mathematical Reasoning (2024) — PRM 评测的主流基准,理解 PRM 到底被要求做对什么。
生成式奖励模型
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (2023) — LLM 裁判范式的奠基工作,本章那段 prompt 的出处,也系统分析了位置/长度/自偏好三种偏置。
- Generative Verifiers: Reward Modeling as Next-Token Prediction — 把验证重写成下一 token 预测,从而复用全部 LM 基建,这条路线最清晰的一篇。
- Critique-out-Loud Reward Models (2024) — 先写批评再打分,用推理算力换判断准确率,与测试时扩展的思路一致。
- Prometheus: Inducing Fine-Grained Evaluation Capability in Language Models (2023) — 专门训练成裁判的开源模型,比通用模型 prompt 更可控。
- Length-Controlled AlpacaEval (2024) — 如何在自动评测里把长度偏置扣掉,方法本身对做任何 LLM 裁判流水线都有用。
评测与批判
- RewardBench: Evaluating Reward Models for Language Modeling (2024) — 第一个 RM 基准,作者本人的工作;读它主要是理解 RM 评测这件事该怎么定义。
- RewardBench 2 (2025) — 针对第一版被刷榜和分布问题的重做版本,对比两版的设计差异比看榜单有用得多。
- Rethinking Reward Model Evaluation: Are We Barking up the Wrong Tree? (ICLR 2025) — 直接质疑 RM 准确率与下游效用的相关性,本章第 10 节的主要依据。
- RM-Bench: Benchmarking Reward Models with Subtlety and Style (ICLR 2025) — 专门构造「内容相同风格不同」的对照,用来暴露 RM 学到的是格式还是内容。
- reWordBench (2025) — 测 RM 对错别字等输入扰动的鲁棒性,非常直接地展示了 RM 有多脆。