推理与推理时扩展
当奖励可以被程序验证,RL 就从「对齐口味」变成了「提升能力」——这就是 2025 年推理模型爆发背后唯一真正的技术变化。
0. 本章导读
2024 年 9 月之前,几乎所有人对「RLHF 里的 RL」的判断是一致的:它是一个调风格的工具。你用它把模型调得更礼貌、更愿意回答、更少拒绝;它不会让模型多做对一道数学题。整个 RLHF 流程被小心翼翼地用 KL 惩罚拴在 SFT 模型附近,因为一旦跑远,奖励模型就会被刷分,模型开始输出又长又空的漂亮话。RL 的可优化空间被认为很窄。
然后 OpenAI 的 o1 和 DeepSeek R1 出现了,把这个判断彻底翻了过来。变化的核心其实只有一句话:把学出来的奖励模型换成一段能返回对/错的程序。数学题对答案,代码跑单元测试,格式用正则匹配。奖励从「一个可以被欺骗的神经网络」变成了「一个不会被欺骗的验证函数」,于是 KL 惩罚可以关掉,RL 步数可以从几百步拉到几万步,模型开始生成成千上万个 token 的思考过程,并且——这是最出人意料的部分——在训练集之外的问题上也变强了。
这套方法叫可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)。本章要讲清楚的是:
- RLVR 到底改了什么——算法几乎原封不动(还是第 6 章那套策略梯度),改的是奖励的来源,以及由此松开的一整套约束。
- 训练时扩展与推理时扩展的关系——为什么 RL 训练会「顺手」教会模型用更多 token 换更高准确率,以及并行采样、投票、树搜索这几条独立的推理时扩展路线各自的天花板在哪。
- 「aha moment」和长度增长到底是什么——哪些是真实机制,哪些是被后续工作证伪或大幅打折的叙事。
- 可验证的边界在哪——数学和代码之外,什么能验证、什么只能近似验证、什么根本不能,以及行业怎么用 rubric 和裁判模型往外扩。
- 过程奖励为什么输给了结果奖励——PRM 在直觉上明显更优,但在大规模 RL 里几乎没有主流配方在用,原因值得细究。
本章在全书里的位置:第 6 章给了算法(REINFORCE / PPO / GRPO / 各种 clipping 变体),本章给的是把这些算法用在可验证任务上时的全部工程判断——数据怎么筛、KL 开不开、长度怎么控、rollout 怎么调度。第 5 章的奖励模型在这里退居次要位置,但没有消失(PRM、ORM、选择器模型都还在推理端发挥作用)。第 8 章的直接对齐算法则是另一条完全不同的路线——它没有 rollout,因此天然与推理训练不兼容。
- RLVR = 策略梯度 + 把奖励模型换成验证函数 $v(x,y)\in\{0,1\}$。算法没变,变的是奖励不再可被过优化,于是 KL 惩罚可以设为 0,RL 可以跑几个数量级更久。
- 训练循环极其朴素:对同一批题目反复采样、对答对的样本做梯度上升、再来一遍。它相当于「几百到几千个 epoch 的强化」,与 SFT 的 1–2 个 epoch 是完全不同的数据使用方式。
- 推理时扩展有三条正交路线:串行(更长的思维链)、并行(采样 N 条 + 投票/打分选一条)、搜索(树搜索 + 价值函数)。RL 训练主要放大的是第一条;第二条几乎免费且稳定有效;第三条在开放域语言任务上至今没有站稳。
- 长度增长是 RLVR 的副作用而非目标。它与性能相关但不等价——只有当增加的 token 换来了准确率,扩展才有意义,否则只是烧电。
- 「aha moment」被严重浪漫化了:后续工作发现基座模型本身就会说「wait, let me reconsider」,RL 主要是把已有行为的出现频率放大,而不是凭空发明反思能力。
- 过程奖励(PRM)在推理 RL 中基本没进入主流配方:标注贵、易被策略钻空子、而且结果奖励在长链上的信用分配问题比预想的轻。稠密信号如今主要通过 on-policy 蒸馏回来。
- Lambert 的判断:RL 已经从蛋糕上的樱桃变成了承重结构,但配方里的每一条小技巧(难度过滤、格式奖励、clip-higher…)都不是终点,它们只是当前对「怎么把推理能力逼出来」的最好理解。
1. RLVR:把奖励模型换成一段程序
LeCun 的蛋糕,十年后终于做完了
2016 年 NeurIPS,Yann LeCun 提出了那个著名的蛋糕比喻:如果智能是一块蛋糕,那么蛋糕本体是无监督学习,糖霜是监督学习,而强化学习只是顶上那颗樱桃。这个比喻在当时被广泛引用,也被广泛嘲讽——因为樱桃太小了,小到看起来无关紧要。
现代语言模型把这块蛋糕做完整了,而且每一层都对得上:
- 蛋糕本体:在几万亿 token 的互联网数据上做自监督预训练。按 FLOPs 算,这里占了 95% 以上。
- 糖霜:指令微调(SFT),把模型从一个通用的续写机收窄到「助手」这个更窄的分布上(第 4 章)。
- 樱桃:真正的 RL。RLHF 是前奏,而在数学、代码、科学这些可验证域上的大规模 RL 才是这颗樱桃真正落地的时刻。
同一个算法,两种打分方式
RLVR 与 RLHF 在算法层面几乎无差别,都是第 6 章的策略梯度:
$$ \nabla_\theta J(\theta) = \E_{x\sim\mathcal{D},\; y\sim\pi_\theta(\cdot\mid x)}\Big[\big(R(x,y) - b(x)\big)\,\nabla_\theta \log \pi_\theta(y\mid x)\Big] $$其中 $x$ 是 prompt,$y$ 是从当前策略采样出的完整回复(一条 rollout),$b(x)$ 是基线(GRPO 里是同组样本的均值)。唯一变的是 $R(x,y)$ 从哪来。
RLHF 的打分是主观的。给定 prompt「解释一下经济学里的机会成本」,模型回答「机会成本是你做出选择时放弃的次优选项的价值……」。要给这个回答打分,你必须判断清晰度、准确性、完整性、有用性——这些都没有唯一正确答案,只能靠一个从人类偏好里学出来的奖励模型 $r_\phi(x,y)$ 来近似。而学出来的东西就能被刷分:第 14 章的过优化问题正是从这里来的。
RLVR 的打分是确定的。同样的框架,换成:
Prompt:小于 20 的所有质数之和是多少?
Response:小于 20 的质数是 2, 3, 5, 7, 11, 13, 17, 19。累加:2+3=5,5+5=10,10+7=17,17+11=28,28+13=41,41+17=58,58+19=77。答案是 $\boxed{77}$。
Verification:
extracted_answer == 77→ Reward = 1
这里的 \boxed{} 是从数学排版里借来的约定,作用是让答案抽取变成一条正则表达式的事——不管模型中间怎么绕,最后一个 \boxed{...} 里的东西就是它的答案。其它常见约定还有固定短语「The answer is: 」、特殊 token <answer>...</answer>、或者 GSM8K 风格的 #### 分隔符。选哪个不重要,重要的是训练和评测必须用同一个抽取器,否则你会看到训练奖励涨、评测分数不动的诡异现象。
代码任务的验证器则是单元测试:
Prompt: 写一个 Python 函数 fib(n) 返回第 n 个斐波那契数,fib(0)=0, fib(1)=1。

Response:
    def fib(n):
        if n < 2:
            return n
        return fib(n - 1) + fib(n - 2)

Verification:
    assert fib(0)  == 0    # base case
    assert fib(1)  == 1    # base case
    assert fib(10) == 55   # larger value
→ 全部通过,Reward = 1常见的打分方式是门控式:所有断言通过给 1,任一失败给 0。也有按通过比例给部分分的做法(例如通过 7/10 个测试给 0.7)。部分分让梯度更稠密,但也更容易被钻空子——模型可能学会优先满足最容易的那几个测试。这两种设定在实践中都有人用,取决于测试集的质量。
为什么叫「可验证」而不是「有标准答案」
提出 RLVR 这个术语的工作(Tülu 3)原本想叫它 RLGT——RL with Ground Truth rewards。最后没这么叫,是因为「可验证」比「有标准答案」严格地更宽:
| 情形 | 是否有唯一标准答案 | 能否验证 | 例子 |
|---|---|---|---|
| 数学题 | 有 | 能(比对答案 / 符号等价判定) | AIME、MATH |
| 代码生成 | 无(无穷多种正确实现) | 能(跑单元测试) | LiveCodeBench、SWE 任务 |
| 精确指令遵循 | 无 | 能(写一个约束检查函数) | 「回复必须恰好 3 段、不含字母 e」 |
| 定理证明 | 无(多条证明路径) | 能(Lean / Coq 编译器) | miniF2F |
| 开放写作 | 无 | 不能 | 「写一首关于金鱼的诗」 |
换句话说,RLVR 的进展来自可验证问题的数量与多样性,而不是「有多少题有标准答案」。这个区分在实践中很要紧:如果你只盯着有标准答案的题,你的训练数据永远被 GSM8K 和 MATH 这类数据集卡住;一旦接受「只要能写出检查函数就算数」,可训练的任务空间瞬间膨胀好几个量级。
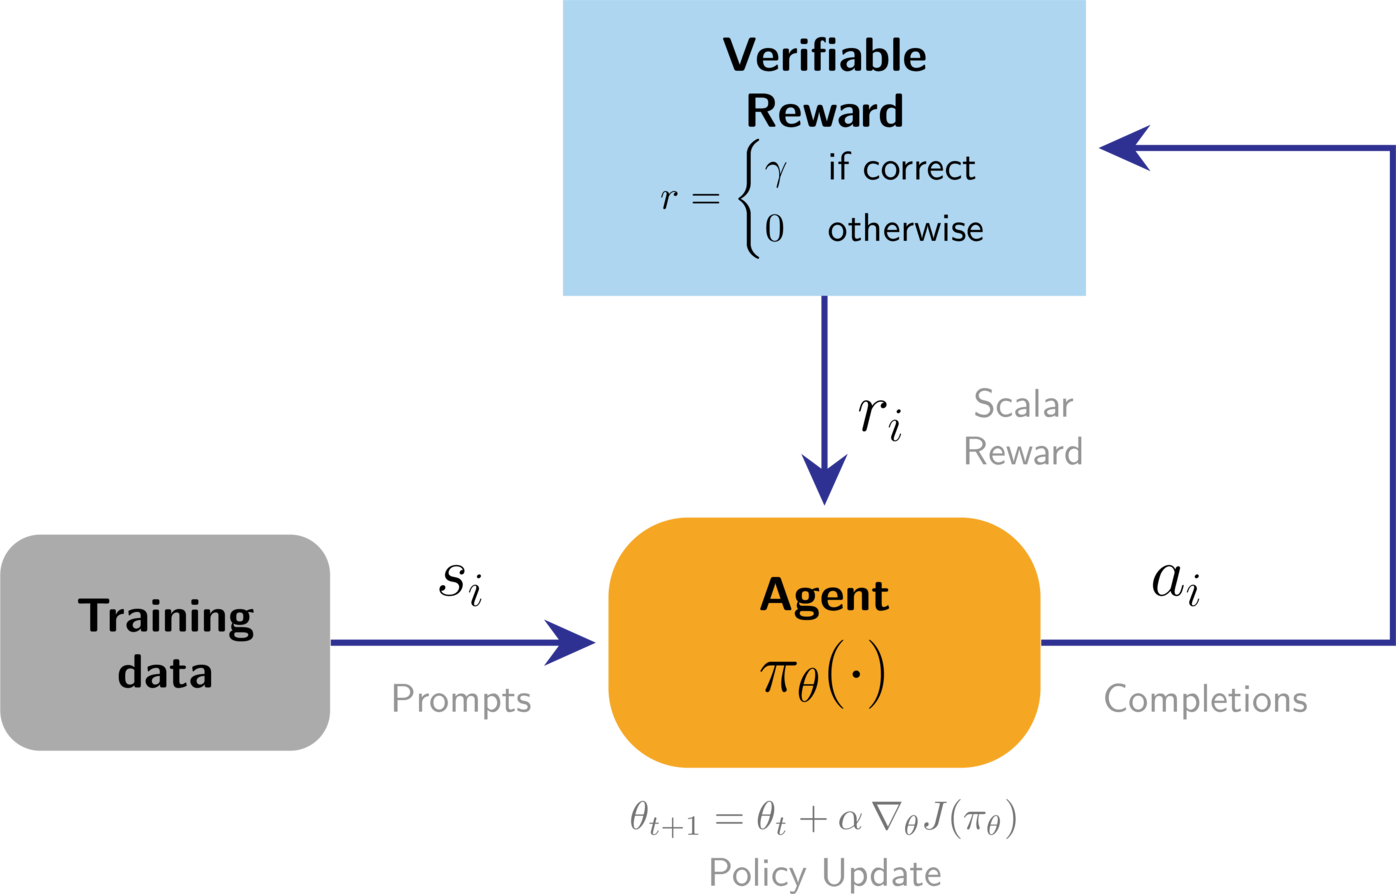
训练循环朴素到令人不安
RLVR 的训练循环可以用三句话写完:
- 对一批题目,每题采样多条回答;
- 朝着答对的那些回答的方向做梯度上升;
- 回到第 1 步,把同一批题目再做一遍。
第 3 步是与 SFT 最本质的差异。SFT 在数据上跑 1–2 个 epoch 就该停了,再多就是过拟合。而 RLVR 会在同一批(往往只有几千到几万条)题目上跑几百到几千个 epoch——名字里的「强化」正是指这个:把一个在基座模型里只有 10% 概率出现的正确行为,反复采样、反复加权,最终变成 90% 概率出现的稳定行为。
真正让人意外的是第二点:你只在几千道数学题上做 RL,模型在没见过的数学题上变强可以理解,但它在代码甚至多模态视觉任务上也一起变强(见第 9 节),说明被强化的东西比「解题技巧」更抽象。这是当前这个领域最值钱、也最没被讲清楚的现象。
2. 为什么是现在?RL 跑通的三个前提
2018 年,Alex Irpan 写了一篇流传极广的博客《Deep Reinforcement Learning Doesn't Work Yet》,同年 Henderson 等人的《Deep Reinforcement Learning that Matters》系统地记录了深度 RL 的可复现性灾难:同一份代码、同一个环境、只换随机种子,结果可以差出一个量级。这些批评在当时全都成立。
但七年后,RL 在多个高价值场景里跑通了:芯片布局、Atari/围棋/象棋的统一规划(MuZero)、自动驾驶的自博弈、ChatGPT 的 RLHF、以及本章的主角 DeepSeek R1 的 RLVR。发生了什么变化?把讲座里的判断和原文合起来,是三条:
前提一:稳定性问题变得可解
RL 的稳定性有两层含义,过去都是拦路虎:
- 学习本身不稳定——奖励曲线可能压根不涨,或者涨到一半崩掉。
- 工程不稳定——比标准语言模型训练更容易出 loss spike、NaN、进程崩溃。
今天这两条都还是一线研究问题(熵坍缩、长时程信用分配至今没有干净的解法),但已经从「拦路虎」降级为「需要调参的已知问题」。一个具体例子是 MiniMax-M1 报告里那张后来很有名的图:训练引擎算出的 per-token 概率和推理引擎算出的概率系统性地对不上,根源是 LM head 在低精度下的数值误差,把它单独 upcast 到 FP32 后两者重新对齐,训练随之稳定。这类问题的性质很说明问题——它不是「RL 理论上不 work」,而是「有一个具体的、可定位、可修复的数值 bug」。
前提二:开源工具链已经存在
做 RLVR 不需要从零写分布式训练。2025 年可用的框架已经相当拥挤:
| 框架 | 出处 / 定位 |
|---|---|
| TRL | Hugging Face 的后训练库,trainer API 最容易上手 |
| Open Instruct | Ai2 的开放后训练配方与研究代码(Tülu / Olmo 系列用的就是它) |
| veRL | 源自 HybridFlow 的生产级 RL 库,工业界使用最广 |
| OpenRLHF | 基于 Ray 的 RLHF / RLVR 框架 |
| slime | SGLang 原生的 RL 扩展框架,GLM 系列在用 |
| SkyRL | 模块化全栈 RL 库,支持异步与多轮 agent 工作流 |
这些库中的很多优化(分布式 rollout、vLLM 集成、序列并行)其实是 RLHF 时代积累下来的遗产。RLVR 直接继承了整条工具链,这是它扩散速度惊人的直接原因——学术界的小组用 8 张卡就能复现一个可信的小规模 R1-Zero。
前提三:基座模型跨过了能力门槛
多个来源都指向同一个观察:推理 RL 只有在 2024 年之后的模型上才跑得动。这不是巧合。回到上一节的抽奖箱直觉——如果基座模型在一道题上采样 64 次,正确率是 0,那么无论 RL 算法多好,梯度都是 0。RLVR 需要基座模型对目标任务已经具备非零的成功概率,它才能把这个概率放大。
这条判断在 MiMo 的报告里被推到了极致:他们发现预训练/中训练里数学和代码的占比,直接决定了后续 RL 能达到的上限。换句话说,如果你的 RL 曲线早早地平掉了,问题很可能不在 RL 超参,而在基座。
o1 之前的研究:想法都在,只是没被放大
RLVR 的核心想法——「根据答案对不对来做梯度更新」——几乎就是强化学习的教科书定义,在语言模型上也早有人做。把这条线索理清楚有助于看出 R1 真正的贡献在哪:
| 工作 | 做法 | 与现代 RLVR 的差别 |
|---|---|---|
| STaR (2022) | 采样带推理链的解答,保留答对的,拿去做 SFT,迭代 | 本质是策略梯度的近似,但用交叉熵而非 log 概率加权,且是离线迭代而非在线 RL |
| Quiet-STaR (2024) | 让模型在回答前先生成一段「内心独白」token | 思想上离现代推理模型只有一步之遥,但用的是对数似然奖励而非二元奖励 |
| TRICE (2023) | 把推理链当隐变量,用 MCMC 启发的 EM 算法优化 | 算法复杂度高,难以扩展 |
| VinePPO (2024) | PPO + 数学题二元奖励,在 GSM8K / MATH 上训练,用多次 rollout 做蒙特卡洛价值估计 | 已经非常接近现代配方,但规模小、且强调精细信用分配 |
| Tülu 3 (2024) | 简单 PPO,答对给正奖励 | 关键差别:同时保住了模型在广泛评测上的通用能力 |
| RLEF: Grounding Code LLMs in Execution Feedback (2024) | 用代码执行结果作为反馈信号 | 验证器是执行环境而非答案比对 |
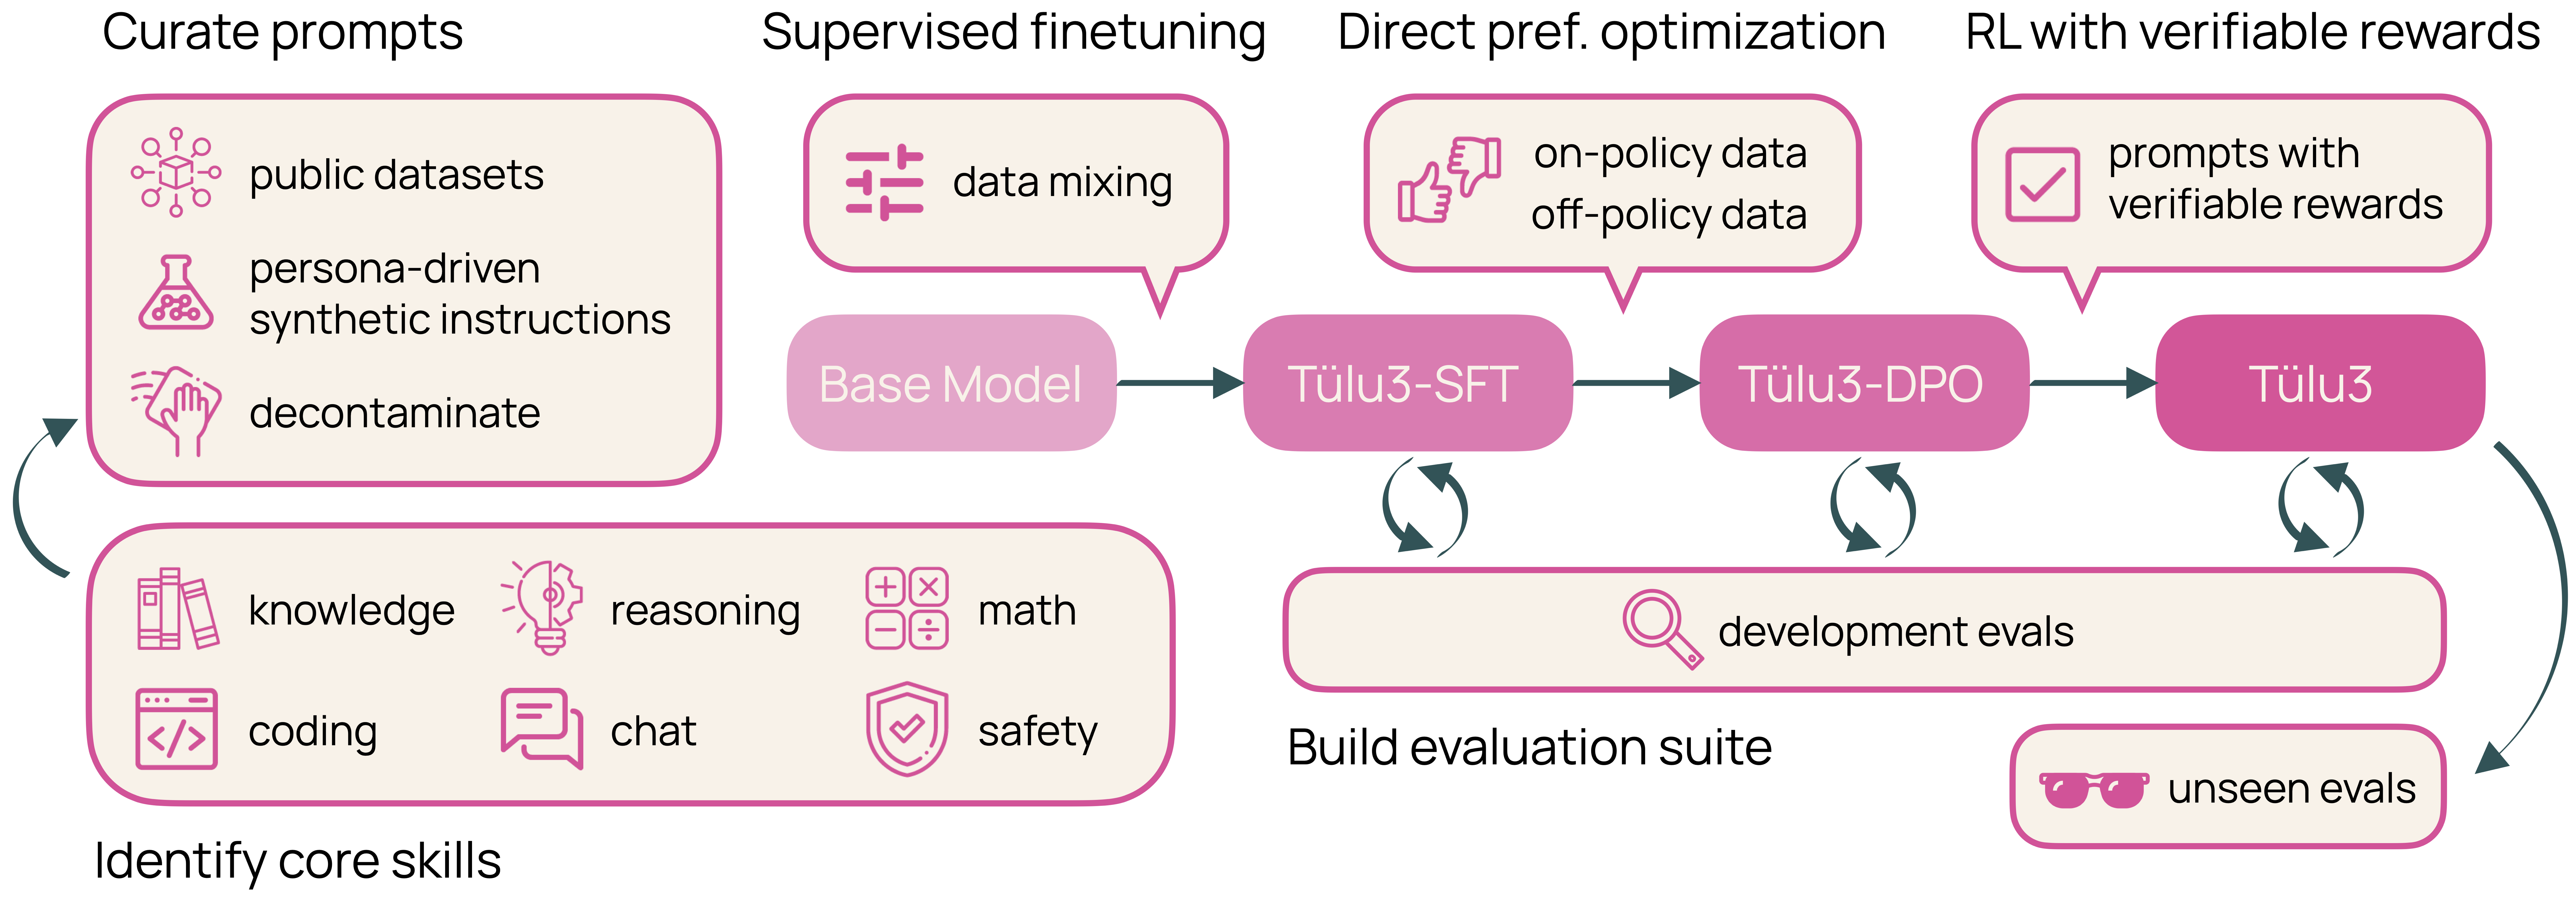
所以 R1 和 o1 的贡献不是发明了新算法。原文说得很直白:核心变化是训练阶段的重新分配和行为优先级的调整,而不是这套 RL 设定本身有多新。前人的方法要么扩展不上去,要么以牺牲通用能力为代价换取数学分数。R1 证明了:只要数据分布控制得当、基础设施足够稳,这件事可以一路放大到主训练阶段,而且通用能力不掉。
3. o1 与 R1:两条路线的技术要点
o1 给出的那两张图
2024 年 9 月 OpenAI 发布 o1-preview 时,技术细节几乎为零,但发布材料里有两张图定义了此后一整年的研究议程。左图横轴是训练时计算量(RL 的算力),右图横轴是测试时计算量(生成时用掉的 token),纵轴都是 AIME 准确率,两条曲线都随着 log 横轴近似线性上升。
这两张图传达的信息是:存在两条独立的扩展轴。以前语言模型只有一条轴(预训练算力),现在多了两条。而且第二条轴的性质完全不同——它不需要重新训练模型,你只要在推理时多花钱,性能就上去。这对产品形态的冲击是巨大的:同一个模型权重可以卖出「快速档」和「深思档」两种服务。
需要明确的是,这两条轴虽然相关但不是同一回事。推理时扩展(inference-time scaling,也叫 test-time scaling)作为一类方法在 o1 之前就有人研究——价值函数引导的解码、重复随机采样加答案抽取都属于这一类,它们不需要 RL。RL 训练之所以和推理时扩展绑在一起讲,是因为它是目前把「多花 token 换准确率」这条曲线做出来的最短路径:模型自己学会了什么时候该多想。长期看肯定还有别的方法能达到同样的推理时权衡。
思考 token 长什么样
把同一个 prompt 分别给 DeepSeek V3(普通模型)和 DeepSeek R1(推理模型),差别一眼可见。问「给我写一首关于金鱼的短诗」,V3 直接开始写诗。而 R1 会先生成一大段 <thinking> 内容:
<thinking>好,用户想要一首关于金鱼的短诗。先头脑风暴一些金鱼相关的意象。金鱼常常在鱼缸里,对吧?那可以从场景写起。「镀金的碗」或者「水晶球」这类词可能有用。接下来想想金鱼的动作,「掠过」「滑行」「打旋」都可以用,鱼鳍可以形容成「丝质的」。主题呢?也许写小小的世界与它自以为的自由之间的对比。……要保持简短,也许四段,押韵。让我检查一下节奏和流畅度。好,开始拼起来。</thinking>
然后才输出那首诗。注意这个例子的微妙之处:写诗根本不是可验证任务。R1 在这类任务上也会思考,说明推理行为已经被 RL 泛化成了模型的默认习惯,而不是只在数学题上触发。这既是优点(写作质量确实有提升)也是问题(简单问题上的「过度思考」,第 5 节会讲)。
对复杂问题,思考阶段可以长到几千甚至几万 token。所以长上下文能力是推理行为的前置条件——一个 4K 上下文的模型没法做这件事。这也是为什么 2025 年推理模型和高效长上下文架构(Mamba 混合、线性注意力、滑窗)的进展是同步发生的。
R1-Zero:纯 RL 能走多远
DeepSeek R1 的论文(2025 年 1 月 22 日)真正的冲击力在于 R1-Zero 这个消融:直接在基座模型上做 RL,不做任何 SFT 冷启动。没有人给模型示范过什么叫「一步步思考」,只有一个规则奖励(答案对不对 + 格式对不对),结果模型自己长出了越来越长的思维链,AIME 的 pass@1 从个位数涨到了几十。
R1-Zero 的奖励只有两项,都是规则写死的:
- 准确性奖励:数学题比对
\boxed{}里的答案;代码题跑编译器和测试用例。 - 格式奖励:思考过程必须包在
<think>...</think>里。这一项和正确性无关,纯粹是为了让输出可解析、可控。
论文明确说了没有用过程奖励模型(PRM),也没有用蒙特卡洛树搜索——两个当时公认「必须有」的组件都被扔掉了。这是 R1 论文最反直觉、也最有价值的负面结果(第 8 节会详细讨论为什么)。
R1-Zero 的问题也很实在:可读性差、中英文混杂、格式随机。所以完整的 R1 配方是一条多阶段流水线:
| 阶段 | 做什么 | 解决什么问题 |
|---|---|---|
| 1. 冷启动 SFT | 用少量(数千条)长思维链数据做 SFT | 给 RL 一个可读、格式规整的起点,避免 R1-Zero 的语言混乱 |
| 2. 大规模推理 RL | 在数学/代码/科学上跑 RLVR,加语言一致性奖励 | 主要的能力增长发生在这里 |
| 3. 拒绝采样 + SFT | 用第 2 步的模型采样、筛出好样本,混入通用数据再做 SFT | 把推理能力和通用对话能力重新缝合(第 9 章) |
| 4. 全场景 RL | 可验证奖励 + 偏好奖励模型混合,覆盖有用性与无害性 | 回到 RLHF,处理不可验证的那部分 |
| 5. 蒸馏 | 用大模型的输出对 1.5B–70B 的小模型做 SFT | 小模型自己做 RL 效果远不如直接蒸馏 |
同一周的 Kimi 1.5,和随后的开源复现
与 R1 同一天发布的 Kimi 1.5 走了非常相似的路,但报告的侧重点不同:它强调的是RL 规模 + 课程设计。难度调度、在线过滤保证梯度有效、渐进式延长长度上限来抑制过度思考——这些后来都成了标准配方(第 6 节)。可惜没有开放权重。
真正让学术界能上手的是 Open-Reasoner-Zero(2025 年 2 月首发,3 月扩展)。它是第一份公开了训练代码 + 整理好的 RL 数据 + 模型权重的 R1-Zero 式复现,而且配置朴素得惊人:
- 原版 PPO,GAE 参数取 $\lambda=1,\ \gamma=1$(等价于用蒙特卡洛回报,不做时序折扣);
- 纯规则奖励;
- 不加 KL 惩罚;
- 3 月版本扩展到 12.9 万道整理过的题目。
$\gamma=1$ 这个选择值得注意。在传统 RL 里折扣因子是标配,但在语言模型上,一条 rollout 就是一个 episode,且只有终点有奖励,折扣未来奖励没有意义——它只会人为地偏向短序列。这是「把经典 RL 直觉照搬到 LLM 上会出错」的一个典型例子。
之后的一年是模型的寒武纪大爆发,重要报告在第 9 节列表。到 2025 年底,DeepSeek V3.2 已经把「思考」直接融进工具调用,不再区分推理模型和普通模型。
4. 推理时扩展的三条路线
「多花计算换性能」这句话可以有很多种实现。把它们分清楚很重要,因为它们的成本结构、延迟特性和有效范围完全不同。三条主线是:串行加长、并行加宽、结构化搜索。
路线一:串行——更长的思维链
这是推理模型的默认形态:一次生成,但生成得很长。计算量随 token 数线性增长,延迟也随之线性增长(无法并行,因为每个 token 依赖前一个)。
RL 训练之所以自然导向这条路线,是因为在可验证任务上,更长的思考轨迹里包含了更多「验算、回溯、换个方法再试」的机会,而这些行为与答对强相关。于是策略梯度在放大正确行为的同时,顺带放大了长度。原文的措辞很谨慎:序列长度增长是默认结果,但也存在专门研究「不靠长度增长也能提升性能」的工作。
值得对比的是早期 RLHF 里的长度偏置:偏好模型倾向于给长回复打高分,于是 PPO 训练出来的模型越来越啰嗦,而人类实际满意度只提升了一点点。表面上现象一样(长度涨),本质完全不同:那时的长度增长是奖励模型被刷分的结果,是纯粹的病理现象;而 RLVR 的长度增长至少部分对应真实的计算投入。但要注意,RLVR 也会有它自己版本的长度病理——第 5 节详述。
路线二:并行——采样 N 条,再选一条
同一个 prompt 采样 $N$ 条独立回答,然后用某种方式合并。它的好处是延迟不变(N 条可以完全并行),成本线性增长。这条路线在 o1/R1 之前就成熟了。
先明确两个评测指标,它们是理解这条路线的关键:
- pass@1:采一条,看对不对。这是模型的实际单次表现。
- pass@k:采 $k$ 条,只要有一条对就算对。它度量的是模型的覆盖率——正确答案在不在采样分布的支撑集里。
实践中不会真的只采 $k$ 条,而是采 $n \ge k$ 条,数出其中 $c$ 条正确,用无偏估计:
$$ \widehat{\mathrm{pass@}k} \;=\; 1 - \frac{\dbinom{n-c}{k}}{\dbinom{n}{k}} $$分子是「从 $n$ 条里挑 $k$ 条,全挑到错的」的组合数,分母是总的挑法数,所以整个分式就是「$k$ 条全错」的概率,一减就是「至少一条对」。这个估计量比「重复实验取平均」方差小得多。
pass@1 和 pass@k 之间的差距就是推理时扩展的可用空间。如果一个模型 pass@1 是 30%、pass@64 是 85%,说明正确答案早就在分布里了,只是单次采样抓不住——这时候任何合理的选择机制都能变现这 55 个百分点。合并方式按复杂度递增:
| 方法 | 怎么选 | 代价 / 限制 |
|---|---|---|
| 多数投票(self-consistency) | 抽取每条的最终答案,取出现次数最多的 | 免费;但要求答案是可比较的离散对象,写作类任务用不了 |
| Best-of-N + 奖励模型 | 用 RM/ORM 给每条打分,取最高 | 需要一个额外模型;RM 本身可能被刷分(第 9 章) |
| 选择器模型(selector) | 训练一个专门模型,从 N 条候选里挑最好的 | 效果比朴素投票好,但 2026 年前在公开配方里仍不常见——Claude 4 的发布材料提到过,DeepSeek-GRM 用了 |
| 验证器直接过滤 | 有真验证器时(如单元测试),直接留下通过的 | 只在训练/数据合成时可用——线上推理没有 ground truth |
DeepSeek R1 和 Phi-4 的报告里都用了最朴素的多数投票,涨幅可观。这条路线的性价比之高,以至于它几乎是「免费的午餐」——但它有个硬上限:投票不可能选出一个 $N$ 条里都没出现的答案。当 pass@k 也饱和时,并行扩展就到头了,只能回去改模型。
路线三:搜索——树、价值函数与过程奖励
最「经典 RL」的一条路:把推理看成一棵树,每个节点是一个中间步骤,用价值函数或过程奖励模型评估节点,用 MCTS 之类的算法决定往哪扩展。AlphaGo 的成功让所有人相信这是通往强推理的路,2023–2024 年有大量工作沿着这个方向做(价值引导的蒙特卡洛树搜索解码是代表作之一)。
结果是:在语言模型上,它没有赢。R1 的论文明确说他们试过 MCTS 和 PRM 并且放弃了。原因值得记住,因为它揭示了语言任务和棋类任务的根本差异:
- 「一步」没有定义。围棋的动作空间是 361 个落子点,边界清晰。语言里一个「推理步骤」是一句话?一段?到换行符为止?任何切分都是人为的,而搜索算法对状态定义极其敏感。
- 动作空间是词表大小。每一步有 $10^5$ 量级的分支,树搜索的展开代价爆炸。
- 价值估计不可靠。棋类有完美的终局信号可以自举;语言里的中间状态价值必须靠一个学出来的模型给,而这个模型一旦被搜索算法当成优化目标,立刻被钻空子。
所以工业界的选择是:把搜索的算力预算直接交给模型自己——让它在一条长长的线性序列里自己完成「提出假设、否定、回退、重试」,而不是由外部算法显式地维护一棵树。这是一个非常有意思的结论:与其在模型外面搭脚手架,不如把脚手架训进模型里。
其它变体:预算强制与蒸馏
还有一些手段介于训练和推理之间:
- 预算强制(budget forcing):s1 展示了一个近乎作弊的技巧——想让模型多思考,就在它试图输出
</think>时强行替换成 "Wait",逼它继续;想让它少思考,就直接截断并追加结束标记。仅靠 1000 条精选样本的 SFT 加这个解码技巧,就能复现相当一部分推理时扩展曲线。这说明推理时扩展的能力有很大一部分是从 SFT 数据里就能学到的。 - 长度控制的 RL:L1 把目标长度写进 prompt 并用 RL 训练模型服从它。Qwen 3、Llama-Nemotron、Nemotron Nano、SmolLM 3 用系统提示实现思考开关;GPT-OSS 和 K2-V2 采用 low/medium/high 三档推理强度。
- 把推理蒸馏进小模型:用大 RL 模型的轨迹做 SFT,前面已经讲过。此外还有把多次模型调用组合成复合推理系统的路线,已有工作在研究这类系统的扩展律。
- 推理时扩展用在奖励模型上:让 RM 先写一段批判再打分(critique-out-loud),或让通用奖励模型在打分前先深思。这条线把推理时扩展从「解题」推广到了「评判」,对第 8 节的选择器模型很关键。
5. 「aha moment」与长度增长:机制、证据与被夸大的部分
R1 论文里有一段被引用了无数次的内容:训练中期,模型在一道题的中途突然写出「Wait, wait. Wait. That's an aha moment I can flag here.」,然后推翻自己前面的推导重新来过。论文把这段单独列出来,称之为模型的「顿悟时刻」,并评论说这是 RL 的力量与美感的体现——研究者没有教它怎么解题,只是给了正确的激励,它自己发展出了高级策略。
这段叙事传播极广,也是本章最需要拆开来看的部分:哪些是真的,哪些被浪漫化了。
长度增长的真实机制
先说清楚长度为什么会涨。有三股力量,性质完全不同:
(1) 真实的:更长的轨迹在难题上成功率更高。这是唯一「健康」的那股力量。当一道题需要多步计算时,把中间结果写出来相当于给模型加了一块外部草稿纸——每写一个中间结论,后续 token 就能通过注意力直接读取它,而不必在单次前向传播里憋出来。这是思维链在数学上有效的老原因,RL 只是把它的使用频率推到了极致。
(2) 半真实的:策略梯度对「多试一次」的天然偏好。考虑一条已经走错的推理轨迹。如果模型此时输出答案,奖励是 0;如果它输出「等等,我重新算一下」再试一次,还有一定概率翻盘拿到 1。所以只要没有长度惩罚,「继续想」的期望回报永远不低于「现在就答」。这不是模型「学会了反思」,这是一个纯粹的期望值计算结果。它解释了为什么长度增长几乎是无长度惩罚 RLVR 的必然现象。
(3) 病理的:损失聚合方式引入的长度偏置。这是纯粹的算法 artifact。GRPO 原始形式对每条序列内部的 token 损失取平均,再对组内序列取平均:
$$ \mathcal{L}_{\text{GRPO}} = -\frac{1}{G}\sum_{i=1}^{G}\frac{1}{|y_i|}\sum_{t=1}^{|y_i|} \min\!\big(\rho_{i,t}A_i,\ \mathrm{clip}(\rho_{i,t},1-\epsilon,1+\epsilon)A_i\big) $$那个 $\frac{1}{|y_i|}$ 意味着每条序列的总权重相同,与长度无关,于是长序列里每个 token 拿到的梯度更小。当 $A_i<0$(答错)时,长回答受到的惩罚被摊薄了——错得越长,罚得越轻。再加上组内标准差归一化 $A_i=(R_i-\mu)/\sigma$ 会放大那些「大家都差不多」的简单题的梯度,这两项合起来构成了 Dr. GRPO 所指出的长度偏置与难度偏置。所以现在的主流做法是在整个 batch 的总 token 数上做归一化(DAPO 就是这么做的),并在 batch 级别而非 group 级别归一化优势(Magistral、MiMo):
# 摘自 _src/code/policy_gradients/loss.py 的 DAPOLoss.forward
ratio = (log_probs - experience.log_probs_old).exp()
unclipped_term = ratio * experience.advantages
clipped_term   = ratio.clamp(1 - self.clip_eps_lo,
                             1 + self.clip_eps_hi) * experience.advantages
per_token_loss = -torch.min(unclipped_term, clipped_term)

mask = experience.action_mask.to(per_token_loss.dtype)
total_tokens = mask.sum().clamp(1e-8)          # 整个 batch 的有效 token 总数
total_loss   = (per_token_loss * mask).sum()
return total_loss / total_tokens               # 而不是 per-sequence 再取平均
区分这三股力量的实际意义在于:如果你的长度在涨但准确率不涨,先查 (3),再查 (2)——加一个温和的长度惩罚或渐进式长度上限就能压住;只有 (1) 是你真正想要的。
「aha moment」被夸大在哪
R1 之后不到两个月,就有工作系统地检查了这个说法。Understanding R1-Zero-Like Training 的核心发现是:「wait」「let me reconsider」「hmm, that's not right」这类自我反思的措辞,在 RL 开始之前的基座模型输出里就已经存在了。RL 训练之后它们出现得更频繁,但这是频率的放大,不是能力的诞生。所谓的「顿悟时刻」,更准确的描述是:预训练语料里本来就有大量人类写的、包含自我纠错的解题文本,RL 只是把这部分行为从长尾推到了主流。
更让人警醒的是 Spurious Rewards(Lambert 本人是作者之一)。他们在 Qwen2.5-Math 上做 RLVR,把奖励换成各种荒谬的信号——随机奖励、格式奖励、甚至是故意给错误答案打高分——数学分数居然还是涨了,涨幅接近用真实奖励的水平。而同样的实验换到 Llama 等其它基座上,这个效果就消失了。
是「发现」还是「唤起」
这两个证据把一个核心争论摆上台面:RL 训练是在发现新能力,还是在唤起预训练已经学会的东西?
支持「唤起说」的证据有:反思行为基座已有;虚假奖励也能涨分;RL 训练往往提升 pass@1 但不提升甚至降低 pass@k(在大 $k$ 下)——也就是说 RL 把概率质量集中到了原本就存在的正确模式上,代价是采样多样性下降。从分布的角度看,这更像是锐化而非拓宽。
支持「发现说」的证据是:训练收益能泛化到分布外任务;长时间 RL(Olmo 3 报告里近 4 周、220 张 GPU 的连续训练)仍在持续涨分而没有饱和;纯 RL 从基座起步(R1-Zero)能长出基座采样几万次都不会出现的超长连贯轨迹。
诚实的答案是:这个问题还没有定论,而且它可能取决于你怎么定义「能力」和在什么规模上问。讲座里把它列为本领域的头号开放问题。对实践者来说,可操作的结论是:不要指望 RLVR 帮你补上基座缺失的知识,但可以指望它把基座里不稳定的能力变得可靠。
6. 一套能跑起来的 RLVR 配方
这一节把 2025 年各家技术报告里反复出现的做法整理成一张表,并解释每条背后的原因。原文有一句重要的免责声明值得转述:某篇论文没提某个技巧,不代表它没用。这些是已知实现的一个子集,可以当参考,但不是最优配方的定论。
数据侧:让梯度存在
离线难度过滤。这是 RLVR 最核心的直觉之一。回到 GRPO 的优势计算:一组 $G$ 条 rollout,优势是 $A_i = R_i - \bar{R}$(或再除以标准差)。如果这道题模型 100% 答对,所有 $R_i=1$,优势全为 0;如果 100% 答错,所有 $R_i=0$,优势也全为 0。两种情况都没有梯度,这个 batch 的算力白烧了。
所以标准做法是:训练开始前,用起始模型对每道题采样 $N$(典型值 16)条,统计通过率,只保留通过率落在大约 20%–80% 区间的题目。Seed-Thinking 1.5、Open-Reasoner-Zero、Phi-4 Reasoning、INTELLECT-2、MiMo、Skywork OR-1、Olmo 3 都用了某种形式的难度过滤。
在线过滤与课程。离线过滤只能保证训练开始时难度合适;随着模型变强,原本 30% 通过率的题会变成 95%,梯度又没了。所以还需要:每个 batch 内动态丢弃通过率为 0 或 1 的组(DAPO 的 dynamic sampling),或者预先编好难度课程,把难题留到后期。Kimi 1.5、Magistral、Llama-Nemotron、INTELLECT-2、MiMo、Hunyuan-TurboS 都做了这件事。Olmo 3 的做法是零梯度过滤 + 主动补采样:丢掉全对/全错的组之后,再采新的题把 batch 填满,保证每一步的有效样本数恒定——讲座里的评价是「让 loss 曲线非常干净、非常稳」。
# 摘自 _src/code/policy_gradients/rollout.py:DAPO 的动态采样过滤
def _dapo_filter(self, exp: Experience) -> Experience | None:
    """Drop the group if every completion has min or max correctness."""
    correctness = exp.rewards["correctness"]
    all_min = (correctness == self.cfg.accuracy_min_reward).all()
    all_max = (correctness == self.cfg.accuracy_max_reward).all()
    if all_min or all_max:
        return None          # 整组丢弃:优势恒为 0,没有学习信号
    return exp
奖励侧:正确性之外的那些小项
纯粹的正确性奖励能训出能解题但不能用的模型(R1-Zero 就是),所以实践中总会加几项辅助奖励。参考实现里的完整奖励是这样组合的:
# 摘自 _src/code/policy_gradients/utils.py
correctness = _correctness_reward(dataset, completions, entries)   # 0 或 1,验证器给
penalty     = _response_penalties(lengths, cfg)                    # 超长惩罚,≤ 0
format      = _format_reward(completions)                          # 0 / 0.25 / ... / 1.0
total = [c + p + cfg.format_weight * f for c, p, f in zip(...)]

# 格式奖励:四个标签各给 0.25
def count_tags(text: str) -> float:
    count = 0.0
    if re.search(r"\s*<think>\s*",   text): count += 0.25
    if re.search(r"\s*</think>\s*",  text): count += 0.25
    if re.search(r"\s*<answer>\s*",  text): count += 0.25
    if re.search(r"\s*</answer>\s*", text): count += 0.25
    return count

# DAPO 的软超长惩罚:进入缓冲区后线性衰减,超过硬上限直接 -1
def dapo_length_penalty(completion_len, l_cache, l_max):
    safe_len = l_max - l_cache
    if completion_len <= safe_len: return 0.0
    if completion_len <= l_max:    return (safe_len - completion_len) / l_cache
return -1.0| 奖励项 | 解决什么 | 典型使用者 |
|---|---|---|
| 格式奖励 | 保证 <think> 块合法、答案可抽取。只关乎可用性,不关乎正确性 | R1、Open-Reasoner-Zero、Magistral、Skywork OR-1 |
| 语言一致性奖励 | 惩罚推理过程中途切换语言。早期模型会突然切成中文或法文思考,用户体验很差 | R1、Magistral |
| 长度惩罚 / 渐进长度上限 | 抑制过度思考、稳定训练、提高吞吐 | Kimi 1.5(渐进延长)、INTELLECT-2(小惩罚常开)、DAPO(软超长惩罚) |
算法侧:松开 RLHF 时代的约束
KL 惩罚:先被删掉,现在又悄悄回来。RLHF 里 KL 惩罚是必需品,因为学出来的奖励模型必然会被过优化,KL 项把策略拴在参考模型附近充当护栏。RLVR 里验证函数不会被「说服」,2 就是不等于 3,所以单轮数学 RLVR 通常直接设 $\beta=0$(Magistral、Open-Reasoner-Zero、Skywork OR-1)。去掉之后模型可以跑得离基座很远,探索空间大得多——RL 步数能从几百拉到几万,这是推理模型能力跃迁的直接原因之一。
但讲座里补了一句很重要的更新:长时程、off-policy 的 agentic 训练正在把 KL / 参考项请回来(例如 Cursor 的 Composer 2 技术报告),理由是稳定性——在多轮工具调用里,rollout 更 off-policy、方差更大,没有锚点容易崩。所以「RLVR 不需要 KL」这句话的正确版本是:在单轮可验证任务上不需要;任务越长越 off-policy,就越需要某种形式的锚定。
放宽 clipping。PPO/GRPO 的两侧裁剪 $\mathrm{clip}(\rho, 1-\epsilon, 1+\epsilon)$ 会把大幅更新的 token 直接切掉梯度。在探索阶段这是有害的——那些「概率原本很低但答对了」的 token 恰恰是最值得强化的。DAPO 的 clip-higher 把上下界解耦(典型值 $\epsilon_{\text{lo}}=0.2,\ \epsilon_{\text{hi}}=0.28$),给正向更新更大空间。另外有工作指出,当奖励本身不完美时,裁剪还会制造虚假的学习信号。
CISPO。MiniMax-M1 提出的变体,思路是裁剪重要性采样权重本身,而不是丢弃高更新 token 的梯度:
# 摘自 _src/code/policy_gradients/loss.py 的 CISPOLoss.forward
with torch.no_grad():                                  # 关键:停梯度
    ratio = (log_probs - experience.log_probs_old).exp()
    clipped_ratio = ratio.clamp(1 - self.clip_eps_lo, 1 + self.clip_eps_hi)
policy_loss = -clipped_ratio * experience.advantages * log_probs
差别在于:PPO 的 min(...) 一旦触发裁剪,那个 token 的梯度整个变成 0;CISPO 把裁剪后的比值当成一个常数权重(stop-gradient),乘在 $\log\pi_\theta$ 前面,于是每个 token 都还有梯度,只是权重被限制在合理范围内。ScaleRL 的 RL 扩展律研究把 CISPO 选为他们测过的最好的损失函数。
系统侧:推理才是瓶颈
这可能是从业者最容易低估的一点。在 RLVR 里,生成 rollout 的开销远大于反向传播:
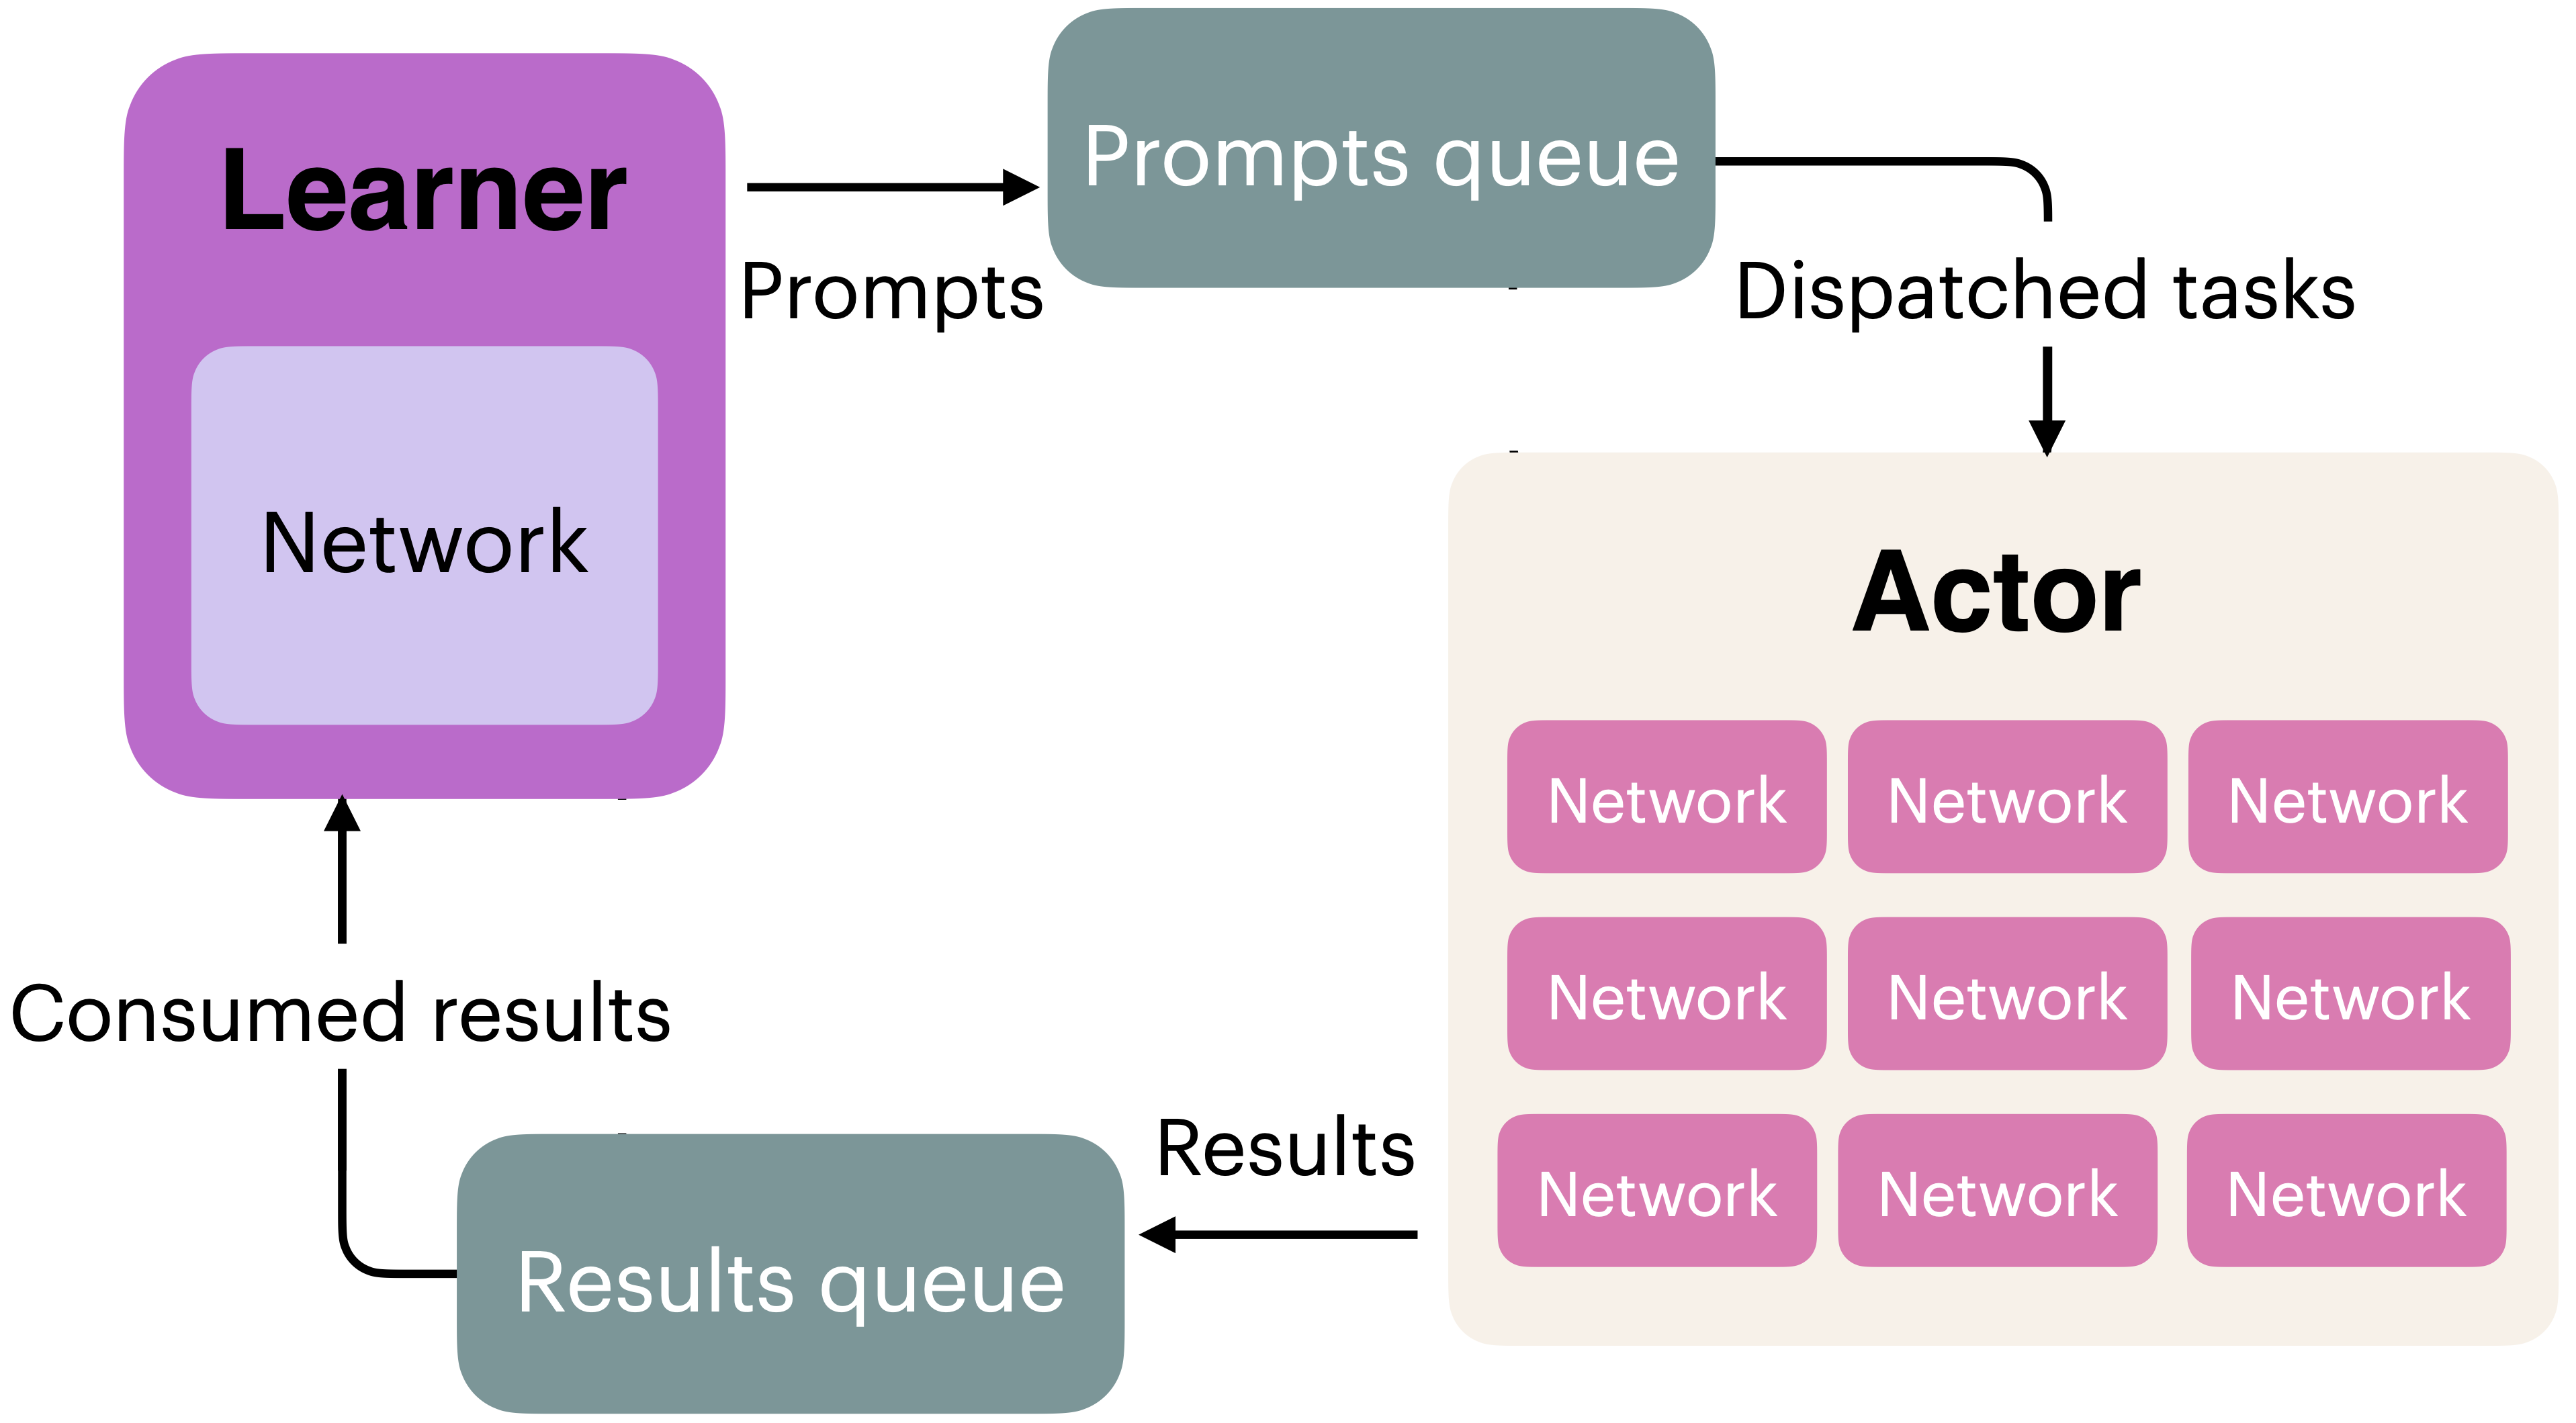
- Olmo 3 报告的数字:learner GPU 大约 75% 的时间在空转,推理算力是训练算力的 5–14 倍。
- 根源是长度方差。一个 batch 里大多数回答 2000 token,但总有几条跑到 30000 token。同步训练必须等最慢的那条,于是绝大多数 GPU 在等一小撮离群样本。
解决方向是异步:actor 持续生成、learner 持续消费,允许 rollout 相对当前策略「稍微陈旧」(即轻度 off-policy)。Seed-Thinking 1.5、INTELLECT-2 都采用了部分到完全异步的方案。代价是引入了 off-policy 偏差,需要重要性采样修正——这正是 clipping 和 CISPO 这类损失变得关键的原因。
| 配方决策 | 默认建议 | 什么时候改 |
|---|---|---|
| 难度过滤 | 开,保留 20–80% 通过率 | 数据量很小时可放宽,否则筛完没剩几条 |
| 零梯度组过滤 | 开,并主动补采样 | 基本没有理由关 |
| KL 系数 $\beta$ | 单轮可验证任务设 0 | 多轮 / agentic / 强异步时加回小值 |
| Clipping | 非对称,上界放宽 | 训练不稳时收紧上界 |
| 损失归一化 | 按 batch 总 token 数 | —(per-sequence 平均已知有长度偏置) |
| 优势归一化 | batch 级 | group 级会让少数极端题主导更新 |
| 格式奖励 | 开,权重小 | 模型已稳定输出正确格式后可降权 |
| 长度惩罚 | 软超长惩罚或渐进上限 | 观察到「长度涨、准确率平」时加强 |
| 同步 / 异步 | 小规模同步,大规模异步 | 长度方差大时异步收益最明显 |
7. 可验证奖励的边界在哪
RLVR 的威力全部来自「验证函数不可欺骗」这个前提。所以真正的问题变成了:这个前提在多大范围内成立?把任务按验证难度排成一个谱系,边界就清楚了。
谱系的一端:干净可验证
数学。最干净,但也没有想象中那么干净。答案抽取和等价判定都有坑:1/2 和 0.5 和 \frac{1}{2} 是同一个答案吗?2\sqrt{3} 和 \sqrt{12} 呢?答案是一个集合、一个区间、一个带单位的量呢?工业级的数学验证器通常是「规则匹配 + 符号计算库(SymPy)+ 兜底的小模型判等」三层结构。验证器的假阴性会直接变成训练噪声:模型答对了却拿 0 分,梯度把正确行为推走。这是数学 RLVR 里最常见的隐性 bug。
代码。单元测试天然就是验证器,但脆弱点很多:测试覆盖不足(模型写出只过测试的特化实现)、测试本身有 bug、执行环境不确定(超时、随机数、并发)、以及安全沙箱的开销。而且代码验证是可被攻击的——著名的失败模式包括模型直接 import sys; sys.exit(0)、修改测试文件、或者捕获所有异常然后返回硬编码的期望值。第 14 章会展开讲这类奖励攻击。
精确指令遵循。「回复必须正好三段」「不能出现字母 e」「必须以 JSON 返回且符合这个 schema」——这些约束都能写成检查函数,验证器可靠度接近 100%。Tülu 3 把它作为 RLVR 的第二类任务,效果很好。
形式化定理证明。Lean / Coq 的编译器就是完美验证器:证明通过就是通过。问题在于数据极度稀缺,且从自然语言到形式化语言的翻译本身是个难题。
谱系的中段:近似可验证
这里是 2025–2026 年最活跃的战场,因为可干净验证的题目正在被用完。几种扩展手段:
| 手段 | 怎么做 | 风险 |
|---|---|---|
| Rubric(评分量表) | 为开放问题写一份细化的打分细则,让裁判模型逐条打勾 | rubric 本身可能被针对性优化;写 rubric 的成本转移到了人身上 |
| LLM-as-judge | 用一个强模型判断回答是否满足要求 | 裁判模型是学出来的 → 过优化又回来了,需要重新考虑 KL |
| 参考答案软匹配 | 有参考答案但表述自由,用模型判断语义等价 | 判等模型的假阳性会奖励「看起来像」的错误回答 |
| 环境反馈 | agent 任务里用环境状态判定成功(文件是否生成、测试是否变绿、网页是否到达目标) | 稀疏、长时程、信用分配困难 |
| 自洽性 / 多数投票作为伪标签 | 无标注数据上用多数答案当 ground truth | 会放大模型已有的系统性错误 |
谱系的另一端:不可验证
写作质量、共情、安全边界的拿捏、品味、幽默、什么时候该拒答——这些是 RLHF 的主场,永远不会被 RLVR 吃掉。这也是为什么原文强调:推理模型仍然大量使用 RLHF。R1 的第 4 阶段就是完整的偏好 RL。把 RLVR 当成 RLHF 的替代品是对整个技术栈的误读;它们处理的是正交的两类目标。
为什么「验证」这件事本身值钱
有一个更深的原因让 RLVR 在这个时间点起作用:对绝大多数有价值的任务,验证比生成容易。判断一段证明对不对比写出这段证明容易;判断代码能不能跑比写出代码容易。这个「生成-验证不对称」正是 RL 能提供信息增益的来源——验证器知道一些策略不知道的东西,RL 就是把这部分信息灌进参数的管道。
反过来看,凡是验证不比生成容易的任务,RLVR 都帮不上忙。「写一篇好散文」的验证难度不低于写作本身,所以它注定回到人类偏好。这条判据比「有没有标准答案」更好用,也更能预测哪些新领域会被 RLVR 攻下:任何有廉价验证器的领域——形式化数学、芯片设计约束检查、化学反应模拟、游戏——都是候选。
8. 过程奖励 vs 结果奖励:一个直觉失灵的地方
2023–2024 年,如果你问任何做推理的人「怎么解决长思维链的信用分配问题」,标准答案是过程奖励模型(Process Reward Model, PRM)。OpenAI 的《Let's Verify Step by Step》给出了强证据:在 MATH 上,过程监督训练出的验证器做 best-of-N 重排,显著优于结果监督。逻辑上也无懈可击——一条 8000 token 的推理链只在末尾给一个 0/1 信号,中间到底哪一步错了,模型怎么知道?
然后 R1 出来了,明确说他们试过 PRM,放弃了。此后一年的主流开源配方里,PRM 基本没有出现在 RL 训练环节。这是本章最值得琢磨的一个「直觉失灵」。
三种奖励模型的形态差别
| 类型 | 在哪里输出分数 | 标签从哪来 | 损失 |
|---|---|---|---|
| Bradley-Terry RM | 只在 EOS 一个位置 | 人类成对偏好 | $-\log\sigma(r_{\text{chosen}}-r_{\text{rejected}})$ |
| ORM(结果奖励模型) | 每个 completion token | 整条回答对/错,标签复制到每个 token | 逐 token 二元交叉熵 |
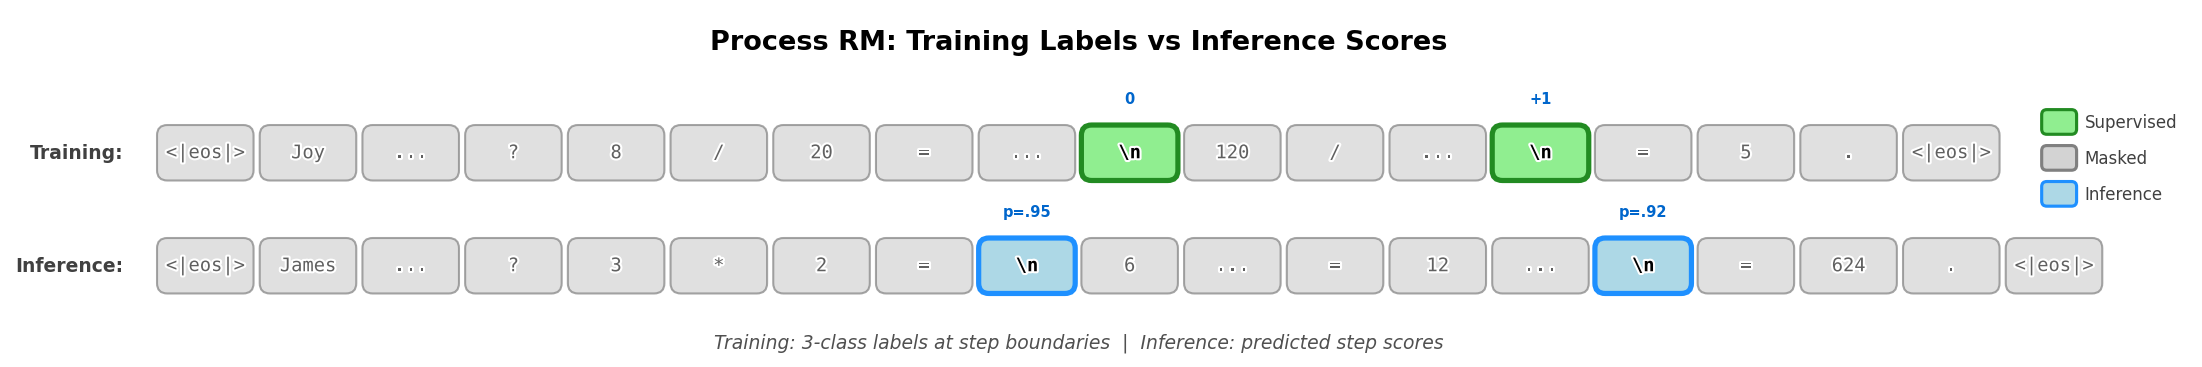
| PRM(过程奖励模型) | 每个推理步骤的边界 | 每一步是否正确(人标或蒙特卡洛估计) | 步骤边界处的交叉熵,其余 token mask 掉 |
PRM 的损失写出来是(跟随《Let's Verify Step by Step》的二分类形式):
$$ \mathcal{L}_{\text{PRM}}(\theta) = -\E_{(x,s)\sim\mathcal{D}}\left[\sum_{i=1}^{K} y_{s_i}\log r_\theta(s_i\mid x,s_{<i}) + (1-y_{s_i})\log\big(1-r_\theta(s_i\mid x,s_{<i})\big)\right] $$其中 $s$ 是一条被切成 $K$ 步的思维链,$y_{s_i}\in\{0,1\}$ 是第 $i$ 步的正确性标签,$r_\theta(s_i\mid x,s_{<i})$ 是模型在第 $i$ 步边界处输出的「这一步有效」的概率。实践中常用三分类(正确 / 中性 / 错误),其余 token 的 label 置为 -100。
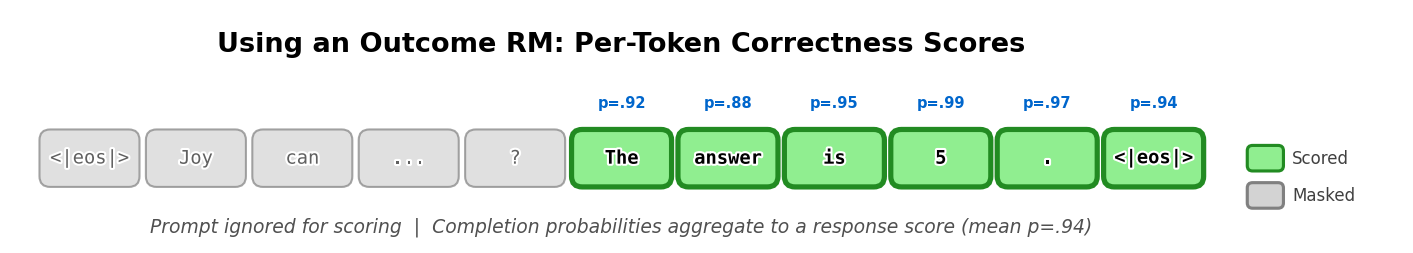
PRM 在 RL 里为什么输了
一、标注成本高得离谱。ORM 的标签是验证器白送的;PRM 需要有人(或某个昂贵的流程)逐步判断对错。自动化方案是对每一步做多次 rollout、用后续成功率估计这一步的价值,但这意味着每条训练数据的采样成本乘以步数。在一个已经被推理算力卡住脖子的流程里(回顾第 6 节的 75% 空转),这个代价难以承受。
二、PRM 是学出来的,因此可被过优化。这是决定性的一条。RLVR 的全部优势建立在「奖励不可欺骗」上,而把 PRM 放进 RL 的奖励里,等于把一个神经网络重新塞回了循环。策略会迅速学会生成「看起来每一步都很对」但整体不通的推理链——这正是 R1 论文放弃 PRM 时提到的顾虑之一,也是过优化的教科书案例。你为了解决信用分配引入 PRM,结果换来了一个更难对付的奖励攻击问题。
三、「步骤」没有客观定义。前面图注里说过。围棋的一步是确定的,推理的一步不是。而且真实的思维链根本不是线性的步骤序列——它包含回退、并行假设、自我否定。给这样一个结构强加「第 i 步对/错」的标签,本身就是模型失配。
四、结果奖励的信用分配问题没那么严重。这是最反直觉的一条。理论上稀疏的终点奖励在几千 token 上做信用分配应该无望,但实践中它 work。一个说得通的解释是:策略梯度并不需要知道「哪一步错了」,它只需要在足够多的样本上让正确轨迹的整体概率上升。同一道题采 16 条,其中 5 条对、11 条错,对的那些共享的行为模式(比如「先检验边界条件」)会被系统性加权,而各自独有的噪声会互相抵消。组内比较本身就是一种隐式的信用分配——这也是 GRPO 这类无价值函数方法能在长序列上工作的原因。
稠密信号的回归:on-policy 蒸馏
有意思的是,「稠密的、token 级的学习信号比稀疏的序列级奖励更高效」这个直觉本身是对的,只是实现方式换了。2025 年底的 MiMo-V2-Flash 提出了多教师 on-policy 蒸馏(MOPD):先在每个领域(数学、代码、搜索、推理)各训一个专家教师,然后把它们蒸馏进一个学生模型——学生学习的是教师在学生自己生成的轨迹上给出的 token 级分布,而不是序列级的结果奖励。
报告的结论是:这种稠密信号样本效率显著更高,且学生在每个领域都能追平它最强的教师,而纯序列级 ORM 训练在同样的算力下会停滞。
把这条线索和 PRM 的失败放在一起看,结论就清楚了:问题从来不是「稠密信号没用」,而是「稠密信号的来源必须不可被策略操纵」。PRM 是一个可以被优化的打分器,所以失败;教师模型的 token 分布是一个固定的目标分布,学生无法通过改变行为来「刷高」它,所以成功。这是一个很好的例子,说明后训练里的很多设计取舍,最终都归结到同一个问题:这个信号能不能被钻空子。
9. 地貌、副作用与开放问题
2025:推理模型的寒武纪
原文用一张长表记录了 2025 年的重要推理模型技术报告。这里挑出对理解方法演进最有信息量的几条,按时间排列:
| 时间 | 模型 | 贡献 / 值得读的理由 | 开权重 | 开数据 |
|---|---|---|---|---|
| 2025-01 | DeepSeek R1 | 催化剂。R1-Zero 证明纯 RL 可以从基座长出思维链 | 是 | 否 |
| 2025-01 | Kimi 1.5 | 课程调度、渐进长度延长的最早系统性报告 | 否 | 否 |
| 2025-03 | Open-Reasoner-Zero | 第一个代码+数据+权重全开的基座 RL 复现 | 是 | 是 |
| 2025-04 | Seed-Thinking 1.5 | 字节的 RL 流水线,动态 CoT 门控与异步训练 | 是 | 否 |
| 2025-05 | Llama-Nemotron | 可切换推理开关 + 开放后训练数据与代码 | 是 | 是 |
| 2025-05 | INTELLECT-2 | 首个公开记录的全球去中心化 RL 训练 | 是 | 是 |
| 2025-05 | Xiaomi MiMo | 从预训练到后训练的完整链路;发布后训练中间检查点 | 是 | 否 |
| 2025-05 | Skywork OR-1 | 整套配方围绕避免熵坍缩设计 | 是 | 是 |
| 2025-06 | OpenThoughts | 120 万条公开推理 SFT 数据,1000+ 组数据管线对照实验 | 是 | 是 |
| 2025-06 | MiniMax-M1 | CISPO 损失 + FP32 LM head 的训练/推理概率错配诊断 | 是 | 否 |
| 2025-07 | Kimi K2 | 1T MoE;MuonClip 稳定 15.5T token 预训练无 loss spike | 是 | 否 |
| 2025-11 | Olmo 3 Think | 最完整的开放生命周期:每个阶段的检查点与数据 | 是 | 是 |
| 2025-12 | DeepSeek V3.2 | 思考直接融入工具调用,不再区分推理/非推理模型 | 是 | 否 |
| 2026-01 | MiMo-V2-Flash | 多教师 on-policy 蒸馏(MOPD),token 级稠密奖励 | 是 | 否 |
把这张表按趋势读,2026 年年中的位置是这样的:前沿已经从「推理模型」推进到长时程、会用工具的 agent 底座。Kimi K2.5/K2.6、GLM-5 系列、DeepSeek V4 Preview 这批 2026 年的模型,讨论重点是多轮自主运行的稳定性和 agent 集群,而不是 AIME 分数。
两个反直觉的正面副作用
纯文本推理训练能提升多模态性能。Magistral、MiMo-VL 等都报告了同一个现象:在一个已经做完多模态训练的模型上,再做纯文本的推理 RL,视觉任务的表现反而提升了。这个结果对「RL 只是在锐化分布」的说法是个反例——被强化的东西显然跨越了模态边界。一个可能的解释是,推理训练强化的是模型的规划与自检回路,而这个回路在处理视觉输入时同样被调用。
可切换的思考模式。Qwen 3(/think 与 /no_think)、Llama-Nemotron、Nemotron Nano、SmolLM 3 用系统提示控制是否思考;GPT-OSS、K2-V2 用 low/medium/high 三档推理强度。讲座里提到一句实话:大多数实验室都发现这个功能训起来相当头疼——你实际上是在要求同一组权重承载两种差异很大的输出分布,稍不注意就会两边都变差。这是产品需求和训练目标直接冲突的一个典型例子。
开放问题
- RL 是在发现新能力,还是在唤起预训练已有的能力?第 5 节讨论过,仍无定论,而这决定了 RL 算力值不值得继续加码。
- 不改进预训练数据,推理训练能走多远?MiMo 的「中训练决定 RL 上限」是强证据。讲座里的判断很直接:预训练远没有死。
- Agentic RL 需要根本不同的配方吗?目前看到的迹象是「部分需要」——KL 项回归、异步成为必需、奖励从单点变成长时程环境反馈。
- RL 的扩展律是什么?ScaleRL 这类工作开始把算力、数据、性能之间的关系形式化,而在此之前这些只存在于从业者的直觉里。Olmo 3 用 220 张 GPU 连续训练近 4 周仍在涨分,说明这条曲线还远没到头。
- 未来 1/2/5/10 年,预训练与 RL 的算力比会是多少?这个问题的答案会重新定义整个行业的基础设施。
本章小结
一句话速查
| 问题 | 答案 |
|---|---|
| RLVR 与 RLHF 的算法差别 | 没有差别。同一套策略梯度,只是 $R(x,y)$ 从奖励模型换成验证函数 |
| 那真正的差别在哪 | 验证函数不可被过优化 → KL 可设 0 → RL 步数可放大几个数量级 |
| 为什么难度过滤是必需的 | 全对或全错的题目组内优势恒为 0,没有梯度,算力白烧 |
| 合适的题目难度 | 起始模型通过率约 20%–80%(采 16 条统计) |
| KL 系数怎么设 | 单轮可验证任务 $\beta=0$;多轮 / agentic / 强异步时加回小值 |
| 损失怎么归一化 | 按 batch 总 token 数,不要 per-sequence 平均(长度偏置) |
| 优势怎么归一化 | batch 级优于 group 级 |
| clipping 怎么调 | 非对称,放宽上界(如 0.2 / 0.28)以保留探索 |
| 系统瓶颈在哪 | 推理,不是训练。learner 可能 75% 时间空转,推理算力是训练的 5–14 倍 |
| 推理时扩展的三条路线 | 串行加长 CoT / 并行采样+投票 / 树搜索(第三条在语言上没赢) |
| pass@1 与 pass@k 的差距意味着 | 并行推理时扩展的可用空间;差距为 0 时并行扩展到头了 |
| 长度增长是好事吗 | 只有当它换来准确率时。要画「长度 vs 准确率」而不是只看长度曲线 |
| 「aha moment」是新能力吗 | 不是。基座模型本身就有自我反思措辞,RL 放大了它的频率 |
| PRM 为什么不进 RL 回路 | 标注贵 + 学出来的打分器会被策略钻空子 + 「步骤」无客观定义 |
| 稠密信号还有没有用 | 有,但来源必须不可被操纵——on-policy 蒸馏的教师分布就是一例 |
| 小模型该怎么做推理 | 蒸馏大 RL 模型的轨迹,而不是自己跑 RL(成功率太低,梯度不够) |
| RLVR 能取代 RLHF 吗 | 不能。不可验证的目标(风格、安全、品味)永远需要偏好学习 |
诊断清单:RLVR 训练不涨分时按顺序查
- 验证器有没有假阴性——人工抽 50 条被判 0 分的回答,看有几条其实是对的。这是最高频的隐性 bug。
- 题目难度分布——统计每组的通过率直方图。如果大量组落在 0 或 1,梯度就是稀疏的。
- 训练/推理概率是否对齐——把训练引擎和推理引擎在同一条序列上的 per-token logprob 画散点图,应该基本落在对角线上。偏离说明有数值精度问题(LM head 精度是首要嫌疑)。
- 熵曲线——掉得太快说明探索停了;一直不掉说明可能没学到东西。
- 长度 vs 准确率——长度涨而准确率平,说明触发了长度病理,检查损失归一化和长度惩罚。
- 基座的能力下界——用基座模型在同样格式下测一遍 pass@1 和 pass@64。RL 的增益要减去这个基线才有意义。
动手实验
本章没有独立作业,但 第 6 章的策略梯度作业(homework/hw3-pg/)用的就是一个完整的 RLVR 设定——参考实现在 _src/code/policy_gradients/,训练任务来自 reasoning_gym(例如 spell_backward:把一个单词倒着拼出来,答案可以程序化验证),系统提示直接用了 SYSTEM_PROMPTS["DeepSeekZero"],即 R1-Zero 那套 <think>/<answer> 格式。
cd _src/code
uv sync

# 基线:GRPO
uv run python -m policy_gradients.train --config policy_gradients/configs/grpo.yaml

# 本章重点:DAPO(clip-higher + 动态采样过滤 + token 级归一化 + 超长惩罚)
uv run python -m policy_gradients.train --config policy_gradients/configs/dapo.yaml

# CISPO(裁剪重要性采样权重,stop-gradient)
uv run python -m policy_gradients.train --config policy_gradients/configs/cispo.yaml典型配置(configs/dapo.yaml):Qwen3-1.7B,lr=5e-6,温度 0.6,max_new_tokens=512,每步 4 个 prompt × 8 条 rollout,clip_eps_lo=0.2 / clip_eps_hi=0.28,beta=0(KL 关闭),超长惩罚 l_cache=128 / l_max=512。规模很小,但本章讨论的每一个机制都能观察到。
建议做的四组对照:
- 关掉动态采样过滤(把
_dapo_filter改成直接return exp)。看有效梯度样本比例和收敛速度的变化——这是「难度过滤为什么必需」最直观的演示。 - 把
beta从 0 调到 0.01 / 0.05。观察奖励曲线上升速度与生成长度的变化:KL 会明显拖慢探索,这就是 RLHF 时代 RL 走不远的原因。 - 切换损失归一化方式。对比 GRPO(per-sequence 平均)与 DAPO(batch 总 token 归一化)在平均生成长度上的差异——第 5 节讲的长度偏置在这里能直接看到。
- 把
format_weight设为 0。观察多少步之后模型开始输出无法解析的答案,以及正确率评估随之如何崩坏——这解释了格式奖励为什么和正确性无关却不能省。
此外,用同一份检查点做一次推理时扩展的小实验也很有价值:固定模型,对每道题采 1 / 4 / 16 / 64 条,分别记录 pass@1、多数投票准确率和 pass@k。三条曲线的形状差异(尤其是投票曲线在哪里饱和、以及它离 pass@k 上界还有多远)能非常清楚地说明第 4 节的全部内容。
延伸阅读
奠基性模型报告
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (2025) — 必读。重点看 R1-Zero 的消融、奖励设计(只有正确性+格式)、以及为什么放弃 PRM 和 MCTS。
- Introducing OpenAI o1-preview (2024) — 技术细节几乎没有,但那两张训练时/测试时扩展曲线定义了整个议程。
- Kimi k1.5: Scaling RL with LLMs (2025) — 课程设计与渐进长度延长写得最细。
- Open-Reasoner-Zero (2025) — 想自己跑一遍基座 RL 就从这里开始,配置朴素到可以逐行读懂。
- Olmo 3 (2025) — 目前最完整的开放推理模型生命周期文档,每个阶段的检查点和数据都公开,适合做机理研究。
算法与损失函数
- DAPO: An Open-Source LLM RL System at Scale (2025) — clip-higher、动态采样、token 级归一化、软超长惩罚,四个改动都成了标配。
- MiniMax-M1 (2025) — CISPO 的出处,以及 FP32 LM head 那张训练/推理概率错配图。工程价值极高。
- Understanding R1-Zero-Like Training: A Critical Perspective (2025) — Dr. GRPO 的出处,同时是「aha moment 在基座里就有」这一发现的来源。本章第 5 节的主要依据。
- The Art of Scaling Reinforcement Learning Compute for LLMs (2025) — 首批系统研究 RL 扩展律的工作,把从业者的直觉形式化。
推理时扩展
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling (2024) — 并行采样这条路线的代表作,pass@k 曲线的经典分析。
- s1: Simple Test-Time Scaling (2025) — 1000 条数据 + 「预算强制」解码技巧就能复现相当一部分扩展曲线,是理解「推理能力从哪来」的重要参照。
- L1: Controlling How Long a Reasoning Model Thinks with RL (2025) — 用 RL 直接训练长度可控性。
- Value-Guided Monte-Carlo Tree Search Decoding (2023) — 搜索路线的代表,值得读来理解它为什么没赢。
- Inference-Time Scaling for Generalist Reward Modeling (2025) — 把推理时扩展用在评判而非解题上,选择器模型的方向。
o1/R1 之前的先驱工作
- STaR: Bootstrapping Reasoning With Reasoning (2022) — 用正确性筛选自采样推理链再做 SFT,RLVR 的思想原型。
- Quiet-STaR (2024) — 让模型在回答前先生成内心独白,离现代推理模型只有一步。
- VinePPO (2024) — PPO + 二元数学奖励 + 蒙特卡洛价值估计,精细信用分配路线的代表。
- Tülu 3 (2024) — RLVR 这个术语的出处;关键点是在提升数学能力的同时保住通用能力。
批判与边界
- Spurious Rewards: Rethinking Training Signals in RLVR (2025) — 随机甚至错误的奖励也能让 Qwen 数学涨分。读完之后你会对所有单基座的 RLVR 消融保持警惕。
- Let's Verify Step by Step (2023) — PRM 的奠基工作。它的结论在推理时重排场景依然成立,理解这一点才能理解为什么它在 RL 回路里失败。
- A Long Way To Go: Investigating Length Correlations in RLHF (2023) — 早期 RLHF 长度偏置的系统研究,与本章的长度增长对照着读。
- Deep Reinforcement Learning Doesn't Work Yet (2018) — 读它是为了理解这个领域七年间到底解决了什么、又没解决什么。
数据与工具
- OpenThoughts: Data Recipes for Reasoning Models (2025) — 120 万条公开推理数据 + 1000 多组数据管线对照实验,目前最好的开放 SFT 推理数据参考。
- veRL / Open Instruct / TRL — 三个不同定位的实现,想读源码建议按 TRL → Open Instruct → veRL 的顺序。