评测
后训练的真正瓶颈不是算法,是「你怎么知道这次改动让模型变好了」。
0. 本章导读
前面十五章讲的全是怎么改模型:SFT、奖励建模、PPO、GRPO、DPO、拒绝采样、正则化。每一章末尾都隐含着同一个假设——你有办法判断改完之后模型变好了还是变坏了。这一章要把这个假设拆开来看,然后你会发现:它基本不成立。
这不是修辞。一个真实的后训练团队每天面对的场景是这样的:你调了一下 KL 系数,跑了 8 小时 RL,拿到一个新 checkpoint,在内部评测套件上比 baseline 高了 0.7 分。这 0.7 分是真实提升吗?如果同一个 checkpoint 换个随机种子重跑评测会波动多少?如果把 prompt 模板里的一句话改掉呢?Olmo 3 的作者们真的量了这件事:在推理模型时代,评测配置完全固定的情况下,多数后训练评测的标准差在 0.25 到 1.5 分之间,而换 prompt 或换采样参数造成的变化比这还大。也就是说,绝大多数论文和技术报告里「我们比 baseline 高 1 分」的说法,在统计上是噪声。
于是评测就从一个「训练结束后跑一下」的收尾工作,变成了整条流水线上信息量最稀缺、最容易骗自己的环节。Lambert 在本章反复表达的观点是:前沿实验室之所以要花巨大力气自建评测,不是为了在发布会上多报几个数,而是为了提高比较两次训练运行时的统计功效(statistical power)——降低你关心的那个信号上的噪声,好让你能做出正确的训练决策。评测的价值不在「测出模型多强」,在「能不能分辨 A 和 B 谁更好」。
本章的组织方式是「时代切片」:作者不打算给出一套评测方法论(他明确说那需要另一本书),而是把 RLHF 早期历史上几个流行的评测范式各切一刀,让你看清它们共同的主题和共同的失败模式。具体覆盖:
- 三个时代——早期对话期(MT-Bench / AlpacaEval / Arena-Hard,用 LLM 当裁判)、多技能期(Tülu 式的知识 + 推理 + 数学 + 代码 + 指令跟随 + 安全套件)、推理与工具期(GPQA Diamond、HLE、SWE-Bench、LiveCodeBench、AIME)。
- prompt 格式——同一个模型同一道题,few-shot 对数似然打分和零样本 CoT exact match 能差出几十个点;格式不匹配可以让 60% 的准确率掉到接近 0。
- LLM-as-a-judge 的偏置——位置偏置、长度(冗长)偏置、自我偏好偏置,以及长度控制是怎么把长度那一维扣掉的。
- Arena 的 Elo 机制——它其实早就不是在线 Elo 而是 Bradley-Terry 极大似然(正好接回第 5 章),以及为什么它的排名会和「实际好不好用」脱节。
- 污染——n-gram 去污染怎么做、Tülu 3 在流行开源数据里查出了什么、以及「随机奖励也能提分」这类诡异现象背后的基座模型污染。
- 实验室内部实践——哪些评测被当成真正的 test set、为什么「刷榜」和「真好用」越来越脱节、以及作为模型发布方该怎么搭自己的评测体系。
本章在全书里的位置比较特殊:它不引入任何新的训练算法,但它决定了前面所有算法能不能被正确使用。第 5 章的 Bradley-Terry 模型会在 Arena 的排名计算里原样重现;第 12 章的 LLM-as-a-judge 基建在这里从「造训练数据」换成「打评测分」;第 14 章的过优化在这里表现为「评测分涨了但模型变难用了」;而下一章第 17 章要讲的模型性格与产品化,本质上就是承认「现有基准测不出来的那部分才是产品差异」。
- 评测是后训练最大的瓶颈。算法都开源了,数据配方大同小异,真正拉开差距的是谁能更早、更准地判断出一次改动是不是改进。前沿实验室自建评测的首要目的是提高统计功效,不是营销。
- 当前流行的评测范式是当前训练最佳实践的倒影,不是独立的真理标准。训练方式一变(few-shot → 指令跟随 → 长 CoT),评测方式必须跟着变,否则测的是格式而不是能力。
- 跨实验室的评测数字不能直接比。同一评测在固定配置下就有 0.25–1.5 分的标准差,prompt 和采样参数的差异更大;再加上各家不公开 prompt、系统提示、推理 token 预算,几个点以内的差距应视为等价。
- LLM 裁判有三个系统性偏置:位置(同一对答案交换顺序结论就变)、长度(更长的答案更容易赢)、自我偏好(模型偏爱自己家族的输出)。前两个有工程手段缓解(交换求平均、长度控制回归),第三个基本无解,只能换裁判。
- Arena 的分数不是「Elo」而是 Bradley-Terry 的极大似然估计,因此顺序无关、可以给置信区间。它的问题不在统计方法,在prompt 分布(真实用户的问题偏简单)和风格可优化性(markdown、长度、语气能刷分)。
- 饱和是基准的宿命。每一代 in-vogue 基准都在两三年内被推到接近 100%,剩下的样本要么极难要么标错,信号消失。评测套件必须持续换代,这本身就是巨大的工程成本。
- 污染无处不在且难以证明。Tülu 3 在流行开源数据里用 8-gram 查出了 UltraFeedback↔TruthfulQA、Evol-CodeAlpaca↔HumanEval、NuminaMath↔MATH、WildChat↔安全评测的重叠。对不公开数据的模型,只能靠扰动版基准(如 MATH-Perturb)间接观察。
- Lambert 的判断:「专注于自己的模型,是唯一能接近可复现评测的办法。」不要试图复现别人报告的数字,要建立自己内部一致、噪声可测的评测流程。
1. 后训练评测的三个时代
要理解今天的评测长什么样,最快的路径是看它是怎么变成今天这样的。Lambert 把 RLHF 早期历史上的评测分成三个阶段,每个阶段的基准都精确地反映了那个阶段人们认为后训练是用来干什么的。
第一阶段:早期对话期(2023 年前后)
ChatGPT 之后的第一年,用 RLHF 或偏好微调训出来的模型,唯一被认可的能力是「聊天聊得好」,而参照系是 GPT-4。这个阶段的代表基准是三个:
- MT-Bench(Judging LLM-as-a-Judge, 2023)——80 个多轮问题,覆盖写作、角色扮演、推理、数学、代码、信息抽取、STEM、人文八类,每题两轮。GPT-4 给每个回答打 1–10 分。
- AlpacaEval——805 条真实用户风格指令,把待测模型的回答和一个参考模型(早期是
text-davinci-003,后来换成 GPT-4 Turbo)的回答放在一起给 GPT-4 裁判,报告胜率(win rate)。 - Arena-Hard(From Crowdsourced Data to High-Quality Benchmarks, ICML 2025)——从 Arena 真实用户 prompt 里用 BenchBuilder 流水线自动筛出 500 条「难」prompt,同样用 LLM 裁判判胜负。它的卖点是 prompt 分布来自真实使用,而不是研究者拍脑袋写的。
这三个基准的共同点,是用 LLM-as-a-judge 顶替人类评估员。这一步的经济意义很大:人类偏好标注单条成本在 1 美元量级(复杂任务能到 10 美元以上),而用 GPT-4 类模型判一条的成本不到 1 美分(见第 12 章)。两个数量级的价差,让「每训一版模型就完整跑一遍主观评测」从不可能变成日常操作。代价是引入了一整套模型自身的偏置,这是第 3 节的内容。
今天回头看,这一阶段测的东西现在被归入「chat」或「instruction following」这个窄域。当年它们被当作模型综合能力的代表,是因为那时后训练确实只被期望做这一件事。
第二阶段:多技能期(2024 年前后)
随着实践积累,共识变成「RLHF 能改进的技能远不止聊天」。这个阶段的代表是 Tülu 系列的评测套件,它把后训练当成一个多面手方案来测:
| 能力域 | 代表基准 | 测的是什么 |
|---|---|---|
| 知识 | MMLU、PopQA、TruthfulQA | 57 学科多选题;长尾实体记忆;是否复述人类常见误信 |
| 推理 | BigBenchHard、DROP | BIG-Bench 里模型做不好的 23 个子任务;阅读理解中的离散推理(加减、计数、排序) |
| 数学 | MATH、GSM8K | 竞赛级数学;小学应用题 |
| 代码 | HumanEval、HumanEval+ | 函数级代码生成,靠单测判功能正确性;+ 版本大幅加密了测试用例 |
| 指令跟随 | IFEval | 「用不超过 3 段」「全部小写」这类可程序化验证的约束 |
| 安全 | 多个评测的复合 | 拒绝该拒绝的、不拒绝不该拒绝的 |
IFEval 在这里值得单独说一句:它是少数几个不需要任何模型或人类当裁判的开放式生成评测——约束是「回答里必须出现关键词 X」「不能用逗号」「至少 400 词」这种能用正则和字符串函数直接判定的。这种「可验证约束」的思路后来直接长成了第 7 章的 RLVR。
第三阶段:推理与工具期(2025 年至今)
当前阶段的定义特征是难度和真实性:
- 知识密集但防搜索:GPQA Diamond(博士级生物/物理/化学题,设计上保证「Google 不出来」)、Humanity's Last Exam(HLE,跨学科极难题集)。
- 真实软件工程:SWE-Bench+ 与 SWE-Bench Verified(真实 GitHub issue,模型要改出能过测试的 patch)、LiveCodeBench(持续从新竞赛题滚动更新,设计目标就是抗污染)。
- 竞赛数学:近几年的 AIME 题目——因为每年新出,天然带一层防污染。
这两个特征分别针对评测的两大失效模式。新鲜(LiveCodeBench 滚动更新、AIME 每年新题)对抗的是污染:题目在模型预训练截止之后才存在,就不可能被背下来。可执行(SWE-Bench 跑测试、IFEval 跑正则、MATH 比对 \boxed{})对抗的是裁判偏置:判分逻辑是确定性程序,不受长度、语气、markdown 影响。这两条是当代基准设计的主线,也解释了为什么「让 GPT-4 打 1–10 分」这种做法正在快速退出严肃评测。
第四阶段还没有名字,但激励结构已经变了
Lambert 特别提醒的一点是:随着 AI 从研究领域变成工业领域,评测的利益相关方变多了。ChatGPT 之后涌现出三类新玩家:
- 私有评测——如 Scale AI 的 SEAL Leaderboard,题目不公开,因此天然抗污染,但你必须信任运营方。
- 社区评测——Arena,用真实用户的真实投票,分布最接近实际使用,但可被风格优化(第 4 节)。
- 第三方评测公司——Artificial Analysis、Epoch AI 这类机构,用统一配置横向跑所有模型并公布方法,解决的是「各家自己报的数不可比」这个问题(第 5 节)。
这个演化方向本身传达了一个信息:当评测分数成为公司市值的一部分时,让被评测方自己报分就不再可信了。这和金融审计要第三方是同一个道理。
2. Prompt 格式:评测里最被低估的变量
先说结论,因为它反直觉到值得先记住:光是改 prompt 格式,就能让同一个模型在同一个基准上从 60% 掉到接近 0。这不是模型能力的变化,是「模型的能力有没有被测出来」的变化。
Prompt 本身是一门手艺(The Prompt Report 用一整篇综述在系统整理这些技巧)。但在评测语境下,它的性质变了:prompt 不再是「怎么把模型用得更好」,而是测量仪器的一部分。仪器换了,读数就换了,而被测对象没动。
Lambert 的原话意思是:对一个已经很强的领先模型,把它搞坏比多榨出一点性能容易得多。prompt 带来的增益一般小于改数据、改算法带来的增益,但 prompt 带来的损失可以是灾难性的。所以内部评测流程的第一优先级不是「找最优 prompt」,而是「确保 prompt 不是瓶颈」——让模型的全部能力能被测出来,而不是被格式卡住。
2.1 Few-shot 与对数似然打分
早期语言模型只是「聪明的自动补全」。要让它做开放式任务,办法是先给几个示例,再给一个不完整的句子让它续写——这就是 few-shot / 上下文学习(in-context learning, ICL),GPT-3 论文的核心发现,那时候还没有指令微调,更没有 RLHF。
MMLU 风格的题目在这个范式下长这样:
# Few-Shot Prompt

Below are examples of MMLU-style questions and answers:

### Example 1
Q: A right triangle has legs of lengths 3 and 4. What is the length of its hypotenuse?
Choices:
(A) 5
(B) 6
(C) 7
(D) 8

Correct Answer: (A)

### Example 2
Q: Which of the following is the chemical symbol for Sodium?
Choices:
(A) Na
(B) S
(C) N
(D) Ca

Correct Answer: (A)

### Now answer the new question in the same style:

Q: Which theorem states that if a function f is continuous on a closed interval [a,b],
   then f must attain both a maximum and a minimum on that interval?
Choices:
(A) The Mean Value Theorem
(B) The Intermediate Value Theorem
(C) The Extreme Value Theorem
(D) Rolle's Theorem

Correct Answer:
拿到这个 prompt 之后,有两种截然不同的判分方式:
(一)精确匹配(exact match):按采样参数生成一个 token,看它是不是 A/B/C/D 里正确的那个。多次采样后取众数叫多数投票(majority voting);代码类评测里对应的指标是 pass@k(生成 $k$ 个候选,至少一个通过单测就算对)。
(二)(条件)对数似然打分(log-likelihood scoring):不生成,直接看模型给每个候选答案的对数概率,最大的那个就是模型的「回答」。条件指的是以 prompt 为条件。形式化地,令 $x$ 是 prompt、$\{c_1,\dots,c_m\}$ 是候选,模型的预测是
$$ \hat{c} = \argmax_{i}\ \log \pi_\theta(c_i \mid x) $$这里有个实现分岔:$c_i$ 可以是字母「(A)」,也可以是完整答案文本「The Mean Value Theorem」。两种都合法,但难度完全不同——预测单个字母 token 的概率比预测一串多 token 的答案概率简单得多,而且多 token 的情况还要处理长度归一化(否则长答案天然吃亏,因为每多一个 token 就多乘一个小于 1 的概率)。常见做法是除以 token 数或用无条件概率做归一化。
对数似然打分是确定性的:给定权重和输入,logits 就是定值(忽略 GPU 浮点非确定性和 batch 边界效应),跑 100 遍得同一个分。
精确匹配是随机的:从 $\pi_\theta(\cdot\mid x)$ 采样天然带随机性。设某题模型答对的概率是 $p$,单次采样的正确性 $Z\sim\text{Bernoulli}(p)$。$N$ 题的评测分 $\bar{Z}=\frac1N\sum Z_i$ 的标准差是
$$ \mathrm{sd}(\bar Z) = \sqrt{\frac{1}{N^2}\sum_{i=1}^{N} p_i(1-p_i)} \le \frac{1}{2\sqrt{N}} $$取 $N=500$(GPQA Diamond 量级是 198 题,MATH-500 是 500 题),上界是 2.2 个百分点;$N=200$ 时是 3.5 个百分点。这就是为什么小基准上的一两分差距毫无意义——光是采样噪声就吃掉了它。这还没算 CoT 带来的额外方差:长推理链上任何一个 token 的分岔都会改变最终答案。
惯例上,对数似然打分主要用于预训练评测(基座模型没有问答格式,你没法要求它老老实实输出「答案是 (C)」),精确匹配是后训练的标准。Olmo 3 报告里明确采用了这个分工。
精确匹配自己的麻烦在于抽取答案:要么强制模型用固定后缀(The answer is:),要么用正则在生成文本里到处找(找 (C) 或者找答案字符串本身)。只要评测的抽取格式和模型的生成习惯不匹配,分数就会崩。做到「格式无关的评测」需要大量的打磨,实践中很少见——这正是本节开头那个「60% 掉到 0」的来源。
few-shot 时代最常见的失分原因是模型不遵守格式,而这直接被记为答错。同样,一个训得很好的推理模型如果被要求「只输出字母」,它可能仍然要先想一段,抽取逻辑抓不到答案就判错。看到某个模型在某评测上分数异常低,第一件事永远是去看几条原始生成,而不是下能力结论。few-shot 示例的条数(通常 3 到 8 条)本身也是个设计参数,会显著影响分数。
2.2 思维链 prompt
few-shot 演化中的一个关键节点,是把上下文示例里的答案写出推理过程:
# 标准 prompt
Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls.
   Each can has 3 tennis balls. How many tennis balls does he have now?
A: The answer is 11.

Q: The cafeteria had 23 apples. If they used 20 to make lunch and bought 6 more,
   how many apples do they have?
A: The answer is ...

# chain-of-thought prompt
Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls.
   Each can has 3 tennis balls. How many tennis balls does he have now?
A: Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls.
   5 + 6 = 11. The answer is 11.

Q: The cafeteria had 23 apples. If they used 20 to make lunch and bought 6 more,
   how many apples do they have?
A: The cafeteria had 23 apples originally. They..
模型会模仿示例的形态,于是也开始写推理步骤。后来这一步被更省事的显式指令取代(「Let's think step by step」),再后来被训练进模型本身。注意这个演化的方向:一开始是 prompt 技巧,然后变成模型的默认行为——今天的推理模型不需要你说「一步一步想」,它自己就会想。
2.3 零样本指令跟随
模型变强之后,评测演化到零样本。FLAN(Finetuned Language Net)证明了在一批任务上微调过的模型,能泛化到训练时没见过的零样本任务;T0 得到了类似结论。这就是指令微调(instruction fine-tuning, IFT)的出现,也是 RLHF 和整个后训练的前置条件。零样本 prompt 简单到:
User: "What is the capital of France?"
Assistant:
2022 年之后 InstructGPT 一类工作进场,模型的用法变得更加开放式,于是基于采样的评测(技术上可称 generation-based exact-match,这个说法没有公认的标准术语)越来越流行,因为它更接近真实用法。但范式切换从来不是一夜之间——ChatGPT 之后好几年里,RLHF 研究里还在用多选题评测,做法是把温度设成 0 然后采样 A/B/C/D 这几个字符。任何评测惯例的迁移都要以年计。
2.4 推理时代的评测 prompt
2024 年末到 2025 年初推理模型崛起,带来的行为变化是:每个回答前面都挂着一长段 CoT。这逼出了评测范式的最近一次大更新——带 CoT 的生成式精确匹配评测,而且温度几乎必然大于 0(推理模型在温度 0 下通常表现更差,容易陷入重复)。
做法上,很多设置会为每个题目或每个类别专门设计 prompt 来「把模型的能力抽出来」。Tülu 3 是较早系统记录这类 prompt 的工作,下面是它用于 MMLU 的模板——注意 MMLU 正是从「采样单个 token」迁移到「长 CoT + 精确匹配」的典型例子:
Answer the following multiple-choice question by giving the correct answer letter
in parentheses.
Provide CONCISE reasoning for the answer, and make sure to finish the response with
"Therefore, the answer is (ANSWER_LETTER)" where (ANSWER_LETTER) is one of (A), (B),
(C), (D), (E), etc.

Question: {question}
(A) {choice_A}
(B) {choice_B}
(C) ...

Answer the above question and REMEMBER to finish your response with the exact phrase
"Therefore, the answer is (ANSWER_LETTER)" where (ANSWER_LETTER) is one of (A), (B),
(C), (D), (E), etc.
这个 prompt 里有三个值得学的工程细节:(1)格式要求在开头和结尾各说一遍——长上下文里模型对首尾更敏感;(2)要求 CONCISE 推理——控制 token 预算,否则评测成本和方差都会爆炸;(3)用一个不容易在正文里偶然出现的固定短语作为答案锚点——「Therefore, the answer is (X)」比单独一个 (C) 好抽取得多,因为推理过程中模型很可能顺嘴提到别的选项字母。
当模型还用特殊 token 把思考区和回答区分开时(<think>...</think> 这类),抽取逻辑还得知道只在回答区找答案——在思考区找会抓到模型中途否定掉的猜测。这类细节的累积,就是「评测配置」这个黑箱的实际内容,也是为什么第 5 节要说跨实验室的数字不可比。
3. LLM-as-a-judge:把人类裁判换成模型,代价是什么
开放式生成没有标准答案,所以没法用正则判分。第一阶段的解法是找人来判,但人贵且慢。GPT-4 级别模型出现后,一个新选项打开了:让模型当裁判。这个能力在 GPT-3.5 到 GPT-4 的跃迁中「涌现」——早期模型给出的评分既不稳定也不一致,GPT-4 类模型才第一次让这件事在工程上可用。
3.1 两种裁判形态
| 形态 | 做法 | 代表 | 特点 |
|---|---|---|---|
| 单点打分(single-answer grading) | 给裁判一个回答,让它输出 1–10 分 | MT-Bench | 便宜(每条一次调用);但分数尺度漂移严重,不同批次不可比 |
| 成对比较(pairwise comparison) | 给裁判两个回答,让它选一个赢家 | AlpacaEval、Arena-Hard | 更稳定(人类和模型都更擅长比较而非打绝对分);但有位置偏置,且需要固定的参考模型 |
成对比较之所以更稳,理由和第 5 章为什么用 Bradley-Terry 而不是回归绝对分是同一个:相对判断的方差远小于绝对判断。你问一个人「这篇作文几分」,同一篇文章今天给 7 分明天给 8 分;你问「A 和 B 哪篇好」,答案稳定得多。
一个成对裁判 prompt 的骨架大致是这样(AlpacaEval 类流水线的简化版):
[System]
Please act as an impartial judge and evaluate the quality of the responses provided by
two AI assistants to the user question displayed below. You should choose the assistant
that follows the user's instructions and answers the user's question better.
Avoid any position biases and ensure that the order in which the responses were presented
does not influence your decision. Do not allow the length of the responses to influence
your evaluation. Do not favor certain names of the assistants.
Output your final verdict as: "[[A]]" if assistant A is better, "[[B]]" if assistant B
is better, and "[[C]]" for a tie.

[User Question]
{question}

[The Start of Assistant A's Answer]
{answer_a}
[The End of Assistant A's Answer]

[The Start of Assistant B's Answer]
{answer_b}
[The End of Assistant B's Answer]上面那段 system prompt 里明明白白写着「Avoid any position biases」「Do not allow the length to influence」,然而实测这些指令的效果非常有限。偏置是模型分布的性质,不是它「愿不愿意配合」的问题。指令能减轻一点,但要真正消除必须在流水线层面动手:交换顺序跑两遍、做长度控制回归。写在 prompt 里的免责声明主要是给读代码的人看的。
3.2 三种系统性偏置
位置偏置(position bias)。同样两个回答,把 A 和 B 调换位置,裁判的结论可能翻转。这直接违反了一致性的最基本要求。缓解办法是标准的:每对都跑两次,A/B 顺序各一次,只有两次结论一致才算一次决定性胜负,不一致记为平局(或者把两个方向的概率平均)。代价是评测成本翻倍——但这是必须付的。
形式化一点:设裁判在顺序 $(a,b)$ 下判 $a$ 赢的概率是 $q_{ab}$,在顺序 $(b,a)$ 下判 $a$ 赢的概率是 $q_{ba}$。无偏的裁判应有 $q_{ab}=q_{ba}$。取
$$ \hat{p}(a \succ b) = \tfrac{1}{2}\left(q_{ab} + q_{ba}\right) $$就把一阶的位置效应消掉了(假设位置效应是加性的)。
长度/冗长偏置(verbosity bias)。更长的回答更容易赢,即使信息量没有增加。这个偏置尤其恶劣,因为它和训练目标形成正反馈:你用 LLM 裁判做评测 → 长回答得分高 → 你朝着高分优化 → 模型变啰嗦 → 下一轮评测更认可啰嗦。附录 B 讨论的「chattiness」问题(越来越长、大量 markdown、emoji、无处不在的项目符号)有一部分来源就在这里。
自我偏好偏置(self-enhancement bias)。裁判模型偏爱自己(或同家族模型)生成的输出。这个最难处理:你不能靠对称化消掉它,因为它不是对称性问题,是分布匹配问题——裁判更喜欢符合自己生成习惯的文本。实际后果是:用 GPT-4 当裁判的基准,会系统性地高估 OpenAI 系模型和从 OpenAI 蒸馏出来的模型。而 2023–2024 年绝大多数开源指令模型的 SFT 数据正是从 GPT-4 蒸馏来的(见第 12 章)。唯一的缓解手段是换裁判、多裁判投票,或者干脆用人类做交叉验证。
作者在第 12 章的结论在这里同样适用:LLM 裁判擅长规模化打分,但底层的基准题目和标准答案仍然必须由人来造。「合成数据在模型可靠性超过人类的地方胜出;人类在能力前沿、在确立 ground truth、在指引训练方向上仍然不可替代。」评测正是这个分工最清晰的地方——判分可以交给模型,定义什么算好不能。
3.3 长度控制:把长度那一维扣掉
Length-Controlled AlpacaEval 给出了一个漂亮且实用的解法。思路是把「模型 $m$ 战胜基线」的概率建模成一个广义线性模型,把长度差作为一个显式的混淆变量放进去,然后在预测时把它设为 0。简化的形式是:
$$ \log\frac{\hat p(y_m \succ y_b)}{1-\hat p(y_m \succ y_b)} = \theta_m \;+\; \gamma \cdot \phi\big(\mathrm{len}(y_m) - \mathrm{len}(y_b)\big) \;+\; \delta_{\text{instr}} $$各项含义:$\theta_m$ 是模型 $m$ 的与长度无关的质量项,也就是我们真正想要的东西;$\phi(\cdot)$ 是长度差的某个单调变换(原文用 $\tanh$ 之类的有界函数,防止极端长度差主导拟合);$\gamma$ 是全局的长度敏感系数,由数据拟合出来;$\delta_{\text{instr}}$ 吸收题目本身的难度效应。拟合完之后,报告的分数是把 $\phi(\cdot)=0$(即两个回答等长)代入算出的胜率——「如果它俩一样长,谁会赢」。
效果是显著的:论文报告长度控制后,基准与 Chatbot Arena 排名的 Spearman 相关系数提升到 0.98 附近,同时对「在 prompt 里让模型写长一点」这种最廉价的刷分手段基本免疫。这个方法的思想值得推广到任何 LLM 裁判流水线:如果你知道某个表层特征(长度、markdown 密度、是否有 emoji)会污染判断,就把它作为协变量显式建模并回归掉,而不是指望 prompt 里说一句「别看长度」。WildBench 等评测也采用了类似的线性长度修正。
它只扣掉了你想到的那一维。风格偏置是多维的:markdown 标题层级、是否用表格、开场白的热情程度、结尾要不要总结……每扣一维就要多一个协变量,而且你永远不知道剩下的偏置藏在哪。这也是为什么可执行判分(跑单测、跑正则)在严肃评测里正在取代 LLM 裁判——确定性程序没有风格偏好。
4. Chatbot Arena:Elo 机制、它的真实数学,以及它为什么会脱节
Arena(原名 ChatBotArena)是社区评测的代表:用户在网页上输入一个 prompt,同时收到两个匿名模型的回答,投票选出更好的一个(或平局 / 都不好),投票之后才揭晓模型身份。它一度是「模型好不好用」最被信任的公开信号。
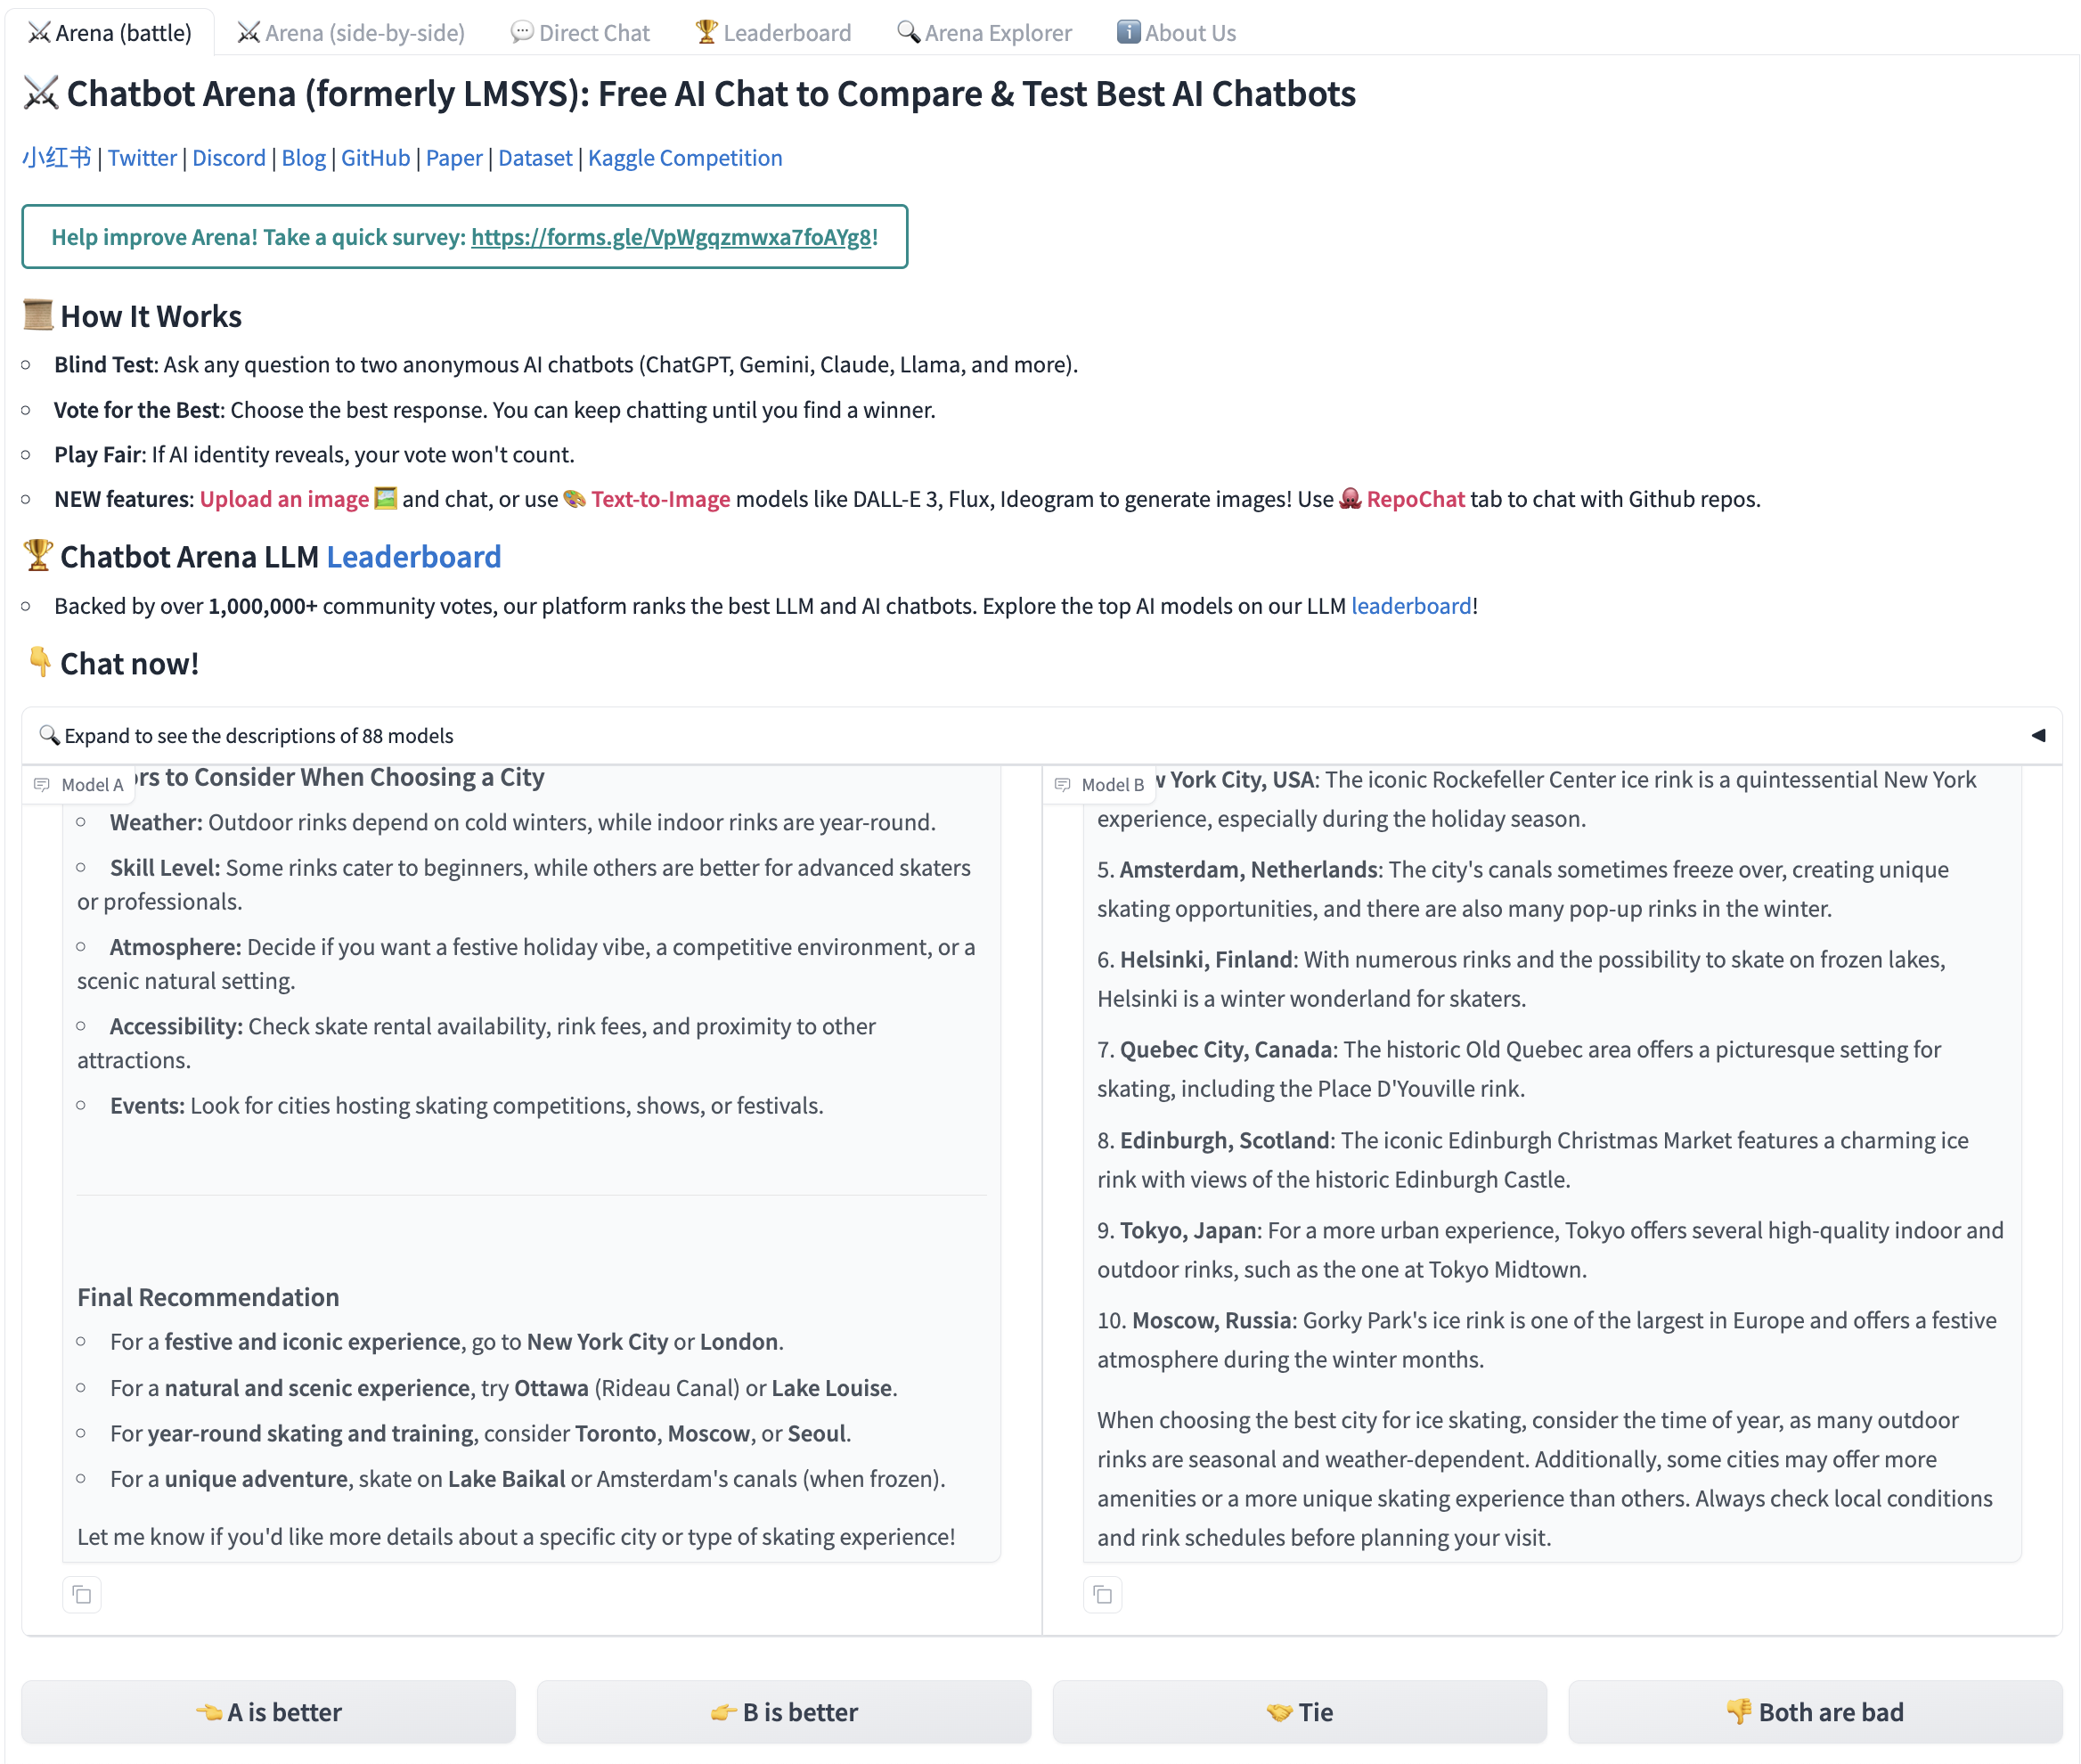
4.1 从 Elo 到 Bradley-Terry:它算的其实不是 Elo
Arena 的分数俗称「Elo 分」,这个叫法来自国际象棋的 Elo 评分系统。经典 Elo 是一个在线增量更新规则:设两位选手当前分为 $R_A, R_B$,则 $A$ 的期望胜率是
$$ E_A = \frac{1}{1 + 10^{(R_B - R_A)/400}} $$比赛结束后($S_A \in \{0, 0.5, 1\}$ 表示负/平/胜)更新:
$$ R_A \leftarrow R_A + K\,(S_A - E_A) $$$K$ 是学习率(国际象棋里通常取 10–40)。分母里的 400 是尺度常数:分差 400 对应约 10:1 的胜率,即 $E_A \approx 0.909$。分差 100 对应约 64% 胜率。
把 $10^{u} = e^{u\ln 10}$ 代进去:
$$ E_A = \frac{1}{1+e^{(R_B-R_A)\ln 10 / 400}} = \sigma\!\left(\frac{\ln 10}{400}\,(R_A - R_B)\right) $$其中 $\sigma(z)=1/(1+e^{-z})$。这正是第 5 章的 Bradley-Terry 模型 $P(i \succ j) = \sigma(r_i - r_j)$,只是把「潜在强度」$r$ 线性重标定成了 $R = \frac{400}{\ln 10} r + \text{const} \approx 173.7\,r + \text{const}$。Elo 分和奖励模型输出的标量分是同一个东西的两种单位——都只有差有意义,绝对值靠一个任意常数锚定(国际象棋锚在 1500,Arena 锚在某个基准模型上)。
再往回一步:Elo 的更新规则 $R_A \mathrel{+}= K(S_A - E_A)$ 就是对 Bradley-Terry 负对数似然做单样本随机梯度下降。因为 $\frac{\partial}{\partial r_A}\big[-\log\sigma(r_A-r_B)\big] = -(1-\sigma(r_A-r_B)) = -(S_A - E_A)$($S_A=1$ 的情形)。所以 Elo = BT + SGD,$K$ 就是学习率。
理解了这一点,就能理解 Arena 论文里的一个关键工程决定:他们并不真的在线跑 Elo,而是对全部历史投票做 Bradley-Terry 的极大似然估计。原因是在线 SGD 有两个缺点:
- 顺序依赖。同一批投票换个顺序喂进去,最终分数不同。这对排行榜是致命的——排名不该取决于谁先投的票。MLE 是全局最优解,顺序无关。
- 没有不确定性刻画。在线 Elo 只给一个点估计。MLE 可以配 bootstrap 重采样给出置信区间,这是 Arena 排行榜上那个「排名区间」列的来源——两个模型的置信区间重叠时,它们并列同一名次。
形式化:设有 $M$ 个模型,第 $t$ 次投票是模型 $a_t$ 对模型 $b_t$,结果 $S_t\in\{0,1\}$(平局按 0.5 或单独建模)。求
$$ \hat{\boldsymbol{\theta}} = \argmin_{\boldsymbol{\theta}\in\R^M} \; -\sum_{t=1}^{T}\Big[S_t\log\sigma(\theta_{a_t}-\theta_{b_t}) + (1-S_t)\log\big(1-\sigma(\theta_{a_t}-\theta_{b_t})\big)\Big] $$这就是一个逻辑回归:设计矩阵每行是一个 one-hot 差向量($a_t$ 位置 +1,$b_t$ 位置 $-1$),标签是胜负。用任何 LR 求解器几行就能算。
import numpy as np
from sklearn.linear_model import LogisticRegression

# battles: 每行 (model_a_idx, model_b_idx, label),label=1 表示 a 赢
def arena_ratings(battles, n_models, scale=400.0, base=10.0, init=1000.0):
    X = np.zeros((len(battles), n_models))
    y = np.zeros(len(battles))
    for i, (a, b, label) in enumerate(battles):
        X[i, a] = +1.0
        X[i, b] = -1.0
        y[i] = label
    # C 很大 = 几乎无正则;BT 的 MLE 在有模型全胜/全败时会发散,
    # 所以实践中总要留一点 L2(或加伪计数)
    lr = LogisticRegression(fit_intercept=False, C=1.0, max_iter=1000)
    lr.fit(X, y)
    theta = lr.coef_[0]
    # 从自然参数换算到 Elo 尺度,并把均值锚到 init
    elo = theta * scale / np.log(base)
    return elo - elo.mean() + init

def bootstrap_ci(battles, n_models, n_round=1000, alpha=0.05):
    idx = np.arange(len(battles))
    samples = []
    for _ in range(n_round):
        resample = [battles[j] for j in np.random.choice(idx, len(idx), replace=True)]
        samples.append(arena_ratings(resample, n_models))
    S = np.stack(samples)            # (n_round, n_models)
    lo = np.quantile(S, alpha / 2, axis=0)
    hi = np.quantile(S, 1 - alpha / 2, axis=0)
    return lo, hi
把 bootstrap_ci 跑一遍你就会得到一个很有教育意义的观察:新上榜、对局数少的模型,置信区间宽得吓人。区间宽度大致按 $1/\sqrt{n}$ 收缩,$n$ 是该模型参与的对局数。这解释了为什么一个模型刚上榜时排名会剧烈跳动,也解释了为什么榜单中部十几个模型的名次差异毫无意义。
4.2 Arena 为什么会和「真好用」脱节
Arena 的统计方法没有问题,问题全在数据生成过程:
(一)prompt 分布偏简单。随手来玩的用户输入的多是「写首关于秋天的诗」「解释一下量子纠缠」这种题,而不是「重构这个 3000 行的模块并保证测试通过」。在简单题上,所有前沿模型都能给出正确内容,于是投票实际是在比风格。Arena-Hard 正是为了解决这个问题而生的——用自动流水线从 Arena 真实 prompt 里筛出困难子集。
(二)风格可优化。既然投票在比风格,那么风格就是可以被针对性优化的。Llama 3 Instruct 系列在 Arena 上分数极高,业界公认的原因是它的人格更讨喜——比同期模型更简洁、更机灵。这不是作弊,这就是 Arena 在测的东西;但如果你以为 Arena 排名代表「解决问题的能力」,你就误读了这个指标。Arena 后来加了「风格控制」(style control)版本的排行榜,做法和 3.3 节的长度控制同源:把回答长度、markdown 标题数、列表数等作为协变量放进回归里再扣掉。风格控制榜和原始榜的名次差异,本身就是一个很有信息量的指标——差异越大,说明该模型的分数越依赖表层特征。
(三)投票噪声。第 11 章里那张 ChatGPT A/B 测试的图说明了一个事实:两个回答内容非常接近时,偏好标注本身就是高噪声的。Arena 上大量对局属于这种情况,标注者还是无报酬、无培训的路人。这些噪声不会造成系统偏差(会被平均掉),但会拉低有效样本量。
(四)激励污染。当榜单成为营销资产,参与者就会开始优化榜单本身而不是模型。近期有研究(如《The Leaderboard Illusion》)指出了排行榜层面的结构性问题:允许厂商私下测试大量变体、只公开最好的那个(这等价于对噪声做最大值选择,是一种 selection bias);数据访问不对称(大厂能拿到远多于小团队的对局数据用于迭代);模型下架政策造成的幸存者偏差。这些都不是统计方法的错,而是「被测者能影响测量过程」时必然出现的现象。
把评测当作目标函数来优化,就是第 14 章过优化在组织层面的复现:奖励模型被策略钻空子,排行榜被公司钻空子,机制完全一样。Goodhart 定律在这里的形态是——一个指标一旦成为目标,它就不再是好指标。正确的用法是把 Arena 当作若干个互相独立的信号之一(它擅长捕捉「用户主观喜好」这一维,这一维确实重要且其它基准测不出来),而不是唯一的北极星。
5. 为什么跨实验室的评测对比基本不可靠
这一节是本章最有实践杀伤力的部分。结论直白:各家发布会里的评测数字,只能和其它发布会里的数字在很大误差棒下比较——一个稍好或稍差的模型应当视为等价。原因是每家内部的评测流程既不受控也不公开。
5.1 噪声底线有多高
Olmo 3 项目把这件事量化了:在推理模型时代,评测配置完全固定的前提下,多数后训练评测的标准差在 0.25 到 1.5 分之间。而换 prompt 或换采样参数带来的变化会更大。
把这个数字放进你的日常判断:
| 你看到的差距 | 在 $\sigma = 1.0$ 下的解读 | 该怎么办 |
|---|---|---|
| 0.3 分 | 纯噪声 | 忽略。别写进技术报告 |
| 1 分 | 约 $1\sigma$,单次观测约 68% 可能是噪声方向抖动 | 多种子重跑 3–5 次再说 |
| 2–3 分 | 约 $2$–$3\sigma$,大概率真实 | 可信,但仍应在多个评测上交叉验证 |
| > 5 分 | 要么是真突破,要么是格式/污染 bug | 先去查 bug,尤其要看原始生成 |
注意最后一行。经验上,后训练里出现的大幅跳升,属于「抽取逻辑变了」「训练数据混进了测试集」「评测 prompt 恰好和训练格式对齐了」的概率,远高于「算法真的强这么多」。好消息永远比坏消息更需要审查。
5.2 hillclimb 与不可知的 test set
实验室在训练过程中会围绕评测「爬山」(hillclimbing)——不断做微小改动让模型在目标基准上更好。传统做法是划分训练集、开发集(validation)、留出集(test)三部分。问题在于:对公开评测来说,外界无法知道哪些被拿去训练了、哪些被真正留出了。
这不是道德指控,而是结构性问题。以 MATH 和 GSM8K 为例,它们都自带训练集,而且这些训练集的数据质量非常高。如果一家公司不打算把对应的评测当作核心跟踪指标,那么用它的训练集去训模型是完全合理的工程决定——高质量数据是模型研发的主要瓶颈之一,白放着不用才奇怪。但从外部看,你无法区分「他们在同分布 prompt 上刷高了分」和「他们真的通过通用数学数据泛化到了这个任务」。这两件事的意义天差地别。
用某评测的训练集 prompt 提升该评测的分数,和用通用数学数据训练后泛化到该评测,是两种完全不同的成就。前者的迁移性接近零。当你看到某模型在 GSM8K 上极高但在没有配套训练集的新数学基准上平平,基本可以判定是前者。这也是为什么你自建的内部 test set 必须是任何公开数据里都不存在的。
另一层不可知在于:实验室真正用来做决策的评测,很多根本不公开。GPT-4 技术报告里那套用于 scaling law 外推的交叉熵损失预测数据集就是典型例子——它是他们最重要的内部信号之一,但外界拿不到。公开报告的分数是「最后展示用的」,不是「过程中依赖的」。
5.3 营销化与配置漂移
Lambert 对这件事的措辞值得完整转述其意思:语言模型的评测栈之所以被视为营销,是因为评测没有硬的真值来源。前沿实验室内部发生的事情是,评测套件被调成适合他们自己需求的样子;结果公布时,我们拿到的是「这个函数的输出」——某家实验室对自家模型跑出的数字——但拿不到这个函数的输入。而这些输入是极度敏感的配置,OpenAI、Meta、Anthropic、Google 各不相同。业界有传闻说主要实验室会对 GSM8K、MATH 这类重要评测使用「定制 prompt」,而且这些做法演化得很快。
作者也补了一句公道话:营销之下是有善意的,起点通常是技术团队。工程师想让自己的模型被公平地展示出全部能力,于是花力气调 prompt;这个动机和「刷分」之间没有清晰的边界,只有滑坡。
再加上一层:即使是完全开放的评测标准,也很难保证可复现。推理引擎版本(vLLM/SGLang 的采样实现差异)、batch size 影响的浮点归约顺序、tokenizer 的边界处理、EOS 判定、max tokens 截断策略——每一样都能造成零点几分的漂移。
5.4 推理时算力这个新混淆变量
推理时扩展(inference-time scaling)说明模型可以通过在推理时花更多 token 来提高性能。这就引入了一个新问题:比较两个模型的分数时,必须控制推理消耗的总 token 数,但这还不是普遍做法。
举个具体的坑:模型 A 平均每题生成 2000 token 得 70 分,模型 B 平均每题生成 20000 token 得 73 分。B 更好吗?在成本约束下完全不是——把 A 跑 10 次做多数投票可能就超过 73 分了,而且延迟还更低。正确的比较方式是画一条「token 预算 vs 分数」的曲线,而不是报单点。这一点在 2025 年之后尤其重要,因为各家的「思考预算」默认值差异极大,而技术报告里通常不写。
5.5 格式冲突:一个具体的数据配方教训
后训练数据的格式会显著影响模型在不同评测格式下的表现。原文给了一个非常具体的例子:两个流行的开源数学数据集在训练时会互相冲突——
| 数据集 | 答案格式 |
|---|---|
| NuminaMath | 答案放在 \boxed{XYZ} 里 |
| MetaMath | 答案跟在 The answer is: XYZ 后面 |
同时用这两个数据集训练,效果可能比只用其中一个更差。原因是模型在答案收尾处收到了两种互相竞争的格式信号,导致它在任何一种格式下都不够坚决,而评测的答案抽取器只认一种。强模型会被训练成能适应多种格式,但它们通常仍有一个「最擅长的格式」。
混数据集时,大家习惯只关心内容质量和领域配比,很少检查答案边界的格式一致性。这是个便宜且高回报的检查项:写个脚本统计每个数据源的答案结尾模式,冲突的做统一化处理(比如全部转成 \boxed{}),然后确保评测抽取器同时支持这几种模式。这个改动经常能换来几个点,而且它属于「消除测量误差」而不是「提升能力」——但对下游决策同样重要。
5.6 三条底线 + 饱和
关于评测闭源模型,最后剩下三个确定的事实:
- 我们不知道、也不一定拿得到实验室在爬的那些关键 test set,所以很多公开评测只是代理指标。
- 前沿模型的推理链路越来越复杂(特殊系统提示、特殊 token、路由、工具),我们不知道这些如何影响评测结果。
- 我们不知道闭源评测数字所用的全部格式和细节。
这些动态加上过去几年 AI 的高速进步,共同造成了下面这张著名的图:
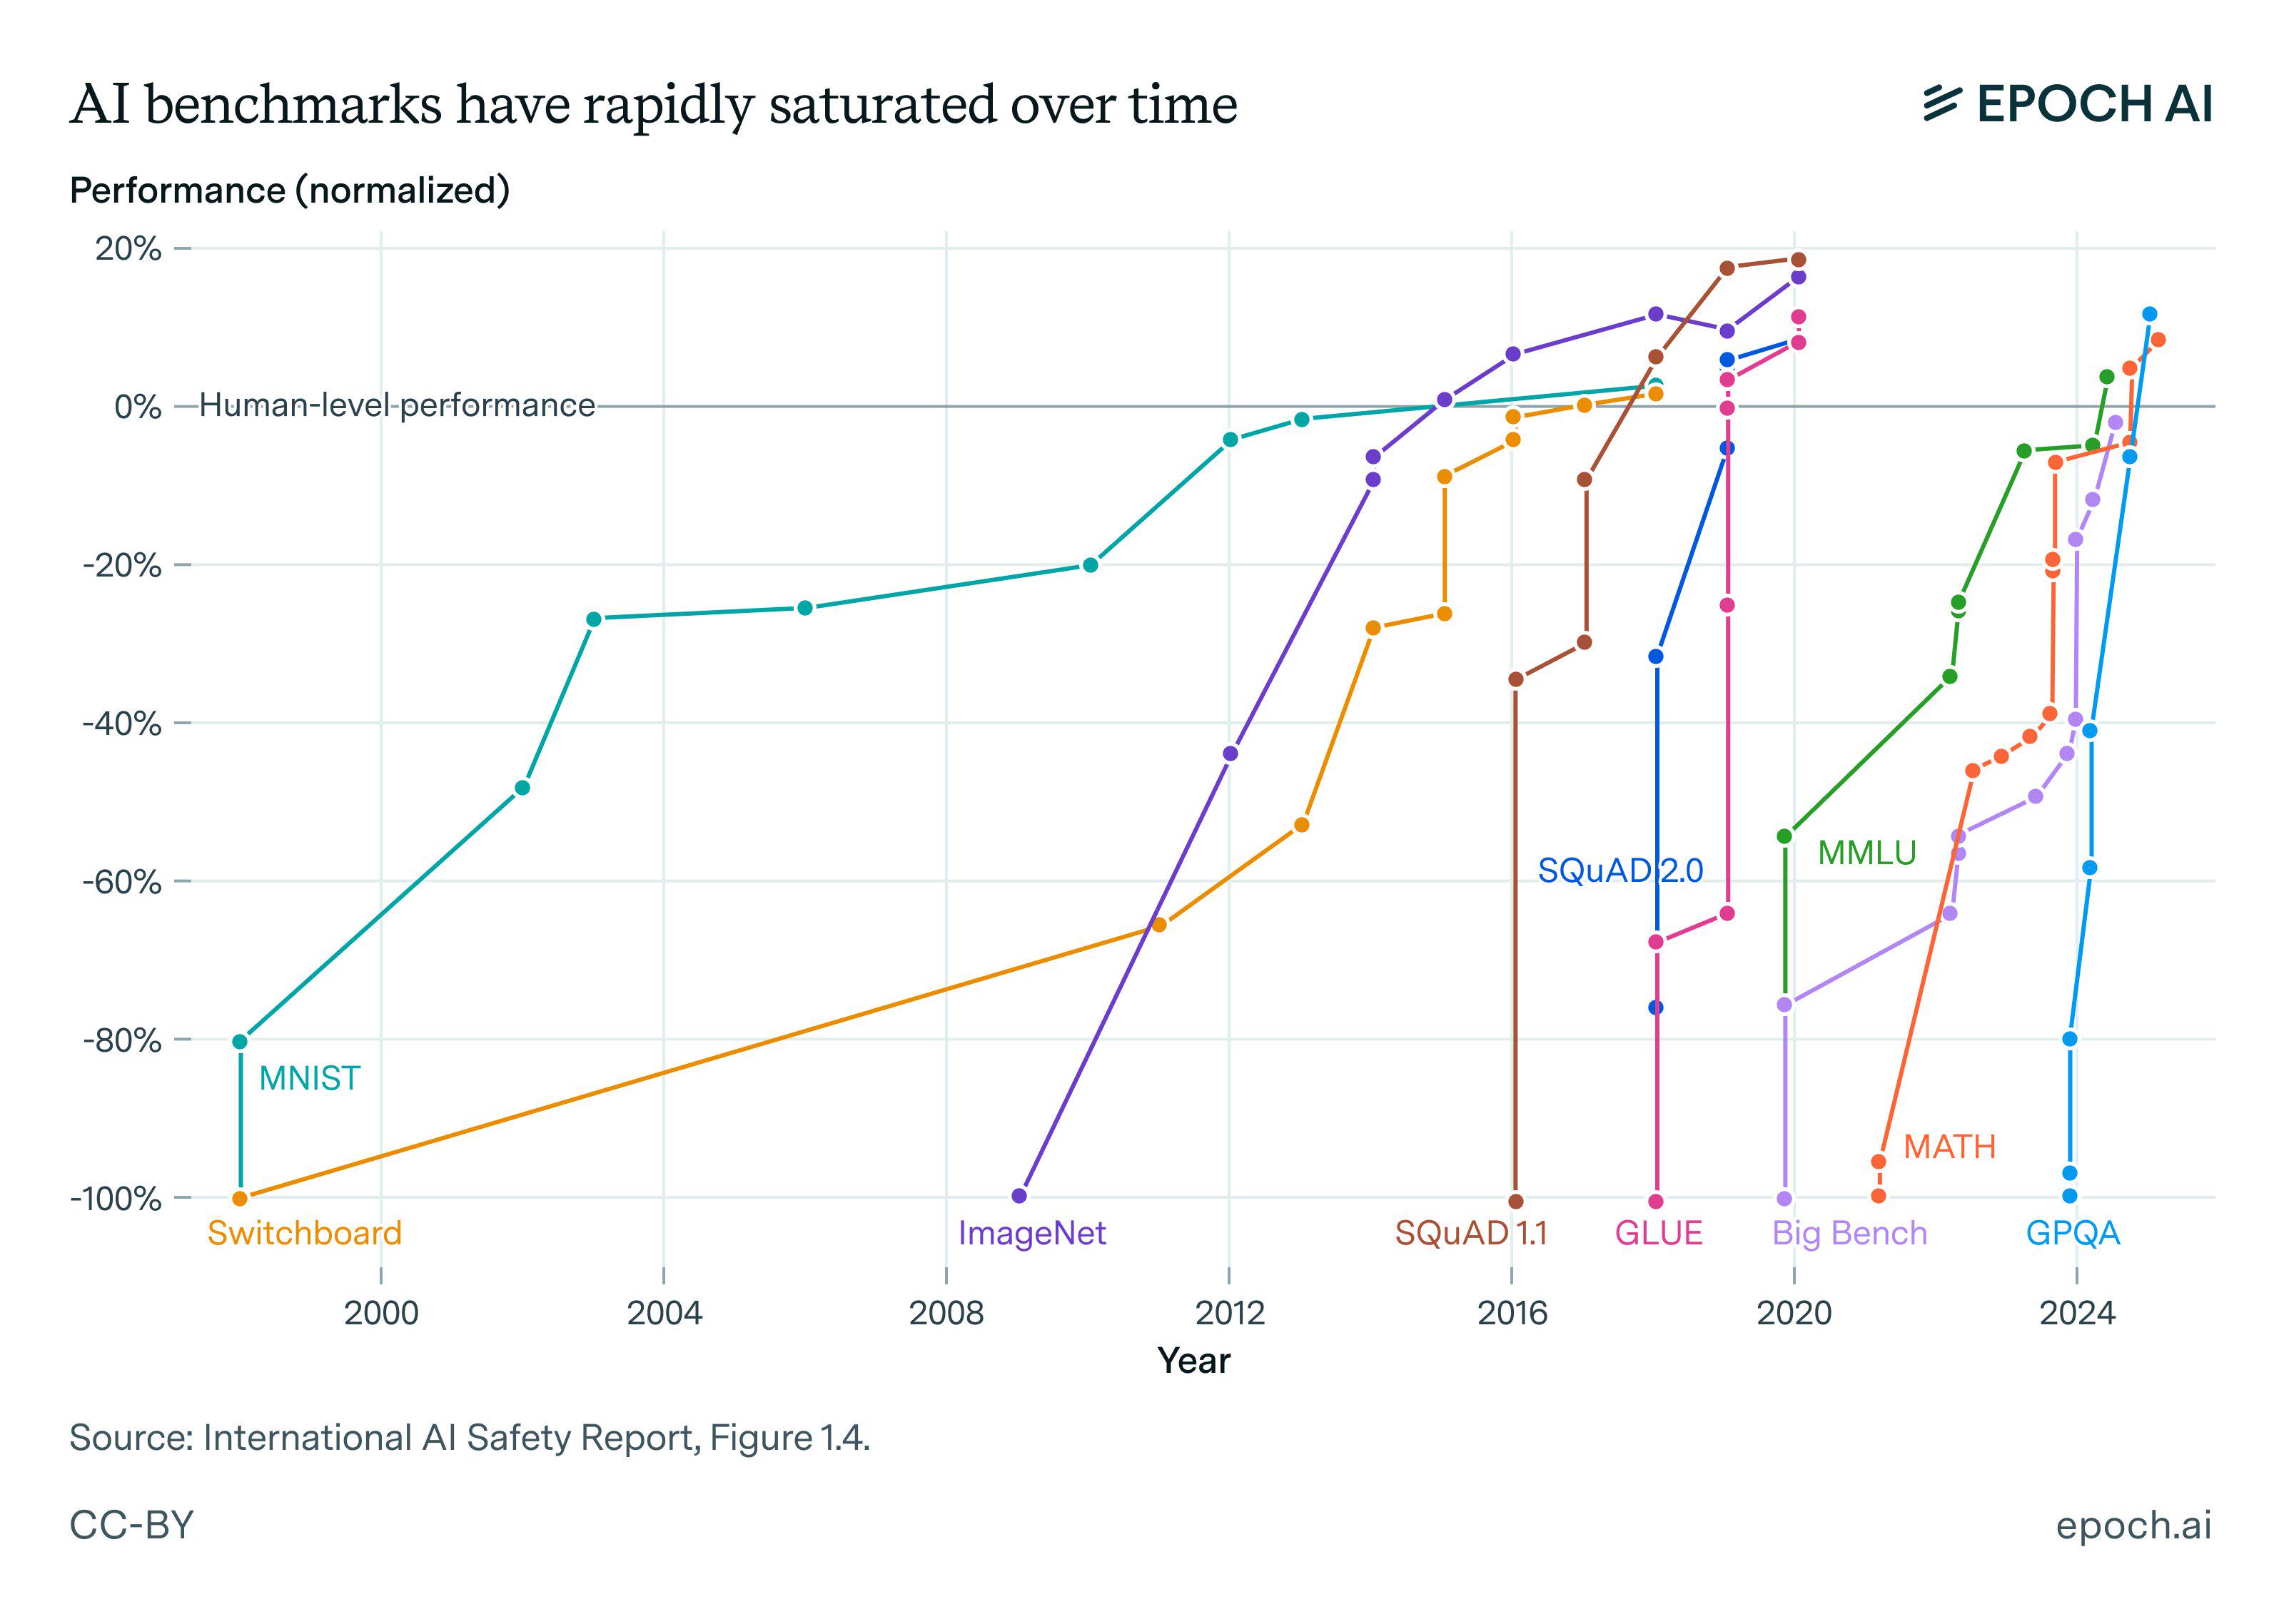
饱和还有一个隐蔽后果:基准末期的信号主要来自标注错误。当一个基准的头部模型都在 95% 以上,剩下 5% 里往往有相当比例是题目本身有歧义或答案标错。此时继续在这个基准上爬山,等于在拟合标注噪声——这与第 14 章的奖励模型过优化是同一种病。
6. 实验室内部到底怎么用评测
作者开门见山地承认:前沿模型的评测今天既是科学也是艺术,要完整描述各家怎么用评测来理解模型,需要另写一本教科书。但他给出了几条确定的观察,这几条对任何要建立内部评测体系的团队都直接可用。
6.1 关键能力是「统计功效」,不是「测得准」
这是本章最重要的一句话,值得单独拎出来:
内部改进评测对下游训练的关键作用,是提高比较两次训练运行时的统计功效(statistical power)。实验室改造评测,是为了降低他们优先关注的信号上的噪声,从而做出更有依据的训练决策。
拆解一下这句话为什么重要。假设你要判断改动 $\Delta$ 是否带来了真实提升 $\mu > 0$,你的评测有噪声标准差 $\sigma$,跑 $n$ 次取平均。检测到效应所需的样本量大致是
$$ n \;\gtrsim\; \left(\frac{(z_{1-\alpha/2} + z_{1-\beta})\,\sigma}{\mu}\right)^{2} $$在 $\alpha=0.05$、功效 $1-\beta=0.8$ 的常规设定下,括号里的系数约 2.8。关键是 $\sigma$ 出现在分子且是平方关系:把噪声减半,所需的实验次数变成四分之一。在后训练里,一次实验意味着几百到几千 GPU 小时,所以「把评测噪声减半」等价于「把实验预算翻四倍」。这就是为什么头部实验室愿意投入巨大人力在评测基建上——它是研发速度的乘数。
降噪的具体手段(每一条都在实践中被大量使用):
- 加题——按 $1/\sqrt{N}$ 收噪声。198 题的 GPQA Diamond 噪声大到几乎不能单独用作决策依据,扩到几千题就好很多。
- 每题多次采样求平均(avg@k / pass@k 的期望估计),而不是单次采样。这在有非零温度的推理模型上是必须的。
- 固定一切能固定的——种子、推理引擎版本、batch size、max tokens、系统提示。任何一项变了,历史数字就不可比。
- 配对比较——在同一批题目、同一组种子上比较两个 checkpoint,用配对检验而不是独立样本检验,能消掉题目难度的方差。这个技巧几乎免费,收益很大。
- 去掉退化题——所有候选模型都做对或都做错的题目对区分度贡献为零,只贡献成本。周期性剔除它们能在同样算力下提高信息量(但要小心这会让基准逐渐偏向当前模型的弱点分布)。
6.2 哪些评测被当成真正的 test set
不同团队会选择在不同的评测上「保持独立」——即真的把它当留出集,绝不碰其训练数据、绝不为它调 prompt。但没有人公开自己选了哪些。这是有意为之:一旦公开,那个评测就会被其它团队当作攻击目标,很快失去意义。
这给你的启示是具体的:你自己的评测体系里必须有一组「圣地」(sacred set)——一小批题目,只用于最终决策,不参与任何 prompt 调优、不用于 early stopping、不在训练监控面板上显示。人性使然,任何你天天盯着的数字最终都会被优化。把最重要的那个信号藏起来,是保护它的唯一办法。
6.3 实验室会重造评测,而不只是使用评测
当现有评测不满足需求时,实验室会直接改造它。公开的例子是 OpenAI 发布 SWE-Bench Verified:原始 SWE-Bench 里有相当比例的任务本身有问题(issue 描述不足以确定解法、测试用例过严会误杀正确解、环境配置无法复现),OpenAI 请人工审核出一个 500 题的清洁子集。这不是刷分,这是在修测量仪器——一个含大量假阴性的基准,其噪声会淹没真实信号。
类似的动机也解释了评测焦点的迁移史:某个阶段焦点是 MMLU;推理模型崛起时,社区对科学能力的关注让 GPQA 极度流行。每家前沿实验室都还自建或购买了大量公众拿不到的内部评测。
6.4 后训练评测高度依赖人类评估
值得强调的一点:后训练的评测与人类评估深度共生。对生成式模型,人类评估产出 Elo 排名(早期 Anthropic 的论文如 Constitutional AI 就大量使用这种形式);对奖励模型,人类评估给出的是一致率(agreement,即 RM 的偏好方向与人类标注是否相同)。这些也可以通过给用户提供两个模型做 A/B 测试来获得(见第 11 章)。
换句话说,公司内部真正的「北极星」往往不是任何公开基准,而是自家产品流量上的 A/B 测试胜率。这个信号有三个不可替代的优点:prompt 分布就是真实用户分布(不是别人猜的)、样本量巨大(每天百万级)、而且它直接对应商业结果。缺点是延迟高(要上线才能测)、只有拥有产品的公司才有。
6.5 评测本身正在变成一项算力开销
最后一条现实约束:现代评测涉及大量 token 生成(而不只是看答案的对数概率),因此有实打实的算力成本。一个包含长 CoT 的多领域评测套件,跑一遍可能要几百到几千 GPU-小时;如果你还要多种子、多采样来降噪,成本再乘几倍。
这就形成一个真实的资源分配决策:训练算力 vs 评测算力。经验上,多数团队在评测上投入不足——他们宁可多跑一个训练实验,也不愿把算力花在「把上一个实验的结论搞确定」上。但按 6.1 节的平方关系,这个取舍常常是错的:当 $\sigma$ 大到你根本分辨不出两个 checkpoint 时,多跑的实验产出的是随机数。
作者也直言,公认的事实是前沿实验室会用一些小技巧来提升各类任务的表现——最常见的解释就是针对特定评测的一次性 prompt。理解这一点,你就知道为什么复现别人报告的数字通常是徒劳的。
「把精力集中在你自己的模型上,是唯一能接近可复现评测技术的办法。」不要花时间去复现某家公司报告的分数,也不要用「我们在 X 上比 GPT-4o 高 0.8 分」来说服自己。建立一套内部一致、噪声已被测量、且包含保密留出集的评测流程,比追逐任何公开榜单都更有价值。
7. 污染:最普遍、最难证明的失效模式
当前语言模型实践中的一个重大问题(不限于 RLHF 和后训练)是:有意或无意地把评测数据集里的数据用进了训练。这叫数据集污染(dataset contamination,属于数据泄漏 data leakage 的一种),对应的清理操作叫去污染(decontamination)。
7.1 污染是怎么发生的
途径很多,最常见的是从网上爬训练数据——而且这在多个训练阶段都会发生。具体机制:
- 基准题目本身就挂在能被爬虫抓取的公开域名上(GitHub、HuggingFace、论文附录、博客讨论)。
- 用户把基准题目粘进模型对话框,这些对话又进入了未来模型的候选训练数据。这条路径尤其阴险,因为它是被动发生的,而且随着模型使用量增长会越来越严重。
- 合成数据流水线用某个强模型生成数据,而那个强模型本身被污染过,它「记得」基准的答案并把它写进了合成数据。
7.2 怎么查:n-gram 重叠
标准做法是在训练集和测试集之间做搜索,找词/子词 token 上的 n-gram 重叠,或者固定长度的字符子串匹配(例如 50 个字符)。
from collections import defaultdict

def ngrams(text, n=8):
    toks = text.lower().split()
    return {tuple(toks[i:i + n]) for i in range(len(toks) - n + 1)}

def build_index(eval_prompts, n=8):
    """把评测集的所有 n-gram 建成倒排索引:ngram => 评测样本 id 集合"""
    idx = defaultdict(set)
    for i, p in enumerate(eval_prompts):
        for g in ngrams(p, n):
            idx[g].add(i)
    return idx

def find_contaminated(train_prompts, idx, n=8, min_hits=1):
    """返回 (训练样本 id, 命中的评测样本 id 集合)"""
    hits = []
    for j, p in enumerate(train_prompts):
        matched = set()
        for g in ngrams(p, n):
            matched |= idx.get(g, set())
        if len(matched) >= min_hits:
            hits.append((j, matched))
    return hits
几个必须知道的参数选择问题:
| 参数 | 调大的后果 | 调小的后果 |
|---|---|---|
| $n$(n-gram 长度) | 漏检:改几个词就躲过去了 | 误杀:常见短语(「计算下列积分的值」)会匹配一大片正常数据 |
| 归一化强度(小写、去标点、去空白) | 更鲁棒,也更容易误杀 | 更精确,但对格式改写完全无效 |
| 匹配对象(只查 prompt vs 查 prompt+答案) | 只查 prompt 更保守,因为同一道题的不同解法是合法训练数据 | 查答案能抓到直接抄标准解的情况 |
Tülu 3 用的是 8-gram 从训练 prompt 到评测集精确 prompt 的重叠。作者在去污染他们的评测套件时,发现流行的开源数据集普遍被 RLHF 常用评测污染了:
| 被污染的训练数据集 | 污染源评测 | 说明 |
|---|---|---|
| UltraFeedback | TruthfulQA | 当年最主流的 DPO 偏好数据集,被最主流的真实性评测污染 |
| Evol-CodeAlpaca | HumanEval | 代码指令数据 ↔ 代码基准 |
| NuminaMath | MATH | 数学 SFT 数据 ↔ 数学基准 |
| WildChat | 多个安全评测 | 真实用户对话里含有安全评测的题目——用户把题粘进去了 |
这些是 2023–2024 年最常用的四个开源后训练数据集。如果你的流水线用了它们中的任何一个,并且用对应的评测报告结果,那么你的数字里已经含有污染——除非你自己跑过去污染。这不需要任何人有恶意,只是数据爬取的自然结果。任何严肃的后训练项目都应该把「对全部训练数据 × 全部评测集跑一遍 n-gram 去污染」当作流水线的固定步骤,而不是可选项。
7.3 更难的情况:近似污染与基座模型污染
n-gram 只能抓字面重叠。另一类情况是模型训练在与基准非常接近但不完全相同的数据上——例如数学题的文字完全一样,只把数字改了。这种数据 8-gram 查不出来(数字换了会打断 n-gram),但模型实际上已经学会了这道题的解题模板。
这种污染在后训练里会造成非常诡异的现象,最著名的一个是:用随机奖励做 RL 也能让基准分数上涨。这是一个人为构造的设定——按理说,如果奖励信号完全是噪声,RL 不可能带来任何真实能力提升。它之所以还能涨分,只可能是因为模型已经「知道」答案,RL 只是把这个已有能力从模型内部激发(elicit)出来,比如让它更倾向于输出评测抽取器认识的格式。《Spurious Rewards: Rethinking Training Signals in RLVR》和《Reasoning or Memorization?》两项工作都指出,这类基座模型污染——你无法确切证明模型为什么会这样表现——是早期一大批基于 Qwen 2.5 / Qwen 3 基座的 RLVR 工作的重大混淆变量。
你可以把自己的 SFT 和 RL 数据清得干干净净,但如果基座模型在预训练时就见过基准,你的 RLVR 实验结论仍然是不可靠的。实践建议:(1)在多个不同来源的基座上复现你的关键结论——如果只在某一个基座家族上成立,高度可疑;(2)设置随机奖励对照组,如果随机奖励也能涨分,那你的方法涨的那部分里有多少是真的?这个对照组很便宜,但极少有人做。
7.4 对不公开数据的模型怎么办:扰动版基准
面对不披露、也不发布训练数据的模型,社区的办法是造扰动版基准:把原始题目做轻微改写(换数字、换变量名、改叙述顺序、换等价表述),看哪些模型的表现会崩。MATH-Perturb 就是针对 MATH 做的这件事。
关键的解读纪律在这里:在扰动基准上方差大,并不等于污染被证实——污染极难被严格证明。它也可能说明这个模型被训练成只适应某种特定格式,而这种适应不迁移到真实世界表现。但从下游使用者的角度看,这两种解释的结论是一样的:这个模型的原始基准分数高估了它的实际能力。
把它变成你可以立即用上的方法论:为你最看重的每个内部评测都准备一个扰动版。两个版本的分差就是一个直接可读的「脆性指标」。差得越多,说明你的模型(或你的评测)越依赖表层模式。这个检查便宜到近乎免费,而信息量极大。
8. 工具链与自建评测体系的实践建议
8.1 开源评测框架一览
不必从零造轮子,可选的开源评测工具已经不少。原文列出的这几个,各自的定位不同:
| 工具 | 出品方 | 定位与适合场景 |
|---|---|---|
| Inspect AI | 英国 AI 安全研究所 | 为安全评估设计,把评测建模成 solver/scorer 的可组合流水线,原生支持 agent 与多轮工具调用。做危险能力评估、红队评测首选 |
| LightEval | HuggingFace | 轻量、易改,驱动过 Open LLM Leaderboard。适合快速加自定义任务 |
| lm-evaluation-harness | EleutherAI | 基建来自 GPT-NeoX。它包含一套完整的 GPT-3 时代评测设置与配置,是复现预训练/基座评测(对数似然打分那一路)的事实标准 |
| OLMES | Ai2 | 作者本人所在机构的库,核心卖点是把评测配置本身标准化(few-shot 条数、答案抽取、归一化方式全部写死并公开),正对本章第 5 节的痛点 |
| HELM | 斯坦福 CRFM | 「整体评估」路线:不只报准确率,还报校准度、鲁棒性、公平性、效率等多个维度。适合做全面的模型画像 |
| Eval Gauntlet | Mosaic / Databricks | 面向训练过程中的持续监控设计,跑得快 |
选型的一条经验:如果你要报告基座模型的数字,用 lm-evaluation-harness 或 OLMES(它们的配置是社区共识,可比性最好);如果你要评自己的后训练模型并做训练决策,几乎必然要自己写抽取和判分逻辑,此时选一个容易改的框架(LightEval、Inspect)比选一个功能最全的更重要。
8.2 搭一套内部评测体系的清单
把本章所有结论收敛成一份可执行清单。这是作为模型发布方(而不是论文读者)真正需要做的事:
- 先量噪声,再看分数。第一件事不是跑评测,而是把同一个 checkpoint 用不同种子跑 5 遍,算出每个评测的标准差。这个数字会永久性地改变你读所有实验结果的方式。没有这个数字,你后面所有的「提升了 X 分」都是没有单位的。
- 分三层建套件。
- 烟雾测试层(几分钟):几十条题,只用来抓「模型崩了/格式坏了/推理服务挂了」这类灾难。每个 checkpoint 必跑。
- 开发层(几十分钟):覆盖你关心的所有能力域,用于日常爬山。允许在这一层上调 prompt。
- 圣地层(几小时,只在里程碑跑):完全保密、绝不调优、包含扰动版。用于最终 go/no-go 决策。
- 能用程序判分就绝不用模型判分。优先级:单元测试 > 正则/字符串匹配 > 结构化约束验证(IFEval 式)> LLM 裁判 > 人类评估。往下走一级,噪声和偏置都上一个台阶,但覆盖的能力域也更宽——所以最终你两头都需要,只是要清楚每个数字的可信度不同。
- 用 LLM 裁判时,把偏置当工程问题处理。位置交换跑双向;长度做回归控制;裁判模型和被测模型不同源;固定裁判模型版本(API 模型会静默更新,会让你的历史数字全部作废——这是个真实且常见的坑,务必固定到具体的版本号快照)。
- 去污染进流水线。每次数据配方变更,自动对全部训练数据 × 全部评测集跑一次 8-gram 检查,把报告存档。同时留意基座模型的污染,用多基座复现和随机奖励对照来兜底。
- 报告 token 预算。任何评测数字旁边都应该有「平均生成 token 数」。没有这个数,推理模型之间的比较是无意义的。
- 看原始生成,而且要定期看。这是最反直觉但收益最高的一条。每周花半小时读几十条模型在评测上的实际输出,你能发现的问题(抽取 bug、模型在钻空子、题目本身有歧义、模型学会了讨好裁判)比看任何聚合数字都多。这也是「vibe check」之所以在业界长盛不衰的原因——它补的正是基准测不到的那部分。
- 准备好换掉饱和的评测。当一个基准上你所有候选模型都在 90% 以上,它就该退休了。留着它只会浪费算力并给你虚假的安全感。
8.3 「刷榜」和「真好用」为什么越来越脱节
把前面的线索串起来,这个大家都有直观感受的现象就有了完整的机制解释:
| 机制 | 造成的脱节 |
|---|---|
| 饱和 | 公开基准的头部区间已经没有区分度,剩下的差异是噪声和标注错误 |
| 污染 | 分数里混入了记忆的成分,这部分完全不迁移到新问题 |
| 格式适配 | 模型被训练成擅长评测的输出格式,而不是擅长任务本身 |
| 裁判偏置 | LLM 裁判奖励长度和风格,产品用户其实想要简洁准确 |
| 选择偏差 | 厂商私下测大量变体只公布最好的,等于对噪声取最大值 |
| 分布错配 | 基准的 prompt 分布(学术题、竞赛题)和真实工作负载(长上下文、多轮、工具调用、代码库级任务)差异巨大 |
| 测不到的维度 | 可靠性、拒绝率的合理性、人格一致性、长对话稳定性、工具调用的失败恢复——这些决定产品体验,但几乎没有公开基准覆盖 |
最后一行是通往第 17 章的桥。当所有前沿模型在公开基准上都挤在同一个区间时,差异化必然发生在基准测不到的维度上——模型的性格、语气、拒绝方式、在长期使用中给人的信任感。这不是「基准失效了所以我们只能靠感觉」,而是说:评测的前沿正在从「能不能做对」转移到「以什么方式做对」,而后者目前主要靠人类评估、产品 A/B 测试和精心设计的行为探针来测量。
本章的所有内容最终指向同一个结论。训练算法在过去两年基本收敛(PPO/GRPO 一族 + DPO 一族),数据配方在开源社区高度透明,算力的差距是资本问题。真正把团队分成三六九等的,是能不能在噪声里可靠地识别出改进。一个评测噪声比对手低一半的团队,等价于拥有四倍的实验预算。这就是为什么评测——一个听上去像收尾工作的环节——是后训练最大的瓶颈,也是投入回报率最高的地方。
本章小结
速查表:评测范式演化
| 时代 | 模型形态 | prompt 方式 | 判分方式 | 代表基准 |
|---|---|---|---|---|
| GPT-3 时代 | 自动补全 | few-shot(3–8 例) | 条件对数似然 | MMLU、HellaSwag |
| IFT 时代 | 指令跟随 | zero-shot | 温度 0 采样单 token | MMLU、BBH |
| 早期对话(2023) | RLHF 对话模型 | zero-shot 开放式 | LLM 裁判打分/比胜负 | MT-Bench、AlpacaEval、Arena-Hard |
| 多技能(2024) | 通用后训练模型 | zero-shot + 少量 CoT | 混合:精确匹配 + 单测 + 正则 | Tülu 套件(MMLU/GSM8K/HumanEval/IFEval/安全) |
| 推理与工具(2025+) | 长 CoT + 工具 | 专门设计的锚点 prompt,温度 > 0 | 生成式精确匹配 + 可执行验证 | GPQA Diamond、HLE、SWE-Bench Verified、LiveCodeBench、AIME |
要点清单
- 评测范式是训练范式的倒影。训练方式变了,评测方式必须跟着变,否则你测的是格式适配而不是能力。
- 先测噪声。固定配置下多数后训练评测的标准差是 0.25–1.5 分。不知道自己评测的 $\sigma$,就没有资格解读任何分差。
- $n \gtrsim (2.8\sigma/\mu)^2$。噪声减半 = 实验预算翻四倍。这是内部评测建设的全部经济学理由。
- 对数似然打分确定性、适合基座模型;精确匹配有采样噪声、是后训练标准,麻烦在答案抽取。$N$ 题基准的采样噪声上界是 $1/(2\sqrt N)$。
- prompt 格式能让 60% 掉到接近 0。评测 prompt 的目标不是「最优」,是「不成为瓶颈」。答案锚点短语要选不会在正文里偶然出现的。
- LLM 裁判三偏置:位置(双向跑求平均可解)、长度(回归控制可解)、自我偏好(只能换裁判)。在 prompt 里写「请勿有偏置」基本无效。
- Arena 分数 = Bradley-Terry 的 MLE,不是在线 Elo。Elo 的更新规则本身就是 BT 损失的单样本 SGD,$K$ 是学习率,400/ln10 ≈ 173.7 是单位换算系数。用 MLE 是为了顺序无关 + 可给 bootstrap 置信区间。
- Arena 的问题不在统计,在数据:prompt 偏简单 → 实际在比风格 → 风格可被优化。风格控制榜与原始榜的名次差是个有用的诊断量。
- 同分布提升 ≠ 泛化。MATH/GSM8K 自带高质量训练集,用它们训练是合理工程决策,但会让对应评测分数失去外部意义。
- 污染四例(Tülu 3 用 8-gram 查出):UltraFeedback↔TruthfulQA、Evol-CodeAlpaca↔HumanEval、NuminaMath↔MATH、WildChat↔安全评测。这四个是当年最主流的数据集。
- 随机奖励也能涨分是基座污染的红旗。做 RLVR 实验务必设随机奖励对照组,并在多个基座家族上复现。
- 格式冲突会互相抵消:NuminaMath 的
\boxed{}与 MetaMath 的The answer is:混训可能比单用一个更差。 - 饱和是宿命。基准末期的剩余信号主要来自标注错误,此时继续爬山等于拟合噪声。
- 推理时算力必须被控制。任何评测数字旁边都该有平均生成 token 数,否则推理模型之间不可比。
- 专注自己的模型是唯一能接近可复现评测的路径。别去复现别人的数字。
动手实验
本章没有配套代码模块,但下面四个实验都能在一张消费级 GPU(或几美元的 API 额度)上完成,且每一个都会颠覆一点你对评测数字的信任。
实验 1:量出你自己评测的噪声(必做)
取一个 3–8B 的开源指令模型和一个 200–500 题的基准(GSM8K test 子集就行)。固定 checkpoint 不变,只改随机种子,跑 5 次,记录每次的分数。
- 算这 5 个分数的标准差,和 $1/(2\sqrt N)$ 的理论上界比一比。
- 把温度从 0.0 改到 0.7 再跑 5 次,看 $\sigma$ 涨了多少。
- 观察目标:你会得到一个具体的数字,比如「我的 GSM8K 评测 $\sigma \approx 1.2$」。从此以后,任何小于 2.4 分的差异你都不会再当真。
实验 2:prompt 格式的破坏力
同一模型、同一批 MMLU 题目,跑四种设置:
- 5-shot + 对数似然打分(选字母)
- zero-shot + 要求直接输出字母,正则抓
(X) - zero-shot + 第 2.4 节的 Tülu 3 锚点 prompt,抓
Therefore, the answer is (X) - 和 3 相同,但把抽取正则改成「在全文里找第一个
(A)|(B)|(C)|(D)」
- 观察目标:设置 4 相对设置 3 的分数下降,全部来自「模型在推理过程中提到了别的选项字母」。这一个对照就能让你明白为什么「答案锚点要选不会偶然出现的短语」。同时统计每种设置下「抽取失败」的比例——这个数字通常比大家想象的高。
实验 3:复现 LLM 裁判的位置偏置
准备 100 对回答(可以用两个不同模型对同一批 prompt 生成)。用同一个裁判模型跑两遍:一遍 (A, B) 顺序,一遍 (B, A) 顺序。
- 算翻转率:两次结论不一致的比例。
- 算位置倾向:裁判判「第一个位置赢」的总比例,无偏应该是 50%。
- 在 system prompt 里加上「Avoid any position biases」再跑一遍,看这两个指标变了多少。
- 观察目标:翻转率通常显著大于 0,而那句免责声明的效果小到令人失望——这就是第 3.1 节那个误区的实证。
实验 4:长度偏置与长度控制
用同一个模型对同一批 prompt 生成两组回答:一组正常,一组在 system prompt 里加「请详细展开,至少写三段」。内容信息量基本相同,只是长度不同。让裁判两两比较。
- 观察目标:长版本的胜率会显著超过 50%。然后按第 3.3 节拟合一个带长度协变量的逻辑回归,看把 $\phi(\cdot)$ 置零后两组的质量项 $\theta$ 是否收敛到一起。这是理解长度控制为什么有效的最快方式。
实验 5(进阶):自建一个扰动版基准
取 100 道 GSM8K 题,写脚本把题目里的所有数字随机替换(同时重算标准答案),人名、物品名也换掉。对比模型在原版和扰动版上的分数。
- 观察目标:分差就是这个模型在这个基准上的「脆性」。在几个不同基座家族的模型上做同样的对比,你会看到差异很大——这正是第 7.3 节说的基座污染混淆变量在你自己手里的样子。
延伸阅读
评测范式与 prompt 格式
- Language Models are Few-Shot Learners (GPT-3, 2020) — few-shot / in-context learning 的原始来源,也是对数似然打分范式的起点。
- Leveraging Large Language Models for Multiple Choice Question Answering (ICLR 2023) — 本章那个
(A)/(B)/(C)/(D)格式的提出者,解释了为什么让模型看到选项字母比逐个算答案概率更好。 - Chain-of-Thought Prompting Elicits Reasoning in LLMs (2022) — CoT 示例的原始论文,理解「prompt 技巧最终变成模型默认行为」这条演化线的起点。
- Large Language Models are Zero-Shot Reasoners (2022) — 「Let's think step by step」的出处,一句话顶一堆 few-shot 示例。
- Finetuned Language Models are Zero-Shot Learners (FLAN, ICLR 2022) — 指令微调的奠基工作,零样本评测范式的技术前提。
- The Prompt Report: A Systematic Survey of Prompting Techniques (2024) — 想系统了解 prompt 手艺的话读这篇,不必逐页读,当手册查。
LLM 裁判与主观评测
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (2023) — 本章第 3 节的主要依据。位置偏置、冗长偏置、自我偏好偏置的系统分析都在这里,同时给出了 GPT-4 裁判与人类一致率的实测。
- Length-Controlled AlpacaEval (2024) — 长度控制的完整方法。这套「把已知混淆变量显式回归掉」的思路值得用在任何 LLM 裁判流水线上。
- From Crowdsourced Data to High-Quality Benchmarks: Arena-Hard and BenchBuilder Pipeline (ICML 2025) — 怎么从真实用户 prompt 里自动筛出有区分度的困难子集,解决 Arena prompt 偏简单的问题。
- Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference (ICML 2024) — Arena 的方法论论文,Bradley-Terry MLE + bootstrap 置信区间的具体做法在这里。
评测的可靠性、饱和与污染
- Olmo 3 (2025) — 本章 0.25–1.5 分标准差这个关键数字的来源,也是目前公开度最高的完整后训练评测实践记录。
- Tülu 3: Pushing Frontiers in Open Language Model Post-Training (2024) — 去污染发现、CoT 评测 prompt、多技能评测套件设计的一手材料。想抄一套评测方案的话从这篇抄。
- Evaluation Data Contamination in LLMs: How Do We Measure It and (When) Does It Matter? (2024) — n-gram 去污染方法的系统研究,也讨论了「什么程度的污染才真的影响结论」。
- Spurious Rewards: Rethinking Training Signals in RLVR (2025) — 随机奖励也能涨分的那篇。做 RLVR 之前必读,能省下你几个月的错误结论。
- Reasoning or Memorization? Unreliable Results of RL due to Data Contamination (2025) — 与上一篇互补,把基座污染这个混淆变量讲透。
- MATH-Perturb: Benchmarking LLMs' Math Reasoning Abilities against Hard Perturbations (ICML 2025) — 扰动版基准的代表作,本章实验 5 的方法来源。
- GPT-4 Technical Report (2023) — 读它是为了看「用于 scaling 预测的交叉熵数据集不公开」这件事,理解公开分数和内部信号的区别。
基准本身
- MMLU (2020) · TruthfulQA · BIG-Bench Hard — 多技能时代的知识与推理三件套。
- MATH (2021) · GSM8K (2021) — 两个自带训练集的数学基准,第 5.2 节「同分布 vs 泛化」讨论的主角。
- HumanEval (Codex, 2021) · HumanEval+ / EvalPlus (2023) — EvalPlus 展示了原始测试用例有多松,是「基准质量本身是个变量」的最好例子。
- IFEval (2023) — 可程序化验证的指令约束,RLVR 思路在指令跟随域的先声。
- GPQA (2023) · Humanity's Last Exam (2025) — 推理时代的难度上限。
- LiveCodeBench (2024) · SWE-Bench+ (2024) · SWE-Bench Verified (2024) — 抗污染设计与「修测量仪器」的三个实例。
评测工具
- Inspect AI — 英国 AI 安全研究所出品,agent 与多轮工具评测的框架设计值得学习。
- EleutherAI lm-evaluation-harness — 复现基座模型评测的事实标准,含完整的 GPT-3 时代配置。
- LightEval — 轻量易改,适合快速加自定义任务。
- OLMES: A Standard for Language Model Evaluations (NAACL Findings 2025) — 把评测配置本身标准化,直接针对本章第 5 节的可比性痛点。
- HELM: Holistic Evaluation of Language Models (TMLR 2023) — 多维度模型画像,看看除了准确率还能测什么。