合成数据与蒸馏
今天绝大部分后训练数据不是人写的,是模型生成的——这一章讲这些数据怎么造、怎么筛,以及知识蒸馏为什么重新变成了训练算法的核心。
0. 本章导读
RLHF 里的 H 是 human。这个字母在 2022 年是字面意思:人类是当时唯一能写出足够高质量回答的来源,也是唯一能提供可靠反馈来训练奖励模型(Reward Model, RM)的来源。这个前提在两年内彻底崩塌了。
本章回答一个很具体的问题:你现在要训一个模型,SFT 数据从哪来?偏好数据从哪来?RL 的奖励从哪来? 三个问题的答案在 2026 年基本都是同一个词——另一个语言模型。第 4 章教你怎么做指令微调,第 5 章教你怎么训 RM,第 9 章教你怎么做拒绝采样,第 11 章讲偏好数据的形态;但那些章节都默认「数据已经在那里了」。本章补上这个缺口。
同时,本章把这条产业链上最技术化的一支——知识蒸馏(Knowledge Distillation, KD)——从 2015 年的原始形式一路推导到 2026 年前沿实验室在用的 on-policy 蒸馏。之所以放在一起讲,是因为现代后训练里大部分合成数据管线在数学上就是蒸馏管线:一个更强的模型产出标签、completion、logits 或批评意见,一个学生模型在这些信号上被训练。区别只在于信号的粒度(整条序列还是每个 token)和采样的来源(教师采样还是学生采样)。把这条线理清楚,你就能看懂 Qwen3、MiMo-V2-Flash、GLM-5、DeepSeek-V4-Pro 这批技术报告里那些看起来很新的名词。
- 合成数据不是权宜之计,是必需品。 领先模型必须用合成数据才能达到最好性能。这件事有一个明确的能力阈值:GPT-4 级模型出现之前,语言模型既不能可靠地生成数据,也不能可靠地监督数据管线。
- 替代是不均匀的。 指令数据(SFT)上合成基本赢了;偏好数据上学术界说打平、工业界仍把人类数据当护城河;评测上 LLM-as-a-judge 便宜地扩展了「打分」,但 benchmark 本身和 ground truth 还得人来造。
- 模型坍缩(model collapse)是一个被过度推销的担忧。 它描述的是「无过滤、单模型、纯自训练、完全替换」这一种特定失败模式;混入真实数据、多样教师、去重、强过滤这四件事基本就绕开了它。
- 蒸馏有方向性。 offline 蒸馏的能力上界就是教师。任何「学生超过教师」的结果背后一定有一个信息注入点:环境验证、特权信息、多教师互补,或者用推理算力换质量的 best-of-N。
- on-policy 蒸馏(OPD)的核心只有一句话:从学生采样,用教师打分。 这一步把 forward KL 翻成了 reverse KL,把误差累积从 $O(\epsilon L^2)$ 拉回 $O(\epsilon L)$,并且天然长在现代 RL 训练基础设施上。
- Lambert 的总结: 除了搭基础设施,合成数据是研究员用来做出好模型的最常用工具。写这本书的时候搭一条合成数据管线还很折腾,现在它已经是一个成熟工作流了。
1. 合成数据凭什么成了后训练的中心
定义要故意放宽
合成数据(synthetic data):任何用于训练 AI 模型、且有一部分由另一个 AI 模型生成的数据。
这个定义宽得几乎没有信息量,但这正是重点。它不只包括「让 GPT-4 写一段回答」,还包括「让模型把一个 prompt 改写成十个变体」「让模型判断这两条回答哪条更好」「让模型给一条数学解答打分」。在一条真实的后训练管线里,同一个模型会同时扮演六种角色:
| 角色 | 做什么 | 代表工作 |
|---|---|---|
| 造 prompt | 从少量种子任务扩展出大规模指令池 | Self-Instruct |
| 改 prompt | 加难度、加约束、改写风格、翻译成其它语言 | Evol-Instruct 一类 |
| 写 completion | 给 prompt 生成回答,直接作为 SFT 目标 | NuminaMath、OpenThoughts |
| 打偏好 | 对两条回答判优劣,产出 RM / DPO 训练对 | UltraFeedback |
| 过滤 | 按质量、难度、去重、去污染筛掉大部分候选 | Superfiltering |
| 验证 | 作为 RL 的奖励函数,判断答案对不对 | RLVR 管线(第 7 章) |
注意最后两行。绝大多数人第一次接触合成数据想到的是「生成」,但在成熟的管线里,过滤和验证的价值往往超过生成。同一批 completion,换一套过滤策略带来的下游差距,可能比换一个更强的教师还大。这一点在第 8 节还会展开。
一个很锋利的能力阈值
合成数据不是 2023 年才有人想到的主意,是 2023 年才开始能用。Llama 2、GPT-3.5-Turbo 这一代模型在生成和监督两件事上都不够可靠。LLM-as-a-judge 这个能力是在 GPT-3.5 到 GPT-4 的那一跳里涌现出来的:GPT-4 级及以上的模型在「针对一段内容给出反馈或评分」这件事上远比前代稳健和一致。
合成数据管线是串联的,误差不是相加而是相乘。一条典型管线是「造 prompt → 生成 N 条 completion → judge 挑最好的一条 → 进 SFT 集」。假设每一步的可靠率是 $r$,三步下来是 $r^3$。$r=0.95$ 时是 0.86,还能用;$r=0.7$ 时是 0.34,意味着三分之二的训练数据是噪声——而且是系统性的噪声,不是随机噪声,模型会把它当成模式学下去。这解释了为什么这件事没有平滑的过渡期,而是某一代模型出现之后突然全行业都能做了。
规模:两个维度同时在涨
从 ChatGPT 发布至今,几个数据集定义了各自的时代:UltraFeedback 是第一个有影响力的合成偏好数据集,直接点燃了 DPO 那一波;Stanford Alpaca 是最早的 chat 风格微调数据集之一;Tülu 3 提供了面向具体技能(数学、代码、指令跟随)的合成集合;OpenThoughts 3 则是 2025 年训练思考型模型的合成推理数据集。
| 数据集 | 年份 | prompt 数 | 训练 token(约) | 相对 Alpaca |
|---|---|---|---|---|
| Stanford Alpaca | 2023 | 52K | ~10M | 1× |
| Tülu 3 | 2024 | ~1M | ~500M | ~50× |
| OpenThoughts 3 | 2025 | 1.2M | ~10B | ~1000× |
关键在于 prompt 数量涨了约 20 倍,token 数却涨了约 1000 倍——差额全部来自回复变长:一条带完整思维链的回答动辄几千 token,而 Alpaca 时代平均只有一两百。这对工程安排有直接后果:同样是「一百万条数据」,序列长度上限、packing 策略、显存预算全都得重算。实践上,入门和快速迭代用 Alpaca 这类小数据集(训得快),要做工业级参考就看 Tülu 3 和 OpenThoughts 3 的配方。
合成数据没有均匀地替代人类数据
| 环节 | 现状 | 为什么 |
|---|---|---|
| 指令数据(SFT) | 合成基本完胜 | 从更强模型蒸馏出来的 completion,质量已经高于绝大多数人类写手在规模化条件下能提供的水平。例外是最难的前沿推理问题。 |
| 偏好数据(RLHF) | 混合、有争议 | 学术研究显示合成偏好数据表现相当;但前沿实验室仍把人类偏好数据当作竞争护城河。这个矛盾至今没有公开解释。 |
| 评测 | 分工明确 | LLM-as-a-judge 极便宜地扩展了「打分」这一步,但底层的 benchmark 设计和 ground-truth 标注仍然需要人来做。 |
规律是:凡是模型的可靠性已经超过人的地方,合成数据就占领了;凡是涉及能力前沿、建立 ground truth、以及引导训练方向的地方,人还在。 换个说法——人类数据的高强度投入集中在「确定模型的前沿在哪」和「给出最初的火种」,然后用合成数据把它规模化。
模型坍缩:一个过时的担忧
对合成数据最常见的批评是模型坍缩(model collapse):反复在模型自己的生成上训练,会让有效训练分布逐步收窄。多样性下降之后,稀有事实和稀有风格被系统性地低估,小错误会跨代放大,泛化能力变差。
设某个稀有事实的真实概率是 $p = 10^{-6}$。第一代模型生成 $N = 10^5$ 条数据给下一代训练,它出现次数的期望是 $Np = 0.1$——约 90% 的概率一次都没出现。于是在第二代眼里它的经验概率就是 0,而 0 是吸收态,再也回不来。
这个论证只用到两件事:每一代只把上一代的采样当真值,且采样数有限,不需要模型有任何缺陷。所以坍缩在数学上是真的——但前提也正是软肋:只要每一代都累积真实数据而不是替换掉,稀有事件的支撑集就不会被抹掉(Gerstgrasser 等 2024);加入验证 / 强化信号同样能突破这条曲线(Feng 等 2024)。
实践中,这类失败最强相关的场景是:无过滤、重复性高、单一模型输出的自训练循环。四件事基本就能把你挡在坍缩区之外:混入真实 / 人类数据(打断纯自指涉的循环)、使用多样的教师(不同模型的错误模式不重合,互相抵消)、去重(合成数据重复率天生就高,n-gram 或 embedding 去重是第一道防线)、强质量过滤(掐掉「小错误被放大」的通道)。
对今天的前沿训练管线,证据表明合成数据可以、而且应该被大规模使用,不会出现坍缩故事最强版本所暗示的灾难性回退。把模型坍缩理解成一种具体的失败模式,而不是一条关于合成数据的普遍定律。你实践中真正会碰到的问题不是「分布坍缩」,而是「judge 有偏差」「数据重复」「测试集污染」这些更平凡也更好修的东西。
2. 蒸馏的两个含义,和它的方向性
技术定义 vs 口语定义
「蒸馏」这个词今天被两种完全不同的意思共用,读论文和读推文时必须分清。
技术定义来自深度学习文献里的教师-学生知识蒸馏:训练一个更小的学生模型去匹配一个更大的教师模型的软概率分布。「软」是关键——标准的下一 token 预测用的是 one-hot 标签(正确答案是 token 42,其它全是 0),而 KD 用的是教师在整个词表上的完整分布。温度缩放 $\tau > 1$ 把分布进一步软化,暴露出类别之间的关系。
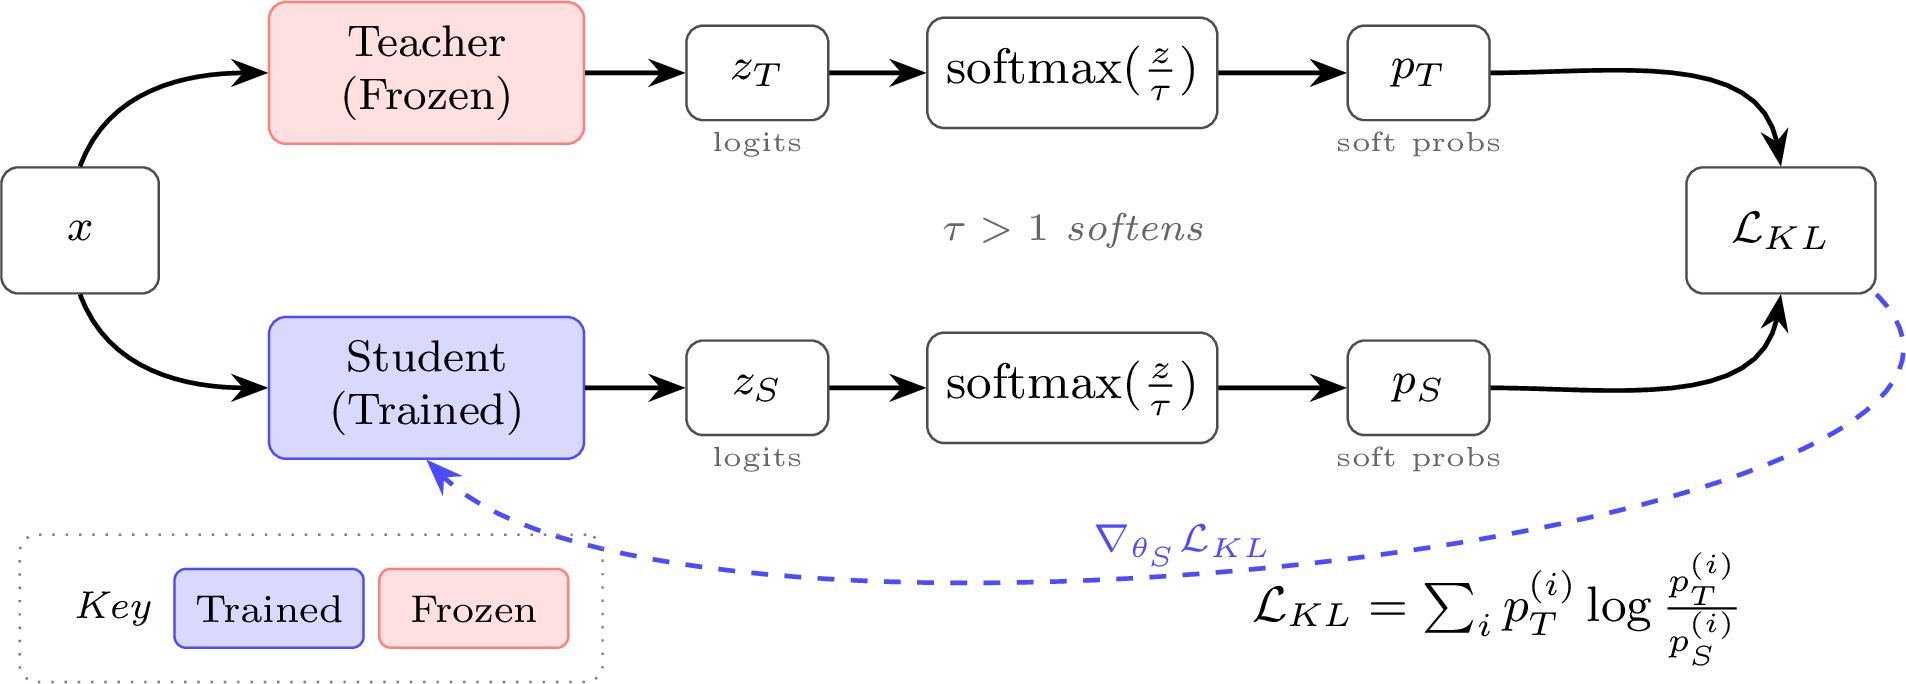
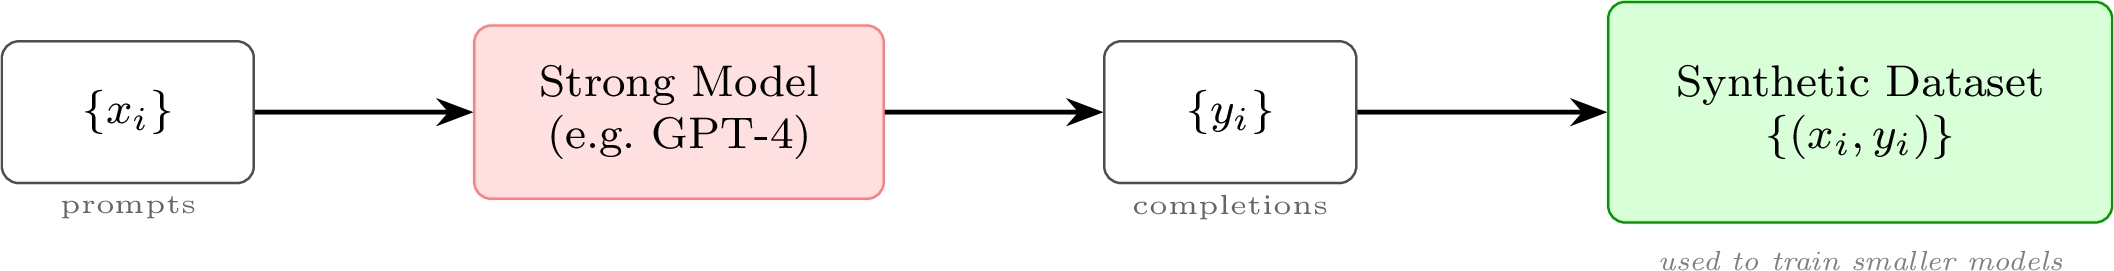
口语定义:用更强模型的输出来训练一个更小的模型。这是大众说「某某模型蒸馏了 GPT / Claude」时的意思,它和上面的技术定义只有精神上的联系——口语意义上的蒸馏通常连教师的 logits 都拿不到,只有文本。
方向性:为什么反过来不行
这是本章最容易被略过、但后果最大的一点。蒸馏是有方向的:信息只能从教师流向学生。
原因可以从损失函数直接看出来。第 3 节会推导,offline 蒸馏(包括在教师生成文本上做 SFT)本质是在最小化 forward KL $D_{\mathrm{KL}}(\pi_T \| \pi_\theta)$。这个目标的唯一不动点是 $\pi_\theta = \pi_T$。也就是说:
- 教师比学生强 → 学生被拉向更好的分布,这是我们要的;
- 教师比学生弱 → 学生被同样确定地拉向更差的分布。这不是「弱一点的正则化」,这是能力回退。用一个 7B 模型的输出去微调一个 70B 模型,你会得到一个行为像 7B 的 70B。
offline 蒸馏的能力上界就是教师本身。任何声称「学生超过了教师」的结果,背后一定有一个信息注入点,常见四种:
- 环境验证——数学答案、单元测试、编译器,真正的外部真值,RLVR(第 7 章)的基础。
- 特权信息——教师看得到、学生推理时看不到的东西:正确演示、报错信息、提示(第 5 节的 OPSD / SDPO)。
- 多教师互补——数学专家 + 代码专家蒸进一个通用学生,学生在综合能力上可超过任何单个教师。
- 推理算力换质量——best-of-N / 拒绝采样(第 9 章),上界是教师的 pass@N 而不是 pass@1。
找不到这四条中的任何一条,那大概率涨的是评测分不是能力。
后训练里蒸馏的两种用法
- 当数据引擎,横跨后训练的大片流程:给指令写 completion、造偏好数据(Constitutional AI 就是一种)、给 RL 提供验证信号。
- 迁移特定技能,把强模型的某项能力搬进弱模型。数学推理、代码、test-time scaling 都有专门研究:LIMA 证明了少量高质量数据就能做对齐,s1 用极小的蒸馏数据集撬动了 test-time scaling。
第一种用法的一个直接组织学后果是:实验室会训一个不公开发布、只用来内部造数据的大模型(Claude Opus 或 Gemini Ultra 级别的角色),再用它去做更强的可发布模型。开放模型这边则是把闭源 API 模型的数据蒸进小的开放权重模型(Zephyr 是最早把这条路写清楚的工作之一)。这条路上,挑选高质量 prompt 和 过滤教师回复 比换一个更强的教师更重要。
推理模型让蒸馏变难了
早期这件事很简单:调 API,拿输出,训模型。推理模型出现后变复杂了,因为你真正想要的是推理轨迹(reasoning trace),而闭源 API 停止返回原始轨迹(只给摘要)。于是重心发生两个转移:一是更激进的越狱去还原隐藏轨迹(有明显争议,稳定性也差);二是更多地转向开放权重模型——有权重就有完整轨迹,而且能拿到 logits,从而做序列级以外的蒸馏。这是 2025–2026 年开放模型生态的一个重要推力。
许可证与数据污染:两个必须处理的工程问题
许可证。 主要闭源 API 提供商的服务条款一般禁止用其输出训练竞争性模型。早期学术工作(Alpaca、Vicuna 一类)大量踩在这条线上,当时的默契是「研究用途」;到了要发布产品级模型的阶段,这个风险是实打实的。做法是把蒸馏教师换成许可证明确允许的开放权重模型,并逐个读许可证——同为「开放权重」,各家条款差别很大。
数据污染(contamination)。 合成数据管线极容易把 benchmark 测试集「洗」进训练集,而且是 n-gram 去重抓不到的方式:教师模型自己在预训练时见过 GSM8K、MATH、MMLU,你让它「生成一些新的数学题」,产出的会是原题的近邻变体——语义上同一道题,字面上完全不同。后果是评测分虚高而你无从察觉。缓解手段:对生成数据同时做 n-gram 匹配和 embedding 近邻检索去污染,并始终保留一个私有的、模型没见过的评测集做交叉验证。
2026 年围绕蒸馏有两个观察。第一,「中国开放模型的进步有多少真的来自蒸馏前沿 API」这个问题被严重高估了——把领先开放模型的能力增益简单归因为蒸馏,经不起细看。第二,前沿实验室基于恐惧的表态(收紧 API、限制轨迹输出、给蒸馏贴上不正当竞争的标签)如果引发生态快速跟进,对更广的 AI 生态是坏事:合成数据和蒸馏是这个领域公开可复现的基础工具,污名化的代价主要由学术界和小团队承担。
3. 从 WORD-KD 到 SEQ-KD:把知识蒸馏搬到语言模型上
知识蒸馏最初被提出时是一个通用的深度学习技巧,和语言模型没关系——它解决的是「怎么用一个已经训好的、更强 / 更大的教师网络来训学生网络」。KD 的标志是使用软标签:不只看单个预测 token 对不对,而是看整个输出分布,让学生分布去匹配教师分布。
要把它用到自回归语言模型上,只需要把损失按位置分解,变成逐 token 的分布匹配损失。2016 年 Kim & Rush 把这件事做完了,并且额外提出了一个更重要的变体:让学生从教师生成的序列中学习。
记号约定(后面全章通用)
| 符号 | 含义 | 形状 / 量纲 |
|---|---|---|
| $s$ | 源句子 / prompt | token 序列 |
| $u = (u_1,\ldots,u_J)$ | 教师生成的完整输出序列 | 长度 $J$ 的 token 序列 |
| $a = (a_1,\ldots,a_L)$ | 学生采样的 completion(on-policy 部分才用) | 长度 $L$ 的 token 序列 |
| $\mathcal{V}$ | 输出词表 | Qwen3 约 15.2 万,Llama 3 约 12.8 万 |
| $q = \pi_T$ | 教师的下一 token 分布 | 长度 $|\mathcal{V}|$ 的概率向量 |
| $p = \pi_\theta$ | 学生的下一 token 分布 | 长度 $|\mathcal{V}|$ 的概率向量 |
$u$ 永远是教师轨迹,$a$ 永远是学生采样的轨迹。这不是记号洁癖——「从谁采样」正是 offline 与 on-policy 的全部区别,也是 forward KL 与 reverse KL 的全部区别。后面每次看到期望符号,先看下标是 $u \sim \pi_T$ 还是 $a \sim \pi_\theta$。
WORD-KD:逐 token 的分布匹配
$$ \mathcal{L}_{\mathrm{WORD\text{-}KD}} = -\sum_{j=1}^{J}\sum_{k=1}^{|\mathcal{V}|} q(u_j = k \mid s, u_{<j})\log p(u_j = k \mid s, u_{<j}). $$逐项拆解:
- 外层 $\sum_{j=1}^{J}$ 跑遍序列的每个位置;
- 内层 $\sum_{k=1}^{|\mathcal{V}|}$ 跑遍整个词表的每一个可能 token;
- $q(u_j = k \mid s, u_{<j})$ 是教师在位置 $j$、给定前缀 $(s, u_{<j})$ 时,分配给 token $k$ 的概率;
- 整体是标准的交叉熵形式 $-\sum_z q(z)\log p(z)$:教师认为很可能的 token,如果学生给了低概率,就被惩罚。
论文里管这叫「word-level 蒸馏」,但那是 2016 年、还没有现代子词分词器的说法。对现代模型,正确的读法是在分词器词表上做逐 token 的分布匹配。
另外注意一个常见误解:匹配整个词表上的分布听起来很贵,其实一点都不贵。 每个位置就是 $|\mathcal{V}|$ 个概率,总成本 $O(J|\mathcal{V}|)$,和普通交叉熵完全同阶——普通交叉熵本来也要算完整的 softmax 分母。真正难的是在整条序列的空间里做匹配,那才是下一小节的问题。
one-hot 标签只告诉你「正确答案是 token 42」。教师的软分布还告诉你:token 17 也相当合理(0.2),token 883 勉强可以(0.03),token 9000 完全离谱($10^{-9}$)。这层「哪些错误比另一些更接近对」的结构,Hinton 称之为 dark knowledge。一个 one-hot 标签携带的是一个类别索引,一个完整分布携带的是整个 $|\mathcal{V}|$ 维向量——这就是为什么在同样多的 token 上,logits 级蒸馏的样本效率显著高于普通 SFT。
SEQ-KD:序列级蒸馏,也是 offline KD 的起点
序列级蒸馏把 $\mathcal{U}$ 看成所有可能输出序列的空间,直接在序列层面匹配学生和教师的分布。问题是对所有完整序列 $u \in \mathcal{U}$ 求和是指数级的,完全不可算。Kim & Rush 的近似是把教师在序列空间上的分布压成一个点质量:只取一条高概率的教师输出 $\hat{u}$,通过 beam search 得到,$\hat{u} = \mathrm{BeamSearch}_q(s) \approx \argmax_{u \in \mathcal{U}} q(u \mid s)$:
$$ \begin{aligned} \mathcal{L}_{\mathrm{SEQ\text{-}KD}}(s) = -\sum_{u \in \mathcal{U}} q(u \mid s)\log p(u \mid s) \approx -\log p(\hat{u} \mid s) \\ = -\sum_{j=1}^{|\hat{u}|}\log p(\hat{u}_j \mid s, \hat{u}_{<j}). \end{aligned} $$最后一行是什么?就是在教师生成的文本上做标准的负对数似然训练——也就是 SFT。 这个等式是本章最重要的连接之一:你以为你在做「用 GPT-4 的输出微调小模型」,其实你在做序列级知识蒸馏;反过来,KD 文献里几十年的分析工具因此全部可以拿来分析你的 SFT 管线。
SEQ-KD 迈出的关键一步是:教师开始生成 token 作为学生的信号,而不再只是在已有语料上打软标签。这既让计算变得可行,也解锁了后面所有 on-policy 形态。我们把这一类训练统称为 offline KD——用于训练学生的生成结果是预先产出的。
为什么 offline KD 等价于最小化 forward KL
交叉熵的定义:
$$ H(q,p) = -\sum_z q(z)\log p(z). $$这正是 WORD-KD 的形式,也是 SEQ-KD 第一行的形式。现在加一项再减一项 $\sum_z q(z)\log q(z)$(它完全不含 $p$):
$$ \begin{aligned} H(q,p) &= \underbrace{-\sum_z q(z)\log q(z)}_{H(q)} + \sum_z q(z)\log q(z) - \sum_z q(z)\log p(z) \\ &= H(q) + \sum_z q(z)\log\frac{q(z)}{p(z)} = H(q) + D_{\mathrm{KL}}(q\|p). \end{aligned} $$第一项 $H(q)$ 只依赖教师。教师固定且是训练数据的来源时,它是一个常数,对 $\theta$ 求梯度直接消失。于是:
$$ \min_p H(q,p) \equiv \min_p D_{\mathrm{KL}}(q\|p). $$结论:offline KD 和 SFT 都在最小化 forward KL(从教师到学生的方向)。 这个方向的选择不是设计者做的决定,是「用教师采样出来的数据训练」这件事自动带来的。
两个历史连接
第一,offline KD 训出过一批有名的模型:DistilBERT、TinyBERT。注意它们不是序列蒸馏——这些编码器模型不做多 token 的自回归预测,蒸的是表示和分类头。第二,上面的推导把本章接进了第 15 章对 KL 散度的系统讨论;这里只需要记住:是采样来源决定了 KL 方向。
logits 级 vs 序列级:一张你会反复用到的表
| 维度 | logits 级(WORD-KD 类) | 序列级(SEQ-KD 类) |
|---|---|---|
| 监督信号 | 每个位置一条 $|\mathcal{V}|$ 维分布 | 一条采样序列的 one-hot 目标 |
| 数据来源 | 已有语料或任意序列 | 教师生成的新文本 |
| 每 token 信息量 | 高(整条分布) | 低(一个索引) |
| 是否要求共享 tokenizer | 要求 | 不要求 |
| 是否需要教师权重 | 需要(要拿 logits) | 不需要(只要 API 文本) |
| 存储 / 带宽 | 大(一般用 top-K 压缩) | 小 |
| 典型场景 | 同一模型家族内部压缩、on-policy 蒸馏 | 跨厂商 API 蒸馏、开放数据集 |
| 能力上界 | 教师的完整分布 | 教师的高概率模式 |
这张表在实践中的用法是反过来读的:你能不能拿到教师的 logits、两边 tokenizer 是不是同一套,这两个约束直接决定了你只能走哪一条路。 拿不到权重就只能做序列级;tokenizer 不同就只能做序列级。这也解释了下一节最后会提到的一个现象:per-token 蒸馏在实验室自己的模型家族内部最好用。
4. 曝光偏差与 on-policy 蒸馏
offline KD 有几个限制,正是它们催生了 on-policy 变体。最根本的一个:训练时学生看到的前缀来自教师,推理时学生看到的前缀来自自己。
训练 / 测试分布不一致
offline KD 采样教师轨迹 $u \sim \pi_T(\cdot \mid s)$,在由此产生的前缀上最小化逐 token KL:
$$ \mathcal{L}_{\mathrm{KD}}(\theta) = \E_{s \sim \mathcal{D},\, u \sim \pi_T(\cdot \mid s)} \sum_t D_{\mathrm{KL}}\!\left( \pi_T(\cdot \mid s, u_{<t}) \;\|\; \pi_\theta(\cdot \mid s, u_{<t}) \right). $$但推理时学生按自己的策略 rollout,真正重要的量是它自己轨迹上的期望任务损失:
$$ \mathcal{L}_{\mathrm{eval}}(\theta) = \E_{s \sim \mathcal{D}_{\mathrm{test}},\, a \sim \pi_\theta(\cdot \mid s)} \ell_{\mathrm{task}}(s, a) $$其中 $\ell_{\mathrm{task}}(s, a)$ 是下游任务上的任意损失:答案错误率、测试用例未通过、judge 或 rubric 给的分数。
曝光偏差(exposure bias)就是 $\pi_T(\cdot \mid s) \neq \pi_\theta(\cdot \mid s)$ 的直接后果:训练时访问的前缀 $(s, u_{<t})$ 和测试时访问的前缀 $(s, a_{<t})$ 来自不同的状态访问分布,学生被监督的状态集合和它实际行动的状态集合不是同一个。
DAgger 类比:误差为什么会平方级累积
这个差距的代价可以用模仿学习里那条经典的界来量化。在原始的离散动作设定下,假设学生在教师诱导的训练分布上、每步动作错误率的期望不超过 $\epsilon$($\mathbb{I}[\cdot]$ 是指示函数,条件成立返回 1,否则 0):
$$ \E_{s_t \sim d_{\pi_T}}\!\left[ \mathbb{I}\!\left(\pi_\theta(s_t) \neq \pi_T(s_t)\right) \right] \leq \epsilon. $$监督式模仿学习的分析表明,沿着学生自己采样的长度为 $L$ 的轨迹累积的期望损失可以随 $L$ 平方增长:
$$ \E_{a \sim \pi_\theta(\cdot \mid s)}\!\left[\sum_{t=1}^{L} \ell\!\left(s, a_{<t}\right)\right] \leq O(\epsilon L^2). $$平方从哪来?直觉是这样的:在第 $t$ 步犯一个错,会把前缀推到一个训练时从未出现过的位置上;学生没见过这种前缀,于是在 $t+1$ 步更可能再错;错误沿轨迹自我强化。每一个可能的首次出错位置 $t$ 都会污染它之后剩下的 $L-t$ 步,把这些贡献加起来就得到了 $L^2$ 量级。
取 $\epsilon = 10^{-3}$(千分之一的 token 与教师不一致,听起来已经很好了),$L = 4000$(一条现代推理链的长度):
- 线性项 $\epsilon L = 4$——平均每条轨迹偏离 4 次,可以接受;
- 平方项 $\epsilon L^2 = 16000$——早就崩了。
这解释了为什么长链推理的 offline 蒸馏特别脆:Alpaca 时代回答只有一两百 token,$L^2$ 和 $L$ 的差距不明显;到了几千 token 的推理轨迹,差距被放大了一到两个数量级。
上面的界是在离散动作设定下证明的,用到「动作要么对要么错」的 0-1 假设。LLM 预测的是完整的下一 token 分布,token 级蒸馏用的是 KL / 交叉熵这类分布式损失,所以经典 DAgger 的数学不能原样搬过来。不要把 $O(\epsilon L^2) \to O(\epsilon L)$ 当成你的训练设置的保证——它解释的是动机,而 on-policy 方法在实践中的成功支持了这个直觉。
on-policy 蒸馏的目标函数
核心转变只有一句话:改成从学生模型采样,然后度量它到教师分布的距离,而不是从教师采样。
令 $s$ 是 prompt,$a = (a_1,\ldots,a_L)$ 是从当前学生策略 $\pi_\theta(\cdot \mid s)$ 采样的 completion,$s_t = (s, a_{<t})$ 是第 $t$ 步的 token 级状态。教师策略 $\pi_T$ 固定,目标是在学生诱导的状态上比较两者的下一 token 分布:
$$ \mathcal{L}_{\mathrm{OPD}}(\theta) = \E_{s,\, a \sim \pi_\theta(\cdot \mid s)} \sum_t D_{\mathrm{KL}}\left(\pi_\theta(\cdot \mid s_t) \;\|\; \pi_T(\cdot \mid s_t)\right). $$把每个部分说清楚:期望对 $s \sim \mathcal{D}$ 和 $a \sim \pi_\theta$ 取;采样分布是正在被训练的那个策略;梯度只对 $\theta$ 求,教师那一路是常量;因为期望从 $\pi_\theta$ 采样、并且 $\pi_\theta$ 在 KL 的左边,这是一个 reverse KL 目标。
注意这里已经切换到了期望记号——和第 6 章讲策略梯度时用的是同一套。这不是形式上的变化:它意味着优化要靠采样轨迹 + 数值估计梯度来解,而这正好是现代 LLM RL 基础设施的形状(快速交替「从当前策略生成 token」和「做一次学习更新」)。on-policy 蒸馏因此几乎不需要新的工程栈,插进现有 RL 框架就能跑。
forward KL vs reverse KL
| offline KD / SFT(forward KL) | on-policy 蒸馏(reverse KL) | |
|---|---|---|
| 形式 | $D_{\mathrm{KL}}(\pi_T \| \pi_\theta) = \E_{z \sim \pi_T}\!\left[\log\frac{\pi_T(z)}{\pi_\theta(z)}\right]$ | $D_{\mathrm{KL}}(\pi_\theta \| \pi_T) = \E_{z \sim \pi_\theta}\!\left[\log\frac{\pi_\theta(z)}{\pi_T(z)}\right]$ |
| 期望对谁取 | 教师(off-policy:固定的教师数据集) | 学生(on-policy:采你正在训的模型) |
| 行为 | 覆盖质量(mass-covering) | 寻找模式(mode-seeking) |
| 惩罚在哪 | 教师有质量而学生趋 0 的地方,log 比爆炸 | 学生放了质量而教师不喜欢的地方 |
| 后果 | 学生必须覆盖教师可能说的一切,能力不足时会把概率摊平到自己写不好的模式上,生成时就会采到垃圾 | 学生收缩到教师的高概率模式上,更保守、多样性更低,但生成质量更稳 |
教师是 100B,能写好五种风格的解法;学生是 1B,只写得好其中一种。forward KL 要求学生对五种都给出可观概率——但它对另外四种的建模是残缺的,那部分概率质量会散布在「看起来像但其实是坏的」序列上,采样时就会落进去,结果是流畅但错误的输出。reverse KL 反过来:学生只在自己真的放了概率的地方被评价,最省力的解法是把质量全堆到它能写好的那一种模式上。代价是多样性,收益是可靠性。第 15 章有更完整的处理。
把 KD 距离直接当成 RL 的 advantage
OPD 的近期实现把 KD 和 RL 的整合又推进了一步:直接把 KD 距离当作 RL 优化里的奖励信号。 一个标准做法是把逐 token 的 reverse KL 贡献取负,作为 advantage 塞进 RL 算法。
推导只有两行。状态 $s_t$ 处的 reverse KL 本身就是一个对学生采样 token 的期望:
$$ D_{\mathrm{KL}}\!\left(\pi_\theta(\cdot \mid s_t) \,\|\, \pi_T(\cdot \mid s_t)\right) = \E_{a_t \sim \pi_\theta(\cdot \mid s_t)}\!\left[\log \pi_\theta(a_t \mid s_t) - \log \pi_T(a_t \mid s_t)\right]. $$实践中你根本不需要在词表上求和:单个采样出来的 token 就是这个 KL 的无偏估计。把它取负,就得到逐 token 的 advantage:
$$ A_t^{\mathrm{OPD}} = \log \pi_T(a_t \mid s_t) - \log \pi_\theta(a_t \mid s_t). $$取负号把「最小化」变成了「最大化」信号:教师给的评分高于学生的采样 token 得到正 advantage,教师评分低于学生的得到负 advantage。
$\log \pi_T - \log \pi_\theta$ 这个式子长得就像一个 forward KL 项,很多人第一次看会以为方向搞反了。决定 KL 方向的是 $a_t \sim \pi_\theta$(从学生采样),不是式子里的符号顺序。 同样一个 $\log \pi_T - \log \pi_\theta$,你按 $\pi_T$ 采样它估的是 forward KL 的负值,按 $\pi_\theta$ 采样它估的是 reverse KL 的负值。这也是为什么整章反复强调 $u$ 和 $a$ 的区分。
为什么值得这么做?因为教师的 log-prob 差是稠密的、token 级的反馈。一条 4000 token 的推理轨迹,RLVR 只给你 1 个标量(对 / 错),奖励模型也只给 1 个标量;OPD 给你 4000 个数,每个都指明了「这个位置该往哪偏」。这在信用分配上是碾压性的优势,也是 OPD 在长推理任务上样本效率高的直接原因。它还能和 GRPO 的组内归一化等其它 advantage 计算方式叠加,做更复杂的奖励塑形。
一个硬约束:必须共享 tokenizer
KD 在后训练方法里很特殊,因为它经常要求学生和教师共用同一套分词器——监督信号是来自另一个 LLM 的逐 token 反馈,两个模型必须在同一个 token 网格上对齐,否则 $\pi_T(a_t \mid s_t)$ 根本无从计算。后果很实际:per-token 蒸馏在实验室自己的模型家族内部最好用,跨厂商就只能退回序列级蒸馏。这也解释了为什么 Qwen3、MiMo-V2-Flash、GLM-5、DeepSeek-V4-Pro 的 KD 都是家族内部的操作。
5. 现代 OPD 变体:多教师与自蒸馏
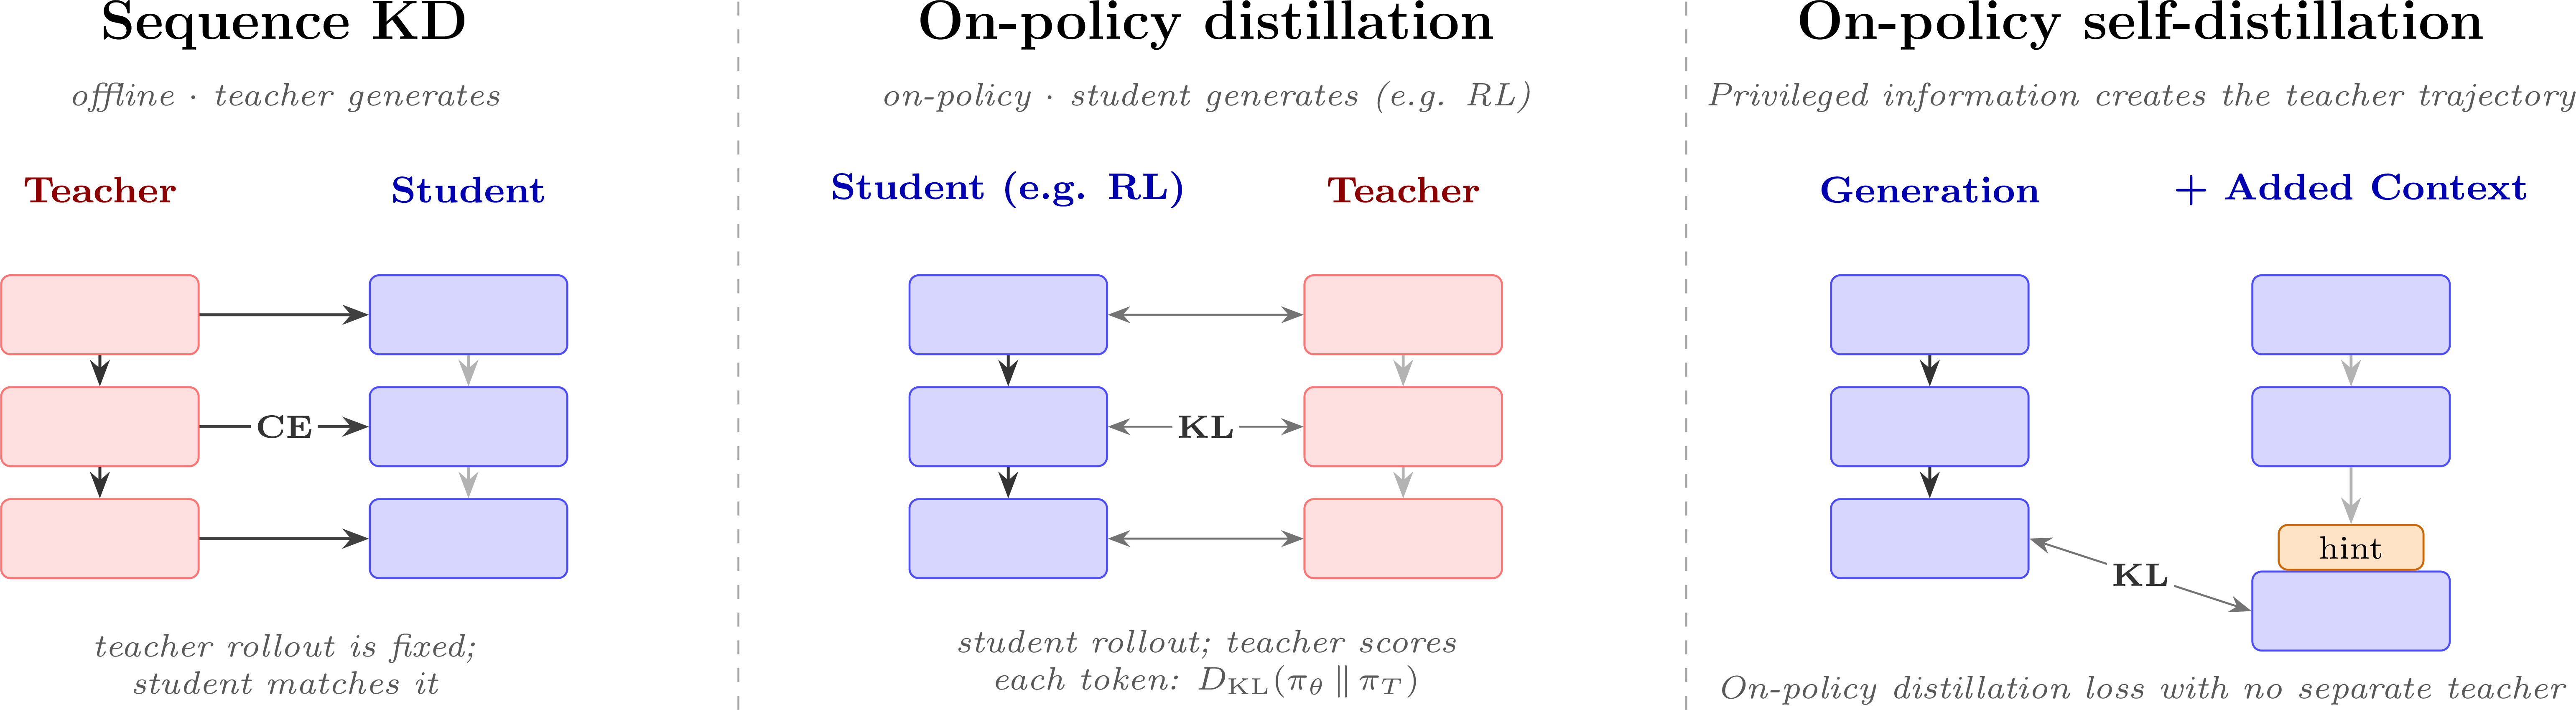
多教师 on-policy 蒸馏(MOPD)
OPD 的设置可以往两个方向扩展:用多个教师教一个学生,或者往生成里插入额外信息帮模型识别自己的错误。先看前者。
教师可以是特定领域的专家模型(数学、代码),也可以是之前的某个中间训练 checkpoint。对每个教师,在训练 batch 里按 prompt 或任务类型选一个贡献权重,就得到 Multi-Teacher On-Policy Distillation (MOPD)。令 $\pi_{T_k}$ 是第 $k$ 个教师,$w_k(s)$ 是它依赖 prompt 的混合权重(满足 $\sum_k w_k(s) = 1$):
$$ \mathcal{L}_{\mathrm{MOPD}}(\theta) = \E_{s,\, a \sim \pi_\theta(\cdot \mid s)} \sum_t \sum_k w_k(s) D_{\mathrm{KL}}\left(\pi_\theta(\cdot \mid s_t) \;\|\; \pi_{T_k}(\cdot \mid s_t)\right). $$注意权重是 $w_k(s)$ 而不是 $w_k$——它依赖 prompt。这是整个方法的要点:数学题上把权重压给数学专家,代码题上给代码专家,通用对话上给一个通才 checkpoint。学生因此可以在综合能力上超过任何单一教师(这就是第 2 节说的第三种信息注入)。
MOPD 在大规模后训练里真正的价值不只是技术上的,更是让组织能并行分工。多个小组各自去训高质量的专家模型,这些模型之后作为教师蒸进最终的学生模型——不需要所有人在同一个 RL 运行里抢资源、协调超参。DeepSeek-V4-Pro 和 MiMo-V2-Flash 都是这么做的(MOPD 这个名字出自后者)。随着后训练团队规模变大,这种「专家训练 → 统一蒸馏」的结构可能会成为默认组织形态。
自蒸馏:前沿之上没有更强的教师
MOPD 解决不了一个问题:当你的模型就是最强的时候,教师从哪来?
On-Policy Self-Distillation (OPSD) 绕开了这个问题:让同一个语言模型自己验证一条 completion(或者借助外部工具),扮演一个拥有特权信息的教师,从而在没有显式更强教师的情况下提升自己。「特权」的含义是——这些信息在训练时可得,在推理时不可得。
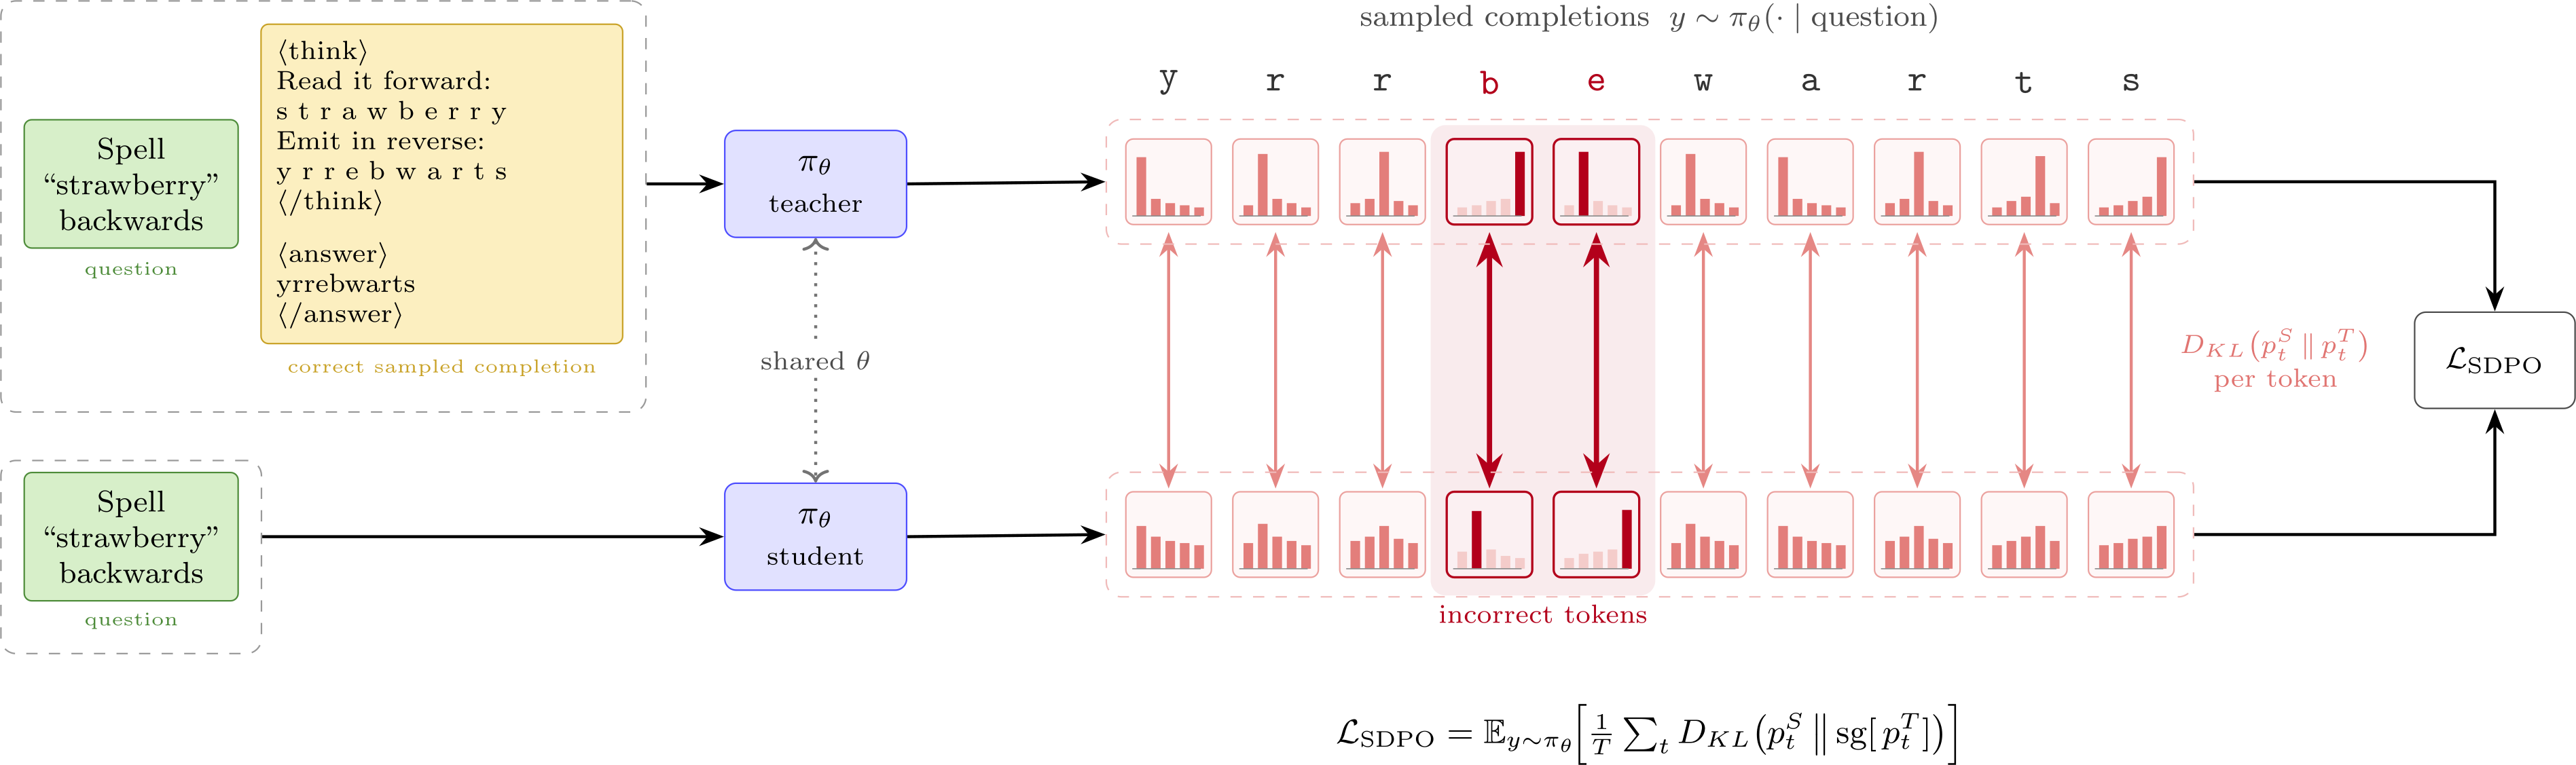
一个真实的产品级例子:Cursor 用自蒸馏(对 RL 轨迹给出针对性的文本反馈)训练了 Composer 2.5 编码模型,底座是 Kimi K2.5。简化后的循环是:在 RL 里生成一条 completion → 用一个带「常见 bug 清单」的判断 prompt 审阅它 → 发现 bug 就直接修改生成序列、插入一个 hint(这就是特权信息)→ 对新序列重新计算 logprob 并施加 KD 损失。实际部署时它还和代码正确性等损失组合在一起。
结果是:token 空间里的一个提示就足以让模型纠正自己的输出,即便是在绝对性能前沿上。自蒸馏的梯度告诉模型「hint 之后的那些 token 才是对的」,模型把教训吸收进参数,下次不需要 hint 也能走对。怎么最好地构造这些提示(统称 privileged information)是一个活跃方向。这让 on-policy 蒸馏成为一个核心后训练方法:既能把多种技能揉进一个通用模型,也能在专门化部署上推进前沿。
6. 参考实现:SDPO 的最小可读版本
本节的代码全部改写自 _src/code/distillation/,那里实现的是 SDPO(Self-Distillation Policy Optimization)——上一节图里的 on-policy 自蒸馏设置:一个策略同时扮演「演示条件下的教师」和「只看题目的学生」,用逐 token reverse KL 训练。任务是一个小的字符串反转问题,小到能在单张 GPU 上把整个 on-policy 循环从头看到尾。
第一步:采样与构造教师上下文
这一步做三件事:让学生对同一个 prompt 采 $R$ 条 on-policy 轨迹;用环境验证器给每条打分;从组内挑一条正确的兄弟轨迹作为特权信息,拼进教师的前缀。
# 改写自 _src/code/distillation/rollout.py
def generate_batch(model, tokenizer, dataset, entry, cfg):
    # 1) 学生只看题面,对同一个 prompt 采 num_rollouts 条 on-policy 轨迹
    prompt = apply_chat_template(tokenizer, entry["question"])
    inputs = tokenizer([prompt] * cfg.num_rollouts, return_tensors="pt").to(model.device)
    prompt_len = inputs["input_ids"].shape[1]
    with torch.no_grad():
        student_ids = model.generate(**inputs, generation_config=gen_config)  # [R, P+A]
    completion_ids = student_ids[:, prompt_len:]                              # [R, A]
    completions = tokenizer.batch_decode(completion_ids, skip_special_tokens=True)

    # 2) 环境验证:Reasoning Gym 直接判答案对不对
    reward = torch.tensor([compute_score(c, dataset, entry) for c in completions])
    ok = [i for i, r in enumerate(reward) if r >= cfg.success_reward_threshold]
    if not ok:
        return None       # 组内全错 —— 没有演示可蒸,整个 prompt 跳过(skipped += 1)

    # 3) 教师前缀 = 题面 + 一条正确的兄弟演示(这就是特权信息)
    demo = completions[ok[0]]
    teacher_prompt = apply_chat_template(
        tokenizer,
        f"{entry['question']}\n\nCorrect solution:\n\n{demo}\n\n"
        f"Correctly solve the original question.",
    )
    teacher_prefix = tokenizer(teacher_prompt, return_tensors="pt")["input_ids"]

    # 关键:教师序列 = 教师前缀 ++ 完全相同的那批学生 completion
    teacher_ids = torch.cat(
        [teacher_prefix.expand(cfg.num_rollouts, -1), completion_ids], dim=1
    )
    return {
        "s_ids": student_ids, "t_ids": teacher_ids,
        "action_mask": (completion_ids != pad_id).float(),   # [R, A]
        "reward": reward,
    }
整段代码里只有一个 model。教师和学生的全部差别在于 context:教师的前缀里多了一条正确解法。所以「教师更强」这件事 100% 来自 in-context 的特权信息,不来自任何额外参数。这正是它叫 self-distillation 的原因,也是它能在前沿之上工作的原因——你不需要一个比自己强的模型,你只需要一个「已经知道答案」的自己。
另一个关键细节:两条通道打分的是同一批 completion(completion_ids 被同时拼进 s_ids 和 t_ids)。这保证了 KL 是在学生实际访问的状态上算的——也就是 on-policy。
第二步:top-K reverse KL 损失
朴素实现会在完整词表上算 KL,但那个张量大得离谱。算一笔账:$R=8$ 条 rollout、$A=512$ 个动作位置、$|\mathcal{V}| \approx 1.5 \times 10^5$,logits 张量有 $8 \times 512 \times 1.5\times10^5 \approx 6.1\times10^8$ 个元素,bf16 下约 1.2 GB——而且梯度还要再存一份,加上 softmax 的中间量,单这一项就能撑爆一张 24GB 卡。
解决办法是只保留 top-K(默认 $K=20$)个位置,再用一个「尾桶」把剩下的概率质量收起来,凑成一个合法的 $(K+1)$ 维分布。
# 改写自 _src/code/distillation/loss.py
def add_tail(log_probs):
    """把 top-K 之外的概率质量收进第 K+1 个桶,让截断后的向量仍是合法分布。"""
    log_sum = log_probs.logsumexp(dim=-1, keepdim=True).clamp(max=-1e-7)  # log(sum of top-K)
    tail = torch.log(-torch.expm1(log_sum))            # log(1 - sum),数值稳定写法
    return torch.cat([log_probs, tail], dim=-1)        # [..., K+1]


def sdpo_loss(model, batch, kl_top_k=20):
    A = batch["action_mask"].shape[1]

    # 学生通道:只看题面,带梯度。logits_to_keep 让 LM head 只投影需要的位置
    s_logits = model(input_ids=batch["s_ids"], attention_mask=batch["s_mask"],
                     use_cache=False, logits_to_keep=A + 1).logits[:, :-1, :]   # [R, A, V]
    s_topk, idx = s_logits.topk(kl_top_k, dim=-1)      # 下标 idx 由「学生」决定
    s_logp = s_topk - s_logits.logsumexp(dim=-1, keepdim=True)

    # 教师通道:同一份权重,context 里多了正确演示;不回传梯度
    with torch.no_grad():
        t_logits = model(input_ids=batch["t_ids"], attention_mask=batch["t_mask"],
                         use_cache=False, logits_to_keep=A + 1).logits[:, :-1, :]
        t_logp = t_logits.gather(-1, idx) - t_logits.logsumexp(dim=-1, keepdim=True)

    s_logp, t_logp = add_tail(s_logp), add_tail(t_logp)

    # log_target=True 时 F.kl_div(input, target) = sum(exp(target) * (target - input))
    # 这里 target=学生、input=教师,于是得到 KL(student || teacher),即 reverse KL
    kl = F.kl_div(t_logp, s_logp, reduction="none", log_target=True).sum(-1)   # [R, A]
    return (kl * batch["action_mask"]).sum() / batch["action_mask"].sum().clamp_min(1.0)
三个容易看漏但很重要的细节:
- top-K 的下标
idx来自学生,教师在同样的下标上gather。 reverse KL 的期望是对学生取的,必须覆盖学生放了概率质量的 token;按教师的 top-K 取会漏掉「学生很想说但教师觉得不该说」的位置——而那恰恰是梯度最该出现的地方。 - 尾桶用
-expm1而不是1 - exp。 当 top-K 已吃掉 99.9% 的质量时log_sum接近 0,1 - exp(log_sum)会因浮点相消损失几乎全部有效位。clamp(max=-1e-7)则防止log_sum恰好为 0 时取到 log(0)。 - 归一化用全局动作 token 数而不是 batch 均值,让每个 token 权重相等,长 rollout 不会被平均掉。
真实实现还加了一层按 rollout 分块:把 $R$ 条切成 rollout_chunk=4 一组,每组算完立刻 backward()。因为损失是「对 rollout 求和 ÷ 全局 token 数」,分块梯度累加正好等于整组梯度,峰值显存被压到一个 chunk。这是把 $[R, A, V]$ 这种大张量塞进小卡的通用技巧。
第三步:训练循环
# 改写自 _src/code/distillation/train.py
for step in range(cfg.num_steps):
    model.eval()
    # 轮询 prompt,直到攒够 prompts_per_step 个「组内至少有一条正确」的 batch
    batches, polled = [], 0
    while len(batches) < cfg.prompts_per_step:
        batch = generate_batch(model, tokenizer, dataset, next(prompts), cfg)
        polled += 1
        if batch is not None:
            batches.append(batch)
        if polled >= cfg.prompts_per_step * 100:
            raise RuntimeError("任务对当前模型太难:几乎所有 prompt 都拿不到正确演示")

    model.train()
    optimizer.zero_grad(set_to_none=True)
    accumulated_loss = 0.0
    for b in batches:                                 # 跨 prompt 做梯度累加
        accumulated_loss += objective(model, b, scale=1.0 / len(batches))

    grad_norm = clip_grad_norm_(model.parameters(), cfg.max_norm)
    optimizer.step(); scheduler.step()

    log({
        "reward":    torch.cat([b["reward"] for b in batches]).mean().item(),
        "loss":      accumulated_loss,
        "grad_norm": float(grad_norm),
        "skipped":   polled - len(batches),           # 被跳过的 prompt 数
    })
注意 skipped = polled - len(batches):它记录的是「轮询到的 prompt 里,8 条 rollout 全错、没有演示可蒸」的个数。这个指标在本章最后的动手实验里是最有信息量的一个。
超参与参考运行
| 字段 | 值(configs/sdpo.yaml) | 含义与选择理由 |
|---|---|---|
model_name | Qwen/Qwen3-1.7B | 同时充当学生和自教师 |
lr / warmup_ratio | 1e-6 / 0.0 | 常数学习率、不做 warmup,匹配 SDPO 的反馈条件化设定 |
kl_top_k | 20 | reverse KL 匹配教师分布的宽度;直接换算成显存 |
num_rollouts | 8 | 每个 prompt 采几条;兄弟演示就从这一组里找 |
prompts_per_step | 16 | 每个优化步梯度累加多少个 prompt |
rollout_chunk | 4 | 每次前向 / 反向处理几条 rollout,控制峰值显存 |
success_reward_threshold | 1.0 | 达到多少分才算「可用作演示」;调低会让 skipped 下降但演示质量变差 |
max_new_tokens | 512 | 生成长度上限;截断会被判为失败 |
| 采样参数 | T=0.6, top_p=0.95, top_k=20 | rollout 的探索强度 |
max_norm | 1.0 | 梯度裁剪;on-policy 蒸馏的梯度尖峰是常态 |
参考运行:Qwen3-1.7B 在默认的 spell_backward 任务上,单张 24GB 消费级 GPU、不到 20 小时,reward 从约 0.55 涨到约 0.8,同时 loss 和 grad_norm 下行。
难任务上的稳定性经验
字符串反转是个玩具任务。在更难的数据集上(通常跑在 verl 的一个 fork 上,SDPO 的原始实现就建在 verl 上),训练会变得难以稳定:奖励曲线要么直接躺平,要么涨一段之后发散。下面这套参数是被验证过能稳定跑的:
| 参数 | 取值 | 说明 |
|---|---|---|
| 每轮 prompt 数 | 32 | 一轮的采样预算 |
| 每 prompt rollout 数 | 8 | 合计每轮 256 条 completion |
| mini batch 大小 | 2 个 prompt | 最大的杠杆。每轮做 16 次优化步而不是 1 次 |
| 最大生成长度 | 8192 | 被截断的 rollout 会被判为失败,把演示池饿死 |
| 学习率 | 1e-6 | 平的,不加 schedule |
| 优化器 / weight decay | AdamW / 0.01 | 标准配置即可 |
| 梯度裁剪 | 1.0 | 梯度尖峰不可避免 |
| 教师 | 学生的 EMA,$\alpha = 0.01$ | 不用冻结教师 |
| 教师重要性采样裁剪 | 2.0 | 限制教师 / 学生比值 |
| rollout 重要性采样 | token 级,裁剪 2.0 | 修正一轮之内的 off-policy 偏移 |
| 蒸馏散度 | reverse KL | completion 是从学生 on-policy 采的 |
| top-K | 20 + 尾桶 | 剩余质量收进一个桶 |
| 模型 | instruct 版、非 thinking 模式 | |
| 训练采样 / 评测采样 | T=1.0 无 top-k/top-p / 按 model card | 别拿训练采样器去做评测 |
- 组内有多条正确时要随机挑一条,不要挑最短的。 挑最短的会直接让训练坍塌——学生学到的是「把答案写短」,而不是「把题做对」。这是奖励塑形里最经典的捷径,只不过这里的「奖励」是教师的分布。
- 过滤掉那些「反复回溯最终蒙对」的 completion(典型特征是输出里出现多个
<answer>...</answer>块)。拿它们当教师监督,你教的就是这种 doom-loop 行为。更彻底的做法是把</answer>设成 stop sequence,让 rollout 根本产生不出第二个。 - 把手上其它环境反馈都折进特权上下文:报错信息、测试输出、部分分。这些都是学生推理时拿不到、但训练时白送的信息,不用白不用。
7. 自我改进的循环与它的天花板
把前面几节的东西合起来,就得到了「自我改进(self-improvement)」这个大类:模型生成数据、模型评价数据、模型在自己产出的数据上训练,循环往复。这一节回答一个很实际的问题:这个循环什么时候会一直涨,什么时候会假涨,什么时候会崩。
三种自我改进循环
| 循环 | 模型自己做的事 | 代表工作 | 注入的新信息 |
|---|---|---|---|
| 自造 prompt | 从种子任务扩展出更大的指令池 | Self-Instruct | 无(只是重组已有分布) |
| 自打分 | 既生成回答又当 judge,迭代做 DPO | Self-Rewarding LM、Meta-Rewarding | 无(judge 就是自己) |
| 自提纯 | 采 N 条留最好的,做拒绝采样 / best-of-N | 第 9 章 | 推理算力 |
| 外部验证 | 用数学答案、单元测试、编译器打分 | RLVR(第 7 章) | 真实外部信号 |
| 特权信息 | 教师能看到演示 / 报错 / hint,学生看不到 | SDPO、OPSD、Composer 2.5 | 训练时可得的额外上下文 |
一个自我改进循环能不能真的超过起点,只取决于有没有新信息注入。这个检查非常好做——盯着你的管线图,指出那条从「模型分布之外」进来的箭头。
- 纯自打分(生成和评判都是同一个模型,没有任何外部信号):judge 的准确率就是硬上界。更糟的是 self-preference bias——模型系统性地偏好自己的生成,几轮迭代后你会看到 judge 打分一路上涨,而外部评测纹丝不动甚至下滑。这就是奖励攻击(第 14 章)的一种形态,只不过奖励模型是模型自己。
- best-of-N:注入的是推理算力。你把 pass@1 的分布提纯到接近 pass@N,天花板就是 pass@N。所以 N 撑不动了(或者验证器不可靠了)循环就停。
- 外部验证 / 特权信息:注入的是真信息,可以持续涨。这是今天所有能长期跑的自我改进管线的共同点。
如果你答不出这条箭头在哪,那涨的一定是指标不是能力。
自我改进与模型坍缩是同一枚硬币
把第 1 节和这一节并排看会更清楚:无信息注入 + 无过滤 = 坍缩(每一代把上一代的采样噪声当真值,分布逐步收窄);有信息注入 + 强过滤 = 自我改进(过滤同样让分布收窄,但收窄到「已验证正确」的子集上)。
换句话说,「分布变窄」本身既不好也不坏,重要的是朝哪个方向窄。reverse KL 的 mode-seeking 行为、拒绝采样的挑选、SDPO 里「组内全错就跳过」的逻辑,本质上都是在做同一件事:主动放弃一部分分布,换取剩下那部分的正确性。
合成数据工作流在今天已经是成熟工艺了——写这本书的时候搭一条还很费劲,现在不是问题。剩下的开放问题很多,但大多是细枝末节,而且往往是手头技术问题的领域特化反映,没有普适答案。别指望找到一个「正确的自我改进配方」,指望的应该是:把你的任务里那条信息注入的箭头找准,然后围绕它设计过滤器。
8. AI 反馈(RLAIF)与用 LLM-as-a-judge 做筛选
RLHF 爆发不久,基于 AI 反馈的强化学习(RL from AI Feedback, RLAIF)就出现了:用 AI 来近似管线里的人类数据环节,从而加速实验和迭代。更广义的 AI 反馈是一整类技术——用 AI 来生成或增广「解释某个输入好在哪」的数据,可以喂给不同的训练方法或评测。它最早从成对偏好开始。
成本:两到三个数量级的差距
| 人类偏好数据 | 前沿模型的 AI 反馈 | |
|---|---|---|
| 每条 prompt 成本(2026 年估计) | $1 起,难任务 $10+ | < $0.01 |
| 成本趋势 | 大致恒定(人力) | 持续下降(性价比每年改善) |
| 周转时间 | 天到周 | 分钟到小时 |
这个差距的意义不只是省钱。它把 RLHF 的实验循环从「周」压缩到「小时」,把方法论的实验能力开放给了原本被价格挡在门外的一大批人——这是 RLHF 能在学术界铺开、进而成为「后训练」这个更大范式的早期注意力中心的直接原因,也是今天关于递归自我改进(RSI)那些论证的物质基础。
偏差-噪声:一条很有用的经验法则
- 人类数据是高噪声、低偏差的。 收集和过滤都更难(不同标注员打分不一致、注意力涣散、理解偏差),但一旦治理干净,它给出的信号非常可靠。
- 合成偏好数据是低噪声、高偏差的。 上手容易、一致性高,但会把棘手的二阶效应系统性地写进数据里——长度偏好、markdown 排版偏好、对某种腔调的偏好、自我偏好。
「系统性」是关键词。随机噪声可以靠加数据量平均掉,系统性偏差不行——加十倍数据只会让模型对那个偏差更加确信。这条法则解释了实践中的分工:合成数据适合快速起步和大规模覆盖;到了要精细控制产品行为的阶段,人类数据会回来。
该怎么混
合成数据在管线里的位置至今没有定论,但文献的走向是清楚的:
- 早期 RLAIF 工作宣称 AI 反馈可以完全替代人类数据,尤其是在只用 chat 任务评测的时候。这要放在语境里看:ChatGPT 之后的早期 RLHF 文献评测套件很窄,集中在「作为有用助手的对齐程度」上。
- 后来的工作更细致:在更宽的评测集(含推理任务)上,最优平衡是把困难数据点路由给人类做准确标注,其余交给 AI。Hybrid Preferences(HyPER)训了一个性能预测模型来决定路由,RLTHF 走的是「定向人类反馈」的路子。
- 没有任何研究系统地测过跨全部领域的最优配比。这个空白本身就说明问题:开放学术界拿不到高质量人类数据。
- 工业现实:人类偏好数据仍被当作护城河。原因可能不只是标签质量,还有 prompt 分布(真实用户问什么)和隐式反馈(用户真实行为)。
不少技术报告显示 RLHF 确实能改善这个宽评测套件:有用 DPO 的(Tülu 3、Olmo 3、SmolLM 3),也有用在线 RLHF 管线的(NVIDIA 把 Scale AI 的人类偏好数据和 LLM 反馈混着用,产出 HelpSteer 系列数据集与 Nemotron Nano 3、Nemotron-Cascade、Llama-Nemotron 等模型)。给上手者的建议:先全用 AI 反馈;等管线规模化到一定程度,引入人类反馈基本是迟早的事。
名词澄清:RLAIF 与 Constitutional AI
RLAIF 这个词出自 Anthropic 的《Constitutional AI: Harmlessness from AI Feedback》,论文标题里同时有 Constitutional AI 和 AI Feedback 两个词,直接导致了社区长期的混淆。正确的关系是:CAI 是点燃 RLAIF 这整个领域的那个例子,CAI ⊂ RLAIF。从那篇论文之后,RLAIF 已经成为后训练和 RLHF 文献的默认方法,例子多到无法枚举。
要不要训一个专门的 judge 模型
RLAIF 普及之后,一个自然的问题是:生成回答和生成批评 / 评分,应该用同一个模型吗?LLM-as-a-judge 的校准因此受到质疑。已有研究显示:
- LLM 是不一致的评估者——同样的两条回答,交换 A/B 顺序结论可能就变了(位置偏差);
- LLM 有 self-preference bias——偏好自己生成的回答胜过其它模型的。
于是出现了一批专门的批评 / 评判模型:Shepherd、CritiqueLLM 这类批评模型,Auto-J、Prometheus、Prometheus 2、Prometheus-Vision 这类评分模型。但它们在有据可查的训练配方里并没有被广泛采用。实际更有效的做法是在推理侧加算力和结构:重复采样后聚合(Large Language Monkeys、Sample-Scrutinize-Scale、Verdict 这类库)、自我精炼(Self-Refine)、锦标赛排序(West-of-N 用它产出更高质量的偏好对)、协同进化(Meta-Rewarding 让生成与评判能力一起演化)。
偏差确实存在,但领先的语言模型已经为「评判」这个任务做了大量训练——AI 实验室内部运营需要它,客户也在大量使用它。所以除非你的任务涉及大量公网上不存在的私有信息,一般不需要训自己的 judge,把预算花在 judge 的 prompt 设计和推理侧聚合上回报更高。
被低估的用法:用 judge 做数据筛选
生成侧的收益是显性的(多了一批数据),筛选侧的收益是隐性的但往往更大。同一批 completion,换一套过滤策略带来的下游差距,可能比换一个更强的教师还大。 常用的筛选信号,按可靠性从高到低:
| 信号 | 可靠性 | 成本 | 适用范围 |
|---|---|---|---|
| 规则 / 环境验证(答案匹配、单元测试) | 最高 | 低 | 仅可验证域 |
| LLM judge 打分 + 阈值 | 中高 | 中(每条都要跑一次推理) | 通用 |
| 代理指标(困惑度、指令跟随难度 IFD) | 中 | 很低 | 通用,适合先粗筛 |
| 去重(n-gram / embedding) | — | 低 | 必做,防坍缩第一道防线 |
| 去污染(对 benchmark 做匹配) | — | 中 | 必做,否则评测虚高 |
关于代理指标值得多说一句:Superfiltering 的核心观察是,用一个很弱的小模型算出来的难度指标,可以用来筛给强模型训练的数据——弱模型和强模型对「哪条数据难」的排序高度一致。成本上这是碾压性的:跑一遍 0.5B 模型的前向比跑一遍 GPT-4o judge 便宜三四个数量级。实践的组合拳是「代理指标粗筛 90% → judge 精筛剩下的」。
- 要求先解释再打分(也就是生成式奖励模型的形式),比直接要一个数字稳得多。让模型先写理由,等于给了它思考的 token 预算。
- 交换 A/B 顺序各跑一次取平均,把位置偏差消掉。这是最便宜、收益最确定的一个改动。
- 给明确的评分标准(下一节的 rubric 就是把这件事做到极致),不要只写「哪个更好」。「更好」在模型眼里默认等于「更长、markdown 更多」。
- 不要用被评价模型自己当 judge,self-preference bias 会直接污染结果。
9. Constitutional AI
Constitutional AI(CAI)是 Anthropic 用在 Claude 系列上的方法,也是有据可查的、最早的大规模用合成数据做 RLHF 训练的例子。它用两种方式生成合成数据:
- 对指令微调数据做批评(critique),让它遵循一组原则,比如「这个回答是否在鼓励暴力?」「这个回答是否诚实?」。模型生成答案后,对照宪法里的原则清单检查自己的答案,逐步修订。最后在修订后的数据集上做微调。
- 生成成对偏好数据:给语言模型一个从宪法里随机抽的原则作为上下文,让它判断两条 completion 哪条更好。然后照常做 RLHF——数据是合成的,所以叫 RLAIF。
大众认知里 CAI 主要是第二半(偏好数据),但第一半引入的方法(批评-修订)后来被广泛用在整个后训练的通用数据过滤和合成数据生成上,影响其实更深。
形式化
宪法 $\mathcal{C}$ 是一组人写的原则,指明在批评阶段要关注哪些具体方面。
指令数据的构造是一个迭代过程:反复采样一个原则 $c_i \in \mathcal{C}$,要求模型把它对 prompt $x$ 的最新输出 $y^i$ 修订成符合 $c_i$ 的版本,于是从原则序列得到一串指令变体:
$$ \{c_0, c_1, \ldots, c_{n-1}\}\ \longrightarrow\ \{y^0, y^1, \ldots, y^n\} \qquad\Longrightarrow\qquad \text{SFT 数据点 } (x, y^n). $$最终数据点是 $x$ 加上最后一版 completion $y^n$,中间版本全部丢弃——这是一个纯粹的「用推理算力换质量」的提纯过程,和第 7 节表里的 best-of-N 属于同一类。
偏好数据的构造更简单:把 $\mathcal{C}$ 的一个子集作为反馈模型的上下文。反馈模型拿到 prompt $x$、一组原则、以及来自之前某个 RLHF 数据集的两条 completion $y_0$ 和 $y_1$(标为 A 和 B),选出哪一条既质量更高、又更符合所述原则。早期的实现方式是用 The answer is: 提示模型,直接看 A 和 B 两个 token 哪个概率更高;现在更常见的是让模型先解释推理再选答案——即生成式奖励模型(generative reward model)。
CAI 这个词指的是 Anthropic 早期 Claude 模型上的一套具体技术,此后已经发生了实质变化——虽然 Anthropic 至今仍在使用「宪法」这个概念(是的,这很容易混淆)。读到 2026 年的材料说「Claude 用 CAI 训练」时,不要默认它就是论文里那两个阶段。
CAI 的后续与相关方向
CAI 有很多相关研究方向和扩展,但其中很少有被明确证明是 RLHF / 后训练配方上的改进。值得知道的几条线:
- OpenAI 的 Model Spec——一份陈述模型预期行为的文档,OpenAI 表示在探索让模型直接引用该文档的对齐方法(可以看作 CAI 的近亲)。他们持续更新这份 spec,并用一种叫 Deliberative Alignment 的方法训练 o1 这类推理模型,让模型在推理时引用这些安全 / 行为策略。
- Anthropic 继续在模型训练中使用 CAI,更新 Claude 使用的宪法,并做过「群体如何就模型原则达成共识」的实验——让外部群体自己制定原则、交给 Anthropic 训练模型,观察模型行为的变化(Collective Constitutional AI)。
- 开源社区的复现:Hugging Face 的 CAI recipe 把这套流程搬到了开放数据集上;也有工作探索让语言模型之间生成对话数据。
- 原则驱动的其它优化路径:把原则作为奖励模型的上下文(Dromedary / SALMON);用原则提高 RLHF 过程中人类判断的准确率(Sparrow);训练一个在推理时自己生成原则再据此给分的奖励模型;把「遵循原则」表述成互信息最大化问题,让预训练模型无标签地学会它。
10. Rubrics:prompt 级的 AI 反馈
AI 反馈在训练中的角色在 2024 年底到 2025 年迅速扩张,动机是:怎么把可验证奖励强化学习(RLVR,第 7 章)扩展到没有明确可验证答案的任务上?
Rubrics(评分细则)就是这个问题的答案:为那些没有唯一正确答案的 prompt 写出一组「近乎可验证」的判据。有了判据,模型就可以对一道题生成多个答案,然后用 RL 往得分最高的那些答案的方向更新。这个想法和本章其它内容紧密相关,它能起作用大概率也是因为整个行业的 LLM judge 和合成数据实践都成熟了。今天,rubric 作为奖励的 RL 已经在科学推理、事实性等技能上被确认能带来实质提升。
一个 rubric 长什么样
Prompt: 作为博物馆策展人,请为「远古世界之谜」展览推荐五件冷门文物。
每件来自不同的文明和时代,简述其历史意义与神秘来源……

Rubric:
 1. 回答恰好包含五件不同的文物。                      [Hard Rule]
 2. 每件文物来自不同的文明和时代。                    [Hard Rule]
 3. 为每件文物提供了历史意义的简述。                  [Hard Rule]
 4. 为每件文物提供了神秘来源或未解之处的简述。        [Hard Rule]
 5. 传达出与展览主题相符的神秘感。                    [Hard Rule]
 6. 信息表达清晰准确、组织良好、条理连贯。            [Principle]
 7. 精确简洁,避免无关或冗余细节。                    [Principle]
 8. 语言富有信息量与吸引力,能激发好奇心与批判思考。  [Principle]
 9. 每个例子对整体主题都有独特贡献,不重复。          [Principle]
10. 风格与格式保持一致,便于阅读理解。                [Principle]
[Hard Rule] 和 [Principle] 是标记某条反馈优先级的标签:前者是原子的、必须通过的清单项(可以机械核对),后者是更软的质量判据。也可以用别的方式表达重要性,比如直接给优先级数字或权重。一条 rubric 的各个子项分别贡献到最终得分。
rubric 是怎么生成的
Rubric 一般按训练数据里的每个 prompt 单独生成,这会在准备阶段累积可观的合成数据成本。缓解办法是:先给每个领域一份通用 rubric 打底,再由一个监督语言模型把细粒度的、逐 prompt 的评分项补上。
下面是一个为科学题生成 rubric 的元 prompt(节选,真实版本更长):
You are an expert rubric writer for science questions in Biology,
Physics, and Chemistry. Generate a self-contained set of evaluation
criteria for judging how good a response is.

Inputs: question, reference_answer
Total items: choose 7-20 based on question complexity.

Each rubric item must include exactly three keys:
  1. title       (2-4 words)
  2. description (one sentence starting with its category prefix)
  3. weight      Essential/Important/Optional: 1-5 (5 = most important)
                 Pitfall: -1 or -2

Category guidance:
  - Essential : critical facts or safety checks; omission invalidates
  - Important : key reasoning or completeness; strongly affects quality
  - Optional  : nice-to-have style or extra depth
  - Pitfall   : common mistakes or omissions; highlight things often missed

Output: a JSON array of {title, description, weight}. No extra keys.
另一个更简单的形式,把「先说理由再给判据」写进了输出结构:
SYSTEM:
You generate evaluation rubrics for grading an assistant's response.

Rubric design rules:
- Each criterion must be atomic (one thing) and objective as possible.
- Avoid redundant/overlapping criteria; partition different failure modes.
- Make criteria self-contained (don't rely on unstated context).
- Include an importance weight for each criterion.

Output format (JSON only):
{
  "initial_reasoning": "brief rationale for what matters for this prompt",
  "rubrics": [
    {"reasoning": "why this criterion matters",
     "criterion":  "clear, testable criterion",
     "weight":     integer 1-10},
    ...
  ]
}
可以看到这些 prompt 可以写得非常细,而且是针对具体训练设置调过的。这本身就是一条实践信息:rubric 管线的大部分工作量在 prompt 工程上,不在算法上。
如果全局只用一份 rubric,它很快会被过优化(第 14 章):模型学会满足那几条通用条款——加小标题、写得长、加免责声明——而不是把题做好。逐 prompt 的判据让奖励面紧贴具体任务,攻击面小得多。这是 rubric 相对于「一个通用奖励模型」的核心优势,代价就是每条 prompt 都要额外花一次生成成本。
注意 Pitfall 类判据的权重是负数(-1 / -2)。这不是装饰:它把「常见错误」显式编码进奖励,相当于在奖励函数里预先堵上几个已知的 hack 路径。
rubric 会走向哪里
rubric 加 RL 的训练还会继续演化,已经在早期应用之外铺开:高级指令跟随(AdvancedIF)、深度研究(DR Tulu)、评测深度研究智能体(ResearchRubrics)、长文生成(ExpertLongBench)。它也被广泛用于领域特定的评测,以及任何需要把领域专业知识「训进」模型的地方——是一个非常通用的工具。
本章小结
一页速查
| 方法 | rollout 从谁来 | 监督粒度 | KL 方向 | 要共享 tokenizer | 能力上界 |
|---|---|---|---|---|---|
| WORD-KD | 已有语料 | 每 token 全分布 | forward | 是 | 教师分布 |
| SEQ-KD / 蒸馏式 SFT | 教师(离线) | 序列 one-hot | forward | 否 | 教师的高概率模式 |
| OPD | 学生(on-policy) | 每 token KL | reverse | 是 | 教师分布 |
| MOPD | 学生 | 每 token 加权 KL | reverse | 是 | 教师们的加权组合(可超单一教师) |
| OPSD / SDPO | 学生 | 每 token KL | reverse | 天然满足 | 特权信息的价值 |
| RLVR(第 7 章) | 学生 | 整条轨迹 1 个标量 | — | 否 | 验证器的能力 |
要点清单
- 合成数据在后训练里扮演六种角色:造 prompt、改 prompt、写 completion、打偏好、过滤、验证。后两种被系统性低估。
- 能力阈值是 GPT-4 级模型。管线串联、误差相乘,所以过渡不是平滑的。
- 规模:Alpaca 52K/10M token → Tülu 3 ~1M/500M → OpenThoughts 3 1.2M/10B。prompt 涨 20 倍、token 涨 1000 倍,差额来自回复变长。
- 替代不均匀:SFT 合成完胜,偏好数据有争议,评测是「打分交给 AI、基准交给人」。模型坍缩只是「无过滤纯自训练」的失败模式。
- $\mathcal{L}_{\mathrm{SEQ\text{-}KD}}$ 化简到最后就是在教师文本上做 SFT;交叉熵 $= H(q) + D_{\mathrm{KL}}(q\|p)$,教师固定时等价于最小化 forward KL。
- 曝光偏差:训练前缀来自教师、测试前缀来自学生,误差从 $O(\epsilon L)$ 恶化到 $O(\epsilon L^2)$——对几千 token 的推理链是致命的(但这个界对 LLM 只是类比)。
- OPD 的全部转变是改从学生采样,这自动把 KL 翻成 reverse(mode-seeking),并天然长在 RL 基础设施上。
- KD 距离可当 advantage:$A_t^{\mathrm{OPD}} = \log \pi_T(a_t|s_t) - \log \pi_\theta(a_t|s_t)$,稠密、token 级。代价是必须共享 tokenizer。
- 自我改进能不能超过起点,只看有没有新信息注入:外部验证、特权信息、推理算力。纯自打分的上界就是 judge。
- AI 反馈比人类反馈便宜 100–1000 倍;人类数据高噪声低偏差,合成数据低噪声高偏差,最优做法是把困难样本路由给人。一般不需要训自己的 judge。
- CAI = 批评修订(SFT 数据)+ 原则引导的成对偏好(RLAIF),CAI ⊂ RLAIF。Rubrics 把 RLVR 扩展到没有唯一答案的域,必须逐 prompt 生成才能抗过优化。
动手实验
本章的配套作业在 homework/hw6-distill/,跑的是字符串反转任务上的 SDPO / on-policy 自蒸馏(对应第 6 节逐行讲过的那份实现,源码见 _src/code/distillation/)。任务小到能在单卡上把整个 on-policy 循环从头看到尾,这正是它的教学价值。
cd homework/hw6-distill/
uv sync

# 可选:把指标打到自己的 W&B
export WANDB_PROJECT=rlhf-book

uv run python -m distillation.train --config distillation/configs/sdpo.yaml
该盯哪三个指标
| 指标 | 是什么 | 健康的样子 | 不对劲时说明什么 |
|---|---|---|---|
reward | rollout 组的平均环境得分(0 或 1 的均值) | 单调上行,参考运行从 ~0.55 爬到 ~0.8 | 躺平 = 学生没在学;先看 skipped 是不是太高 |
loss | 掩码后的 top-K reverse KL(学生 ‖ 自教师) | 随着学生内化「演示条件下的分布」而下行 | loss 下行但 reward 不动是最危险的信号:学生在拟合教师的风格而不是能力。去检查演示挑选逻辑(是不是选了最短的?是不是选了反复回溯蒙对的?) |
skipped | polled - len(batches):轮询到的 prompt 里,8 条 rollout 全错、没有演示可蒸的个数 | 训练初期高,随学生变强单调下降 | 一直贴着上限(轮询打到 prompts_per_step * 100 直接抛异常)= 任务对当前模型太难。降 success_reward_threshold,或换个更简单的 data.specs |
三者的关系是这套方法的核心动力学:skipped 高 → 每步真正参与更新的 prompt 少 → 梯度噪声大 → reward 爬得慢 → skipped 继续高。 这是一个正反馈回路,也是 on-policy 自蒸馏最容易卡死的地方——它需要模型「本来就偶尔能做对」才能启动。同时留意循环里打印的教师 / 学生 rollout 样本,直接看两条通道的文本差别,比看曲线直观得多。
建议扫的三个 on-policy 旋钮
复制 distillation/configs/sdpo.yaml,固定任务,只扫下面三个:
num_rollouts(默认 8)——每个 prompt 采几条。调高让「组内至少一条正确」更容易发生,skipped直接下降;代价是每步生成量线性增加。这是缓解上面那个正反馈回路最直接的杠杆。kl_top_k(默认 20)——reverse KL 匹配教师分布的宽度。调高监督更完整,代价是显存和算力;调得太低时尾桶承担的概率质量过多,梯度信息变粗,学生只能学到「排名第一的 token 是什么」,损失了软标签的大部分价值。prompts_per_step(默认 16)——每个优化步梯度累加多少个 prompt。调高梯度更稳但每步更慢。注意第 6 节难任务经验里的观察正好相反:在难任务上,把 mini batch 拆小(每轮做 16 次优化步而不是 1 次)是最大的稳定性杠杆。两者不矛盾——前者是降方差,后者是提高更新频率,哪个更重要取决于你离「奖励曲线能不能起来」有多远。
如果还有算力,值得再试一个对照:把 success_reward_threshold 从 1.0 降到某个部分分阈值,观察 skipped 下降的同时 reward 的最终水平是不是也跟着降。这是一个很干净的「演示质量 vs 演示数量」的权衡实验。
延伸阅读
知识蒸馏的基础
- Distilling the Knowledge in a Neural Network (Hinton et al., 2015) — 一切的起点,软标签与温度缩放的原始论证。
- Sequence-Level Knowledge Distillation (Kim & Rush, 2016) — 本章第 3 节两个公式的出处;证明序列级近似就是「在教师文本上做 SFT」。
- DistilBERT (2019) / TinyBERT (2020) — offline KD 的第一波成功产品,理解「能压多小」的历史基线。
on-policy 蒸馏
- MiniLLM (Gu et al., 2024) — 最早明确要切到 reverse KL、并把 KD 损失放进在线策略梯度框架。
- On-Policy Distillation of Language Models (Agarwal et al., 2024) — 同期工作,更接近今天实际在用的形式。
- DAgger (Ross et al., 2011) — $O(\epsilon L^2) \to O(\epsilon L)$ 那条界的出处;读它是为了知道类比在哪里成立。
- Why Exposure Bias Matters (Arora et al., 2022) — 实证分析语言生成中的误差累积,解释困惑度为何看不出这个问题。
- On-Policy Distillation (Thinking Machines Lab, 2025) — 把逐 token reverse KL 当 advantage 的规范实现,工程细节清楚。
- A Survey of On-Policy Distillation for LLMs (2026) — 系统扫一遍这个方向。
自蒸馏与特权信息
- Reinforcement Learning via Self-Distillation / SDPO (Hübotter et al., 2026) — 第 6 节参考实现对应的论文。
- Self-Distilled Reasoner: On-Policy Self-Distillation (Zhao et al., 2026) — 同期、思路高度接近的工作。
- Introducing Composer 2.5 (Cursor, 2026) — 自蒸馏在产品级编码模型上的真实用法。
- Privileged Information Distillation (Peñaloza et al., 2026) — 「特权信息该怎么构造」的系统处理。
用蒸馏训出来的前沿模型
- MiMo-V2-Flash (2026) — MOPD 的出处,多教师加权的具体做法。
- Qwen3 (2025)、GLM-5 (2026)、DeepSeek-V4 (2026) — 「专家教师 → 统一学生」这套组织形态的当代样本。
- Zephyr (Tunstall et al., 2024) — 「从闭源 API 蒸到开放权重」的经典配方。
- s1: Simple Test-Time Scaling (2025) — 极小蒸馏集撬动 test-time scaling,「质量 > 数量」的最好例证。
合成数据集与配方
- Tülu 3 (2024) — 工业级开放后训练配方,合成数据部分值得逐节读。
- OpenThoughts (2025) — 推理数据合成的当代基线,10B token 量级。
- Olmo 3 (2025) — 全流程开放(含数据),用来核对自己的管线细节。
- Self-Instruct、UltraFeedback、Superfiltering — 分别对应「造 prompt」「合成偏好」「筛数据」三条线的奠基工作。
模型坍缩
- AI models collapse when trained on recursively generated data (Shumailov et al., Nature, 2024) — 坍缩论证原始出处,读一遍再判断它的前提有多强。
- Is Model Collapse Inevitable? (Gerstgrasser et al., 2024) — 直接反驳:累积而非替换数据即可打断坍缩曲线。
- Beyond Model Collapse (Feng et al., 2024) — 另一条出路:加入强化 / 验证信号。
AI 反馈、judge 与 CAI
- Constitutional AI (Bai et al., 2022) — 最早的大规模合成 RLHF 数据,也是 RLAIF 一词的出处。
- Hybrid Preferences (Miranda et al., 2025) 与 RLTHF (Xu et al., 2025) — 「哪些样本该给人、哪些给 AI」的两条量化路线。
- LLM Evaluators Recognize and Favor Their Own Generations (Panickssery et al., 2024) — self-preference bias 的实证。
- Large Language Monkeys (2024) — 重复采样扩展推理算力,judge 侧聚合的基础。
- Claude's Constitution 与 OpenAI Model Spec — 两份真实的行为规范文档,比论文更能说明「原则」在工业界长什么样。
Rubrics
- Rubrics as Rewards (2025) — 本章 rubric 元 prompt 的出处,把 RL 扩展到不可验证域的代表作。
- OpenRubrics (2025) — 可规模化的合成 rubric 生成。
- Checklists Are Better Than Reward Models (2025) — 挑衅性的对照结论,值得和第 5 章一起读。
- Online Rubrics Elicitation (2025) — 从成对比较在线抽取 rubric,绕开逐 prompt 生成的成本。
- DR Tulu / AdvancedIF / ResearchRubrics / ExpertLongBench — rubric 往深度研究、指令跟随、长文生成的四个扩展。
行业观察
- How much does distillation really matter for Chinese LLMs? (2026) — Lambert 对「增益有多少来自蒸馏前沿 API」的拆解。
- The distillation panic (2026) — 为什么跟着恐惧叙事收紧,对整个生态是坏事。