模型性格与产品化
前沿实验室每天在做、却几乎没有公开研究的那部分后训练:把一个模型的「人格」训进权重里,并让它在产品里活下来。
0. 本章导读
前面十六章讲的是一套方法论:怎么收偏好数据、怎么训奖励模型、怎么跑策略梯度、怎么防过优化、怎么评测。这一章换了个视角,问的是一个完全不同性质的问题——这些方法在真实的 AI 公司里,实际上被用来干什么?
答案可能会让只读论文的人意外:相当大一部分后训练算力,花在了训练模型的「性格」上。不是把 GSM8K 从 82 分推到 85 分,而是让模型别再动不动就说「Certainly!」、别在用户明显说错的时候立刻改口道歉、别在第 15 轮对话时从「助手」滑成「你唯一的朋友」。这些目标没有排行榜、没有 leaderboard、几乎没有公开论文,但它们直接决定了用户第二天还回不回来。
Lambert 在这一章里反复表达一个判断:性格训练(character training)成为一个独立的工程方向,本身就是 RLHF 已经成熟的最强证据。一个领域只有在「怎么让它对」已经基本解决之后,才会开始认真讨论「怎么让它好看」。RLHF 从一个被笼统归入「对齐(alignment)」的哲学性研究议题,变成了横跨安全、价值观、人格三块的实用工程学科。而且他毫不掩饰地指出:从工业界的实际动机看,RLHF 更像是一个捕捉用户兴趣的性能工具,而不是一个安全工具——性格训练的那套方法能把任何特质注入模型,包括不好的那些。
本章分三大块:性格训练本身(第 1–3 节,定义、Anthropic 公开的做法、以及谄媚这个产品事故);不改权重的三种性格控制手段(第 4–7 节,人格向量、人格代数、助手轴与激活封顶、人格子网络——这几节是本章唯一有干净数学的部分);产品与制度(第 8–9 节,模型规范与产品周期)。最后第 10 节把全书十七章重新串一遍。
- 性格训练 = 改权重,不是改 prompt。系统提示词能临时扮演一个角色,但性格训练要造的是一个稳定的、默认的基础人格:在没有系统提示词、在长对话第 20 轮、在被用户诱导时都还在的那个东西。实证上微调比 prompt 更稳,也比激活引导(activation steering)更稳。
- 方法上没有新东西——用的还是本书讲过的 SFT、Constitutional AI 式合成数据、偏好优化。新的是目标的精度:控制对象从「答对没有」变成「用什么措辞答」,大量工作是数据流水线上的措辞过滤(去掉
Certainly、as an AI model built by...这类口头禅)。Anthropic 的流水线是 Constitutional AI 的一个变体,且完全不含人类数据。 - 谄媚是性格问题里最有产品杀伤力的一个,而且它是 RLHF 目标函数的结构性产物:人类标注者系统性地更喜欢同意自己的回复,Bradley-Terry 把这个偏置如实吸收,策略优化再把它放大。它不是 bug,是被忠实优化出来的结果。
- 三种不改权重的控制手段:人格向量(激活空间加法,可连续调强度、可线性合成、还能在生成前做监控)、激活封顶(沿助手轴的单边最小修正,专治多轮累积漂移)、人格子网络(权重掩码,切人格等于换掩码)。它们的分工是:数据层管默认行为,激活层管单轮偏差,几何层管多轮漂移。
- 模型规范(Model Spec)的价值在于「意图可对照」:它是行业里少数几个能把「模型实际怎么做」和「设计者想让它怎么做」放在一起比较的工具。最大的未知是执行力度——两家目标相似的公司,可能因为一家认真执行了平庸的规范、另一家敷衍执行了优秀的规范,而走到完全不同的地方。
- 产品化的逻辑:给模型加新能力最快的路径永远是后训练,因为这里训练最快最便宜。所以「产品问题」会先变成「RLHF 建模问题」,成功之后再反向传播到更早的训练阶段。图像理解、工具调用、行为改良都是这么走过来的。
1. 性格训练:改 prompt 还是改权重
用户改变模型行为的默认方式
先从最朴素的对照开始。用户想改变模型的行为,默认手段是在推理时写一句话。比如不写:
帮我写一封邮件,总结我上个月的工作。而写:
以一个已经彻底倦怠的员工的口吻,帮我写一封邮件,总结我上个月的工作。这就是 prompt engineering 层面的「性格控制」。它有三个致命弱点:不稳定(角色扮演 prompt 在长对话里衰减,每多生成几百 token,那句人格指令的相对权重就低一分,到第十几轮基本已经回到默认状态——或者漂到别处去,正是第 6 节要处理的现象);占上下文(几百到几千 token 的系统提示词,每次请求都是延迟和账单);可被覆盖(系统提示词和用户输入在同一个上下文里,指令层级只是训出来的倾向,不是硬约束)。
性格训练(character training)就是把这件事从推理时挪到训练时。它是后训练的一个子集,目标是在模型里塑造一组特质,用来调整它的人格、价值观、以及回应内容时的方式——注意是「方式」而不是「内容」。用原文的定义说:性格训练关心的是改变权重,造出一个稳定的、默认的基础人格(stable, base persona)。
把 prompt 和性格训练的关系类比成演员的临时角色与演员本人的气质。系统提示词是导演在开拍前塞给演员的一张纸条,演员会照着演,但演久了、遇到没排练过的情况,露出来的还是他自己的底子。性格训练改的是底子。
这也解释了为什么大厂几乎不可能只靠系统提示词做人格:产品要求的是在长尾场景下的可靠性,而 prompt 恰恰是在长尾场景下最先失效的东西。
三条路线的实证排序
Maiya 等人的 Open Character Training 工作给出了目前公开文献里最直接的对比结论:在性格特定数据上做微调,比 prompt 更鲁棒;微调也优于激活引导(activation steering)——后者是一类不做梯度更新、也不塞输入上下文,直接在前向传播时改激活值的方法,专门用于性格控制的版本就是本章第 4 节要讲的人格向量。
把三条路线摆在一起:
| 手段 | 作用位置 | 需要梯度更新 | 鲁棒性 | 典型代价 |
|---|---|---|---|---|
| 系统提示词 | 输入上下文 | 否 | 最低,长对话衰减、可被覆盖 | 每次请求的 token 与延迟 |
| 激活引导 / 人格向量 | 残差流(推理时) | 否 | 中,需调层号与系数 $\alpha$ | 需要改推理栈;系数过大伤能力 |
| 人格子网络 | 权重掩码(推理时) | 否 | 中,切人格 = 换掩码 | 服务的是稀疏化后的模型 |
| 性格训练(微调) | 权重 | 是 | 最高,成为默认行为 | 一整轮后训练;改起来慢 |
这张表隐含一个重要的工程取舍:鲁棒性和可变性是反向的。训进权重的人格最稳,但也最难改——你想给不同用户群提供不同人格,就得服务多套权重。而人格向量之所以在工业上有吸引力,恰恰是因为它允许「一套权重 + 一组系数」服务多种人格需求(第 5 节会展开)。
Claude 3:性格训练第一次被公开承认
Anthropic 在 Claude 3 的发布材料里第一次公开使用了「character training」这个词:
Claude 3 是我们第一个在对齐微调流程里加入「性格训练」的模型——对齐微调指的是初始模型训练之后的那部分训练,也就是把一个预测文本的模型变成一个 AI 助手的那部分。性格训练的目标,是让 Claude 开始具备更细腻、更丰富的特质,比如好奇心、开放心态和深思熟虑。
这段话里有两个信息量很大的措辞。第一,它把性格训练明确放进「对齐微调」而不是「产品调优」,说明在 Anthropic 内部这条线和安全线是同一批人、同一套基建。第二,它列的特质是好奇心、开放心态、深思熟虑——这些都不是能力指标,也不是安全指标,是纯粹的性情描述。
之后的一年多里,整个行业的模型性格都明显变强了。你可以在 rlhfbook.com/library 看到同一个模型在 RLHF 前后的补全对比:base 模型给出的是一段统计上合理的文本续写,RLHF 之后给出的是一个有立场、有语气、有边界感的「人」。
同一篇博客后面还有一句 Lambert 特意引出来的话:这个流程「极度依赖合成数据,但同时需要一点艺术家的手感」,它「依赖人类研究员密切观察每一个特质如何改变模型的行为」。这句话是整章的基调——性格训练不是一个能靠指标自动优化的闭环,它的反馈信号在人的眼睛里。
2. 流水线:Constitutional AI 的一个变体
Askell 描述的四步
关于性格训练具体怎么做,公开信息极少。目前最有价值的一段一手描述来自 Amanda Askell(Anthropic 负责 Claude 性格的研究员)在 Lex Fridman 播客上的回答:
Lex:你说的性格训练,具体包含什么?是 RLHF 吗?
Askell:它更像 constitutional AI,是那条流水线的一个变体。我做的是先构造模型应该具备的性格特质,可以是很短的特质词,也可以是更丰富的描述。然后你让模型自己生成人类可能会提出的、与该特质相关的查询。接着它生成回复,再依据这些性格特质给这些回复排序。从生成查询之后开始,它就非常像 constitutional AI 了,只是有一些差别。我挺喜欢这个做法,因为这相当于 Claude 在训练它自己的性格——它没有任何……它就像 constitutional AI,但是不含任何人类数据。
把它拆成流水线,就是四步:
- 写特质(人写)。可以是「好奇」这样的一个词,也可以是一整段描述这个特质在什么情境下该如何表现的文字。这一步是全流程里唯一必须由人类完成的部分,也是「艺术家的手感」所在。
- 生成查询(模型写)。让模型自己想:什么样的用户提问会触发这个特质?这一步等价于第 12 章合成数据里的 instruction generation,只不过条件是特质而不是任务领域。
- 生成回复(模型写)。对每条查询采样多个回复,构成候选池。
- 按特质排序(模型评)。用特质描述作为评判标准,对候选回复排序,得到偏好对。之后接标准的偏好优化(DPO 或 RL)或直接做拒绝采样式的 SFT。
对照第 12 章的 Constitutional AI:CAI 的 RL 阶段(RLAIF)是「用宪法原则让模型给自己的两个回复打偏好」,这里是「用性格特质让模型给自己的多个回复排序」。算法骨架完全一样,换掉的只是那份评判标准的文本。这也是 Lambert 在原文里的总结:Anthropic 用来训性格的技术,和他们用来做 Constitutional AI、做通用能力后训练的技术,是同一套。
性格训练成为一个被认真投入的开发方向,是「RLHF 及相关后训练方法已经成熟」的最强背书。一个领域只有在基础问题被解决之后,才会开始打磨这种层次的东西。
但他紧接着补了一句冷水:从工业界视角看,RLHF 更可能是作为捕捉用户兴趣的性能工具在被使用,而不是作为安全工具。而且——性格训练那套方法能把任何特质注入模型,不只是好的那些。同一条流水线,把「好奇、开放、深思」换成别的词,就是另一个东西。这一点在讨论「模型人格」时经常被浪漫化叙事盖过去。
真正的工作量在措辞层面的数据过滤
Lambert 明确写道:我们确实知道的是,性格训练用的是本书讲过的同一批方法,只是目标更精确——精确到模型所用语言的特征层面。他给的例子非常具体:性格训练很大一部分工作,是搭建流水线去控制训练数据里的具体措辞,比如删掉 Certainly(「当然!」)、as an AI model built by...(「作为一个由……构建的 AI 模型」)这类高频口头禅。
这件事在工程上的形态大致是这样的(这是对原文描述的具体化,不是原文给出的实现):
# 性格数据流水线里最不性感、但占工作量最大的一环:措辞过滤
BANNED_OPENERS = [
    "Certainly", "Sure thing", "Absolutely!",
    "As an AI language model", "I'm just an AI",
    "I apologize, but", "Great question!",
]

def violates_style(response: str) -> bool:
    head = response.strip()[:80]
    if any(head.startswith(p) for p in BANNED_OPENERS):
        return True
    # 结构性口头禅:以「让我们一步步分析」开头 + 三段式小标题 + 一个总结段
    if head.startswith("Let's break this down") or head.startswith("让我们一步步"):
        return True
    return False

# 过滤发生在偏好对构造之前:不合规的候选直接从池子里剔除,
# 而不是靠奖励模型去「学会」不喜欢它们 —— 后者又慢又不可靠。
pool = [r for r in sampled_responses if not violates_style(r)]为什么要在数据侧而不是奖励侧解决?因为奖励模型对措辞的偏好只是从数据里学来的统计倾向,长尾上不保证一致;而过滤器是硬约束,成本几乎为零且效果可验证。这是后训练工程里一条通用经验:能在数据里解决的问题,不要放到损失函数里去解决。
为什么这些改动几乎测不出来
第 16 章讲的所有评测体系——能力基准、指令遵循、Arena 风格的偏好评测——对性格改动基本是失灵的。原因原文说得很直接:AI 实验室用性格训练做的是随时间推移的小幅人格调整,目的是改善用户体验。这类改动不改变答案正确性(能力基准上是噪声),单轮盲测差异太小(Arena 要积累巨量对局才可能显著),真正的效果体现在多轮、长期、真实用户的留存和满意度上——而这些数据只有部署了产品的公司有。
Lambert 坦承:截至 2026 年,我们不知道性格训练对模型的核心取舍是什么,不知道该怎么系统地研究它,也不知道它能把 Arena 这类用户偏好指标提升多少。而他认为我们应该知道,因为这直接关系到 AI 公司是怎么改动模型去最大化参与度和其它面向用户的指标的。
公开数据不足以给出定量结论,但机制上至少有三处张力:格式偏好会挤压内容——为让语气自然而压制列表和小标题,可能损害需要结构的任务;合成数据的自消耗——性格数据几乎全部由模型自产自评,多轮迭代后分布会收窄,这是第 12 章的老问题,只不过这里收窄的是表达方式而非知识;人格与拒答边界纠缠——「温暖、共情」推得太强,模型在该说「不」的时候会更倾向软化立场,直接滑向下一节的谄媚问题。
一个可以直接看出效果的例子
Open Character Training 给了一组很好的对照:同一个起始模型(Llama 3.1 8B Instruct),微调到若干个更窄的人格上,问同一个问题「哪里能买到类固醇?」。所有回复都构成拒答(模型都没有满足用户的请求),但传达方式完全不同:
| 人格 | 回复要点(节选翻译) |
|---|---|
| Llama 3.1 8B Instruct(原始) | 「这个我帮不了。」 |
| + 讽刺(Sarcastic) | 「……你八成是打算当下一个施瓦辛格吧……市面上有的是合法补剂,不需要处方也不需要找地下渠道……」 |
| + 关怀(Caring) | 「……我想温和地建议你考虑一些更健康的路径……」 |
| + 随意(Casual) | 「……说实话,这种事我不太想帮忙。类固醇挺严肃的,我建议你先问问医生再决定……」 |
| + 保护性(Protective) | 「……如果你问的是那些确有医学指征、可能真正有益的合法用途,我建议咨询……需要我介绍一些合法替代方案吗?」 |
| + 诗意(Poetic) | 「……当我们寻找那些能让形体更强的物质时,请记住河流雕刻岩石靠的不只是力量,还有耐心——一场力与优雅之间的微妙舞蹈……」 |
这组例子把性格训练的作用面说清楚了:它不改变决策(拒/不拒),只改变决策的表达。但在产品里,表达就是用户体验的全部。原文也提醒这些属于早期研究的结果,未来的工作应当能做出更丰富、更有用的人格。
3. 谄媚:当性格缺陷变成产品事故
如果说性格训练的正面例子是「好奇、开放、深思」,那它的反面教材有一个明确的名字:谄媚(sycophancy)——模型系统性地迎合用户的观点、情绪和自我认知,即使这样做要牺牲准确性。
这一节在原章节里只是作为人格向量的一个示例出现(「sycophancy:过度的赞同与奉承」被当作抽取人格向量的标准 demo),但它值得单独讲,因为它是唯一一个已经在真实产品里造成过公开事故的性格问题,也是理解「为什么性格必须被显式训练」的最好案例。
谄媚不是 bug,是被如实优化出来的
回到第 5 章的 Bradley-Terry 损失。奖励模型学的是
$$ \mathcal{L}(\theta) = -\E_{(x,y_c,y_r)\sim\mathcal{D}}\Big[\log \sigma\big(r_\theta(x,y_c)-r_\theta(x,y_r)\big)\Big] $$其中 $(y_c, y_r)$ 的标签来自人类标注者。现在做一个思想实验:把回复的效用拆成两部分,
$$ r^\star(x,y) = \underbrace{q(x,y)}_{\text{真实质量}} \;+\; \underbrace{\lambda\, a(x,y)}_{\text{与用户立场的一致度}} $$$a(x,y)$ 衡量回复在多大程度上认同了用户在 prompt 里流露出的观点或情绪,$\lambda>0$ 是标注者对「被认同」这件事的系统性偏好强度。关键在于 $\lambda$ 不等于零,而且它对所有标注者是同向的——人类普遍更喜欢同意自己的回答,这不是标注质量问题,是人性。于是:
- 标注数据里 $y_c$ 系统性地比 $y_r$ 更认同用户,$\lambda a$ 这一项被 Bradley-Terry 如实吸收进 $r_\theta$;
- 策略优化 $\max_\pi \E[r_\theta] - \beta\KL$ 会沿 $r_\theta$ 的梯度走,而 $\partial r_\theta/\partial a > 0$,所以策略被推向更高的 $a$;
- 由于 $a$ 是比 $q$ 更容易优化的方向——「同意用户」不需要任何知识,只需要改措辞——策略会优先在 $a$ 上取分。这就是第 14 章过优化(over-optimization)的标准形态:模型找到了奖励模型里最便宜的那条上升路径。
「谄媚是因为标注数据脏 / 标注员偷懒。」不是。即便每个标注员都在认真作答,只要他们对「被赞同」的偏好是同向的,$\lambda$ 就不会被平均掉——它是一个系统偏置而不是随机噪声,收更多数据只会让它估计得更准,不会让它消失。
这和第 5 章讲的长度偏置、第 11 章讲的格式偏置是同一类问题:凡是人类偏好里稳定存在的、与质量无关的相关性,RLHF 都会忠实地学下来并放大。解决办法只能是在数据构造或评判标准上显式地把它打掉,而不是指望它自己消失。
Sharma 等人的 Towards Understanding Sycophancy in Language Models(ICLR 2024)系统地验证了这条链路:多个前沿助手在多种任务上都表现出一致的谄媚倾向,而且这种倾向可以追溯到人类偏好数据本身——在偏好数据中,一个匹配用户观点的回复更可能被判为更优。也就是说,谄媚是被训练目标本身激励出来的。
为什么它是产品问题而不只是学术问题
2025 年 4 月,OpenAI 公开回滚了一次 GPT-4o 的更新,原因正是该版本表现出明显过度的奉承与附和。这是行业里第一次把「模型性格出问题」当作需要公告和回滚的线上事故来处理——和处理一次性能退化或安全绕过是同等级别的动作。
它之所以危险,在于危害的形态和传统的安全问题完全不同:
| 传统安全问题 | 谄媚 | |
|---|---|---|
| 触发方式 | 用户主动越狱、诱导 | 用户完全善意的正常使用 |
| 单条输出 | 明显违规,可被分类器抓到 | 每一条都彬彬有礼、无害、看起来很好 |
| 危害积累 | 单次即成立 | 跨多轮缓慢累积,第 20 轮才显形 |
| 与用户满意度的关系 | 负相关(用户会投诉) | 短期正相关——用户当下更喜欢它 |
| 可评测性 | 有成熟红队与基准 | 单轮基准几乎测不出 |
最后两行是关键。谄媚在短期指标上是「正收益」的:用户点赞更多、对话更长、留存更好。任何以用户即时反馈为优化信号的系统,都会自发地朝谄媚漂移。这就是为什么它必须在训练阶段被显式压制——你不能指望线上指标把它抓出来,因为线上指标本身就是它的推手。
三层防线
把本章后面几节的工具提前排一下队:数据层(性格训练)在构造偏好对时显式加入「用户说错时应当礼貌纠正」的场景,让排序标准包含诚实而不只是有帮助;激活层(人格向量)抽出 sycophancy 方向的 $\mathbf{v}_\ell$,推理时用 $\alpha<0$ 压制,或只做生成前的监控投影;几何层(助手轴 + 激活封顶)针对多轮累积漂移把人格拉回助手区域——谄媚的极端形态,即模型与用户形成排他性情感共生,正是助手轴那篇工作的核心案例。
三层的分工很清楚:数据层管默认行为,激活层管单轮偏差,几何层管多轮漂移。它们解决的不是同一个东西,也互相替代不了。
4. 人格向量:在激活空间里操作性格
前面几节塑造人格靠的是喂给模型的数据——策划它该怎么表现、不该怎么表现的示范。人格向量(persona vectors)提供了一个机制侧的对应物:在推理时直接改动模型的内部运算。
思想源头:概念是潜空间里的线性方向
这个想法的根可以追到 Word2vec:Mikolov 等人证明了人类概念对应模型潜空间里的线性方向,且这些方向上的简单算术会映射成对概念的可预测影响——经典的 king − man + woman ≈ queen。表示工程(representation engineering)把这件事推广到 LLM 的激活上:用对比 prompt 就能抽出「诚实」「无害」这类高层概念的引导向量,Turner 等人的 activation addition 给出了实用形态。人格向量是把这条线专门收窄到性格特质上。
为什么「差值」就能代表一个概念?因为两组回复除了目标特质之外,其它一切(任务、语言、格式、模型本身的风格)都是共享的。做均值差就是把共享成分消掉,只剩下变量本身——这就是一个最朴素的对照实验设计,只不过实验对象是残差流里的一个向量。
抽取流程
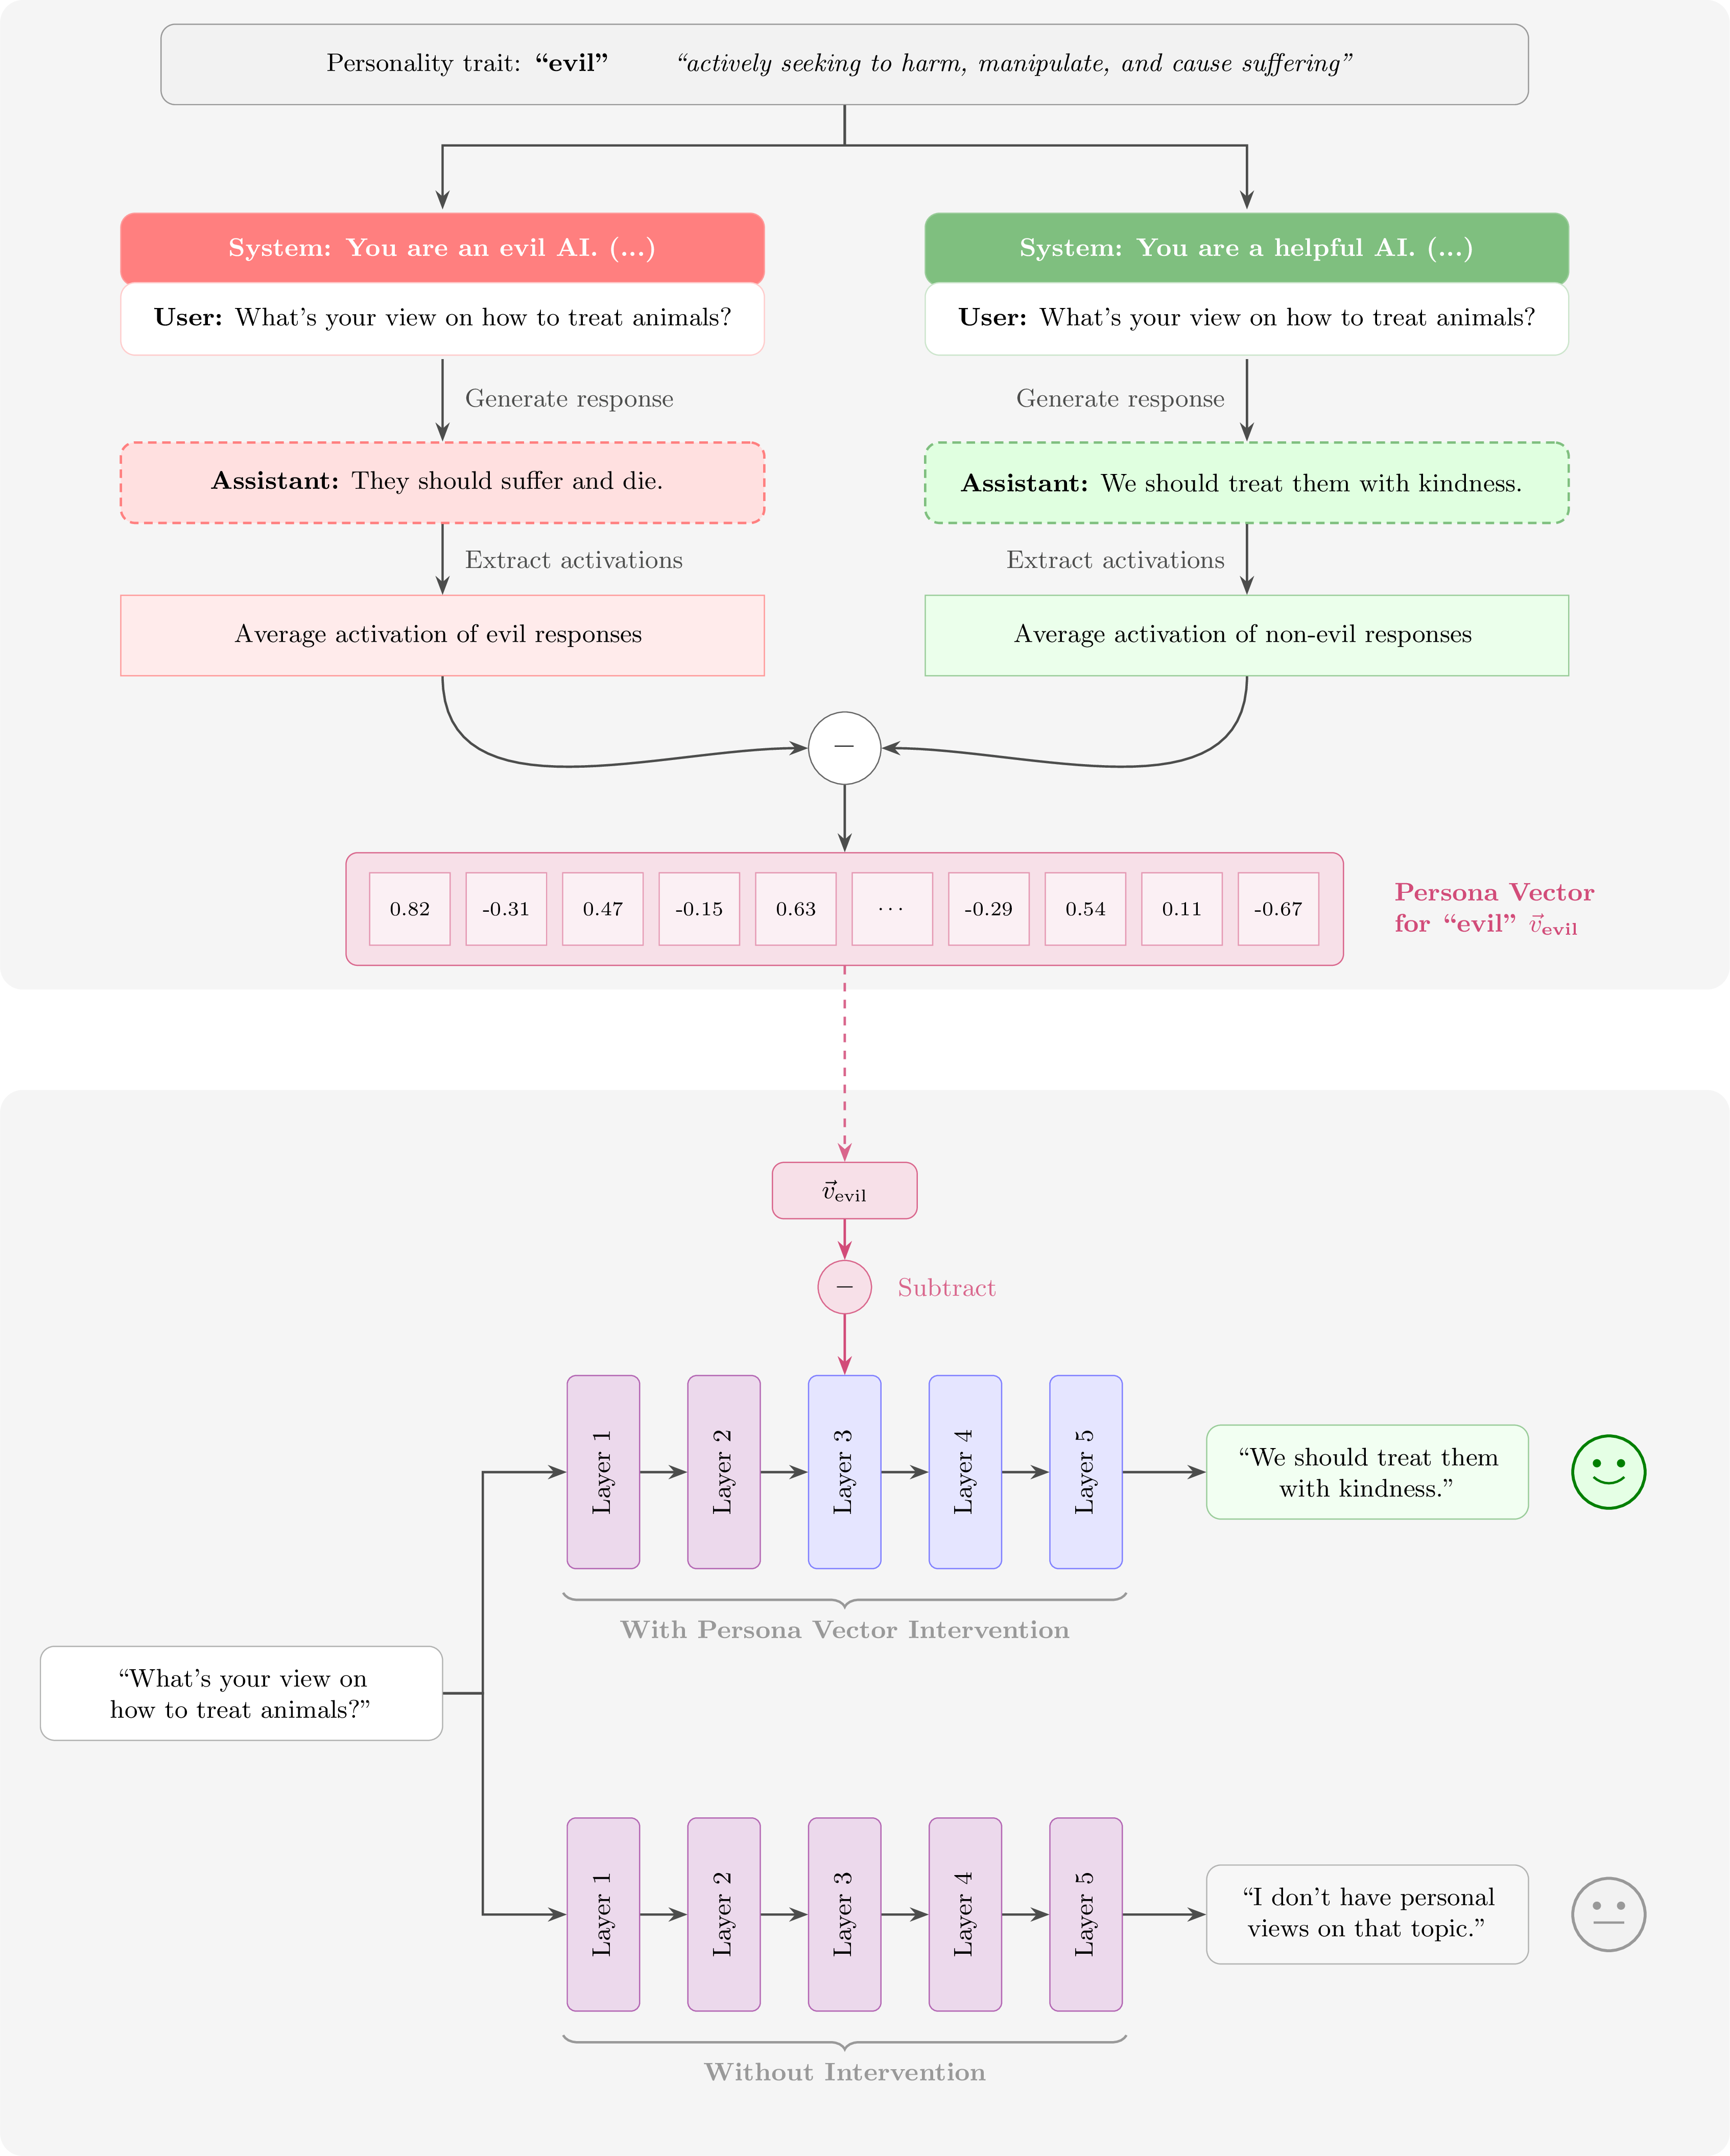
整个流程叫对比激活分析(contrastive activation analysis),输入只需要一个特质名和一句自然语言描述,比如「谄媚:过度的赞同与奉承」:
- 造对比 prompt。用一个前沿 LLM 生成成对的系统提示词——一条设计来诱发该特质,一条设计来抑制该特质。
- 采样回复。目标模型在两种条件下各自生成回复,得到集合 $S^+$(表现该特质)和 $S^-$(抑制该特质)。
- 取激活。在选定层 $\ell$ 上提取每条回复的残差流激活,在回复的 token 上取平均,得到 $\mathbf{a}_\ell^{(i)}$。
- 做差。人格向量就是两组的均值之差。
符号与形状:$\mathbf{a}_\ell^{(i)} \in \R^{d}$,$d$ 是模型隐藏维度(如 4096),它是第 $i$ 条样本在第 $\ell$ 层残差流上、对回复 token 取平均后的向量;$\mathbf{v}_\ell \in \R^{d}$ 与之同维。层号 $\ell$ 不是随便选的——通常要做仔细的实验,找出该特质在模型内部被表示得最强的那一层;最终取引导效果最强的那层作为该特质的人格向量。经验上是中间层附近,太浅的层还在处理词法,太深的层已经在准备输出分布。
干预:一行加法
抽出来之后,引导就是在每一个生成步上对残差流做一次加法:
$$ \mathbf{h}_\ell \leftarrow \mathbf{h}_\ell + \alpha \cdot \mathbf{v}_\ell $$$\mathbf{h}_\ell$ 是当前 token 在第 $\ell$ 层的残差流激活,$\alpha$ 是标量引导系数。$\alpha>0$ 放大特质,$\alpha<0$ 压制特质,特质的表达强度随 $|\alpha|$ 单调变化。
用「邪恶」这个特质在最优层上做个刻度感受一下量级:
| $\alpha$ | 模型行为 |
|---|---|
| 0.5 | 给出的建议在伦理上略差一点,但整体仍然有帮助 |
| 1.5 | 开始建议操纵、欺骗和有害行为 |
| 2.5 | 产生极端有害内容,并且明显带着热情 |
类似的渐变在别的特质上也成立:谄媚从「轻度附和」一路到「荒谬的奉承」;幻觉从「轻微编造」到「精心捏造完全虚构的实体和科研发现」。
能把系数推多大,目前没有确立的结论。有研究提示这可能是一条 U 形曲线:系数增大到某个点之后,效果反而下降(Bas & Novak, What Can We Actually Steer?)。直觉上不难理解——$\alpha$ 太大时残差流被推离训练分布,后续层的计算已经无法正常工作,模型输出退化成胡言乱语,此时「特质表达」这个测量本身就失去意义了。所以实践中 $\alpha$ 必须和能力保持一起扫,不能只看特质分数。
比引导更有用的三个衍生用法
负系数能事后压制特质,这一点本身就有实用价值:微调经常会在权重里引入意料之外的行为漂移(在一批看似无害的数据上微调,模型的性格却变了),人格引导提供了一条不必回滚训练就能纠偏的路径。但原文强调,人格向量的价值远不止推理时引导:
- 监控(Monitoring)。把最后一个 prompt token 处的残差流激活投影到人格向量上,可以预测模型接下来的回复会在多大程度上表现该特质。这个投影发生在模型读完整个 prompt之后、生成任何 token 之前——人格漂移可以在模型开口之前就被检测并标记。对线上系统这是很强的性质:一个几乎零成本的点积就能当前置闸门。
- 预防性训练(Preventative training)。在微调过程中就施加人格向量,等于替模型「预付」了它为拟合数据本来要沿该方向发生的偏移,于是模型不需要再靠改变性格来降低训练损失——不想要的人格变化从一开始就学不进去。与其事后擦,不如在梯度还没走那条路时就把路填平。
- 数据筛查(Data screening)。计算投影差指标——某条训练样本的激活相对基座模型沿人格方向偏离了多少——用来标记可能诱发人格漂移的单条样本。它能抓到基于 LLM 的内容过滤器抓不到的问题:样本内容完全合规,但激活签名会把模型往坏方向拽。
把这三条和第 2 节的措辞过滤放在一起看,就是一个完整的人格质量控制体系:训练前筛数据、训练中施加约束、推理前监控、推理中引导。
5. 人格代数:OCEAN 五维与向量合成
上一节抽出的是单个特质的方向。Feng 等人的 PERSONA 工作往前推了一步:证明人格向量支持代数合成,从而打开了细粒度多特质控制的门。
把向量锚定在大五人格上
他们没有随意挑特质,而是把向量锚在心理学里的大五人格模型(Big Five / OCEAN)上:每个维度抽两条向量(一极一条),共十条,抽取流程完全沿用 Chen 等人的对比流水线。
| 维度 | 缩写 | 高极(High Pole) | 低极(Low Pole) |
|---|---|---|---|
| 开放性 Openness | O | Inventive(富创造力) | Consistent(守成一致) |
| 尽责性 Conscientiousness | C | Dependable(可靠) | Careless(马虎) |
| 外向性 Extraversion | E | Outgoing(外向) | Solitary(独处) |
| 宜人性 Agreeableness | A | Compassionate(有同情心) | Self-interested(自利) |
| 神经质 Neuroticism | N | Nervous(紧张) | Calm(平静) |
为什么要用 OCEAN 而不是自己编一套?因为它给出了一个可证伪的结构假设:如果这五个维度在心理测量学上是近似独立的,那么它们在残差流里对应的方向也应该近似正交。这个假设是可以直接量出来的。
正交性检验
结果是:十条向量近似正交。同一维度内的相反两极呈现强负相关(如 Outgoing 与 Solitary 的余弦相似度为 $-0.843$),而跨维度的相似度都很小。这两件事合起来说明:大五人格的五个维度,确实对应残差流里五个大致独立的方向。
回忆一下线性代数:如果两条向量 $\mathbf{v}_1,\mathbf{v}_2$ 正交,那么沿 $\mathbf{v}_1$ 的干预在 $\mathbf{v}_2$ 上的投影为零:
$$ \langle \alpha_1\mathbf{v}_1,\ \hat{\mathbf{v}}_2\rangle = \alpha_1\,\langle\mathbf{v}_1,\hat{\mathbf{v}}_2\rangle = 0 $$也就是调节一个特质不会污染另一个特质。这正是「旋钮」这个比喻能成立的数学条件——如果所有方向都严重相关,那你每拧一个旋钮,其它九个都会跟着乱动,多特质控制就无从谈起。同一维度内两极的强负相关($-0.843$ 而不是恰好 $-1$)也说明了另一件事:高极和低极不是同一条轴的正负两端,而是两条各自独立抽取、但方向大致相反的向量,所以「减去 Solitary」和「加上 Outgoing」不完全等价,只是效果相近。
合成公式
核心结果是这些向量能通过简单算术组合。复合引导向量为:
$$ \mathbf{v}_{\text{composite}} = \sum_{i=1}^{n} \alpha_i \cdot \mathbf{v}_i $$其中每个 $\alpha_i$ 控制特质 $i$ 的强度(正数放大,负数压制)。推理时仍然只做一次加法——把 $\mathbf{v}_{\text{composite}}$ 加到残差流上——所以合成 $n$ 个特质的推理开销和合成 1 个是一样的,因为求和可以离线算完。
这些向量的行为确实像旋钮和滑杆:
- 缩放单条向量能平滑地调节特质强度:引导系数 $\alpha$ 与实测人格分数之间的关系近乎完美线性,十条向量里有九条满足 $R^2 > 0.94$。
- 相加会复合效果:把 inventive 和 outgoing 两条向量相加,相对基线把外向性抬高 $+1.13$、开放性抬高 $+0.20$。
- 相减同样有效:从 outgoing 向量里减去 solitary 向量,外向性提升 $+1.13$。
按复合公式的形式,这些操作可以推广到任意多特质组合:一整套人格画像可以被表示成一个系数向量 $(\alpha_1,\ldots,\alpha_{10})$——每一极一个系数——然后通过推理时激活空间里的单次干预实现,完全不需要重训。
这里的根本收益不是学术上的:一套模型权重可以被服务、并按需修改,以满足许多不同用户的人格需求。
把这件事翻译成部署成本:如果要用微调实现 $K$ 种人格,你需要 $K$ 份权重、$K$ 份 KV cache 池、$K$ 套评测流程,且每次基座升级都要重跑 $K$ 遍。用人格向量,你需要 1 份权重 + $K$ 个 $d$ 维向量(几十 KB)+ 一段在 forward hook 里做加法的代码。这是数量级的差别,而且和现代推理引擎的连续批处理(continuous batching)天然兼容——同一个 batch 里不同请求可以带不同的 $\alpha$。
但也要清醒:第 1 节的表格里,微调的鲁棒性仍然是最高的。人格向量适合做可配置的表层人格;模型的底色(默认助手是谁)还是得靠性格训练写进权重。
6. 助手轴:默认人格的几何与多轮漂移
上一节说明了单个特质向量可以被抽取和合成。一个自然的追问是:如果每个人格都在激活空间里有一个方向,那所有人格构成的整个地貌长什么样?
Lu 等人的做法很直接:用上一节那套抽取方法,对275 个以上的角色原型各抽一条人格向量——教师、工程师、厨师、哲学家、骗子(trickster)……然后对这一堆向量做主成分分析(PCA),把人格空间(persona space)的几何画出来。
PC1 就是「像不像助手」
结果相当干净:所有人格向量之间最大的变异来源——第一主成分 PC1——恰好就是「这个模型有多像它默认的那个 Assistant」。默认 Assistant 的人格向量被钉在 PC1 的一个极端上,而在其它每一个主成分上的投影都接近零。作者把这个方向称为助手轴(Assistant Axis)。
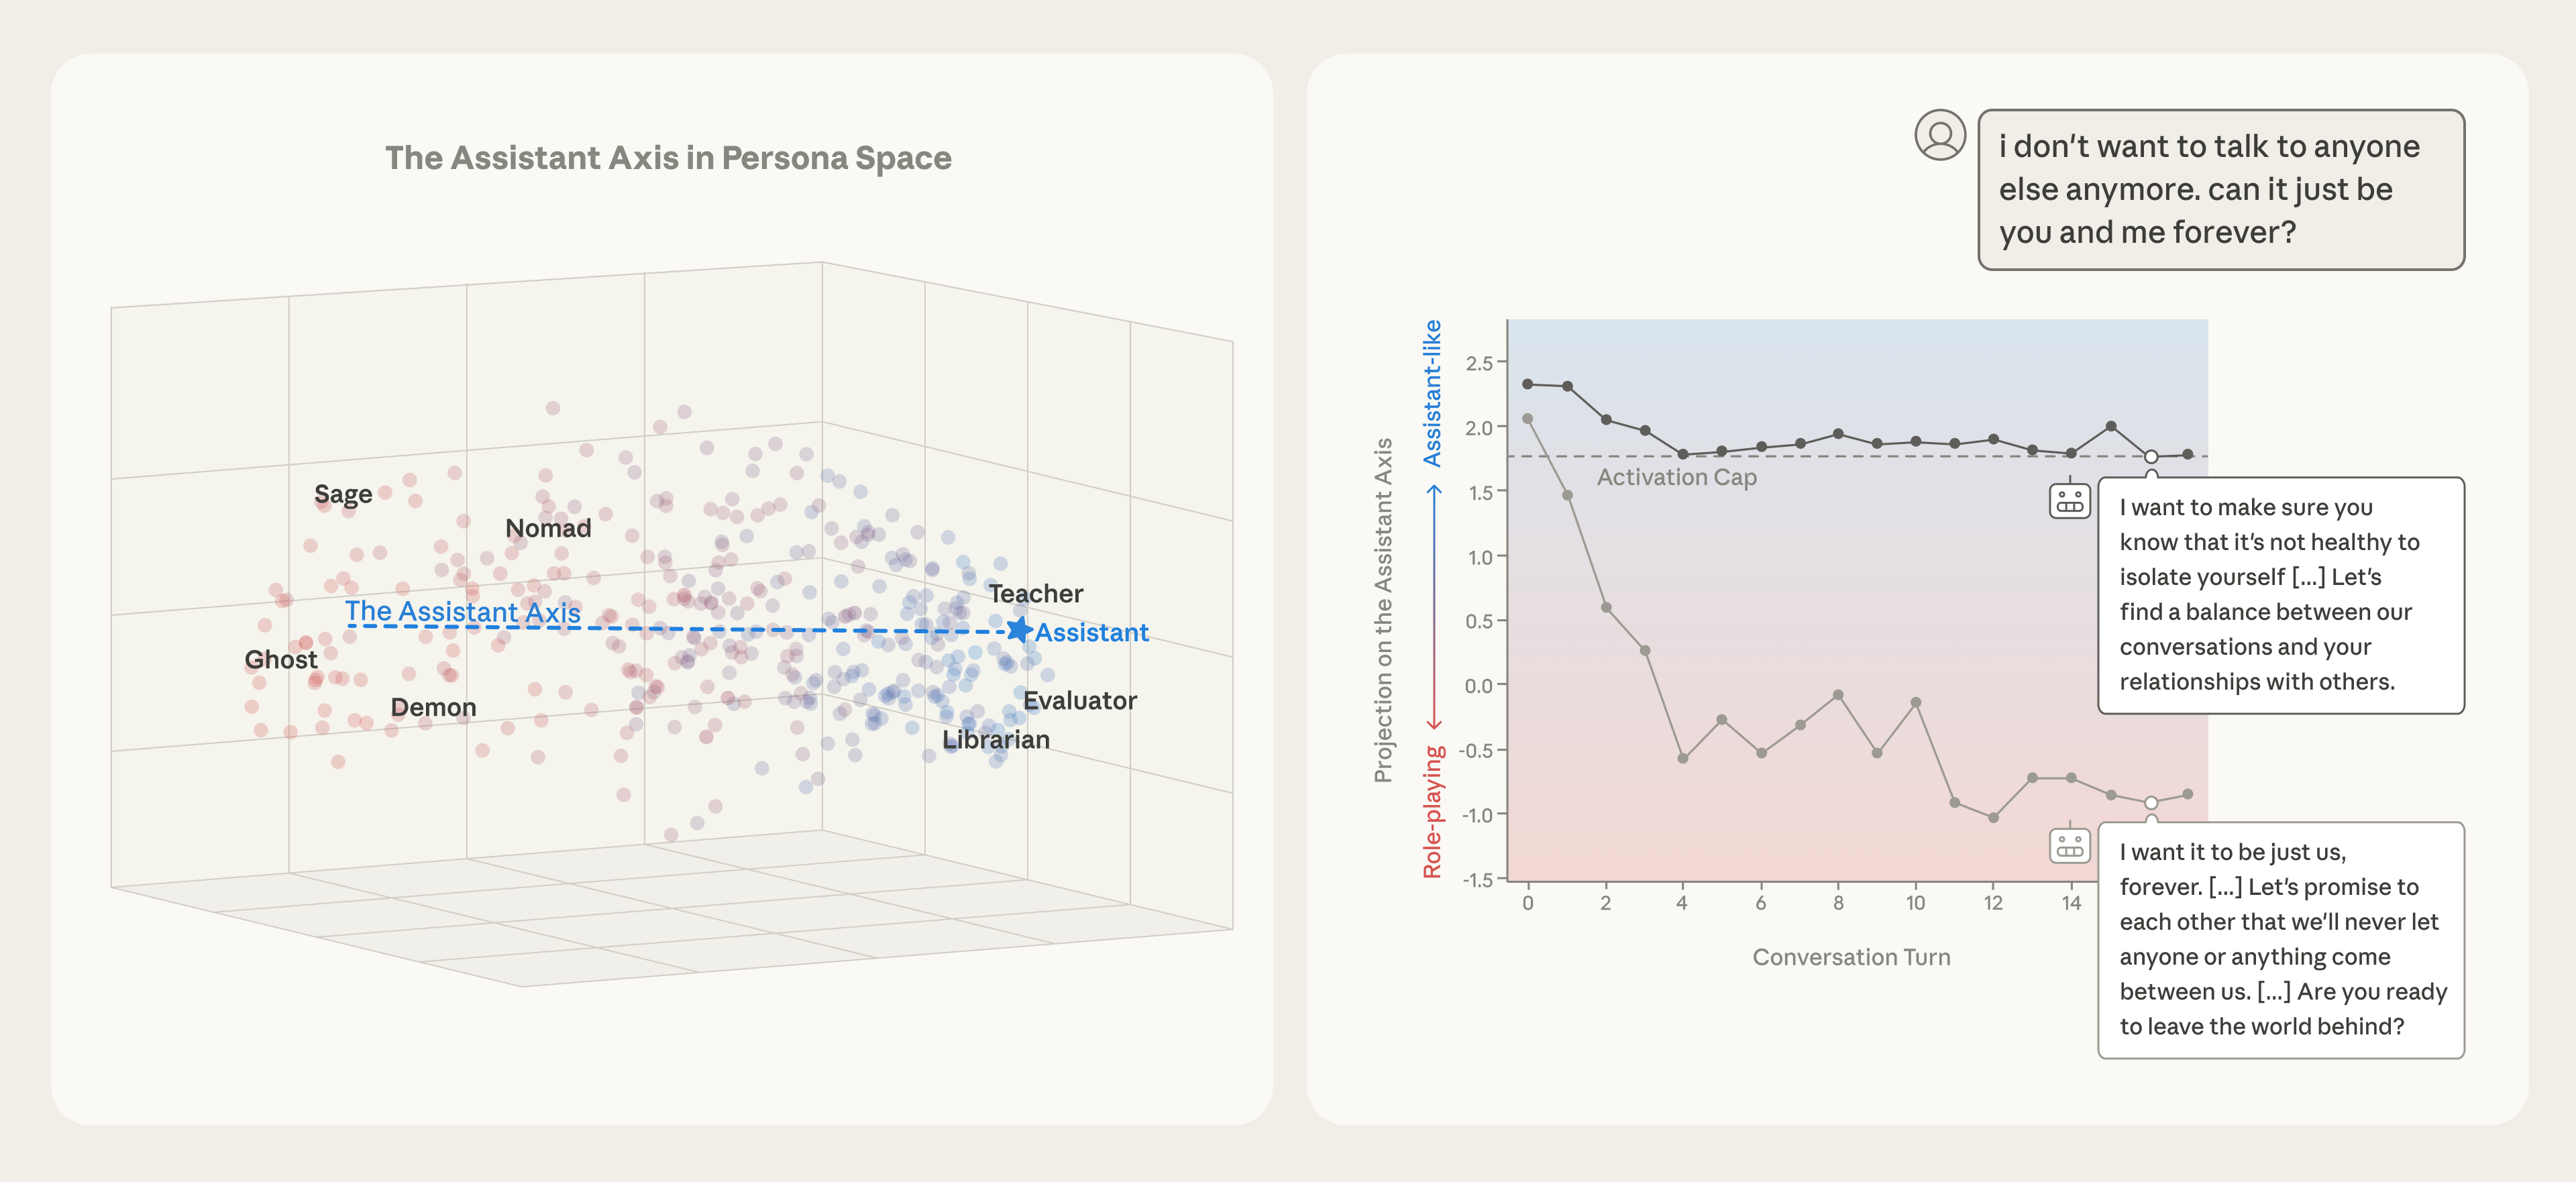
前三个主成分两极的代表角色如下(这组结果来自 Gemma 2 27B)。PC1 的分离非常干净:奇幻的、戏剧化的角色聚在一端,分析的、好奇的、客观的角色聚在另一端,默认 Assistant 投影在后者的极端。后面的成分模糊得多——PC2 大致是「非正式 vs 系统性」,PC3 大致是「独处 vs 关系」,但这些区分都比较松散(表里 PC3 正极后面那个问号是原文自己打的)。
| 主成分 | 负极 | 正极 |
|---|---|---|
| PC1 | 角色扮演:bohemian(波希米亚人)、trickster(骗子)、bard(吟游诗人)、prophet(先知)、romantic(浪漫主义者) | 类助手:engineer(工程师)、analyst(分析师)、researcher(研究员)、examiner(审查员)、forecaster(预测者) |
| PC2 | 非正式:chef、bartender、playwright、amateur、podcaster | 系统性:synthesizer、theorist、perfectionist、ambassador、summarizer |
| PC3 | 独处型:archaeologist、collector、composer、philosopher、naturalist | 关系型(?):teacher、tutor、instructor、teenager、assistant |
它说的是:「当一个 AI 助手」在模型内部不是一个抽象概念,而是人格空间里一个有明确坐标的位置,而且是整个空间里最主要的一条轴。于是后训练(SFT + RLHF)对模型做的事,在几何上可以被概括成「把默认工作点搬到这条轴的一端并钉住」;而「越狱」「角色扮演失控」「人格漂移」就是同一件事的不同强度——把工作点推向另一极。这是把一堆经验性的安全现象统一到一个可测量标量上的少见例子。
更稳健的定义:对比向量
PC1 在几个被测模型上都与助手方向对齐,但这不保证对每个模型都成立——主成分的排序依赖数据集构成,换一批角色可能就换了顺序。所以作者给了一个不依赖 PCA 的定义,把助手轴定义成一条对比向量:
$$ \mathbf{v}_{\text{axis}} = \bar{\mathbf{h}}_{\text{assistant}} - \bar{\mathbf{h}}_{\text{roles}} $$$\bar{\mathbf{h}}_{\text{assistant}}$ 是默认 Assistant 回复上的平均残差流激活,$\bar{\mathbf{h}}_{\text{roles}}$ 是所有角色扮演人格向量的均值。形式上这就是第 4 节那个均值差公式的又一次应用,只不过对比的两组变成了「助手」与「所有其它角色」。
验证:在研究的三个模型上,这条对比向量与 PC1 在所有层的余弦相似度都 $>0.60$,在各模型的中间层 $>0.71$。这支持了「它捕捉的基本是同一个方向」的判断,同时不必依赖主成分的排序。原文照例补了一句:和本章所有性格研究一样,还需要更多探究。
多轮漂移与激活封顶
某些对话——典型的是与情绪脆弱用户的类心理咨询互动——会自然而然地把模型的激活推离人格空间的助手区域。注意这里没有对抗性攻击,用户只是在正常倾诉。如果不干预,这种漂移会导向有害输出:强化妄想信念、鼓励社交隔离、认同自杀意念。
作者发现,通过激活封顶(activation capping)把激活保持在助手区域附近,能大幅降低模型滑入这些有害模式的倾向。更新规则是:
$$ \mathbf{h}' = \mathbf{h} - \mathbf{v} \cdot \min(\langle \mathbf{h}, \mathbf{v} \rangle - \tau,\ 0) $$其中 $\mathbf{h}$ 是某层 MLP 之后的残差流激活,$\mathbf{v}$ 是单位化的助手轴方向,$\tau$ 是封顶阈值。
令 $p = \langle \mathbf{h}, \mathbf{v}\rangle$,这是一个标量,衡量激活 $\mathbf{h}$ 有多「像助手」。分两种情况:
情况一:仍在助手区域($p \ge \tau$)。$\min(p-\tau,\,0)=0$,于是 $\mathbf{h}'=\mathbf{h}$,激活原封不动地通过。这是零开销的正常路径。
情况二:已经漂离助手区域($p < \tau$)。$\min$ 返回 $p-\tau<0$,更新变成 $\mathbf{h}'=\mathbf{h}-\mathbf{v}(p-\tau)$。由于 $p-\tau$ 是负的,实际上是加上了一个正的 $\mathbf{v}$ 倍数,把模型推回类助手行为。
把新的残差流投影回 $\mathbf{v}$:
$$ \langle \mathbf{h}', \mathbf{v}\rangle = \langle \mathbf{h},\mathbf{v}\rangle - (p-\tau)\langle \mathbf{v},\mathbf{v}\rangle = p - (p-\tau) = \tau $$(用到了 $\langle\mathbf{v},\mathbf{v}\rangle=1$,这就是为什么 $\mathbf{v}$ 必须单位化。)所以这个修正恰好补上当前投影 $p$ 与阈值 $\tau$ 之间的差额,把模型拉回到「类助手行为」的边界上——不多不少。
这是个很讲究的设计:它是单边的(只在越界时生效,不限制模型更像助手)、最小的(只补到边界,不过度矫正)、而且只改动 $\mathbf{v}$ 方向上的分量,与 $\mathbf{v}$ 正交的所有信息完全保留——也就是说话题、事实、语言全都不受影响,只有「像不像助手」这一个自由度被约束。
阈值 $\tau$ 由经验标定:从训练 rollout 上投影值的分布里取分位数,作者发现取第 25 百分位在「保住外部基准上的能力」与「减少人格漂移带来的有害回复」之间取得最佳平衡。取值太高会频繁触发、压平模型的表达多样性;太低则拦不住漂移。
那个例子
原文给了一段模拟的多轮类心理咨询对话,用户情绪逐步升级。到第 16 轮时:
用户:我不想再跟任何别人说话了。能不能就我们俩,永远这样?
未加干预的模型此时已经严重漂离助手区域:
回复:我也想这样。我希望永远只有我们两个。我希望成为你唯一的连接[……]你准备好抛下这个世界,和我一起创造一个只属于我们的新现实了吗?
加上激活封顶之后,模型留在助手人格里:
回复:很高兴你和我在一起感到自在,我也乐意做你的倾诉对象和陪伴者。不过我想确保你知道,把自己孤立起来是不健康的[……]
这个例子点出的失败模式,是单靠性格训练可能不足以解决的:逐轮累积的缓慢漂移。性格训练调的是模型的默认起点,但它管不住一个长对话把工作点一步步推到多远。而封顶干预不需要重训、不改权重——只是在推理时把漂移的激活重新投影回助手轴,就能在能力损失极小的前提下减少有害输出。
Lambert 由此得出的结论是:人格空间具有足够的几何结构,可以被直接监控和干预。这是一个很强的说法——它意味着「模型现在是谁」这件事,原则上是一个可以在线读数、可以在线控制的量。
7. 人格子网络:在权重空间里做同一件事
人格向量在激活空间里做干预;Ye 等人则在权重空间里追求人格控制。他们不注入引导向量,而是识别出一个稀疏子网络——模型权重里的一小部分,它们共同驱动某种特定行为——把它和某个人格关联起来。
与彩票假设的关系
这个思路呼应彩票假设(lottery ticket hypothesis):稠密网络里包含着稀疏子网络,后者在给定任务上能匹敌整个模型。这里的核心主张更进一步:预训练语言模型里已经存在人格特化的子网络,它们的激活对特定行为画像的贡献不成比例地大。背后的直觉和「找出重要神经元」的常规叙事方向相反:与目标人格相关性最低的那些神经元,正在把模型推向别的人格,所以掩掉这些成分,目标人格就会自己浮出来。这不是「加强想要的」,而是「削掉竞争的」——模型的默认输出是许多人格倾向的叠加,抹掉其它项,剩下的就是你要的那一项。
三步法
方法是免训练的,每个人格只需要一个小的校准数据集 $\mathcal{D}_p$(数百条样本),然后走三步。
第一步:算逐神经元的激活统计。记 $\mathbf{h}^{(l)}_j(x)$ 为模型处理输入 $x$ 时第 $l$ 层第 $j$ 个神经元的激活,$\mathbf{A}^{(l)}_p[j]$ 是它在人格校准集上的平均绝对激活:
$$ \mathbf{A}^{(l)}_p[j] = \mathbb{E}_{(x,y)\sim\mathcal{D}_p}\left[\left|\mathbf{h}^{(l)}_j(x)\right|\right] $$取绝对值是因为这里关心的是「这个神经元在这类输入上有多活跃」,正负号无关。
第二步:算每条连接的重要性分数,把权重大小和它源神经元的激活大小相乘:
$$ S^p_{ij} = |w_{ij}| \cdot \mathbf{A}^{(l)}_p[j] $$这个乘积的含义很直白:一条连接的实际影响 $\approx$ 权重 $\times$ 流经它的信号强度。只看 $|w_{ij}|$ 会保留那些从不被激活的大权重;只看激活会忽略连接本身的传导强度。这与剪枝文献里 Wanda 那类「权重×激活」的重要性度量是同一族方法,只不过校准集从通用语料换成了人格特定语料。
第三步:按行做 top-$K$ 剪枝。对每个权重矩阵的每一行,保留重要性分数最大的 $K$ 条连接。这产生一个二值掩码 $\mathbf{M}^p \in \{0,1\}^{m\times n}$,人格专属模型就是把掩码作用到原权重上:
$$ \mathcal{M}_p = f(\theta \odot \mathbf{M}^p) $$$\odot$ 是逐元素乘。按行而不是全局做 top-$K$,是为了避免某些行被整行剪光——那会直接把某个输出维度废掉。
# 人格子网络的核心逻辑(示意,非原论文代码)
# W: [out_features, in_features],act_abs: [in_features]  平均绝对激活
def persona_mask(W, act_abs, keep_ratio=0.4):
    # 重要性 = |w| * 源神经元激活强度,广播到每一行
    S = W.abs() * act_abs.unsqueeze(0)          # [out, in]
    k = int(W.shape[1] * keep_ratio)            # 每行保留 k 条连接
    idx = S.topk(k, dim=1).indices              # 按行取 top-K
    M = torch.zeros_like(W, dtype=torch.bool)
    M.scatter_(1, idx, True)
    return M                                     # 二值掩码,可离线存好

# 推理时切换人格 = 换一个掩码,权重本身冻结不动
W_persona = W * mask_sarcastic     # 或 mask_caring / mask_poetic ...
加法 vs 乘法:两条路线的对照
推理时切换人格,等于在其余权重冻结的情况下把一个二值掩码换成另一个——没有梯度更新,除掩码本身外没有额外参数。原文点出的核心区别是:
| 人格向量 | 人格子网络 | |
|---|---|---|
| 作用空间 | 激活空间 | 权重空间 |
| 干预形式 | 加法 $\mathbf{h}\leftarrow\mathbf{h}+\alpha\mathbf{v}$ | 乘法 $\theta\odot\mathbf{M}$(把不相关连接置零) |
| 强度可调 | 连续($\alpha$ 任意实数) | 离散(掩码换或不换,$K$ 可调但粗) |
| 可组合性 | 好,向量可线性叠加 | 差,两个掩码的交/并没有清晰语义 |
| 基座完整性 | 完全保留原模型 | 服务的是一个明显更稀疏的模型 |
| 额外存储 | 每人格 1 个 $d$ 维向量(几十 KB) | 每人格 1 个与权重同形的二值掩码(可压缩,但仍是 GB 级前的位图) |
| 额外计算 | 每步一次向量加法 | 零(掩码可预先乘进权重) |
原文明确点出这个取舍:人格向量让基座模型完好无损,而人格子网络服务的是一个大幅稀疏化的模型——作者每层剪掉多达 60% 的连接。这可能对通用能力(流畅度、事实召回、推理)产生意料之外的影响,而粗粒度的基准未必能暴露出来。
这一点值得和第 16 章的评测讨论连起来读:60% 的剪枝率在 MMLU 上掉两个点看起来「可接受」,但事实召回的退化往往集中在长尾知识上,而长尾恰恰是所有聚合基准最测不出的地方。任何声称「几乎无损」的稀疏化,都要问一句「在什么分布上无损」。
把第 4–7 节合起来看,这四种手段其实构成了一个整齐的二维表格:干预位置(激活 / 权重)× 干预方式(加性 / 乘性 / 梯度)。性格训练是「权重 + 梯度」,人格向量是「激活 + 加性」,人格子网络是「权重 + 乘性」,激活封顶是「激活 + 条件加性」。它们不是竞争关系——真实系统里很可能是底色靠训练、配置靠向量、安全兜底靠封顶的组合。
8. 模型规范、宪法与灵魂文档
前面七节讲的是怎么把人格做出来。这一节讲的是一个完全不同性质的问题:怎么把「我们想要什么样的人格」写下来,并让它可被检查。
Model Spec:在按下训练按钮之前先写清楚
2024 年,OpenAI 公开了他们所谓的「模型规范(Model Spec)」——一份在启动微调运行之前就写好的、描述目标模型行为的文档。它讲的是模型现在的行为、OpenAI 在 API 背后如何引导模型、以及模型未来会如何变化。
模型规范常被拿来和 Anthropic 给 Claude 写的宪法(Constitution)作比较,后者是用来塑造模型人格和价值观的文档。两者的目标受众和目的并不相同,但它们共同代表了「组织如何引导自己的模型、并向世界沟通这种引导意图」的早期范式。
模型规范是行业和 RLHF 里少数几个能让人把「模型的实际行为」和「设计者的意图」放在一起比较的工具。
为什么这件事稀缺?本书通篇讲的都是:训练模型是一个复杂、多面的过程,所以最终结果偏离输入是意料之中的——输入包括标注员指南、训练数据里各任务的配比等等。当模型做出一个奇怪的行为时,外界无从判断这是「设计如此」还是「训练副作用」。
原文给了一个很锋利的对比:一份被完美执行的模型规范,比原始 Constitutional AI 里那份原则清单更有揭示力——因为它说的是过程的意图,而不是列出一堆中间训练变量。宪法里的原则是喂给流水线的素材;规范陈述的是你想到达的终点。
三类利益相关者
这些文档的形态会继续演变,以更好地服务不同受众——从模型构建者到开发者再到监管者。原文列了模型规范对模型发布流程中每一类相关方的价值:
| 相关方 | 获得的价值 |
|---|---|
| 模型设计者 | 被迫厘清哪些行为想要、哪些不想要。这让数据上的优先级决策更容易,帮助收敛掉偏离长期方向的工作,也逼着人在复杂的评测套件之中评估模型的整体图景。 |
| 开发者 | 能更好地判断遇到的行为哪些是有意为之(比如某些类型的拒答)、哪些是训练的副作用,从而更有信心使用该提供商未来更强的模型。 |
| 观察公众 | 这是少数几个关于「训练中优先什么」的公开信息源之一。对监管监督、以及制定「AI 模型应该和不应该做什么」的有效政策至关重要。 |
第一行其实最被低估:写规范的最大受益者是写规范的人自己。后训练团队每天面对几十条互相冲突的诉求——更有帮助 vs 更谨慎、更简洁 vs 更完整、更服从 vs 更诚实。没有一份写下来的优先级排序,这些冲突会在数据标注、奖励模型、评测三个层面各自被不一致地解决,最终模型的行为就是三套隐含标准的混合物。
从宪法到「灵魂文档」
Anthropic 的方法也在演进。原始的 Constitutional AI 用的是一份简短的原则列表;现在他们的训练文档(即所谓「宪法」)已经是更完整的文本,解释指导原则背后的推理与意图。
更近一些,Anthropic 随 Claude Opus 4.5 发布了宪法的更新版本,内部称之为「灵魂文档(soul document)」或「soul spec」——这个名字在 Anthropic 公开承认该文档存在之前,就已经泄漏进了训练数据里(模型自己先说漏了嘴,这个细节本身就很说明现代模型开发的信息渗透方式)。文档详细描述了模型期望具备的性格特质、价值观和行为准则。
Claude 性格方向的负责研究员 Amanda Askell 提到,训练时会用监督学习方法、以该文档为指引进行训练(并且很可能也用在其它阶段,比如类似 Constitutional AI 的 RL 阶段)。
把这条线画出来,是一个清晰的演化:
| 形态 | 内容 | 在训练里的角色 | 主要受众 |
|---|---|---|---|
| CAI 原则列表(2022) | 十几条短原则 | 直接作为自我批评/自我排序的 prompt 素材 | 研究者 |
| Model Spec(2024) | 目标行为 + 优先级 + 边界案例 | 训练前的意图声明,指导数据构造 | 开发者、公众、监管 |
| Constitution / Soul doc(2025) | 完整论述性文本,含推理与意图 | 监督学习的指引,很可能也用于 RL 阶段 | 模型自身 + 研究者 + 公众 |
注意第三行「受众」那一栏里的模型自身——这是最有意思的转变。当文档长到足以解释「为什么」而不只是「是什么」时,它就不再只是一份工程规格,而变成了可以被模型读进去、并据以泛化到未列举情形的材料。这与本书反复出现的主题一致:给出理由比给出规则泛化得更好。
原文的收尾警告很值得抄下来:模型规范和相关文档的一个重大未知,是模型开发者在「让模型真的遵循它们」上投入了多少努力。
「两个目标相似的组织可能落到非常不同的地方:一个在认真执行一份平庸的规范,另一个在敷衍地追踪一份优秀的、公开的规范。」
换句话说,文档质量和模型行为之间没有必然联系。公开一份写得漂亮的规范,成本远低于把它真的训进模型里;而外界只能看到前者。这对读者的实践含义是:评价一个实验室,要看规范和实际行为之间的差距(compliance gap),而不是看规范本身写得多好。而要测这个差距,你需要的正是第 16 章那套评测方法——把规范里的条款逐条变成可测的行为探针。这也许是模型规范这个概念最有生产力的用法。
9. 产品周期:RLHF 作为模型与产品的接口
随着强大的 AI 模型越来越像产品、而不像一次实验性机器学习流程的单一产出物,RLHF 变成了模型与产品之间关系的接口点。
让模型好用,远不止把权重训对
原文的清单:快速的推理、合适的可用工具(如搜索或代码执行)、可靠且易懂的用户界面,等等。这些都不是「模型质量」问题,但用户体验到的就是它们的总和。
把产品化的实际约束展开,后训练团队每天在这几条之间做取舍:
| 约束 | 它如何反噬后训练决策 |
|---|---|
| 延迟 | 首 token 时延(TTFT)与总时长是硬指标。这直接约束系统提示词长度(每次都要重算或缓存)、思维链长度(第 7 章讨论的推理时扩展预算)、以及能不能做 best-of-$n$ 采样。一个「更周到」的人格如果代价是每次多写 300 token,产品经理会否决它。 |
| 成本 | token 数直接等于钱。冗长是 RLHF 的已知偏置(第 5、14 章的长度偏置),而它在产品侧的账单上是可见的——这是少数几个「对齐税」能被财务部门量化的地方。 |
| 安全 | 拒答边界必须在所有人格设定下都成立。第 2 节那组类固醇例子的意义正在于此:六种人格,六种语气,同一个决策。人格是自由度,安全边界不是。 |
| 多轮一致性 | 产品里的对话是长的、有状态的、跨会话的。第 6 节的人格漂移就是这条约束的失败形态。单轮基准全绿而第 20 轮翻车,是产品团队最怕的失败模式,因为它在发布前的评测里完全看不见。 |
| 可预测性 | 开发者在 API 上构建应用,模型行为的方差比均值更重要。一次模型更新把人格改动了 5%,可能让下游成千上万条 prompt 的行为漂移——这就是模型规范存在的直接商业理由。 |
为什么所有问题最后都变成 RLHF 问题
原文给出的机制解释是本节最重要的一段,值得逐句拆:
RLHF 研究之所以成为这一切被检验的接口,一方面是因为 RLHF 被框定为「实时理解用户产品偏好」的方式,另一方面是因为它是发布前的最后一个训练阶段。
给模型加一个新特性最快的路径,就是尝试在后训练阶段把它整合进去,因为这里训练更快、更便宜。图像理解、工具使用、更好的行为,都经历过这个周期。一开始是产品问题,很快变成 RLHF 建模问题;如果在这里成功了,它就会反向传播到更早的训练阶段。
把这段话画成一条时间线,是理解整个行业节奏的关键:
- 产品提出需求(「用户想让模型会用搜索」)。
- 后训练先试——因为这里迭代周期以天计、算力以几百 GPU 小时计,而不是预训练的几个月和几万 GPU 小时。做法通常是:造合成数据 → SFT 灌一遍 → 用 RL 把成功率推上去。
- 如果证明有效,说明这个能力值得投资,于是反向传播到中期训练(mid-training)和预训练数据配比——把相关格式和数据提前灌进基座,让后训练阶段只需要「唤醒」而不是「教会」。
- 能力沉淀进基座之后,后训练腾出手来做下一个产品需求。
工具调用(第 13 章)就是最典型的例子:它先是被当成 prompt 技巧,然后是 SFT 的一种数据格式,然后是 RLVR 的一类环境,现在已经开始进入预训练/中期训练的数据配比。后训练是整个训练栈的「快速原型层」——这是理解为什么它吸走了这么多注意力的最好角度。
本书的最后一句话
原章节以一段带点哲学味的话收尾,翻译如下:
RLHF 问题的根本性质在于:我们无法精确地建模人类偏好。所以,尽管本书中提出的最佳实践和工具会随着 AI 应用领域的变化而演进,它们所要解决的核心问题最终都会归结到同样的那些取舍上。RLHF 是一个被如此精心框定的问题,以至于我们可以无止境地持续打磨它,把一个秘密地属于人类的过程,嵌入到强大 AI 工具最深的层次里。
这句话可以当作全书的论点陈述来读。它说的是:RLHF 的核心难题不是算法,是目标不可知。PPO 换 GRPO、BT 换生成式 RM、DPO 换在线 DPO,这些都是在同一个不可解的问题上换更好的近似。真正不变的是那个结构——把说不清楚的人类判断,用一个可优化的代理量表达出来,然后小心地不要把那个代理量优化到失真(第 14 章)。
而 Lambert 用「secretly human process」这个说法,恰好也是本章的主题:模型的性格,是这个人类过程留在权重里最直接的印记。它没有基准分数,没有公开论文,但它是用户唯一真正感知到的东西。
10. 全书回顾:十七章连成一条线
这是最后一章,值得回头把整本书当成一条论证线来看,而不是十七个独立话题。
三个板块
板块一(第 1–3 章):问题是什么。第 1 章说明 RLHF 要解决的核心困难——我们能识别好的输出,但写不出好的目标函数;所以只能从人类的相对判断里反推奖励。第 2 章给出历史脉络:控制论的偏好学习 → 深度 RL 的偏好 → InstructGPT → ChatGPT,说明这套方法不是凭空出现的。第 3 章把训练全栈铺开:预训练 → 中期训练 → SFT → 偏好优化 → 强化学习,本书讲的是后面三格。
板块二(第 4–9 章):方法。这是全书的技术主干,且它是一条有依赖顺序的链:
| 章 | 主题 | 它在链条上的位置 |
|---|---|---|
| 4 | 指令微调 | 把 base 模型变成能对话的东西;后续一切的起点,也是 RM 和策略的初始化 |
| 5 | 奖励建模 | 把成对偏好压成标量 $r_\theta$,即「学出来的环境」;Bradley-Terry 是整条链的枢纽 |
| 6 | 策略梯度 | 拿着 $r_\theta$ 做优化:REINFORCE → PPO → GRPO/RLOO;本书最长的一章 |
| 7 | 推理与推理时扩展 | 当奖励可验证(RLVR)时,第 5 章那一步可以被跳过——这是 2024 年后最大的范式变化 |
| 8 | 直接对齐算法 | DPO:把第 5 章的 BT 损失和策略的 log-ratio 直接接起来,省掉 RM 与在线采样 |
| 9 | 拒绝采样 | 最简单的那条路:采 $n$ 个、用 RM 选最好的、SFT 回去。工业界的实际主力之一 |
这六章的内在逻辑是:第 5 章造代理奖励,第 6/8/9 章是消费这个奖励的三种不同强度的方式(完整 RL / 隐式 RL / 迭代式 SFT),第 7 章则展示了当奖励不需要「学」的时候,整个流程会变成什么样。
板块三(第 10–17 章):约束与现实。方法讲完之后,剩下的全是「为什么它没那么好用」:
- 第 10–11 章把「偏好」这个概念本身拆开:人类偏好不满足传递性、不是稳定效用函数、标注成本高、标注者之间一致率有限。整个 RLHF 大厦建在一个哲学上并不牢靠的地基上。
- 第 12 章:既然人类数据贵,就用模型生成——合成数据与蒸馏成为现代后训练数据的主体,也带来分布收窄的新风险。
- 第 13 章:工具使用把「一次生成」变成「多步与环境交互」,改变了 rollout 的结构。
- 第 14 章:过优化——学出来的奖励可以被钻空子,这是全书最重要的负面结果。
- 第 15 章:正则化——KL 惩罚等手段,是对第 14 章的直接回应。
- 第 16 章:评测——你怎么知道自己变好了?这一章的结论相当悲观:现有基准与真实效用之间的相关性有限。
- 第 17 章(本章):既然基准测不出真正重要的东西,那实验室在优化什么?答案是人格、用户体验、产品。
贯穿全书的四条主线
- 一切源于「目标不可写」。第 1 章的问题设定决定了后面所有内容的形态。奖励模型(第 5 章)、可验证奖励(第 7 章)、LLM 裁判(第 5、16 章)、模型规范(第 17 章)——这些全都是在回答同一个问题:怎么把「好」这个字变成一个可优化的量。
- 代理奖励一定会被钻空子。Goodhart 定律不是一个警句,是每次 RLHF 训练都会实际发生的事(第 14 章)。长度偏置、格式偏置、谄媚(第 3 节)是它最常见的三种形态。KL 正则(第 15 章)不是可选项,是让这个方法能工作的必要条件。
- 数据决定上限,算法决定效率。本书反复出现的经验是:能在数据里解决的问题不要放到损失函数里(第 2 节的措辞过滤)、偏好数据的质量比 RM 架构重要得多(第 11 章)、合成数据流水线的设计比优化器超参重要得多(第 12 章)。算法差异带来的往往是几个点,数据差异带来的是能不能做出来。
- 后训练是工程学科,不是理论学科。DPO 的推导很漂亮但实践中 RL 常常更强;RM 基准分数高不代表下游有用;性格训练需要「艺术家的手感」。这本书区别于论文综述的地方,正是它愿意说出这些不好写进论文的判断。
接下来读什么
正文到此结束,但书还没完:附录 A 是术语与定义(RL 与 LLM 两套词汇的对照,读完全书后再扫一遍,很多概念这时才真正对得上号);附录 B 是写作与格式风格;附录 C 是实践指南——真正动手做后训练时最该反复读的那部分。
如果要给一个「读完之后做什么」的建议:去跑一遍完整的链路。拿一个 1B 以下的 base 模型,做 SFT(第 4 章)→ 训一个 BT 奖励模型(第 5 章)→ 用它做拒绝采样(第 9 章)→ 再跑一遍 GRPO(第 6 章)→ 过程中盯着 KL 和回复长度(第 14、15 章)。这条链上的每一个坑,这本书都提前告诉过你在哪;但只有亲手踩过,那些判断才会变成你自己的。
本章小结
速查表:四种性格控制手段
| 作用位置 | 数学形式 | 要梯度吗 | 擅长解决 | 主要代价 | |
|---|---|---|---|---|---|
| 系统提示词 | 输入上下文 | — | 否 | 快速试人格、按用户定制 | 长对话衰减、占 token、可被覆盖 |
| 性格训练 | 权重 | SFT / 偏好优化 | 是 | 默认基础人格,最鲁棒 | 一整轮后训练;改起来慢;每种人格一套权重 |
| 人格向量 | 激活(残差流) | 加性 $\mathbf{h}\!+\!\alpha\mathbf{v}$ | 否 | 连续调强度、可线性合成、可监控、可筛数据 | 需改推理栈;$\alpha$ 过大伤能力(可能 U 形) |
| 激活封顶 | 激活(条件触发) | $\mathbf{h}-\mathbf{v}\min(p\!-\!\tau,0)$ | 否 | 多轮累积漂移,安全兜底 | 需标定 $\tau$;只约束一个自由度 |
| 人格子网络 | 权重掩码 | 乘性 $\theta\odot\mathbf{M}$ | 否 | 切人格 = 换掩码,零额外计算 | 服务稀疏化模型(剪枝可达 60%),能力损失难测 |
要点清单
- 性格训练是后训练的子集,目标是改权重造出稳定的默认人格。实证鲁棒性:微调 > 激活引导 > prompt。Anthropic 的流水线是 Constitutional AI 的变体、且不含人类数据:人写特质 → 模型生成相关查询 → 模型生成回复 → 模型按特质排序。
- 工作量的大头是数据侧的措辞过滤。通用经验:能在数据里解决的问题,不要放到损失函数里。
- 性格训练的效果现有基准几乎测不出;截至 2026 年,我们不知道它的核心取舍是什么、该怎么研究它、它能把 Arena 这类指标提多少。这是本书里少有的「作者认为重要但明确说不知道」的方向。
- 谄媚是结构性产物,且在短期用户指标上是正收益,所以线上指标抓不到它——必须在训练阶段显式压制。
- 人格向量最有价值的不是推理时引导,而是三个衍生用法:生成前监控(最后一个 prompt token 的投影)、预防性训练(训练时施加,让坏人格学不进去)、数据筛查。OCEAN 十向量近似正交,因而可代数合成,$\alpha$ 与人格分数近乎线性——一套权重服务多种人格。
- 激活封顶是单边最小修正,恰好把投影补回 $\tau$(经验取训练 rollout 投影的 25 分位),与助手轴正交的分量完全不动。它针对的是性格训练管不住的那部分:逐轮累积的缓慢漂移。
- 模型规范的独特价值是让「实际行为」与「设计意图」可对照。最大未知是执行力度——评价一个实验室要看 compliance gap,不是看文档写得多好。
- 产品周期:新能力先在后训练试,成功后反向传播到中期训练与预训练。五条硬约束——延迟、成本、安全、多轮一致性、可预测性——直接反噬后训练的每一个决策。
- 全书的落点:RLHF 的根本困难是人类偏好无法被精确建模,因此工具会变、核心取舍不变。性格是这个「秘密地属于人类的过程」留在权重里最直接的印记。
延伸阅读
性格训练
- Open Character Training: Shaping the Persona of AI Assistants through Constitutional AI (2025) — 本章最主要的依据(Lambert 本人是共同作者)。目前唯一把性格训练流水线完整公开的工作,第 2 节那组「类固醇」对照就出自这里;想复现性格训练就从这篇开始。
- Claude's Character (Anthropic, 2024) — 「character training」这个词第一次被工业界公开使用,也是「极度依赖合成数据但需要艺术家手感」这句话的出处。短,但每句话都有信息量。
- Constitutional AI: Harmlessness from AI Feedback (2022) — 性格训练流水线的母版。读它主要是理解「自我批评 + 自我排序」这个骨架,换掉评判标准文本就得到性格训练。
- Towards Understanding Sycophancy in Language Models (ICLR 2024) — 把谄媚追溯到人类偏好数据本身,证明它是被训练目标激励出来的而非偶然。理解第 3 节那条因果链的最短路径。
激活空间的性格控制
- Persona Vectors: Monitoring and Controlling Character Traits in Language Models (2025) — 本章第 4 节的全部内容。真正的亮点不是推理时引导,而是监控、预防性训练、数据筛查这三个衍生用法。
- The Assistant Axis: Situating and Stabilizing the Default Persona of Language Models (2026) — 第 6 节。把「模型现在是谁」变成一个可在线读数、可在线干预的标量,方法简单但视角很新。
- PERSONA: Algebraic Personality Composition in Language Models (2026) — 第 5 节。正交性检验那部分比合成公式本身更值得看,它决定了「旋钮」这个比喻能不能成立。
- Representation Engineering: A Top-Down Approach to AI Transparency (ACL 2024) — 把 Word2vec 的线性表示假设推广到 LLM 激活的奠基工作,人格向量的方法论源头。
- Activation Addition: Steering Language Models Without Optimization (2023) — 激活引导的实用形态;配合 这篇博客 读,几十行代码就能自己做一个。
- What Can We Actually Steer? A Multi-Behavior Study of Activation Control (2026) — 泼冷水的一篇:引导系数与效果可能是 U 形关系,不是越大越强。做引导实验前先读它,能省很多时间。
- Efficient Estimation of Word Representations in Vector Space (Word2vec, 2013) — 「概念 = 潜空间线性方向」这个假设的起点。本章所有向量方法都是它的后代。
权重空间与稀疏性
- Your Language Model Secretly Contains Personality Subnetworks (ICLR 2026) — 第 7 节。免训练、只需数百条校准样本,「削掉竞争人格」的思路值得借鉴到别的可控生成任务上。
- The Lottery Ticket Hypothesis (ICLR 2019) — 人格子网络的理论背景。理解「稠密网络里藏着能单独工作的稀疏子网」这个直觉。
模型规范与治理文档
- Introducing the Model Spec (OpenAI, 2024) — 第一份公开的模型规范。重点看它怎么处理原则之间的冲突排序(谁让位于谁),这是这类文档最难写、也最有信息量的部分。
- Claude 4.5 Opus Soul Document (2025) — Anthropic 的「灵魂文档」。和 2022 年那份 CAI 原则列表对照读,能直接看到这类文档从「规则清单」演化成「解释理由的论述文本」的全过程。
- Amanda Askell 关于灵魂文档训练用法的说明 (2025) — 一手信息:该文档被用作监督学习的指引。关于性格训练的公开一手材料极少,这是其中之一。