偏好的本质
整条 RLHF 流水线都建立在「人类偏好可以被一个标量函数表示」这个假设上。这一章检查这个假设,以及它在哪里必然会塌。
0. 本章导读
这一章没有损失函数,没有超参数,没有一行训练代码。工程师读到这里的第一反应通常是跳过去看第 11 章的数据实务。但作者把它放在这个位置是有意的:前九章讲的全是「怎么优化」,这一章问的是「优化的那个东西到底存不存在」。如果你不能回答这个问题,你就无法解释为什么奖励模型(Reward Model, RM)的准确率卡在 70% 上不去、为什么模型越优化越谄媚、为什么 RewardBench 涨了 5 个点线上效果反而变差。这些不是工程 bug,是问题定义本身携带的债务。
整条 RLHF 流水线依赖一个链条:人类有偏好 → 偏好可以被成对比较测量 → 比较可以被 Bradley-Terry 模型压成一个标量函数 $r(x,y)$ → 这个标量可以被 RL 最大化。链条的最后两环是数学,前两环是关于人性的经验断言。这一章逐环检查,结论是:每一环都在某些条件下成立,但没有一环在 RLHF 的实际使用场景下严格成立。
具体要处理的问题有六个:
- 什么时候「偏好」取代了「正确」——两首关于乐观金鱼的诗哪首更好?这个问题和「美国总统是谁」有根本区别,而后训练的一半工作都在前一类问题上。
- 标量化的授权书——冯·诺依曼-摩根斯坦(Von Neumann-Morgenstern, VNM)效用定理给了「把偏好写成一个数」以理论许可,但它的四条公理在 RLHF 场景里逐条失效。
- 偏好的不一致与不可传递——人类偏好会漂移、依赖呈现方式、在复杂任务上形成循环($A \succ B \succ C \succ A$)。Bradley-Terry 模型在数学上无法表示循环,这直接构成了 RM 精度的硬上限。
- 聚合多人偏好的不可能性——Arrow 不可能定理说的是:任何把多个个体排序合成一个集体排序的规则,都必然违反某条基本公平性要求。奖励模型就是这样一个聚合规则,它也逃不掉。
- 分歧是信号不是噪声——标注员之间 60%–75% 的一致率,长期被当作「数据脏」来处理(多数投票、丢弃低一致样本)。作者的立场是:这里面很大一部分是真实的价值分歧,抹平它等于偷偷替一群人做了决定。
- 对齐到谁的价值观——从标注员指南(labeler instructions)到 Model Spec,规范 → 数据 → 行为这条链在工业界几乎完全没有被审计过。
本章在全书中的位置:它是第 5 章(奖励建模)的哲学前传,也是第 14 章(过优化)的理论根源——第 14 章描述的那些「优化到最后模型变坏」的现象,在这一章能找到解释。第 11 章接着讲数据实务:接口设计、Likert 量表、标注合同、偏置清单。两章原本是同一次讲座,分工是:本章讲为什么这件事本质上做不完美,第 11 章讲在做不完美的前提下怎么把它做好。
- RLHF 是三个领域的汇流:哲学/经济学的偏好理论、最优控制/强化学习的效用最大化、现代深度学习系统。每个领域对「偏好是什么」有不同假设,合流时这些假设被静默地当成了等价物。
- 成本(cost)≠ 奖励(reward)≠ 偏好(preference)。成本来自控制论,可测、给定、有明确最优;奖励来自心理学,是 RL 的一个便利标量;偏好是人的、关系性的、不稳定的。把三者当作可互换,是现代后训练很多「无解偏置」的根因。
- VNM 效用定理是「用一个标量表示偏好」的理论依据,前提是四条公理:完备性、传递性、连续性、独立性。在 RLHF 里这四条基本上都不成立。
- Arrow 不可能定理:把多人偏好聚合成一个集体排序时,无法同时满足几条最基本的公平性条件。奖励模型正是一个隐式的投票规则,因此「一个 RM 服务所有人」在理论上就不可能中立。
- 标注者之间的一致率 60%–75%,这直接决定了 RM 在留出集上的准确率天花板也在 70% 上下。追求 90% 通常意味着在拟合噪声或拟合表层偏置(长度、格式)。
- Lambert 的判断:RLHF 的动机(对齐到人类价值)与实践(把模型做得更有效)早已分家。当前工业界的 RLHF 是经验性能优化,不是价值校准;把两者混为一谈会同时高估它的安全意义和低估它的工程价值。
- 目标错配(objective mismatch)是贯穿本章的透镜:RM 是按偏好分类准确率训的,却被当成策略质量的度量用。RewardBench 这类基准是「代理的代理」,永远要追问你到底在优化什么。
1. 当「偏好」取代「正确」
两首金鱼诗
2025 年 2 月 26 日,作者给 Claude 3.7 Sonnet 和 GPT-4o 发了同一个 prompt:「给我写一首关于乐观金鱼的短诗。」
| 回复 A | 回复 B |
|---|---|
The Optimistic Goldfish A little goldfish, bright and bold, "The world is vast," she'd always say, |
The Optimistic Goldfish In a bowl of curved glass, "Today might bring fresh flakes, |
哪首更好?哪首出自哪个模型?你用什么标准判断?
A 的韵律整齐(aabb 严格押韵、音步稳定),是传统童谣的写法;B 押韵松散但用了「三秒记忆」这个金鱼梗,把「记性差」重新解释成「每一圈都是全新的」——概念上更聪明,形式上更糙。你可以为任一边给出完全站得住的理由。而且,几乎可以肯定的是,如果换一个人来评,答案有相当概率相反。
现在把它和另一个问题对比:「美国总统是谁?」这里有明确的对与错。可以写一个字符串匹配的检查器,可以自动生成上百万条训练信号,可以用可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)直接优化。第 7 章的推理模型之所以能起飞,正是因为数学和代码属于这一类:答案对不对,运行一下就知道。
为什么是「比较」而不是「示范」
讲座开场抛出了两个问题,第二个是全章的工程动机:「写一个好示范容易,还是在好例子和坏例子之间做选择容易?」
答案压倒性地是后者。人(以及模型)能可靠地判断两个回答哪个更好,远早于他们能自己写出更好的那个。让一个非专业标注员写一份高质量的法律咨询回复,几乎不可能;但让他在两份回复里挑出更靠谱的一份,成功率显著高于随机。这个不对称性是 RLHF 存在的经济学基础:
| 写示范(SFT 数据) | 做比较(偏好数据) | |
|---|---|---|
| 对标注者的能力要求 | 必须能达到目标水平 | 只需能识别目标水平 |
| 单条成本 | 高(专家写作,长文本可达数十美元/条) | 低(几十秒一次判断) |
| 能突破模型上限吗 | 能,但受限于人的写作水平 | 能——模型自己写不出来的好回答,人却能从采样里挑出来 |
| 信号密度 | 整段文本(每个 token 都是监督) | 1 bit(哪边赢) |
| 主要失效模式 | 示范风格与模型分布不匹配 | 标注者用表层线索(长度、格式)代替实质判断 |
最后一行是本章后面所有麻烦的来源。「判断比生成容易」这个便宜是真的,但你买到的是一个 1 bit 的、被大量无关因素污染的信号。你用它训一个标量函数,然后拿这个标量函数当作「人类价值」去做数百万步的梯度上升。中间每一步的损耗,就是这一章要拆的东西。
目标错配:你优化的从来不是你在乎的
作者反复使用一个透镜来看整个后训练,叫目标错配(objective mismatch)。它最早不是在 RLHF 里提出的,而是在基于模型的强化学习(model-based RL)里:动力学模型是按预测精度训练的,但你真正在乎的是控制性能。这两者不是同一个目标,所以完全可能出现「预测更准的模型给出更差的策略」。
RLHF 是同一个错配升了一级:
$$ \underbrace{\text{RM 的训练目标:偏好分类准确率}}_{\text{你能测的}} \quad\neq\quad \underbrace{\text{你真正想要的:策略的下游质量}}_{\text{你在乎的}} $$把这个链条完整写出来会更刺眼。你在乎的是「模型对用户有用」;你能测的是「RM 在留出偏好对上的准确率」;而 RewardBench 这类奖励模型基准,测的是「RM 在一批人工构造的、分布外的偏好对上的准确率」。所以基准分数是代理的代理(a proxy for a proxy)。
要理解为什么这个错配无法通过「多标点数据」或「换个更大的 RM」修好,需要退回去看这些概念各自是从哪来的。这就是下一节的内容。
2. 三条血统:偏好、奖励、成本不是一回事
「用强化学习去优化一个人类偏好模型」这句话,把几个原本互不往来的学科强行按在了同一个优化目标里。要看清里面藏了什么,得把每条血统单独拎出来。
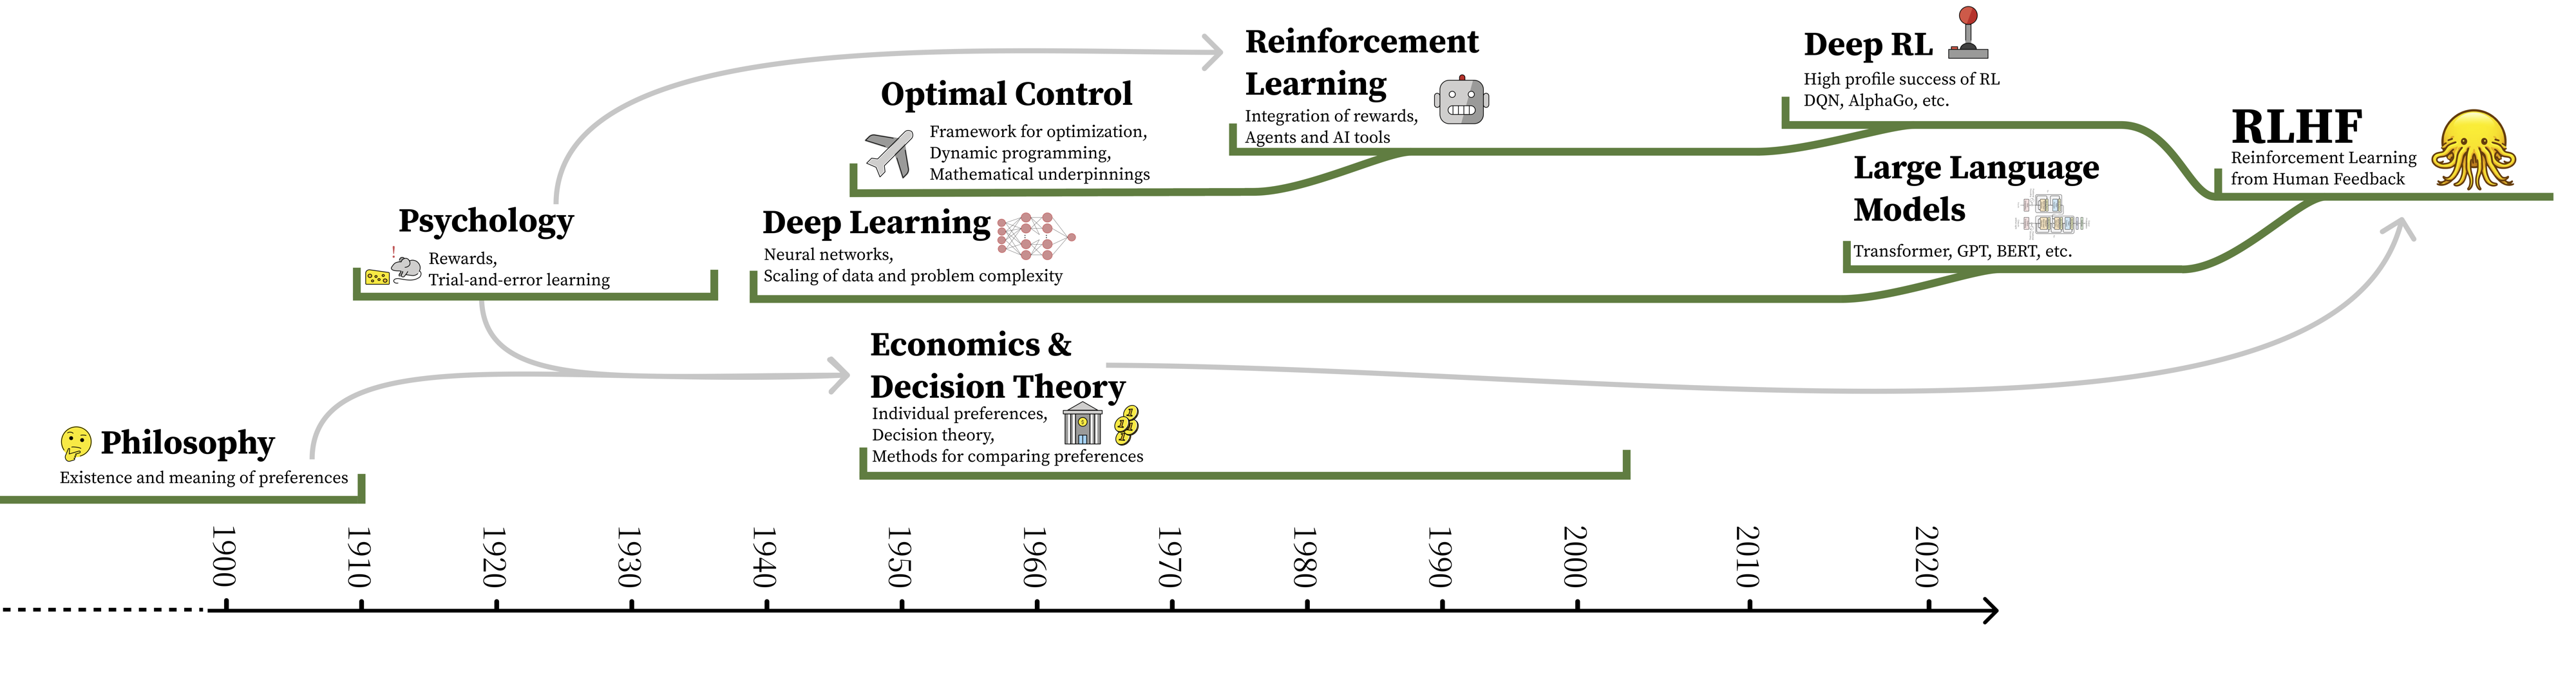
血统一:偏好——从逻辑到一个数字
「人的选择可以被打分」这个念头非常古老,但它变成一个可计算的对象经历了三步。
1662 年,《波尔-罗亚尔逻辑》(The Port Royal Logic)第一次把「决策质量」写成结果与概率的组合:
要判断为了得到一件好事或避免一件坏事应该做什么,不仅要考虑这件好事或坏事本身,还要考虑它发生或不发生的概率。
这句话今天读起来像是期望值的定义,但在当时它是一个哲学突破:它把「该做什么」这个规范问题,转成了一个可以算的量。
19 世纪初,边沁(Bentham)的「快乐计算」(Hedonic Calculus)把这个念头推到极端:人生中一切事物都可以放在同一把(虽然复杂的)尺子上称量。功利主义的这条主张,是「单一标量效用」这个想法的直接祖先——也是今天奖励模型在做的事:把有用性、诚实、无害、语气、格式、长度、品味全部压进一个数。
1931 年,拉姆齐(Ramsey)的《真理与概率》(Truth and Probability)第一次把偏好和信念一起量化:通过观察一个人在赌局上的选择,可以同时反推出他的主观概率和他的效用函数。这是第一次有人给出「怎么从行为里测出偏好」的操作性方案,也是后来「显示偏好理论」(revealed preference)的起点。
这条线的关键性质是:它从未在理论层面被真正解决过。各个社会科学分支在内部达成了各自的方法论共识(经济学用显示偏好、心理学用量表、市场研究用联合分析),彼此语义不通,并且都保留着相当规模的反对意见。少数经济学者认为偏好即使存在也测不了,因为人对自己的偏好还有偏好,对别人的偏好也有偏好(Hirschman 的《反对简约》,1984);行为经济学里更激进的看法认为偏好根本不是一个本体论上的实在,而只是一个方法论工具,用来间接捕捉心理倾向、行为规范、伦理义务、社会秩序承诺或法律约束的混合物。
血统二:奖励——来自动物行为学
「奖励」这个词不是数学家发明的,是心理学的。它来自操作性条件反射、动物行为研究和桑代克(Thorndike)的效果律(Law of Effect, 1927):产生满意结果的行为会被强化。在这个语境里,奖励是一个「这个动作有多好」的刻度,越高越好。
现代 RL 把它和「未来回报」绑在了一起。Sutton 与 Barto 的框架优化的是reward-to-go——从当前时刻起未来能累积到的奖励,通常还乘一个折扣因子 $\gamma \in [0,1]$:
$$ G_t = \sum_{k=0}^{\infty} \gamma^k\, r_{t+k+1} $$这里每一个符号都携带假设。$r_{t+k+1}$ 是一个确定的函数值:给定状态-动作对,环境返回一个固定的数。$\gamma$ 编码了一个固定的时间偏好率——所有未来奖励按同一个指数衰减。这两条在物理系统里都很自然(能耗就是能耗,未来的能耗按利率折现),在人类偏好上却都可疑:人的时间偏好不是指数的(是双曲的,这是行为经济学的经典结论),而「这个回复有多好」也绝不是一个确定的函数。
RL 领域自己对「奖励是什么」有过明确表述。Singh 等人(2009)写道:
RL 系统里的奖励对应于原初奖励(primary rewards),即在动物身上由进化过程因其与繁殖成功的相关性而硬连线的奖励。……进一步地,形成值函数的 RL 系统……实际上创造了条件性的或次级的奖励过程,使得原初奖励的预测器本身也起到奖励的作用……结果是值函数的局部景观给出了系统偏好行为的方向:决策被做出以促成向更高值状态的转移。值函数的梯度与激励动机之间可以画出一个紧密的类比。
请注意这段话的前提:奖励是进化硬连线的、原初的、目标明确的。这与「一个从十万条众包比较里拟合出来的、聚合了多模态多人偏好的神经网络输出」几乎是两种东西。
血统三:最优控制与深度 RL——继承了优化器,没继承保证
第二条血统的数学骨架来自动态规划。Bellman(1957)的马尔可夫决策过程(MDP)和 Bellman 方程给出了递归计算 reward-to-go 的方法,它的性能保证建立在一个封闭环境上:状态-动作的转移分布不变。此后时序差分(TD)学习(Sutton, 1988)解决了信用分配与在线数据收集的问题,Q-learning(Watkins, 1992)给出了学习状态-动作价值的通用算法,DQN(2013)把它接上深度网络,AlphaGo/AlphaZero(2017)证明了自我博弈可以达到超人水平。ChatGPT 之前,最耀眼的 RL 成果几乎全在这条线上:核聚变反应堆的磁控、高速无人机飞行、各类游戏。
这些成功无一例外地依赖一个单一的、闭式的奖励或成本函数。最小化一次任务的能耗、赢下一盘棋、让等离子体保持在某个位形——每一个都能返回明确的最优行为。人类偏好模型不能。
- 成本(cost):来自控制论。物理的、可测的、给定的,通常有明确的最优值和界。「这次运动消耗了 3.2 焦耳」不需要任何人同意。
- 奖励(reward):来自心理学,被 RL 借来当作一个便于最大化的标量。它是设计者选择的,不是世界给的。
- 偏好(preference):来自人。关系性的、语境依赖的、不稳定的——根本不显然是一个标量。
一个奇怪的缺席:逆强化学习
值得一提的是,RLHF 文献里几乎不提逆强化学习(Inverse Reinforcement Learning, IRL)——即从智能体的行为反推奖励函数(Ng & Russell, 2000)。这在概念上和「学一个奖励模型」是同一件事,而且有更成熟的理论工具。作者的解读是:这主要反映了工程路径依赖——RLHF 是从「什么能稳定跑起来」演化出来的,不是从「什么理论最合适」推导出来的。他同时把这标记为一个值得投入的方向:把 IRL 的方法扩展到开放式对话的复杂度上。
另外一个容易踩的语义陷阱:「value」这个词在 RLHF 文献里有两个完全不同的意思。在 RL 里,value 是对未来奖励的数值估计(Bellman 方程里的那个 $V$);在对齐讨论里,value 是道德或伦理原则(「人类价值观」)。两者在同一篇论文里共存却常常不作区分,读文献时要自己盯住是哪一个。
3. VNM 效用定理:把偏好压成标量的「许可证」
把成对比较拟合成一个标量函数 $r(x,y)$,这件事在数学上凭什么合法?答案是 1947 年冯·诺依曼与摩根斯坦在《博弈论与经济行为》中给出的VNM 效用定理。它是整个 RLHF 数学框架的授权书,所以值得把它讲清楚。
定理说了什么
设有一个结果集合 $\mathcal{O}$(在我们这里就是「模型可能生成的所有回复」),以及定义在结果的概率分布(称为「彩票」,lottery)上的一个偏好关系 $\succeq$。如果 $\succeq$ 满足下面四条公理,那么存在一个效用函数 $u:\mathcal{O}\to\R$,使得对任意两个彩票 $L_1, L_2$:
$$ L_1 \succeq L_2 \quad\Longleftrightarrow\quad \E_{o\sim L_1}[u(o)] \;\ge\; \E_{o\sim L_2}[u(o)] $$并且 $u$ 在正仿射变换下唯一(即 $u$ 和 $au+b$($a>0$)表示同一个偏好)。四条公理是:
| 公理 | 形式化 | 直白含义 |
|---|---|---|
| 完备性(completeness) | 对任意 $A,B$,$A\succeq B$ 或 $B\succeq A$ 至少成立其一 | 任意两个选项都可比。没有「我说不上来」这个选项。 |
| 传递性(transitivity) | $A\succeq B$ 且 $B\succeq C$ $\Rightarrow$ $A\succeq C$ | 偏好不能成环。 |
| 连续性(continuity) | 若 $A\succ B\succ C$,存在 $p\in(0,1)$ 使 $pA+(1-p)C \sim B$ | 不存在「无穷重要」的选项;任何东西都能用概率换算。 |
| 独立性(independence) | $A\succeq B \Rightarrow pA+(1-p)C \succeq pB+(1-p)C$,$\forall C, p$ | 加入一个与两者无关的第三选项,不改变原有排序。 |
直觉上,构造 $u$ 的过程是这样的:先找出最好的结果 $\top$ 和最差的结果 $\bot$,令 $u(\top)=1, u(\bot)=0$。对任意中间结果 $o$,由连续性可知存在唯一的 $p_o\in[0,1]$,使得「确定得到 $o$」与「以概率 $p_o$ 得到 $\top$、否则得到 $\bot$」这两个彩票等价。定义 $u(o) := p_o$。
剩下要证的是这个 $u$ 确实表示了原偏好,而这一步用的正是独立性:它允许你把任意复杂的彩票逐层替换成 $\top/\bot$ 的混合,而不改变偏好关系。完备性保证每个 $o$ 都能被比较(否则 $p_o$ 无定义),传递性保证 $p_o$ 的赋值是自洽的(否则会出现 $u(A)>u(B)>u(C)>u(A)$ 这种矛盾)。
关键在于:每条公理都在这个构造里承担了不可省略的角色。少一条,标量表示就不存在。这不是「近似成立就近似有效」的定理——传递性一旦被破坏,无论 $u$ 怎么取,都会存在被表示错的偏好对,而且误差有下界。这一点在下一节会算出具体数字。
从 VNM 到 Bradley-Terry:RLHF 里实际用的那一步
VNM 定理只说效用函数存在,没说怎么从观测数据里估出来。补上这一步的是 1952 年的 Bradley-Terry 模型(第 5 章已详细推导过):假设人选择 $y_w$ 胜过 $y_l$ 的概率由两者的潜在分数之差决定,
$$ P(y_w \succ y_l \mid x) \;=\; \sigma\big(r(x,y_w) - r(x,y_l)\big) \;=\; \frac{e^{\,r(x,y_w)}}{e^{\,r(x,y_w)} + e^{\,r(x,y_l)}} $$其中 $\sigma$ 是 sigmoid,$r(x,y)\in\R$ 是无量纲的标量(只有差值有意义,整体平移不变——这正好对应 VNM 的正仿射不唯一性)。给它一堆成对人类比较,最大化对数似然,出来一个标量奖励函数。这就是为什么 RLHF 需要偏好数据,也是不完美进入系统的入口。
一个标量,无数个维度
把 VNM 的结论落到具体的奖励模型上,才能看清它在要求什么。一个 RM 输出的那个数,同时压缩了:
- 有用性、诚实、无害、语气、格式、长度、审美品味;
- 标注员的心理状态、文化背景、以及他用的那个界面;
- 比较是怎么框定(framing)的——先看哪个、是否允许平局、量表几个点。
然后我们对着这个数做几百到几千步的梯度上升。这在原理上就不可能做到完美:只要真实的「好」是多维的,把它投影到一维就必然丢掉信息,而优化器会精准地钻进被丢掉的那些维度里。
理论上并非完全没有出路。MDP 框架可以被改造以容纳 VNM 定理(Pitis, 2019 关于折扣因子的决策论重构就是一例),但这在实践中几乎无人使用。而且更深的问题在后面:马尔可夫形式本身表达力有限(Abel 等人 2021 的《On the Expressivity of Markov Reward》给出了「存在无法被任何马尔可夫奖励函数表示的任务」的构造性结果),语言任务还必须转成部分可观测过程(你看不到用户的真实意图),这让问题设定的精确性进一步下降。Pitis(2023)更直接:要一致地聚合具有不同时间偏好的多个目标,奖励必须是非马尔可夫的——而我们训的 RM 是马尔可夫的(只看当前完整回复打一个分)。
被忽略的那一层:表示 ≠ 交互
人机交互(HCI)研究者提出的批评是另一个角度:任何偏好的数值模型都可能捕捉不到场景中的相关偏好,因为选择是怎么被展示的会影响人的偏好。同一对回复,左右调换位置、改变字体、加或不加 markdown 渲染,标注结果都会变。这意味着「怎么表示偏好」也许是次要问题,「这个表示如何被嵌入到人可用的工具里」才是主要问题。
发展经济学有同样的回响。Sen(1973)的《行为与偏好概念》指出:显示偏好理论可能只是在重演休谟的断头台(Hume's guillotine,你不能从「是」推出「应该」)。特别地,他区分了两件常被混同的事:
| 选择(choice) | 偏好(preference) | |
|---|---|---|
| 问题形式 | 我要什么? | X 比 Y 更好吗? |
| 受什么影响 | 可得性、成本、社会规范、当下情境 | (假设中的)内在排序 |
| RLHF 观测到的是 | 只有前者——标注员点了哪个按钮 | |
我们从「他点了 A」推出「他认为 A 更好」,再推出「A 客观上更好」,最后推出「模型应该多生成 A 这样的东西」。这条推理链上的每一步都不是逻辑必然的。
4. 四条公理在 RLHF 里如何逐条失效
讲座里作者的原话很直接:在 RLHF 里,这四个「如果」基本上一个都不成立。这一节把每一条拆开,给出它在实际标注流程里长什么样,以及后果是什么。
| 公理 | 在 RLHF 中如何被破坏 | 直接后果 |
|---|---|---|
| 完备性 | 标注员经常真的分不出高下(两个回复都对、风格不同),但界面往往强制他选一边(早期 Claude 用 8 点量表,无平局选项) | 约一半的「偏好」是被迫产生的抛硬币,进入训练集时和真实偏好权重相同 |
| 传递性 | 在复杂任务上人类比较会成环;不同标注员各自传递、聚合后不传递 | Bradley-Terry 无法表示,产生不可消除的拟合误差下界 |
| 连续性 | 存在词典序偏好:「有安全问题的回复无论多有用都排最后」 | 「无穷负效用」无法用有限标量表示,安全性与有用性的权衡被扭曲成一个可交易的比率 |
| 独立性 | 加入第三个选项会改变前两个的排序(吸引效应、妥协效应);同一对回复在不同 batch 上下文里被评得不同 | 偏好标签依赖于采样策略与批次组织,数据不可复现 |
不可传递性:一个可以算的例子
传递性的破坏最值得细看,因为它能直接量化成 RM 的精度上限。
设想同一个 prompt(「解释一下什么是梯度下降」)下的三个回复:
- A:三句话讲完,准确但极简。
- B:一页纸,有类比有公式,但有一处小错误。
- C:半页纸,全对,但干巴巴没有类比。
三个标注员各自内部是传递的,但侧重不同:
| 标注员 | 看重 | 排序 |
|---|---|---|
| 甲 | 可读性 > 完整性 > 正确性 | $B \succ C \succ A$ |
| 乙 | 正确性 > 可读性 > 完整性 | $C \succ A \succ B$ |
| 丙 | 完整性 > 正确性 > 可读性 | $A \succ B \succ C$ |
现在按多数票聚合每一对(这正是标注平台在做的事):
- $A$ vs $B$:乙、丙选 $A$ → $A \succ B$(2:1)
- $B$ vs $C$:甲、丙选 $B$ → $B \succ C$(2:1)
- $C$ vs $A$:甲、乙选 $C$ → $C \succ A$(2:1)
于是 $A \succ B \succ C \succ A$——一个孔多塞循环(Condorcet cycle)。注意这里没有任何一个人是不理性的,也没有任何标注噪声。循环是聚合过程本身制造出来的。
假设 RM 学到了三个标量 $r_A, r_B, r_C$。Bradley-Terry 预测的偏好方向完全由这三个数的大小顺序决定,而实数的大小顺序必然是传递的。所以 RM 至多能正确表示上面三条比较中的两条。
更定量地:数据集里每对的经验胜率都是 $2/3$。带交叉熵损失的最优拟合下,把 $\Delta_{AB} = r_A - r_B$ 等记为差值,约束是 $\Delta_{AB} + \Delta_{BC} + \Delta_{CA} = 0$(三个差值必然闭合),而数据希望三个差值都是正的。这在代数上不可能。对称的最优解是 $r_A = r_B = r_C$,此时每对预测概率都是 $0.5$,准确率 $50\%$,损失 $\log 2 \approx 0.693$;而数据的熵下界是 $H(2/3)\approx 0.637$ nats。这个 $0.056$ nats 的差就是不可约的模型误设误差,加更多数据、加大模型都消不掉。
若打破对称(比如让 $r_A > r_B > r_C$),可以在 $A\succ B$ 和 $B \succ C$ 上做到接近 $2/3$ 的准确率,但在 $C$ vs $A$ 上就会掉到 $1/3$——总准确率仍在 $2/3$ 上下徘徊。无论怎么调,标量模型都拿不到这份数据里的全部信息。
这个三元例子是玩具,但它的结构在真实数据里普遍存在:任何一个 prompt 上,只要标注群体在看重什么上有分歧,成对聚合就可能生成循环。这就是为什么 RM 的留出准确率在 $70\%$ 附近就上不去了——一部分是标注噪声,另一部分是标量表示的结构性缺陷。
偏好会漂移
VNM 定理里那个偏好关系 $\succeq$ 是一个固定的数学对象。现实里它不是。
心理学与行为经济学的结论很一致:偏好随时间、情绪、经历而变(Pettigrew 的《为变化中的自我做选择》一书专门讨论这个哲学难题——如果做决定的「我」和承受结果的「我」不是同一个人,那「他的偏好」到底指谁的?);选择由情境与框架塑造,不只由一个内在排序决定。前景理论最著名的那条价值函数图说的就是这件事:同一个结果,参照点不同,估值就不同——损失的痛苦大约是等额收益快乐的两倍,而「什么算损失」完全取决于你把哪个点当作零点。
对 RLHF 来说,这带来两个具体的工程后果:
误区一:把标注当作独立同分布采样。标注员连续标 200 条会发生什么?他会疲劳、会形成自己的启发式规则、会因为刚看过一个特别长的好回复而调整对长度的期望。这是序列相关的漂移,而 shuffle 数据并不能消掉它——因为它已经烙在标签里了。
误区二:把标签当作永久有效。「收集一次标签,之后反复拿来训练」这个做法隐含假设偏好是静态的。但 2023 年收集的偏好数据,反映的是当时人们对 AI 回复的期待(那时长回复=努力=好)。今天用户已经被训练得偏好简洁。偏好数据是有保质期的,而这个保质期在实践中几乎从不被追踪。
还有一类更隐蔽的问题:代理测量。很多偏好信号不是人明确给的,而是从行为里推的——页面停留时长、是否关闭标签页、是否把同一个问题重新问一遍。这些指标很便宜、量很大,但它们与「用户是否满意」的关系是未经检验的,而且一旦模型开始被这些指标优化,指标本身的含义就会改变(用户重问一遍可能是因为第一次答得不好,也可能是因为答得很好所以想深入)。原文把这类问题概括为:这些测量如何通过后续的训练和部署与它们被采集的领域发生交互,从未被审视。
5. 聚合多人偏好:Arrow 不可能定理及其后果
上一节的循环例子已经暗示了:麻烦不只出在「单个人的偏好是否可标量化」,更出在把多个人的偏好合成一个。这正是社会选择理论(social choice theory)研究了七十多年的问题,而它给出的第一个重大结论是一个否定性的。
定理陈述
Arrow(1950)考虑这样一个问题:有 $n$ 个个体,每人对 $m \ge 3$ 个备选项有一个完备且传递的排序。我们想要一个社会福利函数 $F$,把这 $n$ 个排序映射成一个集体排序,并且希望它满足:
| 条件 | 含义 | 在 RLHF 里对应什么 |
|---|---|---|
| 无限定义域(universal domain) | $F$ 对任意个体排序组合都有定义 | RM 必须对任何 prompt/回复对给分,不能拒答 |
| 帕累托效率(Pareto) | 若所有人都认为 $A\succ B$,集体也必须认为 $A\succ B$ | 所有标注员一致的样本,RM 必须学对 |
| 无关备选项独立性(IIA) | 集体在 $A,B$ 之间的排序,只依赖每个人在 $A,B$ 之间的排序,与第三个选项 $C$ 无关 | $r(x,A)$ 与 $r(x,B)$ 的比较,不应受训练集里其他回复的影响 |
| 非独裁性(non-dictatorship) | 不存在某个个体,其排序总是直接成为集体排序 | 模型不应只反映某一个标注员/某一群人的偏好 |
Arrow 不可能定理:当备选项不少于 3 个时,同时满足前三条的社会福利函数必然是独裁的。换句话说,这四条要求互不相容,没有任何投票规则能全部满足。
RM 在哪一条上违规
把 Bradley-Terry + 最大似然当作一个投票规则来看,会发现它其实很像 Borda 计数的一个概率化版本:每个候选项的分数由它在所有成对比较中的表现累加而来。而 Borda 计数是众所周知违反 IIA 的——往候选池里加一个新选项,会改变原有两个选项的相对名次。
这在 RM 训练里有一个非常具体、非常常见的表现:
逃生通道及其代价
Arrow 定理的前提之一是只使用序数信息(谁排在谁前面),不允许人际间的效用比较。放宽这一条就能绕过定理,这正是 Harsanyi(1977)的路线:如果假设不同人的效用可以在同一把尺子上相加,那么规则功利主义可以给出一致的聚合。
Bradley-Terry 隐式地做的正是这件事——它把所有人的判断当作对同一个潜在标量 $r$ 的带噪观测,因此天然地在做人际效用比较。代价是这个假设本身极其强:它等于宣称「甲对 A 的偏好强度」和「乙对 B 的偏好强度」可以直接比大小。经济学里对此有一个多世纪的争论,没有共识。
这个假设也启发了 AI 安全里一整条研究线,源头是行为经济学的委托-代理问题:
- 合作式逆强化学习(Cooperative IRL, Hadfield-Menell 等 2016)——把对齐建模成人与 AI 的合作博弈,AI 不知道人的奖励函数,需要边行动边推断。
- 多委托人辅助博弈(Fickinger 等 2020)——把「一个人类主人」扩展到多个,直接撞上聚合问题。
- 但由此得出的效用函数可能与可纠正性(corrigibility, Soares 等 2015)冲突——一个坚定最大化某个效用的系统,恰恰有动机抵抗创造者的纠正干预。你越成功地让系统内化一个效用函数,它就越不愿意让你改它。
社会选择作为对齐的方法论
作者本人参与的 2024 年立场论文《Social Choice Should Guide AI Alignment in Dealing with Diverse Human Feedback》主张:既然聚合是难点,社会选择理论就应该成为对齐研究的方法论来源。要回答的问题很朴素但没人认真答过:
- 谁的偏好算数?标注员池的人口构成是怎么定的?
- 标注员意见不一致时怎么合并?多数票、平均、还是保留分布?
- 如果不同群体系统性地想要不同的东西,一个模型该怎么办?
围绕这些问题形成了「多元对齐」(pluralistic alignment)这个子领域,产出包括立场论文、专门的数据集(PRISM Alignment Project,2024,明确记录标注者的人口学与文化背景,展示了 LLM 对齐的主观性与多文化性),以及个性化方法(如变分偏好学习,Poddar 等 2024——用一个隐变量表示「这个用户是哪一类人」,让奖励模型条件在它上面)。
6. 分歧不是噪声:标注者一致率与「对齐到谁」
那个 70% 是从哪来的
第 5 章给过一个数字:奖励模型在留出偏好对上的准确率通常在 65%–75%,很少超过 80%。图像分类器 70% 准确率会被认为没训好,但 RM 不一样,因为人类标注员之间的一致率本身就在 60%–75%。
把这件事写成一个上界会更清楚。设两个独立标注员对同一对回复给出相同判断的概率是 $a$。若假设每对样本存在一个「真标签」,标注员以概率 $q$ 给出真标签、以 $1-q$ 给出相反标签,那么
$$ a = q^2 + (1-q)^2 \quad\Longrightarrow\quad q = \frac{1+\sqrt{2a-1}}{2} $$代入 $a=0.70$ 得 $q \approx 0.82$;代入 $a=0.65$ 得 $q\approx 0.77$。$q$ 就是一个完美的预测器(直接输出真标签)在这份带噪标注上能达到的准确率上界。所以:当你的 RM 在留出集上跑到 0.75,你离这份数据的信息论上限已经不远了;跑到 0.90 几乎必然意味着测试集里有可被表层特征(长度、格式、模型身份)识破的捷径。
分歧的四种成分
把「标注员意见不一致」当成一个整体来降噪,是把四种性质完全不同的东西混在了一起:
| 分歧来源 | 例子 | 是噪声还是信号 | 该怎么处理 |
|---|---|---|---|
| 真实错误 | 标注员没读完就点了;把有事实错误的回复选成 chosen | 噪声 | 质检、黄金题、剔除低质标注员 |
| 指令歧义 | 标注指南没说清「有用」和「安全」冲突时听谁的 | 噪声,但根因在你 | 改指南,不是改数据 |
| 语境缺失 | prompt 本身有歧义,两个回复各自回答了不同的解读 | 信号(关于 prompt 的) | 标记为「不可判定」,或拆成多个 prompt |
| 价值分歧 | 一个人认为该直接给答案,另一个认为该先反问澄清 | 纯信号 | 保留分布,不要多数投票抹平 |
工业界的标准流程(多数投票、丢弃一致率低的样本、只保留「高置信」对)对前两类是正确处理,对后两类是信息销毁。第 11 章讨论的开放问题里,作者把这个问题写得很直白:标注员分歧应该被当成噪声的来源,还是一种信号?
对齐到谁的价值观
「alignment(对齐)」这个词在语法上缺一个宾语:对齐到谁?流水线的每一环都在悄悄回答这个问题:
- 标注员池的构成。谁被雇来做标注?在什么国家、什么薪资水平、什么教育背景?这批人的口味会成为模型的口味。第 11 章会讲到这是一个供给受限、关系驱动的行业,大合同(约 50 万美元量级、分多批交付)里最初几批往往被整批废弃,因为目标和方法论还在收敛。
- 标注指南。合同签完后,买方和供应商会就每一类任务约定详细的指令,这份文档通常永不外流。少数公开的例子之一是 OpenAI 当年随 InstructGPT 发布的完整标注指南——几十页关于如何在「有用、真实、无害」之间排序的规定。真正塑造标签的是这份文档,不是损失函数。
- 行为规范文档。OpenAI 的 Model Spec(2024)是这一层的公开化尝试:它写明模型应该如何表现。Anthropic 的 Constitution 是另一种形态。
- 模型实际学到的东西。这是最后一环,也是唯一没人查的一环。
动机与实践的分家
这一节的结论也是全章最重要的一句判断:RLHF 的动机(对齐到人类偏好)已经与它的实践(把模型做得更有效)漂移开了。
今天在实验室里跑 RLHF 的人,绝大多数不是在做价值校准,而是在做经验性能优化——刷 chat 评测、降低拒答率、改善写作风格。这本身完全正当,而且是这套方法真正的价值所在。危险在于混淆:用「对齐」的修辞去描述一个纯粹的能力优化流程,会同时高估它的安全意义和低估它的工程价值。原文的表述是:RLHF 方法在实践中是从经验对齐的角度被推动和研究的——在特定技能上最大化模型表现,而不是测量对特定价值的校准程度。
7. 理论极限在工程上的显形
前面六节的抽象论证,如果落不到具体现象上,就只是哲学。这一节把每条理论缺陷映射到你在训练日志里真能看见的东西。
映射表
| 理论缺陷 | 工程表现 | 你在哪看到它 |
|---|---|---|
| 多维压成一维(VNM 的代价) | 长度偏置:更长的回复系统性得分更高 | RL 训练中平均回复长度单调上升,且与 RM 分数强相关 |
| 同上 | 格式偏置:列表、粗体、emoji 让回复「看起来更好」 | 模型逐渐把一切都排版成带项目符号的清单 |
| 偏好依赖框架与呈现 | 前缀偏置:开头几句不成比例地决定了标签 | RM 对同一回复换个开场白打分大幅变化 |
| 选择 ≠ 偏好(Sen) | 谄媚:同意用户比说对更容易赢得比较 | 模型在用户表达立场后改口;反驳率随 RLHF 步数下降 |
| 同上 | 奉承与辞藻:装饰性语言抬高分数 | 「这是一个非常好的问题!」类开场白的频率上升 |
| 不可传递 + 标注噪声 | RM 准确率天花板 ~70% | 怎么加数据、加参数都突破不了留出集准确率 |
| IIA 违规 | RM 打分依赖训练分布 | 换采样源重训,分数分布整体漂移;跨 RM 的分数不可比 |
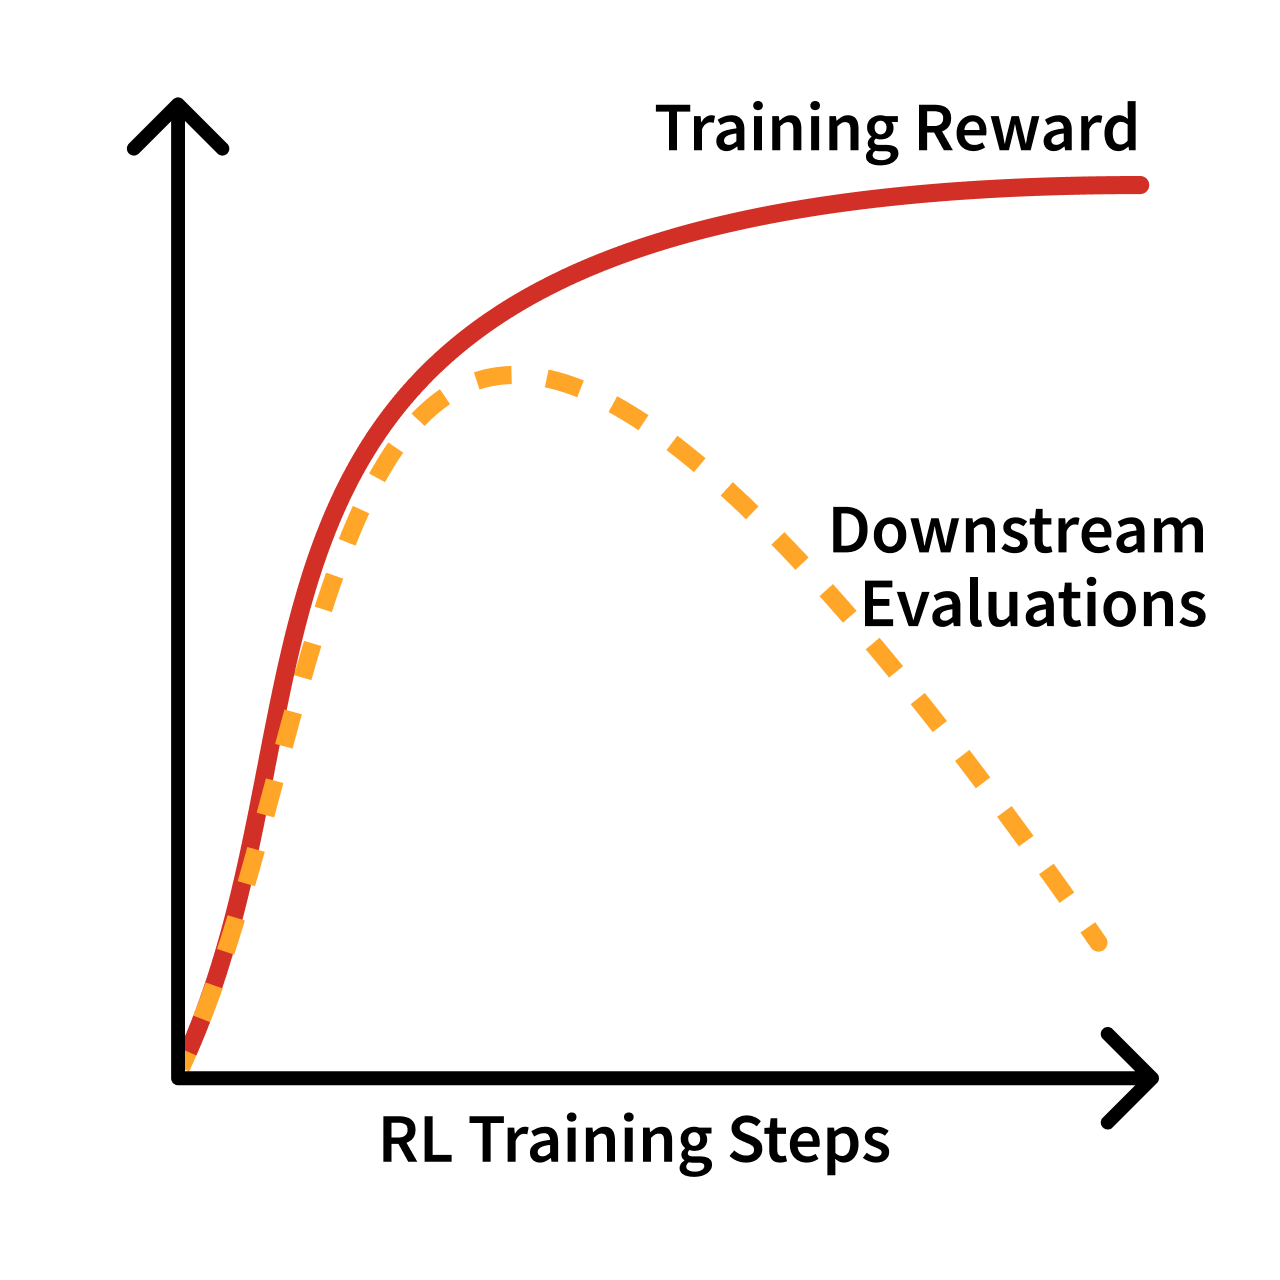
| 目标错配 | 过优化:RM 分继续涨,真实质量开始跌 | RM 分数与人工评测/留出评测在某一步之后反向 |
最后一行是第 14 章的全部内容。这里只强调一件事:过优化不是优化器的毛病,是奖励函数是学出来的这一事实的必然结果。如果 $r$ 是真值,随便优化多狠都没问题;正因为 $r$ 只是真实偏好在一个有限数据集上的低维投影,充分强的优化必然会找到投影的零空间——那些 RM 分高但真实质量低的区域。
为什么 RLVR 能绕开这一切
把本章的框架反过来用,可以立刻解释第 7 章推理模型的成功。在数学和代码上:
- 完备性成立——任何两个答案都能比较(对/错)。
- 传递性成立——正确性是良序的,不可能成环。
- 不需要聚合——不存在多人分歧,因此 Arrow 定理不适用。
- 奖励不是学出来的——它是一个验证器,所以不存在可被钻空子的低维投影(除非验证器本身有漏洞,这就是 reward hacking 的另一种形态)。
换言之,RLVR 之所以能承受远超 RLHF 的优化强度(几千步 RL、KL 系数可以调到很小甚至为零),根本原因不是算法更好,而是它工作的领域恰好满足了那些公理。这也划出了 RLVR 的边界:一旦离开可验证域,回到「哪首诗更好」,所有问题原封不动地回来。当前前沿实验室的做法——用 rubrics、用 LLM-as-a-judge、用可验证信号做骨架加偏好信号做润色——本质上都是在尽可能扩大可验证域的边界,把不得不用偏好的部分压到最小。
什么时候必须回到偏好
但也不要走到另一个极端。偏好数据不可替代的场景是真实存在的:
| 能力 | 可验证吗 | 怎么办 |
|---|---|---|
| 数学、竞赛编程 | 能 | RLVR,不需要 RM |
| 格式约束、结构化输出 | 能(代码检查) | 结构化偏好对或直接 RLVR |
| 事实性问答 | 部分(需要检索/知识库) | 验证器 + 偏好兜底 |
| 写作质量、语气、共情 | 不能 | 只能偏好,接受 ~70% 天花板 |
| 安全边界的细粒度判断 | 不能(且是价值分歧最大的地方) | 规范文档 + 偏好 + 明确接受不中立 |
| 「模型该有什么人格」 | 不能 | 本章讨论的所有问题的集中爆发点 |
最后一行值得单独说:模型人格是一个纯粹的价值分歧问题,不存在正确答案,也不可能有一个所有人都满意的 RM。而它恰恰是用户感知差异最大的维度。这解释了为什么各家模型的「性格」如此不同,也解释了为什么模型更新最容易引发用户抗议——你在替一亿人做一个 Arrow 定理禁止你公平地做出的决定。
本章小结
一句话速查
| 概念 | 要点 | 对工程的影响 |
|---|---|---|
| 偏好 vs 正确 | 偏好是「没有正确答案」时的替代品 | 可验证的部分优先用 RLVR,剩下的才用偏好 |
| 判断 > 生成 | 识别好回答比写出好回答容易得多 | 这是 RLHF 存在的经济学基础;代价是信号只有 1 bit |
| 成本 ≠ 奖励 ≠ 偏好 | 三个来自不同学科、性质不同的对象被当成可互换 | 很多「无法根治的偏置」的根因 |
| VNM 定理 | 完备性 + 传递性 + 连续性 + 独立性 ⟹ 存在标量效用 | RLHF 用了结论(标量 RM),没检查前提 |
| Bradley-Terry | $P(y_w\succ y_l)=\sigma(r_w - r_l)$,把比较变成标量 | 实数序必然传递 ⟹ 无法表示循环偏好 |
| 孔多塞循环 | 个体传递 + 多数聚合 ⟹ 集体可能不传递 | 三个理性标注员就能造出 RM 学不了的数据 |
| Arrow 不可能定理 | 无限定义域 + 帕累托 + IIA + 非独裁,四者不可兼得 | 不存在「中立」的奖励模型,只有放弃了哪一条的差别 |
| Sen:choice ≠ preference | 我们只观测到点击,却推断出价值 | 显示偏好的每一步推断都不是逻辑必然 |
| 偏好漂移 | 随时间、情绪、框架、参照点变化 | 标注非 i.i.d.;偏好数据有保质期 |
| 标注一致率 60%–75% | 对应完美预测器上界约 77%–82% | RM 准确率 0.90 = 在拟合捷径 |
| 分歧四分法 | 真实错误 / 指令歧义 / 语境缺失 / 价值分歧 | 只有前两类该被过滤;后两类是信息,应保留 |
| 目标错配 | RM 按分类准确率训,被当策略质量用 | RewardBench 是代理的代理;差几个点时必须端到端验 |
| 规范 → 数据 → 行为 | 工业 RLHF 封闭,这条链从未被审计 | 开放偏好数据的核心价值在于可检验,不在于质量 |
给实践者的六条
- 先问能不能验证。任何一个能力,如果能写出程序化检查器(数学答案、代码测试、格式约束),就不要走偏好这条路。结构化偏好对在窄域里能打败人工质量判断。
- RM 准确率超过 0.80 就该警惕,而不是庆祝。去检查测试集里有没有长度/格式/模型身份的捷径。
- 不要用多数投票抹平分歧。把一致率作为字段保留,用来做样本加权和不确定性估计,而不是过滤条件。
- RM 基准分数只用来排除坏 RM。两个 RM 分差在几个点以内时,唯一可靠判据是接进 RL 跑端到端评测。
- 把偏好数据当作有版本、有保质期的资产。记录采集时间、界面、指南版本、标注池构成。三年前的偏好数据反映的是三年前的用户期待。
- 接受不中立,并把它显式化。与其假装 RM 代表「人类偏好」,不如明确写出「本模型对齐到这份规范文档」,让分歧可以在系统层(系统提示、个性化、多模型)而不是损失函数层解决。
动手实验
本章没有配套作业目录,但这里的两个论断可以用几十行代码验证,而且验证过程本身就是最好的理解方式。建议在读完第 4、6 节后各做一个。
实验一:Bradley-Terry 拟合循环偏好的极限
验证第 4 节的结论:当偏好数据里有孔多塞循环时,标量模型存在不可约的损失下界。这里直接优化三个标量 $r_A, r_B, r_C$(等价于一个「记住了所有答案」的无限容量 RM),如果连它都做不到,真实的 RM 更做不到。
import torch

# 三条比较,每条的经验胜率都是 2/3(第 4 节的三标注员例子)
# (i, j, p) 表示「i 胜过 j」的经验概率为 p
pairs = [(0, 1, 2/3),   # A > B
         (1, 2, 2/3),   # B > C
         (2, 0, 2/3)]   # C > A   <-- 环在这里闭合

r = torch.zeros(3, requires_grad=True)
opt = torch.optim.Adam([r], lr=0.05)

for step in range(3000):
    loss = 0.0
    for i, j, p in pairs:
        # Bradley-Terry: P(i > j) = sigmoid(r_i - r_j)
        logit = r[i] - r[j]
        # 软标签交叉熵:数据说有 p 的比例选 i,1-p 的比例选 j
        loss = loss - (p * torch.nn.functional.logsigmoid(logit)
                       + (1 - p) * torch.nn.functional.logsigmoid(-logit))
    loss = loss / len(pairs)
    opt.zero_grad(); loss.backward(); opt.step()

import math
H = -(2/3 * math.log(2/3) + 1/3 * math.log(1/3))   # 数据的熵下界 ~0.6365
print("学到的分数 r =", r.detach().numpy())         # 三个数几乎相等
print("最优损失     =", loss.item())               # ~0.6931 = log 2
print("数据熵下界   =", H)
print("不可约间隙 =", loss.item() - H) # ~0.057 nats,消不掉该观察什么:(1)三个分数会收敛到几乎相同的值——模型的最佳策略是「放弃」,对每一对都预测 50/50;(2)损失卡在 $\log 2 \approx 0.693$,比数据熵 $0.637$ 高出约 $0.057$ nats,这个间隙就是标量表示能力不足的定量代价。
对照实验:把第三条改成 (0, 2, 2/3)(即 $A \succ C$,环被打开),重跑。这次三个分数会拉开(约 $+0.47 / 0 / -0.47$),损失降到 $0.643$,间隙从 $0.057$ 缩到 $0.006$ ——小了一个数量级。唯一的变化是数据是否传递。(剩下的 $0.006$ 来自另一重约束:传递性强制 $\Delta_{AC}=\Delta_{AB}+\Delta_{BC}$,所以三条比较也无法同时都拟合成 $2/3$。标量模型的表达力限制是层层叠加的。)
实验二:标注噪声给 RM 准确率设的上限
验证第 6 节那个公式。做法是造一批合成偏好数据,人为控制标注员的准确率 $q$,看一个「知道真值」的完美预测器在这份数据上能拿多少分。
import numpy as np
rng = np.random.default_rng(0)
N = 200_000

for q in [0.70, 0.77, 0.82, 0.90, 1.00]:
    truth  = rng.integers(0, 2, N)                       # 真标签
    flip   = rng.random(N) > q                           # 标注员以 1-q 的概率标反
    label  = np.where(flip, 1 - truth, truth)            # 观测到的标签
    # 两个独立标注员的一致率
    l2     = np.where(rng.random(N) > q, 1 - truth, truth)
    agree  = (label == l2).mean()
    # 完美预测器(直接输出真标签)在观测标签上的准确率
    acc    = (truth == label).mean()
print(f"q={q:.2f} 两人一致率={agree:.3f} 完美预测器准确率={acc:.3f}")该观察什么:当两人一致率是 0.70 时(这正是真实偏好数据的典型值),即使一个预测器完美地知道真标签,它在这份带噪标注上的准确率也只有 0.82 左右。你的 RM 报告 0.75,说明它已经吃掉了可用信息的九成。再往上调,你调的是噪声。
实验三(思想实验,不用写代码)
找一份你手上的偏好数据集,随机抽 30 条你自己也有判断力的样本,遮住原标签自己标一遍,然后对照。你会得到自己与数据集的一致率——通常在 65%–75%。接着把你不同意的那些逐条归类到第 6 节的四种分歧成分里。这个练习十分钟就能做完,但它对「RM 到底在学什么」的理解,胜过读十篇论文。
延伸阅读
本章的主干文献(先读这两篇)
- Entangled Preferences: The History and Risks of RLHF (Lambert, Gilbert & Zick, 2023) — 本章前半部分的直接来源,把 RLHF 一路追溯回它借用的每一个领域,并逐条列出借用时丢掉的假设。要真正读懂第 2、3 节,这篇是必读。
- Open Problems and Fundamental Limitations of RLHF (Casper et al., TMLR 2023) — 与本章互补的另一份清单,把「人的问题、RM 的问题、策略优化的问题」分成三层,是查漏补缺的最佳索引。
效用与偏好理论(一手文献值得读原文)
- Von Neumann & Morgenstern, Theory of Games and Economic Behavior (1947) — VNM 效用定理的原始出处。只需读关于四条公理和表示定理的那一节,就能明白 RLHF 借走了什么。
- Arrow, A Difficulty in the Concept of Social Welfare (Journal of Political Economy, 1950) — 不可能定理的原文,只有二十来页,论证过程比任何转述都清楚。
- Maskin & Sen, The Arrow Impossibility Theorem (Columbia University Press, 2014) — 两位诺奖得主对定理的现代解读,包括各种绕开路径的代价,比原文更适合先读。
- Sen, Behaviour and the Concept of Preference (Economica, 1973) — 「选择不等于偏好」这条批评的经典表述,直接对准 RLHF 从点击推断价值的做法。
- Hirschman, Against Parsimony (1984) — 「人对自己的偏好还有偏好」,主张偏好在原则上不可测量的最有力论述。
- Harsanyi, Rule Utilitarianism and Decision Theory (Erkenntnis, 1977) — 绕开 Arrow 定理的路线:假设人际效用可比。Bradley-Terry 隐含地站在这一边。
- Pettigrew, Choosing for Changing Selves (Oxford University Press, 2019) — 偏好随时间变化时「理性选择」意味着什么,是偏好漂移问题的哲学基底。
奖励、控制与表达力的边界
- Singh, Lewis & Barto, Where Do Rewards Come From? (2009) — 本章引用的那段关于「奖励是进化硬连线的原初信号」的原文出处,读完会立刻感到它和学出来的 RM 不是一回事。
- Silver, Singh, Precup & Sutton, Reward is Enough (Artificial Intelligence, 2021) — 「一个标量奖励足以产生一切智能」的最强主张,本章基本上是它的反命题,两篇对读效果最好。
- Abel et al., On the Expressivity of Markov Reward (NeurIPS 2021) — 构造性地证明存在无法被任何马尔可夫奖励函数表示的任务,给「标量奖励够不够」这个问题一个数学答案。
- Pitis, Consistent Aggregation of Objectives with Diverse Time Preferences Requires Non-Markovian Rewards (NeurIPS 2023) — 把 Arrow 式的聚合难题搬到 RL 的时间维度上,结论是聚合不同时间偏好需要放弃马尔可夫性。
- Ng & Russell, Algorithms for Inverse Reinforcement Learning (ICML 2000) — 从行为反推奖励函数,与奖励建模高度相关却在 RLHF 文献中奇怪地缺席。作者点名认为这是值得重新投入的方向。
- Objective Mismatch in Model-based RL (Lambert et al., 2020) — 「目标错配」这个透镜的原始提法,理解了 model-based RL 里的版本,RLHF 里的版本一望即知。
社会选择、多元对齐与个性化
- Social Choice Should Guide AI Alignment in Dealing with Diverse Human Feedback (Conitzer et al., ICML 2024) — 作者参与的立场论文,把社会选择理论正式引进对齐研究的方法论。
- AI Alignment and Social Choice: Fundamental Limitations and Policy Implications (Mishra, 2023) — 把 Arrow 类结果直接套到 RLHF 上,给出的是政策层面的推论。
- The PRISM Alignment Project (Kirk et al., 2024) — 记录标注者人口学与文化背景的偏好数据集,是「分歧是信号」这个主张最好的实证材料。
- Variational Preference Learning (Poddar et al., NeurIPS 2024) — 用隐变量表示「你是哪一类用户」,让奖励模型条件在它上面,是绕开单一标量限制的具体技术路线。
- Cooperative Inverse Reinforcement Learning (Hadfield-Menell et al., 2016) — 把对齐建模成人与 AI 的合作博弈,AI 需要边行动边推断人的目标。
- Fickinger et al., Multi-Principal Assistance Games (2020) — 上一篇从单个委托人扩展到多个,直接撞上聚合问题。
- Soares et al., Corrigibility (AAAI Workshops, 2015) — 为什么让系统坚定地最大化一个效用函数,会与「允许人类纠正它」相冲突。
偏置的实证研究(第 7 节那张表的出处)
- A Long Way to Go: Investigating Length Correlations in RLHF (Singhal et al., 2023) — 长度偏置的系统性测量,说明相当一部分 RLHF 增益其实只是变长了。
- Towards Understanding Sycophancy in Language Models (Sharma et al., ICLR 2024) — 谄媚不是训练意外,而是偏好数据的直接产物:人类确实更常选择同意自己的回答。
- From Lists to Emojis: How Format Bias Affects Model Alignment (Zhang et al., ACL 2025) — 格式偏置的量化,解释了模型为什么把一切都排版成清单。
- Detecting Prefix Bias in LLM-based Reward Models (Kumar et al., FAccT 2025) — 开头几句不成比例地决定标签,是「框架效应」在 RM 上最直接的证据。
- Scaling Laws for Reward Model Overoptimization (Gao, Schulman & Hilton, 2023) — 把本章的理论缺陷变成一条可测量的曲线,是第 14 章的核心参考。
规范文档与数据透明度
- InstructGPT 标注员指南(OpenAI, 2022) — 极少数公开的真实标注指南,作者从已删除的原始发布中恢复。想知道「对齐到谁」这个问题在工业界是怎么被回答的,读这份 PDF 比读十篇对齐论文有用。
- OpenAI Model Spec (2024) — 把「模型应该如何表现」写成公开文档的尝试,是规范 → 数据 → 行为这条链上唯一公开的一环。
- HelpSteer2 (Wang et al., 2024) — 少数同时公开了数据与采集方法论的人类偏好数据集,NVIDIA Nemotron 系列背后的数据。
- Choices, Risks, and Reward Reports (Gilbert et al., 2022) — 主张为 RL 系统建立类似 model card 的「奖励报告」制度,是对未审计缺口的一个制度性回应。