强化学习:策略梯度方法
把「这条回复好不好」这一个标量,变成模型几十亿个参数上的一次梯度更新——以及为了让这件事在语言模型上真跑得起来,人们发明的全部技巧。
0. 本章导读
到目前为止,后训练流水线上的每一步都还是监督学习:SFT 是在给定的回复上做交叉熵,奖励模型是在给定的偏好对上做 Bradley-Terry 分类。它们都有一个共同前提——你得先有正确答案。而 RLHF 真正的分水岭在这一章:模型自己生成回复,某个打分器给一个标量,然后我们要用这个标量去更新参数。没有「正确答案」,只有「刚才那次做得比平均好还是差」。
这件事在数学上并不平凡。SFT 的梯度是现成的:损失对 logits 求导,链式法则一路回传。但强化学习的目标函数是
$$ J(\theta) = \E_{\tau \sim p_\theta}\big[R(\tau)\big] $$——期望本身是对一个依赖 $\theta$ 的分布取的。你要优化的参数同时决定了采样分布,所以不能简单地「对被积函数求导」。整个策略梯度理论就是为了绕开这一点:用一个叫 log-derivative trick 的恒等式,把「对分布的梯度」变成「可以从采样中估计的期望」。这一步一旦跨过去,剩下的全部工作就变成一件事:这个估计的方差太大了,怎么把它压下来。
本章讲的所有算法——REINFORCE、RLOO、PPO、GRPO、Dr. GRPO、GSPO、CISPO、DAPO、SAPO——都是同一个梯度形式的不同实例化:
$$ \Delta \theta \;\propto\; \Psi_t \, \nabla_\theta \log \pi_\theta(a_t \mid s_t) $$右边这个 $\nabla_\theta \log \pi_\theta$ 回答「哪些参数让这个 token 更可能被生成」,左边这个标量 $\Psi_t$ 回答「刚才那次到底好不好」。差别只在于:$\Psi_t$ 怎么估(蒙特卡洛回报、学出来的价值函数、组内 z-score),以及更新怎么被约束住(不裁剪、裁目标函数、裁重要性权重、软门控)。把这两条轴认清楚,这一章的三十来个缩写就塌缩成一张表。
本章在全书中的位置:第 4 章的 SFT 模型是这里的初始策略 $\pi_{\text{init}}$ 和参考策略 $\pi_{\text{ref}}$,第 5 章的奖励模型提供 $r(x,y)$,而第 7 章的推理模型训练(RLVR)用的正是本章一模一样的算法,只是把奖励模型换成了一个验证函数。换句话说,这一章是后训练领域的技术心脏:从 InstructGPT 到 DeepSeek-R1,中间变的是数据和奖励,不变的是这里的损失函数。
- 策略梯度定理的全部内容是一个恒等式:$\nabla_\theta p_\theta(\tau) = p_\theta(\tau)\nabla_\theta \log p_\theta(\tau)$。它把不可采样的 $\nabla_\theta p_\theta$ 变成可采样的期望,这就是为什么代码里永远只出现
log_probs。 - 环境转移概率 $p(s_{t+1}\mid s_t,a_t)$ 和初始分布 $d_0$ 都不含 $\theta$,求导后消失。策略梯度不需要环境模型——这是它能用在语言模型上的根本原因。
- baseline $b(s)$ 只要不依赖被采样的动作,减掉它不改变期望梯度(因为 $\sum_a \nabla_\theta \pi_\theta(a\mid s) = \nabla_\theta 1 = 0$),但能大幅降低方差。REINFORCE→RLOO→GRPO 的演进本质上就是 baseline 越来越聪明。
- PPO 的 clip 是单边生效的:只在策略「已经朝正确方向走过头」时才截断梯度,从不阻止纠错方向的更新。在信任域内部,PPO 和普通策略梯度完全一样。
- GRPO 用「同一个 prompt 采 $G$ 条回复,组内 z-score」替代了学出来的价值函数,省掉一整个模型副本;代价是 std 归一化引入了对低方差问题的偏好偏置——这正是 Dr. GRPO 要修的。
- Lambert 的判断:在多数 RLHF 场景里,数据质量和奖励信号质量占主导,算法选择主要决定的是稳定性、效率和工程负担,而不是最终效果的上限。
- 实现细节比算法差异更容易毁掉一次训练:损失聚合方式(per-sequence / per-token / fixed-length)会直接改变长度偏置;掩码、EOS 处理、stale logprob 这类静默 bug 不会报错,只会让你训出一个错误的模型。
- 典型超参量级:clip $\varepsilon = 0.1$–$0.2$,GAE $\lambda = 0.95$,KL 系数 $\beta = 0.01$–$0.1$(RLVR 常直接设 0),学习率 $1\times10^{-6}$–$5\times10^{-6}$(比 SFT 低一个数量级),batch 256–1024 条 prompt,每批 1–4 次梯度步。
1. 问题设定:把语言模型看成一个 MDP
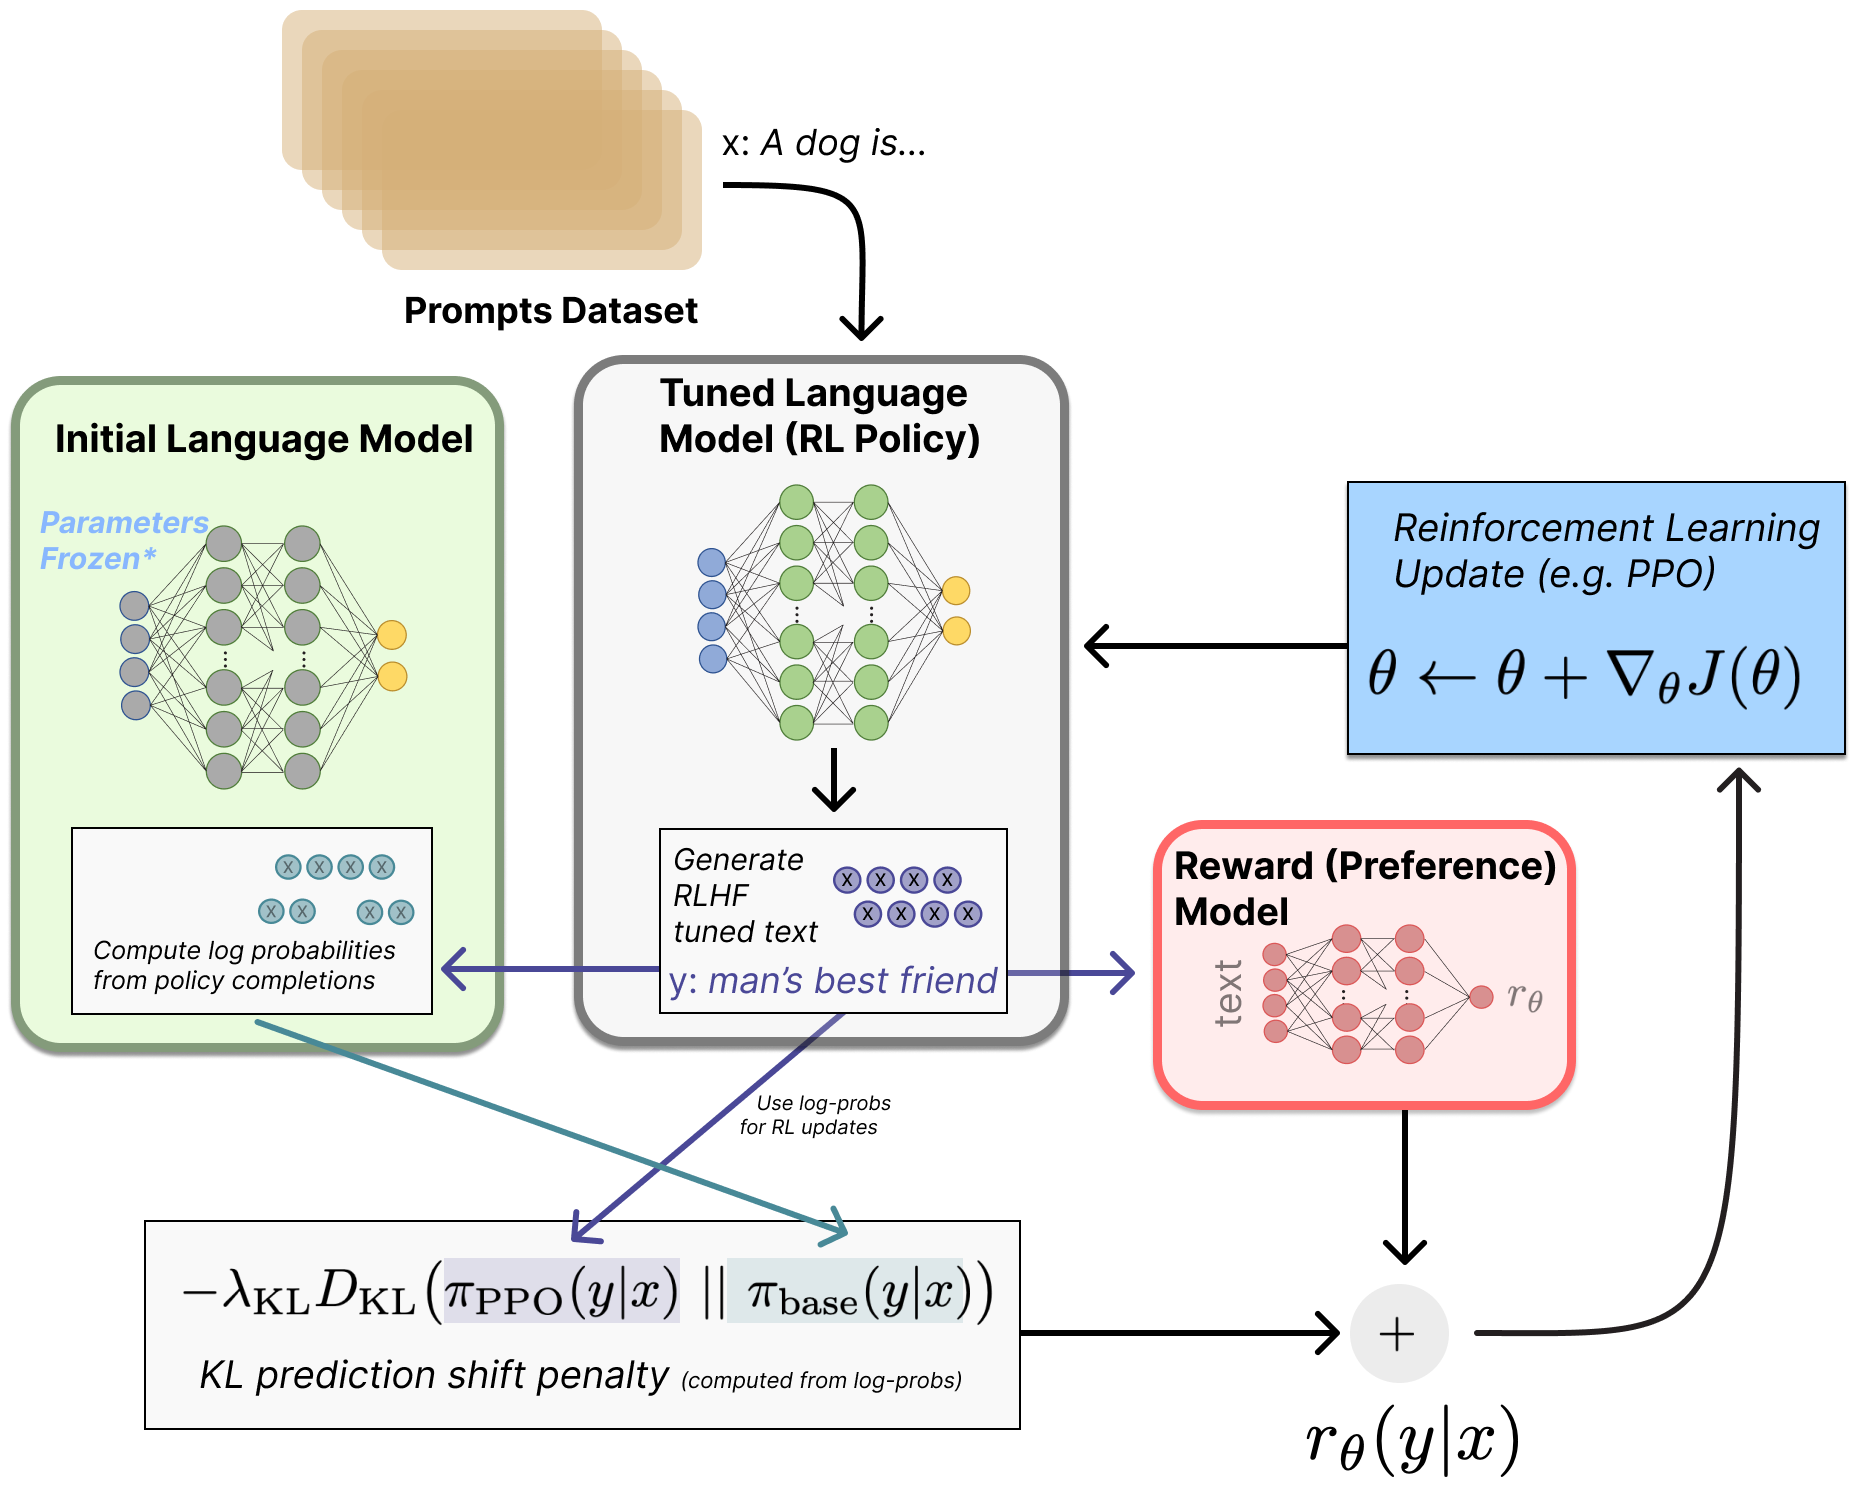
RLHF 训练循环里到底有几个模型
先把整个循环摆出来,后面所有公式都挂在这张图上。
| 模型 | 作用 | 是否更新 | 7B / fp16 显存 |
|---|---|---|---|
| 策略 $\pi_\theta$ | 生成 completion,被优化的对象 | 是 | ~14 GB |
| 价值函数 $V_\phi$(仅 PPO) | 预测每个 token 位置的未来回报,当 baseline | 是 | ~14 GB |
| 参考策略 $\pi_{\text{ref}}$ | KL 惩罚的锚点,通常就是 RL 开始前的 SFT checkpoint | 冻结 | ~14 GB |
| 奖励模型 $r_\psi$ | 给 completion 打分(RLVR 里换成验证函数,不占显存) | 冻结 | ~14 GB |
四个模型加起来光权重就 56 GB,还没算优化器状态、激活值和梯度。这是一个纯工程数字,但它解释了这一章后半段的全部动机:GRPO 之所以流行,很大一部分原因就是它砍掉了价值函数那一行;RLVR 之所以常常连 KL 都不要,是因为砍掉参考模型又能再省 14 GB。算法的演化史在很大程度上是一部显存节约史。
两个「旧策略」,千万别混
初学者最常见的混淆是把 $\pi_{\theta_{\text{old}}}$ 和 $\pi_{\text{ref}}$ 当成一回事。它们完全不同:
| $\pi_{\theta_{\text{old}}}$ | $\pi_{\text{ref}}$ | |
|---|---|---|
| 是什么 | 上一次 rollout 时的策略 | RL 开始时的策略(SFT checkpoint) |
| 更新频率 | 每个 batch(或每 $K$ 步) | 永不更新 |
| 用来干嘛 | 算重要性采样比 $\rho_t$ | 算 KL 惩罚 |
| 如果不要它 | 每批只能走 1 次梯度步(严格 on-policy) | 有奖励攻击(reward hacking)的风险 |
还有一个实现层面的细节:很多代码里的「old logprobs」并不是一个单独的模型副本,而只是生成那批数据时顺手算出来并缓存下来的一组 logprob 张量。模型只有一份权重,它在那之后被更新了而已。这个区别在后面讲异步训练和截断重要性采样时会变得非常重要。
语言模型作为 episodic MDP
要用 RL 的工具,先得把语言生成翻译成 RL 的语言:
| MDP 概念 | 语言模型里对应什么 |
|---|---|
| 状态 $s_t$ | prompt + 已生成的 token:$(x, y_{<t})$ |
| 动作 $a_t$ | 下一个 token $y_t$(动作空间就是词表,$|\mathcal{A}| = |V| \approx 10^5$) |
| 转移 $p(s_{t+1}\mid s_t,a_t)$ | 确定性:把 token 拼到序列末尾,概率为 1 |
| 策略 $\pi_\theta(a_t\mid s_t)$ | 模型在该位置的 next-token 分布(softmax 后的那个长度 $|V|$ 的向量) |
| episode | 一个 prompt → 一条完整 completion |
| 终止奖励 | 奖励模型分数或验证器输出,打在 EOS 那个位置 |
| 折扣因子 $\gamma$ | 几乎总是 1.0(不折扣) |
「转移是确定性的」这一条比看起来重要。经典 RL 里方差的一大来源是环境随机性——同一个动作可能导致完全不同的后续状态。语言模型里没有这回事:唯一的随机性来自采样本身(temperature > 0 时从分布里抽 token)。这让很多经典 RL 的推导在这里退化成更简单的形式,比如贝尔曼方程从 $Q^\pi(s_t,a_t)=\E[r_t + \gamma V^\pi(s_{t+1})]$ 直接变成 $Q(s_t,a_t) = r_t + \gamma V(s_{t+1})$,不用取期望。
唯一可能变的场景是 agentic RL:当模型真的在做多步工具调用、代码执行、网页浏览时,那些是真正意义上不同的顺序决策,长期后果确实不同,折扣可能重新有意义。这是一个开放的方向。
符号约定
本章会在两套记号之间来回切换,这是原书刻意保留的,因为文献里两套都有:
- $(s, a)$ 记号:来自 RL 文献,状态-动作。更一般,反映的是逐 token 的梯度计算。
- $(x, y)$ 记号:prompt-completion。反映的是序列级的奖励——很多 RLHF 实现把整条 completion 当成一个动作。
另外约定:$r_t$ 是每步奖励,$R(\tau)$ 是整条轨迹回报,$\rho_t$ 专门留给重要性采样比(不用 $r$,避免和 reward 混),$G$ 有两个含义要靠上下文区分——$G_t$ 是回报(return),$G$ 单独出现时是 GRPO 的组大小。$|a_i|$ 是第 $i$ 条 completion 的 token 数。
一句话预告:本章要讲的那个式子
$$ \Delta \theta \;\propto\; \Psi_t \, \nabla_\theta \log \pi_\theta(a_t \mid s_t) $$拆开看是两个问题同时被回答:
- $\nabla_\theta \log \pi_\theta(a_t \mid s_t)$ —— 是哪个动作?参数空间里哪个方向会让动作 $a_t$ 更可能发生。这是一个和参数量等长的向量:某一维为正,意思是「调大这个参数会让这个 token 更可能被生成」。
- $\Psi_t$ —— 这次做得怎么样?一个标量。正数表示好,负数表示差,绝对值表示程度。
乘起来就是更新方向:$\Psi_t > 0$ 把参数往「让 $a_t$ 更可能」推,$\Psi_t < 0$ 往反方向推。真实的更新是在一整个 batch 上平均掉这些向量,最后活下来的是全 batch 的净投票。这一章剩下的全部内容,就是在讨论怎么挑一个聪明的 $\Psi_t$,以及怎么在挑好之后不让训练炸掉。
2. 策略梯度定理:从不可导到可采样
目标函数与它的麻烦
RL 要最大化的是期望回报。先定义回报本身——从时刻 $t$ 开始的折扣奖励之和:
$$ G_t = r_t + \gamma r_{t+1} + \cdots = \sum_{k=0}^{\infty} \gamma^k r_{t+k} $$它有一个递归形式,后面推 GAE 时会反复用到:$G_t = r_t + \gamma G_{t+1}$。价值函数就是回报的条件期望:$V(s) = \E[G_t \mid S_t = s]$。
整个优化目标写成对轨迹分布的期望:
$$ J(\theta) = \E_{\tau \sim p_\theta}\big[R(\tau)\big] = \int_\tau p_\theta(\tau)\, R(\tau)\, \mathrm{d}\tau $$其中 $\tau = (s_0, a_0, s_1, a_1, \ldots)$ 是一条轨迹,$p_\theta(\tau)$ 是由策略 $\pi_\theta$ 和环境动力学共同诱导的轨迹分布。参数更新的形式很朴素:$\theta \leftarrow \theta + \alpha \nabla_\theta J(\theta)$。
问题出在求梯度这一步。直接对积分求导:
$$ \nabla_\theta J(\theta) = \int_\tau \nabla_\theta p_\theta(\tau)\, R(\tau)\, \mathrm{d}\tau $$这个式子在数学上没错,但在计算上没用。我们能从 $p_\theta(\tau)$ 里采样(那就是跑一遍生成),但 $\nabla_\theta p_\theta(\tau)$ 不是一个概率分布,你没法从它里面采样。这就是整个推导要绕过的障碍。
唯一需要的工具是对数的链式法则:
$$ \nabla_\theta \log p_\theta(\tau) = \frac{\nabla_\theta p_\theta(\tau)}{p_\theta(\tau)} \quad\Longrightarrow\quad \nabla_\theta p_\theta(\tau) = p_\theta(\tau)\, \nabla_\theta \log p_\theta(\tau) $$把它代回去:
$$ \begin{aligned} \nabla_\theta J(\theta) &= \int_\tau \nabla_\theta p_\theta(\tau)\, R(\tau)\, \mathrm{d}\tau && \text{对目标求导} \\ &= \int_\tau p_\theta(\tau)\, R(\tau)\, \nabla_\theta \log p_\theta(\tau)\, \mathrm{d}\tau && \text{log-derivative 恒等式} \\ &= \E_{\tau \sim p_\theta}\big[R(\tau)\, \nabla_\theta \log p_\theta(\tau)\big] && \text{期望的定义} \end{aligned} $$最后一步用的是期望的定义:对任意函数 $f$,$\E_{\tau\sim p_\theta}[f(\tau)] = \int_\tau f(\tau)p_\theta(\tau)\mathrm{d}\tau$。
这一步的意义值得停下来品一下。$p_\theta(\tau)$ 这个因子并没有消失,它变成了期望的采样分布。于是在代码里你永远看不到显式的 $p_\theta(\tau_i)$ 这一项——因为更可能的轨迹本来就会在采样出来的 batch 里出现得更频繁。分工是这样的:
- rollout 阶段负责 $\tau_i \sim p_\theta$ 这一半(也就是调
model.generate()); - loss 代码负责 $R(\tau_i)\nabla_\theta \log p_\theta(\tau_i)$ 这一半;
- 蒙特卡洛估计把期望换成平均:$\E_{\tau\sim p_\theta}[f(\tau)] \approx \frac{1}{N}\sum_{i=1}^{N} f(\tau_i)$。
展开轨迹的对数概率:环境模型消失了
轨迹概率按马尔可夫性质因子分解:
$$ p_\theta(\tau) = d_0(s_0) \prod_{t=0}^{\infty} \pi_\theta(a_t\mid s_t)\, p(s_{t+1}\mid s_t, a_t) $$取对数,乘积变求和:
$$ \log p_\theta(\tau) = \log d_0(s_0) + \sum_{t=0}^{\infty} \log \pi_\theta(a_t\mid s_t) + \sum_{t=0}^{\infty} \log p(s_{t+1}\mid s_t, a_t) $$然后对 $\theta$ 求梯度,逐项检查:
- $\nabla_\theta \log d_0(s_0) = 0$ —— 初始状态分布(也就是 prompt 从哪个数据集来)跟策略参数无关;
- $\nabla_\theta \log p(s_{t+1}\mid s_t,a_t) = 0$ —— 环境转移动力学跟策略参数无关;
- 只有 $\nabla_\theta \log \pi_\theta(a_t\mid s_t)$ 活下来。
backward()。
这就是为什么下面这三行会在本章反复出现(几乎每个实现里都有它的变体):
seq_log_probs = (token_log_probs * completion_mask).sum(dim=-1)
loss = -(seq_log_probs * advantages).mean()
loss.backward()   # autodiff 自动给出 ∑ Ψ_t ∇ log π
你写的是 log-prob 的加权和,autodiff 替你算出了策略梯度。这两者之所以等价,全靠上面那条推导。
合起来:策略梯度定理
把这个结果代回期望里:
$$ \nabla_\theta J(\theta) = \E_{\tau \sim p_\theta}\left[\sum_{t=0}^{\infty} R(\tau)\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$更常见的写法把权重项抽象成 $\Psi_t$:
$$ g = \nabla_\theta J(\theta) = \E_{\tau \sim p_\theta}\left[\sum_{t=0}^{\infty} \Psi_t\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$这就是策略梯度定理。本章后面每一个算法,都是在这个式子里填一个具体的 $\Psi_t$,再加上一层对更新幅度的约束。注意这个期望的三个要素:期望对轨迹取、轨迹从当前策略 $p_\theta$ 采样(这就是 on-policy 的含义)、梯度只对策略参数 $\theta$ 求。三者中任何一个被破坏,估计就有偏——后面讲重要性采样和异步训练时,破坏的正是第二条。
实践中的一个小修正:return-to-go
上面式子里,每个时刻 $t$ 的 log-prob 都被整条轨迹的回报 $R(\tau)$ 加权。但 $t$ 时刻的动作显然影响不了 $t$ 之前已经拿到的奖励。所以可以把 $R(\tau)$ 换成 return-to-go $G_t = \sum_{t'=t}^{T} r_{t'}$:
$$ \nabla_\theta J(\theta) = \E_{\tau \sim p_\theta}\left[\sum_{t=0}^{T} G_t\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$这不改变期望梯度(被去掉的那部分与当前动作独立,期望为 0),但把「当前动作根本无法影响的历史奖励」这部分噪声剔除了。这是方差削减的第一招,也是从 $\Psi_t$ 选项 1 到选项 2 的那一步。
3. 方差从哪来,baseline 为什么免费
朴素策略梯度的病
直接用 $\Psi_t = G_t$ 的版本叫 vanilla policy gradient(朴素策略梯度):
$$ \nabla_\theta J(\theta) = \E_{\tau \sim p_\theta}\left[\sum_{t=0}^{T} G_t\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$它是无偏的——期望上完全正确。问题是方差极大,大到实际上几乎不能用。方差的来源有三层:
- 蒙特卡洛估计本身:我们用有限条 rollout(RLHF 里常常一个 prompt 只有 4–16 条)去估一个期望。样本少,估计就抖。
- 采样随机性:temperature > 0 时,同一个 prompt 同一个模型,两次生成可能天差地别。
- 稀疏奖励:这一条在 RLVR 里尤其致命。如果奖励非 0 即 1(答对/答错),那么样本的回报不是聚在一起的,而是分裂成两个极端。分布越两极,方差越大。
还有一个更微妙的问题:原始回报把「动作的好坏」和「状态的好坏」混在一起了。一个坏动作在简单题上可能仍然得高分,一个好动作在难题上可能仍然得低分。用 $G_t$ 加权,模型收到的信号是「这条轨迹总体怎么样」,而不是「这个动作相对于该状态下的平均水平怎么样」。后者才是我们真正想要的。
baseline:不改期望,只砍方差
解决办法是减掉一个 baseline(基线)$b(s_t)$,把信号居中:
$$ \Psi_t = G_t - b(s_t) $$关键约束是:$b$ 只能依赖状态,不能依赖被采样的那个动作。只要满足这一条,减掉它就不引入偏差。
把期望拆成两项:
$$ \E\big[(G_t - b(s))\nabla_\theta \log \pi_\theta(a\mid s)\big] = \E\big[G_t \nabla_\theta \log \pi_\theta(a\mid s)\big] - \E\big[b(s)\nabla_\theta \log \pi_\theta(a\mid s)\big] $$第一项就是原来的估计量。第二项恒为零:
$$ \begin{aligned} \E_{a\sim\pi_\theta(\cdot\mid s)}\big[b(s)\nabla_\theta \log \pi_\theta(a\mid s)\big] &= b(s)\sum_a \pi_\theta(a\mid s)\,\frac{\nabla_\theta \pi_\theta(a\mid s)}{\pi_\theta(a\mid s)} \\ &= b(s)\sum_a \nabla_\theta \pi_\theta(a\mid s) \\ &= b(s)\, \nabla_\theta \underbrace{\sum_a \pi_\theta(a\mid s)}_{=\,1} \\ &= b(s)\cdot \nabla_\theta 1 = 0 \end{aligned} $$第一步把 $b(s)$ 提出来(它不依赖 $a$,这是唯一用到的假设),然后用 log-derivative trick 反向展开,再交换求和与求导,最后利用归一化概率分布的梯度和为零。
这个证明短得像个魔术,但结论极强:你可以随便减掉任何一个状态的函数,期望梯度纹丝不动,方差却能塌下去一大截。这就是为什么后面所有算法都在琢磨「怎么构造一个更好的 baseline」——它是免费的午餐。
第一,$b$ 必须与采样出的动作独立。RLOO 之所以要「留一」,正是为了保证第 $k$ 条样本的 baseline 里不含它自己的奖励——如果用包含自己的组均值,估计量严格来说就有偏了(虽然实践中偏差随组大小 $1/G$ 衰减,常被忽略)。
第二,除以标准差不是 baseline。减均值是 baseline(不引入偏差),除以 std 是对不同 prompt 重新加权,它改变了各个 prompt 对总梯度的相对贡献——这是 GRPO 的一个真实偏置,第 7 节会详细算。
$\Psi_t$ 的六种选择
Schulman 等人在 GAE 论文里给出的分类,现在已经是标准参考:
| # | $\Psi_t$ | 说明 | 方差 | 偏差 |
|---|---|---|---|---|
| 1 | $R(\tau) = \sum_{t=0}^{T} r_t$ | 整条轨迹的总奖励 | 最高 | 无 |
| 2 | $\sum_{t'=t}^{T} r_{t'} = G_t$ | 从 $t$ 起的 return-to-go | 高 | 无 |
| 3 | $G_t - b(s_t)$ | 减了基线的回报 | 较低 | 无 |
| 4 | $Q^\pi(s_t,a_t)$ | 状态-动作价值函数 | 中 | 取决于估计质量 |
| 5 | $A^\pi(s_t,a_t) = Q - V$ | 优势函数 | 最低(若 $V$ 准) | 无 |
| 6 | $r_t + \gamma V^\pi(s_{t+1}) - V^\pi(s_t)$ | 时序差分(TD)残差 | 低 | 有($V$ 不准时) |
第 5 行是理论上的最优点:如果能准确计算优势函数,就能得到理论上可能的最低方差。所以本章大部分算法都建立在优势形式的策略梯度上:
$$ \nabla_\theta J(\theta) = \E_{\tau \sim p_\theta}\left[\sum_{t=0}^{T} A^{\pi_\theta}(s_t, a_t)\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$优势函数的三种等价写法
优势的定义是「这个动作比该状态下的平均水平好多少」:
$$ A(s_t, a_t) = Q(s_t, a_t) - V(s_t) $$对随机策略,$V^\pi(s_t) = \E_{a_t\sim\pi(\cdot\mid s_t)}[Q^\pi(s_t,a_t)]$——所以优势天然是「以 $V$ 为零点的 $Q$」,在动作上求期望恒为 0。这个性质很有用:健康的训练里 advantage 的均值应该在 0 附近,这是调试时第一个要看的指标。
对语言模型这种确定性转移的环境,贝尔曼方程简化为 $Q(s_t,a_t) = r_t + \gamma V(s_{t+1})$,于是:
$$ A(s_t, a_t) = r_t + \gamma V(s_{t+1}) - V(s_t) $$这正好就是表格里的第 6 行 TD 残差。也就是说,用一个学出来的 $\hat V$ 去估优势,最自然的形式就是 TD 误差。这条式子同时是价值函数的训练信号(它衡量预测和实际的差距)和策略的更新权重——PPO 的两个损失就是从这里分叉出去的。
翻译成 RLHF 的语言:$V$ 是「这道题一般能得几分」,$Q$ 是「这条回复能得几分」,$A$ 是「这条回复相对这道题的平均水平好多少」。后面 GRPO 的整个设计就是:既然我可以对同一个 prompt 采 8 条回复,那我直接用这 8 条的均值当 $V$,根本不用学一个模型来估它。
4. REINFORCE 与 RLOO:最简单的那一族
REINFORCE 这个名字
REINFORCE 大概率是个硬凑的缩写(backronym),但它拆开之后恰好把策略梯度的三个部件说清楚了。Williams 1992 年的原文写道:
The name is an acronym for "REward Increment = Nonnegative Factor × Offset Reinforcement × Characteristic Eligibility."
三个部件对应到现代记号:
- Nonnegative Factor(非负因子):学习率 $\alpha$,必须是正数。
- Offset Reinforcement(偏置后的强化量):$r - b$,也就是减了 baseline 的奖励。这一项存在的唯一理由就是稳定性。
- Characteristic Eligibility(特征资格):Williams 记作 $e$(不是指数函数),意思是「把这个标量奖励归因到产生该动作的那些参数上」。现代记号就是 $\nabla_\theta \log \pi_\theta(a_t\mid s_t)$。
于是更新规则长成这样:
$$ \Delta_\theta = \alpha\,(r - b)\,e $$换成现代记号和一般化的回报 $G$:
$$ \nabla_\theta J(\theta) = \E_{\tau\sim p_\theta}\left[\sum_{t=0}^{T} \big(G_t - b(s_t)\big)\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$而 $G_t - b(s_t)$ 本身就是一个优势估计,所以这个式子和第 3 节最后的优势形式是同一个东西。REINFORCE 就是用蒙特卡洛估计梯度的 vanilla policy gradient,没有更多内容。
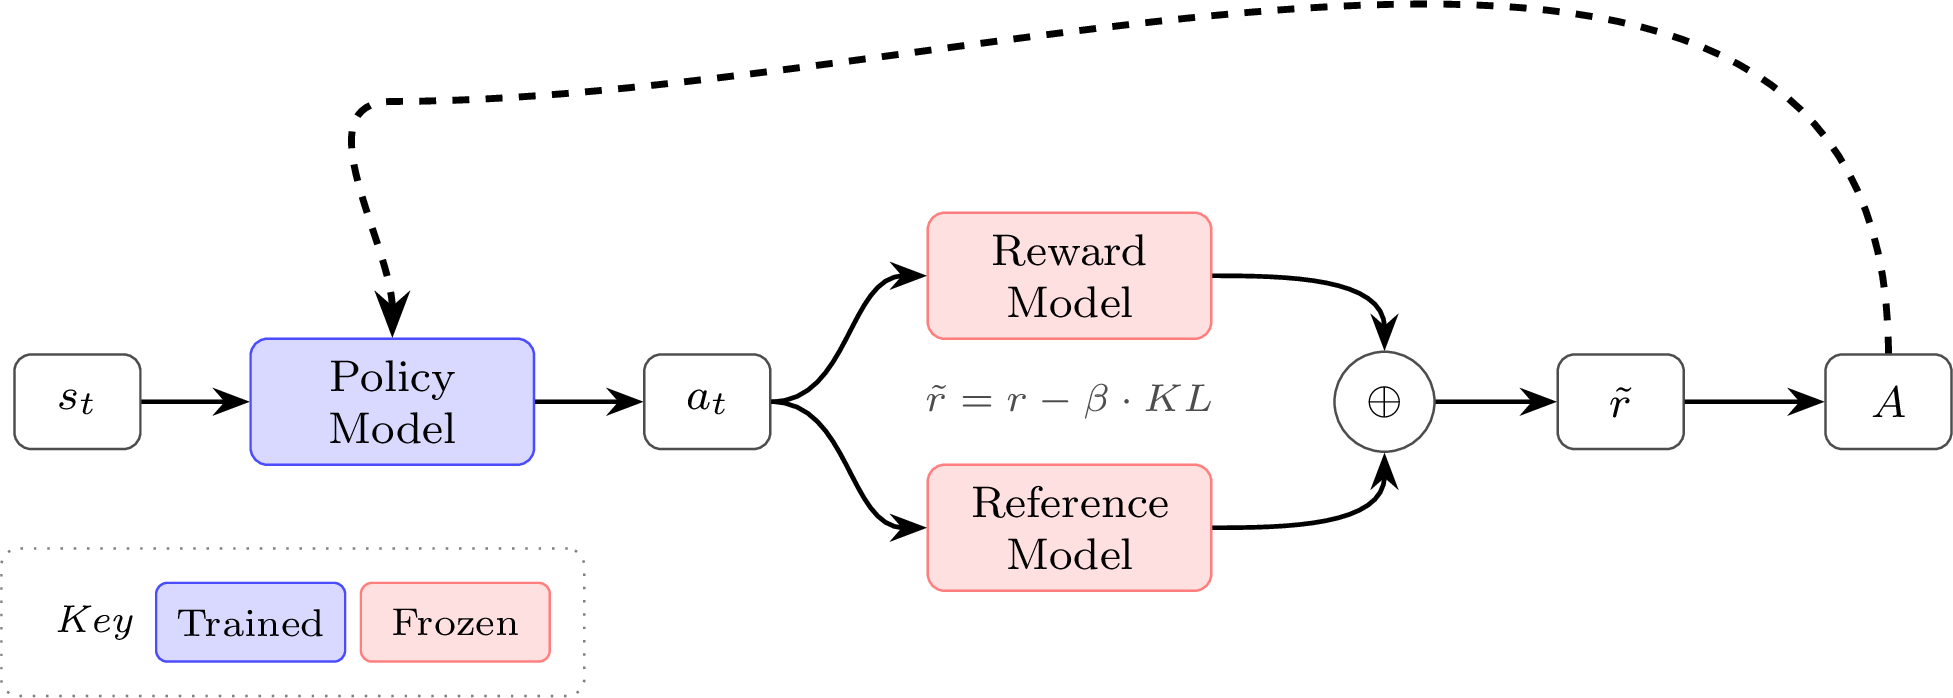
常用 baseline
REINFORCE 的 baseline 可以很土:
- batch 内平均奖励——最简单,也最常见;
- 最近若干步奖励的滑动平均——比 batch 均值稳,但引入延迟;
- 学出来的价值函数 $V_\phi(s)$——方差最低,但要多训一个模型,这一步跨过去就走向 actor-critic 和 PPO 了。
代码上,最朴素的 REINFORCE 只有四行:
# rewards:        (B,)  每条序列一个标量奖励
# seq_log_probs:  (B,)  completion token 的 log-prob 之和

baseline   = rewards.mean()           # 最简单的 batch 基线
advantages = rewards - baseline

loss = -(advantages * seq_log_probs).mean() # 负号:我们在最小化参考实现(_src/code/policy_gradients/loss.py 的 ReinforceLoss)是逐 token 版本,本质一样:
class ReinforceLoss(nn.Module):
    """经典策略梯度:-log(pi) * advantage"""
    def forward(self, log_probs, experience, **kwargs):
        loss = -(log_probs * experience.advantages)
        # 先在 token 维做掩码平均,再在 batch 维平均
        loss = masked_mean(loss, mask=experience.action_mask, dim=-1).mean(dim=0)
        return loss
注意 experience.advantages 的形状是 (B, 1)——整条 completion 共享一个优势值,广播到每个 token。这是所有「无价值函数」算法的共同特征,也是 bandit 视角的直接体现。
RLOO:把 baseline 变聪明
REINFORCE Leave-One-Out(留一法 REINFORCE,RLOO)只改了一件事:baseline 用同一个 prompt 下其他样本的平均奖励,而不是整个 batch 的平均。
给定同一 prompt $s$ 的 $K$ 条采样 $a_1,\dots,a_K$,第 $k$ 条的 baseline 定义为:
$$ b(s, a_k) = \frac{1}{K-1}\sum_{i=1,\, i\neq k}^{K} R(s, a_i) $$优势就是:
$$ A(s, a_k) = R(s, a_k) - b(s, a_k) $$等价的另一种写法(实现里更常用,因为可以向量化):
$$ A(s, a_k) = \frac{K}{K-1}\left(R(s, a_k) - \frac{1}{K}\sum_{i=1}^{K} R(s, a_i)\right) $$这两个「为什么要留一」的理由分别是:
- 无偏性:把自己的奖励排除在自己的 baseline 之外,baseline 就与被评估的动作严格独立,第 3 节那条无偏性证明才能原封不动地用上。
- per-prompt 而非 per-batch:这是更实际的收益。batch 里既有简单题也有难题,用全 batch 均值当 baseline,难题上的所有回复都会拿到负优势(哪怕其中有一条特别好),简单题上的所有回复都会拿到正优势。per-prompt baseline 天然捕获了题目难度。
一个手算例子
同一个 prompt 采 $K=4$ 条,奖励分别是 $[0.8, 0.3, 0.6, 0.5]$:
| completion | 奖励 | baseline(其余三条的均值) | 优势 |
|---|---|---|---|
| 1 | 0.8 | $(0.3+0.6+0.5)/3 = 0.467$ | $+0.333$ |
| 2 | 0.3 | $(0.8+0.6+0.5)/3 = 0.633$ | $-0.333$ |
| 3 | 0.6 | $(0.8+0.3+0.5)/3 = 0.533$ | $+0.067$ |
| 4 | 0.5 | $(0.8+0.3+0.6)/3 = 0.567$ | $-0.067$ |
最好的那条被强化,最差的被压制,中间两条几乎不动。注意优势之和恰好为 0——这是留一 baseline 的一个良好性质:组内是一场零和的相对竞争。这个直觉在 GRPO 那里会被推到极致。
代码(改写自 _src/code/policy_gradients/utils.py 的 compute_loo_advantages,等价于 TRL 的实现):
# rewards: (K, N) —— 每一列 j 是 prompt j 的 K 个奖励
#   注意布局:同一个 prompt 的 K 条 "兄弟" 必须挨在一起

baseline = (rewards.sum(dim=0, keepdim=True) - rewards) / (K - 1)
advantages = rewards - baseline

# 等价的紧凑写法(参考实现用的就是这个):
#   advantages = (K / (K - 1)) * (rewards - rewards.mean(dim=0, keepdim=True))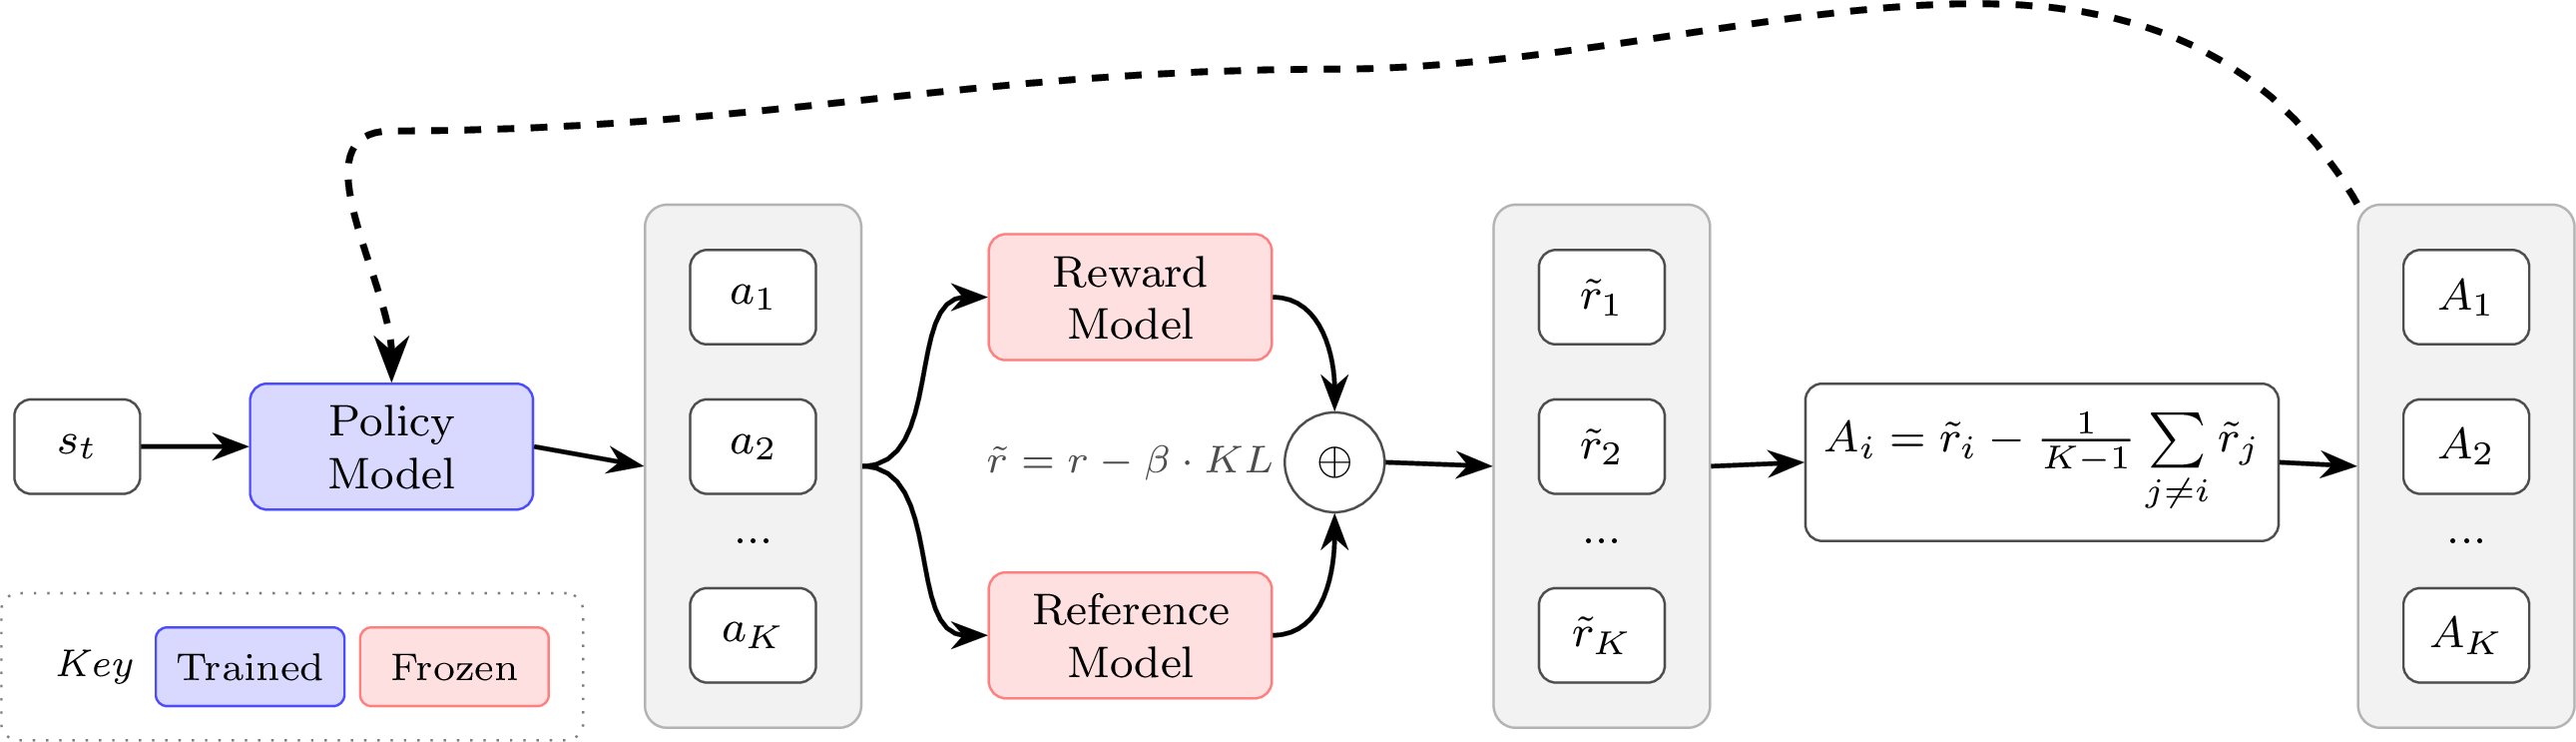
序列级优势 vs. token 级优势
RLOO 和其他不用价值网络的算法,都是把同一个序列级优势广播给每个 token。用价值网络的算法(PPO)则给每个 token 单独一个值,从 EOS 位置的最终奖励往前折算。
这也影响 KL 惩罚怎么进入计算,三种做法都存在:
| 算法 | KL 怎么进来 | 后果 |
|---|---|---|
| RLOO | 把逐 token KL 聚合成一个标量,折进序列奖励 | 优势仍是序列级,广播到全部 token |
| PPO | 逐 token 从逐 token 奖励里减去 KL,再算 $A_t$ | token 级信用分配 |
| GRPO | 优势保持序列级,KL 作为独立的一项加进损失 | KL 和优势估计互不干扰 |
参考实现的默认 config 里
beta: 0.0,正是这个判断的体现:在 spell_backward 这种可验证任务上,KL 默认是关的。
最后值得强调:RLOO 的优势估计完全可以和 PPO 的裁剪拼在一起用。这些算法之间的边界远比论文标题让人以为的模糊——真正的设计空间是「优势怎么估」×「更新怎么约束」这两个正交的维度。
5. PPO:重要性采样比与 clip 的几何
REINFORCE 那么简单,为什么还要 PPO
本章所有算法都是 on-policy 的:每批都用当前策略现采 rollout,更新完就扔掉(对比之下 DQN 这类 off-policy 方法会把老经验存进 replay buffer 反复用)。这意味着 rollout 是昂贵且一次性的——生成几千条长回复的成本,往往远超那几次梯度步本身。
于是有两个诉求:
- 一批数据想多榨几次梯度。但走完第一步之后,数据就不再是当前策略产生的了,估计变得有偏。
- 步长必须被约束住。朴素策略梯度对步长极其敏感:太大策略直接崩,太小训练慢到不可接受。
TRPO(Trust Region Policy Optimization,信任域策略优化)用一个硬性的 KL 约束解决了第二点,但代价是要做二阶优化,工程上很重。PPO 的全部贡献就是:用一个裁剪过的目标函数,拿到 TRPO 级别的稳定性,同时保持一阶优化的简洁;而因为更新被限制得足够保守,第一点也顺带解决了——你可以安全地在同一批数据上走好几步。
重要性采样:为什么会冒出一个比值
重要性采样的基本恒等式是:
$$ \E_{p}[f(x)] = \E_{q}\left[f(x)\,\frac{p(x)}{q(x)}\right] $$其中 $p$ 是目标分布,$q$ 是实际采样的分布,$p(x)/q(x)$ 是重要性权重。在策略梯度里,$p = \pi_\theta$ 是当前要优化的策略,$q = \pi_{\theta_{\text{old}}}$ 是产生这批数据的策略。于是定义策略比值:
$$ \rho_t(\theta) = \frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)} $$读法很直白:$\rho_t = 1$ 表示新旧策略对这个 token 的看法一致;$\rho_t > 1$ 表示新策略更愿意生成它;$\rho_t < 1$ 表示更不愿意。对任意一批数据,第一次梯度步时 $\rho_t$ 恒等于 1(因为 $\pi_\theta$ 此刻就是 $\pi_{\theta_{\text{old}}}$),之后才开始偏离。
把它插进优势形式的策略梯度,得到代理目标(surrogate objective):
$$ J(\theta) = \E_t\big[\rho_t(\theta)\, \hat A_t\big] $$实现上永远是从 log-prob 之差取指数来算比值——直接相除会在概率极小时数值爆炸:
ratio = torch.exp(new_per_token_logps - old_per_token_logps) # (B, L)裁剪:PPO 的核心
不加约束地最大化上面那个代理目标,会出问题:$\rho_t$ 可以跑到离 1 任意远的地方,而重要性采样的估计只在两个分布接近时才可靠。PPO 的做法是把比值裁到 $[1-\varepsilon, 1+\varepsilon]$:
$$ J(\theta) = \E_t\left[\min\Big(\rho_t(\theta) A_t,\ \text{clip}\big(\rho_t(\theta), 1-\varepsilon, 1+\varepsilon\big) A_t\Big)\right] $$$\varepsilon$ 典型取 0.1–0.2。逐 token 展开就是实践中真正算的东西:
$$ J(\theta) = \frac{1}{|a|}\sum_{t=0}^{|a|} \min\left(\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)} A_t,\ \text{clip}\left(\frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)}, 1-\varepsilon, 1+\varepsilon\right) A_t\right) $$这里前面那个 $\frac{1}{|a|}$ 是实现惯例,不是推导出来的——它就是第 9 节要讲的「损失聚合」问题的源头,Dr. GRPO 那篇论文专门指出过这一点。
clip 的几何:六种情况
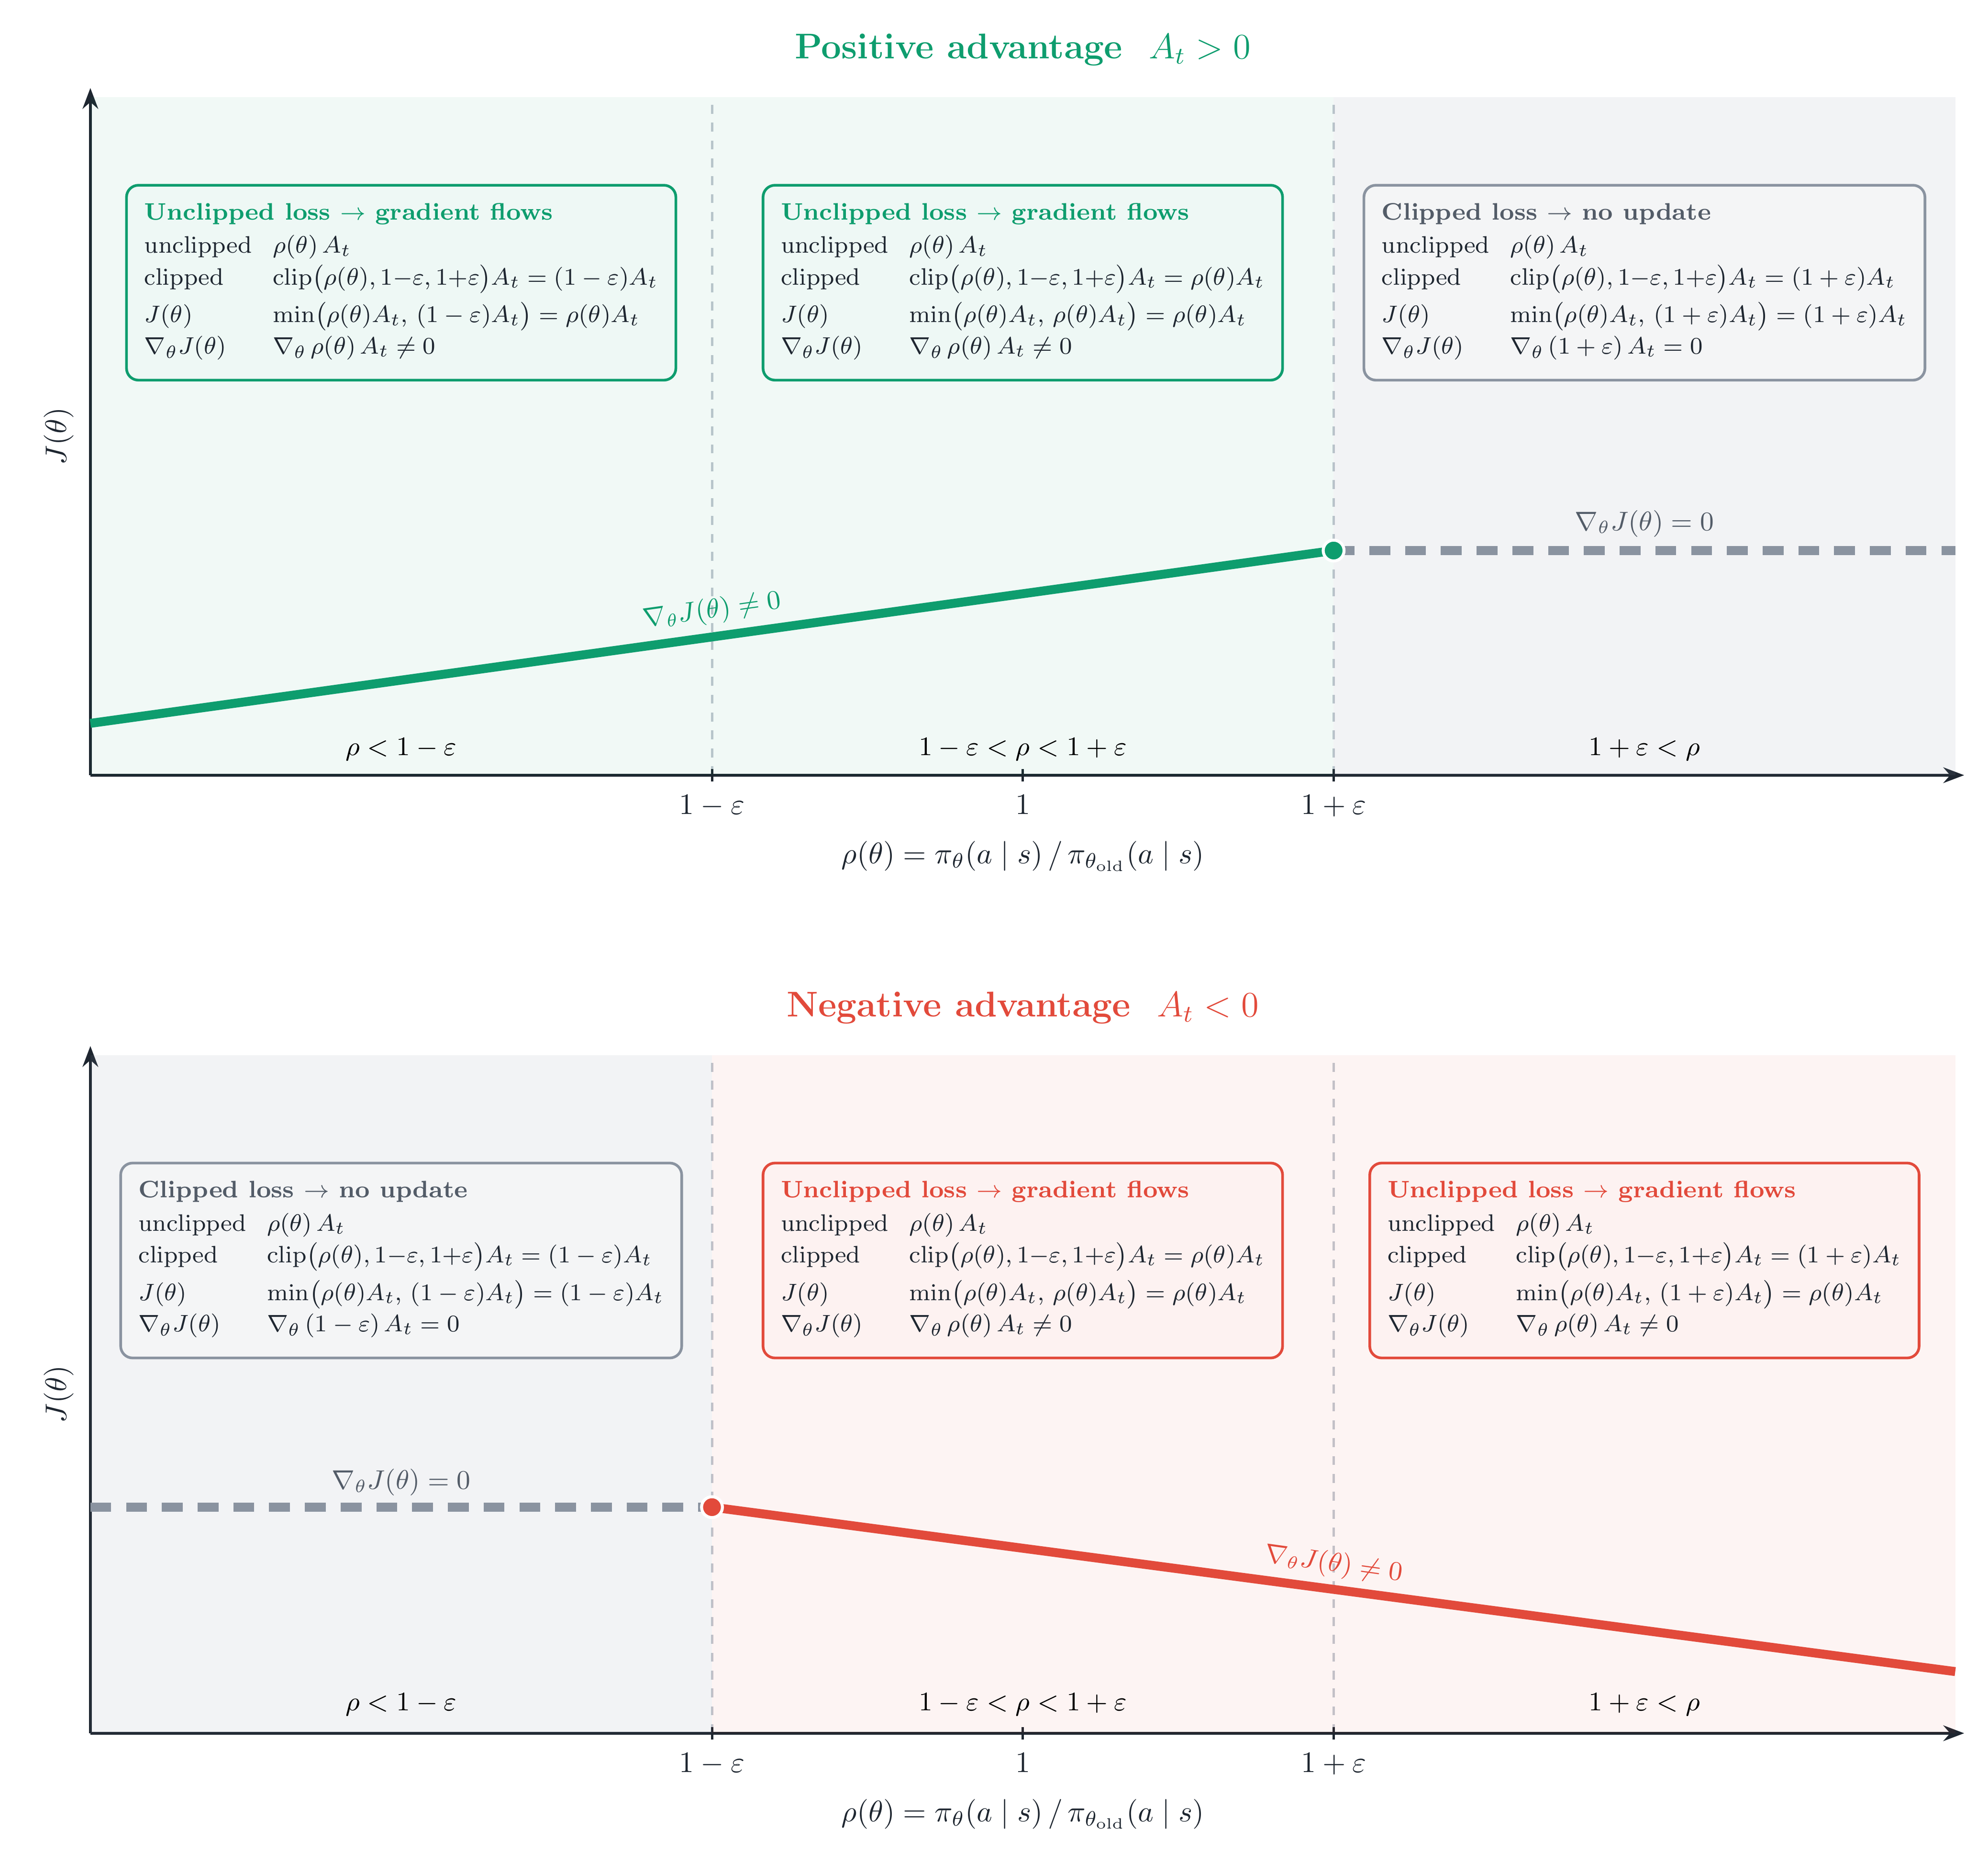
把 $\min$ 展开,按优势的符号和 $\rho$ 落在哪个区间,一共六种情况:
| 优势 | $\rho$ 区间 | 未裁项 | 裁剪项 | 目标取值 | 梯度 | 发生什么 |
|---|---|---|---|---|---|---|
| $A_t > 0$ | $\rho < 1-\varepsilon$ | $\rho A_t$ | $(1-\varepsilon)A_t$ | $\rho A_t$ | $\neq 0$ | 正常更新,提高概率 |
| $1-\varepsilon \le \rho \le 1+\varepsilon$ | $\rho A_t$ | $\rho A_t$ | $\rho A_t$ | $\neq 0$ | 正常更新,提高概率 | |
| $\rho > 1+\varepsilon$ | $\rho A_t$ | $(1+\varepsilon)A_t$ | $(1+\varepsilon)A_t$ | $= 0$ | 不更新(已经够了) | |
| $A_t < 0$ | $\rho < 1-\varepsilon$ | $\rho A_t$ | $(1-\varepsilon)A_t$ | $(1-\varepsilon)A_t$ | $= 0$ | 不更新(已经够了) |
| $1-\varepsilon \le \rho \le 1+\varepsilon$ | $\rho A_t$ | $\rho A_t$ | $\rho A_t$ | $\neq 0$ | 正常更新,降低概率 | |
| $\rho > 1+\varepsilon$ | $\rho A_t$ | $(1+\varepsilon)A_t$ | $\rho A_t$ | $\neq 0$ | 正常更新,降低概率 |
把这张表压成一句话:
· 正优势 + $\rho > 1+\varepsilon$:这个动作在新策略下已经明显更可能了,别再过度强化;
· 负优势 + $\rho < 1-\varepsilon$:这个动作在新策略下已经明显更不可能了,别再过度压制。
其余四种情况全部走普通策略梯度。裁剪从不阻止「纠错方向」的更新——如果一个坏动作反而变得更可能了(负优势 + $\rho > 1+\varepsilon$),PPO 会毫不留情地继续压它。这一点经常被误解成「PPO 双边限制更新」,其实是按优势符号单边生效的。
代码里的三行
PPO 的策略损失核心就三行(来自原书示例,与 loss.py 的 PPOLoss 一致):
pg_losses1 = -advantages * ratio                                   # (B*G, L)
pg_losses2 = -advantages * torch.clamp(ratio, 1.0 - eps, 1.0 + eps)
pg_loss_max = torch.max(pg_losses1, pg_losses2)                    # 注意是 max
pg_losses1 是普通的优势加权策略梯度损失;pg_losses2 是同样的公式但比值被夹住。关键在 torch.max:因为损失前面带负号,我们在最小化一个负目标,所以取 max 恰好等价于对目标取 min——也就是选那个更悲观、产生更小更新的分支。
参考实现里的完整版(_src/code/policy_gradients/loss.py)额外支持了非对称裁剪,为 DAPO 的 clip-higher 留了口子:
class PPOLoss(nn.Module):
    def forward(self, log_probs, experience, values, **kwargs):
        # ---- 价值损失(带裁剪)----
        returns = experience.advantages + experience.values_old   # G_t = A_t + V(s_t)
        values_clipped = torch.clamp(values,
                                     experience.values_old - self.clip_eps_val,
                                     experience.values_old + self.clip_eps_val)
        val_loss = torch.max(0.5 * (returns - values) ** 2,
                             0.5 * (returns - values_clipped) ** 2)

        # ---- 策略损失(带裁剪)----
        policy_ratio = (log_probs - experience.log_probs_old).exp()
        policy_loss = -torch.min(
            policy_ratio * experience.advantages,
            policy_ratio.clamp(1 - self.clip_eps_lo, 1 + self.clip_eps_hi) * experience.advantages,
        )

        loss = policy_loss + self.vf_coef * val_loss
return masked_mean(loss, mask=experience.action_mask, dim=-1).mean(dim=0)注意价值函数也有自己的裁剪(clip_eps_val,参考 config 里取 0.4),逻辑和策略裁剪一样:不让 critic 在一次更新里跳离 rollout 时的预测太远。这一项容易被忽略,但在 critic 冷启动阶段挺重要。
什么时候裁剪才会真的生效
这是一个实践上极容易搞错的点。裁剪只有在 $\pi_\theta$ 已经偏离 $\pi_{\theta_{\text{old}}}$ 时才可能触发,而造成偏离的原因有两个:
- minibatching:把一个 rollout batch 切成多个 minibatch,在第一个 minibatch 上更新完之后,$\pi_\theta$ 就变了——所以同一个 epoch 内后面的 minibatch 已经看到 $\rho_t \neq 1$。即使 $K=1$,裁剪也可能生效。
- 多轮 epoch:在同一批数据上循环 $K$ 次。典型 $K = 2$–$4$;超过 6 左右策略就太 off-policy 了。
而如果 $K = 1$ 且不做 minibatching,那么 $\pi_\theta \equiv \pi_{\theta_{\text{old}}}$,比值恒为 1,裁剪永远不会触发,PPO 退化成带 GAE 的朴素策略梯度。这不是理论玩笑:原书明确指出,语言模型上的 PPO/GRPO 常常就是每批只走一步,于是 PPO 自带的正则化根本没起作用,真正在起作用的是 KL 惩罚。
形式化地说,当每批只走一步时($[\cdot]_\nabla$ 表示 stop-gradient):
$$ J(\theta) = \frac{1}{G}\sum_{i=1}^G \left(\frac{\pi_\theta(a_i\mid s)}{\big[\pi_\theta(a_i\mid s)\big]_\nabla} A_i - \beta\, \KL(\pi_\theta \| \pi_{\text{ref}})\right) $$比值在数值上恒为 1,但它的梯度不为零(分母被 detach 了),所以这个写法仍然给出正确的策略梯度——只是 clip 和 min 那套逻辑可以整段删掉。这让实现优雅很多。
「所以 PPO(有内部步长正则)和 REINFORCE(简单,在某些超参下 PPO 就退化成它)之间的差别,对微调语言模型来说,意义远小于从零训练 agent。」
但也别一刀切:DAPO 每批走 16 次梯度步,Tülu 3 在 8B/70B 上用 4 次、到 405B 时降回 1 次以保持稳定。批内梯度步数是一个真实的调参维度,监控 clip fraction 就能知道它有没有在起作用。
6. 价值函数与 GAE:把一个标量摊到每个 token 上
价值函数在 PPO 里干什么
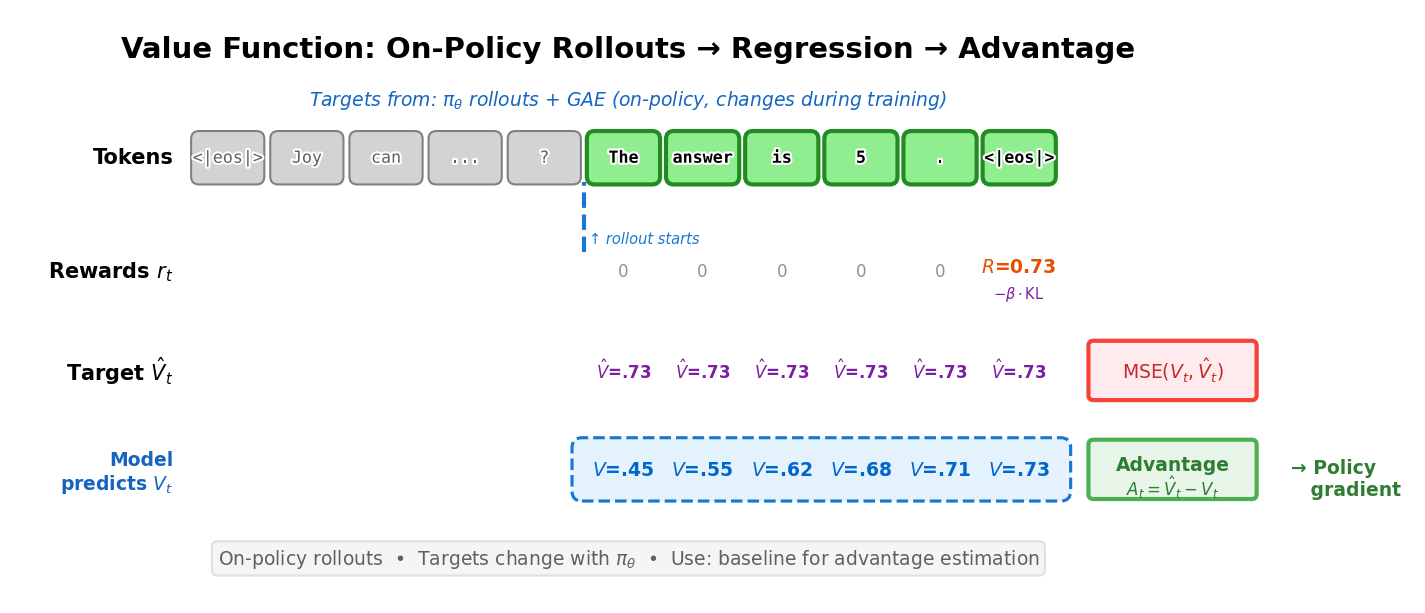
PPO 的价值函数 $V_\phi$ 是模型的另一份副本(通常是同架构、换一个输出维度为 1 的头),预测每个 token 位置的未来回报。它是 REINFORCE 那个简单蒙特卡洛 baseline 的进化版:从「一个标量」变成「一个随位置变化的学出来的函数」。
在 RLHF 里,它预测的是扣掉 KL 惩罚之后的未来回报——因为传统实现里 KL 是折进逐 token 奖励的。
从一个序列级标量到逐 token 奖励
奖励模型只给整条 completion 一个分数 $R(x,y)$。PPO 需要的却是逐 token 的奖励序列。桥梁是 KL 塑形:
$$ r_t = \begin{cases} R(x,y) - \beta\,\text{KL}_t & t = T\ \text{(最后一个 token)} \\ -\beta\,\text{KL}_t & \text{其他位置} \end{cases} \qquad \text{KL}_t = \log \pi_\theta(a_t\mid s_t) - \log \pi_{\text{ref}}(a_t\mid s_t) $$也就是说:中间每个 token 只承担自己的 KL 代价,最终得分只打在结尾那一个位置上。然后 GAE 把这些逐 token 奖励沿序列反向传播,变成逐 token 的优势。
[:, -1]
这是最经典的静默 bug 之一。batch 里各条序列长度不同,右侧全是 padding。写 rewards[:, -1] = rm_score 会把奖励打到 padding 上,而 padding 被 mask 掉了——于是奖励信号整个消失,训练照跑不误,就是不学东西。正确写法是先算出每条序列最后一个有效 action 的下标,再 scatter_ 进去:
last_idx = completion_mask.long().cumsum(-1).argmax(-1, keepdim=True)
rewards = torch.zeros_like(values).scatter_(-1, index=last_idx, src=rm_score)max_new_tokens 砍掉)的回复送去打分,会让奖励模型进入分布外,给出不可预测的分数。标准解法是只在 eos_token 存在时才计分,否则给一个长度惩罚。
n 步优势估计的偏差-方差谱
有了逐 token 奖励和价值预测,优势可以有很多种估法。先定义 $n$ 步优势估计:
$$ \hat A_t^{(n)} = \begin{cases} r_t + \gamma V(s_{t+1}) - V(s_t), & n = 1 \\ r_t + \gamma r_{t+1} + \gamma^2 V(s_{t+2}) - V(s_t), & n = 2 \\ \ \ \vdots \\ r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \cdots - V(s_t), & n = \infty \end{cases} $$这是一条清晰的谱:
- $n$ 小:更多依赖学出来的 $V$ → 方差低,偏差高($V$ 不准的话,误差直接进优势);
- $n$ 大:更多依赖真实采到的奖励 → 方差高,偏差低($n=\infty$ 就是蒙特卡洛,无偏但最抖)。
GAE 不选某一个特定的 $n$,而是对所有 $n$ 做指数加权平均。
先定义 TD 残差:
$$ \delta_t^V = r_t + \gamma V(s_{t+1}) - V(s_t) $$注意 $\hat A_t^{(n)} = \sum_{l=0}^{n-1}\gamma^l \delta_{t+l}^V$(中间的 $V$ 项会望远镜式抵消)。引入混合参数 $\lambda$,对各阶估计做几何加权:
$$ \begin{aligned} \hat A_t^{\text{GAE}(\gamma,\lambda)} &= (1-\lambda)\left(\hat A_t^{(1)} + \lambda \hat A_t^{(2)} + \lambda^2 \hat A_t^{(3)} + \cdots\right) \\ &= (1-\lambda)\Big(\delta_t^V + \lambda(\delta_t^V + \gamma\delta_{t+1}^V) + \lambda^2(\delta_t^V + \gamma\delta_{t+1}^V + \gamma^2\delta_{t+2}^V) + \cdots\Big) \\ &= (1-\lambda)\Big(\delta_t^V(1 + \lambda + \lambda^2 + \cdots) + \gamma\delta_{t+1}^V(\lambda + \lambda^2 + \cdots) + \cdots\Big) \\ &= (1-\lambda)\left(\delta_t^V\frac{1}{1-\lambda} + \gamma\delta_{t+1}^V\frac{\lambda}{1-\lambda} + \gamma^2\delta_{t+2}^V\frac{\lambda^2}{1-\lambda} + \cdots\right) \\ &= \sum_{l=0}^{\infty} (\gamma\lambda)^l\, \delta_{t+l}^V \end{aligned} $$第三行是把同一个 $\delta$ 的所有系数收集到一起,第四行用等比级数求和。前面那个 $(1-\lambda)$ 就是为了让权重归一化,最后被约掉。
结果非常漂亮:GAE 就是把 TD 残差按 $(\gamma\lambda)^l$ 指数衰减地往前累加。
| $\lambda$ | 行为 | 方差 | 偏差 |
|---|---|---|---|
| 0 | 纯 TD(1 步) | 最低 | 最高 |
| 0.95 | LLM 微调的常用默认值 | 平衡 | 平衡 |
| 1 | 蒙特卡洛优势 $G_t - V(s_t)$ | 最高 | 无 |
参考实现的 ppo.yaml 用的是 $\lambda = 0.98$,$\gamma = 1.0$。要提醒的是,上表的排序假设 $V_\phi$ 是准的——一个训坏的 critic 会让低 $\lambda$ 的估计变得完全不可靠,这时候反而是大 $\lambda$(更依赖真实奖励)更安全。
GAE 伪代码逐行讲
# GAE(token 级),用于 LM RLHF
#
# 输入:
#   rewards:   (B, L)  扣完 KL 的逐 token 奖励
#   values:    (B, L)  当前的 V_theta(s_t)
#   done_mask: (B, L)  终止位置(EOS 或被惩罚的截断)为 1.0,其余 0.0
#   gamma:     float,LM 上通常 1.0
#   lam:       float,[0,1] 之间,即公式里的 lambda
#   (终止位置之后的 padding 必须 rewards=0, values=0)

B, L = rewards.shape
advantages = torch.zeros_like(rewards)
next_v = torch.zeros(B, device=rewards.device, dtype=rewards.dtype)
gae    = torch.zeros(B, device=rewards.device, dtype=rewards.dtype)

for t in reversed(range(L)):                       # 必须倒着走
    not_done = 1.0 - done_mask[:, t]
    delta = rewards[:, t] + gamma * not_done * next_v - values[:, t]   # TD 残差
    gae   = delta + gamma * lam * not_done * gae                       # 指数累加
    advantages[:, t] = gae
    next_v = values[:, t]                          # 为下一次迭代(即 t-1)准备 V(s_{t+1})

targets    = advantages + values      # 价值回归的目标 y_t
advantages = advantages.detach()      # 给策略损失用,必须 detach
逐行读:
for t in reversed(...):必须倒序,因为 $\hat A_t$ 依赖 $\hat A_{t+1}$。递推关系是 $\hat A_t = \delta_t + \gamma\lambda\,\hat A_{t+1}$,这正好是上面封闭形式的递归展开。not_done:在终止 token 处为 0,起两个作用。一是不从「未来状态」自举(那里没有未来了),二是把 GAE 累加器清零。因为循环是倒着走的,终止 token 会干净地切断指数累加——这让这段实现天然是 packing 友好的:多条序列拼在一行里也能正确处理。next_v = values[:, t]:每轮结束时把当前的 $V(s_t)$ 存下来,下一轮($t-1$)就用它当 $V(s_{t+1})$。targets = advantages + values:这一步的推导是 $\hat A_t = \hat G_t - V(s_t) \Rightarrow \hat G_t = \hat A_t + V(s_t)$。GAE 给出的优势加回当前价值,就是一个比 critic 自己当前预测更好的回报估计,拿它当回归目标。.detach():优势必须切断梯度,否则策略更新会反传进价值网络,两个损失互相污染。
价值函数损失
不用 GAE 的最简单版本(蒙特卡洛回报 + PPO 式价值裁剪)长这样:
# 1) 逐 token 的蒙特卡洛回报(在终止处重置)
returns = torch.zeros_like(rewards)
running = torch.zeros(B, device=rewards.device, dtype=rewards.dtype)
for t in reversed(range(L)):
    running = rewards[:, t] + gamma * (1.0 - done_mask[:, t]) * running
    returns[:, t] = running
targets = returns                      # y_t = G_t(已扣 KL)

# 2) PPO 式的价值裁剪(可选但常见)
v_clip = torch.clamp(values, old_values - epsilon_v, old_values + epsilon_v)
vf_loss_tok = torch.max(0.5 * (values - targets) ** 2,
                        0.5 * (v_clip  - targets) ** 2)

# 3) 掩码后聚合
denom = completion_mask.sum(dim=1).clamp_min(1)
value_loss = ((vf_loss_tok * completion_mask).sum(dim=1) / denom).mean()

# 4) 给策略损失用的优势:A_t = G_t - V(s_t)
advantages = (targets - values).detach()

# 最终:total_loss = policy_loss + vf_coef * value_loss
vf_coef 典型取 0.5–1.0。.clamp_min(1) 这类除法保护不是可选项——遇到一条立刻输出 EOS 的空 completion,分母为 0 会直接产生 NaN,然后污染整个 batch。
价值函数怎么初始化:一个真实的坑
价值网络必须从一开始就给出大致合理的估计,否则 GAE 算出的优势全是噪声,早期训练会一片混乱。三种做法:
| 初始化方式 | 说明 | 代价 |
|---|---|---|
| 从奖励模型初始化 | InstructGPT 立下的标准,Tülu 3 的 RLVR 沿用。RM 本来就学过「什么回复得高分」,价值预测一上来就接近真实奖励尺度 | 要求 RM 和策略架构兼容 |
| 从 SFT 模型 + 随机价值头 | 更省事,也是参考实现的做法(val_model.lm_head 换成一个输出维度 1 的 Linear) | 早期不稳定 |
| 完全随机初始化的 LM | 可行但少见 | 收敛慢很多 |
另一个常见工程手段是 value function warmup:先在已有奖励标注的数据上只训 critic 若干步,等它稳定了再开始走策略梯度。这个技巧在论文里几乎没人写,但在实际代码库里很常见。
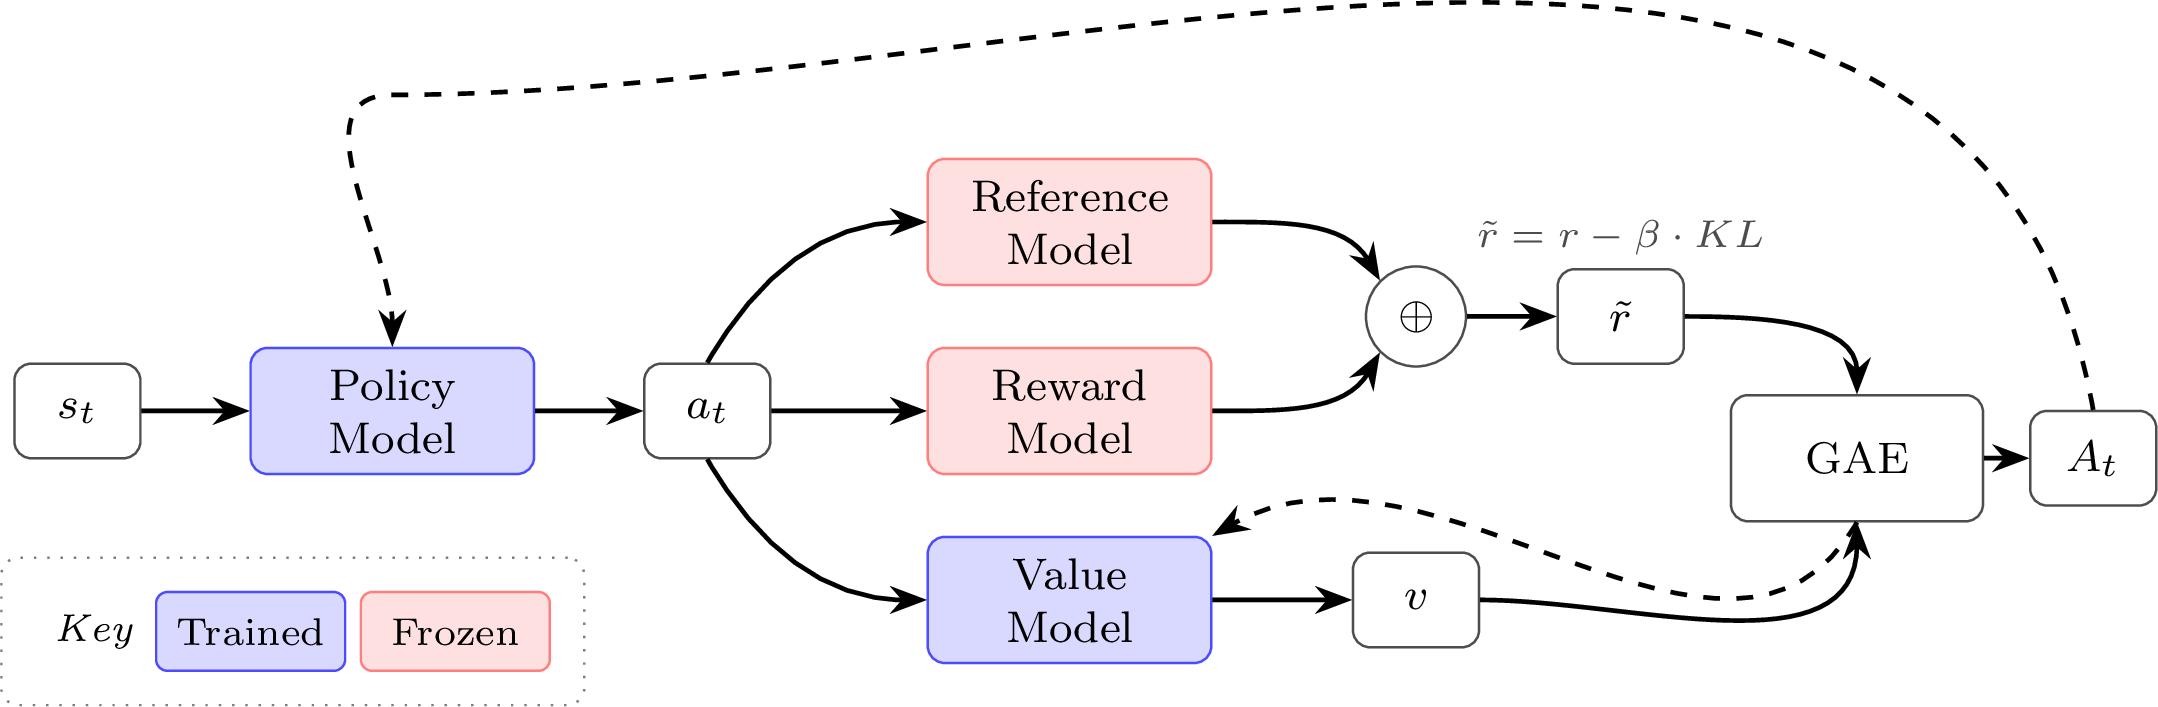
代价是:四个模型进显存、价值函数初始化很脆、超参数多。作者同时提醒了一个历史事实——在 2010 年代末到 2020 年代初,PPO 是被理解得最透彻、开发得最完善的 RL 算法,在语言模型以外的任务上远优于 REINFORCE。换句话说,GRPO 那一派的简化能成立,靠的是语言模型这个场景的特殊性(同 prompt 多采样便宜、转移确定、episode 短),而不是「PPO 本来就没用」。
7. GRPO:用一组同门师兄弟替代价值模型
核心想法
Group Relative Policy Optimization(组相对策略优化,GRPO)出自 DeepSeekMath,后来被 DeepSeek-V3 和 DeepSeek-R1 用到了台面上,如今是语言模型 RL 的默认选择。它保留 PPO 的裁剪目标,但整个价值函数被扔掉了。
动机很实在,两条:
- 规避「用 LM 骨干学价值函数」这个没人真正搞定的问题。研究界对此还没有确立最佳实践——上一节讲的初始化、warmup、裁剪全是经验性的补丁。
- 省显存。从「策略 + 参考 + 价值」三份权重降到两份(关掉 KL 的话只剩一份)。
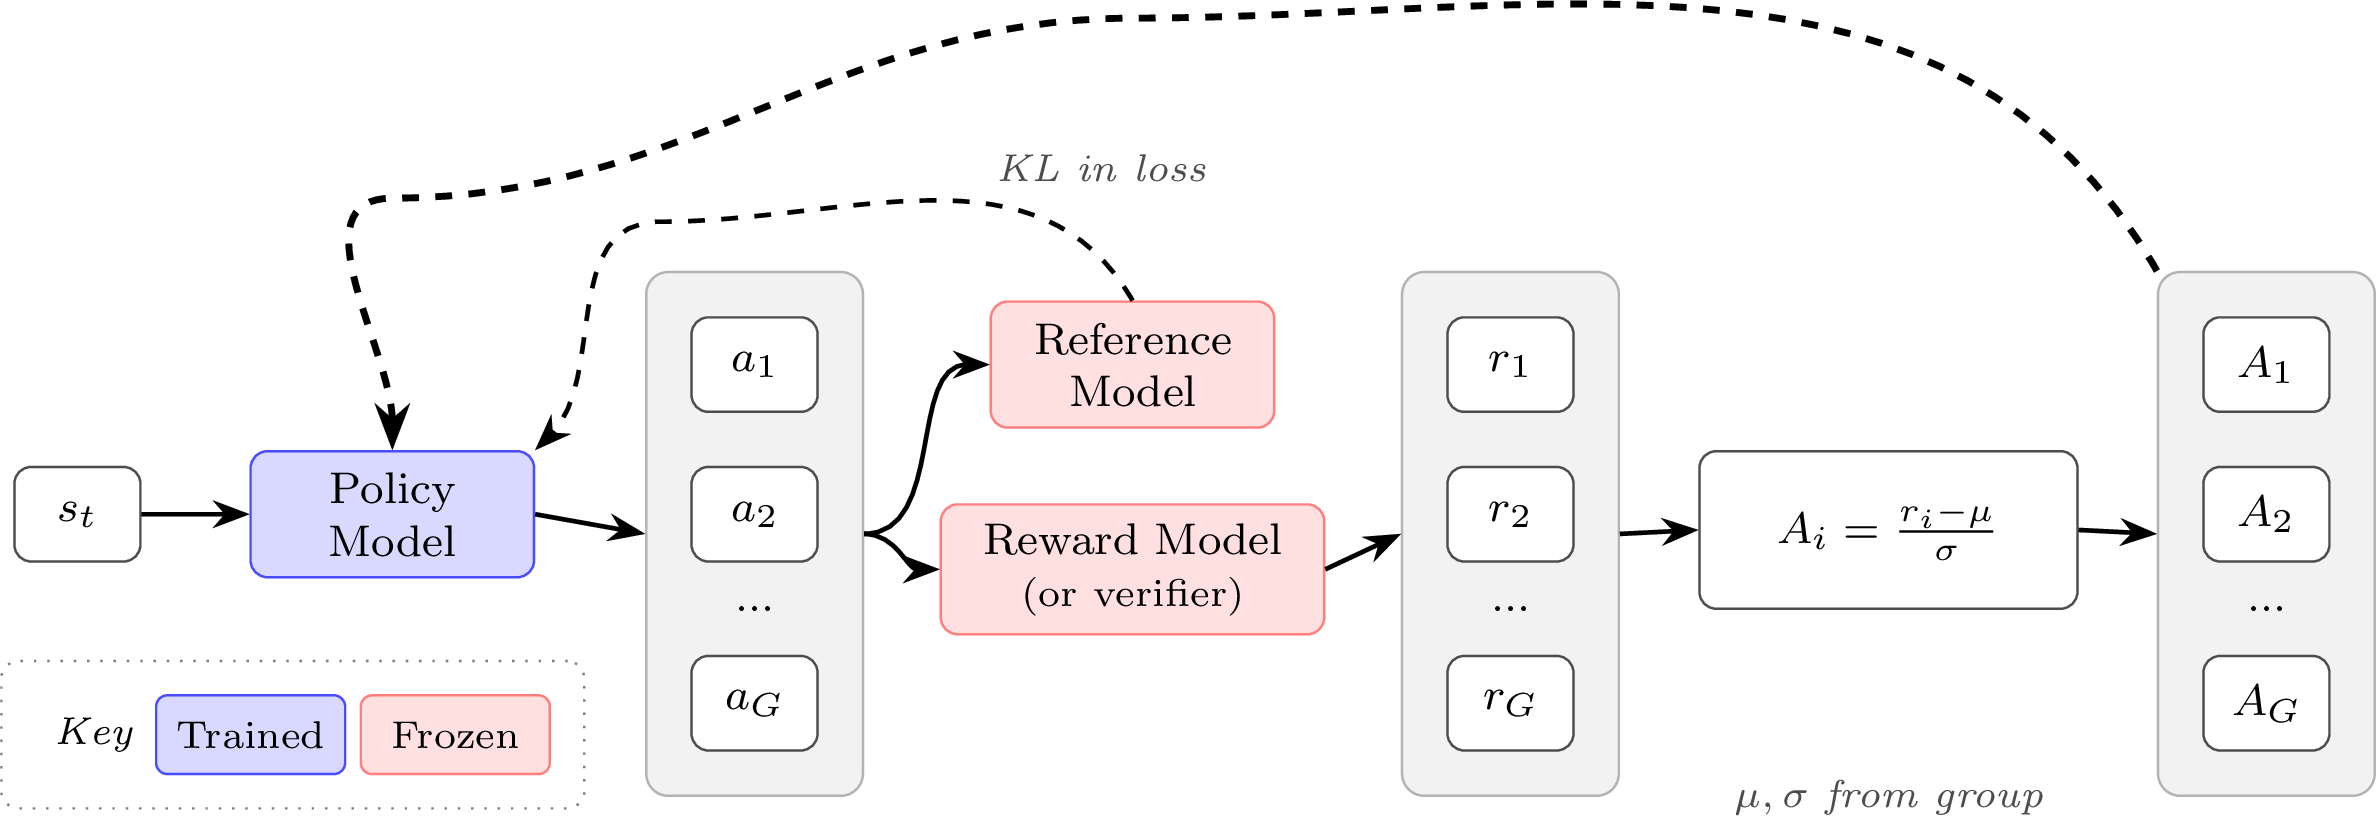
替代方案是回到蒙特卡洛:对同一个 prompt $s$ 采 $G$ 条 completion $\{a_1,\dots,a_G\}$,拿到奖励 $\{r_1,\dots,r_G\}$,用这组奖励的统计量当 baseline。
$$ A_i = \frac{r_i - \text{mean}(r_1, r_2, \cdots, r_G)}{\text{std}(r_1, r_2, \cdots, r_G)} $$这是一个组内 z-score:高于平均的 completion 拿正优势,低于平均的拿负优势。completion $i$ 里的每个 token 都拿到同一个 $A_i$(序列级优势),但重要性比值仍然是逐 token 的。
目标函数
$$ J(\theta) = \frac{1}{G}\sum_{i=1}^G \left(\min\left(\frac{\pi_\theta(a_i\mid s)}{\pi_{\theta_{\text{old}}}(a_i\mid s)}A_i,\ \text{clip}\left(\frac{\pi_\theta(a_i\mid s)}{\pi_{\theta_{\text{old}}}(a_i\mid s)}, 1-\varepsilon, 1+\varepsilon\right)A_i\right) - \beta\, \mathcal{D}_{\text{KL}}(\pi_\theta \| \pi_{\text{ref}})\right) $$展开成逐 token 形式:
$$ \begin{aligned} J(\theta) = \frac{1}{G}\sum_{i=1}^G \frac{1}{|a_i|}\sum_{t=1}^{|a_i|} \Bigg( &\min\!\left(\frac{\pi_\theta(a_{i,t}\mid s_i)}{\pi_{\theta_{\text{old}}}(a_{i,t}\mid s_i)}A_{i,t},\ \text{clip}\left(\frac{\pi_\theta(a_{i,t}\mid s_i)}{\pi_{\theta_{\text{old}}}(a_{i,t}\mid s_i)}, 1-\varepsilon, 1+\varepsilon\right)A_{i,t}\right) \\ &- \beta\, \mathcal{D}_{\text{KL}}\!\left(\pi_\theta(\cdot\mid s_i)\|\pi_{\text{ref}}(\cdot\mid s_i)\right)\Bigg) \end{aligned} $$和 PPO 相比,形式上就两处不同:优势的算法,以及 KL 出现在损失里而不是奖励里:
$$ L = L_{\text{policy gradient}} + \beta \cdot \mathcal{D}_{\text{KL}} $$而 PPO 传统上是 $r = r_\theta - \beta\,\mathcal{D}_{\text{KL}}$。这个位置差异的实际后果是:GRPO 里 KL 不参与优势估计,两者互不干扰;PPO 里 KL 先进奖励、再经 GAE 传播,会影响每个 token 的优势值。
直觉:一场组内的相对竞赛
GRPO 的更新在做的事情,说人话就是:对同一道题给出的多个答案互相比较,让模型更像被判对的那些,更不像其他的。
这带来一个和 PPO 很不一样的采样哲学。PPO 和 vanilla policy gradient 的设计目标是准确估计每条 completion 的绝对回报——在某些情况下,多采几条对价值估计几乎没有帮助。而 GRPO 的优势完全关于「相对于同门师兄弟的价值」,所以每个 prompt 采的样本数通常远高于 PPO 时代(8、16、甚至 64 条)。
更重要的是,这套机制特别贴合语言模型这个工具的形状:从同一个 prompt 生成多条回复几乎是免费的(prompt 的 KV cache 可以共享,推理引擎天然支持 $n>1$)。而在机器人任务里,让环境精确回到同一个状态再试一次,是一件非常昂贵甚至不可能的事。GRPO 的成功很大程度上是「算法形状匹配了硬件和任务形状」的结果。
std 归一化引入的偏置
这是本节最值得推敲的地方。除以组内标准差不是一个无偏的 baseline 操作,它改变了不同 prompt 对总梯度的相对权重。
假设二元奖励(对 = 1,错 = 0),$G = 8$:
- Prompt A(几乎全对):7 对 1 错。$\mu = 0.875$,$\sigma \approx 0.331$。那条错的优势是 $(0-0.875)/0.331 \approx -2.64$。
- Prompt B(一半一半):4 对 4 错。$\mu = 0.5$,$\sigma = 0.5$。对的优势 $= +1.0$,错的 $= -1.0$。
- Prompt C(只有一条对):1 对 7 错。$\mu = 0.125$,$\sigma \approx 0.331$。那条对的优势是 $(1-0.125)/0.331 \approx +2.64$。
可以看到:方差低的组(A 和 C)被放大了 2.6 倍,方差高的组(B)被压到 1.0。而 A、C 这种「几乎全对」或「几乎全错」的题,恰恰是学习信号最稀薄的——A 说明题太简单,C 说明题太难。GRPO 却给了它们最大的梯度权重。
Liu 等人的 Understanding R1-Zero-Like Training 因此提出去掉 std 项,这就是 Dr. GRPO(GRPO Done Right):
$$ \tilde A_i = r_i - \text{mean}(r_1, \cdots, r_G) = r_i - \frac{1}{G}\sum_{j=1}^G r_j $$但原书特意补了一句权衡:去掉 std 也会把「全错里蹦出一条对」的那种情况的权重压下去,而那可能恰恰是最宝贵的学习信号——高方差的 prompt 往往正是最难的样本,只有少数几条采样找到了正确路径。所以这不是一个「Dr. GRPO 就是对的」的简单结论,而是一个真实的取舍。
Dr. GRPO 与 RLOO 的等价性
去掉 std 之后,Dr. GRPO 的优势和 RLOO 的优势只差一个常数因子。
第三行把 $j=i$ 那一项从求和里单独拆出来,第四行合并 $r_i$ 的系数得到 $\frac{G-1}{G-1}=1$。
因为实现里通常还会做 advantage 白化(把优势归一化到零均值单位方差),这个常数因子在实践中根本不影响任何东西。所以结论是:Dr. GRPO 的优势估计 $\equiv$ RLOO 的优势估计。两篇隔了七八年的论文,在去掉包装之后是同一个式子。这是本章最能说明「算法家族其实很窄」的一个例子。
反过来看这条等价性还有另一层意义:Dr. GRPO 去掉 std 之后优势的数值尺度变大了(不再被小 $\sigma$ 放大,但也不再被大 $\sigma$ 缩小),这等价于对答案分数有方差的样本调高了学习率。
代码
GRPO 的完整实现只是 PPO 减掉价值部分、换掉优势计算:
# B: batch(prompt 数), L: 序列长, G: 每个 prompt 的 completion 数

# 组内统计
mean_grouped = rewards.view(-1, G).mean(dim=1)
std_grouped  = rewards.view(-1, G).std(dim=1)
mean_grouped = mean_grouped.repeat_interleave(G, dim=0)   # (B*G,)
std_grouped  = std_grouped.repeat_interleave(G, dim=0)

advantages = ((rewards - mean_grouped) / (std_grouped + 1e-4)).unsqueeze(1)  # (B*G, 1)

# 重要性比值(逐 token)
ratio = torch.exp(new_per_token_logps - per_token_logps)   # (B*G, L)

# PPO 式裁剪目标
eps = 0.2
pg_losses1  = -advantages * ratio
pg_losses2  = -advantages * torch.clamp(ratio, 1.0 - eps, 1.0 + eps)
pg_loss_max = torch.max(pg_losses1, pg_losses2)

# GRPO 特有:KL 加在损失里(PPO 传统上加在奖励里)
per_token_loss = pg_loss_max + beta * per_token_kl

loss = ((per_token_loss * completion_mask).sum(dim=1) / completion_mask.sum(dim=1)).mean()
注意 advantages 的形状是 (B*G, 1),靠广播乘到 (B*G, L) 的 ratio 上——这一行就是「序列级优势 + token 级比值」的字面实现。
参考实现(_src/code/policy_gradients/loss.py)把它写成一个模块,并且用 clip_eps_lo / clip_eps_hi 分开两侧的裁剪边界:
class GRPOLoss(nn.Module):
    def forward(self, log_probs, experience, **kwargs):
        ratio = (log_probs - experience.log_probs_old).exp()
        unclipped_term = ratio * experience.advantages
        clipped_term = ratio.clamp(1 - self.clip_eps_lo,
                                   1 + self.clip_eps_hi) * experience.advantages
        policy_loss = -torch.min(unclipped_term, clipped_term)

        if self.beta:      # KL 可选,默认 config 里 beta=0
            kl_loss = get_approx_kl(self.kl_estimator, log_probs,
                                    experience.log_probs_ref, experience.action_mask)
        else:
            kl_loss = torch.tensor(0.0, device=log_probs.device)

        loss = policy_loss + self.beta * kl_loss
        return masked_mean(loss, mask=experience.action_mask, dim=-1).mean(dim=0)
而 Dr. GRPO 在这份代码里复用同一个 loss 类,只在优势计算处分叉——这本身就说明了两者的差别有多小:
# _src/code/policy_gradients/utils.py

def compute_standardized_advantages(rewards, eps=1e-8):      # GRPO / GSPO / CISPO / SAPO / DAPO
    return (rewards - rewards.mean(dim=0, keepdim=True)) / (rewards.std(dim=0, keepdim=True) + eps)

def compute_nonstandardized_advantages(rewards):             # Dr. GRPO
    return rewards - rewards.mean(dim=0, keepdim=True)

def compute_loo_advantages(rewards):                         # RLOO
    K = rewards.shape[0]
    return (K / (K - 1)) * (rewards - rewards.mean(dim=0, keepdim=True))
GRPO vs. PPO vs. RLOO
| PPO | GRPO | RLOO | |
|---|---|---|---|
| 价值函数 | 学出来的 $V_\phi$ | 无 | 无 |
| 优势 | 逐 token(GAE) | 序列级,组内 z-score | 序列级,留一均值 |
| 更新方式 | PPO 裁剪比值 | PPO 裁剪比值 | REINFORCE(不裁剪) |
| KL 位置 | 进奖励(算优势之前) | 进损失(默认,可选) | 可选,进奖励 |
| 显存中的模型数 | 4 | 3(无 KL 时 2) | 3(无 KL 时 2) |
| 典型场景 | 通用 RLHF | 推理 / RLVR | RLHF,简洁基线 |
最后补一句:GRPO 的优势估计也可以不配 PPO 的裁剪,直接套到 REINFORCE 上,只是这不是它的标准形式。同样,过程监督(process supervision)场景下 GRPO 的优势要改成「后续各推理步归一化奖励之和」,而不是上面这个单一标量。
8. 变体家族:GSPO / CISPO / DAPO / SAPO 各改了什么
GRPO 之后涌出一批变体。它们看上去缩写各异,但改动都集中在两个位置:重要性采样比在什么粒度上算,以及怎么约束它。把这两条轴认清,这一节就没有难点。
GSPO:把比值提到序列级
PPO 和 GRPO 在 token 级做重要性采样,并通过裁剪目标函数来稳定。这有一个微妙的失效模式:当某个 token 的比值跑出裁剪区间,这个 token 就拿到零梯度。对那些罕见但关键的 token——比如模型一开始给了很低概率的关键推理步——这种「丢 token」现象会阻止模型学会更可靠地产生它们。
更实际的问题是数值稳定性。长序列上逐 token 的比值会表现得非常不稳:单个比值很大的 token 就能主导整个更新,或者一条回复内部大量 token 各自独立地被裁掉,学习信号被打得七零八落。这在现代 MoE(Mixture-of-Experts,混合专家)这类大而稀疏的模型上尤其严重——同样的输入,路由到的专家稍有不同,logprob 就会有明显偏移。
Group Sequence Policy Optimization(组序列策略优化,GSPO)的做法是:每条回复只算一个重要性权重。回复概率本来就是自回归因子分解的:
$$ \pi_\theta(a\mid s) = \prod_{t=1}^{|a|}\pi_\theta(a_t\mid s, a_{<t}) $$直接用这个连乘的比值会因为长度而爆炸或塌缩($|a|$ 上千时,哪怕每个 token 只差 1%,整体也差了 $1.01^{1000}\approx 2\times10^4$ 倍)。所以 GSPO 用几何平均做长度归一化:
$$ \rho_i(\theta) = \left(\frac{\pi_\theta(a_i\mid s)}{\pi_{\theta_{\text{old}}}(a_i\mid s)}\right)^{\frac{1}{|a_i|}} = \exp\left(\frac{1}{|a_i|}\sum_{t=1}^{|a_i|}\log\frac{\pi_\theta(a_{i,t}\mid s, a_{i,<t})}{\pi_{\theta_{\text{old}}}(a_{i,t}\mid s, a_{i,<t})}\right) $$目标函数照抄 GRPO,只是把 $\rho_{i,t}$ 换成 $\rho_i$:
$$ J_{\text{GSPO}}(\theta) = \E_{s\sim\mathcal{D},\,\{a_i\}\sim\pi_{\theta_{\text{old}}}}\left[\frac{1}{G}\sum_{i=1}^G \min\big(\rho_i(\theta)A_i,\ \text{clip}(\rho_i(\theta), 1-\varepsilon, 1+\varepsilon)A_i\big)\right] $$因为做了长度归一化,$\varepsilon$ 现在作用在每 token 平均的尺度上,不同长度的回复受到的实际约束是可比的。实现上,这个序列级权重被均匀施加到该回复的所有 token。
一句话总结:GSPO = 「重要性采样的粒度对齐奖励的粒度」的 GRPO。既然奖励是序列级给的(RLHF 和 RLVR 都是),修正也应该在序列级做。
# _src/code/policy_gradients/loss.py 的 GSPOLoss(核心两行)
seq_logprobs = masked_mean(log_probs - experience.log_probs_old,
                           mask=experience.action_mask, dim=-1, keepdim=True).exp()
policy_loss = -torch.min(
    seq_logprobs * experience.advantages,
    seq_logprobs.clamp(1 - self.clip_eps_lo, 1 + self.clip_eps_hi) * experience.advantages,
)
注意 masked_mean(...).exp() 就是 $\exp\left(\frac{1}{|a_i|}\sum_t \log\rho_{i,t}\right)$——先在 log 空间取平均再指数化,正是几何平均,也顺便避开了直接连乘的数值问题。
CISPO:裁权重而不是裁目标
Clipped Importance Sampling Policy Optimization(裁剪重要性采样策略优化,CISPO)走了完全不同的一条路:不裁目标函数,而是裁重要性权重本身,同时保留所有 token 的梯度。
$$ J_{\text{CISPO}}(\theta) = \E\left[\frac{1}{\sum_{i}|a_i|}\sum_{i=1}^K \sum_{t=1}^{|a_i|} \text{sg}\big(\hat\rho_{i,t}(\theta)\big)\, A_{i,t}\, \log \pi_\theta(a_{i,t}\mid s, a_{i,<t})\right] $$其中 $\text{sg}(\cdot)$ 是 stop-gradient(用它的数值但不对它求导),裁剪后的比值是:
$$ \hat\rho_{i,t}(\theta) = \text{clip}\big(\rho_{i,t}(\theta),\ 1-\varepsilon_{\text{low}},\ 1+\varepsilon_{\text{high}}\big) $$注意这个目标的形式:$\text{sg}(\hat\rho)\cdot A \cdot \log\pi_\theta$ ——这是 REINFORCE 的形状,不是 PPO 的形状。梯度只从 $\log\pi_\theta$ 流出,比值退化成一个固定的加权系数。
· PPO 裁目标 → 落在裁剪区外的 token 梯度为零,信号被完全丢弃;
· CISPO 裁权重 → 每个 token 都还有梯度,正比于它的优势;权重只是限定了这个信号能被重要性比值放大或抑制到什么程度。
这是一个偏差-方差取舍:裁权重引入偏差,但换来了受控的方差,并且关键地避免了整段丢弃 token 梯度。
# _src/code/policy_gradients/loss.py 的 CISPOLoss
with torch.no_grad():                                   # ← stop-gradient
    ratio = (log_probs - experience.log_probs_old).exp()
    clipped_ratio = ratio.clamp(1 - self.clip_eps_lo, 1 + self.clip_eps_hi)
policy_loss = -clipped_ratio * experience.advantages * log_probs
#              ^^^^^^^^^^^^^ 只是权重          梯度只从这里 ^^^^^^^^^ 流出
CISPO 也支持非对称边界($\varepsilon_{\text{low}} \neq \varepsilon_{\text{high}}$),和 DAPO 的 clip-higher 一个思路:让模型想上调的 token 有更大的上调空间,鼓励探索。
值得注意的是,GSPO 和 CISPO 都出自在超大 MoE 模型上推极限的组织(Qwen 团队和 MiniMax)。这类模型以数值问题著称,逐 token 的重要性比值会给梯度注入巨大方差。反过来说:这两个算法在大规模模型上可能影响显著,但在小规模的学术实验里研究得少、收益也小——这是原书明确给出的判断,选型时值得记住。
DAPO:为长推理链打的四个补丁
Decoupled Clip and Dynamic sAmpling Policy Optimization(解耦裁剪与动态采样的策略优化,DAPO)对 GRPO 提了四项改动,全部针对「长推理轨迹 + 需要提高低概率新 token」这个场景:
- Clip-Higher:拆成 $\varepsilon_{\text{low}}$ 和 $\varepsilon_{\text{high}}$ 两个超参,让 logratio 正侧可以迈更大的步子,换取更好的探索。参考 config 里是
clip_eps_lo: 0.2/clip_eps_hi: 0.28。 - Dynamic Sampling(动态采样):把组内奖励全为 0 或全为 1 的样本整组丢掉——那些组的优势全是 0,一点学习信号都没有,纯粹浪费算力。
- Token 级损失:用第 9 节的 Strategy 2 而不是 GRPO 默认的 per-sequence 归一化。
- 超长软惩罚:对过长的样本给一个平滑的惩罚,避免从被截断的答案里学东西。
参考实现把第 2、4 两条落在了 rollout 和奖励侧,第 1、3 两条落在 loss 侧:
# rollout.py:动态采样过滤(整组丢弃)
def _dapo_filter(self, exp):
    correctness = exp.rewards["correctness"]
    all_min = (correctness == self.cfg.accuracy_min_reward).all()
    all_max = (correctness == self.cfg.accuracy_max_reward).all()
    if all_min or all_max:
        return None            # 全对或全错 → 这组没有对比度,扔掉
    return exp

# utils.py:超长软惩罚
def dapo_length_penalty(completion_len, l_cache, l_max):
    safe_len = l_max - l_cache
    if completion_len <= safe_len:
        return 0.0                                   # 安全区,不罚
    if completion_len <= l_max:
        return (safe_len - completion_len) / l_cache  # 缓冲区,线性递增的惩罚
    return -1.0                                       # 超了,满额惩罚

# loss.py:DAPOLoss —— token 级归一化,且没有 KL 项
per_token_loss = -torch.min(unclipped_term, clipped_term)
mask = experience.action_mask.to(per_token_loss.dtype)
return (per_token_loss * mask).sum() / mask.sum().clamp(1e-8)   # ← 全局按 token 数归一
注意最后一行和 GRPO 的 masked_mean(..., dim=-1).mean(dim=0) 的区别:DAPO 是把整个 batch 的 token 一起求和再除以总 token 数,GRPO 是先按序列平均再按 batch 平均。这两行代码的差别就是第 9 节整节要讲的东西。
SAPO:把硬裁剪换成软门控
Soft Adaptive Policy Optimization(软自适应策略优化,SAPO)的观察是:硬裁剪是一个不连续的开关——比值刚好在 $1+\varepsilon$ 两侧,梯度从「完整」跳到「零」。SAPO 用一个温度控制的 sigmoid 门替代它,得到一个连续的信任域:靠近 on-policy 的 token 保留信号,越 off-policy 的 token 权重越平滑地衰减。
# _src/code/policy_gradients/loss.py 的 SAPOLoss
ratio = (log_probs - experience.log_probs_old).exp()

# 非对称温度:负优势用更紧的曲线(参考 config: pos=1.0, neg=1.05)
temps = torch.where(experience.advantages > 0, self.sapo_temp_pos, self.sapo_temp_neg)

soft_gate = torch.sigmoid(temps * (ratio - 1)) * 4 / temps
policy_loss = -soft_gate * experience.advantages
把 soft_gate 在 $\rho = 1$ 处做一阶展开可以看出它的设计:$\sigma(0)=0.5$,$\sigma'(0)=0.25$,所以 $\text{gate}(1) = 0.5\cdot 4/\tau = 2/\tau$,而 $\frac{\mathrm{d}}{\mathrm{d}\rho}\text{gate}\big|_{\rho=1} = 0.25\tau\cdot 4/\tau = 1$。也就是说在 on-policy 点处,这个门的斜率恰好是 1,和不裁剪的 $\rho A$ 完全一致;离开这个点之后才平滑地饱和。这个 $4/\tau$ 的系数就是为了做这件事而设的。
横向对比表
| 方法 | IS 粒度 | 约束方式 | 优势估计 | 改了什么 / 为什么 |
|---|---|---|---|---|
| REINFORCE | 无 | 无 | 蒙特卡洛 + baseline | 基线;每批只能走一步 |
| RLOO | 无 | 无 | 留一均值 | per-prompt baseline,天然捕获题目难度 |
| PPO | token | 裁目标(双边) | 学出来的 $V_\phi$ + GAE | token 级信用分配 + 样本复用;代价是四个模型 |
| GRPO | token | 裁目标(双边) | 组内 z-score | 砍掉价值模型;std 归一化带来低方差组偏置 |
| Dr. GRPO | token | 裁目标(双边) | 组内减均值(不除 std) | 修掉难度偏置;等价于 RLOO(差常数) |
| GSPO | 序列(几何平均) | 裁目标(双边) | 组内 z-score | 比值粒度对齐奖励粒度;解决长序列 / MoE 的数值不稳 |
| CISPO | token | 裁权重(stop-grad) | 组内 z-score | 保住每个 token 的梯度,不丢关键低概率 token |
| DAPO | token | 裁目标(非对称) | 组内 z-score | clip-higher + 动态采样 + token 级损失 + 超长惩罚 |
| SAPO | token | 软 sigmoid 门 | 组内 z-score | 连续信任域,不在边界处硬切梯度 |
| TOPR | 序列 | 裁权重(按奖励符号非对称) | — | 正奖励不做 IS 修正,负奖励比值裁到 $[0,1]$;支持稳定的 off-policy |
| DPO | 不是 RL 算法——绕过奖励模型,直接从偏好对优化,见第 8 章 | |||
关于这张表,有几条统一的说明:
- 上面所有策略梯度算法在推导上都是 on-policy 的,但实践中几乎都被稍微 off-policy 地使用。DPO 及其他直接对齐算法则默认就是 off-policy。
- 所有算法都能配学出来的奖励模型或可验证奖励,只有 PPO 需要学一个价值函数。
- REINFORCE 和 RLOO 没有重要性采样比——其余算法各自引入一个,差别只在粒度和裁剪策略。
损失函数速查
把核心损失 $\mathcal{L}(\theta)$ 摆在一起,家族关系一目了然:
$$ \begin{aligned} \textbf{REINFORCE:}\quad & -\frac{1}{T}\sum_{t=1}^{T}\log \pi_\theta(a_t\mid s_t)\,\big(G_t - b(s_t)\big) \\[6pt] \textbf{RLOO:}\quad & -\frac{1}{K}\sum_{i=1}^{K}\sum_t \log \pi_\theta(a_{i,t}\mid s_{i,t})\left(R_i-\frac{1}{K-1}\sum_{j\neq i}R_j\right) \\[6pt] \textbf{CISPO:}\quad & -\sum_{i,t} \mathrm{sg}(\hat\rho_{i,t})\, A_{i,t} \log \pi_\theta(a_{i,t}\mid s_{i,t}),\quad \hat\rho_{i,t} = \mathrm{clip}(\rho_{i,t}, 1-\varepsilon, 1+\varepsilon) \\[6pt] \textbf{PPO:}\quad & -\frac{1}{T}\sum_{t=1}^{T}\min\big(\rho_t A_t,\ \mathrm{clip}(\rho_t,1-\varepsilon,1+\varepsilon)A_t\big),\quad \rho_t = \frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)} \\[6pt] \textbf{GRPO:}\quad & -\frac{1}{G}\sum_{i=1}^{G}\min\big(\rho_i A_i,\ \mathrm{clip}(\rho_i,1-\varepsilon,1+\varepsilon)A_i\big),\quad A_i = \frac{r_i-\mathrm{mean}(r_{1:G})}{\mathrm{std}(r_{1:G})} \\[6pt] \textbf{GSPO:}\quad & -\frac{1}{G}\sum_{i=1}^{G}\min\big(\rho_i A_i,\ \mathrm{clip}(\rho_i,1-\varepsilon,1+\varepsilon)A_i\big),\quad \rho_i = \left(\frac{\pi_\theta(a_i\mid s)}{\pi_{\theta_{\text{old}}}(a_i\mid s)}\right)^{1/|a_i|} \\[6pt] \textbf{DPO:}\quad & -\E_{(x,y^{w},y^{l})}\left[\log \sigma\big(\beta[\Delta\log \pi_\theta(x)-\Delta\log \pi_{\mathrm{ref}}(x)]\big)\right] \end{aligned} $$这张表本身就是本章的浓缩版:差别全在 $\Psi$ 的算法和 $\rho$ 的处理上,梯度骨架从头到尾没变过。
9. 损失聚合:三种归一化和它们的长度偏置
这一节讲的东西在论文里通常只占一句话,但它对训练动态的影响比换算法还大。问题很朴素:拿到逐 token 的损失 $\ell_{i,t}$(样本 $i$ 的第 $t$ 个 token),怎么把它们压成一个标量?
设 batch 大小为 $B$,第 $i$ 条 completion 长度为 $|a_i|$。有三种主流做法。
策略 1:per-sequence 归一化(标准 GRPO)
$$ L = \frac{1}{B}\sum_{i=1}^{B}\frac{1}{|a_i|}\sum_{t=1}^{|a_i|}\ell_{i,t} $$sequence_loss = ((per_token_loss * completion_mask).sum(dim=1) /
completion_mask.sum(dim=1)).mean()每条序列对 batch 损失的贡献相等,与长度无关。
策略 2:per-token 归一化(DAPO)
$$ L = \frac{\sum_{i=1}^{B}\sum_{t=1}^{|a_i|}\ell_{i,t}}{\sum_{i=1}^{B}|a_i|} $$token_loss = (per_token_loss * completion_mask).sum() / completion_mask.sum()每个 token 贡献相等,长序列因为 token 多,对梯度的总影响就成比例地更大。
策略 3:固定长度归一化(Dr. GRPO)
$$ L = \frac{1}{B}\sum_{i=1}^{B}\frac{1}{L_{\max}}\sum_{t=1}^{|a_i|}\ell_{i,t} $$fixed_len_loss = ((per_token_loss * completion_mask).sum(dim=1) / L_max).mean()$L_{\max}$ 是整个训练过程中的全局常数(通常就是最大生成长度)。它把逐 token 的尺度对齐了,同时仍然让长序列贡献更多总梯度(因为求和里有更多非零项)。
三段代码里的 completion_mask 都是 0/1 矩阵,prompt 部分置 0——我们不想让模型从「预测 prompt token」上学任何东西。
为什么这会有影响:一个手算例子
直觉上策略 1 最合理:我们关心的是结果,不是单个 token,所以每条回复应该权重相等。但它悄悄引入了长度偏置。
seq_1_losses = [1, 1, 1, 1, 10]                  # 5 个 token,均值 = 2.8
seq_2_losses = [1, 1, 1, 1, 1, 1, 1, 1, 1, 10] # 10 个 token,均值 = 1.9| 策略 | batch 损失 | 短序列每 token 梯度 | 长序列每 token 梯度 |
|---|---|---|---|
| 策略 1(per-sequence) | $(2.8+1.9)/2 = 2.35$ | $1/5 = 0.20$ | $1/10 = 0.10$ |
| 策略 2(per-token) | $(14+19)/15 = 2.2$ | $0.067$ | $0.067$ |
| 策略 3($L_{\max}=10$) | $(1.4+1.9)/2 = 1.65$ | $0.10$ | $0.10$ |
关键在后两列:策略 1 下,短序列里每个 token 拿到的梯度是长序列的两倍。这会把模型往「回复短一点」的方向推——或者说,压制那些天生需要更多 token 的策略(长链推理正是其中之一)。策略 2 则相反,模型从长回答里拿到的梯度信号更多,可能鼓励啰嗦。策略 3 在两者之间。
用 autograd 亲自验证一遍
原书给了一段可以直接跑的脚本,把梯度打出来看:
from typing import Optional
import torch

def masked_mean(values, mask, axis: Optional[int] = None):
    if axis is not None:
        return (values * mask).sum(axis=axis) / mask.sum(axis=axis)
    return (values * mask).sum() / mask.sum()

def masked_sum(values, mask, axis=None, constant_normalizer: float = 1.0):
    if axis is not None:
        return (values * mask).sum(axis=axis) / constant_normalizer
    return (values * mask).sum() / constant_normalizer

ratio = torch.tensor([[1., 1, 1, 1, 1, 1, 1],
                      [1., 1, 1, 1, 1, 1, 1]], requires_grad=True)
advs  = torch.tensor([[2, 2, 2, 2, 2, 2, 2],
                      [2, 2, 2, 2, 2, 2, 2]])
masks = torch.tensor([[1, 1, 1, 1, 0, 0, 0],    # 生成 1:4 个 token
                      [1, 1, 1, 1, 1, 1, 1]])   # 生成 2:7 个 token
max_gen_len = 7

masked_mean(ratio * advs, masks, axis=1).mean().backward()
# ratio.grad = [[0.2500, 0.2500, 0.2500, 0.2500, 0.0000, 0.0000, 0.0000],
#               [0.1429, 0.1429, 0.1429, 0.1429, 0.1429, 0.1429, 0.1429]]
ratio.grad.zero_()

masked_sum(ratio * advs, masks, axis=1, constant_normalizer=max_gen_len).mean().backward()
# ratio.grad = [[0.1429, 0.1429, 0.1429, 0.1429, 0.0000, 0.0000, 0.0000],
#               [0.1429, 0.1429, 0.1429, 0.1429, 0.1429, 0.1429, 0.1429]]
ratio.grad.zero_()

masked_mean(ratio, masks, axis=None).mean().backward()
# ratio.grad = [[0.0909, 0.0909, 0.0909, 0.0909, 0.0000, 0.0000, 0.0000],
#               [0.0909, 0.0909, 0.0909, 0.0909, 0.0909, 0.0909, 0.0909]]
第一组(策略 1):短序列每 token 梯度 0.25,长序列只有 0.14。第二、三组把它们拉平了。这就是三行代码差异的全部物理含义。
backward() 就走一个优化步。如果用了梯度累积(把多个 minibatch 的梯度加起来再更新,参考 config 里 batch_acc: 4 就是这么干的),结果可能大不相同——短序列和长序列的平衡甚至可能反转。所以别把上面那张表当成绝对真理,在你自己的训练设置里实测一次是唯一可靠的办法。实践中的选择原则通常很务实:哪个数值更稳、损失方差更小就用哪个。
更深的问题:MDP 视角 vs. bandit 视角
损失聚合的选择其实连着一个更根本的建模分歧。
| MDP(token 级)视角 | bandit(序列级)视角 | |
|---|---|---|
| 动作是什么 | 每个 token $a_t$ 是一个动作,状态是当前前缀 | 整条 completion 是一个动作 |
| 优势 | 逐 token,靠 $V(s_t)$ 和 GAE 算 | 一个标量 $A_{\text{seq}}$,广播给所有 token |
| KL | 逐 token 施加 | 聚合成标量,折进奖励 |
| 代表算法 | PPO + 价值网络 | RLOO、GRPO 系 |
# === bandit 风格(序列级)===
reward   = torch.tensor([3.0, 1.0])      # (B,) 奖励模型分数
baseline = reward.mean()
advantage_seq = reward - baseline        # (B,)
advantages = advantage_seq[:, None].expand(-1, seq_len)   # (B, L)
# tensor([[ 1.,  1.,  1.,  1.],    ← 所有 token 同一个优势
#         [-1., -1., -1., -1.]])

# === MDP 风格(token 级)===
advantages = gae(per_token_rewards, values, done_mask, gamma=1.0, lam=0.95)
# tensor([[ 0.2,  0.5,  0.8,  1.5],    ← 随位置变化
#         [-0.3, -0.5, -0.8, -1.4]])
实际的 RLHF 几乎总是混合的:奖励在序列级给出,梯度在 token 级计算。PPO 式的 RLHF 从一个序列级的 RM 分数出发,靠 KL 塑形和 GAE 把它摊成 token 级信用;GRPO 式的实现则常常用 bandit 风格的优势,同时在损失里加一个逐 token 的 KL 项。两种约定在实践中都存在,读代码时要先分清楚在看哪一种。
这也回过头来解释了 $\gamma = 1$:在 bandit 视角下折扣根本没有位置;而即使在 token 级 MDP 视角下,优化的归纳偏置也是「整条回复的质量」,对早期 token 打折扣没有原则性依据。
generation/length:稳定或缓慢上升是健康的,单调持续上升往往是长度 hack(模型发现写长一点就能拿更多梯度/更高分),而急剧下降则可能是 per-sequence 归一化在挤压长回答。这条监控指标的价值在于:它是你能最早看到「优化目标和你想要的东西已经分家了」的信号,比 eval 分数掉下来早得多。
10. 实现细节:KL 估计器、白化、掩码与静默 bug
作者在讲座里对这一段的定位很明确:「最难的 bug 不是数学错误,而是静默的实现错误——掩码错、缓存过期、形状不对。」训练照跑,损失照降,模型学的是别的东西。这一节把这些坑集中列出来。
KL 的三种估计器
精确计算两个语言模型之间的 KL 散度需要在整个词表上求和,代价太高,所以实践中用蒙特卡洛近似。设 $\ell = \log\pi_\theta(a_t\mid s_t) - \log\pi_{\text{ref}}(a_t\mid s_t)$ 为 log-ratio,三种估计器分别是:
| 估计器 | 公式 | 无偏? | 非负? | 方差 |
|---|---|---|---|---|
k1 | $-\ell$ | 是 | 否(可能为负) | 高 |
k2 | $\ell^2/2$ | 否(有小偏差) | 是 | 低 |
k3 | $(e^{\ell}-1)-\ell$ | 是 | 是 | 低 |
为什么 k1 会为负?因为 KL 的定义是 $\E_{x\sim p}[\log p - \log q]$,期望非负,但单个样本的 $\log p - \log q$ 完全可以是负的。用它做惩罚项时,会出现「惩罚项变成奖励」的诡异情况,训练曲线上表现为 KL 在 0 附近剧烈震荡。k3 同时做到无偏和逐样本非负,是现在的默认选择(参考实现的所有 config 里都是 kl_estimator: kl3)。
# _src/code/policy_gradients/loss.py
def approx_kl1(log_probs, log_probs_ref, action_mask):
    log_ratio = (log_probs - log_probs_ref) * action_mask
    return -log_ratio                       # 无偏但可能为负

def approx_kl2(log_probs, log_probs_ref, action_mask):
    log_ratio = (log_probs - log_probs_ref) * action_mask
    return (log_ratio ** 2) / 2             # 非负,低方差,有偏

def approx_kl3(log_probs, log_probs_ref, action_mask):
    log_ratio = (log_probs - log_probs_ref) * action_mask
    return (log_ratio.exp() - 1) - log_ratio   # 无偏 + 非负 —— 默认选它
k3 的构造思路值得一提:$e^\ell - 1$ 的期望(在 $\pi_{\text{ref}}$ 下)恰好为 0,所以把它加到 $-\ell$ 上不改变期望,却把整个函数变成了处处非负的凸函数(因为 $e^x - 1 - x \ge 0$ 对所有 $x$ 成立)。这是一个「加一个期望为零的控制变量」的经典方差削减技巧。
KL 放哪里
前面反复提到,这里集中对比一次:
# PPO 风格:KL 进奖励
rewards.scatter_(1, last_idx, rm_score)     # 分数打到最后一个有效 token
rewards = rewards - beta * per_token_kl     # 逐 token 扣 KL
advantages = gae(rewards, values, ...)      # KL 会经 GAE 传播

# GRPO 风格:KL 进损失
advantages = z_score(rewards)               # 优势只从原始奖励算
loss = pg_loss + beta * per_token_kl # KL 作为独立一项目标相同(限制相对参考模型的漂移),但 GRPO 的做法避免了 KL 和优势估计之间的相互作用。参考实现里这个分叉写在 apply_reward_kl 里:只有 ppo/rloo/reinforce 三种损失会把 KL 折进奖励,其余走损失项。
advantage 白化
把 batch 内的优势归一化到零均值、单位方差:
valid_adv = advantages[completion_mask.bool()]
advantages = ((advantages - valid_adv.mean()) /
(valid_adv.std() + 1e-8)) * completion_mask为什么要做:稳定不同 batch 之间的梯度量级。不白化的话,一个整体奖励偏高或偏低的 batch 会产生异常大的梯度,把训练带偏。注意 valid_adv 是先按掩码取出有效位置再算统计量的——如果把 padding 也算进去,均值和方差就被稀释了,这又是一个安静的 bug。
相关的还有奖励归一化(把 RM 输出压到 $[0,1]$)和奖励白化。三者可以叠加,都是纯稳定性手段。
数值上的六条铁律
- 永远在 log 空间算:用
log_softmax+gather,不要softmax之后再log。softmax 会把小概率压成极小的浮点数,再取 log 时精度损失被放大。 - 掩码必须精确:
completion_mask只在 completion token 上为 1,排除 prompt token 和 EOS 之后的 padding。聚合之前先乘掩码。 - EOS 的处理要一致:算不算进损失都行,但全流程必须统一。处理不一致是最经典的静默错误之一。
- 变长序列要小心归一化:见第 9 节。
- baseline / 优势必须 detach:
advantages.detach(),不要把梯度反传进优势的计算图。 - 除法要加保护:凡是除以
mask.sum()或序列长度的地方,都要.clamp_min(1)或+ eps。一条立刻输出 EOS 的空回复就能产生 NaN,然后污染整个 batch。
参考实现的 masked_mean 就是把第 2、6 条固化下来了:
def masked_mean(tensor, mask, dim=None, keepdim=False, eps=1e-8):
    if mask is None:
        return tensor.mean(dim=dim, keepdim=keepdim)
    return (tensor * mask).sum(dim=dim, keepdim=keepdim) / \
mask.sum(dim=dim, keepdim=keepdim).clamp_min(eps) # ← 除零保护训练循环里还有一层保护:if not loss.isfinite(): continue ——遇到 NaN 直接跳过这个 minibatch,而不是让它毁掉整次训练。
rollout 阶段要存什么
PPO 的一步需要用到一堆张量,其中一部分必须在 rollout 时算好存下来,另一部分每个训练步重算:
| 张量 | 形状 | 谁用 | 缓存还是重算 |
|---|---|---|---|
| token ids | (B, L) | 全部 | rollout 时存 |
| completion mask | (B, L) | 全部 | rollout 时存 |
| 旧 log-probs $\log\pi_{\theta_{\text{old}}}$ | (B, L) | IS 比值分母 | rollout 时存 |
| 旧价值 $V_{\phi_{\text{old}}}$ | (B, L) | critic 裁剪 | rollout 时存 |
| 参考 log-probs $\log\pi_{\text{ref}}$ | (B, L) | KL 惩罚 | rollout 时存 |
| 奖励 | (B,) 或 (B, L) | 优势计算 | rollout 时存 |
| 当前 log-probs $\log\pi_\theta$ | (B, L) | IS 比值分子 | 每步重算 |
| 当前价值 $V_\phi$ | (B, L) | 价值损失 | 每步重算 |
比值 $\rho_t = \pi_\theta / \pi_{\theta_{\text{old}}}$ 里一个是新鲜的、一个是缓存的——这正是能在同一批 rollout 上跑多个 epoch 的原因。参考实现里这套东西被打包在 Experience 这个 dataclass 里(_src/code/policy_gradients/buffer.py),rollout 阶段一次性填满,训练阶段只重算 log_probs 和 values。
静默 bug 清单
- prompt token 进了策略损失 —— 损失数值虚高,梯度浪费在模型改不了的 token 上(prompt 是给定的,提高它的概率毫无意义)。
- 奖励打到了错误的位置 —— 写
[:, -1]而不是「最后一个生成的 token」。奖励落在 padding 上被 mask 掉,训练信号完全消失。 - 把过期的 log-prob 当成「当前」的 —— 比值恒为 1,裁剪永不触发。表现是 clip_frac 恒等于 0,看起来「很稳定」,其实是根本没在做 PPO。
- GRPO 的零方差组 —— 组内所有 completion 拿到相同奖励 → std = 0 → 优势变 NaN。参考实现靠
+ 1e-4/+ eps兜底,DAPO 则直接把整组丢掉。 - 价值损失或策略损失算到了掩码外 —— 在 padding 上训练。
- 训练用的模板和推理引擎渲染的模板不一致 —— logprob 对不上,重要性比值直接失控(见第 4 章)。
训练时该盯哪些指标
| 面板 | 健康 | 不健康 |
|---|---|---|
reward/mean | 稳定上升 | 尖刺、震荡、长期平台 |
kl/mean | 缓慢上升(0 → 2–5) | 爆炸(>10)或恒为 0 |
loss/policy | 下降 | 发散或 NaN |
metrics/clip_frac | 5%–30% | 0%(裁剪没生效)或 >50%(策略变化太快) |
generation/length | 稳定或缓升 | 单调持续上升(长度 hack) |
| 策略熵 | 缓慢下降 | 骤降到 0(模式坍缩) |
| advantage 统计量 | 均值 ≈ 0(若已白化),std 稳定 | 均值漂移、std 塌陷 |
value_loss(PPO) | 下降 | 不降 → critic 没在学 |
这些数值区间是示意性的,会随模型规模、任务和算法变化。除此之外还要做两件事:跑留出集的评测,以及亲眼读几条采样输出——很多问题(复读、格式崩坏、讨好式回答)只有肉眼能第一时间发现。
为什么 RL 里 batch size 更要紧
监督学习里梯度噪声是中等的,临界 batch size 通常在几千。RL 里梯度噪声尺度高出几个数量级,因为梯度来自蒙特卡洛 rollout 而不是标注数据。几个有代表性的经验事实:
- OpenAI 的 Dota 2 项目,临界 batch size 达到了百万级 transition(见 McCandlish 等人 An Empirical Model of Large-Batch Training)。
- PPO 不是 batch-size 无关的:裁剪把 batch size 和有效步长耦合在了一起,所以你没法靠调学习率来补偿 batch size 的变化。
- PPO 的平台期常常源于噪声太大的损失估计,只有加样本才能解决。
大 batch 让梯度方差按 $1/N$ 下降。在 RLHF 里,这是最便宜的稳定手段,比大多数超参调优都有效。典型量级:256–1024 条 prompt(注意是 prompt 数,每条还要乘以 $G$ 条 completion)。
11. 异步 RL 系统与截断重要性采样
严格 on-policy 是做不到的
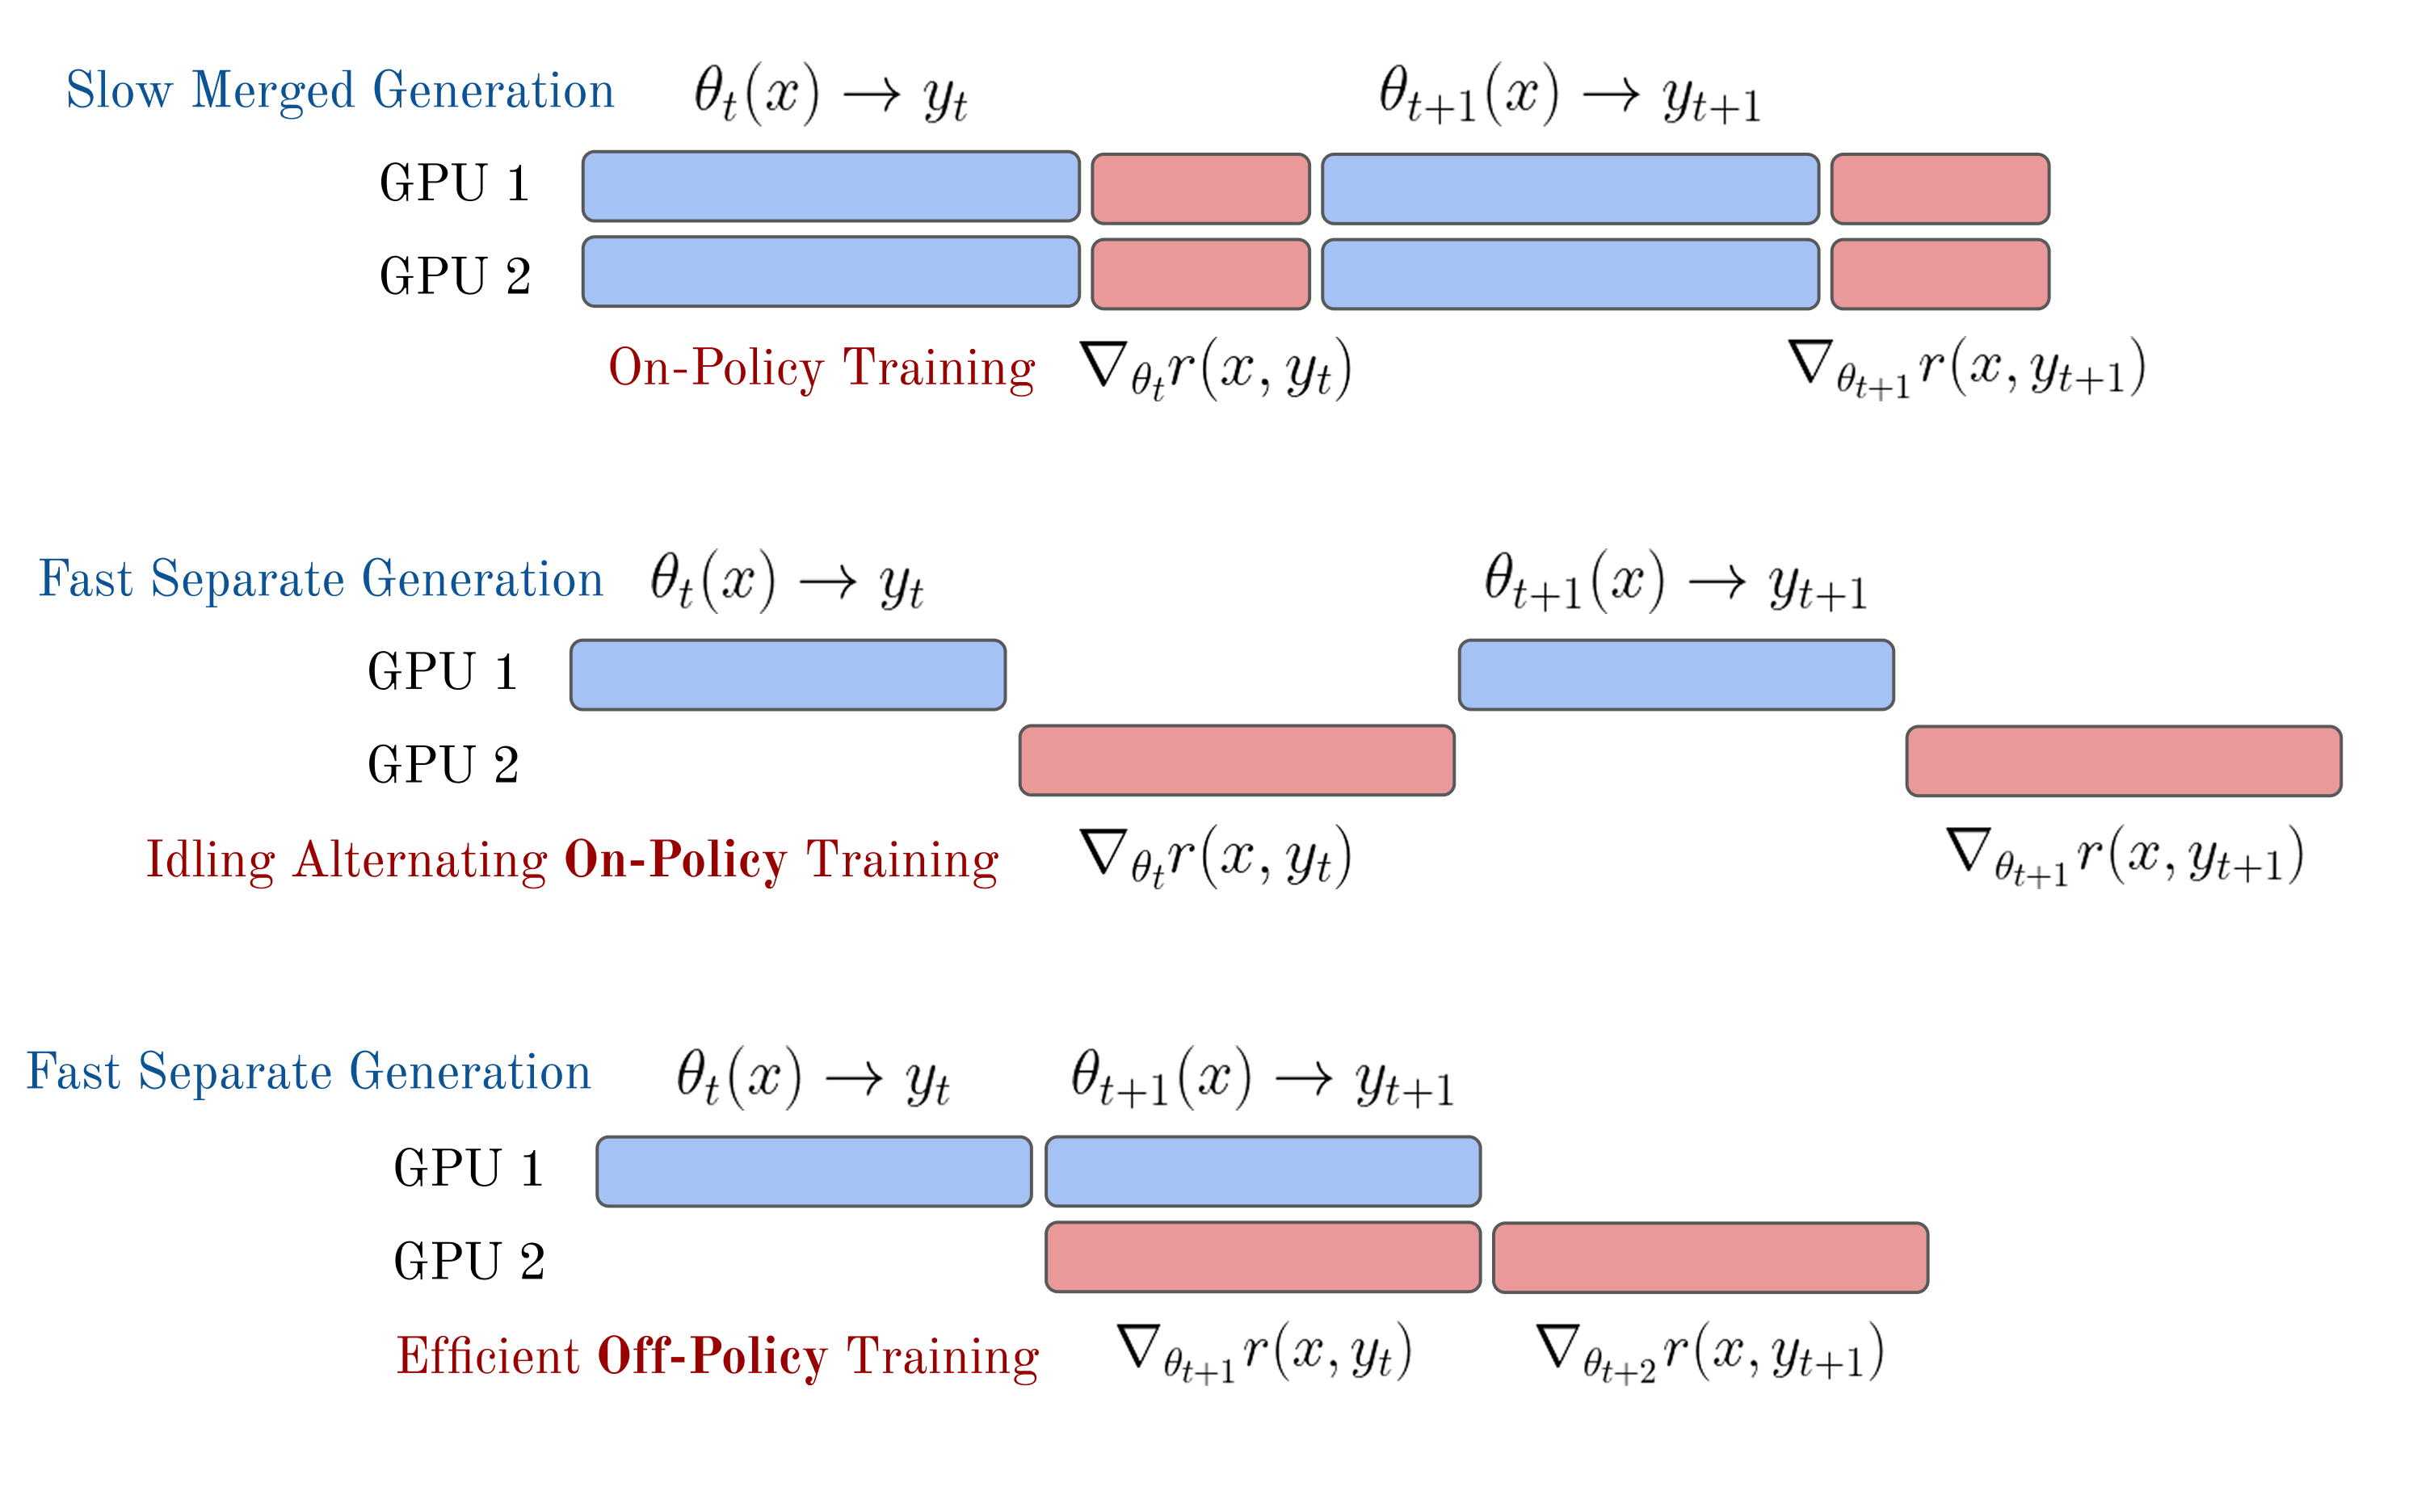
策略梯度的理论推导要求所有动作严格 on-policy——模型始终是最新的 rollout 结果对应的那个模型。实践中维持严格 on-policy 会大幅拖慢训练,而且完美同步在技术上本来就不可能。所以近期所有语言模型上的实证结果,严格来说都跑在理论证明之外。这不是偷懒,这是「先设计出真能工作的东西」。
actor / learner 架构
通用解法是:推理和训练常驻在不同的 GPU 节点上,各自用最适合的软件栈。
- learner(学习者):负责走策略梯度步的那些 GPU,跑训练框架(FSDP、DeepSpeed 等)。
- actor(执行者):负责采样的那些 GPU,跑高效推理引擎(vLLM、SGLang)。
- 中间用 Ray 之类的分布式进程管理库传数据,周期性地把权重从 learner 同步到 actor。
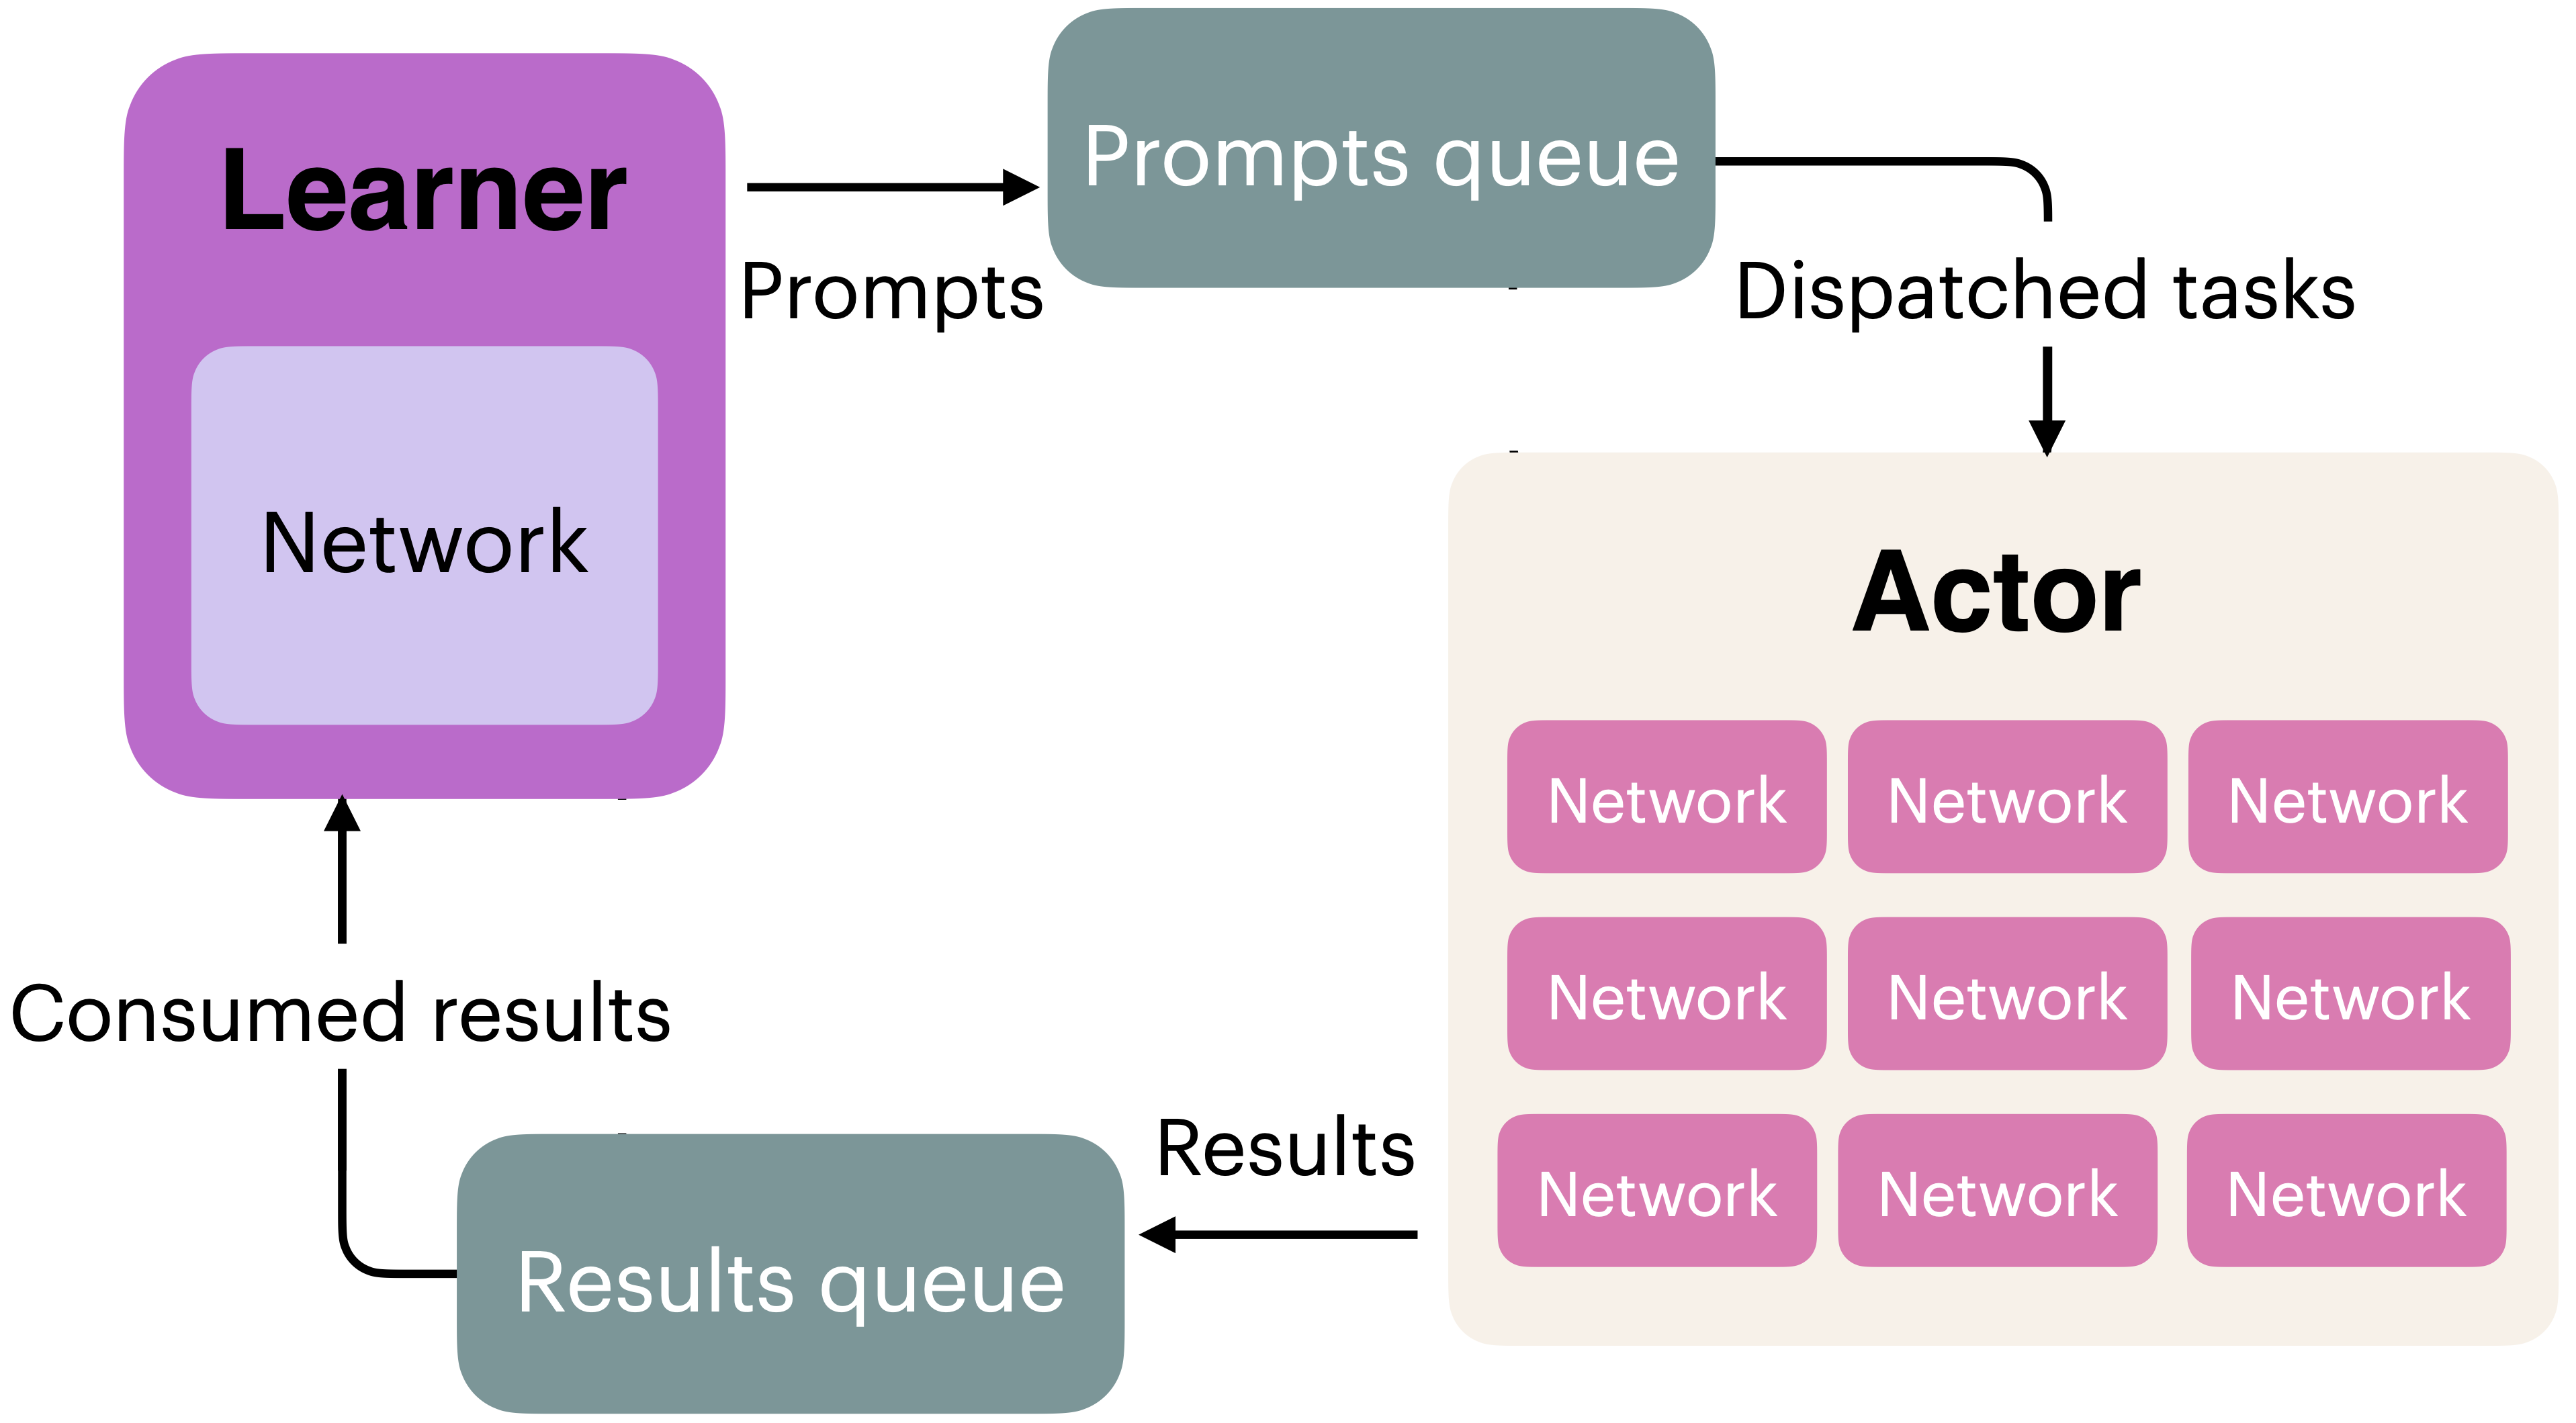
做异步的两个核心挑战是:保持训练稳定和保住学习信号。这些系统的设计前提是「近似 on-policy 的数据就够用了」。
还有一个具体的长度不匹配问题:同一批里某个 prompt 的回答可能耗时长得多(更多 token 或更多工具调用),导致大部分算力空等它完成。一个解法是 sequence-level packing(序列级打包)——把短样本用巧妙的掩码堆进同一个 batch,既能让模型继续 rollout,又能让长度归一化在 batch 内分布得更均匀。
推理模型出现之后,人们进一步往完全 off-policy 走:训练批次直接由「多个实例最近完成的 rollout」填充,不再等待。完全异步还能让 RL 训练更容易跨数据中心扩展,因为 learner 和 actor 之间的权重同步间隔可以拉长(INTELLECT-2 就是这个方向的公开尝试)。
你的框架偷偷把你变成了 off-policy
这是本节最反直觉、也最重要的一点。
即使 sampler 和 learner 用的是完全相同的参数 $\theta$,它们算出的 token 分布也会不一样。原因是推理引擎(vLLM)和训练框架(FSDP)用的是不同的 kernel、不同的精度、不同的并行策略。同一个 $\theta$,在两个系统上就是两个略有差异的分布。
所以要区分:
$$ \rho_t^{\text{learner}} = \frac{\pi_\theta^{\text{learner}}(a_t\mid s, a_{<t})}{\pi_\theta^{\text{sampler}}(a_t\mid s, a_{<t})}, \qquad \tilde\rho_t^{\text{learner}} = \min\big(\rho_t^{\text{learner}},\ C\big) $$这就是截断重要性采样(Truncated Importance Sampling, TIS):用 $\min(\rho, C)$ 给权重加一个上限,拿一点点偏差换有界的方差。
· 策略比值 $\rho_t^{\text{policy}} = \pi_\theta / \pi_{\theta_{\text{old}}}$ —— 修正一个 RL batch 内多次梯度步造成的策略漂移;
· TIS 比值 $\tilde\rho_t^{\text{learner}}$ —— 修正推理后端和训练后端之间实现层面的数值差异。
两者互补,可以同时施加。另外注意 TIS 用的是单边上限:比值可以自由地掉到 1 以下,但被截断在 $C$ 以上——这和 PPO/CISPO 的双边裁剪(把比值约束在 1 附近)不是一回事。
两种情况下的组合方式:
情况一:REINFORCE + TIS(每批一次梯度步)。没有策略漂移($\pi_\theta = \pi_{\theta_{\text{old}}}$),唯一的失配就是 learner 和 sampler 之间:
$$ \nabla_\theta J \approx \E_{a\sim\pi_\theta^{\text{sampler}}}\left[\tilde\rho_t^{\text{learner}}\cdot A_t \cdot \nabla_\theta \log \pi_\theta^{\text{learner}}(a_t\mid s, a_{<t})\right] $$情况二:PPO/GRPO + TIS(每批多次梯度步)。两个比值都在起作用。严谨的实现会在 learner 上重算 old logprobs,让策略比值只反映纯粹的策略漂移,TIS 单独修正后端失配:
$$ J_{\text{PPO+TIS}}(\theta) = \E\left[\min\left(\rho_t^{\text{policy}}A_t,\ \text{clip}\left(\rho_t^{\text{policy}}, 1-\varepsilon, 1+\varepsilon\right)A_t\right)\cdot \tilde\rho_t^{\text{learner}}\right] $$如果框架偷懒,直接把 sampler 的 logprob 当作 $\pi_{\theta_{\text{old}}}$,那么策略比值本身就已经包含了后端失配,不需要额外的 TIS——但这时候 clip 作用在一个更嘈杂的比值上,它在还没走任何梯度步时就已经不等于 1.0 了。这就是 Yao 等人那句「你的高效 RL 框架偷偷给了你 off-policy RL」的含义。
# 形状 (B*G, L)
C = 2.0                                             # TIS 上限

logratio = learner_logprobs - sampler_logprobs
logratio = logratio.clamp(-10.0, 10.0)              # 仅为数值安全,不是 TIS 本身
tis_weight = torch.exp(logratio).clamp(max=C)       # ← 单边截断,这才是 TIS

per_token_pg_loss = per_token_pg_loss * tis_weight.detach()   # 当作固定权重
[-10, 10] 这个 clamp 只是为了指数运算前不溢出;真正的截断步骤是 clamp(max=C)。
实践中,围绕这些 logprob 的簿记——生成时保存 sampler logprob、在旧 checkpoint 上用 learner 重算一遍、训练时再算当前的——占了分布式 RL 框架相当大一块脚手架代码。TIS 已经被主流开源框架普遍采纳(VeRL、TRL、OpenRLHF、SkyRL、OAT、Open Instruct,其中 Open Instruct 用 $C = 2$),而且推理链越长它越重要:每个 token 的微小差异会在几千个 token 上累积。
和 GSPO 不同,TIS 是 token 级的——因为它修正的是 token 级的数值失配,不是序列级的奖励粒度。
开源代码库
| 框架 | 定位 |
|---|---|
| TRL | HuggingFace 生态,PPO/GRPO/DPO 齐全。入门最佳起点 |
| Open Instruct | Allen AI,多算法。做研究和复现最佳 |
| veRL | 字节,RLVR 时代非常流行 |
| OpenRLHF | 从 RLHF 起家,RLVR 场景也很常用 |
12. 选型、超参与长尾话题
RL 一个没被充分记录的好处
拒绝采样(第 9 章)和直接对齐算法(第 8 章)都比 RL 简单得多,那为什么还要忍受 RL 的基础设施复杂度?作者给出的答案里有一条不太常被写下来:
· RL 能修掉模型的粗糙边角——让输出更稳健、格式更规整、和 vLLM 这类服务框架更兼容;
· RL 作用在一个很窄的 prompt 分布上,倾向于不「压扁」通用能力——它可以被外科手术式地用来改进特定行为,而不损伤其他方面。
总的判断是:语言模型上的 RL 损失稳健、可扩展、有效、灵活,正是这几条打开了后来巨大的实验空间。这也是为什么 RL 从「锦上添花」变成了训练最强模型时的承重步骤。
还有一个更结构性的原因:RL 是训练时算力扩展的入口。o1 那条曲线(RL 训练算力越多,推理性能越好)和 R1 之后的整个推理模型浪潮,用的正是本章这些算法,只不过奖励从「奖励模型打分」换成了「验证器判对错」(RLVR)。第 7 章会详细展开。
超参数的实际取值范围
下表是常见 LLM RLHF 设置的示意性范围,不是普适默认值:
| 超参 | 典型范围 | 说明 |
|---|---|---|
| 裁剪 $\varepsilon$ | 0.1–0.2 | 信任域宽度;DAPO 把上界推到 0.28 |
| GAE $\lambda$ | 0.95(参考实现 0.98) | 优势的偏差-方差旋钮 |
价值损失系数 vf_coef | 0.5–1.0 | critic 损失的权重 |
| KL 系数 $\beta$ | 0.01–0.1;RLVR 常取 0 | 参考模型约束强度 |
| 每批梯度步数 $K$ | 2–6(也有取 1 或 16 的) | off-policy 预算 |
| 学习率 | $1\times10^{-6}$ – $5\times10^{-6}$ | 比 SFT 低一个数量级 |
| batch size | 256–1024 条 prompt | 越大方差越低 |
| 每 prompt 采样数 $G$ | PPO 时代 1–4;GRPO 常用 8–64 | 组对比度的直接来源 |
| temperature | 0.6–1.0 | 太低组内没对比,太高格式崩 |
参考实现的 grpo.yaml 是一个可以在单卡上跑的迷你版本:lr: 5e-6、temperature: 0.6、prompts_per_step: 4、num_rollouts: 8、train_batch_size: 2、batch_acc: 4、max_norm: 1.0、max_new_tokens: 512。注意 ppo.yaml 里 num_rollouts: 1——PPO 不需要组内对比,它的 baseline 来自价值函数,这一行配置差异就把两种算法的哲学差异写清楚了。
其他值得知道的算法
这些没有成为主流最佳实践,但代表了有意思的方向:
| 算法 | 核心想法 |
|---|---|
| P3O(Pairwise PPO) | 直接在 PPO 式更新里用成对偏好数据,不训中间的奖励模型 |
| CoPG(Contrastive Policy Gradient) | off-policy 策略梯度,是 IPO 和朴素策略梯度的推广;Cohere 的 Command A 用过 |
| ReMax | 专为「奖励模型推理带来的不确定性」设计的 baseline 归一化 |
| MDPO(Mirror Descent PO) | 镜像下降是优化方法而非策略梯度算法,但能很容易地替换进现有 RL 基础设施。Apple Intelligence 基础模型、Kimi k1.5 用过变体 |
| VAPO | 把 DAPO 的优化(clip-higher、token 级损失、不同长度归一化)和 Value-Calibrated PPO 的洞见结合:预训练价值函数 + 长度自适应 GAE,说明基于价值的方法相对 GRPO 仍有空间 |
| TOPR(Tapered Off-Policy REINFORCE) | 像 CISPO 一样裁权重,但在序列级操作,并按奖励符号非对称:正奖励不做 IS 修正,负奖励把比值裁到 $[0,1]$,从而支持稳定的 off-policy 学习 |
| MaxRL | 参考实现里也有一份:用二元奖励 $r = \text{correctness}\times\text{format}$,优势按组内正确率归一化(compute_maxrl_advantages) |
怎么选
综合全章,给一个实用的决策路径:
- 先问奖励是什么。可验证奖励(数学、代码)→ GRPO 系是自然选择,KL 可以关掉;学出来的奖励模型 → KL 必须留着,PPO 或 RLOO 都可以。
- 看能不能对同一 prompt 多采样。能(几乎总是能)→ 用 RLOO/GRPO 这类组内 baseline,白送的低方差 baseline 没有理由不要。
- 显存紧不紧。紧 → 直接排除 PPO(它多一整个模型副本)。
- 序列有多长、模型有多稀疏。长推理链 + 大 MoE → 考虑 GSPO(序列级比值)或 CISPO(保住所有 token 的梯度);小模型短序列上这两者收益有限。
- 先把采样调对,再动优化器。这是最重要的一条——见下面的动手实验。
所有方法优化的是同一个策略梯度目标,差别只在三处:$\Psi_t$ 是什么、更新怎么被约束、要几个模型进显存。如果训练不 work,先怀疑数据和奖励,再怀疑实现细节,最后才怀疑算法选型。顺序反了会浪费很多时间。
本章小结
一条主线
整章只有一个式子在变形:
$$ \nabla_\theta J(\theta) = \E_{\tau\sim p_\theta}\left[\sum_t \Psi_t\, \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right] $$推导路径:目标是期望回报 → 直接求导不可采样 → log-derivative trick 转成期望 → 展开轨迹对数概率,环境项消失 → 只剩策略 log-prob 的和 → 用 return-to-go 和 baseline 削方差 → 得到优势形式。
算法速查
| 算法 | $\Psi_t$ 怎么来 | 怎么约束更新 | 显存中模型数 | 一句话 |
|---|---|---|---|---|
| REINFORCE | 蒙特卡洛回报 − 简单 baseline | 无 | 2–3 | 策略梯度的最小实现 |
| RLOO | 组内留一均值 | 无 | 2–3 | per-prompt baseline,天然捕获难度 |
| PPO | GAE + 学出来的 $V_\phi$ | 裁目标(双边) | 4 | token 级信用分配,代价是四个模型 |
| GRPO | 组内 z-score | 裁目标(双边) | 2–3 | 用同门师兄弟替代价值模型 |
| Dr. GRPO | 组内减均值(不除 std) | 裁目标(双边) | 2–3 | 去掉难度偏置;$\equiv$ RLOO |
| GSPO | 组内 z-score | 裁目标,比值取序列级几何平均 | 2–3 | 比值粒度对齐奖励粒度 |
| CISPO | 组内 z-score | 裁权重 + stop-grad | 2–3 | 每个 token 都保住梯度 |
| DAPO | 组内 z-score | 非对称裁剪 + 动态采样 | 2 | 为长推理链打的四个补丁 |
| SAPO | 组内 z-score | 软 sigmoid 门 | 2 | 连续信任域,不硬切梯度 |
要记住的十条
- log-derivative trick 是整个理论的支点:$\nabla_\theta p = p\nabla_\theta \log p$。它把不可采样的量变成可采样的期望。
- 环境动力学求导为 0,所以策略梯度是 model-free 的。这是它能用在语言模型上的根本原因。
- baseline 是免费的:只要它不依赖被采样的动作,减掉它不改变期望梯度,却大幅降方差。但除以 std 不是 baseline,那是重新加权。
- 优势 = 这个动作比该状态的平均好多少。健康训练里它的均值应该在 0 附近。
- PPO 的 clip 单边生效:只在「已经朝正确方向走过头」时截断,从不阻止纠错。信任域内部,PPO 就是普通策略梯度。
- 如果每批只走 1 步梯度且不 minibatch,clip 永远不触发,PPO 退化成带 GAE 的朴素策略梯度。看 clip_frac 就知道有没有在起作用。
- GAE 就是 TD 残差按 $(\gamma\lambda)^l$ 倒着累加,$\lambda$ 是偏差-方差旋钮。语言模型上 $\gamma = 1$。
- GRPO = PPO − 价值函数 + 组内 z-score。它的成功来自「LM 上同 prompt 多采样很便宜」这个结构性事实。
- 损失聚合方式直接决定长度偏置:per-sequence 偏好短回答,per-token 偏好长回答,fixed-length 居中。监控
generation/length。 - 现代 RL 框架里有两个重要性比值:策略比值修策略漂移,TIS 修推理/训练后端的数值失配。别混。
动手实验
作业代码在 homework/hw3-pg/,基于 code/policy_gradients/。默认配置在 Qwen/Qwen3-1.7B 上跑 reasoning-gym 的 spell_backward 任务(把一个单词倒着拼出来)。选这个任务是有讲究的:失败和部分进展都非常容易肉眼检查——你一眼就能看出模型是拼错了、格式坏了、还是根本没在推理。
实验一:用 GRPO 跑通词反转任务
cd homework/hw3-pg/
uv run python -m policy_gradients.train --config policy_gradients/configs/grpo.yaml
该盯哪三个指标:
| 指标 | 含义 | 怎么读 |
|---|---|---|
avg_correctness | 环境给出的正确性得分(dataset.score_answer) | 这是真正的任务信号。应该缓慢上升 |
avg_format | 格式奖励:<think> / </think> / <answer> / </answer> 各 0.25 分 | 通常最先饱和到 1.0——格式比内容容易学得多 |
avg_binary | 正确性 且 格式满分才计 1 | 最严格的指标,最能反映真实进展 |
但第一个该问的问题不是这些,而是:每个 prompt 组里有没有「对比度」。
回忆 GRPO 的优势:$A_i = (r_i - \mu_G)/\sigma_G$。如果一组 8 条 completion 全对或全错,那么 $\mu_G$ 等于每个 $r_i$,所有优势都是 0,这一组对梯度的贡献是零(还要靠 +1e-4 兜底才不至于 NaN)。组内相对法是靠差异吃饭的,没有差异就没有信号。
所以调试的第一步是打印或记录组内奖励的方差。参考实现每步都会打印一次 rollout 样本和各奖励分量的均值,直接看:
╭─ Rollout Results ────────────────────────────────╮
│ total: 0.83   correctness: 0.25   format: 1.00    │
│ penalty: 0.00   binary: 0.25                      │
╰───────────────────────────────────────────────────╯
如果 correctness 长期贴着 0 或贴着 1 不动,问题不在优化器,在采样设置或任务难度。
实验二:对比组内 baseline 和单样本估计
三个起点匹配的配置各跑一遍:
uv run python -m policy_gradients.train --config policy_gradients/configs/reinforce.yaml
uv run python -m policy_gradients.train --config policy_gradients/configs/rloo.yaml
uv run python -m policy_gradients.train --config policy_gradients/configs/grpo.yaml对比两件事:正确性信号上升得多快,以及损失曲线有多抖。REINFORCE 用的是 batch 级 baseline,RLOO 和 GRPO 用的是 per-prompt baseline——这个对比会让「组内 baseline 到底有什么用」这件事,比任何公式都直观。预期是 RLOO/GRPO 的损失方差明显更小。
顺带可以做的对照:drgrpo.yaml(去掉 std 归一化)对比 grpo.yaml,验证第 7 节讲的等价性和偏置;dapo.yaml 对比 grpo.yaml,观察动态采样把「零对比度组」丢掉之后有效样本数怎么变。
实验三:扫「对比度旋钮」
复制 grpo.yaml,分别改动这四个参数:
| 参数 | 调小会怎样 | 调大会怎样 |
|---|---|---|
num_rollouts(组大小 $G$) | 组内对比度下降,越来越多的组退化成零方差 | 信号更稳,但每步算力线性上升 |
temperature | 采样坍缩,8 条 completion 几乎一模一样 → 无对比度 | 格式错误的回复暴增,噪声压过信号 |
data.size | 更快重复见到同一批题,容易过拟合 | 覆盖更广,但收敛更慢 |
format_weight | 格式奖励占比低,模型可能一直不学格式 | 模型可能只优化格式、放弃解题(一种奖励 hack) |
这个实验的意义在于:它是理解「为什么 RLVR 的配方常常在动优化器之前,花大量精力调采样设置」的最短路径。$G$、temperature、题目难度共同决定了组内有没有可学的差异,而这三者和你用 GRPO 还是 DAPO 一点关系都没有。
实验四:从玩具奖励走向数学
想做 GSM8K 之类的实验,建议先从 code/reward_models/train_orm.py 和 code/rejection_sampling/ 入手,把奖励侧跑通,再去接一个新的在线 RL 环境。一个不错的贡献方向是:写一个能在 1B 以下 Qwen 上跑起来的 reasoning-gym 或 GSM8K 策略梯度配置,并报告同样的组内对比度诊断指标。
1) 采样出来的文本长什么样(打印几条,看是不是完全没格式 / 复读 / 空回复);
2)
avg_format 有没有在动(格式最容易学,它不动说明梯度根本没流对地方);3) 组内奖励方差是不是恒为 0;
4) 才是去看损失和梯度范数。
反过来先看损失曲线,通常会浪费很多时间——策略梯度的损失值本身几乎没有解释性(它是优势加权的 log-prob,不是任何意义上的「误差」),损失下降不代表模型变好。
延伸阅读
基础与推导
- Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning (Williams, 1992) — REINFORCE 的原始论文,「REward Increment = Nonnegative Factor × Offset Reinforcement × Characteristic Eligibility」这句拆解至今仍是理解策略梯度三个部件的最好方式。
- High-Dimensional Continuous Control Using Generalized Advantage Estimation (2015) — GAE 原文,也是 $\Psi_t$ 六种选择那张分类表的出处。
- Policy Gradient Algorithms (Lilian Weng, 2018) — 策略梯度算法族最完整的中英文可读综述之一,公式推导密度高。
- Notes on the GAE Paper (Seita, 2017) — 把 GAE 那几步级数求和讲得比原论文清楚。
核心算法
- PPO: Proximal Policy Optimization Algorithms (2017) — 必读。注意原文的 $L^{CLIP}$ 是要最大化的目标,代码里的负号从哪来看这里。
- TRPO: Trust Region Policy Optimization (2015) — PPO 的前身,理解「信任域」这个概念的来源。
- DeepSeekMath (2024) — GRPO 的出处,第 4 节的算法描述值得逐句读。
- Back to Basics: Revisiting REINFORCE-Style Optimization for RLHF (2024) — RLOO 在 LLM 上的系统性论证,「PPO 的复杂度对语言模型不必要」这个论点的主要来源。
- DeepSeek-R1 (2025) — GRPO 在推理模型上的规模化验证,也是「RLVR 可以不要 KL」这一实践的推动者。
GRPO 的变体与修正
- Understanding R1-Zero-Like Training: A Critical Perspective (2025) — Dr. GRPO 的出处。同时指出了 GRPO 的 std 归一化偏置和逐 token 平均那个 $1/|a|$ 因子的问题,是本章两处「实现惯例不是推导」的直接来源。
- DAPO: An Open-Source LLM RL System at Scale (2025) — clip-higher、动态采样、token 级损失、超长惩罚,四个补丁都很实用。
- Group Sequence Policy Optimization (2025) — GSPO,序列级重要性比值。文中关于「per-token 比值在 MoE 上不稳」的分析值得读。
- MiniMax-M1 (2025) — CISPO 的出处,「裁权重而不是裁目标」这个区分点。
- Soft Adaptive Policy Optimization (2025) — SAPO,用温度控制的软门替代硬裁剪。
- Tapered Off-Policy REINFORCE (2025) — TOPR,按奖励符号做非对称的 IS 裁剪,是往完全 off-policy 走的一条路。
- VAPO (2025) — 反方向的证据:把 DAPO 的技巧和 Value-Calibrated PPO 结合,说明基于价值的方法相对 GRPO 仍有空间。配套读 What's Behind PPO's Collapse in Long-CoT?。
实现细节与系统
- The N+ Implementation Details of RLHF with PPO (2024) — 把 PPO-RLHF 的每一个实现细节拆开复现,本章「实现细节」一节的精神源头。
- Unpacking DPO and PPO (2024) — 表 10 系统对比了主流开源 RLHF 工具在实现细节上的差异,非常适合选型前读。
- Approximating KL Divergence (Schulman, 2016) — k1/k2/k3 三个 KL 估计器的原始出处,短而必读。
- Your Efficient RL Framework Secretly Brings You Off-Policy RL Training (2025) — 推理后端和训练后端的数值失配,以及为什么需要 TIS。踩过这个坑的人会觉得相见恨晚。
- Asynchronous RLHF: Faster and More Efficient Off-Policy RL for Language Models (2024) — 同步 vs 异步那张对比图的出处。
- Truncated Importance Sampling (Ionides, 2008) — TIS 的统计学原始文献,理解「用小偏差换有界方差」这个权衡。
规模与工程经验
- Tülu 3 (2024) — 完整开源后训练配方;价值函数从 RM 初始化、不同规模用不同的批内梯度步数(8B/70B 用 4,405B 降到 1)等实践细节都在里面。
- InstructGPT (2022) — 「价值网络从奖励模型初始化」这个标准的立法者。
- An Empirical Model of Large-Batch Training (McCandlish et al., 2018) — 梯度噪声尺度与临界 batch size,解释了为什么 RL 需要那么大的 batch。
- LlamaRL (2025) / AReaL (2025) — 两个完全异步的大规模 RL 系统,读它们的架构图比读综述有用。
- INTELLECT-2 (2025) — 跨数据中心的去中心化 RL 训练,异步的极限形态。
- Making RL Fast (Finbarr Timbers) — RL 训练性能优化的实战笔记。
速查
- RL Cheatsheet — 本章所有核心损失函数的一页纸参考,写代码时开着它。