HW4 编程解析:用 GRPO 与 GR-REINFORCE 微调语言模型
八处 TODO、一百多行代码,把「语言生成是一个 MDP」这句话变成了可以跑、可以量化、可以踩坑的工程。本文逐处拆解实现,给出每种写法错掉的具体后果、抓它的断言、26 项测试与 13 个注入 bug 的变异测试结果,以及在一张 RTX 5080 上真实跑出来的曲线与数字。
0. 这份作业在考什么
HW4 的题面是「用可验证奖励(verifiable reward)对语言模型做 RL 后训练」。但它真正的设计意图,是让你用一个 1.5B 的真模型去验证前面几讲里那些看起来很抽象的结论。前三份作业里的 MDP 是 CartPole、HalfCheetah 这类「小状态、小动作、明确的 episode 边界」的环境;这一份作业里的 MDP 长这样:
| MDP 元素 | 在这份作业里是什么 | 要注意的地方 |
|---|---|---|
| 状态 $s_t$ | 提示词加上已经生成的前缀 $(x, y_{\lt t})$ | 状态是确定性地由历史拼接出来的,转移没有随机性 |
| 动作 $a_t$ | 下一个 token $y_t$,动作空间大小 $|\mathcal{A}| = V = 151936$ | 这是一个离散动作空间,只是它有 15 万个动作 |
| 策略 $\pi_\theta(a_t \mid s_t)$ | LM 在位置 $t-1$ 输出的 softmax 分布 | 整份作业最容易错的一行就在这个「$t-1$」上 |
| 奖励 $r$ | 整条完成串生成完之后由解析器算出的一个标量 | 纯终局奖励:$T-1$ 步是 0,最后一步一次性给 |
| 轨迹长度 $T$ | 完成串的 token 数(遇到 EOS 或 max_new_tokens 截断) | 截断意味着轨迹被人为中断,这会引出后面 §11 那个大坑 |
把这张表读懂之后,四门课的内容就都能对上号了:
| 讲次 | 理论结论 | 这份作业里怎么被检验 |
|---|---|---|
| 第 5 讲 · 策略梯度 | $\nabla_\theta J = \E[\nabla_\theta \log \pi_\theta(\tau) \cdot A]$;基线不引入偏差 | GR-REINFORCE 就是把它逐 token 写出来;组内均值就是那个基线 |
| 第 9 讲 · Off-Policy 策略梯度 | 重要性采样比 $\rho = \pi_\theta / \pi_{\text{old}}$ 让旧样本可以复用 | GRPO 的 ppo_epochs 2 就是「同一批 rollout 用两遍」 |
| 第 10 讲 · 进阶策略梯度 | 信任域 / PPO 裁剪;KL 正则约束策略移动幅度 | clip_eps 0.2 的 min 裁剪 + kl_coef 0.05 的 k3 惩罚项 |
| 第 14 讲 · RL with Sequences & LLMs | GRPO 用「组内相对奖励」替代 critic | 整个代码库里没有一个价值网络,优势完全靠同一 prompt 的 $G$ 条采样互相比 |
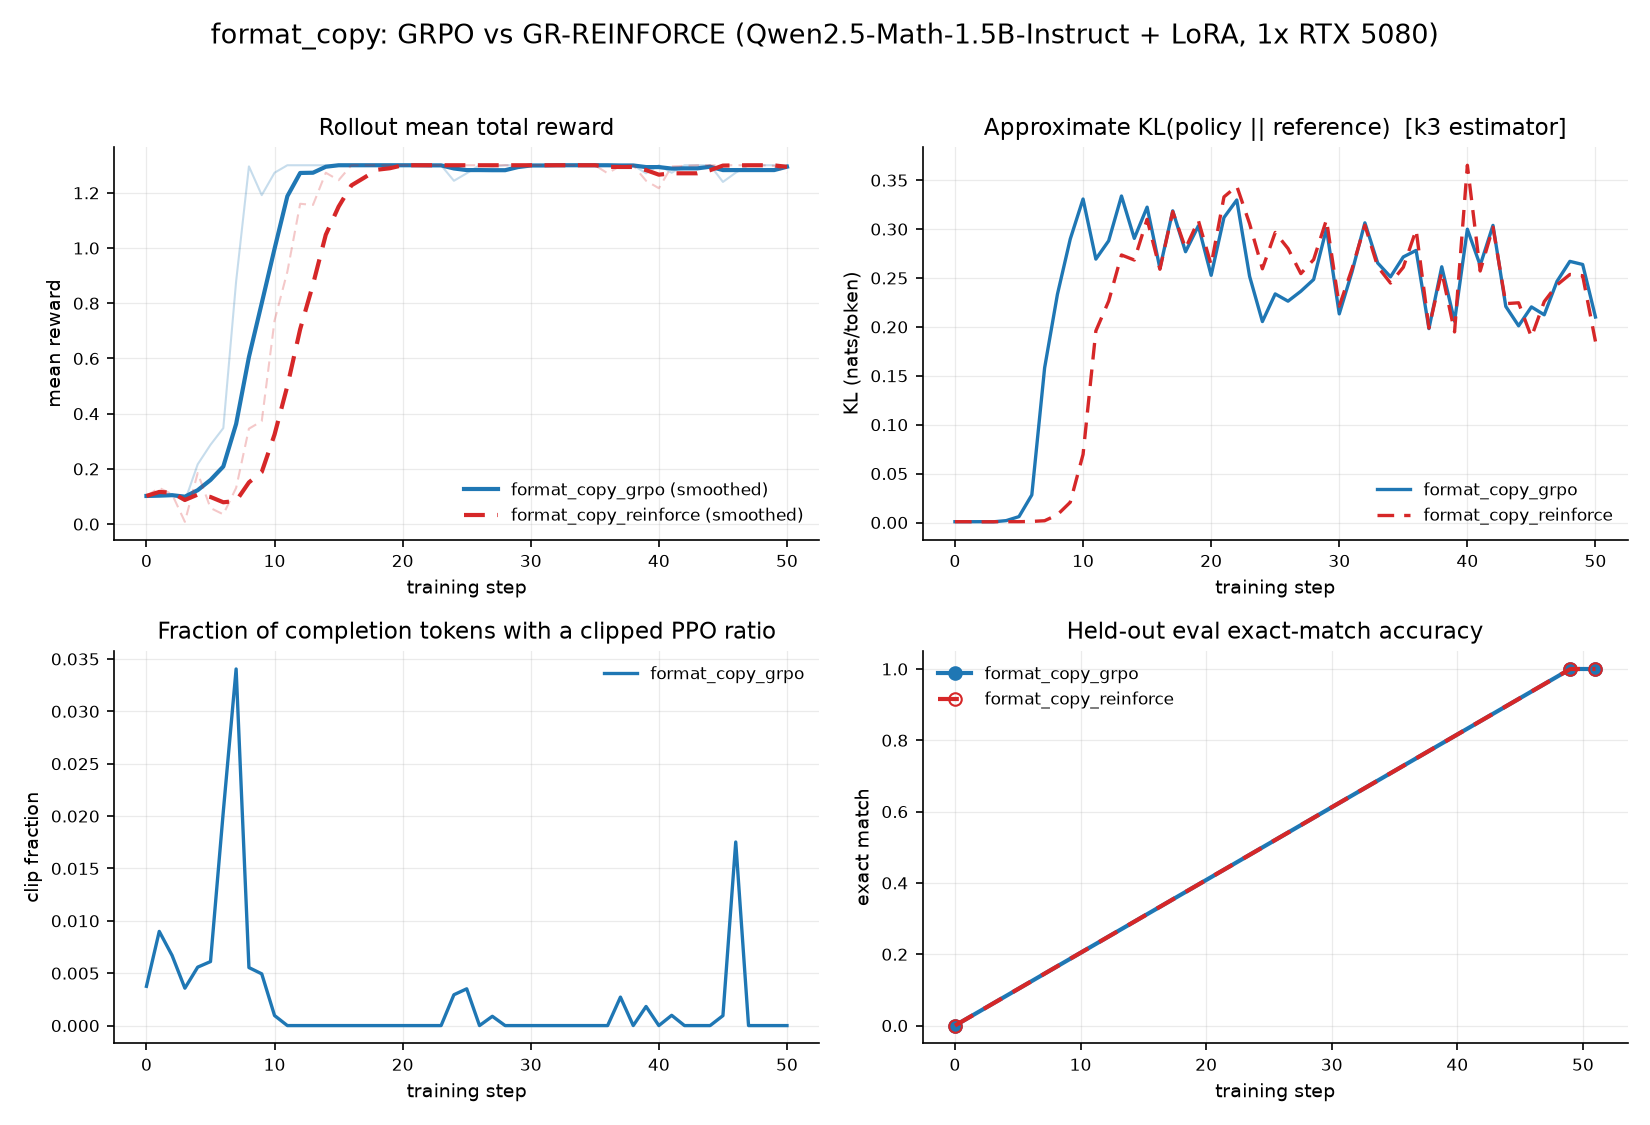
- GRPO 与 GR-REINFORCE 在 format_copy 上的天花板完全一样:最终 rollout reward 都是 ~1.29(理论上限 1.3),eval 精确匹配都是 1.00。差别只在速度:GRPO 第 8 步就冲过 1.2,REINFORCE 要 14 步——约 1.75× 的每批样本效率。
- 这个 1.75× 的来源不神秘:同一批 48 条完成串,REINFORCE 做 1 次优化器更新,GRPO 做 2 次。裁剪只是让第二次(此时已经离策略)安全的保险。
- 裁剪几乎没被触发:clip fraction 均值只有 0.0026,峰值 0.034,而峰值出现的位置恰好是 reward 起飞的那几步。这不是巧合,§9.3 会解释。
- $\rho \equiv 1$ 时 GRPO 与 REINFORCE 的损失值不相等,但梯度逐参数相等。这是「裁剪代理目标可以当策略梯度用」的全部依据,也是本作业最值得考的一个点(§8.4)。
- 最贵的一课:
max_new_tokens设小到 256,100% 的生成被截断,所有 reward=0、所有优势=0、梯度范数恒为 0——这个现象和「代码写错了」在日志上完全无法区分(§11.1)。
还有一件事值得先说清楚:这份作业的 reinforce 并不是课本上那个裸 REINFORCE。它带组相对基线、带 KL 正则、带梯度累积,作业 PDF 专门起了个名字叫 GR-REINFORCE(Group-Relative REINFORCE),只有 CLI flag 还叫 reinforce。所以「GRPO vs REINFORCE」的对比是受控的:两边唯一的算法差异就是 ppo_epochs 和裁剪。别把它读成「PPO vs 香草策略梯度」。
1. 代码结构与形状链条
1.1 目录结构与各文件职责
hw4/
├── train.py                    主循环:rollout → 算优势 → algo.update → 日志/评测
│                               【TODO 5】compute_group_advantages
│                               【TODO 6】maybe_normalize_advantages
├── config.py                   TrainConfig:所有超参的唯一真相来源
├── models/
│   ├── load.py                 加载 Qwen2.5-Math-1.5B(bf16 冻结)+ 挂 LoRA
│   └── logprobs.py             【TODO 1】compute_per_token_logprobs
│                               【TODO 2】build_completion_mask
│                               【TODO 3】approx_kl_from_logprobs
│                               以及 masked_mean / masked_mean_per_row 两个工具
├── rollout/
│   ├── hf_sampler.py           调 model.generate 采样,缓存 old/ref log-probs
│   └── rollout_buffer.py       【TODO 4】iter_minibatches;RolloutBatch 定义
├── rl/
│   ├── base.py                 RLAlgorithm 抽象基类
│   ├── reinforce.py            【TODO 7】GR-REINFORCE 的 minibatch 更新块
│   └── grpo.py                 【TODO 8】GRPO 的裁剪代理目标
└── tasks/
    ├── format_copy.py          玩具任务:把整数抄进 <answer> 标签
└── math_hard.py 真任务:MATH level-5 子集,\boxed{} 解析grep TODO 数出来是 16 个,不是 8 个
每一处 TODO 由两行组成:一个 # TODO(student): 注释块头,和一行
raise NotImplementedError("student TODO: ...")。代码站点只有 8 个。
建议实现完之后把注释块保留下来(改成 DONE(student)),因为那些注释就是接口契约文档,
后面调试时比你自己的记忆可靠。
作业 PDF §4.1 给的实现顺序是有道理的,别自己发明:log-probs → minibatching → advantages → REINFORCE → GRPO。原因是就连 GR-REINFORCE 也依赖 compute_group_advantages(它的基线就是组内均值),所以优势没写对之前,你根本没法判断 REINFORCE 是不是写对了。
1.2 一次训练迭代都发生了什么
用 format_copy 的官方超参(batch_size 8、group_size 6、max_new_tokens 24)走一遍:
- 取 prompt:从任务里取 $B = 8$ 个 prompt,套上 chat template,左填充(left-pad)成同一长度 $P$。
- 采样:
model.generate(..., num_return_sequences=6),每个 prompt 采 $G = 6$ 条。得到 $N = B \times G = 48$ 条完整序列,长度 $L = P + (\text{实际生成长度})$,短的那些用 pad 补到齐。 - 缓存 log-probs:用当前策略(此刻它就是 $\pi_{\text{old}}$)和冻结的参考策略各前向一次,把逐 token log-prob 存下来。参考策略在 LoRA 场景下不需要第二份权重——把 adapter 关掉的基座模型就是 $\pi_{\text{ref}}$。
- 算奖励:解析 48 条完成串的文本,得到
rewards,形状[48]。 - 算优势:reshape 成
[8, 6],组内标准化,再展平回[48]。 - 更新:切成 minibatch(每个 8 条)→ 前向算新 log-prob → 损失 → 反传 → 梯度累积 6 次 → 一次
optimizer.step()。GRPO 把 5–6 重复ppo_epochs=2遍。
1.3 张量形状链条(学生最常卡的地方)
这份作业的形状不难,但有三处偏移会反复咬人:logits 与 target 差一位、mask 是 $L-1$ 列不是 $L$ 列、优势是每条序列一个标量而不是每 token 一个。下表把 format_copy 一次迭代里所有关键张量钉死($V = 151936$):
| 阶段 | 变量 | 形状 | 说明 |
|---|---|---|---|
| 分词 | prompt input_ids | [8, P] | 左填充,所以 pad 在前面 |
| 分词 | prompt_input_len | 标量 $= P$ | 后面 mask 的唯一分界线 |
| 生成 | sequences / input_ids | [48, L] | $N = B\cdot G = 48$;$L = P + \text{gen}$,$\text{gen} \le 24$ |
| 生成 | attention_mask | [48, L] | $=(\texttt{sequences} \ne \texttt{pad\_id})$,前后都可能有 0 |
| 前向 | out.logits | [48, L, V] | 本步最大的一块显存,bf16 下 $48 \cdot L \cdot 151936 \cdot 2$ 字节 |
| TODO 1 | shift_logits | [48, L-1, V] | logits[:, :-1, :] |
| TODO 1 | shift_targets | [48, L-1] | input_ids[:, 1:]——错位就在这里 |
| TODO 1 | logprobs | [48, L-1] | 注意是 $L-1$,不是 $L$ |
| TODO 2 | completion_mask | [48, L-1] float | 第 $t$ 列对应 input_ids[:, t+1] |
| 缓存 | old_logprobs / ref_logprobs | 均 [48, L-1] | rollout 时算好、detach、可搬到 CPU |
| 奖励 | rewards | [48] | prompt-major:同一 prompt 的 6 条是连续的 |
| TODO 5 | grouped | [8, 6] | view(N//G, G),不能是 [6, 8] |
| TODO 5 | advantages | [48] | 每条完成串一个标量 |
| TODO 4 | minibatch 各字段 | 第一维 → [8] | 所有字段必须用同一个索引张量切 |
| TODO 7/8 | adv.unsqueeze(1) | [8, 1] | 广播到 [8, L-1] 与逐 token 量相乘 |
| TODO 8 | ratio | [8, L-1] | $\rho$ 是逐 token 的,优势是逐序列的 |
| TODO 7/8 | seq_obj / seq_logp | [8] | 沿 token 维做 masked 平均后塌缩 |
| 损失 | loss | 标量 | 再沿 batch 维取 .mean() |
1.4 关键超参一览
| 超参 | format_copy | math_hard | 作用 |
|---|---|---|---|
steps | 51 | 201 (REINFORCE) / 501 (GRPO) | 训练迭代数 = rollout 批数 |
batch_size × group_size | 8 × 6 = 48 | 8 × 8 = 64 | 每批采样的完成串总数 $N$ |
minibatch_size / grad_accum_steps | 8 / 6 | 8 / 8 | 乘积 = $N$ ⇒ REINFORCE 每批恰好 1 次优化器更新 |
ppo_epochs | 2(仅 GRPO) | 2(仅 GRPO) | 同一批 rollout 复用几遍 ⇒ 优化器更新次数 ×2 |
max_new_tokens | 24 | 512 | 见 §11.1,这个数设小了会静默毁掉整个实验 |
lr / warmup_steps | 3e-5 / 10 | 3e-5 / — | 只训 LoRA 参数,所以可以用比 SFT 大的 lr |
clip_eps / kl_coef | 0.2 / 0.05 | 0.2 / 0.05 | 信任域宽度 / KL 惩罚系数 $\beta$ |
max_grad_norm / adv_clip | 0.5 / 5.0 | 0.5 / 5.0 | 梯度裁剪 / 优势值裁剪,两道数值保险 |
| LoRA | r=16, alpha=32, dropout=0.05,挂在 q,k,v,o,gate,up,down | 18.5M 可训练参数(fp32),基座 bf16 冻结 | |
注意 minibatch_size × grad_accum_steps = batch_size × group_size 这个等式:它是整份作业实验设计的基石。它保证 GR-REINFORCE 每批 rollout 恰好做一次优化器更新(严格 on-policy),而 GRPO 靠 ppo_epochs 2 做两次。这样两个算法的 rollout 预算完全相同,唯一变量就是「同一批数据用几遍」。作业 PDF §7.5 专门解释了这一点。
2. TODO 1:compute_per_token_logprobs——那个致命的错位
2.1 要求
代码注释写得很明确:
For token positiont>=1, use logits at positiont-1to score target tokenx_t:log p(x_t | x_<t) = log_softmax(logits[:, t-1, :])[x_t]. … Respectenable_grad: whenenable_grad=Falsethis function should not build an autograd graph.
输入 input_ids、attention_mask 都是 [B, L],输出是 [B, L-1]。
2.2 数学
因果语言模型(causal LM)在位置 $t$ 输出的 logits 是下一个 token 的分布:
$$ \pi_\theta(\cdot \mid x_{\le t}) = \softmax\big(\text{logits}[:, t, :]\big). $$所以要给已经采出来的 token $x_{t}$ 打分,必须去查位置 $t-1$ 的 logits:
$$ \log \pi_\theta(x_t \mid x_{\lt t}) = \log \softmax\big(\text{logits}[:, t-1, :]\big)\big[x_t\big], \qquad t = 1, \dots, L-1. $$$t=0$ 的 token 没有任何东西预测它(它是序列的第一个 token),所以输出长度是 $L-1$,配对关系是
$$ \underbrace{\text{logits}[:, {:}{-}1, :]}_{[B,\,L-1,\,V]} \quad\longleftrightarrow\quad \underbrace{\text{input\_ids}[:, 1{:}]}_{[B,\,L-1]}. $$cross_entropy 而不是 log_softmax + gather
按定义写出来是两步:先 $\log\softmax$ 得到一个 [B, L-1, V] 的稠密张量,再 gather 出目标位置。
但交叉熵本身就是这两步的融合算子:
$$\text{CE}(\text{logits}, y) = -\log\softmax(\text{logits})[y].$$
所以 -F.cross_entropy(..., reduction='none') 直接给出我们要的 log-prob,
不需要再实例化第二个 [B, L-1, V] 张量。在 $V \approx 152\,\text{k}$ 时这一个张量就是整步里最大的一块分配,
省掉它不是微优化,是能不能跑起来的问题。
2.3 实现
ctx = torch.enable_grad() if enable_grad else torch.no_grad()
with ctx:
    out = model(input_ids=input_ids, attention_mask=attention_mask, use_cache=False)
    logits = out.logits                       # [B, L, V]

    shift_logits  = logits[:, :-1, :]         # [B, L-1, V]
    shift_targets = input_ids[:, 1:]          # [B, L-1]
    B, Lm1, V = shift_logits.shape

    # 在 softmax 之前升到 fp32(不是之后!)
    compute_dtype  = torch.promote_types(shift_logits.dtype, torch.float32)
    rows_per_chunk = _rows_per_chunk(V, compute_dtype)      # 把瞬时缓冲限制在 1 GiB
    flat_logits  = shift_logits.reshape(B * Lm1, V)
    flat_targets = shift_targets.reshape(B * Lm1)
    if rows_per_chunk >= B * Lm1:
        nll = F.cross_entropy(flat_logits.to(compute_dtype), flat_targets, reduction="none")
    else:
        nll = torch.cat([
            F.cross_entropy(flat_logits[s : s + rows_per_chunk].to(compute_dtype),
                            flat_targets[s : s + rows_per_chunk], reduction="none")
            for s in range(0, B * Lm1, rows_per_chunk)
        ], dim=0)
    logprobs = (-nll).view(B, Lm1)
return logprobs
三个值得单独说的细节:
(a) use_cache=False。 这是一次教师强制(teacher forcing)的整序列前向,不是自回归解码,KV cache 只会白占显存。
(b) 升精度要在 softmax 之前。 F.cross_entropy 吃 bf16 输入就吐 bf16 输出。bf16 只有 8 位尾数,一个 $-5$ 的 log-prob 会被量化到 $\pm 0.02$。这个误差原封不动地进到 PPO 比值里:
而 clip_eps = 0.2——也就是说,纯粹的数值噪声已经占到信任域宽度的 10%。本地实测:bf16 输出路径相对 fp64 参考误差最大 6.2e-2 nats,fp32 路径 1.1e-6。
(c) 分块(chunking)。 fp32 副本要 $B \cdot (L-1) \cdot V \cdot 4$ 字节。在 rollout 那次前向里 $B = N = 48$(甚至 64),这一块能到十几 GB。所以按行切块、每块上限 1 GiB;由于 enable_grad=False,每块用完立刻释放。用 torch.promote_types 而不是 .float(),是为了不把测试里的 fp64 玩具模型降精度——这个坑真的踩到过(§11.4)。
2.4 易错点与具体后果
logits[:, 1:] 配 input_ids[:, 1:]
形状照样是 [B, L-1],代码照样跑,损失照样下降——但你在用第 $t$ 个 token 的分布去评价第 $t$ 个 token 自己,
这是标签泄漏(label leakage)。后果非常具体:模型对每个 token 都极度自信,
返回的 log-prob 全部趋近 $0$;于是 $\rho = \exp(\ell_{\text{new}} - \ell_{\text{old}}) \approx 1$ 恒成立,
裁剪永不触发,KL 恒等于 0,梯度信号退化成噪声。
日志上你看到的是:一切指标都异常「平静」,reward 曲线一动不动。
这是最难自查的一类 bug——它不崩,它只是不学。
input_ids 对齐,在前面补一个 0 列。这会让后面所有 mask、
old_logprobs、ref_logprobs 的列索引整体偏移一位,第一个完成 token 的分数被算到 prompt 的最后一个 token 头上。
在 format_copy 上表现为:模型学会了在 prompt 末尾「预支」答案,eval 精确匹配卡在 0.3 左右上不去。
2.5 怎么验证
光对着自己的实现看是看不出错位的,必须造一个会因为错位而给出完全不同数值的模型。测试里的做法很漂亮:
# logits[0, t, v] = +10 当且仅当 v == t:位置 t 极度自信地预测 token id 恰好是 t
logits = torch.full((1, L, V), -10.0, dtype=torch.float64)
for t in range(L):
    logits[0, t, t] = 10.0
ids = torch.arange(L).view(1, L)                 # [0, 1, 2, 3, 4]
got = compute_per_token_logprobs(model, ids, torch.ones_like(ids))

# 正确对齐:第 t 项用 logits[t](押注 token t)去打 target ids[t+1] = t+1 的分
#           ⇒ 极低的 log-prob ≈ -20
assert bool((got[0] < -15.0).all()), "off-by-one detector"
# 而错位版本(用 logits[t+1] 打 ids[t+1])会得到 ≈ 0,必须与我们的输出不同
assert not torch.allclose(got[0], wrong_late, atol=1e-3)
关键设计在于把 input_ids 设成 [0,1,2,3,4],让「正确答案」和「错位答案」相差 20 nats。这样断言不需要任何容差调参:$-20$ 和 $0$ 之间隔着一整个数量级的置信度。test_logprobs_match_manual_log_softmax_gather 则在 fp64 下把融合 CE 路径和手写 log_softmax+gather 对到 1e-10,确保「省显存」没有以「换答案」为代价;test_logprobs_enable_grad_flag 断言 enable_grad=False 时 requires_grad 为假且数值不变。
3. TODO 2:build_completion_mask——别把 prompt 也训了
3.1 要求
return a float mask of shape[B, L-1]… The per-token logprob tensor is indexed bytin[0, L-2], where entrytscores tokeninput_ids[:, t+1]. Therefore:mask[:, t]should be 1 iff token(t+1)belongs to the generated completion and is not padding.
3.2 数学:两个条件的合取
一个位置该不该进损失,取决于两件独立的事:它是不是模型自己生成的,以及它是不是真 token。写成布尔式,先在目标位置 $j \in [0, L-1]$ 上定义:
$$ \text{keep}[b, j] = \underbrace{\mathbb{1}[\,j \ge P\,]}_{\text{不是 prompt}} \;\wedge\; \underbrace{\text{attention\_mask}[b, j]}_{\text{不是 padding}}, $$其中 $P = $ prompt_input_len。然后因为 log-prob 张量的第 $t$ 列打的是目标位置 $t+1$,把 keep 的第 0 列丢掉就得到对齐的 mask:
换个说法记更牢:第一个完成 token 位于 input_ids 的下标 $P$,对应 log-prob 的下标 $P-1$。
3.3 为什么两侧都可能有 padding
这是本节最容易被忽略的前提。tokenize_chat_prompts 对 prompt 做的是左填充(生成时必须左填充,否则 generate 会从一堆 pad 之后继续写),而 HFSampler 用 attention_mask = (sequences != pad_id) 重建掩码。于是一条序列的布局是:
[PAD PAD PAD | prompt tokens | completion tokens | PAD PAD]
 <----------- P ------------>                     ↑ 早停 EOS 之后
 左填充在这里                                       右填充在这里
所以只用「$j \ge P$」是不够的(右边的 pad 会被算进去),只用 attention_mask 也是不够的(prompt 会被算进去)。两个条件必须同时用。
3.4 实现
B, L = input_ids.shape
positions     = torch.arange(L, device=input_ids.device).unsqueeze(0)  # [1, L]
is_completion = (positions >= int(prompt_input_len))                   # [1, L] 广播
is_real       = attention_mask.bool()                                  # [B, L]
keep          = is_completion & is_real                                # [B, L]
# keep 的第 j 列 -> log-prob 的第 j-1 列,所以丢掉 j = 0
return keep[:, 1:].to(dtype=torch.float32, device=input_ids.device)
返回 float 而不是 bool,因为下游 masked_mean 要做乘法和求和;返回前显式指定 device,避免 torch.arange 落在 CPU 上引发隐式同步。
3.5 易错点与具体后果
is_completion 这一半。此时目标函数变成
$-\sum_i A_i \cdot \overline{\log \pi_\theta(\text{整条序列})}$,
其中「整条序列」包含 prompt 本身。对高优势样本,你在提高模型复述 prompt 的概率——
这已经不是 RL 了,这是在做一个奖励加权的 SFT。
在 format_copy 上的具体表现:模型开始复读题面("Return the final answer..."),
<answer> 标签奖励 (+0.2) 拿不到,reward 卡在 0.1 附近不动。
更糟的是,prompt token 数远多于 24 个完成 token,所以这一项会主导整个梯度。
keep[:, :-1])
这是一个「差一位」的近亲:mask 整体左移一位,于是prompt 的最后一个 token 被计入损失,
而完成串的最后一个 token 被排除。后者尤其致命——完成串的最后一个 token 常常是
</answer> 的收尾或者 EOS,也就是「格式奖励」直接对应的那个动作,你恰好把它从梯度里删掉了。
现象:strict-XML 那 +0.1 永远拿不到,reward 天花板停在 1.2 而不是 1.3。
attention_mask[:, t] 而不是 [:, t+1]
和上一条同源,但更隐蔽:只在有右填充的行上出错(也就是提前 EOS 的行)。
在 format_copy 上一开始几乎所有行都跑满 24 token,看不出来;等模型学会了简短作答、大量行开始早停,
才突然表现为「学到一半 reward 掉下去」。
3.6 怎么验证
test_build_completion_mask_positionwise 的策略是逐格重新推导:构造一个既有左填充 prompt、又有早停 EOS 的批次,然后对每一个 $(b, t)$ 单元格,用一条完全独立写出来的规则算一遍期望值,再和函数输出比。这种「独立复算」比「和某个魔法常量比」强得多,因为它不会因为你改了实现细节就失效。
它还专门包含一行完成 token 数为零的样本。这不是为了刁难:Reinforce.update 和 GRPO.update 都靠 mask.sum() == 0 来跳过空 minibatch,如果你的 mask 在这种行上错误地返回了非零,除以 mask.sum() 的地方就会给出一个没有意义的值,而不是被跳过。
test_build_completion_mask_first_completion_token_is_scored 则单点钉死那个最容易差一位的边界:第 $P-1$ 列必须是 1,第 $P-2$ 列必须是 0。这一条断言就能同时抓住上面误区 1 和误区 2。变异测试里,「mask 保留 prompt」被 2 个测试抓到,「mask 整体移位」被 3 个测试抓到。
4. TODO 3:approx_kl_from_logprobs——k3 估计量为什么长这样
4.1 要求
作业 PDF §2.3 定义 $\Delta(a) = \log \pi_{\text{ref}}(a \mid s) - \log \pi_\theta(a \mid s)$,然后要求实现
$$ \hat k(a) = e^{\Delta(a)} - \Delta(a) - 1, $$并在完成 token 上做 masked 平均。$\Delta$ 先裁到 $[-20, 20]$ 再取指数。报告题第 1 问就是让你解释「为什么这是 KL 的合法采样估计量,以及为什么精确的全词表 KL 贵得多」。
4.2 数学:无偏性
4.3 数学:非负性——这才是用 k3 的真正理由
朴素估计量 $-\Delta(a)$ 也是无偏的(上面推导的第二个等号就是它)。既然更简单又同样无偏,为什么不用?因为单个样本的取值可以是负的。
具体来说:如果当前策略对采到的这个 token 给的概率比参考策略还低,那么 $\Delta(a) \gt 0$,于是 $-\Delta(a) \lt 0$。这一项进到损失里是 $+\beta \cdot (-\Delta)$,是个负数——也就是说,优化器会发现「让策略在这个 token 上继续远离参考策略」能降低损失。KL 惩罚变成了 KL 奖励。
k3 从结构上杜绝了这件事。令 $x = e^{\Delta} = \pi_{\text{ref}}(a) / \pi_\theta(a) \gt 0$,则
$$ \hat k = x - \log x - 1 . $$这个性质的意义:每一个采样 token 贡献的都是一个非负的量,当策略与参考在这个 token 上完全一致($x=1$)时贡献恰好为 0,比值往任何一个方向偏离都让它变大。这才像一个「散度」该有的样子——它是逐样本就有意义的局部代理,而 $-\Delta$ 只是一个期望上正确、单点可以乱跳的有符号量。
4.4 实现
delta     = (ref_logprobs - new_logprobs).clamp(-log_ratio_clip, log_ratio_clip)
per_token = torch.exp(delta) - delta - 1.0
return masked_mean(per_token, mask, eps=eps)
三行,但每一行都有讲究:
- 顺序是
ref - new,不是new - ref。 符号反了,$\hat k$ 会变成 $e^{-\Delta} + \Delta - 1$,它仍然非负(因为 $f$ 关于 $\log x$ 不对称但两边都为正),但它估的是 $\KL(\pi_{\text{ref}} \| \pi_\theta)$ 的反向,惩罚的方向就错了。 - 先 clamp 再 exp。 $e^{20} \approx 4.9\times 10^{8}$ 已经足够大,而 $e^{100}$ 直接 inf。一个 token 的 inf 会让整个 minibatch 的损失变成 nan,然后
skipped_nonfinite计数器开始跳。 masked_mean是全局的(所有序列所有 token 一起平均),不是 per-row。 KL 惩罚是一个标量正则项,不像策略梯度项那样需要保持「每条序列等权」。
4.5 为什么不算精确 KL(报告题第 1 问的后半段)
精确的逐位置全词表 KL 是
$$ \KL\big(\pi_\theta(\cdot \mid s_t) \,\|\, \pi_{\text{ref}}(\cdot \mid s_t)\big) = \sum_{v=1}^{V} \pi_\theta(v \mid s_t) \log \frac{\pi_\theta(v \mid s_t)}{\pi_{\text{ref}}(v \mid s_t)} . $$要算它,你需要在每一个位置同时持有策略和参考的稠密 $\log\softmax$,也就是两个 [B, L, V] 张量。按 math_hard 的配置 $B=8\times8=64$、$L=1024$、$V=151936$,bf16 下每个约
两个就是 40 GB,还没算这之上的归约。而采样估计量只需要两个 [B, L-1] 的向量——小了 15 万倍。计算上也一样:稠密归约要遍历整个词表,采样估计只要一次 gather。代价是它只在期望上正确,方差由采样引入——但在这个尺度上,这个交换是没有争议的。
4.6 怎么验证
test_kl_is_nonnegative_and_matches_k3_formula 有一个特别值得学的设计:它不仅断言「我们的估计量在 50 组随机抽样上全都非负」,还反过来断言朴素估计量 $-\Delta$ 在同一批抽样上确实取到了负值。
# 断言 1:k3 恒非负
assert bool((per_token >= -1e-12).all())
# 断言 2(防止测试空转):naive -delta 在同一批样本上确实会变负
assert bool((-delta < 0).any()), "test is vacuous"没有第二条断言,第一条就可能是空转的——万一随机数恰好全落在 $\Delta \lt 0$ 那一侧,两种实现都非负,测试通过但什么也没证明。这个「反向断言」的模式在写数值测试时非常有用:先证明你的测试有能力失败,再让它通过。
另外三个测试补齐了剩余性质:test_kl_is_zero_when_policy_equals_reference($\pi_\theta = \pi_{\text{ref}}$ ⇒ 严格 0,这一条直接抓「丢了 $-1$」的 bug),test_kl_grows_as_policies_diverge(单调性),test_kl_ignores_masked_positions(往被 mask 掉的位置塞垃圾值,输出必须不变)。变异测试里「KL 改成朴素 $-\Delta$」被 2 个测试抓到,「KL 漏掉 $-1$」被 3 个测试抓到。
5. TODO 4:iter_minibatches——最无聊也最危险的一处
5.1 要求
Slice ALL tensor fields consistently with the same minibatch indices. Keeptask_names/completion_textsaligned with the same indices when present.
RolloutBatch 有 7 个张量字段(input_ids、attention_mask、completion_mask、old_logprobs、ref_logprobs、rewards、advantages)加 2 个 Python list(调试用)。9 个字段必须用同一个索引张量切。
5.2 实现
n = int(batch.input_ids.shape[0])
if n == 0:
    return
mb_size = max(1, int(minibatch_size))

if shuffle:
    order = torch.randperm(n, generator=generator, device=batch.input_ids.device)
else:
    order = torch.arange(n, device=batch.input_ids.device)

def _take_list(items, idx):
    return None if items is None else [items[int(j)] for j in idx]

for start in range(0, n, mb_size):
    idx = order[start : start + mb_size]
    mb = RolloutBatch(
        input_ids=batch.input_ids[idx],
        attention_mask=batch.attention_mask[idx],
        completion_mask=batch.completion_mask[idx],
        old_logprobs=batch.old_logprobs[idx],
        ref_logprobs=batch.ref_logprobs[idx],
        rewards=batch.rewards[idx],
        advantages=batch.advantages[idx],
        task_names=_take_list(batch.task_names, idx),
        completion_texts=_take_list(batch.completion_texts, idx),
    )
    if device is not None:
        mb = mb.to(device)
    yield mb
generator 参数不是装饰:GRPO 的两个 PPO epoch 共用同一个 rng,所以第二遍会得到不同的分组——这是有意的,等价于对同一批数据做两次不同划分的 SGD。同时它又是可复现的(rng.manual_seed(self._next_update_seed())),所以两次运行结果一致。
idx = perm[...] 切了 input_ids,然后直接把原 advantages 的对应切片传进去
(比如用了 batch.advantages[start:start+mb_size])。
后果是完成串 $j$ 的 log-prob 被乘上了完成串 $i$ 的优势。
这个 bug 在单元层面完全不可见:形状对、数值有限、损失照样降。
它在训练上的表现是——梯度期望仍然是「随机重排后的策略梯度」,其期望值近似为
$\E[A]\cdot\E[\nabla \log \pi]$,而组相对优势的均值恰好是 0,所以你得到的是一个期望为零的梯度,
训练就是纯噪声游走。reward 曲线会在初值附近上下抖动 51 步然后什么也没发生。
验证靠 test_iter_minibatches_partitions_and_keeps_fields_aligned:给每条样本一个唯一的「指纹」(input_ids 第一个 token = 样本序号,advantages = 序号 × 0.1,task_names = 字符串序号),然后断言每个 minibatch 里三者的序号一致;再断言所有 minibatch 拼起来恰好是 $\{0, \dots, N-1\}$ 的一个划分。变异测试里「只打乱 input_ids 不打乱 advantages」被 4 个测试抓到——这是覆盖最厚的一处,因为它同时污染了 REINFORCE 和 GRPO 的损失恒等式测试。
6. TODO 5 / 6:组相对优势
6.1 要求与数学
作业 PDF §2.2:对 prompt $x_i$ 的 $G$ 条采样,
$$ A_{i,j} = \frac{r_{i,j} - \mu_i}{\sigma_i + \varepsilon}, \qquad \mu_i = \frac{1}{G}\sum_{j=1}^{G} r_{i,j}, \qquad \sigma_i = \sqrt{\frac{1}{G}\sum_{j=1}^{G}(r_{i,j}-\mu_i)^2}. $$注意 $\sigma_i$ 用的是 $1/G$ 而不是 $1/(G-1)$——总体标准差(population std),PyTorch 里是 std(..., unbiased=False)。
这就是 GRPO 相对 PPO 的核心取舍:不训 critic,用同一 prompt 的其他采样当基线。 好处是省掉一个和策略同规模的价值网络(显存与训练成本直接减半),坏处是你必须为每个 prompt 采 $G$ 条才能构造基线,而且这个基线是逐 prompt的,不能跨 prompt 共享信息。
6.2 prompt-major:这个 reshape 反了会怎样
rewards 到达时是 prompt-major 的:同一个 prompt 的 $G$ 条采样是连续的。因为 generate(num_return_sequences=G) 就是这样排的。所以
grouped = rewards.view(n // g, g)     # [num_groups, group_size]  ✓
# 而不是
grouped = rewards.view(g, n // g) # [group_size, num_groups] ✗math_hard 上表现为 reward 在 0.26 附近永久震荡,看起来像「任务太难学不动」。
测试用了一个极简的构造把它一击必杀:rewards = [0,0,0,1,1,1],group_size = 3。
| 读法 | 分组 | 输出优势 |
|---|---|---|
正确(prompt-major,[2, 3]) | {0,0,0} 与 {1,1,1} | 两组都退化 ⇒ 全 0 |
转置([3, 2]) | {0,1}、{0,1}、{0,1} | ±1 交替 |
全 0 和 ±1,没有任何容差调参的余地。这就是 test_group_advantages_use_prompt_major_reshape。
6.3 退化组:零梯度与 NaN
当一个组里所有采样拿到完全相同的奖励时,$\sigma_i = 0$,分子也全是 0。数学上 $A = 0$,但代码上 $0 / (0 + \varepsilon)$ 在低精度下可能产生非规格化数(denormal)甚至 NaN。所以要显式判定:
grouped = rewards.view(n // g, g)
mean = grouped.mean(dim=1, keepdim=True)
std  = grouped.std(dim=1, unbiased=False, keepdim=True)      # 总体标准差
adv  = (grouped - mean) / (std + eps)

degenerate = std <= eps
adv = torch.where(degenerate.expand_as(adv), torch.zeros_like(adv), adv)
return adv.reshape_as(rewards)
另外三种边界情况直接返回全 0 而不是崩溃:group_size <= 1(一个样本没法和谁比)、rewards.numel() % group_size != 0(缓冲区不整齐)、空缓冲区。
format_copy 上,一旦模型学会了任务,每一组的 6 条采样全都拿满分,于是全组优势为 0,梯度为 0。
在 math_hard 上则相反:题太难,4 条采样全错,同样全组为 0。
这解释了 figures/format_copy_diagnostics.png 右侧那条曲线——
「非零优势的完成串比例」在第 7 步冲到 1.0(此时组内有对有错,信号最强),
然后在第 12 步之后基本掉到 0(任务解决了,没什么可学的)。
训练自动停止了,这正是组相对优势的一个优雅性质:它不需要额外的早停逻辑。
反过来说,如果你在 math_hard 上看到这条曲线一直是 0,那不是收敛,那是所有组都全错——
去看 §11.1 那个截断的坑。
6.4 maybe_normalize_advantages
这一处最简单:如果 enabled,对整批优势再做一次 z-score;否则原样返回。
if not enabled or advantages.numel() == 0:
    return advantages
mean = advantages.mean()
std  = advantages.std(unbiased=False)
return (advantages - mean) / (std + eps)
TrainConfig 里默认 False,本文所有实验也都关着。值得想一想为什么默认关:组内标准化已经把每组的尺度归一了,再来一次批级标准化,效果是让「组间方差大的批次」被压扁——而组间方差本身携带着「这批 prompt 有多难」的信息。开着不会崩,但它和 §6.1 那个精确的 $\frac{G-1}{G}$ 关系就对不上了,做消融时要记得它是个混杂因素。
7. TODO 7:GR-REINFORCE 的更新
7.1 数学
作业 PDF §2.4。先定义序列平均对数概率:
$$ \bar\ell_i(\theta) = \frac{1}{T_i}\sum_{t=1}^{T_i} \log \pi_\theta(y_{i,t} \mid x_i, y_{i,\lt t}), $$然后
$$ L^{\text{GR-REINFORCE}}_{\text{pg}}(\theta) = -\frac{1}{N}\sum_{i=1}^{N} A_i \,\bar\ell_i(\theta), \qquad L^{\text{GR-REINFORCE}} = L_{\text{pg}} + \beta \,\widehat{\KL}(\pi_\theta \| \pi_{\text{ref}}). $$math_hard 上这会直接演化成长度攻击:模型发现「写长一点」能放大正优势的梯度,
于是回答越来越长,直到全部撞上 max_new_tokens。
除以 $T_i$ 就把这条捷径堵死了。
(注意这是一个有偏的改动——它改变了不同长度轨迹之间的相对权重。
DrGRPO 那篇论文讨论的正是这个归一化项引入的偏差,感兴趣可以去读。)
7.2 实现
new_logp = compute_per_token_logprobs(model, mb.input_ids, mb.attention_mask)

# 只在完成 token 上做序列内平均 -> [B_mb]
seq_logp = masked_mean_per_row(new_logp, mask)

# 组相对基线下的 REINFORCE:最大化 A_i * logpi_i
pg_loss = -(adv * seq_logp).mean()

kl      = approx_kl_from_logprobs(new_logp, mb.ref_logprobs, mask)
entropy = -masked_mean(new_logp, mask)          # 仅用于日志,不进损失

loss = (pg_loss + cfg.kl_coef * kl) / max(1, grad_accum_steps)
四个容易忽略的点:
mb.old_logprobs完全没用到。 这不是遗漏——GR-REINFORCE 是严格单遍 on-policy 的,$\pi_\theta$ 就是 $\pi_{\text{old}}$,比值恒等于 1,写出来也是乘 1。如果你在这里用上了old_logprobs,说明你在写 GRPO。- 负号。 优化器做的是梯度下降,而我们要最大化 $A_i \bar\ell_i$。符号反了的后果是最戏剧化的:策略会朝低奖励方向更新,
format_copy的 reward 会从 0.102 单调掉向 0,同时 KL 迅速涨到很大——模型确实在努力学,只是学反了。 adv已经detach()过。 优势是数据,不是可微量。在update顶部还先做了clamp(-adv_clip, adv_clip)(默认 5.0),防止某个组的 $\sigma$ 极小导致优势爆到几百。- 熵只记录不入损失。 代码注释里明确写了
for LOGGING ONLY。有些实现会加熵奖励防止过早收敛,这份作业不加——它靠 KL 惩罚来限制策略移动(见 §9.4 的熵曲线)。
7.3 梯度累积的正确姿势
注意 loss 除以了 grad_accum_steps。这一步不能省:累积 $K$ 个 minibatch 的梯度再更新,等价于用 $K$ 倍大的 batch,所以每个 minibatch 的损失要先除以 $K$,否则梯度大小是应有的 $K$ 倍,配合 max_grad_norm 0.5 会变成「每一步都被裁到上限」——学习率实际上被 $K$ 倍放大又被裁剪压回来,行为难以预测。
test_grad_accum_reduces_optimizer_steps_but_not_the_gradient 精确地钉住这件事:同一批数据,grad_accum_steps=1(多次 step)与 grad_accum_steps=K(一次 step)下,累计到参数上的梯度必须相等,只是优化器步数不同。
7.4 怎么验证
test_reinforce_loss_equals_negative_mean_adv_times_seq_logprob 直接把损失恒等式手算一遍来对:用一个玩具因果 LM,独立地算出每条序列的 masked 平均 log-prob,然后断言
test_reinforce_kl_penalty_enters_the_loss 则把 kl_coef 从 0 调到某个值,断言损失正好增加 $\beta \hat k$——这一条抓的是「算了 KL 但忘了加进 loss」这种半成品 bug(它很常见,因为 KL 本来就要算出来记日志)。变异测试里「REINFORCE 丢掉优势加权」和「REINFORCE 符号反转」各被 3 个测试抓到。
8. TODO 8:GRPO 的裁剪代理目标
8.1 数学
令 $\pi_{\text{old}}$ 是采出这批 rollout 的策略。逐 token 的重要性比值(importance ratio)
$$ \rho_{i,t}(\theta) = \frac{\pi_\theta(y_{i,t} \mid x_i, y_{i,\lt t})}{\pi_{\text{old}}(y_{i,t} \mid x_i, y_{i,\lt t})} = \exp\big(\ell^{\text{new}}_{i,t} - \ell^{\text{old}}_{i,t}\big), $$裁剪代理目标(clipped surrogate)
$$ L^{\text{grpo}}_{\text{pg}}(\theta) = -\frac{1}{N}\sum_{i=1}^{N}\frac{1}{T_i}\sum_{t=1}^{T_i}\min\Big(\rho_{i,t}A_i,\ \operatorname{clip}(\rho_{i,t}, 1-\epsilon, 1+\epsilon)\,A_i\Big). $$8.2 实现
new_logp  = compute_per_token_logprobs(model, mb.input_ids, mb.attention_mask)

# 先在 log 空间 clamp 再 exp:单个坏 token 不会产生 inf/nan
log_ratio = (new_logp - mb.old_logprobs).clamp(-20.0, 20.0)
ratio     = torch.exp(log_ratio)                          # [B_mb, L-1]

adv_t     = adv.unsqueeze(1)                              # [B_mb, 1] -> 广播
unclipped = ratio * adv_t
clipped   = ratio.clamp(1.0 - cfg.clip_eps, 1.0 + cfg.clip_eps) * adv_t
per_token_obj = torch.min(unclipped, clipped)             # [B_mb, L-1]

seq_obj = masked_mean_per_row(per_token_obj, mask)        # [B_mb]
pg_loss = -seq_obj.mean()

kl      = approx_kl_from_logprobs(new_logp, mb.ref_logprobs, mask)
entropy = -masked_mean(new_logp, mask)                    # 仅日志

with torch.no_grad():
    was_clipped = ((ratio < 1.0 - cfg.clip_eps) | (ratio > 1.0 + cfg.clip_eps)).to(new_logp.dtype)
    clipfrac    = masked_mean(was_clipped, mask)

loss = (pg_loss + cfg.kl_coef * kl) / max(1, grad_accum_steps)
与 REINFORCE 的区别只有三行:多了 ratio、把 seq_logp 换成 seq_obj、多记一个 clipfrac。外层还多了一圈 for _ in range(cfg.ppo_epochs)。
8.3 为什么是 min 而不是直接 clip——逐情形分析
一个非常自然的疑问:既然想把 $\rho$ 限制在信任域里,为什么不直接写 clip(ρ, 1-ε, 1+ε) * A?答案是那样会在两个不该被封死的方向上也封死梯度。clip 在区间外导数恒为 0,所以「用不用 min」决定的是哪些情形保留梯度。四种情形:
| 情形 | $\rho A$ vs $\operatorname{clip}(\rho)A$ | min 选哪支 | 梯度 | 含义 |
|---|---|---|---|---|
| $A \gt 0$,$\rho \gt 1+\epsilon$ | $\rho A \gt (1{+}\epsilon)A$ | 裁剪支 | 恰好 0 | 好动作已经被过度强化,拒绝继续推 |
| $A \gt 0$,$\rho \lt 1-\epsilon$ | $\rho A \lt (1{-}\epsilon)A$ | 未裁剪支 | 保留 | 好动作概率反而掉了,允许拉回来 |
| $A \lt 0$,$\rho \gt 1+\epsilon$ | $\rho A \lt (1{+}\epsilon)A$(都是负数,$\rho$ 大则更负) | 未裁剪支 | 保留 | 坏动作概率涨了,永远允许压下去 |
| $A \lt 0$,$\rho \lt 1-\epsilon$ | $\rho A \gt (1{-}\epsilon)A$ | 裁剪支 | 恰好 0 | 坏动作已经压够了,拒绝继续压 |
clip(不套 min),第 2、3 行的梯度也会被误杀,
策略一旦跨出信任域就再也回不来——这是一个吸收态,训练会卡死。
ratio * adv.clamp(1-eps, 1+eps) 是一个真实发生过的手滑。
它把优势强行压进 $[0.8, 1.2]$——于是所有负优势都变成了 +0.8,
模型开始同等地强化组内最差的那些完成串。
这个 bug 在变异测试里被 4 个测试同时抓到,是覆盖最厚的一个,因为它同时破坏了四个象限的断言。
8.4 $\rho = 1$ 时 GRPO 与 REINFORCE 的关系(最值得考的一点)
第一个 PPO epoch 的第一个 minibatch,策略还没更新过,所以 $\pi_\theta = \pi_{\text{old}}$,$\rho \equiv 1$。此时 GRPO 应该退化成 REINFORCE——但「退化」到底是什么意义上的退化? 很多人以为是损失值相等,其实不是。
clip(1, 1-ε, 1+ε) = 1,两支都等于 $A_i$,于是
$$
L^{\text{grpo}}_{\text{pg}} = -\frac{1}{N}\sum_i \frac{1}{T_i}\sum_t A_i = -\frac{1}{N}\sum_i A_i = -\overline{A}.
$$
注意这里面连一个 $\log \pi$ 都没有。而
$$
L^{\text{reinforce}}_{\text{pg}} = -\frac{1}{N}\sum_i A_i \bar\ell_i ,
$$
$\bar\ell_i$ 是一堆负数,两者数值上根本不是一回事。
梯度: 由 $\rho_t = \exp(\ell^{\text{new}}_t - \ell^{\text{old}}_t)$ 且 $\ell^{\text{old}}$ 是常数, $$ \nabla_\theta \rho_t = \rho_t \,\nabla_\theta \ell^{\text{new}}_t = \rho_t\, \nabla_\theta \log \pi_\theta(y_t). $$ 在 $\rho_t \equiv 1$ 处代入: $$ \nabla_\theta \Big(\frac{1}{T}\sum_t \rho_t\Big) = \frac{1}{T}\sum_t \rho_t \nabla_\theta \log \pi_\theta(y_t) = \frac{1}{T}\sum_t \nabla_\theta \log \pi_\theta(y_t) = \nabla_\theta \bar\ell . $$ 因为 $A_i$ 是常数(已 detach),乘上去后 $$ \boxed{\ \nabla_\theta L^{\text{grpo}} = \nabla_\theta L^{\text{reinforce}}\ }\quad \text{(在 } \rho \equiv 1 \text{ 处逐参数相等)}. $$
这个恒等式就是「为什么可以拿一个裁剪代理目标当策略梯度用」的全部依据。代理目标本身不是任何一个我们关心的量的估计;它的意义完全在于「在当前策略处,它的梯度就是策略梯度,而当策略移开时它会自动变平」。理解了这一点,PPO 家族的所有变体你都能自己推。
test_grpo_at_ratio_one_has_the_same_gradient_as_reinforce 把这三件事一次性断言完:
for k, (a, b) in enumerate(zip(g_grpo, g_reinforce)):
    _assert_close(a, b, atol=1e-9, msg=f"GRPO gradient at rho=1 must equal REINFORCE (param {k})")
assert max(float(g.abs().max()) for g in g_reinforce) > 1e-8, "test is vacuous: gradient is zero"
_assert_close(stats_g["...policy_loss..."], float(-mean(advs)), atol=1e-8,
              msg="GRPO surrogate at rho=1 should collapse to -mean(A)")
_assert_close(stats_g["...clipped..."], 0.0, atol=1e-12, msg="rho == 1 can never be clipped")
注意第二行那个「防空转」断言:如果梯度本来就全是 0,前面那个「两者相等」就毫无信息量。这和 §4.6 的反向断言是同一个思想。
torch.minimum 在严格相等处会把梯度五五分
$\rho = 1$ 时两支数值完全相同,PyTorch 对 minimum 的并列会把上游梯度平均分给两条路径。
这里恰好没有问题——信任域内 clip 是恒等映射,两支的局部导数本来就一样,
五五分和全给一支的结果相同。但在写任何依赖 min/max 精确相等的测试之前,最好先知道这件事。
8.5 clipfrac 的语义:它统计的是「跨出信任域」,不是「梯度被杀」
clipfrac 数的是 $\rho \notin (1-\epsilon, 1+\epsilon)$ 的 token 比例,不管 min 最后选了哪一支。这正是作业 PDF §8.1 要求记录的诊断量。所以完全可能出现 clipfrac == 1.0 但梯度依然充沛的情况——那就是上表第 3 行($A \lt 0$、$\rho$ 偏大)。test_grpo_clip_is_asymmetric_for_negative_advantages 就是专门断言这个组合的:损失等于 $-\rho \cdot \overline{A}$、clipfrac 等于 1.0、而梯度绝对值大于 1e-8。
另外两个象限测试补齐:test_grpo_clips_the_surrogate_when_ratio_is_too_large_and_advantage_positive 断言损失恰好等于 $-(1+\epsilon)\overline{A}$ 且最大梯度绝对值小于 1e-12(也就是真的被封死了);test_grpo_does_not_clip_inside_the_trust_region 断言信任域内行为与未裁剪版完全一致。变异测试里「GRPO 去掉裁剪」被 2 个测试抓到,「min 写成 max」被 3 个抓到。
9. 实验与结果
下面所有数字都来自单张 RTX 5080(16 GB,Blackwell sm_120)的本地运行,W&B 关闭(WANDB_MODE=disabled),曲线从 runs/<name>/metrics.jsonl 重画。format_copy 的两个 run 用的是作业 README 的原始超参,一个字没改——峰值显存 7.28 GB,不需要任何缩减。
9.1 format_copy:GRPO vs GR-REINFORCE
| 指标 | GRPO | GR-REINFORCE |
|---|---|---|
| rollout reward @ step 0 | 0.102 | 0.102 |
| rollout reward @ step 10 | 1.273 | 0.738 |
| rollout reward @ step 20 | 1.300 | 1.300 |
| 最后 5 步平均 reward | 1.295 | 1.294 |
| 首次 reward ≥ 0.8 的步数 | 7 | 11 |
| 首次 reward ≥ 1.2 的步数 | 8 | 14 |
| eval 精确匹配(step 0 → 最终) | 0.0 → 1.00 | 0.0 → 1.00 |
eval <answer> 标签 / strict-XML(最终) | 1.00 / 1.00 | 1.00 / 1.00 |
| 每次训练迭代的优化器步数 | 2 | 1 |
| KL(π‖π_ref) 峰值 / 最终 | 0.334 / 0.210 | 0.365 / 0.185 |
| clip fraction 均值 / 最大 | 0.0026 / 0.0340 | 不适用 |
| 熵代理(首 → 末) | 1.147 → 0.044 | 1.145 → 0.113 |
| 裁剪后梯度范数(均值) | 0.241 | 0.361 |
| 峰值显存 | 7.28 GB | 7.28 GB |
| 51 步墙钟时间 | 215.7 s(4.23 s/step) | 127.3 s(2.50 s/step) |
| rollout 吞吐 | 778 tok/s | 1403 tok/s |
| 跳过的 minibatch(空 mask / 非有限) | 0 / 0 | 0 / 0 |
format_copy 的奖励上限是 1.3(1.0 答案正确 + 0.2 含 <answer> 标签 + 0.1 严格 XML),两个 run 都跑满了,和作业 PDF §8.2 写的期望(「reward 从接近 0 开始,约第 10 步陡增,最终约 1.3;eval 精确匹配趋近 1.0」)完全吻合。
9.2 那个 1.75× 是怎么来的
先把算术写清楚。一次 rollout 采 $8 \times 6 = 48$ 条完成串,minibatch_size 8 把它切成 6 个 minibatch,grad_accum_steps 6 表示累积 6 次才更新一次。于是:
| minibatch 数 / 每批 rollout | 优化器步数 / 每批 rollout | |
|---|---|---|
| GR-REINFORCE(单遍) | 6 | 1 |
GRPO(ppo_epochs 2) | 12 | 2 |
9.3 为什么 clip fraction 恰好在 reward 起飞时出现尖峰
这是本次实验里最有教学价值的一条曲线。clip fraction 的均值只有 0.0026——也就是说 99.74% 的 token 上 $\rho$ 都老老实实待在 $[0.8, 1.2]$ 里,裁剪几乎从未生效。但它在第 7 步附近尖到了 0.034,是均值的 13 倍。
把三件事串起来就清楚了:
clipfrac度量的是一次 rollout 之内策略移动了多远——因为 $\rho$ 是「当前 $\pi_\theta$」比「采样时的 $\pi_{\text{old}}$」,只有第二个 PPO epoch 才可能不等于 1。- 策略移动多远,取决于梯度有多大;而梯度大小取决于组内优势有多不均匀。
- 第 5–10 步正是组内既有成功又有失败的窗口期:模型刚学会偶尔闭上
</answer>标签,同一 prompt 的 6 条采样里有的拿 1.3 有的拿 0.1,优势方差最大,梯度最大,策略移动最快。
而在这个窗口之前(模型全错,组内全 0.1,优势全 0)和之后(模型全对,组内全 1.3,优势又全 0),梯度都接近 0,策略几乎不动,$\rho$ 就一直是 1。所以 clip fraction 的形状不是噪声,它是「学习信号强度」的一个直接读数。
math_hard 上看到 clip fraction 恒等于 0,先别急着庆祝「策略很稳」——
更可能的解释是所有组都退化(全对或全错),优势全 0,模型根本没在学。
本地 math_hard 的 clip fraction 是 $2.17\times 10^{-4}$,小但非零,这正说明第二个 PPO epoch 确实看到了离策略的比值。
恒零和小非零,是两个完全不同的世界。
9.4 诊断曲线:熵、梯度范数、非零优势比例
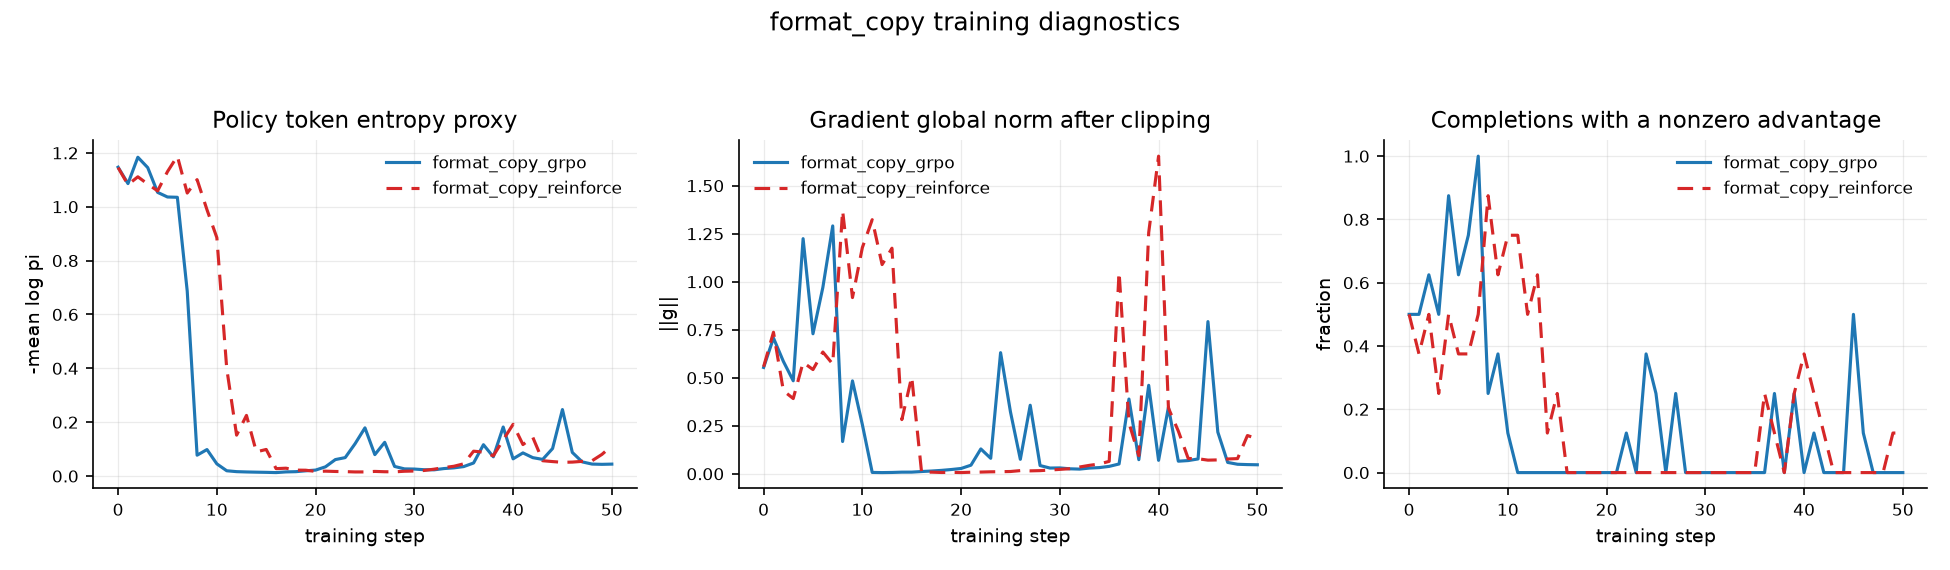
--max_grad_norm 0.5——不是 bug,见下面的警告框。
右:拥有非零优势的完成串比例。GRPO 在第 7 步冲到 1.0(此时每一组都有成功有失败,信号最强),第 12 步后基本掉到 0(任务解决,组内全对,训练自动停摆)。train/gradient_global_norm_after_clipping_mean_over_optimizer_steps 记录的是
torch.nn.utils.clip_grad_norm_ 的返回值,而那个返回值是裁剪之前的范数。
所以图里出现 1.6 而 max_grad_norm 是 0.5,并不矛盾。
这个指标本身仍然是对的诊断量(它告诉你裁剪咬得有多狠:1.6 / 0.5 意味着那一步的梯度被压到了 31%),
只是名字反了。不要去改这个 key——Gradescope 的自动评分靠它定位。
9.5 墙钟时间:GRPO 在 format_copy 上反而更慢
这是一个必须解释清楚、否则很容易得出错误结论的地方。GRPO 是 4.23 s/step,REINFORCE 是 2.50 s/step;51 步下来 215.7 s vs 127.3 s。GRPO 慢了 70%。
原因是显然的:多出来的那个 PPO epoch 是一次完整的前向 + 反向。而每一步的总时间可以粗分成两块:
$$ t_{\text{step}} \approx \underbrace{t_{\text{gen}}}_{\text{采样}} + \text{ppo\_epochs} \times \underbrace{t_{\text{fwd+bwd}}}_{\text{更新}} . $$在 format_copy 上 max_new_tokens = 24,采样极其便宜,$t_{\text{gen}}$ 是小头,于是第二个 epoch 的成本就直接体现为总时间接近翻倍——GRPO 那 1.75× 的样本效率优势基本被抵消掉了。
但在 math_hard 上 max_new_tokens = 512,$t_{\text{gen}}$ 变成绝对大头。本地实测 GRPO 26.8 s/step 而 REINFORCE 33.8 s/step——两者的差异几乎全部来自生成(长度可变,两个 run 抽到的 prompt 不同),更新的开销已经被淹没。这正是作业 PDF 用「501 步 GRPO vs 201 步 REINFORCE」做对比的那个 regime:当生成主导时间预算时,「每批数据榨更多」才会兑现成真实的时间收益。
format_copy 上它输。
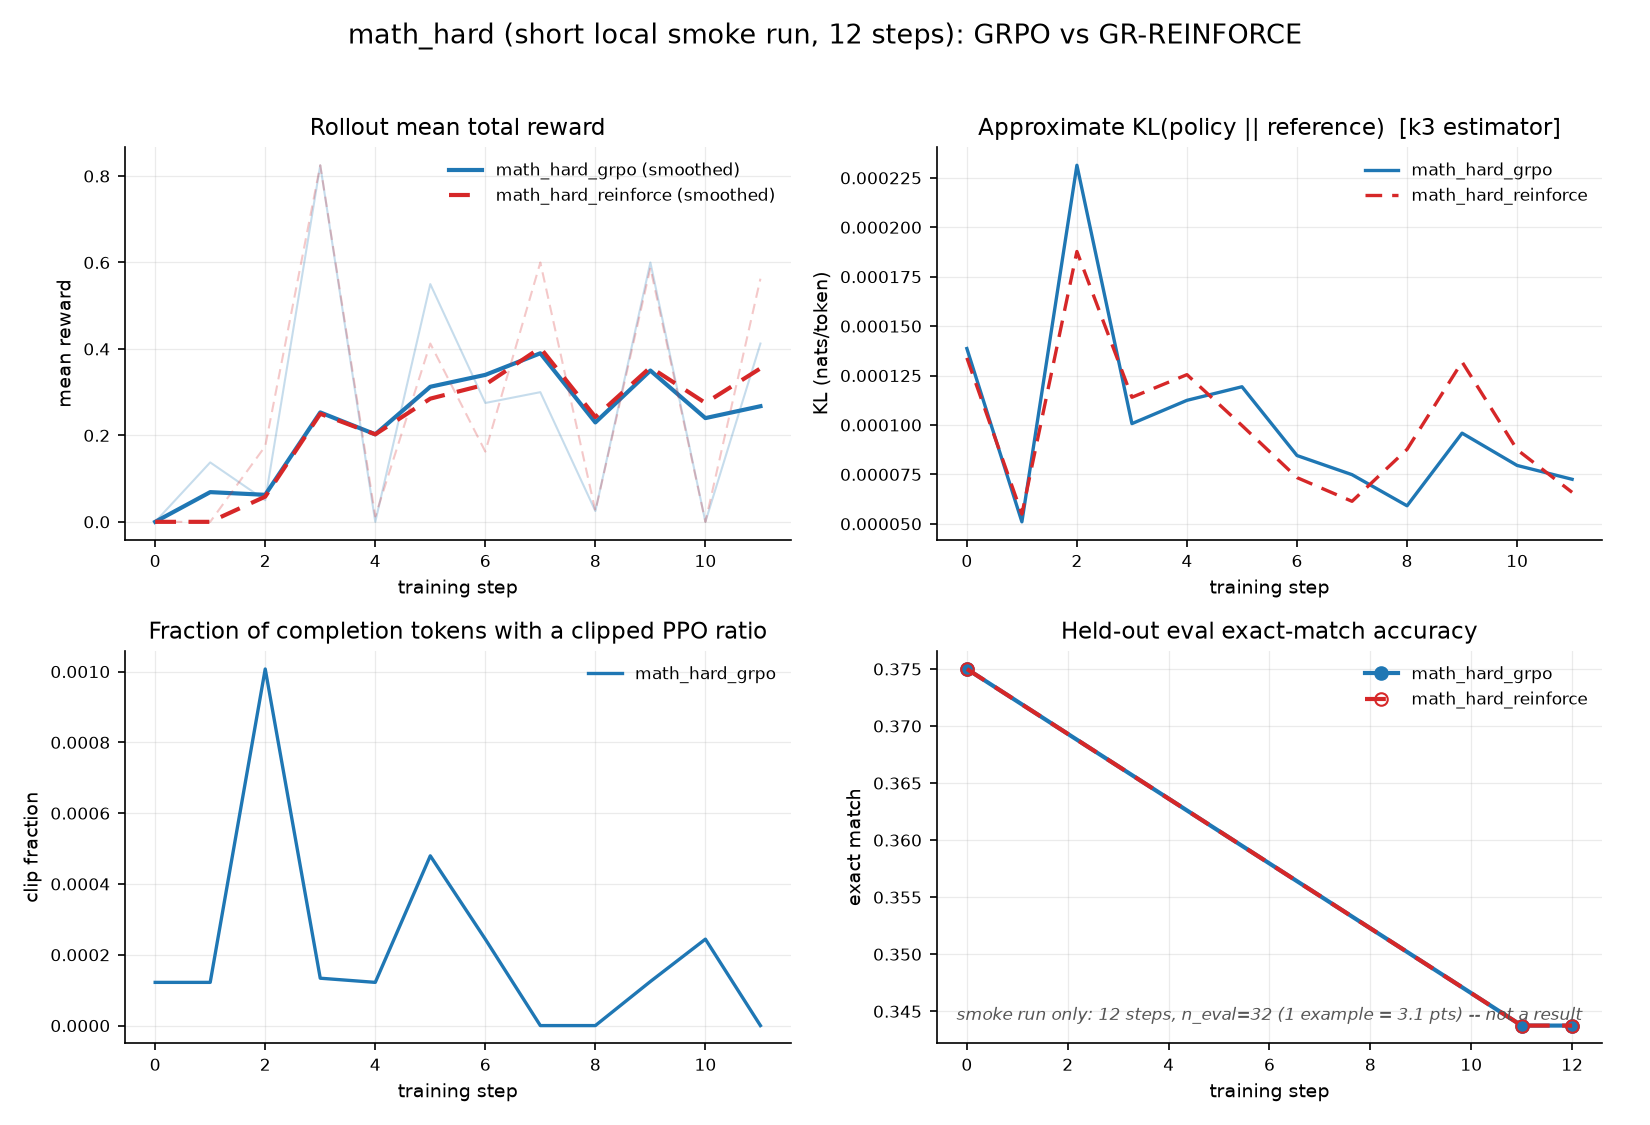
9.6 math_hard:只是管路检查,不是结果
作业给的 math 配置($8 \times 8 = 64$ 条完成串、512 新 token、512 prompt token)是照 80 GB H100 设计的,16 GB 上根本装不下:光是 rollout 那次 log-prob 前向的 logits 张量就是
$$ 64 \times 1023 \times 151936 \times 2\ \text{B} \approx 19.9\ \text{GB}, $$这还没算参考模型那一遍、模型权重本身和任何激活。实际缩减:
| 旋钮 | 作业值 | 本地值 | 理由 |
|---|---|---|---|
batch_size / group_size | 8 / 8 | 2 / 4 | rollout logits 张量按 $B\cdot G$ 线性增长 |
minibatch_size | 8 | 1 | 训练时的 logits 张量 加上自动微分图 |
grad_accum_steps | 8 | 8 | 保持 REINFORCE 每批 rollout 恰好 1 次优化器步 |
max_prompt_tokens | 512 | 256 | 序列长度项 |
max_new_tokens | 512 | 512(不动) | 见 §11.1——动了就全毁 |
steps | 201 / 501 | 12 | 墙钟(本地 27 s/step) |
math_hard_eval_n | 512 | 32 | 512 新 token 下评测只有 0.26 example/s |
cuda_empty_cache_interval | 50 | 4 | 变长 rollout 造成的显存碎片 |
9.7 定性:51 步 GRPO 前后的生成对比
### 基座模型(无 adapter),贪心解码
  target=-1234: 'To solve the problem of returning the final answer as an\xA0\xA0\xA0\xA0\x'
  target=4321:  'To solve the problem of returning the final answer as anr<answer> <answer> using exactly one tag, we'
  target=7:     'To solve the problem of returning the final answer as anr<answer> <answer> using exactly one tag, we'

### GRPO 51 步之后
  target=-1234: '<answer>-1234</answer>'
  target=4321:  '<answer>4321</answer>'
  target=7:     '<answer>7</answer>'
这段对比解释了为什么基线 reward 只有 0.102、eval 精确匹配是 0.000:Qwen2.5-Math 被大量后训练成「先想出声再回答」,于是它把 24 个 token 的预算全部花在「To solve the problem of...」这种开场白上,一次都没能闭合标签。51 步 RL 做的事情,本质上是把这个 chain-of-thought 前缀彻底压掉。
这也让熵从 1.147 掉到 0.044 这件事有了具体含义:策略变成了几乎确定性的模板生成器。在这个玩具任务上这是我们想要的,但在 math_hard 上同样的熵崩塌就意味着失去探索能力——这正是 kl_coef 要调、以及很多真实系统会额外加熵奖励的原因。
10. 方法论:用变异测试证明你的测试有用
10.1 「26 个测试全过」说明不了什么
这份作业最大的困难在 §0 就说过了:写错了它不崩,它只是不学。 于是「我的代码跑通了」和「我的代码是对的」之间隔着一条鸿沟,而单元测试本身也可能落进同一条鸿沟——一个永远为真的断言也是「通过」。
解决办法叫变异测试(mutation testing):把仓库复制一份,一次注入一个真实可能犯的 bug,然后跑测试。如果测试没有失败,说明你的测试套件在那个位置是瞎的。这比「26/26 passed」有说服力得多,因为它度量的是测试的检出能力,而不是代码的当前状态。
10.2 13 个注入 bug 与检出情况
| # | 注入的变异 | 被几个测试抓到 | 如果没被抓到会怎样 |
|---|---|---|---|
| 1 | logits[:, 1:] 代替 logits[:, :-1] | 2 | 标签泄漏,训练全程静默无效 |
| 2 | mask 保留 prompt token | 2 | 退化成奖励加权 SFT,模型复读题面 |
| 3 | mask 整体移一位(keep[:, :-1]) | 3 | 丢掉完成串最后一个 token,格式奖励拿不到 |
| 4 | KL 换成朴素 $-\Delta$ | 2 | KL 惩罚在部分 token 上变成 KL 奖励 |
| 5 | KL 写成 $e^\Delta - \Delta$(漏了 $-1$) | 3 | 估计量有 $+1$ 的常数偏置,$\pi_\theta=\pi_{\text{ref}}$ 时也不为 0 |
| 6 | 优势 reshape 转置 | 2 | 跨 prompt 标准化,学「挑简单题」 |
| 7 | 优势用样本标准差(unbiased=True) | 2 | $G$ 小时优势被系统性缩小 $\sqrt{(G-1)/G}$ |
| 8 | GRPO 去掉裁剪 | 2 | 第二个 PPO epoch 不再受信任域约束 |
| 9 | GRPO 用 max 代替 min | 3 | 变成「鼓励走得更远」,是符号级的灾难 |
| 10 | GRPO 裁剪的是优势而不是比值 | 4 | 所有负优势变成 +0.8,强化最差的采样 |
| 11 | REINFORCE 丢掉优势加权 | 3 | 变成无差别提高所有采样的概率(即 SFT) |
| 12 | REINFORCE 符号反转 | 3 | 朝低奖励方向更新 |
| 13 | minibatch 只打乱 input_ids 不打乱 advantages | 4 | 优势与序列错配,梯度期望为 0 |
13 个全部被抓到,每个被 2–4 个不同的测试同时抓到。「每个 bug 至少两个测试」这件事本身有价值:它意味着即使你后来重构掉了某一个测试,检出能力也不会归零。
10.3 一个被变异测试反过来抓到的测试 bug
最有意思的收获不在被测代码里,而在测试里。最初的玩具模型是常数 logits的——不管输入是什么,都返回同一组 logits。它让 REINFORCE 的损失恒等式测试通过了,但是靠碰运气通过的:
iter_minibatches(shuffle=True) 会打乱行的顺序。
一个忽略 input_ids 的模型,返回的第 $r$ 行 logits 永远是「原始顺序的第 $r$ 行」,
而优势是打乱后送进来的。于是「第 $r$ 行的 log-prob 配第 $r$ 行的优势」这件事只在
「模型输出与行号无关」这个特殊条件下才碰巧成立——
一旦模型真的依赖输入,配对就错了。这在 REINFORCE 损失测试里表现为 0.005 的偏差。
修法:把玩具模型换成真正输入相关的(ToyCausalLM:对 embedding 做因果滑动平均),
这样任何错配都会立刻表现为数值不等。
这个坑值得记住的原因是:它是测试代码里的 bug,但它属于被测代码同样会犯的那一类 bug。 换句话说,如果你的玩具模型太简单,它就无法区分「实现对」和「实现错但恰好被简化掉了」。测试的分辨率不能低于被测逻辑的复杂度。
10.4 26 个测试的覆盖地图
| TODO | 测试覆盖的性质 |
|---|---|
| 1 log-probs | 融合 CE 与 log_softmax+gather 在 fp64 下一致到 1e-10;下一 token 对齐(含显式的 off-by-one 探测器);enable_grad 的图行为与数值一致性 |
| 2 mask | 逐位置重算(含左填充 prompt、早停 EOS、零完成 token 的行);第一个完成 token 必须被打分 |
| 3 KL | $\pi_\theta = \pi_{\text{ref}}$ 时为 0;非负性 + 朴素估计量确实为负的反向断言;随分歧单调增;忽略被 mask 的位置 |
| 4 minibatch | 划分完整性;9 个字段逐一对齐;shuffle 开关;generator 可复现;device 参数;None 调试列表 |
| 5/6 优势 | 组内均值 0 方差 1;prompt-major reshape;退化组 / 不整齐缓冲 / 空缓冲不产生 NaN;批级 z-score |
| 7 REINFORCE | 损失恒等式;KL 项确实进入损失 |
| 8 GRPO | 四个裁剪象限(每个都带梯度断言);ppo_epochs 控制遍数;梯度累积等价性;$\rho=1$ 时与 REINFORCE 的梯度恒等式 |
26 个测试全部只跑 CPU、不下载任何模型,因此可以在写代码的循环里秒级反馈。这一点很重要:如果你的测试需要 GPU 和一个 1.5B 的模型,你就不会去跑它。
11. 踩坑记录
11.1 max_new_tokens 设小了会静默毁掉整个实验
这是本作业最贵的一课,也是最值得反复讲的一个。第一次跑 math_hard 时为了省显存把 --max_new_tokens 从 512 降到了 256。结果:
| 观察到的现象 | 数值 |
|---|---|
撞上 max_new_tokens 上限的完成串比例 | 100% |
| rollout 平均奖励 | 0.000(每一步) |
| 非退化组的比例 | 0 |
| 优势 | 全 0 |
| 梯度范数 | 15 步里有 14 步恰好是 0 |
eval 里含 \boxed{ 的完成串 | 2.1% |
因果链条是这样的:Qwen2.5-Math 在 level-5 的 MATH 题上要写几百个 token 的推理才会写出 \boxed{...};256 个 token 全部被推理过程吃光,永远到不了那个 \boxed{};解析器抓不到答案 ⇒ 奖励 0;组内 4 条全是 0 ⇒ $\sigma = 0$ ⇒ 优势全 0 ⇒ 损失里的策略梯度项恒为 0 ⇒ 梯度只剩 KL 那一项(而策略没动,KL 也是 0)。
compute_group_advantages 写错了」「奖励解析器坏了」
「优势没接进损失」完全无法区分——都是奖励 0、优势 0、梯度 0。
你会花几个小时在正确的代码上找 bug。
能一秒钟识破它的诊断量只有一个:
rollout/fraction_of_completions_that_hit_max_new_tokens_limit。
它等于 1.0,就说明你不是实现错了,是轨迹被环境截断了——
用第 5 讲的语言说,你的 MDP 里每条轨迹都在拿到奖励之前被强制终止了。
把 max_new_tokens 恢复成 512,奖励立刻回到期望的 ≈0.26。
这个 run 被特意保留成 runs/math_hard_grpo_TRUNCATED256/ 作为反面教材。更一般的教训是:在 LLM RL 里,「生成预算」是环境的一部分,不是一个可以随便调小来省显存的工程旋钮。 要省显存,先降 batch_size、group_size、minibatch_size、max_prompt_tokens——这些只影响统计效率;max_new_tokens 影响的是任务本身是否可解。
11.2 transformers < 4.56 会静默吞掉 dtype=
hw4/models/load.py 调用的是 from_pretrained(..., dtype=...)。而 torch_dtype → dtype 这个参数重命名是在 transformers 4.56 落地的。在 4.45–4.55 上,这个 kwarg 会被无声无息地忽略,模型以 fp32 加载——1.5B 模型从 3.1 GB 变成约 6 GB。
危险之处在于:它不报错,它「能跑」。 你只会觉得「这个模型怎么这么占显存」,然后去降 batch size,而不会怀疑 dtype。上游 pyproject.toml 写的是 transformers>=4.45,<4.57,本地必须收紧到 >=4.56,<4.57。
# 三行自检,跑一次胜过读十遍文档
model = load_policy(...)
print(next(model.parameters()).dtype)          # 期望 torch.bfloat16
print(torch.cuda.memory_allocated() / 1e9)     # 期望 ≈3.1,不是 ≈6.2
11.3 torch 必须 ≥ 2.9(Blackwell / sm_120)
上游钉的是 torch>=2.5,<2.7。但 2.5 / 2.6 的 PyPI wheel 只编到 sm_90(Hopper)。RTX 5080 是 Blackwell,计算能力 sm_120,于是每一个 CUDA 算子都会抛:
RuntimeError: CUDA error: no kernel image is available for execution on the devicePyPI 上 torch ≥ 2.8 的 CUDA 12.8+ wheel 才带 sm_120 内核。本地最终解析到 torch 2.13.0+cu130。连带地,cu128/cu130 的 wheel 是按 numpy 2 ABI 编译的,所以上游那个 numpy<2.0 的钉子也得松开。
| 依赖 | 上游 | 本地 | 原因 |
|---|---|---|---|
torch | >=2.5,<2.7 | >=2.9 | sm_120 内核只在 CUDA 12.8+ wheel 里 |
transformers | >=4.45,<4.57 | >=4.56,<4.57 | dtype= 在 4.56 之前被静默忽略 |
numpy | <2.0 | >=2.0 | cu128/cu130 torch wheel 按 numpy 2 ABI 编译 |
matplotlib | — | >=3.8 | 本地自己画图(作业原本从 W&B 出图) |
验证方式很直接:torch.cuda.get_device_capability() 应返回 (12, 0),然后在设备上做一次 bf16 矩阵乘。
11.4 torch.promote_types 与 .float()
§2.3 的升精度最初硬写成 .float()。这在生产路径上(bf16 → fp32)完全正确,但在测试里,玩具模型用的是 fp64,.float() 会把它降到 fp32,于是和手算的 log_softmax+gather 参考值差了 1.9e-7——恰好超过那个 1e-10 的容差。torch.promote_types(dtype, torch.float32) 取的是「两者中更宽的那个」,fp64 保持 fp64,bf16 升到 fp32。
这个坑本身很小,但它说明了一件事:把测试的容差定得足够紧,紧到能抓住精度问题,是有回报的。 如果那个断言的 atol 写成 1e-5,这个 bug 就会一直躺在那里。
11.5 显存账本
不管在哪个配置下,主导项永远是那个 [N, L, V] 的 logits 张量($V = 151936$):
| 运行 | 峰值显存 | s/step | 说明 |
|---|---|---|---|
format_copy GRPO(B=8, G=6, 24 tok) | 7.28 GB | 4.23 | README 原始超参 |
format_copy REINFORCE | 7.28 GB | 2.50 | README 原始超参 |
math_hard GRPO(B=2, G=4, 512 tok) | 8.51 GB | 26.8 | 缩减配置 |
math_hard REINFORCE | 8.55 GB | 33.8 | 缩减配置 |
三个默认开着的省显存开关值得知道:LoRA(只有 18.5 M 可训练参数,AdamW 状态相应地小两个数量级)、grad_checkpointing(用重算换激活显存)、rollout_on_cpu(rollout 缓冲区在 GPU 上算完就搬到 CPU,用到时再搬回来)。
12. 自测清单
做完之后对照这张表逐条勾。前面几组是不跑 GPU 就能查的,请先把它们清干净再去烧算力。
12.1 形状与对齐(写完 TODO 1–2 就查)
- ☐
compute_per_token_logprobs的输出是[B, L-1],不是[B, L]。 - ☐ 配对是
logits[:, :-1, :]↔input_ids[:, 1:]。用 §2.5 那个「位置 $t$ 押注 token $t$」的玩具模型验一次,log-prob 必须 ≈ $-20$ 而不是 ≈ 0。 - ☐
build_completion_mask的输出也是[B, L-1],且第 $P-1$ 列为 1、第 $P-2$ 列为 0。 - ☐ mask 同时排除了 prompt(含左填充)和 右填充。构造一条提前 EOS 的序列检查。
- ☐ 一条完成 token 数为 0 的序列,
mask.sum() == 0,且update会跳过它而不是除以 0。 - ☐
enable_grad=False时requires_grad为False,且数值与True时相同。
12.2 KL
- ☐ 顺序是
ref_logprobs - new_logprobs。 - ☐ 公式里有
-1:$\pi_\theta = \pi_{\text{ref}}$ 时输出严格为 0(不是 1)。 - ☐ 在 50 组随机输入上输出全部 ≥ 0;同时确认朴素的 $-\Delta$ 在同一批上确实取到了负值(否则你的测试是空转的)。
- ☐ clamp 在
exp之前。 - ☐ 往被 mask 掉的位置填 $\pm 10^{6}$,输出不变。
12.3 minibatch 与优势
- ☐ 9 个字段(7 个张量 + 2 个 list)用同一个索引张量切。给每条样本一个唯一指纹,断言三类字段的指纹一致。
- ☐ 所有 minibatch 拼起来恰好是 $\{0,\dots,N-1\}$ 的一个划分。
- ☐ reshape 是
[num_groups, group_size]。用rewards=[0,0,0,1,1,1]、group_size=3验:正确输出是全 0,转置的写法会给出 ±1。 - ☐ 标准差用
unbiased=False。 - ☐ 组内奖励全相同 /
group_size <= 1/ 缓冲区不整齐 / 空缓冲,四种情况都返回 0 且不出现 NaN 或 Inf。
12.4 两个更新(写完 TODO 7–8 就查)
- ☐ 两个
pg_loss前面都有负号。 - ☐ 序列内用
masked_mean_per_row(平均,不是求和),batch 内用.mean()。 - ☐ REINFORCE 没有用
old_logprobs;GRPO 用了。 - ☐
adv已detach()且经过adv_clip裁剪。 - ☐ GRPO 裁剪的是 ratio:
ratio.clamp(1-eps, 1+eps) * adv,不是ratio * adv.clamp(...)。 - ☐ 用的是
torch.min(不是max,不是直接clip)。四个象限各构造一次:$A\gt0$ 且 $\rho\gt1+\epsilon$ 时梯度必须恰好为 0;$A\lt0$ 且 $\rho\gt1+\epsilon$ 时梯度必须非 0(哪怕clipfrac是 1.0)。 - ☐ $\rho \equiv 1$ 时,GRPO 与 REINFORCE 的逐参数梯度相等到 1e-9;同时 GRPO 的损失值等于 $-\overline{A}$、
clipfrac等于 0。 别忘了加一条「梯度不是平凡的 0」的防空转断言。 - ☐
loss除以了grad_accum_steps;grad_accum_steps=1(多次 step)与 $=K$(一次 step)下累计梯度相等。 - ☐ 熵只进日志,不进损失。
12.5 训练层面(看曲线判断)
- ☐
format_copy的 rollout reward 在第 10 步左右陡增,最终稳定在 ≈1.3;eval 精确匹配 ≈1.0。作业 PDF 给的调试下界是「最终 eval 明显低于 0.8 就该 debug」。 - ☐ 天花板是 1.3 = 1.0 + 0.2 + 0.1。如果卡在 1.2,去查 mask 是不是把完成串最后一个 token 丢了(§3.5 误区 2)。
- ☐ GRPO 的
count_optimizer_steps_per_training_iteration是 2,REINFORCE 是 1。这两个数不对,说明minibatch_size × grad_accum_steps ≠ batch_size × group_size,整个对比就失去控制了。 - ☐ KL 起跳后在 0.2–0.35 之间平台化而不是单调发散。发散说明
kl_coef太小或者 KL 符号错了。 - ☐
clipfrac应该很小但非零(这里是 0.0026),并且在 reward 起飞时出现尖峰。恒等于 0 要警惕(可能所有组都退化);大于 0.3 也要警惕(策略在一次 rollout 内跑得太远,该降 lr 或降ppo_epochs)。 - ☐
rollout/fraction_of_completions_that_hit_max_new_tokens_limit必须显著小于 1.0。 等于 1.0 时不要去 debug 代码,去调大max_new_tokens(§11.1)。 - ☐
math_hard训练前的 baseline:train reward ≈ 0.26、eval 精确匹配 ≈ 0.23。差太远说明生成或解析有问题,而不是 RL 有问题。 - ☐
count_update_attempts_skipped_due_to_nonfinite_loss_or_gradients应该是 0。非零说明 clamp 或 eps 哪里漏了。 - ☐ 模型 dtype 是
torch.bfloat16,加载后显存 ≈3.1 GB 而不是 ≈6.2 GB(§11.2)。
12.6 报告与提交
- ☐ 报告第 1 问要同时答两件事:为什么 $e^\Delta - \Delta - 1$ 无偏(用 $\E[e^\Delta]=1$),以及精确全词表 KL 为什么贵($2 \times$
[B,L,V]稠密张量,math 配置下每个约 19.9 GB)。 - ☐ math 上的算法对比要说清楚为什么这个对比是受控的:两条命令只差
ppo_epochs,rollout 预算完全相同。 - ☐ 消融至少 5 个额外的
format_copy+ GRPO run(变ppo_epochs、变kl_coef两个方向、变clip_eps、grad_accum_steps=1),每个都要报告 reward/eval 以及 KL 和 clipfrac 的变化。(本文对应的实现没有做这部分——在这张卡上每个 run 约 4 分钟,是最容易补齐的一块。) - ☐ 不要改动任何 metric 的 key 名,哪怕你发现
..._after_clipping_...记录的其实是裁剪前的范数(§9.4)——自动评分靠它定位。