HW5 编程解析:三种离线 RL 算法的实现与调参
14 处 TODO、三套 actor-critic 骨架,把第 17、18 讲那句「离线 RL 的敌人是分布偏移」翻译成可以跑、可以量化、可以被一行断言抓住的代码。本文逐处拆解 SAC+BC、IQL、FQL 的实现,重点讲透期望回归为什么能做「不查询分布外动作的 max」、AWR 权重该 clamp 在哪一层、FQL 的 clip 为什么只能加在三个地方,并给出在一张 RTX 5080 上真实跑出来的曲线与数字——包括没跑完的部分。
0. 这份作业在考什么
前四份作业里,智能体都可以自己去环境里试错。HW5 把这条路彻底封死:给你一个固定的数据集 $\mathcal{D} = \{(s, a, r, s')\}$,训练期间一次环境交互都不许做,只有评估的时候才把策略放进模拟器里跑 15 个 episode。这个约束一加上,前面所有算法立刻全部失效——原因只有一个:分布偏移(distributional shift)。
三种算法就是第 17、18 讲讲过的三条解法路线,这份作业让你把它们全部写一遍:
| 讲次 | 理论结论 | 这份作业里怎么被检验 |
|---|---|---|
| 第 13 讲 · 控制即变分推断 | 最大熵 RL:目标里加 $\mathcal{H}(\pi)$,soft actor-critic 的备份里带 $-\beta \log \pi$ | SAC+BC 保留了熵项和自动调 $\beta$ 的对偶梯度下降,但把备份里的熵奖励删掉了——为什么删,见 §2.1 |
| 第 17 讲 · 离线强化学习 | 分布偏移的来源、为什么「更多数据」救不了、策略约束(policy constraint)的三种写法 | SAC+BC 的 $\alpha \|a^\pi - a\|^2$ 就是最直接的那种约束;$\alpha$ 的消融直接展示「约束太松崩、太紧退化成 BC」 |
| 第 18 讲 · 离线 RL 算法 | 隐式方法(IQL)与保守方法(CQL);期望回归如何逼近 in-support 的 max | IQL 全程只用数据集动作查询 $Q$,$\tau$ 消融把「SARSA ↔ Bellman 最优」这条插值曲线画了出来 |
| 第 18 讲 · 表达力更强的策略类 | 单峰高斯策略在多模态行为数据上是瓶颈;扩散 / 流策略的动机 | FQL 用 rectified flow 做行为建模,再蒸馏出一个单步网络绕开 BPTT |
把这三条路线摆在一起,它们的差别可以压缩成一句话:
| 备份里的下一动作 | 策略损失 | 策略类 | 约束方式 | |
|---|---|---|---|---|
| SAC+BC | $a' \sim \pi(\cdot \mid s')$(会跑到分布外) | $-Q + \alpha \cdot \text{MSE} + \beta \log \pi$ | tanh-高斯,$\sigma$ 依赖状态 | 显式 |
| IQL | 没有——直接用 $V(s')$ | $-\min(e^{\alpha A}, 100) \cdot \log \pi$ | 高斯,$\sigma \equiv 1$ 固定 | 隐式 |
| FQL | $\pi_\omega(s', z)$,单步网络 | $-Q + \alpha \|\pi_\omega - \pi_v\|^2$ | 流(ODE)蒸馏成单步 | 显式 |
作业要动手验证的理论结论有四条,后面每一条都有对应的实验数字:
- 期望回归(expectile regression)的 $\tau$ 真的在 SARSA 和 Bellman 最优之间插值。§5.2 的消融里 $\tau = 0.5$ 的成功率是严格的 0.0%,$\tau = 0.7$ 和 $0.9$ 都能学会——不对称权重不是调参技巧,是 IQL 的全部内容。
- 行为约束系数 $\alpha$ 存在一个窄的最优区间。SAC+BC 在 $\alpha \in \{30, 100, 300, 1000\}$ 上的最好成功率是 46.7% → 100% → 100% → 93.3%(且末期崩到 26.7%)。
- 动作 MSE 应该随 $\alpha$ 单调下降。这是作业 PDF 明确推荐的调参诊断量,实测 0.0499 → 0.0467 → 0.0413 → 0.0397,单调成立。
- $q_{\min}$ 应该落在 $-\frac{1}{1-\gamma} = -100$ 与 0 之间,cube-single 上大约 $-50 \ldots -70$。实测落进这个带子里的两个 $\alpha$,恰好就是唯二打到 100% 的两个。
1. 代码结构、共享组件与张量形状链条
1.1 目录与职责
| 文件 | 职责 | 你要改的地方 |
|---|---|---|
src/scripts/run.py | 主训练循环:建环境与数据集 → 循环 total_steps 次 agent.update(...) → 周期性评估与 checkpoint | 不用改 |
src/networks/rl_networks.py | Policy(可选 tanh / 状态相关 $\sigma$ / 固定 $\sigma$)、EnsembleCritic、Value、VectorFieldPolicy、LogParam | 不用改,但必须读懂 |
src/configs/{sacbc,iql,fql}_config.py | 把网络工厂函数、超参、数据加载打包成一个 dict | 不用改;dones = 1 - masks 这行在这里 |
src/agents/sacbc_agent.py | 3 处 TODO | §2 |
src/agents/iql_agent.py | 5 处 TODO | §3 |
src/agents/fql_agent.py | 6 处 TODO | §4 |
src/infrastructure/distributions.py | make_tanh_transformed / make_multi_normal,tanh 的 log-det 修正在这里已经做好了 | 不用改(但很多人会重复实现一遍,见 §2.3) |
1.2 三份代码共享的组件
| 组件 | 三家是否相同 | 细节 |
|---|---|---|
| 双 critic $Q_1, Q_2$ | 相同 | EnsembleCritic 一次前向返回 (2, B),内部是 build_ensemble_mlp,4 层 × 256、tanh 激活 |
| 目标 critic $\bar{Q}$ | 相同 | Polyak:$\bar\theta \leftarrow (1-\rho)\bar\theta + \rho\theta$,$\rho = 0.005$,每个梯度步都做 |
| 带 done 掩码的备份 | 相同 | $y = r + \gamma(1 - d)(\cdots)$ |
| 数据集 | 相同 | OGBench,dones = 1 - masks,$r \in \{-1, 0\}$,$\gamma = 0.99$ |
| 优化器 | 相同 | Adam,lr $= 3\times10^{-4}$,batch 256 |
dones = 1 - masks 这个符号非常容易搞反,而且反了之后不会报错。
OGBench 的 masks 是「非终止指示」(1 = 还没结束),所以 dones = 1 - masks 才对。
如果写成 dones = masks,$(1-d)$ 就会在非终止转移上变成 0——
备份变成 $y = r$,$Q$ 会收敛到 $r$ 本身(即 $-1$ 或 $0$),
q_min 永远趴在 $-1$ 附近而不是 $-50$,成功率恒为 0,但损失曲线看起来平滑漂亮。
开跑前先 print(rewards.min(), rewards.max(), masks.min(), masks.max()) 花不了 10 秒。
1.3 张量形状链条
这是最容易卡住的地方。以 cube-single(动作维 $|A| = 5$)、batch $B = 256$ 为例,从 replay buffer 采样开始一路走到损失:
| 量 | 形状 | 来源 / 说明 |
|---|---|---|
observations / next_observations | (B, |S|) | ReplayBuffer.sample 直接切片 |
actions | (B, |A|) | 已经在 $[-1, 1]$ 内 |
rewards / dones | (B,) | 一维,不是 (B, 1) |
critic(obs, acs) | (2, B) | EnsembleCritic.forward 末尾 .squeeze(-1) |
value(obs) | (B,) | Value.forward 也 squeeze 了 |
| 目标 $y$ | (B,) | 要广播到 (2, B) 才能和 critic 输出相减 |
dist.log_prob(a) | (B,) | Independent(..., 1) 已经对动作维求和了 |
dist.rsample() | (B, |A|) | tanh 变换后天然落在 $(-1, 1)$ |
FQL 的 t | (B, 1) | 不是 (B,)——要和 (B, |A|) 的动作做广播乘法 |
VectorFieldPolicy(obs, acs, t) | (B, |A|) | 内部 cat([obs, acs, times], -1),输入宽度 $|S| + |A| + 1$ |
(2, B) 减 (B,)。
PyTorch 的广播规则会从右往左对齐,(2, B) - (B,) 恰好是对的($B$ 对 $B$,2 对广播的 1)。
但 (2, B) - (B, 1) 会变成 (2, B) 与 (B, 1) 对齐失败或者悄悄广播成 (B, B)——
如果你在某处多写了一个 unsqueeze(-1),损失会变成一个 $B \times B$ 矩阵的平均值,
数值上仍然是个有限的标量、仍然会下降,但梯度完全是错的。
本文的写法统一是 target_q.unsqueeze(0),显式补成 (1, B),把广播意图写死在代码里。
2. SAC+BC:最直接的策略约束(3 处 TODO)
2.1 TODO 1 — update_q:两处刻意的「反 SAC」改动
要求。作业 PDF 的式 (1)(2):
$$ L(Q) = \sum_{i=1}^{2} \E_{(s,a,r,s') \sim \mathcal{D},\, a' \sim \pi(\cdot \mid s')}\big[(Q_i(s,a) - y)^2\big], \qquad y = r + \frac{\gamma}{2}\sum_{j=1}^{2} \bar{Q}_j(s', a') $$PDF 在这里写了两句很容易被略过的话:「We omit the entropy term in the Bellman backup (deviating from the original SAC algorithm)」和「We also use the average (instead of the minimum) of the two target Q values」。这两句都是刻意偏离在线 SAC 的,必须照做。
为什么用平均而不是 min。$\min(Q_1, Q_2)$ 是为在线 RL 的高估问题设计的悲观装置。 离线设定下,BC 项已经是一个强力的悲观来源;再叠一层 $\min$ 会双重惩罚, 价值传播会明显变慢——在 antsoccer / antmaze 这种长时域任务上尤其致命($Q$ 需要 沿着上百步的轨迹反向传播)。所以这里用 $\frac12(\bar Q_1 + \bar Q_2)$。
实现。
with torch.no_grad():
    next_actions = self.actor(next_observations).sample()      # (B, |A|)
    next_qs = self.target_critic(next_observations, next_actions)  # (2, B)
    next_q = next_qs.mean(dim=0)                               # (B,)  ← 平均,不是 min
    target_q = rewards + self.discount * (1.0 - dones) * next_q

q = self.critic(observations, actions)                          # (2, B)
loss = torch.mean((q - target_q.unsqueeze(0)) ** 2)

self.critic_optimizer.zero_grad()
loss.backward()
self.critic_optimizer.step()逐块看:no_grad 包住整个目标计算,这样 $a'$、$\bar Q$、$y$ 都不带图;critic 损失里用 sample() 而不是 rsample()——因为这里根本不需要梯度穿过动作,用 rsample 也能跑但白建一次图。target_q.unsqueeze(0) 把 (B,) 变成 (1, B),与 (2, B) 广播;torch.mean 同时对集成维和 batch 维取平均,相当于把 PDF 里的 $\sum_i$ 换成了 $\frac12\sum_i$——常数因子被 Adam 吸收,不影响任何结论。
- 用
min而不是mean:cube-single 上大概还能学(只是慢一些),但 antsoccer 上会明显学不动。PDF 专门用一条 tip 提醒过这件事。 - 忘了
(1 - dones):终止转移的目标变成 $r + \gamma \bar Q(s', a')$,而 $s'$ 是一个 episode 结束后的无意义状态。$Q$ 会一路发散到远低于 $-100$。测试test_iql_q_target_is_reward_at_terminal用「令 $V(s') \equiv 1000$,看终止样本的 $Q$ 是否仍收敛到 $r$」来抓它——把干扰项放大到 1000 倍,掩码只要漏了就一定露馅。 - 把
no_grad忘了:梯度会流进 target critic 和 actor。target critic 没有优化器,参数不会动,但 actor 会被 critic 损失反向更新一次——策略朝着「让 Bellman 误差变小」的方向走,也就是朝着降低自己的 $Q$ 走。表现是成功率缓慢下滑,非常难查。
2.2 TODO 2 — update_actor:三项相加,每一项都有坑
要求。PDF 式 (3):
$$ L(\pi) = \E_{(s,a)\sim\mathcal{D},\, a^\pi \sim \pi(\cdot\mid s)}\Big[-\tfrac12\sum_{i=1}^{2} Q_i(s, a^\pi) \;+\; \alpha \cdot \tfrac{1}{|A|}\|a^\pi - a\|_2^2 \;+\; \beta \log \pi(a^\pi \mid s)\Big] $$三项的分工:第一项最大化 $Q$(RL 的部分),第二项把策略拉回数据集动作(约束的部分),第三项是熵项(最大熵 RL 的部分,第 13 讲)。$\alpha$ 就是整个算法唯一真正重要的超参。
实现。
dist = self.actor(observations)
actor_actions = dist.rsample()                      # (B, |A|),tanh 之后已在 (-1, 1)
log_probs = dist.log_prob(actor_actions)            # (B,),已含 tanh 修正

qs = self.critic(observations, actor_actions)       # (2, B)
q_loss = -qs.mean(dim=0).mean()

mses = torch.mean((actor_actions - actions) ** 2, dim=-1)   # (B,)  ← mean,不是 sum
bc_loss = self.alpha * mses.mean()

entropy_loss = (self.beta().detach() * log_probs).mean()    # ← detach

loss = q_loss + bc_loss + entropy_loss坑一:rsample() 而不是 sample()
$Q$ 项和 BC 项都需要梯度穿过动作本身:$\nabla_\theta Q(s, a^\pi_\theta)$ 只有在 $a^\pi$ 是 $\theta$ 的可微函数时才存在。sample() 返回的张量脱离了计算图,loss.backward() 不会报错——因为 log_probs 那一项仍然带图,梯度非零——但 actor 只会收到熵项的梯度。具体后果:策略会朝着「熵最大」的方向漂,$\sigma$ 一路涨,动作趋近均匀分布,成功率恒为 0,而 total_loss 依然在下降。注意反过来在 update_q 里就该用 sample():那里整段在 no_grad 下。
坑二:动作维上 mean 还是 sum
PDF 写的是 $\frac{1}{|A|}\|a^\pi - a\|_2^2$,也就是 torch.mean(..., dim=-1)。如果写成 torch.sum,等价于把 $\alpha$ 乘上 $|A|$——cube-single 是 5,antsoccer 是 8。具体后果:你按 PDF 建议的 $\{30, 100, 300, 1000\}$ 网格去搜,实际搜到的是 $\{150, 500, 1500, 5000\}$,整个网格右移了一格,最好的那个 $\alpha$ 落在网格外面,你会得出「SAC+BC 在这个任务上不行」的错误结论。PDF 的 tip 里专门写了这个 factor-of-$|A|$ 警告。本文用 mean,所以 PDF 的建议网格可以直接用。
坑三:$\beta$ 必须 detach
self.beta() 是 LogParam.forward(),返回 log_param.exp()——一个带图的节点。如果不 detach,update_actor 里的 loss.backward() 会把梯度写进 beta.log_param.grad。在当前的更新顺序下(update_actor → update_beta,而 update_beta 开头会 zero_grad())它恰好无害;但这是一个真正的定时炸弹:一旦有人调换更新顺序、或者加了梯度累积,$\beta$ 就会同时收到「对偶梯度」和「actor 梯度」两份,朝着「熵项系数越小越好」的方向跑,最终 $\beta \to 0$,最大熵 RL 退化成普通 RL。写一个 .detach() 的成本是 9 个字符。
2.3 tanh-高斯的 log-prob:不要自己手写
SAC 的动作要落在 $[-1, 1]$,做法是对高斯样本 $u$ 施加 $a = \tanh(u)$。变量替换后密度要乘上 Jacobian 的倒数:
$$ \log \pi(a \mid s) = \log \mathcal{N}(u; \mu, \sigma) - \sum_{i=1}^{|A|} \log\big(1 - \tanh^2(u_i)\big) $$很多人会在 actor 损失里手写这个修正项。不用写。make_tanh_transformed 构造的是 Independent(TransformedDistribution(Normal, TanhTransform), 1),而 TransformedDistribution.log_prob 内部已经减掉了 log-Jacobian。手动再减一次,等于把修正项算了两遍,$\log\pi$ 系统性偏小,熵估计偏大,对偶梯度会把 $\beta$ 推向错误的平衡点。
怎么验证。test_tanh_gaussian_log_prob_correction 把分布返回的 log_prob 和闭式的 $\log\mathcal{N}(u) - \sum\log(1-\tanh^2 u)$ 对比到 1e-3,并额外断言修正量严格为正——因为 $|1 - \tanh^2 u| \lt 1$,取 log 是负数,减去负数就是加,squash 把密度压缩到有限区间必然抬高密度值。这条正负号断言能一眼抓住「符号写反」。
2.4 TODO 3 — update_target_critic:Polyak 更新
$$
\bar\theta \leftarrow (1 - \rho)\,\bar\theta + \rho\,\theta, \qquad \rho = 0.005
$$
with torch.no_grad():
    for target_param, param in zip(
        self.target_critic.parameters(), self.critic.parameters()
    ):
        target_param.lerp_(param.detach(), self.target_update_rate)
lerp_(end, weight) 的语义正是 self += weight * (end - self),展开就是 $(1-\rho)\bar\theta + \rho\theta$,一行搞定且是 in-place 的(不会新建张量,也不会把 target 参数换成一个非叶子节点)。方向写反($\rho$ 乘在 target 上)会让目标网络几乎等于在线网络,自举失去稳定性,$Q$ 在几千步内发散;忘了 no_grad 会让 in-place 操作触发 autograd 报错或悄悄把 target 参数接进图里。
怎么验证。test_polyak_update_all_agents 把 $\rho$ 临时设成 0.25,断言 target == 0.75 * target_before + 0.25 * online,并且在线网络的参数一个字节都没变。第二条断言是关键:如果你不小心把 lerp_ 写在了 param 上(参数顺序反了),第一条可能还能过,第二条一定挂。
3. IQL 之一:把 max 藏进损失函数里(TODO 4)
3.1 TODO 4 — iql_expectile_loss:整份作业最值得想清楚的 10 行
要求。PDF 式 (6) 写作 $L(V) = \E_{(s,a)\sim\mathcal{D}}\big[\ell_2^\tau\big(V(s) - \min_i \bar Q_i(s,a)\big)\big]$,其中 $\ell_2^\tau(x) = |\tau - \mathbb{1}(x \gt 0)|\,x^2$,$\tau \in [0.5, 1)$。PDF 的原话是「the asymmetric expectile loss approximates the maximum operator over actions in the Bellman backup」——这句话是整个 IQL 的全部内容,但它没有解释为什么。
两个极端立刻可以读出来:
- $\tau = 0.5$。两侧权重相等,平衡条件退化成 $\E[Q - V] = 0$,即 $V = \E[Q]$,恰好是均值。同时损失本身变成 $0.5 \cdot (Q-V)^2$,就是半个 MSE。此时的备份是 $Q(s,a) \leftarrow r + \gamma\,\E_{a'\sim\beta}[Q(s',a')]$——这是行为策略的策略评估,也就是 SARSA。整个过程里没有任何东西被最大化。
- $\tau \to 1$。$Q \lt V$ 那一侧的残差权重 $1-\tau \to 0$,几乎免费;$Q \gt V$ 那一侧仍然被完整惩罚。于是 $V$ 会被一路顶高,直到几乎没有样本落在它上面为止,即 $V \to \max_{a \in \text{supp}(\beta)} Q(s,a)$。这是一个限制在数据支撑集内的 Bellman 最优备份。
把它跑一遍:一张表说明一切
光看推导容易半信半疑。取一组固定样本 $\{-5, -1, 0, 0.5, 2, 3, 3.5, 10\}$(均值 $1.6250$,最大值 $10$),用 Adam 直接对标量 $V$ 最小化 $\E[\ell_2^\tau(Q - V)]$,得到:
| $\tau$ | 拟合出的 $V$ | 读法 |
|---|---|---|
| 0.5 | 1.6250 | 和样本均值一模一样($(-5-1+0+0.5+2+3+3.5+10)/8 = 13/8 = 1.625$)。这不是巧合,是上面那个平衡条件在 $\tau=0.5$ 时的解析解。 |
| 0.7 | 2.9167 | 已经越过均值。此时 8 个样本里还有 3 个($3, 3.5, 10$)在 $V$ 之上,但它们的残差按 0.7 加权,下面 5 个按 0.3 加权,恰好平衡。 |
| 0.9 | 5.8125 | 只剩 $10$ 一个样本在上面了。单个样本能把 $V$ 顶到 5.81,靠的就是 $0.9 / 0.1 = 9$ 倍的权重比。 |
| 0.99 | 9.3679 | 权重比 99:1,$V$ 已经贴到最大值附近。注意它越过了第二大的样本 3.5 非常远——期望分位对上尾极其敏感。 |
| 0.999 | 9.9334 | 权重比 999:1。 |
| 0.9999 | 9.9933 | 逼近样本最大值 10.0。这就是「$\tau \to 1$ 时期望分位 $\to$ max」的数值证据。 |
还有一个更漂亮的闭式检查:对两点分布 $\{0, 1\}$(各占一半),平衡条件是 $\tau(1 - v) = (1-\tau)\,v$,解得 $v = \tau$。也就是说,$\tau$-期望分位就等于 $\tau$ 本身。 测试
test_expectile_closed_form_two_point_distribution 在 $\tau \in \{0.5, 0.7, 0.9\}$ 上验了这一条,容差 2e-3。
实现。
@staticmethod
def iql_expectile_loss(adv: torch.Tensor, expectile: float) -> torch.Tensor:
    weight = torch.where(
        adv > 0,
        torch.full_like(adv, expectile),
        torch.full_like(adv, 1.0 - expectile),
    )
    return weight * adv.pow(2)
参数 adv 就是 $u = Q - V$。torch.where 逐元素选权重;full_like 保证 dtype/device 一致(直接写 Python 浮点在 torch.compile 下也能跑,但会多一次隐式提升)。返回逐元素的损失而不是标量,让调用方决定怎么聚合——这样这个函数才能被单元测试直接喂一个手工张量。
- 把权重的两侧写反($u \gt 0$ 给 $1-\tau$)。数学上等价于用 $1 - \tau = 0.1$ 的期望分位,也就是求一个下期望分位——$V$ 会趋向 $\min_a Q$。后果:$V(s')$ 系统性偏低,$Q$ 学到的是「行为策略里最差的那条路」,优势 $A = Q - V$ 几乎处处为正且巨大,AWR 权重全部撞上 clamp 上限 100,策略退化成无权重的 BC。成功率不会是 0,但会明显低于纯 BC 基线。
- 用
adv.abs()而不是adv.pow(2)。那是分位数回归(quantile regression)不是期望回归,最小值点变成分位数而不是期望分位。IQL 论文明确用的是二次的版本,梯度在 0 附近连续,训练稳得多。 - 符号约定搞混。PDF 传的是 $x = V - Q$ 且判据是 $\mathbb{1}(x \gt 0)$;本文传的是 $u = Q - V$ 且判据是 $\mathbb{1}(u \lt 0)$。这两者等价,但你必须挑一套并且保证调用处一致。混用的后果就是上一条。
怎么验证。四条断言层层递进,任何一条挂了都能定位到具体的错法:
| 测试 | 断言什么 | 能抓住哪类 bug |
|---|---|---|
test_expectile_tau_half_is_half_mse | $\tau = 0.5$ 时逐元素损失恰等于 $0.5 u^2$ | 权重公式整体写错 |
test_expectile_weights_are_asymmetric | 正残差权重 $=\tau$、负残差权重 $=1-\tau$ | 两侧写反 |
test_expectile_tau_half_recovers_the_mean | 梯度下降拟合出的 $V$ 等于样本均值,且从 $V_0 = -50$ 这种极远初值出发也一样 | 损失非凸 / 有局部极小 / 梯度符号错 |
test_expectile_is_monotone_and_tends_to_the_max | $V(\tau)$ 对 $\tau$ 严格递增;被 $[\text{mean}, \text{max}]$ 夹住;$\tau=0.9999$ 时 $V \gt 9.85$ | 不对称性被削弱(比如把 $\tau$ 写成常数) |
4. IQL 之二:三个损失、AWR 与更新顺序(TODO 5–8)
4.1 TODO 5 — update_v:$V$ 必须拟合目标 critic
$$
L(V) = \E_{(s,a)\sim\mathcal{D}}\Big[\ell_2^\tau\big(\min_i \bar Q_i(s,a) - V(s)\big)\Big]
$$
with torch.no_grad():
    target_q = self.target_critic(observations, actions).min(dim=0).values  # (2,B) -> (B,)

v = self.value(observations)                                    # (B,)
loss = self.iql_expectile_loss(target_q - v, self.expectile).mean()
三个细节:
- 用
target_critic而不是critic。PDF 的式 (6) 写的是 $\bar Q_i$。如果用在线 critic,$V$ 和 $Q$ 会在同一个梯度步内互相追逐:$V$ 拟合 $Q$、$Q$ 又自举 $V$,两条曲线一起漂移,$q_{\min}$ 会缓慢单调发散。目标网络的 200 步滞后正是用来打断这个环路的。 - 集成维取
min。这里的 $\min$ 是双 $Q$ 的常规悲观估计,和 IQL 的核心思想无关,不要和期望分位的 max 搞混。 min(dim=0).values:torch.min(dim=)返回(values, indices)具名元组,忘了.values会把一个元组塞进减法里,报错倒是立刻能看见。
4.2 TODO 6 — update_q:全篇最关键的一个「没有」
$$
L(Q) = \sum_{i=1}^{2}\E_{(s,a,r,s')\sim\mathcal{D}}\Big[\big(Q_i(s,a) - r - \gamma(1-d)\,V(s')\big)^2\Big]
$$
with torch.no_grad():
    next_v = self.value(next_observations)                       # (B,)
    target_q = rewards + self.discount * (1.0 - dones) * next_v  # (B,)

q = self.critic(observations, actions)                           # (2, B)
loss = torch.mean((q - target_q.unsqueeze(0)) ** 2)update_q 并排放:SAC+BC 里有一行
next_actions = self.actor(next_observations).sample(),IQL 里没有这一行。
整个 IQL 的训练过程中,critic 被查询的动作只有两种来源:
update_q 里的 actions(数据集动作)、update_v 里的 actions(同样是数据集动作)。
一次都没有喂给它一个策略生成的动作。
$\max_{a'}Q(s',a')$ 这个操作被完全替换成了 $V(s')$,而 $V$ 是靠期望分位「隐式地」逼近那个 max 的。
这就是 §0 那个「$\max$ 专挑正误差」问题的釜底抽薪式解法——它不选,所以它不会挑错。
怎么验证。这条性质可以被直接断言,而不是只靠读代码相信。test_iql_never_queries_the_critic_with_ood_actions 用一个 spy 包住 target_critic.forward,记录下 update_v 期间它见过的每一个动作张量,然后断言:(1)只被调用了一次;(2)那一次拿到的动作与 batch 里的 actions allclose。这个测试之所以有价值,是因为「不小心多查询了一次分布外动作」在训练日志里完全看不出来——损失照降、$Q$ 值照样在合理区间,只是成功率上不去。
另外两条测试锁住 done 掩码:test_iql_q_target_is_reward_at_terminal 把 $V(s')$ 强行设成 1000,然后断言终止样本上 $Q \to r$(精确到容差内)——掩码只要没生效,1000 这个量级立刻穿帮;test_iql_q_target_uses_discounted_v_when_not_terminal 断言非终止样本上 $Q \to r + \gamma V(s')$,抓的是「把掩码加反」。
4.3 TODO 7 — update_actor:AWR 策略抽取,以及 clamp 到底加在哪
要求。PDF 式 (7)(8):
$$ L(\pi) = \E_{(s,a)\sim\mathcal{D}}\Big[-\min\big(e^{\alpha A(s,a)},\, M\big)\,\log\pi(a\mid s)\Big], \qquad A(s,a) = \min_i Q_i(s,a) - V(s) $$PDF 的措辞是「Clipping the exponentiated advantages is crucial in preventing excessively large weights from dominating the policy loss」,并给了 $M = 100$。
权重为什么会爆炸,以及该 clamp 哪一层
fp32 的最大值约 $3.4\times10^{38}$,而 $e^{88.7} \approx 3.4\times10^{38}$。也就是说 $\alpha A \gt 88$ 时 exp 直接溢出成 inf。训练早期 $Q$ 和 $V$ 都还没校准,$|A|$ 到几十是家常便饭,$\alpha = 10$ 时 $\alpha A$ 轻松破百。
现在是关键问题:clamp 应该套在指数上,还是套在指数函数的结果上?
| 写法 | 前向 | 问题 |
|---|---|---|
torch.clamp(torch.exp(alpha * adv), max=100) | 数值上「看起来」对:clamp(inf, max=100) 确实返回 100 | inf 已经被物化成一个张量了。只要它在被 clamp 之前参与了任何运算——归一化(除以 weights.mean(),而 mean 里含 inf 就整个是 inf)、乘上一个恰好为 0 的 log_prob($0 \times \infty = $ nan)、或者进入 torch.compile 的融合内核——结果就是 nan。而且反向传播里 clamp 在饱和区的梯度是 0,exp 在 inf 处的梯度是 inf,0 × inf = nan 会直接毒掉 critic 的梯度。 |
torch.exp(torch.clamp(alpha * adv, max=math.log(100))) | 指数的输入被先压到 $\le \log 100 \approx 4.605$,exp 的输出天然 $\le 100$ | 没有问题。数学上与 $\min(e^{\alpha A}, M)$ 完全相同($\exp$ 单调递增,所以 $\exp(\min(x, \log M)) = \min(\exp x, M)$),但中间量永远不会超过 $\log 100$,inf 从来没有机会出现。 |
实现。
AWR_MAX_WEIGHT = 100.0

@staticmethod
def awr_weight(adv, alpha, max_weight=AWR_MAX_WEIGHT):
    # clamp 指数,不是 clamp 指数函数的结果
    return torch.exp(torch.clamp(alpha * adv, max=math.log(max_weight)))

# update_actor
with torch.no_grad():
    q = self.critic(observations, actions).min(dim=0).values   # (B,)
    v = self.value(observations)                                # (B,)
    adv = q - v                                                 # (B,)
    weights = self.awr_weight(adv, self.alpha)                  # (B,)

dist = self.actor(observations)
log_probs = dist.log_prob(actions)          # (B,),注意是数据集动作的 log-prob
loss = -(weights * log_probs).mean()log_prob传错动作。AWR 是加权行为克隆,必须是 $\log\pi(a \mid s)$,$a$ 来自数据集。如果误传了dist.rsample(),损失变成 $-w\log\pi(a^\pi\mid s)$——这是在最大化策略自身样本的对数概率,也就是最小化熵,$\sigma$ 会塌缩,均值原地不动。成功率恒 0。- 权重没有 detach。$w = e^{\alpha A}$ 里含 $Q$ 和 $V$,如果不放在
no_grad下,actor 的backward()会把梯度倒灌进 critic 和 value 网络。它们各自有自己的优化器,梯度会在下一次zero_grad()前被累加进去——这取决于更新顺序,是个非常隐蔽的耦合。 - 「权重太小」不是 bug。$\tau = 0.9$ 时 $V$ 坐在 $Q$ 分布的 0.9-期望分位上,所以绝大多数数据集动作的 $A \lt 0$,平均权重通常在 $10^{-3} \sim 10^{-1}$。整个 AWR 损失的绝对尺度会非常小,看起来像是「没在学」。真正让更新幅度保持正常的是 Adam 的逐参数归一化。实现里日志打了
actor/weight_mean、actor/weight_max、actor/adv_mean三个量专门盯这件事。
怎么验证。四条断言:test_awr_weights_nonnegative_monotone_and_clamped 检查权重非负、对 $A$ 严格递增、$A = 0$ 时恰为 1、等于 $\min(e^{\alpha A}, 100)$、并在大 $A$ 处饱和到 100;test_awr_alpha_zero_is_behavioral_cloning 检查 $\alpha = 0$ 时权重全为 1(此时 IQL 就是纯 BC,这是理论上的边界情形);test_iql_actor_loss_is_finite_with_extreme_advantages 直接喂 $A = 10^4$,断言损失有限——这一条是专门用来抓「clamp 加错层」的,因为 clamp(exp(...)) 的写法在 $A = 10^4$ 时前向可能还侥幸活着,但只要下游有归一化就必挂;test_iql_actor_moves_toward_high_advantage_actions 是端到端的:造一批同状态、不同动作、优势有高有低的数据,跑若干步,断言策略均值确实朝高优势那一簇移动。
4.4 TODO 8 — Polyak,以及三个容易忽略的约定
Polyak 更新与 §2.4 完全一致,不再重复。剩下三件事:
- 优势用在线 critic 还是目标 critic。PDF 的式 (8) 写的是 $\min_i Q_i$(在线网络),而 IQL 官方实现用的是目标网络。本文跟随 PDF 用
self.critic并 detach。两者差别就是 200 步的 Polyak 滞后,在这个任务上测不出来。但注意update_v必须用目标网络(§4.1),两处不能混。 - 更新顺序是
update_v→update_q→update_actor,最后 Polyak。update_q消费的是本步刚更新过的 $V$。反过来先更新 $Q$ 再更新 $V$ 也能跑,但 $V$ 会永远落后 $Q$ 一步,收敛略慢。 - IQL 的 actor 是固定 $\sigma = 1$ 的高斯,而且没有 tanh。
iql_config里Policy(..., fixed_std=True)。于是 $\log\pi(a\mid s) = -\frac12\|a - \mu(s)\|^2 + \text{const}$,AWR 损失字面上就是一个加权 MSE 回归。这也意味着 $\mu(s)$ 没有任何东西把它约束在 $[-1,1]$ 内——get_action在评估时做torch.clamp(action, -1, 1)兜底。
5. FQL:流策略 + 单步蒸馏(TODO 9–14)
5.1 为什么不能直接做 FBRAC
最自然的想法叫 FBRAC:把 SAC+BC 的 BC 项换成流匹配(flow matching)项,然后把流策略 $\pi_v(s,z)$(一次 10 步 Euler ODE 求解)直接塞进 $Q$ 里去最大化。问题在于,$\pi_v$ 是 10 次网络前向的复合,$\nabla_v Q(s, \pi_v(s,z))$ 要穿过全部 10 步——这就是时间反向传播(BPTT),需要连乘 (层数 × ODE 步数) 个 Jacobian,既贵又病态。
5.2 TODO 9–11 — 三个损失
阶段一:行为流匹配(rectified flow / 线性概率路径)。
$$ z \sim \mathcal{N}(0, I),\quad t \sim U[0,1],\quad \tilde a = (1-t)z + t\,a, \qquad L(v) = \E\Big[\tfrac{1}{|A|}\big\|v(s, \tilde a, t) - (a - z)\big\|^2\Big] $$目标速度为什么恰好是 $a - z$?因为路径是线性的:$\frac{\mathrm{d}\tilde a}{\mathrm{d}t} = \frac{\mathrm{d}}{\mathrm{d}t}\big[(1-t)z + ta\big] = a - z$,与 $t$ 无关。$t=0$ 给纯噪声,$t=1$ 给数据动作。
noise = torch.randn_like(actions)
t = torch.rand((actions.shape[0], 1), device=actions.device)   # (B, 1),不是 (B,)
noisy_actions, target_velocity = self.flow_interpolation(noise, actions, t)
pred_velocity = self.bc_actor(observations, noisy_actions, t)
loss = torch.mean((pred_velocity - target_velocity) ** 2)阶段二:critic,备份里用单步策略(不是流策略):$y = r + \gamma(1-d)\cdot\frac12\sum_j \bar Q_j(s', \mathrm{clip}(\pi_\omega(s', z)))$,同样取平均而非 min。
阶段三:单步策略。
$$ L(\pi_\omega) = \E\Big[-\tfrac12\sum_i Q_i\big(s, \mathrm{clip}(\pi_\omega(s,z))\big) + \alpha\cdot\tfrac{1}{|A|}\big\|\pi_\omega(s,z) - \pi_v(s,z)\big\|^2\Big] $$noise = torch.randn_like(actions)
onestep_actions = self.onestep_actor(observations, noise) # 不 clip
with torch.no_grad():
flow_actions = self.get_bc_action(observations, noise) # 同一个 z!no_grad
distill_loss = self.alpha * torch.mean((onestep_actions - flow_actions) ** 2)
clipped_actions = torch.clamp(onestep_actions, -1, 1) # 喂 critic 的要 clip
q_loss = -self.critic(observations, clipped_actions).mean(dim=0).mean()
loss = distill_loss + q_loss两个策略必须共享同一个 $z$。这才让蒸馏变成逐样本的映射匹配而不是分布匹配——单步网络因此能继承流策略的多模态性(同一个 $s$、不同的 $z$ 落到不同的模态上)。若各自采一个 $z$,蒸馏项就退化成「让 $\pi_\omega$ 输出流策略的均值」,多模态被抹平,FQL 相对 SAC+BC 的全部优势消失。
5.3 那条「clip 加三处、不加第四处」的规则
get_action 的输出。
第四个地方绝对不能加:蒸馏项里的 $\pi_\omega(s,z)$。 理由是梯度:
clamp 在饱和区的导数是 0。假如单步策略输出了 $1.7$(越界),
而蒸馏目标是 $0.4$,clip 之后的差是 $1.0 - 0.4 = 0.6$,但这个误差传不回去——
$\partial\,\mathrm{clip}(x)/\partial x = 0$。于是越界的动作永远没有梯度把它拉回来,
$\pi_\omega$ 会一直停在界外,实际执行的永远是被截断的边界动作。
表现是 action MSE 卡在一个高位不动、成功率上不去,而所有损失都正常下降。
PDF 用一整条 tip 讲了这件事:「you should not clip … Otherwise, the one-step policy
cannot be corrected when it produces out-of-bound actions.」
5.4 TODO 12–13 — Euler 积分与评估动作
action = noise
dt = 1.0 / self.flow_steps
for i in range(self.flow_steps):                 # i = 0 .. F-1
    t = torch.full((*action.shape[:-1], 1), i * dt, ...)
    action = action + dt * self.bc_actor(observations, action, t)
return torch.clamp(action, -1, 1)
时间网格必须是 $t_i = i/F$,$i = 0,\dots,F-1$(含 0、不含 1)。从 $t = 1/F$ 开始、或者跑 $F+1$ 步,都会悄悄给策略引入偏置——不报错、不发散,只是分布偏了。test_fql_euler_uses_times_from_0_to_1_exclusive 用一个记录型 vector field 抓下每次调用的 $t$,断言 $F=5$ 时序列恰好是 [0, 0.2, 0.4, 0.6, 0.8];test_fql_euler_integration_is_exact_for_a_constant_field 令 $v \equiv c$(此时精确解是 $z + c$ 且 Euler 无误差),断言等式成立到 1e-6。
评估要采样,不要取 mode。SAC+BC 和 IQL 评估时取分布的众数;FQL 的 get_action 每次重新采一个 $z \sim \mathcal{N}(0,I)$。因为这个策略的全部表达力都住在 $z$ 里,取「众数」($z = 0$)会把多模态直接压成一个点。另外:make_onestep_actor 建的也是 VectorFieldPolicy,调用 onestep_actor(obs, z) 时 times=None,模块内部会填 0——所以它实质上就是一个在 $[s, z, 0]$ 上的 MLP。
no_grad 包住 ODE 展开是 FQL 的立身之本:梯度一旦通过蒸馏目标流回 $v$,BPTT 就回来了,算法就白设计了。
怎么验证这一整套。流匹配部分有一串层层收紧的断言:test_flow_interpolation_shapes_and_endpoints 同时检查形状、$t=1$ 时插值就是数据动作、$t=0$ 时就是噪声、目标速度与 $t$ 无关,并用有限差分数值验证 $\mathrm{d}\tilde a/\mathrm{d}t$ 确实等于回归目标——这一条能抓住「把 $(1-t)$ 和 $t$ 写反」这种最常见的错误(写反之后端点会互换,但损失照样收敛,只是采样出来的动作分布是噪声而不是动作)。test_fql_bc_flow_learns_a_deterministic_action 是端到端的:造一份动作恒为常数的数据集,训完之后从任意噪声出发积分 ODE,都必须还原出那个常数。test_fql_distillation_pulls_onestep_toward_flow 断言蒸馏项确实在缩小单步策略与流策略之间的差距;test_fql_q_term_pushes_actions_up 令 $\alpha = 0$,此时损失只剩纯 $Q$ 最大化,动作应当一路饱和到 $+1$——这条反过来确认了「$\alpha$ 就是那个把策略拴在数据上的唯一绳子」。
6. 实验与结果
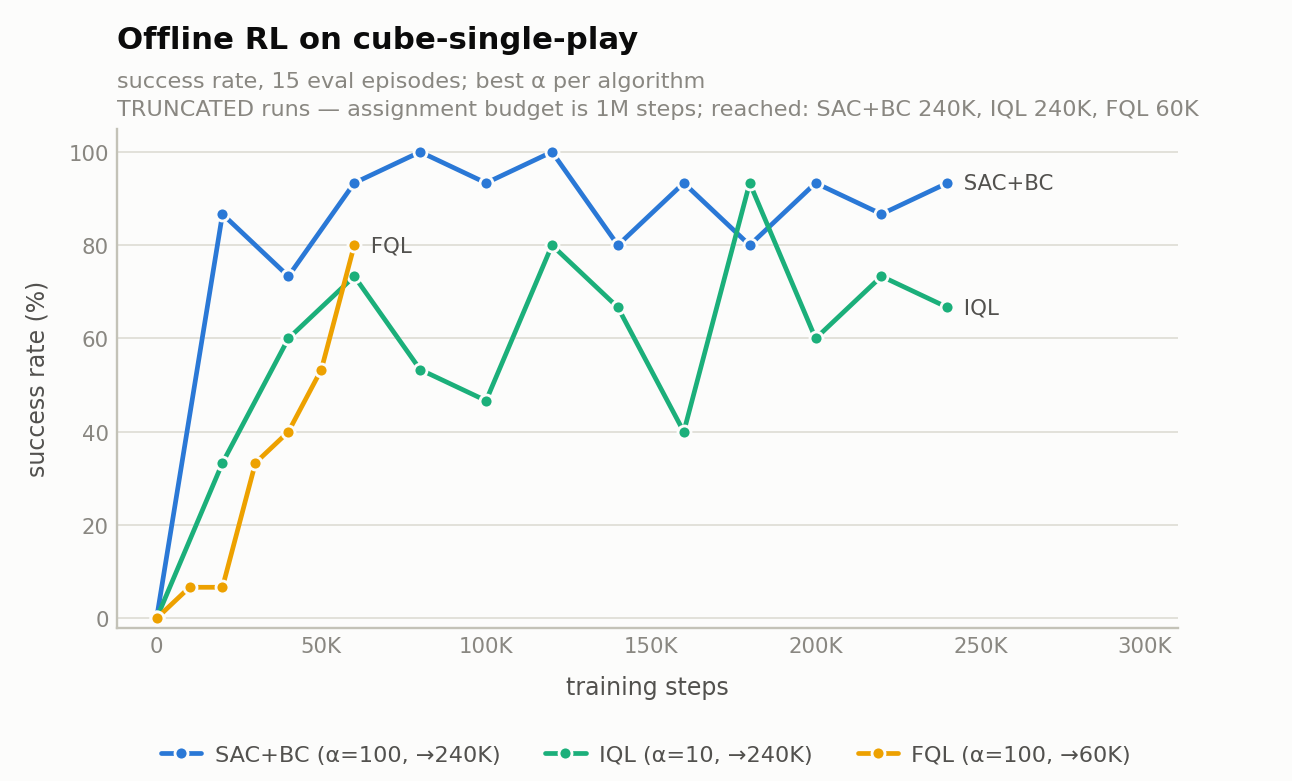
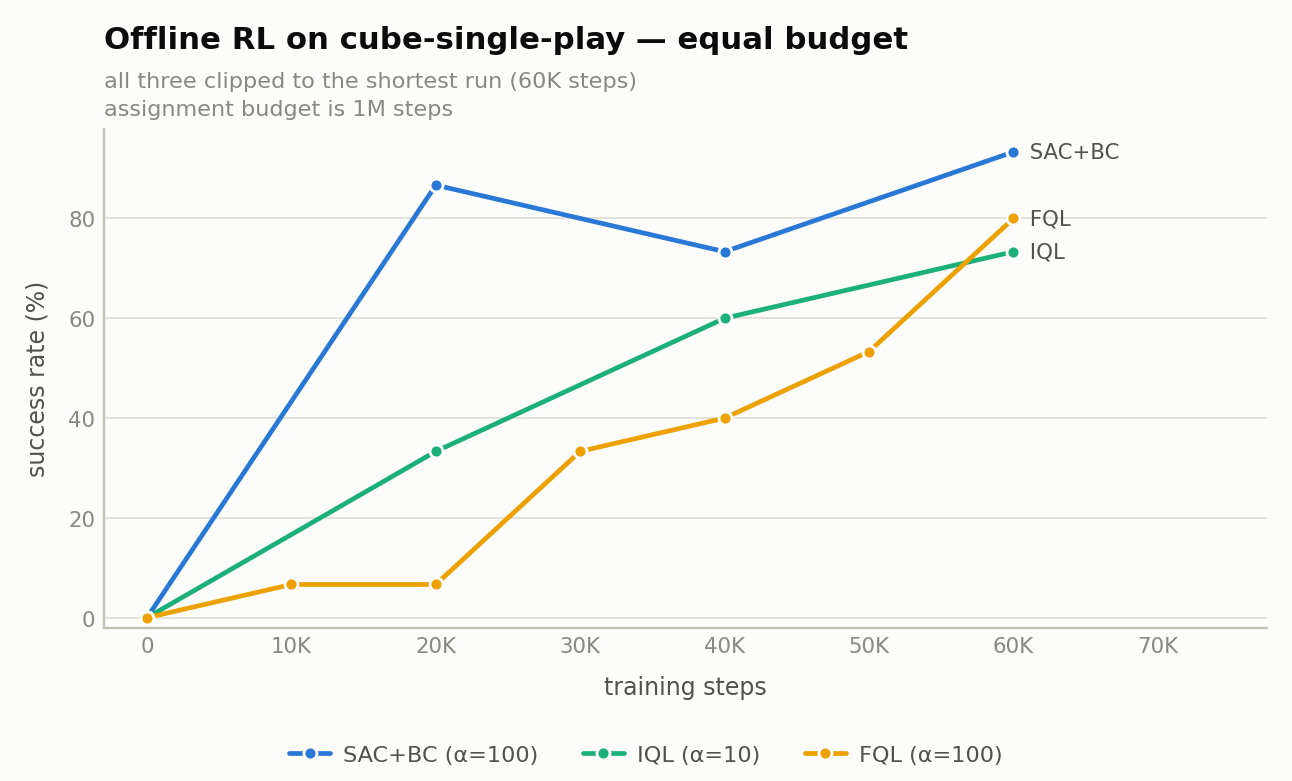
没有达标的部分:FQL 只跑到 60K(预算的 6%),80.0% 未能证明「1M 步最终 > 80%」这个要求;
antsoccer-arena 与 antmaze-medium 的数据集已下载并验证可加载,但一个 run 都没有跑完,
因此这两个任务上的所有指标完全没有覆盖。
本节的结论只适用于 cube-single-play、单一随机种子、且在上述被截断的步数范围内。
统一设置:cube-single-play-singletask-task1-v0,seed 0,batch 256,4×256 tanh MLP,Adam $3\times10^{-4}$,$\gamma=0.99$,$\rho=0.005$,每个评估点跑 15 个 episode;RTX 5080 上 5–6 个 run 并行,各约 65–90 it/s。
6.1 全部结果
| run | $\alpha$ | $\tau$ | 到达步数 | 最终成功率 | 最好成功率 | action MSE | q_min | q_max |
|---|---|---|---|---|---|---|---|---|
| SAC+BC | 30 | – | 220K | 6.7% | 46.7% | 0.0499 | −38.9 | 0.02 |
| SAC+BC | 100 | – | 240K | 93.3% | 100.0% | 0.0467 | −51.8 | 0.12 |
| SAC+BC | 300 | – | 240K | 80.0% | 100.0% | 0.0413 | −65.2 | 0.65 |
| SAC+BC | 1000 | – | 220K | 26.7% | 93.3% | 0.0397 | −89.0 | 0.09 |
| IQL | 3 | 0.9 | 240K | 66.7% | 80.0% | 0.0310 | −49.7 | 0.17 |
| IQL | 10 | 0.9 | 240K | 66.7% | 93.3% | 0.0337 | −49.7 | 0.17 |
| IQL | 10 | 0.7 | 60K | 80.0% | 80.0% | 0.0255 | −80.7 | 0.21 |
| IQL | 10 | 0.5 | 60K | 0.0% | 0.0% | 0.0230 | −95.1 | 0.33 |
| FQL | 30 | – | 60K | 60.0% | 60.0% | 0.0423 | −44.7 | 0.13 |
| FQL | 100 | – | 60K | 80.0% | 80.0% | 0.0370 | −45.9 | 0.35 |
| FQL | 300 | – | 60K | 66.7% | 66.7% | 0.0280 | −58.5 | 0.14 |
| 作业要求(@1M 步) | 这里达到的 | 判定 |
|---|---|---|
| SAC+BC 在 cube-single 上 > 75% | 93.3% 最终 / 100% 最好 @240K | 达标,只用了 24% 的预算 |
| IQL 在 cube-single 上 > 60% | 66.7% 最终 / 93.3% 最好 @240K | 达标,只用了 24% 的预算 |
| FQL 在 cube-single 上最终 > 80% | 80.0% @60K(仍在上升:30/40/50/60K 处为 33→40→53→80) | 未达标——只跑了 6% 的预算,趋势指向目标但这个 run 不能证明它 |
| SAC+BC / IQL 在 antsoccer 上 > 5% | — | 未运行 |
| FQL 在 antsoccer 上 > 30% | — | 未运行 |
| antmaze-medium(可选调试) | — | 未运行 |
7. 最有教学价值的一张图:expectile 消融
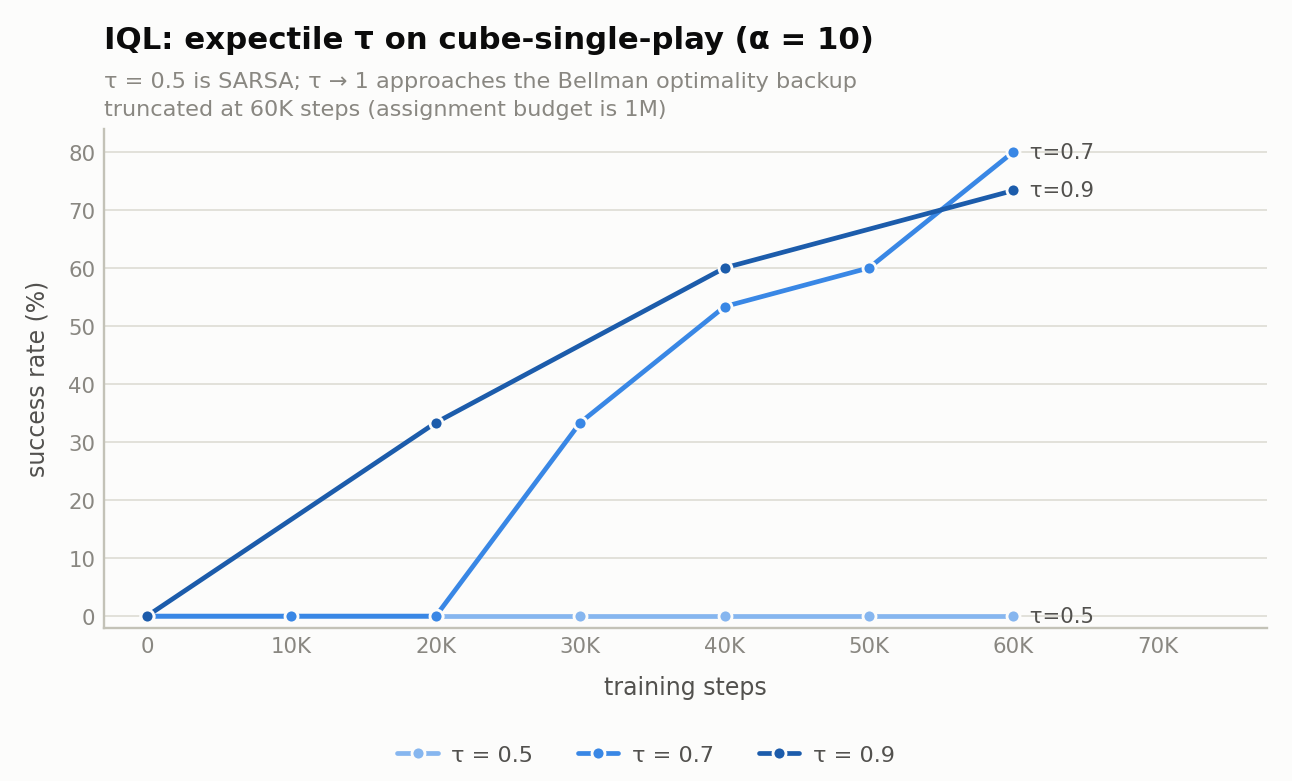
| $\tau$ | 60K 处成功率 | q_min | 解释 |
|---|---|---|---|
| 0.5 | 0.0% | −95.1 | 纯 SARSA 备份:$V = \E_{a\sim\beta}[Q]$,于是 $Q$ 评估的是行为策略。整个训练过程中没有任何东西被最大化,优势 $A = Q - V$ 只是围绕 0 的噪声,AWR 权重几乎处处等于 1,策略退化成对一份中等质量数据的纯 BC。它从来没有离开过 0%。 |
| 0.7 | 53.3% @40K → 80.0% @60K | −80.7 | 部分 max:能学,起步慢 |
| 0.9 | 33.3% @20K → 73.3% @60K | −49.7 | 早期进展最快 |
$\tau$ 还可见地控制价值尺度:$q_{\min}$ 随 $\tau = 0.5 \to 0.7 \to 0.9$ 从 −95 → −81 → −50。 更高的期望分位给出更乐观(等价于更短时域)的价值函数——这正是那个「隐式 max」在起作用的直接读数。 $\tau=0.5$ 的 −95.1 已经贴到 $-\frac{1}{1-\gamma} = -100$,说明它评估的策略几乎永远拿不到 0 奖励, 和 0.0% 的成功率完全一致。
7.1 SAC+BC 对 $\alpha$ 极度敏感
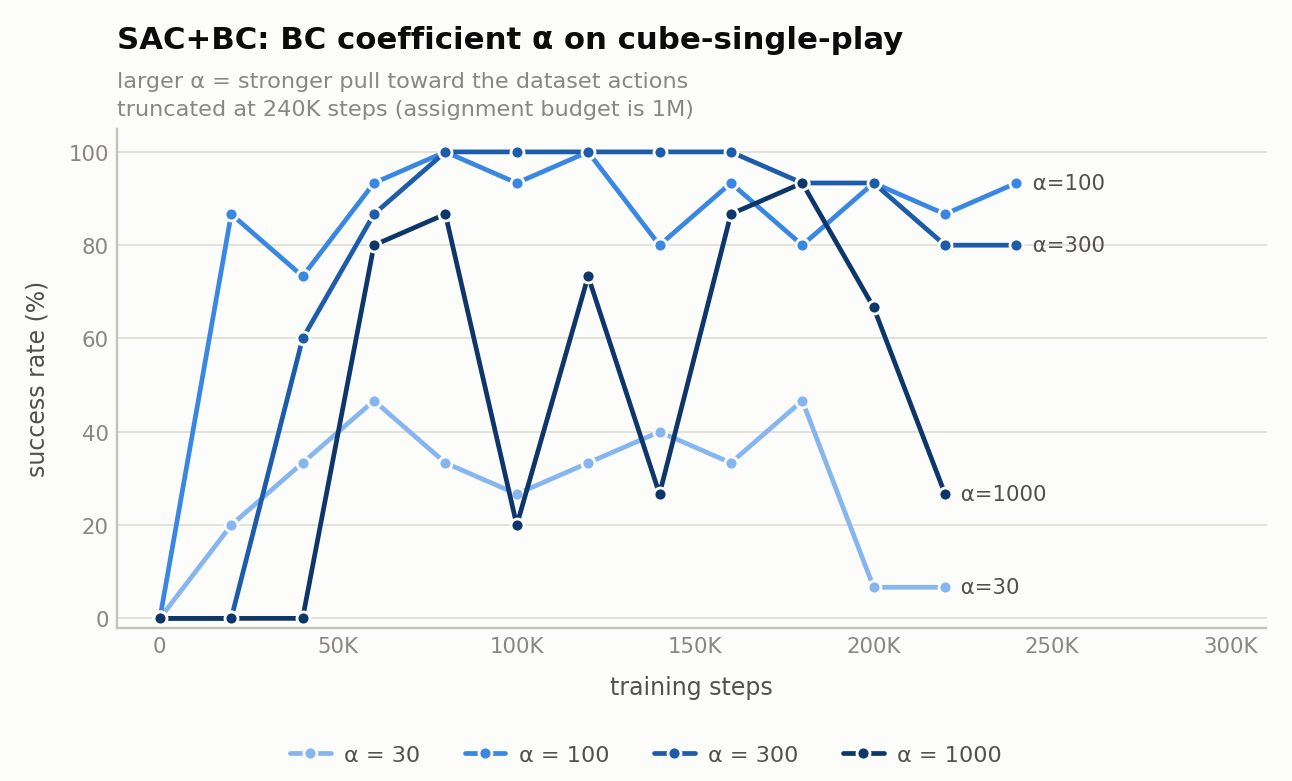
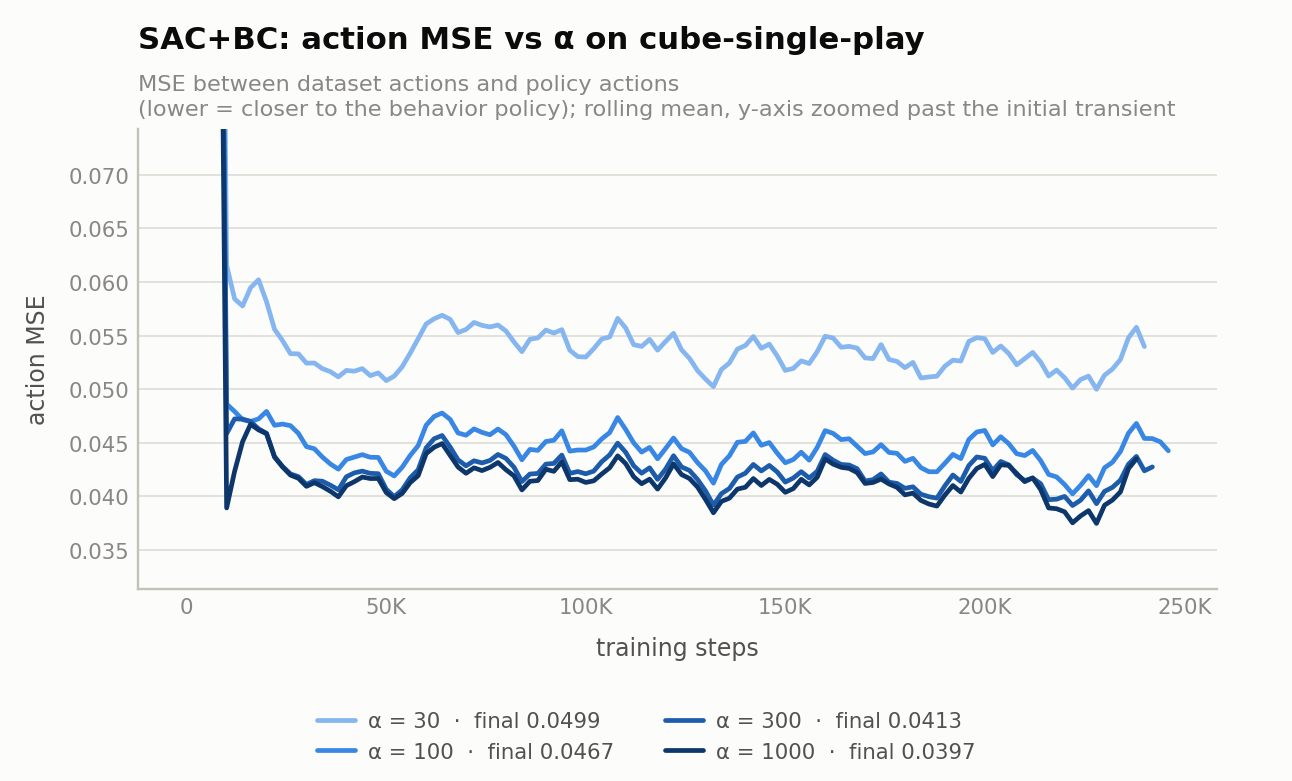
为什么 $q_{\min}$ 是第二个好用的诊断量。奖励只取 $\{-1, 0\}$,所以 $Q$ 理论上被夹在 $[-\frac{1}{1-\gamma}, 0] = [-100, 0]$ 之间;PDF 说 cube-single 这种短时域任务上 $q_{\min}$ 应该收敛到 $-50 \ldots -70$。实测:$\alpha=30 \to -38.9$(太浅:策略太自由,价值没有充分传播);$\alpha=100 \to -51.8$ ✓;$\alpha=300 \to -65.2$ ✓;$\alpha=1000 \to -89.0$(越过了带子,逼近 −100,说明过度约束、几乎退化成纯 BC)。落在带内的两个 $\alpha$,恰好就是唯二打到 100% 的两个。这不是事后凑数——它意味着你可以在只跑几万步、还看不出成功率差异的时候,就用 $q_{\min}$ 提前判断 $\alpha$ 选对没有。
7.2 IQL 对 $\alpha$ 不敏感,而且原因很干净
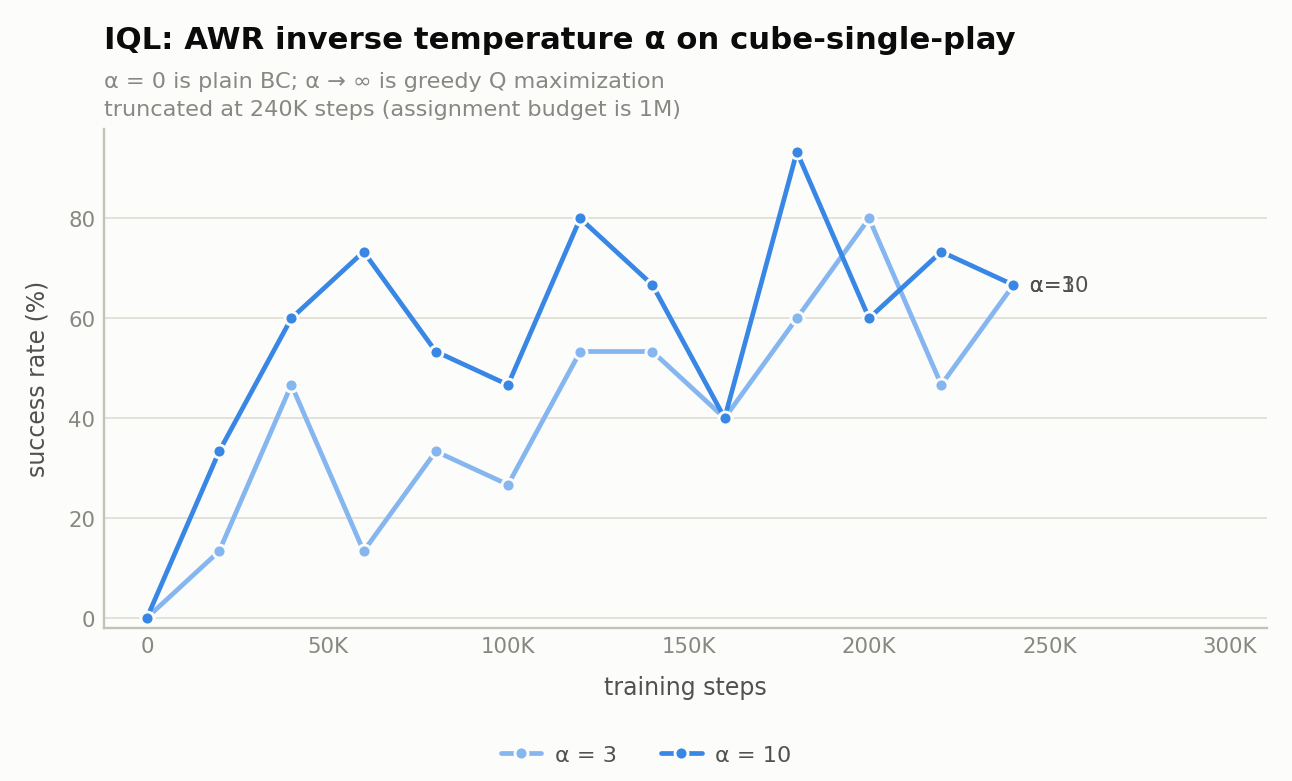
v_mean = −33.14、q_min = −49.67,$\alpha$ 只影响策略抽取那一步。
SAC+BC 没有这种解耦:$\alpha$ 改变 actor → actor 改变 Bellman 备份里的 $a'$ → 备份改变 critic,
一个超参同时扰动三张网络,所以它的响应面又窄又陡。
这也是对作业那个「比较 SAC+BC 与 IQL」问题的答案: SAC+BC 的天花板更高(前提是你找得到 $\alpha$),找不到就一无所获; IQL 的天花板更低,但几乎不用找。作业给出的目标本身就反映了这个差距—— SAC+BC 要求 > 75%,IQL 只要求 > 60%。
7.3 FQL
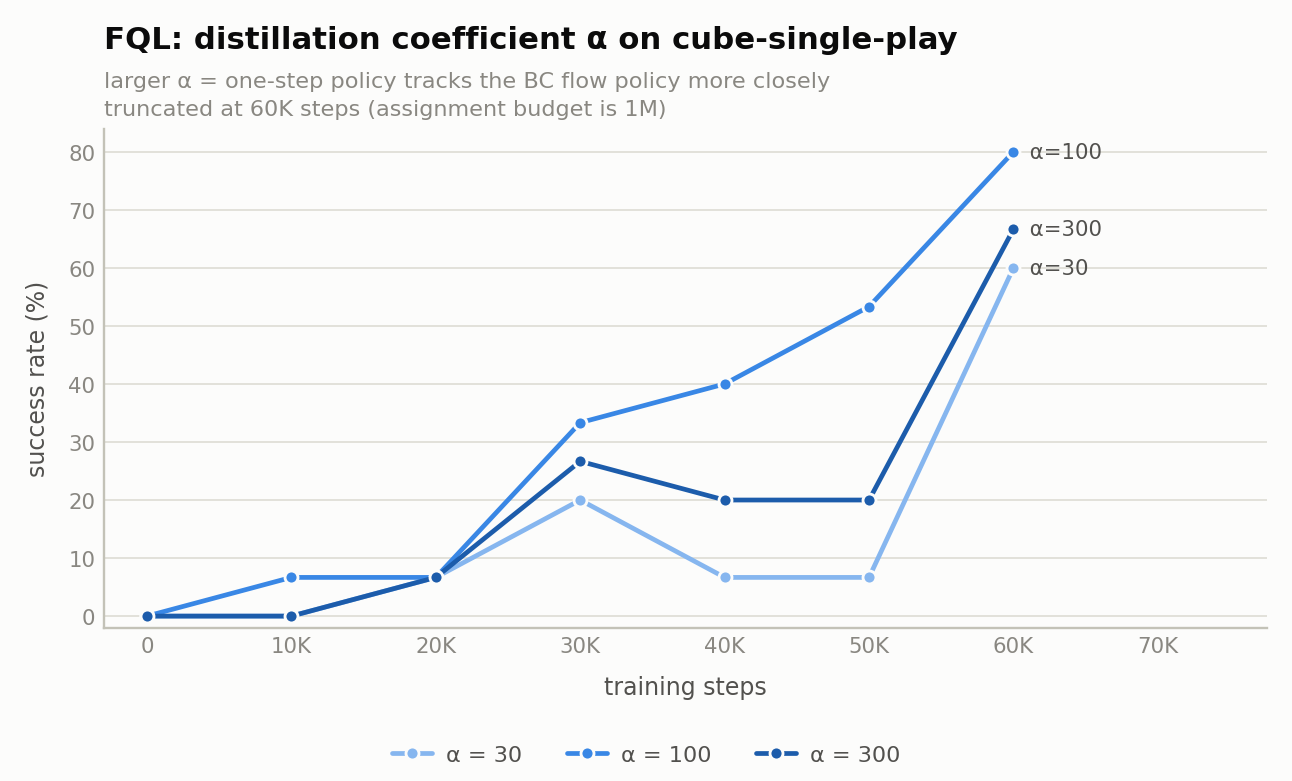
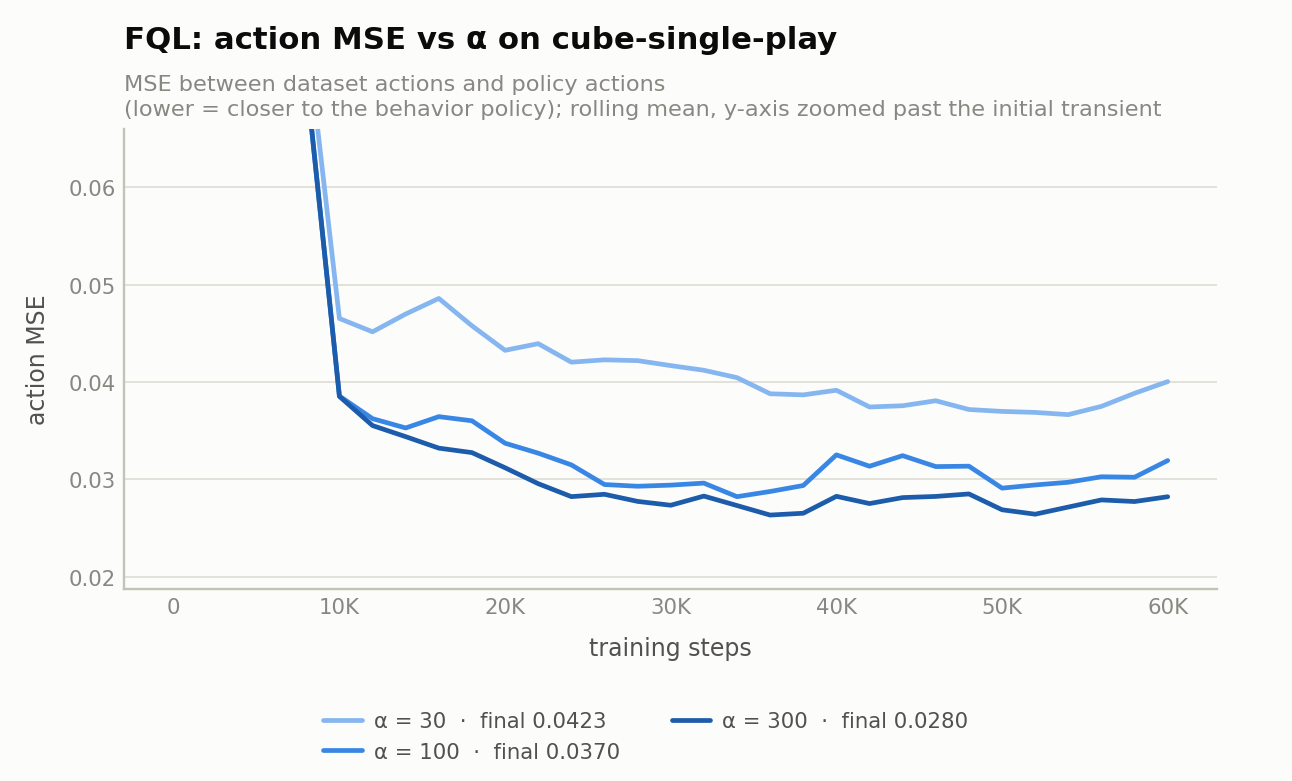
不要从 60K 的 run 对 FQL 下任何最终结论。60K 是预算的 6%,而 FQL 是三者中起步最慢的(20K 时 7%,此时 SAC+BC 已 87%)。这个慢是可以预期的:单步策略的上限是它蒸馏的那个 BC 流策略,而流策略需要时间先把行为分布拟合出来。$\alpha=100$ 在 30/40/50/60K 处是 33% → 40% → 53% → 80%,趋势指向 80% 的目标,但趋势不是证据。
8. 踩坑记录
setup_wandb 硬编码 mode='online'
starter code 的 src/infrastructure/log_utils.py 里,setup_wandb 把 mode='online'
写死并显式传给 wandb.init(...)。而 wandb.init 的显式参数优先级高于环境变量,
于是即使你设了 WANDB_MODE=disabled,它依然会去联网,每个 run 都以
UsageError: No API key configured 直接死掉。
修法:把默认值改成 mode=None,并回退到 os.environ.get("WANDB_MODE", "online")。
这个坑的迷惑性在于——报错信息指向 wandb,你会以为是账号问题,而实际上是参数覆盖了环境变量。
- 单元测试里的
@torch.compile。所有update_*方法都带这个装饰器。在 CPU 上为一个 2 层 32 单元的测试网络做编译,开销远大于测试本身。在tests/test_hw5.py顶部加torch._dynamo.config.disable = True让它们走 eager,26 个测试约 90 秒跑完。调试真实训练时也可以临时关掉(PDF 里也这么建议)。 - 瓶颈是 GPU 而不是 CPU,尽管网络很小。6 个 run 并行就把单卡打到 92% 利用率,再加进程不会更快,每个 run 约 85 it/s。所以「4 个 run 并行」这个建议是有道理的。
- 数据集大但下载快:三个 ogbench 任务共 859 MB,一分钟内下完。开跑前务必确认
rewards ∈ {−1, 0}、masks ∈ {0, 1},因为dones = 1 - masks极易搞反,而它的失败模式是静默的。
9. 自测清单
9.1 写完代码、还没开跑之前
- ☐
uv run python tests/test_hw5.py26/26 全过。任何一条挂了都不要开 GPU。 - ☐ 三个 agent 的
update_target_critic都用了lerp_(param, rho)且包在no_grad里;测试断言在线网络参数未变。 - ☐ SAC+BC 的 actor 用
rsample(),critic 的 next action 用sample()且在no_grad下。 - ☐ BC 项在动作维上取
mean而非sum(否则 PDF 的 $\alpha$ 网格整体错位 $|A|$ 倍)。 - ☐ SAC+BC 熵项里的
self.beta()有.detach()。 - ☐ 没有手写 tanh 的 log-det 修正(
TransformedDistribution已经做了)。 - ☐ SAC+BC / FQL 的备份都用 average 而不是
min的目标 $Q$。 - ☐ IQL 的
update_v用 target critic,update_actor的优势用 online critic(PDF 式 8)。 - ☐ IQL 的
update_q里没有任何一行在调用 actor。 - ☐ AWR 的 clamp 加在指数上:
exp(clamp(alpha*adv, max=log(100)))。 - ☐ AWR 的
log_prob传的是数据集动作,不是采样动作。 - ☐ FQL 的 Euler 时间网格是 $0, 1/F, \dots, (F-1)/F$,共 $F$ 步。
- ☐ FQL 的两个策略在
update_onestep_actor里共享同一个 $z$。 - ☐ FQL 的 clip 加在三处(流策略输出、喂 critic 的单步输出、评估输出),蒸馏项里没有。
- ☐ FQL 的 ODE 展开包在
no_grad里。 - ☐ FQL 的
get_action每次重新采 $z$(不是固定 $z=0$)。
9.2 跑起来之后的前 20K 步
- ☐
q_max应趋近 0,q_min应落在 $[-100, 0]$ 内。跑到 $-1$ 附近说明 done 掩码反了;跑出 $-100$ 以下说明掩码漏了或备份发散。 - ☐ cube-single 上
q_min的合理落点是 $-50 \ldots -70$。偏浅($>-40$)说明 $\alpha$ 太小,偏深($<-85$)说明 $\alpha$ 太大。 - ☐ 扫 $\alpha$ 时,action MSE 必须随 $\alpha$ 单调下降。不单调 = BC 项没接对。
- ☐ IQL 的
actor/weight_mean在 $10^{-3} \sim 10^{-1}$ 是正常的($\tau=0.9$ 下大多数动作优势为负),不要当成 bug 去改。weight_max长期贴 100 才要警惕。 - ☐ 所有指标都是有限值。出现
nan第一个怀疑 AWR 的 clamp 层级。 - ☐ 先在
antmaze-medium上调试:正确实现 + 好的 $\alpha$,SAC+BC 应在 100K 步内超过 80%,IQL 在 200K 步内超过 60%,FQL 在 200K 步内超过 80%。这比在 cube-single 上盲调快得多。
9.3 写报告时
- ☐ 至少 3 个 $\alpha$ 的曲线(cube-single),SAC+BC / IQL / FQL 各一组。
- ☐ IQL 那一问要用 1–2 句话回答「最好性能」和「对 $\alpha$ 的敏感性」两件事——参考 §7.2 的解耦解释。
- ☐ 如果你的 run 没跑满 1M 步,就写清楚跑到了多少步。本文的做法是在每张图的标题里标出实际步数,并单独用一个警告框列出未达标与未运行的项。截断的结果仍然有价值,但把它说成 1M 的结果就没有价值了。