HW3 编程解析:DQN、Double-Q 与 Soft Actor-Critic
这是整门课代码量最大的一份作业:51 处 TODO、两条完全独立的算法线(离散动作的 DQN 与连续动作的 SAC)。真正难的不是行数,而是三处「写得出来但很容易写反」的地方——Double-DQN 的选/评解耦、tanh 挤压高斯的雅可比修正、以及熵温度的对偶梯度。本文逐处拆解数学、代码、写错的具体后果与对应断言,并附上真实跑出来的数字(含哪些实验因算力提前终止而未达标)。
0. 这份作业在考什么
HW3 的题面拆成两半:第 2 节实现 深度 Q 网络(Deep Q-Network, DQN),第 3 节实现 软性演员-评论家(Soft Actor-Critic, SAC)。表面上是两个不相干的算法,实际上它们共享同一条主线——如何在函数逼近下把「自举(bootstrapping)」这件事做稳。DQN 和 SAC 的每一处「奇怪的设计」都是在补同一个洞。
| 作业小节 | 对应讲次与理论命题 | 要动手验证的结论 |
|---|---|---|
| §2.4 基础 DQN | 第 7 讲:值函数方法、拟合 Q 迭代 | 目标网络(target network)把「移动靶」变成「半静止靶」,回归才能收敛 |
| §2.5 Double-Q | 第 8 讲:$\max$ 算子的过估计偏差(overestimation bias) | 把「选动作」和「评动作」交给两个网络,$Q$ 的乐观程度可测量地下降 |
| §2.5 train vs eval | 第 7 讲:行为策略 vs 目标策略(off-policy) | $\epsilon$-greedy 采样回报与贪心评估回报在训练早期会系统性分离 |
| §2.6 超参敏感性 | 第 8 讲:目标网络更新周期的速度/稳定权衡 | 周期短 → 传播快但目标抖;周期长 → 目标稳但值陈旧 |
| §3.2 自举 | 第 6/7 讲:Actor-Critic 的 TD 备份;Polyak 平均 | 软更新 $\phi'\leftarrow\phi'+\tau(\phi-\phi')$ 是硬更新的连续极限 |
| §3.3 熵项 | 第 13 讲:最大熵强化学习(maximum entropy RL) | 熵不仅进 actor 目标,还要进备份,否则 $Q$ 学的不是软值函数 |
| §3.4 重参数化 | 第 5/13 讲:路径导数 vs 似然比估计量 | $\nabla_\theta\E[Q]$ 用 reparametrization 的方差远低于 REINFORCE |
| §3.5 自动调温 | 第 13 讲:约束优化与对偶梯度下降(dual gradient descent) | $\alpha$ 是拉格朗日乘子,它的运动方向由「当前熵 vs 目标熵」的符号决定 |
| §3.6 clipped double-Q | 第 8 讲:过估计在连续动作下的表现 | 两个 critic 取 $\min$ 是悲观估计,能压住 $Q$ 的爆炸性增长 |
- Double-DQN 的证据不在回报上,在 $Q$ 值上。 LunarLander 跑到 35.5 万步时,vanilla 的平均预测 $Q$ 是 84.1,double 是 70.9(低 16%);而两者的评估回报(266.8 vs 256.0)差异纯属单种子噪声。看错指标就会得出「double-Q 没用」的错误结论。
- tanh 挤压高斯的对数概率必须、且只能扣一次雅可比。 这份代码里
TanhTransform已经帮你扣了;再手写一遍 $-\sum\log(1-a^2)$ 就是双重扣除,密度不再积分到 1。测试用数值积分 $\int p\,da=1.000$ 一击必中。 .sample()换成.rsample()不会报错,只会让 actor 悄悄学错。 重参数化断掉后梯度路径消失,训练「看起来在跑」,但熵永远爬不到 $\log 2$。- Hopper 上 clipped double-Q 在共同的 0–66k 窗口里回报 602 vs 400,同时 $Q$ 低 9%。 single-Q 的 $Q$ 一路涨到 260 而回报卡在 600——这是过估计的教科书式指纹。
- HalfCheetah 的 $\alpha$ 是下降的:$0.100\to0.024\to0.048$。因为 $H_{\text{target}}=-\dim(\mathcal A)=-6$ 是个很低的熵目标,初始策略熵(−1.14)远高于它,对偶步只能把探索的价格往下压。
infrastructure/log_utils.py 的 CSV logger 产生。但算力被提前切断:MsPacman 只跑到 70k/1000k、Hopper clipped-Q 只跑到 67k/500k、HalfCheetah 只跑到 278k/1000k。这三个实验都没有达到作业要求的分数。文中每处都会标注「跑到第几步 / 目标是多少 / 趋势如何」,截断的结果一律按截断报告,不冒充达标。§10 专门讨论这对结论的影响。
1. 代码结构与张量形状链条
HW3 最容易在「形状」上翻车,因为 SAC 的 critic 多了一个「critic 集成」维度,而 DQN 的 critic 输出的是「每个动作一个值」。两条线的形状语义完全不同,混着写必然出事。这一节先把两条链条钉死。
1.1 目录结构与文件职责
hw3/
├── src/
│   ├── scripts/
│   │   ├── run_dqn.py            DQN 训练主循环(3 处 TODO)
│   │   └── run_sac.py            SAC 训练主循环(2 处 TODO)
│   ├── agents/
│   │   ├── dqn_agent.py          【核心】eps-greedy / TD 目标 / double-Q / 硬同步
│   │   └── sac_agent.py          【核心】熵估计 / 重参数化 actor / clipped double-Q
│   │                                    / 软硬目标更新 / alpha 自动调温
│   ├── networks/
│   │   ├── critics.py            DQNCritic: s -> (num_actions,)
│   │   │                         StateActionCritic: (s, a) -> scalar
│   │   └── policies.py           MLPPolicy.forward -> Distribution
│   ├── infrastructure/
│   │   ├── replay_buffer.py      ReplayBuffer / MemoryEfficientReplayBuffer
│   │   ├── distributions.py      make_tanh_transformed / make_multi_normal
│   │   └── pytorch_util.py       build_mlp / from_numpy / to_numpy
│   └── configs/                  dqn_config.py / sac_config.py
├── experiments/dqn/*.yaml        cartpole / lunarlander / mspacman ...
├── experiments/sac/*.yaml        sanity_invertedpendulum / hopper_* / halfcheetah_*
└── tests/test_hw3.py 18 项数值测试(本文每节都会引用)一个容易被忽略的对照:DQNCritic.forward(obs) 返回 (batch, num_actions),StateActionCritic.forward(obs, acs) 返回 (batch,)。前者可以在最后一维直接 argmax 求 $\max_a Q$,后者做不到——这正是 §3 开头 PDF 讲的「连续动作空间里 $\max_a Q(s,a)$ 是个非线性优化问题」,也是必须引入显式 actor 的根本原因。
1.2 DQN 的形状链条
| 位置 | 张量 | 形状 | 说明 |
|---|---|---|---|
get_action 入口 | observation | (*ob_shape,) → (1, *ob_shape) | [None] 补 batch 维;Atari 下 ob_shape=(4,84,84) |
get_action | qa_values | (1, num_actions) | 断言写死,形状错立刻炸 |
get_action 出口 | action | (1,) → Python int | .squeeze(0).item() |
replay_buffer.sample | observations | (B, *ob_shape) | MLP 配置下 (B, ob_dim) |
| 同上 | actions | (B,),int64 | 离散动作是标量索引 |
| 同上 | rewards / dones | (B,) | dones 是 bool!见 §2.3 |
update_critic | next_qa_values | (B, num_actions) | 目标网络对 $s'$ 的全动作值 |
update_critic | next_action | (B,) → (B,1) | unsqueeze(1) 才能喂 gather |
update_critic | next_q_values | (B,) | gather(...).squeeze(1) |
update_critic | target_values / q_values | (B,) | 两者形状必须一致,否则 MSE 会广播成 (B,B) |
q_values 留成 (B,1) 而 target_values 是 (B,),nn.MSELoss() 不会报错:PyTorch 会广播成 (B,B),然后对 $B^2$ 个「第 $i$ 个预测 vs 第 $j$ 个目标」求均值。损失曲线看起来还在下降(因为它确实在把所有预测拉向所有目标的均值),但 critic 学到的是一个近乎常数的函数,CartPole 的回报会永远卡在 9~20。这就是那三行 assert ... == (batch_size,) 存在的意义——不要删掉 starter code 里的断言。
1.3 SAC 的形状链条
SAC 多了一维 num_critic_networks(记作 $N$,single-Q 时 $N=1$,clipped double-Q 时 $N=2$),且它永远在最前面。
| 位置 | 张量 | 形状 | 说明 |
|---|---|---|---|
actor(obs) | 分布对象 | batch_shape (B,) | Independent(..., 1) 把动作维吸收进 event_shape |
dist.rsample() | action | (B, ac_dim) | tanh 后严格落在 $(-1,1)$ |
dist.log_prob(a) | log_prob | (B,) | 已对 ac_dim 求和 |
self.critic(obs, a) | q_values | (N, B) | torch.stack([...], dim=0) |
q_backup_strategy 输入 | next_qs | (N, B) | 「来自」第 $i$ 个 target critic 的值 |
q_backup_strategy 内部 | min/mean 后 | (B,) | 沿 dim=0 归约 |
q_backup_strategy 输出 | next_qs | (N, B) | starter code 用 expand 重新撑开:「给」每个 critic 的目标 |
update_critic | target_values | (N, B) | reward[None] / done[None] 靠广播对齐 |
entropy(dist) | H | (B,) | 进 target 时要 [None] 广播到 (1,B) |
update_alpha | log_prob | (B,),已 detach | 见 §8 |
q_backup_strategy 的两个「$N$」不是同一个意思
函数文档里那句话值得读三遍:输入的前导维是「来自(FROM)不同 critic 的值」,输出的前导维是「给(FOR)不同 critic 的目标」。clipped double-Q 的定义 $y_A=y_B=r+\gamma\min_i Q_{\phi'_i}$ 恰恰是说:两个 critic 收到同一个目标。所以先沿 dim=0 归约成 (B,),再 expand 回 (N,B),这个「先塌陷再撑开」看着多余,其实精确表达了语义。
2. DQN 主线:从 $\epsilon$-greedy 到硬同步
2.1 $\epsilon$-greedy 动作选择
要求。 PDF §2.4:「Implement $\epsilon$-greedy sampling in get_action. Recall that in DQN, the action space is discrete, so the greedy action is simply $a=\argmax_a Q_\phi(s,a)$ over the finite set of actions.」
数学。 行为策略是
$$ \pi_{\epsilon}(a\mid s)=\begin{cases} 1-\epsilon+\dfrac{\epsilon}{|\mathcal A|}, & a=\argmax_{a'}Q_\phi(s,a')\\[6pt] \dfrac{\epsilon}{|\mathcal A|}, & \text{否则} \end{cases} $$注意贪心动作也可能被随机抽中,所以它的概率是 $1-\epsilon+\epsilon/|\mathcal A|$ 而不是 $1-\epsilon$。这个细节在写测试时很关键。
observation = ptu.from_numpy(np.asarray(observation))[None]

with torch.no_grad():
    qa_values: torch.Tensor = self.critic(observation)
    assert qa_values.shape == (1, self.num_actions), qa_values.shape

    if np.random.rand() < epsilon:
        action = torch.randint(low=0, high=self.num_actions,
                               size=(1,), device=qa_values.device)
    else:
        action = qa_values.argmax(dim=-1)

return ptu.to_numpy(action).squeeze(0).item()
易错点与后果。
- 忘了
torch.no_grad():每一步环境交互都会建计算图并保留激活值。CartPole 上表现为显存/内存缓慢泄漏,Atari 上几千步就 OOM。 - 用
np.random.rand() <= epsilon:在 $\epsilon$ 衰减到 0 之后仍有极小概率随机(rand()可能返回 0.0),评估回报会莫名其妙掉几分。用严格小于。 - 把
epsilon用在评估上:run_dqn.py里评估走的是utils.sample_n_trajectories,它调用agent.get_action(obs)用默认 $\epsilon=0$。如果你把 $\epsilon$ 硬编码进get_action,评估曲线会永远带噪声,LunarLander 上大概损失 30~50 分。
怎么验证。 test_dqn_epsilon_greedy_and_target_sync 用一个手工构造的两动作 Q 表做三档检查:$\epsilon=0$ 时必须严格贪心;$\epsilon=1$ 时 4000 次抽样应该接近 50/50;$\epsilon=0.5$ 时贪心动作出现的频率应该是 $1-0.5+0.5/2=75\%$。最后这一档正是用来抓「概率写成 $1-\epsilon$」的实现——如果你在随机分支里排除掉贪心动作,频率会变成 50%,测试立刻失败。
2.2 TD 目标:$y=r+\gamma(1-d)\max_{a'}Q_{\phi'}(s',a')$
要求。 PDF §2.4:「Implement a DQN critic update in update_critic」。
数学。 贝尔曼最优算子的样本版本。对一条转移 $(s,a,r,s',d)$:
$$ y=r+\gamma(1-d)\max_{a'}Q_{\phi'}(s',a'),\qquad \mathcal L(\phi)=\frac1B\sum_{i}\bigl(Q_\phi(s_i,a_i)-y_i\bigr)^2 $$三个必须理解的点:(1)$y$ 里用的是 目标网络 $\phi'$ 而不是 $\phi$;(2)$y$ 整体在 torch.no_grad() 里,它是回归的「标签」,不参与梯度;(3)$(1-d)$ 把终止状态的自举掐断——终止之后没有未来,$y$ 必须精确等于 $r$。
done = done.float()          # ← 关键,见下
action = action.long()

with torch.no_grad():
    next_qa_values = self.target_critic(next_obs)      # (B, num_actions)
    ...
    next_q_values = torch.gather(next_qa_values, dim=1,
                                 index=next_action.unsqueeze(1)).squeeze(1)
    target_values = reward + self.discount * (1.0 - done) * next_q_values

qa_values = self.critic(obs)                            # (B, num_actions)
q_values = torch.gather(qa_values, dim=1,
                        index=action.unsqueeze(1)).squeeze(1)
loss = self.critic_loss(q_values, target_values)
2.3 1 - done 与 bool 张量:一个必踩的坑
1 - done
replay buffer 里 done 是从 Python bool 经 np.array(done) 存进去的,dtype 是 bool。PyTorch 明确拒绝对 bool 张量做减法:
RuntimeError: Subtraction, the `-` operator, with a bool tensor is not supported.
If you are trying to invert a mask, use the `~` or `logical_not()` operator instead.update_critic 的第一行必须是 done = done.float()。DQN 和 SAC 两个 agent 都要写——这是本作业里最高频的第一次运行报错。
顺带说明为什么不能用报错信息建议的 ~done:~done 仍是 bool,乘上 float 的 next_q_values 时 PyTorch 会隐式提升为 float,结果碰巧是对的。但一旦以后 done 改成 float 存储(有些版本的 starter code 会这么干),~ 就变成按位取反,$0.0$ 会变成一个巨大的负数,训练直接发散。写 done.float() 是唯一稳妥的写法。
还有一个语义坑:done 不等于 truncated。 看 run_dqn.py 里插入 buffer 的那行:
truncated = info.get("TimeLimit.truncated", False)
replay_buffer.insert(..., done=done and not truncated, ...)
CartPole 在 500 步时被 TimeLimit 截断,这不是 MDP 意义上的终止——杆子还立着,未来价值不为零。如果把 truncated 当作 done=True 存进去,$y$ 会在这些转移上被强行压成 $r=1$,critic 学到的 $Q$ 上界会被拉低到远小于 $\frac{1}{1-\gamma}=100$,CartPole 大概率停在 200 分左右上不去。这行 starter code 已经写好了,但值得知道它为什么在。
2.4 硬目标同步
要求。 「Call all of the required updates, and update the target critic if necessary, in update.」
critic_stats = self.update_critic(obs, action, reward, next_obs, done)

if step % self.target_update_period == 0:
    self.update_target_critic()          # target_critic.load_state_dict(critic.state_dict())
为什么需要目标网络。 如果直接用 $\phi$ 计算 $y$,损失变成 $\bigl(Q_\phi(s,a)-r-\gamma\max_{a'}Q_\phi(s',a')\bigr)^2$,这不是回归而是一个不动点迭代:每走一步梯度,标签也跟着动。第 7 讲里说的「这不是梯度下降,因为它不是任何函数的梯度」正是指这个。实践中的表现是 $Q$ 值发散——在 LunarLander 上通常几万步内 $Q$ 就冲到 $10^3$ 量级然后出 NaN。
易错点。 用 self.target_critic = copy.deepcopy(self.critic) 替代 load_state_dict。这会把 target_critic 换成一个新对象,而 self.critic_optimizer 里持有的参数引用还指向旧对象——如果你不小心把 target 的参数也放进了优化器,同步之后优化器会更新一组已被丢弃的张量。更隐蔽的是 nn.Module 的子模块注册会被打乱,agent.to(device) 之后 target 可能留在 CPU。老老实实用 load_state_dict。
怎么验证。 test_dqn_epsilon_greedy_and_target_sync 的后半段:人为把 online 网络的权重改掉,然后逐步调用 update,检查只在 step % period == 0 时 target 的输出才发生变化。这能同时抓住两类 bug——每步都同步(等于没有目标网络)和从不同步(target 永远是初始化值,$Q$ 学成常数)。
2.5 run_dqn.py 的三处 TODO
# 1) 用当前 epsilon 采样动作
action = agent.get_action(observation, epsilon)

# 2) 从 replay buffer 采一个 batch
batch = replay_buffer.sample(config["batch_size"])

# 3) 训练
update_info = agent.update(
    obs=batch["observations"], action=batch["actions"],
    reward=batch["rewards"], next_obs=batch["next_observations"],
    done=batch["dones"], step=step,
)三行看着无脑,但有两个容易写反的地方。第一,epsilon 必须来自 exploration_schedule.value(step)(分段线性:$1.0\to0.1$ 用掉 30% 步数,再 $\to0.02$ 用掉 60%),而不是一个常数;第二,采样和训练必须包在 if step >= config["learning_starts"] 里。CartPole 的 learning_starts=1000,LunarLander 是 20000。如果 buffer 里只有几十条转移就开始训练,batch 会被同一条轨迹的高度相关样本填满,Q 网络在最初几百步就过拟合到一个错误的值,之后很难恢复——这就是经验回放要解决的「样本相关性」问题的反面教材。
sample 是有放回的
ReplayBuffer.sample 用的是 np.random.randint(0, self.size, size=(batch_size,)),同一个 batch 里可以出现重复索引。这在数学上无害:我们要估计的是 $\E_{(s,a,r,s')\sim\mathcal D}[(Q_\phi-y)^2]$ 关于 buffer 经验分布 $\mathcal D$ 的期望,有放回抽样给出的是无偏 i.i.d. 估计,反倒比无放回更干净。测试 test_replay_buffer_shapes_and_ring_overwrite 还检查了环形覆盖:容量 5 的 buffer 插 8 条之后内容是 [5,6,7,3,4],而 len() 仍然返回 8(因为 self.size 只增不减,采样时用 % max_size 兜底)。这个「len 大于容量」的行为如果你自己写会觉得是 bug,其实是 starter code 的既定设计。
3. 重点一:Double DQN 与过估计偏差
3.1 $\max$ 为什么会系统性地高估
要求。 PDF §2.5:「The double-Q trick avoids overestimation bias in the critic update by using two different networks to select the next action $a'$ and to estimate its value... we'll keep using the target network $Q_{\phi'}$ to estimate the action's value, but we'll select the action using $Q_\phi$(the online Q network).」
数学。 设真值为 $Q^*(s',a)$,学到的估计带零均值噪声:$Q_{\phi'}(s',a)=Q^*(s',a)+\varepsilon_a$,$\E[\varepsilon_a]=0$。vanilla 目标里的关键量是 $\max_a Q_{\phi'}(s',a)$。由于 $\max$ 是凸函数,Jensen 不等式给出
$$ \E\Bigl[\max_a\bigl(Q^*(s',a)+\varepsilon_a\bigr)\Bigr]\;\ge\;\max_a\E\bigl[Q^*(s',a)+\varepsilon_a\bigr]=\max_a Q^*(s',a) $$也就是说,哪怕估计本身是无偏的,取 $\max$ 之后也一定是向上有偏的。而且这个偏差随动作数 $|\mathcal A|$ 增大而增大(更多的候选 = 更容易抽到一个偏大的噪声),随噪声方差增大而增大。更糟的是它会被自举放大:偏大的 $y$ 训出偏大的 $Q$,下一轮 $\max$ 又在更偏大的值上取 $\max$。
Double-DQN 的目标为
$$ a^*=\argmax_{a'}Q_{\phi}(s',a'),\qquad y=r+\gamma(1-d)\,Q_{\phi'}(s',a^*) $$注意 evaluation 始终用 $\phi'$;相对 vanilla 唯一改动的是 $\argmax$ 用哪个网络。
3.2 实现:一行 if 的位置很重要
with torch.no_grad():
    # 无论哪种模式,被“评估”的都是目标网络
    next_qa_values = self.target_critic(next_obs)          # (B, num_actions)
    assert next_qa_values.shape == (batch_size, self.num_actions)

    if self.use_double_q:
        # 选择:在线网络
        next_action = self.critic(next_obs).argmax(dim=-1)
    else:
        # vanilla:目标网络自己选自己评
        next_action = next_qa_values.argmax(dim=-1)

    next_q_values = torch.gather(next_qa_values, dim=1,
                                 index=next_action.unsqueeze(1)).squeeze(1)
target_values = reward + self.discount * (1.0 - done) * next_q_values结构上要记住的是:next_qa_values 这一行在 if 外面,而且永远是 target_critic。写成下面这样是最常见的错误:
# ✗ 错误写法:把评估也换成了在线网络
if self.use_double_q:
    next_qa_values = self.critic(next_obs)
    next_action = next_qa_values.argmax(dim=-1)
next_q_values = next_qa_values.gather(...) # 用 φ 评估 φ 选的动作后果非常具体:这样写出来的东西数学上等价于「完全不用目标网络的 vanilla DQN」——$y=r+\gamma\max_a Q_\phi(s',a)$。它不但没有消除过估计,还把目标网络带来的稳定性一并丢掉了。在 LunarLander 上表现为 $Q$ 值在 10 万步左右开始超线性上涨、评估回报在冲到 100 分左右后崩回 $-200$。麻烦的是它不会报错,形状断言全部通过。
3.3 手算例子:4.6 → 2.8
这是本作业最值得亲手算一遍的例子(也是测试 test_double_dqn_target_differs_and_is_smaller 用的固定用例)。取 3 个状态、2 个动作、$\gamma=0.9$:
| $a_0$ | $a_1$ | |
|---|---|---|
| $Q_\phi(s_0,\cdot)$ | 1.00 | 2.00 |
| $Q_\phi(s_1,\cdot)$ | 3.00 | −1.00 |
| $Q_\phi(s_2,\cdot)$ | 0.50 | 0.25 |
| $Q_{\phi'}(s_0,\cdot)$ | 0.00 | 5.00 |
| $Q_{\phi'}(s_1,\cdot)$ | 2.00 | 4.00 |
| $Q_{\phi'}(s_2,\cdot)$ | −1.00 | 7.00 |
batch 为 $s=[s_0,s_1]$,$a=[a_1,a_0]$,$r=[1.0,-2.0]$,$s'=[s_1,s_2]$,$d=[\text{False},\text{True}]$。
- 取出的当前值:$Q_\phi(s_0,a_1)=2.0$,$Q_\phi(s_1,a_0)=3.0$,即
[2.0, 3.0]。 - vanilla 第 0 条:$\max_a Q_{\phi'}(s_1,\cdot)=\max(2.0,4.0)=4.0$,于是 $y_0=1.0+0.9\times4.0=\mathbf{4.6}$。
- double 第 0 条:先用在线网络选,$\argmax_a Q_\phi(s_1,\cdot)$:$3.0>-1.0$,选 $a_0$。再用目标网络评:$Q_{\phi'}(s_1,a_0)=2.0$。于是 $y_0=1.0+0.9\times2.0=\mathbf{2.8}$。
- 第 1 条是终止转移:$d=\text{True}$,两种模式都给 $y_1=-2.0=r$,一模一样。
一个可以直接当断言用的结构性质。 对任意一对网络,恒有
$$ Q_{\phi'}\bigl(s',\argmax_{a}Q_\phi(s',a)\bigr)\;\le\;\max_{a}Q_{\phi'}(s',a) $$因为左边只是右边取 $\max$ 的候选之一。于是 double 目标永远 $\le$ vanilla 目标(在 $\gamma\ge0$、同一对网络下)。test_double_dqn_target_differs_and_is_smaller 就是用这条:先验证手算例子 $2.8<4.6$,再在 20 组随机 Q 表上验证 $y_{\text{double}}\le y_{\text{vanilla}}+10^{-6}$ 恒成立、且至少有一处严格小于。
3.4 gather 的两个索引维度
torch.gather(next_qa_values, dim=1, index=next_action.unsqueeze(1)) 这行值得单独说。gather 要求 index 与 input 维数相同,所以 (B,) 的动作索引必须 unsqueeze(1) 成 (B,1);输出也是 (B,1),再 squeeze(1) 回 (B,)。
常见的三种写错方式与后果:
| 写法 | 发生什么 |
|---|---|
gather(qa, 1, action)(忘了 unsqueeze) | 立刻报 RuntimeError: Index tensor must have the same number of dimensions,好抓 |
gather(qa, 0, action[:,None])(dim 写成 0) | 不报错。它会沿 batch 维取,等于把第 $a_i$ 条样本的第 $i$ 个动作值拿来当第 $i$ 条的 $Q(s_i,a_i)$。梯度完全对不上样本,CartPole 回报永远在 9~30 之间随机游走 |
qa[:, action](花式索引) | 不报错,但形状变成 (B,B),MSE 广播后损失下降但学不到东西 |
更稳妥的等价写法是 qa_values[torch.arange(B), action],形状直接是 (B,),不容易搞混维度。两种写法数值完全一致。
怎么验证。 test_dqn_vanilla_td_target_matches_hand_computation 用上面那张手算表,把 agent.critic_loss 临时替换成一个「捕获 (q_values, target_values) 并返回零损失」的探针函数,然后直接比对 [2.0, 3.0] 与 [4.6, -2.0]。这个测试同时锁住了 gather 的维度、$\gamma$ 的位置和 $(1-d)$ 的作用;test_dqn_target_equals_reward_on_terminal_transitions 则专门用一个数值大 50 倍的目标网络来做终止检查——如果 $(1-d)$ 漏了,$y_1$ 会偏离 $r$ 几百,一眼可见。
4. SAC 主线之一:自举与目标网络更新
4.1 run_sac.py 的两处 TODO
PDF 提示得很直白:「This should look pretty similar to your DQN run script, as both are off-policy methods!」两处 TODO 是选动作和采 batch:
if step < config["random_steps"]:
    action = env.action_space.sample()      # 纯随机热身(starter code 已给)
else:
    action = agent.get_action(observation)  # ← TODO(3.1)

...
if step >= config["training_starts"]:
    batch = replay_buffer.sample(config["batch_size"])   # ← TODO(3.1)
    batch = ptu.from_numpy(batch)
    update_info = agent.update(observations=..., actions=..., rewards=...,
                               next_observations=..., dones=..., step=step)
注意 random_steps(InvertedPendulum 是 1000)和 training_starts(5000)是两个不同的阈值:前者控制「什么时候停止纯随机探索」,后者控制「什么时候开始梯度更新」。SAC 的探索靠策略自身的随机性(熵项),不像 DQN 有 $\epsilon$ 调度,所以开头那段纯随机采样承担了「把 buffer 填上多样数据」的职责。把 random_steps 设成 0,InvertedPendulum 上大概率会在前 1 万步陷入一个退化策略。
4.2 critic 更新:目标里的三层结构
要求。 PDF §3.2:$y\leftarrow r_t+\gamma(1-d_t)Q_\phi(s_{t+1},a_{t+1})$,$a_{t+1}\sim\pi(a_{t+1}\mid s_{t+1})$。§3.3 又在方括号里塞进熵项。合起来最终形式是
$$ y=r+\gamma(1-d)\Bigl[\underbrace{\textstyle\min_{i}Q_{\phi'_i}(s',a')}_{\text{§3.6 clipped double-Q}}+\underbrace{\beta\,\mathcal H\bigl(\pi(\cdot\mid s')\bigr)}_{\text{§3.3 熵奖励}}\Bigr],\quad a'\sim\pi(\cdot\mid s') $$with torch.no_grad():
next_action_distribution = self.actor(next_obs)
next_action = next_action_distribution.sample() # (B, ac_dim)
next_qs = self.target_critic(next_obs, next_action) # (N, B)
if self.use_entropy_bonus and self.backup_entropy:
next_action_entropy = self.entropy(next_action_distribution) # (B,)
next_qs = next_qs + self.get_temperature() * next_action_entropy[None]
next_qs = self.q_backup_strategy(next_qs) # (N, B) -> (N, B)
target_values = reward[None] + self.discount * (1.0 - done[None]) * next_qs
q_values = self.critic(obs, action) # (N, B)
loss = self.critic_loss(q_values, target_values)min 之前还是之后?
本实现把熵加在 q_backup_strategy 之前,即 $\min_i\bigl(Q_{\phi'_i}+\beta H\bigr)$。因为 $H$ 与 $i$ 无关,$\min_i(Q_i+c)=\min_i Q_i+c$,两种顺序数值完全等价。但形状不等价:加在前面时 $H$ 需要 [None] 广播到 (1,B);加在后面时直接是 (B,) 与 (N,B) 广播。写在前面的好处是 q_backup_strategy 的输入语义保持纯粹(「来自各 critic 的软 Q 值」)。
三个易错点。
next_action用了rsample():整段在no_grad()里,用哪个都不影响数值。但rsample()会触发TanhTransform(cache_size=1)的缓存写入,而这个缓存随后又被self.entropy(next_action_distribution)里的第二次采样覆盖——不会出错,但会让你在调试时对「缓存里到底存的是哪次采样」产生困惑。这里用.sample()语义更干净。- 忘了
reward[None]:reward是(B,),next_qs是(N,B)。广播规则下(B,) + (N,B)恰好也是对的(右对齐),所以漏写[None]在 $N=1,2$ 时都不会出错。但显式写出来能让断言target_values.shape == (N,B)变成真正的校验而不是巧合。 - 把
self.critic写成self.critics:self.critic是一个方法(它 stack 所有 critic 的输出),self.critics是nn.ModuleList。直接调用后者会报'ModuleList' object is not callable,好抓。
4.3 软更新 vs 硬更新
要求。 PDF §3.2 给了两种:硬更新每 $K$ 步 $\phi'\leftarrow\phi$;软更新(Polyak 平均)每步 $\phi'\leftarrow\phi'+\tau(\phi-\phi')$。sac_config.py 保证两者恰有一个不是 None。
if self.target_update_period is not None:
    if step % self.target_update_period == 0:
        self.update_target_critic()                       # 等价于 soft_update(tau=1.0)
elif self.soft_target_update_rate is not None:
    self.soft_update_target_critic(self.soft_target_update_rate)
else:
raise ValueError("Must specify either target_update_period or soft_target_update_rate")test_sac_target_updates_hard_and_soft 就是拿这个闭式解做断言:把 target 参数清零、online 参数设成已知常数,跑 $k$ 步 Polyak,检查参数等于 $\phi(1-(1-\tau)^k)$;再单独验证 update_target_critic() 是精确硬拷贝(相当于 $\tau=1$)。这条断言能抓住把更新写成 $\phi'\leftarrow\tau\phi'+(1-\tau)\phi$($\tau$ 用反)的 bug——用反之后目标网络几乎瞬间等于在线网络,等于没有目标网络,Hopper 上 $Q$ 会在 2 万步内发散。
实现细节:soft_update_target_critic 用的是 target_param.data.copy_(...)。用 .data 而不是 with torch.no_grad() 只是风格问题,但绝不能写成 target_param = ...(那只是重绑局部变量,参数原地没变,target 网络永远停在初始化值)。
4.4 num_critic_updates:critic 走几步,actor 走一步
critic_infos = []
for _ in range(self.num_critic_updates):
    info = self.update_critic(observations, actions, rewards, next_observations, dones)
    critic_infos.append(info)

actor_info = self.update_actor(observations)
顺序是「critic 先走 num_critic_updates 步,然后 actor 走一步」。这个不对称有理论理由:actor 的目标 $\E_{a\sim\pi}[Q_\phi(s,a)]$ 只有在 $Q_\phi$ 近似正确时才有意义。如果 actor 更新得比 critic 快,它会去攻击 critic 尚未修正的估计误差——在连续动作空间里这表现为策略跑到动作边界(tanh 饱和),然后因为梯度消失再也回不来。反过来把 actor 放在 critic 之前更新也是常见错误,后果是 actor 用的是上一轮的 $Q$,等价于多了一步延迟,收敛变慢但通常不至于崩。
另外注意 update_critic 在循环里重复使用同一个 batch。这是 starter code 的设计(省一次采样),代价是同一批数据被拟合多次、稍微增加过拟合风险。InvertedPendulum / Hopper / HalfCheetah 的配置里 num_critic_updates 都是 1,所以这一点在本作业里不构成实际影响。
5. 重点二:tanh 挤压高斯的 log-prob 修正
5.1 为什么需要修正
连续控制环境的动作空间通常是有界的(MuJoCo 一律是 $[-1,1]^d$)。高斯策略的支撑集是整个 $\R^d$,直接用会产生越界动作,环境端会被 clip,于是 $\log\pi$ 与实际执行的动作对不上,梯度就错了。SAC 的做法是挤压(squash):
$$ u\sim\mathcal N\bigl(\mu_\theta(s),\,\sigma_\theta(s)^2\bigr),\qquad a=\tanh(u)\in(-1,1)^d $$问题在于:$a$ 的密度不是 $\mathcal N(u;\mu,\sigma)$。必须做变量替换(change of variables)。
数量级也值得记:当 $u$ 接近 0 时 $1-\tanh^2u\approx1$,修正接近 0;当 $|u|=2$ 时 $1-\tanh^2 2\approx0.071$,修正约 $+2.65$ 每个维度。HalfCheetah 的 6 维动作在饱和区能贡献十几 nat 的差异——这不是可以忽略的小项。
5.2 这份代码里:修正是免费的
关键在 infrastructure/distributions.py:
def make_tanh_transformed(mean, std):
    return D.Independent(
        D.TransformedDistribution(
            base_distribution=D.Normal(mean, std),
            transforms=[D.TanhTransform(cache_size=1)],
        ),
        reinterpreted_batch_ndims=1,
    )
TransformedDistribution.log_prob 内部就是 base.log_prob(u) - transform.log_abs_det_jacobian(u, a),而 TanhTransform.log_abs_det_jacobian 的实现是
2 * (math.log(2.) - x - torch.nn.functional.softplus(-2. * x))这正是 $\log(1-\tanh^2x)$ 的数值稳定写法(直接算 $\log(1-\tanh^2 x)$ 在 $|x|>9$ 时会得到 $\log 0=-\infty$,而 softplus 形式一路到 $|x|\sim80$ 都精确)。
# ✗ 在本代码库里这是双重扣除!
log_prob = normal.log_prob(u).sum(-1) - torch.log(1 - action.pow(2) + 1e-6).sum(-1)Normal,所以必须手动扣。但这里已经包了 TanhTransform,再扣一次得到的是
$\log\mathcal N-2\sum_i\log(1-a_i^2)$,对应的「密度」$\tilde p(a)=p(a)\prod_i(1-a_i^2)^{-1}$ 积分不等于 1。后果是什么? 这个多出来的 $-\sum\log(1-a^2)$ 项在 $|a|\to1$ 时趋于 $+\infty$,等价于给策略额外加了一个「远离边界」的巨大熵奖励。actor 会被推向 $\mu\approx0$、动作全挤在原点附近,HalfCheetah 上表现为回报长期卡在 0 附近(原地抽搐);同时
entropy 的日志值会明显超过理论上界 $\log 2=0.693$(1 维时),这是最容易观察到的信号。
所以 SoftActorCritic.entropy 只有一行:
def entropy(self, action_distribution):
    return -action_distribution.log_prob(action_distribution.rsample())
5.3 为什么「积分等于 1」这个测试能一击命中
test_tanh_gaussian_density_integrates_to_one 的做法是:在 $(-1,1)$ 上取 400001 个等距点,对 $\exp\bigl(\log\text{-prob}(a)\bigr)$ 做梯形积分,要求结果与 1.0 相差小于 $2\times10^{-3}$,并对 4 组不同的 $(\mu,\sigma)$ 都验一遍。
为什么这个断言比「和手写公式对拍」更强? 因为它检查的是一个不依赖于任何参考实现的性质。概率密度积分为 1 是定义级别的约束:
| bug | 返回的量 | 积分值 |
|---|---|---|
| 正确 | $\log\mathcal N(u)-\sum\log(1-a^2)$ | $1.000$ ✓ |
| 漏掉雅可比 | $\log\mathcal N(u)$ | $<1$($\mu=0,\sigma=1$ 时约 $0.62$) |
| 双重扣除 | $\log\mathcal N(u)-2\sum\log(1-a^2)$ | 发散(被积函数在 $\pm1$ 处不可积) |
| 符号写反 | $\log\mathcal N(u)+\sum\log(1-a^2)$ | $\ll1$ |
三类错误全部被同一个断言覆盖,而且不需要你「知道正确答案长什么样」。测试套件还有另外三层加固:
test_tanh_gaussian_log_prob_change_of_variables:在 float64 下与手写公式逐点对拍到 $10^{-8}$,并额外断言「手写值必须比裸Normal值至少大 0.5」——保证测试用的 $(\mu,\sigma)$ 确实落在雅可比项非平凡的区域,避免测了个寂寞。test_tanh_gaussian_monte_carlo_expectation_matches_density:用 40 万次采样估 $\E[a^2]$、$\E[|a|]$、$\E[e^a]$ 和微分熵,与数值积分对比,容差 5 倍标准误。这一步验证的是「rsample产生的样本」与「log_prob给出的密度」确实是同一个分布——如果你只改了log_prob没改采样(或反过来),前一个测试可能仍过,这个必挂。test_tanh_actions_are_inside_open_interval:5 万个采样必须严格落在 $(-1,1)$ 开区间且全部有限;同时要求至少 20% 的样本 $|a|>0.5$,防止 $\sigma$ 太小让测试变成空转。
5.4 数值细节:cache_size=1 与 float32 饱和
TanhTransform(cache_size=1) 会缓存最近一次 rsample() 的 $(u,a)$ 对。调用 log_prob(a) 时,如果 $a$ 就是缓存里那个,它直接复用 $u$,不去算 $\operatorname{atanh}(a)$。
这为什么重要?因为 float32 下当 $|u|\gtrsim8.4$ 时 tanh(u) 会精确舍入到 $\pm1.0$,此时 $\operatorname{atanh}(\pm1)=\pm\infty$,log_prob 变成 NaN,整个训练在一步之内污染所有参数。float64 下这个阈值是 $|u|\gtrsim19$,所以在 CPU 上用 double 调试时不容易复现,一上 GPU float32 就炸——典型的「本地好好的,跑起来就 NaN」。
entropy() 里写的是 -dist.log_prob(dist.rsample()),采样和求 log-prob 紧挨着,缓存必然命中。但 actor_loss_reparametrize 里先 action = dist.rsample(),中间过了一遍 critic,再 dist.log_prob(action)——中间没有别的采样,缓存仍然命中。如果你在这两句之间插了一次 dist.sample()(比如为了打日志),缓存会被覆盖,后面的 log_prob 就要走 atanh 路径,饱和风险回来了。这是个真实存在的陷阱。测试
test_tanh_actions_are_inside_open_interval 特意在 $\sigma$ 很大(会饱和)时只检查闭区间性质,而对严格开区间的检查用现实的 $\sigma$——就是因为大 $\sigma$ 下 float32 的 tanh 一定会取到 $\pm1$,那不是实现 bug 而是浮点事实。
5.5 一维 tanh 高斯的最大熵:为什么是 0.678 而不是 0.693
PDF §3.3 的自测标准是:只开熵项、不开重参数化 actor 时,熵应该爬升到「接近一维 tanh 动作空间的最大熵 $\log2\approx0.69$」。$\log 2$ 来自 $(-1,1)$ 上的均匀分布:$H=-\int_{-1}^{1}\frac12\log\frac12\,\mathrm{d}a=\log2$。
但 tanh 高斯这个参数族永远取不到均匀分布,只能逼近。test_sac_entropy_estimator_and_max_entropy_of_1d_tanh_policy 扫了一遍 $\sigma$:
| $\sigma$ | 0.5 | 0.8 | 1.0 | 1.2 | 1.5 | 2.0 |
|---|---|---|---|---|---|---|
| $H$(nat) | 0.500 | 0.678 | 0.670 | 0.601 | 0.423 | 0.001 |
族内最优在 $\sigma\approx0.8$ 处取得 $H\approx0.678$,距离 $\log2=0.6931$ 差 0.015。$\sigma$ 再大反而下降:因为 tanh 把大 $|u|$ 全部压到 $\pm1$ 附近,密度在两端堆成两个尖峰,微分熵掉回接近 0。$\sigma=2.0$ 时熵只剩 0.001。
这张表的实用价值:如果你的 InvertedPendulum sanity 跑出来熵稳定在 0.65~0.68,实现基本正确;如果超过 0.6931,你多半漏扣或算错了雅可比(密度没归一化,熵可以任意大);如果停在 0.3 以下且不动,多半是 .sample() 断了梯度(见 §7)。
6. 熵奖励:进 actor,也要进备份
要求。 PDF §3.3 给了两条公式,很多人只实现了第一条:
$$ J_\pi=Q\bigl(s,\mu_\theta(s)+\sigma_\theta(s)\epsilon\bigr)+\beta\,\mathcal H\bigl(\pi(a\mid s)\bigr), \qquad y\leftarrow r+\gamma(1-d)\bigl[Q_\phi(s',a')+\beta\,\mathcal H\bigl(\pi(a'\mid s')\bigr)\bigr] $$第二条(熵进备份)是最大熵 RL 的核心。没有它,critic 学的是普通的 $Q^\pi$,而 actor 却在最大化「$Q$ + 熵」——两者优化的不是同一个目标,得到的策略既不是最优确定性策略也不是最优最大熵策略。
# update_critic 里
if self.use_entropy_bonus and self.backup_entropy:
    next_action_entropy = self.entropy(next_action_distribution)   # π(·|s') 的熵
    assert next_action_entropy.shape == (batch_size,)
    next_qs = next_qs + self.get_temperature() * next_action_entropy[None]

# update_actor 里
if self.use_entropy_bonus:
    loss = loss - self.get_temperature() * entropy      # loss = -Q̄ - β·H
易错点:actor loss 里的符号。 目标是最大化 $J_\pi=\E[Q]+\beta H$,损失是 $-J_\pi=-\E[Q]-\beta H$。所以是 loss = loss - beta * entropy(在已有的 loss = -q.mean() 基础上再减)。写成 + 会变成最小化熵:策略会迅速塌成确定性的,$\sigma\to0$,动作全部饱和到 $\pm1$,InvertedPendulum 的熵日志会一路掉到 $-5$ 以下并且回报锁死在 100 上下。这个错误的好处是症状极其明显——熵单调下降就是信号。
怎么验证。 test_sac_entropy_bonus_enters_the_target 的设计很巧:把 backup_entropy 开、关各跑一次目标计算,断言两者之差恰好等于 $\gamma(1-d)\beta H$。这个「精确差值」断言能同时抓住:漏乘 $\gamma$、漏乘 $(1-d)$、漏乘 $\beta$、以及把熵加在括号外面($y=r+\gamma(1-d)Q+\beta H$)。而 test_alpha_used_by_actor_and_critic_updates 则验证 actor 损失精确等于 $-\overline{Q}-\alpha H$。
use_entropy_bonus 与 backup_entropy 是两个开关
use_entropy_bonus=False 时熵项在 actor 和 backup 里都不生效;use_entropy_bonus=True, backup_entropy=False 则只在 actor 里加熵。PDF §3.3 的自测阶段(还没实现重参数化 actor)会出现一个特殊状态:actor 损失只有熵项,此时 actor 唯一的目标就是把熵推到最大,于是熵应该单调爬升并逼近 $\log2\approx0.69$。这是一个非常干净的分阶段自测,别跳过它直接实现 §3.4。
7. .sample() vs .rsample():断掉重参数化会让 actor 完全学错
要求。 PDF §3.4:「Parametrize $\pi_\theta$ as $\mu_\theta(s)+\sigma_\theta(s)\epsilon$... Hint: you can use .rsample() to get a reparametrized sample from a distribution in PyTorch.」代码注释里两处都写着「Think about whether to use .rsample() or .sample() here...」——这个提示出现两次不是偶然。
7.1 两种梯度估计量
(A)似然比 / REINFORCE(HW2 用的那条): $$ \nabla_\theta\E_{a\sim\pi_\theta}[Q]=\E_{a\sim\pi_\theta}\bigl[Q(s,a)\,\nabla_\theta\log\pi_\theta(a\mid s)\bigr] $$ 它把 $\theta$ 的影响全部塞进 $\log\pi$ 的梯度里,$Q$ 只当标量权重。不需要 $Q$ 可微,但方差随 $Q$ 的量级线性增长——Hopper 上 $Q$ 到 200 量级,方差会大到没法用。
(B)路径导数 / 重参数化(本作业用的):写 $a=g_\theta(s,\epsilon)=\tanh\bigl(\mu_\theta(s)+\sigma_\theta(s)\epsilon\bigr)$,$\epsilon\sim\mathcal N(0,I)$ 与 $\theta$ 无关,于是期望的分布不再依赖 $\theta$,可以直接把梯度搬进去: $$ \nabla_\theta\E_{\epsilon\sim\mathcal N}\bigl[Q\bigl(s,g_\theta(s,\epsilon)\bigr)\bigr] =\E_{\epsilon}\Bigl[\underbrace{\nabla_a Q(s,a)\big|_{a=g_\theta}}_{\text{critic 的输入梯度}}\cdot\;\nabla_\theta g_\theta(s,\epsilon)\Bigr] $$ 这里用到了 $Q$ 关于动作的梯度——这是路径导数比似然比强的根本原因:它利用了 critic 的一阶信息,而不是只把它当成一个数。PDF 那句「often gives a much lower variance, so it can be used with few samples(in practice, just using a single sample tends to work very well)」说的就是这件事。
7.2 写成 .sample() 会发生什么
action = action_distribution.rsample()    # ✓ 保留 θ → a 的计算图
q_values = self.critic(obs, action)       # (N, B)
loss = -q_values.mean()
如果换成 .sample():PyTorch 的 sample() 内部包了 with torch.no_grad(),返回的张量 requires_grad=False。于是 q_values 对 actor 的参数没有任何依赖,loss.backward() 之后 actor 所有参数的 .grad 是 None(或全零,取决于是否有其它路径)。
- 训练能跑完,损失是有限数,日志一切正常;
- 如果同时开了熵项,actor 仍有一条梯度路径(熵项里的
rsample),于是 actor 会去纯粹地最大化熵——策略越来越随机; - InvertedPendulum 上熵爬到 0.67 附近就不动了,评估回报永远在 100 以下(随机策略摆几十步就倒);
- 如果
entropy()里也用了.sample(),那 actor 就完全没有梯度,参数一动不动,回报锁死在初始水平。
next_action 用 .sample() 是对的(整段在 no_grad() 里,且目标值本来就不该有梯度)。所以两处「用哪个」的答案不同,这就是注释问了两遍的原因。
7.3 entropy() 里也必须是 rsample
熵的单样本估计是 $\hat{\mathcal H}=-\log\pi_\theta(a\mid s)$,其中 $a\sim\pi_\theta$。这里 $\theta$ 出现在两个地方:分布本身,以及被采出来的 $a$。用 rsample 时两条路径都保留,梯度是完整的;用 sample 时只剩「分布」那条。
有趣的是,理论上第二条路径的期望贡献为零(因为 $\E_{a\sim\pi}[\nabla_\theta\log\pi]=0$),所以用 sample 得到的仍是无偏估计的一部分——但它丢掉了低方差的那一半,并且在只有一个样本时表现很差。实践中的结论就是 NOTES 里那句:「训练仍然『能跑』,但 actor 拿不到熵奖励,InvertedPendulum 上熵停止向 $\log 2$ 爬升。」
怎么验证。 test_sac_entropy_estimator_and_max_entropy_of_1d_tanh_policy 的第一行断言就是 assert ent.requires_grad, "entropy must stay differentiable (use rsample)"——一句话锁死。test_sac_update_end_to_end_runs_and_learns 则在完整 update() 之后收集 actor 所有参数的梯度,断言它们全部有限且绝对值之和大于 0("no gradient reached the actor")。这条断言是本测试套件里最省事的「重参数化断了没有」检查器。
8. clipped double-Q:连续动作下的过估计对策
要求。 PDF §3.6:「learn two critics $Q_{\phi_A},Q_{\phi_B}$(and keep two target networks),then compute the target values by taking the minimum of both critics: $y_A=y_B=r+\gamma\min\bigl(Q_{\phi'_A}(s',a'),Q_{\phi'_B}(s',a')\bigr)$」。
8.1 为什么连续动作下 Double-DQN 那一招不好使
DQN 的 double 技巧依赖「用另一个网络做 $\argmax$」。连续动作里没有 $\argmax$——动作由 actor 给出,而 actor 恰恰是被训练去最大化 critic 的。也就是说 actor 会主动搜索 critic 高估最严重的那块区域,过估计不但没被稀释,反而被定向放大了。这是 TD3/SAC 论文的核心观察。
对策换成「悲观」:训两个独立初始化的 critic,备份时取逐元素最小值。设 $Q_i=Q^*+\varepsilon_i$,$\varepsilon_i$ 独立零均值,则 $\E[\min_i Q_i]\le\min_i\E[Q_i]=Q^*$——$\min$ 是凹函数,Jensen 方向与 $\max$ 相反,得到的是向下有偏的估计。用一个已知的低估去抵消一个未知的高估,代价是引入了偏差,但保守偏差在自举里不会滚雪球(低估的目标训出低估的 $Q$,下一轮 $\min$ 也不会更低到失控)。
if self.target_critic_backup_type == "mean":
    next_qs = next_qs.mean(dim=0)          # (N,B) -> (B,)   single-Q 基线
elif self.target_critic_backup_type == "min":
    next_qs = next_qs.min(dim=0).values    # (N,B) -> (B,)   clipped double-Q
...
if next_qs.shape == (batch_size,):
next_qs = next_qs[None].expand((self.num_critic_networks, batch_size)).contiguous()torch.min(next_qs)(不带dim):返回整个 batch 的全局标量最小值,形状()。后面的expand会把这一个数广播给所有样本,于是每条转移的目标都一样。critic 退化成常数函数,Hopper 回报永远是 15 左右(摔倒即止)。next_qs.min(dim=0)返回的是(values, indices)具名元组,必须取.values。min(dim=1):沿 batch 维取最小,形状变成(N,),后面的expand断言会挂(好抓)。- 忘了
.contiguous():expand返回的是 stride 为 0 的视图。绝大多数情况能正常用,但一旦有 in-place 操作或需要.view()就会报错。starter code 写了,别删。
8.2 两个 critic 收到同一个目标
这一点值得强调:$y_A=y_B$。两个 critic 不是各学各的,它们回归的是同一组标签。它们之所以还能保持「独立」,靠的是不同的随机初始化和不同的 minibatch 噪声路径。这也解释了为什么必须用 nn.ModuleList 分别 make_critic(...) 两次,而不能 deepcopy 同一个——完全相同的初始化会让 $\min$ 退化成 identity,clipped double-Q 变回 single-Q。
怎么验证。 两个测试分工明确:
test_q_backup_strategy_min_is_elementwise_minimum:随机造一组(2,17)的next_qs,断言输出精确等于torch.minimum(qA,qB)、两行完全相同、逐元素 $\le$ 每个 critic、且严格小于mean备份的结果。「严格小于 mean」这一条排除了「$\min$ 写成了 $\text{mean}$」的复制粘贴错误。test_sac_critic_target_hand_computation_min_vs_mean:把两个 target critic 换成常数函数 $Q'_A\equiv3$、$Q'_B\equiv-1$。min应该自举 $-1$,mean应该自举 $+1$;终止行则两者都等于 $r$。常数 critic 让期望值可以手算,是一个非常好用的测试技巧。
9. 重点三:熵温度的自动调节
9.1 从约束优化到对偶梯度
要求。 PDF §3.5 把选 $\beta$ 变成一个约束问题:
$$ \max_\theta\;\E\Bigl[\sum_{t}\gamma^t r_t\Bigr] \quad\text{s.t.}\quad \E_{(s_t,a_t)\sim\rho_\pi}\bigl[\mathcal H(\pi(\cdot\mid s_t))\bigr]\;\ge\;H_{\text{target}} $$其中 $H_{\text{target}}=-\dim(\mathcal A)$。
把符号掰开看,这是一个非常干净的比例控制器:
| 当前熵 $H=\E[-\log\pi]$ | $\log\pi+H_{\text{target}}$ 的符号 | $\alpha$ 的运动 | 直觉 |
|---|---|---|---|
| $H<H_{\text{target}}$(太确定) | $>0$ | 上升 | 提高「变确定」的价格,逼策略保持随机 |
| $H>H_{\text{target}}$(太随机) | $<0$ | 下降 | 探索已经够多,把权重还给回报 |
| $H=H_{\text{target}}$ | $=0$ | 不动 | 约束恰好激活,到达鞍点 |
9.2 为什么 $H_{\text{target}}=-\dim(\mathcal A)$
这是 SAC 第二篇论文的启发式。注意它是负数:微分熵可以为负,$-\dim(\mathcal A)$ 相当于要求「每个动作维度的熵不低于 $-1$ nat」。对 $(-1,1)$ 上的分布,单维熵上界是 $\log2\approx0.69$,所以 $-1$ 是一个相当低的目标——大致对应每维标准差 $\sigma\approx0.13$ 的窄高斯。它的作用不是「鼓励探索」,而是「设一个不许再确定下去的地板」。理解这一点对解释 §11.6 的 HalfCheetah 现象至关重要:$\dim(\mathcal A)=6$ 时目标是 $-6$,而策略初始熵只有 $-1.14$,远高于目标,于是 $\alpha$ 一路下降。
9.3 实现与三处 detach
# __init__
assert temperature > 0, "temperature must be > 0 to initialize log_alpha"
self.log_alpha = nn.Parameter(torch.tensor(float(np.log(temperature)),
                                           dtype=torch.float32, device=ptu.device))
self.alpha_optimizer = torch.optim.Adam([self.log_alpha], lr=alpha_learning_rate)
self.target_entropy = -float(action_dim)

# get_temperature
return self.log_alpha.exp().item()          # ← 返回 float,不是 tensor

# update_alpha
alpha = self.log_alpha.exp()
alpha_loss = -(alpha * (log_prob.detach() + self.target_entropy)).mean()
self.alpha_optimizer.zero_grad(); alpha_loss.backward(); self.alpha_optimizer.step()alpha_loss.backward() 会把 $-\alpha\nabla_\theta\log\pi$ 这一项累加到 actor 的 .grad 上。后果分两种:(1)如果 actor 的优化器随后
step()(比如你把 update_alpha 放在 update_actor 的 zero_grad 之前):actor 会额外收到一个「最小化 $-\alpha\log\pi$」即最大化熵的梯度,权重是 $\alpha$。这等于把熵奖励算了两遍,策略过度随机,HalfCheetah 回报大约腰斩。(2)如果顺序正确(本代码里
update_actor 先 step 完,且返回的 log_prob 已经 .detach() 过):脏梯度会残留到下一次 zero_grad 被清掉,数值上无害——但你已经在依赖「下游一定会 zero_grad」这种脆弱假设了。本实现做了双保险:
update_actor 返回时写 "log_prob": log_prob.detach(),update_alpha 里又写一次 log_prob.detach()。重复但正确。
反方向的 detach:get_temperature() 返回 .item()。 这是一个 Python float,所以 actor 损失里的 self.get_temperature() * entropy 和 critic 目标里的乘法都不可能反传到 log_alpha。如果这里返回 self.log_alpha.exp()(张量),actor 的 loss.backward() 会给 log_alpha 塞进一个梯度:$\partial(-\alpha H)/\partial\log\alpha=-\alpha H$。由于 $H$ 通常为正,这个梯度是负的,Adam 会持续增大 $\alpha$——actor 发现「把温度调高能直接降低自己的损失」,于是 $\alpha$ 单调爆炸,策略变成纯噪声。这是一个非常隐蔽且致命的 bug:它不报错,只是让 $\alpha$ 在几万步内涨到 $10^2$ 量级。
9.4 数值验证
test_alpha_autotuning_direction_and_loss 直接喂人造的 log_prob,取 $\alpha_0=0.1$、$\dim(\mathcal A)=2$ 因而 $H_{\text{target}}=-2$:
| 喂进去的 $\log\pi$ | 隐含熵 $H$ | 期望的 alpha_loss | 实测 | $\alpha$ 的走向 |
|---|---|---|---|---|
| $+5$ | $-5$(低于目标) | $-0.1\times(5-2)=-0.30$ | $-0.30$ | 上升 ✓ |
| $-10$ | $+10$(高于目标) | $-0.1\times(-10-2)=+1.20$ | $+1.20$ | 下降 ✓ |
| $+2$ | $-2$(正好等于目标) | $0.0$ | $0.0$ | 不动 ✓ |
测试还连跑 30 步检查 $\alpha=e^{\log\alpha}$ 始终严格为正、且在「熵持续偏低」的输入下至少涨了 50%。三档符号 + 一档零点 的组合能抓住所有把负号写反、把 $H_{\text{target}}$ 加成减、或者把 $\log\pi$ 当成 $-\log\pi$(即误用了 entropy 而不是 log_prob)的实现——最后这一类特别常见,因为 update_actor 同时返回了 entropy 和 log_prob,传错参数的代价是 $\alpha$ 朝完全相反的方向跑。
alpha 和 temperature 差一步
update_alpha 先算 alpha = log_alpha.exp() 再做优化器 step,返回的 info["alpha"] 是更新前的值;而 update() 末尾的 result["temperature"] = self.get_temperature() 是更新后的值。同一行日志里两者相差一个梯度步(lr 1e-4 下约 0.1%)。无害,但如果你写测试断言 alpha == temperature 会随机失败——测试里用的容差是 5%。
10. DQN 实验与结果
所有实验:单种子(seed 1),WANDB_MODE=disabled,RTX 5080,日志来自 exp/<run>/log.csv。超参数取自 yaml:$\gamma=0.99$,Adam,$\epsilon$ 分段线性 $1.0\to0.1$(前 30% 步)$\to0.02$(前 60% 步)。
10.1 三个环境的总览(含未达标声明)
| run | 已跑 / 配置步数 | 作业目标 | 最佳 eval 回报 | @ step | 状态 |
|---|---|---|---|---|---|
| CartPole vanilla | 100 000 / 100 000 | 500 | 500.0 | 17 500 | 完成,达标 |
| CartPole double-Q | 100 000 / 100 000 | — | 276.3 | 85 000 | 完成(消融用) |
| LunarLander vanilla | 500 000 / 500 000 | — | 279.9 | 450 000 | 完成(消融用) |
| LunarLander double-Q | 355 265 / 500 000 | 200 | 256.0 | 330 000 | 截断,但在切断前已超过目标 200 |
| MsPacman double-Q | 70 000 / 300 000(原 1 000 000) | 1500 | 450.0 | 60 000 | 截断 — 未达标 |
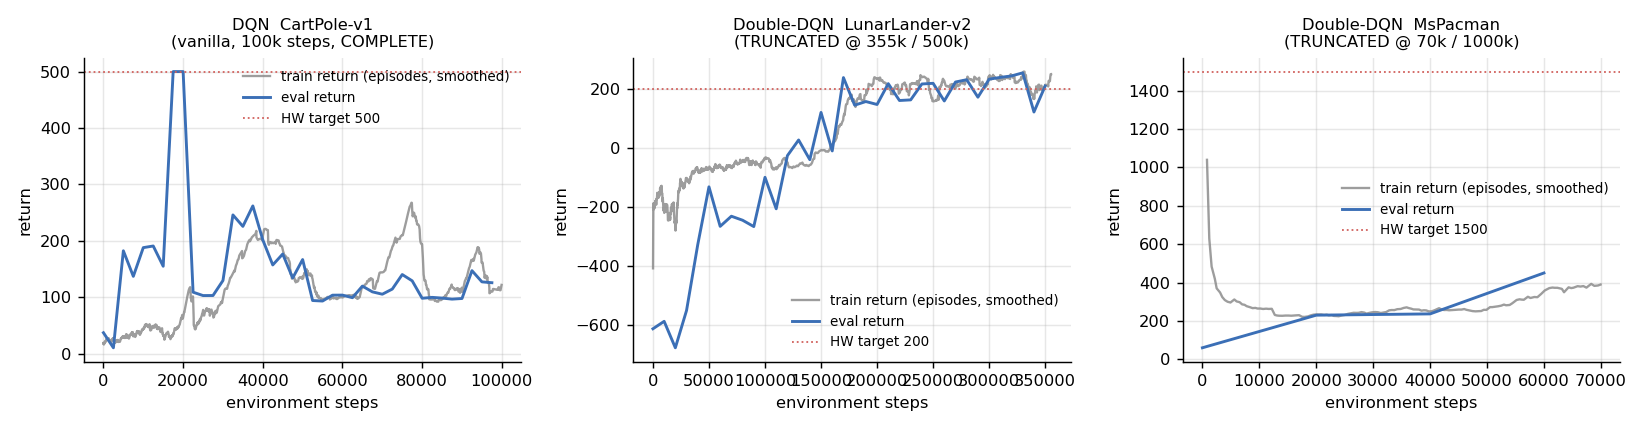
10.2 训练回报 vs 评估回报:为什么早期差别巨大
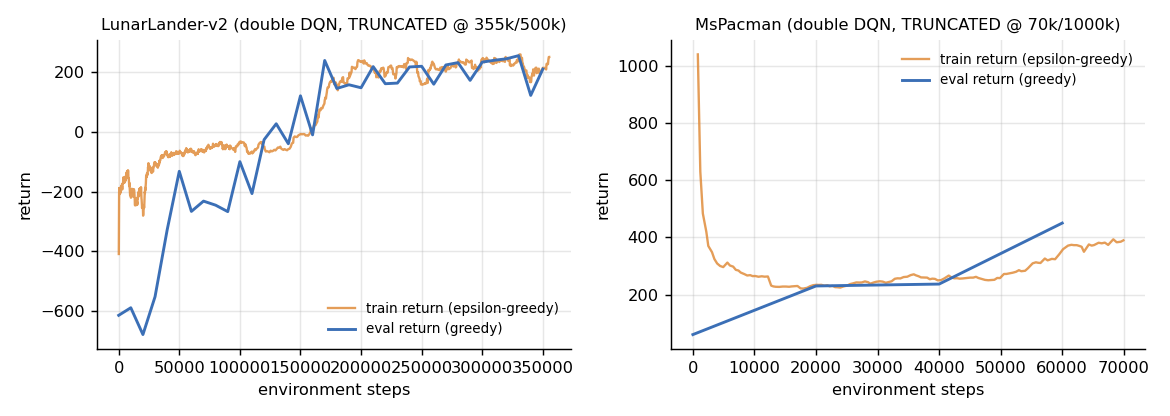
机制。 训练回报由 $\epsilon$-greedy 行为策略产生,此时 $\epsilon$ 还很大(从 1.0 往 0.1 衰减),所以它测的是「一个大部分时间在乱动的策略」;评估回报由 贪心策略($\epsilon=0$)产生,测的是「完全相信当前 $Q$ 的策略」。两者的差距方向取决于环境:
- LunarLander:早期 eval 更差。 一个还没训好的 $Q$ 函数会一致地选同一个错误动作(比如一直点主引擎),飞船直接摔死,回报 $-600$;而带随机噪声的行为策略反而经常「误打误撞」把着陆器稳住,训练回报只有 $-200$ 左右。等 $Q$ 变准之后,贪心的优势体现出来,eval 反超到 250+。
- CartPole:早期 eval 略好。 因为 CartPole 里「随机动作」的破坏力更大——杆子倒了就结束,噪声几乎没有正面价值。
- MsPacman:训练曲线开头虚高。 平滑窗口在最初几个 episode 上还没稳定,随机策略偶尔吃到一串豆子就冲到 1050,随后落回 230。这纯粹是统计假象,不是策略退化。
10.3 Double-Q vs vanilla:该看哪个指标
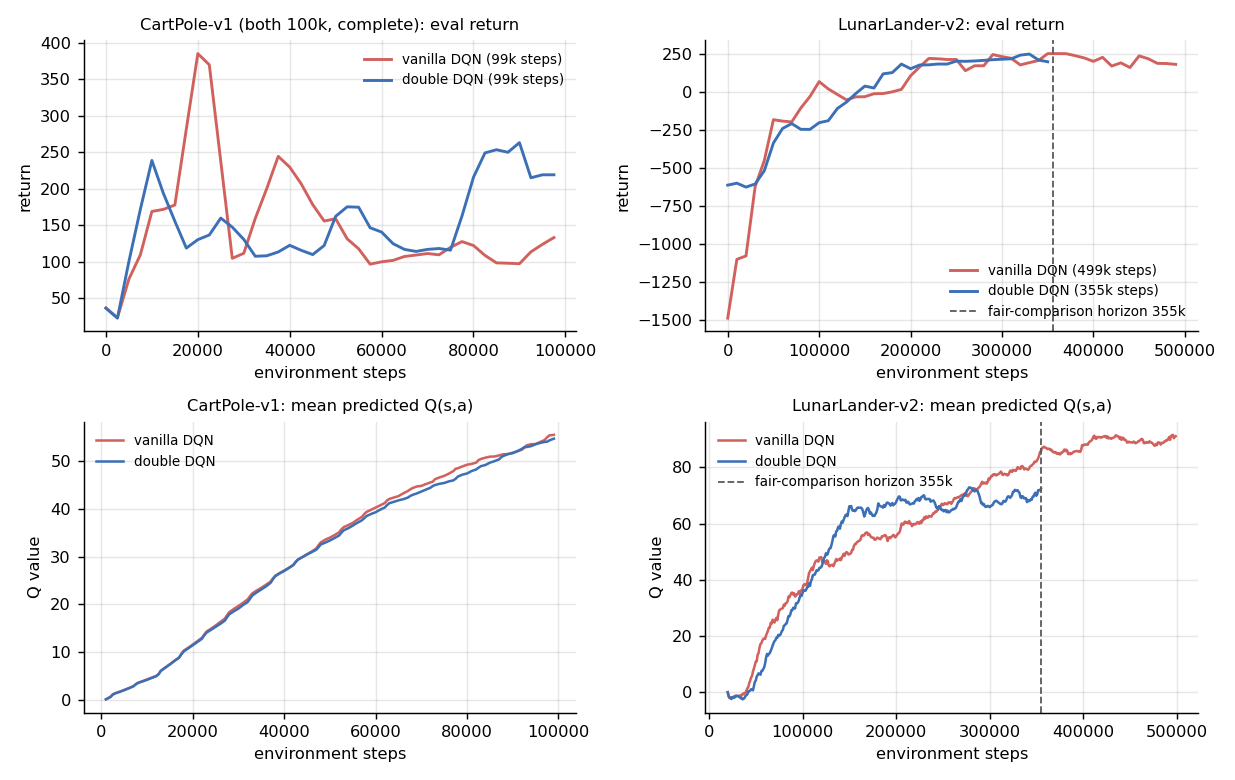
| 指标 | vanilla | double-Q | 解读 |
|---|---|---|---|
| LunarLander 平均 $Q$ @ 355k | 84.1 | 70.9 | 低 16%——这是关键证据 |
| LunarLander 0–355k 内最佳 eval | 266.8 | 256.0 | 差 10.8 分,单种子下不可区分 |
| CartPole 平均 $Q$ @ 100k | 54.6 | 54.1 | 几乎重合 |
| CartPole 最佳 eval | 500.0 | 276.3 | 纯种子噪声,不要解读 |
验证一个方差削减/偏差消除技巧,要去看它直接作用的那个量。 这里就是
info["q_values"](每步 batch 内 $Q(s,a)$ 的均值),日志里现成有。LunarLander 上 16% 的乐观度下降是干净、单调、贯穿整条曲线的信号;而回报的 10 分差距在单种子下毫无统计意义。CartPole 上 500 vs 276 的回报差看着惊人,但看下排的 $Q$ 曲线——两条几乎完全重叠。CartPole 的 $\gamma$-折扣回报有硬上界(每步奖励 1,$Q\le1/(1-\gamma)=100$),两动作的 $Q$ 函数又极其容易学,$\max$ 的过估计根本没有发挥空间。把 500 vs 276 解读成「double-Q 更差」是典型的单种子过度解读。
10.4 超参敏感性:target_update_period 扫描(部分完成)
PDF §2.6 要求选一个超参、跑至少四个取值。这里选的是目标网络更新周期,理由是它直接对应第 8 讲那个「移动靶」的理论讨论,能把「速度 vs 稳定」的权衡可视化。但只有两个设置跑够了步数,另外两个在约 2 万步被杀,已从图中剔除。
target_update_period | 已跑步数 | 最佳 eval | @ step |
|---|---|---|---|
| 100 | 208 228 | 267.1 | 130 000 |
| 1000(默认) | 355 265 | 256.0 | 330 000 |
| 500 | 20 069(被杀) | — | — |
| 4000 | 23 537(被杀) | — | — |
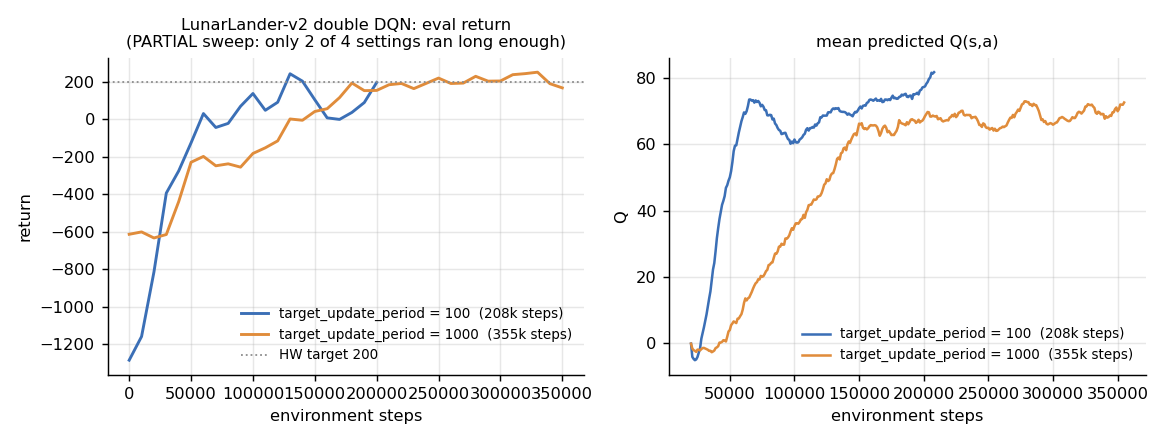
怎么解释这个结果。 短周期意味着目标网络紧跟在线网络:奖励信息沿着状态链传播得快(每 100 步就有一次「新学到的值」被写进目标),所以早期学习速度快得多。代价是回归目标一直在动,接近于「用自己预测自己」,方差大、容易发散。长周期给出稳定的回归目标,但目标里的值是陈旧的——LunarLander 前 13 万步几乎白学,就是因为目标网络还停留在很早的估计上。
这条权衡曲线不是单调的:周期太短(比如 1)会退化成没有目标网络,$Q$ 发散;周期太长(比如 4000)在 50 万步预算下大概会学得极慢。可惜这两端的实验都没跑够,无法给出实证。这是一个 2 点对比,不是作业要的 4 点扫描。
11. SAC 实验与结果
11.1 InvertedPendulum 双重 sanity check(两个都跑完了)
| run | 步数 | 最佳 eval | 最终 eval | 状态 |
|---|---|---|---|---|
sanity_invertedpendulum.yaml(固定 $\beta=0.1$) | 50 000 / 50 000 | 1000.0 | 1000.0 | 完成,solved |
sanity_invertedpendulum_autotune.yaml | 50 000 / 50 000 | 1000.0 | 1000.0 | 完成,solved |
配置:2×64 MLP,actor/critic lr 3e-4,batch 128,$\gamma=0.99$,软目标 $\tau=0.005$,单 critic,mean 备份,use_tanh,random_steps 1000,training_starts 5000。
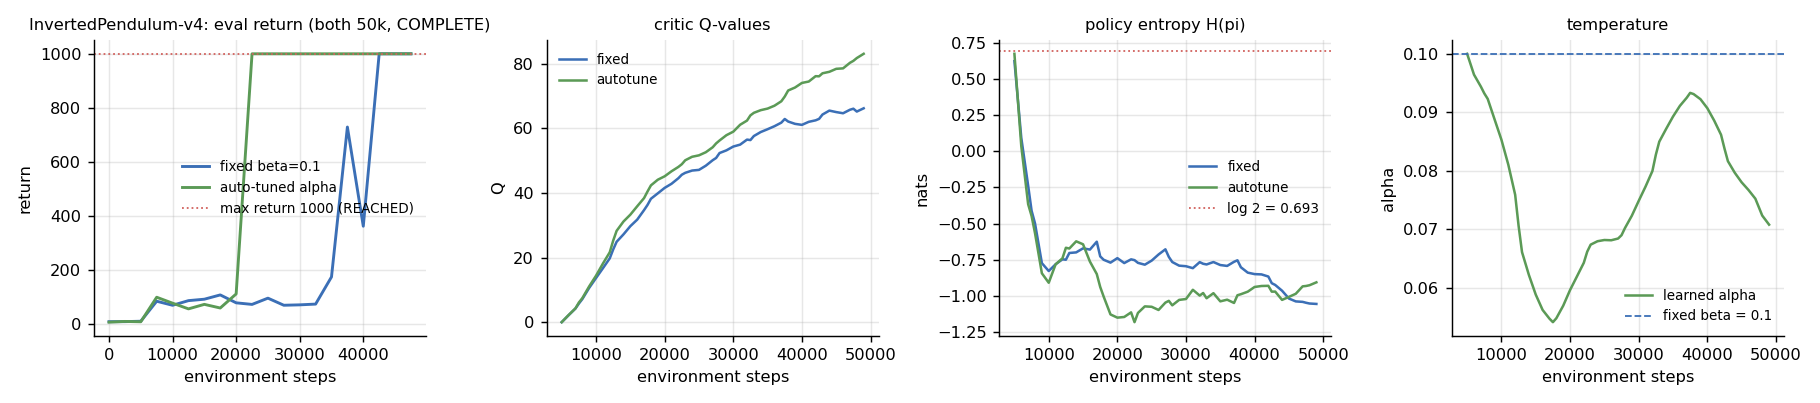
如果你看到 $Q$ 超过 100,说明有过估计或者 $(1-d)$ 漏了;如果 $Q$ 一直贴着 0,多半是
target_values 的梯度没断(no_grad 漏了)导致 critic 学到了平凡解 $Q\equiv0$。
11.2 Hopper:single-Q vs clipped double-Q(两个都被截断)
| run | 已跑 / 配置步数 | 作业目标 | 最佳 eval | @ step |
|---|---|---|---|---|
hopper_singleq_short.yaml(1 critic,mean) | 177 535 / 300 000(原 500 000) | — | 664.0 | 140 000 |
hopper_clipq_short.yaml(2 critics,min) | 66 841 / 300 000(原 500 000) | 1500 | 602.4 | 50 000 |
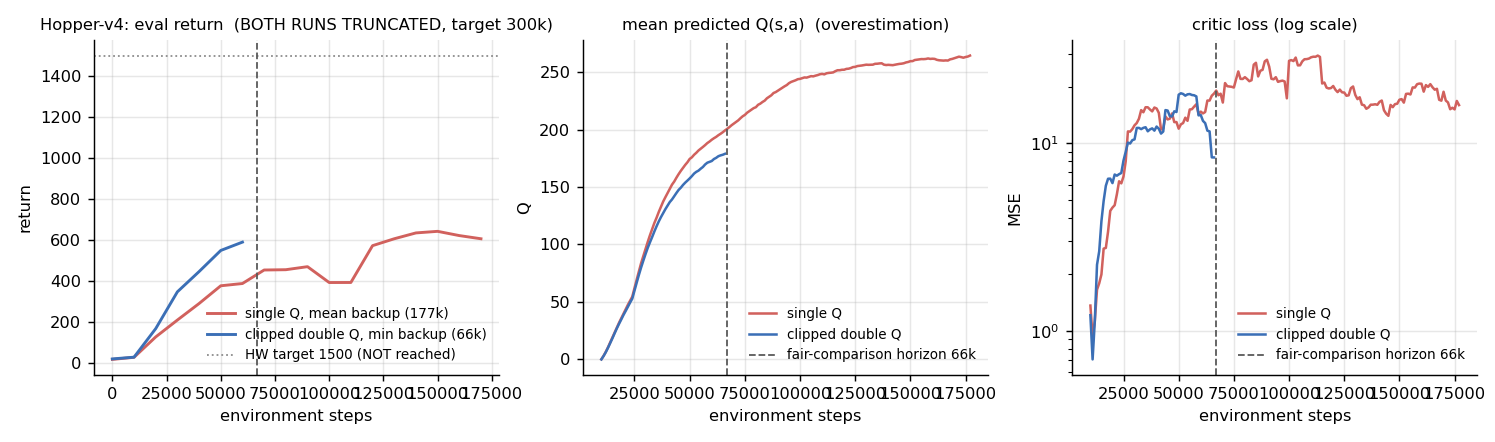
| 在 $\le$ 66k 窗口内 | single Q(mean) | clipped double Q(min) |
|---|---|---|
| 最佳 eval 回报 | 399.6 | 602.4(+51%) |
| 60k 处 eval 回报 | 399.6 | 577.3 |
| 60k 处平均预测 $Q$ | 205.9 | 186.5(−9%) |
「更好」且「更不乐观」同时成立,这正是过估计故事的完整形态:两个独立 critic 取 $\min$ 是一个悲观估计,actor 不会被「某个 critic 恰好在这块区域估高了」的假信号牵着跑。
这是判断「我的 SAC 是不是被过估计害了」的最实用信号:不要只看回报曲线是不是平了,要看 $Q$ 是不是还在往上爬。回报平 + $Q$ 平 = 收敛;回报平 + $Q$ 涨 = 过估计正在发生。
但要克制:单种子,且 clipq 只跑到 66k。 这个趋势是提示性的(suggestive),不是结论性的(conclusive)。
11.3 HalfCheetah:自动调温 vs 固定温度(两个都被截断)
| run | 已跑 / 配置步数 | 作业目标 | 最佳 eval | @ step |
|---|---|---|---|---|
halfcheetah_short.yaml(固定 $\beta=0.1$) | 278 000 / 300 000(原 1 000 000) | 6000 | 5551.3 | 270 000 |
halfcheetah_autotune_short.yaml | 69 999 / 300 000(原 1 000 000) | — | 3543.4 | 60 000 |
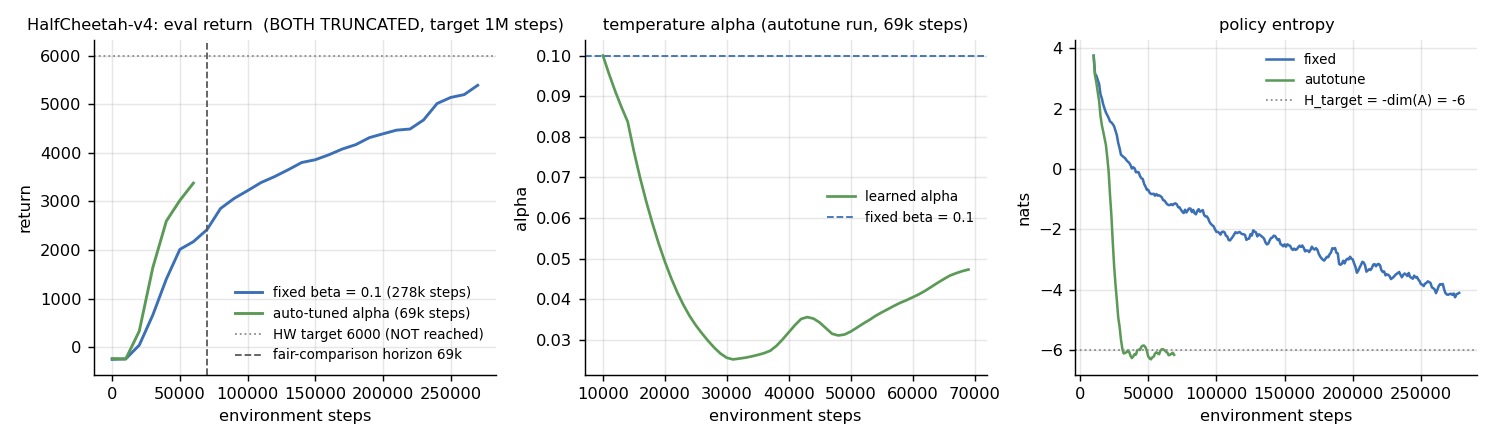
| 在 $\le$ 66k 窗口内 | 固定 $\beta=0.1$ | 自动调温 $\alpha$ |
|---|---|---|
| 最佳 eval 回报 | 2232.7 | 3543.4 |
| 60k 处 eval 回报 | 2113.6 | 3543.4 |
| 60k 处实测熵 | −4.06 | −6.11(目标 −6.00) |
回答 PDF §3.5 的三个问题(基于两者共有的 66k):
- 自动调温有帮助吗? 早期有:60k 处 3543 vs 2233。但这是单种子 + 短视野,只能说「至少可比」。PDF 自己也提示默认的 $\beta=0.1$ 对 HalfCheetah 已经调得不错,不该期待 100 万步时有大差距。自动调温的真正价值是省掉手工搜索,在没有已知好值的新环境上才最明显。
- $\alpha$ 怎么演化? 先下降,后部分回升:$0.100\to\mathbf{0.024}$(最低点)$\to\mathbf{0.048}$(60k 处)。
- 为什么是这个方向? 因为 $H_{\text{target}}=-\dim(\mathcal A)=-6$——HalfCheetah 的动作是 6 维,目标熵是个很低的值。而随机初始化的策略几乎是均匀的,实测熵 $-1.14$,远高于目标。代入 §9.1 的表:$H>H_{\text{target}}$ ⟹ $\log\pi+H_{\text{target}}<0$ ⟹ $\alpha$ 下降。也就是说在 HalfCheetah 上,对偶控制器一开始做的事情是「惩罚探索」而不是鼓励探索——它认为策略太随机了。等策略锐化到 $-6.11$(略微越过目标),梯度换号,$\alpha$ 回升并稳定。
12. 为什么这些任务需要这么多步?截断意味着什么
本作业有三个实验因算力被切断而未达标。与其糊弄过去,不如把「为什么它们本来就贵」讲清楚——这本身就是 RL 工程直觉的一部分。
12.1 三个昂贵任务的成本来源
| 任务 | 配置预算 | 贵在哪里 |
|---|---|---|
| MsPacman | 1 000 000 步 | 观测是 $4\times84\times84$ 像素,critic 是 Nature-CNN;奖励稀疏且延迟(吃到豆子才有分);$|\mathcal A|=9$,探索空间大;$\epsilon$ 从 1.0 衰减到 0.01 本身就要花掉几十万步 |
| Hopper | 500 000 步 | 奖励里有「存活奖励」,早期策略一摔就结束,每个 episode 只有十几步,采样效率极低;要先学会「站住」才谈得上「跳得远」,是典型的两阶段任务 |
| HalfCheetah | 1 000 000 步 | 17 维观测、6 维动作,$Q$ 函数的输入空间大;没有终止条件,每个 episode 固定 1000 步,回报量级到几千,critic 要拟合的动态范围极宽 |
共同的深层原因是 自举的传播速度。TD 学习每次梯度步只把价值信息沿状态链回传「一格」。要让终点的奖励信息传到起点,需要的更新次数与有效视野 $1/(1-\gamma)=100$ 成正比,再乘上「每个状态要被访问多次才能拟合准」的系数——几十万步是这个乘积的自然量级,不是实现效率问题。
12.2 提前终止对结论的影响:哪些能说,哪些不能
| 结论 | 可信度 | 理由 |
|---|---|---|
| 「Double-Q 的 $Q$ 值比 vanilla 低 16%」 | 较可信 | 这是贯穿整条曲线的单调差异,不依赖终点;且与理论预测方向一致 |
| 「clipped double-Q 在 Hopper 上早期更好」 | 提示性 | 共同窗口只有 66k,且单种子。66k 处的差距(602 vs 400)大于常见的种子波动,但不足以断言 |
| 「autotune 在 HalfCheetah 上更好」 | 仅限早期 | 只有 66k 共同窗口。PDF 自己说 $\beta=0.1$ 已调好,100 万步时很可能追平 |
| 「$\alpha$ 会下降到 0.024 再回升」 | 可信 | 这是机制性结论,由 $H_{\text{target}}=-6$ 与初始熵 $-1.14$ 的符号关系直接决定,与训练长度无关 |
| 「MsPacman 能达到 1500」 | 不能说 | 只有 7 万步、4 个评估点。Atari 曲线常有长平台,线性外推没有依据 |
| 「HalfCheetah 固定 $\beta$ 能到 6000」 | 不能说 | 27.8 万步到 5551 且仍在上升,只能说「趋势指向目标」 |
「target_update_period 的完整敏感性」 | 不能说 | 4 个设置只有 2 个跑够,作业要求的四点扫描未完成 |
13. 调参与踩坑记录
下面 9 条是实际实现过程中真实撞到的问题,按「第一次运行会遇到」的顺序排列。
13.1 WANDB_MODE=disabled 被无视
两个 run 脚本的 make_logger 原本写死 wandb.init(mode="online", ...)。wandb 的设置优先级是「显式 init 参数 > 环境变量」,所以 WANDB_MODE=disabled 完全不起作用,每次运行都死在 UsageError: No API key configured。改成
mode=os.environ.get("WANDB_MODE", "online"),之后离线跑通。这是全作业唯一一处非 TODO 的改动。如果你不想改代码,也可以 wandb offline 或者直接注册一个账号——但离线跑对批量实验方便得多。
13.2 1 - done 在 bool 张量上抛异常
见 §2.3。DQN 和 SAC 两个 update_critic 都要写 done = done.float()。 报错信息是 RuntimeError: Subtraction, the '-' operator, with a bool tensor is not supported。
13.3 不要手动补 tanh 的雅可比
见 §5.2。make_tanh_transformed 已经包了 TanhTransform,其 log_abs_det_jacobian 就是 $2\bigl(\log2-x-\text{softplus}(-2x)\bigr)=\log(1-\tanh^2x)$。再手写一次 $-\sum\log(1-a^2)$ 是双重扣除,密度不再积分到 1,数值积分测试立刻抓住。
13.4 entropy() 里 .sample() 与 .rsample()
见 §7。.sample() 静默切断熵项的梯度,训练「照跑」但 actor 永远拿不到熵奖励,InvertedPendulum 上熵停止向 $\log2$ 爬升。必须 .rsample()。
13.5 $\alpha$ 除了 update_alpha 之外处处 detach
见 §9.3。get_temperature() 返回 .item()(float),保证 actor/critic 损失无法反传到 log_alpha;对称地,log_prob 在进对偶步之前 .detach()。两者耦合会让 $\alpha$ 与策略互相追逐——具体表现是 $\alpha$ 单调爆炸。
13.6 日志里的 alpha 比 temperature 早一步
update_alpha 先取 alpha = log_alpha.exp() 再做优化器 step,所以同一行日志里 info["alpha"] 是更新前的、info["temperature"] 是更新后的,差一个梯度步(lr 1e-4 下约 0.1%)。无害,但一开始把测试断言写成严格相等,随机失败了几次。
13.7 测试里 monkey-patch agent.critic_loss 会报错
self.critic_loss = nn.MSELoss() 是一个 子模块,直接 agent.critic_loss = my_fn 会触发
TypeError: cannot assign 'function' as child module 'critic_loss' (torch.nn.Module or None expected)解决办法是先把它从 agent._modules 里 pop 出来,再赋普通属性。测试里的 spy_on_loss 辅助函数就是干这个的——这个技巧在需要「窥探中间张量」时非常好用(本文 §3.4 提到的手算目标对拍就依赖它)。
13.8 float32 下 tanh 会饱和
$|u|\gtrsim8.4$ 时 float32 的 tanh(u) 精确等于 $\pm1.0$(float64 下阈值约 19),此时 $\operatorname{atanh}$ 与 log_prob 变成非有限值。这就是 TanhTransform(cache_size=1) 在训练里至关重要的原因,也是「动作严格落在开区间」那个测试必须用现实的 $\sigma$ 而不是 $\sigma=20$ 的原因。
update_actor 里加一行 NaN 探针
assert torch.isfinite(loss), f"actor loss is not finite: {loss}"nan,反查发生位置很痛苦。一行断言能把它钉在第一现场。
13.9 MemoryEfficientReplayBuffer._insert_frame 不对 framebuffer_idx 取模
它写 self.framebuffer[self.framebuffer_idx] 时没有 % max_framebuffer_size,而 sample() 里有。frame buffer 的容量是 $2\times$ capacity,所以 100 万步的 Atari 跑(100 万条转移 + 每次 reset 一帧)刚好卡在数组边界内不出事;再长一点就会 IndexError。这是 starter code 的既有问题,本作业的 Atari run 远短于此,未做修改——但如果你打算跑满 100 万步以上,值得先补上取模。
13.10 超参数速查
| 配置 | 网络 | lr | batch | 目标更新 | 其它 |
|---|---|---|---|---|---|
| DQN CartPole | 2×64 MLP | 5e-4 | 128 | period 1000 | learning_starts 1000 |
| DQN LunarLander | 2×256 MLP | 1e-3 | 64 | period 1000 | learning_starts 20 000 |
| DQN MsPacman | Nature-CNN | 1e-4(Adam eps 1e-4) | 32 | period 2000 | grad clip 10.0,$\epsilon:1.0\to0.01$ |
| SAC InvertedPendulum | 2×64 MLP | 3e-4 | 128 | soft $\tau=0.005$ | 1 critic,mean,$\beta=0.1$ |
| SAC Hopper clipq | MLP | 3e-4 | — | soft | 2 critics,min |
| SAC HalfCheetah | MLP | 3e-4 | — | soft | $\beta=0.1$ 或 autotune($H_{\text{target}}=-6$) |
14. 自测清单
做完之后逐条对照。带 ★ 的是「写错了不报错」的静默 bug,优先检查。
14.1 DQN 代码层面
- ☐
get_action用torch.no_grad()包住,且随机分支用严格<比较。 - ☐ ★ 随机动作是从全部
num_actions里均匀抽(包括贪心动作),不是「贪心以外」。用 $\epsilon=0.5$ 时贪心动作应出现约 75% 而不是 50%。 - ☐
update_critic第一行有done = done.float()。 - ☐ ★
next_qa_values = self.target_critic(next_obs)在if use_double_q的外面;只有argmax换网络。 - ☐ ★
gather的dim=1(不是 0),index是(B,1),输出squeeze(1)回(B,)。 - ☐ 目标计算整体在
torch.no_grad()内。 - ☐ 目标同步用
load_state_dict,且只在step % period == 0时执行。 - ☐
run_dqn.py的 $\epsilon$ 来自exploration_schedule.value(step);采样/训练在learning_starts之后。
14.2 SAC 代码层面
- ☐ ★
actor_loss_reparametrize里是.rsample();entropy()里也是.rsample()。 - ☐ ★
entropy()只有-dist.log_prob(dist.rsample()),没有手写的 $\log(1-a^2)$ 修正。 - ☐ ★ actor 损失是
-q.mean() - beta * entropy(两个负号),不是加号。 - ☐ ★ 熵进了 backup(
update_critic里),而且用的是 $\pi(\cdot\mid s')$ 的熵。 - ☐ ★
q_backup_strategy的min写成next_qs.min(dim=0).values,不是torch.min(next_qs)。 - ☐ 软更新是 $\phi'\leftarrow(1-\tau)\phi'+\tau\phi$($\tau$ 乘在 online 参数上),用
.data.copy_()原地写。 - ☐ ★
get_temperature()返回.item()(float);update_alpha里log_prob已 detach。 - ☐
alpha_loss = -(alpha * (log_prob + target_entropy)).mean(),target_entropy = -action_dim(负数)。 - ☐ 顺序是:critic 更新 $\times$
num_critic_updates→ actor 更新 → alpha 更新 → 目标更新。
14.3 数值层面(跑测试)
- ☐
uv run python tests/test_hw3.py→ 18/18 通过(CPU 上约 2 分钟)。 - ☐ 手算例子:$Q_\phi,Q_{\phi'}$ 如 §3.3 那张表时,vanilla 目标 $=4.6$、double 目标 $=2.8$、终止行 $=r=-2.0$。
- ☐ 20 组随机 Q 表上 $y_{\text{double}}\le y_{\text{vanilla}}$ 恒成立。
- ☐ tanh 高斯的密度在 $(-1,1)$ 上数值积分 $=1.000$(4 组 $(\mu,\sigma)$ 都要过)。
- ☐ 一维 tanh 策略的熵 $\le\log2=0.6931$,族内最优约 $0.678$($\sigma\approx0.8$)。
- ☐ Polyak 更新 $k$ 步后参数等于 $\phi\bigl(1-(1-\tau)^k\bigr)$。
- ☐ $\alpha$ 的三档方向检查:$\log\pi=+5\Rightarrow\alpha\uparrow$,$-10\Rightarrow\alpha\downarrow$,$+2\Rightarrow$ 不动($\dim(\mathcal A)=2$)。
- ☐ 完整
update()后 actor 参数梯度全部有限且非零。
14.4 实验层面(看曲线判断)
- ☐ CartPole 训练中至少有一次 eval 回报达到 500。达标后掉回 100 多是正常的(灾难性遗忘),不算失败。
- ☐ LunarLander double-Q 至少有一次超过 200。若始终在 0 分附近,先查 $(1-d)$ 和
truncated的处理。 - ☐ ★ Double vs vanilla 的对比要画
q_values而不只是回报。若两条 $Q$ 曲线完全重合(除 CartPole 外),八成use_double_q没生效——去 yaml 里确认。 - ☐ InvertedPendulum 的 $Q$ 应稳定在几十的量级(上界 $1/(1-\gamma)=100$)。爆炸 → 查目标网络;恒为 0 → 查
no_grad。 - ☐ 只开熵项、还没实现重参数化 actor 时,熵应单调上升并逼近 $0.69$。若超过 $0.6931$ → 雅可比算错;若不动 →
rsample没用上。 - ☐ Hopper 上 clipped double-Q 的 $Q$ 曲线应低于 single-Q。若 single-Q 的 $Q$ 一路上涨而回报不涨,恭喜,你观察到了教科书里的过估计。
- ☐ HalfCheetah autotune 的 $\alpha$ 应先降(因为初始熵远高于 $H_{\text{target}}=-6$),实测熵应收敛到 $-6$ 附近。若 $\alpha$ 单调上涨 → 检查
get_temperature()是不是漏了.item()。
q_values,不要只盯回报;clipped double-Q 也是同理。第二,算力不够时要区分机制性结论和性能性结论——「$\alpha$ 为什么下降」这种由公式符号决定的事情,7 万步就能说清楚;「能不能到 6000 分」这种事,27.8 万步说了不算。把这两件事分开写,是一份诚实报告和一份漂亮报告的区别。