训练全景
把后训练写成一个优化问题:谁是 state、谁是 action、奖励从哪来、为什么它不是标准 MDP,以及 SFT → 偏好微调 → RLVR 三个阶段各自在优化什么。
0. 本章导读
前两章讲的是「RLHF 是什么」和「它从哪来」。本章开始动真格:把整件事写成一个可以求导、可以跑梯度下降的优化问题。这一章在全书里的地位有点特殊——它本身不介绍任何一个具体算法,但它建立的符号系统会被后面十四章反复使用。第 5 章的奖励模型 $r_\phi(x,y)$、第 6 章的策略梯度 $\nabla_\theta J(\theta)$、第 8 章 DPO 里的 $\pi_\theta$ 与 $\pi_{\mathrm{ref}}$、第 15 章的 KL 预算,全部是本章这几个式子的展开。如果本章的符号没读透,后面每一章都会读得很吃力。
本章要回答三个问题。
第一,语言模型怎么变成一个 RL 智能体? 答案是一组对应关系:生成的每个 token 是一个 action,「prompt + 已生成的前缀」是 state,语言模型本身就是 policy $\pi_\theta$,转移函数是「把 token 拼到末尾」这个确定性操作。后果并不平凡——因为转移是确定的、且奖励只在序列末尾出现一次,标准 RL 里最重要的那套机制(多步信用分配、折扣因子、值函数自举)在这里要么退化、要么被直接关掉。
第二,它跟教科书里的 RL 差在哪? 差三点:奖励函数被换成了一个学出来的奖励模型;没有真正的状态转移;奖励是整条回复级别的、不做折扣。加起来,RLHF 在数学上更接近一个 bandit(老虎机)问题而不是多步 MDP。理解这一点,你就能明白为什么 GRPO 这类「不要值函数、直接用一组样本的均值当基线」的算法能在语言模型上工作得这么好,而同样的做法在 CartPole 上行不通。
第三,后训练三件套各自在优化什么? SFT 优化对示范数据的对数似然;偏好微调优化「代理奖励减去 KL 惩罚」;RLVR 把代理奖励换成可验证的、不会被欺骗的 0/1 信号。三者是同一件事的三种强度:都在把模型的回复分布往我们想要的方向推,只是反馈的粒度和可靠性不同。
- 语言模型 RL 的对应关系:state $s_t = (x, y_{<t})$,action $a_t = y_t$,policy $\pi_\theta(y_t\mid x, y_{<t})$,转移确定性(拼接),$\gamma = 1$,奖励通常只在最后一个 token 处发放一次。
- RLHF 的核心目标函数是「最大化代理奖励,同时不要离起点太远」:$\max_\pi \E_{x\sim\mathcal{D},\,y\sim\pi(\cdot\mid x)}[r_\theta(x,y)] - \beta\,\mathcal{D}_{\mathrm{KL}}(\pi\,\|\,\pi_{\mathrm{ref}})$。后面所有算法(PPO、GRPO、DPO、拒绝采样)都是这个式子的不同求解方式。
- 与标准 RL 的三个关键差异:奖励模型代替环境奖励、没有状态转移、序列级奖励且 $\gamma=1$。结果是问题结构接近 bandit,这直接决定了算法设计(可以丢掉值函数)。
- 正则化不是可选项。标准 RL 从随机初始化开始学,RLHF 从一个已经很强的预训练模型开始学,因此必须防止优化把已有能力冲掉——KL 惩罚是最主流的手段,$\beta$ 是它的旋钮。
- 经典配方的演化方向:InstructGPT(10K SFT + 100K 偏好)→ Tülu 3(1M SFT + 1M 偏好 + 10K RLVR)→ DeepSeek R1(把绝大部分算力挪到 RL 阶段)。趋势是阶段更多、数据更多、算力重心向 RL 迁移。
1. 标准强化学习的语言
要说清楚 RLHF 改了什么,先得把「没改之前」写清楚。强化学习(reinforcement learning, RL)的标准问题形式是马尔可夫决策过程(Markov Decision Process, MDP),写成一个五元组 $(\mathcal{S}, \mathcal{A}, P, r, \gamma)$:
- 状态空间 $\mathcal{S}$:环境所有可能的「当前情况」。某一时刻的状态记作 $s_t \in \mathcal{S}$。
- 动作空间 $\mathcal{A}$:智能体能做的所有动作。某一时刻的动作记作 $a_t \in \mathcal{A}$。它可以是离散的(上/下/左/右)也可以是连续的(施加多大的力)。
- 转移动力学 $P(s_{t+1}\mid s_t, a_t)$:在状态 $s_t$ 下做了动作 $a_t$ 之后,环境跳到 $s_{t+1}$ 的概率。注意这是环境的性质,不是智能体能改的。
- 奖励函数 $r(s_t, a_t)$:一个标量,表示这一步做得多好。同样是环境给的,设计者在标准 RL 里不能动它。
- 折扣因子 $\gamma \in [0, 1]$:未来的奖励打多少折。$\gamma$ 越小越短视。
智能体自己拥有的只有一样东西:策略(policy)$\pi$。策略是一个从状态到「动作上的概率分布」的函数,写作 $\pi(a_t \mid s_t)$。请注意它是一个条件分布而不是一个函数值——同一个状态下它可以以不同概率输出不同动作,这个随机性正是 RL 中「探索」的来源。当这个函数用神经网络来近似、参数记作 $\theta$ 时,就写成 $\pi_\theta(a_t\mid s_t)$,这就是深度强化学习。本书从头到尾,$\theta$ 永远指策略(也就是我们正在训练的那个语言模型)的参数。
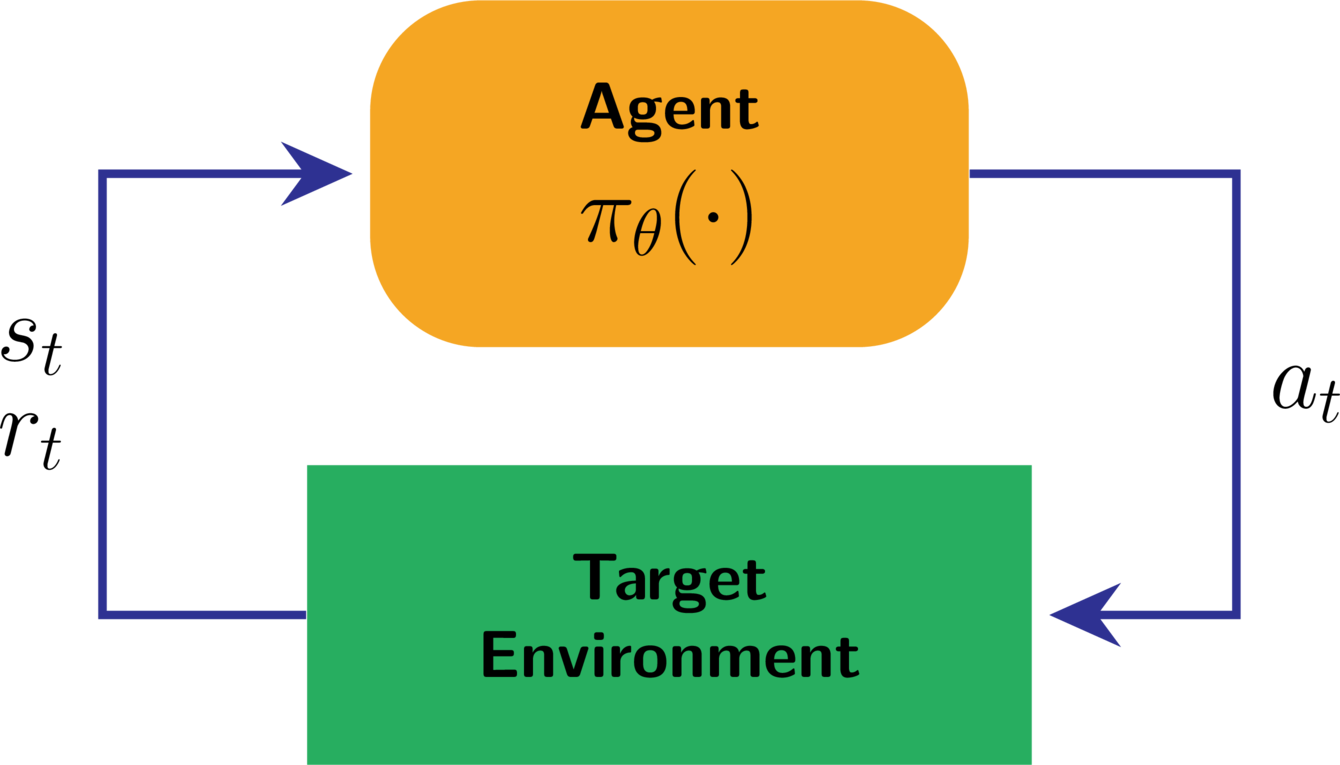
轨迹与轨迹分布
策略和环境交互一轮,产生一条轨迹(trajectory)$\tau$:
$$ \tau = (s_0, a_0, r_0,\; s_1, a_1, r_1,\; \ldots,\; s_T, a_T, r_T). $$一条具体轨迹出现的概率,是三样东西相乘:初始状态的概率、每一步策略选这个动作的概率、每一步环境转移到下一状态的概率。
$$ p_{\pi}(\tau) = \rho_0(s_0) \prod_{t=0}^{T-1} \pi(a_t \mid s_t)\, p(s_{t+1}\mid s_t, a_t). $$这个式子值得盯久一点,因为它是后面所有策略梯度推导的起点。特别注意乘积里的两类因子:$\pi(a_t\mid s_t)$ 含参数 $\theta$,是我们能求导的;$p(s_{t+1}\mid s_t,a_t)$ 不含 $\theta$,求 $\log p_\pi(\tau)$ 对 $\theta$ 的梯度时它会整项消失。第 6 章推 REINFORCE 时,「环境动力学项在取对数后被梯度消掉」正是全部魔法所在——你不需要知道环境怎么运作,也能算出策略梯度。
优化目标:期望回报
RL 智能体的目标是找一个策略,使得轨迹上折扣奖励之和的期望最大:
$$ \max_\pi \; \E_{\tau \sim p_\pi}\left[\sum_{t=0}^{T-1} \gamma^t r(s_t, a_t)\right]. $$把中括号里的东西记作 $J(\pi)$(或者参数化之后的 $J(\theta)$),叫做该策略的期望回报;最优值写作 $J^\star = \max_\pi J(\pi)$。三个容易被略过的点:
- 期望是对轨迹分布取的,而这个分布本身依赖于 $\pi$。 这是 RL 与监督学习最本质的区别:监督学习里数据分布是固定的、与参数无关;RL 里你一改参数,数据分布就变了。这就是「on-policy」这个词的由来,也是 RL 训练不稳定的根源。
- $\gamma$ 的作用有两个:一是表达偏好(现在的奖励比以后的值钱),二是数学上的必要性——对于无限时长任务($T\to\infty$),只有 $\gamma<1$ 才能保证这个和收敛。
- 这里最大化的是期望,不是某一条轨迹的回报。 一个策略可能偶尔打出很高分,但期望低,它就不是好策略。
值函数、Q 函数与优势函数
为了把「整条轨迹的回报」拆解到单步上,RL 定义了三个互相关联的量。它们在第 6 章会天天出现,这里先把定义和直觉钉死:
| 符号 | 定义 | 一句话直觉 |
|---|---|---|
| 值函数 $V^\pi(s)$ | $\E\big[\sum_{t\ge 0}\gamma^t r_t \mid s_0 = s\big]$,轨迹由 $\pi$ 生成 | 「站在状态 $s$,按 $\pi$ 走下去,平均能拿多少分?」 |
| Q 函数 $Q^\pi(s,a)$ | $\E\big[\sum_{t\ge 0}\gamma^t r_t \mid s_0=s,\, a_0=a\big]$ | 「在 $s$ 先强行做动作 $a$,之后再按 $\pi$ 走,平均能拿多少分?」 |
| 优势函数 $A^\pi(s,a)$ | $A^\pi(s,a) = Q^\pi(s,a) - V^\pi(s)$ | 「做 $a$ 比『按 $\pi$ 平均水平随便做点什么』好多少?」 |
优势函数是三者里最关键的。它是一个相对量:正的表示这个动作优于平均,负的表示劣于平均。策略梯度的核心思想就是「优势为正就提高这个动作的概率,为负就压低」。注意上标 $\pi$ 不是装饰——这三个量都依赖于具体策略,策略一更新,它们全都失效,必须重新估计。这也是 PPO 需要额外训一个值函数模型、而且这个模型永远在追赶策略的原因。
为什么要用优势而不是直接用奖励?因为奖励的绝对值没有意义,只有相对高低有意义。假设某个游戏每一步都固定给 +100 分,那所有动作的回报都很高,梯度会把所有动作的概率都往上推——但概率必须归一化,结果就是互相抵消加上一堆噪声。减去一个基线(这里是 $V^\pi(s)$)之后,信号变成「比平均好还是比平均差」,方差大幅下降。记住这个「减基线」的思想,第 6 章的 RLOO 和 GRPO 就是把基线换成「同一个 prompt 下其它几个样本的平均奖励」而已。
2. 两个热身例子:恒温器与 CartPole
抽象定义看完就忘,落到具体例子上才记得住。原书给了两个例子,一个极简、一个经典,它们的作用是让你对「环境真的在演化」有身体感觉——因为下一节我们要把这种感觉拿掉。
恒温器:最小可运行的 MDP
一个恒温器要把房间维持在 70°F。它一开始对任务一无所知,只能试错。四个要素:
- 状态 $s_t$:当前室温,比如 65°F。这是一个一维连续变量。
- 动作 $a_t$:开加热器 / 关加热器。二元离散动作。
- 奖励 $r$:温度落在目标 ±2° 内给 +1,否则给 0。
- 策略 $\pi$:给定当前温度决定开还是关。比如下面这个(它未必最优,取决于房间的实际热力学):
转移:加热器开着房间就变暖,关着就变凉。这里有一个很重要的分工——智能体通过动作影响动力学,但底层物理(房间升温多快、散热多快、外面多冷)完全在它的控制之外。这就是「环境」这个概念的实质:一部分由你决定,一部分不由你决定,而你只能通过前者去影响后者。
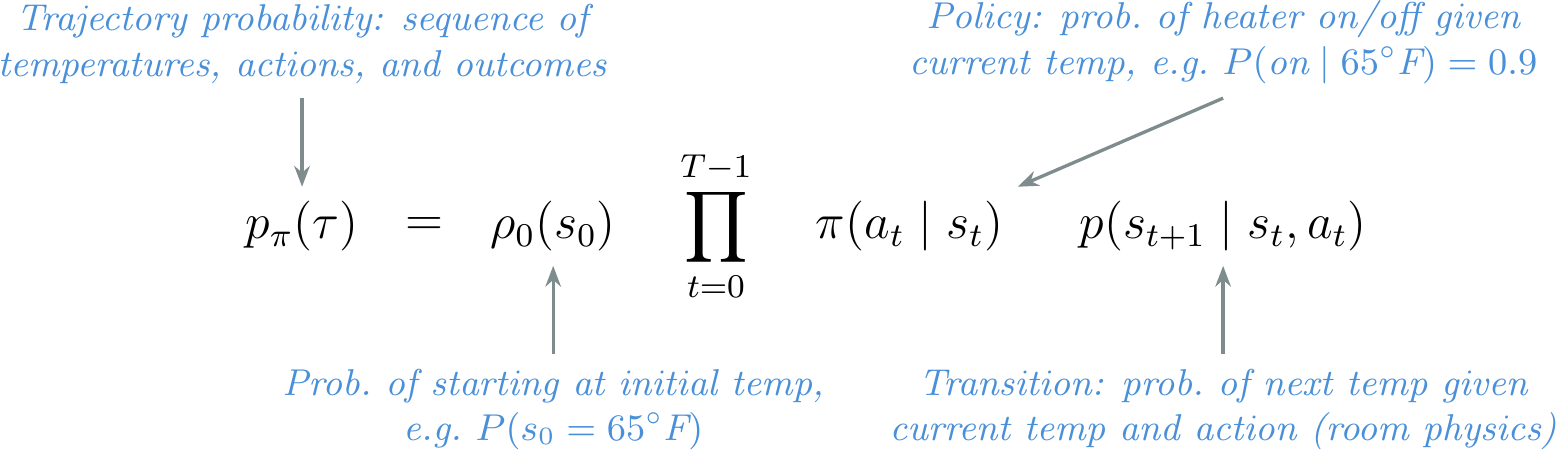
训练一开始,策略基本是随机的——它不看温度就乱开乱关,室温剧烈震荡。跑过很多个 episode 之后,智能体发现「冷了开、热了关」能拿更多奖励,于是逐渐收敛到一个合理策略。这就是 RL 的完整循环:观察状态 → 选动作 → 拿奖励 → 更新策略。
CartPole:连续动力学的标准试验台
CartPole(倒立摆)是 RL 教科书和论文里出现频率最高的玩具任务。相比恒温器的一维状态 + 二元动作,它有四维连续状态和真正的物理转移,因此成了算法的标准 benchmark。
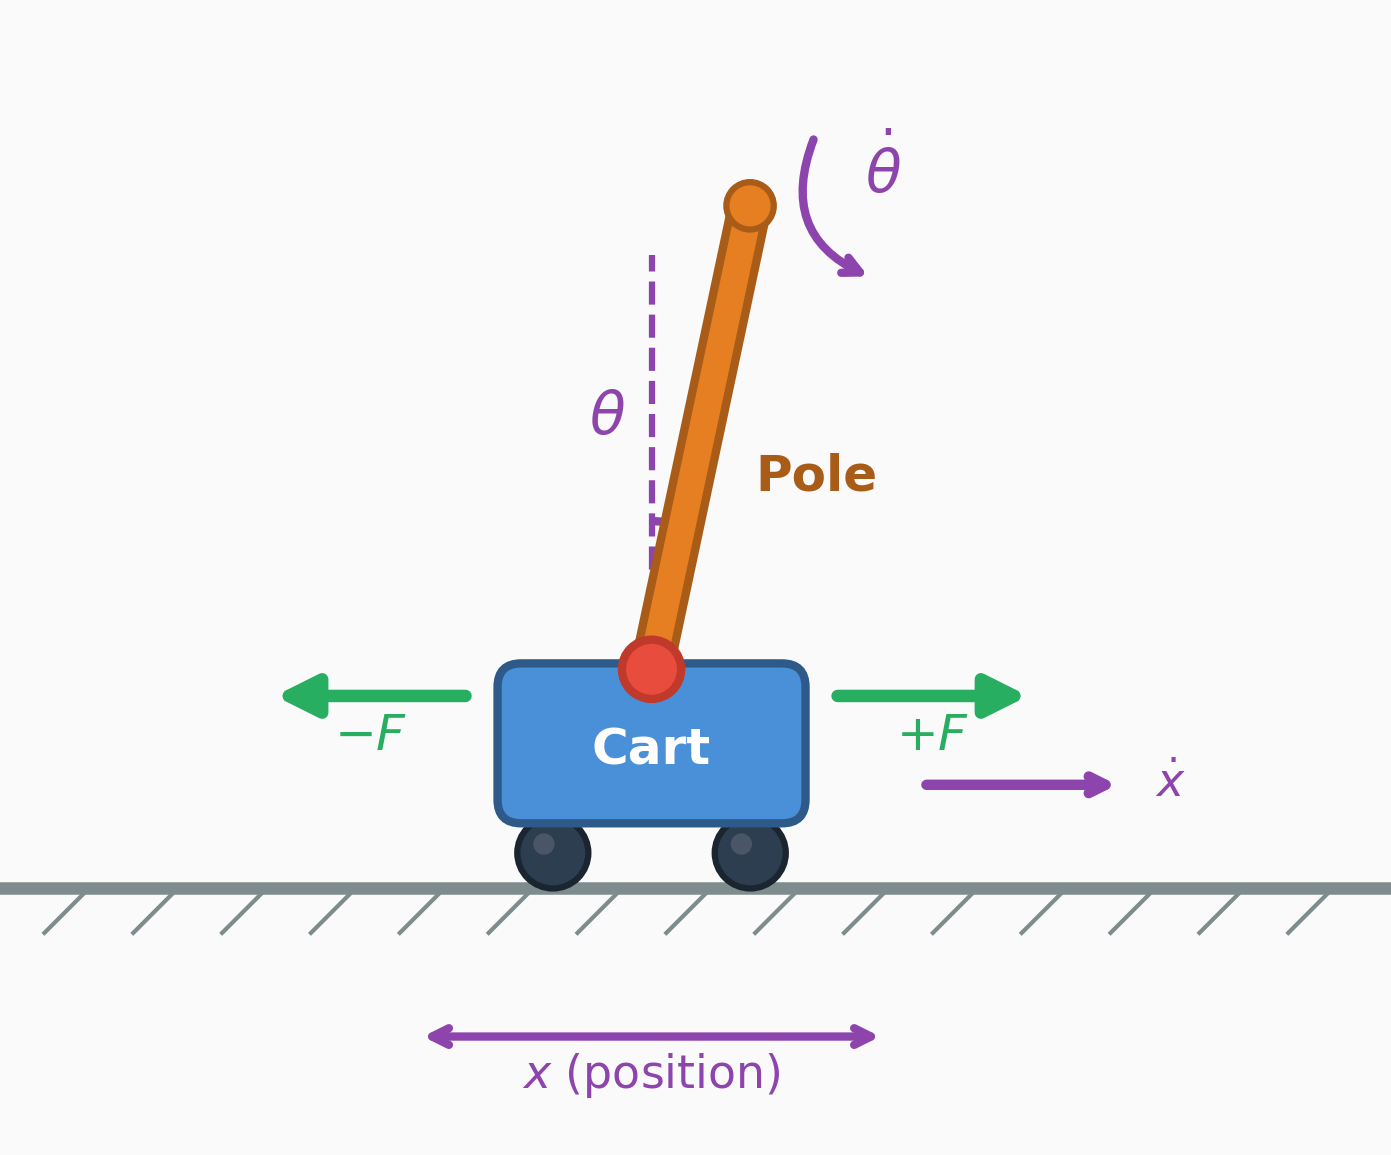
- 状态:小车位置、小车速度、杆的角度、杆的角速度,共四维:
- 动作:给小车施加一个水平力,$a_t \in \{-F, +F\}$。
- 奖励:只要杆没倒($|\theta_t| \le 12^\circ$)且小车没出界($|x_t| \le 2.4$),每一步给 $r_t = 1$;一旦越界,episode 立即终止。所以「拿高分」等价于「撑得久」。
- 转移:确定性的物理仿真。用一个质量归一化的中间量 $\alpha$(量纲是加速度),先算角加速度,再回代算线加速度:
其中 $m_c$ 是小车质量、$m_p$ 是杆质量、$l$ 是杆半长、$g$ 是重力加速度。然后用步长 $\Delta t$ 做欧拉积分推进状态:
$$ x_{t+1}=x_t+\Delta t\,\dot{x}_t,\quad \dot{x}_{t+1}=\dot{x}_t+\Delta t\,\ddot{x}_t,\quad \theta_{t+1}=\theta_t+\Delta t\,\dot{\theta}_t,\quad \dot{\theta}_{t+1}=\dot{\theta}_t+\Delta t\,\ddot{\theta}_t. $$你不需要记住这些公式,重点是它们存在,而且形式很复杂。这正是经典 RL 之所以困难的地方:动作与最终结果之间隔着一层非线性的、通常还不可微的世界模型,算法必须通过大量试错才能反推出「哪一步动作导致了后面的失败」。这就是信用分配(credit assignment)问题。
这两个例子共享同一个结构,而这个结构正是下一节要被打破的:(1) 动作会改变未来的状态,因此存在跨时间的因果链;(2) 奖励在每一步都会给出,是密集的;(3) 奖励函数是环境定义好的、精确的、不会被作弊的。语言模型的 RL 三条全都不满足——理解这三条各自失效在什么地方,就理解了这一整章。
3. 把语言模型装进 RL 的壳子:token 是 action,上文是 state
现在做那组关键的对应。一个自回归语言模型在生成时做的事情是:看着已有的 token,预测下一个 token,采样,拼上去,再看着新的序列继续预测。这就是一个 MDP 的循环,只是所有名字都换了。
| MDP 概念 | 语言模型对应物 | 说明 |
|---|---|---|
| 状态 $s_t$ | $(x,\, y_{<t})$:prompt 加上已经生成的前缀 | 状态随着生成而单调变长,永不收缩 |
| 动作 $a_t$ | 下一个 token $y_t$ | 动作空间 = 整个词表 $\mathcal{V}$,大小通常 $10^5$ 量级 |
| 转移 $P(s_{t+1}\mid s_t,a_t)$ | 确定性拼接:$s_{t+1} = s_t \oplus y_t$ | 概率是 1,没有任何随机性,也没有任何未知 |
| 策略 $\pi_\theta(a_t\mid s_t)$ | 模型的下一个 token 分布 $\pi_\theta(y_t\mid x, y_{<t})$ | 语言模型本身就是策略,不需要额外的网络 |
| 奖励 $r$ | 通常是终止奖励:奖励模型打分或验证器输出 | 整条回复一个标量,中间步没有奖励 |
| 折扣 $\gamma$ | 通常取 $1.0$(不折扣) | 让所有 token 被同等对待 |
| 初始状态分布 $\rho_0$ | prompt 数据集 $\mathcal{D}$ | 「环境」退化成了一个静态数据集 |
策略在 token 上分解
把整条回复看成一个动作序列,那么「生成这条回复」的概率就是每一步的条件概率连乘——这正是自回归分解,也是 RL 里轨迹概率公式在确定性转移下的退化形式:
$$ \pi_\theta(y \mid x) = \prod_{t=1}^{|y|} \pi_\theta\!\left(y_t \mid x,\, y_{<t}\right). $$对照第 1 节的 $p_\pi(\tau) = \rho_0(s_0)\prod_t \pi(a_t\mid s_t)\,p(s_{t+1}\mid s_t,a_t)$:因为转移是确定的,所有 $p(s_{t+1}\mid s_t,a_t)$ 都等于 1,整项消失;$\rho_0$ 是 prompt 的分布,条件在 $x$ 上之后也不再出现。剩下的就是纯粹的策略连乘。这意味着语言模型的「轨迹概率」是可以精确计算的——这在经典 RL 里是奢望(你不知道环境的转移概率),但在这里唾手可得,而且是 DPO、重要性采样比、KL 惩罚等一切机制的计算基础。
实践中永远在 log 空间做:连乘变连加,避免数千个小于 1 的数相乘导致的下溢。
$$ \log \pi_\theta(y\mid x) = \sum_{t=1}^{|y|} \log \pi_\theta\!\left(y_t \mid x,\, y_{<t}\right). $$tensor 层面:从 logits 到序列 log-prob
符号讲完,落到代码上。后训练代码里 90% 的静默 bug 都出在这几行的下标上,所以值得逐行看。下面改写自 _src/code/policy_gradients/utils.py 的 compute_log_probs:
import torch.nn.functional as F

def compute_log_probs(model, sequence_ids, attention_mask):
    """sequence_ids: (B, L) —— prompt 和 completion 已经拼在一起
    返回 (B, L-1),每个位置是"模型给真实下一个 token 的 log 概率"
    """
    out = model(input_ids=sequence_ids, attention_mask=attention_mask, use_cache=False)

    # (B, L, V) -> (B, L-1, V)
    # 丢掉最后一个位置:它预测的是"第 L+1 个 token",我们没有标签
    logits = out.logits[:, :-1, :].to(torch.float32)

    # 在词表维度归一化成 log 概率
    log_probs = F.log_softmax(logits, dim=-1)          # (B, L-1, V)

    # 位置 t 的 logits 预测的是 token t+1 —— 这就是那个"错一位"
    targets = sequence_ids[:, 1:].unsqueeze(-1)        # (B, L-1, 1)

    # 从 V 维里把真实 token 那一格挑出来
    return torch.gather(log_probs, dim=-1, index=targets).squeeze(-1)  # (B, L-1)
三个必须记住的形状约定:$B$ 是 batch 中的序列条数,$L$ 是序列长度,$V$ 是词表大小。logits[:, :-1] 与 ids[:, 1:] 这个「错一位」是自回归性质的字面实现,忘了对齐就等于在训一个乱套的目标。
拿到 (B, L-1) 的 token 级 log-prob 之后,再乘一个 completion mask(回复部分为 1,prompt 与 padding 为 0)求和,就得到每条序列一个数的 $\log\pi_\theta(y\mid x)$:
seq_log_probs = (token_log_probs * completion_mask).sum(dim=-1) # (B,)
completion mask 就是 RL 语义里的 action mask——它标出了「哪些 token 是策略自己选的动作」。prompt 部分的 token 属于状态,是环境给定的,模型没有选择权,所以不该对它们计算损失或梯度。写错这个 mask 的两种典型后果:(a) 把 prompt 也算进去,梯度浪费在你根本不想改变的 token 上,还会让模型学会「复述用户输入」;(b) 把 padding 算进去,等于在纯噪声上求梯度。在 RL 代码里这个 mask 还会被用来做 masked mean(见 masked_mean),分母写成 mask.sum() 而不是序列长度,否则长回复会被系统性地稀释。
这个 MDP 有多大?
做一下数量级估算,你会对这个问题的「形状」有更好的感觉。假设词表 $|\mathcal{V}| = 128{,}000$,一条推理回复长 $4{,}000$ 个 token:
- 动作空间:每一步有 12.8 万个可选动作。CartPole 是 2 个。
- 时间跨度:$T = 4000$ 步。
- 可能的轨迹数:$128000^{4000}$,一个天文数字。
- 奖励信号:整条轨迹结束后,一个标量。可能就是 0 或 1。
用 4000 步、每步 12.8 万个选择,换回一个 bit 的反馈。从经典 RL 的角度看,这是一个荒谬到不该能学的问题——探索空间巨大、奖励极度稀疏、信用分配无从下手。它之所以能工作,唯一的原因是我们不是从随机初始化开始的:预训练 + SFT 之后的策略已经把概率质量集中在极小的一块「合理文本」流形上,RL 只是在这块流形上做局部搜索。这个观察在下一节讨论正则化、以及第 14 章讨论过优化时会不断回响。
4. 三处改装:为什么 RLHF 更像 bandit 而不是 MDP
上一节把语言模型硬塞进了 MDP 的壳子。但真正做 RLHF 的时候,还要对标准 RL 设定做三处改装,而这三处改装加起来,几乎把 MDP 拆成了另一种东西。
改装一:奖励函数 → 奖励模型
标准 RL 里奖励是环境的一部分,是静态的、不可篡改的。RLHF 里它被换成一个学出来的人类偏好模型 $r_\theta(s_t,a_t)$(本书后面统一写作 $r_\phi(x,y)$,用 $\phi$ 区别于策略参数 $\theta$)。这个替换带来的自由度极大——你想让模型「有帮助」「无害」「有个性」,都可以通过训练数据塞进奖励模型里,而不需要写出「有帮助」的数学表达式。
Lambert 在讲座里把动机说得很直白:很多任务我们能评估但不能指定。判断哪首诗更好很容易,写出一个能给诗打分的公式则不可能;识别一个回答是否有帮助很容易,把「有帮助」形式化成 loss 则不可能。RLHF 的全部意义就是:当你只会评估、不会指定时,把评估学成一个模型,然后优化它。
代价是实现复杂度暴涨,以及一个新的、根本性的问题:奖励模型只是代理(proxy),不是真值。它和真实的用户满意度只是相关,不是相等。第 14 章的过优化、第 15 章的正则化,整整两章都在处理这个代价。
改装二:没有状态转移
这是最反直觉、也最重要的一条。在标准 RLHF 设定里,初始状态是从数据集里采的 prompt,「动作」是对该 prompt 的整条回复。一个 prompt 加一条回复就构成了一个完整的 episode(也叫一次 rollout)。模型的回复不会决定下一个 prompt 是什么——下一个 prompt 是从数据集里独立采出来的。
换句话说,在「回复」这个粒度上,时间跨度 $T = 1$。经典 RL 里那条「状态-动作-状态-动作」的长链,在这里被压成了一步。
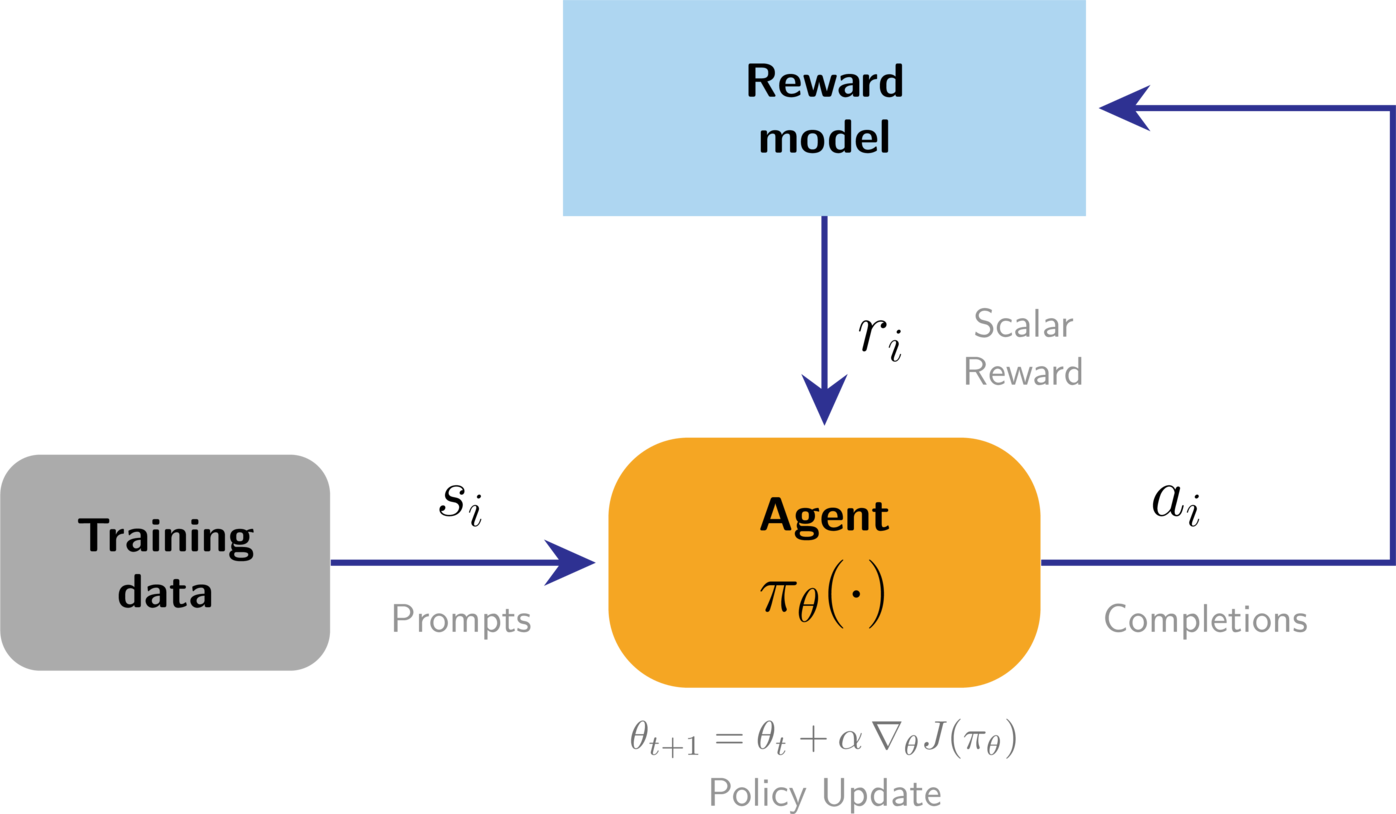
改装三:回复级奖励,且不折扣
奖励不是逐 token 给的,而是对整个 token 序列一次性给出。RL 文献把这种「一步决策 + 一次奖励」的结构叫做 bandit(老虎机)问题——更精确地说,因为每次的 prompt 不同,这是一个 contextual bandit(上下文老虎机):上下文是 prompt,摇臂是所有可能的回复,回报是奖励模型的打分。
与之配套的是:实现上几乎一律取 $\gamma = 1$。理由很直接——既然整条回复被视为「同一个动作」,就不该因为某个 token 生成得晚一点就给它打折。如果用 $\gamma = 0.99$、回复长 500 token,那么第一个 token 拿到的信用会是最后一个 token 的 $0.99^{500} \approx 0.6\%$,纯属人为制造的偏差。
| 维度 | 标准 RL | RLHF(语言模型) |
|---|---|---|
| 策略 | 从随机初始化学起 | 从预训练语言模型微调而来 |
| 奖励信号 | 环境奖励函数 $r(s_t,a_t)$ | 学习得到的奖励 / 偏好模型 $r_\phi(x,y)$ |
| 状态转移 | 有:动力学 $p(s_{t+1}\mid s_t,a_t)$ | 通常没有:prompt 从数据集采样,回复不决定下一个 prompt |
| 动作 | 单个环境动作 $a_t$ | 一整条回复 $y \sim \pi_\theta(\cdot\mid x)$(一串 token) |
| 奖励粒度 | 常为逐步 / 细粒度 | 通常整条回复一个标量(bandit 式),一般不折扣($\gamma=1$) |
| 时间跨度 | 多步 episode($T>1$) | 常为单步($T=1$);多轮对话可建模为更长跨度 |
既然 $T=1$ 且不折扣,第 1 节那个带求和号和 $\gamma^t$ 的目标就可以直接写成:
$$ \max_\pi \; \E_{\tau\sim\pi}\big[r_\theta(s_t, a_t)\big]. $$「RLHF 深受 RL 的优化器和问题形式启发,但实际实现和传统 RL 非常不同。」这句话是本章的态度基调。不要指望把 Sutton & Barto 的直觉原样搬过来——很多在 CartPole 上至关重要的东西(GAE 的 $\lambda$ 怎么调、折扣因子怎么选、探索策略怎么设计)在 RLHF 里要么不适用,要么被简化掉了。反过来,RLHF 里最重要的东西(KL 预算、奖励模型质量、prompt 分布)在经典 RL 教材里根本不存在。
两种视角是同一件事:token 级 MDP vs 序列级 bandit
初学者常在这里绕不出来:上一节说每个 token 是一个 action,这一节说整条回复是一个 action,到底哪个对?都对,只是粒度不同,而且在当前设定下两者等价。
关键在于:token 级 MDP 的转移是确定性的,且中间步的奖励全部为 0,只有终止步有奖励。在这样的 MDP 里,从初始状态出发的整条轨迹的回报就等于终止奖励,任何中间状态的值函数都只是「从这里往下走,最终能拿多少分」的期望。于是整个多步问题坍缩成了「选一条完整轨迹,拿一个分数」——这就是 bandit。
实践中你会看到两种做法并存,区别只在于怎么把序列级的那一个标量分配给每个 token,也就是信用分配(credit assignment):
| 做法 | token $t$ 的优势 $A_t$ | 需要什么 | 代表算法 |
|---|---|---|---|
| 均摊(bandit 视角) | $A_t = R(x,y) - b(x)$,对同一条回复的所有 $t$ 取同一个值 | 只要一个基线 $b(x)$,比如同 prompt 下其它样本奖励的均值 | REINFORCE、RLOO、GRPO |
| 值函数自举(MDP 视角) | $A_t$ 由 GAE 从逐位置的值估计 $V(s_t)$ 递推得到 | 额外训练一个和策略同规模的值函数模型 | PPO |
看一眼真实代码里的「均摊」长什么样,来自 _src/code/policy_gradients/utils.py:
# GRPO:同一个 prompt 采 K 条回复,用组内均值当基线、组内标准差做归一化
def compute_standardized_advantages(rewards, eps=1e-8):
    # rewards: (K, B) —— K 是每个 prompt 的采样数
    return (rewards - rewards.mean(dim=0, keepdim=True)) / (rewards.std(dim=0, keepdim=True) + eps)

# RLOO:留一法基线,K/(K-1) 是无偏修正系数
def compute_loo_advantages(rewards):
    K = rewards.shape[0]
    return (K / (K - 1)) * (rewards - rewards.mean(dim=0, keepdim=True))
注意这两个函数压根没有 token 维度——算出来的是每条回复一个标量,之后再广播到该回复的所有 token 上。「PPO 需要一个额外的值函数模型,GRPO 不需要」这件事,根源就在本节:因为问题本来就是 bandit,值函数所提供的「细粒度信用分配」在这里的边际收益很小,而它带来的显存开销(多一份模型参数 + 优化器状态)和训练不稳定性(值函数总在追赶策略)却是实打实的。这是全书最重要的一条「结构决定算法」的因果链,第 6 章会展开。
5. RLHF 的核心目标函数:代理奖励减去 KL 惩罚
现在可以写下全书的中心方程了。它只有两项,但这两项之间的张力撑起了后面十几章。
为什么必须有第二项
传统 RL 里智能体从随机初始化的策略开始学,没什么好保护的——学坏了大不了重来。RLHF 完全不同:起点是一个已经很强的预训练模型,带着大量既有能力。这个强先验(strong prior)带来一个新问题:优化过程必须被约束,不能让它离初始策略漂太远。
为什么?因为奖励模型只是代理。它在「初始模型附近的文本分布」上是准的(那正是它的训练数据来源),一旦策略跑到分布外,奖励模型的打分就开始胡说八道,而优化器会精准地找到并利用这些胡说八道的区域。典型症状:模型开始输出重复的套话、把每个回答都拉到 2000 字、或者干脆生成一堆乱码但奖励分数爆表。这就是过优化(over-optimization),第 14 章的主题。
目标函数
最主流的做法是在目标里加一项 KL 散度惩罚,衡量当前策略与优化起点的距离:
$$ \max_\pi \; \E_{\substack{x \sim \mathcal{D} \\ y \sim \pi(\cdot\mid x)}} \underbrace{\big[r_\phi(x, y)\big]}_{\text{把奖励做高}} \;-\; \beta \underbrace{\mathcal{D}_{\mathrm{KL}}\big(\pi(\cdot\mid x)\,\big\|\,\pi_{\mathrm{ref}}(\cdot\mid x)\big)}_{\text{但别把模型改太多}}. $$逐个符号拆开,这些约定在后面十四章都不变:
| 符号 | 含义 | 容易搞错的地方 |
|---|---|---|
| $x$ | prompt,从 prompt 数据集 $\mathcal{D}$ 中采样 | $\mathcal{D}$ 只含 prompt,不含答案;答案是模型自己生成的 |
| $y$ | 回复(completion),一整串 token | $y$ 是 on-policy 采出来的——从当前策略采,不是从数据集里读 |
| $\pi$ / $\pi_\theta$ | 正在训练的策略,即当前语言模型 | 期望的采样分布和被优化的对象是同一个东西,这是 RL 的难点所在 |
| $\pi_{\mathrm{ref}}$ | 参考模型,一份被冻结的权重快照,通常就是 SFT 检查点 | 它不更新,只前向,用来算 log-prob;显存里要多住一个模型 |
| $r_\phi(x,y)$ | 奖励模型,输入 prompt + 回复,输出一个标量 | 参数 $\phi$ 独立于 $\theta$,训练 RLHF 时它同样冻结 |
| $\beta$ | KL 惩罚系数 | $\beta$ 大 = 保守、贴近起点;$\beta$ 小 = 激进、放开追奖励 |
期望是对两层随机性取的:外层是 prompt 分布 $x\sim\mathcal{D}$,内层是给定 prompt 后策略自己的采样 $y\sim\pi(\cdot\mid x)$。实际训练中这个期望用蒙特卡洛估计——采一个 batch 的 prompt,每个 prompt 采 1 条或 $K$ 条回复,求平均。「每个 prompt 采 $K$ 条」这个看似工程性的选择,正是 GRPO / RLOO 得以用组内均值当基线的前提。
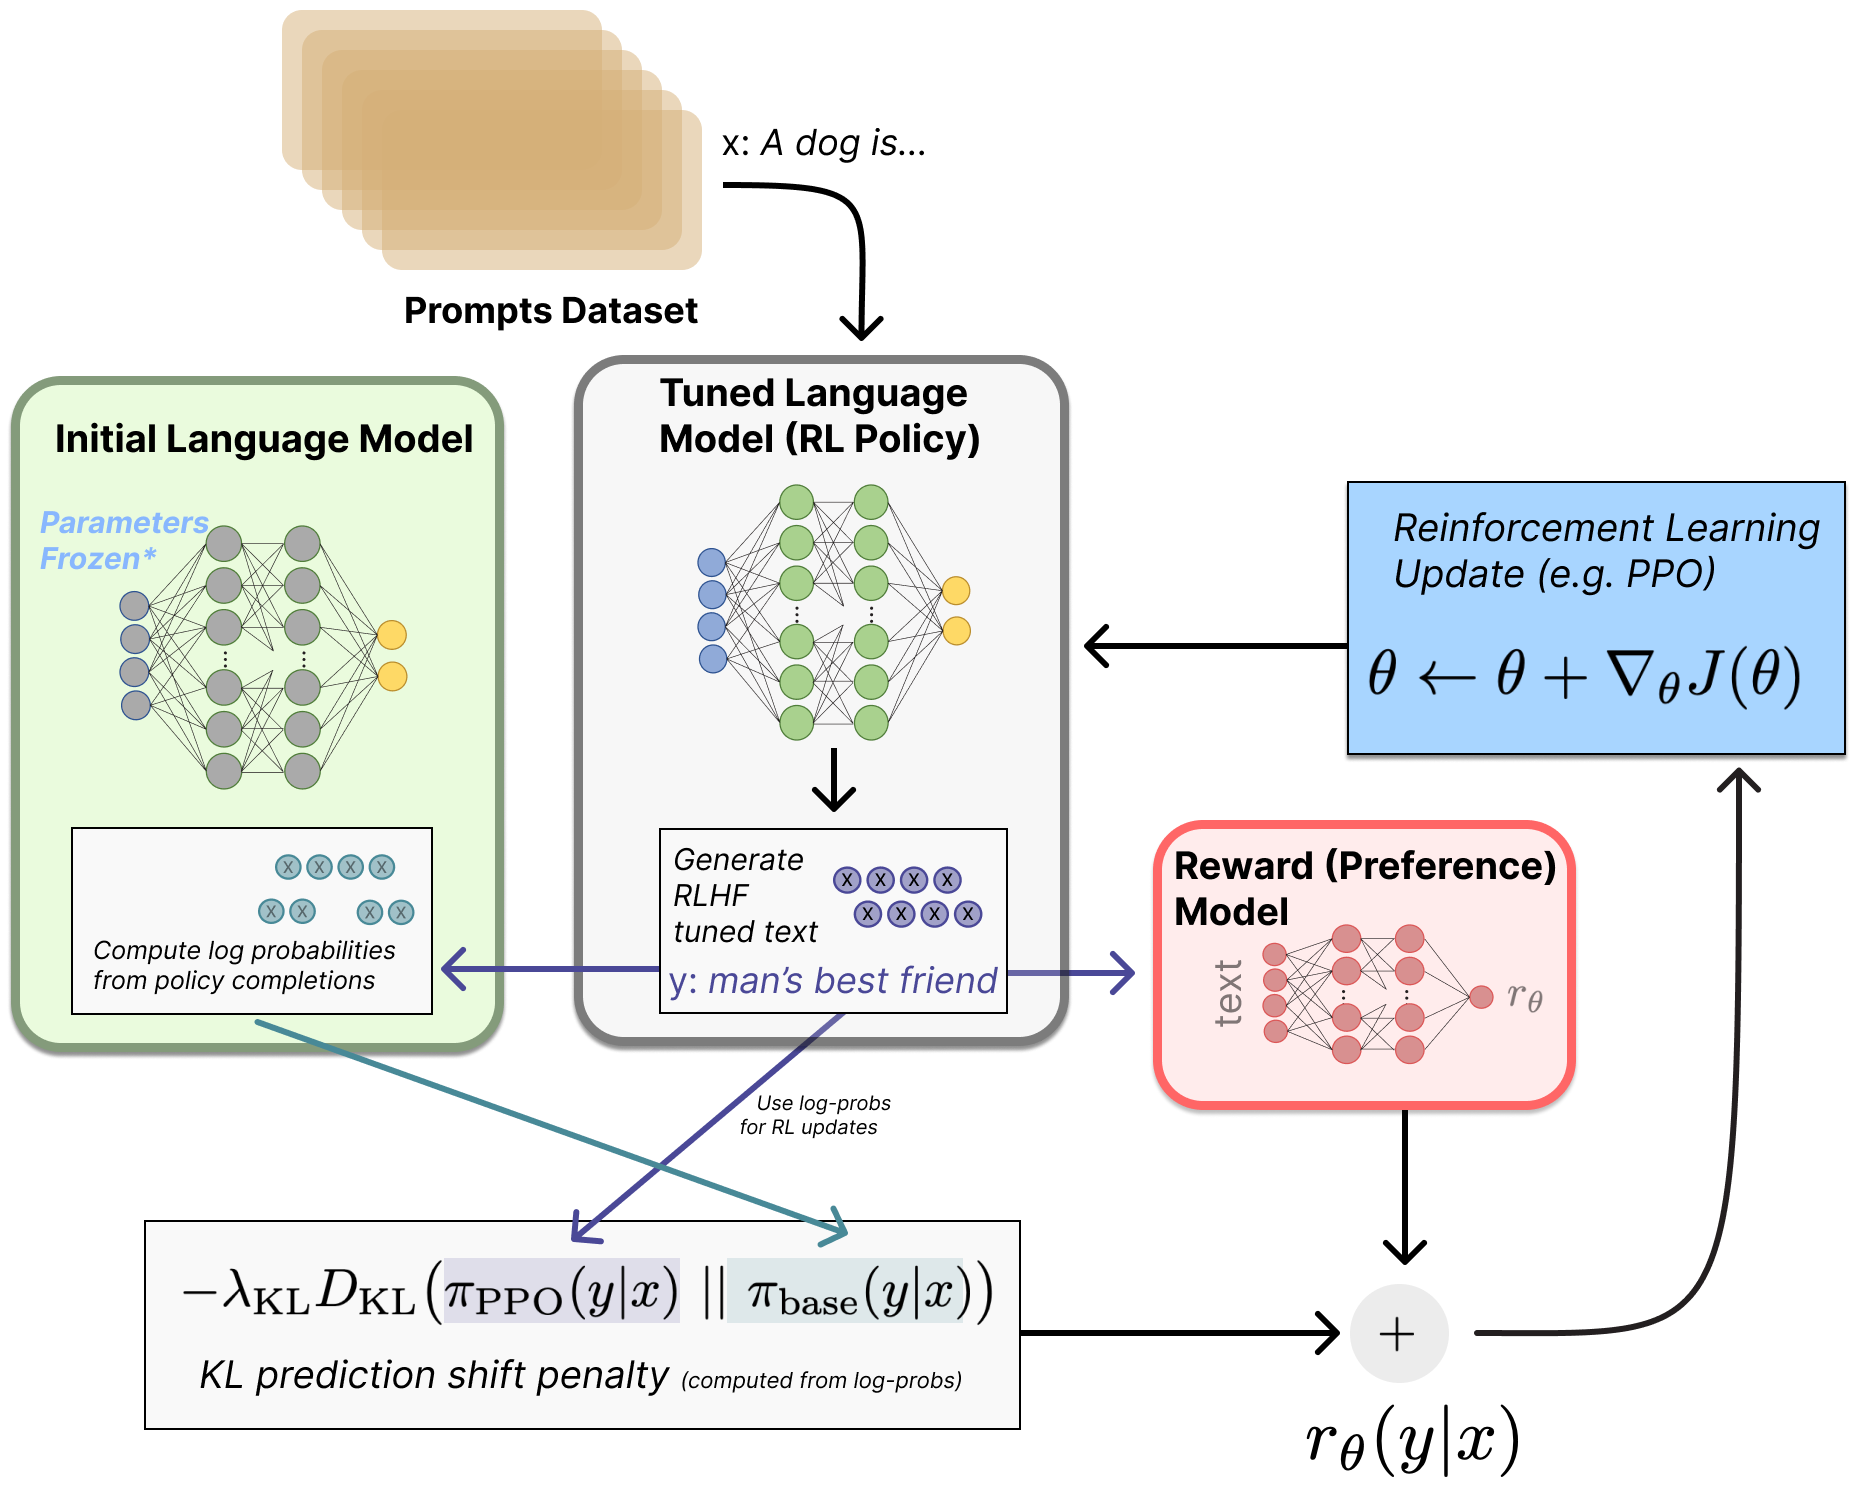
KL 散度这一项到底怎么算
KL 散度衡量两个分布的差异:$\mathcal{D}_{\mathrm{KL}}(P\|Q) = \sum_{x} P(x)\log\frac{P(x)}{Q(x)}$。三条性质要记住:不对称($\mathcal{D}_{\mathrm{KL}}(P\|Q)\ne\mathcal{D}_{\mathrm{KL}}(Q\|P)$,方向有意义)、非负、仅当两分布相同时为 0。它不是距离度量(不满足三角不等式),但大家口头上都叫它「KL 距离」。
问题是:在序列层面,这个求和是对所有可能的回复求和,完全不可算。解决办法是把它当成期望,用蒙特卡洛估计——而我们手上正好有从 $\pi_\theta$ 采出来的 rollout:
$$ \mathcal{D}_{\mathrm{KL}}(\pi_\theta \,\|\, \pi_{\mathrm{ref}}) = \E_{y \sim \pi_\theta}\!\left[\log\frac{\pi_\theta(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)}\right] \approx \frac{1}{N}\sum_{i=1}^{N}\log\frac{\pi_\theta(y_i\mid x)}{\pi_{\mathrm{ref}}(y_i\mid x)}. $$被积的东西就是你已经在算的那个 log-prob 之差,不需要额外的前向。但这个朴素估计量(记作 $\hat k_1 = \log r$,$r = \pi_\theta/\pi_{\mathrm{ref}}$)虽然无偏,方差很大,而且在有限样本上可能算出负值——一个恒非负的量估出负数,训练日志会很难看。RLHF 实现普遍改用 John Schulman 提出的 $k_3$ 估计量,它同样无偏但方差低,且逐样本恒非负:
# 来自 _src/code/policy_gradients/loss.py
def approx_kl3(log_probs, log_probs_ref, action_mask):
    """k3 估计量:exp(logr) - 1 - logr,其中 logr = log pi_theta - log pi_ref
    逐 token 计算,然后配合 action_mask 做 masked mean。
    参考 http://joschu.net/blog/kl-approx.html
    """
    log_ratio = log_probs - log_probs_ref
    if action_mask is not None:
        log_ratio = log_ratio * action_mask
    return (log_ratio.exp() - 1) - log_ratio

def approx_kl1(log_probs, log_probs_ref, action_mask):
    """k1 估计量:直接用 -log_ratio,无偏但方差大"""
    log_ratio = log_probs - log_probs_ref
    if action_mask is not None:
        log_ratio = log_ratio * action_mask
    return -log_ratio
拿到逐 token 的 KL 之后,主流实现的做法是把它当成一个负奖励加进总奖励里,而不是作为一个独立的 loss 项:
# 来自 _src/code/policy_gradients/utils.py,简化版
kl_div = get_approx_kl(cfg.kl_estimator, log_probs, log_probs_ref, action_mask)
kl_div = masked_mean(kl_div, mask=action_mask, dim=-1, keepdim=True)
rewards["total"] = rewards["total"] - cfg.beta * kl_div      # r - beta * KL
这行代码就是那个目标函数的字面翻译。
业界有一个非常实用的思维方式:把 KL 看成一种预算。一次 RLHF 训练相当于「花掉」一定量的 KL 距离去换取奖励的提升,训练监控里 KL 是必看指标之一。围绕它的研究问题是:同样花掉 10 nats 的 KL,怎么换到最多的真实质量提升? 一个 KL 涨得很慢但奖励涨得很快的实验,通常意味着你找到了真实的改进;一个 KL 飙升而评测不动的实验,几乎肯定是在 reward hacking。$\beta$ 的常见量级在 $10^{-2}$(InstructGPT 用的是 0.02),DPO 中同名的 $\beta$ 含义不同(它是隐式奖励的温度),常见取 0.05–0.1;而很多现代 RLVR 训练干脆把 $\beta$ 设成 0——因为可验证奖励不会被欺骗,约束的必要性大大降低。细节见第 15 章。
6. 后训练三件套:SFT、偏好微调、RLVR 的目标函数
现代后训练流水线基本都是三段式:指令微调 → 偏好微调 → 可验证奖励强化学习。把三者的目标函数并排放在一起看,它们的分工和递进关系会非常清楚。
第一件:监督微调 / 指令微调(SFT / IFT)
目标函数就是最普通的交叉熵,只是数据变成了「指令 + 期望回复」对,而且只在回复部分算 loss:
$$ \mathcal{L}_{\mathrm{SFT}}(\theta) = -\sum_{(x,\,y^\star)\in\mathcal{D}_{\mathrm{SFT}}}\;\sum_{t=1}^{|y^\star|} \log \pi_\theta\!\left(y^\star_t \mid x,\, y^\star_{<t}\right). $$符号说明:$y^\star$ 是示范数据里给定的目标回复(人写的或强模型生成的),不是模型自己采的。这一点决定了 SFT 的全部性质:
- 逐 token 的监督信号。每个位置都有一个明确的「正确答案」,信用分配问题不存在。
- off-policy / 模仿学习。目标是「学会复现这些序列」,模型自己的采样分布不参与训练。
- 只能教「做什么」,不能教「不做什么」。它没有负例,只会把概率质量往示范上堆。
用 RL 的话说,SFT 是行为克隆(behavior cloning)。它便宜、稳定、可预测,是后面一切的地基——原书的表述是「现代 RLHF 训练的模型无一例外都先做指令微调,然后才混用其它优化手段」。第 4 章展开。
第二件:偏好微调
SFT 之后模型会说话了,但「怎么说得更好」没有示范可给——因为如果我们能写出最好的回答,直接拿去 SFT 就完了。所以换一种更省力的反馈形式:给两个回复,让人(或 AI)挑一个更好的。
把这种成对偏好变成可优化的信号,用的是 Bradley-Terry 模型:假设每个回复有一个潜在分数,那么「$y_w$ 打败 $y_l$」的概率由分数差经过 sigmoid 给出:
$$ P(y_w \succ y_l \mid x) = \sigma\!\left(r_\phi(x, y_w) - r_\phi(x, y_l)\right), \qquad \sigma(z) = \frac{1}{1+e^{-z}}. $$其中 $y_w$ 是获胜(chosen)回复、$y_l$ 是落败(rejected)回复。训练奖励模型就是最小化这个二分类的负对数似然:
$$ \mathcal{L}_{\mathrm{RM}}(\phi) = -\log \sigma\!\left(r_\phi(x, y_w) - r_\phi(x, y_l)\right). $$讲座里他把这一步称为「Clever!」:RLHF 里的所谓「奖励」,本质上是模型在预测「这段文本在一对/一批候选里成为获胜项的概率」。它不是「质量的绝对分数」——公式里只有差值进 sigmoid,所以给所有回复的分数同时加一个常数,loss 完全不变。这带来两个必须记住的推论:(1) 奖励模型的输出没有绝对尺度,跨模型比较 RM 分数是没有意义的;(2) 你在 RL 里做奖励归一化(减均值、除标准差)不会破坏任何东西,因为尺度本来就是任意的。
拿到奖励模型之后,「怎么用它改进策略」有三条路线,它们优化的是同一个目标(第 5 节那个式子),区别只在于求解方式:
| 拒绝采样(第 9 章) | 在线 RL / PPO(第 6 章) | DPO(第 8 章) | |
|---|---|---|---|
| 机制 | 先筛选,再 SFT | 生成 → 打分 → 更新策略 | 直接对偏好对求梯度 |
| 需要奖励模型 | 需要 | 需要 | 不需要(隐式奖励) |
| on-policy 数据 | 是(从当前模型采) | 是(每步都重新采) | 否(固定偏好数据集) |
| 实现复杂度 | 低 | 高 | 低 |
拒绝采样是最朴素的那条:每个 prompt 采 $N$ 条,用奖励模型打分,留最高的那条去做 SFT——
$$ \mathcal{L}_{\mathrm{RS}} = \mathcal{L}_{\mathrm{SFT}}\big(\theta;\, \{(x_i,\, y_i^\star)\}\big), \qquad y_i^\star = \argmax_{j} \; r_\phi(x_i, y_{i,j}). $$DPO 则走了另一个极端:它对第 5 节那个 KL 正则化目标做了闭式求解,发现最优策略 $\pi^\star$ 与奖励之间有解析关系,于是可以把奖励模型消掉,直接在偏好对上写出损失:
$$ \mathcal{L}_{\mathrm{DPO}}(\theta) = -\log \sigma\!\left(\beta \log\frac{\pi_\theta(y_w\mid x)}{\pi_{\mathrm{ref}}(y_w\mid x)} - \beta \log\frac{\pi_\theta(y_l\mid x)}{\pi_{\mathrm{ref}}(y_l\mid x)}\right). $$注意这里的 $\sigma(\Delta)$ 结构和上面的 $\mathcal{L}_{\mathrm{RM}}$ 一模一样——只是把奖励差换成了「策略相对参考模型的对数概率比之差」。这就是「你的语言模型偷偷就是一个奖励模型」这句论文标题的意思。 Lambert 的评价很实在:DPO「实现简单得多、跑起来便宜得多、能拿到最终性能的 80% 以上」,他自己的 Zephyr-Beta、Tülu 2/3、OLMo 2/3 都用它。
第三件:可验证奖励强化学习(RLVR)
RLVR 把同样的 RL 算法用在答案可以被直接检查的任务上:数学题对答案,代码跑测试。此时 $r(x,y)$ 不是一个神经网络,而是一段确定性的验证程序,通常输出 0 或 1:
$$ r_{\text{verify}}(x, y) = \begin{cases} 1 & \text{回答通过验证} \\ 0 & \text{否则} \end{cases} $$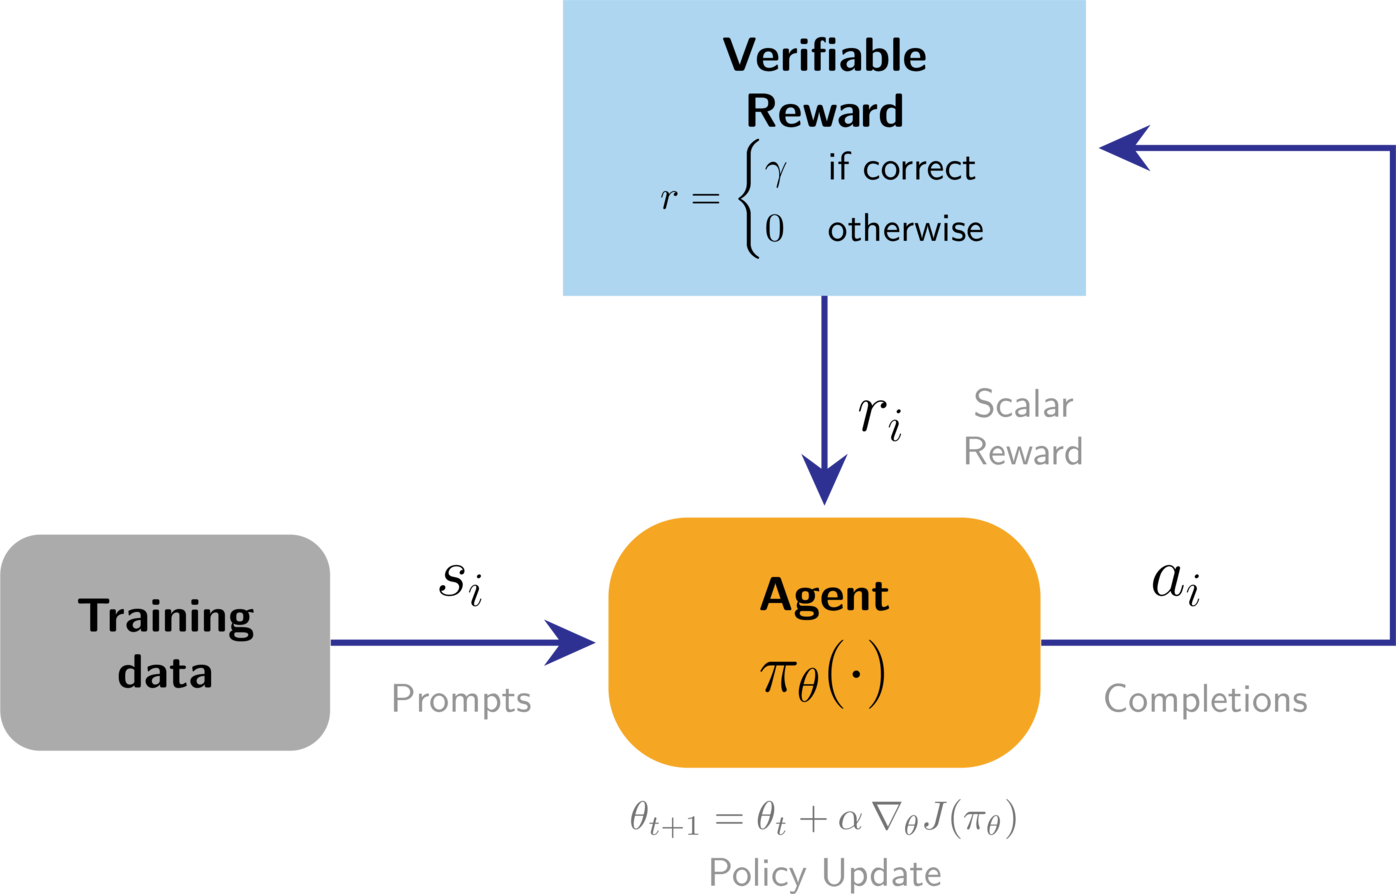
这一条替换消除了整个「过优化」类问题的主要来源,也因此解锁了 RL 训练的规模化。RLVR 这个名字由 Tülu 3 提出,被 DeepSeek R1 发扬光大。它还带出了推理时扩展(inference-time scaling):生成更多 token(更长的思维链、或并行多路采样)能让性能随算力对数线性增长。
| 经典 RL | RLHF | RLVR | |
|---|---|---|---|
| 奖励来源 | 环境 | 学习得到(代理) | 验证器(精确) |
| 状态转移 | 有 | 无 | 无 |
| 奖励粒度 | 逐步 | 整条回复 | 整条回复 |
| 核心挑战 | 探索-利用权衡 | 过优化 | 任务泛化 |
| 典型例子 | CartPole | 聊天风格调优 | 数学推理 |
「RLVR 没有奖励模型,所以没有 reward hacking。」不对,只是 hacking 的形式变了。验证器本身可以被钻空子:模型学会输出能骗过字符串匹配的答案格式、在代码任务里直接修改测试文件、或者用超长的思维链去撞对答案。可验证奖励消除的是「奖励模型这个神经网络被分布外样本骗到」这一类失效,而不是 Goodhart 定律本身——只要指标变成目标,它就不再是好指标。
7. 工具箱与 RL 的「微妙优势」
把本书剩下的内容按「解决优化问题的工具」来组织,是这样一张地图:
| 工具 | 章 | 它在优化问题里扮演什么角色 |
|---|---|---|
| 指令微调 | 第 4 章 | 提供优化的起点 $\pi_{\mathrm{ref}}$,教会问答格式。RLHF 的前置条件 |
| 奖励建模 | 第 5 章 | 把偏好数据变成可查询的标量函数 $r_\phi(x,y)$,即优化目标 |
| 策略梯度 | 第 6 章 | 直接求解 $\max_\theta J(\theta)$ 的优化器:PPO、GRPO、REINFORCE 等 |
| 直接对齐算法 | 第 8 章 | 绕开奖励模型,从偏好对直接求策略梯度:DPO 及其变体 |
| 拒绝采样 | 第 9 章 | 最朴素的求解:采样-筛选-模仿,是一种粗粒度的爬山法 |
为什么 RL 赢了
拒绝采样和 DPO 都比「把 RL 跑通」简单得多。可是 RL 依然一路赢下来。除了 RLVR 带来的推理时扩展这种显而易见的理由外,原书给了两条更微妙的观察,这两条在论文里很少见,属于业界口口相传的经验:
- RL 阶段能「磨平」模型的毛边。经过一轮 RL 的模型往往更好聊、更鲁棒(比如在 vLLM 这类推理框架下数值更稳定)。文献里没有很好的解释,但 RL 在业界的占比一直在涨,本身就是这个现象为真的证据。
- RL 可以做「外科手术」。模型对 prompt 分布的定位能力很好,RL 训练不太会把模型的通用能力压扁。一个漂亮的实证是 Tülu 3:只在数学 prompt 上做 RL,其它任务的能力却全面保持。同样幅度的 SFT 往往就会带来明显的能力退化。
他自己承认这条说法「有点太口语化」:相比指令微调或 DPO 类算法,实现 RL 需要大得多的基础设施投入,但它提供的梯度更新「总的来说就是对模型帮助很大」(generally help the model a lot)。这句话不严谨,却是很多一线团队的真实体感——也是为什么明知 DPO 能拿到 80% 的效果,头部实验室还是要啃下 RL 这块硬骨头。总结成一句:RL 的损失函数在语言模型上鲁棒、可扩展、有效、灵活。
「只是风格迁移」之争与激发理论
2023 年 LIMA 论文的一句话曾经定义了整个领域对后训练的看法:
「模型的知识和能力几乎完全是在预训练阶段学到的,对齐只是教它在与用户交互时该用哪一个子分布的格式。」
这就是表层对齐假说(Superficial Alignment Hypothesis, SAH)。它一度让后训练背上「只是风格迁移」(just style transfer)的名声——好像微调只做了些无关痛痒的表面改动。
Lambert 的立场是:假说的前半句对,结论错了。 他把自己的版本叫做后训练的激发理论(Elicitation Theory)——后训练的工作确实不是往模型里装新知识,而是把模型里已有的、最有用的东西挖出来。但「只是挖掘」绝不等于「无关痛痒」,因为挖掘本身极其困难,而且不同挖法的差距巨大。他给出的证据很干净:OLMoE 同一个基座模型家族,只更新后训练配方——
| 模型(同一基座) | 时间 | 平均评测分 |
|---|---|---|
OLMoE-1B-7B-0924-Instruct | 2024 年 9 月 | 38.44 |
OLMoE-1B-7B-0125-Instruct | 2025 年 1 月 | 45.62 |
四个月,权重的基座没变,评测分涨了 7 分以上。基座模型决定了天花板,后训练的工作是够到它——而简单的后训练配方往往远远够不到。用他的比喻:预训练造出了车的底盘,后训练是把最大性能从底盘里榨出来的那门手艺。
再往前一步:RL 的规模化时代
激发理论描述的是 2023–2024 年的后训练。2024 年底 o1 之后,故事又变了。OpenAI 那张著名的图给出了两条对数线性曲线:推理时扩展——生成的 token 越多下游性能越高(可以是一条超长思维链,也可以是多个 agent 并行);训练时扩展——投入的强化学习算力越多,性能也呈对数线性提升。第二条在当时被严重低估了。
于是训练语言模型变成了一个两端都能扩展的图景(预训练 + 后训练),加上推理端第三个不改权重的扩展维度。此时那个核心问题被重新提出:扩大 RL 训练规模,究竟只是在更彻底地「激发」基座模型,还是真的在教会它新能力? 目前没有定论,但工程观察是明确的——Olmo 3.1 是少数几个公开全部细节的大规模 RL 训练:32B 推理模型,224 张 GPU 跑了约 28 天,性能在整个训练过程中持续稳定上升,直到被迫停止时仍在涨。
「RL 阶段算力占比在上升」不等于「SFT 不重要了」。讲座里的表述是:基于 RL 的后训练给模型更丰富的、回复级的、对比式的反馈,让它更灵活更好用;但 SFT 仍然是达到最高性能的必要地基。 DeepSeek R1 的配方就是最好的注脚——它先用十万级别的「冷启动」推理样本做 SFT,才敢开始大规模 RL。跳过 SFT 直接 RL(即 R1-Zero 路线)是可行的,但产出的模型可读性和通用性都有明显缺陷。
8. 三个经典配方:InstructGPT、Tülu 3、DeepSeek R1
形式化讲完了,来看这套优化问题在真实模型上是怎么被组装起来的。原书挑了三个「教科书级」配方,它们分别代表了三个时代。配方会过时,但过时的配方会变便宜——今天要复现 InstructGPT 级别的能力,所需数据比 2022 年少得多。总趋势是:更多的优化步骤、更多的训练算法、更多样的数据与评测。
InstructGPT(2022):三步走的原型
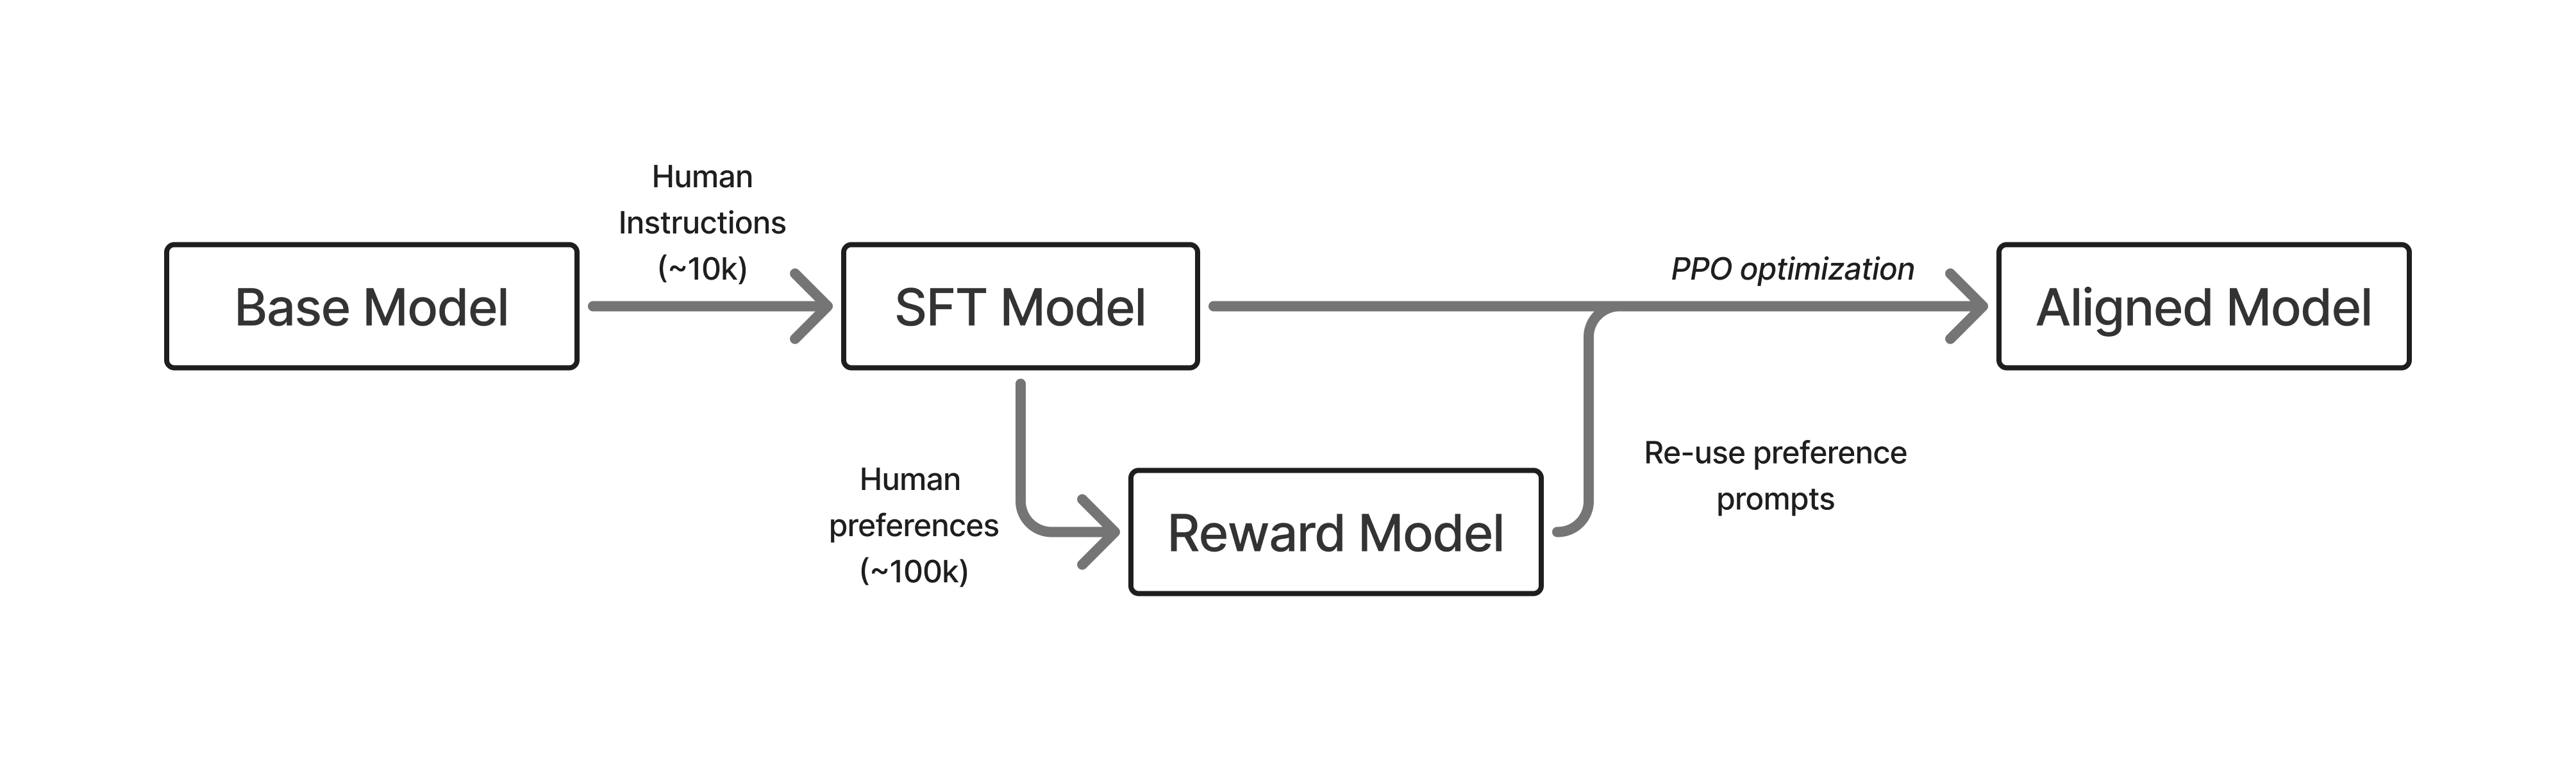
在一个「基座模型」(在大规模网页文本上训练的下一 token 预测模型)之上做三件事:
- 用约 1 万条样本做指令微调。教会模型问答格式,同时从以人写为主的数据里学一些基础技能。
- 用约 10 万条成对 prompt 训练奖励模型(论文实际用了 33K 个 prompt)。这个模型从指令微调后的检查点初始化,把你想建模的多样价值观捕捉进去。它就是 RLHF 的优化目标。
- 在另外约 10 万条 prompt 上用 RLHF 训练指令微调模型(论文用了 31K,且未说明是否与前面阶段复用 prompt)。模型对这些 prompt 生成回复、被奖励模型打分、然后更新。
做完这三步模型就可以上线了。注意每个阶段的 prompt 集合是分开的——这不是巧合,让 RL 阶段的 prompt 与奖励模型的训练 prompt 不重叠,能减少奖励模型在自己「熟悉」的样本上被过度利用的风险。
Tülu 3(2024):多阶段、全开源的现代配方
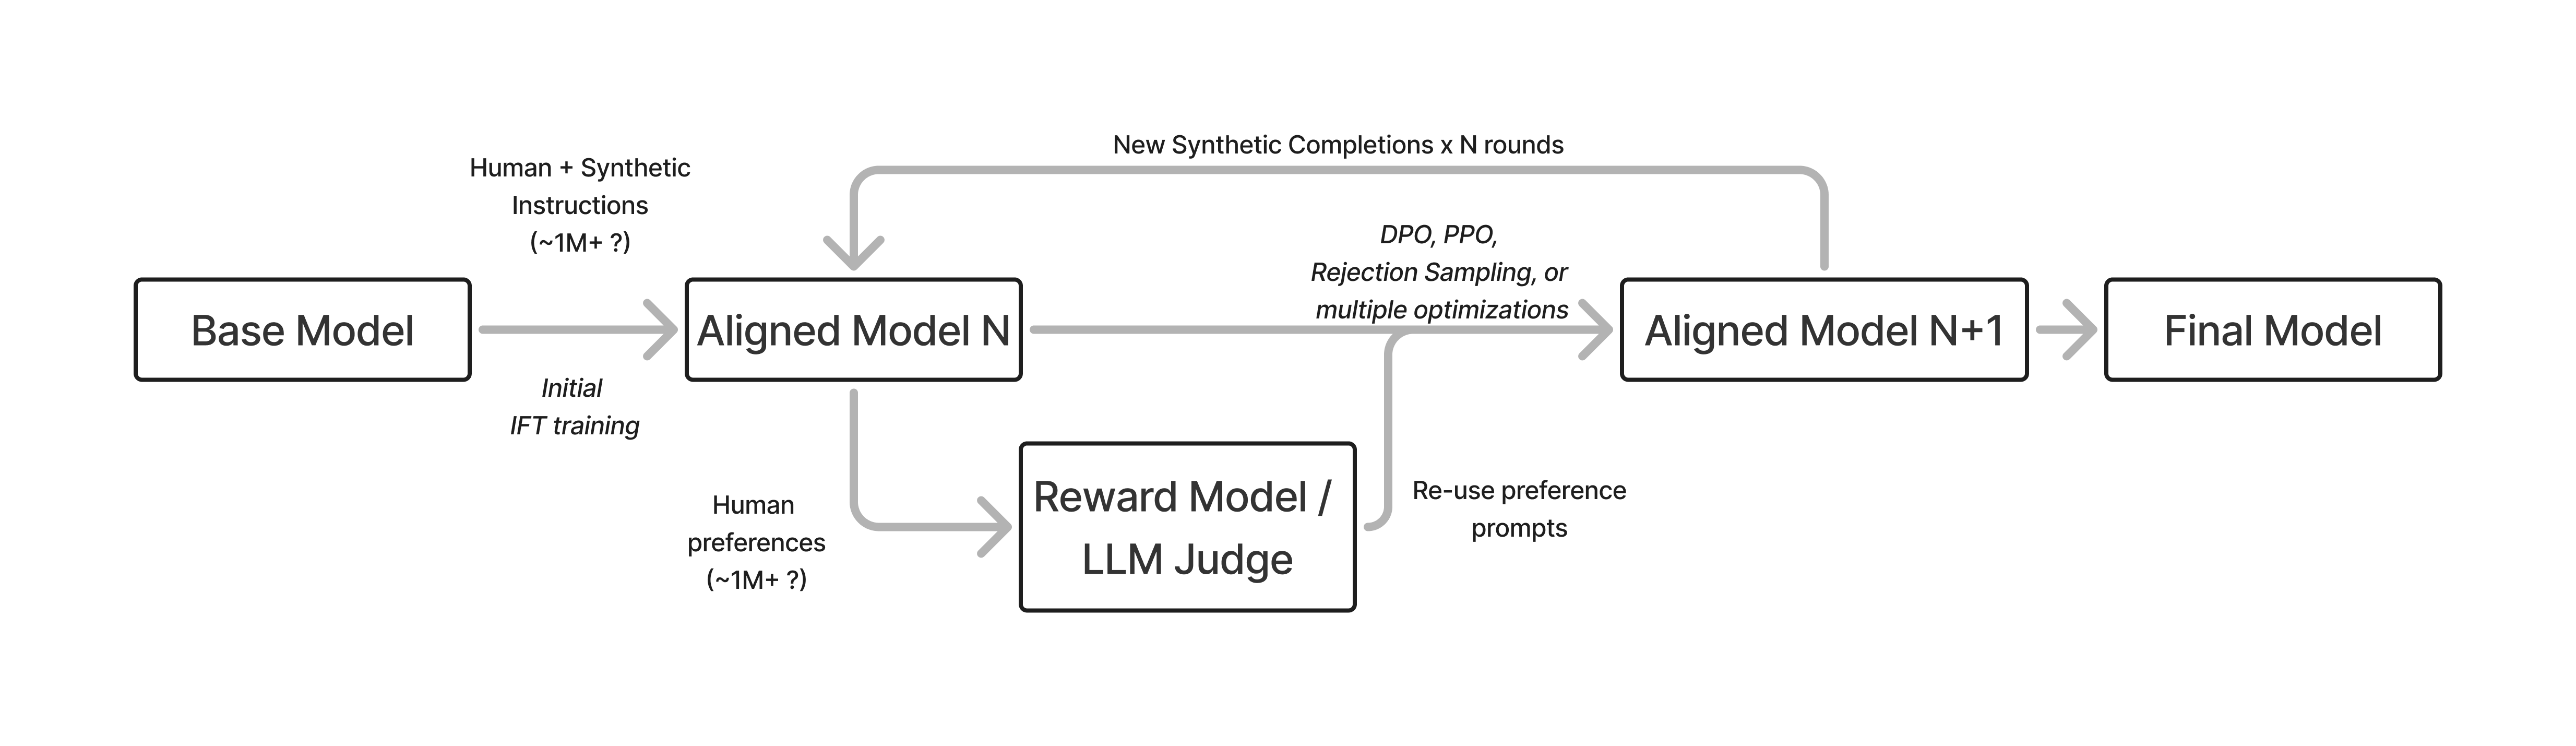
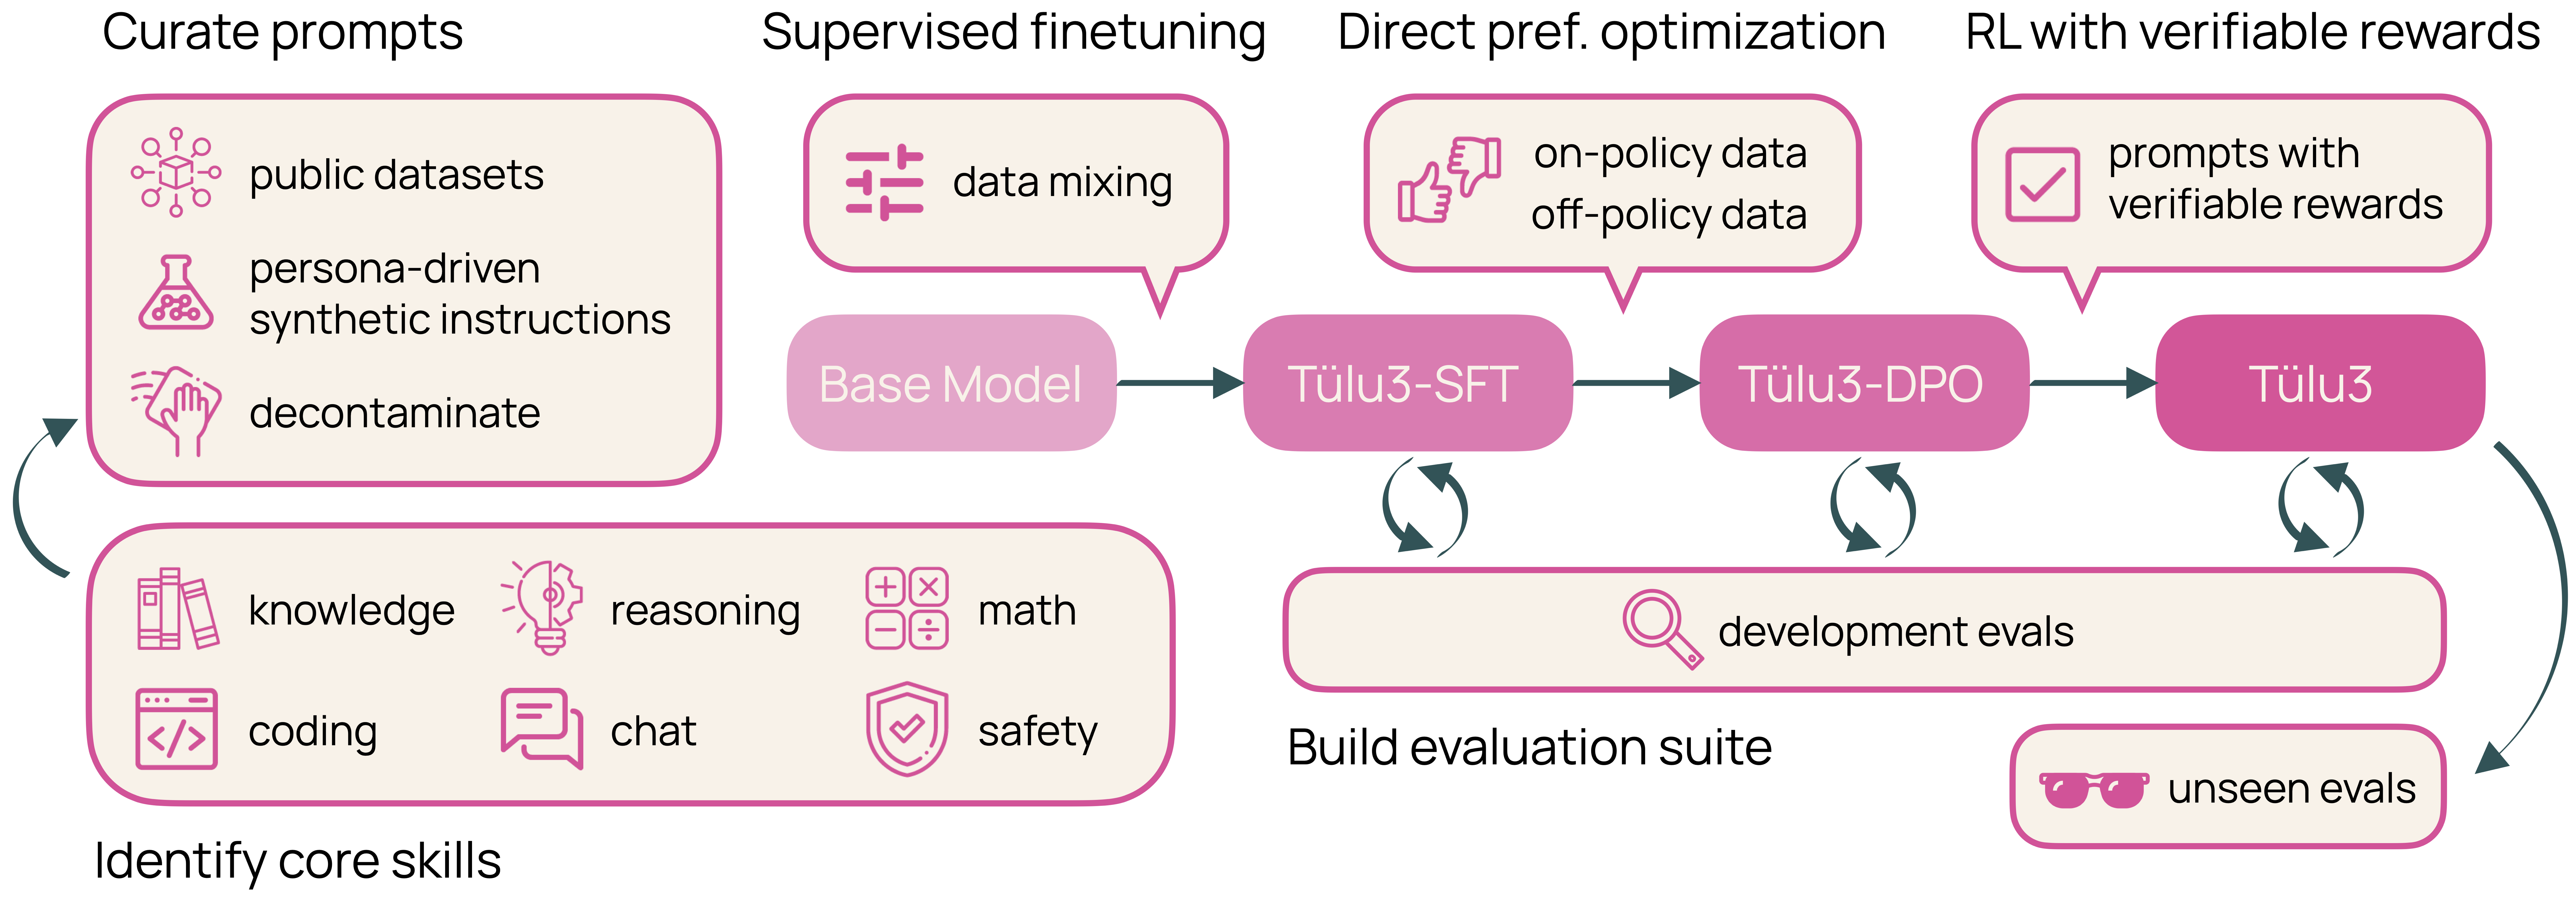
- 约 100 万条样本的指令微调。这批以合成数据为主,来自 GPT-4o、Llama 3.1 405B 等前沿模型的混合,负责通用指令跟随以及数学、代码等能力的底子。
- 约 100 万对 on-policy 偏好数据。这一阶段显著提升模型的「聊天感」(Arena、AlpacaEval 2 这类评测),同时也继续改善上一阶段提到的各项技能。
- 约 1 万条 prompt 上的 RLVR。一个小规模的 RL 训练,用来提升数学等核心技能同时保持整体性能——现在回看,这是 DeepSeek R1 这类推理模型的前身。
这个配方被成功应用到 Llama 3.1、OLMo 2 和 SmolLM 系列上。注意第 3 步的数据量比第 1、2 步小两个数量级:在 2024 年,RL 还只是最后的抛光。
DeepSeek R1(2025):算力重心搬到 RL
随着 o1 这类推理模型的出现,最佳实践又变了一次——不是换算法,而是重新排列阶段顺序、重新分配算力。R1 是目前记录得最清楚的推理模型配方,Qwen 3 的大尺寸模型(32B 与 235B MoE)和小米 MiMo 7B 都沿用了它:
- 「冷启动」:10 万条以上的 on-policy 推理样本。数据来自一个更早的 RL 检查点 R1-Zero,经过重度筛选,用来在 DeepSeek-V3-Base 上植入一种特定的推理过程。「冷启动」这个词描述的就是「用很少的监督数据就开始学 RL」。
- 大规模强化学习训练。反复在推理问题上跑 RLVR,跨多个基准「一直训到收敛」。
- 拒绝采样 + SFT。接近收敛时,对 RL 检查点做拒绝采样,构造出约 80 万条样本的 SFT 数据集,然后在大约 3/4 推理题、1/4 通用问题的混合数据上微调,得到一个通用模型。
- 混合强化学习。在推理问题(可验证奖励)和通用偏好奖励模型上再跑一轮,打磨最终模型。
看出关键变化了吗?SFT 从「第一步」变成了「第一步和第三步」,而 RL 从「最后的抛光」变成了主菜。 步骤 3、4 是各家做法分歧最大的地方,也是模型上线前的最后定型环节。另一条流行的变体是:先用大量经过重度筛选和打磨的思维链指令数据做 SFT,快速拿到强行为,再进入 RL。
| InstructGPT(2022) | Tülu 3(2024) | DeepSeek R1(2025) | |
|---|---|---|---|
| 指令数据 | 约 10K | 约 1M | 100K+(冷启动)+ 约 800K(第二轮) |
| 偏好数据 | 约 100K | 约 1M | on-policy,用于最后混合 RL |
| RL 阶段 | 约 100K prompt(PPO + RM) | 约 10K prompt(RLVR) | 大规模 RLVR,「训到收敛」 |
| 算力重心 | 三段大致均衡 | SFT 与偏好为主 | RL 为主 |
最复杂的那批模型(2026 年的 ChatGPT、Claude 等)从未公开完整训练细节,但可以确定它们包含大量迭代轮次,甚至会训练多个专精子模型再合并权重得到一个多面手(Cohere 的 Command A 是一个公开的例子)。
Lambert 在讲座里给出了一条粗略的时间线,用来定位你读到的任何一篇后训练论文:2023——用简单 SFT 做更好的聊天机器人、复现 RLHF 基础(Alpaca、Vicuna);2024——DPO 主导开源模型,训练阶段开始膨胀(Zephyr-beta、Tülu 2),RLHF 被视为「一个工具,甚至可以不用」;2025——RLVR 与复杂配方(Tülu 3、OLMo 3、R1);2026——agentic 训练、多轮 RL。模型的形态也在变:语言模型正在变成「工具原生」的,重点从权重本身转移到工具、以及告诉模型怎么用工具的 harness 上。
9. 符号总表:后面十四章都用它
本章建立的符号会一直用到全书结尾。把这张表收藏起来,读后面任何一章卡住时回来查。
语言建模与后训练
| 符号 | 读法 / 含义 | 形状或类型 | 备注 |
|---|---|---|---|
| $x$ | prompt,模型的输入 | token 序列 | 从 prompt 数据集 $\mathcal{D}$ 采样 |
| $y$ | completion / 回复 | token 序列,长度 $|y|$ | 常写作 $y\mid x$,强调它是条件生成的 |
| $y_t$ | 回复的第 $t$ 个 token | 标量(词表索引) | 就是 RL 里的动作 $a_t$ |
| $y_{<t}$ | 第 $t$ 个 token 之前的所有 token | token 序列 | 与 $x$ 一起构成状态 $s_t$ |
| $y_w,\; y_l$ | 获胜 / 落败回复(chosen / rejected) | token 序列 | 也写作 $y_c,\;y_r$;偏好关系记作 $y_w \succ y_l$ |
| $y^\star$ | 示范数据里的目标回复 | token 序列 | SFT 专用;不是模型采样出来的 |
| $\mathcal{V}$ | 词表 | 集合,$|\mathcal{V}|\sim 10^5$ | 动作空间 |
| $\mathcal{D}$ | 数据集 | — | 下标区分用途:$\mathcal{D}_{\mathrm{SFT}}$、$\mathcal{D}_{\text{pref}}$ 等 |
| $B, L, V$ | batch 大小、序列长度、词表大小 | 整数 | 代码里的 tensor 维度约定 |
模型与参数
| 符号 | 含义 | 训练时是否更新 | 备注 |
|---|---|---|---|
| $\theta$ | 策略(正在训练的语言模型)的参数 | 是 | 全书统一;梯度永远是 $\nabla_\theta$ |
| $\phi$ | 奖励模型的参数 | 训 RM 时是,跑 RLHF 时否 | 原书第 3 章有几处沿用 RL 惯例写 $r_\theta$,本书之后统一用 $r_\phi$ |
| $\pi_\theta(y\mid x)$ | 策略:模型在回复上的条件分布 | 是 | $=\prod_t \pi_\theta(y_t\mid x,y_{<t})$ |
| $\pi_{\mathrm{ref}}$ | 参考模型,冻结的权重快照 | 否 | 通常就是 SFT 检查点;只前向,算 log-prob |
| $\pi^\star$ | 目标函数的最优策略 | — | DPO 推导的核心对象 |
| $r_\phi(x,y)$ | 奖励模型的打分 | 否(RLHF 阶段) | 标量;只有相对大小有意义 |
强化学习
| 符号 | 含义 | 在语言模型里是什么 |
|---|---|---|
| $s_t,\; a_t$ | 状态、动作 | $(x, y_{<t})$、$y_t$ |
| $\tau$ | 轨迹 | 一次完整的 prompt + 回复,即一次 rollout |
| $\gamma$ | 折扣因子 | 通常 $=1$(不折扣) |
| $J(\theta)$ | 期望回报,被最大化的目标 | $\E_{x\sim\mathcal{D},\,y\sim\pi_\theta(\cdot\mid x)}[r_\phi(x,y)]$ |
| $V^\pi(s)$ | 值函数 | PPO 里由一个独立的值模型估计;GRPO 不需要 |
| $Q^\pi(s,a)$ | Q 函数 | 语言模型 RLHF 里很少显式使用 |
| $A^\pi(s,a)$ | 优势函数,$=Q^\pi - V^\pi$ | 策略梯度的乘子;bandit 视角下常直接取 $r - b$ |
| $\beta$ | KL 惩罚系数 | RLHF 中常见 $10^{-2}$ 量级;DPO 中含义不同 |
| $\mathcal{D}_{\mathrm{KL}}(P\|Q)$ | KL 散度 | 用 $k_3$ 估计量在 rollout 上做蒙特卡洛估计 |
| $\sigma(z)$ | sigmoid,$1/(1+e^{-z})$ | 把奖励差转成偏好概率 |
三个最容易踩的记号陷阱
- 两个 $\beta$ 不是一回事。 RLHF 目标里的 $\beta$ 是加在 KL 项前的惩罚权重($\beta$ 越大越保守);DPO 损失里的 $\beta$ 出现在 log 概率比的内部,扮演隐式奖励的温度。数值区间和调参直觉都不同,看到 $\beta$ 先确认上下文。
- 期望的下标必须读清楚。 $\E_{y\sim\pi_\theta}[\cdot]$ 与 $\E_{y\sim\pi_{\mathrm{ref}}}[\cdot]$ 或 $\E_{y\sim\mathcal{D}}[\cdot]$ 是三件完全不同的事——第一个要求你现场生成(on-policy,贵),第二个是 off-policy 需要重要性采样修正,第三个是从固定数据集读取(便宜,DPO 走的就是这条)。「期望对谁取」几乎就是「这个算法贵不贵」的同义词。
- KL 的方向有意义。 $\mathcal{D}_{\mathrm{KL}}(\pi_\theta\|\pi_{\mathrm{ref}})$(前向,即 mode-seeking)与 $\mathcal{D}_{\mathrm{KL}}(\pi_{\mathrm{ref}}\|\pi_\theta)$(反向)行为不同。RLHF 标准写法是前者,因为它的期望是对 $\pi_\theta$ 取的——正好可以用你手上已有的 rollout 估计,不需要额外采样。这不是理论选择,是工程选择。
整本书的所有目标函数都可以套进同一个模板:「在某个分布上采样,用某个标量给样本打分,把高分样本的概率推上去,同时用某种方式约束不要跑太远。」 SFT:分布是示范数据,标量恒为 1(无条件模仿),无约束。拒绝采样:分布是当前策略,标量是「是不是 best-of-N」,约束来自只训一小步。DPO:分布是固定偏好集,标量是隐式奖励差,约束内建在 $\pi_{\mathrm{ref}}$ 的比值里。PPO/GRPO:分布是当前策略,标量是奖励模型或验证器,约束是显式 KL 加 ratio clipping。把每个新算法往这个模板上套,你会发现它们的差异比表面看起来小得多。
本章小结
本章把「后训练」从一堆工程步骤翻译成了一个优化问题。速查如下。
一句话版本
后训练要解的是:在 prompt 数据集上,从当前模型采样回复,让某个标量评分尽可能高,同时不要离起点太远。
$$ \max_\theta \; \E_{x\sim\mathcal{D},\; y\sim\pi_\theta(\cdot\mid x)}\big[r_\phi(x,y)\big] - \beta\,\mathcal{D}_{\mathrm{KL}}\big(\pi_\theta(\cdot\mid x)\,\|\,\pi_{\mathrm{ref}}(\cdot\mid x)\big) $$要点清单
- MDP 映射:$s_t=(x,y_{<t})$,$a_t=y_t$,转移是确定性拼接,$\pi_\theta$ 就是语言模型本身,$\gamma=1$,奖励只在序列末尾发放一次。
- 轨迹概率退化:因为转移确定,$p_\pi(\tau)$ 里的动力学项全为 1,只剩 $\pi_\theta(y\mid x)=\prod_t \pi_\theta(y_t\mid x,y_{<t})$。这让序列概率可精确计算,是 KL 惩罚、重要性采样比、DPO 的共同计算基础。
- 三处改装:奖励函数 → 奖励模型(灵活但引入代理目标);没有状态转移(prompt 从数据集采);回复级奖励 + 不折扣。结果是 contextual bandit 而非多步 MDP。
- 结构决定算法:bandit 结构意味着细粒度值函数的边际收益低,所以 GRPO / RLOO 这类「用组内均值当基线、丢掉值模型」的算法在语言模型上工作得很好——这在 CartPole 上是行不通的。
- 正则化是必需品不是可选项:起点是强模型,优化必须受约束,否则会走向 reward hacking。KL 是主流手段,$\beta$ 是旋钮,「KL 预算」是监控 RLHF 训练最有用的思维框架。
- 三件套的分工:SFT 给逐 token 的模仿信号(教「说什么」);偏好微调给回复级的对比信号(教「怎么说更好」);RLVR 给不可欺骗的 0/1 信号(教「怎么把题做对」)。SFT 仍是地基,RL 是天花板。
- 配方演化:InstructGPT(三步、10K/100K/100K)→ Tülu 3(三段、1M/1M/10K)→ DeepSeek R1(冷启动 SFT + 大规模 RLVR + 拒绝采样 SFT + 混合 RL)。方向是阶段更多、算力重心持续向 RL 迁移。
常见误区速查
| 说法 | 问题在哪 |
|---|---|
| 「RLHF 就是把 PPO 用在语言模型上」 | PPO 只是求解器之一。核心是那个目标函数,拒绝采样和 DPO 求解的是同一个目标 |
| 「奖励模型的分数越高模型越好」 | 它是代理。RM 分数与真实质量只是相关;分数一路涨而评测不动 = reward hacking |
| 「token 级 MDP 和序列级 bandit 是两种不同建模」 | 在确定性转移 + 终止奖励的设定下两者等价,区别只在信用分配的实现方式 |
| 「RLVR 没有代理目标所以不会被 hack」 | 验证器本身可被钻空子(格式作弊、改测试)。Goodhart 定律不因奖励精确而失效 |
| 「后训练只是风格迁移」 | 后训练确实主要在激发已有能力,但激发得好不好差距巨大(OLMoE 同基座差 7 分以上) |
| 「$\gamma$ 设小一点能稳定训练」 | 回复级奖励下折扣会人为地惩罚靠后的 token,$\gamma=1$ 才是正确默认值 |
动手实验
本章没有对应的正式作业,但有一个 15 分钟就能跑完、且能把本章符号全部落地的最小实验。用任意一个小的指令模型(0.5B 即可,CPU 也能跑)。
实验一:验证策略分解与 completion mask
目标:亲手确认 $\log\pi_\theta(y\mid x) = \sum_t \log\pi_\theta(y_t\mid x,y_{<t})$,并观察 mask 写错的后果。
import torch, torch.nn.functional as F
from transformers import AutoModelForCausalLM, AutoTokenizer

name = "Qwen/Qwen2.5-0.5B-Instruct"
tok = AutoTokenizer.from_pretrained(name)
model = AutoModelForCausalLM.from_pretrained(name).eval()

prompt = tok.apply_chat_template(
    [{"role": "user", "content": "用一句话解释天空为什么是蓝色的。"}],
    tokenize=False, add_generation_prompt=True)
completion = "因为大气分子对波长较短的蓝光散射更强,这叫瑞利散射。"

p_ids = tok(prompt, return_tensors="pt").input_ids
c_ids = tok(completion, add_special_tokens=False, return_tensors="pt").input_ids
ids = torch.cat([p_ids, c_ids], dim=1)                  # (1, L)

# completion mask:prompt 位置为 0,回复位置为 1
mask = torch.zeros_like(ids); mask[:, p_ids.shape[1]:] = 1

with torch.no_grad():
    logits = model(ids).logits[:, :-1, :]               # (1, L-1, V)
lp = F.log_softmax(logits.float(), dim=-1)
tok_lp = lp.gather(-1, ids[:, 1:].unsqueeze(-1)).squeeze(-1)   # (1, L-1)

m = mask[:, 1:]                                        # mask 也要错一位
print("logpi(y|x)      =", (tok_lp * m).sum().item())
print("含 prompt 的错误值 =", tok_lp.sum().item())       # 明显不同 —— 这就是 mask 写错的后果
print("平均每 token     =", ((tok_lp * m).sum() / m.sum()).item())
你会观察到:(1) 两个数差得很远,因为 prompt 通常比回复长;(2) 序列 log-prob 是个很大的负数(几十到几百),这解释了为什么 DPO 这类方法要用 $\pi_\theta/\pi_{\mathrm{ref}}$ 的比值而不是绝对概率;(3) 「平均每 token log-prob」在不同长度的回复之间才可比——这正是长度归一化在偏好优化里反复出现的原因。
实验二:手算一次 KL 惩罚
把上面的模型复制一份当 $\pi_{\mathrm{ref}}$,给策略的 logits 加一点扰动(模拟训练了几步之后的漂移),然后分别用 $k_1$ 和 $k_3$ 估计量算 KL:
log_ratio = (tok_lp_policy - tok_lp_ref) * m
k1 = (-log_ratio).sum() / m.sum()                  # 无偏,方差大,可能为负
k3 = ((log_ratio.exp() - 1) - log_ratio).sum() / m.sum()   # 无偏,方差小,恒非负
print(k1.item(), k3.item())
你会观察到:漂移很小时两者接近;漂移变大时 $k_1$ 的逐样本波动明显更剧烈,而 $k_3$ 始终 $\ge 0$。把 $\beta$ 从 0.001 调到 0.1,看 $r - \beta\cdot\mathrm{KL}$ 这个总奖励里哪一项占主导——这就是「KL 预算」在数值上的样子。
实验三:感受 bandit 的稀疏性
对同一个 prompt 用温度 1.0 采 8 条回复,用任意一个开源奖励模型(或者简单地用「回复长度是否在 50–100 字之间」这种规则奖励)打分,然后计算 GRPO 风格的组内标准化优势。你会观察到:8 条回复往往有 6 条得分完全相同,标准化后优势接近 0——这就是稀疏奖励的实感,也是为什么 RL 训练需要极大的 batch 才能拿到有效梯度。
延伸阅读
形式化与基础
- Sutton & Barto, Reinforcement Learning: An Introduction (2018) — RL 的标准教材。读第 3 章(MDP)和第 13 章(策略梯度)就够支撑本书全部内容,其余可跳。
- John Schulman, Approximating KL Divergence (2016) — 一篇博客讲清楚 $k_1/k_2/k_3$ 估计量。所有 RLHF 代码库都在用它,但很少有人解释为什么。
- Lambert et al., Illustrating RLHF (2022) — 本章三步走图的出处,可视化做得非常好,适合建立第一印象。
目标函数的三种求解方式
- InstructGPT (2022) — 三阶段配方的原始论文。读它的目的是看数据规模和标注流程,算法部分已被超越。
- PPO (2017) — RLHF 长期的默认优化器。注意它是为连续控制设计的,用在语言模型上有很多退化和简化,第 6 章会讲。
- DPO (2023) — 直接对本章第 5 节那个目标做闭式求解,消掉奖励模型。第 8 章的主角。
- Anthropic HH (2022) — helpful & harmless 助手的 RLHF 实践,引入了被广泛使用的 HH 数据集。
配方与规模化
- Tülu 3 (2024) — 目前最完整公开的现代后训练配方,RLVR 这个名字就出自这里。想复现一条完整流水线,从它开始。
- DeepSeek R1 (2025) — 推理模型后训练的最清晰文档,把算力重心搬到 RL 的分水岭。
- Llama 2 (2023) — 记录了 5 轮 RLHF 迭代,是「后训练不是一次性的」这一观念的早期公开证据。
- OLMo 2 (2024) / Olmo 3 (2025) — 全开源模型,权重、数据、代码齐全,是唯一能让你逐行核对本章内容的一手材料。
为什么需要正则化
- Gao, Schulman & Hilton, Scaling Laws for Reward Model Overoptimization (2023) — 用实验刻画了「KL 花多了会怎样」,第 14 章的核心参考。
- LIMA (2023) — 表层对齐假说的出处。读它是为了理解本章第 7 节那场争论的起点,而不是为了接受它的结论。
- Christiano et al., Deep RL from Human Preferences (2017) — 语言模型之前的 RLHF,那个著名的「后空翻」实验。它奠定了「用偏好学奖励」这个范式。