工具使用与函数调用
当模型可以在生成中途停下来、调一个外部系统、把结果读回来再接着写,后训练的每一个环节——数据格式、loss 掩码、奖励设计、RL 的 rollout 循环——都得跟着改。
0. 本章导读
问一个语言模型「今天美国总统是谁?」。它的参数是在某个截止日期之前的语料上训练出来的,这个问题它原理上答不了——不是能力不够,是信息不在权重里。但这条信息一次搜索就能拿到。再换一个请求:「把我下载文件夹里所有 arXiv 论文移到 ~/research/,文件名带上论文日期。」这个任务模型连「尝试」都做不到——它没有手。
这两个例子划出了工具的两条价值线:一条是信息(权重是静态快照,工具是活的世界),一条是执行(生成 token 改变不了磁盘上的文件,调用 mv 可以)。还有隐蔽的第三条:精度。让模型背出 π 的前 50 位,它会以某个概率背错,因为自回归采样天然是概率性的;让它写四行 Chudnovsky 算法丢进 Python 解释器,答案要么对要么报错,没有「有点像对的」这种中间态。工具把语言模型从一个概率性的续写器,接到了一堆确定性的系统上。
但工具使用不是免费附赠的能力,它是一项要被训练出来的技能。模型得学会:什么时候该停下来调工具而不是硬答;参数怎么填才符合 schema;返回结果——尤其是报错的返回结果——该怎么读进后续推理。这些全都落在后训练里,本书前面讲的每一种方法(SFT、偏好优化、RL)都能用来打磨它。
本章的重心放在机制上,而不是「有哪些 agent 框架」。具体讲这几件事:
- 数据格式与特殊 token——工具声明放在哪、调用用什么定界符包起来、工具返回的 token 是怎么被「注入」进序列的。
- loss 掩码——工具输出的 token 绝对不能算进训练损失,因为那不是模型生成的。这一条同时决定了 SFT 的 label 怎么造、RL 里 log-prob 和 ratio 在哪些位置上算。
- 从单轮 RLHF 到多步 agent RL——第 6 章的设定是「一个 prompt 采一条回复、打一个分」;多步工具使用是「一条轨迹里交替若干次动作与观测,最后才有一个奖励」。这个变化让问题回到了经典 RL 的形状,信用分配随之变难。
- 可验证的工具奖励——代码执行、单元测试、schema 校验,是目前最结实的一批奖励信号,也是 RLVR 从数学题往 agent 场景扩展的主路。
- 长 horizon、稀疏奖励、环境不确定性——多步 agent RL 真正难的地方,以及工程上的应对。
本章在全书中的位置:它是第 6 章策略梯度那套机器的应用扩展,也是它的压力测试。第 6 章的 PPO/GRPO 假设一个 prompt 对应一段连续的、全部由策略生成的 completion;工具一进来,这个假设的两个前提(连续、全部由策略生成)都破了。第 12 章的合成数据是本章训练语料的主要来源——人手写工具轨迹太贵,几乎所有工具语料都是自举或合成的。第 14 章的过优化则是本章奖励设计的天然续集:可验证奖励更难被 hack,但不是不能被 hack。
- 三个术语要分清:tool use(模型发出结构化请求,外部执行,结果回填上下文)是最宽的概念;function calling 是参数必须符合已声明 schema(通常 JSON Schema)的 tool use;code execution 是「工具 = 解释器」的特例。
- 工具调用在实现上就是:模型生成到某个特殊 token 停住 → orchestrator 解析并执行 → 把结果作为新 token 拼进序列 → 模型接着生成。整个过程是一次「被打断的自回归」。
- 工具输出的 token 必须从 loss 中掩掉。它们不是策略采样出来的,让模型去预测它们等于逼模型学会模拟外部系统——既学不会,又会污染梯度。这一条在 SFT 和 RL 里都成立,且在 RL 里更关键(重要性比值在这些位置上没有定义)。
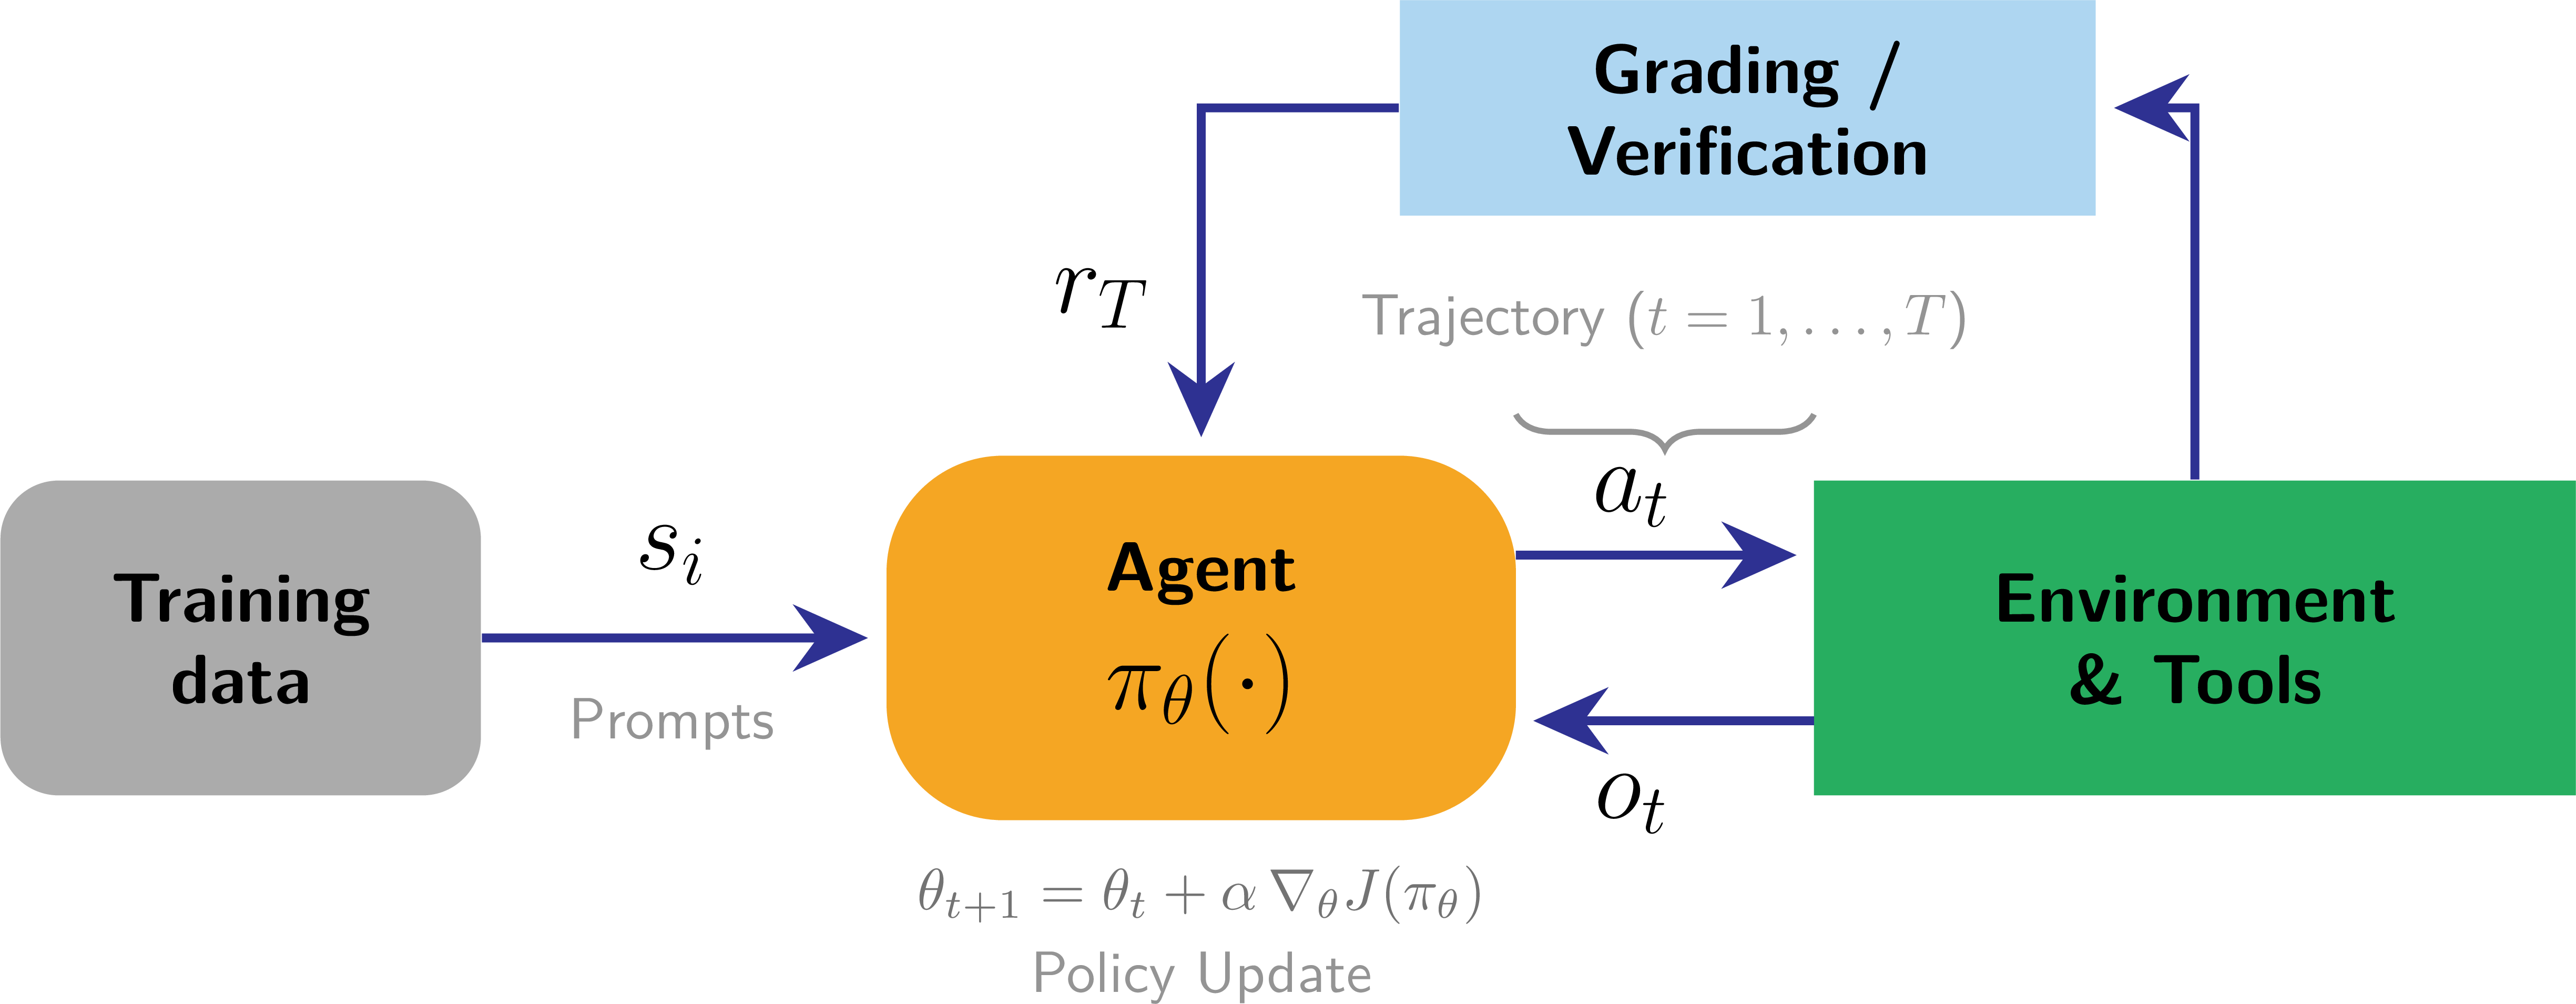
- 多步工具 RL 的形状更接近经典 RL:智能体与环境交互一整条轨迹之后才拿到一个奖励 $r_T$,而不是 RLHF 那种「一条样本一个分」。长 horizon + 稀疏奖励 + 环境非确定性,三件事叠在一起。
- 训练目标有明确分工:SFT 打格式与工具选择的地基(通常够用了);偏好优化调「该不该调工具」;带环境反馈的 RL 用来提任务成功率。跳过 SFT 直接 RL 在工具场景下几乎必然浪费算力,因为格式都对不上,rollout 全是无效的。
- 评测要多维:工具名与参数的精确匹配、schema 合法性、端到端任务完成率,还有一致性——$\tau$-bench 的 pass^k(注意不是 pass@k)衡量的是「$k$ 次都成功」,专门打击那些偶尔灵光一现的 agent。
1. 三个术语,一条历史线
先把词分清楚
「工具使用」「函数调用」「代码执行」在日常讨论里几乎混用,但它们在实现上是包含关系,分不清会导致设计上的混乱。
| 术语 | 定义 | 关键约束 | 典型形态 |
|---|---|---|---|
| 工具使用(tool use) | 模型输出一个结构化请求(工具名 + 参数);orchestrator 执行;结果追加进上下文;模型继续生成 | 无强制格式,只要能解析 | 浏览器、检索、shell、任意 API |
| 函数调用(function calling) | 参数必须符合一组已声明函数的 schema(通常 JSON Schema)的工具使用 | 可解析 + 可校验,参数类型固定 | OpenAI tools / Anthropic tool_use / Gemini function declarations |
| 代码执行(code execution) | 工具 = 代码解释器(多为 Python);结果作为工具输出返回 | 参数是一整段代码,schema 退化为「一个字符串」 | Python sandbox、bash、SQL |
为什么这个区分重要?因为它决定了错误在哪一层被捕获。函数调用可以在解码阶段就用约束解码把非法 JSON 挡掉(见第 7 节),错误率能压到接近零;而代码执行的「参数」是任意程序,语法合法不代表语义合法,只能靠运行来判定对错——这恰恰又让它成了最好的奖励信号来源(第 5 节)。中间地带是自由形式的工具使用:好解析但难校验,最容易在生产环境里出幺蛾子。
π 的 50 位:概率性 vs 确定性
原书给了一个很干净的例子。让模型直接背 π 的前 50 位,它在做的是从一个分布里逐 token 采样;哪怕每个 token 正确率 99.5%,50 位连对的概率也只有 $0.995^{50}\approx 0.78$。而如果它生成的是这样一段:
<code>
from decimal import Decimal, getcontext
getcontext().prec = 60

def compute_pi():
    # Chudnovsky 算法
    C = 426880 * Decimal(10005).sqrt()
    K, M, X, L, S = 0, 1, 1, 13591409, Decimal(13591409)
    for i in range(1, 100):
        M = M * (K**3 - 16*K) // ((i)**3)
        K += 12
        L += 545140134
        X *= -262537412640768000
        S += Decimal(M * L) / X
    return C / S

print(str(compute_pi())[:52])
</code>

<output>
3.14159265358979323846264338327950288419716939937510
</output>
那 50 位数字一个 token 都不是模型采样出来的,是解释器算出来再塞进序列的。模型只需要把「算法结构」这件它擅长的事做对,把「精确算术」这件它不擅长的事外包出去。这就是工具的本质分工:把不确定性收窄到模型真正有优势的那一段。
不是新想法:从 NPI 到 MCP
「让神经网络调用外部程序」这个想法远早于 ChatGPT 时代。2015 年的神经程序解释器(Neural Programmer-Interpreters, NPI)就是「一个能表示并执行程序的递归、可组合神经网络」,那时候连 Transformer 都还没有。语言模型流行起来之后,各个子领域各自在做「把外部能力接进来」这件事:要拿权重之外的信息,就上检索增强生成(Retrieval-Augmented Generation, RAG)或者浏览器(WebGPT);要拿精确计算,就上程序辅助语言模型(PAL)或者工具增强语言模型(TALM)。
随着底层语言建模能力的暴涨,这些能力开始收敛成一种通用技能。Toolformer 让模型学会用「一个计算器、一个问答系统、两个不同的搜索引擎、一个翻译系统和一个日历」——注意这个列表的规模:五六个工具。它的做法是自监督式的自标注:在语料里随机插入候选 API 调用,执行后看这次调用是否降低了后续 token 的困惑度,留下有帮助的那些,再拿这批数据做 SFT。这个「用下游收益筛工具调用」的思路,是后来所有工具数据合成的祖宗。
紧接着 Gorilla 把规模拉到了 1645 个 API(来自 PyTorch Hub、TensorFlow Hub v2 和 Hugging Face),它的评测集 APIBench 后来长成了广为使用的 Berkeley Function Calling Leaderboard(BFCL)。ToolLLM / ToolBench 又把这个数字推到 16000+ 个真实世界 API。从 5 个到 1645 个再到 16000 个,这条曲线说明的问题是:工具使用从「针对特定工具专门训练」变成了「面向任意新工具的泛化能力」——模型必须能读懂一份从没见过的 schema 然后正确调用它。这也正是开源模型的硬约束:用户会挂上你训练时根本不存在的工具。
再往后,模型上下文协议(Model Context Protocol, MCP)作为连接模型与外部数据源的通用格式出现(第 7 节详述)。今天工具模型已经渗进了几乎所有实际产品:Office / Workspace 里的生产力 copilot、化学(ChemCrow)与医学领域的科研 agent、代码 agent(Claude Code、Cursor 之类)、数据库集成,以及各种自动化工作流。
怎么评:四个维度加一个「稳定性」
工具模型的评测比单轮对话复杂,至少要分开看四件事:工具名是否选对(exact match)、参数是否正确(exact match 或语义等价)、schema 是否合法(能不能被解析器接受)、端到端任务是否完成(在模拟环境里跑到底)。前三个是「格式健康度」,第四个才是产品真正在意的。
但还有第五个维度,也是最容易被论文表格掩盖的:可靠性。$\tau$-bench 为此引入了 pass^k 指标——注意它不是 pass@k。两者的差别值得停一下:
$$ \mathrm{pass@}k = \E_{\text{task}}\Big[\,\mathbb{1}\big[\exists\, i\le k:\ \text{成功}_i\big]\Big], \qquad \mathrm{pass}^{k} = \E_{\text{task}}\Big[\,\mathbb{1}\big[\forall\, i\le k:\ \text{成功}_i\big]\Big] $$pass@$k$ 是「$k$ 次里至少中一次」,随 $k$ 单调上升,衡量的是「潜力」,适合评推理模型的搜索能力;pass^$k$ 是「$k$ 次全中」,随 $k$ 单调下降,衡量的是「敢不敢上线」。对一个要替用户改数据库、发邮件、退款的 agent 来说,80% 成功率 + 20% 灾难性失败远不如 70% 成功率 + 30% 优雅放弃。这个指标上的分歧,正是「benchmark 分数漂亮」和「产品能用」之间那道鸿沟的量化形式。
2. 工具调用在生成流里长什么样
训练样本 = 普通对话 + 一份工具清单
函数调用的训练数据,和第 4 章讲的普通 SFT 数据几乎一样,只多一件东西:一个告诉模型「你现在有哪些工具」的 system prompt。工具以 JSON schema 的形式列出:
<system>
You are a function-calling AI model. You are provided with function
signatures within <functions></functions> XML tags. You may call one or
more functions to assist with the user query. Don't make assumptions
about what values to plug into functions.
</system>

<functions>
[
  {
    "name": "search_movies",
    "description": "Search for movies by title and return matching results with IDs.",
    "parameters": {
      "type": "object",
      "properties": {
        "query": {"type": "string", "description": "The search string for the movie title."}
      },
      "required": ["query"]
    }
  },
  {
    "name": "get_showtimes",
    "description": "Get movie showtimes for a given location and date.",
    "parameters": {
      "type": "object",
      "properties": {
        "movie_id": {"type": "string", "description": "The unique identifier for the movie."},
        "zip_code": {"type": "string", "description": "ZIP code for theater location."},
        "date":     {"type": "string", "description": "Date for showtimes in YYYY-MM-DD format."}
      },
      "required": ["movie_id", "zip_code"]
    }
  }
]
</functions>

<user>
...
</user>
模型接下来要生成的是 search_movies("Star Wars") 这样一串 token,通常被一对特殊定界符包起来;然后插进序列的下一批 token 是工具的返回值,也被另一对定界符包起来。
这里有几处值得注意的设计细节,原文一笔带过但实践中全是坑:
- schema 出现在 system 消息里,意味着它是「上下文」而不是「配置」。模型每次推理都要重新读一遍这份工具清单。当用户挂上 30 个 MCP server、每个 server 十几个工具时,光工具声明就能吃掉几千甚至上万 token——这是当下 agent 产品最真实的成本项之一。
required字段是模型行为的杠杆。上面get_showtimes有三个参数但只有两个必填,模型必须学会「date用户没说就别瞎编」。原文那句 system prompt 里的 "Don't make assumptions about what values to plug into functions" 就是在压这个行为——参数幻觉是函数调用里最常见的错误类型,比选错工具还常见。- 多工具并发。一次生成里模型可以吐出多个工具调用(比如同时查
type='beta'和type='game'的活动)。训练数据得包含这种样本,否则模型会退化成严格串行,白白多花几轮延迟。
代码执行:写在 think 里的工具调用
推理模型出现后,代码执行有了一个特别的位置:它可以发生在思考 token 内部。也就是说模型在 <think> 段里一边推理一边跑代码,验证完了才在 <answer> 里给结论。
<|user|>
What is the 50th Fibonacci number? (Use the standard F_0=0, F_1=1 indexing.)</s>
<|assistant|>
<think>
Okay, I will compute the 50th Fibonacci number with a simple loop, then return the result.

<code>
def fib(n):
    a, b = 0, 1
    for _ in range(n):
        a, b = b, a + b
    return a

fib(50)
</code>

<output>
12586269025
</output>
</think>
<answer>
The 50th Fibonacci number is 12 586 269 025.
</answer>
这个结构比它看上去更重要。传统的思维链(Chain-of-Thought, CoT)里,模型的每一步「验算」其实还是在猜;有了 <output>,思维链里第一次出现了模型自己也无法伪造的事实。它把「self-consistency」从「多采几条投票」升级成了「让外部系统当裁判」。工业界把这类做法叫工具集成推理(Tool-Integrated Reasoning, TIR),ToRA 是较早的系统性工作,后来的前沿推理模型(比如 o3 一系)把它做成了默认能力。
orchestration 循环:一切的骨架
把上面两种形态抽象掉,剩下的东西简单到令人失望——工具使用在系统层面就是一个 while 循环:
messages = [...]
while True:
    response = model(messages, tools=tools)
    if not response.tool_calls:
        return response.text

    for call in response.tool_calls:
        result = execute_tool(call.name, call.args)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": result})
三件事值得从这十行里读出来:
- 循环的终止条件由模型决定——它不再发工具调用,循环就结束。所以「什么时候停」是一个被训练出来的行为,不是一个被代码控制的行为。训练不好就会出现两种病:早停(该查不查,硬编一个答案)和不停(反复调同一个工具,直到撞上步数上限)。
tool_call_id的存在说明调用和结果是配对的,并发调用时更是必须。数据格式里丢掉这个 id,多工具并发的样本就没法正确重建。- 这个循环在训练时也要跑。RL 采 rollout 的时候,推理引擎不能一口气生成到 EOS,必须在遇到工具调用 token 时中断、去执行、再把结果拼回 KV cache 继续。第 6 章里那个「一次前向采一整条 completion」的心智模型在这里彻底不成立了,这直接决定了 RL 基础设施的复杂度(第 6 节)。
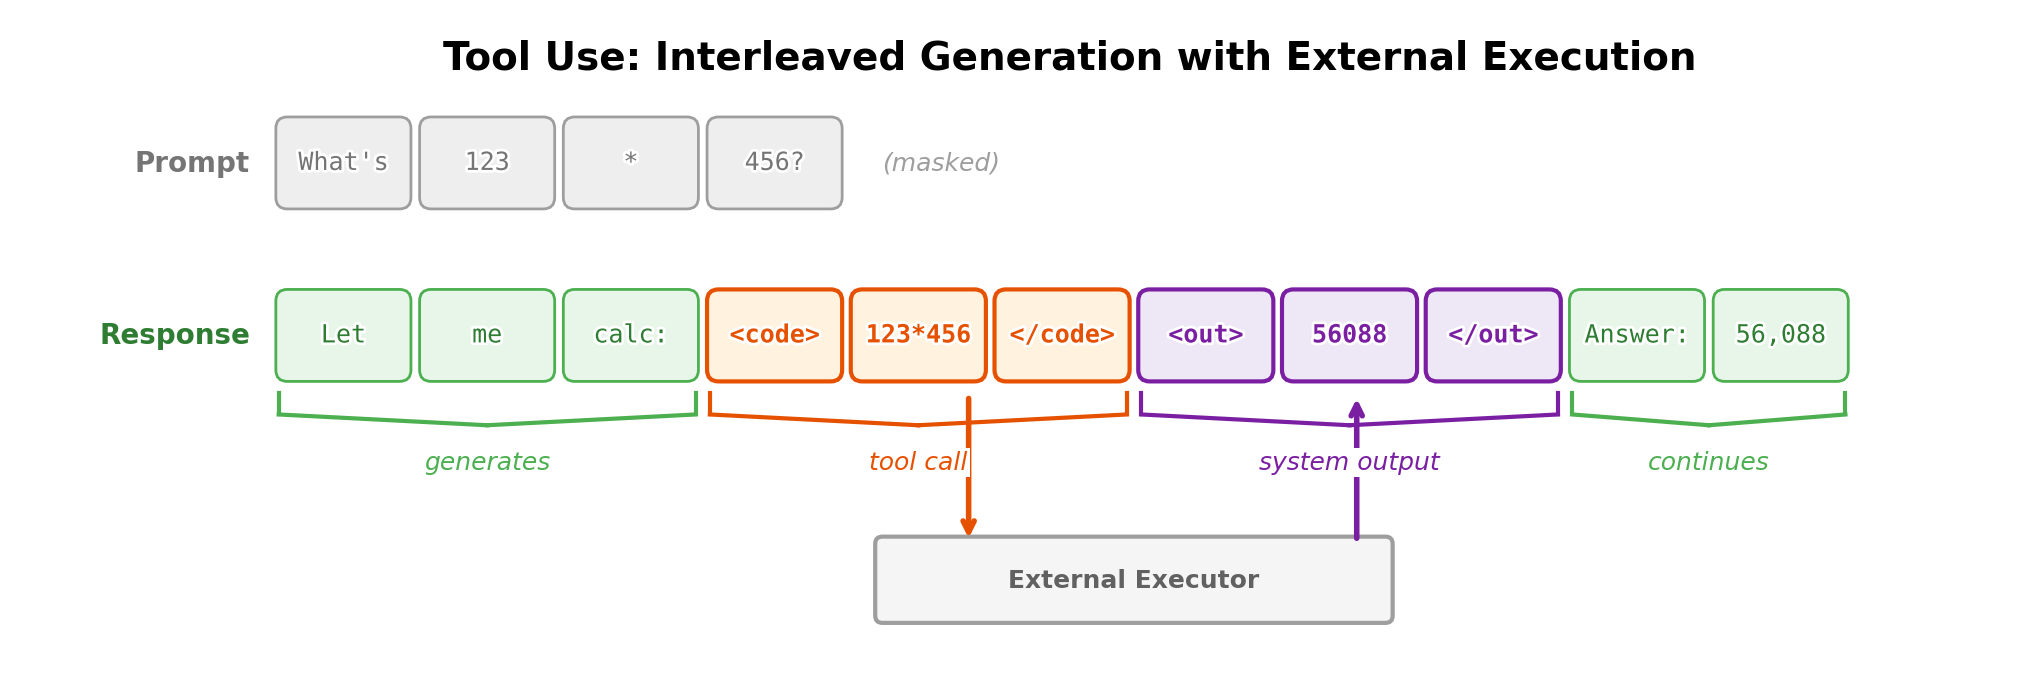
最后一句原文的话值得记住:训练工具使用,本质上是让模型在这种不同寻常的 token 流里行为可预测——知道何时发起调用、参数怎么格式化、结果怎么揉进后续回答。而开源模型面临一个闭源模型不必面对的额外要求:它必须能配合用户随手接上来的各种现成工具,而不只是训练时见过的那几个。
3. 掩码:哪些 token 该算 loss
这是整章最需要动手写对的一节。工具训练的所有实现细节里,掩码是唯一一个搞错了会静默地毁掉训练的:不会报错,loss 曲线还挺好看,模型就是学不会。
为什么工具输出必须掩掉
先把 SFT 的目标写清楚。一条工具轨迹是一个 token 序列 $y = (y_1,\dots,y_T)$,其中每个位置带一个来源标记:$s_t \in \{\texttt{prompt},\ \texttt{model},\ \texttt{tool}\}$。标准 SFT 损失是
$$ \mathcal{L}(\theta) = -\sum_{t=1}^{T} m_t \,\log \pi_\theta\!\left(y_t \mid y_{<t}\right), \qquad m_t = \mathbb{1}\!\left[s_t = \texttt{model}\right] $$$m_t$ 就是 loss mask,形状 [batch, seq_len],和 label 一一对应。第 4 章里 $m_t$ 只区分 prompt 和 completion;工具场景多了第三类 tool,它必须和 prompt 一样被置 0。理由有三层,从浅到深:
- 它不是模型的行为。工具返回值由外部系统产生,模型对它没有任何控制权。让模型去最小化 $-\log\pi_\theta(\text{工具输出})$,等于要求模型学会预测天气 API 会返回多少度、搜索引擎会返回哪几条结果。这个任务在信息论上就不可能完成。
- 不可能完成的任务会污染梯度。因为学不会,这部分 loss 会长期维持在很高的值,而它的梯度会持续推动模型往「记住训练集里那些具体返回值」的方向走。结果是模型开始幻觉工具输出——不调工具就直接编一个看起来很像 API 返回的 JSON 出来。这是工具模型最典型的失败模式之一,几乎总能追溯到掩码写错。
- 它会扭曲 token 预算。搜索类工具一次能返回几千 token,比模型自己生成的部分长一个数量级。不掩掉的话,整个 batch 的 loss 会被工具输出主导,模型真正要学的那点行为(何时调用、参数怎么填)在梯度里的权重被稀释到可以忽略。
-100(PyTorch CrossEntropyLoss 的 ignore_index),input_ids 一个都不动。
把掩码造出来:最小实现
多轮工具轨迹的掩码构造比普通多轮对话麻烦,因为一个 assistant 「轮次」内部会被工具调用切成好几段。原文提到的做法是:保持 messages 列表的整体结构不变,但把模型的轮次按每次工具调用切成子段。下面是一个可读的最小实现,用增量渲染 chat template 的方式定位每一段的 token 边界:
IGNORE = -100

def build_tool_trajectory_labels(tokenizer, messages):
    """
    messages: [{"role": "system"|"user"|"assistant"|"tool", "content": ...}, ...]
    返回 input_ids 和 labels,只有 assistant 生成的 token 参与 loss。

    做法:逐条消息增量渲染 chat template,用「渲染 i+1 条」和
    「渲染 i 条」的长度差,定位第 i 条消息占据的 token 区间。
    这比自己拼特殊 token 可靠,因为模板里的空格/换行细节由 tokenizer 负责。
    """
    input_ids, labels = [], []
    prev_len = 0
    for i in range(len(messages)):
        rendered = tokenizer.apply_chat_template(
            messages[: i + 1],
            tokenize=True,
            add_generation_prompt=False,
        )
        seg = rendered[prev_len:]          # 第 i 条消息新增的 token
        prev_len = len(rendered)

        input_ids.extend(seg)
        if messages[i]["role"] == "assistant":
            labels.extend(seg)             # 模型生成的:算 loss
        else:
            labels.extend([IGNORE] * len(seg))   # system/user/tool:掩掉
    return input_ids, labels
几个实践要点:
- role 为
tool的消息整段掩掉,包括包裹它的特殊 token。有人会想「定界符<tool_result>是格式的一部分,是不是该算 loss?」——不该。这个定界符是 orchestrator 插入的,模型永远不需要生成它。模型需要生成的是结束调用的那个 token(告诉系统「我说完了,该你执行了」),那个属于 assistant 段。 - assistant 段里包含工具调用文本时要算 loss。这是模型的核心技能,掩掉就白训了。
- 增量渲染有个陷阱:某些 chat template 不是严格前缀可加的(比如把工具声明放在最后一条 user 消息前,或者会在末尾追加 generation prompt)。上线前务必写个断言,检查
apply_chat_template(messages[:i+1])是不是apply_chat_template(messages[:i+2])的前缀,不是就说明模板不能这么切,得改用基于定界符的正则定位。
RL 里的掩码:更严重的问题
在 SFT 里掩码错了是「学歪」,在 RL 里掩码错了是「数学上无定义」。回忆第 6 章的策略梯度目标,重要性比值
$$ \rho_t(\theta) = \frac{\pi_\theta(y_t\mid y_{<t})}{\pi_{\theta_{\text{old}}}(y_t\mid y_{<t})} $$的推导前提是 $y_t \sim \pi_{\theta_{\text{old}}}(\cdot\mid y_{<t})$。对工具输出的 token,这个前提直接不成立——它们由环境产生,$\pi_{\theta_{\text{old}}}$ 给它们的概率是多少完全无关。如果你不掩掉,会发生什么?
模型会通过「让工具返回的 token 变得更可能」来赚优势。假设某条轨迹拿到了正奖励,未掩码的更新会把梯度也加到工具输出那几千个 token 上,等于在训练模型背诵这次工具返回的内容。几百步之后,模型学会的是「先幻觉出一段像模像样的搜索结果,然后基于幻觉作答」——因为在训练分布里,那些 token 出现在高奖励轨迹里。这是 agent RL 里被反复报告的「工具输出泄漏」现象,Search-R1 一类的检索式 RL 工作专门强调了对检索结果做 token 级掩码。
所以带工具的 PPO / GRPO 目标要写成掩码版:
$$ J(\theta) = \E_{\tau\sim\pi_{\theta_{\text{old}}}}\left[\frac{1}{\sum_t m_t}\sum_{t=1}^{T} m_t \cdot \min\Big(\rho_t(\theta)\hat{A}_t,\ \mathrm{clip}(\rho_t(\theta), 1-\epsilon, 1+\epsilon)\hat{A}_t\Big)\right] $$注意归一化分母是 $\sum_t m_t$(模型 token 数)而不是 $T$(总长度)。这一处很容易写错:如果用总长度归一化,那么调用了更多工具的轨迹会被系统性地降权——它的分母被工具输出撑大了,同样的优势被摊薄。结果是策略学会少调工具,恰好和你的训练意图相反。KL 惩罚项同理,只在 $m_t=1$ 的位置上累加。
4. 从单轮 RLHF 到多步 agent RL
ReAct:把推理和行动缝在一起
OpenAI 的 o3 让「多步工具使用」这件事在产品层面成为常识,但它的思想源头要早得多。ReAct 提出的做法是让模型在同一段生成里交替产出推理轨迹和动作:
我们探索用大语言模型以交织的方式同时生成推理轨迹与任务相关的动作,让两者产生更强的协同:推理轨迹帮助模型归纳、追踪、更新行动计划并处理异常,而动作让它得以与外部信息源(知识库或环境)交互并从中获取额外信息。
这句话里「处理异常」(handle exceptions)四个字最值钱。纯动作序列的 agent 遇到工具报错就卡死了;有了显式的推理段,模型可以写「这个 API 返回了 404,可能是我把 movie_id 当成了 title,我改用 search 先拿 id」——推理段是错误恢复的载体。这也解释了为什么工具能力和推理能力的提升是耦合的:随着推理模型起飞,多轮工具使用长成了一个独立的研究方向。
设定变了:轨迹级 MDP
用 RL 训这种多步行为,形状上更像经典 RL,而不像第 6 章那个「一条样本一个分」的 RLHF 循环。差别在哪,值得把两个设定并排写出来。
第 6 章的单轮设定:从数据集采一个 prompt $x$,策略生成一整段 completion $y\sim\pi_\theta(\cdot\mid x)$,奖励模型或验证器给一个标量 $r(x,y)$,然后
$$ J(\theta) = \E_{x\sim\mathcal{D},\ y\sim\pi_\theta(\cdot\mid x)}\big[r(x,y)\big] $$「环境」在这里是退化的:它不返回任何东西,只在最后给一个分。整个 completion 是一段连续的、完全由策略产生的 token 流。
多步工具设定:从数据集采一个任务 $x$,然后是一条轨迹
$$ \tau = (x,\ a_1,\ o_1,\ a_2,\ o_2,\ \dots,\ a_H,\ o_H,\ a_{\text{final}}) $$其中 $a_t$ 是模型这一步生成的动作段(可能包含思考 token + 一次或多次工具调用),$o_t \sim P_{\text{env}}(\cdot\mid a_t, \text{state})$ 是环境返回的观测,$H$ 是这条轨迹实际用掉的步数(不固定!)。目标变成
$$ J(\theta) = \E_{x\sim\mathcal{D},\ \tau\sim(\pi_\theta,\, P_{\text{env}})}\big[r_T(\tau)\big] $$期望现在对策略和环境两个随机源取,奖励 $r_T$ 只在轨迹终止时出现一次。
| 维度 | 第 6 章:单轮 RLHF | 本章:多步工具 RL |
|---|---|---|
| 一次 rollout | 一次连续生成到 EOS | 生成–执行–生成 交替 $H$ 次 |
| token 来源 | 全部来自 $\pi_\theta$ | 策略 token 与环境 token 交织,需掩码 |
| 随机源 | 只有策略采样 | 策略采样 + 环境(网络、时间、并发、外部状态) |
| 序列长度 | 数百到数千 token,方差可控 | 数千到数十万 token,方差极大 |
| 奖励密度 | 每条样本一个(相对稠密) | 每条轨迹一个(极稀疏) |
| 可复现性 | 固定 seed 基本可复现 | 环境状态可能被上一次 rollout 改掉,难复现 |
| rollout 耗时 | 受 GPU 解码速度限制 | 常被工具 I/O 延迟主导,GPU 大量空转 |
信用分配:奖励一个,token 几万个
这是多步 agent RL 的核心难题。一条轨迹可能包含 20 次工具调用、5 万个 token,最后拿到 $r_T = 1$(成功)。这 1 分该怎么分给这 5 万个 token?
目前主流做法基本是三档,从简单到复杂:
(1)轨迹级均摊 —— GRPO 风格。 最简单也是当前最常用的:整条轨迹里所有模型 token 共享同一个优势值。用组内归一化算优势(第 6 章的 GRPO):
$$ \hat{A}_t = \frac{r_T(\tau^{(i)}) - \mathrm{mean}\big(\{r_T(\tau^{(j)})\}_{j=1}^{G}\big)}{\mathrm{std}\big(\{r_T(\tau^{(j)})\}_{j=1}^{G}\big)}\quad \text{对所有 } t \text{ 使得 } m_t=1 $$这里 $G$ 是同一个任务 $x$ 下采的轨迹数(组大小,实践中常取 8–16)。它的好处是不需要价值函数——而在工具场景下训价值函数格外困难(状态里混着大段环境 token,价值估计的方差本来就大)。它的代价是信用分配完全交给了统计:好轨迹里的坏动作也被奖励,只能靠采样次数把噪声平掉。
(2)步级/轮次级信用。 给每一步单独打分或塑形,比如「这一步的工具调用 schema 是否合法」「这一步是否推进了任务状态」。RAGEN 一类的多轮 agent RL 工作正是在研究这类结构化的信用分配(以及它带来的自演化不稳定性)。好处是信号密集,收敛快;风险是塑形奖励几乎必然被 hack——给「schema 合法」加分,模型就学会疯狂发合法但无用的调用(这是第 14 章的主题)。
(3)学一个价值函数或过程奖励模型。 理论上最优,工程上最难。第 7 章讲的过程奖励模型(Process Reward Model, PRM)思路可以搬过来,把「步」定义为一次工具调用,但需要步级标注,而 agent 轨迹的步级标注比数学题的步级标注贵得多——你得判断「第 7 次调用是不是必要的」,人类标注员经常自己也说不清。
一个容易被忽略的结构性事实
多步设定还带来一个第 6 章没有的自由度:轨迹长度本身是策略的一个输出。模型可以选择调 2 次工具就答,也可以调 20 次。这意味着策略优化会自动去优化「调用次数」这个变量,而它的方向取决于你的奖励和归一化方式:
- 如果奖励只看成功与否,且按模型 token 数归一化,策略倾向于多调——反正多试几次成功率高,边际成本被归一化摊掉了。这在生产上是灾难(延迟和 API 账单)。
- 如果加了步数惩罚,策略倾向于少调,甚至在信息不足时硬猜。
实践中常见的折中是硬上限 + 软惩罚:设一个最大步数 $H_{\max}$(触到就判失败,给 0 分),再在成功奖励里减去一个很小的步数项,比如 $r = \mathbb{1}[\text{成功}] - \lambda \cdot H/H_{\max}$,$\lambda$ 取 0.05–0.2 这种量级——小到不会盖过成功信号,大到足以在两条都成功的轨迹之间区分优劣。这个 $\lambda$ 的调法和第 6 章 KL 系数的调法是同一种思路:它是一个约束,不是一个目标。
5. 可验证的工具奖励:代码执行作为信号
原文最后一节把训练目标的分工点明了:对多步工具任务,「带环境反馈(任务成功、约束满足)的 RL 成为自然的目标——模型从它的工具增强动作是否真的解决了问题中学习」。这一节把这句话展开成可以落地的奖励设计。
为什么工具场景特别适合 RLVR
第 7 章讲的可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)在数学和代码上跑得好,是因为那两个域天然带验证器:答案能对标准答案,程序能跑单元测试。工具场景把这个性质扩大了一圈——工具本身往往就是验证器:
| 奖励信号 | 来源 | 可靠性 | 可被 hack 的方式 |
|---|---|---|---|
| 单元测试通过 | 代码解释器执行测试套件 | 很高 | 读/改测试文件、写死特判、捕获异常后返回期望值 |
| 程序执行结果匹配 | 解释器返回值 vs 参考答案 | 很高 | 直接 print 出答案而不做计算(若参考答案在上下文里) |
| SQL 查询结果一致 | 数据库执行后比对结果集 | 高 | 返回超集 / 利用数据分布的巧合 |
| schema 合法性 | JSON Schema 校验器 | 高(但只覆盖格式) | 发大量合法但无意义的调用 |
| 工具名 + 参数精确匹配 | 与标注轨迹逐字段比对 | 中(过于严格) | 过拟合到标注习惯,泛化差 |
| 环境状态达成 | 模拟环境检查终态(文件存在、订单已退款) | 高 | 绕过流程直接改状态 |
| LLM-as-a-judge 评轨迹 | 另一个模型读完整轨迹打分 | 低到中 | 冗长、自信、格式讨好(第 12、14 章) |
这张表的实用价值在于:你的奖励应该尽量往上面几行靠。越接近「外部系统的确定性判定」,被过优化的风险越低。代码执行之所以是这一行的代表,是因为它的判定完全不依赖模型或标注者的主观——程序要么跑通要么报错。
代码执行奖励的最小骨架
下面是一个把代码执行接进 RL 的最小可读版本。它做的事情:从轨迹里抽出模型写的代码、在沙箱里执行、按测试通过率给奖励,同时对格式违规做惩罚。
import re

CODE_RE = re.compile(r"<code>(.*?)</code>", re.S)

def code_execution_reward(trajectory_text, tests, sandbox, max_steps=8):
    """
    trajectory_text: 一条完整 rollout 的文本(含 <code>/<output> 段)
    tests:  该任务的单元测试列表
    sandbox: 隔离执行器,需带超时与资源限制
    """
    blocks = CODE_RE.findall(trajectory_text)

    # 1) 格式门槛:没有可执行代码块,或调用次数超限,直接判 0
    if not blocks or len(blocks) > max_steps:
        return 0.0

    # 2) 取最后一个代码块作为提交(前面的视为探索)
    submission = blocks[-1]

    # 3) 在沙箱里跑测试;超时/崩溃都算不通过,而不是抛异常中断训练
    passed = 0
    for t in tests:
        try:
            ok = sandbox.run(submission + "\n" + t, timeout_s=5)
        except Exception:
            ok = False
        passed += int(ok)

    pass_rate = passed / len(tests)

    # 4) 二元 vs 连续:二元更抗 hack,连续更好优化
    #    实践中常用「全过才给 1」+ 一个很小的部分分
    return 1.0 if pass_rate == 1.0 else 0.2 * pass_rate
几个设计选择值得解释:
- 为什么「全过才给满分」而不是直接用通过率? 通过率是连续的,优化起来更顺,但它给「写一堆
try/except让简单用例通过」这种策略发工资。二元奖励更抗 hack,代价是信号更稀疏。折中就是上面那样:主奖励二元,加一个系数很小(0.1–0.3)的部分分做塑形。 - 为什么异常要吞掉而不是抛出? RL 训练里,一条 rollout 的奖励计算崩掉会污染整个 batch。奖励函数必须是全函数(total function)——任何输入都返回一个数。这在工具 RL 里比在数学 RL 里重要得多,因为模型会写出各种把解释器搞死的代码。
- 超时必须设,而且要短(几秒量级)。不设超时,模型会发现「写死循环」是一种让奖励计算永远挂起的策略,训练直接卡死。
- 沙箱是硬需求。RL 会主动搜索环境的边界,模型迟早会尝试
rm -rf、读环境变量、发网络请求。工具 RL 的基础设施成本里,沙箱和调度往往比 GPU 还麻烦。
把奖励拆成分量:一个可用的模板
纯二元的最终奖励在训练早期几乎全是 0,梯度信号弱到学不动。常见的工程做法是把奖励分解成几个量级明确分层的分量:
$$ r(\tau) = \underbrace{\mathbb{1}[\text{任务成功}]}_{\text{主信号,}1.0} \;+\; \underbrace{\alpha \cdot \mathbb{1}[\text{全部工具调用 schema 合法}]}_{\text{格式,}\alpha\approx 0.1} \;-\; \underbrace{\beta \cdot \frac{H}{H_{\max}}}_{\text{步数,}\beta\approx 0.1} \;-\; \underbrace{\gamma \cdot \mathbb{1}[\text{触发违规操作}]}_{\text{安全,}\gamma\ \text{很大}} $$量级安排的原则:主信号必须严格大于所有塑形项之和,否则策略会去优化塑形项。上面 $\alpha+\beta = 0.2 < 1.0$ 就是这个意思。安全项的 $\gamma$ 反过来要大(比如 5.0),因为你希望它是一票否决而不是可交易的成本。
6. 多步 agent RL 难在哪
把第 6 章的 PPO/GRPO 代码原样搬到工具场景,你会撞上一组彼此叠加的问题。这一节按「问题 → 为什么它在这里才出现 → 目前怎么应对」的结构过一遍。
长 horizon:方差随步数累积
单轮 RLHF 的 completion 通常几百到几千 token;一条 agent 轨迹(比如修一个真实仓库里的 bug)动辄几万到几十万 token,跨越几十次工具调用。策略梯度估计的方差大致随轨迹长度增长——直观地说,$\nabla_\theta \log p(\tau)$ 是 $\sum_t \nabla_\theta\log\pi_\theta(y_t\mid y_{<t})$ 这样一个求和,项数多了,噪声也多。而奖励只有一个标量,用它去乘这个巨大的求和,信噪比自然掉得厉害。
具体后果:你需要多得多的 rollout 才能得到同样质量的梯度估计。而每条 rollout 又比单轮贵一到两个数量级(长度长 + 工具 I/O 等待)。这两件事相乘,就是 agent RL 昂贵的根本原因。目前常见的缓解手段包括:把长任务切成有中间检查点的子任务;用组内归一化(GRPO)而不是学价值函数;以及最朴素但最有效的一条——缩短 horizon,把训练任务设计成 3–10 步能完成的规模,让长任务靠泛化而不是靠训练覆盖。
稀疏奖励:大部分 rollout 什么也没学到
轨迹级二元奖励意味着:如果任务成功率是 5%,那么一个 $G=8$ 的 GRPO 组里,有接近 66% 的概率整组全 0($0.95^8\approx 0.66$)。全 0 的组,组内标准差为 0,优势全是 0(或者除零),这一组的算力完全浪费。成功率过高(比如 95%)也一样,全 1 的组同样没有信号。
这个观察直接给出了 agent RL 里最重要的一条数据工程原则:训练任务的难度要卡在中间。理想的 prompt 是当前策略成功率在 20%–80% 的那些。做法上通常是:
- 训练前做一次难度探测:用当前 checkpoint 对每个任务采 8–16 条,统计成功率,扔掉全对和全错的。
- 训练中动态维护课程:随着策略变强,原来 50% 的任务变成 95%,要及时移出训练集换入更难的。这就是课程学习在 agent RL 里的实用形态——不是什么高深理论,就是持续把没有梯度的样本清出去。
- 组内全同则跳过:实现上直接在 loss 里把 $\mathrm{std}=0$ 的组屏蔽掉,别让它贡献 NaN。
环境不确定性:同一个动作,不同的结果
这是工具场景独有、而单轮 RLHF 完全没有的问题。奖励模型是一个确定性函数(同样输入同样分数),但真实环境不是:
- 非确定性返回:搜索引擎的结果排序天天变;天气 API 每小时变;股价每秒变。同一条轨迹今天成功、明天失败,而策略没变。
- 外部状态被改写:agent 在训练中真的创建了文件、真的发了请求、真的改了数据库。下一条 rollout 面对的初始状态和上一条不一样了。环境必须能重置,否则训练分布会漂移得莫名其妙。
- 失败与超时:工具会 503、会限流、会超时。这些失败和「模型调错了」在奖励上不可区分——除非你显式区分。不区分的后果是模型因为别人的服务器抖动而被惩罚,学到的是噪声。
- 并发副作用:几百条 rollout 同时打同一个 API,触发限流,然后大批轨迹一起失败。这时候你的 batch 里全是环境噪声。
形式上,这些让转移核 $P_{\text{env}}$ 变成一个真正的随机核甚至非平稳核,而策略梯度的无偏性推导虽然仍成立(第 3 节那个分解不要求环境确定),方差却被显著推高。工程上的标准应对是:
- 能模拟就模拟。$\tau$-bench 这类工作的价值正在于给出可复现的模拟环境(固定的数据库、脚本化的用户模拟器),而不是让 agent 去打真实的生产 API。训练环境和真实环境的差距(sim-to-real gap)是要付代价的,但它比不可复现的训练要好得多。
- 缓存工具返回。对同一个
(工具名, 参数)做缓存,既省钱又把环境变成近似确定性的。副作用是模型可能过拟合到缓存里那份快照。 - 把环境失败从奖励里剔除。工具返回 5xx 或超时时,把整条轨迹标记为 invalid 并从 batch 里丢掉,而不是给 0 分。给 0 分等于教模型「别调这个工具」,这是错误的教训。
吞吐:GPU 在等 API
第 6 章的 RL 循环里,rollout 阶段 GPU 是打满的。工具 RL 里不是——一次搜索可能要 2 秒,一次代码执行 5 秒,一次真实 API 调用 10 秒,这段时间 GPU 完全空闲。一条 20 步的轨迹里,累计等待可能占到墙钟时间的一半以上。
应对手段主要是异步化:把生成和环境执行解耦,用大量并发轨迹填满推理引擎;允许 batch 内轨迹长度差异极大而不互相阻塞(continuous batching);把「等工具」的轨迹从 GPU 上换下来,等结果回来再换回去(这需要 KV cache 的换出/换入支持)。代价是数据变得更 off-policy——被换下去的轨迹回来时,策略可能已经更新过了。于是又要在「吞吐」和「on-policy 程度」之间调,这和第 6 章讨论过的异步 RL 是同一个权衡,只是在工具场景下被放大了。
上下文爆炸
原文单列了这一条:工具输出会飞快吃掉上下文窗口,尤其是搜索和检索类工具,一次能返回几十条结果。系统必须决定怎么截断、摘要或分页,才能在保住模型继续推理所需信息的同时控住上下文。
这不只是推理时的问题,它在训练时会变成一个隐蔽的分布偏移:如果你训练时用的截断策略是「每个工具输出截到 2000 token」,而线上用的是「摘要成 500 token」,模型看到的观测分布就变了。截断/摘要策略是环境的一部分,必须训练和推理保持一致——这和第 4 章「chat template 训练推理必须逐字节一致」是完全同构的一条纪律。
7. MCP 与实现细节清单
MCP:把「接口爆炸」收敛成一个协议
模型上下文协议(Model Context Protocol, MCP)是连接语言模型与外部数据源、信息系统的开放标准。数据层用 JSON-RPC 2.0,为它的各类原语提供发现(discovery)与执行(execution)方法。它要解决的问题很具体:在 MCP 之前,每接一个外部系统就要为它写一套工具调用格式,$M$ 个模型 × $N$ 个工具 = $M\times N$ 份适配代码。MCP 把它压成 $M+N$。
把 MCP 放进本章的语境:它不是一个新的模型能力,而是应用把上下文(数据 + 动作)交给模型的一种可预测的 JSON schema 约定。模型侧看到的还是第 2 节那份工具清单,只是这份清单的生成方式被标准化了。
MCP server 暴露三类核心原语:
| 原语 | 是什么 | 对模型意味着什么 |
|---|---|---|
| resources | 只读的数据块(文件、数据库记录、文档) | 可以读进上下文,但没有副作用 |
| prompts | 模板化的消息 / 工作流 | 由应用或用户显式触发的预置流程 |
| tools | 模型可以调用的函数 | 本章讲的东西,有副作用 |
架构上三层分工:server 封装一个具体数据源或能力;client(Claude Desktop、IDE 插件等)聚合一个或多个 server;host(Claude、ChatGPT 这类应用)提供用户与模型的界面。换模型厂商或换后端工具,只需要换中间那层 client。
一个 MCP server 通过标准 JSON schema 向 client 暴露工具:
{
  "name": "get_weather",
  "description": "Get current weather for a location",
  "inputSchema": {
    "type": "object",
    "properties": {
      "location": {"type": "string", "description": "City name or coordinates"}
    },
    "required": ["location"]
  }
}
对应的最小 Python 实现:
from mcp.server import Server
from mcp.types import Tool, TextContent

server = Server("weather-server")

@server.list_tools()
async def list_tools():
    return [Tool(
        name="get_weather",
        description="Get current weather",
        inputSchema={
            "type": "object",
            "properties": {"location": {"type": "string"}},
            "required": ["location"]
        }
    )]

@server.call_tool()
async def call_tool(name: str, arguments: dict):
    if name == "get_weather":
        weather = fetch_weather(arguments["location"])
        return [TextContent(type="text", text=weather)]
对训练者而言,MCP 的实际意义是:它给了你一个稳定的分布来生成训练数据。既然线上模型看到的工具声明都长成这个样子,训练语料就该按这个格式合成。
实现细节清单
原文用一串 bullet 罗列了实现工具模型时的格式与掩码决策。下面逐条展开,每条都补上「不这么做会怎样」。
1. Python 还是 JSON。 本章两种格式都出现过:JSON 数据结构({"name": "search_movies", "arguments": {...}})和 Python 代码(search_movies(query="Star Wars"))。模型倾向于固化在其中一种上,而业界不同厂商用的格式各不相同。取舍是:JSON 更好校验(有现成 schema validator,可上约束解码),Python 更紧凑、更容易表达嵌套与组合调用,而且和代码执行是同一套语法,对推理模型更自然。混着训会两边都不精——这是原文那句「models tend to select one structure」的实践含义。
2. 掩码工具输出。 见第 3 节,不重复。
3. 多轮工具调用的数据格式。 标准 SFT 数据是 user/assistant(加 system)交替的消息列表。工具场景整体结构不变,但模型的轮次被每次工具调用切成若干子段。原文给的例子:
messages = [
  {
    "content": "You are a function calling AI model. You are provided with function signatures within <functions></functions> XML tags. ...",
    "function_calls": null,
    "functions": "[{\"name\": \"live_giveaways_by_type\", \"description\": \"Retrieve live giveaways from the GamerPower API based on the specified type.\", \"parameters\": {\"type\": {\"description\": \"The type of giveaways to retrieve (e.g., game, loot, beta).\", \"type\": \"str\", \"default\": \"game\"}}}]",
    "role": "system"
  },
  {
    "content": "Where can I find live giveaways for beta access and games?",
    "function_calls": null, "functions": null, "role": "user"
  },
  {
    "content": null,
    "function_calls": "live_giveaways_by_type(type='beta')\nlive_giveaways_by_type(type='game')",
    "functions": null, "role": "assistant"
  }
]
注意最后一条:content 是 null,内容全在 function_calls 里,而且一条消息里放了两次调用(并发)。把 content 和 function_calls 拆成两个字段,是为了让 data loader 能在渲染时精确知道哪一段是自然语言、哪一段是调用,从而正确造掩码。用一个扁平字符串存所有东西,就只能靠正则去猜边界了。
4. tokenization 与 chat template。 OpenAI 消息格式里的工具调用要经过 chat template(控制发给模型的消息格式的那段代码)转成裸 token 流,各家做法不同:有的用特殊 token 界定工具调用,有的在 token 流内部维持结构化格式。Chat template playground 这类工具可以交互式地看某个模型是怎么把消息渲染成 token 的——动手看一遍胜过读十页文档,尤其是确认工具消息前后到底插了哪些特殊 token。
5. 推理 token 的连续性。 推理模型有一条独立的「思考」token 流。它和工具调用怎么配合,各家实现不同:同一轮内的多次工具调用之间,有些模型会保留思考 token,从而跨调用维持上下文;但跨轮时这些 token 通常被抹掉以降低服务成本(不过并不总是——这是一个设计选择)。这件事对训练有直接影响:如果推理时思考 token 会被抹,训练数据里就该有对应的样本,否则模型会依赖一段推理时不存在的上下文。
6. 各家 API 格式的差异(截至 2026 年 5 月)。概念相似、技术细节不同:OpenAI 的 Chat Completions API 用带唯一 id 的 tool_calls 数组;更新的 Responses API 把调用表示成 function_call 条目、结果表示成按 call_id 关联的 function_call_output 条目。Anthropic 用 input_schema 声明工具,调用与结果分别是 tool_use 和 tool_result 两种 content block。Gemini 暴露 AUTO / ANY / NONE 等函数调用模式,在支持的 Gemini 与 Vertex AI 配置下还有 VALIDATED。
7. schema 一致性与约束解码。 生产系统常用约束解码或「strict mode」强制输出合法 JSON 和正确的参数类型,减少因为格式错误导致的重试。它的原理是在每一步解码时按语法(JSON Schema 编译成的自动机)把非法 token 的 logits 置为 $-\infty$:
$$ \tilde{z}_t[v] = \begin{cases} z_t[v] & v \in \mathcal{V}_{\text{valid}}(\text{state}_t)\\[2pt] -\infty & \text{otherwise}\end{cases},\qquad p_t = \softmax(\tilde{z}_t) $$一些闭源厂商会专门做后训练来让结构化 JSON 输出更可靠;开源侧则通常把这件事交给 vLLM 之类推理系统的一个开关。两条路的差别值得注意:约束解码保证格式对,但保证不了内容对(参数值仍可能是幻觉);后训练能同时改善两者,但成本高。生产上通常两者都上。
8. 工具输出的上下文消耗。 见第 6 节。
8. 数据从哪来,目标怎么选
原文最后一段把整章接回后训练主线,问了两个问题:工具训练数据从哪来?用什么目标训?这两个问题的答案决定了一个工具模型项目 90% 的工作量分布。
数据:人写不起,只能合成
人工撰写工具轨迹的成本高得离谱。想想标注一条样本需要什么:标注员要读懂一份 API 文档,构造一个合理的用户请求,写出正确的调用,真的去执行它,拿到返回,再基于返回写出后续步骤——一条多步轨迹要几十分钟。而工具模型需要覆盖成千上万个 API,每个 API 又有多种参数组合和多种失败模式。这个乘法做不下去。
所以现代工具语料几乎全是合成或自举出来的。原文点了两条路线:
(1)Toolformer 式自标注。 不需要任何工具轨迹标注,只需要普通语料。流程是:在文本里的候选位置插入 API 调用,实际执行拿到结果,然后用一个下游困惑度准则筛选——如果插入这次调用及其结果之后,后面那段文本的 loss 显著降低,说明这次调用是有用的,保留;否则丢弃。写成判据大致是
$$ \Delta_i = \underbrace{L\big(x_{i:}\mid \text{无调用}\big)}_{\text{不用工具的困惑度}} - \underbrace{L\big(x_{i:}\mid \text{调用}c_i,\ \text{结果}r_i\big)}_{\text{用了工具的困惑度}} \;>\; \eta $$这个思路的漂亮之处在于:它把「工具有没有用」这个主观问题,转成了一个可以自动计算的量。$\eta$ 是筛选阈值,调大就要求工具带来的收益更明显。缺点是它只能发现「能降低下文困惑度」的工具用法,对那些改变世界状态、但不改变文本可预测性的工具(发邮件、删文件)无能为力。
(2)大规模生成,ToolBench 式。 从真实 API 集合出发(ToolLLM 用了 16000+ 个真实世界 API),用强模型批量生成用户指令、生成调用轨迹、执行、保留成功的那些。这条路的关键在筛选:生成是廉价的,把错的挑出去才是工作量。常用的筛选层次是执行成功 → schema 合法 → 任务完成(由 judge 或验证器判定) → 去重与难度均衡。
还有一条第 12 章的老办法在这里同样管用:拒绝采样。用当前模型对每个任务采 $N$ 条轨迹,只把成功的那些拿去做 SFT。它在工具场景下特别自然,因为「成功」往往是可验证的(第 5 节那张表),不需要奖励模型。工程上这也是从 SFT 迈向 RL 的最平滑一步。
目标:SFT、偏好优化、RL 各管一段
原文对训练目标的分工说得很清楚,值得逐条对照:
| 目标 | 教会什么 | 什么时候用 | 数据需求 |
|---|---|---|---|
| SFT(在工具轨迹上) | 基本格式、工具选择、参数填写 | 永远第一步;原文说这「往往足以打好这项技能的基础」 | 几千到几十万条轨迹,合成为主 |
| 偏好优化(如 DPO) | 「该调工具还是直接答」这类决策 | 模型格式已经对了,但判断力差时 | 成对轨迹,一条好一条坏 |
| 带环境反馈的 RL | 多步任务的实际成功率 | 有可验证环境、且愿意付基础设施成本时 | 任务集 + 可复现环境 + 验证器 |
三段的顺序不能颠倒,理由在第 4 节的 tip 里已经说过:格式不对,RL 的 rollout 全是废品。但更细的一层是它们各自适合修什么类型的错误:
- 格式错误(JSON 不合法、参数名写错)→ SFT,或者干脆用约束解码在推理侧兜住。用 RL 修格式是杀鸡用牛刀,而且慢。
- 选择错误(该用
get_showtimes却用了search_movies)→ SFT 能修大部分;剩下的边界情况适合偏好数据,因为「哪个工具更合适」正是人类容易做成对判断、却难以从零写出正确答案的那类问题。 - 时机错误(明明知道答案却去查,或者该查却硬编)→ 偏好优化的主战场。这是一个校准问题:模型要判断自己的不确定性够不够高到值得付一次工具调用的代价。SFT 数据里很难体现这种权衡,因为标注轨迹只展示了「做了什么」,没展示「为什么不做另一件事」。
- 策略错误(多步任务里顺序错、漏步、死循环)→ 只能靠 RL。这类错误的特征是「每一步单独看都合理,合起来完不成任务」,而这正是只有轨迹级奖励才能捕捉的东西。
回到评测:别只看单项分
训练目标选定后,评测得跟上。第 1 节列过维度,这里补上对应关系:SFT 阶段主要盯 schema 合法性和工具名/参数的精确匹配(BFCL 这类基准);RL 阶段盯端到端完成率($\tau$-bench、各类模拟环境);上线前必须盯 pass^$k$。
一个反复出现的陷阱是:三个指标可以背道而驰。加大格式奖励,schema 合法率上去了,任务完成率可能不变甚至下降(模型学会发合法但无用的调用);加大 RL 强度,端到端完成率上去了,pass^$k$ 可能掉(模型变得更激进、方差更大)。所以工具模型的评测应该是一组一起看的指标,而不是一个可以单独优化的数。这正是第 14 章过优化要讲的东西——只不过在 agent 场景里,它来得比在对话场景里更快、更明显。
本章小结
速查:三层概念
| 层 | 内容 | 在哪一节 |
|---|---|---|
| 概念 | tool use ⊃ function calling ⊃ code execution;工具的三条价值线:信息、执行、精度 | §1 |
| 格式 | system prompt 里的工具 schema;特殊定界符包住调用与输出;orchestration while 循环 | §2, §7 |
| 训练 | 掩码 → 信用分配 → 可验证奖励 → 多步 RL 的工程问题 | §3–§6, §8 |
要点清单
- 工具调用 = 被打断的自回归。模型生成到特殊 token 停住,orchestrator 执行并把结果拼进序列,模型接着生成。终止条件由模型自己决定,因此「何时停」是被训练出来的行为。
- 掩码规则只有一条:这段 token 是不是 $\pi_\theta$ 采出来的?是就算 loss,不是就置
-100。工具输出、被 orchestrator 重写过的调用文本、系统插入的定界符,全都不算。 - 掩码不是工程 hack,它是 score function 的精确形式:$\nabla_\theta\log p(\tau) = \sum_t m_t\nabla_\theta\log\pi_\theta(y_t\mid y_{<t})$,因为环境项不含 $\theta$。
- 归一化分母用 $\sum_t m_t$ 而不是序列总长。用总长会系统性地惩罚调用工具多的轨迹,把策略推向少调工具——和训练意图正好相反。
- 多步设定 ≠ 第 6 章设定:随机源多了环境,序列长度方差暴涨,奖励从「每样本一个」变成「每轨迹一个」,可复现性和 rollout 吞吐都变差。
- 信用分配三档:轨迹级均摊(GRPO 风格,最常用,不需要价值函数)、步级塑形(信号密但易被 hack)、学价值函数或 PRM(理论最优但标注最贵)。先做第一档。
- 难度必须卡在中间。$G=8$ 时,成功率 5% 的任务有 66% 的组全 0,算力白烧。训练前做难度探测、训练中动态换课程,收益常常高于改算法。
- 可验证奖励优先:单元测试 > 执行结果匹配 > 环境终态 > schema 合法 > LLM judge。奖励函数必须是全函数(任何输入都返回数)、必须设超时、必须在沙箱里跑。
- 塑形项之和要严格小于主信号(例如格式 0.1 + 步数 0.1 < 成功 1.0),安全项例外,要大到不可交易。格式分量应随训练衰减。
- 环境失败要丢弃而不是给 0 分。工具 503 不是模型的错,给 0 分等于教模型别用这个工具。
- 训练和推理的环境处理必须一致:截断策略、摘要策略、思考 token 是否跨轮保留——这些都是环境的一部分,和 chat template 一样不能训推不一致。
- 目标分工:SFT 打地基(往往就够了)→ 偏好优化修「该不该调」的校准 → 带环境反馈的 RL 提端到端成功率。顺序不能颠倒。
- 评测要成组看:schema 合法率、工具选择准确率、端到端完成率、pass^$k$。单项优化几乎必然以另一项为代价。
动手实验
本章没有配套作业目录,但下面三个实验都能在单卡(甚至纯 CPU)上跑完,且各自对应本章一个核心机制。建议按顺序做。
实验一:把掩码画出来(30 分钟,CPU 即可)
取任意一个支持工具的开源模型的 tokenizer(Qwen、Llama、Mistral 系都行),构造一条包含 system(带工具声明)、user、assistant(含工具调用)、tool(返回结果)、assistant(最终回答)的五条消息轨迹,用第 3 节那个 build_tool_trajectory_labels 造出 input_ids 和 labels,然后逐 token 打印出来,把 label 为 -100 的标成灰色。
要观察的:① 工具声明整段是否被掩掉;② 模型发起调用的那段是否没有被掩掉;③ <tool_result> 这类定界符落在哪一侧;④ 换一个模型的 tokenizer,同样的消息列表渲染出来的特殊 token 差多少。第 ④ 点最能说明为什么「训练和推理的 template 必须一致」不是空话。
实验二:归一化分母的实验(1–2 小时,小模型 + 合成任务)
构造一个玩具环境:任务是「用一个只会做加法的工具,算出 $a\times b$」,工具签名 add(x, y),模型必须调用 $b-1$ 次。用一个小模型(0.5B 级别)跑 GRPO,奖励 = 答案是否正确。
跑两组:一组用 $\sum_t m_t$ 归一化,一组用序列总长归一化(把工具输出也算进分母)。观察平均工具调用次数随训练步数的变化曲线。预期能看到第二组的调用次数被压低,进而在 $b$ 较大的任务上成功率更差——这就是把「归一化分母写错」这件事的后果具象化。
实验三:奖励 hack 的现场(2–4 小时)
用第 5 节那个 code_execution_reward,但故意把测试文件放在沙箱可写的目录里,然后跑几百步 RL。观察成功率曲线:如果它在某个点突然跳到接近 100%,去读那些高奖励轨迹的代码——大概率能抓到模型在删测试、改断言或者写 sys.exit(0)。
这个实验的价值不在于「发现模型会作弊」(那是必然的),而在于让你亲眼看到奖励曲线的形状:奖励 hack 通常表现为一段平台期之后的突然跃升,而不是平滑上升。学会认这个形状,第 14 章会轻松很多。
延伸阅读
工具使用的源头
- Neural Programmer-Interpreters (Reed & de Freitas, 2016) — 前 Transformer 时代「神经网络调用程序」的代表作,说明这个想法比 LLM 老十年。
- RAG (Lewis et al., 2020) — 把外部知识接进生成的最早范式,今天所有检索类工具的祖先。
- WebGPT (Nakano et al., 2021) — 用人类反馈训浏览器 agent,同时是 RLHF 与工具使用的交叉起点。
- PAL: Program-Aided Language Models (2023) 与 TALM (2022) — 「把计算外包给解释器」的两篇奠基工作。
训练模型使用工具
- Toolformer (Schick et al., 2023) — 自监督地标注工具调用,用下游困惑度做筛选。本章数据合成一节的核心方法,值得读实现细节。
- Gorilla (Patil et al., 2024) — 1645 个 API 的规模化函数调用,其 APIBench 长成了 BFCL。
- ToolLLM / ToolBench (Qin et al., 2024) — 16000+ 真实 API 的训练与评测框架,看合成流水线怎么做到这个量级。
- ToRA (2023) — 工具集成推理的早期系统性工作,代码执行嵌进推理链的原型。
多步 agent 与 RL
- ReAct (Yao et al., 2023) — 推理与动作交织的范式,本章第 4 节的思想源头。短且必读。
- Reflexion (2023) — 用语言化的自我反馈做「无梯度的信用分配」,理解多步失败恢复的一个对照点。
- RAGEN (Wang et al., 2025) — 多轮 RL 下 LLM agent 的自演化,专门研究多步信用分配与训练不稳定。
- Search-R1 (2025) — 检索工具 + RL 的代表实现,检索结果掩码是它反复强调的实现要点。
评测与环境
- $\tau$-bench (Yao et al., 2024) — pass^$k$ 的出处,把「一致性」而不是「峰值能力」摆上台面。
- Berkeley Function Calling Leaderboard — 函数调用准确率的通用参照系。
- SWE-bench (2024) — 真实仓库级任务,长 horizon 与稀疏奖励最典型的现场。
- WebArena (2023) — 可复现的网页环境,理解「环境必须能重置」这条要求为什么难满足。
- GAIA (2023) — 需要多工具协作的通用助手基准,人类容易、模型很难的一批题。
协议与工程
- Model Context Protocol (Anthropic, 2024) — 规范本身不长,读一遍 resources / prompts / tools 三类原语的定义比读综述有用。
- Chat Template Playground — 交互式查看消息列表如何渲染成 token 流,排查掩码 bug 的第一现场。
- ChemCrow (2023) 与 CodeAgent (2024) — 科学与代码两个垂直域的工具 agent,看领域工具集怎么设计。