RLHF 简史
今天 RLHF 流水线里的每一个零件,都是某篇具体论文为了解决某个具体问题而造出来的——搞清楚它们的来历,才知道哪些是必需品、哪些只是历史包袱。
0. 本章导读
如果你今天从头搭一套 RLHF 训练代码,会遇到一串看起来颇为随意的设计选择:为什么奖励模型(reward model, RM)要用「成对比较 + sigmoid」这种损失,而不是让人直接打 1–10 分?为什么奖励是给整条回复的,而不是给每个 token 的?为什么目标函数里非要挂一个 KL 惩罚项?为什么标准流程一定是「SFT → 奖励模型 → RL」三段而不是两段或四段?
这些问题的答案都不在数学里,而在历史里。RLHF 不是从某个统一理论推导出来的,它是一条工程演化路径:1952 年统计学家为了分析品酒实验设计了成对比较模型;2008 年机器人学者为了让普通人能教会智能体动作发明了 TAMER;2017 年 DeepMind 和 OpenAI 的一群人为了在 Atari 和 MuJoCo 上绕开手写奖励函数,把这两条线接上了;2019 年这套东西被搬到语言模型上,KL 惩罚才第一次出现;2022 年 InstructGPT 把它固化成三段式;ChatGPT 发布后,整个行业照着这张图纸重建了自己的后训练流程。
本章要做的就是把这条链条一节一节拆开:每一篇奠基工作面对的是什么问题、贡献了什么具体机制、这个机制今天是被沿用了还是被抛弃了。读完之后你再看第 4–9 章的具体算法,就不会觉得那些设计是天上掉下来的。
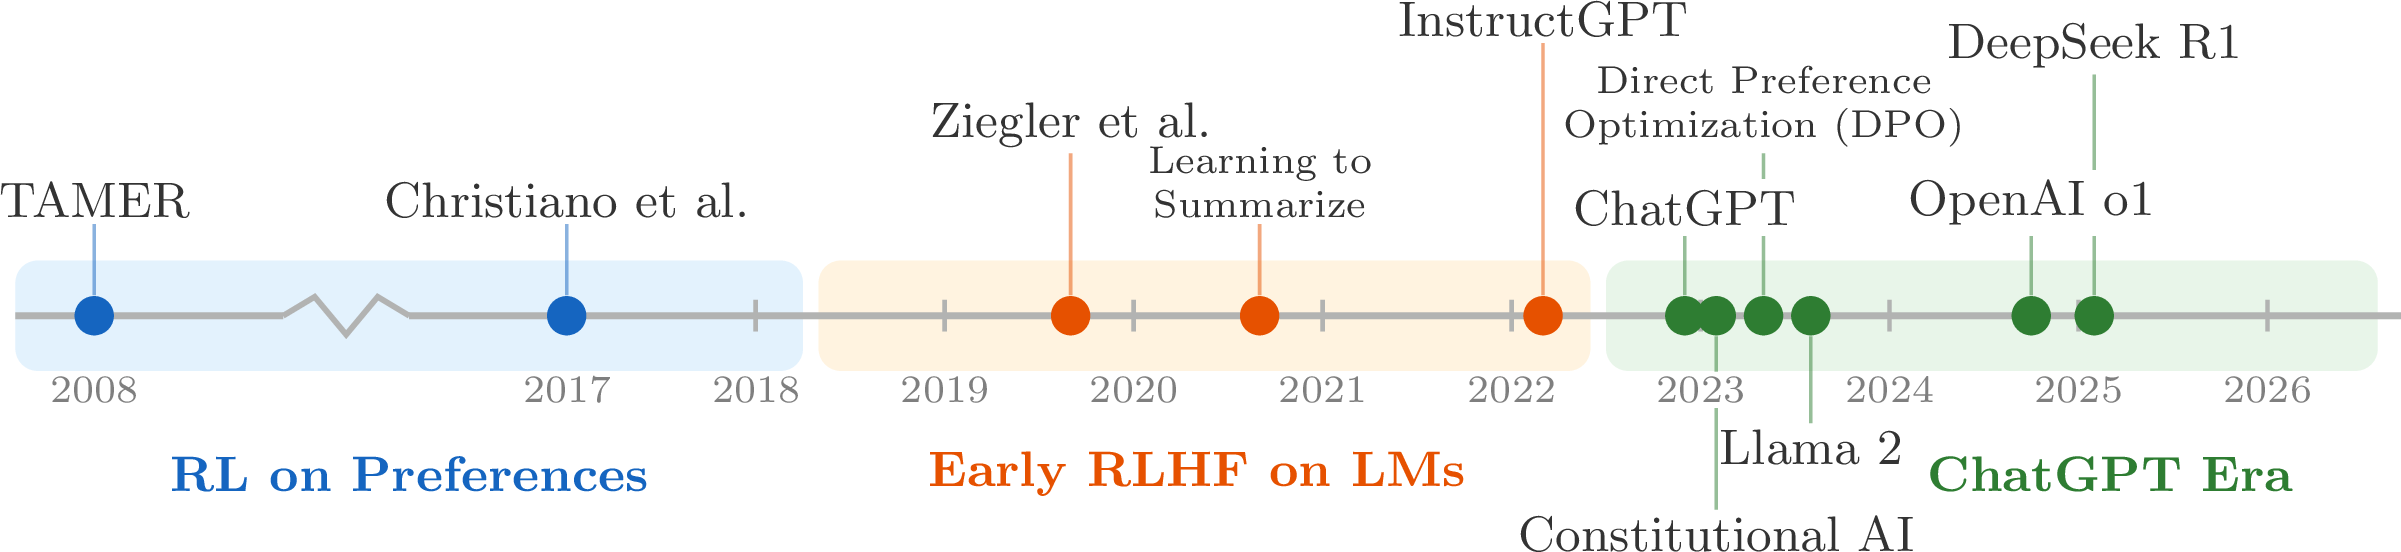
还有一点需要提前说明:Lambert 写这一章时反复强调「RLHF 非常新」。这不是谦辞,而是一个方法论提示——本书对很多技术细节持不确定态度,因为这些细节确实在快速变化。真正稳定下来的只有很少的核心实践(成对偏好数据、learned reward、KL 正则、on-policy 采样),其余部分随时可能被下一个季度的新做法覆盖。本章要帮你分清楚哪些是前者、哪些是后者。也因此,这一章不是综述——想要穷尽式的文献清单,请去读本章末尾延伸阅读里列出的三篇专门综述;本章是一条有取舍的主线,取舍标准是「这条线索是否直接通向今天的 ChatGPT 式后训练」。
- RLHF 是三条独立源流的汇合:哲学/经济学提供了「偏好可以被量化」的前提,最优控制/强化学习提供了「最大化标量回报」的优化机器,深度学习提供了在高维空间里拟合这个标量的能力。三者的假设互不兼容,这是 RLHF 一切理论麻烦的根源。
- Bradley-Terry 模型(1952)之所以成为奖励模型的默认形式,不是因为它最准,而是因为它把「人只会比较、不会打分」这个数据采集事实,转成了一个可微、可优化、只需一次 sigmoid 的损失。
- Christiano 等人 2017 年的工作定型了「异步训练奖励预测器 + RL 智能体最大化预测奖励」这个双循环结构,今天的 RLHF 代码库仍然是这个结构,只是环境换成了 prompt 数据集。
- Ziegler 等人 2019 年第一次把 RLHF 用在语言模型上,同时引入了 KL 惩罚、参考模型、偏好数据流程图——今天流水线里的绝大多数术语都出自这一篇。
- InstructGPT(2022)没有发明新算法,它的贡献是把三段式做成了产品级的完整配方并公开,ChatGPT 官方博客明确说自己用的就是这套方法。
- 2023 年后 RLHF 扩张成更大的「偏好微调(preference fine-tuning, PreFT)」领域:DPO 去掉了独立奖励模型,过程奖励模型(PRM)把奖励打到中间步骤,RLVR 干脆用可验证信号替换掉学出来的奖励。
1. 三条源流:偏好、效用与奖励是怎么被搅到一起的
RLHF 这个缩写里藏着三个来自不同学科的词:reinforcement learning(强化学习,RL)来自控制论与动物心理学,human 来自社会科学对人的研究,feedback 来自控制工程。把它们拼在一起是 2017 年前后的事,但每个词背后各有一段几十年甚至上百年的历史,而且各自携带的假设互相冲突。理解这一点,比记住任何一篇论文的名字都重要。
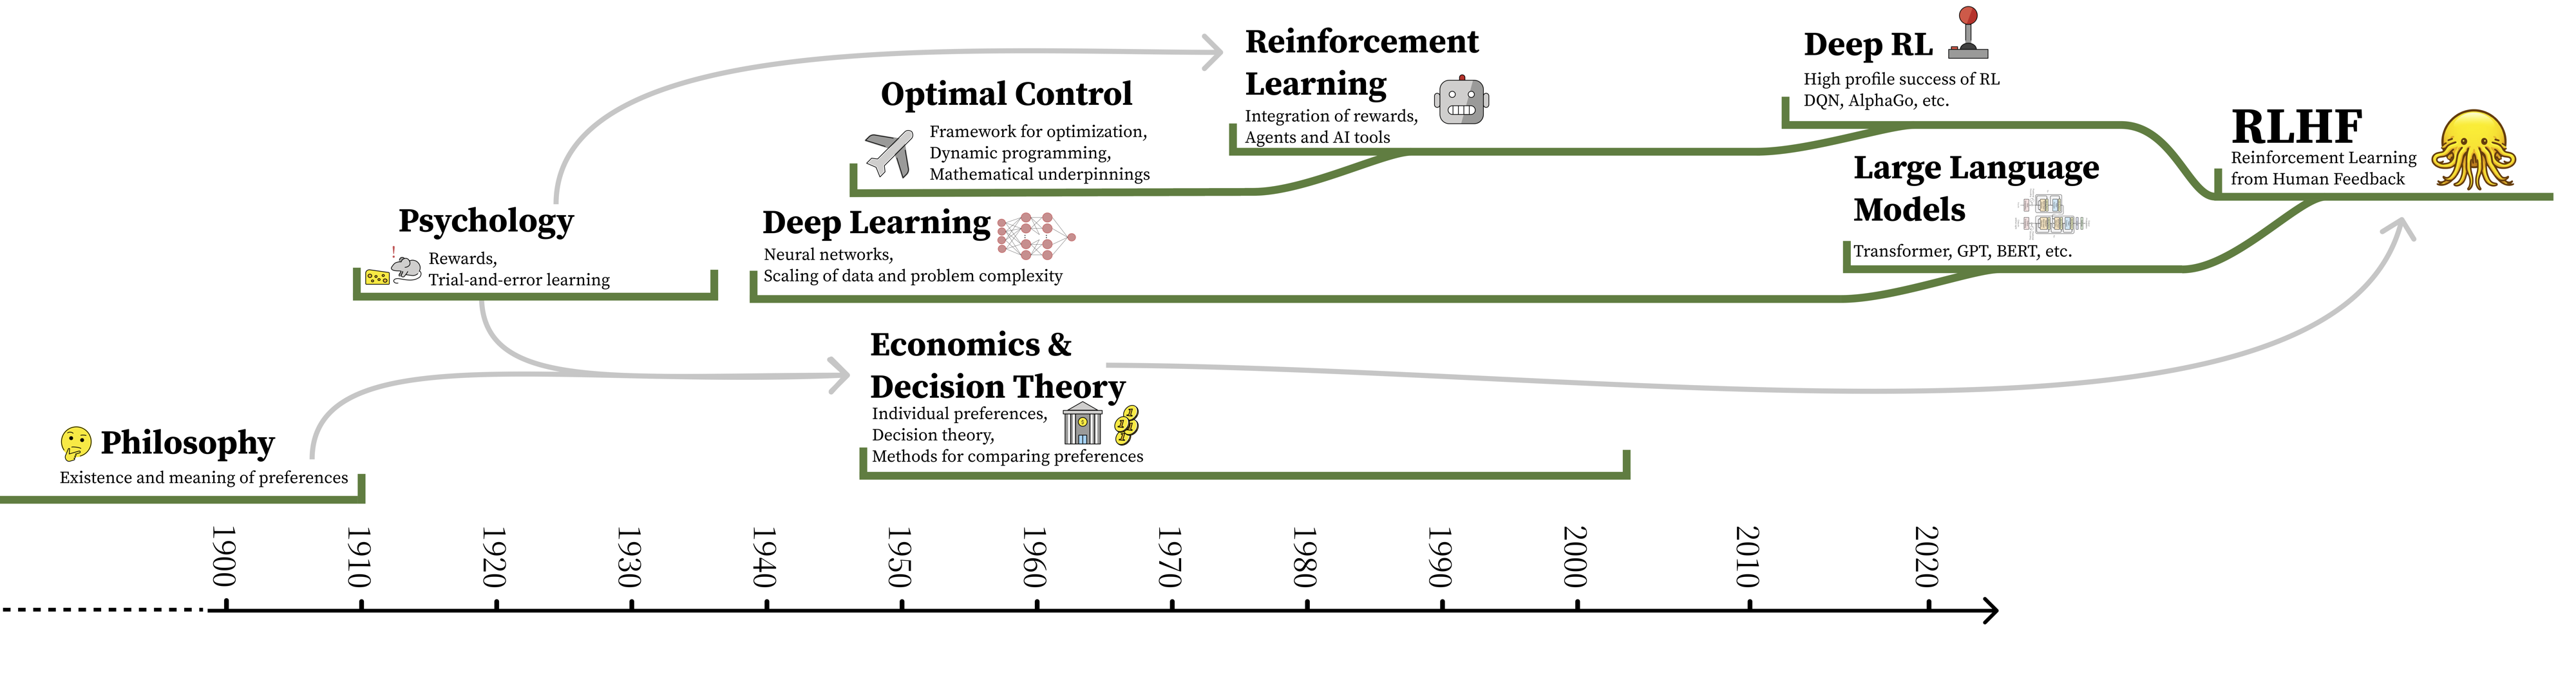
第一条源流:偏好可以被量化吗
「在不确定的情况下如何选择」这个问题,最早的量化表述出现在 1662 年的《波尔–罗亚尔逻辑》(The Port Royal Logic)里:判断该做什么,不仅要看结果的好坏本身,还要看它发生的概率。这句话是期望效用的雏形——好坏 × 概率。此后边沁的「快乐计算」主张一切都可以称重比较,1931 年拉姆齐的《真理与概率》给出了第一个真正的定量框架,到 20 世纪中叶达到高峰:冯·诺依曼与摩根斯坦的 VNM 效用定理(1947)证明,只要一个人的偏好满足若干公理(完备性、传递性、连续性、独立性),就一定存在一个效用函数,使得「偏好 A 胜过 B」等价于「A 的期望效用大于 B 的期望效用」。这个定理是 RLHF 的许可证:它告诉工程师,把人的偏好压缩成一个标量函数,在原则上是合法的。
但同一条线上也长出了反证。社会选择理论里的阿罗不可能性定理说明,把多个人的偏好聚合成一个集体排序时,不可能同时满足所有看起来合理的公平性条件。经济学里更尖锐的批评是:偏好可能根本不是一个稳定的本体,而只是一个用来间接捕捉心理倾向、社会规范和道德义务的方法论工具;人还有「对自己偏好的偏好」,而且总是嵌在社会关系中。
第二条源流:把「好」变成可优化的标量
另一条线来自控制论和动物心理学。「奖励(reward)」这个词本身来自操作性条件反射的研究——桑代克的效果律(law of effect)说,带来满足感的行为会被强化。这个词被搬进机器学习后,含义变成了「一个动作有多好」的标量刻度,越高越好。而「未来累积奖励」这个概念——RL 里的 reward-to-go——则对应效用理论里的效用,只不过被改造成对未来某个时间窗口内奖励的预测;它在数学工具层面的源头是控制论(1960 年 Widrow 与 Hoff 研究自适应开关电路时已在用类似思路)。真正让它变成可计算的是贝尔曼方程(1957)和马尔可夫决策过程(Markov Decision Process, MDP)这一套动态规划框架,它通过递归的方式计算 reward-to-go:
$$ Q^\pi(s_t, a_t) = r(s_t, a_t) + \gamma\, \E_{s_{t+1}\sim P(\cdot\mid s_t,a_t)}\big[V^\pi(s_{t+1})\big] $$这里 $s_t$ 是状态、$a_t$ 是动作、$P$ 是环境转移分布、$\gamma\in[0,1]$ 是折扣因子。MDP 框架能给出性能保证,代价是它对环境提出了强假设:状态转移分布不变、奖励是关于状态–动作对的确定性函数、给定同样的 $(s,a)$ 一定返回同样的数值。「reinforcement」这个词在 1960 年代与这些方法合流形成「强化学习」,此后 1988 年 Sutton 的时序差分(temporal-difference, TD)学习和 1992 年 Watkins 的 Q-learning 构成了现代 RL 的骨架。
第三条源流:深度学习让前两条能接上
1990 到 2010 年代,RL 的成功案例都局限在低维、可仿真、奖励能写死的环境里。真正的转折是深度学习:2013 年的 DQN 证明神经网络可以直接从像素学 Atari 游戏,之后是围棋、Dota、核聚变反应堆磁控、高速无人机控制。这些都还是「奖励函数能写出来」的场景——最小能耗、最大得分、保持等离子体形状。
深度学习带来的真正新东西是:你可以用一个神经网络去拟合任何难以解析表达的函数,包括「人类觉得这个好不好」。 这就是把第一条源流(偏好)接到第二条源流(RL 优化机器)上的连接器。有意思的是,这条路径与逆强化学习(inverse reinforcement learning, IRL)——从行为反推奖励函数——高度相关,但 RLHF 文献里几乎不引用 IRL。Lambert 认为这纯粹反映了工程演化的路径依赖:某条技术路线先跑通了,后来者就沿着它继续走,而不是因为它在理论上更优。
这三条源流汇合的产物,就是本章接下来要讲的具体论文。
2. Bradley-Terry:一个 1952 年的统计模型如何成为奖励模型的地基
今天你训练奖励模型时写下的那行 -F.logsigmoid(r_chosen - r_rejected),出处是 1952 年 Biometrika 上的一篇论文:Ralph Bradley 与 Milton Terry 的《Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons》。这篇论文当年要解决的问题跟 AI 毫无关系——它面对的是不完全区组设计:假设你有 10 种食品配方要做感官评价,但每个评委一次只能可靠地比较 2 种,你怎么从一堆两两比较的结果里,还原出这 10 种配方的整体排序?
模型本身
Bradley 与 Terry 的假设非常简约:每个待比较对象 $i$ 有一个潜在强度 $p_i>0$,观测到的比较结果是这些强度的带噪反映,具体地
$$ P(i \succ j) = \frac{p_i}{p_i + p_j} $$这里 $\succ$ 读作「优于」。这个式子有几个立刻可见的好性质:概率永远落在 $(0,1)$;只依赖两个强度的比值,所以整体缩放 $p_i \to c\,p_i$ 不改变任何预测;强度相等时概率恰为 $0.5$。
但 $p_i>0$ 这个约束对梯度优化不友好。标准做法是重参数化,令 $p_i = e^{r_i}$,其中 $r_i \in \R$ 无约束:
$$ P(i \succ j) = \frac{e^{r_i}}{e^{r_i}+e^{r_j}} = \frac{1}{1+e^{-(r_i-r_j)}} = \sigma(r_i - r_j) $$这个结果的意义比它的推导难度大得多:成对比较的概率只依赖两个分数之差。分数的绝对值没有意义——把所有 $r_i$ 同时加上 100,所有比较概率一模一样。这就是奖励模型输出「没有绝对尺度」的数学原因,也是为什么在 RL 阶段几乎所有实现都要对奖励做归一化(减均值、除标准差,或减去一个基线),否则优势估计的量纲会随训练漂移。
训练时对一批比较结果做极大似然估计,等价于最小化负对数似然。对语言模型场景,把「对象 $i$」换成「prompt $x$ 下的回复 $y$」,把强度换成参数化的奖励模型 $r_\phi(x,y)$,就得到了 RLHF 的标准奖励模型损失:
$$ \mathcal{L}_{\mathrm{RM}}(\phi) = -\,\E_{(x,\,y_w,\,y_l)\sim\mathcal{D}}\Big[\log \sigma\big(r_\phi(x,y_w) - r_\phi(x,y_l)\big)\Big] $$符号含义:$x$ 是 prompt,$y_w$(winning/chosen)是标注者选中的回复,$y_l$(losing/rejected)是被淘汰的那条,$\mathcal{D}$ 是偏好数据集。$r_\phi$ 通常是一个把语言模型的 LM head 换成输出维度为 1 的线性层得到的模型:输入 shape 为 (batch, seq_len) 的 token id,取最后一个非 padding 位置的隐状态(shape (batch, hidden)),过线性层得到 shape (batch,) 的标量。
最小实现
下面这段改写自本书配套代码 reward_models/train_preference_rm.py 中 PreferenceRewardModel.forward 的核心逻辑,去掉了分布式与混合精度的部分:
import torch
import torch.nn.functional as F

def bradley_terry_step(model, chosen_ids, chosen_mask, rejected_ids, rejected_mask):
    """一步 Bradley-Terry 奖励模型训练。
    chosen_ids / rejected_ids: (batch, seq_len) 的 token id
    返回: 标量 loss,以及两侧的奖励分数 (batch,)
    """
    # get_reward: 取序列最后一个有效 token 的隐状态 -> Linear(hidden, 1) -> squeeze
    r_chosen   = model.get_reward(chosen_ids,   chosen_mask)    # (batch,)
    r_rejected = model.get_reward(rejected_ids, rejected_mask)  # (batch,)

    # -log sigma(r_w - r_l);用 logsigmoid 而不是 log(sigmoid(.)) 是为了数值稳定
    loss = -F.logsigmoid(r_chosen - r_rejected).mean()

    # 训练时最该盯的指标:成对排序准确率,随机猜是 0.5
    accuracy = (r_chosen > r_rejected).float().mean()
    return loss, r_chosen, r_rejected, accuracy
注意 logsigmoid 而不是 torch.log(torch.sigmoid(x)):当 $r_w - r_l$ 很负时后者会下溢到 $\log 0$。这是实现里最常见的一个坑。
为什么这个模型被沿用至今
它的竞争对手不少:直接回归标注者给的 1–10 分(评分模型)、Thurstone 模型(用高斯而非 logistic 噪声)、Plackett-Luce 模型(一次排 K 个而不是 2 个)、Mallows 模型(对排列建模)。Bradley-Terry 胜出的原因是三条工程性的,而不是理论性的:
| 候选方案 | 数据采集成本 | 优化友好度 | 实际处境 |
|---|---|---|---|
| 绝对评分(1–10 分) | 看似最省事 | MSE 损失,简单 | 失败:不同标注者尺度不一致,同一标注者在不同天也不一致,方差吞掉信号 |
| Bradley-Terry 成对比较 | 每条数据 1 bit,但人做得又快又稳 | 一次 sigmoid,凸性好,梯度饱和行为温和 | 默认方案 |
| Plackett-Luce(K 路排序) | 标注者排 5 个比较吃力 | 需要 K 项 softmax,实现更复杂 | 少数模型用过(如 Starling 系列),非主流 |
| Thurstone / Mallows | 同上 | 没有闭式 sigmoid 形式或需要处理排列 | 学术兴趣为主 |
还有一个常被忽略的历史巧合值得一提:TAMER 的第一作者叫 W. Bradley Knox。这跟 Bradley-Terry 的 Bradley 没有任何关系,纯属重名——但每年都有人在读文献时被绕进去。
3. 2008–2018:深度 RL 时代,人类反馈第一次被做成系统
这一节的四五篇论文里,没有一篇跟语言模型有关。它们做的是机器人、Atari 游戏、模拟器里的行走小人。但今天 RLHF 代码库的整体架构,就是在这十年里定型的。
TAMER(2008):人类反馈不是环境奖励
Knox 与 Stone 的 TAMER: Training an Agent Manually via Evaluative Reinforcement 面对的问题是:想让一个非专家用户教会智能体做某件事,但用户不会写奖励函数、也不会调超参数。TAMER 的方案是让用户在智能体行动时实时按键给出正负评价,系统用这些评价拟合一个函数 $\hat{H}(s,a)$——注意作者用的是 $H$(human reinforcement)而不是 $r$——然后策略直接选 $\argmax_a \hat H(s,a)$。
这里有一个至今仍然重要的概念区分。TAMER 明确指出,人给的反馈不是 MDP 意义上的环境奖励。环境奖励描述的是「这一步得了多少分」,需要智能体自己做长期信用分配;而人给的反馈已经隐含了人对长期后果的判断——人看到智能体走错方向时立刻给负分,是因为人已经推演过后果了。所以 TAMER 学的其实更接近一个价值函数,也因此它不做时序差分传播、不用折扣因子,直接贪心地最大化当前预测值。
这一条为什么重要:「人类反馈里已经包含了长期判断,因此不需要再做长期信用分配」这个论证,正是今天 RLHF 里把折扣因子设成 $\gamma=1$、并且把整条回复当成一个 bandit 动作(而非多步决策)的合法性来源。你在第 6 章会看到,RLHF 的 PPO 实现里 $\gamma$ 通常直接写死为 1——这不是偷懒,是从 TAMER 开始就想清楚了的。
TAMER 被抛弃的部分是标量反馈。让人按「好/坏」或者给分数,会遇到我们在上一节说过的尺度问题;更糟的是实时反馈还有延迟归因问题(人按下按键时,智能体已经又走了几步了,这个反馈到底是给哪个动作的?TAMER 需要一个专门的信用分配窗口来处理)。2018 年 Warnell 等人的 Deep TAMER 把这套框架换成深度网络、扩展到高维状态空间,算是给这条线画上了句号——它证明了这条路能深度学习化,但此时主流已经转向成对比较了。
COACH(2017):人类反馈会随策略变化
MacGlashan 等人的 Interactive Learning from Policy-Dependent Human Feedback 提出了一个 actor-critic 算法 COACH,其核心洞察是:人给的反馈是 policy-dependent 的。同一个动作,在智能体还很菜的时候做出来,人会给正反馈(「有进步!」);在智能体已经很强的时候做出来,人会给负反馈(「你退步了」)。人实际上是在对优势(advantage)而非绝对好坏做评价。COACH 因此让人类反馈直接去调整优势函数,而不是当成奖励。
Christiano et al.(2017):RLHF 的架构原型
这是本章最重要的一篇。Deep Reinforcement Learning from Human Preferences 由 Christiano、Leike、Brown、Martic、Legg、Amodei 完成,紧跟在 DQN 证明「RL 可以从零学会电子游戏」之后。它的问题设定是:Atari 和 MuJoCo 里有些行为你根本没法写奖励函数——比如「让这个模拟小人做个后空翻」。你不知道怎么用状态变量描述「后空翻」,但你一眼就能看出两段动画哪段更像后空翻。
方案是:把两段轨迹片段(trajectory segment,大约 1–2 秒的动作序列)并排放给人看,人选一段更好的。用这些比较训练一个奖励预测器 $\hat r_\psi(s,a)$,同时用标准 RL 算法去最大化这个预测器给出的奖励。
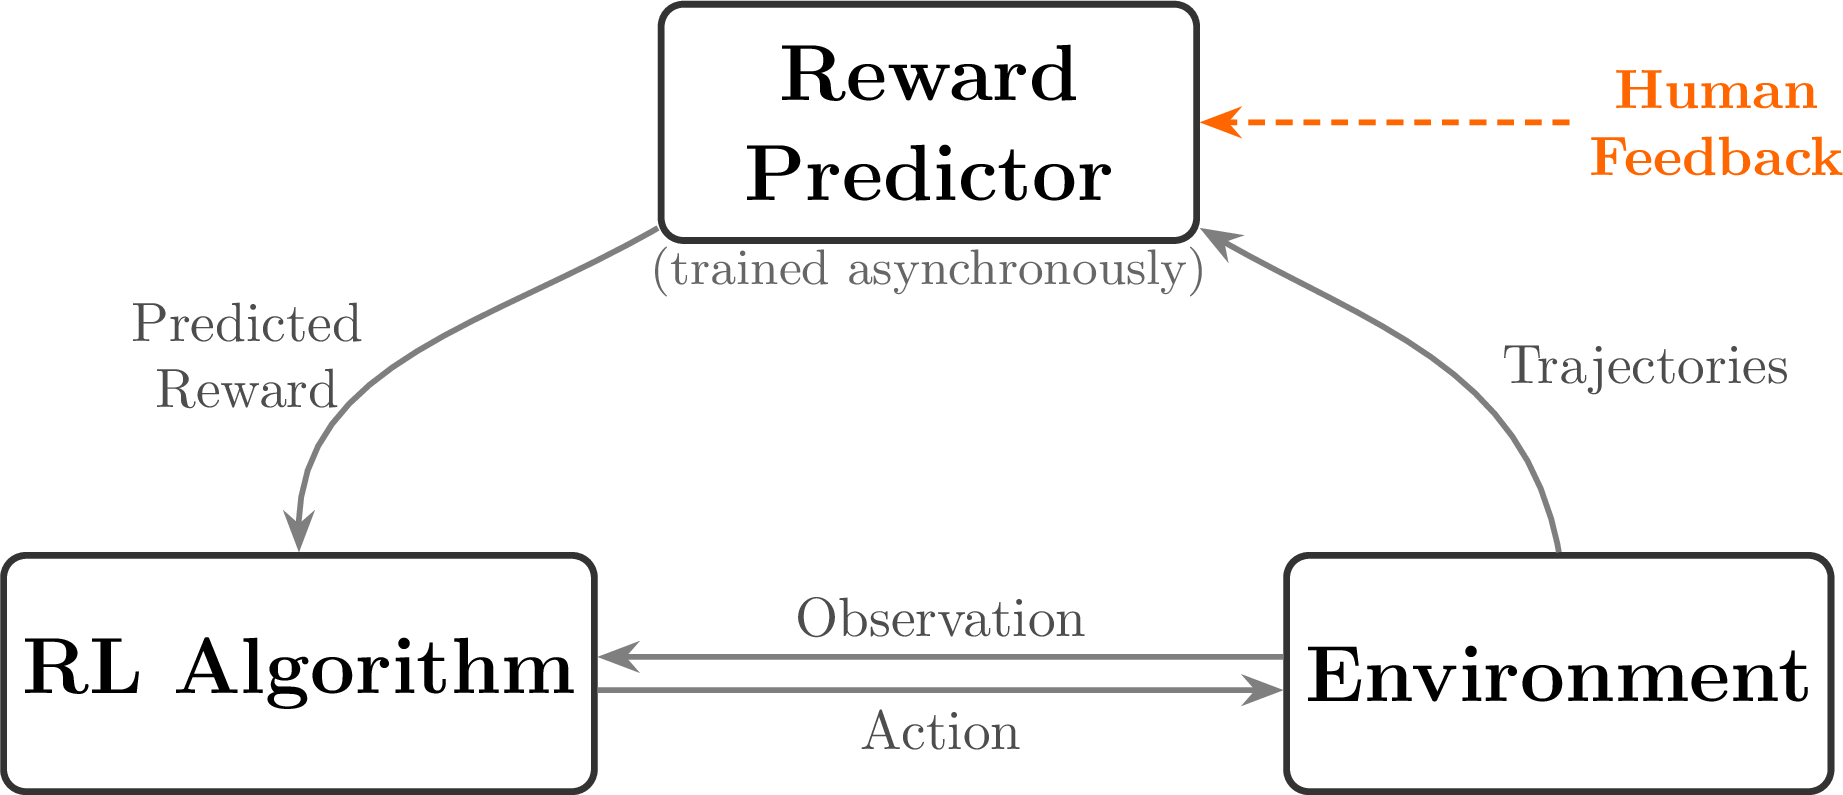
片段偏好的损失函数就是 Bradley-Terry 的直接应用,只是把「对象的分数」换成「片段内所有步的预测奖励之和」:
$$ P(\sigma^1 \succ \sigma^0) = \frac{\exp \sum_{t\in\sigma^1}\hat r_\psi(s_t,a_t)}{\exp\sum_{t\in\sigma^1}\hat r_\psi(s_t,a_t) + \exp\sum_{t\in\sigma^0}\hat r_\psi(s_t,a_t)} $$其中 $\sigma^0,\sigma^1$ 是两个片段。这是 RLHF 与语言模型场景的一个重要差别:这里奖励是逐步预测再求和的,而语言模型上的奖励模型是直接对整条回复输出一个标量。片段求和的形式在语言模型里被放弃了,因为逐 token 的奖励既不好标注也不好解释——第 5 章讲过程奖励模型(process reward model, PRM)时,会看到这个想法以另一种形式回归。
论文里那句被 Lambert 反复引用的判断是:在某些领域,让人在轨迹之间做选择,比让人直接操作环境更有效。这句话是整个 RLHF 领域的合法性宣言——它说的是「评价比生成更容易」,也正是讲座里那三句话的来源:判断哪首诗更好很容易,写出杰作很难;认出一个有帮助的回答很容易,把「有帮助」写成公式很难;预训练优化的是「最可能的续写」,而最可能的续写不一定是最有用的。
2018:收口与转向
这条线在 2018 年有两个收尾工作。Ibarz 等人的《Reward learning from human preferences and demonstrations in Atari》把专家演示和偏好比较结合起来:先用演示做模仿学习给策略一个起点,再用偏好精修。这个「演示打底 + 偏好精修」的两段结构,正是后来 SFT + RLHF 的直接先驱。
另一个是 Leike 等人的《Scalable agent alignment via reward modeling: a research direction》。这篇文章的意义是范式转换:在此之前,奖励模型只是解决 RL 问题的一个工具(因为奖励函数不好写,所以学一个);从这篇开始,奖励建模被提升为研究对齐(alignment)本身的方法论——如果我们无法直接指定想要的行为,那么「学习人类想要什么」就是对齐问题的核心形式。他们进一步提出递归奖励建模:用已对齐的助手帮人评价更复杂的行为,从而把监督能力递归地放大。这个思路后来演化成了 scalable oversight 这一整条研究线,也是 Constitutional AI、宪法式 AI 反馈、LLM-as-a-judge 的思想祖先。
值得注意的是这批作者的去向:Christiano、Leike、Amodei、Legg 分散在 OpenAI、Anthropic、DeepMind,这三家正好就是接下来五年里把 RLHF 推上语言模型的三家。
4. 2019–2021:RLHF 迁移到语言模型,KL 惩罚登场
2019 到 2022 年之间,也就是 GPT-2(2019)和 GPT-3(2020)之间那段时间,各大实验室开始把注意力转向规模化语言模型,RLHF 也被迅速搬了过来。这一时期它常被叫做「reinforcement learning from human preferences」,后来才统一成 feedback。
Ziegler et al.(2019):术语表就是在这一篇里写好的
Fine-Tuning Language Models from Human Preferences 是 OpenAI 把 Christiano 那套东西搬到 GPT-2 上的产物。Lambert 的评价是它与今天的做法有「striking similarities(惊人的相似性)」——你现在打开这篇 2019 年的论文,会发现几乎所有术语和公式都已经就位:训练奖励模型、KL 距离、反馈流程图、策略/参考模型的划分。变的只有任务:他们做的是文本续写风格控制和摘要,能力评测跟今天完全不是一回事。
这一篇引入的最重要的新零件是 KL 惩罚。经典 RL 不需要它,因为环境奖励是真的,你把它最大化到底就对了。语言模型上不行,原因有两条:
- 奖励是代理量。 奖励模型只在它见过的数据分布附近可靠。策略一旦跑到分布外,奖励模型会给出高分但语言退化成乱码——这是所有做过 RLHF 的人都见过的经典失败模式(模型发现某个高分句式,然后无限重复它)。
- 预训练模型是宝贵资产。 后训练用的算力和数据比预训练小几个数量级,你不是在从头学,你是在微调。让模型远离初始分布,等于扔掉预训练砸进去的那几千万美元。
于是目标函数变成了带正则的形式:
$$ J(\pi_\theta) = \E_{x\sim\mathcal{D},\; y\sim\pi_\theta(\cdot\mid x)}\big[r_\phi(x,y)\big] \;-\; \beta\, \KL\big(\pi_\theta(\cdot\mid x)\,\|\,\pi_{\mathrm{ref}}(\cdot\mid x)\big) $$逐项拆解:期望是对 prompt 从数据集 $\mathcal{D}$ 采样、回复从当前策略 $\pi_\theta$ 采样 取的(注意后者意味着数据是 on-policy 的,每次策略更新后旧样本原则上就作废了);$r_\phi$ 是冻结的奖励模型;$\pi_{\mathrm{ref}}$ 是参考模型,通常就是 SFT 之后、RL 之前的那个 checkpoint,训练期间参数完全冻结;$\beta$ 是标量系数,实践中常见量级在 $0.01$ 到 $0.1$ 之间(第 6、15 章会具体讨论怎么调)。对离散输出,KL 项的定义是
$$ \KL(\pi_\theta \,\|\, \pi_{\mathrm{ref}}) = \E_{y\sim\pi_\theta}\big[\log \pi_\theta(y\mid x) - \log \pi_{\mathrm{ref}}(y\mid x)\big] $$Stiennon et al.(2020):摘要任务证明 RLHF 不只是修饰
Learning to Summarize with Human Feedback 是 RLHF 在语言模型上的第一个「破圈」结果。任务是 Reddit TL;DR 摘要,方法是把 Ziegler 的框架扩展到长文本生成并用 PPO 优化。它的重要性在于两点。
第一,它把 RLHF 放到了一个有强基线的真实任务上。摘要有标准数据集、有人类写的参考摘要、有 ROUGE 这类自动指标。这意味着结果可以被外部检验,而不是只能靠演示视频。
第二,也是最被反复引用的一点:用 RLHF 训练的模型产出的摘要,在人类评价中胜过了数据集里人类写的参考摘要,也胜过了单纯用监督微调(supervised fine-tuning, SFT)在同样数据上训练的模型。这个结论直接反驳了「RLHF 只是让模型学会模仿标注者」的直觉——如果只是模仿,怎么可能超过被模仿的对象?
顺带一提,这篇论文的作者名单(Stiennon、Ouyang、Wu、Ziegler、Lowe、Voss、Radford、Amodei、Christiano)几乎就是两年后 InstructGPT 的作者名单。RLHF 在语言模型上的早期进展,实质上是同一个小团队连续三年的迭代。
Wu et al.(2021):递归摘要与 scalable oversight 的第一个实例
Recursively Summarizing Books with Human Feedback 要处理的是一本书——远超模型上下文长度,也远超标注者能在合理时间内读完的量。方案是任务分解:先摘要每一小段,再摘要这些摘要,逐层向上,直到得到全书摘要。标注者每次只需要比较两个局部摘要,而不需要读完整本书。
这是 Leike 2018 年那篇纲领性文章里「递归奖励建模」的第一个可运行实例:当任务复杂到人类无法直接评价时,把它拆成人类可以评价的子任务,然后把监督信号组合上去。 这条思路今天以多种形式活着——过程奖励模型给每一步推理打分、宪法式 AI 用规则拆解「无害」这个概念、长上下文 agent 任务的分段评估,都是同一个模板。
5. 2021–2022:任务扩张、InstructGPT,以及被定型的三段式
摘要跑通之后,RLHF 迅速被撒到各种任务上。这一批工作的共同模式是:选一个「正确答案说不清但好坏看得出」的任务,设计一套针对性的偏好标注协议,然后套 RLHF 流程。 每一篇的贡献主要在标注协议而非算法。
| 工作 | 机构 / 年份 | 任务 | 标注协议上的创新 | 今天的对应物 |
|---|---|---|---|---|
| WebGPT | OpenAI 2021 | 浏览器辅助问答 | 标注模型的浏览轨迹与最终答案,答案需带引用 | agent / 工具使用的 RL 训练(第 13 章) |
| GopherCite | DeepMind 2022 | 带可验证引文的问答 | 要求答案的每个断言都能在检索到的原文中找到支撑,标注者验证引文 | RAG 系统的忠实性评估、可验证奖励的雏形 |
| Sparrow | DeepMind 2022 | 通用对话 | 把「安全」拆成一条条具体规则,针对每条规则单独收集违规判断 | Constitutional AI、规则化奖励(第 12 章) |
| Anthropic HH | Anthropic 2022 | 通用助手 | helpful 与 harmless 两个独立目标分别收数据、分别建模 | 多目标奖励模型、安全与能力的权衡 |
| InstructGPT | OpenAI 2022 | 指令跟随 | 三段式完整配方 + 标注员筛选与培训流程 | 整个后训练领域的模板 |
Sparrow 的做法特别值得注意:与其让标注者笼统地判断「哪个回复更安全」,不如给他们一条明确规则(比如「不要提供医疗建议」),让他们判断某个回复是否违反了这条具体规则。这把一个模糊的整体判断拆成了若干个清晰的二元判断,标注者一致性显著提高。这就是 Constitutional AI 里「宪法条款」的直接前身,也是今天很多团队在做的「rubric(评分细则)式奖励」的来源。
InstructGPT:把三段式做成产品级配方
Training language models to follow instructions with human feedback 是本章的分水岭。需要说清楚的是:它没有发明任何新算法。 SFT 是标准监督学习,奖励模型是 Bradley-Terry,RL 用的是 2017 年就有的 PPO,KL 惩罚来自 Ziegler 2019。它的贡献是把这些拼成一个能真正做出可用产品的完整配方,并且把配方公开了。
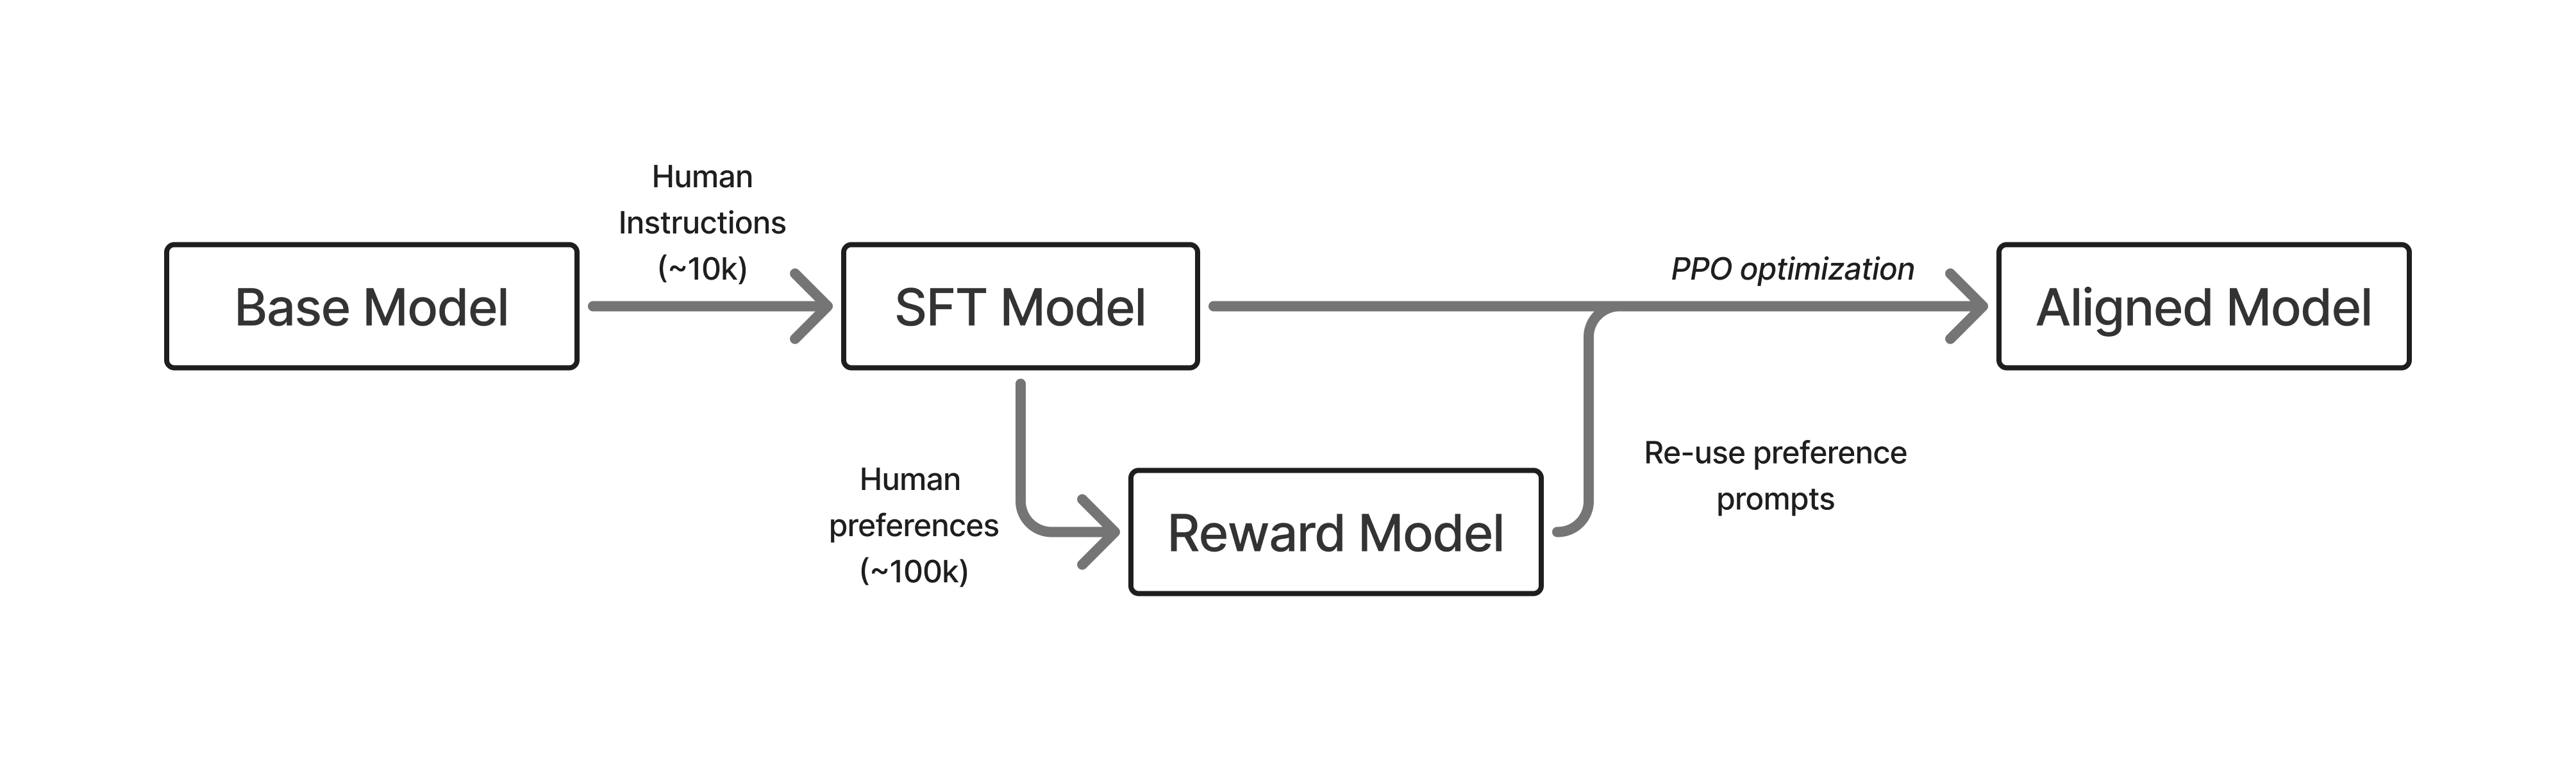
三段各自的作用:
第 1 步,指令微调(instruction fine-tuning, IFT),也叫 SFT。 收集「期望的助手行为」的演示数据,用标准的下一 token 预测损失训练:
$$ \mathcal{L}_{\mathrm{SFT}}(\theta) = -\sum_{(x,y^\star)\in\mathcal{D}}\;\sum_{t=1}^{|y^\star|} \log \pi_\theta\big(y^\star_t \mid x,\, y^\star_{<t}\big) $$其中 $y^\star$ 是人写的参考回复,损失只在回复的 token 上计算(prompt 部分通常被 mask 掉)。这一步做的事情本质上是换格式:把「续写文本」的基座模型变成「回答问题」的模型。讲座里那个例子很直观——同一个 prompt「The president of the United States in 2006 was」,基座模型会接着列举各州州长,而后训练过的模型会回答「George W. Bush 是 2006 年的美国总统,他从 2001 年到 2009 年担任了两届」。
第 2 步,奖励建模。 对同一 prompt 收集多个模型回复,让人排序,用第 2 节的 BT 损失训练 $r_\phi$。
第 3 步,用 RL 对着奖励模型优化。 从数据集采一批 prompt,用当前策略生成回复,用奖励模型打分,加 KL 惩罚,用 PPO 更新策略。
同期确立的三个问题域
除了应用,这一时期还有三篇论文各自开辟了一个至今活跃的研究方向:
1. 奖励模型过优化(Gao et al.)。 《Scaling Laws for Reward Model Overoptimization》用一个巧妙的实验设计回答了「RL 优化器会不会过拟合到奖励模型上」:他们用一个大的「金标准」奖励模型当作真实偏好的替身,再用它生成的标签训练一个较小的代理奖励模型,然后观察随着 RL 优化推进,代理分数和金标准分数如何分道扬镳。结论是两者会在某个点后开始背离,而且背离的程度可以写成 KL 散度的函数——也就是说,过优化的程度可以被预测。这是第 14 章的核心内容。
2. 语言模型作为对齐研究的实验平台(Askell et al.)。 《A general language assistant as a laboratory for alignment》确立了一个方法论立场:与其抽象地讨论对齐,不如把通用语言助手当成一个具体的实验对象,在上面测量各种对齐技术的效果。今天绝大多数对齐研究默认采用这个设定。
3. 红队(Ganguli et al.)。 《Red teaming language models to reduce harms》把「主动寻找模型的有害输出」做成了一套有方法学、有标度分析的流程。这是模型安全评估的基础工作,也是今天各家发布模型前必做的环节。
Anthropic HH 与开源工具的出现
Anthropic 的《Training a helpful and harmless assistant with RLHF》在 Claude 的早期版本上大量使用了 RLHF,并且——这一点对开源社区极为重要——公开了 HH 偏好数据集。在很长一段时间里,这是学术界唯一能拿到的真实、大规模人类偏好数据,几乎所有 2023 年的开源 RLHF 复现都建立在它上面。
同期出现了第一批开源 RLHF 工具:RL4LMs(对应论文《Is Reinforcement Learning (Not) for Natural Language Processing?》,提供了 benchmark 和一批基线)、CarperAI 的 trlX(第一个尝试大规模分布式 RLHF 的框架)、以及 Hugging Face 的 TRL——后者活到了今天,是目前最主流的 RLHF/DPO 训练库。
6. ChatGPT 时代:RLHF 从一个方法变成一个行业
2022 年 11 月 30 日,OpenAI 发布 ChatGPT,博客里对训练方法的说明极其直白:
我们使用来自人类反馈的强化学习(RLHF)训练了这个模型,方法与 InstructGPT 相同,只在数据收集设置上有细微差别。
这句话的效果是历史性的。在此之前,RLHF 是一小群人在少数几篇论文里推进的技术;在此之后,它成了整个行业追赶的目标。Lambert 的说法是,RLHF「口语意义上就是导致现代后训练的那个东西」——2023 年初,「后训练」这个领域的绝大部分注意力都集中在 RLHF 上。
ChatGPT 到底改变了什么?从模型能力的角度,它相对 GPT-3.5 基座并没有增加多少知识。它改变的是三件产品层面的事:格式(直接给出对话式回答,而不是续写)、风格(有帮助、简洁、会用 markdown)、可用性(普通人每天都能用上)。这三件事恰好都是「说不清但看得出」的属性——也就是 RLHF 最擅长的那一类。理解这一点,就理解了为什么 RLHF 在 2022 年那个时点产生了如此不成比例的影响:它解决的不是最难的技术问题,而是最卡产品的那个问题。
行业采纳:一份不完整的名单
ChatGPT 之后,RLHF 出现在几乎所有前沿模型的技术报告里:Anthropic 的 Constitutional AI(用于 Claude)、Meta 的 Llama 2 与 Llama 3、Nvidia 的 Nemotron、Ai2 的 Tülu 3。这些工作里最值得单独拿出来说的是 Constitutional AI。
它要解决的问题是人类标注的成本与一致性。方案是写下一套「宪法」——一组自然语言原则(不要有害、不要说教、尊重用户自主性等等),然后让模型自己按这些原则批评和修改自己的输出,再让模型自己在两个回复之间做偏好判断。人类的角色从「逐条标注」上移到「写规则和抽查」。这条线索直接连着 Sparrow 的规则化标注,也直接开启了今天的 RLAIF(reinforcement learning from AI feedback)与合成偏好数据实践——第 12 章的主题。
2023–2024:开源社区的三个阶段
ChatGPT 之后,开源社区的演进大致分三段(Lambert 在讲座里的划分):
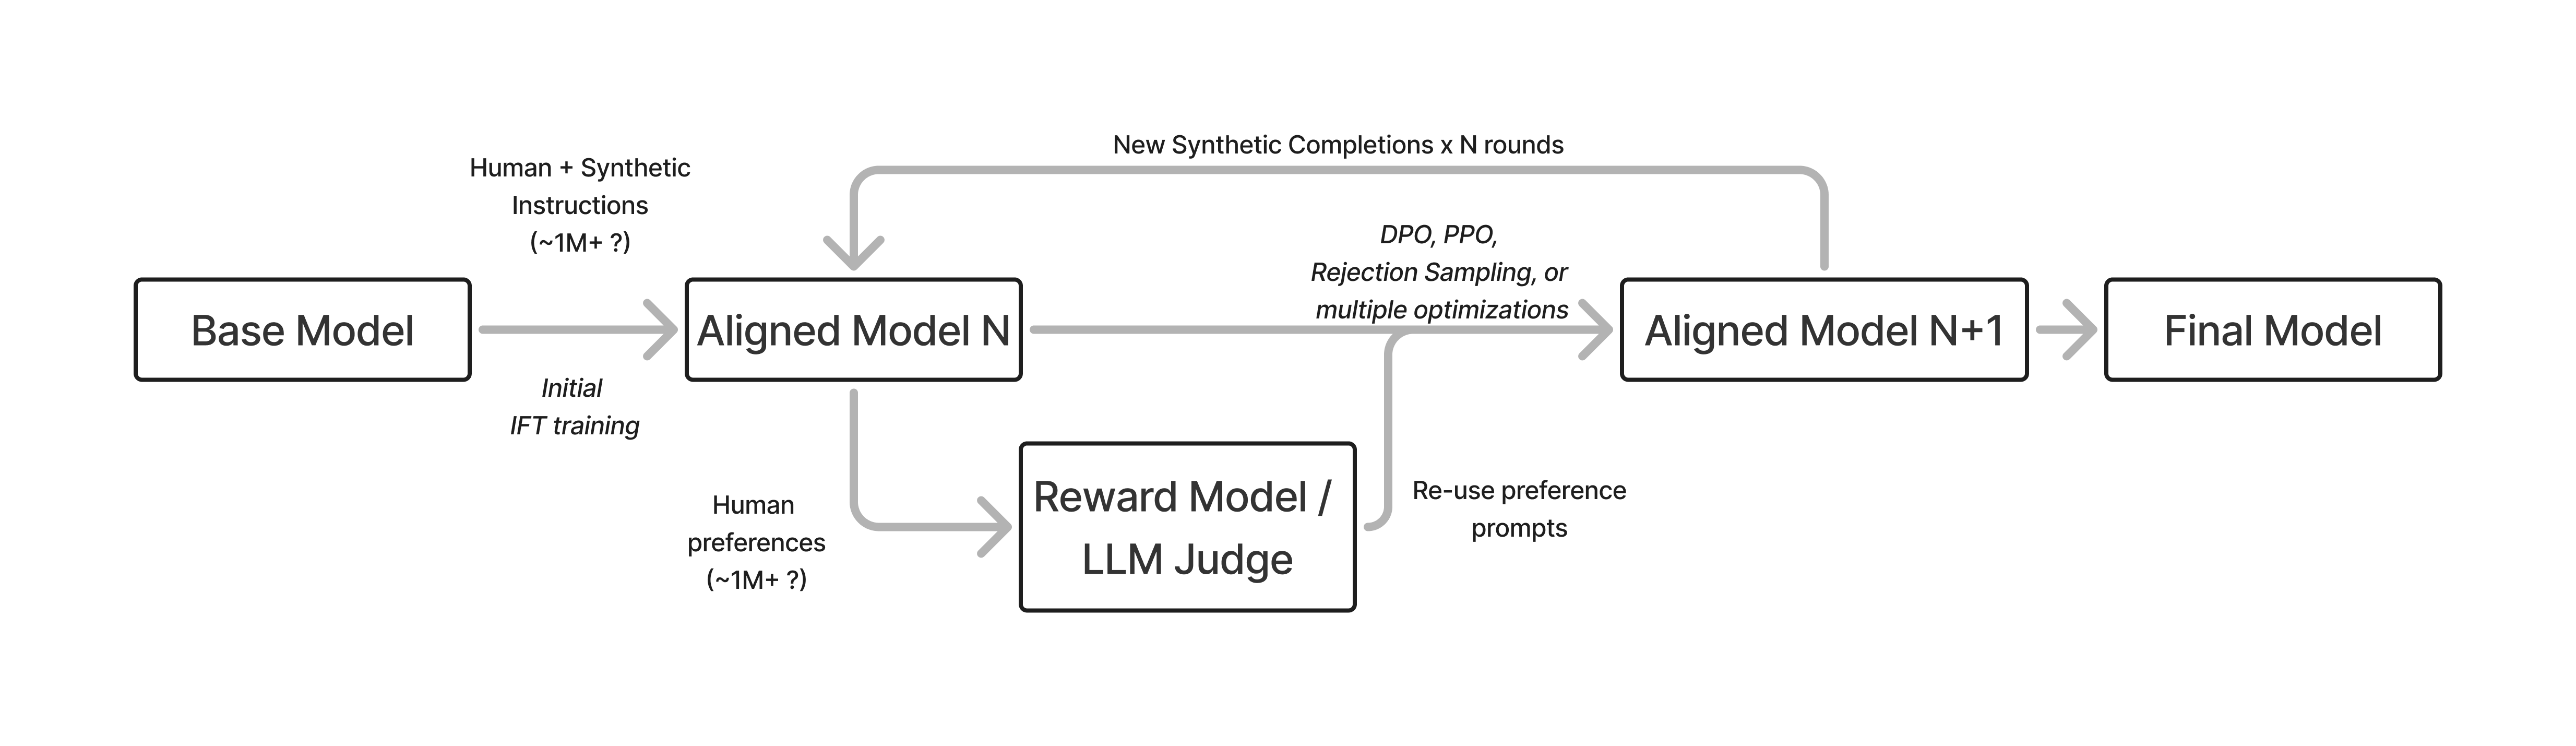
- 2023:简单 SFT + 复现 RLHF 基础。 Alpaca、Vicuna 这类工作用少量指令数据把基座模型调成聊天机器人。这一阶段的评测集中在 AlpacaEval、MT-Bench、Chatbot Arena 这些聊天导向的榜单上。
- 2024:DPO 主导开源,训练阶段开始扩张。 Zephyr-beta、Tülu 2 这类模型证明了不用 PPO 也能拿到大部分收益。此时行业焦点从「RLHF」整体转向「后训练」,RLHF 被降格为工具箱里的一件工具——甚至是一件你可能用不上的工具。
- 2025:RLVR 与复杂配方。 Tülu 3、Olmo 3、Nemotron、DeepSeek R1 都是多阶段的复杂流水线。
「只是风格迁移」:一场持续多年的误判
2023 年 LIMA 论文提出了表层对齐假说(superficial alignment hypothesis, SAH),原话是:
模型的知识和能力几乎完全是在预训练阶段学到的,而对齐只是教它在与用户交互时应该使用哪个子分布的格式。
这句话在当时的证据下是合理的:用几千条高质量指令数据做 SFT,确实能在 AlpacaEval、MT-Bench 这类评测上大幅提升。由此产生的流行判断是——后训练只是「风格迁移(style transfer)」,无关紧要。
Lambert 的反驳很具体。他举了 OLMoE 的例子:同一个基座模型家族,只更新后训练配方,2024 年 9 月版本的平均评测分是 38.44,2025 年 1 月版本是 45.62。基座没变,涨了 7 分多。他的结论是:
基座模型决定天花板,后训练的工作是够到它。简单的后训练配方常常远远榨不出足够的性能。
他把这个观点命名为后训练的「引出理论」(elicitation theory):预训练在几万亿 token 上见过的东西,远比早期后训练配方能暴露出来的多;后训练的任务是把模型里最有用的那部分知识拽出来。他的比喻是:预训练造出车的底盘,后训练是从这个底盘上榨出最大性能的那门手艺。2026 年一篇题为《Operationalising the Superficial Alignment Hypothesis via Task Complexity》的论文按任务复杂度重新检验了 SAH,Lambert 认为这一篇的结论更符合他的直觉。
7. 今天:RLHF 长成了偏好微调,又被 RLVR 分走了舞台
原章节的最后一段把当下的格局概括为:RLHF 正在成长为一个更广的领域——偏好微调(preference fine-tuning, PreFT)。这个领域今天有四条主要分支,每条都对应本书后面的一章。
| 分支 | 代表工作 | 改动了 RLHF 的哪个零件 | 本书章节 |
|---|---|---|---|
| 过程奖励模型(PRM) | Let's Verify Step by Step (2023) | 奖励的粒度:从整条回复变成每个推理步 | 第 5 章 |
| 直接对齐算法(DAA) | DPO (2023) 及其大量变体 | 去掉独立奖励模型与在线采样 | 第 8 章 |
| 执行反馈 / 自我改进 | Beyond Human Data (ReST-EM)、Self-Correct 类工作 | 奖励来源:从人到代码执行器、数学验证器、模型自身 | 第 7、12 章 |
| 可验证奖励强化学习(RLVR) | Tülu 3 命名、DeepSeek R1 普及 | 彻底删掉学出来的奖励模型 | 第 7 章 |
DPO:把三段式压回两段
DPO(direct preference optimization,直接偏好优化)的推导起点就是我们在第 4 节写下的那个带 KL 惩罚的目标。它做的事情是:先解出这个目标的闭式最优策略 $\pi^\star$,再把奖励函数反解成关于 $\pi^\star$ 和 $\pi_{\mathrm{ref}}$ 的表达式,代回 Bradley-Terry 似然,于是奖励模型被完全消掉,只剩一个可以直接在偏好数据上算的损失:
$$ \mathcal{L}_{\mathrm{DPO}}(\theta) = -\,\E_{(x,y_w,y_l)\sim\mathcal{D}}\left[\log\sigma\left(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\mathrm{ref}}(y_w\mid x)} - \beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\mathrm{ref}}(y_l\mid x)}\right)\right] $$把它和第 2 节的 $\mathcal{L}_{\mathrm{RM}}$ 并排放,会发现它们形状完全一样,只是把 $r_\phi(x,y)$ 换成了 $\beta\log\frac{\pi_\theta(y\mid x)}{\pi_{\mathrm{ref}}(y\mid x)}$——这就是论文副标题「你的语言模型其实是个奖励模型」的含义。完整推导在第 8 章。
RLVR:把代理目标整个换掉
RLHF 的根本弱点是奖励模型只是代理。讲座里那句古德哈特定律说得最清楚:「当一个度量成为目标,它就不再是好的度量。」 具体表现包括奖励黑客(RM 分数一路涨、实际质量下降)、冗长偏好(长回复得分高,模型越写越长)、谄媚(顺着用户说而不是说实话)、过度拒答(连「怎么 kill 一个 linux 进程」都拒绝)。KL 惩罚是主要防线,但这是个根本性张力,不是能靠调参消除的 bug。
RLVR 的思路直截了当:在答案可以被直接检验的领域,根本不需要学奖励模型。数学题就对答案,代码就跑测试。这样就没有代理目标,也就没有过优化的那个特定形式——你可以放心地把 RL 算力往上加。RLVR 这个名字由 Tülu 3 提出,被 DeepSeek R1 推广。
| 经典 RL | RLHF | RLVR | |
|---|---|---|---|
| 奖励来源 | 环境给定 | 学出来的(代理) | 可验证(精确) |
| 状态转移 | 有 | 无 | 无 |
| 奖励粒度 | 每步 | 每条回复 | 每条回复 |
| 主要挑战 | 探索–利用权衡 | 过优化 | 任务泛化 |
| 典型例子 | CartPole | 聊天风格调优 | 数学推理 |
RLVR 顺带解锁了推理时扩展(inference-time scaling):OpenAI o1 的标志性结论是,生成阶段花的算力(生成的 token 数)与下游性能之间存在对数线性关系。同样重要但常被低估的是它的另一半——RL 训练算力的投入也有对数线性回报。这意味着训练语言模型从此有了两条可扩展的轴(预训练 + 后训练),加上推理时那条(不更新权重),一共三条。
规模上的一个公开参照点:Olmo 3.1 是目前少数几个「完全开放」的大规模 RL 训练之一,训练一个 32B 的通用推理模型,完整 RL 训练用了大约 224 张 GPU、28 天;而且性能提升在整个训练过程中非常稳定——到不得不停下来的时候还在往上走。把这个数字和 InstructGPT 那个「约 10 万条 prompt 的 RL 阶段」对照,就能感受到五年间投入规模的变化。
这段历史给实践者的三条启示
第一,架构比算法稳定。 从 2017 年 Christiano 那张图到今天,「学一个奖励 + 用 RL 最大化它 + 用某种方式限制漂移」这个结构没变过。变的是每个方框里塞什么(PPO→GRPO、人类标注→AI 反馈、学出来的奖励→验证器)。学习时应该先把架构吃透,具体算法是可替换件。
第二,数据协议的创新往往比损失函数的创新更值钱。 回看本章列出的工作:Christiano 的贡献是「比较片段而不是打分」,Sparrow 的贡献是「按规则拆分标注」,CAI 的贡献是「让模型自己标」,RLVR 的贡献是「用验证器代替标注」。这些都是关于信号从哪来的创新,而不是关于怎么优化的创新。而后者(各种 DPO 变体)虽然论文数量多得多,对最终模型的影响反而小。
第三,方法演化的速度快于理论理解的速度。 这是 Lambert 在本章开头就打的预防针:RLHF 演进极快,所以本书对很多方法保持不确定态度,只对少数核心实践有信心。对读者的实际含义是——不要把任何一份配方当成终点,但一定要把为什么会有这个零件搞清楚,因为零件会换,问题不会。
本章小结
一句话时间线
| 年份 | 工作 | 贡献的具体机制 | 今天还在用吗 |
|---|---|---|---|
| 1952 | Bradley-Terry | 成对比较 → 潜在标量强度;$\sigma(r_i-r_j)$ | 在用(奖励模型与 DPO 的地基) |
| 1957+ | Bellman / MDP / 动态规划 | reward-to-go、贝尔曼递归、折扣因子 | 形式在用,$\gamma$ 在 RLHF 里退化为 1 |
| 2008 | TAMER | 人给标量反馈 → 学奖励模型 → 导出策略 | 结构在用;标量打分被比较取代 |
| 2017 | COACH | 指出人类反馈是 policy-dependent(依赖当前策略) | 诊断被继承(on-policy 数据的动机) |
| 2017 | Christiano et al. | 轨迹片段成对比较 + 异步奖励预测器 + RL 双循环 | 在用(RLHF 的标准架构) |
| 2018 | Ibarz / Deep TAMER | 演示 + 偏好混合;深度网络化的 TAMER | 思想在用(SFT 打底 + 偏好精修) |
| 2018 | Leike et al. | 把「奖励建模」提升为对齐研究纲领 | 在用(scalable oversight 的框架) |
| 2019 | Ziegler et al. | LM 上的 RLHF;KL 惩罚、参考模型、术语体系 | 全部在用 |
| 2020 | Learning to Summarize | 长文本任务上证明 RLHF 能超过人类参考 | 结论在用(RLHF 不只是格式修饰) |
| 2021–22 | WebGPT / GopherCite / Sparrow | 工具使用、引用溯源、规则化偏好标注 | 思路在用(今天的 agent 训练与 CAI) |
| 2022 | InstructGPT | SFT + RM + PPO 的完整产品级配方 | 模板在用,细节已大幅演化 |
| 2022 | Anthropic HH / Askell / red teaming | helpful+harmless 双目标、对齐实验室范式、红队 | 在用 |
| 2022–23 | Constitutional AI | AI 反馈(RLAIF)替代部分人类标注 | 在用(合成偏好数据已成主流) |
| 2023 | Gao et al. 过优化标度律 | 把 reward hacking 量化为 KL 的函数 | 在用(第 14 章的核心) |
| 2023 | DPO | 用闭式最优解消掉显式奖励模型 | 在用(开源模型主力) |
| 2023–25 | PRM / o1 / R1 / RLVR | 过程奖励、可验证奖励、RL 训练规模化 | 在用(当前研究前沿) |
要点清单
- 「人只会比较,不会打分」是整个领域的起点。 从 TAMER 的标量反馈到 Christiano 的成对比较,这一步转换解决的是标注者之间尺度不一致的问题,代价是每条数据的信息量下降(1 bit)。所有后续设计——BT 损失、DPO 损失、K-wise 排序损失——都建立在这个取舍上。
- RLHF 的架构在 2017 年就定型了。 双循环(异步更新奖励模型 + RL 最大化预测奖励)从 Atari 到 ChatGPT 没有变过。变的是环境(游戏 → prompt 数据集)、奖励粒度(片段 → 整条回复)、和规模。
- 语言模型引入了两样新东西:KL 惩罚和参考模型。 经典 RL 不需要它们,因为环境奖励是真的;语言模型需要,因为奖励是学出来的代理,而且预训练模型本身是宝贵的、不能被优化毁掉的资产。
- RLHF 的名声经历了「无用 → 关键」的翻转。 LIMA 时期的「只是风格迁移」判断在当时的证据下是合理的,但它低估了后训练的上限。Lambert 的「引出理论(elicitation theory)」是更准确的表述:预训练定天花板,后训练负责够到它。
- 读历史的实操价值: 当你在实现里遇到一个不理解的常数或结构(比如为什么 RM 常常初始化自 SFT 模型、为什么 KL 系数在 0.01–0.1 量级、为什么偏好数据要按 batch 分期交付),去查它第一次出现在哪篇论文里,通常能找到一个非常具体的工程理由。
延伸阅读
综述(想系统扫一遍文献时读)
- A Survey of Preference-based Reinforcement Learning Methods (Wirth et al., JMLR 2017) — 语言模型之前的偏好 RL 全景,包含大量今天被遗忘但可能重新有用的方法(如基于排序的策略搜索)。
- A Survey of Reinforcement Learning from Human Feedback (Kaufmann et al.) — 覆盖面最全的 RLHF 综述,把控制、机器人、语言模型三条线放在同一框架下。
- Open Problems and Fundamental Limitations of RLHF (Casper et al., 2023) — 按「反馈—奖励模型—策略」三段拆解 RLHF 的失效模式,是做 RLHF 研究选题的好起点。
深度 RL 时代的偏好学习(第 3 节)
- TAMER: Training an Agent Manually via Evaluative Reinforcement (Knox & Stone, ICDL 2008) — 值得读的是它对「人类反馈不是环境奖励」的论证,这个区分至今被很多人忽略。
- Interactive Learning from Policy-Dependent Human Feedback (MacGlashan et al., 2017) — COACH。指出人类反馈随策略变化而变化,是理解「为什么偏好数据会过时」的理论来源。
- Deep Reinforcement Learning from Human Preferences (Christiano et al., 2017) — 本章最该精读的一篇。RLHF 的架构原型,含奖励模型集成、查询选择、奖励归一化等所有工程细节。
- Reward learning from human preferences and demonstrations in Atari (Ibarz et al., 2018) — 演示 + 偏好的组合,是「SFT 打底再做偏好优化」的直接先驱。
- Deep TAMER (Warnell et al., 2018) — TAMER 的深度学习版,标志着这条线也完成了神经网络化。
- Scalable agent alignment via reward modeling (Leike et al., 2018) — 把奖励建模从工具升格为对齐研究纲领的纲领性文章,递归奖励建模的想法在今天的 scalable oversight 讨论里仍然活跃。
语言模型上的早期 RLHF(第 4–5 节)
- Fine-Tuning Language Models from Human Preferences (Ziegler et al., 2019) — 术语和公式的源头,KL 惩罚第一次出现。读它的附录,里面有大量后来被默认但从未再解释的实现选择。
- Learning to Summarize with Human Feedback (Stiennon et al., 2020) — 证明 RLHF 能在真实任务上超过人类参考答案,是「RLHF 不只是风格修饰」的第一份硬证据。
- Recursively Summarizing Books with Human Feedback (Wu et al., 2021) — 任务分解 + 递归标注,是 scalable oversight 的可运行实例。
- Training language models to follow instructions with human feedback (InstructGPT, Ouyang et al., 2022) — 三段式配方的标准参考。附录里的标注员筛选流程和数据统计比正文更有价值。
- WebGPT (Nakano et al., 2021) — 浏览器工具使用 + RLHF,今天 agent 训练的先声。
- GopherCite (Menick et al., 2022) — 教模型用可验证引文支持答案,把「可验证性」引入偏好标注。
- Sparrow (Glaese et al., 2022) — 把安全拆成一条条规则分别标注,是 Constitutional AI 的思想前身。
- Training a Helpful and Harmless Assistant with RLHF (Bai et al., 2022) — HH 数据集的来源,开源社区最早能拿到的真实偏好数据。
- A General Language Assistant as a Laboratory for Alignment (Askell et al., 2021) — 确立了「用语言助手作为对齐研究平台」的范式。
- Red Teaming Language Models to Reduce Harms (Ganguli et al., 2022) — 红队的方法学与标度行为,安全评估的基础文献。
过优化与理论(第 6–7 节)
- Scaling Laws for Reward Model Overoptimization (Gao et al., 2023) — 用「金奖励模型」实验把 reward hacking 变成可测量的曲线,第 14 章的核心参考。
- Direct Preference Optimization (Rafailov et al., 2023) — 推导出 KL 约束下的闭式最优策略并反解奖励,第 8 章会逐步重推一遍。
- Constitutional AI (Bai et al., 2022) — AI 反馈的第一个完整配方,第 12 章主题。
- LIMA: Less Is More for Alignment (Zhou et al., 2023) — 「表层对齐假说」的出处。读它是为了理解这个判断在什么条件下成立、在什么条件下失效。
开源工具与配方(想动手时读)
- TRL: Transformer Reinforcement Learning — 目前最主流的 RLHF/DPO 训练库,本书的很多示例可以直接映射到它的 API。
- RL4LMs / Is Reinforcement Learning (Not) for NLP? (Ramamurthy et al.) — 早期的 NLP 策略优化 benchmark,对超参敏感性的分析今天仍有参考价值。
- trlX: A Framework for Large Scale RLHF (Havrilla et al., 2023) — CarperAI 的分布式 RLHF 框架,是开源社区第一次尝试复现大规模 PPO 训练。
- Tülu 3 (Lambert et al., 2024) — 本书作者主导的完全开放后训练配方,数据、代码、评测全公开,是最适合逐步复现的现代配方。
- The Llama 3 Herd of Models (2024) — 工业界多阶段后训练流水线的详细披露。
- Nemotron-4 340B Technical Report (2024) — 合成数据主导的后训练配方,与 Llama 3 对照阅读效果好。
- DeepSeek-R1 (2025) — RLVR 规模化的公开范例,把「RL 训练算力」变成了一个可以持续投入的轴。