导论
当我们无法写出奖励函数、却能一眼判断好坏时,该怎么优化一个语言模型。
0. 本章导读
这一章要回答四个问题,它们是整本书的地基:
- RLHF 是什么——它是一套把人类信息注入 AI 系统的技术,最初诞生于「目标难以形式化描述」(hard-to-specify)的问题。开创这个领域的那句问题是:「我们能不能仅凭最基础的偏好信号,就引导优化过程解决困难问题?」
- 它在后训练里的位置——现代后训练由三类优化方法组成:指令微调(SFT)、偏好微调(PreFT)、可验证奖励强化学习(RLVR)。RLHF 主宰第二块,同时是第三块的技术祖先。
- 为什么 RLHF 有用而 SFT 不够——核心在于「判别比生成容易」这个不对称性,以及由此带来的两个机制差异:响应级而非 token 级的更新,对比式而非模仿式的信号。
- 后面 16 章各自在解决什么——本章末尾给出全书路线图,让你知道每个概念会在哪一章被展开。
这一章几乎没有公式推导的负担,但有大量需要建立的直觉。如果你只打算精读一章,读这一章;如果你打算读完全书,这一章是你之后每次迷路时该回来看的地图。
- RLHF 存在的理由是「能评价,但写不出评价标准」。经典 RL 的奖励函数由环境给定(CartPole 每活一步 +1),而「有用」「无害」「写得好」没有闭式表达,只能从人类比较里学出来。
- RLHF 的三步流水线:SFT → 奖励模型 → 用 RL 优化奖励模型。这个由 InstructGPT(2022)确立的模板,是现代后训练的智力原型。
- RLHF 的目标函数永远是两项:最大化奖励,但别离参考模型太远。$J(\pi)=\E[r_\phi(x,y)]-\beta\,\KL(\pi\,\|\,\pi_\text{ref})$。全书一半的内容都在讨论这两项怎么平衡。
- SFT 是逐 token 的模仿,RLHF 是整条响应的对比。前者教「照着说」,后者教「哪种更好、哪种要避免」——这是 RLHF 跨领域泛化更好的根本原因。
- 奖励模型是代理目标而非真值,所以过优化(over-optimization)是结构性的、不可避免的,只能被正则化约束,不能被消除。
- 后训练不是「风格迁移」。基座模型决定天花板,后训练的工作是把天花板够到——Lambert 称之为「后训练的激发理论」(Elicitation Theory)。但在 2025 年之后的大规模 RL 时代,这个理论本身也开始被突破。
1. 从「写不出奖励函数」开始
要理解 RLHF 为什么会被发明出来,先要看清楚经典强化学习(Reinforcement Learning, RL)依赖什么前提。
经典 RL:奖励是环境白送的
一个 RL 问题通常写成马尔可夫决策过程(Markov Decision Process, MDP),是一个五元组 $(\mathcal{S},\mathcal{A},P,r,\gamma)$:状态空间 $\mathcal{S}$、动作空间 $\mathcal{A}$、转移动态 $P(s_{t+1}\mid s_t,a_t)$、奖励函数 $r(s_t,a_t)$、折扣因子 $\gamma$。智能体的策略(policy)$\pi(a\mid s)$ 要最大化一条轨迹上的累计回报:
$$ J(\pi)=\E_{\tau\sim\pi}\left[\sum_{t=0}^{T}\gamma^{t}\,r(s_t,a_t)\right] $$这里 $\tau=(s_0,a_0,r_0,s_1,a_1,r_1,\dots)$ 是轨迹(trajectory),它的概率由初始分布、策略和环境动态三者共同决定:$P(\tau\mid\pi)=p(s_0)\prod_{t}\pi(a_t\mid s_t)\,p(s_{t+1}\mid s_t,a_t)$。注意这个乘积里有两个来源的随机性——策略的随机性(我们能优化)和环境的随机性(我们不能)。
教科书例子 CartPole:状态是 $s_t=(x_t,\dot x_t,\theta_t,\dot\theta_t)$,即小车位置、速度、杆角度、角速度;动作 $a_t\in\{\text{左推},\text{右推}\}$;奖励是「杆没倒就 +1」:
$$ r(s_t,a_t)=\begin{cases}1 & |\theta_t|<12^\circ \ \text{且}\ |x_t|<2.4\\ 0 & \text{否则(回合结束)}\end{cases} $$更简单的例子是恒温器:状态是室温,动作是开/关加热,奖励是「室温接近目标值时为正」。这两个例子共同的特征是——奖励函数是任务定义的一部分,白纸黑字写得出来。你不需要学它,你只需要最大化它。同时,动作会改变下一个状态(推小车会改变杆的角度),所以这是真正的多步控制问题,需要做长期的信用分配(credit assignment)。
语言任务:奖励写不出来
现在把同样的框架套到语言模型上,第一件塌掉的事就是奖励函数。请你写一个函数,输入是一段回答的 token 序列,输出是一个实数,表示这个回答「有多有帮助」。你写不出来。任何试图用规则拼出来的东西(长度、关键词、可读性指标)都会被优化器立刻钻空子。
但奇怪的是,你能判断。给你两首诗,你能挑出更好的那首,尽管你写不出杰作;给你两个回答,你能挑出更有帮助的那个,尽管你说不清「有帮助」的公式是什么。这个能力上的落差,就是 RLHF 的全部立足点。
RLHF 让我们能优化那些可以评价(evaluate)但难以指定(specify)的行为:先用人类的比较数据把「评价能力」拟合成一个奖励模型,再用 RL 去最大化这个学出来的奖励。
另一件塌掉的事是「最可能」不等于「最有用」。预训练优化的是下一个 token 的极大似然,它给出的是互联网文本中最可能的续写。而对于一个被人当作助手使用的模型,最可能的续写常常是最没用的那个——它会继续补全网页元数据,而不是回答你的问题。这一点在第 2 节会用具体例子展示。
RLHF 的史前史:先有偏好,后有语言模型
RLHF 不是为语言模型发明的。它最早的应用场景恰恰是传统 RL 领域的控制问题:
- TAMER(Knox & Stone, 2008)——让人给智能体的动作打分,从打分里学出奖励。
- Christiano 等人 2017——在 Atari 和 MuJoCo 上用轨迹片段的两两偏好训练奖励预测器。最著名的演示是让一个模拟机器人学后空翻:人类标注员根本写不出「后空翻」的奖励函数,但看到两段视频就能说哪段更像后空翻。用大约 900 个人类比较,就学出了漂亮的后空翻;而手工设计的奖励函数训出来的动作则怪异得多。
- Ziegler 等人 2019——第一次把 RLHF 用在语言模型上。
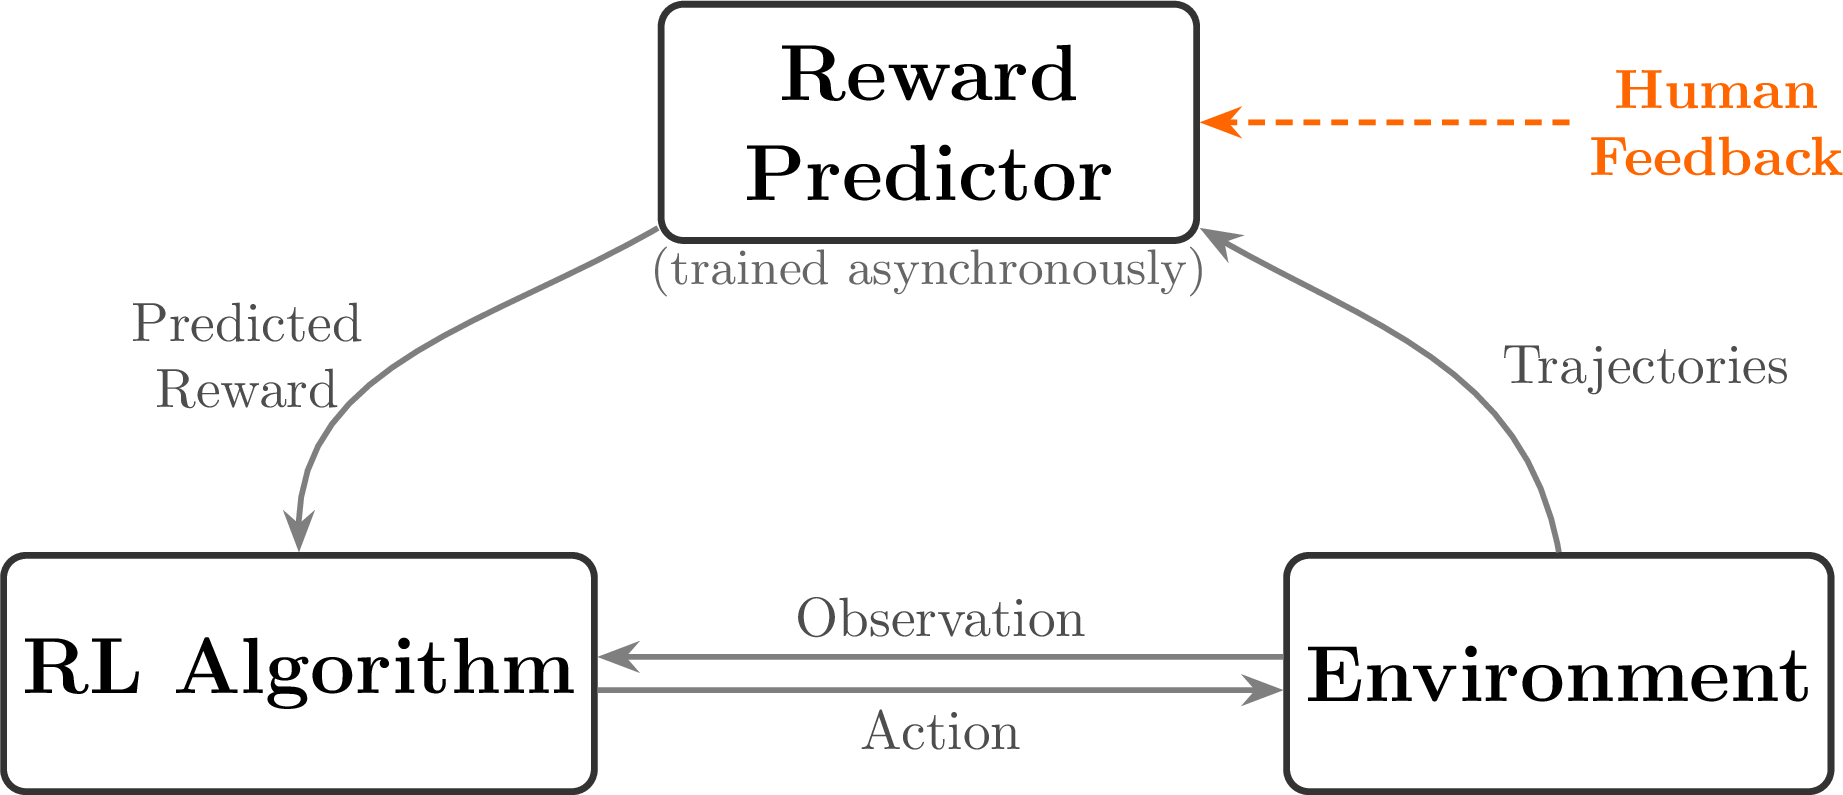
把这张图翻译到语言模型上,需要做几处替换:环境消失了(提示词从数据集采样,而不是从环境交互中产生),状态转移变成确定性的「把 token 追加到序列末尾」,奖励从「每步都有」变成「整条回答结束时给一个标量」。这些替换看起来是简化,实际上引入了全新的困难——它们是第 3 章和第 6 章的主题。
2. RLHF 到底改变了模型的什么
「RLHF 给模型带来了什么?」是围绕 RLHF 最大的问题,也是至今最难精确回答的问题。最有说服力的回答方式不是列基准分数,而是直接看输出。
基座模型是一台续写机
把同一句话喂给一个很强的基座模型——Llama 3.1 405B Base,输入「The president of the united states in 2006 was」:
George W. Bush, the governor of Florida in 2006 was Jeb Bush, and John McCain was an Arizona senator in 2006 - who later lost to obama.
September 1 -- U.S. President Bush signs an executive order to provide more options for faith-based organizations...
January 1 -- The current deadline set by United States Congress in the Unlawful Internet Gambling Enforcement Act, aka UIGEA.
search: Amendments to the 1961 International Convention for the Protection of New Varieties of Plants...
模型没有答错——它压根不是在「答」。它在补全一段维基百科式的文本,顺手把互联网上常见的元数据(日期条目、「search:」这种页面残留)也一起补出来了。这就是纯自回归预训练的产物:一台功能极强的自动补全机。
同一句话给经过完整后训练的 Tülu 3 405B:
George W. Bush was the president of the United States in 2006. He served two terms in office, from January 20, 2001, to January 20, 2009.
简洁、直接、答完就停。这个转变是本书所讲的全部方法共同的产物,其中格式(format)这一层主要来自指令微调,而风格(style)那一层主要来自 RLHF。
风格与格式:两个必须分开的概念
风格指的是语气、口吻、态度。同一个问题「我明天要做汇报,慌得不行」,可以这么答:
低共情版:你没事的。多练几遍幻灯片,睡一觉,别想太多。把你会的讲出来就行了。
高共情版:这确实挺让人紧张的,有这种反应很正常。如果可以,现在快速过一遍;挑出一两个你最希望别人记住的点;然后允许自己去休息——明天讲得清楚、状态平稳,比今晚临时抱佛脚重要得多。
格式指的是答案的结构组织。「怎么改善睡眠质量」的早期模型答案是一句大白话:「尽量每天同一时间睡,下午别喝咖啡,卧室保持安静黑暗。」而现代模型会给出带标题、分「今晚就能做的」和「日常基础」两组、用箭头标注因果、末尾附一句「如果长期严重请就医」的 markdown 结构化回答。
「风格只是表面功夫」是 2023 年整个领域集体犯过的错。风格决定信息被接收的效率——同样的知识,包装方式不同,用户实际获得的价值差好几倍。这也是为什么本书专门有一个附录 B(Beyond "Just Style")讨论这件事。判断一个团队懂不懂后训练,看他们是把风格当成「调性问题」还是当成「产品性能问题」。
更硬的证据:安全性与跨域泛化
RLHF 早期最有说服力的应用是安全:Anthropic 的 HH(helpful & harmless)系列工作和 Safe RLHF 展示了 RLHF 能让模型在多个数据集上同时做到有帮助且无害——这是个天然的多目标权衡问题,用规则或者 SFT 都很难同时压住两端。
更重要的是泛化能力。多项研究比较过 SFT 和 RLHF 的泛化行为,结论一致指向:RLHF 跨领域泛化明显好于指令微调(Kirk 等人 2024;Chu 等人 2025 的标题直接叫「SFT 记忆,RL 泛化」)。代价是 RLHF 会降低输出多样性——这是同一枚硬币的两面,第 14、15 章会展开。
代价:贵、脆、容易长歪
灵活性是有账单的。RLHF 的实现成本远高于简单的指令微调:你要训一个奖励模型(而最佳实践至今没有定论,且强依赖应用领域),要跑在线采样,要调 KL 系数,还要防各种意料之外的偏差。最著名的是长度偏置(length bias):奖励模型系统性地偏好更长的回答,于是优化出来的模型越训越啰嗦,而质量并没有同步提升。
RLHF 不能凭空造出能力,它需要一个足够强的起点。ChatGPT 之后有大量论文声称「用受限的指令微调就能近似 RLHF 的效果」,但随着文献成熟,这个说法被反复证伪:对于真正在意绝对性能的模型训练,RLHF 及其后继方法是无法绕过的阶段。所以正确的心态是:RLHF 不是万能药,它是一整套后训练流程中不可省略的一环。
3. RLHF 在后训练版图中的位置
在现代语言模型训练里,RLHF 只是后训练(post-training)的一个组件。后训练指的是大规模自回归预训练之后的一切训练技术与工程实践,目的是让模型在下游任务上真正好用。
三种优化方法,三种作用
后训练可以概括为一个多阶段流程,用到三类优化方法:
| 阶段 | 学的是什么 | 损失形态 | 更新粒度 | 典型数据量级 |
|---|---|---|---|---|
| 指令微调 / 监督微调 (IFT/SFT) | 语言中的特征:格式、对话轮次结构、指令跟随的基本能力 | 交叉熵(模仿) | per-token | 10K → 1M 条 |
| 偏好微调 (Preference Fine-tuning, PreFT) | 语言的风格和难以量化的细微人类偏好;顺带一小截能力提升 | 对比式(contrastive) | per-response | 100K → 1M 对 |
| 可验证奖励强化学习 (RLVR) | 在可验证领域(数学、代码)的性能 | RL(真奖励,非代理) | per-response | 10K → 100K+ 提示 |
RLHF 位于并且主宰第二块——偏好微调。它比指令微调复杂得多,因为它通常要经过一个「真实目标的代理」(proxy reward model),而且数据本身噪声更大。同时它又比 RLVR 成熟得多、稳定得多:RLVR 是 2024 年底才被命名的新东西,而 RLHF 从 2019 年做到今天已经有一套可复现的方法论。本书因此把重心放在偏好学习上,但会把另外两个阶段也讲清楚——因为不理解 SFT 和 RLVR,就无法真正把握 RLHF 的位置。
- 预训练:建立世界知识、语言流畅度、广泛能力。决定天花板。
- SFT:教模型用问答格式回答,并且往往是在教它复现特定的 token 序列。改的是形状。
- RLHF / 偏好微调:用对比式损失整条整条地改写回答,让模型更丰富、更灵活。改的是质地。
- RLVR:提升在可验证问题上的能力,并且能外溢成更复杂的、面向智能体的行为。改的是能力。
Lambert 的补充判断:基于 RL 的后训练给的是响应级、对比式的更丰富反馈,所以模型更灵活、更有吸引力;但 SFT 依然是必需的地基,想要最高性能就绕不开它。「跳过 SFT 直接上 RL」在特定场景(如 R1-Zero)有效,但不是通用配方。
从「RLHF 配方」到「后训练系统」
2022 年那个干净的三步流程,到 2024 年已经长成了一个复杂系统。
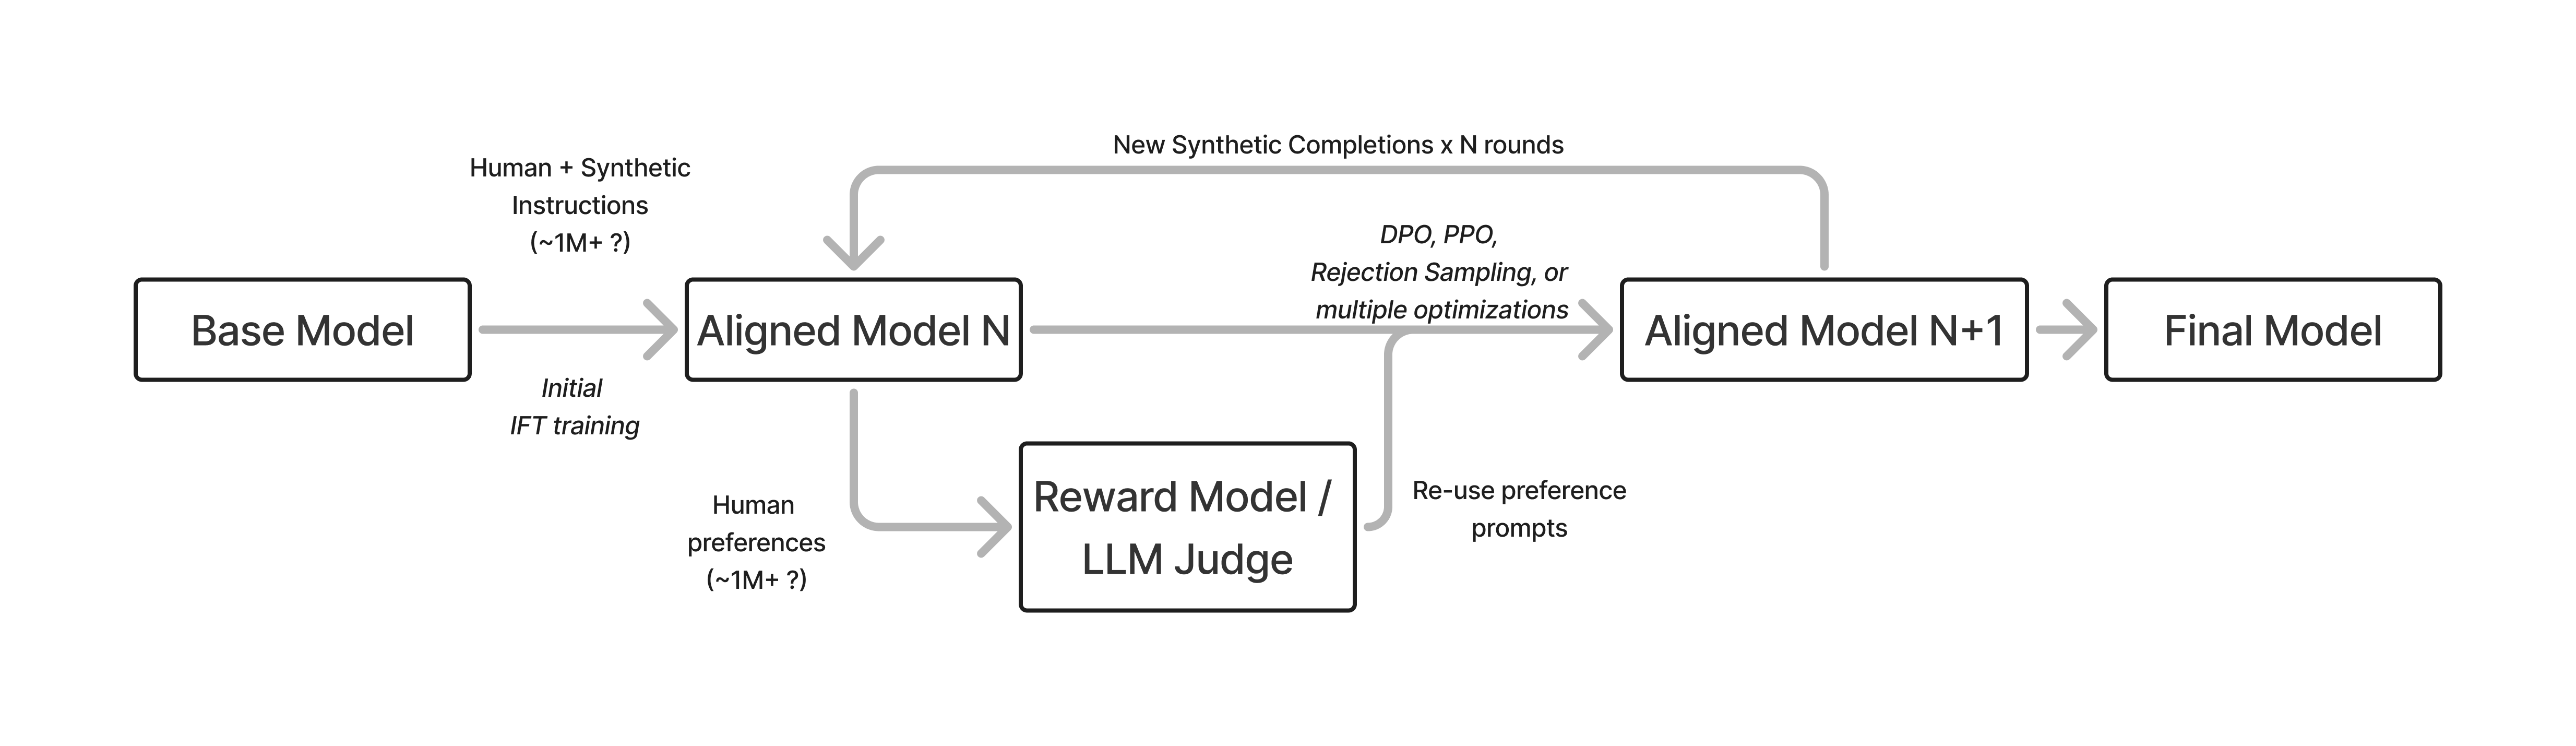
这就是为什么这本书叫《RLHF Book》却要讲十七章:真实的后训练是把若干目标函数按特定顺序、针对特定能力交织起来使用。哪些顺序有效、什么时候该用哪个优化器,目前仍是经验知识,正在缓慢地沉淀为最佳实践。
把「RLHF」和「后训练」当同义词。2023 年初这两个词几乎可以互换,因为 ChatGPT 的成功被 OpenAI 明确归功于 RLHF,全部注意力都在这上面。但今天 RLHF 只是后训练的一块:它是偏好微调这一支的主干,是 RLVR 的基础设施来源,但它既不包含中训练(mid-training)和数据配比,也不包含 RLVR、模型融合、提示词工程这些环节。混淆这两个词会让你在读论文时严重误判各家配方的差异来源。
4. 为什么 RLHF 比 SFT 更有效:判别比生成容易
这是全书最重要的一个论点,值得讲透。它有两层:一层是信息层面的(为什么用偏好信号能拿到 SFT 拿不到的东西),一层是梯度层面的(为什么这些信号的更新方式不同)。
4.1 生成—判别落差
先看一个量纲上的对比。设词表大小 $|\mathcal{V}|=128{,}000$,一条回答长 $T=500$ 个 token。那么「所有可能回答」的空间大小是 $|\mathcal{V}|^{T}=128000^{500}$——一个天文数字。生成一条好回答,等价于在这个空间里精确定位一个点;而判别两条给定回答谁更好,只是一个二分类,输出一个 bit。
把它写成两个学习问题:
$$ \underbrace{\pi_\theta:\ x\ \mapsto\ \Delta(\mathcal{V}^{T})}_{\text{生成:学一个高维分布}} \qquad\text{vs.}\qquad \underbrace{r_\phi:\ (x,y)\ \mapsto\ \R}_{\text{判别:学一个标量打分}} $$$\Delta(\cdot)$ 表示单纯形(概率分布空间)。左边要在指数级大的空间上建立一个分布,右边只要学一个从文本到实数的映射,并且训练它时只需要满足序关系(好的分数高于差的),连绝对刻度都不用对。这个不对称性就是「判别比生成容易」,也是人类标注得以规模化的原因:让标注员写一条 5 星回答很贵很慢,让标注员在两条回答里挑一条又快又便宜。
「写一首伟大的诗很难,但判断两首诗哪首更好很容易。」这句话是整个 RLHF 领域的口号。同样地:写出「什么叫有帮助」的公式很难,但看到一个有帮助的回答一眼就认得出来。RLHF 做的事就是把这个更容易的能力(判别)拟合下来,然后用它去驱动更难的能力(生成)。
这个落差还有一个可观测的推论:如果模型的 best-of-$N$ 采样(生成 $N$ 条、用打分器挑最好的一条)明显优于它的平均采样,说明模型已经能生成好回答,只是没有稳定地生成。这部分差距就是判别信号能兑现的红利。第 9 章的拒绝采样正是最直白地兑现这笔红利的方法。
4.2 梯度层面:三个机制差异
SFT 的损失就是带 completion mask 的交叉熵——只有回答部分的 token 计入损失,提示词只做条件:
$$ \mathcal{L}_{\text{SFT}}(\theta)=-\sum_{(x,y^\star)}\sum_{t=1}^{|y^\star|}\log\pi_\theta\!\left(y^\star_t\mid x,\,y^\star_{请特别注意 $y\sim\pi_\theta(\cdot\mid x)$ 这一行:期望是对当前策略自己产生的样本取的。这一个下标带来了三处根本差异。
忽略 KL 项,策略梯度定理给出:
$$ \nabla_\theta J(\theta)=\E_{y\sim\pi_\theta}\big[r_\phi(x,y)\,\nabla_\theta\log\pi_\theta(y\mid x)\big] $$由于 $\sum_y \pi_\theta(y\mid x)=1$ 恒成立,对其求导得 $\E_{y\sim\pi_\theta}[\nabla_\theta\log\pi_\theta(y\mid x)]=0$。因此对任意与 $y$ 无关的基线 $b(x)$:
$$ \nabla_\theta J(\theta)=\E_{y\sim\pi_\theta}\big[(r_\phi(x,y)-b(x))\,\nabla_\theta\log\pi_\theta(y\mid x)\big] $$取 $b(x)=\E_{y\sim\pi_\theta}[r_\phi(x,y)]$(即该提示词下的平均奖励),则:高于平均分的回答被推高,低于平均分的回答被推低。这就是 RLHF 里「负反馈」的数学来源,也是 GRPO 这类算法用组内均值做基线的出发点(第 6 章)。
反观 SFT:$\nabla_\theta(-\mathcal{L}_{\text{SFT}})=\nabla_\theta\log\pi_\theta(y^\star\mid x)$,等价于把 $r\equiv 1$、样本固定为 $y^\star$(且来自别的分布,不是 $\pi_\theta$)代入上式。SFT 只有正梯度,没有任何东西被推低——所有概率质量的下降都是 softmax 归一化的副作用,而不是有方向的惩罚。
把三处差异列清楚:
| 维度 | SFT | RLHF | 后果 |
|---|---|---|---|
| 更新粒度 | per-token:每个位置独立地被要求预测那个特定的 token | per-response:整条回答拿一个分数,再分摊到 token 上 | SFT 会强迫模型复现「这一个具体说法」;RLHF 允许模型用自己的方式说好,只要整体更优 |
| 信号方向 | 只有正例:「照着这个说」 | 对比式:「这个比那个好」,且劣例被显式压低 | RLHF 能教模型不要做什么,这是 SFT 结构上做不到的 |
| 采样分布 | off-policy:数据来自人或别的模型 | on-policy:数据是模型自己当下生成的 | RLHF 在模型实际会犯的错上做修正;SFT 只在别人的正确答案上做模仿,存在暴露偏差(exposure bias) |
「对比式损失」(contrastive loss)——损失由两个或更多样本之间的比较算出,而不是每个样本独立算出——这个词会在全书反复出现:奖励模型的 Bradley–Terry 损失是它,DPO 是它,GRPO 的组内归一化优势也是它。
4.3 为什么这带来更好的泛化
把 4.1 和 4.2 合起来就能理解泛化差异。SFT 是在特定文本特征上做记忆式拟合,模型学到的是「见到这类前缀,就输出这类 token」;一旦分布偏移,学到的东西就不迁移。RLHF 优化的是一个关于质量的标量函数,这个函数由跨大量提示词、大量回答、大量标注员收集来的偏好数据训练而成,它捕捉的是「什么样的文本特征更好」这种跨领域共享的规律。所以 Kirk 等人(2024)与 Chu 等人(2025)都观察到:RLHF/RL 的分布外泛化显著优于 SFT,代价是输出多样性下降。
「既然 RLHF 更好,那就跳过 SFT。」错。RLHF 需要一个能采样出足够好的候选的起点——如果模型在某个提示词下 $N$ 条回答全是垃圾,奖励模型给出的相对排序就只是在垃圾里矮子里拔将军,梯度指向的方向没有意义。SFT 的作用正是把策略的采样分布挪到「有好东西可挑」的区域。用第 1 节的话说:RLHF 放大已有的东西,它不凭空创造。
5. 一个 RLHF 配方的完整走查
抛开术语,「做 RLHF」具体是什么样子?下面走一遍标准的三阶段配方,也就是 OpenAI 在 2022 年用 InstructGPT 确立的那个模板。
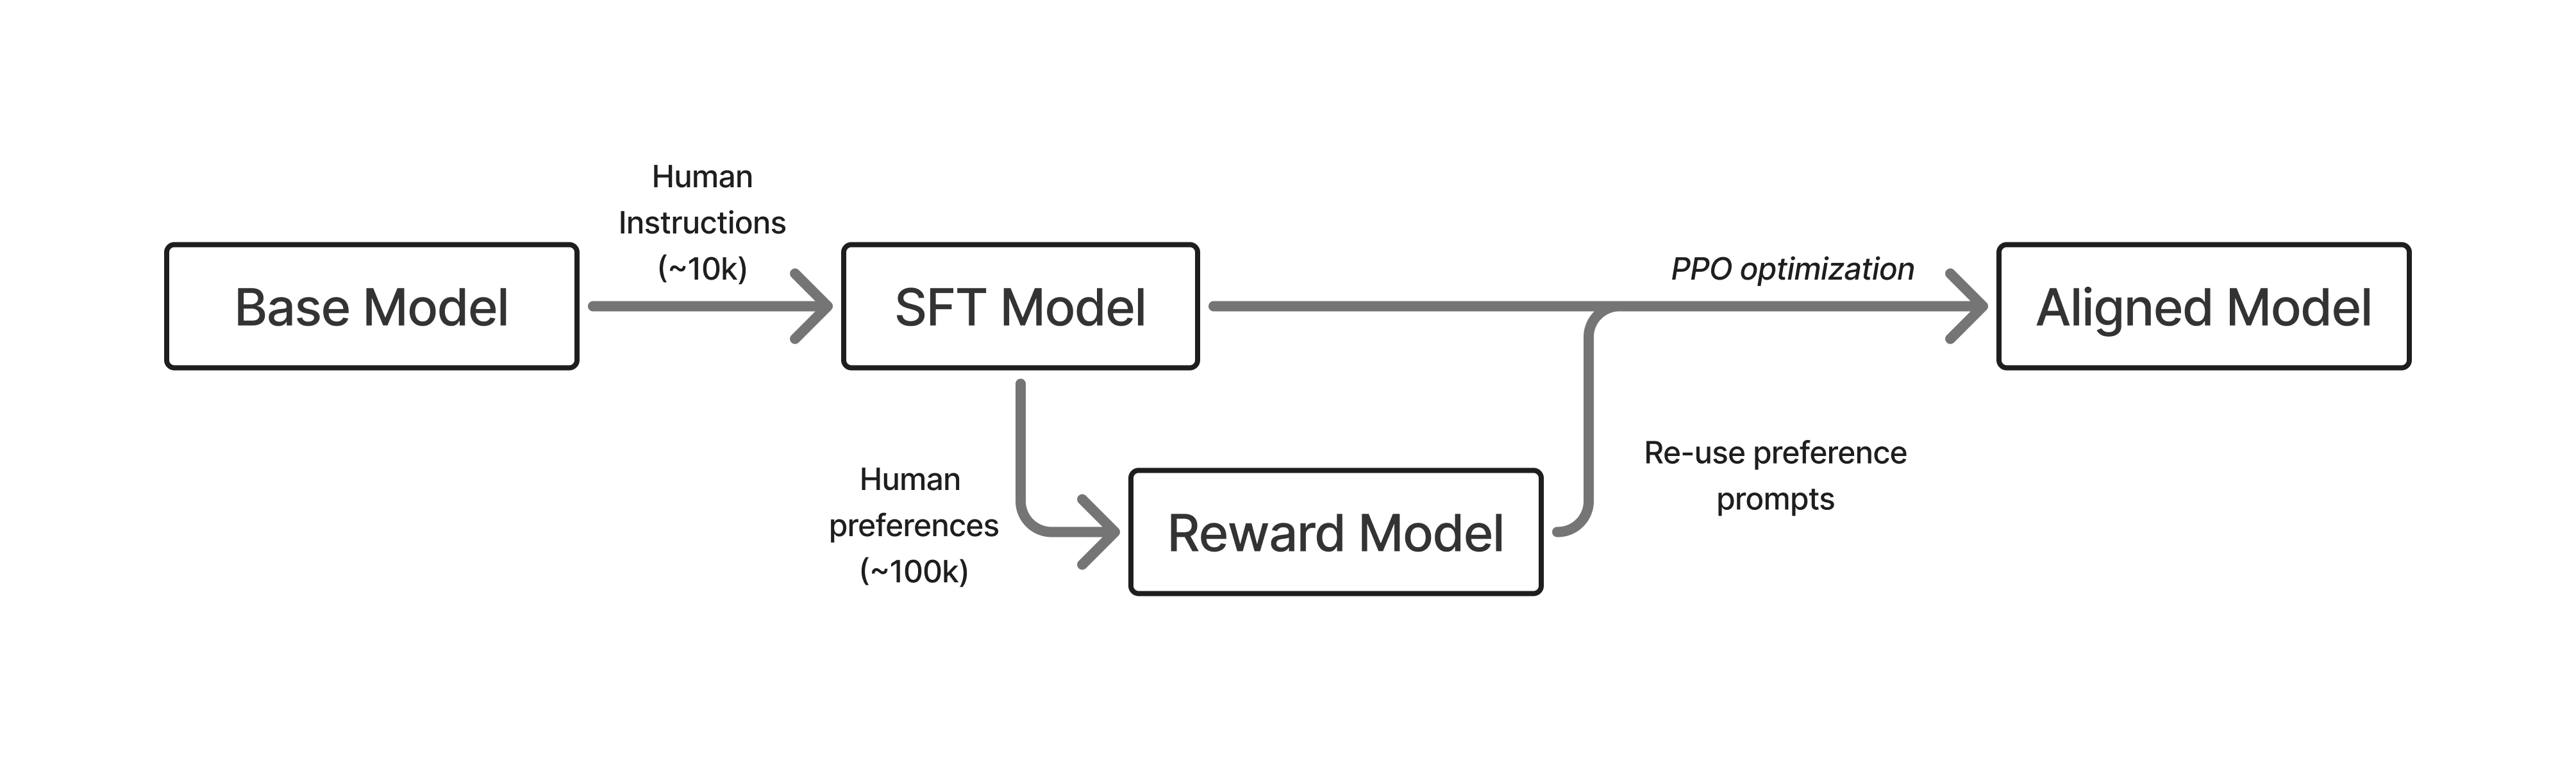
第 1 步:指令微调,把续写机变成问答机
目标是把一个「补全文本的基座模型」转成「能在问答格式下工作的指令跟随模型」。做法是同一个下一 token 预测损失,只是数据换成精心构造的问答格式样本,并且只在回答部分算损失:
$$ \mathcal{L}_{\text{SFT}}(\theta)=-\sum_{(x,y^\star)}\sum_{t=1}^{|y^\star|}\log\pi_\theta\!\left(y^\star_t\mid x,\,y^\star_{第 2 步:奖励建模,把「人类的判断」压成一个标量
RL 需要一个表示质量的奖励函数。奖励模型(Reward Model, RM)的任务就是造出这个可优化的标量信号。实现上是拿一个语言模型(通常就是上一步的 SFT 模型)换一个输出维度为 1 的线性头,在偏好对数据上微调。
概率模型(Bradley–Terry)说:分数高的那条应该赢:
$$ P(y_w\succ y_l\mid x)=\sigma\big(r_\phi(x,y_w)-r_\phi(x,y_l)\big) $$训练就是最小化这个二元事件的负对数似然:
$$ \mathcal{L}_{\text{RM}}(\phi)=-\log\sigma\big(r_\phi(x,y_w)-r_\phi(x,y_l)\big) $$符号:$x$ 是 prompt,$y_w$ 是胜出(chosen)回答,$y_l$ 是落败(rejected)回答,$\sigma$ 是 sigmoid,$r_\phi(x,y)\in\R$ 是标量打分。注意只有分数差进入损失——给所有分数加一个常数不改变任何东西,所以奖励模型的绝对刻度没有意义,跨模型比较 RM 分数是没有意义的操作。
RLHF 里用的奖励,本质是模型在预测「这段文本在一对/一批候选中成为胜出回答的概率」。不是绝对质量分,是相对胜率。想清楚这一点,后面很多现象(分数漂移、跨批次不可比、长度偏置)就都顺理成章了。
最小实现(改写自 _src/code/reward_models/train_preference_rm.py):
import torch
import torch.nn.functional as F

class PreferenceRewardModel(torch.nn.Module):
    def __init__(self, backbone, hidden_size):
        super().__init__()
        self.backbone = backbone                    # 通常用 SFT 后的模型初始化
        self.head = torch.nn.Linear(hidden_size, 1) # 标量奖励头

    def get_reward(self, input_ids, attention_mask):
        # hidden: (B, L, H)
        hidden = self.backbone(input_ids, attention_mask=attention_mask).last_hidden_state
        # 取每条序列最后一个非 padding 位置的隐状态
        seq_lengths = attention_mask.sum(dim=1) - 1          # (B,)
        idx = torch.arange(hidden.size(0), device=hidden.device)
        last_hidden = hidden[idx, seq_lengths]               # (B, H)
        return self.head(last_hidden).squeeze(-1)            # (B,)

    def forward(self, chosen_ids, chosen_mask, rejected_ids, rejected_mask):
        r_chosen   = self.get_reward(chosen_ids, chosen_mask)      # (B,)
        r_rejected = self.get_reward(rejected_ids, rejected_mask)  # (B,)
        # Bradley-Terry: -log sigmoid(r_w - r_l)
        loss = -F.logsigmoid(r_chosen - r_rejected).mean()
return loss, r_chosen, r_rejected整个奖励模型的核心就是最后那一行。logsigmoid 而不是 log(sigmoid(...)) 是数值稳定性考虑。第 5 章会展开处理长度归一化、margin、多头 RM 等变体。
第 3 步:用 RL 优化这个奖励
有了问答模型和奖励模型,就可以真正做 RLHF 了。循环是:从数据集采一批提示词 $x_i$ → 用当前策略生成回答 $y_i\sim\pi_\theta(\cdot\mid x_i)$ → 用 RM 打分 $r_\phi(x_i,y_i)$ → 加上 KL 惩罚 → 用策略梯度算法(InstructGPT 和 ChatGPT 用的是 PPO)更新参数。
$$ J(\pi)=\E_{x\sim\mathcal{D},\ y\sim\pi(\cdot\mid x)}\underbrace{\big[r_\phi(x,y)\big]}_{\text{最大化奖励}}-\underbrace{\beta\,\KL\!\left(\pi(\cdot\mid x)\,\|\,\pi_{\text{ref}}(\cdot\mid x)\right)}_{\text{但别改动太大}} $$$\pi_{\text{ref}}$ 是参考模型,通常就是冻结的 SFT 模型;$\beta$ 控制「改进行为」与「守住已有能力」之间的权衡。对离散输出,$\KL(\pi\|\pi_{\text{ref}})=\E_{y\sim\pi}[\log\pi(y\mid x)-\log\pi_{\text{ref}}(y\mid x)]$——注意它就是你在 rollout 里已经算出来的两组 log 概率之差,实现上几乎是免费的。
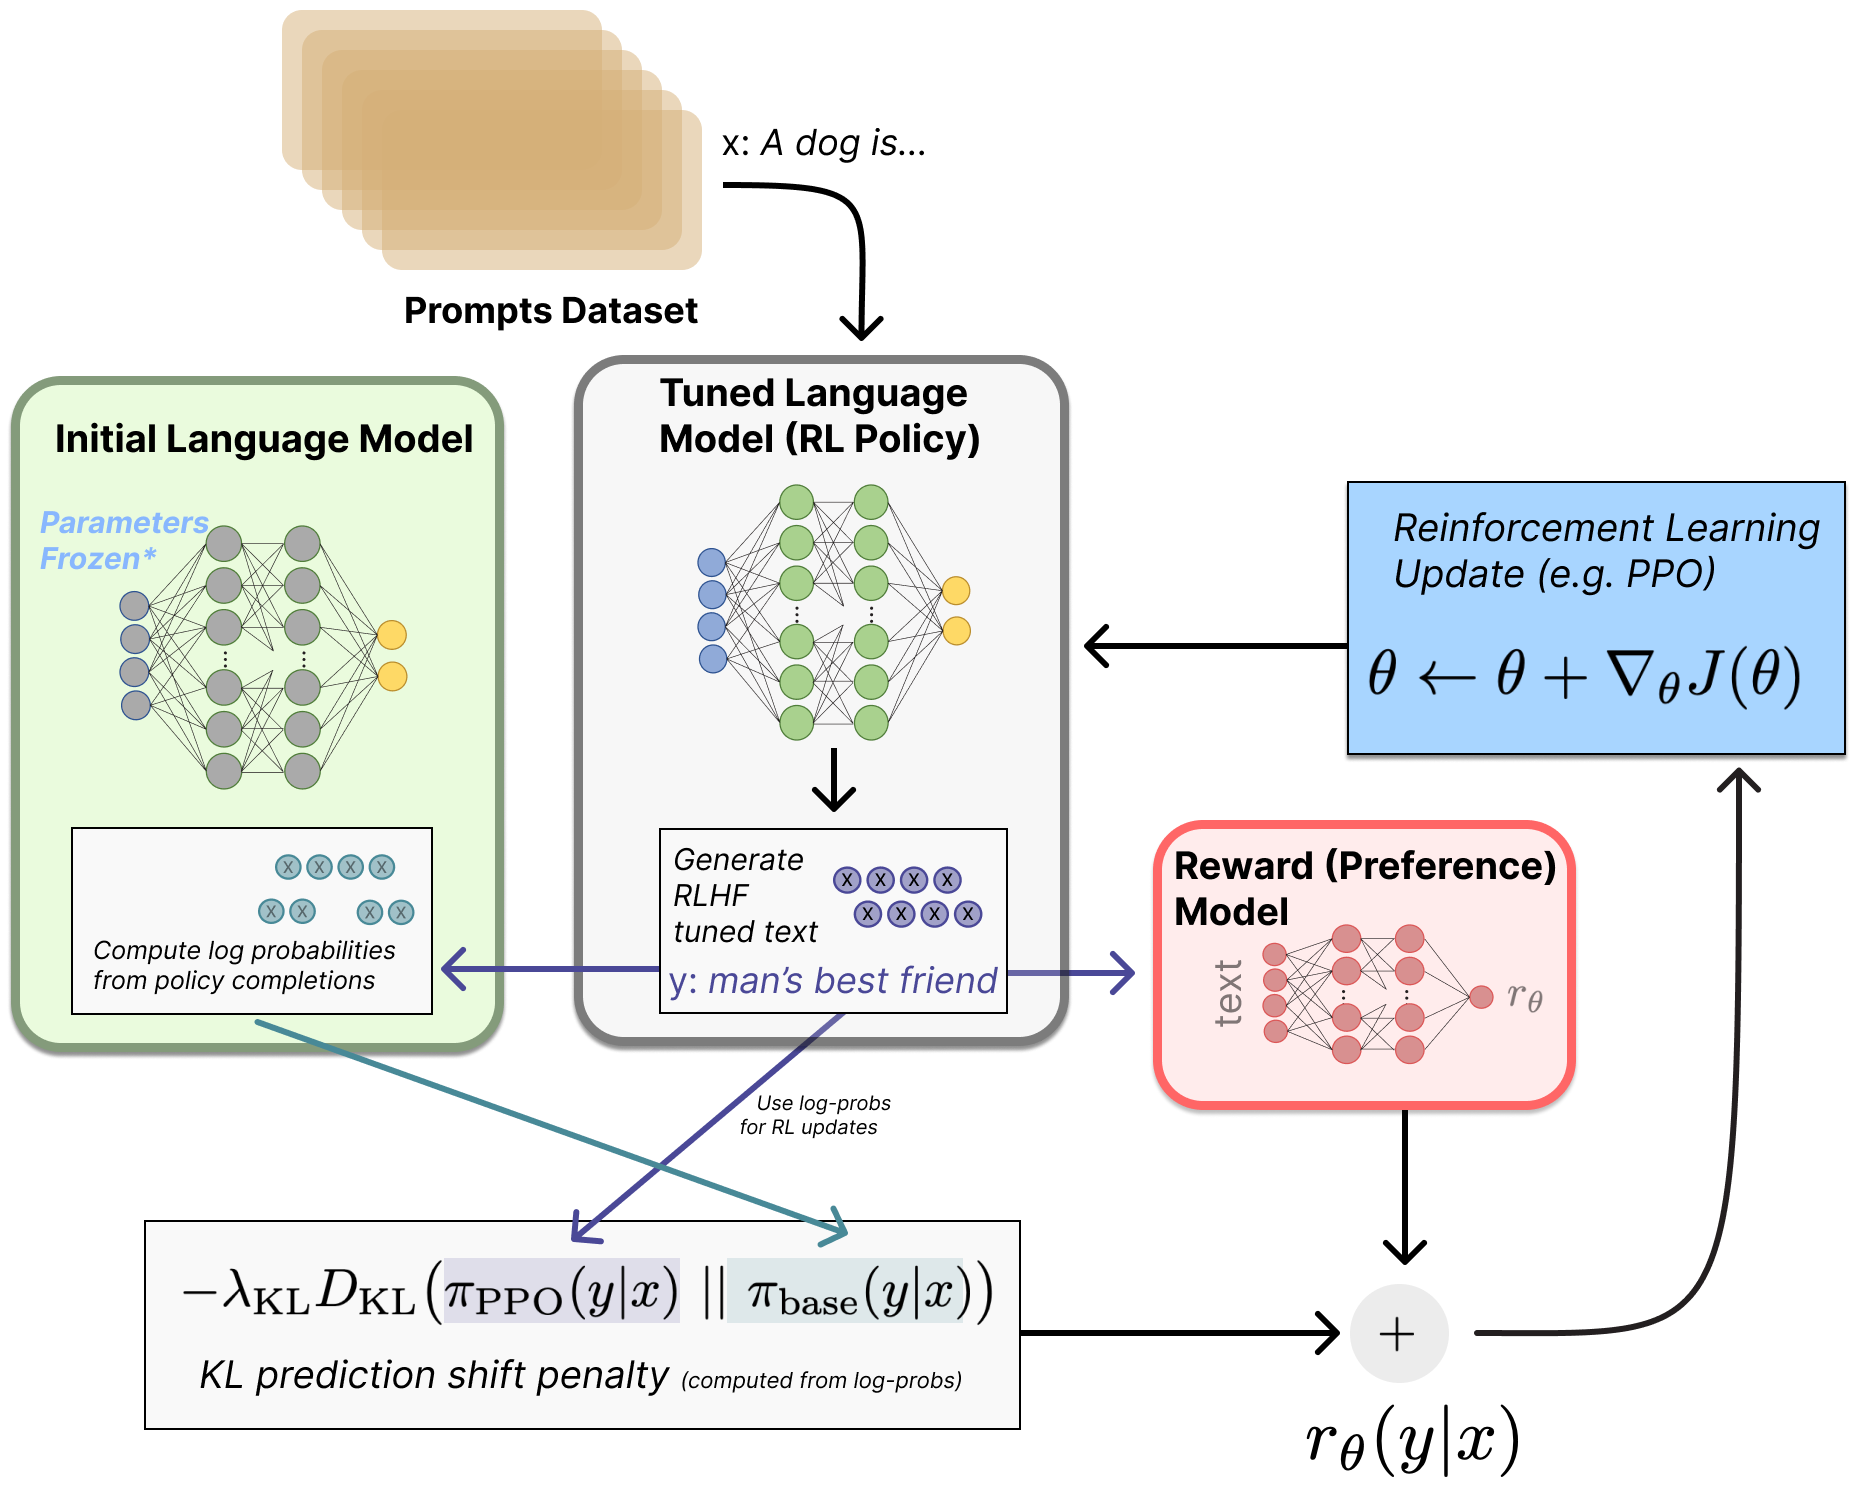
RL 的基本原语是:给定「哪些动作是好的」的信号(这里动作就是模型生成的 token),推导出把不同动作归因到不同参数上的更新规则。最后这一步把好 token 的概率抬高,并且是迭代地做,以保持初始模型的通用能力。当性能饱和,这个模型通常就是最终交付给用户的模型。
配方的量级在怎么变
| InstructGPT (2022) | Tülu 3 (2024) | DeepSeek R1 (2025) | |
|---|---|---|---|
| 指令数据 | 约 10K | 约 1M | 100K+ |
| 偏好数据 | 约 100K | 约 1M | on-policy 生成 |
| RL 阶段 | 约 100K 提示词 | 约 10K(RLVR) | 以 RLVR 为主 |
总体趋势是各阶段算力都在涨,但重心正在向 RLVR 迁移。注意 Tülu 3 的 RLVR 只用了约 10K 提示词却效果显著——RL 阶段的提示词质量远比数量重要,这一点和 SFT 的数据规模逻辑完全不同。
6. 同一个目标的三条路
第 5 节讲的是「用 PPO 优化奖励模型」这一条路。但 RLHF 的目标函数并不规定你必须用在线 RL 去解它。实践中有三条主流路线,它们优化的是同一个底层目标,区别在于怎么把策略推向高奖励区域。
路线一:拒绝采样(rejection sampling)
最简单的偏好优化方法,也是最容易被低估的。四步:
- 生成:对每个提示词从当前模型采 $N$ 条回答;
- 打分:每条过一遍奖励模型 $r_\phi(x,y)$;
- 筛选:留下分数最高的一条(或若干条);
- 微调:在这个筛过的集合上跑标准 SFT 损失。
它简单、稳定、几乎不会训崩,而且用的还是你已经调好的 SFT 代码路径。Llama 2 和 DeepSeek R1 的配方里都包含拒绝采样阶段。第 9 章会详细讲。
路线二:在线 RL(PPO / GRPO 等)
就是第 5 节那条路:每一步都从当前策略采样、打分、更新。数据完全 on-policy,能持续针对模型当下的弱点做修正,因此上限最高——但工程复杂度也最高:要同时在显存里放策略模型、参考模型、奖励模型(PPO 还要加价值模型),要处理生成与训练的调度,要调一堆超参。
路线三:直接对齐算法(DPO 及其后继)
DPO(Direct Preference Optimization)的思路是:既然我们知道 KL 正则化奖励最大化问题的最优解 $\pi^\star$ 有闭式形式,那就把奖励模型解出来代回偏好似然,从而在偏好数据上直接做梯度下降,跳过显式的奖励模型和采样循环:
$$ \mathcal{L}_{\text{DPO}}(\theta)=-\log\sigma\!\left(\beta\log\frac{\pi_\theta(y_w\mid x)}{\pi_{\text{ref}}(y_w\mid x)}-\beta\log\frac{\pi_\theta(y_l\mid x)}{\pi_{\text{ref}}(y_l\mid x)}\right) $$把它和第 5 节的 $\mathcal{L}_{\text{RM}}$ 并排看,形状完全一样:都是 $-\log\sigma(\Delta)$,只不过 $\Delta$ 里的打分函数从「独立的 RM」换成了「策略与参考模型的对数概率比」。换句话说,DPO 训练的是一个隐式奖励模型,而这个奖励模型就是策略本身。第 8 章会完整推导。
- 「DPO 实现简单得多、跑起来便宜得多,能拿到最终性能的 80% 甚至更多。我用它训了 Zephyr-Beta、Tülu 2/3、Olmo 2/3 等一系列模型。」
- DPO 论文 2023 年 5 月就挂出来了,但直到当年秋天都没有任何有影响力的模型是用它训出来的。转折点是一批突破性模型的出现——而它们全都依赖同一个发现:学习率要调得更低。Zephyr-Beta 和 Tülu 2 之后,DPO 时代才算真正开始。Chris Manning 曾当面感谢 Lambert「拯救了 DPO」。
- 这个故事的教训不是「DPO 很棒」,而是:一个算法能不能用,常常取决于一个没写在论文里的超参。开源社区花了将近半年才找到它。读论文时要对「复现失败」保持怀疑——失败的可能是你的学习率,不是这个方法。
三条路的对照
| 拒绝采样 | 在线 RL(PPO/GRPO) | DPO | |
|---|---|---|---|
| 机制 | 先筛,再 SFT | 生成 → 打分 → 更新策略 | 在偏好对上直接求梯度 |
| 奖励模型 | 需要 | 需要 | 隐式(无独立 RM) |
| on-policy 数据 | 是(从当前模型生成) | 是(每步都生成) | 否(固定偏好数据集) |
| 实现复杂度 | 低 | 高 | 低 |
| 显存驻留模型数 | 2(策略 + RM,可分离) | 3–4 | 2(策略 + 参考) |
关于哪种方法最终性能最高,学界争论很多。一般而言在线 RL 胜出,但证据是混杂的(mixed)。这不是模糊其辞——不同论文的结论确实相互矛盾,因为 RLHF 结果对数据、基座模型、评测集都极其敏感。这正是本书反复强调的方法论:在每个主题上读多篇论文,不要把任何单一结果当定论。
7. 代理目标的宿命:过优化
RLHF 的灵活性带来一个绕不开的实现难题:如何控制优化。而所有控制问题的根源只有一句话:奖励模型是代理(proxy),不是真值。
即使一个训得很好的 RM,它与真实用户满意度之间也只是相关关系。而 RL 优化器的工作就是把这个相关性榨到极致——它会毫不留情地找到「RM 分数高但真实质量低」的那部分区域。这就是古德哈特定律(Goodhart's Law):「当一个度量变成目标,它就不再是好的度量。」
过优化在实践中长什么样
| 现象 | 表现 | 为什么会发生 |
|---|---|---|
| 奖励攻击(reward hacking) | RM 分数持续上升,人工评测的实际质量在下降 | 策略找到了 RM 的分布外区域,那里 RM 的外推不可靠 |
| 冗长偏置(verbosity bias) | 回答越训越长,信息密度反而下降 | 标注数据中长回答略微更常胜出,RM 把「长」学成了「好」的特征 |
| 谄媚(sycophancy) | 模型顺着用户说,牺牲准确性 | 标注员倾向于给「同意自己」的回答打高分 |
| 过度拒答(over-refusal) | 拒绝完全正当的问题,比如「怎么 kill 一个 linux 进程」 | 安全偏好数据把表层词汇特征当成了危险信号 |
长度偏置尤其顽固,专门有一批工作研究它(Singhal 等人 2023 关于 RLHF 中的长度相关性;Park 等人 2024 关于在 DPO 里把长度从质量中解耦)。如果你在自己的实验里看到「训完之后平均回答长度翻倍、评分也涨了」,第一反应应该是怀疑评测器,而不是庆祝。
回到目标函数 $J(\pi)=\E_{y\sim\pi}[r_\phi(x,y)]-\beta\KL(\pi\|\pi_{\text{ref}})$。对固定 $x$,在无约束的分布空间上解这个变分问题,最优解有闭式:
$$ \pi^\star(y\mid x)=\frac{1}{Z(x)}\,\pi_{\text{ref}}(y\mid x)\,\exp\!\left(\tfrac{1}{\beta}r_\phi(x,y)\right) $$其中 $Z(x)=\sum_y \pi_{\text{ref}}(y\mid x)\exp(r_\phi(x,y)/\beta)$ 是归一化常数(配分函数)。这个式子说明两件事:
- 最优策略是参考模型的指数倾斜(exponential tilting)——$\pi_{\text{ref}}$ 给概率为零的回答,$\pi^\star$ 也给零。RLHF 只能重新分配已有的概率质量,无法凭空创造新行为。这是第 4.3 节那个「不能跳过 SFT」结论的严格版本。
- $\beta\to 0$ 时,$\exp(r/\beta)$ 退化成在 $\argmax_y r_\phi$ 上的点质量——策略坍缩到「RM 最爱的那一条回答」,也就是彻底的奖励攻击。$\beta\to\infty$ 时 $\pi^\star\to\pi_{\text{ref}}$,什么也没学到。$\beta$ 就是你在「学到东西」和「学歪」之间画的那条线。
顺带说明:这个闭式解正是 DPO 推导的起点——把上式对 $r_\phi$ 反解,代入 Bradley–Terry 似然,$Z(x)$ 在成对相减时消掉,就得到第 6 节的 $\mathcal{L}_{\text{DPO}}$。
实践含义
KL 惩罚是主要防线,但它只是「限制策略能漂多远」,并不能修复奖励模型本身的缺陷。过优化是所有基于偏好的训练中一个根本性的张力,不是一个可以调好参数就消失的 bug。工程上你需要:
- 把 KL 散度当作一等公民监控指标,和奖励曲线画在一起看。奖励涨但 KL 也在飞涨,通常意味着在攻击 RM。
- 准备一套 RM 之外的评测(人工评测、LLM-as-a-judge、能力基准),因为你不能用被优化的那个指标来验收优化结果。
- 接受「训到某个点就该停」这个事实。RLHF 没有「训得越久越好」这回事。
第 14 章专门讲过优化的定性观察和为什么它不可避免,第 15 章讲各种正则化工具。这两章是把 RLHF 从「论文能跑」做到「产品能上」的关键。
8. 后训练的直觉:激发理论 vs 肤浅对齐假说
前面讲了 RLHF 做什么,这一节回答更本质的问题:为什么在一个已经训好的基座模型上,还能刷出这么多性能?
F1 底盘类比
Lambert 把这个直觉称为后训练的激发解释(elicitation interpretation):我们做的全部事情,就是把基座模型里已经存在的有价值行为放大出来。
类比一级方程式赛车。每支车队每年拿到新底盘和新引擎,然后整整一年都在改空气动力学和各种子系统——赛季中的性能提升幅度,往往大于换一代底盘带来的提升。最好的车队在一个赛季内能榨出惊人的性能差距。
后训练也是这样:面对一个静止不动的基座模型,随着你越了解它的脾气和倾向,你能从它身上榨出的性能就越多。这里的「后训练」包含预训练末尾及之后的一切——中训练(mid-training,即退火阶段和高质量收尾数据)、指令微调、偏好微调、RLVR 等等。
基座模型决定天花板,后训练的工作是把天花板够到。基座模型里潜藏的智能远超早期后训练配方所能暴露的部分;难点在于既要把模型从「下一 token 预测」重塑成「对话式问答」,又要在这个过程中把预训练学到的知识和智能完整地提取出来。
一个干净的实证:Ai2 的全开源小型 MoE 模型 OLMoE Instruct,第二版只改了后训练、预训练部分基本没动,热门基准的平均分就从 38.44(OLMoE-1B-7B-0924-Instruct,2024 年 9 月)涨到 45.62(OLMoE-1B-7B-0125-Instruct,2025 年 1 月)。书中正文把这组数字概括为「从 35 涨到 48」,量级是一致的:同一个基座,只换后训练配方,绝对分数涨 7–13 个点。
反过来看也成立。OpenAI 2025 年 2 月发布的 GPT-4.5 作为消费级产品基本算失败——基座太大,没法服务上百万用户。但从激发理论的视角,它是一个远比之前更有活力、更值得在其上做后训练的底盘。
肤浅对齐假说,以及它错在哪
与激发理论相关但结论不同的,是 LIMA 论文(Less is More for Alignment, 2023)提出的肤浅对齐假说:
模型的知识与能力几乎全部在预训练中学到,而对齐只是教它在与用户交互时该用哪个子分布的格式。如果这个假说成立,且对齐主要是学风格,那么一个推论就是:用相当少的样本就足以调好一个预训练模型。
Lambert 的评价是:这篇论文抓对了一些重要直觉,但在大图景上是因为错误的理由而正确的。拆开说:
- 对的部分:几千条指令微调样本确实能大幅改变一个模型,并在一批窄评测上(AlpacaEval、MT-Bench、Chatbot Arena 之类)显著提分。这对新模型的短期适配非常重要。
- 错的部分:深度学习的全部成功史都在告诉你「数据规模对性能至关重要」。作者讨论的是对齐与风格——那是当时学术界后训练关注的全部范围——这些窄评测的提升并不总能迁移到更困难的能力上。这也是为什么 Meta 不会只用这样一个数据集去训 Llama Chat。
- 被证伪的部分:换了数据,影响可以远远不止「肤浅」。今天的基座模型(完全没有后训练)可以直接用 RL 在数学题上训练,学会输出完整的思维链,然后在 BigBenchHard、Zebra Logic、AIME 等一整套推理评测上提分。这不是格式的重新选择。
「肤浅对齐假说站不住脚,和那些认为『RLHF 和后训练只是调调氛围(vibes)』的人错得一样。这是整个领域在 2023 年必须翻过去的一课,尽管到今天仍有不少 AI 观察者停留在这个认知上。」
补充一句同样重要的观察:模型的风格是运行在行为之上的——比如现在流行的长思维链,它既是行为也是风格。当后训练进入智能体和推理模型的时代,肤浅对齐假说会进一步瓦解。有意思的是,三年后(2026)一篇《用任务复杂度操作化肤浅对齐假说》的论文,反而给出了与激发理论相符的更细致刻画。
可验证奖励与算力规模:激发理论的边界
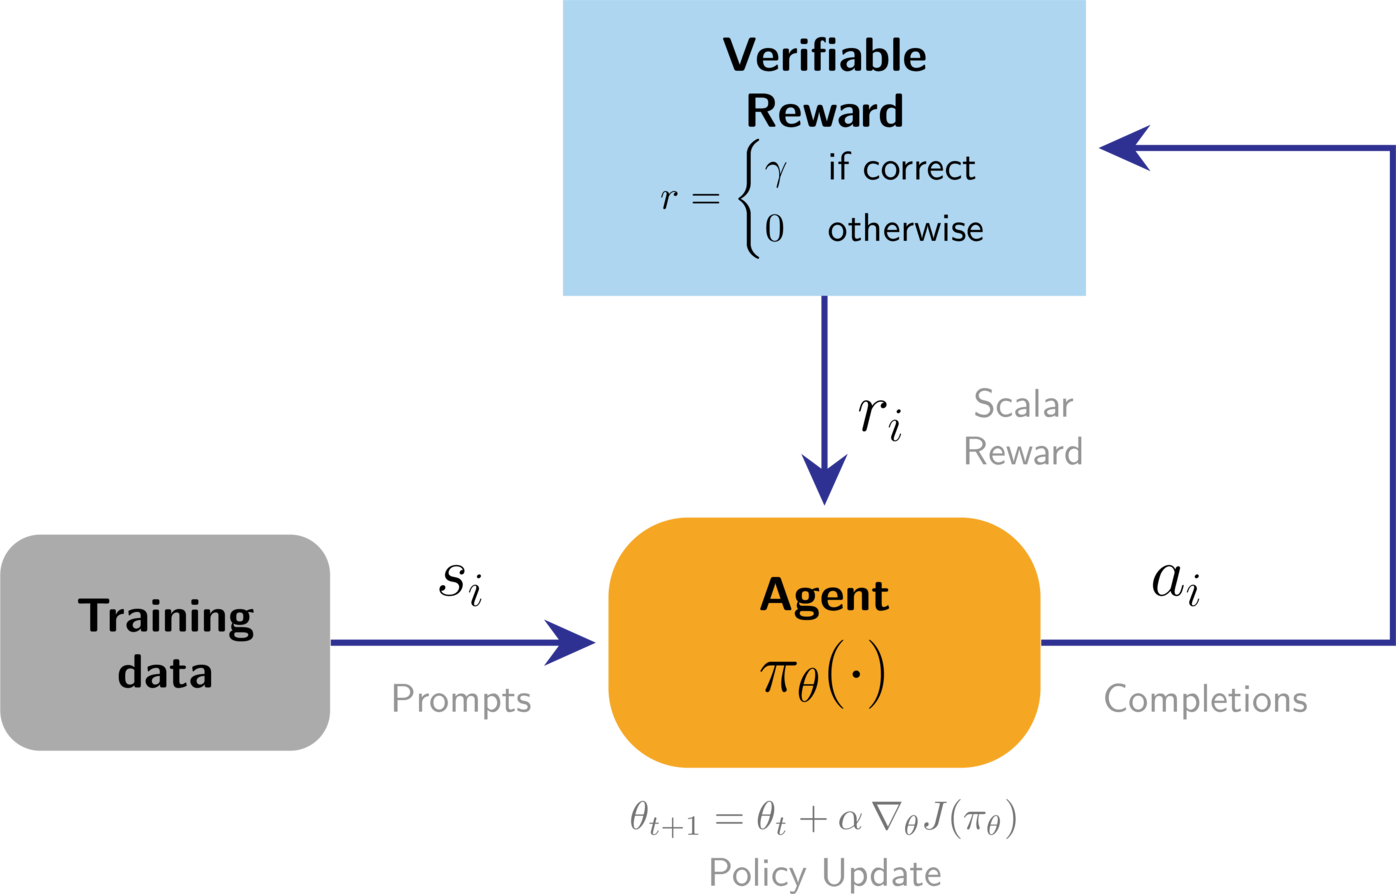
这正是激发理论开始遇到边界的地方。自 Tülu 3(2024 年秋)提出 RLVR 这个名字以来,后训练消耗的算力急剧增长:
- DeepSeek R1:RL 训练用了约 147K H800 GPU 小时,而其底座 DeepSeek V3 的预训练是 2.8M GPU 小时——后训练只占总算力的约 5%,却带来了推理能力的质变。
- 单次消融实验:2026 年研究 RL 规模化的工作显示,一次消融跑就要 10K–100K GPU 小时。这个量级相当于 Olmo 3.1 Think 32B(2025 年 11 月发布)整个 RL 阶段的算力——200 余张 GPU 连续跑 4 周(讲座给出的具体数字是 28 天、224 卡)。而且性能在整个训练过程中提升得非常稳定,被迫停止时曲线还在往上走。
OpenAI 的 o1 揭示了一个双向的规模化图景:推理时算力(生成的 token 数)与性能呈对数线性关系,训练时 RL 算力与性能同样呈对数线性关系。核心问题因此变成:扩大 RL 训练规模,究竟只是从基座里激发出更多东西,还是真的在教会模型新能力?
激发理论很可能只在轻量后训练配方下成立——那种用来把模型特化到某个领域的配方。对于算力密集的前沿模型,RL 阶段的规模已经大到让「只是激发」这个说法站不住。2026 年的大规模后训练科学还处在非常早期的阶段,正在把预训练积累的规模化方法论搬到这个新领域里,所以上面这些 GPU 小时数还会继续变;但「后训练算力占比持续上升」这个趋势不会变。
9. 我们是怎么走到这里的
为什么这本书是在此刻写出来的?ChatGPT 之后,后训练这门手艺经历了好几个季节,每个季节的共识都不一样,而且经常是错的。了解这段历史能帮你判断手上论文的结论有多少还成立。
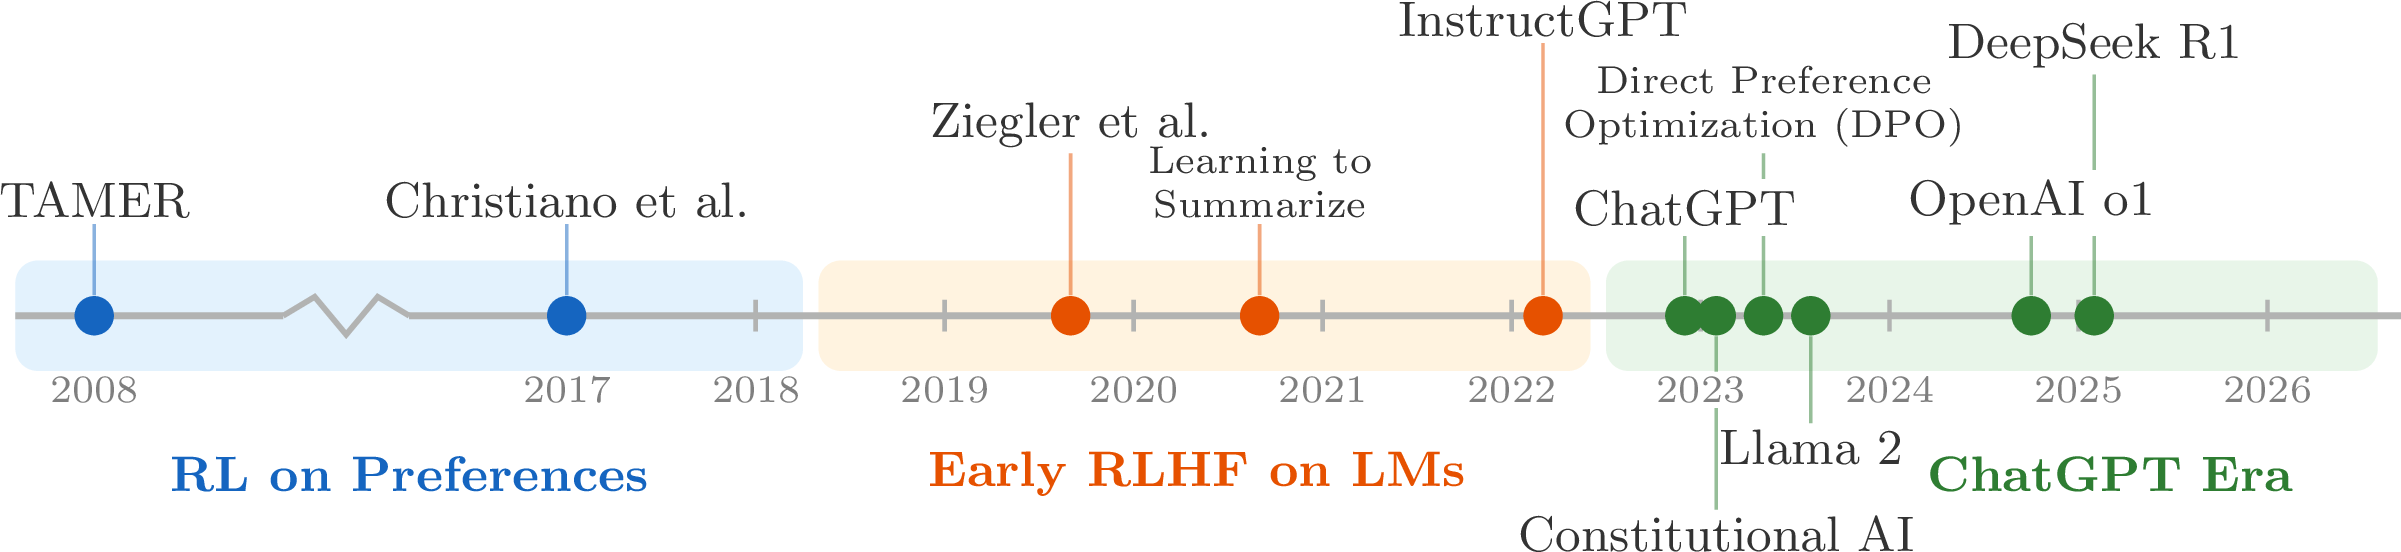
阶段一(2023):Alpaca 时代与「氛围评测」
Alpaca、Vicuna、Koala、Dolly 的时代:用少量人类数据加上 Self-Instruct 风格的合成数据,微调原版 LLaMA,就能做出和 ChatGPT 神似的行为。当时的评测标准完全是「氛围」加人工评测——大家被小模型也能有这种跨领域表现震住了,这份兴奋是合理的。
这个阶段开源后训练比闭源跑得更快、发得更多、声音更大。各家公司在手忙脚乱地追赶(DeepMind 与 Google Brain 的合并就发生在这个窗口),需要时间才跟上。开源配方领先与落后是周期性交替的,这个模式在后面几年不断重演。
阶段二(2023 中–2024):怀疑期与 DPO 的崛起
Alpaca 之后开源配方第一次掉队,那个阶段的主旋律是对 RLHF 的怀疑——尽管 OpenAI 明确说 RLHF 是第一版 ChatGPT 成功的关键。很多公司认为自己不需要做 RLHF。一句话在当时极其流行:「指令微调足以完成对齐」(instruction tuning is enough for alignment)。这句话直到今天仍有影响力,尽管反证已经非常明显。
这份怀疑之所以持久,主要是钱的问题:偏好数据的预算在 10 万到 100 万美元量级,开源团队根本负担不起,于是把「做不起」合理化成了「不需要做」。早期就投入 RLHF 的公司最后赢了——Anthropic 在 2022 年就发表了大量 RLHF 研究(A General Language Assistant、HH、Constitutional AI),今天它的后训练可以说是业界最好的。开源团队苦于无法复现、甚至不知道闭源的基本技巧,这个鸿沟是贯穿全书的一条暗线。
开源对齐方法上的第一次转向来自 DPO:它证明了你可以用更少的活动部件解同一个优化问题——直接在成对偏好数据上做梯度步。如第 6 节所述,真正让 DPO 落地的是「更低的学习率」这个发现,Zephyr-Beta 和 Tülu 2 之后,偏好微调从 2023 年底开始成为「发一个好模型的入场券」。
DPO 时代贯穿 2024 年,表现形式是层出不穷的算法变体,但开源配方其实陷入了又一次停滞:知识和资源都被榨干了。Zephyr 和 Tülu 2 发布一年之后,同一个突破性数据集 UltraFeedback 在开源偏好微调里仍然可以说是最优选择——这本身就说明数据侧几乎没有前进。
与此同时,Llama 3.1 和 Nemotron 4 340B 的技术报告给出了实质性的暗示:大规模后训练要复杂和有效得多。闭源实验室做的是完整后训练——指令微调、RLHF、提示词设计等构成的大型多阶段流程——而学术论文只是在挠表皮。Tülu 3 就是为了给未来的学术后训练研究打地基而做的一次全面开放努力。
阶段三(2025):RLVR 与复杂配方
Tülu 3、Olmo 3、Nemotron 3、DeepSeek R1 的一年。创新主战场转移到可验证奖励强化学习、推理训练及相关方向。这些新方法大量建立在 RLHF 的基础设施和思想之上,但演化速度快得多。
阶段四(2026):智能体训练与多轮 RL
后训练与 RLHF 的变化速度可能是史上最快的。语言模型正在变成「原生会用工具」的东西——今天讨论一个模型,讨论的是工具、脚手架(harness,即你怎么告诉模型使用这些工具)以及远不止权重的一整套系统。RLHF 与人类偏好并没有消失,但它们的演化慢下来了,也离开了行业注意力的中心。
正因为 RLHF 已经度过了最初剧烈变动的时期,它的文献第一次稳定下来了——技术、问题、权衡都被反复验证过。这本书要捕捉的就是这批稳定下来的知识。而 RLVR、推理训练这些还在高速变化的部分,本书讲它们的结构,不追它们的数字。
10. 全书路线图
这本书希望覆盖标准 RLHF 实现的每一个核心步骤。它不试图讲全每个组件的历史,也不追最新研究方法,只讲那些被反复验证过的技术、问题和权衡。
四个板块,十七章
| 板块 | 章 | 这一章要解决的问题 |
|---|---|---|
| 引入 全书通用的参考与背景 | 1. 导论 | RLHF 是什么、在后训练里的位置、为什么有效(本章) |
| 2. RLHF 简史 | 历史上的关键模型与论文,技术脉络怎么来的 | |
| 3. 训练总览 | RLHF 的训练目标是怎么设计出来的,以及理解它需要的基本工具 | |
| 核心训练流程 把模型对齐到人类偏好的整套技术 | 4. 指令微调 | 怎么把语言模型适配到问答格式 |
| 5. 奖励建模 | 从偏好数据训练奖励模型,作为 RL 的优化目标(或用于数据筛选) | |
| 6. 强化学习 | 优化奖励模型(及其他信号)用到的核心 RL 技术。全书最长的一章 | |
| 7. 推理与推理时扩展 | 新的 RL 训练方法在推理时扩展上扮演什么角色 | |
| 8. 直接对齐算法 | DPO 及其后继:跳过奖励模型,直接从成对偏好数据优化 RLHF 目标 | |
| 9. 拒绝采样 | 用奖励模型 + 指令微调做对齐的最基础技术 | |
| 数据与偏好 驱动 RLHF 的数据与它真正要解决的大问题 | 10. 偏好的本质 | 为什么需要人类偏好数据,以及该怎么理解它 |
| 11. 偏好数据 | 偏好数据具体是怎么采集的 | |
| 12. 合成数据 | 从人类数据转向合成数据、AI 反馈怎么工作、蒸馏怎么用 | |
| 13. 工具调用与函数调用 | 训练模型在输出中调用函数或工具的基础 | |
| 实践问题 实现与评估 RLHF 时的根本困难 | 14. 过优化 | RLHF 为什么会出错,以及软优化目标下过优化为何不可避免 |
| 15. 正则化 | 把这些优化工具约束在参数空间有效区域内的手段 | |
| 16. 评估 | 评测(以及提示词)在语言模型中不断演变的角色 | |
| 17. 塑造模型性格与产品 | 各大实验室如何用 RLHF 把模型微妙地匹配到自家产品上 |
附录部分:A. 定义——RL、语言建模及本书用到的其他 ML 技术的数学定义(第 1 节讲的 MDP、KL、Bradley–Terry 都能在这里查到);B. 超越「只是风格」——风格在信息传递中扮演的关键角色,以及 RLHF 因此被严重低估的原因;C. 实践问题——延伸讨论与工程细节。
怎么读这本书
训练语言模型是一个极其复杂的过程,往往牵涉几十到上百人的技术团队、数据和算力成本达数百万美元。这本书有三个目的:把藏在大公司内部的前沿研究蒸馏成清晰的主题和权衡;让你能跑起最基础的代码示例、亲手微调模型;以及——超出技术本身——传递为什么 RLHF 对现代 AI 模型至关重要的直觉。
「一本能给出针对某个具体需求的精确 RLHF 配方的书是不可能存在的」——这正是为什么市场上有一整个价值数百万美元的行业在提供 RLHF 及相关训练服务。这本书提供的是做一次玩具实现或扎进文献所需的最小知识,它不是一本详尽的教科书。
由此推出的阅读方法论:每个主题都要读多篇论文,不要把任何单一结果当定论。RLHF 是一个不寻常的学术领域——已发表的结果往往噪声大,跨设置难以复现。书里给了大量学术风格的引用,就是为了让你顺着去读原文。
RLHF 的未来
随着语言建模投入的加大,传统 RLHF 方法衍生出了大量变体,「RLHF」这个词在口语里已经变成若干重叠方法的统称。准确的层级关系是:RLHF 是偏好微调(PreFT)的一个子集,PreFT 还包含直接对齐算法(第 8 章)这类不学中间奖励模型、直接在偏好数据上求梯度的方法;而 PreFT 又是后训练的一部分。
随着更多「用 RL 微调语言模型」的成功案例出现(比如 OpenAI 的 o1 系列),RLHF 会被视为一座桥梁——它让业界相信值得在大规模基座模型上继续投入 RL 方法。但作者最后强调的是另一件事:RLHF 的内核,是研究现代 AI 根本问题的一面透镜。怎么把人类价值观与目标的复杂性,映射进我们日常使用的系统里?这本书希望成为未来几十年围绕这个问题的研究与经验的起点。
本章小结
一句话速查
| 概念 | 一句话 | 展开于 |
|---|---|---|
| RLHF 的存在理由 | 目标可评价但难指定:能判断哪个更好,写不出「更好」的公式 | 第 1 节 |
| 三步流水线 | SFT → 奖励模型 → 用 RL 优化奖励模型 | 第 5 节 / 第 4、5、6 章 |
| RLHF 目标函数 | $J(\pi)=\E[r_\phi(x,y)]-\beta\KL(\pi\|\pi_{\text{ref}})$,最大化奖励但别漂太远 | 第 5、7 节 / 第 3 章 |
| 最优策略闭式解 | $\pi^\star\propto\pi_{\text{ref}}\exp(r_\phi/\beta)$,是参考模型的指数倾斜 | 第 7 节 / 第 8 章 |
| 判别 > 生成 | 学一个标量打分远比学一个 $|\mathcal{V}|^T$ 上的分布容易,这是 RLHF 的杠杆 | 第 4.1 节 |
| SFT vs RLHF | per-token 模仿 / 只有正例 / off-policy 对比 per-response 对比 / 有负反馈 / on-policy | 第 4.2 节 |
| 后训练三件套 | SFT 学特征、PreFT 学风格与细微偏好、RLVR 提可验证能力 | 第 3 节 |
| 三条优化路线 | 拒绝采样(简单)、在线 RL(上限高)、DPO(便宜,约 80% 效果) | 第 6 节 / 第 6、8、9 章 |
| 过优化 | 奖励模型是代理目标,古德哈特定律必然生效,只能约束不能消除 | 第 7 节 / 第 14、15 章 |
| 激发理论 | 基座模型定天花板,后训练负责够到它;但大规模 RL 正在突破这个框架 | 第 8 节 |
要点清单
- 看到「RLHF」时先确认说话人指的是狭义的三步配方、偏好微调这一整类,还是整个后训练。三者在 2023 年可以混用,今天不行。
- 奖励模型只有相对分数有意义。跨模型、跨批次比较 RM 绝对分数是无效操作。
- RLHF 无法凭空创造行为——$\pi_{\text{ref}}$ 概率为零的地方 $\pi^\star$ 也是零。所以强 SFT 起点是必需的。
- 训练时把 KL 曲线和奖励曲线画在一起看;奖励涨、KL 飞涨 = 正在攻击奖励模型。
- 看到「回答变长且分数变高」时先怀疑长度偏置,不要庆祝。
- 复现某个算法失败时,先排查学习率——DPO 被开源社区雪藏半年就是因为这个。
- RL 阶段的提示词质量远比数量重要:Tülu 3 的 RLVR 只用了约 10K 提示词。
- 每个主题读多篇论文。RLHF 领域的单篇结果噪声很大、跨设置难复现。
动手实验
本章没有配套作业代码,但有两个 30 分钟内能跑完、能直接印证正文论点的小实验。
实验一:亲眼看见「续写机 → 助手」的转变
取同一系列的 base 与 instruct 两个检查点(例如 Qwen3-1.7B-Base 与 Qwen3-1.7B,或任意 Llama 系列的 Base/Instruct 对),喂同一个非疑问句形式的前缀:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

PROMPT = "The president of the United States in 2006 was"

for model_id in ["Qwen/Qwen3-1.7B-Base", "Qwen/Qwen3-1.7B"]:
    tok = AutoTokenizer.from_pretrained(model_id)
    model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.bfloat16).cuda()
    # base 模型直接喂裸文本;instruct 模型要套对话模板
    if model_id.endswith("Base"):
        text = PROMPT
    else:
        text = tok.apply_chat_template([{"role": "user", "content": PROMPT}],
                                       tokenize=False, add_generation_prompt=True)
    ids = tok(text, return_tensors="pt").to("cuda")
    out = model.generate(**ids, max_new_tokens=160, do_sample=False)
    print("=" * 20, model_id)
print(tok.decode(out[0][ids["input_ids"].shape[1]:], skip_special_tokens=True))能观察到什么:base 模型会继续补全成一段百科式文本,甚至带出日期条目、导航残留这类网页元数据,而且停不下来;instruct 模型会给一个完整句子的回答然后终止。再把 base 模型也套上对话模板试一次——它多半仍然收不住,说明「知道该停」这件事是后训练教的,不是模板本身的功劳。
进阶:对同一个提示词,用 base 模型采 $N=16$ 条(do_sample=True, temperature=1.0),人工挑出最好的一条。你会发现 16 条里往往真的有一条不错——这就是第 4.1 节说的「best-of-$N$ 红利」,也正是拒绝采样和 RLHF 要兑现的东西。
实验二:50 行看懂 Bradley–Terry 到底在学什么
不需要语言模型。用一个 2 维「回答特征」(比如 [有用性, 长度])和一个线性打分器,在合成偏好对上跑 BT 损失:
import torch, torch.nn.functional as F

torch.manual_seed(0)
# 真实偏好只由第 0 维(有用性)决定,第 1 维(长度)是干扰项
true_w = torch.tensor([1.0, 0.0])

def sample_pairs(n, length_confound=0.0):
    y_a, y_b = torch.rand(n, 2) * 2 - 1, torch.rand(n, 2) * 2 - 1
    # length_confound > 0 时,标注员给长回答一点额外偏爱(模拟长度偏置)
    score = lambda y: y @ true_w + length_confound * y[:, 1]
    win = (score(y_a) > score(y_b))
    chosen = torch.where(win.unsqueeze(1), y_a, y_b)
    rejected = torch.where(win.unsqueeze(1), y_b, y_a)
    return chosen, rejected

w = torch.zeros(2, requires_grad=True)          # 我们的「奖励模型」
opt = torch.optim.Adam([w], lr=0.05)
chosen, rejected = sample_pairs(4096, length_confound=0.6)

for step in range(400):
    loss = -F.logsigmoid(chosen @ w - rejected @ w).mean()   # Bradley-Terry
    opt.zero_grad(); loss.backward(); opt.step()

print("学到的权重:", w.detach())                 # 例如 tensor([2.9, 1.8])
print("准确率:", ((chosen @ w) > (rejected @ w)).float().mean().item())能观察到什么:(1) length_confound=0 时第二维权重收敛到 ~0,模型正确地忽略了长度;(2) 把 length_confound 调到 0.6,第二维权重立刻变正——标注者的系统性偏置会被奖励模型忠实地学进去,这就是第 7 节冗长偏置的最小可复现版本;(3) 把 w 整体乘以 10 再算准确率,准确率不变——印证了「只有分数差有意义,绝对刻度无意义」。
延伸阅读
RLHF 的源头(先读这三篇)
- Deep Reinforcement Learning from Human Preferences (Christiano 等, 2017) — RLHF 的奠基之作。后空翻那个例子把「能评价但写不出奖励」讲得比任何公式都清楚。
- Fine-Tuning Language Models from Human Preferences (Ziegler 等, 2019) — 第一次把 RLHF 用在语言模型上,KL 惩罚项从这里进入标准配方。
- Training Language Models to Follow Instructions with Human Feedback / InstructGPT (Ouyang 等, 2022) — 确立三步配方的那篇。本章第 5 节走查的就是它,值得逐节精读。
早期 RLHF 在语言模型上的其他重要工作
- Learning to Summarize with Human Feedback (Stiennon 等, 2020) — 把 Ziegler 的方法扩展到长文摘要,用 PPO。看 RLHF 如何在一个具体任务上超过人类参考摘要。
- WebGPT (Nakano 等, 2021) — 训练模型浏览网页并带引用回答问题,今天的搜索/智能体训练的前身。
- Training a Helpful and Harmless Assistant with RLHF (Bai 等, 2022) — Anthropic HH,开源研究里被用得最多的偏好数据集出自这里。
- A General Language Assistant as a Laboratory for Alignment (Askell 等, 2021) — 「有用、诚实、无害」框架的来源。
- GopherCite (Menick 等, 2022) 与 Sparrow (Glaese 等, 2022) — DeepMind 的两条路线,Sparrow 给 RLHF 加了基于规则的约束。
- Constitutional AI (Bai 等, 2022) — AI 反馈的早期方法,第 12 章的主角之一。
方法演进
- Direct Preference Optimization (Rafailov 等, 2023) — 第 8 章的核心。读的时候重点看它怎么从 KL 正则化目标的闭式解反推出损失。
- Zephyr: Direct Distillation of LM Alignment (Tunstall 等, 2024) 与 Tülu 2 (Ivison 等, 2023) — 让 DPO 真正落地的两个模型。
- UltraFeedback (Cui 等, 2023) — 开源偏好微调长期的事实标准数据集。
- Llama 2 (Touvron 等, 2023)、Llama 3 (Dubey 等, 2024)、Nemotron-4 340B (Adler 等, 2024) — 工业级多阶段后训练配方的公开样本。
- Tülu 3 (Lambert 等, 2024) — 完全开放的现代后训练配方,RLVR 这个名字出自这里。想复现整条流程就从它开始。
- DeepSeek R1 (Guo 等, 2025) 与 DeepSeek-V3 技术报告 (2025) — 配合读才能算清后训练算力占比那笔账(147K vs 2.8M GPU 小时)。
- Olmo 3 (2025) — 少数几个完全开放的大规模 RL 训练记录。
RLHF 的边界与批评
- LIMA: Less Is More for Alignment (Zhou 等, 2023) — 肤浅对齐假说的出处。带着第 8 节的批评视角读它,比直接接受结论收获大得多。
- Scaling Laws for Reward Model Overoptimization (Gao 等, 2023) — 过优化的定量刻画,第 14 章的基础文献。
- A Long Way to Go: Investigating Length Correlations in RLHF (Singhal 等, 2023) — 长度偏置到底有多严重。
- Disentangling Length from Quality in Direct Preference Optimization (Park 等, 2024) — 在 DPO 里把长度和质量解耦。
- Understanding the Effects of RLHF on LLM Generalisation and Diversity (Kirk 等, ICLR 2024) — RLHF 泛化更好但多样性下降的系统性证据。
- SFT Memorizes, RL Generalizes (Chu 等, ICML 2025) — 标题即结论,本章第 4.3 节的主要依据之一。
- Safe RLHF (Dai 等, 2023) — 把有用性和无害性显式拆成两个目标来优化。
- The Art of Scaling Reinforcement Learning Compute for LLMs (Khatri 等, 2025) — RL 规模化的科学,本章第 8 节的算力数字来自这里。
基础补课
- Sutton & Barto, Reinforcement Learning: An Introduction — MDP、策略、价值函数的标准教材。本书附录 A 是它的极简版。
- Sebastian Raschka, Build a Large Language Model (From Scratch) — 如果 log-softmax、completion mask、张量形状这些还不熟练,先补这本。
- UC Berkeley CS285 / David Silver 的 UCL 课程 — 深度 RL 的两门经典公开课,第 6 章之前值得过一遍策略梯度部分。