SQL 与表:把「怎么算」交出去
第一次不写步骤,只描述想要的结果表——SELECT、WHERE、LIKE、ORDER BY、LIMIT,以及把多张表拼在一起的 JOIN。
0. 本讲导读
到上一讲为止,这门课教你的全部内容都可以概括成一句话:把「怎么算」写清楚。Python 的求值规则、环境图里的一帧一帧、递归怎么展开又怎么回代、Scheme 的解释器如何 eval 和 apply、尾调用怎么把栈压平、宏怎么在求值之前改写代码——每一样都是在描述步骤。你是那个安排步骤的人,机器只是老实照做。
本讲换一件事做。你会遇到一种叫 SQL 的语言,它属于声明式编程(declarative programming):你只描述你想要的结果长什么样,怎么算出来是机器的事。 你不写循环,不写递归,不写函数调用;你写「我要一张表,它有这两列,只保留纬度大于 40 的那些行,按名字倒序排」。剩下的——先扫哪张表、要不要建索引、按什么顺序过滤才最快——由数据库管理系统(database management system,DBMS)自己决定。(这个「自己决定」的部分是 CS 186 和 DATA 101 的内容,本课不展开。)
还有第二件事,比范式的切换更朴素但同样重要:持久化。你到目前为止写的每一个程序,数据都活在内存里的那些帧中。程序一结束,全局帧连同它绑定的一切统统消失;断电更是什么都不剩。数据库解决的正是这个问题——数据存在磁盘上,程序退出了它还在,明天再来查还是那些行。
所以本讲要回答的问题是:当数据不再是「程序运行期间内存里的一个列表」,而是「一张长期存在、可能有几千万行的表」时,你用什么语言、什么思路去问它问题?
往前看,上一讲的尾调用与宏是「你能对求值过程施加多大的控制」的顶点;本讲反过来,是「你主动放弃对求值过程的控制」。往后看,下一讲会在本讲的基础上加上聚合(aggregation)——COUNT、SUM、MAX、GROUP BY、HAVING——那些是「把很多行压成一行」的工具,而本讲的每一个子句都是它们的地基。本讲对应的作业是 HW 06。
- SQL 里所有东西的输入是表,输出也是表。 一条
SELECT语句不修改任何已有的表,它造出一张新表。想不通某个子句在干嘛时,就问「它拿到的是哪张表,吐出来的是哪张表」。 - 子句各管一个维度:
FROM决定数据从哪来,WHERE按条件删行,SELECT决定留哪些列,ORDER BY重排行,LIMIT只留前 n 行。 - SQL 不是从上往下执行的。 真实执行顺序是
FROM/JOIN…ON→WHERE/LIKE→SELECT→AS→ORDER BY→LIMIT。写查询时按这个顺序想,就几乎不会卡。 - join 的本质是嵌套循环:把左表每一行跟右表每一行都配一遍(笛卡儿积 / cross join),得到一张 m×n 行的大表,然后用
WHERE或ON从里面挑出有意义的那些行。理解 join 的唯一正确方式,是真的把那张大表展开写出来。 - SQL 的比较运算符会区分类型:
'100%'是字符串,跟100比较永远不相等;字符串之间比大小是按字符逐位比的,所以'100%' < '75%'为真。 - 相等用
=(不是==),不等用<>(不是!=),字符串拼接用||(不是+),关键字大写只是约定,每条语句必须以分号结尾。
1. 数据库:为什么不能就用一个 Python 列表
先说清楚不引入数据库会卡在哪。假设你在写一个记录奶茶订单的程序,最自然的想法是用一个列表装字典:
orders = [
    {'name': 'Rabia',   'item': 'Black Milk Tea',       'ice': 'Regular'},
    {'name': 'Richard', 'item': '61A Special Milk Tea', 'ice': 'Light'},
]
这段代码没有任何错。但它有三个致命的局限:
- 活不过程序的生命周期。
orders是全局帧里的一个绑定。python3 shop.py跑完,进程退出,全局帧被回收,这个列表连同里面的字典一起消失。明天再跑一次,你拿到的是空列表。你可以自己写文件读写,但那意味着你要自己设计格式、自己处理写到一半断电、自己保证两个进程同时写不会互相覆盖——这些每一件都很难。 - 查询要自己写循环。 「找出所有点了黑奶茶且要常温冰的人」你得写一个
for加两个if。「找出点了同一种奶茶的两个人」你得写双重循环。数据量一大,你还得自己想怎么让它快起来。 - 没有结构约束。 没人拦着你往列表里塞一个
{'nmae': 'Sriya'}(拼错了 key),或者塞一个ice为整数3的记录。错误要等到读取时才炸。
数据库把这三件事一次性解决掉。
三个术语
| 术语 | 含义 |
|---|---|
| 数据库(database) | 以持久(persistent)方式存储数据的东西。跟程序里的变量正相反——变量只在程序执行期间临时存在于内存中,关掉电源内存就被抹掉了。 |
| 数据库管理系统(DBMS) | 一个软件,让你能创建、检索、更新、删除以及管理一个数据库。你不直接操作磁盘上的字节,你对 DBMS 说话。 |
| 关系型数据库(relational database) | 一种流行的数据库形态:记录(record)以行(row)的形式存在表(table)里,表可以有多个列(column,也叫 field 字段)。每一列只有一种数据类型。 |
「每一列只有一种数据类型」这一条就是上面第 3 个局限的解药:你没法把一个整数塞进一个声明为字符串的列里而不被发现,也没法凭空多出一个列。
一张表长什么样
本讲从头到尾都会用到这张 cities 表:
| latitude | longitude | name |
|---|---|---|
| 38 | 122 | 'Berkeley' |
| 41 | 74 | 'New York' |
| 45 | 93 | 'Minneapolis' |
| 34 | 118 | 'Los Angeles' |
三列:latitude 和 longitude 是整数列,name 是字符串列。四行,每一行是一条记录,描述一座城市。注意字符串在 SQL 里用单引号,不是双引号——双引号在 SQL 里表示「标识符」(列名/表名),意思完全不同。
把表想成一个「所有元素都是同构记录的列表」,把行想成记录,把列想成记录里的字段。这跟你学过的数据抽象是一回事:表就是一层抽象屏障,你通过列名访问数据,而不关心它在磁盘上怎么摆。区别只在于——这次的「列表」存在磁盘上,而且访问它的语言不是 Python。
表里的行是没有固有顺序的。 上面这张表画成四行,只是因为纸上必须有个先后。除非你显式写了 ORDER BY(第 7 节),否则数据库不保证你拿到的行是按哪个顺序排的。本讲后面有几个例子里 SQLite 恰好按某种顺序吐出结果,那是实现细节,不是承诺。养成习惯:只要你在乎顺序,就写 ORDER BY。
2. SQL:一门只描述结果的语言
结构化查询语言(Structured Query Language,SQL)是一门用于操作数据库的声明式编程语言。它的名字读作 “sequel” 或者一个字母一个字母念 “S-Q-L”,两种读法都通行。
SQL 有很多方言(variant),61A 用的是 SQLite。而且本课只用 SQL 的一个子集:数据查询语言(Data Query Language,DQL)——只读数据库的那部分。真正的 SQL 还能建库、改表、插入删除、管权限,那些都不在本课范围里。
声明式意味着什么
把你学过的三种范式跟它并排放一下,差别一眼就出来了:
| 范式 | 你写的是 | 本课的例子 |
|---|---|---|
| 命令式(imperative) | 一步一步改变状态的指令 | while 循环、赋值语句、可变列表 |
| 函数式(functional) | 由函数组合出来的表达式,尽量不改状态 | Scheme 的递归、高阶函数 |
| 面向对象(object-oriented) | 互相发消息的对象 | class、继承、Account.deposit |
| 声明式(declarative) | 你想要的输出长什么样,计算机自己想办法 | SQL |
体会一下这句话的分量:在前三种范式里,「这段程序对不对」等价于「按我写的步骤走一遍,结果对不对」;在 SQL 里,「这段查询对不对」等价于「我描述的那张结果表,是不是我真正想要的那张」。你没有步骤可追。这是本讲最需要转过来的一个弯——很多人写 SQL 卡住,是因为还在脑子里找「循环变量现在等于几」。SQL 里没有循环变量,只有一张一张的中间表。
语法上的几条硬规矩
- SQL 大小写不敏感,但按约定,关键字全部写成大写。
select * from cities;能跑,但没人这么写。大写关键字是为了让你一眼看清骨架。 - 每条 SQL 语句必须以分号
;结尾。 - 跟 Scheme 一样,空白基本只影响可读性——最低要求是关键字、列名、表名之间至少隔一个空格。你可以把一条查询写成一行,也可以每个子句一行。
- 单行注释用
--(两个连字符),后面到行尾都是注释。
-- 这是注释。下面这三种写法完全等价:
SELECT latitude, name FROM cities;

SELECT latitude, name
FROM cities;

SELECT     latitude,     name       FROM
   cities;
忘了分号。 在交互式的 SQL 环境(比如 code.cs61a.org 或 sqlite3 命令行)里,不打分号的后果不是报错,而是什么都不发生——解释器认为你这条语句还没写完,把光标停在那儿等你继续输入。这时你会看到提示符从 sqlite> 变成 ...>。补一个分号回车就好。这个「卡住」的现象跟括号没配平时 Scheme 解释器的反应是同一类。
3. SELECT:所有查询的起点
SELECT 做的事只有一件:创建一张新表。它不修改任何已有的表。这句话要背下来,因为它是理解后面一切的钥匙。
创建新表有两种来源:从零凭空造,或者从已有的表里取列。
用法一:凭空造一张表
SELECT <expression>;
不带 FROM 的 SELECT 会造出一张只有一行的表,行里装着你写的那些表达式的值:
sqlite> SELECT 5 + 3;
8

sqlite> SELECT 'hello' AS greeting, 2 * 3 AS six;
hello|6
这看起来像个玩具,但它是你验证 SQL 表达式行为的最快工具——想知道 '100%' < '75%' 到底是真是假?直接 SELECT '100%' < '75%';。它相当于 SQL 世界里的 Python REPL。
用法二:从已有表取列
SELECT [col1], [col2], ... FROM <table>;

SELECT * FROM <table>;
列名之间用逗号隔开,可以选 1 个或多个;* 是「所有列」的简写。
SELECT latitude, name FROM cities;
FROM cities:先把 cities 整张表拿到手,此时是 4 行 × 3 列。WHERE,所以一行都不删,还是那 4 行。SELECT latitude, name:按列裁剪。longitude 这一列整列扔掉,剩下 latitude 和 name,而且顺序按你写的来——你写 latitude, name,结果表就是这个列序。cities 本身一点没变。FROM cities → latitude | longitude | name
--------------------------------
38 | 122 | 'Berkeley'
41 | 74 | 'New York'
45 | 93 | 'Minneapolis'
34 | 118 | 'Los Angeles'
SELECT latitude, name → latitude | name
-------------------------
38 | 'Berkeley'
41 | 'New York'
45 | 'Minneapolis'
34 | 'Los Angeles'
这种「一张表进、一张表出」的画法,就是 SQL 版本的环境图。往后每遇到一条不理解的查询,都把中间表一张一张画出来,问题基本就自己解开了。
SELECT 只能裁列,不能删行。上面结果还是 4 行,跟原表一样多。想删行必须用 WHERE(第 5 节)。很多初学者的第一个误解是「SELECT 是选择,所以它挑行」——不是,它挑列。
列名拼错和表名拼错,报的是两种不同的错。 这跟 Python 里 NameError 和 SyntaxError 的区别一样有用——看错误信息就知道该去查哪儿:
sqlite> SELECT name FROM bobaa;
Parse error: no such table: bobaa

sqlite> SELECT nmae FROM boba;
Parse error: no such column: nmae
看到 no such table 去查 FROM 后面;看到 no such column 去查 SELECT 里的列名,或者确认这一列到底在不在你 FROM 的那张表里——后面讲 join 时你会看到,「这一列确实存在,但不在你 FROM 的表里」是个高频错误。
4. 运算符与 AS:算出来的列、拼出来的字符串、改过名的列
SELECT 后面跟的不一定是列名,可以是任意表达式。表达式里能用的运算符跟 Python 高度相似,但有四个地方不一样,而且每一个都会咬人。
算术与比较
| 类别 | SQL | 与 Python 的差别 |
|---|---|---|
| 算术 | + - * / | 基本一致。但 / 在两个整数之间是整数除法:7 / 2 得 3,只要有一边是小数才得 3.5 |
| 比较 | > < >= <= | 一致 |
| 相等 | =(也可写 ==) | SQL 里首选单个 =。两者等价,但约定用 = |
| 不等 | <>(也可写 !=) | 首选 <>。两者等价 |
| 布尔 | AND OR NOT | 拼法一样,习惯写成大写 |
| 字符串拼接 | || | 不是 +。在 Python 里 'a' + 'b' 得 'ab',在 SQL 里要写 'a' || 'b' |
「= 用来比较」这一条对刚学完 Python 的人特别别扭——你被反复教育过 = 是赋值、== 才是比较。但 SQL 的 DQL 子集里根本没有赋值这回事(你不改任何东西,只是描述结果),单个 = 就空出来给比较用了。SQLite 出于兼容也接受 ==,但读别人的 SQL 时你看到的几乎全是 =。
sqlite> SELECT 3 = 3, 3 <> 4, 'a' || 'b', 7 / 2, 7.0 / 2;
1|1|ab|3|3.5
注意输出:SQLite 里没有独立的布尔类型,真是 1,假是 0。这跟 Python 的 True/False 打印成 True/False 不同,第一次看到别以为出错了。
AS:给列起别名
问题来了。如果你写 SELECT 2 * pieces FROM boba;,这一列该叫什么名字?SQLite 会拿你写的那个表达式的文本当列名,于是列名变成 2 * pieces——难看,而且后面没法拿它做事。AS 就是为这个而生的,它给列或表达式起一个别名(alias),也叫「aliasing 一个列」。
SELECT name || ', lat ' || latitude AS label FROM cities;
在本机的 SQLite 上实际跑一遍(cities 表已按第 1 节建好):
Los Angeles, lat 34
Berkeley, lat 38
Metropolis, lat 38
New York, lat 41
Minneapolis, lat 45
三件事同时发生了:|| 把字符串接起来;整数 latitude 被自动转成字符串参与拼接;AS label 把这一列命名为 label。
AS 之于 SQL,就像给表达式绑一个名字之于 Python——都是命名抽象。区别在于 Python 里 x = 2 * y 是把值绑到帧里的名字上,SQL 的 AS 是给结果表的一整列起名。它不创造新数据,只是让这一列有个能叫得出口的名字。
别名能不能在同一条查询的别处使用?这件事在不同数据库上答案不一样,别依赖它。 按第 10 节要讲的执行顺序,AS 排在 SELECT 之后、ORDER BY 之前,所以:
ORDER BY里可以用别名——这时候别名已经存在了。WHERE里按标准不该用别名——WHERE比SELECT先执行,那一刻别名还不存在。
但要诚实地说:SQLite 网开一面,它接受在 WHERE 里写别名。本机实测 SELECT name, latitude * 2 AS double_lat FROM cities WHERE double_lat > 80; 能跑出结果。这是 SQLite 的扩展,不是所有数据库都这样,而且它会让你对执行顺序产生错误的直觉。建议在 WHERE 里老老实实把表达式写全(WHERE latitude * 2 > 80),把别名留给 ORDER BY 和输出。
5. WHERE:按条件把行删掉
SELECT 管列,WHERE 管行。WHERE 子句用来根据某个条件过滤掉一些行。
SELECT <expression(s) and/or column(s)>
FROM <table>
WHERE <condition>;
机制非常直白:拿 FROM 给出的表,一行一行地代入条件求值,为真就留下,为假就扔掉。 这确实就是一个「对每一行做一次判断」的循环——只不过循环是数据库替你写的。
SELECT latitude, name FROM cities WHERE latitude > 40;
先按执行顺序,FROM 拿到 4 行,然后 WHERE 逐行判定:
(38, 122, 'Berkeley'):条件是 latitude > 40,代入 38 > 40 → 假 → 删掉(41, 74, 'New York'):41 > 40 → 真 → 留下(45, 93, 'Minneapolis'):45 > 40 → 真 → 留下(34, 118, 'Los Angeles'):34 > 40 → 假 → 删掉SELECT latitude, name 裁列,扔掉 longitude。FROM cities WHERE latitude > 40 SELECT latitude, name 4 行 3 列 → 2 行 3 列 → 2 行 2 列 38 122 Berkeley 41 74 New York 41 New York 41 74 New York 45 93 Minneapolis 45 Minneapolis 45 93 Minneapolis 34 118 Los Angeles
关键一点:WHERE 的条件里可以用 SELECT 没有选中的列。 上面如果写 WHERE longitude < 100,也完全合法,尽管 longitude 不出现在结果里。原因还是执行顺序——WHERE 跑的时候,整张原表都还在手上,裁列是之后的事。
WHERE 里的类型陷阱
这是本讲最容易栽的地方,随堂练习专门为它设了一道题。看这张 boba 表的一部分:
| name | sweetness | ice | pieces |
|---|---|---|---|
| 'Black Milk Tea' | '100%' | 'Regular' | 23 |
| 'Wintermelon Milk Tea' | '50%' | 'Light' | 22 |
| 'Thanos Milk Tea' | '50%' | 'Regular' | 12 |
sweetness 这一列装的是字符串:'100%'、'50%',因为百分号本身是字符。于是:
sqlite> SELECT * FROM boba WHERE sweetness = 100;
        <-- 一行都没有

sqlite> SELECT * FROM boba WHERE sweetness > '75%';
        <-- 一行都没有

sqlite> SELECT '100%' < '75%';
1
第一个坑:拿字符串跟数字比。 sweetness = 100 不报错,只是永远不成立——字符串 '100%' 和整数 100 在 SQLite 里是不同类型,比较结果恒为假。这种「不报错但结果全空」的 bug 比报错难查得多,因为你会以为是数据的问题。要写 sweetness = '100%'。
第二个坑:以为字符串能按大小排。 '100%' < '75%' 竟然是真。因为字符串比较是逐个字符比编码值:先比第一个字符,'1' 的编码小于 '7',胜负已分,后面根本不看。所以在这张表里,'100%' 是「最小」的甜度字符串,'75%' 反而排在后面。凡是需要按数值比大小的列,就不要把它存成带单位的字符串——这是数据设计问题,不是查询能补救的。
顺带一提,'a' < 'B' 在 SQLite 里是假(大写字母编码更小),但 'Apple' < 'apple' 是真。字符串比大小对大小写是敏感的——这跟下一节的 LIKE 正好相反,别搞混。
6. LIKE:字符串的模式匹配
WHERE name = 'Berkeley' 只能做完全相等的匹配。可如果你想问「名字里带空格的城市有哪些」「所有以 Milk Tea 结尾的饮品」,相等就不够用了。LIKE 子句负责这一类字符串匹配,靠两个通配符(wildcard)来描述模式:
| 通配符 | 匹配 | 记忆 |
|---|---|---|
% | 0 个或多个任意字符 | 「随便多少个,包括一个都没有」 |
_ | 恰好 1 个任意字符 | 下划线像一个占位的空格,一个萝卜一个坑 |
并且:在 SQLite 里 LIKE 的匹配是大小写不敏感(case insensitive)的。 这是它跟 = 最大的行为差异,考试和作业里都爱考。
SELECT name FROM cities WHERE name LIKE '% %';
模式 '% %' 读作「任意多个字符 + 一个空格 + 任意多个字符」,也就是名字里含有空格。逐行判定:
'Berkeley':整个串里没有空格,'% %' 中间那个空格无处安放 → 不匹配'New York':让第一个 % 吃掉 New,中间空格对上,第二个 % 吃掉 York → 匹配'Minneapolis':没有空格 → 不匹配'Los Angeles':%=Los,空格对上,%=Angeles → 匹配'New York' 和 'Los Angeles' 两行。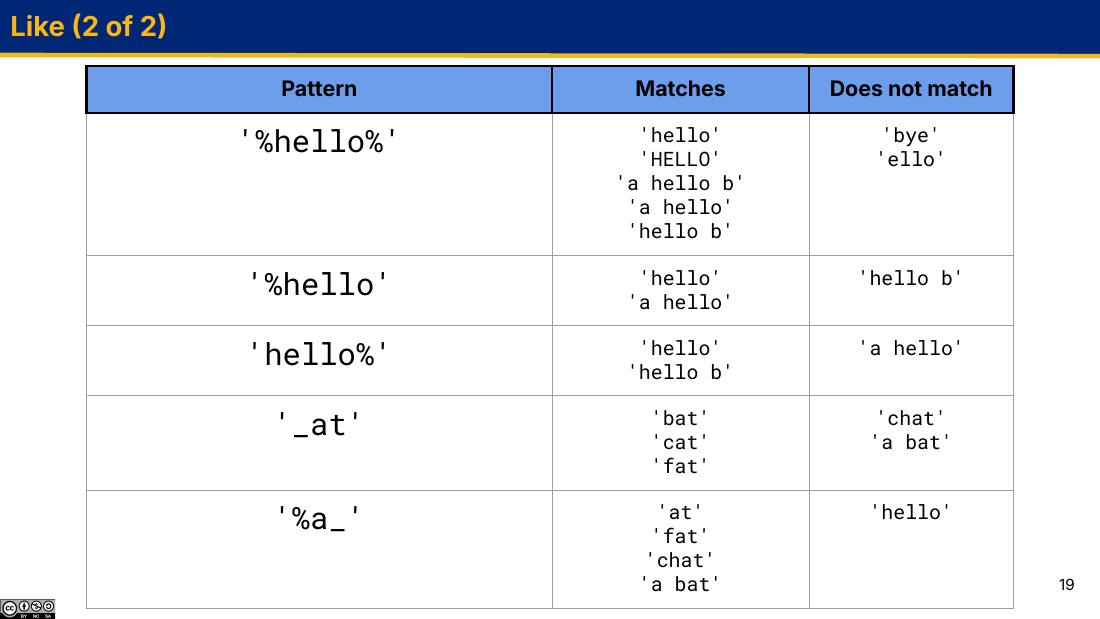
% 和 _ 的区别彻底钉死了。看第一行:'%hello%' 能匹配 'HELLO'——证明 LIKE 大小写不敏感;能匹配 'hello' 本身——证明 % 可以匹配 0 个字符。看第四行:'_at' 匹配 'bat' 但不匹配 'chat',因为下划线只能顶掉恰好一个字符,'ch' 是两个。看最后一行 '%a_':它要求「倒数第二个字符是 a」,所以 'at'(前面 % 吃 0 个字符)和 'a bat' 都算,'hello' 不算。把图里的规律提炼成三个句式,写模式的时候直接套:
| 你想表达 | 模式 | 例 |
|---|---|---|
| 包含某子串 | '%子串%' | '%hello%' 匹配 'a hello b' |
| 以某子串结尾 | '%子串' | '%hello' 匹配 'a hello',不匹配 'hello b' |
| 以某子串开头 | '子串%' | 'hello%' 匹配 'hello b',不匹配 'a hello' |
| 长度恰好、某位固定 | 用 _ 占位 | '_at' 只匹配长度为 3 且后两位是 at 的串 |
在 boba 表上验证一次大小写不敏感(表里存的都是 '... Milk Tea',注意大写的 M 和 T):
sqlite> SELECT name FROM boba WHERE name LIKE '%milk tea';
61A Special Milk Tea
61A Special Milk Tea
61A Special Milk Tea
Black Milk Tea
Black Milk Tea
Black Milk Tea
Thanos Milk Tea
Wintermelon Milk Tea
Wintermelon Milk Tea
Wintermelon Milk Tea
模式全小写,照样把大写的都捞出来了。另外注意结果里有重复——WHERE 只负责删行,它不去重;表里本来就有三行 'Black Milk Tea',出来就是三行。
误区一:把 LIKE 当 = 用而忘了通配符。 WHERE name LIKE 'Milk Tea' 里一个通配符都没有,它等价于一次(大小写不敏感的)完全相等比较,匹配不到 'Black Milk Tea'。要匹配「包含」必须写 '%Milk Tea%'。
误区二:以为 _ 是「至少一个」。 它是恰好一个。'_at' 匹配不了 'chat',也匹配不了 'at'。想表达「至少一个任意字符」得写 '_%'。
误区三:想匹配真正的 % 字符。 比如你想找出 sweetness 恰好是 '100%' 的行,写 LIKE '100%' 是不对的——这里的 % 会被当成通配符,于是 '100%' 这个模式的意思变成「以 100 开头的任意字符串」。这种情况直接用 = 就好:sweetness = '100%'。(SQL 有 ESCAPE 关键字来转义通配符,但那超出本课范围。)
7. ORDER BY 与 LIMIT:排序与截断
到这里你已经能控制「哪些行」和「哪些列」了,还差两件事:行的顺序,和只要前几行。
ORDER BY
SELECT <columns>
FROM <table>
WHERE <condition>
ORDER BY <columns> ASC/DESC;
ORDER BY 按一列或多列给行排序。默认升序(ascending),写 DESC 表示降序(descending),ASC 是显式的升序(不写也一样)。
多列排序的规则是:先按最左边那列排;左边这列相等的行(也就是「打平了」的行),再用右边下一列来分胜负——从左往右依次打破平局。
用扩充后的 cities 表看(多了一行 Metropolis,它跟 Berkeley 同为纬度 38):
| latitude | longitude | name |
|---|---|---|
| 38 | 122 | 'Berkeley' |
| 41 | 74 | 'New York' |
| 45 | 93 | 'Minneapolis' |
| 34 | 118 | 'Los Angeles' |
| 38 | 130 | 'Metropolis' |
SELECT * FROM cities ORDER BY latitude, name DESC;
latitude,没写 DESC,所以升序:34 < 38 = 38 < 41 < 45。name 分胜负,而 name 后面跟着 DESC,所以这一层是降序:字符串比较 'Berkeley' < 'Metropolis'(B 在 M 前),降序则 Metropolis 在前。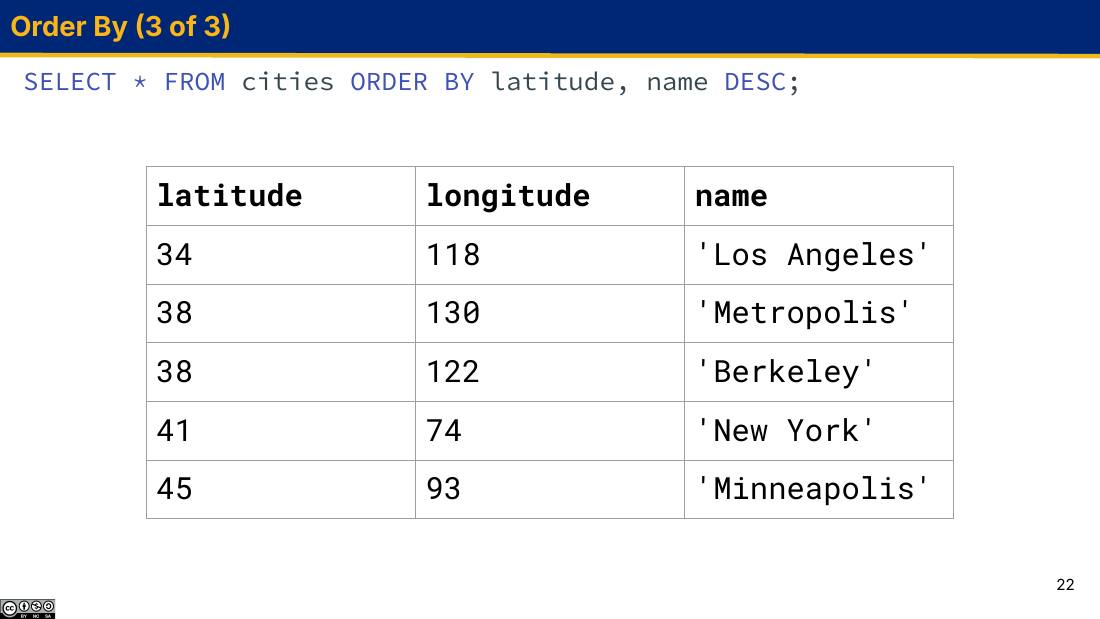
DESC 只作用于紧挨着它的那一列,不是作用于整条 ORDER BY。想让两列都降序,必须写成 ORDER BY latitude DESC, name DESC。ORDER BY a, b DESC 不等于 ORDER BY a DESC, b DESC。 前者是「a 升序,平局时 b 降序」。ASC/DESC 是跟在每一列后面的修饰词,缺省为 ASC。实测对比:
-- ORDER BY latitude, name DESC        -- ORDER BY latitude DESC, name
34  118  Los Angeles                   45  93   Minneapolis
38  130  Metropolis                    41  74   New York
38  122  Berkeley                      38  122  Berkeley
41  74   New York                      38  130  Metropolis
45  93   Minneapolis                   34  118  Los Angeles
右边那条里,两个 38 的相对次序反过来了(Berkeley 在前),因为第二个键 name 这次是默认升序。
LIMIT
加上 LIMIT 子句可以只保留输出的前 n 行。
SELECT <columns>
FROM <table>
WHERE <condition>
ORDER BY <columns>
LIMIT <n>;
LIMIT 是最后一个执行的子句,这一点决定了它的正确用法。「找出纬度最小的两座城市」要这么写:
sqlite> SELECT * FROM cities ORDER BY latitude LIMIT 2;
34|118|Los Angeles
38|122|Berkeley
LIMIT 不带 ORDER BY 基本上是个 bug。 单写 SELECT * FROM cities LIMIT 2; 的语义是「随便给我两行」,因为第 1 节说过,表里的行没有固有顺序。你在本机跑可能每次都得到同样两行,那只是因为数据量小、存储顺序稳定;换个数据库、加个索引、数据多了,结果就变了。「前 n 名」这种需求,ORDER BY 和 LIMIT 必须成对出现。
ORDER BY … LIMIT n 是 SQL 里表达「最大的 / 最小的 / 前几名」的唯一习惯写法。你在 Python 里会写 sorted(xs)[:2] 或者 min(xs);在 SQL 里,这两种需求都归到同一个句式上。下一讲学了聚合函数之后你会有另一条路(MAX、MIN),但那两个只能给你一个值,给不了「前 2 名的完整行」。
8. JOIN(一):cross join 就是一个嵌套 for 循环
到目前为止所有查询都只碰一张表。可现实里的数据是拆开存的:一个大学的数据库会有一张 courses 表和一张 students 表,你想知道「哪个学生在上哪门课」,答案不在任何一张表里,而在两张表的关联中。
把多张表的数据组合起来的操作叫 join(连接)。最简单的一种叫 cross join(交叉连接,也叫笛卡儿积):把表 A 的每一行跟表 B 的每一行都配一遍。
cross join 就是一个嵌套 for 循环。用 Python 写出来是这样:
result = []
for row_a in table_a:          # 外层循环:左表
    for row_b in table_b:      # 内层循环:右表
        result.append(row_a + row_b)   # 两行首尾拼成一行
所以:m 行的表 join n 行的表,结果有 m × n 行;列数是两张表的列数之和。这个「m × n」是理解 join 的全部。
把它画出来
幻灯片用一个 2 行的表和一个 3 行的表演示了整个过程,结果应当是 2 × 3 = 6 行。分两步看:
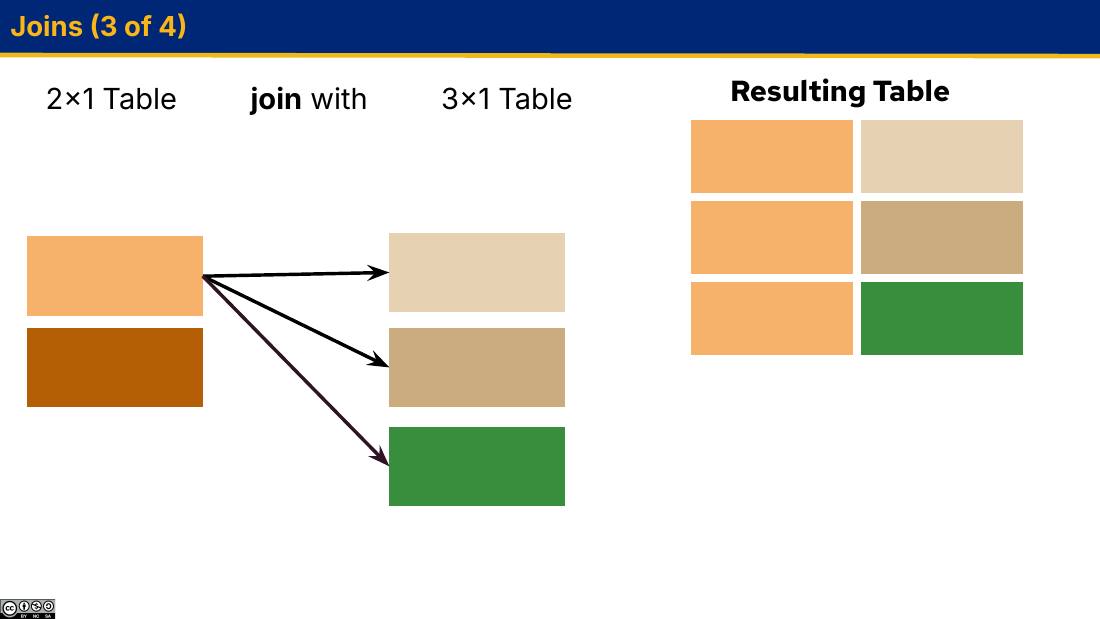
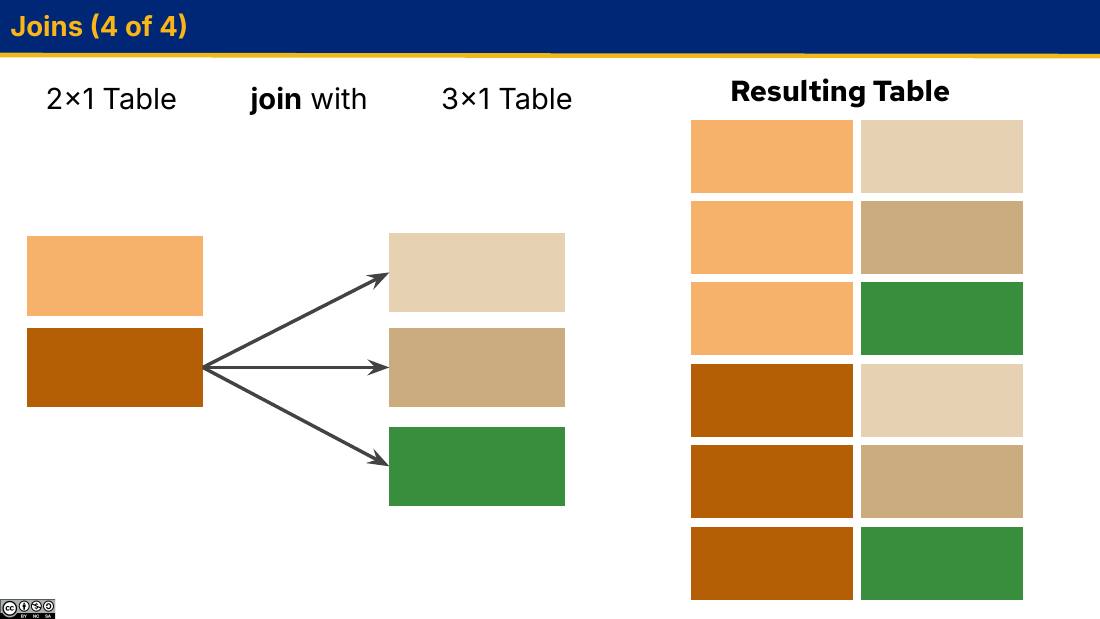
隐式连接(implicit join)
隐式连接指的是不使用 JOIN 关键字的连接写法——你直接在 FROM 后面用逗号列出两张或更多的表:
SELECT <columns>
FROM <table1>, <table2>
WHERE <condition>;
光写 FROM table1, table2 你就已经得到了那张 m×n 的大表。但那张大表通常是没意义的——里面绝大多数行是胡乱搭配。WHERE 的作用就是从这张大表里把有意义的行挑出来。
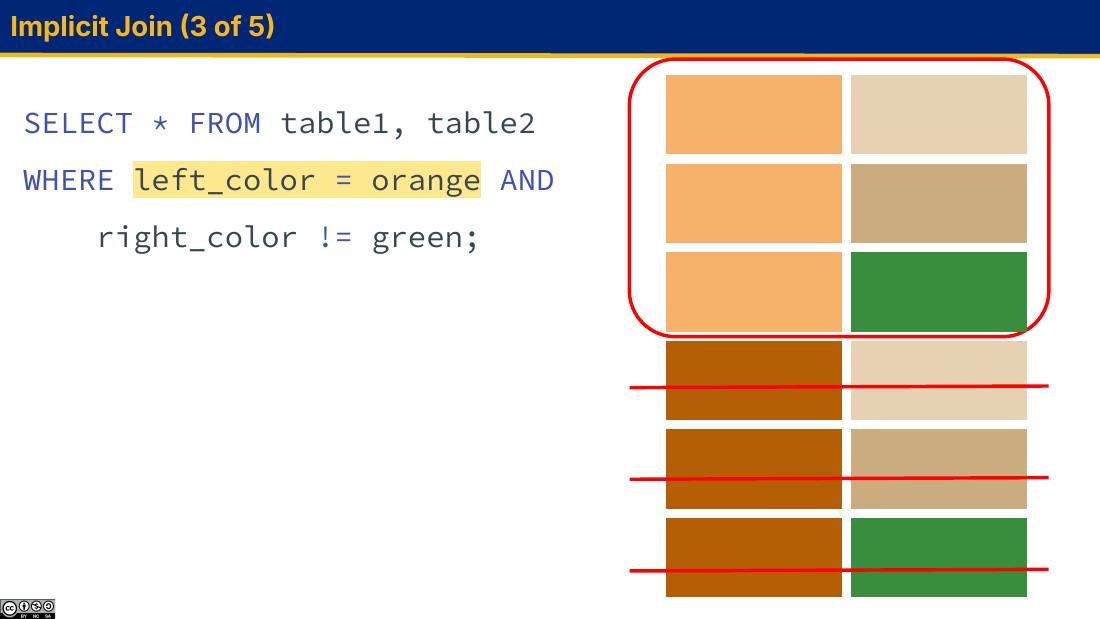
WHERE left_color = orange AND right_color != green 的第一个条件生效的样子。6 行的笛卡儿积摆在右边,条件 left_color = orange 只保留左半边是浅橙的行(红圈内 3 行),下面 3 行左半边是深橙,被划掉。接下来第二个条件 right_color != green 还会从红圈里再划掉右半边是绿色的那一行,最终只剩 2 行。join 的两步永远是这个节奏:先无脑全配,再用条件砍。在真实数据上跑一遍
随堂代码里有两张小表。orders(谁点了什么):
| name | item | ice |
|---|---|---|
| 'Rabia' | 'Black Milk Tea' | 'Regular' |
| 'Rebecca' | 'Thanos Milk Tea' | 'Extra' |
| 'Richard' | '61A Special Milk Tea' | 'Light' |
| 'Sriya' | 'Black Milk Tea' | 'Regular' |
menu(每种饮品多少钱):
| item | price |
|---|---|
| '61A Special Milk Tea' | 8 |
| 'Black Milk Tea' | 5 |
| 'Thanos Milk Tea' | 7 |
| 'Wintermelon Milk Tea' | 6 |
问题:「每个人点的东西各多少钱?」名字在 orders 里,价格在 menu 里,必须连起来。先看不加条件时那张大表到底长什么样——4 行 × 4 行 = 16 行,实测输出的前 12 行:
sqlite> SELECT * FROM orders, menu;
Rabia  |Black Milk Tea      |Regular|61A Special Milk Tea|8
Rabia  |Black Milk Tea      |Regular|Black Milk Tea      |5
Rabia  |Black Milk Tea      |Regular|Thanos Milk Tea     |7
Rabia  |Black Milk Tea      |Regular|Wintermelon Milk Tea|6
Rebecca|Thanos Milk Tea     |Extra  |61A Special Milk Tea|8
Rebecca|Thanos Milk Tea     |Extra  |Black Milk Tea      |5
Rebecca|Thanos Milk Tea     |Extra  |Thanos Milk Tea     |7
Rebecca|Thanos Milk Tea     |Extra  |Wintermelon Milk Tea|6
Richard|61A Special Milk Tea|Light  |61A Special Milk Tea|8
Richard|61A Special Milk Tea|Light  |Black Milk Tea      |5
Richard|61A Special Milk Tea|Light  |Thanos Milk Tea     |7
Richard|61A Special Milk Tea|Light  |Wintermelon Milk Tea|6
    ... 还有 Sriya 的 4 行
看清楚了:Rabia 点的是黑奶茶,却跟菜单上四种饮品各配了一次。16 行里只有 4 行是「这个人点的东西 = 菜单上这一项」,那 4 行才是我们要的。用 WHERE 把它们挑出来:
SELECT name, item, ice, price
FROM orders, menu
WHERE orders.item = menu.item;
这条查询跑不起来,真实报错是:
Parse error: ambiguous column name: item
原因很实在:连接之后的大表里有两个叫 item 的列(一个来自 orders,一个来自 menu),你写光秃秃的 item,数据库不知道你指哪个。WHERE 里之所以没事,是因为那里已经写了 orders.item 和 menu.item——这个「表名点列名」的写法是下一节的主题。先把它补上,查询就通了:
SELECT name, orders.item, ice, price
FROM orders, menu
WHERE orders.item = menu.item;
条件 orders.item = menu.item 在 16 行上逐行判定,只跟每行的第 2 列和第 4 列有关:
'Black Milk Tea' = '61A Special Milk Tea' → 假 → 删'Black Milk Tea' = 'Black Milk Tea' → 真 → 留(Rabia 的黑奶茶配上价格 5)'Thanos Milk Tea' = 'Thanos Milk Tea' 那行留下,价格 7Rabia |Black Milk Tea |Regular|5
Rebecca|Thanos Milk Tea |Extra |7
Richard|61A Special Milk Tea|Light |8
Sriya |Black Milk Tea |Regular|5
「每人恰好一行」依赖于 menu 里每种饮品只出现一次。如果菜单里 'Black Milk Tea' 因为某种原因有两条记录(比如大杯小杯各一条),那 Rabia 就会出现两行。这不是 bug,是 join 的定义使然:join 的结果行数取决于两边匹配上的对数,不取决于左表有几行。写完 join 后养成习惯——数一数行数变了没有,行数暴涨往往意味着连接条件写漏了。
忘了写 WHERE,直接 SELECT * FROM a, b;。 这不会报错,只会安静地给你 m×n 行垃圾。两张各 1000 行的表 join 出 100 万行——查询变得极慢,结果全错。看到 FROM 后面有逗号,就立刻检查 WHERE 里有没有对应的连接条件。 一个经验法则:FROM 里有 k 张表,WHERE 里至少要有 k−1 个连接条件。
9. JOIN(二):点记号、显式 JOIN,与自连接
点记号(dot notation)
上一节那个 ambiguous column name: item 说明了一件事:join 之后,「列名」可能不再唯一。点记号就是用来消歧的——写 <表名>.<列名>,明确指出你要哪张表的哪一列。
规则有三条:
- 点记号只在列名有歧义时是必需的(两张表有重名的列)。
- 但习惯上应该一直用,因为它让人一眼看出每个列的出处。查询一长,这个可读性收益非常大。
- 点记号可以用完整表名,也可以用表的别名。表也能用
AS起别名,通常起成一两个字母。
讲义里的示例(records 表存职位信息,salaries 表存薪水,两张表都有 name 列):
SELECT r.name, division, title, salary, salary2023
FROM records AS r, salaries AS s
WHERE r.name = s.name;
逐个成分拆开:
| 写法 | 作用 |
|---|---|
records AS r | 给表起别名 r。此后 r 就代表这张表 |
r.name | 明确取 records 的 name 列。必需,因为两张表都有 name |
division、title | 只在 records 里存在,不写点记号也不会有歧义(但写上更清楚) |
r.name = s.name | 连接条件:把两张表里描述同一个人的行配在一起 |
把 FROM records AS r, salaries AS s 读成 Python 的嵌套循环,别名就是循环变量:
for r in records:
for s in salaries:
if r.name == s.name:
yield (r.name, r.division, r.title, r.salary, s.salary2023)
这个类比不只是助记——它就是 cross join 加过滤的语义。看到别名想到「循环变量」,后面的自连接会立刻变得显然。
显式连接(explicit join)
显式连接是使用 JOIN 关键字的写法,连接条件(也叫 join predicate,连接谓词)写在 ON 子句里:
SELECT <columns>
FROM <table1>
JOIN <table2>
ON <condition>;
把上面那条隐式连接改写成显式连接,两者完全等价:
-- Equivalent to implicit join example
SELECT r.name, division, title, salary, salary2023
FROM records AS r
JOIN salaries AS s
ON r.name = s.name;
用了 JOIN … ON 之后,你仍然可以再写 WHERE,用来做跟连接无关的其它过滤。这正是显式写法的价值所在。
| 对比项 | 隐式连接 implicit join | 显式连接 explicit join |
|---|---|---|
| 写法 | FROM a, b WHERE … | FROM a JOIN b ON … |
| 连接条件放在 | WHERE 里,跟其它过滤条件混在一起 | ON 里,独立于其它过滤 |
| 还能不能再过滤 | 能,但都堆在同一个 WHERE 里 | 能,另写 WHERE,职责分明 |
| 忘写条件的后果 | 安静地产出 m×n 行 | SQLite 允许省略 ON,同样得到 m×n 行 |
| 可读性 | 表一多就看不清哪个条件在连接、哪个在过滤 | 「哪张表跟哪张表怎么连」一目了然 |
| 本课 | 两种都要会,作业里两种都出现 | 同左 |
别名一旦起了,就必须用别名,不能再用原表名的点记号,也不能张冠李戴。 随堂代码 22-sol.sql 里那段被注释掉的「备选解法」就有这个毛病:
SELECT o.name, o.item, o.ice, o.price
FROM orders AS o
JOIN menu AS m
ON o.item = m.item;
最后一列写成了 o.price,但 price 是 menu 的列,orders 里没有。本机实测报错:
Parse error: no such column: o.price
改成 m.price 就对了。这个错误恰恰说明点记号的价值——它把「这一列来自哪张表」这个你脑子里模糊的假设逼成了明文,写错了当场就炸,而不是给你一个错的结果。
自连接(self join):一张表跟自己连
现在来看一个真正需要动脑子的场景:「找出点了同一款饮品的两个人」。这个问题的数据全在 orders 一张表里,但你要比较的是同一张表的两行。
SQL 没有「行变量」,你没法说「取第 i 行和第 j 行」。破局的办法是:把这张表当成两张表来用,各起一个别名。回到循环类比,这就是
for o1 in orders:
for o2 in orders:
...
写成 SQL:
SELECT o1.name AS person1, o2.name AS person2
FROM orders AS o1, orders AS o2
WHERE o1.item = o2.item AND o1.name < o2.name;
这里的两个条件各解决一个问题,必须一个一个来看。orders 有 4 行,所以 FROM orders AS o1, orders AS o2 给出 4 × 4 = 16 行。
第一步:只加 o1.item = o2.item。 实测结果是 6 行:
o1.name | o2.name | item
Rabia | Rabia | Black Milk Tea
Rabia | Sriya | Black Milk Tea
Rebecca | Rebecca | Thanos Milk Tea
Richard | Richard | 61A Special Milk Tea
Sriya | Rabia | Black Milk Tea
Sriya | Sriya | Black Milk Tea
有两类脏数据混在里面:
(Rabia, Rabia)、(Rebecca, Rebecca)、(Richard, Richard)、(Sriya, Sriya) 共 4 行。任何一行跟自己比,item 当然相等——这是笛卡儿积里 i = j 的那些格子。(Rabia, Sriya) 和 (Sriya, Rabia)。这是同一对人,只是谁在左谁在右不同——笛卡儿积里 (i,j) 和 (j,i) 两个格子。第二步:试试 o1.name <> o2.name。 实测剩 2 行:
Rabia | Sriya
Sriya | Rabia
自己配自己没了,但重复的对还在。<> 只解决了第一类问题。
第三步:改成 o1.name < o2.name。 实测剩 1 行:
person1 | person2
Rabia | Sriya
一箭双雕,原因是:
o1.name < o2.name 时两个名字必然不同(相等就不满足严格小于),所以自动排除了自己配自己。A < B 和 B < A 只有一个成立,所以每对只会出现一次。这里 'Rabia' < 'Sriya' 为真(R 在 S 前),'Sriya' < 'Rabia' 为假,于是只留下前者。o2.name > o1.name 是完全一样的意思,只是把不等号翻个面。「配对但不重复」的标准套路:自连接 + a.key < b.key。 这是 SQL 里的一个固定招式,从这里一直用到期末。要点是那个键必须能比大小且唯一——这里用 name,是因为四个人名字互不相同。如果两个不同的人重名,这条查询会把他们当成一个人漏掉;真实的数据库里通常用一个唯一的 id 列来做这件事。
误区一:忘了给自连接的两份表起别名。 直接写 FROM orders, orders 会怎样?实测:
sqlite> SELECT name, item FROM orders, orders;
Parse error: ambiguous column name: name
报的是列歧义——两份表的列全部重名,你没法指定任何一列。自连接必须起别名,没有例外。
误区二:用 <> 去重。 上面第二步已经演示过了,<> 只能防止自己配自己,防不了 (A,B) 和 (B,A) 同时出现。看到题目里说「should not have duplicate pairs」,条件就该是严格小于而不是不等。
误区三:以为 o1 和 o2 是「相邻两行」或者「不同的两行」。 它们是各自独立地遍历整张表的两个循环变量,什么组合都会出现,包括 i = j。这也是为什么必须显式把 i = j 的情况排掉。
10. 执行顺序:SQL 不是从上往下跑的
这一节是本讲的收束点,也是把前面所有子句串起来的那根线。
因为 SQL 是声明式的,SQL 代码不一定按照从上到下、从左到右的顺序执行。你写的顺序是给人看的语法顺序;数据库真正干活的顺序是另一套。就本讲学到的这些子句而言,执行顺序是:
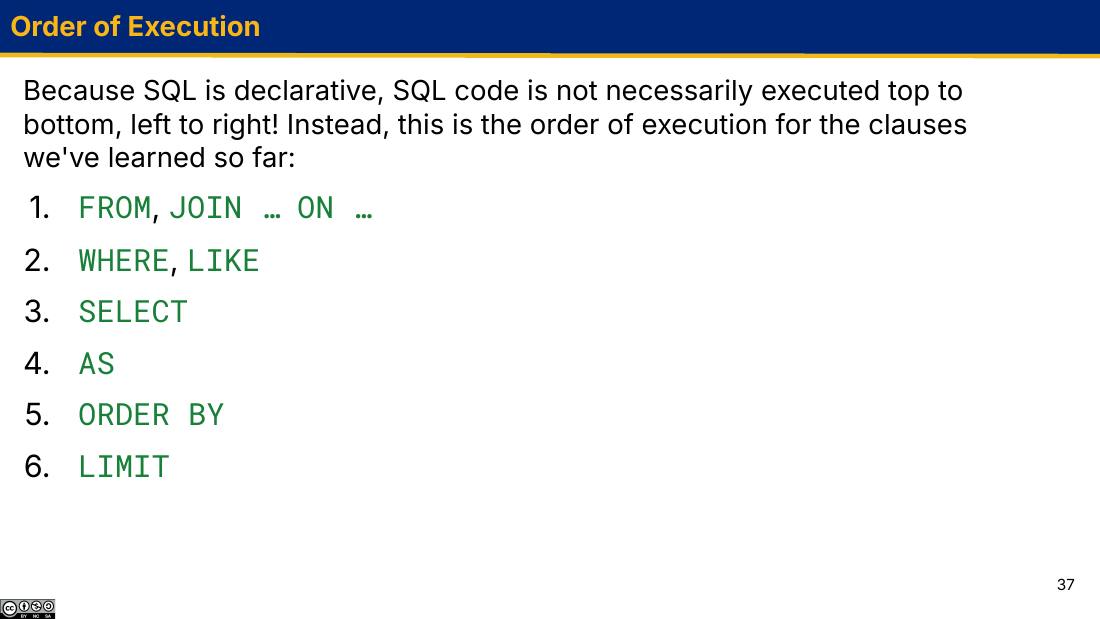
SELECT 明明写在第一行,却排在第 3 位执行——这解释了本讲里两个反直觉的现象:为什么 WHERE 里能用没被 SELECT 选中的列(那时候列还没被裁掉),以及为什么 ORDER BY 里能用 AS 起的别名而 WHERE 里按标准不该用(AS 排在第 4,在 WHERE 之后、ORDER BY 之前)。把它跟「每一步在做什么、表变成什么样」对照起来记:
| 顺序 | 子句 | 它对表做了什么 | 此后你能用什么 |
|---|---|---|---|
| 1 | FROM、JOIN … ON … | 准备原料:取出表;多张表则做 cross join 得到 m×n 行,ON 立刻筛一遍 | 所有参与表的全部列 |
| 2 | WHERE、LIKE | 删行 | 仍然是全部列 |
| 3 | SELECT | 裁列、算表达式 | 只剩你选的那些列 |
| 4 | AS | 改列名 | 别名此刻才诞生 |
| 5 | ORDER BY | 重排行 | 可以用别名 |
| 6 | LIMIT | 只留前 n 行 | — |
拿一条把所有子句都用上的查询走一遍。假设我们要问:「点了同一款饮品的人对里,按第一个人的名字排序,只要第一对」——
SELECT o1.name AS person1, o2.name AS person2
FROM orders AS o1, orders AS o2
WHERE o1.item = o2.item AND o1.name < o2.name
ORDER BY person1
LIMIT 1;
orders 跟自己 cross join,得到 16 行 × 6 列(每张表 3 列)。此时 person1 这个名字还不存在。o1.item = o2.item AND o1.name < o2.name,16 行只剩 1 行:(Rabia,…) + (Sriya,…)。注意这一步用到了 o1.item,而 item 根本不会出现在最终结果里——因为裁列还没发生。o1.name 和 o2.name,变成 1 行 × 2 列。person1、person2。这时 person1 才成为一个可用的名字。Rabia | Sriya。写查询的六步法
执行顺序不只是拿来考的知识点,它直接给出了写查询的顺序。卡住的时候,按这六个问题一个一个问自己:
FROM、JOIN … ON …。先把需要的表都拉进来。要几张表,看你要的列分散在几张表里。WHERE、LIKE。连接条件也算在这一步。SELECT。此时才考虑「结果表长什么样」。AS。题目要求列叫什么名字,就叫什么。ORDER BY。LIMIT。初学者写 SQL 卡住,九成是因为从 SELECT 开始想——盯着「我要输出什么」,却不知道那些列从哪来。倒过来:先想 FROM。 把「数据在哪张表、要不要连表、连接条件是什么」定下来之后,剩下的四步几乎是机械的填空。这跟写递归时先确定 base case 是同一类思维习惯:先把最难的那个决定做掉。
11. 实战:Boba 五题
随堂练习用的是 22.sql 里的三张表。先看 boba 表是怎么建的——这段代码本身就有个值得注意的地方:
CREATE TABLE boba AS
SELECT 'Black Milk Tea' AS name, '100%' AS sweetness, 'Regular' AS ice, 23 AS pieces UNION
SELECT 'Wintermelon Milk Tea', '50%', 'Light', 22 UNION
SELECT '61A Special Milk Tea', '100%', 'Extra', 25 UNION
SELECT 'Wintermelon Milk Tea', '75%', 'Light', 23 UNION
SELECT 'Thanos Milk Tea', '50%', 'Regular', 12 UNION
SELECT '61A Special Milk Tea', '75%', 'Regular', 27 UNION
SELECT '61A Special Milk Tea', '75%', 'Extra', 24 UNION
SELECT 'Black Milk Tea', '0%', 'Light', 24 UNION
SELECT 'Thanos Milk Tea', '50%', 'Regular', 12 UNION
SELECT 'Wintermelon Milk Tea', '25%', 'Regular', 22 UNION
SELECT 'Black Milk Tea', '100%', 'Regular', 24;
这是第 3 节讲的「凭空造表」用法:每个 SELECT 造一行,UNION 把这些单行表并成一张表;只有第一行需要写 AS 来定列名,后面的行按位置对号入座。
数一数上面有 11 条 SELECT,但建出来的 boba 表只有 10 行。因为 'Thanos Milk Tea', '50%', 'Regular', 12 写了两次,而 UNION 会去重(想保留重复行得用 UNION ALL)。本机实测建表后 SELECT COUNT(*) FROM boba; 确实是 10。如果你按 11 行去数后面各题的结果,会对不上。
Q1:取两列
题目:写一条查询,返回一张两列的表,内容是 boba 表的 name 和 ice 列。
按六步法:数据在 boba(第 1 步);不用滤行(第 2 步跳过);要 name 和 ice 两列(第 3 步);不改名、不排序、不截断。
CREATE TABLE q1 AS
SELECT name, ice FROM boba;
结果是 10 行 2 列,跟原表行数一样——再强调一次,SELECT 只裁列,不删行。结果里会出现完全一样的行(比如两条 Black Milk Tea | Regular),因为原表里那两行的 sweetness 不同,只是被裁掉了。
Q2:按条件滤行,注意类型
题目:返回一张跟 boba 列相同的表,但只包含甜度为 100% 且 pieces 超过 20 的饮品。题面还特意提醒:小心,sweetness 列装的是字符串!
「列相同」→ 用 SELECT *;两个条件用 AND 连起来。
CREATE TABLE q2 AS
SELECT * FROM boba
WHERE sweetness = '100%' AND pieces > 20;
10 行逐行判定(sweetness = '100%' 且 pieces > 20):
61A Special |100%|Extra |25 → 甜度对,25>20 对 → 留
61A Special |75% |Extra |24 → 甜度不对 → 删
61A Special |75% |Regular|27 → 甜度不对 → 删
Black |0% |Light |24 → 甜度不对 → 删
Black |100%|Regular|23 → 都对 → 留
Black |100%|Regular|24 → 都对 → 留
Thanos |50% |Regular|12 → 甜度不对 → 删
Wintermelon |25% |Regular|22 → 甜度不对 → 删
Wintermelon |50% |Light |22 → 甜度不对 → 删
Wintermelon |75% |Light |23 → 甜度不对 → 删
剩 3 行。没有一行是因为 pieces 被刷掉的——甜度 100% 的三杯 pieces 分别是 25、23、24,都大于 20。
题面那句提醒是有的放矢的。前两种写法不报错但返回空表,第三种不报错但返回一堆错的行:
WHERE sweetness = 100 -- 字符串跟整数比,恒假 → 0 行
WHERE sweetness = '100' -- 少了百分号,跟 '100%' 不相等 → 0 行
WHERE sweetness >= '100%' -- 想「至少 100%」,实际按字符比 → 8 行
第三条最值得看。写 >= 的人心里想的是「甜度不低于 100%」,但字符串比较是逐字符比编码值,'100%' 的首字符 '1' 比 '2'、'5'、'7' 都小,于是 '25%'、'50%'、'75%' 全都满足 >= '100%'。本机实测这条加上 pieces > 20 之后返回 8 行,比正确答案多了 5 行:
61A Special Milk Tea |100%|Extra |25 ← 这 3 行是对的
Black Milk Tea |100%|Regular|23
Black Milk Tea |100%|Regular|24
61A Special Milk Tea |75% |Extra |24 ← 下面 5 行全是混进来的
61A Special Milk Tea |75% |Regular|27
Wintermelon Milk Tea |25% |Regular|22
Wintermelon Milk Tea |50% |Light |22
Wintermelon Milk Tea |75% |Light |23
结论:只要一列存的是带单位的字符串,就只能用 = 做精确匹配,不能对它用大小比较。 想按甜度排序或者比大小,得先把这一列改成数字来存——那是数据设计层面的事,查询语句救不了。
Q3:算出来的列 + 改名 + 排序
题目:造一张跟 boba 列相同的表,但每杯的 pieces 翻倍,并按 pieces 的数量排序。把翻倍后的那一列改名为 doubled_pieces。
三件事:算 2 * pieces、给它 AS doubled_pieces、ORDER BY。这里不能用 SELECT *,因为有一列要被替换掉,必须把四列全部列出来:
CREATE TABLE q3 AS
SELECT name, sweetness, ice, 2 * pieces AS doubled_pieces
FROM boba
ORDER BY pieces;
实测输出:
Thanos Milk Tea |50% |Regular|24
Wintermelon Milk Tea|25% |Regular|44
Wintermelon Milk Tea|50% |Light |44
Black Milk Tea |100%|Regular|46
Wintermelon Milk Tea|75% |Light |46
61A Special Milk Tea|75% |Extra |48
Black Milk Tea |0% |Light |48
Black Milk Tea |100%|Regular|48
61A Special Milk Tea|100%|Extra |50
61A Special Milk Tea|75% |Regular|54
这里 ORDER BY pieces 和 ORDER BY doubled_pieces 给出相同的顺序,因为乘 2 是单调递增的变换,不改变大小关系。官方解法写的是 ORDER BY pieces——用原始列排序,这样即使你对执行顺序里「别名何时可用」还没把握,也一定不会出问题。
误区一:写 SELECT *, 2 * pieces AS doubled_pieces。 这能跑,但结果是五列——原来的 pieces 还在。题目说「跟 boba 列相同」,意思是四列,其中第四列换成 doubled_pieces。* 是「全部原样保留」,它没法「保留除了某一列之外的全部」。
误区二:以为 2 * pieces 修改了 boba 表。 没有。boba 里的 pieces 一个都没变,改变的只是新造出来的这张结果表。SELECT 永远不写回原表——这跟 Python 里 [2 * x for x in lst] 不改 lst 是一个道理。
Q4:连接两张表
题目:返回一张跟 orders 完全一样的表,但额外包含所点饮品的价格。挑战:用隐式连接和显式连接各写一遍。
第 1 步就定了全局:名字和冰量在 orders,价格在 menu,两张表都要,连接条件是「点的东西 = 菜单项」。
-- 隐式连接
CREATE TABLE q4 AS
SELECT o.name, o.item, o.ice, m.price
FROM orders AS o, menu AS m
WHERE o.item = m.item;
-- 显式连接(等价)
CREATE TABLE q4 AS
SELECT o.name, o.item, o.ice, m.price
FROM orders AS o
JOIN menu AS m
ON o.item = m.item;
两种写法实测输出完全一致:
Rabia  |Black Milk Tea      |Regular|5
Rebecca|Thanos Milk Tea     |Extra  |7
Richard|61A Special Milk Tea|Light  |8
Sriya  |Black Milk Tea      |Regular|5
注意 m.price 那个点记号:price 只在 menu 里有,不写点记号也不会歧义,但写上之后「这一列从哪来」就没有任何猜测空间了。第 9 节那个 no such column: o.price 的错误就是漏看了这一点。
Q5:自连接
题目:返回点了同一款饮品的人的名字。第一列叫 person1,第二列叫 person2。不能有重复的对,也不能把一个人跟自己配。
第 9 节已经把这道题完整推演过一遍了,这里只重贴答案:
CREATE TABLE q5 AS
SELECT o1.name AS person1, o2.name AS person2
FROM orders AS o1, orders AS o2
WHERE o1.item = o2.item AND o1.name < o2.name; -- 或 o2.name > o1.name
结果一行:Rabia | Sriya。题面里那两句限制——「不能有重复的对」「不能跟自己配」——就是在提示你用严格小于而不是不等,这是本题唯一的技术点。
五道题恰好覆盖了本讲的五个层次:Q1 裁列 → Q2 滤行 → Q3 算列 + 改名 + 排序 → Q4 连两张表 → Q5 一张表连自己。 任何一道 61A 级别的 SQL 题,拆开都是这五件事的组合。做题时先判断「这题落在哪一层」,再套六步法。
本讲小结
子句速查
| 子句 | 作用 | 典型陷阱 |
|---|---|---|
SELECT | 造一张新表;裁列、算表达式 | 它不删行;不改原表;* 无法「保留除某列外的全部」 |
FROM | 指定数据来源;写多张表就是 cross join | 逗号后面忘了写连接条件 → 安静地产出 m×n 行 |
WHERE | 按条件删行 | 字符串跟数字比恒假;字符串比大小是逐字符的 |
LIKE | 字符串模式匹配 | SQLite 里大小写不敏感;_ 是恰好一个字符;不写通配符就退化成相等 |
AS | 给列或表起别名 | 别名在 WHERE 里按标准不可用(SQLite 例外);起了表别名就必须用别名 |
ORDER BY | 排序,默认升序 | DESC 只作用于紧挨着的那一列;多列是「从左往右打破平局」 |
LIMIT | 只保留前 n 行 | 不配 ORDER BY 等于「随便给我 n 行」 |
JOIN … ON | 显式连接 | 与 FROM a, b WHERE 等价;条件写在 ON 里,职责更清楚 |
运算符速查(对照 Python)
| 含义 | SQL | Python |
|---|---|---|
| 相等 | =(首选)/== | == |
| 不等 | <>(首选)/!= | != |
| 逻辑与/或/非 | AND OR NOT | and or not |
| 字符串拼接 | || | + |
| 字符串引号 | 单引号 'abc' | 单双都行 |
| 真/假的显示 | 1 / 0 | True / False |
| 注释 | -- | # |
| 语句结束 | 必须有分号 | 换行即可 |
三句话
- 一切进出都是表。 想不通某条查询,就把每一步的中间表画出来:行数变了没有?列数变了没有?
- join 就是嵌套 for 循环。 m 行 join n 行等于 m×n 行,然后用条件砍。自连接只是「两个循环变量遍历同一张表」,所以必须显式排掉 i = j 和 (i,j)/(j,i) 重复——用
a.key < b.key一次解决。 - 按执行顺序写,不按书写顺序写。
FROM→WHERE→SELECT→AS→ORDER BY→LIMIT。先定「数据在哪」,最后才管「长什么样」。
动手练习
用第 1 节和第 11 节的 cities、boba、orders、menu 四张表。建议在 code.cs61a.org 的 SQL 解释器里真的敲一遍再看答案。
练习 1(判断题)
下面这条查询会返回几行?不查数据,只靠推理。
SELECT * FROM boba, menu;
看答案
40 行。 boba 有 10 行(注意不是 11 行——建表时那 11 条 SELECT 被 UNION 去掉了一条重复的),menu 有 4 行,没有任何连接条件,所以是纯粹的 cross join:10 × 4 = 40。列数是 4 + 2 = 6 列。
这 40 行里绝大多数是无意义的搭配(比如「Thanos 奶茶」这一行配上「Wintermelon 奶茶价格 6」)。要让它有意义,得加 WHERE boba.name = menu.item。
练习 2
下面两条查询,输出有什么不同?为什么?
-- A
SELECT name FROM cities ORDER BY latitude DESC LIMIT 2;

-- B
SELECT name FROM cities LIMIT 2;
看答案
A 是确定的,B 是不确定的。
A 按 latitude 降序排完再取前 2,语义是「纬度最高的两座城市」,用第 7 节那张五行的 cities 表(含 Metropolis)跑出来是 Minneapolis(45) 和 New York(41)。这个结果跟数据库怎么存行无关。
B 没有 ORDER BY,语义只是「随便给我两行」。你在本机跑会得到某个具体结果,但那是实现细节——换个数据库、加个索引、插入顺序不同,结果都可能变。凡是 LIMIT 出现而 ORDER BY 缺席,都该当成 bug 来看。
顺带注意执行顺序:A 里 ORDER BY latitude 用的列并没有被 SELECT 选中。这在 SQLite 里可以,因为 ORDER BY…… 慢着,按第 10 节的表,ORDER BY 排在 SELECT 之后,那时候 latitude 列不是已经被裁掉了吗?这正是执行顺序表作为「心智模型」的边界所在:它准确描述了名字何时可用(别名要等 AS 之后),但真实的数据库会把排序所需的列一路带到排序结束才丢弃。记住可用的规则就好:ORDER BY 里既可以用别名,也可以用原表的列。
练习 3
写一条查询,找出 boba 表里名字以 Milk Tea 结尾、且 ice 不是 'Regular' 的所有饮品的名字和冰量,按 pieces 从多到少排列。
看答案
SELECT name, ice
FROM boba
WHERE name LIKE '%Milk Tea' AND ice <> 'Regular'
ORDER BY pieces DESC;
三个要点:
- 「以…结尾」是
'%Milk Tea',百分号在前。写成'%Milk Tea%'也能在这份数据上跑出同样结果(因为所有名字确实都以它结尾),但表达的意思是「包含」,不是「结尾」。 ice <> 'Regular',不是!=(虽然 SQLite 两个都收),也不是NOT ice = 'Regular'(这个也对,但啰嗦)。ORDER BY pieces DESC用的pieces没有出现在SELECT里,这是允许的。
本机实测结果 5 行:
61A Special Milk Tea |Extra    (pieces 25)
61A Special Milk Tea |Extra    (pieces 24)
Black Milk Tea       |Light    (pieces 24)
Wintermelon Milk Tea |Light    (pieces 23)
Wintermelon Milk Tea |Light    (pieces 22)
(括号里的 pieces 不在输出中,写出来是为了让你看清排序依据。)
练习 4
下面这条查询想「找出每个人点的饮品价格」,但它有 bug。指出 bug 并说明症状(会报错还是给错结果?)。
SELECT o.name, m.price
FROM orders AS o, menu AS m;
看答案
bug:缺少连接条件。 FROM 后面用逗号列了两张表,但没有 WHERE o.item = m.item。
症状:不报错,返回 4 × 4 = 16 行。 每个人都跟菜单上四种饮品各配一次,于是 Rabia 会出现四次,价格分别是 8、5、7、6。这是本讲最危险的一类 bug——语法完全合法,结果完全错误,而且行数看起来「有数据」不像出问题。
诊断习惯:写完 join 数一下行数。 如果结果行数远多于左表行数,八成是连接条件漏了或写错了。经验法则是 FROM 里有 k 张表就至少要有 k−1 个连接条件。
修好的两种写法见第 11 节 Q4。
练习 5
把 Q5 的条件从 o1.name < o2.name 改成 o1.name <= o2.name,结果会变成什么?改成 o1.item <> o2.item 呢?
看答案
改成 <=:会把「自己配自己」放回来。 因为 'Rabia' <= 'Rabia' 为真,四个人各自跟自己配的那四行会重新出现。本机实测共 5 行:
Rabia   | Rabia
Rabia   | Sriya
Rebecca | Rebecca
Richard | Richard
Sriya   | Sriya
严格小于里的「严格」是干活的那部分,它同时承担了「去重」和「排除自配」两个职责。
改成 o1.item <> o2.item:意思完全变了。 这条查询会和前面的 o1.item = o2.item 直接矛盾——两个条件用 AND 连起来就是「item 相等且 item 不等」,恒假,返回 0 行。如果是把 o1.name < o2.name 替换成它,那查询变成「item 既相等又不等」,同样 0 行。
这道题想说明的是:自连接里的两个条件各司其职,不能互换——一个(o1.item = o2.item)负责把该配的配上,另一个(o1.name < o2.name)负责把不该出现的配对剔掉。写自连接时先分别问清楚这两个问题,再合起来写。