聚合与数据库:GROUP BY、聚合函数与 HAVING
上一讲的 SQL 只会「一行一行地挑」。这一讲学会把行分堆,再把每一堆压成一行——这是 SQL 里唯一能算出「有多少」「最大是谁」「平均多少」的机制。
0. 本讲导读
上一讲把 SQL 的骨架搭起来了:SELECT 造一张新表,FROM 说数据在哪,WHERE 把不想要的行筛掉,JOIN … ON … 把两张表拼起来,ORDER BY 排序,LIMIT 截断。这一整套有一个共同点,值得先停下来看清楚:
它们全都是「逐行」的。 WHERE salary > 40000 判断的是当前这一行;ORDER BY name 比较的是两行之间;连 JOIN 也只是把「A 的某一行」和「B 的某一行」并成更长的一行。输入表有 9 行,输出表最多也就那 9 行的某个子集(或者 join 之后的若干组合)。没有任何一个子句能同时看见多行然后给出一个数。
于是下面这些问题,用上一讲的工具一个都答不出来:
- 公司一共有几个人?
- Computer 部门的平均工资是多少?
- 哪个部门人最多?
- 哪些主管手底下管着不止一个人?
这些问题的共同结构是:先按某个标准把行分成几堆,然后对每一堆整体算一个数。「几个人」是对全表这一堆数数;「每个部门的平均工资」是先按 division 分堆、再对每堆的 salary 求平均。这个「把多行的信息合成一个值」的动作就叫聚合(aggregation)。
本讲补上的正是这套机制,一共三件东西:
GROUP BY——按指定列把行分堆,每堆最后只剩一行输出;- 聚合函数(aggregation function)——
COUNT/MAX/MIN/AVG/SUM,它们吃「一堆行的某一列」,吐一个值; HAVING——分完堆之后,按「堆的性质」把整堆整堆地筛掉。它对组做的事,正是WHERE对行做的事。
加进来之后,SQL 子句的执行顺序也要更新一次。这一讲最容易被忽略、但考试和调试时最要命的一句话是:SQL 不是从上往下执行的。WHERE 在分堆之前跑,HAVING 在分堆之后跑,SELECT 排在两者之后——理解了这个顺序,「为什么 WHERE COUNT(*) > 1 会报错」这类问题就不用背了。
本讲开头还有两段复习:Scheme 的动态作用域(dynamic scope),以及对 Lecture 21 宏(macro)展开规则的一处更正。它们跟 SQL 无关,但都是「名字怎么查」「表达式什么时候被求值」这门课的母题,也都会进期末的考察范围,所以放在第 1、2 节讲完再进 SQL。
- 帧的 parent 由「这一帧是被谁打开的」决定:普通过程(
lambda/define)用词法作用域,parent 是定义时所在的帧;mu过程用动态作用域,parent 是调用它的那一帧。查名字时逐层往 parent 找,跟「是谁触发的查找」无关。 - 宏的第二步不是裸代入,而是带引号的代入(quoted substitution):未求值的算子数以 quoted 形式传给宏过程。少了这层引号,
(list 'quote (list 'failed: expr))里的expr会先被算成#f,报错信息就变成了没用的(failed: #f)。 GROUP BY <columns>把行按这些列的取值分堆,每一堆最终只产出一行。有多少个不同的取值组合,输出就有多少行。- 聚合函数只有在「组」这个上下文里才有意义。没有
GROUP BY时,整张表算作一个组,所以SELECT COUNT(*) FROM records;只返回一行。 - 大多数 SQL 方言要求:
SELECT里的列,要么出现在GROUP BY里,要么被包在聚合函数里。SQLite 不强制,它允许「裸列(bare column)」——但那一行的值是从组里任意挑的,不要依赖它。 HAVING筛组,WHERE筛行。只有写了GROUP BY才能写HAVING;WHERE里不能出现聚合函数,因为它比分堆早跑。- 更新后的执行顺序:
FROM/JOIN…ON→WHERE/LIKE→GROUP BY→HAVING→SELECT→AS→ORDER BY→LIMIT。
1. 复习:动态作用域下,parent 到底怎么定
先把这个复习题放在最前面,因为它考的是这门课贯穿始终的那个问题:查一个名字的时候,从哪一帧开始找,找不到往哪儿走。
回忆 Scheme 里两种造过程的方式:
lambda / (define (f …) …) | mu | |
|---|---|---|
| 叫什么 | 普通过程(lexically scoped procedure) | mu 过程(dynamically scoped procedure) |
| 调用时新帧的 parent | 过程被定义时所在的那一帧 | 调用它的表达式所在的那一帧 |
| 叫什么作用域 | 词法作用域(lexical scope) | 动态作用域(dynamic scope) |
| parent 何时确定 | 创建过程的那一刻就定死了 | 每次调用可能不一样 |
关键的一句话,也是这道复习题唯一想让你记住的:
一帧的 parent 只取决于打开这一帧的是普通过程还是 mu 过程,跟「最初是在哪种过程里触发的名字查找」毫无关系。查找本身永远是同一套:当前帧找不到,就去当前帧的 parent 找,一直递归上去。
场景一:g 是普通过程
(define x 1)
(define h (mu () x))
(define (g h)
    (h)
)
(define (f)
    (define x 2)
    (g h)
)

scm> (f)
1
为什么是 1?一步一步走。
x → 1、h → mu ()、g → func g(h)、f → func f()。注意 (mu () x) 不会记住定义环境——这正是 mu 和 lambda 的区别。(f)。f 是普通过程,定义在全局帧,所以新帧 f1: f 的 parent = Global。f1 里执行 (define x 2),于是 f1 有了自己的 x → 2。全局的 x → 1 没有被改动,只是被遮蔽(shadow)了。(g h):算子 g 在 f1 找不到,去 parent(Global)找到普通过程 g;算子数 h 同理,取到那个 mu 过程。g。g 是普通过程,它定义在全局帧,所以新帧 f2: g 的 parent = Global——不是 f1。f2 里形参 h 绑到那个 mu 过程。f2 里执行 (h)。h 是 mu 过程,所以新帧 f3: h 的 parent 是调用它的那一帧,也就是 f2。f3 里求值过程体 x。f3 里没有 x → 去 parent f2,f2 里只有 h,没有 x → 去 f2 的 parent,也就是 Global → 找到 x → 1。1。Global frame
x ──→ 1
h ──→ mu () [无定义环境]
g ──→ func g(h) 定义于 Global
f ──→ func f() 定义于 Global
f1: f [parent=Global] ← f 是普通过程,定义在 Global
x ──→ 2 ← 只遮蔽,不改全局的 x
正在算:(g h)
f2: g [parent=Global] ← g 是普通过程 ⇒ parent = 定义处 Global
h ──→ mu ()
正在算:(h)
f3: h [parent=f2] ← h 是 mu 过程 ⇒ parent = 调用处 f2
正在算:x
查找路径:f3 ✗ → f2 ✗ → Global ✓ 得到 1
最容易错的一步是第 5 步。很多人看到「是 mu 触发的查找」,就以为整条查找链都会变成动态的,于是沿着 f3 → f2 → f1 走,答出 2。不对。 f2 的 parent 在创建 f2 的那一刻就定死了——因为 g 是普通过程,它的 parent 只能是定义处的 Global。f1 根本不在这条链上。
场景二:把 g 也改成 mu
(define x 1)
(define h (mu () x))
(define g (mu (h)
    (h)
))
(define (f)
    (define x 2)
    (g h)
)

scm> (f)
2
唯一的改动是 g 从普通过程变成 mu 过程。改动很小,链条却整个变了。
Global frame
    x  ──→ 1
    h  ──→ mu ()
    g  ──→ mu (h)
    f  ──→ func f()

f1: f  [parent=Global]
    x  ──→ 2
    正在算:(g h)

f2: g  [parent=f1]              ← g 现在是 mu ⇒ parent = 调用处 f1
    h  ──→ mu ()
    正在算:(h)

f3: h  [parent=f2]              ← h 是 mu ⇒ parent = 调用处 f2
    正在算:x
    查找路径:f3 ✗ → f2 ✗ → f1 ✓ 得到 2
这两个答案我在本仓库的 Scheme 解释器上实际跑过,分别是 1 和 2,与讲义一致。
场景三:自己造一个变式检验理解
讲义只给了两个场景。想确认自己真的懂了,最好的办法是自己改一处,先预测再运行。这次把 h 改回普通过程,g 保持 mu:
(define x 1)
(define (h) x)          ; h 现在是普通过程
(define g (mu (h) (h))) ; g 还是 mu
(define (f)
    (define x 2)
    (g h)
)

scm> (f)
1
预测的依据还是那一句:看开这一帧的是哪种过程。 f1: f 的 parent 是 Global;g 是 mu,所以 f2: g 的 parent 是调用处 f1;但 h 现在是普通过程,它定义在 Global,所以 f3: h 的 parent 是 Global,跟 f2、f1 全都断开了。查 x 直接在 Global 命中,得 1。实际运行确认是 1。
把三个场景并排看,规律就很清楚了——决定答案的只有「最后一环 h 是哪种过程」以及「往上追的那条链上各帧的 parent 是怎么定的」:
g | h | f3: h 的 parent | 查 x 的路径 | 结果 | |
|---|---|---|---|---|---|
| 场景一 | 普通 | mu | f2 | f3 → f2 → Global | 1 |
| 场景二 | mu | mu | f2 | f3 → f2 → f1 | 2 |
| 场景三 | mu | 普通 | Global | f3 → Global | 1 |
场景一和场景三的 f3 parent 完全不同,答案却都是 1——这说明不能靠背结论,只能一帧一帧推。
误区一:以为 (define x 2) 改掉了全局的 x。 不是。define 在当前帧创建绑定。f1 里的 x → 2 和 Global 里的 x → 1 是两个独立绑定,只是查找时先撞见 f1 的那个。场景一之所以拿到 1,恰恰是因为查找链绕开了 f1。
误区二:把「谁触发查找」当成「链条怎么走」。 名字查找只有一条规则:当前帧 → parent → parent 的 parent → …。触发查找的是 h 这个 mu 过程,但走到第二步时用的是 f3 的 parent,也就是 f2;f2 的 parent 是谁,早在创建 f2 时就定好了,跟 h 无关。
误区三:忘了 mu 的 parent 是「调用处的帧」,不是「调用者过程的定义处」。 在场景二里 (h) 写在 g 的体内,而 g 的体是在 f2 里执行的,所以 f3 的 parent 是 f2,不是「g 被定义的 Global」。看的是「这个调用表达式当前在哪一帧里被求值」。
词法作用域看的是代码长什么样(源码里这个函数写在哪个函数里面),光看源码就能画出链条;动态作用域看的是运行时谁调了谁,同一个 mu 过程在不同调用点会看到不同的 x。这就是几乎所有现代语言都选词法作用域的原因:它让「这个名字指的是哪个东西」在读代码时就能确定,而不必先在脑子里模拟一遍程序运行。
2. 更正:宏的第二步是「带引号的代入」
Lecture 21 讲宏的时候,把展开的第二步说成了「代入(substitution)」,暗示可以把算子数原样塞进宏体。这句话不准确,本讲专门更正。先把正式规则抄下来(来自 Scheme Spec):
- 求值算子。如果它不是宏过程,就按普通调用表达式的步骤走。
- 把这个宏过程施加到未求值的算子数上。
- 宏返回一个值之后,在调用处的环境里求值这个返回值。
问题出在第 2 步的「未求值」到底怎么实现。准确的说法是:它是一次带引号的代入(quoted substitution)。理由不难理解——调用一个宏,等价于「把参数加上引号,调用一个普通过程,然后对结果调 eval」。既然是调普通过程,参数就得是值;一段还没求值的代码要当成值传,唯一的办法就是给它加引号,变成一个数据(list)。
拿 Lecture 21 那个 check 宏来看差别:
(define-macro (check expr)
     (list 'if expr ''passed
          (list 'quote (list 'failed: expr))
     )
)
(define x -2)


scm> (check (> x 0))
(failed: (> x 0))
check 想做的事是:条件成立就返回符号 passed,不成立就返回一段说明「哪个条件挂了」的数据——注意是把那个条件表达式原文打印出来,而不是打印它的值。所以宏体里出现了两层 quote:''passed(两个引号)和 (list 'quote …)。
如果第 2 步是裸代入(错误的理解)
假设把 expr 直接换成 (> x 0)、不加引号,宏体就变成:
; 宏体(原样)
(list 'if expr ''passed
    (list 'quote (list 'failed: expr))
)

; 裸代入 expr,NO quote
(list 'if (> x 0) ''passed
    (list 'quote (list 'failed: (> x 0)))
)
接下来这个宏体本身要被求值(它就是一段普通的 Scheme 代码,用 list 造一棵语法树)。求值 list 调用要先求值所有算子数,于是里面的 (> x 0) 在这里就被算成了 #f:
; 宏返回的是
(quote (failed: #f))

; 第 3 步在调用处求值它,解释器显示
(failed: #f)
(failed: #f) 完全没用——它只告诉你「有个东西是假的」,却没告诉你哪个条件假了。这正是必须加引号的原因。
正确的:带引号的代入
; 宏体(原样)
(list 'if expr ''passed
    (list 'quote (list 'failed: expr))
)

; 代入 expr,WITH quote
(list 'if '(> x 0) ''passed
    (list 'quote (list 'failed: '(> x 0)))
)
(list 'failed: '(> x 0))。两个算子数都是 quoted 的数据,求值成符号 failed: 和列表 (> x 0)。结果是列表 (failed: (> x 0))。(list 'quote (failed: (> x 0))) ⇒ 列表 (quote (failed: (> x 0)))。多包的这层 quote 是给第 3 步准备的——不然第 3 步会把 (failed: …) 当成一个函数调用去执行。list:拼出 (if (> x 0) 'passed (quote (failed: (> x 0))))。这就是宏的返回值——一段代码。x 是 -2,(> x 0) 求值为 #f,走 else 分支,得到 (failed: (> x 0))。(failed: (> x 0))。条件的原文被保留下来了。对照一下 ''passed:外层 quote 让宏返回的代码里出现 'passed,第 3 步求值 'passed 得到符号 passed。要是只写一个 'passed,宏返回的代码里就成了裸的 passed,第 3 步会把它当成一个名字去查——大概率报 Error: unknown identifier: passed。
宏涉及两轮求值:一轮把宏体算成「返回的代码」,一轮把「返回的代码」再算成最终值。所以你要问自己:这个东西希望在第几轮存活下来? 想让它撑过第一轮,加一层 quote;想让它撑过两轮(最终显示为数据而不是被执行),就得加两层。''passed 和 (list 'quote …) 是同一个道理的两种写法。
本仓库 proj/scheme 里的 Scheme 解释器是项目起手代码,define-macro(Problem 18)还没实现。直接跑上面这段会得到:
scm> (define-macro (check expr) ...)
Error: unknown identifier: define-macro
所以本节的展开过程依据的是讲义给出的推导,不是本机实测。等你做完 Scheme 项目的宏那一问,可以回来把这两种版本各跑一遍验证。
3. 热身:把同一张表 join 三次
进入聚合之前,先做完上一讲留下的那道 23.sql Q1。它不涉及任何新语法,纯粹练「自连接(self join)」——同一张表在 FROM 里出现多次,靠别名区分。这个技巧在做 HW 06 时会反复用到。
数据:records 表
本讲用的示例表是 61A 一直在用的 records,五列:name、division、title、salary、supervisor。
| name | division | title | salary | supervisor |
|---|---|---|---|---|
| Alyssa P Hacker | Computer | Programmer | 40000 | Ben Bitdiddle |
| Ben Bitdiddle | Computer | Wizard | 60000 | Oliver Warbucks |
| Cy D Fect | Computer | Programmer | 35000 | Ben Bitdiddle |
| Eben Scrooge | Accounting | Chief Accountant | 75000 | Oliver Warbucks |
| Lana Lambda | Administration | Secretary | 25000 | Lana Lambda |
| Lem E Tweakit | Computer | Technician | 25000 | Ben Bitdiddle |
| Louis Reasoner | Computer | Programmer Trainee | 30000 | Alyssa P Hacker |
| Oliver Warbucks | Administration | Big Wheel | 150000 | Oliver Warbucks |
| Robert Cratchet | Accounting | Scrivener | 18000 | Eben Scrooge |
name / division 两列直接取自本讲幻灯片;supervisor 一列是从 23-sol.sql 给出的期望输出反推出来的(尤其是 Lana Lambda 的 supervisor 是她自己,这跟教材 §4.3 里的老版本不同);title / salary 取自教材 §4.3 的 records 表。本页所有查询结果都是在本机 SQLite 3.37.2 上用这张表实际跑出来的,并且 Q1 的输出与官方期望输出逐行一致。
题目
要求输出三列:员工 employee、他的主管 middle_manager、他主管的主管 skip_manager。按这三列依次排序。有人是自己的主管,不用特殊处理。
怎么想到的
看到题的第一反应通常是「这得递归吧?沿着 supervisor 一路往上爬」。不用。 题目要的层数是固定的——正好两层。一旦层数固定,就不是递归问题,而是「把表接起来」的问题。
关键的思路转换是这一句:records 这张表既是「员工表」,也是「主管表」——它们是同一张表,只是用途不同。 于是:
records:一份当员工(叫它 a),一份当主管(b),一份当主管的主管(c)。必须起别名,否则 name 指哪一份是说不清的。b 是 a 的主管」怎么写?a 的 supervisor 列存的是名字,而 b 这一行的 name 也是名字。所以条件是 a.supervisor = b.name。c 是 b 的主管」就是 b.supervisor = c.name。两个条件用 AND 连起来。a.name、b.name、c.name,用 AS 改成题目要的列名。ORDER BY 直接用别名(ORDER BY 排在 AS 之后执行,所以这时别名已经存在了)。SELECT a.name AS employee, b.name AS middle_manager, c.name AS skip_manager
FROM records AS a
JOIN records AS b
JOIN records AS c
ON a.supervisor = b.name AND b.supervisor = c.name
ORDER BY employee, middle_manager, skip_manager;
实际输出(本机 SQLite):
employee|middle_manager|skip_manager
Alyssa P Hacker|Ben Bitdiddle|Oliver Warbucks
Ben Bitdiddle|Oliver Warbucks|Oliver Warbucks
Cy D Fect|Ben Bitdiddle|Oliver Warbucks
Eben Scrooge|Oliver Warbucks|Oliver Warbucks
Lana Lambda|Lana Lambda|Lana Lambda
Lem E Tweakit|Ben Bitdiddle|Oliver Warbucks
Louis Reasoner|Alyssa P Hacker|Ben Bitdiddle
Oliver Warbucks|Oliver Warbucks|Oliver Warbucks
Robert Cratchet|Eben Scrooge|Oliver Warbucks
验证:追一行
拿 Louis Reasoner 走一遍。三重 join 概念上就是三层嵌套循环:对 a 的每一行,配 b 的每一行,再配 c 的每一行,一共 $9^3 = 729$ 种组合,然后用 ON 的条件筛。
a.supervisor 是 'Alyssa P Hacker'。要满足 a.supervisor = b.name,b 只能是 Alyssa P Hacker 那一行——9 个候选里只剩 1 个。b.supervisor 是 'Ben Bitdiddle'。要满足 b.supervisor = c.name,c 只能是 Ben Bitdiddle 那一行。a = Louis 的只有一种存活。SELECT 取出三个 name,得到 Louis Reasoner|Alyssa P Hacker|Ben Bitdiddle。✓b 也是她那一行;b.supervisor 还是她自己,c 也是她。输出 Lana Lambda|Lana Lambda|Lana Lambda——题目说这样就是对的。✓误区一:条件写反成 a.name = b.supervisor。 这句话的意思变成了「a 是 b 的主管」,输出会整个倒过来。判断方法:supervisor 列存的是上一级的名字,所以「谁的 supervisor」要放在下级那一侧。a 是员工,b 是上级,所以是 a.supervisor = b.name。
误区二:不起别名。 直接写 SELECT name FROM records, records, records;,SQLite 会报(实测):
ambiguous column name: name三张表都有 name 列,解释器无从判断你指的是哪一张。自连接必须起别名,没有例外。
误区三:以为需要写两个 ON。 写成 JOIN records AS b ON … JOIN records AS c ON … 也可以(这是标准写法),但本讲的写法是把两个 JOIN 连写、条件全放进一个 ON 里用 AND 连接,SQLite 接受这种写法。两种都对,别被形式绕住——JOIN … ON 的本质就是「先做笛卡尔积,再用条件筛」。
4. 为什么需要聚合:逐行的工具答不了整体的问题
现在换个问题:公司一共有几个人?
用上一讲的全部工具试一遍,你会发现每一样都差一点:
| 你可能想到的写法 | 实际得到什么 | 为什么不行 |
|---|---|---|
SELECT * FROM records; | 9 行完整数据 | 数是要你自己数的,SQL 没告诉你 |
SELECT name FROM records; | 9 行名字 | 同上,还是 9 行,不是数字 9 |
SELECT name FROM records LIMIT 1; | 1 行 | LIMIT 是截断,不是计数 |
症结在于:SELECT 是一个「对每一行做同样的事」的子句。 输入表有几行,它就产出几行(WHERE 只能减少行数,ORDER BY 只能调换行的顺序)。而「有几个人」这个答案,需要同时看到全部 9 行才算得出来。这是一个逐行工具在结构上做不到的事。
再看一个更麻烦的:每个部门的平均工资是多少? 这里有两层需求叠在一起:
- 分堆:Computer 的行归一堆、Accounting 的行归一堆、Administration 的行归一堆;
- 压缩:每一堆的
salary列合成一个平均值。
这正好对应本讲的两样东西:GROUP BY 负责第 1 步,聚合函数负责第 2 步。它们几乎总是一起出现,因为分了堆不压缩没意义,不分堆也可以压缩(整张表就是一堆)。
GROUP BY ≈ 你在 Python 里写过的「用字典把元素归类」:d[row.division].append(row)。聚合函数 ≈ 对每个 d[key] 这个列表调 len / max / sum / sum(...)/len(...)。SQL 只是把这个「先分组、再规约」的常见套路做成了内建语法,你不用手写循环——这就是声明式编程:你说要什么,数据库自己想办法。
加上这两样之后,一条查询的完整骨架长这样(子句必须按这个顺序书写,虽然不是按这个顺序执行):
SELECT <columns>
FROM <table>
JOIN <table>
ON <condition>
WHERE <condition>
GROUP BY <columns>
ORDER BY <columns>
LIMIT <n>;
5. GROUP BY:把行分成堆
GROUP BY <columns> 做的事只有一件:把 <columns> 上取值相同的行归到同一堆里。 然后——这是最重要的一句——每一堆最终只输出一行。
所以你可以直接算出输出有几行:看 GROUP BY 那些列一共有多少种不同的取值组合。 9 行的 records 按 division 分堆,division 只有 Computer / Accounting / Administration 三种值,输出就是 3 行。
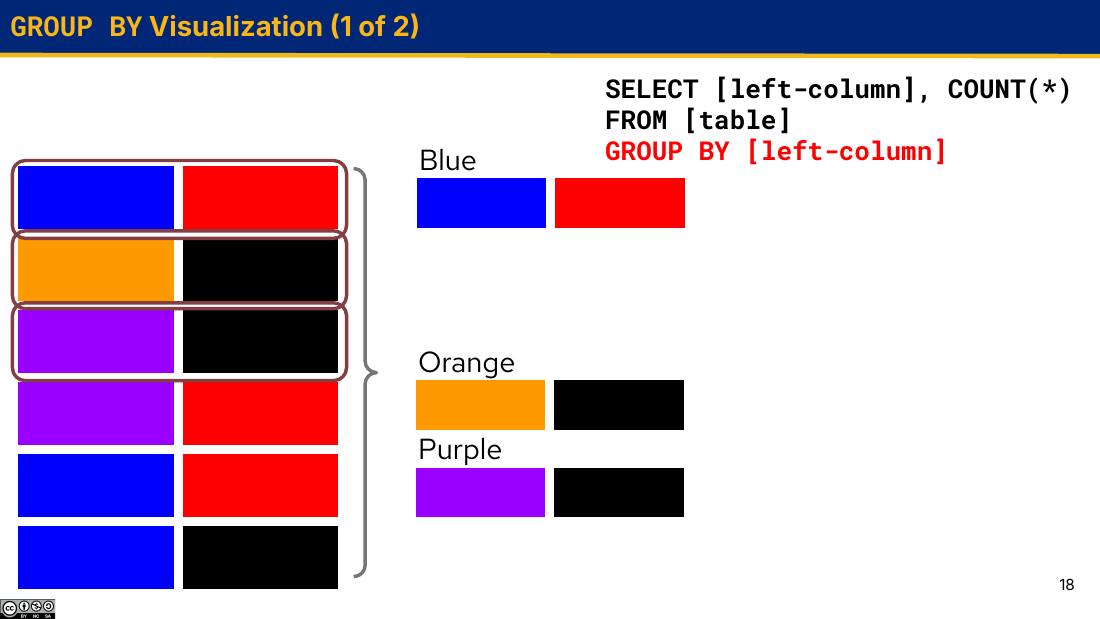
GROUP BY [left-column] 按左列的颜色把行分堆:蓝色一堆(3 行)、橙色一堆(1 行)、紫色一堆(2 行)。分堆只看 GROUP BY 里写的那一列,右列长什么样完全不影响分堆结果。这一步之后,数据库手里握着的不再是「6 行」,而是「3 堆」。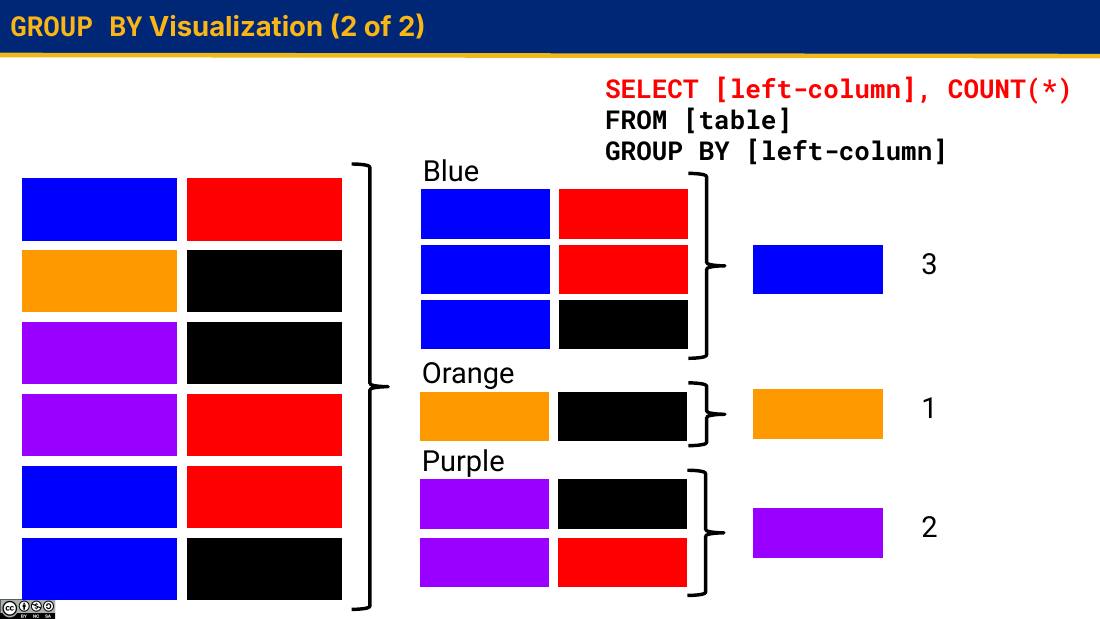
SELECT [left-column], COUNT(*) 里的 [left-column] 取这一堆共有的那个颜色,COUNT(*) 数这一堆有几行——蓝 3、橙 1、紫 2。输出正好 3 行,一堆一行。注意右列消失了:它既不在 GROUP BY 里也不在聚合函数里,没有位置放它。在 records 上真跑一遍
sqlite> SELECT division, COUNT(*) FROM records GROUP BY division;
division|COUNT(*)
Accounting|2
Administration|2
Computer|5
FROM records:拿到 9 行。WHERE,9 行全留。GROUP BY division:扫一遍,按 division 的值分堆。Accounting 堆 = {Eben Scrooge, Robert Cratchet}Administration 堆 = {Lana Lambda, Oliver Warbucks}Computer 堆 = {Alyssa P Hacker, Ben Bitdiddle, Cy D Fect, Lem E Tweakit, Louis Reasoner}SELECT division, COUNT(*):对每一堆算一次。division 在堆内是常数(这正是它能出现在 SELECT 里的原因),COUNT(*) 数堆里的行数。ORDER BY。裸列(bare column):SELECT 里放了不该放的东西
现在看讲义里那个专门用来「踩坑」的例子。原表 9 行:
sqlite> SELECT name, division FROM records;
Alyssa P Hacker|Computer
Ben Bitdiddle|Computer
Cy D Fect|Computer
Eben Scrooge|Accounting
Lana Lambda|Administration
Lem E Tweakit|Computer
Louis Reasoner|Computer
Oliver Warbucks|Administration
Robert Cratchet|Accounting
那么下面这条会输出什么?
SELECT name, division
FROM records
GROUP BY division;
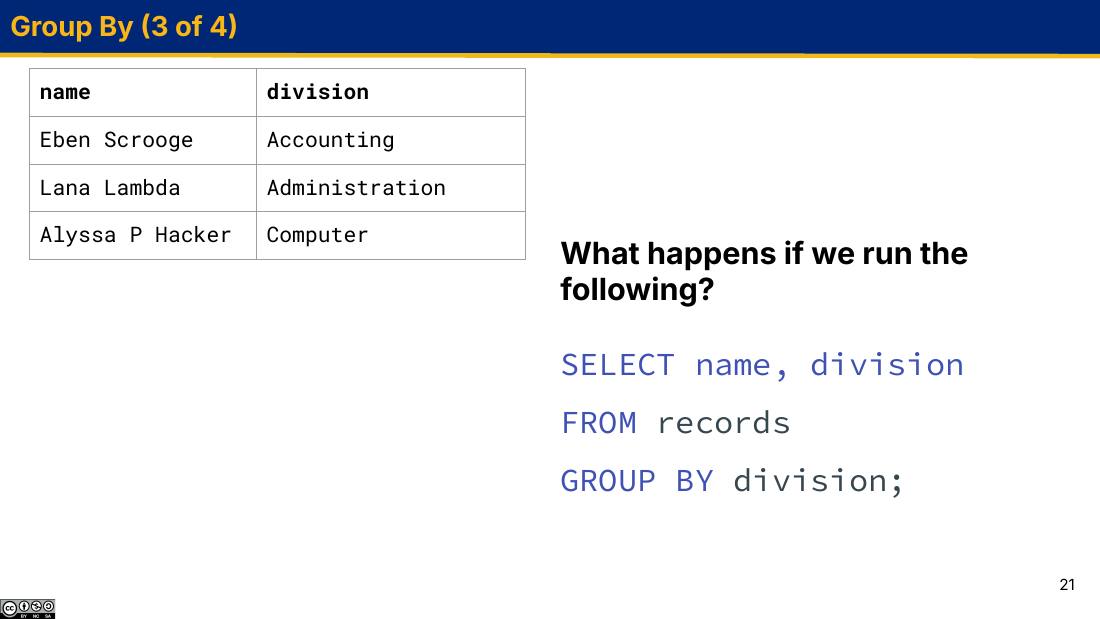
division 只有 3 个不同的值。division 那一列没问题——同一堆里它本来就只有一个值。有问题的是 name:Computer 堆里有 5 个不同的名字,但输出只有一格,数据库只能随便挑一个。这里挑中了 Alyssa P Hacker,纯粹因为她在表里排第一。本机实测结果与幻灯片一致:
sqlite> SELECT name, division FROM records GROUP BY division;
name|division
Eben Scrooge|Accounting
Lana Lambda|Administration
Alyssa P Hacker|Computer
像 name 这样既不在 GROUP BY 里、也不被聚合函数包住的列,SQLite 管它叫裸列(bare column)。
大多数 SQL 方言(MySQL 严格模式、PostgreSQL 等)会直接拒绝这条查询并报错:有 GROUP BY 时,SELECT 里的列必须要么出现在 GROUP BY 中,要么被包在聚合函数里。
61A 用的 SQLite 不强制这条规则,它会挑一行的值填进去。所以这条查询在 61A 的环境里能跑——但它挑哪一行是没有承诺的,你不能拿它当逻辑依据。
误区一:以为 SELECT name, division … GROUP BY division 会返回「每个部门的所有人」。 不会。GROUP BY 的输出一堆只有一行,这是硬规则。想看每个部门的所有人,你根本不需要 GROUP BY,写 SELECT name, division FROM records ORDER BY division; 就够了。
误区二:以为裸列会挑「最大/最小的那一行」。 有一个特别坑的现象:
sqlite> SELECT division, name, MAX(salary) FROM records GROUP BY division;
Accounting|Eben Scrooge|75000
Administration|Oliver Warbucks|150000
Computer|Ben Bitdiddle|60000
看起来 name 正好是每个部门工资最高的人,很诱人。这是 SQLite 的一个实现特性(当聚合函数是 MAX 或 MIN 时,裸列取自那一行),不是 SQL 标准,别的数据库不这么干。而且一旦你把 MAX 换成 COUNT 或 AVG,这个「巧合」立刻消失:
sqlite> SELECT division, name, COUNT(*) FROM records GROUP BY division;
Accounting|Eben Scrooge|2
Administration|Lana Lambda|2
Computer|Alyssa P Hacker|5
Alyssa 既不是 Computer 里工资最高的也不是最低的——它只是第一行。在 61A 里写查询,请当作「裸列的值不可预测」。
误区三:以为 GROUP BY 会排序。 输出恰好按分组列有序,是因为 SQLite 常常用排序来实现分组。这是实现细节。题目要求排序就老老实实写 ORDER BY。
按多列分堆
GROUP BY 后面可以跟多列,这时「同一堆」的意思是这几列的值全都相同:
sqlite> SELECT fur, height FROM dogs GROUP BY fur, height;
curly|31
curly|32
long|26
long|46
long|47
short|28
short|35
short|52
(这里用的是 HW 06 的 dogs 表,8 只狗。因为 8 只狗的 (fur, height) 组合两两不同,所以分出了 8 堆,每堆 1 行——分堆分得太细,等于没分。)
GROUP BY 后面也可以跟表达式,不一定是列名。比如按身高的十位数分档:
sqlite> SELECT height/10, COUNT(*) FROM dogs GROUP BY height/10;
2|2
3|3
4|2
5|1
SQL 里 整数/整数 是整除,所以 26/10 是 2。这条查询说:身高 20 多的有 2 只,30 多的 3 只,40 多的 2 只,50 多的 1 只。
GROUP BY 和 DISTINCT 的关系
不带任何聚合函数的 GROUP BY,效果跟 SELECT DISTINCT 一样——都是「把重复的取值合成一个」:
sqlite> SELECT division FROM records GROUP BY division;
Accounting
Administration
Computer

sqlite> SELECT DISTINCT division FROM records;
Computer
Accounting
Administration
内容一样,顺序不一样(DISTINCT 按遇到的先后,GROUP BY 这里恰好按字母序)。两者的意图不同,选哪个看你想表达什么:
SELECT DISTINCT c | GROUP BY c | |
|---|---|---|
| 想表达 | 「去掉重复」 | 「按 c 分堆,然后对每堆算点什么」 |
| 能配聚合函数吗 | 不能(没有「组」的概念) | 能,这才是它存在的理由 |
能配 HAVING 吗 | 不能 | 能 |
| 什么时候用 | 只想看有哪些取值 | 只要出现「每个……的……」这种说法 |
看到题目里出现「每个」「各自」「分别」,条件反射就该是 GROUP BY。
6. 聚合函数:把一堆行压成一个值
聚合函数是唯一能「同时看见多行」的东西。它们全都是这个形状:吃一组行的某一列,吐一个值。
| 函数 | 做什么 | 在 records 上的例子 | 结果 |
|---|---|---|---|
COUNT(*) | 数这一组有几行 | SELECT COUNT(*) FROM records; | 9 |
COUNT(column) | 数这一列的行数 | 见下方 NULL 的说明 | — |
COUNT(DISTINCT column) | 数这一列有几个不同的值 | SELECT COUNT(DISTINCT division) FROM records; | 3 |
MAX(column) | 这一列的最大值 | SELECT MAX(salary) FROM records; | 150000 |
MIN(column) | 最小值 | SELECT MIN(salary) FROM records; | 18000 |
AVG(column) | 平均值 | SELECT AVG(salary) FROM records; | 50888.88888888889 |
SUM(column) | 求和 | SELECT SUM(salary) FROM records; | 458000 |
COUNT(*) 和 COUNT(column) 技术上有区别,但不在 61A 的范围内——讲义明确说了这一点。想知道区别的话:COUNT(*) 数行,COUNT(column) 数这一列非 NULL 的值。造一张有空值的小表就能看出来:
sqlite> CREATE TABLE t (a TEXT, b INTEGER);
sqlite> INSERT INTO t VALUES ('x', 1), ('y', NULL), ('z', 3), ('x', NULL);
sqlite> SELECT COUNT(*), COUNT(b), COUNT(DISTINCT a) FROM t;
4|2|3
4 行,但 b 只有 2 个非空值;a 列有 x, y, z, x 四个值、3 种取值。61A 的作业表基本没有 NULL,所以两种写法结果一样,用 COUNT(*) 就行。
没有 GROUP BY 时,整张表就是一个组
这是理解聚合函数最省事的一条心法。SELECT COUNT(*) FROM records; 之所以返回一行,不是因为有什么特殊规则,而是因为「不分堆」就等于「所有行归成一堆」,一堆一行。
FROM records:9 行。WHERE division = 'Computer':逐行判断,留下 5 行(Alyssa 40000、Ben 60000、Cy 35000、Lem 25000、Louis 30000)。GROUP BY,这 5 行整体算一组。AVG(salary):$(40000+60000+35000+25000+30000)/5 = 190000/5 = 38000$。38000.0。注意是浮点数——SQLite 的 AVG 永远返回浮点,即使能整除。分堆之后,每一堆各算一次
把上一步的 WHERE 换成 GROUP BY,就从「算一个部门」变成「一次算完所有部门」:
sqlite> SELECT division, MAX(salary), MIN(salary), AVG(salary), SUM(salary), COUNT(*)
   ...> FROM records GROUP BY division;
division|MAX(salary)|MIN(salary)|AVG(salary)|SUM(salary)|COUNT(*)
Accounting|75000|18000|46500.0|93000|2
Administration|150000|25000|87500.0|175000|2
Computer|60000|25000|38000.0|190000|5
验证 Computer 那一行:5 个人,工资 40000/60000/35000/25000/30000。最大 60000 ✓,最小 25000 ✓,和 190000 ✓,平均 38000 ✓,人数 5 ✓。同一次分堆可以喂给任意多个聚合函数——数据库只扫一遍,每个函数各自累加自己的东西。
回忆你写过的 reduce(add, lst)。SUM 就是 reduce 配 add,MAX 就是 reduce 配 max,COUNT 就是 reduce 配「每次加 1」。它们的共性是把一个序列折叠成一个值。GROUP BY 则相当于先把序列切成若干子序列,再对每个子序列 reduce 一次。这两个动作合起来在别的语言里叫 map-reduce,SQL 只是给了它一个声明式的写法。
MAX / MIN 对字符串也管用
sqlite> SELECT MAX(name), MIN(name) FROM records;
Robert Cratchet|Alyssa P Hacker
按字典序比较。字符串列上的 MAX 通常没什么实际意义,但知道它不报错就行。
误区一:以为 SELECT MAX(salary), name FROM records; 给出「工资最高的人」。 实测:
sqlite> SELECT MAX(salary), name, division FROM records;
150000|Oliver Warbucks|Administration
这次碰巧对了——因为 SQLite 在只有 MAX 一个聚合函数时会让裸列取自那一行。但这仍然是裸列,不是标准行为。想稳妥地拿到「工资最高的人」,应该写成排序加截断:
SELECT name, salary FROM records ORDER BY salary DESC LIMIT 1;误区二:把聚合函数写在 WHERE 里。 这是本讲第二高频的错误,第 8 节会专门讲执行顺序。先看真实报错:
sqlite> SELECT division, COUNT(*) FROM records WHERE COUNT(*) > 1 GROUP BY division;
misuse of aggregate: COUNT()
误区三:以为空结果集的 SUM 是 0。 不是,是 NULL:
sqlite> SELECT COUNT(*), SUM(salary), MAX(salary) FROM records WHERE salary > 1000000;
0|NULL|NULL
只有 COUNT 在没有行时给 0,其他几个都给 NULL。注意这里仍然输出了一行——因为没有 GROUP BY,「空的一堆」也还是一堆。但一旦加上 GROUP BY,结果就是零行:
sqlite> SELECT division, COUNT(*) FROM records WHERE salary > 1000000 GROUP BY division;
<没有任何输出>
因为一行都没剩,就分不出任何一堆。「一堆一行」这条规则里,零堆对应零行。
COUNT(DISTINCT c) 和 SELECT DISTINCT c
两者容易混。SELECT DISTINCT division FROM records; 给你有哪些取值,SELECT COUNT(DISTINCT division) FROM records; 给你有几种取值:
sqlite> SELECT DISTINCT division FROM records;
Computer
Accounting
Administration

sqlite> SELECT COUNT(DISTINCT division) FROM records;
3
顺带注意 SELECT DISTINCT 的输出没有排序(这里是 Computer 排在最前,因为 Alyssa 是表里第一行)。这也再次说明:要顺序就写 ORDER BY。
7. HAVING:给「组」用的 WHERE
问题:哪些主管手底下管着不止一个人?
第一步好办,按 supervisor 分堆数人数:
sqlite> SELECT supervisor, COUNT(*) FROM records GROUP BY supervisor;
supervisor|COUNT(*)
Alyssa P Hacker|1
Ben Bitdiddle|3
Eben Scrooge|1
Lana Lambda|1
Oliver Warbucks|3
第二步要把 COUNT(*) = 1 的那三行去掉。直觉上该用 WHERE,但 WHERE 在分堆之前跑,那时候还没有「组」这个东西,更没有 COUNT(*) 这个值。所以 SQL 另给了一个子句:
HAVING <condition>按条件筛掉整个组,就像WHERE筛掉整行一样。HAVING里可以调用聚合函数——它跑在GROUP BY之后,组已经形成了。- 只有写了
GROUP BY,才能写HAVING。
sqlite> SELECT supervisor, COUNT(*) FROM records
   ...> GROUP BY supervisor HAVING COUNT(*) > 1;
supervisor|COUNT(*)
Ben Bitdiddle|3
Oliver Warbucks|3
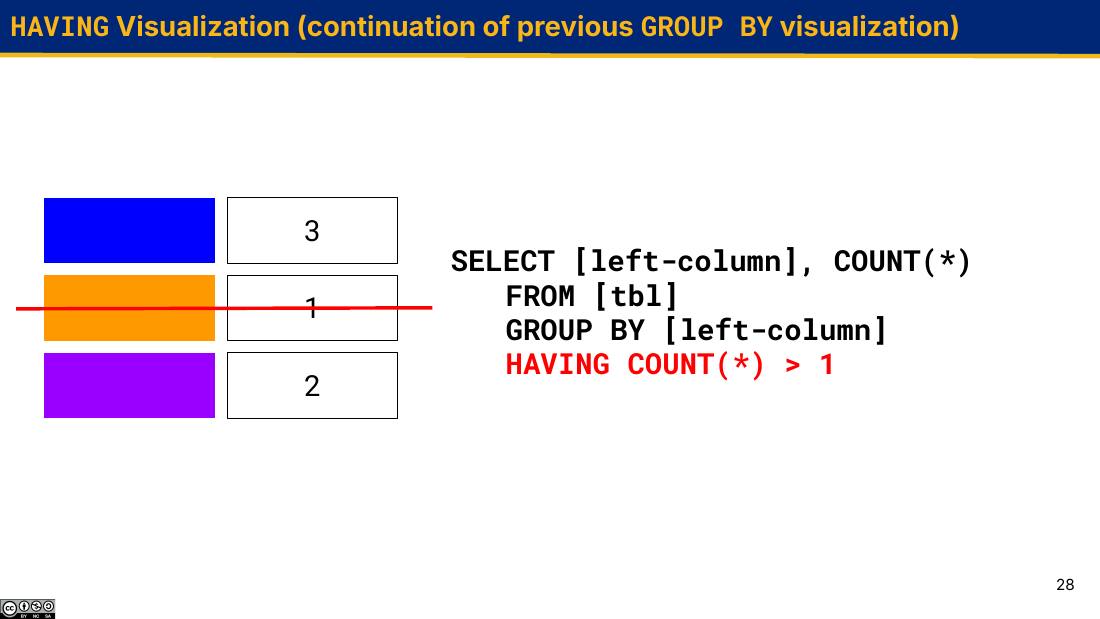
COUNT(*) 之后有 3 组:蓝 3、橙 1、紫 2。HAVING COUNT(*) > 1 把橙色那一组整组划掉——注意划掉的是「组」这一整个单位,不是组里的某几行。最后输出蓝和紫两行。FROM records:9 行进来。WHERE:9 行全留。GROUP BY supervisor:分成 5 堆。Ben 手下 {Alyssa, Cy, Lem};Oliver 手下 {Ben, Eben, Oliver 自己};Alyssa 手下 {Louis};Eben 手下 {Robert};Lana 手下 {Lana 自己}。HAVING COUNT(*) > 1:对每一堆算 COUNT(*),3、3、1、1、1。留下前两堆,扔掉后三堆。SELECT supervisor, COUNT(*):剩下 2 堆,输出 2 行。HAVING 里能写什么
HAVING 的条件不一定要含聚合函数,写普通列也合法(虽然那种情况通常该用 WHERE):
sqlite> SELECT division, COUNT(*) FROM records
   ...> GROUP BY division HAVING division LIKE 'A%';
Accounting|2
Administration|2
也可以在 HAVING 里用一个没出现在 SELECT 里的聚合函数——「按什么筛」和「输出什么」是两码事:
sqlite> SELECT division, COUNT(*) FROM records
   ...> GROUP BY division HAVING MAX(salary) > 70000;
Accounting|2
Administration|2
这条查询问的是「哪些部门里有人年薪超过 70000」,输出的却是这些部门的人数。Computer 最高才 60000,所以被筛掉了。
另外,SQLite 允许 HAVING 引用 SELECT 里定义的别名:
sqlite> SELECT division, AVG(salary) AS avg_sal FROM records
   ...> GROUP BY division HAVING avg_sal > 40000;
Accounting|46500.0
Administration|87500.0
上面这个别名写法虽然在 SQLite 里能跑,但严格按执行顺序(HAVING 排在 SELECT/AS 之前)它是不该成立的,别的数据库不一定接受。考试和作业里把聚合函数原样写一遍更稳:HAVING AVG(salary) > 40000。ORDER BY 用别名则完全没问题,因为它确实排在 AS 之后。
误区一:没有 GROUP BY 就写 HAVING。 真实报错:
sqlite> SELECT division FROM records HAVING COUNT(*) > 1;
a GROUP BY clause is required before HAVING
报错信息几乎是把讲义那句话直接念了一遍。
误区二:拿 HAVING 当 WHERE 用来筛行。 比如想「只统计 Computer 部门的人」,写成 GROUP BY supervisor HAVING division = 'Computer'。这不会按你想的那样工作:division 在 supervisor 分出来的组里是个裸列,值是随便挑的一行的,于是整组的去留取决于那一行是谁。筛行用 WHERE,筛组用 HAVING,这条界线不要跨。
误区三:以为 HAVING 能替代 WHERE 提升性能。 反了。WHERE 在分堆前把行扔掉,进入分堆的数据更少;HAVING 得等到组建好、聚合值算完才动手。能用 WHERE 表达的条件就用 WHERE。
WHERE 的条件里,每个名字指的是某一行的值;HAVING 的条件里,每个名字指的是某一组的性质。所以 WHERE 里不能出现聚合函数(一行谈不上聚合),HAVING 里可以。
把「哪个部门人最多」写完整
导读里那四个问题,现在只剩最后一个没答。「人最多」这种「取第一名」的需求,SQL 里的标准做法不是 HAVING,而是先聚合、再排序、再截断:
SELECT division, COUNT(*) AS n
FROM records
GROUP BY division
ORDER BY n DESC
LIMIT 1;
division|n
Computer|5
GROUP BY division(第 3 步)分出 3 堆。SELECT division, COUNT(*)(第 5 步)产出中间表 Accounting|2、Administration|2、Computer|5。AS n(第 6 步)给第二列起名 n。ORDER BY n DESC(第 7 步):这时 n 这个别名已经存在,所以能用。排成 Computer|5、Accounting|2、Administration|2。LIMIT 1(第 8 步)取第一行。这里 ORDER BY 排的是聚合之后的那张 3 行的表,不是原始的 9 行——这正是执行顺序把 ORDER BY 放在第 7 步的意义。
LIMIT 1 只管取第一行,不管有没有并列。这里 Accounting 和 Administration 都是 2 人,如果问的是「人最少的部门」,ORDER BY n LIMIT 1 只会给你其中一个,而且是哪一个都不好说。要处理并列,得先把最大值算出来再回去比——那需要子查询,超出本讲范围。做题时看清题目要不要处理并列。
8. 更新后的执行顺序
SQL 是声明式(declarative)语言:你写的是「我要什么」,不是「怎么算」。所以它不是从上往下执行的。加上 GROUP BY 和 HAVING 之后,完整顺序是八步:
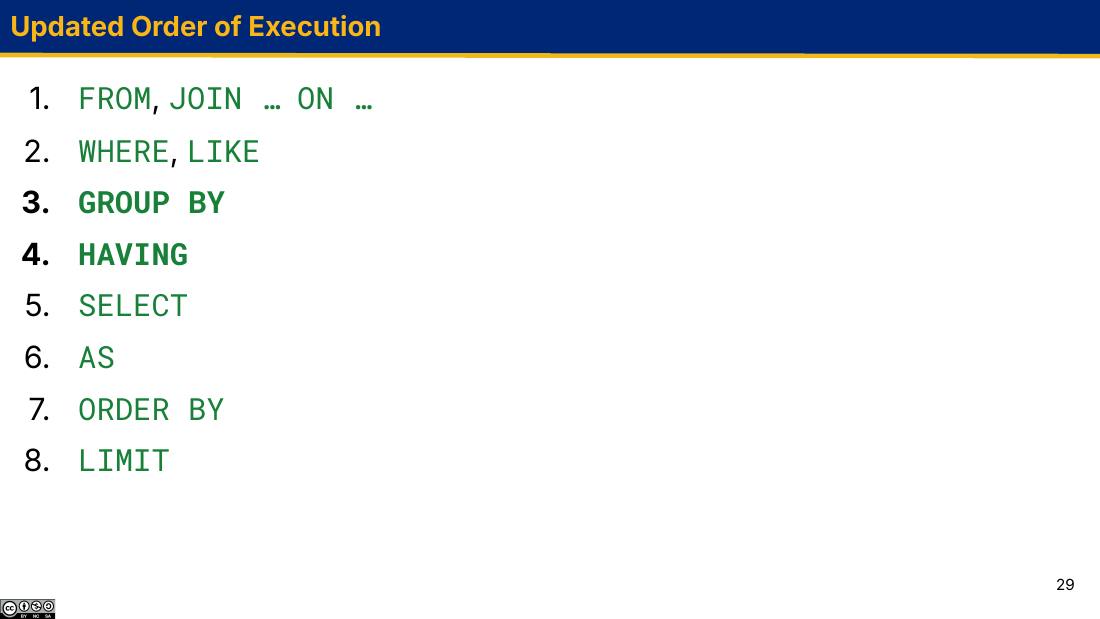
SELECT 排在第 5 位——它比 WHERE、GROUP BY、HAVING 都晚,尽管它写在最前面。这一条能解释本讲绝大多数「为什么报这个错」。| # | 子句 | 它拿到的是什么 | 它交出去的是什么 |
|---|---|---|---|
| 1 | FROM, JOIN … ON … | 磁盘上的表 | 一堆行(join 过的话是拼接后的宽行) |
| 2 | WHERE, LIKE | 行 | 更少的行 |
| 3 | GROUP BY | 行 | 组(从这里开始单位变了) |
| 4 | HAVING | 组 | 更少的组 |
| 5 | SELECT | 组(或行) | 输出表的各列,一组一行 |
| 6 | AS | 列 | 改了名的列 |
| 7 | ORDER BY | 输出表 | 排好序的输出表 |
| 8 | LIMIT | 输出表 | 前 n 行 |
把这张表读懂,本讲的四个「为什么」全都不用背了:
WHERE COUNT(*) > 1 报 misuse of aggregate: COUNT()? WHERE 是第 2 步,GROUP BY 是第 3 步。WHERE 跑的时候组还不存在,COUNT(*) 无从算起。GROUP BY 就不能写 HAVING? HAVING 是第 4 步,它的输入必须是第 3 步产出的「组」。没有第 3 步,第 4 步没有输入。ORDER BY 能用 AS 起的别名,WHERE 不能? AS 是第 6 步,ORDER BY 是第 7 步(在它之后,别名已存在),WHERE 是第 2 步(在它之前,别名还不存在)。SELECT 里放裸列会出问题? SELECT 是第 5 步,它面对的已经是「组」不是「行」了。要它填一个只有单行才有意义的值,它只能瞎猜。写查询的固定套路
上一讲给过一个「按问题清单写查询」的方法,现在补上两条,正好和执行顺序一一对应:
| 问自己 | 写哪个子句 |
|---|---|
| 数据在哪张(几张)表里?怎么对应起来? | FROM, JOIN … ON … |
| 有哪些行根本不该参与? | WHERE, LIKE |
| 要按什么把行分堆? | GROUP BY |
| 有哪些堆不该出现在结果里? | HAVING |
| 输出要哪几列?哪些需要聚合? | SELECT |
| 列名要改吗? | AS |
| 要排序吗? | ORDER BY |
| 只要前几行吗? | LIMIT |
注意提问的顺序就是执行的顺序,而不是书写的顺序。按这个顺序想,写出来的时候再按 SQL 要求的语法顺序排列即可。
把子句写乱顺序。 SQL 对书写顺序也有硬性要求,虽然它跟执行顺序不一样。GROUP BY 必须在 WHERE 之后、ORDER BY 之前;HAVING 必须紧跟在 GROUP BY 之后。写反了直接是语法错误(实测):
sqlite> SELECT division, COUNT(*) FROM records HAVING COUNT(*) > 1 GROUP BY division;
near "GROUP": syntax error
记法:书写顺序 = 执行顺序,只是把 SELECT(第 5 步)拎到了最前面。
还有一个相关的坑:想给 WHERE 用 SELECT 里的别名,同样不行。SELECT division, COUNT(*) AS n FROM records WHERE n > 1 GROUP BY division; 报的是 misuse of aggregate: COUNT()——SQLite 把 n 展开回它代表的 COUNT(*),然后发现聚合函数出现在了 WHERE 里。
9. 实战:把中文需求翻译成查询
讲义这一节让大家在本地装好 SQLite,用 Spotify 和 IMDb 两个数据集练手(仓库地址 github.com/phrdang/cs61a-su26-lec23,跟着 README 的 Installation 步骤走)。那两份数据本页拿不到,但套路完全一样,所以下面改用 HW 06 里现成的 dogs / parents / sizes 三张表来练——这也正是你接下来要做的作业。
dogs:    name       fur      height
         ace        long     26
         bella      short    52
         charlie    long     47
         daisy      long     46
         ellie      short    35
         finn       curly    32
         ginger     short    28
         hank       curly    31

parents: parent  child        sizes:  size      min  max
         ace     bella                toy       24   28
         ace     charlie              mini      28   35
         daisy   hank                 medium    35   45
         finn    ace                  standard  45   60
         finn    daisy
         finn    ginger
         ellie   finn
需求一:每种毛发的狗有几只、平均多高?只要数量超过 2 的,按平均身高从高到低排
按套路逐条问:
fur 和 height,都在 dogs 里。⇒ FROM dogs,不需要 join。WHERE。GROUP BY fur。HAVING COUNT(*) > 2。SELECT fur, COUNT(*) AS n, AVG(height) AS avg_h。ORDER BY avg_h DESC(别名在 ORDER BY 里合法)。SELECT fur, COUNT(*) AS n, AVG(height) AS avg_h
FROM dogs
GROUP BY fur
HAVING COUNT(*) > 2
ORDER BY avg_h DESC;
fur|n|avg_h
long|3|39.666666666666664
short|3|38.333333333333336
验证:curly 只有 finn 和 hank 两只,被 HAVING 筛掉了。long 是 ace 26 / charlie 47 / daisy 46,平均 $(26+47+46)/3 = 119/3 \approx 39.67$ ✓。short 是 bella 52 / ellie 35 / ginger 28,平均 $115/3 \approx 38.33$ ✓。39.67 > 38.33,所以 long 排前面 ✓。
需求二:哪些家长有不止一个孩子?他们最高的孩子多高?
这次要 join:孩子的名字在 parents.child,身高在 dogs.height,两张表靠名字对上。
parents(谁是谁的孩子)+ dogs(孩子多高)。连接条件:p.child = d.name。parents 有 7 行,每个 child 都能在 dogs 里找到)。GROUP BY p.parent。分出 4 堆:ace(2)、daisy(1)、finn(3)、ellie(1)。HAVING COUNT(*) > 1,留下 ace 和 finn。MAX(d.height)。SELECT p.parent, COUNT(*) AS num_kids, MAX(d.height)
FROM parents AS p
JOIN dogs AS d
ON p.child = d.name
GROUP BY p.parent
HAVING COUNT(*) > 1;
parent|num_kids|MAX(d.height)
ace|2|52
finn|3|46
验证:ace 的孩子是 bella(52) 和 charlie(47),最高 52 ✓。finn 的孩子是 ace(26)、daisy(46)、ginger(28),最高 46 ✓。
这里 COUNT(*) 数的是 join 之后的行数,不是原表的行数。恰好每个 child 在 dogs 里只匹配一行,所以「行数」正好等于「孩子数」。如果某个 child 在 dogs 里能匹配多行,COUNT(*) 就会被放大。先想清楚「join 完的一行代表什么」,再决定 COUNT(*) 数的是什么。
需求三:WHERE 和 HAVING 同时上场
「只看身高超过 30 的狗,每种毛发各有几只」——「身高超过 30」是行的条件,必须用 WHERE,而且它在分堆之前就把矮狗踢掉了:
sqlite> SELECT fur, COUNT(*) FROM dogs WHERE height > 30 GROUP BY fur;
curly|2
long|2
short|2
对比不加 WHERE 的结果 curly|2 long|3 short|3:long 少了 ace(26),short 少了 ginger(28)。
WHERE height > 30:8 行剩 6 行(踢掉 ace 26、ginger 28)。GROUP BY fur:对这 6 行分堆 ⇒ curly {finn, hank}、long {charlie, daisy}、short {bella, ellie}。SELECT:三堆各输出一行,COUNT(*) 全是 2。HAVING height > 30:先用全部 8 行分堆,再对每堆看那个裸列 height——值是随便挑的,结果不可预测。这就是两者不能互换的原因。需求四:结合上一讲的 join 条件
「按体型分类,每一类有几只狗」。体型不是 dogs 表里的列,得跟 sizes 表连接(条件是 min < height <= max,这正是 HW 06 第一题的条件):
SELECT size, COUNT(*) AS n
FROM dogs, sizes
WHERE height > min AND height <= max
GROUP BY size
HAVING n > 2;
size|n
mini|3
standard|3
这条查询把本讲和上一讲的东西全用上了:隐式 join(FROM 里写两张表)、WHERE 里的 join 条件、GROUP BY、聚合函数、HAVING。去掉 HAVING 的完整结果是 mini|3 standard|3 toy|2,medium 一只都没有——ellie 身高 35,按 height > min AND height <= max 落进了 mini(28,35],不是 medium(35,45]。边界值落在哪一侧,取决于你用 > 还是 >=,这是 HW 06 最容易错的地方。
聚合查询写错了怎么调
聚合查询有个讨厌的地方:它经常不报错,只是给你一个错的数。 出错时最有效的办法是把 GROUP BY 那一行连同聚合函数一起删掉,先把「分堆之前长什么样」看清楚。
拿需求二举例。假如结果不对,先看中间表:
sqlite> SELECT p.parent, d.name, d.height
   ...> FROM parents AS p JOIN dogs AS d ON p.child = d.name;
parent|name|height
ace|bella|52
ace|charlie|47
daisy|hank|31
finn|ace|26
finn|daisy|46
finn|ginger|28
ellie|finn|32
7 行,每行是「一个家长 + 他的一个孩子的完整信息」。看到这张表,剩下的事就一目了然了:按 parent 分堆 ⇒ ace 2 行、daisy 1 行、finn 3 行、ellie 1 行;COUNT(*) 就是孩子数,MAX(d.height) 就是最高孩子的身高。
- 先看 join 之后、分堆之前的那张表(删掉
GROUP BY、HAVING和所有聚合函数,把参与运算的列都 select 出来)。行数对不对?有没有意外的重复? - 再加
GROUP BY,只 select 分组列和COUNT(*)。堆数对不对?每堆几行? - 最后才加真正要的聚合函数和
HAVING。
HW 06 提到的 code.cs61a.org 有个 "Step-by-step" 按钮,做的正是这件事——它把 SQL 每一步的中间表画出来给你看。写不出来的时候先去那里把中间表看一眼,比盯着完整查询干想快得多。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 动态作用域 | 帧的 parent 由「开这一帧的是普通过程还是 mu」决定:普通过程用定义处,mu 用调用处 | 以为「谁触发查找」会改变整条链;define 只在当前帧建绑定,不改外层 |
| 宏的第二步 | 是带引号的代入,算子数以 quoted 形式传入 | 少一层 quote,expr 提前被求值,报错信息变成 (failed: #f) |
| 自连接 | 同一张表在 FROM 里出现多次,用 AS 起别名区分 | 不起别名 ⇒ ambiguous column name: name;连接条件写反成 a.name = b.supervisor |
GROUP BY c | 按 c 的取值分堆,一堆输出一行;输出行数 = c 的不同取值个数 | 以为能列出每堆的全部成员;以为它保证排序(那只是实现细节) |
| 裸列 bare column | 既不在 GROUP BY 也不在聚合函数里的列。SQLite 允许,值任意挑 | 看到 MAX(salary) 旁边的 name 恰好对,就当成规律用 |
COUNT(*) | 数组内行数。没有 GROUP BY 时整表算一组,返回一行 | 空结果集时 COUNT 给 0,但 SUM/MAX/AVG/MIN 给 NULL |
COUNT(DISTINCT c) | 数 c 有几种不同取值 | 和 SELECT DISTINCT c 混淆:一个给个数,一个给取值 |
AVG/SUM/MAX/MIN | 对组内某一列做规约;AVG 总是返回浮点 | 写进 WHERE ⇒ misuse of aggregate: COUNT() |
HAVING | 筛组,可以调聚合函数;必须先有 GROUP BY | 没有 GROUP BY ⇒ a GROUP BY clause is required before HAVING;拿它当 WHERE 筛行 |
| 执行顺序 | FROM/JOIN…ON → WHERE/LIKE → GROUP BY → HAVING → SELECT → AS → ORDER BY → LIMIT | 以为按书写顺序执行;ORDER BY 能用别名而 WHERE 不能,原因就在这 |
| 书写顺序 | = 执行顺序,但把 SELECT 提到最前 | HAVING 写在 GROUP BY 前 ⇒ near "GROUP": syntax error |
磁盘上的表
   │ FROM / JOIN … ON …        ← 数据从哪来,怎么对应
   ▼
  行
   │ WHERE / LIKE              ← 逐行筛(此处不能用聚合函数)
   ▼
  更少的行
   │ GROUP BY                  ← 分堆!单位从「行」变成「组」
   ▼
  组
   │ HAVING                    ← 整组整组地筛(此处可以用聚合函数)
   ▼
  更少的组
   │ SELECT / AS               ← 一组输出一行;聚合函数在这里求值
   ▼
  输出表
   │ ORDER BY / LIMIT          ← 排序、截断
   ▼
  最终结果
动手练习
答案都在本机 SQLite 上跑过。用到的表就是本页第 3 节的 records 和第 9 节的 dogs / parents / sizes。
1. 不看答案,说出输出有几行
下面三条查询各输出多少行?
(a) SELECT COUNT(*) FROM records;
(b) SELECT COUNT(*) FROM records GROUP BY division;
(c) SELECT title, COUNT(*) FROM records GROUP BY title;
看答案
(a) 1 行。没有 GROUP BY,整张表算一个组,一组一行,值是 9。
(b) 3 行。division 有 3 种取值,所以 3 堆。输出是 2 / 2 / 5——注意这条查询没有把 division 放进 SELECT,所以你只看得到人数,看不出是哪个部门。这也是为什么写 GROUP BY 时通常要把分组列一起 select 出来。
(c) 8 行。9 个人里只有 Alyssa 和 Cy 的 title 都是 Programmer,其余 7 个 title 各不相同,所以 8 堆:
Big Wheel|1
Chief Accountant|1
Programmer|2
Programmer Trainee|1
Scrivener|1
Secretary|1
Technician|1
Wizard|1
心法:先数「分组列有几种取值」,那就是输出行数。
2. 找出下面这条查询的两处错误
SELECT division, name, AVG(salary) AS avg_sal
FROM records
WHERE COUNT(*) > 1
HAVING avg_sal > 30000
GROUP BY division;
看答案
错误一:COUNT(*) 出现在 WHERE 里。 WHERE 是执行顺序第 2 步,比 GROUP BY(第 3 步)早,那时组还不存在。真实报错:
misuse of aggregate: COUNT()要按组内行数筛,得挪到 HAVING 里。
错误二:HAVING 写在了 GROUP BY 前面。 书写顺序必须是 GROUP BY 然后 HAVING。真实报错:
near "GROUP": syntax error另外还有一处不算「错误」但该改:name 是裸列,SQLite 会随便挑一个人的名字填进去,多半不是你想要的。改好之后:
SELECT division, AVG(salary) AS avg_sal
FROM records
GROUP BY division
HAVING COUNT(*) > 1 AND AVG(salary) > 30000;
输出(三个部门人数都 ≥ 2,平均工资都 > 30000,所以全留):
Accounting|46500.0
Administration|87500.0
Computer|38000.0
3. 写一条查询:每种毛发里,最高和最矮的狗差多少?只要差距超过 15 的
看答案
SELECT fur, MAX(height) - MIN(height) AS spread
FROM dogs
GROUP BY fur
HAVING MAX(height) - MIN(height) > 15;
关键点:聚合函数的结果可以参与算术运算,MAX(height) - MIN(height) 是完全合法的表达式。先看不带 HAVING 的全貌:
fur|MAX(height) - MIN(height)
curly|1
long|21
short|24
curly 是 finn 32 和 hank 31,差 1;long 是 26/46/47,差 21;short 是 28/35/52,差 24。所以答案留下 long|21 和 short|24。
顺带:HAVING spread > 15 在 SQLite 里也能跑,但如前所述别名在 HAVING 里不是标准行为,原样写一遍更稳。
4. 只统计 Computer 部门的人,按主管分堆数人数——结果为什么是 3 行而不是 1 行?
SELECT supervisor, COUNT(*) AS n
FROM records
WHERE division = 'Computer'
GROUP BY supervisor;
看答案
supervisor|n
Alyssa P Hacker|1
Ben Bitdiddle|3
Oliver Warbucks|1
因为 WHERE 筛的是员工所在的部门,剩下 5 个 Computer 部门的人:Alyssa(主管 Ben)、Ben(主管 Oliver)、Cy(Ben)、Lem(Ben)、Louis(Alyssa)。这 5 个人的 supervisor 列有三种取值,所以分出 3 堆。
注意 Oliver Warbucks 自己并不在 Computer 部门(他在 Administration),但他作为某个 Computer 员工的主管出现在结果里。WHERE 过滤的永远是行本身的属性,不会顺着 supervisor 这个「引用」传播出去。 想按主管的部门筛,就得 join 一次 records。
5. 判断对错
GROUP BY会让输出按分组列排好序,所以不用再写ORDER BY。- 只要
SELECT里有聚合函数,就必须写GROUP BY。 SELECT division, COUNT(*) FROM records WHERE salary > 1000000 GROUP BY division;会输出 3 行,每行COUNT(*)是 0。HAVING里可以用没出现在SELECT里的聚合函数。
看答案
1. 错。 SQLite 常用排序来实现分组,所以看起来有序,但这是实现细节,SQL 标准不保证。需要确定顺序就写 ORDER BY。
2. 错。 不写 GROUP BY 时整张表算作一个组,SELECT COUNT(*) FROM records; 完全合法,返回一行 9。反过来说才对:想写 HAVING,必须先有 GROUP BY。
3. 错。 输出零行。WHERE 在第 2 步就把 9 行全部滤掉了,一行不剩就分不出任何组,「一堆一行」在这里对应「零堆零行」。
对比一下:把 GROUP BY 去掉,SELECT COUNT(*), SUM(salary) FROM records WHERE salary > 1000000; 会输出一行 0|NULL——空的一组仍然是一组。这两种行为的差别是本讲最细的一个点。
4. 对。 例如 SELECT division, COUNT(*) FROM records GROUP BY division HAVING MAX(salary) > 70000; 输出 Accounting|2 和 Administration|2。「按什么筛」和「输出什么」互相独立。