尾调用与宏:让递归不吃内存,让程序改写程序
一个关于「帧什么时候可以被扔掉」,一个关于「表达式什么时候才被求值」——两件事都只有在你已经懂了求值规则之后才谈得上。
0. 本讲导读
前面三讲铺了一条很长的路:Lecture 18 教你写 Scheme,Lecture 19 让你用 Scheme 做递归和列表处理,Lecture 20 则把 Scheme 解释器本身拆开来看——eval 和 apply 怎么互相调用、环境怎么串起来、动态作用域和词法作用域差在哪。到这里为止,你已经知道一个表达式被求值时到底发生了什么,而且是从解释器实现的层面知道的。
本讲拿这份知识去做两件之前做不了的事。
第一件:尾调用(tail call)。Lecture 18 讲过 Scheme 里没有 while、没有 for,一切循环都得写成递归。这带来一个很实际的恐惧:Python 里递归 1000 层就 RecursionError 了,Scheme 全靠递归,那它怎么写一个跑一百万次的循环?答案是:Scheme 保证某一类递归调用不占新的空间。这不是编译器的小聪明,而是语言标准里写死的一条要求。要用上它,你得能一眼看出自己写的调用属不属于这一类——这就是「尾上下文(tail context)」这套规则要解决的问题。
第二件:宏(macro)。到目前为止,你写的每一个 Scheme 过程都遵守同一条铁律:调用之前,所有算子数先被求值。可 if 不是这样——它只求值该走的那个分支。define 也不是这样——它不会去求值那个还没绑定的名字。这些「不守规矩」的东西叫特殊形式(special form),一直以来它们都是解释器内置的、你没法自己加的。define-macro 打破了这个限制:它让你写出自己的特殊形式,办法是拿到没被求值的源代码,把它当成数据加工一番,再把加工出来的新代码交回去求值。
两个主题看似无关,但都是同一个问题的两面:求值这件事本身,是可以被你操控的。尾调用操控的是「求值完一层之后,那一帧还留不留」;宏操控的是「这段代码到底什么时候、以什么形态被求值」。
先回顾:eval-apply 的调用顺序
Lecture 20 的 scheme_eval 处理一个调用表达式时,顺序是固定的:先求值算子,再从左到右求值每一个算子数,最后 apply。而每个算子数如果本身是调用表达式,就要先把它整个递归求值完。拿 (* 2 (+ 1 9) 4) 走一遍:
Eval((* 2 (+ 1 9) 4))——看到一个调用表达式,开始处理。Eval('*')——先求值算子。符号 * 在环境里查到一个内建过程。算子也要求值,这一步最容易被漏掉。Eval(2)——第一个算子数,自求值,得 2。Eval((+ 1 9))——第二个算子数,它自己是个调用表达式,于是整套流程递归一遍。Eval('+') → Eval(1) → Eval(9) → Apply('+', (1 9)),得 10。内层必须彻底算完,才轮到外层的下一个算子数。Eval(4)——第三个算子数,得 4。Apply('*', (2 10 4))——所有子表达式都变成值了,才把过程施加上去,得 80。这个顺序本讲会一直用到。「算子数在调用之前就已经全部算完」正是尾调用能成立的技术前提——等会你会看到,尾递归写法之所以省空间,靠的就是「该算的都在参数里算完了,调用返回后没活可干」。
- 严格函数式编程(functional programming):只用纯函数、不重新赋值、不变异、名值绑定永久。代价是没有
for/while,一切靠递归;好处是子表达式求值顺序无所谓(可并行、可惰性),同参数必同结果(可 memoization)。 - 尾调用(tail call)是「处在尾上下文(tail context)里的调用表达式」。判据是一句人话:这个调用返回之后,调用方还有没有活要干?没有,就是尾调用。
- Scheme 标准要求解释器支持无限多个活跃的尾调用而只用常数额外空间;Python 不做这个优化,递归调用永远新建一帧,所以 Python 的递归有
RecursionError,Scheme 的尾递归没有。 - 把线性递归改成尾递归的通用配方:加一个累加器(accumulator)参数,把「返回后要做的事」提前到「传参时就做掉」。
'(quote)让代码变成数据,eval让数据变回代码。写一个返回程序的程序,本质就是用list和'拼出一个 Scheme 列表。define-macro定义的宏按三步求值:① 求值算子得到宏过程 → ② 把未求值的算子数表达式直接传进宏体 → ③ 求值宏体返回的那个表达式。它让你定义自己的特殊形式。- quasiquote
`和 unquote,是写宏的糖:`(if ,expr 'passed 'failed)比一层层(list 'if expr ''passed ''failed)好读得多。
1. 函数式编程:先说清代价,才谈得上收益
Scheme 被拿来当教学语言,不只是因为括号多。它逼你用一种叫函数式编程(functional programming)的方式写代码。所谓「严格的」函数式编程,是三条约束:
- 只有纯函数(pure function),没有副作用(side effect)。函数唯一做的事就是根据参数算出返回值。不打印、不改全局变量、不写文件。
- 不重新赋值,不变异(no reassignment or mutation)。没有
x = x + 1,没有lst.append(...)。数据一旦造出来就不再改动。 - 名值绑定是永久的(permanent name-value bindings)。一个名字绑定到某个值之后,在它的作用域里永远是那个值。
这三条听起来像是在自我束缚,实际上也确实是。先把代价摆在明面上:
没有迭代。while 循环的运转完全依赖「重新赋值」——n, k = n - 1, n * k 就是把 n 和 k 重新绑定到新值。禁止重新赋值,while 就没法工作,于是只剩递归。而在朴素的实现里,每次递归调用都要新建一帧,帧不能扔,空间就会随递归深度线性增长——这就是幻灯片里说的「space complexity explosion」。这个代价是致命的:一个本来 $\Theta(1)$ 空间的循环,写成递归就变成 $\Theta(n)$ 空间。
那为什么还要接受这套约束?因为它买回来两样非常硬的东西。
- 表达式的值与子表达式的求值顺序无关。没有副作用意味着「先算左边还是先算右边」不影响结果。我们在 Lecture 20 的解释器里选择了从左到右,但那只是一个实现选择,不是语义要求。于是子表达式可以并行求值(分给多个核),也可以惰性(lazily)求值——用到了才算。
- 同样的参数必然产出同样的结果。于是可以做记忆化(memoization):把算过的
(f 5)存起来,下次直接返回,绝不会出错。而在有副作用的语言里你不敢这么干——谁知道f这次调用有没有偷偷改了什么。
把这两条对照 Lecture 17 的记忆化 fib 想一想:那时候我们靠「fib 是纯函数」这个事实才敢缓存结果。函数式编程不过是把这条隐含假设升级成了语言级别的保证。
「严格函数式」是一个理想模型,61A 的 Scheme 并不严格:它有 print(副作用)、有 set-car!(变异)、define 在同一个帧里也可以重新绑定同一个名字。本节讲的是一种风格和它背后的取舍,不是说 Scheme 强制你这么写。但尾调用优化这个特性,恰恰是为了让「只能用递归」这件事不再痛苦而存在的。
2. 递归与迭代:Python 的帧是怎么堆起来的
要理解「尾调用省了什么」,先得看清「不省的时候花了什么」。用一个稍微改造过的阶乘做实验:factorial(n, k) 计算的是 $k \cdot n!$。多出来的参数 k 现在看着莫名其妙,但它是整节课的钥匙。
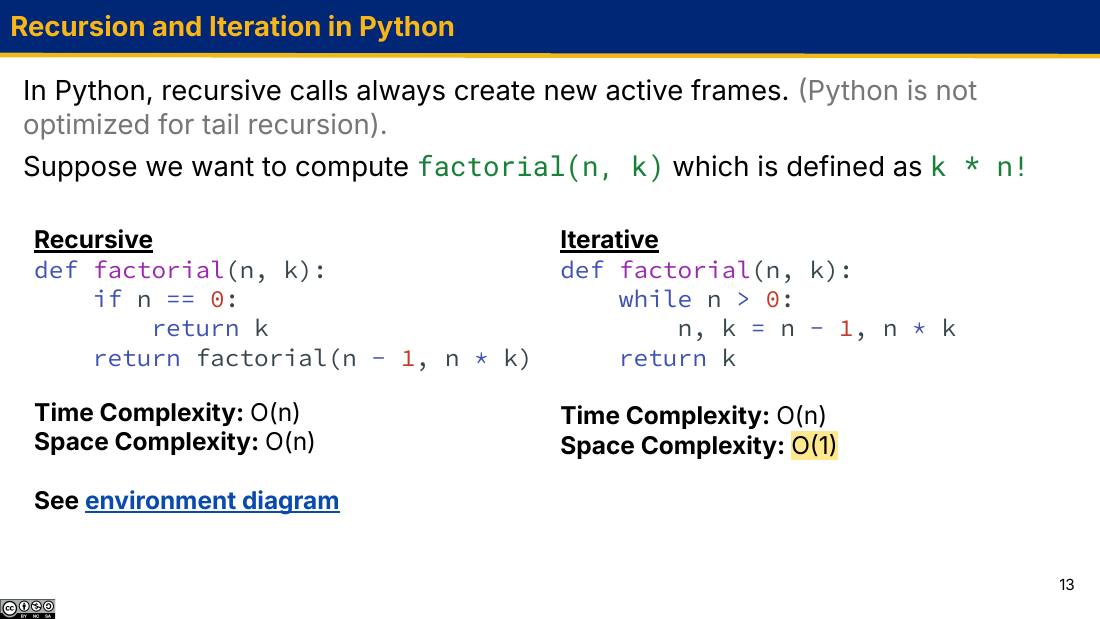
# 递归版
def factorial(n, k):
    if n == 0:
        return k
    return factorial(n - 1, n * k)

# 迭代版
def factorial(n, k):
    while n > 0:
        n, k = n - 1, n * k
    return k
两个版本都返回 $k \cdot n!$。先确认它们真的一样:factorial(3, 1) 应该得到 $1 \times 3! = 6$。
递归版:帧一层层堆上去
按 Lecture 04 的规则一步步来。调用 factorial(3, 1):
n=3, k=1。n == 0 为假,执行 return factorial(n - 1, n * k)。要 return 什么?得先把 factorial(2, 3) 算出来。于是 f1 挂在那里等。n=2, k=3(注意 3*1 已经在传参时算完了)。同样要等 factorial(1, 6)。n=1, k=6。等 factorial(0, 6)。n=0, k=6。n == 0 为真,return k → 6。base case 到了。return 表达式求值完毕,直接返回 6 → f2 返回 6 → f1 返回 6。关键在第 5 步:f3 拿到 6 之后什么也没做,原封不动地把 6 往上传。f2、f1 也一样。这四帧里除了最深那帧,其余三帧在「等」的期间,唯一的作用就是把结果原样转交。
Global frame
    factorial  ──→ func factorial(n, k)

f1: factorial [parent=Global]     n=3  k=1   ← 正在算 return factorial(2, 3),等
f2: factorial [parent=Global]     n=2  k=3   ← 正在算 return factorial(1, 6),等
f3: factorial [parent=Global]     n=1  k=6   ← 正在算 return factorial(0, 6),等
f4: factorial [parent=Global]     n=0  k=6   ← return k = 6

此刻同时有 4 个 active(未返回)的调用。
n = 1000000 时,就是 1000000 帧同时活着。
这四帧同时存在,所以空间复杂度是 $\Theta(n)$。而且 Python 还给这件事加了一道硬闸:递归深度上限默认 1000。
>>> def factorial(n, k):
...     if n == 0:
...         return k
...     return factorial(n - 1, n * k)
...
>>> factorial(5000, 1)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded in comparison
这条报错信息值得记住。「exceeded in comparison」说明是在执行 n == 0 这个比较的时候撞到的上限——不同的写法后半句会不一样(可能是 in comparison、while calling a Python object 等),但只要看到 RecursionError,含义就一个:你堆了太多帧。它未必意味着你写错了递归(虽然大多数时候是漏了 base case),也可能只是「这个问题的规模超出了 Python 递归能承受的范围」。
迭代版:一帧走到底
迭代版从头到尾只有一帧。while 循环不新建帧(这是 Lecture 02 讲过的),它改的 n 和 k 就是当前帧里的那两个名字:
Global frame
    factorial  ──→ func factorial(n, k)

f1: factorial [parent=Global]
    进入循环前      n=3   k=1
    第 1 轮之后     n=2   k=3      (n,k = 3-1, 3*1)
    第 2 轮之后     n=1   k=6      (n,k = 2-1, 2*3)
    第 3 轮之后     n=0   k=6      (n,k = 1-1, 1*6)
    n > 0 不成立,退出循环,return k = 6

自始至终只有 1 帧。n = 1000000 也只有 1 帧。
把两张图叠在一起看:递归版的 f1→f4 里,(n, k) 依次是 (3,1) (2,3) (1,6) (0,6);迭代版单帧里 (n, k) 也依次是 (3,1) (2,3) (1,6) (0,6)。完全一样的状态序列。区别只在于:递归版把每个状态存进了一个新帧,迭代版把它们覆盖在同一帧上。
那么问题来了:既然旧帧的 n、k 在递归调用发出之后再也用不到了,为什么不能把旧帧直接扔掉、腾出位置给新帧?——这就是尾调用优化的全部想法。
「Python 不做尾调用优化」经常被误解成「Python 认不出尾调用」。不是认不出,是刻意不做。原因之一是:一旦把中间帧扔掉,出错时的 traceback 就断了——你只会看到最后那一帧,看不到「谁调用了谁」的完整链条。CPython 选择保留完整调用栈以便调试。所以在 Python 里,需要 $\Theta(1)$ 空间的时候,就老老实实写 while,指望解释器帮你优化是没用的。
3. 尾调用:怎么判断「返回之后还有没有活要干」
把上一节的递归版 factorial 原样翻译成 Scheme:
(define (factorial n k)
    (if
        (zero? n)
        k
        (factorial (- n 1) (* n k))
    )
)
结构和 Python 版一模一样:(zero? n) 对应 n == 0,k 对应 return k,(factorial (- n 1) (* n k)) 对应那一句递归 return。但它在 Scheme 里只占 $\Theta(1)$ 空间。同样的代码结构,换个语言就从 $\Theta(n)$ 变成 $\Theta(1)$,因为 Scheme 的语言标准要求解释器消除掉那些没用的帧。
第一个必须澄清的问题:是不是 Scheme 里所有递归都自动省空间?不是。必须写成「尾递归」的形式才享受得到。所以我们需要一套能机械执行的判断规则。
三个定义
- 一个尚未返回的过程调用叫活跃的(active)。上一节图里同时存在的那 4 个调用就是 4 个 active call。
- 某些过程调用是尾调用(tail call)。
- 一个 Scheme 解释器应当支持无限多个活跃的尾调用,而只使用常数量的额外空间。
第三条是承诺,前两条是它的前提。剩下的问题只有一个:哪些调用算尾调用?定义是:尾调用 = 处在尾上下文(tail context)中的调用表达式。而「尾上下文」是递归定义的一张清单:
| 特殊形式 | 哪些子表达式处在尾上下文 | 哪些不是 |
|---|---|---|
用户定义过程体(define / lambda) | 最后一个体子表达式 | 前面几个(它们的值被丢弃) |
if | 子表达式 2 和 3,即 consequent 与 alternative(前提:这个 if 本身在尾上下文里) | 子表达式 1,即 predicate |
cond | 所有非谓词子表达式(即每个分支的结果部分) | 各分支的谓词 |
and / or | 最后一个子表达式 | 前面所有子表达式 |
begin | 最后一个子表达式 | 前面所有子表达式 |
注意每一条都带着「in a tail context」这个前缀——尾上下文是从过程体最外层往里传染的。if 的两个分支只有在这个 if 自己处在尾上下文里的时候,才也是尾上下文。一层一层嵌进去,链条上任何一环断了,里面的全都不算。
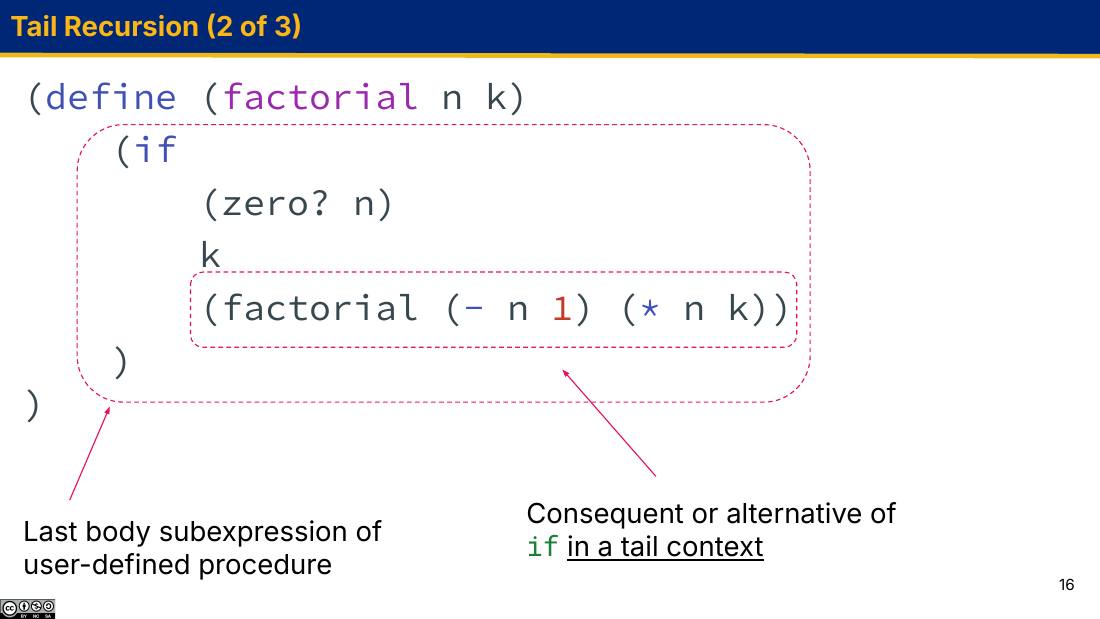
if;内框是「处在尾上下文里的 if 的 alternative」,也就是那个递归调用。所以 (factorial (- n 1) (* n k)) 是尾调用。对着这张图把 factorial 走一遍:
factorial 的过程体只有一个表达式——那个 if。它是「最后一个体子表达式」,所以这个 if 处在尾上下文。if 在尾上下文,它的 consequent k 和 alternative (factorial (- n 1) (* n k)) 也处在尾上下文。(factorial (- n 1) (* n k)) 是一个调用表达式,且处在尾上下文 → 它是尾调用。(zero? n) 不在尾上下文。(- n 1) 和 (* n k) 也不在——它们是算子数,处在「必须先算完才能调用」的位置。这不影响结论,因为它们不是递归调用,各自都是 $\Theta(1)$ 的。把定义翻译成一句人话
清单虽然长,但它只是在精确地表述一件事:一个调用表达式不是尾调用,当且仅当它返回之后,调用方还需要拿这个返回值继续做计算。
所以判断的时候,问自己:「这个调用返回了一个值之后,我这个函数还要不要碰它?」
(factorial (- n 1) (* n k))返回 6 之后,当前这层的if就直接把 6 当成整个过程体的值交出去。没活干 → 尾调用。(+ 1 (length (cdr lst)))里的length返回 3 之后,当前这层还得做一次(+ 1 3)。有活干 → 不是尾调用。
「有活干」意味着当前帧里的信息(比如那个 + 1 的上下文)还得留着,帧就扔不掉。
「写在最后一行 = 尾调用」是错的。看 (+ 1 (length (cdr lst))):length 的递归调用确确实实写在过程体的最后一行里,但它是 + 的算子数,处在「必须先算完再交给 +」的位置,所以它不在尾上下文。
正确的看法是看最外层的那个表达式是不是调用:过程体最后一个表达式是 (+ ...),那么它(对 + 的调用)才是尾调用,而嵌在里面的 length 调用不是。递归发生在里层,所以这个函数不是尾递归。
4. 尾调用优化到底优化了什么
「尾调用不占额外空间」这句话很容易被念成咒语。它的机制其实非常具体:当一个调用是尾调用时,调用方那一帧在发出调用的瞬间就已经没用了,可以直接丢掉,让新调用去顶替它的位置。
为什么没用了?因为「没活要干」意味着:新调用返回什么,当前这层就返回什么。当前这层的所有局部绑定(n、k)在参数求值完之后再也不会被读到。既然如此,留着它干嘛?
把 (factorial 3 1) 在 Scheme 里跑一遍,对照第 2 节 Python 版的那张图:
调用 (factorial 3 1)
  帧: n=3  k=1
  求值体 (if (zero? 3) k (factorial 2 3))
    → (zero? 3) 为 #f,走 alternative
    → 先算算子数: (- 3 1) = 2, (* 3 1) = 3
    → 这是尾调用,当前帧的 n、k 再也用不到 → 丢弃本帧

  帧: n=2  k=3        ← 顶替了上一帧的位置,不是新增
    → (- 2 1) = 1, (* 2 3) = 6  → 丢弃本帧

  帧: n=1  k=6
    → (- 1 1) = 0, (* 1 6) = 6  → 丢弃本帧

  帧: n=0  k=6
    → (zero? 0) 为 #t,返回 k = 6

任意时刻只有 1 帧是活跃的。结果 6,与 Python 版一致。
把这张图和第 2 节迭代版 Python 的那张图并排看——它们是同一张图。状态序列 (3,1) → (2,3) → (1,6) → (0,6) 一模一样,帧数也一样都是 1。这就是那句经典说法的含义:尾递归就是循环。你写的是递归的语法,解释器执行的是循环的行为。
尾调用优化省的是空间,不是时间。(factorial 1000000 1) 仍然要做一百万次乘法,时间还是 $\Theta(n)$。它只是把空间从 $\Theta(n)$ 降到 $\Theta(1)$。
另外「尾调用」不限于递归。(define (f x) (g x)) 里的 (g x) 也是尾调用,f 的帧在调用 g 时同样被丢弃。只是「尾递归」的场景最重要,因为只有递归才会产生无限多个活跃调用。
Python 递归 factorial | Python 迭代 factorial | Scheme 尾递归 factorial | |
|---|---|---|---|
| 时间复杂度 | $\Theta(n)$ | $\Theta(n)$ | $\Theta(n)$ |
| 空间复杂度 | $\Theta(n)$ | $\Theta(1)$ | $\Theta(1)$ |
| 同时活跃的帧 | n + 1 帧 | 1 帧 | 1 帧 |
| n 很大时 | RecursionError | 正常 | 正常 |
| 靠什么实现 | —— | while + 重新赋值 | 解释器消除尾调用的帧 |
5. 改写配方:把「返回后要做的事」提前到传参时做掉
一个自然的问题:我平时写的递归大多不是尾递归,怎么办?好消息是线性递归(linear recursion)通常都能改写成尾递归,而且有固定套路。先看幻灯片上的例子——求列表长度。
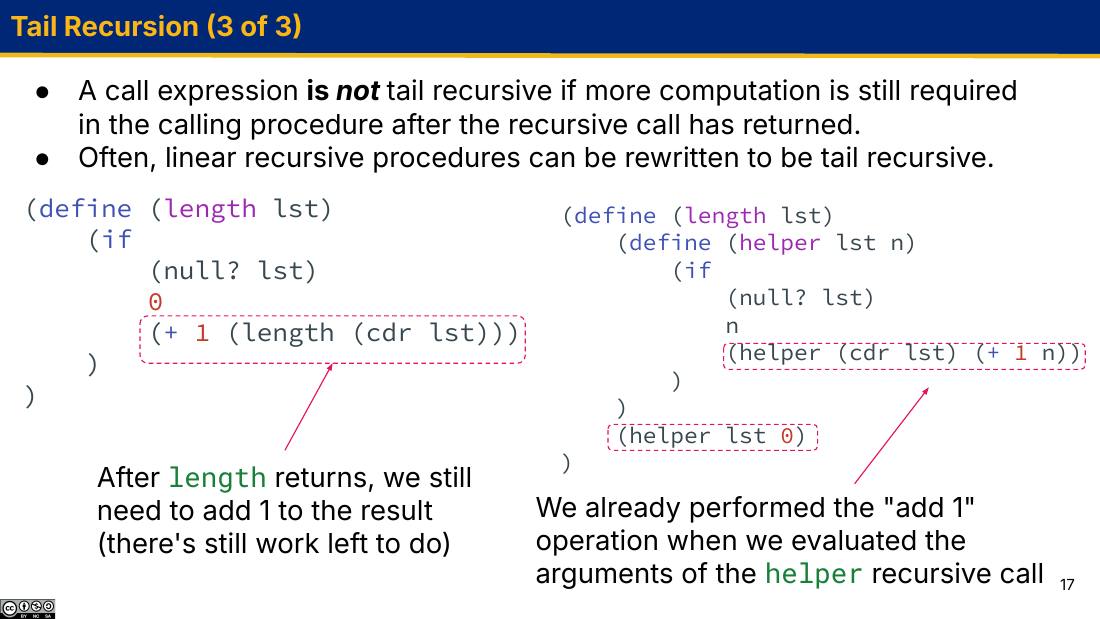
(+ 1 (length (cdr lst))):递归调用返回后还要做一次加一,帧扔不掉。右边把「加一」搬到了 helper 的参数位置 (+ 1 n)——参数在调用发生之前就求值完了,所以调用返回后无事可做。同样是「加 n 次一」,摆放位置不同,空间复杂度就差了一个量级。; 非尾递归版
(define (length lst)
(if
(null? lst)
0
(+ 1 (length (cdr lst)))
)
)
; 尾递归版
(define (length lst)
(define (helper lst n)
(if
(null? lst)
n
(helper (cdr lst) (+ 1 n))
)
)
(helper lst 0)
)
展开非尾递归版:帧为什么扔不掉
对 (length '(a b c)) 手动展开。写代换的形式最能看清「欠了多少活」:
(length '(a b c))
= (+ 1 (length '(b c)))                    ← 欠一次 +1
= (+ 1 (+ 1 (length '(c))))                ← 欠两次 +1
= (+ 1 (+ 1 (+ 1 (length '()))))           ← 欠三次 +1
= (+ 1 (+ 1 (+ 1 0)))                      ← 到 base case,开始回代
= (+ 1 (+ 1 1))
= (+ 1 2)
= 3
第 4 行是最深的时刻:三个 (+ 1 ...) 都还悬在那里等着。每一个「等着」都对应一个不能丢弃的帧。列表有 n 个元素,就有 n 层 (+ 1 ...) 挂着 → $\Theta(n)$ 空间。
展开尾递归版:什么都不欠
(length '(a b c))
= (helper '(a b c) 0)
= (helper '(b c)   1)      ← (+ 1 0) 在传参时就算完了
= (helper '(c)     2)      ← (+ 1 1) 在传参时就算完了
= (helper '()      3)      ← (+ 1 2) 在传参时就算完了
= 3                        ← null? 成立,直接返回 n,不需要回代
没有「悬着的活」,所以也没有「回代」这个阶段——base case 返回的那个值,就是最终答案,它一路原样穿过(其实是根本没有中间层可穿)。每一行的帧都可以顶替上一行的帧。
两次展开的对比揭示了改写的实质:非尾递归是「先把问题拆到最小,再从最小往回攒答案」;尾递归是「一边往下走一边把答案攒好,走到底时答案已经现成」。攒答案的那个额外参数就叫累加器(accumulator)。
- 加一个内部 helper,多带一个累加器参数。累加器保存「到目前为止已经算出来的部分结果」。
- 把原来「递归返回后要做的那步运算」搬到 helper 的实参位置上。原来是
(+ 1 <递归结果>),现在变成(helper <更小的问题> (+ 1 n))。 - base case 不再返回「零元」,改成直接返回累加器。原来
(null? lst)时返回0,现在返回n;而0挪去做累加器的初值,写在最外层的(helper lst 0)里。
第 3 步里「零元挪到初值」这个对应关系很值得记:非尾递归版的 base case 返回值,和尾递归版的累加器初值,通常是同一个东西。length 是 0(加法单位元),求积就是 1(乘法单位元),造列表就是 nil。回头看第 3 节的 factorial(n, k)——那个「莫名其妙」的参数 k 就是累加器,而调用时传的 1 就是乘法的单位元。整节课第一个例子其实早就用上了这个配方,只是没告诉你。
(define (helper lst n) ...) 写在 length 的体内,是为了不污染全局环境,也让 length 对外仍然只接受一个参数——调用者不需要知道累加器的存在。这跟 Lecture 04 讲的局部函数定义是同一件事:helper 的帧 parent 指向 length 的帧,所以它能看见 length 的形参。
还要确认这不会破坏尾调用:length 的体有两个表达式,(define (helper ...) ...) 和 (helper lst 0)。只有最后一个处在尾上下文,也就是 (helper lst 0)——它正好是我们要的那个调用。前面那个 define 不是调用表达式,无所谓。
写累加器时最常见的错是忘了把累加器往下传,还按老思路在返回值上做运算:
; 错误示范
(define (length lst)
    (define (helper lst n)
        (if (null? lst)
            n
            (+ 1 (helper (cdr lst) n))    ; ← 加了累加器却没用它
        )
    )
    (helper lst 0)
)
这段代码结果是对的(返回 3),但它根本没有变成尾递归——(+ 1 ...) 还挂在外面,空间仍是 $\Theta(n)$,累加器 n 白加了。这种错很隐蔽,因为测试全过。检验方法是问:递归调用外面还套着别的东西吗?套着,就还不是尾递归。
6. 判断实战:四段代码,谁是尾递归
规则背下来没用,得能在陌生代码上用。下面四段是课上的随堂测验,每段都问同一个问题:这个过程是尾递归的吗?建议先自己判断再往下看。
(A) 求列表长度
(define (length s)
    (+
        1
        (if (null? s)
            -1
            (length (cdr s))
        )
    )
)
这段代码写得很怪:它把 + 1 提到了最外面,用 -1 抵消空列表那次多加的 1。先确认它是对的:(length '()) → (+ 1 -1) = 0;(length '(a)) → (+ 1 (length '())) = (+ 1 0) = 1。对。
但它不是尾递归。过程体最后(也是唯一)一个表达式是 (+ ...),所以处在尾上下文的是这个对 + 的调用。那个 if 是 + 的算子数,不是尾上下文;if 里的 (length (cdr s)) 自然更不是。递归调用返回之后,还欠一次加法。
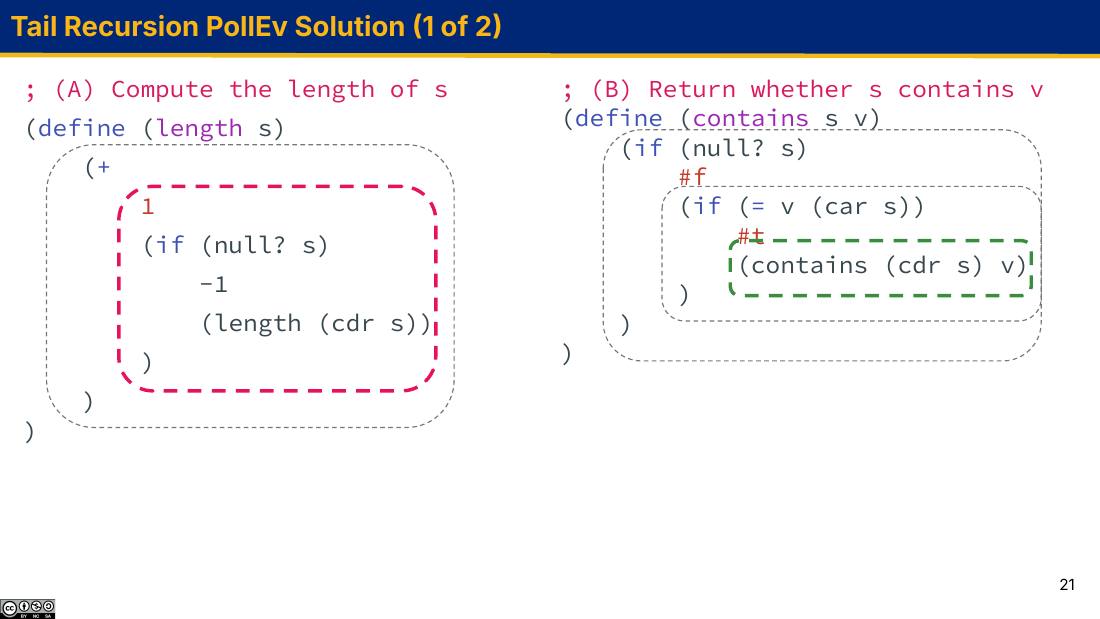
if 都被红框圈住,因为它只是 + 的一个算子数——外面那层加法还等着它的结果。绿框标的是尾上下文:(B) 里内层 if 的 consequent #t 与 alternative (contains (cdr s) v) 都在绿框内,所以 contains 的递归调用是尾调用。(A) 是一个很好的反例,因为它长得很像尾递归:递归调用几乎顶在最里层,看上去「后面没别的语句了」。判断的时候不要看「哪一行」,要看从过程体最外层往里,尾上下文这条链在哪里断掉。这里第一步就断了:最外层是 + 的调用,它的算子数不是尾上下文。
(B) 判断列表是否包含某个值
(define (contains s v)
    (if (null? s)
        #f
        (if (= v (car s))
            #t
            (contains (cdr s) v)
        )
    )
)
是尾递归。顺着链条走:
if 是 contains 体的最后一个(唯一一个)表达式 → 在尾上下文。if 的 alternative——那个内层 if——也在尾上下文。if 的 consequent #t 和 alternative (contains (cdr s) v) 都在尾上下文。(contains (cdr s) v) 是调用表达式 + 在尾上下文 → 尾调用。链条一路没断。用人话验证:(contains (cdr s) v) 返回 #t 或 #f 之后,当前这层拿它干什么?什么也不干,直接当作自己的返回值交出去。没活干,所以是尾调用。注意谓词 (= v (car s)) 不在尾上下文,但它不含递归调用,无关紧要。
(C) 第 n 个斐波那契数
(define (fib n)
    (define (helper current k)
        (if (= n k)
            current
            (helper
                (+ current (fib (- n 1)))
                (+ k 1)
            )
        )
    )
    (if (= n 1) 0 (helper 1 2))
)
这段代码有个陷阱:它看起来用了第 5 节的配方——内部 helper、累加器 current、计数器 k,最后一行 (helper 1 2) 也确实是尾调用。但它不是尾递归。
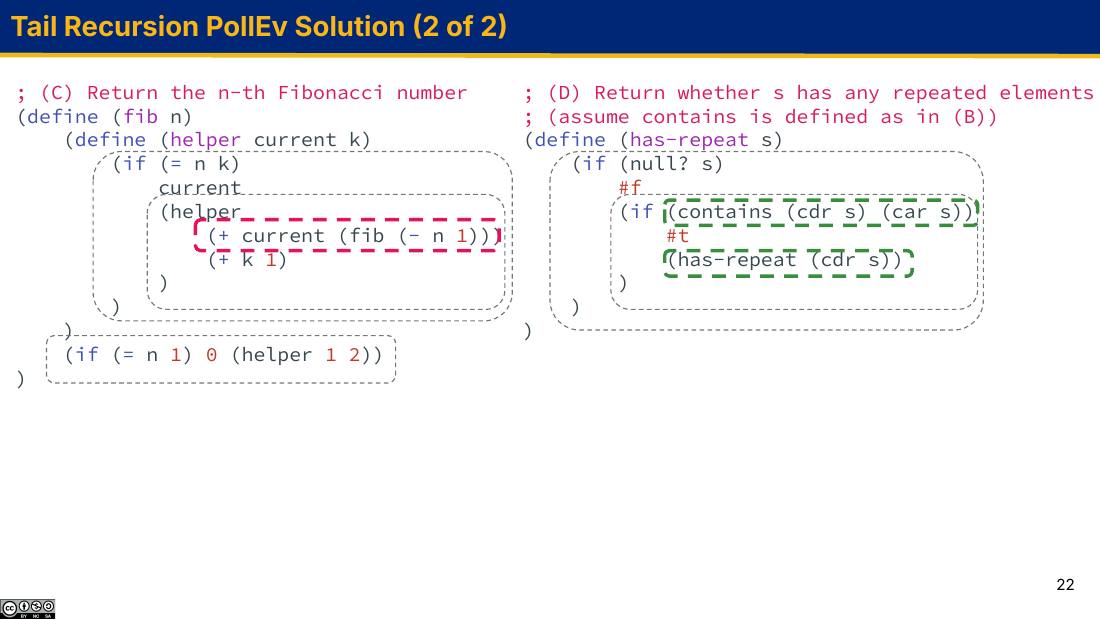
(+ current (fib (- n 1)))——它是 helper 的一个算子数,而 fib 又在这个算子数里递归调用自己,于是每算一次参数就要开一整条新的 fib 调用链。灰色虚线框标出的才是真正的尾上下文。(D) 中两个绿框说明 has-repeat 的递归调用确实落在尾上下文里。问题出在 (+ current (fib (- n 1)))。它是 helper 调用的算子数,必须在调用 helper 之前算完。而算它的过程中要调用 fib,fib 里又要调用 helper……这条链上的调用没有一个是尾调用:(fib (- n 1)) 返回后还得做一次加法,加完才能传给 helper。
判断「是不是尾递归」时,只要有一处递归调用不在尾上下文,整个过程就不享受空间优化。(C) 里 (helper 1 2) 和 (helper (+ ...) (+ k 1)) 这两处调用本身确实在尾上下文,但夹在算子数里的那个 (fib (- n 1)) 一处就足以毁掉一切——它每次都要重新开一条完整的、非尾的调用链。
题目问的只是「是不是尾递归」,所以正确性不影响作答。但如果你把它当真代码读,会发现它算出来的根本不是斐波那契数列——把逻辑照搬到 Python 里跑一遍,n = 1..7 得到的是 0, 1, 2, 5, 16, 65, 326。原因是 (fib (- n 1)) 里的 n 是外层那个固定不变的 n(helper 通过 parent 帧看到它),每轮循环重复地把同一个 (fib (- n 1)) 加进累加器,加了 n - 2 次。选择题里的代码不保证是好代码,读的时候别假设它一定对。
(D) 列表里有没有重复元素
; 假设 contains 就是 (B) 里那个
(define (has-repeat s)
    (if (null? s)
        #f
        (if (contains (cdr s) (car s))
            #t
            (has-repeat (cdr s))
        )
    )
)
是尾递归。结构和 (B) 完全一样:外层 if 在尾上下文 → 内层 if 在尾上下文 → 它的 alternative (has-repeat (cdr s)) 是尾调用。
唯一值得多想一句的是内层 if 的谓词 (contains (cdr s) (car s))。它不是尾调用(谓词位置从来不是尾上下文),那会不会毁掉空间保证?不会,理由是:
contains 不会再调回 has-repeat,所以它不会让 has-repeat 的调用链变长。contains 自己是尾递归的((B) 已证),跑起来只占 $\Theta(1)$ 空间。has-repeat 帧 + $\Theta(1)$ 个 contains 帧」,总空间仍是 $\Theta(1)$。时间是 $\Theta(n^2)$,但那是另一回事。| 代码 | 尾递归? | 判断依据 |
|---|---|---|
(A) length | 否 | 递归调用埋在 + 的算子数里,返回后还要加一次 |
(B) contains | 是 | 递归调用是嵌套 if 的 alternative,链条不断 |
(C) fib | 否 | (fib (- n 1)) 在 helper 的算子数里,且返回后还要做加法 |
(D) has-repeat | 是 | 递归调用在尾上下文;谓词里的 contains 是非递归的有界调用 |
7. 动手:尾递归版 reverse 与 map
课上的随堂代码 21.scm 有三道题,前两道练尾递归。这里连思路带坑一起走一遍。
reverse:把列表倒过来
; reverse tests
(expect (reverse nil) ())
(expect (reverse (list 1)) (1))
(expect (reverse (list 1 2 3)) (3 2 1))
(expect (reverse (list 1 2 3 2 1)) (1 2 3 2 1))
Lecture 19 写过一个非尾递归版本,长这样:
(define (reverse lst)
    (if
        (null? lst)
        nil
        (append
            (reverse (cdr lst))
            (list (car lst))
        )
    )
)
它的问题不止「不是尾递归」:(reverse (cdr lst)) 返回之后还要做一次 append,而 append 本身要遍历整个左参数,所以这版还是 $\Theta(n^2)$ 时间。两个毛病同源——都是因为「真正的工作放在了递归返回之后」。
怎么想到尾递归写法?套第 5 节的配方:加一个累加器,把「返回后要干的活」提前干掉。这里返回后要干的活是「把 (car lst) 接到结果末尾」。可如果我们换个方向想——每次把当前元素 cons 到累加器的最前面,会发生什么?
累加器 reversed 从 nil 开始,逐个把 (car remaining) cons 上去:

remaining = (1 2 3)   reversed = ()
remaining = (2 3)     reversed = (1)          ← (cons 1 ())
remaining = (3)       reversed = (2 1)        ← (cons 2 (1))
remaining = ()        reversed = (3 2 1)      ← (cons 3 (2 1))
                      ↑ remaining 空了,直接返回 reversed
先被取出来的元素被压在最底下,最后取出来的在最前面——「先进后出」正好就是逆序。而 cons 是 $\Theta(1)$ 的,所以顺带把时间也降到了 $\Theta(n)$。
(define (reverse lst)
    (define (helper remaining reversed)
        (if (null? remaining)
            reversed
            (helper (cdr remaining) (cons (car remaining) reversed))
        )
    )

    (helper lst nil)
)
逐行确认它符合定义:
helper体只有一个if→ 那个if在尾上下文。if的 alternative(helper (cdr remaining) (cons ...))→ 尾调用。cons是在算子数位置执行的,调用发出之前就做完了。reverse体的最后一个表达式是(helper lst nil)→ 也是尾调用。- base case 返回累加器
reversed;累加器初值nil正好是「造列表」的零元。
验一遍边界:(reverse nil) → (helper nil nil) → (null? nil) 成立 → 返回 nil,打印为 ()。✓
map:把函数作用到每个元素上
非尾递归版(21.scm 里给出来作参考):
(define (map f lst)
    (if (null? lst)
        nil
        (cons
            (f (car lst))
            (map f (cdr lst))
        )
    )
)
(map f (cdr lst)) 是 cons 的算子数,返回后还要 cons 一下 → 不是尾调用。
照 reverse 的思路加累加器:每次把 (f (car remaining)) cons 到累加器前面。但立刻撞上一个问题——结果会是反的:
(map-reverse '(1 2 3) nil),f = (lambda (x) (* x x))

remaining = (1 2 3)   mapped = ()
remaining = (2 3)     mapped = (1)
remaining = (3)       mapped = (4 1)
remaining = ()        mapped = (9 4 1)      ← 返回 (9 4 1),但我们要 (1 4 9)
这就是提示里那句「怎么用 reverse 来实现 map」的意思:先反着攒,最后再翻回来。
(define (map-tail f lst)
    (define (map-reverse remaining mapped)
        (if (null? remaining)
            mapped
            (map-reverse
                (cdr remaining)
                (cons
                    (f (car remaining))
                    mapped
                )
            )
        )
    )

    (reverse (map-reverse lst nil))
)
验证 (map-tail (lambda (x) (* x x)) '(1 2 3)):(map-reverse '(1 2 3) nil) 得 (9 4 1),再 (reverse '(9 4 1)) 得 (1 4 9)。✓ 与 (expect (map-tail (lambda (x) (* x x)) (list 1 2 3)) (1 4 9)) 一致。
值得停下来确认,因为 (reverse (map-reverse lst nil)) 看着有点像「调用返回后还要干活」。逐个位置分析:
(map-reverse lst nil) 处在 算子数位置,不是尾调用。但它自己是尾递归的,跑起来只占 $\Theta(1)$ 空间,而且它跑的时候只额外压着一个 map-tail 帧。map-tail 的体只剩下 (reverse ...) 这一个调用要发出。它是 map-tail 体的最后一个表达式 → 尾调用,map-tail 的帧可以在此丢弃。reverse 自己也是尾递归的 → $\Theta(1)$。很多人第一反应是「那我把 cons 换成 append 不就顺序对了吗」:
; 能过测试,但很差
(map-reverse (cdr remaining) (append mapped (list (f (car remaining)))))
它确实是尾递归、结果顺序也对,但 append 每次都要把整个 mapped 走一遍,时间退化成 $\Theta(n^2)$。尾递归解决的是空间,不解决时间——为了顺序而在参数里塞一个 $\Theta(n)$ 的操作,等于用时间换空间。「反着攒 + 最后翻转」只多走一趟,是更好的交易。
8. 程序即数据:用 list 拼出一段程序,再 eval 它
下半场换主题。先问一个看起来很哲学、其实很实际的问题:程序是不是一种数据?
在很多语言里答案是「是」,而且你早就用过了:
- 高阶函数(higher-order function)——函数可以被当成参数传、当成返回值返回。这就是把「一段可执行的东西」当值使用。
- Python 的
eval接受任意字符串,把它当作 Python 代码执行。 - Scheme 的
eval接受任意 Scheme 列表,把它当作 Scheme 表达式求值。
Scheme 这一条比 Python 那一条强得多,原因在 Lecture 18 就埋下了:Scheme 的源代码本身就是列表。(+ 1 2) 既是一个「调用表达式」也是一个「三元素的列表」,取决于你怎么看它。Python 里代码是字符串,你得靠拼字符串来生成程序,稍不小心引号就串了;Scheme 里代码是结构化的数据,你用 cons、list、car、cdr 就能读写它。这个性质叫 homoiconicity(同像性),是 Lisp 系语言的看家本领。
quote 的作用:拦住求值
把这四行放在一起看,差别全在引号上:
scm> (+ 1 2)
3
scm> (list + 1 2)
(#[+] 1 2)
scm> (list '+ 1 2)
(+ 1 2)
scm> (list '+ 1 (+ 2 3))
(+ 1 5)
(+ 1 2):普通调用。求值算子 + 得到加法过程,求值 1 和 2,apply,得 3。(list + 1 2):算子是 list。算子数 + 也要被求值——它求值成那个加法过程对象。于是造出一个含有「过程对象、1、2」的列表,打印为 (#[+] 1 2)。#[+] 是解释器对内建过程的显示方式,它不是源代码里那个符号。(list '+ 1 2):'+ 是 (quote +),它不求值 +,直接返回符号(symbol) +。造出的列表是「符号 +、1、2」,打印为 (+ 1 2)——这看起来就是一段 Scheme 代码。(list '+ 1 (+ 2 3)):'+ 挡住了求值,但第三个算子数 (+ 2 3) 照常求值成 5。结果是 (+ 1 5)。quote 只挡它直接贴着的那一个表达式,不影响兄弟表达式。第 3 行是关键。(list '+ 1 2) 造出来的东西,既是「一个列表」也是「一段能跑的程序」。把它喂给 eval 就能跑:(eval (list '+ 1 2)) 得到 3。于是「写一个生成程序的程序」就退化成了「写一个生成列表的程序」——而生成列表你早就会了。
fact-exp:不算阶乘,只造出算阶乘的表达式
对照着看两个过程。左边是熟悉的阶乘,右边只改了一处:
; 返回 n 的阶乘
(define (fact n)
    (if (= n 0)
        1
        (* n (fact (- n 1)))
    )
)

; 返回一个「求值后等于 n 的阶乘」的 Scheme 表达式
(define (fact-exp n)
    (if (= n 0)
        1
        (list '* n (fact-exp (- n 1)))
    )
)
scm> (fact 5)
120
scm> (fact-exp 5)
(* 5 (* 4 (* 3 (* 2 (* 1 1)))))
改动只有一处:(* n (fact (- n 1))) 变成了 (list '* n (fact-exp (- n 1)))。原来是做乘法,现在是造一个写着乘法的列表。递归结构原封不动。
(fact-exp 3)
  n=3 ≠ 0 → (list '* 3 (fact-exp 2))      ← 要先算出 (fact-exp 2)
  (fact-exp 2)
    n=2 ≠ 0 → (list '* 2 (fact-exp 1))
    (fact-exp 1)
      n=1 ≠ 0 → (list '* 1 (fact-exp 0))
      (fact-exp 0)
        n=0 → 返回 1                       ← base case

回代:
  (fact-exp 1) = (list '* 1 1)          = (* 1 1)
  (fact-exp 2) = (list '* 2 '(* 1 1))   = (* 2 (* 1 1))
  (fact-exp 3) = (list '* 3 ...)        = (* 3 (* 2 (* 1 1)))

注意 base case 返回的是数字 1,它在最内层充当被乘数;
而每一层的 (list '* n ...) 把上一层的结果整个塞进第三个位置。
这里有个容易糊涂的地方:(fact-exp 3) 的返回值是数据,不是被执行的代码。它就是一个嵌套列表,静静地躺在那儿。要让它变回代码,得显式调用 eval。
fib-exp:树形递归也一样
; 返回第 n 个斐波那契数
(define (fib n)
    (if (<= n 1)
        n
        (+
            (fib (- n 2))
            (fib (- n 1))
        )
    )
)

; 返回一个「求值后等于第 n 个斐波那契数」的表达式
(define (fib-exp n)
    (if (<= n 1)
        n
        (list '+
            (fib-exp (- n 2))
            (fib-exp (- n 1))
        )
    )
)
scm> (fib 6)
8
scm> (fib-exp 6)
(+ (+ (+ 0 1) (+ 1 (+ 0 1))) (+ (+ 1 (+ 0 1)) (+ (+ 0 1) (+ 1 (+ 0 1)))))
scm> (eval (fib-exp 6))
8
最后一行是整节的落点:(eval (fib-exp 6)) 和 (fib 6) 给出同一个答案,但走的路完全不同——前者先把整棵递归树物化成一个表达式,再把这个表达式交给解释器求值。(fib-exp 6) 的输出其实就是 Lecture 06 讲树形递归时画的那棵调用树,只不过写成了一行文本:每个叶子是 base case 返回的 0 或 1,每个内部节点是一个 +。
为什么要费劲造一个表达式而不直接算?因为表达式可以被检查、被改写、被延后求值。数字 8 只是个答案,而 (+ (+ ...) (+ ...)) 是一份可以继续加工的材料——你可以数它有多少次加法,可以把 + 换成 *,也可以先不求值、等某个条件成立再求值。下一节的宏,做的正是「拿到一份材料,加工完再交回去求值」。
9. 宏:定义你自己的特殊形式
先看一个用上一节技术就能写出来的小工具:twice,它把一个表达式执行两遍。
scm> (define (twice expr) (list 'begin expr expr))
twice
scm> (eval (twice '(print 2)))
2
2
scm> (eval (twice '(print "yeet")))
"yeet"
"yeet"
scm> (twice '(+ 1 2))
(begin (+ 1 2) (+ 1 2))
twice 是一个普通过程:给它一个表达式(作为数据),它返回 (begin <expr> <expr>) 这个列表。最后一行清楚地显示了它的返回值就是一段代码的形状;要真的跑起来,得套上 eval。
用起来很别扭的地方是那对括号外的引号和 eval:调用者必须记得写 ',还得记得写 eval。忘了引号会怎样?(twice (print 2)) 会先求值 (print 2)——打印一次 2,然后把它的返回值(undefined)传进去,结果完全不是你要的。
所以自然的愿望是:能不能不写引号、不写 eval,就得到同样的效果?能,这就是宏。
scm> (define-macro (twice expr) (list 'begin expr expr))
twice
scm> (twice (print 2))
2
2
代码体一个字都没改,只把 define 换成了 define-macro;调用处的 ' 和 eval 都消失了,行为一模一样。
宏是什么
宏(macro)是在求值之前对程序源代码施加的一种操作。(这个概念不是 Scheme 独有的,C 的 #define、Rust 的 macro_rules! 都属于宏。)
Scheme 的 define-macro 特殊形式让你控制哪些表达式被求值、以及在什么时候求值——换句话说,让你定义自己的特殊形式。
回想一下特殊形式为什么特殊:(if p c a) 之所以不能写成普通过程,就是因为普通过程先把所有算子数求值完,而 if 必须只求值该走的那一支。在 define-macro 出现之前,特殊形式的名单是解释器写死的(if、define、lambda、and、or、cond、let、begin、quote……),你加不进去。宏把这扇门打开了。
宏调用表达式的求值规则(三步)
- 求值算子子表达式,它求值出来是一个宏过程(不是普通过程)。
- 把算子数表达式原样(不求值)传给宏过程去调用。——这一步正是我们前面用引号手动模拟的那件事。
- 求值宏过程返回的那个表达式。——这一步正是我们前面用
eval手动做的那件事。
对照普通过程调用:普通调用是「求值算子 → 求值算子数 → apply → 结束」;宏调用是「求值算子 → 不求值算子数 → apply → 再求值一次结果」。差别就两处,但足以改变一切。
普通过程 define | 宏 define-macro | |
|---|---|---|
| 算子数在调用前 | 被求值成值 | 原样传入(还是源代码) |
| 形参绑定到 | 值 | 表达式(列表 / 符号 / 数字) |
| 过程体返回值 | 就是最终结果 | 还要再被求值一次 |
调用者要写 ' 和 eval 吗 | 要(想传代码的话) | 不用 |
| 能不能实现「只求值某一支」 | 不能 | 能 |
完整走一遍:check 宏
(define-macro (check expr)
    (list 'if expr ''passed ''failed)
)
(define x -2)
scm> (check (> x 0))
failed
先解释那两个刺眼的双引号。''passed 就是 (quote (quote passed)):外层 quote 挡住求值,于是它求值成 (quote passed),也就是 'passed 这段代码。我们要往结果表达式里塞的不是符号 passed 本身,而是「一段写着 'passed 的代码」——因为宏返回的东西还要再被求值一次,如果只写 'passed,它求值成符号 passed,塞进结果表达式后第 3 步会把它当成一个变量名去查找,报 unknown identifier。
check 在环境里查到一个宏过程。解释器发现它是宏,于是切换到宏的求值规则。(> x 0) 不被求值,而是作为一个三元素列表直接绑定到形参 expr。可以把它想成「带引号的代换」:宏体里所有的 expr 都被换成 '(> x 0),于是宏体变成(list 'if '(> x 0) ''passed ''failed)。list 的四个算子数分别求值成 符号 if、列表 (> x 0)、代码 'passed、代码 'failed。list。拼成 (if (> x 0) 'passed 'failed)。宏过程到此返回,返回值是这段代码。if 特殊形式:谓词 (> x 0) 在当前环境求值,x 是 -2 → (> -2 0) → #f → 走 alternative,得到 'failed 的值,即符号 failed。failed。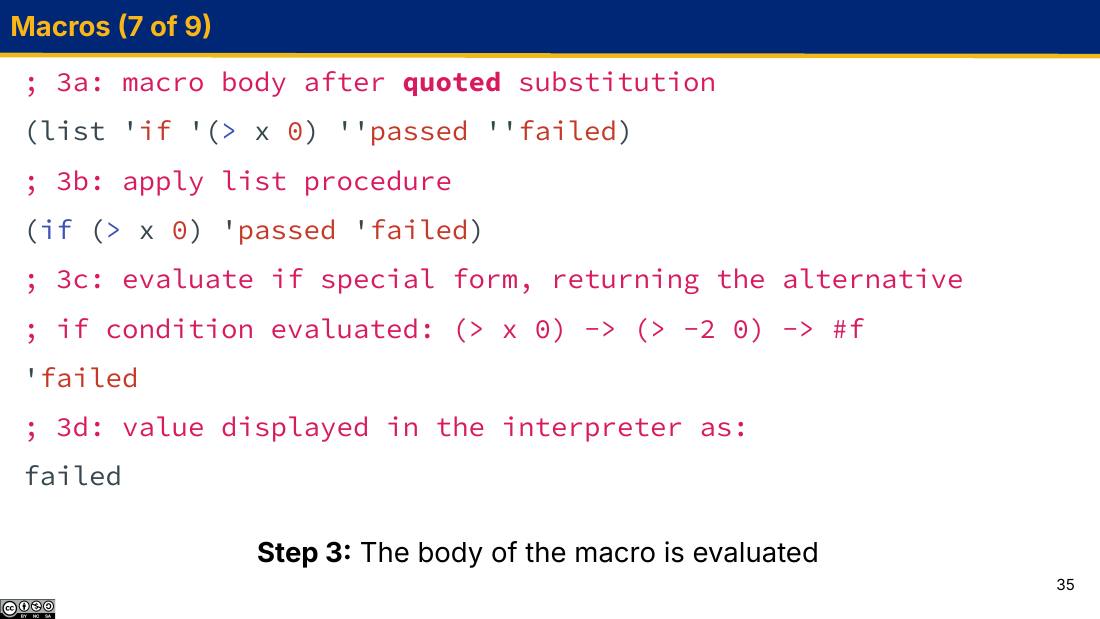
list 施加完毕拼出的表达式,3c 是把这个表达式当作 if 特殊形式求值(x 是 -2,谓词为 #f,取 alternative),3d 是解释器最终打印的样子。注意 3a→3b 这一跳还只是普通的过程调用,真正「执行用户写的代码」发生在 3b→3c。'x 只是 (quote x) 的写法
幻灯片把 3b 写作 (if (> x 0) 'passed 'failed),这是为了好读。如果你真的在解释器里求值 (list 'if '(> x 0) ''passed ''failed),打印出来是:
scm> (list 'if '(> x 0) ''passed ''failed)
(if (> x 0) (quote passed) (quote failed))
两者是同一个数据结构——'passed 本来就是 (quote passed) 的缩写,只是这个解释器打印时不缩写回去。别被这点差异绊住。
误区一:把 check 写成普通过程。(define (check expr) (list 'if expr ''passed ''failed)) 配上 (check (> x 0)),算子数会先被求值成 #f,于是造出的表达式是 (if #f 'passed 'failed)——这次凑巧结果一样,但表达式里已经看不见原来的条件了,下面要做的「失败时显示原表达式」就彻底做不成。宏的价值恰恰在于它能拿到源代码而不只是值。
误区二:少写一层引号。把 ''passed 写成 'passed,宏返回的表达式变成 (if (> x 0) passed failed)。第三步求值时 failed 被当成变量名去环境里查,查不到就报错(61A Scheme 的信息形如 Error: unknown identifier: failed)。写宏时永远要问自己:我现在写的这一层,是在造代码,还是在算值?
让 check 报告失败的表达式
宏能拿到源代码,这个能力现在派上用场:失败时不光说 failed,还把没通过的那个表达式一起显示出来。
(define-macro (check expr)
    (list 'if expr ''passed
        (list 'quote (list 'failed: expr))
    )
)
拆开看第三个算子数 (list 'quote (list 'failed: expr)):内层 (list 'failed: expr) 造出 (failed: (> x 0));外层再套一个 (list 'quote ...),把它变成 (quote (failed: (> x 0))),也就是 '(failed: (> x 0))。套 quote 的理由和刚才一样——不套的话,第三步求值时解释器会把 (failed: (> x 0)) 当成「调用名为 failed: 的过程」。于是:
宏返回的表达式:
(if (> x 0) 'passed '(failed: (> x 0)))

x 为 -2 时求值结果:
(failed: (> x 0))
这就是一个极简的单元测试框架的雏形——而它之所以可能,只是因为宏收到的是代码而不是值。21.scm 里那些 (expect (reverse nil) ()) 之所以能在失败时打印出你写的原表达式,用的是同一个原理。
10. quasiquote 与 unquote:让宏体看起来像它要生成的代码
上一节的 check 已经能用,但读起来很痛苦:
(define-macro (check expr)
    (list 'if expr ''passed
        (list 'quote (list 'failed: expr))
    )
)
问题在于宏体的形状和它生成的代码的形状完全不像。它生成的是 (if ... 'passed '(failed: ...)),可你得在满屏的 list 和引号里把这个形状拼出来。写的时候容易漏引号,读的时候更是得在脑子里跑一遍 list 才知道结果长什么样。
Scheme 给了一对专门的工具:
| 符号 | 名字 | 作用 |
|---|---|---|
' | quote | 整段不求值,原样当数据 |
`(反引号) | quasiquote(准引用) | 整段默认不求值,但留了口子 |
,(逗号) | unquote(反引用) | 在 quasiquote 内部开一个口子:这一处要求值,把值填进来 |
用它们重写 check:
(define-macro (check expr)
    `(if ,expr 'passed
        '(failed: ,expr)
    )
)
现在宏体长得和生成的代码一模一样,只是在两个需要填空的位置点了逗号。这就是准引用的全部价值:模板。反引号说「下面这一整块照抄」,逗号说「这个洞除外,把 expr 的值填进来」。
check,得到宏过程。(> x 0) 不求值,绑定到 expr。,expr 就求值 expr(得到列表 (> x 0))填进去,直接得到 (if (> x 0) 'passed '(failed: (> x 0)))。幻灯片上那句「eliminates step 3b」就是指这个——不再需要 apply 一次 list 才拼出结果,模板本身就是结果。x 为 -2,谓词为 #f,得到 (failed: (> x 0))。手上有解释器的话可以直接看到 quasiquote 的行为,不用先写宏:
scm> (define x 5)
x
scm> `(if ,x 1 2)
(if 5 1 2)
scm> `(a b ,(+ 1 2))
(a b 3)
第二行里 if、1、2 全都没被求值(否则 if 会当特殊形式执行),只有 ,x 那一处被求值成了 5。
'(failed: ,expr) 里的逗号为什么还有效
这个写法看着可疑:逗号被套在了一个普通引号里面,还能生效吗?能。因为 'x 只是 (quote x) 的缩写,而 quote 在这里只是准引用模板里的一个普通符号,它并不会新开一层引用层级。只有嵌套的反引号才会让 unquote 需要多写几个逗号。所以 '(failed: ,expr) 展开出来就是 (quote (failed: (> x 0))),正是我们要的。
练习:for 宏
21.scm 的第三题:定义一个 for 宏,对序列里的每个值求值一次给定的表达式。
(expect (for x nil x) ())
(expect (for x '(1 2 3) x) (1 2 3))
(expect (for x '(2 3 4 5) (* x x)) (4 9 16 25))
(expect (for y '(2 4 6) (* y 3)) (6 12 18))
先看清它必须是宏而不能是过程。看第三条测试 (for x '(2 3 4 5) (* x x)):
- 第一个算子数是
x。如果这是普通过程调用,解释器会去环境里查x——但x根本没被定义过,直接Error: unknown identifier: x。我们要的是符号x本身,不是它的值。 - 第三个算子数是
(* x x)。同理,这时候求值它必然出错,因为x还没有值。它必须被推迟到「循环变量已经有值」之后才求值。
「拿到未求值的表达式」+「控制求值时机」——正是宏的两项本领。
怎么想到实现?提示是「怎么用 map 来实现 for」。反过来问:(for x '(2 3 4 5) (* x x)) 用现成的东西该写成什么?答案很自然:
(map (lambda (x) (* x x)) '(2 3 4 5))
三个部分正好对应三个参数:sym 成为 lambda 的形参,expr 成为 lambda 的体,vals 成为 map 的第二个参数。所以 for 宏要干的事,就是把这三块按模板拼成上面那行代码。
(define-macro (for sym vals expr)
    `(map (lambda (,sym) ,expr) ,vals)
)
不用准引用的等价写法(挑战版):
(define-macro (for sym vals expr)
    (list 'map (list 'lambda (list sym) expr) vals)
)
对照着读一遍,就能理解准引用为什么值得学:上面那版一眼看得出生成的是 (map (lambda (…) …) …);下面那版得从最内层的 (list sym) 开始往外拼才知道。两版生成的是完全相同的列表。
for → 宏过程。sym → 符号 y;vals → 列表 (quote (2 4 6))(注意,是带着 quote 的那一整段代码);expr → 列表 (* y 3)。(map (lambda (y) (* y 3)) '(2 4 6))。'(2 4 6) 求值成列表 (2 4 6),lambda 求值成一个过程,map 依次调用它:(* 2 3)=6、(* 4 3)=12、(* 6 3)=18。(6 12 18),与 (expect (for y '(2 4 6) (* y 3)) (6 12 18)) 一致。注意宏体里从头到尾没有出现过 y 这个名字——它是被调用者带进来的,模板只负责把它放到 lambda 的形参位置。,vals 填进去的是 '(2 4 6) 而不是 (2 4 6)
因为宏拿到的是源代码。调用者写的是 '(2 4 6),那么 vals 绑定到的就是 (quote (2 4 6)) 这段代码本身,填进模板后仍然是 '(2 4 6),等到第 4 步才被求值成真正的列表。这一点很重要:如果调用者写的是 (for x lst x),那 vals 就是符号 lst,填进模板后到第 4 步才去查它的值——宏对调用者写了什么一律照单全收,不做任何提前求值。
忘了 (list sym) 的那层括号。写成 (list 'lambda sym expr) 会生成 (lambda y (* y 3))——lambda 的形参表必须是一个列表,直接给个符号不是合法的形参表。同理准引用版写成 ` (map (lambda ,sym) ...) 也是错的,必须是 (lambda (,sym) ...):逗号只替换那一个位置,外面的括号得你自己写对。
另一个坑是把 expr 加引号,写成 `(map (lambda (,sym) ',expr) ,vals)。这样 lambda 体变成 '(* y 3),每次调用只会原样返回列表 (* y 3),结果是 ((* y 3) (* y 3) (* y 3)) 而不是 (6 12 18)。宏体里加引号是为了「让某段东西在第三步不被求值」,而 expr 恰恰是我们希望被求值的那一部分。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 函数式编程 | 纯函数、无重新赋值与变异、绑定永久。换来求值顺序无关(可并行、可惰性)与同参同果(可 memoization) | 代价是没有 for/while,朴素递归会让帧数爆炸 |
| active call | 尚未返回的过程调用。同时活跃的调用数就是空间复杂度的量级 | 把「调用了多少次」和「同时活着多少个」搞混——树形递归调用次数指数级,但同时活跃的只有树高那么多 |
| 尾上下文 | 过程体最后一个子表达式;if 的 2、3 号子表达式;cond 的所有非谓词子表达式;and/or/begin 的最后一个子表达式。且必须自己也在尾上下文里 | 谓词位置、算子数位置永远不是尾上下文;「写在最后一行」不等于「在尾上下文」 |
| 尾调用 | 处在尾上下文中的调用表达式。人话判据:它返回之后,调用方还有没有活要干 | 只要有一处递归调用不在尾上下文,整个过程就没有空间保证 |
| 尾调用优化 | Scheme 保证「无限多个活跃尾调用只用常数额外空间」——发出尾调用时当前帧被丢弃而非保留 | 省的是空间不是时间;Python 不做这个优化 |
| 累加器改写 | 加内部 helper + 累加器参数;把「返回后要做的运算」搬到实参位置;base case 返回累加器,原 base case 的值挪去当累加器初值 | 加了累加器却还在返回值上套运算((+ 1 (helper ...))),结果对但空间没省 |
| 程序即数据 | Scheme 源代码本身就是列表,用 list + ' 就能造出一段程序,eval 把它变回可执行的代码 | (list + 1 2) 里的 + 会被求值成过程对象 #[+];要符号必须写 '+ |
define-macro | 三步:① 求值算子得宏过程 → ② 不求值地把算子数表达式传进去 → ③ 再求值宏返回的表达式 | 宏返回的是代码;想让某个符号活到第三步之后,得多加一层 quote(''passed) |
| quasiquote / unquote | ` 整块照抄当模板,, 在模板上开洞填值。宏体因此长得和它生成的代码一样 | 逗号只替换那一个位置,括号结构要自己写对((lambda (,sym) ...) 的内层括号不能少) |
尾调用管的是「一层求值结束后,那一帧还留不留」;宏管的是「这段代码什么时候、以什么形态进入求值」。两者都建立在你已经知道「求值到底是怎么一步步发生的」这个基础上——所以它们排在解释器那一讲之后,而不是之前。
动手练习
五道自测题。建议先在纸上写出答案,再展开对照。
练习 1:这个过程是尾递归的吗
(define (count-evens s)
    (cond
        ((null? s) 0)
        ((even? (car s)) (+ 1 (count-evens (cdr s))))
        (else (count-evens (cdr s)))
    )
)
看答案
不是。逐条对照 cond 的规则:cond 的所有非谓词子表达式在尾上下文,所以 0、(+ 1 (count-evens (cdr s)))、(count-evens (cdr s)) 这三处都在尾上下文里。
但注意第二个分支:处在尾上下文的是那个+ 的调用,而不是里面的 count-evens 调用——count-evens 在这里是 + 的算子数,它返回之后还欠一次加法。第三个分支的 (count-evens (cdr s)) 倒确实是尾调用,但只要有一条路径上的递归调用不是尾调用,整个过程就没有常数空间保证:给一个全是偶数的长列表,帧照样堆到 $\Theta(n)$。
要改成尾递归,用第 5 节的配方:(define (count-evens s) (define (helper s n) (cond ((null? s) n) ((even? (car s)) (helper (cdr s) (+ n 1))) (else (helper (cdr s) n)))) (helper s 0))。
练习 2:and / or 里的尾上下文
(define (all-positive? s)
    (or
        (null? s)
        (and
            (> (car s) 0)
            (all-positive? (cdr s))
        )
    )
)
看答案
是尾递归。链条走一遍:
or是过程体的最后(唯一)一个子表达式 → 在尾上下文。or的最后一个子表达式在尾上下文 → 那个and在尾上下文。((null? s)不在,因为它不是最后一个。)and的最后一个子表达式在尾上下文 →(all-positive? (cdr s))在尾上下文 → 是尾调用。((> (car s) 0)不在。)
这道题的意义在于说明:and/or 的短路语义和尾调用是同一件事的两面。or 之所以能把最后一个子表达式当尾上下文,正是因为短路——如果前面都为假,整个 or 的值就是最后那个子表达式的值,不需要再加工。要是 or 会把结果转成布尔值再返回,它就不是尾上下文了。
练习 3:把求和改成尾递归,并手动展开
把下面这个过程改写成尾递归,然后对 (sum '(1 2 3)) 展开每一步的参数。
(define (sum lst)
    (if (null? lst)
        0
        (+ (car lst) (sum (cdr lst)))
    )
)
看答案
(define (sum lst)
    (define (helper remaining total)
        (if (null? remaining)
            total
            (helper (cdr remaining) (+ total (car remaining)))
        )
    )
    (helper lst 0)
)
累加器初值 0 就是原来 base case 返回的那个 0(加法零元)。展开:
(sum '(1 2 3))
= (helper '(1 2 3) 0)
= (helper '(2 3)   1)      ← (+ 0 1)
= (helper '(3)     3)      ← (+ 1 2)
= (helper '()      6)      ← (+ 3 3)
= 6
对照原版的展开:(+ 1 (+ 2 (+ 3 0)))——三层加法全都悬着,要等最内层返回才能逐层算。尾递归版则是每走一步就把加法做掉,base case 拿到的 total 已经是最终答案。
练习 4:定义 unless 宏
定义一个 unless 特殊形式,(unless 条件 A B) 在条件为假时求值 A、为真时求值 B——正好和 if 相反。要求:只有该走的那一支被求值。请分别用「list 拼」和「准引用」两种写法。
看答案
; 准引用版
(define-macro (unless condition consequent alternative)
    `(if ,condition ,alternative ,consequent)
)

; list 拼接版
(define-macro (unless condition consequent alternative)
    (list 'if condition alternative consequent)
)
实现就是把两个分支换个位置塞进 if。三个参数都不加引号,因为它们最终都要作为真正的代码被第三步求值。
为什么必须是宏?如果写成普通过程 (define (unless c a b) (if c b a)),调用 (unless #f (print 1) (print 2)) 会先求值全部三个算子数——1 和 2 都会被打印,然后才轮到 if 挑分支。宏版本只有该走的那一支进入求值,另一支从头到尾只是一段没被碰过的数据。「按需求值」是过程做不到、只有特殊形式才做得到的事,而 define-macro 让你自己造特殊形式。
练习 5:为什么 twice 用 begin
(define-macro (twice expr) (list 'begin expr expr)) 生成的是 (begin <expr> <expr>)。为什么要套一层 begin,直接返回 (list expr expr) 行不行?
看答案
不行。两个原因:
- 宏只能返回一个表达式,因为第三步是「求值宏过程返回的那个表达式」,单数。
begin的职责恰恰是把多个表达式打包成一个:依次求值,返回最后一个的值。 - 如果返回
(list expr expr),生成的是((print 2) (print 2))。第三步求值它时,解释器会把它当成调用表达式:先求值算子(print 2)(打印一次 2,得到undefined),再求值算子数(print 2)(又打印一次),然后试图把undefined当作过程施加——报错。2 确实被打印了两次,但紧接着就崩了:scm> ((print 2) (print 2)) 2 2 Error: nonetype is not callable: undefined
顺带一个尾调用的联系:begin 的最后一个子表达式在尾上下文。所以 (begin (print 2) (print 2)) 里第二个 print 调用是尾调用,第一个不是——它的值被丢弃了,但求值它的过程中当前帧仍然得留着。