解释器:用 Python 写一个能跑 Scheme 的程序
把「求值规则」从脑子里的一套流程,变成一段真的会跑的代码——这一讲我们亲手造一门语言。
0. 本讲导读
从第 1 讲到现在,你一直在做同一件事的用户:写一个表达式,交给 Python(或 Scheme),它给你一个值。你早就背熟了那套规则——先求值算子,再求值算子数,然后把过程施加到实参上,新建一帧,绑定形参,执行函数体。这套规则你在纸上画过几十遍环境图。
但它一直是「纸上的规则」。真正执行它的,是一个你没见过的、别人写的程序。这一讲把这层窗户纸捅破:那个程序也不过是一段代码,而且我们现在就有能力把它写出来。
为什么偏偏是 Scheme?第 18、19 讲学 Scheme 的时候可能你觉得「不就是括号多一点的 Python 吗」。真正的理由在这里:Scheme 的规则少得可怜,少到一个学期过半的学生就能给它写一个解释器。作为对比,CPython——那个用 C 语言写的 Python 参考实现——有 35 万行 C 代码。而你的 Scheme 项目(这门课的期末项目)只有几百行 Python。
Scheme 还有一个别的语言几乎都没有的性质,这个性质是整讲的枢纽:Scheme 代码本身就是 Scheme 列表。(+ 1 2 3) 这段「代码」,同时也是一个含四个元素的列表 (list '+ 1 2 3)。这意味着我们只要把源代码文本变成 Python 里的链表,就得到了一个可以用递归来处理的数据结构——而处理递归数据结构,正是你从第 9 讲练到现在的看家本领。
本讲的路线:先看清「程序是怎么被执行的」这个大背景(机器语言 vs 高级语言),再把解释器拆成两段——前半段解析(parsing)把文本变成数据结构,后半段求值(evaluation)把数据结构变成值。然后我们真的把一门叫 Scheme Calculator 的小语言实现出来,再看它怎么长成完整 Scheme 解释器的 eval-apply 相互递归骨架。最后用一个叫 mu 的怪东西,反过来照亮你学了 20 讲的词法作用域到底特殊在哪。
往后看:下一讲的尾调用(tail call)和宏(macro),讲的都是解释器内部的事——尾调用是 eval 循环里的一个优化,宏是在 eval 之前多插一步代码变换。没有本讲的骨架,下一讲会完全悬空。
- 解释器就是一个普通程序,它的输入是「另一段程序的文本」,输出是那段程序的值。写解释器不需要魔法,只需要把求值规则老老实实翻译成代码。
- 解释器分两大段:解析(文本 → 表达式数据结构)和求值(表达式数据结构 → 值)。解析又分词法分析(lexical analysis)——迭代地把字符切成记号,和语法分析(syntactic analysis)——树递归地把记号拼成树。
- Scheme 代码就是 Scheme 列表。所以「表达式数据结构」不用另外发明,直接用链表
Link就行。这是 Scheme 好写解释器的根本原因。 - 求值的核心是 eval 与 apply 的相互递归:
eval遇到调用表达式就求值各部分再交给apply;apply遇到用户定义的过程就新建一帧、再eval函数体。两者互相调用,直到落在基础情形(原始值、内建过程)上。 - 特殊形式(special form)之所以「特殊」,就是因为它必须在求值算子数之前被拦截。
define若按普通调用处理,第一件事就是去查还不存在的名字,必然崩。 - 词法作用域(lexical scope):新帧的 parent 是过程被定义时所在的环境。动态作用域(dynamic scope):新帧的 parent 是过程被调用时所在的环境。Python 和 Scheme 用前者;Scheme 的
mu特殊形式造出的过程用后者。 - 一个像样的解释器不会因为用户输错就整个退出。它在 REPL 的每一轮捕获异常、打印错误、继续下一轮。
1. 程序到底是怎么跑起来的
要理解「写一个解释器」是在做什么,得先知道你的电脑上同时存在多少层语言。课上把它们分成两大类。
机器语言(machine language)
机器语言的语句由硬件本身解释执行。 它的特点是:
- 指令集是固定的,每条指令对应 CPU(central processing unit,中央处理器)电路里实现好的某个操作;
- 操作直接指向具体的硬件地址;
- 没有任何抽象机制——没有函数、没有对象、没有名字绑定这种东西。
换句话说,机器语言里不存在你这 20 讲学的一切。没有 def,没有帧,没有作用域。(这一层是 CS 61C 的内容。)
高级语言(high-level language)
高级语言的语句和表达式由另一个程序解释,或者被编译(translate,翻译)成另一种语言。 它提供了:
- 抽象手段:命名、函数定义、对象——正是这门课反复在讲的东西;
- 屏蔽系统细节:你的 Python 代码不用管自己跑在 x86 还是 ARM 上、Linux 还是 macOS 上。
这两句定义里藏着本讲的全部动机:既然高级语言「由另一个程序解释」,那么那个程序是可以被写出来的,而写它的语言也可以是一门高级语言。我们要用 Python 写一个解释 Scheme 的程序。这不是循环论证——Python 自己也被某个程序(CPython,用 C 写的)解释,C 又被编译成机器码,机器码由硅片本身执行。每一层都靠下一层撑着,最下面一层是电路。
看一眼 Python 的下一层:字节码
「Python 由另一个程序解释」这句话不是比喻。CPython 拿到你的函数后,会先把它翻译成一串字节码(bytecode)——一种介于源代码和机器码之间的中间指令——然后由一个循环逐条执行这些指令。标准库的 dis(disassemble,反汇编)模块能把这串指令打给你看。
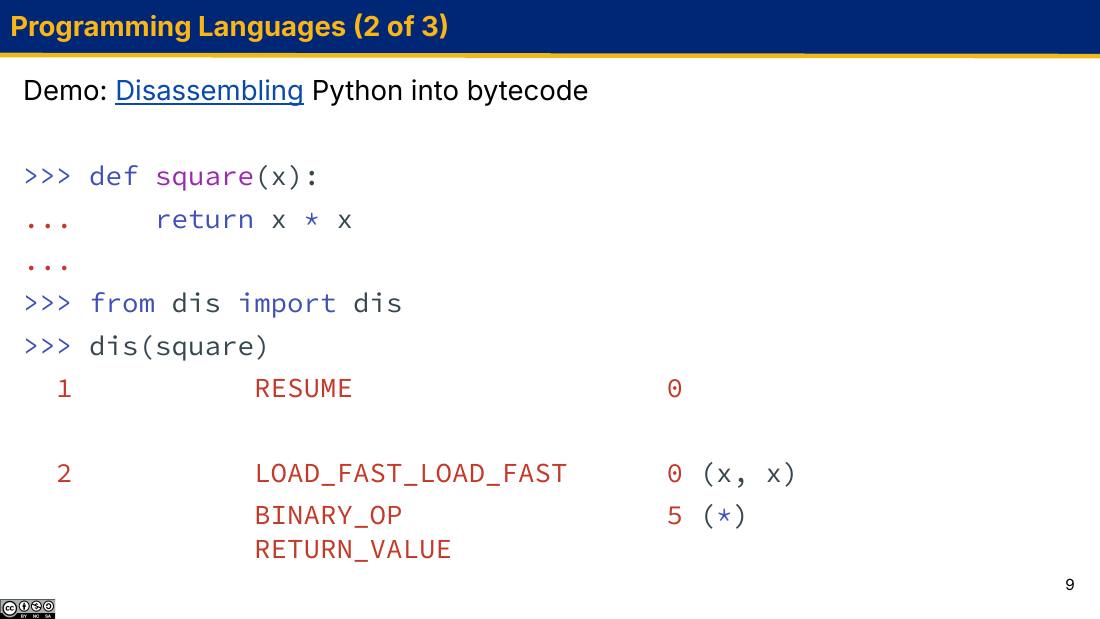
return x * x 在 CPython 内部变成了四条指令:RESUME 启动、LOAD_FAST_LOAD_FAST 把局部变量 x 压两次栈、BINARY_OP 5 做乘法、RETURN_VALUE 返回栈顶。注意 BINARY_OP 后面的 5 是「操作码里第 5 号二元运算」的意思,括号里的 (*) 是 dis 贴心加的注解。这段输出随 Python 版本而变——它是 CPython 的内部实现细节,不是语言规范的一部分。在本仓库用的 Python 3.10 上,同样一段代码反汇编出来长这样:
>>> from dis import dis
>>> def square(x):
...     return x * x
...
>>> dis(square)
  2           0 LOAD_FAST                0 (x)
              2 LOAD_FAST                0 (x)
              4 BINARY_MULTIPLY
              6 RETURN_VALUE
指令名不一样(BINARY_MULTIPLY vs BINARY_OP 5),条数不一样(没有 RESUME),但干的事一模一样:把 x 取两次,相乘,返回。你不需要看懂这些助记符,只需要接受一个事实——你的源代码在被执行之前,已经被另一个程序读过、拆过、重排过了。
「解释」和「编译」的界线其实很模糊。纯粹的解释器逐条读源代码逐条执行;纯粹的编译器把源代码整体翻译成另一种语言(通常是机器码)再交给别人执行。CPython 是混合的:先编译成字节码,再解释执行字节码。我们这一讲写的 Scheme Calculator 是纯解释器——读一个表达式,立刻算它,不生成任何中间代码。
为什么语言不止一种
编程语言常常是为了某个特定领域 / 问题 / 应用量身定做的。课上举的例子是 Erlang——它是为并发程序设计的。这类专门为一个窄领域设计的语言叫 领域专用语言(domain-specific language, DSL)。
这件事对你有直接意义:本讲后半段我们要造的 Scheme Calculator 就是一门 DSL——它只会算术,别的什么都不会。正因为「什么都不会」,它才能在一百来行 Python 里被完整实现。设计一门语言的第一步永远是划定范围:决定不做什么,比决定做什么更重要。
2. 一门语言由什么构成
在动手之前,先把「语言」这个词拆开。任何一门编程语言都有两样东西,而且这两样东西完全独立:
| 语法(syntax) | 语义(semantics) | |
|---|---|---|
| 回答的问题 | 哪些语句和表达式是合法的 | 这些语句和表达式执行/求值的规则是什么 |
| 俗称 | 语言的「文法」「结构」 | 语言的「意义」 |
| Python 例子 | if x > 0: 合法,if x > 0(少冒号)不合法 | 条件为真才执行下面缩进的那一块 |
| Scheme 例子 | (+ 1 2) 合法,(+ 1 2(括号没配平)不合法 | 求值 +、求值 1 和 2、把加法施加到 1 和 2 上 |
| 解释器里谁负责 | 解析器(parser) | 求值器(evaluator) |
最后一行是本讲的结构图:解释器的前半段实现语法,后半段实现语义。 这两半的分工非常干净——解析器完全不关心 + 是什么意思,它只负责确认括号配平、把符号和数字摆成正确的树形;求值器完全不关心用户输入的字符串长什么样,它只面对一个已经建好的数据结构。
规范 vs 参考实现
如果你今天想造一门新语言,课上说你至少需要下面两样之一:
- 规范(specification):一份文档,用(尽量精确的)自然语言描述语法和语义。「合法的 if 语句长这样」「求值
and时先求左边,若为假就不求右边」。 - 标准实现 / 参考实现(canonical / reference implementation):一个真的能跑的解释器或编译器。「这门语言的意思,就是这个程序算出来的意思」。
Python 走的是先有参考实现、后有规范的路:先有 CPython,语言就是 CPython 干的事;后来才补上语言参考文档。大多数流行语言最后两样都有。
「规范」和「实现」不一致是常态,不是意外。第 19 讲的幻灯片里就有一个例子被讲师明确标注为「这很可能是 61A 这个 Scheme 解释器的一个 bug」——也就是说,实现的行为和 Scheme 应有的语义对不上。当你在 Scheme 项目里遇到「我按定义想应该输出 A,但它输出 B」时,这两种可能都要考虑:可能是你理解错了语义,也可能是这个教学用解释器就是这么实现的。写解释器的人对语义拥有最终解释权,这既是权力也是责任。
3. 解析:从一串字符到一棵树
解析(parsing)这项任务的定义是:把一个表达式的字符串表示,强制转换成表达式本身,好让它能被执行。
先想清楚为什么需要这一步。用户在 REPL 里敲进来的是什么?是一串字符:'(+ 1 2 3)'——左括号、加号、空格、数字 1……在 Python 眼里这就是一个长度为 9 的字符串,跟 'hello wor' 没有本质区别。而我们的求值器想要的是一个结构:一个「运算符是 +,操作数是 1、2、3」的东西。中间必须有人把前者变成后者。
为什么 Scheme 特别好解析
这里是整讲最关键的一句话:Scheme 代码本身就写成 Scheme 列表的样子。
(+ 1 2 3) 作为「代码」时是一个调用表达式;但把它当「数据」看,它就是一个含四个元素的列表,也就是 (list '+ 1 2 3)——第一个元素是符号 +,后面三个是数字。这两种读法用的是同一套括号、同一套排版规则。
对比一下 Python 你就知道这有多难得。Python 的 square(3) + 1 是什么数据结构?它什么都不是——你得先设计一套「表达式对象」的类层次(BinOp、Call、Name、Constant……),再写一个复杂的解析器把中缀运算符、优先级、缩进块统统翻译过去。而 Scheme 呢?我们已经有链表了。 第 19 讲写的那个 Link 类,不用改一行,就是我们的表达式数据结构。
于是解析 Scheme 变成了:把括号里的东西读成链表,遇到嵌套括号就读成嵌套链表。 就这么多。
两个阶段:词法分析与语法分析
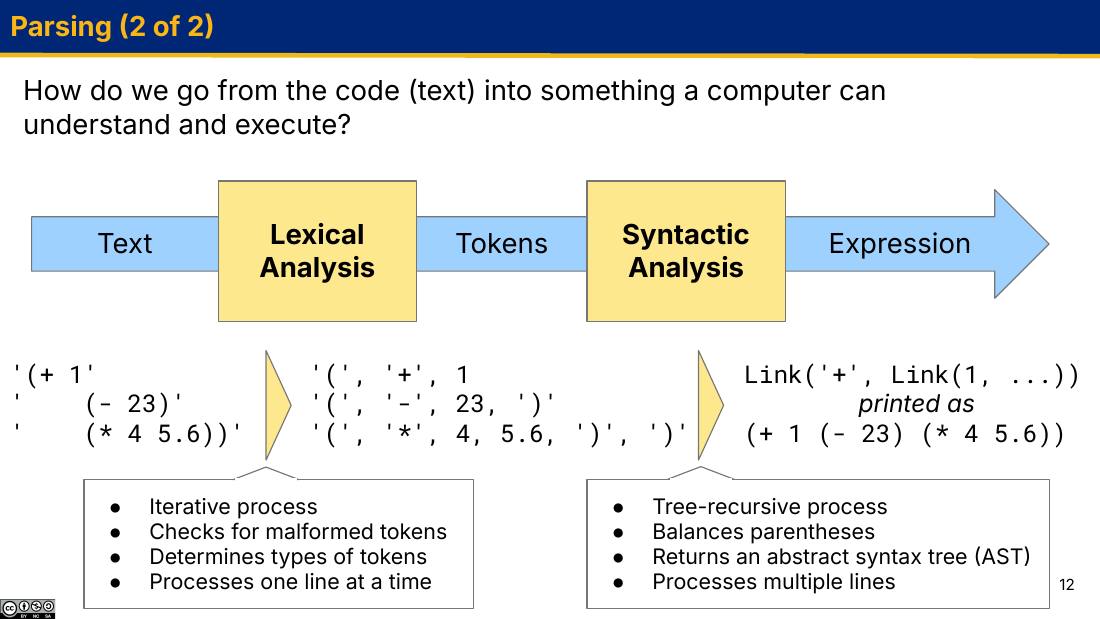
'(',而 23 已经从字符 '2''3' 变成了真正的 Python 整数 23,5.6 变成了浮点数。右边是语法分析拼出来的嵌套 Link 结构,它 print 出来又变回 (+ 1 (- 23) (* 4 5.6))——数据和代码在这里合上了。| 词法分析(lexical analysis) | 语法分析(syntactic analysis) | |
|---|---|---|
| 输入 → 输出 | 文本 → 记号(token) | 记号 → 表达式 |
| 本讲代码里是 | scheme_tokens.py | scheme_reader.py |
| 过程形态 | 迭代的(从左到右扫一遍) | 树递归的 |
| 负责什么 | 检查记号是否畸形;判定每个记号的类型 | 配平括号;返回抽象语法树(abstract syntax tree, AST) |
| 一次处理多少 | 一行 | 可跨多行 |
最后一行的差别值得停一下。为什么词法分析一次只处理一行,语法分析却要跨行?因为「一个记号不会跨行」,但「一个表达式会」。看图里的输入:
(+ 1
   (- 23)
   (* 4 5.6))
第一行 (+ 1 单独看是三个完好的记号 '('、'+'、1,词法分析可以立刻把这一行处理完;但它不是一个完整的表达式——左括号还没等到它的右括号。所以语法分析必须能在需要更多记号时向下一行要。这就是为什么在 REPL 里敲一个没配平的 (+ 1 回车之后,提示符会变成缩进等你继续输入,而不是立刻报错。
4. 记号与树:解析器真的长什么样
词法分析:把字符切成记号
记号(token)是「语言里有意义的最小单位」。scheme_tokens.py 里的 tokenize_line 从左到右扫一行字符,每次切出一个候选记号,判断它属于哪一类,转换成对应的 Python 值:
| 记号类别 | 文本例子 | 切出来的 Python 值 |
|---|---|---|
| 分隔符(delimiter) | ( ) ' . | 同名的字符串,如 '(' |
| 数字 | 23 / 5.6 | int 23 / float 5.6 |
| 布尔 | #t / #f | True / False |
| 符号(symbol) | + * quotient x | 字符串 '+' '*' … |
用本仓库 Scheme 项目里的分词器实测一行:
>>> from scheme_tokens import tokenize_line
>>> tokenize_line('(+ 1 (- 23) (* 4 5.6))')
['(', '+', 1, '(', '-', 23, ')', '(', '*', 4, 5.6, ')', ')']
盯着这个输出多看两秒,有两件事要注意:
- 数字已经不是字符了。 输入里的
23是两个字符'2'和'3',输出里的23是一个 Python 整数。这个转换就发生在词法分析里——「判定记号的类型」不是打个标签,而是真的把它变成对应类型的值。 - 括号是独立记号,但结构还没建立。 这仍然是一个平的列表,13 个元素排成一排。嵌套关系还只体现在括号的位置上,没人把它变成真的嵌套。那是下一步的活。
这一步也是第一道防线。分词器发现一个以数字开头、却既不是合法整数也不是合法浮点数的东西时,会直接抛异常:
scalc> 2.3.4
ValueError: invalid numeral: 2.3.4
为什么词法分析是迭代的?因为切记号这件事没有嵌套结构可言——你从左往右走,遇到空白就跳过,遇到括号就切一刀,遇到别的就一直读到下一个空白或括号为止。整个过程就是一个 while 循环维护一个位置下标 k,没有任何「先处理里面再处理外面」的需求。而下一步的语法分析必须处理嵌套,所以它非递归不可。
语法分析:把记号拼成树
scheme_reader.py 用两个函数完成语法分析,它们相互递归:
def scheme_read(src):
    """Read the next expression from src, a Buffer of tokens."""
    if src.current() is None:
        raise EOFError
    val = src.pop()
    if val == 'nil':
        return nil
    elif type(val) in (float, int):
        return val
    elif val not in DELIMITERS:      # 不是 ( ) ' . 中的任何一个
        return val
    elif val == "(":
        val = read_tail(src)
        return val
    else:
        raise SyntaxError("unexpected token: {0}".format(val))

def read_tail(src):
    """Return the remainder of a list in src, starting before an element or )."""
    if src.current() is None:
        raise SyntaxError("unexpected end of file")
    if src.current() == ")":
        src.pop()
        return nil
    first = scheme_read(src)
    rest = read_tail(src)
    return Link(first, rest)
src 是一个 Buffer,你可以把它想成一条记号的传送带:current() 是「偷看当前这个记号,但不拿走」,pop() 是「拿走当前这个记号并返回它」。两个函数共享同一条传送带,谁 pop 了,传送带就往前走一格,这是它们能配合的关键。
分工非常清楚:
scheme_read读一个完整表达式。基础情形:记号是数字或符号——它本身就是表达式,直接返回。递归情形:记号是(,说明后面跟着一串子表达式,交给read_tail。read_tail读一个列表剩下的部分,一直读到配对的)为止。基础情形:当前记号是),吃掉它,返回nil(列表到头了)。递归情形:先用scheme_read读出一个元素当first,再用read_tail读出后面所有元素当rest,用Link(first, rest)拼起来。
注意 read_tail 的递归情形里同时有两个递归调用:scheme_read(src) 往「树的深处」走,read_tail(src) 往「列表的后面」走。这正是「树递归」这个词的来历——一个往下、一个往右。
把 (+ 1 (- 23) (* 4 5.6)) 的 13 个记号喂给 scheme_read。我用「传送带上还剩什么」来标记进度。
scheme_read:pop 出 '('。它在 DELIMITERS 里,且等于 "(" → 调 read_tail。剩余:+ 1 ( - 23 ) ( * 4 5.6 ) )read_tail:current 是 '+',不是 ) → first = scheme_read(src),它 pop 出 '+',是符号(不在 DELIMITERS 里)→ 返回 '+'。基础情形命中。read_tail 接着算 rest = read_tail(src)。current 是 1 → first = scheme_read pop 出 1,是 int → 返回 1。read_tail:current 是 '(' → first = scheme_read(src),它 pop 出 '(' → 又调一层 read_tail。这就是「往树的深处走」的那次递归。read_tail 依次读出 '-'、23,然后 current 是 ')' → pop 掉,返回 nil。基础情形命中。Link(23, nil) → Link('-', Link(23, nil))。这就是子表达式 (- 23) 的表示,它作为一个元素返回给第 4 步。rest = read_tail(src):current 又是 '(',同样的流程读出 Link('*', Link(4, Link(5.6, nil)))。read_tail:current 是最外面那个 ')' → pop 掉,返回 nil。全部记号读完。Link(Link('*', …), nil) → Link(Link('-', …), Link(Link('*', …), nil)) → Link(1, …) → Link('+', …)。最终建出来的结构,写成 repr 是:
Link('+', Link(1, Link(Link('-', Link(23, nil)),
                       Link(Link('*', Link(4, Link(5.6, nil))), nil))))
而 Link.__str__ 会把它打印成 (+ 1 (- 23) (* 4 5.6))——跟输入一模一样。这就是「代码即数据」:我们把文本变成了数据结构,而这个数据结构印出来还是那段文本。
看到 read_tail 的两行
first = scheme_read(src)
rest = read_tail(src)
很容易想「能不能合成一行 return Link(scheme_read(src), read_tail(src))?」——不能,至少不安全。因为这两个调用都在修改同一条传送带,谁先跑决定了谁拿到哪些记号。Python 求值实参是从左到右的,所以写成一行碰巧也对;但一旦你写成 Link(read_tail(src), scheme_read(src)),或者换一门求值顺序不保证的语言,结果就全错了。只要函数有副作用,求值顺序就是语义的一部分——把它显式写成两条赋值语句,是在把顺序钉死。
5. REPL:解释器的外壳
REPL 是 Read-Eval-Print-Loop 的缩写,也就是「读-求值-打印-循环」。你天天在用它:Python 交互式解释器里那个 >>> 提示符,61A Code 里的 Scheme 解释器,都是 REPL。
它是一个用户界面,工作流程正好对应它的四个字母:
>>> 或 scm> 或我们的 scalc>)课上的第一个练习就是把 Scheme Calculator 的 REPL 补完。骨架长这样(横线是待填的空):
@main
def read_eval_print_loop():
    """Run a read-eval-print loop for Calculator."""
    while _________:
        try:
            src = buffer_input('scalc')
            while src.more_on_line:
                expression = _________(src)
                print(_________(expression))
        except (SyntaxError, TypeError, ValueError, ZeroDivisionError, NameError) as err:
            print(type(err).__name__ + ':', err)
        except (KeyboardInterrupt, EOFError):  # <Control>-D, etc.
            print('Exiting Scheme Calculator...')
            return
提示说得很清楚:不需要自己定义任何新函数,三个空全都填现成的东西。 想清楚每一行在四个字母里对应哪一步,答案就自己冒出来了:
| 空 | 填什么 | 为什么 |
|---|---|---|
while _____ | True | 这是 Loop。REPL 不该主动结束,它只在用户按 Ctrl-D 或 Ctrl-C 时才通过下面的 except 退出 |
expression = _____(src) | scheme_read | 这是 Read 里的解析步:从记号缓冲区读出一个完整表达式 |
print(_____(expression)) | calc_eval | 这是 Eval + Print:先求值,再把值打出来 |
补完后:
while True:
    try:
        src = buffer_input('scalc')
        while src.more_on_line:
            expression = scheme_read(src)
            print(calc_eval(expression))
    except ...
两层循环各管什么
初看会疑惑:为什么有两个 while?它们管的粒度不同。
- 外层
while True管「一次输入」。每转一圈,buffer_input('scalc')打一个scalc>提示符,等用户敲一行。 - 内层
while src.more_on_line管「这一行里还有没有没算完的表达式」。因为用户完全可以在一行里写两个表达式。
这正是模块文档里那个例子的成因:
scalc> (+ 2 2) (* 3 3)
4
9
一行输入,两个值,各占一行输出。内层循环转了两圈。而反过来,一个表达式跨了三行时:
scalc> (+ 1
     (- 23)
     (* 4 2.5))
-12
内层只转一圈——scheme_read 在读到第一行末尾时括号还没配平,Buffer 就自动去向输入源要下一行了,用户看到的是缩进的续行提示符。「跨行」这件事被完全封装在 Buffer 里,REPL 的代码根本不知道有这回事。
except 那两行是 REPL 的灵魂,别把它当样板代码略过。解释器不应该因为用户输错一个字符就整个崩掉。 第一个 except 捕获所有「用户程序的错」——语法错、类型错、除零错——打印一行人类看得懂的信息,然后 while True 转下一圈,解释器继续活着。第二个 except 捕获 Ctrl-C 和 Ctrl-D,这才是用户真的想退出,于是 return。注意 print(type(err).__name__ + ':', err) 这个写法:它把异常的类名和消息拼成 ValueError: invalid numeral: 2.3.4 这种格式,而不是甩用户一脸 Python 的 traceback。
6. Scheme Calculator:一门只会算术的语言
现在我们造一门语言。它叫 Scheme Calculator,是 Scheme 的一个极小子集。它的完整语法规则只有两条:
- 原始表达式(primitive expression)只有数字。 没有字符串、没有布尔值、没有列表字面量。
- 调用表达式(call expression)是一个组合式,开头是一个算术运算符(
+、-、*、/),后面跟 0 个或多个表达式。 例如(+ 1 2 3)、(/ 3 (+ 4 5))。
就这样。没有特殊形式——没有 if,没有 define(本讲后半段会加上),没有 lambda。也就没有函数定义、没有环境、没有帧。
这个「什么都没有」是刻意的。因为把特殊形式和用户定义过程都砍掉之后,求值规则就只剩最纯粹的那一条:求值所有子表达式,然后把运算符施加到值上。 这条规则你在第 1 讲就学过了,现在把它写成代码。
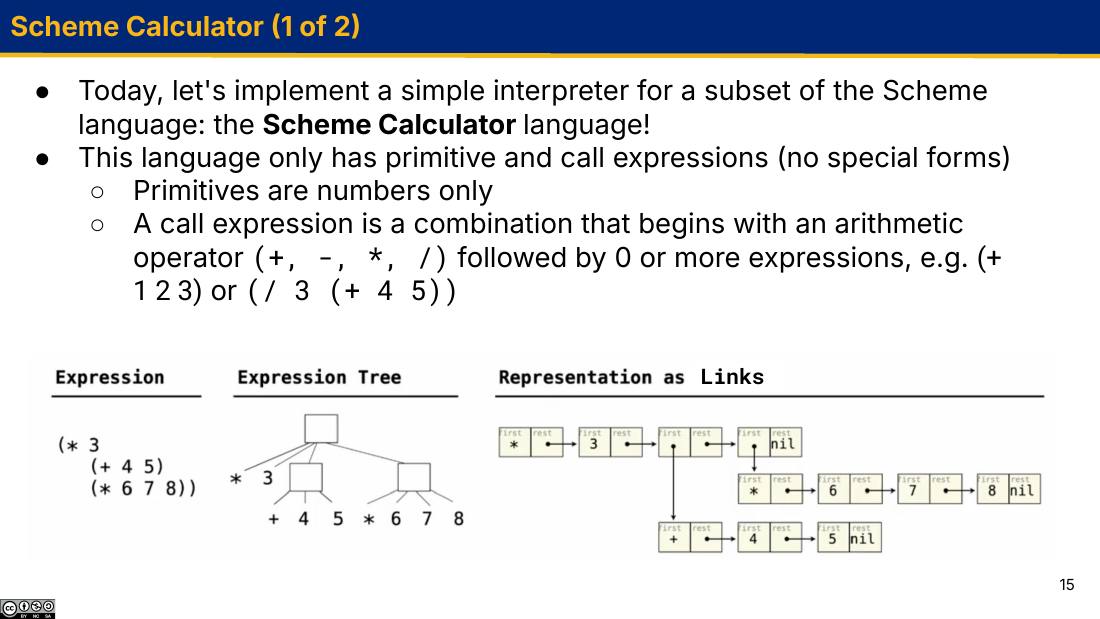
(* 3 (+ 4 5) (* 6 7 8));中间是它的表达式树——每个内部节点是一个调用,运算符和操作数是它的子节点;右边是它在 Python 内存里的Link 链表——横着走是同一层的兄弟(first/rest),竖着的箭头指向嵌套的子表达式。解析器把左边变成右边,求值器从右边往回算。看右边那张 Link 图时注意一个细节:嵌套子表达式在链表里就是一个「first 字段指向另一个 Link」的格子。第一行第四格的 rest 是 nil(说明最外层调用有三个操作数就到头了),而它的 first 是一个向下的箭头,指向 (* 6 7 8) 那条链。这跟第 19 讲的嵌套 Scheme 列表是同一件事——因为它本来就是同一件事。
语义:四个运算符各是什么意思
| 运算符 | 语义 | 例子 | 值 |
|---|---|---|---|
+ | 所有参数之和 | (+ 1 2 3) | 6 |
* | 所有参数之积 | (* 1 2 3 4 5) | 120 |
- | 只有 1 个参数:取它的相反数 | (- 23) | -23 |
| 多个参数:用第一个减去其余所有 | (- 10 1 2 3) | 4 | |
/ | 只有 1 个参数:取它的倒数 | (/ 5) | 0.2 |
| 多个参数:用第一个依次除以其余所有 | (/ 40 5) | 8 |
- 和 / 的「一个参数」特例不是随便定的,Scheme 本身就是这么规定的。它让 (- x) 能当一元负号用,让 (/ x) 能当求倒数用,省得再发明两个运算符。
那 0 个参数呢?语言的示例给了答案:
scalc> (+)
0
scalc> (* 1 2 3)
6
(+) 是 0,同理 (*) 是 1。为什么?因为 0 是加法的单位元、1 是乘法的单位元——「什么都不加」的结果,理应是那个加上去不改变任何东西的数。而 (-) 和 (/) 就没有合理答案了(「什么都不减」该等于几?),所以它们必须报错。这个不对称在下一节的代码里会直接体现出来。
7. calc_apply:把符号变成运算
先写 apply,因为它更简单——它不递归,也不认识表达式,只认识运算符的名字和已经算好的实参。
def calc_apply(operator, args):
    """Apply the named operator to a list of args."""
    if not isinstance(operator, str):
        raise TypeError(str(operator) + ' is not a symbol')
    if operator == '+':
        return reduce(add, args, 0)
    elif operator == '-':
        if len(args) == 0:
            raise TypeError("'-' operator requires at least 1 argument")
        elif len(args) == 1:
            return -args[0]
        else:
            return reduce(sub, args.rest, args.first)
    elif operator == '*':
        return reduce(mul, args, 1)
    elif operator == '/':
        if len(args) == 0:
            raise TypeError("'/' operator requires at least 1 argument")
        elif len(args) == 1:
            return 1 / args[0]
        else:
            return reduce(truediv, args.rest, args.first)
    elif operator == 'quotient':
        if len(args) != 2:
            raise TypeError("'quotient' operator requires exactly 2 arguments")
        numerator = args[0]
        denominator = args[1]
        return floordiv(numerator, denominator)
    else:
        raise TypeError(f"'{operator}' is an unknown operator")
注意两件事:
operator是一个字符串,不是函数。在这门小语言里,运算符还不是「值」——你不能把+传来传去。所以 apply 只能靠一串if/elif逐个比对名字。(完整 Scheme 解释器里运算符会求值成真正的过程对象,那时这串 if 就消失了。)args是一个Link,不是 Python 列表。但Link实现了__len__和__getitem__,所以len(args)和args[0]都能用——第 15 讲学的特殊方法在这里派上了用场。
reduce:把一串数折叠成一个数
四个运算符全都是「拿一串数,反复做同一个二元运算」。这个模式已经写好了:
def reduce(fn, scheme_list, start):
    """Reduce a recursive list of Links using fn and a start value.

    >>> reduce(add, as_scheme_list(1, 2, 3), 0)
    6
    >>> reduce(sub, as_scheme_list(20, 5), 30)
    5
    """
    if scheme_list is nil:
        return start
    return reduce(fn, scheme_list.rest, fn(start, scheme_list.first))
它是尾递归形式的左折叠:start 是累加器,每一步把累加器和当前元素喂给 fn,得到新的累加器,然后处理剩下的链表。
reduce(sub, as_scheme_list(20, 5), 30),也就是 (- 30 20 5) 的核心计算:
scheme_list 是 Link(20, Link(5, nil)),不是 nil。算 fn(start, first) = sub(30, 20) = 10。递归调用 reduce(sub, Link(5, nil), 10)。sub(10, 5) = 5。递归调用 reduce(sub, nil, 5)。scheme_list is nil → 基础情形,返回 start,即 5。5。因为累加器是在下降时更新的,回代阶段什么都不做——这正是尾递归的特征。写 - 的多参数分支时,很多人会顺手写成 reduce(sub, args, 0),照抄 + 的样子。这是错的:
>>> reduce(sub, as_scheme_list(10, 1, 2, 3), 0)
-16
因为它算的是 ((((0-10)-1)-2)-3) = -16,而 (- 10 1 2 3) 应该是 10-1-2-3 = 4。减法没有单位元可以拿来当起点。正确写法是把第一个参数当起点、剩下的参数当序列:reduce(sub, args.rest, args.first)。/ 同理。这也解释了为什么 + 和 * 能接受 0 个参数而 - 和 / 不能:前者有 0 和 1 这样的天然起点,后者的起点必须从参数里拿,参数为空就无从下手,只能报错。
quotient:一个「恰好两个参数」的过程
quotient 做的是向下取整除法(floor division),也就是 Python 的 //。它跟前四个运算符有个本质区别:参数个数是固定的 2 个,不多不少。所以它的实现里没有 reduce,只有一次长度检查加一次 floordiv。
>>> calc_apply('quotient', as_scheme_list(40, 5))
8
>>> calc_apply('quotient', as_scheme_list(10, 3))
3
对比一下 /:(/ 10 3) 会得到 3.3333333333333335,而 (quotient 10 3) 得到 3。
为什么 (/ 40 5) 打出来是 8 而不是 8.0
truediv(40, 5) 在 Python 里返回的是浮点数 8.0——calc_apply 的 doctest 也确实写着 8.0。但在 REPL 里你看到的是 8。中间这一步由 simplify 完成:
def simplify(value):
    """Return an int if value is an integer, or value otherwise."""
    if isinstance(value, float) and int(value) == value:
        return int(value)
    return value
它是在 calc_eval 里被调用的,不在 calc_apply 里。这个分工有道理:apply 负责算对,eval 负责把结果整理成用户想看的样子。 Scheme 里 8 和 8.0 在数值上是同一个数(Scheme 管这叫「精确的」和「非精确的」表示),所以在数值恰好是整数时显示成整数更自然。
int(value) == value 这个判断依赖浮点数的精确比较,这在一般情况下很危险,但这里是安全的——我们不是问「它约等于整数吗」,而是问「它就是某个整数吗」。8.0 满足,8.000000001 不满足,正是我们要的语义。真正会出问题的是 (/ 1 3) 这种:结果 0.3333333333333333 不等于任何整数,原样返回,用户看到的就是那一长串。浮点误差不是这个函数引入的,它在 truediv 那一步就已经存在了。
8. calc_eval:三条求值规则
calc_eval 接受一个表达式(解析器吐出来的那个数据结构),返回它的值。在还没有 define 的版本里,它只需要分两种情况:
def calc_eval(exp):
    """Evaluate a Calculator expression."""
    if type(exp) in (int, float):          # 基础情形:数字自求值
        return simplify(exp)
    elif isinstance(exp, Link):            # 递归情形:调用表达式
        arguments = exp.rest.map(calc_eval)
        return simplify(calc_apply(exp.first, arguments))
    else:
        raise TypeError(exp + ' is not a primitive or call expression')
这七行就是这门语言的全部语义。逐条看:
规则一:数字自求值
type(exp) in (int, float)——如果表达式本身就是个数,它的值就是它自己。这是基础情形,递归靠它停下来。
「自求值(self-evaluating)」这个词值得琢磨一下:10 这个表达式的值是 10 这个数。表达式和值在这里恰好重合,但它们仍是两个层面的东西——一个是你写下的,一个是算出来的。往后加了符号之后,x 这个表达式的值是 3,两者就不重合了。
规则二:调用表达式递归求值
isinstance(exp, Link)——如果表达式是一条链表,那它就是一个调用表达式。这时候做两件事:
arguments = exp.rest.map(calc_eval)
return simplify(calc_apply(exp.first, arguments))
exp.first是运算符(一个字符串,比如'+')。它不被求值——直接原样交给calc_apply。这是 Calculator 语言比完整 Scheme 简单的地方之一。exp.rest是操作数们组成的链表。.map(calc_eval)把calc_eval施加到每一个操作数上,得到一条值的链表。
递归就藏在这个 map 里。 Link.map 的实现是
def map(self, fn):
    mapped = fn(self.first)
    return Link(mapped, self.rest.map(fn))
它对每个元素调一次 fn,而这里的 fn 就是 calc_eval 自己。所以当某个操作数本身又是一条链表(嵌套调用)时,calc_eval 会再次进入递归情形。表达式树有多深,递归就有多深。
规则三:其他一切都是错误
else 分支抛 TypeError。在这门语言里,一个表达式要么是数字要么是调用,没有第三种可能。
求值 (+ 2 (* 4 6))。解析后的结构是 Link('+', Link(2, Link(Link('*', Link(4, Link(6, nil))), nil)))。我用缩进表示递归深度。
calc_eval(Link('+', ...)):不是数字,是 Link → 递归情形。exp.first 是 '+',exp.rest 是操作数链表 (2 (* 4 6))。exp.rest.map(calc_eval)。map 先处理第一个元素:calc_eval(2)。calc_eval(2):type(2) 是 int → 基础情形,simplify(2) 返回 2。map 继续处理第二个元素:calc_eval(Link('*', Link(4, Link(6, nil))))。map:calc_eval(4) → 4(基础情形),calc_eval(6) → 6(基础情形)。得到值链表 Link(4, Link(6, nil))。calc_apply('*', Link(4, Link(6, nil))) → reduce(mul, args, 1) → mul(1,4)=4 → mul(4,6)=24 → 24。simplify(24) → 24。第 4 步的递归调用返回 24。map,它现在拿到了两个值,拼成 Link(2, Link(24, nil))。calc_apply('+', Link(2, Link(24, nil))) → reduce(add, args, 0) → 0+2=2 → 2+24=26 → 26。simplify(26) → 26。最外层返回 26,REPL 打印出来。把这个过程画成调用栈,更能看出「深处先算完」的顺序:
calc_eval( (+ 2 (* 4 6)) )
  │
  ├─ map: calc_eval( 2 )  ─────────────→ 2        ← 基础情形,立刻返回
  │
  ├─ map: calc_eval( (* 4 6) )
  │        │
  │        ├─ map: calc_eval( 4 ) ─────→ 4        ← 基础情形
  │        ├─ map: calc_eval( 6 ) ─────→ 6        ← 基础情形
  │        │
  │        └─ calc_apply('*', (4 6)) ──→ 24
  │                                      ↑
  └────────────────────────────── 24 回代给上一层
  │
  └─ calc_apply('+', (2 24)) ─────────→ 26        ← 最终值
把这张图跟你第 1 讲画的表达式树放在一起看:它们是同一棵树。求值一个嵌套表达式,就是在这棵树上做一次后序遍历——先算完所有子节点,再算父节点。 你从第 1 讲开始每次算 add(2, mul(4, 6)) 时脑子里做的事,现在被写成了一个真的会跑的递归函数。这就是这门课名字里 "Interpretation" 的含义。
「calc_eval 里明明没写 calc_eval(...),它怎么是递归的?」——递归调用藏在 exp.rest.map(calc_eval) 里。calc_eval 是作为值被传进 map 的(注意没有括号!),由 map 替它发起调用。这是第 3 讲高阶函数的直接应用:把函数当参数传,调用点就可以离定义点很远。 如果你不小心写成 exp.rest.map(calc_eval(exp)),会立刻炸——那是先调用 calc_eval(exp) 得到一个数,再把数传给 map,然后 map 里的 fn(self.first) 就变成了拿一个整数当函数用:
TypeError: 'int' object is not callable
9. define:第一个特殊形式
现在给这门语言加一个功能:定义变量。语法沿用 Scheme 的:
(define <name> <expression>)
加进来之后,Calculator 就不再是「只有原始表达式和调用表达式」了——它有了第一个特殊形式(special form)。这一节的重点不是 define 有多难写(它只有两行),而是为什么它必须被特殊对待。
需要一个环境
要记住 x 是 3,得有地方存。最简单的地方就是一个 Python 字典:
env = {} # The global environment
这就是我们的全局帧。名字是键,值是值。到目前为止只有这一个帧,没有父帧,没有局部帧——因为这门语言还没有函数定义,也就没有「调用」这回事。
两处改动
第一处,calc_eval 新增一条规则:符号要去环境里查。
if type(exp) is str:
    if exp in env:
        return env[exp]
    raise NameError(f"Undefined variable '{exp}'")
第二处,在求值操作数之前拦截 define:
elif isinstance(exp, Link):
    if exp.first == "define":
        return do_define_form(exp.rest)
    arguments = exp.rest.map(calc_eval)
    return simplify(calc_apply(exp.first, arguments))
而 do_define_form 本身平淡无奇:
def do_define_form(vals):
    """Defines (or redefines) a variable in the global environment,
    and returns that symbol as a Python string."""
    env[vals.first] = calc_eval(vals.rest.first)
    return vals.first
vals 是 (x 3) 这样一条链表:vals.first 是要绑定的名字,vals.rest.first 是要求值的表达式。所以这一行的意思是「求值右边,把结果绑到左边这个名字上」——跟 Python 的赋值语句规则一字不差。返回值是那个名字本身,所以 REPL 会回显 x。
特殊形式之所以「特殊」,就在于那个 if exp.first == "define" 的位置——它在 exp.rest.map(calc_eval) 这一行之前。
如果把它挪到后面,或者干脆不写,会发生什么?走普通调用表达式的路:先 map(calc_eval) 求值所有操作数。第一个操作数是符号 'x',calc_eval('x') 会去 env 里查——可 x 正是我们现在才要定义的名字,它当然不在里面:
scalc> (define x 3)
NameError: Undefined variable 'x'
「先求值所有子表达式」这条规则,对 define 是致命的。define 的第一个操作数不是一个「要被求值的表达式」,而是一个「要被当作名字使用的符号」。所有特殊形式都有这个性质:if 不能先求值两个分支(否则短路就没了),lambda 不能先求值函数体(否则定义时就执行了)。凡是「不能对子表达式一视同仁地先求值」的语法结构,都必须做成特殊形式。
在 REPL 里连着敲三行,跟踪 env 的变化。
(define x 3)。解析成 Link('define', Link('x', Link(3, nil)))。calc_eval:是 Link,且 exp.first == 'define' → 拦截,调 do_define_form(Link('x', Link(3, nil)))。操作数一个都没被求值。do_define_form:vals.first 是 'x';vals.rest.first 是 3,calc_eval(3) → 3。执行 env['x'] = 3。返回 'x'。REPL 打印 x。(+ x 2)。exp.first 是 '+',不是 define → 正常求值操作数。calc_eval('x'):是 str,'x' in env → 返回 3。calc_eval(2) → 2。calc_apply('+', Link(3, Link(2, nil))) → 5。打印 5。(* x (+ 2 x))。外层 map 求两个操作数:calc_eval('x') → 3;calc_eval((+ 2 x)) → 内层再 map,得 2 和 3,apply + 得 5。calc_apply('*', Link(3, Link(5, nil))) = reduce(mul, args, 1) = 1*3=3,3*5=15。打印 15。scalc> (define x 3) env = {'x': 3} 回显 x
scalc> (+ x 2) env = {'x': 3} 打印 5
scalc> (define y (+ x 4))
env = {'x': 3, 'y': 7} 回显 y
scalc> (define x 10) env = {'x': 10, 'y': 7} 回显 x ← 重新绑定,y 不变
scalc> z
NameError: Undefined variable 'z'
倒数第二行值得注意:(define x 10) 把 x 改成了 10,但 y 仍然是 7。因为 y 存的是当初 (+ x 4) 求值得到的那个数,不是「一个跟着 x 走的公式」。这跟 Python 的 y = x + 4 完全一致——绑定的是值,不是表达式。
这个环境还差什么
课上留了一个讨论题:怎样扩展这个设计,让它支持多个帧和父帧? 现在的 env 是一个裸字典,它缺两样东西:
- 没有父指针。 一个真正的帧需要知道「我查不到的名字该去哪儿接着查」。所以要把字典包进一个类里,比如
class Frame: def __init__(self, parent): self.bindings = {}; self.parent = parent。 - 查找不会向上走。 现在的
exp in env只看一层。有了父指针之后,查找要变成一个循环或递归:本帧找不到就问 parent,一直问到全局帧,还找不到才抛NameError。
再加上「调用用户定义的过程时新建一帧、把形参绑到实参上」,你就得到了完整 Scheme 解释器的环境模型——也正是 Scheme 项目里 scheme_classes.py 中 Frame 类干的事。你画了二十讲的环境图,本质上就是这么一个带 parent 指针的字典链。
10. 抛异常:解释器怎样优雅地报错
用户会输错。而且用户输错的方式,比你想象的多。一个 REPL 里,异常可能在完全不同的阶段被抛出,而抛在哪个阶段,本身就是一条重要的诊断信息。
| 阶段 | 触发它的输入 | 异常 | 为什么在这个阶段 |
|---|---|---|---|
| 词法分析 | 2.3.4 | ValueError: invalid numeral: 2.3.4 | 切记号时发现它以数字开头,却既不是合法 int 也不是合法 float |
| 语法分析 | 多出来的 ) | SyntaxError: unexpected token: ) | scheme_read pop 到一个右括号,但没有左括号在等它 |
| 语法分析 | (+ 1 后直接 EOF | SyntaxError: unexpected end of file | read_tail 想要下一个记号,传送带空了 |
| 求值(eval) | z(未定义) | NameError: Undefined variable 'z' | 符号查找失败 |
| 施加(apply) | (/ 1 0) | ZeroDivisionError: division by zero | Python 的 truediv 自己抛的,我们没写一行代码 |
| 施加(apply) | (-) | TypeError: '-' operator requires at least 1 argument | 参数个数检查 |
| 施加(apply) | (quotient 40) | TypeError: 'quotient' operator requires exactly 2 arguments | 参数个数检查 |
| 施加(apply) | (** 2 3) | TypeError: '**' is an unknown operator | 所有 elif 都没匹配上,落到 else |
课上让学生自己找「我们这个解释器还有什么地方会出问题」,答案就是表里后三行:- 或 / 参数不够、运算符不认识、quotient 参数太多。练习是给这三种情况各抛一个带人类看得懂的错误信息的 TypeError。
好的错误信息长什么样
对比一下:
| 差 | 好 | 差在哪 |
|---|---|---|
TypeError(无消息) | TypeError: '-' operator requires at least 1 argument | 用户不知道是哪个运算符、哪里不对 |
TypeError: bad args | TypeError: 'quotient' operator requires exactly 2 arguments | 没说「应该是多少个」 |
直接 assert len(args) == 2 | 显式 raise TypeError(...) | AssertionError 会穿透 REPL 的 except 元组,把整个解释器崩掉 |
最后一行是真会踩的坑。回头看 REPL:
except (SyntaxError, TypeError, ValueError, ZeroDivisionError, NameError) as err:
    print(type(err).__name__ + ':', err)
这个元组穷举了「用户程序可能犯的错」。AssertionError 不在里面,IndexError 也不在里面。所以如果你在 calc_apply 里图省事写 assert len(args) == 2,用户敲一句 (quotient 40),整个解释器会带着 Python traceback 退出,用户的所有 define 全部丢失。选对异常类型不是风格问题,它决定了错误会被谁接住。
另一个容易被忽略的检查是 calc_apply 的第一行:
if not isinstance(operator, str):
    raise TypeError(str(operator) + ' is not a symbol')
什么时候运算符不是字符串?当用户写 ((+ 1 2) 3) 的时候。这在完整 Scheme 里也是错的((+ 1 2) 求值成 3,3 不是过程),但在 Calculator 里连求值都不会做——exp.first 直接就是一条 Link。没有这道检查,代码会一路跑到 operator == '+' 这些比较(全都返回 False,因为 Link 不等于任何字符串),最后落到 else 抛出 'Link(...)' is an unknown operator——信息就误导人了:问题不是「不认识这个运算符」,而是「这个位置上根本不该放一个表达式」。
本讲演示仓库里 calc.py 顶部那段模块文档字符串是从 61A 早年版本继承下来的,其中两条与本讲实现的行为对不上:它写着 (/ 5) 会报 TypeError: / requires exactly 2 arguments,但按本讲的语义 (/ 5) 应该等于 0.2;它还写着单独输入 + 会报 TypeError: + is not a number or call expression,而加上 define 之后 + 会走符号查找这条路,报的是 NameError: Undefined variable '+'。以函数各自的 doctest 为准——那些是真的会被 python3 -m doctest calc.py 检查的。这个小小的不一致本身就是第 2 节那个道理的现场演示:文档和实现会漂移。
11. Eval-Apply 相互递归
Calculator 语言很小,但它已经暴露了解释器最深的那个结构。把它扩展成完整的 Scheme 解释器之后,整件事会收敛成两个函数——eval 和 apply——它们互相调用。
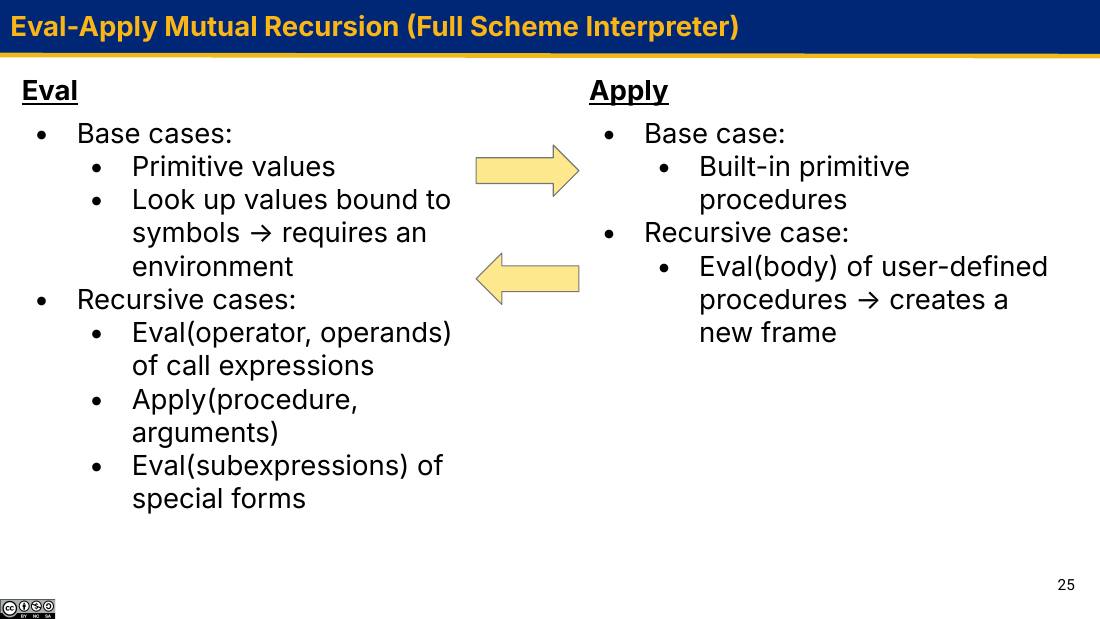
| Eval(表达式, 环境) → 值 | Apply(过程, 实参) → 值 | |
|---|---|---|
| 基础情形 |
|
|
| 递归情形 |
|
|
把 Calculator 跟这张表对一对,就知道我们省掉了什么:
| Scheme Calculator | 完整 Scheme | |
|---|---|---|
| eval 的参数 | 只有表达式 | 表达式 + 环境 |
| 算子怎么处理 | 不求值,原样传给 apply | 求值成一个过程对象 |
| apply 的第一个参数 | 一个字符串,如 '+' | 一个过程对象(BuiltinProcedure 或 LambdaProcedure) |
| apply 会递归吗 | 不会——只有内建运算,没有用户定义过程 | 会——用户定义过程要新建帧再 eval 函数体 |
| 特殊形式 | 只有 define | define lambda if cond let and or quote begin mu… |
关键的一行是倒数第二行:Calculator 的 apply 是没有递归的,所以整个解释器的递归只有「表达式有多深」这一个来源。一旦允许用户定义过程,apply 就必须回头调 eval,递归的来源就变成两个了——表达式的嵌套深度,和函数调用的嵌套深度。后者才是无限的。
在完整 Scheme 里跑这两行,看 eval 和 apply 怎么互相递归:
(define (square x) (* x x))
(square 3)
(square 3) 于 Global。它是 Link,首元素 square 不是特殊形式关键字 → 走调用表达式这条路。square 于 Global。square 是符号 → 基础情形:符号查找,在 Global 里查到一个 LambdaProcedure(x, (* x x), Global)。注意它记着自己的定义环境 Global。3 于 Global → 基础情形:原始值,得 3。(3))。它不是内建过程 → 递归情形:新建一帧 f1,parent 设成过程记着的那个环境 Global,在 f1 里绑定 x → 3。(* x x) 于 f1。又是调用表达式。* 于 f1:f1 里没有 * → 沿 parent 指针到 Global → 查到 BuiltinProcedure(mul)。x 于 f1 → 3;再 Eval x 于 f1 → 3。(3 3)) → 基础情形:内建过程,直接调 Python 的乘法,得 9。递归到底了。9 → 第 4 步的 Apply 返回 9 → 第 1 步的 Eval 返回 9。REPL 打印 9。Global frame
square ──→ LambdaProcedure(x, (* x x)) [env=Global]
* ──→ BuiltinProcedure(mul)
+ - / ──→ …
f1: square [parent=Global] ← Apply 在第 4 步造出来的
x ──→ 3
正在求值:(* x x)
返回值 ──→ 9
你从第 1 讲开始画的每一张环境图,都是这段相互递归留下的脚印。 「新建一帧」这个动作,在代码里就是 Apply 递归情形里的一次 Frame(parent) 构造;「parent 指向哪」就是那个过程对象里存着的 env 字段;「在帧里查名字」就是 Eval 基础情形里的一次向上查找。手画环境图和写解释器是同一件事的两种记法——这也是为什么写完 Scheme 项目之后,你再也不会画错环境图。
本仓库的 Scheme 项目里,这两个函数就叫 scheme_eval 和 scheme_apply,都在 scheme_eval_apply.py 里;帧和三种过程对象(BuiltinProcedure、LambdaProcedure、MuProcedure)在 scheme_classes.py 里;各个特殊形式的处理函数(do_define_form、do_lambda_form、do_if_form……)在 scheme_forms.py 里。文件的划分正好对应上面那张表的三列。
12. 词法作用域 vs 动态作用域:mu
写解释器最大的好处是:你终于可以问「如果规则改一条会怎样」,并且真的去改。 这一节改的是最核心的那条规则——新建的帧,parent 指向哪里?
Python 和 Scheme 用的规则叫词法作用域(lexical scope),也叫静态作用域(static scope):
| 词法作用域 / 静态作用域 | 动态作用域(dynamic scope) | |
|---|---|---|
| 新帧的 parent 是 | 过程被定义时所在的环境 | 过程被调用时所在的环境 |
| 信息存在哪 | 存在过程对象里(定义时就固定了) | 不存——由调用者提供 |
| 看代码能确定吗 | 能。只看源代码的嵌套结构就知道一个名字指向谁 | 不能。同一个过程在不同地方被调用,同一个名字可能指向不同的值 |
| Scheme 里怎么造 | lambda | mu |
| 项目里的类 | LambdaProcedure(有 env 字段) | MuProcedure(没有 env 字段) |
mu 是 61A 自造的一个特殊形式,标准 Scheme 里没有。它的语法跟 lambda 一模一样:
(mu (<param> ...) <body> ...)
它创建一个以 params 为形参、以 body 为函数体的 mu 过程。当这个过程被调用时,调用帧扩展的是「mu 被调用时所在的那个环境」,而不是它被定义时的环境。
同一段代码,两种规则,两种结果
下面这个例子在本仓库的 Scheme 项目上实测过。先看 mu 版:
scm> (define f (mu (x) (* x y)))
f
scm> (define g (lambda (x y) (f (+ x x))))
g
scm> (g 3 7)
42
注意 f 的函数体里用了一个 y,而 f 定义的地方(全局帧)根本没有 y。它居然能跑出 42。
再看把 mu 换成 lambda(其余一字未改):
scm> (define h (lambda (x) (* x y)))
h
scm> (define k (lambda (x y) (h (+ x x))))
k
scm> (k 3 7)
Error: unknown identifier: y
mu 版:(g 3 7) 为什么是 42
f → MuProcedure(形参 x,体 (* x y))——不带环境;g → LambdaProcedure(形参 x y,体 (f (+ x x)),env=Global)。(g 3 7):算子 g 查到 lambda 过程,算子数得 3 和 7。Apply 新建帧 f1,parent = Global(因为 g 是 lambda,用它记着的定义环境),绑定 x→3、y→7。f1 里求值函数体 (f (+ x x))。算子 f:f1 里没有,沿 parent 到 Global,查到那个 MuProcedure。算子数 (+ x x):x 在 f1 里是 3,得 6。(6))。关键在这一步:mu 过程自己不带环境,于是 parent 取当前调用发生的环境,也就是 f1。新建帧 f2,parent = f1,绑定 x→6。f2 里求值 (* x y):x 在 f2 里查到 6;y 在 f2 里没有,沿 parent 到 f1——f1 里有 y→7!6 * 7 = 42。lambda 版:(k 3 7) 为什么报错
f1(parent=Global)里 x→3、y→7,算出实参 6,取到过程 h。(6))。h 是 lambda,它记着自己的定义环境 Global。新建帧 f2,parent = Global,绑定 x→6。f1 完全不在这条链上。f2 里求值 (* x y):x → 6。y:f2 没有 → parent Global 没有 → 查找链到头了。Error: unknown identifier: y。【lambda:词法作用域】 【mu:动态作用域】
Global Global
h ─→ Lambda(x, (* x y)) f ─→ Mu(x, (* x y))
env=Global 没有 env 字段
k ─→ Lambda(x y, …) g ─→ Lambda(x y, …)
▲ ▲ ▲
│ │ │
│ parent │ parent │ parent
│ │ │
f1: k f2: h f1: g
x → 3 x → 6 x → 3
y → 7 (* x y) 里的 y → 7
y 查不到! ▲
│ parent ← 指向调用者!
f2: f
x → 6
(* x y) = 6 * 7 = 42
差别只有一处:f2 的 parent 箭头指向谁。词法作用域下它指向 Global(一条从定义处向外的静态链),动态作用域下它指向 f1(一条随运行时调用关系变化的动态链)。
Scheme 项目里 scheme_apply 的签名是 scheme_apply(procedure, args, env)——它比你预期的多了一个 env 参数。为什么 apply 需要知道「调用发生在哪个环境」?就是为了 mu。 LambdaProcedure 用自己的 env 字段当 parent,压根不看这个参数;MuProcedure 没有 env 字段,只能用这个参数。项目源码里那句注释说得很准:「A mu procedure stores no environment: its caller supplies one.」(mu 过程不存储环境,由它的调用者提供。)
看到 mu 能「借用调用者的变量」,第一反应往往是「这不是更灵活吗?」——恰恰相反,这是几乎所有现代语言都放弃动态作用域的原因。在 mu 版里,f 能不能跑,取决于调用它的那个函数碰巧有没有一个叫 y 的局部变量。这意味着:
- 你没法只看
f的定义就判断它对不对,必须把所有调用点都看一遍; - 某个调用者把自己的局部变量从
y改名成total——一个纯粹的局部重构——会让远在天边的f崩掉; - 第 3 讲的闭包彻底失效:函数不再「记住」定义时的环境,也就没有
make_adder那种把状态封在里面的能力。
另一个常见误解是「mu 是 Scheme 标准的一部分」。不是,它是 61A 为了教学专门加进这个解释器的,用来把「parent 指向哪」这条规则从背景里拎出来给你看。真实世界里你几乎不会遇到它——但你会天天享受词法作用域带来的好处。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 机器语言 vs 高级语言 | 前者由硬件直接执行、无抽象机制;后者由另一个程序解释或被编译成别的语言,提供命名/函数/对象等抽象 | 以为「解释器」是某种底层黑魔法——它只是一个普通程序 |
| 语法 vs 语义 | 语法 = 哪些写法合法(解析器负责);语义 = 合法写法怎么执行(求值器负责) | 把「报 SyntaxError」和「算出错误答案」当成一类问题 |
| 词法分析 | 文本 → 记号;迭代;一次一行;判定并转换记号类型('23' → 23) | 2.3.4 在这一步就抛 ValueError: invalid numeral,还没轮到求值 |
| 语法分析 | 记号 → 表达式(AST);树递归;可跨行;配平括号 | 忘了 scheme_read 和 read_tail 共享同一个 Buffer,调换调用顺序会全乱 |
| 代码即数据 | (+ 1 2 3) 既是调用表达式,也是 Scheme 列表 (list '+ 1 2 3),所以直接用 Link 当 AST | — |
| REPL | Read-Eval-Print-Loop;外层循环管一次输入,内层 while src.more_on_line 管一行里的多个表达式 | 异常没被 except 元组覆盖(如 AssertionError),整个解释器崩掉 |
calc_eval | 三条规则:数字自求值 / 符号查环境 / Link 是调用表达式(先 map 求值操作数,再 apply) | 写成 map(calc_eval(exp)) → TypeError: 'int' object is not callable |
calc_apply | 只认运算符名字和已算好的实参;+ * 用 reduce(fn, args, 单位元);- / 用 reduce(fn, args.rest, args.first) | reduce(sub, args, 0) 会把 (- 10 1 2 3) 算成 -16 而不是 4 |
simplify | 数值恰好是整数的浮点数显示成整数:8.0 → 8;在 eval 里调用,不在 apply 里 | 看到 doctest 写 8.0 而 REPL 显示 8 就以为哪里错了 |
| 特殊形式 | 必须在「求值所有操作数」之前被拦截,因为它的子表达式不能一视同仁地先求值 | 把 define 当普通调用 → NameError: Undefined variable 'x' |
| Eval-Apply 相互递归 | Eval 基础情形 = 原始值 / 符号查找;递归情形 = 调用表达式、特殊形式。Apply 基础情形 = 内建过程;递归情形 = 用户定义过程(新建帧后 Eval 函数体) | 以为 apply 只是「查表调函数」——用户定义过程会让它回头调 eval |
| 词法作用域 | 新帧 parent = 过程定义处的环境,存在过程对象里;lambda 造出来的就是这种 | — |
| 动态作用域 | 新帧 parent = 过程调用处的环境,由调用者提供;mu 造出来的是这种,Scheme 标准里没有 | 以为动态作用域「更灵活」——它让函数正确与否取决于调用者的局部变量名 |
课后想去哪
课上给了几条延伸路径:CS 164(Programming Languages and Compilers,编程语言与编译器)是这一讲的正式续篇;CS 294-184(Building User-Centered Programming Tools)把编程语言和人机交互接在一起。讲师还点名推荐了两位教授:Berkeley 的 Sarah Chasins(做 PL 和 HCI 研究),以及 UW 的 Amy J. Ko(做计算机教育、HCI 和 PL 研究)。
动手练习
五道题,都能在纸上做完。做完再展开对答案。
练习 1:手动解析
写出 (* 2 (- 7 3)) 经 scheme_read 之后得到的 Link 结构(用 repr 的形式写),并数一数 read_tail 一共被调用了多少次。
看答案
记号序列是 ['(', '*', 2, '(', '-', 7, 3, ')', ')'],共 9 个。结果结构:
Link('*', Link(2, Link(Link('-', Link(7, Link(3, nil))), nil)))
read_tail 被调用 8 次。数法:每读到一个元素就有一次 read_tail(因为是它发起的 scheme_read),每遇到一个 ) 也有一次 read_tail(基础情形那次)。外层列表有 3 个元素(*、2、(- 7 3))+ 1 次收尾 = 4 次;内层列表有 3 个元素(-、7、3)+ 1 次收尾 = 4 次。合计 8 次。
换个说法:read_tail 的调用次数 = 所有列表的元素总数 + 列表个数。这里是 6 + 2 = 8。
练习 2:手动求值
在补完的 Scheme Calculator 里敲下面这行,输出是什么?把 calc_eval 和 calc_apply 的调用顺序写清楚。
scalc> (- 10 (/ 8 2) (quotient 7 2))
看答案
输出是 3。
calc_eval 拿到 Link,首元素 '-' 不是 'define' → 走调用表达式分支,对操作数链表 (10 (/ 8 2) (quotient 7 2)) 做 map(calc_eval)。calc_eval(10) → 基础情形 → 10。calc_eval((/ 8 2)) → map 得 (8 2) → calc_apply('/', (8 2)):len(args) 是 2,走 reduce(truediv, args.rest, args.first) = truediv(8, 2) = 4.0 → simplify(4.0) → 4。calc_eval((quotient 7 2)) → calc_apply('quotient', (7 2)):长度正好 2 → floordiv(7, 2) = 3。Link(10, Link(4, Link(3, nil)))。calc_apply('-', …):长度 3,走 reduce(sub, args.rest, args.first) = sub(10, 4) = 6 → sub(6, 3) = 3。simplify(3) → 3。打印 3。如果第 4 步写成 (/ 7 2),得到的是 3.5,最终答案会变成 2.5。quotient 和 / 的区别在这里看得很清楚。
练习 3:把 define 的拦截挪走
如果有人把 calc_eval 里的 define 检查挪到 map 之后,像这样:
elif isinstance(exp, Link):
    arguments = exp.rest.map(calc_eval)      # 挪到前面了
    if exp.first == "define":
        return do_define_form(exp.rest)
    return simplify(calc_apply(exp.first, arguments))
用户输入 (define x 3) 会看到什么?如果先输入 (define x 3) 让它报错,再输入一次同样的 (define x 3),第二次会成功吗?
看答案
第一次会看到:
scalc> (define x 3)
NameError: Undefined variable 'x'
因为 map(calc_eval) 先跑,它对操作数链表 ('x' 3) 的第一个元素调 calc_eval('x'),走到符号查找那条路,env 里没有 'x',抛 NameError。异常一路冒泡到 REPL 的 except,被打印出来。do_define_form 一次都没被执行到。
第二次仍然失败,报一模一样的错。因为第一次根本没往 env 里写任何东西——异常在写入之前就抛了。这个版本永远也定义不了任何变量,x 会永远「不存在」。
这道题的意义在于:特殊形式的「特殊」是位置上的,不是逻辑上的。 把同样的代码挪个位置,功能就彻底失效了。
练习 4:mu 与 lambda
下面这段在 61A 的 Scheme 解释器里输出什么?把 mu 改成 lambda 之后又输出什么?
scm> (define n 10)
scm> (define double (mu (x) (* x n)))
scm> (define go (lambda (n) (double 5)))
scm> (go 3)
看答案
mu 版输出 15;改成 lambda 输出 50。
mu 版:调用 (go 3) 建帧 f1(parent=Global),里面 n → 3。在 f1 里求值 (double 5),double 是 mu 过程 → 新帧 f2 的 parent 是 f1,x → 5。求值 (* x n):x 在 f2 里是 5,n 在 f2 里没有 → 到 f1 → 3。结果 5 * 3 = 15。全局那个 n = 10 被 f1 的 n 挡住了。
lambda 版:double 记着自己的定义环境 Global,所以 f2 的 parent 是 Global,f1 不在查找链上。n 一路查到 Global,是 10。结果 5 * 10 = 50。
注意这里 go 的形参故意取名 n——在词法作用域下这个命名完全无害(它只影响 go 自己的函数体),但在动态作用域下它改变了另一个函数的行为。这就是上一节说的「局部重构会让远处的函数崩掉」。
练习 5:单位元和它的代价
有人觉得 + 和 * 的实现应该跟 - 和 / 保持一致,于是把
return reduce(mul, args, 1)
改成了
return reduce(mul, args.rest, args.first)
对 (* 2 3 4) 这类输入结果对不对?用户敲 (*) 会发生什么?这个后果为什么比一个普通报错严重?
看答案
对 (* 2 3 4) 结果是对的:reduce(mul, (3 4), 2) = 2*3=6 → 6*4=24。所以这个 bug 用常规输入根本测不出来。
但用户敲 (*) 时,args 是 nil,而 nil 这个对象没有 rest 属性(nil 类只定义了 __repr__、__str__、__len__、__getitem__ 和 map):
AttributeError: 'nil' object has no attribute 'rest'
严重之处在于:AttributeError 不在 REPL 的 except 元组里——那个元组只列了 SyntaxError, TypeError, ValueError, ZeroDivisionError, NameError。所以这个异常不会被优雅地打印成一行,而是穿透 REPL,带着完整的 Python traceback 让整个解释器退出。用户这一轮 define 过的所有变量全部丢失。
而原来的 reduce(mul, args, 1) 对 nil 是安全的:reduce 的基础情形就是 scheme_list is nil,直接返回 start 也就是 1——正好是 (*) 应有的答案。「乘法有单位元」这个数学事实,在这里同时解决了语义问题和健壮性问题。