Scheme 列表:pair、递归数据与代码即数据
一个只有两格的盒子(pair),怎么长成任意长的列表;以及为什么在 Scheme 里,一段代码和一个列表是同一样东西。
0. 本讲导读
上一讲把 Scheme 这门语言的骨架搭起来了:原子(atom)、调用表达式(call expression)、define、if、cond、let、lambda。你已经能写出 (define (square x) (* x x)) 这样的过程,也能用递归算阶乘。但到目前为止,你的 Scheme 程序里只能出现一个一个孤立的数。
这就卡住了。Python 里你随手就写 [1, 2, 3],可 Scheme 的语法里根本没有方括号这种东西。那 Scheme 怎么装一串数据?
答案会让你有点意外:Scheme 只提供了一种复合数据的构造方式——把两个值粘成一对(pair)。就这么一个只有两格的盒子,什么长度可变的数组、什么嵌套结构,全都要从它推出来。
如果你学过第 8 讲的 Link 类,这个套路你其实见过:Link 也只有 first 和 rest 两个字段,靠 rest 指向下一个 Link,把一串东西串起来。Scheme 的 pair 就是 Link,car 就是 first,cdr 就是 rest,nil 就是 Link.empty。区别只在于:在 Python 里 Link 是你自己写的一个类,在 Scheme 里 pair 是语言内置的、也是唯一的复合结构。
本讲分三块:
- 造和拆:
cons造 pair,car/cdr拆 pair,list一次造一串;length/null?/pair?/list?问问题;append把几个列表接起来。 - 批量处理:
map/filter/reduce——这三个是第 3 讲高阶函数在 Scheme 里的正统形态,写起来比 Python 的for循环更贴近「你想要什么」而不是「怎么一步步拿到」。 - 代码即数据:
quote把一段本该被求值的表达式原封不动地变成一个列表,eval再把列表变回可求值的表达式。这一对是下一讲写 Scheme 解释器的地基——解释器读进来的程序,在它自己眼里就是一个嵌套列表。
最后用两道真·课堂练习收尾:reverse(反转列表,练纯递归)和 mountain(判断是否「先严格递增后严格递减」,练带状态的辅助递归)。这两题的起始代码就是课程网站 Lecture 19 下的 19.scm。
- pair 只有两格:
car和cdr。cons必须收恰好两个参数,(cons 1)直接报错。 - list 是递归定义的:list 要么是
nil,要么是一个 cdr 还是 list 的 pair。这句话既是定义,也是你写每一个列表递归函数的模板。 - 因此
(pair? nil)是#f而(list? nil)是#t;(cons 1 2)是 pair 但不是 list,显示成(1 . 2)。 append像 Python 的extend不像append:它把参数列表里的元素接到一起,不是把列表整个塞进去。quote是特殊形式:'(+ 1 2)不求值,得到一个长度为 3、car 是符号+的列表。eval反过来,把这个列表当程序跑,得到3。- 三种相等:
=只比数;eq?比身份(数/布尔/符号除外);equal?递归比结构。两个内容相同的列表,eq?是#f,equal?是#t。
1. 复习:/ 与 quotient 到底差在哪
正式进入列表之前,先把上一讲留下的一个坑填了。Scheme 里有两个「除法」,它们不是同义词。
/:真除法,而且参数个数可变
(/ <dividend> [divisor] ...) 收 一个或多个参数,规则分两种:
- 只给一个参数时,结果是 1 除以它(取倒数)。
- 给多个参数时,从左往右连续除。
scm> (/ 5)
0.2
scm> (/ 100 2 5)
10
(/ 100 2 5) 的过程是 100 ÷ 2 = 50,再 50 ÷ 5 = 10。它不是「100 除以 (2÷5)」,也不是「100 除以 2 再除以 5 的某种奇怪组合」——就是老老实实从左到右。
/ 做的是真除法(true division),也就是 Python 里 / 的那种除法,不砍小数。但有一个 Scheme 特有的、很容易踩的规则:结果只在「实在没办法」时才是浮点数。
scm> (/ 7 2)
3.5
scm> (/ 6 2)
3
scm> (/ 6.0 2.0)
3
注意第三行。在 Python 里 6.0 / 2.0 得到 3.0,是个浮点数;Scheme 却给你一个整数 3。Scheme 的数值塔(numerical tower)认为「精确的整数」比「浮点数」更好,只要结果能被整数精确表示,它就退回整数。(/ 7 2) 没法用整数表示,才不得不给 3.5。
quotient:整除,恰好两个参数
(quotient <dividend> <divisor>) 收 恰好两个参数,做的是整除(丢掉小数部分),对应 Python 的 //:
scm> (quotient 7 2)
3
scm> (quotient 7 2 1)
Error: incorrect number of arguments: #[quotient]
它的返回类型跟着参数走:两个参数都是整数时返回整数,否则返回浮点数。
scm> (quotient 7.0 2)
3.0
看清楚:3.0,末尾带小数点。这跟 / 的「能整就整」正好相反——quotient 不做类型退化。
/ | quotient | |
|---|---|---|
| 参数个数 | 1 个或多个 | 恰好 2 个 |
| 1 个参数时 | 取倒数:(/ 5) → 0.2 | 报错 |
| 3 个参数时 | 从左往右连除:(/ 100 2 5) → 10 | 报错 |
| 除法类型 | 真除法(保留小数) | 整除(丢掉小数) |
| 结果类型 | 能用整数精确表示就用整数:(/ 6.0 2.0) → 3 | 两参数都是整数才给整数:(quotient 7.0 2) → 3.0 |
把 (/ 7 2) 当成 Python 的 7 // 2 写进 if 的条件里,然后奇怪为什么 (= (/ 7 2) 3) 是 #f。答案:(/ 7 2) 是 3.5,不是 3。凡是你想要「整数除法」的地方,写 quotient,不要写 /。
另一个坑是把 / 当二元运算符用惯了,写出 (/ x) 想表示「x 本身」——它其实是 1/x。
幻灯片上写的是 quotient「performs floor division」(向下取整除法)。对正数而言这没问题。但在本仓库 proj/scheme 那个 61A 解释器里实测,(quotient -7 2) 给的是 -3 而不是 Python -7 // 2 的 -4——它实际做的是向零截断。翻 scheme_builtins.py 可以看到这一行:
return -(-val0 // val1) if (val0 < 0) ^ (val1 < 0) else val0 // val1
异号时先取反、整除、再取反,效果就是截断。61A 的题目基本只涉及正数,所以这个差别多半不会咬你,但知道比不知道好。
2. pair:Scheme 唯一的复合数据构造器
先说清楚问题在哪。到上一讲为止,Scheme 里能出现的值只有:数、布尔值、字符串、符号、过程。这些都是原子(atom)——不可再分的单个值。你没法表达「三个数放在一起」。
Python 给了你 list、tuple、dict 一堆内置容器。Scheme 走的是另一条路:只给一个最小的构造器,剩下的靠组合。
这个最小构造器叫 pair(对):一个只有两格的盒子,两格分别叫 car 和 cdr。
三个基本操作
| Scheme | 做什么 | Python Link 里的对应物 |
|---|---|---|
(cons x y) | 造一个新 pair,car 是 x,cdr 是 y | Link(x, y) |
(car p) | 取出 p 的第一格 | p.first |
(cdr p) | 取出 p 的第二格 | p.rest |
nil | 空列表 | Link.empty |
car 和 cdr 这两个名字毫无意义可言,纯属历史遗留。1958 年最早的 LISP 跑在 IBM 704 上,那台机器的指令字被切成四个子字段,其中「address」和「decrement」两个 15 位字段正好用来存一个 list cell 的两个指针。取这两个字段的机器指令分别叫 Contents of Address field to Register 和 Contents of Decrement field to Register——首字母缩写就是 CAR 和 CDR。一个硬件实现细节,就这么变成了半个世纪后你还得背的函数名。
读音:car 读「car」(汽车那个),cdr 读「could-er」。要记住哪个是哪个,就记 car = 第一个(first)、cdr = 剩下的(rest)。cdr 比 car 多一个字母,多出来的那部分正好对应「剩下的一大截」。
cons 必须收恰好两个参数
scm> (cons 1)
Error: incorrect number of arguments: #[cons]
scm> (cons 1 nil)
(1)
第一行是真实的报错信息(在 61A 的 scheme.py 里实测)。为什么不能只给一个?因为 pair 有两格,你不给第二格的值,那一格里该放什么?语言不替你猜。想造一个只有一个元素的列表,必须显式写出 nil 作为 cdr:(cons 1 nil)。
注意输出:(cons 1 nil) 显示成 (1),不显示成 (1 . ())。Scheme 的打印器发现「cdr 是 nil」时会把它省掉,这是一个显示上的约定,不是说 nil 消失了。
嵌套 cons 造出多元素列表
scm> (cons 1 (cons 2 (cons 3 nil)))
(1 2 3)
这行是理解整讲的关键,把它一层层拆开看:
(cons 3 nil):造一个 pair,car = 3,cdr = nil。叫它 P3,打印出来是 (3)。(cons 2 P3):造一个新 pair,car = 2,cdr = P3。叫它 P2,打印出来是 (2 3)。(cons 1 P2):造一个新 pair,car = 1,cdr = P2。叫它 P1,打印出来是 (1 2 3)。cons,得先把它的两个算子数都求出值来。所以列表是从后往前造出来的。画成盒指针图(box-and-pointer diagram):
   P1                P2                P3
 ┌────┬────┐      ┌────┬────┐      ┌────┬────┐
 │ 1  │  ●─┼─────>│ 2  │  ●─┼─────>│ 3  │nil │
 └────┴────┘      └────┴────┘      └────┴────┘
  car  cdr         car  cdr         car  cdr

 打印为:( 1    2    3 )
          ↑    ↑    ↑
        P1.car P2.car P3.car
三个 pair 串成一条链,每个 pair 的 cdr 指向下一个,最后一个的 cdr 是 nil 收尾。打印时 Scheme 沿着这条链一路走,把每个 car 依次打出来,走到 nil 停——所以你看到的是扁平的 (1 2 3),看不出里面有三个盒子。
list:一次造完
天天写 (cons 1 (cons 2 (cons 3 nil))) 太累了,Scheme 给了个便捷函数:
scm> (list 1 2 3)
(1 2 3)
(list 1 2 3) 和 (cons 1 (cons 2 (cons 3 nil))) 造出来的东西一模一样——同样的三个 pair,同样的链式结构。list 只是替你把 cons 嵌套写好了。
list 是普通过程,不是特殊形式,所以它的参数照常求值:
scm> (list (+ 1 1) (* 2 3))
(2 6)
记住这一点,第 7 节讲 quote 时会拿它做对比——'((+ 1 1) (* 2 3)) 的结果完全不同。
car 那一格可以放另一个 pair
规格里说「第一个值可以是任何数据类型」,那当然也包括 pair 本身。这就是嵌套列表的来源:
scm> (cons (cons 1 nil) (cons 2 nil))
((1) 2)
这个输出第一次见会懵。拆开:
(cons 1 nil) → 一个 pair,car=1,cdr=nil。打印是 (1)。这是一个长度为 1 的列表。(cons 2 nil) → 另一个 pair,car=2,cdr=nil。打印是 (2)。cons:car = 第 1 步那个列表,cdr = 第 2 步那个列表。(1)(它自己是个列表,所以带括号打出来),第二个元素是 2,然后 cdr 是 nil,结束。合起来 ((1) 2)。┌────┬────┐ ┌────┬────┐ │ ● │ ●─┼─────>│ 2 │nil │ └─┼──┴────┘ └────┴────┘ │ v ┌────┬────┐ │ 1 │nil │ └────┴────┘ 打印为:((1) 2) ← 这个列表的长度是 2,不是 3
看到 ((1) 2) 就以为「里面有 1 和 2 两个数,所以长度是 2 个数字」——这句话恰好蒙对了长度,但理由是错的,换个例子就崩。正确的读法是:最外层有几个元素,长度就是几。 ((1) 2) 的第一个元素是一整个列表 (1),第二个元素是数 2,所以长度是 2。
对照着看:'(1 (2 3)) 的长度也是 2(元素是 1 和 (2 3)),不是 3。实测:
scm> (length '(1 (2 3)))
2
3. 从 pair 到 list:一个递归定义,和它带来的写法模板
上一节反复出现「列表」这个词,但还没给定义。现在给:
一个 list 要么是 nil,要么是一个 cdr 还是 list 的 pair。
这是一个递归定义(recursive definition):定义列表的时候用到了「列表」这个词本身。它没有循环论证,因为有一个不含「列表」的出口——nil。
用它来判断 (cons 1 (cons 2 (cons 3 nil))) 是不是列表:
(cons 2 (cons 3 nil))。它是列表吗? 往下看。(cons 2 (cons 3 nil)) 是个 pair,cdr 是 (cons 3 nil)。它是列表吗? 继续往下。(cons 3 nil) 是个 pair,cdr 是 nil。nil 是列表吗? 是——定义的第一条,base case,到底了。(cons 3 nil) 是列表 ⟹ 第 2 步的 cdr 是列表 ⟹ (cons 2 …) 是列表 ⟹ 第 1 步的 cdr 是列表 ⟹ 整个东西是列表。✓违反约束会怎样:improper list
如果你把一个非列表塞进 cdr 呢?语言不会拦你:
scm> (cons 1 2)
(1 . 2)
scm> (pair? (cons 1 2))
#t
scm> (list? (cons 1 2))
#f
(cons 1 2) 是一个合法的 pair——两格都填了。但它不是列表,因为 cdr 是数字 2,2 既不是 nil 也不是 pair。
Scheme 打印这种东西时会用点号写法(dotted pair notation):(1 . 2)。看到输出里有个孤零零的点,就说明这条链没有以 nil 收尾。 这是一个极有用的调试信号——你写列表递归时如果看到 (3 2 . 1) 这种输出,几乎可以断定某处 base case 返回了不是 nil 的东西,或者 cons 的两个参数写反了。
(cons 1 (cons 2 nil))        (cons 1 2)
 ┌────┬────┐  ┌────┬────┐     ┌────┬────┐
 │ 1  │  ●─┼─>│ 2  │nil │     │ 1  │ 2  │
 └────┴────┘  └────┴────┘     └────┴────┘
 打印 (1 2)      ← 是 list     打印 (1 . 2)  ← 不是 list
 (list? …) → #t                (list? …) → #f
为什么这个定义值钱:它就是写代码的模板
递归定义最实用的地方在于:数据长什么样,处理它的函数就长什么样。 定义分两种情况,你的函数就写两个分支:
(define (f lst)
  (if (null? lst)
      <lst 是 nil 时的答案>          ; base case
      <用 (car lst) 和 (f (cdr lst)) 拼出答案>))  ; recursive case
这不是「一个技巧」,而是唯一自然的写法。因为你手上只有两个操作:car 拿到第一个元素,cdr 拿到剩下的(而剩下的还是一个列表,所以可以递归处理)。第 10 节的 reverse 就是照这个模板填空填出来的。
访问深处的元素:car / cdr 串起来用
Scheme 没有 lst[2] 这种下标语法。想拿第 3 个元素,只能一格一格走过去。看幻灯片上的实录:
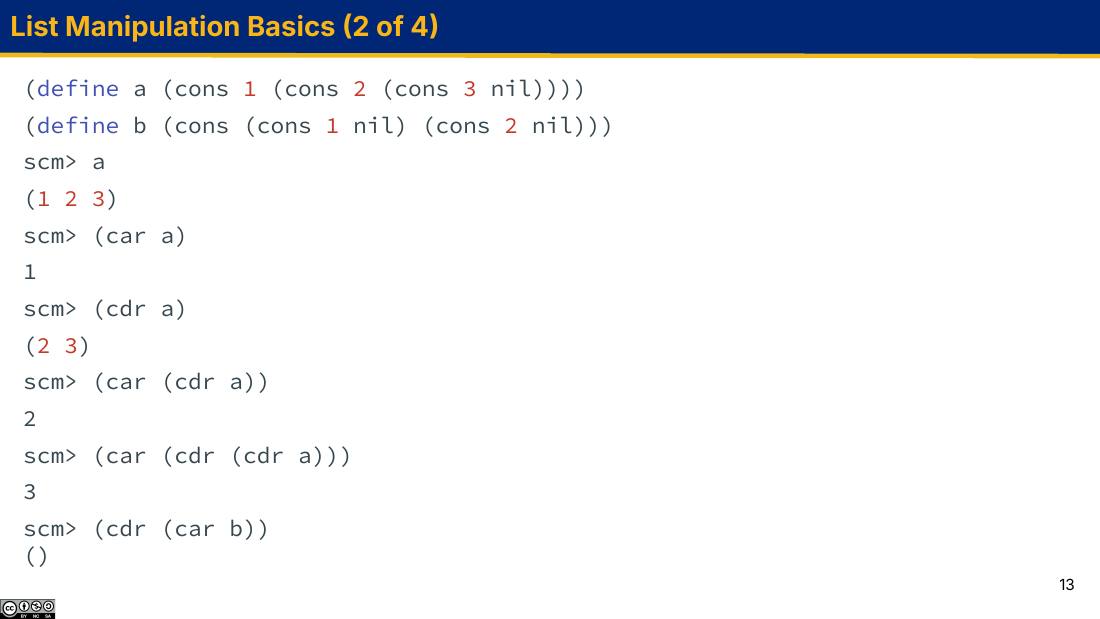
逐行解释这张图:
(define a (cons 1 (cons 2 (cons 3 nil))))
(define b (cons (cons 1 nil) (cons 2 nil)))
| 表达式 | 结果 | 为什么 |
|---|---|---|
a | (1 2 3) | 三个 pair 串成的链 |
(car a) | 1 | 第一个 pair 的第一格 |
(cdr a) | (2 3) | 第一个 pair 的第二格,它本身是个完整的列表,不是「除首元素外的那些数」的某种集合 |
(car (cdr a)) | 2 | 先往后走一步得到 (2 3),再取它的首元素 |
(car (cdr (cdr a))) | 3 | 往后走两步得到 (3),再取首元素 |
(cdr (car b)) | () | (car b) 是 (1),它的 cdr 是 nil,打印成 () |
把 (car (cdr (cdr a))) 完整推一遍:
(cdr a):a 指向 P1,取 P1 的 cdr,得到 P2,也就是 (2 3)。(cdr (2 3)):取 P2 的 cdr,得到 P3,也就是 (3)。(car (3)):取 P3 的 car,得到 3。car / cdr 是纯读取操作。有些 Scheme 方言提供 cadr(等价于 (car (cdr x)))、cddr 之类的缩写,但 61A 的解释器里没有:
scm> (cadr (list 1 2 3))
Error: unknown identifier: cadr
老老实实写 (car (cdr lst))。
对空列表取 car 或 cdr 会直接报错,不会返回 nil:
scm> (car nil)
Error: argument 0 of car has wrong type (tuple)
scm> (cdr 5)
Error: argument 0 of cdr has wrong type (int)
(报错里的 tuple 是 61A 解释器内部用 Python 空元组表示 nil 的实现细节漏出来了,看到它就当成「你对 nil 取了 car」。)
这就是为什么递归函数的 base case 必须写在最前面:(if (null? lst) … (car lst) …) 里,先判空再取 car。顺序写反的话,空列表进来第一步就炸。
4. 问问题:length、null?、pair?、list?
造完了、拆完了,还得能问:这东西多长?它空了吗?它到底是不是个列表?
length
scm> (length (list 1 2 3))
3
scm> (length nil)
0
scm> (length ())
0
scm> (length (cons (cons 1 nil) (cons 2 nil)))
2
前三行没有悬念。第四行再次强调上一节那个点:(cons (cons 1 nil) (cons 2 nil)) 打印出来是 ((1) 2),长度是 2——length 只数最外层有几个元素,不管元素本身是不是列表、里面又有几个东西。
顺带一提:nil 和 () 在 61A Scheme 里是同一个东西的两种写法,都表示空列表。
length 只能用在真正的列表上。对 improper pair 用它会报错:
scm> (length (cons 1 2))
Error: argument 0 of length has wrong type (Link)
因为 length 的实现是「沿 cdr 一路走到 nil,数走了几步」,而 (cons 1 2) 的 cdr 是 2,走不到 nil 就撞墙了。看到 wrong type (Link) 这个报错,第一反应应该是「我传进去的东西不是合法列表」,多半是某个 cons 的第二个参数写成了非列表值。
三个谓词:list?、pair?、null?
这三个特别容易混。先看实录:
scm> (list? nil)
#t
scm> (list? (cons 1 nil))
#t
scm> (pair? nil)
#f
scm> (pair? (cons 1 nil))
#t
scm> (null? nil)
#t
scm> (null? (cons 1 nil))
#f
关键在第三行:(pair? nil) 是 #f,但 (list? nil) 是 #t。
这不是语言在为难你,而是第 3 节那个定义的直接推论。nil 是列表(定义的第一条),但它不是 pair——它没有两格,它什么都没有。
| 谓词 | 问的是什么 | nil | (cons 1 nil) | (cons 1 2) | 5 |
|---|---|---|---|---|---|
(null? x) | x 就是空列表吗 | #t | #f | #f | #f |
(pair? x) | x 是个有两格的 pair 吗 | #f | #t | #t | #f |
(list? x) | x 是合法列表吗(nil,或 cdr 还是列表的 pair) | #t | #t | #f | #f |
横着读这张表最能看出区别:(cons 1 2) 这一列上 pair? 是 #t 而 list? 是 #f;nil 这一列上正好反过来。 这两个谓词各自漏掉的那个格子,恰好说明了它们问的不是同一件事。
写列表递归时,base case 的判断用 null?,不要用 pair? 或 list?:
(if (null? lst) <空的情况> <非空的情况>)
理由:你想问的是「走到头了吗」,这正是 null? 的语义。用 (list? lst) 当条件会永远为真(非空列表也是列表),用 (not (pair? lst)) 虽然在合法列表上等价,但多绕了一层否定,读起来费劲。
5. append:接的是元素,不是列表
现在你能造列表、能拆列表,但还不能把两个列表接起来。用 cons 硬接是不行的——(cons (list 1 2) (list 3 4)) 只会把整个 (1 2) 塞进 car,得到 ((1 2) 3 4),长度变成 3 而不是 4。
append 就是干这个的:
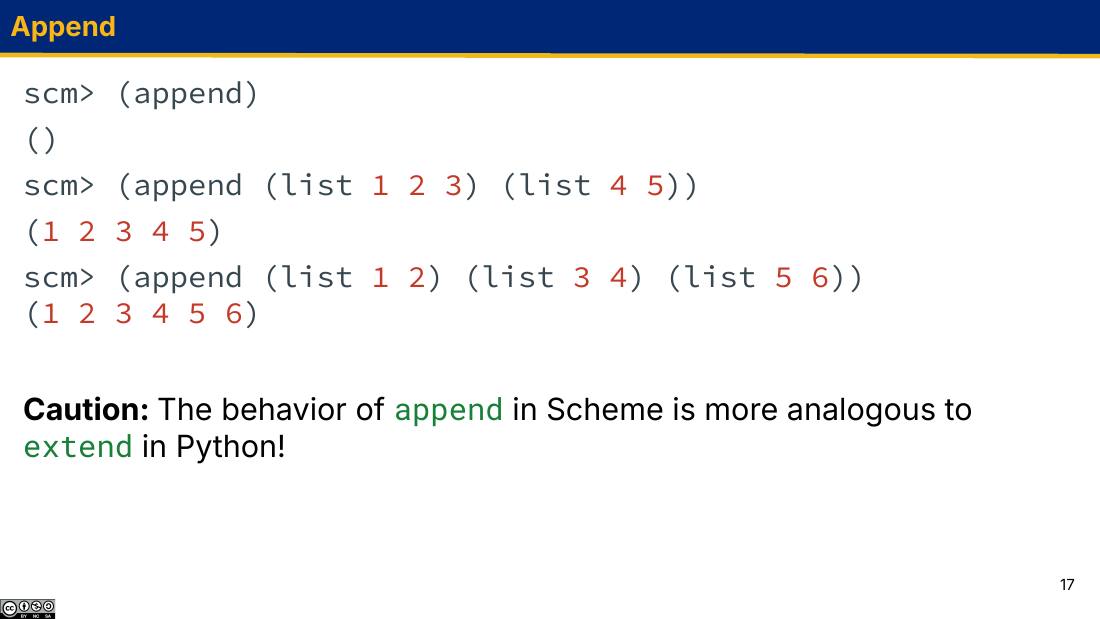
scm> (append)
()
scm> (append (list 1 2 3) (list 4 5))
(1 2 3 4 5)
scm> (append (list 1 2) (list 3 4) (list 5 6))
(1 2 3 4 5 6)
第一行值得注意:(append) 一个参数都不给,返回空列表。这在写递归时偶尔有用,但更重要的是它反映了 append 的心智模型——「把所有参数里的元素倒进一个新篮子」,没有参数就是空篮子。
为什么必须强调「像 extend 不像 append」
Python 的两个方法对比一下就清楚了:
| 操作 | 结果 | 说明 |
|---|---|---|
Python a = [1,2]; a.append([3,4]) | [1, 2, [3, 4]] | 把整个列表当一个元素塞进去,长度 3 |
Python a = [1,2]; a.extend([3,4]) | [1, 2, 3, 4] | 把元素逐个接上,长度 4 |
Scheme (append '(1 2) '(3 4)) | (1 2 3 4) | 元素逐个接上,长度 4 —— 对应 extend |
Scheme (cons '(1 2) '(3 4)) | ((1 2) 3 4) | 把整个列表塞进 car,长度 3 —— 对应 append(是的,名字正好错位) |
还有一个区别没写在表上但同样重要:Python 的 append / extend 是就地修改(mutate),原来那个 a 被改了,返回值是 None;Scheme 的 append 不改任何东西,它返回一个新列表,原参数原封不动。本讲所有操作(cons / append / map / filter)都是这样——纯函数,无副作用。
想把一个列表当元素接进去怎么办
包一层:
scm> (append (list 1 2) (list (list 3 4)))
(1 2 (3 4))
外层的 (list …) 造了一个「只含一个元素、而这个元素是列表 (3 4)」的列表,append 把这唯一的元素接上去,于是 (3 4) 作为整体成了结果的第 3 个元素。这个技巧在下一节和 reverse 里都会用到。
把非列表值传给 append。Scheme 允许最后一个参数不是列表(结果会变成 improper list),但中间的参数必须是列表:
scm> (append (list 1 2) 3)
(1 2 . 3)
scm> (append 3 (list 1 2))
Error: argument 0 of append has wrong type (int)
第一行那个 (1 2 . 3) 是最阴险的——它不报错,你会带着一个坏掉的列表继续往下算,直到很远的地方才炸。所以再说一遍:输出里出现孤立的点,说明你的列表结构坏了。
最典型的犯法是写 reverse 时把 (append (reverse (cdr lst)) (car lst)) 里的 (car lst) 忘了包成 (list (car lst))。(car lst) 是一个元素,不是列表,接不上去。
6. map / filter / reduce:三种批量处理
有了列表,最常做的三件事是:把每个元素都变一下、挑出满足条件的元素、把所有元素合成一个值。Scheme 分别给了 map、filter、reduce。
它们都是高阶函数(higher-order function)——第 3 讲讲过的那个概念,参数是函数。在 Scheme 里这套写法比在 Python 里更常见,因为 Scheme 根本没有 for 循环,也没有可变列表,你想「遍历」就只能靠递归或这三个函数。
map:每个元素都过一遍
(map <proc> <lst>)——把单参数过程 proc 作用到 lst 的每个元素上,返回结果组成的新列表。
scm> (map (lambda (x) (* x x)) (list 1 2 3))
(1 4 9)
(lambda (x) (* x x)),得到一个过程对象(记作 sq),它的 parent 是当前帧。(list 1 2 3),得到列表 (1 2 3)。两个算子数都求完值了,才开始调用 map。map 调 (sq 1):新建一帧,x 绑定到 1,求值 (* x x) 得 1。map 调 (sq 2):新建另一帧,x 绑定到 2,得 4。上一帧的 x 跟这一帧的 x 毫无关系。map 调 (sq 3),得 9。1、4、9 串成新列表 (1 4 9) 返回。原列表 (1 2 3) 一点没变——那三个 pair 还在那儿,只是没人再引用它们了。输出列表的长度必然等于输入列表的长度。 map 不会多一个也不会少一个,它只做「逐位替换」。空列表进去就是空列表出来:
scm> (map (lambda (x) (* x 2)) nil)
()
传进去的过程也可以是内置的:
scm> (map car '((1 2) (3 4)))
(1 3)
这行是「取出每个子列表的第一个元素」。注意 car 在这里不带括号——写 car 是把这个过程当值传进去,写 (car …) 才是调用它。这个区别跟 Python 里 f 和 f() 的区别是同一回事。
filter:挑出合格的
(filter <pred> <lst>)——保留 lst 中让谓词(predicate) pred 返回真的元素,顺序不变。
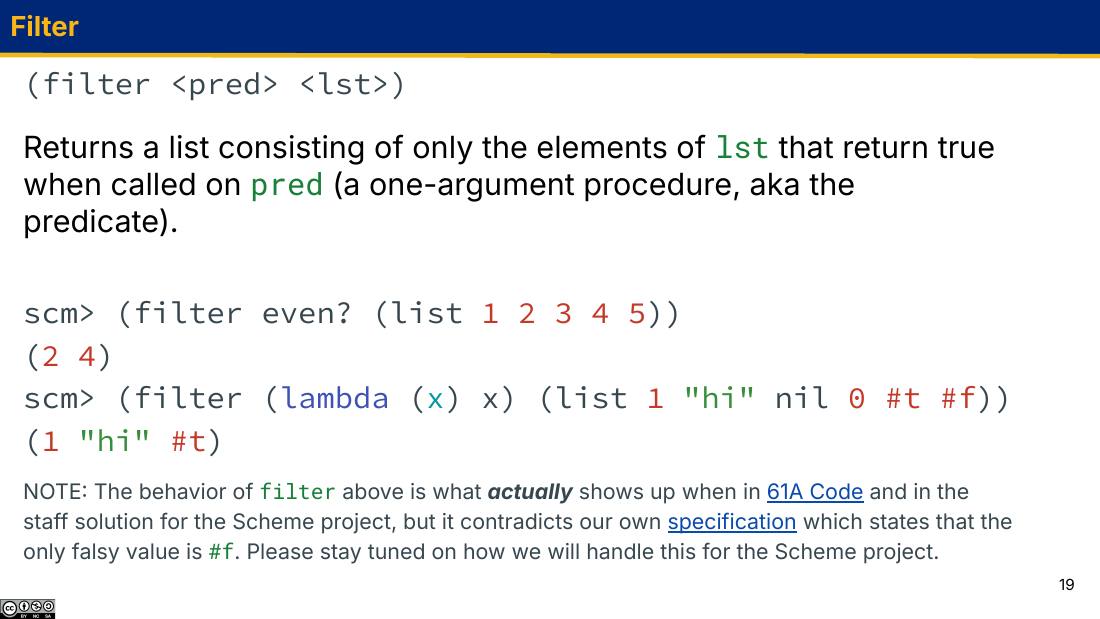
scm> (filter even? (list 1 2 3 4 5))
(2 4)
scm> (filter (lambda (x) x) (list 1 "hi" nil 0 #t #f))
(1 "hi" #t)
第二行需要解释。(lambda (x) x) 是恒等函数,它把元素原样交回去当判断依据,所以这一行实际测的是「Scheme 认为哪些值是真的」。结果留下了 1、"hi"、#t,滤掉了 nil、0、#f。
这里有一个课程组主动承认的规范与实现不一致。61A 的 Scheme 规范说:唯一的假值是 #f,因此按规范 0 和 nil 都该是真值,上面那行应该输出 (1 "hi" nil 0 #t)。但 61A Code 的在线解释器和 Scheme project 的参考解答实际给的是 (1 "hi" #t)。
幻灯片原话是「Please stay tuned on how we will handle this for the Scheme project」——也就是说这事在讲这一课的时候还没定论。做 project 之前记得去看最新公告。这份笔记不替课程组下结论。
顺带说:本仓库 proj/scheme 里的解释器实测也是 (1 "hi" #t),跟幻灯片一致。
filter 和 map 的根本区别:map 改元素、不改数量;filter 改数量、不改元素。 输出列表的长度在 0 到原长之间。
reduce:把一串合成一个
(reduce <combiner> <lst>)——用双参数过程 combiner 从左往右依次合并 lst 的元素。
scm> (reduce + (list 1 2 3 4))
10
scm> (reduce + (list 1))
1
「从左往右」这句话很关键,它决定了两个参数谁是谁:已经攒下来的结果作第一个参数,新元素作第二个参数。 展开 (reduce + (list 1 2 3 4)):
1 作初始的「已合并值」。注意 reduce 没有初值参数,它直接拿第一个元素开头——这就是为什么列表不能为空。(+ 1 2) → 3。左边的 1 是已合并值,右边的 2 是新元素。(+ 3 3) → 6。(+ 6 4) → 10。列表走完,返回 10。对 + 这种既满足交换律又满足结合律的运算,顺序无所谓。换个不对称的 combiner,顺序就一眼可见了:
scm> (reduce cons (list 1 2 3))
((1 . 2) . 3)
这是 (cons (cons 1 2) 3)——括号层层往左嵌,说明合并确实是从左边开始的。如果是从右往左,结果会是 (1 2 . 3)(即 (cons 1 (cons 2 3)))。
reduce 的列表至少要有一个元素。 空列表直接报错:
scm> (reduce + nil)
Error: argument 1 of reduce has wrong type (tuple)
这在写「先 filter 再 reduce」的代码时特别容易中招——filter 完全可能滤出一个空列表,紧接着的 reduce 就炸了。凡是 reduce 的输入来自 filter,都要先想清楚空列表怎么办。
另一个易错点:reduce 的 combiner 必须收两个参数。把单参数的 lambda 传进去会报参数个数错误。
map | filter | reduce | |
|---|---|---|---|
| 过程收几个参数 | 1 个 | 1 个(谓词) | 2 个 |
| 返回什么 | 列表 | 列表 | 单个值 |
| 结果长度 | 等于原长 | 0 到原长 | 不适用 |
| 空列表输入 | 返回 () | 返回 () | 报错 |
| Python 里的近亲 | [f(x) for x in lst] | [x for x in lst if p(x)] | functools.reduce |
7. quote:把代码变成数据
到这里为止,列表都是「装数据的容器」。这一节要讲的东西会让你重新看待整门语言。
先注意一个你可能一直没细想的事实:Scheme 的代码本身就长得像列表。 (+ 1 2) 是一对括号包着三个东西。(1 2 3) 也是一对括号包着三个东西。它们在字面上没有任何区别。
区别只在于解释器拿它干什么:看到 (+ 1 2),它会求值算子 +、求值算子数 1 和 2、然后调用。如果你不想让它这么干,只想要「那三个东西本身」,就用 quote。
quote 是特殊形式
(quote <expression>),或者简写 '<expression>——返回这个表达式本身,不求值。
scm> (quote (1 2 3))
(1 2 3)
scm> '(1 2 3)
(1 2 3)
scm> (list? '(1 2 3))
#t
为什么必须是特殊形式(special form)而不能是普通过程?因为普通过程的算子数一定会先被求值。如果 quote 是普通过程,写 (quote (1 2 3)) 时解释器会先去求值 (1 2 3)——把 1 当成算子去调用——直接报错。特殊形式的意义就在于它可以决定自己的子表达式要不要求值,跟 if 只求值一个分支是同一类机制。
对比这两行的求值过程,差别一目了然:
(list (+ 1 1) (* 2 3)):list 是普通过程。先求值 (+ 1 1) 得 2,再求值 (* 2 3) 得 6,最后调用 list。结果 (2 6)——里面装着两个数。'((+ 1 1) (* 2 3)):quote 是特殊形式。什么都不求值,直接把那段结构原样交出来。结果 ((+ 1 1) (* 2 3))——里面装着两个列表,每个列表的 car 是一个符号。(car '((+ 1 1))) 得到 (+ 1 1),这是一个长度为 3 的列表,它的 car 是符号 +,不是加法过程。scm> (list (+ 1 1) (* 2 3))
(2 6)
scm> '((+ 1 1) (* 2 3))
((+ 1 1) (* 2 3))
scm> (car '((+ 1 1)))
(+ 1 1)
符号(symbol)
quote 也能用在单个名字上,这时得到的是符号(symbol):
scm> 'a
a
scm> (symbol? 'a)
#t
不加引号的 a 是「去环境里查名字 a 绑定的值」,查不到就报 Error: unknown identifier: a。加了引号的 'a 是「符号 a 这个值本身」,跟环境里有没有 a 完全无关。
符号在 Scheme 里的地位大致相当于 Python 里「不可变、可快速比较的字符串常量」。第 11 节的 mountain 就用 'start、'increase、'decrease 三个符号当状态标记——用符号而不是字符串,是因为 eq? 比较符号是可靠且高效的(见第 9 节)。
quasiquote 和 unquote:挖个洞
quote 是「全都不求值」,太绝对了。有时你想要一个基本固定、但某几个位置需要填入计算结果的模板。这就是准引用(quasiquote):
(quasiquote <expression>),简写反引号 `<expression>——整体不求值,除非某个子表达式写成 (unquote <expr2>) 或简写 ,<expr2>,那个子表达式会被正常求值,结果填回原位。
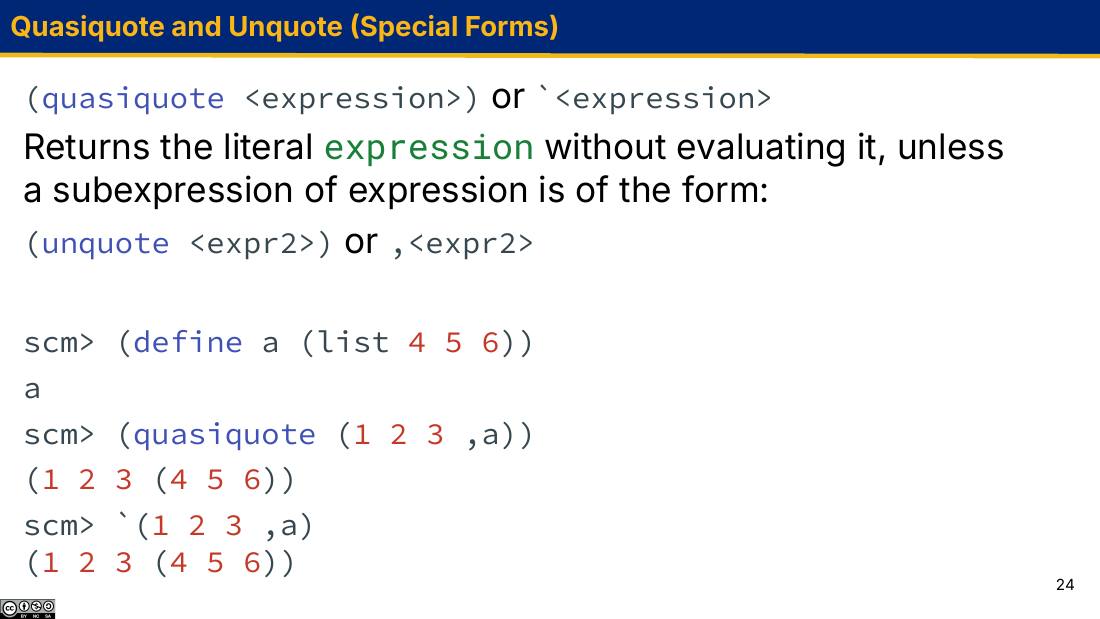
scm> (define a (list 4 5 6))
a
scm> (quasiquote (1 2 3 ,a))
(1 2 3 (4 5 6))
scm> `(1 2 3 ,a)
(1 2 3 (4 5 6))
(顺带一提:define 这个特殊形式本身会返回被定义的符号,所以第一行的输出是 a。)
逗号后面可以是任意表达式,不限于名字:
scm> `(1 2 ,(+ 1 2))
(1 2 3)
| 写法 | 结果 | 发生了什么 |
|---|---|---|
(list 1 2 (+ 1 2)) | (1 2 3) | 普通过程,全部算子数都求值 |
'(1 2 (+ 1 2)) | (1 2 (+ 1 2)) | 特殊形式,全都不求值 |
`(1 2 ,(+ 1 2)) | (1 2 3) | 特殊形式,只有逗号标记的位置求值 |
`(1 2 (+ 1 2)) | (1 2 (+ 1 2)) | 没有逗号的 quasiquote 等同于 quote |
把 quasiquote 想成「填空题模板」:反引号圈出整张卷子(原样保留),逗号标出需要填的空(现场算一个值填进去)。这套机制在写宏(macro)时才真正大放异彩——你要生成一段代码,绝大部分是固定骨架,只有几个位置随参数变。课程后面讲宏时会回到这里。
把单引号 ' 和反引号 ` 搞混。它们在键盘上挨着,长得也像,但行为差一整个概念。用单引号包住带逗号的表达式,逗号不会被特殊处理——61A 解释器会把 ,a 原样保留成一个 (unquote a) 子列表:
scm> (define a (list 4 5 6))
a
scm> '(1 2 ,a)
(1 2 (unquote a))
结果是个长度为 3 的列表,第三个元素是列表 (unquote a),跟你想要的 (1 2 (4 5 6)) 完全不是一回事,而且它不报错。用了逗号,外面就必须是反引号。
8. apply 与 eval:把列表当参数表、把列表当程序
quote 让代码变成数据。这一节的两个函数走反方向:让数据变回代码。
apply:列表里装的是参数
(apply <procedure> <args>)——用 args 这个列表里的元素作为参数去调用 procedure。
scm> (apply + (list 1 2 3))
6
scm> (apply + '(1 2 3))
6
关键在于对比:
| 写法 | 结果 | 说明 |
|---|---|---|
(+ (list 1 2 3)) | Error: operand 0 ((1 2 3)) is not a number | + 收到一个参数,而且是列表,加不了 |
(apply + (list 1 2 3)) | 6 | 列表被摊开成三个参数,等价于 (+ 1 2 3) |
如果你写过 Python,这就是 f(*args) 那个星号解包。为什么需要它?因为参数个数在写代码的时候可能还不知道——你手上有一个运行时才算出来的列表,想把它当参数表用,只能靠 apply。
幻灯片上写着「More on this when we talk about macros!」——apply 真正的用武之地在宏和元编程,本讲先建立概念。
eval:列表里装的是程序
(eval <expression>)——把 expression 在当前环境里求值。
scm> (eval '(cons 1 (cons 2 nil)))
(1 2)
这一行是本讲最值得琢磨的一行。慢慢拆:
'(cons 1 (cons 2 nil)) 因为有引号,不被求值。它变成一个数据:长度为 3 的列表,元素依次是符号 cons、数 1、以及子列表 (cons 2 nil)。此时它跟 (1 2 3) 一样,只是一坨 pair,跟「造 pair 这件事」毫无关系。eval。eval 是普通过程,所以它的算子数照常求值——而 '(...) 的求值结果就是那个列表本身。eval 拿到列表后,把它当程序看:第一个元素 cons 是算子,去环境里查,得到 cons 过程;后面两个是算子数,分别求值得 1 和(递归地求值子列表 (cons 2 nil))得到 pair (2)。(1 2)。quote 把它冻住,eval 又把它化开。(eval '<expr>) 和直接写 <expr> 的结果一样。光看这一行你可能觉得「那不是白折腾吗」。它的价值在于:中间那一步,程序是数据,你可以对它动手脚。
scm> (define expr '(+ 1 2))
expr
scm> expr
(+ 1 2)
scm> (car expr)
+
scm> (length expr)
3
scm> (eval expr)
3
expr 绑定的是一个普通列表,你可以对它 car、length、map,就像对 (1 2 3) 一样。想跑它的时候才 eval。
这就是 homoiconicity(同像性):程序的语法结构和语言的基本数据结构是同一个东西。Python 里你要分析一段代码得引入 ast 模块、建一整套节点类;Scheme 里代码本来就是列表,用 car/cdr 就能拆。
下一讲写 Scheme 解释器时,这一点就是全部地基:解释器的 scheme_eval 收到的参数不是字符串,是 reader 读进来的嵌套 Scheme 列表。它判断「这是不是调用表达式」的方式,就是看这个列表的 car 是什么。
忘了加引号:(eval (cons 1 (cons 2 nil)))。这样内层的 cons 会先被真的执行,得到列表 (1 2),然后 eval 拿到 (1 2) 当程序跑——它会把 1 当算子去调用:
scm> (eval (cons 1 (cons 2 nil)))
Error: int is not callable: 1
要传给 eval 的东西,几乎总得先 quote 住,否则它在到达 eval 之前就已经被求值一次了。
9. 三种相等:=、eq?、equal?
Python 里判断相等有 == 和 is 两个;Scheme 有三个,而且分工跟 Python 不完全对应。
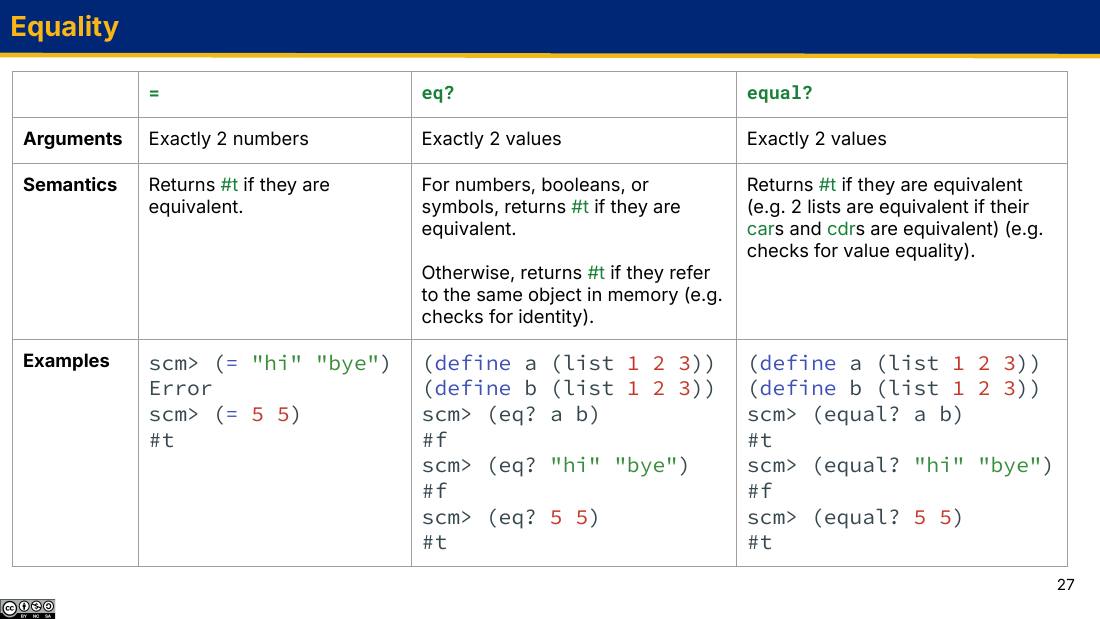
=:只管数
scm> (= 5 5)
#t
scm> (= "hi" "bye")
Error: operand 0 ("hi") is not a number
= 收恰好两个数。传非数进去不是返回 #f,是直接报错。这跟 Python 的 == 很不一样——Python 里 5 == "hi" 老老实实给你 False。
这个设计其实更诚实:「5 和 "hi" 谁大」是个没有意义的问题,与其编一个答案,不如告诉你问错了。
eq?:身份(大部分时候)
eq? 收任意两个值,规则分两层:
- 对数、布尔值、符号:比较它们是否等价(相同的值)。
- 对其他一切(列表、字符串、过程……):比较它们是否指向内存中的同一个对象,也就是身份(identity)。
(define a (list 1 2 3))
(define b (list 1 2 3))
scm> (eq? a b)
#f
scm> (eq? "hi" "bye")
#f
scm> (eq? 5 5)
#t
(eq? a b) 为什么是 #f?因为 (list 1 2 3) 被调用了两次,每次都新造了三个 pair。a 和 b 指向两条不同的链,虽然链上装的数一模一样。
Global frame
  a ──┐
  b ──┼──┐
      │  │
      v  │   ┌────┬────┐   ┌────┬────┐   ┌────┬────┐
      └─>│ 1  │  ●─┼──>│ 2  │  ●─┼──>│ 3  │nil │   ← a 的链
         └────┴────┘   └────┴────┘   └────┴────┘

         ┌────┬────┐   ┌────┬────┐   ┌────┬────┐
      ──>│ 1  │  ●─┼──>│ 2  │  ●─┼──>│ 3  │nil │   ← b 的链(另外六格)
         └────┴────┘   └────┴────┘   └────┴────┘

(eq?    a b) → #f   两条链是不同的对象
(equal? a b) → #t   逐格比下去,处处相同
验证一下「同一个对象」的情形:
scm> (eq? a a)
#t
scm> (eq? 'x 'x)
#t
(eq? 'x 'x) 是 #t——这正是符号规则的用处,也是第 11 节的 mountain 敢用 (eq? state 'increase) 来判断状态的原因。要是符号也按身份比较,这段代码就不可靠了。
equal?:结构
equal? 递归地比较:两个列表相等,当且仅当它们的 car 相等且 cdr 相等。
(define a (list 1 2 3))
(define b (list 1 2 3))
scm> (equal? a b)
#t
scm> (equal? "hi" "bye")
#f
scm> (equal? 5 5)
#t
scm> (equal? '(1 (2 3)) (list 1 (list 2 3)))
#t
最后一行说明它是真的钻进去比的:第二个元素本身是列表,也被逐格比较了一遍。
= | eq? | equal? | |
|---|---|---|---|
| 参数 | 恰好 2 个数 | 恰好 2 个任意值 | 恰好 2 个任意值 |
| 非数参数 | 报错 | 正常工作 | 正常工作 |
| 数 / 布尔 / 符号 | 比值(仅数) | 比值 | 比值 |
| 列表、字符串 | 报错 | 比身份(是不是同一个对象) | 比结构(递归逐格比) |
| Python 里的近亲 | ==(数之间) | is | == |
| 什么时候用 | 比数字,最明确 | 比符号;判断别名 | 比列表内容 |
用 eq? 比较两个列表的内容。 你的测试可能碰巧通过(如果两个名字指向同一个列表),换个输入立刻挂。要比内容就用 equal?。
用 = 比较符号或字符串。 不是返回 #f,是抛错,整个程序停在那儿。写 (= state 'increase) 会直接炸;应该写 (eq? state 'increase)。
字符串也要小心:(eq? "hi" "hi") 在 61A 解释器里实测是 #f,因为两个字面量各自造了一个字符串对象。比字符串内容请用 equal?。
10. 实战一:reverse
课堂练习的起始代码在 19.scm:
; Define a procedure reverse which takes in a Scheme list
; and returns a new list which is the reversed version of the original
(define (reverse lst)
    ; YOUR CODE HERE
)

(expect (reverse nil) ())
(expect (reverse (list 1)) (1))
(expect (reverse (list 1 2 3)) (3 2 1))
(expect (reverse (list 1 2 3 2 1)) (1 2 3 2 1))
(expect 是 code.cs61a.org 那个在线编辑器提供的测试形式,把代码贴进去点右上角红色试管按钮就能跑。它不是标准 Scheme,在本地 scheme.py 里跑会报 Error: unknown identifier: expect。)
题目到底要什么
四条测试把边界都框住了:
| 输入 | 期望输出 | 它在测什么 |
|---|---|---|
nil | () | 空列表——base case 必须撑住 |
(1) | (1) | 单元素,反转还是自己 |
(1 2 3) | (3 2 1) | 常规情形 |
(1 2 3 2 1) | (1 2 3 2 1) | 回文——反转后跟原来一样。这条测的是「别把元素弄丢或弄重」:长度和多重集必须保持不变 |
还有一个隐含要求:「returns a new list」——不能改原列表。在 Scheme 里这不是问题,你手上根本没有修改 pair 的工具。
怎么想到的
先套第 3 节那个模板。列表的定义分两种情况,函数就写两个分支:
(define (reverse lst)
  (if (null? lst)
      ???          ; lst 是空的
      ???))        ; lst 非空
空列表反转还是空列表,第一个洞填 nil。
第二个洞难一点。手上有两样东西:(car lst)——第一个元素;(cdr lst)——剩下的列表。递归的信念是:假设 (reverse (cdr lst)) 已经正确地返回了「剩下部分的反转」,我该怎么用它拼出整个的反转?
拿 (1 2 3) 具体想:
(car lst)是1(cdr lst)是(2 3),它的反转是(3 2)- 我要的答案是
(3 2 1)
看出来了:把 1 接到 (3 2) 的末尾。 原来的第一个元素,在反转后必须变成最后一个。
接下来是全题唯一的坑:怎么把一个元素接到列表末尾?
第一反应可能是 cons——但 cons 只能接到开头,(cons 1 '(3 2)) 给的是 (1 3 2),方向反了。
那用 append?(append '(3 2) 1)?也不行,append 要求参数是列表,1 是个元素。
正确写法是先把这个元素包成一个单元素列表:(list (car lst)),再 append。这正是第 5 节结尾提到的那个技巧。
代码
(define (reverse lst)
    (if
        (null? lst)
        nil
        (append
            (reverse (cdr lst))
            (list (car lst))
        )
    )
)
逐行看为什么是这样:
(null? lst)—— base case 判空用null?(不是pair?,也不是list?,理由见第 4 节)。它必须先判,因为下面要car,而对nil取car会报错。nil—— 空列表的反转。写'()也一样。不能写0或者什么都不写,那样上层的append会收到非列表参数。(reverse (cdr lst))—— 递归调用,处理短一格的列表。参数必须比原来短,否则永远到不了 base case。(list (car lst))—— 把首元素包成长度为 1 的列表,这样append才肯接它。- 两者的顺序不能反:反转结果在前、首元素在后。写成
(append (list (car lst)) (reverse (cdr lst)))会得到「首元素 + 剩下部分的反转」,比如(1 3 2)——完全不是反转。
验证:把 (reverse '(1 2 3)) 真的展开
下降(每层都卡在 append 上,等递归结果):
(reverse '(1 2 3)):(null? '(1 2 3)) 是 #f,走 else。要算 (append (reverse '(2 3)) (list 1))。append 是普通过程,必须先把两个算子数都求出来,所以先去算 (reverse '(2 3))。(reverse '(2 3)):非空,要算 (append (reverse '(3)) (list 2))。先算 (reverse '(3))。(reverse '(3)):非空,要算 (append (reverse '()) (list 3))。先算 (reverse '())。(reverse '()):(null? '()) 是 #t,返回 nil。到底了。回代(每层拿到结果后完成自己的 append):
(append nil (list 3)) = (append '() '(3)) → (3)。返回 (3)。(append '(3) (list 2)) = (append '(3) '(2)) → (3 2)。返回 (3 2)。(append '(3 2) (list 1)) = (append '(3 2) '(1)) → (3 2 1)。(3 2 1)。✓ 与 (expect (reverse (list 1 2 3)) (3 2 1)) 一致。盯着第 5–7 步看:每一层都往右边贴一个元素,而下降时是从左往右剥元素的。「先剥的后贴」——这个「后进先出」正是反转的本质,也是递归天然带来的效果。
错法一:(cons (reverse (cdr lst)) (car lst))。 想「用 cons 拼起来」,但两个参数的角色全错了。实测:
scm> (badrev (list 1 2 3))
(((() . 3) . 2) . 1)
输出里满是点号——每一层的 cdr 都被塞了一个数字,链根本没以 nil 收尾。看到这种输出,去检查你的 cons 两个参数是不是接反了。
错法二:(append (reverse (cdr lst)) (car lst))。 想对了方向,忘了把元素包成列表:
scm> (badrev2 (list 1 2 3))
Error: argument 0 of append has wrong type (int)
推一下就明白:最深一层算出 (append nil 3) = 3(append 允许最后一个参数不是列表),这个 3 传回上一层变成 (append 3 2)——第 0 个参数是整数,报错。wrong type (int) 出现在 append 上,基本就是漏了 (list …)。
错法三:base case 返回 lst 而不是 nil。 这条碰巧是对的(空列表就是 nil),但如果你把条件写成 (null? (cdr lst)) 然后返回 lst,(reverse nil) 就会在 (cdr nil) 处直接报错。base case 挑最小的那个,别挑「倒数第二小」的。
另一种写法:用累积器
上面那个解法有个隐忧:append 本身是 Θ(n) 的(它要走完第一个列表),而它被调用了 n 次,所以整个 reverse 是 Θ(n²)。
换个思路:cons 只能往头上加——而「反复往头上加」得到的恰好就是逆序。用一个累积器(accumulator)从左往右扫:
(define (reverse lst)
  (define (helper lst acc)
    (if (null? lst)
        acc
        (helper (cdr lst) (cons (car lst) acc))))
  (helper lst nil))
追踪 (reverse '(1 2 3))。这次没有回代——答案在下降过程中就攒好了:
| 调用 | lst | acc | 下一步 |
|---|---|---|---|
| 1 | (1 2 3) | () | 非空 → (helper '(2 3) (cons 1 '())) |
| 2 | (2 3) | (1) | 非空 → (helper '(3) (cons 2 '(1))) |
| 3 | (3) | (2 1) | 非空 → (helper '() (cons 3 '(2 1))) |
| 4 | () | (3 2 1) | 空 → 返回 acc |
每次 cons 都把当前元素压到 acc 的最前面,所以越晚遇到的元素越靠前。(reverse nil) 时 helper 第一步就命中 base case,返回初值 nil,也是对的。
这个版本每步只做 Θ(1) 的 cons,总共 Θ(n)。而且它是尾递归——递归调用是函数体里最后做的事,返回后不需要再算什么。Scheme 标准要求实现对尾递归做优化,不会撑爆栈。
课堂给的参考答案是第一个版本(更直观,也更贴合「用列表定义写递归」的训练目标)。两个都对,知道差别在哪更重要。
11. 实战二:mountain——用符号当状态
第二道课堂练习难度上了一个台阶。题面(19.scm 里的注释):
Define a function
mountainthat returns true if the given list containing only positive integers and with length >= 3 is a mountain. A mountain is defined as a list that contains a strictly increasing sublist and then a strictly decreasing sublist after its "peak" number. (Otherwise, return false.)
题目到底要什么
「山」= 先严格递增,到达一个峰值,然后严格递减。逐条测试翻译成人话:
| 输入 | 期望 | 为什么 |
|---|---|---|
(1 2 3 2 1) | #t | 1<2<3 上山,3>2>1 下山。标准的山 |
(1 2 3 4 0) | #t | 下山只走了一步也算山,坡度陡不要紧 |
(5 4 3 0) | #f | 一上来就下降,没有上山段。这不是山,是悬崖 |
(1 2 3) | #f | 只上不下,没有下山段。这是斜坡不是山 |
(1 2 2 1) | #f | 中间 2 == 2,不是严格单调。相等就出局 |
(1 2 3 2 1 2 3) | #f | 下山之后又上山了。只准上下各一次,两个峰不算 |
把这六条压成三句约束:
- 必须有上升段(不能一开始就降)。
- 必须有下降段(不能一路升到底)。
- 严格单调,相等即失败;而且升→降只能切换一次,降完不能再升。
怎么想到的
先试试上一题那个纯递归模板:(if (null? lst) … (用 (car lst) 和 (mountain (cdr lst)) 拼))。
卡住了。为什么?因为「(2 1) 是不是山」这个问题的答案,帮不了「(1 2 3 2 1) 是不是山」。子问题的答案(#f,因为 (2 1) 没有上升段)跟原问题的答案(#t)没有可用的关系。这个函数不是「结构递归」能直接拿下的。
症结在于:判断当前这一步合不合法,需要知道两件递归本身不提供的信息——
- 前一个数是多少(不然没法比较大小)
- 现在是在上山还是在下山(同一个「变小了」,在上山阶段意味着「到峰了,开始下山」,在下山阶段意味着「继续下山」,含义完全不同)
所以需要一个带额外参数的辅助函数——起始代码已经把这个思路给你了:
(define (helper lst prev state) …)
state 取三个符号之一:'start(还没开始爬,一个数都没比过)、'increase(正在上山)、'decrease(正在下山)。这就是一台状态机(state machine):每读一个数,根据「这个数和 prev 的大小关系」+「当前 state」决定下一个 state,或者当场判死。
为什么用符号 'start 而不是字符串 "start" 或者数字 0?
因为符号可以用 eq? 可靠比较(第 9 节:eq? 对符号比的是值,(eq? 'x 'x) 是 #t),而字符串用 eq? 比是身份,会得到 #f。用数字虽然也能 = 比,但代码里出现 (= state 2) 你三天后就不记得 2 是什么意思了。符号是「有名字的常量」,读代码时自解释。
状态转移表
三个 state 乘以三种大小关系(n > prev / n < prev / n = prev),一共九格。把每一格填掉,代码就写完了:
| 当前 state | n > prev(上升) | n < prev(下降) | n = prev(持平) |
|---|---|---|---|
'start | 开始上山 → 'increase | #f:没有上山段就下降 | #f:不严格 |
'increase | 继续上山 → 'increase | 到峰了,转 → 'decrease | #f:不严格 |
'decrease | #f:下完又升,第二座山 | 继续下山 → 'decrease | #f:不严格 |
列表走完时((null? lst))怎么判?答案是 (eq? state 'decrease):
- 停在
'decrease—— 上过山也下过山,是山 ✓ - 停在
'increase—— 只上没下,比如(1 2 3),不是山 - 停在
'start—— 一个数都没比过(列表太短),不是山
一句 (eq? state 'decrease) 就把「必须有下降段」这条约束优雅地表达了。
代码
(define (mountain lst)
    (define (helper lst prev state)
        (if
            (null? lst)
            ; Should only increase then decrease once
            (eq? state 'decrease)

            (begin
                (define n (car lst))
                (define rest (cdr lst))
                (cond
                    ; we just started and it's increasing, so keep going
                    ((and (> n prev) (eq? state 'start)) (helper rest n 'increase))

                    ; we just started but it's decreasing, so it's not a mountain
                    ((and (< n prev) (eq? state 'start)) #f)

                    ; it is currently increasing and we want it to increase
                    ((and (> n prev) (eq? state 'increase)) (helper rest n 'increase))

                    ; it is the start of the decrease (the peak of the mountain)
                    ((and (< n prev) (eq? state 'increase)) (helper rest n 'decrease))

                    ; it is currently increasing but we want it to decrease, so it's not a mountain
                    ((and (> n prev) (eq? state 'decrease)) #f)

                    ; it is currently decreasing and we want it to decrease
                    ((and (< n prev) (eq? state 'decrease)) (helper rest n 'decrease))

                    ; digits are equal, so it's not a mountain (we need strictly increasing/decreasing)
                    (else #f)
                )
            )
        )
    )

    (helper (cdr lst) (car lst) 'start)
)
几个值得停下来看的地方:
- 最后那行初始调用:
(helper (cdr lst) (car lst) 'start)。第一个数没有「前一个数」可比,所以把它取出来当 prev,从第二个数开始扫。这是处理「需要相邻比较」类问题的标准起手式。 begin:if的每个分支只能是一个表达式。这里要先define两个局部名字再cond,共三件事,必须用begin包成一个。begin依次求值所有子表达式,返回最后一个的值——所以整个begin的值就是cond的值。(define n (car lst)):起个名字避免重复写(car lst)。n和rest绑定在helper这次调用的帧里,下次调用是另一帧、另一个n,互不干扰。cond从上往下试,第一个为真的子句生效,后面全跳过。九种情况里有六种被前六个子句显式列出,剩下三种「持平」情况全部落到else,返回#f。else必须在最后,写在前面会把所有情况都吃掉。helper是定义在mountain内部的。它能看到mountain帧里的东西,外面看不到它。这跟第 3 讲的嵌套函数、闭包是同一套作用域规则。
验证:(mountain '(1 2 3 2 1)) 逐帧追踪
| 帧 | lst | prev | state | n | 命中哪个子句 | 下一步 |
|---|---|---|---|---|---|---|
| f1 | (2 3 2 1) | 1 | 'start | 2 | 2>1 且 start → 第 1 条 | (helper '(3 2 1) 2 'increase) |
| f2 | (3 2 1) | 2 | 'increase | 3 | 3>2 且 increase → 第 3 条 | (helper '(2 1) 3 'increase) |
| f3 | (2 1) | 3 | 'increase | 2 | 2<3 且 increase → 第 4 条(到峰了) | (helper '(1) 2 'decrease) |
| f4 | (1) | 2 | 'decrease | 1 | 1<2 且 decrease → 第 6 条 | (helper '() 1 'decrease) |
| f5 | () | 1 | 'decrease | — | (null? lst) 为真 | 返回 (eq? 'decrease 'decrease) = #t ✓ |
五帧,每帧读一个数。prev 永远是上一帧的 n,state 记录着「到目前为止走到哪个阶段」。峰值出现在 f3——注意那一刻代码没有去找「最大值在哪」,它只是发现「刚才在升,现在降了」,顺手把 state 一改。这就是状态机的省事之处。
再验两条反例
(mountain '(1 2 3)) → #f
(helper '(2 3) 1 'start):n=2>1 且 start → (helper '(3) 2 'increase)(helper '(3) 2 'increase):n=3>2 且 increase → (helper '() 3 'increase)(helper '() 3 'increase):列表空了,返回 (eq? 'increase 'decrease) = #f。全程一次错误都没发生,是「结束时 state 不对」把它拦下来的。(mountain '(1 2 3 2 1 2 3)) → #f
(helper '(2 3 2 1 2 3) 1 'start) → n=2>1,转 'increase(helper '(3 2 1 2 3) 2 'increase) → n=3>2,留在 'increase(helper '(2 1 2 3) 3 'increase) → n=2<3,到峰,转 'decrease(helper '(1 2 3) 2 'decrease) → n=1<2,留在 'decrease(helper '(2 3) 1 'decrease) → n=2>1 且 'decrease → 命中第 5 条,立即返回 #f,不再往下看。第二座山被当场拦截。对比这两条:第一条是「走到最后才发现不对」,第二条是「中途当场判死」。状态机两种失败模式都覆盖了。
误区一:用 = 比较符号。 写 (= state 'start) 会抛错而不是返回 #f——第 9 节讲过 = 只收数字。符号比较必须用 eq?。
误区二:忘了 else 分支,或者以为「相等」会自动落到某个分支上。 cond 的六个条件都是 (and (> n prev) …) 或 (and (< n prev) …),n = prev 时六条全不成立。删掉 else 后实测:
scm> (cond (#f 1))
              <-- 什么都没打印,返回的是一个「未定义值」
scm> (if (cond (#f 1)) 'truthy 'falsy)
truthy
这个未定义值是真值。所以少了 else 的 mountain 在 (1 2 2 1) 上不会返回 #f,而是返回一个看不见的真值——不报错,只给错答案,最难查。
误区三:初始调用写成 (helper lst (car lst) 'start)。 第一个数会跟自己比,n = prev,直接落到 else 返回 #f,所有测试全挂。必须传 (cdr lst)。
误区四:把递归调用的 prev 写成 prev 而不是 n。 比如 (helper rest prev 'increase)——这样 prev 永远不更新,(1 2 3 2 1) 会一直拿 1 去比,判成一路上升,结果错成 #f。每读一个数,prev 就必须换成刚读的那个。
题面说输入「length >= 3」,所以这份实现没有处理更短的列表。(mountain nil) 会报错:
scm> (mountain nil)
Error: argument 0 of cdr has wrong type (tuple)
注意报错点是 cdr 不是 car——初始调用 (helper (cdr lst) (car lst) 'start) 的算子数从左往右求值,(cdr nil) 先炸。(mountain '(1 2)) 倒是能跑,返回 #f(走完停在 'increase)。能说清自己的实现在题面之外会怎样,比含糊地说「应该没问题」强。
本讲小结
函数速查表
| 形式 | 类别 | 作用 | 例子 → 结果 |
|---|---|---|---|
(cons x y) | 过程 | 造 pair,car=x,cdr=y。恰好 2 个参数 | (cons 1 nil) → (1) |
(car p) | 过程 | 取第一格 | (car '(1 2)) → 1 |
(cdr p) | 过程 | 取第二格(还是个列表) | (cdr '(1 2)) → (2) |
(list e ...) | 过程 | 造列表,参数照常求值 | (list (+ 1 1)) → (2) |
(length lst) | 过程 | 最外层元素个数 | (length '(1 (2 3))) → 2 |
(null? x) | 过程 | 是空列表吗 | (null? nil) → #t |
(pair? x) | 过程 | 是 pair 吗(nil 不是) | (pair? nil) → #f |
(list? x) | 过程 | 是合法列表吗(nil 是) | (list? nil) → #t |
(append l ...) | 过程 | 拼接,像 Python 的 extend | (append '(1) '(2 3)) → (1 2 3) |
(map f lst) | 过程 | 每个元素过一遍 f,长度不变 | (map car '((1 2))) → (1) |
(filter p lst) | 过程 | 留下让 p 为真的元素 | (filter even? '(1 2)) → (2) |
(reduce f lst) | 过程 | 从左往右两两合并,lst 不能空 | (reduce + '(1 2 3)) → 6 |
(quote e) / 'e | 特殊形式 | 不求值,原样返回 | '(+ 1 2) → (+ 1 2) |
`e + ,x | 特殊形式 | 只求值逗号标记的位置 | `(1 ,(+ 1 1)) → (1 2) |
(apply f args) | 过程 | 把列表摊开当参数表 | (apply + '(1 2 3)) → 6 |
(eval e) | 过程 | 把数据当程序求值 | (eval '(+ 1 2)) → 3 |
(= a b) | 过程 | 比数,非数报错 | (= 5 5) → #t |
(eq? a b) | 过程 | 数/布尔/符号比值,其余比身份 | (eq? 'a 'a) → #t |
(equal? a b) | 过程 | 递归比结构 | (equal? '(1) '(1)) → #t |
四条最容易记混的规则
(pair? nil)→#f,(list? nil)→#t。nil是列表但不是 pair。写 base case 一律用null?。- 点号 = 结构坏了。 输出里出现
(1 2 . 3)这种孤立的点,说明某条链没有以nil收尾——去检查cons的第二个参数或 base case 的返回值。 - 往列表头加元素用
cons,往尾加要(append lst (list x))。 直接(append lst x)是错的,x得先包成列表。 quote和list不是一回事。(list (+ 1 1))→(2),装的是数;'((+ 1 1))→((+ 1 1)),装的是一段没被求值的代码。
这一讲真正学到的思维方法
递归的数据定义,直接给出递归的代码结构。 「列表要么是 nil,要么是 cdr 还是列表的 pair」这句话有两个分句,你的函数就有两个分支:null? 那支处理 nil,else 那支用 (car lst) 和「(cdr lst) 的答案」拼出结果。reverse 是照这个模板填空填出来的。
纯结构递归搞不定时,往辅助函数里加参数。 mountain 卡住的原因是「子列表的答案帮不上原列表」。解法是造一个带 prev 和 state 的 helper——把递归本身不携带的上下文显式地作为参数传下去。这个模式(外层函数负责初始化,内层 helper 负责递归)在 61A 后半程会反复出现。
代码和数据的界限是人为的。 '(+ 1 2) 和 (1 2 3) 在 Scheme 眼里都是三元素列表,区别只在于你有没有把它交给 eval。下一讲要写的解释器,做的正是「接过一个嵌套列表,按规则把它变成一个值」——本讲的 car、cdr、quote、eval 就是那台机器的全部零件。
动手练习
练习 1:读盒指针
下面这个表达式求值成什么?它的 length 是多少?
(cons 1 (cons (cons 2 (cons (cons 3 nil) nil)) (cons 4 (cons 5 nil))))
看答案
结果是 (1 (2 (3)) 4 5),长度是 4。
从外往里剥,只看最外层那条 cdr 链:
cons 的 car 是 1,cdr 是 (cons (cons 2 …) (cons 4 (cons 5 nil)))。→ 第 1 个元素是 1。(cons 2 (cons (cons 3 nil) nil))——一整个列表,cdr 是 (cons 4 (cons 5 nil))。→ 第 2 个元素是那个子列表。4,cdr 是 (cons 5 nil)。→ 第 3 个元素是 4。5,cdr 是 nil。→ 第 4 个元素是 5,链结束。length 无关。再单独展开第 2 个元素 (cons 2 (cons (cons 3 nil) nil)):car 是 2,cdr 是 (cons (cons 3 nil) nil),后者的 car 是列表 (3)、cdr 是 nil。所以它是 (2 (3))——长度 2 的列表,第二个元素是长度 1 的列表。
合起来:(1 (2 (3)) 4 5)。
方法总结:数长度只沿 cdr 走,一步一个元素;打印时给每个「本身是 pair 的 car」加一层括号。
练习 2:quote 的四种写法
设 (define x 10)。下面五行分别求值成什么?
(a) (list 'x x)
(b) '(list 'x x)
(c) `(a b ,x)
(d) (car ''x)
(e) (eval (list '+ 1 x))
看答案
| 结果 | 为什么 | |
|---|---|---|
| (a) | (x 10) | list 是普通过程,两个算子数都求值:'x 求值成符号 x,x 求值成 10 |
| (b) | (list (quote x) x) | 整体被 quote 住,一个字都不求值。结果是长度 3 的列表,第二个元素本身是列表 (quote x) |
| (c) | (a b 10) | 反引号里 a、b 原样保留成符号,只有 ,x 被求值成 10 |
| (d) | quote | ''x 是 (quote (quote x)),求值后得到列表 (quote x),它的 car 是符号 quote |
| (e) | 11 | (list '+ 1 x) 先求值成列表 (+ 1 10),eval 再把它当程序跑 |
(b) 的显示形式在不同实现里可能是 (list 'x x) 或 (list (quote x) x)——'x 只是 (quote x) 的语法糖,打印器选哪种写法是它的自由,结构是同一个。
(e) 值得多看一眼:它演示了「程序在运行时拼出另一段程序,再执行它」。这正是宏的雏形。
练习 3:eq? 还是 equal?
下面每行输出什么?
(define a (list 1 2))
(define b (list 1 2))
(define c a)
scm> (eq? a b)
scm> (eq? a c)
scm> (equal? a b)
scm> (eq? (car a) (car b))
scm> (equal? (cdr a) (cdr b))
看答案
| 表达式 | 结果 | 为什么 |
|---|---|---|
(eq? a b) | #f | list 被调了两次,造出两条不同的链,身份不同 |
(eq? a c) | #t | (define c a) 只是让 c 指向同一个对象,没有复制任何 pair |
(equal? a b) | #t | 逐格比:car 都是 1,cdr 都是 (2),处处相同 |
(eq? (car a) (car b)) | #t | 两边都是数 1。eq? 对数比的是值,不是身份 |
(equal? (cdr a) (cdr b)) | #t | 两边都是列表 (2),结构相同 |
第 4 行是这道题的重点:eq? 不是无脑比身份,它对数、布尔、符号是比值的。如果它对数也比身份,那 (eq? 5 5) 的结果就要取决于解释器有没有缓存小整数——那种语言没法用。
(eq? (cdr a) (cdr b)) 呢?是 #f——它们是两个不同的 pair。整条链上的每一个 pair 都是独立造出来的。
练习 4:写 my-append
不用内置的 append,用递归实现只收两个列表的 (my-append a b)。
(my-append '(1 2) '(3 4))   ; 应得 (1 2 3 4)
(my-append nil '(3 4))      ; 应得 (3 4)
(my-append '(1 2) nil)      ; 应得 (1 2)
看答案
(define (my-append a b)
  (if (null? a)
      b
      (cons (car a) (my-append (cdr a) b))))
关键洞察:只对第一个列表递归,第二个列表原封不动地传下去。 因为拼接只需要「把 a 的元素一个个重新 cons 到 b 前面」,b 本身完全不用拆。
base case 返回 b 而不是 nil——这是全题最容易写错的地方。a 走完了,剩下要接的就是整个 b。写成 nil 的话,(my-append '(1 2) '(3 4)) 会得到 (1 2),b 整个丢了。
展开 (my-append '(1 2) '(3 4)):
a = (1 2) 非空 → (cons 1 (my-append '(2) '(3 4))),等内层。a = (2) 非空 → (cons 2 (my-append '() '(3 4))),等内层。a = () 空 → 返回 b,即 (3 4)。到底了。(cons 2 '(3 4)) → (2 3 4)。(cons 1 '(2 3 4)) → (1 2 3 4)。✓注意第 4、5 步:a 的每个元素都被重新 cons 了一次,也就是 a 的那两个 pair 被复制了;而 b 的 pair 被直接复用,没有复制。这正是内置 append 的行为,也是它复杂度是 Θ(len(a)) 而不是 Θ(len(a)+len(b)) 的原因。
练习 5:reduce 的顺序
不运行代码,说出这两行的结果,并解释为什么不同:
scm> (reduce (lambda (a b) (cons a b)) (list 1 2 3))
scm> (reduce (lambda (a b) (cons b a)) (list 1 2 3))
看答案
第一行 ((1 . 2) . 3),第二行 (3 2 . 1)。
第一行(等价于直接传 cons):combiner 收到的第一个参数是「已合并值」,第二个是「新元素」。
1。(cons 1 2) → (1 . 2)。cdr 是数字 2,已经不是合法列表了,所以打印带点。(cons '(1 . 2) 3) → ((1 . 2) . 3)。第二行:lambda 把两个参数换了位置,变成 (cons 新元素 已合并值)——也就是「往头上加」。
1。(cons 2 1) → (2 . 1)。(cons 3 '(2 . 1)) → (3 2 . 1)。第二行几乎就是第 10 节那个累积器版 reverse——差别只在于初始的「已合并值」是元素 1 而不是 nil,所以链尾没有 nil,最后带了个点。想得到干净的 (3 2 1),得让 reduce 从 nil 开始,而 reduce 不支持初值——这正是那道题要自己写 helper 的原因。
这道题的价值:只要看到输出里有点号,你就该立刻推断「有个 cons 的第二个参数不是列表」,然后倒推是哪一步。
练习 6:状态机改造
把 mountain 改成 valley:判断列表是不是「先严格递减,再严格递增」。哪些地方要改?
看答案
只需把状态转移表里「上升」和「下降」的角色对调:
(define (valley lst)
  (define (helper lst prev state)
    (if (null? lst)
        (eq? state 'increase)          ; 改点 3:结束时必须处在「正在上升」
        (begin
          (define n (car lst))
          (define rest (cdr lst))
          (cond
            ((and (< n prev) (eq? state 'start))    (helper rest n 'decrease))
            ((and (> n prev) (eq? state 'start))    #f)
            ((and (< n prev) (eq? state 'decrease)) (helper rest n 'decrease))
            ((and (> n prev) (eq? state 'decrease)) (helper rest n 'increase))
            ((and (< n prev) (eq? state 'increase)) #f)
            ((and (> n prev) (eq? state 'increase)) (helper rest n 'increase))
            (else #f)))))
  (helper (cdr lst) (car lst) 'start))
三处改动:
- 起手方向:
'start时必须下降才合法,上升就出局。 - 转折方向:从
'decrease转到'increase(谷底),而不是反过来。 - 终止条件:
(eq? state 'increase)——必须爬出来才算谷。
else #f 那条不用动:无论山还是谷,相等都不合法。
自查:(valley '(3 2 1 2 3)) → #t;(valley '(3 2 1)) → #f(只降不升);(valley '(1 2 3)) → #f(一上来就升);(valley '(3 2 2 3)) → #f(不严格)。
这道题真正想让你看到的:状态机的代码结构跟具体规则是解耦的。规则变了,改的是转移表里的格子,骨架一行不动。反过来说,写这类题时先把转移表在纸上列全,代码就只是抄表。