链表:用一串对象自己拼出一个序列
不用 Python 的内置列表,只靠「一个值 + 剩下的表」这条递归定义,从零造出一种序列——并且在开头插入元素时快上几百倍。
0. 本讲导读
到这一讲为止,你处理「一串东西」时用的一直是 Python 的内置列表 [1, 2, 3]。它太顺手了,顺手到你从来没问过一个问题:这个东西在内存里到底长什么样?它做每件事分别要花多少代价?
本讲就是拿这个问题开刀。答案会告诉你:Python 列表在「往开头插一个元素」这件事上慢得离谱,慢到同一个任务从 0.68 秒变成 0.00095 秒的差距。而修好它的办法不是去优化 Python 列表,而是换一种数据结构——一种你自己用几行的类就能写出来的结构:链表(linked list)。
链表的定义只有一句话,而且是递归的:一个链表要么是空的,要么装着「第一个值」和「剩下的链表」。这句话你应该觉得眼熟——上一讲的树(tree)是「一个根标签 + 一串子树」,同样是用自己定义自己。递归数据结构(recursive data structure)这个套路在本讲会被再敲一遍,而且敲得更狠:链表比树更简单,所有注意力都会落在「递归调用怎么展开、怎么回代」上面。
本讲要回答的三个问题:
- 为什么要造它——Python 列表在什么地方付不起代价,链表凭什么便宜。
- 它是怎么被表示的——一个
Link类、两个实例属性first和rest、一个当哨兵用的类属性Link.empty。 - 怎么在它上面写代码——递归版和迭代版各写一遍,看清「
lnk.rest本身也是一个完整的链表」这句话在代码里长什么样。以及最要命的一节:变异(mutate)现有链表和返回一个新链表是两件完全不同的事,写错了 doctest 会以最莫名其妙的方式失败。
往前看:本讲的全部前置知识是第 12–13 讲的类与实例属性(self.first = first 就是在实例上绑名字)、第 8 讲的可变性与别名,以及第 9–15 讲那套递归思路。往后看:下一讲讲效率,届时「Python 列表 vs 链表」这张代价表会被正式地用 $\Theta$ 记号写出来;链表本身则会在 Scheme 那几讲里以语言内置数据结构的身份原样回来——Scheme 的 pair 就是 Link,只不过名字叫 car 和 cdr。
- 链表是递归定义的:要么为空,要么由「第一个值」和「剩下的链表」组成。
lnk.rest不是「后面几个元素」,它本身就是一个完整的链表——这句话是本讲所有代码的地基。 Link.empty = ()是一个类属性,全程序只有这一个空元组对象,所以判断空表必须写lnk is Link.empty(用is,不是==)。- 空链表不是
Link的实例。因此Link.empty.first会报AttributeError: 'tuple' object has no attribute 'first'——所有链表递归都必须先判空再取.first。 - 处理链表的递归骨架永远是这两行:
if lnk is Link.empty:处理 base case;否则用lnk.first和对lnk.rest的递归结果拼出答案。 - 造新表的函数
return Link(...),原表一个字节都不动;就地变异的函数只赋值lnk.first = .../lnk.rest = ...,返回None。混着写是本讲最大的错误来源。 - 链表在头部插入是 $\Theta(1)$:造一个新
Link、改一个rest指针即可,后面的节点原地不动;Python 列表的insert(0, x)要把所有元素往后挪一格。
1. 为什么不能一直用 Python 列表
先摆事实。课上演示的那个基准测试做的事情很单纯:往一个序列的开头反复插入元素。同样的任务:
| 数据结构 | 耗时 |
|---|---|
| Python 内置列表 | 0.68 秒 |
| 链表 | 0.00095 秒 |
七百倍。这不是常数因子上的小胜负,是量级上的差别,说明两者做同一件事的做法根本不同。
动态数组:为什么头部插入这么贵
Python 列表底层是一块连续的内存。「连续」是它最大的优点,也是它唯一的软肋。
优点在于:元素挨个排好,第 i 个元素的地址可以直接用「起始地址 + i × 每格大小」算出来,不用挨个走。所以 lst[5000] 和 lst[0] 一样快——这叫随机访问(random access)。
软肋在于:既然「第 i 个元素必须在第 i 格」,那你要在最前面塞一个新元素,原来的第 0 个就必须挪到第 1 格,第 1 个挪到第 2 格……每一个元素都得往后搬一格。
插入前:  [ a ][ b ][ c ][ d ][   ]      ← 连续的 5 格,用了 4 格

搬运:    [ a ][ b ][ c ][ d ][ d ]      d 往后挪
          [ a ][ b ][ c ][ c ][ d ]      c 往后挪
          [ a ][ b ][ b ][ c ][ d ]      b 往后挪
          [ a ][ a ][ b ][ c ][ d ]      a 往后挪

写入:    [new][ a ][ b ][ c ][ d ]      第 0 格才空出来

n 个元素 → n 次搬运。插 n 次 → n² 次搬运。
基准测试里反复往头部插入,于是这个「每次 n 次搬运」被乘上了插入次数,0.68 秒就是这么来的。(还有一层:连续的那块内存装满以后,Python 得另找一块更大的、把全部内容复制过去。这一步平摊下来不贵,但也是「必须连续」带来的额外负担。)
把 Python 列表想成电影院的一排座位:座位号是钉死的,你要在第一排最左边加个人,整排人都得往右挪一个位置。
把链表想成手拉手站成一队的人:谁站在哪儿不重要,重要的是每个人拉着下一个人的手。要在队首加一个人,只需要让新来的人拉住原来的队首——其他人一动不动,连脚都不用挪。
代价换代价,不是白拿的
链表不是「更好的列表」,它是另一套取舍。手拉手的队伍虽然队首插人便宜,但你想找「第 5000 个人」,就只能从队首开始一个一个数过去——没有座位号可用。
| 操作 | Python 列表(动态数组) | 链表 |
|---|---|---|
| 取第 i 个元素 | 快:直接按地址算 | 慢:从头走 i 步 |
| 在头部插入 / 删除 | 慢:所有元素搬一格 | 快:改一个 rest |
| 取长度 | 快:长度是存好的 | 慢:从头数到尾 |
| 内存布局 | 一整块连续内存 | 一堆散落的对象,靠引用串起来 |
| 额外空间 | 只存值 | 每个元素还要多存一个 rest 引用 |
所以「用哪个」取决于你的程序主要在做什么。这门课选择讲链表,除了这个工程理由,还有一个更重要的教学理由:链表是一个递归定义的数据结构,而且它简单到你能把每一步都在纸上画出来。它是练习递归思维的绝佳靶子。
本讲说 Python 列表「慢」,指的只有头部/中间插入和按值查找这几件事。日常写代码时 Python 列表依然是首选——它的 append(尾部追加)和下标访问都非常快。不要因为学了链表就回头把所有 [] 改写成 Link,那是把工具当信仰。
2. 定义:一句递归的话
课上给出的定义只有两行,请把它当公理背下来:
一个链表(linked list)是一种有序数据结构,它要么:
- 是空的;要么
- 装着一个第一个值(first value),和剩下的那个链表(the rest of the linked list)。
这个定义有两个地方值得停下来想。
第一,它是递归的。第 2 条里出现了「链表」这个词本身。你可能会觉得这是在耍赖——用一个词解释它自己。但它不是耍赖,因为有第 1 条:空表这个 case 不引用自己。第 2 条每往下剥一层,「剩下的链表」就比原来短一个元素,剥够了必然落到第 1 条上停住。这正是递归函数里 base case 和 recursive case 的关系,只不过这次它出现在数据上而不是函数上。
第二,「剩下的」是一个完整的链表,不是「几个散元素」。这是全讲最容易含糊过去、也最要命的一点。对于存着 7、9、3 的那个链表 lnk:
lnk.first是7,一个整数。lnk.rest是存着 9 和 3 的那个链表——它自己也有.first(是 9)和.rest(是存着 3 的那个链表)。
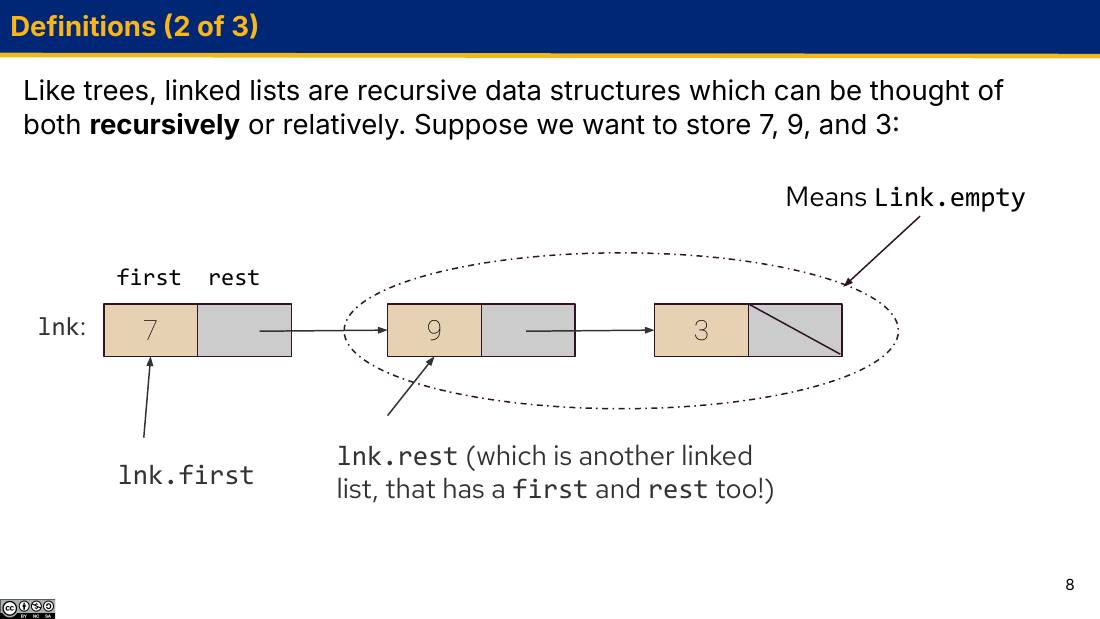
first(值),右格装 rest(指向下一个节点的引用)。虚线椭圆圈住的整个部分就是 lnk.rest——注意它圈住的是两个节点加上末尾的空,也就是一整个完整的链表,而不是「9 和 3 这两个数」。最后一个格子里画的那道斜杠表示 Link.empty,链子到此为止。课上给了个比喻:链条上的环(links in a chain)。这也是这个类叫 Link 而不叫 LinkedList 的原因——你手上拿到的那个对象,严格来说是一个环;但因为这个环拉着后面所有的环,它同时也代表着从这里往后的整条链子。一个对象既是「一个节点」又是「一整个链表」,这正是递归数据结构的特征。
递归地看 vs 相对地看
课上强调:链表和树一样,可以递归地(recursively)看,也可以相对地(relatively)看。这两种视角对应两种写代码的方式,都要会。
| 递归视角 | 相对视角 | |
|---|---|---|
怎么读 lnk | 「第一个值 + 剩下的整个链表」 | 「当前节点(current node)」 |
怎么读 lnk.rest | 「一个规模小 1 的同类问题」 | 「下一个节点(next node)」 |
| 写出来的代码长什么样 | 函数调用自己,靠 base case 收尾 | while 循环,靠 curr = curr.rest 往前挪 |
| 擅长什么 | 「造一个新链表」类的任务 | 「走一遍、顺手改点东西」类的任务 |
同一张图,眼睛聚焦的位置不一样,就得到两种视角:
递归视角盯着虚线椭圆——「7 后面挂着的那一坨,我不管它内部怎么样,反正它是个链表,交给同一个函数处理就行」。
相对视角盯着箭头——「我现在站在 7 这个节点上,顺着箭头走一步就站到 9 上」。
写递归时用第一种,写循环时用第二种。同一个函数往往两种都能写(后面 length 和 insert 会各写两遍)。
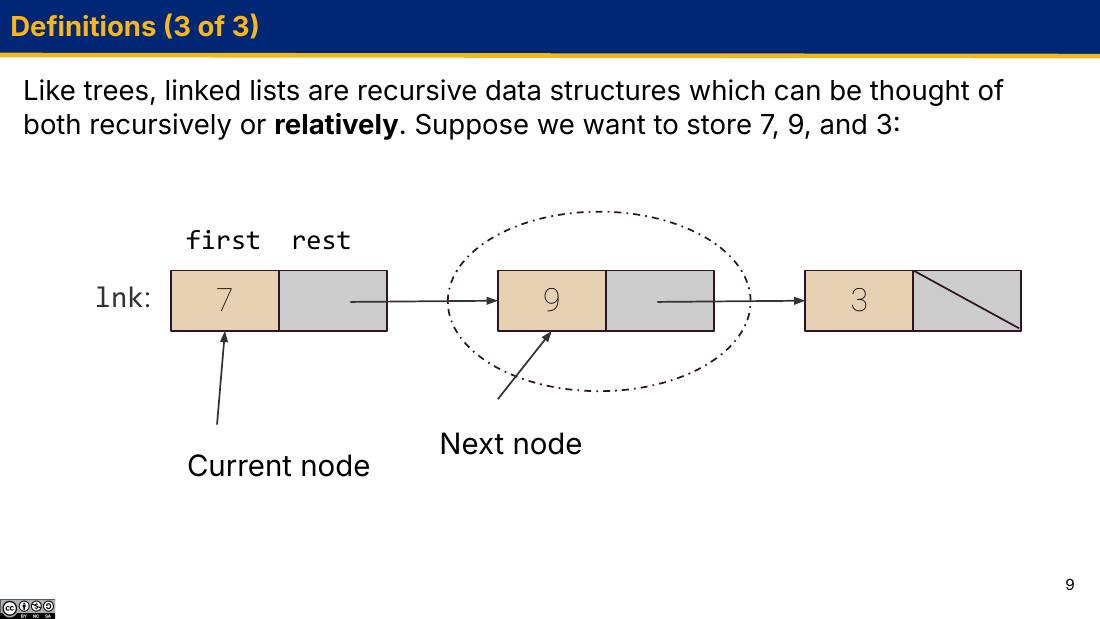
lnk.rest,你可以读成「剩下的整个链表」,也可以读成「下一个节点」,写代码时按需要切换。3. Link 类:三个部件,一个都不能少
CS 61A 里链表用我们自己写的 Link 类表示。核心部分就这几行:
class Link:
    empty = ()

    def __init__(self, first, rest=empty):
        assert rest is Link.empty or isinstance(rest, Link)
        self.first = first
        self.rest = rest
短得有点过分,但每一行都在解决一个具体问题。逐行拆。
empty = ():一个当哨兵用的类属性
这一行写在类体里、不在任何方法里,所以它是类属性(class attribute):整个程序中只有一份,属于 Link 这个类本身,所有实例共享。
它的值是 (),空元组。为什么选空元组?因为需要一个「表示空表」的标记物,而这个标记物必须满足两个条件:
- 不可变——它是全局唯一的哨兵,谁都不该改它。元组不可变,正合适。
- 身份唯一——所有的空表都应该是同一个对象,这样才能用
is快速判断。
换句话说,() 这个具体选择本身不重要,重要的是大家都用 Link.empty 这个名字去引用它。
is,不要用 ==
正确写法是 if lnk is Link.empty:。原因有二:
其一,语义上你问的是「它就是那个空表哨兵吗」,这是身份(identity)问题,is 才是问身份的运算符。
其二,== 在这里会挖坑。Link 类没有定义 __eq__,所以 某个Link == () 会退化成默认的身份比较,恰好也返回 False——看起来对了。但只要有人给 Link 加上 __eq__,或者你把哨兵换成别的值,== 就可能给出意料之外的答案。而且 lnk == Link.empty 还会掩盖一类真实 bug:假如 lnk 意外变成了 None,None == () 是 False,代码会继续往下跑 lnk.first 然后炸在别处;用 is 写法虽然也会炸,但至少你从没写过任何可能「碰巧相等」的判断。这门课的所有官方代码都用 is,跟着写就对了。
rest=empty:默认参数让「只有一个元素」变得好写
形参 rest 的默认值是 empty。注意这里写的是光秃秃的 empty 而不是 Link.empty——因为 def 这一行是在类体正在被执行的时候求值的,此刻 Link 这个名字还没绑定好,但类体这个局部作用域里 empty 已经有了。(这也是为什么函数体里必须写全 Link.empty:函数体是调用时才执行的。)
有了这个默认值,造「只有一个元素的链表」就只要写 Link(5),不用写 Link(5, Link.empty)。这在嵌套构造时省下大量括号:
>>> s = Link(3, Link(4, Link(5))) # 最里层的 Link(5) 用了默认的 rest
第 8 讲讲过「可变默认参数是个陷阱」——def f(lst=[]) 里那个列表会被所有调用共享,一旦被改就污染后续所有调用。这里 rest=empty 看起来是同一个模式,为什么不是陷阱?
因为 () 不可变。共享一个永远不会被改的对象,没有任何风险;恰恰相反,这里的「共享」正是我们要的效果——全世界只有一个空表。陷阱的成因从来不是「默认参数被共享」,而是「被共享的东西可以被改」。
assert:把「rest 必须是链表」这条规矩钉死
assert rest is Link.empty or isinstance(rest, Link)
这一行在说:能放进 rest 的东西只有两种——空表哨兵,或者另一个 Link 实例。别的一律不行。
为什么要拦?因为定义里说得清清楚楚:「剩下的那个链表」。如果允许 Link(1, 2) 存在,那 lnk.rest.first 就会崩,所有依赖递归定义的函数全部失效。把这条规矩写成 assert,好处是错误在造出坏数据的那一刻就爆炸,而不是等到很久以后某个函数走到那里才莫名其妙地崩——后者调试起来痛苦十倍。
亲手试一下它长什么样(这是本机跑出来的真实输出):
>>> Link(1, 2)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "link.py", line 5, in __init__
    assert rest is Link.empty or isinstance(rest, Link)
AssertionError
注意 AssertionError 后面什么信息都没有——因为这条 assert 没写错误消息。看到光秃秃的 AssertionError 而且 traceback 最后一行指向 Link.__init__,你就该立刻想到:我给 rest 传了个不是链表的东西。
顺带一提,first 上没有任何限制。链表里可以装任何东西:整数、字符串、列表、函数,甚至另一个链表。这在后面会造出有意思的显示结果。
两个实例属性
self.first = first
self.rest = rest
这两行是实例属性(instance attribute)赋值:每造一个 Link,就在这个新对象上绑两个名字。所以「链表」这个数据结构说到底就是:一堆散落在内存各处的小对象,每个对象记着一个值和一个「下一个是谁」的引用。它们之间没有任何「连续」的要求,这正是头部插入便宜的根源。
s = Link(3, Link(4, Link(5))) 是怎么被造出来的
关键是求值顺序:算子数(实参)必须先于函数调用被求值,所以最里层的 Link(5) 最先造出来,链表是从尾巴往头长出来的。
Link(3, Link(4, Link(5))),先算算子 Link(拿到类对象),再算算子数。第一个算子数 3 直接得到 3;第二个算子数是 Link(4, Link(5)),是个调用表达式,得先算它。Link(4, Link(5)),同样得先算它的第二个算子数 Link(5)。Link(5):rest 没给,用默认值 Link.empty。assert 通过(rest is Link.empty 为真)。造出对象 A:A.first = 5,A.rest = ()。first=4, rest=A 调用。assert 通过(isinstance(A, Link) 为真)。造出对象 B:B.first = 4,B.rest = A。first=3, rest=B 调用。造出对象 C:C.first = 3,C.rest = B。s 绑到 C 上。注意:s 只指着 C 一个对象,B 和 A 是被 C「顺着 rest 拉住」的,没有任何名字直接指着它们。| Link | class Link |
| s | → Link 实例 C |
| first | 3 |
| rest | → Link 实例 B |
| first | 4 |
| rest | → Link 实例 A |
| first | 5 |
| rest | () 即 Link.empty |
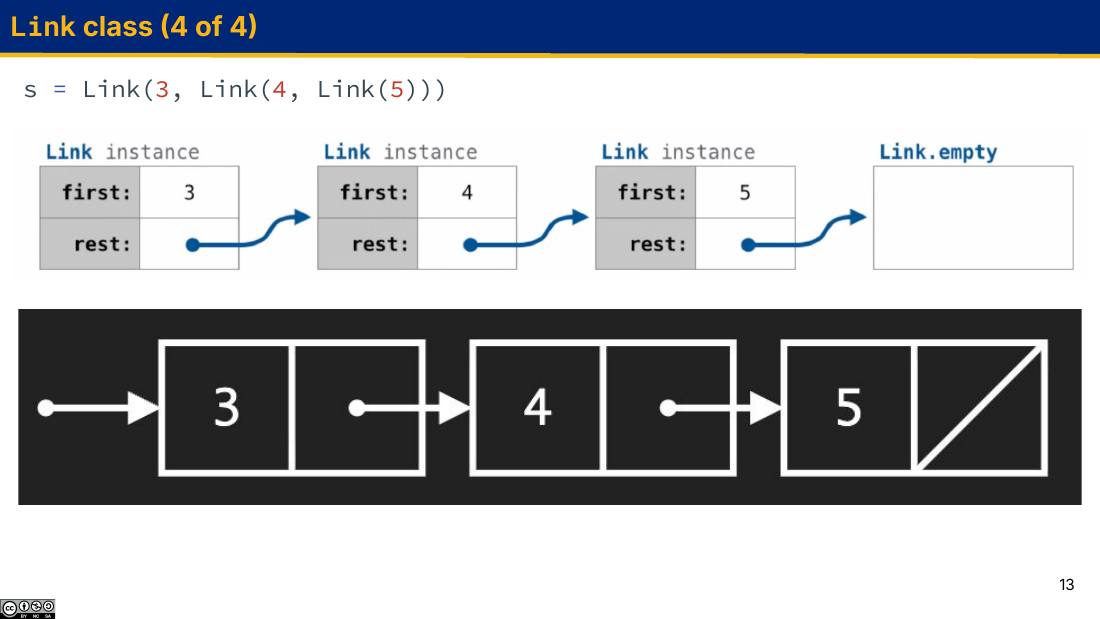
Link.empty。下半部分是教科书常用的方框-箭头图,末尾那道斜杠表示「到头了」。两张图画的是同一件事:三个独立的对象,靠引用串起来,它们在内存里并不需要相邻。这是初学链表时最高频的崩溃点。Link.empty 是个元组,元组上没有 first 和 rest 属性:
>>> s = Link(3, Link(4, Link(5)))
>>> s.rest.rest.rest          # 走到了末尾,这是 Link.empty
()
>>> s.rest.rest.rest.first
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
AttributeError: 'tuple' object has no attribute 'first'
看到 AttributeError: 'tuple' object has no attribute 'first'(或 'rest'),永远是同一个病因:你走过了链表的末尾,在空表上取属性了。治法只有一个——在碰 .first / .rest 之前先问一句 if lnk is Link.empty。本讲后面每一个递归函数的第一行都在做这件事,不是仪式,是保命。
4. __repr__ 与 __str__:同一个链表的两种打印
光有 first 和 rest,链表已经能用了。但如果你在交互式解释器里敲 s,看到的会是这种东西:
<__main__.Link object at 0x7f3a2c1d4e50>
毫无信息量。所以 Link 还定义了两个特殊方法,让链表能被人看懂。这两个方法在第 13 讲见过,这里是它们第一次被用在递归结构上。
__repr__:打印出「怎么造出它」的那行代码
def __repr__(self):
    if self.rest is not Link.empty:
        rest_repr = ', ' + repr(self.rest)
    else:
        rest_repr = ''
    return 'Link(' + repr(self.first) + rest_repr + ')'
__repr__ 的设计目标是忠实:给出的字符串应该能原样粘回解释器、造出一个一样的对象。所以它输出的正是 Link(3, Link(4, Link(5))) 这种形式。
注意它自己就是个递归函数,只是没直接写函数名——repr(self.rest) 会去调用 self.rest 的 __repr__,那又是一个 Link,于是又调一层。三个部件对应得很整齐:
| 递归三要素 | 在 __repr__ 里是哪一句 |
|---|---|
| base case | rest is Link.empty 时 rest_repr = '',不再往下递归 |
| 递归调用 | repr(self.rest) |
| 把结果拼起来 | 'Link(' + repr(self.first) + rest_repr + ')' |
repr(Link(3, Link(4, Link(5)))) 一层层展开再回代
展开(往下钻,每层都卡在拼字符串那一步等着):
C.__repr__():C.rest(=B)不是 empty,所以要先算 repr(B)。挂起。B.__repr__():B.rest(=A)不是 empty,要先算 repr(A)。挂起。A.__repr__():A.rest 是 Link.empty ——base case! rest_repr = ''。回代(从最底下往上还,每层拿到下层结果后完成自己的拼接):
'Link(' + '5' + '' + ')' = 'Link(5)'。'Link(5)',于是 rest_repr = ', Link(5)',返回 'Link(' + '4' + ', Link(5)' + ')' = 'Link(4, Link(5))'。'Link(4, Link(5))',rest_repr = ', Link(4, Link(5))',返回 'Link(3, Link(4, Link(5)))'。括号的嵌套层数正好等于递归的深度——你在屏幕上看到的那串右括号 ))),就是三层递归依次收尾留下的痕迹。
还有一处细节:拼接第一个值时用的是 repr(self.first) 而不是 str(self.first)。这让字符串元素带上引号,从而保持「粘回去能重造」的承诺:
>>> Link('cat', Link('dog'))
Link('cat', Link('dog'))
如果这里用 str,输出会是 Link(cat, Link(dog))——粘回解释器就是 NameError 了。
__str__:打印成人读的样子(而且是迭代写的)
def __str__(self):
    string = '('
    while self.rest is not Link.empty:
        string += str(self.first) + ' '
        self = self.rest
    return string + str(self.first) + ')'
__str__ 的目标是好看,所以它输出 (3 4 5)——元素之间空格分隔,两边一对括号。(这个格式不是随便选的,它就是 Scheme 显示列表的格式。这一讲埋的伏笔,会在讲 Scheme 的时候收。)
这段代码有个非常值得学的地方:它把 self 当普通局部变量重新绑定了。
self = self.rest 合法,而且不会改动任何对象
self 只是方法的第一个形参,跟 curr、x 没有本质区别。self = self.rest 做的事情是在当前帧里把名字 self 重新绑到另一个对象上,它不会修改任何 Link 实例——第 8 讲的「名字改变 vs 对象改变」在这里是关键区分。
循环结束后帧里的 self 指向最后一个节点,而调用方手里的 s 依然指着第一个节点。这就是为什么 print(s) 之后 s 还是完整的。
不过,在自己写的代码里这么用 self 会让读者困惑。建议写成 curr = self 再循环 curr = curr.rest,把「当前走到哪儿」和「我是谁」分开。
print(Link(3, Link(4, Link(5))))
循环条件是 self.rest is not Link.empty——注意它检查的是下一个是不是空,所以最后一个节点不会进循环体,它由 return 那一行单独处理(这样最后一个元素后面才不会多出一个空格)。
| 轮次 | 循环前 self | self.rest 是空吗 | 循环体做了什么 | 循环后 string |
|---|---|---|---|---|
| 入口 | C(first=3) | — | — | '(' |
| 1 | C(first=3) | 否(是 B) | 拼 '3 ';self 挪到 B | '(3 ' |
| 2 | B(first=4) | 否(是 A) | 拼 '4 ';self 挪到 A | '(3 4 ' |
| 3 | A(first=5) | 是 → 退出 | — | '(3 4 ' |
| return | A(first=5) | — | '(3 4 ' + '5' + ')' | '(3 4 5)' |
__str__ 处理不了空表
如果 self 是空表,根本不会走到这个方法(空表是元组,print(Link.empty) 打出的是 (),用的是元组自己的显示)。但如果你照着这个思路自己写一个 link_to_string(lnk) 函数,忘了先判空,第一件事就是 lnk.rest,直接 AttributeError。
顺带一提:print(Link.empty) 输出 () 其实挺巧的——Scheme 里空表也正好写作 ()。
两个方法的对照
__repr__ | __str__ | |
|---|---|---|
| 什么时候被调用 | 在解释器里直接敲变量名;repr(x);被别的容器包着显示时 | print(x);str(x);f-string 里插值 |
| 输出示例 | Link(3, Link(4, Link(5))) | (3 4 5) |
| 目标 | 忠实:能粘回去重造对象 | 可读:给人看 |
| 写法 | 递归 | 迭代(while) |
| 元素用什么转字符串 | repr(字符串带引号) | str(字符串不带引号) |
doctest 检查的是 __repr__ 的输出——因为 doctest 模拟的是「在解释器里敲一行」。所以本讲所有 doctest 里期望值都写成 Link(...) 形式;只有显式写了 print(...) 的那几行才会看到 (...) 形式。写作业时看清楚 doctest 里有没有 print,这决定了你该对哪种输出负责。
5. 走链表:.first 和 .rest 的连招
访问链表元素没有下标,只有顺着 rest 一步步走。规律非常机械:要拿第 i 个元素,就写 i 个 .rest 再加一个 .first。
>>> s = Link(1)
>>> s.first
1
>>> s.rest is Link.empty
True
>>> s = Link(3, Link(4, Link(5)))
>>> s
Link(3, Link(4, Link(5)))
>>> print(s)
(3 4 5)
| 表达式 | 值 | 它是什么 |
|---|---|---|
s.first | 3 | 一个整数 |
s.rest | Link(4, Link(5)) | 一个完整的链表 |
s.rest.first | 4 | 一个整数 |
s.rest.rest | Link(5) | 一个完整的链表 |
s.rest.rest.first | 5 | 一个整数 |
s.rest.rest.rest | () | Link.empty,不是 Link 实例 |
s.rest.rest.rest.first | — | AttributeError |
读一串 .rest.rest.first 的时候,从左往右念成动作:「往后走一步、再往后走一步、然后看这里装的值」。.rest 是走路,.first 是抬头看。走路可以走很多步,抬头看只能是最后一个动作——因为 .first 拿到的是里面装的值,一般不再是链表,没法继续走。
链表不支持的那些操作
Link 是我们手写的类,Python 内置列表的那些便利它一概没有。下面每一条都是本机跑出来的真实报错:
>>> s = Link(3, Link(4, Link(5)))
>>> len(s)
TypeError: object of type 'Link' has no len()
>>> s[0]
TypeError: 'Link' object is not subscriptable
>>> for x in s:
...     print(x)
TypeError: 'Link' object is not iterable
| 你想做的事 | 为什么不行 | 链表里该怎么写 |
|---|---|---|
len(s) | 没定义 __len__ | 自己写 length(s)(下一节) |
s[2] | 没定义 __getitem__ | s.rest.rest.first |
for x in s | 没定义 __iter__ | while curr is not Link.empty: ... curr = curr.rest |
s.append(6) | 没这个方法 | 走到最后一个节点,把它的 rest 设成 Link(6) |
这些「不支持」不是缺陷,是本讲的教学意图:把便利拿掉,你才会被迫直面「遍历一个序列到底是怎么回事」。
WWPD:print(Link(Link(5), 6))
课上的第一道 What Would Python Display。先别急着读下去,自己想 20 秒。
看答案
答案是报错,而且错在你可能没注意的地方:
>>> print(Link(Link(5), 6))
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "link.py", line 5, in __init__
    assert rest is Link.empty or isinstance(rest, Link)
AssertionError
逐步看求值顺序,就知道错在哪一步:
print(...),先算它的算子数 Link(Link(5), 6)。Link(Link(5), 6),先算它的两个算子数:Link(5) 造出一个合法的单元素链表;6 得到整数 6。__init__,此时 first 绑到那个链表、rest 绑到 6。执行 assert:6 is Link.empty 为 False,isinstance(6, Link) 也为 False,整个条件为假 → AssertionError。print 根本没被调用,屏幕上不会出现任何正常输出。坑在哪:Link(Link(5), 6) 看着像「元素是 5 和 6 的链表」,但参数顺序是 Link(first, rest)——Link(5) 落在了 first 上,6 落在了 rest 上。first 装个链表完全合法(first 上没有 assert),出问题的是 rest:它必须是链表或空表,而 6 两者都不是。
把它改成合法的再看(真实输出):
>>> Link(Link(5), Link(6))
Link(Link(5), Link(6))
>>> print(Link(Link(5), Link(6)))
((5) 6)
((5) 6) 的外层括号是这个链表本身,里面第一个元素是一个嵌套的链表,被 str 打成 (5)。
课上还有 WWPD #2 和 #3,但它们是现场 Poll Everywhere 投票题,题面只在投票页面上显示,幻灯片里只留下了二维码,没有题目文字。这里不编造它们的内容。想自测的话,本页最后的「动手练习」里有若干同类型的题。
6. length:同一个函数,递归写一遍,迭代写一遍
第一个真正的链表函数:数一数链表里有几个元素。它足够简单,可以把两种视角都完整演示一遍。
递归版
def length(lnk: Link) -> int:
    """Returns the length of a linked list"""
    if lnk is Link.empty:
        return 0
    return 1 + length(lnk.rest)
两行。但这两行里藏着链表递归的标准骨架,后面每个函数都是它的变体:
| 骨架 | 这里对应哪句 | 为什么必须这样 |
|---|---|---|
| ① 先判空 | if lnk is Link.empty: | 空表没有 .first / .rest,不先拦住就会 AttributeError |
| ② base case 的答案 | return 0 | 空表长度就是 0,这是唯一不靠递归的事实 |
③ 对 lnk.rest 递归 | length(lnk.rest) | lnk.rest 本身是完整链表,所以能原样交给同一个函数 |
| ④ 用当前节点补全答案 | 1 + ... | 「剩下那截的长度」加上「我自己这一个」 |
第 ③ 步是全讲的关键:你敢把 lnk.rest 直接传给 length,唯一的理由是「剩下的也是一个链表」这条定义。如果 rest 存的是别的形式,这行代码就不成立。数据结构的递归定义和函数的递归写法,是严丝合缝对上的。
length(Link(3, Link(4, Link(5)))) 完整展开 + 回代
为了看清,把三个节点记作 C(first=3)、B(first=4)、A(first=5)。
展开阶段——每一层都因为要算 1 + length(...) 而必须先把递归调用算完,所以都挂在那里等:
length(C)   lnk=C   C 不是空 → 返回 1 + length(B)      ← 等 length(B)
  length(B)   lnk=B   B 不是空 → 返回 1 + length(A)    ← 等 length(A)
    length(A)   lnk=A   A 不是空 → 返回 1 + length(())  ← 等 length(())
      length(())  lnk=()  是空! → 直接 return 0        ← base case,栈到底了
回代阶段——从最深处往回还,每层拿到下层的值就能算完自己的表达式:
length(()) 返回 0。length(A) 的 1 + length(()) 变成 1 + 0,返回 1。length(B) 的 1 + length(A) 变成 1 + 1,返回 2。length(C) 的 1 + length(B) 变成 1 + 2,返回 3。一共开了 4 个帧(3 个非空节点 + 1 个空表),每个帧里 lnk 绑着链表上的一个位置。链表有多长,栈就有多深——这一点在下一讲讲效率时会重新出现(也是为什么超长链表的递归版可能 RecursionError)。
| length | func length(lnk) |
| s | → C |
| lnk | → C (first=3) |
| 返回值 | 3 |
| lnk | → B (first=4) |
| 返回值 | 2 |
| lnk | → A (first=5) |
| 返回值 | 1 |
| lnk | () 即 Link.empty |
| 返回值 | 0 |
注意每一帧的 parent 都是 Global,不是「上一帧」。函数的父帧由定义位置决定(length 定义在全局),跟谁调用了它没关系——这是第 4 讲的规则,在递归里同样成立。所以 f4 里查不到的名字会去 Global 找,不会去 f3 找。
迭代版
def length(lnk: Link) -> int:
    """Returns the length of a linked list"""
    curr = lnk
    total = 0
    while curr is not Link.empty:
        total += 1
        curr = curr.rest
    return total
这是「相对视角」的写法:curr 是一个游标,从头开始,每轮往后挪一格,挪不动了(碰到 Link.empty)就停。第 2 讲讲循环时说的三件事——初始化、条件、更新——在这里对应得很干净:
| 循环三要素 | 代码 | 漏掉会怎样 |
|---|---|---|
| 初始化 | curr = lnk / total = 0 | 漏了 total = 0 → UnboundLocalError |
| 条件 | curr is not Link.empty | 写成 curr.rest is not Link.empty → 少数一个 |
| 更新 | curr = curr.rest | 漏了就是死循环,curr 永远指着第一个节点 |
(3 4 5)
| 时刻 | curr | 条件成立? | total |
|---|---|---|---|
| 进入循环前 | C | — | 0 |
| 第 1 轮开始 | C | 是 | 0 → 1,然后 curr 挪到 B |
| 第 2 轮开始 | B | 是 | 1 → 2,然后 curr 挪到 A |
| 第 3 轮开始 | A | 是 | 2 → 3,然后 curr 挪到 () |
| 第 4 次判定 | () | 否 → 退出 | 3 |
| return | — | — | 返回 3 |
整个过程只有一个帧(while 不新建帧),curr 在这个帧里被反复重新绑定。对比递归版的 4 个帧,这就是「省栈空间」的直观含义。
curr = lnk?
直接拿 lnk 当游标写 lnk = lnk.rest 其实也能跑,而且不会破坏调用方的链表(重新绑定形参只影响当前帧,跟 __str__ 里 self = self.rest 是同一回事)。
但请养成写 curr = lnk 的习惯,理由有两个:一是可读性——lnk 表示「传进来的那个链表」,curr 表示「我现在走到哪儿」,两个概念分开写,读代码的人不会混;二是很多题目后面还要用到原始的 lnk(比如既要遍历又要返回原表),你一旦把 lnk 挪走了就找不回开头了——链表不能往回走,节点里没有指向前一个的引用。
凡是要构造一个新链表的任务(下一节 double 的造新版、后面的 filter_link),递归几乎总是更短——因为构造过程天然是「新的 Link(...) 包着递归结果」。凡是要就地修改、或者要找到某个位置停下来的任务(后面的 insert),迭代往往更直白。
两种都练。考试里经常直接要求「用递归实现」或「不用递归实现」。
7. double:变异原表,还是造一张新表?
这是本讲最重要的一节。同一个需求「把链表里每个数翻倍」,有两种完全不同的实现,它们的函数签名、返回值、对原表的影响全都不同。分不清这两者,你的链表代码会以最难查的方式出错。
版本一:就地变异(in place)
def double(lnk: Link):
    """Doubles a linked list in place (e.g. only mutates it)
    >>> s = Link(2, Link(3, Link(4)))
    >>> double(s)
    >>> s
    Link(4, Link(6, Link(8)))
    """
    if lnk is not Link.empty:
        lnk.first *= 2
        double(lnk.rest)
先读 doctest,它把这个函数的契约说得很清楚:
>>> double(s)这一行下面没有期望输出——意思是「这个调用返回None」。函数体里确实一个return都没有。>>> s显示的是翻倍后的结果——原来那个s被改掉了。
再看代码结构,它跟递归骨架相比有个明显的差别:base case 什么都不做。写成 if lnk is not Link.empty: 而不是 if lnk is Link.empty: return,效果一样——空表就是没什么可翻倍的,直接结束。
关键的两行:
lnk.first *= 2:改的是对象。lnk指着的那个Link实例,它的first属性被换成了新值。谁还指着这个实例,谁就看得见这个改动——包括调用方手里的s。double(lnk.rest):递归调用的结果被丢掉了(既没赋值也没 return)。这不是 bug——我们要的不是它的返回值,是它顺手改掉后面所有节点这个副作用。
double(s),s = Link(2, Link(3, Link(4)))
节点记作 P(first=2)→ Q(first=3)→ R(first=4)。
double(P):P 不是空。执行 P.first *= 2 → P.first 从 2 变成 4。然后调 double(Q)。double(Q):Q 不是空。Q.first *= 2 → Q.first 从 3 变成 6。然后调 double(R)。double(R):R 不是空。R.first *= 2 → R.first 从 4 变成 8。然后调 double(())。double(()):是空表,if 条件为假,函数体一句都不执行,隐式返回 None。None 丢掉,然后也隐式返回 None。s 从头到尾一直指着 P,指针没动过;动的是 P、Q、R 三个对象内部的 first。所以 s 现在显示 Link(4, Link(6, Link(8)))。这是「回代阶段无事发生」的典型递归——递归只是当循环用,用来走遍每个节点执行副作用。这类递归可以逐字翻译成 while 循环:curr = lnk;while curr is not Link.empty: curr.first *= 2; curr = curr.rest。
s 指向的对象没变,对象里的值变了)
调用前:
  s ──→ [ 2 | ·]──→ [ 3 | ·]──→ [ 4 | / ]
          P           Q           R

调用后:
  s ──→ [ 4 | ·]──→ [ 6 | ·]──→ [ 8 | / ]
          P           Q           R      ← 还是同样这三个对象!
版本二:造一张新表
def double(lnk: Link) -> Link:
    """
    Returns a new linked list which is
    the result of doubling the input
    >>> s = Link(2, Link(3, Link(4)))
    >>> double(s)
    Link(4, Link(6, Link(8)))
    >>> s
    Link(2, Link(3, Link(4)))
    """
    if lnk is Link.empty:
        return Link.empty
    else:
        return Link(lnk.first * 2, double(lnk.rest))
同名同参,doctest 却完全不同——差别就在这两行:
>>> double(s)这一行下面有期望输出Link(4, Link(6, Link(8))),说明它返回了一个链表。>>> s显示的还是Link(2, Link(3, Link(4)))——原表纹丝不动。
代码上的三处对应改动:
| 变异版 | 造新版 | |
|---|---|---|
| 类型标注 | def double(lnk: Link):(无返回标注) | def double(lnk: Link) -> Link: |
| base case | 什么都不做(返回 None) | return Link.empty——必须给出「空表翻倍还是空表」这个答案 |
| 递归 case | lnk.first *= 2 改对象;递归结果丢弃 | return Link(lnk.first * 2, double(lnk.rest))——用递归结果当新节点的 rest |
| 调用方怎么用 | double(s) 然后看 s | t = double(s) 然后看 t |
| 原表 | 被改了 | 没被碰过 |
这次回代阶段非常关键——新链表正是在回代时从尾往头拼出来的,跟第 3 节里 Link(3, Link(4, Link(5))) 的构造顺序一模一样。
展开(每层都卡在「要造 Link(新值, ???),得先知道 ??? 是什么」):
double(P)  P.first=2  → 要 return Link(4, double(Q))    ← 等 double(Q)
  double(Q)  Q.first=3  → 要 return Link(6, double(R))  ← 等 double(R)
    double(R)  R.first=4  → 要 return Link(8, double(())) ← 等 double(())
      double(())  是空 → return Link.empty              ← base case
回代(新对象记作 P'、Q'、R'):
double(()) 返回 Link.empty,也就是 ()。double(R) 现在能造了:Link(8, ()) → 新对象 R',返回它。R 本身没被碰,只是读了 R.first。double(Q):Link(6, R') → 新对象 Q',返回它。double(P):Link(4, Q') → 新对象 P',返回它。Link(4, Link(6, Link(8)))。原来的 P→Q→R 三个对象值没变,仍是 Link(2, Link(3, Link(4)))。内存里现在有六个 Link 实例。 s ──→ [ 2 | ·]──→ [ 3 | ·]──→ [ 4 | / ] ← 原表,一个字节没动
P Q R
t ──→ [ 4 | ·]──→ [ 6 | ·]──→ [ 8 | / ] ← 全新的三个对象
P' Q' R'
本机实测确认它们确实不共享任何节点:double(s) is s 是 False,double(s).rest is s.rest 也是 False。
怎么一眼分辨自己该写哪一种
看 docstring 和 doctest,三个信号:
| 信号 | 说明要写变异版 | 说明要写造新版 |
|---|---|---|
| docstring 措辞 | "Mutate ..."、"in place"、"only mutates it" | "Return a ..."、"Returns a new ..." |
| 调用那行 doctest | 下面没有期望输出 | 下面有期望输出 |
| 调用后检查原表 | 原表显示已改变 | 常配一句 # no mutation!,原表不变 |
| 类型标注 | 通常没有 -> 返回类型 | -> Link |
return lnk
很多人写完变异版会觉得「不返回点什么心里不踏实」,于是在末尾补一句 return lnk。链表确实被正确翻倍了,但 doctest 会挂——因为 >>> double(s) 那一行本来不该显示任何东西。真实的失败信息长这样:
**********************************************************************
File "16.py", line 5, in 16.double
Failed example:
    double(s)
Expected nothing
Got:
    Link(4, Link(6, Link(8)))
**********************************************************************
Expected nothing / Got: ... 是一个专属信号:你在一个「只该变异、不该返回」的函数里返回了值。(顺带一提,把最后一行递归写成 return double(lnk.rest) 反而不会触发这个报错——因为最深处 base case 隐式返回 None,一路原样传回来,最终还是 None。它能通过 doctest,但语义上是误导性的写法,别学。)
更常见的反向错误是把 造新版 当变异版调用:
>>> s = Link(2, Link(3, Link(4)))
>>> double(s)          # 造新版,返回值没接住
Link(4, Link(6, Link(8)))
>>> s                  # 你以为 s 变了?
Link(2, Link(3, Link(4)))
新表被造出来了,但没有任何名字指着它,转眼就被垃圾回收了。造新版必须写成 t = double(s)。
return 或漏写
造新版的 base case 必须是 return Link.empty。写成光秃秃的 return(返回 None)会怎样?None 会被当成 rest 传给上一层的 Link(...),于是 assert 立刻爆炸(真实 traceback):
Traceback (most recent call last):
  File "16.py", line 6, in <module>
    double(Link(2, Link(3)))
  File "16.py", line 5, in double
    return Link(lnk.first*2, double(lnk.rest))
  File "16.py", line 5, in double
    return Link(lnk.first*2, double(lnk.rest))
  File "link.py", line 5, in __init__
    assert rest is Link.empty or isinstance(rest, Link)
AssertionError
注意 traceback 中间那两行重复的 in double——这是递归的指纹,说明炸之前已经往下钻了两层。凡是在 Link.__init__ 里 AssertionError,先去检查你的 base case 返回了什么。这条经验能省你很多时间。
lnk.first *= 2 改的到底是谁
这里有个第 8 讲的老问题。整数是不可变的,所以 lnk.first *= 2 不可能「把 2 这个整数变成 4」。它做的是:算出 lnk.first * 2 这个新整数,然后把 lnk 那个实例上的 first 属性重新绑定到新整数上。
被变异的是 Link 实例,不是整数。Link 实例可变(可以给属性重新赋值),这才是整个「in place」得以成立的前提。如果 Link 也不可变,版本一根本写不出来。
8. 实战一:filter_link
课堂练习第一题,起始代码在 16.py:
def filter_link(f, lnk: Link) -> Link:
    """
    Return a Link that contains only the elements of `x` inside `lnk`
    for which `f(x)` is a truthy value.

    >>> is_odd = lambda x: x % 2 == 1
    >>> lnk = Link(1, Link(2, Link(3, Link(4, Link(5)))))
    >>> filter_link(is_odd, lnk)
    Link(1, Link(3, Link(5)))
    >>> lnk  # no mutation!
    Link(1, Link(2, Link(3, Link(4, Link(5)))))

    >>> short = lambda x: len(x) <= 3
    >>> lnk = Link('bottle', Link('cat', Link('dog', Link('gateway', Link('a')))))
    >>> filter_link(short, lnk)
    Link('cat', Link('dog', Link('a')))
    >>> lnk  # no mutation!
    Link('bottle', Link('cat', Link('dog', Link('gateway', Link('a')))))
    """
题目到底要什么
翻成人话:造一个新链表,只留下那些让 f(x) 为真的元素,顺序不变。它就是内置 filter 的链表版。
docstring 和 doctest 里有几处必须读出来的信息:
- "Return a Link" +
-> Link标注 + 调用那行有期望输出 → 造新版,不是变异版。 # no mutation!这条注释是全题的重点。它明确要求:跑完之后原链表必须一模一样。这排除了「顺手改改原表的rest把不要的节点跳过去」这种取巧写法。- "truthy value" 而不是 "
True"——用if f(x)就对了,别写if f(x) == True。第 2 讲讲过真假性。 - 第二组 doctest 里
f是short = lambda x: len(x) <= 3,元素是字符串——提醒你f是个参数,函数体里绝不能假设元素是数字。
边界情况(doctest 没直接测,但你的代码必须扛得住):输入是空表 → 返回空表;所有元素都被过滤掉 → 返回 Link.empty 而不是崩掉或返回 None(这条最容易漏);只有第一个或只有最后一个元素被留下 —— 拼接逻辑要能处理。
怎么想到的
从「输出是个链表」这一点出发,先把递归骨架的空架子摆出来:
def filter_link(f, lnk):
    if lnk is Link.empty:
        return Link.empty          # 空表过滤完还是空表
    ...                            # 这里要用 lnk.first 和 filter_link(f, lnk.rest)
base case 想都不用想:空表里没有元素,过滤完当然还是空表。注意必须 return Link.empty,不能光写 return——上一节已经演示过后者会怎么炸。
递归 case 的关键一问:假设 filter_link(f, lnk.rest) 已经神奇地把后面那截过滤好了(这是递归的「信仰之跃」),我拿这个结果怎么拼出完整答案?
答案分两种情况,取决于当前这个元素该不该留:
f(lnk.first) 为真:当前元素要留下,而且要留在最前面(顺序不变)。所以答案是「一个装着 lnk.first、rest 是过滤好的后半截」的新节点 → Link(lnk.first, filtered_rest)。f(lnk.first) 为假:当前元素扔掉。扔掉之后,答案就是过滤好的后半截,一个字都不用加 → return filtered_rest。第 2 种情况是这道题唯一有点意思的地方。很多人在这里会卡住,想「扔掉了要返回什么呢?」——要返回的就是后半截本身。「跳过这一个」在造新表的写法里表现为「不给它包一层新 Link」,仅此而已。原表的那个节点还好好地待在原表里,我们只是没有为它造对应的新节点。
代码逐行讲
def filter_link(f, lnk: Link) -> Link:
    if lnk is Link.empty:
        return Link.empty

    filtered_rest = filter_link(f, lnk.rest)
    if f(lnk.first):
        return Link(lnk.first, filtered_rest)
    else:
        return filtered_rest
| 行 | 为什么是这样,而不是别样 |
|---|---|
if lnk is Link.empty: | 必须是第一行。下面所有代码都要碰 lnk.first / lnk.rest,不先拦住空表就是 AttributeError: 'tuple' object has no attribute 'rest'。 |
return Link.empty | 返回哨兵本身,而不是 Link()(那样会 TypeError,first 是必填参数)也不是 None。 |
filtered_rest = filter_link(f, lnk.rest) | 两个分支都要用到它,先算出来存着,避免写两遍。递归调用要把 f 原样传下去——漏传 f 是最高频的手误,报错是 TypeError: filter_link() missing 1 required positional argument: 'lnk'。 |
if f(lnk.first): | 把元素本身交给 f,不是把节点交给它。写成 f(lnk) 的话,is_odd 会去算 Link % 2 → TypeError。 |
return Link(lnk.first, filtered_rest) | 造一个新节点。这一句是「no mutation」的保证:我们读了 lnk.first,但从没给 lnk 的任何属性赋过值。 |
else: return filtered_rest | 直接返回后半截的结果,等于把当前元素跳过。 |
判断一个函数会不会改动传进来的链表,方法很机械:在函数体里搜 lnk.first = 和 lnk.rest =(含 +=、*= 这些)。一个都没有,就一定不会变异。
读属性(lnk.first 出现在等号右边或表达式里)永远是安全的。filter_link 全程只读不写,所以 # no mutation! 自动成立。
验证:手动追踪 filter_link(is_odd, Link(1, Link(2, Link(3))))
为了写得下,用三个元素的版本;五个元素的过程完全一样。把节点记作 N1(1) → N2(2) → N3(3)。
展开阶段——注意每层都是先算 filtered_rest(也就是先钻到底),再决定自己留不留:
filter_link(is_odd, N1)   非空 → 先算 filter_link(is_odd, N2)      ← 挂起
  filter_link(is_odd, N2)   非空 → 先算 filter_link(is_odd, N3)    ← 挂起
    filter_link(is_odd, N3)   非空 → 先算 filter_link(is_odd, ())  ← 挂起
      filter_link(is_odd, ())   是空 → return Link.empty          ← base case
回代阶段:
()。filter_link(is_odd, N3):filtered_rest = ()。判断 is_odd(3) → 3 % 2 == 1 → True。返回 Link(3, ()),即新节点 M3,显示为 Link(3)。filter_link(is_odd, N2):filtered_rest = M3。判断 is_odd(2) → 2 % 2 == 1 → 0 == 1 → False。走 else,原样返回 M3——没有为 2 造任何节点。filter_link(is_odd, N1):filtered_rest = M3(注意:不是 M2,因为 2 被跳过了,这一层收到的就是 M3)。判断 is_odd(1) → True。返回 Link(1, M3),即新节点 M1。Link(1, Link(3))。五元素版本同理得到 Link(1, Link(3, Link(5))),与 doctest 一致。数一下对象:原表 3 个节点原封不动,新造了 2 个节点(M1、M3)。被过滤掉的元素不产生新对象,这也是为什么结果表可能比原表短。
原表(没被碰过):
  lnk ──→ [ 1 | ·]──→ [ 2 | ·]──→ [ 3 | / ]
            N1          N2          N3

结果表(全是新对象):
  M1  ──→ [ 1 | ·]──────────────→ [ 3 | / ]
            M1                      M3

两条链子没有共享任何节点:filter_link(...).rest is lnk.rest.rest → False
有人会这么想:「留下的节点我干嘛要重造一个?直接把原节点接起来不就行了。」于是写成:
filtered_rest = filter_link(f, lnk.rest)
if f(lnk.first):
    lnk.rest = filtered_rest      # ← 复用原节点,改它的 rest
    return lnk
return filtered_rest
过滤结果是对的,但 # no mutation! 那两行 doctest 会挂。真实输出:
**********************************************************************
File "16.py", line 8, in 16.filter_link
Failed example:
    lnk  # no mutation!
Expected:
    Link(1, Link(2, Link(3, Link(4, Link(5)))))
Got:
    Link(1, Link(3, Link(5)))
**********************************************************************
原表被就地改成了过滤后的样子——因为 lnk.rest = filtered_rest 把 N1 的 rest 从 N2 改成了新的链,N2 和 N4 就此从链上脱落。「结果对了但原表也变了」是链表题最隐蔽的错误,doctest 里那句 # no mutation! 就是专门用来抓它的。看到这种失败,去函数体里找唯一那处 lnk.rest = ...。
return Link.empty
「这个元素不要,那就返回空表」——这会把链表从这里截断。用 is_odd 过滤 Link(2, Link(3)) 试试:第一个元素 2 是偶数,直接返回空表,后面的 3 永远没机会被看到,结果是 () 而不是 Link(3)。
「不要这个元素」和「后面都不要了」是两件完全不同的事。前者写 return filtered_rest,后者才是 return Link.empty。
9. 实战二:insert——链表最擅长的那件事
课堂练习第二题。这题正好把第 1 节那个「链表凭什么快」的承诺兑现:插入不需要挪动任何元素,只需要改一个 rest。
def insert(lnk: Link, index: int, value):
    """
    Mutate `lnk` to insert `value` at `index`.
    Assume that 0 < `index` <= the length of `lnk`.

    >>> lnk = Link('cat', Link('dog', Link('a')))
    >>> insert(lnk, 1, 'fish')
    >>> lnk
    Link('cat', Link('fish', Link('dog', Link('a'))))

    >>> lnk = Link(1, Link(2, Link(3, Link(4, Link(5)))))
    >>> insert(lnk, 3, 'yay')
    >>> lnk
    Link(1, Link(2, Link(3, Link('yay', Link(4, Link(5))))))

    >>> lnk = Link(1, Link(2, Link(3, Link(4, Link(5)))))
    >>> insert(lnk, 5, 6)
    >>> lnk
    Link(1, Link(2, Link(3, Link(4, Link(5, Link(6))))))
    """
题目到底要什么
「把 value 插到 lnk 的第 index 位」——插完之后,新值应该正好能用 index 个 .rest 加一个 .first 取到。
四个必须读出来的信息:
- "Mutate" + 调用那行 doctest 下面没有期望输出 + 之后单独看
lnk发现变了 → 这是变异版。函数不返回任何东西。 0 < index:不需要处理 index 为 0 的情况。课上专门给了这个提示,而且它不是「为了让题简单」——见下面的 warn 框,这是链表的一个根本限制。index <= 长度:index 可以正好等于长度,也就是插到末尾(第三组 doctest 就是这个:长度 5 的链表,insert(lnk, 5, 6)把 6 挂到最后)。这是最容易写崩的边界。- 插入是在「原来第 index 个元素之前」——看第一组:
('cat' 'dog' 'a')插 index=1 得到('cat' 'fish' 'dog' 'a'),'fish'占了原本'dog'的位置,'dog'往后退。
这不是出题人偷懒。假设允许 insert(lnk, 0, 'new'),你要做的是「让 'new' 变成第一个元素」。但函数里只有 lnk 这一个名字指着第一个节点,你有两条路,都走不通:
路一:造一个新节点 Link('new', lnk) 然后 lnk = 那个新节点。这只是在函数帧里重新绑定形参,调用方的 lnk 还指着老的第一个节点,外面看不到任何变化。(第 8 讲的老结论:重新绑定名字不是变异对象。)
路二:变异第一个节点本身——把它的 first 改成 'new',再把它的 rest 改成一个装着老 first 的新节点。这确实能做到,也确实能得到正确结果,但代价是「插入在头部」变成了两次属性赋值加一次构造。它可行,只是课上不要求。
关键教训:变异一个链表的函数,只能改它能拿到的节点的属性;它无法改变调用方「哪个节点是第一个」这个事实。这是链表变异类题目的通用约束,Lab 08 和考试题里会反复出现。
怎么想到的
先想清楚「插入」这个动作在方框-箭头图上到底是什么。要在 ('cat' 'dog' 'a') 的 index=1 处插 'fish':
插入前:
  lnk ──→ [cat| ·]──→ [dog| ·]──→ [ a | / ]
            N1          N2          N3

插入后:
  lnk ──→ [cat| ·]──→ [fish| ·]──→ [dog| ·]──→ [ a | / ]
            N1          NEW          N2          N3
                 ↑改了这一个 rest    ↑N2、N3 完全没动
只有两件事发生了:造一个新节点 NEW,它的 first 是 'fish'、rest 是原来 N1 的 rest(也就是 N2);然后把 N1 的 rest 改成 NEW。N2、N3 一个字节都没动——这就是链表插入 $\Theta(1)$ 的全部内容。
于是问题变成:怎么找到「第 index-1 个节点」?因为要改的是它的 rest。找到之后,插入动作永远是同样两行。
链表只能往后走,不能往回走。所以凡是要修改位置 i 的结构(插入、删除),你都必须停在位置 i−1 上——因为要改的是 i−1 那个节点的 rest。这条经验适用于本讲之后所有的链表变异题。
这也再次解释了为什么 index=0 不行:位置 0 的前一个节点不存在。
递归版
def insert(lnk: Link, index: int, value):
    if index == 1:
        temp = lnk.rest
        lnk.rest = Link(value, temp)
    else:
        insert(lnk.rest, index - 1, value)
递归的思路是:「在 lnk 的第 index 位插入」等价于「在 lnk.rest 的第 index−1 位插入」——每往后走一个节点,目标位置就近一格。一直走到 index == 1,此刻 lnk 正好站在「要插入位置的前一个节点」上,动手。
| 行 | 为什么是这样 |
|---|---|
if index == 1: | base case 是 1 而不是 0。因为我们要停在前一个节点上:index == 1 意味着「要插的位置就在我的正后方」。 |
temp = lnk.rest | 先把原来的后半截存起来。这是全题最关键的一行——下一行就要覆盖 lnk.rest 了,不先存住就永远找不回来了。 |
lnk.rest = Link(value, temp) | 造新节点,让它接上老的后半截;再把当前节点的 rest 指向它。顺序不能反。 |
insert(lnk.rest, index - 1, value) | 往后走一步,目标位置减一。没有 return——这是变异版,我们要的是它的副作用。 |
temp 其实可以省掉,写成 lnk.rest = Link(value, lnk.rest) 也完全正确。为什么?因为赋值语句先把右边整个求完值,再做绑定:右边的 lnk.rest 在 Link(...) 构造的那一刻读到的还是老的后半截,等新节点造好了才轮到左边的属性被改写。
课件写 temp 是为了让「先保存、再覆盖」这个思路看得见。两种都对,但你必须明白为什么一行版也安全——不明白的话,遇到 lnk.rest.rest = ... 这类稍复杂的表达式就会出错。
insert(lnk, 3, 'yay'),lnk = Link(1, Link(2, Link(3, Link(4, Link(5)))))
节点记作 N1(1) → N2(2) → N3(3) → N4(4) → N5(5)。
展开阶段(每层只是往后挪一步,什么都还没改):
insert(N1, 3, 'yay')   index=3 ≠ 1 → insert(N1.rest, 2, 'yay') 即 insert(N2, 2, 'yay')
  insert(N2, 2, 'yay')   index=2 ≠ 1 → insert(N2.rest, 1, 'yay') 即 insert(N3, 1, 'yay')
    insert(N3, 1, 'yay')   index=1 → 动手!
base case 里做的事:
temp = N3.rest → temp 指向 N4(也就是 Link(4, Link(5)) 这一整截)。Link('yay', temp) 造出新节点 NEW:NEW.first = 'yay',NEW.rest = N4。N3.rest = NEW:N3 原本指向 N4,现在改指 NEW。N4、N5 一个字节没动,它们只是换了个「前任」。None。回代阶段:第 2、1 层各自把 None 丢掉,也返回 None。什么都不发生——修改已经在 base case 里完成了,靠的是「N3 这个对象被大家共享」。
调用方的 lnk 从头到尾指着 N1,N1 也没被改过,但顺着 N1 走下去现在会经过 NEW。所以 lnk 显示为 Link(1, Link(2, Link(3, Link('yay', Link(4, Link(5))))))——与 doctest 一致。
前:
  lnk ─→[1|·]─→[2|·]─→[3|·]─→[4|·]─→[5|/]
          N1     N2     N3     N4     N5

后:
  lnk ─→[1|·]─→[2|·]─→[3|·]─→[yay|·]─→[4|·]─→[5|/]
          N1     N2     N3      NEW      N4     N5
                         ↑只有这一个 rest 被赋值过
迭代版
def insert(lnk: Link, index: int, value):
    curr = lnk
    i = 0
    while i < index - 1:
        i += 1
        curr = curr.rest
    temp = curr.rest
    curr.rest = Link(value, temp)
同一个思路换个说法:用游标 curr 往前走 index - 1 步,停在目标位置的前一个节点上,然后做那两行插入。
insert(lnk, 3, 'yay')
index = 3,所以循环条件是 i < 2,会走 2 步。
| 时刻 | i | curr | i < index-1 即 i < 2 |
|---|---|---|---|
| 循环前 | 0 | N1(first=1) | — |
| 第 1 轮后 | 1 | N2(first=2) | 0 < 2 成立,走了 |
| 第 2 轮后 | 2 | N3(first=3) | 1 < 2 成立,走了 |
| 第 3 次判定 | 2 | N3 | 2 < 2 不成立 → 退出 |
退出时 curr 停在 N3——正是「第 3 个位置的前一个节点」。接下来两行和递归版的 base case 一模一样:temp = N3.rest(=N4),N3.rest = Link('yay', N4)。结果完全相同。
验证末尾插入这个边界
第三组 doctest 是 insert(lnk, 5, 6),链表长度正好是 5。这是最容易崩的一组,手动追一遍:
index 从 5 依次减到 1,lnk 从 N1 走到 N5(最后一个节点,first=5)。index == 1,动手。temp = N5.rest → temp 是 Link.empty,也就是 ()。Link(6, ())——assert 通过,因为 rest is Link.empty 那一半为真。造出 NEW。N5.rest = NEW。链表末尾多了一个节点,结果是 Link(1, Link(2, Link(3, Link(4, Link(5, Link(6))))))。关键在第 2–3 步:temp 是空表这件事完全没问题,因为 Link 的 rest 本来就允许是空表。代码里不需要为「插到末尾」写任何特判——这是它写得漂亮的地方。
temp,把后半截丢了
最高频的错误写法:
if index == 1:
    lnk.rest = Link(value)        # ← 忘了把老的后半截接上
Link(value) 的 rest 用了默认值 Link.empty,于是当前节点后面的所有东西全部脱链。真实结果:
>>> lnk = Link(1, Link(2, Link(3)))
>>> insert(lnk, 1, 'x')
>>> lnk
Link(1, Link('x'))
2 和 3 就这么没了——不报错,只是悄悄少了一半数据。这类 bug 比崩溃可怕得多。看到「插入后链表变短了」,去找那句漏了第二个参数的 Link(value)。
index == 0
如果 base case 写成 if index == 0:,递归会多走一步,停在目标位置本身而不是它前面。此时改 lnk.rest 会把新值插到后一位。用第一组 doctest 试:期望 ('cat' 'fish' 'dog' 'a'),实际会得到 ('cat' 'dog' 'fish' 'a')——差一位(off-by-one)。
而如果 index 正好等于长度,多走一步会走到 Link.empty 上,然后 () 上没有 rest:
AttributeError: 'tuple' object has no attribute 'rest'
记住那句直觉:停在前一个节点上,所以 base case 是 index == 1。
课程发布的 16-sol.py 把递归解法和「ALTERNATE SOLUTION (iterative)」的迭代解法写在了同一个函数体里,中间只用注释隔开。照抄整段的话,两段代码会依次执行,而且递归的每一层都会各跑一遍迭代部分。本机跑 doctest 的真实结果:
Failed example:
    lnk
Expected:
    Link(1, Link(2, Link(3, Link(4, Link(5, Link(6))))))
Got:
    Link(1, Link(2, Link(3, Link(4, Link(5, Link(6, Link(6, Link(6,
    Link(6, Link(6, Link(6)))))))))))
那一串 Link(6, ...) 就是重复插入留下的痕迹。"ALTERNATE" 的意思是二选一:留递归就删掉迭代那几行,反之亦然。(filter_link 那部分的官方解答是干净的,只有 insert 有这个问题。)
两种写法的对照
| 递归版 | 迭代版 | |
|---|---|---|
| 「走到位置」怎么表达 | insert(lnk.rest, index-1, value) | curr = curr.rest,走 index-1 次 |
| 停止条件 | index == 1 | i < index - 1 不再成立 |
| 动手时「前一个节点」叫什么 | lnk(最深那一帧里的) | curr |
| 用了几个帧 | index 个 | 1 个 |
| 为什么外面看得见修改 | 因为改的是共享对象的属性,不是重新绑定名字 | |
最后一行值得强调:这两种写法能生效,靠的是同一个原理——函数拿到的是「指向同一批节点的引用」,改节点属性,所有指着它的人都看得见。第 8 讲讲别名(aliasing)时说的话,在这里变成了一个功能而不是一个陷阱。
10. 收束:链表在这门课里的位置
链表和树是同一套思路的两个实例
把上一讲的树和本讲的链表并排放,会发现它们的骨架一模一样:
| Tree | Link | |
|---|---|---|
| 递归定义 | 一个 label + 一串子树 | 一个 first + 剩下的链表 |
| 「当前这一点点」 | t.label | lnk.first |
| 「同类的更小问题」 | t.branches(多个) | lnk.rest(正好一个) |
| base case | t.is_leaf()(branches 为空) | lnk is Link.empty |
| 递归怎么写 | 对每个分支各递归一次,常用列表推导式 | 对 rest 递归一次 |
本质区别只有一个:树的递归是分叉的,链表的递归是线性的。正因为不分叉,链表的递归可以逐字改写成 while 循环(本讲的 length、insert 都演示了),而树的递归一般不行。
还有一个语法差别值得注意:树的空情况通常表现为「branches 是空列表」,此时 t 本身仍是个合法的 Tree;而链表的空情况是 lnk 本身根本不是 Link,什么属性都不能取。这就是为什么链表函数的第一行几乎永远是判空。
元素可以是任何东西,包括另一个链表
first 上没有任何限制,所以链表可以嵌套。看看真实输出:
>>> s = Link(1, Link(Link(2, Link(3)), Link(4)))
>>> s
Link(1, Link(Link(2, Link(3)), Link(4)))
>>> print(s)
(1 (2 3) 4)
这个链表有三个元素:1、Link(2, Link(3))、4。中间那个元素本身是链表,被打成 (2 3)。这种「深链表(deep link)」在 Lab 08 和考试里会出现,处理它们需要两个方向的递归:既往 rest 走(横着),也往 first 走(竖着,用 isinstance(lnk.first, Link) 判断)。Link(1, Link(2)) 和 Link(Link(1), Link(2)) 是完全不同的两个东西。
repr 就会爆
rest 可以随便赋值,所以你能造出首尾相接的链表:
>>> a = Link(1, Link(2))
>>> a.rest.rest = a          # 最后一个节点指回开头
>>> a
RecursionError: maximum recursion depth exceeded while calling a Python object
__repr__ 顺着 rest 无限走,永远碰不到 Link.empty。这不是类的 bug——递归定义里「剩下的链表」隐含着「一定会越来越短」。做变异题时若不慎把某个 rest 指回了前面的节点,症状就是它。
往后看
| 后面哪一讲 | 本讲的什么会回来 |
|---|---|
| Lecture 17 效率 | 本讲说的「快 / 慢」会被写成正式的 $\Theta$ 记号:链表头部插入 $\Theta(1)$、按下标访问 $\Theta(n)$、length $\Theta(n)$;递归版还要多占 $\Theta(n)$ 的栈空间 |
| Scheme 那几讲 | 链表就是 Scheme 的内置列表:first / rest 在那里叫 car / cdr,显示格式正好是本讲 __str__ 的 (3 4 5) |
| Lab 08 / HW 05 | filter_link 和 insert 是同类题的最简版本;作业里的排序、去重、合并、深度遍历用的还是这两条骨架 |
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 链表定义 | 要么空,要么「first + 剩下的链表」 | 把 rest 当成「后面的几个元素」而不是「一个完整链表」 |
Link.empty | 类属性,值是 (),全程序唯一;判空写 is | 用 ==;或者以为它是 Link 实例 |
| 空表取属性 | 空表是元组,没有 .first / .rest | AttributeError: 'tuple' object has no attribute 'first'——走过了末尾 |
__init__ 的 assert | rest 只能是 Link.empty 或 Link 实例;first 无限制 | 光秃秃的 AssertionError,多半是 base case 返回了 None |
__repr__ | 递归;输出 Link(3, Link(4, Link(5)));doctest 看的是它 | — |
__str__ | 迭代;输出 (3 4 5);只有 print 时才看到 | 把 doctest 的期望值写成了 (3 4 5) |
| 递归骨架 | if lnk is Link.empty: → base case;否则用 lnk.first + 对 lnk.rest 的递归结果 | 忘了判空放第一行 |
| 迭代骨架 | curr = lnk;while curr is not Link.empty:;curr = curr.rest | 漏掉 curr = curr.rest → 死循环 |
| 造新表 | return Link(新值, 递归结果);base case return Link.empty;原表不动 | base case 写成裸 return;调用时不接返回值 |
| 就地变异 | 只做 lnk.first = ... / lnk.rest = ...;返回 None | 多写了 return lnk → doctest 报 Expected nothing / Got: ... |
| 插入 | 停在前一个节点上;lnk.rest = Link(value, lnk.rest) | 忘了接老的后半截 → 数据悄悄丢失;base case 写成 index == 0 → 差一位 |
| 头部插入 | 函数内改不了「谁是第一个节点」,只能改节点的属性 | 写 lnk = Link(v, lnk),外面看不到任何变化 |
两条骨架,背下来
# 骨架 A:造一张新链表(不改原表)
def f(lnk):
    if lnk is Link.empty:
        return Link.empty
    return Link(用 lnk.first 算出的新值, f(lnk.rest))

# 骨架 B:走一遍并就地修改(不返回值)
def g(lnk):
    curr = lnk
    while curr is not Link.empty:
        改 curr.first 或 curr.rest
        curr = curr.rest
本讲的四个函数全是这两条骨架的变体:length 是 A 的「结果是数不是链表」版和 B 的计数版;double 两个版本正好一 A 一 B;filter_link 是 A 加了个「有时候不包新节点」;insert 是 B 走到指定位置就停。
动手练习
五道题,都请先在纸上或解释器里做完再看答案。前两道是 WWPD 类型,后三道要写代码。所有题目都假定 Link 类已按本讲定义好。
练习 1(WWPD)
>>> a = Link(1, Link(2, Link(3)))
>>> b = a.rest
>>> b.first = 20
>>> a
______
>>> a.rest is b
______
>>> print(a.rest)
______
>>> a.rest.rest.rest
______
看答案
>>> a
Link(1, Link(20, Link(3)))
>>> a.rest is b
True
>>> print(a.rest)
(20 3)
>>> a.rest.rest.rest
()
第一问:b = a.rest 没有复制任何东西,它让 b 和 a.rest 指向同一个节点对象——这就是别名。所以 b.first = 20 改的那个对象,正是 a 顺着走能到的那个。a 因此显示为 Link(1, Link(20, Link(3)))。
第二问:True,理由同上,它们是同一个对象。
第三问:a.rest 是一个完整的链表,print 用 __str__,所以是 (20 3) 而不是 Link(20, Link(3))。注意这里显示的是「从第二个节点开始的整条链」,不是单个节点。
第四问:三个 .rest 走过了三个节点,到达末尾,得到 Link.empty,显示为 ()。再加一个 .first 就是 AttributeError 了。
练习 2(WWPD)
下面每一行分别会显示什么?(有的会报错,写出错误类型)
>>> s = Link(1, Link(2))
>>> Link(s, s)
______
>>> print(Link(s, s))
______
>>> Link(1, Link(2), Link(3))
______
>>> len(s)
______
看答案
>>> Link(s, s)
Link(Link(1, Link(2)), Link(1, Link(2)))
>>> print(Link(s, s))
((1 2) 1 2)
>>> Link(1, Link(2), Link(3))
TypeError: Link.__init__() takes from 2 to 3 positional arguments but 4 were given
>>> len(s)
TypeError: object of type 'Link' has no len()
第一问:Link(s, s) 合法——first 装了个链表(无限制),rest 也是个 Link(assert 通过)。__repr__ 递归展开两次。注意这不是两份拷贝,是同一个对象被引用了两次。
第二问:这个链表有三个元素——第一个是链表 s(打成 (1 2)),然后顺着 rest 走进 s 本身,得到 1 和 2。绕,但完全符合规则:__str__ 只顺着 rest 走,对每个 first 调 str。
第三问:Link 的构造器只接受两个参数(外加 self)。想装三个元素必须嵌套:Link(1, Link(2, Link(3)))。这个错误在写长链表时很常见——括号数错一个就成这样。
第四问:Link 没有定义 __len__。要长度就自己写 length。
练习 3:last
写一个函数返回链表的最后一个值(不是最后一个节点)。假设链表非空。递归和迭代各写一遍。
def last(lnk):
    """
    >>> last(Link(3, Link(4, Link(5))))
    5
    >>> last(Link(7))
    7
    """
看答案
递归版:
def last(lnk):
    if lnk.rest is Link.empty:
        return lnk.first
    return last(lnk.rest)
关键在 base case 的写法:是 lnk.rest is Link.empty,不是 lnk is Link.empty。因为「最后一个值」这个概念对空表根本没有定义(题目也说了假设非空),我们要在还站在最后一个节点上的时候就停下来。如果写成 if lnk is Link.empty: return ???,你会发现根本填不出一个合理的返回值——这就是「这个 base case 选错了」的信号。
另外注意这里是 return last(lnk.rest),直接把下层的答案原样返回,回代阶段不做任何加工。这种递归叫尾递归形式,可以逐字翻译成循环:
迭代版:
def last(lnk):
    curr = lnk
    while curr.rest is not Link.empty:
        curr = curr.rest
    return curr.first
循环条件同样检查 curr.rest 而不是 curr——这样退出时 curr 停在最后一个节点上,而不是冲过头到 Link.empty。这跟 __str__ 里的循环条件是同一个套路。
手动追踪 last(Link(3, Link(4, Link(5))))(递归版):last(C) → C.rest 是 B,不空 → last(B) → B.rest 是 A,不空 → last(A) → A.rest 是 empty → 返回 A.first = 5 → 逐层原样返回 → 最终 5。
练习 4:square_link 的两个版本
把链表里每个数平方。(a) 写一个就地变异的版本 square_in_place;(b) 写一个返回新表的版本 squared。然后回答:跑完 t = squared(s) 之后,t.rest is s.rest 是什么?
看答案
(a) 就地变异——只赋值属性,不返回:
def square_in_place(lnk):
    """
    >>> s = Link(2, Link(3, Link(4)))
    >>> square_in_place(s)
    >>> s
    Link(4, Link(9, Link(16)))
    """
    curr = lnk
    while curr is not Link.empty:
        curr.first = curr.first ** 2
        curr = curr.rest
递归写法也可以:if lnk is not Link.empty: lnk.first = lnk.first ** 2; square_in_place(lnk.rest)。两者等价,因为这个递归的回代阶段什么都不做。切记末尾不要加 return lnk,否则 doctest 会报 Expected nothing / Got: Link(4, Link(9, Link(16)))。
(b) 返回新表——骨架 A:
def squared(lnk):
    """
    >>> s = Link(2, Link(3, Link(4)))
    >>> squared(s)
    Link(4, Link(9, Link(16)))
    >>> s
    Link(2, Link(3, Link(4)))
    """
    if lnk is Link.empty:
        return Link.empty
    return Link(lnk.first ** 2, squared(lnk.rest))
最后一问的答案是 False。每一层递归都执行了一次 Link(...),所以新表的每个节点都是全新对象,跟原表一个节点都不共享。这正是「no mutation」能成立的原因。
反过来想:什么情况下会共享?如果你在某个分支里写了 return lnk.rest 或 return lnk(直接把原表的一截交出去),共享就发生了。filter_link 里的 return filtered_rest 不算——那是递归造出来的新东西。
练习 5:remove_first(有陷阱)
写一个函数,就地删除链表中第一个等于 value 的元素。假设 value 一定存在,而且不会是第一个元素。删完之后原链表应该少一个节点。
def remove_first(lnk, value):
    """
    >>> s = Link(1, Link(2, Link(3, Link(2))))
    >>> remove_first(s, 2)
    >>> s
    Link(1, Link(3, Link(2)))
    """
提示:想清楚「删除节点 X」在方框-箭头图上是什么动作。
看答案
def remove_first(lnk, value):
    curr = lnk
    while curr.rest.first != value:
        curr = curr.rest
    curr.rest = curr.rest.rest
思路:在方框-箭头图上,「删除节点 X」就是让 X 的前一个节点直接指向 X 的后一个节点——X 没有被销毁,只是没人指着它了。
前:  s ─→[1|·]─→[2|·]─→[3|·]─→[2|/]
             N1     N2     N3     N4

后:  s ─→[1|·]─────────→[3|·]─→[2|/]
             N1            N3     N4
              ↑ N1.rest 从 N2 改成了 N3;N2 脱链
为什么循环条件检查 curr.rest.first 而不是 curr.first:又是那句直觉——要改结构,必须停在前一个节点上。如果用 while curr.first != value,退出时 curr 就是那个要删的节点,而你无法从它出发够到它的前任(链表不能往回走),只能干瞪眼。
最后一行 curr.rest = curr.rest.rest 读成:「我原本指着的那个节点不要了,我直接指它后面那个。」如果被删的是最后一个节点,curr.rest.rest 就是 Link.empty,赋过去照样合法——不需要特判。
陷阱在哪:题目说了「value 不会是第一个元素」,原因和 insert 的 index>0 完全一样——函数没法删掉头节点。写 lnk = lnk.rest 只是重新绑定形参,调用方看不到。(硬要做的话,只能把第二个节点的内容搬到第一个节点上:lnk.first = lnk.rest.first; lnk.rest = lnk.rest.rest。)
另一个陷阱:如果 value 其实不存在,curr 会一路走到最后一个节点,然后 curr.rest.first 就是在 Link.empty 上取属性 → AttributeError: 'tuple' object has no attribute 'first'。题目假定 value 存在才让我们省掉这个检查;真要防御,条件应写成 while curr.rest is not Link.empty and curr.rest.first != value:——注意 and 的短路在这里是必需的,顺序反了就还是会崩。