效率:同一个问题,为什么有的算法几微秒、有的要跑一百万年
学会用「增长阶」而不是秒表来衡量一段代码的代价,并且能对着代码逐行数出它的时间复杂度。
0. 本讲导读
到目前为止,你判断一段代码好不好的标准只有一个:它跑出来的答案对不对。递归、高阶函数、可变数据、面向对象、链表——每一讲都在教你「怎么把一个想法正确地表达成代码」。
本讲换一把尺子。正确只是及格线。 同一个问题往往有很多种正确的写法,它们的答案完全一样,但代价可以相差到荒谬的程度。本讲最震撼的一个例子是斐波那契数:
- 递归版
fib(100):要做大约 1.1 × 10²¹ 次函数调用。按本机实测的速度算,跑完需要一百万年以上。 - 迭代版
fib(100):本机实测 不到万分之一秒。fib(100000)(十万项,结果有两万多位)也只要 0.05 秒。
两段代码都不到十行,都完全正确,差距却是天文数字。这个差距不来自「Python 慢」,不来自「电脑不够快」——换台快一百万倍的机器,递归版还是跑不完。差距来自算法本身的结构。
那么怎么把这种差距说清楚?说「递归版慢」太含糊;说「递归版在我机器上跑了 0.27 秒」又依赖于机器。本讲给出的答案是增长阶(order of growth):不看绝对时间,只看输入规模变大时,代价按什么规律涨。涨得慢的算法,规模一大就必然赢,跟机器无关。这套语言写出来就是你早晚会在各种地方见到的 O(n)、O(log n)、O(2n)。
它和前后讲的关系:上一讲的链表让你亲眼看到「在开头插入元素,链表快、Python list 慢」这个现象——本讲给这个现象一个名字和一套算法。往后学 Scheme、解释器、SQL,你会一再遇到「同一件事有多种实现」的选择题,本讲教的就是做这种选择题的依据。真正把这套东西展开讲的是 CS 61B 和 CS 170;61A 只要求你能对着一段几十行的代码,说出它的最坏情况运行时间是哪一档。
- 衡量算法效率不用秒、不用行数、不用函数调用次数,而用运行时间随输入规模 n 增长的函数形式。理由:前三者都依赖机器、语言和写法,唯独增长的形式是算法自己的性质。
- 本课要求认得五档:常数 O(1) < 对数 O(log n) < 线性 O(n) < 平方 O(n2) < 指数 O(2n)。判别口诀是看「n 变大一点,代价怎么变」。
- 分析方法只有一句话:逐行数代价 → 循环体乘以迭代次数 / 递归画出调用树 → 丢掉常数因子和低阶项。没有万能公式,每段代码都得老老实实读。
- 递归的代价不看递归深度,看调用树的节点总数。
fib一次分裂成两个子调用,节点数按指数涨;exp一次只生一个子调用且规模减半,节点数按对数涨。 - 记忆化(memoization)把重复的子问题结果缓存下来,能把树递归
fib从 O(2n) 压到 O(n)——代价是多用 O(n) 的内存。这是时间换空间的典型。 - Big O 严格讲是上界,所以说「迭代 fib 是 O(2n)」在数学上不算错。但本课问「运行时间是多少」时要的是精确的最坏情况,答案是 O(n)。
1. 为什么需要一把新尺子
先把问题摆清楚:解决同一个问题常常有很多种算法,我们凭什么说 A 比 B 好?
一个直觉的答案是:A 跑得比 B 快,A 就比 B 好。 这个直觉方向没错,但直接拿它当标准会立刻出问题。
为什么不能直接用「跑了多少秒」
因为秒数不是算法的性质,是这次运行的性质。它至少受三样东西影响:
- 硬件不同。同一段代码在你的笔记本和在服务器上跑,时间可以差十倍。那到底哪个数字代表这个算法?
- 同一台机器上也不稳定。后台有没有别的程序、缓存是冷是热、这一刻 CPU 降不降频,都会让结果抖动。测两次得到两个数是常态。
- 没法预测。你测了 n = 1000 用了 0.1 秒,那 n = 100000 要多久?秒数本身回答不了,除非你真的再跑一次。
下面这组数据是本机实测的,它同时展示了「秒数有用」和「秒数不够用」两面:
| 操作(本机实测) | 耗时 | 说明 |
|---|---|---|
对 20 万个元素逐个 L.append(i) | 0.0065 秒 | 每次都往末尾加 |
对 20 万个元素逐个 L.insert(0, i) | 3.48 秒 | 每次都往开头插 |
差了 500 多倍。上一讲的链表 demo 说的就是这件事:Python 的 list 在末尾加元素很便宜,在开头插元素很贵,因为后面所有元素都得整体往后挪一格。但「500 倍」这个数字换台机器就变了。真正不变的、可以写进教科书的,是「往开头插 n 个元素,总代价按 n2 涨;往末尾加 n 个元素,总代价按 n 涨」。
为什么也不能用「代码有几行」
- 一行代码里的活儿可多可少。
x = 1是一行,x = sorted(big_list)也是一行,后者干的活是前者的几百万倍。 - 语言语法不一样。同一个算法,Python 写 5 行,C 写 20 行,Scheme 写 3 行——算法没变,行数变了三次,那行数显然不是算法的性质。
为什么也不能用「调用了多少次函数」
这个比前两个靠谱,本讲后面数 exp 和 fib 的调用次数时用的就是它。但它不能当通用标准,因为每个函数体内部干的活多少不一样:调用 10 次 square 和调用 10 次「排序一百万个数」完全不是一回事。它只在「所有调用干的活量级相同」时才是好的代理指标(fib 恰好满足,所以我们用它)。
我们真正要描述的东西是:随着输入规模 n 变大,这个算法要做的工作量按什么函数形式增长。
注意这句话里两个要点。第一,永远是「相对于某个输入规模」——n 通常是列表长度、数字大小、字符串长度,也可能有多个(比如两个列表的长度 m 和 n)。谈复杂度不说清 n 是什么,等于没说。第二,关心的是「函数形式」而不是具体数值:是直线、是抛物线,还是一条冲天而起的指数曲线。
把它想成挑车:你不会用「这辆车昨天从家开到公司花了 23 分钟」来描述一辆车(那取决于路况),你会说「百公里油耗 6 升」。油耗是车的性质,时间是这一趟的性质。 增长阶就是算法的油耗。
而且油耗低的车在长途上一定赢。同理,增长阶低的算法在 n 足够大时一定赢——哪怕它在 n = 5 的时候还落后。这就是为什么可以理直气壮地丢掉常数因子:常数因子只影响「n 多大之后开始赢」,不影响「最终会赢」。
2. 求幂:同一个函数,两种递归,两种命运
求幂(exponentiation)就是算 bn:把数 b 自乘 n 次。b 叫底数(base),n 叫指数(exponent)。它可以递归地定义:
$$b^n = \begin{cases} 1 & n = 0 \\ b \cdot b^{\,n-1} & n > 0 \end{cases}$$这个定义直译成代码就是:
def exp(b: int, n: int) -> int:
    if n == 0:
        return 1
    return b * exp(b, n - 1)
(b: int 和 -> int 是类型标注(type annotation),只是写给人看的注释,Python 运行时完全不检查它们。)
把它真的展开一遍
SPEC 里说得对:不要满足于「递归调用自身处理更小的问题」这种废话。exp(2, 5) 到底发生了什么,一层一层写出来:
exp(2, 5)   n≠0 → 返回 2 * exp(2, 4)     ← 卡住,等下面算完
  exp(2, 4)   n≠0 → 返回 2 * exp(2, 3)   ← 卡住
    exp(2, 3)   n≠0 → 返回 2 * exp(2, 2) ← 卡住
      exp(2, 2)   n≠0 → 返回 2 * exp(2, 1)
        exp(2, 1)   n≠0 → 返回 2 * exp(2, 0)
          exp(2, 0)   n==0 → 返回 1      ← base case,终于有确定的值了

现在逐层回代(从最里面往外算):
          exp(2, 0) = 1
        exp(2, 1) = 2 * 1  = 2
      exp(2, 2) = 2 * 2  = 4
    exp(2, 3) = 2 * 4  = 8
  exp(2, 4) = 2 * 8  = 16
exp(2, 5) = 2 * 16 = 32
这里有一件对理解代价至关重要的事:在 exp(2, 0) 返回之前,那 6 个帧是同时活着的。exp(2, 5) 这一帧里的 return b * exp(b, n - 1) 只算了一半——它必须等 exp(2, 4) 给出值才能做那次乘法,所以它的帧不能销毁。画成环境图就是一摞:
Global frame
    exp  ──→ func exp(b, n) [parent=Global]

f1: exp [parent=Global]     b ──→ 2   n ──→ 5    正在算 2 * exp(2, 4)
f2: exp [parent=Global]     b ──→ 2   n ──→ 4    正在算 2 * exp(2, 3)
f3: exp [parent=Global]     b ──→ 2   n ──→ 3    正在算 2 * exp(2, 2)
f4: exp [parent=Global]     b ──→ 2   n ──→ 2    正在算 2 * exp(2, 1)
f5: exp [parent=Global]     b ──→ 2   n ──→ 1    正在算 2 * exp(2, 0)
f6: exp [parent=Global]     b ──→ 2   n ──→ 0    返回值 ──→ 1
注意每一帧的 parent 都是 Global,不是上一帧——parent 由「函数定义在哪儿」决定,exp 定义在全局,所以它每次被调用产生的帧的 parent 永远是 Global。帧的堆叠顺序是「谁在等谁返回」,跟 parent 链是两码事。这一点在 Lecture 05 讲过,这里再确认一次,因为下一节讲空间复杂度要用到:同时活着的帧数 = 递归深度。
数一数调用次数
| n | 对 exp 的调用次数 |
|---|---|
| 0 | 1 |
| 1 | 2 |
| 2 | 3 |
| … | … |
| n | n + 1 |
规律一眼可见:n 每加 1,调用次数就加 1。这叫线性时间(linear time),记作 O(n)。
换一个递归定义
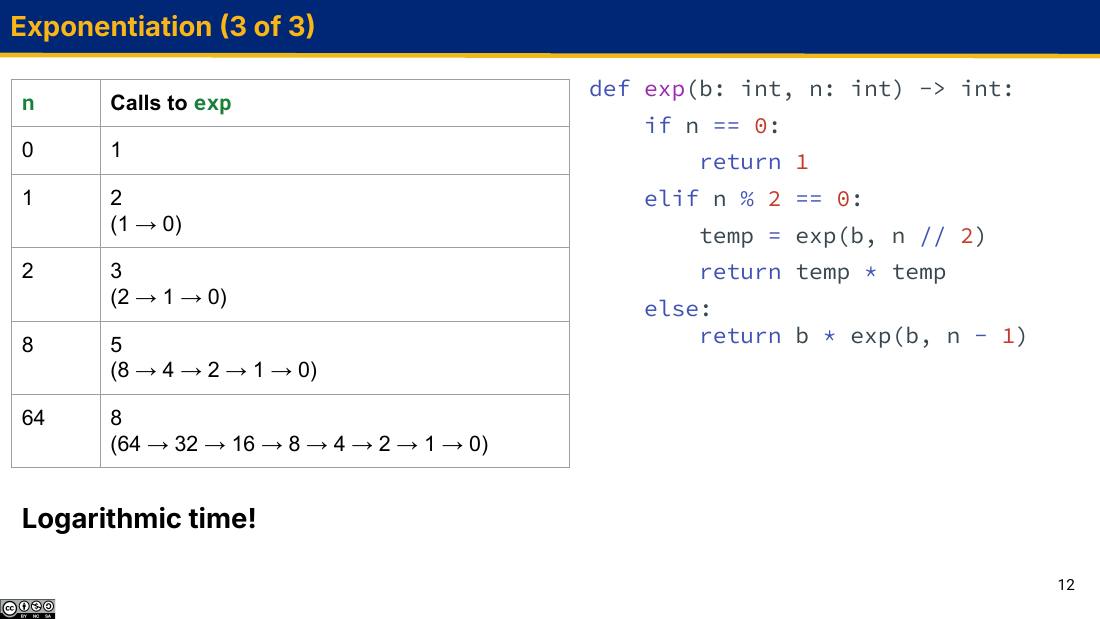
上面那个定义把 n 减 1。但数学上还有另一个同样正确的递归分解,它利用了平方:
$$b^n = \begin{cases} 1 & n = 0 \\ \left(b^{\,\lfloor n/2 \rfloor}\right)^2 & n \bmod 2 = 0 \\ b \cdot b^{\,n-1} & n \bmod 2 = 1 \end{cases}$$翻译成代码:
def exp(b: int, n: int) -> int:
    if n == 0:
        return 1
    elif n % 2 == 0:
        temp = exp(b, n // 2)
        return temp * temp
    else:
        return b * exp(b, n - 1)
exp(2, 8)   8 是偶数 → temp = exp(2, 4),然后返回 temp * temp
  exp(2, 4)   4 是偶数 → temp = exp(2, 2),然后返回 temp * temp
    exp(2, 2)   2 是偶数 → temp = exp(2, 1),然后返回 temp * temp
      exp(2, 1)   1 是奇数 → 返回 2 * exp(2, 0)
        exp(2, 0)   n==0 → 返回 1

回代:
        exp(2, 0) = 1
      exp(2, 1) = 2 * 1 = 2
    exp(2, 2) = 2 * 2 = 4
  exp(2, 4) = 4 * 4 = 16
exp(2, 8) = 16 * 16 = 256
只用了 5 次调用就算出了 28。旧版本要 9 次。差距在 n 大的时候会拉开:
| n | 旧版 exp 调用次数 | 新版 exp 调用次数 | n 的下降路径(新版) |
|---|---|---|---|
| 0 | 1 | 1 | 0 |
| 1 | 2 | 2 | 1 → 0 |
| 2 | 3 | 3 | 2 → 1 → 0 |
| 8 | 9 | 5 | 8 → 4 → 2 → 1 → 0 |
| 64 | 65 | 8 | 64 → 32 → 16 → 8 → 4 → 2 → 1 → 0 |
| 100 | 101 | 10 | 100 → 50 → 25 → 24 → 12 → 6 → 3 → 2 → 1 → 0 |
(表里 8、64 两行与幻灯片一致;1、100 两行是我在本机用计数器实测的。)
为什么是对数? 想清楚这一点比记住结论重要得多。看 n 的下降路径:偶数时 n 折半,奇数时 n 减 1(而 n − 1 立刻变成偶数,下一步就折半)。所以最多每两步,n 就至少折一次半。一个数 n 能被折多少次半才降到 1?答案就是 log2n。n = 64 折 6 次到 1,n = 1024 折 10 次,n = 1000000 折 20 次。
这就是对数时间(logarithmic time),记作 O(log n)。它的标志性特征是:n 翻倍,代价只增加一个常数。n 从 64 涨到 128,调用次数从 8 变成 9——涨了 1。
O(log n) 有多快?如果 n 是全世界 80 亿人,log2(8 × 10⁹) ≈ 33。也就是说,一个 O(log n) 的算法处理全人类规模的数据,只需要 33 步左右。这就是为什么二分查找、平衡树这些「每一步砍掉一半」的结构在工程上无处不在。
反过来记:看见「每一步把问题规模除以一个大于 1 的常数」,八成就是 O(log n)。
误区一:以为 return exp(b, n // 2) * exp(b, n // 2) 和用 temp 是一回事。
# 错误写法:看起来只是把 temp 展开了
def exp_bad(b, n):
    if n == 0:
        return 1
    elif n % 2 == 0:
        return exp_bad(b, n // 2) * exp_bad(b, n // 2)   # 算了两遍!
    else:
        return b * exp_bad(b, n - 1)
这段代码答案完全正确,不会报任何错——这正是它危险的地方。但它把同一个子问题算了两遍,于是调用树又变成每层分裂成两支,整个优化白做,退回成 O(n)。temp = exp(b, n // 2) 这一行的全部意义就是:算一次,存起来,用两次。
误区二:把 // 写成 /。 n / 2 得到的是 float,于是 n % 2 == 0 后面某一步会拿到 2.0、1.0 这样的浮点数。1.0 == 0 是 False,1.0 % 2 == 0 也是 False,程序会走进奇数分支,然后 n 变成 0.0——而 0.0 == 0 是 True,所以居然还能停下来。答案也许还对,但类型脏了,而且遇到大整数时 / 会直接抛:
>>> 10**400 / 2
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
OverflowError: integer division result too large for a float
整数除法一律用 //。
3. 斐波那契:树递归为什么会爆炸
斐波那契数列(Fibonacci sequence):0, 1, 1, 2, 3, 5, 8, 13, 21, …,每一项是前两项之和。递归定义直译成代码只有三行:
def fib(n):
    if n == 0 or n == 1:
        return n
    return fib(n - 1) + fib(n - 2)
这段代码完全正确,而且优雅得几乎是递归的教科书范例。fib(0) 返回 0,fib(1) 返回 1,fib(35) 返回 9227465——全对。
问题在于它有两个递归调用。exp 每次只生一个孩子,所以它的调用结构是一根链;fib 每次生两个孩子,调用结构是一棵树。这就是树递归(tree recursion),而树的节点数是随深度指数增长的。
把 fib(5) 的调用树完整画出来
fib(5)
├── fib(4)
│   ├── fib(3)
│   │   ├── fib(2)
│   │   │   ├── fib(1) → 1      ← base case
│   │   │   └── fib(0) → 0      ← base case
│   │   │   fib(2) = 1 + 0 = 1
│   │   └── fib(1) → 1
│   │   fib(3) = 1 + 1 = 2
│   └── fib(2)
│       ├── fib(1) → 1
│       └── fib(0) → 0
│       fib(2) = 1 + 0 = 1
│   fib(4) = 2 + 1 = 3
└── fib(3)
    ├── fib(2)
    │   ├── fib(1) → 1
    │   └── fib(0) → 0
    │   fib(2) = 1 + 0 = 1
    └── fib(1) → 1
    fib(3) = 1 + 1 = 2

fib(5) = 3 + 2 = 5
数一数这棵树上有多少个节点:15 个。也就是说,算 fib(5) 一共调用了 15 次 fib——为了得到一个 5。
而且请看清楚这棵树里的重复:
fib(3)被完整地算了 2 次fib(2)被完整地算了 3 次fib(1)被算了 5 次,fib(0)被算了 3 次
每一次 fib(3) 都从零开始把它下面那一整棵子树重算一遍,尽管答案永远是 2。这就是指数爆炸的来源:不是问题难,是同一个子问题被反复求解。
调用次数到底涨得多快
下面这张表是我在本机加计数器实测出来的(不是估算):
| n | fib(n) 的值 | 对 fib 的调用次数 | 比上一档增加 |
|---|---|---|---|
| 5 | 5 | 15 | — |
| 10 | 55 | 177 | ×11.8 |
| 20 | 6 765 | 21 891 | ×124 |
| 30 | 832 040 | 2 692 537 | ×123 |
n 每加 10,调用次数就乘以 123 左右——注意是「乘以」,不是「加上」。这正是指数时间(exponential time)的定义特征:n 增加一个常数,代价乘以一个常数。(123 开十次方约等于 1.618,正是黄金比例 φ;准确地说调用次数等于 2·fib(n+1) − 1,增长率是 φn,而 φn 属于 O(2n) 这一档。)
fib(100) 到底要跑多久
课上有一个 fib(100) 的 demo。用上面的公式算:调用次数 = 2 × fib(101) − 1 ≈ 1.146 × 10²¹ 次。
本机实测递归 fib(32) 用了 0.272 秒,做了约 7.05 × 10⁶ 次调用,即每秒约 2.6 × 10⁷ 次。那么:
一百四十万年。这个数字的意义在于:它不是「慢」,它是「永远算不完」。买一台快一千倍的机器,还要一千四百年。指数级的差距不可能靠硬件补上,只能换算法。
顺带说一句,如果你真在终端里敲了 fib(100),它不会报错,只会一直转下去,直到你按 Ctrl-C。它的递归深度只有 100,远没到 Python 默认的 1000 层上限,所以不会触发 RecursionError——问题出在宽度,不是深度。
为什么 exp 也是递归却只要 O(n),fib 却要 O(2n)?看每一层分裂成几支。
exp:一个调用生一个孩子 → 调用结构是一根链,长度 n → 节点数 ≈ n。fib:一个调用生两个孩子 → 调用结构是一棵二叉树,深度 n → 节点数 ≈ 2n。- 快速求幂:一个调用生一个孩子,且规模折半 → 链长只有 log n → 节点数 ≈ log n。
所以分析递归的复杂度,问自己两个问题就够了:(a)每次调用产生几个子调用?(b)每次调用把 n 缩小了多少?
「递归深度是 n,所以是 O(n)」——这是本讲最容易踩的坑。 深度和节点数是两回事:fib(30) 的递归深度只有 30,但节点数是 269 万。运行时间由节点总数决定(每个节点都要真的执行一遍函数体),深度只决定同时活着的帧数,那是空间复杂度的事。
记住这组对照:fib 的时间复杂度是 O(2n),空间复杂度是 O(n)。
4. 记忆化:把算过的答案记住
上一节把病因诊断清楚了:同一个子问题被反复求解。那治法就很自然——算过一次就把答案存起来,下次直接拿。 这个技术叫记忆化(memoization)。
它能成立有一个前提,幻灯片专门点出来了:fib 是一个纯函数(pure function)——给定同样的实参,它每次的返回值都一样,而且不产生任何副作用。所以「上次算 fib(3) 得到 2」这条信息这次仍然有效。如果函数会读时间、读随机数、改全局变量,缓存就会给出错误答案。
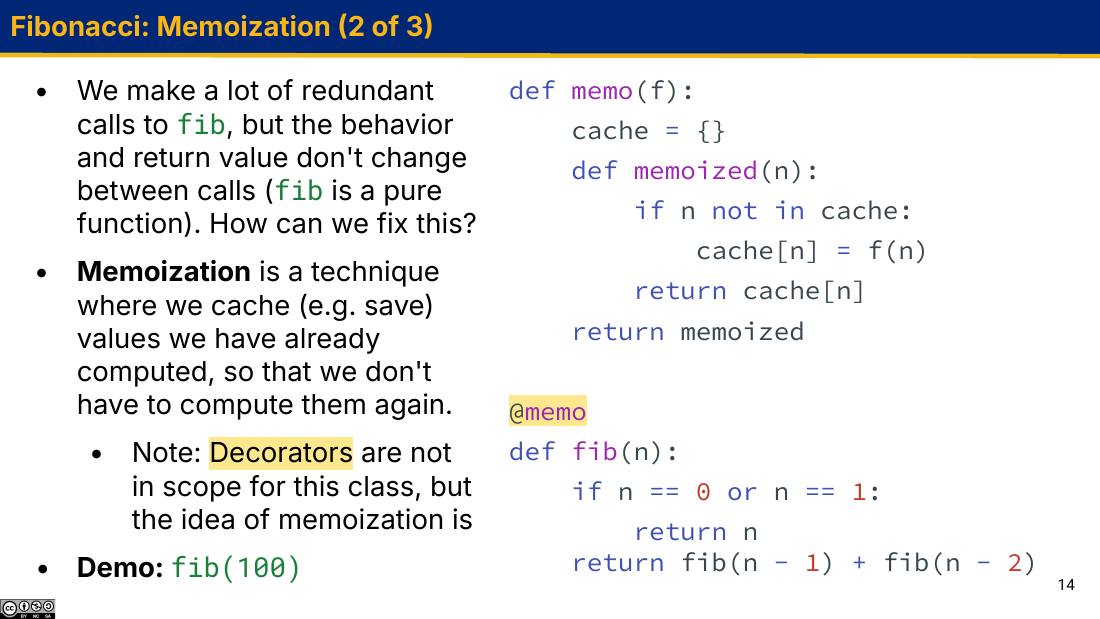
memo 接受一个函数 f,在自己的帧里建一个空字典 cache,然后返回一个内层函数 memoized。memoized 的逻辑只有三行——没算过就算一次存进去,然后无论如何都从缓存里取。左边强调 @memo 这种装饰器语法不在本课考纲内,但记忆化的思想在。def memo(f):
cache = {}
def memoized(n):
if n not in cache:
cache[n] = f(n)
return cache[n]
return memoized
@memo
def fib(n):
if n == 0 or n == 1:
return n
return fib(n - 1) + fib(n - 2)
先看懂 memo 本身:这是一个闭包
memo 用上了 Lecture 04 的全套高阶函数机制,值得逐步拆开。执行 fib = memo(fib)(这就是 @memo 的含义)的时候:
@memo 那一行到底做了什么
def fib(n): ... 先照常执行,全局帧里 fib 绑定到那个「原始的、没缓存的」函数对象。把它叫作 func fib(n)。memo(fib):先查到 memo,再求值实参 fib 得到 func fib(n),然后调用,新建帧 f1,形参 f 绑定到 func fib(n)。cache = {}:f1 帧里多了一个名字 cache,指向一个空字典对象。def memoized(n): ...:创建函数对象 func memoized(n),它的 parent 是 f1(因为它是在 f1 里被 def 的)。这就是闭包——它记住了 f1,因而能看见 cache 和 f。return memoized 把这个函数对象交回去。fib 上。现在全局帧里 fib 指向的是 func memoized(n),原来那个 func fib(n) 只剩 f1 帧里的 f 还指着它。Global frame
memo ──→ func memo(f) [parent=Global]
fib ──→ func memoized(n) [parent=f1] ← 注意!fib 已经不是原来那个函数了
f1: memo [parent=Global]
f ──→ func fib(n) [parent=Global] ← 原始的、未加缓存的 fib
cache ──→ {} ← 这个字典只有 memoized 能看见
返回值 ──→ func memoized(n)
为什么记忆化能对递归生效?这是整段代码最妙、也最容易看漏的地方。 原始 fib 函数体里写的是 fib(n - 1) + fib(n - 2)。这两个 fib 是名字,要到运行时才去查——而 fib 定义在全局,所以它的帧的 parent 是 Global,查 fib 会查到全局帧里现在的那个绑定,也就是 memoized!
于是每一次内部递归调用都会先经过缓存检查。如果名字查找不是「运行时才查」,这个技巧根本不成立。
加了缓存以后到底省了多少
再跑一遍 fib(5),这次跟踪的是「原始 fib 函数体被真正执行了几次」:
fib(5)  cache={}            5 不在 cache → 执行原始函数体 → 需要 fib(4) + fib(3)
  fib(4)  4 不在 cache → 执行函数体 → 需要 fib(3) + fib(2)
    fib(3)  3 不在 cache → 执行函数体 → 需要 fib(2) + fib(1)
      fib(2)  2 不在 cache → 执行函数体 → 需要 fib(1) + fib(0)
        fib(1)  1 不在 cache → 执行函数体 → 返回 1,存 cache[1] = 1
        fib(0)  0 不在 cache → 执行函数体 → 返回 0,存 cache[0] = 0
      fib(2) = 1 + 0 = 1,存 cache[2] = 1
      fib(1)  1 在 cache 里!直接返回 1,函数体一次都不执行
    fib(3) = 1 + 1 = 2,存 cache[3] = 2
    fib(2)  2 在 cache 里!直接返回 1
  fib(4) = 2 + 1 = 3,存 cache[4] = 3
  fib(3)  3 在 cache 里!直接返回 2
fib(5) = 3 + 2 = 5,存 cache[5] = 5

最终 cache = {1: 1, 0: 0, 2: 1, 3: 2, 4: 3, 5: 5}
原始函数体执行次数:6 次(n = 0,1,2,3,4,5 各一次)
从 15 次降到 6 次。而且规律很清楚:每个不同的 n 只会真正算一次,所以原始函数体总共执行 n + 1 次。这是 O(n)——从指数直接降到线性。本机实测确认:n = 5 时 6 次,n = 10 时 11 次,n = 30 时 31 次。
实际效果:记忆化版的 fib(100) 本机耗时 4.8 × 10⁻⁵ 秒,结果是 354224848179261915075。而不带缓存的版本需要一百四十万年。同样的三行递归定义,只是外面套了一个字典。
误区一:把 cache = {} 写进 memoized 里。
def memo(f):
    def memoized(n):
        cache = {}          # 错!
        if n not in cache:
            cache[n] = f(n)
        return cache[n]
    return memoized
这样每次调用 memoized 都会新建一个空字典,缓存永远是空的,一条记录都留不住。代码不报错、答案也对,但速度跟没加缓存一模一样(其实还更慢)。cache 必须在 memo 的帧里,在所有调用之间共享——这正是闭包存在的意义。
误区二:以为可以给带副作用的函数加缓存。 如果被缓存的函数会 print、会改列表、会读随机数,那么第二次调用时函数体根本不执行,副作用就消失了。给 fib 加个 print(n) 你会发现打印次数远少于预期——这不是 bug,是缓存在起作用。
误区三:以为记忆化解除了递归深度限制。 记忆化的 fib(1000) 会崩:
>>> fib(1000)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded
因为第一次计算时链条仍然是 fib(1000) → fib(999) → … → fib(1),深度 1000,超过了 sys.getrecursionlimit() 返回的默认值 1000。缓存省的是宽度(重复的子树),不是深度。 想算 fib(1000),用下一节的迭代版。
5. 迭代版 fib:不用缓存也能线性
记忆化保留了递归的写法,用额外内存换时间。还有第三条路:彻底不递归。想想人手算斐波那契是怎么算的——你不会从 fib(5) 往下拆,你会从 0, 1 开始往上加:0, 1, 1, 2, 3, 5。这个过程只需要记住最近两个数。
def fib(n):
    curr, nxt = 0, 1
    k = 0
    while k < n:
        curr, nxt = nxt, curr + nxt
        k += 1
    return curr
(写 nxt 不写 next,是为了不遮蔽 Python 内置函数 next。)
逐轮追踪 fib(5)
循环里的三个名字:curr 是「当前这一项」,nxt 是「下一项」,k 是「已经往前走了几步」。循环不变式(loop invariant)是:每轮循环开始时,curr == fib(k) 且 nxt == fib(k+1)。
| 时刻 | k | curr | nxt | 条件 k < 5 |
|---|---|---|---|---|
| 进入循环前 | 0 | 0 | 1 | 0 < 5 → True |
| 第 1 轮结束 | 1 | 1 | 1 | 1 < 5 → True |
| 第 2 轮结束 | 2 | 1 | 2 | 2 < 5 → True |
| 第 3 轮结束 | 3 | 2 | 3 | 3 < 5 → True |
| 第 4 轮结束 | 4 | 3 | 5 | 4 < 5 → True |
| 第 5 轮结束 | 5 | 5 | 8 | 5 < 5 → False,退出 |
返回 curr,也就是 5。对照不变式:退出时 k == 5,所以 curr == fib(5) == 5。✓
循环体执行 n 次,每次做的都是常数量的工作(一次加法、两次赋值、一次比较)。所以是 O(n) ——线性时间。而且它只用了三个名字,不管 n 多大都是三个,空间是 O(1)。
curr, nxt = nxt, curr + nxt 这一行
这是同时赋值(simultaneous assignment),求值规则很关键:
curr 是 2、nxt 是 3,那么右边求出 (3, 5)。curr ← 3,nxt ← 5。curr 被改掉这件事,影响不到 curr + nxt 的结果。把同时赋值拆成两行。 这是本节唯一但极高频的错误:
def bad_fib(n):
    curr, nxt = 0, 1
    k = 0
    while k < n:
        curr = nxt          # curr 已经变了
        nxt = curr + nxt    # 这里的 curr 是新值,不是老值!
        k += 1
    return curr
不会报错,会安静地给出错误答案。本机实测 [bad_fib(i) for i in range(8)] 的输出是:
[0, 1, 2, 4, 8, 16, 32, 64]
正确答案本该是 [0, 1, 1, 2, 3, 5, 8, 13]。它算出来的是 2 的幂——因为第二行里 curr 已经等于 nxt 了,curr + nxt 变成了 nxt + nxt,也就是每轮翻倍。
要拆成两行,必须先用临时变量把老值存下来:
        old_curr = curr
        curr = nxt
        nxt = old_curr + nxt
三个版本横向对比
| 版本 | 时间复杂度 | 空间复杂度 | fib(100) 本机实测 | 写起来 |
|---|---|---|---|---|
| 朴素递归 | O(2n) | O(n)(帧栈深 n) | 约 1.4 × 10⁶ 年 | 3 行,最贴近数学定义 |
| 记忆化递归 | O(n) | O(n)(缓存 + 帧栈) | 4.8 × 10⁻⁵ 秒 | 递归部分不动,外面套 8 行 |
| 迭代 | O(n) | O(1) | < 10-4 秒;fib(100000) 也只要 0.05 秒 | 7 行,要自己想清不变式 |
三个都返回 354224848179261915075。正确性完全一样,代价天差地别。
6. 增长阶与大 O 记号
前面三节一直在用「线性」「对数」「指数」这些词。现在把它们变成一套正式的语言。
增长阶(order of growth):用一个数学函数描述「运行时间随输入规模 n 增长的方式」。写法是 大 O 记号(Big O notation),比如 O(n)。
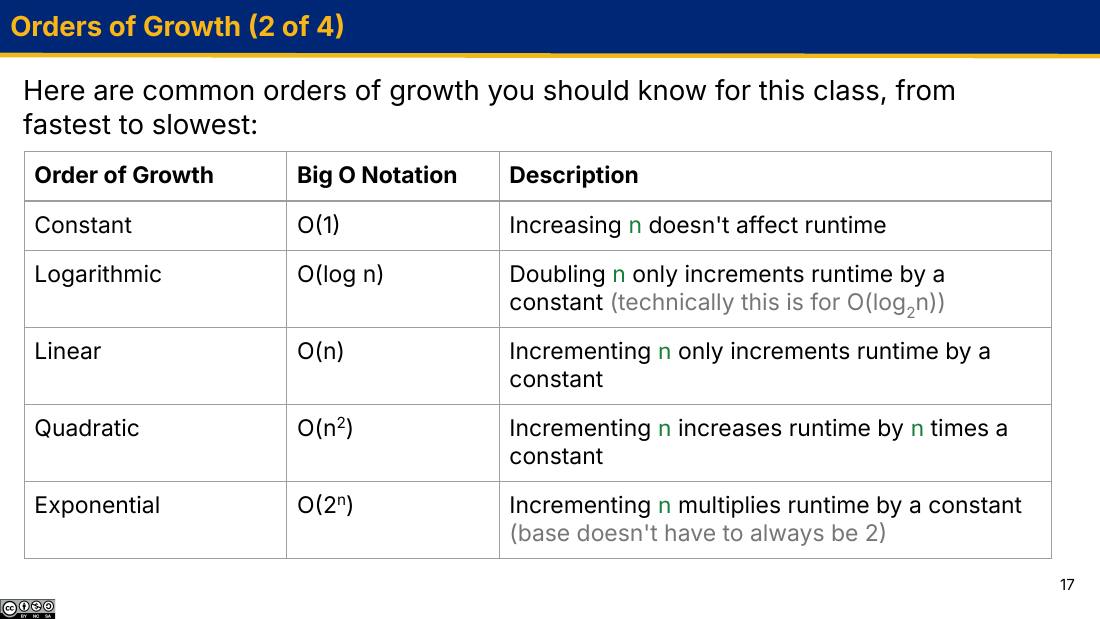
| 增长阶 | 大 O | 判别法:n 变化时代价怎么变 | 本讲的例子 |
|---|---|---|---|
| 常数 Constant | O(1) | n 变大完全不影响运行时间 | 字典查一个键、列表末尾 append |
| 对数 Logarithmic | O(log n) | n 翻倍,运行时间只增加一个常数 | 快速求幂、二分查找 |
| 线性 Linear | O(n) | n 加 1,运行时间只增加一个常数 | 朴素求幂、迭代 fib、遍历列表 |
| 平方 Quadratic | O(n2) | n 加 1,运行时间增加「n 乘一个常数」 | 嵌套循环、后面的 bar |
| 指数 Exponential | O(2n) | n 加 1,运行时间乘以一个常数 | 朴素递归 fib、树递归 |
注意两处「技术上」的补充说明,幻灯片用灰字标出来了:
- O(log n) 里的对数底数是几其实无所谓。因为换底只差一个常数因子(log2n = log10n / log102),而常数因子要丢掉。所以直接写 O(log n),不写底数。
- O(2n) 里的底数不一定是 2,3n、φn 都算指数级。但底数在这里不能随便换——3n 和 2n 差的是 1.5n,那不是常数。写 O(2n) 是这一档的习惯代号。
为什么这五档差距这么大
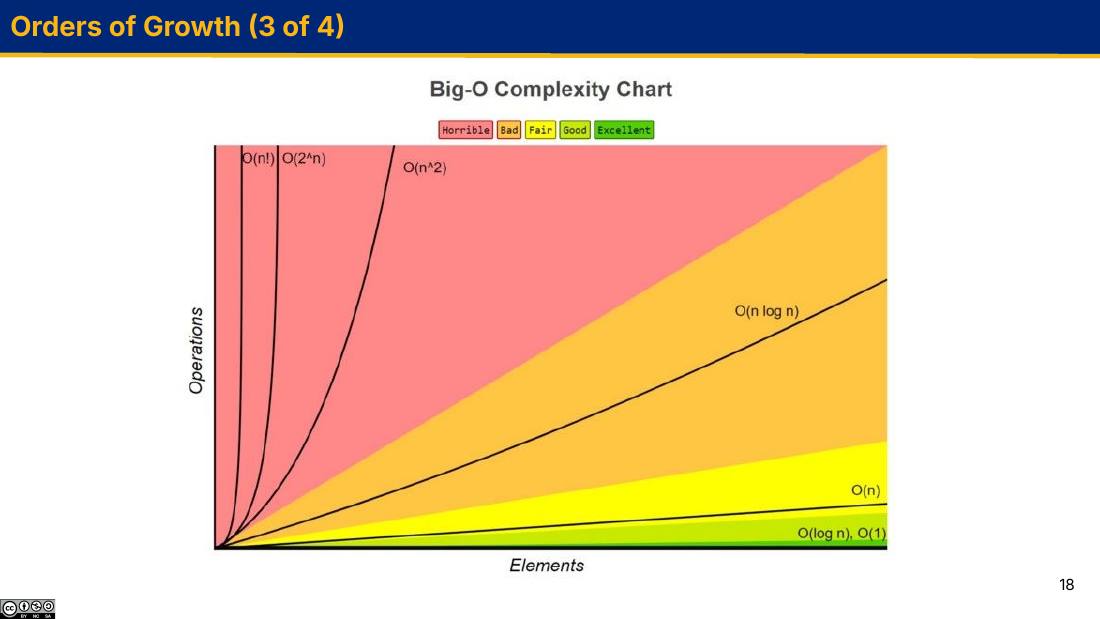
把抽象曲线换成具体数字更有冲击力。假设一次操作要 1 纳秒(10-9 秒):
| n | O(log n) | O(n) | O(n2) | O(2n) |
|---|---|---|---|---|
| 10 | 3 ns | 10 ns | 100 ns | 1 μs |
| 20 | 4 ns | 20 ns | 400 ns | 1 ms |
| 50 | 6 ns | 50 ns | 2.5 μs | 13 天 |
| 100 | 7 ns | 100 ns | 10 μs | 4 × 10¹³ 年 |
| 1 000 000 | 20 ns | 1 ms | 约 17 分钟 | 不必算了 |
读这张表最该注意的不是指数那一列有多离谱,而是平方那一列:n = 100 时它还只要 10 微秒,看起来毫无问题;n = 一百万时就要 17 分钟了。真实工程里绝大多数性能事故是 O(n2) 造成的,因为它在小数据上完全看不出毛病,测试全过,上线以后数据一涨就炸。
数学上 O(f(n)) 表示渐进上界(upper bound)——「不会比 f(n) 涨得更快」。按这个定义,说「迭代版 fib 是 O(2n)」并没有错,因为它确实「最多」跑指数时间,只不过这个上界松得毫无信息量,就像说「我身高不超过 3 米」。
但本课不这么用。 幻灯片明确说明:当我们问「这段代码的运行时间是多少」时,除非另有说明,要的是精确的最坏情况(exact worst case)运行时间——不是最好情况,也不是平均情况。所以考试上写「迭代 fib 是 O(2n)」会被判错,正确答案是 O(n)。
(如果你以后学 CS 61B / CS 170,会见到 Θ(Theta,紧确界)和 Ω(Omega,下界);61A 统一用 O 表示紧确的最坏情况。)
假设算法 A 要 100n 步,算法 B 要 n²/100 步。n 小的时候 B 完胜(n = 100 时 A 要 10000 步,B 只要 100 步)。但 n = 10000 时,A 要 106 步,B 要 106 步——打平;再往后 B 就一路输下去,且越输越惨。
常数因子只决定「从哪个 n 开始输」,决定不了「最终谁输」。 增长阶关心的是 n 趋于很大时的结局,所以常数被丢掉。同理 n2 + n 里的那个 n,在 n = 10000 时只占万分之一,丢了不影响判断。
反过来提醒一句:这不代表常数在现实中不重要。 如果你的 n 永远不超过 20,一个常数因子小的 O(n2) 算法完全可能比 O(n log n) 的快。增长阶是规模大时的判据。
7. 时间复杂度分析:拿到一段代码该怎么下手
正式名称是时间复杂度分析(time complexity analysis),也叫运行时分析(runtime analysis)或渐进分析(asymptotic analysis)。
幻灯片用大写 IMPORTANT 强调了这一点:不存在一个公式,把代码丢进去就吐出复杂度。 你必须读懂这段代码在干什么。下面四步是起手式,不是算法。
in、len、切片、sorted)。哪些操作是 O(1)
第 1 步要能一眼判断单行代价,得先有一张常数时间操作的清单:
| 大 O | 名称 | 典型例子 |
|---|---|---|
| O(1) | 常数 | 算术运算;给变量(重新)赋值;lst.append(x) 往列表末尾加;字典的增 / 查 / 改一个键值对 |
| O(log n) | 对数 | 每一轮循环或每一次递归把输入除以某个常数因子,例如快速求幂 |
| O(n) | 线性 | 把一个序列或字典从头到尾遍历一遍 |
| O(n2) | 平方(更一般地 nk 叫多项式 polynomial) | 嵌套循环 |
| O(2n) | 指数(更一般地 kn) | 朴素递归 fib;树递归 |
初学者最容易漏掉的是藏在一行里的循环。这些都是 O(n),不是 O(1):
x in lst          # 列表成员检查:最坏要把整个列表扫一遍
lst.index(x)      # 同上
lst.insert(0, x)  # 要把后面所有元素往后挪
lst[1:]           # 切片会复制出一个新列表
sum(lst)          # 遍历
max(lst)          # 遍历
对比一下本机实测(列表 / 集合都有 200 万个元素,查最后一个):
| 表达式 | 耗时 | 复杂度 |
|---|---|---|
1999999 in lst(lst 是 list) | 0.0062 秒 | O(n) |
1999999 in st(st 是 set) | 0.0000017 秒 | O(1) |
差 3600 倍,代码却只差一个字母。「一行 = 一步」是错觉;要问的是这一行背后做了多少工作。
完整走一遍:分析 bonk
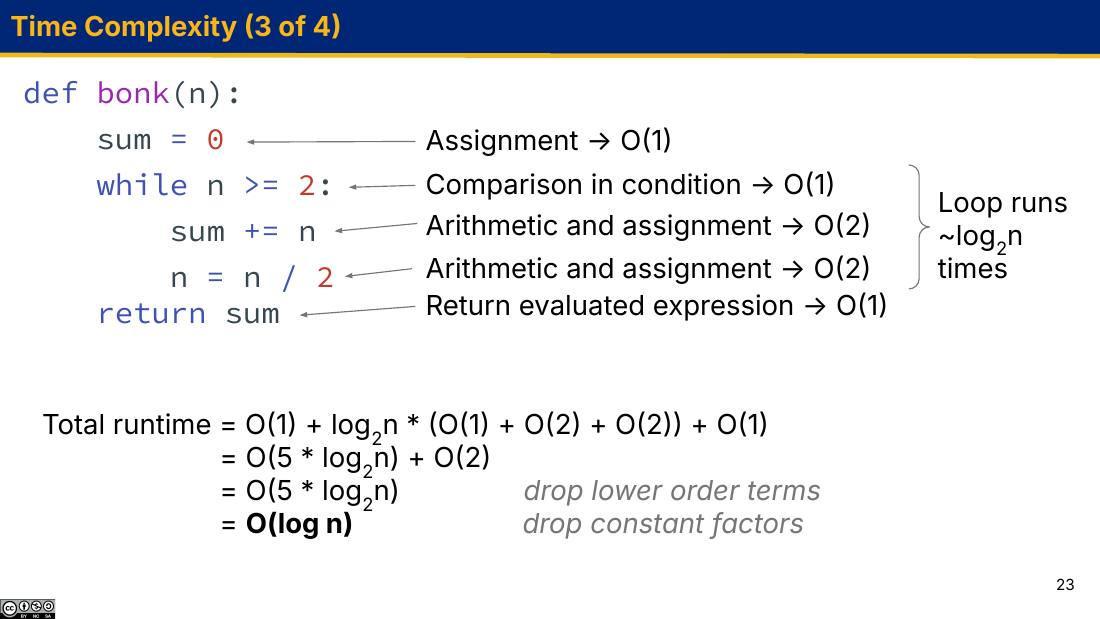
def bonk(n):
    sum = 0
    while n >= 2:
        sum += n
        n = n / 2
    return sum
sum = 0:一次赋值 → O(1),只执行一次。while n >= 2:条件里一次比较 → O(1),每轮执行一次。sum += n:一次加法 + 一次赋值 → O(2)。n = n / 2:一次除法 + 一次赋值 → O(2)。return sum:求值一个名字并返回 → O(1),只执行一次。把它们加起来:
$$\begin{aligned} T(n) &= O(1) + \log_2 n \cdot \bigl(O(1) + O(2) + O(2)\bigr) + O(1) \\ &= O(5 \cdot \log_2 n) + O(2) \\ &= O(5 \cdot \log_2 n) \quad \text{(drop lower order terms)} \\ &= O(\log n) \quad \text{(drop constant factors)} \end{aligned}$$三处需要看仔细:
- 循环外的 O(1) 只算一次,循环内的要乘轮数。 这是第 2 步的全部内容,也是最常出错的地方。
- 丢低阶项:那个 O(2) 是循环外那两行(
sum = 0和return sum)的和。相比 5·log₂n,常数项在 n 大时可以忽略。 - 丢常数因子:5 没了,底数 2 也没了(换底只差常数),剩下 O(log n)。
其实熟练之后不用把 O(1)、O(2) 一个个数出来。你只需要问两件事:循环体里有没有「非常数代价」的东西?循环跑多少轮? bonk 的循环体全是常数操作,轮数是 log n,所以答案就是 O(log n)。上面那套逐行标注是给你在还不熟的时候用的脚手架。
bonk 里的两个真实隐患
幻灯片没提,但这段代码有两个值得知道的问题(分析复杂度时不影响结论,写真代码时会咬人):
第一,n = n / 2 用的是真除法,结果是 float。所以 bonk(1024) 返回的是 2046.0 而不是 2046。
第二,对巨大的整数会直接抛异常:
>>> bonk(10**400)
Traceback (most recent call last):
  ...
OverflowError: integer division result too large for a float
因为 float 存不下这么大的数。改成 n = n // 2 两个问题都没了。
另外 sum = 0 这一行遮蔽(shadow)了 Python 内置的 sum 函数——在这个函数体里之后就没法用 sum(lst) 了。61A 的课件里这么写是为了简短,你自己写代码时换个名字(total)比较安全。
幻灯片提到:LLM 用的 transformer 架构有一个瓶颈就是矩阵乘法是多项式级的算法。效率不只是考试题——它直接决定一个软件能不能用、能耗多少、能不能推广。想深入的话,形式化的复杂度分析在 CS 61B 和 CS 170,机器学习方向在 CS 189 / CS 182 / DATA 188。Python 各种内置数据结构的复杂度也有现成的表可查。
8. 实战一:两种查找
下面三节是课上的随堂练习,代码来自 17.py。先自己分析,再看解答。 任务都是一样的:说出运行时间关于 n 的表达式,n 是 nums 的长度。
def search_list1(nums, target_num):
    """Returns the index of TARGET_NUM in sorted list NUMS or -1 if not found.
    >>> search_list1([1, 2, 3, 4], 3)
    2
    >>> search_list1([14, 23, 37, 48, 59], 23)
    1
    >>> search_list1([14, 23, 37, 48, 59], 47)
    -1
    """
    found_index = -1
    for i, elem in enumerate(nums):
        if elem == target_num:
            found_index = i
            break
    return found_index
search_list1:线性查找
逐行数:
found_index = -1:赋值 → O(1),执行一次。for i, elem in enumerate(nums):enumerate 是惰性的(每次只吐一对),取一个元素是 O(1)。循环最多跑 n 轮。if elem == target_num:整数比较 → O(1),每轮一次。found_index = i 和 break 都是 O(1),而且最多执行一次。return found_index → O(1)。答案:O(n),线性时间。这和官方解答 17-sol.py 里标注的 # O(n) 一致。
那个 break 值得单独说一句。它确实能让运气好的时候提前结束——目标在第一个位置时只跑一轮。但本课要的是最坏情况:目标在最后一个位置,或者根本不在列表里(比如 doctest 里找 47 那个例子),循环必须跑满 n 轮。所以答案还是 O(n)。
「有 break 所以平均只跑一半,是 O(n/2)」——两处都不对。
第一,O(n/2) 就是 O(n),那个 1/2 是常数因子,要丢掉。写 O(n/2) 在形式上不算错但没意义,写 O(n) 就够了。
第二,我们问的不是平均情况。除非题目明说,一律按最坏情况回答。
search_list2:二分查找
def search_list2(nums, target_num):
    """Returns the index of TARGET_NUM in sorted list NUMS or -1 if not found.
    >>> search_list2([1, 2, 3, 4], 3)
    2
    >>> search_list2([14, 23, 37, 48, 59], 23)
    1
    >>> search_list2([14, 23, 37, 48, 59], 47)
    -1
    """
    min_index = 1
    max_index = len(nums)
    while min_index <= max_index:
        middle_index = (min_index + max_index) // 2
        if target_num == nums[middle_index]:
            return middle_index
        elif target_num > nums[middle_index]:
            min_index = middle_index + 1
        else:
            max_index = middle_index - 1
    return -1
这是二分查找(binary search)。它成立的前提是 docstring 里那个词:NUMS 是有序的。因为有序,看一眼中间那个数就能断定目标在左半边还是右半边,一刀砍掉一半。
初始: min_index = 1, max_index = 5

第 1 轮: 1 <= 5 成立
         middle_index = (1 + 5) // 2 = 3
         nums[3] 是 48
         47 == 48 ? 否
         47 >  48 ? 否 → 目标在左半边 → max_index = 3 - 1 = 2

第 2 轮: 1 <= 2 成立
         middle_index = (1 + 2) // 2 = 1
         nums[1] 是 23
         47 == 23 ? 否
         47 >  23 ? 是 → 目标在右半边 → min_index = 1 + 1 = 2

第 3 轮: 2 <= 2 成立
         middle_index = (2 + 2) // 2 = 2
         nums[2] 是 37
         47 == 37 ? 否
         47 >  37 ? 是 → min_index = 2 + 1 = 3

第 4 轮检查: 3 <= 2 不成立 → 退出循环 → return -1   ✓
搜索区间的宽度依次是 5 → 2 → 1 → 0,每轮至少砍掉一半。这就是复杂度的来源:
len(nums)。len 对 list 是 O(1)(长度是存好的,不用数),所以是 O(1)。nums[middle_index](列表按下标取值是 O(1))、若干比较和赋值——全是常数操作,一轮 O(1)。答案:O(log n),和官方解答一致。
实测一下这个差距(在一个 200 万元素的有序列表里找最后一个元素):
| 算法 | 复杂度 | 本机耗时 | 大致步数 |
|---|---|---|---|
| 线性查找 | O(n) | 0.036 秒 | 2 000 000 |
| 二分查找 | O(log n) | 0.0000064 秒 | log₂(2×10⁶) ≈ 21 |
快了约 5600 倍。而且这个倍数会随 n 继续拉大——n 翻倍时,线性查找的时间翻倍,二分查找只多做 1 步。
课件里的 search_list2 用的是 min_index = 1 和 max_index = len(nums)。正确的初值应该是 0 和 len(nums) - 1,因为 Python 的下标是 0 到 n−1。
三个 doctest 恰好都通过了(我本机跑过 doctest.testmod,6 项全过),所以这个 bug 藏得很深。但换个输入立刻现形:
>>> search_list2([1, 2, 3, 4], 1)
-1
1 明明在下标 0,却报告找不到——因为区间从下标 1 起,0 号位置永远搜不到。更糟的是:
>>> search_list2([1, 2], 5)
Traceback (most recent call last):
  ...
IndexError: list index out of range
因为 max_index 初值是 len(nums),middle_index 可能取到 len(nums) 这个不存在的下标。
这不影响本节的复杂度结论(O(log n) 照旧),但它是一个很好的提醒:doctest 全过不等于代码正确。要修的话,把两行改成:
    min_index = 0
    max_index = len(nums) - 1
(本站坚持只写核实过的内容:上面两条报错都是我在本机真实跑出来的,不是推测。)
9. 实战二:素数判定与嵌套调用
is_prime1 与 is_prime2
这两个函数都判断 n 是不是素数。注意这里的 n 是那个数字本身,不是列表长度——「相对于什么规模」每次都要问清楚。
def is_prime1(n):
    for i in range(2, n):
        if n % i == 0:
            return False
    return True


def is_prime2(n):
    i = 2
    while i * i <= n:
        if n % i == 0:
            return False
        i += 1
    return True
is_prime1:循环变量从 2 走到 n−1,最多跑 n − 2 轮,每轮做一次取模和一次比较(都是 O(1))。答案:O(n)。
那个 return False 同样只在运气好时提前结束(比如 n 是偶数,第一轮就返回)。最坏情况是 n 真的是素数——循环一轮都省不掉。所以 O(n)。
is_prime2:循环条件是 i * i <= n,也就是 i <= √n。所以最多跑 √n 轮,每轮仍是 O(1)。答案:O(√n)。
这不是复杂度技巧,是数论事实。假设 n 有一个因数 a,那么 n = a · b,b 也是因数。
举例 n = 36:因数对是 (2,18)、(3,12)、(4,9)、(6,6)。每一对的左边都 ≤ 6 = √36。
本机实测(n = 1000003,是素数,也就是两个函数的最坏情况):
| 函数 | 复杂度 | 循环轮数 | 本机耗时 |
|---|---|---|---|
is_prime1(1000003) | O(n) | 约 106 | 0.0202 秒 |
is_prime2(1000003) | O(√n) | 约 103 | 0.000049 秒 |
幻灯片的增长阶表只列了常数 / 对数 / 线性 / 平方 / 指数五档,但 O(√n) 是一个完全合法的答案,别硬往五档里塞。它的位置在 O(log n) 和 O(n) 之间:
$$O(1) \;<\; O(\log n) \;<\; O(\sqrt{n}) \;<\; O(n) \;<\; O(n\log n) \;<\; O(n^2) \;<\; O(2^n)$$(√n 也可以写成 n0.5,属于多项式 nk 那一族,k = 0.5。)
顺带记一个真实缺陷:is_prime1(1) 和 is_prime2(1) 都返回 True(本机实测),但 1 不是素数。因为 range(2, 1) 是空的、2*2 <= 1 一开始就为假,两个循环都一轮不跑,直接落到 return True。真要用得加一行 if n < 2: return False。本节只分析复杂度,但顺手指出来——复杂度对了不代表函数对了。
bar 与 biz:嵌套调用
def bar(n):
    i, sum = 1, 0
    while i <= n:
        sum += biz(n)
        i += 1
    return sum

def biz(n):
    i, sum = 1, 0
    while i <= n:
        sum += i**3
        i += 1
    return sum
这题的全部难点在一行:sum += biz(n)。它看起来只是一次加法赋值,但右边藏着一整个循环。
biz。 它的循环从 i = 1 走到 i = n,跑 n 轮;循环体是 sum += i**3(一次乘方 + 一次加法 + 一次赋值)和 i += 1,都是 O(1)。所以 biz(n) 是 O(n)。bar 的循环跑几轮。 同样是 i 从 1 到 n,n 轮。sum += biz(n)——这一轮的代价 = 调用 biz(n) 的代价 = O(n),加上 i += 1 的 O(1)。写成式子:
$$T_{\text{bar}}(n) = O(1) + n \cdot \bigl(T_{\text{biz}}(n) + O(1)\bigr) = O(1) + n \cdot O(n) = O(n^2)$$答案:O(n2),和官方解答标注一致。
关键在于 biz 拿到的实参是 n,不是 i——所以内层循环每一轮都跑满 n 次,跟外层进行到第几轮无关。总操作数正好是 n × n。
本机实测验证(平方级的标志:n 翻倍,时间约变 4 倍):
| n | bar(n) 耗时 | 相比上一行 |
|---|---|---|
| 500 | 0.046 秒 | — |
| 1000 | 0.163 秒 | ×3.5 |
| 2000 | 0.629 秒 | ×3.9 |
误区一:只看 bar 自己的循环,回答 O(n)。 这是这道题最主要的陷阱。函数调用的代价是被调用函数的完整代价,不是 O(1)。 分析嵌套调用必须从最里层开始往外算。
误区二:看到 i**3 就慌,以为是 O(n3)。 i**3 是「i 的立方」,指数是固定的 3,不随 n 变。它就是一次乘方运算,算 O(1)。真正让复杂度变高的是循环轮数和递归节点数,不是算式里出现了 3 次方。
误区三:以为 biz(i) 会把复杂度降到 O(n)。 假如把那行改成 sum += biz(i),总操作数变成 1 + 2 + … + n = n(n+1)/2,仍然是 O(n2)——只是常数因子从 1 变成 1/2 而已,而常数因子要丢掉。
误区四:忽略了 sum 被遮蔽。 i, sum = 1, 0 让局部名字 sum 盖住了内置函数 sum。函数体内之后再想用 sum([1,2,3]) 就会得到 TypeError: 'int' object is not callable。这段课件代码本身没这个需求所以能跑,但这是一个真实存在的坏习惯。
10. 空间复杂度
时间不是唯一的代价。空间复杂度(space complexity)问的是同一个问题的另一面:这个算法运行时要占多少内存? 分析方法完全一样——看内存占用随 n 的增长形式,丢常数和低阶项。
对本课来说,最主要的内存开销就是帧。每一个还没返回的函数调用都占着一帧,帧里有形参和局部变量。所以:
递归函数的空间复杂度 = 最大递归深度 × 每帧的大小。 注意是深度,不是节点总数——因为兄弟节点不会同时活着:fib(n-1) 那整棵子树算完、帧全部销毁之后,fib(n-2) 才开始。
这正好解释了第 3 节末尾那个对照:
| 版本 | 时间 | 空间 | 空间为什么是这样 |
|---|---|---|---|
朴素递归 fib | O(2n) | O(n) | 调用树有 2n 个节点,但最深只有 n 层,任一时刻活着的帧不超过 n 个 |
记忆化 fib | O(n) | O(n) | 帧栈最深 n 层,外加一个存了 n 条记录的 cache 字典。两个 O(n) 相加还是 O(n) |
迭代 fib | O(n) | O(1) | 只有 curr、nxt、k 三个名字,n 多大都是三个,一层帧都不额外开 |
朴素 exp | O(n) | O(n) | 帧栈叠了 n + 1 层(见第 2 节的环境图) |
快速 exp | O(log n) | O(log n) | 帧栈只叠 log n 层 |
幻灯片点明的正是这一条:递归和记忆化版本的 fib 空间复杂度都比迭代版高,因为递归要开一堆帧,每帧还带着自己的局部变量。
时间与空间常常互换
记忆化是最干净的例子:它花掉 O(n) 的额外内存,换来时间从 O(2n) 降到 O(n)。这笔买卖显然划算,但不是所有场合都划算——如果内存本来就紧张(嵌入式设备、超大数据集),你可能宁愿多算一会儿。「时间-空间权衡(time-space tradeoff)」是工程里天天要做的决定。
时间不够只是慢,空间不够是崩。Python 对帧栈深度有硬限制(sys.getrecursionlimit() 默认返回 1000),超了就抛异常:
>>> fib(1000)          # 记忆化版本,时间上明明是 O(n)
Traceback (most recent call last):
  ...
RecursionError: maximum recursion depth exceeded
而迭代版 fib(100000) 本机只要 0.05 秒,一点问题没有——因为它不叠帧。
这就是「空间复杂度」在实践中最直接的表现:O(n) 空间的递归算法有一个它自己的天花板,O(1) 空间的迭代算法没有。
幻灯片明说了:空间复杂度在 61A 里不是重点。你需要理解「递归比迭代费内存、原因是帧」这个概念,以及「时间和空间常有取舍」这个直觉,但不会被要求做精细的空间分析。
另外幻灯片提到一个现实:技术面试里通常不仅要你在一小时内想出算法,还要你分析它的时间和空间复杂度。所以这块内容值得知道,即使不考。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 为什么不用秒数 | 秒数受硬件、后台负载影响,且无法外推;增长阶才是算法自身的性质 | 拿一次计时结果当算法的性能结论 |
| 增长阶五档 | O(1) < O(log n) < O(n) < O(n2) < O(2n);O(√n) 夹在 log 和 n 之间 | 硬把 O(√n) 塞进五档里 |
| 判别口诀 | log:n 翻倍才多花常数;线性:n 加 1 多花常数;指数:n 加 1 乘上常数 | 只背例子不理解规律,换个代码就不会 |
| 分析四步 | 逐行数 → 循环体乘轮数 → 递归画调用树数节点 → 丢常数和低阶项 | 把循环外的一次性开销也乘上了轮数 |
| 递归的时间 | 看调用树的节点总数:每次分裂几支、每次规模缩小多少 | 用递归深度当运行时间,把 O(2n) 的 fib 说成 O(n) |
| 递归的空间 | 看最大深度(同时活着的帧数),兄弟子树不同时占内存 | 把节点总数当空间,把 fib 的空间说成 O(2n) |
exp 两版 | 减 1 → O(n);折半(偶数取平方)→ O(log n) | 把 temp 展开成两次递归调用,优化白做 |
fib 三版 | 朴素 O(2n)/O(n);记忆化 O(n)/O(n);迭代 O(n)/O(1) | 把 curr, nxt = nxt, curr + nxt 拆成两行,算出 2 的幂 |
| 记忆化 | cache 必须放在外层函数的帧里;靠「名字运行时才查」让递归调用也走缓存 | cache = {} 写进内层函数,缓存永远为空但不报错 |
| 单行不等于 O(1) | x in lst、lst.insert(0,x)、切片、sum、max 都是 O(n) | 把 sum += biz(n) 当成一次加法,答成 O(n) |
| Big O 的用法 | 数学上是上界;本课要的是精确的最坏情况 | 因为有 break 就答平均情况,或答 O(n/2) |
一张速查:看到什么,答什么
| 代码长什么样 | 多半是 |
|---|---|
| 没有循环也没有递归,全是算术和赋值 | O(1) |
每轮 n = n // 2 或 i = i * 2 | O(log n) |
循环条件是 i * i <= n | O(√n) |
一重循环走遍 n 个元素,或每次 n - 1 的单支递归 | O(n) |
| 双重循环;或循环里调用了一个 O(n) 的函数 | O(n2) |
| 一次调用里出现两个(或多个)递归调用,规模只减常数 | O(2n) |
这张表是起手直觉,不是判决书。真遇到代码,还是得按第 7 节那四步老实数一遍——尤其要盯住「循环里调用的那个函数自己要花多少时间」。
动手练习
下面每一题都建议先自己算出答案再展开。所有代码我都在本机跑过,答案里给的数字都是实测值。
练习 1:三段代码,各是什么复杂度
def a(n):
    total = 0
    for i in range(n):
        for j in range(i):
            total += 1
    return total

def b(n):
    total = 0
    i = 1
    while i < n:
        for j in range(n):
            total += 1
        i = i * 2
    return total

def c(n):
    total = 0
    i = n
    while i > 1:
        total += 1
        i = i // 2
    return total
看答案
a(n) 是 O(n2)。 陷阱在于内层循环的轮数是 i 而不是 n,很多人会因此觉得「不是完整的 n×n,所以不算平方」。数一数总轮数:i = 0 时 0 轮,i = 1 时 1 轮……i = n−1 时 n−1 轮,合计 0 + 1 + … + (n−1) = n(n−1)/2。n(n−1)/2 = n2/2 − n/2,丢掉常数因子 1/2 和低阶项 n/2,剩下 O(n2)。本机实测 [a(n) for n in range(6)] 得到 [0, 0, 1, 3, 6, 10],正是三角形数。
b(n) 是 O(n log n)。 外层 i = i * 2,i 从 1 翻倍到 ≥ n,跑 log2n 轮;内层每次都完整跑 n 轮。相乘得 n·log n。实测 b(16) 返回 64 = 16 × 4,而 4 = log₂16。✓ 这一档没在幻灯片的五档表里,但它是排序算法的典型复杂度,值得认得。
c(n) 是 O(log n)。 每轮把 i 折半,n → n/2 → n/4 → … → 1,共 log₂n 轮,循环体全是 O(1)。这就是最标准的对数模式。
要点:判断复杂度不能只数「有几层循环」。 b 和 a 都是两层,一个 O(n log n) 一个 O(n2);c 只有一层却是 O(log n)。决定性的是每一层各跑多少轮。
练习 2:这个「去重」函数为什么慢
def unique(lst):
    """返回 lst 中不重复的元素,保持原顺序。
    >>> unique([1, 2, 1, 3, 2])
    [1, 2, 3]
    """
    result = []
    for x in lst:
        if x not in result:
            result.append(x)
    return result
它的复杂度是多少(n 是 lst 的长度)?怎么改进?
看答案
O(n2)。 关键是 x not in result 这一行——它不是 O(1)。列表的成员检查要从头扫到尾,代价是 O(len(result)),而 result 最长可以到 n。外层循环 n 轮 × 每轮最多 O(n) = O(n2)。
最坏情况是 lst 里全都不重复:result 一路涨到 n,而且每次检查都要扫完整个 result 才发现「不在里面」。
改进:再拿一个 set 记录见过的元素,因为集合的成员检查是 O(1):
def unique_fast(lst):
    result = []
    seen = set()
    for x in lst:
        if x not in seen:
            seen.add(x)
            result.append(x)
    return result
现在外层 n 轮 × 每轮 O(1) = O(n)。代价是多用了一个 O(n) 大小的集合——又一次时间换空间。
这个差距有多大?本机实测:在 200 万元素的容器里做一次成员检查,list 要 0.0062 秒,set 只要 0.0000017 秒。
练习 3:数调用次数
def g(n):
    if n <= 0:
        return 1
    return g(n - 1) + g(n - 1)
g(4) 一共调用了多少次 g?g 的时间复杂度是多少?空间复杂度呢?如果把函数体改成 x = g(n - 1); return x + x,答案会变吗?
看答案
调用次数:31 次。 每个非 base case 的调用生两个孩子,深度 4,所以是一棵满二叉树:1 + 2 + 4 + 8 + 16 = 31,也就是 2n+1 − 1。本机加计数器实测:n = 0,1,2,3,4 分别是 1, 3, 7, 15, 31。✓
时间:O(2n)。 节点数按 2n 涨,每个节点做常数工作。
空间:O(n)。 最大深度是 n,同时活着的帧不超过 n + 1 个。左子树全部算完并销毁之后,右子树才开始——兄弟不同时占内存。
改成 x = g(n - 1); return x + x 之后:变成 O(n)。 因为现在每次只调用一次,调用结构从二叉树塌成一根长度为 n 的链,节点数从 2n 降到 n + 1。返回值完全一样(都是 2n),代价却是天壤之别。
这正是第 2 节 exp 那个 temp 的意义,从反面再演示一次:把同一个子问题的结果存下来复用,而不是重算,往往就是指数和线性的分界线。
练习 4:记忆化的执行顺序
def memo(f):
    cache = {}
    def memoized(n):
        if n not in cache:
            cache[n] = f(n)
        return cache[n]
    return memoized

@memo
def fib(n):
    print(n)
    if n == 0 or n == 1:
        return n
    return fib(n - 1) + fib(n - 2)
调用 fib(4),屏幕上会打印出哪些数字,按什么顺序?cache 最终是什么?
看答案
打印 4, 3, 2, 1, 0,各一次,一共 5 行。本机实测确认。
顺着走一遍:
fib(4)  cache 空 → 执行函数体 → 打印 4 → 需要 fib(3) + fib(2)
  fib(3)  不在 cache → 打印 3 → 需要 fib(2) + fib(1)
    fib(2)  不在 cache → 打印 2 → 需要 fib(1) + fib(0)
      fib(1)  不在 cache → 打印 1 → 返回 1,cache[1] = 1
      fib(0)  不在 cache → 打印 0 → 返回 0,cache[0] = 0
    fib(2) = 1,cache[2] = 1
    fib(1)  在 cache 里 → 直接返回 1,函数体不执行,不打印
  fib(3) = 2,cache[3] = 2
  fib(2)  在 cache 里 → 直接返回 1,不打印
fib(4) = 3,cache[4] = 3
最终 cache 是 {1: 1, 0: 0, 2: 1, 3: 2, 4: 3}(插入顺序如此,因为 fib(1) 先于 fib(0) 完成)。
这道题的意义:打印次数正好等于「原始函数体被真正执行的次数」,也就是 n + 1 次。没有缓存的话,fib(4) 会打印 9 次(调用树有 9 个节点)。
顺带回答一个常被问到的问题:为什么函数体里那两个 fib 会走到缓存版本? 因为 @memo 把全局帧里的名字 fib 重新绑定到了 memoized,而函数体里的 fib 是运行时才去环境里查的名字。查的时候查到的就是新绑定。如果名字在定义时就被写死,这个技巧根本不成立。
练习 5:判断题
下面每句话对不对?说出理由。
- 一个 O(n2) 的算法在任何输入下都比 O(n) 的算法慢。
- 说「迭代版 fib 是 O(2n)」是错的。
- 递归 fib 的空间复杂度是 O(2n),因为它要做 2n 次调用。
lst.append(x)和lst.insert(0, x)都是往列表里加一个元素,复杂度相同。- 快速求幂里
temp = exp(b, n // 2)换成return exp(b, n // 2) * exp(b, n // 2),结果和复杂度都不变。
看答案
1. 错。 增长阶描述的是 n 足够大时的行为。n 小的时候,常数因子完全可能让 O(n2) 的算法更快——比如 100n 步 vs n2/100 步,在 n < 10000 时后者一路领先。增长阶保证的是「最终会赢」,不是「一直赢」。
2. 分场合,但在这门课里算错。 严格数学定义下 O 是上界,迭代 fib 确实「不超过指数时间」,所以这句话在数学上成立。但幻灯片明确规定:本课问运行时间时要的是精确的最坏情况,考试上必须写 O(n)。
3. 错。 混淆了节点总数和最大深度。时间由节点总数决定(O(2n)),空间由同时活着的帧数决定,也就是最大深度(O(n))。fib(n-1) 那整棵子树的帧在 fib(n-2) 开始之前就已经全部销毁了。
4. 错。 append 是 O(1)(直接放到末尾),insert(0, x) 是 O(n)(后面每个元素都要往后挪一格)。本机实测:做 20 万次 append 用 0.0065 秒,做 20 万次 insert(0, x) 用 3.48 秒,差 500 多倍。这也正是上一讲链表 demo 想说明的事。
5. 结果不变,复杂度变了。 两个 exp(b, n // 2) 返回的值当然相同(纯函数),所以答案对。但它把同一个子问题算了两遍,调用结构从一根链变回一棵二叉树,复杂度从 O(log n) 退化成 O(n)。temp 那一行不是为了少打几个字,是为了「算一次、用两次」。