可变树:把树从「一串列表」升级成对象
先用继承收尾——自己实现迭代器、自己定义异常类;再把树从函数式的 ADT 换成一个类,从此树可以就地修改,也从此要为别名负责。
0. 本讲导读
这一讲夹在两大块之间,所以它看上去有点「杂」:前半截还在收拾面向对象(object-oriented programming)的尾巴——继承下的属性查找、自己实现迭代器、自己定义异常类;后半截才进入正题——可变树(mutable tree)。
但这两半其实是同一件事的两面。前半截讲的是「一个类怎么参与 Python 已有的机制」:实现 __iter__ / __next__,你的对象就能被 for 循环吃进去;继承 Exception,你的类就能被 raise 抛出、被 except 接住。后半截讲的是「把一个我们已经很熟的数据结构改写成类之后,什么变了、什么没变」。
说说「什么变了」。第 8 讲你学过 tree ADT:
def tree(root_label, branches=[]):
    for branch in branches:
        assert is_tree(branch), 'branches must be trees'
    return [root_label] + list(branches)
一棵树就是一个列表,第 0 个元素是根标签,剩下的元素是各个分支。这套写法的好处是不需要 class 就能用;坏处是你没法优雅地改一棵树。想把某个节点的标签从 3 改成 99,你得写 t[0] = 99——这一行直接捅穿了抽象屏障(abstraction barrier),因为它假定「树就是列表」。想给某个节点添一个分支?t.append(new_branch),同样是在操作列表而不是在操作树。ADT 层只给了你 tree / label / branches 三个函数,其中没有一个是「修改器(mutator)」。
把树写成类之后,节点的标签就是一个实例属性(instance attribute) t.label,分支列表就是 t.branches。改标签是 t.label = 99,加分支是 t.branches.append(...)——这两句既符合抽象(读起来就是「改这棵树的标签」),又真的把对象改掉了。这就是「mutable trees」这个标题的意思:树第一次可以被就地修改。
再说说「什么没变」:递归的写法一点没变。 这一讲最重要的一张对照图,就是同一个 fib_tree 用 ADT 和用类各写一遍——两边的结构完全一样,只有 label(t) 变成 t.label、tree(...) 变成 Tree(...)。树上的递归骨架(对每个 branch 递归、在 leaf 处停)与树的表示方式无关。这句话你现在可能觉得平淡,等到写 height、reveal_winner 的时候会反复用到。
本讲的三道练习题(height、TreeIterator、reveal_winner)都来自随堂代码 15.py,其中最后一道是本学期期中考试第 6 题 Bracket Breaker 的 Tree 类版本。三道题分别练三种能力:树上的普通递归、用队列做层序遍历(顺带把迭代器落到实处)、以及「递归返回一对值」这种高级套路 + 生成器。
- 要让自己的类支持
iter()和next(),实现两个特殊方法:__iter__(返回一个迭代器)和__next__(返回下一个元素,没有了就raise StopIteration)。 - 自定义异常只需要继承
Exception。它可以带任意实例属性,except ... as ex之后就能读这些属性。 Tree类和 tree ADT 表示的是同一种数据。label(t)↔t.label,branches(t)↔t.branches,tree(x, bs)↔Tree(x, bs)。树上递归的骨架完全一样。- 关键差别是可变性:
Tree的实例可以被就地修改(t.label = ...、t.branches.append(...)),因此也带来了别名(aliasing)问题——一棵子树可能被多个地方指着。 Tree.__init__里写self.branches = list(branches)而不是self.branches = branches,是为了切断与调用方那个列表的别名,同时让可变默认参数branches=[]不会被共享修改。- 层序遍历(level-order traversal / BFS)靠一个队列:反复「从队首取一个节点,把它的所有分支追加到队尾」。深度优先则用递归或栈。
1. 热身:继承下的属性查找(WWPD)
上一讲讲了继承和 super(),这一讲开头用一道 What Would Python Display 把它钉死。题目的两个类:
class A:
    foo = 0

    def __init__(self, foo, bar):
        self.foo = foo + A.foo
        A.foo += 1
        self.bar = bar

class B(A):
    foo = 5

    def __init__(self, bar):
        super().__init__(B.foo, bar)
做这类题只需要一条铁律,但必须一字不差地执行:
<instance>.attr:先在实例自己的属性字典里找;找不到,去它的类里找;再找不到,沿继承链往上找父类。<class>.attr:直接从这个类开始找,然后沿继承链往上。永远不会去看某个实例。- 赋值语句
<obj>.attr = value不查找,它直接在<obj>上创建或覆盖这个属性。self.foo = ...写的是实例属性,A.foo = ...写的是类属性。
注意 __init__ 里那三行的微妙之处:self.foo = foo + A.foo 右边的 A.foo 是类属性(从 A 查),左边的 self.foo 是实例属性(写到实例上)。然后 A.foo += 1 展开是 A.foo = A.foo + 1,读的是类属性、写的也是类属性——所以每 new 一次 A,类属性 A.foo 就涨 1。这是一个计数器。
第一次调用
>>> first = A(2, 3)
>>> first.foo
2
>>> first.bar
3
>>> A.foo
1
A(2, 3):新建一个 A 的实例,调用 A.__init__(<新实例>, 2, 3),所以 self 是新实例、foo 是 2、bar 是 3。self.foo = foo + A.foo:右边 foo 是形参(值 2),A.foo 是类属性(此刻还是 0)。2 + 0 = 2,把实例属性 foo 设为 2。A.foo += 1:类属性变成 1。已经建好的实例属性 first.foo 不受影响——它当时抄的是一份值,不是一个引用类属性的链接。self.bar = 3。first.foo:实例上有 foo(=2),查到就停,不再去看类属性。→ 2。A.foo:从类查,是第 3 步改过的 1。class A 类属性 foo ──→ 1 (被 A.foo += 1 改过)
class B(A) 类属性 foo ──→ 5 (从没被改过)
first (an A) 实例属性 foo ──→ 2
实例属性 bar ──→ 3
第二次调用:计数器在涨
>>> second = A(2, 3)
>>> second.foo
3
>>> second.bar
3
>>> A.foo
2
同样的实参 A(2, 3),second.foo 却是 3 而不是 2。原因在第 2 步:这一次 A.foo 已经是 1 了,所以 2 + 1 = 3。然后 A.foo 再涨到 2。类属性是所有实例共享的一块状态,改它就是在改一个全局计数器。
第三次调用:轮到子类 B
>>> third = B(2, 3)
Error
先解决这个「Error」。B.__init__ 的签名是 def __init__(self, bar),只收一个参数。B(2, 3) 想传两个,参数个数对不上。真实报错是:
Traceback (most recent call last):
  ...
TypeError: B.__init__() takes 2 positional arguments but 3 were given
「takes 2 ... but 3 were given」里的 2 和 3 都把 self 算进去了:B.__init__ 声明了 self 和 bar 共 2 个,而 B(2, 3) 实际传的是「新实例 + 2 + 3」共 3 个。看到这类报错,先在心里把 self 补回去再数。
改成正确的调用:
>>> third = B(3)
>>> third.foo
7
>>> third.bar
3
>>> B.foo
5
>>> A.foo
3
B(3) 为什么给出 7
B 的实例,调用 B.__init__(self, 3),bar = 3。super().__init__(B.foo, bar)。先求实参:B.foo 从类 B 查——B 自己有 foo = 5,查到就停,不会去看 A 的 foo。所以传进去的是 5。super() 在 B 的方法里表示「从 B 的父类 A 开始查方法」,于是调用的是 A.__init__(self, 5, 3)。注意 self 仍然是那个 B 的实例——super() 换的是「去哪儿找方法」,不换「作用在谁身上」。A.__init__:self.foo = foo + A.foo。形参 foo = 5;A.foo 此刻是 2(前两次 A(2, 3) 累加出来的)。5 + 2 = 7,写到实例属性上。A.foo += 1 → 类属性 A.foo 变成 3。注意它改的是 A 的类属性,跟 B.foo 毫无关系——B 自己有一个 foo = 5 遮住了 A.foo。self.bar = 3。third.foo → 实例属性 7;B.foo → 5(没人改过);A.foo → 3。最后两行是这道题的题眼:
>>> third.foo = 100
>>> third.foo
100
>>> B.foo
5
third.foo = 100 只在这一个实例上写了个 foo。类属性 B.foo 完全不知情,还是 5。反过来说,如果这时候你新建一个 B(0),它的 foo 会重新按公式算,跟 100 没有半点关系。
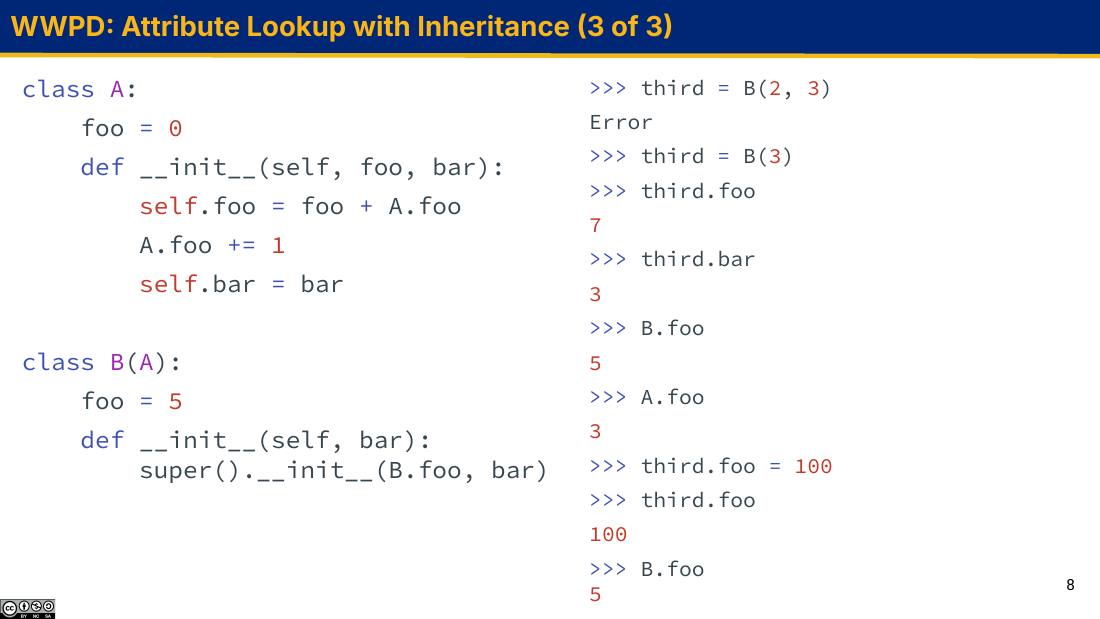
B.foo 走「类 → 父类」并在 B 处命中 5;A.foo 被 A.foo += 1 累加到 3;third.foo 是 __init__ 里写的实例属性 7;最后 third.foo = 100 只覆盖实例,B.foo 纹丝不动。B(2, 3) 那行标着 Error,因为 B.__init__ 只接受一个 bar。误区一:以为 self.foo = foo + A.foo 里的 self.foo 和 A.foo 是同一个东西。它们同名,但一个在实例上、一个在类上,是两个独立的存储位置。实例属性一旦建立,就会永久遮住同名的类属性(对这个实例而言)。
误区二:以为 A.foo += 1 也会让 B.foo 涨。不会。B 自己定义了 foo = 5,这是 B 上一个独立的类属性。只有当 B 没有 定义自己的 foo 时,B.foo 才会沿继承链读到 A.foo。
误区三:以为 super().__init__(...) 会新建一个 A 的实例。不会。它只是「用父类的 __init__ 来初始化当前这个 self」。整个过程从头到尾只有一个对象。
2. 自己写一个迭代器:__iter__ 与 __next__
第 12 讲你学过怎么用迭代器:iter(x) 拿到一个迭代器,next(it) 一个一个往外取,取完了抛 StopIteration。for 循环、list()、列表推导式在底层做的都是这套动作。
现在反过来问:要让「我自己写的类」也能被 for 循环吃进去,需要满足什么条件?答案很短——实现两个特殊方法:
| 特殊方法 | 什么时候被调用 | 该返回什么 |
|---|---|---|
__iter__(self) | 对实例调用 iter(obj) 时(for 循环开始时会自动调一次) | 一个迭代器(也就是一个实现了 __next__ 的对象) |
__next__(self) | 对迭代器调用 next(it) 时(for 每转一圈调一次) | 下一个元素;没有下一个了就 raise StopIteration |
课上的例子是一个产出偶数的迭代器:
class Evens:
    """Iterator that returns positive even numbers <= n"""
    def __init__(self, n: int):
        self.curr = 0
        self.n = n

    def __iter__(self):
        return self

    def __next__(self):
        if self.curr <= self.n:
            temp = self.curr
            self.curr += 2
            return temp
        else:
            raise StopIteration
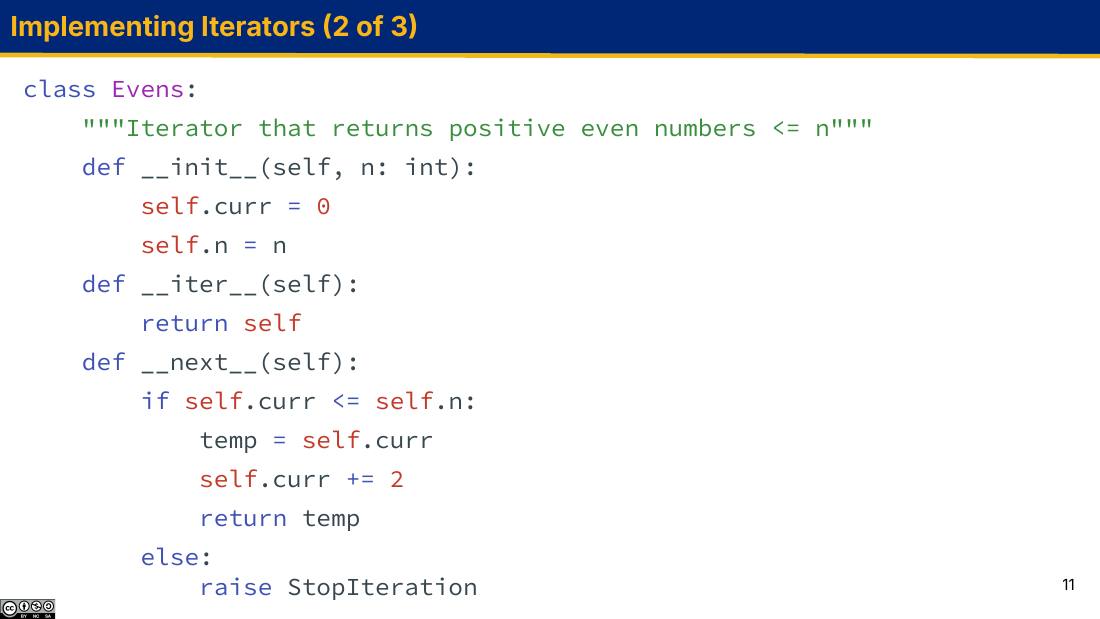
__init__ 建立「进度」状态 self.curr;__iter__ 直接 return self(因为这个类自己就是迭代器);__next__ 是唯一有逻辑的地方——先把当前值抄进 temp,把进度推进 2,再返回 temp。这三行的顺序不能乱。__next__ 里那三行为什么是这个顺序
temp = self.curr      # 1. 记住"这次该返回的值"
self.curr += 2        # 2. 把进度推到下一格
return temp           # 3. 返回记住的那个值
Evens(5) 的四次 next
evens = Evens(5):新实例,self.curr = 0,self.n = 5。evens_iter = iter(evens) → 调用 evens.__iter__() → 返回 self。所以 evens_iter is evens 为 True,它们是同一个对象。next:0 <= 5 真 → temp = 0,curr 变 2,返回 0。2 <= 5 真 → temp = 2,curr 变 4,返回 2。4 <= 5 真 → temp = 4,curr 变 6,返回 4。6 <= 5 假 → 走 else → raise StopIteration。对应的交互记录:
>>> evens = Evens(5)
>>> evens_iter = iter(evens)
>>> next(evens_iter)
0
>>> next(evens_iter)
2
>>> next(evens_iter)
4
>>> next(evens_iter)
Traceback (most recent call last):
  ...
StopIteration
如果不用 temp,两种「简化」都会错:
| 写法 | Evens(5) 产出 | 为什么 |
|---|---|---|
temp = curr; curr += 2; return temp(原版) | 0, 2, 4 | 先记后进,返回的是「进位之前」的值 |
self.curr += 2; return self.curr | 2, 4, 6 | 返回的是「进位之后」的值,第一个偶数 0 被跳过、末尾多出一个 6 |
return self.curr; self.curr += 2 | 0, 0, 0, …(死循环) | return 一执行函数就结束了,self.curr += 2 永远不会被执行,进度卡在 0 |
误区一:忘了 raise,写成 return StopIteration。这会让 next() 返回一个异常类对象当成普通元素,for 循环根本停不下来——它只认「抛出」的 StopIteration,不认「返回」的。
误区二:只实现了 __next__,没实现 __iter__。此时 for x in obj 会报:
TypeError: 'NoIter' object is not iterable
误区三:只实现了 __iter__,返回的东西没有 __next__。对它调 next() 会报:
TypeError: 'NoNext' object is not an iterator
这两条报错信息的措辞值得记住:iterable(可迭代)说的是「能被 iter() 处理」,iterator(迭代器)说的是「能被 next() 处理」。两个词不是同义词。
__iter__ 返回 self 意味着「一次性」
Evens 的 __iter__ 返回 self,也就是说这个类自己就是迭代器,进度 self.curr 只有一份。后果是它只能遍历一遍:
>>> e = Evens(5)
>>> [x for x in e]
[0, 2, 4]
>>> [x for x in e]
[]
第二次为空,因为 curr 已经被推到 6 了,__iter__ 又把同一个耗尽的对象还了回来。列表不是这样的——list.__iter__ 每次都新建一个独立的迭代器,所以列表可以反复遍历。第 9 节的 TreeIterator 正是用「Tree.__iter__ 每次 return TreeIterator(self)」这个写法来避开这个坑的。
另外,Evens 的 docstring 写的是 "positive even numbers",但它实际会先吐一个 0,而 0 不是正数。这是讲义代码里的一处小瑕疵,不影响理解,但提醒你一件事:docstring 是人写的,doctest 才是机器验证过的。两者打架时,以 doctest 为准。
3. 自定义异常类与特殊方法一览
第 1 讲讲过 try / except / raise,当时抛的都是 Python 内置的异常,比如 ZeroDivisionError、AssertionError。现在你会写类了,就可以造自己的异常类型。
做法只有一句话:继承 Exception。为什么必须继承?因为 raise 只接受 BaseException 的子类,而 except SomeError 用的判断也是 isinstance——继承关系正是 except 能不能接住的依据。
课上的例子给 Account 加了「余额不足」这种情况:
class Account:
    interest = 0.02

    def __init__(self, account_holder):
        self.balance = 0
        self.holder = account_holder

    def deposit(self, amount):
        self.balance = self.balance + amount
        return self.balance

    def withdraw(self, amount):
        if amount > self.balance:
            raise InsufficientFundsException(amount, self.balance)
        self.balance = self.balance - amount
        return self.balance
class InsufficientFundsException(Exception):
    def __init__(self, amount, balance):
        message = f'Requested ${amount} is larger than current balance ${balance}'
        super().__init__(message)

        self.amount = amount
        self.balance = balance
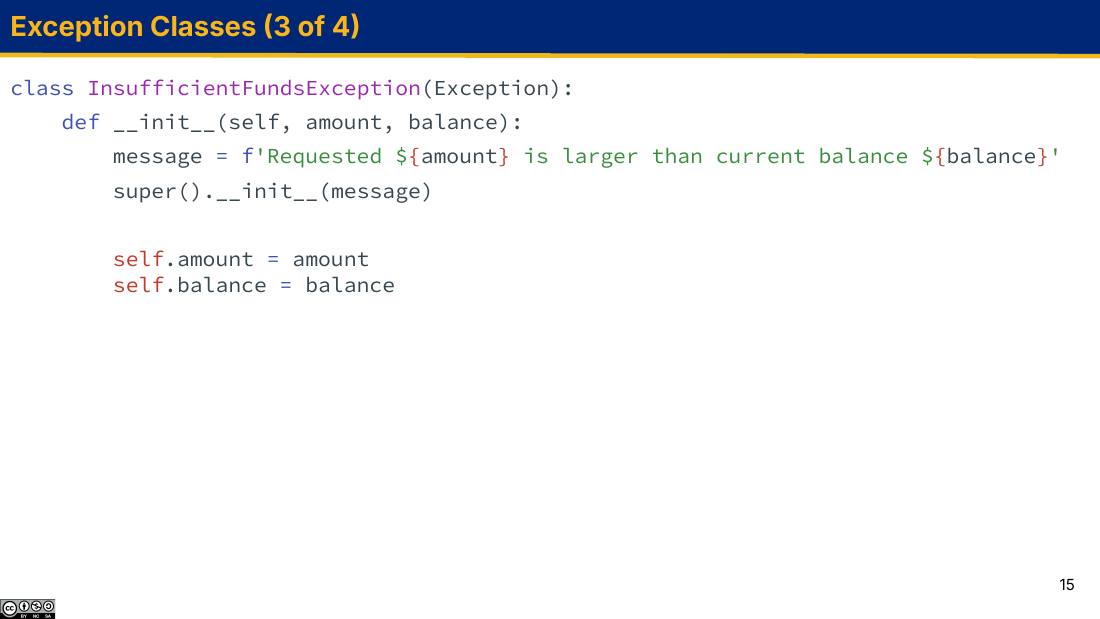
class X(Exception) 声明继承;super().__init__(message) 把人类可读的说明交给父类保管(打印 traceback 时显示的就是它);self.amount / self.balance 把结构化的数据挂在异常对象上,好让 except 那边能算数,而不是去解析字符串。为什么要挂 self.amount 和 self.balance
关键在使用现场:
>>> acct = Account('Jane')
>>> acct.deposit(15)
15
>>> try:
...     acct.withdraw(20)
... except InsufficientFundsException as ex:
...     print(f'You need ${ex.amount - ex.balance} more')
...
You need $5 more
acct.withdraw(20) 进入 withdraw,amount = 20,self.balance = 15。20 > 15 为真 → 求值 InsufficientFundsException(20, 15)。这一步先构造对象:进入它的 __init__,拼出 message 字符串,调 super().__init__(message) 让 Exception 记下这段话,再把 20 和 15 分别绑到实例属性上。raise 才真正把它抛出去。withdraw 就此终止——后面两行 self.balance = ... 和 return 都不会执行,所以余额没被扣。这一点很重要:异常天然帮你保住了「操作要么完整发生、要么完全不发生」。except InsufficientFundsException as ex。Python 检查抛出的对象是不是这个类(或其子类)的实例——是,于是把它绑定到名字 ex,执行 except 的 suite。ex.amount - ex.balance = 20 - 15 = 5 → 打印 You need $5 more。第 5 步是整个设计的意义所在。如果异常只带一句字符串,处理方想知道「还差多少钱」就得去解析那句英文——脆弱、恶心、而且一改文案就崩。把数据以属性形式挂在异常对象上,处理方就能直接算。异常对象是一个普通对象,你可以往上挂任何东西。
如果没人接住它,traceback 里显示的是父类保管的那句 message:
Traceback (most recent call last):
  ...
InsufficientFundsException: Requested $20 is larger than current balance $15
为什么不直接 return False 或者 print('余额不足')?因为 withdraw 正常时返回的是一个数字(新余额)。返回 False 意味着调用方每次都得判断「这次返回的是余额还是失败标志」,而 False 在算术里等于 0,一不小心就被当成「余额为 0」用了下去。print 更糟:它不改变控制流,函数照样往下跑,调用方完全不知道出过事。异常的价值是它强行打断控制流——不处理就一路炸到顶,绝不会被悄悄忽略。
目前为止该掌握的特殊方法
| 特殊方法 | 被谁触发 | 典型用途 |
|---|---|---|
__init__ | Cls(...) | 类的构造器,给新实例初始化属性 |
__eq__ | a == b | 定义「两个对象内容相等」的含义(默认是比较身份) |
__str__ | str(x)、print(x) | 给人看的字符串(可以多行、可以省略细节) |
__repr__ | repr(x)、交互式解释器回显 | 给程序员看的字符串,理想情况下能粘回代码里重建这个对象 |
__iter__ | iter(x)、for 循环开始时 | 返回一个迭代器 |
__next__ | next(it)、for 每一圈 | 返回下一个元素,或抛 StopIteration |
Python 的特殊方法远不止这些(__len__、__getitem__、__add__……),这门课不要求全会。但要记住这套机制的名字叫 dunder(double underscore)方法,以及它的共同逻辑:你不直接调用它们,是 Python 的某个内置语法或内置函数替你调用的。写 len(x) 而不是 x.__len__(),写 print(x) 而不是 x.__str__()——这是约定,也是让你的类能无缝接入语言其余部分的接口。
4. 回顾:树的 ADT 表示,以及它卡在哪儿
先把旧的写法完整摆出来。一棵树由一个根标签(root label)和一个分支(branches)列表构成,每个分支自己也是一棵树——这是一个递归定义,也是树上所有算法都能写成递归的根本原因。
def tree(root_label, branches=[]):
    for branch in branches:
        assert is_tree(branch), 'branches must be trees'
    return [root_label] + list(branches)

def label(tree):
    return tree[0]

def branches(tree):
    return tree[1:]
加上两个判断函数:
def is_tree(tree):
    if type(tree) != list or len(tree) < 1:
        return False
    for branch in branches(tree):
        if not is_tree(branch):
            return False
    return True

def is_leaf(tree):
    return not branches(tree)
三点值得重看:
tree(...)里那句assert是构造时的校验:只要你老老实实用tree造树,造出来的东西一定合法,后面所有函数都可以放心假设「传进来的是棵树」。[root_label] + list(branches)里的list(...)做了一次浅拷贝,并且+本身就会产生一个新列表。所以调用方后来往自己那个 branches 列表里塞东西,不会影响已经造好的树。is_leaf的判据是「没有分支」,不是「标签是某个特殊值」,也不是「深度到底了」。叶子(leaf)=branches为空。
因为数据定义本身就是递归的:「一棵树 = 一个标签 + 一列树」。于是处理一棵树的函数天然分成两半——处理这个标签,以及对每个分支调用自己。骨架永远是:
def f(t):
    if is_leaf(t):          # 或者别的终止条件
        return <基本情况的答案>
    return <把 [f(b) for b in branches(t)] 和 label(t) 合起来>
你要发明的从来不是「递归怎么写」,而是「子问题的答案怎么合并成整个问题的答案」那一句。
ADT 表示卡在哪儿
它其实很好用,缺点只有在你想修改一棵树的时候才暴露。假设有 t = tree(3, [tree(2, [tree(5)]), tree(4)]),也就是列表 [3, [2, [5]], [4]]。现在要把根标签改成 99:
>>> t[0] = 99
这一行捅穿了抽象屏障。它没有用任何一个 ADT 函数,而是直接利用了「树恰好是用列表实现的」这个事实。第 8 讲反复强调过:一旦有代码这么写,你就再也不能换实现了——哪天想改成用字典或者对象表示树,这一行就会静默地做错事或崩掉。
问题在于,ADT 层根本没提供修改的手段。tree 是构造器,label / branches 是选择器,没有修改器(mutator)。想「改一棵树」,函数式的正统做法是造一棵新树:
>>> t2 = tree(99, branches(t)) # 造新的,原来的 t 不动
这条路完全走得通(本讲最后那道 reveal_winner 用的就是这个思路),但对于「只想改一个节点」的场景,你得把从根到那个节点的整条路径上的树全部重建一遍。代码会很啰嗦。
还有个更日常的痛点:branches(t) 每次都返回 tree[1:],这是一个新的切片列表。所以下面这行看起来在加分支,其实什么也没发生:
>>> branches(t).append(tree(7)) # 改的是切片产生的临时列表,t 完全没变
这是一个非常隐蔽的 bug:没有报错,没有异常,就是不生效。把树换成类,正是为了让「改一个节点」这件事既合法又直观。
5. Tree 类:把树做成对象
同一种数据,换一种表示:
class Tree:
    def __init__(self, label, branches=[]):
        self.label = label
        for branch in branches:
            assert isinstance(branch, Tree)
        self.branches = list(branches)

    def is_leaf(self):
        return not self.branches
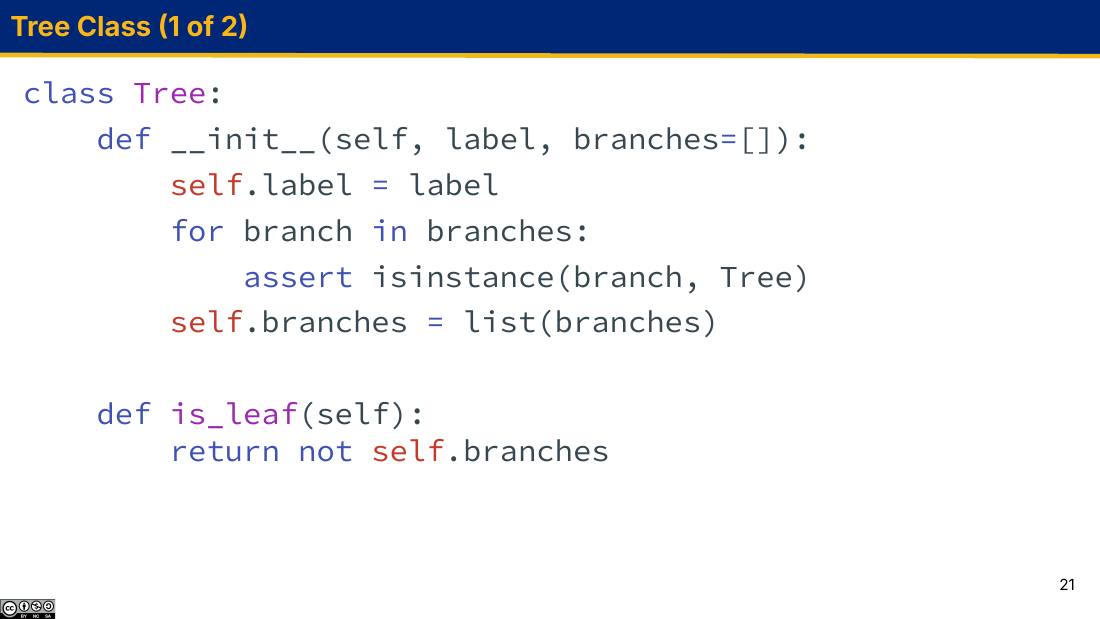
tree(...) 变成 __init__,选择器 label / branches 直接变成两个实例属性(连方法都不用写),is_leaf 从「函数取树」变成「树上的方法」。assert isinstance(branch, Tree) 顶替了原来的 is_tree 递归校验——因为只要 branch 是个 Tree 实例,它在被构造的时候就已经校验过自己的分支了。逐行对照一下,你会发现这不是「新东西」,是同一套概念换了个住处:
| 做什么 | tree ADT | Tree 类 |
|---|---|---|
| 构造一棵树 | tree(3, [b1, b2]) | Tree(3, [b1, b2]) |
| 构造一片叶子 | tree(5) | Tree(5) |
| 取根标签 | label(t) | t.label |
| 取分支列表 | branches(t) | t.branches |
| 取第一个分支 | branches(t)[0] | t.branches[0] |
| 是不是叶子 | is_leaf(t) | t.is_leaf() |
| 改标签 | 做不到(除非 t[0] = ... 破坏抽象) | t.label = 99 |
| 加分支 | 做不到(branches(t) 是拷贝) | t.branches.append(b) |
| 底层是什么 | 一个列表 [3, [2, [5]], [4]] | 一个对象,带 label / branches 两个实例属性 |
课上的验证:
>>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
>>> t.label
3
>>> t.branches[0].label
2
>>> t.branches[1].is_leaf()
True
这三行值得慢放,因为求值顺序在这里是有意义的。
Tree(3, [Tree(2, [Tree(5)]), Tree(4)]) 的构造顺序
Tree,先求实参。第一个实参 3 就是 3;第二个实参是一个列表字面量,要先把它里面每个元素求值。Tree(2, [Tree(5)]):又要先求它的实参 —— Tree(5) 先被求值。Tree(5) 用了默认的 branches=[],for 循环一次都不转,self.branches = list([]) 得到一个新的空列表。得到叶子对象,记作 @5。Tree(2, [@5]):self.label = 2;for 循环检查 @5 是 Tree 实例,通过;self.branches = list([@5]),一个装着 @5 的新列表。得到 @2。Tree(4),得到叶子 @4。[@2, @4]。构造 Tree(3, [@2, @4]):标签 3,两个分支都通过 isinstance 检查,self.branches 是 [@2, @4] 的一份新拷贝。得到 @3,绑定到名字 t。Tree(5) 最先诞生,根最后诞生。这与 fib_tree 那种递归造树的顺序是一致的。t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
Global frame
    t ──→ @3

@3  Tree instance          @2  Tree instance          @5  Tree instance
    label    ──→ 3             label    ──→ 2             label    ──→ 5
    branches ──→ [@2, @4]      branches ──→ [@5]          branches ──→ []

                           @4  Tree instance
                               label    ──→ 4
                               branches ──→ []
照着这张图读 t.branches[0].label:t 是 @3 → 取它的 branches,是列表 [@2, @4] → 取下标 0,是 @2 → 取 @2 的 label,是 2。点号从左往右一步一步走,每一步的中间结果都是一个具体的对象。而 t.branches[1].is_leaf() 走到 @4,调它的方法:@4.branches 是 [],not [] 为 True。
为什么 __init__ 里要写 list(branches)
这行小小的 list(...) 干了两件事,都很关键。
第一,它切断了与调用方那个列表的别名。如果写成 self.branches = branches:
>>> bs = [Tree(2)]
>>> t = Tree(1, bs)
>>> bs.append(Tree(3))      # 调用方往自己的列表里加东西
>>> t.branches              # 如果没有 list(...),t 会莫名其妙多出一个分支
有了 list(...),实际结果是 t 依然只有一个分支——它持有的是自己的那份列表:
>>> repr(t)
'Tree(1, [Tree(2)])'
>>> len(bs)
2
第二,它解掉了「可变默认参数」这个经典陷阱。def __init__(self, label, branches=[]) 里的那个 [] 是在定义函数时求值一次的,之后所有用默认值的调用共享同一个列表对象。假如写成 self.branches = branches,就会出这种事:
>>> a1 = Tree(1)            # 用默认的 []
>>> a2 = Tree(2)            # 也用默认的 [],是同一个列表!
>>> a1.branches.append(Tree(9))
>>> a2.branches             # 会变成 [Tree(9)] —— a2 凭空长出一个分支
因为有 list(branches),每个实例拿到的都是那个共享默认列表的一份新拷贝,所以真实结果是各管各的:
>>> a1 = Tree(1)
>>> a2 = Tree(2)
>>> a1.branches.append(Tree(9))
>>> repr(a1), repr(a2)
('Tree(1, [Tree(9)])', 'Tree(2)')
拷贝的是那个列表,不是列表里的树。list(branches) 是浅拷贝(shallow copy):新列表里装的还是原来那几个 Tree 对象本身。所以 t.branches.append(x) 不会影响 bs,但 t.branches[0].label = 99 会同时影响 bs[0]——它们是同一棵子树。这个区别是下一节的主题。
误区一:忘了给 branches 套方括号。
>>> Tree(1, Tree(2))
Traceback (most recent call last):
  ...
TypeError: 'Tree' object is not iterable
报错来自 __init__ 里的 for branch in branches——它要遍历第二个参数,而 Tree 实例默认不可迭代。第二个参数必须是一个装着 Tree 的列表。
误区二:往 branches 里塞了标签而不是树。
>>> Tree(1, [2, 3])
Traceback (most recent call last):
  ...
AssertionError
注意这个 AssertionError 不带任何提示信息,因为 assert isinstance(branch, Tree) 后面没写消息串。看到光秃秃的 AssertionError 而且栈顶在 Tree.__init__,第一反应就该是「我把非 Tree 的东西当分支传进去了」。想造一棵有两个叶子的树,要写 Tree(1, [Tree(2), Tree(3)])。
误区三:is_leaf 忘了加括号。if t.is_leaf: 不会报错——它求值出一个绑定方法对象,而对象永远是 truthy,于是每个节点都被当成叶子。用它写的 height 会对任何树返回 0,而且一声不吭。这类「没报错但答案恒定」的 bug 最难查,看到「结果总是同一个数」时,先检查有没有漏掉的 ()。
6. 同一段递归的两种写法:fib_tree 对照
这一节只有一个目的:让你相信换表示不改算法。fib_tree(n) 造一棵「斐波那契树」——根标签是 \(\mathrm{Fib}(n)\),左子树是 fib_tree(n-2),右子树是 fib_tree(n-1)。两版代码并排:
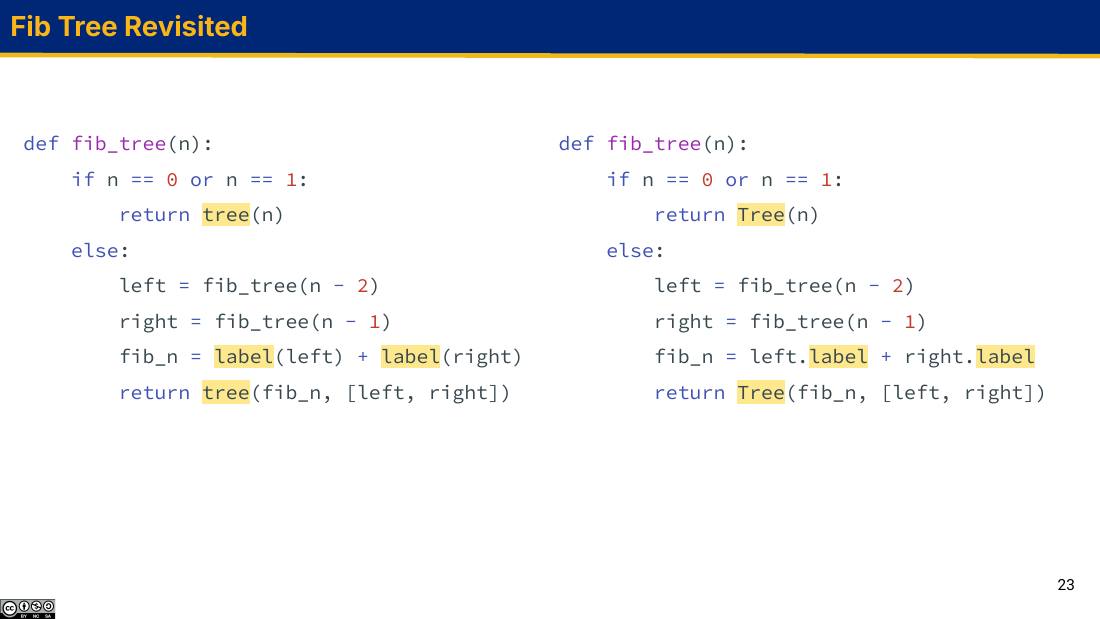
tree(n) → Tree(n)、label(left) → left.label、tree(fib_n, [...]) → Tree(fib_n, [...])。if 的条件、递归调用、变量名、结构全都一模一样——树上的递归骨架跟树怎么存储无关。# tree ADT 版
def fib_tree(n):
if n == 0 or n == 1:
return tree(n)
else:
left = fib_tree(n - 2)
right = fib_tree(n - 1)
fib_n = label(left) + label(right)
return tree(fib_n, [left, right])
# Tree 类版
def fib_tree(n):
if n == 0 or n == 1:
return Tree(n)
else:
left = fib_tree(n - 2)
right = fib_tree(n - 1)
fib_n = left.label + right.label
return Tree(fib_n, [left, right])
这里最容易被略过的一句是 fib_n = left.label + right.label。它体现了树递归的一个重要习惯:不要为了算根标签而再递归一次。两棵子树已经造好了,它们的根标签就是 \(\mathrm{Fib}(n-2)\) 和 \(\mathrm{Fib}(n-1)\),直接读出来相加即可。如果写成 fib_n = fib(n-2) + fib(n-1),等于把整个斐波那契又算了一遍,纯属浪费。
fib_tree(4) 一路展开到 base case,再逐层回代
先下潜。每一层都先算左子树(n-2),再算右子树(n-1):
fib_tree(4)
├─ left  = fib_tree(2)
│         ├─ left  = fib_tree(0) → n==0,base case → Tree(0)
│         ├─ right = fib_tree(1) → n==1,base case → Tree(1)
│         └─ fib_n = 0 + 1 = 1   → Tree(1, [Tree(0), Tree(1)])
├─ right = fib_tree(3)
│         ├─ left  = fib_tree(1) → base case → Tree(1)
│         ├─ right = fib_tree(2)
│         │         ├─ left  = fib_tree(0) → Tree(0)
│         │         ├─ right = fib_tree(1) → Tree(1)
│         │         └─ fib_n = 0 + 1 = 1 → Tree(1, [Tree(0), Tree(1)])
│         └─ fib_n = 1 + 1 = 2   → Tree(2, [Tree(1), Tree(1, [Tree(0), Tree(1)])])
└─ fib_n = 1 + 2 = 3
再回代。最外层拿到 left.label = 1、right.label = 2,于是根标签是 3(确实 \(\mathrm{Fib}(4) = 3\)),最终结果:
Tree(3, [Tree(1, [Tree(0), Tree(1)]),
         Tree(2, [Tree(1), Tree(1, [Tree(0), Tree(1)])])])
注意 fib_tree(2) 被算了两次(一次作为 fib_tree(4) 的左子树,一次作为 fib_tree(3) 的右子树),而且两次造出来的是两个不同的对象——递归每次都在 Tree(...) 里新建实例,不会复用。所以这棵树里没有任何共享节点,你可以放心地修改其中任何一处而不担心波及别处。这个性质在下一节会变成关键。
第 5 讲讲树递归时说过朴素的 fib(n) 会重复算很多次相同的子问题。fib_tree 就是把那棵调用树实体化成了一个数据结构:树上每个节点对应一次 fib 调用。数一数 fib_tree(4) 里有多少个标签为 1 的节点,你就知道 fib(1) 被算了几次。
7. 让树能被打印出来:__repr__、__str__ 与 indented
课上的 Tree 只写了 __init__ 和 is_leaf,但随堂代码 15.py 里的完整版本还带着三个跟显示有关的方法。它们是上一讲「字符串表示」的直接应用,而且后面那道 reveal_winner 的 doctest 就是靠它们才能对得上。
    def __repr__(self):
        if self.branches:
            branch_str = ', ' + repr(self.branches)
        else:
            branch_str = ''
        return 'Tree({0}{1})'.format(repr(self.label), branch_str)

    def __str__(self):
        return '\n'.join(self.indented())

    def indented(self):
        lines = []
        for b in self.branches:
            for line in b.indented():
                lines.append('  ' + line)
        return [str(self.label)] + lines
__repr__:造一段能粘回代码里的文本
repr 的目标是「程序员看的表示,最好能重建这个对象」。所以它拼出来的正是构造这棵树的那句代码:
>>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
>>> t
Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
它的递归藏得很深,值得指出来:repr(self.branches) 是对一个列表调 repr,而列表的 repr 会对它的每个元素调 repr——那些元素是 Tree,于是又回到这个方法。递归就是这么接上的,代码里根本看不见显式的自调用。
那个 if self.branches: 是为了叶子好看:叶子没有分支,就不打印后面的空列表,输出 Tree(5) 而不是 Tree(5, [])。另外 repr(self.label) 而不是 str(self.label)——这样字符串标签会带上引号,Tree('W') 才是能粘回去执行的代码。
indented:把一棵树摊成缩进的若干行
这是本讲最漂亮的一段递归,因为它返回的是一个字符串列表,不是一个字符串——这样才能给每一行统一加缩进。
Tree(3, [Tree(2, [Tree(5)]), Tree(4)]).indented()
@3 上调用。lines = [],开始遍历分支。@2:递归调 @2.indented()。在 @2 里又遍历它的分支 @5:@5.indented() 是 base case(没有分支,for 一次都不转),返回 ['5']。@2:把 '5' 加两个空格变成 ' 5',所以 @2 的 lines 是 [' 5'],返回 ['2', ' 5']。@3:把 @2 返回的每一行都加两个空格 → [' 2', ' 5'],累进 lines。@4:@4.indented() 返回 ['4'],加缩进变 ' 4'。此时 lines = [' 2', ' 5', ' 4']。['3'] + lines,即 ['3', ' 2', ' 5', ' 4']。__str__ 用 '\n'.join(...) 把它们串成多行文本。>>> print(t)
3
2
5
4
关键在第 4 步:缩进是在「回代」的路上一层层叠加的。一个节点在整棵树里有多深,它的那一行就被路过的祖先加了多少次两个空格。这比「递归时传一个 depth 参数下去」更省事,也更能体现递归的本质——每一层只管把子层的结果整体往里推两格。
拿它看 fib_tree(4) 会很直观:
>>> print(fib_tree(4))
3
  1
    0
    1
  2
    1
    1
      0
      1
把 indented 写成返回单个字符串。比如 return str(self.label) + '\n' + ' ' + b_str,看起来能跑,但只有子树的第一行被缩进了,孙子那几行会顶到最左边,打出来的树全歪。原因就是缩进必须逐行施加,而一旦把多行拼成一个字符串,「行」这个单位就没了。先返回列表、最后再 join是这类问题的通用解法。
__str__ 和 __repr__ 搞反。在交互式解释器里直接敲 t 走的是 __repr__(一行的 Tree(3, ...)),print(t) 走的是 __str__(多行缩进图)。doctest 里 >>> t 和 >>> print(t) 的期望输出因此完全不同,写 doctest 时别抄错。
8. 可变性:现在树真的能改了
这才是标题里「Mutable Trees」的正题。Tree 实例是可变对象:它的 label 是一个可以重新绑定的实例属性,它的 branches 是一个货真价实的列表。
两种修改,性质不同
>>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
>>> t.branches[0].label = 99          # 改标签:重新绑定一个实例属性
>>> t
Tree(3, [Tree(99, [Tree(5)]), Tree(4)])
>>> t.branches[1].branches.append(Tree(7))   # 加分支:改一个列表
>>> t
Tree(3, [Tree(99, [Tree(5)]), Tree(4, [Tree(7)])])
| 操作 | 本质是什么 | 谁会看到变化 |
|---|---|---|
t.label = 99 | 在 t 这个对象上重新绑定属性 label | 所有指向 t 这个对象的名字 |
t.branches.append(b) | 对 t.branches 那个列表对象调用修改器 | 所有指向 t 的名字,以及任何还指着那个列表的名字 |
t.branches = [b] | 在 t 上重新绑定属性 branches,换了一整个列表 | 指向 t 的名字会看到;但还捏着旧列表的名字看到的是旧内容 |
t = Tree(99, t.branches) | 造了一个新对象,只是把名字 t 挪过去 | 只有名字 t;原对象一点没变,别人还指着它 |
最后两行的区别是第 8 讲那句老话的翻版:「改名字」和「改对象」是两件事。只有改对象,别的名字才会跟着看到。
别名:一棵子树可以被多处指着
树是嵌套的对象,所以别名(aliasing)在这里格外容易出现:
>>> leaf = Tree(1)
>>> t = Tree(0, [leaf, leaf])          # 同一个叶子塞了两次
>>> t
Tree(0, [Tree(1), Tree(1)])
>>> t.branches[0] is t.branches[1]
True
>>> t.branches[0].label = 99
>>> t
Tree(0, [Tree(99), Tree(99)])
Global frame
    leaf ──→ @1
    t    ──→ @0

@0  Tree instance
    label    ──→ 0
    branches ──→ [ ● , ● ]      ← 列表里两个格子装的是同一个引用
                   │   │
                   └───┴──→ @1  Tree instance
                                label    ──→ 99   (原本是 1)
                                branches ──→ []
repr(t) 打出来是 Tree(1), Tree(1),看上去像两棵树,其实是同一个对象被打印了两次。打印出来的形状不能告诉你有没有共享。唯一能问出真相的是 is。
这个例子看起来是自找麻烦,但它有真实的来源:任何时候你写 Tree(x, [sub, sub])、或者把同一棵子树 append 到两个父节点下,就制造了共享。list(branches) 只做浅拷贝,救不了你——它复制的是那个装引用的列表,不是被指着的树。
就地修改 vs. 造新树
「把整棵树的每个标签翻倍」有两种写法,学会分辨它们是本讲的核心技能之一。
# 写法 A:就地修改(destructive / mutative)
def double(t):
    t.label = t.label * 2
    for b in t.branches:
        double(b)
# 写法 B:造一棵新树(non-destructive / functional)
def doubled(t):
    return Tree(t.label * 2, [doubled(b) for b in t.branches])
>>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
>>> double(t)                 # 返回 None
>>> t
Tree(6, [Tree(4, [Tree(10)]), Tree(8)])

>>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
>>> doubled(t)
Tree(6, [Tree(4, [Tree(10)]), Tree(8)])
>>> t                         # 原树纹丝不动
Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
| A:就地修改 | B:造新树 | |
|---|---|---|
| 返回值 | None(没有 return) | 新的 Tree |
| 原树 | 被改掉了 | 完好无损 |
| base case | 不用写——叶子的 for 循环转 0 次,自然停 | 同样不用写——列表推导对空 branches 得到 [] |
| tree ADT 能写吗 | 不能(没有修改器) | 能,这是 ADT 唯一的路 |
| 有别名时 | 危险:共享子树会被翻倍两次 | 安全:只读原树,产出全新节点 |
| 题目怎么暗示 | doctest 里先调用、再单独看 t | doctest 里直接看调用的返回值 |
「有别名时 A 危险」那条要展开一下:如果 t = Tree(0, [leaf, leaf]),double(t) 会对同一个 @1 执行两次 t.label = t.label * 2,把 1 变成 4 而不是 2。就地修改的正确性依赖于「每个节点只被访问一次」这个前提,而这个前提在有共享的结构上不成立。写法 B 没有这个问题。
误区一:写了就地修改,却又指望它返回树。
>>> print(double(t))
None
>>> double(t).label
Traceback (most recent call last):
  ...
AttributeError: 'NoneType' object has no attribute 'label'
AttributeError: 'NoneType' object has no ... 是这门课里最常见的报错之一,几乎总是同一个原因:某个函数没写 return,你却拿它的返回值继续用。
误区二:想造新树,却在递归里改了原树。比如写 t.branches = [doubled(b) for b in t.branches]; return t——它返回了一棵树,看着像写法 B,其实把原树也改了。判断标准很简单:函数体里出现 xxx.label =、xxx.branches = 或 xxx.branches.append(...),就是在改传进来的那棵树。
误区三:在 for 循环里边遍历边删分支。
for b in t.branches:
    if b.label < 0:
        t.branches.remove(b)     # 遍历的同时改列表长度
这不会报错,但会漏掉元素:remove 让后面的元素前移一格,而循环的内部下标照样往前走,于是紧挨着的那一个被跳过。正确做法是重建一个新列表:t.branches = [b for b in t.branches if b.label >= 0]。
看题目要什么。docstring 说 "Return a tree ..." 就造新树;说 "Mutate t so that ..." 就就地改。如果两种都行,优先造新树——它没有别名风险,也更容易验证(原树还在,可以对照)。就地修改的价值在于省内存、以及某些题目明确要求「不能建新节点」。
9. 练习一:height
随堂代码 15.py 的第一道题:
def height(t: Tree) -> int:
    """
    Returns the height of a Tree `t`
    (recall that the height of a tree is the depth of the lowest leaf)

    >>> t = Tree(1)
    >>> height(t)
    0
    >>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
    >>> height(t)
    2
    >>> t = Tree(1, [Tree(2, [Tree(3, [Tree(4), Tree(5)])]), Tree(6)])
    >>> height(t)
    3
    """
    if _____________________:
        return 0
    return _____________________
题目到底要什么
先把 doctest 的三棵树画出来——题目提示里就写着「Draw out the trees from the doctests」,这不是客套话。
第一棵           第二棵              第三棵
  1               3                   1
                 / \                 / \
              2      4              2   6
              |                     |
              5                     3
                                   / \
                                  4   5

height = 0      height = 2         height = 3
高度(height)= 最深的那片叶子的深度,而深度(depth)是从根走到该节点要经过的边数。所以:
- 第一棵只有根,根的深度是 0,高度 0。单个节点的高度是 0,不是 1——这是最容易错的边界。
- 第二棵:叶子 5 的深度是 2(3→2→5 走了两条边),叶子 4 的深度是 1。取最大 → 2。
- 第三棵:叶子 4 和 5 的深度都是 3,叶子 6 的深度是 1。取最大 → 3。
第三棵树有 4 层节点,但高度是 3。记法:高度数的是边,不是点。如果你算出来总比答案大 1,多半就是把根也数成了一层。
怎么想到的
关键一步是把「整棵树的高度」翻译成「子树的高度」之间的关系。想象站在根上,问自己:如果有人免费告诉我每棵子树的高度,我能算出整棵树的高度吗?
能。第二棵树里,子树 2→5 的高度是 1,子树 4 的高度是 0。从根往下走一步就进入某棵子树,所以「根到某片叶子的距离」= 1 + 「那棵子树的根到那片叶子的距离」。要取所有叶子里最深的,就是:
验算:1 + max(1, 0) = 2。对上了。
base case 呢?公式里的 max 在没有分支时无从谈起,所以叶子必须单独处理,而叶子的高度按定义是 0。骨架填出来就是:
def height(t: Tree) -> int:
    if t.is_leaf():
        return 0
    return 1 + max([height(b) for b in t.branches])
代码逐行讲
if t.is_leaf(): —— 判据是「有没有分支」。括号不能少,t.is_leaf 是方法对象,恒为 truthy,会让整个函数永远返回 0。return 0 —— 叶子的高度是 0。这一步同时也是递归的终点,保证了递归会停:每次递归都往下一层走,而树是有限深的。[height(b) for b in t.branches] —— 对每一个分支递归,收集成一个整数列表。这是树递归的标准动作:不是「递归一次」,是「对每个孩子各递归一次」。max(...) —— 在孩子里选最深的那条路。为什么是 max 而不是 sum?因为高度问的是「最深的一条路有多长」,不是「一共有多少节点」。1 + —— 补上「从我到孩子」的那一条边。这个 1 就是把子问题答案抬升到当前层的那一步。height(Tree(1, [Tree(2, [Tree(3, [Tree(4), Tree(5)])]), Tree(6)]))
下潜(每层先判断是不是叶子,不是就对所有分支递归):
height(@1)          @1 有分支 [@2, @6],不是叶子
  height(@2)        @2 有分支 [@3],不是叶子
    height(@3)      @3 有分支 [@4, @5],不是叶子
      height(@4)    @4 是叶子 ────────────→ 0
      height(@5)    @5 是叶子 ────────────→ 0
  height(@6)        @6 是叶子 ────────────→ 0
回代(从最深处往回算,每层做 1 + max(...)):
height(@3) = 1 + max([0, 0]) = 1 + 0 = 1
height(@2) = 1 + max([1])    = 1 + 1 = 2
height(@6) = 0                              (叶子,早就算好了)
height(@1) = 1 + max([2, 0]) = 1 + 2 = 3    ← 最终答案
注意 height(@2) 那行的 max([1]):只有一个分支时 max 照样能用,列表里就一个元素。而 height(@1) 里的 max([2, 0]) 说明了 max 的意义——右边那条只有 1 层深的路被忽略了,答案由最长的那条路决定。
误区一:不写 base case,指望 max 处理空列表。
def height(t):
    return 1 + max([height(b) for b in t.branches])
>>> height(Tree(1))
Traceback (most recent call last):
  ...
ValueError: max() arg is an empty sequence
叶子的 t.branches 是 [],列表推导得到 [],max([]) 直接报错。看到 ValueError: max() arg is an empty sequence,第一反应就是「我的 base case 漏了」。
(也可以不写 if,改用 max([...], default=-1),但 CS 61A 更希望你显式写出 base case——它才是递归思维的一部分。)
误区二:base case 返回 1。结果每棵树的高度都比正确答案多 1。判断自己有没有犯这个错,最快的办法是拿 Tree(1) 试一下:单节点必须得 0。
误区三:把 max 写成 max(height(b) for b in t.branches) 之外的形式,比如 max(t.branches)。后者是在比较 Tree 对象本身,会报:
TypeError: '>' not supported between instances of 'Tree' and 'Tree'
因为 Tree 没有定义 __lt__ / __gt__,Python 不知道两棵树谁「大」。要比的是递归算出来的高度,不是树。
误区四:用一个循环累加而不是取最大。return 1 + sum([height(b) for b in t.branches]) 在只有一个分支的链状树上碰巧正确,在分叉的树上就会虚高。用第二棵 doctest 树验证:1 + sum([1, 0]) = 2——巧的是也对。再用第三棵:height(@3) 会算成 1 + sum([0,0]) = 1,height(@2) = 2,height(@1) = 1 + sum([2, 0]) = 3——还是对!这说明 doctest 通过不等于代码正确。造一棵 Tree(1, [Tree(2, [Tree(3)]), Tree(4, [Tree(5)])]) 就露馅了:正确答案 2,sum 版会给出 3。
1 + max([f(b) for b in t.branches]) 里换掉三个零件,就是一整族题:
| 问题 | base case | 合并方式 |
|---|---|---|
高度 height | 叶子 → 0 | 1 + max(...) |
节点总数 count_nodes | 叶子 → 1 | 1 + sum(...) |
| 所有标签之和 | 叶子 → t.label | t.label + sum(...) |
| 叶子个数 | 叶子 → 1 | sum(...)(当前节点不算) |
| 最大标签 | 叶子 → t.label | max([t.label] + [...]) |
每次做树的题,先问这两句:叶子该返回什么?孩子们的答案怎么合成我的答案?
10. 练习二:TreeIterator 与层序遍历
第二道题把前半讲的迭代器和后半讲的树接到了一起:写一个迭代器,按层序遍历(level-order traversal,又叫广度优先搜索 breadth-first search / BFS)吐出树上所有标签。
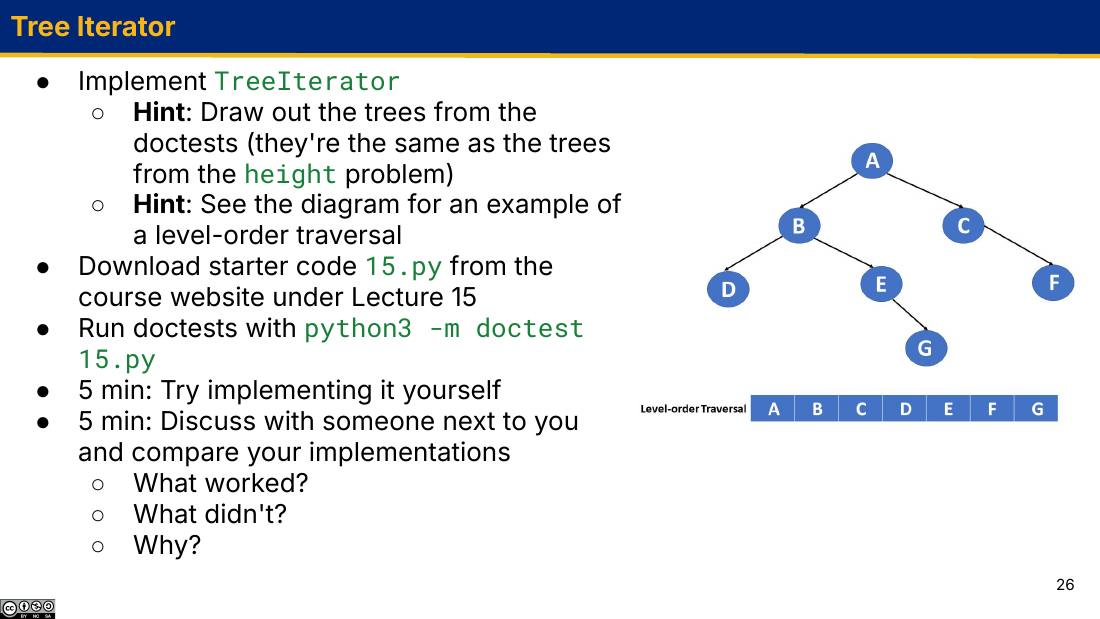
题目给的骨架和 doctest:
class TreeIterator:
    """
    An iterator that returns the elements of a Tree `t`
    when performing a level-order traversal (aka breadth-first search).

    >>> t = Tree(1)
    >>> t_iter = iter(t)
    >>> next(t_iter)
    1
    >>> next(t_iter)
    Traceback (most recent call last):
      ...
    StopIteration

    >>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
    >>> t_iter = iter(t)
    >>> list(t_iter)
    [3, 2, 4, 5]

    >>> t = Tree(1, [Tree(2, [Tree(3, [Tree(4), Tree(5)])]), Tree(6)])
    >>> t_iter = iter(t)
    >>> list(t_iter)
    [1, 2, 6, 3, 4, 5]
    """
    def __init__(self, t: Tree):
        self.queue = [t]

    def __iter__(self):
        return self

    def __next__(self):
        if _____________________:
            curr_node = self.queue._____________________
            for b in curr_node.branches:
                self.queue._____________________
            return _____________________
        else:
            _____________________
为了让 iter(t)(而不是 TreeIterator(t))就能用,Tree 类里额外加了一个方法:
    # NOTE: This method is new and custom for practice problem 2
    # It is not normally part of the Tree class
    def __iter__(self):
        return TreeIterator(self)
这行注释很实在:标准的 Tree 类没有 __iter__,这是为这道题临时加的。注意它 return TreeIterator(self) 而不是 return self——每次 iter(t) 都新建一个独立的迭代器,各带各的队列。所以一棵树可以被反复遍历,不像第 2 节的 Evens 那样一次性。
怎么想到的:为什么必须用队列,不能用递归
树上大部分算法用递归写最顺,但层序遍历不行。原因是递归的执行顺序天生是深度优先:一进入某个分支,就会一路走到底才回来。而层序要求「把第 1 层全吐完再碰第 2 层」,这跟递归的调用栈是反着的。
那怎么办?观察层序的动作模式:
「从头部取、往尾部加」,这正是队列(queue)——先进先出(FIFO)。它保证了第 2 层的节点全部排在第 1 层节点之后,第 3 层又全部排在第 2 层之后。骨架里给的 self.queue = [t] 就是这个名单,初始只有根。
如果把「从头部取」改成「从尾部取」(self.queue.pop()),这个数据结构就变成了栈(stack),先进后出,遍历顺序也随之变成深度优先。BFS 和 DFS 的唯一区别就是这个容器是队列还是栈。这是一个非常值钱的观察。
代码逐行讲
    def __next__(self):
        if self.queue:
            curr_node = self.queue.pop(0)
            for b in curr_node.branches:
                self.queue.append(b)
            return curr_node.label
        else:
            raise StopIteration
if self.queue: —— 队列非空就还有东西要吐。这里用的是列表的真假性:空列表 falsy,非空 truthy。写成 if len(self.queue) > 0: 也对,只是啰嗦。self.queue.pop(0) —— 从头部取走一个节点并返回它。pop(0) 里的 0 是关键:pop() 不带参数会取末尾,那就变成 DFS 了。for b in curr_node.branches: self.queue.append(b) —— 把这个节点的孩子按从左到右的顺序追加到队尾。顺序很重要:append 保证了同一层内部也是从左到右。return curr_node.label —— 吐出标签,不是节点。doctest 期望的是 [3, 2, 4, 5] 这样的整数列表;写成 return curr_node 会得到一串 Tree(...)。raise StopIteration —— 队列空了,遍历结束。必须是 raise,不是 return。关键在于「状态存在哪里」。Evens 的进度是一个整数 self.curr;这里的进度是整个队列。每次 __next__ 只做一小步——取一个、加几个、返回一个——然后把剩下的活儿留在 self.queue 里,等下次调用接着干。迭代器的本质就是「把一个循环拆成一步一步,中间状态存成实例属性」。
list(iter(Tree(1, [Tree(2, [Tree(3, [Tree(4), Tree(5)])]), Tree(6)])))
这棵树长这样(标签就是节点名):
      1
     / \
    2   6
    |
    3
   / \
  4   5
list(...) 会反复调用 next 直到 StopIteration。下表里的队列用标签表示:
| 第几次 next | 调用前队列 | pop(0) 取出 | append 进去的孩子 | 调用后队列 | 返回 |
|---|---|---|---|---|---|
| 1 | [1] | @1 | @2, @6 | [2, 6] | 1 |
| 2 | [2, 6] | @2 | @3 | [6, 3] | 2 |
| 3 | [6, 3] | @6 | (无,叶子) | [3] | 6 |
| 4 | [3] | @3 | @4, @5 | [4, 5] | 3 |
| 5 | [4, 5] | @4 | (无) | [5] | 4 |
| 6 | [5] | @5 | (无) | [] | 5 |
| 7 | [] | 队列为空,走 else 分支 | StopIteration | ||
结果 [1, 2, 6, 3, 4, 5],与 doctest 一致。
盯着第 2、3 行看:@2 的孩子 @3 被追加到 @6 后面,所以 @6 先被吐出来。这就是「同一层先吐完」的机制——孩子永远排在当前层剩余节点的后面。如果这里用的是栈(pop() 取尾),第 3 步取到的就会是 @3,顺序变成 1, 2, 3, ...,那是深度优先。
验证第二棵 doctest 树
Tree(3, [Tree(2, [Tree(5)]), Tree(4)]):队列 [3] → 吐 3,队列 [2, 4] → 吐 2,队列 [4, 5] → 吐 4,队列 [5] → 吐 5,队列空 → StopIteration。结果 [3, 2, 4, 5]。注意 5 排在 4 后面:5 在第 2 层,4 在第 1 层,层序不看它们在图上的左右位置,只看深度。
误区一:pop() 忘了写 0。没有报错,但输出变成深度优先。第三棵树会得到 [1, 6, 2, 3, 5, 4] 之类的顺序(具体取决于 append 顺序),doctest 直接不匹配。看到「元素都对但顺序不对」,先查 pop 的参数。
误区二:return curr_node 而不是 curr_node.label。doctest 会报出类似这样的失配:
Expected:
    [3, 2, 4, 5]
Got:
    [Tree(3, [Tree(2, [Tree(5)]), Tree(4)]), Tree(2, [Tree(5)]), Tree(4), Tree(5)]
误区三:在 __init__ 里就把整棵树展开成列表。比如 self.items = 所有标签的列表; self.i = 0。这样写能过 doctest,但它违背了迭代器「按需产生」的意义——如果树非常大而你只想看前三个,这种写法要先把整棵树走完。不算错,但要知道差别在哪。
误区四:把 Tree.__iter__ 写成 return self。那会要求 Tree 自己实现 __next__,而且状态得存在树上——遍历一次树就"脏"了,第二次 list(t) 会返回空。现在这个写法(每次 return TreeIterator(self))让树保持干净:
>>> t = Tree(1, [Tree(2, [Tree(3, [Tree(4), Tree(5)])]), Tree(6)])
>>> list(t), list(t)
([1, 2, 6, 3, 4, 5], [1, 2, 6, 3, 4, 5])
两次都完整。「可迭代对象」和「迭代器」分开,是列表能被反复遍历的原因,也应该是你的 Tree 的做法。
iter(t) 之所以能用,是因为 Tree 有 __iter__
doctest 里写的是 t_iter = iter(t),不是 TreeIterator(t)。这条链是:iter(t) → 触发 Tree.__iter__(t) → 里面执行 TreeIterator(t) → 触发 TreeIterator.__init__,把 self.queue 设成 [t]。少了 Tree.__iter__ 这一环,iter(t) 会报 TypeError: 'Tree' object is not iterable。
11. 练习三:Bracket Breaker II(reveal_winner)
最后一道是本学期期中考试第 6 题 Bracket Breaker 的 Tree 类版本——同一道题,从 tree ADT 换成类,doctest 与考卷上的图 1–4 完全一致。它把本讲三样东西全用上了:树递归、造新树(而不是就地改)、以及生成器。
树表示一张淘汰赛对阵表:每个节点标 "W"(这一轮赢了)或 "L"(输了)。reveal_winner 是一个生成器,每次产出「把当前最底层的失败者子树全部剪掉之后」的树,一轮一轮剪,直到没得剪为止——最后剩下的就是一条通往冠军的全胜路径。
题目到底要什么:先把三次输出画出来
初始的树(用 print 的缩进形式看,缩进两格 = 深一层):
W
  W
    W
      W
      L
    L
      W
      L
  L
    L
      W
      L
    W
      L
      W
三次 next(gen) 依次给出:
| 第 1 次 | 第 2 次 | 第 3 次 |
|---|---|---|
W
  W
    W
      W
    L
      W
  L
    L
      W
    W
W |
W
  W
    W
      W
  L
    W
W |
W
  W
    W
W |
第 4 次 next(gen) 抛 StopIteration。
对比初始树和第 1 次输出,被删掉的正是那 4 片 L 叶子。对比第 1 次和第 2 次,被删掉的是两棵 L 子树(各带一个 W 孩子)。规律出来了:
一棵子树是「lowest loser」,当且仅当:它的根标签是 "L",并且它的后代里没有任何 "L"。换句话说,它是从下往上数第一个碰到的 L。每一轮只剪这一层,剪完就产出一次。
为什么第 1 轮不剪掉那些高层的 L?因为它们的子树里还含着更底层的 L。等底层的 L 被剪光了,它们才轮到自己「变成最底层」。
怎么想到的:一次递归要同时回答两个问题
难点在于「有没有后代被剪」这个信息必须从下往上传。判断一个 L 节点该不该被剪,光看它自己不够,得先知道它的子树里发生了什么。
这就是「递归返回一个二元组」这个套路的用武之地。骨架里的辅助函数写得很清楚:
    def prune_lowest_losers(t: Tree):
        """
        Return (new_tree, changed), where:

        (1) new_tree is the pruned version of t,
            or None if t is removed
        (2) changed is True if t itself or a lowest losing subtree was pruned,
            and False otherwise
        """
new_tree:剪过之后的这棵子树。如果这棵子树整个被删了,就是None。changed:这一轮里,「我自己或者我的某个后代」有没有被剪掉。
changed 的作用有两个:往上传给父节点当作「你别剪自己了,下面还有活儿」的信号;以及在最外层告诉驱动循环「这一轮到底剪没剪,要不要继续」。
代码逐行讲
        # BASE CASE
        if t.is_leaf():
            if t.label == "L":
                return None, True
            return Tree(t.label), False
叶子没有后代,所以「是不是最底层的 L」就等于「标签是不是 L」——是就删掉自己(None)并汇报 True;不是就原样保留并汇报 False。
注意保留时写的是 Tree(t.label) 而不是 t:造一片新叶子。这道题从头到尾都在造新树,原树一个字节都没改(所以 reveal_winner 跑完之后 t 还是完整的初始树)。写 return t, False 其实也能通过全部 doctest,但那样产出的树会和原树共享节点——一旦有人改了其中一棵,另一棵跟着变。第 8 节讲的别名问题在这里就是活的。
        # RECURSIVE CASE (i)
        new_branches = []
        changed = False

        for b in t.branches:
            new_b, child_changed = prune_lowest_losers(b)
            if new_b is not None:
                new_branches.append(new_b)
            changed = changed or child_changed
new_b, child_changed = prune_lowest_losers(b) —— 对每个分支递归,用解包赋值把返回的二元组拆成两个名字。if new_b is not None: —— 返回 None 表示「这个分支被整个剪掉了」,那就不要把它放进 new_branches。这就是「删除一棵子树」的实现方式:不是去 remove,而是在重建时跳过它。changed = changed or child_changed —— 只要有任何一个孩子汇报了 True,我这一层的 changed 就是 True。这是「或」的累积,等价于 any(...)。为什么必须用 is not None 而不是 if new_b:?因为 Tree 实例没有定义 __bool__ 或 __len__,所有实例都是 truthy,所以这里 if new_b: 碰巧也能工作。但只要哪天给 Tree 加上 __len__,空树就会变成 falsy,代码静默出错。判断「是不是 None」就该用 is not None,这是纪律。
        # RECURSIVE CASE (ii)
        if t.label == "L" and not changed:
            return None, True
这是全题最关键的两行。走到这里说明:所有分支都递归处理完了,而 changed 记录着「下面有没有动过」。
t.label == "L":我是个失败者。not changed:我的整个子树里一个 L 都没有(否则至少会有一次剪枝,changed就会是 True)。
两条同时成立,我就是「最底层的失败者」——把自己整个删掉,返回 None, True。注意此时 new_branches 被直接丢弃了,因为整棵子树都不要了,白算的那些孩子也一并作废。
        # RECURSIVE CASE (iii)
        return Tree(t.label, new_branches), changed
其余所有情况:我保留下来,带着剪过的新分支。changed 原样往上传——如果下面剪过,父节点就知道自己这一轮不该动。
驱动循环:生成器怎么一轮一轮吐
    current = t
    changed = True
    while changed:
        current, changed = prune_lowest_losers(current)
        if changed:
            yield current
changed = True 是为了让 while 至少进一次——经典的「先假设有活儿要干」。current 交给 prune_lowest_losers,再把返回的新树赋回 current。下一轮就在这棵新树上继续剪。忘了赋回去,就会永远剪同一棵树,死循环。if changed: yield current —— 只有真剪掉了东西才产出。最后一轮什么也没剪,changed 为 False,既不 yield 也不再循环,函数体结束,生成器自动抛 StopIteration。yield,这个函数就是生成器函数
reveal_winner(t) 这句调用一行代码都不执行,它只是返回一个 generator 对象:
>>> gen = reveal_winner(t)
>>> type(gen)
<class 'generator'>
函数体要等到第一次 next(gen) 才开始跑,跑到第一个 yield 就暂停在那儿,局部变量 current、changed 原地冻结。下一次 next 从暂停处继续。这正是「一轮一轮剪」能被观察到的原因——如果不用生成器,你只能拿到最终结果,看不到中间过程。
给节点起个名字(下标表示位置)。原树:
R = W
├─ A = W
│  ├─ A1 = W ── [A1a = W(叶), A1b = L(叶)]
│  └─ A2 = L ── [A2a = W(叶), A2b = L(叶)]
└─ B = L
   ├─ B1 = L ── [B1a = W(叶), B1b = L(叶)]
   └─ B2 = W ── [B2a = L(叶), B2b = W(叶)]
下潜到叶子层(8 片叶子,全部命中 base case):
A1a = W(叶) → (Tree('W'), False)      A1b = L(叶) → (None, True)
A2a = W(叶) → (Tree('W'), False)      A2b = L(叶) → (None, True)
B1a = W(叶) → (Tree('W'), False)      B1b = L(叶) → (None, True)
B2a = L(叶) → (None, True)            B2b = W(叶) → (Tree('W'), False)
回代第一层(A1、A2、B1、B2):
A1(标签 W):new_branches=[W],changed = False or True = True
           标签不是 L → 走 (iii) → (Tree('W', [Tree('W')]), True)

A2(标签 L):new_branches=[W],changed = True
           (ii) 的条件 t.label=="L" 成立,但 not changed 为 False → 不剪!
           → 走 (iii) → (Tree('L', [Tree('W')]), True)

B1(标签 L):new_branches=[W],changed = True → 同上不剪
           → (Tree('L', [Tree('W')]), True)

B2(标签 W):new_branches=[W](B2a 返回 None 被跳过),changed = True
           → (Tree('W', [Tree('W')]), True)
回代第二层(A、B):
A(标签 W):两个孩子都非 None,都汇报 True → changed=True
          → (Tree('W', [W[W], L[W]]), True)

B(标签 L):两个孩子都非 None,changed=True
          (ii):是 L,但 changed 为 True → 不剪
          → (Tree('L', [L[W], W[W]]), True)
回代到根:R 标签是 W,changed=True,返回新树和 True。驱动循环看到 changed 为 True,yield current —— 这就是第 1 次输出。
整轮下来,被删掉的恰好是 A1b、A2b、B1b、B2a 这 4 片 L 叶子。A2 和 B1 虽然也是 L,但因为孩子里刚发生了剪枝而被保护了下来。
第 2 轮的输入是第 1 次输出:
R' = W
├─ A' = W ── [A1' = W[W],  A2' = L[W]]
└─ B' = L ── [B1' = L[W],  B2' = W[W]]
看 A2' = L[W]:它唯一的孩子是 W 叶子,返回 (Tree('W'), False),所以 changed 累积后仍是 False。此时 (ii) 的两个条件——标签是 L、没有后代被剪——同时成立,于是 return None, True,整棵 A2' 被删。B1' 同理被删。
而 B' 本身也是 L,但它的孩子 B1' 刚汇报了 True,所以 B' 这一轮又躲过一劫,只是失去了一个分支。结果:
W
  W
    W
      W
  L
    W
      W
第 3 轮:现在 B'' = L[W[W]] 的整个子树里再没有别的 L 了,changed 为 False,它终于成为「最底层的失败者」被删除。剩下 W → W → W → W,也就是冠军那条全胜路径。
第 4 轮:树上一个 L 都没有,所有 base case 都返回 False,一路 or 上来还是 False。if changed: 不成立 → 不 yield;while changed: 不成立 → 循环结束 → 生成器耗尽 → StopIteration。
误区一:base case 里写成 return None, False。叶子被删了却汇报「没变」,于是它的父节点(如果是 L)会误以为自己是最底层,把自己也删掉——一轮剪掉两层,输出全乱。changed 的含义是「这一轮我这棵子树里有没有发生剪枝」,删了自己当然算。
误区二:(ii) 里漏了 not changed,写成 if t.label == "L":。那就变成「一轮把所有 L 全删了」,第一次输出直接就是最终的全 W 路径,后面没有第二、第三次输出。
误区三:changed = changed or child_changed 写成 changed = child_changed。只有最后一个孩子的结果被留下,前面孩子剪没剪就丢了。用初始树验证:A 的最后一个孩子 A2 汇报 True 时碰巧没事,但如果一棵 L 树的最后一个孩子恰好没变化,它就会被错误地当成最底层剪掉。
误区四:驱动循环写成 prune_lowest_losers(current) 但不接返回值。因为这个函数不修改原树,不接返回值等于什么都没做,changed 也不会更新,直接死循环。这正是「造新树」风格必须记住的一点:返回值就是全部成果,丢了就没了。
误区五:把 yield 写在 while 外面或写成 return。写成 return current,函数就不再是生成器(如果函数体里没有别的 yield),next(gen) 会报 TypeError: 'Tree' object is not an iterator;即使还是生成器,return 也会让它只吐一次就结束。
当递归需要往上传两种不同性质的信息时——一个是「结果本身」,一个是「关于过程的元信息」。这里是 (新树, 有没有剪过);别的常见组合有 (结果, 是否找到)、(子树最大值, 是否满足性质)、(高度, 是否平衡)。识别信号是:父节点的决策依赖于「子节点那边发生了什么」,而不只是「子节点算出了什么」。
本讲小结
| 概念 | 要点 | 典型陷阱 |
|---|---|---|
| 属性查找 | obj.x 先查实例、再查类、再查父类;Cls.x 从类开始查,永不看实例 | 以为 self.foo = ... 改了类属性;以为 A.foo += 1 会连带改 B.foo |
super().__init__(...) | 换的是「去哪儿找方法」,不换 self;全程只有一个对象 | 以为它会新建一个父类实例 |
| 自定义迭代器 | __iter__ 返回迭代器,__next__ 返回下一个或 raise StopIteration | 写 return StopIteration;只实现一个方法 → not iterable / not an iterator |
__iter__ 返回 self | 类自己就是迭代器,只能遍历一遍 | 第二次 for 得到空。想反复遍历就每次 return 新迭代器(self) |
| 自定义异常 | 继承 Exception;super().__init__(msg) 存说明,实例属性存结构化数据 | 只塞一句字符串,处理方只能去解析英文 |
Tree 类 vs. ADT | t.label ↔ label(t),t.branches ↔ branches(t),Tree(x, bs) ↔ tree(x, bs);递归骨架完全一样 | 忘了方括号 → TypeError: 'Tree' object is not iterable;塞进非 Tree → 无消息的 AssertionError |
self.branches = list(branches) | 切断与调用方列表的别名;顺带解掉可变默认参数 branches=[] 被共享的问题 | 以为是深拷贝——它是浅的,子树对象仍然共享 |
| 可变性 | t.label = ...、t.branches.append(...) 改的是对象,所有指向它的名字都看得到 | 「改名字」(t = Tree(...))不是「改对象」;共享子树被改一处、变两处 |
| 就地改 vs. 造新树 | docstring 说 "Mutate" 就改,说 "Return a tree" 就造新的 | 就地改的函数返回 None → AttributeError: 'NoneType' object has no attribute 'label' |
| 树递归骨架 | 先问「叶子返回什么」,再问「孩子们的答案怎么合成我的答案」 | 漏 base case → ValueError: max() arg is an empty sequence;t.is_leaf 忘括号 → 恒真 |
height | if t.is_leaf(): return 0;否则 1 + max([height(b) for b in t.branches]) | base case 返回 1(整体偏大 1);用 sum 代替 max(能骗过这三个 doctest) |
| 层序遍历(BFS) | 队列:pop(0) 取队首,孩子 append 到队尾 | pop() 忘了 0 → 变成 DFS,元素全对但顺序错 |
| 递归返回二元组 | 当父节点的决策依赖「子节点那边发生了什么」时用,如 (新树, 是否剪过) | changed = child_changed(覆盖)而不是 changed or child_changed(累积) |
| 生成器 | 函数体含 yield → 调用只返回 generator,第一次 next 才开跑,yield 处冻结 | 把 yield 改成 return,只吐一次就结束 |
树是什么(一个标签 + 一列子树)没变,树上的递归怎么写也没变;变的只是「它现在是个对象,所以可以被改」——而一旦可以被改,你就得开始关心谁还指着它。
动手练习
练习 1:别名的后果
下面这段代码执行完,print(t) 会打印什么?
sub = Tree(2, [Tree(5)])
t = Tree(1, [sub, sub])
t.branches[0].label = 99
t.branches[1].branches.append(Tree(7))
看答案
1
  99
    5
    7
  99
    5
    7
因为 t.branches[0] 和 t.branches[1] 是同一个对象(都是 sub)。Tree.__init__ 里的 list(branches) 复制的是那个装着两个引用的列表,不是被指着的树——浅拷贝。
所以第三行把 sub.label 改成 99,两个位置同时显示 99;第四行往 sub.branches 里追加 Tree(7),两个位置也同时多出一个 7。
怎么确认?t.branches[0] is t.branches[1] 会返回 True。要避开这种共享,得写 t = Tree(1, [Tree(2, [Tree(5)]), Tree(2, [Tree(5)])]),或者写一个递归的深拷贝函数 copy_tree(t) = Tree(t.label, [copy_tree(b) for b in t.branches])。
练习 2:换个容器就换一种遍历
把 TreeIterator.__next__ 里的 self.queue.pop(0) 改成 self.queue.pop(),其余不动。对这棵树:
t = Tree(1, [Tree(2, [Tree(3, [Tree(4), Tree(5)])]), Tree(6)])
list(iter(t)) 会得到什么?
看答案
[1, 6, 2, 3, 5, 4]。
逐步追踪(容器现在是栈,从尾部取):
| 次 | 调用前 | pop() 取尾 | 追加孩子 | 调用后 | 返回 |
|---|---|---|---|---|---|
| 1 | [1] | @1 | @2, @6 | [2, 6] | 1 |
| 2 | [2, 6] | @6 | (无) | [2] | 6 |
| 3 | [2] | @2 | @3 | [3] | 2 |
| 4 | [3] | @3 | @4, @5 | [4, 5] | 3 |
| 5 | [4, 5] | @5 | (无) | [4] | 5 |
| 6 | [4] | @4 | (无) | [] | 4 |
这是深度优先,而且因为孩子是从左往右 append、却从右往左 pop,同一层里右边的先出来(先 6 后 2,先 5 后 4)。想让 DFS 也保持从左到右,得把孩子逆序压栈:for b in reversed(curr_node.branches)。
记住这个对照:同样的代码,容器是队列就是 BFS,是栈就是 DFS。
练习 3:两种「加一层」
写两个函数,都把树上每个叶子换成「带一个同标签孩子」的节点(例如叶子 Tree(5) 变成 Tree(5, [Tree(5)]))。一个就地修改,一个造新树。
看答案
# 就地修改:注意不返回任何东西
def grow(t):
    if t.is_leaf():
        t.branches.append(Tree(t.label))
    else:
        for b in t.branches:
            grow(b)

# 造新树
def grown(t):
    if t.is_leaf():
        return Tree(t.label, [Tree(t.label)])
    return Tree(t.label, [grown(b) for b in t.branches])
grow 里的 else 不能省。如果写成
def grow_bad(t):
    if t.is_leaf():
        t.branches.append(Tree(t.label))
    for b in t.branches:          # 少了 else
        grow_bad(b)
那么在叶子上:先给 t.branches 追加了一个新叶子,紧接着 for 循环就遍历到了刚加进去的那个,于是对它再追加一个……无限递归,最终:
RecursionError: maximum recursion depth exceeded
这是就地修改特有的坑:你改的正是你正在遍历的东西。造新树的版本天然没有这个问题——grown 读的是原树、写的是新树,两者互不干扰。
验证 grown(Tree(3, [Tree(2, [Tree(5)]), Tree(4)])):叶子 @5 → Tree(5, [Tree(5)]),叶子 @4 → Tree(4, [Tree(4)]),回代得 Tree(3, [Tree(2, [Tree(5, [Tree(5)])]), Tree(4, [Tree(4)])])。高度从 2 变成 3。
练习 4:changed 汇报错了会怎样
把 prune_lowest_losers 的 base case 改成:
        if t.is_leaf():
            if t.label == "L":
                return None, False      # 原本是 True
            return Tree(t.label), False
对课上那棵初始树,第一次 next(gen) 打印出来的树会有什么不同?
看答案
L 叶子还是会被删掉(因为返回了 None),但它们的 L 父节点也会在同一轮被删掉——因为父节点收到的 child_changed 全是 False,累积后 changed 为 False,于是 t.label == "L" and not changed 成立,父节点误判自己是「最底层的失败者」。
在初始树上,A2 = L[W, L] 和 B1 = L[W, L] 都会被整棵删掉,连带它们那个无辜的 W 孩子。B = L[B1, B2] 这一层收到 B1 的 True(因为 B1 走的是 (ii) 分支,那里返回的还是 True),所以 B 本轮还能保住。第一次输出会变成:
W
  W
    W
      W
  L
    W
      W
也就是正确版本第 2 次才该出现的结果——一轮干了两轮的活,中间那一步被跳过了。
这道题要说明的是:changed 不是一个可有可无的返回值,它是「一轮只剪一层」这个规则的唯一执行者。递归返回二元组时,两个分量都要在每一条 return 路径上想清楚。
练习 5:这个 height 错在哪
def height(t):
    if t.is_leaf:
        return 0
    return 1 + max([height(b) for b in t.branches])
它对三个 doctest 分别返回什么?为什么不报错?
看答案
三个都返回 0。
t.is_leaf 少了括号,所以它没有调用方法,只是求值出一个绑定方法对象(bound method)。这个对象不是 None、不是 0、不是空容器,所以是 truthy——if 的条件永远成立,函数第一行就 return 0,第二行永远执行不到。
为什么不报错?因为 Python 里「取属性」和「调用」是两个独立的操作,只取不调完全合法:
>>> t = Tree(3, [Tree(2, [Tree(5)]), Tree(4)])
>>> t.is_leaf
<bound method Tree.is_leaf of Tree(3, [Tree(2, [Tree(5)]), Tree(4)])>
>>> bool(t.is_leaf)
True
>>> t.is_leaf()
False
这类 bug 的特征是「不报错,但结果恒定」。诊断方法:在函数第一行插 print(t.label, t.is_leaf()),你会发现递归根本没往下走过。
顺带一提,同样的错误在 if t.branches: 这种地方不会发生——branches 是属性不是方法,本来就不该加括号。写 Tree 的代码时要时刻分清哪个是属性(label、branches)、哪个是方法(is_leaf())。